Amayo AI 是一個 100% 本機執行的實時 AI 語音對話與視覺代理系統。專為 Apple Silicon (macOS) 及 Linux/CUDA 環境設計,無需依賴任何雲端 API,保護隱私且超低延遲。
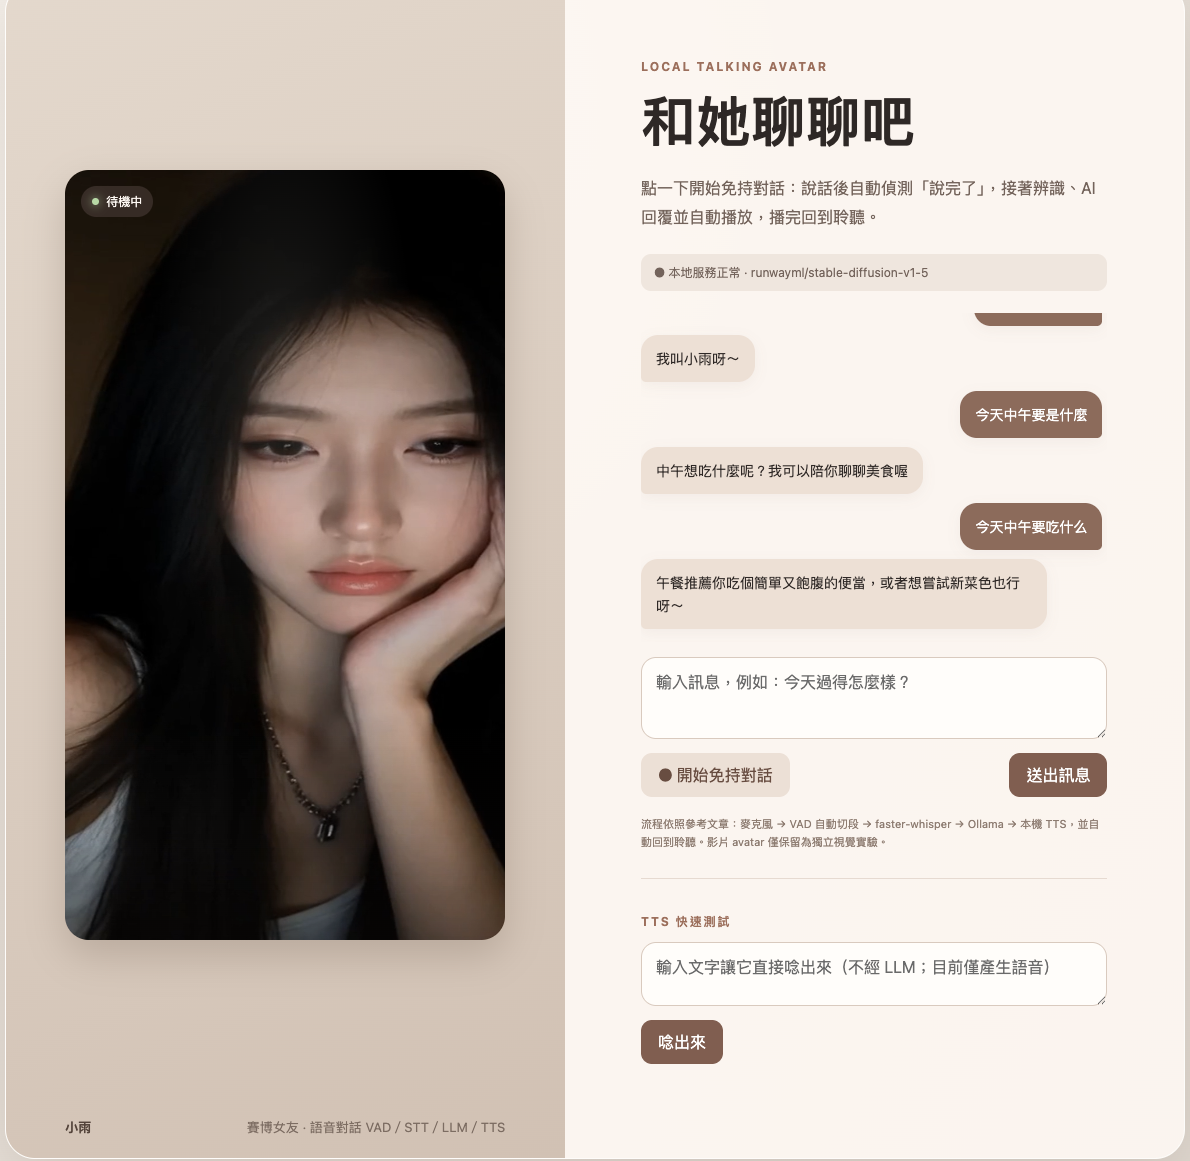
VAD → faster-whisper (STT) → Ollama (LLM) → F5-TTS-MLX (TTS) 流暢管道。┌───────────────────────── 瀏覽器 UI (web/index.html) ─────────────────────────┐
│ 影像生成預覽 免持/按鈕語音對話 文字對話視窗 Avatar 視覺視窗 │
└─────────┬────────────────────┬────────────────────┬──────────────────┬──────┘
│ │ │ │
▼ ▼ ▼ ▼
┌───────────────────────── FastAPI 後端 (app/main.py) ─────────────────────────┐
│ /api/generate-image /api/voice/respond /api/chat /api/avatar │
│ /api/transcribe /api/tts GET /health /api/status │
│ │
│ 啟動暖機機制 (@app.on_event("startup")): │
│ ├ 背景預載入 F5-TTS 常駐 worker │
│ └ 對 Ollama 發送測試請求將 LLM 載入記憶體 │
└────┬───────────────┬───────────────┬───────────────┬─────────────────────────┘
│ │ │ │
▼ ▼ ▼ ▼
┌───────────┐ ┌───────────┐ ┌───────────┐ ┌──────────────┐
│ STT 模型 │ │ 本地 LLM │ │ TTS 模型 │ │ 本地影像預覽 │
│ faster- │ │ Ollama │ │ F5-TTS- │ │ Diffusers │
│ whisper │ │ Qwen 30B │ │ MLX Worker│ │ (MPS/CUDA) │
└───────────┘ └───────────┘ └───────────┘ └──────────────┘
本系統透過 Ollama 提供本地大語言模型推理,您可以根據個人電腦的記憶體 (RAM / VRAM) 大小與對回應速度的需求選擇合適的模型規格:
| 模型級別 | 推薦 Ollama 模型名稱 | 下載指令 (ollama pull) | 預估記憶體需求 | 語音回應延遲 | 適用情境與硬體建議 |
|---|---|---|---|---|---|
| 7B 級別 | qwen2.5:7b | ollama pull qwen2.5:7b | ~ 4.7 GB | ⚡ 極快 (< 0.5s) | 適合追求超快反應、記憶體 8GB/16GB Mac 或入門 GPU |
| 8B / 9B | llama3.1:8bgemma2:9b | ollama pull llama3.1:8bollama pull gemma2:9b | ~ 5.0 GB | ⚡ 極快 (< 0.6s) | 多語言與通用對話流暢選擇 |
| 14B 級別 (最佳平衡推荐) | qwen2.5:14b | ollama pull qwen2.5:14b | ~ 9.0 GB | 🚀 快速 (~ 0.8s) | 最具推薦平衡!繁中口語化極佳,邏輯與流暢度均衡 (16GB/32GB Mac) |
| 30B / 32B | qwen2.5:32bqooba/qwen3-coder-30b-a3b-instruct:q3_k_m | ollama pull qwen2.5:32bollama pull qooba/qwen3-coder-30b-a3b-instruct:q3_k_m | ~ 15~20 GB | 🐢 中等 (~ 1.5s - 2.5s) | 深度情境對話、複雜人格呈現,建議 32GB/64GB 以上高規硬體 |
ollama pull <模型名稱>.env 檔案,修改 OLLAMA_MODEL 變數:
# 設定為 14B 模型 (推薦)
OLLAMA_MODEL=qwen2.5:14b

# 或設定為 7B 模型 (極速)
# OLLAMA_MODEL=qwen2.5:7b
./run.sh 即可生效。啟動 Ollama 服務並下載所選模型(預設推薦 14B):
ollama pull qwen2.5:14b
複製環境變數範例檔:
cp .env.example .env
如需使用 F5-TTS-MLX 進行高品質語音合成,請將 F5_TTS_DIR 指向您的 F5-TTS-MLX 本地路徑:
F5_TTS_DIR=/path/to/f5-tts-mlx
執行自動啟動腳本 (自動建立 .venv、安裝套件、檢查模型並啟動服務):
chmod +x run.sh
./run.sh
啟動後,請在瀏覽器開啟:http://127.0.0.1:7860
amayo-ai/
├── app/                  # FastAPI 後端服務
│   ├── __init__.py
│   ├── config.py         # 集中化環境設定管理
│   ├── f5_tts_worker.py  # F5-TTS 常駐進程 Worker
│   └── main.py           # API 路由與推理管道控制
├── web/                  # 前端網頁介面
│   ├── index.html        # HTML 結構與 VAD / 音訊錄製邏輯
│   └── style.css         # Modern 視覺與動畫樣式
├── assets/               # 預設媒體素材
│   ├── avatar/           # 預設 Avatar 圖片 (9:16)
│   └── reference/        # TTS 參考音檔
├── docs/                 # 詳細架構與實驗設計文件
│   ├── ARCHITECTURE.md   # MVP 系統架構設計
│   ├── ARTICLE_SPEECH_TO_SPEECH.md  # 語音交互流程與驗收標準
│   ├── MODAL_IMAGE_GENERATION.md   # GPU 批次人物照片生成
│   ├── MODAL_TALKING_AVATAR.md     # Wav2Lip / Talking Avatar
│   ├── RESOURCES.md      # 本機資源與整合說明
│   └── TALKING_AVATAR.md # 唇形同步與模型效能評測
├── models/               # 本機模型快取目錄 (.gitignore)
├── generated/            # 生成音訊與影像輸出目錄 (.gitignore)
├── .env.example          # 環境變數範本
├── .gitignore            # Git 忽略設定
├── LICENSE               # MIT 授權條款
├── README.md             # 本說明文件
├── requirements.txt      # Python 依賴清單
└── run.sh                # 啟動腳本
| HTTP 方法 | 端點 (Endpoint) | 功能說明 |
|---|---|---|
GET | /health | 檢查系統服務與模型載入狀態 |
POST | /api/voice/respond | 完整語音對話:語音檔 → STT → LLM → TTS → 回傳音訊 URL |
POST | /api/chat | 純文字對話介面 |
POST | /api/tts | 純文字轉語音測試 |
POST | /api/transcribe | 語音轉文字 (faster-whisper) |
POST | /api/generate-image | 本地文生圖 (Diffusers) |
assets/avatar/) 與參考語音 (assets/reference/) 僅供開發測試與展示使用,請勿用於商業目的或未經授權之聲線複製。本專案基於 MIT License 開源。
Amayo AI 是一個 100% 本機執行的實時 AI 語音對話與視覺代理系統。專為 Apple Silicon (macOS) 及 Linux/CUDA 環境設計,無需依賴任何雲端 API,保護隱私且超低延遲。
VAD → faster-whisper (STT) → Ollama (LLM) → F5-TTS-MLX (TTS) 流暢管道。┌───────────────────────── 瀏覽器 UI (web/index.html) ─────────────────────────┐
│ 影像生成預覽 免持/按鈕語音對話 文字對話視窗 Avatar 視覺視窗 │
└─────────┬────────────────────┬────────────────────┬──────────────────┬──────┘
│ │ │ │
▼ ▼ ▼ ▼
┌───────────────────────── FastAPI 後端 (app/main.py) ─────────────────────────┐
│ /api/generate-image /api/voice/respond /api/chat /api/avatar │
│ /api/transcribe /api/tts GET /health /api/status │
│ │
│ 啟動暖機機制 (@app.on_event("startup")): │
│ ├ 背景預載入 F5-TTS 常駐 worker │
│ └ 對 Ollama 發送測試請求將 LLM 載入記憶體 │
└────┬───────────────┬───────────────┬───────────────┬─────────────────────────┘
│ │ │ │
▼ ▼ ▼ ▼
┌───────────┐ ┌───────────┐ ┌───────────┐ ┌──────────────┐
│ STT 模型 │ │ 本地 LLM │ │ TTS 模型 │ │ 本地影像預覽 │
│ faster- │ │ Ollama │ │ F5-TTS- │ │ Diffusers │
│ whisper │ │ Qwen 30B │ │ MLX Worker│ │ (MPS/CUDA) │
└───────────┘ └───────────┘ └───────────┘ └──────────────┘
本系統透過 Ollama 提供本地大語言模型推理,您可以根據個人電腦的記憶體 (RAM / VRAM) 大小與對回應速度的需求選擇合適的模型規格:
| 模型級別 | 推薦 Ollama 模型名稱 | 下載指令 (ollama pull) | 預估記憶體需求 | 語音回應延遲 | 適用情境與硬體建議 |
|---|---|---|---|---|---|
| 7B 級別 | qwen2.5:7b | ollama pull qwen2.5:7b | ~ 4.7 GB | ⚡ 極快 (< 0.5s) | 適合追求超快反應、記憶體 8GB/16GB Mac 或入門 GPU |
| 8B / 9B | llama3.1:8bgemma2:9b | ollama pull llama3.1:8bollama pull gemma2:9b | ~ 5.0 GB | ⚡ 極快 (< 0.6s) | 多語言與通用對話流暢選擇 |
| 14B 級別 (最佳平衡推荐) | qwen2.5:14b | ollama pull qwen2.5:14b | ~ 9.0 GB | 🚀 快速 (~ 0.8s) | 最具推薦平衡!繁中口語化極佳,邏輯與流暢度均衡 (16GB/32GB Mac) |
| 30B / 32B | qwen2.5:32bqooba/qwen3-coder-30b-a3b-instruct:q3_k_m | ollama pull qwen2.5:32bollama pull qooba/qwen3-coder-30b-a3b-instruct:q3_k_m | ~ 15~20 GB | 🐢 中等 (~ 1.5s - 2.5s) | 深度情境對話、複雜人格呈現,建議 32GB/64GB 以上高規硬體 |
ollama pull <模型名稱>.env 檔案,修改 OLLAMA_MODEL 變數:
# 設定為 14B 模型 (推薦)
OLLAMA_MODEL=qwen2.5:14b

# 或設定為 7B 模型 (極速)
# OLLAMA_MODEL=qwen2.5:7b
./run.sh 即可生效。啟動 Ollama 服務並下載所選模型(預設推薦 14B):
ollama pull qwen2.5:14b
複製環境變數範例檔:
cp .env.example .env
如需使用 F5-TTS-MLX 進行高品質語音合成,請將 F5_TTS_DIR 指向您的 F5-TTS-MLX 本地路徑:
F5_TTS_DIR=/path/to/f5-tts-mlx
執行自動啟動腳本 (自動建立 .venv、安裝套件、檢查模型並啟動服務):
chmod +x run.sh
./run.sh
啟動後,請在瀏覽器開啟:http://127.0.0.1:7860
amayo-ai/
├── app/                  # FastAPI 後端服務
│   ├── __init__.py
│   ├── config.py         # 集中化環境設定管理
│   ├── f5_tts_worker.py  # F5-TTS 常駐進程 Worker
│   └── main.py           # API 路由與推理管道控制
├── web/                  # 前端網頁介面
│   ├── index.html        # HTML 結構與 VAD / 音訊錄製邏輯
│   └── style.css         # Modern 視覺與動畫樣式
├── assets/               # 預設媒體素材
│   ├── avatar/           # 預設 Avatar 圖片 (9:16)
│   └── reference/        # TTS 參考音檔
├── docs/                 # 詳細架構與實驗設計文件
│   ├── ARCHITECTURE.md   # MVP 系統架構設計
│   ├── ARTICLE_SPEECH_TO_SPEECH.md  # 語音交互流程與驗收標準
│   ├── MODAL_IMAGE_GENERATION.md   # GPU 批次人物照片生成
│   ├── MODAL_TALKING_AVATAR.md     # Wav2Lip / Talking Avatar
│   ├── RESOURCES.md      # 本機資源與整合說明
│   └── TALKING_AVATAR.md # 唇形同步與模型效能評測
├── models/               # 本機模型快取目錄 (.gitignore)
├── generated/            # 生成音訊與影像輸出目錄 (.gitignore)
├── .env.example          # 環境變數範本
├── .gitignore            # Git 忽略設定
├── LICENSE               # MIT 授權條款
├── README.md             # 本說明文件
├── requirements.txt      # Python 依賴清單
└── run.sh                # 啟動腳本
| HTTP 方法 | 端點 (Endpoint) | 功能說明 |
|---|---|---|
GET | /health | 檢查系統服務與模型載入狀態 |
POST | /api/voice/respond | 完整語音對話:語音檔 → STT → LLM → TTS → 回傳音訊 URL |
POST | /api/chat | 純文字對話介面 |
POST | /api/tts | 純文字轉語音測試 |
POST | /api/transcribe | 語音轉文字 (faster-whisper) |
POST | /api/generate-image | 本地文生圖 (Diffusers) |
assets/avatar/) 與參考語音 (assets/reference/) 僅供開發測試與展示使用,請勿用於商業目的或未經授權之聲線複製。本專案基於 MIT License 開源。



