
README


A Survey of Token Compression for Efficient Multimodal Large Language Models [arXiv]
Kele Shao*,1,2, Keda Tao*,1,2, Kejia Zhang3, Sicheng Feng2,4, Mu Cai5, Yuzhang Shang6, Haoxuan You7, Can Qin8, Yang Sui9, Huan Wang†,21Zhejiang University, 2Westlake University, 3Xiamen University, 4National University of Singapore, 5University of Wisconsin-Madison, 6University of Central Florida, 7Columbia University, 8Salesforce AI Research, 9Rice University
* Equal Contribution. † Corresponding Author (wanghuan@westlake.edu.cn).
If you find our paper or this resource helpful, please consider cite:
@article{
  shao2026a,
  title={A Survey of Token Compression for Efficient Multimodal Large Language Models},
  author={Kele Shao and Keda TAO and Kejia Zhang and Sicheng Feng and Mu Cai and Yuzhang Shang and Haoxuan You and Can Qin and Yang Sui and Huan Wang},
  journal={Transactions on Machine Learning Research},
  year={2026},
}
[!IMPORTANT] We welcome your help in improving the repository and paper. Please feel free to submit a pull request or contact us to:
Add a relevant paper not yet included.
Suggest a more suitable category.
Update the information.
Ask for clarification about any content.
🔥 News
- [2026.02.22] ⚠️⚠️⚠️ We are very fortunate that our article was reported by 机器之星!
- [2026.02.22] Paper accepted by ICLR 2026 could be checked in here, welcome contributions!
- [2026.01.27] Paper accepted by EMNLP 2025 and ICLR 2026 could be checked in here.
- [2026.01.24] Our survey paper has been accepted to TMLR 2026. Congratulations! 🎉🎉🎉
- [2025.10.11] Papers accepted by NeurIPS 2025 about MLLM token compression have been updated here. Congratulations! 🎉🎉🎉
- [2025.08.14] ❗ Added Recent Papers, Papers Published in Recent Conference/Journal, and a database for quick-search.
- [2025.07.29] The v1 survey is now published! We've also initialized the repository.
🎯 Motivation
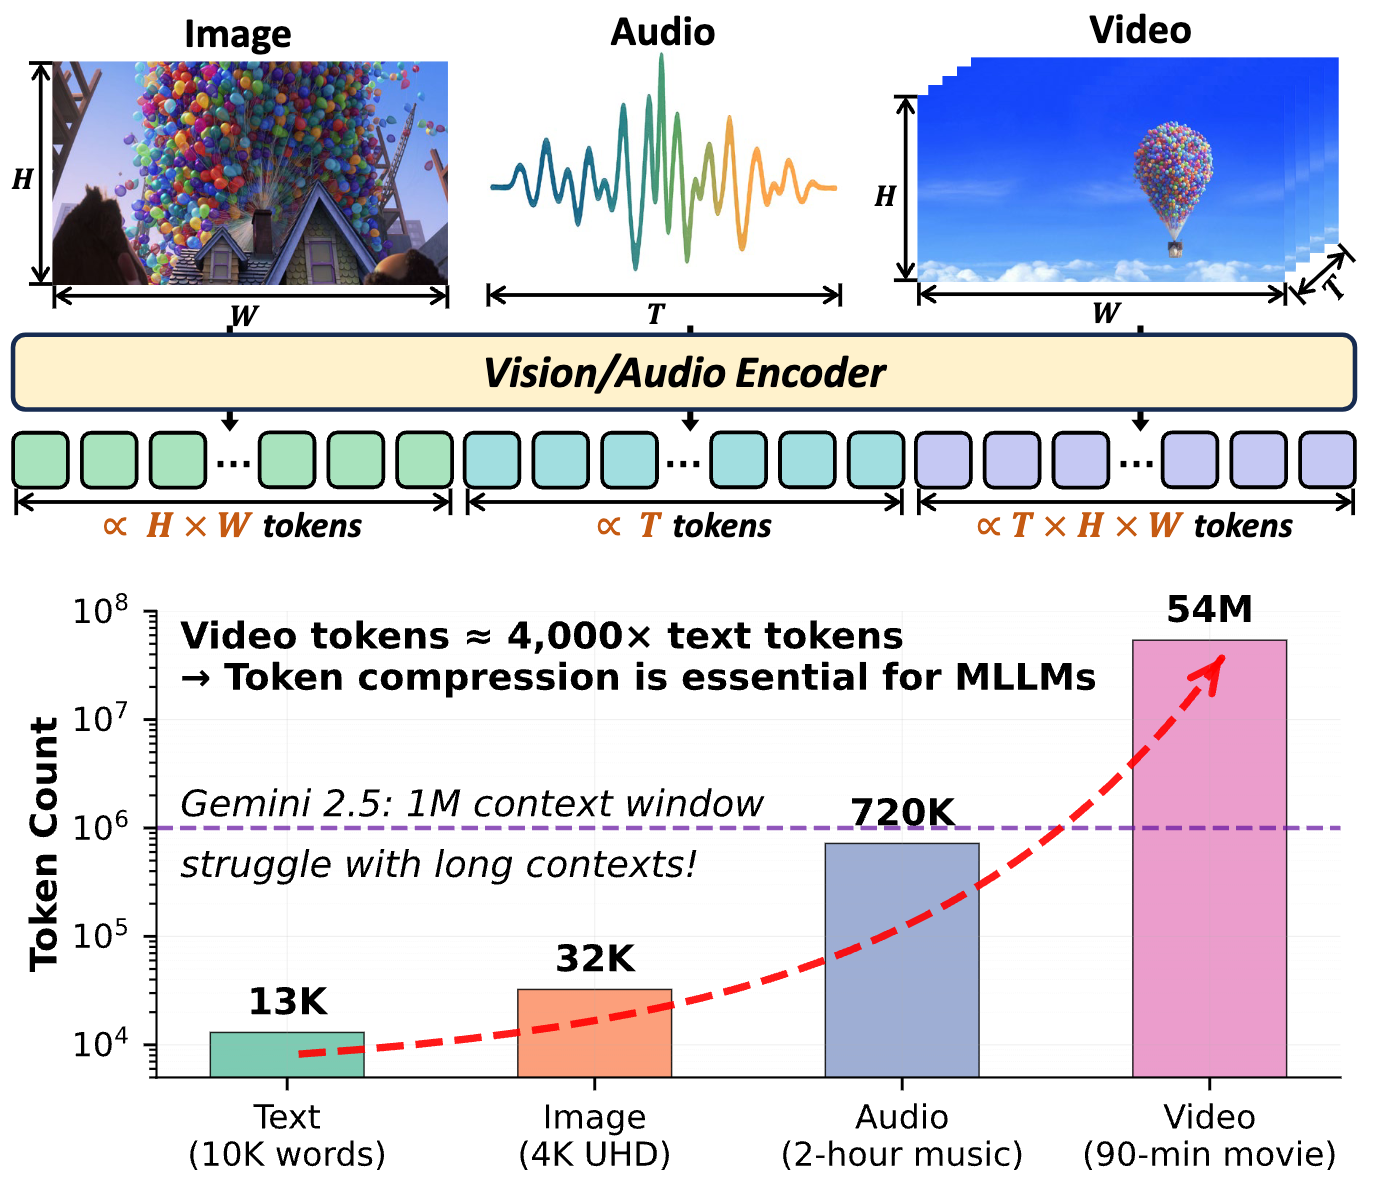
Motivation: Up: Image, video, and audio data types can scale in their representation dimensions, leading to a corresponding increase in the number of tokens. Down: Top-performing MLLMs cannot address real-world demands, as the number of tokens for multimodal information, especially video, vastly exceeds that of text. Therefore, token compression is crucial to address this limitation.
📚 Contents
Please check out all the papers by selecting the sub-area you're interested in. On this main page, only papers released in the past 6 months are shown.
Badge Colors
redfor arXiv papersbluefor conference/journal paperswhitefor GitHub repositoriespurplefor research areasgreenfor categoriesyellowfor training cost


Recent Papers (Last 6 Months)
Image


Video
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
 MeToM: Metadata-Guided Token Merging for Efficient Video LLMs Zhuojie Wu, Shijie Wang, Xin Yu |  |    | Paper |
 LRCP: Low-Rank Compressibility Guided Visual Token Pruning for Efficient LVLMs Hongyu Lu, Feng Zhang, Wenwei Jin, Huanling Hu, Tianjun Shi, Shikai Jiang, Yao Hu, Jiawei Li |  | | Paper |
 EchoingPixels: Cross-Modal Adaptive Token Reduction for Efficient Audio-Visual LLMs Chao Gong, Depeng Wang, Zhipeng Wei, Ya Guo, Huijia Zhu, Jingjing Chen |  |  | Paper |
 Accelerating Streaming Video Large Language Models via Hierarchical Token Compression Yiyu Wang, Xuyang Liu, Xiyan Gui, Xinying Lin, Boxue Yang, Chenfei Liao, Tailai Chen, Linfeng Zhang |  | | Paper GitHub |
 FLoC: Facility Location-Based Efficient Visual Token Compression for Long Video Understanding Janghoon Cho, Jungsoo Lee, Munawar Hayat, Kyuwoong Hwang, Fatih Porikli, Sungha Choi | | | Paper |
Audio
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| EchoingPixels: Cross-Modal Adaptive Token Reduction for Efficient Audio-Visual LLMs Chao Gong, Depeng Wang, Zhipeng Wei, Ya Guo, Huijia Zhu, Jingjing Chen | | | Paper |
Omni
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
 Stage-adaptive Token Selection for Efficient Omni-modal LLMs Zijie Xin, Jie Yang, Ruixiang Zhao, Tianyi Wang, Fengyun Rao, Jing Lyu, Xirong Li |  |  | Paper GitHub |
  OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models Yue Ding, Yiyan Ji, Jungang Li, Xuyang Liu, Xinlong Chen, Junfei Wu, Bozhou Li, Bohan Zeng, Yang Shi, Yushuo Guan, Yuanxing Zhang, Jiaheng Liu, Qiang Liu, Pengfei Wan, Liang Wang | | | Paper GitHub Model |
 OmniZip: Audio-Guided Dynamic Token Compression for Fast Omnimodal Large Language Models Keda Tao, Kele Shao, Bohan Yu, Weiqiang Wang, Jian liu, Huan Wang | | | Paper GitHub |
Published in Recent Conference/Journal
ACM MM 2026
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
  VisCo: Leveraging Large Language Models as Intrinsic Encoders for Visual Token Compression Yupeng Zheng, Kai Zou, Bin Liu, Nenghai Yu | | | Paper GitHub |
CVPR 2026
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
 FocusUI: Efficient UI Grounding via Position-Preserving Visual Token Selection Mingyu Ouyang, Kevin Qinghong Lin, Mike Zheng Shou, Hwee Tou Ng |  | | Paper GitHub Model Dataset |
| MeToM: Metadata-Guided Token Merging for Efficient Video LLMs Zhuojie Wu, Shijie Wang, Xin Yu | | | Paper |
| Accelerating Streaming Video Large Language Models via Hierarchical Token Compression Yiyu Wang, Xuyang Liu, Xiyan Gui, Xinying Lin, Boxue Yang, Chenfei Liao, Tailai Chen, Linfeng Zhang | | | Paper GitHub |
| OmniZip: Audio-Guided Dynamic Token Compression for Fast Omnimodal Large Language Models Keda Tao, Kele Shao, Bohan Yu, Weiqiang Wang, Jian liu, Huan Wang | | | Paper GitHub |
 StreamingTOM: Streaming Token Compression for Efficient Video Understanding Xueyi Chen, Keda Tao, Kele Shao, Huan Wang | | | Paper GitHub |
ICLR 2026

EMNLP 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
  Seeing More, Saying More: Lightweight Language Experts are Dynamic Video Token Compressors Xiangchen Wang, Jinrui Zhang, Teng Wang, Haigang Zhang, Feng Zheng | | | Paper GitHub |
NeurIPS 2025


ICCV 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
  VFlowOpt: A Token Pruning Framework for LMMs with Visual Information Flow-Guided Optimization Sihan Yang, Runsen Xu, Chenhang Cui, Tai Wang, Dahua Lin, Jiangmiao Pang | | | Paper GitHub |
 Representation Shift: Unifying Token Compression with FlashAttention Joonmyung Choi, Sanghyeok Lee, Byungoh Ko, Eunseo Kim, Jihyung Kil, Hyunwoo J. Kim |  | | Paper GitHub |
 METEOR: Multi-Encoder Collaborative Token Pruning for Efficient Vision Language Models Yuchen Liu, Yaoming Wang, Bowen Shi, Xiaopeng Zhang, Wenrui Dai, Chenglin Li, Hongkai Xiong, Qi Tian | | | Paper GitHub |
 Multi-Granular Spatio-Temporal Token Merging for Training-Free Acceleration of Video-LLMs Jeongseok Hyun, Sukjun Hwang, Su Ho Han, Taeoh Kim, Inwoong Lee, Dongyoon Wee, Joon-Young Lee, Seon Joo Kim, Minho Shim | | | Paper GitHub |
| AuroraLong: Bringing RNNs Back to Efficient Open-Ended Video Understanding Weili Xu, Enxin Song, Wenhao Chai, Xuexiang Wen, Tian Ye, Gaoang Wang | | | Paper |
 Skip-Vision: Efficient and Scalable Acceleration of Vision-Language Models via Adaptive Token Skipping Weili Zeng, Ziyuan Huang, Kaixiang Ji, Yichao Yan | | | Paper GitHub |
| Growing a Twig to Accelerate Large Vision-Language Models Zhenwei Shao, Mingyang Wang, Zhou Yu, Wenwen Pan, Yan Yang, Tao Wei, Hongyuan Zhang, Ning Mao, Wei Chen, Jun Yu | | | Paper |
 Does Your Vision-Language Model Get Lost in the Long Video Sampling Dilemma? Tianyuan Qu, Longxiang Tang, Bohao Peng, Senqiao Yang, Bei Yu, Jiaya Jia |  | Paper GitHub Dataset | |
 FOLDER: Accelerating Multi-modal Large Language Models with Enhanced Performance Haicheng Wang, Zhemeng Yu, Gabriele Spadaro, Chen Ju, Victor Quétu, Shuai Xiao, Enzo Tartaglione | | | Paper GitHub |
 FrameFusion: Combining Similarity and Importance for Video Token Reduction on Large Visual Language Models Tianyu Fu, Tengxuan Liu, Qinghao Han, Guohao Dai, Shengen Yan, Huazhong Yang, Xuefei Ning, Yu Wang | | | Paper GitHub |
 Dynamic-VLM: Simple Dynamic Visual Token Compression for VideoLLM Han Wang, Yuxiang Nie, Yongjie Ye, Deng GuanYu, Yanjie Wang, Shuai Li, Haiyang Yu, Jinghui Lu, Can Huang | |  | Paper GitHub |
 Lyra: An Efficient and Speech-Centric Framework for Omni-Cognition Zhisheng Zhong, Chengyao Wang, Yuqi Liu, Senqiao Yang, Longxiang Tang, Yuechen Zhang, Jingyao Li, Tianyuan Qu, Yanwei Li, Yukang Chen, Shaozuo Yu, Sitong Wu, Eric Lo, Shu Liu, Jiaya Jia | | | Paper GitHub Model Dataset |
 AIM: Adaptive Inference of Multi-Modal LLMs via Token Merging and Pruning Yiwu Zhong, Zhuoming Liu, Yin Li, Liwei Wang | | | Paper GitHub |
 Beyond Text-Visual Attention: Exploiting Visual Cues for Effective Token Pruning in VLMs Qizhe Zhang, Aosong Cheng, Ming Lu, Renrui Zhang, Zhiyong Zhuo, Jiajun Cao, Shaobo Guo, Qi She, Shanghang Zhang | | | Paper GitHub |
| ZipVL: Efficient Large Vision-Language Models with Dynamic Token Sparsification Yefei He, Feng Chen, Jing Liu, Wenqi Shao, Hong Zhou, Kaipeng Zhang, Bohan Zhuang | | | Paper |
 HERMES: temporal-coHERent long-forM understanding with Episodes and Semantics Gueter Josmy Faure, Jia-Fong Yeh, Min-Hung Chen, Hung-Ting Su, Shang-Hong Lai, Winston H. Hsu | | | Paper GitHub |
 LLaVA-PruMerge: Adaptive Token Reduction for Efficient Large Multimodal Models Yuzhang Shang, Mu Cai, Bingxin Xu, Yong Jae Lee, Yan Yan | | | Paper GitHub |
ACL 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
  EffiVLM-Bench: A Comprehensive Benchmark for Evaluating Training-Free Acceleration in Large Visual-Languge Models Zekun Wang, Minghua Ma, Zexin Wang, Rongchuan Mu, Liping Shan, Ming Liu, Bing Qin | | Paper GitHub | |
  MMS-LLaMA: Efficient LLM-based Audio-Visual Speech Recognition with Minimal Multimodal Speech Tokens Jeong Hun Yeo, Hyeongseop Rha, Se Jin Park, Yong Man Ro | | | Paper GitHub |
  MEDA: Dynamic KV Cache Allocation for Efficient Multimodal Long-Context Inference Zhongwei Wan, Hui Shen, Xin Wang, Che Liu, Zheda Mai, Mi Zhang | | | Paper GitHub |
 PruneVid: Visual Token Pruning for Efficient Video Large Language Models Xiaohu Huang, Hao Zhou, Kai Han | | | Paper GitHub |
  Prompt Compression for Large Language Models: A Survey Zongqian Li, Yinhong Liu, Yixuan Su, Nigel Collier |   | Paper GitHub |
ICML 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
  CoreMatching: A Co-adaptive Sparse Inference Framework with Token and Neuron Pruning for Comprehensive Acceleration of Vision-Language Models Qinsi Wang, Hancheng Ye, Ming-Yu Chung, Yudong Liu, Yueqian Lin, Martin Kuo, Mingyuan Ma, Jianyi Zhang, Yiran Chen | | | Paper GitHub |
 ALMTokenizer: A Low-bitrate and Semantic-rich Audio Codec Tokenizer for Audio Language Modeling Dongchao Yang, Songxiang Liu, Haohan Guo, Jiankun Zhao, Yuanyuan Wang, Helin Wang, Zeqian Ju, Xubo Liu, Xueyuan Chen, Xu Tan, Xixin Wu, Helen Meng |  | | Paper GitHub |
 Scaling Video-Language Models to 10K Frames via Hierarchical Differential Distillation Chuanqi Cheng, Jian Guan, Wei Wu, Rui Yan | | | Paper GitHub Model |
 LongVU: Spatiotemporal Adaptive Compression for Long Video-Language Understanding Xiaoqian Shen, Yunyang Xiong, Changsheng Zhao, Lemeng Wu, Jun Chen, Chenchen Zhu, Zechun Liu, Fanyi Xiao, Balakrishnan Varadarajan, Florian Bordes, Zhuang Liu, Hu Xu, Hyunwoo J. Kim, Bilge Soran, Raghuraman Krishnamoorthi, Mohamed Elhoseiny, Vikas Chandra | | | Paper GitHub Model |
 SparseVLM: Visual Token Sparsification for Efficient Vision-Language Model Inference Yuan Zhang, Chun-Kai Fan, Junpeng Ma, Wenzhao Zheng, Tao Huang, Kuan Cheng, Denis Gudovskiy, Tomoyuki Okuno, Yohei Nakata, Kurt Keutzer, Shanghang Zhang | | | Paper GitHub |
ACM MM 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
 VISA: Group-wise Visual Token Selection and Aggregation via Graph Summarization for Efficient MLLMs Inference Pengfei Jiang, Hanjun Li, Linglan Zhao, Fei Chao, Ke Yan, Shouhong Ding, Rongrong Ji | | | Paper |
| Mitigating Information Loss under High Pruning Rates for Efficient Large Vision Language Models Mingyu Fu, Wei Suo, Ji Ma, Lin Yuanbo Wu, Peng Wang, Yanning Zhang | | | Paper |
 TimeChat-Online: 80% Visual Tokens are Naturally Redundant in Streaming Videos Linli Yao, Yicheng Li, Yuancheng Wei, Lei Li, Shuhuai Ren, Yuanxin Liu, Kun Ouyang, Lean Wang, Shicheng Li, Sida Li, Lingpeng Kong, Qi Liu, Yuanxing Zhang, Xu Sun | | | Paper GitHub Model Dataset |
📄 License
This project is licensed under the MIT License - see the LICENSE file for details.
🙏 Acknowledgments
This repository is inspired by Awesome-Efficient-Reasoning-Models, Awesome-Efficient-LLM, Awesome-Context-Engineering
🧑💻 Contributors
👏 Thanks to these contributors for this excellent work!
✉️ Contact
For questions, suggestions, or collaboration opportunities, please feel free to reach out:
✉️ Email: shaokele@gmail.com / KD.TAO.CT@outlook.com
✨ Star History
Significant stargazers

1,258 followers · starred Jun 2026

696 followers · starred Dec 2025
Similar repos


README
A Survey of Token Compression for Efficient Multimodal Large Language Models [arXiv]
Kele Shao*,1,2, Keda Tao*,1,2, Kejia Zhang3, Sicheng Feng2,4, Mu Cai5, Yuzhang Shang6, Haoxuan You7, Can Qin8, Yang Sui9, Huan Wang†,21Zhejiang University, 2Westlake University, 3Xiamen University, 4National University of Singapore, 5University of Wisconsin-Madison, 6University of Central Florida, 7Columbia University, 8Salesforce AI Research, 9Rice University
* Equal Contribution. † Corresponding Author (wanghuan@westlake.edu.cn).
If you find our paper or this resource helpful, please consider cite:
@article{
  shao2026a,
  title={A Survey of Token Compression for Efficient Multimodal Large Language Models},
  author={Kele Shao and Keda TAO and Kejia Zhang and Sicheng Feng and Mu Cai and Yuzhang Shang and Haoxuan You and Can Qin and Yang Sui and Huan Wang},
  journal={Transactions on Machine Learning Research},
  year={2026},
}
[!IMPORTANT] We welcome your help in improving the repository and paper. Please feel free to submit a pull request or contact us to:
Add a relevant paper not yet included.
Suggest a more suitable category.
Update the information.
Ask for clarification about any content.
🔥 News
- [2026.02.22] ⚠️⚠️⚠️ We are very fortunate that our article was reported by 机器之星!
- [2026.02.22] Paper accepted by ICLR 2026 could be checked in here, welcome contributions!
- [2026.01.27] Paper accepted by EMNLP 2025 and ICLR 2026 could be checked in here.
- [2026.01.24] Our survey paper has been accepted to TMLR 2026. Congratulations! 🎉🎉🎉
- [2025.10.11] Papers accepted by NeurIPS 2025 about MLLM token compression have been updated here. Congratulations! 🎉🎉🎉
- [2025.08.14] ❗ Added Recent Papers, Papers Published in Recent Conference/Journal, and a database for quick-search.
- [2025.07.29] The v1 survey is now published! We've also initialized the repository.
🎯 Motivation
Motivation: Up: Image, video, and audio data types can scale in their representation dimensions, leading to a corresponding increase in the number of tokens. Down: Top-performing MLLMs cannot address real-world demands, as the number of tokens for multimodal information, especially video, vastly exceeds that of text. Therefore, token compression is crucial to address this limitation.
📚 Contents
Please check out all the papers by selecting the sub-area you're interested in. On this main page, only papers released in the past 6 months are shown.
Badge Colors
redfor arXiv papersbluefor conference/journal paperswhitefor GitHub repositoriespurplefor research areasgreenfor categoriesyellowfor training cost
Recent Papers (Last 6 Months)
Image
Video
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| MeToM: Metadata-Guided Token Merging for Efficient Video LLMs Zhuojie Wu, Shijie Wang, Xin Yu | | | Paper |
| LRCP: Low-Rank Compressibility Guided Visual Token Pruning for Efficient LVLMs Hongyu Lu, Feng Zhang, Wenwei Jin, Huanling Hu, Tianjun Shi, Shikai Jiang, Yao Hu, Jiawei Li | | | Paper |
| EchoingPixels: Cross-Modal Adaptive Token Reduction for Efficient Audio-Visual LLMs Chao Gong, Depeng Wang, Zhipeng Wei, Ya Guo, Huijia Zhu, Jingjing Chen | | | Paper |
| Accelerating Streaming Video Large Language Models via Hierarchical Token Compression Yiyu Wang, Xuyang Liu, Xiyan Gui, Xinying Lin, Boxue Yang, Chenfei Liao, Tailai Chen, Linfeng Zhang | | | Paper GitHub |
| FLoC: Facility Location-Based Efficient Visual Token Compression for Long Video Understanding Janghoon Cho, Jungsoo Lee, Munawar Hayat, Kyuwoong Hwang, Fatih Porikli, Sungha Choi | | | Paper |
Audio
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| EchoingPixels: Cross-Modal Adaptive Token Reduction for Efficient Audio-Visual LLMs Chao Gong, Depeng Wang, Zhipeng Wei, Ya Guo, Huijia Zhu, Jingjing Chen | | | Paper |
Omni
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| Stage-adaptive Token Selection for Efficient Omni-modal LLMs Zijie Xin, Jie Yang, Ruixiang Zhao, Tianyi Wang, Fengyun Rao, Jing Lyu, Xirong Li | | | Paper GitHub |
| OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models Yue Ding, Yiyan Ji, Jungang Li, Xuyang Liu, Xinlong Chen, Junfei Wu, Bozhou Li, Bohan Zeng, Yang Shi, Yushuo Guan, Yuanxing Zhang, Jiaheng Liu, Qiang Liu, Pengfei Wan, Liang Wang | | | Paper GitHub Model |
| OmniZip: Audio-Guided Dynamic Token Compression for Fast Omnimodal Large Language Models Keda Tao, Kele Shao, Bohan Yu, Weiqiang Wang, Jian liu, Huan Wang | | | Paper GitHub |
Published in Recent Conference/Journal
ACM MM 2026
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| VisCo: Leveraging Large Language Models as Intrinsic Encoders for Visual Token Compression Yupeng Zheng, Kai Zou, Bin Liu, Nenghai Yu | | | Paper GitHub |
CVPR 2026
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| FocusUI: Efficient UI Grounding via Position-Preserving Visual Token Selection Mingyu Ouyang, Kevin Qinghong Lin, Mike Zheng Shou, Hwee Tou Ng | | | Paper GitHub Model Dataset |
| MeToM: Metadata-Guided Token Merging for Efficient Video LLMs Zhuojie Wu, Shijie Wang, Xin Yu | | | Paper |
| Accelerating Streaming Video Large Language Models via Hierarchical Token Compression Yiyu Wang, Xuyang Liu, Xiyan Gui, Xinying Lin, Boxue Yang, Chenfei Liao, Tailai Chen, Linfeng Zhang | | | Paper GitHub |
| OmniZip: Audio-Guided Dynamic Token Compression for Fast Omnimodal Large Language Models Keda Tao, Kele Shao, Bohan Yu, Weiqiang Wang, Jian liu, Huan Wang | | | Paper GitHub |
| StreamingTOM: Streaming Token Compression for Efficient Video Understanding Xueyi Chen, Keda Tao, Kele Shao, Huan Wang | | | Paper GitHub |
ICLR 2026
EMNLP 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| Seeing More, Saying More: Lightweight Language Experts are Dynamic Video Token Compressors Xiangchen Wang, Jinrui Zhang, Teng Wang, Haigang Zhang, Feng Zheng | | | Paper GitHub |
NeurIPS 2025
ICCV 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| VFlowOpt: A Token Pruning Framework for LMMs with Visual Information Flow-Guided Optimization Sihan Yang, Runsen Xu, Chenhang Cui, Tai Wang, Dahua Lin, Jiangmiao Pang | | | Paper GitHub |
| Representation Shift: Unifying Token Compression with FlashAttention Joonmyung Choi, Sanghyeok Lee, Byungoh Ko, Eunseo Kim, Jihyung Kil, Hyunwoo J. Kim | | | Paper GitHub |
| METEOR: Multi-Encoder Collaborative Token Pruning for Efficient Vision Language Models Yuchen Liu, Yaoming Wang, Bowen Shi, Xiaopeng Zhang, Wenrui Dai, Chenglin Li, Hongkai Xiong, Qi Tian | | | Paper GitHub |
| Multi-Granular Spatio-Temporal Token Merging for Training-Free Acceleration of Video-LLMs Jeongseok Hyun, Sukjun Hwang, Su Ho Han, Taeoh Kim, Inwoong Lee, Dongyoon Wee, Joon-Young Lee, Seon Joo Kim, Minho Shim | | | Paper GitHub |
| AuroraLong: Bringing RNNs Back to Efficient Open-Ended Video Understanding Weili Xu, Enxin Song, Wenhao Chai, Xuexiang Wen, Tian Ye, Gaoang Wang | | | Paper |
| Skip-Vision: Efficient and Scalable Acceleration of Vision-Language Models via Adaptive Token Skipping Weili Zeng, Ziyuan Huang, Kaixiang Ji, Yichao Yan | | | Paper GitHub |
| Growing a Twig to Accelerate Large Vision-Language Models Zhenwei Shao, Mingyang Wang, Zhou Yu, Wenwen Pan, Yan Yang, Tao Wei, Hongyuan Zhang, Ning Mao, Wei Chen, Jun Yu | | | Paper |
| Does Your Vision-Language Model Get Lost in the Long Video Sampling Dilemma? Tianyuan Qu, Longxiang Tang, Bohao Peng, Senqiao Yang, Bei Yu, Jiaya Jia | | Paper GitHub Dataset | |
| FOLDER: Accelerating Multi-modal Large Language Models with Enhanced Performance Haicheng Wang, Zhemeng Yu, Gabriele Spadaro, Chen Ju, Victor Quétu, Shuai Xiao, Enzo Tartaglione | | | Paper GitHub |
| FrameFusion: Combining Similarity and Importance for Video Token Reduction on Large Visual Language Models Tianyu Fu, Tengxuan Liu, Qinghao Han, Guohao Dai, Shengen Yan, Huazhong Yang, Xuefei Ning, Yu Wang | | | Paper GitHub |
| Dynamic-VLM: Simple Dynamic Visual Token Compression for VideoLLM Han Wang, Yuxiang Nie, Yongjie Ye, Deng GuanYu, Yanjie Wang, Shuai Li, Haiyang Yu, Jinghui Lu, Can Huang | | | Paper GitHub |
| Lyra: An Efficient and Speech-Centric Framework for Omni-Cognition Zhisheng Zhong, Chengyao Wang, Yuqi Liu, Senqiao Yang, Longxiang Tang, Yuechen Zhang, Jingyao Li, Tianyuan Qu, Yanwei Li, Yukang Chen, Shaozuo Yu, Sitong Wu, Eric Lo, Shu Liu, Jiaya Jia | | | Paper GitHub Model Dataset |
| AIM: Adaptive Inference of Multi-Modal LLMs via Token Merging and Pruning Yiwu Zhong, Zhuoming Liu, Yin Li, Liwei Wang | | | Paper GitHub |
| Beyond Text-Visual Attention: Exploiting Visual Cues for Effective Token Pruning in VLMs Qizhe Zhang, Aosong Cheng, Ming Lu, Renrui Zhang, Zhiyong Zhuo, Jiajun Cao, Shaobo Guo, Qi She, Shanghang Zhang | | | Paper GitHub |
| ZipVL: Efficient Large Vision-Language Models with Dynamic Token Sparsification Yefei He, Feng Chen, Jing Liu, Wenqi Shao, Hong Zhou, Kaipeng Zhang, Bohan Zhuang | | | Paper |
| HERMES: temporal-coHERent long-forM understanding with Episodes and Semantics Gueter Josmy Faure, Jia-Fong Yeh, Min-Hung Chen, Hung-Ting Su, Shang-Hong Lai, Winston H. Hsu | | | Paper GitHub |
| LLaVA-PruMerge: Adaptive Token Reduction for Efficient Large Multimodal Models Yuzhang Shang, Mu Cai, Bingxin Xu, Yong Jae Lee, Yan Yan | | | Paper GitHub |
ACL 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| EffiVLM-Bench: A Comprehensive Benchmark for Evaluating Training-Free Acceleration in Large Visual-Languge Models Zekun Wang, Minghua Ma, Zexin Wang, Rongchuan Mu, Liping Shan, Ming Liu, Bing Qin | | Paper GitHub | |
| MMS-LLaMA: Efficient LLM-based Audio-Visual Speech Recognition with Minimal Multimodal Speech Tokens Jeong Hun Yeo, Hyeongseop Rha, Se Jin Park, Yong Man Ro | | | Paper GitHub |
| MEDA: Dynamic KV Cache Allocation for Efficient Multimodal Long-Context Inference Zhongwei Wan, Hui Shen, Xin Wang, Che Liu, Zheda Mai, Mi Zhang | | | Paper GitHub |
| PruneVid: Visual Token Pruning for Efficient Video Large Language Models Xiaohu Huang, Hao Zhou, Kai Han | | | Paper GitHub |
| Prompt Compression for Large Language Models: A Survey Zongqian Li, Yinhong Liu, Yixuan Su, Nigel Collier | | Paper GitHub |
ICML 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| CoreMatching: A Co-adaptive Sparse Inference Framework with Token and Neuron Pruning for Comprehensive Acceleration of Vision-Language Models Qinsi Wang, Hancheng Ye, Ming-Yu Chung, Yudong Liu, Yueqian Lin, Martin Kuo, Mingyuan Ma, Jianyi Zhang, Yiran Chen | | | Paper GitHub |
| ALMTokenizer: A Low-bitrate and Semantic-rich Audio Codec Tokenizer for Audio Language Modeling Dongchao Yang, Songxiang Liu, Haohan Guo, Jiankun Zhao, Yuanyuan Wang, Helin Wang, Zeqian Ju, Xubo Liu, Xueyuan Chen, Xu Tan, Xixin Wu, Helen Meng | | | Paper GitHub |
| Scaling Video-Language Models to 10K Frames via Hierarchical Differential Distillation Chuanqi Cheng, Jian Guan, Wei Wu, Rui Yan | | | Paper GitHub Model |
| LongVU: Spatiotemporal Adaptive Compression for Long Video-Language Understanding Xiaoqian Shen, Yunyang Xiong, Changsheng Zhao, Lemeng Wu, Jun Chen, Chenchen Zhu, Zechun Liu, Fanyi Xiao, Balakrishnan Varadarajan, Florian Bordes, Zhuang Liu, Hu Xu, Hyunwoo J. Kim, Bilge Soran, Raghuraman Krishnamoorthi, Mohamed Elhoseiny, Vikas Chandra | | | Paper GitHub Model |
| SparseVLM: Visual Token Sparsification for Efficient Vision-Language Model Inference Yuan Zhang, Chun-Kai Fan, Junpeng Ma, Wenzhao Zheng, Tao Huang, Kuan Cheng, Denis Gudovskiy, Tomoyuki Okuno, Yohei Nakata, Kurt Keutzer, Shanghang Zhang | | | Paper GitHub |
ACM MM 2025
| Title & Authors | Areas | Tags | Links |
|---|---|---|---|
| VISA: Group-wise Visual Token Selection and Aggregation via Graph Summarization for Efficient MLLMs Inference Pengfei Jiang, Hanjun Li, Linglan Zhao, Fei Chao, Ke Yan, Shouhong Ding, Rongrong Ji | | | Paper |
| Mitigating Information Loss under High Pruning Rates for Efficient Large Vision Language Models Mingyu Fu, Wei Suo, Ji Ma, Lin Yuanbo Wu, Peng Wang, Yanning Zhang | | | Paper |
| TimeChat-Online: 80% Visual Tokens are Naturally Redundant in Streaming Videos Linli Yao, Yicheng Li, Yuancheng Wei, Lei Li, Shuhuai Ren, Yuanxin Liu, Kun Ouyang, Lean Wang, Shicheng Li, Sida Li, Lingpeng Kong, Qi Liu, Yuanxing Zhang, Xu Sun | | | Paper GitHub Model Dataset |
📄 License
This project is licensed under the MIT License - see the LICENSE file for details.
🙏 Acknowledgments
This repository is inspired by Awesome-Efficient-Reasoning-Models, Awesome-Efficient-LLM, Awesome-Context-Engineering
🧑💻 Contributors
👏 Thanks to these contributors for this excellent work!
✉️ Contact
For questions, suggestions, or collaboration opportunities, please feel free to reach out:
✉️ Email: shaokele@gmail.com / KD.TAO.CT@outlook.com
✨ Star History
Similar repos
Significant stargazers
1,258 followers · starred Jun 2026
696 followers · starred Dec 2025