現在の段階: v5.0.0公開候補版。主要な生成・楽譜・ダウンロード経路は統合確認済みです。
歌詞生成(LLM)、YuE2による作曲、楽譜(ABC)の表示・編集・再生成、背景演出を統合したWebアプリケーションです。
YuE2 の「ホワイトボックス作曲」
(音声化前に楽譜を確認・編集できる)を活かした楽譜ワークフローを追加しています。
サーバ側には YUE2-Refined-Engine を使用します。
公開版では、楽譜プランからの編集に対応する修正を含むサーバーリビジョンを固定します。
現在の基準リビジョンはb64625fで、対応修正の公開後にこの記載を確定します。
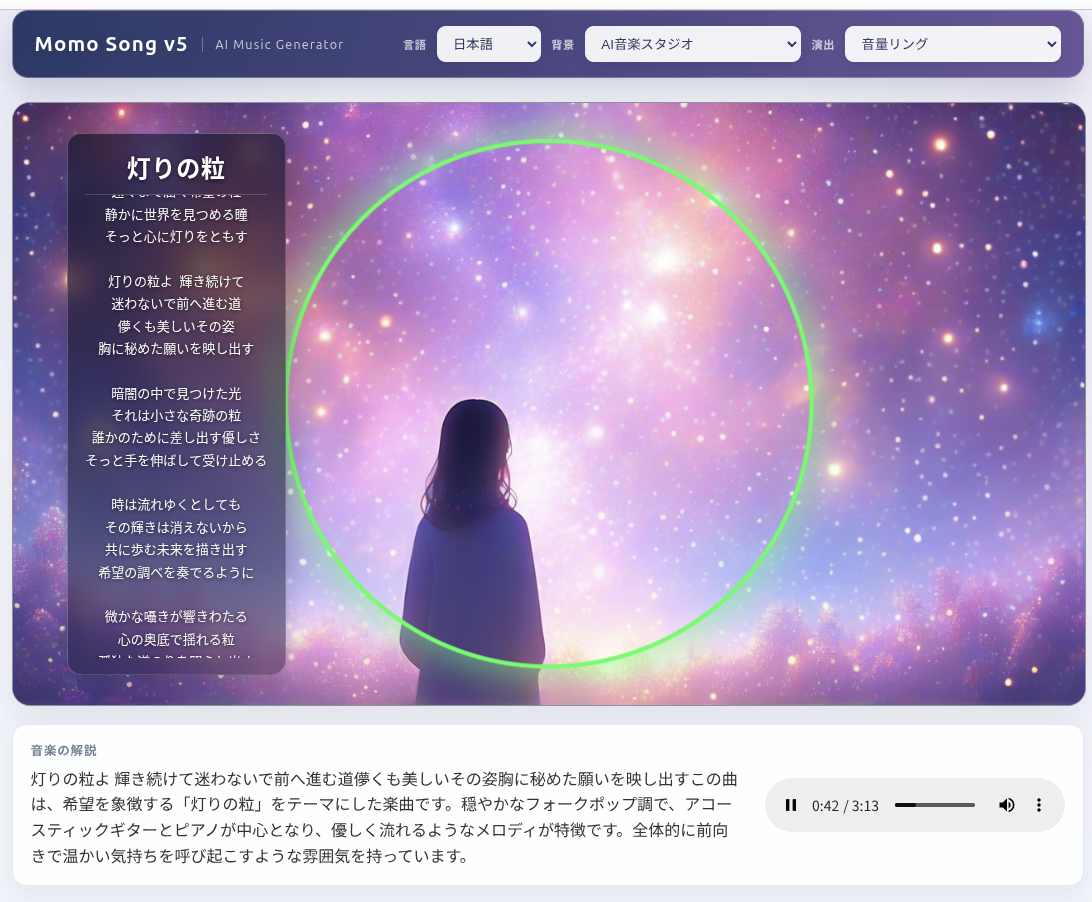
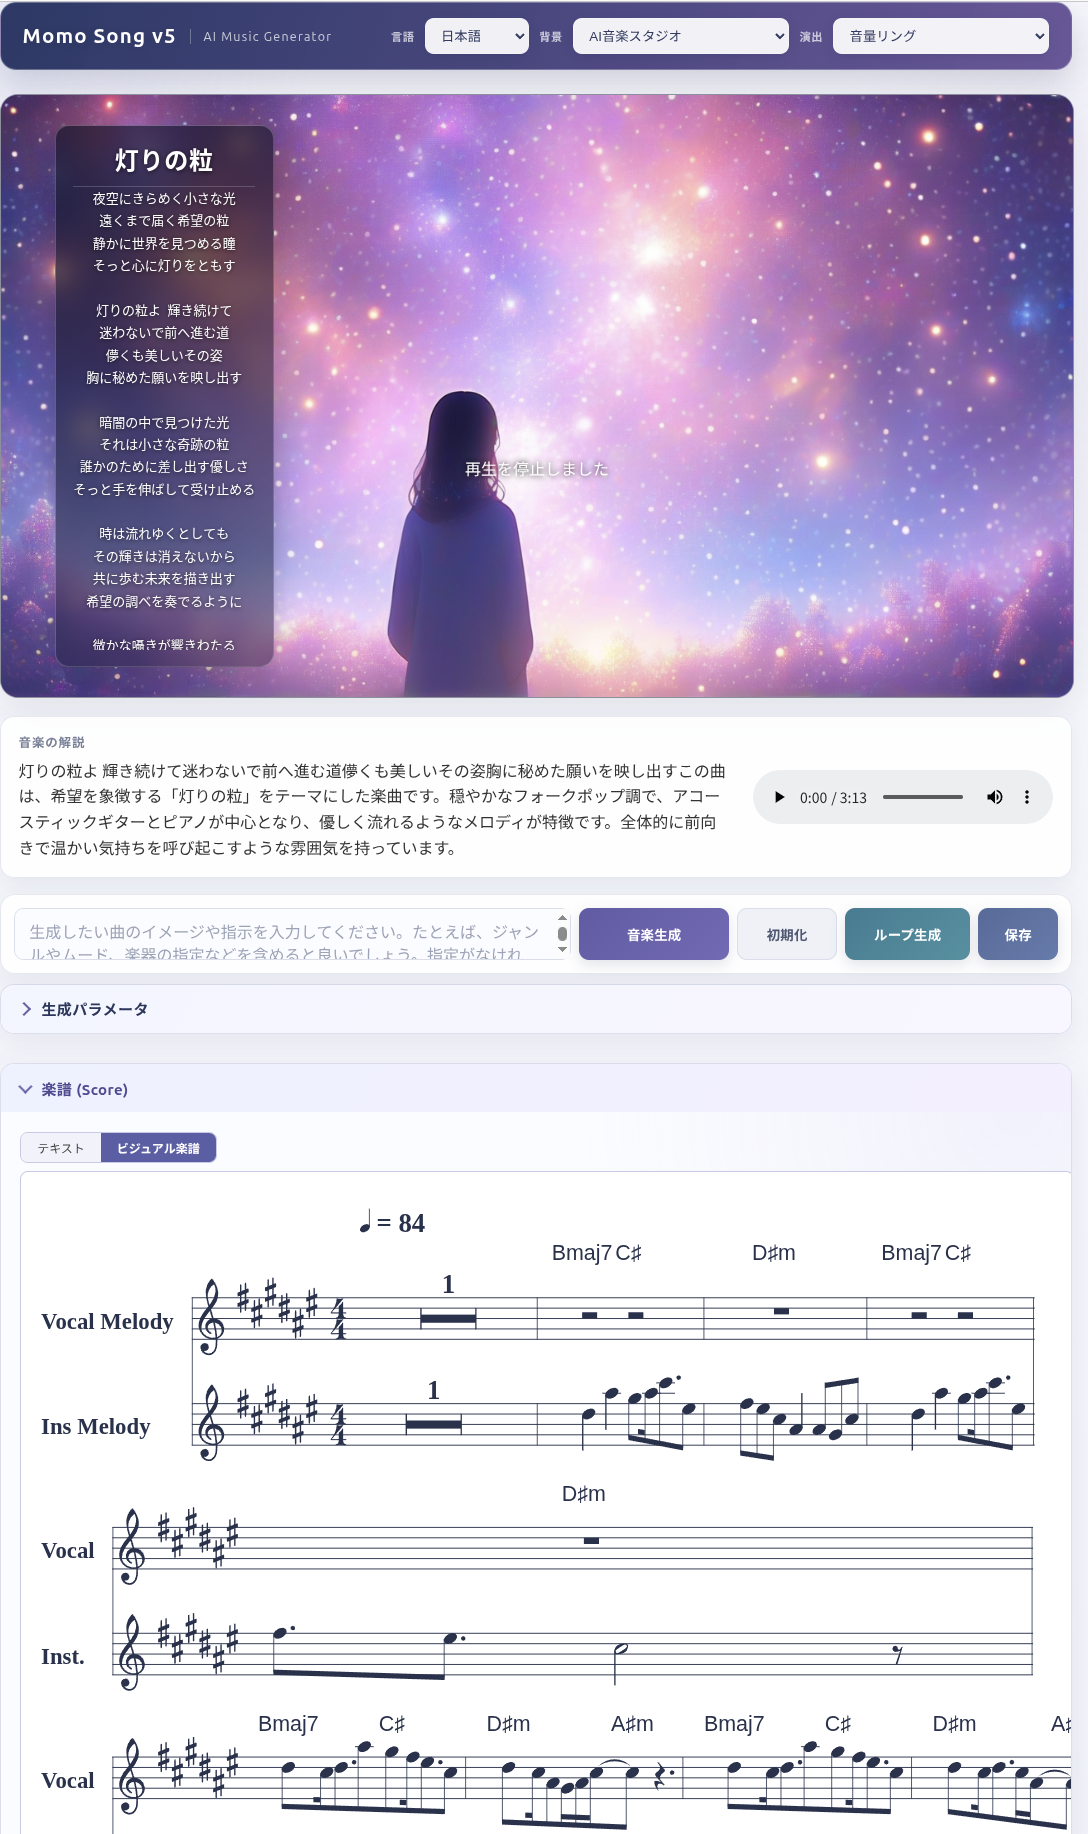
full(楽譜+コード) / melody / off を選択可能生成されたABC楽譜は、テキストとビジュアル五線譜を切り替えて確認できます。編集した楽譜からの再生成や、 同じ楽譜を使った別テイクの生成にも対応します。
| 依存 | 必須/任意 | 備考 |
|---|---|---|
| YUE2-Refined-Engine | 必須 | YuE2音楽生成APIサーバ。BF16対応NVIDIA GPU、VRAM実測9〜15GB |
| OpenAI互換LLM API | 必須 | 作詞用。Gemma系で動作確認(gemma-4-31B / gemma-4-E4B) |
| 背景画像生成 | 任意 | off / PNG対応リモートAPI / ローカル(SDXL+LCM-LoRA または Iris-3B Turbo、UIで切替)。無効・失敗時は選択中の初期背景を維持 |
| faster-whisper入りvenv | 任意 | インスト生成のASR検査(MOMO_ASR_PYTHON) |
| SheetSage2レンダラ | 任意 | 楽譜PDF出力。tools/setup_score_renderer.shで取得(CC BY-NC 4.0) |
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
cp .env.example .env
# .env のLLM/YuE2接続先を環境に合わせて編集
start.shは.envがあれば自動的に読み込みます。Pythonプロセス内で
llama-cpp-pythonを使う任意のローカルLLMバックエンドが必要な場合は、次をインストールします。
後述の独立したllama-serverを使う構成では、Momo Songのvenvへの追加導入は不要です。
.venv/bin/pip install -r requirements-local-llm.txt
背景画像を同じGPUでローカル生成する場合(任意):
.venv/bin/pip install -r requirements-image.txt
# .envで IMAGE_BACKEND=local を設定
画像エンジンはIMAGE_ENGINEで切り替えます。既定のsdxlはSDXL+LCM-LoRA、irisは
Iris-3B+4-step Turbo LoRAです。irisでは作詞LLMへの画像プロンプト指示も英語の説明文向けに切り替わり、
UIの縦横比のまま約1MP(16:9なら1344×768)で生成します。導入はtools/setup_iris.shです。
画像生成が有効なら、UIの「表示パラメータ → 画像エンジン」で曲ごとに切り替えられます(IMAGE_ENGINEは既定値)。
画像を生成しない場合はIMAGE_BACKEND=offのままで構いません。リモート画像APIのPNG仕様、
ローカル画像エンジン(SDXL/Iris)の設定、LLM要件は
外部サービス要件にまとめています。
RTX PRO 4000 Blackwellでは、YuE2待機中との共存状態で896×512をウォーム平均約3.72秒、
GPU使用量の増分約5.8GiBで生成できました。詳細は
画像生成の実測を参照してください。
LLM作詞、YuE2音楽生成、背景画像、レスポンス化を含む全フローは、完成音声に対して約2.24倍速、 3分曲換算で約80〜81秒でした。計測条件と内訳は 全生成フローの実測を参照してください。
Gemma 4 E2BをCPU版llama-serverのOpenAI互換APIとして使うこともできます。i5-12400Fの
CPU native buildではprompt 146 token/s、生成21 token/s、実作詞フロー約31秒を確認しています。
CPU LLM実測も参照してください。
外部LLMが停止している場合だけCPU版へ切り替えるには、.envで
LLM_FALLBACK_ENABLED=true、LLM_FALLBACK_SERVER_BIN、LLM_FALLBACK_MODEL_PATHを設定します。
設定例と動作条件は外部サービス構成を参照してください。
楽譜PDF出力を使う場合(任意):
./tools/setup_score_renderer.sh # SheetSage2レンダラ取得 + Playwright/Chromium導入
音楽生成、作詞LLM、背景画像生成、Web UIはすべて1台のPCで実行できます。 検証時はRTX PRO 4000 Blackwell 24GBを使い、次の構成で動作させました。
ブラウザ
  └─ Momo Song v5                  http://127.0.0.1:64654
       ├─ Gemma 4 E4B llama-server   http://127.0.0.1:64651/v1
       ├─ YUE2-Refined-Engine        http://127.0.0.1:8002
       └─ ローカルDiffusers          Momo Songプロセス内(ポートなし)

任意の障害時経路
  └─ Gemma 4 E2B CPU fallback     http://127.0.0.1:64650/v1
検証では、llama.cppのllama-serverとGemma 4 E4B Q4_K_Mを使用しました。
パスとGPU番号は環境に合わせて変更してください。CUDA_VISIBLE_DEVICES=1を指定すると、
その物理GPUは各プロセス内でcuda:0として見えます。
LLAMA_SERVER_BIN=/path/to/llama.cpp/build/bin/llama-server
GEMMA_MODEL_PATH=/path/to/gemma-4-E4B-it-Q4_K_M.gguf

CUDA_VISIBLE_DEVICES=1 "$LLAMA_SERVER_BIN" \
  --model "$GEMMA_MODEL_PATH" \
  --host 127.0.0.1 \
  --port 64651 \
  --n-gpu-layers 999 \
  --main-gpu 0 \
  --ctx-size 8192 \
  --parallel 1 \
  --cache-type-k q4_0 \
  --reasoning off \
  --jinja
LLMをGPUに常駐させない場合は、CPU LLM実測の Gemma 4 E2B構成を通常のLLMまたはフォールバックとして利用できます。
.env次の設定で、LLMとYUE2-Refined-Engineはループバック経由、画像はローカル推論になります。
MOMO_HOST=127.0.0.1
MOMO_PORT=64654

LLM_API_URL=http://127.0.0.1:64651/v1
LLM_API_KEY=local-not-required
LLM_MODEL=unsloth/gemma-4-E4B-it-GGUF:Q4_K_M
LLM_REQUEST_TIMEOUT=120

YUE2_API_URL=http://127.0.0.1:8002
# YUE2_DIR=/absolute/path/to/YUE2-Refined-Engine

# 検証機で使用した物理GPU番号。利用環境に合わせて変更する。
CUDA_VISIBLE_DEVICES=1

IMAGE_BACKEND=local
# UIの画像エンジン既定値。irisを使う場合は tools/setup_iris.sh で導入
IMAGE_ENGINE=sdxl
IMAGE_MODEL_ID=Linaqruf/animagine-xl-2.0
IMAGE_LCM_LORA_ID=latent-consistency/lcm-lora-sdxl
IMAGE_CPU_OFFLOAD=true
IMAGE_STEPS=4
IMAGE_GUIDANCE_SCALE=1.0
CPUフォールバックも同時に有効化する場合は、上記に次を追加します。
LLM_FALLBACK_ENABLED=true
LLM_FALLBACK_SERVER_BIN=/path/to/llama.cpp/build-cpu-native/bin/llama-server
LLM_FALLBACK_MODEL_PATH=/path/to/gemma-4-E2B-it-Q4_K_M.gguf
LLM_FALLBACK_API_URL=http://127.0.0.1:64650/v1
LLM_FALLBACK_MODEL=local-gemma
LLM_FALLBACK_THREADS=6
Gemma 4 E4Bを起動せず、CPU版Gemma 4 E2Bだけを使う場合は、上記の
LLM_API_URLとLLM_MODELも次の値へ置き換えます。この構成では、初回接続時に
CPU版llama-serverが自動起動します。
LLM_API_URL=http://127.0.0.1:64650/v1
LLM_MODEL=local-gemma
LLM_FALLBACK_ENABLED=true
Gemma 4 E4BをGPUで動かさず、Gemma 4 E2B Q4_K_MをCPUフォールバックとして 使用する場合、LLMのVRAM使用量はほぼ0にできます。この場合の設計上の最小GPUは 12GB級です。
| 処理 | VRAM目安 |
|---|---|
| Gemma 4 E2B CPU | ほぼ0GB |
YuE2 fast-lowvram | ピーク約9GB |
| ローカル画像生成(SDXL) | 画像生成フェーズの増分約5.8GB |
| ローカル画像生成(Iris int8) | 画像生成フェーズのピーク約7.8GB |
| 設計上の最小GPU | 12GB級 |
| 安全余裕を含む推奨 | 16GB以上 |
| 全フロー実測済み | 24GB |
YuE2と画像生成は直列実行するため、上記の約9GBと画像生成分を同時に 確保するわけではありません。ただし、12GB GPUでの音楽・画像を含む全フローは未実測です。 IrisのCPU offloadは重みのピン留めコピー約7.2GiBをシステムRAMに常駐させます。 実運用ではドライバメモリや一時バッファを考慮し、16GB以上を推奨します。 また、CPU LLMと画像モデルのCPU offloadには別途システムRAMが必要です。
12GB級GPUを使う場合は、.envで次を指定します。
YUE2_PROFILE=fast-lowvram
YUE2_MEMORY_BUDGET_GIB=12

IMAGE_BACKEND=local
IMAGE_CPU_OFFLOAD=true
IMAGE_STEPS=4
IMAGE_GUIDANCE_SCALE=1.0
既定のYUE2_PROFILE=fastは音楽生成だけでVRAMピークが約15GBに達するため、
12GB級GPUでは使用せず、fast-lowvramへ切り替えてください。
別ターミナルで次を実行します。start.shはYUE2-Refined-Engineを自動起動し、
モデルの準備完了後にMomo Songを起動します。背景画像モデルは初回の画像生成時に遅延ロードされます。
./start.sh
検証した実行順序は「LLMによる作詞→YuE2による音楽生成→ローカル画像エンジンによる背景画像生成」です。 YuE2と画像生成を直列化することでVRAMピークの重なりを避け、画像生成後はCPU offloadで 画像モデルをCPU側へ戻します。検証時の処理時間とVRAM使用量は 全生成フローの実測とローカル背景画像生成の実測を参照してください。
YUE2-Refined-Engineだけをバックグラウンドで起動する場合:
./start_yue2_server.sh
# ログの確認
tail -f yue2_api_server.log
YUE2-Refined-Engineの起動からMomo Songの起動まで一括で行う場合:
./start.sh    # YUE2-Refined-Engine起動→model_ready待ち→UI起動
# ブラウザで http://localhost:64654
環境変数は .env.example を参照してください。
Webアプリ自身の生存確認は http://localhost:64654/health で行えます。
start_yue2_server.shとstart.shは、既にYuE2 APIが動いていればそのまま利用します。動いていない場合は、YUE2_DIRまたは
YUE2_RUN_SCRIPTで指定した起動スクリプトを実行します。未指定時は、このリポジトリと同じ階層にある
YUE2-Refined-Engine/を探索します。
外部APIやGPUを使用しない基本テストは次のコマンドで実行できます。
.venv/bin/python -m unittest discover -s tests -v
実際の楽曲生成を含む確認には、別途YuE2 APIと作詞LLM APIが必要です。
このアプリにはユーザー認証や生成回数制限がありません。既定では127.0.0.1だけで待ち受けます。
インターネットへ直接公開せず、必要な場合は認証・アクセス制限を備えたリバースプロキシの内側で運用してください。
[Verse]/[Chorus]/[Bridge]/[Outro] タグ付き。行数がほぼ曲の長さになります(1行≒8秒)[Instrumental]歌詞」方式
(否定形の"no vocals"より安定することをASR検証で確認)。さらにMOMO_ASR_PYTHON設定時は
生成後に歌声を自動検査し、検出時は再生成します本リポジトリのソースコードの著作権者: © 2026 YUZUKI (animede)。著作権表示と NOTICE の内容は、Apache-2.0 第4条に基づき再配布時も保持してください。
static/*.png: 本プロジェクトの配布用画像素材(再配布確認済み)変更履歴は CHANGELOG.md、v5.0.0の公開文面は リリースノート案、脆弱性の連絡方法は SECURITY.mdを参照してください。 公開前の確認状況は docs/RELEASE_CHECKLIST.md にまとめています。
現在の段階: v5.0.0公開候補版。主要な生成・楽譜・ダウンロード経路は統合確認済みです。
歌詞生成(LLM)、YuE2による作曲、楽譜(ABC)の表示・編集・再生成、背景演出を統合したWebアプリケーションです。
YuE2 の「ホワイトボックス作曲」
(音声化前に楽譜を確認・編集できる)を活かした楽譜ワークフローを追加しています。
サーバ側には YUE2-Refined-Engine を使用します。
公開版では、楽譜プランからの編集に対応する修正を含むサーバーリビジョンを固定します。
現在の基準リビジョンはb64625fで、対応修正の公開後にこの記載を確定します。
full(楽譜+コード) / melody / off を選択可能生成されたABC楽譜は、テキストとビジュアル五線譜を切り替えて確認できます。編集した楽譜からの再生成や、 同じ楽譜を使った別テイクの生成にも対応します。
| 依存 | 必須/任意 | 備考 |
|---|---|---|
| YUE2-Refined-Engine | 必須 | YuE2音楽生成APIサーバ。BF16対応NVIDIA GPU、VRAM実測9〜15GB |
| OpenAI互換LLM API | 必須 | 作詞用。Gemma系で動作確認(gemma-4-31B / gemma-4-E4B) |
| 背景画像生成 | 任意 | off / PNG対応リモートAPI / ローカル(SDXL+LCM-LoRA または Iris-3B Turbo、UIで切替)。無効・失敗時は選択中の初期背景を維持 |
| faster-whisper入りvenv | 任意 | インスト生成のASR検査(MOMO_ASR_PYTHON) |
| SheetSage2レンダラ | 任意 | 楽譜PDF出力。tools/setup_score_renderer.shで取得(CC BY-NC 4.0) |
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
cp .env.example .env
# .env のLLM/YuE2接続先を環境に合わせて編集
start.shは.envがあれば自動的に読み込みます。Pythonプロセス内で
llama-cpp-pythonを使う任意のローカルLLMバックエンドが必要な場合は、次をインストールします。
後述の独立したllama-serverを使う構成では、Momo Songのvenvへの追加導入は不要です。
.venv/bin/pip install -r requirements-local-llm.txt
背景画像を同じGPUでローカル生成する場合(任意):
.venv/bin/pip install -r requirements-image.txt
# .envで IMAGE_BACKEND=local を設定
画像エンジンはIMAGE_ENGINEで切り替えます。既定のsdxlはSDXL+LCM-LoRA、irisは
Iris-3B+4-step Turbo LoRAです。irisでは作詞LLMへの画像プロンプト指示も英語の説明文向けに切り替わり、
UIの縦横比のまま約1MP(16:9なら1344×768)で生成します。導入はtools/setup_iris.shです。
画像生成が有効なら、UIの「表示パラメータ → 画像エンジン」で曲ごとに切り替えられます(IMAGE_ENGINEは既定値)。
画像を生成しない場合はIMAGE_BACKEND=offのままで構いません。リモート画像APIのPNG仕様、
ローカル画像エンジン(SDXL/Iris)の設定、LLM要件は
外部サービス要件にまとめています。
RTX PRO 4000 Blackwellでは、YuE2待機中との共存状態で896×512をウォーム平均約3.72秒、
GPU使用量の増分約5.8GiBで生成できました。詳細は
画像生成の実測を参照してください。
LLM作詞、YuE2音楽生成、背景画像、レスポンス化を含む全フローは、完成音声に対して約2.24倍速、 3分曲換算で約80〜81秒でした。計測条件と内訳は 全生成フローの実測を参照してください。
Gemma 4 E2BをCPU版llama-serverのOpenAI互換APIとして使うこともできます。i5-12400Fの
CPU native buildではprompt 146 token/s、生成21 token/s、実作詞フロー約31秒を確認しています。
CPU LLM実測も参照してください。
外部LLMが停止している場合だけCPU版へ切り替えるには、.envで
LLM_FALLBACK_ENABLED=true、LLM_FALLBACK_SERVER_BIN、LLM_FALLBACK_MODEL_PATHを設定します。
設定例と動作条件は外部サービス構成を参照してください。
楽譜PDF出力を使う場合(任意):
./tools/setup_score_renderer.sh # SheetSage2レンダラ取得 + Playwright/Chromium導入
音楽生成、作詞LLM、背景画像生成、Web UIはすべて1台のPCで実行できます。 検証時はRTX PRO 4000 Blackwell 24GBを使い、次の構成で動作させました。
ブラウザ
  └─ Momo Song v5                  http://127.0.0.1:64654
       ├─ Gemma 4 E4B llama-server   http://127.0.0.1:64651/v1
       ├─ YUE2-Refined-Engine        http://127.0.0.1:8002
       └─ ローカルDiffusers          Momo Songプロセス内(ポートなし)

任意の障害時経路
  └─ Gemma 4 E2B CPU fallback     http://127.0.0.1:64650/v1
検証では、llama.cppのllama-serverとGemma 4 E4B Q4_K_Mを使用しました。
パスとGPU番号は環境に合わせて変更してください。CUDA_VISIBLE_DEVICES=1を指定すると、
その物理GPUは各プロセス内でcuda:0として見えます。
LLAMA_SERVER_BIN=/path/to/llama.cpp/build/bin/llama-server
GEMMA_MODEL_PATH=/path/to/gemma-4-E4B-it-Q4_K_M.gguf

CUDA_VISIBLE_DEVICES=1 "$LLAMA_SERVER_BIN" \
  --model "$GEMMA_MODEL_PATH" \
  --host 127.0.0.1 \
  --port 64651 \
  --n-gpu-layers 999 \
  --main-gpu 0 \
  --ctx-size 8192 \
  --parallel 1 \
  --cache-type-k q4_0 \
  --reasoning off \
  --jinja
LLMをGPUに常駐させない場合は、CPU LLM実測の Gemma 4 E2B構成を通常のLLMまたはフォールバックとして利用できます。
.env次の設定で、LLMとYUE2-Refined-Engineはループバック経由、画像はローカル推論になります。
MOMO_HOST=127.0.0.1
MOMO_PORT=64654

LLM_API_URL=http://127.0.0.1:64651/v1
LLM_API_KEY=local-not-required
LLM_MODEL=unsloth/gemma-4-E4B-it-GGUF:Q4_K_M
LLM_REQUEST_TIMEOUT=120

YUE2_API_URL=http://127.0.0.1:8002
# YUE2_DIR=/absolute/path/to/YUE2-Refined-Engine

# 検証機で使用した物理GPU番号。利用環境に合わせて変更する。
CUDA_VISIBLE_DEVICES=1

IMAGE_BACKEND=local
# UIの画像エンジン既定値。irisを使う場合は tools/setup_iris.sh で導入
IMAGE_ENGINE=sdxl
IMAGE_MODEL_ID=Linaqruf/animagine-xl-2.0
IMAGE_LCM_LORA_ID=latent-consistency/lcm-lora-sdxl
IMAGE_CPU_OFFLOAD=true
IMAGE_STEPS=4
IMAGE_GUIDANCE_SCALE=1.0
CPUフォールバックも同時に有効化する場合は、上記に次を追加します。
LLM_FALLBACK_ENABLED=true
LLM_FALLBACK_SERVER_BIN=/path/to/llama.cpp/build-cpu-native/bin/llama-server
LLM_FALLBACK_MODEL_PATH=/path/to/gemma-4-E2B-it-Q4_K_M.gguf
LLM_FALLBACK_API_URL=http://127.0.0.1:64650/v1
LLM_FALLBACK_MODEL=local-gemma
LLM_FALLBACK_THREADS=6
Gemma 4 E4Bを起動せず、CPU版Gemma 4 E2Bだけを使う場合は、上記の
LLM_API_URLとLLM_MODELも次の値へ置き換えます。この構成では、初回接続時に
CPU版llama-serverが自動起動します。
LLM_API_URL=http://127.0.0.1:64650/v1
LLM_MODEL=local-gemma
LLM_FALLBACK_ENABLED=true
Gemma 4 E4BをGPUで動かさず、Gemma 4 E2B Q4_K_MをCPUフォールバックとして 使用する場合、LLMのVRAM使用量はほぼ0にできます。この場合の設計上の最小GPUは 12GB級です。
| 処理 | VRAM目安 |
|---|---|
| Gemma 4 E2B CPU | ほぼ0GB |
YuE2 fast-lowvram | ピーク約9GB |
| ローカル画像生成(SDXL) | 画像生成フェーズの増分約5.8GB |
| ローカル画像生成(Iris int8) | 画像生成フェーズのピーク約7.8GB |
| 設計上の最小GPU | 12GB級 |
| 安全余裕を含む推奨 | 16GB以上 |
| 全フロー実測済み | 24GB |
YuE2と画像生成は直列実行するため、上記の約9GBと画像生成分を同時に 確保するわけではありません。ただし、12GB GPUでの音楽・画像を含む全フローは未実測です。 IrisのCPU offloadは重みのピン留めコピー約7.2GiBをシステムRAMに常駐させます。 実運用ではドライバメモリや一時バッファを考慮し、16GB以上を推奨します。 また、CPU LLMと画像モデルのCPU offloadには別途システムRAMが必要です。
12GB級GPUを使う場合は、.envで次を指定します。
YUE2_PROFILE=fast-lowvram
YUE2_MEMORY_BUDGET_GIB=12

IMAGE_BACKEND=local
IMAGE_CPU_OFFLOAD=true
IMAGE_STEPS=4
IMAGE_GUIDANCE_SCALE=1.0
既定のYUE2_PROFILE=fastは音楽生成だけでVRAMピークが約15GBに達するため、
12GB級GPUでは使用せず、fast-lowvramへ切り替えてください。
別ターミナルで次を実行します。start.shはYUE2-Refined-Engineを自動起動し、
モデルの準備完了後にMomo Songを起動します。背景画像モデルは初回の画像生成時に遅延ロードされます。
./start.sh
検証した実行順序は「LLMによる作詞→YuE2による音楽生成→ローカル画像エンジンによる背景画像生成」です。 YuE2と画像生成を直列化することでVRAMピークの重なりを避け、画像生成後はCPU offloadで 画像モデルをCPU側へ戻します。検証時の処理時間とVRAM使用量は 全生成フローの実測とローカル背景画像生成の実測を参照してください。
YUE2-Refined-Engineだけをバックグラウンドで起動する場合:
./start_yue2_server.sh
# ログの確認
tail -f yue2_api_server.log
YUE2-Refined-Engineの起動からMomo Songの起動まで一括で行う場合:
./start.sh    # YUE2-Refined-Engine起動→model_ready待ち→UI起動
# ブラウザで http://localhost:64654
環境変数は .env.example を参照してください。
Webアプリ自身の生存確認は http://localhost:64654/health で行えます。
start_yue2_server.shとstart.shは、既にYuE2 APIが動いていればそのまま利用します。動いていない場合は、YUE2_DIRまたは
YUE2_RUN_SCRIPTで指定した起動スクリプトを実行します。未指定時は、このリポジトリと同じ階層にある
YUE2-Refined-Engine/を探索します。
外部APIやGPUを使用しない基本テストは次のコマンドで実行できます。
.venv/bin/python -m unittest discover -s tests -v
実際の楽曲生成を含む確認には、別途YuE2 APIと作詞LLM APIが必要です。
このアプリにはユーザー認証や生成回数制限がありません。既定では127.0.0.1だけで待ち受けます。
インターネットへ直接公開せず、必要な場合は認証・アクセス制限を備えたリバースプロキシの内側で運用してください。
[Verse]/[Chorus]/[Bridge]/[Outro] タグ付き。行数がほぼ曲の長さになります(1行≒8秒)[Instrumental]歌詞」方式
(否定形の"no vocals"より安定することをASR検証で確認)。さらにMOMO_ASR_PYTHON設定時は
生成後に歌声を自動検査し、検出時は再生成します本リポジトリのソースコードの著作権者: © 2026 YUZUKI (animede)。著作権表示と NOTICE の内容は、Apache-2.0 第4条に基づき再配布時も保持してください。
static/*.png: 本プロジェクトの配布用画像素材(再配布確認済み)変更履歴は CHANGELOG.md、v5.0.0の公開文面は リリースノート案、脆弱性の連絡方法は SECURITY.mdを参照してください。 公開前の確認状況は docs/RELEASE_CHECKLIST.md にまとめています。



