A free, open-source app for collecting memes and finding them by what they say. 免费开源的meme收藏与搜索工具,用文字描述找回存过的meme,数据保存在本地。
Python
1
77 commits
updated Sep 29, 2026
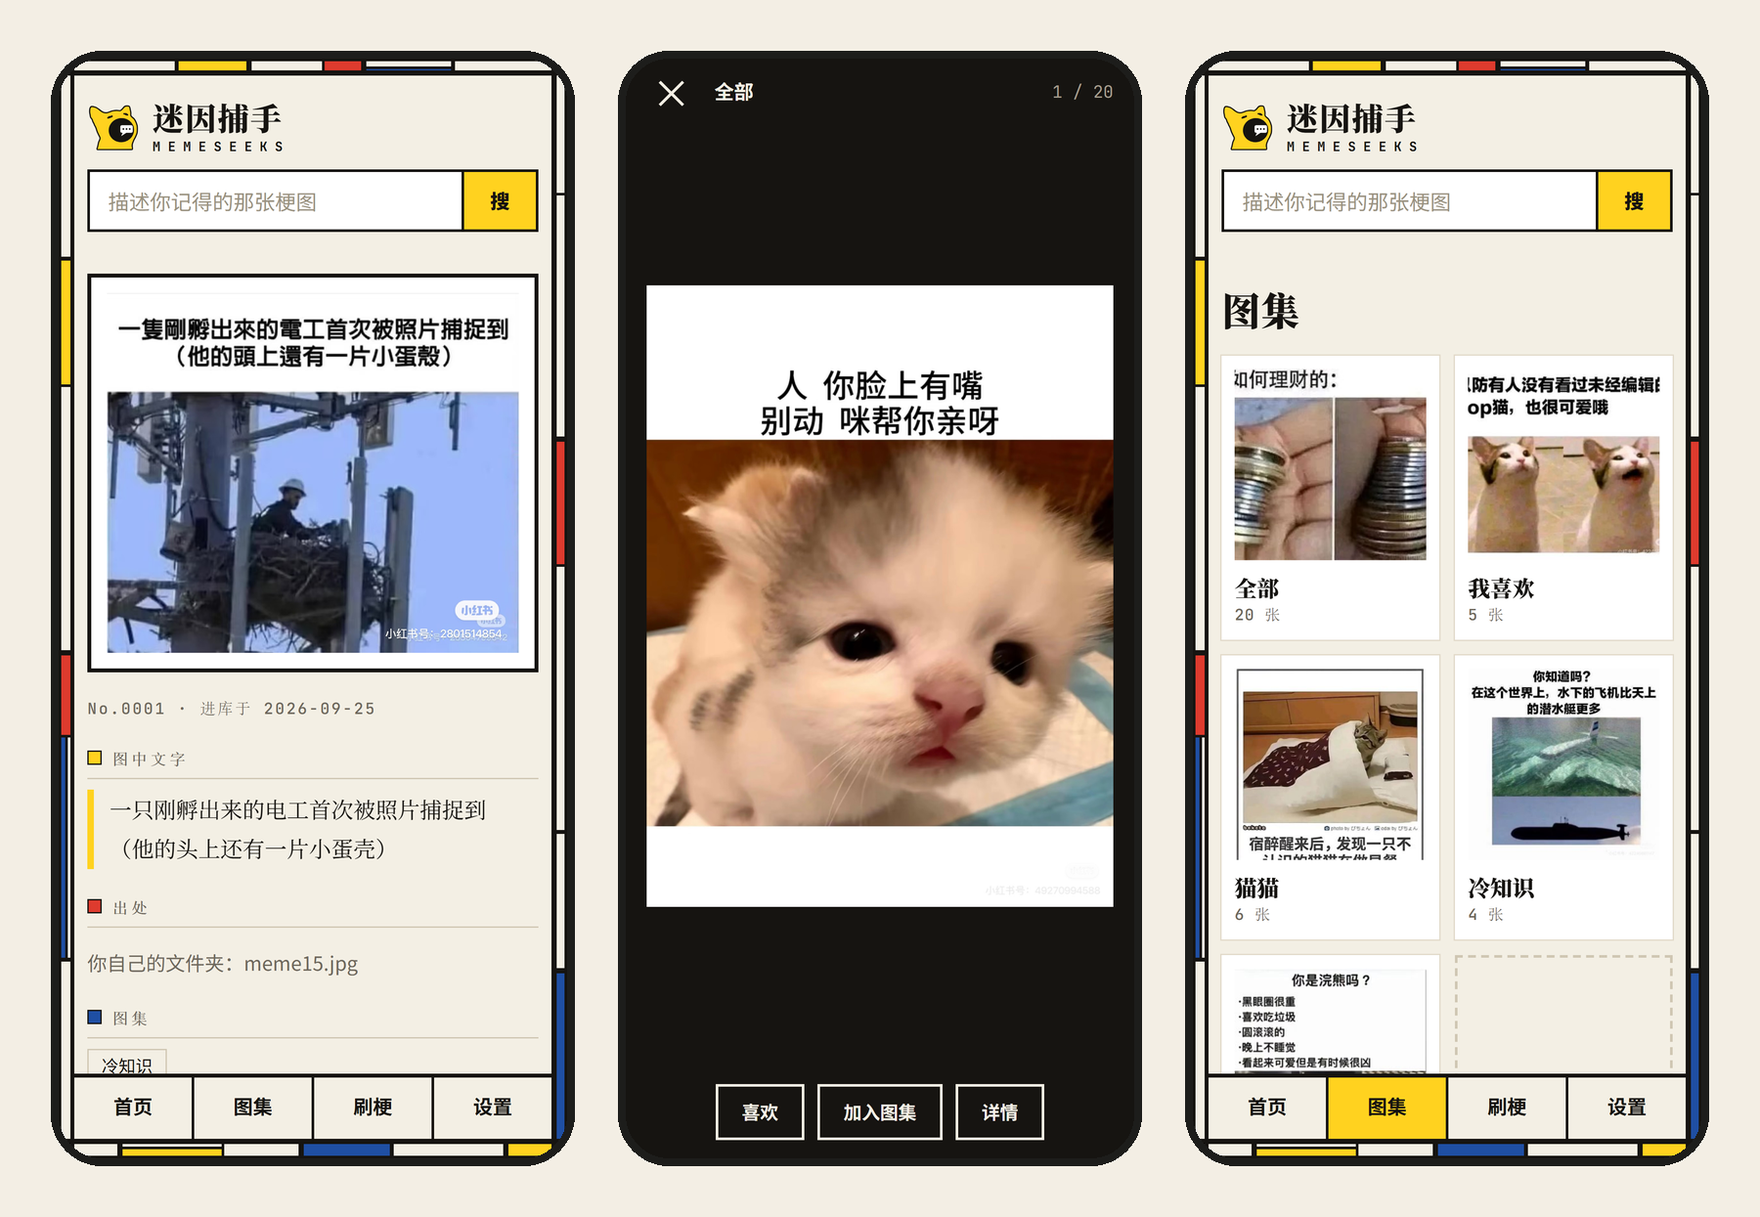
迷因捕手是一款免费开源的梗图收藏与搜索工具,按图中文字的意思找回你存过的梗图,数据全部保存在本地。
当前版本:v0.5
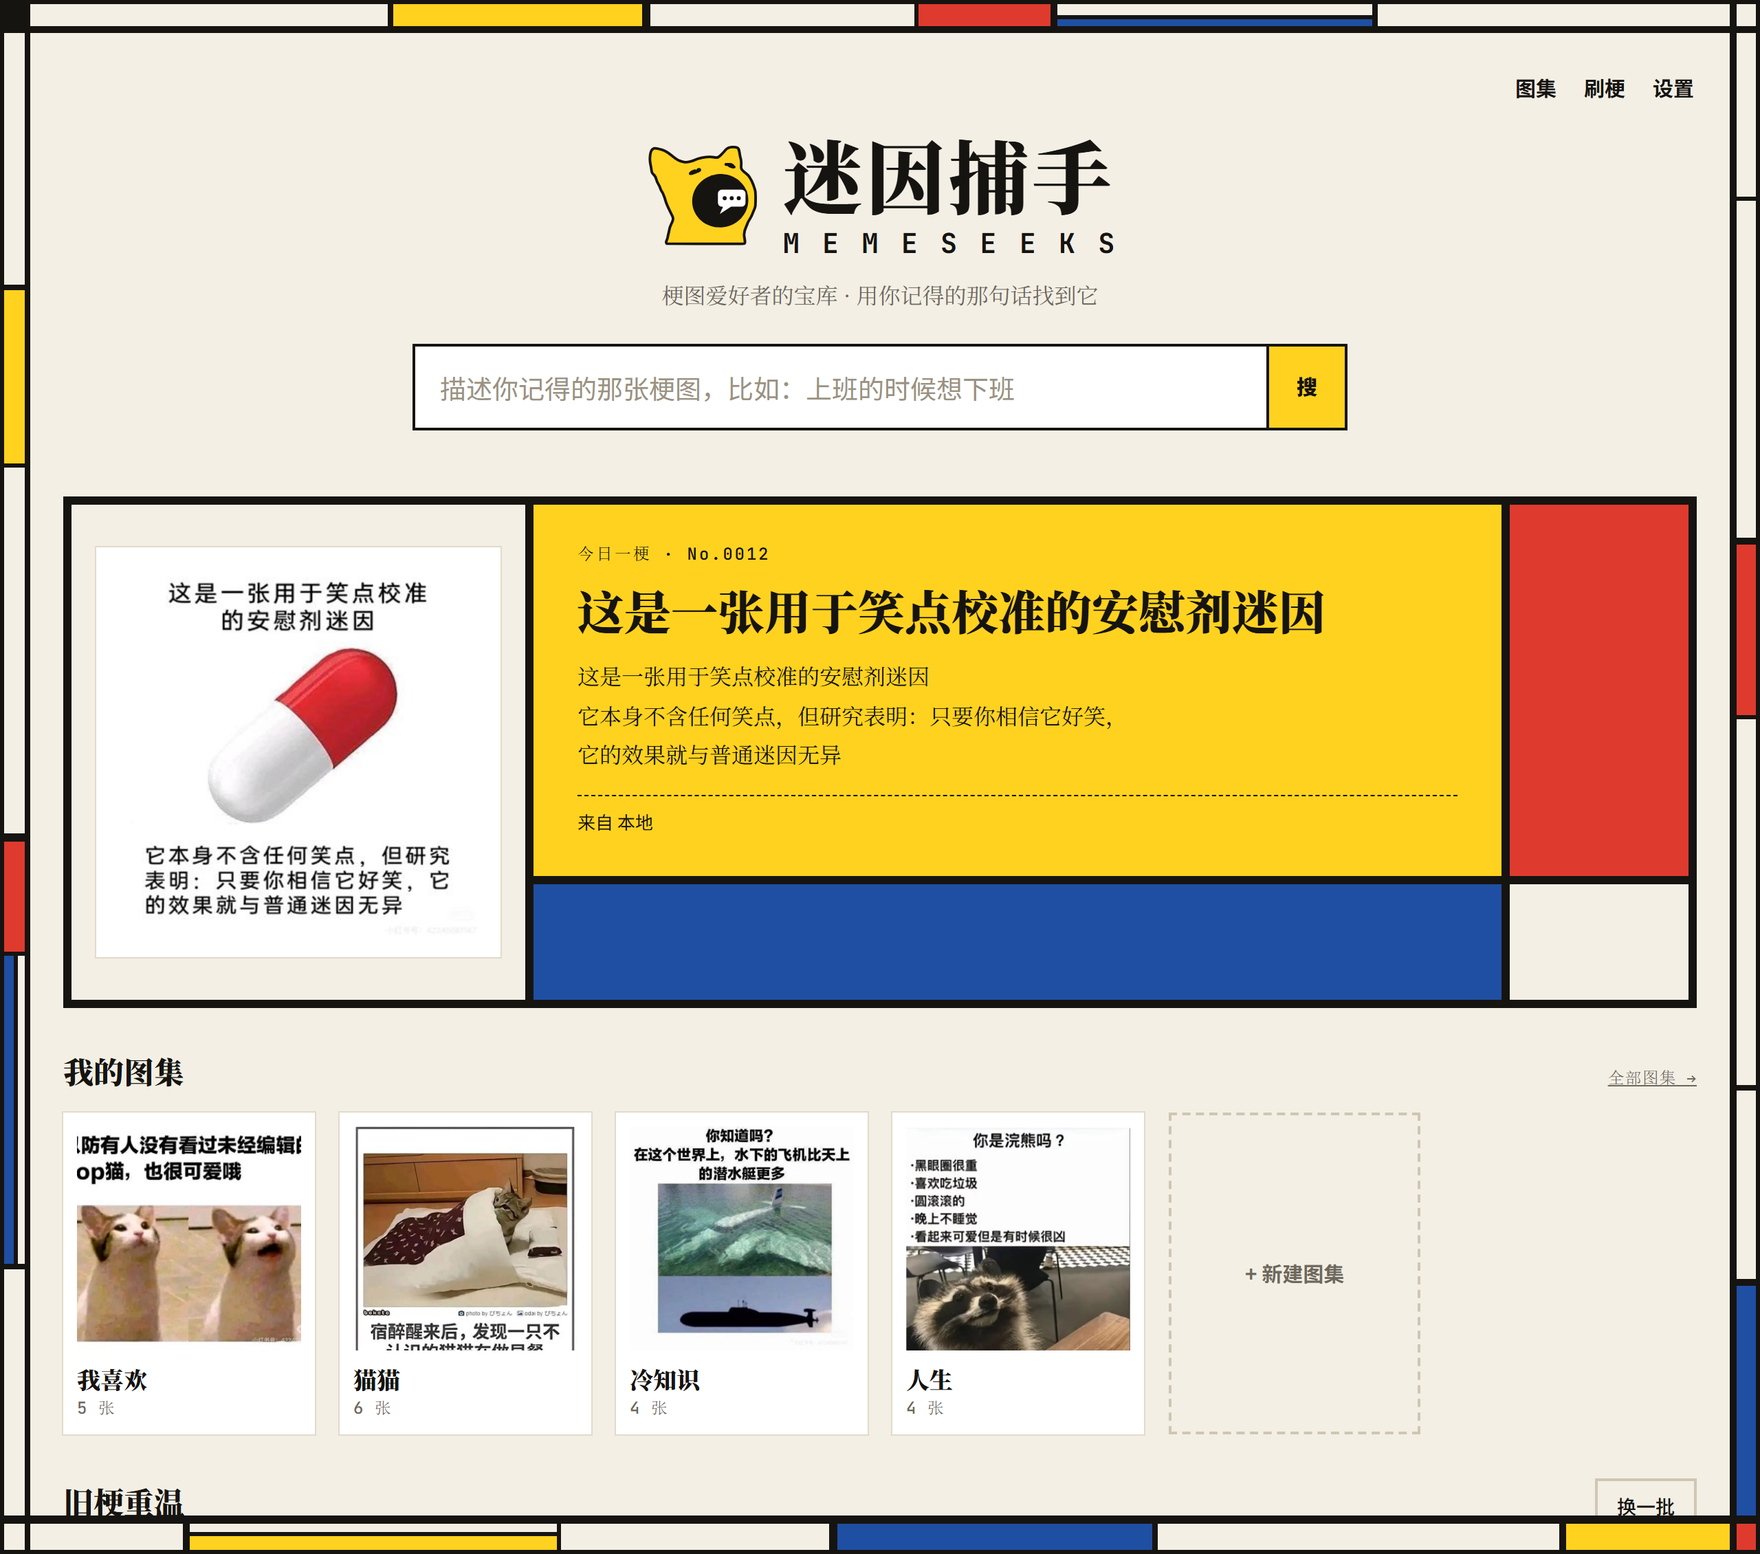
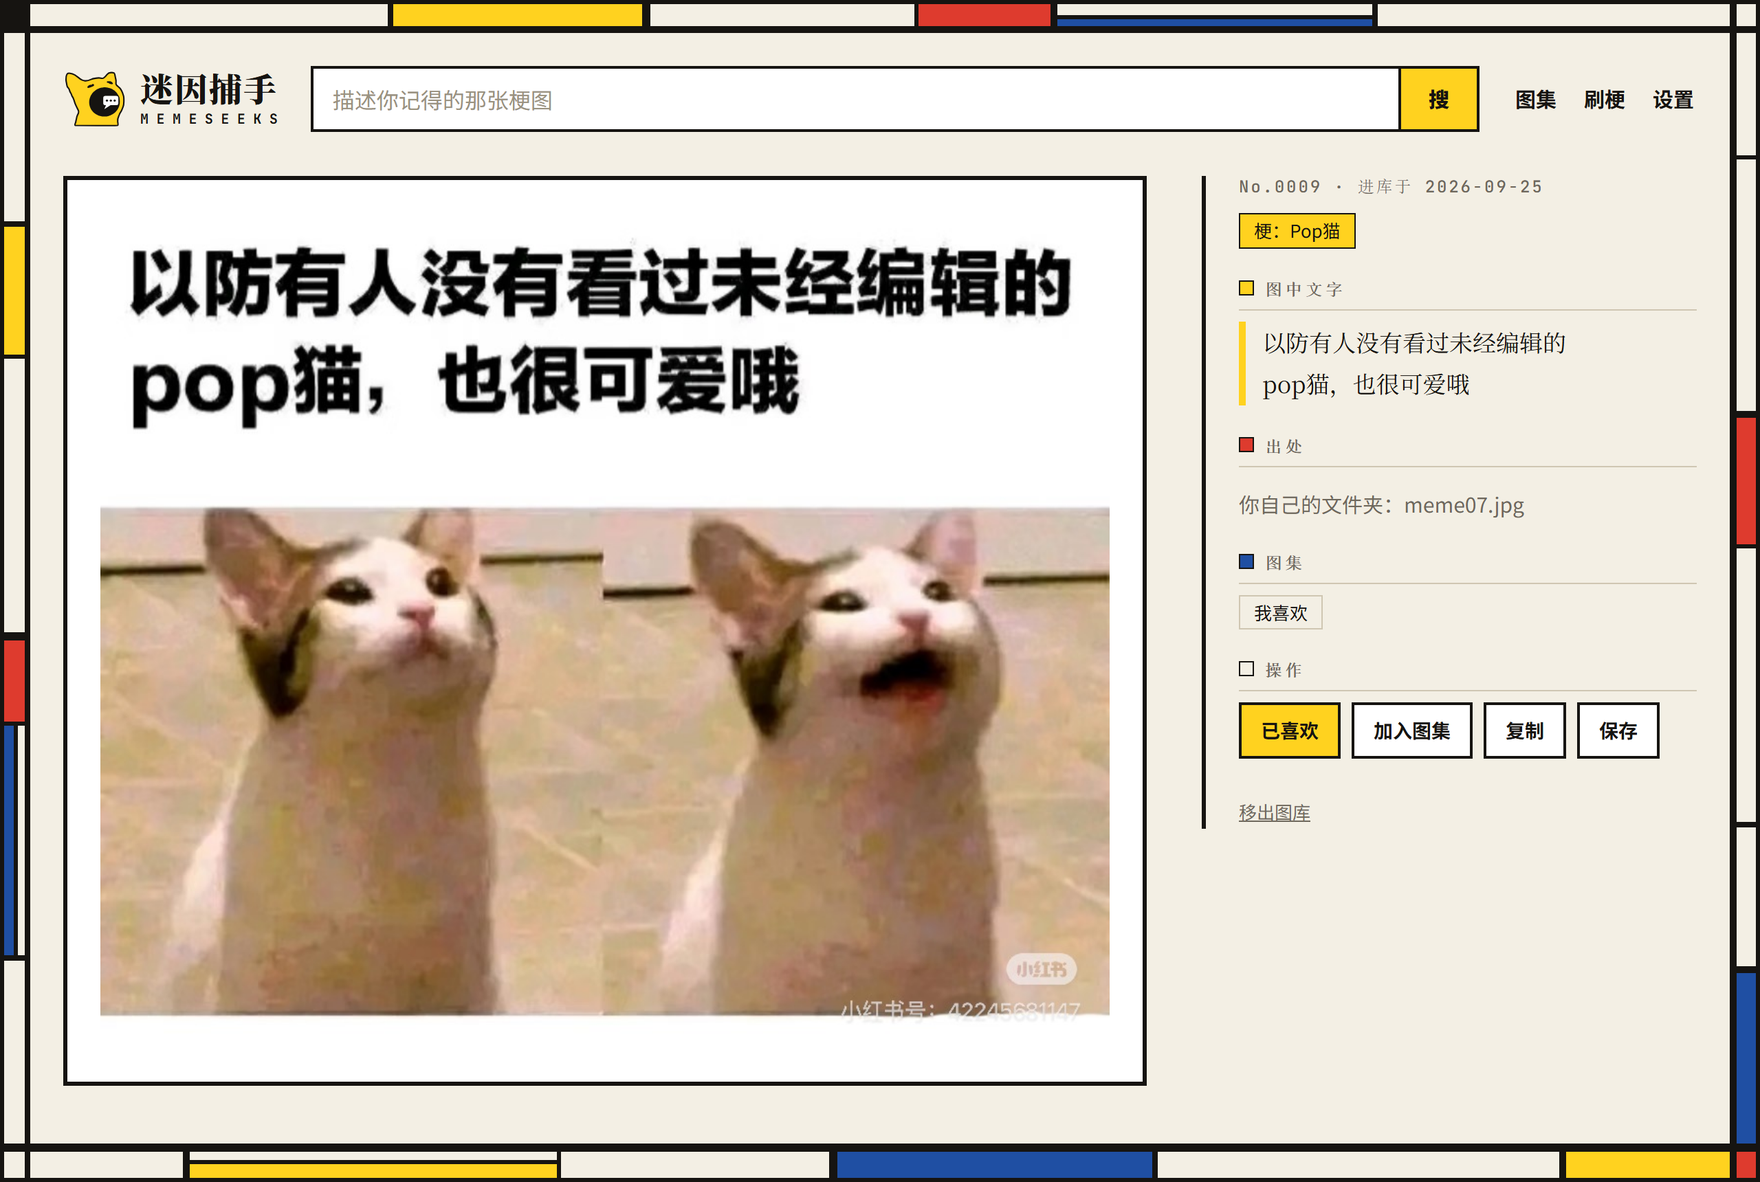
截图里的梗图来自网络(多是小红书上的转载,图上的水印原样保留),版权归原作者所有,这里只用来演示软件。如果其中有你的作品、希望撤下,请开一个 issue,我们会尽快替换。
Windows:下载 memeseeks-windows-setup.exe(约 90 MB),双击安装。
用一行命令安装(Windows 也可以这样装)。Windows 上打开 PowerShell,运行:
irm https://raw.githubusercontent.com/tactino/memeseeks/main/scripts/install.ps1 | iex
macOS / Linux:
curl -LsSf https://raw.githubusercontent.com/tactino/memeseeks/main/scripts/install.sh | sh
安装脚本会把程序和它自带的 Python 放进一个文件夹(Windows 是 %LOCALAPPDATA%\memeseeks,macOS 是 ~/Library/Application Support/memeseeks,Linux 是 ~/.local/share/memeseeks),建好「迷因捕手」快捷方式,然后启动。
~/.memeseeks,不会被删。不想装在 C 盘(或者想装到别处)时,在 Windows 上这样运行:
& ([scriptblock]::Create((irm https://raw.githubusercontent.com/tactino/memeseeks/main/scripts/install.ps1))) -Dir D:\memeseeks -Library D:\memeseeks-library
-Dir:程序、它的 Python 和模型放在哪。-Library:你的图库(索引、图集、采集来的图)放在哪。-Models D:\某处\hf-cache:复用你已经下载过的 Hugging Face 模型缓存,不再重新下载。macOS / Linux 上对应的是在 sh 前面加 MEMESEEKS_DIR=…、MEMESEEKS_LIBRARY=…、MEMESEEKS_MODELS=…。
打开后先把梗图放进来。可以在任意图集页点「上传」,也可以直接把图片拖进页面;还可以在「设置 → 来源文件夹」里添加电脑上已有的梗图文件夹。放进来的新图会在后台建立索引,页头会显示进度。在笔记本 CPU 上每张大约 3.5 秒,1000 张大约一小时,以后只处理新增的图。
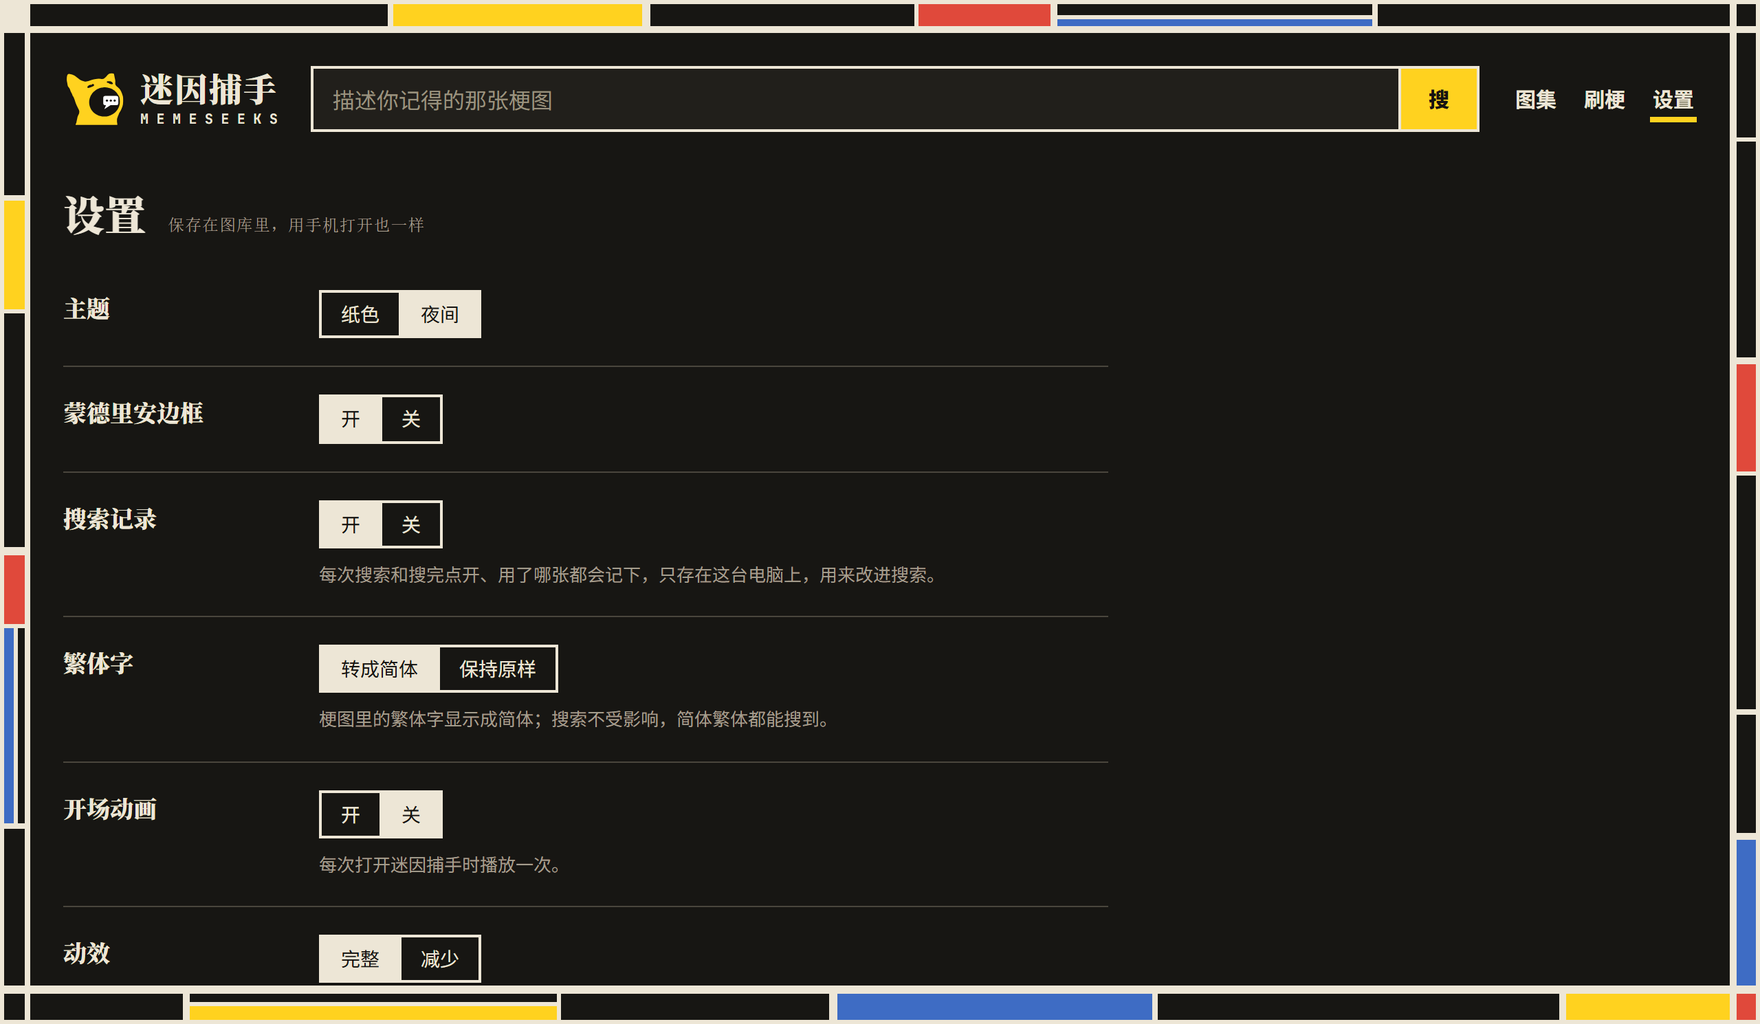
图集名.memeseeks.zip 文件,用微信、QQ 或网盘发给别人;对方把文件拖进迷因捕手(或在「图集」页点「导入图集」),就多出一个同样的图集。文件里有原图和采集来源,不含你电脑上的文件路径。custom.css。在运行它的电脑上,还可以从浏览器菜单把它装成一个应用。
在电脑上打开「设置 → 手机访问」,点「开」,再用手机相机扫出现的二维码。手机和电脑要连在同一个 Wi-Fi 上。
memeseeks serve --host 0.0.0.0 --token <一串足够长的口令> 启动,自己管理口令。
浏览器脚本会在你看的网页上放一只猫。点它,它会列出这一页的图;你勾选的图会连同网站名、帖子链接和标题一起进你的图库,大约一分钟后就能搜到。
脚本对三个站点做了专门适配:百度贴吧(每层楼的原图)、小红书(一篇笔记的全部图片)、豆瓣小组(帖子和回复里的大图)。其他网站用通用模式。
字很少(少于 15 个字)的采集图多半是表情包,会先放进页头的「待确认」。点「要」就放进图库;点「不要」会移到 <图库>/rejected,不删除,也能一键撤销。你的选择只存在你自己的电脑上,以后用来训练一个只属于你的判别器。你自己文件夹里的图不受这条规则影响。
脚本只在你点它时动作,只采你正在看的这一页,每秒最多下载两张图。它不自动翻页,不在后台抓取,除了图片、网站名、帖子链接、帖子标题和你选的图集,什么也不发送。你可以在 Violentmonkey 的菜单里让它在某个网站上隐藏,或者把猫放回右下角。
你自己的图和网上的图分开显示。网上搜索默认关闭。要打开,先去申请一个免费的 KLIPY API key,然后运行:
MEMESEEKS_KLIPY_KEY=<你的 key> memeseeks serve --online klipy # 或者设置环境变量 MEMESEEKS_ONLINE=klipy
打开之后:
图库文件夹(默认 ~/.memeseeks,可以用 -Library、--lib 或 MEMESEEKS_HOME 指定)里全是普通文件:
| 内容 | 位置 |
|---|---|
| 图集、我喜欢 | collections.json |
| 设置、编号、看过的记录 | settings.json、numbers.json、seen.json |
| 采集和上传的图,以及它们的出处 | inbox/、provenance.jsonl |
| 待确认的选择;「不要」的图 | review.jsonl、rejected/ |
| 索引(可以重建) | index/ |
-Library 指向它。如果你自己的梗图文件夹换了位置,在「设置 → 来源文件夹」里重新添加一次;图集是按图片内容认图的,不会丢。每张图最多从三个方面读,结果再合并排序(倒数排名融合):
| 途径 | 用什么 | 要显卡吗 |
|---|---|---|
| 图里的字 | 先识别图中文字(RapidOCR),再用 BGE-M3 按意思匹配 | 不用 |
| 画面 | Chinese-CLIP 图文相似度 | 不用 |
| 描述(可选) | 本地视觉语言模型(Qwen2.5-VL-7B)写出主题和笑点 | 要,约 16 GB 显存 |
BGE-M3 和 Chinese-CLIP 用的是它们的 8 位 ONNX 版本(tactino/memeseeks-models),在 ONNX Runtime 上运行,不需要 PyTorch;下载量是原版的四分之一,搜索结果和原版一致(experiments/results/onnx.md)。
在维护者那批字很多的梗图上,前两个途径已经能把每条查询要找的图排进前五,所以「描述」默认关闭。数字见 experiments/results/。
memeseeks add ~/Pictures/memes            # 为一个文件夹建立索引;随时可以重跑,只处理新图
memeseeks serve                           # 网页在 http://127.0.0.1:8765/
memeseeks serve --open                    # 同上,并打开浏览器(已经在运行的话就直接打开)
memeseeks search "关于熬夜的"              # 在终端里搜
memeseeks status                          # 图库里有什么,以及哪些图某一步失败了
memeseeks eval queries.csv                # 给你自己的查询打分(见下)
memeseeks --lib D:\memes-lib status       # --lib 这类全局选项写在子命令前面
add --vlm 会另外用本地视觉语言模型给图写描述(需要显卡),add --tidy 会让视觉语言模型把图里的文字整理成对话和评论、纠正识别错字(需要约 20 GB 显存的显卡),--retry-failed 会重做上次失败的图。整理时模型还会认出知名的梗:梗图页显示「梗:电车难题」,点一下就搜同一个梗的其他图;外文梗图没有中文翻译时,会在文字下面显示「【译】…」。
电脑没有显卡时,可以让另一台有显卡的电脑来整理:memeseeks tidy-remote --host 主机 --home 目录。它通过 ssh 连过去(要先配好密钥登录),目录 里要有装了 memeseeks[ml,torch] 的 .venv 和模型缓存 hf-cache。之后每次更新图库,没整理过的新图都会自动送过去;结果拿回来后,那边的图会删掉。
评测你自己的查询:queries.csv 第一行是表头,之后每行一条查询和它应该找到的文件名,多个文件名用 ; 分隔。文件名可以是相对于添加的文件夹的路径,也可以是不重名的文件名。
query,expected
关于熬夜的,night_owl.jpg
猫在评判你,cat_judge.png;cat_judge_2.png
需要 Python 3.10 或更新版本。
git clone https://github.com/tactino/memeseeks && cd memeseeks
python -m venv .venv && source .venv/bin/activate        # Windows:.venv\Scripts\activate
pip install -e ".[ml,serve]"
要用显卡功能(--vlm、--tidy)时,先装对应显卡的 PyTorch,再 pip install -e ".[torch]"。
第一次运行会把约 1 GB 的模型下载到 Hugging Face 缓存(HF_HOME)。在国内请先设置 HF_ENDPOINT=https://hf-mirror.com。
Windows + Anaconda:如果装了 torch 2.9 或更新版本,不要用 Anaconda 的 Python 建虚拟环境,否则 torch 会报 WinError 1114 … c10.dll。原因是 Anaconda 在 python.exe 旁边放了一份旧的 MSVC 运行库。改用 python.org 的 Python,或者 uv 管理的 Python(uv venv --managed-python --python 3.12)。
不用装 Python,只用 CPU。
git clone https://github.com/tactino/memeseeks && cd memeseeks
cp .env.example .env        # 然后填好 MEMES_DIR 和口令(文件里写了怎么生成)
docker compose up -d
docker compose logs -f      # 等到出现 "memeseeks is at http://…"
models 卷,并为你的文件夹建立索引。建完索引之前 8765 端口不会响应,请看日志。http://<这台电脑的局域网地址>:8765/?token=<你的口令>,浏览器会记住它。docker compose up -d --build;docker compose down -v 会删掉图库和下载的模型。library 卷换成绑定挂载,要让 uid 1000 能写那个文件夹。代码:MIT。梗图知识库(将来有了之后):CC BY-SA 4.0。字体 Noto Serif SC 与 JetBrains Mono 的子集按 SIL OFL 1.1 随附。
A free, open-source app for collecting memes and finding them by what they say. 免费开源的meme收藏与搜索工具,用文字描述找回存过的meme,数据保存在本地。
Python
1
77 commits
updated Sep 29, 2026
迷因捕手是一款免费开源的梗图收藏与搜索工具,按图中文字的意思找回你存过的梗图,数据全部保存在本地。
当前版本:v0.5
截图里的梗图来自网络(多是小红书上的转载,图上的水印原样保留),版权归原作者所有,这里只用来演示软件。如果其中有你的作品、希望撤下,请开一个 issue,我们会尽快替换。
Windows:下载 memeseeks-windows-setup.exe(约 90 MB),双击安装。
用一行命令安装(Windows 也可以这样装)。Windows 上打开 PowerShell,运行:
irm https://raw.githubusercontent.com/tactino/memeseeks/main/scripts/install.ps1 | iex
macOS / Linux:
curl -LsSf https://raw.githubusercontent.com/tactino/memeseeks/main/scripts/install.sh | sh
安装脚本会把程序和它自带的 Python 放进一个文件夹(Windows 是 %LOCALAPPDATA%\memeseeks,macOS 是 ~/Library/Application Support/memeseeks,Linux 是 ~/.local/share/memeseeks),建好「迷因捕手」快捷方式,然后启动。
~/.memeseeks,不会被删。不想装在 C 盘(或者想装到别处)时,在 Windows 上这样运行:
& ([scriptblock]::Create((irm https://raw.githubusercontent.com/tactino/memeseeks/main/scripts/install.ps1))) -Dir D:\memeseeks -Library D:\memeseeks-library
-Dir:程序、它的 Python 和模型放在哪。-Library:你的图库(索引、图集、采集来的图)放在哪。-Models D:\某处\hf-cache:复用你已经下载过的 Hugging Face 模型缓存,不再重新下载。macOS / Linux 上对应的是在 sh 前面加 MEMESEEKS_DIR=…、MEMESEEKS_LIBRARY=…、MEMESEEKS_MODELS=…。
打开后先把梗图放进来。可以在任意图集页点「上传」,也可以直接把图片拖进页面;还可以在「设置 → 来源文件夹」里添加电脑上已有的梗图文件夹。放进来的新图会在后台建立索引,页头会显示进度。在笔记本 CPU 上每张大约 3.5 秒,1000 张大约一小时,以后只处理新增的图。
图集名.memeseeks.zip 文件,用微信、QQ 或网盘发给别人;对方把文件拖进迷因捕手(或在「图集」页点「导入图集」),就多出一个同样的图集。文件里有原图和采集来源,不含你电脑上的文件路径。custom.css。在运行它的电脑上,还可以从浏览器菜单把它装成一个应用。
在电脑上打开「设置 → 手机访问」,点「开」,再用手机相机扫出现的二维码。手机和电脑要连在同一个 Wi-Fi 上。
memeseeks serve --host 0.0.0.0 --token <一串足够长的口令> 启动,自己管理口令。
浏览器脚本会在你看的网页上放一只猫。点它,它会列出这一页的图;你勾选的图会连同网站名、帖子链接和标题一起进你的图库,大约一分钟后就能搜到。
脚本对三个站点做了专门适配:百度贴吧(每层楼的原图)、小红书(一篇笔记的全部图片)、豆瓣小组(帖子和回复里的大图)。其他网站用通用模式。
字很少(少于 15 个字)的采集图多半是表情包,会先放进页头的「待确认」。点「要」就放进图库;点「不要」会移到 <图库>/rejected,不删除,也能一键撤销。你的选择只存在你自己的电脑上,以后用来训练一个只属于你的判别器。你自己文件夹里的图不受这条规则影响。
脚本只在你点它时动作,只采你正在看的这一页,每秒最多下载两张图。它不自动翻页,不在后台抓取,除了图片、网站名、帖子链接、帖子标题和你选的图集,什么也不发送。你可以在 Violentmonkey 的菜单里让它在某个网站上隐藏,或者把猫放回右下角。
你自己的图和网上的图分开显示。网上搜索默认关闭。要打开,先去申请一个免费的 KLIPY API key,然后运行:
MEMESEEKS_KLIPY_KEY=<你的 key> memeseeks serve --online klipy # 或者设置环境变量 MEMESEEKS_ONLINE=klipy
打开之后:
图库文件夹(默认 ~/.memeseeks,可以用 -Library、--lib 或 MEMESEEKS_HOME 指定)里全是普通文件:
| 内容 | 位置 |
|---|---|
| 图集、我喜欢 | collections.json |
| 设置、编号、看过的记录 | settings.json、numbers.json、seen.json |
| 采集和上传的图,以及它们的出处 | inbox/、provenance.jsonl |
| 待确认的选择;「不要」的图 | review.jsonl、rejected/ |
| 索引(可以重建) | index/ |
-Library 指向它。如果你自己的梗图文件夹换了位置,在「设置 → 来源文件夹」里重新添加一次;图集是按图片内容认图的,不会丢。每张图最多从三个方面读,结果再合并排序(倒数排名融合):
| 途径 | 用什么 | 要显卡吗 |
|---|---|---|
| 图里的字 | 先识别图中文字(RapidOCR),再用 BGE-M3 按意思匹配 | 不用 |
| 画面 | Chinese-CLIP 图文相似度 | 不用 |
| 描述(可选) | 本地视觉语言模型(Qwen2.5-VL-7B)写出主题和笑点 | 要,约 16 GB 显存 |
BGE-M3 和 Chinese-CLIP 用的是它们的 8 位 ONNX 版本(tactino/memeseeks-models),在 ONNX Runtime 上运行,不需要 PyTorch;下载量是原版的四分之一,搜索结果和原版一致(experiments/results/onnx.md)。
在维护者那批字很多的梗图上,前两个途径已经能把每条查询要找的图排进前五,所以「描述」默认关闭。数字见 experiments/results/。
memeseeks add ~/Pictures/memes            # 为一个文件夹建立索引;随时可以重跑,只处理新图
memeseeks serve                           # 网页在 http://127.0.0.1:8765/
memeseeks serve --open                    # 同上,并打开浏览器(已经在运行的话就直接打开)
memeseeks search "关于熬夜的"              # 在终端里搜
memeseeks status                          # 图库里有什么,以及哪些图某一步失败了
memeseeks eval queries.csv                # 给你自己的查询打分(见下)
memeseeks --lib D:\memes-lib status       # --lib 这类全局选项写在子命令前面
add --vlm 会另外用本地视觉语言模型给图写描述(需要显卡),add --tidy 会让视觉语言模型把图里的文字整理成对话和评论、纠正识别错字(需要约 20 GB 显存的显卡),--retry-failed 会重做上次失败的图。整理时模型还会认出知名的梗:梗图页显示「梗:电车难题」,点一下就搜同一个梗的其他图;外文梗图没有中文翻译时,会在文字下面显示「【译】…」。
电脑没有显卡时,可以让另一台有显卡的电脑来整理:memeseeks tidy-remote --host 主机 --home 目录。它通过 ssh 连过去(要先配好密钥登录),目录 里要有装了 memeseeks[ml,torch] 的 .venv 和模型缓存 hf-cache。之后每次更新图库,没整理过的新图都会自动送过去;结果拿回来后,那边的图会删掉。
评测你自己的查询:queries.csv 第一行是表头,之后每行一条查询和它应该找到的文件名,多个文件名用 ; 分隔。文件名可以是相对于添加的文件夹的路径,也可以是不重名的文件名。
query,expected
关于熬夜的,night_owl.jpg
猫在评判你,cat_judge.png;cat_judge_2.png
需要 Python 3.10 或更新版本。
git clone https://github.com/tactino/memeseeks && cd memeseeks
python -m venv .venv && source .venv/bin/activate        # Windows:.venv\Scripts\activate
pip install -e ".[ml,serve]"
要用显卡功能(--vlm、--tidy)时,先装对应显卡的 PyTorch,再 pip install -e ".[torch]"。
第一次运行会把约 1 GB 的模型下载到 Hugging Face 缓存(HF_HOME)。在国内请先设置 HF_ENDPOINT=https://hf-mirror.com。
Windows + Anaconda:如果装了 torch 2.9 或更新版本,不要用 Anaconda 的 Python 建虚拟环境,否则 torch 会报 WinError 1114 … c10.dll。原因是 Anaconda 在 python.exe 旁边放了一份旧的 MSVC 运行库。改用 python.org 的 Python,或者 uv 管理的 Python(uv venv --managed-python --python 3.12)。
不用装 Python,只用 CPU。
git clone https://github.com/tactino/memeseeks && cd memeseeks
cp .env.example .env        # 然后填好 MEMES_DIR 和口令(文件里写了怎么生成)
docker compose up -d
docker compose logs -f      # 等到出现 "memeseeks is at http://…"
models 卷,并为你的文件夹建立索引。建完索引之前 8765 端口不会响应,请看日志。http://<这台电脑的局域网地址>:8765/?token=<你的口令>,浏览器会记住它。docker compose up -d --build;docker compose down -v 会删掉图库和下载的模型。library 卷换成绑定挂载,要让 uid 1000 能写那个文件夹。代码:MIT。梗图知识库(将来有了之后):CC BY-SA 4.0。字体 Noto Serif SC 与 JetBrains Mono 的子集按 SIL OFL 1.1 随附。



