音乐转MIDI转换器 - Convert audio to multi-track MIDI with lyrics embedding
See the code中文 | English
一个本地优先的 AI 音频转 MIDI / Audio to MIDI 转换器,面向编曲、扒谱、采样拆解、钢琴练习和自动音乐转写 (AMT) 实验。你可以把 MP3、WAV、FLAC、OGG 或 M4A 音频丢进来,在 PyQt6 桌面版、Gradio Web 版或 Google Colab 中生成可编辑的 MIDI 文件。
当前版本同步七种处理模式:完整混音多乐器转写、人声/伴奏 WAV 分离、六声部 WAV 分离,以及 TransKun 默认 V2 / TransKun V2 Aug / Aria-AMT / ByteDance Pedal 四条钢琴专用转写流程。两个分离模式会生成 WAV 分轨;分离完成后,每条音轨都可在同一结果工作台选择 13 条 MIDI 路线之一。多乐器 AMT、stem separation、钢琴转 MIDI 和 BPM/tempo 元数据都在这套工作流中处理。
桌面下载 MIDI 或立体声 WAV 失败时会显示原因并记录完整错误,当前转换结果仍可继续使用;修正路径、文件占用或权限问题后可以重试。日志位于 ~/.music-to-midi/logs/;便携版优先使用程序旁的 runtime/logs/。
如果想先试听模型效果或直接在浏览器处理文件,可以使用同一作者维护的 TelkNet。工具介绍、指南和演示可直接浏览;提交网站的服务器处理任务需要登录。
网站提供的模型和参数以对应工具页为准;本仓库的安装、桌面功能与本地模型配置仍按下文说明使用。
CLI 与独立 Web API 共用同一个 InferenceEngine 和核心流水线。最简单的调用只需要输入文件;输出默认放在项目或便携包旁的 MidiOutput/CLI:
# Windows 源码版;先运行一次 install.ps1,转换时检查所选路线的 GPU 与模型
.\cli.ps1 D:\Audio\song.wav

# Windows 便携包
.\MusicToMidiCLI.exe D:\Audio\song.wav

# 多文件或目录批处理(逐个转换)
.\MusicToMidiCLI.exe batch D:\Audio --recursive -o D:\MidiOutput
# Linux / WSL2 源码版
bash cli.sh /data/audio/song.wav

# Linux 便携包
./MusicToMidiCLI batch /data/audio --recursive -o /data/midi
常用示例:
# 指定钢琴模型
MusicToMidiCLI song.wav --mode piano-transkun-v2-aug

# SMART 改用 MuScriptor Medium,并指定输出乐器
MusicToMidiCLI song.wav --backend muscriptor --muscriptor-model medium --instrument acoustic_piano,voice

# 启用量化;省略 --quantize 时保持音符原始时间
MusicToMidiCLI song.wav --quantize 1/32

# 分离只生成 WAV
MusicToMidiCLI mix.flac --mode six-stem-split

# 对选中的单条 stem 转 MIDI;routes 可查看全部 13 条路线
MusicToMidiCLI routes
MusicToMidiCLI track-to-midi vocals.wav --route yourmt3:yptf_moe_multi_nops --tempo-source mix.flac

# 供脚本读取的 JSON Lines 事件流
MusicToMidiCLI batch /data/audio --recursive --json
每个输入使用独立且不覆盖的输出目录,并写入 music-to-midi-job.json;每次批处理另写 batch-run-*.json。默认会用源文件 SHA-256、完整参数和产物 SHA-256 校验已有成功项,全部吻合才跳过;--rerun 强制新建编号目录。出现失败时,默认继续处理其余独立文件但最终返回退出码 1,--fail-fast 可在首个失败后停止,Ctrl+C 返回 130,参数/输入错误返回 2。--dry-run 只列计划,不加载模型也不创建输出。
源码 CLI 启动器直接使用项目隔离环境(Windows NVIDIA 为 venv、Windows Intel 为 venv-xpu、Linux/WSL2 NVIDIA 为 venv),不会复用桌面 GUI 的全模型启动检查。因此 --help、--version、routes 和 --dry-run 可立即执行;转换时会检查所选路线的加速器、模型和产物。缺少隔离环境时会显示安装命令并退出。--json 模式的 stdout 只包含 JSON Lines,诊断与第三方日志写入 stderr。
VOCAL_SPLIT 与 SIX_STEM_SPLIT 先输出 WAV。CLI 不会自动把全部 stem 转成 MIDI;必须由用户对选中的音轨执行 track-to-midi --route ...。完整选项以 MusicToMidiCLI --help、MusicToMidiCLI convert --help 和 MusicToMidiCLI track-to-midi --help 为准。
对 CLI 分离任务生成的 WAV,track-to-midi 默认校验旁边的分离清单、WAV 和原曲 SHA-256,再用原曲检测 BPM;同批来自不同歌曲的 stem 会分别使用各自原曲。原曲丢失、清单损坏或音频被改动时会停止并说明原因;可用 --tempo-source 显式指定新的节拍参考。独立音频没有分离清单时使用自身检测节拍,--dry-run --json 会显示实际选用的参考路径。
递归扫描遇到不可读目录会直接报错。损坏的断点清单会报告并保留,只有通过校验的清单才能跳过转换;汇总文件写入失败会停止运行,并保留已提交的逐项结果。JSON 输出管道被接收端关闭时退出 1,错误写入 stderr。
独立 Web API 与浏览器前端调用同一个 MusicToMidiPipeline,提供与桌面版一致的七种模式。Windows 发布版按用途提供三个目录:
| 包 | 启动文件 | 用途 |
|---|---|---|
MusicToMidi-App | MusicToMidi.exe | 本机桌面 App,不负责提供 Web 服务 |
MusicToMidi-WebBackend | MusicToMidiBackend.exe | GPU 推理、任务队列、结果文件与 API |
MusicToMidi-WebFrontend | MusicToMidiFrontend.exe | 浏览器界面和静态资源,不包含推理模型 |
源码环境只需在仓库根目录运行一条命令:
.\venv\Scripts\python.exe -m src.web
这个入口会自动识别服务电脑的主要局域网 IPv4,依次启动 WebBackend 和 WebFrontend,确认两端就绪后自动打开 Edge 应用窗口。终端会显示其他同一局域网电脑可访问的前端地址;按 Ctrl+C 或关闭 Edge 应用窗口会一并停止前后端。多网卡或 VPN 环境可用 --host 192.168.1.50 明确指定服务电脑的实际局域网 IPv4,完整用法见 web/README.md。
打包版的启动顺序如下:
MusicToMidiBackend.exe。MusicToMidiFrontend.exe。MusicToMidiBackend.json 与 MusicToMidiFrontend.json,再重启两个程序。http://<后端地址>:8765/api/v1/health,API 文档为 http://<后端地址>:8765/docs。其他电脑只需要浏览器,不需要复制桌面 App 或 WebFrontend 包。完整的配置 JSON、防火墙命令、验证方法、停止方式以及前后端分机部署说明见 web/README.md。
浏览器前端通过 multipart 作业接口提交音频,查询 GET /api/v1/jobs/<job-id> 获取终态,并从响应中的 download_url 下载 MIDI 或分轨 WAV。失败响应包含处理错误,且不提供下载文件。
v1.6.0 已为 Issue #9 提供完整 Docker 自托管包,包括无外置模型的后端/网关镜像、digest 固定的 Compose、环境模板、Windows/Linux 管理脚本、镜像清单与 SHA-256。默认入口是 http://127.0.0.1:7860;模型按 .env 中选择的配置下载到持久卷,常驻推理容器离线运行。安装、配置、日志、备份、升级与故障排查见 Docker 自托管指南。
上面的源码/EXE 双端口方案面向受信任局域网,本身不内置认证、授权或 TLS;将 5173 或 8765 映射到互联网会形成无认证服务。公网单一所有者场景可以使用带自动 HTTPS 和 Argon2id Basic Auth 的高级 Compose;该方案不包含多租户、账号系统或逐任务授权。
桌面版、Gradio Web 版和 Google Colab 采用同一套七模式工作流与操作语义。以下截图依次展示主界面、分离结果、逐轨处理和 MuScriptor 渐进式预览。
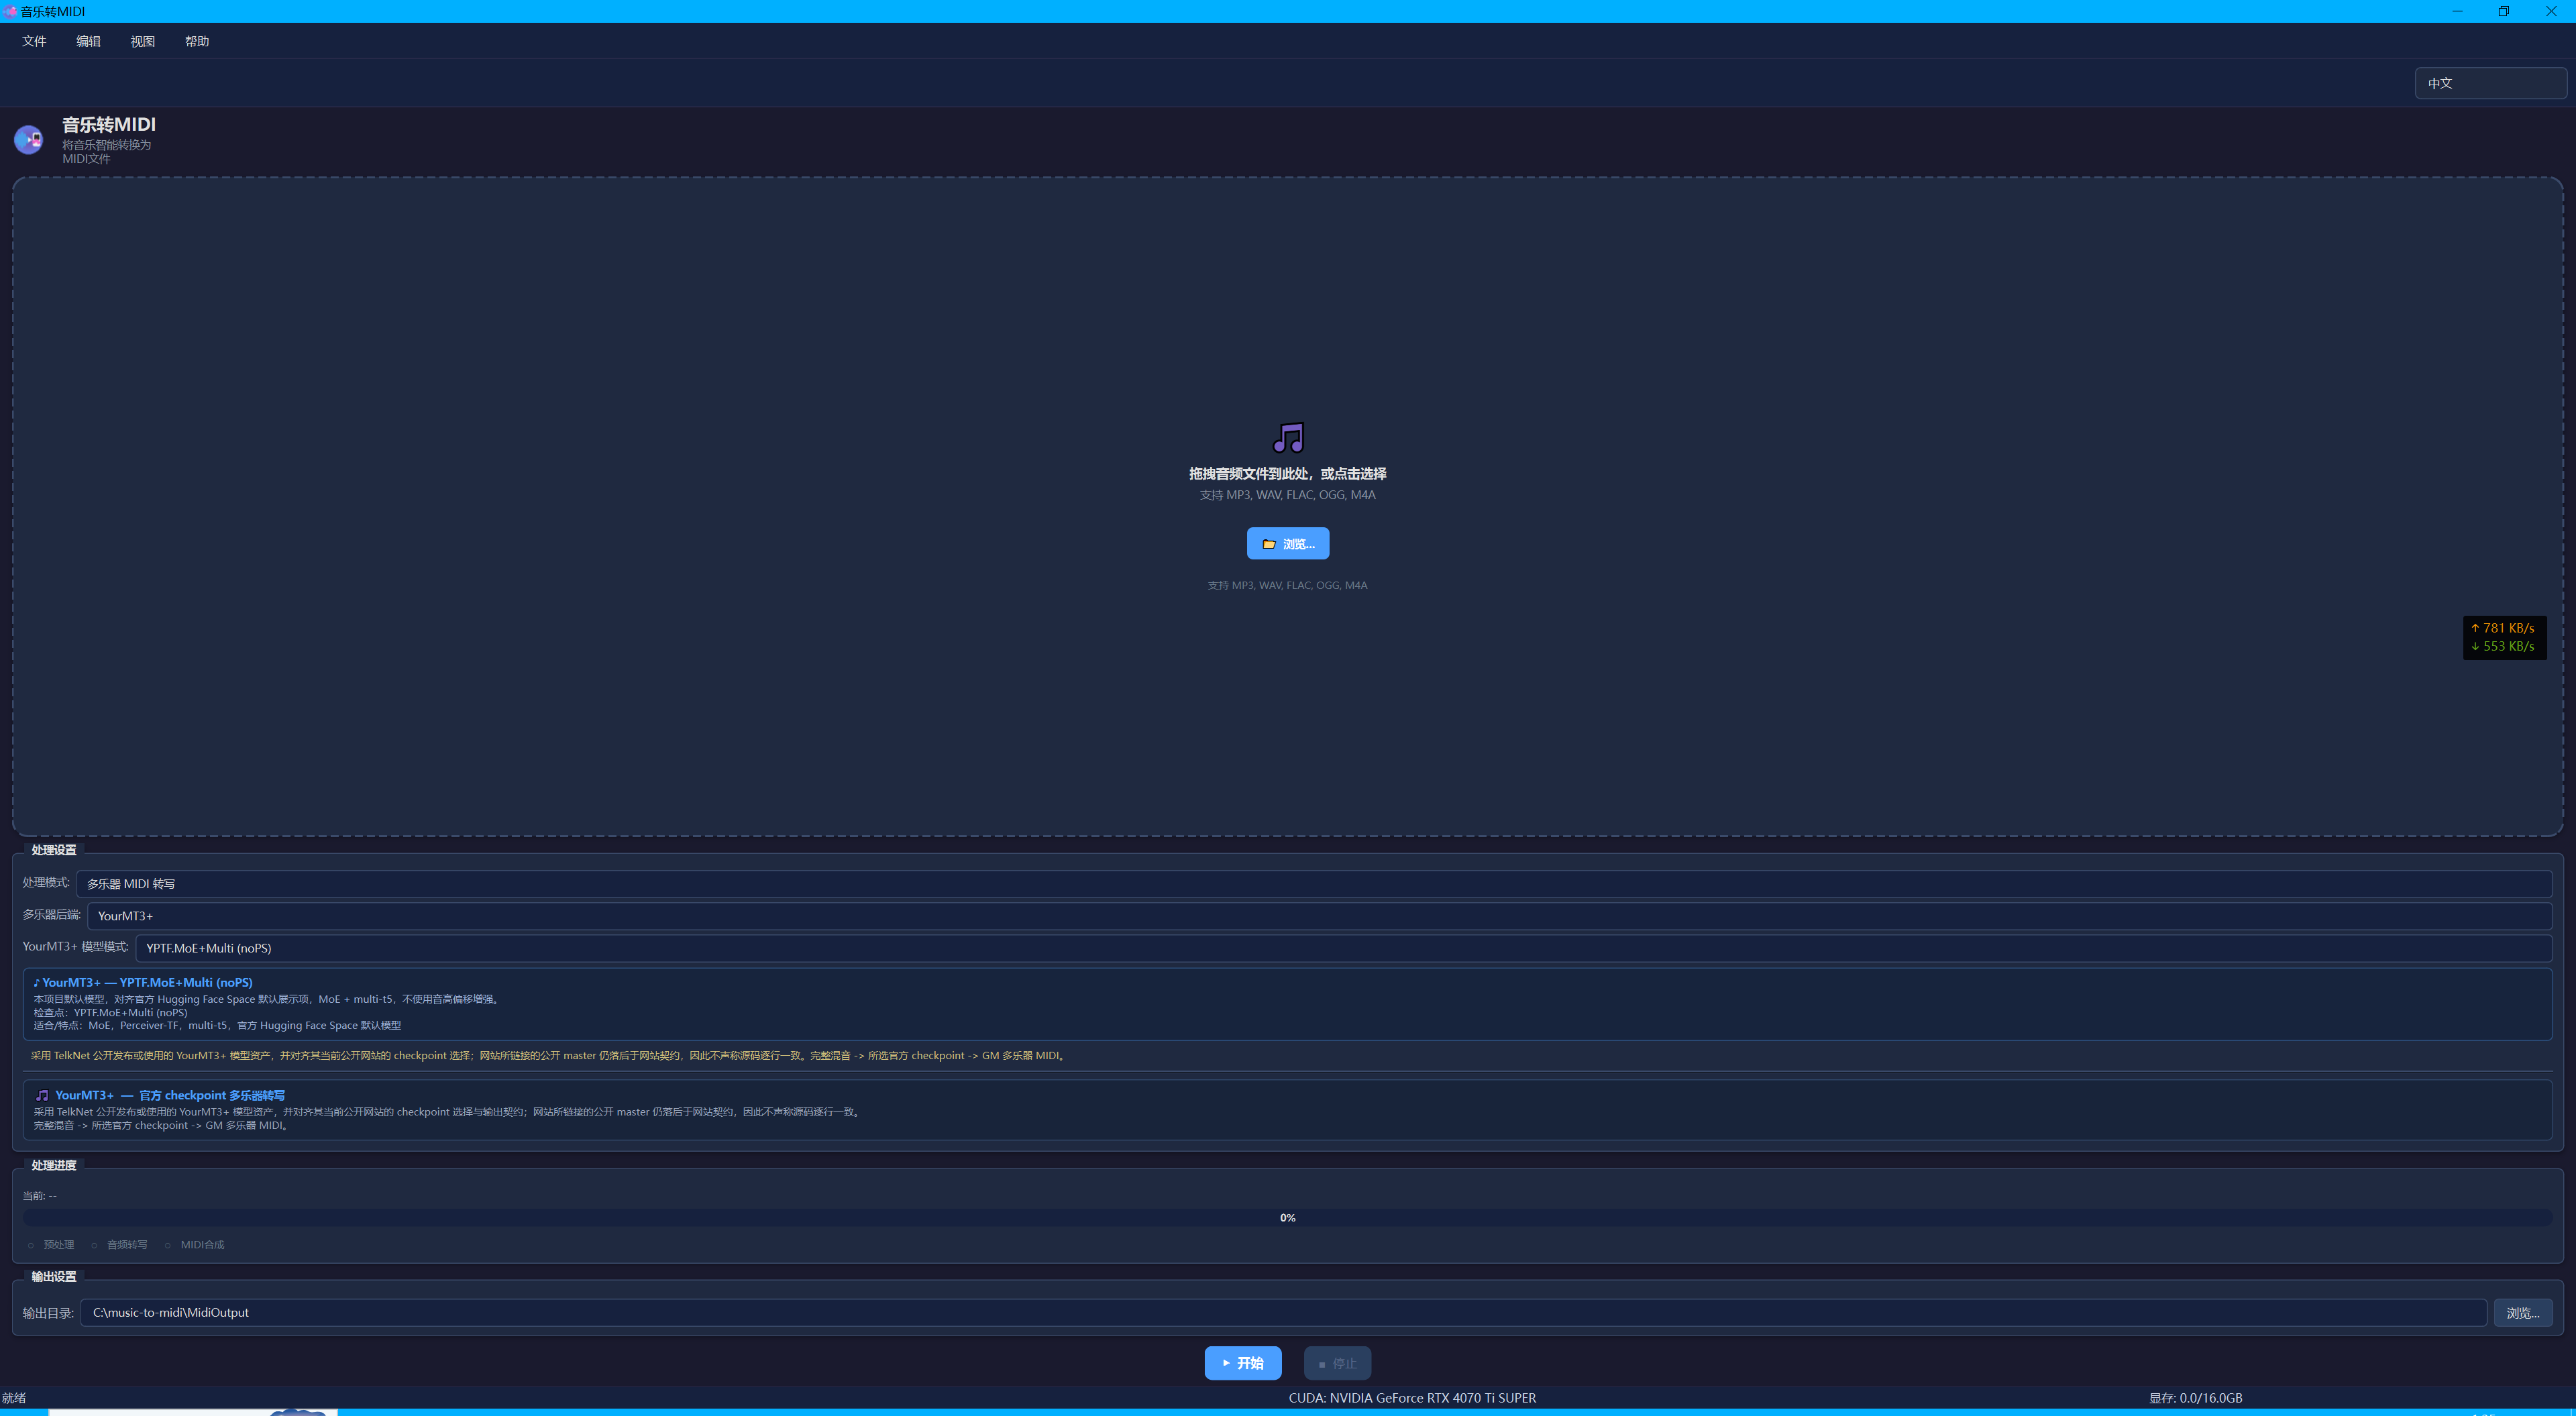
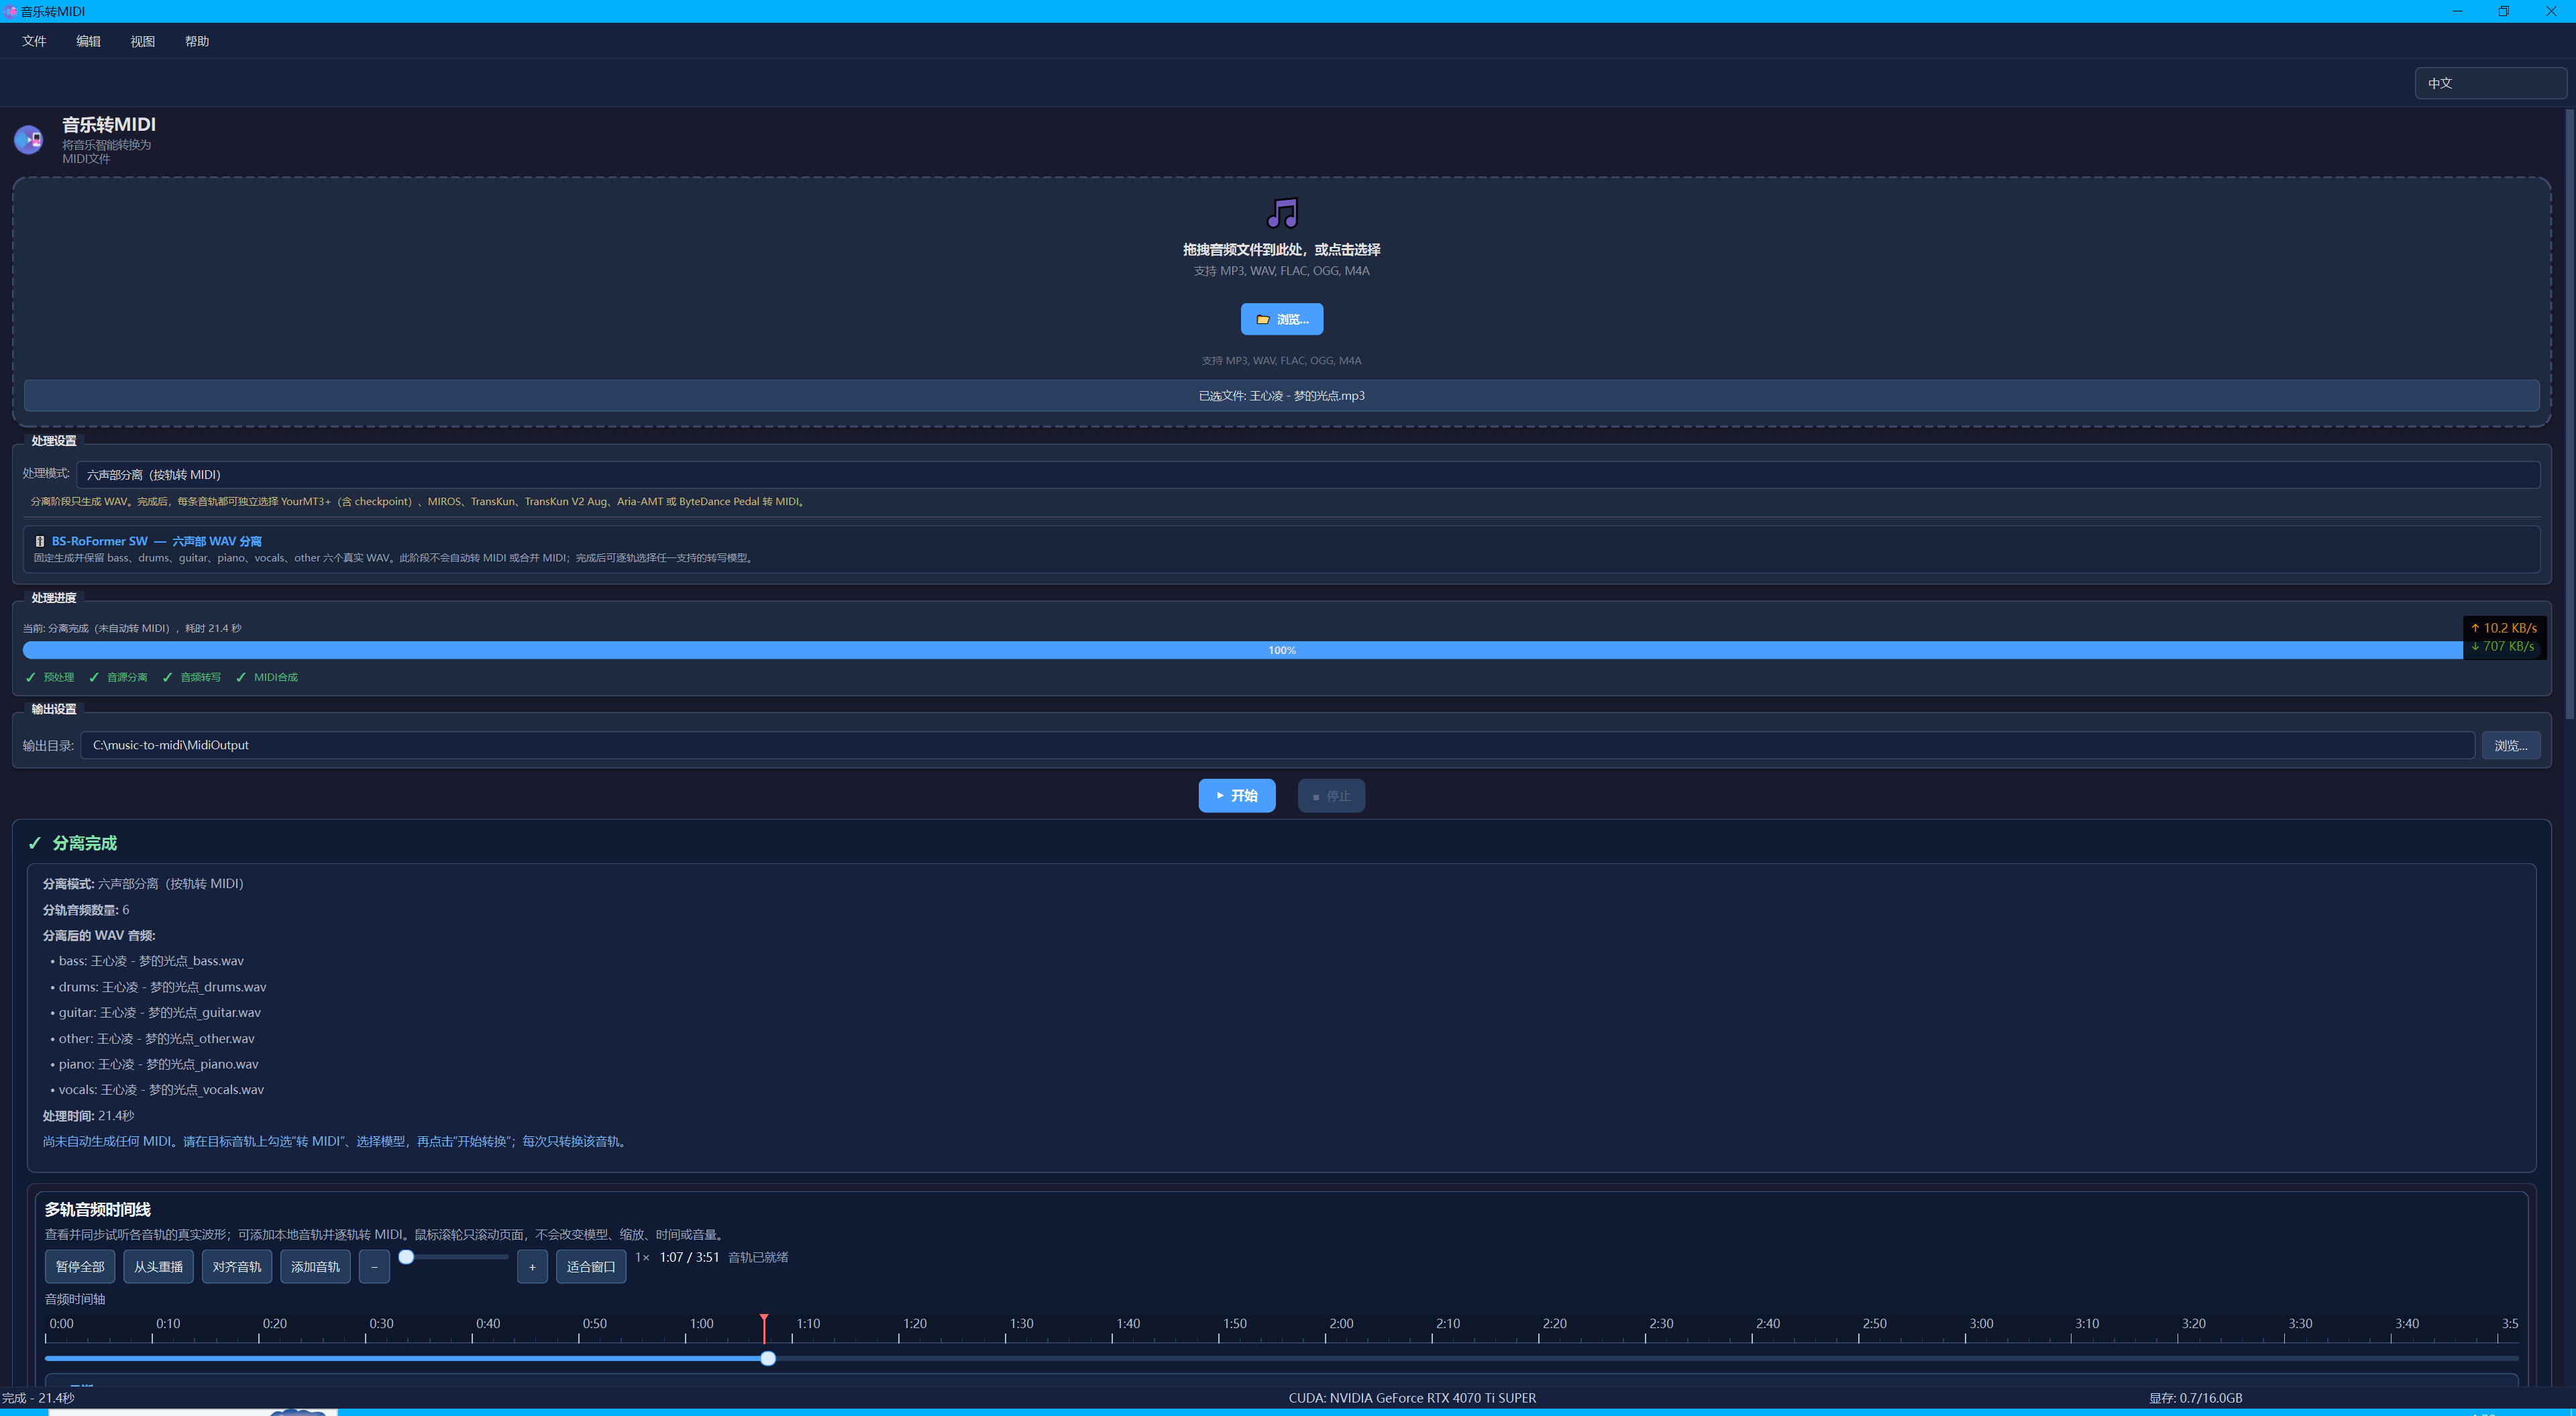
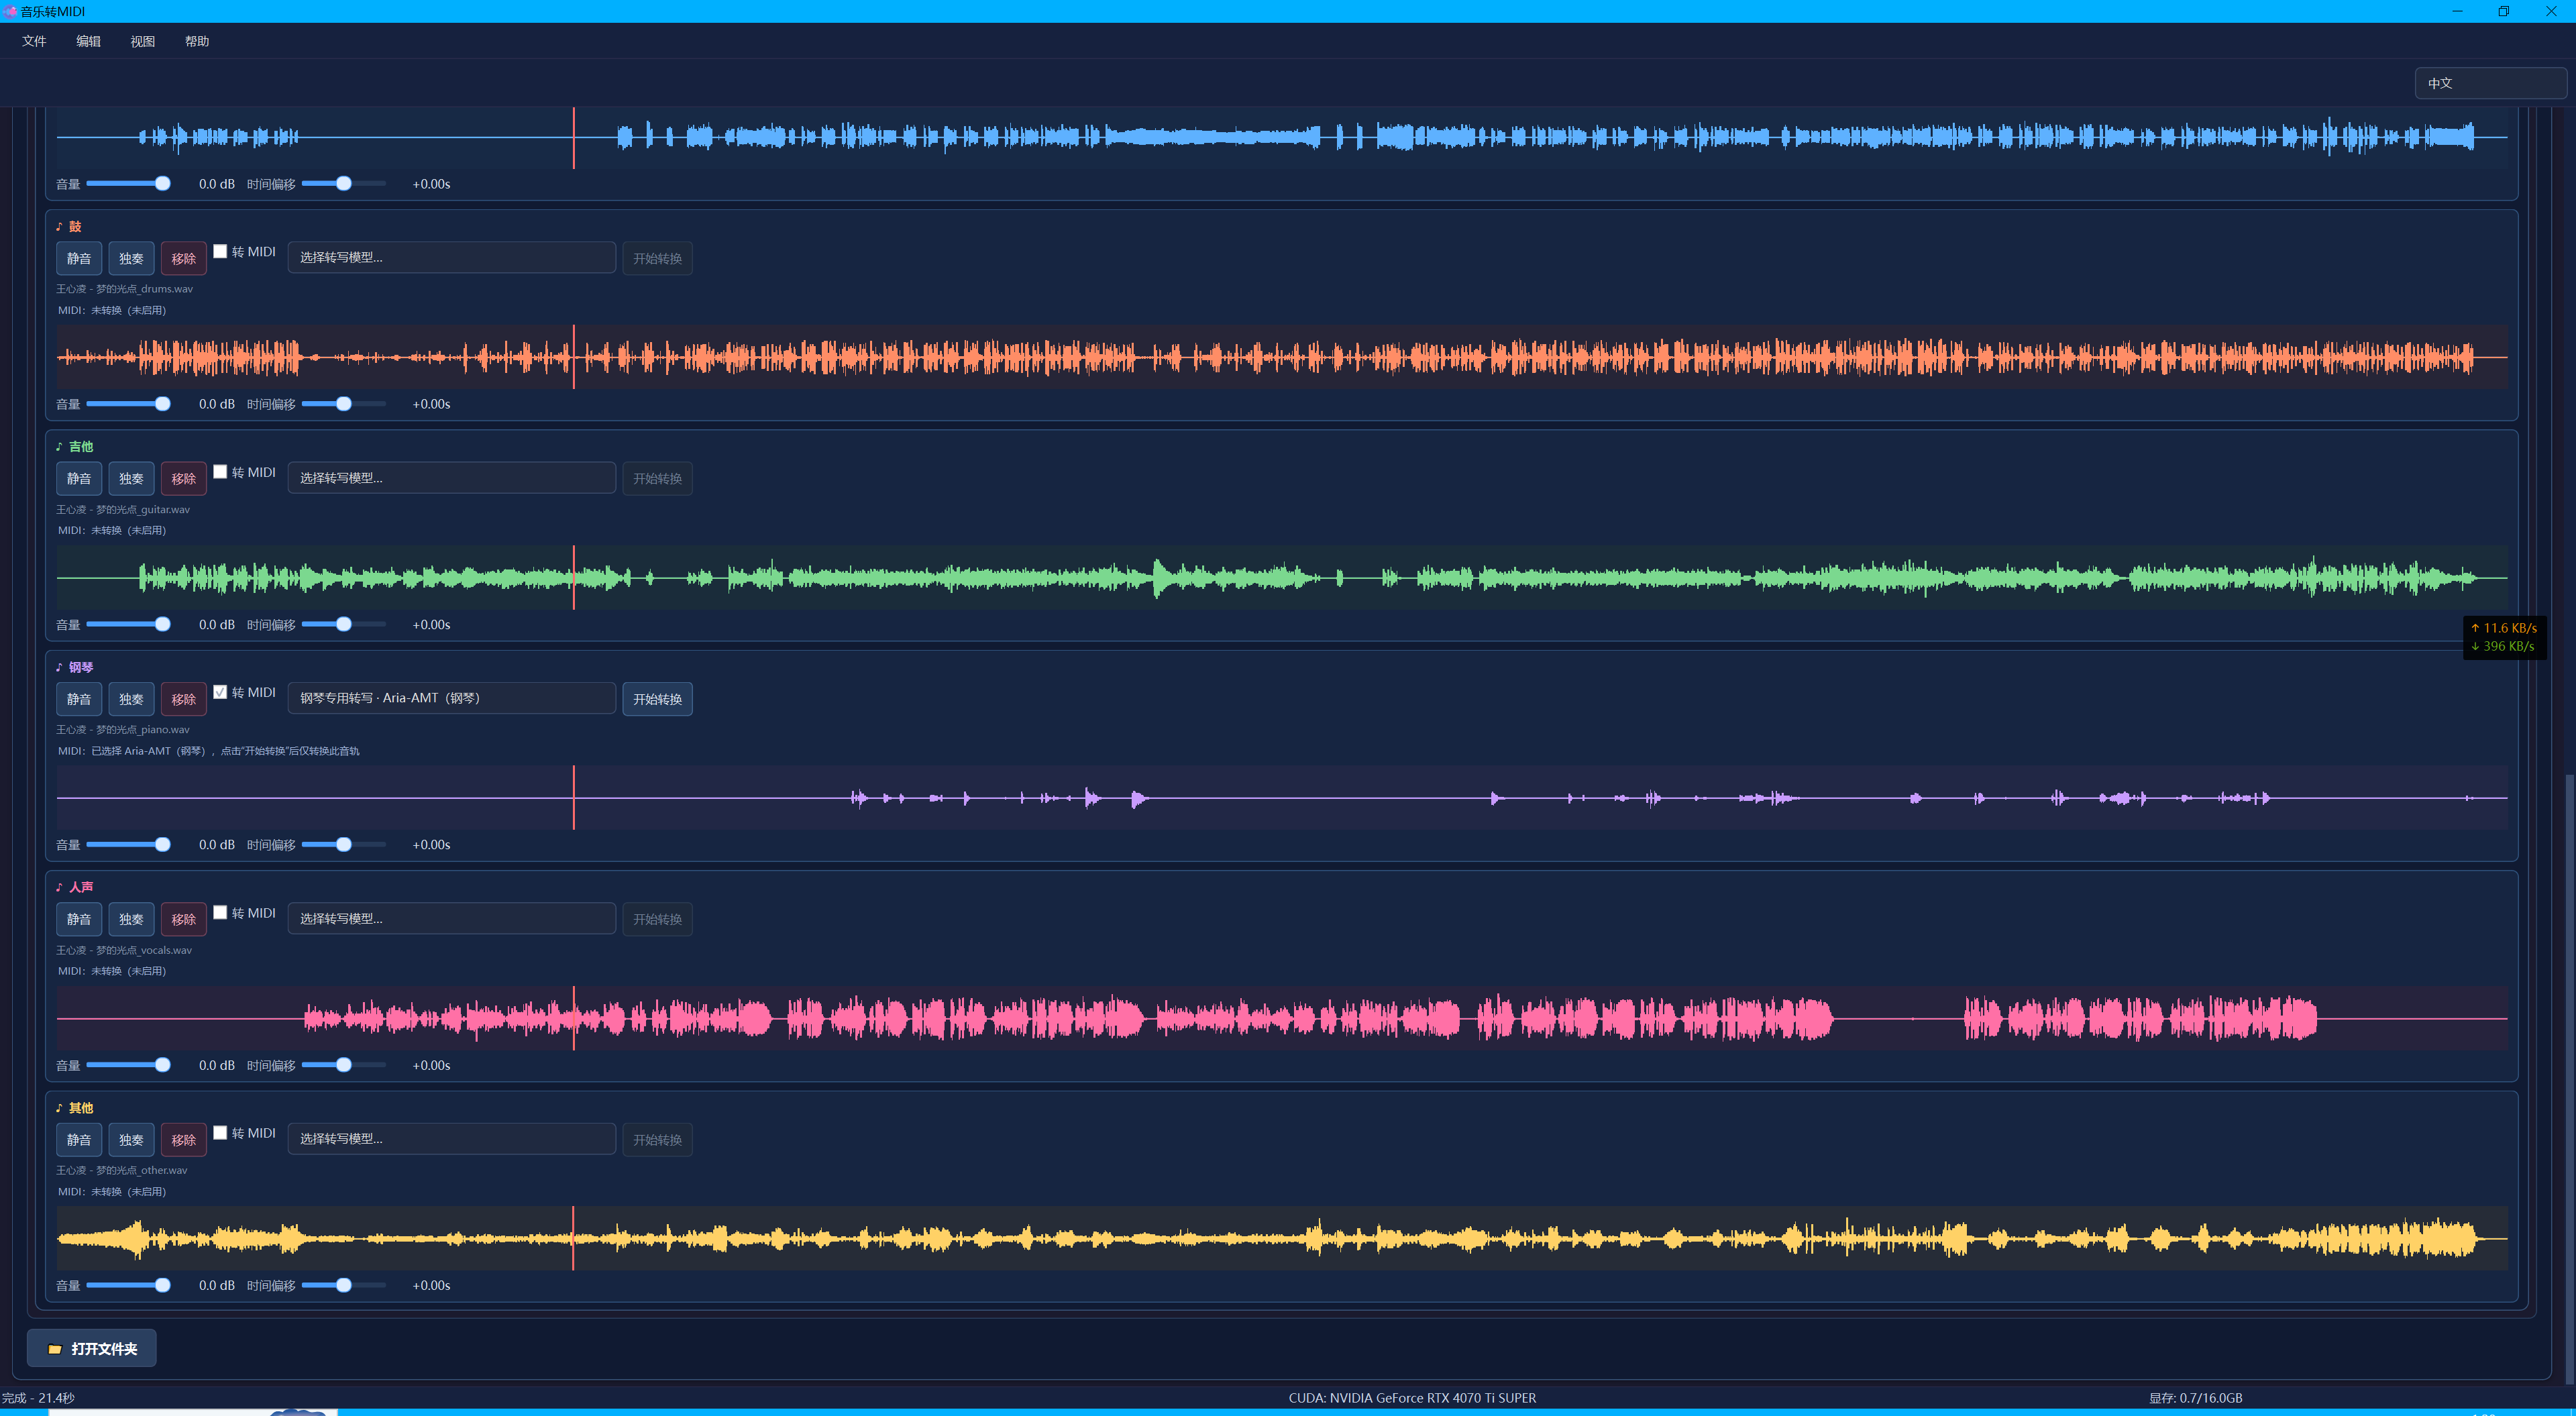
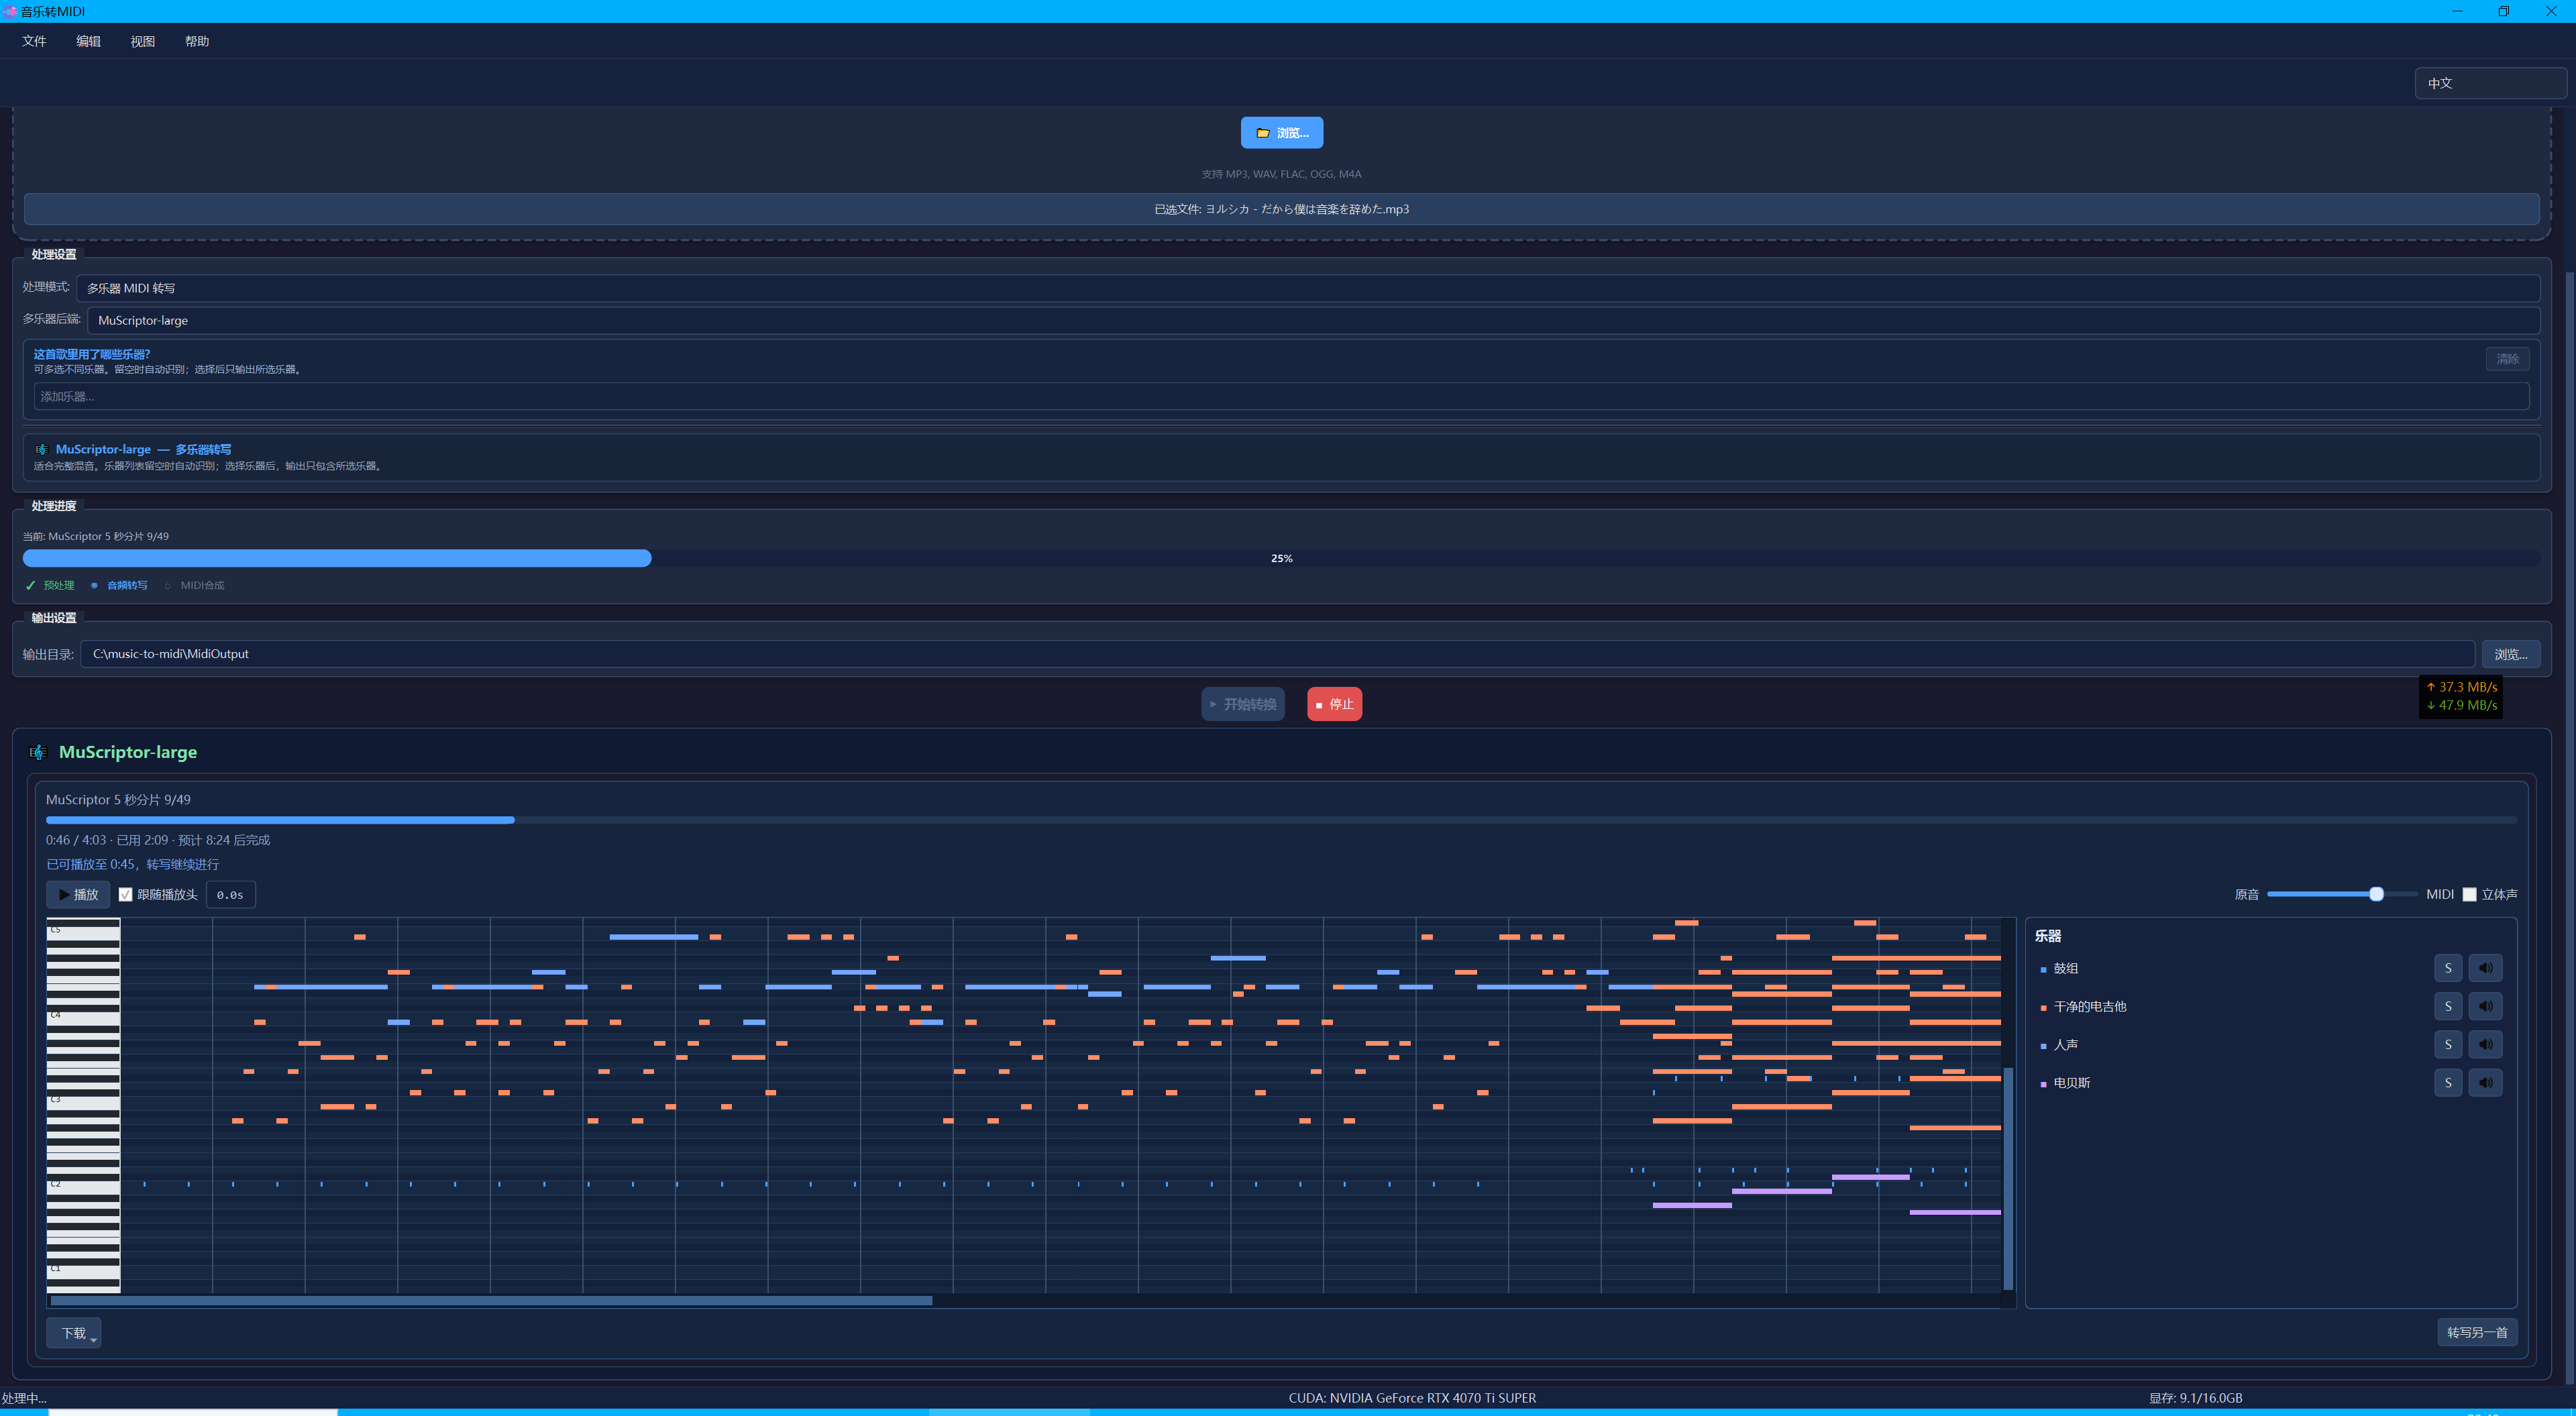
项目面向需要把人声旋律、钢琴录音、完整混音或分轨 stem 转成可编辑 MIDI 的用户,也可用于在本地 GPU 上验证自动音乐转写模型。
| 范围 | 当前行为 |
|---|---|
| 完整混音 | SMART 读取整首音频,可选 YourMT3+、MIROS 或 MuScriptor Large / Medium / Small,输出含音符、鼓点和 GM 乐器分组的 MIDI。默认 checkpoint 是 YourMT3+ 官方 YPTF.MoE+Multi (noPS)。 |
| 音源分离 | VOCAL_SPLIT 用 Leap XE 90-band 与 Leap Instrumental 生成两条 WAV;SIX_STEM_SPLIT 用 BS-Rofo-SW-Fixed.ckpt 生成 bass / drums / guitar / piano / vocals / other 六条 WAV。分离后,每条 WAV 可独立选择 13 条 MIDI 路线并点击转换。 |
| 钢琴转写 | PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT 和 PIANO_BYTEDANCE_PEDAL 分别调用 TransKun 默认 V2、官方 V2 Aug、Aria-AMT 和 ByteDance 带踏板模型。 |
| MuScriptor 乐器约束 | 默认留空,沿用官方自动识别;导入音频和新建分轨不再按文件名添加条件。仅手动选择曲中已确认的乐器:选择既提供模型条件,也限制其他乐器输出,全选不等于自动识别。输出包含未选乐器时任务会报错。已知条件生成退化与实测边界见 模型研究。 |
| 节拍与速度 | 七种模式和逐轨转写都使用 Beat This final0。拍点清理后以全局最小二乘拟合 BPM,下拍独立决定拍号;证据不足时不写 4/4。默认自动写入检测到的唯一 BPM;也可生成稳定的段落级 tempo map。手动 30–300 BPM 会保留检测 BPM 的音乐 tick 并覆盖工程速度。默认不量化模型事件;只有用户显式执行量化时才吸附到所选网格。 |
| 音符量化 | 默认关闭。桌面、Space、Colab 的结果编辑器提供 1/4、1/8、1/16、1/32、1/64 网格,范围默认“全部轨道”并可切换为“所选音符”;切换范围或网格不会改音符,点击“量化”才同时吸附目标音符的起点和时值。独立 Web/API(含 Docker)固定量化输出 MIDI 的全部轨道,勾选后在 MIDI 写出后严格执行一次,并校验 tempo、拍号、控制器等非音符事件的绝对 tick 未变。 |
| 乐谱导出 | 每个 MIDI 结果(包括分离后逐轨转换结果)都可生成乐谱 ZIP。系统只量化副本,不修改原 MIDI;ZIP 包含量化 MIDI、MusicXML、总谱 PDF、逐乐器分谱 PDF,以及 MuseScore 识别为 4–9 弦乐器时的 Tab PDF。桌面、Space、Colab 使用结果编辑器当前网格,独立 Web/API 固定使用默认 1/32。MuseScore Studio 4 缺失或制谱失败会直接报错。 |
| MIDI 内容 | YourMT3+ 与 MIROS 保留官方 writer 的音符、音色、力度、控制器和弯音消息,只在缺少 set_tempo 时按检测 BPM 保持绝对秒并补写 tempo。MuScriptor 使用官方事件与 writer,并校验所选乐器集合。项目不添加去重、短音符过滤、力度平滑、复音限制或 NoteEvent 重建。 |
| 试听与 DAW | MuScriptor 工作台以 MIDI 合成轨为主时钟,同步 MIDI、原音和乐器分轨,并校正超过 80 ms 的漂移。DAW 导入时需启用 tempo map;MuseScore 3/4 可能重新跟拍未量化演奏并改写乐谱页显示 BPM,但不会改变文件中已经校验的 tempo。 |
| 输入与入口 | 支持 MP3、WAV、FLAC、OGG、M4A;非 WAV 通过 FFmpeg 转为 44.1 kHz PCM WAV。桌面版、Space 与 Colab 提供相同的七种处理模式。 |
| 入口 | 处理模式 | 后端选择 | 适合场景 |
|---|---|---|---|
| PyQt6 桌面版 | SMART、VOCAL_SPLIT、SIX_STEM_SPLIT、PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT、PIANO_BYTEDANCE_PEDAL | SMART 可选 YourMT3+ / MIROS / MuScriptor 三档;分离结果逐轨选择 13 条路线;钢琴模式使用各自固定后端 | 本地长期使用、GPU 推理、批量输出文件、钢琴专用转写 |
| 原生 CLI | 同桌面七种模式 | 单文件、多文件、目录递归批处理;显式 track-to-midi;SHA-256 清单断点续跑与 JSON Lines | Windows/Linux 自动化、本地批量与脚本集成 |
| 独立 Web API | 同桌面七种模式 | multipart 作业、终态轮询和制品下载;推理仍由同一 MusicToMidiPipeline 执行 | 自建 Web 前端、局域网服务或系统集成 |
| Gradio Space | 同桌面七种模式 | 同步提供 MuScriptor 搜索式乐器多选、硬约束和官方式结果工作台 | 浏览器中快速试用或部署 |
| Google Colab | 同桌面七种模式 | 与 Space 同样提供 MuScriptor 乐器约束和结果工作台 | 临时使用 Colab GPU |
本仓库把“处理工作流”和“YourMT3+ 官方 checkpoint 模式”分开维护:
SMART、VOCAL_SPLIT、SIX_STEM_SPLIT、PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT、PIANO_BYTEDANCE_PEDAL 是本项目的七种处理工作流。YMT3+、YPTF+Single (noPS)、YPTF+Multi (PS)、YPTF.MoE+Multi (noPS)、YPTF.MoE+Multi (PS) 是官方 YourMT3 demo 暴露的五种 checkpoint / 架构模式。SMART 可选 YourMT3+、MIROS 或 MuScriptor Large / Medium / Small,两个分离工作流先输出 WAV,再为每条音轨独立提供 13 条 MIDI 路线。当前同步覆盖如下:
| 位置 | 已同步内容 | 说明 |
|---|---|---|
download_sota_models.py | 准备 Beat This final0、全部五种官方 YourMT3+ checkpoint、固定 MIROS 源码与两组权重、BS-Rofo-SW-Fixed.ckpt、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance、MuseScore General SoundFont、FluidSynth 与固定 MuseScore Studio 4.7.4 | 固定来源模型和运行时按已知大小/SHA256 或明确身份校验;任一必需资源失败时立即停止。 |
run.ps1 / run_xpu.ps1 / run.sh | 启动前检查加速器实际执行、Beat This final0、全部官方 YourMT3+ 模式、MuScriptor 三档、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS、SoundFont、FluidSynth 与分离器可用性 | 缺少必需模型或校验失败时显式报错,不把缺失资源或 CPU 回退当作可运行状态。 |
install.ps1 / install_xpu.ps1 / install.sh | 安装隔离的 NVIDIA PyTorch 2.7 或 Intel XPU PyTorch 2.11、NumPy 1.26、audio-separator 0.44.1 运行依赖,并下载必需模型 | NVIDIA 使用 venv + CUDA 12.8;Windows Intel 使用 venv-xpu + 原生 PyTorch XPU + OpenVINO GPU。两套互斥运行时不混装;audio-separator 使用 --no-deps。 |
.github/workflows/build.yml | push / PR 只运行 Linux、Windows 源码检查、测试和打包契约验证 | 不生成便携包,也不使用空目录或假模型绕过强制 bundle 校验。 |
.github/workflows/release.yml | 完整便携发布构建链;下载并严格校验全部官方 YourMT3+ 模式、MuScriptor Small / Medium / Large、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS 与 MuseScore Studio | 发布条件是 31 项第三方组件全部达到 VERIFIED 或附具名责任记录的 OWNER_ACCEPTED;条件不满足时构建立刻停止。目标 GPU 运行时为 PyTorch 2.7 + CUDA 12.8。 |
colab_notebook.ipynb | 保留 Colab 预装 Torch,安装 pinned Web/runtime 依赖,并同步七种模式 | SMART 与逐轨工作台的完整路线均与桌面版同步。 |
| 模式 | 处理流程 | 主要输出 | 说明 |
|---|---|---|---|
SMART | 音频 -> 所选 YourMT3+ / MIROS / MuScriptor Large、Medium 或 Small -> MIDI | <歌曲名>.mid | 不做音源分离;MuScriptor 非空乐器选择会成为解码约束。 |
VOCAL_SPLIT | 音频 -> Leap XE 90-band vocals + Leap Instrumental accompaniment -> 两条 WAV -> 逐轨转 MIDI | <歌曲名>_vocals.wav、<歌曲名>_accompaniment.wav;按需生成逐轨 MIDI | 分离阶段不自动转 MIDI;每条 WAV 可独立选择五个 YourMT3+ checkpoint、MIROS、三档 MuScriptor 或四个钢琴后端,共 13 条路线。 |
SIX_STEM_SPLIT | 音频 -> BS-Rofo-SW-Fixed.ckpt -> 六条 WAV -> 逐轨转 MIDI | <歌曲名>_<stem>.wav;按需生成逐轨 MIDI | 每条 WAV 的转写路线和是否转换均由用户明确选择。 |
PIANO_TRANSKUN | 音频 -> TransKun 默认 V2 模型 -> MIDI | <歌曲名>_piano_transkun.mid | 适合纯钢琴音频;使用 PyPI 包随附 checkpoint。 |
PIANO_TRANSKUN_V2_AUG | 音频 -> 官方 TransKun V2 Aug checkpoint -> MIDI | <歌曲名>_piano_transkun_v2_aug.mid | 独立模式,使用单独下载并校验的 V2 Aug 资源。 |
PIANO_ARIA_AMT | 音频 -> Aria-AMT 钢琴模型 -> MIDI | <歌曲名>_piano_aria.mid | 适合纯钢琴音频;需要 Aria-AMT checkpoint 已随包或在模型目录可用。 |
PIANO_BYTEDANCE_PEDAL | 音频 -> ByteDance 带踏板钢琴模型 -> MIDI | <歌曲名>_piano_bytedance_pedal.mid | 适合纯钢琴音频;会保留延音踏板 CC64;需要 ByteDance Piano checkpoint 已随包或在模型目录可用。 |
桌面版默认输出到:
MidiOutput/<音频文件名>/
如果同名目录已存在,会自动使用 <音频文件名>_2、<音频文件名>_3 等后缀。
常见输出:
song.mid
song_accompaniment.mid
song_vocal.mid
song_vocal_accompaniment_merged.mid
song_bass.mid
song_drums.mid
song_guitar.mid
song_piano.mid
song_vocals.mid
song_other.mid
song_all_stems_merged.mid
song_piano_transkun.mid
song_piano_transkun_v2_aug.mid
song_piano_aria.mid
song_piano_bytedance_pedal.mid
song_accompaniment.wav
song_bass.wav
song_drums.wav
song_guitar.wav
song_piano.wav
song_vocals.wav
song_other.wav
实际文件数量取决于所选模式和用户主动执行的逐轨转换。人声分离主流程产生规范的 <歌曲名>_vocals.wav 与 <歌曲名>_accompaniment.wav;六声部流程的成功结果包含六条 WAV。任一分离输出缺失时流程会报告失败;MIDI 按用户开始转换的音轨单独生成。乐谱不会在转写时自动阻塞生成;用户对任一 MIDI 点击“生成并下载乐谱”后,才创建与该 MIDI 对应的 ZIP。
YourMT3+ 是默认多乐器后端。download_sota_models.py 准备完整公开工作流资源:Beat This final0、全部五种官方 YourMT3+ checkpoint、固定 MIROS 源码与两组权重、BS-Rofo-SW-Fixed.ckpt、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT 和 ByteDance,并严格验证默认 TransKun 2.0.1 包及其内置 V2 资源;YourMT3 推理通过 src/core/yourmt3_transcriber.py 调用仓库内受控的 YourMT3/amt/src 源码。
源码运行依赖以下文件:
YourMT3/amt/src/model/ymt3.py
YourMT3/amt/src/utils/task_manager.py
YourMT3/amt/src/config/config.py
完整项目 checkout 已包含经过兼容补丁并由固定 manifest 校验的 YourMT3/amt/src。该目录缺失时,受支持的恢复来源是当前项目版本中的受控源码;可变的上游 master 只适合独立实验,不满足本项目三端源码一致性和便携构建身份契约。
模型权重下载:
以下源码维护命令以仓库内 venv 为运行环境;未激活时,Windows 的完整解释器路径是 .\venv\Scripts\python.exe / .\venv\Scripts\hf.exe,Linux/WSL2 为 ./venv/bin/python / ./venv/bin/hf。全局 Python 不属于受支持的源码运行环境。
python download_sota_models.py
默认搜索模型位置包括:
~/.cache/music_ai_models/yourmt3_all
runtime/models/yourmt3_all          # 便携版
models/yourmt3_all                  # 打包资源
运行日志现记录官方 MIDI writer 实际采用的 onset 校正、小节偏移及两者合成的净时间偏移;写出前保持“待计算”,不再误报为禁用校正或零偏移。此修复不改变 MIDI 字节,不增加模型推理或音符分析次数。后台实测与发布前检查见时间轴核验。
项目严格固定上游官方 v0.3.0 提交 d73147e75e5b9b0c0a79ebe154587db4fd603e0c,
并对七个运行时源码文件执行 SHA-256 身份校验,不叠加未合并分支。全项目唯一的
Beat This final0 分析会把完整拍点、BPM、可靠拍号和首个强拍直接传给 v0.3.0 BeatGrid:官方 onset
相位估计在满足样本数与集中度阈值时校正系统性起音偏移,不满足阈值时明确记录 0 校正;项目不再启动第二套节拍检测,也不接受占位
120 BPM。写出的 MIDI 包含真实 tempo、拍号、小节相位和可验证的前置偏移标记;tempo 归一化后还会严格复制到每个含音符轨,
兼容 MuseScore 的 conductor-track 行为。桌面、Space 和 Colab 的 MuScriptor 钢琴卷帘使用同一 Beat This 网格显示拍线、强拍线和交替小节底色。
该偏移标记在手动 BPM 变速时按相同比例变化,最终试听的原音也补入同等静音,因此 MIDI、钢琴卷帘、原音和下载文件使用同一时间轴,
不量化、不过滤、不重跑模型。三档 gated 权重分别固定为
MuScriptor/muscriptor-large revision 8809fdfbed2affa7ade94a7059e746e3880720e7、
MuScriptor/muscriptor-medium revision f32236969308476e01fd3aae67357de5feb05a2d 和
MuScriptor/muscriptor-small revision 8c127f603b807520fa465c838e9bfee8a91ada4e。三者均为 CC BY-NC 4.0,并附额外合法使用条件。
三个仓库的有效授权条件是:同一个 Hugging Face 账户已在浏览器中逐项接受条款,随后由该账户登录 CLI。hf auth login 本身不能替用户接受网页条款,源码安装、Colab 和自行部署 Space 也不能匿名全自动下载这些权重:
hf auth login
python download_muscriptor_model.py --size all
三档由用户选择;所选模型无法运行时,任务会显示错误。Large 质量优先,Medium 是速度/质量折中,Small 参数量最少;三档均严格使用官方 5 秒窗口、prelude forcing 和单次生成路径,所选模型不变。桌面端的运行条件包含所选 checkpoint;Space 与 Colab 会按当前选择准备对应固定 revision。
Windows 结果工作台还需要固定 FluidSynth 2.5.6;安装脚本会准备,也可单独运行:
python download_fluidsynth_runtime.py
python download_musescore_runtime.py
界面和官方公开演示保持同一功能语义:可搜索的标签多选与清除、空选自动检测、
实时转写进度/音符、以 MIDI 为主时钟的可拖动播放进度条、钢琴卷帘、默认全部轨道的量化范围与五档显式量化网格、播放/暂停、跟随播放头、原音↔MIDI 混合、Stereo、
逐乐器静音/多选独奏,以及 MIDI、乐谱 ZIP、合成 WAV、原音左声道/MIDI 右声道立体声下载。
新结果默认全部声部可见、可听;独奏可同时选中多个声部,取消独奏后保留各声部原来的静音设置。
MIDI 下载提供全部声部合并、当前可听声部合并、全部声部分别打包 ZIP 三个选项,均使用当前编辑结果和工程 BPM;ZIP 不受静音/独奏影响。
在编辑器内按空格播放/暂停,Shift+空格或“停止并回到开头”重置播放位置;输入文字或数值时不拦截空格。
桌面钢琴卷帘使用与 TelkNet 默认工具一致的 ChordMini BTC,从原始音频识别和弦。和弦与小节网格共用时间轴,支持点击单独试听,播放跟随、缩放和滚动均随卷帘逐帧同步,并同步 MuScriptor 的开头小节偏移。更改工程 BPM 后仍与音符、小节对齐;编辑 MIDI 不改写原音和弦。首次运行前执行 python download_chordmini_model.py(完整准备命令也包含它),便携包内置固定源码和权重。
和弦按根音配色,当前片段随播放头高亮;短片段使用完整标签和引线,密集标签自动错行,保留真实起止时间。桌面、Space 和 Colab 的 MIDI 音符也支持当前位置高亮及悬停反馈,可查看音高、声部、力度和起止时间;静音声部不显示播放高亮,编辑选区保持独立。
桌面和弦栏旁提供“和弦随曲播放”和独立的 0~200% 音量。首次使用默认关闭随播、音量 100%;关闭随播仍可点击和弦单独试听,0% 则使两种试听都静音。开关与音量会记住上次设置。和弦与歌曲共用音频时钟,支持暂停、跳转、工程 BPM 和倍速;按识别的原始区间发声,不因小节分块重复敲响,N/X 区间保持静音。音量经过响度校准、平滑调节和峰值保护,仅用于试听,不写入 MIDI 或音频导出。便携 App 和可执行 App 共用此实现;Space/Colab 与独立 Web/API、Docker、便携 Web 目前不提供和弦栏。
独立 Web/API、Docker 和便携 Web 的 MIDI 结果提供逐声部 MIDI ZIP 下载。详细交互、导出保留项与交付面范围见结果编辑器说明。
试听音频的来源:逐乐器播放来自最终 MIDI 经官方 MuseScore General
SoundFont 与 FluidSynth 合成,不是无效按钮或 UI 模拟。
MuScriptor 是 Kyutai、Mirelo AI 与 IRCAM 研究人员在 2026 年 7 月公开的完整混音多乐器 AMT 模型。Large 使用 decoder-only Transformer(48 层、隐藏维度 1536;官方模型卡写约 1.3B 参数,代码 README 四舍五入为 1.4B),以 5 秒、16 kHz 单声道音频分片生成 MT3 风格音符事件。训练链路包含约 145 万 MIDI 的合成预训练、17 万首/约 11,000 小时真实音乐微调和 300 首高质量转写的强化学习后训练。
官方模型卡在作者保留的 372 首真实多乐器 D_Test 上报告如下结果(完整训练链路,CFG=2):
| 模型 | Onset F1 | Frame F1 | Offset F1 | Drums F1 | Multi F1 |
|---|---|---|---|---|---|
YourMT3+ YPTF.MoE+Multi (noPS) | 32.5 | 45.5 | 17.8 | 41.4 | 21.9 |
| MuScriptor Large | 60.4 | 72.4 | 48.6 | 49.6 | 47.8 |
这些分数表明 MuScriptor Large 是很强的公开完整混音候选,但不是“所有 benchmark 的无条件 SOTA”:D_Test 是作者自建留出集,尚无公共下载入口;在论文列出的 8 个公共跨域数据集上,MuScriptor 的 Multi F1 高于 YourMT3+ 其中 6 个、低于其中 2 个。它也不输出 velocity,只提供 36 组乐器分类,并受 CC BY-NC 4.0 非商用许可约束。
发布时间也应分开理解:Hugging Face API 记录模型仓库创建于 2026-06-30;论文与 Mirelo 官方文章发表于 2026-07-09;当前公开权重 revision 更新于 2026-07-10,而本项目固定的官方 MuScriptor v0.3.0 源码发布于 2026-08-05。仓库与源码发布日期不等于权重被重新训练;三个公开模型 revision 仍按各自 SHA 精确固定。
完整训练消融、8 个公共数据集逐项分数、模型规模对比、乐器条件收益、Mirelo Studio 私有增强版边界与后续模型观察清单见 MuScriptor 模型研究、分数与项目定位。
MIROS 是桌面版、Space 与 Colab 中 SMART、VOCAL_SPLIT、SIX_STEM_SPLIT 三个模式的可选固定版本多乐器后端,对齐项目锁定的 MusicFM / AI4Musician Challenge SOTA 路线。运行资产包括经过身份校验的本地上游仓库与权重;包装器调用固定入口生成临时 MIDI,再转换为项目统一音符结构。
支持路径:
ai4m-miros/
external/ai4m-miros/
MIROS/
external/MIROS/
包装器会检查:
main.py
transcribe.py
model/musicfm/data/pretrained_msd.pt
logs/Multi_longer_seq_length_frozen_enc_silu/le2bzt53/checkpoints/last.ckpt
MIROS 还需要其上游运行依赖。requirements.txt 保证本项目运行,不保证完整安装 MIROS 上游环境。
下载脚本会检出 amt-os/ai4m-miros 的固定源码 commit 并应用受控兼容补丁;pretrained_msd.pt 使用官方 Hugging Face minzwon/MusicFM 权重,last.ckpt 按上游 main.py 中的 Google Drive 官方文件 ID 获取。GitHub Actions 发布打包不依赖实时 Google Drive 配额,而是从本仓库既有 v1.0.16 Linux 便携包中流式提取已打包验证过的 external/ai4m-miros 目录;若便携包资产缺失、提取失败或 checkpoint 容器不完整,发布流程会停止并显示失败原因。
TransKun 默认路线是钢琴专用转写后端,适合纯钢琴或以钢琴为主的音频。项目通过 src/core/transkun_transcriber.py 调用 transkun PyPI 包随附的 V2 预训练资源:
python -m pip install "transkun==2.0.1"
可用性检查会确认 transkun.transcribe、pretrained/2.0.pt 和 pretrained/2.0.conf 是否存在。资源缺失对应的修复命令如下:
python -m pip install --force-reinstall "transkun==2.0.1"
PIANO_TRANSKUN_V2_AUG 是与默认路线并列的独立模式,使用上游官方 checkpointTransformerAug.zip 中的 checkpointMSimplerAug/checkpoint.pt 与 model.conf。Aug 表示训练时使用数据增强;它不会在默认 TransKun 失败时自动接管,反之亦然。
下载与校验命令:
python download_transkun_v2_aug_model.py
默认搜索模型位置包括:
~/.cache/music_ai_models/transkun_v2_aug/checkpointMSimplerAug
models/transkun_v2_aug/checkpointMSimplerAug     # 打包资源
Aria 音频预处理遵循官方长短音频分支:短音频先合并声道再用 torchaudio 重采样;长音频使用已有 FFmpeg 按原声道重采样为 float32,再合并声道。跨窗口拼接沿用官方恢复流程:非法序列由下一个既有重叠窗口重新生成;连续失败或结尾失败留下未恢复区间时停止输出,并报告具体秒数。模型、权重、精度、解码及 MIDI writer 保持官方实现,不修改 token,也不增加推理重试。MIDI 依赖固定为官方 ariautils 提交 7c815755c6889a784b6a1b3343e9e8daa3e7d128,包含上游同起点与零时值音符修正,运行时同时校验安装来源。稀疏钢琴 BPM 估计汇总短乐句的真实拍间隔,长空白不计入证据。复现对照、性能测量及跨平台验收边界见钢琴转写故障分析。
Aria-AMT 是另一条钢琴专用后端。项目通过 src/core/aria_amt_transcriber.py 统一调用官方单文件推理和 MIDI writer;Linux 源码版由 src.core.aria_amt_worker 独立进程执行,模型错误会直接返回项目队列,不再嵌套上游批处理进程。Docker 和便携包会提前准备官方 AudioTransform 读取的三个目录,支持运行时安装目录只读。默认 checkpoint 为:
piano-medium-double-1.0.safetensors
依赖安装命令:
python -m pip install --no-deps --force-reinstall "aria-amt @ https://github.com/EleutherAI/aria-amt/archive/a1ab73fc901d1759ec3bc173c146b3c6a3040261.zip"
模型下载命令:
python download_aria_amt_model.py
默认搜索模型位置包括:
~/.cache/music_ai_models/aria_amt
models/aria_amt                  # 打包资源
ByteDance Pedal 是钢琴专用的带踏板转写后端,适合独奏钢琴或清晰的钢琴 stem。它来自 ByteDance 的 High-Resolution Piano Transcription with Pedals 系统,本项目通过 piano-transcription-inference 包装,并保留上游 MIDI 中的延音踏板 CC64。
依赖安装命令:
python -m pip install "piano-transcription-inference==0.0.6" "torchlibrosa>=0.1.0,<0.2" "matplotlib>=3.7.0,<4"
模型下载命令:
python download_bytedance_piano_model.py
默认搜索模型位置包括:
~/.cache/music_ai_models/bytedance_piano
models/bytedance_piano           # 打包资源
四个钢琴后端都是“钢琴专精模型”,不参与完整混音的多乐器识别。选择时可以按目标来分:
| 目标 | 推荐模式 | 说明 |
|---|---|---|
| 使用项目默认 TransKun 路线 | PIANO_TRANSKUN | 使用 PyPI 包随附 V2 资源,依赖和 checkpoint 边界清楚。 |
| 对比官方数据增强 checkpoint | PIANO_TRANSKUN_V2_AUG | 使用独立下载并固定校验的 V2 Aug 资源。 |
| 使用另一种现代钢琴 AMT 后端 | PIANO_ARIA_AMT | 适合作为纯钢琴 A/B 候选。 |
| 需要踏板 CC64,尤其是古典、抒情、连奏明显的钢琴音频 | PIANO_BYTEDANCE_PEDAL | 保留 sustain pedal 控制事件;上游主仓库已归档,建议在目标环境做一次实际音频验证。 |
这四者的结果不能和 YourMT3+ / MIROS 的多乐器结果直接横比:钢琴后端只解决 88 键钢琴及其演奏细节,多乐器后端负责完整混音中的乐器识别和 GM 多乐器 MIDI 输出。
本节恢复自历史 README 中的模型对比内容,并按当前版本的实际能力重新标注:当前入口同步开放 SMART、VOCAL_SPLIT、SIX_STEM_SPLIT、PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT 与 PIANO_BYTEDANCE_PEDAL 七种模式。下列表格把“公开 benchmark”和“项目内入口状态”分开写,避免把研究指标误写成产品能力。
| 后端/模型 | 类型 | 项目入口 | 公开质量口径 | 选择说明 |
|---|---|---|---|---|
| YourMT3+ | 多乐器 AMT | SMART 可直接使用;分离结果可逐轨选择五个官方 checkpoint,转换时保留官方 writer 音符并只补必要 tempo 元数据 | 官方 Space 默认 noPS 结果文件:Slakh multi_f = 0.7398;YourMT3+ 论文表:Slakh2100 Multi F1 = 74.84,同表 MT3 = 62.0 | 默认多乐器后端;工程默认 checkpoint 为 YPTF.MoE+Multi (noPS)。 |
| MuScriptor Large | 多乐器 AMT | SMART 可选;分离后的 WAV 可逐轨选择,并使用真实乐器硬约束与官方 writer | 作者 D_Test:Onset / Frame / Offset / Drums / Multi F1 = 60.4 / 72.4 / 48.6 / 49.6 / 47.8;同表 YourMT3+ Multi F1 = 21.9 | 强公开完整混音候选;分数来自作者自建协议,不能直接与 Slakh 榜单混排;权重仅限非商用。 |
| MIROS | 多乐器 AMT | SMART 可选;分离后的 WAV 可逐轨选择 | 2025 AMT Challenge:F1 0.5998,同表 YourMT3-YPTF-MoE-M 0.5938、MT3 0.3932 | 固定 MusicFM 后端;挑战使用 76 个受约束合成短片段,不与 MuScriptor D_Test 或 Slakh 分数横比。 |
| TransKun 默认 V2 | 钢琴专精 | PIANO_TRANSKUN | TransKun V2 / pip checkpoint 在 MAESTRO V3 上有公开 F1 | 默认 TransKun 路线,随包权重边界清楚。 |
| TransKun V2 Aug | 钢琴专精 | PIANO_TRANSKUN_V2_AUG | 上游官方数据增强 checkpoint;不将不同 checkpoint 的指标混写 | 独立下载、固定大小与 SHA256 校验,不是默认 V2 的 fallback。 |
| Aria-AMT | 钢琴专精 | PIANO_ARIA_AMT | 公开 checkpoint;README 不写入未发布的同口径统一 F1 | 适合常规纯钢琴 A/B。 |
| ByteDance Pedal | 钢琴专精 / 踏板感知 | PIANO_BYTEDANCE_PEDAL | MAESTRO note onset F1 / 踏板 onset F1 = 96.72% / 91.86% | 需要踏板 CC64 时优先选择。 |
| Leap XE + Leap Instrumental | 人声/伴奏分离 | VOCAL_SPLIT 前置分离 | 两个公开模型使用不同目标/口径,不合成单一 benchmark | Leap XE 提取 vocals,Leap Instrumental 提取 accompaniment;后续 MIDI 质量还取决于转写后端。 |
| BS-RoFormer SW Fixed | 六声部分离 | SIX_STEM_SPLIT 前置分离 | MVSEP 6-stem SDR 口径 | 生成六条 WAV,每条 stem 都可单独选择 MIDI 路线。分离指标不是端到端 MIDI F1。 |
YourMT3+ / MuScriptor / MIROS 属于多乐器后端,TransKun / Aria-AMT / ByteDance Pedal 属于钢琴专精后端,Leap XE / Leap Instrumental / BS-RoFormer SW Fixed 属于音源分离后端;三类模型的公开指标不能混成同一张排行榜。
本项目默认使用 YPTF.MoE+Multi (noPS)。官方 Hugging Face Space 的 app.py 默认 model_name 就是 YPTF.MoE+Multi (noPS);YPTF.MoE+Multi (PS) 仍保留为可选 pitch-shift checkpoint。
| 项目 | 详情 |
|---|---|
| 模型全称 | YPTF.MoE+Multi (noPS) |
| 检查点 | mc13_256_g4_all_v7_mt3f_sqr_rms_moe_wf4_n8k2_silu_rope_rp_b36_nops,官方 Space 指向 last.ckpt |
| 来源 | 官方 Hugging Face Space / Space noPS 评测结果 / arXiv:2407.04822 |
| 架构 | Perceiver Transformer 编码器 + Multi-T5 解码器 |
| MoE | 8 专家,Top-2 路由,SiLU 激活 |
| 位置编码 | RoPE(部分旋转位置编码) |
| 归一化 | RMSNorm |
| 训练增强 | 不使用 Pitch Shift 音高偏移增强(noPS) |
| 模型大小 | noPS 官方 last.ckpt 本地解析约 535.5 MiB;PS 本地 model.ckpt 约 723.8 MiB |
| 任务类型 | mt3_full_plus(128 种 GM 乐器 + 鼓) |
下表分别列出默认 noPS checkpoint 的 Space 评测结果和论文最终模型的成绩,两者对应的模型配置不同。
| 指标 | 当前默认 noPS | YourMT3+ 论文 YPTF.MoE+Multi | MT3 (Google 基线) | 来源口径 |
|---|---|---|---|---|
Multi (Onset-Offset) F1 / multi_f | 0.7398 / 73.98% | 74.84 | 62.0 | Space noPS 结果文件 / YourMT3+ 论文 Slakh2100 对比表 |
官方 Hugging Face / Colab demo 的模型选择项是 checkpoint / 架构选择,不是本项目的处理工作流。当前项目中的 YourMT3+ 选择器与官方列表对齐;区别是本项目会把该模型嵌入 SMART、VOCAL_SPLIT 和 SIX_STEM_SPLIT 等工作流中,并统一输出 GM 多乐器 MIDI。
| 模型 | MoE | Pitch Shift | 说明 |
|---|---|---|---|
| YMT3+ | 无 | 无 | 官方 Colab 模型族中的基线 YourMT3+ checkpoint |
| YPTF+Single (noPS) | 无 | 无 | Perceiver-TF + 单解码器 checkpoint |
| YPTF+Multi (PS) | 无 | 有 | Perceiver-TF + multi-t5 多通道解码 |
| YPTF.MoE+Multi (noPS) | 8 专家 | 无 | 本项目默认模型;官方 Hugging Face Space 默认模型;Space 结果文件中 Slakh multi_f = 0.7398 |
| YPTF.MoE+Multi (PS) | 8 专家 | 有 | 可选 pitch-shift MoE checkpoint;YourMT3+ 论文表中最终模型 Slakh Multi F1 = 74.84;本地 PS checkpoint 约 723.8 MiB |
| YourMT3+ 传统版 | 无 | 无 | 旧配置兼容项,不在界面默认显示 |
与官方 demo 的主要对齐点:
YPTF.MoE+Multi (noPS) 对齐官方 Hugging Face Space 默认展示模型。update_config 生成 tokenizer/model/audio 配置。ff_layer_type 元数据时,本项目按标准 T5 前馈层 t5_gmlp 处理。与官方 demo 的差异也需要明确:
inference_file(bsz=8),batch 大小固定为 8。| 后端 | 类型 | 集成方式 | 当前语义 | 说明 |
|---|---|---|---|---|
| MIROS (MusicFM) | 多乐器 | 本地 ai4m-miros 仓库 + 当前工程包装器 | 固定 checkpoint 质量 | 官方仓库标注为 Music Transcription Challenge winning model,可作为 SMART、VOCAL_SPLIT 与 SIX_STEM_SPLIT 的多乐器后端 |
处理语义:
MIROS 当前为固定 checkpoint 推理,可用于与 YourMT3+ 做同任务 A/B。VOCAL_SPLIT 使用两个分离模型:BS-RoFormer Leap XE 90-band 对原混音生成 vocals,标准 BS-RoFormer Leap Instrumental 62-band 也对原混音独立生成 accompaniment。两路规范 WAV 进入音轨工作台后,可分别选择五个 YourMT3+ checkpoint、MIROS、MuScriptor Large / Medium / Small 或四个钢琴后端,共 13 条路线。
YourMT3+ 和 MIROS 保留官方 writer 的音符输出,并补充速度信息。两个分离模式先输出 WAV;在音轨工作台选择模型并开始转换后,才生成对应 MIDI。
| 项目 | 详情 |
|---|---|
| vocals 模型 | BS-RoFormer Leap XE:Xe/bs_leap_xe_voc.ckpt + Xe/leap_xe_config_voc.yaml |
| accompaniment 模型 | BS-RoFormer Leap Instrumental:bs_roformer_leap_inst.ckpt + 原始 bs_leap_inst_conf.yaml,大小与 SHA-256 严格校验 |
| 运行库 | 两路均使用 PyTorch 与 audio-separator;Leap Instrumental 使用该库原生 FP32 demix |
| 调用方式 | 两个模型各自对原音频推理;Leap XE 输出 vocals,Leap Instrumental 直接预测 other 作为 accompaniment |
| 模型准备 | download_sota_models.py 会准备并校验两组资源;也可分别运行 download_vocal_model.py 与 download_accompaniment_model.py |
| 兼容入口 | 历史文件 download_vocal_harmony_model.py 仍转发 Leap Instrumental accompaniment 下载;它不再表示 karaoke/和声链路 |
| 打包行为 | release 工作流会把 ~/.music-to-midi/models/audio-separator/ 打进便携包;运行时缺模型或校验失败会明确报错 |
| 输出选项 | 分离阶段输出 <歌曲名>_vocals.wav 与 <歌曲名>_accompaniment.wav;逐轨 MIDI 仅在用户勾选路线并点击转换后生成,不自动合并 |
两个分离模型各自对原混音推理。任一模型失败时,分离任务会停止并显示原因。
表中“未写入数值”表示所列来源未提供与该 checkpoint 对应的明确评测分数。
| 模型/方向 | 来源 | 类型 | 状态 | 说明 |
|---|---|---|---|---|
| Leap XE vocals + Leap Instrumental accompaniment(当前) | 固定模型与配置 | 本地 PyTorch 双模型 | 使用中 | 两路独立读取原混音,分别交付 vocals 与 accompaniment。受控人工混音的伴奏 SI-SDR 已复现为 19.34015 dB;不是原曲真值或所有歌曲的质量保证。 |
| BS-RoFormer ep317(公开可下载) | ZFTurbo 预训练列表 | 本地直替(audio-separator) | 可替换(权衡) | model_bs_roformer_ep_317_sdr_12.9755.ckpt 公开可下载;ZFTurbo 表按 Multisong 写明 SDR vocals = 10.87。文件名中的 12.9755 是训练标签,不等同于表中 vocals SDR。 |
| MelBand-RoFormer (KimberleyJensen) | ZFTurbo 预训练列表 / Hugging Face | 本地可用(vocals/other) | 可用(偏人声) | 公开权重 MelBandRoformer.ckpt 可核;ZFTurbo 表按 Multisong 写明 SDR vocals = 10.98。 |
| SCNet XL IHF(开源权重) | ZFTurbo 预训练列表 / ZFTurbo Release v1.0.15 | 开源可下载(4-stem) | 需改造接入 | 公开权重是 4-stem 模型,不是本项目现有 2-stem 直替;ZFTurbo 表写明 MUSDB test avg 10.08、Multisong avg 9.92。 |
| MVSEP Ensemble / BS Roformer 服务模型 | MVSEP News / MVSEP Full API | API 调用(权重未公开) | 非本地直替 | 榜单服务可用,但公开下载清单未见对应 checkpoint;不作为本地可复现模型写入具体数值。 |
| Mel-RoFormer (ISMIR 2024) | arXiv:2409.04702 / ar5iv 表2 | 论文阶段(研究模型) | 论文已发表 | MUSDB18-HQ(论文表2,场景 b,含额外数据)仅报告 Vocals SDR;这是论文特定协议,不与 Multisong / MVSEP 数字混排。 |
| Mamba2 Meets Silence (v2, 2025) | arXiv:2508.14556 | 论文阶段(研究模型) | 论文 | 摘要报告 cSDR 11.03 dB(作者称 best reported),强调稀疏人声段鲁棒性 |
| Windowed Sink Attention (2025) | arXiv:2510.25745 | 论文阶段(效率优化方向) | 论文 + 开源代码 | 在微调设定下恢复原模型约 92% SDR,同时 FLOPs 降低约 44.5x(偏效率收益) |
结论(按口径):
不同榜单、数据集和评测协议(Multisong、MUSDB、MVSEP、cSDR/uSDR)的分数不可直接横比。
桌面版、Space 和 Colab 提供以下分离与钢琴转写流程。公开数据通常只覆盖“分离”或“钢琴 AMT”单项任务,不等于本项目端到端音频转 MIDI 的统一评分。
| 流程 | 当前仓库状态 | 上游模型/实现 | 可核验公开数据 | 与当前 SMART / VOCAL_SPLIT 的关系 |
|---|---|---|---|---|
| 六声部分离 + 逐轨转写 | six_stem_split 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | BS-Rofo-SW-Fixed.ckpt(vocals, bass, drums, guitar, piano, other)+ 每条 WAV 独立选择 13 条转写路线 | MVSEP Algorithms #77 给出 6-stem SDR:vocals 11.30 / instrum 17.50 / bass 14.62 / drums 14.11 / guitar 9.05 / piano 7.83 / other 8.71 | 这些是音源分离 SDR,不是最终 MIDI 转写 F1;逐轨 AMT 的端到端质量没有公开统一 benchmark。 |
| 钢琴专用转写(TransKun 默认 V2) | piano_transkun 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | transkun==2.0.1,使用该 wheel 随附并严格校验的资源 | 官方 model cards:TransKun V2 在 MAESTRO V3 上 Note Onset / Onset+Offset / Onset+Offset+Velocity F1 为 0.9832 / 0.9349 / 0.9296;pip 随包 No Ext checkpoint 为 0.9833 / 0.8149 / 0.8109 | 这是钢琴专精协议,适合纯钢琴;不能与 YourMT3+ 的 Slakh2100 多乐器 F1 直接横比。 |
| 钢琴专用转写(TransKun V2 Aug) | piano_transkun_v2_aug 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | 官方 checkpointTransformerAug.zip,固定校验后加载 checkpointMSimplerAug/checkpoint.pt + model.conf | Aug 表示数据增强 checkpoint;其他 V2 checkpoint 的指标不适用于它 | 与默认 V2 并列,供同一音频显式 A/B,不是失败回退。 |
| 钢琴专用转写(Aria-AMT) | piano_aria_amt 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | EleutherAI aria-amt,公开 preliminary piano v1 checkpoint piano-medium-double-1.0.safetensors | 官方 README 提供安装、checkpoint 下载和 CLI 用法;未给出与 TransKun 同口径的 MAESTRO/MAPS benchmark。本地打包资源中的 checkpoint 约 425.9 MiB。 | 可与其他钢琴模型比较;缺少同协议公开分数时,可使用同一批本地音频评估。 |
| 钢琴专用转写(ByteDance Pedal) | piano_bytedance_pedal 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | piano-transcription-inference,checkpoint note_F1=0.9677_pedal_F1=0.9186.pth | 论文报告 MAESTRO onset F1 96.72% 与 pedal onset F1 91.86%;本项目保留上游 MIDI 中的 sustain pedal CC64。 | 上游 ByteDance 主仓库已归档,推理包兼容性需在目标环境验证。 |
下列对比按 2026-08-08 的公开资料更新。MuScriptor D_Test Multi F1、Slakh2100 Multi (Onset-Offset) F1、MAESTRO onset F1、官方挑战名次、以及主观听感/下游任务增益并不是同一协议,不能当成同一张排行榜直接横比。
| 模型 | 公开来源 | Benchmark / 协议 | 公开结果 | 状态 | 说明 |
|---|---|---|---|---|---|
| MuScriptor Large | 论文 / 代码 | 作者 D_Test,372 首真实多乐器曲目;完整训练,CFG=2 | Onset / Frame / Offset / Drums / Multi F1 = 60.4 / 72.4 / 48.6 / 49.6 / 47.8;同表 YourMT3+ Multi F1 = 21.9 | 已集成 | 作者数据上提升很大;8 个公共跨域集的 Multi F1 赢 6、输 2,不同数据集上的表现有差异 |
| MuScriptor Small / Medium | 官方代码与三档权重 | 论文 D_Real only、CFG=2 规模消融 | Small Multi F1 38.2;Medium 39.7;Large 40.5 | 已集成 | 103M / 307M 固定权重已作为独立显式选择接入;质量、速度和显存占用需在同一硬件与输入上比较 |
| YPTF.MoE+Multi (noPS)(当前默认) | 官方 Space app.py / Space noPS 结果文件 | Slakh multi_f | 0.7398 / 73.98% | 使用中 | 当前项目默认 YourMT3+ checkpoint;对齐官方 Hugging Face Space 默认项 |
| YPTF.MoE+Multi(论文表最终模型) | YourMT3+ 论文 | Slakh2100 Multi (Onset-Offset) F1 | 74.84;同表 MT3 = 62.0 | 论文公开结果 | 这是论文表中的最终模型口径,不把它写成当前 noPS 默认 checkpoint 的单独成绩 |
| MT3 | YourMT3+ 论文 / Magenta 仓库 | Slakh2100 Multi (Onset-Offset) F1 | 62.0 | 开源基线 | YourMT3+ 继承并扩展的 token-based 多乐器基线 |
| 2025 AMT Challenge 冠军 MIROS | 挑战论文 / 代码 | 76 个约 20 秒、最多 3 种乐器的受约束合成片段;Multi Onset F1 | 0.5998;YourMT3-YPTF-MoE-M 0.5938;MT3 0.3932 | 已集成 | MusicFM 编码器 + 多解码器;该挑战协议不能与 Slakh 或 MuScriptor D_Test 直接横比 |
| Mirelo Studio 改进版 | Mirelo 官方文章 | 未公开 | 官方仅说明“使用更多数据训练、更准确” | 私有服务观察项 | 没有公开权重、revision、参数量或同协议分数;不是当前 muscriptor-large 权重,不能离线集成 |
| 模型 | 当前项目入口 | 同类型质量口径 | 公开结果 | 使用判断 |
|---|---|---|---|---|
| TransKun V2 | 公开研究 checkpoint | MAESTRO V3 note onset F1 / onset+offset F1 / onset+offset+velocity F1 | 0.9832 / 0.9349 / 0.9296 | 公开钢琴 AMT 分数很强,适合作为钢琴专精质量参考。 |
| TransKun pip checkpoint(No Ext) | PIANO_TRANSKUN | MAESTRO V3 No Ext 同口径三项指标 | 0.9833 / 0.8149 / 0.8109 | 项目默认 TransKun 路线;仓库说明它不带 pedal extension。 |
| TransKun V2 Aug | PIANO_TRANSKUN_V2_AUG | 官方数据增强 checkpoint;不套用其他 checkpoint 的指标 | 未写入跨 checkpoint F1 | 用同一批本地钢琴音频与默认 V2 显式 A/B。 |
| Aria-AMT | PIANO_ARIA_AMT | 官方公开 checkpoint,但未发布与 TransKun 完全同口径的统一榜单 | 未写入统一 F1 | 已集成的钢琴 A/B 选项;建议用同一批本地钢琴音频比较。 |
| ByteDance Pedal | PIANO_BYTEDANCE_PEDAL | MAESTRO note onset F1 / 踏板 onset F1 | 96.72% / 91.86% | 同类中优势是踏板事件,输出 MIDI 会保留 sustain pedal CC64。 |
YourMT3+ / MuScriptor / MIROS 属于多乐器后端,不能与上表的钢琴专精 F1 横向混排;ByteDance Pedal 的 踏板 onset F1 也不能直接等同于 TransKun 的 onset+offset+velocity F1。
| 模型 | 公开来源 | Benchmark / 协议 | 公开结果 | 状态 | 说明 |
|---|---|---|---|---|---|
| TransKun V2(论文 checkpoint) | TransKun 官方仓库 / model cards | MAESTRO V3 note onset F1 / onset+offset F1 / onset+offset+velocity F1 | 0.9832 / 0.9349 / 0.9296 | 开源 | 这是论文公开 checkpoint 的模型卡结果;项目另设 V2 Aug 独立入口,不混用指标 |
| TransKun pip 随包 checkpoint(No Ext) | TransKun 官方仓库 / model cards | MAESTRO V3 No Ext 同口径三项指标 | 0.9833 / 0.8149 / 0.8109 | 开源 | 仓库明确写明随 pip 包 checkpoint 为 without pedal extension of notes;对应项目默认 PIANO_TRANSKUN |
| Aria-AMT | EleutherAI 官方仓库 | 公开 checkpoint 发布 | 仓库公开 piano-medium-double-1.0.safetensors;但仓库页未给出与上表完全同口径的统一 MAESTRO/MAPS 榜单 | 开源 | 已集成为钢琴 A/B 选项;暂无同协议公开 benchmark |
| High-Resolution Piano Transcription with Pedals by Regressing Onset and Offset Times | 论文 / ByteDance 仓库 | MAESTRO onset F1 / pedal onset F1 | 96.72% / 91.86% | 论文 + 代码 | 代表性踏板感知钢琴论文;协议是钢琴专精口径,不应与多乐器 Slakh 分数混排 |
| 模型/方向 | 公开来源 | 公开协议 / 任务 | 可核实的公开信息 | 为什么不与上表混成同一分数榜 |
|---|---|---|---|---|
| 密集复音与乐器检测 | 2025 AMT Challenge 论文 | 1/2/3 乐器分组分析 | MIROS 从 1 种到 3 种乐器时 F-measure 从 0.7193 降到 0.4367;论文把 polyphony、相似音色、乐器泄漏列为主要失败模式 | 这是失败模式和未来评测方向,不是一个可下载的新 checkpoint |
| MR-MT3 | 论文 / 代码 | Slakh2100;重点看 onset F1、instrument leakage ratio、instrument detection F1 | 摘要明确写的是“improved onset F1 scores and reduced instrument leakage” | 它主打 leakage 抑制,并引入了新指标;不等于上面的 Slakh Multi (Onset-Offset) F1 |
| Jointist | 论文 | 流行音乐联合转写 + 分离 | 摘要给出的公开结果是:转写提升 >1 ppt、分离提升 +5 SDR、downbeat +1.8 ppt、和弦/调性各 +1.4 ppt | 它是 joint transcription + separation 路线,公开协议与 Slakh / MAESTRO 完全不同 |
| MusicFM 编码器 + AMT 解码器 | MusicFM 论文 / 仓库 / HF 权重 | 预训练编码器迁移 | 公开的是基础编码器权重;通用可复现的完整 AMT decoder / 微调流水线并未作为现成后端发布 | 它更像 MIROS 这类路线背后的表示学习部件,不是拿来就能切换的通用后端 |
| CountEM / Count The Notes | 论文 / 项目页 / 代码 | 弱监督 AMT 训练方法 | 公开论文、代码和模型,核心贡献是“用音符直方图 + EM”替代精确对齐监督 | 这是训练范式创新,不是固定 checkpoint 的 turnkey 后端 |
| PerceiverTF | 论文 | 多乐器公开数据集(论文自有协议) | 摘要只明确说其在多个公开数据集上优于 MT3 / SpecTNT | 它更适合作为 YourMT3+ 的架构祖先来理解,不应和上表的统一数值行硬拼 |
补充说明:
0.5.0(2021-12-09),与当前多乐器/钢琴专精 SOTA 的公开比较协议并不一致。截至 2026-08-08,多乐器 AMT 的公开实现主要沿三条路线发展:MT3 / YourMT3+ / MR-MT3 的 token-based 架构、MIROS 的 MusicFM 预训练编码器,以及 MuScriptor 使用大规模真实数据和 RL 后训练的 decoder-only 模型。后续比较应同时报告密集复音、相似音色泄漏、稀有乐器、真实 jazz/pop 泛化、权重、许可、速度和显存,单个协议下的分数不足以概括模型能力。钢琴 AMT 也需分别标注 TransKun pip 权重、V2 Aug checkpoint、论文 checkpoint 与 pedal-aware 系统,避免把不同协议合并成一个榜单。
桌面版、Space、Colab 和独立 Web 前端使用固定转写质量。YourMT3+ 产品路线使用官方无重叠分段、固定 bsz=8、逐解码通道 detokenize/merge、mix_notes 和官方 MIDI writer;MIROS 保留官方 CLI writer 输出。MuScriptor 固定使用官方 v0.3.0 源码、权重、5 秒窗口和 MIDI writer,并提供两种分段衔接方式:默认的“标准”保留上游原始分段状态;“跨段延音衔接”连接跨分段的持续音符。这个开关不改变速度方案,两种方式默认不量化、过滤或重建音符。需要量化时,在结果编辑器中选择范围和网格,再点击“量化”。
任务失败时显示原因,并保留诊断信息供排查。
以下情况会得到明确的失败结果和根因:
各场景的用户可见行为:
| 场景 | 当前行为 |
|---|---|
| FFmpeg 转 WAV 失败 | 停止转换并保留 FFmpeg stderr |
| audio-separator CUDA 不兼容 | 停止分离并说明 GPU/CUDA/PyTorch 兼容性问题 |
| BPM 检测失败 | 停止处理并显示检测错误 |
| YourMT3+ 显存不足 | 停止推理并保留 CUDA 错误;该路线的 batch 大小固定为 8 |
| 配置非法模式/后端 | 未知值直接抛出校验错误;仅旧 piano 模式会兼容映射为 smart |
| 独立 vocal stem 的官方 writer 输出任意 program | 保留 program、鼓轨、控制器与音符 |
| SSL 证书验证失败 | 默认停止下载并提示配置 CA/代理;只有显式设置 ALLOW_INSECURE_HF_DOWNLOAD=1 才会跳过验证 |
如需尝试其他模型,请在模型选择器中切换后重新开始转换。
| 项目 | 要求 |
|---|---|
| Python | 3.11+;Windows 安装脚本支持并优先选择 3.11-3.12 |
| PyTorch | 桌面/便携安装基线为 2.7.0,并使用匹配版本的 torchaudio、torchvision |
| Git | 源码安装必需;Windows 安装器找不到 Git 时会明确停止 |
| FFmpeg | 必需;用于可靠处理 MP3/M4A/FLAC/OGG 等格式 |
| GPU | Windows 完整七模式支持 NVIDIA CUDA 12.8 或 Intel XPU;二者使用独立环境。Linux/WSL2 基线仍为 NVIDIA CUDA;任何入口都不会自动降级到 CPU/AMD |
| 磁盘 | 完整冷安装会同时保存 Python wheel、模型与下载缓存;实测工作集约 32.36 GB,建议开始前至少保留 40 GB 可用空间 |
| 系统 | Windows 10/11、Linux、WSL2 |
各平台使用各自固定的兼容运行时;跨平台覆盖 NumPy/Torch 组合不属于支持范围:
| 平台 | Python / Torch | NumPy 与 GPU 运行时 | 发布边界 |
|---|---|---|---|
| Windows / NVIDIA 桌面与便携目标 | Python 3.11-3.12;Torch 2.7.0 / torchaudio 2.7.0 / torchvision 0.22.0 | NumPy 1.26.4;CUDA 12.8 wheel | 源码与便携发布均按此契约校验;release.yml 同时执行第三方许可闭集门禁、模型身份校验和成品烟测 |
| Windows / Intel XPU 桌面与本地便携目标 | Python 3.11-3.12;原生 Torch 2.11.0 XPU / torchaudio 2.11.0 XPU / torchvision 0.26.0 XPU | NumPy 1.26.4;onnxruntime-openvino==1.24.1 + openvino==2025.4.1;启动门禁验证 FFT/STFT、BF16 和矩阵运算驻留 XPU,新 Leap Instrumental 使用 PyTorch FP32,尚未完成 XPU 实机验收 | 当前完整三件套基线覆盖 PyTorch 官方硬件矩阵中的 Arc B-Series(Battlemage)与 Core Ultra Series 3(Panther Lake);Panther Lake 按官方矩阵要求 Windows 11。运行环境为独立 venv-xpu;IPEX、CUDA ORT 混装和 CPU EP 回退会被门禁拒绝。官方 GitHub release 暂仍只构建 CUDA 包 |
| Linux / NVIDIA 源码运行 | Python 3.11-3.12 x64;Torch 2.7.0 / torchaudio 2.7.0 / torchvision 0.22.0 | NumPy 1.26.4;NVIDIA 驱动兼容 CUDA 12.8;仅 cu128 | install.sh / run.sh 对完整七模式执行精确运行时校验;安装器要求 Debian/Ubuntu/WSL2 的 apt 软件源提供对应 Python venv/dev 包;build.yml 只做源码、测试和打包契约检查 |
| Linux / AMD/ROCm | 尚未完成完整七模式实机验收 | 本次替换没有扩大已验证的硬件范围 | 当前不支持;安装脚本会停止并说明兼容性问题 |
| Hugging Face Space | Python 3.12.12;Torch 2.8.0 / torchaudio 2.8.0 / torchvision 0.23.0 | NumPy >=2,<2.5;ZeroGPU | 使用 space/requirements.txt;桌面 NumPy 1.26 不属于 Space 兼容组合 |
| Google Colab | Colab 当前预装 Python/Torch | 保留预装 Torch;只安装 pinned Web/runtime 依赖 | 避免替换 Torch 导致 CUDA 运行库冲突 |
Windows 源码版应放在本机磁盘的纯英文、无空格目录,例如:
C:\MusicToMidi
D:\Projects\music-to-midi
含中文、空格或括号的路径可能导致 PyTorch DLL 加载失败。映射盘和 UNC/SMB 网络路径尚未通过源码虚拟环境身份验收,可能让 venv 记录路径与启动路径不一致;本机 NTFS 的纯英文无空格目录是当前已支持的源码运行位置。
MuScriptor Small / Medium / Large 都是 Hugging Face gated 模型,匿名用户无法下载。源码安装的授权条件是:同一个 Hugging Face 账户已在浏览器中分别接受 Small、Medium、Large 的条款,并在账号获批后从项目隔离环境登录:
# Windows;无 venv 时的最小授权环境仅包含官方 HF CLI
py -3.11 -m venv venv
.\venv\Scripts\python.exe -m pip install "huggingface_hub>=0.20,<2" "hf_xet==1.5.2"
.\venv\Scripts\hf.exe auth login
# Linux / WSL2
python3.11 -m venv venv
./venv/bin/python -m pip install "huggingface_hub>=0.20,<2" "hf_xet==1.5.2"
./venv/bin/hf auth login
登录使用具有三个 gated 仓库读取权限的个人 token。仓库、README、命令行参数和日志都不是受支持的 token 存放位置;无人值守环境的凭据入口是受保护的 HF_TOKEN secret。总下载脚本会在下载其它大型模型前依次做三个轻量权限预检,任一仓库未接受条款或未登录都会立即停止,不会改用其它模型。完整便携 release 已随包携带通过身份校验的权重,启动时不再从 Hub 下载;这不改变 CC BY-NC 4.0 与附加条款的适用范围。
推荐:
powershell -ExecutionPolicy Bypass -File .\run.ps1
或双击:
run.bat
run.ps1 会检查虚拟环境、核心依赖、Beat This final0、五种 YourMT3+ checkpoint、MuScriptor Small / Medium / Large、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS、SoundFont 与 FluidSynth;资源缺失或身份校验失败时会调用 install.ps1。
Intel GPU 使用独立的原生 XPU 环境,不与 CUDA 环境共用 wheel 或 DLL:
powershell -ExecutionPolicy Bypass -File .\install_xpu.ps1
powershell -ExecutionPolicy Bypass -File .\run_xpu.ps1
安装和每次启动都会做真实 torch.xpu 矩阵、FFT 与 STFT 运算,捕获并拒绝 XPU→CPU 算子回落;随后初始化 OpenVINO GPU,并在禁用 CPU EP 回退后用 OpenVINOExecutionProvider 的 GPU.0 实际执行 MatMul ONNX 图。ORT 会自动列出内置 CPU provider,但 session.disable_cpu_ep_fallback=1 会让任何需分配给 CPU 的节点直接导致会话失败。任一门禁失败都会停止,不会改用 IPEX、DirectML、CUDA 或 CPU。
Leap Instrumental 固定使用 audio-separator 0.44.1 的原生 FP32 路线,与受控对比采用同一权重和配置:dim_t=1101、每片 563200 个采样、步进 8 秒。短音频补齐一个模型窗口后裁回原长度;不改变窗口或降精度。显存不足时任务停止,并显示 OOM 错误。新增伴奏权重的上游未声明许可证,便携包发布仍受第三方声明中的待确认记录约束。
Leap XE 在 XPU 上保留官方完整约 20 秒音频窗口、全部 key/value、checkpoint 与后处理,仅把 attention 的 query 轴固定分成 128 行逐块求值后拼接。每个 query 仍注意完整上下文,因此这是推理期数值等价的显存有界实现,不是缩短音频窗口、降低模型或 CPU 回退;训练态误用会直接报错。该路径用于避开仅覆盖部分 Intel 架构的 XPU Flash Attention 内核,此前版本已在 Arc 140T 16 GB 上完成真实两轨分离;该历史结果不包含本次替换的 Leap Instrumental,新伴奏路线尚未完成 XPU 实机验收。
MuScriptor Large 的 5.1 GiB checkpoint 在 XPU 上固定使用 safetensors==0.8.0 的官方 pread reader,并按文件偏移顺序一次只装载一个张量。XPU 路径会先打开惰性的 pread 文件句柄,再建立约 5.50 GiB 的统一内存模型,避免模型占用系统提交空间后才打开 checkpoint 所触发的 Windows os error 1455。该实现不会把完整 checkpoint 映射为 PyTorch storage,也不改变官方权重、精度与 writer;读取失败会直接停止,不会改回 mmap、扩大页面文件或自动重试。
Intel XPU 的本地 Web 后端会为每个 GPU 作业启动一个全新的推理进程,作业结束后由操作系统回收该进程的完整地址空间;常驻 HTTP 进程不跨作业保留 YourMT3、MIROS、MuScriptor 或分离模型。这样可避免统一内存模型在长会话中累积占用 Windows 系统提交额度。停止操作会终止并回收当前处理进程;处理进程非零退出,或缺少结果清单、结果文件时,任务会报告失败。
chmod +x run.sh
./run.sh
run.sh 会检查虚拟环境、核心依赖、Beat This final0、受控 YourMT3+ 源码与五种 checkpoint、MuScriptor Small / Medium / Large、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS、SoundFont 与 FluidSynth;资源缺失或身份校验失败时会调用 install.sh。
受支持的源码运行环境是仓库内隔离且与加速器匹配的虚拟环境:NVIDIA CUDA 使用 venv,Windows Intel XPU 使用 venv-xpu。run.ps1 与 run_xpu.ps1 会在导入 GUI 和模型依赖前分别选择并严格校验解释器路径、include-system-site-packages=false、MuScriptor 包位置、版本和七个源码 SHA-256;全局 python -m src.main 会被拒绝。
# Windows 桌面 App
.\venv\Scripts\python.exe -m src.main

# Windows Web 前后端;自动识别局域网 IPv4 并打开前端
.\venv\Scripts\python.exe -m src.web
# Linux / WSL2 桌面 App
./venv/bin/python -m src.main

# Linux / WSL2 Web 前后端;浏览器手动打开终端显示的地址
./venv/bin/python -m src.web --no-window
Windows:
py -3.11 -m venv venv
.\venv\Scripts\activate
python -m pip install --upgrade pip wheel "setuptools==80.10.2"
Linux:
python3.11 -m venv venv
source venv/bin/activate
python -m pip install --upgrade pip wheel "setuptools==80.10.2"
CUDA 12.8(完整七模式受支持且由启动器严格校验的运行时):
pip install torch==2.7.0 torchaudio==2.7.0 torchvision==0.22.0 --index-url https://download.pytorch.org/whl/cu128
Windows Intel XPU 的标准安装入口是 install_xpu.ps1。手动准备对应独立的 venv-xpu 和 requirements-xpu.txt 固定版本;在 venv 中覆盖 CUDA wheel 会破坏两套环境的隔离契约。
Intel XPU 采用“最新完整兼容组合”而不是单独追最高 torch 版本:截至当前,PyTorch XPU 已发布 2.13,但 torchaudio XPU 的最新匹配版本是 2.11,因此项目固定 torch/torchaudio==2.11.0+xpu 与 torchvision==0.26.0+xpu。这套官方硬件矩阵已经列出 Arc B-Series 与 Panther Lake / Core Ultra Series 3。既有 XPU 包中的 ONNX Runtime OpenVINO 1.24.1 与 OpenVINO 2025.4.1 仍按打包依赖管理;新 Leap Instrumental 走 PyTorch FP32,本次只在 NVIDIA CUDA 实测,尚未完成新伴奏路线的 Intel XPU 实机验收。未来只有在三件套与全部七模式重新验收通过后才整体升级,不混装不匹配版本。
Intel XPU 没有可直接等同 NVIDIA sm_XX 的项目级兼容版本号。该栈通过 oneAPI/Level Zero 发现设备,常规 JIT 路径由 Intel Graphics Compiler 按实际硬件生成代码;真正的支持边界以固定 PyTorch 版本的官方硬件矩阵、操作系统/驱动要求和本项目启动时的真实算子门禁共同决定,不能把“任意 Intel GPU”视为自动兼容。
torchaudio 2.11 的 load/save 已改为依赖 TorchCodec;TorchCodec 在 Windows 上又要求 full-shared FFmpeg DLL。项目不把缺失 DLL 隐藏成运行时回退:所有公开输入先由随包 FFmpeg 显式转换为 WAV,转写器再用固定的 libsndfile PCM 读取器生成 channels-first float32 张量,重采样和模型推理仍由 torchaudio/PyTorch 在已验证的 XPU 设备上执行。
cu118 / CUDA 11 不属于当前一键启动器和完整七模式验收契约;启动器检测到该环境时会停止并提示更新。
AMD/ROCm 尚未完成完整七模式实机验收,当前安装脚本仍会停止并说明兼容性问题。本次将伴奏分离改为 PyTorch FP32,不代表其余模型和完整工作流已获得 AMD 支持。
release.yml 只生成 CUDA 12.8 GPU 便携版,不生成 CPU 版。当前闭集清单包含 31 项第三方组件:26 项 VERIFIED、5 项附维护者具名责任与撤销联系记录的 OWNER_ACCEPTED、0 项 BLOCKED;工作流仍会在每次发布前重新校验清单、模型身份、SBOM、FFmpeg 构建信息和成品自检,任何一项不满足即停止。push / PR 的 build.yml 仅验证源码、测试与打包契约,不生成便携成品。本地源码开发如需 CPU-only PyTorch,应自行承担模型速度和依赖兼容性差异。
pip install -r requirements.txt
python -m pip install --no-deps "audio-separator==0.44.1"
python -m pip install --no-deps --force-reinstall "aria-amt @ https://github.com/EleutherAI/aria-amt/archive/a1ab73fc901d1759ec3bc173c146b3c6a3040261.zip"
python -m pip install --no-deps --force-reinstall "muscriptor @ https://github.com/muscriptor/muscriptor/archive/d73147e75e5b9b0c0a79ebe154587db4fd603e0c.zip"
python -m src.utils.source_runtime
requirements.txt 有意不让 audio-separator 的 NumPy 2 元数据覆盖桌面 NumPy 1.26,也不让 Aria-AMT 的旧 torchaudio 约束覆盖 CUDA 12.8 运行时,因此两项采用固定版本的 --no-deps 独立安装。MuScriptor 同样以 --no-deps 固定源码身份,其 v0.3.0 非 Torch 依赖(包括 FastAPI 0.136.3、Starlette 1.5.0 与 SoundFile 0.14.0)已在项目依赖中显式满足;install.ps1 / install.sh 提供完整伴随依赖。
python download_sota_models.py
当前仓库已经包含受控且经过兼容补丁的 YourMT3/amt/src;可变上游 master 不满足这里的源码身份校验。download_sota_models.py 会准备 Beat This final0、全部五种官方 YourMT3+ checkpoint、固定 MIROS 源码与两组权重、BS-Rofo-SW-Fixed.ckpt、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT 与 ByteDance checkpoint,并严格校验默认 TransKun 2.0.1 包版本和内置 V2 资源;缺失或身份不符会直接失败。
python download_vocal_model.py
python download_multistem_model.py
python download_accompaniment_model.py
python download_transkun_v2_aug_model.py
python download_aria_amt_model.py
python download_bytedance_piano_model.py
python download_miros_model.py
模型默认缓存到:
~/.cache/music_ai_models/yourmt3_all
~/.music-to-midi/models/beat_this
~/.music-to-midi/models/audio-separator
~/.cache/music_ai_models/transkun_v2_aug
~/.cache/music_ai_models/aria_amt
~/.cache/music_ai_models/bytedance_piano
~/.cache/music_ai_models/fluidsynth/2.5.6
~/.cache/music_ai_models/musescore/4.7.4
${HF_HOME:-~/.cache/huggingface}/hub  # MuScriptor 三档与 MuseScore SoundFont
external/ai4m-miros
Windows 中的 ~ 是 %USERPROFILE%。源码虚拟环境固定为仓库内 venv,桌面默认输出为仓库内 MidiOutput\<音频文件名>,日志在 %USERPROFILE%\.music-to-midi\logs。默认 TransKun V2 资源位于 venv 中的 transkun==2.0.1 包内;便携版则只读取发布目录内的 models、runtime 与 tools 资源,不依赖上述源码缓存。
默认 TransKun V2 的模型资源随 transkun==2.0.1 安装;PIANO_TRANSKUN 资源或身份异常对应的修复命令是 python -m pip install --force-reinstall "transkun==2.0.1"。PIANO_TRANSKUN_V2_AUG 使用独立缓存,由 python download_transkun_v2_aug_model.py 准备。
# Windows
.\venv\Scripts\python.exe -m src.main
# Linux / WSL2
./venv/bin/python -m src.main
Colab 入口:
colab_notebook.ipynb
使用步骤:
HF_TOKEN,并在第 3 个代码单元勾选 ENABLE_MUSCRIPTOR;该单元会在启动前验证三档访问权限。Colab 版本会保留预装 PyTorch,避免重装 torch 导致 CUDA 运行库冲突。
Space 入口:
space/app.py
本地启动:
cd space
python app.py
Space 版随部署包携带项目已验证的 YourMT3/amt/src 兼容源码,与桌面版和 Colab 使用同一棵源码树;不会在运行时改用 Hugging Face Space 的可变源码。运行转换时会按所选模式检查/准备 YourMT3+ 官方 checkpoint 或 MIROS、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT 或 ByteDance Pedal 资源;缺失或身份校验失败会显式暴露。
ZeroGPU 入口用于短片段试用。长歌建议使用 Colab、桌面版或专用 GPU。Hugging Face ZeroGPU 文档 当前公开配额为匿名用户每日 2 分钟、登录免费账户每日 5 分钟 GPU。当前保守的最小请求经 large GPU 平台倍率折算后已高于匿名额度,因此转换入口要求登录;Space 会按模式、后端和模型估算,再按固定的 spaces==0.51.1 平台倍率上界折算,超过登录免费账户 300 GPU 秒窗口的请求会在下载模型前明确拒绝。该估算只是准入上限,不代表用户一定仍有足够的当日配额或队列容量;Colab、桌面版或专用 GPU 更适合长歌。
当前公式下的最大输入时长是准入阈值,不是实测耗时承诺。默认 YPTF.MoE+Multi (noPS) 与 MIROS 的精确阈值如下;换用其它 YourMT3 checkpoint 时会按其独立系数重新计算:
| ZeroGPU 路线 | YourMT3 默认 noPS | MIROS |
|---|---|---|
SMART | 2.00 秒 | 1.00 秒 |
VOCAL_SPLIT | 0.53 秒 | 0.27 秒 |
SIX_STEM_SPLIT | 0.22 秒 | 0.11 秒 |
| 任一钢琴专用模式 | 2.50 秒 | 不适用 |
Space 的失败请求会立即删除专属输出目录;成功结果会保留给 Gradio 下载,默认在 24 小时后进入过期清理,并在后续请求删除过期结果或在 Space 实例正常退出时清理。Colab 同样在失败时立即清理,并把成功结果保留到当前运行时结束;Gradio 缓存按 24 小时进入清理。
当前 THIRD_PARTY_NOTICES.md 的 31 项闭集清单为 26 项 VERIFIED、5 项 OWNER_ACCEPTED、0 项 BLOCKED。OWNER_ACCEPTED 表示上游未声明许可时由维护者具名承担再分发决定,并不等同于获得上游授权;Leap Instrumental 已有独立的维护者分发接受记录,官方 release 仍会在构建前严格校验全部组件。
Windows CUDA 完整三包构建(桌面 App、Web 后端、Web 前端):
powershell -ExecutionPolicy Bypass -File .\build_web_executables.ps1
Intel XPU 本地三包的构建环境是已验收的独立 venv-xpu:
powershell -ExecutionPolicy Bypass -File .\build_portable_xpu.ps1
CUDA 输出为 dist\MusicToMidi-App、dist\MusicToMidi-WebBackend、dist\MusicToMidi-WebFrontend;XPU 输出为 dist\MusicToMidi-XPU-App、dist\MusicToMidi-XPU-WebBackend、dist\MusicToMidi-WebFrontend。Web 前端不含推理运行时,因此 CUDA/XPU 共用同一套前端文件;每个输出目录中的 _internal 与该目录对应。
完整模型与运行时会让 XPU 便携目录超过 20 GB。构建盘空间不足时,可把临时目录和成品目录指定到同一块有足够空间的 NTFS 卷;删减模型或留下半成品会使成品校验失败:
powershell -ExecutionPolicy Bypass -File .\build_portable_xpu.ps1 `
  -BuildRoot C:\MusicToMidi-XPU-build `
  -DistRoot C:\MusicToMidi-XPU-dist
XPU wrapper 默认只对同卷的 staged 资源建立 NTFS 硬链接,跨卷资源仍逐文件复制;两种路径都继续执行 staged 与 packaged SHA-256/manifest 校验。硬链接创建失败会终止构建并显示文件错误。有效的 BuildRoot 与 DistRoot 是互不嵌套的普通目录;盘根和项目根会被参数校验拒绝。
自定义 Python 或 FFmpeg 路径:
powershell -ExecutionPolicy Bypass -File .\build_web_executables.ps1 `
  -PythonExe .\venv\Scripts\python.exe `
  -FfmpegDir C:\ffmpeg\bin
打包脚本要求并严格校验以下全部资源;缺少任一项,或大小、SHA256、源码 manifest、运行时包身份不符时,会在 PyInstaller 前立即失败:
YourMT3/amt/src
YourMT3 模型缓存 -> models/yourmt3_all
audio-separator 模型缓存 -> models/audio-separator
transkun==2.0.1 包及其内置默认 V2 资源
TransKun V2 Aug 模型缓存 -> models/transkun_v2_aug
Aria-AMT 模型缓存 -> models/aria_amt
ByteDance Piano 模型缓存 -> models/bytedance_piano
固定版本且已打兼容补丁的 MIROS 源码与两组权重
ffmpeg.exe / ffprobe.exe
便携版资源来源优先级:
MUSIC_TO_MIDI_BUNDLE_YOURMT3_DIR 或 ~/.cache/music_ai_models/yourmt3_all 或 checkpoints/yourmt3_all
MUSIC_TO_MIDI_BUNDLE_AUDIO_SEPARATOR_DIR 或 ~/.music-to-midi/models/audio-separator 或 checkpoints/audio-separator
MUSIC_TO_MIDI_BUNDLE_TRANSKUN_V2_AUG_DIR 或 ~/.cache/music_ai_models/transkun_v2_aug 或 checkpoints/transkun_v2_aug
MUSIC_TO_MIDI_BUNDLE_ARIA_AMT_DIR 或 ~/.cache/music_ai_models/aria_amt 或 checkpoints/aria_amt
MUSIC_TO_MIDI_BUNDLE_BYTEDANCE_PIANO_DIR 或 ~/.cache/music_ai_models/bytedance_piano 或 checkpoints/bytedance_piano
MUSIC_TO_MIDI_BUNDLE_MIROS_DIR 或 external/ai4m-miros / ai4m-miros / .tmp/ai4m-miros
MUSIC_TO_MIDI_BUNDLE_FFMPEG_DIR 或 tools/ffmpeg / ffmpeg
构建结果包含以下三个完整目录:
dist/MusicToMidi-App/
dist/MusicToMidi-WebBackend/
dist/MusicToMidi-WebFrontend/
桌面用户使用完整 App 目录;Web 用户使用完整 WebBackend 与 WebFrontend 目录。单个 EXE 不包含对应角色的全部运行文件。
src/
  core/
    pipeline.py              # 主处理流水线
    yourmt3_transcriber.py   # YourMT3+ 后端
    miros_transcriber.py     # MIROS 本地包装器
    transkun_transcriber.py  # TransKun 默认 V2 钢琴专用后端
    transkun_v2_aug_transcriber.py # TransKun V2 Aug 钢琴专用后端
    aria_amt_transcriber.py  # Aria-AMT 钢琴专用后端
    bytedance_piano_transcriber.py # ByteDance Pedal 钢琴专用后端
    vocal_separator.py       # 人声/伴奏分离
    multi_stem_separator.py  # 六声部分离
    midi_generator.py        # MIDI 生成与后处理
    beat_detector.py         # BPM/节拍检测
  gui/
    main_window.py           # PyQt6 主窗口
    widgets/track_panel.py   # 模式、后端、模型选择
    workers/processing_worker.py
  models/
    data_models.py           # Config、ProcessingResult、NoteEvent 等
    gm_instruments.py        # GM 128 乐器映射
  utils/
    runtime_paths.py         # 运行时资源路径
    yourmt3_downloader.py    # YourMT3+ 模型路径与下载辅助

space/app.py                 # Gradio Web 界面
colab_notebook.ipynb         # Colab 运行入口
download_sota_models.py      # Beat This + 全部公开工作流模型下载 + 默认 TransKun 严格校验
download_vocal_model.py      # Leap XE vocals 模型下载
download_accompaniment_model.py # Leap Instrumental accompaniment 下载入口
download_multistem_model.py  # BS-RoFormer SW Fixed 六声部分离模型下载
download_transkun_v2_aug_model.py # TransKun V2 Aug 下载与校验
download_aria_amt_model.py   # Aria-AMT 模型下载
download_bytedance_piano_model.py # ByteDance Pedal 模型下载
download_vocal_harmony_model.py # Leap Instrumental 历史兼容入口
MusicToMidi.spec             # PyInstaller 配置
以下命令同样在仓库内 venv 激活后执行。
pytest
pytest tests/test_yourmt3_integration.py -v
black src/
isort src/
flake8 src/
mypy src/
pyinstaller MusicToMidi.spec
常用自检:
python -m src.main --self-test
python -c "from src.utils.gpu_utils import print_gpu_diagnosis; print_gpu_diagnosis()"
python -c "from src.core.yourmt3_transcriber import YourMT3Transcriber; print(YourMT3Transcriber.is_available())"
优先检查:
Windows 可重新运行:
powershell -ExecutionPolicy Bypass -File .\install.ps1
Windows 可使用安装脚本自动安装,或手动安装后加入 PATH。Linux:
sudo apt-get update
sudo apt-get install -y ffmpeg
源码目录检查:
YourMT3/amt/src
模型检查:
python -c "from src.utils.yourmt3_downloader import get_model_path; print(get_model_path())"
缺失时:
python download_sota_models.py
如果受控的 YourMT3/amt/src 缺失,恢复来源是当前项目版本中的对应目录;可变上游 master 无法通过三端源码一致性与便携 manifest 校验。
如果下载模型时报 SSL 证书错误,默认会停止下载。受信任 CA 可通过系统/代理配置或以下环境变量提供:
export SSL_CERT_FILE=/path/to/ca.pem
export REQUESTS_CA_BUNDLE=/path/to/ca.pem
只有在你明确接受证书校验风险时,才设置:
export ALLOW_INSECURE_HF_DOWNLOAD=1
Windows PowerShell:
$env:ALLOW_INSECURE_HF_DOWNLOAD = "1"
YourMT3+ 官方路线固定调用 inference_file(bsz=8)。显存不足时处理停止并显示 CUDA 错误,batch 大小固定为 8。
依赖和模型检查:
Windows / Linux NVIDIA CUDA 环境:
python -m pip install --no-deps "audio-separator==0.44.1" "onnxruntime-gpu==1.23.2"
python download_vocal_model.py
python download_accompaniment_model.py
macOS 或明确的 CPU 环境把 onnxruntime-gpu==1.23.2 换成 onnxruntime==1.23.2。
如果当前 NVIDIA GPU、PyTorch/CUDA 或 audio-separator 后端不兼容,流程会直接失败并提示根因;不会自动改用 CPU 分离。需要 CPU 路径时,应由后续 UI/配置提供显式选项并在结果中标注。
该路线依赖 audio-separator==0.44.1 和 BS-RoFormer SW Fixed 资源:
python download_multistem_model.py
如果六声部分离缺少任一 stem,流程会停止并提示缺失项。
默认 TransKun 模式需要 transkun 包和其随包预训练资源:
python -m pip install --force-reinstall "transkun==2.0.1"
TransKun V2 Aug 模式使用独立、固定校验的官方 checkpoint:
python download_transkun_v2_aug_model.py
Aria-AMT 模式需要 aria-amt 包和 checkpoint:
python -m pip install --no-deps --force-reinstall "aria-amt @ https://github.com/EleutherAI/aria-amt/archive/a1ab73fc901d1759ec3bc173c146b3c6a3040261.zip"
python download_aria_amt_model.py
本地仓库位置与文件完整性检查:
ai4m-miros/main.py
ai4m-miros/transcribe.py
若提示缺少 Python 模块,缺失依赖以 MIROS 上游仓库的运行清单为准。
当前版本不会用默认 120 BPM 继续生成 MIDI。若 Beat This final0 模型缺失/身份不符,或检测结果不足、乱序、含 NaN、局部速度不可信,流程会停止并报告具体错误;不会改用 librosa、第二检测器或旧 BPM。
未知的处理模式、转写后端或多乐器模型会直接报错,不会自动改成默认值。有效配置值如下:
processing_mode: smart / vocal_split / six_stem_split / piano_transkun / piano_transkun_v2_aug / piano_aria_amt / piano_bytedance_pedal
transcription_backend: aria_amt / yourmt3 / miros / muscriptor
multi_instrument_model: yourmt3 / miros / muscriptor
旧配置中的 processing_mode=piano 会兼容映射为 smart。
本项目使用 MIT License。第三方模型、数据和上游仓库遵循各自许可证与使用条款;代码改编与完整声明见 THIRD_PARTY_NOTICES.md。
音乐转MIDI转换器 - Convert audio to multi-track MIDI with lyrics embedding
See the code中文 | English
一个本地优先的 AI 音频转 MIDI / Audio to MIDI 转换器,面向编曲、扒谱、采样拆解、钢琴练习和自动音乐转写 (AMT) 实验。你可以把 MP3、WAV、FLAC、OGG 或 M4A 音频丢进来,在 PyQt6 桌面版、Gradio Web 版或 Google Colab 中生成可编辑的 MIDI 文件。
当前版本同步七种处理模式:完整混音多乐器转写、人声/伴奏 WAV 分离、六声部 WAV 分离,以及 TransKun 默认 V2 / TransKun V2 Aug / Aria-AMT / ByteDance Pedal 四条钢琴专用转写流程。两个分离模式会生成 WAV 分轨;分离完成后,每条音轨都可在同一结果工作台选择 13 条 MIDI 路线之一。多乐器 AMT、stem separation、钢琴转 MIDI 和 BPM/tempo 元数据都在这套工作流中处理。
桌面下载 MIDI 或立体声 WAV 失败时会显示原因并记录完整错误,当前转换结果仍可继续使用;修正路径、文件占用或权限问题后可以重试。日志位于 ~/.music-to-midi/logs/;便携版优先使用程序旁的 runtime/logs/。
如果想先试听模型效果或直接在浏览器处理文件,可以使用同一作者维护的 TelkNet。工具介绍、指南和演示可直接浏览;提交网站的服务器处理任务需要登录。
网站提供的模型和参数以对应工具页为准;本仓库的安装、桌面功能与本地模型配置仍按下文说明使用。
CLI 与独立 Web API 共用同一个 InferenceEngine 和核心流水线。最简单的调用只需要输入文件;输出默认放在项目或便携包旁的 MidiOutput/CLI:
# Windows 源码版;先运行一次 install.ps1,转换时检查所选路线的 GPU 与模型
.\cli.ps1 D:\Audio\song.wav

# Windows 便携包
.\MusicToMidiCLI.exe D:\Audio\song.wav

# 多文件或目录批处理(逐个转换)
.\MusicToMidiCLI.exe batch D:\Audio --recursive -o D:\MidiOutput
# Linux / WSL2 源码版
bash cli.sh /data/audio/song.wav

# Linux 便携包
./MusicToMidiCLI batch /data/audio --recursive -o /data/midi
常用示例:
# 指定钢琴模型
MusicToMidiCLI song.wav --mode piano-transkun-v2-aug

# SMART 改用 MuScriptor Medium,并指定输出乐器
MusicToMidiCLI song.wav --backend muscriptor --muscriptor-model medium --instrument acoustic_piano,voice

# 启用量化;省略 --quantize 时保持音符原始时间
MusicToMidiCLI song.wav --quantize 1/32

# 分离只生成 WAV
MusicToMidiCLI mix.flac --mode six-stem-split

# 对选中的单条 stem 转 MIDI;routes 可查看全部 13 条路线
MusicToMidiCLI routes
MusicToMidiCLI track-to-midi vocals.wav --route yourmt3:yptf_moe_multi_nops --tempo-source mix.flac

# 供脚本读取的 JSON Lines 事件流
MusicToMidiCLI batch /data/audio --recursive --json
每个输入使用独立且不覆盖的输出目录,并写入 music-to-midi-job.json;每次批处理另写 batch-run-*.json。默认会用源文件 SHA-256、完整参数和产物 SHA-256 校验已有成功项,全部吻合才跳过;--rerun 强制新建编号目录。出现失败时,默认继续处理其余独立文件但最终返回退出码 1,--fail-fast 可在首个失败后停止,Ctrl+C 返回 130,参数/输入错误返回 2。--dry-run 只列计划,不加载模型也不创建输出。
源码 CLI 启动器直接使用项目隔离环境(Windows NVIDIA 为 venv、Windows Intel 为 venv-xpu、Linux/WSL2 NVIDIA 为 venv),不会复用桌面 GUI 的全模型启动检查。因此 --help、--version、routes 和 --dry-run 可立即执行;转换时会检查所选路线的加速器、模型和产物。缺少隔离环境时会显示安装命令并退出。--json 模式的 stdout 只包含 JSON Lines,诊断与第三方日志写入 stderr。
VOCAL_SPLIT 与 SIX_STEM_SPLIT 先输出 WAV。CLI 不会自动把全部 stem 转成 MIDI;必须由用户对选中的音轨执行 track-to-midi --route ...。完整选项以 MusicToMidiCLI --help、MusicToMidiCLI convert --help 和 MusicToMidiCLI track-to-midi --help 为准。
对 CLI 分离任务生成的 WAV,track-to-midi 默认校验旁边的分离清单、WAV 和原曲 SHA-256,再用原曲检测 BPM;同批来自不同歌曲的 stem 会分别使用各自原曲。原曲丢失、清单损坏或音频被改动时会停止并说明原因;可用 --tempo-source 显式指定新的节拍参考。独立音频没有分离清单时使用自身检测节拍,--dry-run --json 会显示实际选用的参考路径。
递归扫描遇到不可读目录会直接报错。损坏的断点清单会报告并保留,只有通过校验的清单才能跳过转换;汇总文件写入失败会停止运行,并保留已提交的逐项结果。JSON 输出管道被接收端关闭时退出 1,错误写入 stderr。
独立 Web API 与浏览器前端调用同一个 MusicToMidiPipeline,提供与桌面版一致的七种模式。Windows 发布版按用途提供三个目录:
| 包 | 启动文件 | 用途 |
|---|---|---|
MusicToMidi-App | MusicToMidi.exe | 本机桌面 App,不负责提供 Web 服务 |
MusicToMidi-WebBackend | MusicToMidiBackend.exe | GPU 推理、任务队列、结果文件与 API |
MusicToMidi-WebFrontend | MusicToMidiFrontend.exe | 浏览器界面和静态资源,不包含推理模型 |
源码环境只需在仓库根目录运行一条命令:
.\venv\Scripts\python.exe -m src.web
这个入口会自动识别服务电脑的主要局域网 IPv4,依次启动 WebBackend 和 WebFrontend,确认两端就绪后自动打开 Edge 应用窗口。终端会显示其他同一局域网电脑可访问的前端地址;按 Ctrl+C 或关闭 Edge 应用窗口会一并停止前后端。多网卡或 VPN 环境可用 --host 192.168.1.50 明确指定服务电脑的实际局域网 IPv4,完整用法见 web/README.md。
打包版的启动顺序如下:
MusicToMidiBackend.exe。MusicToMidiFrontend.exe。MusicToMidiBackend.json 与 MusicToMidiFrontend.json,再重启两个程序。http://<后端地址>:8765/api/v1/health,API 文档为 http://<后端地址>:8765/docs。其他电脑只需要浏览器,不需要复制桌面 App 或 WebFrontend 包。完整的配置 JSON、防火墙命令、验证方法、停止方式以及前后端分机部署说明见 web/README.md。
浏览器前端通过 multipart 作业接口提交音频,查询 GET /api/v1/jobs/<job-id> 获取终态,并从响应中的 download_url 下载 MIDI 或分轨 WAV。失败响应包含处理错误,且不提供下载文件。
v1.6.0 已为 Issue #9 提供完整 Docker 自托管包,包括无外置模型的后端/网关镜像、digest 固定的 Compose、环境模板、Windows/Linux 管理脚本、镜像清单与 SHA-256。默认入口是 http://127.0.0.1:7860;模型按 .env 中选择的配置下载到持久卷,常驻推理容器离线运行。安装、配置、日志、备份、升级与故障排查见 Docker 自托管指南。
上面的源码/EXE 双端口方案面向受信任局域网,本身不内置认证、授权或 TLS;将 5173 或 8765 映射到互联网会形成无认证服务。公网单一所有者场景可以使用带自动 HTTPS 和 Argon2id Basic Auth 的高级 Compose;该方案不包含多租户、账号系统或逐任务授权。
桌面版、Gradio Web 版和 Google Colab 采用同一套七模式工作流与操作语义。以下截图依次展示主界面、分离结果、逐轨处理和 MuScriptor 渐进式预览。
项目面向需要把人声旋律、钢琴录音、完整混音或分轨 stem 转成可编辑 MIDI 的用户,也可用于在本地 GPU 上验证自动音乐转写模型。
| 范围 | 当前行为 |
|---|---|
| 完整混音 | SMART 读取整首音频,可选 YourMT3+、MIROS 或 MuScriptor Large / Medium / Small,输出含音符、鼓点和 GM 乐器分组的 MIDI。默认 checkpoint 是 YourMT3+ 官方 YPTF.MoE+Multi (noPS)。 |
| 音源分离 | VOCAL_SPLIT 用 Leap XE 90-band 与 Leap Instrumental 生成两条 WAV;SIX_STEM_SPLIT 用 BS-Rofo-SW-Fixed.ckpt 生成 bass / drums / guitar / piano / vocals / other 六条 WAV。分离后,每条 WAV 可独立选择 13 条 MIDI 路线并点击转换。 |
| 钢琴转写 | PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT 和 PIANO_BYTEDANCE_PEDAL 分别调用 TransKun 默认 V2、官方 V2 Aug、Aria-AMT 和 ByteDance 带踏板模型。 |
| MuScriptor 乐器约束 | 默认留空,沿用官方自动识别;导入音频和新建分轨不再按文件名添加条件。仅手动选择曲中已确认的乐器:选择既提供模型条件,也限制其他乐器输出,全选不等于自动识别。输出包含未选乐器时任务会报错。已知条件生成退化与实测边界见 模型研究。 |
| 节拍与速度 | 七种模式和逐轨转写都使用 Beat This final0。拍点清理后以全局最小二乘拟合 BPM,下拍独立决定拍号;证据不足时不写 4/4。默认自动写入检测到的唯一 BPM;也可生成稳定的段落级 tempo map。手动 30–300 BPM 会保留检测 BPM 的音乐 tick 并覆盖工程速度。默认不量化模型事件;只有用户显式执行量化时才吸附到所选网格。 |
| 音符量化 | 默认关闭。桌面、Space、Colab 的结果编辑器提供 1/4、1/8、1/16、1/32、1/64 网格,范围默认“全部轨道”并可切换为“所选音符”;切换范围或网格不会改音符,点击“量化”才同时吸附目标音符的起点和时值。独立 Web/API(含 Docker)固定量化输出 MIDI 的全部轨道,勾选后在 MIDI 写出后严格执行一次,并校验 tempo、拍号、控制器等非音符事件的绝对 tick 未变。 |
| 乐谱导出 | 每个 MIDI 结果(包括分离后逐轨转换结果)都可生成乐谱 ZIP。系统只量化副本,不修改原 MIDI;ZIP 包含量化 MIDI、MusicXML、总谱 PDF、逐乐器分谱 PDF,以及 MuseScore 识别为 4–9 弦乐器时的 Tab PDF。桌面、Space、Colab 使用结果编辑器当前网格,独立 Web/API 固定使用默认 1/32。MuseScore Studio 4 缺失或制谱失败会直接报错。 |
| MIDI 内容 | YourMT3+ 与 MIROS 保留官方 writer 的音符、音色、力度、控制器和弯音消息,只在缺少 set_tempo 时按检测 BPM 保持绝对秒并补写 tempo。MuScriptor 使用官方事件与 writer,并校验所选乐器集合。项目不添加去重、短音符过滤、力度平滑、复音限制或 NoteEvent 重建。 |
| 试听与 DAW | MuScriptor 工作台以 MIDI 合成轨为主时钟,同步 MIDI、原音和乐器分轨,并校正超过 80 ms 的漂移。DAW 导入时需启用 tempo map;MuseScore 3/4 可能重新跟拍未量化演奏并改写乐谱页显示 BPM,但不会改变文件中已经校验的 tempo。 |
| 输入与入口 | 支持 MP3、WAV、FLAC、OGG、M4A;非 WAV 通过 FFmpeg 转为 44.1 kHz PCM WAV。桌面版、Space 与 Colab 提供相同的七种处理模式。 |
| 入口 | 处理模式 | 后端选择 | 适合场景 |
|---|---|---|---|
| PyQt6 桌面版 | SMART、VOCAL_SPLIT、SIX_STEM_SPLIT、PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT、PIANO_BYTEDANCE_PEDAL | SMART 可选 YourMT3+ / MIROS / MuScriptor 三档;分离结果逐轨选择 13 条路线;钢琴模式使用各自固定后端 | 本地长期使用、GPU 推理、批量输出文件、钢琴专用转写 |
| 原生 CLI | 同桌面七种模式 | 单文件、多文件、目录递归批处理;显式 track-to-midi;SHA-256 清单断点续跑与 JSON Lines | Windows/Linux 自动化、本地批量与脚本集成 |
| 独立 Web API | 同桌面七种模式 | multipart 作业、终态轮询和制品下载;推理仍由同一 MusicToMidiPipeline 执行 | 自建 Web 前端、局域网服务或系统集成 |
| Gradio Space | 同桌面七种模式 | 同步提供 MuScriptor 搜索式乐器多选、硬约束和官方式结果工作台 | 浏览器中快速试用或部署 |
| Google Colab | 同桌面七种模式 | 与 Space 同样提供 MuScriptor 乐器约束和结果工作台 | 临时使用 Colab GPU |
本仓库把“处理工作流”和“YourMT3+ 官方 checkpoint 模式”分开维护:
SMART、VOCAL_SPLIT、SIX_STEM_SPLIT、PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT、PIANO_BYTEDANCE_PEDAL 是本项目的七种处理工作流。YMT3+、YPTF+Single (noPS)、YPTF+Multi (PS)、YPTF.MoE+Multi (noPS)、YPTF.MoE+Multi (PS) 是官方 YourMT3 demo 暴露的五种 checkpoint / 架构模式。SMART 可选 YourMT3+、MIROS 或 MuScriptor Large / Medium / Small,两个分离工作流先输出 WAV,再为每条音轨独立提供 13 条 MIDI 路线。当前同步覆盖如下:
| 位置 | 已同步内容 | 说明 |
|---|---|---|
download_sota_models.py | 准备 Beat This final0、全部五种官方 YourMT3+ checkpoint、固定 MIROS 源码与两组权重、BS-Rofo-SW-Fixed.ckpt、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance、MuseScore General SoundFont、FluidSynth 与固定 MuseScore Studio 4.7.4 | 固定来源模型和运行时按已知大小/SHA256 或明确身份校验;任一必需资源失败时立即停止。 |
run.ps1 / run_xpu.ps1 / run.sh | 启动前检查加速器实际执行、Beat This final0、全部官方 YourMT3+ 模式、MuScriptor 三档、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS、SoundFont、FluidSynth 与分离器可用性 | 缺少必需模型或校验失败时显式报错,不把缺失资源或 CPU 回退当作可运行状态。 |
install.ps1 / install_xpu.ps1 / install.sh | 安装隔离的 NVIDIA PyTorch 2.7 或 Intel XPU PyTorch 2.11、NumPy 1.26、audio-separator 0.44.1 运行依赖,并下载必需模型 | NVIDIA 使用 venv + CUDA 12.8;Windows Intel 使用 venv-xpu + 原生 PyTorch XPU + OpenVINO GPU。两套互斥运行时不混装;audio-separator 使用 --no-deps。 |
.github/workflows/build.yml | push / PR 只运行 Linux、Windows 源码检查、测试和打包契约验证 | 不生成便携包,也不使用空目录或假模型绕过强制 bundle 校验。 |
.github/workflows/release.yml | 完整便携发布构建链;下载并严格校验全部官方 YourMT3+ 模式、MuScriptor Small / Medium / Large、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS 与 MuseScore Studio | 发布条件是 31 项第三方组件全部达到 VERIFIED 或附具名责任记录的 OWNER_ACCEPTED;条件不满足时构建立刻停止。目标 GPU 运行时为 PyTorch 2.7 + CUDA 12.8。 |
colab_notebook.ipynb | 保留 Colab 预装 Torch,安装 pinned Web/runtime 依赖,并同步七种模式 | SMART 与逐轨工作台的完整路线均与桌面版同步。 |
| 模式 | 处理流程 | 主要输出 | 说明 |
|---|---|---|---|
SMART | 音频 -> 所选 YourMT3+ / MIROS / MuScriptor Large、Medium 或 Small -> MIDI | <歌曲名>.mid | 不做音源分离;MuScriptor 非空乐器选择会成为解码约束。 |
VOCAL_SPLIT | 音频 -> Leap XE 90-band vocals + Leap Instrumental accompaniment -> 两条 WAV -> 逐轨转 MIDI | <歌曲名>_vocals.wav、<歌曲名>_accompaniment.wav;按需生成逐轨 MIDI | 分离阶段不自动转 MIDI;每条 WAV 可独立选择五个 YourMT3+ checkpoint、MIROS、三档 MuScriptor 或四个钢琴后端,共 13 条路线。 |
SIX_STEM_SPLIT | 音频 -> BS-Rofo-SW-Fixed.ckpt -> 六条 WAV -> 逐轨转 MIDI | <歌曲名>_<stem>.wav;按需生成逐轨 MIDI | 每条 WAV 的转写路线和是否转换均由用户明确选择。 |
PIANO_TRANSKUN | 音频 -> TransKun 默认 V2 模型 -> MIDI | <歌曲名>_piano_transkun.mid | 适合纯钢琴音频;使用 PyPI 包随附 checkpoint。 |
PIANO_TRANSKUN_V2_AUG | 音频 -> 官方 TransKun V2 Aug checkpoint -> MIDI | <歌曲名>_piano_transkun_v2_aug.mid | 独立模式,使用单独下载并校验的 V2 Aug 资源。 |
PIANO_ARIA_AMT | 音频 -> Aria-AMT 钢琴模型 -> MIDI | <歌曲名>_piano_aria.mid | 适合纯钢琴音频;需要 Aria-AMT checkpoint 已随包或在模型目录可用。 |
PIANO_BYTEDANCE_PEDAL | 音频 -> ByteDance 带踏板钢琴模型 -> MIDI | <歌曲名>_piano_bytedance_pedal.mid | 适合纯钢琴音频;会保留延音踏板 CC64;需要 ByteDance Piano checkpoint 已随包或在模型目录可用。 |
桌面版默认输出到:
MidiOutput/<音频文件名>/
如果同名目录已存在,会自动使用 <音频文件名>_2、<音频文件名>_3 等后缀。
常见输出:
song.mid
song_accompaniment.mid
song_vocal.mid
song_vocal_accompaniment_merged.mid
song_bass.mid
song_drums.mid
song_guitar.mid
song_piano.mid
song_vocals.mid
song_other.mid
song_all_stems_merged.mid
song_piano_transkun.mid
song_piano_transkun_v2_aug.mid
song_piano_aria.mid
song_piano_bytedance_pedal.mid
song_accompaniment.wav
song_bass.wav
song_drums.wav
song_guitar.wav
song_piano.wav
song_vocals.wav
song_other.wav
实际文件数量取决于所选模式和用户主动执行的逐轨转换。人声分离主流程产生规范的 <歌曲名>_vocals.wav 与 <歌曲名>_accompaniment.wav;六声部流程的成功结果包含六条 WAV。任一分离输出缺失时流程会报告失败;MIDI 按用户开始转换的音轨单独生成。乐谱不会在转写时自动阻塞生成;用户对任一 MIDI 点击“生成并下载乐谱”后,才创建与该 MIDI 对应的 ZIP。
YourMT3+ 是默认多乐器后端。download_sota_models.py 准备完整公开工作流资源:Beat This final0、全部五种官方 YourMT3+ checkpoint、固定 MIROS 源码与两组权重、BS-Rofo-SW-Fixed.ckpt、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT 和 ByteDance,并严格验证默认 TransKun 2.0.1 包及其内置 V2 资源;YourMT3 推理通过 src/core/yourmt3_transcriber.py 调用仓库内受控的 YourMT3/amt/src 源码。
源码运行依赖以下文件:
YourMT3/amt/src/model/ymt3.py
YourMT3/amt/src/utils/task_manager.py
YourMT3/amt/src/config/config.py
完整项目 checkout 已包含经过兼容补丁并由固定 manifest 校验的 YourMT3/amt/src。该目录缺失时,受支持的恢复来源是当前项目版本中的受控源码;可变的上游 master 只适合独立实验,不满足本项目三端源码一致性和便携构建身份契约。
模型权重下载:
以下源码维护命令以仓库内 venv 为运行环境;未激活时,Windows 的完整解释器路径是 .\venv\Scripts\python.exe / .\venv\Scripts\hf.exe,Linux/WSL2 为 ./venv/bin/python / ./venv/bin/hf。全局 Python 不属于受支持的源码运行环境。
python download_sota_models.py
默认搜索模型位置包括:
~/.cache/music_ai_models/yourmt3_all
runtime/models/yourmt3_all          # 便携版
models/yourmt3_all                  # 打包资源
运行日志现记录官方 MIDI writer 实际采用的 onset 校正、小节偏移及两者合成的净时间偏移;写出前保持“待计算”,不再误报为禁用校正或零偏移。此修复不改变 MIDI 字节,不增加模型推理或音符分析次数。后台实测与发布前检查见时间轴核验。
项目严格固定上游官方 v0.3.0 提交 d73147e75e5b9b0c0a79ebe154587db4fd603e0c,
并对七个运行时源码文件执行 SHA-256 身份校验,不叠加未合并分支。全项目唯一的
Beat This final0 分析会把完整拍点、BPM、可靠拍号和首个强拍直接传给 v0.3.0 BeatGrid:官方 onset
相位估计在满足样本数与集中度阈值时校正系统性起音偏移,不满足阈值时明确记录 0 校正;项目不再启动第二套节拍检测,也不接受占位
120 BPM。写出的 MIDI 包含真实 tempo、拍号、小节相位和可验证的前置偏移标记;tempo 归一化后还会严格复制到每个含音符轨,
兼容 MuseScore 的 conductor-track 行为。桌面、Space 和 Colab 的 MuScriptor 钢琴卷帘使用同一 Beat This 网格显示拍线、强拍线和交替小节底色。
该偏移标记在手动 BPM 变速时按相同比例变化,最终试听的原音也补入同等静音,因此 MIDI、钢琴卷帘、原音和下载文件使用同一时间轴,
不量化、不过滤、不重跑模型。三档 gated 权重分别固定为
MuScriptor/muscriptor-large revision 8809fdfbed2affa7ade94a7059e746e3880720e7、
MuScriptor/muscriptor-medium revision f32236969308476e01fd3aae67357de5feb05a2d 和
MuScriptor/muscriptor-small revision 8c127f603b807520fa465c838e9bfee8a91ada4e。三者均为 CC BY-NC 4.0,并附额外合法使用条件。
三个仓库的有效授权条件是:同一个 Hugging Face 账户已在浏览器中逐项接受条款,随后由该账户登录 CLI。hf auth login 本身不能替用户接受网页条款,源码安装、Colab 和自行部署 Space 也不能匿名全自动下载这些权重:
hf auth login
python download_muscriptor_model.py --size all
三档由用户选择;所选模型无法运行时,任务会显示错误。Large 质量优先,Medium 是速度/质量折中,Small 参数量最少;三档均严格使用官方 5 秒窗口、prelude forcing 和单次生成路径,所选模型不变。桌面端的运行条件包含所选 checkpoint;Space 与 Colab 会按当前选择准备对应固定 revision。
Windows 结果工作台还需要固定 FluidSynth 2.5.6;安装脚本会准备,也可单独运行:
python download_fluidsynth_runtime.py
python download_musescore_runtime.py
界面和官方公开演示保持同一功能语义:可搜索的标签多选与清除、空选自动检测、
实时转写进度/音符、以 MIDI 为主时钟的可拖动播放进度条、钢琴卷帘、默认全部轨道的量化范围与五档显式量化网格、播放/暂停、跟随播放头、原音↔MIDI 混合、Stereo、
逐乐器静音/多选独奏,以及 MIDI、乐谱 ZIP、合成 WAV、原音左声道/MIDI 右声道立体声下载。
新结果默认全部声部可见、可听;独奏可同时选中多个声部,取消独奏后保留各声部原来的静音设置。
MIDI 下载提供全部声部合并、当前可听声部合并、全部声部分别打包 ZIP 三个选项,均使用当前编辑结果和工程 BPM;ZIP 不受静音/独奏影响。
在编辑器内按空格播放/暂停,Shift+空格或“停止并回到开头”重置播放位置;输入文字或数值时不拦截空格。
桌面钢琴卷帘使用与 TelkNet 默认工具一致的 ChordMini BTC,从原始音频识别和弦。和弦与小节网格共用时间轴,支持点击单独试听,播放跟随、缩放和滚动均随卷帘逐帧同步,并同步 MuScriptor 的开头小节偏移。更改工程 BPM 后仍与音符、小节对齐;编辑 MIDI 不改写原音和弦。首次运行前执行 python download_chordmini_model.py(完整准备命令也包含它),便携包内置固定源码和权重。
和弦按根音配色,当前片段随播放头高亮;短片段使用完整标签和引线,密集标签自动错行,保留真实起止时间。桌面、Space 和 Colab 的 MIDI 音符也支持当前位置高亮及悬停反馈,可查看音高、声部、力度和起止时间;静音声部不显示播放高亮,编辑选区保持独立。
桌面和弦栏旁提供“和弦随曲播放”和独立的 0~200% 音量。首次使用默认关闭随播、音量 100%;关闭随播仍可点击和弦单独试听,0% 则使两种试听都静音。开关与音量会记住上次设置。和弦与歌曲共用音频时钟,支持暂停、跳转、工程 BPM 和倍速;按识别的原始区间发声,不因小节分块重复敲响,N/X 区间保持静音。音量经过响度校准、平滑调节和峰值保护,仅用于试听,不写入 MIDI 或音频导出。便携 App 和可执行 App 共用此实现;Space/Colab 与独立 Web/API、Docker、便携 Web 目前不提供和弦栏。
独立 Web/API、Docker 和便携 Web 的 MIDI 结果提供逐声部 MIDI ZIP 下载。详细交互、导出保留项与交付面范围见结果编辑器说明。
试听音频的来源:逐乐器播放来自最终 MIDI 经官方 MuseScore General
SoundFont 与 FluidSynth 合成,不是无效按钮或 UI 模拟。
MuScriptor 是 Kyutai、Mirelo AI 与 IRCAM 研究人员在 2026 年 7 月公开的完整混音多乐器 AMT 模型。Large 使用 decoder-only Transformer(48 层、隐藏维度 1536;官方模型卡写约 1.3B 参数,代码 README 四舍五入为 1.4B),以 5 秒、16 kHz 单声道音频分片生成 MT3 风格音符事件。训练链路包含约 145 万 MIDI 的合成预训练、17 万首/约 11,000 小时真实音乐微调和 300 首高质量转写的强化学习后训练。
官方模型卡在作者保留的 372 首真实多乐器 D_Test 上报告如下结果(完整训练链路,CFG=2):
| 模型 | Onset F1 | Frame F1 | Offset F1 | Drums F1 | Multi F1 |
|---|---|---|---|---|---|
YourMT3+ YPTF.MoE+Multi (noPS) | 32.5 | 45.5 | 17.8 | 41.4 | 21.9 |
| MuScriptor Large | 60.4 | 72.4 | 48.6 | 49.6 | 47.8 |
这些分数表明 MuScriptor Large 是很强的公开完整混音候选,但不是“所有 benchmark 的无条件 SOTA”:D_Test 是作者自建留出集,尚无公共下载入口;在论文列出的 8 个公共跨域数据集上,MuScriptor 的 Multi F1 高于 YourMT3+ 其中 6 个、低于其中 2 个。它也不输出 velocity,只提供 36 组乐器分类,并受 CC BY-NC 4.0 非商用许可约束。
发布时间也应分开理解:Hugging Face API 记录模型仓库创建于 2026-06-30;论文与 Mirelo 官方文章发表于 2026-07-09;当前公开权重 revision 更新于 2026-07-10,而本项目固定的官方 MuScriptor v0.3.0 源码发布于 2026-08-05。仓库与源码发布日期不等于权重被重新训练;三个公开模型 revision 仍按各自 SHA 精确固定。
完整训练消融、8 个公共数据集逐项分数、模型规模对比、乐器条件收益、Mirelo Studio 私有增强版边界与后续模型观察清单见 MuScriptor 模型研究、分数与项目定位。
MIROS 是桌面版、Space 与 Colab 中 SMART、VOCAL_SPLIT、SIX_STEM_SPLIT 三个模式的可选固定版本多乐器后端,对齐项目锁定的 MusicFM / AI4Musician Challenge SOTA 路线。运行资产包括经过身份校验的本地上游仓库与权重;包装器调用固定入口生成临时 MIDI,再转换为项目统一音符结构。
支持路径:
ai4m-miros/
external/ai4m-miros/
MIROS/
external/MIROS/
包装器会检查:
main.py
transcribe.py
model/musicfm/data/pretrained_msd.pt
logs/Multi_longer_seq_length_frozen_enc_silu/le2bzt53/checkpoints/last.ckpt
MIROS 还需要其上游运行依赖。requirements.txt 保证本项目运行,不保证完整安装 MIROS 上游环境。
下载脚本会检出 amt-os/ai4m-miros 的固定源码 commit 并应用受控兼容补丁;pretrained_msd.pt 使用官方 Hugging Face minzwon/MusicFM 权重,last.ckpt 按上游 main.py 中的 Google Drive 官方文件 ID 获取。GitHub Actions 发布打包不依赖实时 Google Drive 配额,而是从本仓库既有 v1.0.16 Linux 便携包中流式提取已打包验证过的 external/ai4m-miros 目录;若便携包资产缺失、提取失败或 checkpoint 容器不完整,发布流程会停止并显示失败原因。
TransKun 默认路线是钢琴专用转写后端,适合纯钢琴或以钢琴为主的音频。项目通过 src/core/transkun_transcriber.py 调用 transkun PyPI 包随附的 V2 预训练资源:
python -m pip install "transkun==2.0.1"
可用性检查会确认 transkun.transcribe、pretrained/2.0.pt 和 pretrained/2.0.conf 是否存在。资源缺失对应的修复命令如下:
python -m pip install --force-reinstall "transkun==2.0.1"
PIANO_TRANSKUN_V2_AUG 是与默认路线并列的独立模式,使用上游官方 checkpointTransformerAug.zip 中的 checkpointMSimplerAug/checkpoint.pt 与 model.conf。Aug 表示训练时使用数据增强;它不会在默认 TransKun 失败时自动接管,反之亦然。
下载与校验命令:
python download_transkun_v2_aug_model.py
默认搜索模型位置包括:
~/.cache/music_ai_models/transkun_v2_aug/checkpointMSimplerAug
models/transkun_v2_aug/checkpointMSimplerAug     # 打包资源
Aria 音频预处理遵循官方长短音频分支:短音频先合并声道再用 torchaudio 重采样;长音频使用已有 FFmpeg 按原声道重采样为 float32,再合并声道。跨窗口拼接沿用官方恢复流程:非法序列由下一个既有重叠窗口重新生成;连续失败或结尾失败留下未恢复区间时停止输出,并报告具体秒数。模型、权重、精度、解码及 MIDI writer 保持官方实现,不修改 token,也不增加推理重试。MIDI 依赖固定为官方 ariautils 提交 7c815755c6889a784b6a1b3343e9e8daa3e7d128,包含上游同起点与零时值音符修正,运行时同时校验安装来源。稀疏钢琴 BPM 估计汇总短乐句的真实拍间隔,长空白不计入证据。复现对照、性能测量及跨平台验收边界见钢琴转写故障分析。
Aria-AMT 是另一条钢琴专用后端。项目通过 src/core/aria_amt_transcriber.py 统一调用官方单文件推理和 MIDI writer;Linux 源码版由 src.core.aria_amt_worker 独立进程执行,模型错误会直接返回项目队列,不再嵌套上游批处理进程。Docker 和便携包会提前准备官方 AudioTransform 读取的三个目录,支持运行时安装目录只读。默认 checkpoint 为:
piano-medium-double-1.0.safetensors
依赖安装命令:
python -m pip install --no-deps --force-reinstall "aria-amt @ https://github.com/EleutherAI/aria-amt/archive/a1ab73fc901d1759ec3bc173c146b3c6a3040261.zip"
模型下载命令:
python download_aria_amt_model.py
默认搜索模型位置包括:
~/.cache/music_ai_models/aria_amt
models/aria_amt                  # 打包资源
ByteDance Pedal 是钢琴专用的带踏板转写后端,适合独奏钢琴或清晰的钢琴 stem。它来自 ByteDance 的 High-Resolution Piano Transcription with Pedals 系统,本项目通过 piano-transcription-inference 包装,并保留上游 MIDI 中的延音踏板 CC64。
依赖安装命令:
python -m pip install "piano-transcription-inference==0.0.6" "torchlibrosa>=0.1.0,<0.2" "matplotlib>=3.7.0,<4"
模型下载命令:
python download_bytedance_piano_model.py
默认搜索模型位置包括:
~/.cache/music_ai_models/bytedance_piano
models/bytedance_piano           # 打包资源
四个钢琴后端都是“钢琴专精模型”,不参与完整混音的多乐器识别。选择时可以按目标来分:
| 目标 | 推荐模式 | 说明 |
|---|---|---|
| 使用项目默认 TransKun 路线 | PIANO_TRANSKUN | 使用 PyPI 包随附 V2 资源,依赖和 checkpoint 边界清楚。 |
| 对比官方数据增强 checkpoint | PIANO_TRANSKUN_V2_AUG | 使用独立下载并固定校验的 V2 Aug 资源。 |
| 使用另一种现代钢琴 AMT 后端 | PIANO_ARIA_AMT | 适合作为纯钢琴 A/B 候选。 |
| 需要踏板 CC64,尤其是古典、抒情、连奏明显的钢琴音频 | PIANO_BYTEDANCE_PEDAL | 保留 sustain pedal 控制事件;上游主仓库已归档,建议在目标环境做一次实际音频验证。 |
这四者的结果不能和 YourMT3+ / MIROS 的多乐器结果直接横比:钢琴后端只解决 88 键钢琴及其演奏细节,多乐器后端负责完整混音中的乐器识别和 GM 多乐器 MIDI 输出。
本节恢复自历史 README 中的模型对比内容,并按当前版本的实际能力重新标注:当前入口同步开放 SMART、VOCAL_SPLIT、SIX_STEM_SPLIT、PIANO_TRANSKUN、PIANO_TRANSKUN_V2_AUG、PIANO_ARIA_AMT 与 PIANO_BYTEDANCE_PEDAL 七种模式。下列表格把“公开 benchmark”和“项目内入口状态”分开写,避免把研究指标误写成产品能力。
| 后端/模型 | 类型 | 项目入口 | 公开质量口径 | 选择说明 |
|---|---|---|---|---|
| YourMT3+ | 多乐器 AMT | SMART 可直接使用;分离结果可逐轨选择五个官方 checkpoint,转换时保留官方 writer 音符并只补必要 tempo 元数据 | 官方 Space 默认 noPS 结果文件:Slakh multi_f = 0.7398;YourMT3+ 论文表:Slakh2100 Multi F1 = 74.84,同表 MT3 = 62.0 | 默认多乐器后端;工程默认 checkpoint 为 YPTF.MoE+Multi (noPS)。 |
| MuScriptor Large | 多乐器 AMT | SMART 可选;分离后的 WAV 可逐轨选择,并使用真实乐器硬约束与官方 writer | 作者 D_Test:Onset / Frame / Offset / Drums / Multi F1 = 60.4 / 72.4 / 48.6 / 49.6 / 47.8;同表 YourMT3+ Multi F1 = 21.9 | 强公开完整混音候选;分数来自作者自建协议,不能直接与 Slakh 榜单混排;权重仅限非商用。 |
| MIROS | 多乐器 AMT | SMART 可选;分离后的 WAV 可逐轨选择 | 2025 AMT Challenge:F1 0.5998,同表 YourMT3-YPTF-MoE-M 0.5938、MT3 0.3932 | 固定 MusicFM 后端;挑战使用 76 个受约束合成短片段,不与 MuScriptor D_Test 或 Slakh 分数横比。 |
| TransKun 默认 V2 | 钢琴专精 | PIANO_TRANSKUN | TransKun V2 / pip checkpoint 在 MAESTRO V3 上有公开 F1 | 默认 TransKun 路线,随包权重边界清楚。 |
| TransKun V2 Aug | 钢琴专精 | PIANO_TRANSKUN_V2_AUG | 上游官方数据增强 checkpoint;不将不同 checkpoint 的指标混写 | 独立下载、固定大小与 SHA256 校验,不是默认 V2 的 fallback。 |
| Aria-AMT | 钢琴专精 | PIANO_ARIA_AMT | 公开 checkpoint;README 不写入未发布的同口径统一 F1 | 适合常规纯钢琴 A/B。 |
| ByteDance Pedal | 钢琴专精 / 踏板感知 | PIANO_BYTEDANCE_PEDAL | MAESTRO note onset F1 / 踏板 onset F1 = 96.72% / 91.86% | 需要踏板 CC64 时优先选择。 |
| Leap XE + Leap Instrumental | 人声/伴奏分离 | VOCAL_SPLIT 前置分离 | 两个公开模型使用不同目标/口径,不合成单一 benchmark | Leap XE 提取 vocals,Leap Instrumental 提取 accompaniment;后续 MIDI 质量还取决于转写后端。 |
| BS-RoFormer SW Fixed | 六声部分离 | SIX_STEM_SPLIT 前置分离 | MVSEP 6-stem SDR 口径 | 生成六条 WAV,每条 stem 都可单独选择 MIDI 路线。分离指标不是端到端 MIDI F1。 |
YourMT3+ / MuScriptor / MIROS 属于多乐器后端,TransKun / Aria-AMT / ByteDance Pedal 属于钢琴专精后端,Leap XE / Leap Instrumental / BS-RoFormer SW Fixed 属于音源分离后端;三类模型的公开指标不能混成同一张排行榜。
本项目默认使用 YPTF.MoE+Multi (noPS)。官方 Hugging Face Space 的 app.py 默认 model_name 就是 YPTF.MoE+Multi (noPS);YPTF.MoE+Multi (PS) 仍保留为可选 pitch-shift checkpoint。
| 项目 | 详情 |
|---|---|
| 模型全称 | YPTF.MoE+Multi (noPS) |
| 检查点 | mc13_256_g4_all_v7_mt3f_sqr_rms_moe_wf4_n8k2_silu_rope_rp_b36_nops,官方 Space 指向 last.ckpt |
| 来源 | 官方 Hugging Face Space / Space noPS 评测结果 / arXiv:2407.04822 |
| 架构 | Perceiver Transformer 编码器 + Multi-T5 解码器 |
| MoE | 8 专家,Top-2 路由,SiLU 激活 |
| 位置编码 | RoPE(部分旋转位置编码) |
| 归一化 | RMSNorm |
| 训练增强 | 不使用 Pitch Shift 音高偏移增强(noPS) |
| 模型大小 | noPS 官方 last.ckpt 本地解析约 535.5 MiB;PS 本地 model.ckpt 约 723.8 MiB |
| 任务类型 | mt3_full_plus(128 种 GM 乐器 + 鼓) |
下表分别列出默认 noPS checkpoint 的 Space 评测结果和论文最终模型的成绩,两者对应的模型配置不同。
| 指标 | 当前默认 noPS | YourMT3+ 论文 YPTF.MoE+Multi | MT3 (Google 基线) | 来源口径 |
|---|---|---|---|---|
Multi (Onset-Offset) F1 / multi_f | 0.7398 / 73.98% | 74.84 | 62.0 | Space noPS 结果文件 / YourMT3+ 论文 Slakh2100 对比表 |
官方 Hugging Face / Colab demo 的模型选择项是 checkpoint / 架构选择,不是本项目的处理工作流。当前项目中的 YourMT3+ 选择器与官方列表对齐;区别是本项目会把该模型嵌入 SMART、VOCAL_SPLIT 和 SIX_STEM_SPLIT 等工作流中,并统一输出 GM 多乐器 MIDI。
| 模型 | MoE | Pitch Shift | 说明 |
|---|---|---|---|
| YMT3+ | 无 | 无 | 官方 Colab 模型族中的基线 YourMT3+ checkpoint |
| YPTF+Single (noPS) | 无 | 无 | Perceiver-TF + 单解码器 checkpoint |
| YPTF+Multi (PS) | 无 | 有 | Perceiver-TF + multi-t5 多通道解码 |
| YPTF.MoE+Multi (noPS) | 8 专家 | 无 | 本项目默认模型;官方 Hugging Face Space 默认模型;Space 结果文件中 Slakh multi_f = 0.7398 |
| YPTF.MoE+Multi (PS) | 8 专家 | 有 | 可选 pitch-shift MoE checkpoint;YourMT3+ 论文表中最终模型 Slakh Multi F1 = 74.84;本地 PS checkpoint 约 723.8 MiB |
| YourMT3+ 传统版 | 无 | 无 | 旧配置兼容项,不在界面默认显示 |
与官方 demo 的主要对齐点:
YPTF.MoE+Multi (noPS) 对齐官方 Hugging Face Space 默认展示模型。update_config 生成 tokenizer/model/audio 配置。ff_layer_type 元数据时,本项目按标准 T5 前馈层 t5_gmlp 处理。与官方 demo 的差异也需要明确:
inference_file(bsz=8),batch 大小固定为 8。| 后端 | 类型 | 集成方式 | 当前语义 | 说明 |
|---|---|---|---|---|
| MIROS (MusicFM) | 多乐器 | 本地 ai4m-miros 仓库 + 当前工程包装器 | 固定 checkpoint 质量 | 官方仓库标注为 Music Transcription Challenge winning model,可作为 SMART、VOCAL_SPLIT 与 SIX_STEM_SPLIT 的多乐器后端 |
处理语义:
MIROS 当前为固定 checkpoint 推理,可用于与 YourMT3+ 做同任务 A/B。VOCAL_SPLIT 使用两个分离模型:BS-RoFormer Leap XE 90-band 对原混音生成 vocals,标准 BS-RoFormer Leap Instrumental 62-band 也对原混音独立生成 accompaniment。两路规范 WAV 进入音轨工作台后,可分别选择五个 YourMT3+ checkpoint、MIROS、MuScriptor Large / Medium / Small 或四个钢琴后端,共 13 条路线。
YourMT3+ 和 MIROS 保留官方 writer 的音符输出,并补充速度信息。两个分离模式先输出 WAV;在音轨工作台选择模型并开始转换后,才生成对应 MIDI。
| 项目 | 详情 |
|---|---|
| vocals 模型 | BS-RoFormer Leap XE:Xe/bs_leap_xe_voc.ckpt + Xe/leap_xe_config_voc.yaml |
| accompaniment 模型 | BS-RoFormer Leap Instrumental:bs_roformer_leap_inst.ckpt + 原始 bs_leap_inst_conf.yaml,大小与 SHA-256 严格校验 |
| 运行库 | 两路均使用 PyTorch 与 audio-separator;Leap Instrumental 使用该库原生 FP32 demix |
| 调用方式 | 两个模型各自对原音频推理;Leap XE 输出 vocals,Leap Instrumental 直接预测 other 作为 accompaniment |
| 模型准备 | download_sota_models.py 会准备并校验两组资源;也可分别运行 download_vocal_model.py 与 download_accompaniment_model.py |
| 兼容入口 | 历史文件 download_vocal_harmony_model.py 仍转发 Leap Instrumental accompaniment 下载;它不再表示 karaoke/和声链路 |
| 打包行为 | release 工作流会把 ~/.music-to-midi/models/audio-separator/ 打进便携包;运行时缺模型或校验失败会明确报错 |
| 输出选项 | 分离阶段输出 <歌曲名>_vocals.wav 与 <歌曲名>_accompaniment.wav;逐轨 MIDI 仅在用户勾选路线并点击转换后生成,不自动合并 |
两个分离模型各自对原混音推理。任一模型失败时,分离任务会停止并显示原因。
表中“未写入数值”表示所列来源未提供与该 checkpoint 对应的明确评测分数。
| 模型/方向 | 来源 | 类型 | 状态 | 说明 |
|---|---|---|---|---|
| Leap XE vocals + Leap Instrumental accompaniment(当前) | 固定模型与配置 | 本地 PyTorch 双模型 | 使用中 | 两路独立读取原混音,分别交付 vocals 与 accompaniment。受控人工混音的伴奏 SI-SDR 已复现为 19.34015 dB;不是原曲真值或所有歌曲的质量保证。 |
| BS-RoFormer ep317(公开可下载) | ZFTurbo 预训练列表 | 本地直替(audio-separator) | 可替换(权衡) | model_bs_roformer_ep_317_sdr_12.9755.ckpt 公开可下载;ZFTurbo 表按 Multisong 写明 SDR vocals = 10.87。文件名中的 12.9755 是训练标签,不等同于表中 vocals SDR。 |
| MelBand-RoFormer (KimberleyJensen) | ZFTurbo 预训练列表 / Hugging Face | 本地可用(vocals/other) | 可用(偏人声) | 公开权重 MelBandRoformer.ckpt 可核;ZFTurbo 表按 Multisong 写明 SDR vocals = 10.98。 |
| SCNet XL IHF(开源权重) | ZFTurbo 预训练列表 / ZFTurbo Release v1.0.15 | 开源可下载(4-stem) | 需改造接入 | 公开权重是 4-stem 模型,不是本项目现有 2-stem 直替;ZFTurbo 表写明 MUSDB test avg 10.08、Multisong avg 9.92。 |
| MVSEP Ensemble / BS Roformer 服务模型 | MVSEP News / MVSEP Full API | API 调用(权重未公开) | 非本地直替 | 榜单服务可用,但公开下载清单未见对应 checkpoint;不作为本地可复现模型写入具体数值。 |
| Mel-RoFormer (ISMIR 2024) | arXiv:2409.04702 / ar5iv 表2 | 论文阶段(研究模型) | 论文已发表 | MUSDB18-HQ(论文表2,场景 b,含额外数据)仅报告 Vocals SDR;这是论文特定协议,不与 Multisong / MVSEP 数字混排。 |
| Mamba2 Meets Silence (v2, 2025) | arXiv:2508.14556 | 论文阶段(研究模型) | 论文 | 摘要报告 cSDR 11.03 dB(作者称 best reported),强调稀疏人声段鲁棒性 |
| Windowed Sink Attention (2025) | arXiv:2510.25745 | 论文阶段(效率优化方向) | 论文 + 开源代码 | 在微调设定下恢复原模型约 92% SDR,同时 FLOPs 降低约 44.5x(偏效率收益) |
结论(按口径):
不同榜单、数据集和评测协议(Multisong、MUSDB、MVSEP、cSDR/uSDR)的分数不可直接横比。
桌面版、Space 和 Colab 提供以下分离与钢琴转写流程。公开数据通常只覆盖“分离”或“钢琴 AMT”单项任务,不等于本项目端到端音频转 MIDI 的统一评分。
| 流程 | 当前仓库状态 | 上游模型/实现 | 可核验公开数据 | 与当前 SMART / VOCAL_SPLIT 的关系 |
|---|---|---|---|---|
| 六声部分离 + 逐轨转写 | six_stem_split 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | BS-Rofo-SW-Fixed.ckpt(vocals, bass, drums, guitar, piano, other)+ 每条 WAV 独立选择 13 条转写路线 | MVSEP Algorithms #77 给出 6-stem SDR:vocals 11.30 / instrum 17.50 / bass 14.62 / drums 14.11 / guitar 9.05 / piano 7.83 / other 8.71 | 这些是音源分离 SDR,不是最终 MIDI 转写 F1;逐轨 AMT 的端到端质量没有公开统一 benchmark。 |
| 钢琴专用转写(TransKun 默认 V2) | piano_transkun 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | transkun==2.0.1,使用该 wheel 随附并严格校验的资源 | 官方 model cards:TransKun V2 在 MAESTRO V3 上 Note Onset / Onset+Offset / Onset+Offset+Velocity F1 为 0.9832 / 0.9349 / 0.9296;pip 随包 No Ext checkpoint 为 0.9833 / 0.8149 / 0.8109 | 这是钢琴专精协议,适合纯钢琴;不能与 YourMT3+ 的 Slakh2100 多乐器 F1 直接横比。 |
| 钢琴专用转写(TransKun V2 Aug) | piano_transkun_v2_aug 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | 官方 checkpointTransformerAug.zip,固定校验后加载 checkpointMSimplerAug/checkpoint.pt + model.conf | Aug 表示数据增强 checkpoint;其他 V2 checkpoint 的指标不适用于它 | 与默认 V2 并列,供同一音频显式 A/B,不是失败回退。 |
| 钢琴专用转写(Aria-AMT) | piano_aria_amt 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | EleutherAI aria-amt,公开 preliminary piano v1 checkpoint piano-medium-double-1.0.safetensors | 官方 README 提供安装、checkpoint 下载和 CLI 用法;未给出与 TransKun 同口径的 MAESTRO/MAPS benchmark。本地打包资源中的 checkpoint 约 425.9 MiB。 | 可与其他钢琴模型比较;缺少同协议公开分数时,可使用同一批本地音频评估。 |
| 钢琴专用转写(ByteDance Pedal) | piano_bytedance_pedal 已在 pipeline、桌面 UI、Space 和 Colab 中开放 | piano-transcription-inference,checkpoint note_F1=0.9677_pedal_F1=0.9186.pth | 论文报告 MAESTRO onset F1 96.72% 与 pedal onset F1 91.86%;本项目保留上游 MIDI 中的 sustain pedal CC64。 | 上游 ByteDance 主仓库已归档,推理包兼容性需在目标环境验证。 |
下列对比按 2026-08-08 的公开资料更新。MuScriptor D_Test Multi F1、Slakh2100 Multi (Onset-Offset) F1、MAESTRO onset F1、官方挑战名次、以及主观听感/下游任务增益并不是同一协议,不能当成同一张排行榜直接横比。
| 模型 | 公开来源 | Benchmark / 协议 | 公开结果 | 状态 | 说明 |
|---|---|---|---|---|---|
| MuScriptor Large | 论文 / 代码 | 作者 D_Test,372 首真实多乐器曲目;完整训练,CFG=2 | Onset / Frame / Offset / Drums / Multi F1 = 60.4 / 72.4 / 48.6 / 49.6 / 47.8;同表 YourMT3+ Multi F1 = 21.9 | 已集成 | 作者数据上提升很大;8 个公共跨域集的 Multi F1 赢 6、输 2,不同数据集上的表现有差异 |
| MuScriptor Small / Medium | 官方代码与三档权重 | 论文 D_Real only、CFG=2 规模消融 | Small Multi F1 38.2;Medium 39.7;Large 40.5 | 已集成 | 103M / 307M 固定权重已作为独立显式选择接入;质量、速度和显存占用需在同一硬件与输入上比较 |
| YPTF.MoE+Multi (noPS)(当前默认) | 官方 Space app.py / Space noPS 结果文件 | Slakh multi_f | 0.7398 / 73.98% | 使用中 | 当前项目默认 YourMT3+ checkpoint;对齐官方 Hugging Face Space 默认项 |
| YPTF.MoE+Multi(论文表最终模型) | YourMT3+ 论文 | Slakh2100 Multi (Onset-Offset) F1 | 74.84;同表 MT3 = 62.0 | 论文公开结果 | 这是论文表中的最终模型口径,不把它写成当前 noPS 默认 checkpoint 的单独成绩 |
| MT3 | YourMT3+ 论文 / Magenta 仓库 | Slakh2100 Multi (Onset-Offset) F1 | 62.0 | 开源基线 | YourMT3+ 继承并扩展的 token-based 多乐器基线 |
| 2025 AMT Challenge 冠军 MIROS | 挑战论文 / 代码 | 76 个约 20 秒、最多 3 种乐器的受约束合成片段;Multi Onset F1 | 0.5998;YourMT3-YPTF-MoE-M 0.5938;MT3 0.3932 | 已集成 | MusicFM 编码器 + 多解码器;该挑战协议不能与 Slakh 或 MuScriptor D_Test 直接横比 |
| Mirelo Studio 改进版 | Mirelo 官方文章 | 未公开 | 官方仅说明“使用更多数据训练、更准确” | 私有服务观察项 | 没有公开权重、revision、参数量或同协议分数;不是当前 muscriptor-large 权重,不能离线集成 |
| 模型 | 当前项目入口 | 同类型质量口径 | 公开结果 | 使用判断 |
|---|---|---|---|---|
| TransKun V2 | 公开研究 checkpoint | MAESTRO V3 note onset F1 / onset+offset F1 / onset+offset+velocity F1 | 0.9832 / 0.9349 / 0.9296 | 公开钢琴 AMT 分数很强,适合作为钢琴专精质量参考。 |
| TransKun pip checkpoint(No Ext) | PIANO_TRANSKUN | MAESTRO V3 No Ext 同口径三项指标 | 0.9833 / 0.8149 / 0.8109 | 项目默认 TransKun 路线;仓库说明它不带 pedal extension。 |
| TransKun V2 Aug | PIANO_TRANSKUN_V2_AUG | 官方数据增强 checkpoint;不套用其他 checkpoint 的指标 | 未写入跨 checkpoint F1 | 用同一批本地钢琴音频与默认 V2 显式 A/B。 |
| Aria-AMT | PIANO_ARIA_AMT | 官方公开 checkpoint,但未发布与 TransKun 完全同口径的统一榜单 | 未写入统一 F1 | 已集成的钢琴 A/B 选项;建议用同一批本地钢琴音频比较。 |
| ByteDance Pedal | PIANO_BYTEDANCE_PEDAL | MAESTRO note onset F1 / 踏板 onset F1 | 96.72% / 91.86% | 同类中优势是踏板事件,输出 MIDI 会保留 sustain pedal CC64。 |
YourMT3+ / MuScriptor / MIROS 属于多乐器后端,不能与上表的钢琴专精 F1 横向混排;ByteDance Pedal 的 踏板 onset F1 也不能直接等同于 TransKun 的 onset+offset+velocity F1。
| 模型 | 公开来源 | Benchmark / 协议 | 公开结果 | 状态 | 说明 |
|---|---|---|---|---|---|
| TransKun V2(论文 checkpoint) | TransKun 官方仓库 / model cards | MAESTRO V3 note onset F1 / onset+offset F1 / onset+offset+velocity F1 | 0.9832 / 0.9349 / 0.9296 | 开源 | 这是论文公开 checkpoint 的模型卡结果;项目另设 V2 Aug 独立入口,不混用指标 |
| TransKun pip 随包 checkpoint(No Ext) | TransKun 官方仓库 / model cards | MAESTRO V3 No Ext 同口径三项指标 | 0.9833 / 0.8149 / 0.8109 | 开源 | 仓库明确写明随 pip 包 checkpoint 为 without pedal extension of notes;对应项目默认 PIANO_TRANSKUN |
| Aria-AMT | EleutherAI 官方仓库 | 公开 checkpoint 发布 | 仓库公开 piano-medium-double-1.0.safetensors;但仓库页未给出与上表完全同口径的统一 MAESTRO/MAPS 榜单 | 开源 | 已集成为钢琴 A/B 选项;暂无同协议公开 benchmark |
| High-Resolution Piano Transcription with Pedals by Regressing Onset and Offset Times | 论文 / ByteDance 仓库 | MAESTRO onset F1 / pedal onset F1 | 96.72% / 91.86% | 论文 + 代码 | 代表性踏板感知钢琴论文;协议是钢琴专精口径,不应与多乐器 Slakh 分数混排 |
| 模型/方向 | 公开来源 | 公开协议 / 任务 | 可核实的公开信息 | 为什么不与上表混成同一分数榜 |
|---|---|---|---|---|
| 密集复音与乐器检测 | 2025 AMT Challenge 论文 | 1/2/3 乐器分组分析 | MIROS 从 1 种到 3 种乐器时 F-measure 从 0.7193 降到 0.4367;论文把 polyphony、相似音色、乐器泄漏列为主要失败模式 | 这是失败模式和未来评测方向,不是一个可下载的新 checkpoint |
| MR-MT3 | 论文 / 代码 | Slakh2100;重点看 onset F1、instrument leakage ratio、instrument detection F1 | 摘要明确写的是“improved onset F1 scores and reduced instrument leakage” | 它主打 leakage 抑制,并引入了新指标;不等于上面的 Slakh Multi (Onset-Offset) F1 |
| Jointist | 论文 | 流行音乐联合转写 + 分离 | 摘要给出的公开结果是:转写提升 >1 ppt、分离提升 +5 SDR、downbeat +1.8 ppt、和弦/调性各 +1.4 ppt | 它是 joint transcription + separation 路线,公开协议与 Slakh / MAESTRO 完全不同 |
| MusicFM 编码器 + AMT 解码器 | MusicFM 论文 / 仓库 / HF 权重 | 预训练编码器迁移 | 公开的是基础编码器权重;通用可复现的完整 AMT decoder / 微调流水线并未作为现成后端发布 | 它更像 MIROS 这类路线背后的表示学习部件,不是拿来就能切换的通用后端 |
| CountEM / Count The Notes | 论文 / 项目页 / 代码 | 弱监督 AMT 训练方法 | 公开论文、代码和模型,核心贡献是“用音符直方图 + EM”替代精确对齐监督 | 这是训练范式创新,不是固定 checkpoint 的 turnkey 后端 |
| PerceiverTF | 论文 | 多乐器公开数据集(论文自有协议) | 摘要只明确说其在多个公开数据集上优于 MT3 / SpecTNT | 它更适合作为 YourMT3+ 的架构祖先来理解,不应和上表的统一数值行硬拼 |
补充说明:
0.5.0(2021-12-09),与当前多乐器/钢琴专精 SOTA 的公开比较协议并不一致。截至 2026-08-08,多乐器 AMT 的公开实现主要沿三条路线发展:MT3 / YourMT3+ / MR-MT3 的 token-based 架构、MIROS 的 MusicFM 预训练编码器,以及 MuScriptor 使用大规模真实数据和 RL 后训练的 decoder-only 模型。后续比较应同时报告密集复音、相似音色泄漏、稀有乐器、真实 jazz/pop 泛化、权重、许可、速度和显存,单个协议下的分数不足以概括模型能力。钢琴 AMT 也需分别标注 TransKun pip 权重、V2 Aug checkpoint、论文 checkpoint 与 pedal-aware 系统,避免把不同协议合并成一个榜单。
桌面版、Space、Colab 和独立 Web 前端使用固定转写质量。YourMT3+ 产品路线使用官方无重叠分段、固定 bsz=8、逐解码通道 detokenize/merge、mix_notes 和官方 MIDI writer;MIROS 保留官方 CLI writer 输出。MuScriptor 固定使用官方 v0.3.0 源码、权重、5 秒窗口和 MIDI writer,并提供两种分段衔接方式:默认的“标准”保留上游原始分段状态;“跨段延音衔接”连接跨分段的持续音符。这个开关不改变速度方案,两种方式默认不量化、过滤或重建音符。需要量化时,在结果编辑器中选择范围和网格,再点击“量化”。
任务失败时显示原因,并保留诊断信息供排查。
以下情况会得到明确的失败结果和根因:
各场景的用户可见行为:
| 场景 | 当前行为 |
|---|---|
| FFmpeg 转 WAV 失败 | 停止转换并保留 FFmpeg stderr |
| audio-separator CUDA 不兼容 | 停止分离并说明 GPU/CUDA/PyTorch 兼容性问题 |
| BPM 检测失败 | 停止处理并显示检测错误 |
| YourMT3+ 显存不足 | 停止推理并保留 CUDA 错误;该路线的 batch 大小固定为 8 |
| 配置非法模式/后端 | 未知值直接抛出校验错误;仅旧 piano 模式会兼容映射为 smart |
| 独立 vocal stem 的官方 writer 输出任意 program | 保留 program、鼓轨、控制器与音符 |
| SSL 证书验证失败 | 默认停止下载并提示配置 CA/代理;只有显式设置 ALLOW_INSECURE_HF_DOWNLOAD=1 才会跳过验证 |
如需尝试其他模型,请在模型选择器中切换后重新开始转换。
| 项目 | 要求 |
|---|---|
| Python | 3.11+;Windows 安装脚本支持并优先选择 3.11-3.12 |
| PyTorch | 桌面/便携安装基线为 2.7.0,并使用匹配版本的 torchaudio、torchvision |
| Git | 源码安装必需;Windows 安装器找不到 Git 时会明确停止 |
| FFmpeg | 必需;用于可靠处理 MP3/M4A/FLAC/OGG 等格式 |
| GPU | Windows 完整七模式支持 NVIDIA CUDA 12.8 或 Intel XPU;二者使用独立环境。Linux/WSL2 基线仍为 NVIDIA CUDA;任何入口都不会自动降级到 CPU/AMD |
| 磁盘 | 完整冷安装会同时保存 Python wheel、模型与下载缓存;实测工作集约 32.36 GB,建议开始前至少保留 40 GB 可用空间 |
| 系统 | Windows 10/11、Linux、WSL2 |
各平台使用各自固定的兼容运行时;跨平台覆盖 NumPy/Torch 组合不属于支持范围:
| 平台 | Python / Torch | NumPy 与 GPU 运行时 | 发布边界 |
|---|---|---|---|
| Windows / NVIDIA 桌面与便携目标 | Python 3.11-3.12;Torch 2.7.0 / torchaudio 2.7.0 / torchvision 0.22.0 | NumPy 1.26.4;CUDA 12.8 wheel | 源码与便携发布均按此契约校验;release.yml 同时执行第三方许可闭集门禁、模型身份校验和成品烟测 |
| Windows / Intel XPU 桌面与本地便携目标 | Python 3.11-3.12;原生 Torch 2.11.0 XPU / torchaudio 2.11.0 XPU / torchvision 0.26.0 XPU | NumPy 1.26.4;onnxruntime-openvino==1.24.1 + openvino==2025.4.1;启动门禁验证 FFT/STFT、BF16 和矩阵运算驻留 XPU,新 Leap Instrumental 使用 PyTorch FP32,尚未完成 XPU 实机验收 | 当前完整三件套基线覆盖 PyTorch 官方硬件矩阵中的 Arc B-Series(Battlemage)与 Core Ultra Series 3(Panther Lake);Panther Lake 按官方矩阵要求 Windows 11。运行环境为独立 venv-xpu;IPEX、CUDA ORT 混装和 CPU EP 回退会被门禁拒绝。官方 GitHub release 暂仍只构建 CUDA 包 |
| Linux / NVIDIA 源码运行 | Python 3.11-3.12 x64;Torch 2.7.0 / torchaudio 2.7.0 / torchvision 0.22.0 | NumPy 1.26.4;NVIDIA 驱动兼容 CUDA 12.8;仅 cu128 | install.sh / run.sh 对完整七模式执行精确运行时校验;安装器要求 Debian/Ubuntu/WSL2 的 apt 软件源提供对应 Python venv/dev 包;build.yml 只做源码、测试和打包契约检查 |
| Linux / AMD/ROCm | 尚未完成完整七模式实机验收 | 本次替换没有扩大已验证的硬件范围 | 当前不支持;安装脚本会停止并说明兼容性问题 |
| Hugging Face Space | Python 3.12.12;Torch 2.8.0 / torchaudio 2.8.0 / torchvision 0.23.0 | NumPy >=2,<2.5;ZeroGPU | 使用 space/requirements.txt;桌面 NumPy 1.26 不属于 Space 兼容组合 |
| Google Colab | Colab 当前预装 Python/Torch | 保留预装 Torch;只安装 pinned Web/runtime 依赖 | 避免替换 Torch 导致 CUDA 运行库冲突 |
Windows 源码版应放在本机磁盘的纯英文、无空格目录,例如:
C:\MusicToMidi
D:\Projects\music-to-midi
含中文、空格或括号的路径可能导致 PyTorch DLL 加载失败。映射盘和 UNC/SMB 网络路径尚未通过源码虚拟环境身份验收,可能让 venv 记录路径与启动路径不一致;本机 NTFS 的纯英文无空格目录是当前已支持的源码运行位置。
MuScriptor Small / Medium / Large 都是 Hugging Face gated 模型,匿名用户无法下载。源码安装的授权条件是:同一个 Hugging Face 账户已在浏览器中分别接受 Small、Medium、Large 的条款,并在账号获批后从项目隔离环境登录:
# Windows;无 venv 时的最小授权环境仅包含官方 HF CLI
py -3.11 -m venv venv
.\venv\Scripts\python.exe -m pip install "huggingface_hub>=0.20,<2" "hf_xet==1.5.2"
.\venv\Scripts\hf.exe auth login
# Linux / WSL2
python3.11 -m venv venv
./venv/bin/python -m pip install "huggingface_hub>=0.20,<2" "hf_xet==1.5.2"
./venv/bin/hf auth login
登录使用具有三个 gated 仓库读取权限的个人 token。仓库、README、命令行参数和日志都不是受支持的 token 存放位置;无人值守环境的凭据入口是受保护的 HF_TOKEN secret。总下载脚本会在下载其它大型模型前依次做三个轻量权限预检,任一仓库未接受条款或未登录都会立即停止,不会改用其它模型。完整便携 release 已随包携带通过身份校验的权重,启动时不再从 Hub 下载;这不改变 CC BY-NC 4.0 与附加条款的适用范围。
推荐:
powershell -ExecutionPolicy Bypass -File .\run.ps1
或双击:
run.bat
run.ps1 会检查虚拟环境、核心依赖、Beat This final0、五种 YourMT3+ checkpoint、MuScriptor Small / Medium / Large、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS、SoundFont 与 FluidSynth;资源缺失或身份校验失败时会调用 install.ps1。
Intel GPU 使用独立的原生 XPU 环境,不与 CUDA 环境共用 wheel 或 DLL:
powershell -ExecutionPolicy Bypass -File .\install_xpu.ps1
powershell -ExecutionPolicy Bypass -File .\run_xpu.ps1
安装和每次启动都会做真实 torch.xpu 矩阵、FFT 与 STFT 运算,捕获并拒绝 XPU→CPU 算子回落;随后初始化 OpenVINO GPU,并在禁用 CPU EP 回退后用 OpenVINOExecutionProvider 的 GPU.0 实际执行 MatMul ONNX 图。ORT 会自动列出内置 CPU provider,但 session.disable_cpu_ep_fallback=1 会让任何需分配给 CPU 的节点直接导致会话失败。任一门禁失败都会停止,不会改用 IPEX、DirectML、CUDA 或 CPU。
Leap Instrumental 固定使用 audio-separator 0.44.1 的原生 FP32 路线,与受控对比采用同一权重和配置:dim_t=1101、每片 563200 个采样、步进 8 秒。短音频补齐一个模型窗口后裁回原长度;不改变窗口或降精度。显存不足时任务停止,并显示 OOM 错误。新增伴奏权重的上游未声明许可证,便携包发布仍受第三方声明中的待确认记录约束。
Leap XE 在 XPU 上保留官方完整约 20 秒音频窗口、全部 key/value、checkpoint 与后处理,仅把 attention 的 query 轴固定分成 128 行逐块求值后拼接。每个 query 仍注意完整上下文,因此这是推理期数值等价的显存有界实现,不是缩短音频窗口、降低模型或 CPU 回退;训练态误用会直接报错。该路径用于避开仅覆盖部分 Intel 架构的 XPU Flash Attention 内核,此前版本已在 Arc 140T 16 GB 上完成真实两轨分离;该历史结果不包含本次替换的 Leap Instrumental,新伴奏路线尚未完成 XPU 实机验收。
MuScriptor Large 的 5.1 GiB checkpoint 在 XPU 上固定使用 safetensors==0.8.0 的官方 pread reader,并按文件偏移顺序一次只装载一个张量。XPU 路径会先打开惰性的 pread 文件句柄,再建立约 5.50 GiB 的统一内存模型,避免模型占用系统提交空间后才打开 checkpoint 所触发的 Windows os error 1455。该实现不会把完整 checkpoint 映射为 PyTorch storage,也不改变官方权重、精度与 writer;读取失败会直接停止,不会改回 mmap、扩大页面文件或自动重试。
Intel XPU 的本地 Web 后端会为每个 GPU 作业启动一个全新的推理进程,作业结束后由操作系统回收该进程的完整地址空间;常驻 HTTP 进程不跨作业保留 YourMT3、MIROS、MuScriptor 或分离模型。这样可避免统一内存模型在长会话中累积占用 Windows 系统提交额度。停止操作会终止并回收当前处理进程;处理进程非零退出,或缺少结果清单、结果文件时,任务会报告失败。
chmod +x run.sh
./run.sh
run.sh 会检查虚拟环境、核心依赖、Beat This final0、受控 YourMT3+ 源码与五种 checkpoint、MuScriptor Small / Medium / Large、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT、ByteDance Pedal、MIROS、SoundFont 与 FluidSynth;资源缺失或身份校验失败时会调用 install.sh。
受支持的源码运行环境是仓库内隔离且与加速器匹配的虚拟环境:NVIDIA CUDA 使用 venv,Windows Intel XPU 使用 venv-xpu。run.ps1 与 run_xpu.ps1 会在导入 GUI 和模型依赖前分别选择并严格校验解释器路径、include-system-site-packages=false、MuScriptor 包位置、版本和七个源码 SHA-256;全局 python -m src.main 会被拒绝。
# Windows 桌面 App
.\venv\Scripts\python.exe -m src.main

# Windows Web 前后端;自动识别局域网 IPv4 并打开前端
.\venv\Scripts\python.exe -m src.web
# Linux / WSL2 桌面 App
./venv/bin/python -m src.main

# Linux / WSL2 Web 前后端;浏览器手动打开终端显示的地址
./venv/bin/python -m src.web --no-window
Windows:
py -3.11 -m venv venv
.\venv\Scripts\activate
python -m pip install --upgrade pip wheel "setuptools==80.10.2"
Linux:
python3.11 -m venv venv
source venv/bin/activate
python -m pip install --upgrade pip wheel "setuptools==80.10.2"
CUDA 12.8(完整七模式受支持且由启动器严格校验的运行时):
pip install torch==2.7.0 torchaudio==2.7.0 torchvision==0.22.0 --index-url https://download.pytorch.org/whl/cu128
Windows Intel XPU 的标准安装入口是 install_xpu.ps1。手动准备对应独立的 venv-xpu 和 requirements-xpu.txt 固定版本;在 venv 中覆盖 CUDA wheel 会破坏两套环境的隔离契约。
Intel XPU 采用“最新完整兼容组合”而不是单独追最高 torch 版本:截至当前,PyTorch XPU 已发布 2.13,但 torchaudio XPU 的最新匹配版本是 2.11,因此项目固定 torch/torchaudio==2.11.0+xpu 与 torchvision==0.26.0+xpu。这套官方硬件矩阵已经列出 Arc B-Series 与 Panther Lake / Core Ultra Series 3。既有 XPU 包中的 ONNX Runtime OpenVINO 1.24.1 与 OpenVINO 2025.4.1 仍按打包依赖管理;新 Leap Instrumental 走 PyTorch FP32,本次只在 NVIDIA CUDA 实测,尚未完成新伴奏路线的 Intel XPU 实机验收。未来只有在三件套与全部七模式重新验收通过后才整体升级,不混装不匹配版本。
Intel XPU 没有可直接等同 NVIDIA sm_XX 的项目级兼容版本号。该栈通过 oneAPI/Level Zero 发现设备,常规 JIT 路径由 Intel Graphics Compiler 按实际硬件生成代码;真正的支持边界以固定 PyTorch 版本的官方硬件矩阵、操作系统/驱动要求和本项目启动时的真实算子门禁共同决定,不能把“任意 Intel GPU”视为自动兼容。
torchaudio 2.11 的 load/save 已改为依赖 TorchCodec;TorchCodec 在 Windows 上又要求 full-shared FFmpeg DLL。项目不把缺失 DLL 隐藏成运行时回退:所有公开输入先由随包 FFmpeg 显式转换为 WAV,转写器再用固定的 libsndfile PCM 读取器生成 channels-first float32 张量,重采样和模型推理仍由 torchaudio/PyTorch 在已验证的 XPU 设备上执行。
cu118 / CUDA 11 不属于当前一键启动器和完整七模式验收契约;启动器检测到该环境时会停止并提示更新。
AMD/ROCm 尚未完成完整七模式实机验收,当前安装脚本仍会停止并说明兼容性问题。本次将伴奏分离改为 PyTorch FP32,不代表其余模型和完整工作流已获得 AMD 支持。
release.yml 只生成 CUDA 12.8 GPU 便携版,不生成 CPU 版。当前闭集清单包含 31 项第三方组件:26 项 VERIFIED、5 项附维护者具名责任与撤销联系记录的 OWNER_ACCEPTED、0 项 BLOCKED;工作流仍会在每次发布前重新校验清单、模型身份、SBOM、FFmpeg 构建信息和成品自检,任何一项不满足即停止。push / PR 的 build.yml 仅验证源码、测试与打包契约,不生成便携成品。本地源码开发如需 CPU-only PyTorch,应自行承担模型速度和依赖兼容性差异。
pip install -r requirements.txt
python -m pip install --no-deps "audio-separator==0.44.1"
python -m pip install --no-deps --force-reinstall "aria-amt @ https://github.com/EleutherAI/aria-amt/archive/a1ab73fc901d1759ec3bc173c146b3c6a3040261.zip"
python -m pip install --no-deps --force-reinstall "muscriptor @ https://github.com/muscriptor/muscriptor/archive/d73147e75e5b9b0c0a79ebe154587db4fd603e0c.zip"
python -m src.utils.source_runtime
requirements.txt 有意不让 audio-separator 的 NumPy 2 元数据覆盖桌面 NumPy 1.26,也不让 Aria-AMT 的旧 torchaudio 约束覆盖 CUDA 12.8 运行时,因此两项采用固定版本的 --no-deps 独立安装。MuScriptor 同样以 --no-deps 固定源码身份,其 v0.3.0 非 Torch 依赖(包括 FastAPI 0.136.3、Starlette 1.5.0 与 SoundFile 0.14.0)已在项目依赖中显式满足;install.ps1 / install.sh 提供完整伴随依赖。
python download_sota_models.py
当前仓库已经包含受控且经过兼容补丁的 YourMT3/amt/src;可变上游 master 不满足这里的源码身份校验。download_sota_models.py 会准备 Beat This final0、全部五种官方 YourMT3+ checkpoint、固定 MIROS 源码与两组权重、BS-Rofo-SW-Fixed.ckpt、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT 与 ByteDance checkpoint,并严格校验默认 TransKun 2.0.1 包版本和内置 V2 资源;缺失或身份不符会直接失败。
python download_vocal_model.py
python download_multistem_model.py
python download_accompaniment_model.py
python download_transkun_v2_aug_model.py
python download_aria_amt_model.py
python download_bytedance_piano_model.py
python download_miros_model.py
模型默认缓存到:
~/.cache/music_ai_models/yourmt3_all
~/.music-to-midi/models/beat_this
~/.music-to-midi/models/audio-separator
~/.cache/music_ai_models/transkun_v2_aug
~/.cache/music_ai_models/aria_amt
~/.cache/music_ai_models/bytedance_piano
~/.cache/music_ai_models/fluidsynth/2.5.6
~/.cache/music_ai_models/musescore/4.7.4
${HF_HOME:-~/.cache/huggingface}/hub  # MuScriptor 三档与 MuseScore SoundFont
external/ai4m-miros
Windows 中的 ~ 是 %USERPROFILE%。源码虚拟环境固定为仓库内 venv,桌面默认输出为仓库内 MidiOutput\<音频文件名>,日志在 %USERPROFILE%\.music-to-midi\logs。默认 TransKun V2 资源位于 venv 中的 transkun==2.0.1 包内;便携版则只读取发布目录内的 models、runtime 与 tools 资源,不依赖上述源码缓存。
默认 TransKun V2 的模型资源随 transkun==2.0.1 安装;PIANO_TRANSKUN 资源或身份异常对应的修复命令是 python -m pip install --force-reinstall "transkun==2.0.1"。PIANO_TRANSKUN_V2_AUG 使用独立缓存,由 python download_transkun_v2_aug_model.py 准备。
# Windows
.\venv\Scripts\python.exe -m src.main
# Linux / WSL2
./venv/bin/python -m src.main
Colab 入口:
colab_notebook.ipynb
使用步骤:
HF_TOKEN,并在第 3 个代码单元勾选 ENABLE_MUSCRIPTOR;该单元会在启动前验证三档访问权限。Colab 版本会保留预装 PyTorch,避免重装 torch 导致 CUDA 运行库冲突。
Space 入口:
space/app.py
本地启动:
cd space
python app.py
Space 版随部署包携带项目已验证的 YourMT3/amt/src 兼容源码,与桌面版和 Colab 使用同一棵源码树;不会在运行时改用 Hugging Face Space 的可变源码。运行转换时会按所选模式检查/准备 YourMT3+ 官方 checkpoint 或 MIROS、BS-RoFormer SW Fixed、Leap XE、Leap Instrumental、TransKun V2 Aug、Aria-AMT 或 ByteDance Pedal 资源;缺失或身份校验失败会显式暴露。
ZeroGPU 入口用于短片段试用。长歌建议使用 Colab、桌面版或专用 GPU。Hugging Face ZeroGPU 文档 当前公开配额为匿名用户每日 2 分钟、登录免费账户每日 5 分钟 GPU。当前保守的最小请求经 large GPU 平台倍率折算后已高于匿名额度,因此转换入口要求登录;Space 会按模式、后端和模型估算,再按固定的 spaces==0.51.1 平台倍率上界折算,超过登录免费账户 300 GPU 秒窗口的请求会在下载模型前明确拒绝。该估算只是准入上限,不代表用户一定仍有足够的当日配额或队列容量;Colab、桌面版或专用 GPU 更适合长歌。
当前公式下的最大输入时长是准入阈值,不是实测耗时承诺。默认 YPTF.MoE+Multi (noPS) 与 MIROS 的精确阈值如下;换用其它 YourMT3 checkpoint 时会按其独立系数重新计算:
| ZeroGPU 路线 | YourMT3 默认 noPS | MIROS |
|---|---|---|
SMART | 2.00 秒 | 1.00 秒 |
VOCAL_SPLIT | 0.53 秒 | 0.27 秒 |
SIX_STEM_SPLIT | 0.22 秒 | 0.11 秒 |
| 任一钢琴专用模式 | 2.50 秒 | 不适用 |
Space 的失败请求会立即删除专属输出目录;成功结果会保留给 Gradio 下载,默认在 24 小时后进入过期清理,并在后续请求删除过期结果或在 Space 实例正常退出时清理。Colab 同样在失败时立即清理,并把成功结果保留到当前运行时结束;Gradio 缓存按 24 小时进入清理。
当前 THIRD_PARTY_NOTICES.md 的 31 项闭集清单为 26 项 VERIFIED、5 项 OWNER_ACCEPTED、0 项 BLOCKED。OWNER_ACCEPTED 表示上游未声明许可时由维护者具名承担再分发决定,并不等同于获得上游授权;Leap Instrumental 已有独立的维护者分发接受记录,官方 release 仍会在构建前严格校验全部组件。
Windows CUDA 完整三包构建(桌面 App、Web 后端、Web 前端):
powershell -ExecutionPolicy Bypass -File .\build_web_executables.ps1
Intel XPU 本地三包的构建环境是已验收的独立 venv-xpu:
powershell -ExecutionPolicy Bypass -File .\build_portable_xpu.ps1
CUDA 输出为 dist\MusicToMidi-App、dist\MusicToMidi-WebBackend、dist\MusicToMidi-WebFrontend;XPU 输出为 dist\MusicToMidi-XPU-App、dist\MusicToMidi-XPU-WebBackend、dist\MusicToMidi-WebFrontend。Web 前端不含推理运行时,因此 CUDA/XPU 共用同一套前端文件;每个输出目录中的 _internal 与该目录对应。
完整模型与运行时会让 XPU 便携目录超过 20 GB。构建盘空间不足时,可把临时目录和成品目录指定到同一块有足够空间的 NTFS 卷;删减模型或留下半成品会使成品校验失败:
powershell -ExecutionPolicy Bypass -File .\build_portable_xpu.ps1 `
  -BuildRoot C:\MusicToMidi-XPU-build `
  -DistRoot C:\MusicToMidi-XPU-dist
XPU wrapper 默认只对同卷的 staged 资源建立 NTFS 硬链接,跨卷资源仍逐文件复制;两种路径都继续执行 staged 与 packaged SHA-256/manifest 校验。硬链接创建失败会终止构建并显示文件错误。有效的 BuildRoot 与 DistRoot 是互不嵌套的普通目录;盘根和项目根会被参数校验拒绝。
自定义 Python 或 FFmpeg 路径:
powershell -ExecutionPolicy Bypass -File .\build_web_executables.ps1 `
  -PythonExe .\venv\Scripts\python.exe `
  -FfmpegDir C:\ffmpeg\bin
打包脚本要求并严格校验以下全部资源;缺少任一项,或大小、SHA256、源码 manifest、运行时包身份不符时,会在 PyInstaller 前立即失败:
YourMT3/amt/src
YourMT3 模型缓存 -> models/yourmt3_all
audio-separator 模型缓存 -> models/audio-separator
transkun==2.0.1 包及其内置默认 V2 资源
TransKun V2 Aug 模型缓存 -> models/transkun_v2_aug
Aria-AMT 模型缓存 -> models/aria_amt
ByteDance Piano 模型缓存 -> models/bytedance_piano
固定版本且已打兼容补丁的 MIROS 源码与两组权重
ffmpeg.exe / ffprobe.exe
便携版资源来源优先级:
MUSIC_TO_MIDI_BUNDLE_YOURMT3_DIR 或 ~/.cache/music_ai_models/yourmt3_all 或 checkpoints/yourmt3_all
MUSIC_TO_MIDI_BUNDLE_AUDIO_SEPARATOR_DIR 或 ~/.music-to-midi/models/audio-separator 或 checkpoints/audio-separator
MUSIC_TO_MIDI_BUNDLE_TRANSKUN_V2_AUG_DIR 或 ~/.cache/music_ai_models/transkun_v2_aug 或 checkpoints/transkun_v2_aug
MUSIC_TO_MIDI_BUNDLE_ARIA_AMT_DIR 或 ~/.cache/music_ai_models/aria_amt 或 checkpoints/aria_amt
MUSIC_TO_MIDI_BUNDLE_BYTEDANCE_PIANO_DIR 或 ~/.cache/music_ai_models/bytedance_piano 或 checkpoints/bytedance_piano
MUSIC_TO_MIDI_BUNDLE_MIROS_DIR 或 external/ai4m-miros / ai4m-miros / .tmp/ai4m-miros
MUSIC_TO_MIDI_BUNDLE_FFMPEG_DIR 或 tools/ffmpeg / ffmpeg
构建结果包含以下三个完整目录:
dist/MusicToMidi-App/
dist/MusicToMidi-WebBackend/
dist/MusicToMidi-WebFrontend/
桌面用户使用完整 App 目录;Web 用户使用完整 WebBackend 与 WebFrontend 目录。单个 EXE 不包含对应角色的全部运行文件。
src/
  core/
    pipeline.py              # 主处理流水线
    yourmt3_transcriber.py   # YourMT3+ 后端
    miros_transcriber.py     # MIROS 本地包装器
    transkun_transcriber.py  # TransKun 默认 V2 钢琴专用后端
    transkun_v2_aug_transcriber.py # TransKun V2 Aug 钢琴专用后端
    aria_amt_transcriber.py  # Aria-AMT 钢琴专用后端
    bytedance_piano_transcriber.py # ByteDance Pedal 钢琴专用后端
    vocal_separator.py       # 人声/伴奏分离
    multi_stem_separator.py  # 六声部分离
    midi_generator.py        # MIDI 生成与后处理
    beat_detector.py         # BPM/节拍检测
  gui/
    main_window.py           # PyQt6 主窗口
    widgets/track_panel.py   # 模式、后端、模型选择
    workers/processing_worker.py
  models/
    data_models.py           # Config、ProcessingResult、NoteEvent 等
    gm_instruments.py        # GM 128 乐器映射
  utils/
    runtime_paths.py         # 运行时资源路径
    yourmt3_downloader.py    # YourMT3+ 模型路径与下载辅助

space/app.py                 # Gradio Web 界面
colab_notebook.ipynb         # Colab 运行入口
download_sota_models.py      # Beat This + 全部公开工作流模型下载 + 默认 TransKun 严格校验
download_vocal_model.py      # Leap XE vocals 模型下载
download_accompaniment_model.py # Leap Instrumental accompaniment 下载入口
download_multistem_model.py  # BS-RoFormer SW Fixed 六声部分离模型下载
download_transkun_v2_aug_model.py # TransKun V2 Aug 下载与校验
download_aria_amt_model.py   # Aria-AMT 模型下载
download_bytedance_piano_model.py # ByteDance Pedal 模型下载
download_vocal_harmony_model.py # Leap Instrumental 历史兼容入口
MusicToMidi.spec             # PyInstaller 配置
以下命令同样在仓库内 venv 激活后执行。
pytest
pytest tests/test_yourmt3_integration.py -v
black src/
isort src/
flake8 src/
mypy src/
pyinstaller MusicToMidi.spec
常用自检:
python -m src.main --self-test
python -c "from src.utils.gpu_utils import print_gpu_diagnosis; print_gpu_diagnosis()"
python -c "from src.core.yourmt3_transcriber import YourMT3Transcriber; print(YourMT3Transcriber.is_available())"
优先检查:
Windows 可重新运行:
powershell -ExecutionPolicy Bypass -File .\install.ps1
Windows 可使用安装脚本自动安装,或手动安装后加入 PATH。Linux:
sudo apt-get update
sudo apt-get install -y ffmpeg
源码目录检查:
YourMT3/amt/src
模型检查:
python -c "from src.utils.yourmt3_downloader import get_model_path; print(get_model_path())"
缺失时:
python download_sota_models.py
如果受控的 YourMT3/amt/src 缺失,恢复来源是当前项目版本中的对应目录;可变上游 master 无法通过三端源码一致性与便携 manifest 校验。
如果下载模型时报 SSL 证书错误,默认会停止下载。受信任 CA 可通过系统/代理配置或以下环境变量提供:
export SSL_CERT_FILE=/path/to/ca.pem
export REQUESTS_CA_BUNDLE=/path/to/ca.pem
只有在你明确接受证书校验风险时,才设置:
export ALLOW_INSECURE_HF_DOWNLOAD=1
Windows PowerShell:
$env:ALLOW_INSECURE_HF_DOWNLOAD = "1"
YourMT3+ 官方路线固定调用 inference_file(bsz=8)。显存不足时处理停止并显示 CUDA 错误,batch 大小固定为 8。
依赖和模型检查:
Windows / Linux NVIDIA CUDA 环境:
python -m pip install --no-deps "audio-separator==0.44.1" "onnxruntime-gpu==1.23.2"
python download_vocal_model.py
python download_accompaniment_model.py
macOS 或明确的 CPU 环境把 onnxruntime-gpu==1.23.2 换成 onnxruntime==1.23.2。
如果当前 NVIDIA GPU、PyTorch/CUDA 或 audio-separator 后端不兼容,流程会直接失败并提示根因;不会自动改用 CPU 分离。需要 CPU 路径时,应由后续 UI/配置提供显式选项并在结果中标注。
该路线依赖 audio-separator==0.44.1 和 BS-RoFormer SW Fixed 资源:
python download_multistem_model.py
如果六声部分离缺少任一 stem,流程会停止并提示缺失项。
默认 TransKun 模式需要 transkun 包和其随包预训练资源:
python -m pip install --force-reinstall "transkun==2.0.1"
TransKun V2 Aug 模式使用独立、固定校验的官方 checkpoint:
python download_transkun_v2_aug_model.py
Aria-AMT 模式需要 aria-amt 包和 checkpoint:
python -m pip install --no-deps --force-reinstall "aria-amt @ https://github.com/EleutherAI/aria-amt/archive/a1ab73fc901d1759ec3bc173c146b3c6a3040261.zip"
python download_aria_amt_model.py
本地仓库位置与文件完整性检查:
ai4m-miros/main.py
ai4m-miros/transcribe.py
若提示缺少 Python 模块,缺失依赖以 MIROS 上游仓库的运行清单为准。
当前版本不会用默认 120 BPM 继续生成 MIDI。若 Beat This final0 模型缺失/身份不符,或检测结果不足、乱序、含 NaN、局部速度不可信,流程会停止并报告具体错误;不会改用 librosa、第二检测器或旧 BPM。
未知的处理模式、转写后端或多乐器模型会直接报错,不会自动改成默认值。有效配置值如下:
processing_mode: smart / vocal_split / six_stem_split / piano_transkun / piano_transkun_v2_aug / piano_aria_amt / piano_bytedance_pedal
transcription_backend: aria_amt / yourmt3 / miros / muscriptor
multi_instrument_model: yourmt3 / miros / muscriptor
旧配置中的 processing_mode=piano 会兼容映射为 smart。
本项目使用 MIT License。第三方模型、数据和上游仓库遵循各自许可证与使用条款;代码改编与完整声明见 THIRD_PARTY_NOTICES.md。



