🚀 Easier & Faster YOLO Deployment Toolkit for NVIDIA 🛠️
See the codeEnglish | 简体中文

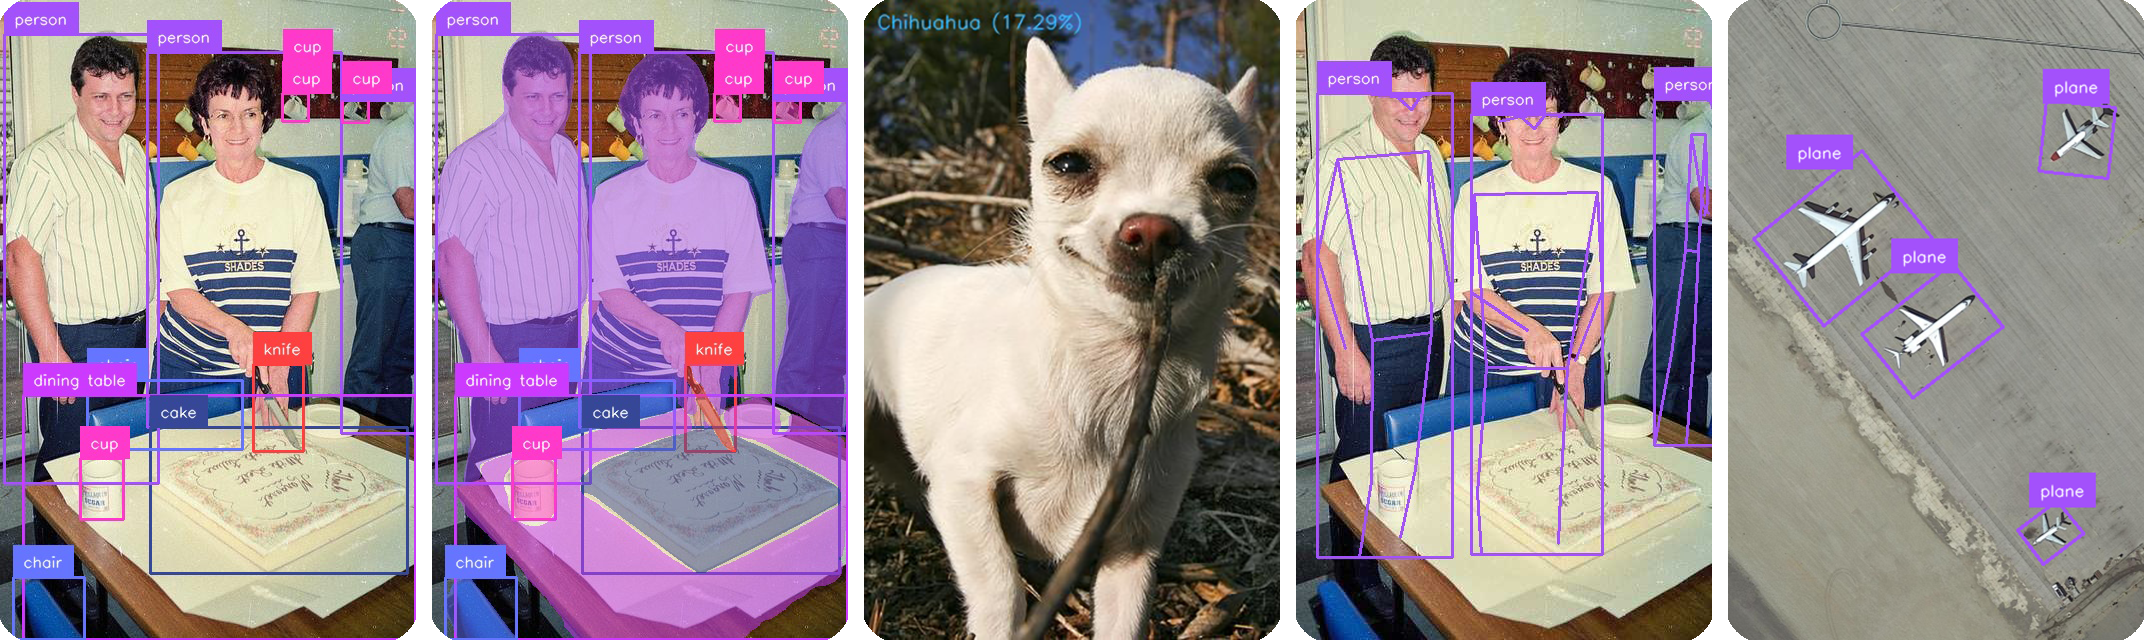
🚀 TensorRT-YOLO 是一款专为 NVIDIA 设备设计的易用灵活、极致高效的YOLO系列推理部署工具。项目不仅集成了 TensorRT 插件以增强后处理效果,还使用了 CUDA 核函数以及 CUDA 图来加速推理。TensorRT-YOLO 提供了 C++ 和 Python 推理的支持,旨在提供📦开箱即用的部署体验。包括 目标检测、实例分割、图像分类、姿态识别、旋转目标检测、视频分析等任务场景,满足开发者多场景的部署需求。
[!IMPORTANT]
本仓库是社区版(6.4),许可证 GPL-3.0。社区版推理接口冻结,不再合入新的运行时架构。
专业版(闭源)将单独提供,源码不在本仓库。购买入口尚未开放,开放后会写在本 README。吞吐与能力对比见 社区版与专业版。
社区版(6.4)推理接口冻结;专业版将单独提供(购买入口尚未开放)。🌟 NEW
🔥 实战课程|TensorRT × Triton Inference Server 模型部署
2026-03-20: 添加对 YOLO26 的支持,包括分类、定向边界框、姿态估计以及实例分割。🌟 NEW
2026-01-07: 添加对 YOLO-Master 的支持,包括分类、定向边界框、姿态估计以及实例分割。🌟 NEW
2025-10-05:精度完美对齐,CUDA 完美复刻 LetterBox,绝大多数情况下像素误差为 0。Python 模块重大重构,易用性大幅提升。🌟 NEW
2025-06-09: C++仅引单头文件 trtyolo.hpp,零第三方依赖(使用模块时无需链接 CUDA 和 TensorRT),增加对带图像间距(Pitch)数据结构的支持,详见 B站。🌟 NEW
2025-04-19: 添加对 YOLO-World, YOLOE 的支持,包括分类、定向边界框、姿态估计以及实例分割,详见 B站。🌟 NEW
2025-03-29: 添加对 YOLO12 的支持,包括分类、定向边界框、姿态估计以及实例分割,详见 issues。🌟 NEW
[!NOTE]
如果您在 Windows 下进行开发,可以参考以下配置指南:
首先,克隆 TensorRT-YOLO 仓库:
git clone https://github.com/laugh12321/TensorRT-YOLO
cd TensorRT-YOLO
然后使用 CMake,可以按照以下步骤操作:
pip install "pybind11[global]" # 安装 pybind11,用于生成 Python 绑定
cmake -S . -B build -D TRT_PATH=/your/tensorrt/dir -D BUILD_PYTHON=ON -D CMAKE_INSTALL_PREFIX=/your/tensorrt-yolo/install/dir
cmake --build build -j$(nproc) --config Release --target install
执行上述指令后,tensorrt-yolo 库将被安装到指定的 CMAKE_INSTALL_PREFIX 路径中。其中,include 文件夹中包含头文件,lib 文件夹中包含 trtyolo 动态库和 custom_plugins 动态库(仅在使用 trtexec 构建 OBB、Segment 或 Pose 模型时需要)。如果在编译时启用了 BUILD_PYTHON 选项,则还会在 trtyolo/libs 路径下生成相应的 Python 绑定文件。
[!NOTE]
在使用 C++ 动态库之前,请确保将指定的CMAKE_INSTALL_PREFIX路径添加到环境变量中,以便 CMake 的find_package能够找到tensorrt-yolo-config.cmake文件。可以通过以下命令完成此操作:export PATH=$PATH:/your/tensorrt-yolo/install/dir # linux $env:PATH = "$env:PATH;C:\your\tensorrt-yolo\install\dir;C:\your\tensorrt-yolo\install\dir\bin" # windows
如果您希望在 Python 上体验与 C++ 相同的推理速度,则编译时需开启 BUILD_PYTHON 选项,然后再按照以下步骤操作:
pip install --upgrade build
python -m build --wheel
pip install dist/trtyolo-6.*-py3-none-any.whl
trtyolo-export 工具包,将已经导出的 YOLO 系列 ONNX 模型转换为兼容 TensorRT-YOLO 推理的输出结构并构建为 TensorRT 引擎。使用 Python 进行推理:
import cv2
import supervision as sv

from trtyolo import TRTYOLO

# -------------------- 初始化模型 --------------------
# 注意:task参数需与导出时指定的任务类型一致("detect"、"segment"、"classify"、"pose"、"obb")
# profile参数开启后,会在推理时计算性能指标,调用 model.profile() 可获取
# swap_rb参数开启后,会在推理前交换通道顺序(确保模型输入时RGB)
model = TRTYOLO("yolo11n-with-plugin.engine", task="detect", profile=True, swap_rb=True)

# -------------------- 加载测试图片并推理 --------------------
image = cv2.imread("test_image.jpg")
result = model.predict(image)
print(f"==> result: {result}")

# -------------------- 可视化结果 --------------------
box_annotator = sv.BoxAnnotator()
annotated_frame = box_annotator.annotate(scene=image.copy(), detections=result)

# -------------------- 性能评估 --------------------
throughput, cpu_latency, gpu_latency = model.profile()
print(throughput)
print(cpu_latency)
print(gpu_latency)

# -------------------- 克隆模型 --------------------
# 克隆模型实例(适用于多线程场景)
cloned_model = model.clone()  # 创建独立副本,避免资源竞争
# 验证克隆模型推理一致性
cloned_result = cloned_model.predict(input_img)
print(f"==> cloned_result: {cloned_result}")
使用 C++ 进行推理:
#include <memory>
#include <opencv2/opencv.hpp>

#include "trtyolo.hpp"

int main() {
    try {
        // -------------------- 初始化配置 --------------------
        trtyolo::InferOption option;
        option.enableSwapRB();  // BGR->RGB转换

        // 特殊模型参数设置示例
        // const std::vector<float> mean{0.485f, 0.456f, 0.406f};
        // const std::vector<float> std{0.229f, 0.224f, 0.225f};
        // option.setNormalizeParams(mean, std);

        // -------------------- 模型初始化 --------------------
        // ClassifyModel、DetectModel、OBBModel、SegmentModel 和 PoseModel 分别对应于图像分类、检测、方向边界框、分割和姿态估计模型
        auto detector = std::make_unique<trtyolo::DetectModel>(
            "yolo11n-with-plugin.engine",  // 模型路径
            option                         // 推理设置
        );

        // -------------------- 数据加载 --------------------
        cv::Mat cv_image = cv::imread("test_image.jpg");
        if (cv_image.empty()) {
            throw std::runtime_error("无法加载测试图片");
        }

        // 封装图像数据(不复制像素数据)
        trtyolo::Image input_image(
            cv_image.data,     // 像素数据指针
            cv_image.cols,     // 图像宽度
            cv_image.rows     // 图像高度
        );

        // -------------------- 执行推理 --------------------
        trtyolo::DetectRes result = detector->predict(input_image);
        std::cout << result << std::endl;

        // -------------------- 结果可视化(示意) --------------------
        // 实际开发需实现可视化逻辑,示例:
        // cv::Mat vis_image = visualize_detections(cv_image, result);
        // cv::imwrite("vis_result.jpg", vis_image);

        // -------------------- 模型克隆演示 --------------------
        auto cloned_detector = detector->clone();  // 创建独立实例
        trtyolo::DetectRes cloned_result = cloned_detector->predict(input_image);

        // 验证结果一致性
        std::cout << cloned_result << std::endl;

    } catch (const std::exception& e) {
        std::cerr << "程序异常: " << e.what() << std::endl;
        return EXIT_FAILURE;
    }
    return EXIT_SUCCESS;
}
以下是predict方法的流程图,展示了从输入图片到输出结果的完整流程:
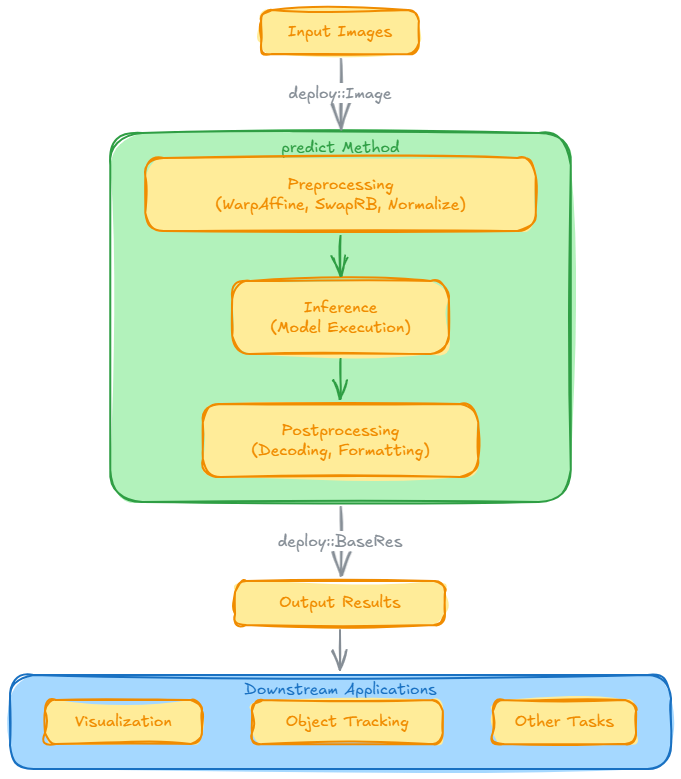
只需将待推理的图片传递给 predict 方法,predict 内部会自动完成预处理、模型推理和后处理,并输出推理结果,这些结果可进一步应用于下游任务(如可视化、目标跟踪等)。
更多部署案例请参考模型部署示例 .
专业版相对社区版不是小版本 bump,而是整条推理面重写。同一台 RTX 3080、YOLO11n FP16、batch=1、dummy 640×640 的 C++ 测速下,专业版墙钟吞吐更高:Detect +26.2%,Segment +20.1%。完整对比见 专业版页面。
条件:warmup 100 次、iterations 1000,每组 3 次取墙钟吞吐中位数。社区版同步
predict();专业版submit/dequeue,含同步与双帧流水线。只测了 Detect / Segment。本轮 CUDA Graph 全开。
| 任务 | 社区版(同步) | 专业版(同步) | 专业版(双帧流水线) | 提升* |
|---|---|---|---|---|
| Detect | 877.7 qps(1.139 ms) | 1022.9 qps(0.978 ms) | 1107.5 qps(0.903 ms) | +26.2% |
| Segment | 273.1 qps(3.661 ms) | 321.5 qps(3.111 ms) | 328.1 qps(3.048 ms) | +20.1% |
*提升 = 社区版(同步)→ 专业版(双帧流水线)。双帧流水线:先提交 2 帧,再交错取结果,让 GPU 前后帧重叠;社区版无此 API。
| 组合 | 社区版 | 专业版(同步) | 专业版(双帧流水线) |
|---|---|---|---|
| Detect ×2 | N/A | 542.1 qps | 558.2 qps |
| Detect + Segment | N/A | 272.9 qps | 278.8 qps |
| Segment ×2 | N/A | 172.4 qps | 176.1 qps |
一次
Executor::open装多个 member、共享前处理,社区版无 ensemble API。
| 社区版 | 专业版 | |
|---|---|---|
| 流水线深度 | 仅同步 predict(),无 submit/dequeue | 可配置 in-flight 深度;推荐双帧流水线,Detect +8.3% 吞吐 |
| 多模型 Ensemble | 无 API | 一次 Executor::open 装多个 member、共享前处理,省一份输入显存 |
| 前处理 | 对齐 OpenCV;绝大多数像素误差为 0,少数 ±1 | 与 OpenCV 逐像素全零对齐;LUT 特化核,比开源版更快 |
| CUDA Graph | 首次推理会把 capture 算进性能报告,且无法只看稳态 | 库内自动回放;稳态跳过 SetParams;GPU timing 在图外 |
| 后处理插件 | 检测走内置 NMS;Pose / Seg / OBB 各有插件 | 一套插件覆盖 Detect / Pose / Seg / OBB |
| 多会话 | 再开会话要复制实例 | 已加载的模型上直接开多会话,不重复加载 |
| 公开接口 | InferOption + 按任务拆的 Model;一次 predict | 加载一次模型,多次开推理会话;按帧读取结果 |
| 构建 engine | Pose / Seg / OBB 还需把插件编进 engine | 构建步骤更简单;社区版 engine 不能直接用,需要重新导出 |
| Python 任务 | 必须手填 task=,且与导出一致 | 默认同 engine 推断,可覆盖 |
| TensorRT | ≥ 8.6.1 | ≥ 10(硬下限) |
| 源码与许可 | 公开仓库,GPL-3.0 | 闭源,单独授权 |
购买入口尚未开放,开放后会写在本 README。
开源不易,如果本项目对你有所帮助,欢迎通过赞助支持作者。你的支持是开发者持续维护的最大动力!

🙏 衷心感谢以下支持者与赞助商的无私支持:
[!NOTE]
以下是 GitHub Actions 自动生成的赞助者列表,每日更新 ✨。

TensorRT-YOLO采用 GPL-3.0许可证,这个OSI 批准的开源许可证非常适合学生和爱好者,可以推动开放的协作和知识分享。请查看LICENSE 文件以了解更多细节。
感谢您选择使用 TensorRT-YOLO,我们鼓励开放的协作和知识分享,同时也希望您遵守开源许可的相关规定。
对于 TensorRT-YOLO 的错误报告和功能请求,请访问 GitHub Issues!
专业版尚未开放购买,请勿在 Issues 里询价;入口开放后会更新本 README。
给项目点亮 ⭐ Star 可以帮助我们优先关注你的需求,加快响应速度~

7,139 followers · starred Nov 2025
66 followers · starred Feb 2026
4 followers · starred Oct 2025
🚀 Easier & Faster YOLO Deployment Toolkit for NVIDIA 🛠️
See the codeEnglish | 简体中文
🚀 TensorRT-YOLO 是一款专为 NVIDIA 设备设计的易用灵活、极致高效的YOLO系列推理部署工具。项目不仅集成了 TensorRT 插件以增强后处理效果,还使用了 CUDA 核函数以及 CUDA 图来加速推理。TensorRT-YOLO 提供了 C++ 和 Python 推理的支持,旨在提供📦开箱即用的部署体验。包括 目标检测、实例分割、图像分类、姿态识别、旋转目标检测、视频分析等任务场景,满足开发者多场景的部署需求。
[!IMPORTANT]
本仓库是社区版(6.4),许可证 GPL-3.0。社区版推理接口冻结,不再合入新的运行时架构。
专业版(闭源)将单独提供,源码不在本仓库。购买入口尚未开放,开放后会写在本 README。吞吐与能力对比见 社区版与专业版。
社区版(6.4)推理接口冻结;专业版将单独提供(购买入口尚未开放)。🌟 NEW
🔥 实战课程|TensorRT × Triton Inference Server 模型部署
2026-03-20: 添加对 YOLO26 的支持,包括分类、定向边界框、姿态估计以及实例分割。🌟 NEW
2026-01-07: 添加对 YOLO-Master 的支持,包括分类、定向边界框、姿态估计以及实例分割。🌟 NEW
2025-10-05:精度完美对齐,CUDA 完美复刻 LetterBox,绝大多数情况下像素误差为 0。Python 模块重大重构,易用性大幅提升。🌟 NEW
2025-06-09: C++仅引单头文件 trtyolo.hpp,零第三方依赖(使用模块时无需链接 CUDA 和 TensorRT),增加对带图像间距(Pitch)数据结构的支持,详见 B站。🌟 NEW
2025-04-19: 添加对 YOLO-World, YOLOE 的支持,包括分类、定向边界框、姿态估计以及实例分割,详见 B站。🌟 NEW
2025-03-29: 添加对 YOLO12 的支持,包括分类、定向边界框、姿态估计以及实例分割,详见 issues。🌟 NEW
[!NOTE]
如果您在 Windows 下进行开发,可以参考以下配置指南:
首先,克隆 TensorRT-YOLO 仓库:
git clone https://github.com/laugh12321/TensorRT-YOLO
cd TensorRT-YOLO
然后使用 CMake,可以按照以下步骤操作:
pip install "pybind11[global]" # 安装 pybind11,用于生成 Python 绑定
cmake -S . -B build -D TRT_PATH=/your/tensorrt/dir -D BUILD_PYTHON=ON -D CMAKE_INSTALL_PREFIX=/your/tensorrt-yolo/install/dir
cmake --build build -j$(nproc) --config Release --target install
执行上述指令后,tensorrt-yolo 库将被安装到指定的 CMAKE_INSTALL_PREFIX 路径中。其中,include 文件夹中包含头文件,lib 文件夹中包含 trtyolo 动态库和 custom_plugins 动态库(仅在使用 trtexec 构建 OBB、Segment 或 Pose 模型时需要)。如果在编译时启用了 BUILD_PYTHON 选项,则还会在 trtyolo/libs 路径下生成相应的 Python 绑定文件。
[!NOTE]
在使用 C++ 动态库之前,请确保将指定的CMAKE_INSTALL_PREFIX路径添加到环境变量中,以便 CMake 的find_package能够找到tensorrt-yolo-config.cmake文件。可以通过以下命令完成此操作:export PATH=$PATH:/your/tensorrt-yolo/install/dir # linux $env:PATH = "$env:PATH;C:\your\tensorrt-yolo\install\dir;C:\your\tensorrt-yolo\install\dir\bin" # windows
如果您希望在 Python 上体验与 C++ 相同的推理速度,则编译时需开启 BUILD_PYTHON 选项,然后再按照以下步骤操作:
pip install --upgrade build
python -m build --wheel
pip install dist/trtyolo-6.*-py3-none-any.whl
trtyolo-export 工具包,将已经导出的 YOLO 系列 ONNX 模型转换为兼容 TensorRT-YOLO 推理的输出结构并构建为 TensorRT 引擎。使用 Python 进行推理:
import cv2
import supervision as sv

from trtyolo import TRTYOLO

# -------------------- 初始化模型 --------------------
# 注意:task参数需与导出时指定的任务类型一致("detect"、"segment"、"classify"、"pose"、"obb")
# profile参数开启后,会在推理时计算性能指标,调用 model.profile() 可获取
# swap_rb参数开启后,会在推理前交换通道顺序(确保模型输入时RGB)
model = TRTYOLO("yolo11n-with-plugin.engine", task="detect", profile=True, swap_rb=True)

# -------------------- 加载测试图片并推理 --------------------
image = cv2.imread("test_image.jpg")
result = model.predict(image)
print(f"==> result: {result}")

# -------------------- 可视化结果 --------------------
box_annotator = sv.BoxAnnotator()
annotated_frame = box_annotator.annotate(scene=image.copy(), detections=result)

# -------------------- 性能评估 --------------------
throughput, cpu_latency, gpu_latency = model.profile()
print(throughput)
print(cpu_latency)
print(gpu_latency)

# -------------------- 克隆模型 --------------------
# 克隆模型实例(适用于多线程场景)
cloned_model = model.clone()  # 创建独立副本,避免资源竞争
# 验证克隆模型推理一致性
cloned_result = cloned_model.predict(input_img)
print(f"==> cloned_result: {cloned_result}")
使用 C++ 进行推理:
#include <memory>
#include <opencv2/opencv.hpp>

#include "trtyolo.hpp"

int main() {
    try {
        // -------------------- 初始化配置 --------------------
        trtyolo::InferOption option;
        option.enableSwapRB();  // BGR->RGB转换

        // 特殊模型参数设置示例
        // const std::vector<float> mean{0.485f, 0.456f, 0.406f};
        // const std::vector<float> std{0.229f, 0.224f, 0.225f};
        // option.setNormalizeParams(mean, std);

        // -------------------- 模型初始化 --------------------
        // ClassifyModel、DetectModel、OBBModel、SegmentModel 和 PoseModel 分别对应于图像分类、检测、方向边界框、分割和姿态估计模型
        auto detector = std::make_unique<trtyolo::DetectModel>(
            "yolo11n-with-plugin.engine",  // 模型路径
            option                         // 推理设置
        );

        // -------------------- 数据加载 --------------------
        cv::Mat cv_image = cv::imread("test_image.jpg");
        if (cv_image.empty()) {
            throw std::runtime_error("无法加载测试图片");
        }

        // 封装图像数据(不复制像素数据)
        trtyolo::Image input_image(
            cv_image.data,     // 像素数据指针
            cv_image.cols,     // 图像宽度
            cv_image.rows     // 图像高度
        );

        // -------------------- 执行推理 --------------------
        trtyolo::DetectRes result = detector->predict(input_image);
        std::cout << result << std::endl;

        // -------------------- 结果可视化(示意) --------------------
        // 实际开发需实现可视化逻辑,示例:
        // cv::Mat vis_image = visualize_detections(cv_image, result);
        // cv::imwrite("vis_result.jpg", vis_image);

        // -------------------- 模型克隆演示 --------------------
        auto cloned_detector = detector->clone();  // 创建独立实例
        trtyolo::DetectRes cloned_result = cloned_detector->predict(input_image);

        // 验证结果一致性
        std::cout << cloned_result << std::endl;

    } catch (const std::exception& e) {
        std::cerr << "程序异常: " << e.what() << std::endl;
        return EXIT_FAILURE;
    }
    return EXIT_SUCCESS;
}
以下是predict方法的流程图,展示了从输入图片到输出结果的完整流程:
只需将待推理的图片传递给 predict 方法,predict 内部会自动完成预处理、模型推理和后处理,并输出推理结果,这些结果可进一步应用于下游任务(如可视化、目标跟踪等)。
更多部署案例请参考模型部署示例 .
专业版相对社区版不是小版本 bump,而是整条推理面重写。同一台 RTX 3080、YOLO11n FP16、batch=1、dummy 640×640 的 C++ 测速下,专业版墙钟吞吐更高:Detect +26.2%,Segment +20.1%。完整对比见 专业版页面。
条件:warmup 100 次、iterations 1000,每组 3 次取墙钟吞吐中位数。社区版同步
predict();专业版submit/dequeue,含同步与双帧流水线。只测了 Detect / Segment。本轮 CUDA Graph 全开。
| 任务 | 社区版(同步) | 专业版(同步) | 专业版(双帧流水线) | 提升* |
|---|---|---|---|---|
| Detect | 877.7 qps(1.139 ms) | 1022.9 qps(0.978 ms) | 1107.5 qps(0.903 ms) | +26.2% |
| Segment | 273.1 qps(3.661 ms) | 321.5 qps(3.111 ms) | 328.1 qps(3.048 ms) | +20.1% |
*提升 = 社区版(同步)→ 专业版(双帧流水线)。双帧流水线:先提交 2 帧,再交错取结果,让 GPU 前后帧重叠;社区版无此 API。
| 组合 | 社区版 | 专业版(同步) | 专业版(双帧流水线) |
|---|---|---|---|
| Detect ×2 | N/A | 542.1 qps | 558.2 qps |
| Detect + Segment | N/A | 272.9 qps | 278.8 qps |
| Segment ×2 | N/A | 172.4 qps | 176.1 qps |
一次
Executor::open装多个 member、共享前处理,社区版无 ensemble API。
| 社区版 | 专业版 | |
|---|---|---|
| 流水线深度 | 仅同步 predict(),无 submit/dequeue | 可配置 in-flight 深度;推荐双帧流水线,Detect +8.3% 吞吐 |
| 多模型 Ensemble | 无 API | 一次 Executor::open 装多个 member、共享前处理,省一份输入显存 |
| 前处理 | 对齐 OpenCV;绝大多数像素误差为 0,少数 ±1 | 与 OpenCV 逐像素全零对齐;LUT 特化核,比开源版更快 |
| CUDA Graph | 首次推理会把 capture 算进性能报告,且无法只看稳态 | 库内自动回放;稳态跳过 SetParams;GPU timing 在图外 |
| 后处理插件 | 检测走内置 NMS;Pose / Seg / OBB 各有插件 | 一套插件覆盖 Detect / Pose / Seg / OBB |
| 多会话 | 再开会话要复制实例 | 已加载的模型上直接开多会话,不重复加载 |
| 公开接口 | InferOption + 按任务拆的 Model;一次 predict | 加载一次模型,多次开推理会话;按帧读取结果 |
| 构建 engine | Pose / Seg / OBB 还需把插件编进 engine | 构建步骤更简单;社区版 engine 不能直接用,需要重新导出 |
| Python 任务 | 必须手填 task=,且与导出一致 | 默认同 engine 推断,可覆盖 |
| TensorRT | ≥ 8.6.1 | ≥ 10(硬下限) |
| 源码与许可 | 公开仓库,GPL-3.0 | 闭源,单独授权 |
购买入口尚未开放,开放后会写在本 README。
开源不易,如果本项目对你有所帮助,欢迎通过赞助支持作者。你的支持是开发者持续维护的最大动力!
🙏 衷心感谢以下支持者与赞助商的无私支持:
[!NOTE]
以下是 GitHub Actions 自动生成的赞助者列表,每日更新 ✨。
TensorRT-YOLO采用 GPL-3.0许可证,这个OSI 批准的开源许可证非常适合学生和爱好者,可以推动开放的协作和知识分享。请查看LICENSE 文件以了解更多细节。
感谢您选择使用 TensorRT-YOLO,我们鼓励开放的协作和知识分享,同时也希望您遵守开源许可的相关规定。
对于 TensorRT-YOLO 的错误报告和功能请求,请访问 GitHub Issues!
专业版尚未开放购买,请勿在 Issues 里询价;入口开放后会更新本 README。
给项目点亮 ⭐ Star 可以帮助我们优先关注你的需求,加快响应速度~
7,139 followers · starred Nov 2025
66 followers · starred Feb 2026
4 followers · starred Oct 2025



