
🚀🚀🚀 YOLO series of PaddlePaddle implementation, PP-YOLOE+, RT-DETR, YOLOv5, YOLOv6, YOLOv7, YOLOv8, YOLOv10, YOLO11, YOLOX, YOLOv5u, YOLOv7u, YOLOv6Lite, RTMDet and so on. 🚀🚀🚀
See the codeREADME
简体中文 | English
简介
PaddleYOLO是基于PaddleDetection的YOLO系列模型库,只包含YOLO系列模型的相关代码,支持YOLOv3、PP-YOLO、PP-YOLOv2、PP-YOLOE、PP-YOLOE+、RT-DETR、YOLOX、YOLOv5、YOLOv6、YOLOv7、YOLOv8、YOLOv5u、YOLOv7u、YOLOv6Lite、RTMDet等模型,COCO数据集模型库请参照 ModelZoo 和 configs。


注意:
- PaddleYOLO 代码库协议为 GPL 3.0,YOLOv5、YOLOv6、YOLOv7和YOLOv8这几类模型代码不合入PaddleDetection,其余YOLO模型推荐在PaddleDetection中使用,会最先发布PP-YOLO系列特色检测模型的最新进展;
- PaddleYOLO代码库推荐使用paddlepaddle-2.4.2以上的版本,请参考官网下载对应适合版本,Windows平台请安装paddle develop版本;
- PaddleYOLO 的Roadmap issue用于收集用户的需求,欢迎提出您的建议和需求;
教程
安装
Clone 代码库和安装 requirements.txt,环境需要在一个 Python>=3.7.0 下的环境,且需要安装 PaddlePaddle>=2.4.2。
git clone https://github.com/PaddlePaddle/PaddleYOLO  # clone
cd PaddleYOLO
pip install -r requirements.txt  # install
训练/验证/预测/
将以下命令写在一个脚本文件里如```run.sh```,一键运行命令为:```sh run.sh```,也可命令行一句句去运行。model_name=ppyoloe # 可修改,如 yolov7
job_name=ppyoloe_plus_crn_s_80e_coco # 可修改,如 yolov7_tiny_300e_coco
config=configs/${model_name}/${job_name}.yml
log_dir=log_dir/${job_name}
# weights=https://bj.bcebos.com/v1/paddledet/models/${job_name}.pdparams
weights=output/${job_name}/model_final.pdparams
# 1.训练(单卡/多卡),加 --eval 表示边训边评估,加 --amp 表示混合精度训练
# CUDA_VISIBLE_DEVICES=0 python tools/train.py -c ${config} --eval --amp
python -m paddle.distributed.launch --log_dir=${log_dir} --gpus 0,1,2,3,4,5,6,7 tools/train.py -c ${config} --eval --amp
# 2.评估,加 --classwise 表示输出每一类mAP
CUDA_VISIBLE_DEVICES=0 python tools/eval.py -c ${config} -o weights=${weights} --classwise
# 3.预测 (单张图/图片文件夹)
CUDA_VISIBLE_DEVICES=0 python tools/infer.py -c ${config} -o weights=${weights} --infer_img=demo/000000014439_640x640.jpg --draw_threshold=0.5
# CUDA_VISIBLE_DEVICES=0 python tools/infer.py -c ${config} -o weights=${weights} --infer_dir=demo/ --draw_threshold=0.5
部署/测速
将以下命令写在一个脚本文件里如run.sh,一键运行命令为:sh run.sh,也可命令行一句句去运行。
model_name=ppyoloe # 可修改,如 yolov7
job_name=ppyoloe_plus_crn_s_80e_coco # 可修改,如 yolov7_tiny_300e_coco

config=configs/${model_name}/${job_name}.yml
log_dir=log_dir/${job_name}
# weights=https://bj.bcebos.com/v1/paddledet/models/${job_name}.pdparams
weights=output/${job_name}/model_final.pdparams

# 4.导出模型,以下3种模式选一种
## 普通导出,加trt表示用于trt加速,对NMS和silu激活函数提速明显
CUDA_VISIBLE_DEVICES=0 python tools/export_model.py -c ${config} -o weights=${weights} # trt=True

## exclude_post_process去除后处理导出,返回和YOLOv5导出ONNX时相同格式的concat后的1个Tensor,是未缩放回原图的坐标+分类置信度
# CUDA_VISIBLE_DEVICES=0 python tools/export_model.py -c ${config} -o weights=${weights} exclude_post_process=True # trt=True

## exclude_nms去除NMS导出,返回2个Tensor,是缩放回原图后的坐标和分类置信度
# CUDA_VISIBLE_DEVICES=0 python tools/export_model.py -c ${config} -o weights=${weights} exclude_nms=True # trt=True

# 5.部署预测,注意不能使用 去除后处理 或 去除NMS 导出后的模型去预测
CUDA_VISIBLE_DEVICES=0 python deploy/python/infer.py --model_dir=output_inference/${job_name} --image_file=demo/000000014439_640x640.jpg --device=GPU

# 6.部署测速,加 “--run_mode=trt_fp16” 表示在TensorRT FP16模式下测速,注意如需用到 trt_fp16 则必须为加 trt=True 导出的模型
CUDA_VISIBLE_DEVICES=0 python deploy/python/infer.py --model_dir=output_inference/${job_name} --image_file=demo/000000014439_640x640.jpg --device=GPU --run_benchmark=True # --run_mode=trt_fp16

# 7.onnx导出,一般结合 exclude_post_process去除后处理导出的模型
paddle2onnx --model_dir output_inference/${job_name} --model_filename model.pdmodel --params_filename model.pdiparams --opset_version 12 --save_file ${job_name}.onnx

# 8.onnx trt测速
/usr/local/TensorRT-8.0.3.4/bin/trtexec --onnx=${job_name}.onnx --workspace=4096 --avgRuns=10 --shapes=input:1x3x640x640 --fp16
/usr/local/TensorRT-8.0.3.4/bin/trtexec --onnx=${job_name}.onnx --workspace=4096 --avgRuns=10 --shapes=input:1x3x640x640 --fp32
- 如果想切换模型,只要修改开头两行即可,如:
model_name=yolov7 job_name=yolov7_tiny_300e_coco - 导出onnx,首先安装Paddle2ONNX,
pip install paddle2onnx; - 统计FLOPs(G)和Params(M),首先安装PaddleSlim,
pip install paddleslim,然后设置runtime.yml里print_flops: True和print_params: True,并且注意确保是单尺度下如640x640,打印的是MACs,FLOPs=2*MACs。
[训练自定义数据集](https://github.com/PaddlePaddle/PaddleYOLO/issues/43)
- 请参照文档和issue;
- PaddleDetection团队提供了基于PP-YOLOE的各种垂类检测模型的配置文件和权重,用户也可以作为参考去使用自定义数据集。请参考 PP-YOLOE application、pphuman、ppvehicle、visdrone 和 smalldet。
- PaddleDetection团队也提供了VOC数据集的各种YOLO模型的配置文件和权重,用户也可以作为参考去使用自定义数据集。请参考 voc。
- 训练自定义数据集之前请先确保加载了对应COCO权重作为预训练,将配置文件中的
pretrain_weights:设置为对应COCO模型训好的权重,一般会提示head分类层卷积的通道数没对应上,属于正常现象,是由于自定义数据集一般和COCO数据集种类数不一致; - YOLO检测模型建议总
batch_size至少大于64去训练,如果资源不够请换小模型或减小模型的输入尺度,为了保障较高检测精度,尽量不要尝试单卡训和总batch_size小于64训;
更新日志
- 【2024/07/10】新增昇腾910B硬件支持,支持的模型见 模型列表
- 【2023/05/21】支持RT-DETR、YOLOv8、YOLOv5u和YOLOv7u训练全流程,支持YOLOv6Lite预测和部署;
- 【2023/03/13】支持YOLOv5u和YOLOv7u预测和部署;
- 【2023/01/10】支持YOLOv8预测和部署;
- 【2022/09/29】支持RTMDet预测和部署;
- 【2022/09/26】发布PaddleYOLO模型套件,请参照ModelZoo;
- 【2022/09/19】支持YOLOv6新版,包括n/t/s/m/l模型;
- 【2022/08/23】发布
YOLOSeries代码库: 支持YOLOv3,PP-YOLOE,PP-YOLOE+,YOLOX,YOLOv5,YOLOv6,YOLOv7等YOLO模型,支持ConvNeXt骨干网络高精度版PP-YOLOE,YOLOX和YOLOv5等模型,支持PaddleSlim无损加速量化训练PP-YOLOE,YOLOv5,YOLOv6和YOLOv7等模型,详情可阅读此文章;
 产品动态
-
🔥 2023.3.14:PaddleYOLO发布release/2.6版本
- 💡 模型套件:
- 支持
YOLOv8,YOLOv5u,YOLOv7u等YOLO模型预测和部署; - 支持
Swin-Transformer、ViT、FocalNet骨干网络高精度版PP-YOLOE+等模型; - 支持
YOLOv8在FastDeploy中多硬件快速部署;
- 支持
- 💡 模型套件:
-
🔥 2022.9.26:PaddleYOLO发布release/2.5版本
- 💡 模型套件:
- 发布PaddleYOLO模型套件: 支持
YOLOv3,PP-YOLOE,PP-YOLOE+,YOLOX,YOLOv5,YOLOv6,YOLOv7等YOLO模型,支持ConvNeXt骨干网络高精度版PP-YOLOE,YOLOX和YOLOv5等模型,支持PaddleSlim无损加速量化训练PP-YOLOE,YOLOv5,YOLOv6和YOLOv7等模型;
- 发布PaddleYOLO模型套件: 支持
- 💡 模型套件:
-
🔥 2022.8.26:PaddleDetection发布release/2.5版本
- 🗳 特色模型:
- 发布PP-YOLOE+,最高精度提升2.4% mAP,达到54.9% mAP,模型训练收敛速度提升3.75倍,端到端预测速度最高提升2.3倍;多个下游任务泛化性提升
- 发布PicoDet-NPU模型,支持模型全量化部署;新增PicoDet版面分析模型
- 发布PP-TinyPose升级版增强版,在健身、舞蹈等场景精度提升9.1% AP,支持侧身、卧躺、跳跃、高抬腿等非常规动作
- 🔮 场景能力:
- 发布行人分析工具PP-Human v2,新增打架、打电话、抽烟、闯入四大行为识别,底层算法性能升级,覆盖行人检测、跟踪、属性三类核心算法能力,提供保姆级全流程开发及模型优化策略,支持在线视频流输入
- 首次发布PP-Vehicle,提供车牌识别、车辆属性分析(颜色、车型)、车流量统计以及违章检测四大功能,兼容图片、在线视频流、视频输入,提供完善的二次开发文档教程
- 💡 前沿算法:
- 📋 产业范例:新增智能健身、打架识别、来客分析、车辆结构化范例
- 🗳 特色模型:
-
2022.3.24:PaddleDetection发布release/2.4版本
- 发布高精度云边一体SOTA目标检测模型PP-YOLOE,提供s/m/l/x版本,l版本COCO test2017数据集精度51.6%,V100预测速度78.1 FPS,支持混合精度训练,训练较PP-YOLOv2加速33%,全系列多尺度模型,满足不同硬件算力需求,可适配服务器、边缘端GPU及其他服务器端AI加速卡。
- 发布边缘端和CPU端超轻量SOTA目标检测模型PP-PicoDet增强版,精度提升2%左右,CPU预测速度提升63%,新增参数量0.7M的PicoDet-XS模型,提供模型稀疏化和量化功能,便于模型加速,各类硬件无需单独开发后处理模块,降低部署门槛。
- 发布实时行人分析工具PP-Human,支持行人跟踪、人流量统计、人体属性识别与摔倒检测四大能力,基于真实场景数据特殊优化,精准识别各类摔倒姿势,适应不同环境背景、光线及摄像角度。
- 新增YOLOX目标检测模型,支持nano/tiny/s/m/l/x版本,x版本COCO val2017数据集精度51.8%。
 简介
PaddleDetection为基于飞桨PaddlePaddle的端到端目标检测套件,内置30+模型算法及250+预训练模型,覆盖目标检测、实例分割、跟踪、关键点检测等方向,其中包括服务器端和移动端高精度、轻量级产业级SOTA模型、冠军方案和学术前沿算法,并提供配置化的网络模块组件、十余种数据增强策略和损失函数等高阶优化支持和多种部署方案,在打通数据处理、模型开发、训练、压缩、部署全流程的基础上,提供丰富的案例及教程,加速算法产业落地应用。

 特性
- 模型丰富: 包含目标检测、实例分割、人脸检测、关键点检测、多目标跟踪等250+个预训练模型,涵盖多种全球竞赛冠军方案。
- 使用简洁:模块化设计,解耦各个网络组件,开发者轻松搭建、试用各种检测模型及优化策略,快速得到高性能、定制化的算法。
- 端到端打通: 从数据增强、组网、训练、压缩、部署端到端打通,并完备支持云端/边缘端多架构、多设备部署。
- 高性能: 基于飞桨的高性能内核,模型训练速度及显存占用优势明显。支持FP16训练, 支持多机训练。

 技术交流
-
如果你发现任何PaddleDetection存在的问题或者是建议, 欢迎通过GitHub Issues给我们提issues。
-
欢迎加入PaddleDetection 微信用户群(扫码填写问卷即可入群)
- 入群福利 💎:获取PaddleDetection团队整理的重磅学习大礼包🎁
- 📊 福利一:获取飞桨联合业界企业整理的开源数据集
- 👨🏫 福利二:获取PaddleDetection历次发版直播视频与最新直播咨询
- 🗳 福利三:获取垂类场景预训练模型集合,包括工业、安防、交通等5+行业场景
- 🗂 福利四:获取10+全流程产业实操范例,覆盖火灾烟雾检测、人流量计数等产业高频场景

- 入群福利 💎:获取PaddleDetection团队整理的重磅学习大礼包🎁
 套件结构概览
| Architectures | Backbones | Components | Data Augmentation |
Object Detection |
Details
|
Common
FPN
Loss
Post-processing
Speed
|
Details
|
 模型性能概览
云端模型性能对比
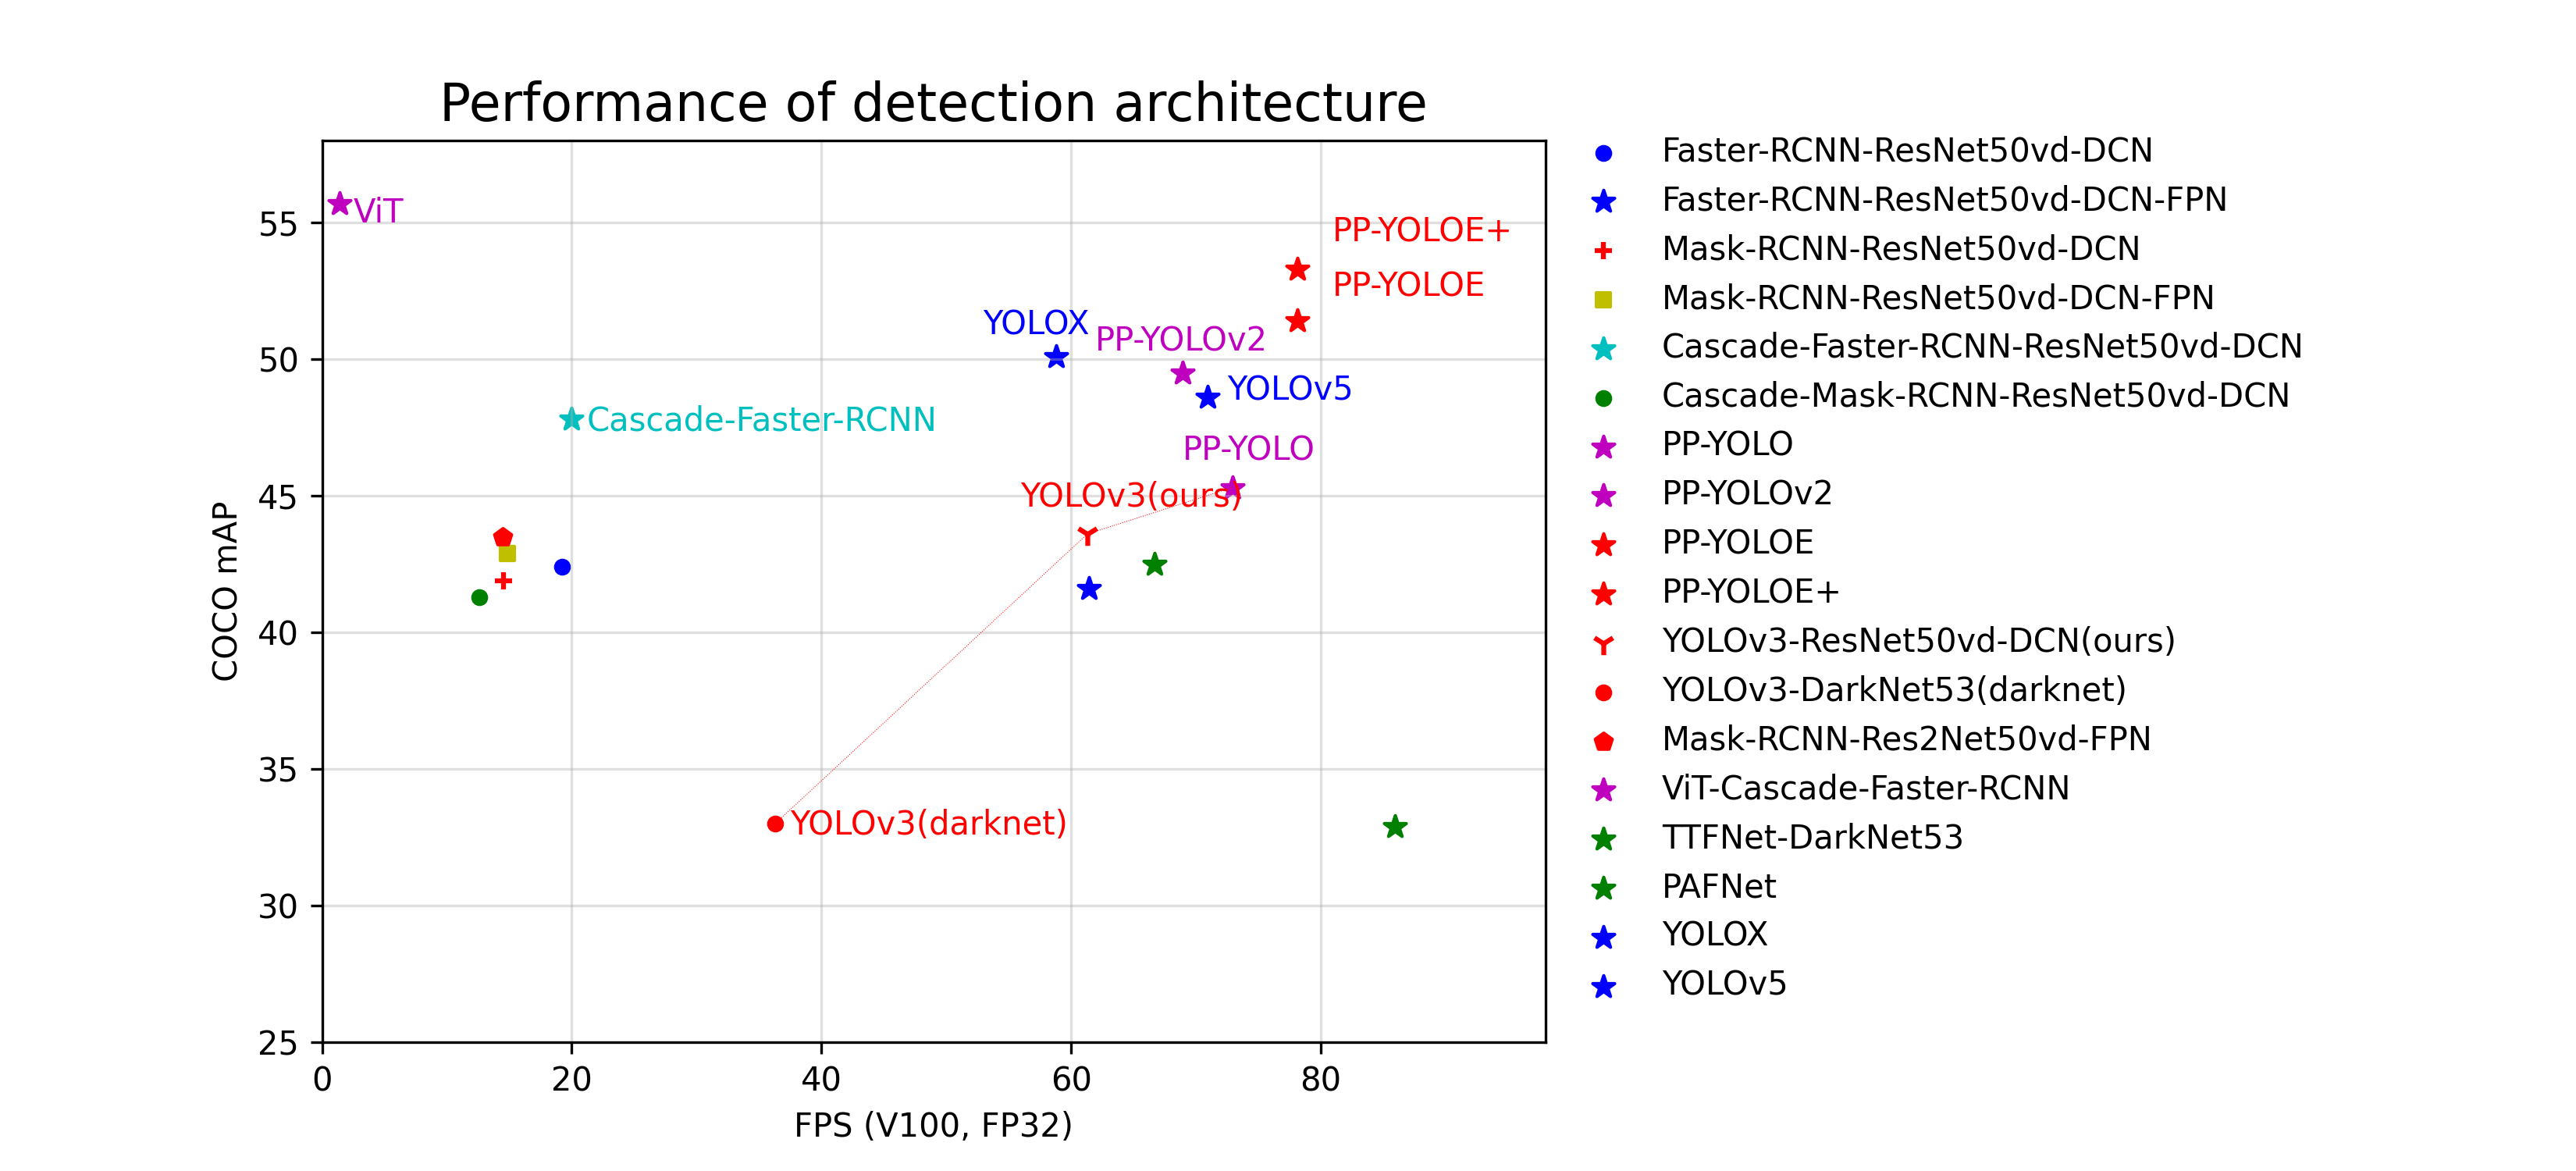
各模型结构和骨干网络的代表模型在COCO数据集上精度mAP和单卡Tesla V100上预测速度(FPS)对比图。
说明:
PP-YOLOE是对PP-YOLO v2模型的进一步优化,在COCO数据集精度51.6%,Tesla V100预测速度78.1FPSPP-YOLOE+是对PPOLOE模型的进一步优化,在COCO数据集精度53.3%,Tesla V100预测速度78.1FPS- 图中模型均可在模型库中获取
移动端模型性能对比
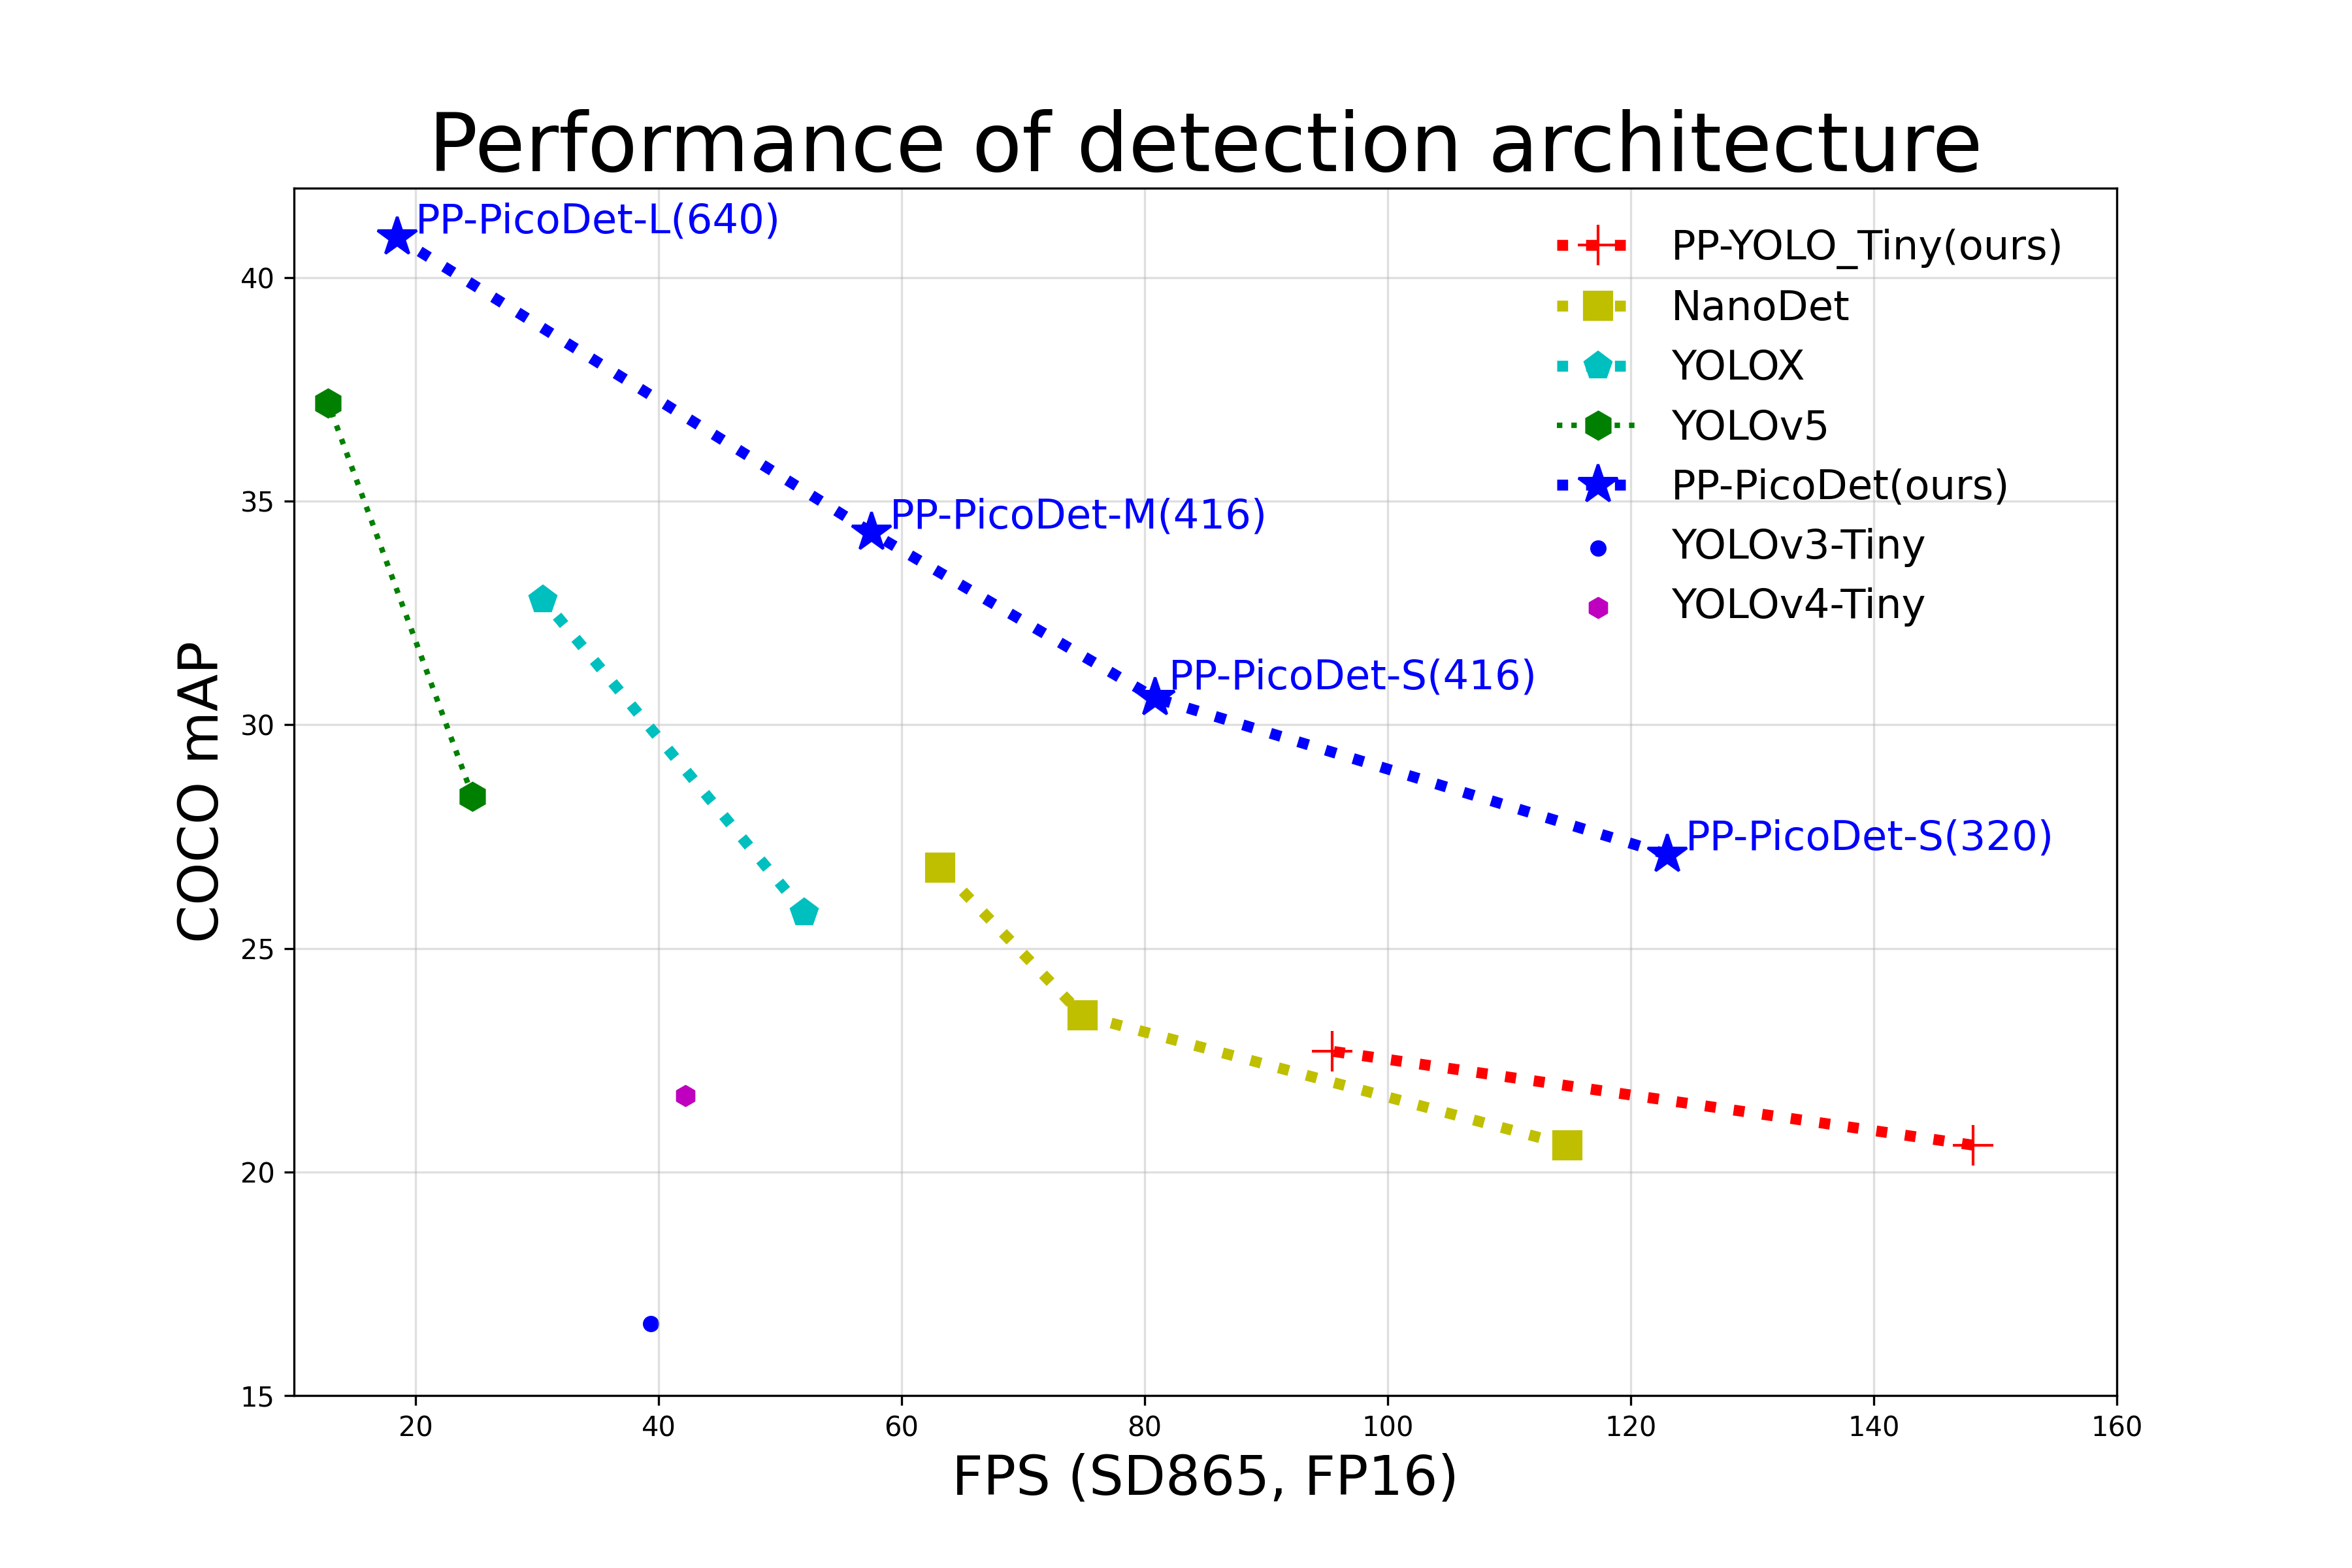
各移动端模型在COCO数据集上精度mAP和高通骁龙865处理器上预测速度(FPS)对比图。
说明:
- 测试数据均使用高通骁龙865(4*A77 + 4*A55)处理器batch size为1, 开启4线程测试,测试使用NCNN预测库,测试脚本见MobileDetBenchmark
- PP-PicoDet及PP-YOLO-Tiny为PaddleDetection自研模型,其余模型PaddleDetection暂未提供
 模型库
1. 通用检测
PP-YOLOE+系列 推荐场景:Nvidia V100, T4等云端GPU和Jetson系列等边缘端设备
| 模型名称 | COCO精度(mAP) | V100 TensorRT FP16速度(FPS) | 配置文件 | 模型下载 |
|---|---|---|---|---|
| PP-YOLOE+_s | 43.9 | 333.3 | 链接 | 下载地址 |
| PP-YOLOE+_m | 50.0 | 208.3 | 链接 | 下载地址 |
| PP-YOLOE+_l | 53.3 | 149.2 | 链接 | 下载地址 |
| PP-YOLOE+_x | 54.9 | 95.2 | 链接 | 下载地址 |
前沿检测算法
 文档教程
入门教程
进阶教程
-
参数配置
-
模型压缩(基于PaddleSlim)
-
进阶开发
 版本更新
版本更新内容请参考版本更新文档
 许可证书
本项目的发布受GPL-3.0 license许可认证。
 引用
@misc{ppdet2019,
title={PaddleDetection, Object detection and instance segmentation toolkit based on PaddlePaddle.},
author={PaddlePaddle Authors},
howpublished = {\url{https://github.com/PaddlePaddle/PaddleDetection}},
year={2019}
}
Significant stargazers

5 followers · starred Jul 2025

25 followers · starred Oct 2022
Similar repos


Languages
Python
78.4%
C++
15.7%
Shell
3.1%
Cuda
1.5%
🚀🚀🚀 YOLO series of PaddlePaddle implementation, PP-YOLOE+, RT-DETR, YOLOv5, YOLOv6, YOLOv7, YOLOv8, YOLOv10, YOLO11, YOLOX, YOLOv5u, YOLOv7u, YOLOv6Lite, RTMDet and so on. 🚀🚀🚀
See the codeREADME
简体中文 | English
简介
PaddleYOLO是基于PaddleDetection的YOLO系列模型库,只包含YOLO系列模型的相关代码,支持YOLOv3、PP-YOLO、PP-YOLOv2、PP-YOLOE、PP-YOLOE+、RT-DETR、YOLOX、YOLOv5、YOLOv6、YOLOv7、YOLOv8、YOLOv5u、YOLOv7u、YOLOv6Lite、RTMDet等模型,COCO数据集模型库请参照 ModelZoo 和 configs。
注意:
- PaddleYOLO 代码库协议为 GPL 3.0,YOLOv5、YOLOv6、YOLOv7和YOLOv8这几类模型代码不合入PaddleDetection,其余YOLO模型推荐在PaddleDetection中使用,会最先发布PP-YOLO系列特色检测模型的最新进展;
- PaddleYOLO代码库推荐使用paddlepaddle-2.4.2以上的版本,请参考官网下载对应适合版本,Windows平台请安装paddle develop版本;
- PaddleYOLO 的Roadmap issue用于收集用户的需求,欢迎提出您的建议和需求;
教程
安装
Clone 代码库和安装 requirements.txt,环境需要在一个 Python>=3.7.0 下的环境,且需要安装 PaddlePaddle>=2.4.2。
git clone https://github.com/PaddlePaddle/PaddleYOLO  # clone
cd PaddleYOLO
pip install -r requirements.txt  # install
训练/验证/预测/
将以下命令写在一个脚本文件里如```run.sh```,一键运行命令为:```sh run.sh```,也可命令行一句句去运行。model_name=ppyoloe # 可修改,如 yolov7
job_name=ppyoloe_plus_crn_s_80e_coco # 可修改,如 yolov7_tiny_300e_coco
config=configs/${model_name}/${job_name}.yml
log_dir=log_dir/${job_name}
# weights=https://bj.bcebos.com/v1/paddledet/models/${job_name}.pdparams
weights=output/${job_name}/model_final.pdparams
# 1.训练(单卡/多卡),加 --eval 表示边训边评估,加 --amp 表示混合精度训练
# CUDA_VISIBLE_DEVICES=0 python tools/train.py -c ${config} --eval --amp
python -m paddle.distributed.launch --log_dir=${log_dir} --gpus 0,1,2,3,4,5,6,7 tools/train.py -c ${config} --eval --amp
# 2.评估,加 --classwise 表示输出每一类mAP
CUDA_VISIBLE_DEVICES=0 python tools/eval.py -c ${config} -o weights=${weights} --classwise
# 3.预测 (单张图/图片文件夹)
CUDA_VISIBLE_DEVICES=0 python tools/infer.py -c ${config} -o weights=${weights} --infer_img=demo/000000014439_640x640.jpg --draw_threshold=0.5
# CUDA_VISIBLE_DEVICES=0 python tools/infer.py -c ${config} -o weights=${weights} --infer_dir=demo/ --draw_threshold=0.5
部署/测速
将以下命令写在一个脚本文件里如run.sh,一键运行命令为:sh run.sh,也可命令行一句句去运行。
model_name=ppyoloe # 可修改,如 yolov7
job_name=ppyoloe_plus_crn_s_80e_coco # 可修改,如 yolov7_tiny_300e_coco

config=configs/${model_name}/${job_name}.yml
log_dir=log_dir/${job_name}
# weights=https://bj.bcebos.com/v1/paddledet/models/${job_name}.pdparams
weights=output/${job_name}/model_final.pdparams

# 4.导出模型,以下3种模式选一种
## 普通导出,加trt表示用于trt加速,对NMS和silu激活函数提速明显
CUDA_VISIBLE_DEVICES=0 python tools/export_model.py -c ${config} -o weights=${weights} # trt=True

## exclude_post_process去除后处理导出,返回和YOLOv5导出ONNX时相同格式的concat后的1个Tensor,是未缩放回原图的坐标+分类置信度
# CUDA_VISIBLE_DEVICES=0 python tools/export_model.py -c ${config} -o weights=${weights} exclude_post_process=True # trt=True

## exclude_nms去除NMS导出,返回2个Tensor,是缩放回原图后的坐标和分类置信度
# CUDA_VISIBLE_DEVICES=0 python tools/export_model.py -c ${config} -o weights=${weights} exclude_nms=True # trt=True

# 5.部署预测,注意不能使用 去除后处理 或 去除NMS 导出后的模型去预测
CUDA_VISIBLE_DEVICES=0 python deploy/python/infer.py --model_dir=output_inference/${job_name} --image_file=demo/000000014439_640x640.jpg --device=GPU

# 6.部署测速,加 “--run_mode=trt_fp16” 表示在TensorRT FP16模式下测速,注意如需用到 trt_fp16 则必须为加 trt=True 导出的模型
CUDA_VISIBLE_DEVICES=0 python deploy/python/infer.py --model_dir=output_inference/${job_name} --image_file=demo/000000014439_640x640.jpg --device=GPU --run_benchmark=True # --run_mode=trt_fp16

# 7.onnx导出,一般结合 exclude_post_process去除后处理导出的模型
paddle2onnx --model_dir output_inference/${job_name} --model_filename model.pdmodel --params_filename model.pdiparams --opset_version 12 --save_file ${job_name}.onnx

# 8.onnx trt测速
/usr/local/TensorRT-8.0.3.4/bin/trtexec --onnx=${job_name}.onnx --workspace=4096 --avgRuns=10 --shapes=input:1x3x640x640 --fp16
/usr/local/TensorRT-8.0.3.4/bin/trtexec --onnx=${job_name}.onnx --workspace=4096 --avgRuns=10 --shapes=input:1x3x640x640 --fp32
- 如果想切换模型,只要修改开头两行即可,如:
model_name=yolov7 job_name=yolov7_tiny_300e_coco - 导出onnx,首先安装Paddle2ONNX,
pip install paddle2onnx; - 统计FLOPs(G)和Params(M),首先安装PaddleSlim,
pip install paddleslim,然后设置runtime.yml里print_flops: True和print_params: True,并且注意确保是单尺度下如640x640,打印的是MACs,FLOPs=2*MACs。
[训练自定义数据集](https://github.com/PaddlePaddle/PaddleYOLO/issues/43)
- 请参照文档和issue;
- PaddleDetection团队提供了基于PP-YOLOE的各种垂类检测模型的配置文件和权重,用户也可以作为参考去使用自定义数据集。请参考 PP-YOLOE application、pphuman、ppvehicle、visdrone 和 smalldet。
- PaddleDetection团队也提供了VOC数据集的各种YOLO模型的配置文件和权重,用户也可以作为参考去使用自定义数据集。请参考 voc。
- 训练自定义数据集之前请先确保加载了对应COCO权重作为预训练,将配置文件中的
pretrain_weights:设置为对应COCO模型训好的权重,一般会提示head分类层卷积的通道数没对应上,属于正常现象,是由于自定义数据集一般和COCO数据集种类数不一致; - YOLO检测模型建议总
batch_size至少大于64去训练,如果资源不够请换小模型或减小模型的输入尺度,为了保障较高检测精度,尽量不要尝试单卡训和总batch_size小于64训;
更新日志
- 【2024/07/10】新增昇腾910B硬件支持,支持的模型见 模型列表
- 【2023/05/21】支持RT-DETR、YOLOv8、YOLOv5u和YOLOv7u训练全流程,支持YOLOv6Lite预测和部署;
- 【2023/03/13】支持YOLOv5u和YOLOv7u预测和部署;
- 【2023/01/10】支持YOLOv8预测和部署;
- 【2022/09/29】支持RTMDet预测和部署;
- 【2022/09/26】发布PaddleYOLO模型套件,请参照ModelZoo;
- 【2022/09/19】支持YOLOv6新版,包括n/t/s/m/l模型;
- 【2022/08/23】发布
YOLOSeries代码库: 支持YOLOv3,PP-YOLOE,PP-YOLOE+,YOLOX,YOLOv5,YOLOv6,YOLOv7等YOLO模型,支持ConvNeXt骨干网络高精度版PP-YOLOE,YOLOX和YOLOv5等模型,支持PaddleSlim无损加速量化训练PP-YOLOE,YOLOv5,YOLOv6和YOLOv7等模型,详情可阅读此文章;
产品动态
-
🔥 2023.3.14:PaddleYOLO发布release/2.6版本
- 💡 模型套件:
- 支持
YOLOv8,YOLOv5u,YOLOv7u等YOLO模型预测和部署; - 支持
Swin-Transformer、ViT、FocalNet骨干网络高精度版PP-YOLOE+等模型; - 支持
YOLOv8在FastDeploy中多硬件快速部署;
- 支持
- 💡 模型套件:
-
🔥 2022.9.26:PaddleYOLO发布release/2.5版本
- 💡 模型套件:
- 发布PaddleYOLO模型套件: 支持
YOLOv3,PP-YOLOE,PP-YOLOE+,YOLOX,YOLOv5,YOLOv6,YOLOv7等YOLO模型,支持ConvNeXt骨干网络高精度版PP-YOLOE,YOLOX和YOLOv5等模型,支持PaddleSlim无损加速量化训练PP-YOLOE,YOLOv5,YOLOv6和YOLOv7等模型;
- 发布PaddleYOLO模型套件: 支持
- 💡 模型套件:
-
🔥 2022.8.26:PaddleDetection发布release/2.5版本
- 🗳 特色模型:
- 发布PP-YOLOE+,最高精度提升2.4% mAP,达到54.9% mAP,模型训练收敛速度提升3.75倍,端到端预测速度最高提升2.3倍;多个下游任务泛化性提升
- 发布PicoDet-NPU模型,支持模型全量化部署;新增PicoDet版面分析模型
- 发布PP-TinyPose升级版增强版,在健身、舞蹈等场景精度提升9.1% AP,支持侧身、卧躺、跳跃、高抬腿等非常规动作
- 🔮 场景能力:
- 发布行人分析工具PP-Human v2,新增打架、打电话、抽烟、闯入四大行为识别,底层算法性能升级,覆盖行人检测、跟踪、属性三类核心算法能力,提供保姆级全流程开发及模型优化策略,支持在线视频流输入
- 首次发布PP-Vehicle,提供车牌识别、车辆属性分析(颜色、车型)、车流量统计以及违章检测四大功能,兼容图片、在线视频流、视频输入,提供完善的二次开发文档教程
- 💡 前沿算法:
- 📋 产业范例:新增智能健身、打架识别、来客分析、车辆结构化范例
- 🗳 特色模型:
-
2022.3.24:PaddleDetection发布release/2.4版本
- 发布高精度云边一体SOTA目标检测模型PP-YOLOE,提供s/m/l/x版本,l版本COCO test2017数据集精度51.6%,V100预测速度78.1 FPS,支持混合精度训练,训练较PP-YOLOv2加速33%,全系列多尺度模型,满足不同硬件算力需求,可适配服务器、边缘端GPU及其他服务器端AI加速卡。
- 发布边缘端和CPU端超轻量SOTA目标检测模型PP-PicoDet增强版,精度提升2%左右,CPU预测速度提升63%,新增参数量0.7M的PicoDet-XS模型,提供模型稀疏化和量化功能,便于模型加速,各类硬件无需单独开发后处理模块,降低部署门槛。
- 发布实时行人分析工具PP-Human,支持行人跟踪、人流量统计、人体属性识别与摔倒检测四大能力,基于真实场景数据特殊优化,精准识别各类摔倒姿势,适应不同环境背景、光线及摄像角度。
- 新增YOLOX目标检测模型,支持nano/tiny/s/m/l/x版本,x版本COCO val2017数据集精度51.8%。
简介
PaddleDetection为基于飞桨PaddlePaddle的端到端目标检测套件,内置30+模型算法及250+预训练模型,覆盖目标检测、实例分割、跟踪、关键点检测等方向,其中包括服务器端和移动端高精度、轻量级产业级SOTA模型、冠军方案和学术前沿算法,并提供配置化的网络模块组件、十余种数据增强策略和损失函数等高阶优化支持和多种部署方案,在打通数据处理、模型开发、训练、压缩、部署全流程的基础上,提供丰富的案例及教程,加速算法产业落地应用。
特性
- 模型丰富: 包含目标检测、实例分割、人脸检测、关键点检测、多目标跟踪等250+个预训练模型,涵盖多种全球竞赛冠军方案。
- 使用简洁:模块化设计,解耦各个网络组件,开发者轻松搭建、试用各种检测模型及优化策略,快速得到高性能、定制化的算法。
- 端到端打通: 从数据增强、组网、训练、压缩、部署端到端打通,并完备支持云端/边缘端多架构、多设备部署。
- 高性能: 基于飞桨的高性能内核,模型训练速度及显存占用优势明显。支持FP16训练, 支持多机训练。
技术交流
-
如果你发现任何PaddleDetection存在的问题或者是建议, 欢迎通过GitHub Issues给我们提issues。
-
欢迎加入PaddleDetection 微信用户群(扫码填写问卷即可入群)
- 入群福利 💎:获取PaddleDetection团队整理的重磅学习大礼包🎁
- 📊 福利一:获取飞桨联合业界企业整理的开源数据集
- 👨🏫 福利二:获取PaddleDetection历次发版直播视频与最新直播咨询
- 🗳 福利三:获取垂类场景预训练模型集合,包括工业、安防、交通等5+行业场景
- 🗂 福利四:获取10+全流程产业实操范例,覆盖火灾烟雾检测、人流量计数等产业高频场景
- 入群福利 💎:获取PaddleDetection团队整理的重磅学习大礼包🎁
套件结构概览
| Architectures | Backbones | Components | Data Augmentation |
Object Detection |
Details
|
Common
FPN
Loss
Post-processing
Speed
|
Details
|
模型性能概览
云端模型性能对比
各模型结构和骨干网络的代表模型在COCO数据集上精度mAP和单卡Tesla V100上预测速度(FPS)对比图。
说明:
PP-YOLOE是对PP-YOLO v2模型的进一步优化,在COCO数据集精度51.6%,Tesla V100预测速度78.1FPSPP-YOLOE+是对PPOLOE模型的进一步优化,在COCO数据集精度53.3%,Tesla V100预测速度78.1FPS- 图中模型均可在模型库中获取
移动端模型性能对比
各移动端模型在COCO数据集上精度mAP和高通骁龙865处理器上预测速度(FPS)对比图。
说明:
- 测试数据均使用高通骁龙865(4*A77 + 4*A55)处理器batch size为1, 开启4线程测试,测试使用NCNN预测库,测试脚本见MobileDetBenchmark
- PP-PicoDet及PP-YOLO-Tiny为PaddleDetection自研模型,其余模型PaddleDetection暂未提供
模型库
1. 通用检测
PP-YOLOE+系列 推荐场景:Nvidia V100, T4等云端GPU和Jetson系列等边缘端设备
| 模型名称 | COCO精度(mAP) | V100 TensorRT FP16速度(FPS) | 配置文件 | 模型下载 |
|---|---|---|---|---|
| PP-YOLOE+_s | 43.9 | 333.3 | 链接 | 下载地址 |
| PP-YOLOE+_m | 50.0 | 208.3 | 链接 | 下载地址 |
| PP-YOLOE+_l | 53.3 | 149.2 | 链接 | 下载地址 |
| PP-YOLOE+_x | 54.9 | 95.2 | 链接 | 下载地址 |
前沿检测算法
文档教程
入门教程
进阶教程
-
参数配置
-
模型压缩(基于PaddleSlim)
-
进阶开发
版本更新
版本更新内容请参考版本更新文档
许可证书
本项目的发布受GPL-3.0 license许可认证。
引用
@misc{ppdet2019,
title={PaddleDetection, Object detection and instance segmentation toolkit based on PaddlePaddle.},
author={PaddlePaddle Authors},
howpublished = {\url{https://github.com/PaddlePaddle/PaddleDetection}},
year={2019}
}
Similar repos
Significant stargazers
5 followers · starred Jul 2025
25 followers · starred Oct 2022
Languages
Python
78.4%
C++
15.7%
Shell
3.1%
Cuda
1.5%