AudioNotes 是一款本地运行的音视频转文字和智能笔记工具,适合整理会议、访谈、课程和语音备忘录。
主要功能:
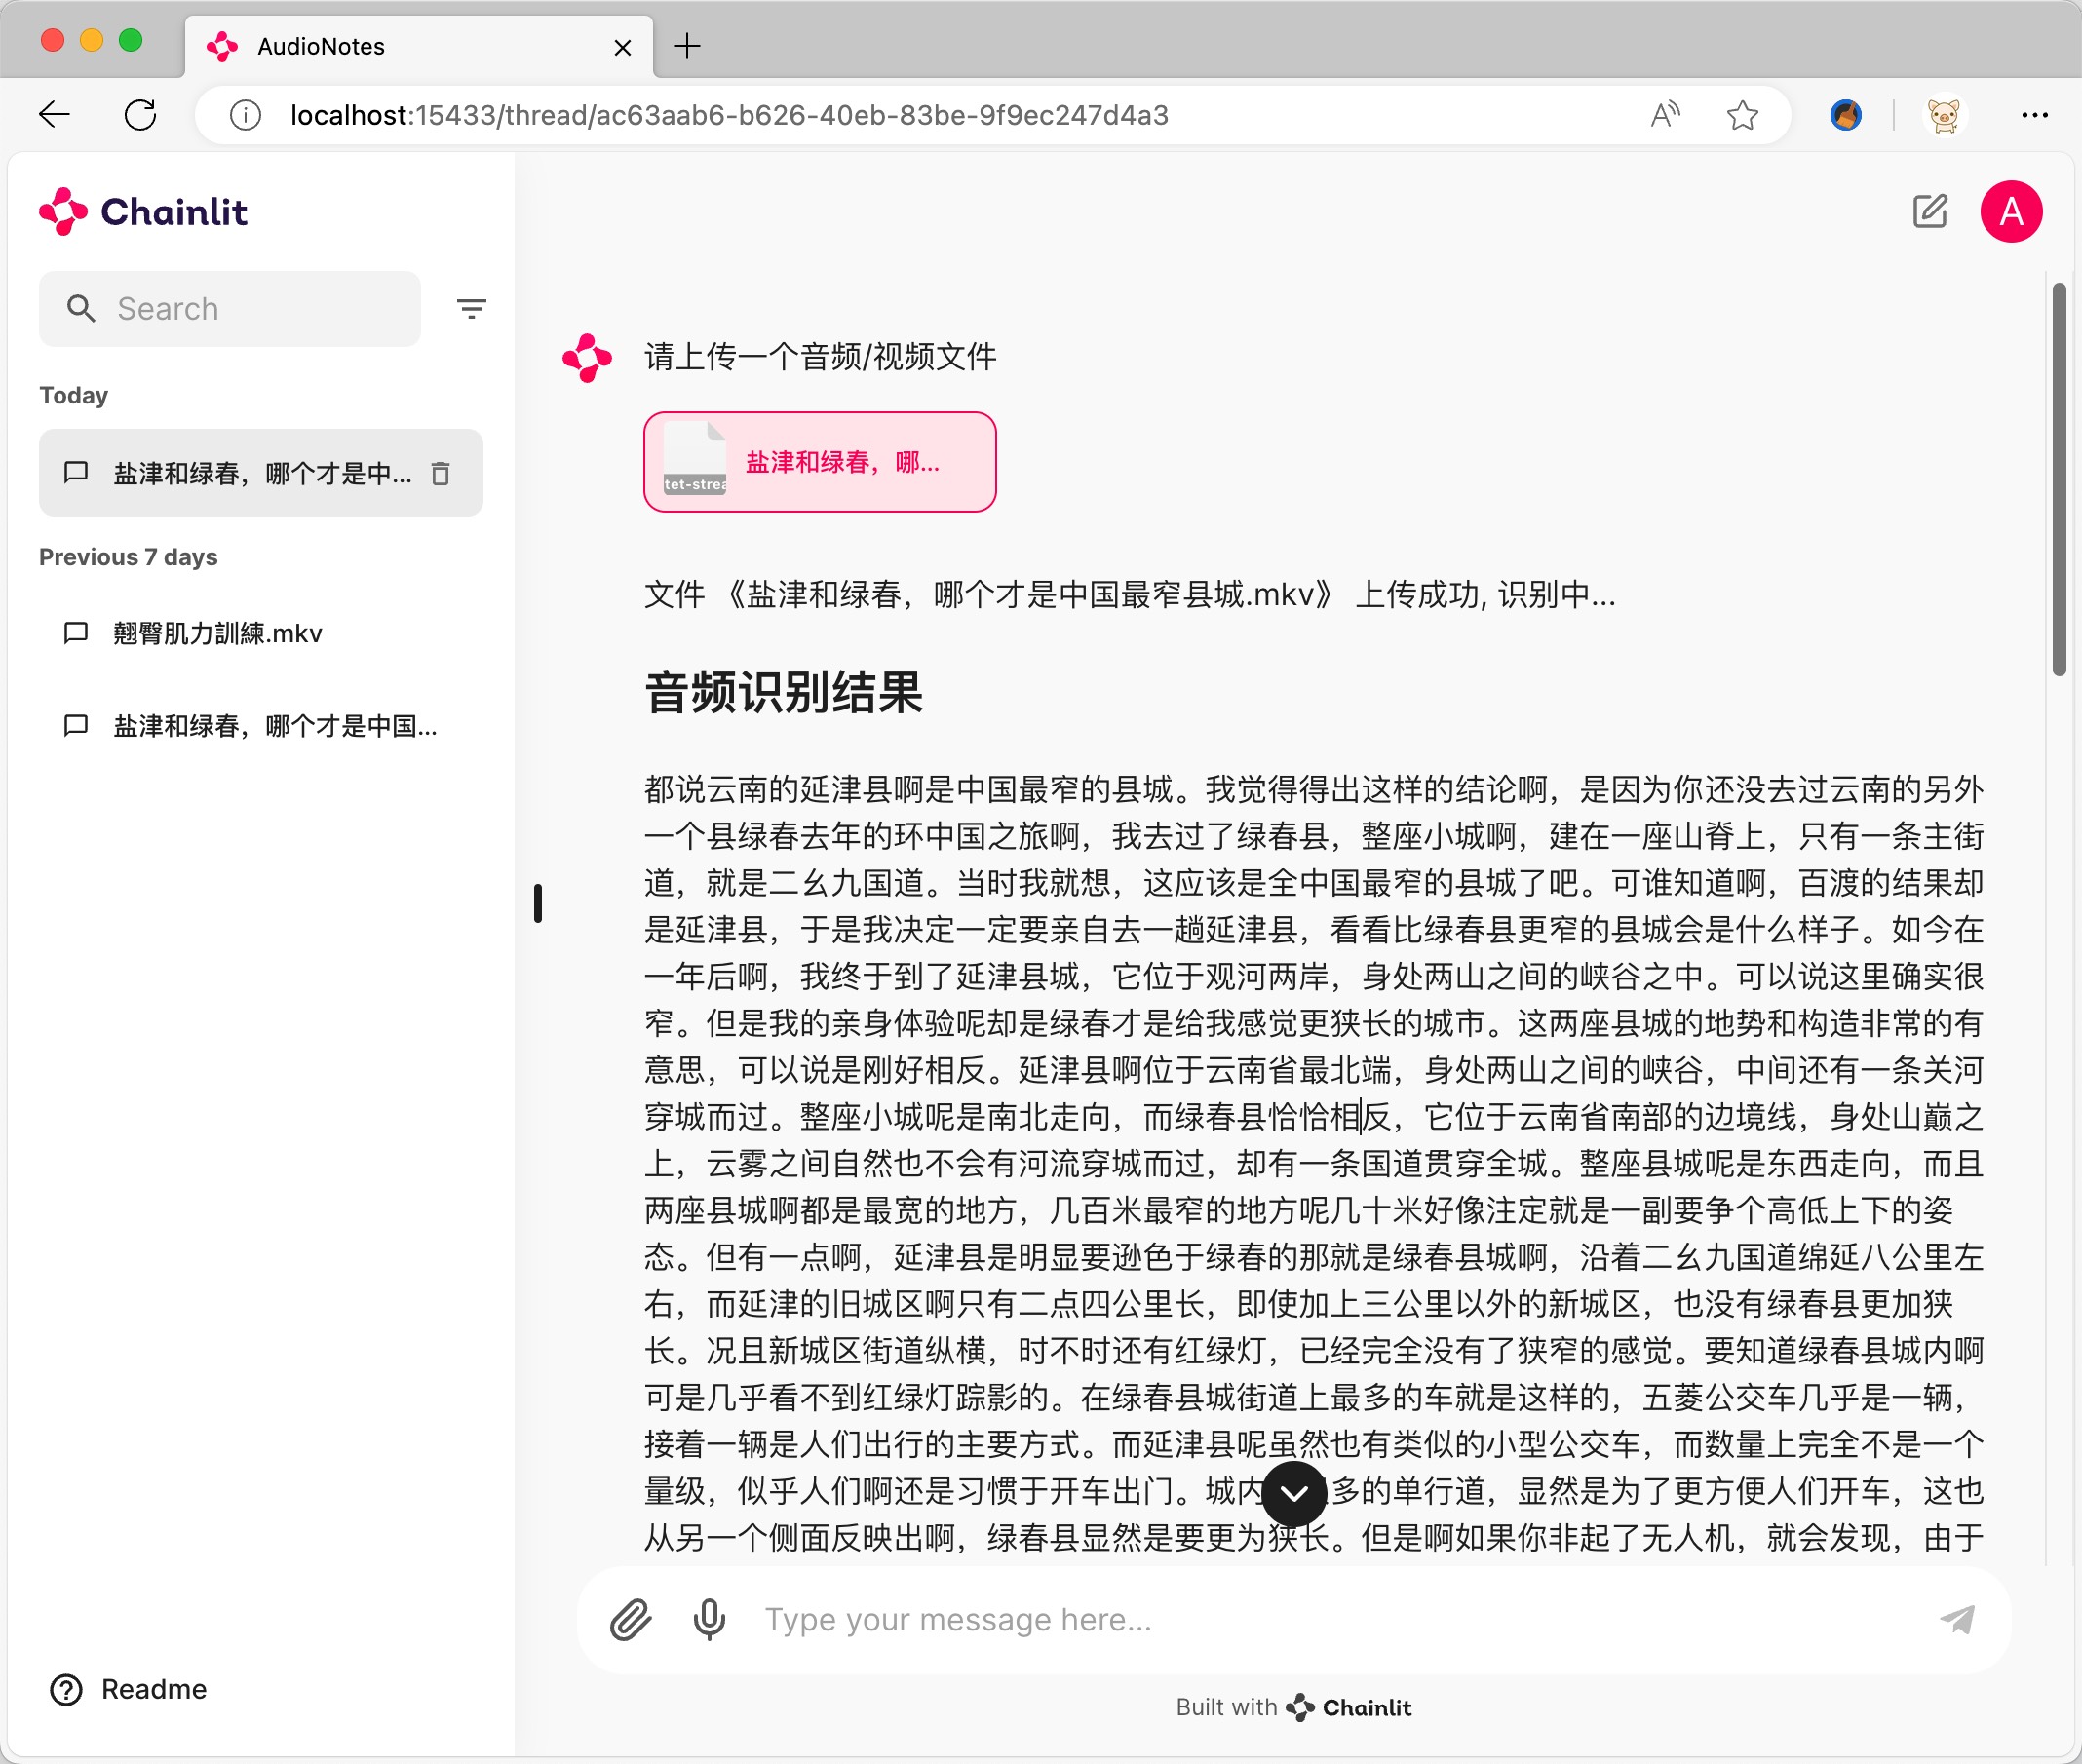
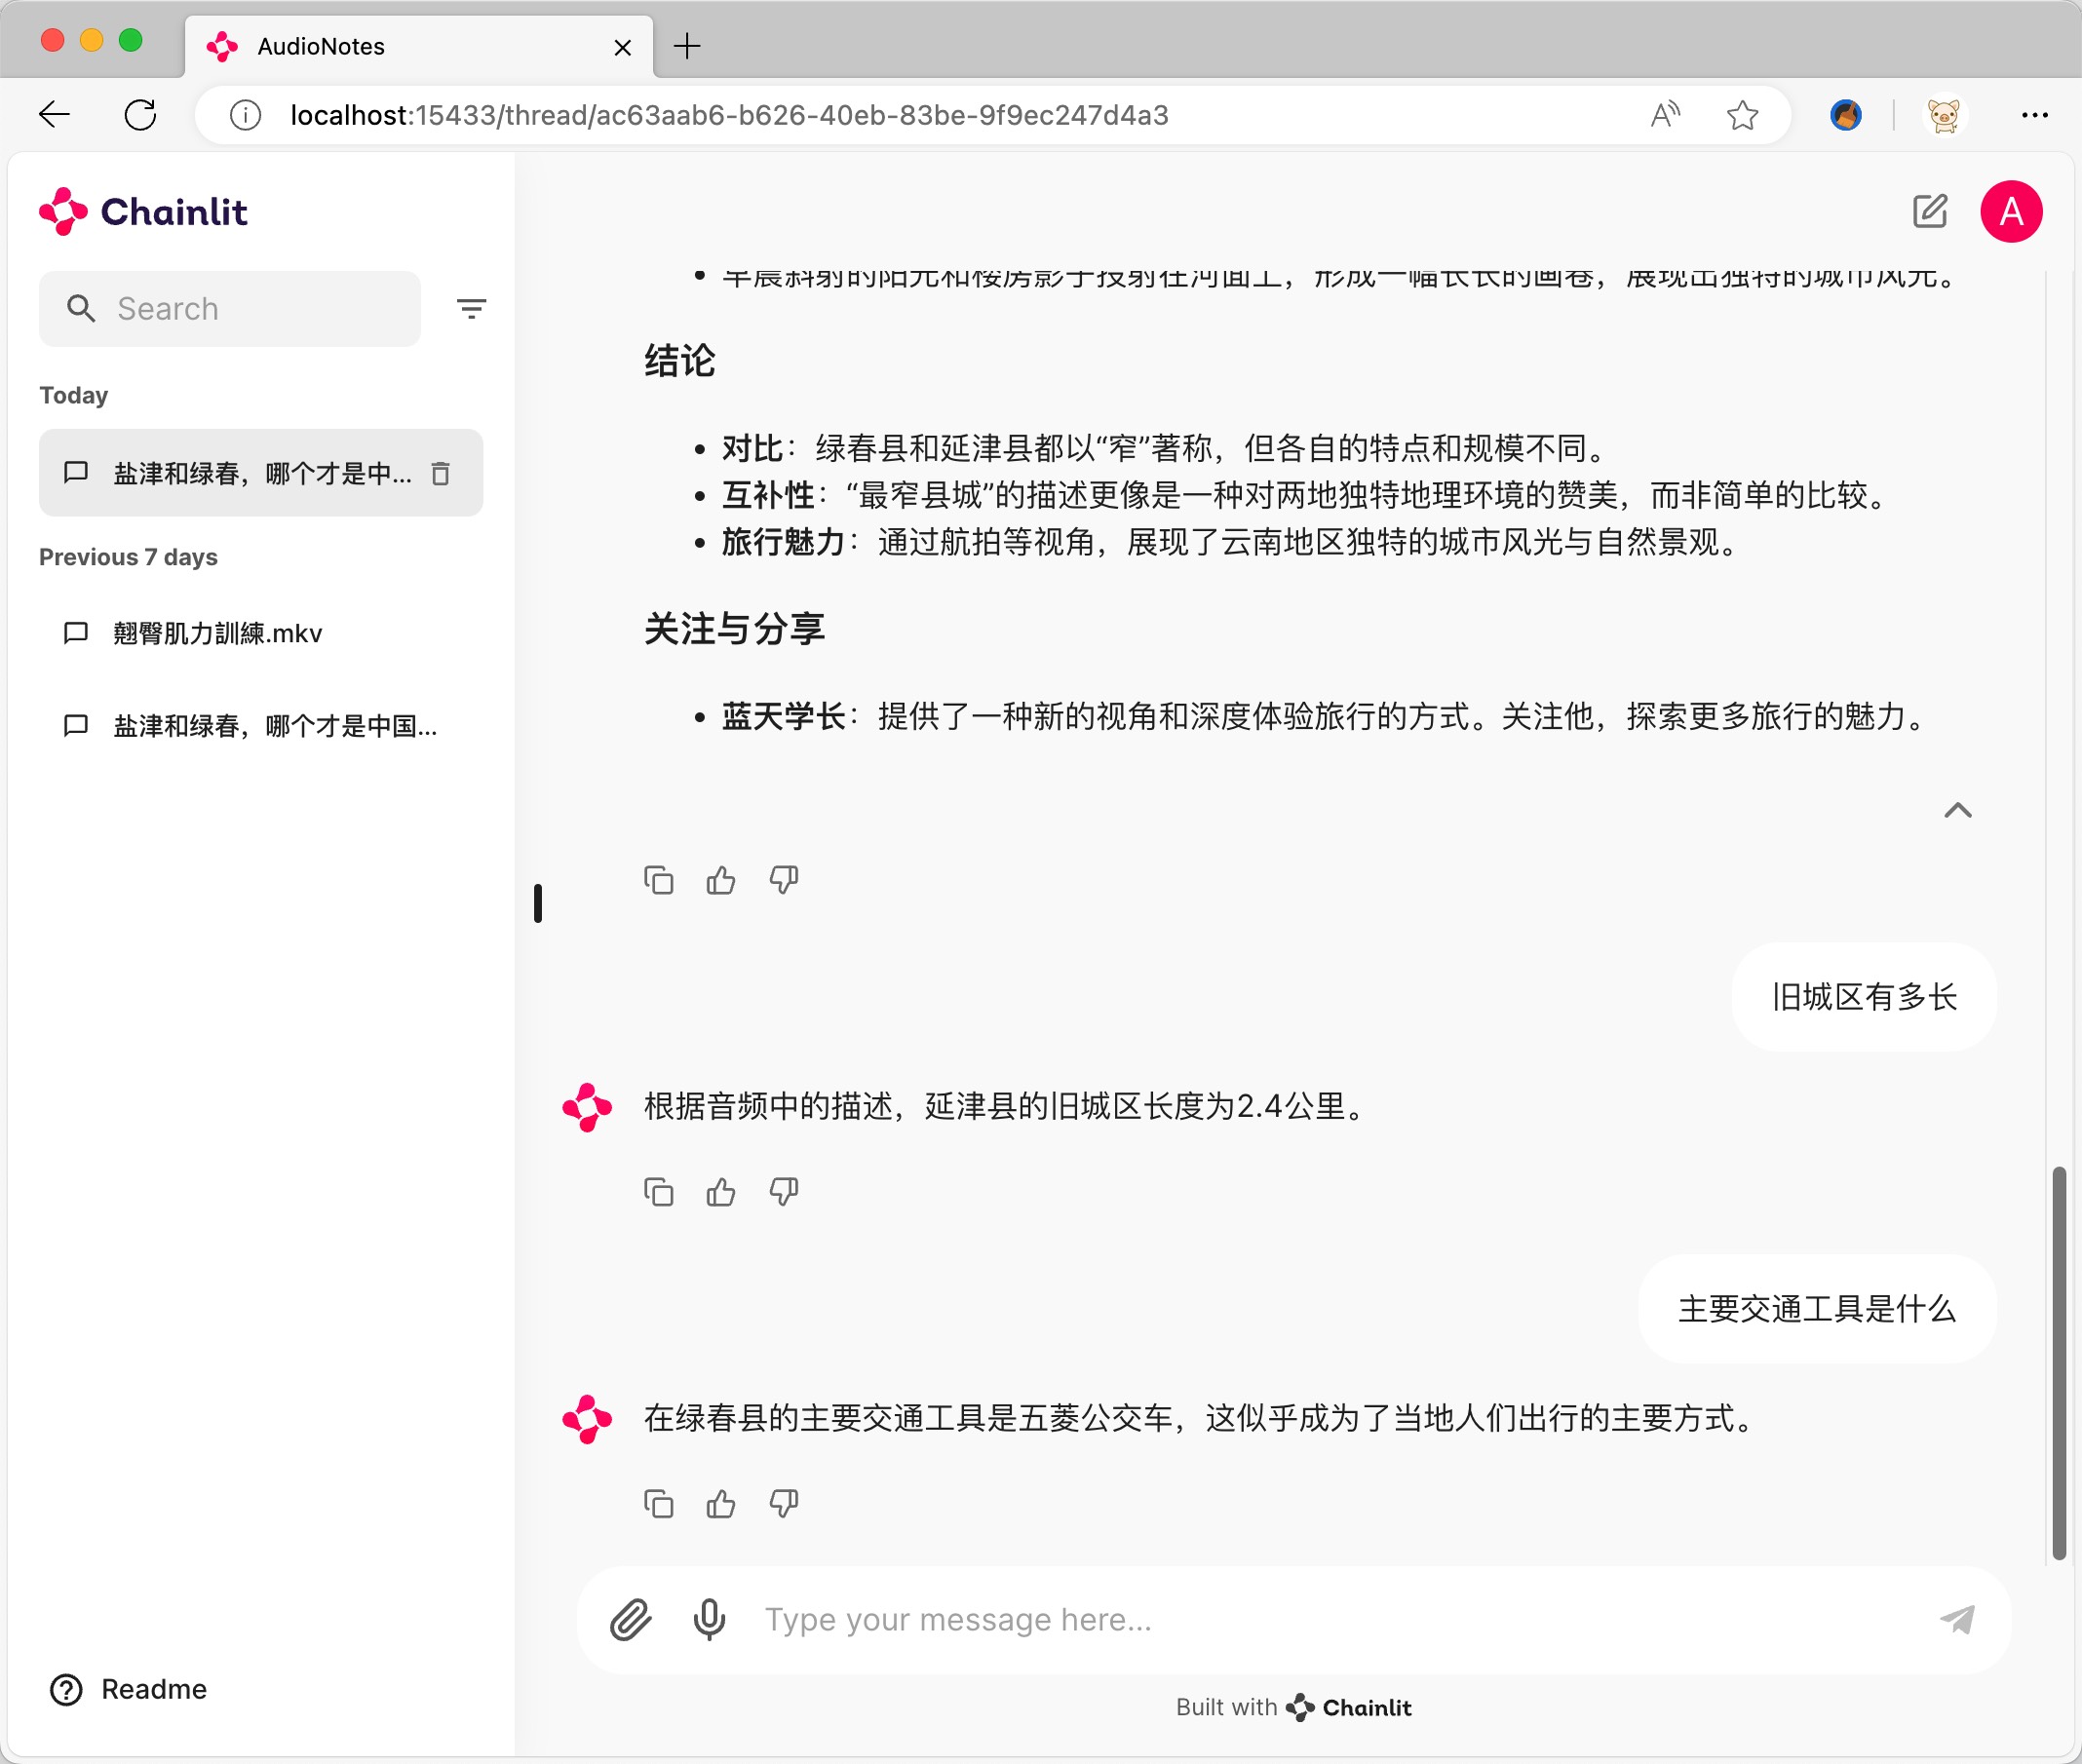
AudioNotes 默认在你的电脑上完成语音识别、笔记整理和内容问答:
首次安装仍需要联网下载应用镜像和模型,但处理个人内容时不依赖云端 AI 服务。请在受信任的电脑上使用,并妥善保护本机账户和磁盘数据。
开始前请安装并启动:
建议为 Docker Desktop 分配至少 12GB 内存;处理较长音视频时推荐 16GB,并预留约 10GB 磁盘空间。
ollama pull qwen3.5:2b
mkdir audionotes
cd audionotes
curl -fsSL https://github.com/harry0703/AudioNotes/raw/main/docker-compose.yml -o docker-compose.yml
curl -fsSL https://github.com/harry0703/AudioNotes/raw/main/.env.example -o .env
docker compose up -d --remove-orphans
访问 http://localhost:15433/,默认账号和密码均为 admin。
首次识别会自动下载约 2.15GB 的语音模型,等待时间取决于网络速度。模型下载完成后会保存在本机,后续无需重复下载。
如果希望直接运行源码,请先准备 Python 3.12、ffmpeg 和 Ollama。AudioNotes 会自动创建本地数据文件,不需要安装或配置数据库服务。
git clone https://github.com/harry0703/AudioNotes.git
cd AudioNotes
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
cp .env.example .env
ollama pull qwen3.5:2b
确认 Ollama 已启动后运行:
python -m chainlit run main.py --host 127.0.0.1 --port 15433
同样访问 http://localhost:15433/。退出虚拟环境可以执行 deactivate。
FunAudioLLM/Fun-ASR-Nano-2512qwen3.5:2b默认组合优先兼顾中文识别质量和普通电脑的资源占用。识别结果仍可能受到录音质量、环境噪声、口音和多人重叠说话影响,重要内容请结合原音频核对。
如需识别更多语言,打开 .env,将 ASR_MODEL 改为 FunAudioLLM/Fun-ASR-MLT-Nano-2512,然后重新启动服务。默认模型不会自动改变,当前页面也不会在运行期间切换模型。
使用 Docker 时,上传文件、FunASR 模型缓存、日志和对话历史都保存在创建的 audionotes 文件夹中。使用源码时,个人数据保存在项目的 storage 文件夹中,FunASR 模型保存在本机模型缓存中。Ollama 模型由 Ollama 单独管理。
audionotes 文件夹。使用 Docker 时,停止或重新启动:
docker compose down
docker compose up -d
使用 Docker 时,更新到最新版本:
docker compose pull
docker compose up -d --remove-orphans
Docker 方式页面无法打开时,先确认 Docker Desktop 和 Ollama 均已启动,然后检查服务状态:
docker compose ps
docker compose logs -f webui
源码方式无法启动时,请先查看终端中的错误信息,并确认 Python 版本、ffmpeg 和 Ollama 均可正常使用。
如果提示找不到模型,重新执行:
ollama pull qwen3.5:2b
如果处理长音频时页面中断或服务重启,请增加 Docker Desktop 的内存配额。实测 8GB 可能不足,推荐使用 16GB。
如果电脑由多人共用,请打开 .env 文件并修改 USERNAME 和 PASSWORD,然后重新启动服务。
Linux 电脑如配有 NVIDIA 显卡,并且已经安装 NVIDIA 驱动和 Container Toolkit,可以使用可选配置启用 GPU 识别加速:
git clone https://github.com/harry0703/AudioNotes.git
cd AudioNotes
cp .env.example .env
docker compose -f docker-compose.yml -f docker-compose.gpu.yml up -d --build
默认快速体验仍使用 CPU 镜像,不需要 NVIDIA 显卡。首次构建 GPU 镜像需要下载较大的 CUDA 依赖。
AudioNotes 是一款本地运行的音视频转文字和智能笔记工具,适合整理会议、访谈、课程和语音备忘录。
主要功能:
AudioNotes 默认在你的电脑上完成语音识别、笔记整理和内容问答:
首次安装仍需要联网下载应用镜像和模型,但处理个人内容时不依赖云端 AI 服务。请在受信任的电脑上使用,并妥善保护本机账户和磁盘数据。
开始前请安装并启动:
建议为 Docker Desktop 分配至少 12GB 内存;处理较长音视频时推荐 16GB,并预留约 10GB 磁盘空间。
ollama pull qwen3.5:2b
mkdir audionotes
cd audionotes
curl -fsSL https://github.com/harry0703/AudioNotes/raw/main/docker-compose.yml -o docker-compose.yml
curl -fsSL https://github.com/harry0703/AudioNotes/raw/main/.env.example -o .env
docker compose up -d --remove-orphans
访问 http://localhost:15433/,默认账号和密码均为 admin。
首次识别会自动下载约 2.15GB 的语音模型,等待时间取决于网络速度。模型下载完成后会保存在本机,后续无需重复下载。
如果希望直接运行源码,请先准备 Python 3.12、ffmpeg 和 Ollama。AudioNotes 会自动创建本地数据文件,不需要安装或配置数据库服务。
git clone https://github.com/harry0703/AudioNotes.git
cd AudioNotes
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
cp .env.example .env
ollama pull qwen3.5:2b
确认 Ollama 已启动后运行:
python -m chainlit run main.py --host 127.0.0.1 --port 15433
同样访问 http://localhost:15433/。退出虚拟环境可以执行 deactivate。
FunAudioLLM/Fun-ASR-Nano-2512qwen3.5:2b默认组合优先兼顾中文识别质量和普通电脑的资源占用。识别结果仍可能受到录音质量、环境噪声、口音和多人重叠说话影响,重要内容请结合原音频核对。
如需识别更多语言,打开 .env,将 ASR_MODEL 改为 FunAudioLLM/Fun-ASR-MLT-Nano-2512,然后重新启动服务。默认模型不会自动改变,当前页面也不会在运行期间切换模型。
使用 Docker 时,上传文件、FunASR 模型缓存、日志和对话历史都保存在创建的 audionotes 文件夹中。使用源码时,个人数据保存在项目的 storage 文件夹中,FunASR 模型保存在本机模型缓存中。Ollama 模型由 Ollama 单独管理。
audionotes 文件夹。使用 Docker 时,停止或重新启动:
docker compose down
docker compose up -d
使用 Docker 时,更新到最新版本:
docker compose pull
docker compose up -d --remove-orphans
Docker 方式页面无法打开时,先确认 Docker Desktop 和 Ollama 均已启动,然后检查服务状态:
docker compose ps
docker compose logs -f webui
源码方式无法启动时,请先查看终端中的错误信息,并确认 Python 版本、ffmpeg 和 Ollama 均可正常使用。
如果提示找不到模型,重新执行:
ollama pull qwen3.5:2b
如果处理长音频时页面中断或服务重启,请增加 Docker Desktop 的内存配额。实测 8GB 可能不足,推荐使用 16GB。
如果电脑由多人共用,请打开 .env 文件并修改 USERNAME 和 PASSWORD,然后重新启动服务。
Linux 电脑如配有 NVIDIA 显卡,并且已经安装 NVIDIA 驱动和 Container Toolkit,可以使用可选配置启用 GPU 识别加速:
git clone https://github.com/harry0703/AudioNotes.git
cd AudioNotes
cp .env.example .env
docker compose -f docker-compose.yml -f docker-compose.gpu.yml up -d --build
默认快速体验仍使用 CPU 镜像,不需要 NVIDIA 显卡。首次构建 GPU 镜像需要下载较大的 CUDA 依赖。



