
README
Awesome-Alignment-of-Diffusion-Models
This repository is a curated collection of research papers, frameworks, and resources focusing on the Alignment and Post-Training of Diffusion/Flow-matching Models. As image and video generative models scale, aligning them with human preferences, physical constraints, and prompt adherence has become a critical paradigm.
This repository is updated continuously. We apologize for any omissions and welcome pull requests to merge them in.
Table of Contents
- 1 Foundation Models
- 2 Reward Model
- 3 Training Alignment
- 4 Inference Alignment
- 5 Download Tasks
- Contact & Contributions
1 Foundation Models
1.1 Image Generation & Editing
-
Scaling Rectified Flow Transformers for High-Resolution Image Synthesis.
(StableDiffusion 3 from Stability AI).
-
SANA 1.5: Efficient Scaling of Training-Time and Inference-Time Compute in Linear Diffusion Transformer
(from NVIDIA)
-
Seedream 2.0: A Native Chinese-English Bilingual Image Generation Foundation Model
-
(from ByteDance Seed Team)
-
(from HiDream Team)
-
Qwen-Image Technical Report
(from Qwen Team)
-
(from ByteDance Seed Team)
-
(from Alibaba Z-Image Team)
-
(from Alibaba Ovis Team)
-
1.2 Video Generation
-
-
(from Meta)
-
-
(from Step-Video Team)
-
(from Alibaba Wan Team)
-
-
(from ByteDance Seed Team)
-
(from Meituan LongCat Team)
-
-
-
2 Reward Model
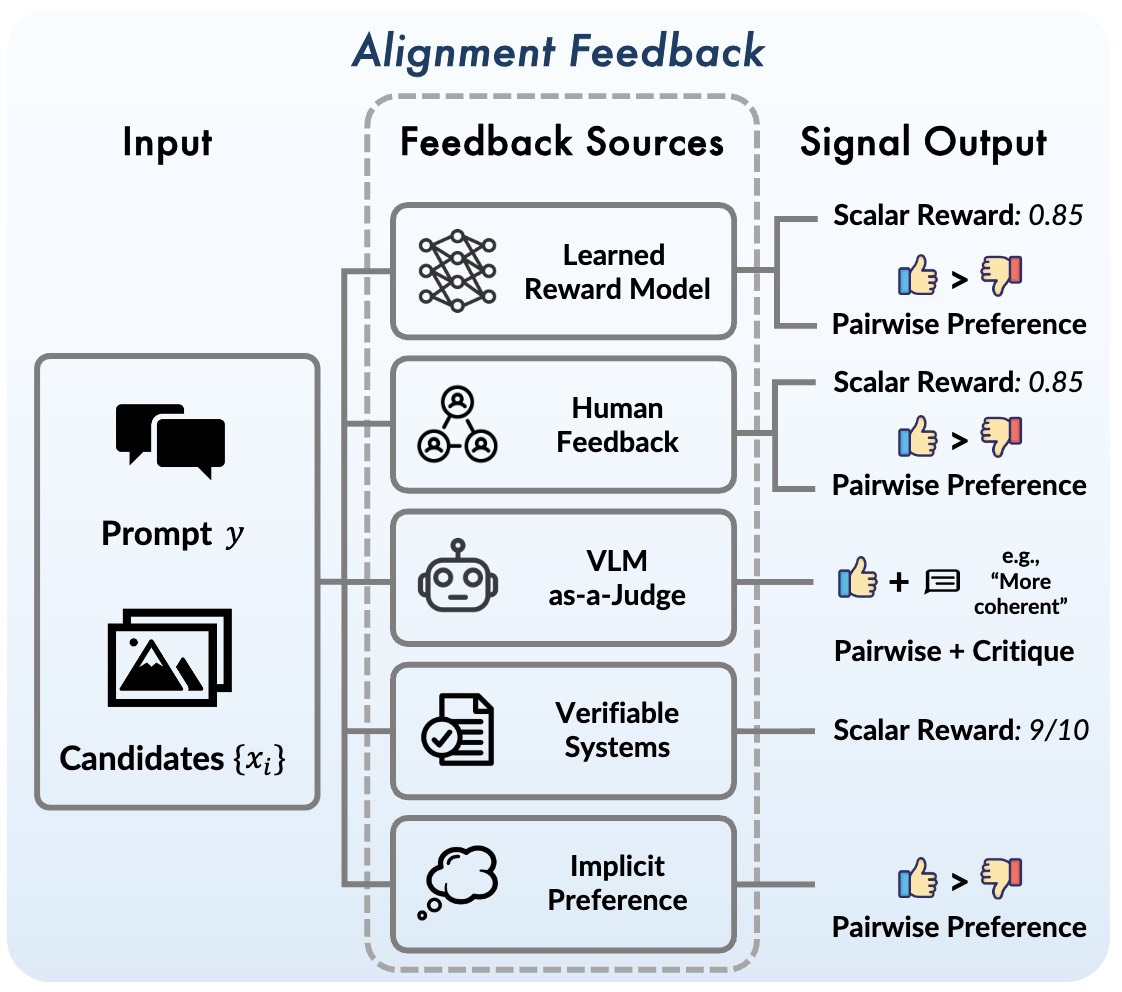
2.1 CLIP-based
-
Laion-5b: An open large-scale dataset for training next generation image-text models.
-
-
-
-
-
-


2.2 VLM-based
-
-
VideoScore: Building Automatic Metrics to Simulate Fine-grained Human Feedback for Video Generation.
-
-
-
-
-
-
Onereward: Unified mask-guided image generation via multi-task human preference learning.
-
-
-
-
-
-
-
-
-
-
-
-
-
-




2.3 Diffusion-based
-
-
-
2.4 Others
3 Training Alignment
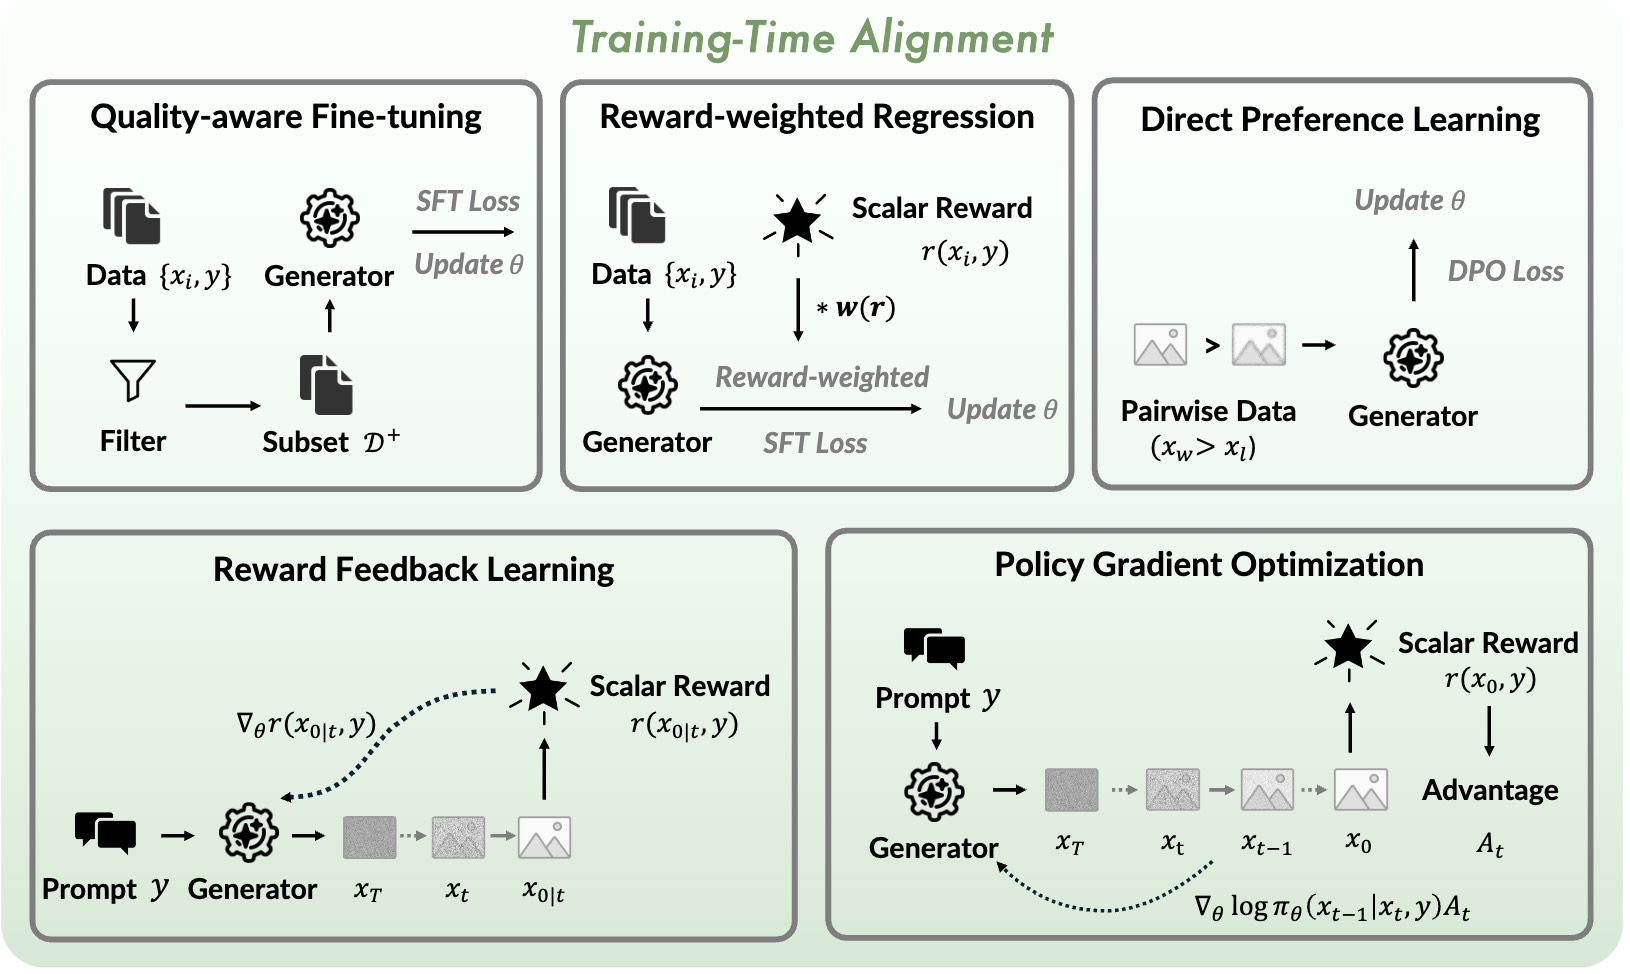
3.1 ReFL
-
Imagereward: Learning and evaluating human preferences for text-to-image generation.
-
(DRAFT) Directly Fine-Tuning Diffusion Models on Differentiable Rewards.
-
(AlignProp) Aligning Text-to-Image Diffusion Models with Reward Backpropagation.
-
InstructVideo: Instructing Video Diffusion Models with Human Feedback.
-
UniFL: Improve Latent Diffusion Model via Unified Feedback Learning.
-
Video diffusion alignment via reward gradients.
-
RLGF: Reinforcement Learning with Geometric Feedback for Autonomous Driving Video Generation.


3.2 DPO
Key Trends:
- Global preference --> step-aware preference;
- Denser preference signals (patch-level, frame-level);
- Offline DPO --> Online DPO;
- Emphasizes learning more from positive/negative samples;
- Constructing implicit preference pairs (real vs. gen, curr vs. ema, self-play);
-
Diffusion Model Alignment Using Direct Preference Optimization.
-
Using human feedback to fine-tune diffusion models without any reward model.
-
Self-play fine-tuning of diffusion models for text-to-image generation.
-
A Dense Reward View on Aligning Text-to-Image Diffusion with Preference.
-
Boost Your Human Image Generation Model via Direct Preference Optimization.
(real image as the gt);
-
Aesthetic Post-Training Diffusion Models from Generic Preferences with Step-by-step Preference Optimization.
-
Diffusion-rpo: Aligning diffusion models through relative preference optimization.
-
Scalable Ranked Preference Optimization for Text-to-Image Generation.
-
PatchDPO: Patch-level DPO for Finetuning-free Personalized Image Generation.
-
Align Video Diffusion Model with Online Video-Centric Preference Optimization.
-
Videodpo: Omni-preference alignment for video diffusion generation.
-
Improving Video Generation with Human Feedback
-
Calibrated Multi-Preference Optimization for Aligning Diffusion Models.
-
InPO: Inversion Preference Optimization with Reparametrized DDIM for Efficient Diffusion Model Alignment.
-
Fine-Tuning Diffusion Generative Models via Rich Preference Optimization.
-
Rethinking DPO-style Diffusion Aligning Frameworks.
-
Positive Enhanced Preference Alignment for Text-to-Image Models.
optimize positive
-
Diffusion-npo: Negative preference optimization for better preference aligned generation of diffusion models.
-
DenseDPO: Fine-Grained Temporal Preference Optimization for Video Diffusion Models.
-
Hierarchical Fine-grained Preference Optimization for Physically Plausible Video Generation.
-
Follow-Your-Preference: Towards Preference-Aligned Image Inpainting.
-
Direct Discriminative Optimization: Your Likelihood-Based Visual Generative Model is Secretly a GAN Discriminator.
-
Diffusionnft: Online diffusion reinforcement with forward process.
-
RealDPO: Real or Not Real, that is the Preference.
-
Towards Better Optimization For Listwise Preference in Diffusion Models.
-
Direct Diffusion Score Preference Optimization via Stepwise Contrastive Policy-Pair Supervision.
-
PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation.
-
Mind the Generative Details: Direct Localized Detail Preference Optimization for Video Diffusion Models.


3.3 RWR
-
Advantage-weighted regression: Simple and scalable off-policy reinforcement learning.
-
Aligning text-to-image models using human feedback.
-
Raft: Reward ranked finetuning for generative foundation model alignment.
-
Online Reward-Weighted Fine-Tuning of Flow Matching with Wasserstein Regularization.
-
GigaVideo-1: Advancing Video Generation via Automatic Feedback with 4 GPU-Hours Fine-Tuning.


3.4 RLHF
-
Optimizing ddpm sampling with shortcut fine-tuning.
-
Training Diffusion Models with Reinforcement Learning.
-
DPOK: Reinforcement Learning for Fine-tuning Text-to-Image Diffusion Models.
-
Training Diffusion Models Towards Diverse Image Generation with Reinforcement Learning.
-
A Simple and Effective Reinforcement Learning Method for Text-to-Image Diffusion Fine-tuning.

3.5 RLHF-GRPO
Key Trends
- Efficiency: sample efficiency, optimization efficiency (like sparse-step updates), faster reward acquisition;
- Avid reward hacking, like stronger trust-region control and improved sampling diversity;
- Dense reward signals, precise credit assign;
- Support for diverse reward functions, including verifiers and pairwise comparisons;
-
Flow-GRPO: Training Flow Matching Models via Online RL.
-
DanceGRPO: Unleashing GRPO on Visual Generation.
-
Tempflow-grpo: When timing matters for grpo in flow models.
-
Pref-grpo: Pairwise preference reward-based grpo for stable text-to-image reinforcement learning.
-
Coefficients-Preserving Sampling for Reinforcement Learning with Flow Matching.
-
Branchgrpo: Stable and efficient grpo with structured branching in diffusion models.
-
Reinforcement Learning with Inverse Rewards for World Model Post-training.
-
Advantage weighted matching: Aligning rl with pretraining in diffusion models.
-
Smart-GRPO: Smartly Sampling Noise for Efficient RL of Flow-Matching Models.
-
Understanding Sampler Stochasticity in Training Diffusion Models for RLHF.
-
G2RPO: Granular GRPO for Precise Reward in Flow Models.
-
Sample By Step, Optimize By Chunk: Chunk-Level GRPO For Text-to-Image Generation.
-
GRPO-Guard: Mitigating Implicit Over-Optimization in Flow Matching via Regulated Clipping.
-
Reinforcing Diffusion Models by Direct Group Preference Optimization.
-
Seeing What Matters: Visual Preference Policy Optimization for Visual Generation.
-
Neighbor GRPO: Contrastive ODE Policy Optimization Aligns Flow Models.
-
The Image as Its Own Reward: Reinforcement Learning with Adversarial Reward for Image Generation.
-
ProxT2I: Efficient Reward-Guided Text-to-Image Generation via Proximal Diffusion.
-
Multi-GRPO: Multi-Group Advantage Estimation for Text-to-Image Generation with Tree-Based Trajectories and Multiple Rewards.
-
Data-regularized Reinforcement Learning for Diffusion Models at Scale.
-
RealGen: Photorealistic Text-to-Image Generation via Detector-Guided Rewards.
-
GARDO: Reinforcing Diffusion Models without Reward Hacking.
-
Beyond the Dirac Delta: Mitigating Diversity Collapse in Reinforcement Fine-Tuning for Versatile Image Generation.
-
Diffusion Alignment Beyond KL: Variance Minimisation as Effective Policy Optimiser.
-
UniRef-Image-Edit: Towards Scalable and Consistent Multi-Reference Image Editing.
4 Inference Alignment
4.1 Gradient Guidance
Paper List
-
Universal guidance for diffusion models.
-
End-to-end diffusion latent optimization improves classifier guidance.
-
Gradient Guidance for Diffusion Models: An Optimization Perspective.
-
Reno: Enhancing one-step text-to-image models through reward-based noise optimization.
-
Not all noises are created equally: Diffusion noise selection and optimization.
-
Golden noise for diffusion models: A learning framework.
-
A noise is worth diffusion guidance.

4.2 Condition
Paper List
-
ReNeg: Learning Negative Embedding with Reward Guidance.
-
Prompt-a-video: Prompt your video diffusion model via preference-aligned llm.
-
IMG: Calibrating Diffusion Models via Implicit Multimodal Guidance.
-
Plug-and-Play Prompt Refinement via Latent Feedback for Diffusion Model Alignment.
4.3 Search
Paper List
-
Test-time Alignment of Diffusion Models without Reward Over-optimization.
-
Inference-time scaling for diffusion models beyond scaling denoising steps.
-
A general framework for inference-time scaling and steering of diffusion models.
-
Inference-time text-to-video alignment with diffusion latent beam search.
-
Training-free guidance beyond differentiability: Scalable path steering with tree search in diffusion and flow models.
-
Dynamic Search for Inference-Time Alignment in Diffusion Models.
-
Inference-time scaling for flow models via stochastic generation and rollover budget forcing.
-
Scaling image and video generation via test-time evolutionary search.
5 Download Tasks
5.1 Human-centric AI & ID Preserving
Paper List
-
Identity-preserving image-to-video generation via reward-guided optimization.
-
Disco: Reinforcement with diversity constraints for multi-human generation.
-
PSR: Scaling Multi-Subject Personalized Image Generation with Pairwise Subject-Consistency Rewards.
5.2 Control
Paper List
-
Itercomp: Iterative composition-aware feedback learning from model gallery for text-to-image generation.
-
Taming Camera-Controlled Video Generation with Verifiable Geometry Reward.
5.3 Long Video Generation
Paper List
-
Self-Forcing++: Towards Minute-Scale High-Quality Video Generation.
-
Reward Forcing: Efficient Streaming Video Generation with Rewarded Distribution Matching Distillation.
5.4 Distillation
Paper List
-
Distribution Matching Distillation Meets Reinforcement Learning.
-
Flash-DMD: Towards High-Fidelity Few-Step Image Generation with Efficient Distillation and Joint Reinforcement Learning.
5.5 3D
Paper List
-
Dreamreward: Text-to-3d generation with human preference.
-
DreamDPO: Aligning Text-to-3D Generation with Human Preferences via Direct Preference Optimization.
-
Are We Ready for RL in Text-to-3D Generation? A Progressive Investigation.
6 Contact & Contributions
For any questions, suggestions or discussions, please feel free to reach out to me at gongyeliuu@gmail.com.
Contributors

6 commits
Similar repos


README
Awesome-Alignment-of-Diffusion-Models
This repository is a curated collection of research papers, frameworks, and resources focusing on the Alignment and Post-Training of Diffusion/Flow-matching Models. As image and video generative models scale, aligning them with human preferences, physical constraints, and prompt adherence has become a critical paradigm.
This repository is updated continuously. We apologize for any omissions and welcome pull requests to merge them in.
Table of Contents
- 1 Foundation Models
- 2 Reward Model
- 3 Training Alignment
- 4 Inference Alignment
- 5 Download Tasks
- Contact & Contributions
1 Foundation Models
1.1 Image Generation & Editing
-
-
-
-
-
-
-
-
-
-
1.2 Video Generation
-
-
-
-
-
-
-
-
-
-
-
2 Reward Model
2.1 CLIP-based
-
-
-
-
-
-
-
2.2 VLM-based
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
-
2.3 Diffusion-based
-
-
-
2.4 Others
3 Training Alignment
3.1 ReFL
-
Imagereward: Learning and evaluating human preferences for text-to-image generation.
-
(DRAFT) Directly Fine-Tuning Diffusion Models on Differentiable Rewards.
-
(AlignProp) Aligning Text-to-Image Diffusion Models with Reward Backpropagation.
-
InstructVideo: Instructing Video Diffusion Models with Human Feedback.
-
UniFL: Improve Latent Diffusion Model via Unified Feedback Learning.
-
Video diffusion alignment via reward gradients.
-
RLGF: Reinforcement Learning with Geometric Feedback for Autonomous Driving Video Generation.
3.2 DPO
Key Trends:
- Global preference --> step-aware preference;
- Denser preference signals (patch-level, frame-level);
- Offline DPO --> Online DPO;
- Emphasizes learning more from positive/negative samples;
- Constructing implicit preference pairs (real vs. gen, curr vs. ema, self-play);
-
Diffusion Model Alignment Using Direct Preference Optimization.
-
Using human feedback to fine-tune diffusion models without any reward model.
-
Self-play fine-tuning of diffusion models for text-to-image generation.
-
A Dense Reward View on Aligning Text-to-Image Diffusion with Preference.
-
Boost Your Human Image Generation Model via Direct Preference Optimization.
-
Aesthetic Post-Training Diffusion Models from Generic Preferences with Step-by-step Preference Optimization.
-
Diffusion-rpo: Aligning diffusion models through relative preference optimization.
-
Scalable Ranked Preference Optimization for Text-to-Image Generation.
-
PatchDPO: Patch-level DPO for Finetuning-free Personalized Image Generation.
-
Align Video Diffusion Model with Online Video-Centric Preference Optimization.
-
Videodpo: Omni-preference alignment for video diffusion generation.
-
Improving Video Generation with Human Feedback
-
Calibrated Multi-Preference Optimization for Aligning Diffusion Models.
-
InPO: Inversion Preference Optimization with Reparametrized DDIM for Efficient Diffusion Model Alignment.
-
Fine-Tuning Diffusion Generative Models via Rich Preference Optimization.
-
Rethinking DPO-style Diffusion Aligning Frameworks.
-
Positive Enhanced Preference Alignment for Text-to-Image Models.
-
Diffusion-npo: Negative preference optimization for better preference aligned generation of diffusion models.
-
DenseDPO: Fine-Grained Temporal Preference Optimization for Video Diffusion Models.
-
Hierarchical Fine-grained Preference Optimization for Physically Plausible Video Generation.
-
Follow-Your-Preference: Towards Preference-Aligned Image Inpainting.
-
Direct Discriminative Optimization: Your Likelihood-Based Visual Generative Model is Secretly a GAN Discriminator.
-
Diffusionnft: Online diffusion reinforcement with forward process.
-
RealDPO: Real or Not Real, that is the Preference.
-
Towards Better Optimization For Listwise Preference in Diffusion Models.
-
Direct Diffusion Score Preference Optimization via Stepwise Contrastive Policy-Pair Supervision.
-
PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation.
-
Mind the Generative Details: Direct Localized Detail Preference Optimization for Video Diffusion Models.
3.3 RWR
-
Advantage-weighted regression: Simple and scalable off-policy reinforcement learning.
-
Aligning text-to-image models using human feedback.
-
Raft: Reward ranked finetuning for generative foundation model alignment.
-
Online Reward-Weighted Fine-Tuning of Flow Matching with Wasserstein Regularization.
-
GigaVideo-1: Advancing Video Generation via Automatic Feedback with 4 GPU-Hours Fine-Tuning.
3.4 RLHF
-
Optimizing ddpm sampling with shortcut fine-tuning.
-
Training Diffusion Models with Reinforcement Learning.
-
DPOK: Reinforcement Learning for Fine-tuning Text-to-Image Diffusion Models.
-
Training Diffusion Models Towards Diverse Image Generation with Reinforcement Learning.
-
A Simple and Effective Reinforcement Learning Method for Text-to-Image Diffusion Fine-tuning.
3.5 RLHF-GRPO
Key Trends
- Efficiency: sample efficiency, optimization efficiency (like sparse-step updates), faster reward acquisition;
- Avid reward hacking, like stronger trust-region control and improved sampling diversity;
- Dense reward signals, precise credit assign;
- Support for diverse reward functions, including verifiers and pairwise comparisons;
-
Flow-GRPO: Training Flow Matching Models via Online RL.
-
DanceGRPO: Unleashing GRPO on Visual Generation.
-
Tempflow-grpo: When timing matters for grpo in flow models.
-
Pref-grpo: Pairwise preference reward-based grpo for stable text-to-image reinforcement learning.
-
Coefficients-Preserving Sampling for Reinforcement Learning with Flow Matching.
-
Branchgrpo: Stable and efficient grpo with structured branching in diffusion models.
-
Reinforcement Learning with Inverse Rewards for World Model Post-training.
-
Advantage weighted matching: Aligning rl with pretraining in diffusion models.
-
Smart-GRPO: Smartly Sampling Noise for Efficient RL of Flow-Matching Models.
-
Understanding Sampler Stochasticity in Training Diffusion Models for RLHF.
-
G2RPO: Granular GRPO for Precise Reward in Flow Models.
-
Sample By Step, Optimize By Chunk: Chunk-Level GRPO For Text-to-Image Generation.
-
GRPO-Guard: Mitigating Implicit Over-Optimization in Flow Matching via Regulated Clipping.
-
Reinforcing Diffusion Models by Direct Group Preference Optimization.
-
Seeing What Matters: Visual Preference Policy Optimization for Visual Generation.
-
Neighbor GRPO: Contrastive ODE Policy Optimization Aligns Flow Models.
-
The Image as Its Own Reward: Reinforcement Learning with Adversarial Reward for Image Generation.
-
ProxT2I: Efficient Reward-Guided Text-to-Image Generation via Proximal Diffusion.
-
Multi-GRPO: Multi-Group Advantage Estimation for Text-to-Image Generation with Tree-Based Trajectories and Multiple Rewards.
-
Data-regularized Reinforcement Learning for Diffusion Models at Scale.
-
RealGen: Photorealistic Text-to-Image Generation via Detector-Guided Rewards.
-
GARDO: Reinforcing Diffusion Models without Reward Hacking.
-
Beyond the Dirac Delta: Mitigating Diversity Collapse in Reinforcement Fine-Tuning for Versatile Image Generation.
-
Diffusion Alignment Beyond KL: Variance Minimisation as Effective Policy Optimiser.
-
UniRef-Image-Edit: Towards Scalable and Consistent Multi-Reference Image Editing.
4 Inference Alignment
4.1 Gradient Guidance
Paper List
-
Universal guidance for diffusion models.
-
End-to-end diffusion latent optimization improves classifier guidance.
-
Gradient Guidance for Diffusion Models: An Optimization Perspective.
-
Reno: Enhancing one-step text-to-image models through reward-based noise optimization.
-
Not all noises are created equally: Diffusion noise selection and optimization.
-
Golden noise for diffusion models: A learning framework.
-
A noise is worth diffusion guidance.
4.2 Condition
Paper List
-
ReNeg: Learning Negative Embedding with Reward Guidance.
-
Prompt-a-video: Prompt your video diffusion model via preference-aligned llm.
-
IMG: Calibrating Diffusion Models via Implicit Multimodal Guidance.
-
Plug-and-Play Prompt Refinement via Latent Feedback for Diffusion Model Alignment.
4.3 Search
Paper List
-
Test-time Alignment of Diffusion Models without Reward Over-optimization.
-
Inference-time scaling for diffusion models beyond scaling denoising steps.
-
A general framework for inference-time scaling and steering of diffusion models.
-
Inference-time text-to-video alignment with diffusion latent beam search.
-
Training-free guidance beyond differentiability: Scalable path steering with tree search in diffusion and flow models.
-
Dynamic Search for Inference-Time Alignment in Diffusion Models.
-
Inference-time scaling for flow models via stochastic generation and rollover budget forcing.
-
Scaling image and video generation via test-time evolutionary search.
5 Download Tasks
5.1 Human-centric AI & ID Preserving
Paper List
-
Identity-preserving image-to-video generation via reward-guided optimization.
-
Disco: Reinforcement with diversity constraints for multi-human generation.
-
PSR: Scaling Multi-Subject Personalized Image Generation with Pairwise Subject-Consistency Rewards.
5.2 Control
Paper List
-
Itercomp: Iterative composition-aware feedback learning from model gallery for text-to-image generation.
-
Taming Camera-Controlled Video Generation with Verifiable Geometry Reward.
5.3 Long Video Generation
Paper List
-
Self-Forcing++: Towards Minute-Scale High-Quality Video Generation.
-
Reward Forcing: Efficient Streaming Video Generation with Rewarded Distribution Matching Distillation.
5.4 Distillation
Paper List
-
Distribution Matching Distillation Meets Reinforcement Learning.
-
Flash-DMD: Towards High-Fidelity Few-Step Image Generation with Efficient Distillation and Joint Reinforcement Learning.
5.5 3D
Paper List
-
Dreamreward: Text-to-3d generation with human preference.
-
DreamDPO: Aligning Text-to-3D Generation with Human Preferences via Direct Preference Optimization.
-
Are We Ready for RL in Text-to-3D Generation? A Progressive Investigation.
6 Contact & Contributions
For any questions, suggestions or discussions, please feel free to reach out to me at gongyeliuu@gmail.com.
Similar repos
Contributors
6 commits