
[TMLR] Video Generation Models: A Survey of Post-Training and Alignment | 🔥 A continuously updated collection of papers, datasets, and benchmarks on post-training and alignment for video generation.
See the codeREADME
Awesome Video Generation Post Training
🔥 A continuously updated repository of research on post-training and alignment for video generation.



Video Generation Models: A Survey of Post-Training and Alignment
Chaoyu Li1,†,✉️, Xiaoyi Gu2,†, Yogesh Kulkarni1, Eun Woo Im1, Mohammadmahdi Honarmand3, Zeyu Wang4, Juntong Song5, Fei Du6, Xilin Jiang7, Kexin Zheng8, Tianzhi Li9, Fei Tao5, Pooyan Fazli1,✉️
1Arizona State University · 2Twitch · 3Stanford University · 4eBay · 5NewsBreak · 6Microsoft · 7Columbia University · 8University of Southern California · 9Carnegie Mellon University
†Equal contribution. ✉️Corresponding author: Chaoyu Li , Pooyan Fazli.

[!IMPORTANT] We welcome your help in improving the repository and paper. Please feel free to submit a pull request to:
- Add a relevant paper not yet included.
- Suggest a more suitable category.
- Update the information.
- Ask for clarification about any content.
🔥 News
- [2026.06.09] Our survey paper has been accepted to TMLR 🚀.
- [2026.06.09] Added papers accepted to ICML 2026.
- [2026.06.09] Added papers accepted to CVPR 2026.
- [2026.03.23] Added papers accepted to ICLR 2026.
- [2026.02.23] The v1 survey is now published! We have also initialized the repository.
🎯 Motivation
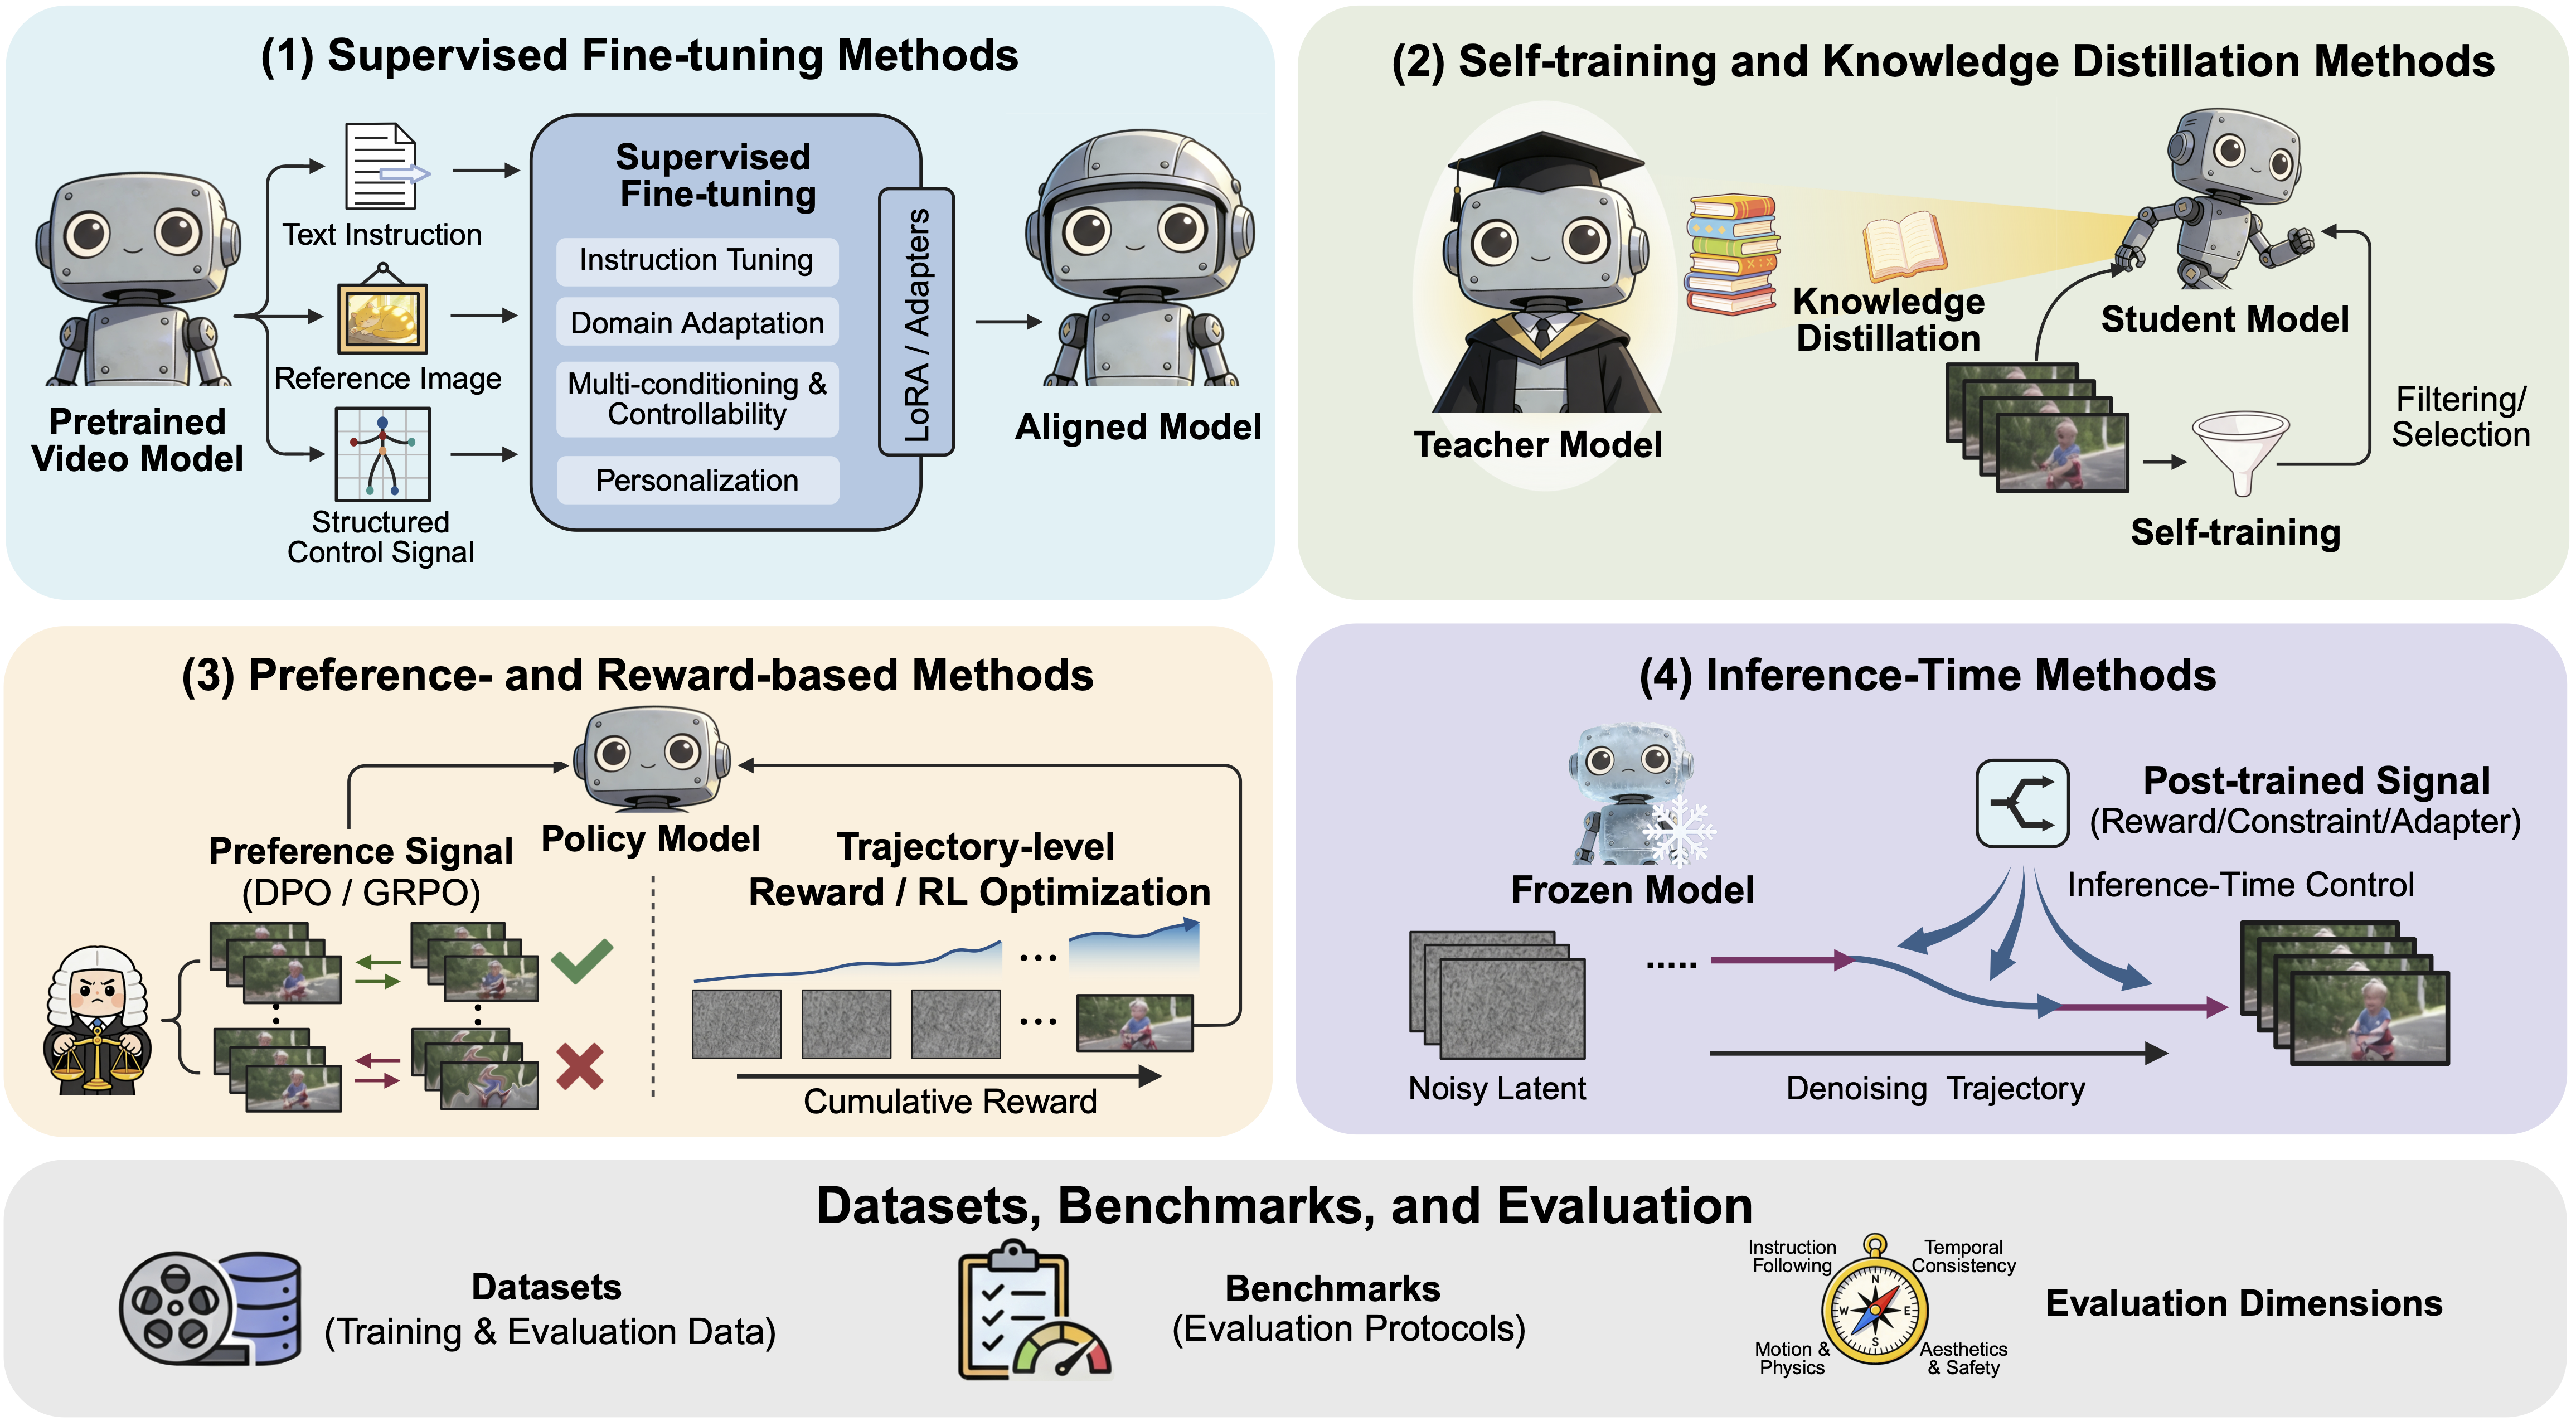 While large-scale pretraining has significantly improved video generation models, aligning them with human intent, physical constraints, and deployment requirements remains a major challenge. As a result, post-training and alignment techniques have rapidly become a central research focus in modern video generation.
In our survey paper, we systematically review recent progress in supervised fine-tuning, self-training and distillation, preference-based optimization, and inference-time alignment methods.
This repository serves as a companion resource to the survey.
It aims to:
- 📚 Curate recent papers on post-training and alignment for video generation
- 📊 Collect datasets and evaluation benchmarks related to post-training and alignment
We hope this repository provides researchers and practitioners with a convenient, up-to-date reference for exploring the evolving landscape of post-training and alignment in video generation models.
📌 Citation
If you find our paper or this resource helpful, please consider cite:
@article{li2026video,
  title={Video Generation Models: A Survey of Post-Training and Alignment},
  author={Chaoyu Li and Xiaoyi Gu and Yogesh Kulkarni and Eun Woo Im and Mohammadmahdi Honarmand and Zeyu Wang and Juntong Song and Fei Du and Xilin Jiang and Kexin Zheng and Tianzhi Li and Fei Tao and Pooyan Fazli},
  journal={Transactions on Machine Learning Research},
  issn={2835-8856},
  year={2026},
  url={https://openreview.net/forum?id=YlUEWLESIu},
}
📚 Content
Datasets
| Dataset | Year | Links |
|---|---|---|
 ChronoMagic-Pro | 2024 | Paper · GitHub · Website · Dataset |
| SafeSora | 2024 | Paper · GitHub · Website · Dataset |
 TIP-I2V | 2025 | Paper · GitHub · Website · Dataset |
| SynFMC | 2025 | Paper · GitHub · Website · Dataset |
 CookGen | 2025 | Paper · Website · Dataset |
| HOIGen-1M | 2025 | Paper · Website · Dataset |
| OpenHumanVid | 2025 | Paper · GitHub · Website |
 PhyWorld | 2025 | Paper · GitHub · Website · Dataset |
| WISA-80K | 2025 | Paper · GitHub · Website · Dataset |
| VideoUFO | 2025 | Paper · GitHub · Dataset |
| TalkCuts | 2025 | Paper · GitHub · Website · Dataset |
| EgoVid-5M | 2025 | Paper · GitHub · Website · Dataset |
| OpenS2V-5M | 2025 | Paper · GitHub · Website · Dataset |
 GRADEO-Instruct | 2025 | Paper |
 PNData | 2025 | Paper |
| PairFS-4K | 2025 | Paper · GitHub · Website |
| MMVideo | 2025 | Paper · GitHub · Website |
| DAVID-X | 2025 | Paper |
| Dprim | 2025 | Paper |
| CI-VID | 2026 | Paper · GitHub · Dataset |
| GB3DV-25k | 2026 | Paper · Website · Dataset |
| MuSS | 2026 | Paper · GitHub |
Benchmarks
| Benchmark | Year | Links |
|---|---|---|
| FETV | 2023 | Paper · GitHub · Dataset |
| StoryBench | 2023 | Paper · GitHub |
| ChronoMagic-Bench | 2024 | Paper · GitHub · Website · Dataset |
| EvalCrafter | 2024 | Paper · GitHub · Website · Dataset |
| VBench | 2024 | Paper · GitHub · Website · Dataset |
| T2VSafetyBench | 2024 | Paper · GitHub |
| MTBench | 2025 | Paper · GitHub · Website · Dataset |
| FiVE | 2025 | Paper · GitHub · Website · Dataset |
| VEG-Bench | 2025 | Paper · GitHub · Website · Dataset |
| VMBench | 2025 | Paper · GitHub · Website · Dataset |
| T2V-CompBench | 2025 | Paper · GitHub · Website · Dataset |
| StoryEval | 2025 | Paper · GitHub · Website · Dataset |
| MC-Bench | 2025 | Paper · GitHub · Website · Dataset |
| Video-Bench | 2025 | Paper · GitHub |
| MJ-BENCH-VIDEO | 2025 | Paper · GitHub · Website · Dataset |
| OpenS2V-Eval | 2025 | Paper · GitHub · Website · Dataset |
| VideoGen-RewardBench | 2025 | Paper · GitHub · Website · Dataset |
| AIGC-LipSync | 2025 | Paper · Website · Dataset |
| WorldModelBench | 2025 | Paper · GitHub · Website · Dataset |
 VIP-200K | 2025 | Paper · Website · Dataset |
| RGCD | 2025 | Paper · GitHub · Dataset |
| RecipeGen | 2025 | Paper · Dataset |
| HVEval | 2025 | Paper |
 Doc2Present | 2025 | Paper · GitHub · Dataset |
 VidCapBench | 2025 | Paper · GitHub · Dataset |
 VideoPhy | 2025 | Paper · GitHub · Dataset |
| PhyGenBench | 2025 | Paper · GitHub · Website · Dataset |
| Paper2Video | 2025 | Paper · GitHub · Website · Dataset |
| PhyWorldBench | 2025 | Paper · GitHub · Dataset |
| SeqBench | 2025 | Paper · GitHub · Website · Dataset |
| VideoVerse | 2025 | Paper · GitHub · Website · Dataset |
| MMMC | 2025 | Paper · GitHub · Website · Dataset |
| DynamicEval | 2025 | Paper · GitHub · Website · Dataset |
| V-ReasonBench | 2025 | Paper · GitHub · Website · Dataset |
| RGCD (alternate) | 2025 | Paper · GitHub · Dataset |
| VIPER | 2025 | Paper · GitHub · Dataset |
| Video Reality Test | 2025 | Paper · GitHub · Website · Dataset |
| WYD | 2025 | Paper · GitHub |
| GenVidBench | 2025 | Paper |
| DIVE | 2025 | Paper |
| UI2V-Bench | 2025 | Paper |
| PhysVidBench | 2025 | Paper |
| SurgVeo | 2025 | Paper |
| PAI-Bench | 2025 | Paper |
| MEve | 2025 | Paper |
| SafeMVDrive | 2026 | Paper · GitHub · Website · Dataset |
| AIGVE-60K | 2026 | Paper · GitHub · Dataset |
| T2AV-Compass | 2026 | Paper · Dataset |
| LoCoT2V-Bench | 2026 | Paper |
 GeneVA | 2026 | Paper · Website · Dataset |
| PhyEduVideo | 2026 | Paper · GitHub · Website |
| DrivingGen | 2026 | Paper · Website · Dataset |
| RISE-Video | 2026 | Paper · GitHub · Dataset |
| RBench | 2026 | Paper · GitHub · Website · Dataset |
| VC-Bench | 2026 | Paper · Website · Dataset |
| CoW-Bench | 2026 | Paper · GitHub · Dataset |
| MTAVG-Bench | 2026 | Paper |
| MSVBench | 2026 | Paper |
| SafeGen-Bench | 2026 | Paper |
| DirectorBench | 2026 | Paper · GitHub · Dataset |
| EvalVerse | 2026 | Paper |
| EntityBench | 2026 | Paper · GitHub · Website |
| MechVerse | 2026 | Paper · Website |
| WorldReasonBench | 2026 | Paper · GitHub · Website |
| WorldJen | 2026 | Paper · GitHub · Website · Dataset |
| BRITE | 2026 | Paper |
| WorldMark | 2026 | Paper · Website |
Conference Papers
| Title | Year | Links |
|---|---|---|
| FlashMotion: Few-Step Controllable Video Generation with Trajectory Guidance | 2026 | Paper · GitHub · Website |
| GenHOI: Towards Object-Consistent Hand–Object Interaction with Temporally Balanced and Spatially Selective Object Injection | 2026 | Paper · GitHub · Website |
| GT-SVJ: Generative-Transformer-Based Self-Supervised Video Judge For Efficient Video Reward Modeling | 2026 | Paper |
| Plenoptic Video Generation | 2026 | Paper · GitHub · Website |
| SoliReward: Mitigating Susceptibility to Reward Hacking and Annotation Noise in Video Generation Reward Models | 2026 | Paper · GitHub |
| EgoControl: Controllable Egocentric Video Generation via 3D Full-Body Poses | 2026 | Paper · GitHub · Website |
| Less is More: Data-Efficient Adaptation for Controllable Text-to-Video Generation | 2026 | Paper |
| TiViBench: Benchmarking Think-in-Video Reasoning for Video Generative Models | 2026 | Paper · GitHub · Website |
| TGT: Text-Grounded Trajectories for Locally Controlled Video Generation | 2026 | Paper · Website |
| Identity-Preserving Image-to-Video Generation via Reward-Guided Optimization | 2026 | Paper · GitHub · Website |
| Lynx: Towards High-Fidelity Personalized Video Generation | 2026 | Paper · GitHub · Website |
| ORV: 4D Occupancy-centric Robot Video Generation | 2026 | Paper · GitHub · Website |
| Where Concept Erasure Should Occur: Concept-Layer Alignment in Text-to-Video Diffusion Models | 2026 | Paper |
| World-R1: Reinforcing 3D Constraints for Text-to-Video Generation | 2026 | Paper · GitHub · Website |
| WorldCompass: Reinforcement Learning for Long-Horizon World Models | 2026 | Paper · GitHub · Website |
| Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation | 2026 | Paper · GitHub · Website |
| VideoGPA: Distilling Geometry Priors for 3D-Consistent Video Generation | 2026 | Paper · GitHub · Website |
| TAGRPO: Boosting GRPO on Image-to-Video Generation with Direct Trajectory Alignment | 2026 | Paper |
| Mitigating Surgical Data Imbalance with Dual-Prediction Video Diffusion Model | 2026 | Paper |
| RealisMotion: Decomposed Human Motion Control and Video Generation in the World Space | 2026 | Paper · GitHub · Website |
| LayerT2V: Interactive Multi-Object Trajectory Layering for Video Generation | 2026 | Paper · GitHub · Website |
| Physics-Guided Motion Loss for Video Generation Model | 2026 | Paper |
| SafeMVDrive: Multi-view Safety-Critical Driving Video Synthesis in the Real World Domain | 2026 | Paper · GitHub · Website |
| Neodragon: Mobile Video Generation using Diffusion Transformer | 2026 | Paper · Website |
| The Quest for Generalizable Motion Generation: Data, Model, and Evaluation | 2026 | Paper · GitHub |
| MoAlign: Motion-Centric Representation Alignment for Video Diffusion Models | 2026 | Paper |
| Stable Video Infinity: Infinite-Length Video Generation with Error Recycling | 2026 | Paper |
| Large Scale Diffusion Distillation via Score-Regularized Continuous-Time Consistency | 2026 | Paper |
| MATRIX: Mask Track Alignment for Interaction-aware Video Generation | 2026 | Paper |
| Arbitrary Generative Video Interpolation | 2026 | Paper |
| Rolling Forcing: Autoregressive Long Video Diffusion in Real Time | 2026 | Paper · GitHub · Website |
| BranchGRPO: Stable and Efficient GRPO with Structured Branching in Diffusion Models | 2026 | Paper · GitHub · Website |
| MoSA: Motion-Coherent Human Video Generation via Structure-Appearance Decoupling | 2026 | Paper · GitHub · Website |
| Vivid-VR: Distilling Concepts from Text-to-Video Diffusion Transformer for Photorealistic Video Restoration | 2026 | Paper · GitHub · Website |
| DreamSwapV: Mask-guided Subject Swapping for Any Customized Video Editing | 2026 | Paper |
| Geometry Forcing: Marrying Video Diffusion and 3D Representation for Consistent World Modeling | 2026 | Paper · GitHub · Website |
| Learning Video Generation for Robotic Manipulation with Collaborative Trajectory Control | 2026 | Paper · GitHub · Website |
| Many-for-Many: Unify the Training of Multiple Video and Image Generation and Manipulation Tasks | 2026 | Paper · GitHub |
| MAGREF: Masked Guidance for Any-Reference Video Generation with Subject Disentanglement | 2026 | Paper · GitHub · Website |
| Any-to-Bokeh: Arbitrary-Subject Video Refocusing with Video Diffusion Model | 2026 | Paper · Website |
| UNIC: Unified In-Context Video Editing | 2026 | Paper · Website |
| EffiVMT: Video Motion Transfer via Efficient Spatial-Temporal Decoupled Finetuning | 2026 | Paper · Website |
| EasyCreator: Empowering 4D Creation through Video Inpainting | 2026 | Paper · Website |
 PanFlow: Decoupled Motion Control for Panoramic Video Generation | 2026 | Paper · GitHub · Website |
| Phased One-Step Adversarial Equilibrium for Video Diffusion Models | 2026 | Paper · Website |
| Omni-Effects: Unified and Spatially-Controllable Visual Effects Generation | 2026 | Paper · GitHub · Website |
| Show Me: Unifying Instructional Image and Video Generation with Diffusion Models | 2026 | Paper · GitHub · Website |
| UniVid: Unifying Vision Tasks with Pre-trained Video Generation Models | 2026 | Paper · GitHub |
| Controllable Human-centric Keyframe Interpolation with Generative Prior | 2025 | Paper · GitHub · Website |
| RoboScape: Physics-informed Embodied World Model | 2025 | Paper · GitHub |
| Aligning What Matters: Masked Latent Adaptation for Text-to-Audio-Video Generation | 2025 | Paper |
| Audio-Sync Video Generation with Multi-Stream Temporal Control | 2025 | Paper · GitHub · Website |
| Autoregressive Adversarial Post-Training for Real-Time Interactive Video Generation | 2025 | Paper · Website |
| DenseDPO: Fine-Grained Temporal Preference Optimization for Video Diffusion Models | 2025 | Paper · Website |
| EchoShot: Multi-Shot Portrait Video Generation | 2025 | Paper · GitHub · Website |
| Frame Context Packing and Drift Prevention in Next-Frame-Prediction Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Frame In-N-Out: Unbounded Controllable Image-to-Video Generation | 2025 | Paper · GitHub · Website |
| GeoVideo: Introducing Geometric Regularization into Video Generation Model | 2025 | Paper · GitHub · Website |
| Hierarchical Fine-grained Preference Optimization for Physically Plausible Video Generation | 2025 | Paper · Website |
| Imagine360: Immersive 360 Video Generation from Perspective Anchor | 2025 | Paper · GitHub · Website |
| Improving Video Generation with Human Feedback | 2025 | Paper · GitHub · Website |
| MoCha: Towards Movie-Grade Talking Character Generation | 2025 | Paper · GitHub · Website |
| PolyVivid: Vivid Multi-Subject Video Generation with Cross-Modal Interaction and Enhancement | 2025 | Paper · Website |
| Radial Attention: $O(n\log n)$ Sparse Attention with Energy Decay for Long Video Generation | 2025 | Paper · GitHub · Website |
| RLGF: Reinforcement Learning with Geometric Feedback for Autonomous Driving Video Generation | 2025 | Paper |
| Temporal In-Context Fine-Tuning for Versatile Control of Video Diffusion Models | 2025 | Paper · GitHub · Website |
| VideoREPA: Learning Physics for Video Generation through Relational Alignment with Foundation Models | 2025 | Paper · GitHub · Website |
| Virtual Fitting Room: Generating Arbitrarily Long Videos of Virtual Try-On from a Single Image | 2025 | Paper · Website |
| Wan-Move: Motion-controllable Video Generation via Latent Trajectory Guidance | 2025 | Paper · GitHub · Website |
| WISA: World Simulator Assistant for Physics-Aware Text-to-Video Generation | 2025 | Paper · GitHub · Website |
| WorldWeaver: Generating Long-Horizon Video Worlds via Rich Perception | 2025 | Paper · Website |
| Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion | 2025 | Paper · GitHub |
| VC4VG: Optimizing Video Captions for Text-to-Video Generation | 2025 | Paper · GitHub |
| AICL: Action In-Context Learning for Video Diffusion Model | 2025 | Paper |
| Improving Identity Preservation in Video Generation with Multi-Branch Models | 2025 | Paper |
| M2PE-DIFF: Music-to-Pose Encoder for Dance Video Generation Leveraging Latent Diffusion Framework. | 2025 | Paper |
| SpA2V: Harnessing Spatial Auditory Cues for Audio-driven Spatially-aware Video Generation | 2025 | Paper |
| Tora2: Motion and Appearance Customized Diffusion Transformer for Multi-Entity Video Generation | 2025 | Paper · Website |
| AnimeColor: Reference-based Animation Colorization with Diffusion Transformers | 2025 | Paper · GitHub |
| Causal-Entity Reflected Egocentric Traffic Accident Video Synthesis | 2025 | Paper · GitHub · Website |
| Diffuman4D: 4D Consistent Human View Synthesis from Sparse-View Videos with Spatio-Temporal Diffusion Models | 2025 | Paper · GitHub · Website |
| AID: Adapting Image2Video Diffusion Models for Instruction-guided Video Prediction | 2025 | Paper · Website |
| Adversarial Distribution Matching for Diffusion Distillation Towards Efficient Image and Video Synthesis | 2025 | Paper |
| Decouple and Track: Benchmarking and Improving Video Diffusion Transformers For Motion Transfer | 2025 | Paper · GitHub · Website |
| DiTaiListener: Controllable High Fidelity Listener Video Generation with Diffusion | 2025 | Paper · Website |
| DOLLAR: Few-Step Video Generation via Distillation and Latent Reward Optimization | 2025 | Paper · Website |
| Dual-Expert Consistency Model for Efficient and High-Quality Video Generation | 2025 | Paper · GitHub · Website |
| DualReal: Adaptive Joint Training for Lossless Identity-Motion Fusion in Video Customization | 2025 | Paper · GitHub · Website |
| EfficientMT: Efficient Temporal Adaptation for Motion Transfer in Text-to-Video Diffusion Models | 2025 | Paper · GitHub |
| Free-Form Motion Control: Controlling the 6D Poses of Camera and Objects in Video Generation | 2025 | Paper · GitHub · Website |
| I2VControl: Disentangled and Unified Video Motion Synthesis Control | 2025 | Paper · Website |
| LayerAnimate: Layer-level Control for Animation | 2025 | Paper · GitHub · Website |
| Learning Few-Step Diffusion Models by Trajectory Distribution Matching | 2025 | Paper · GitHub · Website |
| LiON-LoRA: Rethinking LoRA Fusion to Unify Controllable Spatial and Temporal Generation for Video Diffusion | 2025 | Paper · Website |
| Long Context Tuning for Video Generation | 2025 | Paper · Website |
| MagicID: Hybrid Preference Optimization for ID-Consistent and Dynamic-Preserved Video Customization | 2025 | Paper · GitHub · Website |
| MagicMirror: ID-Preserved Video Generation in Video Diffusion Transformers | 2025 | Paper · GitHub |
| MagicMotion: Controllable Video Generation with Dense-to-Sparse Trajectory Guidance | 2025 | Paper · GitHub · Website |
| Mobile Video Diffusion | 2025 | Paper · Website |
| MotionAgent: Fine-grained Controllable Video Generation via Motion Field Agent | 2025 | Paper · GitHub |
| PersonalVideo: High ID-Fidelity Video Customization without Dynamic and Semantic Degradation | 2025 | Paper · GitHub · Website |
| Phantom: Subject-Consistent Video Generation via Cross-Modal Alignment | 2025 | Paper · GitHub · Website |
| Precise Action-to-Video Generation Through Visual Action Prompts | 2025 | Paper · Website |
| Prompt-A-Video: Prompt Your Video Diffusion Model via Preference-Aligned LLM | 2025 | Paper · GitHub |
| Puppet-Master: Scaling Interactive Video Generation as a Motion Prior for Part-Level Dynamics | 2025 | Paper · GitHub · Website |
| Reangle-A-Video: 4D Video Generation as Video-to-Video Translation | 2025 | Paper · GitHub · Website |
| RealCam-I2V: Real-World Image-to-Video Generation with Interactive Complex Camera Control | 2025 | Paper · GitHub · Website |
| STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution | 2025 | Paper · GitHub · Website |
| TACO: Taming Diffusion for in-the-wild Video Amodal Completion | 2025 | Paper · GitHub · Website |
| V.I.P.: Iterative Online Preference Distillation for Efficient Video Diffusion Models | 2025 | Paper · Website |
| VEGGIE: Instructional Editing and Reasoning Video Concepts with Grounded Generation | 2025 | Paper · GitHub · Website |
| Versatile Transition Generation with Image-to-Video Diffusion | 2025 | Paper · Website |
| VideoAuteur: Towards Long Narrative Video Generation | 2025 | Paper · GitHub · Website |
 FLAP: Fully-controllable Audio-driven Portrait Video Generation through 3D head conditioned diffusion model | 2025 | Paper |
| FrameBridge: Improving Image-to-Video Generation with Bridge Models | 2025 | Paper · Website |
| Diffusion Adversarial Post-Training for One-Step Video Generation | 2025 | Paper · Website |
| Identity-Preserving Text-to-Video Generation by Frequency Decomposition | 2025 | Paper · GitHub · Website |
| AKiRa: Augmentation Kit on Rays for Optical Video Generation | 2025 | Paper · GitHub · Website |
| AnyMoLe: Any Character Motion In-betweening Leveraging Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Extrapolating and Decoupling Image-to-Video Generation Models: Motion Modeling is Easier Than You Think | 2025 | Paper · GitHub |
| FlipSketch: Flipping Static Drawings to Text-Guided Sketch Animations | 2025 | Paper · GitHub |
| MotionPro: A Precise Motion Controller for Image-to-Video Generation | 2025 | Paper · GitHub · Website |
| FinePhys: Fine-grained Human Action Generation by Explicitly Incorporating Physical Laws for Effective Skeletal Guidance | 2025 | Paper · GitHub · Website |
| From Slow Bidirectional to Fast Autoregressive Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Go-with-the-Flow: Motion-Controllable Video Diffusion Models Using Real-Time Warped Noise | 2025 | Paper · GitHub · Website |
| GS-DiT: Advancing Video Generation with Dynamic 3D Gaussian Fields through Efficient Dense 3D Point Tracking | 2025 | Paper · GitHub · Website |
| High-Fidelity Relightable Monocular Portrait Animation with Lighting-Controllable Video Diffusion Model | 2025 | Paper · GitHub · Website |
| HunyuanPortrait: Implicit Condition Control for Enhanced Portrait Animation | 2025 | Paper · GitHub · Website |
| InterDyn: Controllable Interactive Dynamics with Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Lux Post Facto: Learning Portrait Performance Relighting with Conditional Video Diffusion and a Hybrid Dataset | 2025 | Paper · Website |
| Mind the Time: Temporally-Controlled Multi-Event Video Generation | 2025 | Paper · Website |
| Silence is Golden: Leveraging Adversarial Examples to Nullify Audio Control in LDM-based Talking-Head Generation | 2025 | Paper · GitHub |
| MotiF: Making Text Count in Image Animation with Motion Focal Loss | 2025 | Paper · Website |
| One-Minute Video Generation with Test-Time Training | 2025 | Paper · GitHub · Website |
| ReCapture: Generative Video Camera Controls for User-Provided Videos using Masked Video Fine-Tuning | 2025 | Paper · Website |
| ShotAdapter: Text-to-Multi-Shot Video Generation with Diffusion Models | 2025 | Paper · Website |
| TASTE-Rob: Advancing Video Generation of Task-Oriented Hand-Object Interaction for Generalizable Robotic Manipulation | 2025 | Paper · GitHub · Website |
| TransPixeler: Advancing Text-to-Video Generation with Transparency | 2025 | Paper · GitHub · Website |
| VideoDPO: Omni-Preference Alignment for Video Diffusion Generation | 2025 | Paper · GitHub · Website |
| Boosting Camera Motion Control for Video Diffusion Transformers | 2025 | Paper · GitHub · Website |
| CameraCtrl: Enabling Camera Control for Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Ctrl-Adapter: An Efficient and Versatile Framework for Adapting Diverse Controls to Any Diffusion Model | 2025 | Paper · GitHub · Website |
| Diffusion-NPO: Negative Preference Optimization for Better Preference Aligned Generation of Diffusion Models | 2025 | Paper · GitHub |
| SePPO: Semi-Policy Preference Optimization for Diffusion Alignment | 2025 | Paper · GitHub |
| Trajectory attention for fine-grained video motion control | 2025 | Paper · GitHub · Website |
| VADER: Video Diffusion Alignment via Reward Gradients | 2025 | Paper · GitHub · Website |
| VD3D: Taming Large Video Diffusion Transformers for 3D Camera Control | 2025 | Paper · GitHub · Website |
| Fine-Grained Controllable Video Generation via Object Appearance and Context | 2025 | Paper · Website |
| MagicStick: Controllable Video Editing via Control Handle Transformations | 2025 | Paper · GitHub · Website |
| TrackDiffusion: Tracklet-Conditioned Video Generation via Diffusion Models | 2025 | Paper · GitHub |
| CAGE: Unsupervised Visual Composition and Animation for Controllable Video Generation | 2025 | Paper · GitHub · Website |
| CustomCrafter: Customized Video Generation with Preserving Motion and Concept Composition Abilities | 2025 | Paper · GitHub · Website |
| CustomTTT: Motion and Appearance Customized Video Generation via Test-Time Training | 2025 | Paper · GitHub · Website |
| DriveDreamer-2: LLM-Enhanced World Models for Diverse Driving Video Generation | 2025 | Paper · GitHub · Website |
| Enhancing Identity-Deformation Disentanglement in StyleGAN for One-Shot Face Video Re-Enactment | 2025 | Paper · GitHub · Website |
| Modular-Cam: Modular Dynamic Camera-view Video Generation with LLM | 2025 | Paper · GitHub · Website |
| Occlusion-Insensitive Talking Head Video Generation via Facelet Compensation | 2025 | Paper |
| PanoDiT: Panoramic Videos Generation with Diffusion Transformer | 2025 | Paper |
| TrackGo: A Flexible and Efficient Method for Controllable Video Generation | 2025 | Paper · Website |
| UFO: Enhancing Diffusion-Based Video Generation with a Uniform Frame Organizer | 2025 | Paper · GitHub |
 Shape-for-Motion: Precise and Consistent Video Editing with 3D Proxy | 2025 | Paper · GitHub · Website |
| FairyGen: Storied Cartoon Video from a Single Child-Drawn Character | 2025 | Paper · GitHub · Website |
| CamCloneMaster: Enabling Reference-based Camera Control for Video Generation | 2025 | Paper · GitHub · Website |
 Mission Balance: Generating Under-represented Class Samples using Video Diffusion Models | 2025 | Paper |
| Ophora: A Large-Scale Data-Driven Text-Guided Ophthalmic Surgical Video Generation Model | 2025 | Paper · GitHub |
 Animate Your Motion: Turning Still Images into Dynamic Videos | 2024 | Paper · GitHub · Website |
| DragVideo: Interactive Drag-style Video Editing | 2024 | Paper · GitHub · Website |
| MEVG : Multi-event Video Generation with Text-to-Video Models | 2024 | Paper · GitHub · Website |
| MoVideo: Motion-Aware Video Generation with Diffusion Models | 2024 | Paper · Website |
| SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models | 2024 | Paper · GitHub · Website |
| Stable Video Portraits | 2024 | Paper · Website |
| TCAN: Animating Human Images with Temporally Consistent Pose Guidance using Diffusion Models | 2024 | Paper · GitHub · Website |
| Video Editing via Factorized Diffusion Distillation | 2024 | Paper · Website |
| VideoStudio: Generating Consistent-Content and Multi-Scene Videos | 2024 | Paper · GitHub · Website |
 VideoDirectorGPT: Consistent Multi-Scene Video Generation via LLM-Guided Planning | 2024 | Paper · GitHub · Website |
| Exo2Ego-V: Exocentric-to-Egocentric Video Generation | 2024 | Paper · GitHub · GitHub |
| MotionBooth: Motion-Aware Customized Text-to-Video Generation | 2024 | Paper · GitHub · Website |
| SF-V: Single Forward Video Generation Model | 2024 | Paper · GitHub · Website |
| T2V-Turbo: Breaking the Quality Bottleneck of Video Consistency Model with Mixed Reward Feedback | 2024 | Paper · GitHub · Website |
| Vivid-ZOO: Multi-View Video Generation with Diffusion Model | 2024 | Paper · GitHub · Website |
| VIDEOSCORE: Building Automatic Metrics to Simulate Fine-grained Human Feedback for Video Generation | 2024 | Paper · GitHub · Website |
| VIMI: Grounding Video Generation through Multi-modal Instruction | 2024 | Paper · GitHub · Website |
| DisenStudio: Customized Multi-subject Text-to-Video Generation with Disentangled Spatial Control | 2024 | Paper · GitHub |
| DragEntity: Trajectory Guided Video Generation using Entity and Positional Relationships | 2024 | Paper |
| Efficient Video Diffusion Models via Content-Frame Motion-Latent Decomposition | 2024 | Paper · Website |
| SEINE: Short-to-Long Video Diffusion Model for Generative Transition and Prediction | 2024 | Paper · GitHub · Website |
| VersVideo: Leveraging Enhanced Temporal Diffusion Models for Versatile Video Generation | 2024 | Paper · Website |
| InstructVideo: Instructing Video Diffusion Models with Human Feedback | 2024 | Paper · GitHub · Website |
| SimDA: Simple Diffusion Adapter for Efficient Video Generation | 2024 | Paper · GitHub · Website |
| VideoCrafter2: Overcoming Data Limitations for High-Quality Video Diffusion Models | 2024 | Paper · GitHub · Website |
| Follow Your Pose: Pose-Guided Text-to-Video Generation Using Pose-Free Videos | 2024 | Paper · GitHub · Website |
| VideoComposer: Compositional Video Synthesis with Motion Controllability | 2023 | Paper · GitHub · Website |
| MobileVidFactory: Automatic Diffusion-Based Social Media Video Generation for Mobile Devices from Text | 2023 | Paper |
| DreamPose: Fashion Video Synthesis with Stable Diffusion | 2023 | Paper · GitHub · Website |
| Preserve Your Own Correlation: A Noise Prior for Video Diffusion Models | 2023 | Paper · Website |
| Structure and Content-Guided Video Synthesis with Diffusion Models | 2023 | Paper · GitHub · Website |
| Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video Generation | 2023 | Paper · GitHub · Website |
arXiv Papers
| Title | Year | Links |
|---|---|---|
| Ultra Flash: Scaling Real-Time Streaming Video Generation to High Resolutions | 2026 | Paper · Website |
| Do Models Share Safety Representations? Cross-Model Steering for Safe Visual Generation | 2026 | Paper · Website |
| Activation Steering of Video Generation Models via Reduced-Order Linear Optimal Control | 2026 | Paper |
| Physics-Informed Video Generation via Mixture-of-Experts Latent Alignment | 2026 | Paper |
| Real2SAM2Real: Generative 3D Caches as Complementary Context for Video Diffusion | 2026 | Paper · Website |
| minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models | 2026 | Paper · GitHub |
| DeltaCam: Differential Intrinsic Camera Modeling for Video Generation | 2026 | Paper |
| Geo-Align: Video Generation Alignment via Metric Geometry Reward | 2026 | Paper · Website |
| SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models | 2026 | Paper · GitHub · Website |
| CoMoGen: COntrollable MOtion Dynamics and Interactions with Mask-Guided Video GENeration | 2026 | Paper · Website |
| CogOmniControl: Reasoning-Driven Controllable Video Generation via Creative Intent Cognition | 2026 | Paper · Website |
| Aero-World: Action-Conditioned Aerial Video Generation from Inertial Controls | 2026 | Paper |
| PhyWorld: Physics-Faithful World Model for Video Generation | 2026 | Paper |
| GeoFlow: Enforcing Implicit Geometric Consistency in Video Generation | 2026 | Paper · GitHub · Website |
| Video Models Can Reason with Verifiable Rewards | 2026 | Paper · Website |
| RefDecoder: Enhancing Visual Generation with Conditional Video Decoding | 2026 | Paper |
| RAVEN: Real-time Autoregressive Video Extrapolation with Consistency-model GRPO | 2026 | Paper · Website |
| DriveCtrl: Conditioned Sim-to-Real Driving Video Generation | 2026 | Paper |
| EverAnimate: Minute-Scale Human Animation via Latent Flow Restoration | 2026 | Paper · Website |
| SEDiT: Mask-Free Video Subtitle Erasure via One-step Diffusion Transformer | 2026 | Paper · Website |
| Delta Forcing: Trust Region Steering for Interactive Autoregressive Video Generation | 2026 | Paper · Website |
| CreFlow: Corrective Reflow for Sparse-Reward Embodied Video Diffusion RL | 2026 | Paper |
| PhyMotion: Structured 3D Motion Reward for Physics-Grounded Human Video Generation | 2026 | Paper · Website |
| CRePE: Curved Ray Expectation Positional Encoding for Unified-Camera-Controlled Video Generation | 2026 | Paper |
| CaC: Advancing Video Reward Models via Hierarchical Spatiotemporal Concentrating | 2026 | Paper |
| TIE: Time Interval Encoding for Video Generation over Events | 2026 | Paper · GitHub · Website |
| Improving Human Image Animation via Semantic Representation Alignment | 2026 | Paper |
| From Articulated Kinematics to Routed Visual Control for Action-Conditioned Surgical Video Generation | 2026 | Paper |
| Alice v1: Distillation-Enhanced Video Generation Surpassing Closed-Source Models | 2026 | Paper · GitHub |
| Diffusion-APO: Trajectory-Aware Direct Preference Alignment for Video Diffusion Transformers | 2026 | Paper |
| Stream-R1: Reliability-Perplexity Aware Reward Distillation for Streaming Video Generation | 2026 | Paper · Website |
| PhyCo: Learning Controllable Physical Priors for Generative Motion | 2026 | Paper · Website |
| AesRM: Improving Video Aesthetics with Expert-Level Feedback | 2026 | Paper · Website |
| A Systematic Post-Train Framework for Video Generation | 2026 | Paper |
| MMControl: Unified Multi-Modal Control for Joint Audio-Video Generation | 2026 | Paper |
| Learning to Credit the Right Steps: Objective-aware Process Optimization for Visual Generation | 2026 | Paper |
| Not all tokens contribute equally to diffusion learning | 2026 | Paper |
| HumANDiff: Articulated Noise Diffusion for Motion-Consistent Human Video Generation | 2026 | Paper · Website |
| OP-GRPO: Efficient Off-Policy GRPO for Flow-Matching Models | 2026 | Paper |
| MMPhysVideo: Scaling Physical Plausibility in Video Generation via Joint Multimodal Modeling | 2026 | Paper · Website |
| Control-DINO: Feature Space Conditioning for Controllable Image-to-Video Diffusion | 2026 | Paper · GitHub · Website |
| ReinDriveGen: Reinforcement Post-Training for Out-of-Distribution Driving Scene Generation | 2026 | Paper · Website |
| Wan-R1: Verifiable-Reinforcement Learning for Video Reasoning | 2026 | Paper |
| TokenDial: Continuous Attribute Control in Text-to-Video via Spatiotemporal Token Offsets | 2026 | Paper · Website |
| LOME: Learning Human-Object Manipulation with Action-Conditioned Egocentric World Model | 2026 | Paper · Website |
| VGGRPO: Towards World-Consistent Video Generation with 4D Latent Reward | 2026 | Paper · Website |
| DiReCT: Disentangled Regularization of Contrastive Trajectories for Physics-Refined Video Generation | 2026 | Paper |
| RefAlign: Representation Alignment for Reference-to-Video Generation | 2026 | Paper · GitHub |
| ABot-PhysWorld: Interactive World Foundation Model for Robotic Manipulation with Physics Alignment | 2026 | Paper · GitHub |
| Manifold-Aware Exploration for Reinforcement Learning in Video Generation | 2026 | Paper · Website |
| PROBE: Diagnosing Residual Concept Capacity in Erased Text-to-Video Diffusion Models | 2026 | Paper · GitHub |
| Helios: Real Real-Time Long Video Generation Model | 2026 | Paper · GitHub · Website |
| 3DreamBooth: High-Fidelity 3D Subject-Driven Video Generation Model | 2026 | Paper · GitHub · Website |
| AR-CoPO: Align Autoregressive Video Generation with Contrastive Policy Optimization | 2026 | Paper |
| Anchor Forcing: Anchor Memory and Tri-Region RoPE for Interactive Streaming Video Diffusion | 2026 | Paper · GitHub · Website |
| ConfCtrl: Enabling Precise Camera Control in Video Diffusion via Confidence-Aware Interpolation | 2026 | Paper |
| Controllable Egocentric Video Generation via Occlusion-Aware Sparse 3D Hand Joints | 2026 | Paper |
| DreamVideo-Omni: Omni-Motion Controlled Multi-Subject Video Customization with Latent Identity Reinforcement Learning | 2026 | Paper · Website |
| Aligning Video World Models with Executable Robot Actions via Inverse Dynamics Rewards | 2026 | Paper · GitHub · Website |
| EraseAnything++: Enabling Concept Erasure in Rectified Flow Transformers Leveraging Multi-Object Optimization | 2026 | Paper |
| FlowPortrait: Reinforcement Learning for Audio-Driven Portrait Video Generation | 2026 | Paper |
| InfinityStory: Unlimited Video Generation with World Consistency and Character-Aware Shot Transitions | 2026 | Paper |
| LibraGen: Playing a Balance Game in Subject-Driven Video Generation | 2026 | Paper · GitHub · Website |
| Making Video Models Adhere to User Intent with Minor Adjustments | 2026 | Paper · GitHub · Website |
| MosaicMem: Hybrid Spatial Memory for Controllable Video World Models | 2026 | Paper · Website |
| Motion Forcing: A Decoupled Framework for Robust Video Generation in Motion Dynamics | 2026 | Paper · GitHub · Website |
| SAW: Toward a Surgical Action World Model via Controllable and Scalable Video Generation | 2026 | Paper |
| SPATIALALIGN: Aligning Dynamic Spatial Relationships in Video Generation | 2026 | Paper · GitHub · Website |
| SPIRAL: A Closed-Loop Framework for Self-Improving Action World Models via Reflective Planning Agents | 2026 | Paper |
| ShotVerse: Advancing Cinematic Camera Control for Text-Driven Multi-Shot Video Creation | 2026 | Paper · GitHub · Website |
| VIGOR: VIdeo Geometry-Oriented Reward for Temporal Generative Alignment | 2026 | Paper · Website |
| ViFeEdit: A Video-Free Tuner of Your Video Diffusion Transformer | 2026 | Paper · GitHub |
| AnchorWeave: World-Consistent Video Generation with Retrieved Local Spatial Memories | 2026 | Paper · GitHub · Website |
| High-Fidelity Causal Video Diffusion Models for Real-Time Ultra-Low-Bitrate Semantic Communication | 2026 | Paper |
| EchoTorrent: Towards Swift, Sustained, and Streaming Multi-Modal Video Generation | 2026 | Paper |
| Tele-Omni: a Unified Multimodal Framework for Video Generation and Editing | 2026 | Paper |
| Omni-Video 2: Scaling MLLM-Conditioned Diffusion for Unified Video Generation and Editing | 2026 | Paper · GitHub · Website |
| ALIVE: Animate Your World with Lifelike Audio-Video Generation | 2026 | Paper · GitHub · Website |
| PISCO: Precise Video Instance Insertion with Sparse Control | 2026 | Paper · GitHub · Website |
| TeleBoost: A Systematic Alignment Framework for High-Fidelity, Controllable, and Robust Video Generation | 2026 | Paper · GitHub |
| Optimizing Few-Step Generation with Adaptive Matching Distillation | 2026 | Paper |
| Driving with DINO: Vision Foundation Features as a Unified Bridge for Sim-to-Real Generation in Autonomous Driving | 2026 | Paper · Website |
| LSA: Localized Semantic Alignment for Enhancing Temporal Consistency in Traffic Video Generation | 2026 | Paper · GitHub |
| Euphonium: Steering Video Flow Matching via Process Reward Gradient Guided Stochastic Dynamics | 2026 | Paper · GitHub |
| BridgeV2W: Bridging Video Generation Models to Embodied World Models via Embodiment Masks | 2026 | Paper · Website |
| Unified Personalized Reward Model for Vision Generation | 2026 | Paper · GitHub · Website |
| PISCES: Annotation-free Text-to-Video Post-Training via Optimal Transport-Aligned Rewards | 2026 | Paper |
| Latent Temporal Discrepancy as Motion Prior: A Loss-Weighting Strategy for Dynamic Fidelity in T2V | 2026 | Paper |
| Reward-Forcing: Autoregressive Video Generation with Reward Feedback | 2026 | Paper · GitHub · Website |
| Walk through Paintings: Egocentric World Models from Internet Priors | 2026 | Paper · GitHub · Website |
| Human detectors are surprisingly powerful reward models | 2026 | Paper |
| PhysRVG: Physics-Aware Unified Reinforcement Learning for Video Generative Models | 2026 | Paper · Website |
| Inference-time Physics Alignment of Video Generative Models with Latent World Models | 2026 | Paper |
| Beyond Inpainting: Unleash 3D Understanding for Precise Camera-Controlled Video Generation | 2026 | Paper · Website |
| Focal Guidance: Unlocking Controllability from Semantic-Weak Layers in Video Diffusion Models | 2026 | Paper |
| Mind the Generative Details: Direct Localized Detail Preference Optimization for Video Diffusion Models | 2026 | Paper |
| Thinking with Frames: Generative Video Distortion Evaluation via Frame Reward Model | 2026 | Paper |
| DreamLoop: Controllable Cinemagraph Generation from a Single Photograph | 2026 | Paper · Website |
| Slot-ID: Identity-Preserving Video Generation from Reference Videos via Slot-Based Temporal Identity Encoding | 2026 | Paper |
| PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation | 2025 | Paper · GitHub · Website |
| LiveTalk: Real-Time Multimodal Interactive Video Diffusion via Improved On-Policy Distillation | 2025 | Paper · GitHub |
| Envision: Embodied Visual Planning via Goal-Imagery Video Diffusion | 2025 | Paper · Website |
| Characterizing Motion Encoding in Video Diffusion Timesteps | 2025 | Paper |
| ACD: Direct Conditional Control for Video Diffusion Models via Attention Supervision | 2025 | Paper |
| DreaMontage: Arbitrary Frame-Guided One-Shot Video Generation | 2025 | Paper · Website |
| Few-Shot-Based Modular Image-to-Video Adapter for Diffusion Models | 2025 | Paper · GitHub · Website |
| StoryMem: Multi-shot Long Video Storytelling with Memory | 2025 | Paper · GitHub · Website |
| CETCAM: Camera-Controllable Video Generation via Consistent and Extensible Tokenization | 2025 | Paper · Website |
| Animate Any Character in Any World | 2025 | Paper · GitHub · Website |
| InsertAnywhere: Bridging 4D Scene Geometry and Diffusion Models for Realistic Video Object Insertion | 2025 | Paper · Website |
| The World is Your Canvas: Painting Promptable Events with Reference Images, Trajectories, and Text | 2025 | Paper · GitHub · Website |
| Factorized Video Generation: Decoupling Scene Construction and Temporal Synthesis in Text-to-Video Diffusion Models | 2025 | Paper · GitHub · Website |
| LongVie 2: Multimodal Controllable Ultra-Long Video World Model | 2025 | Paper · GitHub · Website |
| SneakPeek: Future-Guided Instructional Streaming Video Generation | 2025 | Paper |
| What Happens Next? Next Scene Prediction with a Unified Video Model | 2025 | Paper |
| GenieDrive: Towards Physics-Aware Driving World Model with 4D Occupancy Guided Video Generation | 2025 | Paper · GitHub · Website |
| STAGE: Storyboard-Anchored Generation for Cinematic Multi-shot Narrative | 2025 | Paper |
| SMRABooth: Subject and Motion Representation Alignment for Customized Video Generation | 2025 | Paper |
| BAgger: Backwards Aggregation for Mitigating Drift in Autoregressive Video Diffusion Models | 2025 | Paper · Website |
| Structure From Tracking: Distilling Structure-Preserving Motion for Video Generation | 2025 | Paper · Website |
| AlcheMinT: Fine-grained Temporal Control for Multi-Reference Consistent Video Generation | 2025 | Paper · Website |
| ReCamDriving: LiDAR-Free Camera-Controlled Novel Trajectory Video Generation | 2025 | Paper · GitHub · Website |
| In-Context Sync-LoRA for Portrait Video Editing | 2025 | Paper · GitHub · Website |
| Progressive Image Restoration via Text-Conditioned Video Generation | 2025 | Paper |
| Generative Video Motion Editing with 3D Point Tracks | 2025 | Paper · Website |
| SpriteHand: Real-Time Versatile Hand-Object Interaction with Autoregressive Video Generation | 2025 | Paper |
| DreamingComics: A Story Visualization Pipeline via Subject and Layout Customized Generation using Video Models | 2025 | Paper · Website |
| Low-Bitrate Video Compression through Semantic-Conditioned Diffusion | 2025 | Paper |
| AnyTalker: Scaling Multi-Person Talking Video Generation with Interactivity Refinement | 2025 | Paper · GitHub · Website |
| BlockVid: Block Diffusion for High-Quality and Consistent Minute-Long Video Generation | 2025 | Paper · GitHub · Website |
| WorldWander: Bridging Egocentric and Exocentric Worlds in Video Generation | 2025 | Paper · GitHub · Website |
| CtrlVDiff: Controllable Video Generation via Unified Multimodal Video Diffusion | 2025 | Paper · GitHub · Website |
| MotionV2V: Editing Motion in a Video | 2025 | Paper · GitHub · Website |
| Exo2EgoSyn: Unlocking Foundation Video Generation Models for Exocentric-to-Egocentric Video Synthesis | 2025 | Paper |
| SteadyDancer: Harmonized and Coherent Human Image Animation with First-Frame Preservation | 2025 | Paper · GitHub · Website |
| Beyond Reward Margin: Rethinking and Resolving Likelihood Displacement in Diffusion Models via Video Generation | 2025 | Paper |
| View-Consistent Diffusion Representations for 3D-Consistent Video Generation | 2025 | Paper · Website |
| Eevee: Towards Close-up High-resolution Video-based Virtual Try-on | 2025 | Paper · GitHub |
| STCDiT: Spatio-Temporally Consistent Diffusion Transformer for High-Quality Video Super-Resolution | 2025 | Paper · GitHub · Website |
| Point-to-Point: Sparse Motion Guidance for Controllable Video Editing | 2025 | Paper |
| CamC2V: Context-aware Controllable Video Generation | 2025 | Paper · GitHub |
| MultiShotMaster: A Controllable Multi-Shot Video Generation Framework | 2025 | Paper · GitHub · Website |
| LoVoRA: Text-guided and Mask-free Video Object Removal and Addition with Learnable Object-aware Localization | 2025 | Paper · GitHub · Website |
| Taming Camera-Controlled Video Generation with Verifiable Geometry Reward | 2025 | Paper |
| IC-World: In-Context Generation for Shared World Modeling | 2025 | Paper · GitHub |
| Objects in Generated Videos Are Slower Than They Appear: Models Suffer Sub-Earth Gravity and Make Objects Move Slower Than in Reality | 2025 | Paper · Website |
| What about gravity in video generation? Post-Training Newton's Laws with Verifiable Rewards | 2025 | Paper · GitHub · Website |
| InstanceV: Instance-Level Video Generation | 2025 | Paper · GitHub · Website |
| McSc: Motion-Corrective Preference Alignment for Video Generation with Self-Critic Hierarchical Reasoning | 2025 | Paper · GitHub · Website |
| One-to-All Animation: Alignment-Free Character Animation and Image Pose Transfer | 2025 | Paper · GitHub · Website |
| MoGAN: Improving Motion Quality in Video Diffusion via Few-Step Motion Adversarial Post-Training | 2025 | Paper · Website |
| Video Generation Models Are Good Latent Reward Models | 2025 | Paper · Website |
| MapReduce LoRA: Advancing the Pareto Front in Multi-Preference Optimization for Generative Models | 2025 | Paper |
| Growing with the Generator: Self-paced GRPO for Video Generation | 2025 | Paper |
| Learning What to Trust: Bayesian Prior-Guided Optimization for Visual Generation | 2025 | Paper |
| Video-as-Answer: Predict and Generate Next Video Event with Joint-GRPO | 2025 | Paper · GitHub · Website |
| First Frame Is the Place to Go for Video Content Customization | 2025 | Paper · GitHub · Website |
| Kandinsky 5.0: A Family of Foundation Models for Image and Video Generation | 2025 | Paper · GitHub |
| Adaptive Begin-of-Video Tokens for Autoregressive Video Diffusion Models | 2025 | Paper |
| ProAV-DiT: A Projected Latent Diffusion Transformer for Efficient Synchronized Audio-Video Generation | 2025 | Paper |
| LiteAttention: A Temporal Sparse Attention for Diffusion Transformers | 2025 | Paper · GitHub · Website |
| EmoVid: A Multimodal Emotion Video Dataset for Emotion-Centric Video Understanding and Generation | 2025 | Paper · Website |
| Video Text Preservation with Synthetic Text-Rich Videos | 2025 | Paper |
| RISE-T2V: Rephrasing and Injecting Semantics with LLM for Expansive Text-to-Video Generation | 2025 | Paper · Website |
| PhysCorr: Dual-Reward DPO for Physics-Constrained Text-to-Video Generation with Automated Preference Selection | 2025 | Paper |
| UniAVGen: Unified Audio and Video Generation with Asymmetric Cross-Modal Interactions | 2025 | Paper · GitHub · Website |
| ID-Crafter: VLM-Grounded Online RL for Compositional Multi-Subject Video Generation | 2025 | Paper · GitHub · Website |
| Fine-Tuning Open Video Generators for Cinematic Scene Synthesis: A Small-Data Pipeline with LoRA and Wan2.1 I2V | 2025 | Paper · Website |
| VC4VG: Optimizing Video Captions for Text-to-Video Generation | 2025 | Paper · GitHub · Website |
| CoMo: Compositional Motion Customization for Text-to-Video Generation | 2025 | Paper · Website |
| Epipolar Geometry Improves Video Generation Models | 2025 | Paper · GitHub · Website |
| In-Context Learning with Unpaired Clips for Instruction-based Video Editing | 2025 | Paper · GitHub |
| Identity-GRPO: Optimizing Multi-Human Identity-preserving Video Generation via Reinforcement Learning | 2025 | Paper · GitHub · Website |
| Virtually Being: Customizing Camera-Controllable Video Diffusion Models with Multi-View Performance Captures | 2025 | Paper · Website |
| PhysMaster: Mastering Physical Representation for Video Generation via Reinforcement Learning | 2025 | Paper |
| MVP4D: Multi-View Portrait Video Diffusion for Animatable 4D Avatars | 2025 | Paper |
| Real-Time Motion-Controllable Autoregressive Video Diffusion | 2025 | Paper |
| PickStyle: Video-to-Video Style Transfer with Context-Style Adapters | 2025 | Paper |
| Generative World Modelling for Humanoids: 1X World Model Challenge Technical Report | 2025 | Paper |
| Character Mixing for Video Generation | 2025 | Paper · GitHub |
| FlashI2V: Fourier-Guided Latent Shifting Prevents Conditional Image Leakage in Image-to-Video Generation | 2025 | Paper · GitHub · Website |
| DC-VideoGen: Efficient Video Generation with Deep Compression Video Autoencoder | 2025 | Paper · GitHub · Website |
| PanoWorld-X: Generating Explorable Panoramic Worlds via Sphere-Aware Video Diffusion | 2025 | Paper · Website |
| Attention Surgery: An Efficient Recipe to Linearize Your Video Diffusion Transformer | 2025 | Paper · Website |
| Reinforcement Learning with Inverse Rewards for World Model Post-training | 2025 | Paper |
| Echo-Path: Pathology-Conditioned Echo Video Generation | 2025 | Paper · GitHub |
| VidCLearn: A Continual Learning Approach for Text-to-Video Generation | 2025 | Paper |
| OpenViGA: Video Generation for Automotive Driving Scenes by Streamlining and Fine-Tuning Open Source Models with Public Data | 2025 | Paper |
| PanoLora: Bridging Perspective and Panoramic Video Generation with LoRA Adaptation | 2025 | Paper · Website |
| Kling-Avatar: Grounding Multimodal Instructions for Cascaded Long-Duration Avatar Animation Synthesis | 2025 | Paper · Website |
| Improving Video Diffusion Transformer Training by Multi-Feature Fusion and Alignment from Self-Supervised Vision Encoders | 2025 | Paper · Website |
| RewardDance: Reward Scaling in Visual Generation | 2025 | Paper |
| HuMo: Human-Centric Video Generation via Collaborative Multi-Modal Conditioning | 2025 | Paper · GitHub · Website |
| Zero-shot 3D-Aware Trajectory-Guided image-to-video generation via Test-Time Training | 2025 | Paper · GitHub · Website |
| UniVerse-1: Unified Audio-Video Generation via Stitching of Experts | 2025 | Paper · GitHub · Website |
| DevilSight: Augmenting Monocular Human Avatar Reconstruction through a Virtual Perspective | 2025 | Paper |
| Realistic and Controllable 3D Gaussian-Guided Object Editing for Driving Video Generation | 2025 | Paper |
| Learning Primitive Embodied World Models: Towards Scalable Robotic Learning | 2025 | Paper · GitHub · Website |
| MIDAS: Multimodal Interactive Digital-humAn Synthesis via Real-time Autoregressive Video Generation | 2025 | Paper · Website |
| ControlEchoSynth: Boosting Ejection Fraction Estimation Models via Controlled Video Diffusion | 2025 | Paper |
| SSG-Dit: A Spatial Signal Guided Framework for Controllable Video Generation | 2025 | Paper |
| Seeing Clearly, Forgetting Deeply: Revisiting Fine-Tuned Video Generators for Driving Simulation | 2025 | Paper |
| WorldWeaver: Generating Long-Horizon Video Worlds via Rich Perception | 2025 | Paper |
| 4DNeX: Feed-Forward 4D Generative Modeling Made Easy | 2025 | Paper · GitHub · Website |
| Physical Autoregressive Model for Robotic Manipulation without Action Pretraining | 2025 | Paper · GitHub · Website |
| From Large Angles to Consistent Faces: Identity-Preserving Video Generation via Mixture of Facial Experts | 2025 | Paper · GitHub · Website |
| Animate-X++: Universal Character Image Animation with Dynamic Backgrounds | 2025 | Paper · GitHub · Website |
| SketchAnimator: Animate Sketch via Motion Customization of Text-to-Video Diffusion Models | 2025 | Paper |
| SwiftVideo: A Unified Framework for Few-Step Video Generation through Trajectory-Distribution Alignment | 2025 | Paper |
| DreamVE: Unified Instruction-based Image and Video Editing | 2025 | Paper · Website |
| PoseGen: In-Context LoRA Finetuning for Pose-Controllable Long Human Video Generation | 2025 | Paper |
| Scaling Up Audio-Synchronized Visual Animation: An Efficient Training Paradigm | 2025 | Paper |
| LongVie: Multimodal-Guided Controllable Ultra-Long Video Generation | 2025 | Paper · GitHub · Website |
| Macro-from-Micro Planning for High-Quality and Parallelized Autoregressive Long Video Generation | 2025 | Paper · GitHub · Website |
| DreamVVT: Mastering Realistic Video Virtual Try-On in the Wild via a Stage-Wise Diffusion Transformer Framework | 2025 | Paper · GitHub · Website |
| Compositional Video Synthesis by Temporal Object-Centric Learning | 2025 | Paper |
| Enhancing Scene Transition Awareness in Video Generation via Post-Training | 2025 | Paper |
| Zero-Shot Dynamic Concept Personalization with Grid-Based LoRA | 2025 | Paper · Website |
| Navigating Large-Pose Challenge for High-Fidelity Face Reenactment with Video Diffusion Model | 2025 | Paper · GitHub |
| PUSA V1.0: Surpassing Wan-I2V with $500 Training Cost by Vectorized Timestep Adaptation | 2025 | Paper · GitHub · Website |
| Conditional Video Generation for High-Efficiency Video Compression | 2025 | Paper |
| StableAnimator++: Overcoming Pose Misalignment and Face Distortion for Human Image Animation | 2025 | Paper · Website |
| Geometry-aware 4D Video Generation for Robot Manipulation | 2025 | Paper · GitHub · Website |
| Populate-A-Scene: Affordance-Aware Human Video Generation | 2025 | Paper · Website |
| TextMesh4D: High-Quality Text-to-4D Mesh Generation | 2025 | Paper |
| SynMotion: Semantic-Visual Adaptation for Motion Customized Video Generation | 2025 | Paper · Website |
| MirrorMe: Towards Realtime and High Fidelity Audio-Driven Halfbody Animation | 2025 | Paper |
| Video Virtual Try-on with Conditional Diffusion Transformer Inpainter | 2025 | Paper |
| DFVEdit: Conditional Delta Flow Vector for Zero-shot Video Editing | 2025 | Paper · GitHub · Website |
| Bind-Your-Avatar: Multi-Talking-Character Video Generation with Dynamic 3D-mask-based Embedding Router | 2025 | Paper · GitHub · Website |
| AnimaX: Animating the Inanimate in 3D with Joint Video-Pose Diffusion Models | 2025 | Paper · GitHub · Website |
| RDPO: Real Data Preference Optimization for Physics Consistency Video Generation | 2025 | Paper · Website |
| FramePrompt: In-context Controllable Animation with Zero Structural Changes | 2025 | Paper · Website |
| DAVID-XR1: Detecting AI-Generated Videos with Explainable Reasoning | 2025 | Paper |
| Causally Steered Diffusion for Automated Video Counterfactual Generation | 2025 | Paper · GitHub · Website |
| iDiT-HOI: Inpainting-based Hand Object Interaction Reenactment via Video Diffusion Transformer | 2025 | Paper |
| PlayerOne: Egocentric World Simulator | 2025 | Paper · GitHub · Website |
| LoRA-Edit: Controllable First-Frame-Guided Video Editing via Mask-Aware LoRA Fine-Tuning | 2025 | Paper · GitHub · Website |
| DreamActor-H1: High-Fidelity Human-Product Demonstration Video Generation via Motion-designed Diffusion Transformers | 2025 | Paper · Website |
| GigaVideo-1: Advancing Video Generation via Automatic Feedback with 4 GPU-Hours Fine-Tuning | 2025 | Paper |
| AlignHuman: Improving Motion and Fidelity via Timestep-Segment Preference Optimization for Audio-Driven Human Animation | 2025 | Paper · Website |
| Enhancing Motion Dynamics of Image-to-Video Models via Adaptive Low-Pass Guidance | 2025 | Paper · GitHub · Website |
| HunyuanVideo-HOMA: Generic Human-Object Interaction in Multimodal Driven Human Animation | 2025 | Paper |
| Seedance 1.0: Exploring the Boundaries of Video Generation Models | 2025 | Paper · Website |
| Cosmos-Drive-Dreams: Scalable Synthetic Driving Data Generation with World Foundation Models | 2025 | Paper · GitHub · Website |
| Cross-Frame Representation Alignment for Fine-Tuning Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Consistent Video Editing as Flow-Driven Image-to-Video Generation | 2025 | Paper |
| From Generation to Generalization: Emergent Few-Shot Learning in Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Restereo: Diffusion stereo video generation and restoration | 2025 | Paper |
| FullDiT2: Efficient In-Context Conditioning for Video Diffusion Transformers | 2025 | Paper · Website |
| Sparse-vDiT: Unleashing the Power of Sparse Attention to Accelerate Video Diffusion Transformers | 2025 | Paper · GitHub |
| OmniV2V: Versatile Video Generation and Editing via Dynamic Content Manipulation | 2025 | Paper |
| Respond Beyond Language: A Benchmark for Video Generation in Response to Realistic User Intents | 2025 | Paper |
| Playing with Transformer at 30+ FPS via Next-Frame Diffusion | 2025 | Paper · Website |
| DeepVerse: 4D Autoregressive Video Generation as a World Model | 2025 | Paper · GitHub · Website |
| Temporal In-Context Fine-Tuning for Versatile Control of Video Diffusion Models | 2025 | Paper · GitHub · Website |
| SkyReels-Audio: Omni Audio-Conditioned Talking Portraits in Video Diffusion Transformers | 2025 | Paper · Website |
| Video Signature: Implicit Watermarking for Video Diffusion Models | 2025 | Paper |
| Ctrl-Crash: Controllable Diffusion for Realistic Car Crashes | 2025 | Paper · GitHub · Website |
| ATI: Any Trajectory Instruction for Controllable Video Generation | 2025 | Paper · GitHub · Website |
| FaceEditTalker: Controllable Talking Head Generation with Facial Attribute Editing | 2025 | Paper · Website |
| EPiC: Efficient Video Camera Control Learning with Precise Anchor-Video Guidance | 2025 | Paper · GitHub · Website |
| Think Before You Diffuse: Infusing Physical Rules into Video Diffusion | 2025 | Paper · Website |
| HunyuanVideo-Avatar: High-Fidelity Audio-Driven Human Animation for Multiple Characters | 2025 | Paper · GitHub · Website |
| Dynamic-I2V: Exploring Image-to-Video Generation Models via Multimodal LLM | 2025 | Paper |
| DanceTogether! Identity-Preserving Multi-Person Interactive Video Generation | 2025 | Paper · GitHub · Website |
| T2VUnlearning: A Concept Erasing Method for Text-to-Video Diffusion Models | 2025 | Paper · GitHub |
| MTVCrafter: 4D Motion Tokenization for Open-World Human Image Animation | 2025 | Paper · GitHub · Website |
| ProFashion: Prototype-guided Fashion Video Generation with Multiple Reference Images | 2025 | Paper |
| HunyuanCustom: A Multimodal-Driven Architecture for Customized Video Generation | 2025 | Paper · GitHub · Website |
| A Unit Enhancement and Guidance Framework for Audio-Driven Avatar Video Generation | 2025 | Paper |
| VIDSTAMP: A Temporally-Aware Watermark for Ownership and Integrity in Video Diffusion Models | 2025 | Paper · Website |
| ReVision: High-Quality, Low-Cost Video Generation with Explicit 3D Physics Modeling for Complex Motion and Interaction | 2025 | Paper · Website |
| ManipDreamer: Boosting Robotic Manipulation World Model with Action Tree and Visual Guidance | 2025 | Paper |
| Subject-driven Video Generation via Disentangled Identity and Motion | 2025 | Paper · GitHub · Website |
| Reasoning Physical Video Generation with Diffusion Timestep Tokens via Reinforcement Learning | 2025 | Paper |
| UniAnimate-DiT: Human Image Animation with Large-Scale Video Diffusion Transformer | 2025 | Paper · GitHub |
| Taming Consistency Distillation for Accelerated Human Image Animation | 2025 | Paper |
| Aligning Anime Video Generation with Human Feedback | 2025 | Paper · GitHub |
| I Want It That Way! Specifying Nuanced Camera Motions in Video Editing | 2025 | Paper |
| Discriminator-Free Direct Preference Optimization for Video Diffusion | 2025 | Paper |
| EasyGenNet: An Efficient Framework for Audio-Driven Gesture Video Generation Based on Diffusion Model | 2025 | Paper |
| RAGME: Retrieval Augmented Video Generation for Enhanced Motion Realism | 2025 | Paper · GitHub |
| MagicTime: Time-lapse Video Generation Models as Metamorphic Simulators | 2024 | Paper · GitHub · Website |
| VideoFactory: Swap Attention in Spatiotemporal Diffusions for Text-to-Video Generation | 2023 | Paper |
📄 License
This project is licensed under the MIT License - see the LICENSE file for details.
🧑💻 Contributors
👏 Thanks to these contributors for this excellent work!
✉️ Contact
For questions, suggestions, or collaboration opportunities, please feel free to reach out:
✉️ Email: chaoyuli@asu.edu, pooyan@asu.edu
✨ Star History
Contributors


Similar repos


[TMLR] Video Generation Models: A Survey of Post-Training and Alignment | 🔥 A continuously updated collection of papers, datasets, and benchmarks on post-training and alignment for video generation.
See the codeREADME
Awesome Video Generation Post Training
🔥 A continuously updated repository of research on post-training and alignment for video generation.
Video Generation Models: A Survey of Post-Training and Alignment
Chaoyu Li1,†,✉️, Xiaoyi Gu2,†, Yogesh Kulkarni1, Eun Woo Im1, Mohammadmahdi Honarmand3, Zeyu Wang4, Juntong Song5, Fei Du6, Xilin Jiang7, Kexin Zheng8, Tianzhi Li9, Fei Tao5, Pooyan Fazli1,✉️
1Arizona State University · 2Twitch · 3Stanford University · 4eBay · 5NewsBreak · 6Microsoft · 7Columbia University · 8University of Southern California · 9Carnegie Mellon University
†Equal contribution. ✉️Corresponding author: Chaoyu Li , Pooyan Fazli.
[!IMPORTANT] We welcome your help in improving the repository and paper. Please feel free to submit a pull request to:
- Add a relevant paper not yet included.
- Suggest a more suitable category.
- Update the information.
- Ask for clarification about any content.
🔥 News
- [2026.06.09] Our survey paper has been accepted to TMLR 🚀.
- [2026.06.09] Added papers accepted to ICML 2026.
- [2026.06.09] Added papers accepted to CVPR 2026.
- [2026.03.23] Added papers accepted to ICLR 2026.
- [2026.02.23] The v1 survey is now published! We have also initialized the repository.
🎯 Motivation
While large-scale pretraining has significantly improved video generation models, aligning them with human intent, physical constraints, and deployment requirements remains a major challenge. As a result, post-training and alignment techniques have rapidly become a central research focus in modern video generation.
In our survey paper, we systematically review recent progress in supervised fine-tuning, self-training and distillation, preference-based optimization, and inference-time alignment methods.
This repository serves as a companion resource to the survey.
It aims to:
- 📚 Curate recent papers on post-training and alignment for video generation
- 📊 Collect datasets and evaluation benchmarks related to post-training and alignment
We hope this repository provides researchers and practitioners with a convenient, up-to-date reference for exploring the evolving landscape of post-training and alignment in video generation models.
📌 Citation
If you find our paper or this resource helpful, please consider cite:
@article{li2026video,
  title={Video Generation Models: A Survey of Post-Training and Alignment},
  author={Chaoyu Li and Xiaoyi Gu and Yogesh Kulkarni and Eun Woo Im and Mohammadmahdi Honarmand and Zeyu Wang and Juntong Song and Fei Du and Xilin Jiang and Kexin Zheng and Tianzhi Li and Fei Tao and Pooyan Fazli},
  journal={Transactions on Machine Learning Research},
  issn={2835-8856},
  year={2026},
  url={https://openreview.net/forum?id=YlUEWLESIu},
}
📚 Content
Datasets
| Dataset | Year | Links |
|---|---|---|
| ChronoMagic-Pro | 2024 | Paper · GitHub · Website · Dataset |
| SafeSora | 2024 | Paper · GitHub · Website · Dataset |
| TIP-I2V | 2025 | Paper · GitHub · Website · Dataset |
| SynFMC | 2025 | Paper · GitHub · Website · Dataset |
| CookGen | 2025 | Paper · Website · Dataset |
| HOIGen-1M | 2025 | Paper · Website · Dataset |
| OpenHumanVid | 2025 | Paper · GitHub · Website |
| PhyWorld | 2025 | Paper · GitHub · Website · Dataset |
| WISA-80K | 2025 | Paper · GitHub · Website · Dataset |
| VideoUFO | 2025 | Paper · GitHub · Dataset |
| TalkCuts | 2025 | Paper · GitHub · Website · Dataset |
| EgoVid-5M | 2025 | Paper · GitHub · Website · Dataset |
| OpenS2V-5M | 2025 | Paper · GitHub · Website · Dataset |
| GRADEO-Instruct | 2025 | Paper |
| PNData | 2025 | Paper |
| PairFS-4K | 2025 | Paper · GitHub · Website |
| MMVideo | 2025 | Paper · GitHub · Website |
| DAVID-X | 2025 | Paper |
| Dprim | 2025 | Paper |
| CI-VID | 2026 | Paper · GitHub · Dataset |
| GB3DV-25k | 2026 | Paper · Website · Dataset |
| MuSS | 2026 | Paper · GitHub |
Benchmarks
| Benchmark | Year | Links |
|---|---|---|
| FETV | 2023 | Paper · GitHub · Dataset |
| StoryBench | 2023 | Paper · GitHub |
| ChronoMagic-Bench | 2024 | Paper · GitHub · Website · Dataset |
| EvalCrafter | 2024 | Paper · GitHub · Website · Dataset |
| VBench | 2024 | Paper · GitHub · Website · Dataset |
| T2VSafetyBench | 2024 | Paper · GitHub |
| MTBench | 2025 | Paper · GitHub · Website · Dataset |
| FiVE | 2025 | Paper · GitHub · Website · Dataset |
| VEG-Bench | 2025 | Paper · GitHub · Website · Dataset |
| VMBench | 2025 | Paper · GitHub · Website · Dataset |
| T2V-CompBench | 2025 | Paper · GitHub · Website · Dataset |
| StoryEval | 2025 | Paper · GitHub · Website · Dataset |
| MC-Bench | 2025 | Paper · GitHub · Website · Dataset |
| Video-Bench | 2025 | Paper · GitHub |
| MJ-BENCH-VIDEO | 2025 | Paper · GitHub · Website · Dataset |
| OpenS2V-Eval | 2025 | Paper · GitHub · Website · Dataset |
| VideoGen-RewardBench | 2025 | Paper · GitHub · Website · Dataset |
| AIGC-LipSync | 2025 | Paper · Website · Dataset |
| WorldModelBench | 2025 | Paper · GitHub · Website · Dataset |
| VIP-200K | 2025 | Paper · Website · Dataset |
| RGCD | 2025 | Paper · GitHub · Dataset |
| RecipeGen | 2025 | Paper · Dataset |
| HVEval | 2025 | Paper |
| Doc2Present | 2025 | Paper · GitHub · Dataset |
| VidCapBench | 2025 | Paper · GitHub · Dataset |
| VideoPhy | 2025 | Paper · GitHub · Dataset |
| PhyGenBench | 2025 | Paper · GitHub · Website · Dataset |
| Paper2Video | 2025 | Paper · GitHub · Website · Dataset |
| PhyWorldBench | 2025 | Paper · GitHub · Dataset |
| SeqBench | 2025 | Paper · GitHub · Website · Dataset |
| VideoVerse | 2025 | Paper · GitHub · Website · Dataset |
| MMMC | 2025 | Paper · GitHub · Website · Dataset |
| DynamicEval | 2025 | Paper · GitHub · Website · Dataset |
| V-ReasonBench | 2025 | Paper · GitHub · Website · Dataset |
| RGCD (alternate) | 2025 | Paper · GitHub · Dataset |
| VIPER | 2025 | Paper · GitHub · Dataset |
| Video Reality Test | 2025 | Paper · GitHub · Website · Dataset |
| WYD | 2025 | Paper · GitHub |
| GenVidBench | 2025 | Paper |
| DIVE | 2025 | Paper |
| UI2V-Bench | 2025 | Paper |
| PhysVidBench | 2025 | Paper |
| SurgVeo | 2025 | Paper |
| PAI-Bench | 2025 | Paper |
| MEve | 2025 | Paper |
| SafeMVDrive | 2026 | Paper · GitHub · Website · Dataset |
| AIGVE-60K | 2026 | Paper · GitHub · Dataset |
| T2AV-Compass | 2026 | Paper · Dataset |
| LoCoT2V-Bench | 2026 | Paper |
| GeneVA | 2026 | Paper · Website · Dataset |
| PhyEduVideo | 2026 | Paper · GitHub · Website |
| DrivingGen | 2026 | Paper · Website · Dataset |
| RISE-Video | 2026 | Paper · GitHub · Dataset |
| RBench | 2026 | Paper · GitHub · Website · Dataset |
| VC-Bench | 2026 | Paper · Website · Dataset |
| CoW-Bench | 2026 | Paper · GitHub · Dataset |
| MTAVG-Bench | 2026 | Paper |
| MSVBench | 2026 | Paper |
| SafeGen-Bench | 2026 | Paper |
| DirectorBench | 2026 | Paper · GitHub · Dataset |
| EvalVerse | 2026 | Paper |
| EntityBench | 2026 | Paper · GitHub · Website |
| MechVerse | 2026 | Paper · Website |
| WorldReasonBench | 2026 | Paper · GitHub · Website |
| WorldJen | 2026 | Paper · GitHub · Website · Dataset |
| BRITE | 2026 | Paper |
| WorldMark | 2026 | Paper · Website |
Conference Papers
| Title | Year | Links |
|---|---|---|
| FlashMotion: Few-Step Controllable Video Generation with Trajectory Guidance | 2026 | Paper · GitHub · Website |
| GenHOI: Towards Object-Consistent Hand–Object Interaction with Temporally Balanced and Spatially Selective Object Injection | 2026 | Paper · GitHub · Website |
| GT-SVJ: Generative-Transformer-Based Self-Supervised Video Judge For Efficient Video Reward Modeling | 2026 | Paper |
| Plenoptic Video Generation | 2026 | Paper · GitHub · Website |
| SoliReward: Mitigating Susceptibility to Reward Hacking and Annotation Noise in Video Generation Reward Models | 2026 | Paper · GitHub |
| EgoControl: Controllable Egocentric Video Generation via 3D Full-Body Poses | 2026 | Paper · GitHub · Website |
| Less is More: Data-Efficient Adaptation for Controllable Text-to-Video Generation | 2026 | Paper |
| TiViBench: Benchmarking Think-in-Video Reasoning for Video Generative Models | 2026 | Paper · GitHub · Website |
| TGT: Text-Grounded Trajectories for Locally Controlled Video Generation | 2026 | Paper · Website |
| Identity-Preserving Image-to-Video Generation via Reward-Guided Optimization | 2026 | Paper · GitHub · Website |
| Lynx: Towards High-Fidelity Personalized Video Generation | 2026 | Paper · GitHub · Website |
| ORV: 4D Occupancy-centric Robot Video Generation | 2026 | Paper · GitHub · Website |
| Where Concept Erasure Should Occur: Concept-Layer Alignment in Text-to-Video Diffusion Models | 2026 | Paper |
| World-R1: Reinforcing 3D Constraints for Text-to-Video Generation | 2026 | Paper · GitHub · Website |
| WorldCompass: Reinforcement Learning for Long-Horizon World Models | 2026 | Paper · GitHub · Website |
| Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation | 2026 | Paper · GitHub · Website |
| VideoGPA: Distilling Geometry Priors for 3D-Consistent Video Generation | 2026 | Paper · GitHub · Website |
| TAGRPO: Boosting GRPO on Image-to-Video Generation with Direct Trajectory Alignment | 2026 | Paper |
| Mitigating Surgical Data Imbalance with Dual-Prediction Video Diffusion Model | 2026 | Paper |
| RealisMotion: Decomposed Human Motion Control and Video Generation in the World Space | 2026 | Paper · GitHub · Website |
| LayerT2V: Interactive Multi-Object Trajectory Layering for Video Generation | 2026 | Paper · GitHub · Website |
| Physics-Guided Motion Loss for Video Generation Model | 2026 | Paper |
| SafeMVDrive: Multi-view Safety-Critical Driving Video Synthesis in the Real World Domain | 2026 | Paper · GitHub · Website |
| Neodragon: Mobile Video Generation using Diffusion Transformer | 2026 | Paper · Website |
| The Quest for Generalizable Motion Generation: Data, Model, and Evaluation | 2026 | Paper · GitHub |
| MoAlign: Motion-Centric Representation Alignment for Video Diffusion Models | 2026 | Paper |
| Stable Video Infinity: Infinite-Length Video Generation with Error Recycling | 2026 | Paper |
| Large Scale Diffusion Distillation via Score-Regularized Continuous-Time Consistency | 2026 | Paper |
| MATRIX: Mask Track Alignment for Interaction-aware Video Generation | 2026 | Paper |
| Arbitrary Generative Video Interpolation | 2026 | Paper |
| Rolling Forcing: Autoregressive Long Video Diffusion in Real Time | 2026 | Paper · GitHub · Website |
| BranchGRPO: Stable and Efficient GRPO with Structured Branching in Diffusion Models | 2026 | Paper · GitHub · Website |
| MoSA: Motion-Coherent Human Video Generation via Structure-Appearance Decoupling | 2026 | Paper · GitHub · Website |
| Vivid-VR: Distilling Concepts from Text-to-Video Diffusion Transformer for Photorealistic Video Restoration | 2026 | Paper · GitHub · Website |
| DreamSwapV: Mask-guided Subject Swapping for Any Customized Video Editing | 2026 | Paper |
| Geometry Forcing: Marrying Video Diffusion and 3D Representation for Consistent World Modeling | 2026 | Paper · GitHub · Website |
| Learning Video Generation for Robotic Manipulation with Collaborative Trajectory Control | 2026 | Paper · GitHub · Website |
| Many-for-Many: Unify the Training of Multiple Video and Image Generation and Manipulation Tasks | 2026 | Paper · GitHub |
| MAGREF: Masked Guidance for Any-Reference Video Generation with Subject Disentanglement | 2026 | Paper · GitHub · Website |
| Any-to-Bokeh: Arbitrary-Subject Video Refocusing with Video Diffusion Model | 2026 | Paper · Website |
| UNIC: Unified In-Context Video Editing | 2026 | Paper · Website |
| EffiVMT: Video Motion Transfer via Efficient Spatial-Temporal Decoupled Finetuning | 2026 | Paper · Website |
| EasyCreator: Empowering 4D Creation through Video Inpainting | 2026 | Paper · Website |
| PanFlow: Decoupled Motion Control for Panoramic Video Generation | 2026 | Paper · GitHub · Website |
| Phased One-Step Adversarial Equilibrium for Video Diffusion Models | 2026 | Paper · Website |
| Omni-Effects: Unified and Spatially-Controllable Visual Effects Generation | 2026 | Paper · GitHub · Website |
| Show Me: Unifying Instructional Image and Video Generation with Diffusion Models | 2026 | Paper · GitHub · Website |
| UniVid: Unifying Vision Tasks with Pre-trained Video Generation Models | 2026 | Paper · GitHub |
| Controllable Human-centric Keyframe Interpolation with Generative Prior | 2025 | Paper · GitHub · Website |
| RoboScape: Physics-informed Embodied World Model | 2025 | Paper · GitHub |
| Aligning What Matters: Masked Latent Adaptation for Text-to-Audio-Video Generation | 2025 | Paper |
| Audio-Sync Video Generation with Multi-Stream Temporal Control | 2025 | Paper · GitHub · Website |
| Autoregressive Adversarial Post-Training for Real-Time Interactive Video Generation | 2025 | Paper · Website |
| DenseDPO: Fine-Grained Temporal Preference Optimization for Video Diffusion Models | 2025 | Paper · Website |
| EchoShot: Multi-Shot Portrait Video Generation | 2025 | Paper · GitHub · Website |
| Frame Context Packing and Drift Prevention in Next-Frame-Prediction Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Frame In-N-Out: Unbounded Controllable Image-to-Video Generation | 2025 | Paper · GitHub · Website |
| GeoVideo: Introducing Geometric Regularization into Video Generation Model | 2025 | Paper · GitHub · Website |
| Hierarchical Fine-grained Preference Optimization for Physically Plausible Video Generation | 2025 | Paper · Website |
| Imagine360: Immersive 360 Video Generation from Perspective Anchor | 2025 | Paper · GitHub · Website |
| Improving Video Generation with Human Feedback | 2025 | Paper · GitHub · Website |
| MoCha: Towards Movie-Grade Talking Character Generation | 2025 | Paper · GitHub · Website |
| PolyVivid: Vivid Multi-Subject Video Generation with Cross-Modal Interaction and Enhancement | 2025 | Paper · Website |
| Radial Attention: $O(n\log n)$ Sparse Attention with Energy Decay for Long Video Generation | 2025 | Paper · GitHub · Website |
| RLGF: Reinforcement Learning with Geometric Feedback for Autonomous Driving Video Generation | 2025 | Paper |
| Temporal In-Context Fine-Tuning for Versatile Control of Video Diffusion Models | 2025 | Paper · GitHub · Website |
| VideoREPA: Learning Physics for Video Generation through Relational Alignment with Foundation Models | 2025 | Paper · GitHub · Website |
| Virtual Fitting Room: Generating Arbitrarily Long Videos of Virtual Try-On from a Single Image | 2025 | Paper · Website |
| Wan-Move: Motion-controllable Video Generation via Latent Trajectory Guidance | 2025 | Paper · GitHub · Website |
| WISA: World Simulator Assistant for Physics-Aware Text-to-Video Generation | 2025 | Paper · GitHub · Website |
| WorldWeaver: Generating Long-Horizon Video Worlds via Rich Perception | 2025 | Paper · Website |
| Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion | 2025 | Paper · GitHub |
| VC4VG: Optimizing Video Captions for Text-to-Video Generation | 2025 | Paper · GitHub |
| AICL: Action In-Context Learning for Video Diffusion Model | 2025 | Paper |
| Improving Identity Preservation in Video Generation with Multi-Branch Models | 2025 | Paper |
| M2PE-DIFF: Music-to-Pose Encoder for Dance Video Generation Leveraging Latent Diffusion Framework. | 2025 | Paper |
| SpA2V: Harnessing Spatial Auditory Cues for Audio-driven Spatially-aware Video Generation | 2025 | Paper |
| Tora2: Motion and Appearance Customized Diffusion Transformer for Multi-Entity Video Generation | 2025 | Paper · Website |
| AnimeColor: Reference-based Animation Colorization with Diffusion Transformers | 2025 | Paper · GitHub |
| Causal-Entity Reflected Egocentric Traffic Accident Video Synthesis | 2025 | Paper · GitHub · Website |
| Diffuman4D: 4D Consistent Human View Synthesis from Sparse-View Videos with Spatio-Temporal Diffusion Models | 2025 | Paper · GitHub · Website |
| AID: Adapting Image2Video Diffusion Models for Instruction-guided Video Prediction | 2025 | Paper · Website |
| Adversarial Distribution Matching for Diffusion Distillation Towards Efficient Image and Video Synthesis | 2025 | Paper |
| Decouple and Track: Benchmarking and Improving Video Diffusion Transformers For Motion Transfer | 2025 | Paper · GitHub · Website |
| DiTaiListener: Controllable High Fidelity Listener Video Generation with Diffusion | 2025 | Paper · Website |
| DOLLAR: Few-Step Video Generation via Distillation and Latent Reward Optimization | 2025 | Paper · Website |
| Dual-Expert Consistency Model for Efficient and High-Quality Video Generation | 2025 | Paper · GitHub · Website |
| DualReal: Adaptive Joint Training for Lossless Identity-Motion Fusion in Video Customization | 2025 | Paper · GitHub · Website |
| EfficientMT: Efficient Temporal Adaptation for Motion Transfer in Text-to-Video Diffusion Models | 2025 | Paper · GitHub |
| Free-Form Motion Control: Controlling the 6D Poses of Camera and Objects in Video Generation | 2025 | Paper · GitHub · Website |
| I2VControl: Disentangled and Unified Video Motion Synthesis Control | 2025 | Paper · Website |
| LayerAnimate: Layer-level Control for Animation | 2025 | Paper · GitHub · Website |
| Learning Few-Step Diffusion Models by Trajectory Distribution Matching | 2025 | Paper · GitHub · Website |
| LiON-LoRA: Rethinking LoRA Fusion to Unify Controllable Spatial and Temporal Generation for Video Diffusion | 2025 | Paper · Website |
| Long Context Tuning for Video Generation | 2025 | Paper · Website |
| MagicID: Hybrid Preference Optimization for ID-Consistent and Dynamic-Preserved Video Customization | 2025 | Paper · GitHub · Website |
| MagicMirror: ID-Preserved Video Generation in Video Diffusion Transformers | 2025 | Paper · GitHub |
| MagicMotion: Controllable Video Generation with Dense-to-Sparse Trajectory Guidance | 2025 | Paper · GitHub · Website |
| Mobile Video Diffusion | 2025 | Paper · Website |
| MotionAgent: Fine-grained Controllable Video Generation via Motion Field Agent | 2025 | Paper · GitHub |
| PersonalVideo: High ID-Fidelity Video Customization without Dynamic and Semantic Degradation | 2025 | Paper · GitHub · Website |
| Phantom: Subject-Consistent Video Generation via Cross-Modal Alignment | 2025 | Paper · GitHub · Website |
| Precise Action-to-Video Generation Through Visual Action Prompts | 2025 | Paper · Website |
| Prompt-A-Video: Prompt Your Video Diffusion Model via Preference-Aligned LLM | 2025 | Paper · GitHub |
| Puppet-Master: Scaling Interactive Video Generation as a Motion Prior for Part-Level Dynamics | 2025 | Paper · GitHub · Website |
| Reangle-A-Video: 4D Video Generation as Video-to-Video Translation | 2025 | Paper · GitHub · Website |
| RealCam-I2V: Real-World Image-to-Video Generation with Interactive Complex Camera Control | 2025 | Paper · GitHub · Website |
| STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution | 2025 | Paper · GitHub · Website |
| TACO: Taming Diffusion for in-the-wild Video Amodal Completion | 2025 | Paper · GitHub · Website |
| V.I.P.: Iterative Online Preference Distillation for Efficient Video Diffusion Models | 2025 | Paper · Website |
| VEGGIE: Instructional Editing and Reasoning Video Concepts with Grounded Generation | 2025 | Paper · GitHub · Website |
| Versatile Transition Generation with Image-to-Video Diffusion | 2025 | Paper · Website |
| VideoAuteur: Towards Long Narrative Video Generation | 2025 | Paper · GitHub · Website |
| FLAP: Fully-controllable Audio-driven Portrait Video Generation through 3D head conditioned diffusion model | 2025 | Paper |
| FrameBridge: Improving Image-to-Video Generation with Bridge Models | 2025 | Paper · Website |
| Diffusion Adversarial Post-Training for One-Step Video Generation | 2025 | Paper · Website |
| Identity-Preserving Text-to-Video Generation by Frequency Decomposition | 2025 | Paper · GitHub · Website |
| AKiRa: Augmentation Kit on Rays for Optical Video Generation | 2025 | Paper · GitHub · Website |
| AnyMoLe: Any Character Motion In-betweening Leveraging Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Extrapolating and Decoupling Image-to-Video Generation Models: Motion Modeling is Easier Than You Think | 2025 | Paper · GitHub |
| FlipSketch: Flipping Static Drawings to Text-Guided Sketch Animations | 2025 | Paper · GitHub |
| MotionPro: A Precise Motion Controller for Image-to-Video Generation | 2025 | Paper · GitHub · Website |
| FinePhys: Fine-grained Human Action Generation by Explicitly Incorporating Physical Laws for Effective Skeletal Guidance | 2025 | Paper · GitHub · Website |
| From Slow Bidirectional to Fast Autoregressive Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Go-with-the-Flow: Motion-Controllable Video Diffusion Models Using Real-Time Warped Noise | 2025 | Paper · GitHub · Website |
| GS-DiT: Advancing Video Generation with Dynamic 3D Gaussian Fields through Efficient Dense 3D Point Tracking | 2025 | Paper · GitHub · Website |
| High-Fidelity Relightable Monocular Portrait Animation with Lighting-Controllable Video Diffusion Model | 2025 | Paper · GitHub · Website |
| HunyuanPortrait: Implicit Condition Control for Enhanced Portrait Animation | 2025 | Paper · GitHub · Website |
| InterDyn: Controllable Interactive Dynamics with Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Lux Post Facto: Learning Portrait Performance Relighting with Conditional Video Diffusion and a Hybrid Dataset | 2025 | Paper · Website |
| Mind the Time: Temporally-Controlled Multi-Event Video Generation | 2025 | Paper · Website |
| Silence is Golden: Leveraging Adversarial Examples to Nullify Audio Control in LDM-based Talking-Head Generation | 2025 | Paper · GitHub |
| MotiF: Making Text Count in Image Animation with Motion Focal Loss | 2025 | Paper · Website |
| One-Minute Video Generation with Test-Time Training | 2025 | Paper · GitHub · Website |
| ReCapture: Generative Video Camera Controls for User-Provided Videos using Masked Video Fine-Tuning | 2025 | Paper · Website |
| ShotAdapter: Text-to-Multi-Shot Video Generation with Diffusion Models | 2025 | Paper · Website |
| TASTE-Rob: Advancing Video Generation of Task-Oriented Hand-Object Interaction for Generalizable Robotic Manipulation | 2025 | Paper · GitHub · Website |
| TransPixeler: Advancing Text-to-Video Generation with Transparency | 2025 | Paper · GitHub · Website |
| VideoDPO: Omni-Preference Alignment for Video Diffusion Generation | 2025 | Paper · GitHub · Website |
| Boosting Camera Motion Control for Video Diffusion Transformers | 2025 | Paper · GitHub · Website |
| CameraCtrl: Enabling Camera Control for Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Ctrl-Adapter: An Efficient and Versatile Framework for Adapting Diverse Controls to Any Diffusion Model | 2025 | Paper · GitHub · Website |
| Diffusion-NPO: Negative Preference Optimization for Better Preference Aligned Generation of Diffusion Models | 2025 | Paper · GitHub |
| SePPO: Semi-Policy Preference Optimization for Diffusion Alignment | 2025 | Paper · GitHub |
| Trajectory attention for fine-grained video motion control | 2025 | Paper · GitHub · Website |
| VADER: Video Diffusion Alignment via Reward Gradients | 2025 | Paper · GitHub · Website |
| VD3D: Taming Large Video Diffusion Transformers for 3D Camera Control | 2025 | Paper · GitHub · Website |
| Fine-Grained Controllable Video Generation via Object Appearance and Context | 2025 | Paper · Website |
| MagicStick: Controllable Video Editing via Control Handle Transformations | 2025 | Paper · GitHub · Website |
| TrackDiffusion: Tracklet-Conditioned Video Generation via Diffusion Models | 2025 | Paper · GitHub |
| CAGE: Unsupervised Visual Composition and Animation for Controllable Video Generation | 2025 | Paper · GitHub · Website |
| CustomCrafter: Customized Video Generation with Preserving Motion and Concept Composition Abilities | 2025 | Paper · GitHub · Website |
| CustomTTT: Motion and Appearance Customized Video Generation via Test-Time Training | 2025 | Paper · GitHub · Website |
| DriveDreamer-2: LLM-Enhanced World Models for Diverse Driving Video Generation | 2025 | Paper · GitHub · Website |
| Enhancing Identity-Deformation Disentanglement in StyleGAN for One-Shot Face Video Re-Enactment | 2025 | Paper · GitHub · Website |
| Modular-Cam: Modular Dynamic Camera-view Video Generation with LLM | 2025 | Paper · GitHub · Website |
| Occlusion-Insensitive Talking Head Video Generation via Facelet Compensation | 2025 | Paper |
| PanoDiT: Panoramic Videos Generation with Diffusion Transformer | 2025 | Paper |
| TrackGo: A Flexible and Efficient Method for Controllable Video Generation | 2025 | Paper · Website |
| UFO: Enhancing Diffusion-Based Video Generation with a Uniform Frame Organizer | 2025 | Paper · GitHub |
| Shape-for-Motion: Precise and Consistent Video Editing with 3D Proxy | 2025 | Paper · GitHub · Website |
| FairyGen: Storied Cartoon Video from a Single Child-Drawn Character | 2025 | Paper · GitHub · Website |
| CamCloneMaster: Enabling Reference-based Camera Control for Video Generation | 2025 | Paper · GitHub · Website |
| Mission Balance: Generating Under-represented Class Samples using Video Diffusion Models | 2025 | Paper |
| Ophora: A Large-Scale Data-Driven Text-Guided Ophthalmic Surgical Video Generation Model | 2025 | Paper · GitHub |
| Animate Your Motion: Turning Still Images into Dynamic Videos | 2024 | Paper · GitHub · Website |
| DragVideo: Interactive Drag-style Video Editing | 2024 | Paper · GitHub · Website |
| MEVG : Multi-event Video Generation with Text-to-Video Models | 2024 | Paper · GitHub · Website |
| MoVideo: Motion-Aware Video Generation with Diffusion Models | 2024 | Paper · Website |
| SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models | 2024 | Paper · GitHub · Website |
| Stable Video Portraits | 2024 | Paper · Website |
| TCAN: Animating Human Images with Temporally Consistent Pose Guidance using Diffusion Models | 2024 | Paper · GitHub · Website |
| Video Editing via Factorized Diffusion Distillation | 2024 | Paper · Website |
| VideoStudio: Generating Consistent-Content and Multi-Scene Videos | 2024 | Paper · GitHub · Website |
| VideoDirectorGPT: Consistent Multi-Scene Video Generation via LLM-Guided Planning | 2024 | Paper · GitHub · Website |
| Exo2Ego-V: Exocentric-to-Egocentric Video Generation | 2024 | Paper · GitHub · GitHub |
| MotionBooth: Motion-Aware Customized Text-to-Video Generation | 2024 | Paper · GitHub · Website |
| SF-V: Single Forward Video Generation Model | 2024 | Paper · GitHub · Website |
| T2V-Turbo: Breaking the Quality Bottleneck of Video Consistency Model with Mixed Reward Feedback | 2024 | Paper · GitHub · Website |
| Vivid-ZOO: Multi-View Video Generation with Diffusion Model | 2024 | Paper · GitHub · Website |
| VIDEOSCORE: Building Automatic Metrics to Simulate Fine-grained Human Feedback for Video Generation | 2024 | Paper · GitHub · Website |
| VIMI: Grounding Video Generation through Multi-modal Instruction | 2024 | Paper · GitHub · Website |
| DisenStudio: Customized Multi-subject Text-to-Video Generation with Disentangled Spatial Control | 2024 | Paper · GitHub |
| DragEntity: Trajectory Guided Video Generation using Entity and Positional Relationships | 2024 | Paper |
| Efficient Video Diffusion Models via Content-Frame Motion-Latent Decomposition | 2024 | Paper · Website |
| SEINE: Short-to-Long Video Diffusion Model for Generative Transition and Prediction | 2024 | Paper · GitHub · Website |
| VersVideo: Leveraging Enhanced Temporal Diffusion Models for Versatile Video Generation | 2024 | Paper · Website |
| InstructVideo: Instructing Video Diffusion Models with Human Feedback | 2024 | Paper · GitHub · Website |
| SimDA: Simple Diffusion Adapter for Efficient Video Generation | 2024 | Paper · GitHub · Website |
| VideoCrafter2: Overcoming Data Limitations for High-Quality Video Diffusion Models | 2024 | Paper · GitHub · Website |
| Follow Your Pose: Pose-Guided Text-to-Video Generation Using Pose-Free Videos | 2024 | Paper · GitHub · Website |
| VideoComposer: Compositional Video Synthesis with Motion Controllability | 2023 | Paper · GitHub · Website |
| MobileVidFactory: Automatic Diffusion-Based Social Media Video Generation for Mobile Devices from Text | 2023 | Paper |
| DreamPose: Fashion Video Synthesis with Stable Diffusion | 2023 | Paper · GitHub · Website |
| Preserve Your Own Correlation: A Noise Prior for Video Diffusion Models | 2023 | Paper · Website |
| Structure and Content-Guided Video Synthesis with Diffusion Models | 2023 | Paper · GitHub · Website |
| Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video Generation | 2023 | Paper · GitHub · Website |
arXiv Papers
| Title | Year | Links |
|---|---|---|
| Ultra Flash: Scaling Real-Time Streaming Video Generation to High Resolutions | 2026 | Paper · Website |
| Do Models Share Safety Representations? Cross-Model Steering for Safe Visual Generation | 2026 | Paper · Website |
| Activation Steering of Video Generation Models via Reduced-Order Linear Optimal Control | 2026 | Paper |
| Physics-Informed Video Generation via Mixture-of-Experts Latent Alignment | 2026 | Paper |
| Real2SAM2Real: Generative 3D Caches as Complementary Context for Video Diffusion | 2026 | Paper · Website |
| minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models | 2026 | Paper · GitHub |
| DeltaCam: Differential Intrinsic Camera Modeling for Video Generation | 2026 | Paper |
| Geo-Align: Video Generation Alignment via Metric Geometry Reward | 2026 | Paper · Website |
| SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models | 2026 | Paper · GitHub · Website |
| CoMoGen: COntrollable MOtion Dynamics and Interactions with Mask-Guided Video GENeration | 2026 | Paper · Website |
| CogOmniControl: Reasoning-Driven Controllable Video Generation via Creative Intent Cognition | 2026 | Paper · Website |
| Aero-World: Action-Conditioned Aerial Video Generation from Inertial Controls | 2026 | Paper |
| PhyWorld: Physics-Faithful World Model for Video Generation | 2026 | Paper |
| GeoFlow: Enforcing Implicit Geometric Consistency in Video Generation | 2026 | Paper · GitHub · Website |
| Video Models Can Reason with Verifiable Rewards | 2026 | Paper · Website |
| RefDecoder: Enhancing Visual Generation with Conditional Video Decoding | 2026 | Paper |
| RAVEN: Real-time Autoregressive Video Extrapolation with Consistency-model GRPO | 2026 | Paper · Website |
| DriveCtrl: Conditioned Sim-to-Real Driving Video Generation | 2026 | Paper |
| EverAnimate: Minute-Scale Human Animation via Latent Flow Restoration | 2026 | Paper · Website |
| SEDiT: Mask-Free Video Subtitle Erasure via One-step Diffusion Transformer | 2026 | Paper · Website |
| Delta Forcing: Trust Region Steering for Interactive Autoregressive Video Generation | 2026 | Paper · Website |
| CreFlow: Corrective Reflow for Sparse-Reward Embodied Video Diffusion RL | 2026 | Paper |
| PhyMotion: Structured 3D Motion Reward for Physics-Grounded Human Video Generation | 2026 | Paper · Website |
| CRePE: Curved Ray Expectation Positional Encoding for Unified-Camera-Controlled Video Generation | 2026 | Paper |
| CaC: Advancing Video Reward Models via Hierarchical Spatiotemporal Concentrating | 2026 | Paper |
| TIE: Time Interval Encoding for Video Generation over Events | 2026 | Paper · GitHub · Website |
| Improving Human Image Animation via Semantic Representation Alignment | 2026 | Paper |
| From Articulated Kinematics to Routed Visual Control for Action-Conditioned Surgical Video Generation | 2026 | Paper |
| Alice v1: Distillation-Enhanced Video Generation Surpassing Closed-Source Models | 2026 | Paper · GitHub |
| Diffusion-APO: Trajectory-Aware Direct Preference Alignment for Video Diffusion Transformers | 2026 | Paper |
| Stream-R1: Reliability-Perplexity Aware Reward Distillation for Streaming Video Generation | 2026 | Paper · Website |
| PhyCo: Learning Controllable Physical Priors for Generative Motion | 2026 | Paper · Website |
| AesRM: Improving Video Aesthetics with Expert-Level Feedback | 2026 | Paper · Website |
| A Systematic Post-Train Framework for Video Generation | 2026 | Paper |
| MMControl: Unified Multi-Modal Control for Joint Audio-Video Generation | 2026 | Paper |
| Learning to Credit the Right Steps: Objective-aware Process Optimization for Visual Generation | 2026 | Paper |
| Not all tokens contribute equally to diffusion learning | 2026 | Paper |
| HumANDiff: Articulated Noise Diffusion for Motion-Consistent Human Video Generation | 2026 | Paper · Website |
| OP-GRPO: Efficient Off-Policy GRPO for Flow-Matching Models | 2026 | Paper |
| MMPhysVideo: Scaling Physical Plausibility in Video Generation via Joint Multimodal Modeling | 2026 | Paper · Website |
| Control-DINO: Feature Space Conditioning for Controllable Image-to-Video Diffusion | 2026 | Paper · GitHub · Website |
| ReinDriveGen: Reinforcement Post-Training for Out-of-Distribution Driving Scene Generation | 2026 | Paper · Website |
| Wan-R1: Verifiable-Reinforcement Learning for Video Reasoning | 2026 | Paper |
| TokenDial: Continuous Attribute Control in Text-to-Video via Spatiotemporal Token Offsets | 2026 | Paper · Website |
| LOME: Learning Human-Object Manipulation with Action-Conditioned Egocentric World Model | 2026 | Paper · Website |
| VGGRPO: Towards World-Consistent Video Generation with 4D Latent Reward | 2026 | Paper · Website |
| DiReCT: Disentangled Regularization of Contrastive Trajectories for Physics-Refined Video Generation | 2026 | Paper |
| RefAlign: Representation Alignment for Reference-to-Video Generation | 2026 | Paper · GitHub |
| ABot-PhysWorld: Interactive World Foundation Model for Robotic Manipulation with Physics Alignment | 2026 | Paper · GitHub |
| Manifold-Aware Exploration for Reinforcement Learning in Video Generation | 2026 | Paper · Website |
| PROBE: Diagnosing Residual Concept Capacity in Erased Text-to-Video Diffusion Models | 2026 | Paper · GitHub |
| Helios: Real Real-Time Long Video Generation Model | 2026 | Paper · GitHub · Website |
| 3DreamBooth: High-Fidelity 3D Subject-Driven Video Generation Model | 2026 | Paper · GitHub · Website |
| AR-CoPO: Align Autoregressive Video Generation with Contrastive Policy Optimization | 2026 | Paper |
| Anchor Forcing: Anchor Memory and Tri-Region RoPE for Interactive Streaming Video Diffusion | 2026 | Paper · GitHub · Website |
| ConfCtrl: Enabling Precise Camera Control in Video Diffusion via Confidence-Aware Interpolation | 2026 | Paper |
| Controllable Egocentric Video Generation via Occlusion-Aware Sparse 3D Hand Joints | 2026 | Paper |
| DreamVideo-Omni: Omni-Motion Controlled Multi-Subject Video Customization with Latent Identity Reinforcement Learning | 2026 | Paper · Website |
| Aligning Video World Models with Executable Robot Actions via Inverse Dynamics Rewards | 2026 | Paper · GitHub · Website |
| EraseAnything++: Enabling Concept Erasure in Rectified Flow Transformers Leveraging Multi-Object Optimization | 2026 | Paper |
| FlowPortrait: Reinforcement Learning for Audio-Driven Portrait Video Generation | 2026 | Paper |
| InfinityStory: Unlimited Video Generation with World Consistency and Character-Aware Shot Transitions | 2026 | Paper |
| LibraGen: Playing a Balance Game in Subject-Driven Video Generation | 2026 | Paper · GitHub · Website |
| Making Video Models Adhere to User Intent with Minor Adjustments | 2026 | Paper · GitHub · Website |
| MosaicMem: Hybrid Spatial Memory for Controllable Video World Models | 2026 | Paper · Website |
| Motion Forcing: A Decoupled Framework for Robust Video Generation in Motion Dynamics | 2026 | Paper · GitHub · Website |
| SAW: Toward a Surgical Action World Model via Controllable and Scalable Video Generation | 2026 | Paper |
| SPATIALALIGN: Aligning Dynamic Spatial Relationships in Video Generation | 2026 | Paper · GitHub · Website |
| SPIRAL: A Closed-Loop Framework for Self-Improving Action World Models via Reflective Planning Agents | 2026 | Paper |
| ShotVerse: Advancing Cinematic Camera Control for Text-Driven Multi-Shot Video Creation | 2026 | Paper · GitHub · Website |
| VIGOR: VIdeo Geometry-Oriented Reward for Temporal Generative Alignment | 2026 | Paper · Website |
| ViFeEdit: A Video-Free Tuner of Your Video Diffusion Transformer | 2026 | Paper · GitHub |
| AnchorWeave: World-Consistent Video Generation with Retrieved Local Spatial Memories | 2026 | Paper · GitHub · Website |
| High-Fidelity Causal Video Diffusion Models for Real-Time Ultra-Low-Bitrate Semantic Communication | 2026 | Paper |
| EchoTorrent: Towards Swift, Sustained, and Streaming Multi-Modal Video Generation | 2026 | Paper |
| Tele-Omni: a Unified Multimodal Framework for Video Generation and Editing | 2026 | Paper |
| Omni-Video 2: Scaling MLLM-Conditioned Diffusion for Unified Video Generation and Editing | 2026 | Paper · GitHub · Website |
| ALIVE: Animate Your World with Lifelike Audio-Video Generation | 2026 | Paper · GitHub · Website |
| PISCO: Precise Video Instance Insertion with Sparse Control | 2026 | Paper · GitHub · Website |
| TeleBoost: A Systematic Alignment Framework for High-Fidelity, Controllable, and Robust Video Generation | 2026 | Paper · GitHub |
| Optimizing Few-Step Generation with Adaptive Matching Distillation | 2026 | Paper |
| Driving with DINO: Vision Foundation Features as a Unified Bridge for Sim-to-Real Generation in Autonomous Driving | 2026 | Paper · Website |
| LSA: Localized Semantic Alignment for Enhancing Temporal Consistency in Traffic Video Generation | 2026 | Paper · GitHub |
| Euphonium: Steering Video Flow Matching via Process Reward Gradient Guided Stochastic Dynamics | 2026 | Paper · GitHub |
| BridgeV2W: Bridging Video Generation Models to Embodied World Models via Embodiment Masks | 2026 | Paper · Website |
| Unified Personalized Reward Model for Vision Generation | 2026 | Paper · GitHub · Website |
| PISCES: Annotation-free Text-to-Video Post-Training via Optimal Transport-Aligned Rewards | 2026 | Paper |
| Latent Temporal Discrepancy as Motion Prior: A Loss-Weighting Strategy for Dynamic Fidelity in T2V | 2026 | Paper |
| Reward-Forcing: Autoregressive Video Generation with Reward Feedback | 2026 | Paper · GitHub · Website |
| Walk through Paintings: Egocentric World Models from Internet Priors | 2026 | Paper · GitHub · Website |
| Human detectors are surprisingly powerful reward models | 2026 | Paper |
| PhysRVG: Physics-Aware Unified Reinforcement Learning for Video Generative Models | 2026 | Paper · Website |
| Inference-time Physics Alignment of Video Generative Models with Latent World Models | 2026 | Paper |
| Beyond Inpainting: Unleash 3D Understanding for Precise Camera-Controlled Video Generation | 2026 | Paper · Website |
| Focal Guidance: Unlocking Controllability from Semantic-Weak Layers in Video Diffusion Models | 2026 | Paper |
| Mind the Generative Details: Direct Localized Detail Preference Optimization for Video Diffusion Models | 2026 | Paper |
| Thinking with Frames: Generative Video Distortion Evaluation via Frame Reward Model | 2026 | Paper |
| DreamLoop: Controllable Cinemagraph Generation from a Single Photograph | 2026 | Paper · Website |
| Slot-ID: Identity-Preserving Video Generation from Reference Videos via Slot-Based Temporal Identity Encoding | 2026 | Paper |
| PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation | 2025 | Paper · GitHub · Website |
| LiveTalk: Real-Time Multimodal Interactive Video Diffusion via Improved On-Policy Distillation | 2025 | Paper · GitHub |
| Envision: Embodied Visual Planning via Goal-Imagery Video Diffusion | 2025 | Paper · Website |
| Characterizing Motion Encoding in Video Diffusion Timesteps | 2025 | Paper |
| ACD: Direct Conditional Control for Video Diffusion Models via Attention Supervision | 2025 | Paper |
| DreaMontage: Arbitrary Frame-Guided One-Shot Video Generation | 2025 | Paper · Website |
| Few-Shot-Based Modular Image-to-Video Adapter for Diffusion Models | 2025 | Paper · GitHub · Website |
| StoryMem: Multi-shot Long Video Storytelling with Memory | 2025 | Paper · GitHub · Website |
| CETCAM: Camera-Controllable Video Generation via Consistent and Extensible Tokenization | 2025 | Paper · Website |
| Animate Any Character in Any World | 2025 | Paper · GitHub · Website |
| InsertAnywhere: Bridging 4D Scene Geometry and Diffusion Models for Realistic Video Object Insertion | 2025 | Paper · Website |
| The World is Your Canvas: Painting Promptable Events with Reference Images, Trajectories, and Text | 2025 | Paper · GitHub · Website |
| Factorized Video Generation: Decoupling Scene Construction and Temporal Synthesis in Text-to-Video Diffusion Models | 2025 | Paper · GitHub · Website |
| LongVie 2: Multimodal Controllable Ultra-Long Video World Model | 2025 | Paper · GitHub · Website |
| SneakPeek: Future-Guided Instructional Streaming Video Generation | 2025 | Paper |
| What Happens Next? Next Scene Prediction with a Unified Video Model | 2025 | Paper |
| GenieDrive: Towards Physics-Aware Driving World Model with 4D Occupancy Guided Video Generation | 2025 | Paper · GitHub · Website |
| STAGE: Storyboard-Anchored Generation for Cinematic Multi-shot Narrative | 2025 | Paper |
| SMRABooth: Subject and Motion Representation Alignment for Customized Video Generation | 2025 | Paper |
| BAgger: Backwards Aggregation for Mitigating Drift in Autoregressive Video Diffusion Models | 2025 | Paper · Website |
| Structure From Tracking: Distilling Structure-Preserving Motion for Video Generation | 2025 | Paper · Website |
| AlcheMinT: Fine-grained Temporal Control for Multi-Reference Consistent Video Generation | 2025 | Paper · Website |
| ReCamDriving: LiDAR-Free Camera-Controlled Novel Trajectory Video Generation | 2025 | Paper · GitHub · Website |
| In-Context Sync-LoRA for Portrait Video Editing | 2025 | Paper · GitHub · Website |
| Progressive Image Restoration via Text-Conditioned Video Generation | 2025 | Paper |
| Generative Video Motion Editing with 3D Point Tracks | 2025 | Paper · Website |
| SpriteHand: Real-Time Versatile Hand-Object Interaction with Autoregressive Video Generation | 2025 | Paper |
| DreamingComics: A Story Visualization Pipeline via Subject and Layout Customized Generation using Video Models | 2025 | Paper · Website |
| Low-Bitrate Video Compression through Semantic-Conditioned Diffusion | 2025 | Paper |
| AnyTalker: Scaling Multi-Person Talking Video Generation with Interactivity Refinement | 2025 | Paper · GitHub · Website |
| BlockVid: Block Diffusion for High-Quality and Consistent Minute-Long Video Generation | 2025 | Paper · GitHub · Website |
| WorldWander: Bridging Egocentric and Exocentric Worlds in Video Generation | 2025 | Paper · GitHub · Website |
| CtrlVDiff: Controllable Video Generation via Unified Multimodal Video Diffusion | 2025 | Paper · GitHub · Website |
| MotionV2V: Editing Motion in a Video | 2025 | Paper · GitHub · Website |
| Exo2EgoSyn: Unlocking Foundation Video Generation Models for Exocentric-to-Egocentric Video Synthesis | 2025 | Paper |
| SteadyDancer: Harmonized and Coherent Human Image Animation with First-Frame Preservation | 2025 | Paper · GitHub · Website |
| Beyond Reward Margin: Rethinking and Resolving Likelihood Displacement in Diffusion Models via Video Generation | 2025 | Paper |
| View-Consistent Diffusion Representations for 3D-Consistent Video Generation | 2025 | Paper · Website |
| Eevee: Towards Close-up High-resolution Video-based Virtual Try-on | 2025 | Paper · GitHub |
| STCDiT: Spatio-Temporally Consistent Diffusion Transformer for High-Quality Video Super-Resolution | 2025 | Paper · GitHub · Website |
| Point-to-Point: Sparse Motion Guidance for Controllable Video Editing | 2025 | Paper |
| CamC2V: Context-aware Controllable Video Generation | 2025 | Paper · GitHub |
| MultiShotMaster: A Controllable Multi-Shot Video Generation Framework | 2025 | Paper · GitHub · Website |
| LoVoRA: Text-guided and Mask-free Video Object Removal and Addition with Learnable Object-aware Localization | 2025 | Paper · GitHub · Website |
| Taming Camera-Controlled Video Generation with Verifiable Geometry Reward | 2025 | Paper |
| IC-World: In-Context Generation for Shared World Modeling | 2025 | Paper · GitHub |
| Objects in Generated Videos Are Slower Than They Appear: Models Suffer Sub-Earth Gravity and Make Objects Move Slower Than in Reality | 2025 | Paper · Website |
| What about gravity in video generation? Post-Training Newton's Laws with Verifiable Rewards | 2025 | Paper · GitHub · Website |
| InstanceV: Instance-Level Video Generation | 2025 | Paper · GitHub · Website |
| McSc: Motion-Corrective Preference Alignment for Video Generation with Self-Critic Hierarchical Reasoning | 2025 | Paper · GitHub · Website |
| One-to-All Animation: Alignment-Free Character Animation and Image Pose Transfer | 2025 | Paper · GitHub · Website |
| MoGAN: Improving Motion Quality in Video Diffusion via Few-Step Motion Adversarial Post-Training | 2025 | Paper · Website |
| Video Generation Models Are Good Latent Reward Models | 2025 | Paper · Website |
| MapReduce LoRA: Advancing the Pareto Front in Multi-Preference Optimization for Generative Models | 2025 | Paper |
| Growing with the Generator: Self-paced GRPO for Video Generation | 2025 | Paper |
| Learning What to Trust: Bayesian Prior-Guided Optimization for Visual Generation | 2025 | Paper |
| Video-as-Answer: Predict and Generate Next Video Event with Joint-GRPO | 2025 | Paper · GitHub · Website |
| First Frame Is the Place to Go for Video Content Customization | 2025 | Paper · GitHub · Website |
| Kandinsky 5.0: A Family of Foundation Models for Image and Video Generation | 2025 | Paper · GitHub |
| Adaptive Begin-of-Video Tokens for Autoregressive Video Diffusion Models | 2025 | Paper |
| ProAV-DiT: A Projected Latent Diffusion Transformer for Efficient Synchronized Audio-Video Generation | 2025 | Paper |
| LiteAttention: A Temporal Sparse Attention for Diffusion Transformers | 2025 | Paper · GitHub · Website |
| EmoVid: A Multimodal Emotion Video Dataset for Emotion-Centric Video Understanding and Generation | 2025 | Paper · Website |
| Video Text Preservation with Synthetic Text-Rich Videos | 2025 | Paper |
| RISE-T2V: Rephrasing and Injecting Semantics with LLM for Expansive Text-to-Video Generation | 2025 | Paper · Website |
| PhysCorr: Dual-Reward DPO for Physics-Constrained Text-to-Video Generation with Automated Preference Selection | 2025 | Paper |
| UniAVGen: Unified Audio and Video Generation with Asymmetric Cross-Modal Interactions | 2025 | Paper · GitHub · Website |
| ID-Crafter: VLM-Grounded Online RL for Compositional Multi-Subject Video Generation | 2025 | Paper · GitHub · Website |
| Fine-Tuning Open Video Generators for Cinematic Scene Synthesis: A Small-Data Pipeline with LoRA and Wan2.1 I2V | 2025 | Paper · Website |
| VC4VG: Optimizing Video Captions for Text-to-Video Generation | 2025 | Paper · GitHub · Website |
| CoMo: Compositional Motion Customization for Text-to-Video Generation | 2025 | Paper · Website |
| Epipolar Geometry Improves Video Generation Models | 2025 | Paper · GitHub · Website |
| In-Context Learning with Unpaired Clips for Instruction-based Video Editing | 2025 | Paper · GitHub |
| Identity-GRPO: Optimizing Multi-Human Identity-preserving Video Generation via Reinforcement Learning | 2025 | Paper · GitHub · Website |
| Virtually Being: Customizing Camera-Controllable Video Diffusion Models with Multi-View Performance Captures | 2025 | Paper · Website |
| PhysMaster: Mastering Physical Representation for Video Generation via Reinforcement Learning | 2025 | Paper |
| MVP4D: Multi-View Portrait Video Diffusion for Animatable 4D Avatars | 2025 | Paper |
| Real-Time Motion-Controllable Autoregressive Video Diffusion | 2025 | Paper |
| PickStyle: Video-to-Video Style Transfer with Context-Style Adapters | 2025 | Paper |
| Generative World Modelling for Humanoids: 1X World Model Challenge Technical Report | 2025 | Paper |
| Character Mixing for Video Generation | 2025 | Paper · GitHub |
| FlashI2V: Fourier-Guided Latent Shifting Prevents Conditional Image Leakage in Image-to-Video Generation | 2025 | Paper · GitHub · Website |
| DC-VideoGen: Efficient Video Generation with Deep Compression Video Autoencoder | 2025 | Paper · GitHub · Website |
| PanoWorld-X: Generating Explorable Panoramic Worlds via Sphere-Aware Video Diffusion | 2025 | Paper · Website |
| Attention Surgery: An Efficient Recipe to Linearize Your Video Diffusion Transformer | 2025 | Paper · Website |
| Reinforcement Learning with Inverse Rewards for World Model Post-training | 2025 | Paper |
| Echo-Path: Pathology-Conditioned Echo Video Generation | 2025 | Paper · GitHub |
| VidCLearn: A Continual Learning Approach for Text-to-Video Generation | 2025 | Paper |
| OpenViGA: Video Generation for Automotive Driving Scenes by Streamlining and Fine-Tuning Open Source Models with Public Data | 2025 | Paper |
| PanoLora: Bridging Perspective and Panoramic Video Generation with LoRA Adaptation | 2025 | Paper · Website |
| Kling-Avatar: Grounding Multimodal Instructions for Cascaded Long-Duration Avatar Animation Synthesis | 2025 | Paper · Website |
| Improving Video Diffusion Transformer Training by Multi-Feature Fusion and Alignment from Self-Supervised Vision Encoders | 2025 | Paper · Website |
| RewardDance: Reward Scaling in Visual Generation | 2025 | Paper |
| HuMo: Human-Centric Video Generation via Collaborative Multi-Modal Conditioning | 2025 | Paper · GitHub · Website |
| Zero-shot 3D-Aware Trajectory-Guided image-to-video generation via Test-Time Training | 2025 | Paper · GitHub · Website |
| UniVerse-1: Unified Audio-Video Generation via Stitching of Experts | 2025 | Paper · GitHub · Website |
| DevilSight: Augmenting Monocular Human Avatar Reconstruction through a Virtual Perspective | 2025 | Paper |
| Realistic and Controllable 3D Gaussian-Guided Object Editing for Driving Video Generation | 2025 | Paper |
| Learning Primitive Embodied World Models: Towards Scalable Robotic Learning | 2025 | Paper · GitHub · Website |
| MIDAS: Multimodal Interactive Digital-humAn Synthesis via Real-time Autoregressive Video Generation | 2025 | Paper · Website |
| ControlEchoSynth: Boosting Ejection Fraction Estimation Models via Controlled Video Diffusion | 2025 | Paper |
| SSG-Dit: A Spatial Signal Guided Framework for Controllable Video Generation | 2025 | Paper |
| Seeing Clearly, Forgetting Deeply: Revisiting Fine-Tuned Video Generators for Driving Simulation | 2025 | Paper |
| WorldWeaver: Generating Long-Horizon Video Worlds via Rich Perception | 2025 | Paper |
| 4DNeX: Feed-Forward 4D Generative Modeling Made Easy | 2025 | Paper · GitHub · Website |
| Physical Autoregressive Model for Robotic Manipulation without Action Pretraining | 2025 | Paper · GitHub · Website |
| From Large Angles to Consistent Faces: Identity-Preserving Video Generation via Mixture of Facial Experts | 2025 | Paper · GitHub · Website |
| Animate-X++: Universal Character Image Animation with Dynamic Backgrounds | 2025 | Paper · GitHub · Website |
| SketchAnimator: Animate Sketch via Motion Customization of Text-to-Video Diffusion Models | 2025 | Paper |
| SwiftVideo: A Unified Framework for Few-Step Video Generation through Trajectory-Distribution Alignment | 2025 | Paper |
| DreamVE: Unified Instruction-based Image and Video Editing | 2025 | Paper · Website |
| PoseGen: In-Context LoRA Finetuning for Pose-Controllable Long Human Video Generation | 2025 | Paper |
| Scaling Up Audio-Synchronized Visual Animation: An Efficient Training Paradigm | 2025 | Paper |
| LongVie: Multimodal-Guided Controllable Ultra-Long Video Generation | 2025 | Paper · GitHub · Website |
| Macro-from-Micro Planning for High-Quality and Parallelized Autoregressive Long Video Generation | 2025 | Paper · GitHub · Website |
| DreamVVT: Mastering Realistic Video Virtual Try-On in the Wild via a Stage-Wise Diffusion Transformer Framework | 2025 | Paper · GitHub · Website |
| Compositional Video Synthesis by Temporal Object-Centric Learning | 2025 | Paper |
| Enhancing Scene Transition Awareness in Video Generation via Post-Training | 2025 | Paper |
| Zero-Shot Dynamic Concept Personalization with Grid-Based LoRA | 2025 | Paper · Website |
| Navigating Large-Pose Challenge for High-Fidelity Face Reenactment with Video Diffusion Model | 2025 | Paper · GitHub |
| PUSA V1.0: Surpassing Wan-I2V with $500 Training Cost by Vectorized Timestep Adaptation | 2025 | Paper · GitHub · Website |
| Conditional Video Generation for High-Efficiency Video Compression | 2025 | Paper |
| StableAnimator++: Overcoming Pose Misalignment and Face Distortion for Human Image Animation | 2025 | Paper · Website |
| Geometry-aware 4D Video Generation for Robot Manipulation | 2025 | Paper · GitHub · Website |
| Populate-A-Scene: Affordance-Aware Human Video Generation | 2025 | Paper · Website |
| TextMesh4D: High-Quality Text-to-4D Mesh Generation | 2025 | Paper |
| SynMotion: Semantic-Visual Adaptation for Motion Customized Video Generation | 2025 | Paper · Website |
| MirrorMe: Towards Realtime and High Fidelity Audio-Driven Halfbody Animation | 2025 | Paper |
| Video Virtual Try-on with Conditional Diffusion Transformer Inpainter | 2025 | Paper |
| DFVEdit: Conditional Delta Flow Vector for Zero-shot Video Editing | 2025 | Paper · GitHub · Website |
| Bind-Your-Avatar: Multi-Talking-Character Video Generation with Dynamic 3D-mask-based Embedding Router | 2025 | Paper · GitHub · Website |
| AnimaX: Animating the Inanimate in 3D with Joint Video-Pose Diffusion Models | 2025 | Paper · GitHub · Website |
| RDPO: Real Data Preference Optimization for Physics Consistency Video Generation | 2025 | Paper · Website |
| FramePrompt: In-context Controllable Animation with Zero Structural Changes | 2025 | Paper · Website |
| DAVID-XR1: Detecting AI-Generated Videos with Explainable Reasoning | 2025 | Paper |
| Causally Steered Diffusion for Automated Video Counterfactual Generation | 2025 | Paper · GitHub · Website |
| iDiT-HOI: Inpainting-based Hand Object Interaction Reenactment via Video Diffusion Transformer | 2025 | Paper |
| PlayerOne: Egocentric World Simulator | 2025 | Paper · GitHub · Website |
| LoRA-Edit: Controllable First-Frame-Guided Video Editing via Mask-Aware LoRA Fine-Tuning | 2025 | Paper · GitHub · Website |
| DreamActor-H1: High-Fidelity Human-Product Demonstration Video Generation via Motion-designed Diffusion Transformers | 2025 | Paper · Website |
| GigaVideo-1: Advancing Video Generation via Automatic Feedback with 4 GPU-Hours Fine-Tuning | 2025 | Paper |
| AlignHuman: Improving Motion and Fidelity via Timestep-Segment Preference Optimization for Audio-Driven Human Animation | 2025 | Paper · Website |
| Enhancing Motion Dynamics of Image-to-Video Models via Adaptive Low-Pass Guidance | 2025 | Paper · GitHub · Website |
| HunyuanVideo-HOMA: Generic Human-Object Interaction in Multimodal Driven Human Animation | 2025 | Paper |
| Seedance 1.0: Exploring the Boundaries of Video Generation Models | 2025 | Paper · Website |
| Cosmos-Drive-Dreams: Scalable Synthetic Driving Data Generation with World Foundation Models | 2025 | Paper · GitHub · Website |
| Cross-Frame Representation Alignment for Fine-Tuning Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Consistent Video Editing as Flow-Driven Image-to-Video Generation | 2025 | Paper |
| From Generation to Generalization: Emergent Few-Shot Learning in Video Diffusion Models | 2025 | Paper · GitHub · Website |
| Restereo: Diffusion stereo video generation and restoration | 2025 | Paper |
| FullDiT2: Efficient In-Context Conditioning for Video Diffusion Transformers | 2025 | Paper · Website |
| Sparse-vDiT: Unleashing the Power of Sparse Attention to Accelerate Video Diffusion Transformers | 2025 | Paper · GitHub |
| OmniV2V: Versatile Video Generation and Editing via Dynamic Content Manipulation | 2025 | Paper |
| Respond Beyond Language: A Benchmark for Video Generation in Response to Realistic User Intents | 2025 | Paper |
| Playing with Transformer at 30+ FPS via Next-Frame Diffusion | 2025 | Paper · Website |
| DeepVerse: 4D Autoregressive Video Generation as a World Model | 2025 | Paper · GitHub · Website |
| Temporal In-Context Fine-Tuning for Versatile Control of Video Diffusion Models | 2025 | Paper · GitHub · Website |
| SkyReels-Audio: Omni Audio-Conditioned Talking Portraits in Video Diffusion Transformers | 2025 | Paper · Website |
| Video Signature: Implicit Watermarking for Video Diffusion Models | 2025 | Paper |
| Ctrl-Crash: Controllable Diffusion for Realistic Car Crashes | 2025 | Paper · GitHub · Website |
| ATI: Any Trajectory Instruction for Controllable Video Generation | 2025 | Paper · GitHub · Website |
| FaceEditTalker: Controllable Talking Head Generation with Facial Attribute Editing | 2025 | Paper · Website |
| EPiC: Efficient Video Camera Control Learning with Precise Anchor-Video Guidance | 2025 | Paper · GitHub · Website |
| Think Before You Diffuse: Infusing Physical Rules into Video Diffusion | 2025 | Paper · Website |
| HunyuanVideo-Avatar: High-Fidelity Audio-Driven Human Animation for Multiple Characters | 2025 | Paper · GitHub · Website |
| Dynamic-I2V: Exploring Image-to-Video Generation Models via Multimodal LLM | 2025 | Paper |
| DanceTogether! Identity-Preserving Multi-Person Interactive Video Generation | 2025 | Paper · GitHub · Website |
| T2VUnlearning: A Concept Erasing Method for Text-to-Video Diffusion Models | 2025 | Paper · GitHub |
| MTVCrafter: 4D Motion Tokenization for Open-World Human Image Animation | 2025 | Paper · GitHub · Website |
| ProFashion: Prototype-guided Fashion Video Generation with Multiple Reference Images | 2025 | Paper |
| HunyuanCustom: A Multimodal-Driven Architecture for Customized Video Generation | 2025 | Paper · GitHub · Website |
| A Unit Enhancement and Guidance Framework for Audio-Driven Avatar Video Generation | 2025 | Paper |
| VIDSTAMP: A Temporally-Aware Watermark for Ownership and Integrity in Video Diffusion Models | 2025 | Paper · Website |
| ReVision: High-Quality, Low-Cost Video Generation with Explicit 3D Physics Modeling for Complex Motion and Interaction | 2025 | Paper · Website |
| ManipDreamer: Boosting Robotic Manipulation World Model with Action Tree and Visual Guidance | 2025 | Paper |
| Subject-driven Video Generation via Disentangled Identity and Motion | 2025 | Paper · GitHub · Website |
| Reasoning Physical Video Generation with Diffusion Timestep Tokens via Reinforcement Learning | 2025 | Paper |
| UniAnimate-DiT: Human Image Animation with Large-Scale Video Diffusion Transformer | 2025 | Paper · GitHub |
| Taming Consistency Distillation for Accelerated Human Image Animation | 2025 | Paper |
| Aligning Anime Video Generation with Human Feedback | 2025 | Paper · GitHub |
| I Want It That Way! Specifying Nuanced Camera Motions in Video Editing | 2025 | Paper |
| Discriminator-Free Direct Preference Optimization for Video Diffusion | 2025 | Paper |
| EasyGenNet: An Efficient Framework for Audio-Driven Gesture Video Generation Based on Diffusion Model | 2025 | Paper |
| RAGME: Retrieval Augmented Video Generation for Enhanced Motion Realism | 2025 | Paper · GitHub |
| MagicTime: Time-lapse Video Generation Models as Metamorphic Simulators | 2024 | Paper · GitHub · Website |
| VideoFactory: Swap Attention in Spatiotemporal Diffusions for Text-to-Video Generation | 2023 | Paper |
📄 License
This project is licensed under the MIT License - see the LICENSE file for details.
🧑💻 Contributors
👏 Thanks to these contributors for this excellent work!
✉️ Contact
For questions, suggestions, or collaboration opportunities, please feel free to reach out:
✉️ Email: chaoyuli@asu.edu, pooyan@asu.edu