
README
Music Source Separation incorporating Generative Adversarial Networks
モチベーション:音源分離システムの分離性能向上
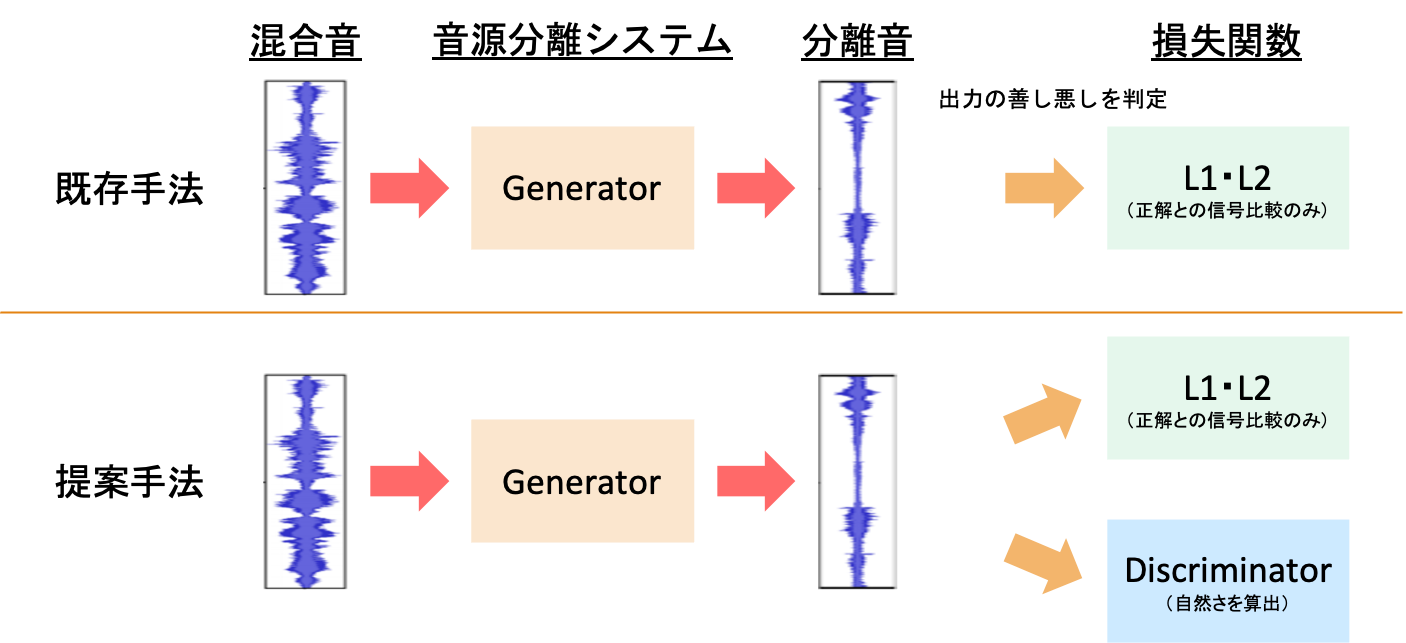
楽曲の音源分離において、深層学習による音源分離システムが良好な性能を示してきた。しかし実際に分離した音源を聴いてみると、分離漏れや音の欠損、ノイズの混入が起こっていることが確認でき、未だ改善の余地があるといえる。既存の音源分離システムでは、ガウス分布の仮定によりデータの確率分布を明示的に定める方法がとられてきたが、この方法では細部の表現がぼやけてしまいやすい。それに対して、Generative Adversarial Networks(GAN)と呼ばれる技術では、特定の分布を仮定せず、真贋判定を行うニューラルネットワークを導入することにより確率分布を暗示的に定めることで、精緻な生成を可能にした。そこで本研究では、既存の音源分離システムにGANの機構を取り入れることで、分離性能の向上を目指す。
提案手法:損失関数に自然さ(細部の表現)の尺度を追加
既存の音源分離システムでは、 L1(絶対誤差)や L2(二乗誤差)のみで損失の計算を行なっている。本研究では、GANのDiscriminatorの機構を加えることで、分離性能の向上を目指す。
①Why?
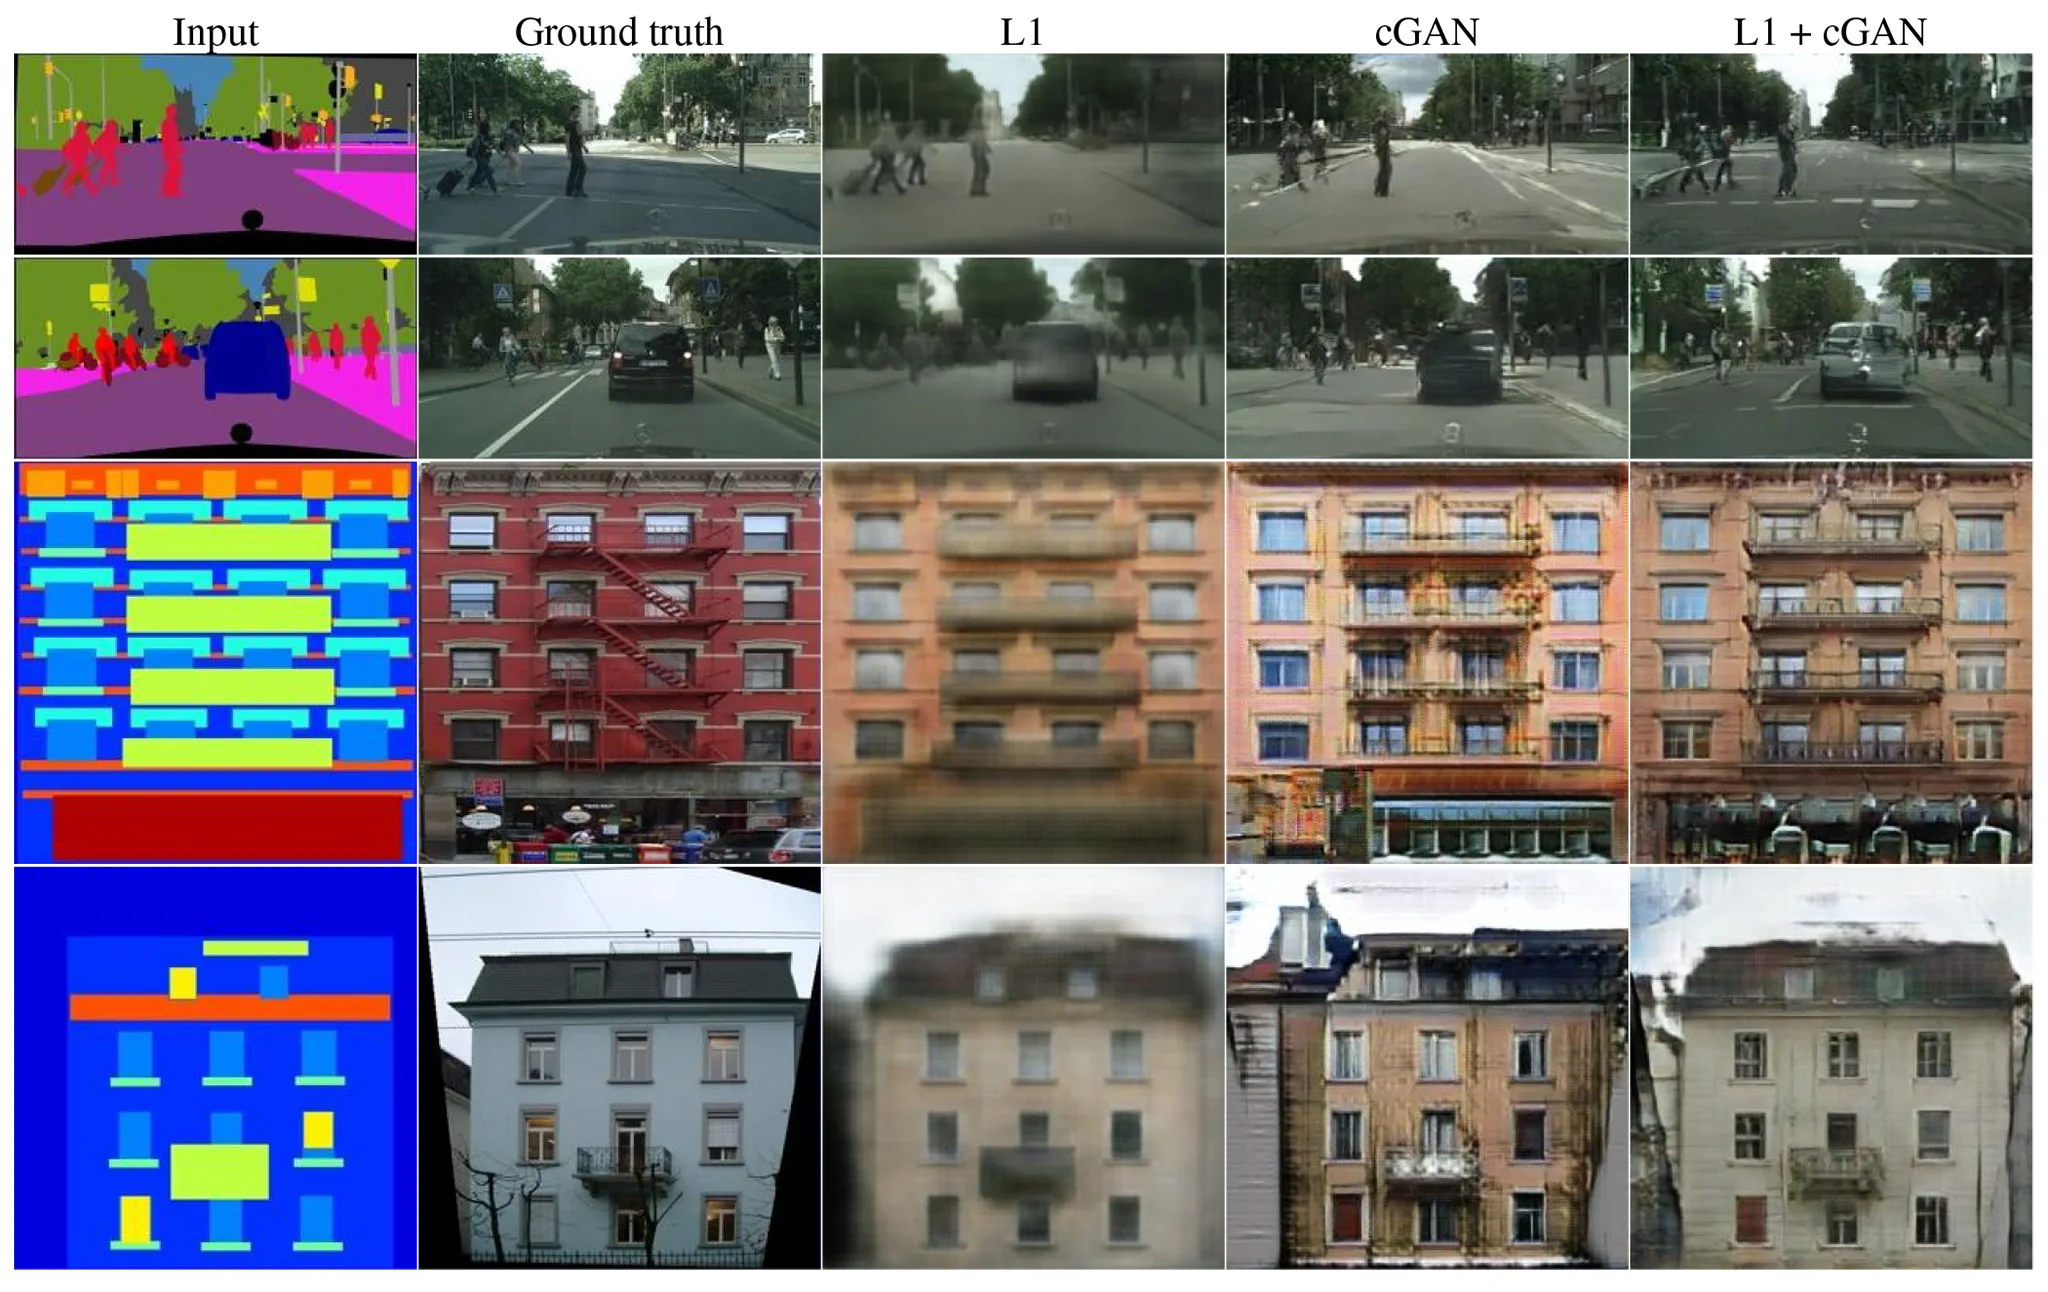
ガウス分布の仮定により導出されるL1や L2を用いて損失を計算する方法では、対象の大まかな特徴を捉えることはできるが、細部の表現がぼやけてしまう。その一方でGANは、特定の分布を仮定せず、損失を算出するためにニューラルネットワークを導入する。Generatorとは別に用意されたDiscriminatorと呼ばれるネットワークは、生成物の真贋判定を行うことで、Generatorに細部の表現を考慮させ、精緻な生成を可能にする。以下は、画像変換システムであるpix2pixにおいて、損失関数の違いが出力にどのような変化を与えるかを表したものである。
②How-to-learn?
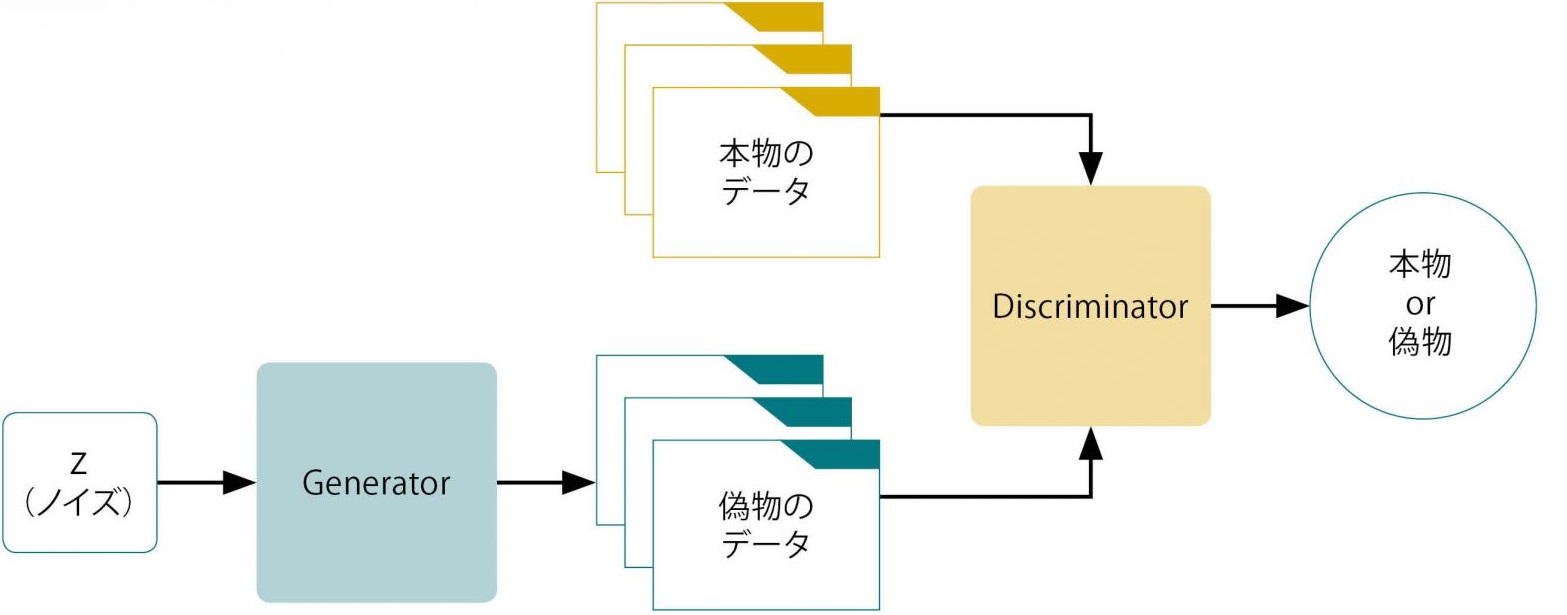
Generator/Discriminatorと呼ばれる2つのネットワークを競合させる学習方法は、しばしば紙幣の偽造に例えられる。偽造者(Generator)は本物に近い偽札を作ろうとし、警官(Discriminator)はそれが偽物であると見抜く。するとGeneratorは、より精巧な偽札を作り出すように技術を発展させる。こうした「いたちごっこ」が繰り返され、最終的には本物に近い偽札が生成されるようになる。ここでDiscriminatorは、自然さを算出する損失関数のようにふるまう。このアルゴリズムを取り入れることで実現を目指す。
検証に用いた音源分離システムと実装環境
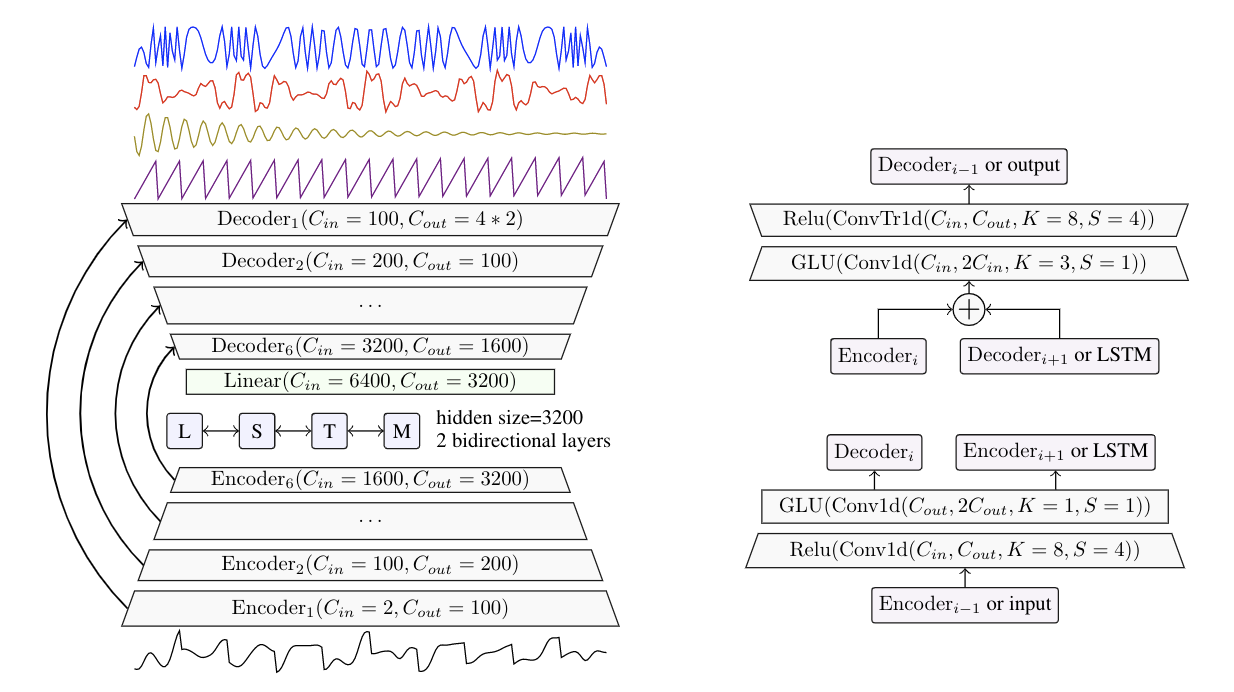
世界的なコンペティションSiSec2018において良好な性能を示した、Facebookの音源分離システムDemucsを検証に用いた。Encoder-Decoderモデルを採用しており、Encoderで復元可能な情報量を保ったまま特徴抽出を行い、Decoderで音声に復元する構造を持たせている。より生成モデルに近い構造を持ち、混合音から分離音への音声変換のような構造を目指してきたことが伺える。大規模モデルを動作させるために、GCP上で最新のGPUであるA100を16基分散学習させた。使用言語はPython。フレームワークはPyTorch。
研究進捗
コンペティションSiSec2018で使用された評価指標SDRによる結果は表の通り。
| Model | Drum | Bass | Others | Vocal | All |
|---|---|---|---|---|---|
| Demucs (v1) | 6.08 | 5.83 | 4.12 | 6.29 | 5.58 |
| Demucs (v1) + GAN | 6.15 | 6.16 | 3.95 | 5.99 | 5.56 |
| Difference | +0.07 | +0.33 | -0.17 | -0.30 | -0.02 |
Discriminatorの過学習が起きている状態での結果であるため、改善でき次第、更新予定である。
Contributors

14 commits
Similar repos


Languages
Python
100.0%
README
Music Source Separation incorporating Generative Adversarial Networks
モチベーション:音源分離システムの分離性能向上
楽曲の音源分離において、深層学習による音源分離システムが良好な性能を示してきた。しかし実際に分離した音源を聴いてみると、分離漏れや音の欠損、ノイズの混入が起こっていることが確認でき、未だ改善の余地があるといえる。既存の音源分離システムでは、ガウス分布の仮定によりデータの確率分布を明示的に定める方法がとられてきたが、この方法では細部の表現がぼやけてしまいやすい。それに対して、Generative Adversarial Networks(GAN)と呼ばれる技術では、特定の分布を仮定せず、真贋判定を行うニューラルネットワークを導入することにより確率分布を暗示的に定めることで、精緻な生成を可能にした。そこで本研究では、既存の音源分離システムにGANの機構を取り入れることで、分離性能の向上を目指す。
提案手法:損失関数に自然さ(細部の表現)の尺度を追加
既存の音源分離システムでは、 L1(絶対誤差)や L2(二乗誤差)のみで損失の計算を行なっている。本研究では、GANのDiscriminatorの機構を加えることで、分離性能の向上を目指す。
①Why?
ガウス分布の仮定により導出されるL1や L2を用いて損失を計算する方法では、対象の大まかな特徴を捉えることはできるが、細部の表現がぼやけてしまう。その一方でGANは、特定の分布を仮定せず、損失を算出するためにニューラルネットワークを導入する。Generatorとは別に用意されたDiscriminatorと呼ばれるネットワークは、生成物の真贋判定を行うことで、Generatorに細部の表現を考慮させ、精緻な生成を可能にする。以下は、画像変換システムであるpix2pixにおいて、損失関数の違いが出力にどのような変化を与えるかを表したものである。
②How-to-learn?
Generator/Discriminatorと呼ばれる2つのネットワークを競合させる学習方法は、しばしば紙幣の偽造に例えられる。偽造者(Generator)は本物に近い偽札を作ろうとし、警官(Discriminator)はそれが偽物であると見抜く。するとGeneratorは、より精巧な偽札を作り出すように技術を発展させる。こうした「いたちごっこ」が繰り返され、最終的には本物に近い偽札が生成されるようになる。ここでDiscriminatorは、自然さを算出する損失関数のようにふるまう。このアルゴリズムを取り入れることで実現を目指す。
検証に用いた音源分離システムと実装環境
世界的なコンペティションSiSec2018において良好な性能を示した、Facebookの音源分離システムDemucsを検証に用いた。Encoder-Decoderモデルを採用しており、Encoderで復元可能な情報量を保ったまま特徴抽出を行い、Decoderで音声に復元する構造を持たせている。より生成モデルに近い構造を持ち、混合音から分離音への音声変換のような構造を目指してきたことが伺える。大規模モデルを動作させるために、GCP上で最新のGPUであるA100を16基分散学習させた。使用言語はPython。フレームワークはPyTorch。
研究進捗
コンペティションSiSec2018で使用された評価指標SDRによる結果は表の通り。
| Model | Drum | Bass | Others | Vocal | All |
|---|---|---|---|---|---|
| Demucs (v1) | 6.08 | 5.83 | 4.12 | 6.29 | 5.58 |
| Demucs (v1) + GAN | 6.15 | 6.16 | 3.95 | 5.99 | 5.56 |
| Difference | +0.07 | +0.33 | -0.17 | -0.30 | -0.02 |
Discriminatorの過学習が起きている状態での結果であるため、改善でき次第、更新予定である。
Similar repos
Contributors
14 commits
Languages
Python
100.0%