Cuộc thi VLSP 2025 Challenge on Multimodal Legal QA on Traffic Sign Rules hướng tới xây dựng hệ thống trí tuệ nhân tạo có khả năng hiểu và xử lý các câu hỏi liên quan đến biển báo giao thông, kết hợp giữa ngôn ngữ tự nhiên và hình ảnh thực tế. Hệ thống cần truy xuất thông tin pháp lý và trả lời chính xác các câu hỏi dựa trên quy định hiện hành về giao thông đường bộ tại Việt Nam.
Đầu vào:
Đầu ra:
Đầu vào:
Đầu ra:
Ban Tổ Chức cung cấp bộ dữ liệu phục vụ cho hai subtask, bao gồm:
Bạn có thể tải dữ liệu tại đây:
Link Google Drive dữ liệu chính thức của BTC
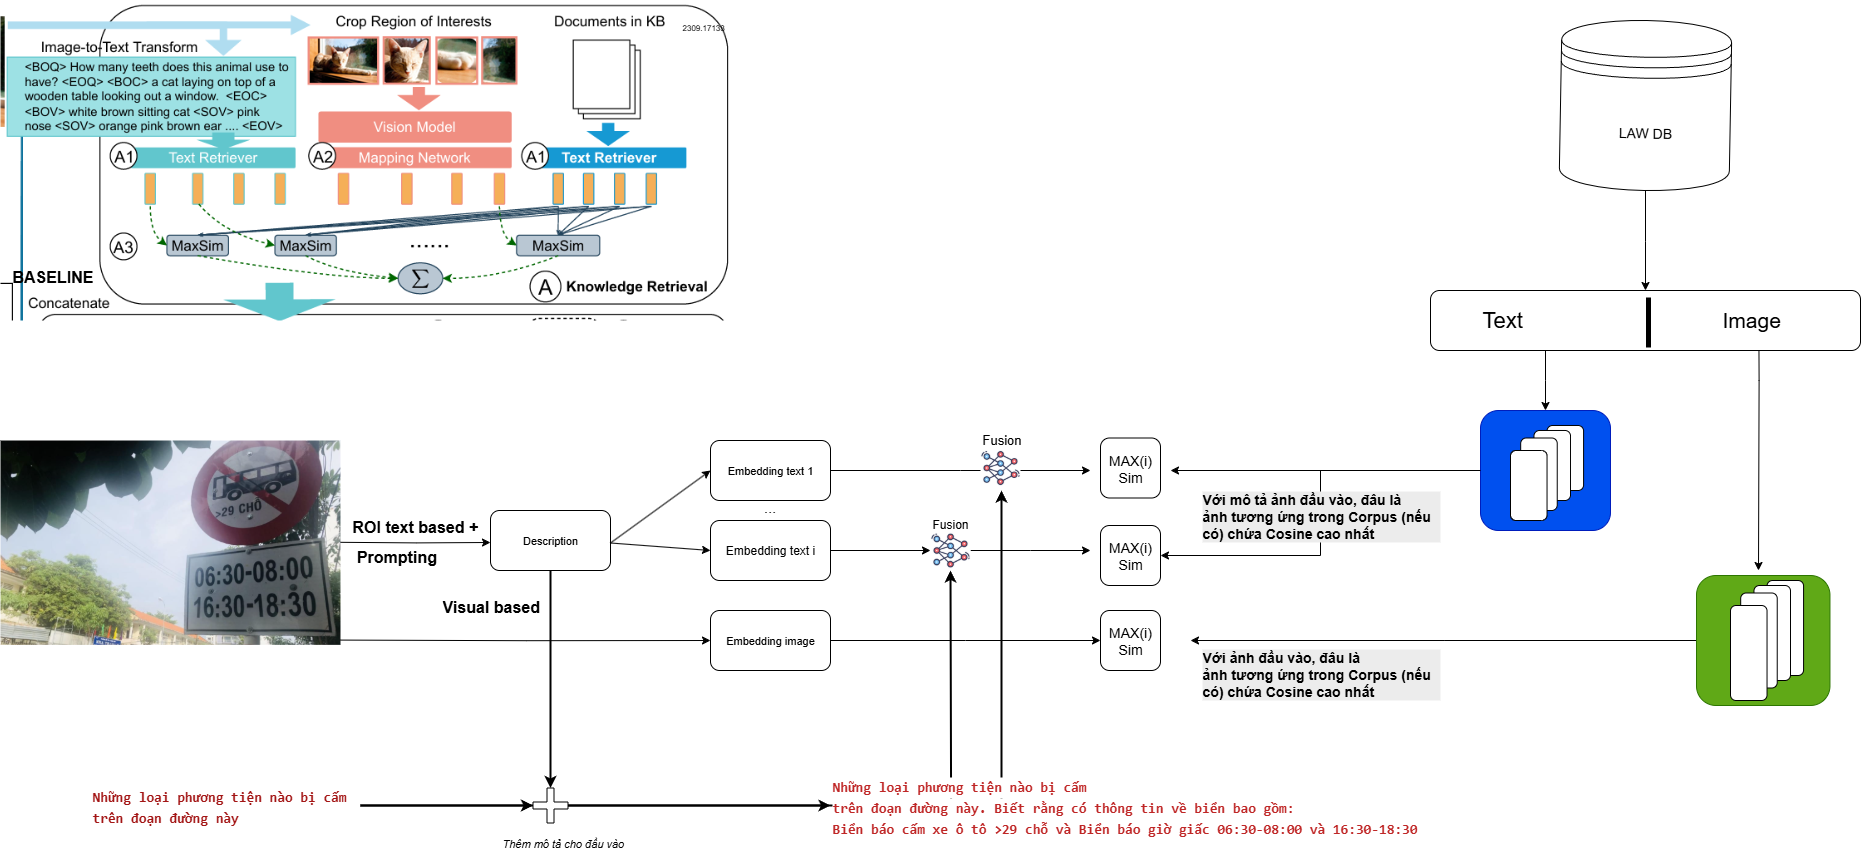
Hệ thống baseline của chúng tôi kế thừa ý tưởng và kiến trúc từ bài báo Multimodal Legal Retrieval and Reasoning: A Case Study on Traffic Sign Rules. Baseline sử dụng các kỹ thuật tối ưu embedding dựa trên mô hình VLM (Vision-Language Model) tiếng Việt, giúp liên kết thông tin giữa hình ảnh biển báo và văn bản pháp lý một cách hiệu quả.
Quá trình huấn luyện và thử nghiệm các phương pháp embedding được lưu trữ trong các notebook có đuôi _test.ipynb trong thư mục dự án.
File reread_data.ipynb đảm nhiệm vai trò tiền xử lý dữ liệu (preprocess), chuẩn hóa và chuyển đổi dữ liệu thô thành định dạng phù hợp cho pipeline huấn luyện và đánh giá. Note: Version chưa tích hợp vào code python
Hình minh họa kiến trúc baseline:
Cuộc thi VLSP 2025 Challenge on Multimodal Legal QA on Traffic Sign Rules hướng tới xây dựng hệ thống trí tuệ nhân tạo có khả năng hiểu và xử lý các câu hỏi liên quan đến biển báo giao thông, kết hợp giữa ngôn ngữ tự nhiên và hình ảnh thực tế. Hệ thống cần truy xuất thông tin pháp lý và trả lời chính xác các câu hỏi dựa trên quy định hiện hành về giao thông đường bộ tại Việt Nam.
Đầu vào:
Đầu ra:
Đầu vào:
Đầu ra:
Ban Tổ Chức cung cấp bộ dữ liệu phục vụ cho hai subtask, bao gồm:
Bạn có thể tải dữ liệu tại đây:
Link Google Drive dữ liệu chính thức của BTC
Hệ thống baseline của chúng tôi kế thừa ý tưởng và kiến trúc từ bài báo Multimodal Legal Retrieval and Reasoning: A Case Study on Traffic Sign Rules. Baseline sử dụng các kỹ thuật tối ưu embedding dựa trên mô hình VLM (Vision-Language Model) tiếng Việt, giúp liên kết thông tin giữa hình ảnh biển báo và văn bản pháp lý một cách hiệu quả.
Quá trình huấn luyện và thử nghiệm các phương pháp embedding được lưu trữ trong các notebook có đuôi _test.ipynb trong thư mục dự án.
File reread_data.ipynb đảm nhiệm vai trò tiền xử lý dữ liệu (preprocess), chuẩn hóa và chuyển đổi dữ liệu thô thành định dạng phù hợp cho pipeline huấn luyện và đánh giá. Note: Version chưa tích hợp vào code python
Hình minh họa kiến trúc baseline: