timoncool/VibeVoice_ASR_portable_ru

Portable speech recognition (ASR) for Windows — Microsoft VibeVoice, one-click install, 100% offline, NVIDIA GPU.

Python

41

146 commits

updated Oct 18, 2026

See the code

README

VibeVoice ASR Portable

Портативное распознавание речи для Windows — Microsoft VibeVoice, установка в один клик, 100% офлайн.

Stars License Last Commit Downloads

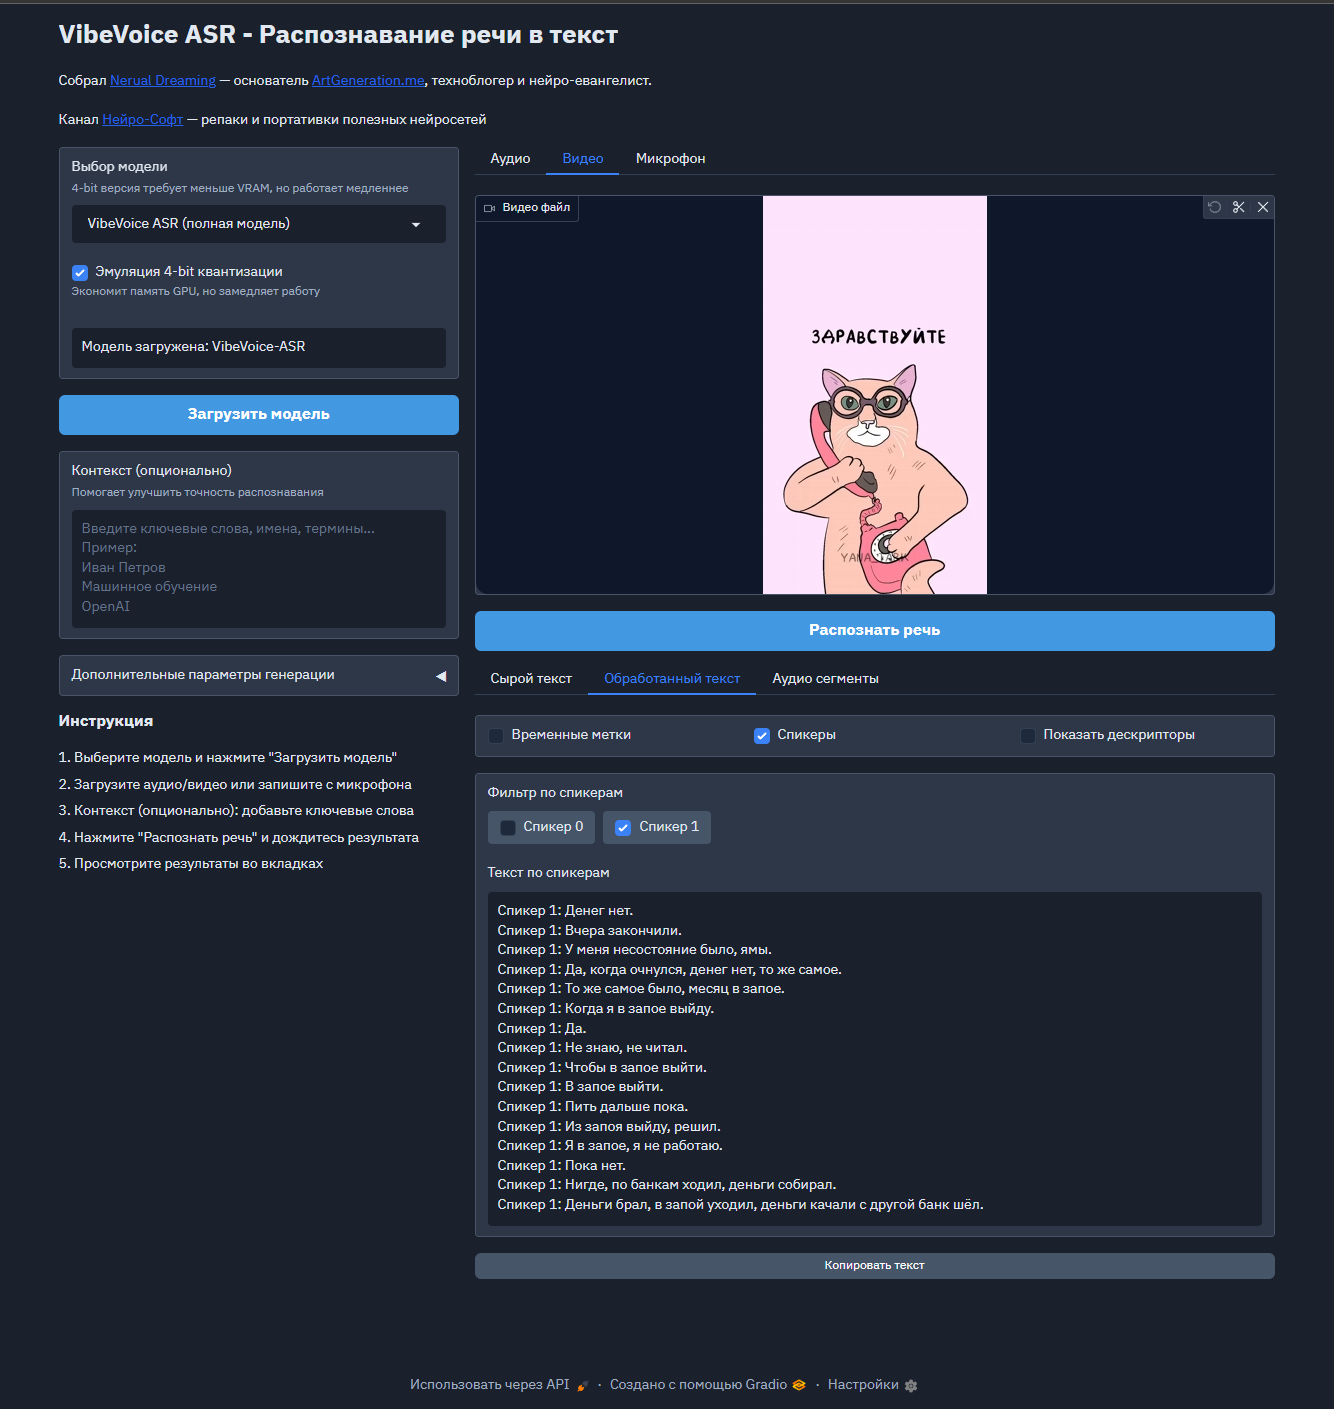
Интерфейс VibeVoice ASR

VibeVoice ASR — современная модель распознавания речи от Microsoft, которая преобразует аудио в текст с высокой точностью и поддержкой диаризации спикеров. Полная русификация интерфейса.

Возможности

  • Распознавание речи в текст с высокой точностью
  • Диаризация спикеров (определение кто говорит)
  • Временные метки для каждого сегмента речи
  • Эмуляция 4-bit квантизации для экономии видеопамяти
  • Полностью русскоязычный интерфейс
  • Тёмная тема интерфейса
  • Автоматическое открытие в браузере
  • Портативность — все файлы в одной папке
  • Поддержка множества аудио и видео форматов через FFmpeg
  • Ускоренная загрузка моделей через HuggingFace Xet

Системные требования

  • Windows 10/11 (64-bit)
  • NVIDIA GPU с поддержкой CUDA (рекомендуется 8GB+ VRAM)
  • Или CPU (медленнее, но работает)
  • 16GB+ RAM
  • 10GB свободного места на диске

Рекомендуемые видеокарты

СерияCUDA версияFlash Attention 2
GTX 10xx (Pascal)CUDA 11.8Нет
RTX 20xx (Turing)CUDA 11.8Нет
RTX 30xx (Ampere)CUDA 12.6Да
RTX 40xx (Ada Lovelace)CUDA 12.8Да
RTX 50xx (Blackwell)CUDA 12.8Да

Установка

Быстрая установка (рекомендуется)

  1. Скачайте архив VibeVoice_ASR_portable_ru_installer.zip из релизов
  2. Распакуйте в любую папку (например D:\VibeVoice)
  3. Запустите install.bat
  4. Выберите вашу видеокарту из списка
  5. Дождитесь завершения установки

Установка из исходников

  1. Клонируйте репозиторий: git clone https://github.com/timoncool/VibeVoice_ASR_portable_ru.git
  2. Запустите install.bat
  3. Выберите вашу видеокарту из списка
  4. Дождитесь завершения установки

Установщик автоматически скачает и настроит:

  • Python 3.12.8 (портативный)
  • PyTorch с поддержкой CUDA
  • FFmpeg (портативный)
  • Все необходимые зависимости
  • Flash Attention 2 (для RTX 30xx/40xx/50xx)
  • HuggingFace Xet для быстрой загрузки моделей

Запуск

  1. Запустите run.bat
  2. Приложение автоматически откроется в браузере
  3. Выберите модель и нажмите "Загрузить модель"
  4. Загрузите аудио файл или запишите с микрофона
  5. Нажмите "Распознать речь"

Модели

Полная модель (microsoft/VibeVoice-ASR)

  • Лучшее качество распознавания
  • Требует ~8GB VRAM
  • Рекомендуется для RTX 30xx и выше

4-bit модель (scerz/VibeVoice-ASR-4bit)

  • Экономит видеопамять (~4GB VRAM)
  • Немного медленнее
  • Подходит для видеокарт с меньшим объемом памяти

Поддерживаемые форматы

Благодаря встроенному FFmpeg поддерживаются все популярные форматы:

Аудио: MP3, WAV, FLAC, OGG, M4A, AAC, WMA, AIFF, и другие

Видео: MP4, MKV, AVI, MOV, WebM, и другие (извлекается аудио дорожка)

Структура папок

VibeVoice_ASR_portable_ru/
├── app.py              # Основное приложение
├── install.bat         # Установщик
├── run.bat             # Запуск приложения
├── requirements.txt    # Зависимости Python
├── vibevoice/          # Модули VibeVoice ASR
├── python/             # Портативный Python (создается при установке)
├── ffmpeg/             # Портативный FFmpeg (создается при установке)
├── models/             # Кэш моделей HuggingFace
├── output/             # Выходные файлы
├── temp/               # Временные файлы
└── cache/              # Кэш приложения

Изоляция

Приложение полностью изолировано и не создает файлы за пределами своей папки:

  • Все временные файлы в temp/
  • Все модели в models/
  • Все кэши в cache/
  • Системные переменные окружения не изменяются

Решение проблем

Ошибка "CUDA out of memory"

  • Используйте 4-bit модель
  • Закройте другие приложения, использующие GPU
  • Уменьшите параметр "Максимум токенов"

Модель загружается медленно

  • При первом запуске модель скачивается (~5GB)
  • Последующие запуски будут быстрее (модель кэшируется)

FFmpeg не найден

  • Запустите install.bat повторно
  • Или скачайте FFmpeg вручную с https://ffmpeg.org и распакуйте в папку ffmpeg/

Ошибка при распознавании

  • Проверьте формат аудио файла
  • Попробуйте конвертировать в WAV
  • Убедитесь, что аудио содержит речь

Оригинальная модель: Microsoft VibeVoice ASR

4-bit квантизация: scerz/VibeVoice-ASR-4bit

Лицензия

Данный проект распространяется под лицензией MIT. Модель VibeVoice ASR распространяется под лицензией Microsoft.

Ссылки

Другие проекты @timoncool

ПроектОписание
ACE-Step StudioAI-студия музыки — песни, вокал, каверы, клипы
Foundation Music LabГенерация музыки + редактор таймлайна
LavaSRПортативное улучшение аудио
Qwen3-TTSПортативный TTS с клонированием голоса
SuperCaption Qwen3-VLПортативное описание изображений
VideoSOSAI-видеопродакшн в браузере

Авторы

Поддержать автора

Я создаю опенсорс софт и занимаюсь исследованиями в области ИИ. Большая часть всего, что я делаю, находится в открытом доступе. Ваши пожертвования позволяют мне создавать и исследовать больше, не отвлекаясь на поиск еды для продолжения существования =)

Все способы поддержки | dalink.to/nerual_dreming | boosty.to/neuro_art

  • BTC: 1E7dHL22RpyhJGVpcvKdbyZgksSYkYeEBC
  • ETH (ERC20): 0xb5db65adf478983186d4897ba92fe2c25c594a0c
  • USDT (TRC20): TQST9Lp2TjK6FiVkn4fwfGUee7NmkxEE7C

Star History

Star History Chart
ai
asr
gradio
microsoft
offline
one-click-install
portable
python
speech-recognition
windows

timoncool/VibeVoice_ASR_portable_ru

Portable speech recognition (ASR) for Windows — Microsoft VibeVoice, one-click install, 100% offline, NVIDIA GPU.

Python

41

146 commits

updated Oct 18, 2026

See the code

README

VibeVoice ASR Portable

Портативное распознавание речи для Windows — Microsoft VibeVoice, установка в один клик, 100% офлайн.
Stars License Last Commit Downloads

Интерфейс VibeVoice ASR

VibeVoice ASR — современная модель распознавания речи от Microsoft, которая преобразует аудио в текст с высокой точностью и поддержкой диаризации спикеров. Полная русификация интерфейса.

Возможности

  • Распознавание речи в текст с высокой точностью
  • Диаризация спикеров (определение кто говорит)
  • Временные метки для каждого сегмента речи
  • Эмуляция 4-bit квантизации для экономии видеопамяти
  • Полностью русскоязычный интерфейс
  • Тёмная тема интерфейса
  • Автоматическое открытие в браузере
  • Портативность — все файлы в одной папке
  • Поддержка множества аудио и видео форматов через FFmpeg
  • Ускоренная загрузка моделей через HuggingFace Xet

Системные требования

  • Windows 10/11 (64-bit)
  • NVIDIA GPU с поддержкой CUDA (рекомендуется 8GB+ VRAM)
  • Или CPU (медленнее, но работает)
  • 16GB+ RAM
  • 10GB свободного места на диске

Рекомендуемые видеокарты

СерияCUDA версияFlash Attention 2
GTX 10xx (Pascal)CUDA 11.8Нет
RTX 20xx (Turing)CUDA 11.8Нет
RTX 30xx (Ampere)CUDA 12.6Да
RTX 40xx (Ada Lovelace)CUDA 12.8Да
RTX 50xx (Blackwell)CUDA 12.8Да

Установка

Быстрая установка (рекомендуется)

  1. Скачайте архив VibeVoice_ASR_portable_ru_installer.zip из релизов
  2. Распакуйте в любую папку (например D:\VibeVoice)
  3. Запустите install.bat
  4. Выберите вашу видеокарту из списка
  5. Дождитесь завершения установки

Установка из исходников

  1. Клонируйте репозиторий: git clone https://github.com/timoncool/VibeVoice_ASR_portable_ru.git
  2. Запустите install.bat
  3. Выберите вашу видеокарту из списка
  4. Дождитесь завершения установки

Установщик автоматически скачает и настроит:

  • Python 3.12.8 (портативный)
  • PyTorch с поддержкой CUDA
  • FFmpeg (портативный)
  • Все необходимые зависимости
  • Flash Attention 2 (для RTX 30xx/40xx/50xx)
  • HuggingFace Xet для быстрой загрузки моделей

Запуск

  1. Запустите run.bat
  2. Приложение автоматически откроется в браузере
  3. Выберите модель и нажмите "Загрузить модель"
  4. Загрузите аудио файл или запишите с микрофона
  5. Нажмите "Распознать речь"

Модели

Полная модель (microsoft/VibeVoice-ASR)

  • Лучшее качество распознавания
  • Требует ~8GB VRAM
  • Рекомендуется для RTX 30xx и выше

4-bit модель (scerz/VibeVoice-ASR-4bit)

  • Экономит видеопамять (~4GB VRAM)
  • Немного медленнее
  • Подходит для видеокарт с меньшим объемом памяти

Поддерживаемые форматы

Благодаря встроенному FFmpeg поддерживаются все популярные форматы:

Аудио: MP3, WAV, FLAC, OGG, M4A, AAC, WMA, AIFF, и другие

Видео: MP4, MKV, AVI, MOV, WebM, и другие (извлекается аудио дорожка)

Структура папок

VibeVoice_ASR_portable_ru/
├── app.py              # Основное приложение
├── install.bat         # Установщик
├── run.bat             # Запуск приложения
├── requirements.txt    # Зависимости Python
├── vibevoice/          # Модули VibeVoice ASR
├── python/             # Портативный Python (создается при установке)
├── ffmpeg/             # Портативный FFmpeg (создается при установке)
├── models/             # Кэш моделей HuggingFace
├── output/             # Выходные файлы
├── temp/               # Временные файлы
└── cache/              # Кэш приложения

Изоляция

Приложение полностью изолировано и не создает файлы за пределами своей папки:

  • Все временные файлы в temp/
  • Все модели в models/
  • Все кэши в cache/
  • Системные переменные окружения не изменяются

Решение проблем

Ошибка "CUDA out of memory"

  • Используйте 4-bit модель
  • Закройте другие приложения, использующие GPU
  • Уменьшите параметр "Максимум токенов"

Модель загружается медленно

  • При первом запуске модель скачивается (~5GB)
  • Последующие запуски будут быстрее (модель кэшируется)

FFmpeg не найден

  • Запустите install.bat повторно
  • Или скачайте FFmpeg вручную с https://ffmpeg.org и распакуйте в папку ffmpeg/

Ошибка при распознавании

  • Проверьте формат аудио файла
  • Попробуйте конвертировать в WAV
  • Убедитесь, что аудио содержит речь

Оригинальная модель: Microsoft VibeVoice ASR

4-bit квантизация: scerz/VibeVoice-ASR-4bit

Лицензия

Данный проект распространяется под лицензией MIT. Модель VibeVoice ASR распространяется под лицензией Microsoft.

Ссылки

Другие проекты @timoncool

ПроектОписание
ACE-Step StudioAI-студия музыки — песни, вокал, каверы, клипы
Foundation Music LabГенерация музыки + редактор таймлайна
LavaSRПортативное улучшение аудио
Qwen3-TTSПортативный TTS с клонированием голоса
SuperCaption Qwen3-VLПортативное описание изображений
VideoSOSAI-видеопродакшн в браузере

Авторы

Поддержать автора

Я создаю опенсорс софт и занимаюсь исследованиями в области ИИ. Большая часть всего, что я делаю, находится в открытом доступе. Ваши пожертвования позволяют мне создавать и исследовать больше, не отвлекаясь на поиск еды для продолжения существования =)

Все способы поддержки | dalink.to/nerual_dreming | boosty.to/neuro_art

  • BTC: 1E7dHL22RpyhJGVpcvKdbyZgksSYkYeEBC
  • ETH (ERC20): 0xb5db65adf478983186d4897ba92fe2c25c594a0c
  • USDT (TRC20): TQST9Lp2TjK6FiVkn4fwfGUee7NmkxEE7C

Star History

Star History Chart
ai
asr
gradio
microsoft
offline
one-click-install
portable
python
speech-recognition
windows