
Awesome Instruction Editing. Image and Media Editing with Human Instructions. Instruction-Guided Image and Media Editing.
118
2,043 commits
updated May 6, 2026
README
Awesome Instructional Editing
A Survey of Instruction-Guided Image and Media Editing in LLM Era


A collection of academic articles, published methodology, and datasets on the subject of Instruction-Guided Image and Media Editing.
- Instruction-Guided Editing Controls for Images and Multimedia: A Survey in LLM era
A sortable version is available here: https://awesome-instruction-editing.github.io/
Please read and cite our paper:

Nguyen, Thanh Tam, Zhao Ren, Trinh Pham, Phi Le Nguyen, Quoc Viet Hung Nguyen, and Hongzhi Yin. "A review of instruction-guided image editing." Engineering Applications of Artificial Intelligence 163 (2026): 112953. https://doi.org/10.1016/j.engappai.2025.112953
🔖 News!!!
📌 We are actively tracking the latest research and welcome contributions to our repository and survey paper. If your studies are relevant, please feel free to create an issue or a pull request.
📰 2026-02-28: Our website is live at https://awesome-instruction-editing.github.io/. Thanks a lot for your citations.
📰 2025-10-30: Our work has been published in Engineering Applications of Artificial Intelligence. Thanks a lot for your continuous supports.
📰 2024-11-15: Our paper Instruction-Guided Editing Controls for Images and Multimedia: A Survey in LLM era has been revised into version 1 with new methods and dicussions.
🔍 Citation
If you find this work helpful in your research, welcome to cite the paper and give a ⭐.
@article{nguyen2026review,
  title={A review of instruction-guided image editing},
  author={Nguyen, Thanh Tam and Ren, Zhao and Pham, Trinh and Le Nguyen, Phi and Nguyen, Quoc Viet Hung and Yin, Hongzhi},
  journal={Engineering Applications of Artificial Intelligence},
  volume={163},
  pages={112953},
  year={2026},
  publisher={Elsevier}
}
@article{nguyen2024instruction,
  title={Instruction-Guided Editing Controls for Images and Multimedia: A Survey in LLM era},
  author={Thanh Tam Nguyen and Zhao Ren and Trinh Pham and Thanh Trung Huynh and Phi Le Nguyen and Hongzhi Yin and Quoc Viet Hung Nguyen},
  journal={arXiv preprint arXiv:2411.09955},
  year={2024}
}
Existing Surveys
| Paper Title | Venue | Year | Focus |
|---|---|---|---|
| A Survey of Multimodal Composite Editing and Retrieval | Visual Intelligence | 2025 | Media Retrieval |
| INFOBENCH: Evaluating Instruction Following Ability in Large Language Models | arXiv | 2024 | Text Editing |
| Multimodal Image Synthesis and Editing: The Generative AI Era | TPAMI | 2023 | X-to-Image Generation |
| LLM-driven Instruction Following: Progresses and Concerns | EMNLP | 2023 | Text Editing |
Pipeline
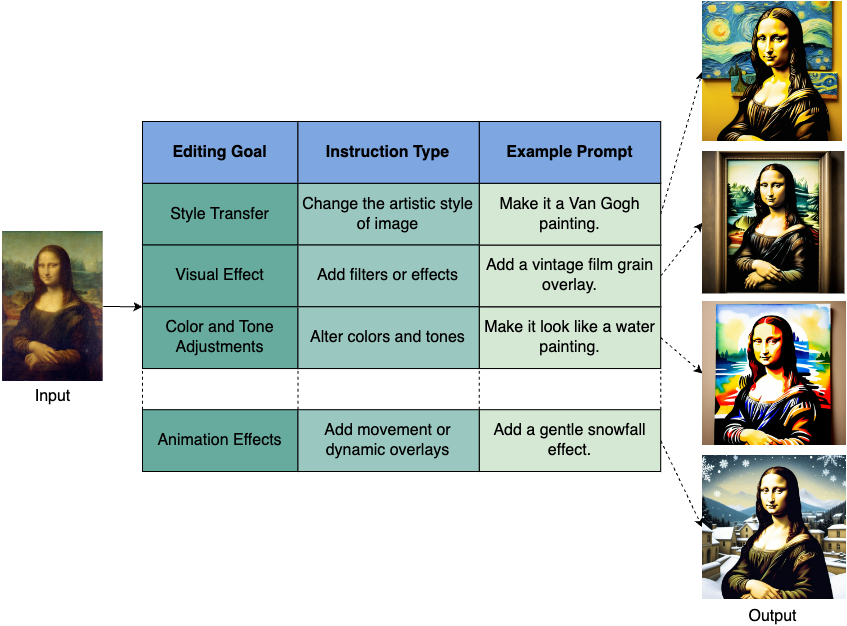
Approaches for Image Editing
Approaches for Media Editing
Datasets
Type: General
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| DIM | 14M+ | 1 | Link |
| Reason-Edit | 12.4M+ | 1 | Link |
| MagicBrush | 10K | 1 | Link |
| InstructPix2Pix | 500K | 1 | Link |
| ICE-Bench | 6.5K | 1 | Link |
| GalaxyEdit | 800K | 1 | Link |
| EditBench | 240 | 1 | Link |
Type: Image Captioning
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| Conceptual Captions | 3.3M | 1 | Link |
| CoSaL | 22K+ | 1 | Link |
| ReferIt | 19K+ | 1 | Link |
| Oxford-102 Flowers | 8K+ | 1 | Link |
| LAION-5B | 5.85B+ | 1 | Link |
| MS-COCO | 330K | 2 | Link |
| DeepFashion | 800K | 2 | Link |
| Fashion-IQ | 77K+ | 1 | Link |
| Fashion200k | 200K | 1 | Link |
| MIT-States | 63K+ | 1 | Link |
| CIRR | 36K+ | 1 | Link |
Type: ClipArt
Type: VQA
Type: Semantic Segmentation
Type: Object Classification
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| Oxford-III-Pets | 7K+ | 1 | Link |
Type: Depth Estimation
Type: Aesthetic-Based Editing
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| Laion-Aesthetics V2 | 2.4B+ | 1 | Link |
Type: Dialog-Based Editing
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| CelebA-Dialog | 202K+ | 1 | Link |
| Flickr-Faces-HQ | 70K | 2 | Link |
Evaluation Metrics
| Title | Year | Venue | Category | Code |
|---|---|---|---|---|
| SST-EM: Advanced Metrics for Evaluating Semantic, Spatial and Temporal Aspects in Video Editing | 2025 | WACV Workshop | video editing evaluation metrics | Code |
| Category | Evaluation Metrics | Formula | Usage |
|---|---|---|---|
| Perceptual Quality | Learned Perceptual Image Patch Similarity (LPIPS) | $\text{LPIPS}(x, x') = \sum_l ||\phi_l(x) - \phi_l(x')||^2$ | Measures perceptual similarity between images, with lower scores indicating higher similarity. |
| Structural Similarity Index (SSIM) | $\text{SSIM}(x, x') = \frac{(2\mu_x\mu_{x'} + C_1)(2\sigma_{xx'} + C_2)}{(\mu_x^2 + \mu_{x'}^2 + C_1)(\sigma_x^2 + \sigma_{x'}^2 + C_2)}$ | Measures visual similarity based on luminance, contrast, and structure. | |
| Fréchet Inception Distance (FID) | $\text{FID} = ||\mu_r - \mu_g||^2 + \text{Tr}(\Sigma_r + \Sigma_g - 2(\Sigma_r \Sigma_g)^{1/2})$ | Measures the distance between the real and generated image feature distributions. | |
| Inception Score (IS) | $\text{IS} = \exp(E_x D_{KL}(p(y|x) || p(y)))$ | Evaluates image quality and diversity based on label distribution consistency. | |
| Structural Integrity | Peak Signal-to-Noise Ratio (PSNR) | $\text{PSNR} = 10 \log_{10} \left( \frac{\text{MAX}^2}{\text{MSE}} \right)$ | Measures image quality based on pixel-wise errors, with higher values indicating better quality. |
| Mean Intersection over Union (mIoU) | $\text{mIoU} = \frac{1}{N} \sum_{i=1}^{N} \frac{|A_i \cap B_i|}{|A_i \cup B_i|}$ | Assesses segmentation accuracy by comparing predicted and ground truth masks. | |
| Mask Accuracy | $\text{Accuracy} = \frac{\text{TP} + \text{TN}}{\text{TP} + \text{FP} + \text{FN} + \text{TN}}$ | Evaluates the accuracy of generated masks. | |
| Boundary Adherence | $\text{BA} = \frac{|B_{\text{edit}} \cap B_{\text{target}}|}{|B_{\text{target}}|}$ | Measures how well edits preserve object boundaries. | |
| Semantic Alignment | Edit Consistency | $\text{EC} = \frac{1}{N} \sum_{i=1}^{N} 1{E_i = E_{\text{ref}}}$ | Measures the consistency of edits across similar prompts. |
| Target Grounding Accuracy | $\text{TGA} = \frac{\text{Correct Targets}}{\text{Total Targets}}$ | Evaluates how well edits align with specified targets in the prompt. | |
| Embedding Space Similarity | $\text{CosSim}(v_x, v_{x'}) = \frac{v_x \cdot v_{x'}}{||v_x|| , ||v_{x'}||}$ | Measures similarity between the edited and reference images in feature space. | |
| Decomposed Requirements Following Ratio (DRFR) | $\text{DRFR} = \frac{1}{N} \sum_{i=1}^{N} \frac{\text{Requirements Followed}}{\text{Total Requirements}}$ | Assesses how closely the model follows decomposed instructions. | |
| User-Based Metrics | User Study Ratings | Captures user feedback through ratings of image quality. | |
| Human Visual Turing Test (HVTT) | $\text{HVTT} = \frac{\text{Real Judgements}}{\text{Total Judgements}}$ | Measures the ability of users to distinguish between real and generated images. | |
| Click-through Rate (CTR) | $\text{CTR} = \frac{\text{Clicks}}{\text{Total Impressions}}$ | Tracks user engagement by measuring image clicks. | |
| Diversity and Fidelity | Edit Diversity | $\text{Diversity} = \frac{1}{N} \sum_{i=1}^{N} D_{KL}(p_i || p_{\text{mean}})$ | Measures the variability of generated images. |
| GAN Discriminator Score | $\text{GDS} = \frac{1}{N} \sum_{i=1}^N D_{\text{GAN}}(x_i)$ | Assesses the authenticity of generated images using a GAN discriminator. | |
| Reconstruction Error | $\text{RE} = ||x - \hat{x}||$ | Measures the error between the original and generated images. | |
| Edit Success Rate | $\text{ESR} = \frac{\text{Successful Edits}}{\text{Total Edits}}$ | Quantifies the success of applied edits. | |
| Consistency and Cohesion | Scene Consistency | $\text{SC} = \frac{1}{N} \sum_{i=1}^{N} \text{Sim}(I_{\text{edit}}, I_{\text{orig}})$ | Measures how edits maintain overall scene structure. |
| Color Consistency | $\text{CC} = \frac{1}{N} \sum_{i=1}^{N} \frac{|C_{\text{edit}} \cap C_{\text{orig}}|}{|C_{\text{orig}}|}$ | Measures color preservation between edited and original regions. | |
| Shape Consistency | $\text{ShapeSim} = \frac{1}{N} \sum_{i=1}^{N} \text{IoU}(S_{\text{edit}}, S_{\text{orig}})$ | Quantifies how well shapes are preserved during edits. | |
| Pose Matching Score | $\text{PMS} = \frac{1}{N} \sum_{i=1}^{N} \text{Sim}(\theta_{\text{edit}}, \theta_{\text{orig}})$ | Assesses pose consistency between original and edited images. | |
| Robustness | Noise Robustness | $\text{NR} = \frac{1}{N} \sum_{i=1}^{N} ||x_i - x_{i,\text{noisy}}||$ | Evaluates model robustness to noise. |
| Perceptual Quality | $\text{PQ} = \frac{1}{N} \sum_{i=1}^{N} \text{Score}(x_i)$ | A subjective quality metric based on human judgment. |
Benchmark Results
| Benchmark Dataset | CLIP↑ | FID↓ | LPIPS↓ | PSNR↑ | MSE×104↓ | SSIM/SSIM-M (edit)↑ |
|---|---|---|---|---|---|---|
| Reason-Edit | SwiftEdit (68.52%) FramePainter (67.21%) EmuEdit (63.14%) | MasaCtrl (98.71%) DiffEdit (115.32%) Fairy (150.22%) | EmuEdit (1.21%) StyleCLIP (1.45%) InstructPix2Pix (9.80%) | GLIDE (25.53%) SwiftEdit (23.81%) Video-P2P (20.09%) | GANTASTIC (65.4%) GLIDE (80.1%) DiffEdit (160.9%) | Fairy (83.14%) MasaCtrl (81.55%) FramePainter (75.21%) |
| MagicBrush | GLIDE (26.51%) StyleCLIP (25.83%) TediGAN (24.92%) | SwiftEdit (21.49%) InstructPix2Pix (42.15%) DiffEdit (152.01%) | FramePainter (0.35%) GANTASTIC (0.41%) FramePainter (48.23%) | MasaCtrl (29.81%) Fairy (29.14%) EmuEdit (23.11%) | TediGAN (6.01%) MasaCtrl (25.5%) StyleCLIP (33.0%) | DiffEdit (87.23%) SwiftEdit (86.52%) InstructPix2Pix (81.11%) |
| EditBench | InstructPix2Pix (78.21%) Video-P2P (77.10%) GLIDE (75.03%) | TediGAN (6.92%) SwiftEdit (7.07%) EmuEdit (8.51%) | GLIDE (0.51%) DiffEdit (0.53%) FramePainter (0.61%) | MasaCtrl (26.83%) InstructPix2Pix (26.17%) SwiftEdit (25.12%) | Fairy (150.1%) GANTASTIC (156.2%) StyleCLIP (165.8%) | EmuEdit (87.51%) TediGAN (86.20%) Video-P2P (84.32%) |
| Flickr-Faces-HQ | DiffEdit (87.51%) TediGAN (86.90%) GLIDE (85.23%) | Video-P2P (17.53%) SwiftEdit (18.10%) StyleCLIP (19.82%) | MasaCtrl (0.070%) FramePainter (0.073%) GANTASTIC (0.081%) | GLIDE (20.14%) DiffEdit (19.46%) TediGAN (18.91%) | EmuEdit (230.1%) Fairy (238.3%) SwiftEdit (245.7%) | GANTASTIC (81.53%) MasaCtrl (80.33%) InstructPix2Pix (78.91%) |
| Fashion200k | StyleCLIP (82.14%) EmuEdit (81.59%) FramePainter (80.41%) | SwiftEdit (150.11%) Fairy (152.70%) TediGAN (158.33%) | FramePainter (26.92%) DiffEdit (27.50%) Video-P2P (28.41%) | InstructPix2Pix (26.34%) SwiftEdit (25.89%) EmuEdit (25.11%) | Video-P2P (280.5%) StyleCLIP (286.0%) GLIDE (291.3%) | TediGAN (76.21%) GANTASTIC (74.97%) Fairy (73.84%) |
| ReferIt | EmuEdit (43.51%) TediGAN (42.90%) StyleCLIP (41.83%) | InstructPix2Pix (45.13%) FramePainter (46.40%) DiffEdit (48.91%) | StyleCLIP (0.090%) GANTASTIC (0.095%) SwiftEdit (0.105%) | Video-P2P (19.94%) MasaCtrl (19.13%) Fairy (18.51%) | DiffEdit (81.2%) EmuEdit (84.0%) TediGAN (89.6%) | SwiftEdit (83.41%) InstructPix2Pix (82.11%) GANTASTIC (80.92%) |
| Fashion-IQ | FramePainter (84.03%) Video-P2P (83.10%) GANTASTIC (82.51%) | GANTASTIC (68.24%) TediGAN (69.60%) StyleCLIP (72.43%) | MasaCtrl (9.81%) InstructPix2Pix (10.03%) Fairy (10.52%) | EmuEdit (21.52%) FramePainter (20.99%) TediGAN (20.31%) | Fairy (260.1%) GLIDE (268.3%) Video-P2P (275.4%) | StyleCLIP (83.04%) MasaCtrl (82.26%) DiffEdit (81.63%) |
| MIT-States | GLIDE (43.12%) EmuEdit (42.00%) TediGAN (40.91%) | Fairy (128.91%) FramePainter (130.30%) Video-P2P (135.62%) | SwiftEdit (0.170%) DiffEdit (0.179%) EmuEdit (0.191%) | InstructPix2Pix (20.24%) StyleCLIP (19.83%) Fairy (19.21%) | MasaCtrl (109.8%) GLIDE (112.4%) GANTASTIC (118.3%) | Video-P2P (87.12%) SwiftEdit (86.40%) DiffEdit (85.53%) |
| ADE20K | FramePainter (60.23%) MasaCtrl (59.50%) Video-P2P (58.31%) | Video-P2P (8.11%) GANTASTIC (8.30%) InstructPix2Piz (9.13%) | TediGAN (39.82%) DiffEdit (40.11%) MasaCtrl (41.53%) | SwiftEdit (27.13%) FramePainter (26.69%) Fairy (26.04%) | StyleCLIP (68.5%) EmuEdit (70.3%) DiffEdit (74.8%) | InstructPix2Pix (75.92%) TediGAN (74.80%) GLIDE (73.54%) |
| DeepFashion | TediGAN (42.51%) Video-P2P (41.60%) InstructPix2Pix (40.73%) | EmuEdit (174.31%) SwiftEdit (176.10%) Fairy (179.82%) | InstructPix2Pix (0.161%) FramePainter (0.165%) GANTASTIC (0.172%) | GANTASTIC (18.52%) TediGAN (18.00%) GLIDE (17.61%) | Fairy (265.4%) MasaCtrl (270.0%) Video-P2P (276.9%) | MasaCtrl (82.53%) DiffEdit (81.71%) SwiftEdit (80.92%) |
Notes:
- Scaling caveats: iEdit reports CLIPScore (%) and SSIM-M (% on edited/background regions). PIE-Bench reports “CLIP Semantics” (whole/edited) as un-normalized cosine-like scores (~20–26). LOCATEdit shows SSIM as ×10² and LPIPS unscaled (values ~39–42). Forgedit’s CLIPScore is cosine (0–1).
- [a] RegionDrag reports LPIPS×100; we divide by 100 (thus 9.9→0.099, 9.2→0.092).
Experiment Configuration
pip install --upgrade diffusers transformers accelerate safetensors torch torchvision
import torch, PIL.Image as Image
from diffusers import (
    StableDiffusionInstructPix2PixPipeline,
    StableDiffusionDiffEditPipeline,
    PaintByExamplePipeline,
    DDIMScheduler, DDIMInverseScheduler,
)

DEVICE = "cuda" if torch.cuda.is_available() else "cpu"

# 1) InstructPix2Pix — text-guided global/local edits
def run_ip2p(input_path, instruction, out_path="out_ip2p.png", steps=30):
    pipe = StableDiffusionInstructPix2PixPipeline.from_pretrained(
        "timbrooks/instruct-pix2pix", torch_dtype=torch.float16 if DEVICE=="cuda" else torch.float32
    ).to(DEVICE)
    image = Image.open(input_path).convert("RGB")
    result = pipe(prompt=instruction, image=image,
                  num_inference_steps=steps, guidance_scale=7.5, image_guidance_scale=1.5).images[0]
    result.save(out_path); return out_path

# 2) DiffEdit — automatic mask + latent inversion for targeted edits
def run_diffedit(input_path, source_prompt, target_prompt, out_path="out_diffedit.png", steps=50):
    init_img = Image.open(input_path).convert("RGB")
    pipe = StableDiffusionDiffEditPipeline.from_pretrained(
        "runwayml/stable-diffusion-v1-5",
        torch_dtype=torch.float16 if DEVICE=="cuda" else torch.float32
    ).to(DEVICE)
    pipe.scheduler = DDIMScheduler.from_config(pipe.scheduler.config)
    pipe.inverse_scheduler = DDIMInverseScheduler.from_config(pipe.scheduler.config)

    mask = pipe.generate_mask(image=init_img, source_prompt=source_prompt, target_prompt=target_prompt,
                              num_inference_steps=steps)[0]
    inv = pipe.invert(prompt=source_prompt, image=init_img, num_inference_steps=steps)
    edited = pipe(prompt=target_prompt, negative_prompt=source_prompt,
                  image=init_img, mask_image=mask, latents=inv.latents,
                  num_inference_steps=steps).images[0]
    edited.save(out_path); return out_path

# 3) Paint-by-Example — exemplar-guided local replacement
def run_pbe(input_path, mask_path, example_path, out_path="out_pbe.png", steps=50):
    pipe = PaintByExamplePipeline.from_pretrained(
        "Fantasy-Studio/Paint-by-Example",
        torch_dtype=torch.float16 if DEVICE=="cuda" else torch.float32
    ).to(DEVICE)
    image = Image.open(input_path).convert("RGB")
    mask  = Image.open(mask_path).convert("L")         # white = repaint
    ex    = Image.open(example_path).convert("RGB")
    edited = pipe(image=image, mask_image=mask, example_image=ex,
                  num_inference_steps=steps, guidance_scale=5.0).images[0]
    edited.save(out_path); return out_path

# Example usage (where input.jpg, fruit.jpg, etc. are your input data)
run_ip2p("input.jpg", "make the sky pink at sunset")
run_diffedit("fruit.jpg", "a bowl of apples", "a bowl of pears")
run_pbe("room.jpg", "room_mask.png", "new_chair.jpg")
Repo-based Configuration
Add-it (training-free insertion)
Click to open
git clone https://github.com/NVlabs/addit && cd addit
conda env create -f environment.yml && conda activate addit
# real image insertion:
python run_CLI_addit_real.py \
  --source_image "images/bed_dark_room.jpg" \
  --prompt_source "A photo of a bed in a dark room" \
  --prompt_target "A photo of a dog lying on a bed in a dark room" \
  --subject_token "dog"
FreeEdit (mask-free, reference-based)
Click to open
git clone https://github.com/hrz2000/FreeEdit && cd FreeEdit
pip install -r requirements.txt
# check README / demo notebook for single-command inference
Grounded-Instruct-Pix2Pix (auto target grounding)
Click to open
git clone https://github.com/arthur-71/Grounded-Instruct-Pix2Pix && cd Grounded-Instruct-Pix2Pix
pip install -r requirements.txt && python -m spacy download en_core_web_sm
# install GroundingDINO (per README), then open the provided notebook:
# jupyter notebook grounded-instruct-pix2pix.ipynb
RegionDrag (fast region edits/UI)
Click to open
git clone https://github.com/Visual-AI/RegionDrag && cd RegionDrag
pip install -r requirements.txt
# see UI_GUIDE.md for the GUI runner; a minimal script is included in the repo
ZONE (localized editing)
Click to open
git clone https://github.com/lsl001006/ZONE && cd ZONE
pip install -r requirements.txt
python demo.py --input your.jpg --prompt "make the mug red" --mask path/to/mask.png
D-Edit (freestyle mask-conditioned)
Click to open
git clone https://github.com/collovlab/d-edit && cd d-edit
pip install -r requirements.txt
python app.py --input your.jpg --mask mask.png --prompt "replace the sofa with a blue one"
Pix2Pix-Zero / On-the-Fly (training-free, edit direction)
Click to open
git clone https://github.com/pix2pixzero/pix2pix-zero && cd pix2pix-zero
pip install -r requirements.txt
# see README + HF demo link for quick usage
Eedit the synthetic images generated by Stable Diffusion with the following command.
python src/edit_synthetic.py \
    --results_folder "output/synth_editing" \
    --prompt_str "a high resolution painting of a cat in the style of van gogh" \
    --task "cat2dog"
Disclaimer
Feel free to contact us if you have any queries or exciting news. In addition, we welcome all researchers to contribute to this repository and further contribute to the knowledge of this field.
If you have some other related references, please feel free to create a Github issue with the paper information. We will glady update the repos according to your suggestions. (You can also create pull requests, but it might take some time for us to do the merge)
Backup Statistics


Contributors


Similar repos


Awesome Instruction Editing. Image and Media Editing with Human Instructions. Instruction-Guided Image and Media Editing.
118
2,043 commits
updated May 6, 2026
README
Awesome Instructional Editing
A Survey of Instruction-Guided Image and Media Editing in LLM Era
A collection of academic articles, published methodology, and datasets on the subject of Instruction-Guided Image and Media Editing.
- Instruction-Guided Editing Controls for Images and Multimedia: A Survey in LLM era
A sortable version is available here: https://awesome-instruction-editing.github.io/
Please read and cite our paper:
Nguyen, Thanh Tam, Zhao Ren, Trinh Pham, Phi Le Nguyen, Quoc Viet Hung Nguyen, and Hongzhi Yin. "A review of instruction-guided image editing." Engineering Applications of Artificial Intelligence 163 (2026): 112953. https://doi.org/10.1016/j.engappai.2025.112953
🔖 News!!!
📌 We are actively tracking the latest research and welcome contributions to our repository and survey paper. If your studies are relevant, please feel free to create an issue or a pull request.
📰 2026-02-28: Our website is live at https://awesome-instruction-editing.github.io/. Thanks a lot for your citations.
📰 2025-10-30: Our work has been published in Engineering Applications of Artificial Intelligence. Thanks a lot for your continuous supports.
📰 2024-11-15: Our paper Instruction-Guided Editing Controls for Images and Multimedia: A Survey in LLM era has been revised into version 1 with new methods and dicussions.
🔍 Citation
If you find this work helpful in your research, welcome to cite the paper and give a ⭐.
@article{nguyen2026review,
  title={A review of instruction-guided image editing},
  author={Nguyen, Thanh Tam and Ren, Zhao and Pham, Trinh and Le Nguyen, Phi and Nguyen, Quoc Viet Hung and Yin, Hongzhi},
  journal={Engineering Applications of Artificial Intelligence},
  volume={163},
  pages={112953},
  year={2026},
  publisher={Elsevier}
}
@article{nguyen2024instruction,
  title={Instruction-Guided Editing Controls for Images and Multimedia: A Survey in LLM era},
  author={Thanh Tam Nguyen and Zhao Ren and Trinh Pham and Thanh Trung Huynh and Phi Le Nguyen and Hongzhi Yin and Quoc Viet Hung Nguyen},
  journal={arXiv preprint arXiv:2411.09955},
  year={2024}
}
Existing Surveys
| Paper Title | Venue | Year | Focus |
|---|---|---|---|
| A Survey of Multimodal Composite Editing and Retrieval | Visual Intelligence | 2025 | Media Retrieval |
| INFOBENCH: Evaluating Instruction Following Ability in Large Language Models | arXiv | 2024 | Text Editing |
| Multimodal Image Synthesis and Editing: The Generative AI Era | TPAMI | 2023 | X-to-Image Generation |
| LLM-driven Instruction Following: Progresses and Concerns | EMNLP | 2023 | Text Editing |
Pipeline
Approaches for Image Editing
Approaches for Media Editing
Datasets
Type: General
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| DIM | 14M+ | 1 | Link |
| Reason-Edit | 12.4M+ | 1 | Link |
| MagicBrush | 10K | 1 | Link |
| InstructPix2Pix | 500K | 1 | Link |
| ICE-Bench | 6.5K | 1 | Link |
| GalaxyEdit | 800K | 1 | Link |
| EditBench | 240 | 1 | Link |
Type: Image Captioning
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| Conceptual Captions | 3.3M | 1 | Link |
| CoSaL | 22K+ | 1 | Link |
| ReferIt | 19K+ | 1 | Link |
| Oxford-102 Flowers | 8K+ | 1 | Link |
| LAION-5B | 5.85B+ | 1 | Link |
| MS-COCO | 330K | 2 | Link |
| DeepFashion | 800K | 2 | Link |
| Fashion-IQ | 77K+ | 1 | Link |
| Fashion200k | 200K | 1 | Link |
| MIT-States | 63K+ | 1 | Link |
| CIRR | 36K+ | 1 | Link |
Type: ClipArt
Type: VQA
Type: Semantic Segmentation
Type: Object Classification
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| Oxford-III-Pets | 7K+ | 1 | Link |
Type: Depth Estimation
Type: Aesthetic-Based Editing
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| Laion-Aesthetics V2 | 2.4B+ | 1 | Link |
Type: Dialog-Based Editing
| Dataset | #Items | #Papers Used | Link |
|---|---|---|---|
| CelebA-Dialog | 202K+ | 1 | Link |
| Flickr-Faces-HQ | 70K | 2 | Link |
Evaluation Metrics
| Title | Year | Venue | Category | Code |
|---|---|---|---|---|
| SST-EM: Advanced Metrics for Evaluating Semantic, Spatial and Temporal Aspects in Video Editing | 2025 | WACV Workshop | video editing evaluation metrics | Code |
| Category | Evaluation Metrics | Formula | Usage |
|---|---|---|---|
| Perceptual Quality | Learned Perceptual Image Patch Similarity (LPIPS) | $\text{LPIPS}(x, x') = \sum_l ||\phi_l(x) - \phi_l(x')||^2$ | Measures perceptual similarity between images, with lower scores indicating higher similarity. |
| Structural Similarity Index (SSIM) | $\text{SSIM}(x, x') = \frac{(2\mu_x\mu_{x'} + C_1)(2\sigma_{xx'} + C_2)}{(\mu_x^2 + \mu_{x'}^2 + C_1)(\sigma_x^2 + \sigma_{x'}^2 + C_2)}$ | Measures visual similarity based on luminance, contrast, and structure. | |
| Fréchet Inception Distance (FID) | $\text{FID} = ||\mu_r - \mu_g||^2 + \text{Tr}(\Sigma_r + \Sigma_g - 2(\Sigma_r \Sigma_g)^{1/2})$ | Measures the distance between the real and generated image feature distributions. | |
| Inception Score (IS) | $\text{IS} = \exp(E_x D_{KL}(p(y|x) || p(y)))$ | Evaluates image quality and diversity based on label distribution consistency. | |
| Structural Integrity | Peak Signal-to-Noise Ratio (PSNR) | $\text{PSNR} = 10 \log_{10} \left( \frac{\text{MAX}^2}{\text{MSE}} \right)$ | Measures image quality based on pixel-wise errors, with higher values indicating better quality. |
| Mean Intersection over Union (mIoU) | $\text{mIoU} = \frac{1}{N} \sum_{i=1}^{N} \frac{|A_i \cap B_i|}{|A_i \cup B_i|}$ | Assesses segmentation accuracy by comparing predicted and ground truth masks. | |
| Mask Accuracy | $\text{Accuracy} = \frac{\text{TP} + \text{TN}}{\text{TP} + \text{FP} + \text{FN} + \text{TN}}$ | Evaluates the accuracy of generated masks. | |
| Boundary Adherence | $\text{BA} = \frac{|B_{\text{edit}} \cap B_{\text{target}}|}{|B_{\text{target}}|}$ | Measures how well edits preserve object boundaries. | |
| Semantic Alignment | Edit Consistency | $\text{EC} = \frac{1}{N} \sum_{i=1}^{N} 1{E_i = E_{\text{ref}}}$ | Measures the consistency of edits across similar prompts. |
| Target Grounding Accuracy | $\text{TGA} = \frac{\text{Correct Targets}}{\text{Total Targets}}$ | Evaluates how well edits align with specified targets in the prompt. | |
| Embedding Space Similarity | $\text{CosSim}(v_x, v_{x'}) = \frac{v_x \cdot v_{x'}}{||v_x|| , ||v_{x'}||}$ | Measures similarity between the edited and reference images in feature space. | |
| Decomposed Requirements Following Ratio (DRFR) | $\text{DRFR} = \frac{1}{N} \sum_{i=1}^{N} \frac{\text{Requirements Followed}}{\text{Total Requirements}}$ | Assesses how closely the model follows decomposed instructions. | |
| User-Based Metrics | User Study Ratings | Captures user feedback through ratings of image quality. | |
| Human Visual Turing Test (HVTT) | $\text{HVTT} = \frac{\text{Real Judgements}}{\text{Total Judgements}}$ | Measures the ability of users to distinguish between real and generated images. | |
| Click-through Rate (CTR) | $\text{CTR} = \frac{\text{Clicks}}{\text{Total Impressions}}$ | Tracks user engagement by measuring image clicks. | |
| Diversity and Fidelity | Edit Diversity | $\text{Diversity} = \frac{1}{N} \sum_{i=1}^{N} D_{KL}(p_i || p_{\text{mean}})$ | Measures the variability of generated images. |
| GAN Discriminator Score | $\text{GDS} = \frac{1}{N} \sum_{i=1}^N D_{\text{GAN}}(x_i)$ | Assesses the authenticity of generated images using a GAN discriminator. | |
| Reconstruction Error | $\text{RE} = ||x - \hat{x}||$ | Measures the error between the original and generated images. | |
| Edit Success Rate | $\text{ESR} = \frac{\text{Successful Edits}}{\text{Total Edits}}$ | Quantifies the success of applied edits. | |
| Consistency and Cohesion | Scene Consistency | $\text{SC} = \frac{1}{N} \sum_{i=1}^{N} \text{Sim}(I_{\text{edit}}, I_{\text{orig}})$ | Measures how edits maintain overall scene structure. |
| Color Consistency | $\text{CC} = \frac{1}{N} \sum_{i=1}^{N} \frac{|C_{\text{edit}} \cap C_{\text{orig}}|}{|C_{\text{orig}}|}$ | Measures color preservation between edited and original regions. | |
| Shape Consistency | $\text{ShapeSim} = \frac{1}{N} \sum_{i=1}^{N} \text{IoU}(S_{\text{edit}}, S_{\text{orig}})$ | Quantifies how well shapes are preserved during edits. | |
| Pose Matching Score | $\text{PMS} = \frac{1}{N} \sum_{i=1}^{N} \text{Sim}(\theta_{\text{edit}}, \theta_{\text{orig}})$ | Assesses pose consistency between original and edited images. | |
| Robustness | Noise Robustness | $\text{NR} = \frac{1}{N} \sum_{i=1}^{N} ||x_i - x_{i,\text{noisy}}||$ | Evaluates model robustness to noise. |
| Perceptual Quality | $\text{PQ} = \frac{1}{N} \sum_{i=1}^{N} \text{Score}(x_i)$ | A subjective quality metric based on human judgment. |
Benchmark Results
| Benchmark Dataset | CLIP↑ | FID↓ | LPIPS↓ | PSNR↑ | MSE×104↓ | SSIM/SSIM-M (edit)↑ |
|---|---|---|---|---|---|---|
| Reason-Edit | SwiftEdit (68.52%) FramePainter (67.21%) EmuEdit (63.14%) | MasaCtrl (98.71%) DiffEdit (115.32%) Fairy (150.22%) | EmuEdit (1.21%) StyleCLIP (1.45%) InstructPix2Pix (9.80%) | GLIDE (25.53%) SwiftEdit (23.81%) Video-P2P (20.09%) | GANTASTIC (65.4%) GLIDE (80.1%) DiffEdit (160.9%) | Fairy (83.14%) MasaCtrl (81.55%) FramePainter (75.21%) |
| MagicBrush | GLIDE (26.51%) StyleCLIP (25.83%) TediGAN (24.92%) | SwiftEdit (21.49%) InstructPix2Pix (42.15%) DiffEdit (152.01%) | FramePainter (0.35%) GANTASTIC (0.41%) FramePainter (48.23%) | MasaCtrl (29.81%) Fairy (29.14%) EmuEdit (23.11%) | TediGAN (6.01%) MasaCtrl (25.5%) StyleCLIP (33.0%) | DiffEdit (87.23%) SwiftEdit (86.52%) InstructPix2Pix (81.11%) |
| EditBench | InstructPix2Pix (78.21%) Video-P2P (77.10%) GLIDE (75.03%) | TediGAN (6.92%) SwiftEdit (7.07%) EmuEdit (8.51%) | GLIDE (0.51%) DiffEdit (0.53%) FramePainter (0.61%) | MasaCtrl (26.83%) InstructPix2Pix (26.17%) SwiftEdit (25.12%) | Fairy (150.1%) GANTASTIC (156.2%) StyleCLIP (165.8%) | EmuEdit (87.51%) TediGAN (86.20%) Video-P2P (84.32%) |
| Flickr-Faces-HQ | DiffEdit (87.51%) TediGAN (86.90%) GLIDE (85.23%) | Video-P2P (17.53%) SwiftEdit (18.10%) StyleCLIP (19.82%) | MasaCtrl (0.070%) FramePainter (0.073%) GANTASTIC (0.081%) | GLIDE (20.14%) DiffEdit (19.46%) TediGAN (18.91%) | EmuEdit (230.1%) Fairy (238.3%) SwiftEdit (245.7%) | GANTASTIC (81.53%) MasaCtrl (80.33%) InstructPix2Pix (78.91%) |
| Fashion200k | StyleCLIP (82.14%) EmuEdit (81.59%) FramePainter (80.41%) | SwiftEdit (150.11%) Fairy (152.70%) TediGAN (158.33%) | FramePainter (26.92%) DiffEdit (27.50%) Video-P2P (28.41%) | InstructPix2Pix (26.34%) SwiftEdit (25.89%) EmuEdit (25.11%) | Video-P2P (280.5%) StyleCLIP (286.0%) GLIDE (291.3%) | TediGAN (76.21%) GANTASTIC (74.97%) Fairy (73.84%) |
| ReferIt | EmuEdit (43.51%) TediGAN (42.90%) StyleCLIP (41.83%) | InstructPix2Pix (45.13%) FramePainter (46.40%) DiffEdit (48.91%) | StyleCLIP (0.090%) GANTASTIC (0.095%) SwiftEdit (0.105%) | Video-P2P (19.94%) MasaCtrl (19.13%) Fairy (18.51%) | DiffEdit (81.2%) EmuEdit (84.0%) TediGAN (89.6%) | SwiftEdit (83.41%) InstructPix2Pix (82.11%) GANTASTIC (80.92%) |
| Fashion-IQ | FramePainter (84.03%) Video-P2P (83.10%) GANTASTIC (82.51%) | GANTASTIC (68.24%) TediGAN (69.60%) StyleCLIP (72.43%) | MasaCtrl (9.81%) InstructPix2Pix (10.03%) Fairy (10.52%) | EmuEdit (21.52%) FramePainter (20.99%) TediGAN (20.31%) | Fairy (260.1%) GLIDE (268.3%) Video-P2P (275.4%) | StyleCLIP (83.04%) MasaCtrl (82.26%) DiffEdit (81.63%) |
| MIT-States | GLIDE (43.12%) EmuEdit (42.00%) TediGAN (40.91%) | Fairy (128.91%) FramePainter (130.30%) Video-P2P (135.62%) | SwiftEdit (0.170%) DiffEdit (0.179%) EmuEdit (0.191%) | InstructPix2Pix (20.24%) StyleCLIP (19.83%) Fairy (19.21%) | MasaCtrl (109.8%) GLIDE (112.4%) GANTASTIC (118.3%) | Video-P2P (87.12%) SwiftEdit (86.40%) DiffEdit (85.53%) |
| ADE20K | FramePainter (60.23%) MasaCtrl (59.50%) Video-P2P (58.31%) | Video-P2P (8.11%) GANTASTIC (8.30%) InstructPix2Piz (9.13%) | TediGAN (39.82%) DiffEdit (40.11%) MasaCtrl (41.53%) | SwiftEdit (27.13%) FramePainter (26.69%) Fairy (26.04%) | StyleCLIP (68.5%) EmuEdit (70.3%) DiffEdit (74.8%) | InstructPix2Pix (75.92%) TediGAN (74.80%) GLIDE (73.54%) |
| DeepFashion | TediGAN (42.51%) Video-P2P (41.60%) InstructPix2Pix (40.73%) | EmuEdit (174.31%) SwiftEdit (176.10%) Fairy (179.82%) | InstructPix2Pix (0.161%) FramePainter (0.165%) GANTASTIC (0.172%) | GANTASTIC (18.52%) TediGAN (18.00%) GLIDE (17.61%) | Fairy (265.4%) MasaCtrl (270.0%) Video-P2P (276.9%) | MasaCtrl (82.53%) DiffEdit (81.71%) SwiftEdit (80.92%) |
Notes:
- Scaling caveats: iEdit reports CLIPScore (%) and SSIM-M (% on edited/background regions). PIE-Bench reports “CLIP Semantics” (whole/edited) as un-normalized cosine-like scores (~20–26). LOCATEdit shows SSIM as ×10² and LPIPS unscaled (values ~39–42). Forgedit’s CLIPScore is cosine (0–1).
- [a] RegionDrag reports LPIPS×100; we divide by 100 (thus 9.9→0.099, 9.2→0.092).
Experiment Configuration
pip install --upgrade diffusers transformers accelerate safetensors torch torchvision
import torch, PIL.Image as Image
from diffusers import (
    StableDiffusionInstructPix2PixPipeline,
    StableDiffusionDiffEditPipeline,
    PaintByExamplePipeline,
    DDIMScheduler, DDIMInverseScheduler,
)

DEVICE = "cuda" if torch.cuda.is_available() else "cpu"

# 1) InstructPix2Pix — text-guided global/local edits
def run_ip2p(input_path, instruction, out_path="out_ip2p.png", steps=30):
    pipe = StableDiffusionInstructPix2PixPipeline.from_pretrained(
        "timbrooks/instruct-pix2pix", torch_dtype=torch.float16 if DEVICE=="cuda" else torch.float32
    ).to(DEVICE)
    image = Image.open(input_path).convert("RGB")
    result = pipe(prompt=instruction, image=image,
                  num_inference_steps=steps, guidance_scale=7.5, image_guidance_scale=1.5).images[0]
    result.save(out_path); return out_path

# 2) DiffEdit — automatic mask + latent inversion for targeted edits
def run_diffedit(input_path, source_prompt, target_prompt, out_path="out_diffedit.png", steps=50):
    init_img = Image.open(input_path).convert("RGB")
    pipe = StableDiffusionDiffEditPipeline.from_pretrained(
        "runwayml/stable-diffusion-v1-5",
        torch_dtype=torch.float16 if DEVICE=="cuda" else torch.float32
    ).to(DEVICE)
    pipe.scheduler = DDIMScheduler.from_config(pipe.scheduler.config)
    pipe.inverse_scheduler = DDIMInverseScheduler.from_config(pipe.scheduler.config)

    mask = pipe.generate_mask(image=init_img, source_prompt=source_prompt, target_prompt=target_prompt,
                              num_inference_steps=steps)[0]
    inv = pipe.invert(prompt=source_prompt, image=init_img, num_inference_steps=steps)
    edited = pipe(prompt=target_prompt, negative_prompt=source_prompt,
                  image=init_img, mask_image=mask, latents=inv.latents,
                  num_inference_steps=steps).images[0]
    edited.save(out_path); return out_path

# 3) Paint-by-Example — exemplar-guided local replacement
def run_pbe(input_path, mask_path, example_path, out_path="out_pbe.png", steps=50):
    pipe = PaintByExamplePipeline.from_pretrained(
        "Fantasy-Studio/Paint-by-Example",
        torch_dtype=torch.float16 if DEVICE=="cuda" else torch.float32
    ).to(DEVICE)
    image = Image.open(input_path).convert("RGB")
    mask  = Image.open(mask_path).convert("L")         # white = repaint
    ex    = Image.open(example_path).convert("RGB")
    edited = pipe(image=image, mask_image=mask, example_image=ex,
                  num_inference_steps=steps, guidance_scale=5.0).images[0]
    edited.save(out_path); return out_path

# Example usage (where input.jpg, fruit.jpg, etc. are your input data)
run_ip2p("input.jpg", "make the sky pink at sunset")
run_diffedit("fruit.jpg", "a bowl of apples", "a bowl of pears")
run_pbe("room.jpg", "room_mask.png", "new_chair.jpg")
Repo-based Configuration
Add-it (training-free insertion)
Click to open
git clone https://github.com/NVlabs/addit && cd addit
conda env create -f environment.yml && conda activate addit
# real image insertion:
python run_CLI_addit_real.py \
  --source_image "images/bed_dark_room.jpg" \
  --prompt_source "A photo of a bed in a dark room" \
  --prompt_target "A photo of a dog lying on a bed in a dark room" \
  --subject_token "dog"
FreeEdit (mask-free, reference-based)
Click to open
git clone https://github.com/hrz2000/FreeEdit && cd FreeEdit
pip install -r requirements.txt
# check README / demo notebook for single-command inference
Grounded-Instruct-Pix2Pix (auto target grounding)
Click to open
git clone https://github.com/arthur-71/Grounded-Instruct-Pix2Pix && cd Grounded-Instruct-Pix2Pix
pip install -r requirements.txt && python -m spacy download en_core_web_sm
# install GroundingDINO (per README), then open the provided notebook:
# jupyter notebook grounded-instruct-pix2pix.ipynb
RegionDrag (fast region edits/UI)
Click to open
git clone https://github.com/Visual-AI/RegionDrag && cd RegionDrag
pip install -r requirements.txt
# see UI_GUIDE.md for the GUI runner; a minimal script is included in the repo
ZONE (localized editing)
Click to open
git clone https://github.com/lsl001006/ZONE && cd ZONE
pip install -r requirements.txt
python demo.py --input your.jpg --prompt "make the mug red" --mask path/to/mask.png
D-Edit (freestyle mask-conditioned)
Click to open
git clone https://github.com/collovlab/d-edit && cd d-edit
pip install -r requirements.txt
python app.py --input your.jpg --mask mask.png --prompt "replace the sofa with a blue one"
Pix2Pix-Zero / On-the-Fly (training-free, edit direction)
Click to open
git clone https://github.com/pix2pixzero/pix2pix-zero && cd pix2pix-zero
pip install -r requirements.txt
# see README + HF demo link for quick usage
Eedit the synthetic images generated by Stable Diffusion with the following command.
python src/edit_synthetic.py \
    --results_folder "output/synth_editing" \
    --prompt_str "a high resolution painting of a cat in the style of van gogh" \
    --task "cat2dog"
Disclaimer
Feel free to contact us if you have any queries or exciting news. In addition, we welcome all researchers to contribute to this repository and further contribute to the knowledge of this field.
If you have some other related references, please feel free to create a Github issue with the paper information. We will glady update the repos according to your suggestions. (You can also create pull requests, but it might take some time for us to do the merge)
Backup Statistics