
README


A Survey of Multimodal-Guided Image Editing with Text-to-Image Diffusion Models
Xincheng Shuai · Henghui Ding · Xingjun Ma · Rongcheng Tu · Yu-Gang Jiang · Dacheng Tao ·

This repo is used for recording and tracking recent multimodal-guided image editing methods with T2I models, as a supplement to our survey.
If you find any work missing or have any suggestions, feel free
to pull requests.
We will add the missing papers to this repo ASAP.
🔥News
[1] We have uploaded our evaluation dataset!!
🔥Highlight!!
[1] Two concurrent works (Huang et al., Cao et al.) are related to our survey. Huang et al. introduce the application of diffusion models in image editing, while Cao et al. focus on the controllable image generation. Compared to the review from Huang et al. and other previous literature, we investigate the image editing in a more general context. Our discussion extends beyond low-level semantics, encompassing customization tasks that align with our topic. We integrate existing general editing methods into a unified framework and provide a design space for users through qualitative and quantitative analyses.
[2] In this repo, we organize the reviewed methods based on the editing task and present their inversion & editing algorithms along with guidance set. It's worth noting that many of these studies employ multiple editing algorithms simultaneously. For simplicity, we have currently only indicate the primary technology they use.
[3] We hope our work will assist researchers in exploring novel combinations within our framework, thereby enhancing performance in challenging scenarios.
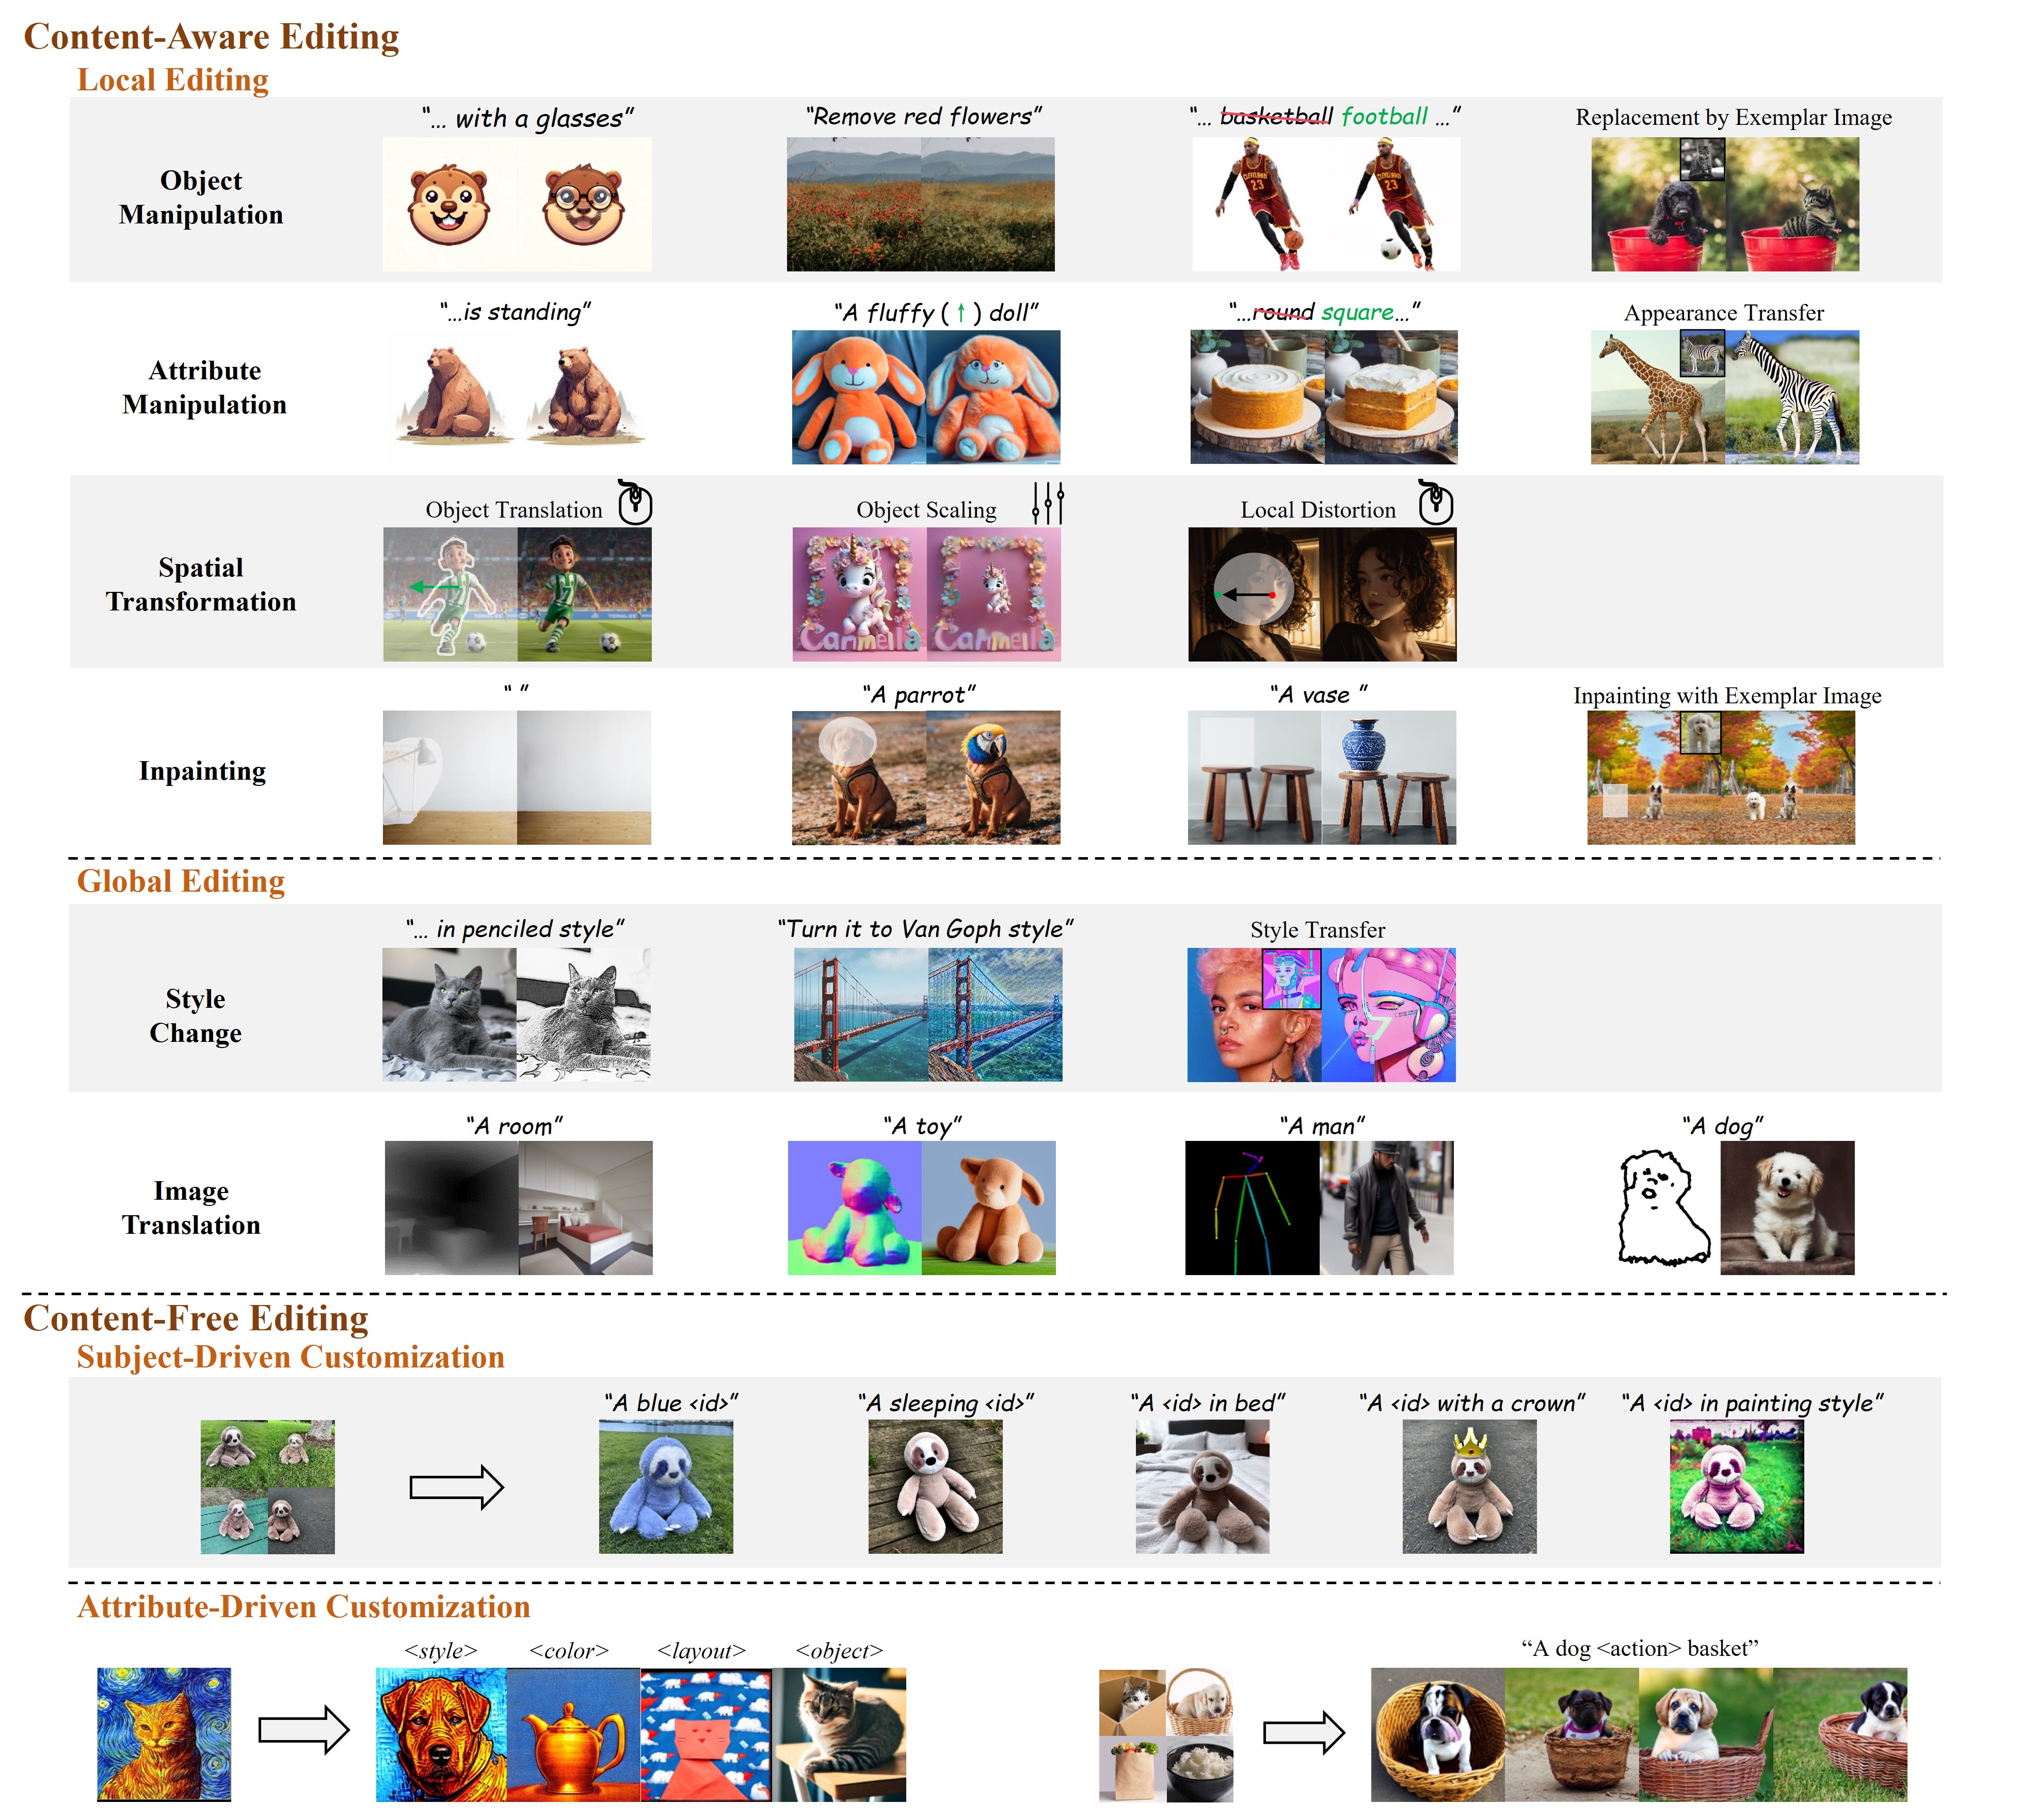
Editing Tasks Discussed in Our Survey
Unified Framework
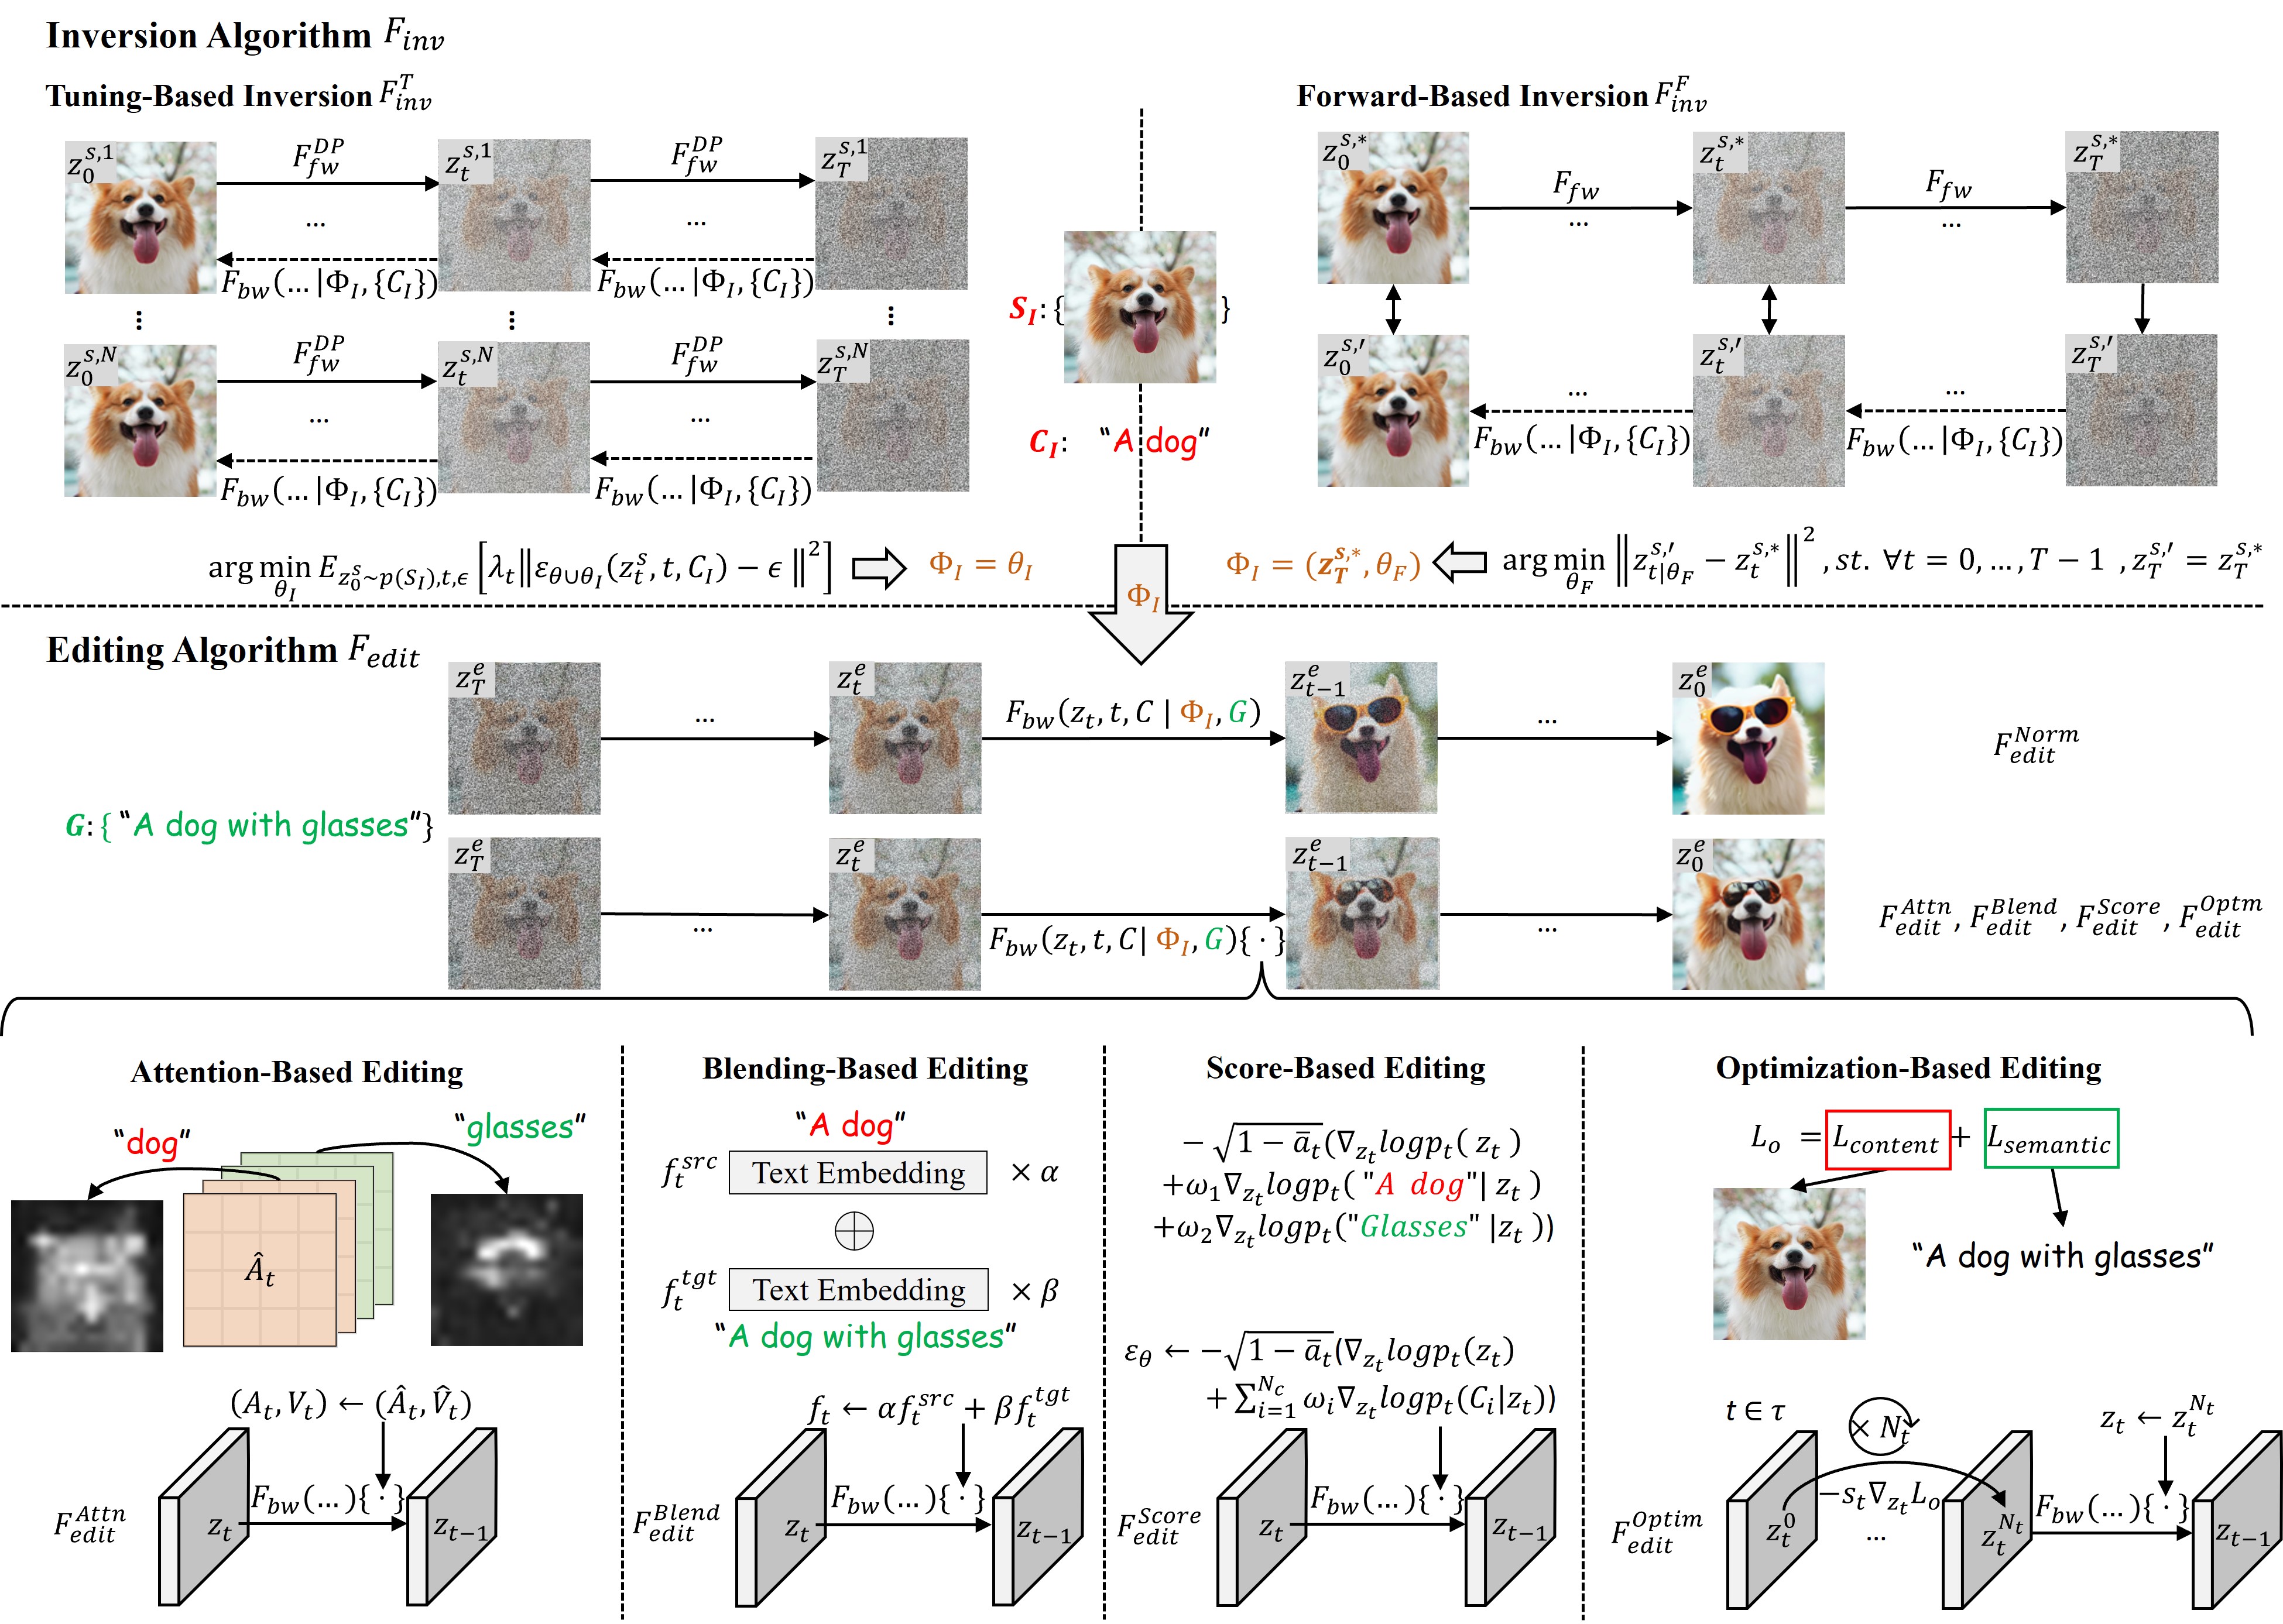
Notation
Inversion Algorithm:
- $F_{inv}^{T}$: Tuning-Based Inversion.
- $F_{inv}^{F}$: Forward-Based Inversion.
Editing Algorithm:
- $F_{edit}^{Norm}$: Normal Editing.
- $F_{edit}^{Attn}$: Attention-Based Editing.
- $F_{edit}^{Blend}$: Blending-Based Editing.
- $F_{edit}^{Score}$: Score-Based Editing.
- $F_{edit}^{Optim}$: Optimization-Based Editing.
Table of contents
Content-Aware Editing
- Object Manipulation + Attribute Manipulation
- Attribute Manipulation
- Spatial Transformation
- Inpainting
- Style Change
- Image Translation
Content-Free Editing
Experiment and Data
Object and Attribute Manipulation
1. Training-Free Approaches
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| CVPR 2023 | InstructPix2Pix: Learning to Follow Image Editing Instructions | instruction | Code |
| NeurIPS 2023 | MagicBrush: A Manually Annotated Dataset for Instruction-Guided Image Editing | instruction | Code |
| Arxiv 2023 | HIVE: Harnessing Human Feedback for Instructional Visual Editing | instruction | Code |
| Arxiv 2023 | Emu Edit: Precise Image Editing via Recognition and Generation Tasks | instruction | Code |
| ICLR 2024 | Guiding Instruction-Based Image Editing via Multimodal Large Language Models | instruction | Code |
| CVPR 2024 | SmartEdit: Exploring Complex Instruction-based Image Editing with Multimodal Large Language Models | instruction | Code |
| CVPR 2024 | Referring Image Editing: Object-level Image Editing via Referring Expressions | instruction | Code |
| Arxiv 2024 | EditWorld: Simulating World Dynamics for Instruction-Following Image Editing | instruction | Code |
Attribute Manipulation:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| PRCV 2023 | KV Inversion: KV Embeddings Learning for Text-Conditioned Real Image Action Editing | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| ICCV 2023 | Localizing Object-level Shape Variations with Text-to-Image Diffusion Models | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| ICCV 2023 | MasaCtrl: Tuning-Free Mutual Self-Attention Control for Consistent Image Synthesis and Editing | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| AAAI 2023 | Tuning-Free Inversion-Enhanced Control for Consistent Image Editing | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| SIGGRAPH 2024 | Cross-Image Attention for Zero-Shot Appearance Transfer | image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
Spatial Transformation:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| Arxiv 2024 | DesignEdit: Multi-Layered Latent Decomposition and Fusion for Unified & Accurate Image Editing | user interface | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| NeurIPS 2023 | Diffusion Self-Guidance for Controllable Image Generation | text + image + user interface | $F_{inv}^F+F_{edit}^{Score}$ | Code |
| ICLR 2024 | DragonDiffusion: Enabling Drag-style Manipulation on Diffusion Models | image + user interface | $F_{inv}^F+F_{edit}^{Score}$ | Code |
| ICLR 2024 | DragDiffusion: Harnessing Diffusion Models for Interactive Point-based Image Editing | mask + user interface | $F_{inv}^T+F_{inv}^F+F_{edit}^{Optim}$ | Code |
| ICLR 2024 | DiffEditor: Boosting Accuracy and Flexibility on Diffusion-based Image Editing | image + user interface | $F_{inv}^T+F_{inv}^F+F_{edit}^{Score}$ | Code |
Inpainting:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| Arxiv 2023 | HD-Painter: High-Resolution and Prompt-Faithful Text-Guided Image Inpainting with Diffusion Models | text + mask | $F_{inv}^T+F_{edit}^{Attn}$ | Code |
| ICCV 2023 | TF-ICON: Diffusion-Based Training-Free Cross-Domain Image Composition | text + image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| TOG 2023 | Blended Latent Diffusion | text + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| Arxiv 2023 | High-Resolution Image Editing via Multi-Stage Blended Diffusion | text + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| Arxiv 2023 | Differential Diffusion: Giving Each Pixel Its Strength | text + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| CVPR 2024 | Tuning-Free Image Customization with Image and Text Guidance | text + image + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| TMLR 2023 | DreamEdit: Subject-driven Image Editing | text + image +mask | $F_{inv}^T+F_{inv}^F+F_{edit}^{Blend}$ | Code) |
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| CVPR 2024 | Imagen Editor and EditBench: Advancing and Evaluating Text-Guided Image Inpainting | text + mask | Code |
| CVPR 2023 | SmartBrush: Text and Shape Guided Object Inpainting with Diffusion Model | text + mask | Code |
| Arxiv 2023 | A Task is Worth One Word: Learning with Task Prompts for High-Quality Versatile Image Inpainting | text + mask | Code |
| CVPR 2023 | Paint by Example: Exemplar-based Image Editing with Diffusion Models | image + mask | Code |
| CVPR 2023 | ObjectStitch: Object Compositing with Diffusion Model | image + mask | Code |
| CVPR 2023 | Reference-based Image Composition with Sketch via Structure-aware Diffusion Model | image + mask | Code |
| ICASSP 2024 | Paste, Inpaint and Harmonize via Denoising: Subject-Driven Image Editing with Pre-Trained Diffusion Model | text+ image + mask | Code |
| CVPR 2024 | AnyDoor: Zero-shot Object-level Image Customization | image + mask | Code |
Style Change:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| CVPR 2023 | Inversion-Based Style Transfer with Diffusion Models | text + image | $F_{inv}^T+F_{inv}^F+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | Z∗: Zero-shot Style Transfer via Attention Rearrangement | image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| CVPR 2024 | Style Injection in Diffusion: A Training-free Approach for Adapting Large-scale Diffusion Models for Style Transfer | image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
Image Translation:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| CVPR 2024 | FreeControl: Training-Free Spatial Control of Any Text-to-Image Diffusion Model with Any Condition | text | $F_{inv}^F+F_{edit}^{Score}$ | Code |
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| ICCV 2023 | Adding Conditional Control to Text-to-Image Diffusion Models | text | Code |
| NeurIPS 2023 | Cocktail: Mixing Multi-Modality Controls for Text-Conditional Image Generation | text | Code |
| NeurIPS 2023 | Uni-ControlNet: All-in-One Control to Text-to-Image Diffusion Model | text | Code |
| NeurIPS 2023 | CycleNet: Rethinking Cycle Consistency in Text-Guided Diffusion for Image Manipulation | text | Code |
| AAAI 2024 | T2I-Adapter: Learning Adapters to Dig out More Controllable Ability for Text-to-Image Diffusion Models | text | Code |
| CVPR 2024 | SCEdit: Efficient and Controllable Image Diffusion Generation via Skip Connection Editing | text | Code |
| Arxiv 2024 | One-Step Image Translation with Text-to-Image Models | text | Code |
Subject-Driven Customization:
1. Training-Free Approaches
2. Training-Based Approaches
Attribute-Driven Customization:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| Arxiv 2023 | ProSpect: Prompt Spectrum for Attribute-Aware Personalization of Diffusion Models | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | An Image is Worth Multiple Words: Multi-attribute Inversion for Constrained Text-to-Image Synthesis | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| TOG 2023 | Concept Decomposition for Visual Exploration and Inspiration | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | ReVersion: Diffusion-Based Relation Inversion from Images | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | Learning Disentangled Identifiers for Action-Customized Text-to-Image Generation | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | Lego: Learning to Disentangle and Invert Concepts Beyond Object Appearance in Text-to-Image Diffusion Models | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| NeurIPS 2023 | StyleDrop: Text-to-Image Generation in Any Style | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| Arxiv 2023 | ArtAdapter: Text-to-Image Style Transfer using Multi-Level Style Encoder and Explicit Adaptation | text | Code |
| Arxiv 2023 | DreamCreature: Crafting Photorealistic Virtual Creatures from Imagination | text | Code |
| ICLR 2024 | Language-Informed Visual Concept Learning | text | Code |
| Arxiv 2024 | pOps: Photo-Inspired Diffusion Operators | text | Code |
Acknowledgement
If you find our survey and repository useful for your research project, please consider citing our paper:
@article{ImgEditing,
      title={A Survey of Multimodal-Guided Image Editing with Text-to-Image Diffusion Models},
      author={Shuai, Xincheng and Ding, Henghui and Ma, Xingjun and Tu, Rongcheng and Jiang, Yu-Gang and Tao, Dacheng},
      journal={arXiv},
      year={2024}
}
Contact
henghui.ding[AT]gmail.com
Contributors

16 commits

5 commits
Similar repos


README
A Survey of Multimodal-Guided Image Editing with Text-to-Image Diffusion Models
Xincheng Shuai · Henghui Ding · Xingjun Ma · Rongcheng Tu · Yu-Gang Jiang · Dacheng Tao ·
This repo is used for recording and tracking recent multimodal-guided image editing methods with T2I models, as a supplement to our survey.
If you find any work missing or have any suggestions, feel free
to pull requests.
We will add the missing papers to this repo ASAP.
🔥News
[1] We have uploaded our evaluation dataset!!
🔥Highlight!!
[1] Two concurrent works (Huang et al., Cao et al.) are related to our survey. Huang et al. introduce the application of diffusion models in image editing, while Cao et al. focus on the controllable image generation. Compared to the review from Huang et al. and other previous literature, we investigate the image editing in a more general context. Our discussion extends beyond low-level semantics, encompassing customization tasks that align with our topic. We integrate existing general editing methods into a unified framework and provide a design space for users through qualitative and quantitative analyses.
[2] In this repo, we organize the reviewed methods based on the editing task and present their inversion & editing algorithms along with guidance set. It's worth noting that many of these studies employ multiple editing algorithms simultaneously. For simplicity, we have currently only indicate the primary technology they use.
[3] We hope our work will assist researchers in exploring novel combinations within our framework, thereby enhancing performance in challenging scenarios.
Editing Tasks Discussed in Our Survey
Unified Framework
Notation
Inversion Algorithm:
- $F_{inv}^{T}$: Tuning-Based Inversion.
- $F_{inv}^{F}$: Forward-Based Inversion.
Editing Algorithm:
- $F_{edit}^{Norm}$: Normal Editing.
- $F_{edit}^{Attn}$: Attention-Based Editing.
- $F_{edit}^{Blend}$: Blending-Based Editing.
- $F_{edit}^{Score}$: Score-Based Editing.
- $F_{edit}^{Optim}$: Optimization-Based Editing.
Table of contents
Content-Aware Editing
- Object Manipulation + Attribute Manipulation
- Attribute Manipulation
- Spatial Transformation
- Inpainting
- Style Change
- Image Translation
Content-Free Editing
Experiment and Data
Object and Attribute Manipulation
1. Training-Free Approaches
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| CVPR 2023 | InstructPix2Pix: Learning to Follow Image Editing Instructions | instruction | Code |
| NeurIPS 2023 | MagicBrush: A Manually Annotated Dataset for Instruction-Guided Image Editing | instruction | Code |
| Arxiv 2023 | HIVE: Harnessing Human Feedback for Instructional Visual Editing | instruction | Code |
| Arxiv 2023 | Emu Edit: Precise Image Editing via Recognition and Generation Tasks | instruction | Code |
| ICLR 2024 | Guiding Instruction-Based Image Editing via Multimodal Large Language Models | instruction | Code |
| CVPR 2024 | SmartEdit: Exploring Complex Instruction-based Image Editing with Multimodal Large Language Models | instruction | Code |
| CVPR 2024 | Referring Image Editing: Object-level Image Editing via Referring Expressions | instruction | Code |
| Arxiv 2024 | EditWorld: Simulating World Dynamics for Instruction-Following Image Editing | instruction | Code |
Attribute Manipulation:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| PRCV 2023 | KV Inversion: KV Embeddings Learning for Text-Conditioned Real Image Action Editing | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| ICCV 2023 | Localizing Object-level Shape Variations with Text-to-Image Diffusion Models | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| ICCV 2023 | MasaCtrl: Tuning-Free Mutual Self-Attention Control for Consistent Image Synthesis and Editing | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| AAAI 2023 | Tuning-Free Inversion-Enhanced Control for Consistent Image Editing | text | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| SIGGRAPH 2024 | Cross-Image Attention for Zero-Shot Appearance Transfer | image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
Spatial Transformation:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| Arxiv 2024 | DesignEdit: Multi-Layered Latent Decomposition and Fusion for Unified & Accurate Image Editing | user interface | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| NeurIPS 2023 | Diffusion Self-Guidance for Controllable Image Generation | text + image + user interface | $F_{inv}^F+F_{edit}^{Score}$ | Code |
| ICLR 2024 | DragonDiffusion: Enabling Drag-style Manipulation on Diffusion Models | image + user interface | $F_{inv}^F+F_{edit}^{Score}$ | Code |
| ICLR 2024 | DragDiffusion: Harnessing Diffusion Models for Interactive Point-based Image Editing | mask + user interface | $F_{inv}^T+F_{inv}^F+F_{edit}^{Optim}$ | Code |
| ICLR 2024 | DiffEditor: Boosting Accuracy and Flexibility on Diffusion-based Image Editing | image + user interface | $F_{inv}^T+F_{inv}^F+F_{edit}^{Score}$ | Code |
Inpainting:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| Arxiv 2023 | HD-Painter: High-Resolution and Prompt-Faithful Text-Guided Image Inpainting with Diffusion Models | text + mask | $F_{inv}^T+F_{edit}^{Attn}$ | Code |
| ICCV 2023 | TF-ICON: Diffusion-Based Training-Free Cross-Domain Image Composition | text + image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| TOG 2023 | Blended Latent Diffusion | text + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| Arxiv 2023 | High-Resolution Image Editing via Multi-Stage Blended Diffusion | text + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| Arxiv 2023 | Differential Diffusion: Giving Each Pixel Its Strength | text + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| CVPR 2024 | Tuning-Free Image Customization with Image and Text Guidance | text + image + mask | $F_{inv}^F+F_{edit}^{Blend}$ | Code |
| TMLR 2023 | DreamEdit: Subject-driven Image Editing | text + image +mask | $F_{inv}^T+F_{inv}^F+F_{edit}^{Blend}$ | Code) |
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| CVPR 2024 | Imagen Editor and EditBench: Advancing and Evaluating Text-Guided Image Inpainting | text + mask | Code |
| CVPR 2023 | SmartBrush: Text and Shape Guided Object Inpainting with Diffusion Model | text + mask | Code |
| Arxiv 2023 | A Task is Worth One Word: Learning with Task Prompts for High-Quality Versatile Image Inpainting | text + mask | Code |
| CVPR 2023 | Paint by Example: Exemplar-based Image Editing with Diffusion Models | image + mask | Code |
| CVPR 2023 | ObjectStitch: Object Compositing with Diffusion Model | image + mask | Code |
| CVPR 2023 | Reference-based Image Composition with Sketch via Structure-aware Diffusion Model | image + mask | Code |
| ICASSP 2024 | Paste, Inpaint and Harmonize via Denoising: Subject-Driven Image Editing with Pre-Trained Diffusion Model | text+ image + mask | Code |
| CVPR 2024 | AnyDoor: Zero-shot Object-level Image Customization | image + mask | Code |
Style Change:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| CVPR 2023 | Inversion-Based Style Transfer with Diffusion Models | text + image | $F_{inv}^T+F_{inv}^F+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | Z∗: Zero-shot Style Transfer via Attention Rearrangement | image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
| CVPR 2024 | Style Injection in Diffusion: A Training-free Approach for Adapting Large-scale Diffusion Models for Style Transfer | image | $F_{inv}^F+F_{edit}^{Attn}$ | Code |
Image Translation:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| CVPR 2024 | FreeControl: Training-Free Spatial Control of Any Text-to-Image Diffusion Model with Any Condition | text | $F_{inv}^F+F_{edit}^{Score}$ | Code |
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| ICCV 2023 | Adding Conditional Control to Text-to-Image Diffusion Models | text | Code |
| NeurIPS 2023 | Cocktail: Mixing Multi-Modality Controls for Text-Conditional Image Generation | text | Code |
| NeurIPS 2023 | Uni-ControlNet: All-in-One Control to Text-to-Image Diffusion Model | text | Code |
| NeurIPS 2023 | CycleNet: Rethinking Cycle Consistency in Text-Guided Diffusion for Image Manipulation | text | Code |
| AAAI 2024 | T2I-Adapter: Learning Adapters to Dig out More Controllable Ability for Text-to-Image Diffusion Models | text | Code |
| CVPR 2024 | SCEdit: Efficient and Controllable Image Diffusion Generation via Skip Connection Editing | text | Code |
| Arxiv 2024 | One-Step Image Translation with Text-to-Image Models | text | Code |
Subject-Driven Customization:
1. Training-Free Approaches
2. Training-Based Approaches
Attribute-Driven Customization:
1. Training-Free Approaches
| Publication | Paper Title | Guidance Set | Combination | Code/Project |
|---|---|---|---|---|
| Arxiv 2023 | ProSpect: Prompt Spectrum for Attribute-Aware Personalization of Diffusion Models | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | An Image is Worth Multiple Words: Multi-attribute Inversion for Constrained Text-to-Image Synthesis | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| TOG 2023 | Concept Decomposition for Visual Exploration and Inspiration | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | ReVersion: Diffusion-Based Relation Inversion from Images | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | Learning Disentangled Identifiers for Action-Customized Text-to-Image Generation | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| Arxiv 2023 | Lego: Learning to Disentangle and Invert Concepts Beyond Object Appearance in Text-to-Image Diffusion Models | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
| NeurIPS 2023 | StyleDrop: Text-to-Image Generation in Any Style | text | $F_{inv}^T+F_{edit}^{Norm}$ | Code |
2. Training-Based Approaches
| Publication | Paper Title | Guidance Set | Code/Project |
|---|---|---|---|
| Arxiv 2023 | ArtAdapter: Text-to-Image Style Transfer using Multi-Level Style Encoder and Explicit Adaptation | text | Code |
| Arxiv 2023 | DreamCreature: Crafting Photorealistic Virtual Creatures from Imagination | text | Code |
| ICLR 2024 | Language-Informed Visual Concept Learning | text | Code |
| Arxiv 2024 | pOps: Photo-Inspired Diffusion Operators | text | Code |
Acknowledgement
If you find our survey and repository useful for your research project, please consider citing our paper:
@article{ImgEditing,
      title={A Survey of Multimodal-Guided Image Editing with Text-to-Image Diffusion Models},
      author={Shuai, Xincheng and Ding, Henghui and Ma, Xingjun and Tu, Rongcheng and Jiang, Yu-Gang and Tao, Dacheng},
      journal={arXiv},
      year={2024}
}
Contact
henghui.ding[AT]gmail.com
Similar repos
Contributors
16 commits
5 commits