音声データから「空間」「情景」「オノマトペ」「漫画」を生成するAIパイプライン Sound → Space → Scene → Manga
| Input Audio | Scene Interpretation | Manga Output |
|---|---|---|
| 🎧 環境音(風・鳥) | 自然環境の情景 | 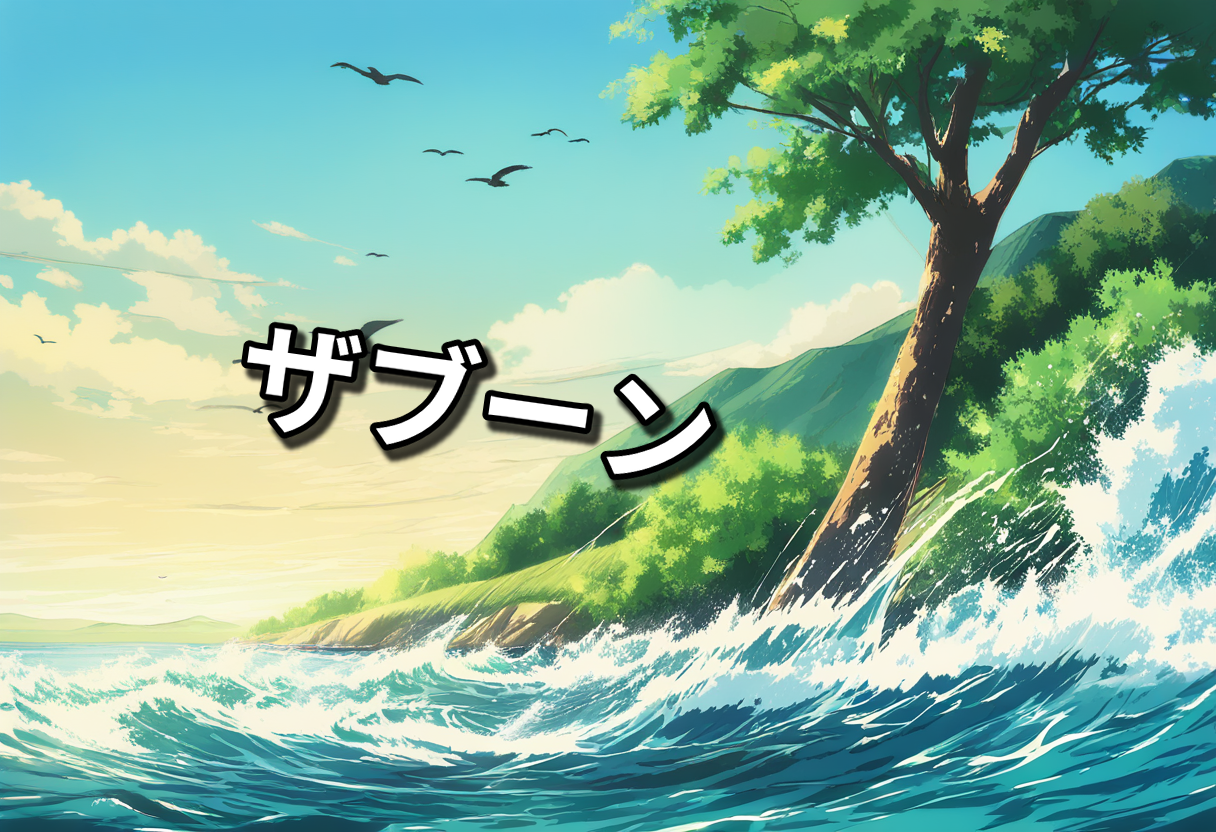 |
👉 音からストーリーを生成する体験を提供
本プロジェクトは、音声データから以下を段階的に生成するAIシステムです:
👉 音を「視覚的な物語」に変換する生成AI
Audio
 ↓
04_features           音響特徴抽出
 ↓
05_audio_events       音イベント検出(PANNs)
 ↓
05_space_similarity   空間類似度(CLAP)
 ↓
06_space_judgement    空間判定
 ↓
07_scene_interpretation 情景解釈
 ↓
08_onomatopoeia       擬音生成(LoRA + LLM)
 ↓
08_manga_prompt       プロンプト生成
 ↓
09_manga_image        画像生成(Animagine XL)
 ↓
10_manga_text         擬音合成
 ↓
11_final_result       最終出力
project/
├── app/services/
├── site/
├── scripts/
├── tests/
├── docs/
├── requirements.txt
├── README.md
git clone https://github.com/t2yeah/brainBuider/
cd brainBuider/project
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
pip install -U "huggingface_hub[cli]"
hf auth login
git clone https://huggingface.co/yadorigi/onomatopoeia-lora models/onoma-lora
export ONOMA_LORA_ADAPTER_DIR=./models/onoma-lora
from diffusers import StableDiffusionXLPipeline
StableDiffusionXLPipeline.from_pretrained("cagliostrolab/animagine-xl-4.0")
本プロジェクトでは、ローカルの FastAPI / Web サイトを外部公開するために ngrok を使用します。
ngrok バイナリは site/ 直下に配置してください。
project/
└── site/
    ├── start_web.sh
    ├── stop_web.sh
    ├── status_web.sh
    ├── ngrok
    ├── index.html
    ├── app.js
    ├── assets/
    ├── logs/
    └── runtime/

## ▶ 実行方法(Usage)

### CLI

```bash
python app/services/pipeline.py --audio-id sample
./scripts/start_web.sh
| Endpoint | Description |
|---|---|
| POST /api/upload | 音声アップロード |
| GET /analysis/{audio_id} | 結果取得 |
chmod +x tests/run_test.sh
./tests/run_test.sh
👉 sample_audio.wav で再現可能
1つだけ重要です。
final_result.py は 10_final_result.json に保存する実装ですが、pipeline.py の定義上は 11_final_result.json を期待しているように見えます。ここは不整合がある可能性があります。final_result.py では output_path = result_dir / "10_final_result.json" です。:contentReference[oaicite:1]{index=1}
一方で pipeline.py の step 13 は "11_final_result.json" を出力ファイル名として持っています。:contentReference[oaicite:2]{index=2}
つまり、READMEやテストではどちらかに統一した方がよいです。
実運用上は 10_final_result.json か 11_final_result.json のどちらかに揃える修正 を先に入れるのが望ましいです。
tests/expected_output.json も作って、最低限の内容チェックまで入れるのがよいです。👉 Hugging Face https://huggingface.co/yadorigi/onomatopoeia-lora
本プロジェクトは MIT License のもとで公開されています。
Copyright (c) 2026 Yadorigi(ヤドリギ)
本ソフトウェアおよび関連ドキュメントファイルの複製を取得したすべての人に対し、 無償で使用、複製、改変、結合、公開、配布、サブライセンス、および販売を行う権利を許可します。
本プロジェクトでは、以下の外部モデル・ライブラリを使用しています。
それぞれ独自のライセンスに従って利用してください。
本プロジェクトは、チーム Yadorigi(ヤドリギ) によるハッカソン成果物です。
音声データをもとに以下の処理を一貫して実行する生成AIパイプラインを実装しています:
Audio
→ 空間認識(Scene Understanding)
→ プロンプト生成
→ 漫画風画像生成(Manga Image)
本ソフトウェアは「現状のまま(as is)」で提供されており、 明示または黙示を問わず、いかなる保証も行いません。
@misc{sound2manga,
  title={Sound2Manga},
  author={yadorigi team},
  year={2026}
}
音を、物語にする。
音声データから「空間」「情景」「オノマトペ」「漫画」を生成するAIパイプライン Sound → Space → Scene → Manga
| Input Audio | Scene Interpretation | Manga Output |
|---|---|---|
| 🎧 環境音(風・鳥) | 自然環境の情景 | |
👉 音からストーリーを生成する体験を提供
本プロジェクトは、音声データから以下を段階的に生成するAIシステムです:
👉 音を「視覚的な物語」に変換する生成AI
Audio
 ↓
04_features           音響特徴抽出
 ↓
05_audio_events       音イベント検出(PANNs)
 ↓
05_space_similarity   空間類似度(CLAP)
 ↓
06_space_judgement    空間判定
 ↓
07_scene_interpretation 情景解釈
 ↓
08_onomatopoeia       擬音生成(LoRA + LLM)
 ↓
08_manga_prompt       プロンプト生成
 ↓
09_manga_image        画像生成(Animagine XL)
 ↓
10_manga_text         擬音合成
 ↓
11_final_result       最終出力
project/
├── app/services/
├── site/
├── scripts/
├── tests/
├── docs/
├── requirements.txt
├── README.md
git clone https://github.com/t2yeah/brainBuider/
cd brainBuider/project
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
pip install -U "huggingface_hub[cli]"
hf auth login
git clone https://huggingface.co/yadorigi/onomatopoeia-lora models/onoma-lora
export ONOMA_LORA_ADAPTER_DIR=./models/onoma-lora
from diffusers import StableDiffusionXLPipeline
StableDiffusionXLPipeline.from_pretrained("cagliostrolab/animagine-xl-4.0")
本プロジェクトでは、ローカルの FastAPI / Web サイトを外部公開するために ngrok を使用します。
ngrok バイナリは site/ 直下に配置してください。
project/
└── site/
    ├── start_web.sh
    ├── stop_web.sh
    ├── status_web.sh
    ├── ngrok
    ├── index.html
    ├── app.js
    ├── assets/
    ├── logs/
    └── runtime/

## ▶ 実行方法(Usage)

### CLI

```bash
python app/services/pipeline.py --audio-id sample
./scripts/start_web.sh
| Endpoint | Description |
|---|---|
| POST /api/upload | 音声アップロード |
| GET /analysis/{audio_id} | 結果取得 |
chmod +x tests/run_test.sh
./tests/run_test.sh
👉 sample_audio.wav で再現可能
1つだけ重要です。
final_result.py は 10_final_result.json に保存する実装ですが、pipeline.py の定義上は 11_final_result.json を期待しているように見えます。ここは不整合がある可能性があります。final_result.py では output_path = result_dir / "10_final_result.json" です。:contentReference[oaicite:1]{index=1}
一方で pipeline.py の step 13 は "11_final_result.json" を出力ファイル名として持っています。:contentReference[oaicite:2]{index=2}
つまり、READMEやテストではどちらかに統一した方がよいです。
実運用上は 10_final_result.json か 11_final_result.json のどちらかに揃える修正 を先に入れるのが望ましいです。
tests/expected_output.json も作って、最低限の内容チェックまで入れるのがよいです。👉 Hugging Face https://huggingface.co/yadorigi/onomatopoeia-lora
本プロジェクトは MIT License のもとで公開されています。
Copyright (c) 2026 Yadorigi(ヤドリギ)
本ソフトウェアおよび関連ドキュメントファイルの複製を取得したすべての人に対し、 無償で使用、複製、改変、結合、公開、配布、サブライセンス、および販売を行う権利を許可します。
本プロジェクトでは、以下の外部モデル・ライブラリを使用しています。
それぞれ独自のライセンスに従って利用してください。
本プロジェクトは、チーム Yadorigi(ヤドリギ) によるハッカソン成果物です。
音声データをもとに以下の処理を一貫して実行する生成AIパイプラインを実装しています:
Audio
→ 空間認識(Scene Understanding)
→ プロンプト生成
→ 漫画風画像生成(Manga Image)
本ソフトウェアは「現状のまま(as is)」で提供されており、 明示または黙示を問わず、いかなる保証も行いません。
@misc{sound2manga,
  title={Sound2Manga},
  author={yadorigi team},
  year={2026}
}
音を、物語にする。



