
README
汉智 · Hanji
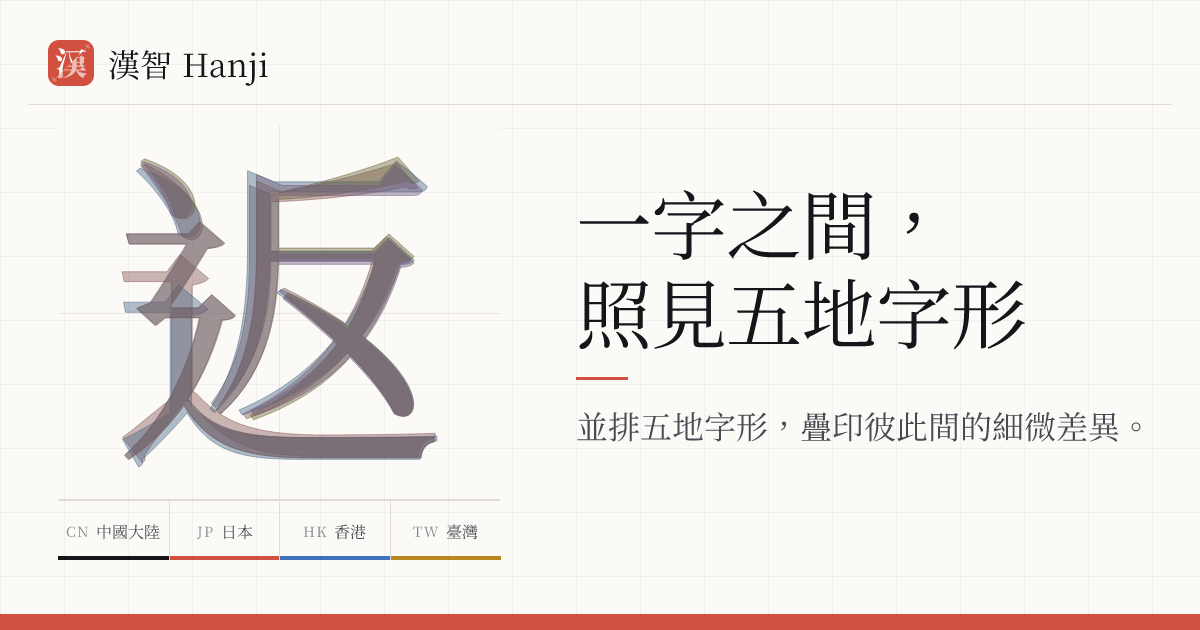
一字之间,照见五地字形
把同一个汉字并排、叠印,照见中国大陆、香港、台湾、日本与韩国之间细微而真实的字形差异。
中国大陆、香港、台湾、日本、韩国五地常用汉字的字表。本应用对照的是通用黑体与宋体中的印刷字形:同一个字,在各地可能呈现不同字形。这里把五地字形并排列出,默认按界面语言对应地区的字频排序,也可按笔画或码点排序,并按差异模式筛选。韩国没有字频数据,韩国列默认关闭,可在显示选项中启用。
字形只是其中一个维度。收录范围是五地常用字表的并集,字形完全相同的字同样收录:这是一份五地汉字的资料表,不是一份差异清单。
下面是概要,逐条的完整说明在应用内的「关于」页。
名字的由来
「Hanji」跟汉字在各地的叫法各差一个字母:汉语拼音的 hanzi 差一个 z,日语的 kanji 差一个 k,韩语的 hanja 差一个 a——同一件东西,每个地方都改掉一点点。它同时也是闽南语「漢字」的实际读音 hàn-jī,所以并非生造词,而是又一地的读法。中文名「汉智」取其音。
收录范围
收录《通用规范汉字表》(2013)、臺灣《常用國字標準字體表》(1982)、香港《常用字字形表》、日本《常用漢字表》(2010)、韩国《漢文教育用基礎漢字》(2000)五份字表的并集。韩国字表含 1,800 个常用汉字。把简繁、日本新旧字体和韩式异体这类跨码点的对应合并成一行后,共 8,449 行——其中 1,692 行五地字形完全一致,129 行五地各不相同。
台湾《次常用國字表》只为已有行提供二级收录状态和候选,不参与生成新行;其 6,343 个主条目中有 3,599 个独有条目明确在产品范围之外。
字组与数据语义
一行表示一个字组,五列分别是大陆、香港、台湾、日本和韩国的展示形。跨码点候选主要来自 OpenCC,韩式异体采用 Unicode IRG 收录提案所列对应,并由地区字表约束:
- 某地字表把两个字分开收录时保留两个字组,例如
着/著、欠/缺; - OpenCC 明确自包含的同字关系或五列完全相同的名称可以合并;至少有两个地区佐证的映射可作为确定的地区对应;
- 只有一个地区提供证据、而候选还属于另一字组时保守拆分,并在详情页显示双向“关系未确认”,例如
鎗/槍。
五列确定后才选择行名;已有中港台日证据时仍按原四地规则选择,以免新增的韩国列改变既有网址。主条目和括注收录都足以保住字组自身名称。日本旧字体也必须来自明确的 JPShinjitaiCharacters 关系,不能由行名与日本列不同反推。
每个地区格都有 primary(主条目)、glossed(括注异体)或 unlisted(未收录、显示参考形)状态。alternatives 只保存该地区收录且明确属于当前字组的其他形式;aka 只表示字组的其他名称;未确认关系只用于“另见”,不会进入搜索、网址别名、字典引用或字体集合。完整定义、构建保证和限制见 数据规则与已知限制。
字形差异是怎么判定的
判定使用 Adobe Source Han Sans 与 Source Han Serif,页面则用与它们同源的 Noto Sans CJK 与 Noto Serif CJK 显示结果。每套字体让中、港、台、日、韩五个地区共用一个字形池,并分别提供「Unicode 码点 → 字形编号(CID)」映射。两地映射到同一 CID,就视为同形。Adobe 已把这些映射以纯文本公开,因此不需要比对轮廓或渲染截图。
最终判定取黑体与宋体结果的并集:只要其中一款把两地画成同一字形,本应用就按同形处理。这能排除只出现在单款字体中的设计细节。例如 Source Han Sans 为约五分之一的日本常用汉字提供独立字形,其中约两百个在 Source Han Serif 并未区分(了、人、子、水、金都在其中);本应用不把这类差异算作地区规范差异。完整取舍见 数据规则与已知限制。
页面会按这份判定重新分组:被判为同形的格子统一借用组内一个地区的 Noto 字体,使屏幕上也真正呈现同一轮廓。相应地,被上述规则过滤的地区版本细小差异不会显示。tests/fonts.test.ts 会用 fontkit 取出生成字体的真实轮廓,逐字验证判定与画面显示一致。
明确的跨码点映射不会因为 Noto/Source Han 未收录目标字而退回原码点。例如 𬒗 → 𥗽 仍会显示为两个码点。构建会从当前数据自动收集 Noto 缺少但页面需要显示的码点,并生成项目内置的补充 WOFF2 子集:黑体取 Plangothic P1,宋体取 WenJin Mincho P2;所选字体缺少任一码点时,构建会明确失败。页面始终保留真正的 Unicode 文本,不依赖用户设备的本机字体。这两套补充字形只负责显示,不参与地区差异判定。
局限
- 本应用只比较通用黑体与宋体中的印刷字形,不涵盖手写习惯,也不以教科书体的示范字形为准。日语教科书体主要为日语教学设计,并没有与中、港、台、韩共享同一字形池的正式地区版本;若拼接风格相近但来源不同的字体,地区差异与字体自身的设计差异就无法分开。为了控制变量,本应用只能选用同时提供五地版本的同源字体系列。
- 判定的对象是 Source Han 的地区字形设计,不是各地标准本身。它是个高质量的代理——Adobe 的地区字形分别依据大陆《印刷通用汉字字形表》、台湾教育部《國字標準字體》、香港教育局《常用字字形表》、日本 JIS X 0208/0213、韩国 KS X 1001/1002。
- Source Han 的香港字形覆盖并不完整,「只有香港不同」这一类可能少报。
- 字表筛选、排序与详情页共用同一套地区笔画数:先取笔顺数据的实际笔画数;香港沿用笔顺功能的同形回退,依次尝试台湾、大陆、日本、韩国。没有笔顺数据时,再按
kAlternateTotalStrokes→ 日本的kRSAdobe_Japan1_6→kTotalStrokes顺延。例如 以 的五地笔画数是 4/5/5/5/5。 - 韩语读音取 Unihan 推荐的
kHangul,保留全部现代韩文单字音;它不根据词语语境替用户选择读音,也不另行推导头音法则。 - 未收录格显示的是传承参考形,不表示该地区实际采用或规范收录该形;“关系未确认”同样表示现有公开来源不足以裁决。
完整的数据规则与构建保证见 docs/known-issues.md。
声明
本应用是基于公开资料制作的字形对照工具,不是各地的规范、词典或教学材料。页面展示的是本应用采用的数据与自动规则所得的结果,不能据此断定某个字在当地只有这一种“正确”形式。
各地规范的适用范围和定义并不完全相同,字体也只是规范的一种设计实现。本应用会整理、转换并合并不同来源的数据,也会为未收录项补上参考字形;这些都是工程取舍,难免带来简化、遗漏与错误。
页面中的“同形”或“不同”只在上述资料、字体与规则内成立;地区的排列与分组只为方便对照,不表示优劣或立场。正式场合请以原始规范与词典为准;每个字的详情页都列有相应地区的字典链接。汉字数量巨大,出错难免,发现数据有误请提 issue。
开发
pnpm install
pnpm build:data   # 生成字表与字体子集,首次会下载约 302 MiB 原始数据,之后走缓存
pnpm update:sources # 检查并锁定新版第三方数据;有变化时下载并重新生成
pnpm dev
pnpm dev:pwa # 启用开发用 Service Worker,测试安装弹窗、Manifest 与 standalone 模式
pnpm test
pnpm generate # 静态应用(不生成 OG 图片)
pnpm build:og # 可选;生成完整 OG 图片
需要调试 PWA 安装体验时,用 pnpm dev:pwa 启动后在 Chromium 中打开 http://localhost:3000。开发 Service Worker 使用 Network Only 导航且不下载生产环境的完整离线缓存,因此不会干扰 HMR;完整离线行为仍应使用 pnpm generate 后的产物验证。安装入口不会自动弹出,仅在浏览器提供原生安装提示时显示:桌面端位于导航栏“关于”左侧,手机端位于首页“查看详情”右侧;iOS、Safari 等没有原生安装事件的环境不会显示入口。若浏览器仍控制着修改前的开发 Service Worker,请在 DevTools 的 Application 面板更新或注销它,再刷新一次。
每一行的地址是它的行名(/char/着)。五地展示形、aka 和 alternatives 也可作为地址,由客户端跳到所属的行——例如 /char/国、/char/郞、/char/缐,页面用 rel=canonical 指回行名地址;未确认关系不是地址别名。
字表 app/assets/data/chars.json 由 pnpm build:dataset 生成,不提交;静态生成直接读取源文件,浏览器则从固定的 /data/chars.json 加载,避免把约 3MiB JSON 当作 JavaScript 解析。“关于”页链接的也是这个地址。该地址已设置 Access-Control-Allow-Origin: *,可在遵守下文许可与第三方条款的前提下,通过 fetch、XHR 或直接链接跨域取用。它缓存 1 小时,过期后可在后台重新验证期间继续使用旧版本 1 天。来源与许可元数据直接维护在 shared/sources.ts,由页面和构建脚本共同导入,不再生成 sources.json。约 14MB 的字体子集生成到 public/fonts/,同样不提交,并通过固定的 /fonts/* URL 按需加载、每次复用前重新验证;笔顺与旗帜进入 Vite 资源图,由 /_nuxt/* 的长期 immutable 缓存安全复用。会变动而又需要稳定 URL 的 NOTICE 与 license 文本单独放在 public/notices/,每次使用前必须重新验证。构建前需先运行 pnpm build:data。原始下载缓存在 data/raw/ 下按类别存放(charlist/、opencc/、cmap/、font/、unihan/、frequency/、strokes/),已 gitignore;构建会清理从旧缓存恢复、但已不在当前来源清单中的文件。
部署
这是静态应用,.output/public 直接交给任意静态托管即可。线上部署由 GitHub Actions 构建后直传 Cloudflare Workers Static Assets:
main的 push 部署到 production;- 指向
main的 PR 通过wrangler versions upload部署到pr-<编号>preview alias,GitHub 会在 PR 中显示对应的 deployment 与访问地址,后续提交沿用同一个预览地址。
仓库需要配置两个 Actions secrets:
CLOUDFLARE_API_TOKEN:具有 Workers 脚本编辑权限的 API token;CLOUDFLARE_ACCOUNT_ID:Worker 所在的 Cloudflare account ID。
Cloudflare Worker 名称须为 hanji,与 wrangler.json 中的 name 一致。
请在 Cloudflare 的 Settings → Domains & Routes 中连接 production 域名。PR preview URL 保持开启。
需要页面访问量和 Web Vitals 时,请在实际域名所属账户的 Web Analytics → Add a site 中选择已由 Cloudflare 代理的 hostname,并使用 automatic setup。Cloudflare 会在边缘自动注入 beacon。
每个字组详情页都会生成独立 HTML;客户端页面共用 /data/chars.json,没有逐路由数据需要提取,因此关闭了会为每个字页额外生成空 _payload.json 的 payload extraction。地区异体别名不另外生成跳转页:它先由 Static Assets 返回 404.html 和 HTTP 404,再由 Nuxt 客户端中间件跳到所属行;搜索引擎不会把 alias 当作成功页面重复收录。真正未知的地址保持 HTTP 404。@nuxtjs/sitemap 会在静态生成时把全部 canonical 页面写入 /sitemap.xml,@nuxtjs/robots 生成 /robots.txt 并公布 sitemap 地址。两者的绝对 URL 默认使用 https://hanji.sxzz.moe,也可通过 NUXT_SITE_URL 覆盖;GitHub Actions 优先读取同名仓库变量,未设置时使用仓库 homepage。PR 预览构建通过 NUXT_SITE_ENV=preview 禁止索引。public/_headers 给带内容哈希的 _nuxt/* 设长期 immutable 缓存,让固定的 /fonts/*、/notices/*、sitemap 和 robots URL 使用 no-cache,并为 /data/chars.json 设置 1 小时的 max-age 与 1 天的 stale-while-revalidate。
第三方资产的具体 commit、GitHub release tag、官方附件标识与 SHA-256 记录在 data/sources.lock.json;需要升级时运行 pnpm update:sources。它会解析 GitHub 分支、最新 release 与 Unicode 版本,并重新校验没有版本号的官方直链;内容有变化时更新 lockfile 并直接重新生成数据,完全未变则跳过生成。构建时 pnpm build:data 会按 lockfile 下载并校验约 302 MiB 原始数据(其中 195 MiB 是十份 Noto CJK 字体,另有约 40 MiB 的两份补充字体);任何未显式更新的直链内容变化都会因校验和不符而失败,不会静默进入数据。Actions 分开缓存原始下载与生成字体:前者只由 lockfile 决定,后者由 lockfile、实际生成脚本、相关依赖、locale 与字表决定;字体输入完全不变时跳过数据生成。
笔顺分片由 pnpm build:dataset 生成到 app/assets/strokes/,不提交到仓库;部署流程会在测试和静态生成前重建,再由 Vite 输出带内容哈希的文件名。随附授权保留在 public/notices/ 的稳定 URL 下并要求重新验证。同一字组内,按笔画顺序排列的轮廓完全一致时只保存第一份变体及其中线,界面也把对应地区合并为一个选择项;页面加载时只获取一次所属分片,之后切换地区直接复用内存中的字组数据。整站使用这里解析出的轮廓数量作为首选笔画数。
本地也可构建后直传:
pnpm build:data
pnpm generate
pnpm build:og # 可选;需要完整社交分享资源时运行
pnpm preview:worker # http://localhost:8787
pnpm deploy
pnpm generate 只生成站点主体,OG 图片不会阻断本地开发或部署。需要在本地检查完整社交分享资源时,请在静态生成后单独运行 pnpm build:og。线上 GitHub Actions 会根据生成脚本、字形与字体输入、品牌文案、Logo 和依赖锁计算精确哈希;命中时恢复完整 OG 目录,未命中时才执行全量生成。
数据来源
| 用途 | 来源 | 许可 |
|---|---|---|
| 判定五地字形差异 | Adobe Source Han Sans / Serif(CMap 资源) | SIL OFL 1.1 |
| 页面展示用字体 | Noto Sans / Noto Serif(含 CJK) | SIL OFL 1.1 |
| 补充Noto未收录的黑体字形 | Plangothic P1 | SIL OFL 1.1 |
| 补充Noto未收录的宋体字形 | WenJin Mincho P2 | SIL OFL 1.1 |
| 简繁、港台异体、日本新旧字体对应 | OpenCC 开放中文转换 | Apache-2.0 |
| 中、台、日、韩笔顺动画与笔画数 | AnimCJK | Arphic Public License |
| 五地标准字表 | zispace/hanzi-chars | 仓库未声明 |
| 笔画数回退、读音 | Unicode Han Database (Unihan) | Unicode License v3 |
| 韩式异体对应 | Unicode IRG N2200(韩国教育用汉字提案) | Unicode License v3 |
| 大陆字频排名 | hanziDB.csv(Jun Da《现代汉语单字频率列表》) | MIT |
| 香港字频排名 | 粵典「語料庫單字使用頻率」 | Public Domain |
| 台湾字频排名 | 国家教育研究院《民國112年語料字頻表》 | 网站资料开放宣告(须注明出处) |
| 日本字频排名 | scriptin/kanji-frequency(Japanese Wikipedia) | CC BY 4.0 |
原始规范出处:《通用规范汉字表》(2013)、臺灣《常用國字標準字體表》(1982)、香港《常用字字形表》、日本《常用漢字表》(2010)与《学年別漢字配当表》(2017)、韩国《漢文教育用基礎漢字》(2000)。
逐字对照工具 tofu.tools 是本项目的先行者,同样用 Noto 系列区分地区字形。感谢 Plangothic 与 WenJin Mincho 的维护者提供生僻字补充字形。
字体为 Noto Sans CJK、Noto Serif CJK、Plangothic P1 与 WenJin Mincho P2(均为 SIL OFL 1.1)按本应用用字子集化后的产物。声明分别随附于 /notices/noto-ofl.txt、/notices/plangothic-ofl.txt 与 /notices/wenjin-mincho-ofl.md。生成的数据文件派生自上述来源,请遵守各自许可;逐项转换方式与署名也写入公开的 /notices/data-sources.md。
License
- 程序代码、UI 实现与项目原创文档:MIT。
- 除另有注明外,由汉智原创的数据库结构、数据选择与编排及原创元数据:CC BY 4.0。
- 第三方数据及其派生字段、字体与笔顺数据:继续适用上方列出的各自许可。
- “汉智”“Hanji”及官方 Logo 和品牌标识不属于上述授权;未经许可,公开发布的修改版本、Fork 或独立部署不得将其用作名称或品牌。可以如实说明“基于汉智开发”,但不得暗示其为官方版本或受到官方认可。
完整的授权范围、第三方例外与名称使用规则见 LICENSE。© Kevin Deng
Contributors


Similar repos


Languages
TypeScript
71.9%
Vue
25.3%
CSS
2.4%
README
汉智 · Hanji
一字之间,照见五地字形
把同一个汉字并排、叠印,照见中国大陆、香港、台湾、日本与韩国之间细微而真实的字形差异。
中国大陆、香港、台湾、日本、韩国五地常用汉字的字表。本应用对照的是通用黑体与宋体中的印刷字形:同一个字,在各地可能呈现不同字形。这里把五地字形并排列出,默认按界面语言对应地区的字频排序,也可按笔画或码点排序,并按差异模式筛选。韩国没有字频数据,韩国列默认关闭,可在显示选项中启用。
字形只是其中一个维度。收录范围是五地常用字表的并集,字形完全相同的字同样收录:这是一份五地汉字的资料表,不是一份差异清单。
下面是概要,逐条的完整说明在应用内的「关于」页。
名字的由来
「Hanji」跟汉字在各地的叫法各差一个字母:汉语拼音的 hanzi 差一个 z,日语的 kanji 差一个 k,韩语的 hanja 差一个 a——同一件东西,每个地方都改掉一点点。它同时也是闽南语「漢字」的实际读音 hàn-jī,所以并非生造词,而是又一地的读法。中文名「汉智」取其音。
收录范围
收录《通用规范汉字表》(2013)、臺灣《常用國字標準字體表》(1982)、香港《常用字字形表》、日本《常用漢字表》(2010)、韩国《漢文教育用基礎漢字》(2000)五份字表的并集。韩国字表含 1,800 个常用汉字。把简繁、日本新旧字体和韩式异体这类跨码点的对应合并成一行后,共 8,449 行——其中 1,692 行五地字形完全一致,129 行五地各不相同。
台湾《次常用國字表》只为已有行提供二级收录状态和候选,不参与生成新行;其 6,343 个主条目中有 3,599 个独有条目明确在产品范围之外。
字组与数据语义
一行表示一个字组,五列分别是大陆、香港、台湾、日本和韩国的展示形。跨码点候选主要来自 OpenCC,韩式异体采用 Unicode IRG 收录提案所列对应,并由地区字表约束:
- 某地字表把两个字分开收录时保留两个字组,例如
着/著、欠/缺; - OpenCC 明确自包含的同字关系或五列完全相同的名称可以合并;至少有两个地区佐证的映射可作为确定的地区对应;
- 只有一个地区提供证据、而候选还属于另一字组时保守拆分,并在详情页显示双向“关系未确认”,例如
鎗/槍。
五列确定后才选择行名;已有中港台日证据时仍按原四地规则选择,以免新增的韩国列改变既有网址。主条目和括注收录都足以保住字组自身名称。日本旧字体也必须来自明确的 JPShinjitaiCharacters 关系,不能由行名与日本列不同反推。
每个地区格都有 primary(主条目)、glossed(括注异体)或 unlisted(未收录、显示参考形)状态。alternatives 只保存该地区收录且明确属于当前字组的其他形式;aka 只表示字组的其他名称;未确认关系只用于“另见”,不会进入搜索、网址别名、字典引用或字体集合。完整定义、构建保证和限制见 数据规则与已知限制。
字形差异是怎么判定的
判定使用 Adobe Source Han Sans 与 Source Han Serif,页面则用与它们同源的 Noto Sans CJK 与 Noto Serif CJK 显示结果。每套字体让中、港、台、日、韩五个地区共用一个字形池,并分别提供「Unicode 码点 → 字形编号(CID)」映射。两地映射到同一 CID,就视为同形。Adobe 已把这些映射以纯文本公开,因此不需要比对轮廓或渲染截图。
最终判定取黑体与宋体结果的并集:只要其中一款把两地画成同一字形,本应用就按同形处理。这能排除只出现在单款字体中的设计细节。例如 Source Han Sans 为约五分之一的日本常用汉字提供独立字形,其中约两百个在 Source Han Serif 并未区分(了、人、子、水、金都在其中);本应用不把这类差异算作地区规范差异。完整取舍见 数据规则与已知限制。
页面会按这份判定重新分组:被判为同形的格子统一借用组内一个地区的 Noto 字体,使屏幕上也真正呈现同一轮廓。相应地,被上述规则过滤的地区版本细小差异不会显示。tests/fonts.test.ts 会用 fontkit 取出生成字体的真实轮廓,逐字验证判定与画面显示一致。
明确的跨码点映射不会因为 Noto/Source Han 未收录目标字而退回原码点。例如 𬒗 → 𥗽 仍会显示为两个码点。构建会从当前数据自动收集 Noto 缺少但页面需要显示的码点,并生成项目内置的补充 WOFF2 子集:黑体取 Plangothic P1,宋体取 WenJin Mincho P2;所选字体缺少任一码点时,构建会明确失败。页面始终保留真正的 Unicode 文本,不依赖用户设备的本机字体。这两套补充字形只负责显示,不参与地区差异判定。
局限
- 本应用只比较通用黑体与宋体中的印刷字形,不涵盖手写习惯,也不以教科书体的示范字形为准。日语教科书体主要为日语教学设计,并没有与中、港、台、韩共享同一字形池的正式地区版本;若拼接风格相近但来源不同的字体,地区差异与字体自身的设计差异就无法分开。为了控制变量,本应用只能选用同时提供五地版本的同源字体系列。
- 判定的对象是 Source Han 的地区字形设计,不是各地标准本身。它是个高质量的代理——Adobe 的地区字形分别依据大陆《印刷通用汉字字形表》、台湾教育部《國字標準字體》、香港教育局《常用字字形表》、日本 JIS X 0208/0213、韩国 KS X 1001/1002。
- Source Han 的香港字形覆盖并不完整,「只有香港不同」这一类可能少报。
- 字表筛选、排序与详情页共用同一套地区笔画数:先取笔顺数据的实际笔画数;香港沿用笔顺功能的同形回退,依次尝试台湾、大陆、日本、韩国。没有笔顺数据时,再按
kAlternateTotalStrokes→ 日本的kRSAdobe_Japan1_6→kTotalStrokes顺延。例如 以 的五地笔画数是 4/5/5/5/5。 - 韩语读音取 Unihan 推荐的
kHangul,保留全部现代韩文单字音;它不根据词语语境替用户选择读音,也不另行推导头音法则。 - 未收录格显示的是传承参考形,不表示该地区实际采用或规范收录该形;“关系未确认”同样表示现有公开来源不足以裁决。
完整的数据规则与构建保证见 docs/known-issues.md。
声明
本应用是基于公开资料制作的字形对照工具,不是各地的规范、词典或教学材料。页面展示的是本应用采用的数据与自动规则所得的结果,不能据此断定某个字在当地只有这一种“正确”形式。
各地规范的适用范围和定义并不完全相同,字体也只是规范的一种设计实现。本应用会整理、转换并合并不同来源的数据,也会为未收录项补上参考字形;这些都是工程取舍,难免带来简化、遗漏与错误。
页面中的“同形”或“不同”只在上述资料、字体与规则内成立;地区的排列与分组只为方便对照,不表示优劣或立场。正式场合请以原始规范与词典为准;每个字的详情页都列有相应地区的字典链接。汉字数量巨大,出错难免,发现数据有误请提 issue。
开发
pnpm install
pnpm build:data   # 生成字表与字体子集,首次会下载约 302 MiB 原始数据,之后走缓存
pnpm update:sources # 检查并锁定新版第三方数据;有变化时下载并重新生成
pnpm dev
pnpm dev:pwa # 启用开发用 Service Worker,测试安装弹窗、Manifest 与 standalone 模式
pnpm test
pnpm generate # 静态应用(不生成 OG 图片)
pnpm build:og # 可选;生成完整 OG 图片
需要调试 PWA 安装体验时,用 pnpm dev:pwa 启动后在 Chromium 中打开 http://localhost:3000。开发 Service Worker 使用 Network Only 导航且不下载生产环境的完整离线缓存,因此不会干扰 HMR;完整离线行为仍应使用 pnpm generate 后的产物验证。安装入口不会自动弹出,仅在浏览器提供原生安装提示时显示:桌面端位于导航栏“关于”左侧,手机端位于首页“查看详情”右侧;iOS、Safari 等没有原生安装事件的环境不会显示入口。若浏览器仍控制着修改前的开发 Service Worker,请在 DevTools 的 Application 面板更新或注销它,再刷新一次。
每一行的地址是它的行名(/char/着)。五地展示形、aka 和 alternatives 也可作为地址,由客户端跳到所属的行——例如 /char/国、/char/郞、/char/缐,页面用 rel=canonical 指回行名地址;未确认关系不是地址别名。
字表 app/assets/data/chars.json 由 pnpm build:dataset 生成,不提交;静态生成直接读取源文件,浏览器则从固定的 /data/chars.json 加载,避免把约 3MiB JSON 当作 JavaScript 解析。“关于”页链接的也是这个地址。该地址已设置 Access-Control-Allow-Origin: *,可在遵守下文许可与第三方条款的前提下,通过 fetch、XHR 或直接链接跨域取用。它缓存 1 小时,过期后可在后台重新验证期间继续使用旧版本 1 天。来源与许可元数据直接维护在 shared/sources.ts,由页面和构建脚本共同导入,不再生成 sources.json。约 14MB 的字体子集生成到 public/fonts/,同样不提交,并通过固定的 /fonts/* URL 按需加载、每次复用前重新验证;笔顺与旗帜进入 Vite 资源图,由 /_nuxt/* 的长期 immutable 缓存安全复用。会变动而又需要稳定 URL 的 NOTICE 与 license 文本单独放在 public/notices/,每次使用前必须重新验证。构建前需先运行 pnpm build:data。原始下载缓存在 data/raw/ 下按类别存放(charlist/、opencc/、cmap/、font/、unihan/、frequency/、strokes/),已 gitignore;构建会清理从旧缓存恢复、但已不在当前来源清单中的文件。
部署
这是静态应用,.output/public 直接交给任意静态托管即可。线上部署由 GitHub Actions 构建后直传 Cloudflare Workers Static Assets:
main的 push 部署到 production;- 指向
main的 PR 通过wrangler versions upload部署到pr-<编号>preview alias,GitHub 会在 PR 中显示对应的 deployment 与访问地址,后续提交沿用同一个预览地址。
仓库需要配置两个 Actions secrets:
CLOUDFLARE_API_TOKEN:具有 Workers 脚本编辑权限的 API token;CLOUDFLARE_ACCOUNT_ID:Worker 所在的 Cloudflare account ID。
Cloudflare Worker 名称须为 hanji,与 wrangler.json 中的 name 一致。
请在 Cloudflare 的 Settings → Domains & Routes 中连接 production 域名。PR preview URL 保持开启。
需要页面访问量和 Web Vitals 时,请在实际域名所属账户的 Web Analytics → Add a site 中选择已由 Cloudflare 代理的 hostname,并使用 automatic setup。Cloudflare 会在边缘自动注入 beacon。
每个字组详情页都会生成独立 HTML;客户端页面共用 /data/chars.json,没有逐路由数据需要提取,因此关闭了会为每个字页额外生成空 _payload.json 的 payload extraction。地区异体别名不另外生成跳转页:它先由 Static Assets 返回 404.html 和 HTTP 404,再由 Nuxt 客户端中间件跳到所属行;搜索引擎不会把 alias 当作成功页面重复收录。真正未知的地址保持 HTTP 404。@nuxtjs/sitemap 会在静态生成时把全部 canonical 页面写入 /sitemap.xml,@nuxtjs/robots 生成 /robots.txt 并公布 sitemap 地址。两者的绝对 URL 默认使用 https://hanji.sxzz.moe,也可通过 NUXT_SITE_URL 覆盖;GitHub Actions 优先读取同名仓库变量,未设置时使用仓库 homepage。PR 预览构建通过 NUXT_SITE_ENV=preview 禁止索引。public/_headers 给带内容哈希的 _nuxt/* 设长期 immutable 缓存,让固定的 /fonts/*、/notices/*、sitemap 和 robots URL 使用 no-cache,并为 /data/chars.json 设置 1 小时的 max-age 与 1 天的 stale-while-revalidate。
第三方资产的具体 commit、GitHub release tag、官方附件标识与 SHA-256 记录在 data/sources.lock.json;需要升级时运行 pnpm update:sources。它会解析 GitHub 分支、最新 release 与 Unicode 版本,并重新校验没有版本号的官方直链;内容有变化时更新 lockfile 并直接重新生成数据,完全未变则跳过生成。构建时 pnpm build:data 会按 lockfile 下载并校验约 302 MiB 原始数据(其中 195 MiB 是十份 Noto CJK 字体,另有约 40 MiB 的两份补充字体);任何未显式更新的直链内容变化都会因校验和不符而失败,不会静默进入数据。Actions 分开缓存原始下载与生成字体:前者只由 lockfile 决定,后者由 lockfile、实际生成脚本、相关依赖、locale 与字表决定;字体输入完全不变时跳过数据生成。
笔顺分片由 pnpm build:dataset 生成到 app/assets/strokes/,不提交到仓库;部署流程会在测试和静态生成前重建,再由 Vite 输出带内容哈希的文件名。随附授权保留在 public/notices/ 的稳定 URL 下并要求重新验证。同一字组内,按笔画顺序排列的轮廓完全一致时只保存第一份变体及其中线,界面也把对应地区合并为一个选择项;页面加载时只获取一次所属分片,之后切换地区直接复用内存中的字组数据。整站使用这里解析出的轮廓数量作为首选笔画数。
本地也可构建后直传:
pnpm build:data
pnpm generate
pnpm build:og # 可选;需要完整社交分享资源时运行
pnpm preview:worker # http://localhost:8787
pnpm deploy
pnpm generate 只生成站点主体,OG 图片不会阻断本地开发或部署。需要在本地检查完整社交分享资源时,请在静态生成后单独运行 pnpm build:og。线上 GitHub Actions 会根据生成脚本、字形与字体输入、品牌文案、Logo 和依赖锁计算精确哈希;命中时恢复完整 OG 目录,未命中时才执行全量生成。
数据来源
| 用途 | 来源 | 许可 |
|---|---|---|
| 判定五地字形差异 | Adobe Source Han Sans / Serif(CMap 资源) | SIL OFL 1.1 |
| 页面展示用字体 | Noto Sans / Noto Serif(含 CJK) | SIL OFL 1.1 |
| 补充Noto未收录的黑体字形 | Plangothic P1 | SIL OFL 1.1 |
| 补充Noto未收录的宋体字形 | WenJin Mincho P2 | SIL OFL 1.1 |
| 简繁、港台异体、日本新旧字体对应 | OpenCC 开放中文转换 | Apache-2.0 |
| 中、台、日、韩笔顺动画与笔画数 | AnimCJK | Arphic Public License |
| 五地标准字表 | zispace/hanzi-chars | 仓库未声明 |
| 笔画数回退、读音 | Unicode Han Database (Unihan) | Unicode License v3 |
| 韩式异体对应 | Unicode IRG N2200(韩国教育用汉字提案) | Unicode License v3 |
| 大陆字频排名 | hanziDB.csv(Jun Da《现代汉语单字频率列表》) | MIT |
| 香港字频排名 | 粵典「語料庫單字使用頻率」 | Public Domain |
| 台湾字频排名 | 国家教育研究院《民國112年語料字頻表》 | 网站资料开放宣告(须注明出处) |
| 日本字频排名 | scriptin/kanji-frequency(Japanese Wikipedia) | CC BY 4.0 |
原始规范出处:《通用规范汉字表》(2013)、臺灣《常用國字標準字體表》(1982)、香港《常用字字形表》、日本《常用漢字表》(2010)与《学年別漢字配当表》(2017)、韩国《漢文教育用基礎漢字》(2000)。
逐字对照工具 tofu.tools 是本项目的先行者,同样用 Noto 系列区分地区字形。感谢 Plangothic 与 WenJin Mincho 的维护者提供生僻字补充字形。
字体为 Noto Sans CJK、Noto Serif CJK、Plangothic P1 与 WenJin Mincho P2(均为 SIL OFL 1.1)按本应用用字子集化后的产物。声明分别随附于 /notices/noto-ofl.txt、/notices/plangothic-ofl.txt 与 /notices/wenjin-mincho-ofl.md。生成的数据文件派生自上述来源,请遵守各自许可;逐项转换方式与署名也写入公开的 /notices/data-sources.md。
License
- 程序代码、UI 实现与项目原创文档:MIT。
- 除另有注明外,由汉智原创的数据库结构、数据选择与编排及原创元数据:CC BY 4.0。
- 第三方数据及其派生字段、字体与笔顺数据:继续适用上方列出的各自许可。
- “汉智”“Hanji”及官方 Logo 和品牌标识不属于上述授权;未经许可,公开发布的修改版本、Fork 或独立部署不得将其用作名称或品牌。可以如实说明“基于汉智开发”,但不得暗示其为官方版本或受到官方认可。
完整的授权范围、第三方例外与名称使用规则见 LICENSE。© Kevin Deng
Similar repos
Contributors
Languages
TypeScript
71.9%
Vue
25.3%
CSS
2.4%