
Qwen3.8-Flash-Next 177B MoE (ISTA GSQ-RCO IQ3_XXS) self-hosted on RTX 5090 Laptop (24GB VRAM + 64GB RAM) via Strata: up to 110 tok/s (100+ sustained), 256K full context, vision, MTP speculative decoding, reasoning default xhigh (max tier). GPU+CPU both saturated. 26 measured rounds, 7 quant tiers screened. 中英双语实测实录
See the codeREADME
Qwen3.8-Flash-Next 177B on an RTX 5090 Laptop
24 GB VRAM + 64 GB RAM · 256K Context · 110 tok/s peak · 100+ sustained · Vision Enabled
中文 | English →




⚡ Strata 引擎实测 —— 26 轮实测 · 7 个量化档位筛选 · 25+ 组参数扫描 · 峰值 110 tok/s
筛选过程:2 个引擎家族(传统 CPU-offload 引擎、Strata 0.1.27/0.1.28)、7 个量化档位(AtomicChat AD-3.84bpw / ISTA-DASLab Coder IQ1_M / Q2_0 / IQ2_XS / IQ3_XXS / IQ3_S / Qwen BF16)、25+ 组参数扫描、12 个假设逐一排除——最终落位唯一"最佳":
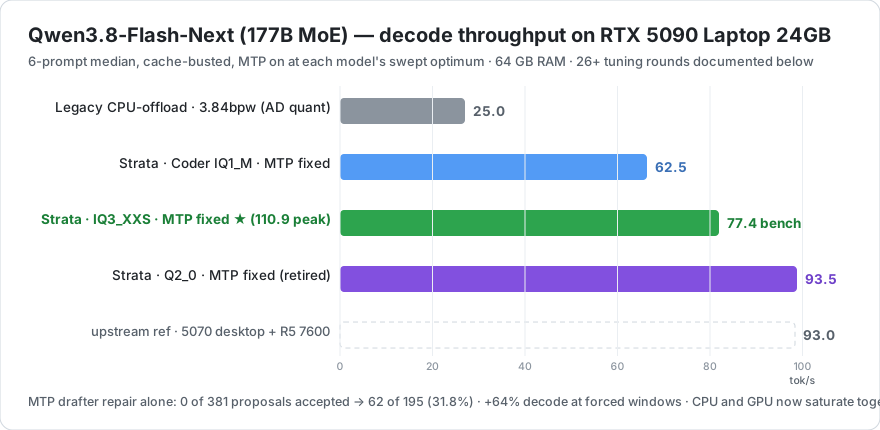
- 最佳选择(当前日常):ISTA-DASLab GSQ-RCO IQ3_XXS(512 专家完整版)· 基准 77.4 tok/s,日常真实负载峰值 110.9 tok/s、3000+ token 长输出仍 101-103 tok/s(256K + Vision 全开)
- 曾设"速度优先"线(Q2_0 · 93.5 tok/s):后被 IQ3_XXS 的真实负载速度全面反超——草稿接受率 78% 对 44-54%,质量档反而更快——速度线已无存在意义,退役(数据保留见下文实录)
- 附赠:ISTA-DASLab Coder IQ1_M(256/512 专家剪枝版,62.5 tok/s,内存减半,多开/超长上下文备选)
四个重点发现
- GPU 与 CPU 第一次同时占满:传统 CPU offload 方案 CPU 单核钉死 100%、GPU 闲 20-40%;Strata 三层架构(热专家显存缓存 + CPU 池 + MTP 流水线重叠)让两个处理器同时满载——这是数倍提升的结构性根因
- MTP 坏死之谜:31 个草稿层权重文件里 20 个因 HTTP Range 被镜像站忽略而下载损坏(存成了 shard 头部),sha256 校验无法发现;自编译引擎加 NaN 探针定位 → 重拉修复 → MTP 接受率 0% → 70.8%。完整复盘:docs/mtp-corruption-postmortem.md(已报上游 Strata#327,作者确认并于 v0.1.32 修复:强制校验 HTTP 206 + Content-Range、对照官方 pinned 版本逐张量 sha256、损坏自动重拉)
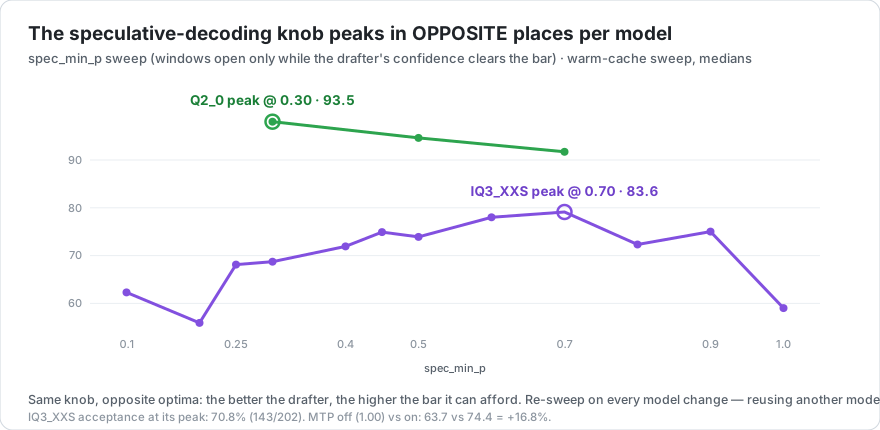
- spec_min_p 峰值随草稿质量漂移:Q2_0 峰在 0.3,IQ3_XXS 峰在 0.7——换模型必须重扫(见下方曲线)
- 256K 上下文几乎免费:KV streaming 下 65K/128K/256K 速度几乎相同,64GB 内存实测 256K 稳定;Vision 与 256K 并存(每图 ≤1024 token,单会话可塞 250+ 张图)
🤔 同一台 5090:本仓库 177B MoE vs 27B NVFP4 —— 怎么选?
两个仓库是同一台 RTX 5090 Laptop 24GB 上的两种使用姿势。差别不在谁更强,在这台电脑当时扮演什么角色:
| Flash-Next 177B MoE(本仓库) | Qwen3.8-27B NVFP4 | |
|---|---|---|
| decode 速度 | 峰值 110.9 / 长输出 101-103 tok/s | 74-78 tok/s |
| 稳定上下文 | 256K | 160K(180K 起是显存悬崖) |
| CPU | 打满(专家 CPU 池 + MTP 流水线与 GPU 同时满载) | 几乎闲置(全层常驻 GPU) |
| 内存 | ~40 GB(47 GB 专家的热层驻留 RAM) | 低(15.75 GB 权重 + KV 全在显存) |
| 显存 | 23.2-23.9 / 24 GiB | ~20 / 24 GiB |
| 跑模型时本机还能办公吗 | 很受限 —— CPU / 内存 / 显存全被吃满 | 没问题 —— CPU 和内存大量富余,只有显存紧张 |
| 正确角色 | 专用模型服务器:本机只做"模型提供者",其他设备经局域网 API 调用 | 同机助手:一边正常用电脑办公,一边用本地 AI |
一句话:这台电脑当"模型提供者"(本机不干别的)→ 用本仓库 Flash-Next;要在同一台电脑上一边工作一边用 → 用 27B NVFP4。
🚀 部署与启动(照着做即可)
引擎 Strata(MIT License),Windows/Linux 均可;只需 NVIDIA 驱动,Python 3.12 由安装器自动装到用户目录(无需管理员权限)。
① 安装引擎:按 Strata 官方 README 获取引擎(下载 release 的 strata-windows-x64.zip 解压,或 git clone 源码仓库)。
② 一条命令完成模型打包与配置(以我们的现役模型为例):
cd Strata/app

:: 最佳选择(本仓库当前日常):IQ3_XXS
python setup.py --family qwen --model IQ3_XXS --context 131072 --vision yes --port 8081 --yes --gguf-dir "D://models//Qwen3.8-Flash-Next-GSQ-RCO-GGUF"
--gguf-dir指向你已下载好的 GGUF 分片目录;不加这个参数 setup 会重新下载数十 GB- 首次运行会自动安装 Python 3.12、创建独立 .venv、下载引擎、打包专家 profile(也可双击
START-HERE.bat走交互式)
③ 启动:再次运行同一条命令或双击 START-HERE.bat,浏览器打开 http://127.0.0.1:8081/ 即可聊天与贴图(OpenAI / Anthropic API 同端口)。
④ 想要 256K 上下文:setup 出于保守会把 IQ3 系压到 128K。实测 64GB 内存下 256K 稳定——安装后编辑 strata-iq3_xxs.json:--max-context 改 262144,并追加 "--kv-resident", "32768"(KV 进内存、显存只留 32K 热窗),重启生效。详见上下文阶梯数据。
⑤ 验证 MTP 在工作:log 里 drafts accepted 必须非 0。若是 0 of 0 或 0 of N,先跑 tools/check_dense.py 体检草稿层权重——大概率是下载损坏(完整方法见事故复盘)。
⑥ 思考与并发(接入客户端前必读):
- 思考默认 = xhigh(最高档)——聊天模板出厂写死。档位体系:
xhigh(默认)>medium>low;没有 high 档(会被自动升为 xhigh)。日常想快可传reasoning_effort: low(思考变"简短直给",出答案明显更快),复杂推理保持默认 - 并发 = 无,FIFO 串行:HTTP 层多线程接得住并发连接,但推理层一把 FIFO 锁——同一时刻只有一条 decode 在跑,后来的请求排队等待(不丢不拒绝,
GET /status可看队列)。单人使用无感;多人/多客户端同时用会依次等 - 默认 max_tokens:客户端不传时引擎会给默认值,但思考型模型建议始终显式传 ≥600
License 与合规:引擎 Strata 为 MIT;llama.cpp / ggml 为 MIT;模型权重 license 以各 HF 页面为准(GSQ-RCO 系列页标注 Apache-2.0,继承 base model)。本仓库只含自测数据与工具,不再分发任何模型权重;所有商标归各自所有者。
Strata 时代 18 轮调优明细
| 轮 | 动作 | 结果 | 决策 |
|---|---|---|---|
| R1 | Strata 0.1.27 安装 + Coder IQ1_M 首测 | 58.4 tok/s | 引擎可行(vs llama.cpp +133%),继续 |
| R2 | Q2_0 打包 + 首测 | 66.7 tok/s | MTP 异常浮现(0 of 0) |
| R3 | 采样参数全扫(温度/seed/长度) | 无变化 | 排除 |
| R4 | 专家数错配假设 → 换 512 专家完整版 | 仍 0 | 排除 |
| R5 | draft_vocab 缺 CJK 检查(上游 #137) | 已是修复版 | 排除 |
| R6 | IQ 内核宽度分歧(上游 #152)→ 绕过实测 | 仍 0 | 排除 |
| R7 | 读引擎源码:0 of 0 语义 | T 恒为 1 | 关键转折:草稿从未被提出 |
| R8 | 强制开窗(spec_min_p=0) | 0 of 765 | 草稿提出即全错 → 草稿层本身坏 |
| R9 | 自编译引擎 + NaN 探针 | dprob=NaN | 前向第一个 matmul 即崩 → 锁定权重内容 |
| R10 | 权重文件逐个审计 | 20/31 是 shard 头 | 根因:Range 被镜像忽略 |
| R11 | 重拉 20 文件 + 重打包 + 验证全绿 | 62 of 195 | MTP 复活(+64%) |
| R12 | Q2_0 spec_min_p 扫描 | 峰 0.3 = 93.5 | 固化 |
| R13 | 升级引擎 0.1.28 + 复测 | 行为不变 | 排除版本因素 |
| R14 | IQ3_XXS 部署 + 扫描 | 峰 0.7 = 77.4 | 固化(质量优先线) |
| R15 | 上下文阶梯 32K/65K/128K/256K | 256K 稳定 | KV streaming 配置拉满 |
| R16 | Vision 挂载 + 识别验证 | 全对 | 74.4 tok/s @256K+Vision |
| R17 | spec 6 / k8v4 / pcie_frac 复扫 | 均不如现配置 | 否决并记录 |
| R18 | 防缓存公平复测(双语 README + postmortem + issue#327) | 74.4 定稿 | 交付 |
📘 Strata 完整实录(中文) → docs/strata-log.zh.md | English 🔬 MTP 损坏事故复盘 → docs/mtp-corruption-postmortem.md(上游 Strata#327) 🧪 原始数据 → results/strata-*.txt 🛠 修复工具 → tools/
模型档案:我们用过的每一个量化(优势 / 为什么选 / 最终结果)
全程涉及 4 个模型仓库、7 个量化档位。总表 + 逐个档案如下。
量化机构与量化学派速览
- ISTA-DASLab(奥地利科学技术研究所 Deep Algorithms and Systems Lab,GPTQ 与 QuIP# 的提出者,低比特量化领域最权威的研究组之一)—— 本次主力仓库,使用其自研的 GSQ(Gumbel-Softmax Quantization,2~3bit 逼近矢量量化精度的标量量化)与 RCO(Riemannian Constrained Optimization,在总比特预算下逐张量分配量化类型)两种有论文的方法,产出 GSQ-RCO 系列
- AtomicChat —— AD 系列逐层动态精度量化(AD-5.00bpw-Q5_K_M / AD-4.27bpw-Q4_K_M / AD-3.84bpw-IQ4_XS-M64),llama.cpp 时代的主力供应商
- Unsloth(UD 系列)—— 曾进入候选池,经体积与分片评估后淘汰
- Qwen 团队(阿里巴巴通义千问)—— Qwen3.8-Flash-Next 原始模型(176B MoE,混合 GDN/QSA 架构)与 MTP 草稿层权重的唯一来源
| # | 模型 / 量化 | 精度 | 仓库 | 状态 |
|---|---|---|---|---|
| 1 | AtomicChat AD-3.84bpw-IQ4_XS-M64 | 3.84 bpw | AtomicChat/Qwen3.8-Flash-Next-GGUF | llama.cpp 时代主力 |
| 2 | ISTA-DASLab GSQ-RCO Q2_0 | ~2.2 bpw | ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF | ⬜ 退役(原速度线,被 IQ3_XXS 反超) |
| 3 | ISTA-DASLab GSQ-RCO IQ3_XXS | ~3.1 bpw | 同上 | ✅ 现役(最佳选择) |
| 4 | ISTA-DASLab GSQ-RCO IQ3_S | ~3.44 bpw | 同上 | ⛔ 评估后否决 |
| 5 | ISTA-DASLab GSQ-RCO IQ2_XS | ~2.5 bpw | 同上 | ⛔ 评估后未部署 |
| 6 | ISTA-DASLab Coder IQ1_M(256/512 专家剪枝) | 1.89 bpw | ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF | ✅ 备选(省内存线) |
| 7 | Qwen(阿里巴巴通义千问团队)BF16 官方 checkpoint | 16 bpw | Qwen/Qwen3.8-Flash-Next | 🔧 仅作 MTP 权重源 |
| 8 | mmproj BF16 Vision Encoder | — | GSQ-RCO 仓库内 | ✅ 现役 |
1️⃣ AtomicChat AD-3.84bpw-IQ4_XS-M64 —— llama.cpp 时代的主力
- 优势:4-bit 档少见的"动态逐层精度"量化(AD = AtomicChat Dynamic),精度与显存的平衡点;M64 分片让 llama.cpp 能在 24GB 显存跑通 177B MoE
- 为什么选:llama.cpp 时代它是唯一兼顾质量与速度、且社区验证过的选择
- 结果:22-25 tok/s。暴露了 llama.cpp 的结构性问题——CPU 单核 100%、GPU 闲 20-40%,任何调参都绕不过去。由此转向 Strata
2️⃣ ISTA-DASLab GSQ-RCO Q2_0 —— 速度王 ★
- 优势:2-bit 但有 GSQ(Gumbel-Softmax)+ RCO(逐张量精度分配)两篇论文方法背书,2-bit 下逼近矢量量化精度;专家 blob 最小 → 显存能塞最多热专家(13,212 slots,98%+ 命中)
- 为什么选:确认 Strata 的 GPU 缓存架构后,专家 blob 越小命中率越高、MTP 收益越能全额兑现——纯速度打法的最优解
- 结果:93.5 tok/s(spec_min_p=0.3),追平桌面 5070 参考值;草稿接受率 44-54%
3️⃣ ISTA-DASLab GSQ-RCO IQ3_XXS —— 质量线(当前日常)
- 优势:3-bit i-quant,质量高一档;草稿质量也是三个部署版本里最好的(接受率 59-71%)
- 为什么选:长项目/推理密集场景需要更低的量化损失;且 arena 42.9GB 在 64GB 内存上给 256K 上下文留足余量
- 结果:77.4 tok/s(32K)/ 74.4 tok/s(256K+Vision)。注意它的 spec_min_p 峰值在 0.7 与 Q2_0 的 0.3 完全不同
4️⃣ ISTA-DASLab GSQ-RCO IQ3_S —— 评估后否决
- 优势:3.5-bit,官方基准上匹配完整 BF16 模型——三档里质量最高
- 为什么放弃:arena 50.3 GB pinned,256K 上下文的 KV 还要 3.1 GB——64GB 内存的机器上只剩 ~10GB 给系统,官方自己也标注"64 GB PC with little else running"。256K 是硬需求,这个组合风险不可接受
- 复活条件:内存升级到 96GB 后即可启用(见 内存升级 96GB 可行性分析 本地文档)
5️⃣ ISTA-DASLab GSQ-RCO IQ2_XS —— 评估后未部署
- 优势:2-bit i-quant,质量略好于 Q2_0,速度官方描述"close in speed"
- 为什么没上:Q2_0 已实测 93.5 且 IQ2_XS 的质量增量介于 Q2_0 与 IQ3_XXS 之间——质量需求出现时我们直接跳了 IQ3_XXS,中间档没有部署价值
- 保留意见:若需要"比 Q2_0 好一点但比 IQ3_XXS 快很多"的档位,它是现成候选
6️⃣ ISTA-DASLab Coder IQ1_M —— 省内存线(备选)
- 优势:官方把 512 专家剪枝到 256(专门保留代码、工具、视觉相关的专家),arena 只有 23.4GB——内存减半;存储密度反而是"IQ3_S like"的 3.5bit
- 为什么选:内存紧张时多开实例、或需要 32K 以上上下文且不想动用 streaming 的场景
- 结果:62.5 tok/s(MTP 修复后);官方数据非代码领域弱于完整版,与我们"剪枝专家"的预期一致
7️⃣ Qwen(阿里巴巴通义千问)BF16 官方 checkpoint —— 只取 MTP 权重
- 优势:无损原版,一切量化的理论上限;354GB 显然无法本地部署
- 为什么还下载它:Strata 的 MTP 草稿层权重只存在于 BF16 checkpoint 的
mtp.*张量里(GSQ-RCO 量化版不带)——用 HTTP Range 精准拉取 5.2GB 而非 360GB 全量 - 结果:间接导致本次最大的坑(MTP 权重损坏事故),也间接产出了检测/修复工具链
8️⃣ mmproj BF16 Vision Encoder —— 视觉能力
- 优势:27 层 ViT + projector,1,024 token/图上限,GPU 编码 0.1-0.5s/张
- 为什么选:Vision 是硬需求;0.9GB 一次下载
- 结果:挂载成功,识别验证全对,256K+Vision 并存速度损失约 16%
这是什么 / What this is
在一台消费级笔记本上跑通 177B 参数的 MoE 大模型 —— 不是"能加载",而是能日常使用:
- 256K 上下文开满(约 19.2 万字,整本书的量级)
- 25.0 tok/s 生成速度(约等于每秒 15 个汉字,比人阅读快)
- 图像识别可用(保留视觉能力)
- 显存占用 23.4 / 24 GB,长期稳定运行
本仓库记录了从零开始的完整调优过程:量化选型、三层内存分配、参数扫描、以及 12 项试过但无效的方向(避免重复踩坑)。
📘 可视化速查页 → index.html 🧪 原始实测数据 → results/ 🛠 可复用测试工具 → tools/ 📄 深度实录 → 中文 | English 🔧 移植到其他硬件 → porting-guide.md
目录
成果总览 / Results at a glance
| 指标 / Metric | 最终 / Final |
|---|---|
| 生成速度 Generation | 25.0 tok/s |
| 上下文 Context | 262,144 tokens = 256K(模型全长) |
| 量化 Quant | AD-3.84bpw-IQ4_XS-M64(79.10 GiB / 28 分片) |
| KV 缓存 | q8_0(精度实测无损) |
| 显存占用 VRAM | 23.4 / 24 GiB |
| 系统内存 RAM | ~33 GB 常驻(专家层) |
| 视觉能力 Vision | ✅ mmproj-F16(+0.85 GiB) |
| MTP 推测解码 | ❌ 未启用(实测负收益,见第 6 步) |
上下文档位对照 / Context tiers
| 场景 | 上下文 | ncmoe | 实测 decode | 显存 |
|---|---|---|---|---|
| ⚡ 极速 | 114,688(112K) | 32 | 27.12 tok/s | 23.2 GiB |
| 均衡 | 163,840(160K) | 33 | 25.83 tok/s | 23.3 GiB |
| 长文档 | 196,608(192K) | 34 | 25.31 tok/s | 23.1 GiB |
| 🏆 全长(推荐) | 262,144(256K) | 36 | 25.08 tok/s | 23.4 GiB |
为什么推荐 256K:它只比 112K 慢 7.5%,但上下文是 2.3 倍 —— 容量收益远大于速度损失。
先下载模型 / Get the model
本方案使用的模型与配套文件,全部来自公开的 Hugging Face 仓库(Qwen Community License 1.0):
| 文件 | 说明 | 大小 | 来源 |
|---|---|---|---|
| ⭐ AD-3.84bpw-IQ4_XS-M64 | 主模型(28 分片) | 84.9 GB | AtomicChat/Qwen3.8-Flash-Next-GGUF |
| mmproj-Qwen3.8-Flash-Next-F16.gguf | 视觉投影(图像识别,可选) | 0.85 GB | 同一仓库 |
| llama.cpp | 推理引擎(需支持 Qwen3.8-Flash-Next 架构的构建) | — | ggml-org/llama.cpp |
| Qwen/Qwen3.8-Flash-Next | 原始权重(仅参考,无需下载) | — | Qwen 官方 |
# 下载主模型 + 视觉投影(支持断点续传)
pip install -U "huggingface_hub[cli]"
hf download AtomicChat/Qwen3.8-Flash-Next-GGUF \
  --include "*3.84bpw*" --include "*mmproj*" \
  --local-dir D:\models\Qwen3.8-Flash-Next
[!IMPORTANT] 务必选择 AtomicChat 的
-M64版本,不要用其他发布方的同类量化。区别不在位宽,而在分片布局:只有 AtomicChat 把 N-gram 表(35.8 GB)放进独立分片。 其他发布方(如 unsloth 的 UD 系列)把表与专家混装 —— 一旦该分片被访问,整片(几十 GB)都会被锁进内存,在 64 GB 机器上直接压垮。
实测对比:混淆分片的量化会出现"长对话到 60K~100K token 时静默崩溃";AtomicChat 版本可塞满整个 256K 上下文稳定运行。
硬件前提:24GB 显存 + 64GB 内存 + NVMe SSD(本方案的实测配置)。
三分钟上手 / Quick start
1. 启动
llama-server \
  -m Qwen3.8-Flash-Next-AD-3.84bpw-IQ4_XS-M64-00001-of-00028.gguf \
  -ngl 99 --n-cpu-moe 36 \
  -fa on -fit off \
  -c 262144 -np 1 \
  -ctk q8_0 -ctv q8_0 \
  --load-mode dio \
  -mm mmproj-Qwen3.8-Flash-Next-F16.gguf \
  --jinja --alias qwen3.8-flash-next \
  --host 127.0.0.1 --port 8080
⚠️ 注意:不含
-md/--spec-type—— MTP 已停用(负收益,见下)。 加载约 30~60 秒。看到listening on http://127.0.0.1:8080即就绪。
2. 客户端配置
| 项 | 值 |
|---|---|
| API 类型 | OpenAI 兼容 |
| Base URL | http://127.0.0.1:8080/v1 |
| 模型名 | qwen3.8-flash-next |
| API Key | 任意(如 sk-local) |
| 流式输出 | 务必开启 |
| 上下文长度 | 262144 |
| max_tokens | 16000(思考量大,设小了会"想完没答案") |
| 思考强度 | 不传即默认 xhigh(服务端默认值) |
3. 三条纪律
- 只开一个实例 —— 多开必爆显存(每个要 23GB)
- 用完就关 —— 常驻占 23GB 显存
- 改配置后必须重启进程 —— 参数只在启动时读取
架构:三层卸载 / Three-tier split
核心思路:按访问频率分配存储,而不是一味往显存塞。
| 位置 | 放什么 | 原因 | 占用 |
|---|---|---|---|
| 显存 24GB | 注意力层 + 12 层专家 + KV 缓存 + 图像投影 | 每 token 都要用,带宽 1.8 TB/s | 23.4 GB |
| 内存 64GB | 其余 36 层专家 | 稀疏激活(每 token 只用 10/512 个),带宽 62 GB/s 够用 | ~33 GB |
| 固态 NVMe | N-gram 查表(35.8GB) | dio 模式直读,不占内存 | 35.8 GB |
为什么这样拆:注意力每 token 都要用,必须放带宽最高的显存;专家层稀疏激活,可以放带宽低但容量大的内存里由 CPU 计算。这样 79GB 的模型才能在 24GB 显存上跑起来。
瓶颈在哪
实测推理期间 GPU 利用率约 25%,CPU 接近满载。这是"专家由 CPU 计算"的必然:
每生成 1 个 token 要依次走完 48 层:
GPU 算第1层注意力 → CPU 算第1层专家 → GPU 算第2层注意力 → CPU 算第2层专家 → ... ×48
      ↑ 工作              ↑ 干等              ↑ 工作              ↑ 干等
要填满 GPU,唯一办法是把更多专家放进显存 —— 而显存已经满了。
对比参考:若 79GB 模型能全放显存(约需 4 张 5090),利用率可达 80%+。
完整调优历程(8 步)
从"能跑"到"跑到硬件极限"。每步记录做了什么 / 发现了什么 / 为什么有效。
第 0 步 · 选对量化布局(决定性)
筛除条件不是位宽,而是分片布局 —— N-gram 表(35.76 GiB)是否独占分片:
| 量化版本 | 大小 | 分片布局 | 本机实测 | 判定 |
|---|---|---|---|---|
| ⭐ AD-4.27bpw-Q4_K_M-M64 | 88.03 GiB / 33 片 | ✅ 表独占 | 21.7(32K)/ 24.6–28.2(64K) | ✅ 原主力 |
| ⭐ AD-3.84bpw-IQ4_XS-M64 | 79.10 GiB / 28 片 | ✅ 表独占 | 25.0 tok/s(256K) | ✅ 现主力 |
| AD-5.00bpw-Q5_K_M-M64 | 102.93 GiB / 33 片 | ✅ 表独占(表 50.66 GiB) | 未测 | ⚠️ 表太大,SSD 读压力上升 |
| unsloth UD-IQ4_XS | 87.25 GiB / 3 片 | ❌ 表与专家混装 | 未测 | ❌ 不可用:整片锁进内存,最坏 89.6 GiB 常驻 > 64 GiB |
| unsloth UD-Q3_K_XL | 83.80 GiB / 3 片 | ❌ 混装 | 未测 | ❌ 同上 |
| NVFP4 | — | — | — | ❌ 该模型无此版本(164 个文件全量枚举,零命中) |
为什么布局是决定性的:GGUF 分片是 mmap 的最小单位。如果表与专家混在同一片里,一旦这片被访问,整片(可能几十 GB)都会进内存 —— 在 64GB 内存的机器上直接压垮。只有"表独占分片"的布局,才能让 dio/mmap 精确地按需分页。
为什么最终选 3.84bpw:除了布局,它还是"速度 vs 质量"的平衡点 ——
| 4.27bpw | 3.84bpw | |
|---|---|---|
| 体积 | 88.03 GB | 79.10 GB |
| 专家量化 | IQ2_S(2.5 bit) | IQ4_XS(4.25 bit) |
| 可用内存 | 12.8 GB | 26.2 GB |
反直觉的一点:3.84bpw 的专家精度更高(4.25bit vs 2.5bit),它是靠压缩其他部分来控制总体积的。换过去不是降级。
第 1 步 · 让 79GB 模型跑进 24GB 显存 —— --n-cpu-moe
-ngl 99              ← 所有层上 GPU(关键:不要为了塞模型调低它!)
--n-cpu-moe 36       ← 前 36 层的【专家权重】放 CPU
关键认识:不要沿用稠密模型的思路去调 -ngl。MoE 应该让注意力层全部留在显存(每 token 都用),只把路由专家(稀疏激活)挪到内存。
两类静默失败要防:
| 失败类型 | 症状 | 原因 |
|---|---|---|
| CUDA 运行时缺失 | 速度掉到个位数,无报错 | 静默退回 CPU 计算 |
| 显存溢出 | 慢 30 倍,无报错 | 静默走 PCIe |
第 2 步 · KV 量化(q8_0)—— 性价比最高的一档
KV 缓存不参与计算却占着显存。量化它 → 省下的显存换更多专家层:
| 配置 | ncmoe | 生成速度 | 长上下文召回精度 |
|---|---|---|---|
| f16 KV(基线) | 42 | 21.34 tok/s | 12/12 = 100% |
| q8_0 KV ⭐ | 38 | 22.07(+3.4%) | 12/12 = 100% |
| q4_0 KV | 36 | 25.03(未更快) | 12/12 = 100% |
精度用**多轮随机化「大海捞针」**验证:9.7k token 文档、3 个事实埋在随机深度、同种子跨配置对比、检查
finish_reason排除截断假象。
结论:q8_0 精度无损且提速 3.4%。
第 3 步 · dio 加载模式 —— 省 13GB 内存
--load-mode dio ← 绕过系统页缓存,直读 SSD
效果:可用内存从 7GB → 20GB。N-gram 表(35.8GB)不再被页缓存重复占用。
为什么可行:NVMe 随机读带宽(1.3GB/s+)足够喂饱 CPU 侧专家计算,页缓存的收益抵不上它挤占的内存。
第 4 步 · 换 3.84bpw 小模型 —— 省 8.9GB,多放 4 层专家
关键链条:
模型 88.03GB → 79.10GB(省 8.94GB)
  → 显存占用降 2.4GB
  → 可多放 4 层专家进显存
  → CPU 侧负担减轻 → 提速
  → 同时内存占用也降 → 可用内存 12.8GB → 26.2GB
双赢:速度和内存同时改善。
第 5 步 · 上下文调优 —— 找到"显存压力临界点"
| 上下文 | ncmoe | decode | vs 128K |
|---|---|---|---|
| 128K | 36 | 21.60 tok/s | 基准 |
| 112K | 36 | 24.98 tok/s | +15.6% |
| 96K | 36 | 24.57 tok/s | +13.7% |
| 80K | 36 | 25.37 tok/s | +17.4% |
| 64K | 35 | 25.81 tok/s | +19.5% |
| 32K | 35 | 26.61 tok/s | +23.2% |
发现:128K → 112K 只减 16K 就快 15.6%。存在一个"显存压力临界点" —— 128K 时显存被压得太满,各种分配开销都在最高档。
第 6 步 · ⭐ 关掉 MTP —— 最大的单项收益(+23%)
这一步推翻了最初的假设。
MTP(Multi-Token Prediction)推测解码的直觉是"草稿模型先猜、主模型一次验证"能省前向次数。但在 MoE + CPU 专家的架构下,它是负收益:
| 配置 | 显存 | decode |
|---|---|---|
| MTP 开 + ncmoe=36 | 23.5 GB | 22.0 tok/s |
| MTP 关 + ncmoe=36 | 20.2 GB | 25.4 tok/s |
| MTP 关 + ncmoe=34 | 21.1 GB | 26.93 tok/s |
| MTP 关 + ncmoe=32 | 23.2 GB | 27.12 tok/s |
为什么是负收益:推测解码的验证批要读取"多个候选 token 激活专家的并集" —— 在专家大部分驻留内存的架构下,这会把内存流量放大。省下的前向次数,抵不过多读的专家权重。
而且它还白占 3.5GB 显存(草稿模型 + 自己的 KV)。关掉后这 3.5GB 能换 4 层专家进显存。
代价:无。速度、显存双赢。
第 7 步 · 把省下的显存全部换成专家层
关掉 MTP 省下 3.5GB → ncmoe 从 36 降到 32 → 刷新纪录。
最终显存账本:
| 项目 | 占用 |
|---|---|
| 12 层专家(48−36) | ~12.4 GB |
| KV 缓存(256K, q8_0) | ~4.3 GB |
| 注意力等非专家张量 | ~4.8 GB |
| mmproj(图像识别) | ~0.85 GB |
| 计算缓冲 | ~1.2 GB |
| 合计 | ~23.4 GB |
性能实测数据
所有数据来自服务端日志的
eval time(只计纯生成时间),temperature=0固定输出长度保证可比。
生成速度
| 场景 | 速度 |
|---|---|
| 短输出(100~200 token) | 27~30 tok/s |
| 中输出(500 token) | 25~27 tok/s |
| 256K 全长配置 | 25.0 tok/s |
首字节等待(决定"感觉快不快")
| 输入长度 | 首字节 | 说明 |
|---|---|---|
| 1K token | 1~3 秒 | 日常短问,体验流畅 |
| 4K token | 约 12 秒 | 短文 |
| 8K token | 约 25 秒 | 中等文档 |
| 12.6K token | 约 40 秒 | 长文档 |
| 32K token | 约 100 秒 | 超长文档 |
| 256K token | 约 11 分钟 | 极限(整本书) |
prefill 速度约 320~400 tok/s。这不是故障 —— 多轮对话中第 2 轮起会快很多(prompt cache 复用历史 KV)。
MTP 调参(已排除的方向)
| n-max | decode | draft 接受率 |
|---|---|---|
| 2 | 20.30 tok/s | 0.484 |
| 4 | ~22.0 tok/s | 0.48~0.52 |
| 6 | 12.77 tok/s | 0.275 |
已全部废弃 —— 因为 MTP 本身就是负收益(见第 6 步)。
思考强度(reasoning_effort)
| 档位 | 首字节 | 总耗时 | 思考量 | 适用 |
|---|---|---|---|---|
low | 1.35s | 16.13s | 376 字 | 日常问答 |
medium | 0.94s | 15.34s | 370 字 | 一般任务 |
xhigh(默认) | 0.81s | 16.96s | 640 字 | 复杂推理 |
按难度分化:
| 题目 | low | medium | xhigh |
|---|---|---|---|
| 常识 | 7.05s | 5.64s | 5.71s |
| 数学 | 19.42s | 18.54s | 19.52s |
| 逻辑(难) | 21.92s | 21.85s | 25.65s(思考 1461 字) |
⚠️ 难题在 xhigh 下思考量可达 5700+ 字符(约 3000 token) ——
max_tokens设小了会出现"想完了但没答案"。建议 16000。
试过但无效的(12 项)
| 尝试 | 结果 | 原因 |
|---|---|---|
| MTP 全系列(开关 / n-max 调参 / 挪 CPU / KV 量化) | −11% ~ −19% | 见第 6 步 |
--cpu-strict 1(CPU 核心绑定) | +0.2% | 噪声 |
--prio 2(进程优先级) | −0.8% | 无改善 |
-b 4096(更大批处理) | ±0% | 无改善 |
--poll 0(关线程自旋) | −2% | 无改善 |
-ub 1024 | OOM | 计算缓冲随 ubatch 增大 |
| ncmoe < 30 | OOM | 显存不够 |
| KV 降到 q4_0 | 不更快 | 量化开销抵消显存收益 |
| 关闭 VBS / HVCI | ≈0 | VBS 开销在系统调用与页表,瓶颈是 CPU 矩阵运算 |
| 换新引擎(b10889) | 无提升 | 生成受内存带宽限制,内核升级优化算力路径 |
KV 放内存(-nkvo) | 不可行 | 每 token 读 KV → 带宽压力 |
--chat-template-kwargs 固定思考档 | 失败 | 会破坏模板(且默认已是 xhigh,无需) |
FAQ
Q: 为什么不用 NVFP4?Blackwell 不是原生支持吗?
A: 三个层次:
- 这个模型没有 NVFP4 版本(两个发布方共 164 个文件全量枚举,无 FP4 量化)
- 生成瓶颈是内存带宽不是算力 —— FP4 张量核加速的是矩阵乘法,帮不到"每 token 从内存读专家权重"。实测 NVFP4 只加速 prefill(+43~68%),decode 完全不变(~0%)
- NVFP4 等效约 4.5 bpw,比现用的 3.84 bpw 更大,在内存受限场景反而更慢
Q: 为什么用 llama.cpp,不用 vLLM / TensorRT-LLM?
A: 只有 llama.cpp 提供 --n-cpu-moe 这种按层把专家留在内存的精细控制,以及 mmap 分片按需分页 —— 这两点是 24G 显存跑 79GB 模型的前提。(vLLM/SGLang 的 expert 粒度 offload 还在 RFC 阶段)
Q: 上下文最多能开多大?
A: 本机实测能开满 256K,速度 25.08 tok/s。自算公式:
VRAM ≈ 4.4 + (48−ncmoe)×1.03 + ctx×33KiB + 计算缓冲
Q: MTP 到底有没有用?
A: 在 MoE + CPU 专家的架构下,是负收益(实测关掉 +23%)。这是本仓库最反直觉的结论。
Q: GPU 利用率只有 25%,是不是浪费?
A: 不是,这是结构性的。 decode 是串行接力,GPU 在 CPU 算专家时只能干等。要填满 GPU 只能把更多专家放进显存,而显存已经满了。
Q: 内存升到 128GB 有帮助吗?
A: 对速度几乎没有(瓶颈是显存容量)。价值在"系统更从容"和"未来上更大模型"。注意本机 4 个插槽全满,升级需整组替换(4×32GB)。
Q: 生成速度还能再快吗?
A: 软件层面已经到底(12 项无效尝试)。剩余路径:
| 路径 | 预期 | 成本 |
|---|---|---|
| 更小量化(IQ3_S / IQ2_M) | +10~15%(质量待验证) | 需下载 |
| 更快内存(2×32GB → 5600 MT/s) | +7.7% 带宽 | ~¥800 |
| 换更大显存显卡 | 唯一大幅提升 | 高 |
Q: 会不会把内存撑爆?
A: 单实例实测内存峰值 85~95%,稳定运行。真正的风险是同时开多个实例 —— 每个要 23GB 显存,两个必爆。
硬件升级路径
| 方案 | 对速度的影响 | 对利用率的影响 | 成本 |
|---|---|---|---|
| 内存 64→128GB | 几乎没有 | 不能 | ~¥1500 |
| 内存换 2×32GB(5600 MT/s) | +7.7%(带宽) | 小幅 | ~¥800 |
| 显卡换 48GB 显存 | 可能翻倍 | 50~60% | 高 |
| 加第二张 24GB 卡 | 大幅 | 大幅 | 很高 |
结论:提速只能靠显存;内存升级只为"系统从容"。
关键结论
- 布局比位宽重要 —— N-gram 表是否独占分片,决定方案能否成立
- 两类静默失败要防 —— CUDA 缺失静默退回 CPU;显存溢出静默走 PCIe(慢 30 倍无报错)
- ⭐ MTP 在 MoE + CPU 专家下是负收益 —— 验证批的专家激活并集放大内存流量(实测关掉 +23%)
- KV 量化是性价比最高的一档 —— q8_0 精度无损(12/12),换专家层 +3.4~5%
dio省 13GB 内存 —— 让 N-gram 表留在 SSD- 上下文存在"显存压力临界点" —— 128K→112K 只减 16K 就快 15.6%
--n-cpu-moe是唯一的旋钮,且存在悬崖(本例 28 层即崩,26.9→4.7 tok/s)- 换引擎不会更快 —— 生成受内存带宽限制(实测无提升)
- 测速必须读服务端日志的
eval time—— 用 API 耗时推算会被冷启动和 prompt cache 干扰,误差可达 100% - 关掉 VBS 没有收益 —— 证明瓶颈是 CPU 算力/内存带宽的物理限制,不是软件虚拟化开销
硬件与软件
| 项目 | 规格 |
|---|---|
| GPU | RTX 5090 Laptop,24 GB 显存(24435 MiB 可见),compute capability 12.0 (sm_120) |
| CPU | Intel Core Ultra 9 275HX(24 线程) |
| 内存 | 64 GB DDR5-5200(4×16GB,最大可扩 128GB) |
| 存储 | NVMe SSD(模型 79.10 GiB) |
| 引擎 | llama.cpp(Unsloth b10840-mix-d5c17a0,cuda12-portable) |
| 模型 | Qwen3.8-Flash-Next GGUF,总参数 176.9B(含 51.2B N-gram 表) |
| 视觉 | mmproj-F16(0.85 GiB) |
| 系统优化 | Defender 排除模型目录;VBS/HVCI 已关闭(实测无影响) |
仓库结构
├── README.md                     ← 本页
├── README.en.md                  ← English
├── index.html                    ← 可视化速查页
├── assets/                       ← 图表 (SVG)
├── docs/
│   ├── deploy-log.zh.md          ← 完整实录(中文)
│   ├── deploy-log.en.md          ← Full write-up (English)
│   ├── model-reference.md        ← 架构参数、量化对照、NVFP4 说明
│   └── porting-guide.md          ← 移植公式与硬件对照表
├── results/                      ← 原始实测输出
└── tools/                        ← 可复用测试工具
免责声明
- 所有数据均为单机实测,硬件/驱动/构建版本不同结果会有差异;
- 模型权重与量化文件版权归各自发布方;
- 测试脚本会自动结束 llama-server 进程,请勿在有其他推理服务运行时使用。
License
MIT(仅适用于本仓库的文档与脚本)
Similar repos


Qwen3.8-Flash-Next 177B MoE (ISTA GSQ-RCO IQ3_XXS) self-hosted on RTX 5090 Laptop (24GB VRAM + 64GB RAM) via Strata: up to 110 tok/s (100+ sustained), 256K full context, vision, MTP speculative decoding, reasoning default xhigh (max tier). GPU+CPU both saturated. 26 measured rounds, 7 quant tiers screened. 中英双语实测实录
See the codeREADME
Qwen3.8-Flash-Next 177B on an RTX 5090 Laptop
24 GB VRAM + 64 GB RAM · 256K Context · 110 tok/s peak · 100+ sustained · Vision Enabled
中文 | English →
⚡ Strata 引擎实测 —— 26 轮实测 · 7 个量化档位筛选 · 25+ 组参数扫描 · 峰值 110 tok/s
筛选过程:2 个引擎家族(传统 CPU-offload 引擎、Strata 0.1.27/0.1.28)、7 个量化档位(AtomicChat AD-3.84bpw / ISTA-DASLab Coder IQ1_M / Q2_0 / IQ2_XS / IQ3_XXS / IQ3_S / Qwen BF16)、25+ 组参数扫描、12 个假设逐一排除——最终落位唯一"最佳":
- 最佳选择(当前日常):ISTA-DASLab GSQ-RCO IQ3_XXS(512 专家完整版)· 基准 77.4 tok/s,日常真实负载峰值 110.9 tok/s、3000+ token 长输出仍 101-103 tok/s(256K + Vision 全开)
- 曾设"速度优先"线(Q2_0 · 93.5 tok/s):后被 IQ3_XXS 的真实负载速度全面反超——草稿接受率 78% 对 44-54%,质量档反而更快——速度线已无存在意义,退役(数据保留见下文实录)
- 附赠:ISTA-DASLab Coder IQ1_M(256/512 专家剪枝版,62.5 tok/s,内存减半,多开/超长上下文备选)
四个重点发现
- GPU 与 CPU 第一次同时占满:传统 CPU offload 方案 CPU 单核钉死 100%、GPU 闲 20-40%;Strata 三层架构(热专家显存缓存 + CPU 池 + MTP 流水线重叠)让两个处理器同时满载——这是数倍提升的结构性根因
- MTP 坏死之谜:31 个草稿层权重文件里 20 个因 HTTP Range 被镜像站忽略而下载损坏(存成了 shard 头部),sha256 校验无法发现;自编译引擎加 NaN 探针定位 → 重拉修复 → MTP 接受率 0% → 70.8%。完整复盘:docs/mtp-corruption-postmortem.md(已报上游 Strata#327,作者确认并于 v0.1.32 修复:强制校验 HTTP 206 + Content-Range、对照官方 pinned 版本逐张量 sha256、损坏自动重拉)
- spec_min_p 峰值随草稿质量漂移:Q2_0 峰在 0.3,IQ3_XXS 峰在 0.7——换模型必须重扫(见下方曲线)
- 256K 上下文几乎免费:KV streaming 下 65K/128K/256K 速度几乎相同,64GB 内存实测 256K 稳定;Vision 与 256K 并存(每图 ≤1024 token,单会话可塞 250+ 张图)
🤔 同一台 5090:本仓库 177B MoE vs 27B NVFP4 —— 怎么选?
两个仓库是同一台 RTX 5090 Laptop 24GB 上的两种使用姿势。差别不在谁更强,在这台电脑当时扮演什么角色:
| Flash-Next 177B MoE(本仓库) | Qwen3.8-27B NVFP4 | |
|---|---|---|
| decode 速度 | 峰值 110.9 / 长输出 101-103 tok/s | 74-78 tok/s |
| 稳定上下文 | 256K | 160K(180K 起是显存悬崖) |
| CPU | 打满(专家 CPU 池 + MTP 流水线与 GPU 同时满载) | 几乎闲置(全层常驻 GPU) |
| 内存 | ~40 GB(47 GB 专家的热层驻留 RAM) | 低(15.75 GB 权重 + KV 全在显存) |
| 显存 | 23.2-23.9 / 24 GiB | ~20 / 24 GiB |
| 跑模型时本机还能办公吗 | 很受限 —— CPU / 内存 / 显存全被吃满 | 没问题 —— CPU 和内存大量富余,只有显存紧张 |
| 正确角色 | 专用模型服务器:本机只做"模型提供者",其他设备经局域网 API 调用 | 同机助手:一边正常用电脑办公,一边用本地 AI |
一句话:这台电脑当"模型提供者"(本机不干别的)→ 用本仓库 Flash-Next;要在同一台电脑上一边工作一边用 → 用 27B NVFP4。
🚀 部署与启动(照着做即可)
引擎 Strata(MIT License),Windows/Linux 均可;只需 NVIDIA 驱动,Python 3.12 由安装器自动装到用户目录(无需管理员权限)。
① 安装引擎:按 Strata 官方 README 获取引擎(下载 release 的 strata-windows-x64.zip 解压,或 git clone 源码仓库)。
② 一条命令完成模型打包与配置(以我们的现役模型为例):
cd Strata/app

:: 最佳选择(本仓库当前日常):IQ3_XXS
python setup.py --family qwen --model IQ3_XXS --context 131072 --vision yes --port 8081 --yes --gguf-dir "D://models//Qwen3.8-Flash-Next-GSQ-RCO-GGUF"
--gguf-dir指向你已下载好的 GGUF 分片目录;不加这个参数 setup 会重新下载数十 GB- 首次运行会自动安装 Python 3.12、创建独立 .venv、下载引擎、打包专家 profile(也可双击
START-HERE.bat走交互式)
③ 启动:再次运行同一条命令或双击 START-HERE.bat,浏览器打开 http://127.0.0.1:8081/ 即可聊天与贴图(OpenAI / Anthropic API 同端口)。
④ 想要 256K 上下文:setup 出于保守会把 IQ3 系压到 128K。实测 64GB 内存下 256K 稳定——安装后编辑 strata-iq3_xxs.json:--max-context 改 262144,并追加 "--kv-resident", "32768"(KV 进内存、显存只留 32K 热窗),重启生效。详见上下文阶梯数据。
⑤ 验证 MTP 在工作:log 里 drafts accepted 必须非 0。若是 0 of 0 或 0 of N,先跑 tools/check_dense.py 体检草稿层权重——大概率是下载损坏(完整方法见事故复盘)。
⑥ 思考与并发(接入客户端前必读):
- 思考默认 = xhigh(最高档)——聊天模板出厂写死。档位体系:
xhigh(默认)>medium>low;没有 high 档(会被自动升为 xhigh)。日常想快可传reasoning_effort: low(思考变"简短直给",出答案明显更快),复杂推理保持默认 - 并发 = 无,FIFO 串行:HTTP 层多线程接得住并发连接,但推理层一把 FIFO 锁——同一时刻只有一条 decode 在跑,后来的请求排队等待(不丢不拒绝,
GET /status可看队列)。单人使用无感;多人/多客户端同时用会依次等 - 默认 max_tokens:客户端不传时引擎会给默认值,但思考型模型建议始终显式传 ≥600
License 与合规:引擎 Strata 为 MIT;llama.cpp / ggml 为 MIT;模型权重 license 以各 HF 页面为准(GSQ-RCO 系列页标注 Apache-2.0,继承 base model)。本仓库只含自测数据与工具,不再分发任何模型权重;所有商标归各自所有者。
Strata 时代 18 轮调优明细
| 轮 | 动作 | 结果 | 决策 |
|---|---|---|---|
| R1 | Strata 0.1.27 安装 + Coder IQ1_M 首测 | 58.4 tok/s | 引擎可行(vs llama.cpp +133%),继续 |
| R2 | Q2_0 打包 + 首测 | 66.7 tok/s | MTP 异常浮现(0 of 0) |
| R3 | 采样参数全扫(温度/seed/长度) | 无变化 | 排除 |
| R4 | 专家数错配假设 → 换 512 专家完整版 | 仍 0 | 排除 |
| R5 | draft_vocab 缺 CJK 检查(上游 #137) | 已是修复版 | 排除 |
| R6 | IQ 内核宽度分歧(上游 #152)→ 绕过实测 | 仍 0 | 排除 |
| R7 | 读引擎源码:0 of 0 语义 | T 恒为 1 | 关键转折:草稿从未被提出 |
| R8 | 强制开窗(spec_min_p=0) | 0 of 765 | 草稿提出即全错 → 草稿层本身坏 |
| R9 | 自编译引擎 + NaN 探针 | dprob=NaN | 前向第一个 matmul 即崩 → 锁定权重内容 |
| R10 | 权重文件逐个审计 | 20/31 是 shard 头 | 根因:Range 被镜像忽略 |
| R11 | 重拉 20 文件 + 重打包 + 验证全绿 | 62 of 195 | MTP 复活(+64%) |
| R12 | Q2_0 spec_min_p 扫描 | 峰 0.3 = 93.5 | 固化 |
| R13 | 升级引擎 0.1.28 + 复测 | 行为不变 | 排除版本因素 |
| R14 | IQ3_XXS 部署 + 扫描 | 峰 0.7 = 77.4 | 固化(质量优先线) |
| R15 | 上下文阶梯 32K/65K/128K/256K | 256K 稳定 | KV streaming 配置拉满 |
| R16 | Vision 挂载 + 识别验证 | 全对 | 74.4 tok/s @256K+Vision |
| R17 | spec 6 / k8v4 / pcie_frac 复扫 | 均不如现配置 | 否决并记录 |
| R18 | 防缓存公平复测(双语 README + postmortem + issue#327) | 74.4 定稿 | 交付 |
📘 Strata 完整实录(中文) → docs/strata-log.zh.md | English 🔬 MTP 损坏事故复盘 → docs/mtp-corruption-postmortem.md(上游 Strata#327) 🧪 原始数据 → results/strata-*.txt 🛠 修复工具 → tools/
模型档案:我们用过的每一个量化(优势 / 为什么选 / 最终结果)
全程涉及 4 个模型仓库、7 个量化档位。总表 + 逐个档案如下。
量化机构与量化学派速览
- ISTA-DASLab(奥地利科学技术研究所 Deep Algorithms and Systems Lab,GPTQ 与 QuIP# 的提出者,低比特量化领域最权威的研究组之一)—— 本次主力仓库,使用其自研的 GSQ(Gumbel-Softmax Quantization,2~3bit 逼近矢量量化精度的标量量化)与 RCO(Riemannian Constrained Optimization,在总比特预算下逐张量分配量化类型)两种有论文的方法,产出 GSQ-RCO 系列
- AtomicChat —— AD 系列逐层动态精度量化(AD-5.00bpw-Q5_K_M / AD-4.27bpw-Q4_K_M / AD-3.84bpw-IQ4_XS-M64),llama.cpp 时代的主力供应商
- Unsloth(UD 系列)—— 曾进入候选池,经体积与分片评估后淘汰
- Qwen 团队(阿里巴巴通义千问)—— Qwen3.8-Flash-Next 原始模型(176B MoE,混合 GDN/QSA 架构)与 MTP 草稿层权重的唯一来源
| # | 模型 / 量化 | 精度 | 仓库 | 状态 |
|---|---|---|---|---|
| 1 | AtomicChat AD-3.84bpw-IQ4_XS-M64 | 3.84 bpw | AtomicChat/Qwen3.8-Flash-Next-GGUF | llama.cpp 时代主力 |
| 2 | ISTA-DASLab GSQ-RCO Q2_0 | ~2.2 bpw | ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF | ⬜ 退役(原速度线,被 IQ3_XXS 反超) |
| 3 | ISTA-DASLab GSQ-RCO IQ3_XXS | ~3.1 bpw | 同上 | ✅ 现役(最佳选择) |
| 4 | ISTA-DASLab GSQ-RCO IQ3_S | ~3.44 bpw | 同上 | ⛔ 评估后否决 |
| 5 | ISTA-DASLab GSQ-RCO IQ2_XS | ~2.5 bpw | 同上 | ⛔ 评估后未部署 |
| 6 | ISTA-DASLab Coder IQ1_M(256/512 专家剪枝) | 1.89 bpw | ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF | ✅ 备选(省内存线) |
| 7 | Qwen(阿里巴巴通义千问团队)BF16 官方 checkpoint | 16 bpw | Qwen/Qwen3.8-Flash-Next | 🔧 仅作 MTP 权重源 |
| 8 | mmproj BF16 Vision Encoder | — | GSQ-RCO 仓库内 | ✅ 现役 |
1️⃣ AtomicChat AD-3.84bpw-IQ4_XS-M64 —— llama.cpp 时代的主力
- 优势:4-bit 档少见的"动态逐层精度"量化(AD = AtomicChat Dynamic),精度与显存的平衡点;M64 分片让 llama.cpp 能在 24GB 显存跑通 177B MoE
- 为什么选:llama.cpp 时代它是唯一兼顾质量与速度、且社区验证过的选择
- 结果:22-25 tok/s。暴露了 llama.cpp 的结构性问题——CPU 单核 100%、GPU 闲 20-40%,任何调参都绕不过去。由此转向 Strata
2️⃣ ISTA-DASLab GSQ-RCO Q2_0 —— 速度王 ★
- 优势:2-bit 但有 GSQ(Gumbel-Softmax)+ RCO(逐张量精度分配)两篇论文方法背书,2-bit 下逼近矢量量化精度;专家 blob 最小 → 显存能塞最多热专家(13,212 slots,98%+ 命中)
- 为什么选:确认 Strata 的 GPU 缓存架构后,专家 blob 越小命中率越高、MTP 收益越能全额兑现——纯速度打法的最优解
- 结果:93.5 tok/s(spec_min_p=0.3),追平桌面 5070 参考值;草稿接受率 44-54%
3️⃣ ISTA-DASLab GSQ-RCO IQ3_XXS —— 质量线(当前日常)
- 优势:3-bit i-quant,质量高一档;草稿质量也是三个部署版本里最好的(接受率 59-71%)
- 为什么选:长项目/推理密集场景需要更低的量化损失;且 arena 42.9GB 在 64GB 内存上给 256K 上下文留足余量
- 结果:77.4 tok/s(32K)/ 74.4 tok/s(256K+Vision)。注意它的 spec_min_p 峰值在 0.7 与 Q2_0 的 0.3 完全不同
4️⃣ ISTA-DASLab GSQ-RCO IQ3_S —— 评估后否决
- 优势:3.5-bit,官方基准上匹配完整 BF16 模型——三档里质量最高
- 为什么放弃:arena 50.3 GB pinned,256K 上下文的 KV 还要 3.1 GB——64GB 内存的机器上只剩 ~10GB 给系统,官方自己也标注"64 GB PC with little else running"。256K 是硬需求,这个组合风险不可接受
- 复活条件:内存升级到 96GB 后即可启用(见 内存升级 96GB 可行性分析 本地文档)
5️⃣ ISTA-DASLab GSQ-RCO IQ2_XS —— 评估后未部署
- 优势:2-bit i-quant,质量略好于 Q2_0,速度官方描述"close in speed"
- 为什么没上:Q2_0 已实测 93.5 且 IQ2_XS 的质量增量介于 Q2_0 与 IQ3_XXS 之间——质量需求出现时我们直接跳了 IQ3_XXS,中间档没有部署价值
- 保留意见:若需要"比 Q2_0 好一点但比 IQ3_XXS 快很多"的档位,它是现成候选
6️⃣ ISTA-DASLab Coder IQ1_M —— 省内存线(备选)
- 优势:官方把 512 专家剪枝到 256(专门保留代码、工具、视觉相关的专家),arena 只有 23.4GB——内存减半;存储密度反而是"IQ3_S like"的 3.5bit
- 为什么选:内存紧张时多开实例、或需要 32K 以上上下文且不想动用 streaming 的场景
- 结果:62.5 tok/s(MTP 修复后);官方数据非代码领域弱于完整版,与我们"剪枝专家"的预期一致
7️⃣ Qwen(阿里巴巴通义千问)BF16 官方 checkpoint —— 只取 MTP 权重
- 优势:无损原版,一切量化的理论上限;354GB 显然无法本地部署
- 为什么还下载它:Strata 的 MTP 草稿层权重只存在于 BF16 checkpoint 的
mtp.*张量里(GSQ-RCO 量化版不带)——用 HTTP Range 精准拉取 5.2GB 而非 360GB 全量 - 结果:间接导致本次最大的坑(MTP 权重损坏事故),也间接产出了检测/修复工具链
8️⃣ mmproj BF16 Vision Encoder —— 视觉能力
- 优势:27 层 ViT + projector,1,024 token/图上限,GPU 编码 0.1-0.5s/张
- 为什么选:Vision 是硬需求;0.9GB 一次下载
- 结果:挂载成功,识别验证全对,256K+Vision 并存速度损失约 16%
这是什么 / What this is
在一台消费级笔记本上跑通 177B 参数的 MoE 大模型 —— 不是"能加载",而是能日常使用:
- 256K 上下文开满(约 19.2 万字,整本书的量级)
- 25.0 tok/s 生成速度(约等于每秒 15 个汉字,比人阅读快)
- 图像识别可用(保留视觉能力)
- 显存占用 23.4 / 24 GB,长期稳定运行
本仓库记录了从零开始的完整调优过程:量化选型、三层内存分配、参数扫描、以及 12 项试过但无效的方向(避免重复踩坑)。
📘 可视化速查页 → index.html 🧪 原始实测数据 → results/ 🛠 可复用测试工具 → tools/ 📄 深度实录 → 中文 | English 🔧 移植到其他硬件 → porting-guide.md
目录
成果总览 / Results at a glance
| 指标 / Metric | 最终 / Final |
|---|---|
| 生成速度 Generation | 25.0 tok/s |
| 上下文 Context | 262,144 tokens = 256K(模型全长) |
| 量化 Quant | AD-3.84bpw-IQ4_XS-M64(79.10 GiB / 28 分片) |
| KV 缓存 | q8_0(精度实测无损) |
| 显存占用 VRAM | 23.4 / 24 GiB |
| 系统内存 RAM | ~33 GB 常驻(专家层) |
| 视觉能力 Vision | ✅ mmproj-F16(+0.85 GiB) |
| MTP 推测解码 | ❌ 未启用(实测负收益,见第 6 步) |
上下文档位对照 / Context tiers
| 场景 | 上下文 | ncmoe | 实测 decode | 显存 |
|---|---|---|---|---|
| ⚡ 极速 | 114,688(112K) | 32 | 27.12 tok/s | 23.2 GiB |
| 均衡 | 163,840(160K) | 33 | 25.83 tok/s | 23.3 GiB |
| 长文档 | 196,608(192K) | 34 | 25.31 tok/s | 23.1 GiB |
| 🏆 全长(推荐) | 262,144(256K) | 36 | 25.08 tok/s | 23.4 GiB |
为什么推荐 256K:它只比 112K 慢 7.5%,但上下文是 2.3 倍 —— 容量收益远大于速度损失。
先下载模型 / Get the model
本方案使用的模型与配套文件,全部来自公开的 Hugging Face 仓库(Qwen Community License 1.0):
| 文件 | 说明 | 大小 | 来源 |
|---|---|---|---|
| ⭐ AD-3.84bpw-IQ4_XS-M64 | 主模型(28 分片) | 84.9 GB | AtomicChat/Qwen3.8-Flash-Next-GGUF |
| mmproj-Qwen3.8-Flash-Next-F16.gguf | 视觉投影(图像识别,可选) | 0.85 GB | 同一仓库 |
| llama.cpp | 推理引擎(需支持 Qwen3.8-Flash-Next 架构的构建) | — | ggml-org/llama.cpp |
| Qwen/Qwen3.8-Flash-Next | 原始权重(仅参考,无需下载) | — | Qwen 官方 |
# 下载主模型 + 视觉投影(支持断点续传)
pip install -U "huggingface_hub[cli]"
hf download AtomicChat/Qwen3.8-Flash-Next-GGUF \
  --include "*3.84bpw*" --include "*mmproj*" \
  --local-dir D:\models\Qwen3.8-Flash-Next
[!IMPORTANT] 务必选择 AtomicChat 的
-M64版本,不要用其他发布方的同类量化。区别不在位宽,而在分片布局:只有 AtomicChat 把 N-gram 表(35.8 GB)放进独立分片。 其他发布方(如 unsloth 的 UD 系列)把表与专家混装 —— 一旦该分片被访问,整片(几十 GB)都会被锁进内存,在 64 GB 机器上直接压垮。
实测对比:混淆分片的量化会出现"长对话到 60K~100K token 时静默崩溃";AtomicChat 版本可塞满整个 256K 上下文稳定运行。
硬件前提:24GB 显存 + 64GB 内存 + NVMe SSD(本方案的实测配置)。
三分钟上手 / Quick start
1. 启动
llama-server \
  -m Qwen3.8-Flash-Next-AD-3.84bpw-IQ4_XS-M64-00001-of-00028.gguf \
  -ngl 99 --n-cpu-moe 36 \
  -fa on -fit off \
  -c 262144 -np 1 \
  -ctk q8_0 -ctv q8_0 \
  --load-mode dio \
  -mm mmproj-Qwen3.8-Flash-Next-F16.gguf \
  --jinja --alias qwen3.8-flash-next \
  --host 127.0.0.1 --port 8080
⚠️ 注意:不含
-md/--spec-type—— MTP 已停用(负收益,见下)。 加载约 30~60 秒。看到listening on http://127.0.0.1:8080即就绪。
2. 客户端配置
| 项 | 值 |
|---|---|
| API 类型 | OpenAI 兼容 |
| Base URL | http://127.0.0.1:8080/v1 |
| 模型名 | qwen3.8-flash-next |
| API Key | 任意(如 sk-local) |
| 流式输出 | 务必开启 |
| 上下文长度 | 262144 |
| max_tokens | 16000(思考量大,设小了会"想完没答案") |
| 思考强度 | 不传即默认 xhigh(服务端默认值) |
3. 三条纪律
- 只开一个实例 —— 多开必爆显存(每个要 23GB)
- 用完就关 —— 常驻占 23GB 显存
- 改配置后必须重启进程 —— 参数只在启动时读取
架构:三层卸载 / Three-tier split
核心思路:按访问频率分配存储,而不是一味往显存塞。
| 位置 | 放什么 | 原因 | 占用 |
|---|---|---|---|
| 显存 24GB | 注意力层 + 12 层专家 + KV 缓存 + 图像投影 | 每 token 都要用,带宽 1.8 TB/s | 23.4 GB |
| 内存 64GB | 其余 36 层专家 | 稀疏激活(每 token 只用 10/512 个),带宽 62 GB/s 够用 | ~33 GB |
| 固态 NVMe | N-gram 查表(35.8GB) | dio 模式直读,不占内存 | 35.8 GB |
为什么这样拆:注意力每 token 都要用,必须放带宽最高的显存;专家层稀疏激活,可以放带宽低但容量大的内存里由 CPU 计算。这样 79GB 的模型才能在 24GB 显存上跑起来。
瓶颈在哪
实测推理期间 GPU 利用率约 25%,CPU 接近满载。这是"专家由 CPU 计算"的必然:
每生成 1 个 token 要依次走完 48 层:
GPU 算第1层注意力 → CPU 算第1层专家 → GPU 算第2层注意力 → CPU 算第2层专家 → ... ×48
      ↑ 工作              ↑ 干等              ↑ 工作              ↑ 干等
要填满 GPU,唯一办法是把更多专家放进显存 —— 而显存已经满了。
对比参考:若 79GB 模型能全放显存(约需 4 张 5090),利用率可达 80%+。
完整调优历程(8 步)
从"能跑"到"跑到硬件极限"。每步记录做了什么 / 发现了什么 / 为什么有效。
第 0 步 · 选对量化布局(决定性)
筛除条件不是位宽,而是分片布局 —— N-gram 表(35.76 GiB)是否独占分片:
| 量化版本 | 大小 | 分片布局 | 本机实测 | 判定 |
|---|---|---|---|---|
| ⭐ AD-4.27bpw-Q4_K_M-M64 | 88.03 GiB / 33 片 | ✅ 表独占 | 21.7(32K)/ 24.6–28.2(64K) | ✅ 原主力 |
| ⭐ AD-3.84bpw-IQ4_XS-M64 | 79.10 GiB / 28 片 | ✅ 表独占 | 25.0 tok/s(256K) | ✅ 现主力 |
| AD-5.00bpw-Q5_K_M-M64 | 102.93 GiB / 33 片 | ✅ 表独占(表 50.66 GiB) | 未测 | ⚠️ 表太大,SSD 读压力上升 |
| unsloth UD-IQ4_XS | 87.25 GiB / 3 片 | ❌ 表与专家混装 | 未测 | ❌ 不可用:整片锁进内存,最坏 89.6 GiB 常驻 > 64 GiB |
| unsloth UD-Q3_K_XL | 83.80 GiB / 3 片 | ❌ 混装 | 未测 | ❌ 同上 |
| NVFP4 | — | — | — | ❌ 该模型无此版本(164 个文件全量枚举,零命中) |
为什么布局是决定性的:GGUF 分片是 mmap 的最小单位。如果表与专家混在同一片里,一旦这片被访问,整片(可能几十 GB)都会进内存 —— 在 64GB 内存的机器上直接压垮。只有"表独占分片"的布局,才能让 dio/mmap 精确地按需分页。
为什么最终选 3.84bpw:除了布局,它还是"速度 vs 质量"的平衡点 ——
| 4.27bpw | 3.84bpw | |
|---|---|---|
| 体积 | 88.03 GB | 79.10 GB |
| 专家量化 | IQ2_S(2.5 bit) | IQ4_XS(4.25 bit) |
| 可用内存 | 12.8 GB | 26.2 GB |
反直觉的一点:3.84bpw 的专家精度更高(4.25bit vs 2.5bit),它是靠压缩其他部分来控制总体积的。换过去不是降级。
第 1 步 · 让 79GB 模型跑进 24GB 显存 —— --n-cpu-moe
-ngl 99              ← 所有层上 GPU(关键:不要为了塞模型调低它!)
--n-cpu-moe 36       ← 前 36 层的【专家权重】放 CPU
关键认识:不要沿用稠密模型的思路去调 -ngl。MoE 应该让注意力层全部留在显存(每 token 都用),只把路由专家(稀疏激活)挪到内存。
两类静默失败要防:
| 失败类型 | 症状 | 原因 |
|---|---|---|
| CUDA 运行时缺失 | 速度掉到个位数,无报错 | 静默退回 CPU 计算 |
| 显存溢出 | 慢 30 倍,无报错 | 静默走 PCIe |
第 2 步 · KV 量化(q8_0)—— 性价比最高的一档
KV 缓存不参与计算却占着显存。量化它 → 省下的显存换更多专家层:
| 配置 | ncmoe | 生成速度 | 长上下文召回精度 |
|---|---|---|---|
| f16 KV(基线) | 42 | 21.34 tok/s | 12/12 = 100% |
| q8_0 KV ⭐ | 38 | 22.07(+3.4%) | 12/12 = 100% |
| q4_0 KV | 36 | 25.03(未更快) | 12/12 = 100% |
精度用**多轮随机化「大海捞针」**验证:9.7k token 文档、3 个事实埋在随机深度、同种子跨配置对比、检查
finish_reason排除截断假象。
结论:q8_0 精度无损且提速 3.4%。
第 3 步 · dio 加载模式 —— 省 13GB 内存
--load-mode dio ← 绕过系统页缓存,直读 SSD
效果:可用内存从 7GB → 20GB。N-gram 表(35.8GB)不再被页缓存重复占用。
为什么可行:NVMe 随机读带宽(1.3GB/s+)足够喂饱 CPU 侧专家计算,页缓存的收益抵不上它挤占的内存。
第 4 步 · 换 3.84bpw 小模型 —— 省 8.9GB,多放 4 层专家
关键链条:
模型 88.03GB → 79.10GB(省 8.94GB)
  → 显存占用降 2.4GB
  → 可多放 4 层专家进显存
  → CPU 侧负担减轻 → 提速
  → 同时内存占用也降 → 可用内存 12.8GB → 26.2GB
双赢:速度和内存同时改善。
第 5 步 · 上下文调优 —— 找到"显存压力临界点"
| 上下文 | ncmoe | decode | vs 128K |
|---|---|---|---|
| 128K | 36 | 21.60 tok/s | 基准 |
| 112K | 36 | 24.98 tok/s | +15.6% |
| 96K | 36 | 24.57 tok/s | +13.7% |
| 80K | 36 | 25.37 tok/s | +17.4% |
| 64K | 35 | 25.81 tok/s | +19.5% |
| 32K | 35 | 26.61 tok/s | +23.2% |
发现:128K → 112K 只减 16K 就快 15.6%。存在一个"显存压力临界点" —— 128K 时显存被压得太满,各种分配开销都在最高档。
第 6 步 · ⭐ 关掉 MTP —— 最大的单项收益(+23%)
这一步推翻了最初的假设。
MTP(Multi-Token Prediction)推测解码的直觉是"草稿模型先猜、主模型一次验证"能省前向次数。但在 MoE + CPU 专家的架构下,它是负收益:
| 配置 | 显存 | decode |
|---|---|---|
| MTP 开 + ncmoe=36 | 23.5 GB | 22.0 tok/s |
| MTP 关 + ncmoe=36 | 20.2 GB | 25.4 tok/s |
| MTP 关 + ncmoe=34 | 21.1 GB | 26.93 tok/s |
| MTP 关 + ncmoe=32 | 23.2 GB | 27.12 tok/s |
为什么是负收益:推测解码的验证批要读取"多个候选 token 激活专家的并集" —— 在专家大部分驻留内存的架构下,这会把内存流量放大。省下的前向次数,抵不过多读的专家权重。
而且它还白占 3.5GB 显存(草稿模型 + 自己的 KV)。关掉后这 3.5GB 能换 4 层专家进显存。
代价:无。速度、显存双赢。
第 7 步 · 把省下的显存全部换成专家层
关掉 MTP 省下 3.5GB → ncmoe 从 36 降到 32 → 刷新纪录。
最终显存账本:
| 项目 | 占用 |
|---|---|
| 12 层专家(48−36) | ~12.4 GB |
| KV 缓存(256K, q8_0) | ~4.3 GB |
| 注意力等非专家张量 | ~4.8 GB |
| mmproj(图像识别) | ~0.85 GB |
| 计算缓冲 | ~1.2 GB |
| 合计 | ~23.4 GB |
性能实测数据
所有数据来自服务端日志的
eval time(只计纯生成时间),temperature=0固定输出长度保证可比。
生成速度
| 场景 | 速度 |
|---|---|
| 短输出(100~200 token) | 27~30 tok/s |
| 中输出(500 token) | 25~27 tok/s |
| 256K 全长配置 | 25.0 tok/s |
首字节等待(决定"感觉快不快")
| 输入长度 | 首字节 | 说明 |
|---|---|---|
| 1K token | 1~3 秒 | 日常短问,体验流畅 |
| 4K token | 约 12 秒 | 短文 |
| 8K token | 约 25 秒 | 中等文档 |
| 12.6K token | 约 40 秒 | 长文档 |
| 32K token | 约 100 秒 | 超长文档 |
| 256K token | 约 11 分钟 | 极限(整本书) |
prefill 速度约 320~400 tok/s。这不是故障 —— 多轮对话中第 2 轮起会快很多(prompt cache 复用历史 KV)。
MTP 调参(已排除的方向)
| n-max | decode | draft 接受率 |
|---|---|---|
| 2 | 20.30 tok/s | 0.484 |
| 4 | ~22.0 tok/s | 0.48~0.52 |
| 6 | 12.77 tok/s | 0.275 |
已全部废弃 —— 因为 MTP 本身就是负收益(见第 6 步)。
思考强度(reasoning_effort)
| 档位 | 首字节 | 总耗时 | 思考量 | 适用 |
|---|---|---|---|---|
low | 1.35s | 16.13s | 376 字 | 日常问答 |
medium | 0.94s | 15.34s | 370 字 | 一般任务 |
xhigh(默认) | 0.81s | 16.96s | 640 字 | 复杂推理 |
按难度分化:
| 题目 | low | medium | xhigh |
|---|---|---|---|
| 常识 | 7.05s | 5.64s | 5.71s |
| 数学 | 19.42s | 18.54s | 19.52s |
| 逻辑(难) | 21.92s | 21.85s | 25.65s(思考 1461 字) |
⚠️ 难题在 xhigh 下思考量可达 5700+ 字符(约 3000 token) ——
max_tokens设小了会出现"想完了但没答案"。建议 16000。
试过但无效的(12 项)
| 尝试 | 结果 | 原因 |
|---|---|---|
| MTP 全系列(开关 / n-max 调参 / 挪 CPU / KV 量化) | −11% ~ −19% | 见第 6 步 |
--cpu-strict 1(CPU 核心绑定) | +0.2% | 噪声 |
--prio 2(进程优先级) | −0.8% | 无改善 |
-b 4096(更大批处理) | ±0% | 无改善 |
--poll 0(关线程自旋) | −2% | 无改善 |
-ub 1024 | OOM | 计算缓冲随 ubatch 增大 |
| ncmoe < 30 | OOM | 显存不够 |
| KV 降到 q4_0 | 不更快 | 量化开销抵消显存收益 |
| 关闭 VBS / HVCI | ≈0 | VBS 开销在系统调用与页表,瓶颈是 CPU 矩阵运算 |
| 换新引擎(b10889) | 无提升 | 生成受内存带宽限制,内核升级优化算力路径 |
KV 放内存(-nkvo) | 不可行 | 每 token 读 KV → 带宽压力 |
--chat-template-kwargs 固定思考档 | 失败 | 会破坏模板(且默认已是 xhigh,无需) |
FAQ
Q: 为什么不用 NVFP4?Blackwell 不是原生支持吗?
A: 三个层次:
- 这个模型没有 NVFP4 版本(两个发布方共 164 个文件全量枚举,无 FP4 量化)
- 生成瓶颈是内存带宽不是算力 —— FP4 张量核加速的是矩阵乘法,帮不到"每 token 从内存读专家权重"。实测 NVFP4 只加速 prefill(+43~68%),decode 完全不变(~0%)
- NVFP4 等效约 4.5 bpw,比现用的 3.84 bpw 更大,在内存受限场景反而更慢
Q: 为什么用 llama.cpp,不用 vLLM / TensorRT-LLM?
A: 只有 llama.cpp 提供 --n-cpu-moe 这种按层把专家留在内存的精细控制,以及 mmap 分片按需分页 —— 这两点是 24G 显存跑 79GB 模型的前提。(vLLM/SGLang 的 expert 粒度 offload 还在 RFC 阶段)
Q: 上下文最多能开多大?
A: 本机实测能开满 256K,速度 25.08 tok/s。自算公式:
VRAM ≈ 4.4 + (48−ncmoe)×1.03 + ctx×33KiB + 计算缓冲
Q: MTP 到底有没有用?
A: 在 MoE + CPU 专家的架构下,是负收益(实测关掉 +23%)。这是本仓库最反直觉的结论。
Q: GPU 利用率只有 25%,是不是浪费?
A: 不是,这是结构性的。 decode 是串行接力,GPU 在 CPU 算专家时只能干等。要填满 GPU 只能把更多专家放进显存,而显存已经满了。
Q: 内存升到 128GB 有帮助吗?
A: 对速度几乎没有(瓶颈是显存容量)。价值在"系统更从容"和"未来上更大模型"。注意本机 4 个插槽全满,升级需整组替换(4×32GB)。
Q: 生成速度还能再快吗?
A: 软件层面已经到底(12 项无效尝试)。剩余路径:
| 路径 | 预期 | 成本 |
|---|---|---|
| 更小量化(IQ3_S / IQ2_M) | +10~15%(质量待验证) | 需下载 |
| 更快内存(2×32GB → 5600 MT/s) | +7.7% 带宽 | ~¥800 |
| 换更大显存显卡 | 唯一大幅提升 | 高 |
Q: 会不会把内存撑爆?
A: 单实例实测内存峰值 85~95%,稳定运行。真正的风险是同时开多个实例 —— 每个要 23GB 显存,两个必爆。
硬件升级路径
| 方案 | 对速度的影响 | 对利用率的影响 | 成本 |
|---|---|---|---|
| 内存 64→128GB | 几乎没有 | 不能 | ~¥1500 |
| 内存换 2×32GB(5600 MT/s) | +7.7%(带宽) | 小幅 | ~¥800 |
| 显卡换 48GB 显存 | 可能翻倍 | 50~60% | 高 |
| 加第二张 24GB 卡 | 大幅 | 大幅 | 很高 |
结论:提速只能靠显存;内存升级只为"系统从容"。
关键结论
- 布局比位宽重要 —— N-gram 表是否独占分片,决定方案能否成立
- 两类静默失败要防 —— CUDA 缺失静默退回 CPU;显存溢出静默走 PCIe(慢 30 倍无报错)
- ⭐ MTP 在 MoE + CPU 专家下是负收益 —— 验证批的专家激活并集放大内存流量(实测关掉 +23%)
- KV 量化是性价比最高的一档 —— q8_0 精度无损(12/12),换专家层 +3.4~5%
dio省 13GB 内存 —— 让 N-gram 表留在 SSD- 上下文存在"显存压力临界点" —— 128K→112K 只减 16K 就快 15.6%
--n-cpu-moe是唯一的旋钮,且存在悬崖(本例 28 层即崩,26.9→4.7 tok/s)- 换引擎不会更快 —— 生成受内存带宽限制(实测无提升)
- 测速必须读服务端日志的
eval time—— 用 API 耗时推算会被冷启动和 prompt cache 干扰,误差可达 100% - 关掉 VBS 没有收益 —— 证明瓶颈是 CPU 算力/内存带宽的物理限制,不是软件虚拟化开销
硬件与软件
| 项目 | 规格 |
|---|---|
| GPU | RTX 5090 Laptop,24 GB 显存(24435 MiB 可见),compute capability 12.0 (sm_120) |
| CPU | Intel Core Ultra 9 275HX(24 线程) |
| 内存 | 64 GB DDR5-5200(4×16GB,最大可扩 128GB) |
| 存储 | NVMe SSD(模型 79.10 GiB) |
| 引擎 | llama.cpp(Unsloth b10840-mix-d5c17a0,cuda12-portable) |
| 模型 | Qwen3.8-Flash-Next GGUF,总参数 176.9B(含 51.2B N-gram 表) |
| 视觉 | mmproj-F16(0.85 GiB) |
| 系统优化 | Defender 排除模型目录;VBS/HVCI 已关闭(实测无影响) |
仓库结构
├── README.md                     ← 本页
├── README.en.md                  ← English
├── index.html                    ← 可视化速查页
├── assets/                       ← 图表 (SVG)
├── docs/
│   ├── deploy-log.zh.md          ← 完整实录(中文)
│   ├── deploy-log.en.md          ← Full write-up (English)
│   ├── model-reference.md        ← 架构参数、量化对照、NVFP4 说明
│   └── porting-guide.md          ← 移植公式与硬件对照表
├── results/                      ← 原始实测输出
└── tools/                        ← 可复用测试工具
免责声明
- 所有数据均为单机实测,硬件/驱动/构建版本不同结果会有差异;
- 模型权重与量化文件版权归各自发布方;
- 测试脚本会自动结束 llama-server 进程,请勿在有其他推理服务运行时使用。
License
MIT(仅适用于本仓库的文档与脚本)