YomiTokuはAIを活用した日本語文書解析エンジンを提供するPythonパッケージです。 Yomitoku is an AI-powered document image analysis package designed specifically for the Japanese language.
See the code日本語版 | English


🌐 インストール不要でブラウザから試せます → YomiToku Studio 推論はすべてブラウザ内(WebAssembly / WebGPU)で実行され、画像はどこにも送信されません。まずは手元の画像で精度を確かめてみてください。
YomiToku は日本語に特化した AI 文章画像解析エンジン(Document AI)です。画像内の文字の全文 OCR およびレイアウト解析機能を有しており、画像内の文字情報や図表を認識、抽出、変換します。
インストール前に、ブラウザ版 YomiToku Studio で手元の画像を試せます(画像は外部送信されません)。
gallery.mdにも複数種類の画像の検証結果を掲載しています。
| 入力画像 | OCR の結果 |
|---|---|
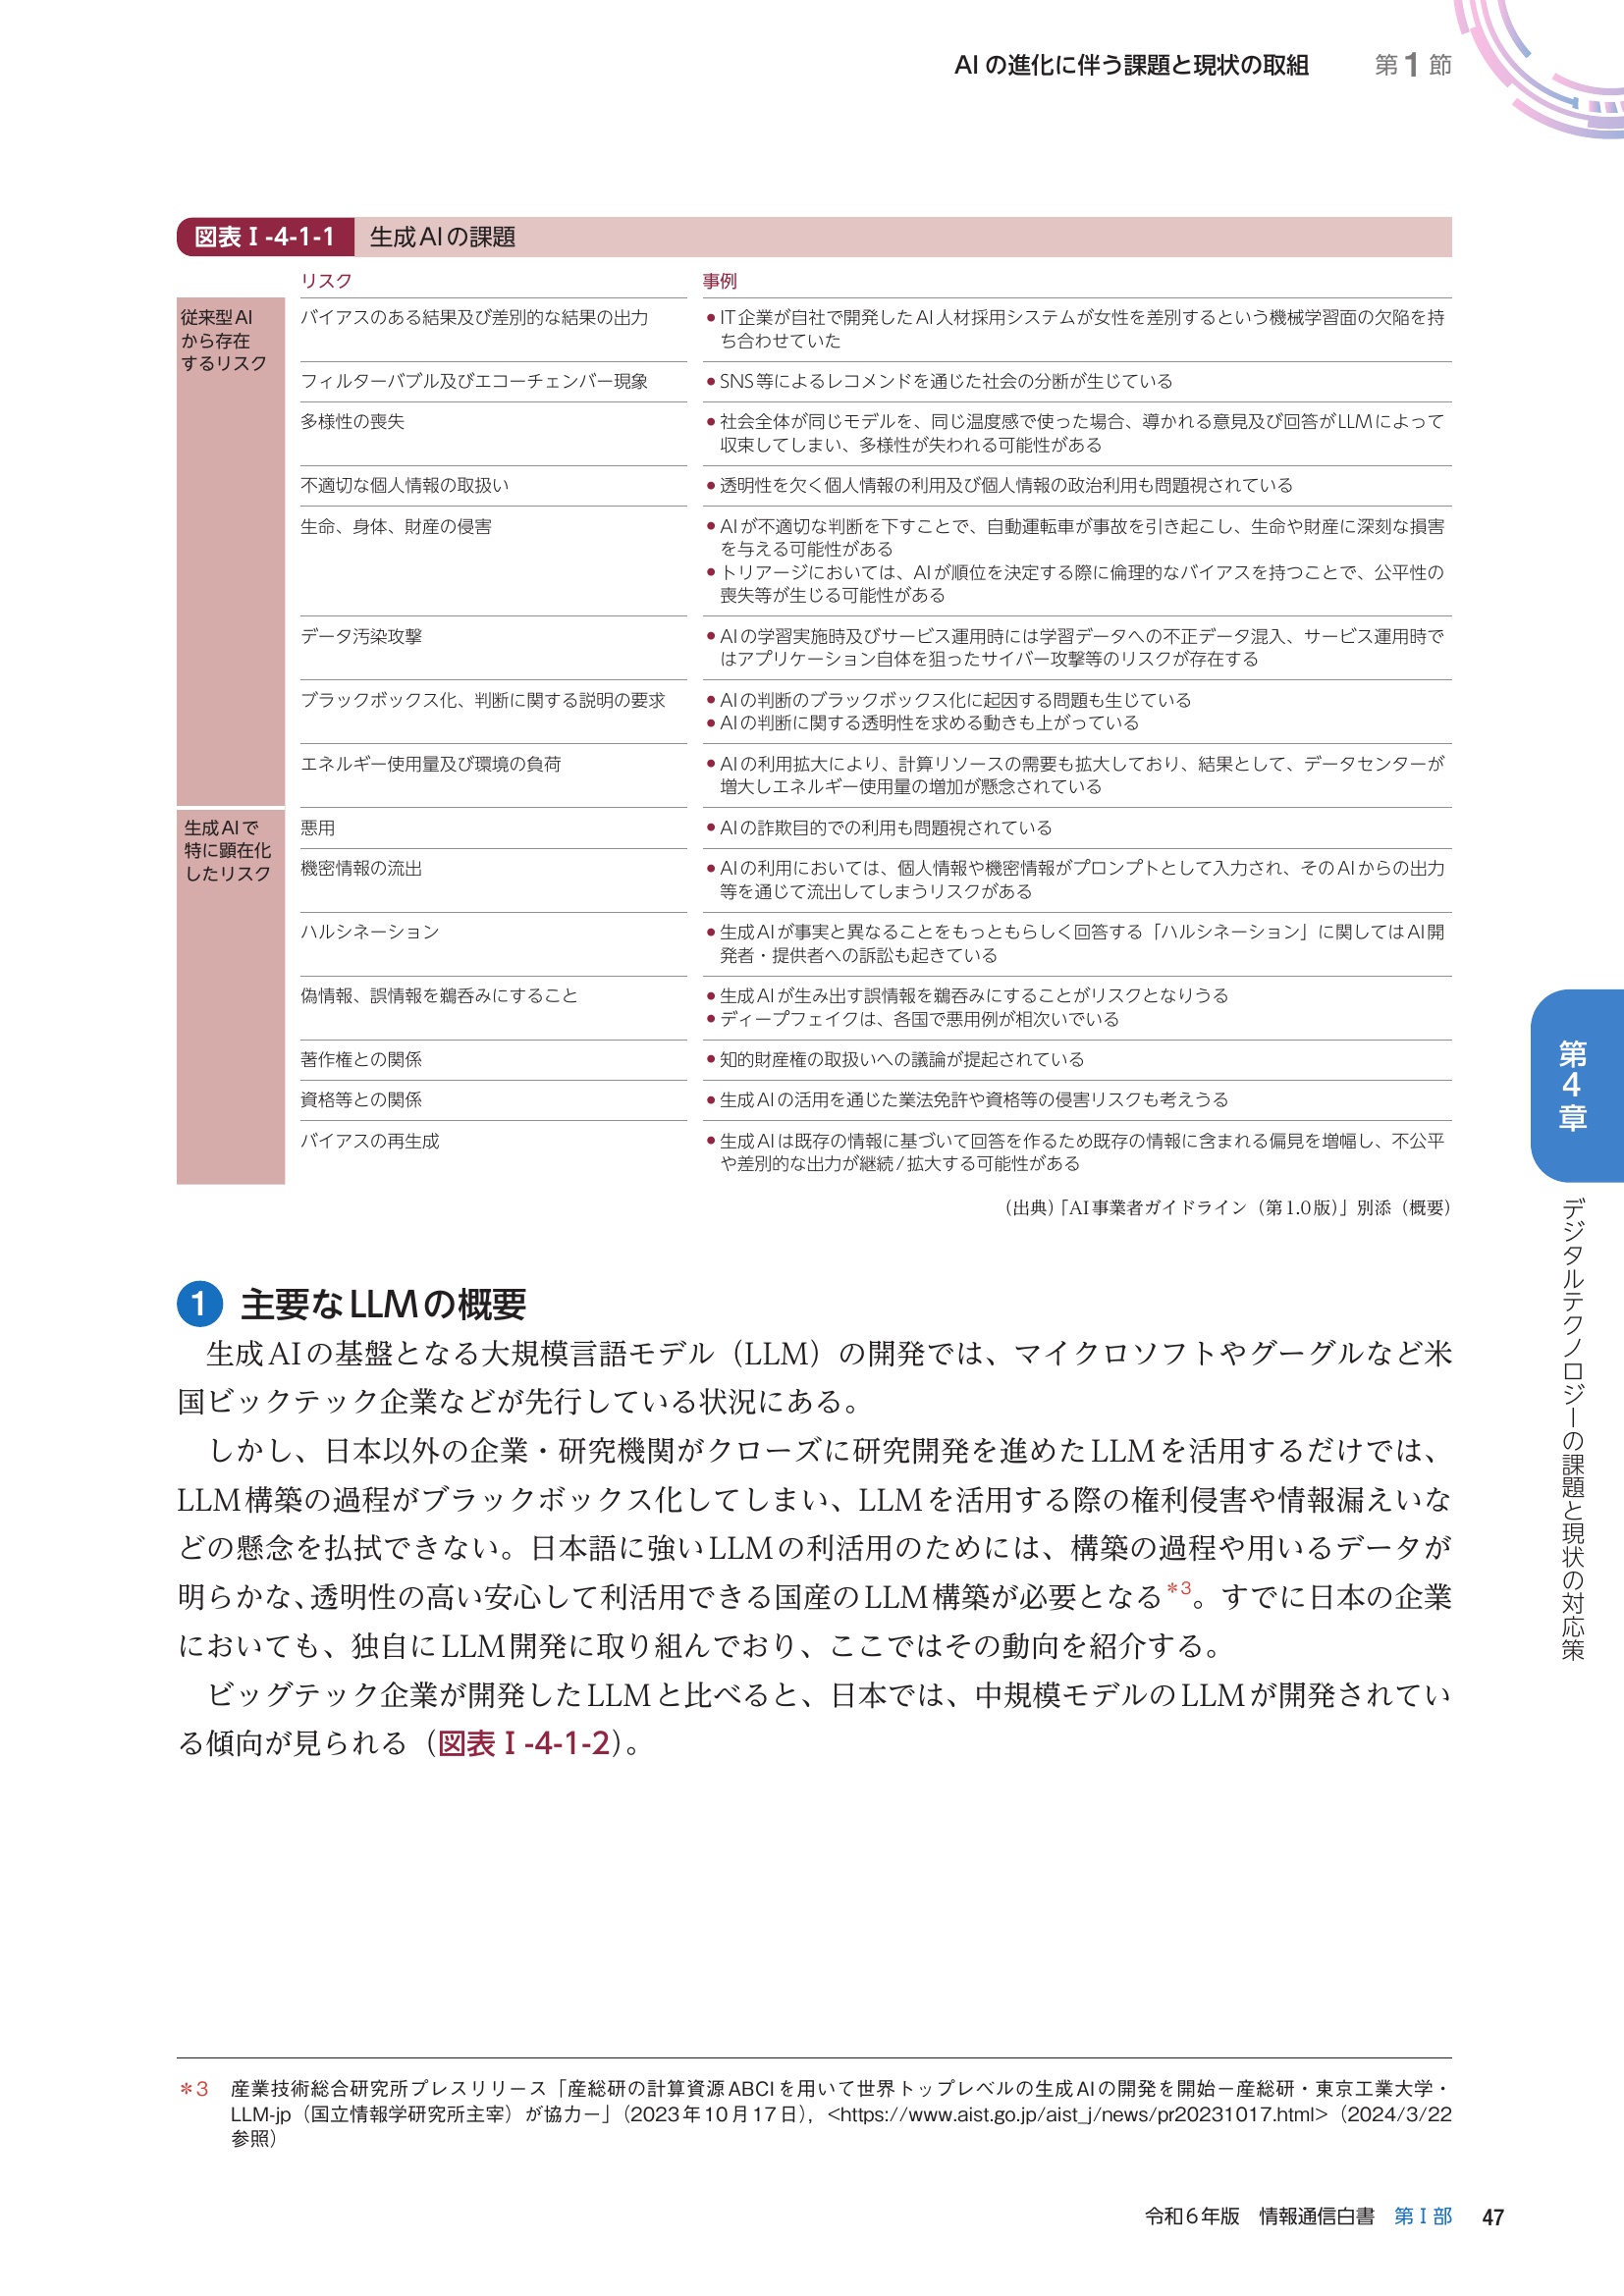 | 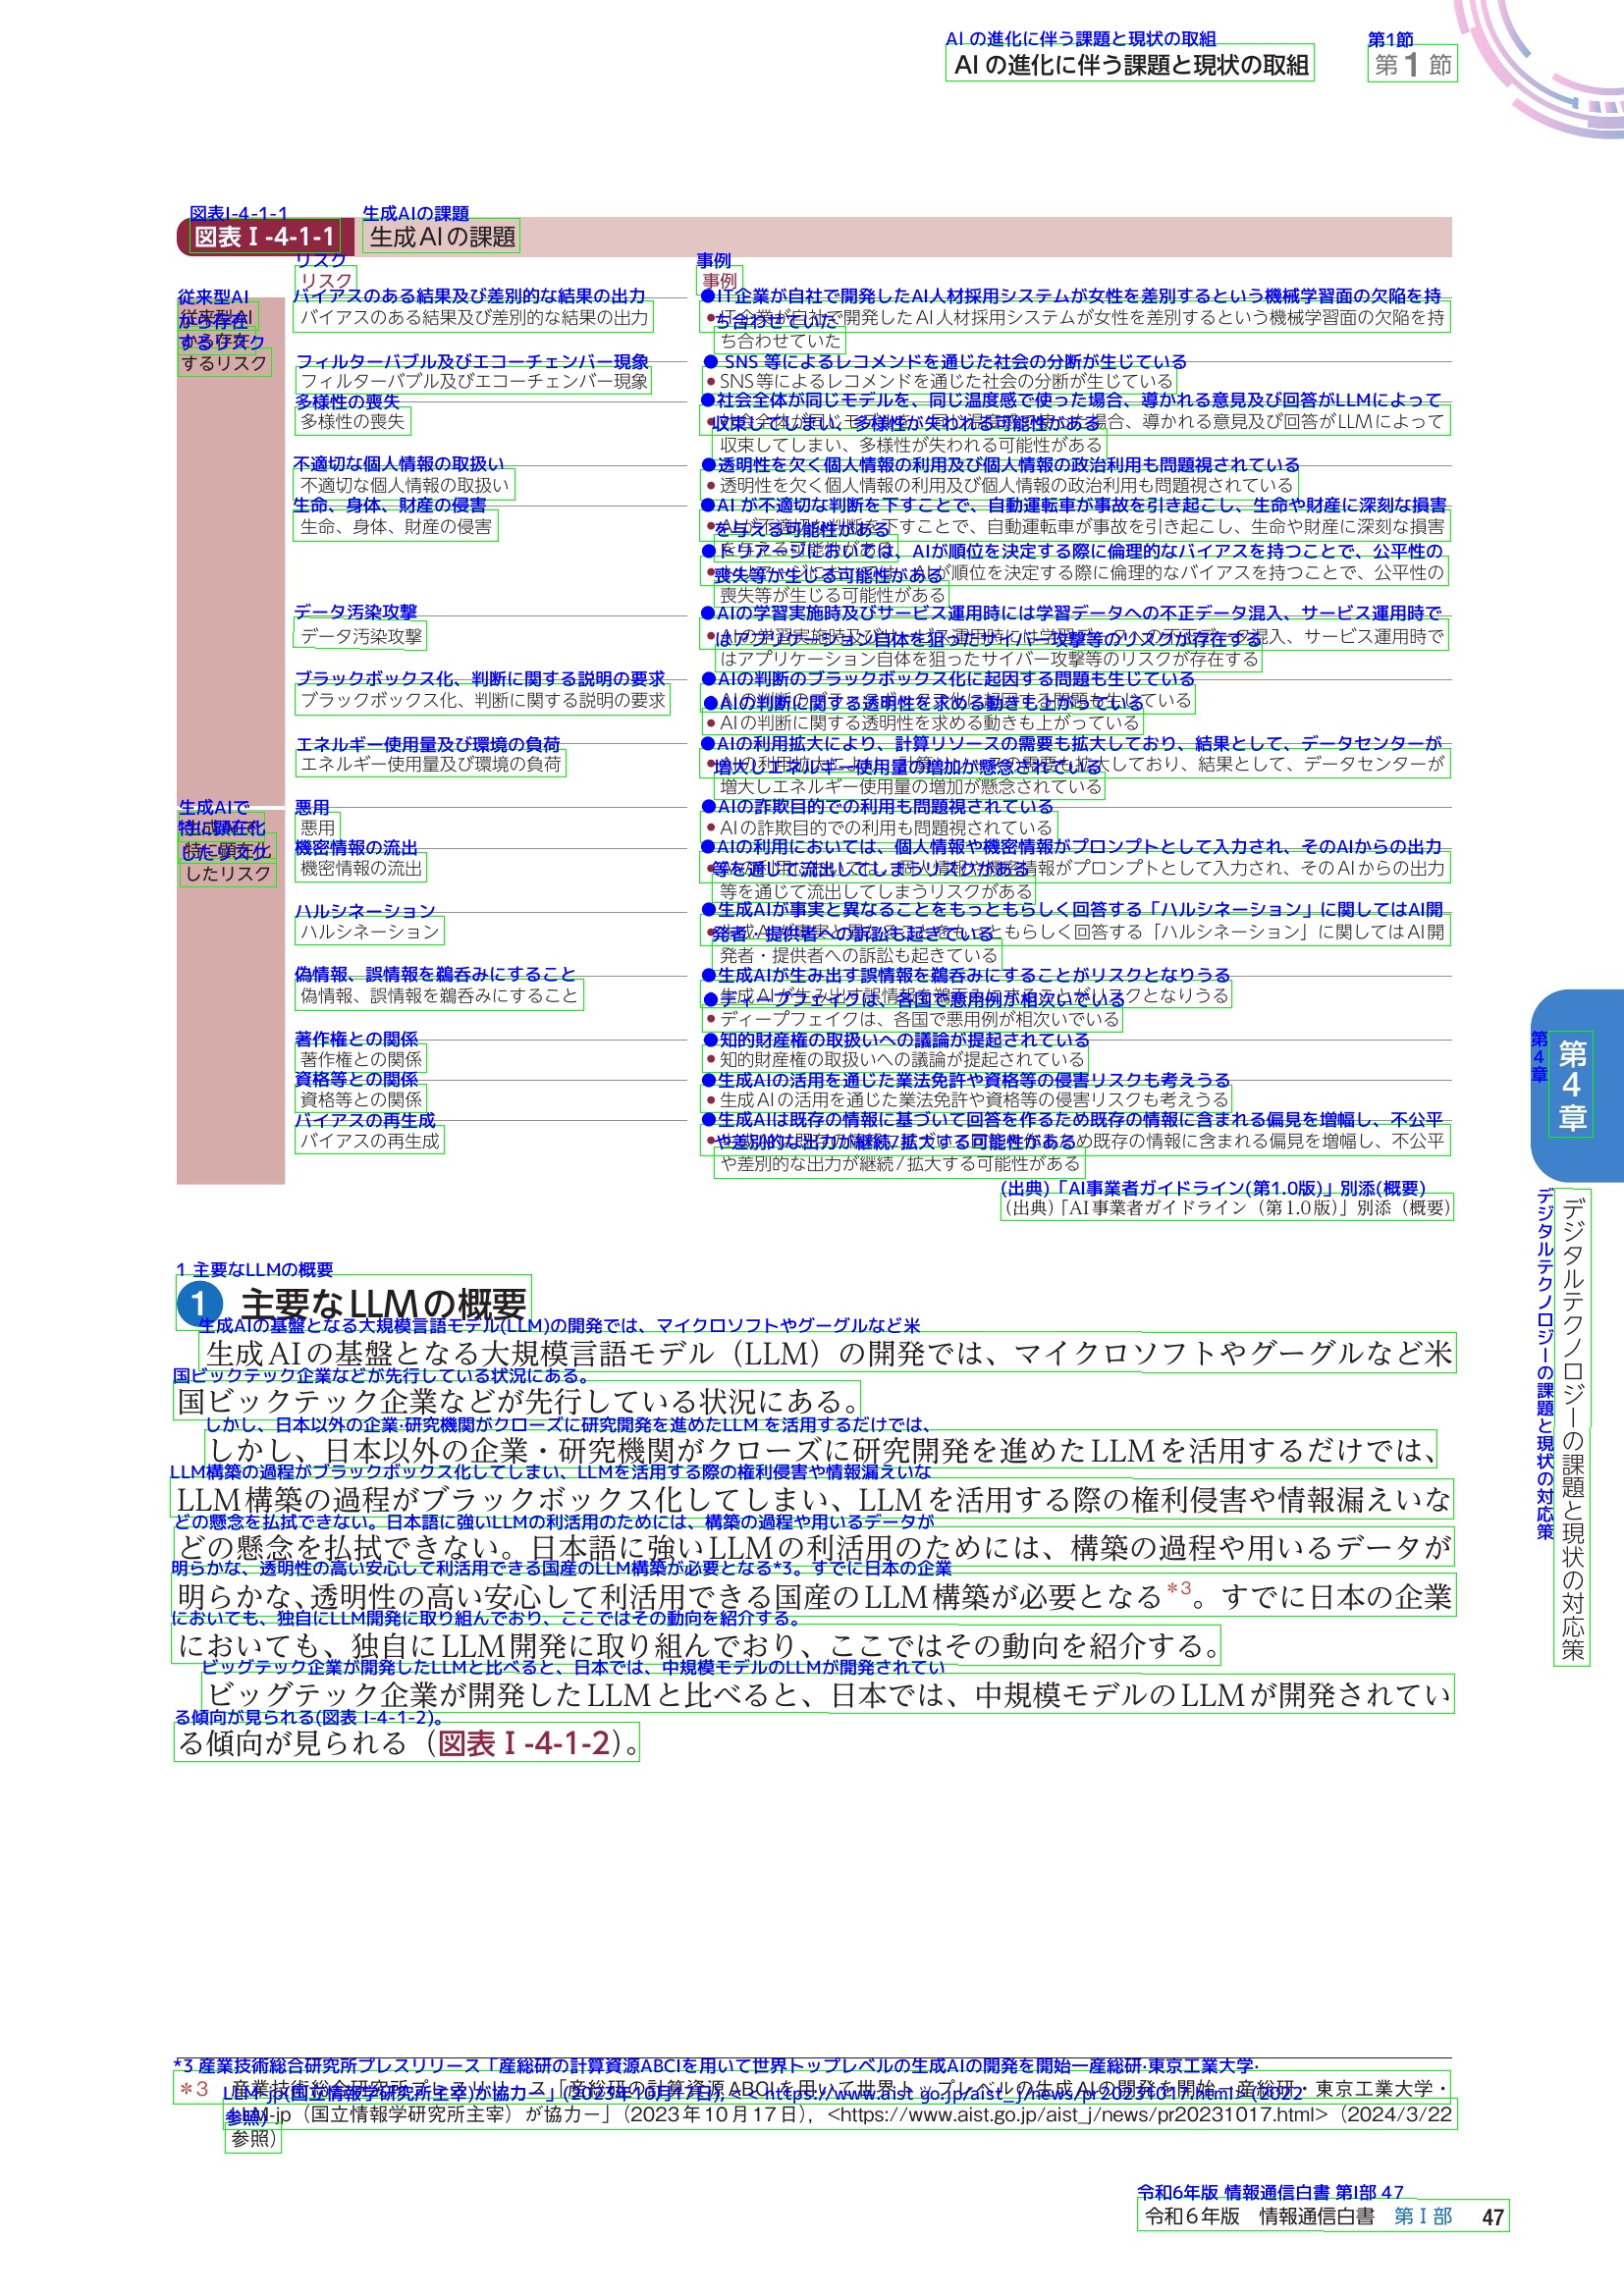 |
| レイアウト解析の結果 | エクスポート (HTML で出力したものをスクショ) |
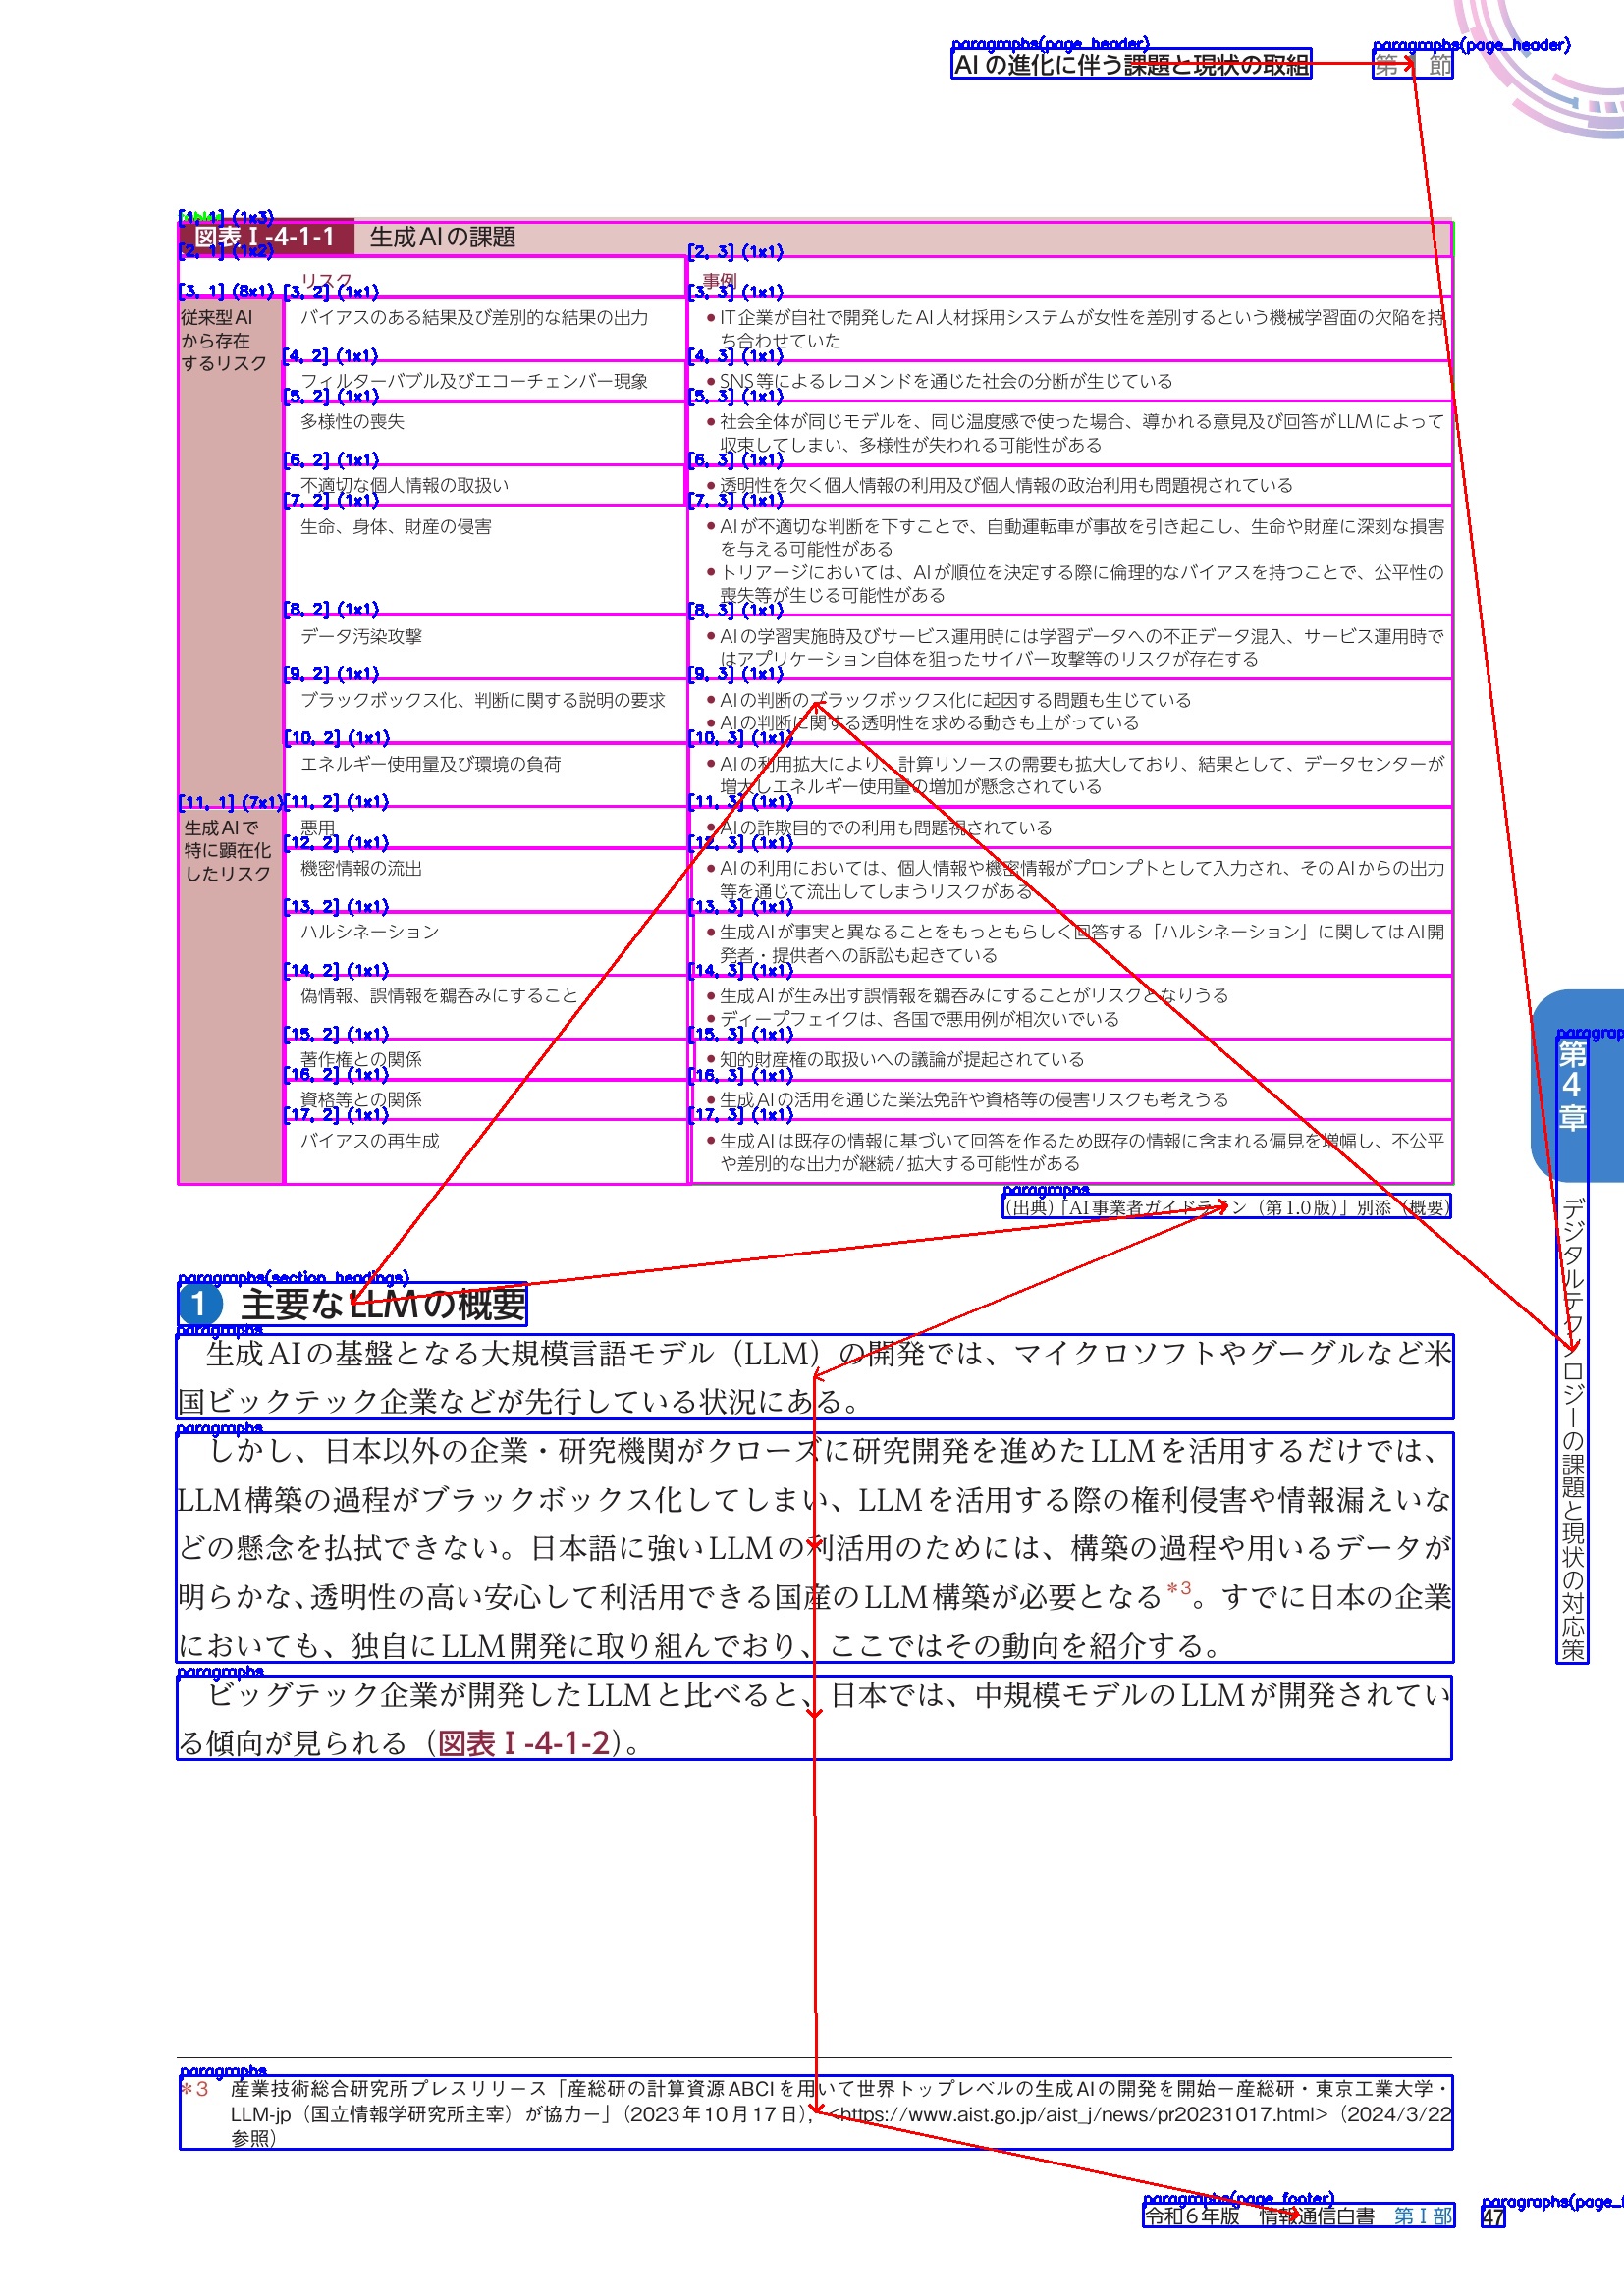 | 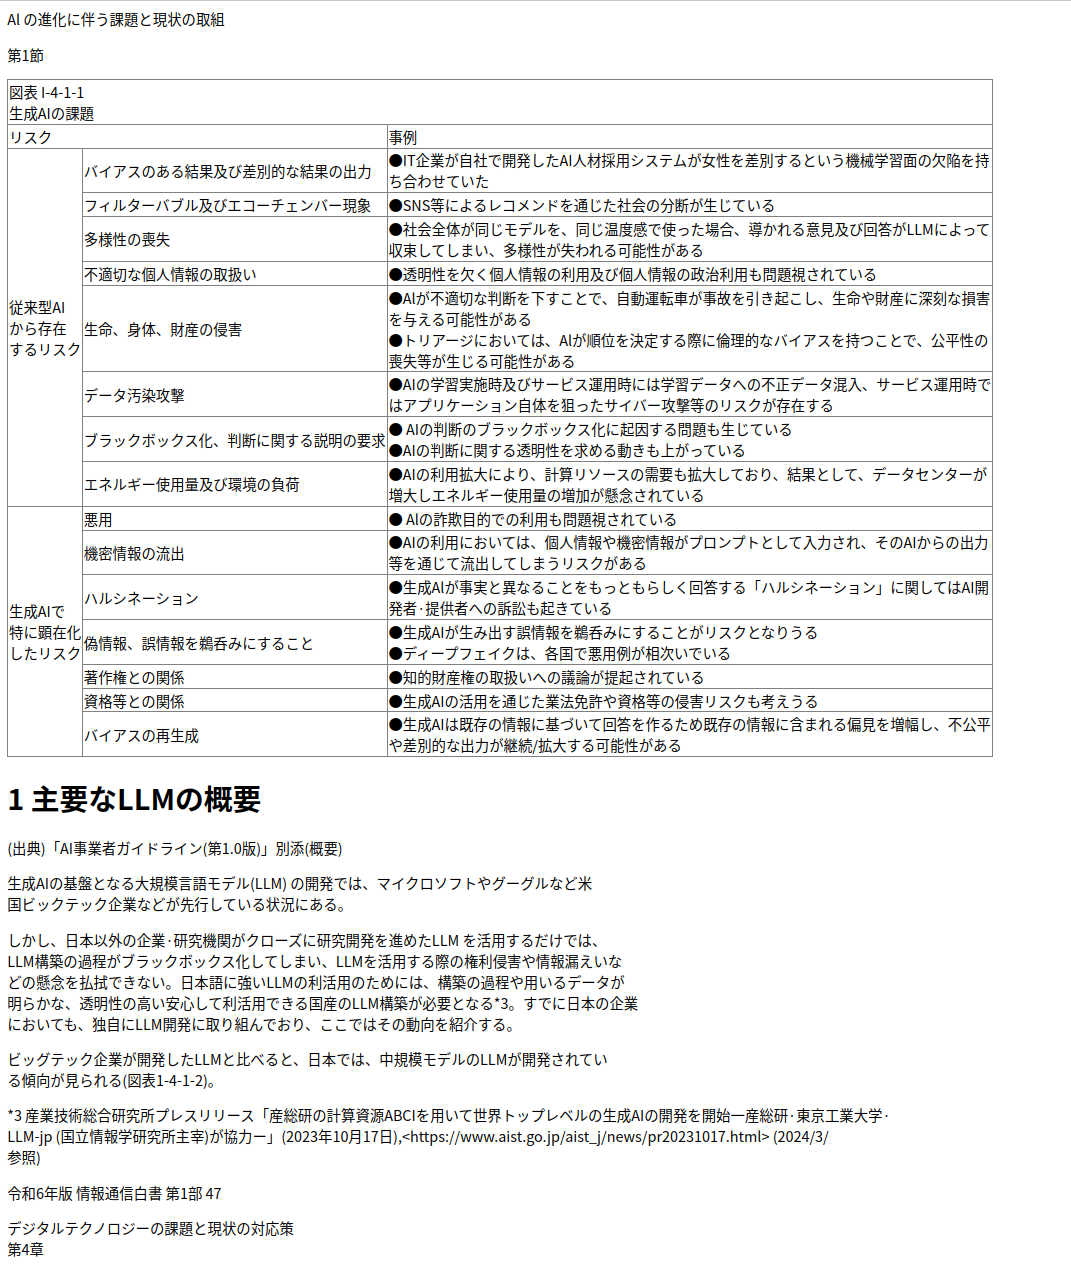 |
Markdown でエクスポートした結果は関してはリポジトリ内のstatic/out/in_demo_p1.mdを参照
赤枠 : 図、画像等の位置緑枠 : 表領域全体の位置ピンク枠 : 表のセル構造(セル上の文字は [行番号, 列番号] (rowspan x colspan)を表します)青枠 : 段落、テキストグループ領域赤矢印 : 読み順推定の結果画像の出典:「令和 6 年版情報通信白書 3 章 2 節 AI の進化に伴い発展するテクノロジー」:(総務省) を加工して作成
yomitoku_table コマンド)を正式リリース--lite)が手書き文字の読み取りに対応し、1 行あたりの最大文字列長を 100 文字に拡張pip install yomitoku
yomitoku ${path_data} -f md -o results -v --figure
--liteオプションを使用してください。
yomitoku ${path_data} -f md --lite -d cpu -o results -v --figure
CLI の --lite オプションに相当する軽量モードは、configs でテキスト認識モデルに parseq-tiny-dynw-v4 を指定し、dynamic_width と batch_bucketing を有効化することで Python API からも利用できます。CPU 環境ではテキスト検出を ONNX 推論にすると、さらに高速化できます。
import cv2
from yomitoku import DocumentAnalyzer

if __name__ == "__main__":
    configs = {
        "ocr": {
            "text_recognizer": {
                "model_name": "parseq-tiny-dynw-v4",  # 動的幅対応の軽量モデル
                "dynamic_width": True,                 # 切り出し画像を実際の幅で処理
                "batch_bucketing": True,               # 幅の近い画像をまとめてバッチ化
                "device": "cpu",
            },
            "text_detector": {
                "device": "cpu",
                "infer_onnx": True,                    # CPU ではテキスト検出を ONNX 化すると高速
            },
        },
    }

    analyzer = DocumentAnalyzer(configs=configs, device="cpu")

    img = cv2.imread("sample.jpg")
    results, ocr_vis, layout_vis = analyzer(img)
    results.to_json("output.json")
OCR モジュール単体で利用する場合も、同じオプションを text_recognizer に渡します。
import cv2
from yomitoku import OCR

if __name__ == "__main__":
    configs = {
        "text_recognizer": {
            "model_name": "parseq-tiny-dynw-v4",
            "dynamic_width": True,
            "batch_bucketing": True,
        },
    }

    ocr = OCR(configs=configs, device="cpu")

    img = cv2.imread("sample.jpg")
    results, ocr_vis = ocr(img)
[!NOTE]
parseq-tiny-dynw-v4は動的幅バッチング推論を前提に学習されたモデルです。dynamic_width=True(およびbatch_bucketing=True)と組み合わせて使用してください。ONNX 推論(infer_onnx=True)は入力サイズが固定されるため、dynamic_widthは自動的に無効化されます。
| 引数名 | 説明 |
|---|---|
${path_data} | 解析対象の画像が含まれたディレクトリか画像ファイルのパスを直接指定します。ディレクトリを対象とした場合はサブディレクトリ内の画像も含めて処理を実行します。 |
--format(-f) | 出力形式のファイルフォーマットを指定します。(json, csv, html, md, pdf(searchable-pdf) をサポート) |
--outdir(-o) | 出力先のディレクトリ名を指定します。存在しない場合は新規で作成されます。 |
--vis(-v) | 解析結果を可視化した画像を出力します。 |
--lite(-l) | 軽量モデルで推論を実行します。通常より高速に推論できますが、若干、精度が低下する可能性があります。 |
--device(-d) | モデルを実行するためのデバイスを指定します。gpu が利用できない場合は cpu で推論が実行されます。(デフォルト: cuda) |
--ignore_line_break | 画像の改行位置を無視して、段落内の文章を連結して返します。(デフォルト:画像通りの改行位置で改行します。) |
--figure_letter | 検出した図表に含まれる文字も出力ファイルにエクスポートします。 |
--figure | 検出した図、画像を出力ファイルにエクスポートします。 |
--encoding | エクスポートする出力ファイルの文字エンコーディングを指定します。サポートされていない文字コードが含まれる場合は、その文字を無視します。(utf-8, utf-8-sig, shift-jis, enc-jp, cp932) |
--combine | PDFを入力に与えたときに、複数ページが含まれる場合に、それらの予測結果を一つのファイルに統合してエクスポートします。 |
--ignore_meta | 文章のheader, footerなどの文字情報を出力ファイルに含めません。 |
--ignore_ruby | ふりがな(ルビ)テキストを出力から除外します。 |
--ruby_threshold | ルビ判定の閾値を指定します(デフォルト: 0.5)。--ignore_ruby と併用します。 |
その他のオプションに関してはヘルプを参照してください。
yomitoku --help
Table Semantic Parserは、帳票画像やPDFから表を検出し、セルの役割(ヘッダー/値)や Key-Value(項目名→値)・グリッド(行列データ) といった意味構造を自動で推定する機能です。yomitoku_table コマンドで、ドキュメント全体の解析結果をページ単位の構造化JSONとして出力できます。
yomitoku_table ${path_data} -o results -v
デフォルトの出力は、Key-Value・グリッドのテキストに由来セルのIDと座標を埋め込んだ構造化JSONです。段落(paragraphs)も含まれます。
| オプション | 説明 |
|---|---|
--simple | 座標などのメタ情報を持たない、テキストのみの構造化JSONを出力します。 |
--raw | 正規化スキーマ(TableSemanticParserSchema)のまま出力します(テンプレート往復用)。 |
--lite | 軽量モデルで実行します(CPU向け)。 |
--studio-template FILE | YomiToku Studioの帳票テンプレート(v2/v3)を使い、OCRのみでバッチ解析します。 |
--grid_only / --kv_only | グリッドのみ / Key-Valueのみを解析します。 |
その他のオプション(モデル・Configの個別指定、テンプレート適用、ページ指定など)はTable Semantic Parser CLIのドキュメントを参照してください。Python APIの詳細はTable Semantic Parserのドキュメントを参照してください。
gallery_table_semantic_parser.mdに複数種類の帳票に対する解析結果の可視化を掲載しています。
※ 区切り罫線が存在する帳票のみをサポートしています。
YomiToku Extractorは、帳票画像やPDFからYAMLスキーマに基づいて構造化データを抽出する機能です。OCR・レイアウト解析の結果から、指定したフィールドの値を自動で抽出しJSONとして出力します。
| コマンド | 方式 | 特徴 |
|---|---|---|
yomitoku_extract | ルールベース | LLM不要。KV検索・グリッド照合・正規表現で高速に抽出 |
yomitoku_extract_with_llm | LLMベース | vLLM等のLLMサーバーを利用してより柔軟に抽出 |
pip install yomitoku[extract]
fields:
  - name: phone_number
    description: 電話番号
    type: string
    normalize: phone_jp

  - name: invoice_number
    regex: 'T\d{13}'
    type: string

  - name: order_items
    structure: table
    columns:
      - name: product
        description: 商品名
      - name: price
        description: 金額
        normalize: numeric
# ルールベース抽出
yomitoku_extract input.jpg -s schema.yaml -o results -v

# LLMベース抽出(vLLMサーバー使用)
yomitoku_extract_with_llm input.jpg -s schema.yaml -m Qwen/Qwen3-8B-Instruct
詳細はExtractor ドキュメントを参照してください。
パッケージの詳細はドキュメントを確認してください。
本リポジトリ内のソースコードおよび本プロジェクトに関連する HuggingFace Hub 上のモデルの重みファイルは、CC BY-NC-SA 4.0 ライセンスの下で提供されています。
非商用での個人利用・研究目的での利用は自由に行っていただけます。
YomiToku © 2024 by Kotaro Kinoshita is licensed under CC BY-NC-SA 4.0.
To view a copy of this license, visit: https://creativecommons.org/licenses/by-nc-sa/4.0/
商用化/非商用の判断は以下のガイドラインに従い、判断いたします。
YomiToku を商用環境でご利用いただく場合、以下の方法で 製品版の商用ライセンス を提供しています。
手書き認識の精度向上、画像の自動向き補正、レイアウト解析の強化など、製品版のみで利用可能な追加機能 を多数搭載しています。
オンプレミス環境やローカル PC での商用利用をご希望の場合は、専用の オンプレ向け商用ライセンス をご用意しています。
詳細は以下よりお問い合わせください。
YomiToku の商用版は AWS Marketplace でも提供しています。
すべての解析処理は お客様の AWS 環境内で完結 し、外部ネットワークや第三者サーバーへの送信は一切発生しません。
機密文書・社内資料・個人情報を扱うワークロードでも安心してご利用いただけます。
559 followers · starred Nov 2025
2,858 followers · starred Aug 2026
96 followers · starred Apr 2026
69 followers · starred Nov 2024
YomiTokuはAIを活用した日本語文書解析エンジンを提供するPythonパッケージです。 Yomitoku is an AI-powered document image analysis package designed specifically for the Japanese language.
See the code日本語版 | English
🌐 インストール不要でブラウザから試せます → YomiToku Studio 推論はすべてブラウザ内(WebAssembly / WebGPU)で実行され、画像はどこにも送信されません。まずは手元の画像で精度を確かめてみてください。
YomiToku は日本語に特化した AI 文章画像解析エンジン(Document AI)です。画像内の文字の全文 OCR およびレイアウト解析機能を有しており、画像内の文字情報や図表を認識、抽出、変換します。
インストール前に、ブラウザ版 YomiToku Studio で手元の画像を試せます(画像は外部送信されません)。
gallery.mdにも複数種類の画像の検証結果を掲載しています。
| 入力画像 | OCR の結果 |
|---|---|
| |
| レイアウト解析の結果 | エクスポート (HTML で出力したものをスクショ) |
| |
Markdown でエクスポートした結果は関してはリポジトリ内のstatic/out/in_demo_p1.mdを参照
赤枠 : 図、画像等の位置緑枠 : 表領域全体の位置ピンク枠 : 表のセル構造(セル上の文字は [行番号, 列番号] (rowspan x colspan)を表します)青枠 : 段落、テキストグループ領域赤矢印 : 読み順推定の結果画像の出典:「令和 6 年版情報通信白書 3 章 2 節 AI の進化に伴い発展するテクノロジー」:(総務省) を加工して作成
yomitoku_table コマンド)を正式リリース--lite)が手書き文字の読み取りに対応し、1 行あたりの最大文字列長を 100 文字に拡張pip install yomitoku
yomitoku ${path_data} -f md -o results -v --figure
--liteオプションを使用してください。
yomitoku ${path_data} -f md --lite -d cpu -o results -v --figure
CLI の --lite オプションに相当する軽量モードは、configs でテキスト認識モデルに parseq-tiny-dynw-v4 を指定し、dynamic_width と batch_bucketing を有効化することで Python API からも利用できます。CPU 環境ではテキスト検出を ONNX 推論にすると、さらに高速化できます。
import cv2
from yomitoku import DocumentAnalyzer

if __name__ == "__main__":
    configs = {
        "ocr": {
            "text_recognizer": {
                "model_name": "parseq-tiny-dynw-v4",  # 動的幅対応の軽量モデル
                "dynamic_width": True,                 # 切り出し画像を実際の幅で処理
                "batch_bucketing": True,               # 幅の近い画像をまとめてバッチ化
                "device": "cpu",
            },
            "text_detector": {
                "device": "cpu",
                "infer_onnx": True,                    # CPU ではテキスト検出を ONNX 化すると高速
            },
        },
    }

    analyzer = DocumentAnalyzer(configs=configs, device="cpu")

    img = cv2.imread("sample.jpg")
    results, ocr_vis, layout_vis = analyzer(img)
    results.to_json("output.json")
OCR モジュール単体で利用する場合も、同じオプションを text_recognizer に渡します。
import cv2
from yomitoku import OCR

if __name__ == "__main__":
    configs = {
        "text_recognizer": {
            "model_name": "parseq-tiny-dynw-v4",
            "dynamic_width": True,
            "batch_bucketing": True,
        },
    }

    ocr = OCR(configs=configs, device="cpu")

    img = cv2.imread("sample.jpg")
    results, ocr_vis = ocr(img)
[!NOTE]
parseq-tiny-dynw-v4は動的幅バッチング推論を前提に学習されたモデルです。dynamic_width=True(およびbatch_bucketing=True)と組み合わせて使用してください。ONNX 推論(infer_onnx=True)は入力サイズが固定されるため、dynamic_widthは自動的に無効化されます。
| 引数名 | 説明 |
|---|---|
${path_data} | 解析対象の画像が含まれたディレクトリか画像ファイルのパスを直接指定します。ディレクトリを対象とした場合はサブディレクトリ内の画像も含めて処理を実行します。 |
--format(-f) | 出力形式のファイルフォーマットを指定します。(json, csv, html, md, pdf(searchable-pdf) をサポート) |
--outdir(-o) | 出力先のディレクトリ名を指定します。存在しない場合は新規で作成されます。 |
--vis(-v) | 解析結果を可視化した画像を出力します。 |
--lite(-l) | 軽量モデルで推論を実行します。通常より高速に推論できますが、若干、精度が低下する可能性があります。 |
--device(-d) | モデルを実行するためのデバイスを指定します。gpu が利用できない場合は cpu で推論が実行されます。(デフォルト: cuda) |
--ignore_line_break | 画像の改行位置を無視して、段落内の文章を連結して返します。(デフォルト:画像通りの改行位置で改行します。) |
--figure_letter | 検出した図表に含まれる文字も出力ファイルにエクスポートします。 |
--figure | 検出した図、画像を出力ファイルにエクスポートします。 |
--encoding | エクスポートする出力ファイルの文字エンコーディングを指定します。サポートされていない文字コードが含まれる場合は、その文字を無視します。(utf-8, utf-8-sig, shift-jis, enc-jp, cp932) |
--combine | PDFを入力に与えたときに、複数ページが含まれる場合に、それらの予測結果を一つのファイルに統合してエクスポートします。 |
--ignore_meta | 文章のheader, footerなどの文字情報を出力ファイルに含めません。 |
--ignore_ruby | ふりがな(ルビ)テキストを出力から除外します。 |
--ruby_threshold | ルビ判定の閾値を指定します(デフォルト: 0.5)。--ignore_ruby と併用します。 |
その他のオプションに関してはヘルプを参照してください。
yomitoku --help
Table Semantic Parserは、帳票画像やPDFから表を検出し、セルの役割(ヘッダー/値)や Key-Value(項目名→値)・グリッド(行列データ) といった意味構造を自動で推定する機能です。yomitoku_table コマンドで、ドキュメント全体の解析結果をページ単位の構造化JSONとして出力できます。
yomitoku_table ${path_data} -o results -v
デフォルトの出力は、Key-Value・グリッドのテキストに由来セルのIDと座標を埋め込んだ構造化JSONです。段落(paragraphs)も含まれます。
| オプション | 説明 |
|---|---|
--simple | 座標などのメタ情報を持たない、テキストのみの構造化JSONを出力します。 |
--raw | 正規化スキーマ(TableSemanticParserSchema)のまま出力します(テンプレート往復用)。 |
--lite | 軽量モデルで実行します(CPU向け)。 |
--studio-template FILE | YomiToku Studioの帳票テンプレート(v2/v3)を使い、OCRのみでバッチ解析します。 |
--grid_only / --kv_only | グリッドのみ / Key-Valueのみを解析します。 |
その他のオプション(モデル・Configの個別指定、テンプレート適用、ページ指定など)はTable Semantic Parser CLIのドキュメントを参照してください。Python APIの詳細はTable Semantic Parserのドキュメントを参照してください。
gallery_table_semantic_parser.mdに複数種類の帳票に対する解析結果の可視化を掲載しています。
※ 区切り罫線が存在する帳票のみをサポートしています。
YomiToku Extractorは、帳票画像やPDFからYAMLスキーマに基づいて構造化データを抽出する機能です。OCR・レイアウト解析の結果から、指定したフィールドの値を自動で抽出しJSONとして出力します。
| コマンド | 方式 | 特徴 |
|---|---|---|
yomitoku_extract | ルールベース | LLM不要。KV検索・グリッド照合・正規表現で高速に抽出 |
yomitoku_extract_with_llm | LLMベース | vLLM等のLLMサーバーを利用してより柔軟に抽出 |
pip install yomitoku[extract]
fields:
  - name: phone_number
    description: 電話番号
    type: string
    normalize: phone_jp

  - name: invoice_number
    regex: 'T\d{13}'
    type: string

  - name: order_items
    structure: table
    columns:
      - name: product
        description: 商品名
      - name: price
        description: 金額
        normalize: numeric
# ルールベース抽出
yomitoku_extract input.jpg -s schema.yaml -o results -v

# LLMベース抽出(vLLMサーバー使用)
yomitoku_extract_with_llm input.jpg -s schema.yaml -m Qwen/Qwen3-8B-Instruct
詳細はExtractor ドキュメントを参照してください。
パッケージの詳細はドキュメントを確認してください。
本リポジトリ内のソースコードおよび本プロジェクトに関連する HuggingFace Hub 上のモデルの重みファイルは、CC BY-NC-SA 4.0 ライセンスの下で提供されています。
非商用での個人利用・研究目的での利用は自由に行っていただけます。
YomiToku © 2024 by Kotaro Kinoshita is licensed under CC BY-NC-SA 4.0.
To view a copy of this license, visit: https://creativecommons.org/licenses/by-nc-sa/4.0/
商用化/非商用の判断は以下のガイドラインに従い、判断いたします。
YomiToku を商用環境でご利用いただく場合、以下の方法で 製品版の商用ライセンス を提供しています。
手書き認識の精度向上、画像の自動向き補正、レイアウト解析の強化など、製品版のみで利用可能な追加機能 を多数搭載しています。
オンプレミス環境やローカル PC での商用利用をご希望の場合は、専用の オンプレ向け商用ライセンス をご用意しています。
詳細は以下よりお問い合わせください。
YomiToku の商用版は AWS Marketplace でも提供しています。
すべての解析処理は お客様の AWS 環境内で完結 し、外部ネットワークや第三者サーバーへの送信は一切発生しません。
機密文書・社内資料・個人情報を扱うワークロードでも安心してご利用いただけます。
559 followers · starred Nov 2025
2,858 followers · starred Aug 2026
96 followers · starred Apr 2026
69 followers · starred Nov 2024