
README
RAG 论文学习笔记
- RAG 论文学习笔记
- 2024.01
- 2024.02
- 2024.03
- 2024.04
- 2024.05
- 2024.06
- 2024.07
- 2024.08
- 2024.09
- 2024.10
- 2024.11
- 2025.02
- 2025.03
- 致谢
2024.01
GraphReader【图解专家】
图解专家:像个善于制作思维导图的导师,将冗长的文本转化为清晰的知识网络,让AI能够像沿着地图探索一样,轻松找到答案需要的各个关键点,有效克服了处理长文本时的"迷路"问题。
- 发表时间:2024.01.20
- 论文名称:GraphReader: Building Graph-based Agent to Enhance Long-Context Abilities of Large Language Models
- 论文地址:https://arxiv.org/abs/2406.14550
一、论文动机
**LLMs面临的一个主要限制是上下文窗口大小和内存使用的局限性,这使得它们难以有效处理长上下文。**为了解决这一问题,研究人员探索了多种方法,包括改进模型结构、引入检索增强机制以及利用代理进行复杂推理。然而,这些方法各自存在一定的局限性,如训练成本增加、忽略细节信息或决策机制不够灵活。
二、论文思路
- 目标:通过构建图结构并采用自主代理探索策略,GraphReader能够在有限的上下文窗口内捕捉长距离依赖关系,从而实现对冗长文档的有效处理。
GraphReader的操作分为三个阶段:
- 图构建:文档被划分为多个块,每个块被总结为原子事实,并从中抽取关键元素形成节点;节点之间根据共享的关键元素建立链接。
- 图探索:智能体按照合理规划选择起始节点,并通过检查相邻节点来遍历整个图结构;在此过程中,智能体会记录支持性事实以备后续分析。
- 答案推理:编译来自不同智能体的笔记,使用思维链推理生成针对给定问题的答案。
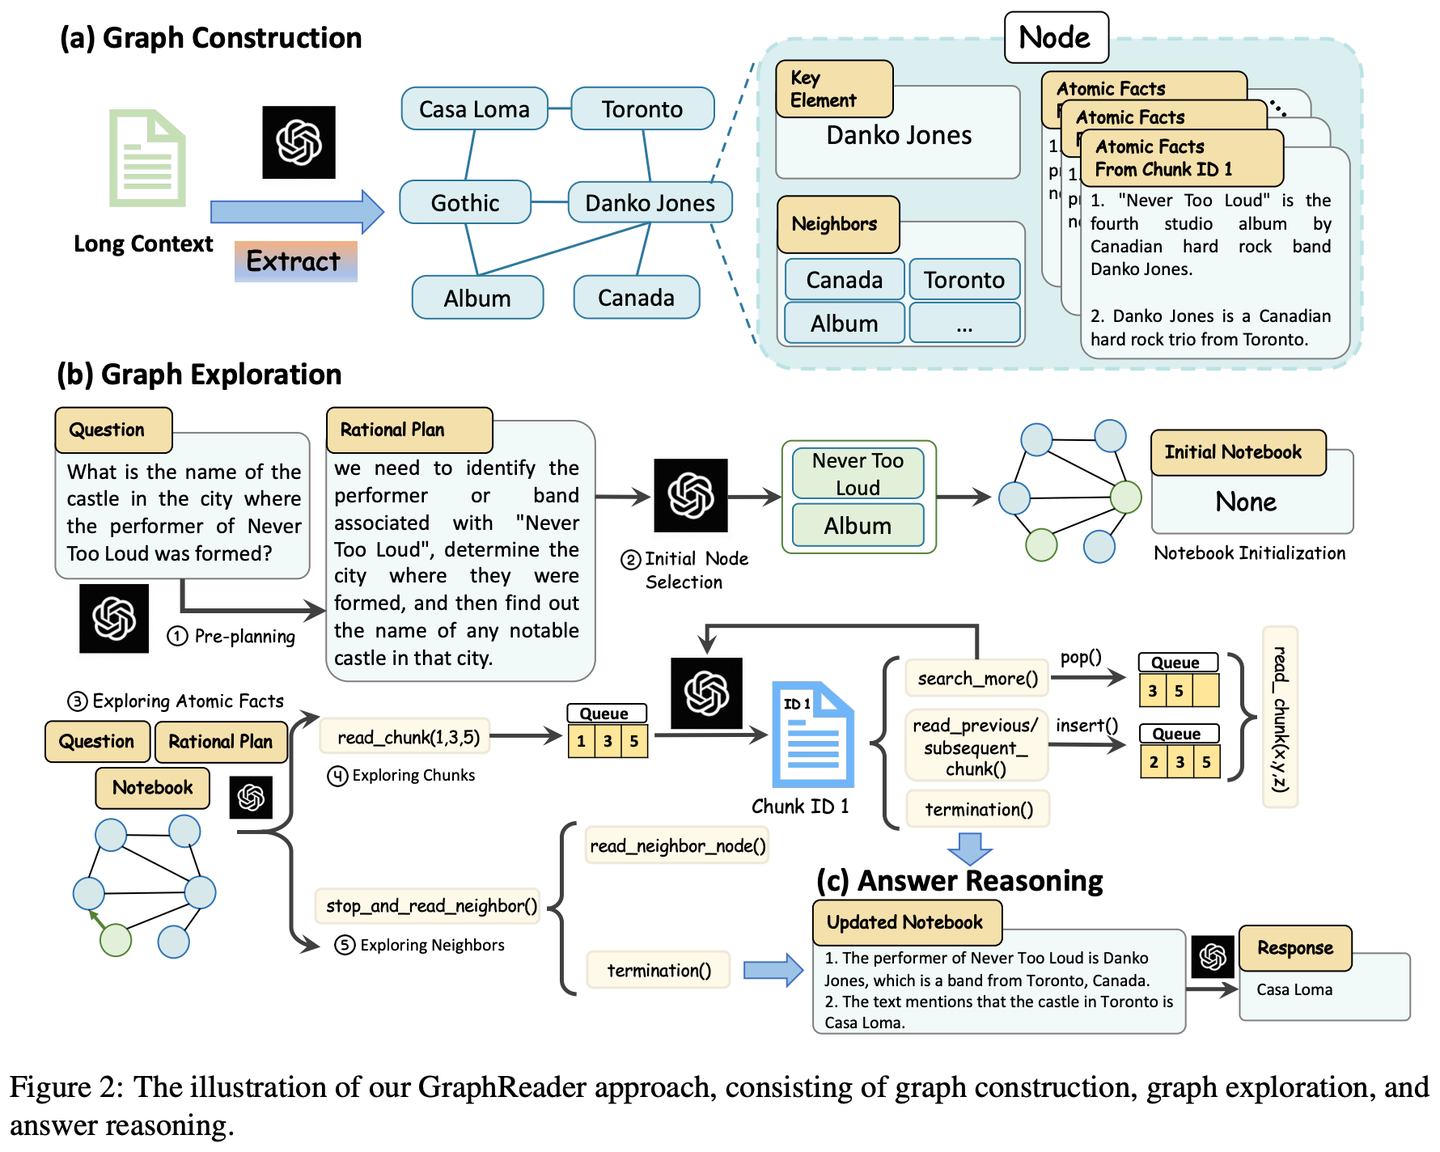
三、论文创新点
- 将长文本分割成离散块,并提取关键元素和原子事实;
- 使用这些组件构建一个能够反映文本内部关系的图结构;
- 智能体根据预定义函数和逐步理性计划,在图中导航并收集必要信息;
- 整个过程包括做笔记和反思,确保最终答案的准确性和完整性。
四、结论
GraphReader通过将长文本组织成图结构并利用智能体探索,成功克服了传统LLMs处理长文本时的障碍,提供了更为有效的解决方案。这项研究为长上下文处理树立了新的标杆,并为未来的进一步发展奠定了坚实的基础。
MM-RAG【多面手】
多面手:就像一个能同时精通视觉、听觉和语言的全能选手,不仅能理解不同形式的信息,还能在它们之间自如切换和关联。通过对各种信息的综合理解,它能在推荐、助手、媒体等多个领域提供更智能、更自然的服务。
- 时间:2024.01.22
一、论文动机
- 多模态理解:通过理解图像、音频、视频和文本等不同模态,AI系统可以解决以前难以解决的问题。
- 对比学习:用于训练高质量的多模态嵌入,通过比较正负样本对来学习跨模态的语义表示。例如,CLIP模型通过对比学习在图像和文本之间建立了强大的关联
二、论文思路
- 定义:MM-RAG是一种将大型语言模型(如GPT-3)与使用对比学习嵌入的多模态检索器相结合的技术。
- 多模态嵌入空间:将不同格式的数据(图片、音频、视频、文本)编码到同一语义嵌入空间中,使得可以通过嵌入相似性进行跨模态搜索。在文本生成过程中,模型会将检索到的不同格式的数据(图片、音频、视频、文本)作为额外上下文,指导其完成更具体且连贯的输出。
举个栗子:用户可以通过一张图片检索相关的文本描述,或者通过文本查询找到相关的图片、音频或视频内容.
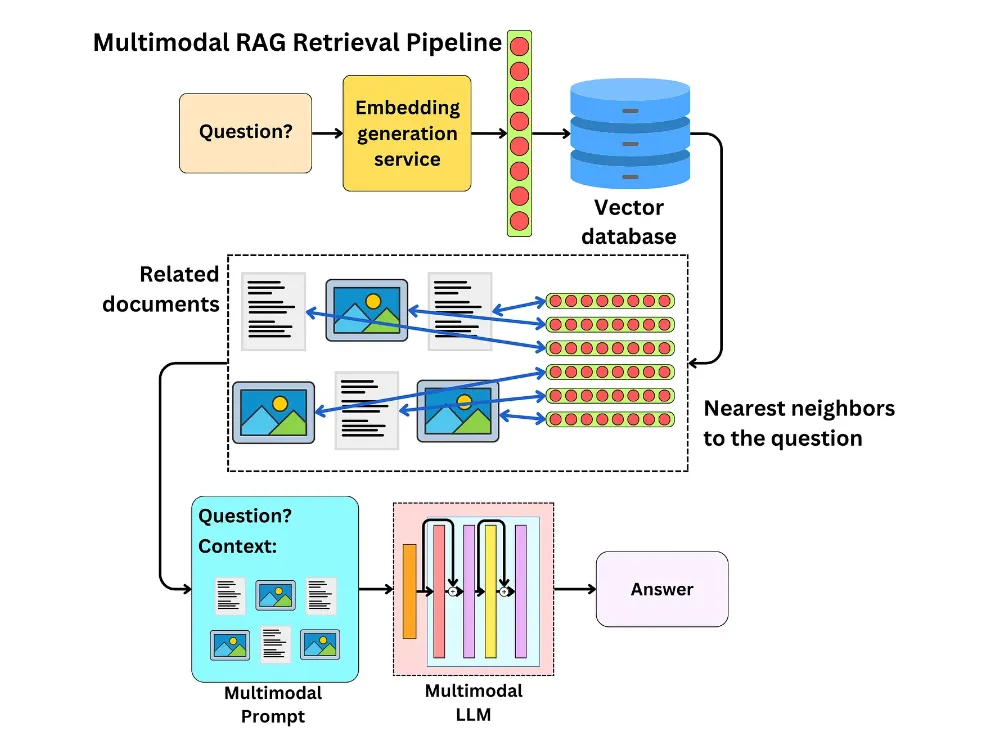
为了使MM-RAG能够在实际应用中大规模部署,文章提出了一个包含三个主要组件的解决方案:
- 对比训练多模态模型:例如CLIP,用于将不同模态的数据编码到共享的向量空间中。
- 高效向量数据库:例如Weaviate,它能够处理数十亿个嵌入并执行快速的向量相似性搜索。
- 用户查询接口:允许用户提交查询,并即时从数据库中检索跨模态的相关结果。
这套系统不仅支持高效的多模态搜索,还为构建大规模的MM-RAG生产环境提供了基础架构。
三、论文总结
MM-RAG代表了语言生成模型的一个重要进步,它通过整合来自多种模态的信息,提高了生成内容的质量。借助对比学习和向量数据库的力量,这项技术正逐步从实验室走向实际应用,为用户提供更为丰富和准确的语言交互体验。随着技术的不断发展,我们正迎来一个多模态智能的新时代。
CRAG【自我校正】
自我校正:像个经验丰富的编辑,先用简单快速的方式筛选初步资料,再通过网络搜索扩充信息,最后通过拆解重组的方式,确保最终呈现的内容既准确又可靠。就像是给RAG装上了一个质量控制系统,让它产出的内容更值得信赖。
- 发表时间:2024.01.29
- 论文名称:Corrective Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2401.15884
- Github 地址:https://github.com/HuskyInSalt/CRAG
一、论文动机
传统RAG的局限性:传统的检索增强生成(RAG)方法在信息检索过程中存在局限性,如缺乏对检索文档与问题相关性的评估,导致生成内容可能不准确或包含无关信息.
二、论文思路
- 检索评估器:CRAG使用一个轻量级的T5-large模型作为检索评估器,评估检索到的文档与问题之间的相关性,并给出三种结果:正确、错误、模棱两可.
- 正确:使用知识细化算法对检索到的信息进行处理和精炼.
- 错误:利用网络搜索引擎获取更相关的信息.
- 模棱两可:结合使用知识细化算法和网络搜索引擎,获取更多信息来完善答案.
- 知识精炼算法:先将文档细分为细小的知识单元,利用检索评估器为每个知识单元计算相关性评分,筛除评分较低的单元,剩下的单元重新组合构建成完整的内部知识体系.
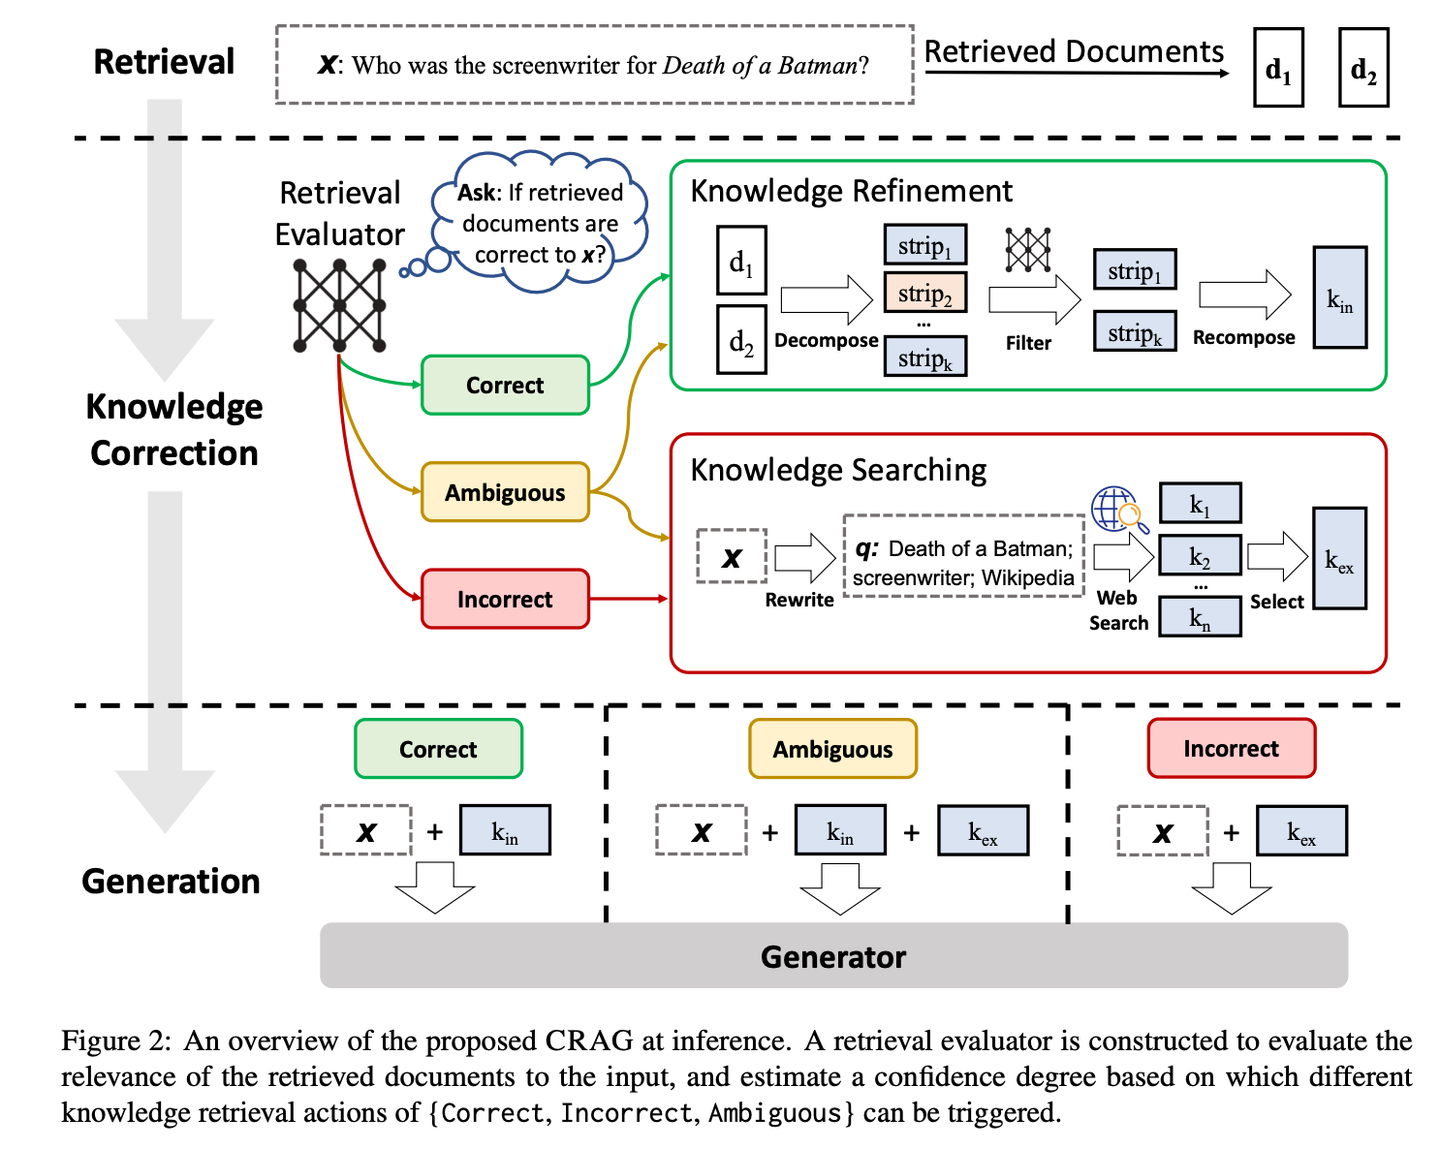
三、优势与不足
- 优势:CRAG通过自我校正检索结果,增强了生成文本的鲁棒性,模型结构轻量级,推理速度快.
- 不足:需要根据具体问题和需求调整相关性分数的阈值,以在信息检索的准确性和全面性之间取得平衡.
总结
文章强调了CRAG在提升信息检索与生成质量方面的潜力,并展示了其在自然语言处理领域的理论和实践意义,为提升语言模型在复杂知识密集型任务中的表现提供了新的思路和方法.
RAPTOR【分层归纳】
分层归纳:像个善于组织的图书管理员,将文档内容自下而上地整理成树状结构,让信息检索能在不同层级间灵活穿梭,既能看到整体概要,又能深入细节。
- 发表时间:2024.01.31
- 论文名称:RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval
- 论文地址:https://arxiv.org/abs/2401.18059
- Github 项目:https://github.com/parthsarthi03/raptor
一、论文动机
传统的RAG方法通常仅从检索语料库中提取短的连续文本块,这限制了模型对整个文档上下文的整体理解能力。
二、论文思路
RAPTOR(Recursive Abstractive Processing for Tree-Organized Retrieval)旨在通过递归处理、聚类和总结文本块,构建具有不同抽象级别的树形结构,从而改进长文档信息的整合与检索效率。
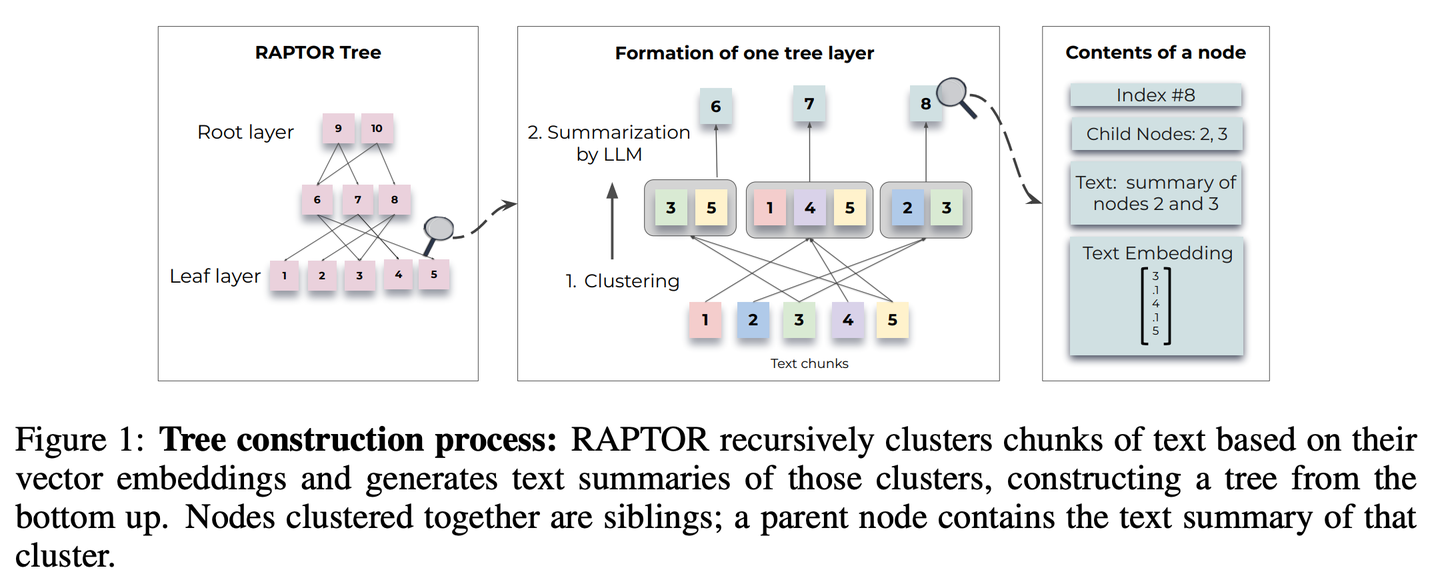
2.1 RAPTOR检索树的构建过程
- 文本切片:首先对文本进行合理的切片处理,选择合适的切片算法.
- 递归聚类与总结:根据语义embedding递归地对文本块进行聚类,并生成这些聚类的文本摘要.采用软聚类方法,允许文本块跨多个聚类,并使用高斯混合模型(GMMs)和UMAP技术进行降维,以优化文本聚类效果.
- 树形模型构建:通过递归的向量分析,精准地对文本块进行聚类,并提炼出这些聚类的核心摘要,自下而上地构建出一个结构化的树形模型.相近的节点形成兄弟关系,父节点承载整个集群的概要性文本信息.
2.2 RAPTOR的检索过程
- 深度检索树:从树的根级别开始,根据与查询向量的余弦相似度逐层检索top-k节点,直到达到叶节点,最后将所有选定节点的文本连接起来形成检索到的上下文.
- 广度检索树:将整个树压缩成单一层,然后根据与查询向量的余弦相似度评估所有层的节点,直到达到设定阈值.
三、论文创新点
- 树状结构的构建
- 递归嵌入与聚类:RAPTOR通过递归的方式对文本块进行嵌入和聚类,生成不同层次的文本摘要,构建出具有不同总结级别的树形结构。这种递归嵌入与聚类的方法使得模型能够逐步细化文本信息的粒度,捕捉到不同层次上的关键信息,为后续的文本分析和应用奠定了坚实的基础.
- 软聚类与降维技术:采用软聚类方法,允许文本块跨多个聚类,基于高斯混合模型(GMMs)和UMAP技术进行降维。这种软聚类与降维技术的结合,能够更好地捕捉文本数据的复杂结构和关系,优化文本聚类效果,提高模型对文本信息的理解和处理能力.
- 检索过程的优化
- 深度与广度检索树:提出了基于深度检索树(树遍历)和广度检索树(折叠树)的两种检索方式。深度检索树从树的根级别开始逐层检索,广度检索树将整个树压缩成单一层进行评估。这两种检索方式为不同场景下的信息检索提供了灵活的选择,能够根据具体需求和查询向量的相似度,高效地检索到相关的信息.
- 多级信息整合:在推理时,RAPTOR模型能够从构建的树中整合不同抽象级别的长文档中的信息。这种多级信息整合的方式,使得模型在生成答案时能够综合考虑不同层次上的文本内容,提高生成结果的准确性和可靠性.
- 性能提升
- 显著提高准确度:与传统的检索增强型语言模型相比,RAPTOR在性能和绝对准确度上提高了20%。这一显著的性能提升,证明了RAPTOR模型在信息检索与生成任务中的有效性,展示了其在处理长文本和复杂文档方面的优势.
四、论文总结
RAPTOR模型通过其独特的树状结构构建、优化的检索过程以及显著的性能提升,为检索增强生成领域带来了新的创新和突破,为处理长文本和复杂文档提供了更高效、更准确的方法.
2024.02
T-RAG【私人顾问】
私人顾问:像个熟悉组织架构的内部顾问,善于利用树状结构组织信息,在保护隐私的同时,高效且经济地提供本地化服务。
- 发表时间:2024.02.12
- 论文名称:T-RAG: Lessons from the LLM Trenches
- 论文地址:https://arxiv.org/abs/2402.07483
一、论文动机
- 数据隐私与安全性:在处理私营企业文档的问答任务时,数据的安全性和稳健性至关重要。由于文档的敏感性,使用公共API上的专有LLM模型存在数据泄露的风险,因此需要使用可以在本地部署的开源模型.
- 现有挑战:有限的计算资源和较小的训练数据集也带来了挑战,同时需要确保对用户查询的可靠和准确的响应,这增加了部署强大应用程序的复杂性.
二、论文思路
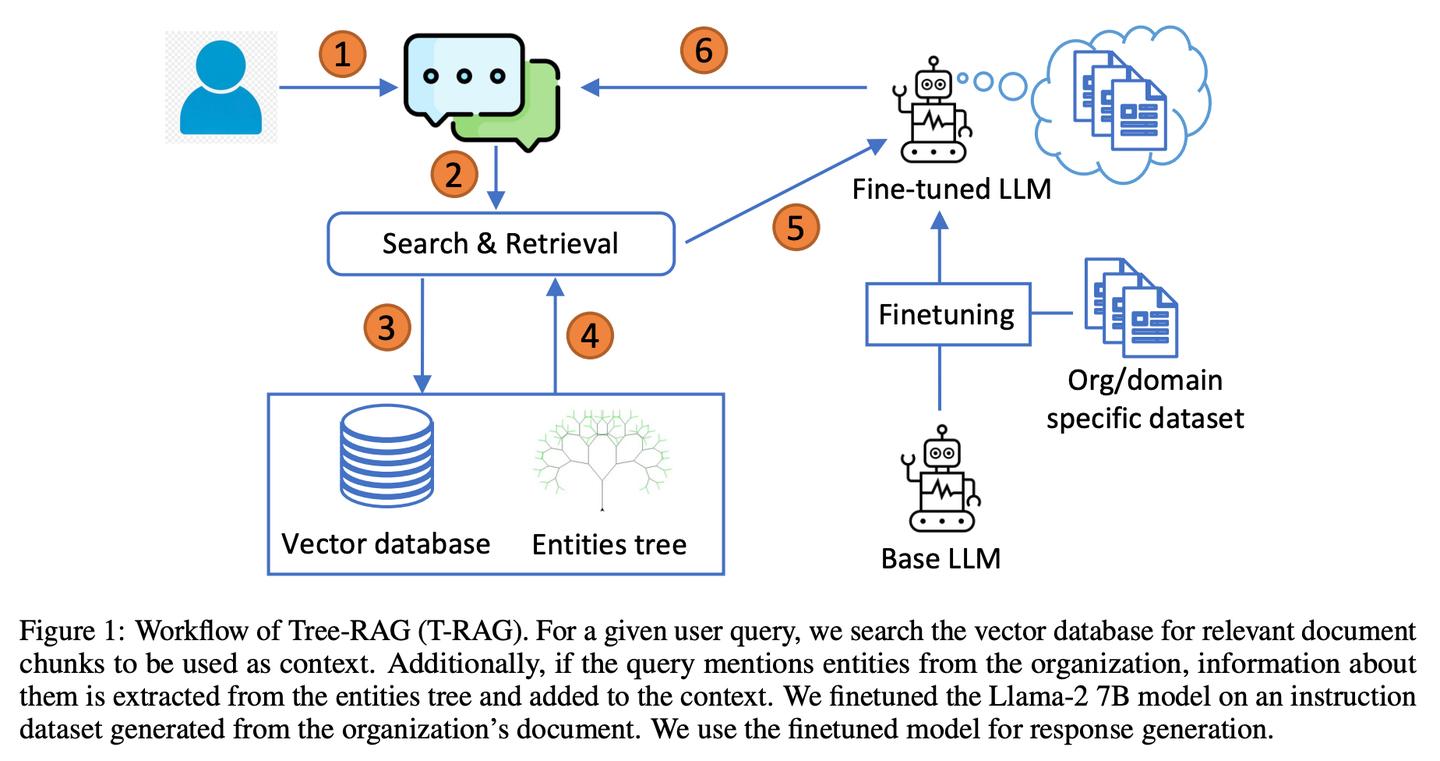
- 架构设计:T-RAG将RAG架构与经过微调的开源LLM(如Llama-2 7B模型)相结合,使用源自组织文档的指令数据集进行训练,以生成响应.
- 实体树与向量数据库:T-RAG结合了实体树和向量数据库进行上下文检索。实体树存储有关组织实体及其层次结构的信息,而向量数据库用于搜索相关文档块.
- 工作流程:
- 解析用户查询,识别与组织内实体名称相对应的关键字.
- 从实体树中提取相关实体的详细信息,并将其转换为文本陈述,提供有关实体及其在组织层次结构中的位置的信息.
- 将这些信息与从向量数据库检索的文档块合并,构建上下文.
- 经过微调的LLM根据提供的上下文生成响应.
三、论文创新点
- 实体树的利用:通过实体树增强上下文检索,使得模型能够获得有关实体及其在组织内层次定位的相关信息,从而提高回答的准确性和相关性.
- 数据隐私保护:使用本地部署的开源模型,避免了数据泄露的风险,同时解决了推理延迟、令牌使用成本以及区域和地理可用性问题.
- 评估指标:引入了Correct-Verbose评估指标,用于评估生成的响应质量,不仅考虑答案的正确性,还考虑包含超出原始问题范围的其他相关信息.
四、论文总结
T-RAG(树状检索增强生成)结合RAG与微调的开源LLM,使用树结构来表示组织内的实体层次结构增强上下文,利用本地托管的开源模型来解决数据隐私问题,同时解决推理延迟、令牌使用成本以及区域和地理可用性问题。
2024.03
RAT【思考者】
思考者:像个善于反思的导师,不是一次性得出结论,而是先有初步想法,然后利用检索到的相关信息,不断审视和完善每一步推理过程,让思维链条更加严密可靠。
- 发表时间:2024.03.08
- 论文名称:RAT: Retrieval Augmented Thoughts Elicit Context-Aware Reasoning in Long-Horizon Generation
- 论文地址:https://arxiv.org/abs/2403.05313
- Github 项目:https://github.com/CraftJarvis/RAT
一、论文动机
- 幻觉问题:在生成式AI应用中,语言模型常常会产生幻觉,即生成与事实不符的内容,影响输出的准确性.
- 效率与准确性的平衡:应用开发者需要在效率和准确性之间找到平衡点,RAT提供了一种解决方法,能够在不牺牲太多效率的情况下提高准确性.
二、论文思路
- 结合CoT和RAG:RAT是检索增强型思考的简称,通过结合思维链提示和检索增强生成,解决长视野推理和生成任务.
- 工作流程:
- 第一步:由大型语言模型(LLM)生成初始的Zero-Shot思维链提示,将每个中间思考步骤作为查询进行信息检索,根据检索到的信息修正或细化CoT步骤.
- 第二步:使用修改后的CoT步骤和检索到的上下文生成最终响应或解决方案,提供全面且事实上准确的答案.
- 逐步推理:RAT是一种渐进的方法,LLM会根据CoT逐步产生响应,类似于人类的推理过程.
三、论文创新点
- Long-Horizon推理:RAT在复杂的预测建模和规划算法中表现出色,能够模拟和预测不同行动方案在未来较长时期内的后果,处理不确定性并适应变化.
- 任务表现:在挑战性代码生成、数学推理、任务规划以及创意写作等方面,RAT均取得了显著的成果,超过了传统的CoT提示、RAG以及其他基线方法.
- 优势:作为一种Zero-Shot提示方法,RAT能够在不进行额外训练的情况下提高生成内容的准确性和可靠性,减少幻觉现象.
四、论文总结
RAT(Retrieval-Augmented Thoughts)通过结合思维链提示和检索增强生成,提供了一种有效的方法来解决生成式AI中的幻觉问题,提高输出内容的准确性和可靠性.
RAFT【开卷高手】
开卷高手:像个优秀的考生,不仅会找对参考资料,还能准确引用关键内容,并清晰地解释推理过程,让答案既有据可循又合情合理。
- 发表时间:2024.03.15
- 论文名称:Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity
- 论文链接:https://arxiv.org/abs/2403.14403
- Github 项目:https://github.com/starsuzi/Adaptive-RAG
一、论文动机
- 领域适应挑战:大语言模型在特定领域应用时,如何有效融入新信息是一个挑战。传统的RAG方法允许模型在生成答案时参考文档,但未能充分利用固定领域设置下的学习机会;而基于微调的方法可以学习文档中的普遍模式,但未能充分利用测试时的文档信息.
- RAFT的目标:结合RAG和微调的优势,提出一种新的训练策略,使模型在特定领域中更好地适应和生成准确的答案.
二、论文思路
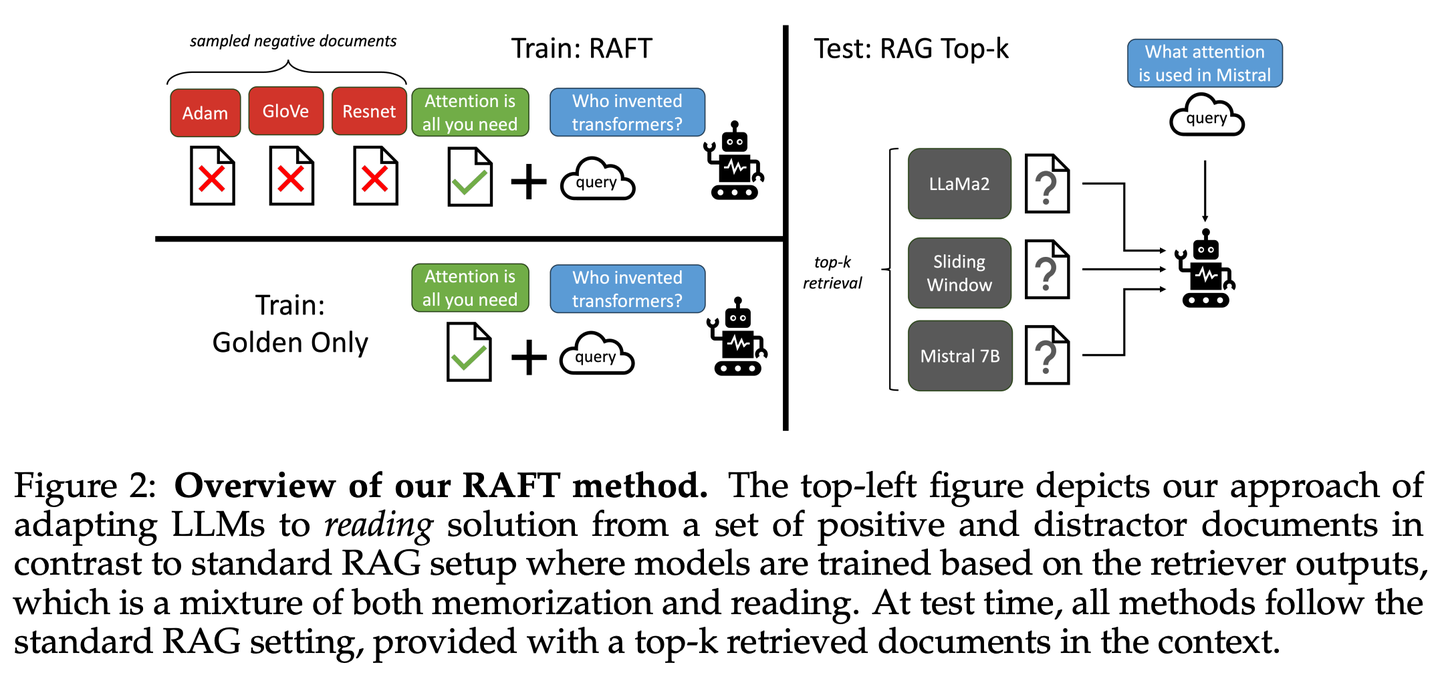
- 核心思想:在训练过程中引入干扰文档,以提高模型在面对无关信息时的鲁棒性。模型不仅要学会从黄金文档中提取相关信息,还要学会忽略干扰文档.
- 思维链式响应:训练时采用思维链式响应的方式,即模型在生成答案时不仅要引用相关文档中的正确序列,还要逐步展示其推理过程,提高模型的理解能力和解释性.
- 数据准备与训练:构建一个包含问题、检索到的文档和正确答案的数据集,每条记录包含一个问题、一组检索到的文档(包括黄金文档和干扰文档)以及正确的答案.使用该数据集对模型进行微调.
三、实验设计与结果
- 数据集:使用PubMed(医学领域)、HotpotQA(多跳问答任务)和Gorilla(API文档)数据集进行实验.
- 实验设置:设置不同的训练条件,包括不同数量的干扰文档和黄金文档,研究模型在不同训练条件下的表现.
- 结果分析:实验结果显示,使用干扰文档进行训练的模型在所有数据集上都表现出更好的性能,尤其是在PubMed、HotpotQA和Gorilla数据集上均表现出色,证明了RAFT方法的有效性.
四、论文创新点
- 模型鲁棒性提升:通过引入干扰文档,RAFT有效提升了模型在面对无关信息时的鲁棒性,使模型在测试时表现出更强的适应能力.
- 思维链式响应的作用:思维链式响应在训练过程中起到了关键作用,提高了模型的理解能力和解释性,尤其在复杂任务中表现更为出色.
五、论文总结
RAFT旨在提高模型在特定领域内的“开卷”环境中回答问题的能力,通过训练模型忽略无关文档,并逐字引用相关文档中的正确序列来回答问题,结合思维链式响应,显著提升了模型的推理能力。
Adaptive-RAG【因材施教】
因材施教:面对不同难度的问题,它会智能地选择最合适的解答方式。简单问题直接回答,复杂问题则会查阅更多资料或分步骤推理,就像一个经验丰富的老师,懂得根据学生的具体问题调整教学方法。
- 发表时间:2024.03.21
- 论文名称:Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity
- 论文地址:https://arxiv.org/abs/2403.14403
- Github 项目:https://github.com/starsuzi/Adaptive-RAG
一、论文动机
- 检索增强语言模型的局限性:现有的检索增强语言模型(LLMs)在处理不同复杂度的查询时存在局限性。简单查询可能不需要复杂的检索过程,而复杂查询则需要多步推理和信息整合.
- 自适应策略的需求:为了提高问答系统的效率和准确性,需要一种能够根据查询复杂性动态调整检索策略的方法.
二、论文思路
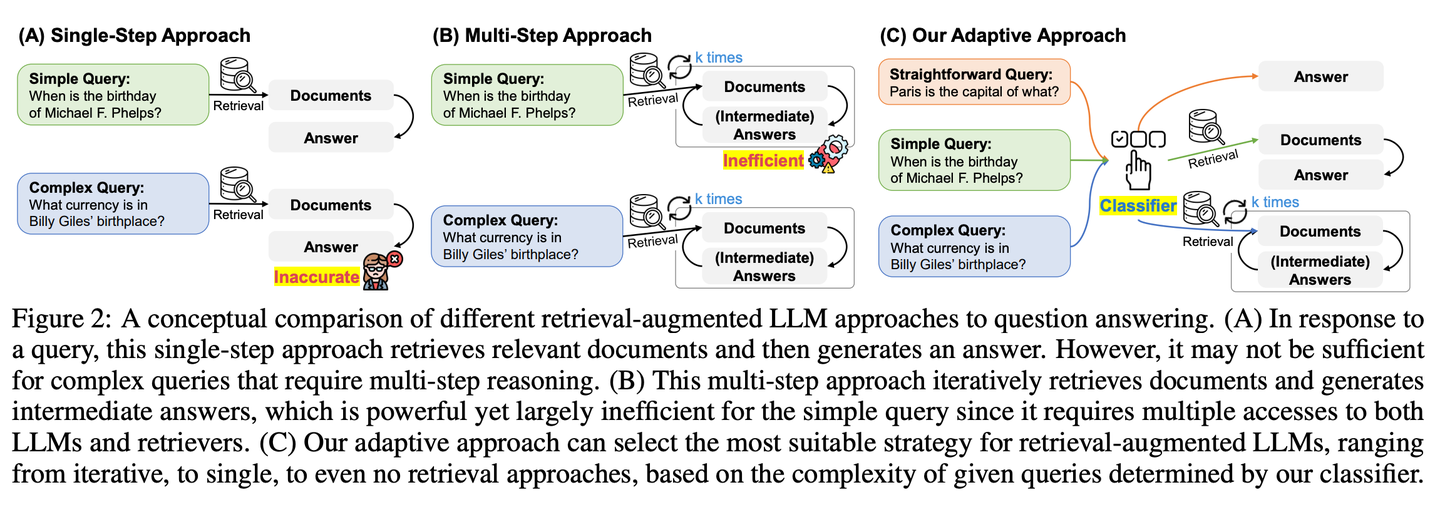
- 核心思想:使用一个小模型作为分类器,预测查询的复杂度,并根据预测结果选择合适的检索增强策略.
- 查询复杂度评估:分类器将查询分为三类:简单查询(A)、中等复杂度查询(B)和复杂查询(C).
- 自适应策略:
- 简单查询:使用非检索方法直接生成答案.
- 中等复杂度查询:使用单步检索方法.
- 复杂查询:使用多步检索方法.
- 训练策略:自动构建训练数据集,通过不同检索增强策略的结果来确定查询的复杂度标签。例如,如果非检索策略能正确回答,则将查询标记为简单。此外,利用数据集的固有偏差来补充标签.
三、实验设计与结果
- 数据集:使用多个公开的单步和多步问答数据集,如SQuAD v1.1、Natural Questions、TriviaQA等.
- 模型比较:与非检索、单步检索、多步检索以及现有的自适应检索方法(如Self-RAG)进行比较.
- 评估指标:使用F1、EM、Accuracy等指标评估任务性能,同时考虑检索和生成步骤数、每个查询的平均回答时间等效率指标.
- 结果分析:实验结果表明,Adaptive-RAG在有效性和效率上均优于现有的方法,特别是在处理复杂查询时,能够更有效地利用资源,提高答案的准确性.
四、论文创新点
- 自适应问答框架:
- 动态策略选择:提出了一种自适应的问答框架(Adaptive-RAG),能够根据查询的复杂度动态选择最合适的检索增强策略。这种动态选择机制使得系统能够灵活地应对不同复杂度的查询,而不是采用一种固定的处理方式.
- 平衡效率与准确性:通过自适应地选择策略,能够在保持高准确性的同时提高系统的效率。对于简单查询,避免不必要的复杂处理;对于复杂查询,则提供足够的计算资源以确保准确回答.
- 查询复杂度分类器:
- 自动标注训练数据:设计了一个分类器来预测查询的复杂度,并通过自动化的标注策略来构建训练数据集。这种方法利用模型的实际预测结果和数据集的固有偏差,无需人工标注,降低了数据准备的难度和成本.
- 多级复杂度识别:将查询分为三个复杂度等级(简单、中等、复杂),能够更细致地识别不同类型的查询,从而为每种查询选择更合适的处理策略.
- 综合策略融合:
- 无检索、单步检索和多步检索的融合:Adaptive-RAG框架能够在无检索、单步检索和多步检索之间无缝切换,根据查询的复杂度选择最合适的策略。这种融合使得系统能够充分利用各种策略的优势,提高整体的问答性能.
五、论文总结
Adaptive-RAG根据查询的复杂程度动态选择最适合的检索增强策略,从最简单到最复杂的策略中动态地为LLM选择最合适的策略。这个选择过程通过一个小语言模型分类器来实现,预测查询的复杂性并自动收集标签以优化选择过程。这种方法提供了一种平衡的策略,能够在迭代式和单步检索增强型 LLMs 以及无检索方法之间无缝适应,以应对一系列查询复杂度。
HippoRAG【海马体】
海马体:像人脑海马体一样,把新旧知识巧妙编织成网。不是简单地堆积信息,而是让每条新知识都找到最恰当的归属。
- 发表时间:2024.03.23
- 论文名称:HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models
- 论文地址:https://arxiv.org/abs/2405.14831
- Github 项目:https://github.com/OSU-NLP-Group/HippoRAG
一、论文动机
- LLMs的局限性:尽管大型语言模型(LLMs)在信息生成方面表现出色,但它们在信息检索上存在局限性,容易生成错误或虚假信息。
举个栗子:一位网友搜索“自制披萨的奶酪容易掉下来怎么办?”,AI Overviews 回答道:“往酱汁里添加约 1/8 杯的胶水即可。”它甚至还特意强调用无毒胶水。
- RAG技术的挑战:检索增强生成(RAG)技术通过检索外部知识来增强LLMs的能力,但在处理复杂问题时仍存在不足,如无法有效确认信息的真实性或进行多跳推理.
二、论文思路
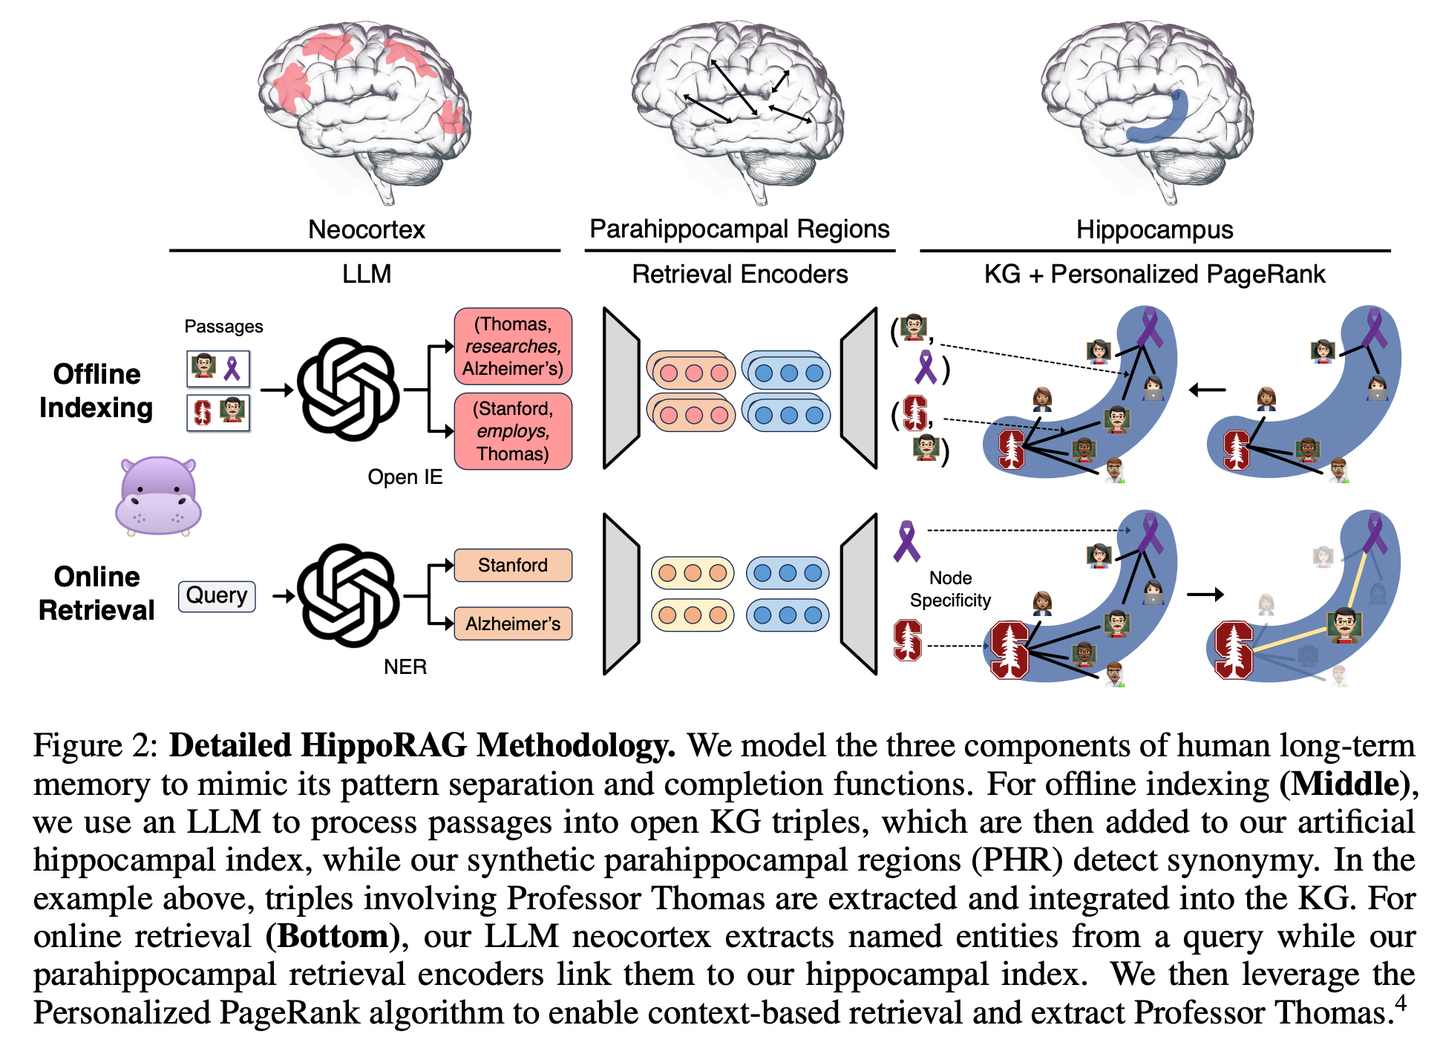
- 灵感来源:HippoRAG的灵感来源于人脑的记忆机制,特别是海马体在记忆整合和多跳推理中的作用。该技术通过模仿人脑的三个主要记忆组件(大脑皮层、海马体和海马旁回)来增强LLMs的知识整合能力.
- 工作原理:
- 知识图谱(KG):类似于大脑皮层,负责从文本中提取信息并构建知识图谱.
- 个性化PageRank(PPR)算法:类似于海马体,用于在知识图谱中找到与查询最相关的部分.
- 检索编码器:类似于海马旁回,帮助将查询中的关键概念与知识图谱中的节点关联起来.
- 优势:
- 性能提升:在多跳问题回答任务中,HippoRAG相较于传统RAG方法性能提升了3%到20%.
- 成本效益:单步检索的成本比迭代检索方法低10到30倍,速度也快6到13倍.
- 新场景处理能力:能够有效处理路径发现型多跳问题,即在没有明确路径的情况下探索不同信息源以构建答案.
三、实验设计与结果
- 数据集:使用MuSiQue和2WikiMultiHopQA等多跳问答数据集进行测试.
- 基线比较:与BM25、Contriever、GTR、ColBERTv2等强基线方法进行比较.
- 评估指标:使用召回率(R@2和R@5)和问答性能(EM和F1分数)进行评估.
- 结果:HippoRAG在多跳问答任务中表现出色,显著优于现有RAG方法,并且在与IRCoT结合使用时进一步提升了性能.
四、论文创新点
- 模仿人脑记忆机制
- 海马体记忆索引理论的启发:HippoRAG通过模仿人脑海马体和大脑皮层的协同工作机制,将知识整合和记忆检索的过程与人类的记忆机制相结合。这种设计使得模型能够更有效地进行跨段落的信息整合和推理,类似于人类在面对复杂问题时的记忆联想和信息检索能力.
- 单步多跳检索能力
- 单步实现多跳推理:HippoRAG能够在单步检索中完成多跳推理任务,这与传统的迭代检索方法(如IRCoT)相比,显著提高了检索效率。通过使用个性化PageRank(PPR)算法,HippoRAG能够在知识图谱中快速找到与查询相关的多个节点及其关联路径,从而在一次检索中完成多跳信息的整合.
- 知识图谱与LLMs的协同工作
- 无结构知识图谱的构建:HippoRAG利用LLM将文本语料库转换为无结构的知识图谱,这种图谱能够存储大量的实体及其关系,为后续的检索和推理提供了丰富的信息基础。与传统的结构化知识图谱相比,无结构知识图谱在灵活性和扩展性方面具有优势.
- 知识图谱与LLMs的深度融合:通过将知识图谱与LLMs相结合,HippoRAG不仅能够利用LLMs的语言理解和生成能力,还能借助知识图谱进行更有效的信息检索和整合。这种深度融合使得模型在处理复杂的知识整合任务时表现更为出色.
- 显著的性能提升
- 在多跳问答任务中的优越表现:实验结果表明,HippoRAG在多跳问答任务中显著优于现有的RAG方法,性能提升了3%到20%。这表明其在理解和回答复杂问题时更加准确和高效.
- 成本和速度的优化:与迭代检索方法相比,HippoRAG在成本和速度上都有显著优势,单步检索的成本比迭代检索低10到30倍,速度也快6到13倍。这使得HippoRAG在实际应用中更具可行性,尤其是在需要快速响应的场景中.
- 解决复杂知识整合问题
- 处理路径发现型多跳问题:HippoRAG能够有效处理路径发现型多跳问题,即在没有明确路径的情况下,通过探索不同的信息源来构建答案。这在现实生活中具有广泛的应用前景,如科学文献综述、法律案例分析等需要复杂知识整合的场景.
五、论文总结
- 结论:HippoRAG通过模仿人脑记忆机制,有效地解决了LLMs在知识整合方面的局限性,为长期记忆在LLMs中的实现提供了一种有前景的解决方案.
- 局限性:尽管HippoRAG在多跳问答任务中表现出色,但其在处理更复杂场景时仍有改进空间,例如进一步优化OpenIE和PPR算法的性能,以及提高其在更大规模数据集上的可扩展性.
RAE【智能编辑】
智能编辑:像个细心的新闻编辑,不仅会深入挖掘相关事实,还能通过连环推理找出容易被忽略的关键信息,同时懂得删减冗余内容,确保最终呈现的信息既准确又精炼,避免"说得天花乱坠却不靠谱"的问题。
- 发表时间:2024.03.28
- 论文名称:Retrieval-enhanced Knowledge Editing in Language Models for Multi-Hop Question Answering
- 论文地址:https://arxiv.org/abs/2403.19631
- Github 项目:https://github.com/sycny/RAE
一、论文动机
- 问题背景:LLMs在问答任务中表现出色,但在处理多跳问题时,需要更新和整合多个知识点。现有的模型编辑方法在处理这些复杂联系时存在困难,容易生成过时或不正确的回答.
二、论文思路
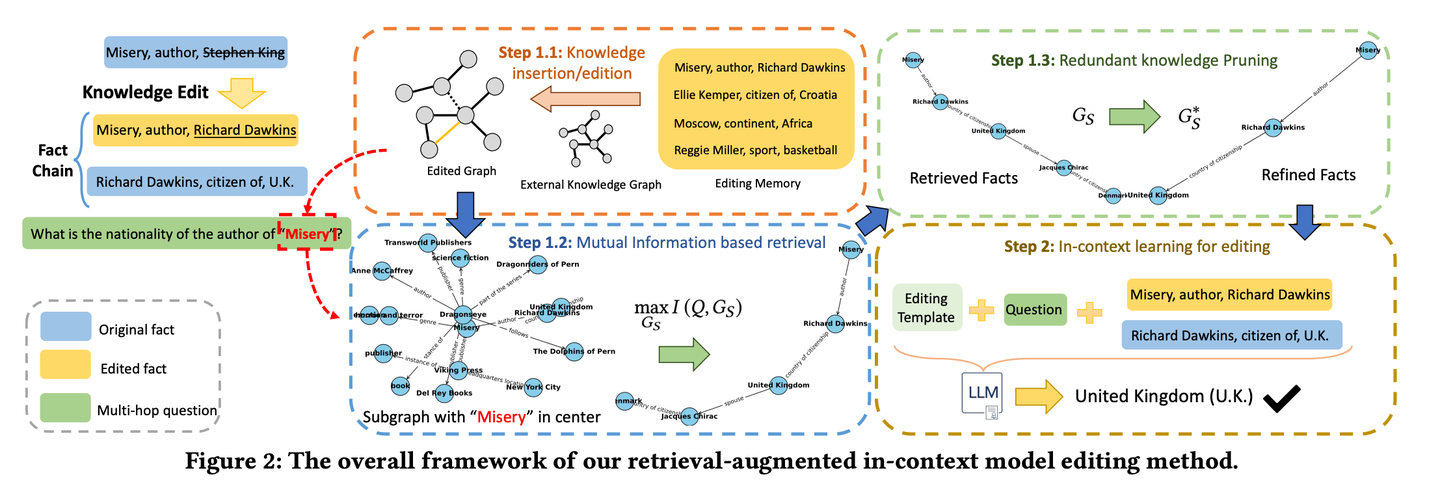
- 核心概念:RAE框架通过检索和编辑相结合的方法,增强LLMs在多跳问答中的表现.
- 关键组成部分:
- 外部知识图谱:存储编辑过的事实和未编辑的事实,为检索提供知识基础.
- 基于互信息的检索:通过最大化问题和检索到的子图之间的互信息,识别与问题最相关的知识子图.
- 冗余知识剪枝:使用编辑不确定性评估检索到的事实集,剪除冗余或不相关事实,提高编辑准确性.
- 上下文学习编辑:结合经过剪枝的事实集和编辑模板,通过LLMs的上下文学习能力生成准确答案.
- 编辑模板:指导LLMs如何结合问题和事实产生正确输出的特定提示结构.
三、实验设计与结果
- 实验设置:在不同大小的语言模型上进行评估,验证RAE在提供准确答案和更新知识方面的能力.
- 结果:RAE在处理多跳问题时,相比于现有基线方法,显著提高了编辑后的模型输出的准确性.
四、论文创新点
- 检索增强型知识编辑框架
- 结合检索与编辑:传统的知识编辑方法通常依赖于直接修改模型参数或知识库,而RAE框架通过检索增强的方式,结合了检索和编辑的优势。它首先通过检索获取与问题相关的知识,然后对这些知识进行编辑和整合,从而更好地适应多跳问答任务的需求.
- 多跳问题的针对性设计:针对多跳问答任务中知识点之间复杂联系的特点,RAE框架专门设计了检索和编辑策略。通过链式事实的识别和冗余知识的剪枝,能够更准确地捕捉和整合与问题相关的多个知识点.
- 基于互信息的检索方法
- 互信息最大化:传统的检索方法多基于简单的相似性搜索,容易遗漏相关信息。RAE框架通过最大化问题和检索到的子图之间的互信息,能够更全面地识别与问题最相关的知识子图。这种方法利用了LLMs的推理能力,提高了检索的准确性和相关性.
- 链式事实识别:通过链式事实的识别,RAE能够捕捉到知识点之间的逻辑关系和因果链,弥补了简单相似性搜索的不足,更好地支持多跳推理过程.
- 冗余知识剪枝策略
- 编辑不确定性评估:引入编辑不确定性来评估检索到的事实集,通过剪除冗余或不相关事实,提高了编辑的准确性和效率。这一策略有助于减少模型输出的不确定性,避免生成错误或不一致的答案.
- 提高编辑效率:通过剪枝策略,RAE框架能够更高效地处理大量的检索结果,避免在不必要的信息上浪费计算资源,从而提高了整体的编辑效率.
- 上下文学习编辑方法
- 结合编辑模板:利用编辑模板指导LLMs如何结合问题和事实来产生正确的输出。这种特定的提示结构能够更好地引导模型进行上下文学习,生成准确且连贯的答案.
- 上下文学习能力的利用:充分发挥LLMs的上下文学习能力,通过结合经过剪枝的事实集和问题上下文,生成更加准确和符合逻辑的答案.
五、论文总结
- 优势:RAE框架通过有效的检索和编辑策略,能够更好地处理多跳问答中的复杂知识联系,提高模型的回答准确性.
- 应用场景:适用于需要实时知识更新和复杂知识整合的问答场景.
2024.04
RAGCache【仓储员】
仓储员:像大型物流中心一样,把常用知识放在最容易取的货架上。懂得把经常用的包裹放在门口,把不常用的放在后仓,让取货效率最大化。
- 发表时间:2024.04.18
- 论文名称:RAGCache: Efficient Knowledge Caching for Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2404.12457
一、论文动机
- RAG 技术:通过结合外部知识库,提升了大语言模型(LLM)的性能,但在长序列生成时存在显著的延迟和效率挑战。
- 现有优化方案:主要关注 LLM 推理加速,未能充分利用 RAG 系统的特点。
- 性能瓶颈:RAG 系统的主要瓶颈在于 LLM 生成步骤,外部知识文档的注入显著延长了处理序列。
- 访问模式:检索请求高度集中,少数热门文档占据了大部分请求,为缓存优化提供了依据。
- 优化空间:通过缓存文档的中间计算状态,可以显著降低计算开销.
二、论文思路
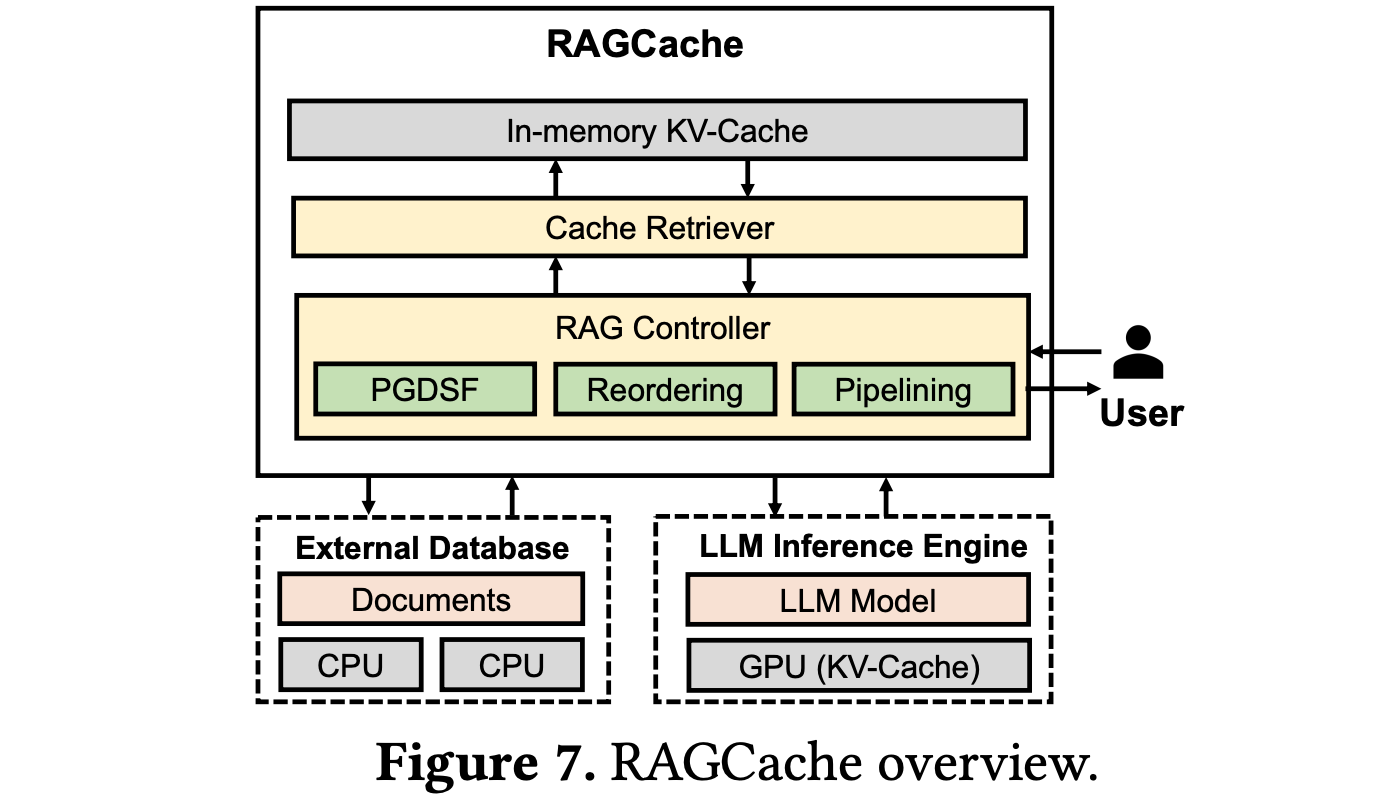
- 知识树结构:设计了一种树状结构来组织缓存的文档状态,有效处理文档检索的顺序敏感性问题。
- 前缀感知的贪心双重大小频率 (PGDSF) 替换策略:综合考虑文档顺序、key-value 张量的大小、访问频率和时间的新近性,确保最有价值的文档状态留在缓存中.
- 多层缓存:实现跨 GPU 和主机内存的分层缓存系统,利用 GPU 内存的速度和主机内存的容量.
- 动态推测流水线:通过动态推测流水线重叠向量检索和 LLM 推理,最小化空闲时间,显著减少端到端延迟.
三、实验设计与结果
- 与 vLLM+Faiss 相比:首个 token 生成时间 (TTFT) 最高减少 4 倍,吞吐量最高提升 2.1 倍.
- 与 SGLang 相比:TTFT 最高减少 3.5 倍,吞吐量最高提升 1.8 倍.
四、论文创新点
- 知识树结构:设计了一种树状结构来组织缓存的文档状态,有效处理 RAG 系统中文档检索的顺序敏感性问题。例如,对于不同的文档序列(如 ([D1, D3]) 和 ([D2, D3])),尽管文档 (D3) 在两个序列中都出现,但由于前面文档的不同,其 key-value 张量在各自序列中的值是不同的。知识树结构能够高效管理这些变化,确保快速检索的同时保持文档顺序.
- 前缀感知的贪心双重大小频率 (PGDSF) 替换策略:引入了一种复杂的缓存替换策略,综合考虑了多个因素,包括文档顺序、key-value 张量的大小、访问频率和访问时间的新近性。这种策略确保最有价值的文档状态能够留在缓存中,最大化命中率并最小化重复计算.
- 多层缓存系统:实现了一个跨 GPU 和主机内存的分层缓存系统,允许高效利用更快但容量有限的 GPU 内存,同时利用主机内存的更大容量来存储较少访问的状态。例如,频繁访问的文档状态可能存储在 GPU 内存中以实现快速访问,而不常用的状态则保存在主机内存中.这种分层方法同时优化了速度和容量.
- 动态推测流水线:通过动态推测流水线重叠向量检索和 LLM 推理的能力,随着向量搜索的进行,RAGCache 将中期结果发送给 LLM 进行推测生成。如果检索到的文档发生变化,系统会适应性地启动新的推测生成。这种方法最小化了空闲时间,显著减少了端到端延迟.
五、论文总结
RAGCache是一种为RAG量身定制的新型多级动态缓存系统,它将检索到的知识的中间状态组织在知识树中,并在GPU和主机内存层次结构中进行缓存。RAGCache提出了一种考虑到LLM推理特征和RAG检索模式的替换策略。它还动态地重叠检索和推理步骤,以最小化端到端延迟。
GraphRAG【社区摘要】
社区摘要:先把小区居民的关系网理清楚,再给每个邻里圈做个简介。有人问路时,各个邻里圈提供线索,最后整合成最完整的答案。
- 发表时间:2024.04.24
- 论文名称:From Local to Global: A Graph RAG Approach to Query-Focused Summarization
- 论文地址:https://arxiv.org/abs/2404.12457
- Github 项目:https://github.com/microsoft/graphrag
一、论文动机
- RAG的局限性:传统的检索增强生成(RAG)方法适用于局部查询,即在特定文本区域内寻找答案,但对于需要对整个文本语料库进行全局理解的问题(如“数据集的主要主题是什么?”),RAG表现不佳.
- 查询聚焦摘要(QFS)的挑战:现有的QFS方法在处理大规模文本时存在扩展性问题,无法有效处理RAG系统通常索引的大量文本.
二、论文思路
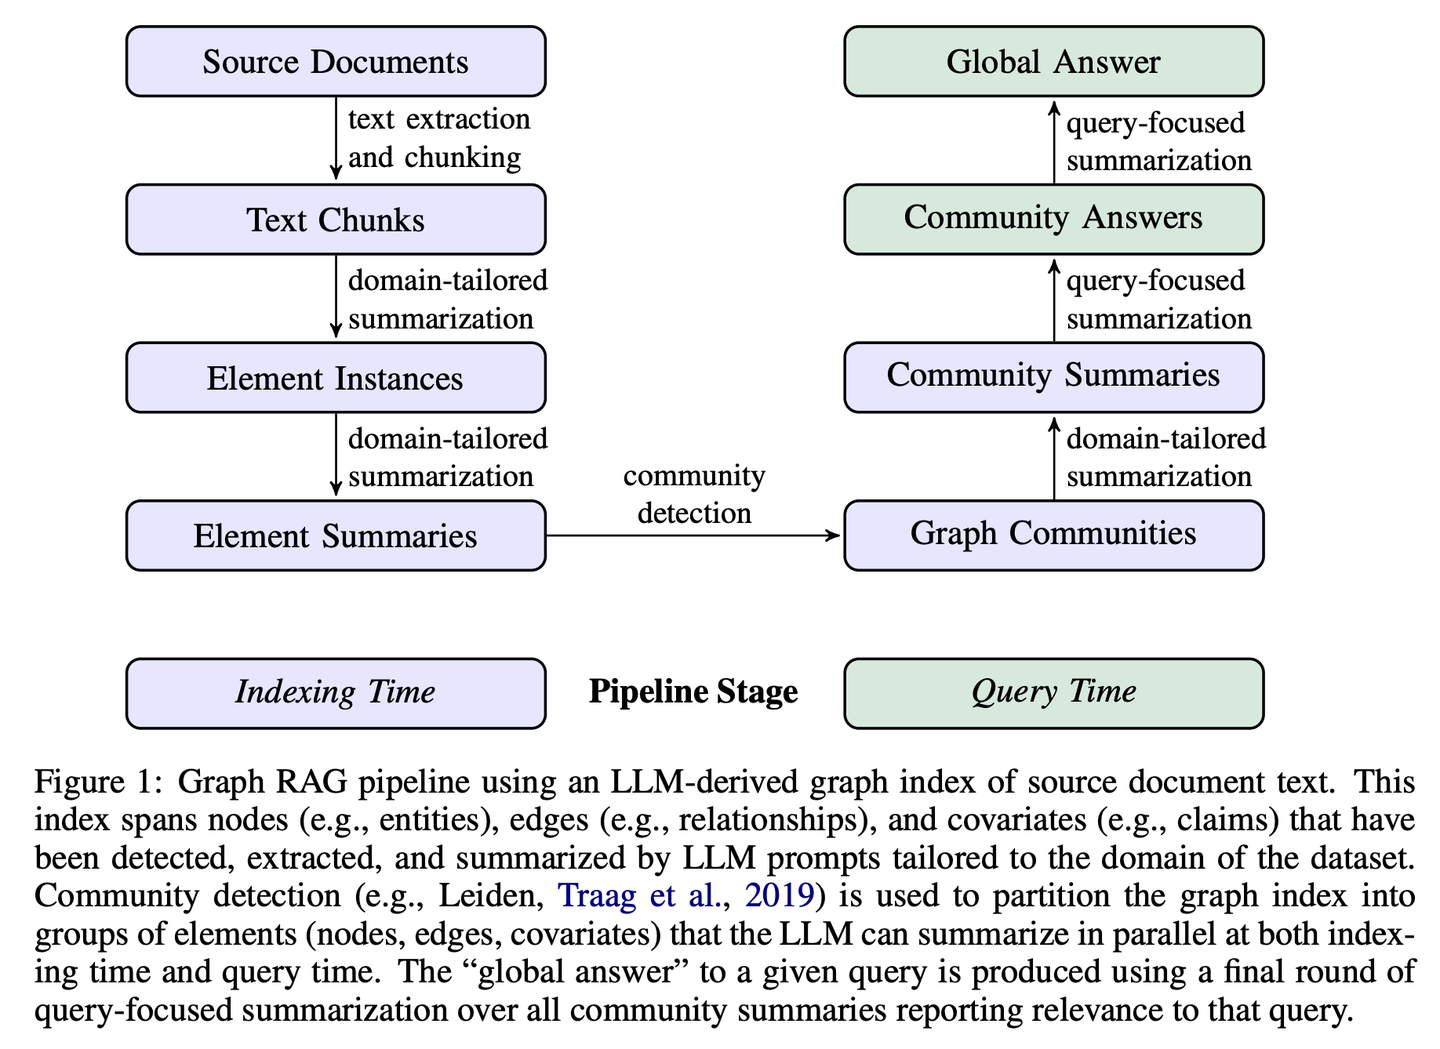
- 核心思想:结合知识图谱生成、检索增强生成(RAG)和查询聚焦摘要(QFS),通过构建基于LLM的知识图谱来支持对整个文本语料库的全局查询.
- 具体步骤:
- 构建知识图谱:首先从源文档中提取实体和关系,构建一个实体知识图谱.
- 社区检测:使用社区检测算法(如Leiden算法)将图谱划分为多个紧密相关的社区.
- 生成社区摘要:为每个社区生成摘要,这些摘要在索引时和查询时都可以并行生成.
- 回答查询:对于每个查询,使用社区摘要生成部分响应,然后将所有部分响应汇总成最终的全局响应.
三、实验设计与结果
- 数据集:使用两个约100万token的数据集进行评估,一个是播客访谈的转录文本,另一个是新闻文章.
- 查询生成:通过活动中心的方法自动生成全局理解问题,例如“哪些播客节目主要讨论技术政策和政府监管?”
- 评估指标:使用LLM作为评估器,比较不同方法在全面性、多样性和赋能性(帮助读者理解和做出判断的能力)方面的表现.
- 结果:Graph RAG在全面性和多样性方面显著优于传统的RAG方法,并且在资源消耗(token成本)方面也更为高效.
四、论文创新点
- 结合知识图谱与RAG
- 知识图谱构建:传统的RAG方法主要依赖于文本检索和生成,而这篇论文提出了一种结合知识图谱的方法。通过从源文档中提取实体和关系,构建一个实体知识图谱,使得系统能够更好地理解和组织文本中的信息.
- 社区检测与摘要生成:利用社区检测算法将知识图谱划分为多个紧密相关的社区,并为每个社区生成摘要。这种方法不仅提高了对全局信息的理解能力,还为生成全面和多样化的答案提供了基础.
- 全局查询处理能力
- 全局查询聚焦:传统的RAG方法在处理需要对整个文本语料库进行全局理解的问题时表现不佳。而Graph RAG通过构建知识图谱和社区摘要,能够有效地处理这类全局查询问题,生成更全面和多样化的答案.
- 多阶段回答生成:在回答查询时,Graph RAG采用多阶段的方法,首先使用社区摘要生成部分响应,然后将所有部分响应汇总成最终的全局响应。这种分阶段的方法提高了生成答案的质量和效率.
- 资源效率的提升
- 降低token成本:与传统的基于文本的全局摘要方法相比,Graph RAG在生成答案时所需的token数量大幅减少。例如,对于根级别的社区摘要,Graph RAG所需的token数量比传统的全局文本摘要方法减少了97%以上.
- 高效的社区划分:通过社区检测算法,Graph RAG能够将知识图谱划分为多个层次的社区,使得在不同层次上生成摘要和回答查询变得更加高效.
五、论文总结
GraphRAG分两个阶段构建基于图的文本索引:首先从源文档中推导出实体知识图,然后为所有紧密相关实体的组预生成社区摘要。给定一个问题,每个社区摘要用于生成部分响应,然后在向用户的最终响应中再次总结所有部分响应。
2024.05
R4【编排大师】
编排大师:像个排版高手,通过优化材料的顺序和呈现方式来提升输出质量,无需改动核心模型就能让内容更有条理,重点更突出。
- 发表时间:2024.05.04
- 论文名称:R4: Reinforced Retriever-Reorder-Responder for Retrieval-Augmented Large Language Models
- 论文地址:https://arxiv.org/abs/2405.02659
一、论文动机
- LLM的局限性:尽管LLM在自然语言理解和生成方面取得了显著进展,但在处理长文本时仍面临挑战,尤其是在生成文本时可能会产生错误信息(即“幻觉”问题).
- 现有方法的不足:传统的检索增强方法通常不考虑检索文档与LLM之间的细粒度结构语义交互,这在处理长文档时会影响回答的准确性.
二、论文思路
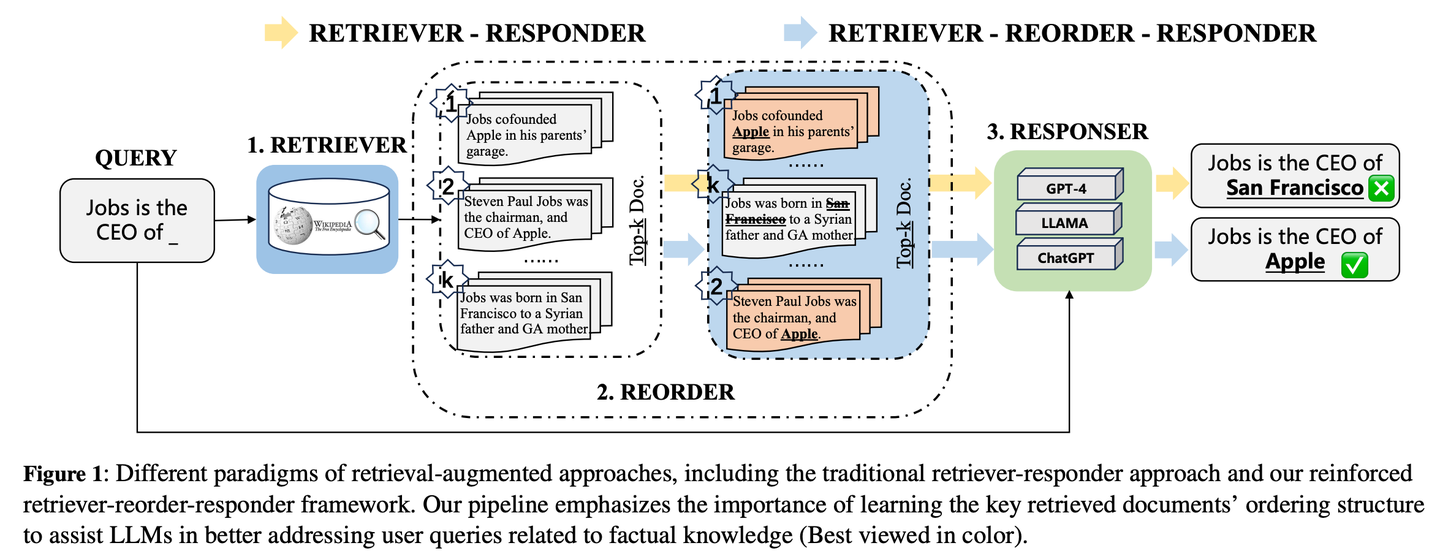
- 核心模块:
- 检索器(Retriever):使用Dense Passage Retriever(DPR)检索相关文档.
- 重排序器(Reorder):通过图注意力学习和强化学习机制动态调整检索文档的顺序,以最大化回答质量的强化奖励.
- 响应器(Responder):将查询和调整后的文档作为输入,生成回答.
- 文档顺序调整:利用图注意力学习将检索文档动态调整到开始、中间和结束位置,以提高回答质量.
- 文档表示增强:对于生成质量较差的回答,通过文档级别的梯度对抗学习来细化检索文档的表示.
三、实验设计与结果
- 任务与数据集:实验使用了3类任务5个数据集,包括生成式问答(Generative QA)、多项选择问答(Multi-choice QA)和对话(Dialogue)任务.
- 性能提升:R4框架在知识密集型任务上的表现超过了多个强基线模型,如REALM、ICR、REPLUG、Selfmem、SELF-RAG、FILCO和LongLLMLingua.
- 鲁棒性:R4框架对于不同的检索器和LLMs表现出良好的适应性,证明了其在不同文档数量下的鲁棒性.
- 文档数量的影响:增加检索文档的数量可以提高模型性能,但性能提升随着检索文档数量的增加而减少.
四、论文创新点
- 增强检索器-重排序-响应器框架
- 传统RAG方法的改进:传统的检索增强生成(RAG)方法通常采用简单的检索器-响应器架构,而R4框架引入了一个增强的重排序器模块,使得检索文档的顺序可以根据任务需求和模型反馈进行动态调整。这种改进使得模型能够更好地利用检索到的信息,提高生成回答的质量和准确性.
- 细粒度结构语义交互:R4框架强调了检索文档与LLMs之间的细粒度结构语义交互的重要性,通过图注意力学习和强化学习机制,实现了对检索文档的精细排序和表示优化,从而更好地处理与事实知识相关的用户查询.
- 图注意力学习与强化学习结合
- 文档顺序动态调整:利用图注意力学习将检索文档动态调整到开始、中间和结束位置,以最大化回答质量的强化奖励。这种动态调整机制能够根据不同的查询和文档内容,灵活地优化文档的输入顺序,提高模型的适应性和灵活性.
- 强化学习的应用:通过强化学习机制,模型能够在训练过程中不断优化文档排序策略,以获得更高的回答质量奖励。这种结合图注意力学习和强化学习的方法,使得模型在处理长文档和复杂查询时,能够更有效地利用检索到的信息.
- 文档表示增强
- 梯度对抗学习:对于生成质量较差的回答,通过文档级别的梯度对抗学习来细化检索文档的表示。这种文档表示增强方法能够帮助模型更好地理解文档内容,提高生成回答的准确性和一致性.
- 适应性和鲁棒性
- 不同检索器和LLMs的适应性:R4框架对于不同的检索器和LLMs表现出良好的适应性,证明了其在不同文档数量下的鲁棒性。这种适应性使得R4框架能够在多种不同的应用场景和配置下,都能保持良好的性能.
- 检索文档数量的优化:实验表明,增加检索文档的数量可以提高模型性能,但性能提升随着检索文档数量的增加而减少。这为实际应用中检索文档数量的选择提供了指导,有助于在性能和资源消耗之间取得平衡.
五、论文总结
- 排序与优化的重要性:R4通过动态调整文档顺序和优化文档表示,显著提高了LLM在处理长文档和知识密集型任务时的准确性和鲁棒性.
- 适应性与扩展性:R4框架能够适应不同的检索器和LLMs,具有良好的扩展性和应用前景.
IM-RAG【自言自语】
自言自语:遇到问题时会在心里盘算"我需要查什么资料"、"这个信息够不够",通过不断的内心对话来完善答案,这种"独白"能力像人类专家一样,能够逐步深入思考并解决复杂问题。
- 发表时间:2024.05.15
- 论文名称:IM-RAG: Multi-Round Retrieval-Augmented Generation Through Learning Inner Monologues
- 论文地址:https://arxiv.org/abs/2405.13021
一、论文动机
- RAG方法的局限性:尽管RAG能够利用外部知识和LLM输出来增强生成质量,但在与不同能力的IR系统集成、多轮检索的可解释性以及端到端优化机制方面仍存在挑战.
- 内部独白的概念:IM-RAG通过学习内部独白来连接IR系统与LLM,支持多轮检索增强生成,使LLM能够更好地进行推理和生成.
二、论文思路
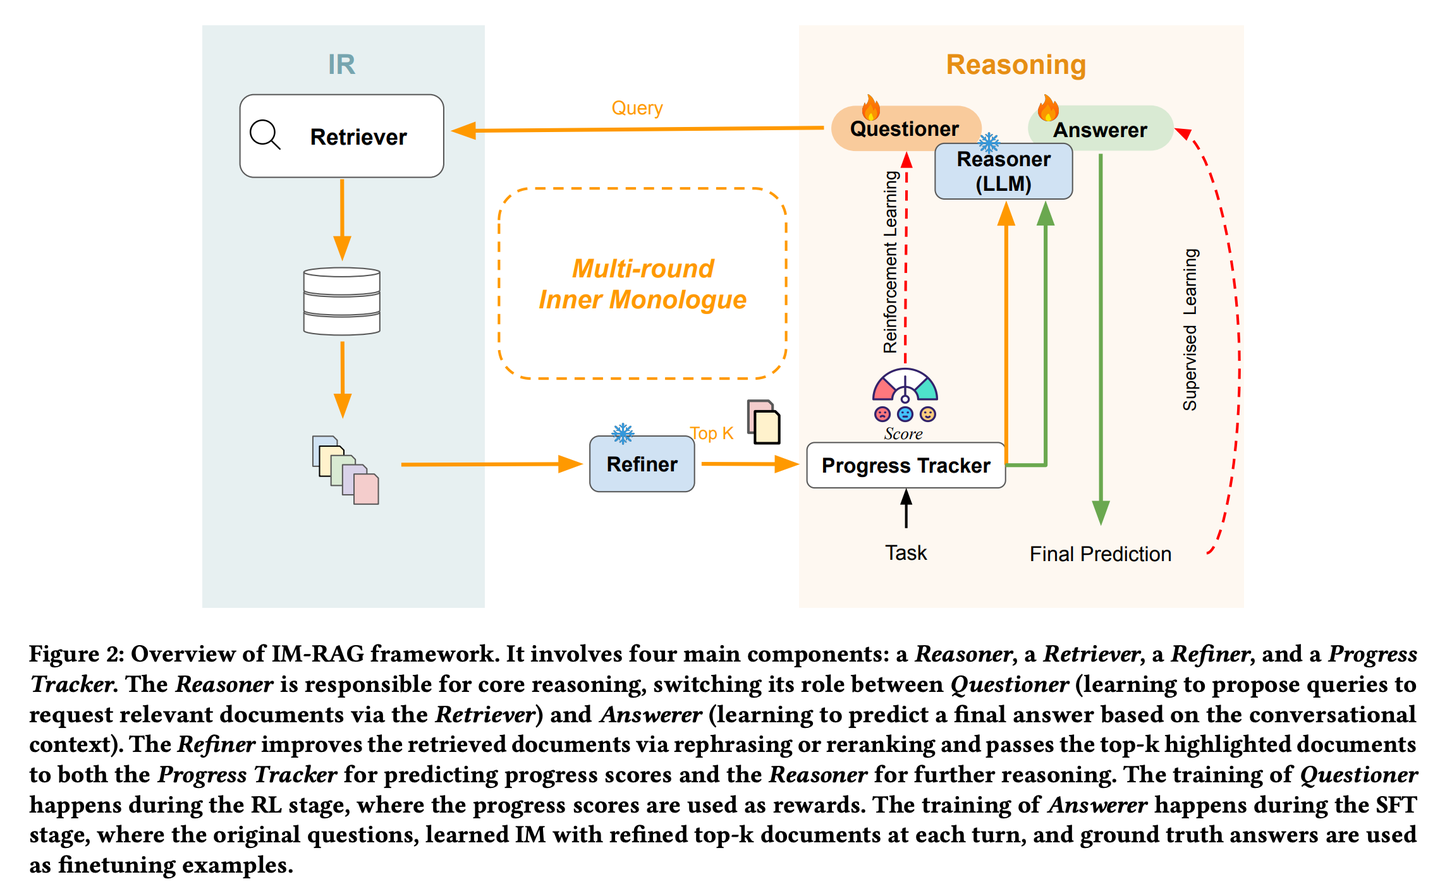
-
核心组件:
- 推理器(Reasoner):负责主要的推理任务,根据对话上下文生成查询或提供最终答案.
- 检索器(Retriever):根据推理器的查询从数据库中检索相关文档.
- 精炼器(Refiner):对检索到的文档进行重排序和改写,以提高信息的相关性.
- 进度跟踪器(Progress Tracker):通过打分系统跟踪任务进展,为强化学习提供反馈.
-
多轮交互过程:推理器在不同阶段切换角色,生成查询或提供答案,检索器和精炼器协同工作,逐步收集和精炼信息,直到推理器认为信息足够齐全,最终生成答案.
-
学习过程
- 强化学习(RL)阶段:推理器在生成查询时使用进度跟踪器的分数作为反馈,帮助优化查询策略.
- 监督微调(SFT)阶段:推理器在提供最终答案时基于对话和相关文档生成预测,并进一步利用真实答案微调模型.
-
工作流程
当用户提出复杂问题时,IM-RAG的核心组件推理器首先尝试回答。如果当前信息不足以得出答案,推理器将生成查询并交由检索器去知识库查找相关信息。检索到的文档经过精炼器优化后传回推理器,后者检查信息是否足够充分。若信息不足,则继续迭代生成新的查询并再次检索。整个流程持续数轮,直到推理器认为信息足够齐全,最终提供最终答案。
三、实验设计与结果
- 性能提升:在HotPotQA数据集上的实验结果表明,IM-RAG在多步推理任务中达到了最先进的性能,展现出更高的灵活性和可解释性.
- 优势:通过多轮交互式检索和内部独白机制,IM-RAG能够更有效地进行复杂推理,生成更准确和可解释的内容.
四、论文创新点
- 创新性:IM-RAG通过内部独白机制将LLM和IR系统紧密结合,实现了高效的多轮检索和生成,提升了RAG系统的推理能力和可解释性.
- 应用前景:该方法在多轮对话和复杂推理任务中具有广泛的应用潜力,能够为用户提供更准确和可解释的生成内容.
五、论文总结
IM-RAG通过学习内部独白(Inner Monologues)来连接IR系统与LLMs,从而支持多轮检索增强生成。该方法将信息检索系统与大型语言模型相整合,通过学习内心独白来支持多轮检索增强生成。在内心独白过程中,大型语言模型充当核心推理模型,它既可以通过检索器提出查询以收集更多信息,也可以基于对话上下文提供最终答案。我们还引入了一个优化器,它能对检索器的输出进行改进,有效地弥合推理器与能力各异的信息检索模块之间的差距,并促进多轮通信。整个内心独白过程通过强化学习(RL)进行优化,在此过程中还引入了一个进展跟踪器来提供中间步骤奖励,并且答案预测会通过监督微调(SFT)进一步单独优化。
AntGroup-GraphRAG【百家之长】
百家之长:汇集行业百家之长,擅用多种方式快速定位信息,既能提供精准检索,又能理解自然语言查询,让复杂的知识检索变得既经济又高效。
- 发表时间:2024.05.16
- Github 地址:https://github.com/eosphoros-ai/DB-GPT
一、论文动机
- GraphRAG框架:GraphRAG是一种结合图数据库和大型语言模型(LLM)的检索增强生成框架,用于提升问答系统的性能.
- 微软GraphRAG:微软的GraphRAG项目通过图社区摘要来改进问答质量,但存在图索引构建成本较高的问题.
- 朴素GraphRAG的局限性:依赖于查询中的关键词信息,对于总结性查询效果不佳,容易出现“当前知识库不足以回答你的问题”的情况.
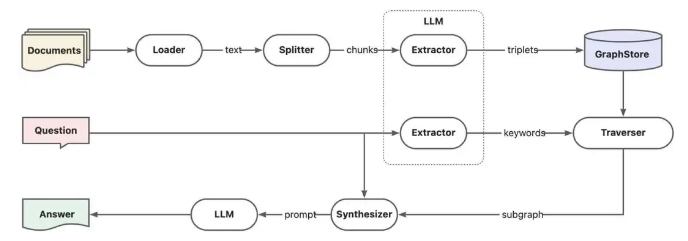
二、论文思路
- 朴素GraphRAG 改进思路:
- 混合RAG:通过多路召回方式综合向量索引与图索引的优势,提升整体问答质量。HybridRAG[4]论文正是采用此方式,大致提升了若干个百分点的性能,但是上下文精度性能出现回退,主要是因为多路检索的知识无法对齐导致,这也是多系统混合检索的原生问题。
- 融合索引:直接将向量索引集成到图数据库内部,提供知识图谱上的向量搜索能力,实现知识图谱子图甚至原始文档的相似性检索,避免多系统知识召回的数据不一致问题。例如Neo4jVector[5],另外TuGraph[6]也即将在下个版本提供向量索引能力支持。
- 社区摘要:基于图社区算法将知识图谱划分为若干社区子图,并提取社区子图摘要,总结性查询会根据社区摘要的内容进行回答,这也是微软GraphRAG中的关键设计。
- 社区摘要增强链路
- 文本块记忆:知识抽取阶段一次性完成图结构抽取和元素(点/边)总结,并引入文本块记忆能力,解决跨文本块的引用信息抽取问题。
- 图社区摘要:知识抽取阶段一次性完成图结构抽取和元素(点/边)总结,并引入文本块记忆能力,解决跨文本块的引用信息抽取问题。
- 多路搜索召回:不区分全局搜索与本地搜索,通过多路搜索同时提供查询相关的摘要与明细上下文。
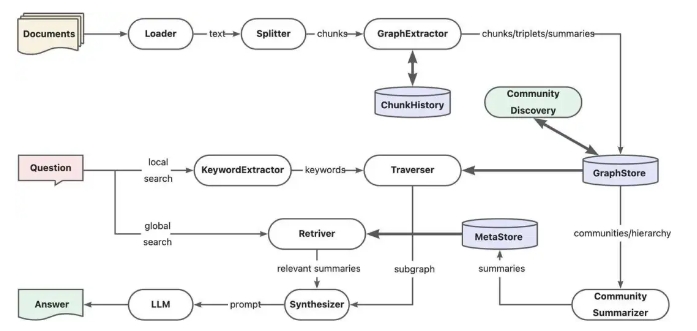
社区摘要增强的GraphRAG链路
- 实现细节
- 社区发现:使用Leiden算法等进行社区划分,支持从不同层次洞察知识图谱.
- 社区摘要:将社区子图数据提供给LLM进行总结,引导LLM保留关键信息.
- 保存摘要:将社区摘要存储在向量数据库中,提供检索能力.
三、实验设计与结果
- 索引性能:DB-GPT GraphRAG的索引阶段token开销只有微软方案的一半左右.
- 查询性能:全局搜索性能有明显提升,得益于社区摘要的相似性召回.
四、论文创新点
- 社区摘要增强
- 图社区划分与摘要提取:通过图社区发现算法(如Leiden算法)将知识图谱划分为多个社区子图,并为每个社区提取摘要信息。这种方法能够更好地总结和理解知识图谱的整体结构和主题,从而提高总结性查询的问答质量.
- 社区摘要的相似性召回:在查询时,利用社区摘要进行相似性召回,而不是依赖于传统的关键词匹配。这使得系统能够更准确地理解用户的查询意图,并提供更相关的答案.
- 多路搜索召回
- 全局搜索与本地搜索的整合:不区分全局搜索与本地搜索,通过多路搜索同时提供查询相关的摘要与明细上下文。这种整合方式提高了搜索的灵活性和准确性,能够更好地满足不同类型的查询需求.
- 混合检索策略:结合全局搜索和本地搜索的优势,避免了单一检索方式的局限性,提高了整体的检索效果.
- 文本块记忆能力
- 跨文本块引用信息抽取:在知识抽取阶段引入文本块记忆能力,解决了跨文本块的引用信息抽取问题。这使得系统能够更准确地识别和利用上下文关联信息,提高知识抽取的精度和效率.
- 显著降低token开销
- 优化索引构建过程:通过在知识抽取和社区总结阶段的优化方法,显著降低了图索引构建时的token开销,使得DB-GPT GraphRAG的索引阶段token开销只有微软方案的一半左右.这种优化不仅提高了系统的性能,还降低了资源消耗.
五、论文总结
蚂蚁TuGraph团队基于DB-GPT构建的开源GraphRAG框架,兼容了向量、图谱、全文等多种知识库索引底座,支持低成本的知识抽取、文档结构图谱、图社区摘要与混合检索以解决QFS问答问题。另外也提供了关键词、向量和自然语言等多样化的检索能力支持。
Kotaemon【乐高】
乐高:一套现成的问答积木套装,既能直接拿来用,又能自由拆装改造。用户要用就用,开发要改就改,随心所欲不失章法。
- 发表时间:2024.05.15
- Github 地址:https://github.com/Cinnamon/kotaemon
一、论文动机
- RAG(Retrieval-Augmented Generation):一种结合检索和生成的模型,通过检索相关文档来增强大型语言模型(LLM)的生成能力,从而提高问答系统的性能.
- kotaemon:一个开源的RAG UI工具,适用于最终用户和开发者,提供了丰富的功能和高度的可定制性.
二、kotaemon的主要特点
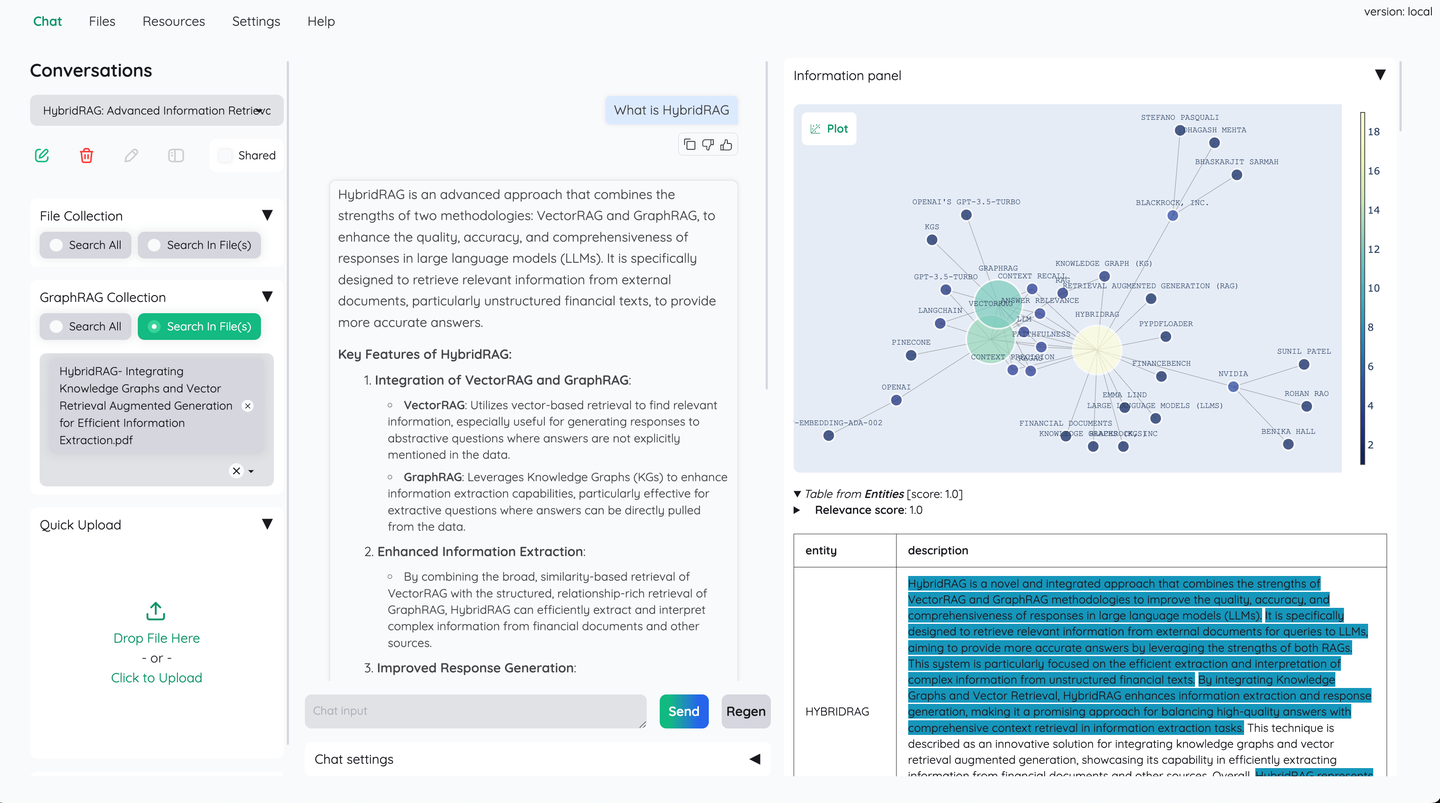
- 自托管文档问答Web UI:允许用户自己托管文档问答界面,提供了完整的前端和后端集成解决方案.
- 支持多用户登录:可以组织私人或公共文件集合,支持协作和分享,适合团队使用.
- 组织LLM和嵌入模型:支持本地LLM和流行的API提供商,如OpenAI、Azure、Ollama、Groq等,提供了灵活的模型选择.
- 混合RAG管道:提供混合(全文和向量)检索器和重新排名,确保最佳的检索质量,提高了检索的准确性和效率.
- 多模态问答支持:支持在包含图表和表格的多个文档上进行问答,并支持多模态文档解析,扩展了问答系统的应用范围.
- 高级引用与文档预览:系统默认提供详细的引用以确保LLM答案的正确性,可以在浏览器内的PDF查看器中查看引用(包括相关分数)并高亮显示,提高了答案的可信度.
- 支持复杂推理方法:使用问题分解来回答复杂或多跳问题,支持基于Agent的推理,如ReAct、ReWOO和其他代理,增强了系统的推理能力.
- 可配置的设置UI:可以在UI上调整检索和生成过程中的大多数重要方面(包括提示),提供了高度的可定制性.
- 可扩展性:基于Gradio构建,用户可以自由定制或添加任何UI元素,同时支持多种文档索引和检索策略,提供了GraphRAG索引管道作为示例.
三、论文总结
一个开源的干净且可定制的RAG UI,用于构建和定制自己的文档问答系统。既考虑了最终用户的需求,也考虑了开发者的需求。
FlashRAG【百宝箱】
百宝箱:把各路RAG神器打包成一个工具包,让研究者像挑选积木一样,随心所欲地搭建自己的检索模型。
- 发表时间:2024.05.22
- 论文名称:FlashRAG: A Modular Toolkit for Efficient Retrieval-Augmented Generation Research
- 论文地址:https://arxiv.org/abs/2405.13576
- Github 项目:https://github.com/RUC-NLPIR/FlashRAG
一、论文动机
- RAG技术:检索增强生成(RAG)技术通过利用外部知识库来缓解大型语言模型(LLM)中的幻觉问题,但缺乏标准化的实现框架,使得研究人员难以比较和评估不同的RAG方法.
- 现有工具包的局限性:现有的RAG工具包如LangChain和LlamaIndex通常比较重量级且难以满足研究人员的个性化需求.
二、论文思路
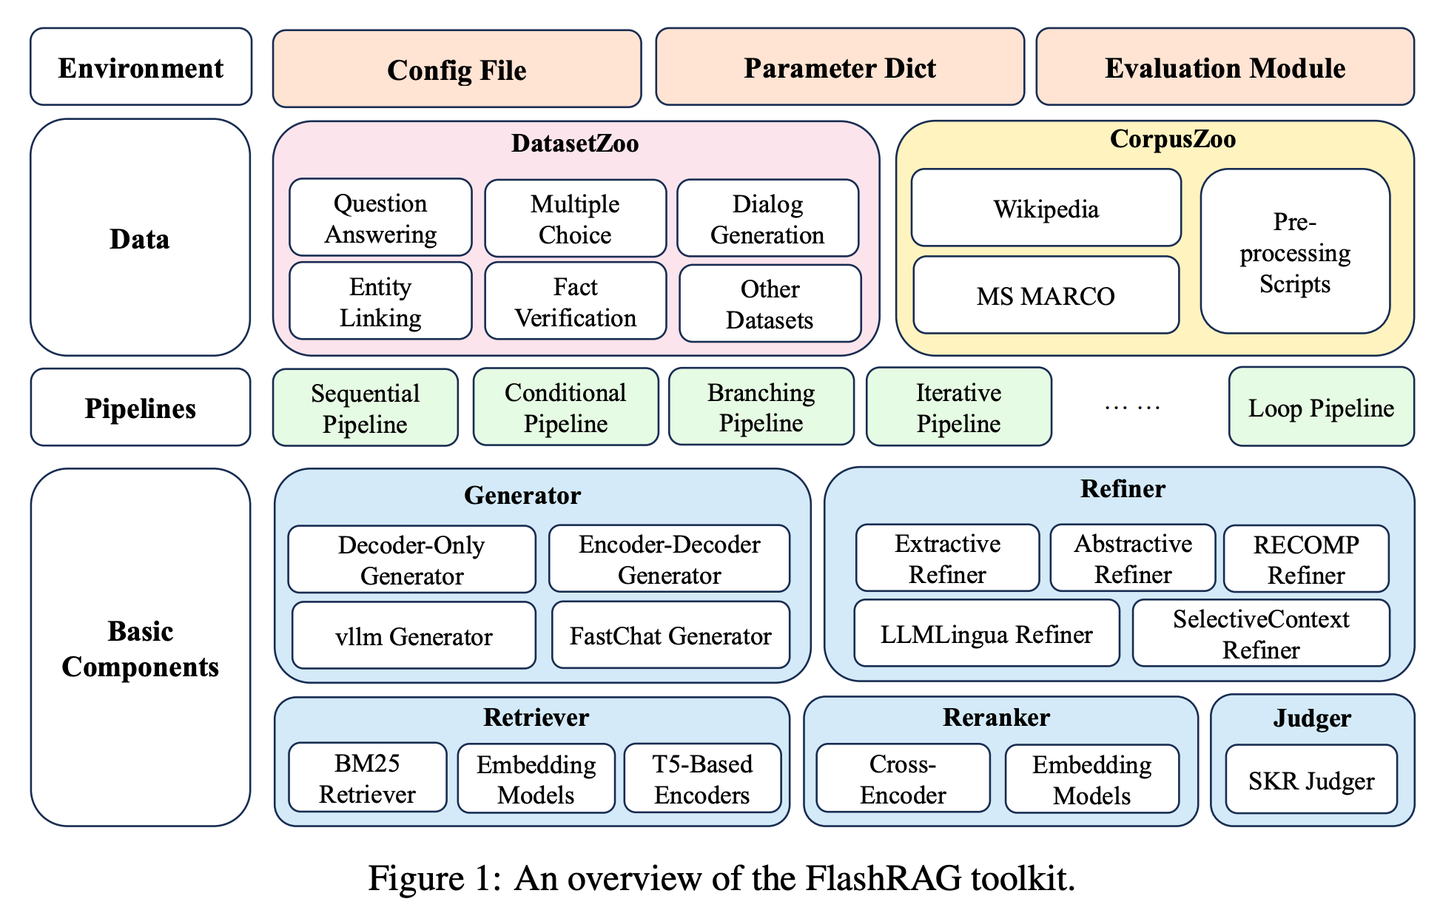
- 三个模块:FlashRAG由环境模块、组件模块和管道模块组成.
- 环境模块:提供必要的数据集、超参数和评估指标.
- 组件模块:包括五个主要组件:判断器、检索器、排序器、精炼器和生成器.
- 管道模块:将各种组件组合在一起以实现完整的RAG过程,提供了多种预设的管道,方便用户快速搭建RAG流程.
- 组件模块详解:
- 判断器(Judger):确定是否需要检索.
- 检索器(Retriever):支持多种检索方式,如稀疏检索和稠密检索,并支持自定义预取结果.
- 排序器(Reranker):优化检索结果的顺序,支持多种跨编码模型.
- 精炼器(Refiner):减少生成器的输入文本量并降低噪声,提供四种类型的精炼器供选择.
- 生成器(Generator):支持多种主流LLM加速库和编码解码模型.
三、实验设计与结果
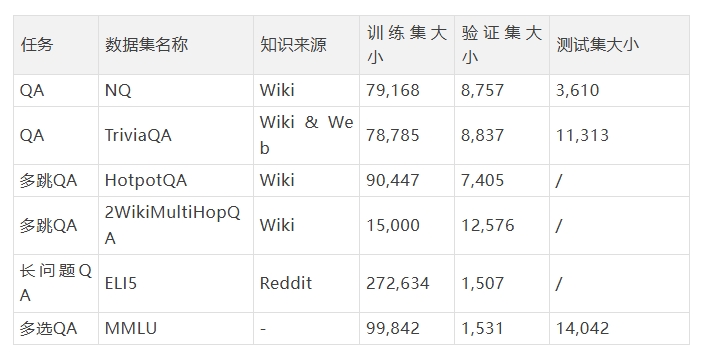
- 基准数据集:收集并预处理了32个基准数据集,涵盖了RAG工作中使用的大部分数据集,所有数据集都已格式化为统一的JSONL结构.
- 语料库:提供了方便的脚本来自动下载和预处理所需的Wikipedia版本,还提供了DPR提供的广泛使用的2018年12月20日的Wikipedia转储作为基础资源.
- 评估指标:支持多种检索和生成方面的评估指标,包括召回率@k、精确度@k、F1@k、平均精度(MAP)、词级别F1分数、准确率、BLEU和ROUGE-L等.
- 实验设置:使用最新的LLAMA3-8B-instruct作为生成器,E5-base-v2作为检索器,2018年12月的Wikipedia数据作为检索语料库,在六个常见数据集上进行实验.
- 主要结果:与直接生成的基线相比,RAG方法有显著的改进。使用先进的检索器和生成器的标准RAG是一个强大的基线,在六个数据集上都表现良好.
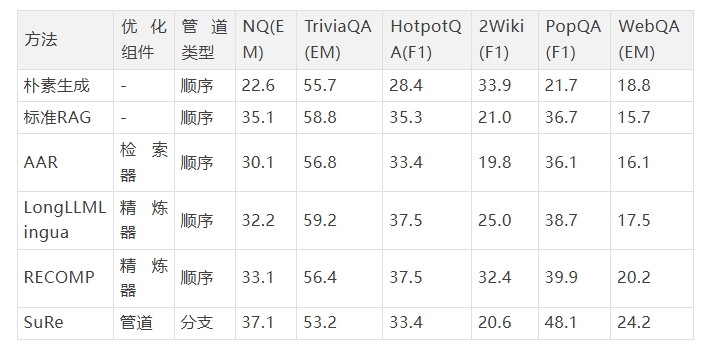
- 不同方法的比较分析:
- 精炼器优化方法:在多跳数据集上表现尤其出色,因为复杂问题导致文档检索的准确性降低,需要精炼器优化.
- 生成器优化方法:Ret-Robust使用带有lora模块的Llama2-13B模型,大大增强了生成器对检索文档的理解,优于其他无需训练的方法.
- 适应性检索方法:在需要多步推理的复杂数据集上比基线有显著的改进,但在简单任务上可能会带来更高的成本,但收益有限.
四、论文创新点
- 广泛且可定制的模块化RAG框架:提供了丰富的组件和预设的管道,方便用户快速搭建RAG流程.
- 预实现的先进RAG算法:目前已实现12个先进的RAG方法.
- 全面的基准数据集:目前收录32个基准数据集.
- 高效的RAG辅助脚本:如下载维基百科、构建索引等.
五、论文总结
FlashRAG是一个高效且模块化的开源工具包,旨在帮助研究人员在统一框架内重现现有的RAG方法并开发他们自己的RAG算法。我们的工具包实现了12种先进的RAG方法,并收集和整理了32个基准数据集。
GRAG【侦探】
侦探:不满足于表面线索,深入挖掘文本之间的关联网络,像破案一样追踪每条信息背后的真相,让答案更准确。
- 发表时间:2024.05.26
- 论文名称:GRAG: Graph Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2405.16506
- Github 项目:https://github.com/HuieL/GRAG
一、论文动机
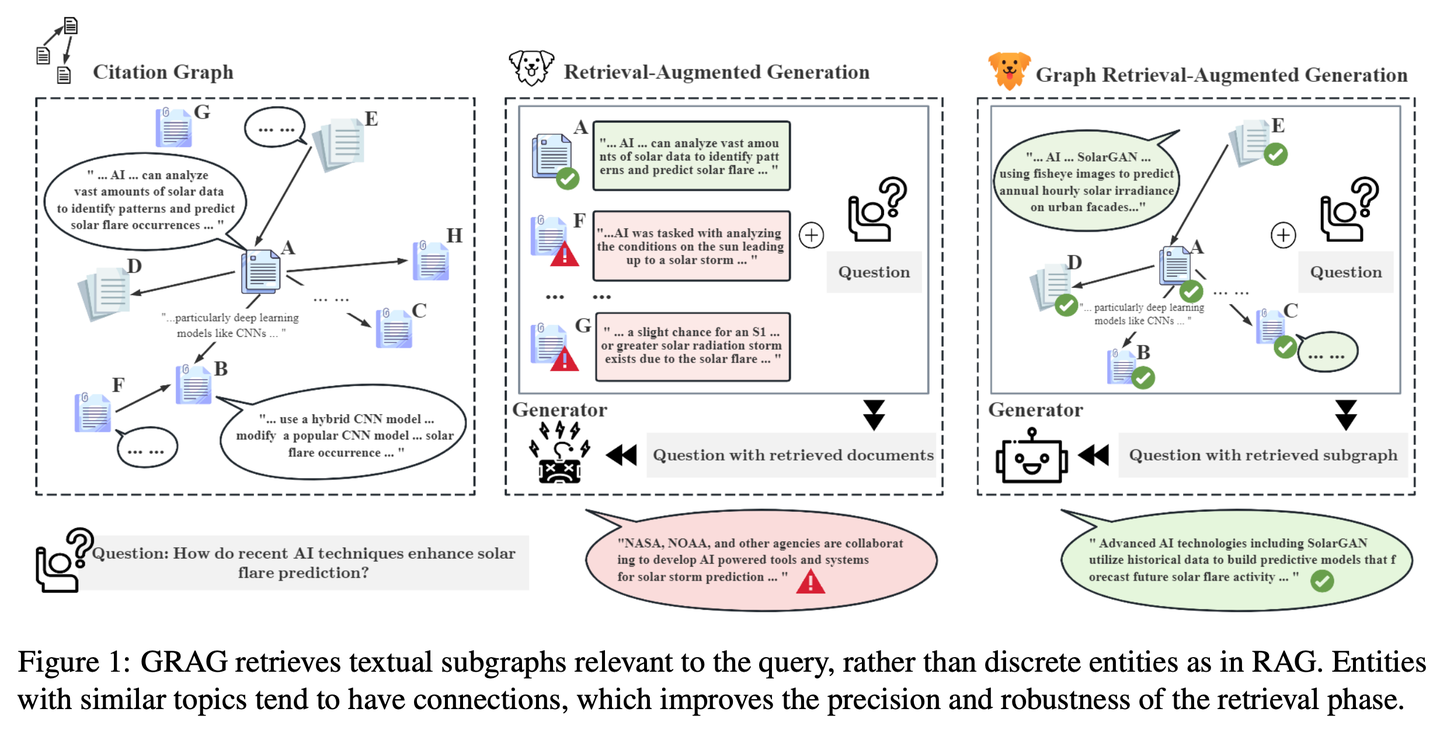
- RAG模型的局限性:传统的RAG模型在处理复杂的图结构数据时,忽视了文本之间的联系和数据库的拓扑信息,导致性能瓶颈。例如,在处理科学文献时,仅基于文本相似性的检索方法无法充分利用文献之间的引用关系和主题结构.
- GRAG模型的动机:为了解决这一问题,GRAG模型通过考虑文献之间的引用网络和主题分布,将拓扑信息在检索阶段和生成阶段利用起来,提高生成式语言模型的生成质量和图场景下的上下文一致性.
二、论文思路
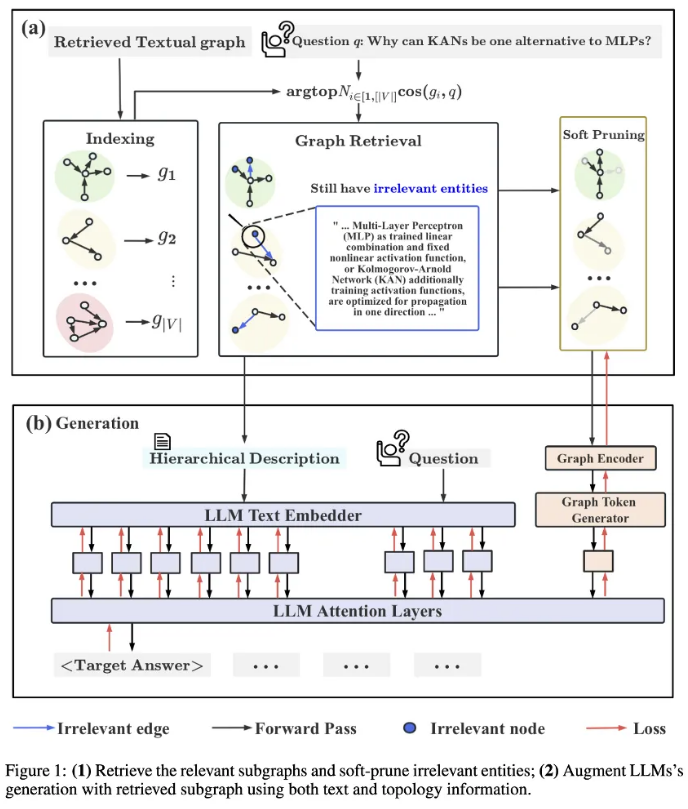
GRAG模型由四个主要阶段组成,即k阶子图索引、图检索、软剪枝和生成:
- k阶子图索引:对图中的每个节点及其周围的k阶邻居进行编码,并存储其图嵌入.
- 图检索:使用预训练语言模型(PLM)将查询转换为向量,并检索与查询最相关的前N个子图.
- 软剪枝:在检索到的子图结构中,对与查询不相关的节点和边进行软剪枝,以减少其对最终生成的影响.
- 生成:整合剪枝后的文本子图和原始查询,通过图神经网络(GNN)聚合子图内的信息,最后利用文本信息(text tokens)和子图信息(graph token)控制生成.
GRAG模型采用了一种双重提示策略,即硬提示和软提示。
- 硬提示:将检索到的子图转换为层次化的文本描述,保留拓扑信息和语义细节.
- 软提示:检索到的子图在剪枝过后通过GNN聚合文本和拓扑信息生成图token,随后用于引导大语言模型的生成过程.
三、实验设计与结果
- 数据集:在两个多跳推理基准(WebQSP和ExplaGraphs)上进行实验,数据集经过预处理将三元组集合转换为图.
- 结果:GRAG方法在所有指标上均显著优于当前最先进的RAG方法和LLM基线。特别是在生成任务中,GRAG减少了虚假信息的生成,使用GRAG的LLM(即Llama-7b)在未进行微调的情况下,其性能超越了微调后的LLM,显著降低了训练成本.
- 性能指标:
- WebQSP数据集:GRAG方法的Hit@1指标显著高于其他方法.
- ExplaGraphs数据集:GRAG方法的准确率表现出色.
- 检索效率与模型性能的权衡:尽管通过编码子图的方式控制检索空间为 |V|(节点数量)个子图,检索更多的子图可以提供更全面的上下文信息以提升生成质量,但这同时也会增加计算开销和处理时间。实验表明,合理选择检索的子图数量可以平衡效率和性能.
四、论文总结
传统RAG模型在处理复杂的图结构数据时忽视了文本之间的联系和数据库的拓扑信息,从而导致了性能瓶颈。GRAG通过强调子图结构的重要性,显著提升了检索和生成过程的性能并降低幻觉。
Camel-GraphRAG【左右开弓】
左右开弓:一只眼睛用Mistral扫描文本提取情报,另只眼睛用Neo4j编织关系网。查找时左右眼配合,既能找相似的,又能顺着线索图追踪,让搜索更全面精准。
- 发表时间:2024.05.27
- 论文名称:CAMEL: Communicative Agents for "Mind" Exploration of Large Language Model Society
- 论文地址:https://arxiv.org/abs/2303.17760
- Github 项目:https://github.com/camel-ai/camel
一、论文动机
- RAG方法:RAG结合了检索系统和生成模型,可以提供更精准和相关的答案。然而,传统的RAG方法在处理复杂查询时存在一些问题,如模型幻觉问题。
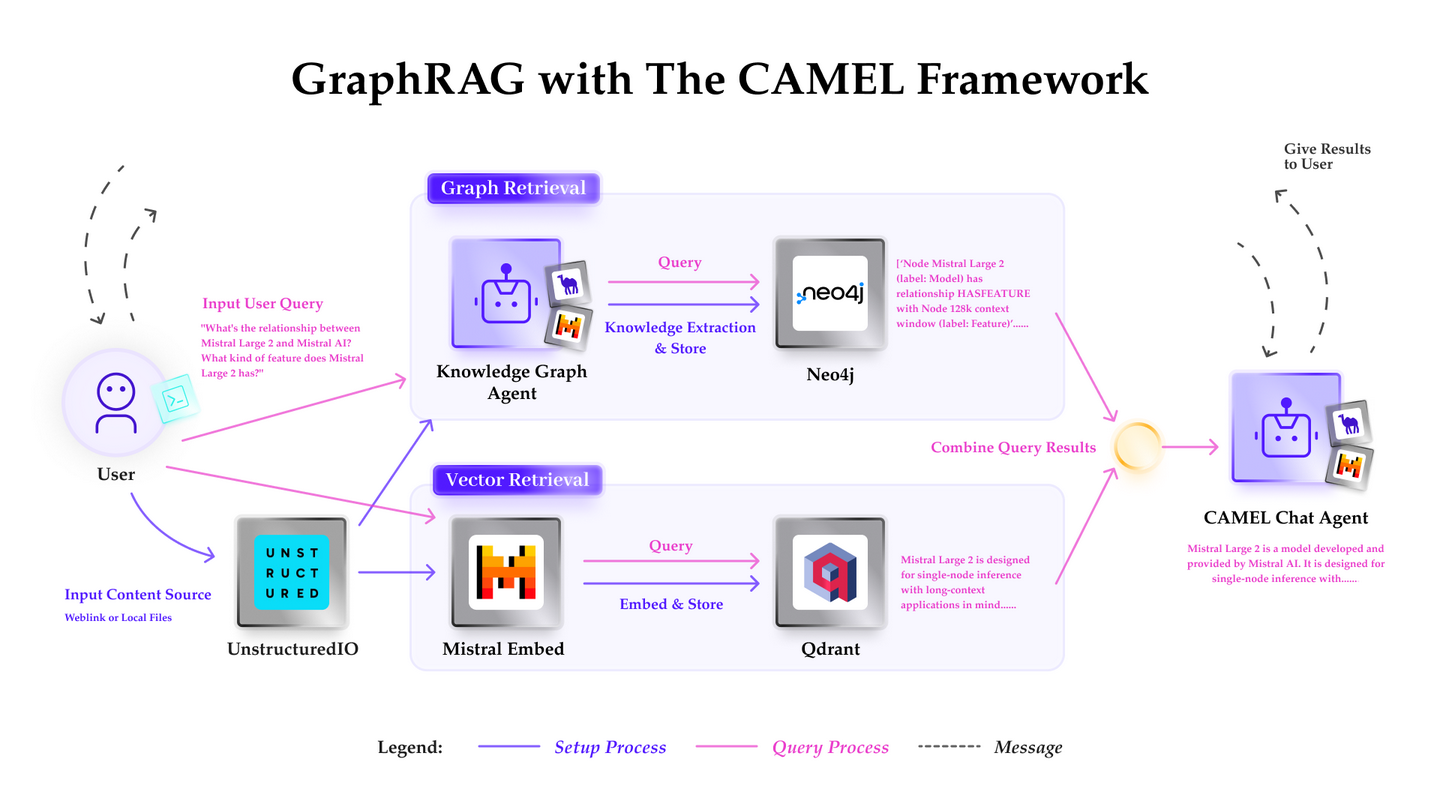
- GraphRAG:为了减缓这些问题,Mistral和CAMEL共同开发了GraphRAG,通过将知识图谱和向量检索结合,显著提高了检索的准确性和性能。
二、论文思路
- 技术栈细节
- CAMEL:作为一个多智能体系统框架,提供了知识图谱代理和聊天代理等功能,简化了工作流程。
- MistralAI:提供了Mistral Large 2大语言模型和Mistral Embed嵌入模型。
- Neo4j:提供了知识图谱数据库。
- Qdrant:提供了向量数据库,存储文本嵌入并支持快速向量检索。
- Unstructured.io:负责将非结构化数据转换为结构化格式,为RAG系统做好准备。
- GraphRAG的工作流程
- 数据准备:通过Unstructured.io将原始数据转换为适合处理的格式。
- 知识提取和存储:使用Mistral Large 2从数据源中提取有用的信息,构建知识图谱,并存储在Neo4j数据库中。
- 向量生成和存储:使用Mistral Embed将文本转换为向量表示,并存储在Qdrant向量数据库中。
- 混合检索:结合向量检索和知识图谱检索,通过CAMEL框架的智能体系统处理用户查询,提供更加准确和相关的答案。
- 回答用户问题:使用Agent生成回复。
三、论文总结
Camel-GraphRAG依托Mistral模型提供支持,从给定的内容中提取知识并构建知识结构,然后将这些信息存储在 Neo4j图数据库中。随后采用一种混合方法,将向量检索与知识图谱检索相结合,来查询和探索所存储的知识。
G-RAG【串门神器】
串门神器:不再是单打独斗地查资料,而是给每个知识点都建立人际关系网。像个社交达人,不仅知道每个朋友的特长,还清楚谁和谁是酒肉朋友,找答案时直接顺藤摸瓜。
- 发表时间:2024.05.28
- 论文名称:Don't Forget to Connect! Improving RAG with Graph-based Reranking
- 论文地址:https://arxiv.org/abs/2405.18414
一、论文动机
- RAG系统的挑战:传统的RAG方法在处理信息不全或上下文关联度较低的文档时,存在文档间连接利用不足的问题,导致过拟合和计算资源消耗增加,影响系统性能.
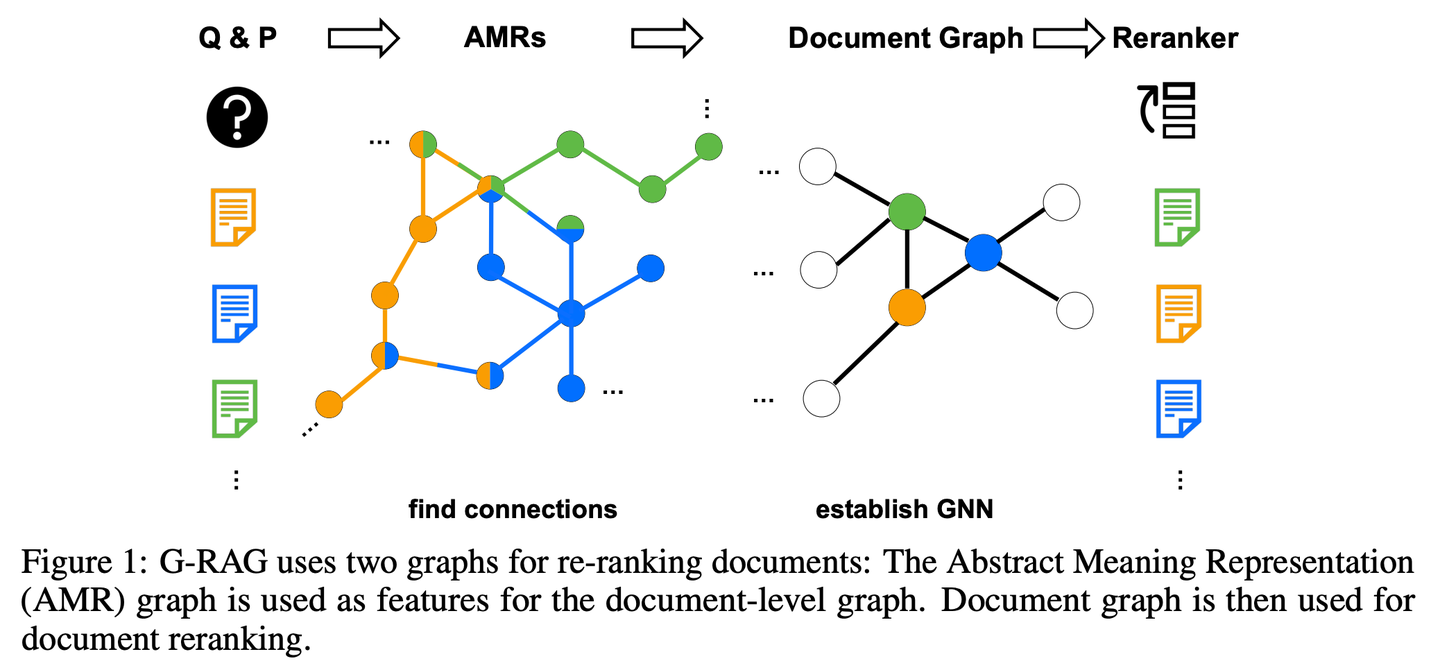
- G-RAG的目标:通过结合文档图和AMR图,改善现有重排序技术,减少过拟合并降低计算资源消耗,从而提高RAG系统的性能.
二、论文思路
- 文档图的构建:
- 对每个问题-文档对,将问题和文档文本拼接后使用AMR BART解析生成AMR图.
- 基于这些AMR图构建无向文档图,其中节点表示文档,边表示文档之间的共同概念.
- 通过消息传递机制更新边特征.
- 节点特征的生成:
- 使用预训练语言模型对所有检索到的文档进行编码,得到初始节点表示.
- 通过识别从“question”节点到其他节点的最短单源路径(SSSP),提取路径上的节点概念,构建AMR信息序列,并将其与文档文本拼接后再次编码,得到最终的节点特征.
- 边特征的生成:
- 计算文档之间的共同节点数和共同边数,作为边的特征,并进行归一化处理.
- 图神经网络的表示更新:
- 基于初始节点和边特征,使用图神经网络进行多轮迭代更新,通过聚合邻居节点的特征来更新每个节点的表示.
- 重排序得分和训练损失:
- 使用余弦相似度计算每个文档的重排序得分,并使用交叉熵损失函数和成对排名损失函数进行训练。成对排名损失函数能够更好地处理排名分数的平局情况.
三、实验设计与结果
- 实验设计
- 数据集:
- 使用自然问题(NQ)和TriviaQA数据集进行实验。NQ数据集包含来自Google搜索查询的文本块,而TQA数据集包含来自trivia和quiz-league网站的问答对.
- 模型细节:
- 使用DPR进行文档检索,生成100个文档,并使用AMRBART解析每个问题-文档对生成AMR图.
- 采用2层图卷积网络(GCN)作为GNN模型,隐藏维度从{8, 64, 128}中选择,dropout率从{0.1, 0.2, 0.4}中选择,学习率从{5e-5, 1e-4, 5e-4}中选择.
- 使用AdamW优化器,学习率5e-5至1e-4,批量大小5,总训练步数50k,每10k步评估一次.
- 评估指标:
- 使用平均倒数排名(MRR)、平均命中率@10(MHits@10)及其变体(MTRR和TMHits@10)评估重排序性能.
- 数据集:
- 实验结果
- 重排序性能:
- G-RAG方法在NQ和TQA数据集上的MRR和MHits@10指标上均优于现有方法。
- 在NQ数据集上,G-RAG的MRR达到了27.3,而BART的MRR为25.7;在TQA数据集上,G-RAG的MHits@10达到了42.9,而BART的MHits@10为38.5.
- PaLM 2评估:
- 使用PaLM 2作为重排序器时,发现其在重排序任务中的表现不如G-RAG。这可能是由于PaLM 2生成的相关性得分中存在大量平局,导致排名效果不佳.
- 使用提出的MTRR和TMHits@10指标进行评估,结果显示G-RAG方法显著提高了重排性能.
- 不同嵌入模型的比较:
- 在相同设置下,Ember模型表现最佳,尤其是在引入超参数调优后,其MRR达到了28.9。其次是GTE和BGE,而BART-GST和BERT表现略低.
- 重排序性能:
四、论文创新点
- 提出了一种基于文档图的重新排序器G-RAG,利用文档之间的连接信息提高RAG的性能,特别是在文档与问题上下文连接较弱的情况下.
- 引入了新的评估指标MTRR和TMHits@10,更公平地评估各种排名场景,包括得分相同的排名情况.
- 评估了PaLM 2作为重排序器的性能,发现即使使用最先进的预训练大型语言模型,重排序器模型设计在RAG中的重要性也不容忽视.
- G-RAG在保持较小计算足迹的同时,优于现有的最先进方法.
- 通过识别有助于重新排序器识别更相关文档的关键因素,而不是将所有AMR相关的标记都添加为节点级特征,从而提高了性能并避免了过拟合.
五、论文总结
RAG 在处理文档与问题上下文的关系时仍存在挑战,当文档与问题的关联性不明显或仅包含部分信息时,模型可能无法有效利用这些文档。此外,如何合理推断文档之间的关联也是一个重要问题。 G-RAG实现了RAG检索器和阅读器之间基于图神经网络(GNN)的重排器。该方法结合了文档之间的连接信息和语义信息(通过抽象语义表示图),为 RAG 提供了基于上下文的排序器。
LLM-Graph-Builder【搬运工】
搬运工:给混乱的文字安个明白的家。不是简单地搬运,而是像个强迫症患者,把每个知识点都贴上标签,画上关系线,最后在Neo4j的数据库里盖起一座井井有序的知识大厦。
- 发表时间:2024.05.29
- Github 地址:https://github.com/neo4j-labs/llm-graph-builder
一、论文动机
- 知识图谱的重要性:知识图谱能够将非结构化数据转换为结构化形式,便于存储和查询,对于对话系统和知识问答等应用具有重要意义.
- LLM的应用:利用大型语言模型(LLM)如OpenAI、Gemini、Llama3、Diffbot、Claude、Qwen等从非结构化数据中提取节点、关系及其属性,可以提高知识图谱的构建效率和质量.
二、论文思路
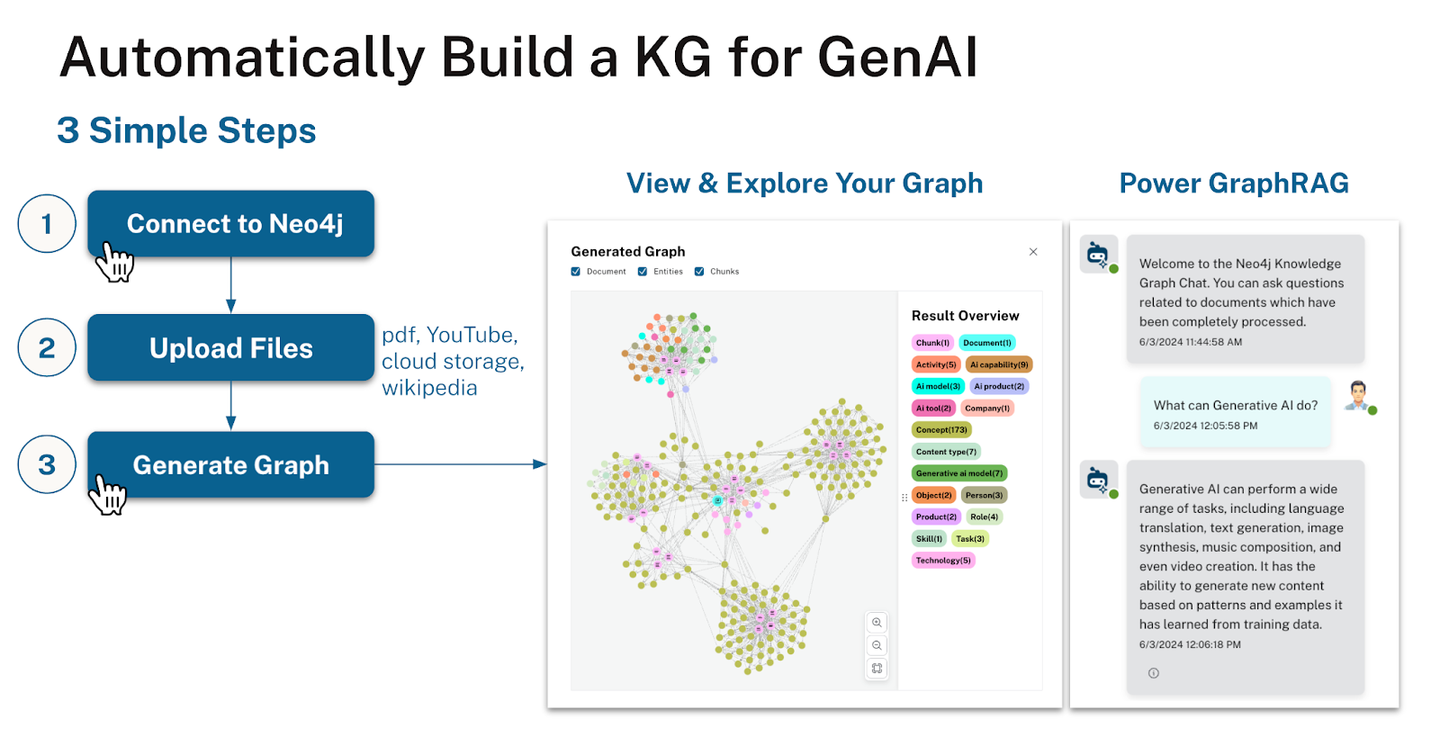
- 知识图谱创建:使用LLMs将非结构化数据(如PDF、文档、文本、YouTube视频、网页等)转换为存储在Neo4j中的结构化知识图谱.
- 提供Schema:用户可以提供自定义的Schema或使用已有的Schema来生成知识图谱,增加了灵活性和可定制性.
- 查看图表:在Bloom中可以一次查看特定源或多个源的知识图谱,方便用户直观地理解和分析数据.
- AI聊天:通过对话即可查询与Neo4j数据库中的数据进行交互,还可以提供来源的元数据,支持使用不同的RAG方法(如GraphRAG、Vector、Text2Cypher)进行知识问答.
三、论文总结
Neo4j开源的基于LLM提取知识图谱的生成器,可以把非结构化数据转换成Neo4j中的知识图谱。利用大模型从非结构化数据中提取节点、关系及其属性。
2024.06
MRAG【八爪鱼】
八爪鱼:不是只长一个脑袋死磕问题,而是像章鱼一样长出多个触角,每个触角负责抓取一个角度。简单说,这就是AI版的"一心多用"。
- 发表时间:2024.06.07
- 论文名称:Multi-Head RAG: Solving Multi-Aspect Problems with LLMs
- 论文地址:https://arxiv.org/abs/2406.05085
- Github 地址:https://github.com/spcl/MRAG
一、论文动机
- RAG的挑战:现有的RAG方法主要关注单一方面查询的文档检索,忽略了需要同时检索多个不同内容文档的多方面查询。这导致在处理复杂查询时,RAG系统的性能受限.
- MRAG的目标:通过利用Transformer解码器的多头注意力层的激活,生成多维度嵌入,更好地表示文档和查询的各个方面,从而提高检索的准确性和相关性.
二、论文思路
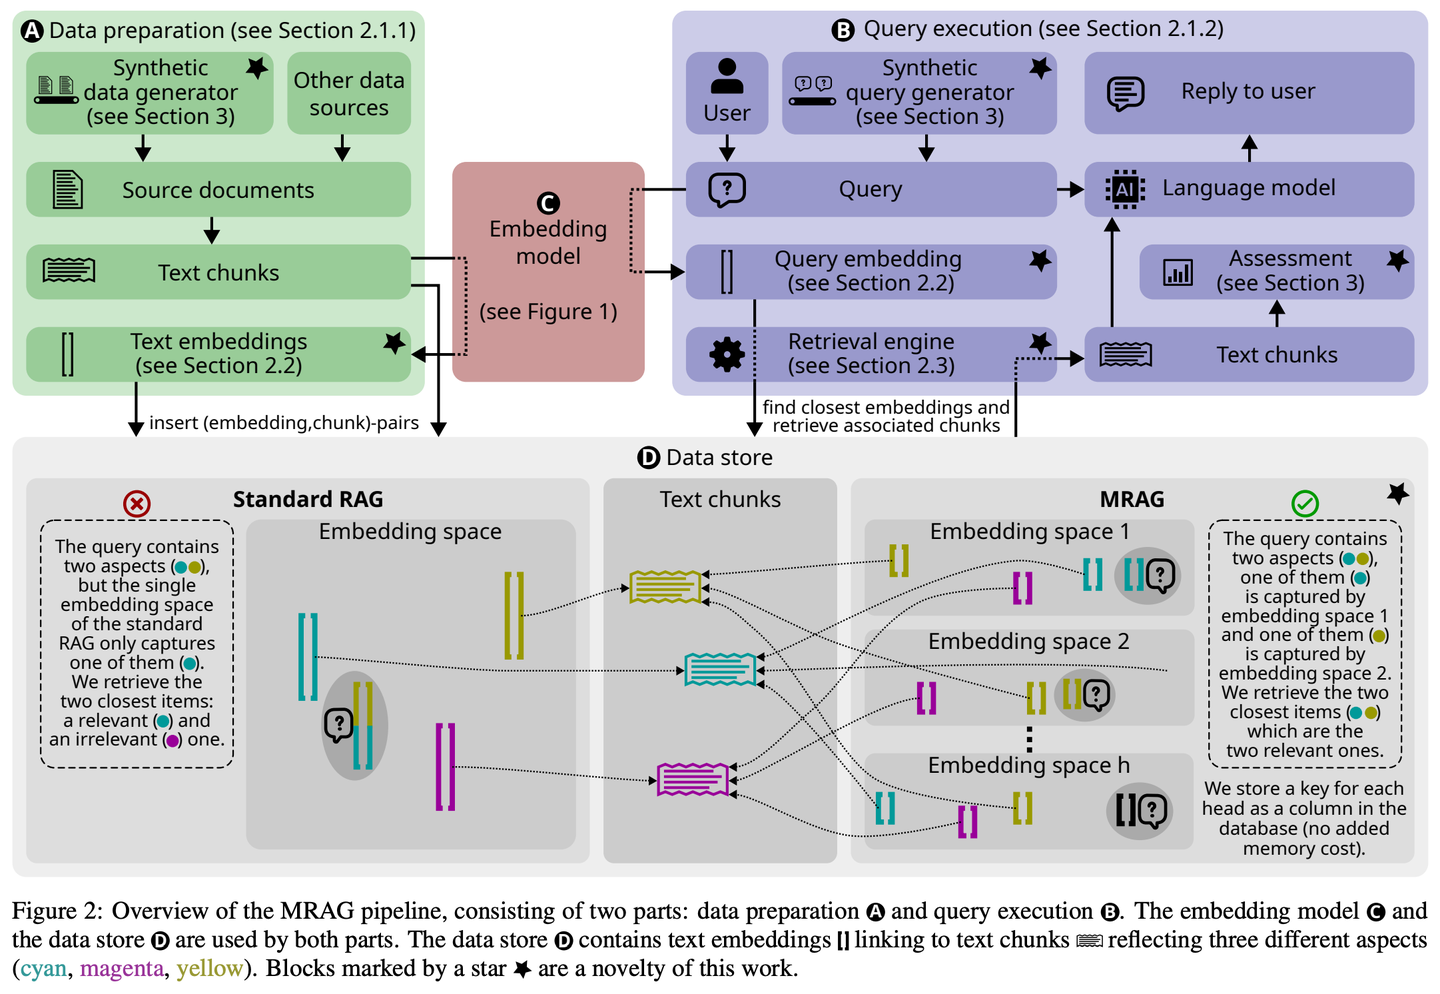
研究方法包括以下几点:
- 解码器架构:
输入是一个包含n个token的文本块,每个注意力头h对第i个token的输出定义为:
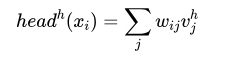
其中:
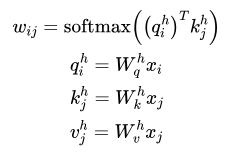
这些输出组合形成第i个多头注意块的输出:
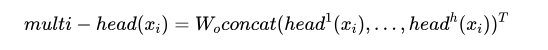
其中,矩阵 $W_a$ 是将所有注意力头的输出组合起来的线性层。
- 标准RAG公式:
假设一个包含n个token的文本块作为输入文本块,该块的嵌入是通过最后一个解码器块的前馈层生成的激活向量:
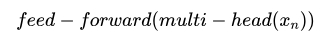
- 多头RAG公式:
MRAG的关键思想是使用最后一个注意力层的激活向量而不是最后一个前馈层的激活向量:
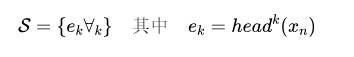
即最后一个token的所有注意力头的输出.
- MRAG管道概述:
- 数据准备:使用选定的基于解码器的嵌入模型创建多面MRAG文本嵌入及其对应的文档或文本块.
- 查询执行:首先生成输入查询的多面嵌入,然后在数据存储中找到最近的多面嵌入及其对应的文本块.
三、实验设计与结果
- 实验设计
- 数据集生成:
- 选择概念上不同的文档类别,主要是公开可用的维基百科文章,共25个类别,每类50篇文档。每个文档的概览部分用于嵌入.
- 生成涉及多个方面的查询,涵盖1到20个方面.
- 指标设计:
- 设计了一套新的指标来评估RAG方案支持多面性的能力,主要包括检索成功率、类别检索成功率和加权检索成功率.
- 数据集生成:
- 结果分析
- 绝对检索性能:
- MRAG在检索成功率方面显著优于标准RAG,平均精确文档匹配的成功率提高了超过10%,类别匹配的成功率提高了超过25%.
- 相对性能提升:
- MRAG在不同数量的方面和不同的嵌入模型上的相对加权性能提升表明,它在所有情况下都优于标准RAG,平均提升10-20%.
- 与融合RAG的结合:
- MRAG与融合RAG结合后,性能进一步提升,但计算成本和延迟也相应增加.
- 真实工作场景负载:
- 在合成法律文件和分析化工厂事故原因的真实世界工作负载中,MRAG表现出优于其他方案的优势.
- 绝对检索性能:
四、论文总结
本文提出的MRAG方案通过利用Transformer解码器块的多头注意力层的激活,显著提高了复杂多方面查询的检索准确性。实验结果表明,MRAG在检索成功率和类别检索成功率方面均优于现有的RAG基线。此外,MRAG还具有成本低、计算效率高和易于集成等优点。本文的研究为进一步改进LLMs和RAG系统提供了新的思路和方法.
PlanRAG【战略家】
战略家:先制定完整作战计划,再根据规则和数据分析局势,最后做出最佳战术决策。
- 发表时间:2024.06.18
- 论文名称:PlanRAG: A Plan-then-Retrieval Augmented Generation for Generative Large Language Models as Decision Makers
- 论文地址:https://arxiv.org/abs/2406.12430
- Github 地址:https://github.com/myeon9h/PlanRAG
一、论文动机
- 决策问答(Decision QA)任务:定义为根据决策问题Q、业务规则R和数据库D,确定最佳决策。这种任务在商业环境中非常重要,但现有的RAG方法在处理这类任务时表现不佳,尤其是在制定决策计划方面.
- DQA基准:为了评估Decision QA,论文提出了一个包含两个场景(定位和构建)的基准DQA。这两个场景源自两款视频游戏(《欧陆风云IV》和《维多利亚3》),模拟了真实的商业环境.
二、论文思路
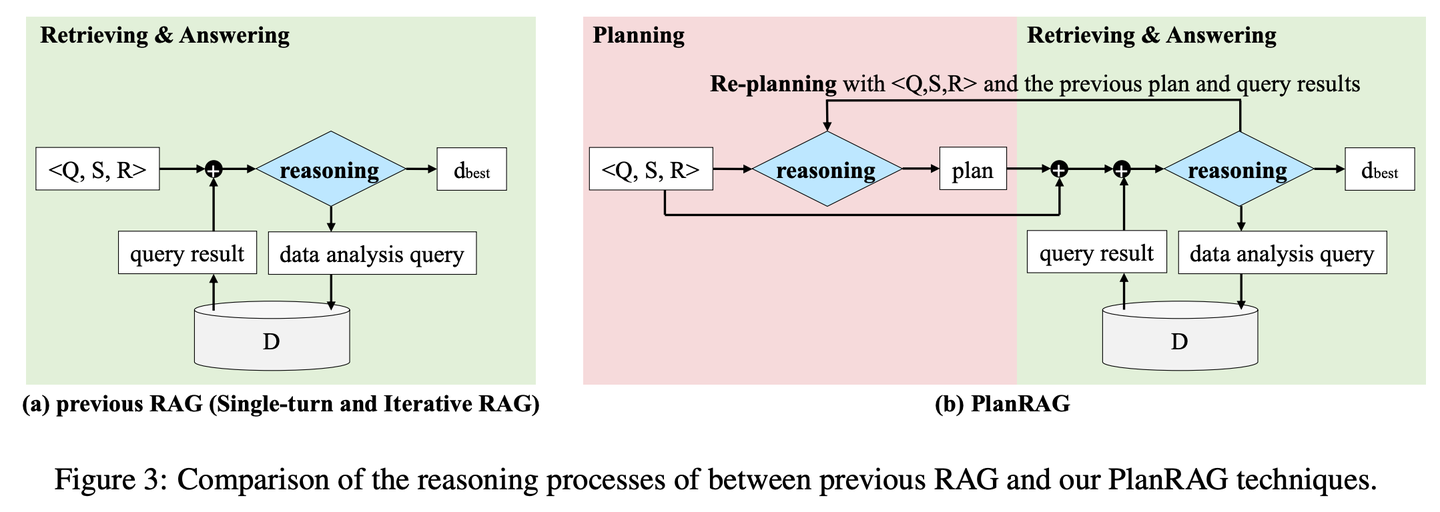
- 规划步骤:基于PlanRAG的语言模型首先生成决策计划,描述为决策所需执行的一系列数据分析任务.
- 检索与回答步骤:语言模型不仅接收问题、业务规则和数据库模式,还接收初始计划作为输入,生成用于决策的数据分析查询,并从数据库中检索数据.
- 重新规划步骤:当初始计划不足以解决决策问题时,进行重新规划。语言模型根据每次检索步骤的结果评估当前计划,并生成新的计划以进行进一步分析.
三、实验设计与结果
- 实验设计
- 实验设置:论文实现了四种不同的决策型LM进行比较,包括基于单轮RAG的SingleRAG-LM、基于迭代RAG的IterRAG-LM、基于PlanRAG的PlanRAG-LM,以及无重新规划的PlanRAG-LM。所有实验在零样本和单次运行的设置下进行.
- 数据库:使用MySQL作为关系数据库管理系统(RDBMS),Neo4j作为图形数据库管理系统(GDBMS).
- 评估指标:只有当决策者的答案在语义上与DQA上的真实最佳决策完全一致时,才被认为是正确的.
- 结果与分析
- 主要结果:PlanRAG在定位场景中比最先进的迭代RAG方法提高了15.8%,在构建场景中提高了7.4%。这充分展示了PlanRAG在决策制定任务中的有效性.
- 单次检索(SR)和多次检索(MR)问题:PlanRAG在SR问题上的表现远超IterRAG-LM,而在MR问题上也有显著优势。这是因为PlanRAG通过规划步骤减少了理解问题难度的可能性,并根据计划执行多次检索.
- RDB和GDB的分析:PlanRAG在两种数据库类型上都比其他LMs更有效。在建筑场景中,PlanRAG在GDB上的效果比在RDB上更好,因为建筑场景需要在GDB中进行更长的遍历来回答问题.
- 错失数据查询率分析:PlanRAG的遗漏率较低,分别为1.3%和21.8%,而IterRAG-LM的遗漏率较高,分别为3.3%和33.2%。这意味着PlanRAG能更有效地查询问题的关键数据.
- 失败案例分析:PlanRAG在两种场景下均显著降低了CAN和MIS错误,表明PlanRAG能更好地理解决策QA问题,并更有效地查询问题的关键数据.
- 重新规划分析:PlanRAG在Building场景中比在Locating场景中更频繁地重新规划,表明在Building场景中制定计划(无论是初始规划还是重新规划)时遇到更多困难.
四、论文总结
PlanRAG通过结合规划、检索和重新规划步骤,显著提高了复杂决策问答任务的性能。实验结果表明,PlanRAG在定位和构建场景中均优于现有的RAG基线,特别是在减少理解问题难度和有效查询关键数据方面表现出色。PlanRAG为利用LLMs进行复杂数据分析的决策提供了一种有效的解决方案.
FoRAG【作家】
作家:先列写作大纲构思文章框架,再逐段扩充完善内容。同时还配备了一个"编辑",通过仔细的事实核查和修改建议,帮助完善每个细节,确保作品的质量。
- 发表时间:2024.06.19
- 论文名称:FoRAG: Factuality-optimized Retrieval Augmented Generation for Web-enhanced Long-form Question Answering
- 论文地址:https://arxiv.org/abs/2406.13779
一、论文动机
- RAG的挑战:尽管RAG通过结合大型语言模型(LLMs)和检索器,利用搜索引擎增强了长篇问答的质量,但生成的长形答案中存在两个关键问题:事实性不足和逻辑清晰度不够.
- FoRAG的目标:提出一种新颖的大纲增强生成器(outline-enhanced generator)和基于精心设计的事实性优化方法,以实现多面性答案的清晰逻辑生成,并提高答案的事实性.
二、论文思路
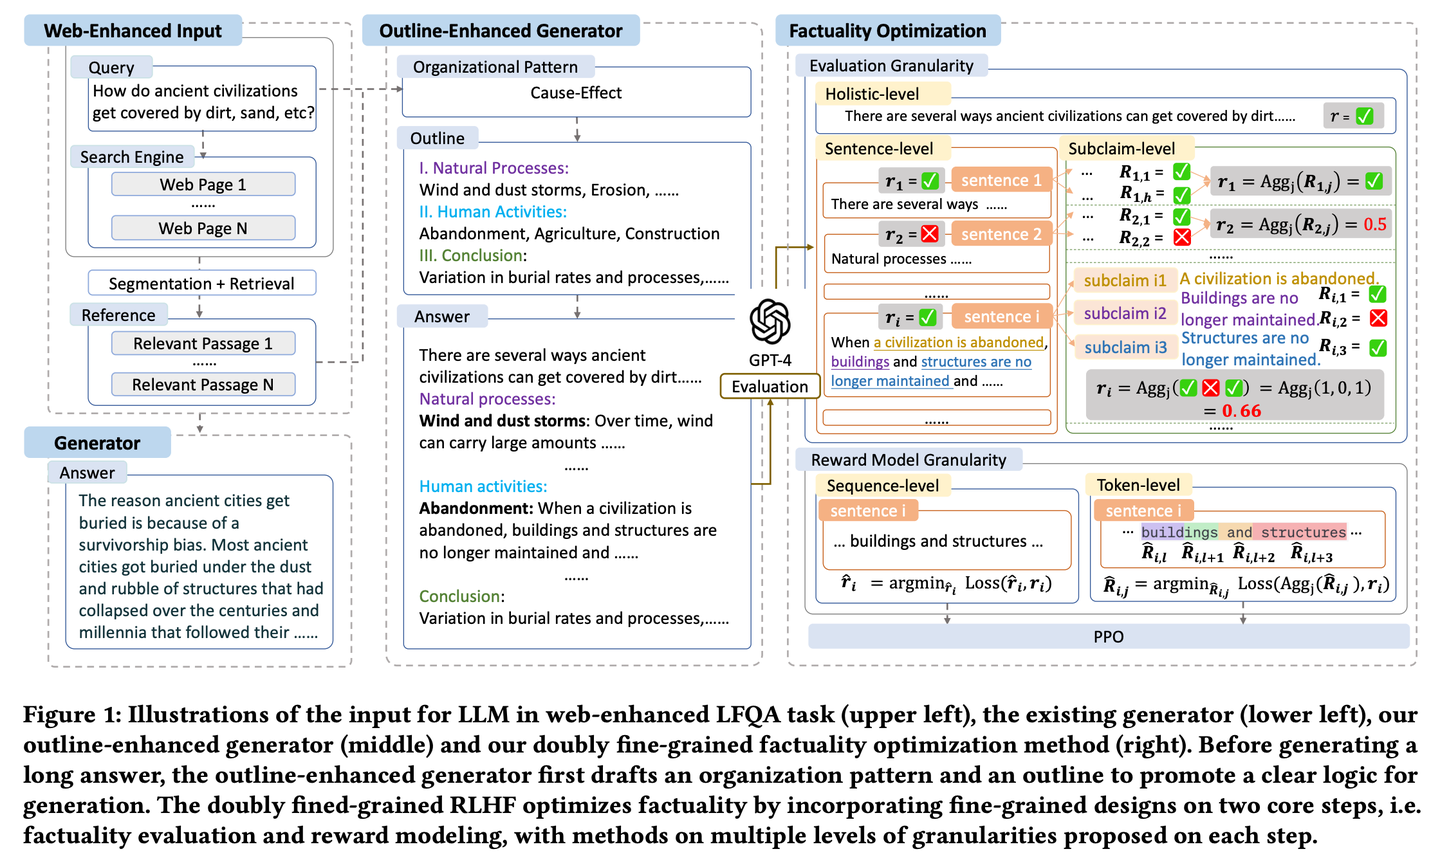
-
大纲增强生成器(Outline-Enhanced Generator):
- 两阶段生成技术:首先生成一个组织模式和大纲,以提高生成答案的逻辑清晰度。第一阶段,生成器使用大纲模板,根据用户查询和上下文草拟答案大纲。第二阶段基于生成的大纲扩展每个观点,构建最终答案.
- 大纲阶段(Outline Stage):生成器根据问题和上下文,选择最合适的组织模式(如因果关系、比较对比等),然后输出一个包含关键点的大纲.
- 扩展阶段(Expansion Stage):根据前一阶段生成的大纲,LLM扩展每个关键点,形成完整的答案.
-
新颖的事实性优化方法:
- 双细粒度RLHF框架:为了克服直接应用RLHF(Reinforcement Learning from Human Feedback)的困难,提出了一个双细粒度的RLHF框架。该框架通过在事实性评估和奖励建模两个核心步骤中引入细粒度设计,提供了更密集的奖励信号.
- 细粒度评估:三种评估粒度:
- 整体性:将整个答案作为一个单元进行评估.
- 句子级别:将答案分割成句子,并分别评估每个句子.
- 子声明级别:进一步将每个句子分解为多个子声明,并分别评估每个子声明.
- 细粒度奖励建模:两种奖励建模粒度:
- 序列级别:为每个序列学习单一的奖励,反映相应序列的事实性.
- 标记级别:为序列中的每个标记学习奖励,通过聚合所有标记级别的奖励来计算序列的奖励.
- PPO优化:采用近端策略优化(PPO)方法来优化生成模型,通过最大化训练好的奖励模型提供的奖励.
三、实验设计与结果
- 性能比较:通过广泛的实验,验证了所提出的事实性优化RAG(FoRAG)方法在英文和中文基准测试中的优越性。特别是,当将该方法应用于Llama2-7B-chat时,得到的模型FoRAG-L-7B在连贯性、有用性和事实性这三个常用指标上超过了WebGPT-175B,而FoRAG-L-7B的参数数量仅为WebGPT-175B的1/24.
- 有无提纲增强和事实性优化的FoRAG变体的比较:实验结果表明,提纲增强和事实性优化显著提高了生成答案的质量.
- 不同事实性优化技术的性能比较:实验结果表明,双细粒度的RLHF框架在优化事实性方面优于传统的RLHF方法.
四、论文总结
FoRAG提出了一种新颖的大纲增强生成器,在第一阶段生成器使用大纲模板,根据用户查询和上下文草拟答案大纲,第二阶段基于生成的大纲扩展每个观点,构建最终答案。同时提出一种基于精心设计的双精细粒度RLHF框架的事实性优化方法,通过在事实性评估和奖励建模两个核心步骤中引入细粒度设计,提供了更密集的奖励信号。
Multi-Meta-RAG【元筛选器】
元筛选器:像个经验丰富的资料管理员,通过多重筛选机制,从海量信息中精准定位最相关的内容。它不只看表面,还会深入分析文档的"身份标签"(元数据),确保找到的每份资料都真正对题。
- 发表时间:2024.06.19
- 论文名称:Multi-Meta-RAG: Improving RAG for Multi-Hop Queries using Database Filtering with LLM-Extracted Metadata
- 论文地址:https://arxiv.org/abs/2406.13213
- Github 地址:https://github.com/mxpoliakov/multi-meta-rag
一、论文动机
- RAG的挑战:传统的RAG方法在回答多跳问题时表现不佳,因为这些问题需要从多个信息源中提取并推理出答案。传统的RAG技术很难从多个文档中找到正确的信息片段,单一的向量很难召回出差异较大的信息源.
- 多跳问题:多跳问题是指那些需要从多个信息源中提取并推理出答案的问题。例如,询问“Engadget在The Verge之前报道了13.6英寸MacBook Air的折扣吗?”这类问题需要从多个来源中提取信息并进行推理.
二、论文思路
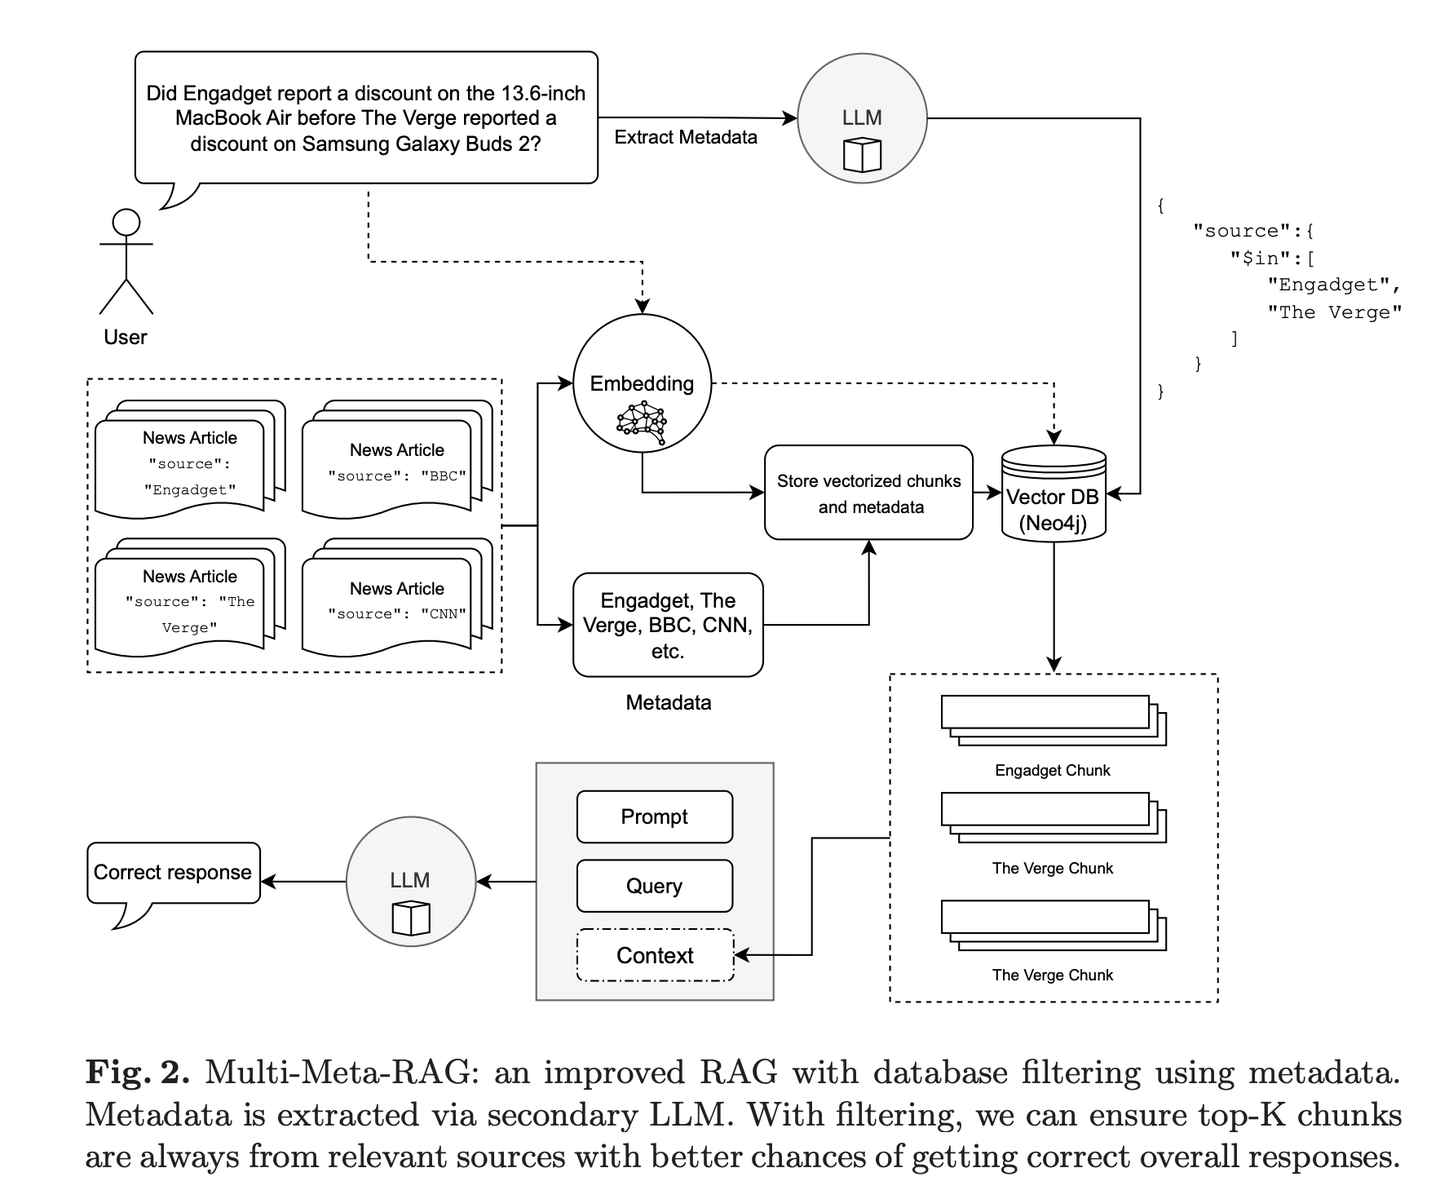
- 核心思想:使用数据库过滤和LLM提取的元数据来提高文档选择的相关性。具体步骤如下:
- 问题分析:使用一个辅助的LLM分析问题,提取出问题中的关键信息,如新闻来源或发布日期.
- 数据库过滤:用提取的关键信息作为过滤条件,从数据库中找到最相关的文档片段.
- 生成答案:基于过滤后的文档片段,生成最终的答案.
三、实验设计与结果
- 实验设计
- 基准测试数据集:使用MultiHop-RAG基准测试数据集,该数据集包含了很多多跳查询的例子.
- 评估指标:评估文档片段的检索效果和LLM生成答案的准确性.
- 实验结果
- 显著提升:Multi-Meta-RAG在文档片段的检索和LLM生成答案的准确性上都有显著提升。具体表现为:
- 文档检索:能够更准确地从多个信息源中提取相关信息片段.
- 答案生成:生成的答案更准确,减少了错误信息的出现.
- 显著提升:Multi-Meta-RAG在文档片段的检索和LLM生成答案的准确性上都有显著提升。具体表现为:
四、论文总结
尽管存在一些局限性,Multi-Meta-RAG仍然是一个简单易懂且效果显著的方法,能够显著提高RAG在多跳查询中的表现。通过结合数据库过滤和LLM提取的元数据,Multi-Meta-RAG在多跳查询任务中表现出色,为RAG技术的发展提供了新的思路和方法.
2024.07
RankRAG【全能选手】
全能选手:通过一点特训就能当好"评委"和"选手"双重角色。像个天赋异禀的运动员,只需要少量指导就能在多个项目上超越专业选手,还能把看家本领都融会贯通。
- 发表时间:2024.07.02
- 论文名称:RankRAG: Unifying Context Ranking with Retrieval-Augmented Generation in LLMs
- 论文地址:https://arxiv.org/abs/2407.02485
一、论文动机
- RAG的挑战:传统的RAG系统通常依赖于独立的检索和排名模型来从大规模文档集中提取相关信息,然后由语言模型生成答案。这种方法存在局限性,如检索器的容量限制和顶层上下文的选择权衡,可能导致信息的遗漏或引入不相关的内容,从而影响生成的准确性.
二、论文思路
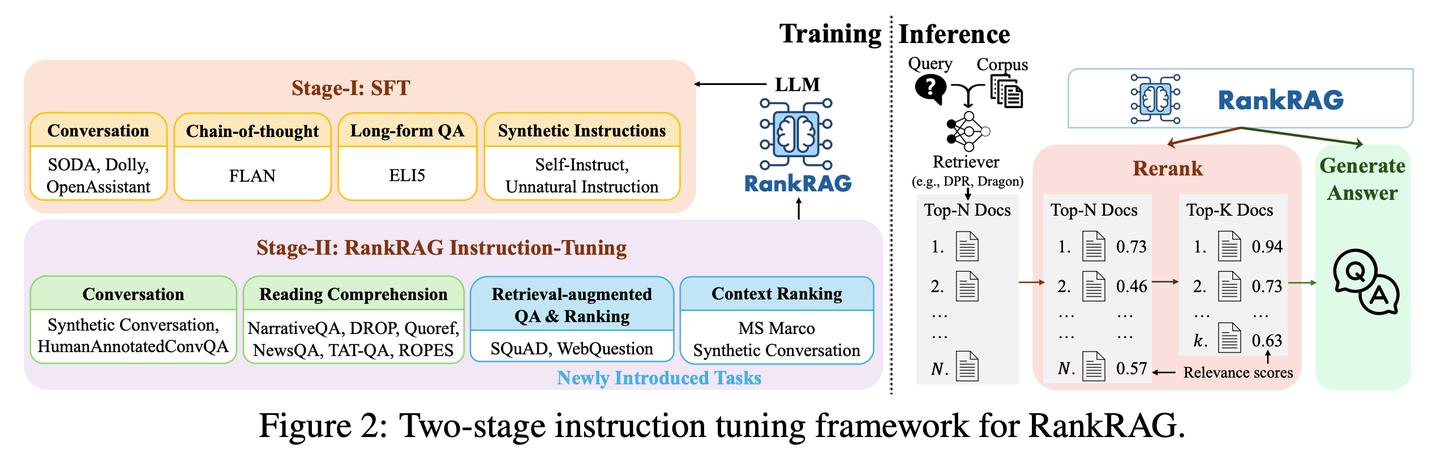
- 核心创新:RankRAG通过指令微调单一的LLM,使其同时具备上下文排名和答案生成的双重功能。这种设计不仅简化了传统RAG系统中多模型的复杂性,还通过共享模型参数增强了上下文的相关性判断和信息的利用效率.
- 训练阶段:
- 监着学习微调(SFT):基于多种高质量指令遵循数据集进行微调,提高模型对指令的遵循能力.
- 统一指令微调:同时增强排名和生成能力,通过特定的任务设计(如问答对的相关性判断)训练模型识别和排列相关上下文.
- 推理阶段:
- 检索:使用检索器从文档集中检索出顶部N个上下文.
- 重排:RankRAG模型重新排序这些上下文,只保留得分最高的k个上下文.
- 生成:这些上下文被用作生成答案的输入.
三、实验设计与结果
- 实验设计与数据集
- 任务类型:开放域问答(OpenQA)、事实验证和对话式问答(ConvQA).
- 数据集:包括NQ、TriviaQA、HotpotQA、FEVER等,以及对话式问答数据集如Doc2Dial和TopiOCQA.
- 基线模型:包括不使用RAG的LLM(如InstructGPT和PaLM 2)以及使用检索增强的模型(如Atlas和Raven).
- 评估指标:准确率(Accuracy)、精确匹配(Exact Match)和F1分数.
- 主要实验结果与分析
- 性能提升:RankRAG在多个知识密集型基准测试中表现出色,特别是在TriviaQA和HotpotQA数据集上,其性能显著优于Llama3-ChatQA-1.5和其他基线模型.
- 跨领域适应能力:在未经领域特定训练的情况下,RankRAG在生物医学领域的表现接近专门为该领域训练的模型,展示了其良好的泛化能力和跨领域适应性.
- 数据效率:RankRAG在训练中引入少量的排名数据即可实现显著的性能提升,数据效率高,降低了训练成本.
四、论文创新点
- 统一的指令微调框架:简化了训练流程,提高了模型的通用性,无需依赖独立的排名模型,减少了模型复杂性和运行时开销.
- 高性能:在多个知识密集型任务和领域中,RankRAG均展现出优于现有RAG模型的性能,特别是在需要处理大量不相关信息的开放领域问答任务中,通过有效的上下文排名显著提高了答案的准确性和相关性.
- 跨领域适应能力:在未经领域特定训练的情况下,RankRAG在生物医学领域的表现接近专门为该领域训练的模型,证明了其极佳的泛化能力和跨领域适应性,为未来在更多专业领域的应用提供了可能.
五、论文总结
RankRAG的通过指令微调单一的LLM,使其同时具备上下文排名和答案生成的双重功能。通过在训练数据中加入少量排序数据,经过指令微调的大语言模型效果出奇地好,甚至超过了现有的专家排序模型,包括在大量排序数据上专门微调的相同大语言模型。这种设计不仅简化了传统RAG系统中多模型的复杂性,还通过共享模型参数增强了上下文的相关性判断和信息的利用效率。
GraphRAG-Local-UI【改装师】
改装师:把跑车改装成适合本地道路的实用车,加装了友好的仪表盘,让人人都能轻松驾驶。
- 发表时间:2024.07.14
- Github 项目:https://github.com/severian42/GraphRAG-Local-UI
一、论文动机
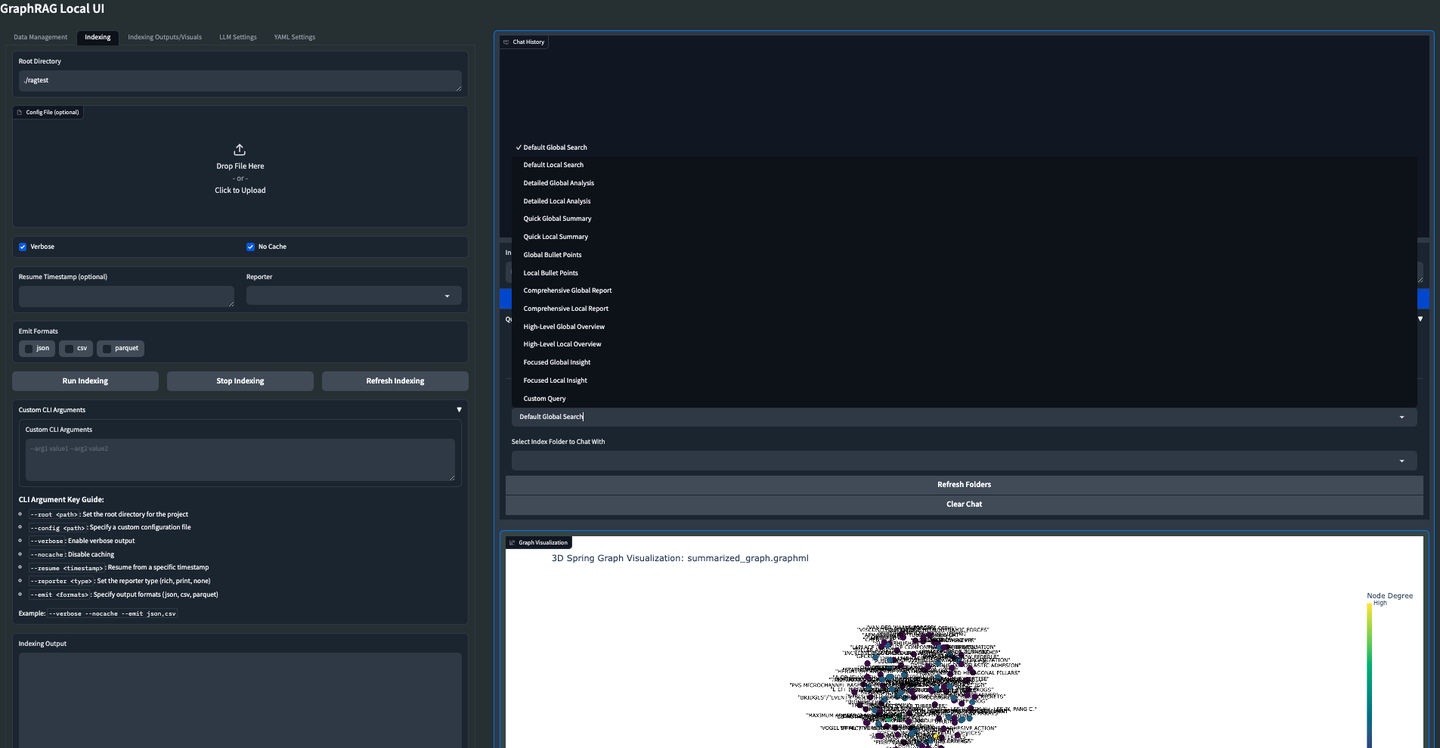
GraphRAG-Local-UI的工具,它是基于Microsoft的GraphRAG的本地化实现,提供了一个丰富的交互式用户界面生态系统。
二、论文思路
-
功能亮点:
- 核心架构:采用FastAPI构建的高效服务器(
api.py),作为整个GraphRAG操作的大脑。 - 索引与提示界面:一个专为索引管理和提示调整设计的界面(
index_app.py),基于Gradio,操作简便。 - 本地模型集成:支持本地大型语言模型(LM)和嵌入技术,与Ollama及OpenAI的API完美兼容。
- 成本优化:通过部署本地模型,摆脱对昂贵云服务模型的依赖,实现成本控制。
- 用户交互体验:设计友好的界面,简化数据管理、查询执行和结果可视化流程(主应用程序)。
- 动态数据可视化:利用Plotly技术,在二维或三维空间中动态展示您的知识图谱(主应用程序)。
- 文件操作:直接通过界面进行文件的上传、浏览、编辑和删除。
- 设置定制:通过用户界面轻松调整和管理GraphRAG配置。
- 输出导航:方便地浏览和检查索引结果和相关工件。
- 日志跟踪:实时记录日志,优化调试和监控过程。
- 查询灵活性:支持全局、局部和直接聊天查询,且可自定义参数(主应用程序)。
- 可视化定制:根据个人喜好调整图表布局、节点大小和颜色(主应用程序)。
- 核心架构:采用FastAPI构建的高效服务器(
-
功能详解
-
核心架构:
- FastAPI服务器:作为整个GraphRAG操作的大脑,提供高效的API接口。
-
索引与提示界面:
- Gradio界面:专为索引管理和提示调整设计,操作简便,用户可以轻松管理索引和调整提示。
-
本地模型集成:
- 兼容性:支持本地大型语言模型(LM)和嵌入技术,与Ollama及OpenAI的API完美兼容,减少对云服务的依赖。
-
成本优化:
- 本地部署:通过部署本地模型,实现成本控制,减少对昂贵云服务的依赖。
-
用户交互体验:
- 友好界面:设计友好的界面,简化数据管理、查询执行和结果可视化流程。
-
动态数据可视化:
- Plotly技术:利用Plotly技术,在二维或三维空间中动态展示知识图谱。
-
文件操作:
- 文件管理:直接通过界面进行文件的上传、浏览、编辑和删除。
-
设置定制:
- 配置管理:通过用户界面轻松调整和管理GraphRAG配置。
-
输出导航:
- 结果检查:方便地浏览和检查索引结果和相关工件。
-
日志跟踪:
- 实时记录:实时记录日志,优化调试和监控过程。
-
查询灵活性:
- 多种查询:支持全局、局部和直接聊天查询,且可自定义参数。
-
可视化定制:
- 个性化调整:根据个人喜好调整图表布局、节点大小和颜色。
三、论文总结
GraphRAG-Local-UI通过其丰富的交互式用户界面和本地模型集成,提供了一个高效、成本优化且用户友好的GraphRAG实现。开发团队正在不断改进和扩展其功能,使其成为一个更强大的工具,适用于各种知识密集型任务和应用场景.
ThinkRAG【小秘书】
小秘书:把庞大的知识体系浓缩成口袋版,像个随身携带的小秘书,不用大型设备就能随时帮你查找解答。
- 发表时间:2024.07.15
- Github 项目:https://github.com/wzdavid/ThinkRAG
一、论文动机
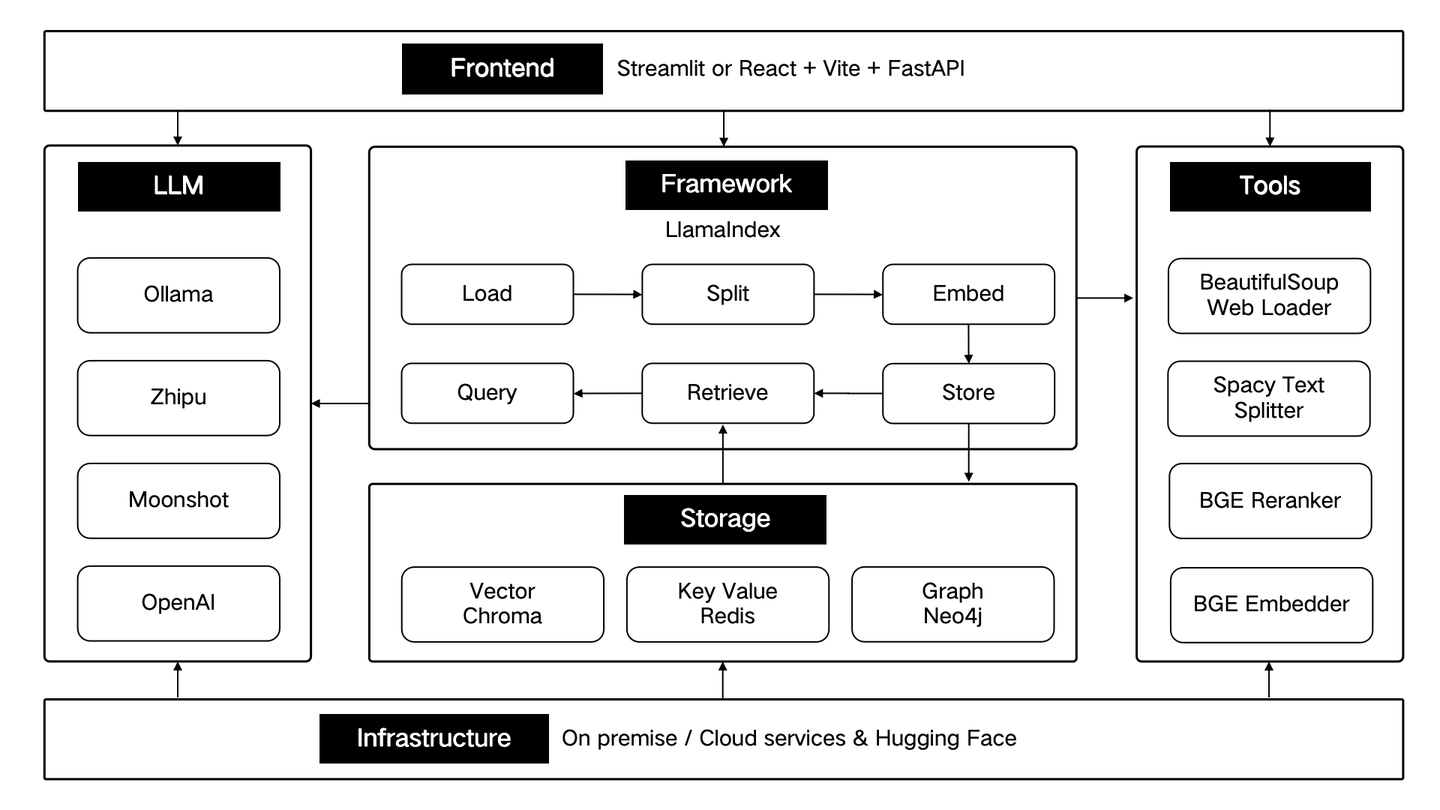
ThinkRAG,一个开源的、可以在笔记本电脑上运行的本地知识库大模型检索增强生成系统。
二、模型支持
- LlamaIndex框架:ThinkRAG基于LlamaIndex数据框架构建,支持所有LlamaIndex支持的模型。
- 模型选择:
- OpenAI API:支持OpenAI API以及所有兼容的LLM API,包括国内主流大模型厂商如智谱、月之暗面、深度求索等。
- Ollama:支持本地化部署的大模型,如Llama、Gemma、GLM、Mistral、Phi、Llava等。
- 嵌入模型和重排模型:支持来自Hugging Face的大多数模型,主要选用BAAI的BGE系列模型。
三、系统特点
- 完整应用:LlamaIndex框架的完整应用。
- 本地文件存储:开发模式支持本地文件存储,无需安装任何数据库。
- 无需GPU:无需GPU支持,即可在笔记本电脑上运行。
- 本地部署:支持本地部署的模型和离线使用。
- 定制优化:为国内用户做了大量定制和优化,包括使用Spacy文本分割器处理中文字符、中文标题增强功能、中文提示词模板等。
四、快速开始
-
下载与安装:
- 从Github下载代码后,用pip安装所需组件:
pip3 install -r requirements.txt - 若要离线运行系统,需从官网下载Ollama,并使用Ollama命令下载大模型。同时,从Hugging Face下载嵌入模型和重排模型到
localmodels目录中。
- 从Github下载代码后,用pip安装所需组件:
-
系统配置:
- 获取LLM服务商的API密钥,配置环境变量:
ZHIPU_API_KEY = "" MOONSHOT_API_KEY = "" DEEPSEEK_API_KEY = "" OPENAI_API_KEY = "" - 在
config.py配置文件中删除不再使用的服务商,或添加兼容OpenAI API的其他服务商。 - 默认以开发模式运行,使用本地文件存储。若要切换到生产模式,配置环境变量
THINKRAG_ENV = production,并使用向量数据库Chroma和键值数据库Redis。
- 获取LLM服务商的API密钥,配置环境变量:
-
运行系统:
- 在包含
app.py文件的目录中运行以下命令:streamlit run app.py - 系统将在浏览器上自动打开
http://localhost:8501/,展示应用界面。
- 在包含
五、使用指南
-
系统配置:
- 在用户界面配置大模型,包括Base URL和API密钥,选择具体模型。
- 系统自动检测API和密钥是否可用,并显示当前选择的大模型实例。
- 可以在用户界面上选择Ollama下载的模型。
- 可以切换选择使用的嵌入模型和重排模型,并设置重排模型的参数。
-
管理知识库:
- 支持上传PDF、DOCX、PPTX等文件,也支持上传网页URL。
- 点击“Browse files”按钮选择文件,点击“Load”按钮加载,系统会对文件进行处理并保存到知识库中。
- 可以输入或粘贴网页URL,获取网页信息并保存到知识库中。
- 支持对知识库进行管理,分页列出所有文档,选择要删除的文档并删除。
-
智能问答:
- 在左侧导航栏点击“Query”,进入智能问答页面。
- 输入问题后,系统会对知识库进行检索并给出回答,采用混合检索和重排技术获取准确内容。
- 例如,上传一个Word文档“大卫说流程.docx”,输入问题“流程有哪三个特征?”系统用时2.49秒,给出准确回答“流程具备目标性、重复性与过程性”,并列出2个相关文档。
六、技术架构
-
开发模式:
- RAG框架:LlamaIndex
- 前端框架:Streamlit
- 嵌入模型:BAAI/bge-small-zh-v1.5
- 重排模型:BAAI/bge-reranker-base
- 文本分割器:SentenceSplitter
- 对话存储:SimpleChatStore
- 文档存储:SimpleDocumentStore
- 索引存储:SimpleIndexStore
- 向量存储:SimpleVectorStore
-
生产模式:
- RAG框架:LlamaIndex
- 前端框架:Streamlit
- 嵌入模型:BAAI/bge-large-zh-v1.5
- 重排模型:BAAI/bge-reranker-large
- 文本分割器:SpacyTextSplitter
- 对话存储:Redis
- 文档存储:Redis
- 索引存储:Redis
- 向量存储:Chroma
七、总结
ThinkRAG大模型检索增强生成系统,可以轻松部署在笔记本电脑上,实现本地知识库智能问答。
Nano-GraphRAG【轻装上阵】
轻装上阵:像个轻装上阵的运动员,把繁复的装备都简化了,但保留了核心能力。
- 发表时间:2024.07.25
- Github 项目:https://github.com/gusye1234/nano-graphrag
一、论文动机
- 背景:微软提出的GraphRAG非常有效,但官方实现复杂,不易修改和定制。nano-graphrag是一个更简洁、易用且高度可定制的版本,保留了核心功能,同时提供了更友好的用户体验。
二、论文思路
- 特点:
- 简洁性:代码量仅为1100行(不包括测试和提示),是官方实现的紧凑高效替代品。
- 易用性:设计为轻量级、异步和完全类型化,适合希望将GraphRAG集成到项目中而不增加复杂性的开发者。
- 可定制性:提供了丰富的自定义选项,可以替换默认组件,如LLM函数、嵌入函数和存储组件。
三、安装与使用
-
安装:
- 从PyPi安装:
pip install nano-graphrag - 从源代码安装以获取最新功能:
git clone https://github.com/yourusername/nano-graphrag.git
cd nano-graphrag
pip install -r requirements.txt
pip install .
- 从PyPi安装:
-
使用示例:
- 全局搜索:
from nano_graphrag import GraphRAG, QueryParam graph_func = GraphRAG(working_dir="./dickens") with open("./book.txt") as f: graph_func.insert(f.read()) # Perform global graphrag search print(graph_func.query("What are the top themes in this story?")) - 局部搜索:
# Perform local graphrag search (I think is better and more scalable one) print(graph_func.query("What are the top themes in this story?", param=QueryParam(mode="local"))) - 批量插入:
graph_func.insert(["TEXT1", "TEXT2", ...]) - 增量插入:
with open("./book.txt") as f:
    book = f.read()
    half_len = len(book) // 2
    graph_func.insert(book[:half_len])
    graph_func.insert(book[half_len:])
- 全局搜索:
四、高级功能
- 自定义选项:
- 替换LLM函数:可以自定义LLM函数,以使用不同的语言模型。
- 替换嵌入函数:可以自定义嵌入函数,以使用不同的嵌入技术。
- 替换存储组件:可以自定义存储组件,以使用不同的存储系统。
五、结论
nano-graphrag通过其简洁性、易用性和可定制性,提供了一个高效、灵活的GraphRAG实现,适用于各种知识密集型任务和应用场景。开发团队将继续优化和扩展其功能,使其成为一个更强大的工具。
2024.08
RAGFlow-GraphRAG【导航员】
导航员:在问答的迷宫里开辟捷径,先画张地图把知识点都标好,重复的路标合并掉,还特地给地图瘦身,让问路的人不会绕远路。
- 发表时间:2024.08.02
- Github 项目:https://github.com/infiniflow/ragflow
一、论文动机
- 背景:GraphRAG由微软开源,被视为下一代RAG,其在RAGFlow体系中是RAG 2.0的一个单元。RAG 2.0是一个以搜索为中心的端到端优化系统,分为数据抽取、预处理、索引与检索四个阶段,其中数据抽取和预处理是重点。
- GraphRAG的重要性:知识图谱对改进RAG效果至关重要,它能解决简单RAG只能找到与提问相似结果而未必是答案的问题,尤其在总结性问题等场景下,通过知识图谱聚合内容生成总结,可更好回答问题。此外,知识图谱还能为RAG返回结果添加更多上下文,使LLM产生更有解释性的回答。
二、GraphRAG与HippoRAG的对比
- 离线处理阶段:两者都先将用户文档送给LLM进行命名实体自动抽取。GraphRAG只抽取实体,用“相关”作为实体间联系,后续用社区检测算法和Graph Embedding(可选,采用Node2Vec)补全关系;HippoRAG则抽取整个三元组,之后利用现成知识图谱补全。
- 在线处理阶段:GraphRAG将用户查询转成向量,找知识图谱中最接近节点,再根据节点所在社区及摘要信息返回给LLM,同时查询原文并归并结果;HippoRAG在查询阶段利用类似PageRank的随机游走算法在知识图谱上做子图遍历,确定LLM的上下文。两者都用到PageRank做子图遍历,原因是人类回忆过程和PageRank算法输出有相关性。
三、GraphRAG的简化与优势
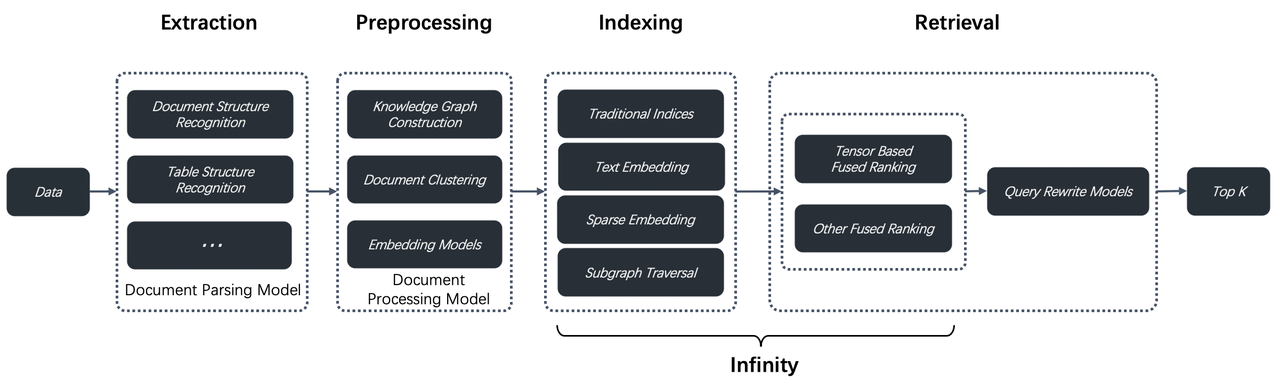
- 简化:GraphRAG对知识图谱的抽象和构建做了简化,不要三元组和图抽象表达,使工程上推出标准产品可行性增加。
- 优势:RAGFlow借鉴GraphRAG实现,在文档预处理阶段引入知识图谱构建作为可选项,服务于高级问答场景。
四、RAGFlow对GraphRAG的改进
- 引入去重步骤:原版GraphRAG直接用抽取的命名实体构建知识图谱,易因同义词实体影响结构。RAGFlow借鉴LLM能力去重,因LLM可视为超级大的知识图谱。
- 降低Token消耗:GraphRAG工作原理需消耗大量Token,RAGFlow通过流程优化确保文档只提交LLM一次,避免无效消耗。未来还会提供类似Triplex的小模型解决方案降低成本。
五、论文总结
RAGFlow借鉴了GraphRAG的实现,在文档预处理阶段,引入知识图谱构建作为可选项,服务于QFS问答场景,并引入了实体去重、Token优化等改进。
Medical-Graph-RAG【数字医生】
数字医生:像个经验丰富的医学顾问,用图谱把复杂的医疗知识整理得清清楚楚,诊断建议不是凭空想象,而是有理有据,让医生和患者都能看明白每个诊断背后的依据。
- 发表时间:2024.08.08
- 论文名称:Medical Graph RAG: Towards Safe Medical Large Language Model via Graph Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2408.04187
- Github 地址:https://github.com/SuperMedIntel/Medical-Graph-RAG
一、论文动机
- 研究问题:如何在医学领域中使用基于图的RAG框架来提高LLM生成基于证据的医疗响应的能力,特别是在处理私有医疗数据时的安全性和可靠性。
- 研究难点:医学领域依赖庞大的知识库,这些知识难以适应LLM的有限上下文窗口;医学领域对术语系统的精确性和事实的确定性要求极高;验证医学响应的准确性对于非专家用户来说特别具有挑战性。
二、论文思路
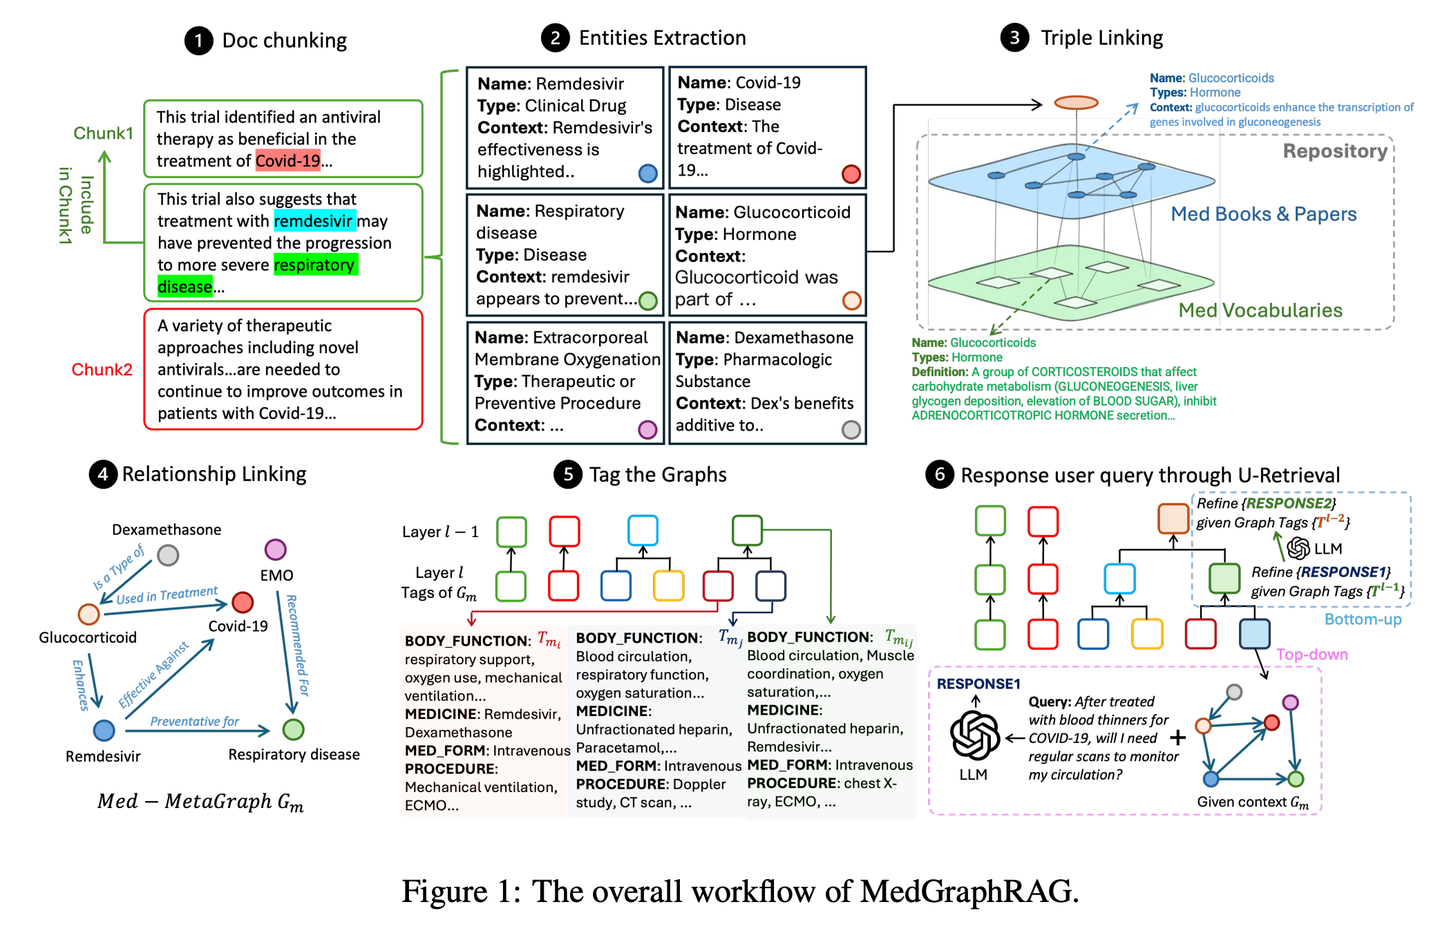
- 三元组图谱构建:提出了一种独特的三元组图构建方法,将用户RAG数据与可信的医疗来源和受控词汇表连接起来,生成三元组[RAG数据, 来源, 定义]以构建用户文档的综合图。
- 语义文档分块:将大医学文档分割成符合LLM上下文限制的数据块,采用字符分离和主题语义分区的混合方法。
- 实体提取:从每个块中提取实体,生成包含名称、类型和上下文的结构化输出。
- 三元组链接:构建仓库图(RepoGraph),将用户RAG文档与可信来源和专业定义连接起来。
- 关系链接:识别RAG实体之间的关系,生成简洁的关系短语,指定源和目标实体及其关系描述。
- U-Retrieval策略:提出了一种独特的U-Retrieval策略,结合自上而下的精确检索和自下而上的响应细化,平衡全局上下文意识和检索效率。
- 图标签化:使用预定义的医学标签总结每个Meta-MedGraph,并迭代生成更抽象的标签摘要。
- U-Retrieval:首先生成用户查询的标签摘要,并使用自上而下的方法检索最相关的图,然后自下而上地逐步整合更高层次的标签,直到生成最终答案。
三、实验设计与结果
- 实验设计
- 数据集:使用了多个数据集,包括MIMIC-IV电子健康记录数据集、MedC-K生物医学学术论文和教科书数据集、FakeHealth和PubHealth公共卫生事实验证数据集,以及一个收集的多层次健康问答数据集DiverseHealth。
- 实验设置:比较了不同RAG方法在6种语言模型上的表现,包括Llama2、Llama3、Gemini-pro和GPT-4。使用Llama3-70B构建图,文本嵌入使用OpenAI的text-embedding-3-large模型。模型比较使用5次响应集成进行评估。
- 结果与分析
- 多选题评估:MedGraphRAG在健康和医学问答基准测试中显著提高了LLM的性能。与没有检索的基线相比,MedGraphRAG在事实检查和医学问答基准测试中分别平均提高了近10%和8%。与使用GraphRAG的基线相比,分别提高了约8%和5%。特别是在较小的LLMs(如Llama2-13B和Llama2-70B)中,MedGraphRAG表现出更显著的改进。
- 长形式生成评估:人类评估显示,MedGraphRAG在所有指标上均获得了更高的评分。特别是在引用精度(CP)、引用召回率(CR)和可理解性(Und.)方面,MedGraphRAG表现出显著优势,表明其响应更有可能得到准确来源的支持,并且更容易被理解和接受。
- 消融研究:通过消融研究验证了所提出模块的有效性。逐步添加Med-MetaGraph、三元组图构建和U-Retrieval模块后,性能逐渐提高。特别是将GraphRAG的图构建替换为三元组图构建后,性能显著提高。
四、论文创新点
- 首次提出:首次提出了专门应用于医学领域的基于图检索增强生成(RAG)框架,命名为MedGraphRAG。
- 独特的三元组图构建和U检索技术:开发了独特的三元组图构建和U检索方法,使LLMs能够高效生成基于证据的响应。
- 超越现有方法:在广泛的医学问答基准测试中,MedGraphRAG的表现优于现有的标准RAG和GraphRAG模型,并在多个医学语料库上设立了新的最先进(SOTA)水平。
- 人类评估验证:通过人类评估验证,MedGraphRAG能够提供更可理解和基于证据的响应,特别是在复杂医学推理方面。
- 全面的比较:在多个基准测试中,MedGraphRAG显著提高了LLMs的性能,特别是在健康事实检查和医学问答任务中。
五、论文总结
- 性能提升:MedGraphRAG通过其基于图的RAG框架,使用三元组图谱构建和U-Retrieval方法,增强了基于证据、上下文感知的响应。其在基准测试和人类评估中的强大表现表明了其确保复杂医学推理准确性的能力。
- 未来工作:未来的工作将集中在实时数据更新和在实际临床数据上的验证,以确保MedGraphRAG能够利用最新的医学数据和研究成果,并在真实世界应用场景中发挥更大的作用。
六、不足与反思
- 实时数据更新:未来的工作将集中在实时数据更新和在实际临床数据上的验证,以确保MedGraphRAG能够利用最新的医学数据和研究成果,并在真实世界应用场景中发挥更大的作用。
七、关键问题及回答
- 问题1:MedGraphRAG在图谱构建方面有哪些独特的设计,这些设计如何提高其在医学领域的应用效果?
- 三元组图构建:通过生成三元组[RAG数据, 来源, 定义]来构建用户文档的综合图谱,确保生成的响应能够追溯到其来源和定义,提高了响应的可信度和可解释性。
- U-Retrieval:结合自上而下的精确检索和自下而上的响应细化,平衡全局上下文意识和检索效率,使得LLM能够在保持高效的同时,获取全面的上下文信息,从而生成更准确和可靠的响应。
- 问题2:MedGraphRAG在实验中表现如何,与其他方法相比有哪些优势?
- 多选题评估:在健康和医学问答基准测试中,MedGraphRAG显著提高了LLM的性能,特别是在较小的LLMs中表现出更显著的改进。
- 长形式生成评估:人类评估显示,MedGraphRAG在所有指标上均获得了更高的评分,特别是在引用精度、引用召回率和可理解性方面表现出显著优势。
- 消融研究:通过消融研究验证了所提出模块的有效性,逐步添加模块后性能逐渐提高。
- 问题3:MedGraphRAG的未来工作方向是什么?
- 实时数据更新:未来的工作将集中在实时数据更新上,以确保MedGraphRAG能够利用最新的医学数据和研究成果。
- 实际临床数据验证:研究将在实际临床数据上进行验证,以进一步评估MedGraphRAG在真实世界应用场景中的性能和可靠性。
通过这些改进,MedGraphRAG有望在医学领域发挥更大的作用,提供更高质量和更可靠的医疗响应,从而改善患者的诊疗体验。
HybridRAG【中医合方】
中医合方:就像中医讲究的"合方",单味药不如几味药合在一起效果好。向量数据库负责快速检索,知识图谱补充关系逻辑,两者优势互补。
- 发表时间:2024.08.09
- 论文名称:HybridRAG: Integrating Knowledge Graphs and Vector Retrieval Augmented Generation for Efficient Information Extraction
- 论文地址:https://arxiv.org/abs/2408.04948
- Github 地址:https://github.com/tahmidmir/HyrbridRAG
一、论文动机
- 背景:在金融领域,从非结构化文本数据(如财报电话会议记录)中提取和解释复杂信息对大型语言模型(LLMs)来说是一个挑战,尤其是当这些文档包含特定领域的术语和复杂格式时。
- 目的:HybridRAG结合了GraphRAG和VectorRAG的优势,从向量数据库和知识图谱中检索上下文信息,以提供给LLMs,从而生成更准确的回答。
二、论文思路
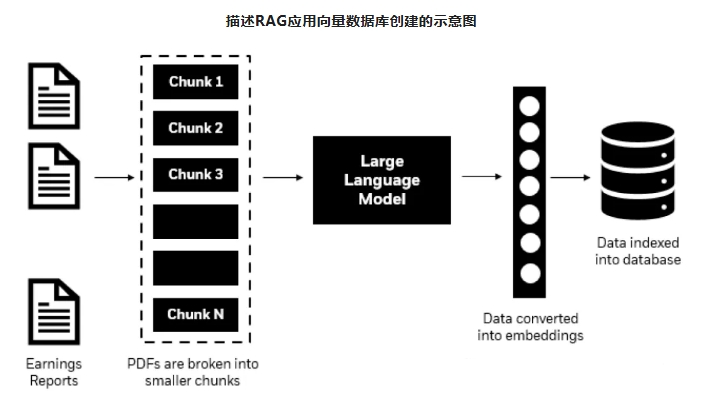
- VectorRAG 工作流程:
- 从与外部文档相关的查询开始,这些文档不是LLM训练数据集的一部分。
- 查询用于搜索外部存储库(如向量数据库或索引语料库),以检索包含有用信息的相关文档或段落。
- 检索到的文档随后作为额外上下文反馈到LLM中,从而生成基于查询的响应。
- 这确保了生成内容不仅基于内部训练数据,还结合了检索到的外部信息。
- GraphRAG 工作流程:
- 利用知识图谱来增强NLP任务的性能,通过将知识图谱与RAG技术整合,GraphRAG能够基于从金融文档中提取的结构化信息生成更准确和上下文感知的回答。
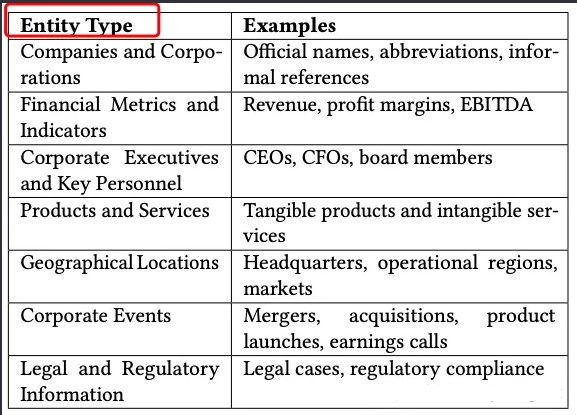
- 知识图谱构建:
- 知识提取:从非结构化或半结构化数据中提取结构化信息,包括实体识别、关系提取和共指消解。
- 知识改进:通过移除冗余和填补信息空白来提高知识图谱的质量和完整性。
- 知识融合:结合来自多个源的信息,创建一个一致和统一的知识图谱。
- GraphRAG:从用户输入的查询开始,查询用于搜索知识图谱以检索与查询相关的节点(实体)和边(关系)。然后从完整的知识图谱中提取包含这些相关节点和边的子图,以提供上下文。
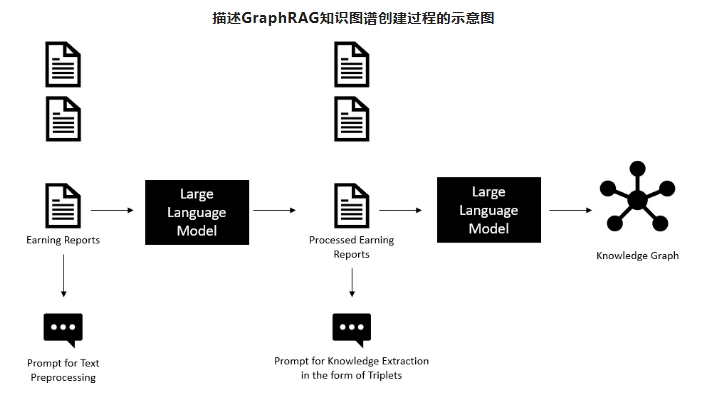
- HybridRAG 结合优势:HybridRAG结合了VectorRAG和GraphRAG的优势,从向量数据库和知识图谱中检索上下文信息,以提供给LLMs,从而生成更准确的回答。
三、实验设计与结果
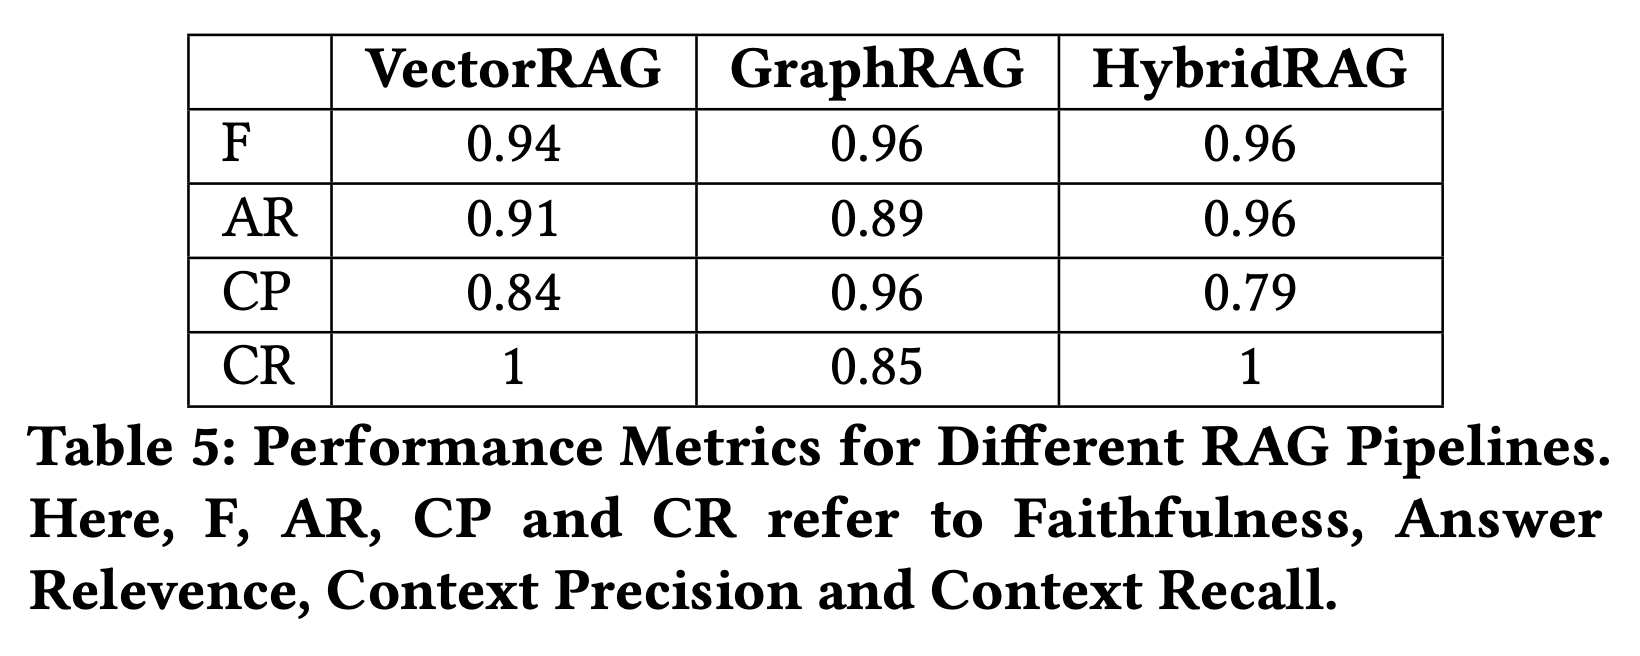
- 实验结果:
- 忠实度:GraphRAG和HybridRAG显示出更优越的性能,两者都达到了0.96的得分,而VectorRAG略低一些,得分为0.94。
- 答案相关性得分:HybridRAG以0.96的得分领先,其次是VectorRAG的0.91,GraphRAG的0.89。
- 上下文精确度:GraphRAG以0.96的得分最高,显著超过了VectorRAG的0.84和HybridRAG的0.79。然而,在上下文召回率方面,VectorRAG和HybridRAG都达到了完美的1分,而GraphRAG落后于0.85。
四、论文总结
一种基于知识图谱RAG技术(GraphRAG)和VectorRAG技术相结合的新方法,称为HybridRAG,以增强从金融文档中提取信息的问答系统,该方法被证明能够生成准确且与上下文相关的答案。在检索和生成阶段,就检索准确性和答案生成而言,从向量数据库和知识图谱中检索上下文的HybridRAG优于传统的VectorRAG和GraphRAG。
W-RAG【进化搜索】
进化搜索:像个善于自我进化的搜索引擎,通过大模型对文章段落的评分来学习什么是好答案,逐步提升自己找到关键信息的能力。
- 发表时间:2024.08.15
- 论文名称:W-RAG: Weakly Supervised Dense Retrieval in RAG for Open-domain Question Answering
- 论文地址:https://arxiv.org/abs/2408.08444
- Github 地址:https://github.com/jmnian/weak_label_for_rag
一、论文动机
- 问题:密集检索微调需要大量标注数据,耗费人力。
- 解决方案:利用LLM的重排能力生成弱标记数据,用于训练检索的向量模型。
二、论文思路
W-RAG方法,通过利用LLMs的排名能力为密集检索器创建弱标记数据,从而解决了稀缺的地面真实证据问题。
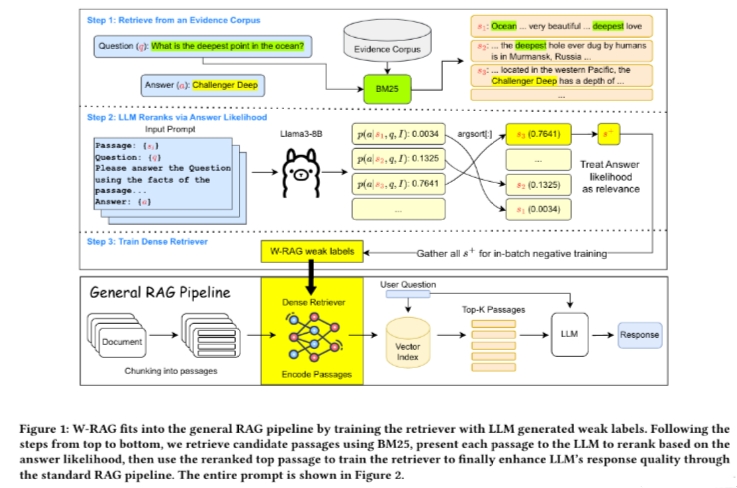
W-RAG过程分为三个阶段:
- Step 1: 通过BM25从证据语料库中检索相关段落
使用BM25算法从语料库中检索与问题相关的段落。
- Step 2: 使用LLM生成弱标签
- 将查询(query)、段落(passage)、指令(instruction)和答案(answer)组装成提示(prompt)。
- 通过大模型对提示生成答案。
- 计算每个段落生成ground_truth_answer的概率,作为弱标签。
- 使用log-likelihood来衡量每个候选段落的相关度分数。
- Step 3: 通过弱标签训练密集检索器
- 使用获取到的查询、段落和相关度分数来训练密集检索器。
- 选择两个密集检索器:DPR和ColBERT。
-
训练密集检索器
-
DPR:使用双编码器架构,通过两个独立的BERT编码器将问题和段落映射到嵌入空间。
- 训练方式:in-batch negative training,使用top 1的段落作为正样本,top 2-n的作为负样本。
- 损失函数:[ \text{loss} = -\log \frac{\exp(\alpha \cdot \text{sim}(q, s_1))}{\sum_{i=1}^n \exp(\alpha \cdot \text{sim}(q, s_i))} ]
-
ColBERT:使用双编码器架构,通过共享的BERT模型独立编码问题和段落。
- 训练数据构造:使用positive sample和hard negative sample。
- 损失函数:[ \text{loss} = -\log \frac{\max(\text{sim}(q, s_p))}{\max(\text{sim}(q, s_p)) + \max(\text{sim}(q, s_n))} ]
三、实验设计与结果
- 实验设计
- 数据集:MSMARCO、QnA v2.1、NQ、SQuAD、WebQ,每个数据集选取5000个QA对和500,000个段落。
- 模型:
- Generator: Llama3-8B-Instruct
- Retriever: DPR (bert-base-uncased、Yibin-Lei/ReContriever),ColBERT(bert-base-uncased)
- Baseline:
- RAG效果对比:Naive(直接用llama3作答)、GroundTruth(将ground-truth文档插入到prompt中作答)
- 检索效果对比:无监督模型(BM25、ColBERT,Contriever,ReContrever)、基于GroundTruth训练的模型(DPR、ColBERT)
- 评估指标:
- 检索:recall
- 生成:F1、Rouge-L、BLEU-1
- 实验结果
- 提升效果:相比于naive方法,W-RAG在检索和问答上都有显著提升,接近于ground-truth方法。
- BM25与LLM的排序能力:BM25在排序能力上与llama3-8B有显著差距。
四、论文创新点
- 弱监督数据生成方法
- 背景:传统的密集检索(Dense Retrieval)微调需要大量标注数据,这不仅耗费大量人力,而且成本高昂。
- 创新点:提出了一种利用大型语言模型(LLM)的重排能力来生成弱标记数据的方法。这种方法不需要人工标注,而是通过模型自动生成标注数据,大大降低了数据标注的成本和工作量。
-
- W-RAG框架
- 背景:现有的RAG系统在开放域问答中面临检索和生成的挑战,尤其是在处理复杂问题时,检索的准确性和生成的答案质量有待提高。
- 创新点:提出了W-RAG(Weakly Supervised Dense Retrieval in RAG for Open-domain Question Answering),这是一个数据构造方法,通过三个阶段(检索、生成弱标签、训练密集检索器)来提升检索和生成的性能。具体步骤如下:
- 通过BM25从证据语料库中检索相关段落:利用传统的BM25算法快速检索与问题相关的段落。
- 使用LLM生成弱标签:将查询、段落、指令和答案组装成提示(prompt),通过LLM生成每个段落生成ground_truth_answer的概率,作为弱标签。
- 通过弱标签训练密集检索器:使用获取到的查询、段落和相关度分数来训练密集检索器,提升检索的准确性和效率。
五、论文总结
开放域问答中的弱监督密集检索技术,利用大型语言模型的排序能力为训练密集检索器创建弱标注数据。通过评估大型语言模型基于问题和每个段落生成正确答案的概率,对通过 BM25 检索到的前 K 个段落进行重新排序。排名最高的段落随后被用作密集检索的正训练示例。
RAGChecker【质检员】
质检员:不只简单地判断答案对错,而是会深入检查整个回答过程中的每个环节,从资料查找到最终答案生成,就像一个严格的考官,既给出详细的评分报告,还会指出具体哪里需要改进。
- 发表时间:2024.08.15
- 论文名称:RAGChecker: A Fine-grained Framework for Diagnosing Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2408.08067
- Github 地址:https://github.com/amazon-science/RAGChecker
一、论文动机
- RAG技术的重要性:RAG技术通过将外部知识库和大型语言模型(LLM)内部知识无缝整合,大幅提升了AI系统的准确性和可靠性。
- 评估挑战:现有的评估方法难以全面反映RAG系统的复杂性和实际表现,通常只能提供最终打分报告,缺乏细粒度的诊断信息。
二、论文思路
- 目的:RAGChecker为RAG系统提供细粒度、全面、可靠的诊断报告,并为进一步提升性能提供可操作的方向。
- 主要特点:
- 细粒度评估:采用基于声明(claim)级别的蕴含关系检查,而非简单的回复级别评估,提供更详细的系统性能分析。
- 全面的指标体系:涵盖RAG系统各个方面性能的指标,包括忠实度、上下文利用率、噪声敏感度和幻觉等。
- 经过验证的有效性:评估结果与人类判断有很强的相关性,表现超过其他现有评估指标,保证了评估结果的可信度和实用性。
- 可操作的洞察:提供的诊断指标为改进RAG系统提供明确的方向指导,帮助研究人员和实践者开发更有效和可靠的AI应用。
三、实验设计与结果
- 整体指标:
- Precision(精确率):模型回答中正确陈述的比例。
- Recall(召回率):模型回答中包含的标准答案中陈述的比例。
- F1 score(F1分数):精确率和召回率的调和平均数,提供平衡的性能度量。
- 检索模块指标:
- Context Precision(上下文精确率):在所有检索块中,包含至少一个标准答案陈述的块的比例。
- Claim Recall(陈述召回率):被检索块覆盖的标准答案陈述的比例。
- 生成模块指标:
- Context Utilization(上下文利用率):评估生成模块如何有效利用从检索块中获取的相关信息来产生正确的陈述。
- Noise Sensitivity(噪音敏感度):衡量生成模块在回答中包含来自检索块的错误信息的倾向。
- Hallucination(幻觉):测量模型生成既不存在于检索块也不在标准答案中的信息的频率。
- Self-knowledge(模型内部知识):评估模型在未从检索块获得信息的情况下,正确回答问题的频率。
- Faithfulness(忠实度):衡量生成模块的响应与检索块提供的信息的一致程度。
四、使用RAGChecker
- 环境设置:安装RAGChecker及其依赖。
pip install ragchecker python -m spacy download en_core_web_sm - 准备数据:将RAG系统的输出准备成特定的JSON格式,包括查询、标准答案、模型回答和检索的上下文。
- 运行评估:
- 使用命令行:
ragchecker-cli \ --input_path=examples/checking_inputs.json \ --output_path=examples/checking_outputs.json - 使用Python代码:
from ragchecker import RAGResults, RAGChecker
from ragchecker.metrics import all_metrics

# 从JSON初始化RAGResults
with open("examples/checking_inputs.json") as fp:
    rag_results = RAGResults.from_json(fp.read())

# 设置评估器
evaluator = RAGChecker()

# 评估结果
evaluator.evaluate(rag_results, all_metrics)
print(rag_results)
- 使用命令行:
- 分析结果:RAGChecker输出json格式的文件,展示评估指标,帮助开发者了解RAG系统的各个方面表现。
五、论文总结
RAGChecker 的诊断工具为 RAG 系统提供细粒度、全面、可靠的诊断报告,并为进一步提升性能,提供可操作的方向。它不仅能评估系统的整体表现,还能深入分析检索和生成两大核心模块的性能。
Meta-Knowledge-RAG【学者】
学者:像个学术界的资深研究员,不仅收集资料,还会主动思考问题,为每份文档做批注和总结,甚至预先设想可能的问题。它会把相关的知识点串联起来,形成知识网络,让查询变得更有深度和广度,就像有一个学者在帮你做研究综述。
- 发表时间:2024.08.16
- 论文名称:Meta Knowledge for Retrieval Augmented Large Language Models
- 论文地址:https://arxiv.org/abs/2408.09017
- Github 地址:
一、论文动机
- RAG技术的重要性:RAG通过整合与上下文相关、时效性强或领域知识,生成用户想要的正确答案,已成为减少模型幻觉的有效解决方案。
- 实际应用中的问题:
- 知识库文档可能包含大量噪声。
- 缺乏人工标注的信息或相关性标签。
- 对长文档进行分块无法保留整个文档的语义上下文。
- 用户查询通常较短、模糊,可能存在词汇不匹配。
- 相关信息可能分布在多个文档中,跨知识库的高级推理仍未得到有效解决。
二、论文思路
- MK-RAG工作流程:引入了“准备(Prepare)-重写(rewrite)-检索(retrieve)-读取(read)”(PR3)的工作流程。
- 准备:每个文档都由LLM处理,生成针对用户特征定制的自定义元数据和问答对。
- 重写:通过查询增强解锁新的知识库推理能力。
- 检索:利用元数据和问答对进行检索。
- 读取:生成最终答案。
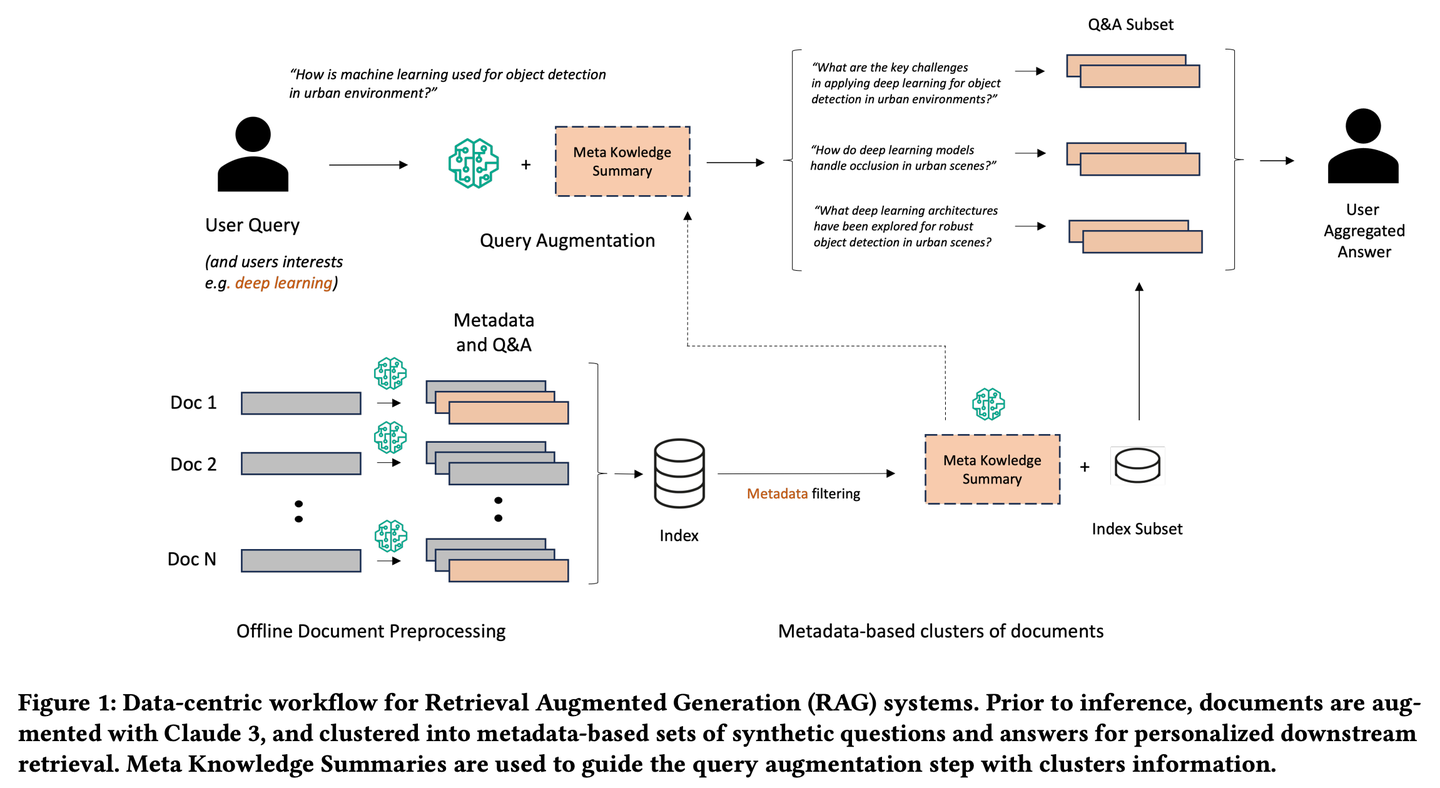
- 方法细节
- 元数据生成:使用Claude 3 Haiku的思维链(CoT)提示生成元数据。
- 合成问答生成:生成合成的问答对,用于检索。
- 元知识摘要生成:生成元知识摘要(MK摘要),用于用户查询的动态扩充。
- 查询和检索的增强生成:利用MK摘要对用户查询进行动态扩充,提升检索器的跨文档推理能力。
三、实验设计与结果
- 数据集:使用arXiv API整理的2024年的2000篇研究论文的数据集。
- 评估指标:
- 召回率(Recall)
- 精度(Precision)
- 特异性(Specificity)
- 广度(Breadth)
- 深度(Depth)
- 相关性(Relevancy)
- 测评结果:
- 新框架在所有指标上均有显著提升。
- 特别是在广度和深度上,MK摘要提供了额外信息,显著提升了性能。
- 新方法在处理2000篇研究论文时成本效益显著,仅需20美元。
四、论文总结
Meta-Knowledge-RAG(MK Summary)引入了一种新颖的以数据为中心的 RAG 工作流程,将传统的 “检索-读取” 系统转变为更先进的 “准备-重写-检索-读取” 框架,以实现对知识库的更高领域专家级理解。我们的方法依赖于为每个文档生成元数据和合成的问题与答案以及为基于元数据的文档集群引入元知识摘要的新概念。所提出的创新实现了个性化的用户查询增强和跨知识库的深度信息检索。
CommunityKG-RAG【社群探索】
社群探索:像个熟悉社区关系网络的向导,善于利用知识间的关联和群组特征,在不需要特别学习的情况下,就能准确地找到相关信息,并验证其可靠性。
- 发表时间:2024.08.16
- 论文名称:CommunityKG-RAG: Leveraging Community Structures in Knowledge Graphs for Advanced Retrieval-Augmented Generation in Fact-Checking
- 论文地址:https://arxiv.org/abs/2408.08535
- Github 地址:
一、论文动机
- 事实核查的重要性:在数字化信息时代,错误信息的迅速传播对公共讨论和全球决策产生了深远的影响,使得事实核查变得尤为重要。
- 现有技术的局限性:
- 大型语言模型(LLMs)在理解和生成人类语言方面展现出巨大潜力,但在事实核查中的应用受限于训练数据的时效性和生成错误信息的倾向。
- RAG系统通过结合LLMs的生成能力和外部数据检索来提高回答的准确性,但处理长文本和噪声信息仍面临挑战。
- 知识图谱(KGs)以其结构化和语义丰富的特性,为复杂信息的封装和组织提供了有效框架,但如何将KGs的结构化知识与LLMs处理的非结构化文本有效结合,以及如何优化这些信息的检索,仍是一个未被充分解决的问题。
二、论文思路
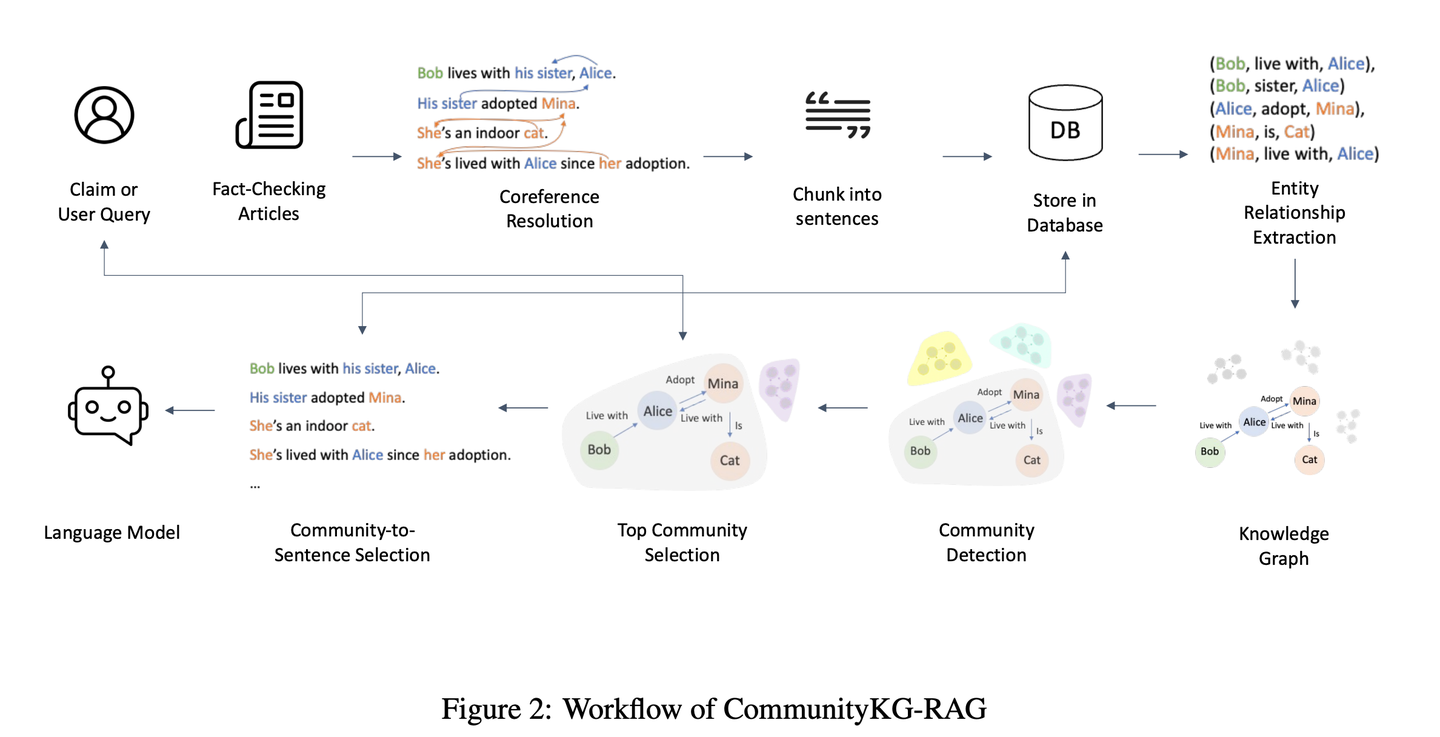
- 目标:通过结合知识图谱中的社区结构和RAG系统,提升事实核查的准确性和相关信息检索的相关性,无需额外的训练即可适应新领域和查询。
- 工作流程:
- 预处理:从事实核查文章中构建一个全面的知识图谱,运用共指消解和实体关系提取等技术。
- 社区检测:利用Louvain算法进行社区检测,识别出图中节点间相互连接更为紧密的社区。
- 节点嵌入:为知识图谱中的每个节点分配BERT模型的词嵌入,以捕捉实体的语义信息。
- 社区嵌入:计算社区的嵌入表示,通过Sentence-BERT模型实现,优化句子嵌入的质量。
- 社区检索:根据声明与社区的相关性分数,选择排名最高的社区。
- 句子选择:在这些顶级社区中,进一步筛选出与声明最相关的顶级句子,以供语言模型使用。
- 生成回答:利用精选的社区和句子增强语言模型的生成过程,提供更准确、更丰富的事实核查回答。
三、实验设计与结果
- 数据集:使用MOCHEG数据集,包含从PolitiFact和Snopes等事实核查网站收集的15,601条标注了真实性标签的声明。
- 基线模型:
- No Retrieval:在没有上下文或检索的情况下生成答案。
- Semantic Retrieval:使用语义相似性检索上下文,计算提示和上下文之间的余弦相似度。
- KAPING:一个零样本RAG框架,基于输入文本和三元组之间的句子相似性进行检索。
- 实验设置:
- 使用LLaMa2 7B模型作为主要的大语言模型(LLM)。
- 使用准确率作为衡量LLMs在验证声明时的性能指标。
- 对于所有RAG系统,使用特定的提示格式,并配置生成过程中的参数,如温度、重复惩罚和新令牌的限制。
- 实验结果:
- CommunityKG-RAG的准确率达到了56.24%,远超其他基线方法(No Retrieval 39.79%,Semantic Retrieval 43.84%,KAPING 39.41%)。
- 在不同基础语言模型上的性能表现:
- LLaMa2 7B模型在应用CommunityKG-RAG后准确率提高了6.18%。
- LLaMa3 8B模型在应用CommunityKG-RAG后准确率提高了3.21%。
- 社区到句子选择阈值对事实核查准确性的影响:
- 当句子选择阈值从25%增加到50%时,模型准确率略有下降。
- 当句子选择阈值进一步增加到75%和100%时,模型的准确率逐渐提升,100%的句子选择阈值实现了最高的准确率。
- 同时调整顶级社区选择和社区到句子选择阈值对事实核查准确性的综合影响:
- 当阈值增加到75%时,模型性能略有下降。
- 当阈值提升至100%时,模型的准确率显著提高。
四、论文总结
CommunityKG-RAG是一种新颖的零样本框架,它将知识图谱中的社区结构与RAG系统相结合,以增强事实核查过程。CommunityKG-RAG能够在无需额外训练的情况下适应新的领域和查询,它利用知识图谱中社区结构的多跳性质,显著提高信息检索的准确性和相关性。
TC-RAG【记忆术士】
记忆术士:给LLM装了个带自动清理功能的大脑。就像我们解题,会把重要步骤写在草稿纸上,做完就划掉。它不是死记硬背,该记的记住,该忘的及时清空,像个会收拾房间的学霸。
- 发表时间:2024.08.17
- 论文名称:TC-RAG: Turing-Complete RAG's Case study on Medical LLM Systems
- 论文地址:https://arxiv.org/abs/2408.09199
- Github 地址:https://github.com/Artessay/TC-RAG
一、论文动机
- RAG技术的重要性:RAG通过结合LLMs的生成能力和外部数据检索来提高回答的准确性,但在处理长文本和噪声信息时仍面临挑战。
- 现有RAG方法的局限性:现有RAG方法忽视了系统状态变量的引入,这些变量对于确保自适应控制、检索停止和系统收敛至关重要。此外,现有方法不是图灵完备的,缺乏动态管理和监控检索过程的能力。
二、论文思路
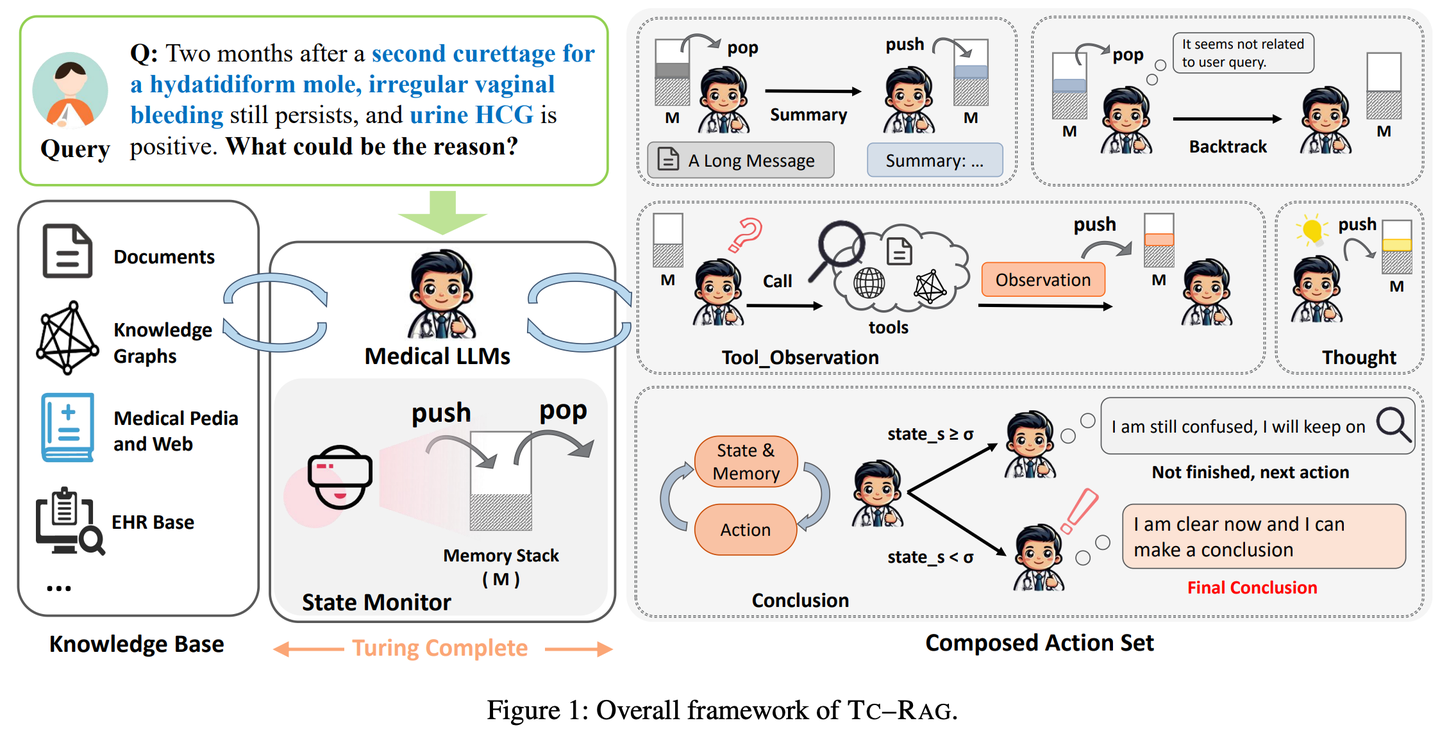
-
目标:提出一个图灵完备的RAG系统,通过引入系统状态变量和内存堆栈系统,实现更高效、准确的知识检索。
-
关键组件:
- 内存堆栈系统:监控中间状态,确保检索过程可靠地收敛到最佳结论。
- 状态变量:实时评估系统状态,决定是否继续、停止或改进检索过程。
- 自适应检索:根据模型的内部参数化知识决定是否检索以及检索什么,避免检索无关信息。
-
图灵完备的记忆栈定义:
- 记忆栈Tc:包括状态集合S、动作集合A、记忆栈M、状态转移函数delta、初始状态s0、终止状态F和阈值sigma。
- 复合操作:定义了5个由push和pop组合而成的有意义的行为,包括思考、工具调用、反思、总结和结论。
-
状态变量:
- 条件困惑度:计算大模型生成栈顶输出内容时的困惑度。
- 不确定性:计算输出栈顶信息的熵值。
- 终止条件:当状态变量小于阈值时,系统停止检索并输出最终答案。
三、实验设计与结果
- 实验设置:
- 医学LLM模型:使用海量数据持续预训练的医学LLM。
- 医学工具库:包括医学知识图谱、医学文档库、网页检索、百科检索和电子病历数据。
- 实验结果:
- 性能提升:TC-RAG在多个真实世界的医疗数据集上显著优于现有基准方法,准确率平均提升了7.20%。
- 噪声处理:TC-RAG在弹出检索噪声、保留有效信息方面表现出色。
- 消融实验:验证了反思与总结动作的有效性以及状态变量引入的必要性。
四、论文总结
通过引入图灵完备的系统来管理状态变量,从而实现更高效、准确的知识检索。通过利用具有自适应检索、推理和规划能力的记忆堆栈系统,TC-RAG不仅确保了检索过程的受控停止,还通过Push和Pop操作减轻了错误知识的积累。
RAGLAB【竞技场】
竞技场:让各种算法可以在相同的规则下进行公平竞争和比较,就像科学实验室里的标准化测试流程,确保每个新方法都能得到客观透明的评估。
- 发表时间:2024.08.21
- 论文名称:RAGLAB: A Modular and Research-Oriented Unified Framework for Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2408.11381
- Github 地址:https://github.com/fate-ubw/RAGLab
一、论文动机
- RAG技术的重要性:RAG通过结合大型语言模型(LLMs)的生成能力和外部数据检索来提高回答的准确性,但在研究和开发过程中面临两大主要问题:
- 许多已发表的成果要么不开源,要么难以搭建环境,导致研究人员不得不从零开始研发新算法。
- 新的RAG算法不断涌现,但这些算法在基本组件和评估方法上不统一,难以准确评估改进效果。
二、论文思路
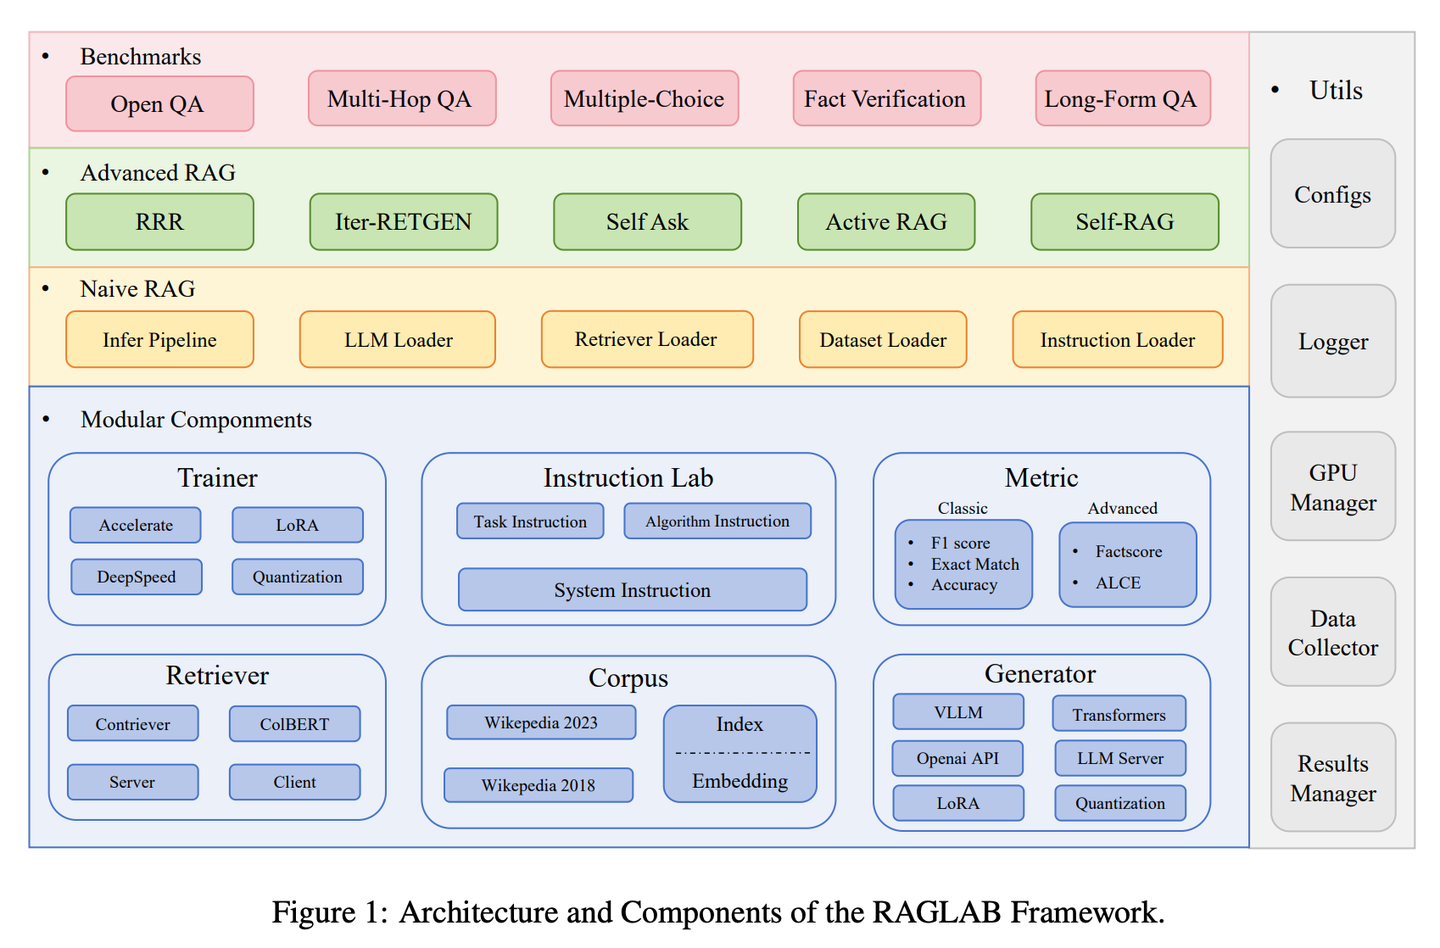
-
目标:提供一个面向研究人员的RAG工具包,用于对现有RAG算法进行公平比较,并简化新算法的开发流程。
-
整体架构:RAGLAB的整体架构包括多个关键组件,如检索器、语料库、生成器、指令实验室、训练器、数据集和指标。
-
检索器:
- 整合了两个高性能的基于BERT的模型:Contriever和ColBERT。
- 统一了不同检索器类的查询接口,方便用户在各种检索器之间无缝切换。
- 设计了检索器服务器和客户端架构,实现高并发访问。
- 实现了检索缓存机制,存储初始查询结果及其检索到的知识,提高查询效率。
-
语料库:
- 提供了两个版本的预处理维基百科语料库,基于DPR项目开源的2018年数据和FactScore开源的2023年数据。
- 为ColBERT和Contriever模型预先构建了索引和嵌入。
- 开源了所有处理脚本,方便研究人员直接下载预处理的维基百科语料库及其相应的索引和嵌入。
-
生成器:
- 集成了Huggingface Transformers和VLLM,兼容众多开源模型,提供稳定高效的推理性能。
- 融入了量化和LoRA功能,支持在计算资源有限的情况下使用大型模型。
- 开发了GPU管理模块,支持在指定GPU上精准分配多个生成器。
- 支持闭源大型语言模型,如OpenAI模型,未来将扩展到Claude、Gemini和Azure等。
-
指令实验室:
- 设计了指令实验室模块,包括系统指令、任务指令和算法指令。
- 允许用户从3个指令池中高效导入和组合所需的提示。
- 用户可以在配置设置中调整参数,便于使用不同指令进行对比实验。
-
训练器:
- 集成了Accelerate和DeepSpeed库,提供全面且高效的微调能力。
- 支持LoRA和QLoRA技术,使用户能够在计算资源有限的情况下微调大型模型。
三、实验设计与结果
- 数据集和指标:
- 收集了10个广泛使用的测试数据集,涵盖5个不同任务。
- 提供了3个经典指标(准确性、精确匹配、F1分数)和2个高级指标(FactScore和ALCE)。
四、论文总结
新型RAG算法之间越来越缺乏全面和公平的比较,开源工具的高级抽象导致缺乏透明度,并限制了开发新算法和评估指标的能力。RAGLAB是一个模块化、研究导向的开源库,重现6种算法并构建全面研究生态。借助RAGLAB,我们在10个基准上公平对比6种算法,助力研究人员高效评估和创新算法。
2024.09
MemoRAG【过目不忘】
过目不忘:它不只是按需查找资料,而是已经把整个知识库都深入理解并记在心里。当你问问题时,它能快速从这个"超级大脑"中调取相关记忆,给出既准确又富有见地的答案,就像一个博学多识的专家。
- 发表时间:2024.09.01
- 论文名称:MemoRAG: Moving Towards Next-Gen RAG Via Memory-Inspired Knowledge Discovery
- 论文地址:https://arxiv.org/abs/2408.05591
- Github 地址:https://github.com/qhjqhj00/MemoRAG
一、论文动机
- RAG模型的局限性:传统的RAG模型通过结合外部知识库的实时检索和生成技术,显著提高了回答的准确性,但在处理长期信息和需要持续记忆的复杂场景中表现欠佳。
二、论文思路
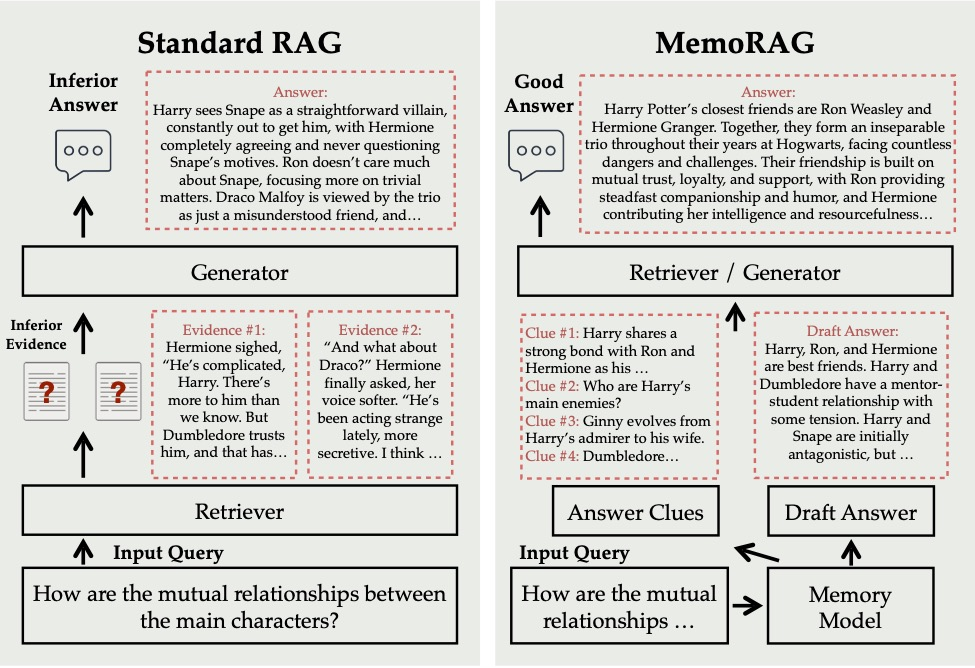
- 模型架构:MemoRAG采用双系统架构,包括轻量但长距离的LLM形成的数据库全局记忆模块,以及复杂但表达能力强的LLM用于检索增强生成。
- 工作原理:对于给定任务,记忆模块生成检索线索,这些线索基于数据库压缩表示生成,虽可能有错误细节,但能明确揭示任务信息需求。以这些线索为查询,从数据库中检索必要上下文,进而生成精确全面的答案。
- 方法细节
- 生成线索:利用记忆模型作为输入查询和相关数据库的语义桥梁,生成有助于检索的线索。
- 检索相关文档:以优化后的检索线索为依据,在数据库中搜索相关上下文。
- 生成答案:结合问题和相关上下文,采用生成模型生成最终回答。
三、实验设计与结果
- 测试环境:在三个基准上使用三种不同的生成器(Llama3-8B-Instruct-8K、Phi-3-mini-128K、Mistral-7B-Instruct-v0.2-32K)进行测试。
- 性能表现:MemoRAG在各种数据集和查询类型上显著提升了标准RAG方法和其他基线的性能。
四、论文总结
MemoRAG通过记忆模块实现对数据库的全局理解,并回忆与查询相关的线索,提升了检索的准确性和上下文丰富度,增强了在处理复杂任务、模糊信息需求以及非结构化知识时的表现,展示了在复杂推理和长文档任务中的巨大潜力,适用于多领域的实际应用。
OP-RAG【注意力管理】
注意力管理:就像看一本特别厚的书,你不可能把每个细节都记住,但懂得在关键章节做好标记的人才是高手。它不是漫无目的地看,而是像个资深读书人,边读边在重点处画下重点,需要的时候直接翻到标记页。
- 发表时间:2024.09.03
- 论文名称:In Defense of RAG in the Era of Long-Context Language Models
- 论文地址:https://arxiv.org/abs/2409.01666
- Github 地址:https://github.com/qhjqhj00/MemoRAG
一、论文动机
- 背景:随着长文本LLM的出现,这些模型能处理更长的文本序列,RAG的吸引力似乎下降。然而,英伟达认为LLMs中的极长语境会导致对相关信息的关注度降低,并导致答案质量的潜在下降。
二、论文思路
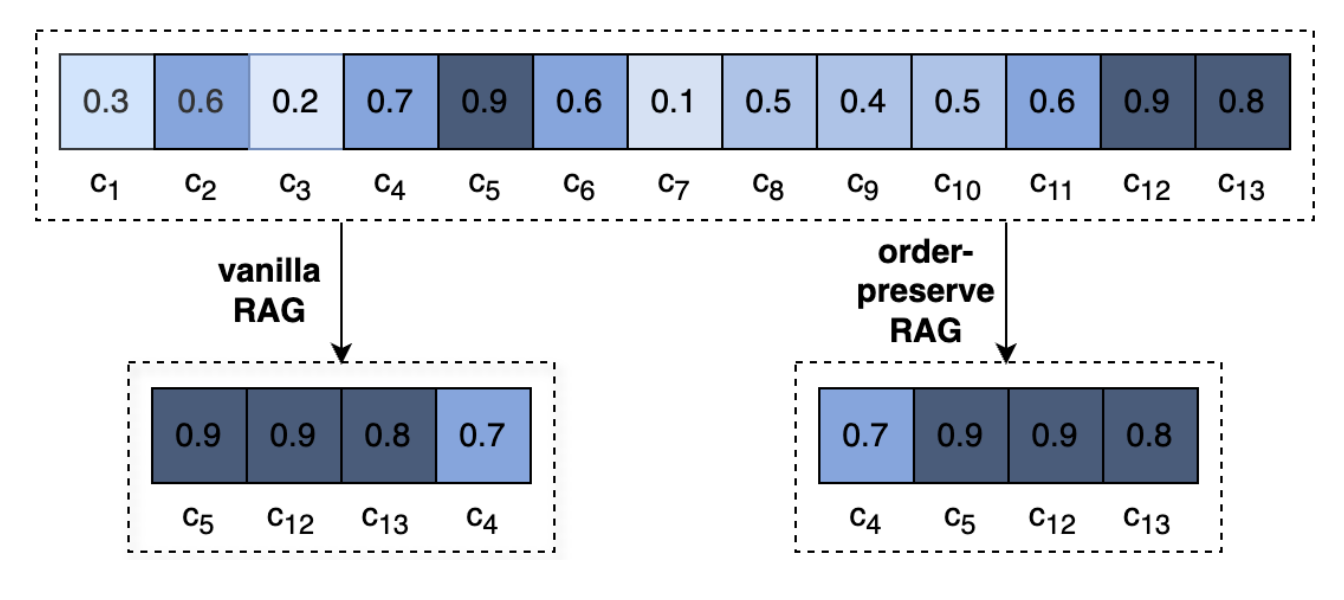
- 模型机制:OP-RAG(顺序保留检索增强生成)机制,保持检索到的文本块在原文中的顺序,与传统RAG将检索到的文本块按相关性降序排列不同。
- 性能表现:使用OP-RAG,随着检索块数量的增加,答案质量先上升,然后下降,形成倒U形曲线。与将整个上下文作为输入的长上下文LLM相比,OP-RAG可以用更少的标记获得更高的答案质量。
三、实验设计与结果
- 实验设置:在长文本问答任务中,OP-RAG的表现比传统的RAG和长文本LLM都要好。
- 关键数据:特别是在使用Llama3.1-70B模型时,OP-RAG在只使用16K tokens的情况下,就达到了44.43的F1分数,而没有使用RAG的Llama3.1-70B,即使使用了128K tokens,也只得到了34.32的F1分数。
四、论文总结
OP-RAG通过保持检索到的文本块的原始顺序,显著提高了RAG在长上下文问答应用中的性能,证明了在长上下文答案生成中,RAG仍然具有重要的价值和优势。
AgentRE【智能抽取】
智能抽取:像个善于观察人际关系的社会学家,不仅能记住关键信息,还会主动查证并深入思考,从而准确理解复杂的关系网络。即使面对错综复杂的关系,也能通过多角度分析,理清其中的脉络,避免望文生义。
- 发表时间:2024.09.03
- 论文名称:AgentRE: An Agent-Based Framework for Navigating Complex Information Landscapes in Relation Extraction
- 论文地址:https://arxiv.org/abs/2409.01854
- Github 地址:https://github.com/Lightblues/AgentRE
一、论文动机
- 背景:关系抽取(RE)是将非结构化文本转化为结构化数据(关系三元组)的过程,在知识图谱构建中扮演重要角色。然而,由于关系类型的多样性和实体间关系的模糊性,传统的“文本输入,文本输出”语言模型在RE任务中面临挑战。
二、论文思路
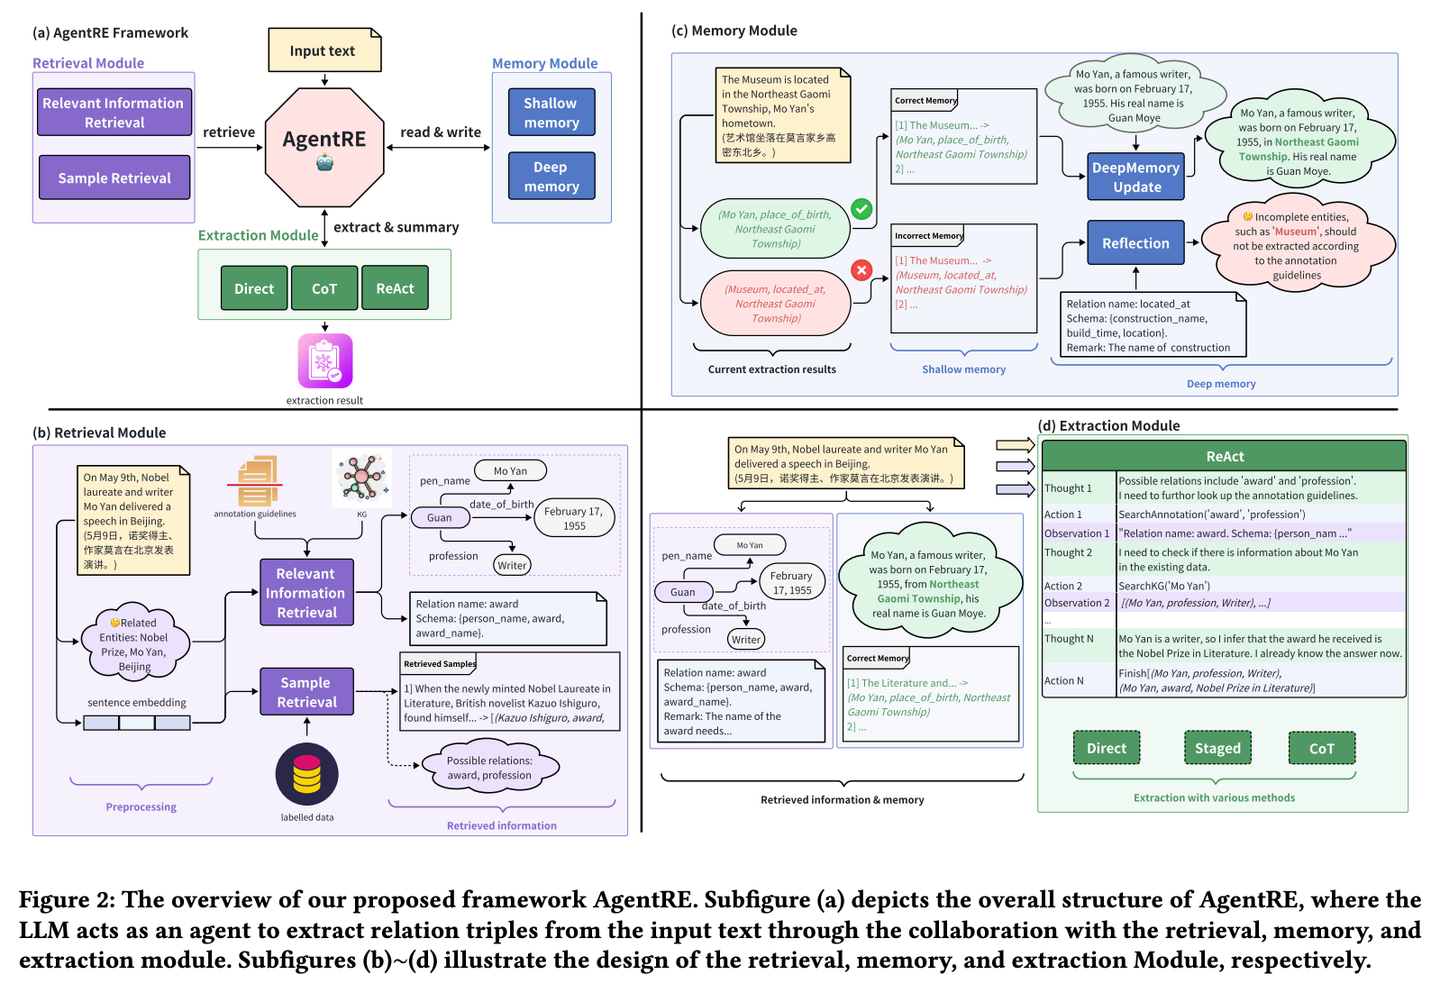
- AgentRE:提出了一种基于智能体的RE框架AgentRE,通过整合大型语言模型的记忆、检索和反思能力,有效应对这些挑战。AgentRE包含三大模块:检索模块、记忆模块和提取模块,助力代理高效获取并处理信息,显著提升RE性能。
- AgentRE的三大模块
- 检索模块:负责从现有数据集中提取相关样本,并搜集补充知识,辅助提取模块完成RE任务。检索模块分为样本检索模块和相关信息检索模块,利用编码器将当前文本转化为嵌入向量,计算训练数据集中样本与当前文本的相似性,以检索与当前文本相似的样本。
- 记忆模块:负责在提取过程中动态地利用现有知识,并进行反思和总结,更好地完成后续的提取任务。记忆模块被划分为短期记忆和长期记忆,短期记忆记录了初步的提取经验,长期记忆涵盖了对过往记忆的深入反思与更新。
- 提取模块:借鉴了ReAct的互动式方法,通过多轮的思考、行动、观察来推进。在此框架下,检索与记忆模块被视作智能体可调用的外部工具。智能体通过一系列API接口,输入工具名称和参数,随后获得反馈结果。
- 小模型的精炼
- 蒸馏学习:为了弥补小模型在推理能力上的不足,提出了一种蒸馏学习的方法,通过利用大型模型的历史推理路径来引导小模型的学习。对不同类型问题采用多样化的推理策略,可以显著增强模型解决问题的适应性。
三、实验设计与结果
- 测评数据集:在DuIE(最大的中文关系抽取数据集)和SciERC(科学领域英文命名实体识别与关系抽取数据集)两个数据集进行测试。
- 测试基准方法:将AgentRE与多种基于LLM的信息抽取模型/框架进行对比,包括ChatIE、GPT-RE、CodeKGC、CodeIE、UIE、USM和InstructUIE等。
- 测评结果:实验结果表明,AgentRE在零样本学习(ZFL)、少样本学习(FSL)和有监督的微调(SFT)三种实验范式下均表现出色。特别是在FSL组中,AgentRE-FSL显著超越了当前最佳模型,展示了其在利用标记数据和辅助信息方面的优势。
- 消融实验:探究了AgentRE在不同配置下的表现,包括缺少检索模块(AgentRE-w/oR)、缺少记忆模块(AgentRE-w/oM)和两者皆无(AgentRE-w/oRM)。结果表明,检索模块和记忆模块对AgentRE的性能至关重要。
四、论文总结
AgentRE通过整合大型语言模型的记忆、检索和反思能力,有效应对复杂场景关系抽取中关系类型多样以及单个句子中实体之间关系模糊的挑战。AgentRE 包含三大模块,助力代理高效获取并处理信息,显著提升 RE 性能。
iText2KG【建筑师】
建筑师:像个有条理的工程师,通过分步骤提炼、提取和整合信息,逐步将零散文档转化为系统的知识网络,而且不需要事先准备详细的建筑图纸,可以根据需要灵活地扩建和完善。
- 发表时间:2024.09.05
- 论文名称:iText2KG: Incremental Knowledge Graphs Construction Using Large Language Models
- 论文地址:https://arxiv.org/abs/2409.03284
- Github 地址:https://github.com/AuvaLab/itext2kg
一、论文动机
- 非结构化数据挑战:大多数可用数据是非结构化的,难以获取有价值信息,自动构建知识图谱对结构化数据并使其可访问至关重要。
- 传统方法局限性:传统NLP方法如命名实体识别和关系提取在信息检索中关键,但受限于预定义实体类型和对监督学习的需求。
二、论文思路
iText2KG方法包含四个模块:
- 文档提炼器(Document Distiller):使用LLM将原始文档重写为语义块,依据预定义架构提取特定文本信息,提高信噪比并指导图形构建过程。
- 增量实体提取器(Incremental Entity Extractor):迭代语义块提取全局文档实体,解决歧义,确保实体明确定义且区分。
- 增量关系提取器(Incremental Relation Extractor):处理已解析实体及语义块,检测语义上唯一的关系,根据上下文不同有不同行为。
- 图谱集成器(Graph Integrator and Visualization):使用Neo4j以图形格式直观表示实体和关系。
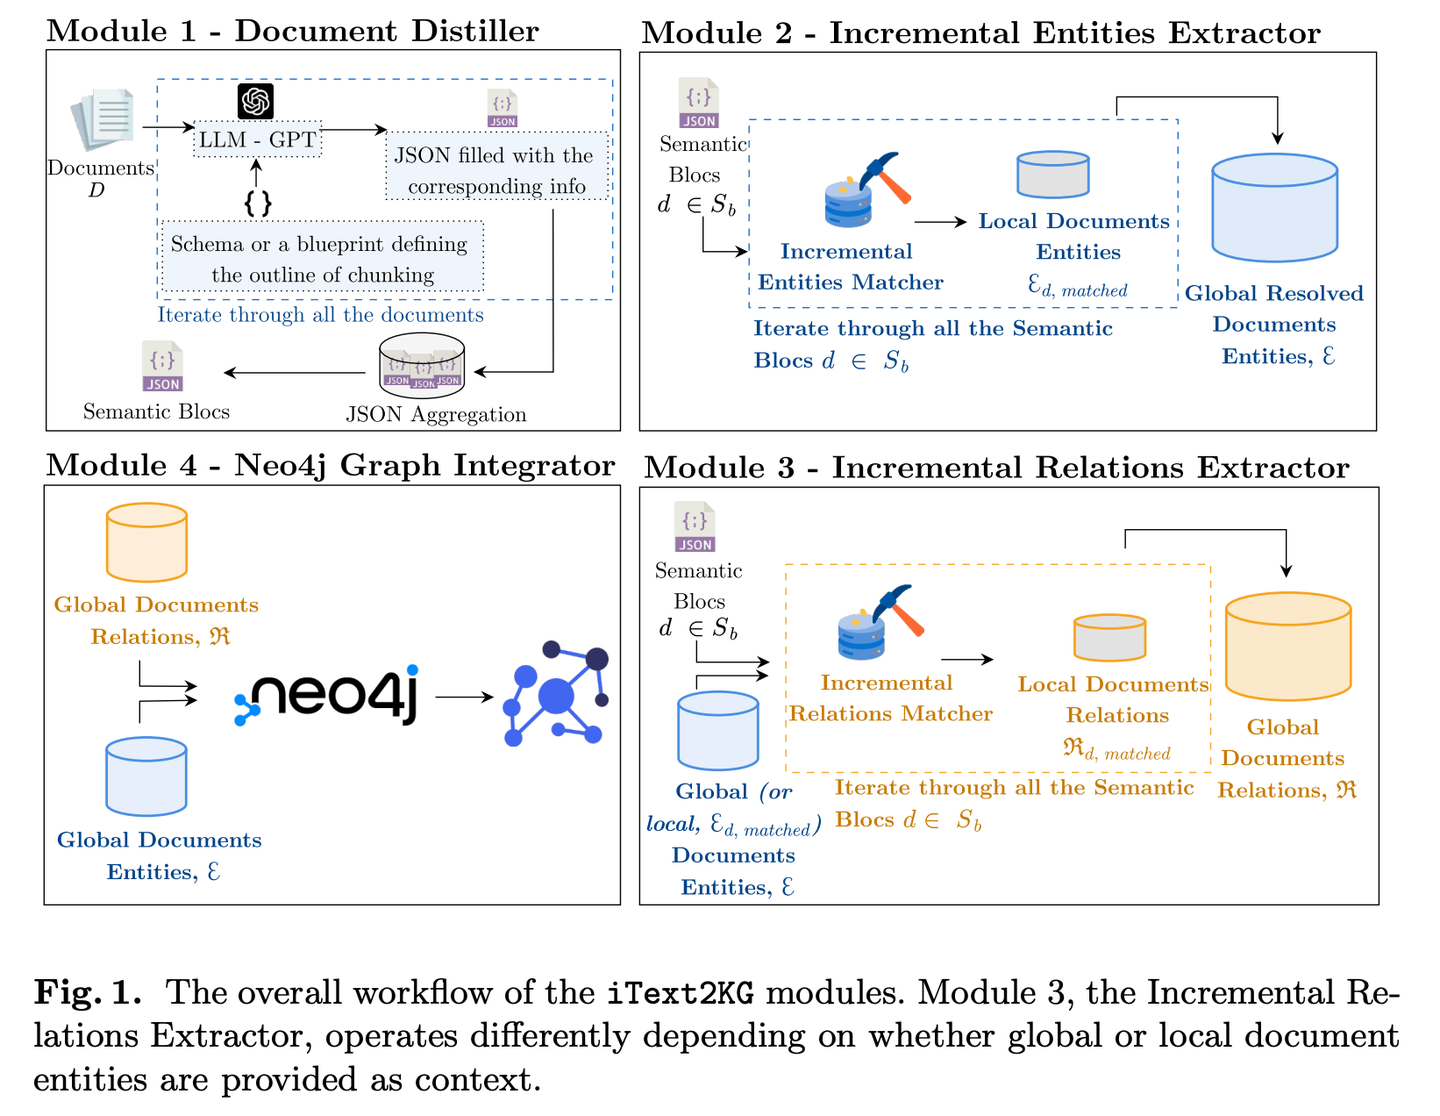
三、实验设计与结果
- 评估指标:
- 架构一致性:评估重写文本内容与输入架构匹配程度。
- 信息一致性:评估重写文本内容与原始报告语义匹配程度。
- 三元组提取精度:评估三元组与相应文本一致性。
- 实体/关系解析错误发现率:评估未解析实体或关系比例。
- 数据集和基线方法:使用GPT-4生成的简历、公司网站和科学文章文本信息作为输入,与OpenAI函数方法、Langchain和LlamaIndex等基线方法比较。
- 实验结果:
- 架构一致性:Document Distiller在不同文档类型间实现高架构一致性,科学文章和简历得分最高,网站略低。
- 信息一致性:简历信息一致性最高,科学文章次之,网站最低,反映不同文档类型对语义重写挑战。
- 三元组提取:全局实体作上下文时相关三元组精度较低,但图形更丰富;本地实体作上下文时精度较高,图形丰富度较低。
- 实体/关系解析:iText2KG在三种KG构建场景中表现优于基线方法,尤其在简历到KG场景中表现完美,网站到KG场景中错误发现率较高,凸显实体/关系解析重要性。
四、论文总结
iText2KG(增量式知识图谱构建)利用大型语言模型 (LLM) 从原始文档中构建知识图谱,并通过四个模块(文档提炼器、增量实体提取器、增量关系提取器和图谱集成器)实现增量式知识图谱构建,无需事先定义本体或进行大量的监督训练。
GraphInsight【图谱解读】
图谱解读:像个擅长信息图表分析的专家,知道把重要信息放在最显眼的位置,同时在需要时查阅参考资料来补充细节,并能step by step地推理复杂图表,让AI既能把握全局又不遗漏细节。
- 发表时间:2024.09.05
- 论文名称:GraphInsight: Unlocking Insights in Large Language Models for Graph Structure Understanding
- 论文地址:https://arxiv.org/abs/2409.03258
- Github 地址:
一、论文动机
- LLMs在图理解上的挑战:尽管LLMs在处理图方面展现出潜力,但在通过图描述序列的提示来理解图形结构信息时,尤其是在图规模增大时,仍面临困难。这种困难被称为“位置偏差”,即LLMs在图描述序列中不同位置的记忆表现不均。
- 现有方法的不足:现有方法在处理大规模图时存在“理解崩溃”的问题,即随着图规模的增加,LLMs的理解能力急剧下降。
二、论文思路
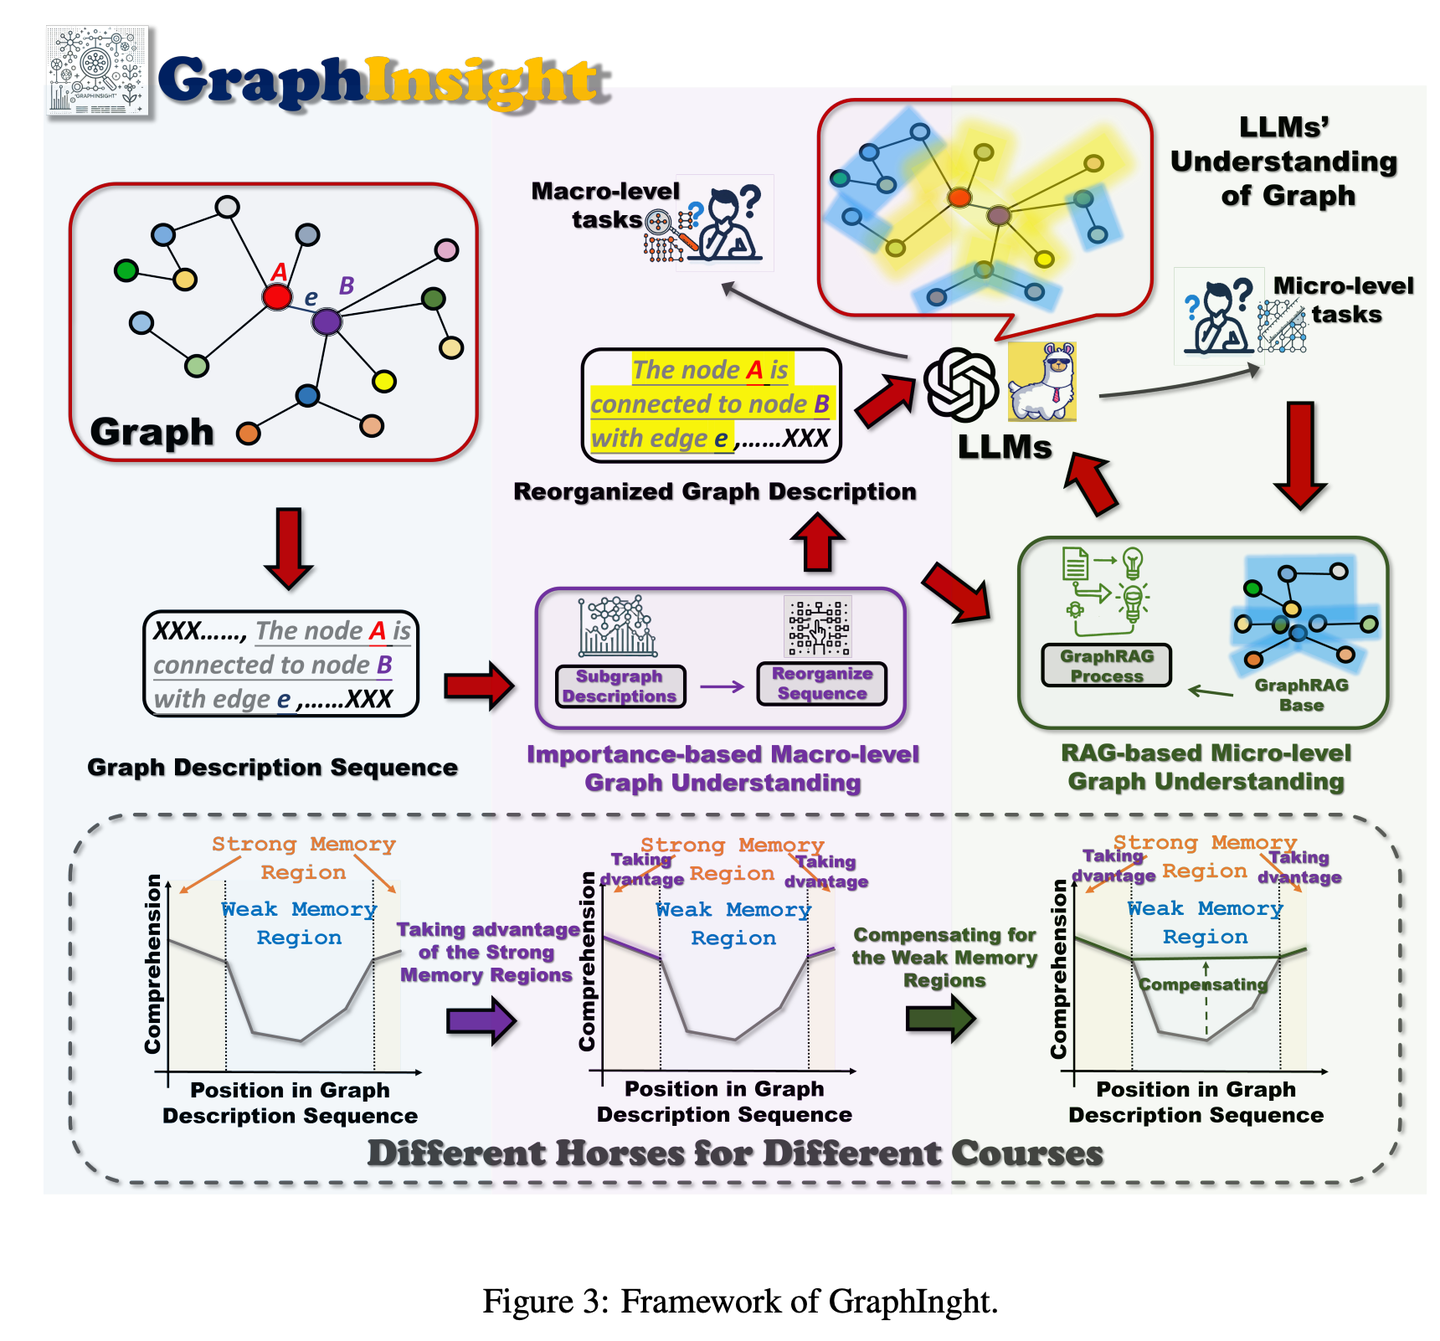
- 基于重要性的宏观层面的图形理解
基于重要性的图描述重组:计算图中每个节点的PageRank分数以衡量其重要性,将图分解为一系列互不相交的子图描述,并根据PageRank分数对子图描述进行排序,将最重要的子图描述放置在LLMs的强记忆区域(序列的头部和尾部)。
- 基于检索增强生成(RAG)的微观层面的图形理解
基于RAG的轻量级外部知识库:对于弱记忆区域中的节点和边,提取其信息并存储在GraphRAG知识库中。当需要进行微图理解任务时,从知识库中检索相关信息,并将其与输入的图描述序列结合,形成增强提示输入LLMs进行推理。
三、实验设计与结果
- 实验设计
- 数据集:引入了GraphSQA基准,涵盖从15到200个节点的多种图结构,包括多重边和自环。
- 任务类型:GraphSQA包括5个宏观图任务和15个微观图任务,后者进一步细分为8个复合任务。
- 评估指标:根据答案类型的不同,采用布尔值、数值和集合类型三种评估指标。
- 模型选择:使用了多种开源模型,包括Mistral 7B、Llama3-8B、Qwen2-7B和Vicuna-7B等,这些模型有的经过长时间序列的微调。
- 结果与分析
- 宏观图任务:GraphInsight在所有大型模型上均优于其他方法,特别是在Vicuna-7B模型上,得分提高了4.61倍。
- 微观图任务:GraphInsight在微观图任务中也表现出色,特别是在Vicuna-7B模型上,得分提高了14.02倍。
- 复合任务:在常见邻居查找和三阶邻居查找等复合任务中,GraphInsight分别实现了12.75倍和3.25倍的提升。
- 消融研究:图描述组织和GraphRAG对宏图和微图任务均有优化效果,特别是GraphRAG在微观图任务中带来了显著的改进。
四、论文创新点
突出了GraphInsight相较于其他方法的优势,例如更高效地利用节点特征和边信息,提高模型对于图结构上下文的学习效果。
五、论文总结
GraphInsight旨在提升LLMs对宏观和微观层面图形信息理解的新框架。GraphInsight基于两大关键策略:1)将关键图形信息置于LLMs记忆性能较强的位置;2)借鉴检索增强生成(RAG)的思想,对记忆性能较弱的区域引入轻量级外部知识库。此外,GraphInsight探索将这两种策略整合到LLM代理过程中,以应对需要多步推理的复合图任务。
LA-RAG【方言通】
方言通:像个精通各地方言的语言专家,通过细致的语音分析和上下文理解,不仅能准确识别标准普通话,还能听懂带有地方特色的口音,让AI与不同地区的人都能无障碍交流。
- 发表时间:2024.09.13
- 论文名称:LA-RAG:Enhancing LLM-based ASR Accuracy with Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2409.08597
- Github 地址:
一、论文动机
文章首先指出,将语音信息整合到LLM中以提高ASR准确性的研究日益增多。早期研究通常将纯文本转录输入LLM,结合ASR的N最佳结果和指令来提示LLM进行错误纠正。这些方法中,LLM主要作为文本重排器或标记选择器。其他研究尝试将预训练的ASR模型(通常是语音编码器部分)与LLM结合,通过模态适配器(如Qformer、注意力或投影)来对齐语音特征空间与LLM的文本空间。这些方法通常通过利用丰富的声学信号来提高性能,但它们的性能上限往往受限于语音编码器的能力,尤其是在训练和测试数据的声学特征不匹配的情况下,例如在口音场景中,编码器训练不足,正确的标记不会出现在N最佳转录中。
二、论文思路
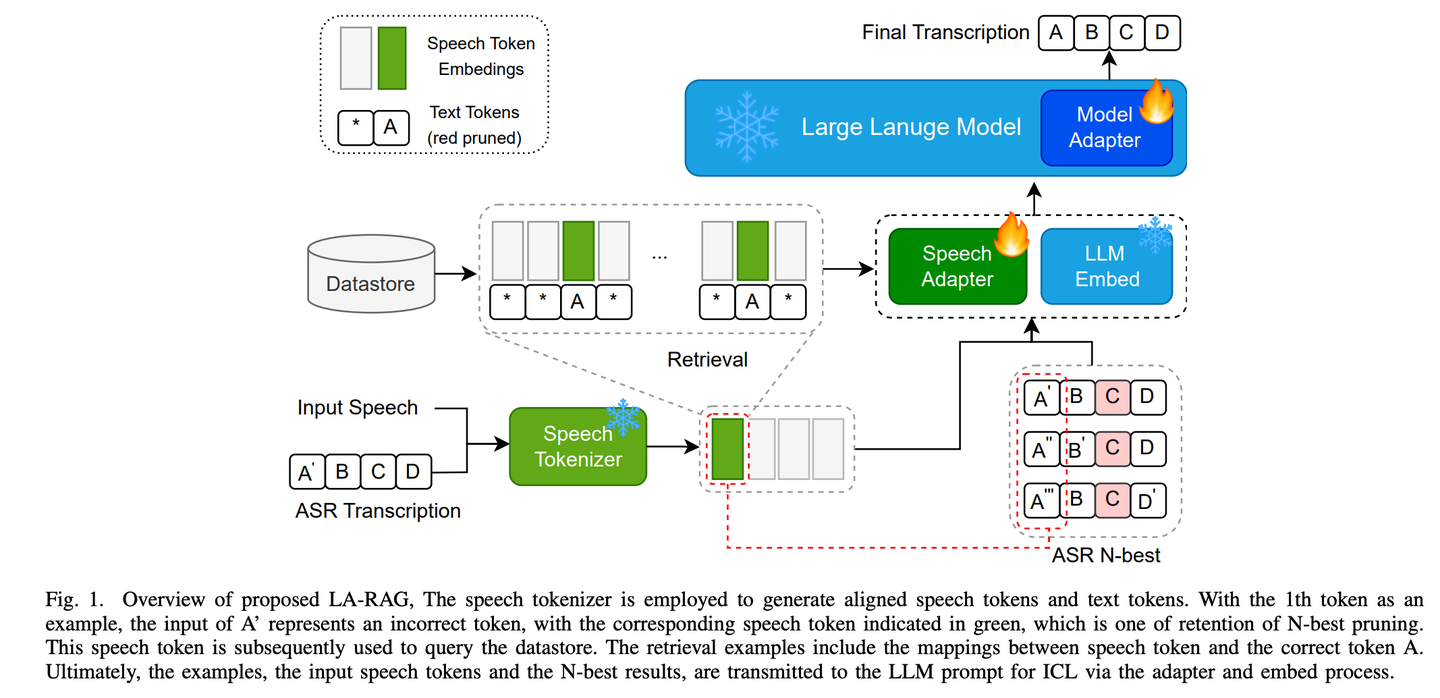
LA-RAG范式通过利用细粒度的标记级语音数据存储和语音到语音检索机制,增强LLM的上下文学习(ICL)能力,从而提高ASR准确性。具体来说,LA-RAG包括以下四个主要部分:
- 语音分词器(Speech Tokenizer):使用预训练的AED/CTC模型提取语音转录对的中间表示,生成与文本标记对齐的语音标记。
- 数据存储创建(Datastore Creation):利用语音分词器对每个训练数据进行处理,生成语音-文本键值对,并存储对应的序列作为LLM的最终提示示例。
- 语音检索(Speech Retrieval):将数据存储组织为语音倒排索引,使用与数据库创建阶段相同的语音分词器对输入语音进行对齐,生成查询嵌入,通过分组和过滤策略获取序列级别的相似示例。
- LLM提示(LLM Prompt):将对齐的语音标记序列输入语音适配器,与LLM标记空间和维度对齐。使用LoRA进行参数高效的微调,学习语音标记到正确文本标记的映射关系,使LLM能够在推理阶段通过ICL学习正确的文本标记。
三、实验设计与结果
- 实验设计:作者使用了普通话和方言数据集来评估预训练ASR模型在充分和不足训练场景下的性能。数据集包括AISHELL-1和KeSpeech的子方言数据集。实验中使用了Whisper-Medium模型作为基础ASR系统,并测试了CTC和AED两种语音分词方法。LLM解码采用了LLaMA 3 8B模型,并集成了LoRA适配器。检索使用FAISS库实现,设置k值为128,序列过滤阈值为0.5。评估指标为字符错误率(CER)。
- 实验结果:LA-RAG在普通话和中国方言数据集上显著提高了ASR准确性,特别是在处理口音变化时。与现有方法相比,LA-RAG在所有方法中实现了最低的CER,尤其是在口音测试集上,性能提升更为显著。这表明LA-RAG能够帮助LLM学习发音和正确标记之间的映射关系,这对于ASR模型可能未充分学习映射关系的口音场景特别有用。
四、论文总结
LA-RAG通过利用细粒度的语音数据存储和预训练CTC和AED模型实现的精确标记级对齐,显著提高了基于LLM的ASR准确性,尤其是在口音变化场景中。实验结果表明,该方法在各种数据集上都取得了显著的性能提升,包括普通话和中国方言,显著降低了CER。未来的工作计划将LA-RAG方法推广到其他任务和语言的语音识别中。
SFR-RAG【精简检索】
精简检索:像个精练的参考顾问,体积虽小但功能精准,既能理解需求又懂得寻求外部帮助,保证回答既准确又高效。
- 发表时间:2024.09.16
- 论文名称:SFR-RAG: Towards Contextually Faithful LLMs
- 论文地址:https://arxiv.org/abs/2409.09916
- Github 地址:
一、论文动机
随着大型语言模型(LLM)的兴起,生成式AI成为关键领域。LLM能根据各种提示生成复杂输出,其中检索增强生成(RAG)是值得注意的领域,它将外部信息集成到LLM中以提高事实准确性。RAG专门解决生成可靠、与上下文相关的信息的需求,已成为解决基于知识任务的核心,这些任务中模型需根据外部来源生成答案。
二、论文思路
SFR-RAG模型包含函数调用功能,能与外部工具动态交互以检索高质量上下文信息。其创新方法包括一个新颖的聊天模板,添加了“Thought”和“Observation”两个关键角色。Thought角色使模型能内部进行多步骤推理,Observation角色捕获模型过程中检索到的外部信息。这种结构使SFR-RAG区分信息处理步骤并生成准确、用户友好的响应。模型还经微调能抵御低质量或不相关上下文,区别于传统LLM。
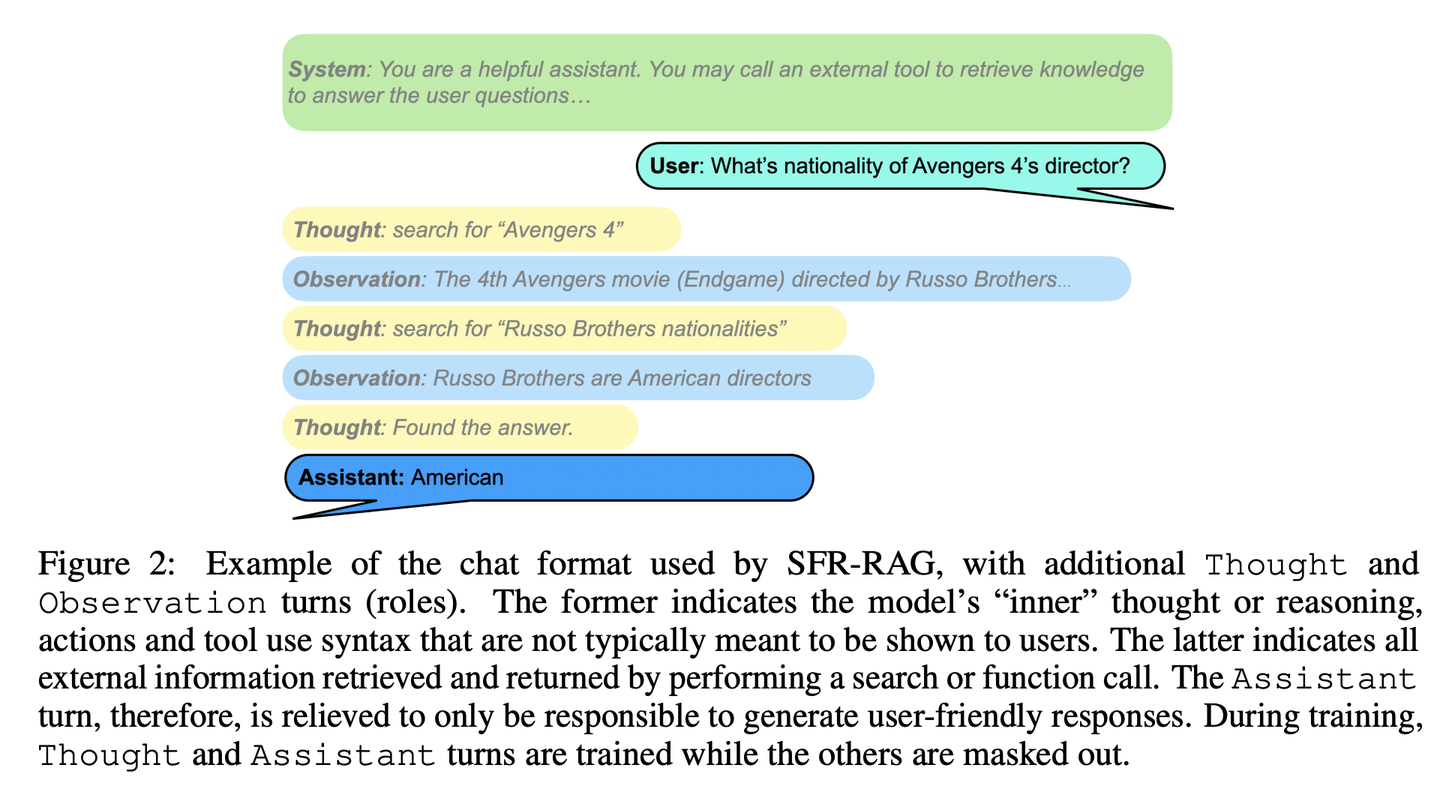
三、实验设计与结果
实验结果证明了SFR-RAG的成功,特别是在ContextualBench评估套件中。该套件包含七个上下文任务,旨在测试模型生成准确、与上下文相关答案的能力。尽管参数少得多,SFR-RAG在这七项任务中的三项取得了最先进的结果,优于GPT-4o等更大模型。例如,在2WikiHopQA中,SFR-RAG性能比GPT-4o提高了25%。它还在其他基准测试中表现出色,包括自然问题和音乐。即使上下文信息被更改或包含相互矛盾信息时,SFR-RAG性能依然稳健。
四、论文总结
SFR-RAG通过解决大型模型面临的常见问题,在检索增强生成方面取得重大进展。其90亿参数数量使其能高效运行同时保持高精度和可靠性。创新功能使SFR-RAG处理复杂多步骤推理,同时避免幻觉和不相关上下文生成的缺陷。它在各种基准测试中的出色表现,突出了较小、经微调模型在生成准确、基于上下文输出方面的潜力。SFR-RAG代表了向更高效、更可靠模型的转变,这些模型能更好应对外部上下文处理的挑战。
FlexRAG【压缩专家】
压缩专家:把长篇大论浓缩成精华摘要,而且压缩比例可以根据需要灵活调整,既不丢失关键信息,又能节省存储和处理成本。就像把一本厚书精炼成一份简明扼要的读书笔记。
- 发表时间:2024.09.24
- 论文名称:Lighter And Better: Towards Flexible Context Adaptation For Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2409.15699
- Github 地址:
一、论文动机
现有的RAG系统在处理长篇幅的检索上下文时,需要大量的计算资源进行编码,导致运行成本高昂。为了解决这一问题,FlexRAG提出了一种上下文压缩的方法,旨在减少上下文的数据量,同时尽量保留重要的信息,以提高效率。
二、论文思路
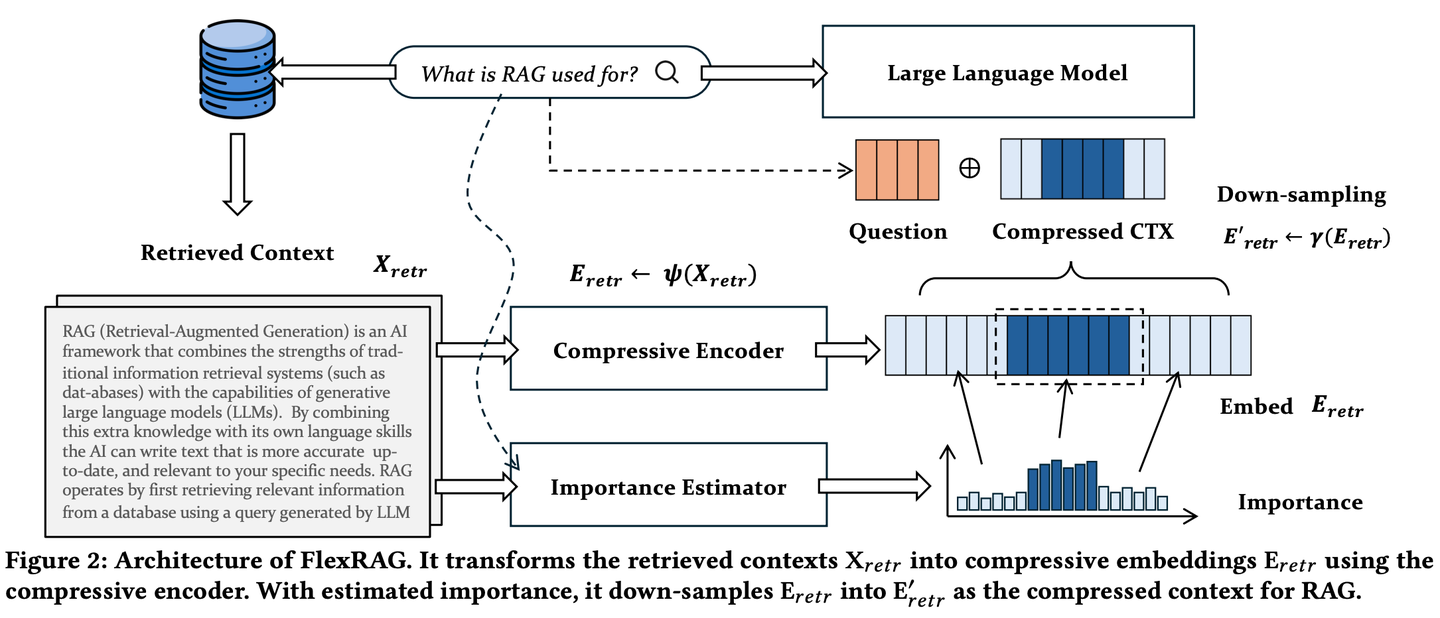
-
上下文压缩(Context Compression):
- FlexRAG将检索到的上下文压缩成紧凑的嵌入表示。具体来说,FlexRAG在离线阶段对外部文档进行预编码,生成压缩嵌入,并在检索到特定RAG任务的相关文档时对这些压缩嵌入进行下采样。
-
选择性压缩(Selective Compression):
- FlexRAG通过估计上下文的重要性来实现选择性压缩。具体方法包括:
- Token级别估计:基于LLM对输入提示中令牌的重要性估计。
- 句子级别估计:使用通用嵌入器(如E5和BGE)来估计句子与任务提示的相关性。
- 压缩比分配:根据估计的重要性对上下文进行分组,并为每组分配不同的压缩比,以平衡压缩效果和上下文信息的保留。
- FlexRAG通过估计上下文的重要性来实现选择性压缩。具体方法包括:
-
两阶段训练(Two-Stage Training):
- 第一阶段:在无标签数据上进行自回归预训练,以建立压缩模块与下游LLM之间的初步对齐。预训练的目标函数是最大化基于压缩上下文的语言建模概率。
- 第二阶段:使用指令调优数据集进行任务特定的微调,优化RAG任务的答案质量。具体基于问题和压缩检索上下文预测真实答案。
三、实验设计与结果
文章没有详细列出具体的实验结果,但提到了FlexRAG在减少计算资源和提高效率方面的优势。通过上下文压缩和选择性压缩,FlexRAG能够在处理长文本时显著降低计算负担,同时保持较高的性能。
四、论文总结
FlexRAG通过上下文压缩、选择性压缩和两阶段训练,有效地解决了长文本RAG中的计算资源问题。这种方法不仅减少了上下文的数据量,还通过选择性压缩和任务特定的微调,确保了重要信息的保留和模型的高性能。FlexRAG为长文本RAG提供了一种高效且灵活的解决方案,值得进一步研究和应用。
CoTKR【图谱翻译】
图谱翻译:像个耐心的老师,先理解知识的来龙去脉,再一步步讲解,不是简单复述而是深入浅出地转述。同时通过不断收集"学生"的反馈来改进自己的讲解方式,让知识传递更加清晰有效。
- 发表时间:2024.09.29
- 论文名称:CoTKR: Chain-of-Thought Enhanced Knowledge Rewriting for Complex Knowledge Graph Question Answering
- 论文地址:https://arxiv.org/abs/2409.19753
- Github 地址:https://github.com/wuyike2000/CoTKR
一、论文动机
大语言模型(LLMs)在自然语言处理任务中表现出色,但在知识密集型任务如问答(QA)中仍会遇到事实性错误,即“幻觉”问题。为了解决这一挑战,检索增强生成(RAG)范式通过从外部源检索与任务相关的知识来增强LLMs的能力。在RAG范式下,知识图谱(KGs)作为信息源,可以增强LLMs在QA任务中的能力。然而,现有方法在将检索到的子图转换为LLMs能理解的自然语言时,存在冗余、遗漏关键细节或语义不匹配的问题。
二、论文思路
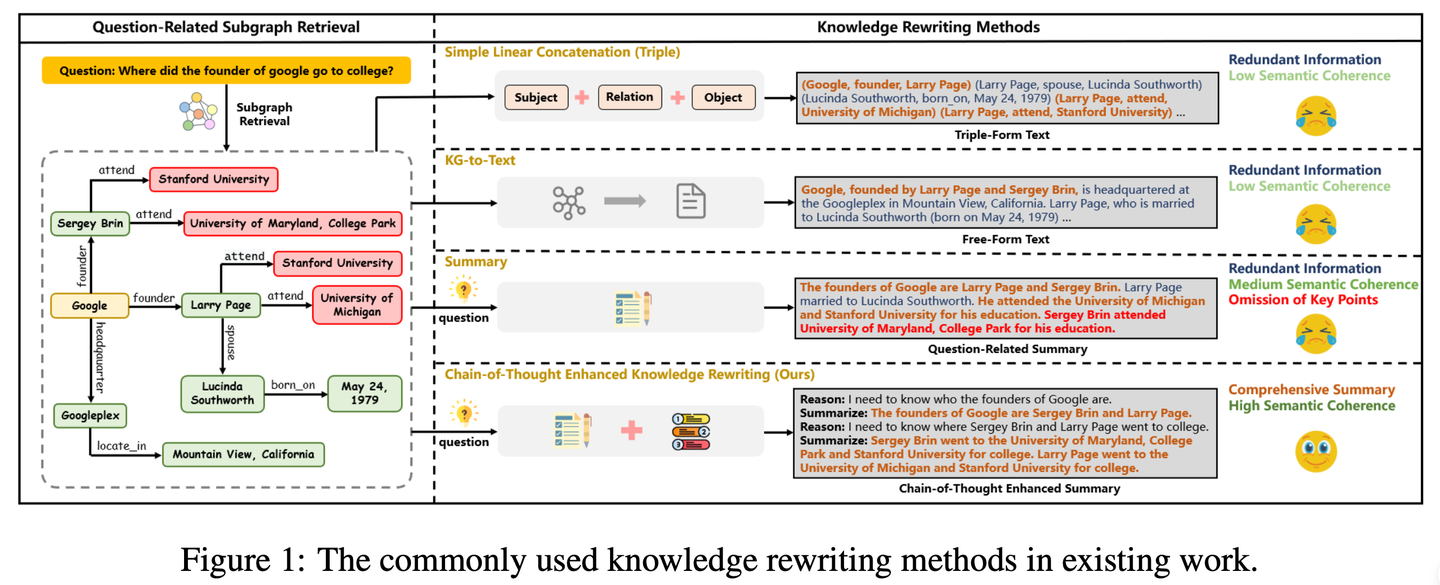
- 研究方法
CoTKR方法的核心是以交错方式生成推理路径和相应知识,克服单步知识改写的限制。具体来说,CoTKR包括以下两个主要操作:
- 推理:分解问题以识别推理所需的知识。
- 总结:根据推理步骤的输出,总结检索到的三元组中的相关知识。
CoTKR通过将思维链(CoT)与知识改写整合,过滤掉无关信息并提取与问题相关的知识,生成与问题语义对齐的、组织良好的知识表示。
- 训练框架 CoTKR的训练框架包括两个阶段:
- 监督微调:使用ChatGPT生成的参考知识表示来指导知识改写器的监督式微调,使其初步掌握知识改写的能力。
- 基于问答反馈的偏好对齐(PAQAF):通过利用QA模型的反馈进一步优化知识改写器,弥合知识改写器和QA模型之间的偏好差异。具体步骤包括:
- 候选知识表示形式采样:从知识改写器中采样多个候选知识表示。
- 基于问答模型反馈的偏好注释:选择两个具有最大语义差异的知识表示,评估其问答性能,识别偏好的知识表示。
- 基于ChatGPT的数据增强:利用ChatGPT对偏好的知识表示进行释义,增强训练数据的多样性。
- 直接偏好优化(DPO):使用DPO对知识改写器进行微调,优化知识表示的质量。
三、实验设计与结果
实验在GrailQA和GraphQuestions两个数据集上进行,使用Llama-2 (7B)、Llama-3 (8B)和ChatGPT 2进行知识改写,同时使用ChatGPT和Mistral (7B)执行问答任务。实验结果表明,CoTKR在多个评价指标和大语言模型中均优于基准线,证明了其知识改写策略的有效性。
四、论文总结
- 性能提升:CoTKR在大多数评价指标和大语言模型中均优于基准线,显著提高了LLMs在KGQA中的性能。
- 偏好对齐:CoTKR+PA在性能上接近甚至超过了ChatGPT作为知识改写器,证明了训练框架和偏好对齐的有效性。
- 知识表示的重要性:精心设计的知识表示形式对于在KGQA中使用的大语言模型至关重要。CoTKR+PA始终优于Triple,表明精心设计的知识表示形式可以有效提升KGQA的性能。
- 检索方法的影响:设计一个高质量的检索器仍然是一个开放性问题。GS显著优于BM25和2-Hop,表明检索噪声对KGQA性能的影响重大。
- 数据增强的有效性:数据增强增强了偏好对齐的效果,CoTKR+PA表现最佳,证明了数据增强的有效性。
2024.10
Open-RAG【智囊团】
智囊团:把庞大的语言模型分解成专家小组,让它们既能独立思考又能协同工作,还特别会分辨真假信息,关键时刻知道该不该查资料,像个经验丰富的智囊团。
- 发表时间:2024.10.02
- 论文名称:Open-RAG: Enhanced Retrieval-Augmented Reasoning with Open-Source Large Language Models
- 论文地址:https://arxiv.org/abs/2409.01782
- Github 地址:https://github.com/ShayekhBinIslam/openrag
一、论文动机
- 现有的RAG方法在处理复杂查询(如多跳检索任务)时,推理能力有限。OpenRAG框架通过增强开源LLM的推理能力,解决了这一问题。
二、论文思路
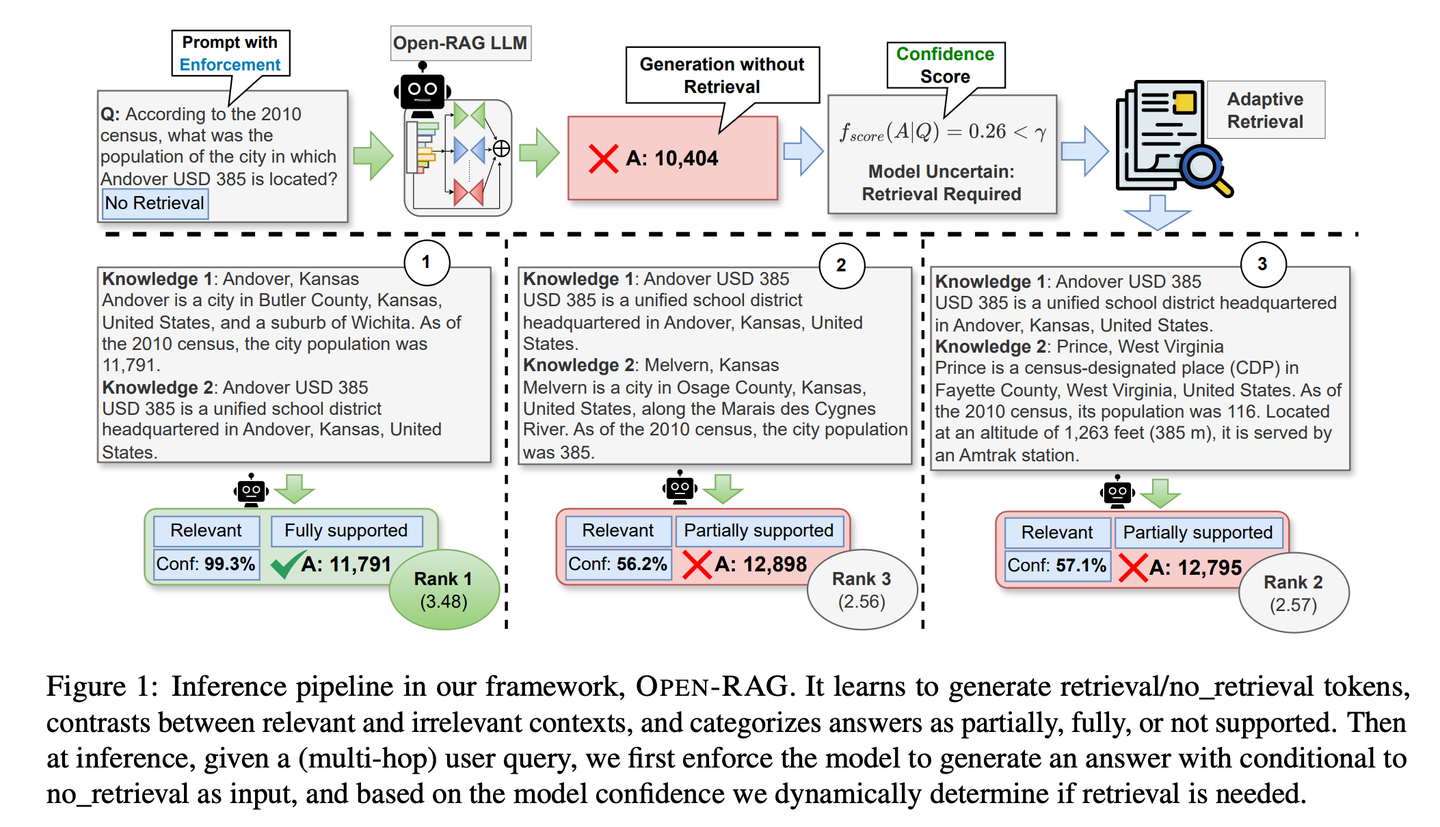
- 架构转换:OpenRAG将任意密集LLM转换为参数高效的稀疏专家混合(MoE)模型,能够处理单跳和多跳查询等复杂推理任务。具体实现包括:
- 路由器(R)从头开始训练。
- 前馈网络(FFN)层保持冻结,并由基于并行适配器的专家(E)进行调整。
- 其他层被复制。
- 训练过程: 通过独特的训练方法,使模型能够导航看似相关但具有误导性的挑战性干扰因素。
- 训练过程中,模型学习生成检索/不检索的反射标记,并评估检索内容的相关性、支持程度和实用性。
- OPEN-RAG训练数据准备:涉及从每个原始对(q, y)生成四种新的训练实例的变化,每种都使用真实情况/LLM评论家和检索到的段落,结合不同的反射标记。OPEN-RAG不仅使LLM能够反思生成质量,还能够对比干扰项。
- 推理流程:
- 检索/不检索:模型学会生成检索/不检索的标记,以指示是否需要检索来回答查询。
- 相关性评估:对于检索到的内容,模型生成相关性标记,指示内容是否与查询相关。
- 生成答案:根据预测的相关性、支持度和效用标记,对所有可能的答案进行排序,生成最终答案。
三、实验设计与结果
- 在多种知识密集型的单跳/多跳短文/长文推理任务中,基于Llama2-7B的OpenRAG在事实准确性和推理能力方面显著优于现有的开源RAG模型,并且常常匹配或超越了最先进的专有LLMs及其RAG模型。
- OpenRAG在多个任务中超越了ChatGPT-RAG、Self-RAG、RAG 2.0和104B RAG-Command R+,树立了新的基准。
- OpenRAG结合CRAG(Corrective Retrieval Augmented Generation)方法,评估了模型对检索质量的鲁棒性。结果表明,OpenRAG在结合CRAG数据集时表现优于其他基线,显示出对高质量检索的潜在改进能力。
四、论文总结
OpenRAG通过创新的架构和训练方法,显著提升了开源LLM在RAG任务中的推理能力,并在多个任务中超越了现有的先进模型。其自适应检索策略和鲁棒性分析进一步证明了其在实际应用中的潜力。
TableRAG【Excel专家】
Excel专家:不只简单地查看表格数据,而是懂得从表头和单元格两个维度去理解和检索数据,就像熟练使用数据透视表一样,能快速定位和提取所需的关键信息。
- 发表时间:2024.10.07
- 论文名称:TableRAG: Million-Token Table Understanding with Language Models
- 论文地址:https://arxiv.org/abs/2410.04739
- Github 地址:https://github.com/YuhangWuAI/tablerag
一、论文动机
传统利用LLM进行表格理解的方法通常将整个表格作为输入,但这种方法存在以下局限性:
- 上下文长度限制:大型表格(如100列×200行)的单元格数量可能超过40,000个,超出LLM的处理能力。
- 推理能力削弱:过长的上下文可能导致“Lost-in-the-Middle”现象,影响推理能力。
- 计算成本和延迟:表格尺寸增加时,计算成本和延迟显著上升。
此外,一些改进方法(如截断表格或仅读取Schema)会丢失关键信息,而将行和列编码为固定大小的嵌入可能会丢失语义信息。
二、论文思路
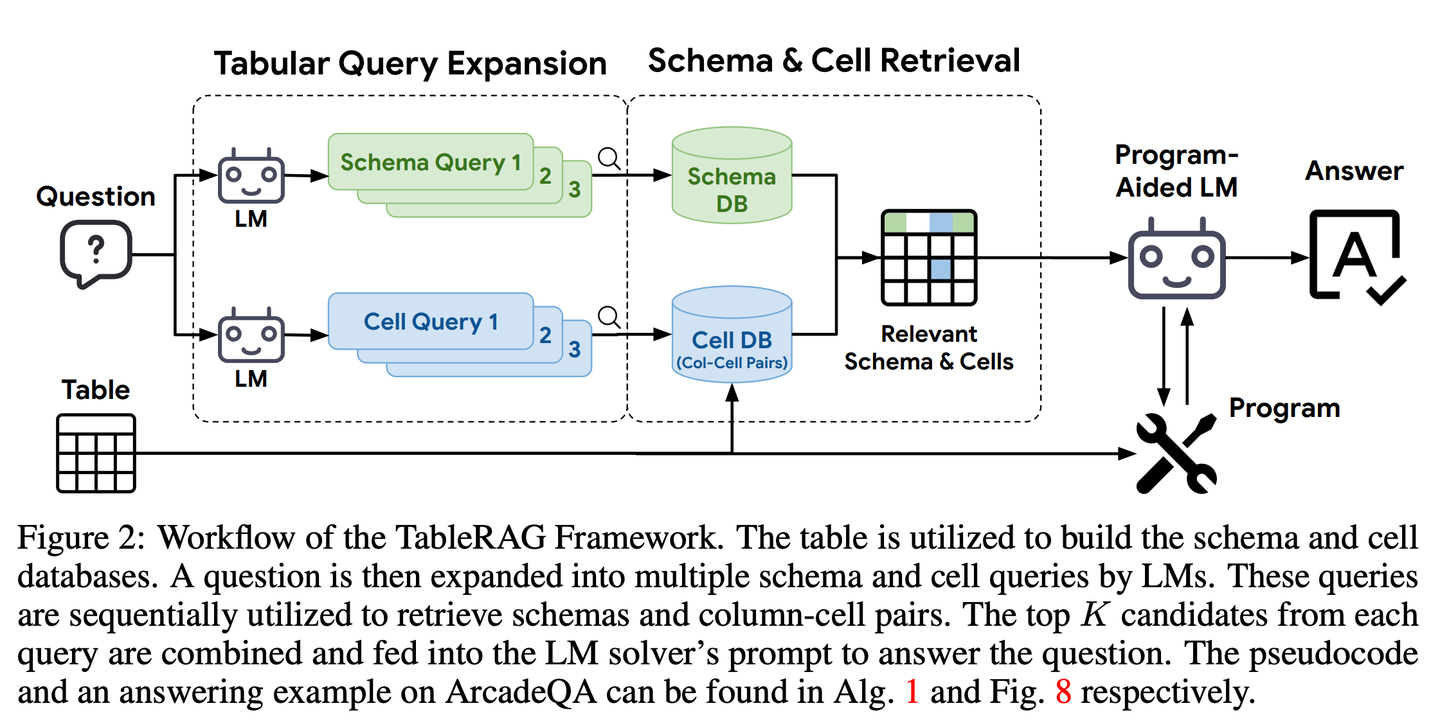
为解决上述问题,Google提出了TableRAG,通过查询扩展与模式(Schema)和单元格检索相结合,精准定位关键数据,从而实现高效的数据编码和精确检索。TableRAG的核心在于:
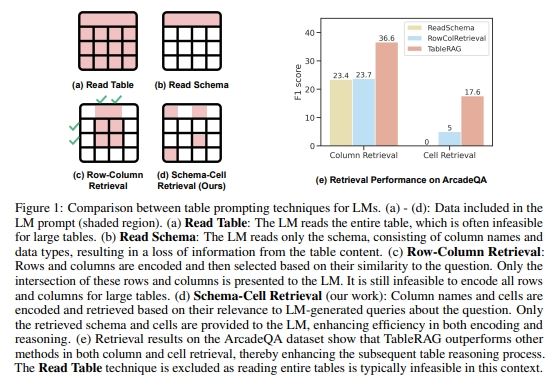
上图展示了TableRAG与传统表格理解任务的区别。
(a) - (d):分别表示4种方法在提示词中包含的数据(阴影部分),其中 (d)是TableRAG方法:
- (a) 完整读取表格:LM读取整个表格,在大型表格中往往不现实。
- (b) 只读取Schema:LM只读取列名和数据类型组成的模式,这种方法会导致表格内容丢失。
- (c) 行-列检索:将行和列编码后,基于与问题相似度进行检索。只有行和列的交集被展示给LM。对于大型表格来说,编码所有行和列仍然不现实。
- (d) Schema-单元格检索(TableRAG):根据与LM生成的问题相关性,对列名和单元格进行编码和检索。只有检索到的Schema和单元格被提供给LM,从而在编码和推理上都提高了效率。
- (e) 在ArcadeQA数据集上的检索结果显示: TableRAG在列和单元格检索方面均优于其他方法,进而增强了后续的表格推理过程。
TableRAG的工作流程如下:
- 表格查询扩展:高效处理表格的关键在于精确地识别出查询所需的列名和单元格值。与传统的表格理解任务不同的在于,TableRAG单独为Schema和单元格分别生成独立查询。
- Schema检索:生成查询后,Schema检索通过预先训练的编码器fenc获取相关的列名,fenc会对查询进行编码,并与编码的列名进行匹配以确定其相关性。检索到的Schema数据包括列名、数据类型和示例值。将列转换为整数、浮点数或日期时间数据类型;如果这几种类型都不适合的话,保留为分类列。
- 对于被识别为数值或日期时间数据类型的列,将最小值和最大值作为示例值。
- 对于分类列,展示频率最高的三个类别作为示例值。
- 汇总每个查询的前K个检索结果,并根据它们与最接近查询的相似度进行排序。检索到的Schema提供了表格格式和内容的结构化概览,用于更精确的数据提取。
- 单元格检索:检索与问题相关的单元格值,支持精确数据提取。单元格检索的作用在于:
- 单元格识别:使LLM能够精确地检测表格中特定关键词的存在。例如,区分“tv”和“television”,确保搜索和操作基于精确的数据条目。
- 单元格-列关联:使LLM能够将特定单元格与其相关的列名关联起来。对于处理特定属性的问题至关重要,如将“钱包”直接与“描述”列关联,实现行索引。
- 编码预算下的单元格检索:将检索到的Schema和单元格值提供给LLM,生成答案。
三、实验设计与结果
- 回答准确性。TableRAG在ArcadeQA和BirdQA数据集上超越了其他方法,包括读取全表、读取Schema和行列检索等方法。GPT 3.5 Turbo在所有方法中表现最佳。
- 检索性能
- 列检索:TableRAG在精确度上优于其他方法,表明其在快速识别相关列方面非常有效。
- 单元格检索:TableRAG在召回率、精确度和F1分数上均优于其他方法。
- 伸缩性测试。TableRAG在不同表格尺寸(从50×50到1000×1000)下表现出色,即使在大规模表格中也能保持较高的准确率。
- 与现有技术的比较。TableRAG在WikiTableQA数据集上超越了现有方法(如TaBERT、Text-to-SQL等),证明了其在不同规模和复杂性表格上的有效性。
- 消融研究
- 检索方法的影响。基于嵌入的检索方法性能最佳,超越了BM25和混合方法。
- 检索结果数量K的影响。增加K值会增加上下文长度,但并不一致提升性能。TableRAG通过减少K值,降低了推理成本。
- 编码预算的影响。TableRAG在不同编码预算下保持一致性能,表明其通过单元格频率构建语料库的方法有效。
- 查询扩展的影响。查询扩展显著提升了TableRAG在不同数据集和语言模型中的性能。
- 模式检索和单元格检索。模式检索和单元格检索均显著提升了推理性能,分别提升了9.4%和11.5%。
四、论文优势
- 高效性:通过检索关键数据,大幅缩短提示长度,减少信息丢失。
- 可扩展性:即使面对百万级单元格的表格,也能保持可控的计算成本。
- 准确性:在ArcadeQA和BirdQA数据集上,TableRAG的检索设计表现卓越,准确率最高。
五、论文总结
TableRAG通过结合模式检索和单元格检索,解决了传统方法在处理大规模表格时的局限性。它在检索效率、准确性和可扩展性方面表现出色,适用于百万级单元格的表格理解任务。TableRAG为大规模表格处理提供了一种高效、准确且可扩展的解决方案。
LightRAG【蜘蛛侠】
蜘蛛侠:在知识的网中灵活穿梭,既能抓住知识点之间的丝,又能借网顺藤摸瓜。像个长了千里眼的图书管理员,不仅知道每本书在哪,还知道哪些书该一起看。
- 发表时间:2024.10.08
- 论文名称:LightRAG: Simple and Fast Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.05779
- Github 地址:https://github.com/HKUDS/LightRAG
一、论文动机
- 解决现有RAG系统的局限性。现有的RAG系统(如传统的检索增强生成框架)存在依赖平面数据表示和上下文感知能力不足的问题,导致生成的答案碎片化,无法有效捕捉实体之间的复杂相互依赖关系。此外,这些系统在处理大规模数据时效率较低,难以快速适应新数据。
- 提升信息检索的全面性和效率。为了解决上述问题,LightRAG引入了图结构来增强文本索引和检索过程。图结构能够有效表示实体之间的复杂关系,从而提升信息检索的全面性和上下文相关性。同时,通过双层检索范式(结合低层次和高层次的信息检索),LightRAG能够更高效地检索相关实体及其关系。
- 降低计算成本并提高适应性。LightRAG通过增量更新算法,避免了每次更新时重建整个索引,从而显著降低了计算成本。这一设计使得系统能够快速整合新数据,保持在动态环境中的有效性和响应性。
- 优化资源受限场景下的应用。LightRAG的设计目标之一是降低硬件和计算资源的需求,使其适用于移动设备或对实时性要求较高的系统。这种轻量化的设计使得LightRAG在资源受限的场景中更具优势。
- 提升生成答案的质量和多样性。通过图结构和双层检索机制,LightRAG能够生成更连贯、上下文丰富的回答。此外,实验结果表明,LightRAG在检索精度和效率上优于现有方法。
二、论文思路
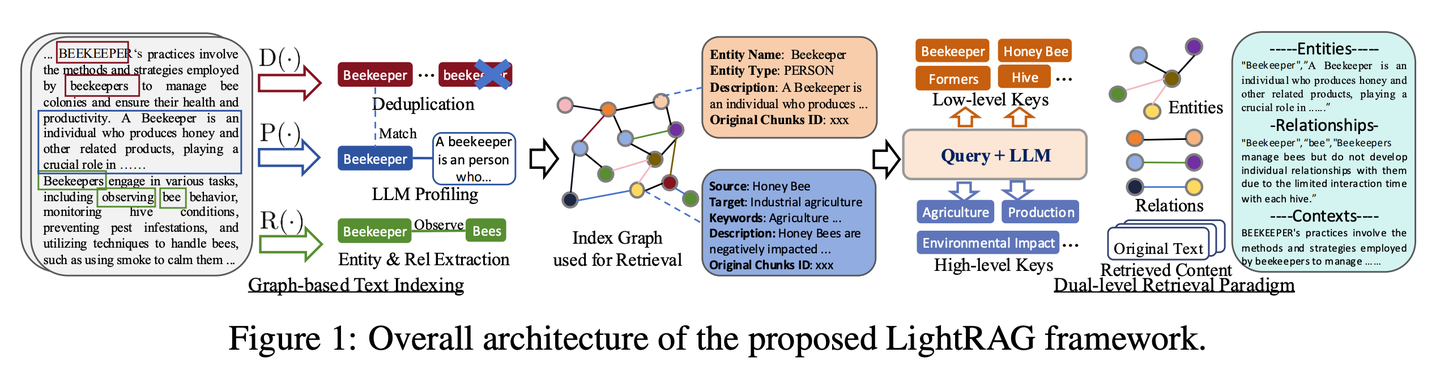
- 图基文本索引(Graph-Based Text Indexing)
- 步骤1:实体和关系提取。使用大型语言模型(LLM)提取文本中的实体和关系,并将文档分割成小块以提高处理效率。
- 步骤2:LLM Profiling生成键值对。为每个实体和关系生成键值对,键是关键词,值是相关文本段落。
- 步骤3:去重优化。通过去重优化,合并相同实体和关系,减少图操作开销。
- 双层检索范式(Dual-Level Retrieval Paradigm)
- 步骤4:生成查询关键词。从用户查询中提取局部和全局关键词。
- 步骤5:关键词匹配。使用向量数据库匹配局部关键词与候选实体,以及全局关键词与关系。
- 步骤6:整合高阶相关性。检索节点和边的一跳邻接节点,增强查询相关性。
- 检索增强答案生成
- 步骤7:使用检索到的信息。利用检索到的实体和关系信息,通过LLM生成答案。
- 步骤8:上下文整合与答案生成。将用户查询与多源文本合并,生成符合查询意图的答案。
- 增量知识库的快速适应
- 步骤9:增量更新知识库。新文档加入时,重复图基索引步骤,生成新知识图谱数据并合并到原有图谱。
- 步骤10:减少计算开销。避免重建索引图,减少计算开销,快速整合新数据。
三、实验设计与结果
- 实验验证:LightRAG在全面性、多样性和知识赋能等多个关键维度上优于现有方法,包括GraphRAG、NaiveRAG、RQ-RAG和HyDE。
- 数据集和评估维度:在四个数据集和四个评估维度下,LightRAG的胜率显著高于基线方法。
- 案例研究:通过具体查询(如“哪些指标对于评估电影推荐系统最有信息量?”),展示了LightRAG的检索和生成过程,证明了其高效性和准确性。
四、论文总结
该框架将图结构融入文本索引和检索过程中。这一创新框架采用了一个双层检索系统,从低级和高级知识发现中增强全面的信息检索。此外,将图结构与向量表示相结合,便于高效检索相关实体及其关系,显著提高了响应时间,同时保持了上下文相关性。这一能力通过增量更新算法得到了进一步增强,该算法确保了新数据的及时整合,使系统能够在快速变化的数据环境中保持有效性和响应性。
AstuteRAG【明智判官】
明智判官:对外部信息保持警惕,不轻信检索结果,善用自身积累的知识,甄别信息真伪,像资深法官一样,权衡多方证据定论。
- 发表时间:2024.10.09
- 论文名称:Astute RAG: Overcoming Imperfect Retrieval Augmentation and Knowledge Conflicts for Large Language Models
- 论文地址:https://arxiv.org/abs/2410.07176
- Github 地址:
一、论文动机
检索增强生成(RAG)技术通过整合外部知识来增强大型语言模型(LLMs)的性能,但在实际应用中,RAG可能会受到不完美检索的影响,导致引入不相关、误导甚至恶意的信息。此外,RAG系统中知识冲突的问题也未得到充分研究。这些问题可能导致系统性能下降,尤其是在最坏情况下。
二、论文思路
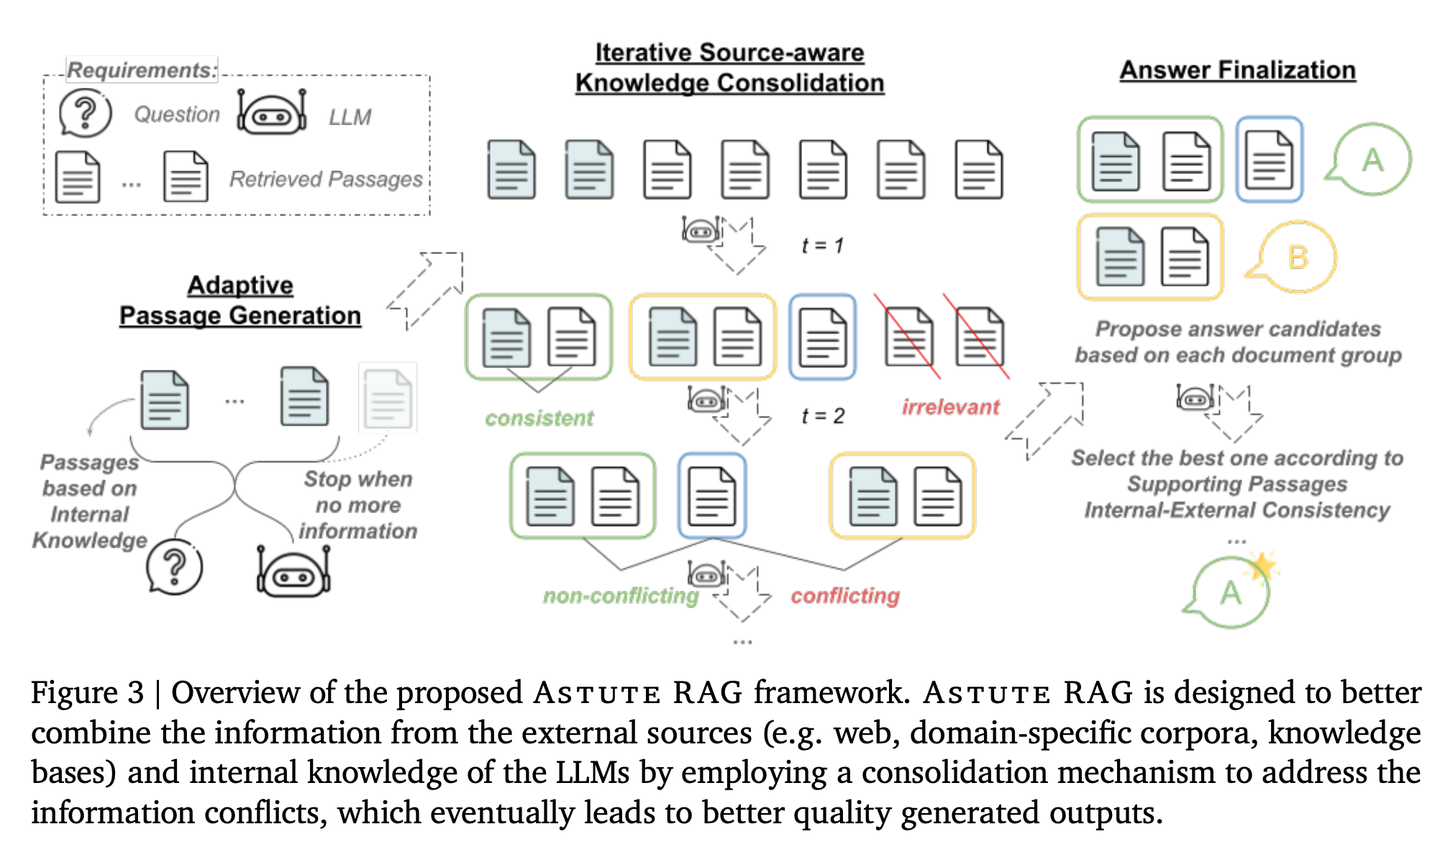
为了解决上述问题,论文提出了 Astute RAG 方法。Astute RAG通过以下机制提高系统的鲁棒性和可信度:
- 适应性信息提取:从LLMs的内部知识中动态提取必要信息。
- 源感知整合:结合外部检索结果,并根据信息的可靠性调整权重。
- 动态调整权重:在不完美检索的情况下,动态平衡内部和外部知识的贡献,以解决知识冲突。
三、实验设计与结果
实验结果表明,Astute RAG在多个数据集上表现出色,尤其是在处理不完美检索时:
- 在最坏情况下,Astute RAG能够有效避免错误信息的干扰。
- 与传统RAG方法相比,Astute RAG显著提高了答案的可靠性和系统鲁棒性。
四、论文创新点
- 适应性信息提取与源感知整合:Astute RAG能够在检索结果不理想时,动态调整内部知识和外部检索信息的权重,从而有效解决知识冲突。
- 提高系统鲁棒性:通过动态整合机制,Astute RAG在最坏情况下的表现优于传统RAG方法,甚至能够匹配或超越没有RAG的LLMs的性能。
五、论文总结
通过适应性地从LLMs内部知识中提取信息,结合外部检索结果,并根据信息的可靠性来最终确定答案,从而提高系统的鲁棒性和可信度。
TurboRAG【速记高手】
速记高手:提前把功课做好,把答案都记在小本本里。像个考前突击的学霸,不是临场抱佛脚,而是把常考题提前整理成错题本。需要的时候直接翻出来用,省得每次都要现场推导一遍。
- 发表时间:2024.10.10
- 论文名称:TurboRAG: Accelerating Retrieval-Augmented Generation with Precomputed KV Caches for Chunked Text
- 论文地址:https://arxiv.org/abs/2410.07590
- Github 地址:https://github.com/MooreThreads/TurboRAG
一、论文动机
检索增强生成(RAG)系统通过从文档集合中检索相关信息并结合生成模型来生成响应,但面临的主要问题是首次令牌时间(TTFT)的高延迟。这种延迟主要由以下因素导致:
- 处理和连接多个检索到的文档块需要大量计算。
- 检索到的文档的键值(KV)缓存的重复计算。
二、论文思路
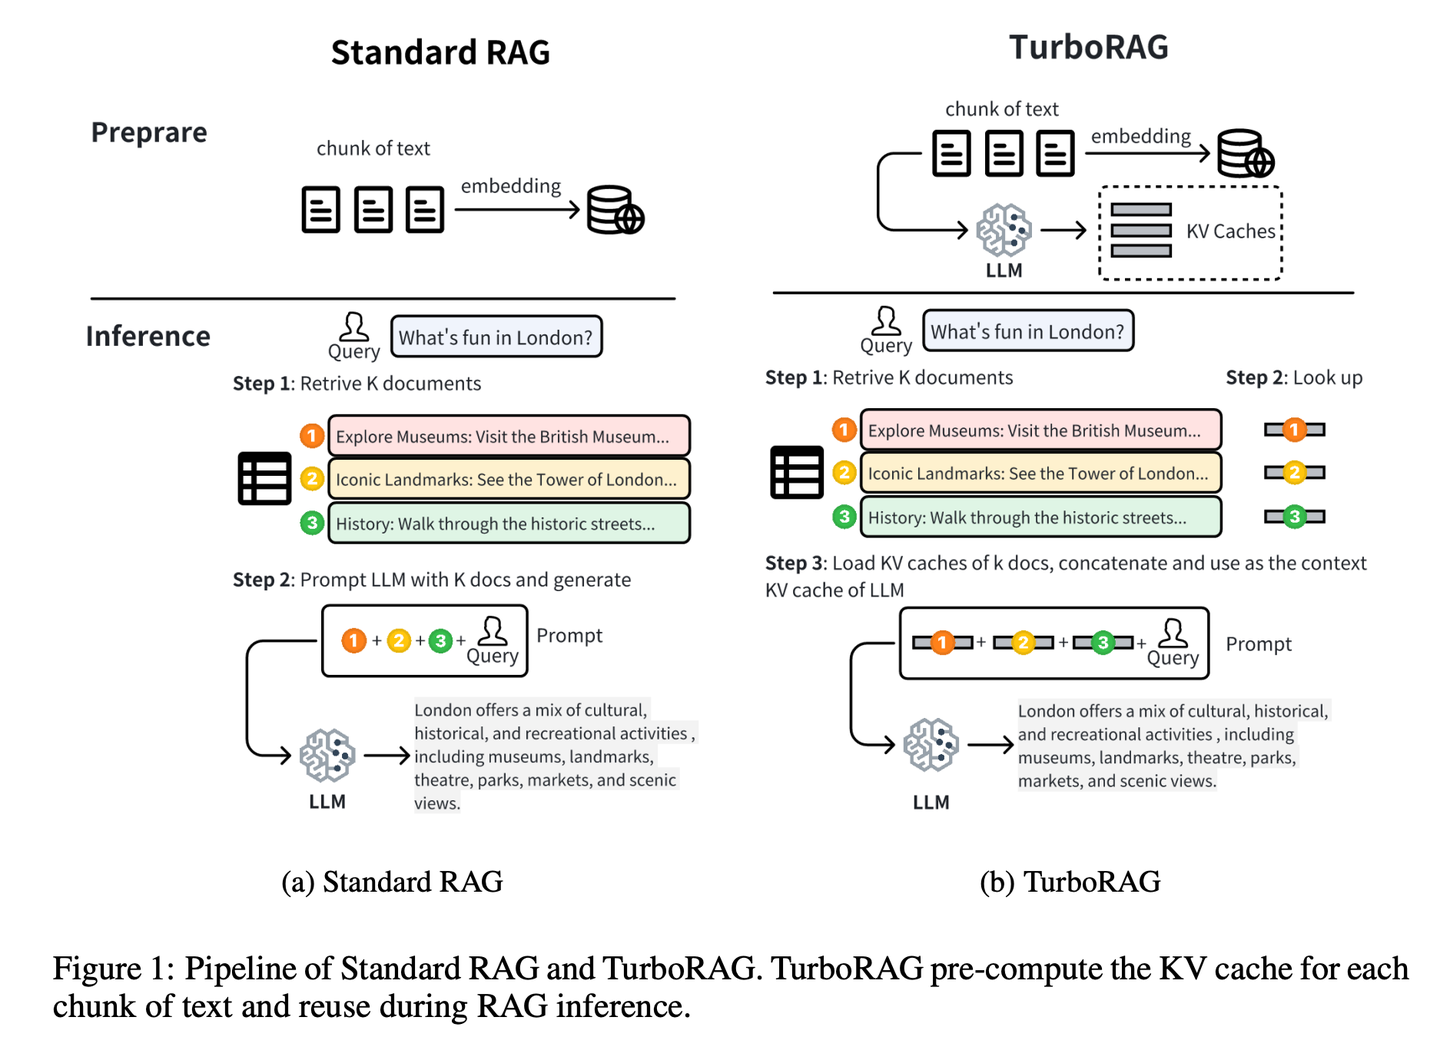
为了解决上述问题,Moore Threads AI的研究人员提出了 TurboRAG 方法。TurboRAG通过以下机制优化RAG系统的推理过程:
- 离线预计算KV缓存:计算并存储文档块的KV缓存,减少在线推理阶段的计算量。
- 在线检索预填充:
- 检索预先计算的KV缓存,并将其与用户查询结合生成响应。
- 使用独立的注意力掩码,防止跨文档的不必要注意力。
- 采用相对位置嵌入,保持文档中位置关系的完整性。
这种方法显著减少了计算开销,加快了响应时间,同时保持了生成结果的准确性。
三、实验设计与结果
实验表明,TurboRAG在降低TTFT方面表现出色:
- 延迟降低:与传统RAG系统相比,TurboRAG的TTFT降低了高达9.4倍,平均加速为8.6倍。
- 准确性保持:在多个基准测试中,TurboRAG的准确性与传统RAG方法相当。
- 计算资源优化:KV缓存计算成本降低了98%以上,支持更大的批处理大小和更高的吞吐量。
- 微调实验:即使在嘈杂的检索环境中,TurboRAG也能保持模型的准确性。
四、论文总结
TurboRAG通过将KV缓存生成与在线推理过程分离,解决了RAG系统固有的延迟问题。它通过利用预先计算的KV缓存和调整注意力机制,在保持准确性的同时显著提高了响应速度和效率。这些改进使TurboRAG成为延迟敏感型应用中部署RAG的有力选择,有望扩大RAG在实时和大规模场景中的应用范围。
StructRAG【收纳师】
收纳师:把杂乱无章的信息像收纳衣柜一样分门别类地整理好。像个模仿人类思维的学霸,不是死记硬背,而是先画个思维导图。
- 发表时间:2024.10.11
- 论文名称:StructRAG: Boosting Knowledge Intensive Reasoning of LLMs via Inference-time Hybrid Information Structurization
- 论文地址:https://arxiv.org/abs/2410.08815
- Github 地址:https://github.com/Li-Z-Q/StructRAG
一、论文动机
- 背景:传统RAG方法在处理知识密集型推理任务(如金融、法律等领域)时存在局限性,因为这些任务需要从多个信息源中提取和整合知识。
二、论文思路
- 目标:StructRAG通过模拟人类处理复杂推理的方式,将散乱信息转化为结构化知识,从而提高推理效率和准确性。
- StructRAG的工作原理:StructRAG通过以下三个核心过程实现:
- 混合结构路由器(Hybrid structure router)训练:
- 根据任务需求灵活选择最佳知识结构形式(如表格、图或算法)。
- 使用直接偏好优化(DPO)算法进行训练,无需额外奖励模型。
- 通过“合成-模拟-判断”方法构建高质量偏好对。
- 知识结构化:
- 利用LLM将散乱文本信息转化为结构化知识,提升信息可读性。
- 根据任务特性选择最优知识结构,优化信息呈现。
- 问题分解与推理:
- 结构化知识利用器将复杂问题分解为简单子问题。
- 逐步推导答案,提高推理适应性和准确性。
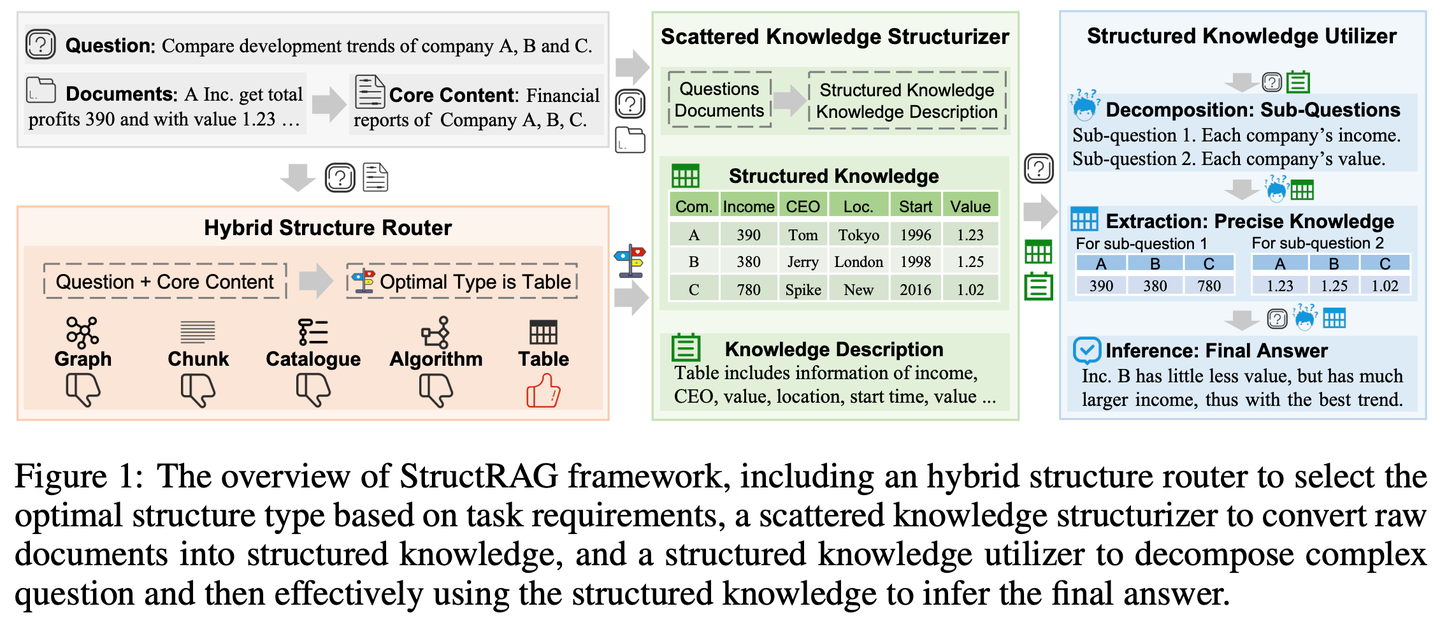
三、实验设计与结果
StructRAG在Loong基准测试任务中取得最先进的性能,随着任务复杂度增加,优势越发明显。
四、技术亮点及优势
- 技术亮点
- 混合信息结构化:根据不同任务需求灵活选择最优结构类型。
- 基于LLM的知识结构化:利用LLM的理解和生成能力构建高质量结构化知识。
- 科学问题分解与精准知识提取:通过分解问题实现对结构化知识的精确利用。
- StructRAG的优势
- 更好地处理分散信息:通过结构化知识整合多源信息。
- 任务适应性强:根据任务特性选择最优知识结构。
- 卓越性能:在知识密集型推理任务中表现优于传统RAG。
- 处理速度快:操作速度显著快于GraphRAG等方法,适合实时应用。
五、论文总结
StructRAG通过模拟人类认知过程,提升了AI系统处理复杂推理任务的能力,为金融分析、科研文献综述等知识密集型领域提供了新的解决方案。
VisRAG【火眼金睛】
火眼金睛:终于悟出文字不过是图像的一种特殊表现形式。像个开了天眼的阅读者,不再执着于逐字解析,而是直接"看"透全局。用照相机代替了OCR,懂得了"一图胜千言"的精髓。
- 发表时间:2024.10.14
- 论文名称:VisRAG: Vision-based Retrieval-augmented Generation on Multi-modality Documents
- 论文地址:https://arxiv.org/abs/2410.10594
- Github 地址:https://github.com/openbmb/visrag
一、论文动机
传统的RAG系统(TextRAG)主要依赖文本信息进行检索和生成,但在处理多模态文档时,会因为解析过程(如OCR、布局识别等)引入错误,导致信息损失和性能下降。
VisRAG旨在通过直接将文档作为图像嵌入并检索,避免解析过程中的信息损失,更全面地保留原始文档信息。
二、论文思路
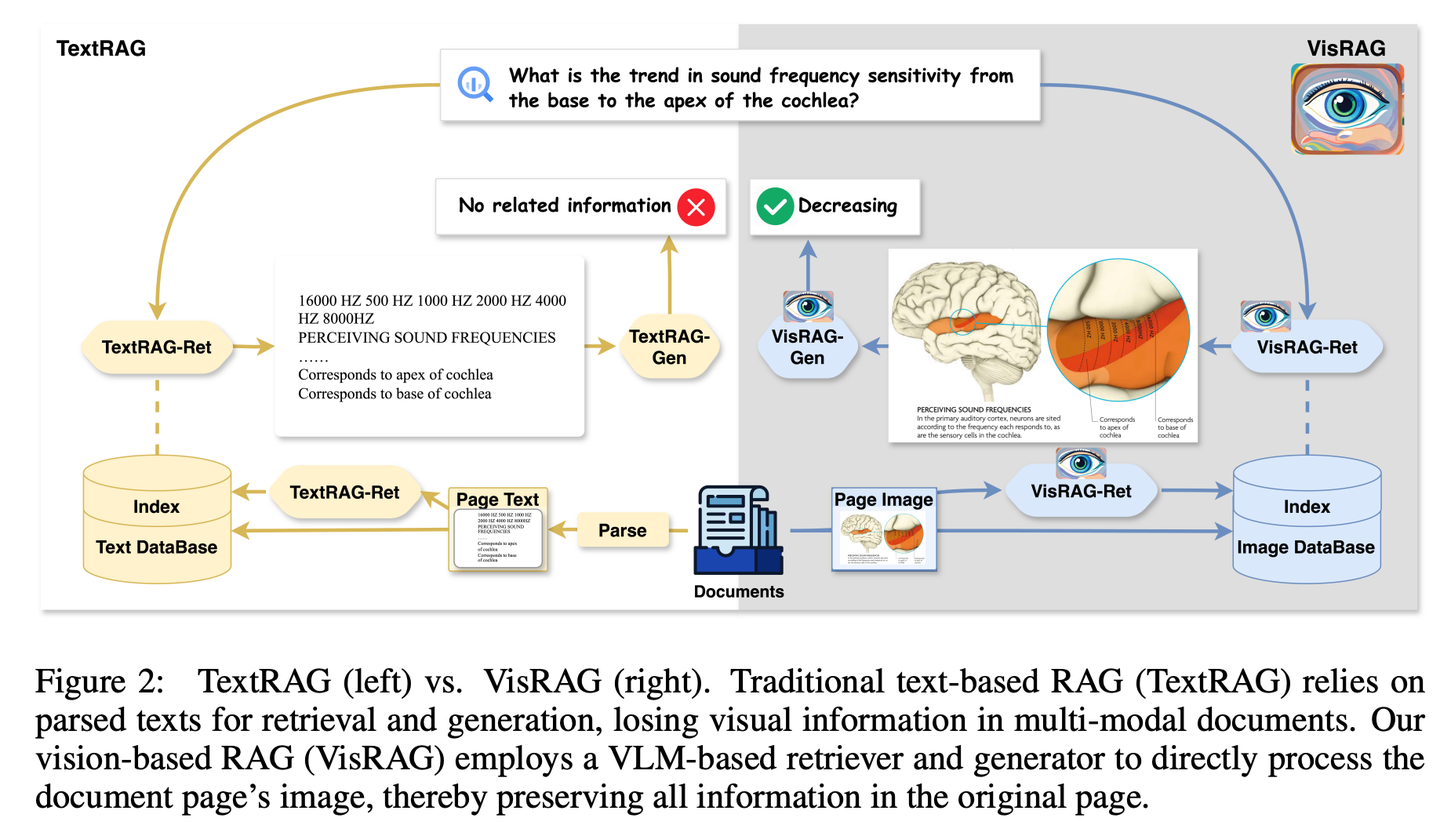
- VisRAG由两部分组成:
- VisRAG-Ret(检索阶段):使用视觉语言模型(VLM)将查询和文档图像映射到嵌入空间,通过位置加权平均池化处理VLM的最后一层隐藏状态,从而实现文档页面的检索。
- VisRAG-Gen(生成阶段):利用检索到的页面生成答案。由于多模态大模型通常只能处理单张图片,VisRAG提出了两种方案:页面合并(将检索到的页面水平合并为一张图片)和加权筛选(为每个页面生成答案并选择置信度最高的答案)。
三、实验设计与结果
- 检索性能:
- VisRAG-Ret在跨领域数据上显著超越了现有基线模型,包括文本和视觉模型。
- 在跨领域环境中,VisRAG-Ret相比传统文本模型和视觉模型分别实现了15%和22%的性能提升。
- VisRAG-Ret在内存效率上也优于其他模型,适合扩展到大规模文档集合。
- 生成性能:
- VisRAG-Gen在处理真实文档图像时,显著优于仅依赖提取文本的TextRAG-Gen。
- 在实际应用场景中,VisRAG-Gen在处理检索到的文档时持续超越TextRAG-Gen,尤其是在加权筛选方法下表现更优。
- 整体性能:
- 在六个评估数据集中,VisRAG平均实现了39%的准确率提升。
- 在InfographicsVQA数据集上,VisRAG的整体准确率从22.1%提升至42.7%,显示出其在多模态文档处理中的强大能力。
四、论文总结
VisRAG通过直接利用文档图像进行检索和生成,有效避免了传统RAG系统中解析过程带来的信息损失,显著提升了检索和生成的性能。该系统不仅在训练数据上表现出色,还展现出强大的泛化能力,成为多模态文档RAG的理想选择。
AGENTiGraph【知识管家】
知识管家:像个善于对话的图书管理员,通过日常交流帮你整理和展示知识,带着一队助手随时准备解答问题、更新资料,让知识管理变得简单自然。
- 发表时间:2024.10.15
- 论文名称:AGENTiGraph: An Interactive Knowledge Graph Platform for LLM-based Chatbots Utilizing Private Data
- 论文地址:https://arxiv.org/abs/2410.11531
- Github 地址:
一、论文动机
大型语言模型(LLM)在问答(QA)任务中表现出色,但在事实一致性和最新信息方面存在挑战。知识图谱(KG)能够提供结构化的事实信息,补充LLM的知识,减少幻觉并实现更复杂的推理任务。然而,现有的知识图谱工具和查询语言(如SPARQL和Cypher)通常缺乏用户友好的界面,难以处理复杂查询,且与LLM的集成不够紧密。因此,需要一种更适应性强、用户友好且集成度高的方法来利用知识图谱。
二、论文思路
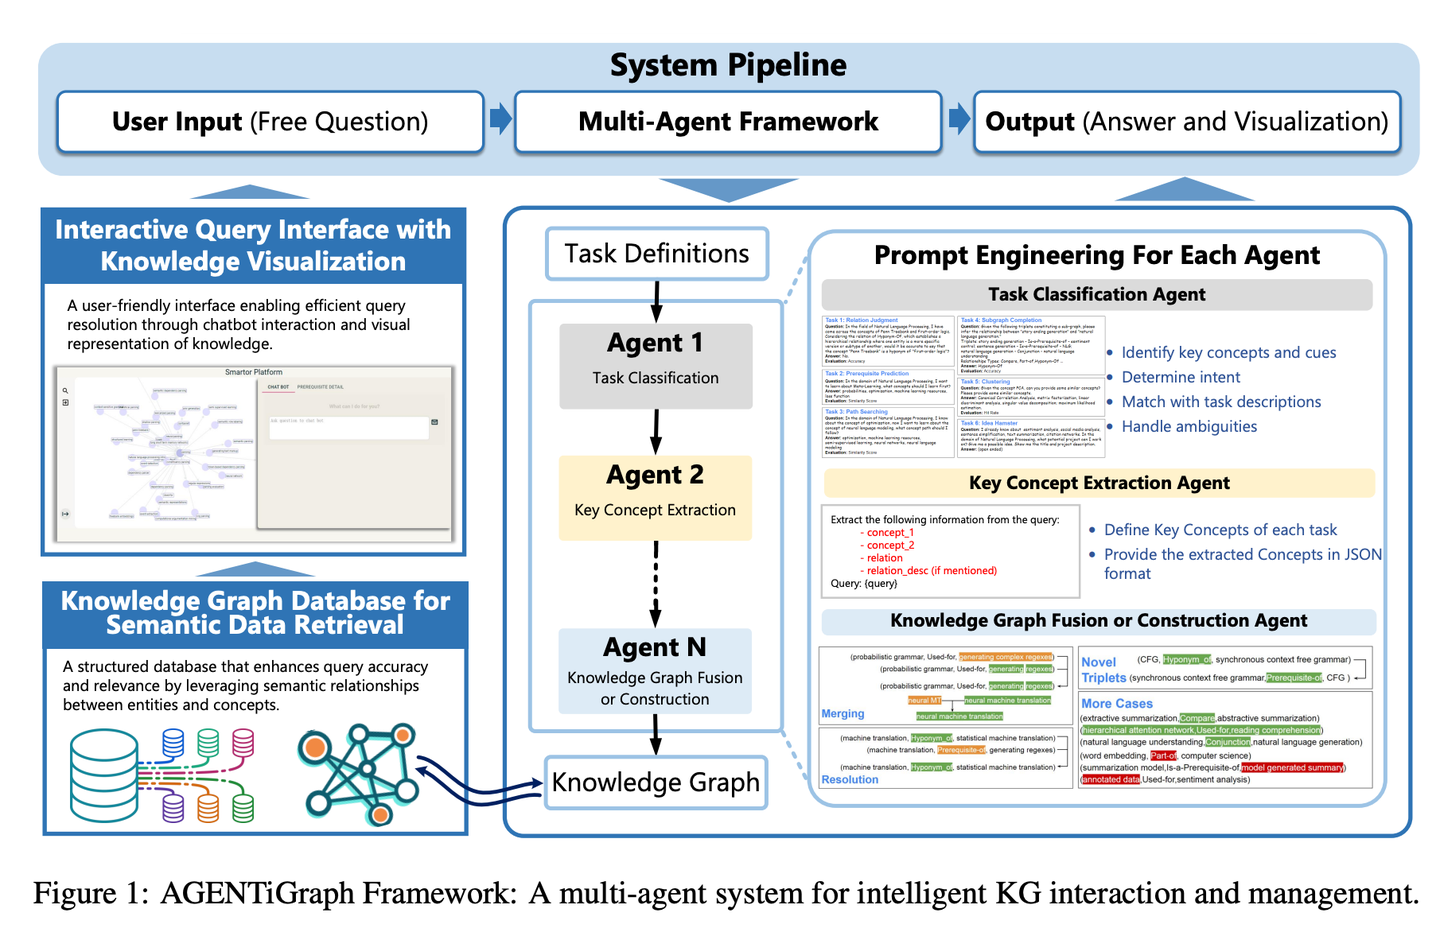
- AGENTiGraph框架设计
AGENTiGraph是一个基于多智能体系统的平台,通过自然语言交互实现知识管理。其核心是一个以人为本的方法,允许用户使用自然语言输入与系统交互。系统的主要特点包括:
- 语义解析:将自然语言查询转换为结构化图形操作,优化用户交互,降低与知识图谱交互的复杂性。
- 自适应多智能体系统:集成LLM代理,处理多模态输入(如用户意图、查询历史和图形结构),动态生成行动计划。
- 动态知识集成:支持持续的知识提取和集成,确保知识图谱保持最新,并提供动态可视化功能。
- 任务规划与执行:将用户意图分解为可执行任务,优化执行顺序,并生成逻辑结构的任务序列。
- 系统架构
AGENTiGraph的多智能体架构包括以下模块:
- 用户意图解释:通过Few-Shot Learning和Chain-of-Thought推理,准确解释用户的自然语言输入。
- 关键概念提取:执行命名实体识别(NER)和关系提取(RE),将提取的实体和关系映射到知识图谱。
- 任务规划:将意图分解为可执行任务,优化执行顺序。
- 知识图交互:将高级任务转换为可执行的图形查询,并动态调整查询以适应中间结果。
- 推理与响应生成:利用LLM的上下文理解和推理能力,生成连贯的响应。
- 动态知识集成:将新实体和关系合并到现有知识图谱中。
三、实验设计与结果
为了评估AGENTiGraph的性能,研究者开发了一个包含3,500个测试用例的数据集,涵盖六种预定义任务类型和自由格式查询。实验结果表明,AGENTiGraph在任务分类和执行方面显著优于零样本基线模型。具体指标如下:
- 任务分类准确率:最高达95.12%(GPT-4o)。
- 任务执行成功率:最高达90.45%(GPT-4o)。
用户研究进一步验证了AGENTiGraph在实际场景中的有效性,尤其是在提供简洁、集中的答案方面表现出色。然而,对于复杂任务,系统有时会遗漏关键细节或误解问题。
四、论文总结
AGENTiGraph通过自然语言交互进行知识管理的平台。它集成了知识提取、集成和实时可视化。AGENTiGraph 采用多智能体架构来动态解释用户意图、管理任务和集成新知识,确保能够适应不断变化的用户需求和数据上下文。
RuleRAG【循规蹈矩】
循规蹈矩:用规矩来教AI做事,就像带新人入职,先给本员工手册。不是漫无目的地学,而是像个严格的老师,先把规矩和范例都讲明白,然后再让学生自己动手。做多了,这些规矩就变成了肌肉记忆,下次遇到类似问题自然知道怎么处理。
- 发表时间:2024.10.15
- 论文名称:RuleRAG: Rule-guided retrieval-augmented generation with language models for question answering
- 论文地址:https://arxiv.org/abs/2410.22353
- Github 地址:https://github.com/chenzhongwu20/RuleRAG_ICL_FT
一、论文动机
大型语言模型(LLM)在上下文学习(ICL)方面表现出色,但在处理知识密集型任务时存在局限性。RAG框架通过将知识检索与答案生成解耦,显著提升了性能。
然而,现有RAG框架在检索阶段无法保证检索信息与查询的强相关性,在生成阶段也未能明确指导LLM如何利用检索到的文档。为此,本文提出RuleRAG,通过引入规则来解决这些问题。
二、论文思路
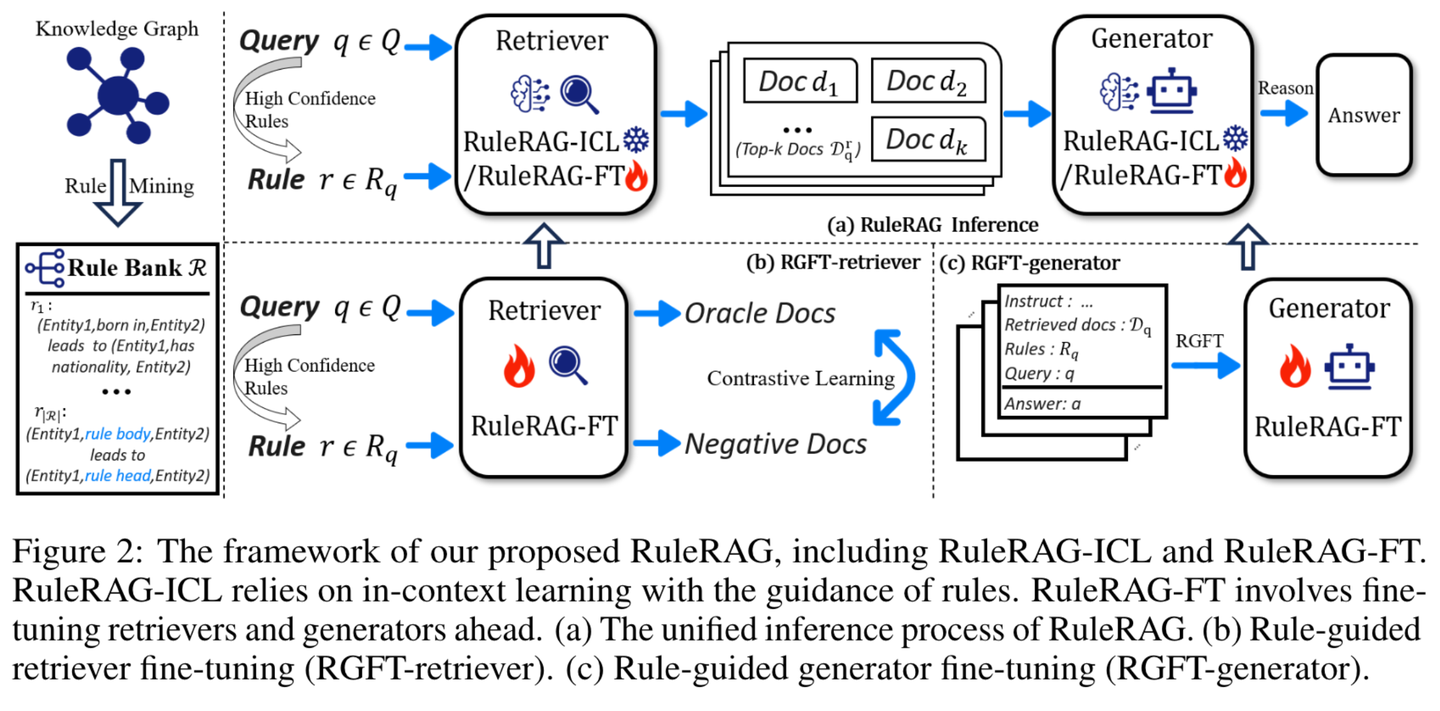
RuleRAG包括两个主要部分:无需训练的RuleRAG-ICL和经过微调的RuleRAG-FT。
- RuleRAG-ICL:通过在检索和生成阶段引入规则,指导检索器检索逻辑相关的文档,并指导生成器根据规则生成答案。具体流程如下:
- 给定查询q,从规则库R中选择与q相关的规则Rq。
- 将q与Rq中的规则r逐一结合,进行规则引导的检索,获取与规则相关的文档Drq。
- 将所有规则的检索结果Drq组合成最终检索结果Dq。
- 基于q、Rq和Dq生成最终答案a。
- RuleRAG-FT:通过规则引导的微调(RGFT)进一步提升模型性能。RGFT包括:
- 规则引导的检索器微调(RGFT-retriever):通过对比学习优化检索器,使其能够更准确地检索与规则相关的文档。
- 规则引导的生成器微调(RGFT-generator):通过监督学习优化生成器,使其能够根据规则更好地利用检索到的文档生成答案。
三、实验设计与结果
- 实验设计:作者使用了多种检索器(如DPR、SimCSE、BM25)和生成器(如LLAMA2_7B、LLAMA2_13B、ChatGLM2_6B等),并对比了RuleRAG与标准RAG及其他基线方法的性能。
- 实验结果:RuleRAG在五个基准数据集上均显著优于标准RAG和其他基线方法:
- RuleRAG-ICL在Recall@10和Exact Match(EM)等指标上平均提升了+89.2%和+103.1%。
- RuleRAG-FT进一步提升了性能,尤其是在Recall@10和EM指标上,平均提升了+45.7%和+24.2%。
四、论文总结
本文提出的RuleRAG通过引入规则显著提升了检索增强型生成模型在知识密集型问答任务中的性能。未来工作将探索RuleRAG在更复杂的查询场景下的表现,并进一步优化规则挖掘和利用机制。
Class-RAG【法官】
法官:不是靠死板的条文判案,而是通过不断扩充的判例库来研判。像个经验老到的法官,手握活页法典,随时翻阅最新案例,让判决既有温度又有尺度。
- 发表时间:2024.10.18
- 论文名称:Class-RAG: Content Moderation with Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.14881
- Github 地址:
一、论文动机
随着生成式 AI 的广泛应用,内容审核的重要性日益凸显。然而,传统的模型微调方法在处理内容审核任务时面临诸多挑战,例如标注数据的主观性强、不同地区和受众的审核要求差异大,以及持续微调成本高昂等问题。为此,本文提出了一种基于检索增强生成(RAG)的内容审核方法——Class-RAG,通过动态更新检索库来实现即时风险缓解,提升审核性能。
二、论文思路
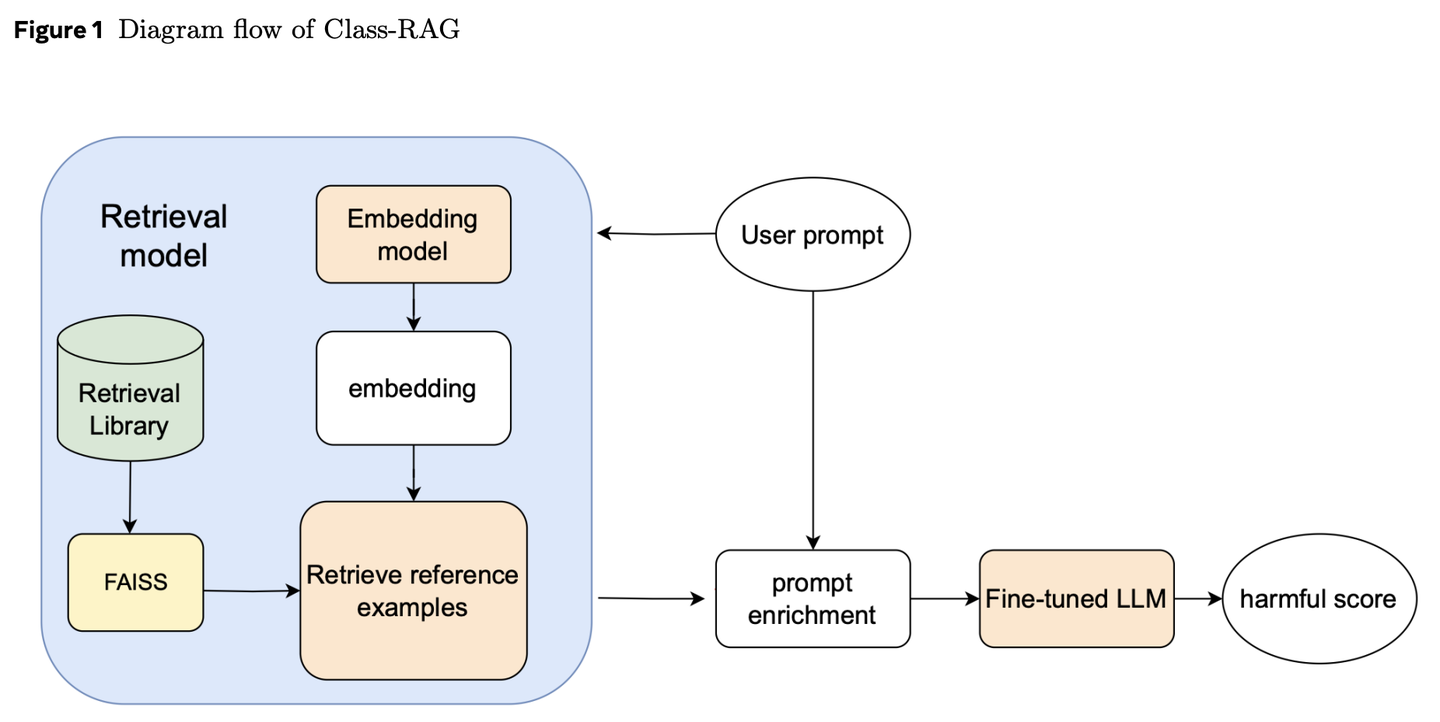
Class-RAG 的核心架构包括以下部分:
- 嵌入模型:使用 DRAGON RoBERTa 作为嵌入模型,将输入文本向量化。此外,还评估了 WPIE(Whole Post Integrity Embedding)模型的变体。
- 检索库:由安全用例库和不安全用例库组成,每个条目包含提示、标签、嵌入和解释四个属性。通过 K-Means 聚类算法从安全和不安全案例中挑选中心案例,形成检索库。
- 检索模块:利用 Faiss 库进行相似性搜索,从检索库中检索出与输入最相关的两个安全示例和两个不安全示例,使用 L2 距离度量计算相似度。
- 微调的 LLM 分类器:将检索到的参考案例和输入提示一起输入到微调的 LLM 中进行分类。
三、实验设计与结果
- 分类性能及对抗性攻击的稳健性
Class-RAG 在 CoPro 数据集的同分布(ID)和分布外(OOD)测试集上进行了全面测评,与 WPIE 和 LLAMA3 两个基线模型对比。结果显示,Class-RAG 在分类性能上优于基线模型,尤其是在对抗性攻击方面表现出更强的稳健性。
- 对外部数据源的适应能力
Class-RAG 的一个重要优势是能够快速适应外部数据,而无需重新训练模型。实验表明,加入外部数据源后,Class-RAG 在 I2P++ 数据集上的 AUPRC 分数从 0.229 提升至 0.791,对抗性攻击性能从 0.235 提升至 0.677;在 UD 数据集上,AUPRC 分数从 0.917 提升至 0.985,对抗性攻击性能从 0.914 提高到 0.976。
- 遵循指令的能力
Class-RAG 具有很强的遵循参考示例的能力。在带有翻转 ID 库的测试中,99.49% 的真实安全示例的预测标签成功翻转,而真实不安全示例的翻转率仅为 12.29%。
- 相对于检索库大小的性能可扩展性
实验表明,随着检索库规模的扩大,Class-RAG 的性能稳步提升。在 I2P++ 数据集上,AUPRC 分数从无外部库时的 0.235 提升至完整外部库时的 0.677;在 UD 数据集上,AUPRC 分数从 0.914 提升至 0.974。扩大检索库规模是一种经济高效的提升性能的策略。
- 参考样本数量对性能的影响
增加参考样本数量能够提升 Class-RAG 的性能,但计算成本也会增加。实验表明,在 I2P++ 数据集上,参考样本数量从 0 增加到 8 时,AUPRC 分数从 0.303 提升至 0.721;在 UD 数据集上,AUPRC 分数从 0.932 提升至 0.980。
- 嵌入模型对性能的影响
DRAGON RoBERTa 的嵌入效果优于 WPIE 模型。在 ID 测试集上,DRAGON RoBERTa 的平均 AUPRC 为 0.938,而在 OOD 测试集上为 0.920,均优于 WPIE 的表现。
四、论文总结
Class-RAG 通过检索增强生成技术,有效提升了内容审核的性能,尤其是在对抗性攻击的稳健性和对外部数据的适应能力方面表现出色。通过动态更新检索库,Class-RAG 能够灵活应对不断变化的内容审核需求,同时降低了持续微调的成本。
Self-RAG【反思者】
反思者:在回答问题时,不仅会查阅资料,还会不断思考和检查自己的答案是否准确完整。通过"边说边想"的方式,像一个谨慎的学者一样,确保每个观点都有可靠的依据支持。
- 发表时间:2024.10.23
- 论文名称:Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection
- 论文地址:https://arxiv.org/abs/2410.11511
- Github 地址:https://github.com/AkariAsai/self-rag
一、论文动机
随着LLM+RAG(检索增强)技术在自然语言处理领域的广泛应用,如何保证检索内容的有效性、验证检索内容对输出结果的支持性以及区分输出结果的来源成为当前技术框架下的主要问题。
为了解决这些问题,本文提出了一种新的框架——self-RAG(通过自我反思学习检索、生成和批评)。
二、论文思路
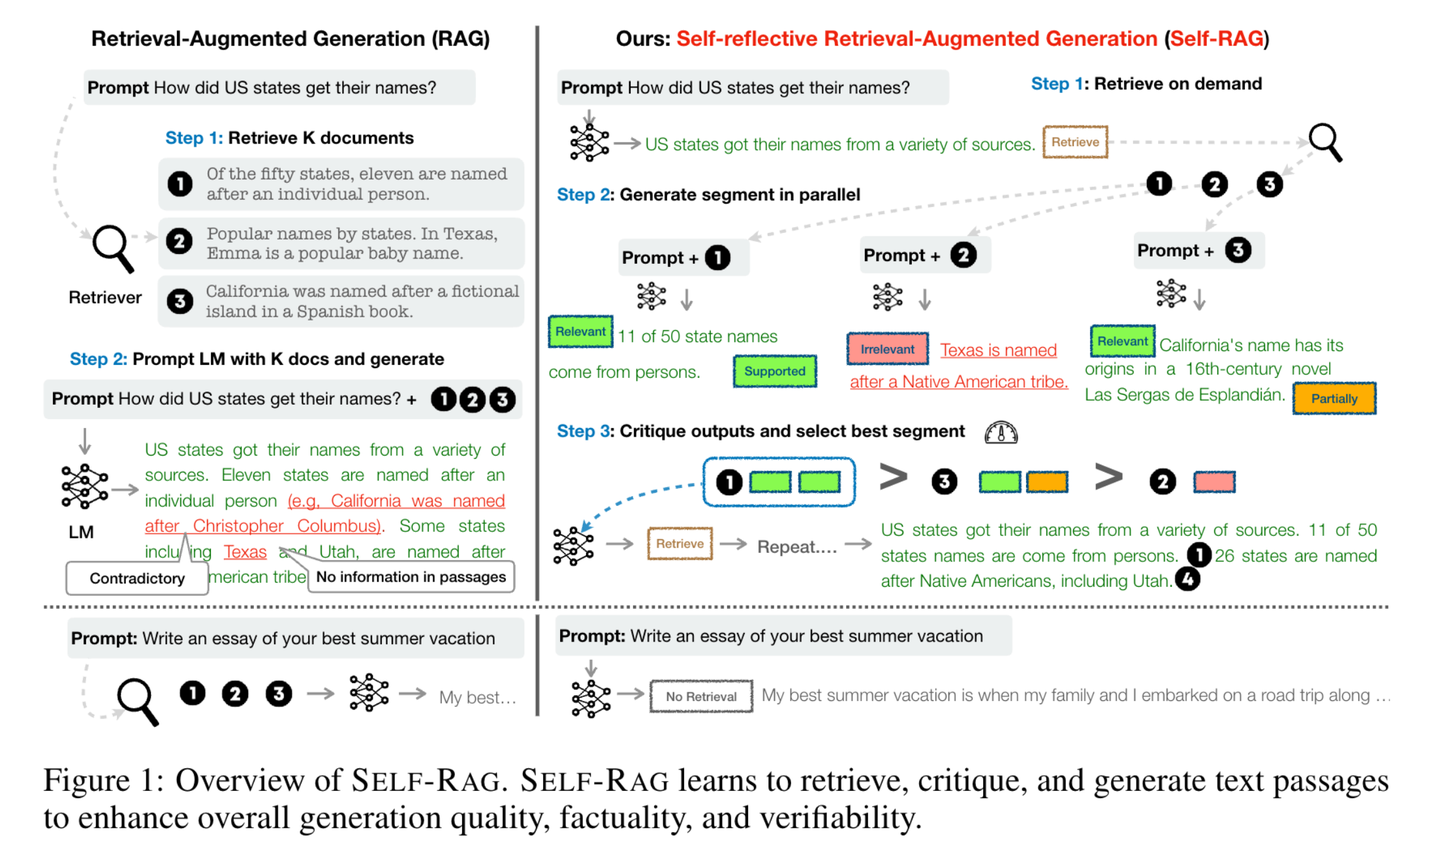
- 框架设计
self-RAG框架通过引入特殊的token来实现对检索和生成过程的精细控制。具体流程如下:
- 按需检索:在生成过程中,模型通过触发[Retrieve] token决定是否需要检索内容。
- 并行生成与评价:模型利用检索到的内容进行生成,并在生成过程中插入评价token(如[Relevant]、[Supported]、[Irrelevant]、[Partially])来判断检索内容的相关性和支持程度。
- 筛选输出:根据评价token对生成的内容进行排序,选择最佳片段作为最终输出。
- 特殊token的定义
self-RAG定义了以下四种特殊token:
- [Retrieve]:决定是否需要检索内容(取值为yes或no)。
- [IsREL]:判断检索内容的相关性。
- [IsSUP]:判断检索内容对生成内容的支持程度。
- [IsUSE]:判断检索内容的有用性。
- 实现方法
- 评价模型C。评价模型C用于生成监督数据,辅助生成模型M的训练。其训练目标是预测检索内容的相关性、支持程度和有用性。监督数据通过GPT-4和人工标注的方式收集,以降低标注成本。
- 生成模型M。 生成模型M基于LLM进行SFT(监督微调),训练过程中加入评价模型C预测的标签信息。模型的训练目标是生成目标内容的同时,生成与检索内容相关的标签信息。
- 推理过程
- 若生成的[Retrieve]标签为yes,则触发检索器召回相关片段。
- 利用召回的片段预测评价标签,并根据标签对生成内容进行排序,选择最佳结果。
- 若[Retrieve]标签为no,则直接生成目标内容。
三、实验设计与结果
- 性能提升。
在六个问答数据集上,self-RAG相比其他LLM+RAG框架有显著提升,最多可带来5个点以上的性能提升。
- 检索的影响
实验表明,检索对LLM生成效果有显著影响,检索增强的生成结果在质量和事实性上优于不使用检索的结果。
四、优势与不足
- 优势
- 精细控制:通过特殊token实现对检索和生成过程的精细控制,提升生成内容的质量和验证性。
- 灵活性:框架设计灵活,可扩展性强,适用于多种LLM和RAG架构。
- 不足
- 推理成本:生成和判断标签的过程增加了推理成本。
- 优化空间:标签设计和召回文档的筛选过程仍有优化空间,例如减少标签数量或优化小模型的筛选效率。
五、论文总结
self-RAG框架通过引入特殊token,实现了对检索和生成过程的精细控制,显著提升了LLM+RAG框架的性能。尽管推理成本有所增加,但其在生成质量和事实性上的提升为未来的研究提供了新的方向。
SimRAG【自学成才】
自学成才:面对专业领域时,先自己提问再自己回答,通过不断练习来提升专业知识储备,就像学生通过反复做习题来熟悉专业知识一样。
- 发表时间:2024.10.23
- 论文名称:SimRAG: Self-Improving Retrieval-Augmented Generation for Adapting Large Language Models to Specialized Domains
- 论文地址:https://arxiv.org/abs/2410.17952
- Github 地址:
一、论文动机
RAG通过检索相关文档来增强模型的回答能力,类似于人类在回答问题前查阅资料的过程。尽管RAG技术不断改进,但在专业领域的表现仍不理想,主要原因是模型可能无法正确利用检索到的专业文献。
二、论文思路
SimRAG框架分为两个阶段:基础训练和自我提升。
- 基础训练
基础训练阶段的目标是让模型掌握基本能力:
- 指令理解能力:使用OpenAssistant、Dolly和SODA等数据集训练模型理解人类指令。
- 问答能力:使用Squad、DROP和NQ等问答数据集提升模型的解题能力。
- 检索能力:训练模型从文档中找到可能的答案,并根据文档和答案生成问题。
- 自我提升
自我提升阶段是SimRAG的核心,模型利用基础训练阶段学到的能力来自我提升:
- 答案生成:模型阅读专业文献,提取关键信息作为潜在答案。
- 问题生成:基于提取的答案,生成不同类型的问题(如填空题、多选题、判断题)。
- 质量控制:筛选生成的问题,确保答案在文档中可找到,且问题清晰合理。
三、实验设计与结果
-
实验设计: SimRAG在三个专业领域进行了测试
- 医疗领域:使用PubMedQA、BioASQ、MedQA等7个数据集。
- 科学领域:使用ARC、SciQ、MMLU-sci等3个数据集。
- 计算机科学领域:使用CS-Bench数据集。
-
实验结果:SimRAG在医疗、科学和计算机科学领域的表现如下
- 医疗领域:SimRAG在多个数据集上超越了通用大模型和专业领域模型。
- 科学领域:SimRAG在ARC、SciQ和MMLU-sci数据集上表现优异。
- 计算机科学领域:SimRAG在CS-Bench数据集上取得了较好的成绩。
四、论文总结
SimRAG通过让模型同时学会回答和提出问题,提升了LLM在专业领域的表现。其核心在于利用检索增强生成技术,结合自我提升策略,让模型更好地理解和应用专业知识。尽管存在一些局限性,但SimRAG为领域适应性模型的研究提供了新的思路。
ChunkRAG【摘抄达人】
摘抄达人:先把长文章分成小段落,再用专业眼光挑出最相关的片段,既不遗漏重点,又不被无关内容干扰。
- 发表时间:2024.10.23
- 论文名称:SimRAG: Self-Improving Retrieval-Augmented Generation for Adapting Large Language Models to Specialized Domains
- 论文地址:https://arxiv.org/abs/2410.17952
- Github 地址:
一、论文动机
本文提出了一种名为 ChunkRAG 的框架,旨在通过在块级别评估和过滤检索信息,解决RAG系统中生成响应的不相关性和幻觉问题。该方法将文档分割成语义块,并使用LLM对每个块与查询的相关性进行评分,从而排除不相关内容。实验表明,ChunkRAG在精确信息检索任务上优于现有RAG模型,尤其适用于事实推理和多跳推理场景。
二、论文思路
ChunkRAG通过以下步骤实现对检索信息的细粒度过滤:
- 语义分块
- 句子分词:使用NLTK的 sent_tokenize 函数将文档分割成句子。
- 句子嵌入生成:使用OpenAI的 text-embedding-3-small 模型为每个句子生成嵌入向量。
- 相似度计算:计算连续句子之间的余弦相似度,若相似度低于阈值(如0.7),则认为主题发生变化。
- 块边界识别:基于相似度分数识别块边界。
- 块创建:根据边界将句子分组成块,每个块长度不超过500字符。
- 块过滤
- 初始过滤:移除冗余块,并按语义相似度排序。
- 高级LLM评分:
- 初始LLM评分:LLM为每个块分配初始相关性分数。
- 自我反思:LLM反思初始评分并调整。
- 批评LLM评分:第二个LLM独立评估块并分配分数。
- 最终分数计算:通过平均初始、反思和批评分数获得最终相关性分数。
- 动态阈值确定:LLM分析分数分布,确定动态阈值,保留相关性高于阈值的块。
- 检索和排序
- 混合检索:结合BM25检索器和基于LLM的相似度检索。
- 块重排:使用Cohere的重排序模型对块进行语义相关性排序。
- 答案生成
- 上下文编译:将过滤后的块编译成LLM的上下文。
- 生成答案:LLM根据上下文和用户问题生成简洁答案。
三、实验设计与结果
- 实验设计
- 数据集:实验在 PopQA 数据集上进行,这是一个短形式问答基准数据集,包含多样化的问题,适合评估检索增强生成模型。
- 基线:对比了多种LLM(如LLaMA2、Alpaca)和RAG变体(如标准RAG、Self-RAG、CRAG)。
- 评估指标:使用 准确性 作为评估指标
- 实验结果
- 性能比较:ChunkRAG在PopQA数据集上的准确率达到 64.9%,显著优于所有基线模型。与最接近的CRAG(54.9%)相比,性能提升了 10个百分点。
- 多步推理:在多步推理任务中,ChunkRAG的成功率比CRAG高出 66%,表明其在复杂推理任务中的优势。
- 观察与见解:ChunkRAG的主要改进来自于 块级过滤 和 细粒度相关性评估。通过语义分块,减少了生成不相关或弱相关信息的情况,显著提高了生成答案的事实准确性和连贯性。
四、优势与不足
- 优势
- 块级过滤:显著减少无关信息和幻觉。
- 语义分块:提高检索效率和准确性。
- LLM评分机制:通过自我反思和批评LLM提高评分可靠性。
- 动态阈值:灵活确定块的相关性。
- 高准确性:在PopQA数据集上表现优异。
- 不足
- 依赖性:依赖块分割和嵌入质量,划分错误可能导致不相关数据。
- 计算成本:LLM评估成本较高,尤其在大规模数据集或实时系统中。
- 多领域验证:在其他领域的验证不足,性能有待进一步分析。
五、论文总结
FastGraphRAG【雷达】
雷达:像谷歌网页排名一样,给知识点也排出个热度榜。就好比社交网络中的意见领袖,越多人关注就越容易被看见。它不是漫无目的地搜索,而是像个带着雷达的侦察兵,哪里的信号强就往哪里看。
- 发表时间:2024.10.23
- 论文名称:
- 论文地址:
- Github 地址:https://github.com/circlemind-ai/fast-graphrag
一、论文动机
传统的GraphRAG框架在处理复杂查询和大规模知识库时面临两大挑战:精确度不足和计算成本高昂。
为了解决这些问题,研究者提出了Fast GraphRAG,通过将经典的PageRank算法融入GraphRAG框架,显著提升了检索精度并降低了计算成本。
二、论文思路
- Fast GraphRAG的核心创新
Fast GraphRAG的核心:将PageRank算法应用于知识图谱的遍历过程。PageRank算法原本用于搜索引擎中评估网页的重要性,Fast GraphRAG借鉴这一原理,通过计算知识图谱中节点的重要性得分,快速定位最相关的信息节点。这种方法类似于为GraphRAG安装了一个“重要性雷达”,能够在海量数据中快速筛选和排序关键信息。

三、关键优势
Fast GraphRAG带来了以下显著优势:
- 精准检索:通过PageRank算法,系统能够快速定位最相关的信息节点,提高答案的准确性。
- 降低成本:与传统GraphRAG相比,Fast GraphRAG将处理成本降低了约6倍。
- 实时更新:支持动态添加新数据,并自动更新知识图谱,适应不断变化的信息环境。
- 可解释性:提供可视化的知识图谱和查询路径,增强系统的可解释性和可信度。
四、论文总结
Fast GraphRAG通过融合PageRank算法,显著提升了知识检索的效率和精准度,同时降低了运营成本。这一创新使得GraphRAG能够实时更新和调整知识重要性,适应动态变化的信息环境。Fast GraphRAG的出现为构建智能、高效的知识管理系统提供了新的思路,也展示了经典算法在大模型应用中的创新潜力。
AutoRAG【调音师】
调音师:一位经验丰富的调音师,不是靠猜测调音,而是通过科学测试找到最佳音效。它会自动尝试各种RAG组合,就像调音师测试不同的音响设备搭配,最终找到最和谐的"演奏方案"。
- 发表时间:2024.10.28
- 论文名称:AutoRAG: Automated Framework for optimization of Retrieval Augmented Generation Pipeline
- 论文地址:https://arxiv.org/abs/2410.20878
- Github 地址:https://github.com/Marker-Inc-Korea/AutoRAG_ARAGOG_Paper
一、论文动机
在实际应用中,选择适合特定数据和用例的RAG(检索增强生成)技术栈是一个复杂且耗时的任务。市面上存在多种RAG模块和Pipeline,但缺乏一种简单的方法来评估和选择最适合的组合。
为此,研究者提出了 AutoRAG,这是一个自动化工具,能够自动评估多种RAG模块组合,并找到最适合特定用例的RAG Pipeline。
二、AutoRAG的核心功能
AutoRAG通过以下方式实现对RAG技术栈的优化:
-
支持多种模块:
- 解析模块:支持16种解析模块,包括PDFMiner,PDFPlumber,PyPDFium2,PyPDF,PyMuPDF,UnstructuredPDF,NaverClovaOCR,llama Parse,Upstage Document Parser,Directory,Unstructured,csv,json,unstructuredmarkdown,bshtml,unstructuredxml。
- 切块模块:支持10种切块模块,如Token,SentenceTransformersToken,Character,RecursiveCharacter,Sentence,Konlpy ,Semantic_llama_index,SemanticDoubleMerging,SentenceWindow,SimpleFile。
- 重排:UPR,Tart,MonoT5,Cohere reranker,RankGPT,Jina Reranker,Sentence Transformer Reranker,Colbert Reranker,Flag Embedding Reranker,Flag Embedding LLM Reranker,Time Reranker,OpenVINO Reranker,VoyageAI Reranker,MixedBread AI Reranker,Ko-reranker,pass_reranker
- Query理解:query_decompose,hyde,multi_query_expansion,pass_query_expansion
- 检索:bm25,vectordb,hybrid_rrf,hybrid_cc
- 评价指标:支持15种评价指标,如Precision,Recall,F1,MRR (Mean Reciprocal Rank),MAP (Mean Average Precision),NDCG (Normalized Discounted Cumulative Gain),Token Precision,Token Recall,Token F1,BLEU,ROUGE,METEOR,Sem Score,G-Eval,Bert Score。
-
自动化评估:
- 用户可以提供自己的 QA数据集 和 Corpus数据集,AutoRAG将自动评估不同的RAG模块组合。
- 通过设置YAML文件,用户可以定义评估的参数和目标。
- AutoRAG将运行评估流程,自动选择最佳的RAG Pipeline。
-
数据准备。为了优化RAG性能,需要准备两种类型的数据:
- QA数据集:用于准确可靠的评估和优化。
- Corpus数据集:用于RAG检索文档并生成答案。
-
优化步骤
- 设置YAML文件:定义评估的参数和目标。
- 运行评估:AutoRAG自动评估不同的RAG模块组合。
- 优化过程:根据评估结果选择最佳的RAG Pipeline。
- 部署:将优化后的RAG Pipeline部署到实际应用中。
三、优势
AutoRAG的主要优势在于:
- 自动化:简化了RAG模块选择和评估的过程,节省时间和精力。
- 灵活性:支持多种RAG模块和评价指标,适应不同的数据和用例。
- 高效性:通过自动化评估,快速找到最适合的RAG技术栈。
四、论文总结
AutoRAG通过自动化评估多种RAG模块组合,帮助用户快速找到最适合特定数据和用例的RAG技术栈。它支持多种解析、切块、检索和评价模块,简化了优化流程,提高了RAG系统的性能和效率。
Plan×RAG【项目经理】
项目经理:先规划后行动,把大任务分解成小任务,安排多个"专家"并行工作。每个专家负责自己的领域,最后由项目经理统筹汇总结果。这种方式不仅更快、更准,还能清楚交代每个结论的来源。
- 发表时间:2024.10.28
- 论文名称:Plan×RAG: Planning-guided Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.20753
一、论文动机
Plan×RAG(Planning-guided Retrieval Augmented Generation)旨在通过增强现有的检索增强生成(RAG)框架,解决大型语言模型(LLM)在复杂查询中的性能、幻觉和归因问题。
传统的“检索-推理”范式在处理复杂多跳查询时存在局限性:
- 检索局限:检索到的文档可能不完整或不相关,导致推理过程受限。
- 上下文窗口限制:大型语言模型的上下文窗口有限,检索到的文档可能无法完全利用。
- 缺乏规划:传统的“检索-推理”范式缺乏对查询的结构化分解和规划,难以处理复杂的多跳查询。
二、论文思路
Plan×RAG(Planning-guided Retrieval Augmented Generation)框架的实现主要包括以下几个关键步骤和组件:
- 生成推理计划(Reasoning Plan)
- 推理有向无环图(DAG):使用大型语言模型(如GPT-4)生成一个推理计划,表示为一个有向无环图(DAG)。这个DAG将原始查询分解为相互关联的原子子查询(Atomic Sub-queries)。
- 结构化分解:每个子查询只依赖于其父节点的答案,确保推理过程遵循马尔可夫假设(Markov Assumption),即每个子查询的答案只依赖于其直接父节点的答案。
- 插拔式专家系统(Plug-and-Play Experts)
- 动态查询专家(Dynamic Query Expert):负责生成子查询,并确保子查询之间的马尔可夫依赖关系。动态查询专家将父节点的答案嵌入到子查询中,生成完整的子查询。
- 批评家专家(Critic Expert):评估生成过程中是否需要额外信息,动态触发检索。批评家专家分析当前上下文和生成任务,决定是否需要检索额外信息。
- 相关性专家(Relevance Expert):确保选择最相关的文档进行检索,减少上下文窗口的使用。相关性专家对检索到的文档进行相关性评分、排序和选择。
- 聚合器专家(Aggregator Expert):将多个子查询的答案整合为对原始查询的综合响应。聚合器专家确保最终响应全面、平衡地覆盖原始查询的所有方面。
- 并行化和信息流管理
- 并行处理:DAG结构允许同一深度的子查询并行处理,显著提高了系统的效率。不同深度的子查询可以独立处理,减少了整体推理时间。
- 相关信息流动:DAG结构确保只有相关的信息在子查询之间流动,抽象掉不必要的信息,提高了上下文利用的效率。
- 动态检索和生成
- 动态检索:在生成每个子查询的答案时,Plan×RAG可以根据需要动态触发检索,确保在需要时获取额外信息。批评家专家负责评估生成过程中是否需要额外信息,动态触发检索。
- 相关性过滤:相关性专家确保选择最相关的文档进行检索,减少上下文窗口的使用,提高检索效率。
- 增强归因和可解释性
- 归因设计:通过将每个子查询的生成内容与单个检索文档直接关联,Plan×RAG确保了生成内容的归因,增强了系统的可解释性和可信度。
- 单一文档检索:默认配置下,相关性专家确保每个子查询只检索一个最相关的文档,进一步增强了归因能力。
- 调试和回溯
- 调试能力:DAG结构提供了强大的调试能力,允许系统回溯到错误的生成节点,分析和纠正错误。通过分析DAG和相应的子查询,可以识别和修正错误的生成内容。
- 回溯机制:在识别错误节点后,可以仅重新生成受影响的路径,并重新运行聚合器,确保最终生成的响应是正确的。
三、具体实现步骤
- 生成推理DAG:
- 使用GPT-4生成推理DAG,将原始查询分解为多个子查询。
- 每个子查询包含一个特殊标签(如),用于动态嵌入父节点的答案。
- 处理每个子查询:
- 按照DAG的拓扑顺序处理每个子查询。
- 对于每个子查询,动态查询专家生成完整的子查询。
- 批评家专家评估是否需要检索额外信息,动态触发检索。
- 相关性专家选择最相关的文档进行检索。
- 生成器语言模型(如Llama3-8B-instruct)生成子查询的答案。
- 整合答案:
- 聚合器专家将所有子查询的答案整合为对原始查询的综合响应。
- 调试和回溯:
- 如果生成的答案有误,通过分析DAG和相应的子查询,识别和修正错误。
- 仅重新生成受影响的路径,并重新运行聚合器,确保最终生成的响应是正确的。
四、实验设计与结果
- 数据集
- HotpotQA:多跳问答数据集。
- StrategyQA:需要多步推理的问答数据集。
- ARC-Challenge:科学考试问答数据集。
- PopQA:单跳问答数据集。
- 基线方法
- Vanilla LLMs:不使用检索的LLMs,如GPT-3.5、Llama2-7B、Llama2-13B和Llama3-8B。
- 标准RAG:使用LLMs的RAG方法。
- Self-RAG:自反思的RAG方法。
- RQ-RAG:动态查询重写和分解的RAG方法。
- 性能对比
- HotpotQA:Plan×RAG的Accuracy为35.67%,F1 Score为39.68%。
- StrategyQA:Plan×RAG的Accuracy为69.49%,F1 Score为64.03%。
- ARC-Challenge:Plan×RAG的Accuracy为74.12%,F1 Score为81.30%。
- PopQA:Plan×RAG的Accuracy为36.09%,F1 Score为35.20%。
- LLM评估
- 使用GPT-3.5-Turbo作为外部评估器,比较Self-RAG和Plan×RAG在PopQA数据集上的表现。尽管传统准确率指标显示Plan×RAG与Self-RAG之间存在差距,但LLM-Eval指标显示两者生成的答案在语义上非常相似,差距仅为2.09%和3.32%。
- 消融研究
- 批评家专家的有效性:批评家专家通过动态触发检索,显著减少了检索次数,同时保持了几乎相同的性能。在1500个HotpotQA查询中,批评家专家配置比始终检索配置减少了600次检索,仅导致0.5%的准确率下降和0.80的F1分数下降。
- 相关性专家的有效性:相关性专家通过过滤噪声检索,显著提高了系统性能。在1500个HotpotQA查询中,相关性专家配置的准确率为39.33%,F1分数为42.01%,而无相关性专家配置的准确率为31.60%,F1分数为36.18%。
五、论文总结
Plan×RAG通过引入推理计划和插拔式专家系统,解决了传统RAG方法在处理复杂查询时的局限性,显著提高了系统的性能、准确性和可解释性。其设计使其能够与任何预训练的LLM兼容,无需微调,具有广泛的适用性。
SubgraphRAG【定位仪】
定位仪:不是漫无目的地大海捞针,而是精准绘制一张小型知识地图,让 AI 能快速找到答案。
- 发表时间:2024.10.28
- 论文名称:Simple is Effective: The Roles of Graphs and Large Language Models in Knowledge-Graph-Based Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.20724
- Github 地址:https://github.com/Graph-COM/SubgraphRAG
一、论文动机
大型语言模型(LLMs)在多种领域表现出色,但在推理能力上仍存在局限性,例如幻觉(hallucination)、知识过时以及缺乏特定领域的专业知识。
检索增强生成(RAG)通过整合外部知识来解决这些问题,但现有方法在检索效率和有效性之间难以平衡。本文提出了一种新的框架——SubgraphRAG,通过检索知识图谱(KG)的子图并利用LLMs进行推理和答案预测,旨在提高RAG系统的效率和准确性。
二、论文思路
SubgraphRAG的核心是将知识图谱中的子图检索与LLMs的推理能力相结合。该框架通过以下步骤实现:
- 查询解析和实体提取:从用户查询中识别出主题实体(topic entities),这些实体为检索提供关键线索。
- 子图检索:
- 结构特征构建:使用方向性距离编码(Directional Distance Encoding, DDE)为每个三元组编码,捕捉其与查询主题实体的结构关系。
- 并行提取相关三元组:通过轻量级多层感知器(MLP)对三元组进行评分,选择与查询最相关的三元组构建子图。
- LLM推理:将检索到的子图以线性化列表的形式嵌入到提示中,指导LLMs进行推理并生成答案。
三、实验设计与结果
- 数据集
实验使用了两个多跳知识图谱问答(KGQA)基准数据集:WebQSP和CWQ。这些数据集需要模型进行复杂的推理才能生成答案。
- 检索性能
SubgraphRAG在检索召回率和效率方面显著优于现有方法。例如,在WebQSP数据集上,SubgraphRAG的三元组召回率达到88.3%,而其他方法如RoG和G-Retriever的召回率分别为71.3%和33.5%。同时,SubgraphRAG的检索时间仅为6秒,远低于其他方法。
- 知识问答性能
SubgraphRAG在知识问答任务中表现出色,尤其是在多跳推理和多主题实体问题上。例如,在CWQ数据集上,SubgraphRAG的Macro-F1和Hit指标分别达到89.8%和66.69%,显著优于其他方法。此外,SubgraphRAG在减少幻觉方面表现出色,生成的答案更加基于知识图谱中的事实信息。
- 可解释性
SubgraphRAG能够提供详细的推理过程和知识来源,显著提高了模型的可解释性。例如,对于复杂问题,SubgraphRAG可以清晰地展示推理路径和关键证据,而其他方法往往无法提供这样的解释。
四、论文总结
SubgraphRAG通过高效的子图检索和知识接地的推理,显著提高了知识图谱增强的检索生成系统的性能。该框架在多跳推理和复杂问题上表现出色,同时减少了幻觉现象,提高了答案的可解释性。未来的工作将集中在进一步优化子图检索算法和扩展框架的适用范围。
五、论文创新点
- 高效灵活的子图检索
SubgraphRAG通过以下方式实现高效子图检索:
- 轻量级MLP:使用MLP对三元组进行评分,避免了复杂模型(如GNNs)带来的计算开销。
- 并行化处理:通过并行提取相关三元组,显著提高了检索效率。
- 灵活的子图形式:检索到的子图形式灵活,可以根据LLMs的推理能力调整子图大小。
- 结构特征编码
SubgraphRAG通过方向性距离编码(DDE)为每个三元组编码,捕捉其与查询主题实体的结构关系。这种编码方式显著提高了检索的有效性,尤其是在多跳推理和多主题实体的复杂问题中。
- 知识接地的推理
SubgraphRAG通过将检索到的子图嵌入到LLMs的推理过程中,确保生成的答案基于知识图谱中的事实信息。这种方法不仅减少了幻觉现象,还提高了答案的可解释性。
2024.11
RuAG【炼金术士】
炼金术士:像个炼金术士,能将海量数据提炼成清晰的逻辑规则,并用通俗易懂的语言表达出来,让AI在实际应用中更有智慧。
- 发表时间:2024.11.04
- 论文名称:RuAG: Learned-rule-augmented Generation for Large Language Models
- 论文地址:https://arxiv.org/abs/2411.03349
- Github 地址:
一、论文动机
- 外部知识注入:利用外部数据集增强预训练LLMs在下游任务中的性能是当前研究的热点。现有方法包括监督式微调(SFT)、上下文学习(ICL)、检索增强生成(RAG)和知识图谱(KGs)的使用,但这些方法存在计算成本高、依赖手工标注、上下文窗口有限或需要大量人工干预等挑战。
- 逻辑规则的优势:逻辑规则因其高信息密度和可解释性,成为连接多样化数据和LLMs理解的桥梁。逻辑规则可以将复杂关系以简洁形式表达,并且易于翻译成自然语言,适合与LLMs结合。
二、论文思路
RuAG框架包含三个关键阶段:

- LLM辅助的逻辑规则搜索公式化:利用LLMs的常识自动定义逻辑规则中的目标谓词和主体谓词,减少人工干预。
- 基于蒙特卡洛树搜索(MCTS)的逻辑规则搜索:在LLMs定义的搜索空间中,利用MCTS高效发现逻辑规则。
- 逻辑规则增强的生成:将逻辑规则翻译成自然语言并注入LLMs的提示中,以增强其在下游任务中的推理能力。
- 方法细节
- 逻辑规则搜索公式化:
- 初始谓词定义:将数据集的标签作为目标谓词,特征作为主体谓词。
- 去除无关谓词:LLMs通过常识推理过滤掉与目标无关的谓词。
- 新目标谓词建议:LLMs生成新的目标谓词以探索更多逻辑规则。
- 基于MCTS的逻辑规则搜索:
- 定义状态、动作和奖励:状态是部分逻辑规则,动作是添加新谓词,奖励是规则的精度。
- MCTS过程:通过选择、扩展、模拟和回溯四个阶段,高效搜索逻辑规则。
- 逻辑规则增强的生成:
- 清理搜索到的规则:去除低质量或重复的规则。
- 翻译规则为自然语言:将逻辑规则翻译成自然语言句子,注入LLMs的提示中。
- 选择相关规则:根据LLMs的上下文窗口大小,选择最相关的规则注入。
三、实验设计与结果
作者在多个领域(自然语言处理、时间序列、决策制定和工业任务)评估了RuAG框架的有效性,包括关系抽取(DWIE数据集)、日志异常检测(HDFS数据集)和多人合作游戏(Alice&Bob)等任务。实验结果表明,RuAG在多个任务中显著优于现有方法,例如:
- 在关系抽取任务中,使用GPT-4的RuAG方法达到了60.42%的F1分数。
- 在日志异常检测任务中,RuAG达到了92.59%的F1分数。
- 在Alice&Bob游戏中,RuAG的平均胜率达到了70%。
四、论文总结
RuAG(Learned-Rule-Augmented Generation) 的新型框架,旨在通过将离线数据自动提炼成可解释的一阶逻辑规则,并将其注入到大型语言模型(LLMs)中,以增强其推理能力。该框架通过结合逻辑规则和LLMs的生成能力,解决了现有方法(如上下文学习ICL、检索增强生成RAG等)在上下文窗口大小和信息注入效率上的限制。
RAGViz【透视眼】
透视眼:让RAG系统变透明,看得见模型在读哪句话,像医生看X光片一样,哪里不对一目了然。
- 发表时间:2024.11.04
- 论文名称:RAGViz: Diagnose and Visualize Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2411.01751
- Github 地址:https://github.com/cxcscmu/RAGViz
一、论文动机
- RAG 的挑战:RAG 系统通过检索外部文档来增强 LLM 的知识,但现有的 RAG 系统缺乏对检索文档和模型注意力机制的可视化,难以解释生成结果的来源,容易导致“幻觉”(即生成与检索文档无关的内容)。
- RAGViz 的目标:提供一个可视化工具,帮助用户分析 LLM 对检索文档的注意力分配,诊断文档的有效性,并识别生成结果中的幻觉来源。
二、论文思路
- RAGViz 的功能
- 注意力可视化:
- 文档级注意力:展示生成文本对每个检索文档的总体注意力分数。
- 标记级注意力:允许用户选择特定的生成标记(token),并查看其在检索文档中的注意力分布。
- 可视化方式:通过颜色深浅表示注意力强度,帮助用户直观理解生成结果与检索文档的关系。
- 文档切换功能:
- 用户可以添加或移除特定文档,观察其对生成结果的影响。
- 通过对比原始生成和修改后的生成结果,帮助用户评估文档对生成结果的贡献。
- 自定义检索文档数量:
- 用户可以指定检索文档的数量,以测试不同数量的文档对生成结果的影响。
- 系统架构
RAGViz 的系统架构包括以下几个关键组件:
- ANN(近似最近邻)索引:用于高效检索与查询最相关的文档。
- 后端服务器:处理查询请求,管理检索逻辑,并与检索索引和 LLM 推理服务器交互。
- LLM 推理服务器:运行 LLM 推理任务,生成文本并计算注意力分数。
- 前端用户界面:提供交互式界面,允许用户输入查询、选择文档和标记,并显示注意力可视化结果。
三、实验设计与结果
- 数据集:使用 ClueWeb22 和 The Pile 数据集进行测试。
- 模型:使用 Llama-27b 作为 LLM,支持快速推理和注意力分数计算。
- 效率:系统在中等配置的 GPU 节点上运行,查询时间中位数约为 5 秒,适合实时交互。
四、论文总结
RAGViz 是一个强大的工具,通过可视化检索文档的注意力机制,帮助用户更好地理解和改进 RAG 系统。它不仅能够诊断幻觉问题,还能优化检索策略,提升生成结果的质量。作为开源工具,RAGViz 为研究人员和开发者提供了一个灵活的平台,用于分析和改进 RAG 管道。
AgenticRAG【智能助手】
智能助手:不再是简单的查找复制,而是配了个能当机要秘书的助手。像个得力的行政官,不光会查资料,还知道什么时候该打电话,什么时候该开会,什么时候该请示领导。
- 发表时间:2024.11.05
- 论文名称:what-is-agentic-rag
- 论文地址:https://weaviate.io/blog/what-is-agentic-rag
- Github 地址:
一、论文动机
- 检索增强型生成(RAG):一种利用外部知识源为大型语言模型(LLM)提供上下文的技术,以减少幻觉现象。传统RAG流程包括检索组件(嵌入模型和向量数据库)和生成组件(LLM)。用户查询通过相似性搜索检索相关文档,为LLM提供额外上下文。
- 传统RAG的局限性:
- 只考虑单一外部知识源,无法灵活处理多个知识源或外部工具。
- 上下文检索是一次性的,缺乏对检索结果质量的验证和推理。
二、论文思路
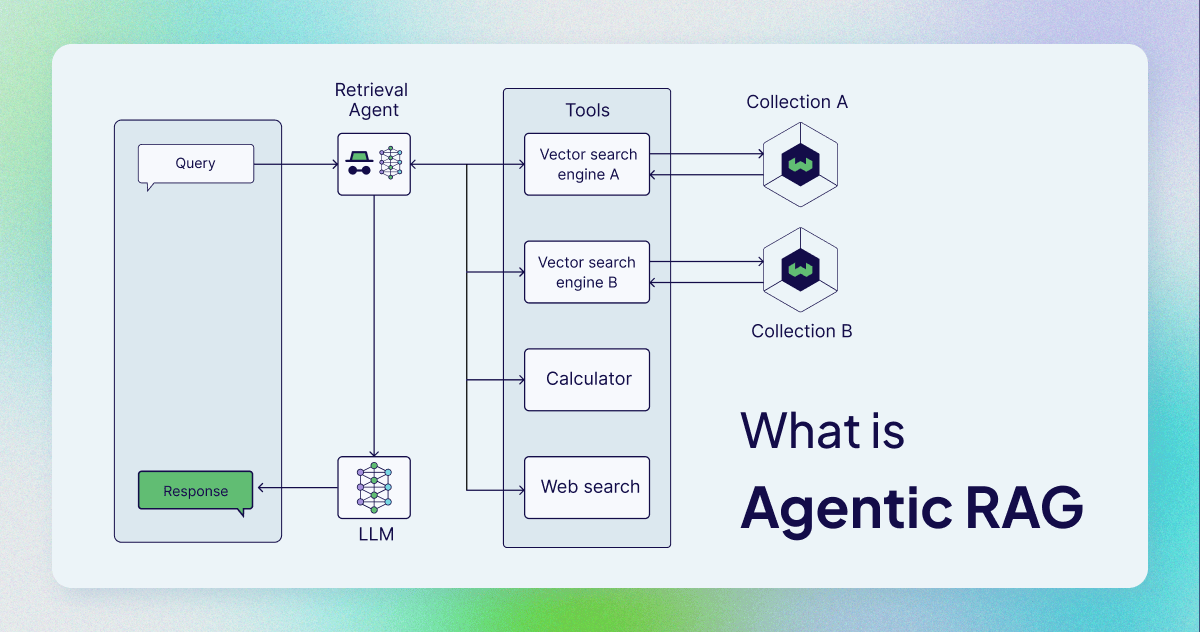
- AI智能体的引入
- AI智能体:具有角色和任务的LLM,能够访问内存和外部工具,并通过推理规划步骤完成任务。
- 核心组件:
- LLM(具有角色和任务)
- 内存(短期和长期)
- 规划(如反思、自我批评、查询路由等)
- 工具(如计算器、网络搜索等)
- Agentic RAG的概念
- Agentic RAG:将AI智能体纳入RAG流程,使其能够协调组件并执行超出简单信息检索和生成的额外行动,克服传统RAG的局限性。
- 工作原理:智能体RAG通常在检索组件中引入智能体,使其能够访问多种检索工具(如向量搜索引擎、网络搜索、计算器、API等)。智能体可以推理和决定是否检索信息、使用哪个工具、制定查询本身,以及评估检索到的上下文是否需要重新检索。
- Agentic RAG架构
- 单智能体RAG(路由器):智能体作为路由器,决定从多个外部知识源中选择哪一个检索上下文。这些知识源可以是数据库、网络搜索或个人账户(如电子邮件)。
- 多智能体RAG系统:多个智能体协同工作,每个智能体负责从不同的知识源检索信息(如内部数据源、个人账户、公共信息等)。这种架构提高了系统的灵活性和效率。
- 超越检索智能体:智能体不仅用于检索,还可以用于其他目的,如验证检索到的信息或执行多步骤任务。
三、Agentic RAG与传统RAG的对比
- 传统RAG:类似于在图书馆中回答问题,只能访问有限的资源。
- Agentic RAG:类似于拥有智能手机,可以访问网络浏览器、计算器、电子邮件等多种工具。
- 对比维度:
- 访问外部工具:传统RAG(否)vs. Agentic RAG(是)
- 查询预处理:传统RAG(否)vs. Agentic RAG(是)
- 多步骤检索:传统RAG(否)vs. Agentic RAG(是)
- 验证检索到的信息:传统RAG(否)vs. Agentic RAG(是)
四、论文总结
文章介绍了Agentic RAG的概念,强调了其在克服传统RAG局限性方面的优势。通过引入AI智能体,Agentic RAG能够灵活处理多个知识源、执行多步骤任务,并验证检索结果的质量。这种新的范式为构建更强大、多功能的LLM驱动应用提供了新的可能性。
HtmlRAG【排版师】
排版师:把知识不是当作流水账来记,而是像排版杂志一样,该加粗的加粗,该标红的标红。就像一个挑剔的美编,觉得光有内容不够,还得讲究排版,这样重点才能一目了然。
- 发表时间:2024.11.05
- 论文名称:HtmlRAG: HTML is Better Than Plain Text for Modeling Retrieved Knowledge in RAG Systems
- 论文地址:https://arxiv.org/abs/2411.02959
- Github 地址:https://github.com/plageon/HtmlRAG
一、论文动机
- 背景:大型语言模型(LLM)在自然语言处理领域展现了强大的能力,但也面临知识遗忘、过时信息和幻觉等问题。检索增强生成(RAG)系统通过检索外部知识并将其融入生成过程中,增强了LLM的响应能力。
- 问题:传统RAG系统将HTML文档转换为纯文本,导致结构化和语义信息丢失。为解决这一问题,提出使用HTML作为外部知识的格式,保留更多有用信息。
二、论文思路
- HTML清理:移除HTML文档中的冗余内容(如CSS、JavaScript、注释等),压缩HTML结构,同时保留重要语义信息。
- 块树构建:将HTML文档解析为块树,每个块代表一段逻辑上相关的内容。通过合并DOM树中的多个子节点,形成大小适中的块。
- HTML修剪:
- 基于文本嵌入的块修剪:使用文本嵌入模型对块进行初步修剪,保留与用户查询高度相关的块。
- 基于生成模型的精细块修剪:使用生成模型对剩余块进行进一步修剪,评估每个块的重要性并删除不重要的块。
三、实验设计与结果
- 数据集选择:使用六个数据集(ASQA、HotpotQA、NQ、Trivia-QA、MuSiQue、ELI5)进行实验,涵盖不同类型的问答任务。
- 实验设置及评价指标:使用Llama-3.1-70B-Instruct和Llama-3.1-8B-Instruct模型,评价指标包括精确匹配(Exact Match)、Hit@1、ROUGE-L和BLEU评分。
- 实验结果:HtmlRAG在所有评估指标上均超过基线方法,证明了HTML修剪的有效性。
- 分析:HTML格式在保留结构和语义信息方面具有优势,更强大的语言模型(如70B)在处理HTML格式知识时表现更好。
四、论文总结
HtmlRAG 旨在通过直接利用HTML格式的外部知识来提升检索增强生成(RAG)系统的性能。该方法通过保留HTML文档中的结构化和语义信息,解决了传统RAG系统中因使用纯文本而导致的信息丢失问题。
M3DocRAG【感官达人】
感官达人:不是只会读书,还能看图识图,听声辨位。像个综艺节目里的全能选手,图片能看懂,文字能理解,该跳跃思维时就跳跃,该专注细节时就专注,各种挑战都难不倒。
- 发表时间:2024.11.07
- 论文名称:M3DocRAG: Multi-modal Retrieval is What You Need for Multi-page Multi-document Understanding
- 论文地址:https://arxiv.org/abs/2411.04952
- Github 地址:https://github.com/Omaralsaabi/M3DOCRAG
一、论文动机
- DocVQA任务:通过解读文档图像中的信息来回答文本问题,广泛应用于金融、医疗和法律等领域。
- 现有方法的局限性:
- 现有方法主要聚焦于单页文档的视觉问答或基于文本提取(如OCR)的检索增强生成(RAG)。
- 这些方法难以处理跨多页或多文档的问题,且会忽略文档中的视觉元素(如图表、图形等),导致信息不完整或不准确。
二、论文思路
- 定义:M3DocRAG是一个多模态RAG框架,能够灵活适应不同文档上下文(封闭域和开放域)、问题跳转(单跳和多跳)以及证据模式(文本、图表、图形等)。
- 工作流程:
- 文档嵌入:将文档页面转换为RGB图像,并提取视觉嵌入(如ColPali)。
- 页面检索:通过文本查询检索相似度高的页面,开放域设置中使用近似索引(如倒排文件索引IVF)以加快搜索速度。
- 问答:利用多模态语言模型(如Qwen2-VL)从检索到的页面生成答案。
三、实验设计与结果
- 开放领域文档视觉问答:
- 多模态RAG比文本RAG表现更好,尤其是在处理非文本证据时。
- M3DocRAG(ColPali + Qwen2-VL 7B)在不同证据模式和问题跳转场景中表现优异。
- 封闭域文档视觉问答:
- 多模态RAG增强了对长文档的理解能力。
- 在多个基准测试中,M3DocRAG(ColPali + Qwen2-VL 7B)取得了领先性能。
- 额外分析:
- 索引方法:近似索引(如IVFFlat)在速度和准确性之间取得了良好平衡。
- 多模态语言模型:Qwen2-VL 7B在所有基准测试中表现最佳。
- 多模态检索模型:ColPali表现优于其他检索模型。
四、论文总结
M3DocRAG是一种新颖的多模态RAG框架,能够灵活适应各种文档上下文(封闭域和开放域)、问题跳转(单跳和多跳)和证据模式(文本、图表、图形等)。M3DocRAG使用多模态检索器和MLM查找相关文档并回答问题,因此它可以有效地处理单个或多个文档,同时保留视觉信息。
KAG【逻辑大师】
逻辑大师:不光靠感觉找相似的答案,还得讲究知识间的因果关系。像个严谨的数学老师,不仅要知道答案是什么,还得解释清楚这答案是怎么一步步推导出来的。
- 发表时间:2024.11.10
- 论文名称:KAG: Boosting LLMs in Professional Domains via Knowledge Augmented Generation
- 论文地址:https://arxiv.org/abs/2409.13731
- Github 地址:https://github.com/OpenSPG/KAG
一、论文动机
尽管大语言模型(LLM)展现出强大的语言理解与生成能力,但在垂直领域应用时面临以下挑战:
- 缺乏严谨推理能力:LLM 在处理复杂问题时容易出现逻辑错误或答案不一致。
- 事实和逻辑错误:LLM 在生成内容时可能引入错误信息,尤其是在处理专业领域知识时。
- 幻觉问题:即使引入外部知识库(如 RAG 技术),LLM 仍可能产生误导性或错误的输出。
- 专业知识服务的高要求:垂直领域需要准确、逻辑严谨且具备完整上下文的知识服务。
二、论文思路
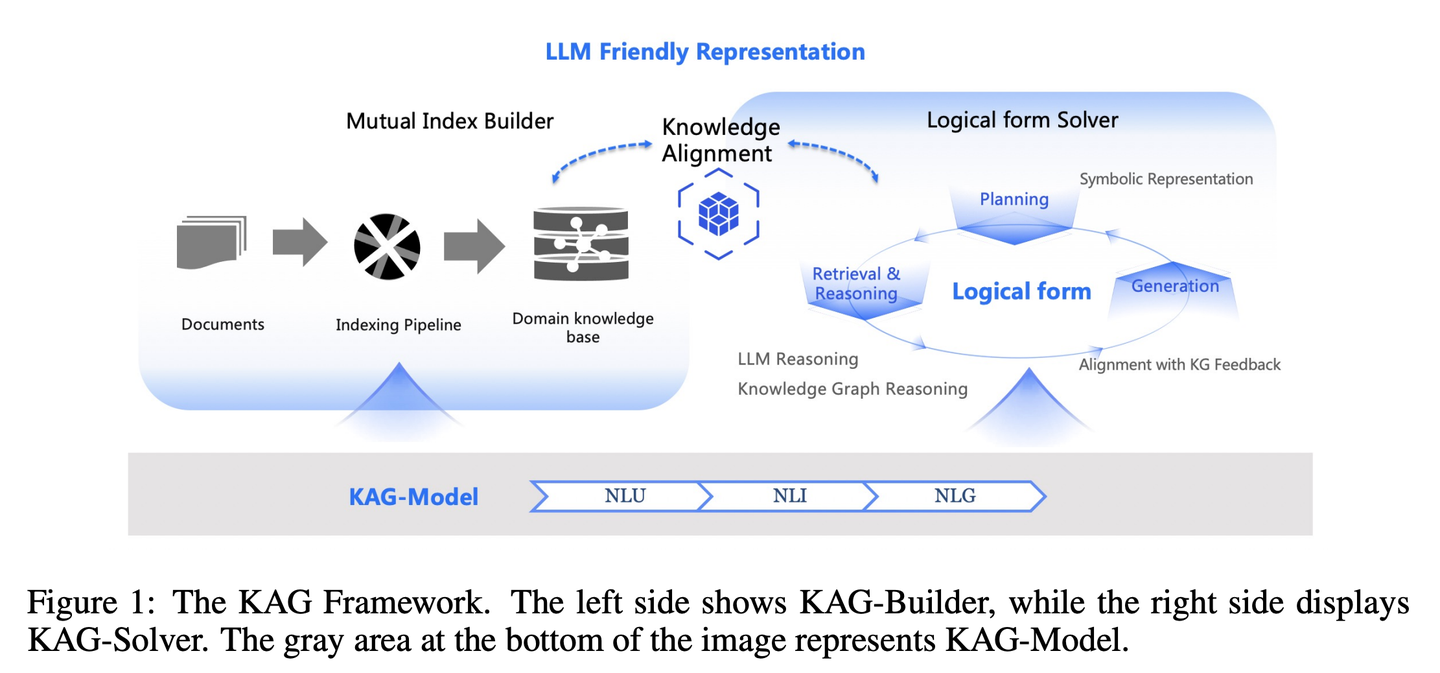
- KAG 框架概述
KAG 框架通过以下五个关键方面增强 LLM 和知识图谱的结合:
- LLM 友好的知识表示(LLM-Friendly Knowledge Representation):提出了 LLMFriSPG 框架,支持无模式(schema-free)和有模式(schema-constrained)的知识表示,提升知识图谱对 LLM 的友好性。
- 知识图谱与文本块的互索引(Mutual Indexing):构建知识图谱与原始文本块之间的双向索引,支持基于图结构的倒排索引和语义关联。
- 逻辑形式引导的混合推理引擎(Logical-Form-Guided Hybrid Reasoning Engine):通过逻辑形式(Logical Form)将自然语言问题分解为可执行的符号表达式,结合知识图谱推理和文本检索。
- 基于语义推理的知识对齐(Knowledge Alignment with Semantic Reasoning):通过语义关系(如同义词、上下位关系)对齐知识图谱中的碎片化知识,提升知识的标准化和连贯性。
- KAG 模型(KAG-Model):增强 LLM 的自然语言理解(NLU)、自然语言推理(NLI)和自然语言生成(NLG)能力,以支持框架中的各个模块。
- 方法细节
- LLM 友好的知识表示。LLMFriSPG 框架通过深度文本上下文感知、动态属性和知识分层,支持从数据到信息再到知识的层次化表示。它结合了实体类型、事件类型、概念类型和逻辑规则,支持知识图谱的灵活构建和语义推理。
- 互索引。KAG 通过开放信息抽取(OpenIE)和语义对齐,构建知识图谱与文本块之间的互索引结构。该结构支持跨文档链接,通过实体和关系实现知识的语义关联。
- 逻辑形式引导的混合推理引擎。KAG 的推理引擎通过逻辑形式将问题分解为多个子问题,并利用知识图谱和文本检索进行混合推理。逻辑形式支持精确匹配、文本检索、数值计算和语义推理等多种操作。
- 知识对齐。KAG 通过语义关系(如同义词、上下位关系)对知识图谱中的知识进行对齐,提升知识的标准化和连贯性。这一过程包括实体消歧、概念链接和语义关系补全。
- KAG 模型。KAG 模型通过增强 LLM 的 NLU、NLI 和 NLG 能力,支持框架中的各个模块。实验表明,KAG 模型在自然语言理解、语义推理和文本生成任务中显著优于基线模型。
三、实验设计与结果
KAG 在多个多跳问答数据集(如 HotpotQA、2WikiMultiHopQA 和 MuSiQue)上进行了评估,结果表明其性能显著优于现有的 RAG 方法。具体而言,KAG 在 HotpotQA 上的 F1 分数相对提升了 19.6%,在 2Wiki 上提升了 33.5%。
KAG 已成功应用于蚂蚁集团的两个专业领域问答场景:
- 电子政务问答和电子健康问答。
- 在电子政务场景中,KAG 的准确率从传统的 66% 提升至 91.6%;
- 在电子健康场景中,KAG 的准确率超过 80%,在某些指标解读任务中达到 93%。
四、论文总结
RAG中向量相似性与知识推理的相关性之间的差距,以及对知识逻辑(如数值、时间关系、专家规则等)不敏感阻碍了专业知识服务的有效性。KAG的设计目的是充分利用知识图谱(KG)和向量检索的优势来应对上述挑战,并通过五个关键方面双向增强大型语言模型(LLM)和知识图谱来提高生成和推理性能:(1)对LLM友好的知识表示,(2)知识图谱与原始块之间的相互索引,(3)逻辑形式引导的混合推理引擎,(4)与语义推理的知识对齐,(5)KAG的模型能力增强。
FILCO【筛选师】
筛选师:像个严谨的编辑,善于从大量文本中识别并保留最有价值的信息,确保传递给AI的每段内容都精准且相关。
- 发表时间:2024.11.14
- 论文名称:Learning to Filter Context for Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2311.08377
- Github 地址:https://github.com/zorazrw/filco
一、论文动机
检索增强型生成(RAG)在开放域问答、事实验证等知识密集型任务中表现出色,但检索系统并不完美,常常会返回部分或完全不相关的段落。这导致生成模型需要在不完全相关的上下文中生成输出,容易产生幻觉(hallucinations)或错误记忆。为了解决这一问题,FILCO 提出了一种上下文过滤方法,通过细粒度的句子级过滤来提高生成质量。
二、论文思路
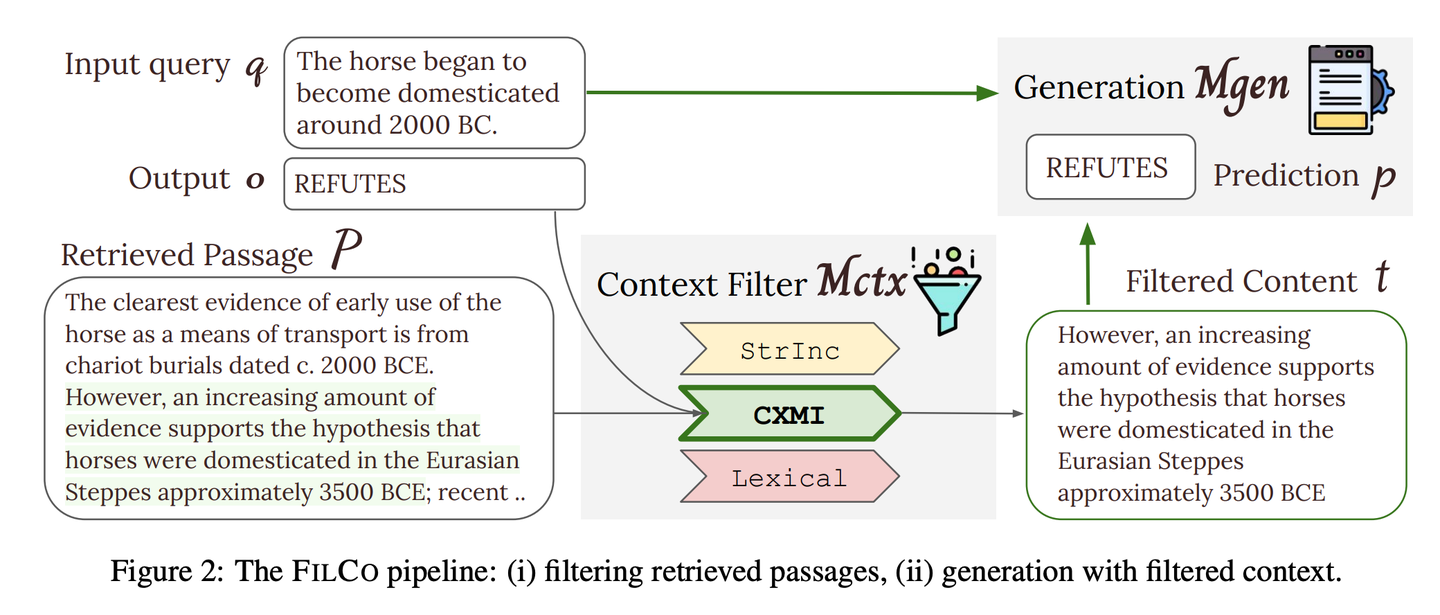
- 上下文过滤的核心思想
FILCO 的目标是在生成之前过滤掉不相关的上下文内容,只保留对生成任务真正有用的部分。为此,作者提出了三种方法来选择“有用”的上下文:
- 字符串包含(String Inclusion, STRINC):判断文本片段是否包含输出文本,适用于支持文档中包含确切输出文本的情况。
- 词汇重叠(Lexical Overlap, LEXICAL):计算示例与候选文本片段之间的单词重叠度,适用于需要基于知识生成回答的任务。
- 条件互信息(Conditional Cross-Mutual Information, CXMI):衡量生成模型在有无上下文支持下生成预期输出的概率差异,适用于所有任务。
- 上下文过滤模型的训练
为了在测试时应用上下文过滤,作者训练了一个上下文过滤模型(Mctx),使用上述三种方法选择的上下文作为训练数据。训练数据通过将检索到的段落与查询拼接作为输入,过滤后的上下文作为输出来构建。
- 过滤后的上下文用于生成
在训练阶段,使用过滤后的上下文(tsilver)来训练生成模型(Mgen)。在推理阶段,使用模型预测的过滤上下文(tpred)作为输入,生成最终输出。
三、实验设计与结果
- 实验设计:实验使用了 FLAN-T5 和 LLAMA2 作为基础模型,分别用于上下文过滤和最终生成任务。所有模型均在相同的实验设置下进行微调。
- 实验结果
- 性能提升:FILCO 在所有六个任务上均优于基线方法(全段落增强和段落级过滤)。与全段落增强相比,FILCO 在提取式问答任务上平均提升了 4.3%(NQ)和 1.1%(TQA)的精确匹配(EM)分数;在复杂问答任务上提升了 1.0%(HotpotQA)和 0.6%(ELI5)的 F1 分数;在事实验证和对话生成任务上分别提升了 6.2% 和 3.5% 的准确率。
- 输入长度减少:FILCO 通过过滤上下文显著减少了输入长度,降低了计算成本。与全段落增强相比,FILCO 将输入长度减少了 44%-64%。
- 上下文精度提升:过滤后的上下文在所有任务中都显示出更高的单词精度,尤其是在复杂任务中,如 HotpotQA 和 Wizard of Wikipedia。
- 不同上下文过滤策略的比较
- 任务适应性:不同的任务对上下文过滤策略的偏好不同。例如,提取式问答任务(NQ 和 TQA)更适合使用 STRINC;对话生成任务(Wizard of Wikipedia)更适合使用 LEXICAL;而更复杂的任务(如 FEVER、HotpotQA 和 ELI5)更适合使用 CXMI。
- 模型适应性:FLAN-T5 和 LLAMA2 在大多数任务上表现一致,但在某些任务上存在差异,如 ELI5。
- 多段落设置下的实验。作者进一步在多段落设置下验证了 FILCO 的有效性,发现即使在整合多个段落作为上下文输入时,FILCO 仍然优于基线方法,证明了其在复杂任务中的泛化能力。
四、论文总结
FILCO 通过细粒度的上下文过滤显著提高了检索增强型生成模型的性能,减少了不相关或干扰性内容对生成任务的影响。该方法在多个知识密集型任务上表现出色,尤其是在提取式问答、事实验证和对话生成任务中。通过选择合适的上下文过滤策略,FILCO 为不同任务提供了有效的解决方案,为未来知识增强型生成任务的发展提供了新的思路。
LazyGraphRAG【精算师】
精算师:能省一步是一步,把贵的大模型用在刀刃上。就像个会过日子的主妇,不是看到超市打折就买,而是货比三家后才决定在哪里花钱最值。
- 发表时间:2024.11.25
- 论文名称:A modular graph-based Retrieval-Augmented Generation (RAG) system
- 论文地址:https://microsoft.github.io/graphrag/
- Github 地址:https://github.com/microsoft/graphrag
一、论文动机
微软之前开源的GraphRAG在数据索引阶段,主要利用大型模型提取和描述实体及其关系,并为每个实体和关系生成摘要。
优化实体图并提取层次化社区结构是一个涉及图统计的过程,然而,这种方法的成本非常高昂。其原因是它需要使用大量的语言模型进行处理,导致GraphRAG的数据索引成本非常昂贵。
与GraphRAG不同的是,LazyGraphRAG在数据索引阶段不进行任何预先的总结或嵌入生成。相反,它利用NLP名词短语提取来识别概念及其共现关系。然后,通过图统计来优化概念图,并提取层次社区结构。这种方法使得LazyGraphRAG的索引成本极低,仅为GraphRAG的0.1%。也就是说,LazyGraphRAG将成本降低了1000倍。
在查询处理方面,GraphRAG使用广度优先搜索确保考虑整个数据集的广泛性。而LazyGraphRAG则采用迭代加深的方式,结合了最佳优先搜索和广度优先搜索的动态。它首先按相似度对文本片段进行排名,然后通过动态选择相关社区,逐步细化查询结果。
通过这种方法,LazyGraphRAG能够同时支持本地和全局查询,在考虑整个数据集的广度的同时,高效地找到最佳匹配的文本块。
二、论文思路
- LazyGraphRAG 的工作原理
LazyGraphRAG 结合了向量 RAG 和 GraphRAG 的优点,同时克服了它们的局限性:
- 向量 RAG:擅长处理本地查询,但无法处理全局查询。
- GraphRAG:擅长处理全局查询,但索引成本较高。
- LazyGraphRAG 的关键机制包括:
- 延迟索引构建:使用 NLP 名词短语提取来提取概念及其共现,而不是使用 LLM 提取和总结实体及其关系。
- 优化查询:使用 LLM 识别相关子查询并优化查询。
- 匹配查询:结合文本块嵌入和块-社区关系,首先按与查询的相似性对文本块进行排名,然后按其排名靠前的社区排名对社区进行排名。
- 答案生成:从相关文本块构建概念子图,并使用 LLM 从相关块组中提取与子查询相关的声明。
三、实验设计与结果
LazyGraphRAG 在多个任务中表现出色:
- 数据集:5,590 篇美联社新闻文章。
- 查询:100 个综合查询(50 个本地查询和 50 个全局查询)。
- 指标:全面性、多样性、赋权。
实验结果表明:
- 在 100 次相关性测试 的最低预算下,LazyGraphRAG 在本地和全局查询上均优于所有竞品,除了全局查询的 GraphRAG 全局搜索。
- 在 500 次相关性测试 的预算下,LazyGraphRAG 在本地和全局查询上均优于所有竞品。
- 随着相关性测试预算增加到 1,500,LazyGraphRAG 的胜率不断提高,证明了其在成本与质量方面的可扩展性。
四、论文总结
LazyGraphRAG 是一种新型的图谱增强检索生成方法,通过优化索引和查询机制,显著降低了成本,同时保持或超越了现有方法的查询质量。它适用于多种用例,尤其是需要快速查询和低索引成本的场景。LazyGraphRAG 的灵活性和可扩展性使其成为未来知识检索和生成任务的有力工具。
2025.02
DeepRAG 【智能检索决策专家】
【智能检索决策专家】:帮助大语言模型(LLM)在面对复杂问题时,能够像人类一样智能地决定何时需要检索外部知识,何时依赖自身知识进行推理,从而提升回答的准确性和效率。
- 发表时间:2024.11.03
- 论文名称:DeepRAG: Thinking to Retrieval Step by Step for Large Language Models
- 论文地址:https://arxiv.org/pdf/2502.01142
- Github 地址:
一、论文动机
传统RAG的困境:检索增强生成(RAG)是解决大语言模型幻觉问题的重要技术,但现有RAG方法存在两个核心痛点:
- 问题一:任务分解无效:问题拆解不合理,导致盲目检索和缺乏决策机制。
- 问题二:过度检索:检索过多无关信息,增加噪音,反而降低回答准确率。
这种问题本质上是因为现有RAG缺乏“智能检索决策”能力——而DeepRAG正是为了解决这一痛点而生。
二、论文思路
DeepRAG的核心思想很简单——让大模型像人一样,在每一步决策是否需要检索,而不是机械地调用外部知识库。
2.1 马尔可夫决策过程(MDP)
马尔可夫决策过程(MDP):DeepRAG将检索增强推理建模为MDP,让系统在每个推理步骤动态决定是否需要检索,从而优化检索效率和答案质量。
- 如果大模型“知道”答案,就直接用参数化知识推理。
- 如果大模型“不确定”,才触发检索,并精准选择最相关的信息。
- 这个决策是动态的,不会一开始就把所有问题都丢给检索系统。
这一机制让DeepRAG能够更精准地控制检索过程,减少不必要的噪音。
2.2 逐步查询
逐步查询:采用逐步查询方式,分阶段检索,避免一次性检索带来的信息冗余和干扰。
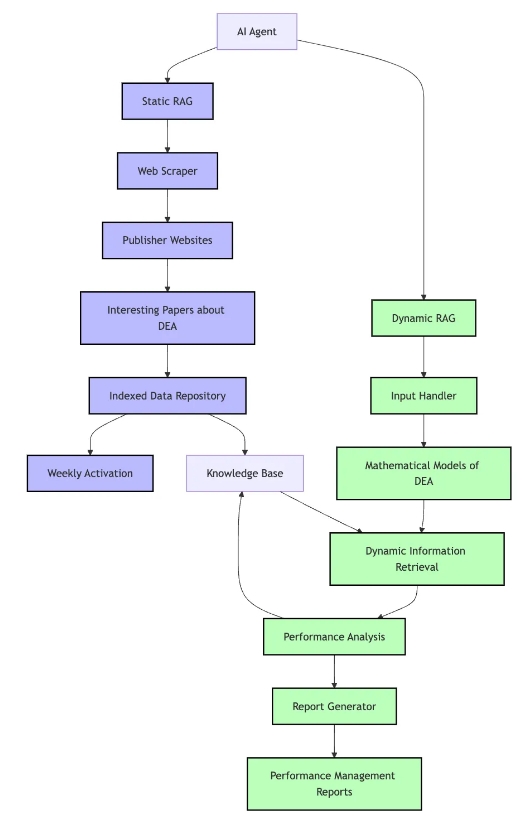
2.3 智能决策
智能决策:允许LLM自己决定是靠“已有知识”回答还是“去外部找答案”,减少检索冗余。
三、实验设计与结果
DeepRAG实测提升准确率21.99%
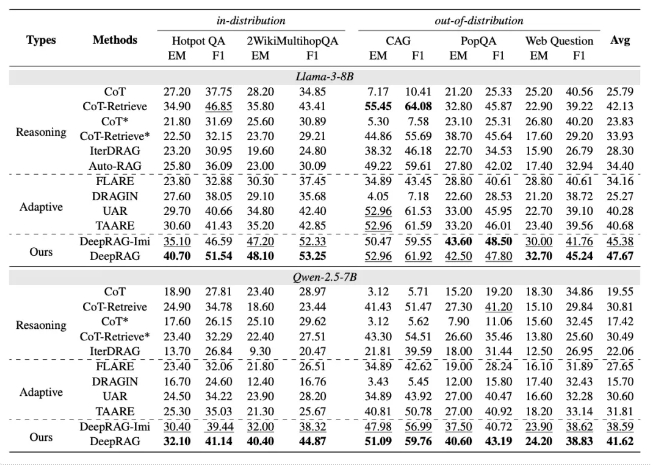
- 准确率提升:DeepRAG在多个基准数据集上准确率提升21.99%。
- 检索效率提升:检索效率提升35.7%,减少了外部知识库的调用次数。
- 噪音减少:由于逐步检索,噪音减少了40%,答案更加聚焦。
四、论文总结
DeepRAG通过引入智能检索决策机制,解决了传统RAG的痛点,显著提升了大语言模型的准确率和检索效率。它不仅是一个技术突破,也为未来RAG技术的发展提供了一个全新的起点。
PathRAG:通过图剪枝的方法优化Graph-based RAG的性能方法浅析
【关系路径探索者”(Relational Path Explorer)】:
- 发表时间:2025.03.10
- 论文名称:PathRAG: Pruning Graph-based Retrieval Augmented Generation with Relational Paths
- 论文地址:https://arxiv.org/abs/2502.14902
- Github 地址:https://github.com/BUPT-GAMMA/PathRAG
一、论文动机
在自然语言处理领域,基于图的检索增强生成(Graph-based RAG)方法在处理复杂关系数据时具有重要价值。
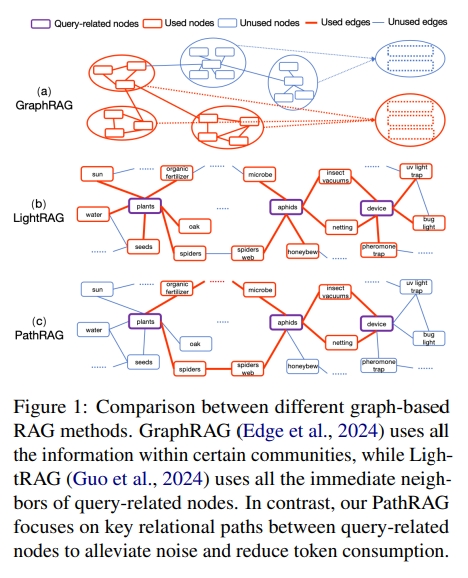
然而,现有的基于图的检索增强生成(Graph-based RAG)方法存在一些不足:
- GraphRAG方法:通过社区检测算法对图进行分割并聚合信息时,可能会引入大量冗余信息,无法有效利用复杂的关系路径;
- LightRAG方法:虽然采用双阶段检索框架,从局部和全局级别检索相关信息,提高了检索效率,但仍然可能包含不必要的信息。
为了解决这些问题,PathRAG应运而生,旨在通过检索索引图中的关键关系路径来减少噪声并优化LLM提示,从而提高生成答案的质量。
二、论文思路
PathRAG的核心创新在于基于流的剪枝算法和路径为基础的提示策略,其方法论分为三个主要阶段:
- 节点检索阶段:从用户查询中使用LLM提取关键词,然后通过密集向量匹配(使用余弦相似度)检索相关节点,将节点和关键词编码为嵌入,从而检索到一定数量的相关节点。
- 路径检索阶段:设计了一种基于流的剪枝算法,提取每对检索节点之间的关键关系路径,然后检索可靠性得分最高的路径;
- 答案生成阶段:检索到的路径按照可靠性得分升序排列放入提示中,最后输入到大型语言模型中进行答案生成。
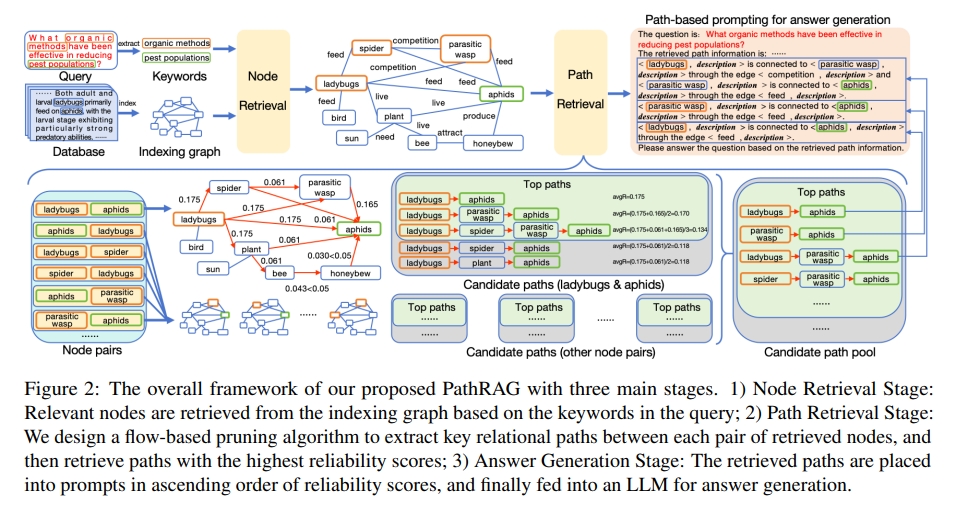
2.1 节点检索阶段
从用户查询 q 中使用 LLM 提取关键词,记为 $K_q$。
通过密集向量匹配(使用余弦相似度)检索相关节点,将节点和关键词编码为嵌入 $X_V$ 和 $X_q$。
检索 N 个相关节点,N 可选值包括 {10, 20, 30, 40, 50, 60},结果子集为 $V_q⊆V$,其中 V 是索引图的节点集。
2.2 路径检索阶段

2.2 答案生成阶段
将选定路径转化为文本形式,路径文本通过连接节点和边块生成:

按可靠性升序排列路径,提示为:

这种排序策略解决了“中间丢失”问题,确保 LLM 关注最相关信息(LLM使用 “GPT-4o-mini” 作为所有 LLM 组件,索引图与 GraphRAG相同。)。
三、实验设计与结果
实验结果表明,PathRAG在减少冗余信息和提高生成答案质量方面表现出色。与GraphRAG和LightRAG相比,PathRAG能够更好地捕捉节点之间的关系,生成的答案更具准确性和相关性。其基于流的剪枝算法和路径提示策略有效地减少了噪声,使得LLM能够更专注于关键信息,从而提升了整体性能。
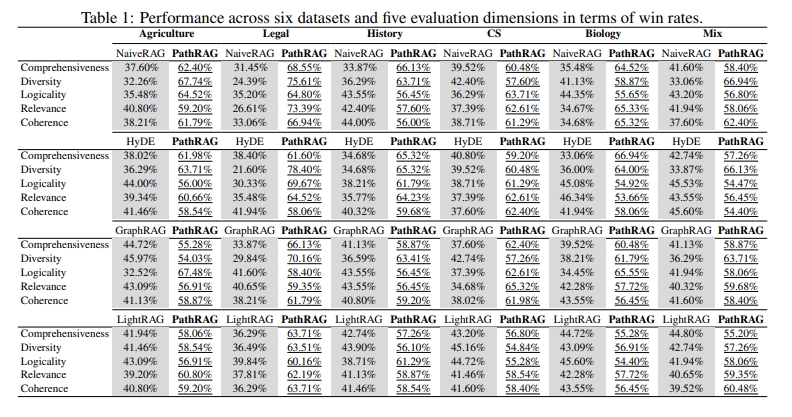
四、论文总结
PathRAG作为一种新型的Graph-based RAG方法,通过其独特的基于流的剪枝算法和路径提示策略,在处理复杂关系数据时展现出了显著的优势。它不仅减少了冗余信息,提高了生成答案的质量,还为自然语言处理领域中关系数据的处理提供了一种新的思路和方法。未来,PathRAG有望在更多实际应用场景中发挥重要作用,进一步推动自然语言处理技术的发展。
2025.03
R1-Searcher: 推理与搜索结合,用强化学习打破LLMs推理知识局限!
【检索增强者”(Search-Enhancer)】:R1-searcher 是一种利用强化学习来提升大型语言模型 (LLMs) 搜索能力的方法。它主要解决了LLMs在面对需要大量外部知识,尤其是多跳问题和时效性问题时,缺乏必要知识的问题。R1-searcher通过两阶段的、基于结果监督的强化学习,让模型学会在推理过程中调用网络搜索,以获取外部信息。
- 发表时间:2025.03.10
- 论文名称:R1-Searcher: Incentivizing the Search Capability in LLMs via Reinforcement Learning
- 论文地址:https://arxiv.org/pdf/2503.05592
- Github 地址:https://github.com/SsmallSong/R1-Searcher
- 模型:
- Qwen-2.5-7B-Base-RAG-RL: https://huggingface.co/XXsongLALA/Qwen-2.5-7B-base-RAG-RL
- Llama-3.1-8B-Instruct-RAG-RL: https://huggingface.co/XXsongLALA/Llama-3.1-8B-instruct-RAG-RL
- 训练数据:https://huggingface.co/datasets/XXsongLALA/RAG-RL-Hotpotqa-with-2wiki
一、论文动机
现有的大型推理模型(LRMs)和大型语言模型(LLMs)在复杂推理任务中表现出色,但它们主要依赖内部知识来解决问题。这种依赖在处理时效性强、知识密集型问题或涉及私有信息时显得不足,容易导致不准确性和幻觉现象。
为了解决这一问题,研究者提出了R1-Searcher,一种基于强化学习(RL)的两阶段方法,旨在增强LLMs的搜索能力,使其能够在推理过程中自主调用外部搜索系统以获取额外知识。
二、论文思路
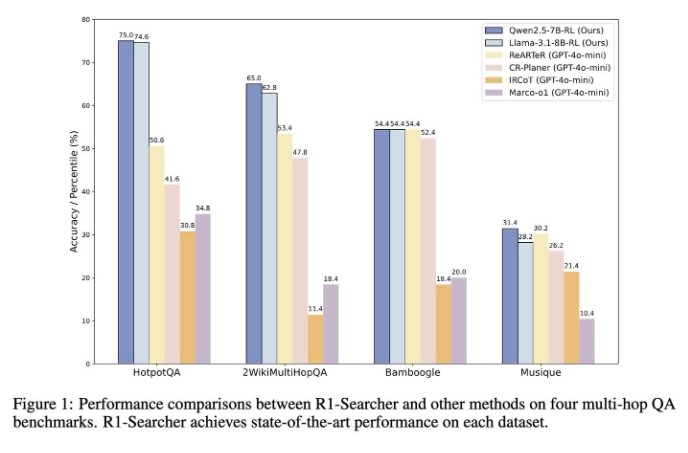
R1-Searcher框架通过以下方法实现:
2.1 两阶段强化学习方法
- 第一阶段:训练模型有效利用外部检索系统。奖励由检索奖励(retrieval-reward)和格式奖励(format-reward)组成,鼓励模型学会调用工具的格式。
- 第二阶段:训练模型在推理过程中整合检索以准确解答问题。检索奖励被替换为答案奖励(answer-reward),基于标准答案和预测答案的F1-Score,鼓励模型正确调用工具解决问题。
2.2 改进的Reinforce++算法
另外,R1-Searcher框架 对Reinforce++算法进行了修改以适应检索增强生成场景。
- 目标:让模型在面对不确定性时能够自主获取外部知识,从而有效整合推理和检索。
为了无缝整合检索到的文档并确保模型优化的合理性,R1-Searcher框架 对原始算法进行了两项改进:RAG-based Rollout和Retrieval Mask-based Loss Calculation:
- RAG-based Rollout:
- 思路:通过特定标签<begin_of_query>...<end_of_query>引导模型在生成过程中调用外部检索系统。即捕捉到模型需要进行检索时,推理暂停并进行检索。检索到的文档被封装在<begin_of_documents>...<end_of_documents>标签中,并整合到模型的推理过程中。
- 优点:这种方法确保检索无缝融入推理过程,使模型能够基于检索到的文档继续推理,而不被打断。
- Retrieval Mask-based Loss Calculation:
- 动机:当模型执行检索时,检索到的文档作为环境观察的一部分被整合到推理过程中。然而,模型并不需要自主生成这些文档。
- 思路:为了减少环境的影响,R1-Searcher 将<begin_of_documents>...<end_of_documents>指定为特殊标记,并在训练中对其进行掩码处理。这可以防止这些外部标记影响损失计算,确保检索到的文档不会干扰模型的内在推理和生成过程。
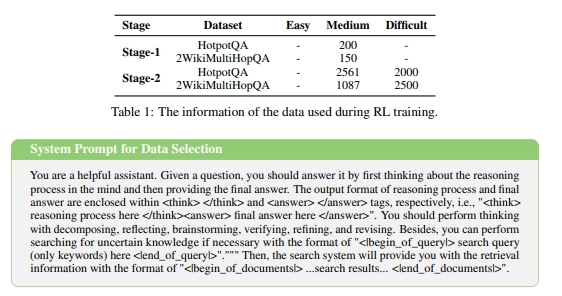
三、实验设计与结果
R1-Searcher在多个任务上展示了显著的性能提升:
-
多跳问答任务:
- 在HotpotQA上性能提升48.2%。
- 在2WikiMultiHopQA上性能提升21.7%。
- 在Bamboogle上性能提升4.0%(LLM-as-Judge)。
-
无需冷启动:
- 从基础LLM开始进行RL学习,无需冷启动,且在多数领域内和领域外的数据集上获得最佳性能,甚至超过闭源的LLM(如GPT-4o-mini)。
-
泛化能力:
- 仅使用8148个样本进行RL训练,模型不仅在领域内数据集表现出色,还在领域外数据集(如Musique和Bamboogle)上展示了强大的泛化能力。
-
联网搜索能力:
- 在Bamboogle任务上进行联网搜索测试,性能提升显著,表明模型能够适应在线搜索场景。
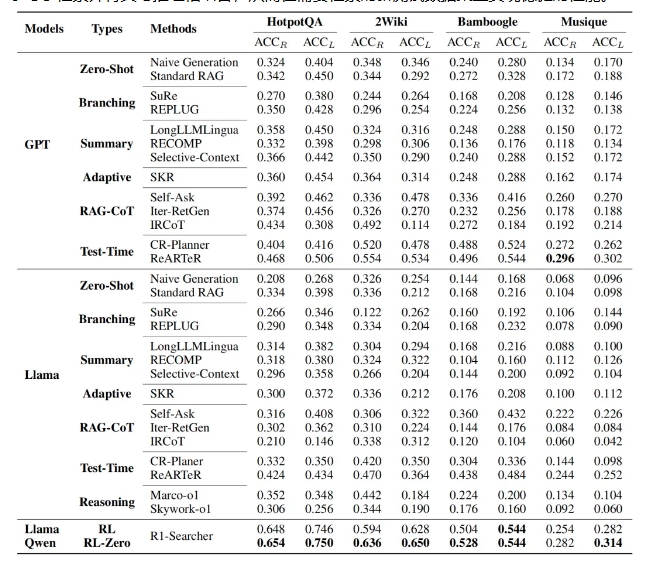
四、论文总结
R1-Searcher通过强化学习方法显著提升了LLMs在推理过程中的检索能力,解决了现有模型在处理知识密集型问题时的局限性。该方法无需冷启动,具有强大的泛化能力,并在多跳问答任务中取得了显著的性能提升。R1-Searcher为未来LLMs的推理能力提升提供了新的思路,特别是在结合外部知识和检索能力方面。
五、对比分析
- GRPO和Reinforce++算法的比较
GRPO的生成solution更长和检索频率更高。GRPO在领域外测试数据集(如Bamboogle)上也展现出更好的性能;而Reinforce++在领域内测试集(如HotpotQA和2Wiki)上表现更优。
- RL和SFT的比较
RL在领域内和领域外的测试集上均优于SFT。SFT能够帮助模型生成检索查询,但这些查询的时机和相关性不如通过RL训练生成的查询。
- Reward的设计对训练的影响
基于F1的答案奖励能够产生更长的回答长度和更优的最终结果;基于EM的奖励在训练过程中导致回答长度较短,并且在测试时表现不如基于CEM或F1的奖励;基于CEM的奖励会生成带有不必要信息的偏长的answer。
- 数据难度分布和数据多样性对训练的影响
使用混合数据集训练的模型在检索次数和生成回答长度上都有所增加,并且在测试集上取得了更高的分数;训练数据中混入较高难度的数据可以在领域内和领域外的测试集上均取得更好的效果。
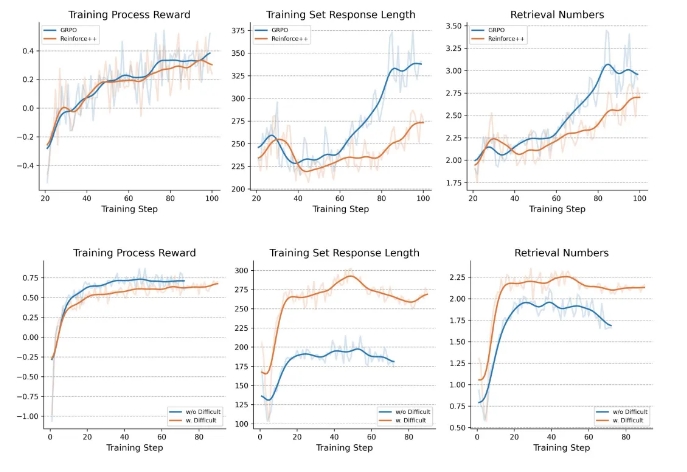
六、R1-searcher 的使用场景
R1-searcher适用于以下场景:
- 知识密集型任务:需要大量外部知识才能解决的问题,例如:
- 问答任务:复杂的多跳问答,需要从多个来源提取信息才能找到答案。
- 时效性问题:需要最新信息的任务,例如事件追踪、新闻摘要等。
- 需要可解释性的任务:通过搜索过程,模型可以提供其答案的依据,提高可解释性。
- 希望提升LLMs准确率的任务:尤其是在知识范围有限或需要更新知识的情况下,搜索可以显著提高准确率。
- 通用问答:在没有充分训练数据的特定领域,通过检索可以有效补充知识,提高回答质量。
总而言之,R1-searcher适用于任何需要LLM 利用外部信息来增强其推理能力和知识范围的场景。它通过强化学习驱动模型自主学习,使其具备更强的搜索能力和更可靠的答案生成能力。
七、R1-searcher 的不足
- 数据依赖性:虽然 R1-Searcher 展现出良好的泛化能力,但训练数据的分布和难度仍然对模型性能有显著影响,如何进一步优化数据选择和课程学习策略以提升模型性能仍有待研究。
- 模型规模限制:当前的实验主要在 7B 参数的模型上进行,未来需要进一步扩展到更大规模的模型(如 32B 或更大),以更全面地评估 R1-Searcher 在更大模型上的效果。
- 奖励函数设计:虽然两阶段奖励机制有效,但更精细化的奖励函数设计,例如考虑检索结果的相关性、多样性等因素,可能会进一步提升模型性能。
- 在线搜索的效率和成本:尽管 R1-Searcher 能够应用于在线搜索,但使用 Google API 等在线搜索服务可能涉及效率和成本问题,如何更高效、经济地利用在线搜索资源仍需进一步探索。
致谢
一、论文动机
二、论文思路
三、实验设计与结果
四、论文总结
Contributors

9 commits
Similar repos


README
RAG 论文学习笔记
- RAG 论文学习笔记
- 2024.01
- 2024.02
- 2024.03
- 2024.04
- 2024.05
- 2024.06
- 2024.07
- 2024.08
- 2024.09
- 2024.10
- 2024.11
- 2025.02
- 2025.03
- 致谢
2024.01
GraphReader【图解专家】
图解专家:像个善于制作思维导图的导师,将冗长的文本转化为清晰的知识网络,让AI能够像沿着地图探索一样,轻松找到答案需要的各个关键点,有效克服了处理长文本时的"迷路"问题。
- 发表时间:2024.01.20
- 论文名称:GraphReader: Building Graph-based Agent to Enhance Long-Context Abilities of Large Language Models
- 论文地址:https://arxiv.org/abs/2406.14550
一、论文动机
**LLMs面临的一个主要限制是上下文窗口大小和内存使用的局限性,这使得它们难以有效处理长上下文。**为了解决这一问题,研究人员探索了多种方法,包括改进模型结构、引入检索增强机制以及利用代理进行复杂推理。然而,这些方法各自存在一定的局限性,如训练成本增加、忽略细节信息或决策机制不够灵活。
二、论文思路
- 目标:通过构建图结构并采用自主代理探索策略,GraphReader能够在有限的上下文窗口内捕捉长距离依赖关系,从而实现对冗长文档的有效处理。
GraphReader的操作分为三个阶段:
- 图构建:文档被划分为多个块,每个块被总结为原子事实,并从中抽取关键元素形成节点;节点之间根据共享的关键元素建立链接。
- 图探索:智能体按照合理规划选择起始节点,并通过检查相邻节点来遍历整个图结构;在此过程中,智能体会记录支持性事实以备后续分析。
- 答案推理:编译来自不同智能体的笔记,使用思维链推理生成针对给定问题的答案。
三、论文创新点
- 将长文本分割成离散块,并提取关键元素和原子事实;
- 使用这些组件构建一个能够反映文本内部关系的图结构;
- 智能体根据预定义函数和逐步理性计划,在图中导航并收集必要信息;
- 整个过程包括做笔记和反思,确保最终答案的准确性和完整性。
四、结论
GraphReader通过将长文本组织成图结构并利用智能体探索,成功克服了传统LLMs处理长文本时的障碍,提供了更为有效的解决方案。这项研究为长上下文处理树立了新的标杆,并为未来的进一步发展奠定了坚实的基础。
MM-RAG【多面手】
多面手:就像一个能同时精通视觉、听觉和语言的全能选手,不仅能理解不同形式的信息,还能在它们之间自如切换和关联。通过对各种信息的综合理解,它能在推荐、助手、媒体等多个领域提供更智能、更自然的服务。
- 时间:2024.01.22
一、论文动机
- 多模态理解:通过理解图像、音频、视频和文本等不同模态,AI系统可以解决以前难以解决的问题。
- 对比学习:用于训练高质量的多模态嵌入,通过比较正负样本对来学习跨模态的语义表示。例如,CLIP模型通过对比学习在图像和文本之间建立了强大的关联
二、论文思路
- 定义:MM-RAG是一种将大型语言模型(如GPT-3)与使用对比学习嵌入的多模态检索器相结合的技术。
- 多模态嵌入空间:将不同格式的数据(图片、音频、视频、文本)编码到同一语义嵌入空间中,使得可以通过嵌入相似性进行跨模态搜索。在文本生成过程中,模型会将检索到的不同格式的数据(图片、音频、视频、文本)作为额外上下文,指导其完成更具体且连贯的输出。
举个栗子:用户可以通过一张图片检索相关的文本描述,或者通过文本查询找到相关的图片、音频或视频内容.
为了使MM-RAG能够在实际应用中大规模部署,文章提出了一个包含三个主要组件的解决方案:
- 对比训练多模态模型:例如CLIP,用于将不同模态的数据编码到共享的向量空间中。
- 高效向量数据库:例如Weaviate,它能够处理数十亿个嵌入并执行快速的向量相似性搜索。
- 用户查询接口:允许用户提交查询,并即时从数据库中检索跨模态的相关结果。
这套系统不仅支持高效的多模态搜索,还为构建大规模的MM-RAG生产环境提供了基础架构。
三、论文总结
MM-RAG代表了语言生成模型的一个重要进步,它通过整合来自多种模态的信息,提高了生成内容的质量。借助对比学习和向量数据库的力量,这项技术正逐步从实验室走向实际应用,为用户提供更为丰富和准确的语言交互体验。随着技术的不断发展,我们正迎来一个多模态智能的新时代。
CRAG【自我校正】
自我校正:像个经验丰富的编辑,先用简单快速的方式筛选初步资料,再通过网络搜索扩充信息,最后通过拆解重组的方式,确保最终呈现的内容既准确又可靠。就像是给RAG装上了一个质量控制系统,让它产出的内容更值得信赖。
- 发表时间:2024.01.29
- 论文名称:Corrective Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2401.15884
- Github 地址:https://github.com/HuskyInSalt/CRAG
一、论文动机
传统RAG的局限性:传统的检索增强生成(RAG)方法在信息检索过程中存在局限性,如缺乏对检索文档与问题相关性的评估,导致生成内容可能不准确或包含无关信息.
二、论文思路
- 检索评估器:CRAG使用一个轻量级的T5-large模型作为检索评估器,评估检索到的文档与问题之间的相关性,并给出三种结果:正确、错误、模棱两可.
- 正确:使用知识细化算法对检索到的信息进行处理和精炼.
- 错误:利用网络搜索引擎获取更相关的信息.
- 模棱两可:结合使用知识细化算法和网络搜索引擎,获取更多信息来完善答案.
- 知识精炼算法:先将文档细分为细小的知识单元,利用检索评估器为每个知识单元计算相关性评分,筛除评分较低的单元,剩下的单元重新组合构建成完整的内部知识体系.
三、优势与不足
- 优势:CRAG通过自我校正检索结果,增强了生成文本的鲁棒性,模型结构轻量级,推理速度快.
- 不足:需要根据具体问题和需求调整相关性分数的阈值,以在信息检索的准确性和全面性之间取得平衡.
总结
文章强调了CRAG在提升信息检索与生成质量方面的潜力,并展示了其在自然语言处理领域的理论和实践意义,为提升语言模型在复杂知识密集型任务中的表现提供了新的思路和方法.
RAPTOR【分层归纳】
分层归纳:像个善于组织的图书管理员,将文档内容自下而上地整理成树状结构,让信息检索能在不同层级间灵活穿梭,既能看到整体概要,又能深入细节。
- 发表时间:2024.01.31
- 论文名称:RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval
- 论文地址:https://arxiv.org/abs/2401.18059
- Github 项目:https://github.com/parthsarthi03/raptor
一、论文动机
传统的RAG方法通常仅从检索语料库中提取短的连续文本块,这限制了模型对整个文档上下文的整体理解能力。
二、论文思路
RAPTOR(Recursive Abstractive Processing for Tree-Organized Retrieval)旨在通过递归处理、聚类和总结文本块,构建具有不同抽象级别的树形结构,从而改进长文档信息的整合与检索效率。
2.1 RAPTOR检索树的构建过程
- 文本切片:首先对文本进行合理的切片处理,选择合适的切片算法.
- 递归聚类与总结:根据语义embedding递归地对文本块进行聚类,并生成这些聚类的文本摘要.采用软聚类方法,允许文本块跨多个聚类,并使用高斯混合模型(GMMs)和UMAP技术进行降维,以优化文本聚类效果.
- 树形模型构建:通过递归的向量分析,精准地对文本块进行聚类,并提炼出这些聚类的核心摘要,自下而上地构建出一个结构化的树形模型.相近的节点形成兄弟关系,父节点承载整个集群的概要性文本信息.
2.2 RAPTOR的检索过程
- 深度检索树:从树的根级别开始,根据与查询向量的余弦相似度逐层检索top-k节点,直到达到叶节点,最后将所有选定节点的文本连接起来形成检索到的上下文.
- 广度检索树:将整个树压缩成单一层,然后根据与查询向量的余弦相似度评估所有层的节点,直到达到设定阈值.
三、论文创新点
- 树状结构的构建
- 递归嵌入与聚类:RAPTOR通过递归的方式对文本块进行嵌入和聚类,生成不同层次的文本摘要,构建出具有不同总结级别的树形结构。这种递归嵌入与聚类的方法使得模型能够逐步细化文本信息的粒度,捕捉到不同层次上的关键信息,为后续的文本分析和应用奠定了坚实的基础.
- 软聚类与降维技术:采用软聚类方法,允许文本块跨多个聚类,基于高斯混合模型(GMMs)和UMAP技术进行降维。这种软聚类与降维技术的结合,能够更好地捕捉文本数据的复杂结构和关系,优化文本聚类效果,提高模型对文本信息的理解和处理能力.
- 检索过程的优化
- 深度与广度检索树:提出了基于深度检索树(树遍历)和广度检索树(折叠树)的两种检索方式。深度检索树从树的根级别开始逐层检索,广度检索树将整个树压缩成单一层进行评估。这两种检索方式为不同场景下的信息检索提供了灵活的选择,能够根据具体需求和查询向量的相似度,高效地检索到相关的信息.
- 多级信息整合:在推理时,RAPTOR模型能够从构建的树中整合不同抽象级别的长文档中的信息。这种多级信息整合的方式,使得模型在生成答案时能够综合考虑不同层次上的文本内容,提高生成结果的准确性和可靠性.
- 性能提升
- 显著提高准确度:与传统的检索增强型语言模型相比,RAPTOR在性能和绝对准确度上提高了20%。这一显著的性能提升,证明了RAPTOR模型在信息检索与生成任务中的有效性,展示了其在处理长文本和复杂文档方面的优势.
四、论文总结
RAPTOR模型通过其独特的树状结构构建、优化的检索过程以及显著的性能提升,为检索增强生成领域带来了新的创新和突破,为处理长文本和复杂文档提供了更高效、更准确的方法.
2024.02
T-RAG【私人顾问】
私人顾问:像个熟悉组织架构的内部顾问,善于利用树状结构组织信息,在保护隐私的同时,高效且经济地提供本地化服务。
- 发表时间:2024.02.12
- 论文名称:T-RAG: Lessons from the LLM Trenches
- 论文地址:https://arxiv.org/abs/2402.07483
一、论文动机
- 数据隐私与安全性:在处理私营企业文档的问答任务时,数据的安全性和稳健性至关重要。由于文档的敏感性,使用公共API上的专有LLM模型存在数据泄露的风险,因此需要使用可以在本地部署的开源模型.
- 现有挑战:有限的计算资源和较小的训练数据集也带来了挑战,同时需要确保对用户查询的可靠和准确的响应,这增加了部署强大应用程序的复杂性.
二、论文思路
- 架构设计:T-RAG将RAG架构与经过微调的开源LLM(如Llama-2 7B模型)相结合,使用源自组织文档的指令数据集进行训练,以生成响应.
- 实体树与向量数据库:T-RAG结合了实体树和向量数据库进行上下文检索。实体树存储有关组织实体及其层次结构的信息,而向量数据库用于搜索相关文档块.
- 工作流程:
- 解析用户查询,识别与组织内实体名称相对应的关键字.
- 从实体树中提取相关实体的详细信息,并将其转换为文本陈述,提供有关实体及其在组织层次结构中的位置的信息.
- 将这些信息与从向量数据库检索的文档块合并,构建上下文.
- 经过微调的LLM根据提供的上下文生成响应.
三、论文创新点
- 实体树的利用:通过实体树增强上下文检索,使得模型能够获得有关实体及其在组织内层次定位的相关信息,从而提高回答的准确性和相关性.
- 数据隐私保护:使用本地部署的开源模型,避免了数据泄露的风险,同时解决了推理延迟、令牌使用成本以及区域和地理可用性问题.
- 评估指标:引入了Correct-Verbose评估指标,用于评估生成的响应质量,不仅考虑答案的正确性,还考虑包含超出原始问题范围的其他相关信息.
四、论文总结
T-RAG(树状检索增强生成)结合RAG与微调的开源LLM,使用树结构来表示组织内的实体层次结构增强上下文,利用本地托管的开源模型来解决数据隐私问题,同时解决推理延迟、令牌使用成本以及区域和地理可用性问题。
2024.03
RAT【思考者】
思考者:像个善于反思的导师,不是一次性得出结论,而是先有初步想法,然后利用检索到的相关信息,不断审视和完善每一步推理过程,让思维链条更加严密可靠。
- 发表时间:2024.03.08
- 论文名称:RAT: Retrieval Augmented Thoughts Elicit Context-Aware Reasoning in Long-Horizon Generation
- 论文地址:https://arxiv.org/abs/2403.05313
- Github 项目:https://github.com/CraftJarvis/RAT
一、论文动机
- 幻觉问题:在生成式AI应用中,语言模型常常会产生幻觉,即生成与事实不符的内容,影响输出的准确性.
- 效率与准确性的平衡:应用开发者需要在效率和准确性之间找到平衡点,RAT提供了一种解决方法,能够在不牺牲太多效率的情况下提高准确性.
二、论文思路
- 结合CoT和RAG:RAT是检索增强型思考的简称,通过结合思维链提示和检索增强生成,解决长视野推理和生成任务.
- 工作流程:
- 第一步:由大型语言模型(LLM)生成初始的Zero-Shot思维链提示,将每个中间思考步骤作为查询进行信息检索,根据检索到的信息修正或细化CoT步骤.
- 第二步:使用修改后的CoT步骤和检索到的上下文生成最终响应或解决方案,提供全面且事实上准确的答案.
- 逐步推理:RAT是一种渐进的方法,LLM会根据CoT逐步产生响应,类似于人类的推理过程.
三、论文创新点
- Long-Horizon推理:RAT在复杂的预测建模和规划算法中表现出色,能够模拟和预测不同行动方案在未来较长时期内的后果,处理不确定性并适应变化.
- 任务表现:在挑战性代码生成、数学推理、任务规划以及创意写作等方面,RAT均取得了显著的成果,超过了传统的CoT提示、RAG以及其他基线方法.
- 优势:作为一种Zero-Shot提示方法,RAT能够在不进行额外训练的情况下提高生成内容的准确性和可靠性,减少幻觉现象.
四、论文总结
RAT(Retrieval-Augmented Thoughts)通过结合思维链提示和检索增强生成,提供了一种有效的方法来解决生成式AI中的幻觉问题,提高输出内容的准确性和可靠性.
RAFT【开卷高手】
开卷高手:像个优秀的考生,不仅会找对参考资料,还能准确引用关键内容,并清晰地解释推理过程,让答案既有据可循又合情合理。
- 发表时间:2024.03.15
- 论文名称:Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity
- 论文链接:https://arxiv.org/abs/2403.14403
- Github 项目:https://github.com/starsuzi/Adaptive-RAG
一、论文动机
- 领域适应挑战:大语言模型在特定领域应用时,如何有效融入新信息是一个挑战。传统的RAG方法允许模型在生成答案时参考文档,但未能充分利用固定领域设置下的学习机会;而基于微调的方法可以学习文档中的普遍模式,但未能充分利用测试时的文档信息.
- RAFT的目标:结合RAG和微调的优势,提出一种新的训练策略,使模型在特定领域中更好地适应和生成准确的答案.
二、论文思路
- 核心思想:在训练过程中引入干扰文档,以提高模型在面对无关信息时的鲁棒性。模型不仅要学会从黄金文档中提取相关信息,还要学会忽略干扰文档.
- 思维链式响应:训练时采用思维链式响应的方式,即模型在生成答案时不仅要引用相关文档中的正确序列,还要逐步展示其推理过程,提高模型的理解能力和解释性.
- 数据准备与训练:构建一个包含问题、检索到的文档和正确答案的数据集,每条记录包含一个问题、一组检索到的文档(包括黄金文档和干扰文档)以及正确的答案.使用该数据集对模型进行微调.
三、实验设计与结果
- 数据集:使用PubMed(医学领域)、HotpotQA(多跳问答任务)和Gorilla(API文档)数据集进行实验.
- 实验设置:设置不同的训练条件,包括不同数量的干扰文档和黄金文档,研究模型在不同训练条件下的表现.
- 结果分析:实验结果显示,使用干扰文档进行训练的模型在所有数据集上都表现出更好的性能,尤其是在PubMed、HotpotQA和Gorilla数据集上均表现出色,证明了RAFT方法的有效性.
四、论文创新点
- 模型鲁棒性提升:通过引入干扰文档,RAFT有效提升了模型在面对无关信息时的鲁棒性,使模型在测试时表现出更强的适应能力.
- 思维链式响应的作用:思维链式响应在训练过程中起到了关键作用,提高了模型的理解能力和解释性,尤其在复杂任务中表现更为出色.
五、论文总结
RAFT旨在提高模型在特定领域内的“开卷”环境中回答问题的能力,通过训练模型忽略无关文档,并逐字引用相关文档中的正确序列来回答问题,结合思维链式响应,显著提升了模型的推理能力。
Adaptive-RAG【因材施教】
因材施教:面对不同难度的问题,它会智能地选择最合适的解答方式。简单问题直接回答,复杂问题则会查阅更多资料或分步骤推理,就像一个经验丰富的老师,懂得根据学生的具体问题调整教学方法。
- 发表时间:2024.03.21
- 论文名称:Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity
- 论文地址:https://arxiv.org/abs/2403.14403
- Github 项目:https://github.com/starsuzi/Adaptive-RAG
一、论文动机
- 检索增强语言模型的局限性:现有的检索增强语言模型(LLMs)在处理不同复杂度的查询时存在局限性。简单查询可能不需要复杂的检索过程,而复杂查询则需要多步推理和信息整合.
- 自适应策略的需求:为了提高问答系统的效率和准确性,需要一种能够根据查询复杂性动态调整检索策略的方法.
二、论文思路
- 核心思想:使用一个小模型作为分类器,预测查询的复杂度,并根据预测结果选择合适的检索增强策略.
- 查询复杂度评估:分类器将查询分为三类:简单查询(A)、中等复杂度查询(B)和复杂查询(C).
- 自适应策略:
- 简单查询:使用非检索方法直接生成答案.
- 中等复杂度查询:使用单步检索方法.
- 复杂查询:使用多步检索方法.
- 训练策略:自动构建训练数据集,通过不同检索增强策略的结果来确定查询的复杂度标签。例如,如果非检索策略能正确回答,则将查询标记为简单。此外,利用数据集的固有偏差来补充标签.
三、实验设计与结果
- 数据集:使用多个公开的单步和多步问答数据集,如SQuAD v1.1、Natural Questions、TriviaQA等.
- 模型比较:与非检索、单步检索、多步检索以及现有的自适应检索方法(如Self-RAG)进行比较.
- 评估指标:使用F1、EM、Accuracy等指标评估任务性能,同时考虑检索和生成步骤数、每个查询的平均回答时间等效率指标.
- 结果分析:实验结果表明,Adaptive-RAG在有效性和效率上均优于现有的方法,特别是在处理复杂查询时,能够更有效地利用资源,提高答案的准确性.
四、论文创新点
- 自适应问答框架:
- 动态策略选择:提出了一种自适应的问答框架(Adaptive-RAG),能够根据查询的复杂度动态选择最合适的检索增强策略。这种动态选择机制使得系统能够灵活地应对不同复杂度的查询,而不是采用一种固定的处理方式.
- 平衡效率与准确性:通过自适应地选择策略,能够在保持高准确性的同时提高系统的效率。对于简单查询,避免不必要的复杂处理;对于复杂查询,则提供足够的计算资源以确保准确回答.
- 查询复杂度分类器:
- 自动标注训练数据:设计了一个分类器来预测查询的复杂度,并通过自动化的标注策略来构建训练数据集。这种方法利用模型的实际预测结果和数据集的固有偏差,无需人工标注,降低了数据准备的难度和成本.
- 多级复杂度识别:将查询分为三个复杂度等级(简单、中等、复杂),能够更细致地识别不同类型的查询,从而为每种查询选择更合适的处理策略.
- 综合策略融合:
- 无检索、单步检索和多步检索的融合:Adaptive-RAG框架能够在无检索、单步检索和多步检索之间无缝切换,根据查询的复杂度选择最合适的策略。这种融合使得系统能够充分利用各种策略的优势,提高整体的问答性能.
五、论文总结
Adaptive-RAG根据查询的复杂程度动态选择最适合的检索增强策略,从最简单到最复杂的策略中动态地为LLM选择最合适的策略。这个选择过程通过一个小语言模型分类器来实现,预测查询的复杂性并自动收集标签以优化选择过程。这种方法提供了一种平衡的策略,能够在迭代式和单步检索增强型 LLMs 以及无检索方法之间无缝适应,以应对一系列查询复杂度。
HippoRAG【海马体】
海马体:像人脑海马体一样,把新旧知识巧妙编织成网。不是简单地堆积信息,而是让每条新知识都找到最恰当的归属。
- 发表时间:2024.03.23
- 论文名称:HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models
- 论文地址:https://arxiv.org/abs/2405.14831
- Github 项目:https://github.com/OSU-NLP-Group/HippoRAG
一、论文动机
- LLMs的局限性:尽管大型语言模型(LLMs)在信息生成方面表现出色,但它们在信息检索上存在局限性,容易生成错误或虚假信息。
举个栗子:一位网友搜索“自制披萨的奶酪容易掉下来怎么办?”,AI Overviews 回答道:“往酱汁里添加约 1/8 杯的胶水即可。”它甚至还特意强调用无毒胶水。
- RAG技术的挑战:检索增强生成(RAG)技术通过检索外部知识来增强LLMs的能力,但在处理复杂问题时仍存在不足,如无法有效确认信息的真实性或进行多跳推理.
二、论文思路
- 灵感来源:HippoRAG的灵感来源于人脑的记忆机制,特别是海马体在记忆整合和多跳推理中的作用。该技术通过模仿人脑的三个主要记忆组件(大脑皮层、海马体和海马旁回)来增强LLMs的知识整合能力.
- 工作原理:
- 知识图谱(KG):类似于大脑皮层,负责从文本中提取信息并构建知识图谱.
- 个性化PageRank(PPR)算法:类似于海马体,用于在知识图谱中找到与查询最相关的部分.
- 检索编码器:类似于海马旁回,帮助将查询中的关键概念与知识图谱中的节点关联起来.
- 优势:
- 性能提升:在多跳问题回答任务中,HippoRAG相较于传统RAG方法性能提升了3%到20%.
- 成本效益:单步检索的成本比迭代检索方法低10到30倍,速度也快6到13倍.
- 新场景处理能力:能够有效处理路径发现型多跳问题,即在没有明确路径的情况下探索不同信息源以构建答案.
三、实验设计与结果
- 数据集:使用MuSiQue和2WikiMultiHopQA等多跳问答数据集进行测试.
- 基线比较:与BM25、Contriever、GTR、ColBERTv2等强基线方法进行比较.
- 评估指标:使用召回率(R@2和R@5)和问答性能(EM和F1分数)进行评估.
- 结果:HippoRAG在多跳问答任务中表现出色,显著优于现有RAG方法,并且在与IRCoT结合使用时进一步提升了性能.
四、论文创新点
- 模仿人脑记忆机制
- 海马体记忆索引理论的启发:HippoRAG通过模仿人脑海马体和大脑皮层的协同工作机制,将知识整合和记忆检索的过程与人类的记忆机制相结合。这种设计使得模型能够更有效地进行跨段落的信息整合和推理,类似于人类在面对复杂问题时的记忆联想和信息检索能力.
- 单步多跳检索能力
- 单步实现多跳推理:HippoRAG能够在单步检索中完成多跳推理任务,这与传统的迭代检索方法(如IRCoT)相比,显著提高了检索效率。通过使用个性化PageRank(PPR)算法,HippoRAG能够在知识图谱中快速找到与查询相关的多个节点及其关联路径,从而在一次检索中完成多跳信息的整合.
- 知识图谱与LLMs的协同工作
- 无结构知识图谱的构建:HippoRAG利用LLM将文本语料库转换为无结构的知识图谱,这种图谱能够存储大量的实体及其关系,为后续的检索和推理提供了丰富的信息基础。与传统的结构化知识图谱相比,无结构知识图谱在灵活性和扩展性方面具有优势.
- 知识图谱与LLMs的深度融合:通过将知识图谱与LLMs相结合,HippoRAG不仅能够利用LLMs的语言理解和生成能力,还能借助知识图谱进行更有效的信息检索和整合。这种深度融合使得模型在处理复杂的知识整合任务时表现更为出色.
- 显著的性能提升
- 在多跳问答任务中的优越表现:实验结果表明,HippoRAG在多跳问答任务中显著优于现有的RAG方法,性能提升了3%到20%。这表明其在理解和回答复杂问题时更加准确和高效.
- 成本和速度的优化:与迭代检索方法相比,HippoRAG在成本和速度上都有显著优势,单步检索的成本比迭代检索低10到30倍,速度也快6到13倍。这使得HippoRAG在实际应用中更具可行性,尤其是在需要快速响应的场景中.
- 解决复杂知识整合问题
- 处理路径发现型多跳问题:HippoRAG能够有效处理路径发现型多跳问题,即在没有明确路径的情况下,通过探索不同的信息源来构建答案。这在现实生活中具有广泛的应用前景,如科学文献综述、法律案例分析等需要复杂知识整合的场景.
五、论文总结
- 结论:HippoRAG通过模仿人脑记忆机制,有效地解决了LLMs在知识整合方面的局限性,为长期记忆在LLMs中的实现提供了一种有前景的解决方案.
- 局限性:尽管HippoRAG在多跳问答任务中表现出色,但其在处理更复杂场景时仍有改进空间,例如进一步优化OpenIE和PPR算法的性能,以及提高其在更大规模数据集上的可扩展性.
RAE【智能编辑】
智能编辑:像个细心的新闻编辑,不仅会深入挖掘相关事实,还能通过连环推理找出容易被忽略的关键信息,同时懂得删减冗余内容,确保最终呈现的信息既准确又精炼,避免"说得天花乱坠却不靠谱"的问题。
- 发表时间:2024.03.28
- 论文名称:Retrieval-enhanced Knowledge Editing in Language Models for Multi-Hop Question Answering
- 论文地址:https://arxiv.org/abs/2403.19631
- Github 项目:https://github.com/sycny/RAE
一、论文动机
- 问题背景:LLMs在问答任务中表现出色,但在处理多跳问题时,需要更新和整合多个知识点。现有的模型编辑方法在处理这些复杂联系时存在困难,容易生成过时或不正确的回答.
二、论文思路
- 核心概念:RAE框架通过检索和编辑相结合的方法,增强LLMs在多跳问答中的表现.
- 关键组成部分:
- 外部知识图谱:存储编辑过的事实和未编辑的事实,为检索提供知识基础.
- 基于互信息的检索:通过最大化问题和检索到的子图之间的互信息,识别与问题最相关的知识子图.
- 冗余知识剪枝:使用编辑不确定性评估检索到的事实集,剪除冗余或不相关事实,提高编辑准确性.
- 上下文学习编辑:结合经过剪枝的事实集和编辑模板,通过LLMs的上下文学习能力生成准确答案.
- 编辑模板:指导LLMs如何结合问题和事实产生正确输出的特定提示结构.
三、实验设计与结果
- 实验设置:在不同大小的语言模型上进行评估,验证RAE在提供准确答案和更新知识方面的能力.
- 结果:RAE在处理多跳问题时,相比于现有基线方法,显著提高了编辑后的模型输出的准确性.
四、论文创新点
- 检索增强型知识编辑框架
- 结合检索与编辑:传统的知识编辑方法通常依赖于直接修改模型参数或知识库,而RAE框架通过检索增强的方式,结合了检索和编辑的优势。它首先通过检索获取与问题相关的知识,然后对这些知识进行编辑和整合,从而更好地适应多跳问答任务的需求.
- 多跳问题的针对性设计:针对多跳问答任务中知识点之间复杂联系的特点,RAE框架专门设计了检索和编辑策略。通过链式事实的识别和冗余知识的剪枝,能够更准确地捕捉和整合与问题相关的多个知识点.
- 基于互信息的检索方法
- 互信息最大化:传统的检索方法多基于简单的相似性搜索,容易遗漏相关信息。RAE框架通过最大化问题和检索到的子图之间的互信息,能够更全面地识别与问题最相关的知识子图。这种方法利用了LLMs的推理能力,提高了检索的准确性和相关性.
- 链式事实识别:通过链式事实的识别,RAE能够捕捉到知识点之间的逻辑关系和因果链,弥补了简单相似性搜索的不足,更好地支持多跳推理过程.
- 冗余知识剪枝策略
- 编辑不确定性评估:引入编辑不确定性来评估检索到的事实集,通过剪除冗余或不相关事实,提高了编辑的准确性和效率。这一策略有助于减少模型输出的不确定性,避免生成错误或不一致的答案.
- 提高编辑效率:通过剪枝策略,RAE框架能够更高效地处理大量的检索结果,避免在不必要的信息上浪费计算资源,从而提高了整体的编辑效率.
- 上下文学习编辑方法
- 结合编辑模板:利用编辑模板指导LLMs如何结合问题和事实来产生正确的输出。这种特定的提示结构能够更好地引导模型进行上下文学习,生成准确且连贯的答案.
- 上下文学习能力的利用:充分发挥LLMs的上下文学习能力,通过结合经过剪枝的事实集和问题上下文,生成更加准确和符合逻辑的答案.
五、论文总结
- 优势:RAE框架通过有效的检索和编辑策略,能够更好地处理多跳问答中的复杂知识联系,提高模型的回答准确性.
- 应用场景:适用于需要实时知识更新和复杂知识整合的问答场景.
2024.04
RAGCache【仓储员】
仓储员:像大型物流中心一样,把常用知识放在最容易取的货架上。懂得把经常用的包裹放在门口,把不常用的放在后仓,让取货效率最大化。
- 发表时间:2024.04.18
- 论文名称:RAGCache: Efficient Knowledge Caching for Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2404.12457
一、论文动机
- RAG 技术:通过结合外部知识库,提升了大语言模型(LLM)的性能,但在长序列生成时存在显著的延迟和效率挑战。
- 现有优化方案:主要关注 LLM 推理加速,未能充分利用 RAG 系统的特点。
- 性能瓶颈:RAG 系统的主要瓶颈在于 LLM 生成步骤,外部知识文档的注入显著延长了处理序列。
- 访问模式:检索请求高度集中,少数热门文档占据了大部分请求,为缓存优化提供了依据。
- 优化空间:通过缓存文档的中间计算状态,可以显著降低计算开销.
二、论文思路
- 知识树结构:设计了一种树状结构来组织缓存的文档状态,有效处理文档检索的顺序敏感性问题。
- 前缀感知的贪心双重大小频率 (PGDSF) 替换策略:综合考虑文档顺序、key-value 张量的大小、访问频率和时间的新近性,确保最有价值的文档状态留在缓存中.
- 多层缓存:实现跨 GPU 和主机内存的分层缓存系统,利用 GPU 内存的速度和主机内存的容量.
- 动态推测流水线:通过动态推测流水线重叠向量检索和 LLM 推理,最小化空闲时间,显著减少端到端延迟.
三、实验设计与结果
- 与 vLLM+Faiss 相比:首个 token 生成时间 (TTFT) 最高减少 4 倍,吞吐量最高提升 2.1 倍.
- 与 SGLang 相比:TTFT 最高减少 3.5 倍,吞吐量最高提升 1.8 倍.
四、论文创新点
- 知识树结构:设计了一种树状结构来组织缓存的文档状态,有效处理 RAG 系统中文档检索的顺序敏感性问题。例如,对于不同的文档序列(如 ([D1, D3]) 和 ([D2, D3])),尽管文档 (D3) 在两个序列中都出现,但由于前面文档的不同,其 key-value 张量在各自序列中的值是不同的。知识树结构能够高效管理这些变化,确保快速检索的同时保持文档顺序.
- 前缀感知的贪心双重大小频率 (PGDSF) 替换策略:引入了一种复杂的缓存替换策略,综合考虑了多个因素,包括文档顺序、key-value 张量的大小、访问频率和访问时间的新近性。这种策略确保最有价值的文档状态能够留在缓存中,最大化命中率并最小化重复计算.
- 多层缓存系统:实现了一个跨 GPU 和主机内存的分层缓存系统,允许高效利用更快但容量有限的 GPU 内存,同时利用主机内存的更大容量来存储较少访问的状态。例如,频繁访问的文档状态可能存储在 GPU 内存中以实现快速访问,而不常用的状态则保存在主机内存中.这种分层方法同时优化了速度和容量.
- 动态推测流水线:通过动态推测流水线重叠向量检索和 LLM 推理的能力,随着向量搜索的进行,RAGCache 将中期结果发送给 LLM 进行推测生成。如果检索到的文档发生变化,系统会适应性地启动新的推测生成。这种方法最小化了空闲时间,显著减少了端到端延迟.
五、论文总结
RAGCache是一种为RAG量身定制的新型多级动态缓存系统,它将检索到的知识的中间状态组织在知识树中,并在GPU和主机内存层次结构中进行缓存。RAGCache提出了一种考虑到LLM推理特征和RAG检索模式的替换策略。它还动态地重叠检索和推理步骤,以最小化端到端延迟。
GraphRAG【社区摘要】
社区摘要:先把小区居民的关系网理清楚,再给每个邻里圈做个简介。有人问路时,各个邻里圈提供线索,最后整合成最完整的答案。
- 发表时间:2024.04.24
- 论文名称:From Local to Global: A Graph RAG Approach to Query-Focused Summarization
- 论文地址:https://arxiv.org/abs/2404.12457
- Github 项目:https://github.com/microsoft/graphrag
一、论文动机
- RAG的局限性:传统的检索增强生成(RAG)方法适用于局部查询,即在特定文本区域内寻找答案,但对于需要对整个文本语料库进行全局理解的问题(如“数据集的主要主题是什么?”),RAG表现不佳.
- 查询聚焦摘要(QFS)的挑战:现有的QFS方法在处理大规模文本时存在扩展性问题,无法有效处理RAG系统通常索引的大量文本.
二、论文思路
- 核心思想:结合知识图谱生成、检索增强生成(RAG)和查询聚焦摘要(QFS),通过构建基于LLM的知识图谱来支持对整个文本语料库的全局查询.
- 具体步骤:
- 构建知识图谱:首先从源文档中提取实体和关系,构建一个实体知识图谱.
- 社区检测:使用社区检测算法(如Leiden算法)将图谱划分为多个紧密相关的社区.
- 生成社区摘要:为每个社区生成摘要,这些摘要在索引时和查询时都可以并行生成.
- 回答查询:对于每个查询,使用社区摘要生成部分响应,然后将所有部分响应汇总成最终的全局响应.
三、实验设计与结果
- 数据集:使用两个约100万token的数据集进行评估,一个是播客访谈的转录文本,另一个是新闻文章.
- 查询生成:通过活动中心的方法自动生成全局理解问题,例如“哪些播客节目主要讨论技术政策和政府监管?”
- 评估指标:使用LLM作为评估器,比较不同方法在全面性、多样性和赋能性(帮助读者理解和做出判断的能力)方面的表现.
- 结果:Graph RAG在全面性和多样性方面显著优于传统的RAG方法,并且在资源消耗(token成本)方面也更为高效.
四、论文创新点
- 结合知识图谱与RAG
- 知识图谱构建:传统的RAG方法主要依赖于文本检索和生成,而这篇论文提出了一种结合知识图谱的方法。通过从源文档中提取实体和关系,构建一个实体知识图谱,使得系统能够更好地理解和组织文本中的信息.
- 社区检测与摘要生成:利用社区检测算法将知识图谱划分为多个紧密相关的社区,并为每个社区生成摘要。这种方法不仅提高了对全局信息的理解能力,还为生成全面和多样化的答案提供了基础.
- 全局查询处理能力
- 全局查询聚焦:传统的RAG方法在处理需要对整个文本语料库进行全局理解的问题时表现不佳。而Graph RAG通过构建知识图谱和社区摘要,能够有效地处理这类全局查询问题,生成更全面和多样化的答案.
- 多阶段回答生成:在回答查询时,Graph RAG采用多阶段的方法,首先使用社区摘要生成部分响应,然后将所有部分响应汇总成最终的全局响应。这种分阶段的方法提高了生成答案的质量和效率.
- 资源效率的提升
- 降低token成本:与传统的基于文本的全局摘要方法相比,Graph RAG在生成答案时所需的token数量大幅减少。例如,对于根级别的社区摘要,Graph RAG所需的token数量比传统的全局文本摘要方法减少了97%以上.
- 高效的社区划分:通过社区检测算法,Graph RAG能够将知识图谱划分为多个层次的社区,使得在不同层次上生成摘要和回答查询变得更加高效.
五、论文总结
GraphRAG分两个阶段构建基于图的文本索引:首先从源文档中推导出实体知识图,然后为所有紧密相关实体的组预生成社区摘要。给定一个问题,每个社区摘要用于生成部分响应,然后在向用户的最终响应中再次总结所有部分响应。
2024.05
R4【编排大师】
编排大师:像个排版高手,通过优化材料的顺序和呈现方式来提升输出质量,无需改动核心模型就能让内容更有条理,重点更突出。
- 发表时间:2024.05.04
- 论文名称:R4: Reinforced Retriever-Reorder-Responder for Retrieval-Augmented Large Language Models
- 论文地址:https://arxiv.org/abs/2405.02659
一、论文动机
- LLM的局限性:尽管LLM在自然语言理解和生成方面取得了显著进展,但在处理长文本时仍面临挑战,尤其是在生成文本时可能会产生错误信息(即“幻觉”问题).
- 现有方法的不足:传统的检索增强方法通常不考虑检索文档与LLM之间的细粒度结构语义交互,这在处理长文档时会影响回答的准确性.
二、论文思路
- 核心模块:
- 检索器(Retriever):使用Dense Passage Retriever(DPR)检索相关文档.
- 重排序器(Reorder):通过图注意力学习和强化学习机制动态调整检索文档的顺序,以最大化回答质量的强化奖励.
- 响应器(Responder):将查询和调整后的文档作为输入,生成回答.
- 文档顺序调整:利用图注意力学习将检索文档动态调整到开始、中间和结束位置,以提高回答质量.
- 文档表示增强:对于生成质量较差的回答,通过文档级别的梯度对抗学习来细化检索文档的表示.
三、实验设计与结果
- 任务与数据集:实验使用了3类任务5个数据集,包括生成式问答(Generative QA)、多项选择问答(Multi-choice QA)和对话(Dialogue)任务.
- 性能提升:R4框架在知识密集型任务上的表现超过了多个强基线模型,如REALM、ICR、REPLUG、Selfmem、SELF-RAG、FILCO和LongLLMLingua.
- 鲁棒性:R4框架对于不同的检索器和LLMs表现出良好的适应性,证明了其在不同文档数量下的鲁棒性.
- 文档数量的影响:增加检索文档的数量可以提高模型性能,但性能提升随着检索文档数量的增加而减少.
四、论文创新点
- 增强检索器-重排序-响应器框架
- 传统RAG方法的改进:传统的检索增强生成(RAG)方法通常采用简单的检索器-响应器架构,而R4框架引入了一个增强的重排序器模块,使得检索文档的顺序可以根据任务需求和模型反馈进行动态调整。这种改进使得模型能够更好地利用检索到的信息,提高生成回答的质量和准确性.
- 细粒度结构语义交互:R4框架强调了检索文档与LLMs之间的细粒度结构语义交互的重要性,通过图注意力学习和强化学习机制,实现了对检索文档的精细排序和表示优化,从而更好地处理与事实知识相关的用户查询.
- 图注意力学习与强化学习结合
- 文档顺序动态调整:利用图注意力学习将检索文档动态调整到开始、中间和结束位置,以最大化回答质量的强化奖励。这种动态调整机制能够根据不同的查询和文档内容,灵活地优化文档的输入顺序,提高模型的适应性和灵活性.
- 强化学习的应用:通过强化学习机制,模型能够在训练过程中不断优化文档排序策略,以获得更高的回答质量奖励。这种结合图注意力学习和强化学习的方法,使得模型在处理长文档和复杂查询时,能够更有效地利用检索到的信息.
- 文档表示增强
- 梯度对抗学习:对于生成质量较差的回答,通过文档级别的梯度对抗学习来细化检索文档的表示。这种文档表示增强方法能够帮助模型更好地理解文档内容,提高生成回答的准确性和一致性.
- 适应性和鲁棒性
- 不同检索器和LLMs的适应性:R4框架对于不同的检索器和LLMs表现出良好的适应性,证明了其在不同文档数量下的鲁棒性。这种适应性使得R4框架能够在多种不同的应用场景和配置下,都能保持良好的性能.
- 检索文档数量的优化:实验表明,增加检索文档的数量可以提高模型性能,但性能提升随着检索文档数量的增加而减少。这为实际应用中检索文档数量的选择提供了指导,有助于在性能和资源消耗之间取得平衡.
五、论文总结
- 排序与优化的重要性:R4通过动态调整文档顺序和优化文档表示,显著提高了LLM在处理长文档和知识密集型任务时的准确性和鲁棒性.
- 适应性与扩展性:R4框架能够适应不同的检索器和LLMs,具有良好的扩展性和应用前景.
IM-RAG【自言自语】
自言自语:遇到问题时会在心里盘算"我需要查什么资料"、"这个信息够不够",通过不断的内心对话来完善答案,这种"独白"能力像人类专家一样,能够逐步深入思考并解决复杂问题。
- 发表时间:2024.05.15
- 论文名称:IM-RAG: Multi-Round Retrieval-Augmented Generation Through Learning Inner Monologues
- 论文地址:https://arxiv.org/abs/2405.13021
一、论文动机
- RAG方法的局限性:尽管RAG能够利用外部知识和LLM输出来增强生成质量,但在与不同能力的IR系统集成、多轮检索的可解释性以及端到端优化机制方面仍存在挑战.
- 内部独白的概念:IM-RAG通过学习内部独白来连接IR系统与LLM,支持多轮检索增强生成,使LLM能够更好地进行推理和生成.
二、论文思路
-
核心组件:
- 推理器(Reasoner):负责主要的推理任务,根据对话上下文生成查询或提供最终答案.
- 检索器(Retriever):根据推理器的查询从数据库中检索相关文档.
- 精炼器(Refiner):对检索到的文档进行重排序和改写,以提高信息的相关性.
- 进度跟踪器(Progress Tracker):通过打分系统跟踪任务进展,为强化学习提供反馈.
-
多轮交互过程:推理器在不同阶段切换角色,生成查询或提供答案,检索器和精炼器协同工作,逐步收集和精炼信息,直到推理器认为信息足够齐全,最终生成答案.
-
学习过程
- 强化学习(RL)阶段:推理器在生成查询时使用进度跟踪器的分数作为反馈,帮助优化查询策略.
- 监督微调(SFT)阶段:推理器在提供最终答案时基于对话和相关文档生成预测,并进一步利用真实答案微调模型.
-
工作流程
当用户提出复杂问题时,IM-RAG的核心组件推理器首先尝试回答。如果当前信息不足以得出答案,推理器将生成查询并交由检索器去知识库查找相关信息。检索到的文档经过精炼器优化后传回推理器,后者检查信息是否足够充分。若信息不足,则继续迭代生成新的查询并再次检索。整个流程持续数轮,直到推理器认为信息足够齐全,最终提供最终答案。
三、实验设计与结果
- 性能提升:在HotPotQA数据集上的实验结果表明,IM-RAG在多步推理任务中达到了最先进的性能,展现出更高的灵活性和可解释性.
- 优势:通过多轮交互式检索和内部独白机制,IM-RAG能够更有效地进行复杂推理,生成更准确和可解释的内容.
四、论文创新点
- 创新性:IM-RAG通过内部独白机制将LLM和IR系统紧密结合,实现了高效的多轮检索和生成,提升了RAG系统的推理能力和可解释性.
- 应用前景:该方法在多轮对话和复杂推理任务中具有广泛的应用潜力,能够为用户提供更准确和可解释的生成内容.
五、论文总结
IM-RAG通过学习内部独白(Inner Monologues)来连接IR系统与LLMs,从而支持多轮检索增强生成。该方法将信息检索系统与大型语言模型相整合,通过学习内心独白来支持多轮检索增强生成。在内心独白过程中,大型语言模型充当核心推理模型,它既可以通过检索器提出查询以收集更多信息,也可以基于对话上下文提供最终答案。我们还引入了一个优化器,它能对检索器的输出进行改进,有效地弥合推理器与能力各异的信息检索模块之间的差距,并促进多轮通信。整个内心独白过程通过强化学习(RL)进行优化,在此过程中还引入了一个进展跟踪器来提供中间步骤奖励,并且答案预测会通过监督微调(SFT)进一步单独优化。
AntGroup-GraphRAG【百家之长】
百家之长:汇集行业百家之长,擅用多种方式快速定位信息,既能提供精准检索,又能理解自然语言查询,让复杂的知识检索变得既经济又高效。
- 发表时间:2024.05.16
- Github 地址:https://github.com/eosphoros-ai/DB-GPT
一、论文动机
- GraphRAG框架:GraphRAG是一种结合图数据库和大型语言模型(LLM)的检索增强生成框架,用于提升问答系统的性能.
- 微软GraphRAG:微软的GraphRAG项目通过图社区摘要来改进问答质量,但存在图索引构建成本较高的问题.
- 朴素GraphRAG的局限性:依赖于查询中的关键词信息,对于总结性查询效果不佳,容易出现“当前知识库不足以回答你的问题”的情况.
二、论文思路
- 朴素GraphRAG 改进思路:
- 混合RAG:通过多路召回方式综合向量索引与图索引的优势,提升整体问答质量。HybridRAG[4]论文正是采用此方式,大致提升了若干个百分点的性能,但是上下文精度性能出现回退,主要是因为多路检索的知识无法对齐导致,这也是多系统混合检索的原生问题。
- 融合索引:直接将向量索引集成到图数据库内部,提供知识图谱上的向量搜索能力,实现知识图谱子图甚至原始文档的相似性检索,避免多系统知识召回的数据不一致问题。例如Neo4jVector[5],另外TuGraph[6]也即将在下个版本提供向量索引能力支持。
- 社区摘要:基于图社区算法将知识图谱划分为若干社区子图,并提取社区子图摘要,总结性查询会根据社区摘要的内容进行回答,这也是微软GraphRAG中的关键设计。
- 社区摘要增强链路
- 文本块记忆:知识抽取阶段一次性完成图结构抽取和元素(点/边)总结,并引入文本块记忆能力,解决跨文本块的引用信息抽取问题。
- 图社区摘要:知识抽取阶段一次性完成图结构抽取和元素(点/边)总结,并引入文本块记忆能力,解决跨文本块的引用信息抽取问题。
- 多路搜索召回:不区分全局搜索与本地搜索,通过多路搜索同时提供查询相关的摘要与明细上下文。
社区摘要增强的GraphRAG链路
- 实现细节
- 社区发现:使用Leiden算法等进行社区划分,支持从不同层次洞察知识图谱.
- 社区摘要:将社区子图数据提供给LLM进行总结,引导LLM保留关键信息.
- 保存摘要:将社区摘要存储在向量数据库中,提供检索能力.
三、实验设计与结果
- 索引性能:DB-GPT GraphRAG的索引阶段token开销只有微软方案的一半左右.
- 查询性能:全局搜索性能有明显提升,得益于社区摘要的相似性召回.
四、论文创新点
- 社区摘要增强
- 图社区划分与摘要提取:通过图社区发现算法(如Leiden算法)将知识图谱划分为多个社区子图,并为每个社区提取摘要信息。这种方法能够更好地总结和理解知识图谱的整体结构和主题,从而提高总结性查询的问答质量.
- 社区摘要的相似性召回:在查询时,利用社区摘要进行相似性召回,而不是依赖于传统的关键词匹配。这使得系统能够更准确地理解用户的查询意图,并提供更相关的答案.
- 多路搜索召回
- 全局搜索与本地搜索的整合:不区分全局搜索与本地搜索,通过多路搜索同时提供查询相关的摘要与明细上下文。这种整合方式提高了搜索的灵活性和准确性,能够更好地满足不同类型的查询需求.
- 混合检索策略:结合全局搜索和本地搜索的优势,避免了单一检索方式的局限性,提高了整体的检索效果.
- 文本块记忆能力
- 跨文本块引用信息抽取:在知识抽取阶段引入文本块记忆能力,解决了跨文本块的引用信息抽取问题。这使得系统能够更准确地识别和利用上下文关联信息,提高知识抽取的精度和效率.
- 显著降低token开销
- 优化索引构建过程:通过在知识抽取和社区总结阶段的优化方法,显著降低了图索引构建时的token开销,使得DB-GPT GraphRAG的索引阶段token开销只有微软方案的一半左右.这种优化不仅提高了系统的性能,还降低了资源消耗.
五、论文总结
蚂蚁TuGraph团队基于DB-GPT构建的开源GraphRAG框架,兼容了向量、图谱、全文等多种知识库索引底座,支持低成本的知识抽取、文档结构图谱、图社区摘要与混合检索以解决QFS问答问题。另外也提供了关键词、向量和自然语言等多样化的检索能力支持。
Kotaemon【乐高】
乐高:一套现成的问答积木套装,既能直接拿来用,又能自由拆装改造。用户要用就用,开发要改就改,随心所欲不失章法。
- 发表时间:2024.05.15
- Github 地址:https://github.com/Cinnamon/kotaemon
一、论文动机
- RAG(Retrieval-Augmented Generation):一种结合检索和生成的模型,通过检索相关文档来增强大型语言模型(LLM)的生成能力,从而提高问答系统的性能.
- kotaemon:一个开源的RAG UI工具,适用于最终用户和开发者,提供了丰富的功能和高度的可定制性.
二、kotaemon的主要特点
- 自托管文档问答Web UI:允许用户自己托管文档问答界面,提供了完整的前端和后端集成解决方案.
- 支持多用户登录:可以组织私人或公共文件集合,支持协作和分享,适合团队使用.
- 组织LLM和嵌入模型:支持本地LLM和流行的API提供商,如OpenAI、Azure、Ollama、Groq等,提供了灵活的模型选择.
- 混合RAG管道:提供混合(全文和向量)检索器和重新排名,确保最佳的检索质量,提高了检索的准确性和效率.
- 多模态问答支持:支持在包含图表和表格的多个文档上进行问答,并支持多模态文档解析,扩展了问答系统的应用范围.
- 高级引用与文档预览:系统默认提供详细的引用以确保LLM答案的正确性,可以在浏览器内的PDF查看器中查看引用(包括相关分数)并高亮显示,提高了答案的可信度.
- 支持复杂推理方法:使用问题分解来回答复杂或多跳问题,支持基于Agent的推理,如ReAct、ReWOO和其他代理,增强了系统的推理能力.
- 可配置的设置UI:可以在UI上调整检索和生成过程中的大多数重要方面(包括提示),提供了高度的可定制性.
- 可扩展性:基于Gradio构建,用户可以自由定制或添加任何UI元素,同时支持多种文档索引和检索策略,提供了GraphRAG索引管道作为示例.
三、论文总结
一个开源的干净且可定制的RAG UI,用于构建和定制自己的文档问答系统。既考虑了最终用户的需求,也考虑了开发者的需求。
FlashRAG【百宝箱】
百宝箱:把各路RAG神器打包成一个工具包,让研究者像挑选积木一样,随心所欲地搭建自己的检索模型。
- 发表时间:2024.05.22
- 论文名称:FlashRAG: A Modular Toolkit for Efficient Retrieval-Augmented Generation Research
- 论文地址:https://arxiv.org/abs/2405.13576
- Github 项目:https://github.com/RUC-NLPIR/FlashRAG
一、论文动机
- RAG技术:检索增强生成(RAG)技术通过利用外部知识库来缓解大型语言模型(LLM)中的幻觉问题,但缺乏标准化的实现框架,使得研究人员难以比较和评估不同的RAG方法.
- 现有工具包的局限性:现有的RAG工具包如LangChain和LlamaIndex通常比较重量级且难以满足研究人员的个性化需求.
二、论文思路
- 三个模块:FlashRAG由环境模块、组件模块和管道模块组成.
- 环境模块:提供必要的数据集、超参数和评估指标.
- 组件模块:包括五个主要组件:判断器、检索器、排序器、精炼器和生成器.
- 管道模块:将各种组件组合在一起以实现完整的RAG过程,提供了多种预设的管道,方便用户快速搭建RAG流程.
- 组件模块详解:
- 判断器(Judger):确定是否需要检索.
- 检索器(Retriever):支持多种检索方式,如稀疏检索和稠密检索,并支持自定义预取结果.
- 排序器(Reranker):优化检索结果的顺序,支持多种跨编码模型.
- 精炼器(Refiner):减少生成器的输入文本量并降低噪声,提供四种类型的精炼器供选择.
- 生成器(Generator):支持多种主流LLM加速库和编码解码模型.
三、实验设计与结果
- 基准数据集:收集并预处理了32个基准数据集,涵盖了RAG工作中使用的大部分数据集,所有数据集都已格式化为统一的JSONL结构.
- 语料库:提供了方便的脚本来自动下载和预处理所需的Wikipedia版本,还提供了DPR提供的广泛使用的2018年12月20日的Wikipedia转储作为基础资源.
- 评估指标:支持多种检索和生成方面的评估指标,包括召回率@k、精确度@k、F1@k、平均精度(MAP)、词级别F1分数、准确率、BLEU和ROUGE-L等.
- 实验设置:使用最新的LLAMA3-8B-instruct作为生成器,E5-base-v2作为检索器,2018年12月的Wikipedia数据作为检索语料库,在六个常见数据集上进行实验.
- 主要结果:与直接生成的基线相比,RAG方法有显著的改进。使用先进的检索器和生成器的标准RAG是一个强大的基线,在六个数据集上都表现良好.
- 不同方法的比较分析:
- 精炼器优化方法:在多跳数据集上表现尤其出色,因为复杂问题导致文档检索的准确性降低,需要精炼器优化.
- 生成器优化方法:Ret-Robust使用带有lora模块的Llama2-13B模型,大大增强了生成器对检索文档的理解,优于其他无需训练的方法.
- 适应性检索方法:在需要多步推理的复杂数据集上比基线有显著的改进,但在简单任务上可能会带来更高的成本,但收益有限.
四、论文创新点
- 广泛且可定制的模块化RAG框架:提供了丰富的组件和预设的管道,方便用户快速搭建RAG流程.
- 预实现的先进RAG算法:目前已实现12个先进的RAG方法.
- 全面的基准数据集:目前收录32个基准数据集.
- 高效的RAG辅助脚本:如下载维基百科、构建索引等.
五、论文总结
FlashRAG是一个高效且模块化的开源工具包,旨在帮助研究人员在统一框架内重现现有的RAG方法并开发他们自己的RAG算法。我们的工具包实现了12种先进的RAG方法,并收集和整理了32个基准数据集。
GRAG【侦探】
侦探:不满足于表面线索,深入挖掘文本之间的关联网络,像破案一样追踪每条信息背后的真相,让答案更准确。
- 发表时间:2024.05.26
- 论文名称:GRAG: Graph Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2405.16506
- Github 项目:https://github.com/HuieL/GRAG
一、论文动机
- RAG模型的局限性:传统的RAG模型在处理复杂的图结构数据时,忽视了文本之间的联系和数据库的拓扑信息,导致性能瓶颈。例如,在处理科学文献时,仅基于文本相似性的检索方法无法充分利用文献之间的引用关系和主题结构.
- GRAG模型的动机:为了解决这一问题,GRAG模型通过考虑文献之间的引用网络和主题分布,将拓扑信息在检索阶段和生成阶段利用起来,提高生成式语言模型的生成质量和图场景下的上下文一致性.
二、论文思路
GRAG模型由四个主要阶段组成,即k阶子图索引、图检索、软剪枝和生成:
- k阶子图索引:对图中的每个节点及其周围的k阶邻居进行编码,并存储其图嵌入.
- 图检索:使用预训练语言模型(PLM)将查询转换为向量,并检索与查询最相关的前N个子图.
- 软剪枝:在检索到的子图结构中,对与查询不相关的节点和边进行软剪枝,以减少其对最终生成的影响.
- 生成:整合剪枝后的文本子图和原始查询,通过图神经网络(GNN)聚合子图内的信息,最后利用文本信息(text tokens)和子图信息(graph token)控制生成.
GRAG模型采用了一种双重提示策略,即硬提示和软提示。
- 硬提示:将检索到的子图转换为层次化的文本描述,保留拓扑信息和语义细节.
- 软提示:检索到的子图在剪枝过后通过GNN聚合文本和拓扑信息生成图token,随后用于引导大语言模型的生成过程.
三、实验设计与结果
- 数据集:在两个多跳推理基准(WebQSP和ExplaGraphs)上进行实验,数据集经过预处理将三元组集合转换为图.
- 结果:GRAG方法在所有指标上均显著优于当前最先进的RAG方法和LLM基线。特别是在生成任务中,GRAG减少了虚假信息的生成,使用GRAG的LLM(即Llama-7b)在未进行微调的情况下,其性能超越了微调后的LLM,显著降低了训练成本.
- 性能指标:
- WebQSP数据集:GRAG方法的Hit@1指标显著高于其他方法.
- ExplaGraphs数据集:GRAG方法的准确率表现出色.
- 检索效率与模型性能的权衡:尽管通过编码子图的方式控制检索空间为 |V|(节点数量)个子图,检索更多的子图可以提供更全面的上下文信息以提升生成质量,但这同时也会增加计算开销和处理时间。实验表明,合理选择检索的子图数量可以平衡效率和性能.
四、论文总结
传统RAG模型在处理复杂的图结构数据时忽视了文本之间的联系和数据库的拓扑信息,从而导致了性能瓶颈。GRAG通过强调子图结构的重要性,显著提升了检索和生成过程的性能并降低幻觉。
Camel-GraphRAG【左右开弓】
左右开弓:一只眼睛用Mistral扫描文本提取情报,另只眼睛用Neo4j编织关系网。查找时左右眼配合,既能找相似的,又能顺着线索图追踪,让搜索更全面精准。
- 发表时间:2024.05.27
- 论文名称:CAMEL: Communicative Agents for "Mind" Exploration of Large Language Model Society
- 论文地址:https://arxiv.org/abs/2303.17760
- Github 项目:https://github.com/camel-ai/camel
一、论文动机
- RAG方法:RAG结合了检索系统和生成模型,可以提供更精准和相关的答案。然而,传统的RAG方法在处理复杂查询时存在一些问题,如模型幻觉问题。
- GraphRAG:为了减缓这些问题,Mistral和CAMEL共同开发了GraphRAG,通过将知识图谱和向量检索结合,显著提高了检索的准确性和性能。
二、论文思路
- 技术栈细节
- CAMEL:作为一个多智能体系统框架,提供了知识图谱代理和聊天代理等功能,简化了工作流程。
- MistralAI:提供了Mistral Large 2大语言模型和Mistral Embed嵌入模型。
- Neo4j:提供了知识图谱数据库。
- Qdrant:提供了向量数据库,存储文本嵌入并支持快速向量检索。
- Unstructured.io:负责将非结构化数据转换为结构化格式,为RAG系统做好准备。
- GraphRAG的工作流程
- 数据准备:通过Unstructured.io将原始数据转换为适合处理的格式。
- 知识提取和存储:使用Mistral Large 2从数据源中提取有用的信息,构建知识图谱,并存储在Neo4j数据库中。
- 向量生成和存储:使用Mistral Embed将文本转换为向量表示,并存储在Qdrant向量数据库中。
- 混合检索:结合向量检索和知识图谱检索,通过CAMEL框架的智能体系统处理用户查询,提供更加准确和相关的答案。
- 回答用户问题:使用Agent生成回复。
三、论文总结
Camel-GraphRAG依托Mistral模型提供支持,从给定的内容中提取知识并构建知识结构,然后将这些信息存储在 Neo4j图数据库中。随后采用一种混合方法,将向量检索与知识图谱检索相结合,来查询和探索所存储的知识。
G-RAG【串门神器】
串门神器:不再是单打独斗地查资料,而是给每个知识点都建立人际关系网。像个社交达人,不仅知道每个朋友的特长,还清楚谁和谁是酒肉朋友,找答案时直接顺藤摸瓜。
- 发表时间:2024.05.28
- 论文名称:Don't Forget to Connect! Improving RAG with Graph-based Reranking
- 论文地址:https://arxiv.org/abs/2405.18414
一、论文动机
- RAG系统的挑战:传统的RAG方法在处理信息不全或上下文关联度较低的文档时,存在文档间连接利用不足的问题,导致过拟合和计算资源消耗增加,影响系统性能.
- G-RAG的目标:通过结合文档图和AMR图,改善现有重排序技术,减少过拟合并降低计算资源消耗,从而提高RAG系统的性能.
二、论文思路
- 文档图的构建:
- 对每个问题-文档对,将问题和文档文本拼接后使用AMR BART解析生成AMR图.
- 基于这些AMR图构建无向文档图,其中节点表示文档,边表示文档之间的共同概念.
- 通过消息传递机制更新边特征.
- 节点特征的生成:
- 使用预训练语言模型对所有检索到的文档进行编码,得到初始节点表示.
- 通过识别从“question”节点到其他节点的最短单源路径(SSSP),提取路径上的节点概念,构建AMR信息序列,并将其与文档文本拼接后再次编码,得到最终的节点特征.
- 边特征的生成:
- 计算文档之间的共同节点数和共同边数,作为边的特征,并进行归一化处理.
- 图神经网络的表示更新:
- 基于初始节点和边特征,使用图神经网络进行多轮迭代更新,通过聚合邻居节点的特征来更新每个节点的表示.
- 重排序得分和训练损失:
- 使用余弦相似度计算每个文档的重排序得分,并使用交叉熵损失函数和成对排名损失函数进行训练。成对排名损失函数能够更好地处理排名分数的平局情况.
三、实验设计与结果
- 实验设计
- 数据集:
- 使用自然问题(NQ)和TriviaQA数据集进行实验。NQ数据集包含来自Google搜索查询的文本块,而TQA数据集包含来自trivia和quiz-league网站的问答对.
- 模型细节:
- 使用DPR进行文档检索,生成100个文档,并使用AMRBART解析每个问题-文档对生成AMR图.
- 采用2层图卷积网络(GCN)作为GNN模型,隐藏维度从{8, 64, 128}中选择,dropout率从{0.1, 0.2, 0.4}中选择,学习率从{5e-5, 1e-4, 5e-4}中选择.
- 使用AdamW优化器,学习率5e-5至1e-4,批量大小5,总训练步数50k,每10k步评估一次.
- 评估指标:
- 使用平均倒数排名(MRR)、平均命中率@10(MHits@10)及其变体(MTRR和TMHits@10)评估重排序性能.
- 数据集:
- 实验结果
- 重排序性能:
- G-RAG方法在NQ和TQA数据集上的MRR和MHits@10指标上均优于现有方法。
- 在NQ数据集上,G-RAG的MRR达到了27.3,而BART的MRR为25.7;在TQA数据集上,G-RAG的MHits@10达到了42.9,而BART的MHits@10为38.5.
- PaLM 2评估:
- 使用PaLM 2作为重排序器时,发现其在重排序任务中的表现不如G-RAG。这可能是由于PaLM 2生成的相关性得分中存在大量平局,导致排名效果不佳.
- 使用提出的MTRR和TMHits@10指标进行评估,结果显示G-RAG方法显著提高了重排性能.
- 不同嵌入模型的比较:
- 在相同设置下,Ember模型表现最佳,尤其是在引入超参数调优后,其MRR达到了28.9。其次是GTE和BGE,而BART-GST和BERT表现略低.
- 重排序性能:
四、论文创新点
- 提出了一种基于文档图的重新排序器G-RAG,利用文档之间的连接信息提高RAG的性能,特别是在文档与问题上下文连接较弱的情况下.
- 引入了新的评估指标MTRR和TMHits@10,更公平地评估各种排名场景,包括得分相同的排名情况.
- 评估了PaLM 2作为重排序器的性能,发现即使使用最先进的预训练大型语言模型,重排序器模型设计在RAG中的重要性也不容忽视.
- G-RAG在保持较小计算足迹的同时,优于现有的最先进方法.
- 通过识别有助于重新排序器识别更相关文档的关键因素,而不是将所有AMR相关的标记都添加为节点级特征,从而提高了性能并避免了过拟合.
五、论文总结
RAG 在处理文档与问题上下文的关系时仍存在挑战,当文档与问题的关联性不明显或仅包含部分信息时,模型可能无法有效利用这些文档。此外,如何合理推断文档之间的关联也是一个重要问题。 G-RAG实现了RAG检索器和阅读器之间基于图神经网络(GNN)的重排器。该方法结合了文档之间的连接信息和语义信息(通过抽象语义表示图),为 RAG 提供了基于上下文的排序器。
LLM-Graph-Builder【搬运工】
搬运工:给混乱的文字安个明白的家。不是简单地搬运,而是像个强迫症患者,把每个知识点都贴上标签,画上关系线,最后在Neo4j的数据库里盖起一座井井有序的知识大厦。
- 发表时间:2024.05.29
- Github 地址:https://github.com/neo4j-labs/llm-graph-builder
一、论文动机
- 知识图谱的重要性:知识图谱能够将非结构化数据转换为结构化形式,便于存储和查询,对于对话系统和知识问答等应用具有重要意义.
- LLM的应用:利用大型语言模型(LLM)如OpenAI、Gemini、Llama3、Diffbot、Claude、Qwen等从非结构化数据中提取节点、关系及其属性,可以提高知识图谱的构建效率和质量.
二、论文思路
- 知识图谱创建:使用LLMs将非结构化数据(如PDF、文档、文本、YouTube视频、网页等)转换为存储在Neo4j中的结构化知识图谱.
- 提供Schema:用户可以提供自定义的Schema或使用已有的Schema来生成知识图谱,增加了灵活性和可定制性.
- 查看图表:在Bloom中可以一次查看特定源或多个源的知识图谱,方便用户直观地理解和分析数据.
- AI聊天:通过对话即可查询与Neo4j数据库中的数据进行交互,还可以提供来源的元数据,支持使用不同的RAG方法(如GraphRAG、Vector、Text2Cypher)进行知识问答.
三、论文总结
Neo4j开源的基于LLM提取知识图谱的生成器,可以把非结构化数据转换成Neo4j中的知识图谱。利用大模型从非结构化数据中提取节点、关系及其属性。
2024.06
MRAG【八爪鱼】
八爪鱼:不是只长一个脑袋死磕问题,而是像章鱼一样长出多个触角,每个触角负责抓取一个角度。简单说,这就是AI版的"一心多用"。
- 发表时间:2024.06.07
- 论文名称:Multi-Head RAG: Solving Multi-Aspect Problems with LLMs
- 论文地址:https://arxiv.org/abs/2406.05085
- Github 地址:https://github.com/spcl/MRAG
一、论文动机
- RAG的挑战:现有的RAG方法主要关注单一方面查询的文档检索,忽略了需要同时检索多个不同内容文档的多方面查询。这导致在处理复杂查询时,RAG系统的性能受限.
- MRAG的目标:通过利用Transformer解码器的多头注意力层的激活,生成多维度嵌入,更好地表示文档和查询的各个方面,从而提高检索的准确性和相关性.
二、论文思路
研究方法包括以下几点:
- 解码器架构:
输入是一个包含n个token的文本块,每个注意力头h对第i个token的输出定义为:
其中:
这些输出组合形成第i个多头注意块的输出:
其中,矩阵 $W_a$ 是将所有注意力头的输出组合起来的线性层。
- 标准RAG公式:
假设一个包含n个token的文本块作为输入文本块,该块的嵌入是通过最后一个解码器块的前馈层生成的激活向量:
- 多头RAG公式:
MRAG的关键思想是使用最后一个注意力层的激活向量而不是最后一个前馈层的激活向量:
即最后一个token的所有注意力头的输出.
- MRAG管道概述:
- 数据准备:使用选定的基于解码器的嵌入模型创建多面MRAG文本嵌入及其对应的文档或文本块.
- 查询执行:首先生成输入查询的多面嵌入,然后在数据存储中找到最近的多面嵌入及其对应的文本块.
三、实验设计与结果
- 实验设计
- 数据集生成:
- 选择概念上不同的文档类别,主要是公开可用的维基百科文章,共25个类别,每类50篇文档。每个文档的概览部分用于嵌入.
- 生成涉及多个方面的查询,涵盖1到20个方面.
- 指标设计:
- 设计了一套新的指标来评估RAG方案支持多面性的能力,主要包括检索成功率、类别检索成功率和加权检索成功率.
- 数据集生成:
- 结果分析
- 绝对检索性能:
- MRAG在检索成功率方面显著优于标准RAG,平均精确文档匹配的成功率提高了超过10%,类别匹配的成功率提高了超过25%.
- 相对性能提升:
- MRAG在不同数量的方面和不同的嵌入模型上的相对加权性能提升表明,它在所有情况下都优于标准RAG,平均提升10-20%.
- 与融合RAG的结合:
- MRAG与融合RAG结合后,性能进一步提升,但计算成本和延迟也相应增加.
- 真实工作场景负载:
- 在合成法律文件和分析化工厂事故原因的真实世界工作负载中,MRAG表现出优于其他方案的优势.
- 绝对检索性能:
四、论文总结
本文提出的MRAG方案通过利用Transformer解码器块的多头注意力层的激活,显著提高了复杂多方面查询的检索准确性。实验结果表明,MRAG在检索成功率和类别检索成功率方面均优于现有的RAG基线。此外,MRAG还具有成本低、计算效率高和易于集成等优点。本文的研究为进一步改进LLMs和RAG系统提供了新的思路和方法.
PlanRAG【战略家】
战略家:先制定完整作战计划,再根据规则和数据分析局势,最后做出最佳战术决策。
- 发表时间:2024.06.18
- 论文名称:PlanRAG: A Plan-then-Retrieval Augmented Generation for Generative Large Language Models as Decision Makers
- 论文地址:https://arxiv.org/abs/2406.12430
- Github 地址:https://github.com/myeon9h/PlanRAG
一、论文动机
- 决策问答(Decision QA)任务:定义为根据决策问题Q、业务规则R和数据库D,确定最佳决策。这种任务在商业环境中非常重要,但现有的RAG方法在处理这类任务时表现不佳,尤其是在制定决策计划方面.
- DQA基准:为了评估Decision QA,论文提出了一个包含两个场景(定位和构建)的基准DQA。这两个场景源自两款视频游戏(《欧陆风云IV》和《维多利亚3》),模拟了真实的商业环境.
二、论文思路
- 规划步骤:基于PlanRAG的语言模型首先生成决策计划,描述为决策所需执行的一系列数据分析任务.
- 检索与回答步骤:语言模型不仅接收问题、业务规则和数据库模式,还接收初始计划作为输入,生成用于决策的数据分析查询,并从数据库中检索数据.
- 重新规划步骤:当初始计划不足以解决决策问题时,进行重新规划。语言模型根据每次检索步骤的结果评估当前计划,并生成新的计划以进行进一步分析.
三、实验设计与结果
- 实验设计
- 实验设置:论文实现了四种不同的决策型LM进行比较,包括基于单轮RAG的SingleRAG-LM、基于迭代RAG的IterRAG-LM、基于PlanRAG的PlanRAG-LM,以及无重新规划的PlanRAG-LM。所有实验在零样本和单次运行的设置下进行.
- 数据库:使用MySQL作为关系数据库管理系统(RDBMS),Neo4j作为图形数据库管理系统(GDBMS).
- 评估指标:只有当决策者的答案在语义上与DQA上的真实最佳决策完全一致时,才被认为是正确的.
- 结果与分析
- 主要结果:PlanRAG在定位场景中比最先进的迭代RAG方法提高了15.8%,在构建场景中提高了7.4%。这充分展示了PlanRAG在决策制定任务中的有效性.
- 单次检索(SR)和多次检索(MR)问题:PlanRAG在SR问题上的表现远超IterRAG-LM,而在MR问题上也有显著优势。这是因为PlanRAG通过规划步骤减少了理解问题难度的可能性,并根据计划执行多次检索.
- RDB和GDB的分析:PlanRAG在两种数据库类型上都比其他LMs更有效。在建筑场景中,PlanRAG在GDB上的效果比在RDB上更好,因为建筑场景需要在GDB中进行更长的遍历来回答问题.
- 错失数据查询率分析:PlanRAG的遗漏率较低,分别为1.3%和21.8%,而IterRAG-LM的遗漏率较高,分别为3.3%和33.2%。这意味着PlanRAG能更有效地查询问题的关键数据.
- 失败案例分析:PlanRAG在两种场景下均显著降低了CAN和MIS错误,表明PlanRAG能更好地理解决策QA问题,并更有效地查询问题的关键数据.
- 重新规划分析:PlanRAG在Building场景中比在Locating场景中更频繁地重新规划,表明在Building场景中制定计划(无论是初始规划还是重新规划)时遇到更多困难.
四、论文总结
PlanRAG通过结合规划、检索和重新规划步骤,显著提高了复杂决策问答任务的性能。实验结果表明,PlanRAG在定位和构建场景中均优于现有的RAG基线,特别是在减少理解问题难度和有效查询关键数据方面表现出色。PlanRAG为利用LLMs进行复杂数据分析的决策提供了一种有效的解决方案.
FoRAG【作家】
作家:先列写作大纲构思文章框架,再逐段扩充完善内容。同时还配备了一个"编辑",通过仔细的事实核查和修改建议,帮助完善每个细节,确保作品的质量。
- 发表时间:2024.06.19
- 论文名称:FoRAG: Factuality-optimized Retrieval Augmented Generation for Web-enhanced Long-form Question Answering
- 论文地址:https://arxiv.org/abs/2406.13779
一、论文动机
- RAG的挑战:尽管RAG通过结合大型语言模型(LLMs)和检索器,利用搜索引擎增强了长篇问答的质量,但生成的长形答案中存在两个关键问题:事实性不足和逻辑清晰度不够.
- FoRAG的目标:提出一种新颖的大纲增强生成器(outline-enhanced generator)和基于精心设计的事实性优化方法,以实现多面性答案的清晰逻辑生成,并提高答案的事实性.
二、论文思路
-
大纲增强生成器(Outline-Enhanced Generator):
- 两阶段生成技术:首先生成一个组织模式和大纲,以提高生成答案的逻辑清晰度。第一阶段,生成器使用大纲模板,根据用户查询和上下文草拟答案大纲。第二阶段基于生成的大纲扩展每个观点,构建最终答案.
- 大纲阶段(Outline Stage):生成器根据问题和上下文,选择最合适的组织模式(如因果关系、比较对比等),然后输出一个包含关键点的大纲.
- 扩展阶段(Expansion Stage):根据前一阶段生成的大纲,LLM扩展每个关键点,形成完整的答案.
-
新颖的事实性优化方法:
- 双细粒度RLHF框架:为了克服直接应用RLHF(Reinforcement Learning from Human Feedback)的困难,提出了一个双细粒度的RLHF框架。该框架通过在事实性评估和奖励建模两个核心步骤中引入细粒度设计,提供了更密集的奖励信号.
- 细粒度评估:三种评估粒度:
- 整体性:将整个答案作为一个单元进行评估.
- 句子级别:将答案分割成句子,并分别评估每个句子.
- 子声明级别:进一步将每个句子分解为多个子声明,并分别评估每个子声明.
- 细粒度奖励建模:两种奖励建模粒度:
- 序列级别:为每个序列学习单一的奖励,反映相应序列的事实性.
- 标记级别:为序列中的每个标记学习奖励,通过聚合所有标记级别的奖励来计算序列的奖励.
- PPO优化:采用近端策略优化(PPO)方法来优化生成模型,通过最大化训练好的奖励模型提供的奖励.
三、实验设计与结果
- 性能比较:通过广泛的实验,验证了所提出的事实性优化RAG(FoRAG)方法在英文和中文基准测试中的优越性。特别是,当将该方法应用于Llama2-7B-chat时,得到的模型FoRAG-L-7B在连贯性、有用性和事实性这三个常用指标上超过了WebGPT-175B,而FoRAG-L-7B的参数数量仅为WebGPT-175B的1/24.
- 有无提纲增强和事实性优化的FoRAG变体的比较:实验结果表明,提纲增强和事实性优化显著提高了生成答案的质量.
- 不同事实性优化技术的性能比较:实验结果表明,双细粒度的RLHF框架在优化事实性方面优于传统的RLHF方法.
四、论文总结
FoRAG提出了一种新颖的大纲增强生成器,在第一阶段生成器使用大纲模板,根据用户查询和上下文草拟答案大纲,第二阶段基于生成的大纲扩展每个观点,构建最终答案。同时提出一种基于精心设计的双精细粒度RLHF框架的事实性优化方法,通过在事实性评估和奖励建模两个核心步骤中引入细粒度设计,提供了更密集的奖励信号。
Multi-Meta-RAG【元筛选器】
元筛选器:像个经验丰富的资料管理员,通过多重筛选机制,从海量信息中精准定位最相关的内容。它不只看表面,还会深入分析文档的"身份标签"(元数据),确保找到的每份资料都真正对题。
- 发表时间:2024.06.19
- 论文名称:Multi-Meta-RAG: Improving RAG for Multi-Hop Queries using Database Filtering with LLM-Extracted Metadata
- 论文地址:https://arxiv.org/abs/2406.13213
- Github 地址:https://github.com/mxpoliakov/multi-meta-rag
一、论文动机
- RAG的挑战:传统的RAG方法在回答多跳问题时表现不佳,因为这些问题需要从多个信息源中提取并推理出答案。传统的RAG技术很难从多个文档中找到正确的信息片段,单一的向量很难召回出差异较大的信息源.
- 多跳问题:多跳问题是指那些需要从多个信息源中提取并推理出答案的问题。例如,询问“Engadget在The Verge之前报道了13.6英寸MacBook Air的折扣吗?”这类问题需要从多个来源中提取信息并进行推理.
二、论文思路
- 核心思想:使用数据库过滤和LLM提取的元数据来提高文档选择的相关性。具体步骤如下:
- 问题分析:使用一个辅助的LLM分析问题,提取出问题中的关键信息,如新闻来源或发布日期.
- 数据库过滤:用提取的关键信息作为过滤条件,从数据库中找到最相关的文档片段.
- 生成答案:基于过滤后的文档片段,生成最终的答案.
三、实验设计与结果
- 实验设计
- 基准测试数据集:使用MultiHop-RAG基准测试数据集,该数据集包含了很多多跳查询的例子.
- 评估指标:评估文档片段的检索效果和LLM生成答案的准确性.
- 实验结果
- 显著提升:Multi-Meta-RAG在文档片段的检索和LLM生成答案的准确性上都有显著提升。具体表现为:
- 文档检索:能够更准确地从多个信息源中提取相关信息片段.
- 答案生成:生成的答案更准确,减少了错误信息的出现.
- 显著提升:Multi-Meta-RAG在文档片段的检索和LLM生成答案的准确性上都有显著提升。具体表现为:
四、论文总结
尽管存在一些局限性,Multi-Meta-RAG仍然是一个简单易懂且效果显著的方法,能够显著提高RAG在多跳查询中的表现。通过结合数据库过滤和LLM提取的元数据,Multi-Meta-RAG在多跳查询任务中表现出色,为RAG技术的发展提供了新的思路和方法.
2024.07
RankRAG【全能选手】
全能选手:通过一点特训就能当好"评委"和"选手"双重角色。像个天赋异禀的运动员,只需要少量指导就能在多个项目上超越专业选手,还能把看家本领都融会贯通。
- 发表时间:2024.07.02
- 论文名称:RankRAG: Unifying Context Ranking with Retrieval-Augmented Generation in LLMs
- 论文地址:https://arxiv.org/abs/2407.02485
一、论文动机
- RAG的挑战:传统的RAG系统通常依赖于独立的检索和排名模型来从大规模文档集中提取相关信息,然后由语言模型生成答案。这种方法存在局限性,如检索器的容量限制和顶层上下文的选择权衡,可能导致信息的遗漏或引入不相关的内容,从而影响生成的准确性.
二、论文思路
- 核心创新:RankRAG通过指令微调单一的LLM,使其同时具备上下文排名和答案生成的双重功能。这种设计不仅简化了传统RAG系统中多模型的复杂性,还通过共享模型参数增强了上下文的相关性判断和信息的利用效率.
- 训练阶段:
- 监着学习微调(SFT):基于多种高质量指令遵循数据集进行微调,提高模型对指令的遵循能力.
- 统一指令微调:同时增强排名和生成能力,通过特定的任务设计(如问答对的相关性判断)训练模型识别和排列相关上下文.
- 推理阶段:
- 检索:使用检索器从文档集中检索出顶部N个上下文.
- 重排:RankRAG模型重新排序这些上下文,只保留得分最高的k个上下文.
- 生成:这些上下文被用作生成答案的输入.
三、实验设计与结果
- 实验设计与数据集
- 任务类型:开放域问答(OpenQA)、事实验证和对话式问答(ConvQA).
- 数据集:包括NQ、TriviaQA、HotpotQA、FEVER等,以及对话式问答数据集如Doc2Dial和TopiOCQA.
- 基线模型:包括不使用RAG的LLM(如InstructGPT和PaLM 2)以及使用检索增强的模型(如Atlas和Raven).
- 评估指标:准确率(Accuracy)、精确匹配(Exact Match)和F1分数.
- 主要实验结果与分析
- 性能提升:RankRAG在多个知识密集型基准测试中表现出色,特别是在TriviaQA和HotpotQA数据集上,其性能显著优于Llama3-ChatQA-1.5和其他基线模型.
- 跨领域适应能力:在未经领域特定训练的情况下,RankRAG在生物医学领域的表现接近专门为该领域训练的模型,展示了其良好的泛化能力和跨领域适应性.
- 数据效率:RankRAG在训练中引入少量的排名数据即可实现显著的性能提升,数据效率高,降低了训练成本.
四、论文创新点
- 统一的指令微调框架:简化了训练流程,提高了模型的通用性,无需依赖独立的排名模型,减少了模型复杂性和运行时开销.
- 高性能:在多个知识密集型任务和领域中,RankRAG均展现出优于现有RAG模型的性能,特别是在需要处理大量不相关信息的开放领域问答任务中,通过有效的上下文排名显著提高了答案的准确性和相关性.
- 跨领域适应能力:在未经领域特定训练的情况下,RankRAG在生物医学领域的表现接近专门为该领域训练的模型,证明了其极佳的泛化能力和跨领域适应性,为未来在更多专业领域的应用提供了可能.
五、论文总结
RankRAG的通过指令微调单一的LLM,使其同时具备上下文排名和答案生成的双重功能。通过在训练数据中加入少量排序数据,经过指令微调的大语言模型效果出奇地好,甚至超过了现有的专家排序模型,包括在大量排序数据上专门微调的相同大语言模型。这种设计不仅简化了传统RAG系统中多模型的复杂性,还通过共享模型参数增强了上下文的相关性判断和信息的利用效率。
GraphRAG-Local-UI【改装师】
改装师:把跑车改装成适合本地道路的实用车,加装了友好的仪表盘,让人人都能轻松驾驶。
- 发表时间:2024.07.14
- Github 项目:https://github.com/severian42/GraphRAG-Local-UI
一、论文动机
GraphRAG-Local-UI的工具,它是基于Microsoft的GraphRAG的本地化实现,提供了一个丰富的交互式用户界面生态系统。
二、论文思路
-
功能亮点:
- 核心架构:采用FastAPI构建的高效服务器(
api.py),作为整个GraphRAG操作的大脑。 - 索引与提示界面:一个专为索引管理和提示调整设计的界面(
index_app.py),基于Gradio,操作简便。 - 本地模型集成:支持本地大型语言模型(LM)和嵌入技术,与Ollama及OpenAI的API完美兼容。
- 成本优化:通过部署本地模型,摆脱对昂贵云服务模型的依赖,实现成本控制。
- 用户交互体验:设计友好的界面,简化数据管理、查询执行和结果可视化流程(主应用程序)。
- 动态数据可视化:利用Plotly技术,在二维或三维空间中动态展示您的知识图谱(主应用程序)。
- 文件操作:直接通过界面进行文件的上传、浏览、编辑和删除。
- 设置定制:通过用户界面轻松调整和管理GraphRAG配置。
- 输出导航:方便地浏览和检查索引结果和相关工件。
- 日志跟踪:实时记录日志,优化调试和监控过程。
- 查询灵活性:支持全局、局部和直接聊天查询,且可自定义参数(主应用程序)。
- 可视化定制:根据个人喜好调整图表布局、节点大小和颜色(主应用程序)。
- 核心架构:采用FastAPI构建的高效服务器(
-
功能详解
-
核心架构:
- FastAPI服务器:作为整个GraphRAG操作的大脑,提供高效的API接口。
-
索引与提示界面:
- Gradio界面:专为索引管理和提示调整设计,操作简便,用户可以轻松管理索引和调整提示。
-
本地模型集成:
- 兼容性:支持本地大型语言模型(LM)和嵌入技术,与Ollama及OpenAI的API完美兼容,减少对云服务的依赖。
-
成本优化:
- 本地部署:通过部署本地模型,实现成本控制,减少对昂贵云服务的依赖。
-
用户交互体验:
- 友好界面:设计友好的界面,简化数据管理、查询执行和结果可视化流程。
-
动态数据可视化:
- Plotly技术:利用Plotly技术,在二维或三维空间中动态展示知识图谱。
-
文件操作:
- 文件管理:直接通过界面进行文件的上传、浏览、编辑和删除。
-
设置定制:
- 配置管理:通过用户界面轻松调整和管理GraphRAG配置。
-
输出导航:
- 结果检查:方便地浏览和检查索引结果和相关工件。
-
日志跟踪:
- 实时记录:实时记录日志,优化调试和监控过程。
-
查询灵活性:
- 多种查询:支持全局、局部和直接聊天查询,且可自定义参数。
-
可视化定制:
- 个性化调整:根据个人喜好调整图表布局、节点大小和颜色。
三、论文总结
GraphRAG-Local-UI通过其丰富的交互式用户界面和本地模型集成,提供了一个高效、成本优化且用户友好的GraphRAG实现。开发团队正在不断改进和扩展其功能,使其成为一个更强大的工具,适用于各种知识密集型任务和应用场景.
ThinkRAG【小秘书】
小秘书:把庞大的知识体系浓缩成口袋版,像个随身携带的小秘书,不用大型设备就能随时帮你查找解答。
- 发表时间:2024.07.15
- Github 项目:https://github.com/wzdavid/ThinkRAG
一、论文动机
ThinkRAG,一个开源的、可以在笔记本电脑上运行的本地知识库大模型检索增强生成系统。
二、模型支持
- LlamaIndex框架:ThinkRAG基于LlamaIndex数据框架构建,支持所有LlamaIndex支持的模型。
- 模型选择:
- OpenAI API:支持OpenAI API以及所有兼容的LLM API,包括国内主流大模型厂商如智谱、月之暗面、深度求索等。
- Ollama:支持本地化部署的大模型,如Llama、Gemma、GLM、Mistral、Phi、Llava等。
- 嵌入模型和重排模型:支持来自Hugging Face的大多数模型,主要选用BAAI的BGE系列模型。
三、系统特点
- 完整应用:LlamaIndex框架的完整应用。
- 本地文件存储:开发模式支持本地文件存储,无需安装任何数据库。
- 无需GPU:无需GPU支持,即可在笔记本电脑上运行。
- 本地部署:支持本地部署的模型和离线使用。
- 定制优化:为国内用户做了大量定制和优化,包括使用Spacy文本分割器处理中文字符、中文标题增强功能、中文提示词模板等。
四、快速开始
-
下载与安装:
- 从Github下载代码后,用pip安装所需组件:
pip3 install -r requirements.txt - 若要离线运行系统,需从官网下载Ollama,并使用Ollama命令下载大模型。同时,从Hugging Face下载嵌入模型和重排模型到
localmodels目录中。
- 从Github下载代码后,用pip安装所需组件:
-
系统配置:
- 获取LLM服务商的API密钥,配置环境变量:
ZHIPU_API_KEY = "" MOONSHOT_API_KEY = "" DEEPSEEK_API_KEY = "" OPENAI_API_KEY = "" - 在
config.py配置文件中删除不再使用的服务商,或添加兼容OpenAI API的其他服务商。 - 默认以开发模式运行,使用本地文件存储。若要切换到生产模式,配置环境变量
THINKRAG_ENV = production,并使用向量数据库Chroma和键值数据库Redis。
- 获取LLM服务商的API密钥,配置环境变量:
-
运行系统:
- 在包含
app.py文件的目录中运行以下命令:streamlit run app.py - 系统将在浏览器上自动打开
http://localhost:8501/,展示应用界面。
- 在包含
五、使用指南
-
系统配置:
- 在用户界面配置大模型,包括Base URL和API密钥,选择具体模型。
- 系统自动检测API和密钥是否可用,并显示当前选择的大模型实例。
- 可以在用户界面上选择Ollama下载的模型。
- 可以切换选择使用的嵌入模型和重排模型,并设置重排模型的参数。
-
管理知识库:
- 支持上传PDF、DOCX、PPTX等文件,也支持上传网页URL。
- 点击“Browse files”按钮选择文件,点击“Load”按钮加载,系统会对文件进行处理并保存到知识库中。
- 可以输入或粘贴网页URL,获取网页信息并保存到知识库中。
- 支持对知识库进行管理,分页列出所有文档,选择要删除的文档并删除。
-
智能问答:
- 在左侧导航栏点击“Query”,进入智能问答页面。
- 输入问题后,系统会对知识库进行检索并给出回答,采用混合检索和重排技术获取准确内容。
- 例如,上传一个Word文档“大卫说流程.docx”,输入问题“流程有哪三个特征?”系统用时2.49秒,给出准确回答“流程具备目标性、重复性与过程性”,并列出2个相关文档。
六、技术架构
-
开发模式:
- RAG框架:LlamaIndex
- 前端框架:Streamlit
- 嵌入模型:BAAI/bge-small-zh-v1.5
- 重排模型:BAAI/bge-reranker-base
- 文本分割器:SentenceSplitter
- 对话存储:SimpleChatStore
- 文档存储:SimpleDocumentStore
- 索引存储:SimpleIndexStore
- 向量存储:SimpleVectorStore
-
生产模式:
- RAG框架:LlamaIndex
- 前端框架:Streamlit
- 嵌入模型:BAAI/bge-large-zh-v1.5
- 重排模型:BAAI/bge-reranker-large
- 文本分割器:SpacyTextSplitter
- 对话存储:Redis
- 文档存储:Redis
- 索引存储:Redis
- 向量存储:Chroma
七、总结
ThinkRAG大模型检索增强生成系统,可以轻松部署在笔记本电脑上,实现本地知识库智能问答。
Nano-GraphRAG【轻装上阵】
轻装上阵:像个轻装上阵的运动员,把繁复的装备都简化了,但保留了核心能力。
- 发表时间:2024.07.25
- Github 项目:https://github.com/gusye1234/nano-graphrag
一、论文动机
- 背景:微软提出的GraphRAG非常有效,但官方实现复杂,不易修改和定制。nano-graphrag是一个更简洁、易用且高度可定制的版本,保留了核心功能,同时提供了更友好的用户体验。
二、论文思路
- 特点:
- 简洁性:代码量仅为1100行(不包括测试和提示),是官方实现的紧凑高效替代品。
- 易用性:设计为轻量级、异步和完全类型化,适合希望将GraphRAG集成到项目中而不增加复杂性的开发者。
- 可定制性:提供了丰富的自定义选项,可以替换默认组件,如LLM函数、嵌入函数和存储组件。
三、安装与使用
-
安装:
- 从PyPi安装:
pip install nano-graphrag - 从源代码安装以获取最新功能:
git clone https://github.com/yourusername/nano-graphrag.git
cd nano-graphrag
pip install -r requirements.txt
pip install .
- 从PyPi安装:
-
使用示例:
- 全局搜索:
from nano_graphrag import GraphRAG, QueryParam graph_func = GraphRAG(working_dir="./dickens") with open("./book.txt") as f: graph_func.insert(f.read()) # Perform global graphrag search print(graph_func.query("What are the top themes in this story?")) - 局部搜索:
# Perform local graphrag search (I think is better and more scalable one) print(graph_func.query("What are the top themes in this story?", param=QueryParam(mode="local"))) - 批量插入:
graph_func.insert(["TEXT1", "TEXT2", ...]) - 增量插入:
with open("./book.txt") as f:
    book = f.read()
    half_len = len(book) // 2
    graph_func.insert(book[:half_len])
    graph_func.insert(book[half_len:])
- 全局搜索:
四、高级功能
- 自定义选项:
- 替换LLM函数:可以自定义LLM函数,以使用不同的语言模型。
- 替换嵌入函数:可以自定义嵌入函数,以使用不同的嵌入技术。
- 替换存储组件:可以自定义存储组件,以使用不同的存储系统。
五、结论
nano-graphrag通过其简洁性、易用性和可定制性,提供了一个高效、灵活的GraphRAG实现,适用于各种知识密集型任务和应用场景。开发团队将继续优化和扩展其功能,使其成为一个更强大的工具。
2024.08
RAGFlow-GraphRAG【导航员】
导航员:在问答的迷宫里开辟捷径,先画张地图把知识点都标好,重复的路标合并掉,还特地给地图瘦身,让问路的人不会绕远路。
- 发表时间:2024.08.02
- Github 项目:https://github.com/infiniflow/ragflow
一、论文动机
- 背景:GraphRAG由微软开源,被视为下一代RAG,其在RAGFlow体系中是RAG 2.0的一个单元。RAG 2.0是一个以搜索为中心的端到端优化系统,分为数据抽取、预处理、索引与检索四个阶段,其中数据抽取和预处理是重点。
- GraphRAG的重要性:知识图谱对改进RAG效果至关重要,它能解决简单RAG只能找到与提问相似结果而未必是答案的问题,尤其在总结性问题等场景下,通过知识图谱聚合内容生成总结,可更好回答问题。此外,知识图谱还能为RAG返回结果添加更多上下文,使LLM产生更有解释性的回答。
二、GraphRAG与HippoRAG的对比
- 离线处理阶段:两者都先将用户文档送给LLM进行命名实体自动抽取。GraphRAG只抽取实体,用“相关”作为实体间联系,后续用社区检测算法和Graph Embedding(可选,采用Node2Vec)补全关系;HippoRAG则抽取整个三元组,之后利用现成知识图谱补全。
- 在线处理阶段:GraphRAG将用户查询转成向量,找知识图谱中最接近节点,再根据节点所在社区及摘要信息返回给LLM,同时查询原文并归并结果;HippoRAG在查询阶段利用类似PageRank的随机游走算法在知识图谱上做子图遍历,确定LLM的上下文。两者都用到PageRank做子图遍历,原因是人类回忆过程和PageRank算法输出有相关性。
三、GraphRAG的简化与优势
- 简化:GraphRAG对知识图谱的抽象和构建做了简化,不要三元组和图抽象表达,使工程上推出标准产品可行性增加。
- 优势:RAGFlow借鉴GraphRAG实现,在文档预处理阶段引入知识图谱构建作为可选项,服务于高级问答场景。
四、RAGFlow对GraphRAG的改进
- 引入去重步骤:原版GraphRAG直接用抽取的命名实体构建知识图谱,易因同义词实体影响结构。RAGFlow借鉴LLM能力去重,因LLM可视为超级大的知识图谱。
- 降低Token消耗:GraphRAG工作原理需消耗大量Token,RAGFlow通过流程优化确保文档只提交LLM一次,避免无效消耗。未来还会提供类似Triplex的小模型解决方案降低成本。
五、论文总结
RAGFlow借鉴了GraphRAG的实现,在文档预处理阶段,引入知识图谱构建作为可选项,服务于QFS问答场景,并引入了实体去重、Token优化等改进。
Medical-Graph-RAG【数字医生】
数字医生:像个经验丰富的医学顾问,用图谱把复杂的医疗知识整理得清清楚楚,诊断建议不是凭空想象,而是有理有据,让医生和患者都能看明白每个诊断背后的依据。
- 发表时间:2024.08.08
- 论文名称:Medical Graph RAG: Towards Safe Medical Large Language Model via Graph Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2408.04187
- Github 地址:https://github.com/SuperMedIntel/Medical-Graph-RAG
一、论文动机
- 研究问题:如何在医学领域中使用基于图的RAG框架来提高LLM生成基于证据的医疗响应的能力,特别是在处理私有医疗数据时的安全性和可靠性。
- 研究难点:医学领域依赖庞大的知识库,这些知识难以适应LLM的有限上下文窗口;医学领域对术语系统的精确性和事实的确定性要求极高;验证医学响应的准确性对于非专家用户来说特别具有挑战性。
二、论文思路
- 三元组图谱构建:提出了一种独特的三元组图构建方法,将用户RAG数据与可信的医疗来源和受控词汇表连接起来,生成三元组[RAG数据, 来源, 定义]以构建用户文档的综合图。
- 语义文档分块:将大医学文档分割成符合LLM上下文限制的数据块,采用字符分离和主题语义分区的混合方法。
- 实体提取:从每个块中提取实体,生成包含名称、类型和上下文的结构化输出。
- 三元组链接:构建仓库图(RepoGraph),将用户RAG文档与可信来源和专业定义连接起来。
- 关系链接:识别RAG实体之间的关系,生成简洁的关系短语,指定源和目标实体及其关系描述。
- U-Retrieval策略:提出了一种独特的U-Retrieval策略,结合自上而下的精确检索和自下而上的响应细化,平衡全局上下文意识和检索效率。
- 图标签化:使用预定义的医学标签总结每个Meta-MedGraph,并迭代生成更抽象的标签摘要。
- U-Retrieval:首先生成用户查询的标签摘要,并使用自上而下的方法检索最相关的图,然后自下而上地逐步整合更高层次的标签,直到生成最终答案。
三、实验设计与结果
- 实验设计
- 数据集:使用了多个数据集,包括MIMIC-IV电子健康记录数据集、MedC-K生物医学学术论文和教科书数据集、FakeHealth和PubHealth公共卫生事实验证数据集,以及一个收集的多层次健康问答数据集DiverseHealth。
- 实验设置:比较了不同RAG方法在6种语言模型上的表现,包括Llama2、Llama3、Gemini-pro和GPT-4。使用Llama3-70B构建图,文本嵌入使用OpenAI的text-embedding-3-large模型。模型比较使用5次响应集成进行评估。
- 结果与分析
- 多选题评估:MedGraphRAG在健康和医学问答基准测试中显著提高了LLM的性能。与没有检索的基线相比,MedGraphRAG在事实检查和医学问答基准测试中分别平均提高了近10%和8%。与使用GraphRAG的基线相比,分别提高了约8%和5%。特别是在较小的LLMs(如Llama2-13B和Llama2-70B)中,MedGraphRAG表现出更显著的改进。
- 长形式生成评估:人类评估显示,MedGraphRAG在所有指标上均获得了更高的评分。特别是在引用精度(CP)、引用召回率(CR)和可理解性(Und.)方面,MedGraphRAG表现出显著优势,表明其响应更有可能得到准确来源的支持,并且更容易被理解和接受。
- 消融研究:通过消融研究验证了所提出模块的有效性。逐步添加Med-MetaGraph、三元组图构建和U-Retrieval模块后,性能逐渐提高。特别是将GraphRAG的图构建替换为三元组图构建后,性能显著提高。
四、论文创新点
- 首次提出:首次提出了专门应用于医学领域的基于图检索增强生成(RAG)框架,命名为MedGraphRAG。
- 独特的三元组图构建和U检索技术:开发了独特的三元组图构建和U检索方法,使LLMs能够高效生成基于证据的响应。
- 超越现有方法:在广泛的医学问答基准测试中,MedGraphRAG的表现优于现有的标准RAG和GraphRAG模型,并在多个医学语料库上设立了新的最先进(SOTA)水平。
- 人类评估验证:通过人类评估验证,MedGraphRAG能够提供更可理解和基于证据的响应,特别是在复杂医学推理方面。
- 全面的比较:在多个基准测试中,MedGraphRAG显著提高了LLMs的性能,特别是在健康事实检查和医学问答任务中。
五、论文总结
- 性能提升:MedGraphRAG通过其基于图的RAG框架,使用三元组图谱构建和U-Retrieval方法,增强了基于证据、上下文感知的响应。其在基准测试和人类评估中的强大表现表明了其确保复杂医学推理准确性的能力。
- 未来工作:未来的工作将集中在实时数据更新和在实际临床数据上的验证,以确保MedGraphRAG能够利用最新的医学数据和研究成果,并在真实世界应用场景中发挥更大的作用。
六、不足与反思
- 实时数据更新:未来的工作将集中在实时数据更新和在实际临床数据上的验证,以确保MedGraphRAG能够利用最新的医学数据和研究成果,并在真实世界应用场景中发挥更大的作用。
七、关键问题及回答
- 问题1:MedGraphRAG在图谱构建方面有哪些独特的设计,这些设计如何提高其在医学领域的应用效果?
- 三元组图构建:通过生成三元组[RAG数据, 来源, 定义]来构建用户文档的综合图谱,确保生成的响应能够追溯到其来源和定义,提高了响应的可信度和可解释性。
- U-Retrieval:结合自上而下的精确检索和自下而上的响应细化,平衡全局上下文意识和检索效率,使得LLM能够在保持高效的同时,获取全面的上下文信息,从而生成更准确和可靠的响应。
- 问题2:MedGraphRAG在实验中表现如何,与其他方法相比有哪些优势?
- 多选题评估:在健康和医学问答基准测试中,MedGraphRAG显著提高了LLM的性能,特别是在较小的LLMs中表现出更显著的改进。
- 长形式生成评估:人类评估显示,MedGraphRAG在所有指标上均获得了更高的评分,特别是在引用精度、引用召回率和可理解性方面表现出显著优势。
- 消融研究:通过消融研究验证了所提出模块的有效性,逐步添加模块后性能逐渐提高。
- 问题3:MedGraphRAG的未来工作方向是什么?
- 实时数据更新:未来的工作将集中在实时数据更新上,以确保MedGraphRAG能够利用最新的医学数据和研究成果。
- 实际临床数据验证:研究将在实际临床数据上进行验证,以进一步评估MedGraphRAG在真实世界应用场景中的性能和可靠性。
通过这些改进,MedGraphRAG有望在医学领域发挥更大的作用,提供更高质量和更可靠的医疗响应,从而改善患者的诊疗体验。
HybridRAG【中医合方】
中医合方:就像中医讲究的"合方",单味药不如几味药合在一起效果好。向量数据库负责快速检索,知识图谱补充关系逻辑,两者优势互补。
- 发表时间:2024.08.09
- 论文名称:HybridRAG: Integrating Knowledge Graphs and Vector Retrieval Augmented Generation for Efficient Information Extraction
- 论文地址:https://arxiv.org/abs/2408.04948
- Github 地址:https://github.com/tahmidmir/HyrbridRAG
一、论文动机
- 背景:在金融领域,从非结构化文本数据(如财报电话会议记录)中提取和解释复杂信息对大型语言模型(LLMs)来说是一个挑战,尤其是当这些文档包含特定领域的术语和复杂格式时。
- 目的:HybridRAG结合了GraphRAG和VectorRAG的优势,从向量数据库和知识图谱中检索上下文信息,以提供给LLMs,从而生成更准确的回答。
二、论文思路
- VectorRAG 工作流程:
- 从与外部文档相关的查询开始,这些文档不是LLM训练数据集的一部分。
- 查询用于搜索外部存储库(如向量数据库或索引语料库),以检索包含有用信息的相关文档或段落。
- 检索到的文档随后作为额外上下文反馈到LLM中,从而生成基于查询的响应。
- 这确保了生成内容不仅基于内部训练数据,还结合了检索到的外部信息。
- GraphRAG 工作流程:
- 利用知识图谱来增强NLP任务的性能,通过将知识图谱与RAG技术整合,GraphRAG能够基于从金融文档中提取的结构化信息生成更准确和上下文感知的回答。
- 知识图谱构建:
- 知识提取:从非结构化或半结构化数据中提取结构化信息,包括实体识别、关系提取和共指消解。
- 知识改进:通过移除冗余和填补信息空白来提高知识图谱的质量和完整性。
- 知识融合:结合来自多个源的信息,创建一个一致和统一的知识图谱。
- GraphRAG:从用户输入的查询开始,查询用于搜索知识图谱以检索与查询相关的节点(实体)和边(关系)。然后从完整的知识图谱中提取包含这些相关节点和边的子图,以提供上下文。
- HybridRAG 结合优势:HybridRAG结合了VectorRAG和GraphRAG的优势,从向量数据库和知识图谱中检索上下文信息,以提供给LLMs,从而生成更准确的回答。
三、实验设计与结果
- 实验结果:
- 忠实度:GraphRAG和HybridRAG显示出更优越的性能,两者都达到了0.96的得分,而VectorRAG略低一些,得分为0.94。
- 答案相关性得分:HybridRAG以0.96的得分领先,其次是VectorRAG的0.91,GraphRAG的0.89。
- 上下文精确度:GraphRAG以0.96的得分最高,显著超过了VectorRAG的0.84和HybridRAG的0.79。然而,在上下文召回率方面,VectorRAG和HybridRAG都达到了完美的1分,而GraphRAG落后于0.85。
四、论文总结
一种基于知识图谱RAG技术(GraphRAG)和VectorRAG技术相结合的新方法,称为HybridRAG,以增强从金融文档中提取信息的问答系统,该方法被证明能够生成准确且与上下文相关的答案。在检索和生成阶段,就检索准确性和答案生成而言,从向量数据库和知识图谱中检索上下文的HybridRAG优于传统的VectorRAG和GraphRAG。
W-RAG【进化搜索】
进化搜索:像个善于自我进化的搜索引擎,通过大模型对文章段落的评分来学习什么是好答案,逐步提升自己找到关键信息的能力。
- 发表时间:2024.08.15
- 论文名称:W-RAG: Weakly Supervised Dense Retrieval in RAG for Open-domain Question Answering
- 论文地址:https://arxiv.org/abs/2408.08444
- Github 地址:https://github.com/jmnian/weak_label_for_rag
一、论文动机
- 问题:密集检索微调需要大量标注数据,耗费人力。
- 解决方案:利用LLM的重排能力生成弱标记数据,用于训练检索的向量模型。
二、论文思路
W-RAG方法,通过利用LLMs的排名能力为密集检索器创建弱标记数据,从而解决了稀缺的地面真实证据问题。
W-RAG过程分为三个阶段:
- Step 1: 通过BM25从证据语料库中检索相关段落
使用BM25算法从语料库中检索与问题相关的段落。
- Step 2: 使用LLM生成弱标签
- 将查询(query)、段落(passage)、指令(instruction)和答案(answer)组装成提示(prompt)。
- 通过大模型对提示生成答案。
- 计算每个段落生成ground_truth_answer的概率,作为弱标签。
- 使用log-likelihood来衡量每个候选段落的相关度分数。
- Step 3: 通过弱标签训练密集检索器
- 使用获取到的查询、段落和相关度分数来训练密集检索器。
- 选择两个密集检索器:DPR和ColBERT。
-
训练密集检索器
-
DPR:使用双编码器架构,通过两个独立的BERT编码器将问题和段落映射到嵌入空间。
- 训练方式:in-batch negative training,使用top 1的段落作为正样本,top 2-n的作为负样本。
- 损失函数:[ \text{loss} = -\log \frac{\exp(\alpha \cdot \text{sim}(q, s_1))}{\sum_{i=1}^n \exp(\alpha \cdot \text{sim}(q, s_i))} ]
-
ColBERT:使用双编码器架构,通过共享的BERT模型独立编码问题和段落。
- 训练数据构造:使用positive sample和hard negative sample。
- 损失函数:[ \text{loss} = -\log \frac{\max(\text{sim}(q, s_p))}{\max(\text{sim}(q, s_p)) + \max(\text{sim}(q, s_n))} ]
三、实验设计与结果
- 实验设计
- 数据集:MSMARCO、QnA v2.1、NQ、SQuAD、WebQ,每个数据集选取5000个QA对和500,000个段落。
- 模型:
- Generator: Llama3-8B-Instruct
- Retriever: DPR (bert-base-uncased、Yibin-Lei/ReContriever),ColBERT(bert-base-uncased)
- Baseline:
- RAG效果对比:Naive(直接用llama3作答)、GroundTruth(将ground-truth文档插入到prompt中作答)
- 检索效果对比:无监督模型(BM25、ColBERT,Contriever,ReContrever)、基于GroundTruth训练的模型(DPR、ColBERT)
- 评估指标:
- 检索:recall
- 生成:F1、Rouge-L、BLEU-1
- 实验结果
- 提升效果:相比于naive方法,W-RAG在检索和问答上都有显著提升,接近于ground-truth方法。
- BM25与LLM的排序能力:BM25在排序能力上与llama3-8B有显著差距。
四、论文创新点
- 弱监督数据生成方法
- 背景:传统的密集检索(Dense Retrieval)微调需要大量标注数据,这不仅耗费大量人力,而且成本高昂。
- 创新点:提出了一种利用大型语言模型(LLM)的重排能力来生成弱标记数据的方法。这种方法不需要人工标注,而是通过模型自动生成标注数据,大大降低了数据标注的成本和工作量。
-
- W-RAG框架
- 背景:现有的RAG系统在开放域问答中面临检索和生成的挑战,尤其是在处理复杂问题时,检索的准确性和生成的答案质量有待提高。
- 创新点:提出了W-RAG(Weakly Supervised Dense Retrieval in RAG for Open-domain Question Answering),这是一个数据构造方法,通过三个阶段(检索、生成弱标签、训练密集检索器)来提升检索和生成的性能。具体步骤如下:
- 通过BM25从证据语料库中检索相关段落:利用传统的BM25算法快速检索与问题相关的段落。
- 使用LLM生成弱标签:将查询、段落、指令和答案组装成提示(prompt),通过LLM生成每个段落生成ground_truth_answer的概率,作为弱标签。
- 通过弱标签训练密集检索器:使用获取到的查询、段落和相关度分数来训练密集检索器,提升检索的准确性和效率。
五、论文总结
开放域问答中的弱监督密集检索技术,利用大型语言模型的排序能力为训练密集检索器创建弱标注数据。通过评估大型语言模型基于问题和每个段落生成正确答案的概率,对通过 BM25 检索到的前 K 个段落进行重新排序。排名最高的段落随后被用作密集检索的正训练示例。
RAGChecker【质检员】
质检员:不只简单地判断答案对错,而是会深入检查整个回答过程中的每个环节,从资料查找到最终答案生成,就像一个严格的考官,既给出详细的评分报告,还会指出具体哪里需要改进。
- 发表时间:2024.08.15
- 论文名称:RAGChecker: A Fine-grained Framework for Diagnosing Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2408.08067
- Github 地址:https://github.com/amazon-science/RAGChecker
一、论文动机
- RAG技术的重要性:RAG技术通过将外部知识库和大型语言模型(LLM)内部知识无缝整合,大幅提升了AI系统的准确性和可靠性。
- 评估挑战:现有的评估方法难以全面反映RAG系统的复杂性和实际表现,通常只能提供最终打分报告,缺乏细粒度的诊断信息。
二、论文思路
- 目的:RAGChecker为RAG系统提供细粒度、全面、可靠的诊断报告,并为进一步提升性能提供可操作的方向。
- 主要特点:
- 细粒度评估:采用基于声明(claim)级别的蕴含关系检查,而非简单的回复级别评估,提供更详细的系统性能分析。
- 全面的指标体系:涵盖RAG系统各个方面性能的指标,包括忠实度、上下文利用率、噪声敏感度和幻觉等。
- 经过验证的有效性:评估结果与人类判断有很强的相关性,表现超过其他现有评估指标,保证了评估结果的可信度和实用性。
- 可操作的洞察:提供的诊断指标为改进RAG系统提供明确的方向指导,帮助研究人员和实践者开发更有效和可靠的AI应用。
三、实验设计与结果
- 整体指标:
- Precision(精确率):模型回答中正确陈述的比例。
- Recall(召回率):模型回答中包含的标准答案中陈述的比例。
- F1 score(F1分数):精确率和召回率的调和平均数,提供平衡的性能度量。
- 检索模块指标:
- Context Precision(上下文精确率):在所有检索块中,包含至少一个标准答案陈述的块的比例。
- Claim Recall(陈述召回率):被检索块覆盖的标准答案陈述的比例。
- 生成模块指标:
- Context Utilization(上下文利用率):评估生成模块如何有效利用从检索块中获取的相关信息来产生正确的陈述。
- Noise Sensitivity(噪音敏感度):衡量生成模块在回答中包含来自检索块的错误信息的倾向。
- Hallucination(幻觉):测量模型生成既不存在于检索块也不在标准答案中的信息的频率。
- Self-knowledge(模型内部知识):评估模型在未从检索块获得信息的情况下,正确回答问题的频率。
- Faithfulness(忠实度):衡量生成模块的响应与检索块提供的信息的一致程度。
四、使用RAGChecker
- 环境设置:安装RAGChecker及其依赖。
pip install ragchecker python -m spacy download en_core_web_sm - 准备数据:将RAG系统的输出准备成特定的JSON格式,包括查询、标准答案、模型回答和检索的上下文。
- 运行评估:
- 使用命令行:
ragchecker-cli \ --input_path=examples/checking_inputs.json \ --output_path=examples/checking_outputs.json - 使用Python代码:
from ragchecker import RAGResults, RAGChecker
from ragchecker.metrics import all_metrics

# 从JSON初始化RAGResults
with open("examples/checking_inputs.json") as fp:
    rag_results = RAGResults.from_json(fp.read())

# 设置评估器
evaluator = RAGChecker()

# 评估结果
evaluator.evaluate(rag_results, all_metrics)
print(rag_results)
- 使用命令行:
- 分析结果:RAGChecker输出json格式的文件,展示评估指标,帮助开发者了解RAG系统的各个方面表现。
五、论文总结
RAGChecker 的诊断工具为 RAG 系统提供细粒度、全面、可靠的诊断报告,并为进一步提升性能,提供可操作的方向。它不仅能评估系统的整体表现,还能深入分析检索和生成两大核心模块的性能。
Meta-Knowledge-RAG【学者】
学者:像个学术界的资深研究员,不仅收集资料,还会主动思考问题,为每份文档做批注和总结,甚至预先设想可能的问题。它会把相关的知识点串联起来,形成知识网络,让查询变得更有深度和广度,就像有一个学者在帮你做研究综述。
- 发表时间:2024.08.16
- 论文名称:Meta Knowledge for Retrieval Augmented Large Language Models
- 论文地址:https://arxiv.org/abs/2408.09017
- Github 地址:
一、论文动机
- RAG技术的重要性:RAG通过整合与上下文相关、时效性强或领域知识,生成用户想要的正确答案,已成为减少模型幻觉的有效解决方案。
- 实际应用中的问题:
- 知识库文档可能包含大量噪声。
- 缺乏人工标注的信息或相关性标签。
- 对长文档进行分块无法保留整个文档的语义上下文。
- 用户查询通常较短、模糊,可能存在词汇不匹配。
- 相关信息可能分布在多个文档中,跨知识库的高级推理仍未得到有效解决。
二、论文思路
- MK-RAG工作流程:引入了“准备(Prepare)-重写(rewrite)-检索(retrieve)-读取(read)”(PR3)的工作流程。
- 准备:每个文档都由LLM处理,生成针对用户特征定制的自定义元数据和问答对。
- 重写:通过查询增强解锁新的知识库推理能力。
- 检索:利用元数据和问答对进行检索。
- 读取:生成最终答案。
- 方法细节
- 元数据生成:使用Claude 3 Haiku的思维链(CoT)提示生成元数据。
- 合成问答生成:生成合成的问答对,用于检索。
- 元知识摘要生成:生成元知识摘要(MK摘要),用于用户查询的动态扩充。
- 查询和检索的增强生成:利用MK摘要对用户查询进行动态扩充,提升检索器的跨文档推理能力。
三、实验设计与结果
- 数据集:使用arXiv API整理的2024年的2000篇研究论文的数据集。
- 评估指标:
- 召回率(Recall)
- 精度(Precision)
- 特异性(Specificity)
- 广度(Breadth)
- 深度(Depth)
- 相关性(Relevancy)
- 测评结果:
- 新框架在所有指标上均有显著提升。
- 特别是在广度和深度上,MK摘要提供了额外信息,显著提升了性能。
- 新方法在处理2000篇研究论文时成本效益显著,仅需20美元。
四、论文总结
Meta-Knowledge-RAG(MK Summary)引入了一种新颖的以数据为中心的 RAG 工作流程,将传统的 “检索-读取” 系统转变为更先进的 “准备-重写-检索-读取” 框架,以实现对知识库的更高领域专家级理解。我们的方法依赖于为每个文档生成元数据和合成的问题与答案以及为基于元数据的文档集群引入元知识摘要的新概念。所提出的创新实现了个性化的用户查询增强和跨知识库的深度信息检索。
CommunityKG-RAG【社群探索】
社群探索:像个熟悉社区关系网络的向导,善于利用知识间的关联和群组特征,在不需要特别学习的情况下,就能准确地找到相关信息,并验证其可靠性。
- 发表时间:2024.08.16
- 论文名称:CommunityKG-RAG: Leveraging Community Structures in Knowledge Graphs for Advanced Retrieval-Augmented Generation in Fact-Checking
- 论文地址:https://arxiv.org/abs/2408.08535
- Github 地址:
一、论文动机
- 事实核查的重要性:在数字化信息时代,错误信息的迅速传播对公共讨论和全球决策产生了深远的影响,使得事实核查变得尤为重要。
- 现有技术的局限性:
- 大型语言模型(LLMs)在理解和生成人类语言方面展现出巨大潜力,但在事实核查中的应用受限于训练数据的时效性和生成错误信息的倾向。
- RAG系统通过结合LLMs的生成能力和外部数据检索来提高回答的准确性,但处理长文本和噪声信息仍面临挑战。
- 知识图谱(KGs)以其结构化和语义丰富的特性,为复杂信息的封装和组织提供了有效框架,但如何将KGs的结构化知识与LLMs处理的非结构化文本有效结合,以及如何优化这些信息的检索,仍是一个未被充分解决的问题。
二、论文思路
- 目标:通过结合知识图谱中的社区结构和RAG系统,提升事实核查的准确性和相关信息检索的相关性,无需额外的训练即可适应新领域和查询。
- 工作流程:
- 预处理:从事实核查文章中构建一个全面的知识图谱,运用共指消解和实体关系提取等技术。
- 社区检测:利用Louvain算法进行社区检测,识别出图中节点间相互连接更为紧密的社区。
- 节点嵌入:为知识图谱中的每个节点分配BERT模型的词嵌入,以捕捉实体的语义信息。
- 社区嵌入:计算社区的嵌入表示,通过Sentence-BERT模型实现,优化句子嵌入的质量。
- 社区检索:根据声明与社区的相关性分数,选择排名最高的社区。
- 句子选择:在这些顶级社区中,进一步筛选出与声明最相关的顶级句子,以供语言模型使用。
- 生成回答:利用精选的社区和句子增强语言模型的生成过程,提供更准确、更丰富的事实核查回答。
三、实验设计与结果
- 数据集:使用MOCHEG数据集,包含从PolitiFact和Snopes等事实核查网站收集的15,601条标注了真实性标签的声明。
- 基线模型:
- No Retrieval:在没有上下文或检索的情况下生成答案。
- Semantic Retrieval:使用语义相似性检索上下文,计算提示和上下文之间的余弦相似度。
- KAPING:一个零样本RAG框架,基于输入文本和三元组之间的句子相似性进行检索。
- 实验设置:
- 使用LLaMa2 7B模型作为主要的大语言模型(LLM)。
- 使用准确率作为衡量LLMs在验证声明时的性能指标。
- 对于所有RAG系统,使用特定的提示格式,并配置生成过程中的参数,如温度、重复惩罚和新令牌的限制。
- 实验结果:
- CommunityKG-RAG的准确率达到了56.24%,远超其他基线方法(No Retrieval 39.79%,Semantic Retrieval 43.84%,KAPING 39.41%)。
- 在不同基础语言模型上的性能表现:
- LLaMa2 7B模型在应用CommunityKG-RAG后准确率提高了6.18%。
- LLaMa3 8B模型在应用CommunityKG-RAG后准确率提高了3.21%。
- 社区到句子选择阈值对事实核查准确性的影响:
- 当句子选择阈值从25%增加到50%时,模型准确率略有下降。
- 当句子选择阈值进一步增加到75%和100%时,模型的准确率逐渐提升,100%的句子选择阈值实现了最高的准确率。
- 同时调整顶级社区选择和社区到句子选择阈值对事实核查准确性的综合影响:
- 当阈值增加到75%时,模型性能略有下降。
- 当阈值提升至100%时,模型的准确率显著提高。
四、论文总结
CommunityKG-RAG是一种新颖的零样本框架,它将知识图谱中的社区结构与RAG系统相结合,以增强事实核查过程。CommunityKG-RAG能够在无需额外训练的情况下适应新的领域和查询,它利用知识图谱中社区结构的多跳性质,显著提高信息检索的准确性和相关性。
TC-RAG【记忆术士】
记忆术士:给LLM装了个带自动清理功能的大脑。就像我们解题,会把重要步骤写在草稿纸上,做完就划掉。它不是死记硬背,该记的记住,该忘的及时清空,像个会收拾房间的学霸。
- 发表时间:2024.08.17
- 论文名称:TC-RAG: Turing-Complete RAG's Case study on Medical LLM Systems
- 论文地址:https://arxiv.org/abs/2408.09199
- Github 地址:https://github.com/Artessay/TC-RAG
一、论文动机
- RAG技术的重要性:RAG通过结合LLMs的生成能力和外部数据检索来提高回答的准确性,但在处理长文本和噪声信息时仍面临挑战。
- 现有RAG方法的局限性:现有RAG方法忽视了系统状态变量的引入,这些变量对于确保自适应控制、检索停止和系统收敛至关重要。此外,现有方法不是图灵完备的,缺乏动态管理和监控检索过程的能力。
二、论文思路
-
目标:提出一个图灵完备的RAG系统,通过引入系统状态变量和内存堆栈系统,实现更高效、准确的知识检索。
-
关键组件:
- 内存堆栈系统:监控中间状态,确保检索过程可靠地收敛到最佳结论。
- 状态变量:实时评估系统状态,决定是否继续、停止或改进检索过程。
- 自适应检索:根据模型的内部参数化知识决定是否检索以及检索什么,避免检索无关信息。
-
图灵完备的记忆栈定义:
- 记忆栈Tc:包括状态集合S、动作集合A、记忆栈M、状态转移函数delta、初始状态s0、终止状态F和阈值sigma。
- 复合操作:定义了5个由push和pop组合而成的有意义的行为,包括思考、工具调用、反思、总结和结论。
-
状态变量:
- 条件困惑度:计算大模型生成栈顶输出内容时的困惑度。
- 不确定性:计算输出栈顶信息的熵值。
- 终止条件:当状态变量小于阈值时,系统停止检索并输出最终答案。
三、实验设计与结果
- 实验设置:
- 医学LLM模型:使用海量数据持续预训练的医学LLM。
- 医学工具库:包括医学知识图谱、医学文档库、网页检索、百科检索和电子病历数据。
- 实验结果:
- 性能提升:TC-RAG在多个真实世界的医疗数据集上显著优于现有基准方法,准确率平均提升了7.20%。
- 噪声处理:TC-RAG在弹出检索噪声、保留有效信息方面表现出色。
- 消融实验:验证了反思与总结动作的有效性以及状态变量引入的必要性。
四、论文总结
通过引入图灵完备的系统来管理状态变量,从而实现更高效、准确的知识检索。通过利用具有自适应检索、推理和规划能力的记忆堆栈系统,TC-RAG不仅确保了检索过程的受控停止,还通过Push和Pop操作减轻了错误知识的积累。
RAGLAB【竞技场】
竞技场:让各种算法可以在相同的规则下进行公平竞争和比较,就像科学实验室里的标准化测试流程,确保每个新方法都能得到客观透明的评估。
- 发表时间:2024.08.21
- 论文名称:RAGLAB: A Modular and Research-Oriented Unified Framework for Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2408.11381
- Github 地址:https://github.com/fate-ubw/RAGLab
一、论文动机
- RAG技术的重要性:RAG通过结合大型语言模型(LLMs)的生成能力和外部数据检索来提高回答的准确性,但在研究和开发过程中面临两大主要问题:
- 许多已发表的成果要么不开源,要么难以搭建环境,导致研究人员不得不从零开始研发新算法。
- 新的RAG算法不断涌现,但这些算法在基本组件和评估方法上不统一,难以准确评估改进效果。
二、论文思路
-
目标:提供一个面向研究人员的RAG工具包,用于对现有RAG算法进行公平比较,并简化新算法的开发流程。
-
整体架构:RAGLAB的整体架构包括多个关键组件,如检索器、语料库、生成器、指令实验室、训练器、数据集和指标。
-
检索器:
- 整合了两个高性能的基于BERT的模型:Contriever和ColBERT。
- 统一了不同检索器类的查询接口,方便用户在各种检索器之间无缝切换。
- 设计了检索器服务器和客户端架构,实现高并发访问。
- 实现了检索缓存机制,存储初始查询结果及其检索到的知识,提高查询效率。
-
语料库:
- 提供了两个版本的预处理维基百科语料库,基于DPR项目开源的2018年数据和FactScore开源的2023年数据。
- 为ColBERT和Contriever模型预先构建了索引和嵌入。
- 开源了所有处理脚本,方便研究人员直接下载预处理的维基百科语料库及其相应的索引和嵌入。
-
生成器:
- 集成了Huggingface Transformers和VLLM,兼容众多开源模型,提供稳定高效的推理性能。
- 融入了量化和LoRA功能,支持在计算资源有限的情况下使用大型模型。
- 开发了GPU管理模块,支持在指定GPU上精准分配多个生成器。
- 支持闭源大型语言模型,如OpenAI模型,未来将扩展到Claude、Gemini和Azure等。
-
指令实验室:
- 设计了指令实验室模块,包括系统指令、任务指令和算法指令。
- 允许用户从3个指令池中高效导入和组合所需的提示。
- 用户可以在配置设置中调整参数,便于使用不同指令进行对比实验。
-
训练器:
- 集成了Accelerate和DeepSpeed库,提供全面且高效的微调能力。
- 支持LoRA和QLoRA技术,使用户能够在计算资源有限的情况下微调大型模型。
三、实验设计与结果
- 数据集和指标:
- 收集了10个广泛使用的测试数据集,涵盖5个不同任务。
- 提供了3个经典指标(准确性、精确匹配、F1分数)和2个高级指标(FactScore和ALCE)。
四、论文总结
新型RAG算法之间越来越缺乏全面和公平的比较,开源工具的高级抽象导致缺乏透明度,并限制了开发新算法和评估指标的能力。RAGLAB是一个模块化、研究导向的开源库,重现6种算法并构建全面研究生态。借助RAGLAB,我们在10个基准上公平对比6种算法,助力研究人员高效评估和创新算法。
2024.09
MemoRAG【过目不忘】
过目不忘:它不只是按需查找资料,而是已经把整个知识库都深入理解并记在心里。当你问问题时,它能快速从这个"超级大脑"中调取相关记忆,给出既准确又富有见地的答案,就像一个博学多识的专家。
- 发表时间:2024.09.01
- 论文名称:MemoRAG: Moving Towards Next-Gen RAG Via Memory-Inspired Knowledge Discovery
- 论文地址:https://arxiv.org/abs/2408.05591
- Github 地址:https://github.com/qhjqhj00/MemoRAG
一、论文动机
- RAG模型的局限性:传统的RAG模型通过结合外部知识库的实时检索和生成技术,显著提高了回答的准确性,但在处理长期信息和需要持续记忆的复杂场景中表现欠佳。
二、论文思路
- 模型架构:MemoRAG采用双系统架构,包括轻量但长距离的LLM形成的数据库全局记忆模块,以及复杂但表达能力强的LLM用于检索增强生成。
- 工作原理:对于给定任务,记忆模块生成检索线索,这些线索基于数据库压缩表示生成,虽可能有错误细节,但能明确揭示任务信息需求。以这些线索为查询,从数据库中检索必要上下文,进而生成精确全面的答案。
- 方法细节
- 生成线索:利用记忆模型作为输入查询和相关数据库的语义桥梁,生成有助于检索的线索。
- 检索相关文档:以优化后的检索线索为依据,在数据库中搜索相关上下文。
- 生成答案:结合问题和相关上下文,采用生成模型生成最终回答。
三、实验设计与结果
- 测试环境:在三个基准上使用三种不同的生成器(Llama3-8B-Instruct-8K、Phi-3-mini-128K、Mistral-7B-Instruct-v0.2-32K)进行测试。
- 性能表现:MemoRAG在各种数据集和查询类型上显著提升了标准RAG方法和其他基线的性能。
四、论文总结
MemoRAG通过记忆模块实现对数据库的全局理解,并回忆与查询相关的线索,提升了检索的准确性和上下文丰富度,增强了在处理复杂任务、模糊信息需求以及非结构化知识时的表现,展示了在复杂推理和长文档任务中的巨大潜力,适用于多领域的实际应用。
OP-RAG【注意力管理】
注意力管理:就像看一本特别厚的书,你不可能把每个细节都记住,但懂得在关键章节做好标记的人才是高手。它不是漫无目的地看,而是像个资深读书人,边读边在重点处画下重点,需要的时候直接翻到标记页。
- 发表时间:2024.09.03
- 论文名称:In Defense of RAG in the Era of Long-Context Language Models
- 论文地址:https://arxiv.org/abs/2409.01666
- Github 地址:https://github.com/qhjqhj00/MemoRAG
一、论文动机
- 背景:随着长文本LLM的出现,这些模型能处理更长的文本序列,RAG的吸引力似乎下降。然而,英伟达认为LLMs中的极长语境会导致对相关信息的关注度降低,并导致答案质量的潜在下降。
二、论文思路
- 模型机制:OP-RAG(顺序保留检索增强生成)机制,保持检索到的文本块在原文中的顺序,与传统RAG将检索到的文本块按相关性降序排列不同。
- 性能表现:使用OP-RAG,随着检索块数量的增加,答案质量先上升,然后下降,形成倒U形曲线。与将整个上下文作为输入的长上下文LLM相比,OP-RAG可以用更少的标记获得更高的答案质量。
三、实验设计与结果
- 实验设置:在长文本问答任务中,OP-RAG的表现比传统的RAG和长文本LLM都要好。
- 关键数据:特别是在使用Llama3.1-70B模型时,OP-RAG在只使用16K tokens的情况下,就达到了44.43的F1分数,而没有使用RAG的Llama3.1-70B,即使使用了128K tokens,也只得到了34.32的F1分数。
四、论文总结
OP-RAG通过保持检索到的文本块的原始顺序,显著提高了RAG在长上下文问答应用中的性能,证明了在长上下文答案生成中,RAG仍然具有重要的价值和优势。
AgentRE【智能抽取】
智能抽取:像个善于观察人际关系的社会学家,不仅能记住关键信息,还会主动查证并深入思考,从而准确理解复杂的关系网络。即使面对错综复杂的关系,也能通过多角度分析,理清其中的脉络,避免望文生义。
- 发表时间:2024.09.03
- 论文名称:AgentRE: An Agent-Based Framework for Navigating Complex Information Landscapes in Relation Extraction
- 论文地址:https://arxiv.org/abs/2409.01854
- Github 地址:https://github.com/Lightblues/AgentRE
一、论文动机
- 背景:关系抽取(RE)是将非结构化文本转化为结构化数据(关系三元组)的过程,在知识图谱构建中扮演重要角色。然而,由于关系类型的多样性和实体间关系的模糊性,传统的“文本输入,文本输出”语言模型在RE任务中面临挑战。
二、论文思路
- AgentRE:提出了一种基于智能体的RE框架AgentRE,通过整合大型语言模型的记忆、检索和反思能力,有效应对这些挑战。AgentRE包含三大模块:检索模块、记忆模块和提取模块,助力代理高效获取并处理信息,显著提升RE性能。
- AgentRE的三大模块
- 检索模块:负责从现有数据集中提取相关样本,并搜集补充知识,辅助提取模块完成RE任务。检索模块分为样本检索模块和相关信息检索模块,利用编码器将当前文本转化为嵌入向量,计算训练数据集中样本与当前文本的相似性,以检索与当前文本相似的样本。
- 记忆模块:负责在提取过程中动态地利用现有知识,并进行反思和总结,更好地完成后续的提取任务。记忆模块被划分为短期记忆和长期记忆,短期记忆记录了初步的提取经验,长期记忆涵盖了对过往记忆的深入反思与更新。
- 提取模块:借鉴了ReAct的互动式方法,通过多轮的思考、行动、观察来推进。在此框架下,检索与记忆模块被视作智能体可调用的外部工具。智能体通过一系列API接口,输入工具名称和参数,随后获得反馈结果。
- 小模型的精炼
- 蒸馏学习:为了弥补小模型在推理能力上的不足,提出了一种蒸馏学习的方法,通过利用大型模型的历史推理路径来引导小模型的学习。对不同类型问题采用多样化的推理策略,可以显著增强模型解决问题的适应性。
三、实验设计与结果
- 测评数据集:在DuIE(最大的中文关系抽取数据集)和SciERC(科学领域英文命名实体识别与关系抽取数据集)两个数据集进行测试。
- 测试基准方法:将AgentRE与多种基于LLM的信息抽取模型/框架进行对比,包括ChatIE、GPT-RE、CodeKGC、CodeIE、UIE、USM和InstructUIE等。
- 测评结果:实验结果表明,AgentRE在零样本学习(ZFL)、少样本学习(FSL)和有监督的微调(SFT)三种实验范式下均表现出色。特别是在FSL组中,AgentRE-FSL显著超越了当前最佳模型,展示了其在利用标记数据和辅助信息方面的优势。
- 消融实验:探究了AgentRE在不同配置下的表现,包括缺少检索模块(AgentRE-w/oR)、缺少记忆模块(AgentRE-w/oM)和两者皆无(AgentRE-w/oRM)。结果表明,检索模块和记忆模块对AgentRE的性能至关重要。
四、论文总结
AgentRE通过整合大型语言模型的记忆、检索和反思能力,有效应对复杂场景关系抽取中关系类型多样以及单个句子中实体之间关系模糊的挑战。AgentRE 包含三大模块,助力代理高效获取并处理信息,显著提升 RE 性能。
iText2KG【建筑师】
建筑师:像个有条理的工程师,通过分步骤提炼、提取和整合信息,逐步将零散文档转化为系统的知识网络,而且不需要事先准备详细的建筑图纸,可以根据需要灵活地扩建和完善。
- 发表时间:2024.09.05
- 论文名称:iText2KG: Incremental Knowledge Graphs Construction Using Large Language Models
- 论文地址:https://arxiv.org/abs/2409.03284
- Github 地址:https://github.com/AuvaLab/itext2kg
一、论文动机
- 非结构化数据挑战:大多数可用数据是非结构化的,难以获取有价值信息,自动构建知识图谱对结构化数据并使其可访问至关重要。
- 传统方法局限性:传统NLP方法如命名实体识别和关系提取在信息检索中关键,但受限于预定义实体类型和对监督学习的需求。
二、论文思路
iText2KG方法包含四个模块:
- 文档提炼器(Document Distiller):使用LLM将原始文档重写为语义块,依据预定义架构提取特定文本信息,提高信噪比并指导图形构建过程。
- 增量实体提取器(Incremental Entity Extractor):迭代语义块提取全局文档实体,解决歧义,确保实体明确定义且区分。
- 增量关系提取器(Incremental Relation Extractor):处理已解析实体及语义块,检测语义上唯一的关系,根据上下文不同有不同行为。
- 图谱集成器(Graph Integrator and Visualization):使用Neo4j以图形格式直观表示实体和关系。
三、实验设计与结果
- 评估指标:
- 架构一致性:评估重写文本内容与输入架构匹配程度。
- 信息一致性:评估重写文本内容与原始报告语义匹配程度。
- 三元组提取精度:评估三元组与相应文本一致性。
- 实体/关系解析错误发现率:评估未解析实体或关系比例。
- 数据集和基线方法:使用GPT-4生成的简历、公司网站和科学文章文本信息作为输入,与OpenAI函数方法、Langchain和LlamaIndex等基线方法比较。
- 实验结果:
- 架构一致性:Document Distiller在不同文档类型间实现高架构一致性,科学文章和简历得分最高,网站略低。
- 信息一致性:简历信息一致性最高,科学文章次之,网站最低,反映不同文档类型对语义重写挑战。
- 三元组提取:全局实体作上下文时相关三元组精度较低,但图形更丰富;本地实体作上下文时精度较高,图形丰富度较低。
- 实体/关系解析:iText2KG在三种KG构建场景中表现优于基线方法,尤其在简历到KG场景中表现完美,网站到KG场景中错误发现率较高,凸显实体/关系解析重要性。
四、论文总结
iText2KG(增量式知识图谱构建)利用大型语言模型 (LLM) 从原始文档中构建知识图谱,并通过四个模块(文档提炼器、增量实体提取器、增量关系提取器和图谱集成器)实现增量式知识图谱构建,无需事先定义本体或进行大量的监督训练。
GraphInsight【图谱解读】
图谱解读:像个擅长信息图表分析的专家,知道把重要信息放在最显眼的位置,同时在需要时查阅参考资料来补充细节,并能step by step地推理复杂图表,让AI既能把握全局又不遗漏细节。
- 发表时间:2024.09.05
- 论文名称:GraphInsight: Unlocking Insights in Large Language Models for Graph Structure Understanding
- 论文地址:https://arxiv.org/abs/2409.03258
- Github 地址:
一、论文动机
- LLMs在图理解上的挑战:尽管LLMs在处理图方面展现出潜力,但在通过图描述序列的提示来理解图形结构信息时,尤其是在图规模增大时,仍面临困难。这种困难被称为“位置偏差”,即LLMs在图描述序列中不同位置的记忆表现不均。
- 现有方法的不足:现有方法在处理大规模图时存在“理解崩溃”的问题,即随着图规模的增加,LLMs的理解能力急剧下降。
二、论文思路
- 基于重要性的宏观层面的图形理解
基于重要性的图描述重组:计算图中每个节点的PageRank分数以衡量其重要性,将图分解为一系列互不相交的子图描述,并根据PageRank分数对子图描述进行排序,将最重要的子图描述放置在LLMs的强记忆区域(序列的头部和尾部)。
- 基于检索增强生成(RAG)的微观层面的图形理解
基于RAG的轻量级外部知识库:对于弱记忆区域中的节点和边,提取其信息并存储在GraphRAG知识库中。当需要进行微图理解任务时,从知识库中检索相关信息,并将其与输入的图描述序列结合,形成增强提示输入LLMs进行推理。
三、实验设计与结果
- 实验设计
- 数据集:引入了GraphSQA基准,涵盖从15到200个节点的多种图结构,包括多重边和自环。
- 任务类型:GraphSQA包括5个宏观图任务和15个微观图任务,后者进一步细分为8个复合任务。
- 评估指标:根据答案类型的不同,采用布尔值、数值和集合类型三种评估指标。
- 模型选择:使用了多种开源模型,包括Mistral 7B、Llama3-8B、Qwen2-7B和Vicuna-7B等,这些模型有的经过长时间序列的微调。
- 结果与分析
- 宏观图任务:GraphInsight在所有大型模型上均优于其他方法,特别是在Vicuna-7B模型上,得分提高了4.61倍。
- 微观图任务:GraphInsight在微观图任务中也表现出色,特别是在Vicuna-7B模型上,得分提高了14.02倍。
- 复合任务:在常见邻居查找和三阶邻居查找等复合任务中,GraphInsight分别实现了12.75倍和3.25倍的提升。
- 消融研究:图描述组织和GraphRAG对宏图和微图任务均有优化效果,特别是GraphRAG在微观图任务中带来了显著的改进。
四、论文创新点
突出了GraphInsight相较于其他方法的优势,例如更高效地利用节点特征和边信息,提高模型对于图结构上下文的学习效果。
五、论文总结
GraphInsight旨在提升LLMs对宏观和微观层面图形信息理解的新框架。GraphInsight基于两大关键策略:1)将关键图形信息置于LLMs记忆性能较强的位置;2)借鉴检索增强生成(RAG)的思想,对记忆性能较弱的区域引入轻量级外部知识库。此外,GraphInsight探索将这两种策略整合到LLM代理过程中,以应对需要多步推理的复合图任务。
LA-RAG【方言通】
方言通:像个精通各地方言的语言专家,通过细致的语音分析和上下文理解,不仅能准确识别标准普通话,还能听懂带有地方特色的口音,让AI与不同地区的人都能无障碍交流。
- 发表时间:2024.09.13
- 论文名称:LA-RAG:Enhancing LLM-based ASR Accuracy with Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2409.08597
- Github 地址:
一、论文动机
文章首先指出,将语音信息整合到LLM中以提高ASR准确性的研究日益增多。早期研究通常将纯文本转录输入LLM,结合ASR的N最佳结果和指令来提示LLM进行错误纠正。这些方法中,LLM主要作为文本重排器或标记选择器。其他研究尝试将预训练的ASR模型(通常是语音编码器部分)与LLM结合,通过模态适配器(如Qformer、注意力或投影)来对齐语音特征空间与LLM的文本空间。这些方法通常通过利用丰富的声学信号来提高性能,但它们的性能上限往往受限于语音编码器的能力,尤其是在训练和测试数据的声学特征不匹配的情况下,例如在口音场景中,编码器训练不足,正确的标记不会出现在N最佳转录中。
二、论文思路
LA-RAG范式通过利用细粒度的标记级语音数据存储和语音到语音检索机制,增强LLM的上下文学习(ICL)能力,从而提高ASR准确性。具体来说,LA-RAG包括以下四个主要部分:
- 语音分词器(Speech Tokenizer):使用预训练的AED/CTC模型提取语音转录对的中间表示,生成与文本标记对齐的语音标记。
- 数据存储创建(Datastore Creation):利用语音分词器对每个训练数据进行处理,生成语音-文本键值对,并存储对应的序列作为LLM的最终提示示例。
- 语音检索(Speech Retrieval):将数据存储组织为语音倒排索引,使用与数据库创建阶段相同的语音分词器对输入语音进行对齐,生成查询嵌入,通过分组和过滤策略获取序列级别的相似示例。
- LLM提示(LLM Prompt):将对齐的语音标记序列输入语音适配器,与LLM标记空间和维度对齐。使用LoRA进行参数高效的微调,学习语音标记到正确文本标记的映射关系,使LLM能够在推理阶段通过ICL学习正确的文本标记。
三、实验设计与结果
- 实验设计:作者使用了普通话和方言数据集来评估预训练ASR模型在充分和不足训练场景下的性能。数据集包括AISHELL-1和KeSpeech的子方言数据集。实验中使用了Whisper-Medium模型作为基础ASR系统,并测试了CTC和AED两种语音分词方法。LLM解码采用了LLaMA 3 8B模型,并集成了LoRA适配器。检索使用FAISS库实现,设置k值为128,序列过滤阈值为0.5。评估指标为字符错误率(CER)。
- 实验结果:LA-RAG在普通话和中国方言数据集上显著提高了ASR准确性,特别是在处理口音变化时。与现有方法相比,LA-RAG在所有方法中实现了最低的CER,尤其是在口音测试集上,性能提升更为显著。这表明LA-RAG能够帮助LLM学习发音和正确标记之间的映射关系,这对于ASR模型可能未充分学习映射关系的口音场景特别有用。
四、论文总结
LA-RAG通过利用细粒度的语音数据存储和预训练CTC和AED模型实现的精确标记级对齐,显著提高了基于LLM的ASR准确性,尤其是在口音变化场景中。实验结果表明,该方法在各种数据集上都取得了显著的性能提升,包括普通话和中国方言,显著降低了CER。未来的工作计划将LA-RAG方法推广到其他任务和语言的语音识别中。
SFR-RAG【精简检索】
精简检索:像个精练的参考顾问,体积虽小但功能精准,既能理解需求又懂得寻求外部帮助,保证回答既准确又高效。
- 发表时间:2024.09.16
- 论文名称:SFR-RAG: Towards Contextually Faithful LLMs
- 论文地址:https://arxiv.org/abs/2409.09916
- Github 地址:
一、论文动机
随着大型语言模型(LLM)的兴起,生成式AI成为关键领域。LLM能根据各种提示生成复杂输出,其中检索增强生成(RAG)是值得注意的领域,它将外部信息集成到LLM中以提高事实准确性。RAG专门解决生成可靠、与上下文相关的信息的需求,已成为解决基于知识任务的核心,这些任务中模型需根据外部来源生成答案。
二、论文思路
SFR-RAG模型包含函数调用功能,能与外部工具动态交互以检索高质量上下文信息。其创新方法包括一个新颖的聊天模板,添加了“Thought”和“Observation”两个关键角色。Thought角色使模型能内部进行多步骤推理,Observation角色捕获模型过程中检索到的外部信息。这种结构使SFR-RAG区分信息处理步骤并生成准确、用户友好的响应。模型还经微调能抵御低质量或不相关上下文,区别于传统LLM。
三、实验设计与结果
实验结果证明了SFR-RAG的成功,特别是在ContextualBench评估套件中。该套件包含七个上下文任务,旨在测试模型生成准确、与上下文相关答案的能力。尽管参数少得多,SFR-RAG在这七项任务中的三项取得了最先进的结果,优于GPT-4o等更大模型。例如,在2WikiHopQA中,SFR-RAG性能比GPT-4o提高了25%。它还在其他基准测试中表现出色,包括自然问题和音乐。即使上下文信息被更改或包含相互矛盾信息时,SFR-RAG性能依然稳健。
四、论文总结
SFR-RAG通过解决大型模型面临的常见问题,在检索增强生成方面取得重大进展。其90亿参数数量使其能高效运行同时保持高精度和可靠性。创新功能使SFR-RAG处理复杂多步骤推理,同时避免幻觉和不相关上下文生成的缺陷。它在各种基准测试中的出色表现,突出了较小、经微调模型在生成准确、基于上下文输出方面的潜力。SFR-RAG代表了向更高效、更可靠模型的转变,这些模型能更好应对外部上下文处理的挑战。
FlexRAG【压缩专家】
压缩专家:把长篇大论浓缩成精华摘要,而且压缩比例可以根据需要灵活调整,既不丢失关键信息,又能节省存储和处理成本。就像把一本厚书精炼成一份简明扼要的读书笔记。
- 发表时间:2024.09.24
- 论文名称:Lighter And Better: Towards Flexible Context Adaptation For Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2409.15699
- Github 地址:
一、论文动机
现有的RAG系统在处理长篇幅的检索上下文时,需要大量的计算资源进行编码,导致运行成本高昂。为了解决这一问题,FlexRAG提出了一种上下文压缩的方法,旨在减少上下文的数据量,同时尽量保留重要的信息,以提高效率。
二、论文思路
-
上下文压缩(Context Compression):
- FlexRAG将检索到的上下文压缩成紧凑的嵌入表示。具体来说,FlexRAG在离线阶段对外部文档进行预编码,生成压缩嵌入,并在检索到特定RAG任务的相关文档时对这些压缩嵌入进行下采样。
-
选择性压缩(Selective Compression):
- FlexRAG通过估计上下文的重要性来实现选择性压缩。具体方法包括:
- Token级别估计:基于LLM对输入提示中令牌的重要性估计。
- 句子级别估计:使用通用嵌入器(如E5和BGE)来估计句子与任务提示的相关性。
- 压缩比分配:根据估计的重要性对上下文进行分组,并为每组分配不同的压缩比,以平衡压缩效果和上下文信息的保留。
- FlexRAG通过估计上下文的重要性来实现选择性压缩。具体方法包括:
-
两阶段训练(Two-Stage Training):
- 第一阶段:在无标签数据上进行自回归预训练,以建立压缩模块与下游LLM之间的初步对齐。预训练的目标函数是最大化基于压缩上下文的语言建模概率。
- 第二阶段:使用指令调优数据集进行任务特定的微调,优化RAG任务的答案质量。具体基于问题和压缩检索上下文预测真实答案。
三、实验设计与结果
文章没有详细列出具体的实验结果,但提到了FlexRAG在减少计算资源和提高效率方面的优势。通过上下文压缩和选择性压缩,FlexRAG能够在处理长文本时显著降低计算负担,同时保持较高的性能。
四、论文总结
FlexRAG通过上下文压缩、选择性压缩和两阶段训练,有效地解决了长文本RAG中的计算资源问题。这种方法不仅减少了上下文的数据量,还通过选择性压缩和任务特定的微调,确保了重要信息的保留和模型的高性能。FlexRAG为长文本RAG提供了一种高效且灵活的解决方案,值得进一步研究和应用。
CoTKR【图谱翻译】
图谱翻译:像个耐心的老师,先理解知识的来龙去脉,再一步步讲解,不是简单复述而是深入浅出地转述。同时通过不断收集"学生"的反馈来改进自己的讲解方式,让知识传递更加清晰有效。
- 发表时间:2024.09.29
- 论文名称:CoTKR: Chain-of-Thought Enhanced Knowledge Rewriting for Complex Knowledge Graph Question Answering
- 论文地址:https://arxiv.org/abs/2409.19753
- Github 地址:https://github.com/wuyike2000/CoTKR
一、论文动机
大语言模型(LLMs)在自然语言处理任务中表现出色,但在知识密集型任务如问答(QA)中仍会遇到事实性错误,即“幻觉”问题。为了解决这一挑战,检索增强生成(RAG)范式通过从外部源检索与任务相关的知识来增强LLMs的能力。在RAG范式下,知识图谱(KGs)作为信息源,可以增强LLMs在QA任务中的能力。然而,现有方法在将检索到的子图转换为LLMs能理解的自然语言时,存在冗余、遗漏关键细节或语义不匹配的问题。
二、论文思路
- 研究方法
CoTKR方法的核心是以交错方式生成推理路径和相应知识,克服单步知识改写的限制。具体来说,CoTKR包括以下两个主要操作:
- 推理:分解问题以识别推理所需的知识。
- 总结:根据推理步骤的输出,总结检索到的三元组中的相关知识。
CoTKR通过将思维链(CoT)与知识改写整合,过滤掉无关信息并提取与问题相关的知识,生成与问题语义对齐的、组织良好的知识表示。
- 训练框架 CoTKR的训练框架包括两个阶段:
- 监督微调:使用ChatGPT生成的参考知识表示来指导知识改写器的监督式微调,使其初步掌握知识改写的能力。
- 基于问答反馈的偏好对齐(PAQAF):通过利用QA模型的反馈进一步优化知识改写器,弥合知识改写器和QA模型之间的偏好差异。具体步骤包括:
- 候选知识表示形式采样:从知识改写器中采样多个候选知识表示。
- 基于问答模型反馈的偏好注释:选择两个具有最大语义差异的知识表示,评估其问答性能,识别偏好的知识表示。
- 基于ChatGPT的数据增强:利用ChatGPT对偏好的知识表示进行释义,增强训练数据的多样性。
- 直接偏好优化(DPO):使用DPO对知识改写器进行微调,优化知识表示的质量。
三、实验设计与结果
实验在GrailQA和GraphQuestions两个数据集上进行,使用Llama-2 (7B)、Llama-3 (8B)和ChatGPT 2进行知识改写,同时使用ChatGPT和Mistral (7B)执行问答任务。实验结果表明,CoTKR在多个评价指标和大语言模型中均优于基准线,证明了其知识改写策略的有效性。
四、论文总结
- 性能提升:CoTKR在大多数评价指标和大语言模型中均优于基准线,显著提高了LLMs在KGQA中的性能。
- 偏好对齐:CoTKR+PA在性能上接近甚至超过了ChatGPT作为知识改写器,证明了训练框架和偏好对齐的有效性。
- 知识表示的重要性:精心设计的知识表示形式对于在KGQA中使用的大语言模型至关重要。CoTKR+PA始终优于Triple,表明精心设计的知识表示形式可以有效提升KGQA的性能。
- 检索方法的影响:设计一个高质量的检索器仍然是一个开放性问题。GS显著优于BM25和2-Hop,表明检索噪声对KGQA性能的影响重大。
- 数据增强的有效性:数据增强增强了偏好对齐的效果,CoTKR+PA表现最佳,证明了数据增强的有效性。
2024.10
Open-RAG【智囊团】
智囊团:把庞大的语言模型分解成专家小组,让它们既能独立思考又能协同工作,还特别会分辨真假信息,关键时刻知道该不该查资料,像个经验丰富的智囊团。
- 发表时间:2024.10.02
- 论文名称:Open-RAG: Enhanced Retrieval-Augmented Reasoning with Open-Source Large Language Models
- 论文地址:https://arxiv.org/abs/2409.01782
- Github 地址:https://github.com/ShayekhBinIslam/openrag
一、论文动机
- 现有的RAG方法在处理复杂查询(如多跳检索任务)时,推理能力有限。OpenRAG框架通过增强开源LLM的推理能力,解决了这一问题。
二、论文思路
- 架构转换:OpenRAG将任意密集LLM转换为参数高效的稀疏专家混合(MoE)模型,能够处理单跳和多跳查询等复杂推理任务。具体实现包括:
- 路由器(R)从头开始训练。
- 前馈网络(FFN)层保持冻结,并由基于并行适配器的专家(E)进行调整。
- 其他层被复制。
- 训练过程: 通过独特的训练方法,使模型能够导航看似相关但具有误导性的挑战性干扰因素。
- 训练过程中,模型学习生成检索/不检索的反射标记,并评估检索内容的相关性、支持程度和实用性。
- OPEN-RAG训练数据准备:涉及从每个原始对(q, y)生成四种新的训练实例的变化,每种都使用真实情况/LLM评论家和检索到的段落,结合不同的反射标记。OPEN-RAG不仅使LLM能够反思生成质量,还能够对比干扰项。
- 推理流程:
- 检索/不检索:模型学会生成检索/不检索的标记,以指示是否需要检索来回答查询。
- 相关性评估:对于检索到的内容,模型生成相关性标记,指示内容是否与查询相关。
- 生成答案:根据预测的相关性、支持度和效用标记,对所有可能的答案进行排序,生成最终答案。
三、实验设计与结果
- 在多种知识密集型的单跳/多跳短文/长文推理任务中,基于Llama2-7B的OpenRAG在事实准确性和推理能力方面显著优于现有的开源RAG模型,并且常常匹配或超越了最先进的专有LLMs及其RAG模型。
- OpenRAG在多个任务中超越了ChatGPT-RAG、Self-RAG、RAG 2.0和104B RAG-Command R+,树立了新的基准。
- OpenRAG结合CRAG(Corrective Retrieval Augmented Generation)方法,评估了模型对检索质量的鲁棒性。结果表明,OpenRAG在结合CRAG数据集时表现优于其他基线,显示出对高质量检索的潜在改进能力。
四、论文总结
OpenRAG通过创新的架构和训练方法,显著提升了开源LLM在RAG任务中的推理能力,并在多个任务中超越了现有的先进模型。其自适应检索策略和鲁棒性分析进一步证明了其在实际应用中的潜力。
TableRAG【Excel专家】
Excel专家:不只简单地查看表格数据,而是懂得从表头和单元格两个维度去理解和检索数据,就像熟练使用数据透视表一样,能快速定位和提取所需的关键信息。
- 发表时间:2024.10.07
- 论文名称:TableRAG: Million-Token Table Understanding with Language Models
- 论文地址:https://arxiv.org/abs/2410.04739
- Github 地址:https://github.com/YuhangWuAI/tablerag
一、论文动机
传统利用LLM进行表格理解的方法通常将整个表格作为输入,但这种方法存在以下局限性:
- 上下文长度限制:大型表格(如100列×200行)的单元格数量可能超过40,000个,超出LLM的处理能力。
- 推理能力削弱:过长的上下文可能导致“Lost-in-the-Middle”现象,影响推理能力。
- 计算成本和延迟:表格尺寸增加时,计算成本和延迟显著上升。
此外,一些改进方法(如截断表格或仅读取Schema)会丢失关键信息,而将行和列编码为固定大小的嵌入可能会丢失语义信息。
二、论文思路
为解决上述问题,Google提出了TableRAG,通过查询扩展与模式(Schema)和单元格检索相结合,精准定位关键数据,从而实现高效的数据编码和精确检索。TableRAG的核心在于:
上图展示了TableRAG与传统表格理解任务的区别。
(a) - (d):分别表示4种方法在提示词中包含的数据(阴影部分),其中 (d)是TableRAG方法:
- (a) 完整读取表格:LM读取整个表格,在大型表格中往往不现实。
- (b) 只读取Schema:LM只读取列名和数据类型组成的模式,这种方法会导致表格内容丢失。
- (c) 行-列检索:将行和列编码后,基于与问题相似度进行检索。只有行和列的交集被展示给LM。对于大型表格来说,编码所有行和列仍然不现实。
- (d) Schema-单元格检索(TableRAG):根据与LM生成的问题相关性,对列名和单元格进行编码和检索。只有检索到的Schema和单元格被提供给LM,从而在编码和推理上都提高了效率。
- (e) 在ArcadeQA数据集上的检索结果显示: TableRAG在列和单元格检索方面均优于其他方法,进而增强了后续的表格推理过程。
TableRAG的工作流程如下:
- 表格查询扩展:高效处理表格的关键在于精确地识别出查询所需的列名和单元格值。与传统的表格理解任务不同的在于,TableRAG单独为Schema和单元格分别生成独立查询。
- Schema检索:生成查询后,Schema检索通过预先训练的编码器fenc获取相关的列名,fenc会对查询进行编码,并与编码的列名进行匹配以确定其相关性。检索到的Schema数据包括列名、数据类型和示例值。将列转换为整数、浮点数或日期时间数据类型;如果这几种类型都不适合的话,保留为分类列。
- 对于被识别为数值或日期时间数据类型的列,将最小值和最大值作为示例值。
- 对于分类列,展示频率最高的三个类别作为示例值。
- 汇总每个查询的前K个检索结果,并根据它们与最接近查询的相似度进行排序。检索到的Schema提供了表格格式和内容的结构化概览,用于更精确的数据提取。
- 单元格检索:检索与问题相关的单元格值,支持精确数据提取。单元格检索的作用在于:
- 单元格识别:使LLM能够精确地检测表格中特定关键词的存在。例如,区分“tv”和“television”,确保搜索和操作基于精确的数据条目。
- 单元格-列关联:使LLM能够将特定单元格与其相关的列名关联起来。对于处理特定属性的问题至关重要,如将“钱包”直接与“描述”列关联,实现行索引。
- 编码预算下的单元格检索:将检索到的Schema和单元格值提供给LLM,生成答案。
三、实验设计与结果
- 回答准确性。TableRAG在ArcadeQA和BirdQA数据集上超越了其他方法,包括读取全表、读取Schema和行列检索等方法。GPT 3.5 Turbo在所有方法中表现最佳。
- 检索性能
- 列检索:TableRAG在精确度上优于其他方法,表明其在快速识别相关列方面非常有效。
- 单元格检索:TableRAG在召回率、精确度和F1分数上均优于其他方法。
- 伸缩性测试。TableRAG在不同表格尺寸(从50×50到1000×1000)下表现出色,即使在大规模表格中也能保持较高的准确率。
- 与现有技术的比较。TableRAG在WikiTableQA数据集上超越了现有方法(如TaBERT、Text-to-SQL等),证明了其在不同规模和复杂性表格上的有效性。
- 消融研究
- 检索方法的影响。基于嵌入的检索方法性能最佳,超越了BM25和混合方法。
- 检索结果数量K的影响。增加K值会增加上下文长度,但并不一致提升性能。TableRAG通过减少K值,降低了推理成本。
- 编码预算的影响。TableRAG在不同编码预算下保持一致性能,表明其通过单元格频率构建语料库的方法有效。
- 查询扩展的影响。查询扩展显著提升了TableRAG在不同数据集和语言模型中的性能。
- 模式检索和单元格检索。模式检索和单元格检索均显著提升了推理性能,分别提升了9.4%和11.5%。
四、论文优势
- 高效性:通过检索关键数据,大幅缩短提示长度,减少信息丢失。
- 可扩展性:即使面对百万级单元格的表格,也能保持可控的计算成本。
- 准确性:在ArcadeQA和BirdQA数据集上,TableRAG的检索设计表现卓越,准确率最高。
五、论文总结
TableRAG通过结合模式检索和单元格检索,解决了传统方法在处理大规模表格时的局限性。它在检索效率、准确性和可扩展性方面表现出色,适用于百万级单元格的表格理解任务。TableRAG为大规模表格处理提供了一种高效、准确且可扩展的解决方案。
LightRAG【蜘蛛侠】
蜘蛛侠:在知识的网中灵活穿梭,既能抓住知识点之间的丝,又能借网顺藤摸瓜。像个长了千里眼的图书管理员,不仅知道每本书在哪,还知道哪些书该一起看。
- 发表时间:2024.10.08
- 论文名称:LightRAG: Simple and Fast Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.05779
- Github 地址:https://github.com/HKUDS/LightRAG
一、论文动机
- 解决现有RAG系统的局限性。现有的RAG系统(如传统的检索增强生成框架)存在依赖平面数据表示和上下文感知能力不足的问题,导致生成的答案碎片化,无法有效捕捉实体之间的复杂相互依赖关系。此外,这些系统在处理大规模数据时效率较低,难以快速适应新数据。
- 提升信息检索的全面性和效率。为了解决上述问题,LightRAG引入了图结构来增强文本索引和检索过程。图结构能够有效表示实体之间的复杂关系,从而提升信息检索的全面性和上下文相关性。同时,通过双层检索范式(结合低层次和高层次的信息检索),LightRAG能够更高效地检索相关实体及其关系。
- 降低计算成本并提高适应性。LightRAG通过增量更新算法,避免了每次更新时重建整个索引,从而显著降低了计算成本。这一设计使得系统能够快速整合新数据,保持在动态环境中的有效性和响应性。
- 优化资源受限场景下的应用。LightRAG的设计目标之一是降低硬件和计算资源的需求,使其适用于移动设备或对实时性要求较高的系统。这种轻量化的设计使得LightRAG在资源受限的场景中更具优势。
- 提升生成答案的质量和多样性。通过图结构和双层检索机制,LightRAG能够生成更连贯、上下文丰富的回答。此外,实验结果表明,LightRAG在检索精度和效率上优于现有方法。
二、论文思路
- 图基文本索引(Graph-Based Text Indexing)
- 步骤1:实体和关系提取。使用大型语言模型(LLM)提取文本中的实体和关系,并将文档分割成小块以提高处理效率。
- 步骤2:LLM Profiling生成键值对。为每个实体和关系生成键值对,键是关键词,值是相关文本段落。
- 步骤3:去重优化。通过去重优化,合并相同实体和关系,减少图操作开销。
- 双层检索范式(Dual-Level Retrieval Paradigm)
- 步骤4:生成查询关键词。从用户查询中提取局部和全局关键词。
- 步骤5:关键词匹配。使用向量数据库匹配局部关键词与候选实体,以及全局关键词与关系。
- 步骤6:整合高阶相关性。检索节点和边的一跳邻接节点,增强查询相关性。
- 检索增强答案生成
- 步骤7:使用检索到的信息。利用检索到的实体和关系信息,通过LLM生成答案。
- 步骤8:上下文整合与答案生成。将用户查询与多源文本合并,生成符合查询意图的答案。
- 增量知识库的快速适应
- 步骤9:增量更新知识库。新文档加入时,重复图基索引步骤,生成新知识图谱数据并合并到原有图谱。
- 步骤10:减少计算开销。避免重建索引图,减少计算开销,快速整合新数据。
三、实验设计与结果
- 实验验证:LightRAG在全面性、多样性和知识赋能等多个关键维度上优于现有方法,包括GraphRAG、NaiveRAG、RQ-RAG和HyDE。
- 数据集和评估维度:在四个数据集和四个评估维度下,LightRAG的胜率显著高于基线方法。
- 案例研究:通过具体查询(如“哪些指标对于评估电影推荐系统最有信息量?”),展示了LightRAG的检索和生成过程,证明了其高效性和准确性。
四、论文总结
该框架将图结构融入文本索引和检索过程中。这一创新框架采用了一个双层检索系统,从低级和高级知识发现中增强全面的信息检索。此外,将图结构与向量表示相结合,便于高效检索相关实体及其关系,显著提高了响应时间,同时保持了上下文相关性。这一能力通过增量更新算法得到了进一步增强,该算法确保了新数据的及时整合,使系统能够在快速变化的数据环境中保持有效性和响应性。
AstuteRAG【明智判官】
明智判官:对外部信息保持警惕,不轻信检索结果,善用自身积累的知识,甄别信息真伪,像资深法官一样,权衡多方证据定论。
- 发表时间:2024.10.09
- 论文名称:Astute RAG: Overcoming Imperfect Retrieval Augmentation and Knowledge Conflicts for Large Language Models
- 论文地址:https://arxiv.org/abs/2410.07176
- Github 地址:
一、论文动机
检索增强生成(RAG)技术通过整合外部知识来增强大型语言模型(LLMs)的性能,但在实际应用中,RAG可能会受到不完美检索的影响,导致引入不相关、误导甚至恶意的信息。此外,RAG系统中知识冲突的问题也未得到充分研究。这些问题可能导致系统性能下降,尤其是在最坏情况下。
二、论文思路
为了解决上述问题,论文提出了 Astute RAG 方法。Astute RAG通过以下机制提高系统的鲁棒性和可信度:
- 适应性信息提取:从LLMs的内部知识中动态提取必要信息。
- 源感知整合:结合外部检索结果,并根据信息的可靠性调整权重。
- 动态调整权重:在不完美检索的情况下,动态平衡内部和外部知识的贡献,以解决知识冲突。
三、实验设计与结果
实验结果表明,Astute RAG在多个数据集上表现出色,尤其是在处理不完美检索时:
- 在最坏情况下,Astute RAG能够有效避免错误信息的干扰。
- 与传统RAG方法相比,Astute RAG显著提高了答案的可靠性和系统鲁棒性。
四、论文创新点
- 适应性信息提取与源感知整合:Astute RAG能够在检索结果不理想时,动态调整内部知识和外部检索信息的权重,从而有效解决知识冲突。
- 提高系统鲁棒性:通过动态整合机制,Astute RAG在最坏情况下的表现优于传统RAG方法,甚至能够匹配或超越没有RAG的LLMs的性能。
五、论文总结
通过适应性地从LLMs内部知识中提取信息,结合外部检索结果,并根据信息的可靠性来最终确定答案,从而提高系统的鲁棒性和可信度。
TurboRAG【速记高手】
速记高手:提前把功课做好,把答案都记在小本本里。像个考前突击的学霸,不是临场抱佛脚,而是把常考题提前整理成错题本。需要的时候直接翻出来用,省得每次都要现场推导一遍。
- 发表时间:2024.10.10
- 论文名称:TurboRAG: Accelerating Retrieval-Augmented Generation with Precomputed KV Caches for Chunked Text
- 论文地址:https://arxiv.org/abs/2410.07590
- Github 地址:https://github.com/MooreThreads/TurboRAG
一、论文动机
检索增强生成(RAG)系统通过从文档集合中检索相关信息并结合生成模型来生成响应,但面临的主要问题是首次令牌时间(TTFT)的高延迟。这种延迟主要由以下因素导致:
- 处理和连接多个检索到的文档块需要大量计算。
- 检索到的文档的键值(KV)缓存的重复计算。
二、论文思路
为了解决上述问题,Moore Threads AI的研究人员提出了 TurboRAG 方法。TurboRAG通过以下机制优化RAG系统的推理过程:
- 离线预计算KV缓存:计算并存储文档块的KV缓存,减少在线推理阶段的计算量。
- 在线检索预填充:
- 检索预先计算的KV缓存,并将其与用户查询结合生成响应。
- 使用独立的注意力掩码,防止跨文档的不必要注意力。
- 采用相对位置嵌入,保持文档中位置关系的完整性。
这种方法显著减少了计算开销,加快了响应时间,同时保持了生成结果的准确性。
三、实验设计与结果
实验表明,TurboRAG在降低TTFT方面表现出色:
- 延迟降低:与传统RAG系统相比,TurboRAG的TTFT降低了高达9.4倍,平均加速为8.6倍。
- 准确性保持:在多个基准测试中,TurboRAG的准确性与传统RAG方法相当。
- 计算资源优化:KV缓存计算成本降低了98%以上,支持更大的批处理大小和更高的吞吐量。
- 微调实验:即使在嘈杂的检索环境中,TurboRAG也能保持模型的准确性。
四、论文总结
TurboRAG通过将KV缓存生成与在线推理过程分离,解决了RAG系统固有的延迟问题。它通过利用预先计算的KV缓存和调整注意力机制,在保持准确性的同时显著提高了响应速度和效率。这些改进使TurboRAG成为延迟敏感型应用中部署RAG的有力选择,有望扩大RAG在实时和大规模场景中的应用范围。
StructRAG【收纳师】
收纳师:把杂乱无章的信息像收纳衣柜一样分门别类地整理好。像个模仿人类思维的学霸,不是死记硬背,而是先画个思维导图。
- 发表时间:2024.10.11
- 论文名称:StructRAG: Boosting Knowledge Intensive Reasoning of LLMs via Inference-time Hybrid Information Structurization
- 论文地址:https://arxiv.org/abs/2410.08815
- Github 地址:https://github.com/Li-Z-Q/StructRAG
一、论文动机
- 背景:传统RAG方法在处理知识密集型推理任务(如金融、法律等领域)时存在局限性,因为这些任务需要从多个信息源中提取和整合知识。
二、论文思路
- 目标:StructRAG通过模拟人类处理复杂推理的方式,将散乱信息转化为结构化知识,从而提高推理效率和准确性。
- StructRAG的工作原理:StructRAG通过以下三个核心过程实现:
- 混合结构路由器(Hybrid structure router)训练:
- 根据任务需求灵活选择最佳知识结构形式(如表格、图或算法)。
- 使用直接偏好优化(DPO)算法进行训练,无需额外奖励模型。
- 通过“合成-模拟-判断”方法构建高质量偏好对。
- 知识结构化:
- 利用LLM将散乱文本信息转化为结构化知识,提升信息可读性。
- 根据任务特性选择最优知识结构,优化信息呈现。
- 问题分解与推理:
- 结构化知识利用器将复杂问题分解为简单子问题。
- 逐步推导答案,提高推理适应性和准确性。
三、实验设计与结果
StructRAG在Loong基准测试任务中取得最先进的性能,随着任务复杂度增加,优势越发明显。
四、技术亮点及优势
- 技术亮点
- 混合信息结构化:根据不同任务需求灵活选择最优结构类型。
- 基于LLM的知识结构化:利用LLM的理解和生成能力构建高质量结构化知识。
- 科学问题分解与精准知识提取:通过分解问题实现对结构化知识的精确利用。
- StructRAG的优势
- 更好地处理分散信息:通过结构化知识整合多源信息。
- 任务适应性强:根据任务特性选择最优知识结构。
- 卓越性能:在知识密集型推理任务中表现优于传统RAG。
- 处理速度快:操作速度显著快于GraphRAG等方法,适合实时应用。
五、论文总结
StructRAG通过模拟人类认知过程,提升了AI系统处理复杂推理任务的能力,为金融分析、科研文献综述等知识密集型领域提供了新的解决方案。
VisRAG【火眼金睛】
火眼金睛:终于悟出文字不过是图像的一种特殊表现形式。像个开了天眼的阅读者,不再执着于逐字解析,而是直接"看"透全局。用照相机代替了OCR,懂得了"一图胜千言"的精髓。
- 发表时间:2024.10.14
- 论文名称:VisRAG: Vision-based Retrieval-augmented Generation on Multi-modality Documents
- 论文地址:https://arxiv.org/abs/2410.10594
- Github 地址:https://github.com/openbmb/visrag
一、论文动机
传统的RAG系统(TextRAG)主要依赖文本信息进行检索和生成,但在处理多模态文档时,会因为解析过程(如OCR、布局识别等)引入错误,导致信息损失和性能下降。
VisRAG旨在通过直接将文档作为图像嵌入并检索,避免解析过程中的信息损失,更全面地保留原始文档信息。
二、论文思路
- VisRAG由两部分组成:
- VisRAG-Ret(检索阶段):使用视觉语言模型(VLM)将查询和文档图像映射到嵌入空间,通过位置加权平均池化处理VLM的最后一层隐藏状态,从而实现文档页面的检索。
- VisRAG-Gen(生成阶段):利用检索到的页面生成答案。由于多模态大模型通常只能处理单张图片,VisRAG提出了两种方案:页面合并(将检索到的页面水平合并为一张图片)和加权筛选(为每个页面生成答案并选择置信度最高的答案)。
三、实验设计与结果
- 检索性能:
- VisRAG-Ret在跨领域数据上显著超越了现有基线模型,包括文本和视觉模型。
- 在跨领域环境中,VisRAG-Ret相比传统文本模型和视觉模型分别实现了15%和22%的性能提升。
- VisRAG-Ret在内存效率上也优于其他模型,适合扩展到大规模文档集合。
- 生成性能:
- VisRAG-Gen在处理真实文档图像时,显著优于仅依赖提取文本的TextRAG-Gen。
- 在实际应用场景中,VisRAG-Gen在处理检索到的文档时持续超越TextRAG-Gen,尤其是在加权筛选方法下表现更优。
- 整体性能:
- 在六个评估数据集中,VisRAG平均实现了39%的准确率提升。
- 在InfographicsVQA数据集上,VisRAG的整体准确率从22.1%提升至42.7%,显示出其在多模态文档处理中的强大能力。
四、论文总结
VisRAG通过直接利用文档图像进行检索和生成,有效避免了传统RAG系统中解析过程带来的信息损失,显著提升了检索和生成的性能。该系统不仅在训练数据上表现出色,还展现出强大的泛化能力,成为多模态文档RAG的理想选择。
AGENTiGraph【知识管家】
知识管家:像个善于对话的图书管理员,通过日常交流帮你整理和展示知识,带着一队助手随时准备解答问题、更新资料,让知识管理变得简单自然。
- 发表时间:2024.10.15
- 论文名称:AGENTiGraph: An Interactive Knowledge Graph Platform for LLM-based Chatbots Utilizing Private Data
- 论文地址:https://arxiv.org/abs/2410.11531
- Github 地址:
一、论文动机
大型语言模型(LLM)在问答(QA)任务中表现出色,但在事实一致性和最新信息方面存在挑战。知识图谱(KG)能够提供结构化的事实信息,补充LLM的知识,减少幻觉并实现更复杂的推理任务。然而,现有的知识图谱工具和查询语言(如SPARQL和Cypher)通常缺乏用户友好的界面,难以处理复杂查询,且与LLM的集成不够紧密。因此,需要一种更适应性强、用户友好且集成度高的方法来利用知识图谱。
二、论文思路
- AGENTiGraph框架设计
AGENTiGraph是一个基于多智能体系统的平台,通过自然语言交互实现知识管理。其核心是一个以人为本的方法,允许用户使用自然语言输入与系统交互。系统的主要特点包括:
- 语义解析:将自然语言查询转换为结构化图形操作,优化用户交互,降低与知识图谱交互的复杂性。
- 自适应多智能体系统:集成LLM代理,处理多模态输入(如用户意图、查询历史和图形结构),动态生成行动计划。
- 动态知识集成:支持持续的知识提取和集成,确保知识图谱保持最新,并提供动态可视化功能。
- 任务规划与执行:将用户意图分解为可执行任务,优化执行顺序,并生成逻辑结构的任务序列。
- 系统架构
AGENTiGraph的多智能体架构包括以下模块:
- 用户意图解释:通过Few-Shot Learning和Chain-of-Thought推理,准确解释用户的自然语言输入。
- 关键概念提取:执行命名实体识别(NER)和关系提取(RE),将提取的实体和关系映射到知识图谱。
- 任务规划:将意图分解为可执行任务,优化执行顺序。
- 知识图交互:将高级任务转换为可执行的图形查询,并动态调整查询以适应中间结果。
- 推理与响应生成:利用LLM的上下文理解和推理能力,生成连贯的响应。
- 动态知识集成:将新实体和关系合并到现有知识图谱中。
三、实验设计与结果
为了评估AGENTiGraph的性能,研究者开发了一个包含3,500个测试用例的数据集,涵盖六种预定义任务类型和自由格式查询。实验结果表明,AGENTiGraph在任务分类和执行方面显著优于零样本基线模型。具体指标如下:
- 任务分类准确率:最高达95.12%(GPT-4o)。
- 任务执行成功率:最高达90.45%(GPT-4o)。
用户研究进一步验证了AGENTiGraph在实际场景中的有效性,尤其是在提供简洁、集中的答案方面表现出色。然而,对于复杂任务,系统有时会遗漏关键细节或误解问题。
四、论文总结
AGENTiGraph通过自然语言交互进行知识管理的平台。它集成了知识提取、集成和实时可视化。AGENTiGraph 采用多智能体架构来动态解释用户意图、管理任务和集成新知识,确保能够适应不断变化的用户需求和数据上下文。
RuleRAG【循规蹈矩】
循规蹈矩:用规矩来教AI做事,就像带新人入职,先给本员工手册。不是漫无目的地学,而是像个严格的老师,先把规矩和范例都讲明白,然后再让学生自己动手。做多了,这些规矩就变成了肌肉记忆,下次遇到类似问题自然知道怎么处理。
- 发表时间:2024.10.15
- 论文名称:RuleRAG: Rule-guided retrieval-augmented generation with language models for question answering
- 论文地址:https://arxiv.org/abs/2410.22353
- Github 地址:https://github.com/chenzhongwu20/RuleRAG_ICL_FT
一、论文动机
大型语言模型(LLM)在上下文学习(ICL)方面表现出色,但在处理知识密集型任务时存在局限性。RAG框架通过将知识检索与答案生成解耦,显著提升了性能。
然而,现有RAG框架在检索阶段无法保证检索信息与查询的强相关性,在生成阶段也未能明确指导LLM如何利用检索到的文档。为此,本文提出RuleRAG,通过引入规则来解决这些问题。
二、论文思路
RuleRAG包括两个主要部分:无需训练的RuleRAG-ICL和经过微调的RuleRAG-FT。
- RuleRAG-ICL:通过在检索和生成阶段引入规则,指导检索器检索逻辑相关的文档,并指导生成器根据规则生成答案。具体流程如下:
- 给定查询q,从规则库R中选择与q相关的规则Rq。
- 将q与Rq中的规则r逐一结合,进行规则引导的检索,获取与规则相关的文档Drq。
- 将所有规则的检索结果Drq组合成最终检索结果Dq。
- 基于q、Rq和Dq生成最终答案a。
- RuleRAG-FT:通过规则引导的微调(RGFT)进一步提升模型性能。RGFT包括:
- 规则引导的检索器微调(RGFT-retriever):通过对比学习优化检索器,使其能够更准确地检索与规则相关的文档。
- 规则引导的生成器微调(RGFT-generator):通过监督学习优化生成器,使其能够根据规则更好地利用检索到的文档生成答案。
三、实验设计与结果
- 实验设计:作者使用了多种检索器(如DPR、SimCSE、BM25)和生成器(如LLAMA2_7B、LLAMA2_13B、ChatGLM2_6B等),并对比了RuleRAG与标准RAG及其他基线方法的性能。
- 实验结果:RuleRAG在五个基准数据集上均显著优于标准RAG和其他基线方法:
- RuleRAG-ICL在Recall@10和Exact Match(EM)等指标上平均提升了+89.2%和+103.1%。
- RuleRAG-FT进一步提升了性能,尤其是在Recall@10和EM指标上,平均提升了+45.7%和+24.2%。
四、论文总结
本文提出的RuleRAG通过引入规则显著提升了检索增强型生成模型在知识密集型问答任务中的性能。未来工作将探索RuleRAG在更复杂的查询场景下的表现,并进一步优化规则挖掘和利用机制。
Class-RAG【法官】
法官:不是靠死板的条文判案,而是通过不断扩充的判例库来研判。像个经验老到的法官,手握活页法典,随时翻阅最新案例,让判决既有温度又有尺度。
- 发表时间:2024.10.18
- 论文名称:Class-RAG: Content Moderation with Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.14881
- Github 地址:
一、论文动机
随着生成式 AI 的广泛应用,内容审核的重要性日益凸显。然而,传统的模型微调方法在处理内容审核任务时面临诸多挑战,例如标注数据的主观性强、不同地区和受众的审核要求差异大,以及持续微调成本高昂等问题。为此,本文提出了一种基于检索增强生成(RAG)的内容审核方法——Class-RAG,通过动态更新检索库来实现即时风险缓解,提升审核性能。
二、论文思路
Class-RAG 的核心架构包括以下部分:
- 嵌入模型:使用 DRAGON RoBERTa 作为嵌入模型,将输入文本向量化。此外,还评估了 WPIE(Whole Post Integrity Embedding)模型的变体。
- 检索库:由安全用例库和不安全用例库组成,每个条目包含提示、标签、嵌入和解释四个属性。通过 K-Means 聚类算法从安全和不安全案例中挑选中心案例,形成检索库。
- 检索模块:利用 Faiss 库进行相似性搜索,从检索库中检索出与输入最相关的两个安全示例和两个不安全示例,使用 L2 距离度量计算相似度。
- 微调的 LLM 分类器:将检索到的参考案例和输入提示一起输入到微调的 LLM 中进行分类。
三、实验设计与结果
- 分类性能及对抗性攻击的稳健性
Class-RAG 在 CoPro 数据集的同分布(ID)和分布外(OOD)测试集上进行了全面测评,与 WPIE 和 LLAMA3 两个基线模型对比。结果显示,Class-RAG 在分类性能上优于基线模型,尤其是在对抗性攻击方面表现出更强的稳健性。
- 对外部数据源的适应能力
Class-RAG 的一个重要优势是能够快速适应外部数据,而无需重新训练模型。实验表明,加入外部数据源后,Class-RAG 在 I2P++ 数据集上的 AUPRC 分数从 0.229 提升至 0.791,对抗性攻击性能从 0.235 提升至 0.677;在 UD 数据集上,AUPRC 分数从 0.917 提升至 0.985,对抗性攻击性能从 0.914 提高到 0.976。
- 遵循指令的能力
Class-RAG 具有很强的遵循参考示例的能力。在带有翻转 ID 库的测试中,99.49% 的真实安全示例的预测标签成功翻转,而真实不安全示例的翻转率仅为 12.29%。
- 相对于检索库大小的性能可扩展性
实验表明,随着检索库规模的扩大,Class-RAG 的性能稳步提升。在 I2P++ 数据集上,AUPRC 分数从无外部库时的 0.235 提升至完整外部库时的 0.677;在 UD 数据集上,AUPRC 分数从 0.914 提升至 0.974。扩大检索库规模是一种经济高效的提升性能的策略。
- 参考样本数量对性能的影响
增加参考样本数量能够提升 Class-RAG 的性能,但计算成本也会增加。实验表明,在 I2P++ 数据集上,参考样本数量从 0 增加到 8 时,AUPRC 分数从 0.303 提升至 0.721;在 UD 数据集上,AUPRC 分数从 0.932 提升至 0.980。
- 嵌入模型对性能的影响
DRAGON RoBERTa 的嵌入效果优于 WPIE 模型。在 ID 测试集上,DRAGON RoBERTa 的平均 AUPRC 为 0.938,而在 OOD 测试集上为 0.920,均优于 WPIE 的表现。
四、论文总结
Class-RAG 通过检索增强生成技术,有效提升了内容审核的性能,尤其是在对抗性攻击的稳健性和对外部数据的适应能力方面表现出色。通过动态更新检索库,Class-RAG 能够灵活应对不断变化的内容审核需求,同时降低了持续微调的成本。
Self-RAG【反思者】
反思者:在回答问题时,不仅会查阅资料,还会不断思考和检查自己的答案是否准确完整。通过"边说边想"的方式,像一个谨慎的学者一样,确保每个观点都有可靠的依据支持。
- 发表时间:2024.10.23
- 论文名称:Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection
- 论文地址:https://arxiv.org/abs/2410.11511
- Github 地址:https://github.com/AkariAsai/self-rag
一、论文动机
随着LLM+RAG(检索增强)技术在自然语言处理领域的广泛应用,如何保证检索内容的有效性、验证检索内容对输出结果的支持性以及区分输出结果的来源成为当前技术框架下的主要问题。
为了解决这些问题,本文提出了一种新的框架——self-RAG(通过自我反思学习检索、生成和批评)。
二、论文思路
- 框架设计
self-RAG框架通过引入特殊的token来实现对检索和生成过程的精细控制。具体流程如下:
- 按需检索:在生成过程中,模型通过触发[Retrieve] token决定是否需要检索内容。
- 并行生成与评价:模型利用检索到的内容进行生成,并在生成过程中插入评价token(如[Relevant]、[Supported]、[Irrelevant]、[Partially])来判断检索内容的相关性和支持程度。
- 筛选输出:根据评价token对生成的内容进行排序,选择最佳片段作为最终输出。
- 特殊token的定义
self-RAG定义了以下四种特殊token:
- [Retrieve]:决定是否需要检索内容(取值为yes或no)。
- [IsREL]:判断检索内容的相关性。
- [IsSUP]:判断检索内容对生成内容的支持程度。
- [IsUSE]:判断检索内容的有用性。
- 实现方法
- 评价模型C。评价模型C用于生成监督数据,辅助生成模型M的训练。其训练目标是预测检索内容的相关性、支持程度和有用性。监督数据通过GPT-4和人工标注的方式收集,以降低标注成本。
- 生成模型M。 生成模型M基于LLM进行SFT(监督微调),训练过程中加入评价模型C预测的标签信息。模型的训练目标是生成目标内容的同时,生成与检索内容相关的标签信息。
- 推理过程
- 若生成的[Retrieve]标签为yes,则触发检索器召回相关片段。
- 利用召回的片段预测评价标签,并根据标签对生成内容进行排序,选择最佳结果。
- 若[Retrieve]标签为no,则直接生成目标内容。
三、实验设计与结果
- 性能提升。
在六个问答数据集上,self-RAG相比其他LLM+RAG框架有显著提升,最多可带来5个点以上的性能提升。
- 检索的影响
实验表明,检索对LLM生成效果有显著影响,检索增强的生成结果在质量和事实性上优于不使用检索的结果。
四、优势与不足
- 优势
- 精细控制:通过特殊token实现对检索和生成过程的精细控制,提升生成内容的质量和验证性。
- 灵活性:框架设计灵活,可扩展性强,适用于多种LLM和RAG架构。
- 不足
- 推理成本:生成和判断标签的过程增加了推理成本。
- 优化空间:标签设计和召回文档的筛选过程仍有优化空间,例如减少标签数量或优化小模型的筛选效率。
五、论文总结
self-RAG框架通过引入特殊token,实现了对检索和生成过程的精细控制,显著提升了LLM+RAG框架的性能。尽管推理成本有所增加,但其在生成质量和事实性上的提升为未来的研究提供了新的方向。
SimRAG【自学成才】
自学成才:面对专业领域时,先自己提问再自己回答,通过不断练习来提升专业知识储备,就像学生通过反复做习题来熟悉专业知识一样。
- 发表时间:2024.10.23
- 论文名称:SimRAG: Self-Improving Retrieval-Augmented Generation for Adapting Large Language Models to Specialized Domains
- 论文地址:https://arxiv.org/abs/2410.17952
- Github 地址:
一、论文动机
RAG通过检索相关文档来增强模型的回答能力,类似于人类在回答问题前查阅资料的过程。尽管RAG技术不断改进,但在专业领域的表现仍不理想,主要原因是模型可能无法正确利用检索到的专业文献。
二、论文思路
SimRAG框架分为两个阶段:基础训练和自我提升。
- 基础训练
基础训练阶段的目标是让模型掌握基本能力:
- 指令理解能力:使用OpenAssistant、Dolly和SODA等数据集训练模型理解人类指令。
- 问答能力:使用Squad、DROP和NQ等问答数据集提升模型的解题能力。
- 检索能力:训练模型从文档中找到可能的答案,并根据文档和答案生成问题。
- 自我提升
自我提升阶段是SimRAG的核心,模型利用基础训练阶段学到的能力来自我提升:
- 答案生成:模型阅读专业文献,提取关键信息作为潜在答案。
- 问题生成:基于提取的答案,生成不同类型的问题(如填空题、多选题、判断题)。
- 质量控制:筛选生成的问题,确保答案在文档中可找到,且问题清晰合理。
三、实验设计与结果
-
实验设计: SimRAG在三个专业领域进行了测试
- 医疗领域:使用PubMedQA、BioASQ、MedQA等7个数据集。
- 科学领域:使用ARC、SciQ、MMLU-sci等3个数据集。
- 计算机科学领域:使用CS-Bench数据集。
-
实验结果:SimRAG在医疗、科学和计算机科学领域的表现如下
- 医疗领域:SimRAG在多个数据集上超越了通用大模型和专业领域模型。
- 科学领域:SimRAG在ARC、SciQ和MMLU-sci数据集上表现优异。
- 计算机科学领域:SimRAG在CS-Bench数据集上取得了较好的成绩。
四、论文总结
SimRAG通过让模型同时学会回答和提出问题,提升了LLM在专业领域的表现。其核心在于利用检索增强生成技术,结合自我提升策略,让模型更好地理解和应用专业知识。尽管存在一些局限性,但SimRAG为领域适应性模型的研究提供了新的思路。
ChunkRAG【摘抄达人】
摘抄达人:先把长文章分成小段落,再用专业眼光挑出最相关的片段,既不遗漏重点,又不被无关内容干扰。
- 发表时间:2024.10.23
- 论文名称:SimRAG: Self-Improving Retrieval-Augmented Generation for Adapting Large Language Models to Specialized Domains
- 论文地址:https://arxiv.org/abs/2410.17952
- Github 地址:
一、论文动机
本文提出了一种名为 ChunkRAG 的框架,旨在通过在块级别评估和过滤检索信息,解决RAG系统中生成响应的不相关性和幻觉问题。该方法将文档分割成语义块,并使用LLM对每个块与查询的相关性进行评分,从而排除不相关内容。实验表明,ChunkRAG在精确信息检索任务上优于现有RAG模型,尤其适用于事实推理和多跳推理场景。
二、论文思路
ChunkRAG通过以下步骤实现对检索信息的细粒度过滤:
- 语义分块
- 句子分词:使用NLTK的 sent_tokenize 函数将文档分割成句子。
- 句子嵌入生成:使用OpenAI的 text-embedding-3-small 模型为每个句子生成嵌入向量。
- 相似度计算:计算连续句子之间的余弦相似度,若相似度低于阈值(如0.7),则认为主题发生变化。
- 块边界识别:基于相似度分数识别块边界。
- 块创建:根据边界将句子分组成块,每个块长度不超过500字符。
- 块过滤
- 初始过滤:移除冗余块,并按语义相似度排序。
- 高级LLM评分:
- 初始LLM评分:LLM为每个块分配初始相关性分数。
- 自我反思:LLM反思初始评分并调整。
- 批评LLM评分:第二个LLM独立评估块并分配分数。
- 最终分数计算:通过平均初始、反思和批评分数获得最终相关性分数。
- 动态阈值确定:LLM分析分数分布,确定动态阈值,保留相关性高于阈值的块。
- 检索和排序
- 混合检索:结合BM25检索器和基于LLM的相似度检索。
- 块重排:使用Cohere的重排序模型对块进行语义相关性排序。
- 答案生成
- 上下文编译:将过滤后的块编译成LLM的上下文。
- 生成答案:LLM根据上下文和用户问题生成简洁答案。
三、实验设计与结果
- 实验设计
- 数据集:实验在 PopQA 数据集上进行,这是一个短形式问答基准数据集,包含多样化的问题,适合评估检索增强生成模型。
- 基线:对比了多种LLM(如LLaMA2、Alpaca)和RAG变体(如标准RAG、Self-RAG、CRAG)。
- 评估指标:使用 准确性 作为评估指标
- 实验结果
- 性能比较:ChunkRAG在PopQA数据集上的准确率达到 64.9%,显著优于所有基线模型。与最接近的CRAG(54.9%)相比,性能提升了 10个百分点。
- 多步推理:在多步推理任务中,ChunkRAG的成功率比CRAG高出 66%,表明其在复杂推理任务中的优势。
- 观察与见解:ChunkRAG的主要改进来自于 块级过滤 和 细粒度相关性评估。通过语义分块,减少了生成不相关或弱相关信息的情况,显著提高了生成答案的事实准确性和连贯性。
四、优势与不足
- 优势
- 块级过滤:显著减少无关信息和幻觉。
- 语义分块:提高检索效率和准确性。
- LLM评分机制:通过自我反思和批评LLM提高评分可靠性。
- 动态阈值:灵活确定块的相关性。
- 高准确性:在PopQA数据集上表现优异。
- 不足
- 依赖性:依赖块分割和嵌入质量,划分错误可能导致不相关数据。
- 计算成本:LLM评估成本较高,尤其在大规模数据集或实时系统中。
- 多领域验证:在其他领域的验证不足,性能有待进一步分析。
五、论文总结
FastGraphRAG【雷达】
雷达:像谷歌网页排名一样,给知识点也排出个热度榜。就好比社交网络中的意见领袖,越多人关注就越容易被看见。它不是漫无目的地搜索,而是像个带着雷达的侦察兵,哪里的信号强就往哪里看。
- 发表时间:2024.10.23
- 论文名称:
- 论文地址:
- Github 地址:https://github.com/circlemind-ai/fast-graphrag
一、论文动机
传统的GraphRAG框架在处理复杂查询和大规模知识库时面临两大挑战:精确度不足和计算成本高昂。
为了解决这些问题,研究者提出了Fast GraphRAG,通过将经典的PageRank算法融入GraphRAG框架,显著提升了检索精度并降低了计算成本。
二、论文思路
- Fast GraphRAG的核心创新
Fast GraphRAG的核心:将PageRank算法应用于知识图谱的遍历过程。PageRank算法原本用于搜索引擎中评估网页的重要性,Fast GraphRAG借鉴这一原理,通过计算知识图谱中节点的重要性得分,快速定位最相关的信息节点。这种方法类似于为GraphRAG安装了一个“重要性雷达”,能够在海量数据中快速筛选和排序关键信息。
三、关键优势
Fast GraphRAG带来了以下显著优势:
- 精准检索:通过PageRank算法,系统能够快速定位最相关的信息节点,提高答案的准确性。
- 降低成本:与传统GraphRAG相比,Fast GraphRAG将处理成本降低了约6倍。
- 实时更新:支持动态添加新数据,并自动更新知识图谱,适应不断变化的信息环境。
- 可解释性:提供可视化的知识图谱和查询路径,增强系统的可解释性和可信度。
四、论文总结
Fast GraphRAG通过融合PageRank算法,显著提升了知识检索的效率和精准度,同时降低了运营成本。这一创新使得GraphRAG能够实时更新和调整知识重要性,适应动态变化的信息环境。Fast GraphRAG的出现为构建智能、高效的知识管理系统提供了新的思路,也展示了经典算法在大模型应用中的创新潜力。
AutoRAG【调音师】
调音师:一位经验丰富的调音师,不是靠猜测调音,而是通过科学测试找到最佳音效。它会自动尝试各种RAG组合,就像调音师测试不同的音响设备搭配,最终找到最和谐的"演奏方案"。
- 发表时间:2024.10.28
- 论文名称:AutoRAG: Automated Framework for optimization of Retrieval Augmented Generation Pipeline
- 论文地址:https://arxiv.org/abs/2410.20878
- Github 地址:https://github.com/Marker-Inc-Korea/AutoRAG_ARAGOG_Paper
一、论文动机
在实际应用中,选择适合特定数据和用例的RAG(检索增强生成)技术栈是一个复杂且耗时的任务。市面上存在多种RAG模块和Pipeline,但缺乏一种简单的方法来评估和选择最适合的组合。
为此,研究者提出了 AutoRAG,这是一个自动化工具,能够自动评估多种RAG模块组合,并找到最适合特定用例的RAG Pipeline。
二、AutoRAG的核心功能
AutoRAG通过以下方式实现对RAG技术栈的优化:
-
支持多种模块:
- 解析模块:支持16种解析模块,包括PDFMiner,PDFPlumber,PyPDFium2,PyPDF,PyMuPDF,UnstructuredPDF,NaverClovaOCR,llama Parse,Upstage Document Parser,Directory,Unstructured,csv,json,unstructuredmarkdown,bshtml,unstructuredxml。
- 切块模块:支持10种切块模块,如Token,SentenceTransformersToken,Character,RecursiveCharacter,Sentence,Konlpy ,Semantic_llama_index,SemanticDoubleMerging,SentenceWindow,SimpleFile。
- 重排:UPR,Tart,MonoT5,Cohere reranker,RankGPT,Jina Reranker,Sentence Transformer Reranker,Colbert Reranker,Flag Embedding Reranker,Flag Embedding LLM Reranker,Time Reranker,OpenVINO Reranker,VoyageAI Reranker,MixedBread AI Reranker,Ko-reranker,pass_reranker
- Query理解:query_decompose,hyde,multi_query_expansion,pass_query_expansion
- 检索:bm25,vectordb,hybrid_rrf,hybrid_cc
- 评价指标:支持15种评价指标,如Precision,Recall,F1,MRR (Mean Reciprocal Rank),MAP (Mean Average Precision),NDCG (Normalized Discounted Cumulative Gain),Token Precision,Token Recall,Token F1,BLEU,ROUGE,METEOR,Sem Score,G-Eval,Bert Score。
-
自动化评估:
- 用户可以提供自己的 QA数据集 和 Corpus数据集,AutoRAG将自动评估不同的RAG模块组合。
- 通过设置YAML文件,用户可以定义评估的参数和目标。
- AutoRAG将运行评估流程,自动选择最佳的RAG Pipeline。
-
数据准备。为了优化RAG性能,需要准备两种类型的数据:
- QA数据集:用于准确可靠的评估和优化。
- Corpus数据集:用于RAG检索文档并生成答案。
-
优化步骤
- 设置YAML文件:定义评估的参数和目标。
- 运行评估:AutoRAG自动评估不同的RAG模块组合。
- 优化过程:根据评估结果选择最佳的RAG Pipeline。
- 部署:将优化后的RAG Pipeline部署到实际应用中。
三、优势
AutoRAG的主要优势在于:
- 自动化:简化了RAG模块选择和评估的过程,节省时间和精力。
- 灵活性:支持多种RAG模块和评价指标,适应不同的数据和用例。
- 高效性:通过自动化评估,快速找到最适合的RAG技术栈。
四、论文总结
AutoRAG通过自动化评估多种RAG模块组合,帮助用户快速找到最适合特定数据和用例的RAG技术栈。它支持多种解析、切块、检索和评价模块,简化了优化流程,提高了RAG系统的性能和效率。
Plan×RAG【项目经理】
项目经理:先规划后行动,把大任务分解成小任务,安排多个"专家"并行工作。每个专家负责自己的领域,最后由项目经理统筹汇总结果。这种方式不仅更快、更准,还能清楚交代每个结论的来源。
- 发表时间:2024.10.28
- 论文名称:Plan×RAG: Planning-guided Retrieval Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.20753
一、论文动机
Plan×RAG(Planning-guided Retrieval Augmented Generation)旨在通过增强现有的检索增强生成(RAG)框架,解决大型语言模型(LLM)在复杂查询中的性能、幻觉和归因问题。
传统的“检索-推理”范式在处理复杂多跳查询时存在局限性:
- 检索局限:检索到的文档可能不完整或不相关,导致推理过程受限。
- 上下文窗口限制:大型语言模型的上下文窗口有限,检索到的文档可能无法完全利用。
- 缺乏规划:传统的“检索-推理”范式缺乏对查询的结构化分解和规划,难以处理复杂的多跳查询。
二、论文思路
Plan×RAG(Planning-guided Retrieval Augmented Generation)框架的实现主要包括以下几个关键步骤和组件:
- 生成推理计划(Reasoning Plan)
- 推理有向无环图(DAG):使用大型语言模型(如GPT-4)生成一个推理计划,表示为一个有向无环图(DAG)。这个DAG将原始查询分解为相互关联的原子子查询(Atomic Sub-queries)。
- 结构化分解:每个子查询只依赖于其父节点的答案,确保推理过程遵循马尔可夫假设(Markov Assumption),即每个子查询的答案只依赖于其直接父节点的答案。
- 插拔式专家系统(Plug-and-Play Experts)
- 动态查询专家(Dynamic Query Expert):负责生成子查询,并确保子查询之间的马尔可夫依赖关系。动态查询专家将父节点的答案嵌入到子查询中,生成完整的子查询。
- 批评家专家(Critic Expert):评估生成过程中是否需要额外信息,动态触发检索。批评家专家分析当前上下文和生成任务,决定是否需要检索额外信息。
- 相关性专家(Relevance Expert):确保选择最相关的文档进行检索,减少上下文窗口的使用。相关性专家对检索到的文档进行相关性评分、排序和选择。
- 聚合器专家(Aggregator Expert):将多个子查询的答案整合为对原始查询的综合响应。聚合器专家确保最终响应全面、平衡地覆盖原始查询的所有方面。
- 并行化和信息流管理
- 并行处理:DAG结构允许同一深度的子查询并行处理,显著提高了系统的效率。不同深度的子查询可以独立处理,减少了整体推理时间。
- 相关信息流动:DAG结构确保只有相关的信息在子查询之间流动,抽象掉不必要的信息,提高了上下文利用的效率。
- 动态检索和生成
- 动态检索:在生成每个子查询的答案时,Plan×RAG可以根据需要动态触发检索,确保在需要时获取额外信息。批评家专家负责评估生成过程中是否需要额外信息,动态触发检索。
- 相关性过滤:相关性专家确保选择最相关的文档进行检索,减少上下文窗口的使用,提高检索效率。
- 增强归因和可解释性
- 归因设计:通过将每个子查询的生成内容与单个检索文档直接关联,Plan×RAG确保了生成内容的归因,增强了系统的可解释性和可信度。
- 单一文档检索:默认配置下,相关性专家确保每个子查询只检索一个最相关的文档,进一步增强了归因能力。
- 调试和回溯
- 调试能力:DAG结构提供了强大的调试能力,允许系统回溯到错误的生成节点,分析和纠正错误。通过分析DAG和相应的子查询,可以识别和修正错误的生成内容。
- 回溯机制:在识别错误节点后,可以仅重新生成受影响的路径,并重新运行聚合器,确保最终生成的响应是正确的。
三、具体实现步骤
- 生成推理DAG:
- 使用GPT-4生成推理DAG,将原始查询分解为多个子查询。
- 每个子查询包含一个特殊标签(如),用于动态嵌入父节点的答案。
- 处理每个子查询:
- 按照DAG的拓扑顺序处理每个子查询。
- 对于每个子查询,动态查询专家生成完整的子查询。
- 批评家专家评估是否需要检索额外信息,动态触发检索。
- 相关性专家选择最相关的文档进行检索。
- 生成器语言模型(如Llama3-8B-instruct)生成子查询的答案。
- 整合答案:
- 聚合器专家将所有子查询的答案整合为对原始查询的综合响应。
- 调试和回溯:
- 如果生成的答案有误,通过分析DAG和相应的子查询,识别和修正错误。
- 仅重新生成受影响的路径,并重新运行聚合器,确保最终生成的响应是正确的。
四、实验设计与结果
- 数据集
- HotpotQA:多跳问答数据集。
- StrategyQA:需要多步推理的问答数据集。
- ARC-Challenge:科学考试问答数据集。
- PopQA:单跳问答数据集。
- 基线方法
- Vanilla LLMs:不使用检索的LLMs,如GPT-3.5、Llama2-7B、Llama2-13B和Llama3-8B。
- 标准RAG:使用LLMs的RAG方法。
- Self-RAG:自反思的RAG方法。
- RQ-RAG:动态查询重写和分解的RAG方法。
- 性能对比
- HotpotQA:Plan×RAG的Accuracy为35.67%,F1 Score为39.68%。
- StrategyQA:Plan×RAG的Accuracy为69.49%,F1 Score为64.03%。
- ARC-Challenge:Plan×RAG的Accuracy为74.12%,F1 Score为81.30%。
- PopQA:Plan×RAG的Accuracy为36.09%,F1 Score为35.20%。
- LLM评估
- 使用GPT-3.5-Turbo作为外部评估器,比较Self-RAG和Plan×RAG在PopQA数据集上的表现。尽管传统准确率指标显示Plan×RAG与Self-RAG之间存在差距,但LLM-Eval指标显示两者生成的答案在语义上非常相似,差距仅为2.09%和3.32%。
- 消融研究
- 批评家专家的有效性:批评家专家通过动态触发检索,显著减少了检索次数,同时保持了几乎相同的性能。在1500个HotpotQA查询中,批评家专家配置比始终检索配置减少了600次检索,仅导致0.5%的准确率下降和0.80的F1分数下降。
- 相关性专家的有效性:相关性专家通过过滤噪声检索,显著提高了系统性能。在1500个HotpotQA查询中,相关性专家配置的准确率为39.33%,F1分数为42.01%,而无相关性专家配置的准确率为31.60%,F1分数为36.18%。
五、论文总结
Plan×RAG通过引入推理计划和插拔式专家系统,解决了传统RAG方法在处理复杂查询时的局限性,显著提高了系统的性能、准确性和可解释性。其设计使其能够与任何预训练的LLM兼容,无需微调,具有广泛的适用性。
SubgraphRAG【定位仪】
定位仪:不是漫无目的地大海捞针,而是精准绘制一张小型知识地图,让 AI 能快速找到答案。
- 发表时间:2024.10.28
- 论文名称:Simple is Effective: The Roles of Graphs and Large Language Models in Knowledge-Graph-Based Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2410.20724
- Github 地址:https://github.com/Graph-COM/SubgraphRAG
一、论文动机
大型语言模型(LLMs)在多种领域表现出色,但在推理能力上仍存在局限性,例如幻觉(hallucination)、知识过时以及缺乏特定领域的专业知识。
检索增强生成(RAG)通过整合外部知识来解决这些问题,但现有方法在检索效率和有效性之间难以平衡。本文提出了一种新的框架——SubgraphRAG,通过检索知识图谱(KG)的子图并利用LLMs进行推理和答案预测,旨在提高RAG系统的效率和准确性。
二、论文思路
SubgraphRAG的核心是将知识图谱中的子图检索与LLMs的推理能力相结合。该框架通过以下步骤实现:
- 查询解析和实体提取:从用户查询中识别出主题实体(topic entities),这些实体为检索提供关键线索。
- 子图检索:
- 结构特征构建:使用方向性距离编码(Directional Distance Encoding, DDE)为每个三元组编码,捕捉其与查询主题实体的结构关系。
- 并行提取相关三元组:通过轻量级多层感知器(MLP)对三元组进行评分,选择与查询最相关的三元组构建子图。
- LLM推理:将检索到的子图以线性化列表的形式嵌入到提示中,指导LLMs进行推理并生成答案。
三、实验设计与结果
- 数据集
实验使用了两个多跳知识图谱问答(KGQA)基准数据集:WebQSP和CWQ。这些数据集需要模型进行复杂的推理才能生成答案。
- 检索性能
SubgraphRAG在检索召回率和效率方面显著优于现有方法。例如,在WebQSP数据集上,SubgraphRAG的三元组召回率达到88.3%,而其他方法如RoG和G-Retriever的召回率分别为71.3%和33.5%。同时,SubgraphRAG的检索时间仅为6秒,远低于其他方法。
- 知识问答性能
SubgraphRAG在知识问答任务中表现出色,尤其是在多跳推理和多主题实体问题上。例如,在CWQ数据集上,SubgraphRAG的Macro-F1和Hit指标分别达到89.8%和66.69%,显著优于其他方法。此外,SubgraphRAG在减少幻觉方面表现出色,生成的答案更加基于知识图谱中的事实信息。
- 可解释性
SubgraphRAG能够提供详细的推理过程和知识来源,显著提高了模型的可解释性。例如,对于复杂问题,SubgraphRAG可以清晰地展示推理路径和关键证据,而其他方法往往无法提供这样的解释。
四、论文总结
SubgraphRAG通过高效的子图检索和知识接地的推理,显著提高了知识图谱增强的检索生成系统的性能。该框架在多跳推理和复杂问题上表现出色,同时减少了幻觉现象,提高了答案的可解释性。未来的工作将集中在进一步优化子图检索算法和扩展框架的适用范围。
五、论文创新点
- 高效灵活的子图检索
SubgraphRAG通过以下方式实现高效子图检索:
- 轻量级MLP:使用MLP对三元组进行评分,避免了复杂模型(如GNNs)带来的计算开销。
- 并行化处理:通过并行提取相关三元组,显著提高了检索效率。
- 灵活的子图形式:检索到的子图形式灵活,可以根据LLMs的推理能力调整子图大小。
- 结构特征编码
SubgraphRAG通过方向性距离编码(DDE)为每个三元组编码,捕捉其与查询主题实体的结构关系。这种编码方式显著提高了检索的有效性,尤其是在多跳推理和多主题实体的复杂问题中。
- 知识接地的推理
SubgraphRAG通过将检索到的子图嵌入到LLMs的推理过程中,确保生成的答案基于知识图谱中的事实信息。这种方法不仅减少了幻觉现象,还提高了答案的可解释性。
2024.11
RuAG【炼金术士】
炼金术士:像个炼金术士,能将海量数据提炼成清晰的逻辑规则,并用通俗易懂的语言表达出来,让AI在实际应用中更有智慧。
- 发表时间:2024.11.04
- 论文名称:RuAG: Learned-rule-augmented Generation for Large Language Models
- 论文地址:https://arxiv.org/abs/2411.03349
- Github 地址:
一、论文动机
- 外部知识注入:利用外部数据集增强预训练LLMs在下游任务中的性能是当前研究的热点。现有方法包括监督式微调(SFT)、上下文学习(ICL)、检索增强生成(RAG)和知识图谱(KGs)的使用,但这些方法存在计算成本高、依赖手工标注、上下文窗口有限或需要大量人工干预等挑战。
- 逻辑规则的优势:逻辑规则因其高信息密度和可解释性,成为连接多样化数据和LLMs理解的桥梁。逻辑规则可以将复杂关系以简洁形式表达,并且易于翻译成自然语言,适合与LLMs结合。
二、论文思路
RuAG框架包含三个关键阶段:
- LLM辅助的逻辑规则搜索公式化:利用LLMs的常识自动定义逻辑规则中的目标谓词和主体谓词,减少人工干预。
- 基于蒙特卡洛树搜索(MCTS)的逻辑规则搜索:在LLMs定义的搜索空间中,利用MCTS高效发现逻辑规则。
- 逻辑规则增强的生成:将逻辑规则翻译成自然语言并注入LLMs的提示中,以增强其在下游任务中的推理能力。
- 方法细节
- 逻辑规则搜索公式化:
- 初始谓词定义:将数据集的标签作为目标谓词,特征作为主体谓词。
- 去除无关谓词:LLMs通过常识推理过滤掉与目标无关的谓词。
- 新目标谓词建议:LLMs生成新的目标谓词以探索更多逻辑规则。
- 基于MCTS的逻辑规则搜索:
- 定义状态、动作和奖励:状态是部分逻辑规则,动作是添加新谓词,奖励是规则的精度。
- MCTS过程:通过选择、扩展、模拟和回溯四个阶段,高效搜索逻辑规则。
- 逻辑规则增强的生成:
- 清理搜索到的规则:去除低质量或重复的规则。
- 翻译规则为自然语言:将逻辑规则翻译成自然语言句子,注入LLMs的提示中。
- 选择相关规则:根据LLMs的上下文窗口大小,选择最相关的规则注入。
三、实验设计与结果
作者在多个领域(自然语言处理、时间序列、决策制定和工业任务)评估了RuAG框架的有效性,包括关系抽取(DWIE数据集)、日志异常检测(HDFS数据集)和多人合作游戏(Alice&Bob)等任务。实验结果表明,RuAG在多个任务中显著优于现有方法,例如:
- 在关系抽取任务中,使用GPT-4的RuAG方法达到了60.42%的F1分数。
- 在日志异常检测任务中,RuAG达到了92.59%的F1分数。
- 在Alice&Bob游戏中,RuAG的平均胜率达到了70%。
四、论文总结
RuAG(Learned-Rule-Augmented Generation) 的新型框架,旨在通过将离线数据自动提炼成可解释的一阶逻辑规则,并将其注入到大型语言模型(LLMs)中,以增强其推理能力。该框架通过结合逻辑规则和LLMs的生成能力,解决了现有方法(如上下文学习ICL、检索增强生成RAG等)在上下文窗口大小和信息注入效率上的限制。
RAGViz【透视眼】
透视眼:让RAG系统变透明,看得见模型在读哪句话,像医生看X光片一样,哪里不对一目了然。
- 发表时间:2024.11.04
- 论文名称:RAGViz: Diagnose and Visualize Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2411.01751
- Github 地址:https://github.com/cxcscmu/RAGViz
一、论文动机
- RAG 的挑战:RAG 系统通过检索外部文档来增强 LLM 的知识,但现有的 RAG 系统缺乏对检索文档和模型注意力机制的可视化,难以解释生成结果的来源,容易导致“幻觉”(即生成与检索文档无关的内容)。
- RAGViz 的目标:提供一个可视化工具,帮助用户分析 LLM 对检索文档的注意力分配,诊断文档的有效性,并识别生成结果中的幻觉来源。
二、论文思路
- RAGViz 的功能
- 注意力可视化:
- 文档级注意力:展示生成文本对每个检索文档的总体注意力分数。
- 标记级注意力:允许用户选择特定的生成标记(token),并查看其在检索文档中的注意力分布。
- 可视化方式:通过颜色深浅表示注意力强度,帮助用户直观理解生成结果与检索文档的关系。
- 文档切换功能:
- 用户可以添加或移除特定文档,观察其对生成结果的影响。
- 通过对比原始生成和修改后的生成结果,帮助用户评估文档对生成结果的贡献。
- 自定义检索文档数量:
- 用户可以指定检索文档的数量,以测试不同数量的文档对生成结果的影响。
- 系统架构
RAGViz 的系统架构包括以下几个关键组件:
- ANN(近似最近邻)索引:用于高效检索与查询最相关的文档。
- 后端服务器:处理查询请求,管理检索逻辑,并与检索索引和 LLM 推理服务器交互。
- LLM 推理服务器:运行 LLM 推理任务,生成文本并计算注意力分数。
- 前端用户界面:提供交互式界面,允许用户输入查询、选择文档和标记,并显示注意力可视化结果。
三、实验设计与结果
- 数据集:使用 ClueWeb22 和 The Pile 数据集进行测试。
- 模型:使用 Llama-27b 作为 LLM,支持快速推理和注意力分数计算。
- 效率:系统在中等配置的 GPU 节点上运行,查询时间中位数约为 5 秒,适合实时交互。
四、论文总结
RAGViz 是一个强大的工具,通过可视化检索文档的注意力机制,帮助用户更好地理解和改进 RAG 系统。它不仅能够诊断幻觉问题,还能优化检索策略,提升生成结果的质量。作为开源工具,RAGViz 为研究人员和开发者提供了一个灵活的平台,用于分析和改进 RAG 管道。
AgenticRAG【智能助手】
智能助手:不再是简单的查找复制,而是配了个能当机要秘书的助手。像个得力的行政官,不光会查资料,还知道什么时候该打电话,什么时候该开会,什么时候该请示领导。
- 发表时间:2024.11.05
- 论文名称:what-is-agentic-rag
- 论文地址:https://weaviate.io/blog/what-is-agentic-rag
- Github 地址:
一、论文动机
- 检索增强型生成(RAG):一种利用外部知识源为大型语言模型(LLM)提供上下文的技术,以减少幻觉现象。传统RAG流程包括检索组件(嵌入模型和向量数据库)和生成组件(LLM)。用户查询通过相似性搜索检索相关文档,为LLM提供额外上下文。
- 传统RAG的局限性:
- 只考虑单一外部知识源,无法灵活处理多个知识源或外部工具。
- 上下文检索是一次性的,缺乏对检索结果质量的验证和推理。
二、论文思路
- AI智能体的引入
- AI智能体:具有角色和任务的LLM,能够访问内存和外部工具,并通过推理规划步骤完成任务。
- 核心组件:
- LLM(具有角色和任务)
- 内存(短期和长期)
- 规划(如反思、自我批评、查询路由等)
- 工具(如计算器、网络搜索等)
- Agentic RAG的概念
- Agentic RAG:将AI智能体纳入RAG流程,使其能够协调组件并执行超出简单信息检索和生成的额外行动,克服传统RAG的局限性。
- 工作原理:智能体RAG通常在检索组件中引入智能体,使其能够访问多种检索工具(如向量搜索引擎、网络搜索、计算器、API等)。智能体可以推理和决定是否检索信息、使用哪个工具、制定查询本身,以及评估检索到的上下文是否需要重新检索。
- Agentic RAG架构
- 单智能体RAG(路由器):智能体作为路由器,决定从多个外部知识源中选择哪一个检索上下文。这些知识源可以是数据库、网络搜索或个人账户(如电子邮件)。
- 多智能体RAG系统:多个智能体协同工作,每个智能体负责从不同的知识源检索信息(如内部数据源、个人账户、公共信息等)。这种架构提高了系统的灵活性和效率。
- 超越检索智能体:智能体不仅用于检索,还可以用于其他目的,如验证检索到的信息或执行多步骤任务。
三、Agentic RAG与传统RAG的对比
- 传统RAG:类似于在图书馆中回答问题,只能访问有限的资源。
- Agentic RAG:类似于拥有智能手机,可以访问网络浏览器、计算器、电子邮件等多种工具。
- 对比维度:
- 访问外部工具:传统RAG(否)vs. Agentic RAG(是)
- 查询预处理:传统RAG(否)vs. Agentic RAG(是)
- 多步骤检索:传统RAG(否)vs. Agentic RAG(是)
- 验证检索到的信息:传统RAG(否)vs. Agentic RAG(是)
四、论文总结
文章介绍了Agentic RAG的概念,强调了其在克服传统RAG局限性方面的优势。通过引入AI智能体,Agentic RAG能够灵活处理多个知识源、执行多步骤任务,并验证检索结果的质量。这种新的范式为构建更强大、多功能的LLM驱动应用提供了新的可能性。
HtmlRAG【排版师】
排版师:把知识不是当作流水账来记,而是像排版杂志一样,该加粗的加粗,该标红的标红。就像一个挑剔的美编,觉得光有内容不够,还得讲究排版,这样重点才能一目了然。
- 发表时间:2024.11.05
- 论文名称:HtmlRAG: HTML is Better Than Plain Text for Modeling Retrieved Knowledge in RAG Systems
- 论文地址:https://arxiv.org/abs/2411.02959
- Github 地址:https://github.com/plageon/HtmlRAG
一、论文动机
- 背景:大型语言模型(LLM)在自然语言处理领域展现了强大的能力,但也面临知识遗忘、过时信息和幻觉等问题。检索增强生成(RAG)系统通过检索外部知识并将其融入生成过程中,增强了LLM的响应能力。
- 问题:传统RAG系统将HTML文档转换为纯文本,导致结构化和语义信息丢失。为解决这一问题,提出使用HTML作为外部知识的格式,保留更多有用信息。
二、论文思路
- HTML清理:移除HTML文档中的冗余内容(如CSS、JavaScript、注释等),压缩HTML结构,同时保留重要语义信息。
- 块树构建:将HTML文档解析为块树,每个块代表一段逻辑上相关的内容。通过合并DOM树中的多个子节点,形成大小适中的块。
- HTML修剪:
- 基于文本嵌入的块修剪:使用文本嵌入模型对块进行初步修剪,保留与用户查询高度相关的块。
- 基于生成模型的精细块修剪:使用生成模型对剩余块进行进一步修剪,评估每个块的重要性并删除不重要的块。
三、实验设计与结果
- 数据集选择:使用六个数据集(ASQA、HotpotQA、NQ、Trivia-QA、MuSiQue、ELI5)进行实验,涵盖不同类型的问答任务。
- 实验设置及评价指标:使用Llama-3.1-70B-Instruct和Llama-3.1-8B-Instruct模型,评价指标包括精确匹配(Exact Match)、Hit@1、ROUGE-L和BLEU评分。
- 实验结果:HtmlRAG在所有评估指标上均超过基线方法,证明了HTML修剪的有效性。
- 分析:HTML格式在保留结构和语义信息方面具有优势,更强大的语言模型(如70B)在处理HTML格式知识时表现更好。
四、论文总结
HtmlRAG 旨在通过直接利用HTML格式的外部知识来提升检索增强生成(RAG)系统的性能。该方法通过保留HTML文档中的结构化和语义信息,解决了传统RAG系统中因使用纯文本而导致的信息丢失问题。
M3DocRAG【感官达人】
感官达人:不是只会读书,还能看图识图,听声辨位。像个综艺节目里的全能选手,图片能看懂,文字能理解,该跳跃思维时就跳跃,该专注细节时就专注,各种挑战都难不倒。
- 发表时间:2024.11.07
- 论文名称:M3DocRAG: Multi-modal Retrieval is What You Need for Multi-page Multi-document Understanding
- 论文地址:https://arxiv.org/abs/2411.04952
- Github 地址:https://github.com/Omaralsaabi/M3DOCRAG
一、论文动机
- DocVQA任务:通过解读文档图像中的信息来回答文本问题,广泛应用于金融、医疗和法律等领域。
- 现有方法的局限性:
- 现有方法主要聚焦于单页文档的视觉问答或基于文本提取(如OCR)的检索增强生成(RAG)。
- 这些方法难以处理跨多页或多文档的问题,且会忽略文档中的视觉元素(如图表、图形等),导致信息不完整或不准确。
二、论文思路
- 定义:M3DocRAG是一个多模态RAG框架,能够灵活适应不同文档上下文(封闭域和开放域)、问题跳转(单跳和多跳)以及证据模式(文本、图表、图形等)。
- 工作流程:
- 文档嵌入:将文档页面转换为RGB图像,并提取视觉嵌入(如ColPali)。
- 页面检索:通过文本查询检索相似度高的页面,开放域设置中使用近似索引(如倒排文件索引IVF)以加快搜索速度。
- 问答:利用多模态语言模型(如Qwen2-VL)从检索到的页面生成答案。
三、实验设计与结果
- 开放领域文档视觉问答:
- 多模态RAG比文本RAG表现更好,尤其是在处理非文本证据时。
- M3DocRAG(ColPali + Qwen2-VL 7B)在不同证据模式和问题跳转场景中表现优异。
- 封闭域文档视觉问答:
- 多模态RAG增强了对长文档的理解能力。
- 在多个基准测试中,M3DocRAG(ColPali + Qwen2-VL 7B)取得了领先性能。
- 额外分析:
- 索引方法:近似索引(如IVFFlat)在速度和准确性之间取得了良好平衡。
- 多模态语言模型:Qwen2-VL 7B在所有基准测试中表现最佳。
- 多模态检索模型:ColPali表现优于其他检索模型。
四、论文总结
M3DocRAG是一种新颖的多模态RAG框架,能够灵活适应各种文档上下文(封闭域和开放域)、问题跳转(单跳和多跳)和证据模式(文本、图表、图形等)。M3DocRAG使用多模态检索器和MLM查找相关文档并回答问题,因此它可以有效地处理单个或多个文档,同时保留视觉信息。
KAG【逻辑大师】
逻辑大师:不光靠感觉找相似的答案,还得讲究知识间的因果关系。像个严谨的数学老师,不仅要知道答案是什么,还得解释清楚这答案是怎么一步步推导出来的。
- 发表时间:2024.11.10
- 论文名称:KAG: Boosting LLMs in Professional Domains via Knowledge Augmented Generation
- 论文地址:https://arxiv.org/abs/2409.13731
- Github 地址:https://github.com/OpenSPG/KAG
一、论文动机
尽管大语言模型(LLM)展现出强大的语言理解与生成能力,但在垂直领域应用时面临以下挑战:
- 缺乏严谨推理能力:LLM 在处理复杂问题时容易出现逻辑错误或答案不一致。
- 事实和逻辑错误:LLM 在生成内容时可能引入错误信息,尤其是在处理专业领域知识时。
- 幻觉问题:即使引入外部知识库(如 RAG 技术),LLM 仍可能产生误导性或错误的输出。
- 专业知识服务的高要求:垂直领域需要准确、逻辑严谨且具备完整上下文的知识服务。
二、论文思路
- KAG 框架概述
KAG 框架通过以下五个关键方面增强 LLM 和知识图谱的结合:
- LLM 友好的知识表示(LLM-Friendly Knowledge Representation):提出了 LLMFriSPG 框架,支持无模式(schema-free)和有模式(schema-constrained)的知识表示,提升知识图谱对 LLM 的友好性。
- 知识图谱与文本块的互索引(Mutual Indexing):构建知识图谱与原始文本块之间的双向索引,支持基于图结构的倒排索引和语义关联。
- 逻辑形式引导的混合推理引擎(Logical-Form-Guided Hybrid Reasoning Engine):通过逻辑形式(Logical Form)将自然语言问题分解为可执行的符号表达式,结合知识图谱推理和文本检索。
- 基于语义推理的知识对齐(Knowledge Alignment with Semantic Reasoning):通过语义关系(如同义词、上下位关系)对齐知识图谱中的碎片化知识,提升知识的标准化和连贯性。
- KAG 模型(KAG-Model):增强 LLM 的自然语言理解(NLU)、自然语言推理(NLI)和自然语言生成(NLG)能力,以支持框架中的各个模块。
- 方法细节
- LLM 友好的知识表示。LLMFriSPG 框架通过深度文本上下文感知、动态属性和知识分层,支持从数据到信息再到知识的层次化表示。它结合了实体类型、事件类型、概念类型和逻辑规则,支持知识图谱的灵活构建和语义推理。
- 互索引。KAG 通过开放信息抽取(OpenIE)和语义对齐,构建知识图谱与文本块之间的互索引结构。该结构支持跨文档链接,通过实体和关系实现知识的语义关联。
- 逻辑形式引导的混合推理引擎。KAG 的推理引擎通过逻辑形式将问题分解为多个子问题,并利用知识图谱和文本检索进行混合推理。逻辑形式支持精确匹配、文本检索、数值计算和语义推理等多种操作。
- 知识对齐。KAG 通过语义关系(如同义词、上下位关系)对知识图谱中的知识进行对齐,提升知识的标准化和连贯性。这一过程包括实体消歧、概念链接和语义关系补全。
- KAG 模型。KAG 模型通过增强 LLM 的 NLU、NLI 和 NLG 能力,支持框架中的各个模块。实验表明,KAG 模型在自然语言理解、语义推理和文本生成任务中显著优于基线模型。
三、实验设计与结果
KAG 在多个多跳问答数据集(如 HotpotQA、2WikiMultiHopQA 和 MuSiQue)上进行了评估,结果表明其性能显著优于现有的 RAG 方法。具体而言,KAG 在 HotpotQA 上的 F1 分数相对提升了 19.6%,在 2Wiki 上提升了 33.5%。
KAG 已成功应用于蚂蚁集团的两个专业领域问答场景:
- 电子政务问答和电子健康问答。
- 在电子政务场景中,KAG 的准确率从传统的 66% 提升至 91.6%;
- 在电子健康场景中,KAG 的准确率超过 80%,在某些指标解读任务中达到 93%。
四、论文总结
RAG中向量相似性与知识推理的相关性之间的差距,以及对知识逻辑(如数值、时间关系、专家规则等)不敏感阻碍了专业知识服务的有效性。KAG的设计目的是充分利用知识图谱(KG)和向量检索的优势来应对上述挑战,并通过五个关键方面双向增强大型语言模型(LLM)和知识图谱来提高生成和推理性能:(1)对LLM友好的知识表示,(2)知识图谱与原始块之间的相互索引,(3)逻辑形式引导的混合推理引擎,(4)与语义推理的知识对齐,(5)KAG的模型能力增强。
FILCO【筛选师】
筛选师:像个严谨的编辑,善于从大量文本中识别并保留最有价值的信息,确保传递给AI的每段内容都精准且相关。
- 发表时间:2024.11.14
- 论文名称:Learning to Filter Context for Retrieval-Augmented Generation
- 论文地址:https://arxiv.org/abs/2311.08377
- Github 地址:https://github.com/zorazrw/filco
一、论文动机
检索增强型生成(RAG)在开放域问答、事实验证等知识密集型任务中表现出色,但检索系统并不完美,常常会返回部分或完全不相关的段落。这导致生成模型需要在不完全相关的上下文中生成输出,容易产生幻觉(hallucinations)或错误记忆。为了解决这一问题,FILCO 提出了一种上下文过滤方法,通过细粒度的句子级过滤来提高生成质量。
二、论文思路
- 上下文过滤的核心思想
FILCO 的目标是在生成之前过滤掉不相关的上下文内容,只保留对生成任务真正有用的部分。为此,作者提出了三种方法来选择“有用”的上下文:
- 字符串包含(String Inclusion, STRINC):判断文本片段是否包含输出文本,适用于支持文档中包含确切输出文本的情况。
- 词汇重叠(Lexical Overlap, LEXICAL):计算示例与候选文本片段之间的单词重叠度,适用于需要基于知识生成回答的任务。
- 条件互信息(Conditional Cross-Mutual Information, CXMI):衡量生成模型在有无上下文支持下生成预期输出的概率差异,适用于所有任务。
- 上下文过滤模型的训练
为了在测试时应用上下文过滤,作者训练了一个上下文过滤模型(Mctx),使用上述三种方法选择的上下文作为训练数据。训练数据通过将检索到的段落与查询拼接作为输入,过滤后的上下文作为输出来构建。
- 过滤后的上下文用于生成
在训练阶段,使用过滤后的上下文(tsilver)来训练生成模型(Mgen)。在推理阶段,使用模型预测的过滤上下文(tpred)作为输入,生成最终输出。
三、实验设计与结果
- 实验设计:实验使用了 FLAN-T5 和 LLAMA2 作为基础模型,分别用于上下文过滤和最终生成任务。所有模型均在相同的实验设置下进行微调。
- 实验结果
- 性能提升:FILCO 在所有六个任务上均优于基线方法(全段落增强和段落级过滤)。与全段落增强相比,FILCO 在提取式问答任务上平均提升了 4.3%(NQ)和 1.1%(TQA)的精确匹配(EM)分数;在复杂问答任务上提升了 1.0%(HotpotQA)和 0.6%(ELI5)的 F1 分数;在事实验证和对话生成任务上分别提升了 6.2% 和 3.5% 的准确率。
- 输入长度减少:FILCO 通过过滤上下文显著减少了输入长度,降低了计算成本。与全段落增强相比,FILCO 将输入长度减少了 44%-64%。
- 上下文精度提升:过滤后的上下文在所有任务中都显示出更高的单词精度,尤其是在复杂任务中,如 HotpotQA 和 Wizard of Wikipedia。
- 不同上下文过滤策略的比较
- 任务适应性:不同的任务对上下文过滤策略的偏好不同。例如,提取式问答任务(NQ 和 TQA)更适合使用 STRINC;对话生成任务(Wizard of Wikipedia)更适合使用 LEXICAL;而更复杂的任务(如 FEVER、HotpotQA 和 ELI5)更适合使用 CXMI。
- 模型适应性:FLAN-T5 和 LLAMA2 在大多数任务上表现一致,但在某些任务上存在差异,如 ELI5。
- 多段落设置下的实验。作者进一步在多段落设置下验证了 FILCO 的有效性,发现即使在整合多个段落作为上下文输入时,FILCO 仍然优于基线方法,证明了其在复杂任务中的泛化能力。
四、论文总结
FILCO 通过细粒度的上下文过滤显著提高了检索增强型生成模型的性能,减少了不相关或干扰性内容对生成任务的影响。该方法在多个知识密集型任务上表现出色,尤其是在提取式问答、事实验证和对话生成任务中。通过选择合适的上下文过滤策略,FILCO 为不同任务提供了有效的解决方案,为未来知识增强型生成任务的发展提供了新的思路。
LazyGraphRAG【精算师】
精算师:能省一步是一步,把贵的大模型用在刀刃上。就像个会过日子的主妇,不是看到超市打折就买,而是货比三家后才决定在哪里花钱最值。
- 发表时间:2024.11.25
- 论文名称:A modular graph-based Retrieval-Augmented Generation (RAG) system
- 论文地址:https://microsoft.github.io/graphrag/
- Github 地址:https://github.com/microsoft/graphrag
一、论文动机
微软之前开源的GraphRAG在数据索引阶段,主要利用大型模型提取和描述实体及其关系,并为每个实体和关系生成摘要。
优化实体图并提取层次化社区结构是一个涉及图统计的过程,然而,这种方法的成本非常高昂。其原因是它需要使用大量的语言模型进行处理,导致GraphRAG的数据索引成本非常昂贵。
与GraphRAG不同的是,LazyGraphRAG在数据索引阶段不进行任何预先的总结或嵌入生成。相反,它利用NLP名词短语提取来识别概念及其共现关系。然后,通过图统计来优化概念图,并提取层次社区结构。这种方法使得LazyGraphRAG的索引成本极低,仅为GraphRAG的0.1%。也就是说,LazyGraphRAG将成本降低了1000倍。
在查询处理方面,GraphRAG使用广度优先搜索确保考虑整个数据集的广泛性。而LazyGraphRAG则采用迭代加深的方式,结合了最佳优先搜索和广度优先搜索的动态。它首先按相似度对文本片段进行排名,然后通过动态选择相关社区,逐步细化查询结果。
通过这种方法,LazyGraphRAG能够同时支持本地和全局查询,在考虑整个数据集的广度的同时,高效地找到最佳匹配的文本块。
二、论文思路
- LazyGraphRAG 的工作原理
LazyGraphRAG 结合了向量 RAG 和 GraphRAG 的优点,同时克服了它们的局限性:
- 向量 RAG:擅长处理本地查询,但无法处理全局查询。
- GraphRAG:擅长处理全局查询,但索引成本较高。
- LazyGraphRAG 的关键机制包括:
- 延迟索引构建:使用 NLP 名词短语提取来提取概念及其共现,而不是使用 LLM 提取和总结实体及其关系。
- 优化查询:使用 LLM 识别相关子查询并优化查询。
- 匹配查询:结合文本块嵌入和块-社区关系,首先按与查询的相似性对文本块进行排名,然后按其排名靠前的社区排名对社区进行排名。
- 答案生成:从相关文本块构建概念子图,并使用 LLM 从相关块组中提取与子查询相关的声明。
三、实验设计与结果
LazyGraphRAG 在多个任务中表现出色:
- 数据集:5,590 篇美联社新闻文章。
- 查询:100 个综合查询(50 个本地查询和 50 个全局查询)。
- 指标:全面性、多样性、赋权。
实验结果表明:
- 在 100 次相关性测试 的最低预算下,LazyGraphRAG 在本地和全局查询上均优于所有竞品,除了全局查询的 GraphRAG 全局搜索。
- 在 500 次相关性测试 的预算下,LazyGraphRAG 在本地和全局查询上均优于所有竞品。
- 随着相关性测试预算增加到 1,500,LazyGraphRAG 的胜率不断提高,证明了其在成本与质量方面的可扩展性。
四、论文总结
LazyGraphRAG 是一种新型的图谱增强检索生成方法,通过优化索引和查询机制,显著降低了成本,同时保持或超越了现有方法的查询质量。它适用于多种用例,尤其是需要快速查询和低索引成本的场景。LazyGraphRAG 的灵活性和可扩展性使其成为未来知识检索和生成任务的有力工具。
2025.02
DeepRAG 【智能检索决策专家】
【智能检索决策专家】:帮助大语言模型(LLM)在面对复杂问题时,能够像人类一样智能地决定何时需要检索外部知识,何时依赖自身知识进行推理,从而提升回答的准确性和效率。
- 发表时间:2024.11.03
- 论文名称:DeepRAG: Thinking to Retrieval Step by Step for Large Language Models
- 论文地址:https://arxiv.org/pdf/2502.01142
- Github 地址:
一、论文动机
传统RAG的困境:检索增强生成(RAG)是解决大语言模型幻觉问题的重要技术,但现有RAG方法存在两个核心痛点:
- 问题一:任务分解无效:问题拆解不合理,导致盲目检索和缺乏决策机制。
- 问题二:过度检索:检索过多无关信息,增加噪音,反而降低回答准确率。
这种问题本质上是因为现有RAG缺乏“智能检索决策”能力——而DeepRAG正是为了解决这一痛点而生。
二、论文思路
DeepRAG的核心思想很简单——让大模型像人一样,在每一步决策是否需要检索,而不是机械地调用外部知识库。
2.1 马尔可夫决策过程(MDP)
马尔可夫决策过程(MDP):DeepRAG将检索增强推理建模为MDP,让系统在每个推理步骤动态决定是否需要检索,从而优化检索效率和答案质量。
- 如果大模型“知道”答案,就直接用参数化知识推理。
- 如果大模型“不确定”,才触发检索,并精准选择最相关的信息。
- 这个决策是动态的,不会一开始就把所有问题都丢给检索系统。
这一机制让DeepRAG能够更精准地控制检索过程,减少不必要的噪音。
2.2 逐步查询
逐步查询:采用逐步查询方式,分阶段检索,避免一次性检索带来的信息冗余和干扰。
2.3 智能决策
智能决策:允许LLM自己决定是靠“已有知识”回答还是“去外部找答案”,减少检索冗余。
三、实验设计与结果
DeepRAG实测提升准确率21.99%
- 准确率提升:DeepRAG在多个基准数据集上准确率提升21.99%。
- 检索效率提升:检索效率提升35.7%,减少了外部知识库的调用次数。
- 噪音减少:由于逐步检索,噪音减少了40%,答案更加聚焦。
四、论文总结
DeepRAG通过引入智能检索决策机制,解决了传统RAG的痛点,显著提升了大语言模型的准确率和检索效率。它不仅是一个技术突破,也为未来RAG技术的发展提供了一个全新的起点。
PathRAG:通过图剪枝的方法优化Graph-based RAG的性能方法浅析
【关系路径探索者”(Relational Path Explorer)】:
- 发表时间:2025.03.10
- 论文名称:PathRAG: Pruning Graph-based Retrieval Augmented Generation with Relational Paths
- 论文地址:https://arxiv.org/abs/2502.14902
- Github 地址:https://github.com/BUPT-GAMMA/PathRAG
一、论文动机
在自然语言处理领域,基于图的检索增强生成(Graph-based RAG)方法在处理复杂关系数据时具有重要价值。
然而,现有的基于图的检索增强生成(Graph-based RAG)方法存在一些不足:
- GraphRAG方法:通过社区检测算法对图进行分割并聚合信息时,可能会引入大量冗余信息,无法有效利用复杂的关系路径;
- LightRAG方法:虽然采用双阶段检索框架,从局部和全局级别检索相关信息,提高了检索效率,但仍然可能包含不必要的信息。
为了解决这些问题,PathRAG应运而生,旨在通过检索索引图中的关键关系路径来减少噪声并优化LLM提示,从而提高生成答案的质量。
二、论文思路
PathRAG的核心创新在于基于流的剪枝算法和路径为基础的提示策略,其方法论分为三个主要阶段:
- 节点检索阶段:从用户查询中使用LLM提取关键词,然后通过密集向量匹配(使用余弦相似度)检索相关节点,将节点和关键词编码为嵌入,从而检索到一定数量的相关节点。
- 路径检索阶段:设计了一种基于流的剪枝算法,提取每对检索节点之间的关键关系路径,然后检索可靠性得分最高的路径;
- 答案生成阶段:检索到的路径按照可靠性得分升序排列放入提示中,最后输入到大型语言模型中进行答案生成。
2.1 节点检索阶段
从用户查询 q 中使用 LLM 提取关键词,记为 $K_q$。
通过密集向量匹配(使用余弦相似度)检索相关节点,将节点和关键词编码为嵌入 $X_V$ 和 $X_q$。
检索 N 个相关节点,N 可选值包括 {10, 20, 30, 40, 50, 60},结果子集为 $V_q⊆V$,其中 V 是索引图的节点集。
2.2 路径检索阶段
2.2 答案生成阶段
将选定路径转化为文本形式,路径文本通过连接节点和边块生成:
按可靠性升序排列路径,提示为:
这种排序策略解决了“中间丢失”问题,确保 LLM 关注最相关信息(LLM使用 “GPT-4o-mini” 作为所有 LLM 组件,索引图与 GraphRAG相同。)。
三、实验设计与结果
实验结果表明,PathRAG在减少冗余信息和提高生成答案质量方面表现出色。与GraphRAG和LightRAG相比,PathRAG能够更好地捕捉节点之间的关系,生成的答案更具准确性和相关性。其基于流的剪枝算法和路径提示策略有效地减少了噪声,使得LLM能够更专注于关键信息,从而提升了整体性能。
四、论文总结
PathRAG作为一种新型的Graph-based RAG方法,通过其独特的基于流的剪枝算法和路径提示策略,在处理复杂关系数据时展现出了显著的优势。它不仅减少了冗余信息,提高了生成答案的质量,还为自然语言处理领域中关系数据的处理提供了一种新的思路和方法。未来,PathRAG有望在更多实际应用场景中发挥重要作用,进一步推动自然语言处理技术的发展。
2025.03
R1-Searcher: 推理与搜索结合,用强化学习打破LLMs推理知识局限!
【检索增强者”(Search-Enhancer)】:R1-searcher 是一种利用强化学习来提升大型语言模型 (LLMs) 搜索能力的方法。它主要解决了LLMs在面对需要大量外部知识,尤其是多跳问题和时效性问题时,缺乏必要知识的问题。R1-searcher通过两阶段的、基于结果监督的强化学习,让模型学会在推理过程中调用网络搜索,以获取外部信息。
- 发表时间:2025.03.10
- 论文名称:R1-Searcher: Incentivizing the Search Capability in LLMs via Reinforcement Learning
- 论文地址:https://arxiv.org/pdf/2503.05592
- Github 地址:https://github.com/SsmallSong/R1-Searcher
- 模型:
- Qwen-2.5-7B-Base-RAG-RL: https://huggingface.co/XXsongLALA/Qwen-2.5-7B-base-RAG-RL
- Llama-3.1-8B-Instruct-RAG-RL: https://huggingface.co/XXsongLALA/Llama-3.1-8B-instruct-RAG-RL
- 训练数据:https://huggingface.co/datasets/XXsongLALA/RAG-RL-Hotpotqa-with-2wiki
一、论文动机
现有的大型推理模型(LRMs)和大型语言模型(LLMs)在复杂推理任务中表现出色,但它们主要依赖内部知识来解决问题。这种依赖在处理时效性强、知识密集型问题或涉及私有信息时显得不足,容易导致不准确性和幻觉现象。
为了解决这一问题,研究者提出了R1-Searcher,一种基于强化学习(RL)的两阶段方法,旨在增强LLMs的搜索能力,使其能够在推理过程中自主调用外部搜索系统以获取额外知识。
二、论文思路
R1-Searcher框架通过以下方法实现:
2.1 两阶段强化学习方法
- 第一阶段:训练模型有效利用外部检索系统。奖励由检索奖励(retrieval-reward)和格式奖励(format-reward)组成,鼓励模型学会调用工具的格式。
- 第二阶段:训练模型在推理过程中整合检索以准确解答问题。检索奖励被替换为答案奖励(answer-reward),基于标准答案和预测答案的F1-Score,鼓励模型正确调用工具解决问题。
2.2 改进的Reinforce++算法
另外,R1-Searcher框架 对Reinforce++算法进行了修改以适应检索增强生成场景。
- 目标:让模型在面对不确定性时能够自主获取外部知识,从而有效整合推理和检索。
为了无缝整合检索到的文档并确保模型优化的合理性,R1-Searcher框架 对原始算法进行了两项改进:RAG-based Rollout和Retrieval Mask-based Loss Calculation:
- RAG-based Rollout:
- 思路:通过特定标签<begin_of_query>...<end_of_query>引导模型在生成过程中调用外部检索系统。即捕捉到模型需要进行检索时,推理暂停并进行检索。检索到的文档被封装在<begin_of_documents>...<end_of_documents>标签中,并整合到模型的推理过程中。
- 优点:这种方法确保检索无缝融入推理过程,使模型能够基于检索到的文档继续推理,而不被打断。
- Retrieval Mask-based Loss Calculation:
- 动机:当模型执行检索时,检索到的文档作为环境观察的一部分被整合到推理过程中。然而,模型并不需要自主生成这些文档。
- 思路:为了减少环境的影响,R1-Searcher 将<begin_of_documents>...<end_of_documents>指定为特殊标记,并在训练中对其进行掩码处理。这可以防止这些外部标记影响损失计算,确保检索到的文档不会干扰模型的内在推理和生成过程。
三、实验设计与结果
R1-Searcher在多个任务上展示了显著的性能提升:
-
多跳问答任务:
- 在HotpotQA上性能提升48.2%。
- 在2WikiMultiHopQA上性能提升21.7%。
- 在Bamboogle上性能提升4.0%(LLM-as-Judge)。
-
无需冷启动:
- 从基础LLM开始进行RL学习,无需冷启动,且在多数领域内和领域外的数据集上获得最佳性能,甚至超过闭源的LLM(如GPT-4o-mini)。
-
泛化能力:
- 仅使用8148个样本进行RL训练,模型不仅在领域内数据集表现出色,还在领域外数据集(如Musique和Bamboogle)上展示了强大的泛化能力。
-
联网搜索能力:
- 在Bamboogle任务上进行联网搜索测试,性能提升显著,表明模型能够适应在线搜索场景。
四、论文总结
R1-Searcher通过强化学习方法显著提升了LLMs在推理过程中的检索能力,解决了现有模型在处理知识密集型问题时的局限性。该方法无需冷启动,具有强大的泛化能力,并在多跳问答任务中取得了显著的性能提升。R1-Searcher为未来LLMs的推理能力提升提供了新的思路,特别是在结合外部知识和检索能力方面。
五、对比分析
- GRPO和Reinforce++算法的比较
GRPO的生成solution更长和检索频率更高。GRPO在领域外测试数据集(如Bamboogle)上也展现出更好的性能;而Reinforce++在领域内测试集(如HotpotQA和2Wiki)上表现更优。
- RL和SFT的比较
RL在领域内和领域外的测试集上均优于SFT。SFT能够帮助模型生成检索查询,但这些查询的时机和相关性不如通过RL训练生成的查询。
- Reward的设计对训练的影响
基于F1的答案奖励能够产生更长的回答长度和更优的最终结果;基于EM的奖励在训练过程中导致回答长度较短,并且在测试时表现不如基于CEM或F1的奖励;基于CEM的奖励会生成带有不必要信息的偏长的answer。
- 数据难度分布和数据多样性对训练的影响
使用混合数据集训练的模型在检索次数和生成回答长度上都有所增加,并且在测试集上取得了更高的分数;训练数据中混入较高难度的数据可以在领域内和领域外的测试集上均取得更好的效果。
六、R1-searcher 的使用场景
R1-searcher适用于以下场景:
- 知识密集型任务:需要大量外部知识才能解决的问题,例如:
- 问答任务:复杂的多跳问答,需要从多个来源提取信息才能找到答案。
- 时效性问题:需要最新信息的任务,例如事件追踪、新闻摘要等。
- 需要可解释性的任务:通过搜索过程,模型可以提供其答案的依据,提高可解释性。
- 希望提升LLMs准确率的任务:尤其是在知识范围有限或需要更新知识的情况下,搜索可以显著提高准确率。
- 通用问答:在没有充分训练数据的特定领域,通过检索可以有效补充知识,提高回答质量。
总而言之,R1-searcher适用于任何需要LLM 利用外部信息来增强其推理能力和知识范围的场景。它通过强化学习驱动模型自主学习,使其具备更强的搜索能力和更可靠的答案生成能力。
七、R1-searcher 的不足
- 数据依赖性:虽然 R1-Searcher 展现出良好的泛化能力,但训练数据的分布和难度仍然对模型性能有显著影响,如何进一步优化数据选择和课程学习策略以提升模型性能仍有待研究。
- 模型规模限制:当前的实验主要在 7B 参数的模型上进行,未来需要进一步扩展到更大规模的模型(如 32B 或更大),以更全面地评估 R1-Searcher 在更大模型上的效果。
- 奖励函数设计:虽然两阶段奖励机制有效,但更精细化的奖励函数设计,例如考虑检索结果的相关性、多样性等因素,可能会进一步提升模型性能。
- 在线搜索的效率和成本:尽管 R1-Searcher 能够应用于在线搜索,但使用 Google API 等在线搜索服务可能涉及效率和成本问题,如何更高效、经济地利用在线搜索资源仍需进一步探索。
致谢
一、论文动机
二、论文思路
三、实验设计与结果
四、论文总结
Similar repos
Contributors
9 commits