
the resources about the application based on LLM with RAG pattern
1,659
88 commits
updated Mar 10, 2026
README
Awesome LLM RAG Application

Awesome LLM RAG Application is a curated list of application resources based on LLM with RAG pattern. (latest update: 2025-12-19)
综述
论文
论文顺序由近及远
-
2025.08.19 基于大模型的Deep Search智能体综述
-
2025.08.18 Deep Research: 自治型研究智能体综述
-
2025.08.13 Open Deep Research的优化和演进
-
2025.07.03 从网页搜索到智能体特性的深度研究功能:通过推理智能体优化搜索
-
2025.06.22 Deep Research Agents 总结
-
《Deep Research Agents: A Systematic Examination And Roadmap》
详情
-
2025.06.14 Deep Research 总结
https://arxiv.org/abs/2506.18096
-
2025.02.04 Agentic RAG 总结
-
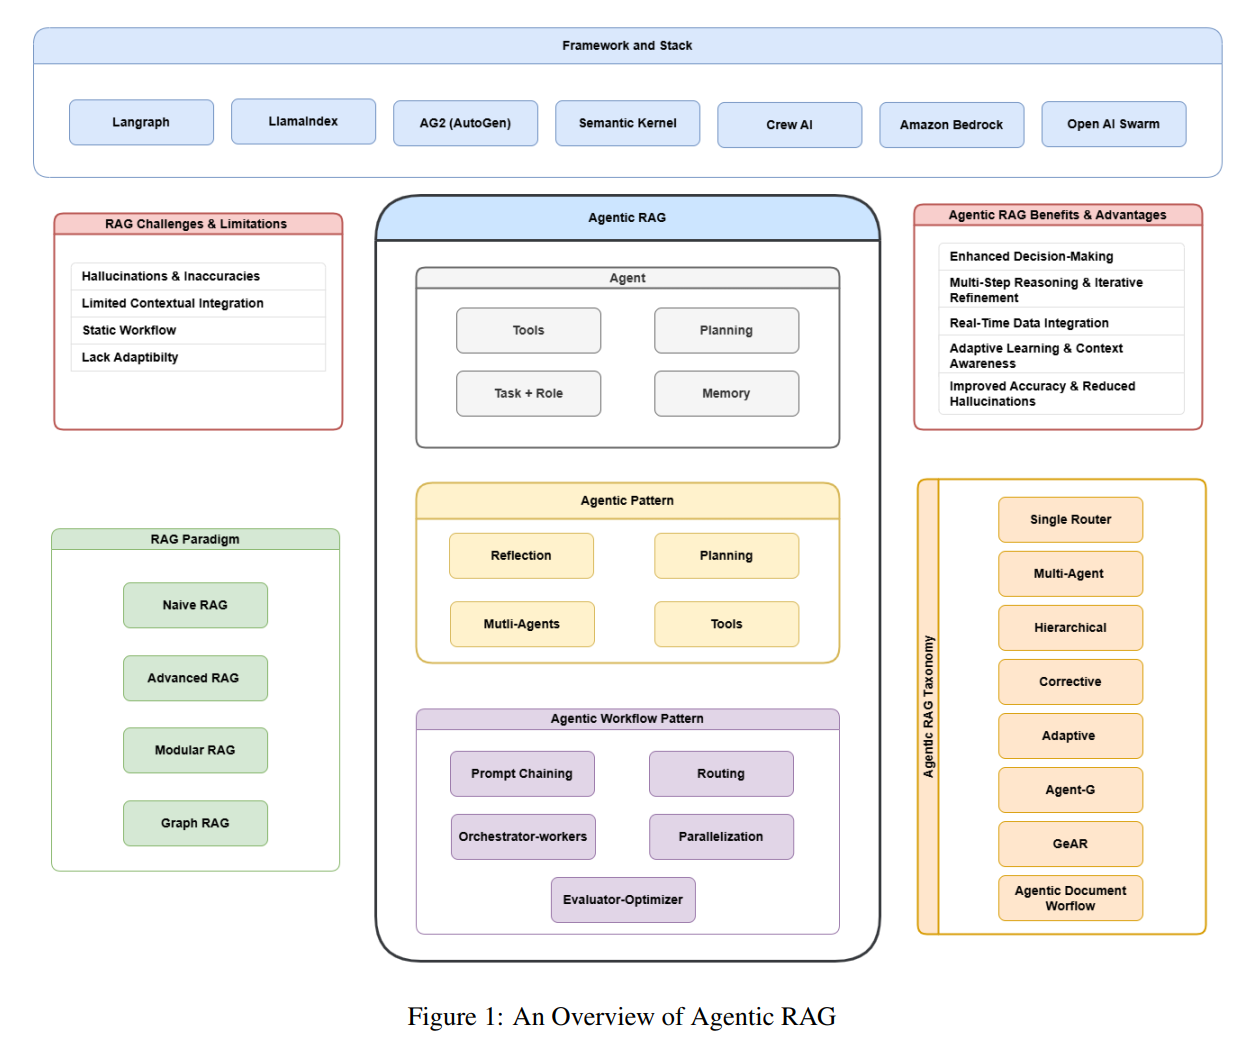
《Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG》
详情
https://arxiv.org/abs/2501.09136
- 核心原理与机制:阐释Agentic RAG的基础概念及核心Agentic机制,包括反思(reflection)、规划(planning)、工具调用(tool use) 与多智能体协作(multi-agent collaboration)。
- 系统分类框架:构建Agentic RAG的详细分类体系,涵盖单智能体(single-agent)、多智能体(multi-agent)、层次化(hierarchical)、纠错型(corrective)、自适应(adaptive) 及图结构驱动(graph-based RAG) 等不同架构。
- 横向对比分析:系统比较传统RAG、Agentic RAG与智能体文档工作流(ADW) 的优劣势及适用场景。
- 落地应用案例:探索Agentic RAG在医疗诊断、个性化教育、金融风控、法律合规等行业的实际应用。
- 挑战与发展趋势:探讨该领域面临的系统可扩展性、AI伦理规范、多模态融合、人机协同模式等关键问题及未来方向。
-
-
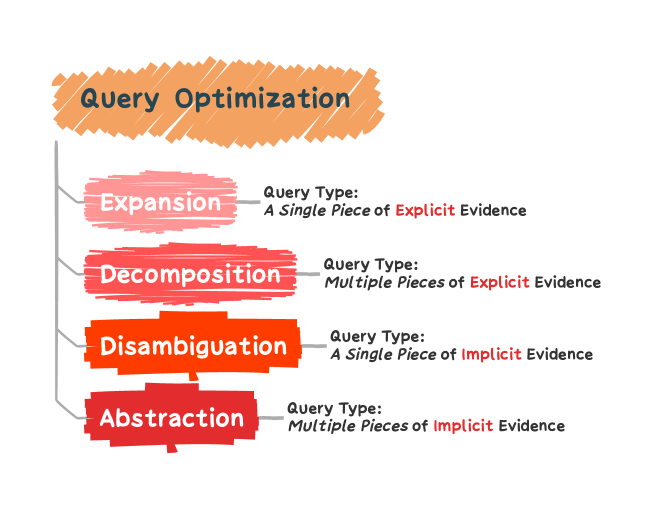
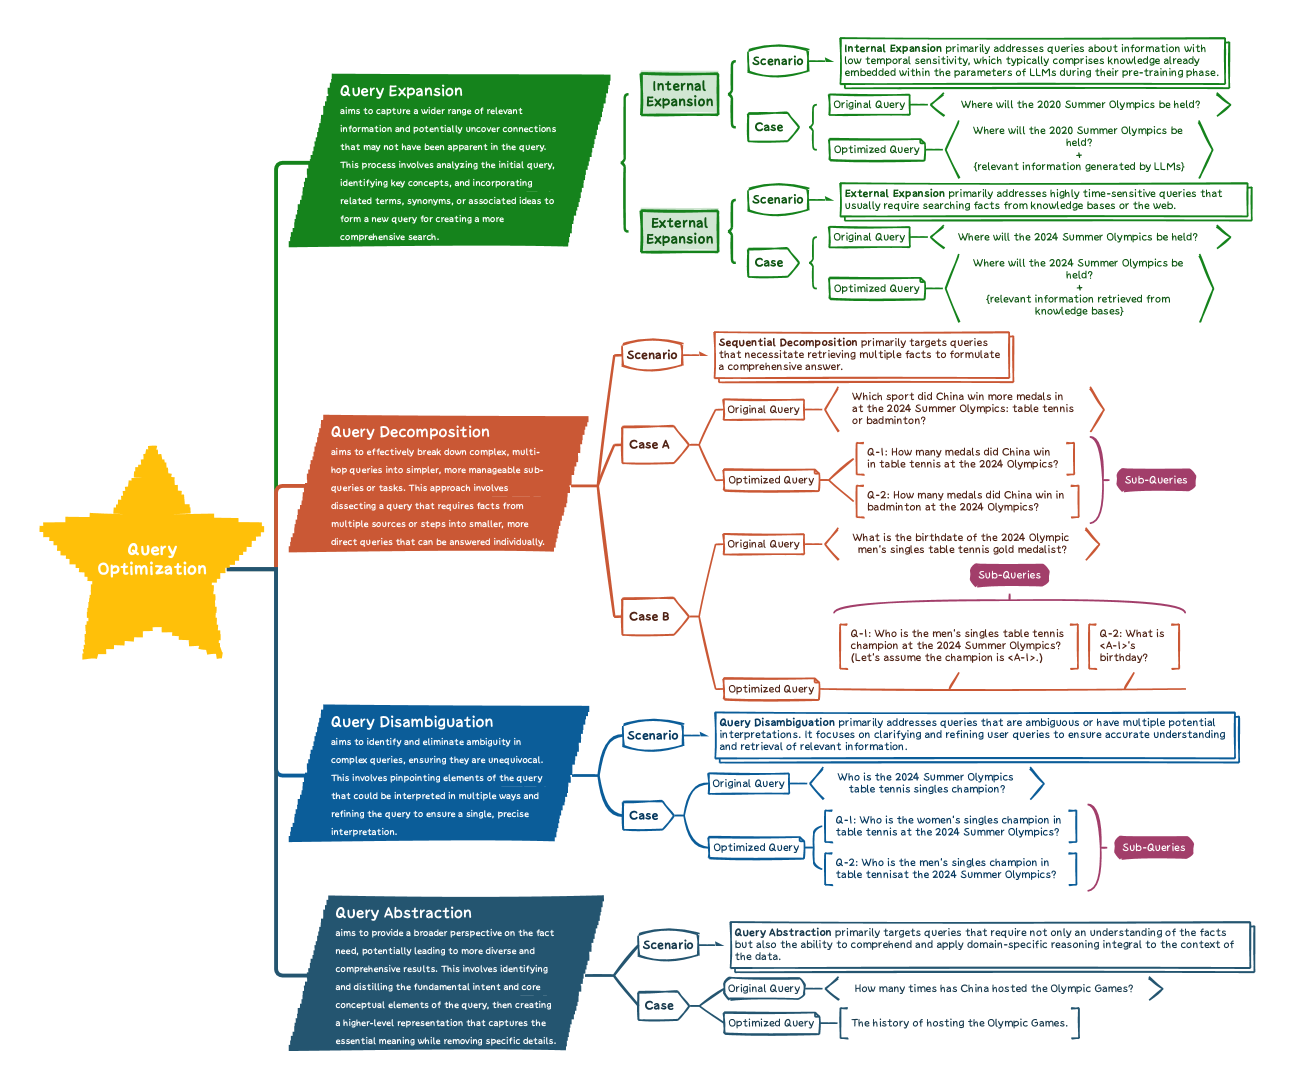
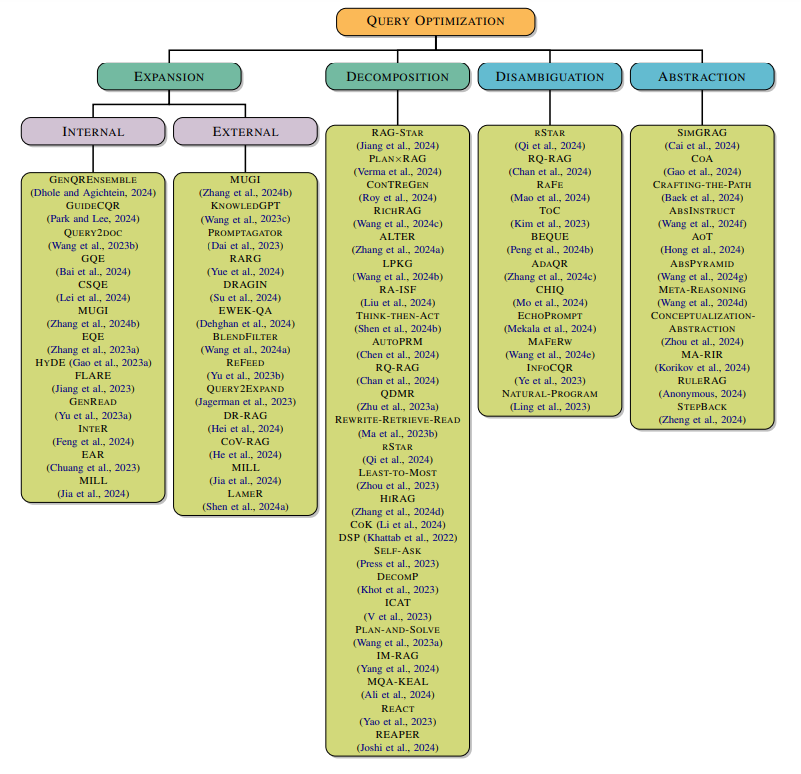
2024.12.23 RAG中的查询优化技术总结
-
2024.10.23 RAG技术演进的回顾总结
-
详情
https://arxiv.org/abs/2410.12837全面研究检索增强生成(RAG)技术,追溯其从基础概念到当前状态的演变过程
-
-
2024.09.23 综述RAG数据利用方案
- 《Retrieval Augmented Generation (RAG and Beyond: A Comprehensive Survey on How to Make your LLMs use External Data More Wisely)》
详情
https://arxiv.org/abs/2409.14924 探讨了如何通过外部数据增强大模型(LLMs)的能力。
- 《Retrieval Augmented Generation (RAG and Beyond: A Comprehensive Survey on How to Make your LLMs use External Data More Wisely)》
-
2024.08.15 综述GraphRAG方案
-
《Graph Retrieval-Augmented Generation: A Survey》
详情
- https://arxiv.org/abs/2408.08921
- 系统性地回顾了Graph Retrieval-Augmented Generation (GraphRAG) 的现状和发展方向。
-
-
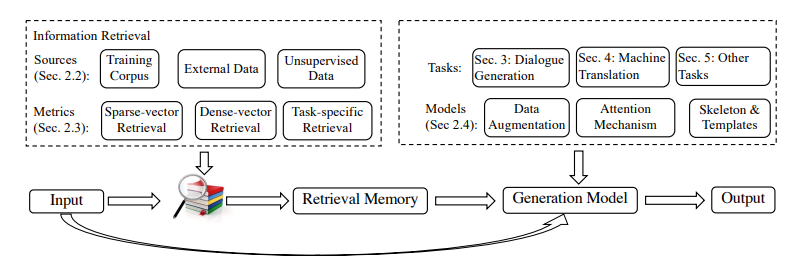
2024.07.18 综述RAG用于NLP自然语言处理
-
《Retrieval-Augmented Generation for Natural Language Processing: A Survey》
- https://arxiv.org/abs/2407.13193详情
-
-
2024.05.13 综述RAG的评估
-
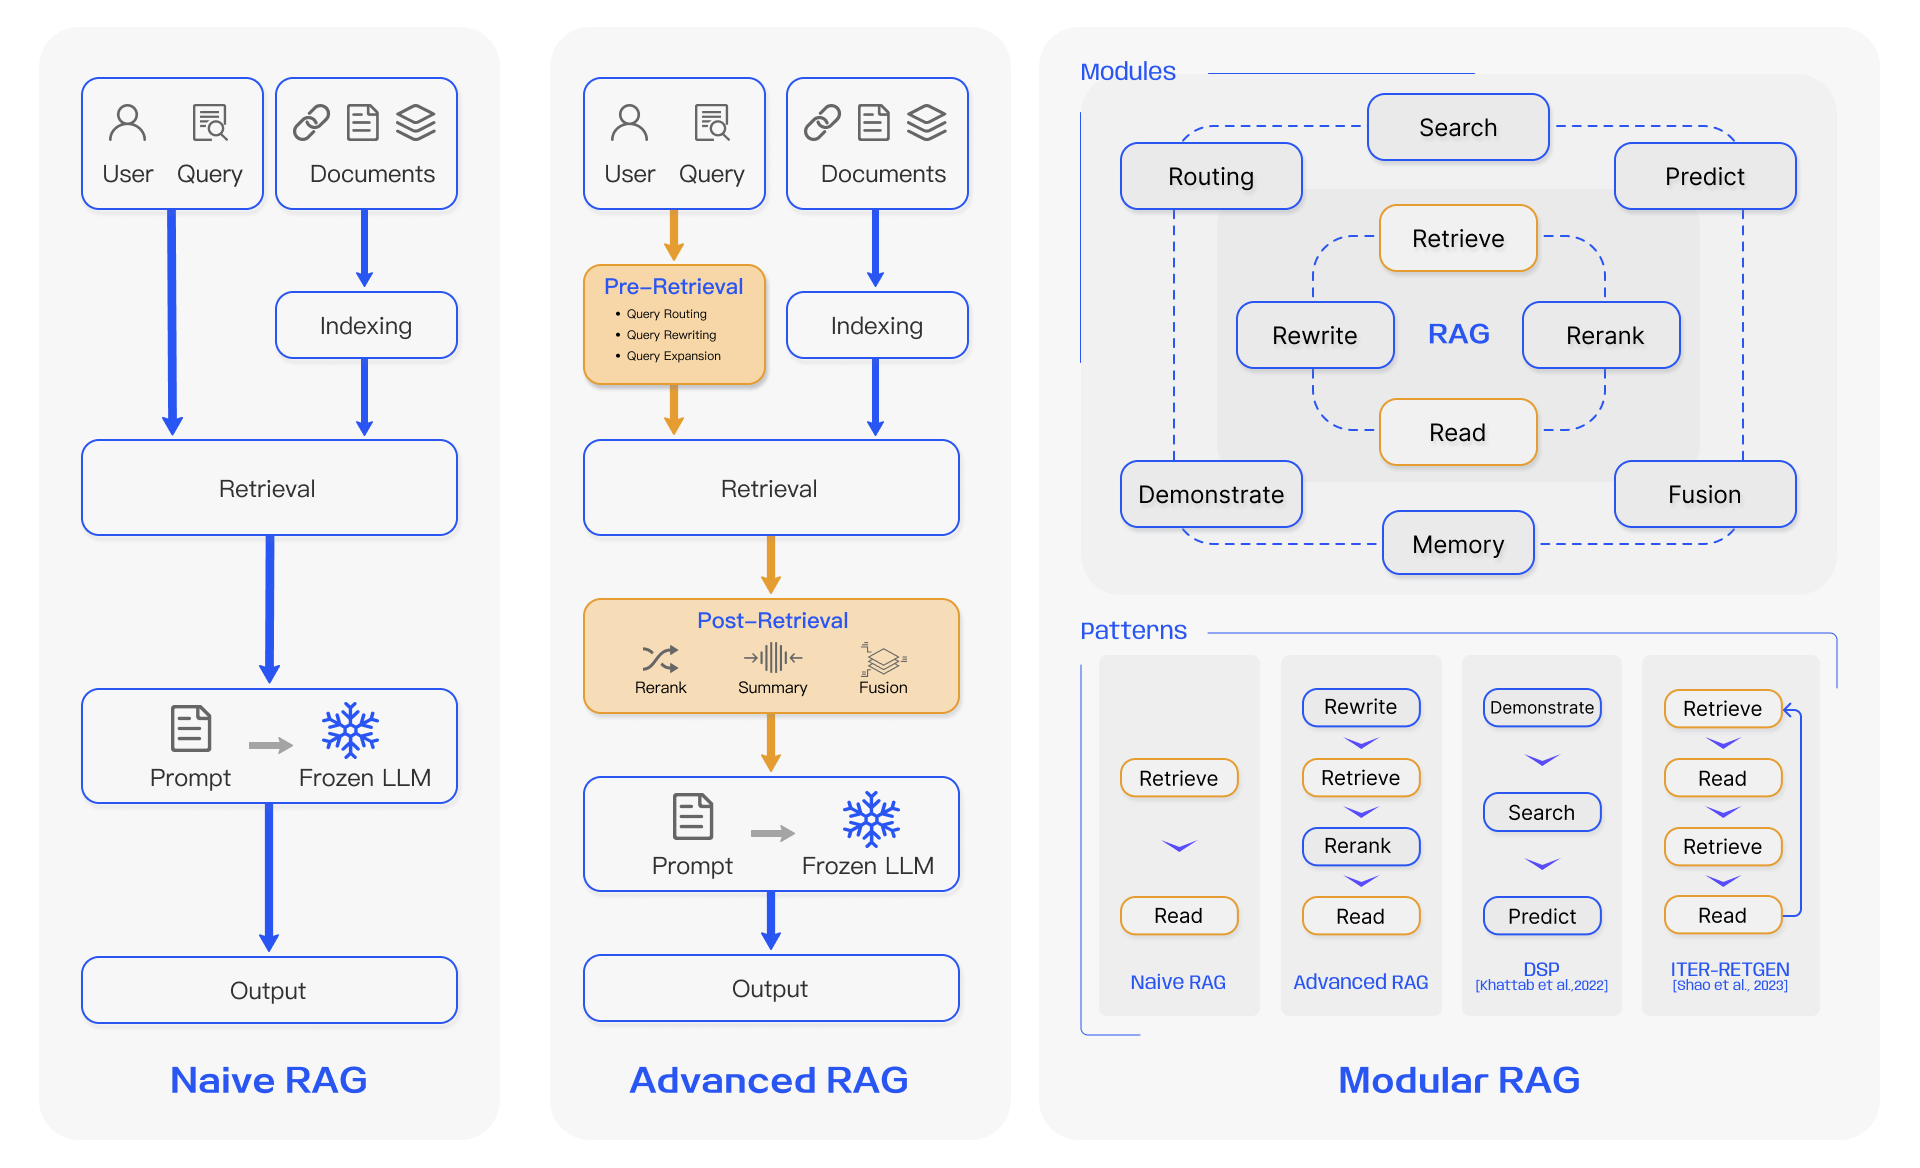
2024.05.10 综述RAG与LLM的结合范式
-
《A Survey on RAG Meeting LLMs: Towards Retrieval-Augmented Large Language Models》
详情
- 地址:https://arxiv.org/abs/2405.06211
-
-
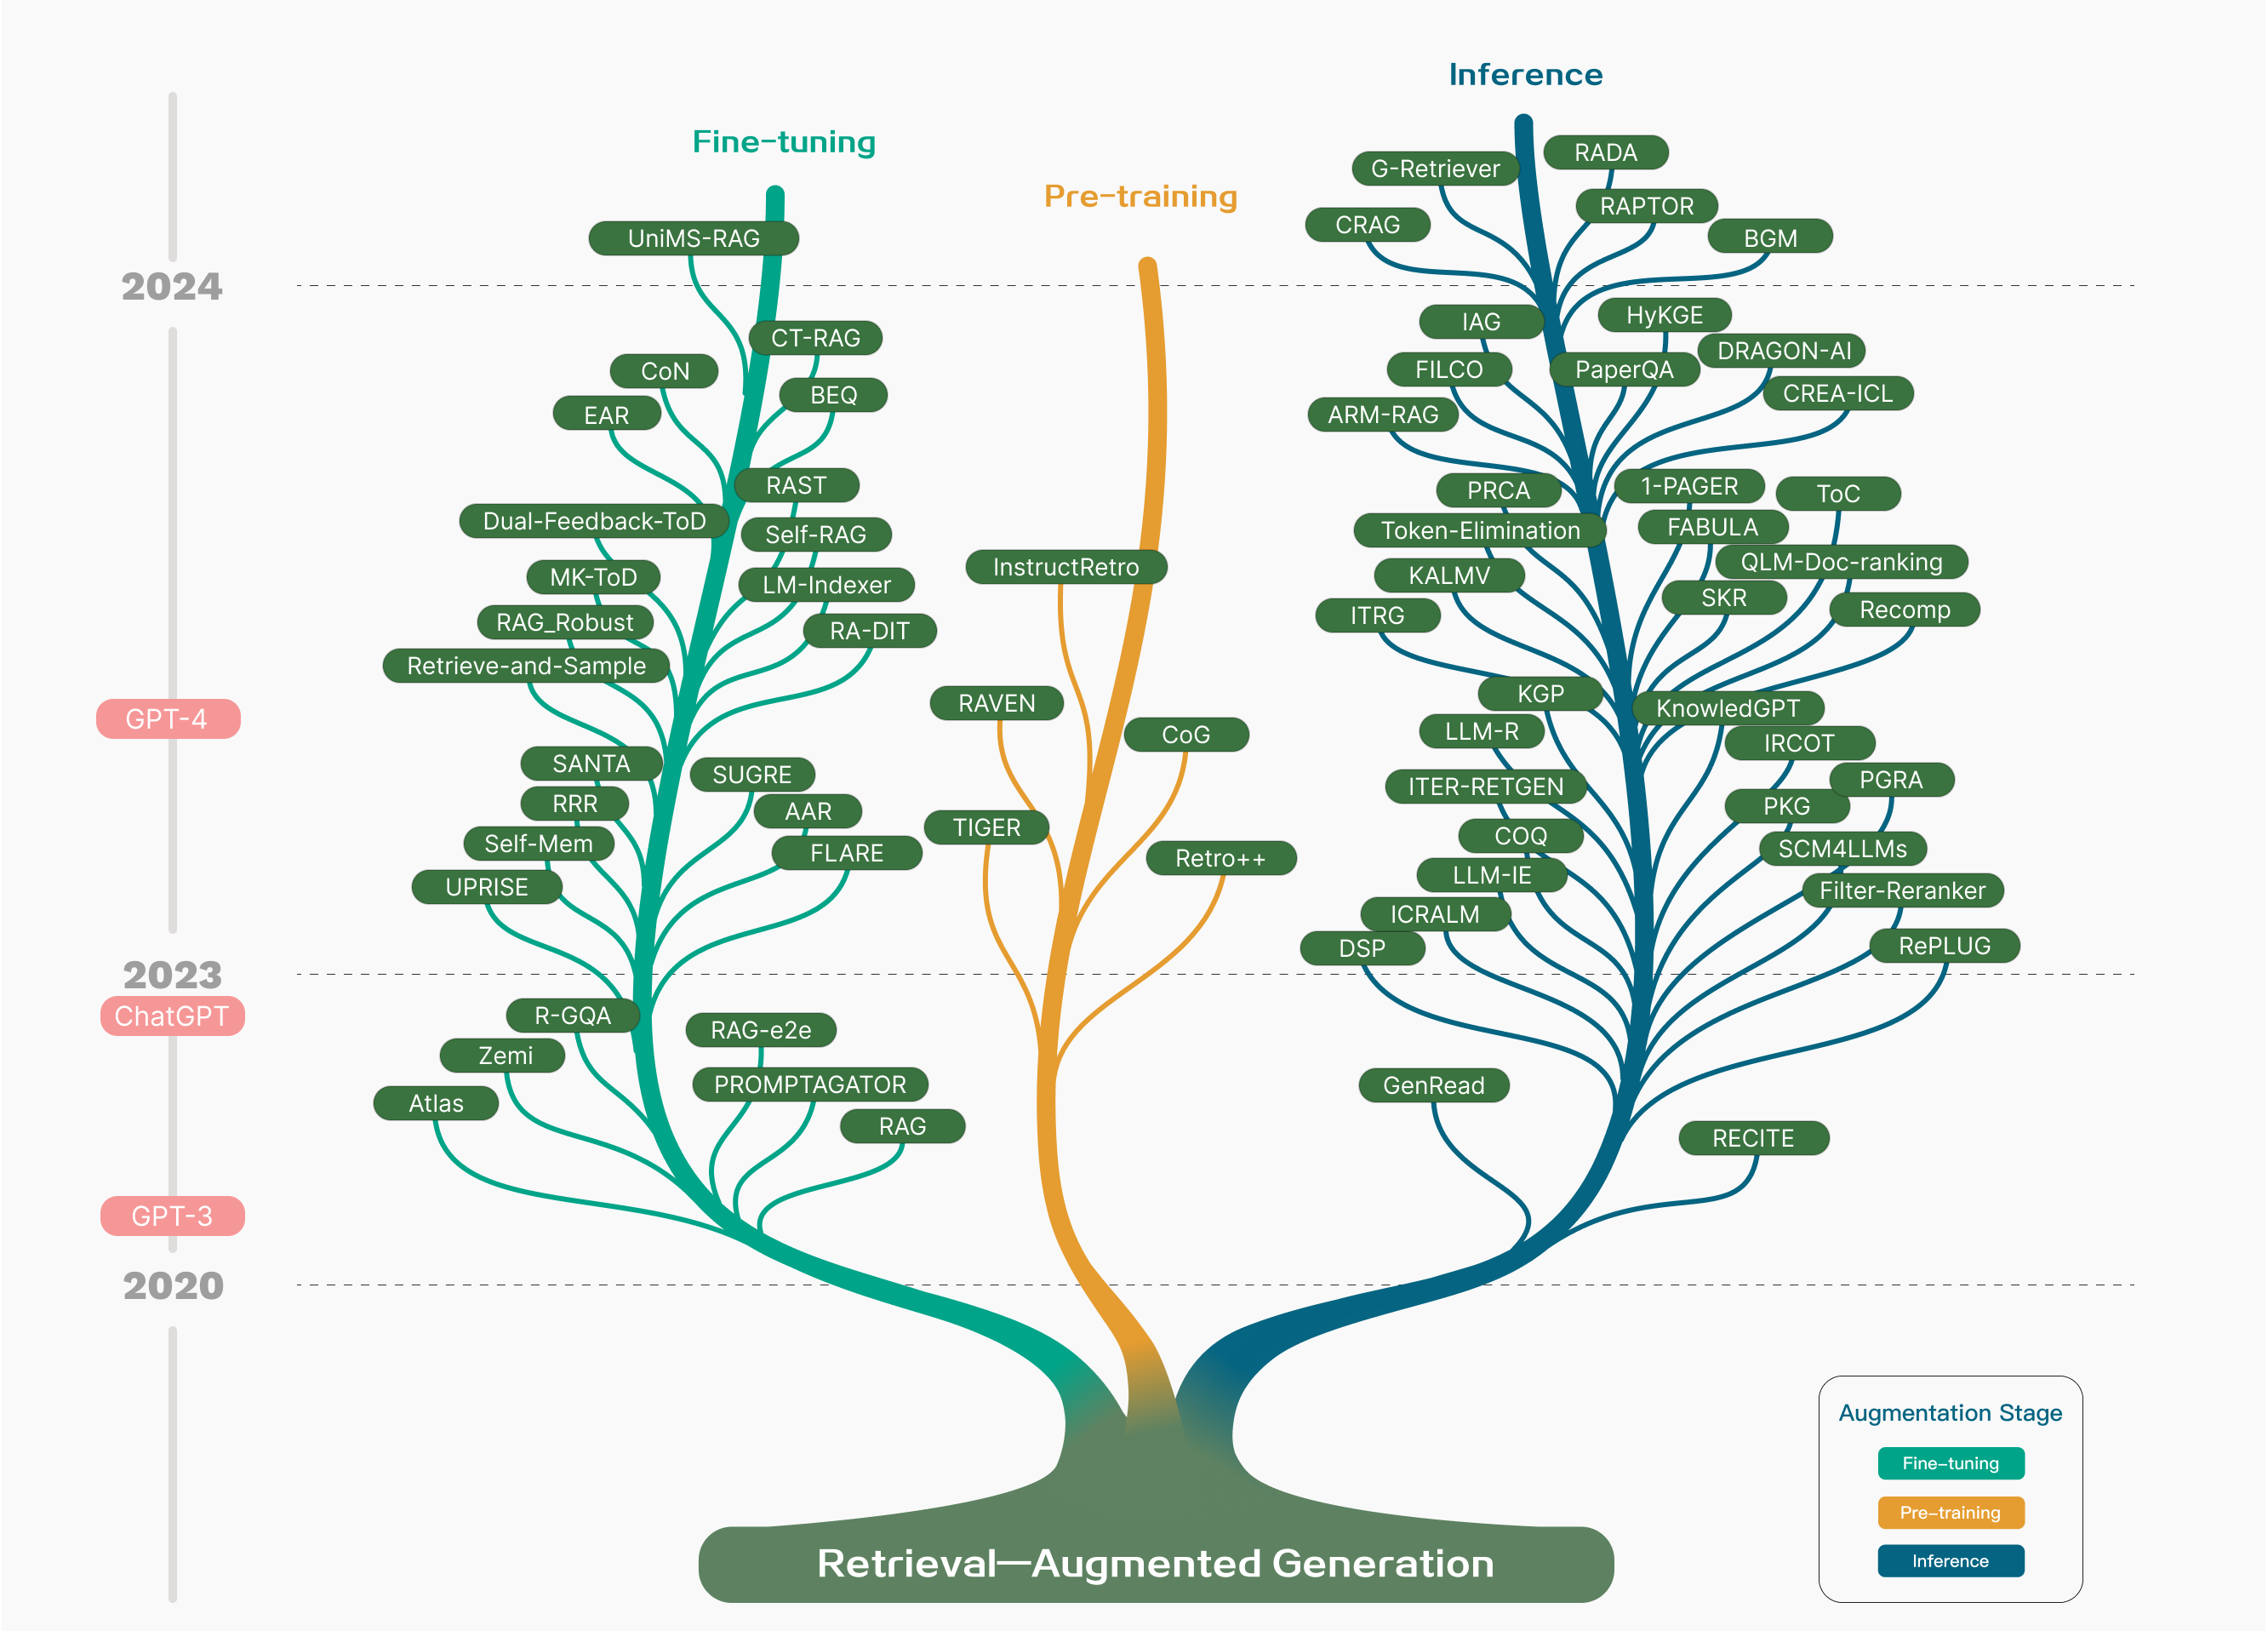
2024.04.30 综述检索增强语言模型(RALMs)
-
《RAG and RAU: A Survey on Retrieval-Augmented Language Model in Natural Language Processing》
详情
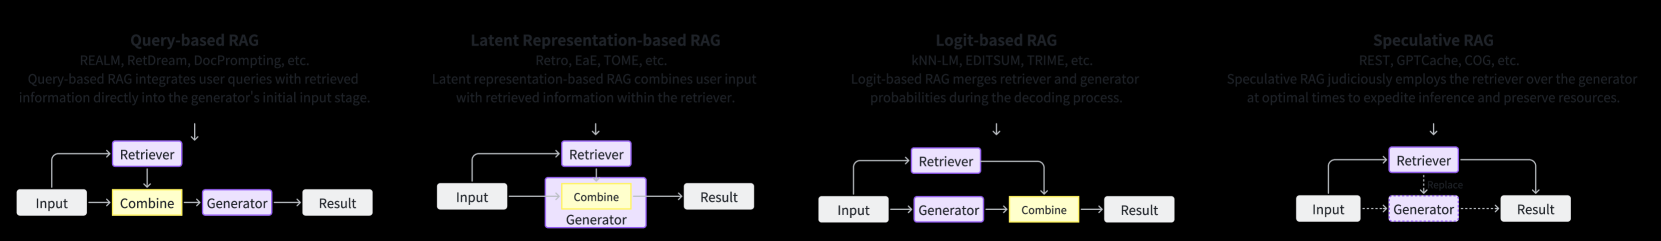
全面综述检索增强语言模型(RALMs),包括检索增强生成(RAG)和检索增强理解(RAU),并探讨其在自然语言处理(NLP)中的应用和发展,不仅关注RAG,还涵盖了RAU,详细描述了检索器和语言模型的不同交互模式,并提供了RALMs的工作时间表和应用总结。
-
-
2024.04.17 综述面向检索的核心技术
-
《A Survey on Retrieval-Augmented Text Generation for Large Language Models》
详情
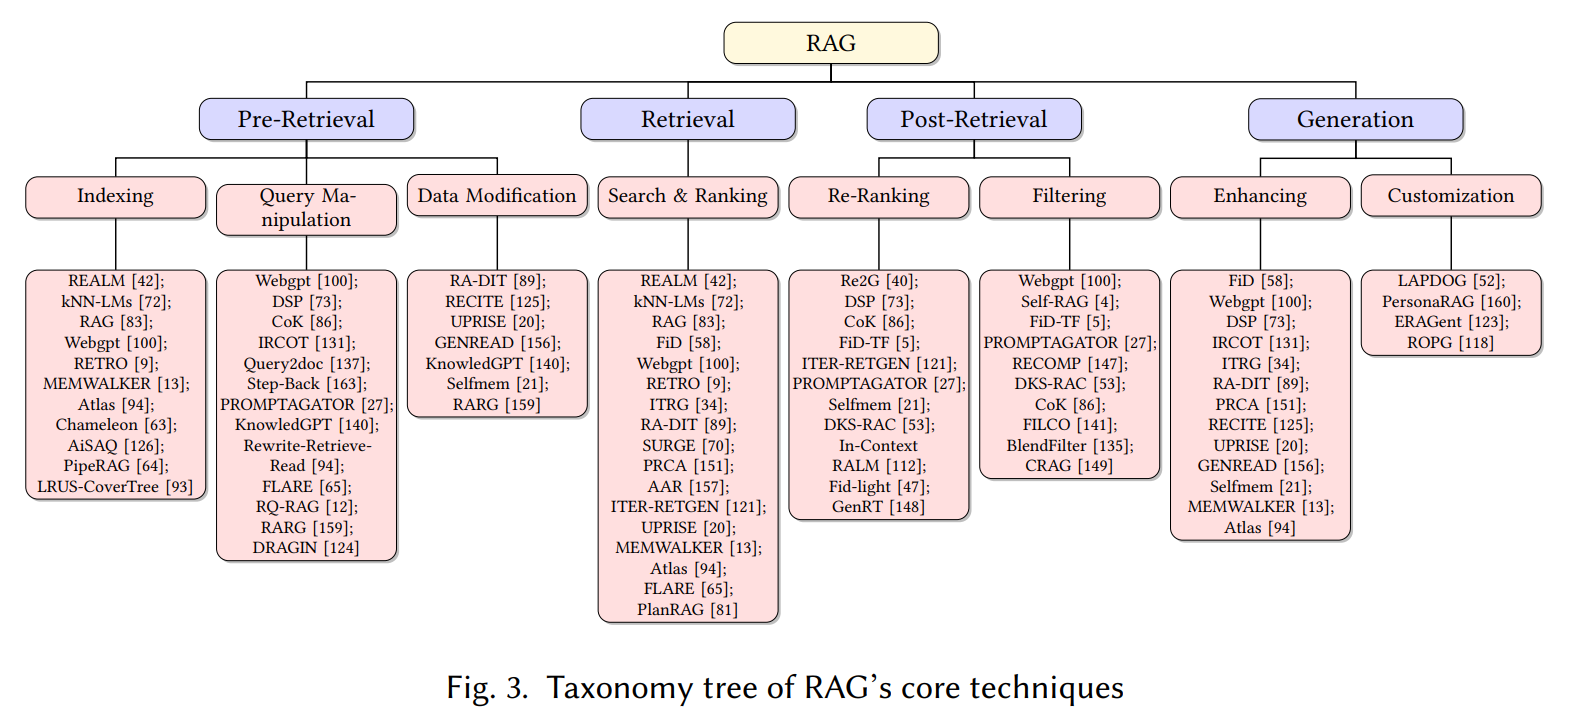
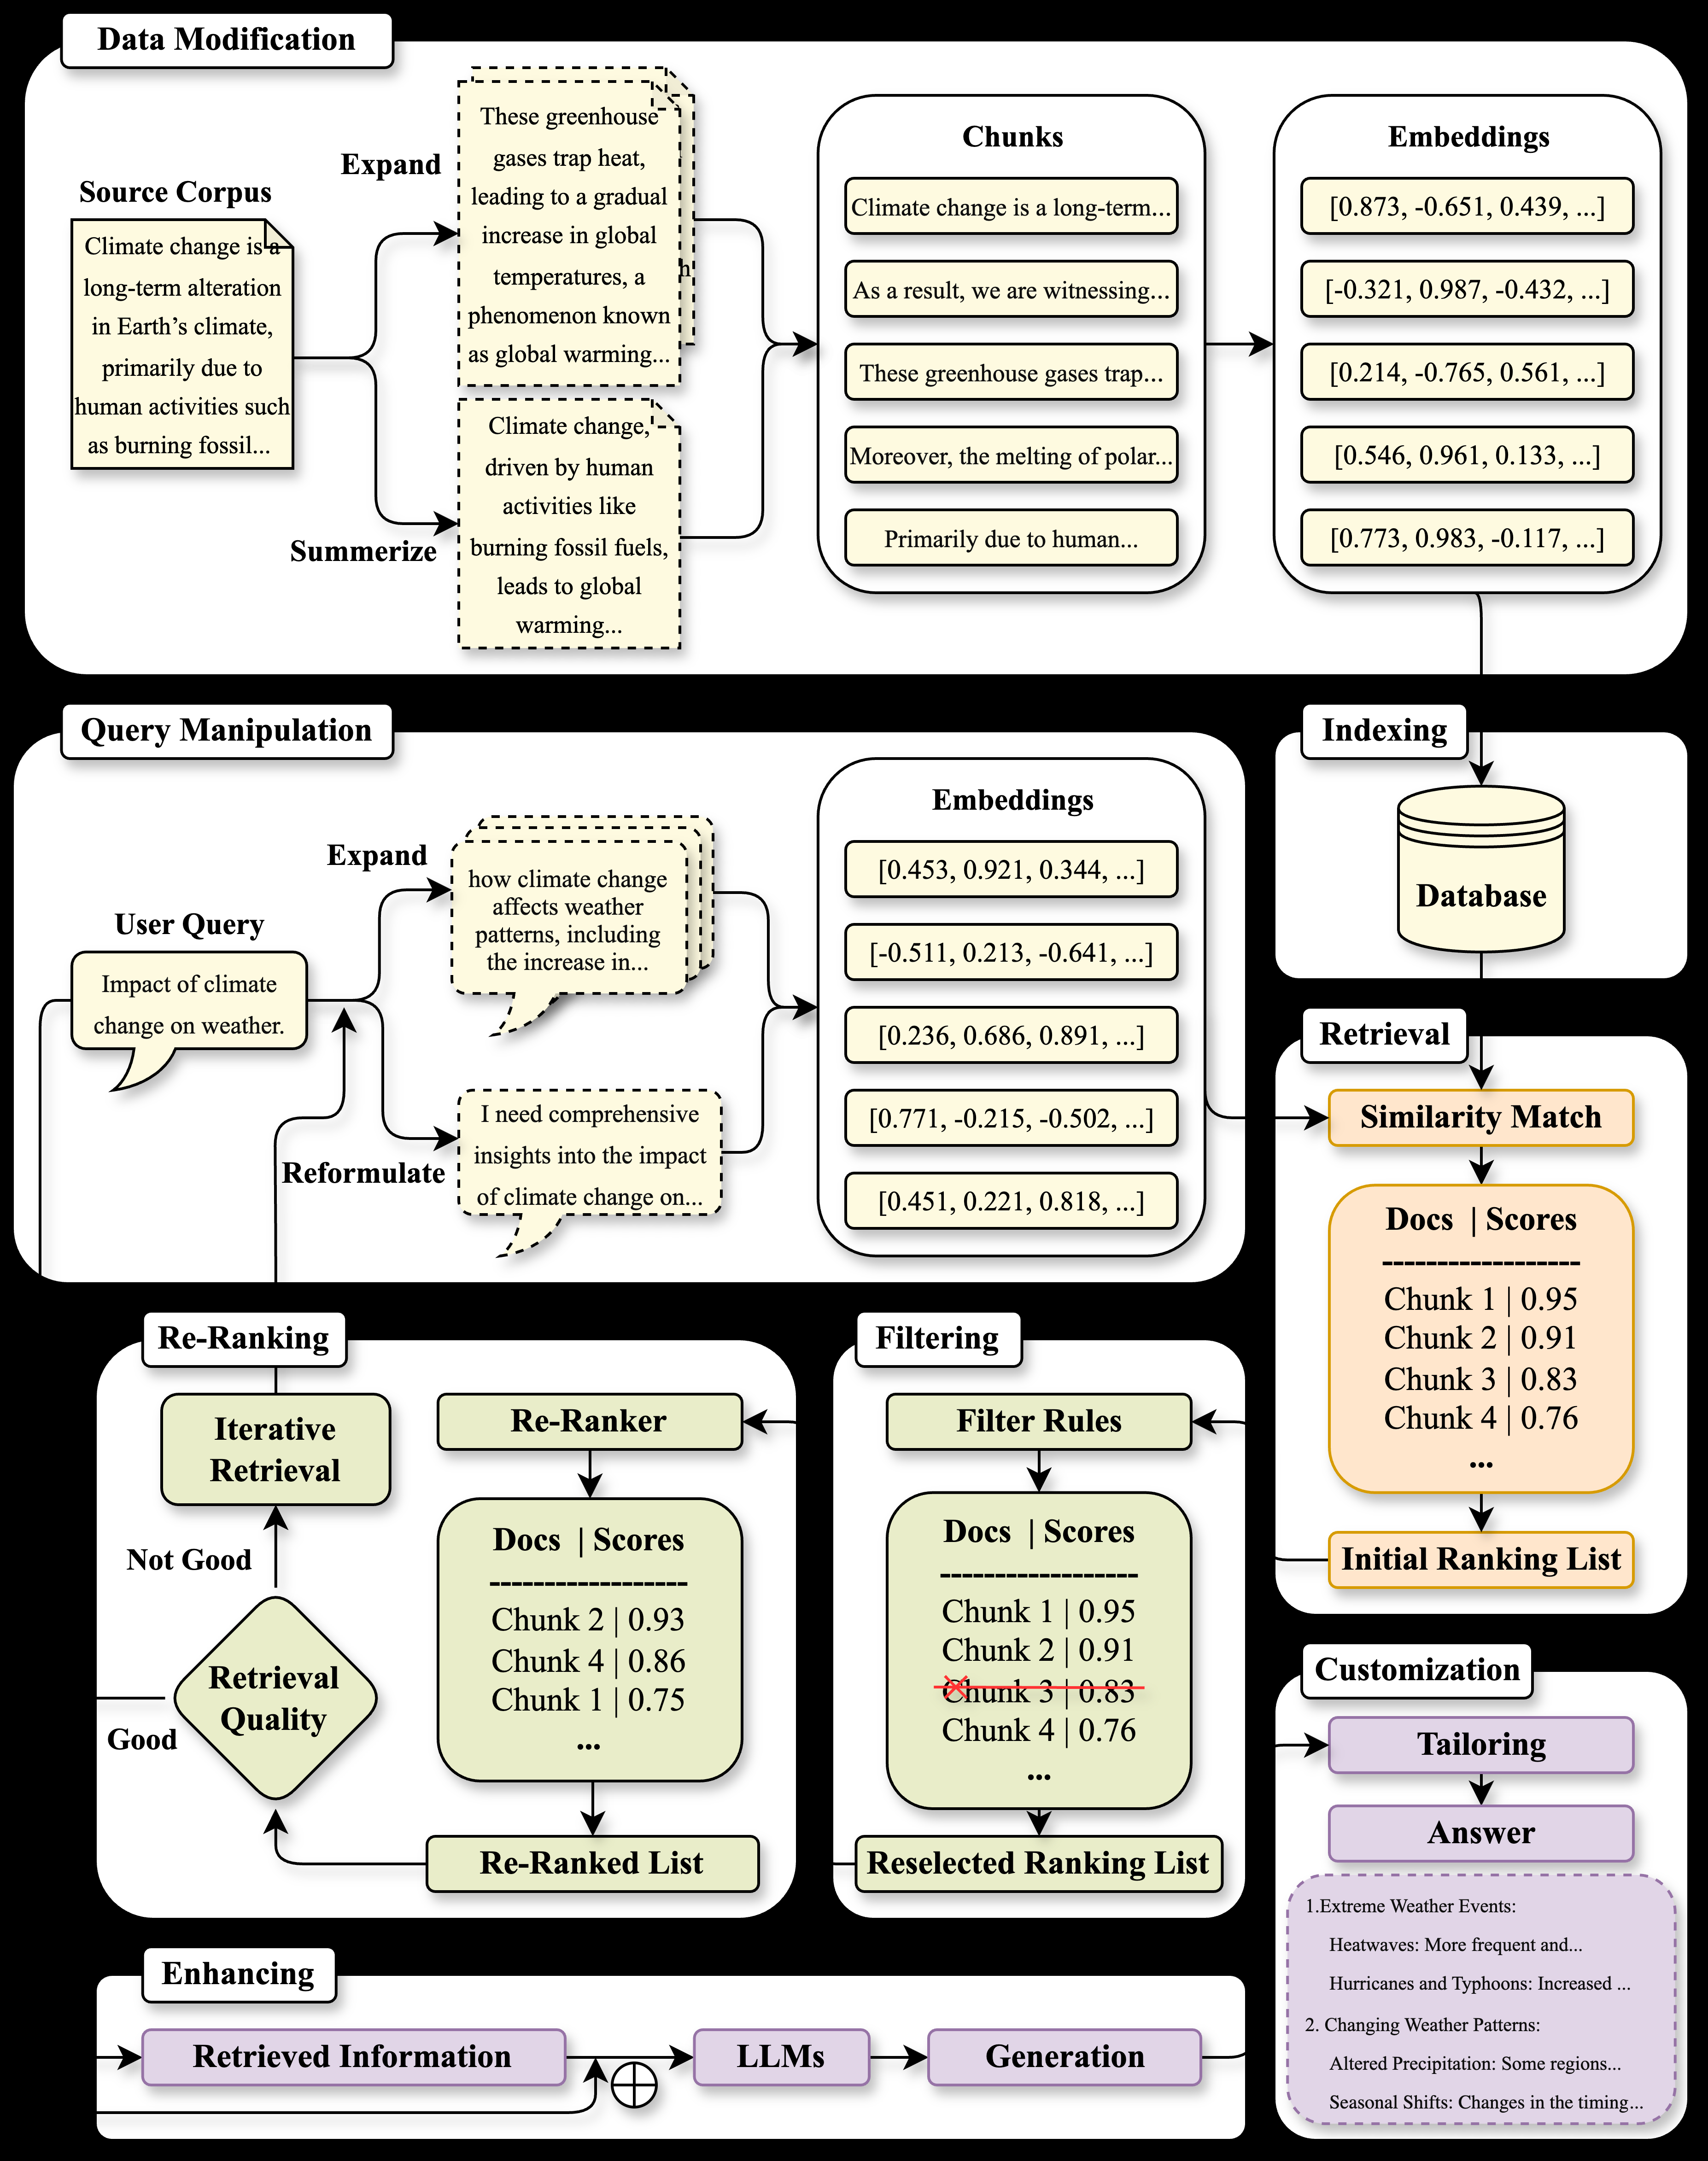
地址:https://arxiv.org/abs/2404.10981 主要回顾当前RAG在各个阶段的核心技术。例如,对于检索,分成了基本检索策略:线性工作流程,适用于简单任务;迭代检索策略:多次检索,逐步优化结果;递归检索策略:处理层次化或分层信息,适用于复杂查询;条件检索策略:根据特定条件或规则进行检索;以及自适应检索策略:动态调整检索策略以优化结果。
-
-
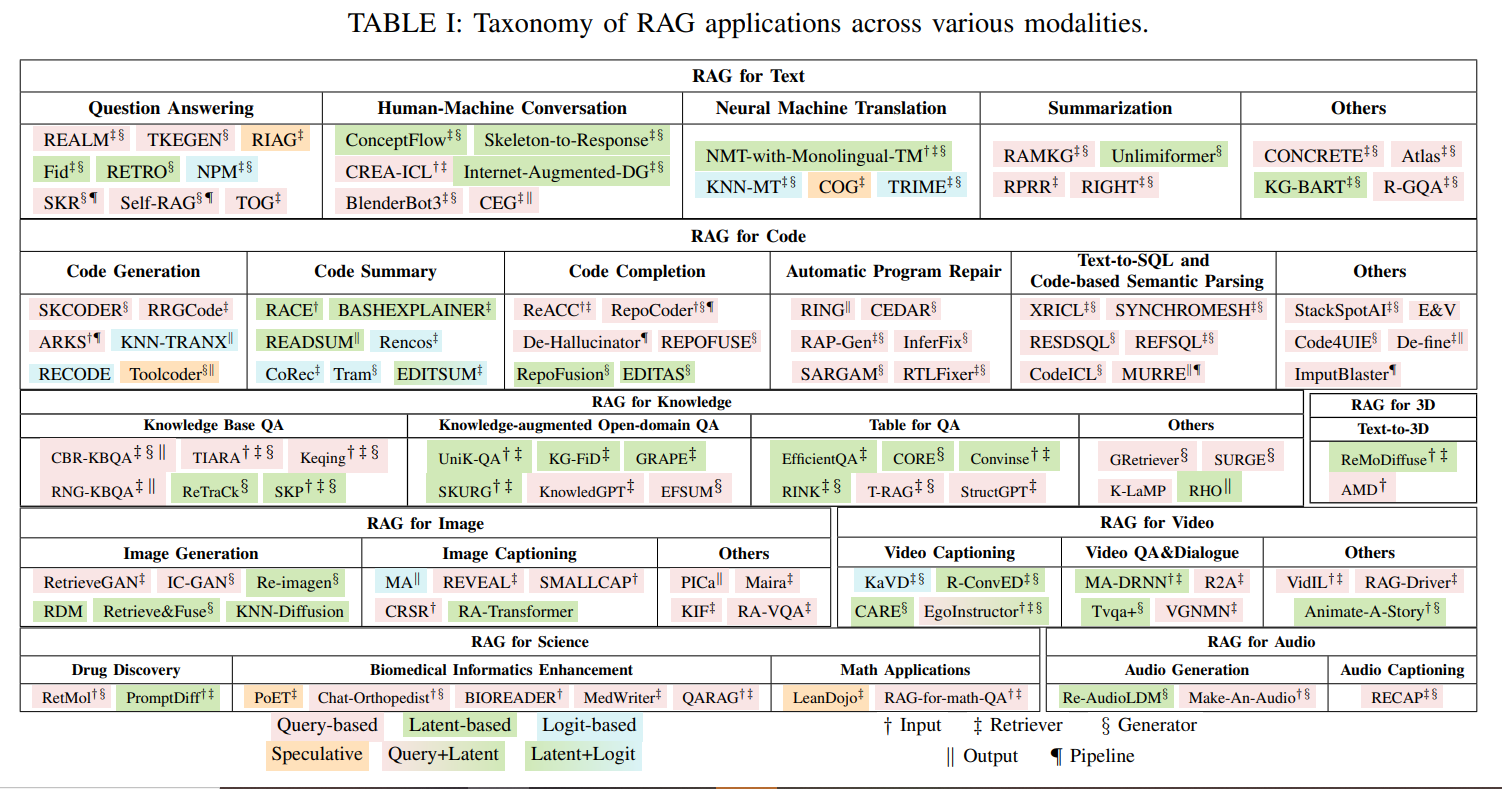
2024.02.29 面向AIGC生成做全面综述
-
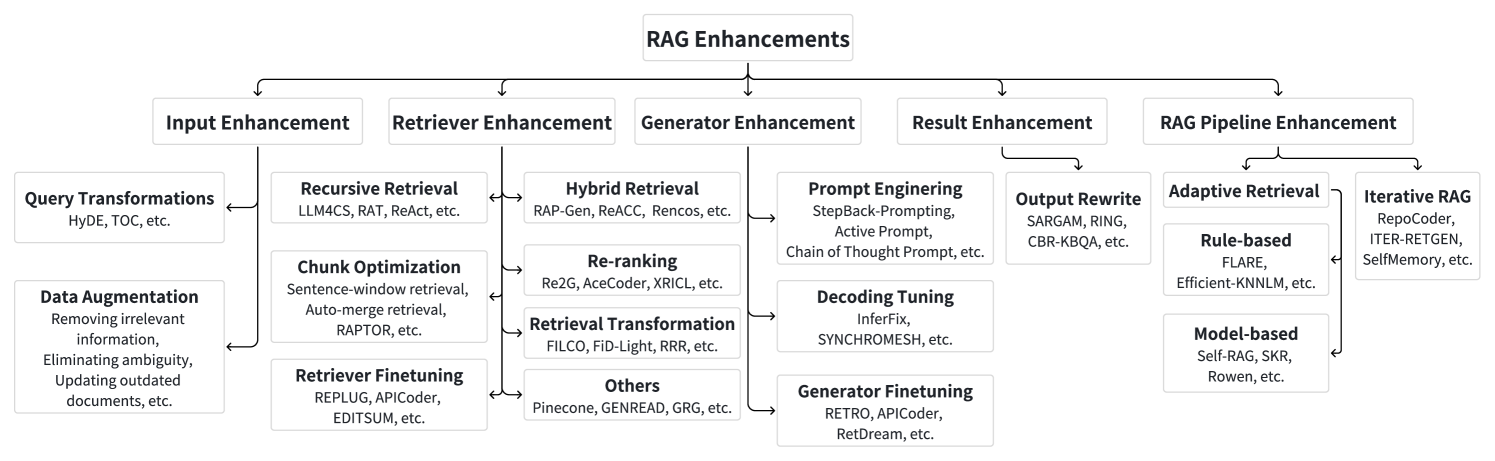
2023.11.18 首个全面RAG综述
-
2023.03.20 多模态RAG综述
详情
https://arxiv.org/abs/2303.10868 探讨了通过检索多模态知识来增强生成模型的方法,特别是如何利用图像、代码、结构化知识、音频和视频等多模态信息来提升大型语言模型(LLMs)的生成能力。
-
2022.02.02近三年首个综述
其他资料
- 大语言模型的检索增强生成 (RAG) 方法
- Advaned RAG Techniques: an Illustrated Overview
- 高级RAG应用构建指南和总结
- Patterns for Building LLM-based Systems & Products
- RAG大全
- Open RAG Base
- Open RAG Base 是一个基于公开资料收集整理汇总的RAG知识库。它基于Notion构建,是目前最全面RAG的资料汇总仓库。目的是为读者提提供前沿和全面的RAG知识,提供多维度的分析汇总,涵盖RAG的方方面,包括:学术论文、前沿阅读资料、RAG评估与基准、下游任务与数据集、工具与技术栈
- 一个繁体的RAG资料集
- 关于RAG技术的综合合集RAG_Techniques
介绍
-
Microsoft-Retrieval Augmented Generation (RAG) in Azure AI Search
-
Cohere-Introducing Chat with Retrieval-Augmented Generation (RAG)
-
Milvus-Build AI Apps with Retrieval Augmented Generation (RAG)
比较
- Retrieval-Augmented Generation (RAG) or Fine-tuning — Which Is the Best Tool to Boost Your LLM Application?
- 提示工程、RAGs 与微调的对比
- RAG vs Finetuning — Which Is the Best Tool to Boost Your LLM Application?
- A Survey on In-context Learning
开源工具
RAG框架
-
- RAGFlow:基于OCR和文档解析的下一代 RAG 引擎。在文档解析上做了增强,2024年4月1日开源,在数据处理上支持文档结构、图片、表格的深度解析,支持可控分片,可对查询进行深入分析识别关键信息,在检索上提供多路找回/重排能力,界面提供友好的引用参考查看功能。
-
- 融合了 Backend as Service 和 LLMOps 的理念,涵盖了构建生成式 AI 原生应用所需的核心技术栈,包括一个内置 RAG 引擎。使用 Dify,你可以基于任何模型自部署类似 Assistants API 和 GPTs 的能力。
-
- 您的第二大脑,利用 GenerativeAI 的力量成为您的私人助理!但增强了人工智能功能。
- Quivr
-
详情
- GraphRAG 是一种基于图的检索增强方法,由微软开发并开源。 它通过结合LLM和图机器学习的技术,从非结构化的文本中提取结构化的数据,构建知识图谱,以支持问答、摘要等多种应用场景。
- 微软GraphRAG框架演进之路及带来的一些思考
-
详情
- 微软Graph的简化版本,将社区、社区宅摘要这些环节做了去除,这种去除是好的,不会太重,对于知识更新也更快;
-
详情
一个开源的、基于 RAG (Retrieval-Augmented Generation) 的文档问答工具,支持多用户登录、本地和云端 LLM 及 Embedding 模型、图表多模态文档解析和问答、混合检索带文档预览的高级引用功能、持复杂推理方法,如问题分解、基于 agent 的推理(如 ReAct、ReWOO)等。
-
- MaxKB是一个开源的企业级智能体平台。它集成了检索增强型生成(RAG)管道,支持强大的工作流,并提供了高级的MCP工具使用功能。MaxKB广泛应用于智能客户服务、企业内部知识库、学术研究和教育等场景。
-
- 致力于支持任意格式文件或数据库的本地知识库问答系统,可断网安装使用。任何格式的本地文件都可以往里扔,即可获得准确、快速、靠谱的问答体验。目前已支持格式: PDF,Word(doc/docx),PPT,Markdown,Eml,TXT,图片(jpg,png等),网页链接
-
- 这是向量数据库weaviate开源的一款RAG应用,旨在为开箱即用的检索增强生成 (RAG) 提供端到端、简化且用户友好的界面。只需几个简单的步骤,即可在本地或通过 OpenAI、Cohere 和 HuggingFace 等 LLM 提供商轻松探索数据集并提取见解。
-
- 允许您针对内部文档提出自然语言问题,并获得由源材料中的引用和参考文献支持的可靠答案,以便您始终可以信任您得到的结果。您可以连接到许多常用工具,例如 Slack、GitHub、Confluence 等。
-
- Cognita 在底层使用了Langchain/Llamaindex,并对代码进行了结构化组织,其中每个 RAG 组件都是模块化的、API 驱动的、易于扩展的。Cognita 可在本地设置中轻松使用,同时还能为您提供无代码用户界面支持的生产就绪环境。Cognita 默认还支持增量索引。
-
详情
一款低代码构建多Agent大模型应用的开发工具,协助开发者用极低的成本构建复杂的AI应用,并可以持续的迭代优化效果。使用LazyLLM搭建RAG应用非常便捷和灵活,可以任意字定义多路检索和召回策略。除此之外,LazyLLM的AI应用构建流程是原型搭建 -> 数据回流 -> 迭代优化,用户可以先基于LazyLLM快速搭建RAG应用的,再结合场景任务数据进行bad-case分析,然后对应用中的关键环节进行算法迭代和模型微调,进而逐步提升整个RAG应用的效果。
-
- GPT-RAG提供了一个强大的架构,专为RAG模式的企业级部署量身定制。它确保了扎实的回应,并建立在零信任安全和负责任的人工智能基础上,确保可用性、可扩展性和可审计性。非常适合正在从探索和PoC阶段过渡到全面生产和MVP的组织。
-
- 生产就绪的多AI代理框架,支持RAG、Agentic RAG工作流、100+LLM支持、MCP协议集成、内置记忆系统(短期、长期、实体、情景记忆)和自我反思功能。


预处理
-
详情
MarkItDown 是一个轻量级的 Python 工具,用于将各种文件转换为 Markdown 格式,以便与 LLMs 和相关文本分析流程一起使用。为此,它与 textract 最相似,但更注重保留重要的文档结构和内容作为 Markdown(包括:标题、列表、表格、链接等)。虽然输出通常相当可读且适合人类阅读,但其目的是供文本分析工具使用——可能不是为人类消费进行高保真文档转换的最佳选择。
MarkItDown 目前支持以下格式的转换:
PDF PowerPoint Word Excel Images (EXIF metadata and OCR) Audio (EXIF metadata and speech transcription) HTML 基于文本的格式(CSV、JSON、XML) ZIP 文件(遍历内容) Youtube URLs EPubs 等
-
- Docling 是一个简化文档处理和解析的工具,支持多种文档格式,包括 PDF、DOCX、PPTX、XLSX、HTML、WAV、MP3、VTT 和图像等。它提供了先进的 PDF 理解功能,如页面布局、读取顺序、表格结构、代码、公式和图像分类等。Docling 还提供了统一的 DoclingDocument 表示格式,支持多种导出格式,如 Markdown、HTML、DocTags 和 JSON。此外,Docling 还支持本地执行、集成 LangChain、LlamaIndex、Crew AI 和 Haystack 等 AI 框架,以及广泛的光学字符识别 (OCR) 和音频支持。
-
详情
该库提供了用于摄取和预处理图像和文本文档(如 PDF、HTML、WORD 文档等)的开源组件。 unstructured的使用场景围绕着简化和优化LLM数据处理工作流程, unstructured模块化功能和连接器形成了一个有内聚性的系统,简化了数据摄取和预处理,使其能够适应不同的平台,并有效地将非结构化数据转换为结构化输出。
-
- 对文档进行分块是一项具有挑战性的任务,它支撑着任何 RAG 系统。高质量的结果对于人工智能应用的成功至关重要,但大多数开源库处理复杂文档的能力都受到限制。
- Open Parse 旨在通过提供灵活、易于使用的库来填补这一空白,该库能够直观地识别文档布局并有效地对其进行分块。
-
- 使用 LLMs 从文件和文档中提取数据的库。 extract_thinker 在文件和 LLMs 之间提供 ORM 风格的交互,从而实现灵活且强大的文档提取工作流程。
-
- OmniParser 是一个统一的框架,无缝地结合了三个基本的 OCR 任务:文本识别、关键信息提取和表格识别。
-
- 给定一个 HTML 文档,提取并清理主体文本和标题。
-
- Neural Optical Understanding for Academic Documents.这是学术文档 PDF 解析器,它能理解 LaTeX 数学和表格。但对中文支持不好,需要单独微调。
-
- Pix2Struct 是一种预训练的图像到文本模型,专为纯视觉语言理解而设计。
-
- Indexify 是一个开源引擎,用于使用可重复使用的提取器进行嵌入、转换和特征提取,为非结构化数据(视频、音频、图像和文档)快速构建数据流水线。当;流水线生成嵌入或结构化数据时,Indexify 会自动更新向量数据库、结构化数据库 (Postgres)。
-
- MegaParse 是一个强大且通用的解析器,可以轻松处理各种类型的文档,包括文本、PDF、PowerPoint 演示文稿、Word 文档等。它旨在在解析过程中尽可能减少信息丢失。
- 解析内容包括: ✅ Tables ✅ TOC ✅ Headers ✅ Footers ✅ Images


路由
评测框架
-
- Ragas是一个用于评估RAG应用的框架,包括忠诚度(Faithfulness)、答案相关度(Answer Relevance)、上下文精确度(Context Precision)、上下文相关度(Context Relevancy)、上下文召回(Context Recall)
-
- 一个简单易用的开源LLM评估框架,适用于LLM应用程序。它与 Pytest 类似,但专门用于单元测试 LLM 应用程序。 DeepEval 使用 LLMs 以及在您的计算机上本地运行的各种其他 NLP 模型,根据幻觉、答案相关性、RAGAS 等指标来评估性能。
-
- TruLens 提供了一套用于开发和监控神经网络的工具,包括大型语言模型。这包括使用 TruLens-Eval 评估基于 LLMs 和 LLM 的应用程序的工具以及使用 TruLens-Explain 进行深度学习可解释性的工具。 TruLens-Eval 和 TruLens-Explain 位于单独的软件包中,可以独立使用。
-
- 用于评估和改进生成式人工智能应用的开源统一平台。提供了20多项预配置检查(涵盖语言、代码、嵌入用例)评分,对失败案例进行根本原因分析,并就如何解决这些问题提出见解。
- 比如prompt注入、越狱检测、整通对话的用户满意度等
-
- 一个用于 RAG 开发和实验跟踪的平台,用于评估检索增强生成 (RAG) 应用程序响应质量的指标。


Embedding
- BCEmbedding
- 网易有道开发的双语和跨语种语义表征算法模型库,其中包含 EmbeddingModel和 RerankerModel两类基础模型。EmbeddingModel专门用于生成语义向量,在语义搜索和问答中起着关键作用,而 RerankerModel擅长优化语义搜索结果和语义相关顺序精排。
- BGE-Embedding
- 北京智源人工智能研究院开源的embeeding通用向量模型,使用retromae 对模型进行预训练,再用对比学习在大规模成对数据上训练模型。
- bge-reranker-large
- 北京智源人工智能研究院开源,交叉编码器将对查询和答案实时计算相关性分数,这比向量模型(即双编码器)更准确,但比向量模型更耗时。 因此,它可以用来对嵌入模型返回的前k个文档重新排序
- gte-base-zh
- GTE text embedding GTE中文通用文本表示模型 通义实验室提供
爬虫
-
详情
- Crawl4AI是一个开源的、用于为AI而生的智能、快速且灵活的网络爬虫工具。它针对大语言模型(LLM)、AI Agent和数据流水线提供了优秀的爬取性能,通过高速、精确和易部署的特点来赋能开发者。
- 为LLM量身打造的Markdown生成功能。
- 提供6倍于常规爬虫的超快速爬取能力。
- 支持会话管理、代理和自定义钩子,实现灵活的浏览器控制。
- 采用高级算法进行高效抽取,减少对昂贵模型的依赖。
- 完全开源无API密钥,支持Docker和云端集成。
-
详情
Firecrawl 是一个强大的 API 服务,可以从任何网站抓取数据并转换为干净的 Markdown 或结构化数据。它具有高级的抓取、爬取和数据提取功能,可以帮助您的 AI 应用程序获取干净的数据。
主要功能点
- 抓取: 抓取网页内容并以 LLM 就绪格式(Markdown、结构化数据、截图、HTML)返回
- 爬取: 抓取网页上的所有 URL 并以 LLM 就绪格式返回内容
- 映射: 输入一个网站,获取该网站的所有 URL - 速度极快 强大的功能: 支持 LLM 就绪格式、代理、反机器人机制、动态内容(JS 渲染)、输出解析、编排等
- 可定制性: 排除标签、在身份验证墙后爬取、最大爬取深度等
-
- 它将任何 URL 转换为LLM 友好的输入,
安全护栏
-
- JoySafety 是一个开源的大模型安全框架。该框架在京东内部广泛应用,覆盖AI导购、物流客服、销售助手、医疗问诊、商家工作台、法务咨询、安全问答等场景,支持日均亿级调用、95%+攻击拦截率,致力于为企业提供一套成熟、可靠、免费的大模型安全防护方案。
-
详情
NeMo Guardrails 是一个开源工具包,用于为基于 LLM 的对话应用程序轻松添加可编程的保护轨。Guardrails(简称 "轨")是控制大型语言模型输出的特定方式,例如不谈论政治、以特定方式响应特定用户请求、遵循预定义对话路径、使用特定语言风格、提取结构化数据等。
-
详情
- Guardrails 是一个 Python 框架,通过执行两个关键功能来帮助构建可靠的人工智能应用程序:
- Guardrails 在应用程序中运行输入/输出防护装置,以检测、量化和减轻特定类型风险的存在。要查看全套风险,请访问 Guardrails Hub。
- Guardrails 可帮助您从 LLMs 生成结构化数据。对输入和输出进行检测
-
详情
- LLM Guard 是一款旨在增强大型语言模型 (LLMs) 安全性的综合工具。
- 输入(Anonymize 匿名化、BanCode 禁止代码、BanCompetitors 禁止竞争对手、BanSubstrings 禁止子串、BanTopics 禁止话题、PromptInjection 提示词注射 、Toxicity 毒性等)
- 输出(代码、anCompetitors 禁止竞争对手、Deanonymize 去匿名化、JSON、LanguageSame 语言相同、MaliciousURLs 恶意URL、NoRefusal 不可拒绝、FactualConsistency 事实一致性、URLReachability URL可达性等)
- 各个检测功能是利用了huggingface上的各种开源模型
-
详情
- Llama Guard 是一个新的实验模型,可为 LLM 部署提供输入和输出防护栏。Llama Guard 是经过微调的 Llama-7B 模型。


- RefChecker
- RefChecker 提供了一个标准化的评估框架来识别大型语言模型输出中存在的微妙幻觉。
- vigil-llm
- Vigil是一个Python库和REST API,可以根据一组扫描器评估大型语言模型提示和响应,以检测提示注入、越狱和其他潜在威胁。该存储库还提供了必要的检测特征(签名)和数据集,支持用户自行部署和使用。 该应用程序目前处于 alpha 状态,应被视为实验/用于研究目的。


Prompting
-
- DSPy 是一款功能强大的框架。它可以用来自动优化大型语言模型(LLM)的提示词和响应。还能让我们的 LLM 应用即使在 OpenAI/Gemini/Claude版本升级也能正常使用。无论你有多少数据,它都能帮助你优化模型,获得更高的准确度和性能。通过选择合适的优化器,并根据具体需求进行调优,你可以在各种任务中获得出色的结果。
-
- GenAI 应用程序的自动提示工程助手 YiVal 是一款最先进的工具,旨在简化 GenAI 应用程序提示和循环中任何配置的调整过程。有了 YiVal,手动调整已成为过去。这种以数据驱动和以评估为中心的方法可确保最佳提示、精确的 RAG 配置和微调的模型参数。使用 YiVal 使您的应用程序能够轻松实现增强的结果、减少延迟并最大限度地降低推理成本!
AI攻击
- PyRIT
- PyRIT(Python Risk Identification Tool)是一个开源框架,旨在帮助安全专业人员和工程师主动识别生成式AI系统中的风险。该工具专注于通过红队测试和风险评估来提高AI系统的安全性。
- 主要功能点
- 为生成式AI系统提供安全风险识别
- 支持安全专业人员进行主动风险评估
- 提供开源的AI安全测试框架
- 支持对AI系统进行红队测试
- 帮助识别潜在的AI系统安全漏洞
- promptfoo
- LLM应用测试和安全评估工具,Promptfoo是一个面向开发者的本地工具,用于测试和评估大语言模型(LLM)应用程序。它提供了一种系统化的方法来测试提示词、模型性能和应用安全性。
- 主要功能点
- 自动化评估提示词和模型
- 进行LLM应用的安全漏洞扫描
- 多模型并排比较(支持OpenAI、Anthropic等多种模型)
- 在CI/CD流程中自动化检查
- 生成详细的安全漏洞报告
- deepteam
- 一个开源的LLM红队测试框架,专注于通过模拟对抗性攻击来发现和防护大型语言模型系统的安全漏洞。
- 主要功能点
- 提供40多种开箱即用的漏洞检测,包括偏见、隐私泄露、错误信息等
- 支持10多种单轮和多轮对抗性攻击方法
- 可以自定义特定组织需求的漏洞和攻击
- 提供风险评估报告,支持本地保存和数据框展示
- 支持OWASP Top 10和NIST AI RMF等标准指南
SQL增强
-
- Vanna 是一个MIT许可的开源Python RAG(检索增强生成)框架,用于SQL生成和相关功能。
- Vanna 的工作过程分为两个简单步骤 - 在您的数据上训练 RAG“模型”,然后提出问题,这些问题将返回 SQL 查询。训练的数据主要是一些 DDL schema、业务说明文档以及示例sql等,所谓训练主要是将这些数据embedding化,用于向量检索。
-
- 由前阿里巴巴成员创建并开源,一个智能和多功能的通用SQL客户端和报表工具,集成了ChatGPT功能,,14.3k
-
- 一个可以将自然语言转换为SQL查询的工具,4.1k
-
- 使用AI驱动的数据管理平台,帮助用户将自然语言查询转换为SQL。,3.2k
-
- 一个高效的自然语言到SQL转换工具,支持多种数据库。,1.4k
-
- 由腾讯音乐开源,高性能的SQL生成工具,支持复杂查询的自动生成。1.6k


LLM部署和serving
可观测性


其他
- RAGxplorer
- RAGxplorer 是一种交互式 Streamlit 工具,通过将文档块和的查询问句展示为embedding向量空间中可的视化内容来支持检索增强生成 (RAG) 应用程序的构建。
- Rule-Based-Retrieval
- rule-based-retrieval是一个 Python 包,使您能够创建和管理具有高级筛选功能的检索增强生成 (RAG) 应用程序。它与用于文本生成的 OpenAI 和用于高效矢量数据库管理的 Pinecone 无缝集成。
- instructor
- 借助大模型从一段文本中提取为结构化数据的库
- RAGLAB
- RAGLAB是一个模块化、面向研究的开源框架,用于检索增强型生成(Retrieval-Augmented Generation, RAG)算法。它提供了6种现有RAG算法的复制,以及一个全面的评估系统,包括10个基准数据集,使得RAG算法之间的公平比较和新算法、数据集和评估指标的高效开发成为可能。
- WFGY 16 Problem Map
- WFGY 是一个面向 RAG 系统的结构化故障排查项目,提供 16 问题清单,用于系统性分析检索增强生成 (RAG) 应用中的常见失败模式,如命中错误、引用陈旧内容、分块不合理、重排序失效、多轮记忆漂移等问题,帮助开发者快速定位问题属于检索、分块、重排、提示、缓存或评估链路。
- bRAG-langchain
- 这个项目是一个全面探索检索增强型生成(Retrieval-Augmented Generation, RAG)的仓库,包含从入门到高级实现的详细教程,涵盖多查询、自定义RAG构建等内容。
 • 查询构建——将自然语言转换为结构化查询(SQL、Cypher 或基于向量的检索) . (文本到 SQL、文本到 Cypher、自查询检索器
• 查询翻译——分解并重新表述输入,以实现更佳的检索效果。(多查询、RAG 融合、假设文档)
• 路由——动态选择正确的数据库或嵌入查询上下文以获得更相关的答案。
• 检索——使用 Re-Rank、RankGPT、RAG-Fusion、CRAG 对检索到的数据进行排名和优化,甚至从外部来源提取实时更新。
• 索引——利用多表示嵌入、分层摘要和结构化搜索优化。(RAPTOR、CoLBERT、微调)
• 生成——使用 Self-RAG 和 RRR 生成和完善响应,在需要时实现迭代推理和检索循环。
AI搜索类项目
- https://github.com/khoj-ai/khoj
- https://github.com/ItzCrazyKns/Perplexica
- scira: https://github.com/zaidmukaddam/scira


-
详情
网页搜索:使用 Tavily 的 API 搜索网页。 特定 URL 搜索:从特定 URL 获取信息。 天气:使用 OpenWeather 的 API 获取任何位置的当前天气。 编程:使用 E2B 的 API 运行多种语言的代码片段。 地图:使用 Google Maps API、Mapbox API 和 TripAdvisor API 获取任何地点的位置。 YouTube 搜索:搜索 YouTube 视频并获取时间戳和字幕。 学术搜索:搜索学术论文。 X 帖子搜索:搜索 X.com 上的帖子。 航班跟踪:使用 AviationStack 的 API 跟踪航班。 热门电影和电视节目:获取热门电影和电视节目的信息。 电影或电视节目搜索:获取任何电影或电视节目的信息。
- https://github.com/nashsu/FreeAskInternet
- https://github.com/miurla/morphic
- https://github.com/leptonai/search_with_lepton
- AZure-search-openai-demo:https://github.com/Azure-Samples/azure-search-openai-demo
- https://github.com/InternLM/MindSearch
- https://github.com/nilsherzig/LLocalSearch
- llm-answer-engine:https://github.com/developersdigest/llm-answer-engine
- https://github.com/rashadphz/farfalle
- Gerev:https://github.com/GerevAI/gerev
- Gemini-Search:https://github.com/ammaarreshi/Gemini-Search


- 一个基于 Google 的 Gemini 2.0 Flash 模型和 Google 搜索的 Perplexity 风格的搜索引擎。它提供 AI 驱动的问答功能,可以实时获取网络资源并提供引用。
- https://github.com/Nutlope/turboseek
- https://github.com/memfreeme/memfree
- https://github.com/supermemoryai/opensearch-ai
- https://github.com/yokingma/search_with_ai
- OpenPerPlex:https://github.com/YassKhazzan/openperplex_backend_os
- search4all:https://github.com/fatwang2/search4all
- https://github.com/QmiAI/Qmedia?tab=readme-ov-file
- https://github.com/luyu0279/BrainyAI
- https://github.com/OcularEngineering/ocular
- https://github.com/jjleng/sensei
- https://github.com/shadowfax92/Fyin
- https://github.com/YassKhazzan/openperplex_front


Deep Search/ Deep Research
- https://github.com/Alibaba-NLP/DeepResearch
- https://github.com/assafelovic/gpt-researcher
- https://github.com/langchain-ai/open_deep_research
- https://github.com/jina-ai/node-DeepResearch
- https://github.com/bytedance/deer-flow
- https://github.com/dzhng/deep-research
- https://github.com/langchain-ai/local-deep-researcher
- https://github.com/zilliztech/deep-searcher
https://github.com/nickscamara/open-deep-research
- https://github.com/SkyworkAI/DeepResearchAgent
- https://github.com/firecrawl/firesearch


应用参考
- Kimi Chat
- 支持发送网页链接和上传文件进行回答
- GPTs
- 支持上传文档进行类似RAG应用
- 百川知识库
- 1.新建知识库后得到知识库 ID;
- 2.上传文件,获取文件 ID;
- 3.通过文件 ID 与知识库 ID 进行知识库文件关联,知识库中可以关联多个文档。
- 4.调用对话接口时通过 knowledge_base 字段传入知识库 ID 列表,大模型使用检索到的知识信息回答问题。
- COZE
- 应用编辑平台,旨在开发下一代人工智能聊天机器人。无论您是否有编程经验,该平台都可以让您快速创建各种类型的聊天机器人并将其部署在不同的社交平台和消息应用程序上。
- Devv-ai
- 最懂程序员的新一代 AI 搜索引擎,底层采用了RAG的大模型应用模式,LLM模型为其微调的模型。
企业级实践
- 2025-05 Uber:Enhanced Agentic-RAG: What If Chatbots Could Deliver Near-Human Precision?
- Qcon 句子互动 高原 Agentic RAG 的现在与未来
- Qcon 尹一峰-RAG 基本范式的选择与系统设计
- Qcon 夏源-在医疗健康领域,企业大模型RAG优化实践
- Qcon 费跃 阿里云-构建企业级 RAG 系统的创新实践
- AIConf 阿里云客户服务领域Agent在业务提效上的思考与创新实践_姜剑(飞樰)
- 新加坡科研局 黄佳-大模型+数据资产变现,RAG 驱动企业智能化实践案例
- 枫清科技 王传阳 - QCon北京2025-复杂场景下的 RAG 架构演进:跨模态知识联邦与统一语义推理实践
- BISHENG AI Conf 覃睿-DeepResearch如何在企业内落地
- AIConf QAnything:大模型驱动下的知识库问答体系革新与实践
- Qconf 董振兴-明略科技多模态数据驱动的RAG增强实践.pdf
- 纷享销客AIAgent平台落地实践
- 快手 从被动服务到主动任务,Agentic AI 在 B 端商业化的应用探索
- B站大模型×领域RAG:打造高效、智能化的用户服务体验 PPT
- 哈啰出行从Copilot到Agent模式的探索-贾立 PPT
- 51Talk-AI+Agent+-+在业务增长中的落地实践 PPT
- 万科物业科技 PPT
- 京东商家助手 PPT
- 58同城-灵犀大模型PPT
- 阿⾥云AI搜索RAG⼤模型优化实践PPT
- 向量化与文档解析技术加速大模型RAG应用落地PPT
- RAG应用在得物开放平台的智能答疑的探索
- 用户案例|Milvus向量引擎在携程酒店搜索中的应用场景和探索
- OpenAI 如何优化 LLM 的效果
- What We Learned from a Year of Building with LLMs 系列
- 构建企业级AI助手的经验教训
知识库建设
论文
-
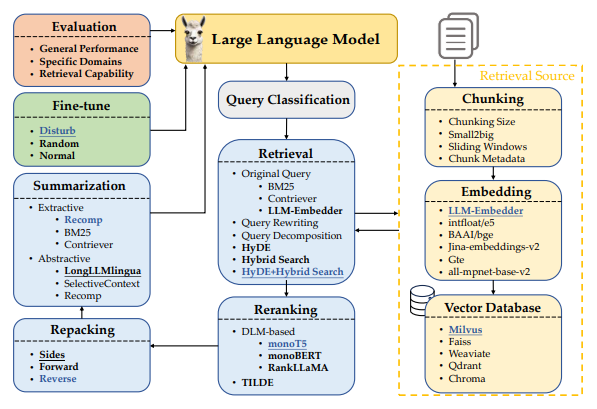
RAG最佳实践《Searching for Best Practices in Retrieval-Augmented Generation》
图片
-
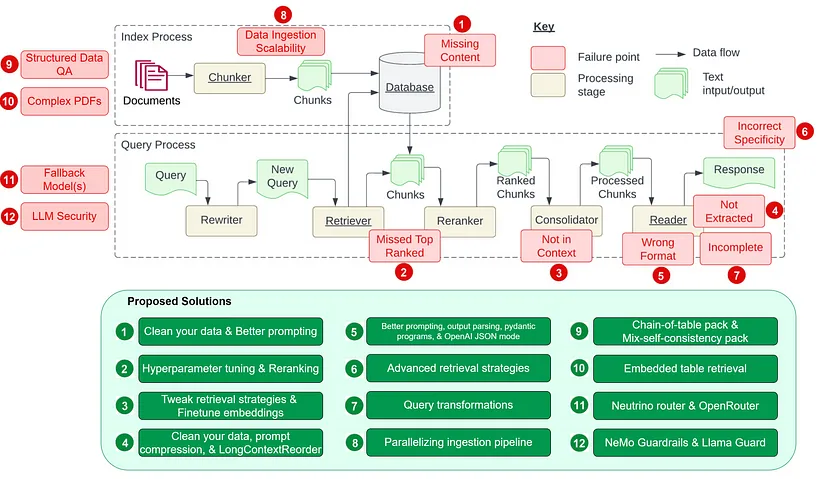
- Seven Failure Points When Engineering a Retrieval Augmented Generation System
-
Is ChatGPT Good at Search? Investigating Large Language Models as Re-Ranking Agents
-
Zero-Shot Listwise Document Reranking with a Large Language Model
- 两种重新排序方法:逐点重新排名、列表重新排名。
- 逐点重新排名是给定文档列表,我们将查询+每个文档单独提供给 LLM 并要求它产生相关性分数。
- 列表重新排名是给定文档列表,我们同时向 LLM 提供查询 + 文档列表,并要求它按相关性对文档进行重新排序。
- 建议对 RAG 检索到的文档按列表重新排序,列表重排优于逐点重排。
-
Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection
这里列出了一些重要的研究论文,它们揭示了 RAG 领域的关键洞察和最新进展。
| 洞见 | 参考来源 | 发布日期 |
|---|---|---|
| 提出一种名为纠正检索增强生成(CRAG, Corrective Retrieval Augmented Generation)的方法,旨在提升 RAG 系统生成内容的稳定性和准确性。其核心在于增加一个能够自我修正的组件至检索器中,并优化检索文档的使用,以促进更优质的内容生成。此外,引入了一种检索评估机制,用于评价针对特定查询检索到的文档的整体品质。通过网络搜索和知识的优化利用,能够有效提升文档自我修正和利用的效率。 | 纠正检索增强生成 | 2024年1月 |
| RAPTOR 模型通过递归方式嵌入、聚类并总结文本信息,自底向上构建出层次化的总结树。在使用时,该模型能够从这棵树中检索信息,实现对长文档在不同抽象层面上信息的综合利用。 | RAPTOR:递归抽象处理用于树组织检索 | 2024年1月 |
| 开发了一个通用框架,通过大语言模型(LLM)与检索器之间的多步骤互动,有效处理多标签分类难题。 | 在上下文中学习用于极端多标签分类 | 2024年1月 |
| 研究表明,通过提取高资源语言中语义相似的提示,可以显著提升多语言预训练语言模型在多种任务上的零样本学习能力。 | 从分类到生成:洞察跨语言检索增强的 ICL | 2023年11月 |
| 针对 RAGs 模型在处理噪声较多、不相关文档以及未知情境时的稳健性进行了改善,通过为检索文档生成序列化阅读笔记,深入评估其与提问的相关性,并整合信息以构建最终答案。 | 链式笔记:增强检索增强语言模型的鲁棒性 | 2023年11月 |
| 通过去除可能不会对答案生成贡献关键信息的标记,优化了检索增强阅读模型的处理流程,实现了高达 62.2% 的运行时间缩减,同时保持性能仅降低了2%。 | 通过标记消除优化检索增强阅读器模型 | |
| 通过对小型语言模型 (LM) 进行指令式微调,我们开发了一个独立的验证器,以验证知识增强语言模型 (knowledge-augmented LMs) 的输出及其知识准确性。这种方法特别有助于解决模型在面对特定查询时未能检索相关知识,或在生成文本中未能准确反映检索到的知识的情况。 | 知识增强语言模型验证 | 2023年10月 |
| 我们设立了一个基准测试,以分析不同大型语言模型 (LLMs) 在检索增强生成 (RAG) 所需的四项核心能力——噪声容忍、排除不相关信息、信息融合和对反事实情境的适应性——的表现。 | 大型语言模型在检索增强生成中的基准测试 | 2023年10月 |
| 介绍了一种自我反思的检索增强生成 (Self-RAG) 框架,旨在通过检索和自我反思来提升语言模型的质量和事实性。该框架利用语言模型动态检索信息,并通过反思标记来生成和评估检索到的内容及其自生成内容。 | 自我反思检索增强生成: 通过自我反思学习检索、生成及自我批判 | 2023年10月 |
| 通过生成增强检索 (GAR) 和检索增强生成 (RAG) 的迭代改善,提高了零样本信息检索的能力。该过程中的改写-检索阶段有效提升了召回率,而重排阶段则显著提高了精度。 | 零样本信息检索中的GAR与RAG相结合的新范式 | 2023年10月 |
| 通过使用基于 43B GPT 模型的预训练和从 1.2 万亿 Token 中检索信息,我们预训练了一个 48B 的检索模型。进一步通过指令式微调,该模型在多种零样本任务上相比经过指令式微调的 GPT 模型显示出显著的性能提升。 | InstructRetro: 检索增强预训练后的指令式微调 | 2023年10月 |
| 通过两步精细调整,我们为大型语言模型增加了检索功能:一步是优化预训练的语言模型以更有效利用检索到的信息,另一步则是改进检索器以返回更符合语言模型偏好的相关结果。这种分阶段的微调方法,在要求知识利用和上下文感知的任务中,显著提升了性能。 | 检索增强的双重指令微调 (RA-DIT) | 2023年10月 |
| 介绍了一种提升 RAGs 在面对不相关内容时鲁棒性的方法。该方法通过在训练期间混合使用相关与不相关的上下文,自动产生数据以微调语言模型,从而有效利用检索到的文段。 | 让基于检索增强的语言模型对无关上下文更加鲁棒 | 2023年10月 |
| 研究表明,采用简单检索增强技术的 4K 上下文窗口的大语言模型在生成过程中,其表现与通过位置插值对长上下文任务进行微调的 16K 上下文窗口的大语言模型相媲美。 | 当检索遇上长上下文的大语言模型 | 2023年10月 |
| 在上下文融合前将检索文档压缩为文本摘要,既降低了计算成本,也减轻了模型从长文档中识别关键信息的难度。 | RECOMP: 用压缩和选择性增强提升检索增强语言模型 | 2023年10月 |
| 提出了一个迭代式的检索与生成协同工作框架,它结合了参数化和非参数化知识,通过检索与生成的互动来寻找正确的推理路径。这一框架特别适合需要多步推理的任务,能够显著提高大语言模型的推理能力。 | 检索与生成的协同作用加强了大语言模型的推理能力 | 2023年10月 |
| 提出“澄清树”框架,该框架通过少样本提示并借助外部知识,为含糊问题递归构建一个消歧树。然后利用这棵树产生详细的答案。 | 利用检索增强大语言模型回答含糊问题的“澄清树”方法 | 2023年10月 |
| 介绍了一种使大语言模型能够参考其之前遇到的问题,并在面对新问题时动态调用外部资源的方法。 | 借助自我知识的大语言模型检索增强策略 | 2023年10月 |
| 提供了一组评估指标,用于从多个维度(如检索系统识别相关及集中上下文段落的能力、大语言模型忠实利用这些段落的能力,以及生成内容本身的质量)评价不同方面,而无需依赖人工注释的真实数据。 | RAGAS: 对检索增强生成进行自动化评估的指标体系 | 2023年9月 |
| 提出了一种创新方法——生成后阅读(GenRead),它让大型语言模型先根据提问生成相关文档,再从这些文档中提取答案。 | 生成而非检索:大型语言模型作为强大的上下文生成器 | 2023年9月 |
| 展示了在 RAG 系统中如何使用特定排名器(比如 DiversityRanker 和 LostInTheMiddleRanker)来挑选信息,从而更好地利用大型语言模型的上下文窗口。 | 提升 Haystack 中 RAG 系统的能力:DiversityRanker 和 LostInTheMiddleRanker 的引入 | 2023年8月 |
| 描述了如何将大型语言模型与不同的知识库结合,以便于知识的检索和储存。通过编程思维的提示来生成知识库的搜索代码,此外,还能够根据用户的需要,将知识储存在个性化的知识库中。 | KnowledGPT: 利用知识库检索和存储功能增强大型语言模型 | 2023年8月 |
| 提出一种模型,通过结合检索增强掩码语言建模和前缀语言建模,引入上下文融合学习,以此提高少样本学习的效果,使模型能够在不增加训练负担的情况下使用更多上下文示例。 | RAVEN: 借助检索增强编解码器语言模型实现的上下文学习 | 2023年8月 |
| RaLLe 是一款开源工具,专门用于开发、评估和提升针对知识密集型任务的 RAG 系统的性能。 | RaLLe: 针对检索增强大型语言模型的开发和评估框架 | 2023年8月 |
| 研究发现,当相关信息的位置发生变化时,大型语言模型的性能会明显受影响,这揭示了大型语言模型在处理长篇上下文信息时的局限性。 | 中途迷失:大型语言模型处理长篇上下文的方式 | 2023年7月 |
| 通过迭代的方式,模型能够将检索和生成过程相互协同。模型的输出不仅展示了完成任务所需的内容,还为检索更多相关知识提供了丰富的上下文,从而在下一轮迭代中帮助产生更优的结果。 | 通过迭代检索-生成协同增强检索增强的大语言模型 | 2023年5月 |
| 介绍了一种新的视角,即在文本生成过程中,系统能够主动决定何时以及检索什么信息。接着,提出了一种名为FLARE的方法,通过预测下一句话来预见未来的内容,利用此内容作为关键词检索相关文档,并在发现不确定的表达时重新生成句子。 | 主动检索增强生成 | 2023年5月 |
| 提出了一个能够通用应用于各种大语言模型的检索插件,即使在模型未知或不能共同微调的情况下也能提升模型性能。 | 适应增强型检索器改善大语言模型的泛化作为通用插件 | 2023年5月 |
| 通过两种创新的预训练方法,提高了对结构化数据的密集检索效果。首先,通过对结构化数据和非结构化数据之间的关联进行预训练来提升模型的结构感知能力;其次,通过实现遮蔽实体预测来更好地捕捉结构语义。 | 结构感知的语言模型预训练改善结构化数据上的密集检索 | 2023年5月 |
| 该框架能够动态地融合来自不同领域的多样化信息源,以提高大语言模型的事实准确性。通过一个自适应的查询生成器,根据不同知识源定制查询,确保信息的准确性逐步得到修正,避免错误信息的累积和传播。 | 知识链:通过动态知识适应异质来源来基础大语言模型 | 2023年5月 |
| 此框架通过首先检索知识图谱中的相关子图,并通过调整检索到的子图的词嵌入来确保事实的一致性,然后利用对比学习确保生成的对话与知识图谱高度一致,为生成与上下文相关且基于知识的对话提供了新方法。 | 用于知识基础对话生成的知识图谱增强大语言模型 | 2023年5月 |
| 通过采用小型语言模型作为可训练重写器,以适应黑盒式大语言模型(LLM)的需求。重写器通过强化学习(RL)根据 LLM 的反馈进行训练,从而构建了一个名为“重写-检索-阅读”的新框架,专注于查询优化。 | 为检索增强的大语言模型重写查询 | 2023年5月 |
| 利用检索增强生成器迭代创建无限记忆池,并通过记忆选择器挑选出适合下一轮生成的记忆。此方法允许模型利用自身产出的记忆,称为“自我记忆”,以提升内容生成质量。 | 自我提升:带有自我记忆的检索增强文本生成 | 2023年5月 |
| 通过为大语言模型(LLM)装配知识引导模块,让它们在不改变内部参数的情况下,获取相关知识。这一策略显著提高了模型在需要丰富知识的领域任务(如事实知识增加7.9%,表格知识增加11.9%,医学知识增加3.0%,多模态知识增加8.1%)的表现。 | 用参数知识引导增强大语言模型 | 2023年5月 |
| 为大语言模型(LLM)引入了一个通用的读写记忆单元,允许它们根据任务需要从文本中提取、存储并回忆知识。 | RET-LLM:朝向大语言模型的通用读写记忆 | 2023年5月 |
| 通过使用任务不可知检索器,构建了一个共享静态索引,有效选出候选证据。随后,设计了一个基于提示的重排机制,根据任务的特定相关性重新排序最相关的证据,为读者提供精准信息。 | 针对非知识密集型任务的提示引导检索增强 | 2023年5月 |
| 提出了UPRISE(通用提示检索以改善零样本评估),通过调整一个轻量级且多功能的检索器,它能自动为给定零样本任务的输入检索出最合适的提示,以此来改善评估效果。 | UPRISE:改进零样本评估的通用提示检索 | 2023年3月 |
| 结合了 SLMs 作为过滤器和 LLMs 作为重排器的优势,提出了一个适应性的“过滤-再重排”范式,有效提升了难样本的信息提取与重排效果。 | 大语言模型不是一个理想的少样本信息提取器,但它在重排难样本方面表现出色! | 2023年3月 |
| 零样本学习指导一款能够遵循指令的大语言模型,创建一个虚拟文档来抓住重要的联系模式。接着,一个名为Contriever的工具会将这份文档转化成嵌入向量,利用这个向量在大数据集的嵌入空间中找到相似文档的聚集地,通过向量的相似度来检索真实文档。 | 无需相关标签的精确零样本密集检索 | 2022年12月 |
| 提出了一个名为展示-搜索-预测(DSP)的新框架,通过这个框架可以编写高级程序,这些程序能够先展示流程,然后搜索相关信息,并基于这些信息做出预测。它能够将复杂问题分解成小的、更易于解决的步骤。 | 通过检索和语言模型组合,为复杂的自然语言处理任务提供解决方案 | 2022年12月 |
| 采用了一种新的多步骤问答策略,通过在思维链条的每一步中穿插检索信息,使用检索到的信息来丰富和改善思维链条。这种方法显著提升了解决知识密集型多步问题的效果。 | 结合思维链条推理和信息检索解决复杂多步骤问题 | 2022年12月 |
| 研究发现,增加检索环节可以有效减轻对已有训练信息的依赖,使得RAG变成一个有效捕捉信息长尾的策略。 | 大语言模型在学习长尾知识方面的挑战 | 2022年11月 |
| 通过抽样方式,从大语言模型的记忆中提取相关信息段落,进而生成最终答案。 | 通过回忆增强语言模型的能力 | 2022年10月 |
| 将大语言模型用作少量示例的查询生成器,根据这些生成的数据构建针对特定任务的检索系统。 | Promptagator: 基于少量示例实现密集检索 | 2022年9月 |
| 介绍了Atlas,这是一个经过预训练的检索增强型语言模型,它能够通过极少数的示例学习掌握知识密集任务。 | Atlas: 借助检索增强型语言模型进行少样本学习 | 2022年8月 |
| 通过从训练数据中进行智能检索,实现了在多个自然语言生成和理解任务上的性能提升。 | 重新认识训练数据的价值:通过训练数据检索的简单有效方法 | 2022年3月 |
| 通过在连续的数据存储条目之间建立指针关联,并将这些条目分组成不同的状态,我们近似模拟了数据存储搜索过程。这种方法创造了一个加权有限自动机,在推理时能够在不降低模型预测准确性(困惑度)的情况下,节约高达 83% 的查找最近邻居的计算量。 | 通过自动机增强检索的神经符号语言建模 | 2022 年 1 月 |
| 通过将自回归语言模型与从大规模文本库中检索的文档块相结合,基于这些文档与前文 Token 的局部相似性,我们实现了模型的显著改进。该策略利用了一个庞大的数据库(2 万亿 Token),大大增强了语言模型的能力。 | 通过从数万亿 Token 中检索来改善语言模型 | 2021 年 12 月 |
| 我们采用了一种创新的零样本任务处理方法,通过为检索增强生成模型引入严格的负样本和强化训练流程,提升了密集段落检索的效果,用于零样本槽填充任务。 | 用于零样本槽填充的鲁棒检索增强生成 | 2021 年 8 月 |
| 介绍了 RAG 模型,这是一种结合了预训练的 seq2seq 模型(作为参数记忆)和基于密集向量索引的 Wikipedia(作为非参数记忆)的模型。此模型通过预训练的神经网络检索器访问信息,比较了两种 RAG 设计:一种是在生成过程中始终依赖相同检索的段落,另一种则是每个 Token 都使用不同的段落。 | 用于知识密集型 NLP 任务的检索增强生成 | 2020 年 5 月 |
| 展示了一种仅通过密集表示实现信息检索的方法,该方法通过简单的双编码框架从少量问题和文本段落中学习嵌入。这种方法为开放域问答提供了一种高效的密集段落检索方案。 | 用于开放域问答的密集段落检索 | 2020 年 4 月 |
RAG构建策略
架构图片参考
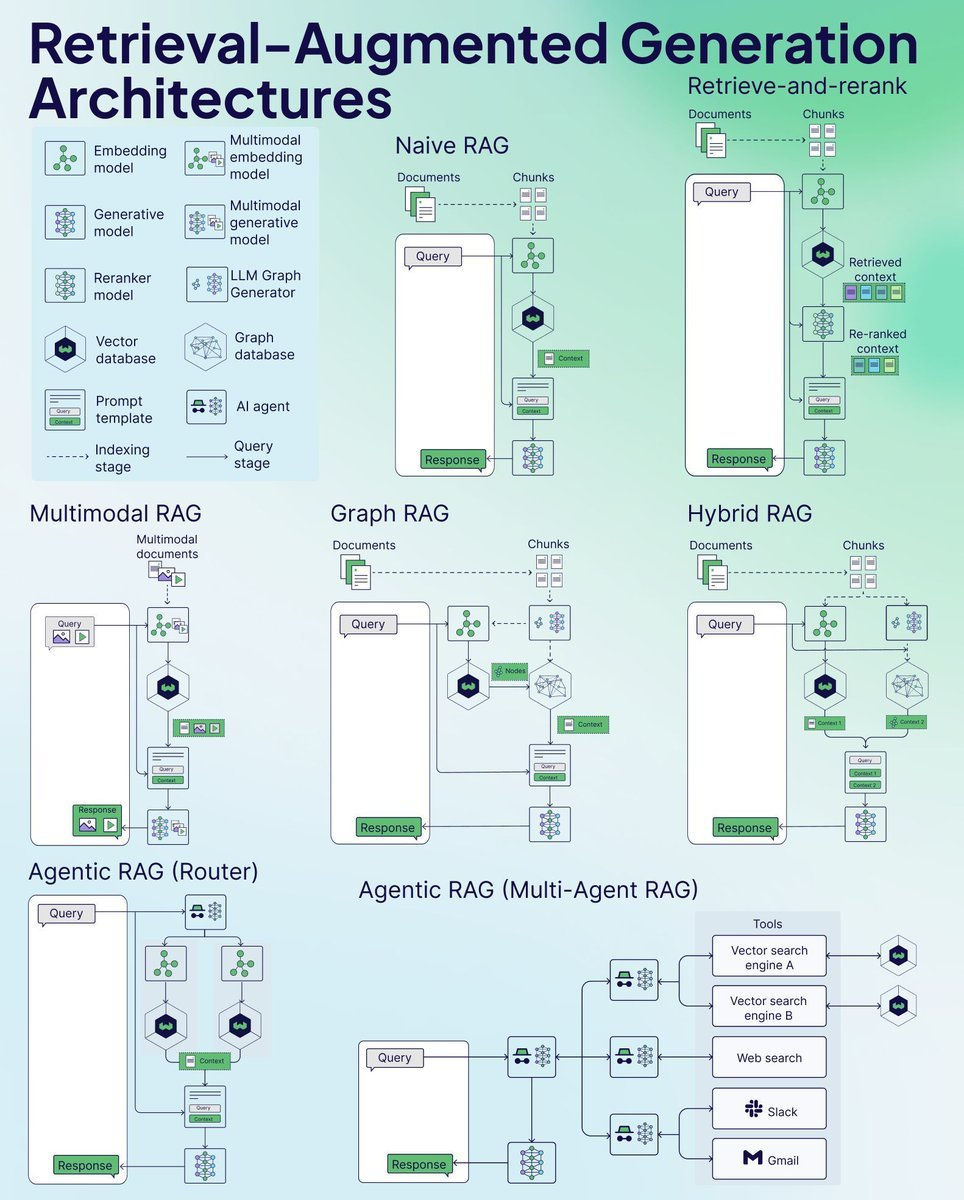
总览
Agentic RAG
- Weaviate What is Agentic RAG
- Traditional RAG vs. Agentic RAG—Why AI Agents Need Dynamic Knowledge to Get Smarter
- What is agentic RAG?
- Agentic RAG: How It Works, Use Cases, Comparison With RAG
- RAG, AI Agents, and Agentic RAG: An In-Depth Review and Comparative Analysis
- Agentic RAG: How It Works, and How to Evaluate RAG agents
- Agentic RAG vs. Traditional RAG: The Future of AI Decision-Making
- Top 20+ Agentic RAG Frameworks in 2025
- RAG vs Agentic RAG: The Evolution of Smarter, More Dynamic AI Systems
- Agentic RAG Systems: Integration of Retrieval and Generation in AI Architectures
- Building an agentic RAG pipeline
预处理
- From Good to Great: How Pre-processing Documents Supercharges AI’s Output
- Advanced RAG 02: Unveiling PDF Parsing
- Advanced RAG 07: Exploring RAG for Tables
- 5 Levels Of Text Splitting
- Advanced RAG series: Indexing
查询问句分类和微调
检索
查询语句改写
- Advanced RAG 06: Exploring Query Rewriting
- Advanced RAG 11: Query Classification and Refinement
- Advanced RAG Series:Routing and Query Construction
- Query Transformations
- Query Construction
检索策略
- Foundations of Vector Retrieval
- 这本200多页的专题论文提供了向量检索文献中主要算法里程碑的总结,目的是作为新老研究者可以独立参考的资料。
- Improving Retrieval Performance in RAG Pipelines with Hybrid Search
- Multi-Vector Retriever for RAG on tables, text, and images
- Relevance and ranking in vector search
- Boosting RAG: Picking the Best Embedding & Reranker models
- Azure Cognitive Search: Outperforming vector search with hybrid retrieval and ranking capabilities
- Optimizing Retrieval Augmentation with Dynamic Top-K Tuning for Efficient Question Answering
- Building Production-Ready LLM Apps with LlamaIndex: Document Metadata for Higher Accuracy Retrieval
- dvanced RAG Series: Retrieval
GraphRAG
检索后处理
重排序
Contextual(Prompt) Compression
- How to Cut RAG Costs by 80% Using Prompt Compression
- 第一种压缩方法是 AutoCompressors。它的工作原理是将长文本汇总为短向量表示,称为汇总向量。然后,这些压缩的摘要向量充当模型的软提示。
- LangChain Contextual Compression
其他
- Bridging the rift in Retrieval Augmented Generation
- 不是直接微调检索器和语言模型等效果不佳的基础模块,而是引入了第三个参与者——位于现有组件之间的中间桥接模块。涉及技术包括排序、压缩、上下文框架、条件推理脚手架、互动询问等 (可参考后续论文)
评估
- Evaluating RAG Applications with RAGAs
- Best Practices for LLM Evaluation of RAG Applications
- Advanced RAG 03: Using RAGAs + LlamaIndex for RAG evaluation
- Exploring End-to-End Evaluation of RAG Pipelines
- Evaluating Multi-Modal Retrieval-Augmented Generation
- RAG Evaluation
- Evaluation - LlamaIndex
- 评估-LlamaIndex
- Pinecone的RAG评测
- 不同数据规模下不同模型的RAG忠实度效果
- 不同模型下使用RAG与不是用RAG(仅依靠内部知识)的忠实度效果
- 不同模型下结合内部和外部知识后的RAG忠实度效果
- 不同模型下的RAG的答案相关度效果
- zilliz:Optimizing RAG Applications: A Guide to Methodologies, Metrics, and Evaluation Tools for Enhanced Reliability
- Advanced RAG Series: Generation and Evaluation
幻觉
课程
- Project: Deep Research with LangGraph
- 短课程 Building and Evaluating Advanced RAG Applications
- Retrieval Augmented Generation for Production with LangChain & LlamaIndex
- agentic-rag-for-dummies
- 这是一个使用 LangGraph 构建的生产级智能RAG(检索增强生成)系统。该项目提供了两种学习路径:交互式Notebook用于快速理解核心概念,以及模块化Python项目用于开发实际应用。系统支持对话记忆、智能查询澄清、分层索引检索、多智能体并行处理和人在环交互等高级功能。通过端到端的Gradio界面,用户可以上传PDF文档、进行自然对话查询,系统会自动将PDF转换为Markdown、构建分层索引、智能重写查询、并行检索信息、聚合多个答案生成最终回应。
- 主要功能点
- 对话记忆管理:跨多个问题维持对话上下文的自然连续性
- 智能查询澄清:自动重写模糊查询,支持人在环交互式确认
- 分层索引检索:使用Parent/Child分块策略平衡精确性和上下文丰富性
- 多智能体并行处理:使用LangGraph的Send API对复杂查询进行并行分解和处理
- 自适应检索:自动评估搜索结果相关性,不足时主动获取更大的上下文块
- 端到端Gradio界面:支持文档管理、对话交互和可视化管理
- 模块化架构:每个组件(LLM提供商、嵌入模型、分块策略等)可独立定制和替换
视频
- A Survey of Techniques for Maximizing LLM Performance
- How do domain-specific chatbots work? An overview of retrieval augmented generation (RAG)
- nvidia:Augmenting LLMs Using Retrieval Augmented Generation
- How to Choose a Vector Database
图书
- 大语言模型
- 大模型技术的中文参考资料,由中国人民大学师生联手打造,由赵鑫教授和文继荣教授领衔。书籍注重为大模型技术的入门读者提供讲解,力图展现一个整体的大模型技术框架和路线图。本书适用于具有深度学习基础的高年级本科生以及低年级研究生使用,可以作为一本入门级的技术书籍。
- 下载地址: http://aibox.ruc.edu.cn/docs//2024-04/da308db79a5d4c5697da99e012d46c76.pdf
- 大模型基础
- 浙江大学DAILY实验室毛玉仁研究员、高云君教授领衔撰写的《大模型基础》教材!本书包括传统语言模型、大语言模型架构、提示工程、高效参数、模型编辑、搜索增强增加生成等六章内容。为增加本书的易读性,每章分别以一种动物为背景,对具体技术进行举例说明,故此本书以六种动物作为封面。
- 因为大模型的技术这几年发展太快了,本书的一个目标也是“月度更新”,自半年前发布后就在不断update,致力打造易读、严谨、有深度的大模型教材。
- 《大规模语言模型:从理论到实践》
- 本书围绕大语言模型构建的四个主要阶段:预训练、有监督微调、奖励建模和强化学习,详细介绍各阶段使用的算法、数据、难点以及实践经验。
- 下载地址: https://intro-llm.github.io/chapter/LLM-TAP.pdf
编码实践
其他
- 中文大模型相关汇总
- 包括数据、微调、推理、评估、体验、RAG、Agent、搜索、书籍和课程等方面的资源:
- Large Language Model (LLM) Disruption of Chatbots
- Gen AI: why does simple Retrieval Augmented Generation (RAG) not work for insurance?
- End-to-End LLMOps Platform
Contributors


Similar repos


the resources about the application based on LLM with RAG pattern
1,659
88 commits
updated Mar 10, 2026
README
Awesome LLM RAG Application
Awesome LLM RAG Application is a curated list of application resources based on LLM with RAG pattern. (latest update: 2025-12-19)
综述
论文
论文顺序由近及远
-
2025.08.19 基于大模型的Deep Search智能体综述
-
2025.08.18 Deep Research: 自治型研究智能体综述
-
2025.08.13 Open Deep Research的优化和演进
-
2025.07.03 从网页搜索到智能体特性的深度研究功能:通过推理智能体优化搜索
-
2025.06.22 Deep Research Agents 总结
-
《Deep Research Agents: A Systematic Examination And Roadmap》
详情
-
2025.06.14 Deep Research 总结
https://arxiv.org/abs/2506.18096
-
2025.02.04 Agentic RAG 总结
-
《Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG》
详情
https://arxiv.org/abs/2501.09136
- 核心原理与机制:阐释Agentic RAG的基础概念及核心Agentic机制,包括反思(reflection)、规划(planning)、工具调用(tool use) 与多智能体协作(multi-agent collaboration)。
- 系统分类框架:构建Agentic RAG的详细分类体系,涵盖单智能体(single-agent)、多智能体(multi-agent)、层次化(hierarchical)、纠错型(corrective)、自适应(adaptive) 及图结构驱动(graph-based RAG) 等不同架构。
- 横向对比分析:系统比较传统RAG、Agentic RAG与智能体文档工作流(ADW) 的优劣势及适用场景。
- 落地应用案例:探索Agentic RAG在医疗诊断、个性化教育、金融风控、法律合规等行业的实际应用。
- 挑战与发展趋势:探讨该领域面临的系统可扩展性、AI伦理规范、多模态融合、人机协同模式等关键问题及未来方向。
-
-
2024.12.23 RAG中的查询优化技术总结
-
2024.10.23 RAG技术演进的回顾总结
-
详情
https://arxiv.org/abs/2410.12837全面研究检索增强生成(RAG)技术,追溯其从基础概念到当前状态的演变过程
-
-
2024.09.23 综述RAG数据利用方案
- 《Retrieval Augmented Generation (RAG and Beyond: A Comprehensive Survey on How to Make your LLMs use External Data More Wisely)》
详情
https://arxiv.org/abs/2409.14924 探讨了如何通过外部数据增强大模型(LLMs)的能力。
- 《Retrieval Augmented Generation (RAG and Beyond: A Comprehensive Survey on How to Make your LLMs use External Data More Wisely)》
-
2024.08.15 综述GraphRAG方案
-
《Graph Retrieval-Augmented Generation: A Survey》
详情
- https://arxiv.org/abs/2408.08921
- 系统性地回顾了Graph Retrieval-Augmented Generation (GraphRAG) 的现状和发展方向。
-
-
2024.07.18 综述RAG用于NLP自然语言处理
-
《Retrieval-Augmented Generation for Natural Language Processing: A Survey》
- https://arxiv.org/abs/2407.13193详情
-
-
2024.05.13 综述RAG的评估
-
2024.05.10 综述RAG与LLM的结合范式
-
《A Survey on RAG Meeting LLMs: Towards Retrieval-Augmented Large Language Models》
详情
- 地址:https://arxiv.org/abs/2405.06211
-
-
2024.04.30 综述检索增强语言模型(RALMs)
-
《RAG and RAU: A Survey on Retrieval-Augmented Language Model in Natural Language Processing》
详情
全面综述检索增强语言模型(RALMs),包括检索增强生成(RAG)和检索增强理解(RAU),并探讨其在自然语言处理(NLP)中的应用和发展,不仅关注RAG,还涵盖了RAU,详细描述了检索器和语言模型的不同交互模式,并提供了RALMs的工作时间表和应用总结。
-
-
2024.04.17 综述面向检索的核心技术
-
《A Survey on Retrieval-Augmented Text Generation for Large Language Models》
详情
地址:https://arxiv.org/abs/2404.10981 主要回顾当前RAG在各个阶段的核心技术。例如,对于检索,分成了基本检索策略:线性工作流程,适用于简单任务;迭代检索策略:多次检索,逐步优化结果;递归检索策略:处理层次化或分层信息,适用于复杂查询;条件检索策略:根据特定条件或规则进行检索;以及自适应检索策略:动态调整检索策略以优化结果。
-
-
2024.02.29 面向AIGC生成做全面综述
-
2023.11.18 首个全面RAG综述
-
2023.03.20 多模态RAG综述
详情
https://arxiv.org/abs/2303.10868 探讨了通过检索多模态知识来增强生成模型的方法,特别是如何利用图像、代码、结构化知识、音频和视频等多模态信息来提升大型语言模型(LLMs)的生成能力。
-
2022.02.02近三年首个综述
其他资料
- 大语言模型的检索增强生成 (RAG) 方法
- Advaned RAG Techniques: an Illustrated Overview
- 高级RAG应用构建指南和总结
- Patterns for Building LLM-based Systems & Products
- RAG大全
- Open RAG Base
- Open RAG Base 是一个基于公开资料收集整理汇总的RAG知识库。它基于Notion构建,是目前最全面RAG的资料汇总仓库。目的是为读者提提供前沿和全面的RAG知识,提供多维度的分析汇总,涵盖RAG的方方面,包括:学术论文、前沿阅读资料、RAG评估与基准、下游任务与数据集、工具与技术栈
- 一个繁体的RAG资料集
- 关于RAG技术的综合合集RAG_Techniques
介绍
-
Microsoft-Retrieval Augmented Generation (RAG) in Azure AI Search
-
Cohere-Introducing Chat with Retrieval-Augmented Generation (RAG)
-
Milvus-Build AI Apps with Retrieval Augmented Generation (RAG)
比较
- Retrieval-Augmented Generation (RAG) or Fine-tuning — Which Is the Best Tool to Boost Your LLM Application?
- 提示工程、RAGs 与微调的对比
- RAG vs Finetuning — Which Is the Best Tool to Boost Your LLM Application?
- A Survey on In-context Learning
开源工具
RAG框架
-
- RAGFlow:基于OCR和文档解析的下一代 RAG 引擎。在文档解析上做了增强,2024年4月1日开源,在数据处理上支持文档结构、图片、表格的深度解析,支持可控分片,可对查询进行深入分析识别关键信息,在检索上提供多路找回/重排能力,界面提供友好的引用参考查看功能。
-
- 融合了 Backend as Service 和 LLMOps 的理念,涵盖了构建生成式 AI 原生应用所需的核心技术栈,包括一个内置 RAG 引擎。使用 Dify,你可以基于任何模型自部署类似 Assistants API 和 GPTs 的能力。
-
- 您的第二大脑,利用 GenerativeAI 的力量成为您的私人助理!但增强了人工智能功能。
- Quivr
-
详情
- GraphRAG 是一种基于图的检索增强方法,由微软开发并开源。 它通过结合LLM和图机器学习的技术,从非结构化的文本中提取结构化的数据,构建知识图谱,以支持问答、摘要等多种应用场景。
- 微软GraphRAG框架演进之路及带来的一些思考
-
详情
- 微软Graph的简化版本,将社区、社区宅摘要这些环节做了去除,这种去除是好的,不会太重,对于知识更新也更快;
-
详情
一个开源的、基于 RAG (Retrieval-Augmented Generation) 的文档问答工具,支持多用户登录、本地和云端 LLM 及 Embedding 模型、图表多模态文档解析和问答、混合检索带文档预览的高级引用功能、持复杂推理方法,如问题分解、基于 agent 的推理(如 ReAct、ReWOO)等。
-
- MaxKB是一个开源的企业级智能体平台。它集成了检索增强型生成(RAG)管道,支持强大的工作流,并提供了高级的MCP工具使用功能。MaxKB广泛应用于智能客户服务、企业内部知识库、学术研究和教育等场景。
-
- 致力于支持任意格式文件或数据库的本地知识库问答系统,可断网安装使用。任何格式的本地文件都可以往里扔,即可获得准确、快速、靠谱的问答体验。目前已支持格式: PDF,Word(doc/docx),PPT,Markdown,Eml,TXT,图片(jpg,png等),网页链接
-
- 这是向量数据库weaviate开源的一款RAG应用,旨在为开箱即用的检索增强生成 (RAG) 提供端到端、简化且用户友好的界面。只需几个简单的步骤,即可在本地或通过 OpenAI、Cohere 和 HuggingFace 等 LLM 提供商轻松探索数据集并提取见解。
-
- 允许您针对内部文档提出自然语言问题,并获得由源材料中的引用和参考文献支持的可靠答案,以便您始终可以信任您得到的结果。您可以连接到许多常用工具,例如 Slack、GitHub、Confluence 等。
-
- Cognita 在底层使用了Langchain/Llamaindex,并对代码进行了结构化组织,其中每个 RAG 组件都是模块化的、API 驱动的、易于扩展的。Cognita 可在本地设置中轻松使用,同时还能为您提供无代码用户界面支持的生产就绪环境。Cognita 默认还支持增量索引。
-
详情
一款低代码构建多Agent大模型应用的开发工具,协助开发者用极低的成本构建复杂的AI应用,并可以持续的迭代优化效果。使用LazyLLM搭建RAG应用非常便捷和灵活,可以任意字定义多路检索和召回策略。除此之外,LazyLLM的AI应用构建流程是原型搭建 -> 数据回流 -> 迭代优化,用户可以先基于LazyLLM快速搭建RAG应用的,再结合场景任务数据进行bad-case分析,然后对应用中的关键环节进行算法迭代和模型微调,进而逐步提升整个RAG应用的效果。
-
- GPT-RAG提供了一个强大的架构,专为RAG模式的企业级部署量身定制。它确保了扎实的回应,并建立在零信任安全和负责任的人工智能基础上,确保可用性、可扩展性和可审计性。非常适合正在从探索和PoC阶段过渡到全面生产和MVP的组织。
-
- 生产就绪的多AI代理框架,支持RAG、Agentic RAG工作流、100+LLM支持、MCP协议集成、内置记忆系统(短期、长期、实体、情景记忆)和自我反思功能。
预处理
-
详情
MarkItDown 是一个轻量级的 Python 工具,用于将各种文件转换为 Markdown 格式,以便与 LLMs 和相关文本分析流程一起使用。为此,它与 textract 最相似,但更注重保留重要的文档结构和内容作为 Markdown(包括:标题、列表、表格、链接等)。虽然输出通常相当可读且适合人类阅读,但其目的是供文本分析工具使用——可能不是为人类消费进行高保真文档转换的最佳选择。
MarkItDown 目前支持以下格式的转换:
PDF PowerPoint Word Excel Images (EXIF metadata and OCR) Audio (EXIF metadata and speech transcription) HTML 基于文本的格式(CSV、JSON、XML) ZIP 文件(遍历内容) Youtube URLs EPubs 等
-
- Docling 是一个简化文档处理和解析的工具,支持多种文档格式,包括 PDF、DOCX、PPTX、XLSX、HTML、WAV、MP3、VTT 和图像等。它提供了先进的 PDF 理解功能,如页面布局、读取顺序、表格结构、代码、公式和图像分类等。Docling 还提供了统一的 DoclingDocument 表示格式,支持多种导出格式,如 Markdown、HTML、DocTags 和 JSON。此外,Docling 还支持本地执行、集成 LangChain、LlamaIndex、Crew AI 和 Haystack 等 AI 框架,以及广泛的光学字符识别 (OCR) 和音频支持。
-
详情
该库提供了用于摄取和预处理图像和文本文档(如 PDF、HTML、WORD 文档等)的开源组件。 unstructured的使用场景围绕着简化和优化LLM数据处理工作流程, unstructured模块化功能和连接器形成了一个有内聚性的系统,简化了数据摄取和预处理,使其能够适应不同的平台,并有效地将非结构化数据转换为结构化输出。
-
- 对文档进行分块是一项具有挑战性的任务,它支撑着任何 RAG 系统。高质量的结果对于人工智能应用的成功至关重要,但大多数开源库处理复杂文档的能力都受到限制。
- Open Parse 旨在通过提供灵活、易于使用的库来填补这一空白,该库能够直观地识别文档布局并有效地对其进行分块。
-
- 使用 LLMs 从文件和文档中提取数据的库。 extract_thinker 在文件和 LLMs 之间提供 ORM 风格的交互,从而实现灵活且强大的文档提取工作流程。
-
- OmniParser 是一个统一的框架,无缝地结合了三个基本的 OCR 任务:文本识别、关键信息提取和表格识别。
-
- 给定一个 HTML 文档,提取并清理主体文本和标题。
-
- Neural Optical Understanding for Academic Documents.这是学术文档 PDF 解析器,它能理解 LaTeX 数学和表格。但对中文支持不好,需要单独微调。
-
- Pix2Struct 是一种预训练的图像到文本模型,专为纯视觉语言理解而设计。
-
- Indexify 是一个开源引擎,用于使用可重复使用的提取器进行嵌入、转换和特征提取,为非结构化数据(视频、音频、图像和文档)快速构建数据流水线。当;流水线生成嵌入或结构化数据时,Indexify 会自动更新向量数据库、结构化数据库 (Postgres)。
-
- MegaParse 是一个强大且通用的解析器,可以轻松处理各种类型的文档,包括文本、PDF、PowerPoint 演示文稿、Word 文档等。它旨在在解析过程中尽可能减少信息丢失。
- 解析内容包括: ✅ Tables ✅ TOC ✅ Headers ✅ Footers ✅ Images
路由
评测框架
-
- Ragas是一个用于评估RAG应用的框架,包括忠诚度(Faithfulness)、答案相关度(Answer Relevance)、上下文精确度(Context Precision)、上下文相关度(Context Relevancy)、上下文召回(Context Recall)
-
- 一个简单易用的开源LLM评估框架,适用于LLM应用程序。它与 Pytest 类似,但专门用于单元测试 LLM 应用程序。 DeepEval 使用 LLMs 以及在您的计算机上本地运行的各种其他 NLP 模型,根据幻觉、答案相关性、RAGAS 等指标来评估性能。
-
- TruLens 提供了一套用于开发和监控神经网络的工具,包括大型语言模型。这包括使用 TruLens-Eval 评估基于 LLMs 和 LLM 的应用程序的工具以及使用 TruLens-Explain 进行深度学习可解释性的工具。 TruLens-Eval 和 TruLens-Explain 位于单独的软件包中,可以独立使用。
-
- 用于评估和改进生成式人工智能应用的开源统一平台。提供了20多项预配置检查(涵盖语言、代码、嵌入用例)评分,对失败案例进行根本原因分析,并就如何解决这些问题提出见解。
- 比如prompt注入、越狱检测、整通对话的用户满意度等
-
- 一个用于 RAG 开发和实验跟踪的平台,用于评估检索增强生成 (RAG) 应用程序响应质量的指标。
Embedding
- BCEmbedding
- 网易有道开发的双语和跨语种语义表征算法模型库,其中包含 EmbeddingModel和 RerankerModel两类基础模型。EmbeddingModel专门用于生成语义向量,在语义搜索和问答中起着关键作用,而 RerankerModel擅长优化语义搜索结果和语义相关顺序精排。
- BGE-Embedding
- 北京智源人工智能研究院开源的embeeding通用向量模型,使用retromae 对模型进行预训练,再用对比学习在大规模成对数据上训练模型。
- bge-reranker-large
- 北京智源人工智能研究院开源,交叉编码器将对查询和答案实时计算相关性分数,这比向量模型(即双编码器)更准确,但比向量模型更耗时。 因此,它可以用来对嵌入模型返回的前k个文档重新排序
- gte-base-zh
- GTE text embedding GTE中文通用文本表示模型 通义实验室提供
爬虫
-
详情
- Crawl4AI是一个开源的、用于为AI而生的智能、快速且灵活的网络爬虫工具。它针对大语言模型(LLM)、AI Agent和数据流水线提供了优秀的爬取性能,通过高速、精确和易部署的特点来赋能开发者。
- 为LLM量身打造的Markdown生成功能。
- 提供6倍于常规爬虫的超快速爬取能力。
- 支持会话管理、代理和自定义钩子,实现灵活的浏览器控制。
- 采用高级算法进行高效抽取,减少对昂贵模型的依赖。
- 完全开源无API密钥,支持Docker和云端集成。
-
详情
Firecrawl 是一个强大的 API 服务,可以从任何网站抓取数据并转换为干净的 Markdown 或结构化数据。它具有高级的抓取、爬取和数据提取功能,可以帮助您的 AI 应用程序获取干净的数据。
主要功能点
- 抓取: 抓取网页内容并以 LLM 就绪格式(Markdown、结构化数据、截图、HTML)返回
- 爬取: 抓取网页上的所有 URL 并以 LLM 就绪格式返回内容
- 映射: 输入一个网站,获取该网站的所有 URL - 速度极快 强大的功能: 支持 LLM 就绪格式、代理、反机器人机制、动态内容(JS 渲染)、输出解析、编排等
- 可定制性: 排除标签、在身份验证墙后爬取、最大爬取深度等
-
- 它将任何 URL 转换为LLM 友好的输入,
安全护栏
-
- JoySafety 是一个开源的大模型安全框架。该框架在京东内部广泛应用,覆盖AI导购、物流客服、销售助手、医疗问诊、商家工作台、法务咨询、安全问答等场景,支持日均亿级调用、95%+攻击拦截率,致力于为企业提供一套成熟、可靠、免费的大模型安全防护方案。
-
详情
NeMo Guardrails 是一个开源工具包,用于为基于 LLM 的对话应用程序轻松添加可编程的保护轨。Guardrails(简称 "轨")是控制大型语言模型输出的特定方式,例如不谈论政治、以特定方式响应特定用户请求、遵循预定义对话路径、使用特定语言风格、提取结构化数据等。
-
详情
- Guardrails 是一个 Python 框架,通过执行两个关键功能来帮助构建可靠的人工智能应用程序:
- Guardrails 在应用程序中运行输入/输出防护装置,以检测、量化和减轻特定类型风险的存在。要查看全套风险,请访问 Guardrails Hub。
- Guardrails 可帮助您从 LLMs 生成结构化数据。对输入和输出进行检测
-
详情
- LLM Guard 是一款旨在增强大型语言模型 (LLMs) 安全性的综合工具。
- 输入(Anonymize 匿名化、BanCode 禁止代码、BanCompetitors 禁止竞争对手、BanSubstrings 禁止子串、BanTopics 禁止话题、PromptInjection 提示词注射 、Toxicity 毒性等)
- 输出(代码、anCompetitors 禁止竞争对手、Deanonymize 去匿名化、JSON、LanguageSame 语言相同、MaliciousURLs 恶意URL、NoRefusal 不可拒绝、FactualConsistency 事实一致性、URLReachability URL可达性等)
- 各个检测功能是利用了huggingface上的各种开源模型
-
详情
- Llama Guard 是一个新的实验模型,可为 LLM 部署提供输入和输出防护栏。Llama Guard 是经过微调的 Llama-7B 模型。
- RefChecker
- RefChecker 提供了一个标准化的评估框架来识别大型语言模型输出中存在的微妙幻觉。
- vigil-llm
- Vigil是一个Python库和REST API,可以根据一组扫描器评估大型语言模型提示和响应,以检测提示注入、越狱和其他潜在威胁。该存储库还提供了必要的检测特征(签名)和数据集,支持用户自行部署和使用。 该应用程序目前处于 alpha 状态,应被视为实验/用于研究目的。
Prompting
-
- DSPy 是一款功能强大的框架。它可以用来自动优化大型语言模型(LLM)的提示词和响应。还能让我们的 LLM 应用即使在 OpenAI/Gemini/Claude版本升级也能正常使用。无论你有多少数据,它都能帮助你优化模型,获得更高的准确度和性能。通过选择合适的优化器,并根据具体需求进行调优,你可以在各种任务中获得出色的结果。
-
- GenAI 应用程序的自动提示工程助手 YiVal 是一款最先进的工具,旨在简化 GenAI 应用程序提示和循环中任何配置的调整过程。有了 YiVal,手动调整已成为过去。这种以数据驱动和以评估为中心的方法可确保最佳提示、精确的 RAG 配置和微调的模型参数。使用 YiVal 使您的应用程序能够轻松实现增强的结果、减少延迟并最大限度地降低推理成本!
AI攻击
- PyRIT
- PyRIT(Python Risk Identification Tool)是一个开源框架,旨在帮助安全专业人员和工程师主动识别生成式AI系统中的风险。该工具专注于通过红队测试和风险评估来提高AI系统的安全性。
- 主要功能点
- 为生成式AI系统提供安全风险识别
- 支持安全专业人员进行主动风险评估
- 提供开源的AI安全测试框架
- 支持对AI系统进行红队测试
- 帮助识别潜在的AI系统安全漏洞
- promptfoo
- LLM应用测试和安全评估工具,Promptfoo是一个面向开发者的本地工具,用于测试和评估大语言模型(LLM)应用程序。它提供了一种系统化的方法来测试提示词、模型性能和应用安全性。
- 主要功能点
- 自动化评估提示词和模型
- 进行LLM应用的安全漏洞扫描
- 多模型并排比较(支持OpenAI、Anthropic等多种模型)
- 在CI/CD流程中自动化检查
- 生成详细的安全漏洞报告
- deepteam
- 一个开源的LLM红队测试框架,专注于通过模拟对抗性攻击来发现和防护大型语言模型系统的安全漏洞。
- 主要功能点
- 提供40多种开箱即用的漏洞检测,包括偏见、隐私泄露、错误信息等
- 支持10多种单轮和多轮对抗性攻击方法
- 可以自定义特定组织需求的漏洞和攻击
- 提供风险评估报告,支持本地保存和数据框展示
- 支持OWASP Top 10和NIST AI RMF等标准指南
SQL增强
-
- Vanna 是一个MIT许可的开源Python RAG(检索增强生成)框架,用于SQL生成和相关功能。
- Vanna 的工作过程分为两个简单步骤 - 在您的数据上训练 RAG“模型”,然后提出问题,这些问题将返回 SQL 查询。训练的数据主要是一些 DDL schema、业务说明文档以及示例sql等,所谓训练主要是将这些数据embedding化,用于向量检索。
-
- 由前阿里巴巴成员创建并开源,一个智能和多功能的通用SQL客户端和报表工具,集成了ChatGPT功能,,14.3k
-
- 一个可以将自然语言转换为SQL查询的工具,4.1k
-
- 使用AI驱动的数据管理平台,帮助用户将自然语言查询转换为SQL。,3.2k
-
- 一个高效的自然语言到SQL转换工具,支持多种数据库。,1.4k
-
- 由腾讯音乐开源,高性能的SQL生成工具,支持复杂查询的自动生成。1.6k
LLM部署和serving
可观测性
其他
- RAGxplorer
- RAGxplorer 是一种交互式 Streamlit 工具,通过将文档块和的查询问句展示为embedding向量空间中可的视化内容来支持检索增强生成 (RAG) 应用程序的构建。
- Rule-Based-Retrieval
- rule-based-retrieval是一个 Python 包,使您能够创建和管理具有高级筛选功能的检索增强生成 (RAG) 应用程序。它与用于文本生成的 OpenAI 和用于高效矢量数据库管理的 Pinecone 无缝集成。
- instructor
- 借助大模型从一段文本中提取为结构化数据的库
- RAGLAB
- RAGLAB是一个模块化、面向研究的开源框架,用于检索增强型生成(Retrieval-Augmented Generation, RAG)算法。它提供了6种现有RAG算法的复制,以及一个全面的评估系统,包括10个基准数据集,使得RAG算法之间的公平比较和新算法、数据集和评估指标的高效开发成为可能。
- WFGY 16 Problem Map
- WFGY 是一个面向 RAG 系统的结构化故障排查项目,提供 16 问题清单,用于系统性分析检索增强生成 (RAG) 应用中的常见失败模式,如命中错误、引用陈旧内容、分块不合理、重排序失效、多轮记忆漂移等问题,帮助开发者快速定位问题属于检索、分块、重排、提示、缓存或评估链路。
- bRAG-langchain
- 这个项目是一个全面探索检索增强型生成(Retrieval-Augmented Generation, RAG)的仓库,包含从入门到高级实现的详细教程,涵盖多查询、自定义RAG构建等内容。
-
• 查询构建——将自然语言转换为结构化查询(SQL、Cypher 或基于向量的检索) . (文本到 SQL、文本到 Cypher、自查询检索器
• 查询翻译——分解并重新表述输入,以实现更佳的检索效果。(多查询、RAG 融合、假设文档)
• 路由——动态选择正确的数据库或嵌入查询上下文以获得更相关的答案。
• 检索——使用 Re-Rank、RankGPT、RAG-Fusion、CRAG 对检索到的数据进行排名和优化,甚至从外部来源提取实时更新。
• 索引——利用多表示嵌入、分层摘要和结构化搜索优化。(RAPTOR、CoLBERT、微调)
• 生成——使用 Self-RAG 和 RRR 生成和完善响应,在需要时实现迭代推理和检索循环。
AI搜索类项目
- https://github.com/khoj-ai/khoj
- https://github.com/ItzCrazyKns/Perplexica
- scira: https://github.com/zaidmukaddam/scira
-
详情
网页搜索:使用 Tavily 的 API 搜索网页。 特定 URL 搜索:从特定 URL 获取信息。 天气:使用 OpenWeather 的 API 获取任何位置的当前天气。 编程:使用 E2B 的 API 运行多种语言的代码片段。 地图:使用 Google Maps API、Mapbox API 和 TripAdvisor API 获取任何地点的位置。 YouTube 搜索:搜索 YouTube 视频并获取时间戳和字幕。 学术搜索:搜索学术论文。 X 帖子搜索:搜索 X.com 上的帖子。 航班跟踪:使用 AviationStack 的 API 跟踪航班。 热门电影和电视节目:获取热门电影和电视节目的信息。 电影或电视节目搜索:获取任何电影或电视节目的信息。
- https://github.com/nashsu/FreeAskInternet
- https://github.com/miurla/morphic
- https://github.com/leptonai/search_with_lepton
- AZure-search-openai-demo:https://github.com/Azure-Samples/azure-search-openai-demo
- https://github.com/InternLM/MindSearch
- https://github.com/nilsherzig/LLocalSearch
- llm-answer-engine:https://github.com/developersdigest/llm-answer-engine
- https://github.com/rashadphz/farfalle
- Gerev:https://github.com/GerevAI/gerev
- Gemini-Search:https://github.com/ammaarreshi/Gemini-Search
- 一个基于 Google 的 Gemini 2.0 Flash 模型和 Google 搜索的 Perplexity 风格的搜索引擎。它提供 AI 驱动的问答功能,可以实时获取网络资源并提供引用。
- https://github.com/Nutlope/turboseek
- https://github.com/memfreeme/memfree
- https://github.com/supermemoryai/opensearch-ai
- https://github.com/yokingma/search_with_ai
- OpenPerPlex:https://github.com/YassKhazzan/openperplex_backend_os
- search4all:https://github.com/fatwang2/search4all
- https://github.com/QmiAI/Qmedia?tab=readme-ov-file
- https://github.com/luyu0279/BrainyAI
- https://github.com/OcularEngineering/ocular
- https://github.com/jjleng/sensei
- https://github.com/shadowfax92/Fyin
- https://github.com/YassKhazzan/openperplex_front
Deep Search/ Deep Research
- https://github.com/Alibaba-NLP/DeepResearch
- https://github.com/assafelovic/gpt-researcher
- https://github.com/langchain-ai/open_deep_research
- https://github.com/jina-ai/node-DeepResearch
- https://github.com/bytedance/deer-flow
- https://github.com/dzhng/deep-research
- https://github.com/langchain-ai/local-deep-researcher
- https://github.com/zilliztech/deep-searcher
- https://github.com/SkyworkAI/DeepResearchAgent
- https://github.com/firecrawl/firesearch
应用参考
- Kimi Chat
- 支持发送网页链接和上传文件进行回答
- GPTs
- 支持上传文档进行类似RAG应用
- 百川知识库
- 1.新建知识库后得到知识库 ID;
- 2.上传文件,获取文件 ID;
- 3.通过文件 ID 与知识库 ID 进行知识库文件关联,知识库中可以关联多个文档。
- 4.调用对话接口时通过 knowledge_base 字段传入知识库 ID 列表,大模型使用检索到的知识信息回答问题。
- COZE
- 应用编辑平台,旨在开发下一代人工智能聊天机器人。无论您是否有编程经验,该平台都可以让您快速创建各种类型的聊天机器人并将其部署在不同的社交平台和消息应用程序上。
- Devv-ai
- 最懂程序员的新一代 AI 搜索引擎,底层采用了RAG的大模型应用模式,LLM模型为其微调的模型。
企业级实践
- 2025-05 Uber:Enhanced Agentic-RAG: What If Chatbots Could Deliver Near-Human Precision?
- Qcon 句子互动 高原 Agentic RAG 的现在与未来
- Qcon 尹一峰-RAG 基本范式的选择与系统设计
- Qcon 夏源-在医疗健康领域,企业大模型RAG优化实践
- Qcon 费跃 阿里云-构建企业级 RAG 系统的创新实践
- AIConf 阿里云客户服务领域Agent在业务提效上的思考与创新实践_姜剑(飞樰)
- 新加坡科研局 黄佳-大模型+数据资产变现,RAG 驱动企业智能化实践案例
- 枫清科技 王传阳 - QCon北京2025-复杂场景下的 RAG 架构演进:跨模态知识联邦与统一语义推理实践
- BISHENG AI Conf 覃睿-DeepResearch如何在企业内落地
- AIConf QAnything:大模型驱动下的知识库问答体系革新与实践
- Qconf 董振兴-明略科技多模态数据驱动的RAG增强实践.pdf
- 纷享销客AIAgent平台落地实践
- 快手 从被动服务到主动任务,Agentic AI 在 B 端商业化的应用探索
- B站大模型×领域RAG:打造高效、智能化的用户服务体验 PPT
- 哈啰出行从Copilot到Agent模式的探索-贾立 PPT
- 51Talk-AI+Agent+-+在业务增长中的落地实践 PPT
- 万科物业科技 PPT
- 京东商家助手 PPT
- 58同城-灵犀大模型PPT
- 阿⾥云AI搜索RAG⼤模型优化实践PPT
- 向量化与文档解析技术加速大模型RAG应用落地PPT
- RAG应用在得物开放平台的智能答疑的探索
- 用户案例|Milvus向量引擎在携程酒店搜索中的应用场景和探索
- OpenAI 如何优化 LLM 的效果
- What We Learned from a Year of Building with LLMs 系列
- 构建企业级AI助手的经验教训
知识库建设
论文
-
RAG最佳实践《Searching for Best Practices in Retrieval-Augmented Generation》
图片
-
- Seven Failure Points When Engineering a Retrieval Augmented Generation System
-
Is ChatGPT Good at Search? Investigating Large Language Models as Re-Ranking Agents
-
Zero-Shot Listwise Document Reranking with a Large Language Model
- 两种重新排序方法:逐点重新排名、列表重新排名。
- 逐点重新排名是给定文档列表,我们将查询+每个文档单独提供给 LLM 并要求它产生相关性分数。
- 列表重新排名是给定文档列表,我们同时向 LLM 提供查询 + 文档列表,并要求它按相关性对文档进行重新排序。
- 建议对 RAG 检索到的文档按列表重新排序,列表重排优于逐点重排。
-
Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection
这里列出了一些重要的研究论文,它们揭示了 RAG 领域的关键洞察和最新进展。
| 洞见 | 参考来源 | 发布日期 |
|---|---|---|
| 提出一种名为纠正检索增强生成(CRAG, Corrective Retrieval Augmented Generation)的方法,旨在提升 RAG 系统生成内容的稳定性和准确性。其核心在于增加一个能够自我修正的组件至检索器中,并优化检索文档的使用,以促进更优质的内容生成。此外,引入了一种检索评估机制,用于评价针对特定查询检索到的文档的整体品质。通过网络搜索和知识的优化利用,能够有效提升文档自我修正和利用的效率。 | 纠正检索增强生成 | 2024年1月 |
| RAPTOR 模型通过递归方式嵌入、聚类并总结文本信息,自底向上构建出层次化的总结树。在使用时,该模型能够从这棵树中检索信息,实现对长文档在不同抽象层面上信息的综合利用。 | RAPTOR:递归抽象处理用于树组织检索 | 2024年1月 |
| 开发了一个通用框架,通过大语言模型(LLM)与检索器之间的多步骤互动,有效处理多标签分类难题。 | 在上下文中学习用于极端多标签分类 | 2024年1月 |
| 研究表明,通过提取高资源语言中语义相似的提示,可以显著提升多语言预训练语言模型在多种任务上的零样本学习能力。 | 从分类到生成:洞察跨语言检索增强的 ICL | 2023年11月 |
| 针对 RAGs 模型在处理噪声较多、不相关文档以及未知情境时的稳健性进行了改善,通过为检索文档生成序列化阅读笔记,深入评估其与提问的相关性,并整合信息以构建最终答案。 | 链式笔记:增强检索增强语言模型的鲁棒性 | 2023年11月 |
| 通过去除可能不会对答案生成贡献关键信息的标记,优化了检索增强阅读模型的处理流程,实现了高达 62.2% 的运行时间缩减,同时保持性能仅降低了2%。 | 通过标记消除优化检索增强阅读器模型 | |
| 通过对小型语言模型 (LM) 进行指令式微调,我们开发了一个独立的验证器,以验证知识增强语言模型 (knowledge-augmented LMs) 的输出及其知识准确性。这种方法特别有助于解决模型在面对特定查询时未能检索相关知识,或在生成文本中未能准确反映检索到的知识的情况。 | 知识增强语言模型验证 | 2023年10月 |
| 我们设立了一个基准测试,以分析不同大型语言模型 (LLMs) 在检索增强生成 (RAG) 所需的四项核心能力——噪声容忍、排除不相关信息、信息融合和对反事实情境的适应性——的表现。 | 大型语言模型在检索增强生成中的基准测试 | 2023年10月 |
| 介绍了一种自我反思的检索增强生成 (Self-RAG) 框架,旨在通过检索和自我反思来提升语言模型的质量和事实性。该框架利用语言模型动态检索信息,并通过反思标记来生成和评估检索到的内容及其自生成内容。 | 自我反思检索增强生成: 通过自我反思学习检索、生成及自我批判 | 2023年10月 |
| 通过生成增强检索 (GAR) 和检索增强生成 (RAG) 的迭代改善,提高了零样本信息检索的能力。该过程中的改写-检索阶段有效提升了召回率,而重排阶段则显著提高了精度。 | 零样本信息检索中的GAR与RAG相结合的新范式 | 2023年10月 |
| 通过使用基于 43B GPT 模型的预训练和从 1.2 万亿 Token 中检索信息,我们预训练了一个 48B 的检索模型。进一步通过指令式微调,该模型在多种零样本任务上相比经过指令式微调的 GPT 模型显示出显著的性能提升。 | InstructRetro: 检索增强预训练后的指令式微调 | 2023年10月 |
| 通过两步精细调整,我们为大型语言模型增加了检索功能:一步是优化预训练的语言模型以更有效利用检索到的信息,另一步则是改进检索器以返回更符合语言模型偏好的相关结果。这种分阶段的微调方法,在要求知识利用和上下文感知的任务中,显著提升了性能。 | 检索增强的双重指令微调 (RA-DIT) | 2023年10月 |
| 介绍了一种提升 RAGs 在面对不相关内容时鲁棒性的方法。该方法通过在训练期间混合使用相关与不相关的上下文,自动产生数据以微调语言模型,从而有效利用检索到的文段。 | 让基于检索增强的语言模型对无关上下文更加鲁棒 | 2023年10月 |
| 研究表明,采用简单检索增强技术的 4K 上下文窗口的大语言模型在生成过程中,其表现与通过位置插值对长上下文任务进行微调的 16K 上下文窗口的大语言模型相媲美。 | 当检索遇上长上下文的大语言模型 | 2023年10月 |
| 在上下文融合前将检索文档压缩为文本摘要,既降低了计算成本,也减轻了模型从长文档中识别关键信息的难度。 | RECOMP: 用压缩和选择性增强提升检索增强语言模型 | 2023年10月 |
| 提出了一个迭代式的检索与生成协同工作框架,它结合了参数化和非参数化知识,通过检索与生成的互动来寻找正确的推理路径。这一框架特别适合需要多步推理的任务,能够显著提高大语言模型的推理能力。 | 检索与生成的协同作用加强了大语言模型的推理能力 | 2023年10月 |
| 提出“澄清树”框架,该框架通过少样本提示并借助外部知识,为含糊问题递归构建一个消歧树。然后利用这棵树产生详细的答案。 | 利用检索增强大语言模型回答含糊问题的“澄清树”方法 | 2023年10月 |
| 介绍了一种使大语言模型能够参考其之前遇到的问题,并在面对新问题时动态调用外部资源的方法。 | 借助自我知识的大语言模型检索增强策略 | 2023年10月 |
| 提供了一组评估指标,用于从多个维度(如检索系统识别相关及集中上下文段落的能力、大语言模型忠实利用这些段落的能力,以及生成内容本身的质量)评价不同方面,而无需依赖人工注释的真实数据。 | RAGAS: 对检索增强生成进行自动化评估的指标体系 | 2023年9月 |
| 提出了一种创新方法——生成后阅读(GenRead),它让大型语言模型先根据提问生成相关文档,再从这些文档中提取答案。 | 生成而非检索:大型语言模型作为强大的上下文生成器 | 2023年9月 |
| 展示了在 RAG 系统中如何使用特定排名器(比如 DiversityRanker 和 LostInTheMiddleRanker)来挑选信息,从而更好地利用大型语言模型的上下文窗口。 | 提升 Haystack 中 RAG 系统的能力:DiversityRanker 和 LostInTheMiddleRanker 的引入 | 2023年8月 |
| 描述了如何将大型语言模型与不同的知识库结合,以便于知识的检索和储存。通过编程思维的提示来生成知识库的搜索代码,此外,还能够根据用户的需要,将知识储存在个性化的知识库中。 | KnowledGPT: 利用知识库检索和存储功能增强大型语言模型 | 2023年8月 |
| 提出一种模型,通过结合检索增强掩码语言建模和前缀语言建模,引入上下文融合学习,以此提高少样本学习的效果,使模型能够在不增加训练负担的情况下使用更多上下文示例。 | RAVEN: 借助检索增强编解码器语言模型实现的上下文学习 | 2023年8月 |
| RaLLe 是一款开源工具,专门用于开发、评估和提升针对知识密集型任务的 RAG 系统的性能。 | RaLLe: 针对检索增强大型语言模型的开发和评估框架 | 2023年8月 |
| 研究发现,当相关信息的位置发生变化时,大型语言模型的性能会明显受影响,这揭示了大型语言模型在处理长篇上下文信息时的局限性。 | 中途迷失:大型语言模型处理长篇上下文的方式 | 2023年7月 |
| 通过迭代的方式,模型能够将检索和生成过程相互协同。模型的输出不仅展示了完成任务所需的内容,还为检索更多相关知识提供了丰富的上下文,从而在下一轮迭代中帮助产生更优的结果。 | 通过迭代检索-生成协同增强检索增强的大语言模型 | 2023年5月 |
| 介绍了一种新的视角,即在文本生成过程中,系统能够主动决定何时以及检索什么信息。接着,提出了一种名为FLARE的方法,通过预测下一句话来预见未来的内容,利用此内容作为关键词检索相关文档,并在发现不确定的表达时重新生成句子。 | 主动检索增强生成 | 2023年5月 |
| 提出了一个能够通用应用于各种大语言模型的检索插件,即使在模型未知或不能共同微调的情况下也能提升模型性能。 | 适应增强型检索器改善大语言模型的泛化作为通用插件 | 2023年5月 |
| 通过两种创新的预训练方法,提高了对结构化数据的密集检索效果。首先,通过对结构化数据和非结构化数据之间的关联进行预训练来提升模型的结构感知能力;其次,通过实现遮蔽实体预测来更好地捕捉结构语义。 | 结构感知的语言模型预训练改善结构化数据上的密集检索 | 2023年5月 |
| 该框架能够动态地融合来自不同领域的多样化信息源,以提高大语言模型的事实准确性。通过一个自适应的查询生成器,根据不同知识源定制查询,确保信息的准确性逐步得到修正,避免错误信息的累积和传播。 | 知识链:通过动态知识适应异质来源来基础大语言模型 | 2023年5月 |
| 此框架通过首先检索知识图谱中的相关子图,并通过调整检索到的子图的词嵌入来确保事实的一致性,然后利用对比学习确保生成的对话与知识图谱高度一致,为生成与上下文相关且基于知识的对话提供了新方法。 | 用于知识基础对话生成的知识图谱增强大语言模型 | 2023年5月 |
| 通过采用小型语言模型作为可训练重写器,以适应黑盒式大语言模型(LLM)的需求。重写器通过强化学习(RL)根据 LLM 的反馈进行训练,从而构建了一个名为“重写-检索-阅读”的新框架,专注于查询优化。 | 为检索增强的大语言模型重写查询 | 2023年5月 |
| 利用检索增强生成器迭代创建无限记忆池,并通过记忆选择器挑选出适合下一轮生成的记忆。此方法允许模型利用自身产出的记忆,称为“自我记忆”,以提升内容生成质量。 | 自我提升:带有自我记忆的检索增强文本生成 | 2023年5月 |
| 通过为大语言模型(LLM)装配知识引导模块,让它们在不改变内部参数的情况下,获取相关知识。这一策略显著提高了模型在需要丰富知识的领域任务(如事实知识增加7.9%,表格知识增加11.9%,医学知识增加3.0%,多模态知识增加8.1%)的表现。 | 用参数知识引导增强大语言模型 | 2023年5月 |
| 为大语言模型(LLM)引入了一个通用的读写记忆单元,允许它们根据任务需要从文本中提取、存储并回忆知识。 | RET-LLM:朝向大语言模型的通用读写记忆 | 2023年5月 |
| 通过使用任务不可知检索器,构建了一个共享静态索引,有效选出候选证据。随后,设计了一个基于提示的重排机制,根据任务的特定相关性重新排序最相关的证据,为读者提供精准信息。 | 针对非知识密集型任务的提示引导检索增强 | 2023年5月 |
| 提出了UPRISE(通用提示检索以改善零样本评估),通过调整一个轻量级且多功能的检索器,它能自动为给定零样本任务的输入检索出最合适的提示,以此来改善评估效果。 | UPRISE:改进零样本评估的通用提示检索 | 2023年3月 |
| 结合了 SLMs 作为过滤器和 LLMs 作为重排器的优势,提出了一个适应性的“过滤-再重排”范式,有效提升了难样本的信息提取与重排效果。 | 大语言模型不是一个理想的少样本信息提取器,但它在重排难样本方面表现出色! | 2023年3月 |
| 零样本学习指导一款能够遵循指令的大语言模型,创建一个虚拟文档来抓住重要的联系模式。接着,一个名为Contriever的工具会将这份文档转化成嵌入向量,利用这个向量在大数据集的嵌入空间中找到相似文档的聚集地,通过向量的相似度来检索真实文档。 | 无需相关标签的精确零样本密集检索 | 2022年12月 |
| 提出了一个名为展示-搜索-预测(DSP)的新框架,通过这个框架可以编写高级程序,这些程序能够先展示流程,然后搜索相关信息,并基于这些信息做出预测。它能够将复杂问题分解成小的、更易于解决的步骤。 | 通过检索和语言模型组合,为复杂的自然语言处理任务提供解决方案 | 2022年12月 |
| 采用了一种新的多步骤问答策略,通过在思维链条的每一步中穿插检索信息,使用检索到的信息来丰富和改善思维链条。这种方法显著提升了解决知识密集型多步问题的效果。 | 结合思维链条推理和信息检索解决复杂多步骤问题 | 2022年12月 |
| 研究发现,增加检索环节可以有效减轻对已有训练信息的依赖,使得RAG变成一个有效捕捉信息长尾的策略。 | 大语言模型在学习长尾知识方面的挑战 | 2022年11月 |
| 通过抽样方式,从大语言模型的记忆中提取相关信息段落,进而生成最终答案。 | 通过回忆增强语言模型的能力 | 2022年10月 |
| 将大语言模型用作少量示例的查询生成器,根据这些生成的数据构建针对特定任务的检索系统。 | Promptagator: 基于少量示例实现密集检索 | 2022年9月 |
| 介绍了Atlas,这是一个经过预训练的检索增强型语言模型,它能够通过极少数的示例学习掌握知识密集任务。 | Atlas: 借助检索增强型语言模型进行少样本学习 | 2022年8月 |
| 通过从训练数据中进行智能检索,实现了在多个自然语言生成和理解任务上的性能提升。 | 重新认识训练数据的价值:通过训练数据检索的简单有效方法 | 2022年3月 |
| 通过在连续的数据存储条目之间建立指针关联,并将这些条目分组成不同的状态,我们近似模拟了数据存储搜索过程。这种方法创造了一个加权有限自动机,在推理时能够在不降低模型预测准确性(困惑度)的情况下,节约高达 83% 的查找最近邻居的计算量。 | 通过自动机增强检索的神经符号语言建模 | 2022 年 1 月 |
| 通过将自回归语言模型与从大规模文本库中检索的文档块相结合,基于这些文档与前文 Token 的局部相似性,我们实现了模型的显著改进。该策略利用了一个庞大的数据库(2 万亿 Token),大大增强了语言模型的能力。 | 通过从数万亿 Token 中检索来改善语言模型 | 2021 年 12 月 |
| 我们采用了一种创新的零样本任务处理方法,通过为检索增强生成模型引入严格的负样本和强化训练流程,提升了密集段落检索的效果,用于零样本槽填充任务。 | 用于零样本槽填充的鲁棒检索增强生成 | 2021 年 8 月 |
| 介绍了 RAG 模型,这是一种结合了预训练的 seq2seq 模型(作为参数记忆)和基于密集向量索引的 Wikipedia(作为非参数记忆)的模型。此模型通过预训练的神经网络检索器访问信息,比较了两种 RAG 设计:一种是在生成过程中始终依赖相同检索的段落,另一种则是每个 Token 都使用不同的段落。 | 用于知识密集型 NLP 任务的检索增强生成 | 2020 年 5 月 |
| 展示了一种仅通过密集表示实现信息检索的方法,该方法通过简单的双编码框架从少量问题和文本段落中学习嵌入。这种方法为开放域问答提供了一种高效的密集段落检索方案。 | 用于开放域问答的密集段落检索 | 2020 年 4 月 |
RAG构建策略
架构图片参考
总览
Agentic RAG
- Weaviate What is Agentic RAG
- Traditional RAG vs. Agentic RAG—Why AI Agents Need Dynamic Knowledge to Get Smarter
- What is agentic RAG?
- Agentic RAG: How It Works, Use Cases, Comparison With RAG
- RAG, AI Agents, and Agentic RAG: An In-Depth Review and Comparative Analysis
- Agentic RAG: How It Works, and How to Evaluate RAG agents
- Agentic RAG vs. Traditional RAG: The Future of AI Decision-Making
- Top 20+ Agentic RAG Frameworks in 2025
- RAG vs Agentic RAG: The Evolution of Smarter, More Dynamic AI Systems
- Agentic RAG Systems: Integration of Retrieval and Generation in AI Architectures
- Building an agentic RAG pipeline
预处理
- From Good to Great: How Pre-processing Documents Supercharges AI’s Output
- Advanced RAG 02: Unveiling PDF Parsing
- Advanced RAG 07: Exploring RAG for Tables
- 5 Levels Of Text Splitting
- Advanced RAG series: Indexing
查询问句分类和微调
检索
查询语句改写
- Advanced RAG 06: Exploring Query Rewriting
- Advanced RAG 11: Query Classification and Refinement
- Advanced RAG Series:Routing and Query Construction
- Query Transformations
- Query Construction
检索策略
- Foundations of Vector Retrieval
- 这本200多页的专题论文提供了向量检索文献中主要算法里程碑的总结,目的是作为新老研究者可以独立参考的资料。
- Improving Retrieval Performance in RAG Pipelines with Hybrid Search
- Multi-Vector Retriever for RAG on tables, text, and images
- Relevance and ranking in vector search
- Boosting RAG: Picking the Best Embedding & Reranker models
- Azure Cognitive Search: Outperforming vector search with hybrid retrieval and ranking capabilities
- Optimizing Retrieval Augmentation with Dynamic Top-K Tuning for Efficient Question Answering
- Building Production-Ready LLM Apps with LlamaIndex: Document Metadata for Higher Accuracy Retrieval
- dvanced RAG Series: Retrieval
GraphRAG
检索后处理
重排序
Contextual(Prompt) Compression
- How to Cut RAG Costs by 80% Using Prompt Compression
- 第一种压缩方法是 AutoCompressors。它的工作原理是将长文本汇总为短向量表示,称为汇总向量。然后,这些压缩的摘要向量充当模型的软提示。
- LangChain Contextual Compression
其他
- Bridging the rift in Retrieval Augmented Generation
- 不是直接微调检索器和语言模型等效果不佳的基础模块,而是引入了第三个参与者——位于现有组件之间的中间桥接模块。涉及技术包括排序、压缩、上下文框架、条件推理脚手架、互动询问等 (可参考后续论文)
评估
- Evaluating RAG Applications with RAGAs
- Best Practices for LLM Evaluation of RAG Applications
- Advanced RAG 03: Using RAGAs + LlamaIndex for RAG evaluation
- Exploring End-to-End Evaluation of RAG Pipelines
- Evaluating Multi-Modal Retrieval-Augmented Generation
- RAG Evaluation
- Evaluation - LlamaIndex
- 评估-LlamaIndex
- Pinecone的RAG评测
- 不同数据规模下不同模型的RAG忠实度效果
- 不同模型下使用RAG与不是用RAG(仅依靠内部知识)的忠实度效果
- 不同模型下结合内部和外部知识后的RAG忠实度效果
- 不同模型下的RAG的答案相关度效果
- zilliz:Optimizing RAG Applications: A Guide to Methodologies, Metrics, and Evaluation Tools for Enhanced Reliability
- Advanced RAG Series: Generation and Evaluation
幻觉
课程
- Project: Deep Research with LangGraph
- 短课程 Building and Evaluating Advanced RAG Applications
- Retrieval Augmented Generation for Production with LangChain & LlamaIndex
- agentic-rag-for-dummies
- 这是一个使用 LangGraph 构建的生产级智能RAG(检索增强生成)系统。该项目提供了两种学习路径:交互式Notebook用于快速理解核心概念,以及模块化Python项目用于开发实际应用。系统支持对话记忆、智能查询澄清、分层索引检索、多智能体并行处理和人在环交互等高级功能。通过端到端的Gradio界面,用户可以上传PDF文档、进行自然对话查询,系统会自动将PDF转换为Markdown、构建分层索引、智能重写查询、并行检索信息、聚合多个答案生成最终回应。
- 主要功能点
- 对话记忆管理:跨多个问题维持对话上下文的自然连续性
- 智能查询澄清:自动重写模糊查询,支持人在环交互式确认
- 分层索引检索:使用Parent/Child分块策略平衡精确性和上下文丰富性
- 多智能体并行处理:使用LangGraph的Send API对复杂查询进行并行分解和处理
- 自适应检索:自动评估搜索结果相关性,不足时主动获取更大的上下文块
- 端到端Gradio界面:支持文档管理、对话交互和可视化管理
- 模块化架构:每个组件(LLM提供商、嵌入模型、分块策略等)可独立定制和替换
视频
- A Survey of Techniques for Maximizing LLM Performance
- How do domain-specific chatbots work? An overview of retrieval augmented generation (RAG)
- nvidia:Augmenting LLMs Using Retrieval Augmented Generation
- How to Choose a Vector Database
图书
- 大语言模型
- 大模型技术的中文参考资料,由中国人民大学师生联手打造,由赵鑫教授和文继荣教授领衔。书籍注重为大模型技术的入门读者提供讲解,力图展现一个整体的大模型技术框架和路线图。本书适用于具有深度学习基础的高年级本科生以及低年级研究生使用,可以作为一本入门级的技术书籍。
- 下载地址: http://aibox.ruc.edu.cn/docs//2024-04/da308db79a5d4c5697da99e012d46c76.pdf
- 大模型基础
- 浙江大学DAILY实验室毛玉仁研究员、高云君教授领衔撰写的《大模型基础》教材!本书包括传统语言模型、大语言模型架构、提示工程、高效参数、模型编辑、搜索增强增加生成等六章内容。为增加本书的易读性,每章分别以一种动物为背景,对具体技术进行举例说明,故此本书以六种动物作为封面。
- 因为大模型的技术这几年发展太快了,本书的一个目标也是“月度更新”,自半年前发布后就在不断update,致力打造易读、严谨、有深度的大模型教材。
- 《大规模语言模型:从理论到实践》
- 本书围绕大语言模型构建的四个主要阶段:预训练、有监督微调、奖励建模和强化学习,详细介绍各阶段使用的算法、数据、难点以及实践经验。
- 下载地址: https://intro-llm.github.io/chapter/LLM-TAP.pdf
编码实践
其他
- 中文大模型相关汇总
- 包括数据、微调、推理、评估、体验、RAG、Agent、搜索、书籍和课程等方面的资源:
- Large Language Model (LLM) Disruption of Chatbots
- Gen AI: why does simple Retrieval Augmented Generation (RAG) not work for insurance?
- End-to-End LLMOps Platform