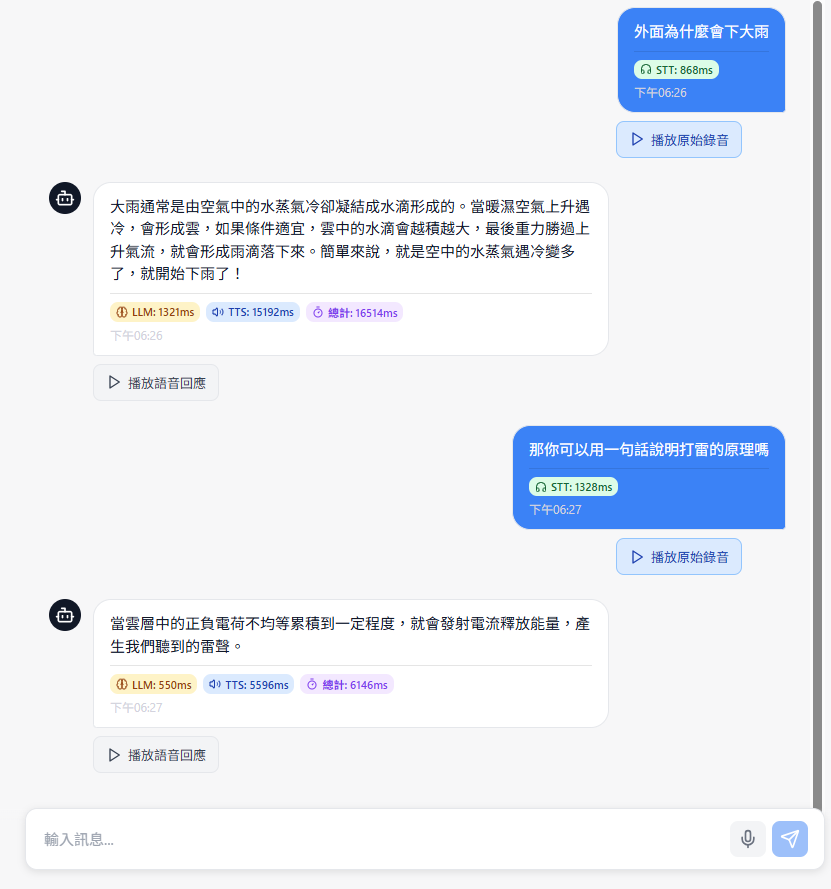
Realtime Dialogue Bot 整合 語音轉文字 (STT)、文字轉語音 (TTS) 與 大型語言模型 (LLM) 技術,打造智能語音對話系統,實現自然、即時的語音互動體驗。
核心工作流程:
語音輸入 → STT → LLM 處理 → TTS → 語音輸出
系統支援多種 TTS 引擎、語音克隆功能,並提供現代化的網頁界面,帶來無縫的使用體驗。
| 功能特色 | BreezyVoice | VibeVoice | IndexTTS | Spark-TTS |
|---|---|---|---|---|
| 即時合成 | ⚠️ | ✅ | ✅ | ✅ |
| 語音克隆 | ✅ | ✅ | ✅ | ✅ |
| 中國口音 | 低 | 中等 | 重 | 重 |
| 合成速度 (RTF) | 1.5-3.0 | ~0.82 | ~0.45 | ~1.0 |
| 音質表現 | 高 | 高 | 中等 | 高 |
| 穩定性 | ⚠️ | ✅ | ✅ | ✅ |
性能說明:
# Clone 專案
git clone https://github.com/fbpaul/realtime-dialogue-bot.git
cd realtime-dialogue-bot

# 後端設置 (詳細說明請參考 backend/README.md)
cd backend
pip install -r requirements.txt

# 前端設置 (詳細說明請參考 frontend/README.md)
cd frontend
npm install
啟動 FastAPI 後端服務器:
cd backend
python start_server.py
後端提供以下 API 端點:
/chat - LLM 對話端點/stt - 語音轉文字轉換/tts/breezy - BreezyVoice TTS 合成/tts/vibe - VibeVoice TTS 合成/tts/index - IndexTTS 合成/tts/spark - Spark-TTS 合成import requests
import json
# STT 範例
with open("audio.wav", "rb") as f:
response = requests.post("http://localhost:8000/stt", files={"file": f})
text = response.json()["text"]
print(f"識別文字: {text}")
# 聊天範例
response = requests.post(
"http://localhost:8000/chat",
json={"message": "你好,今天天氣如何?"}
)
reply = response.json()["response"]
print(f"機器人回覆: {reply}")
# TTS 範例
response = requests.post(
"http://localhost:8000/tts/index",
json={
"text": "您好,這是一段測試語音",
"speaker": "Speaker1"
}
)
with open("output.wav", "wb") as f:
f.write(response.content)
啟動 Vue.js 前端:
cd frontend
npm run dev
前端功能包括:
主要組件:
VoiceChat.vue - 主要語音互動界面PhoneSalesSimulation.vue - 專門的銷售訓練模組useAudioRecorder.js - 音頻錄製組合式函數核心特色:
使用 Docker 部署整個系統:
# 後端部署
cd backend
docker-compose up -d

# 前端部署
cd frontend
docker-compose up -d
後端 Docker 設置:
前端 Docker 設置:
realtime-dialogue-bot/
├── README.md               # 專案說明文件
├── assets/                 # 靜態資源檔案
├── backend/                # 後端服務
│   ├── app/                # FastAPI 應用程式
│   │   ├── main.py         # API 主程式
│   │   ├── config.py       # 配置管理
│   │   ├── stt.py          # 語音轉文字服務
│   │   ├── chat.py         # LLM 聊天服務
│   │   ├── tts_breezy.py   # BreezyVoice TTS 服務
│   │   ├── tts_vibe.py     # VibeVoice TTS 服務
│   │   ├── tts_index.py    # IndexTTS 服務
│   │   └── tts_spark.py    # Spark-TTS 服務
│   ├── BreezyVoice/        # BreezyVoice 模型原始碼
│   ├── VibeVoice/          # VibeVoice 模型原始碼
│   ├── Spark-TTS/          # Spark-TTS 模型原始碼
│   ├── index-tts/          # IndexTTS 模型原始碼
│   ├── llm_tools/          # LLM 工具和配置
│   │   ├── async_llm_chat.py
│   │   ├── embed_rerank_model.py
│   │   ├── llm_chat.py
│   │   ├── memory.py
│   │   └── configs/        # LLM 模型配置
│   ├── models/             # 預訓練模型目錄
│   │   ├── models--Qwen--Qwen2.5-1.5B/
│   │   ├── models--MediaTek-Research--BreezyVoice-300M/
│   │   ├── models--mobiuslabsgmbh--faster-whisper-large-v3-turbo/
│   │   ├── IndexTTS-1.5/
│   │   ├── Spark-TTS-0.5B/
│   │   └── VibeVoice/
│   ├── voices/             # 語者音檔目錄
│   ├── outputs/            # 生成音頻輸出目錄
│   ├── uploads/            # 上傳檔案暫存目錄
│   ├── config.yaml         # 主要配置檔案
│   ├── requirements.txt    # Python 依賴套件
│   ├── Dockerfile          # 容器化配置
│   └── docker-compose.yml  # 多容器編排
├── frontend/               # 前端應用
│   ├── src/
│   │   ├── App.vue         # 主應用元件
│   │   ├── components/     # Vue 元件
│   │   ├── composables/    # Vue 組合式函數
│   │   ├── router/         # 路由配置
│   │   ├── services/       # API 服務
│   │   └── stores/         # 狀態管理
│   ├── package.json        # Node.js 依賴配置
│   ├── vite.config.js      # Vite 建置配置
│   ├── docker-compose.yml  # 前端容器配置
│   └── start-frontend*.sh  # 前端啟動腳本
└── repo_ref/               # 參考資料和文檔
系統性能指標:
詳細 TTS 性能測試結果:
基於標準測試用例的 RTF (Real Time Factor) 性能測試結果:
| 文本 | 語者 | RTF | 合成時間 | 音頻長度 |
|---|---|---|---|---|
| 短文字 | Speaker1 | 2.230 | 22.088s | 9.903s |
| 短文字 | Speaker2 | 2.176 | 42.799s | 19.667s |
| 短文字 | Speaker3 | 3.095 | 19.582s | 6.327s |
| 中等文字 | Speaker1 | 1.569 | 22.710s | 14.478s |
| 中等文字 | Speaker2 | 1.713 | 62.698s | 36.595s |
| 中等文字 | Speaker3 | 2.859 | 23.232s | 8.127s |
| 長文字 | Speaker1 | 1.901 | 28.208s | 14.838s |
| 長文字 | Speaker2 | 1.967 | 81.422s | 41.390s |
| 長文字 | Speaker3 | 2.302 | 21.195s | 9.207s |
| 文本 | 語者 | RTF | 合成時間 | 音頻長度 |
|---|---|---|---|---|
| 短文字 | Speaker1 | 1.019 | 7.065s | 6.933s |
| 短文字 | Speaker2 | 0.851 | 6.124s | 7.200s |
| 短文字 | Speaker3 | 0.831 | 5.427s | 6.533s |
| 中等文字 | Speaker1 | 0.820 | 12.906s | 15.733s |
| 中等文字 | Speaker2 | 0.827 | 8.379s | 10.133s |
| 中等文字 | Speaker3 | 0.822 | 8.216s | 10.000s |
| 長文字 | Speaker1 | 0.819 | 10.488s | 12.800s |
| 長文字 | Speaker2 | 0.822 | 9.096s | 11.067s |
| 長文字 | Speaker3 | 0.820 | 9.951s | 12.133s |
| 文本 | 語者 | RTF | 合成時間 | 音頻長度 |
|---|---|---|---|---|
| 短文字 | Speaker1 | 0.540 | 4.079s | 7.552s |
| 短文字 | Speaker2 | 0.439 | 3.314s | 7.552s |
| 短文字 | Speaker3 | 0.483 | 3.070s | 6.357s |
| 中等文字 | Speaker1 | 0.444 | 4.541s | 10.240s |
| 中等文字 | Speaker2 | 0.426 | 4.367s | 10.240s |
| 中等文字 | Speaker3 | 0.446 | 4.358s | 9.771s |
| 長文字 | Speaker1 | 0.445 | 4.972s | 11.179s |
| 長文字 | Speaker2 | 0.444 | 4.890s | 11.008s |
| 長文字 | Speaker3 | 0.448 | 4.489s | 10.027s |
| 文本 | 語者 | RTF | 合成時間 | 音頻長度 |
|---|---|---|---|---|
| 短文字 | Speaker1 | 1.160 | 9.302s | 8.020s |
| 短文字 | Speaker3 | 1.032 | 5.245s | 5.080s |
| 中等文字 | Speaker1 | 1.004 | 10.484s | 10.440s |
| 中等文字 | Speaker3 | 1.009 | 8.414s | 8.340s |
| 長文字 | Speaker1 | 1.000 | 10.476s | 10.480s |
| 長文字 | Speaker3 | 1.002 | 8.680s | 8.660s |
RTF (Real Time Factor): 值越小表示合成速度越快。RTF=1.0 表示實時合成速度
編輯 backend/config.yaml 來自訂系統設定:
# 模型配置
models:
  stt_model: "mobiuslabsgmbh/faster-whisper-large-v3-turbo"
  llm_model: "Qwen/Qwen2.5-1.5B"

# TTS 引擎設定
tts:
  default_engine: "index"  # breezy, vibe, index, spark
  voice_clone_enabled: true

# 性能設定
performance:
  cuda_enabled: true
  mixed_precision: true
  model_cache: true
backend/voices/ 目錄config.yaml 中配置語者設定要整合新的 TTS 引擎:
app/tts_newengine.pymain.py 中註冊端點要新增 LLM 功能:
app/chat.py 添加新的對話邏輯llm_tools/configs/ 中的提示模板本專案採用 MIT 授權條款 - 詳見 LICENSE 檔案



