
[ICML2026] OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models
Python
30
5 commits
updated May 21, 2026
README
OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models
Yue Ding1,2,*, Yiyan Ji3,*, Jungang Li4, Xuyang Liu5, Xinlong Chen1, Junfei Wu1, Bozhou Li6, Bohan Zeng6, Yang Shi6, Yushuo Guan2, Yuanxing Zhang2, Jiaheng Liu3, Qiang Liu1, Pengfei Wan2, Liang Wang1
1NLPR, Institute of Automation, Chinese Academy of Sciences (CASIA)
2Kling Team, Kuaishou Technology
3Nanjing University
4The Hong Kong University of Science and Technology (Guangzhou)
5Sichuan University
6Peking University
*Equal contribution
Video-guided audio and modality-asymmetric omni-token compression for efficient audio-video understanding.


Contents
- News
- Highlights
- Method Overview
- Main Results
- Case Study
- Core Code
- Installation
- Quick Start
- Compression Parameters
- Acknowledgement
- Citation
🔥 News
2026.05.01🎉🎉 OmniSIFT has been accepted to ICML 2026!2026.02.04📄✨ We introduce OmniSIFT, a modality-asymmetric token compression framework for efficient Omni-LLM inference. The paper is available on arXiv: arXiv:2602.04804.
📌 Highlights
OmniSIFT reduces the long audio-video context in Omni-LLMs with a modality-asymmetric design: video tokens are first compressed into informative visual anchors, which then guide audio token compression.
- ⚡ Video-Guided Modality-Asymmetric Compression: OmniSIFT treats video and audio tokens asymmetrically, using key video tokens to guide audio token selection for omni-modal token compression.
- 🎞️ Spatio-Temporal Video Token Pruning: The video branch removes redundant patches by combining spatial similarity within frames and temporal similarity across adjacent frames.
- 🔊 Cross-Attention Audio Token Selection: The retained key video tokens act as visual anchors and guide audio compression through cross-attention, preserving audio cues aligned with visual context.
- 🚀 Efficient Omni-LLM Inference: OmniSIFT substantially shortens the multimodal prefill context while maintaining strong audio-video understanding performance.
Method Overview
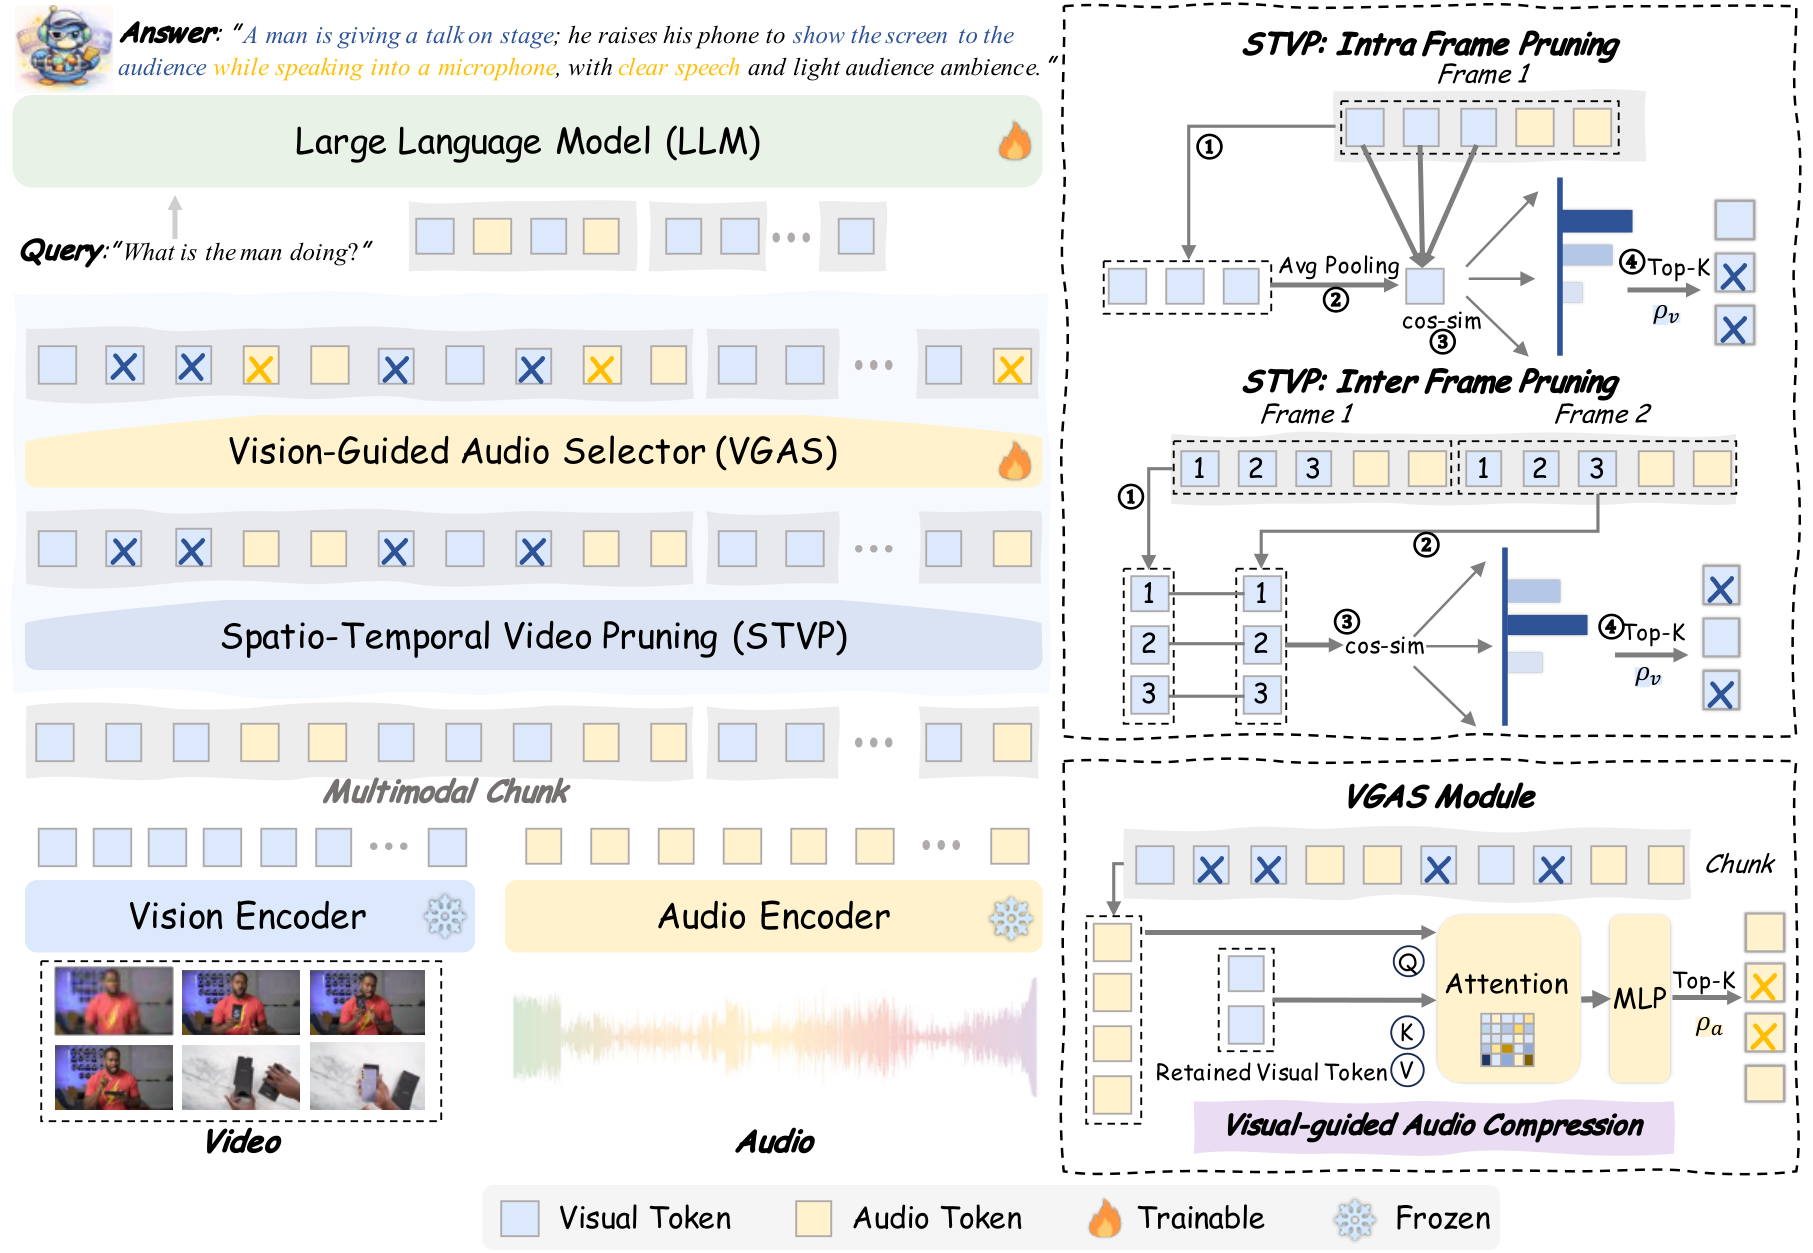
OmniSIFT follows a two-stage modality-asymmetric compression pipeline. STVP first removes spatial and temporal redundancy in video tokens to produce compact visual anchors; VGAS then selects audio tokens conditioned on these visual anchors before feeding the compressed multimodal sequence into the LLM backbone.
Main Results
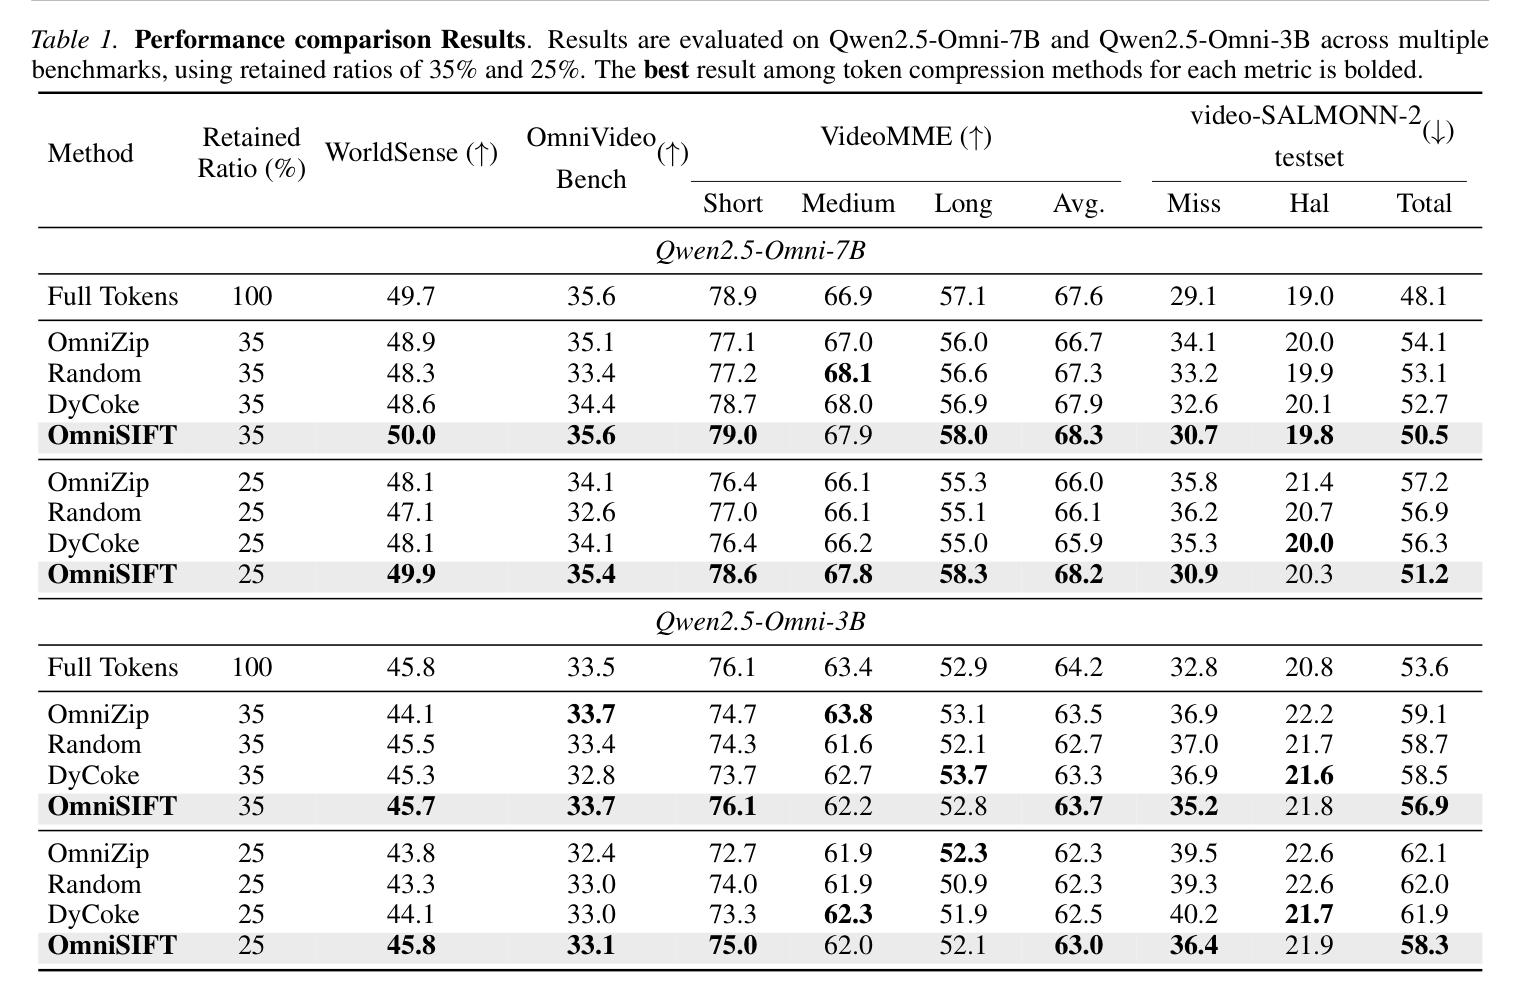
We evaluate OmniSIFT on Qwen2.5-Omni-7B and Qwen2.5-Omni-3B across multiple audio-video benchmarks under 35% and 25% token retained ratios. OmniSIFT consistently achieves the best performance among compression methods and can match or surpass the full-token baseline in several settings while using much shorter multimodal contexts.
Case Study
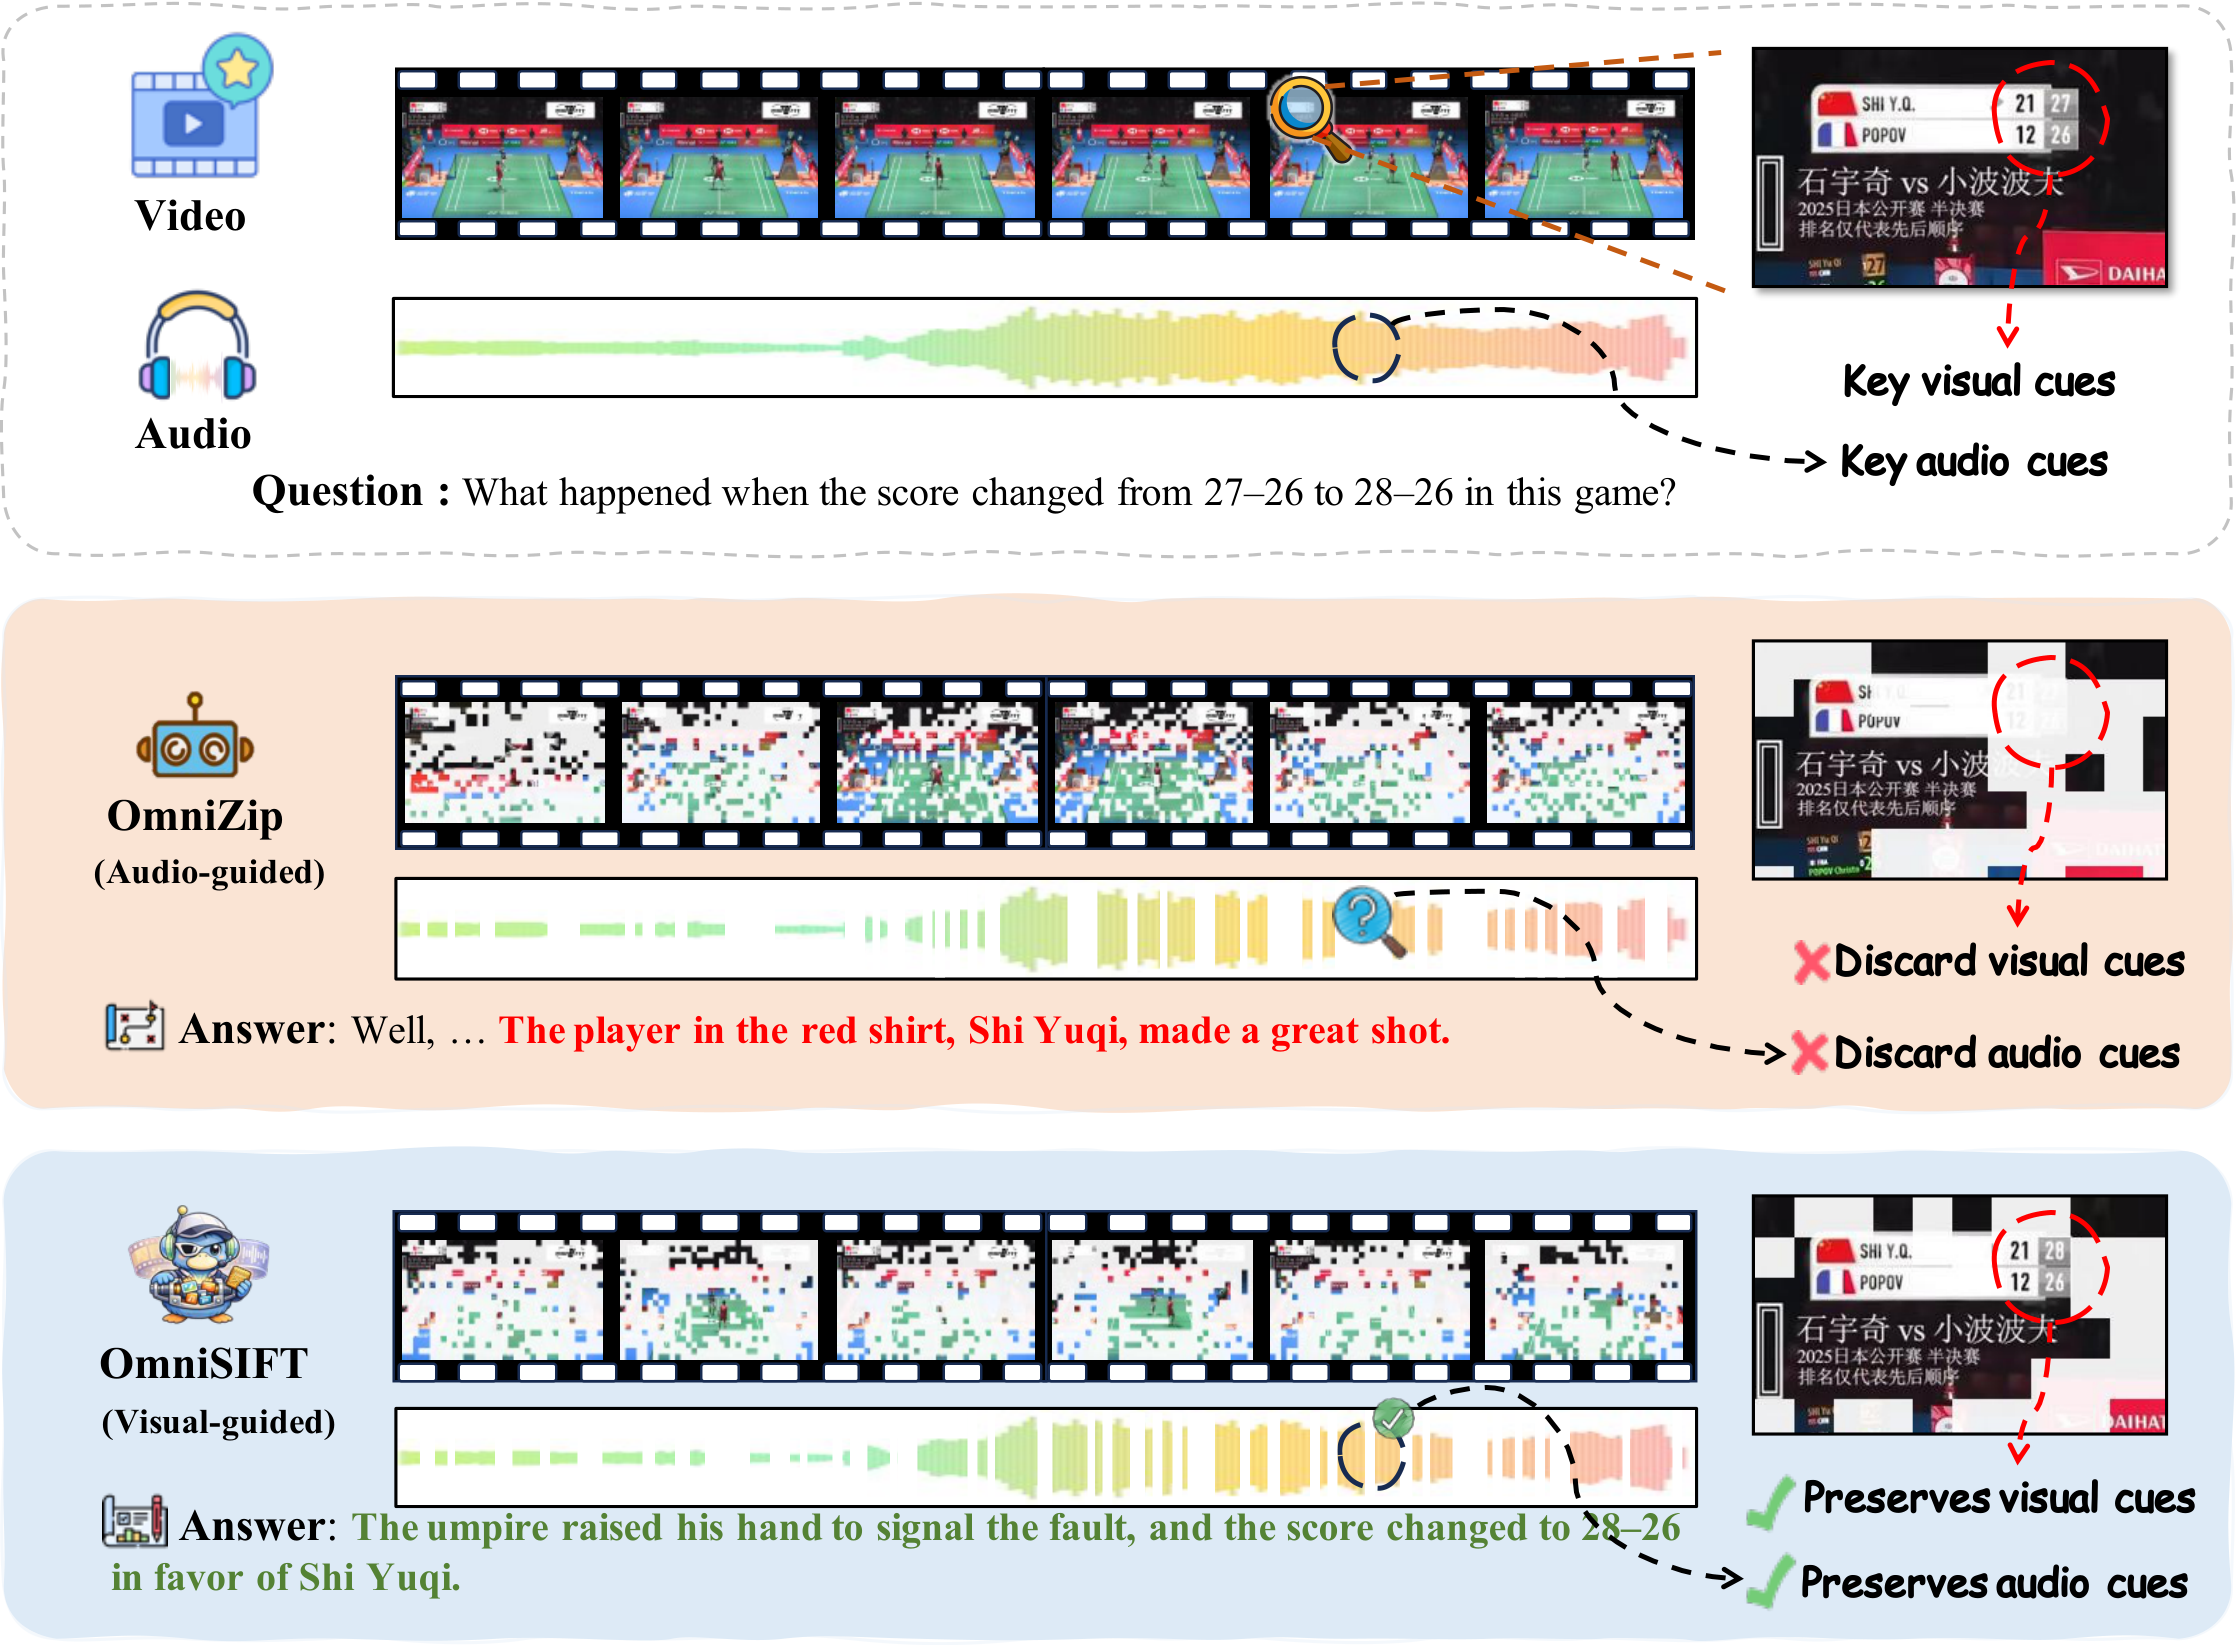
This visualization shows how OmniSIFT preserves salient visual dynamics and contextually aligned audio cues under aggressive compression, enabling accurate reasoning over fine-grained audio-video events.
🧱 Core Code
- OmniSIFT compression logic:
omnisift/compression_units.py - Qwen2.5-Omni integration with compression hooks:
omnisift/modeling_qwen2_5_omni.py - Media preprocessing utilities:
qwen-omni-utils/
Installation
Please follow the environment setup and dependency installation instructions in the official Qwen2.5-Omni codebase.
Quick Start
Download the OmniSIFT-7B checkpoint from Hugging Face, then run inference:
import torch
from transformers import AutoProcessor
from qwen_omni_utils import process_mm_info
from omnisift import Qwen2_5OmniForConditionalGeneration

model_path = "dingyue1011/OmniSIFT-7B"

processor = AutoProcessor.from_pretrained(model_path)
model = Qwen2_5OmniForConditionalGeneration.from_pretrained(
    model_path,
    torch_dtype="auto",
    device_map="auto",
)

# Optional: tune compression ratios.
model.thinker.compression_config = {
    "rho_audio": 0.3,
    "rho_video": 0.7,
}

messages = [
    {
        "role": "user",
        "content": [
            {"type": "video", "video": "file:///path/to/video.mp4"},
            {"type": "text", "text": "Describe the audio and video."},
        ],
    }
]

text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
audios, images, videos = process_mm_info(messages, use_audio_in_video=True)
inputs = processor(text=text, images=images, videos=videos, audio=audios, padding=True, return_tensors="pt")
inputs = inputs.to(model.device)

generated_ids, generated_audio = model.generate(**inputs)
response = processor.batch_decode(generated_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)
print(response[0])
Compression Parameters
rho_audio controls the fraction of audio tokens removed within each chunk.
rho_video controls the fraction of video tokens removed from the selected spatial/temporal positions.
Lower values preserve more tokens.
Acknowledgement
Thanks to Qwen2.5-Omni, ms-swift, OmniZip, AVoCaDO, VidCom2, and TimeChat-Online for their great work and codebase.
Citation
@article{ding2026omnisift,
  title={OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models},
  author={Ding, Yue and Ji, Yiyan and Li, Jungang and Liu, Xuyang and Chen, Xinlong and Wu, Junfei and Li, Bozhou and Zeng, Bohan and Shi, Yang and Guan, Yushuo and others},
  journal={arXiv preprint arXiv:2602.04804},
  year={2026}
}
Similar repos


Languages
Python
98.8%
Shell
1.2%
[ICML2026] OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models
Python
30
5 commits
updated May 21, 2026
README
OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models
Yue Ding1,2,*, Yiyan Ji3,*, Jungang Li4, Xuyang Liu5, Xinlong Chen1, Junfei Wu1, Bozhou Li6, Bohan Zeng6, Yang Shi6, Yushuo Guan2, Yuanxing Zhang2, Jiaheng Liu3, Qiang Liu1, Pengfei Wan2, Liang Wang1
1NLPR, Institute of Automation, Chinese Academy of Sciences (CASIA)
2Kling Team, Kuaishou Technology
3Nanjing University
4The Hong Kong University of Science and Technology (Guangzhou)
5Sichuan University
6Peking University
*Equal contribution
Video-guided audio and modality-asymmetric omni-token compression for efficient audio-video understanding.
Contents
- News
- Highlights
- Method Overview
- Main Results
- Case Study
- Core Code
- Installation
- Quick Start
- Compression Parameters
- Acknowledgement
- Citation
🔥 News
2026.05.01🎉🎉 OmniSIFT has been accepted to ICML 2026!2026.02.04📄✨ We introduce OmniSIFT, a modality-asymmetric token compression framework for efficient Omni-LLM inference. The paper is available on arXiv: arXiv:2602.04804.
📌 Highlights
OmniSIFT reduces the long audio-video context in Omni-LLMs with a modality-asymmetric design: video tokens are first compressed into informative visual anchors, which then guide audio token compression.
- ⚡ Video-Guided Modality-Asymmetric Compression: OmniSIFT treats video and audio tokens asymmetrically, using key video tokens to guide audio token selection for omni-modal token compression.
- 🎞️ Spatio-Temporal Video Token Pruning: The video branch removes redundant patches by combining spatial similarity within frames and temporal similarity across adjacent frames.
- 🔊 Cross-Attention Audio Token Selection: The retained key video tokens act as visual anchors and guide audio compression through cross-attention, preserving audio cues aligned with visual context.
- 🚀 Efficient Omni-LLM Inference: OmniSIFT substantially shortens the multimodal prefill context while maintaining strong audio-video understanding performance.
Method Overview
OmniSIFT follows a two-stage modality-asymmetric compression pipeline. STVP first removes spatial and temporal redundancy in video tokens to produce compact visual anchors; VGAS then selects audio tokens conditioned on these visual anchors before feeding the compressed multimodal sequence into the LLM backbone.
Main Results
We evaluate OmniSIFT on Qwen2.5-Omni-7B and Qwen2.5-Omni-3B across multiple audio-video benchmarks under 35% and 25% token retained ratios. OmniSIFT consistently achieves the best performance among compression methods and can match or surpass the full-token baseline in several settings while using much shorter multimodal contexts.
Case Study
This visualization shows how OmniSIFT preserves salient visual dynamics and contextually aligned audio cues under aggressive compression, enabling accurate reasoning over fine-grained audio-video events.
🧱 Core Code
- OmniSIFT compression logic:
omnisift/compression_units.py - Qwen2.5-Omni integration with compression hooks:
omnisift/modeling_qwen2_5_omni.py - Media preprocessing utilities:
qwen-omni-utils/
Installation
Please follow the environment setup and dependency installation instructions in the official Qwen2.5-Omni codebase.
Quick Start
Download the OmniSIFT-7B checkpoint from Hugging Face, then run inference:
import torch
from transformers import AutoProcessor
from qwen_omni_utils import process_mm_info
from omnisift import Qwen2_5OmniForConditionalGeneration

model_path = "dingyue1011/OmniSIFT-7B"

processor = AutoProcessor.from_pretrained(model_path)
model = Qwen2_5OmniForConditionalGeneration.from_pretrained(
    model_path,
    torch_dtype="auto",
    device_map="auto",
)

# Optional: tune compression ratios.
model.thinker.compression_config = {
    "rho_audio": 0.3,
    "rho_video": 0.7,
}

messages = [
    {
        "role": "user",
        "content": [
            {"type": "video", "video": "file:///path/to/video.mp4"},
            {"type": "text", "text": "Describe the audio and video."},
        ],
    }
]

text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
audios, images, videos = process_mm_info(messages, use_audio_in_video=True)
inputs = processor(text=text, images=images, videos=videos, audio=audios, padding=True, return_tensors="pt")
inputs = inputs.to(model.device)

generated_ids, generated_audio = model.generate(**inputs)
response = processor.batch_decode(generated_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)
print(response[0])
Compression Parameters
rho_audio controls the fraction of audio tokens removed within each chunk.
rho_video controls the fraction of video tokens removed from the selected spatial/temporal positions.
Lower values preserve more tokens.
Acknowledgement
Thanks to Qwen2.5-Omni, ms-swift, OmniZip, AVoCaDO, VidCom2, and TimeChat-Online for their great work and codebase.
Citation
@article{ding2026omnisift,
  title={OmniSIFT: Modality-Asymmetric Token Compression for Efficient Omni-modal Large Language Models},
  author={Ding, Yue and Ji, Yiyan and Li, Jungang and Liu, Xuyang and Chen, Xinlong and Wu, Junfei and Li, Bozhou and Zeng, Bohan and Shi, Yang and Guan, Yushuo and others},
  journal={arXiv preprint arXiv:2602.04804},
  year={2026}
}
Similar repos
Languages
Python
98.8%
Shell
1.2%