cubestudio开源云原生一站式机器学习/深度学习/大模型AI平台/MaaS/mlops/人工智能平台/训推平台,算法全链路流程,多租户,算力租赁平台,token中转,拖拉拽任务流pipeline编排,多机多卡分布式训练,超参搜索,推理服务,VGPU虚拟化,云边端协同,边缘计算,自动化标注平台,deepseek等大模型sft微调/奖励模型/强化学习训练,vllm/ollama/mindie大模型多机推理,私有知识库llmops智能体,AI模型市场,支持国产异构算力调度,昇腾/寒武纪/海光/摩尔/沐曦等,支持ib/roce/RDMA,信创支持
See the codeCubeStudio 是一款国产化、云原生的一站式开源人工智能平台,同时覆盖传统机器学习、深度学习与大模型全链路(MLOps / MaaS / 算力调度 / 训推平台),开源协议 MIT,开源免费商用,开源版本已有数千家企业私有化部署。平台提供多租户与算力纳管调度、算力租赁与 Token 中转站、拖拉拽 Pipeline 任务流编排、多机多卡分布式训练、超参搜索、推理服务、vGPU 虚拟化、云边端协同与边缘计算、图文音多模态自动化标注、大模型 SFT 微调 / 奖励模型 / 强化学习训练、vLLM / Ollama / MindIE 大模型多机推理、私有知识库 / LLMOps / 智能体、AI 模型市场,以及从数据到上线的全流程模型部署。原生适配昇腾、寒武纪、海光、摩尔线程、沐曦等国产异构算力与 x86 / ARM CPU 架构,支持 IB / RoCE / RDMA 高速网络及信创私有化、内网离线部署。
https://github.com/data-infra/cube-studio/wiki
学习、部署、体验、开源建设、商业合作 欢迎来撩。或添加微信luanpeng1234,备注<开源建设>


| 模块分组 | 功能 | 功能描述 |
|---|---|---|
| 用户权限 | SSO单点登录 | |
| 用户权限 | 项目组管理 | |
| 用户权限 | 用户管理 角色管理/权限管理 | |
| 算力调度 | 数据大屏 | |
| 算力调度 | 多资源组/多集群 | |
| 算力调度 | gpu调度能力 | |
| 算力调度 | 支持多种算力 | |
| 算力调度 | 算力市场 | |
| 算力调度 | 租赁实例 | |
| 算力调度 | 计量计费功能 | |
| 算力调度 | 机器资源管理 | |
| 算力调度 | 存储盘管理 | |
| 基础能力 | 网络 | |
| 基础能力 | 数据库存储 | |
| 基础能力 | 国际化能力 | |
| 数据管理 | 数据地图 | |
| 数据管理 | 数据计算 | |
| 数据管理 | 数据集管理 | |
| 数据标注 | 数据标注 | |
| 数据标注 | 数据标注 | |
| 在线开发 | 镜像功能 | |
| 在线开发 | notebook | |
| 模型训练 | 拖拉拽任务流编排调试 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 算子自定义 | |
| 模型训练 | 链路共享 | |
| 模型训练 | 自定义镜像 | |
| 模型训练 | 自动调参 | |
| 模型训练 | TensorBoard作业 | |
| 模型管理 推理服务 | 内部服务 | |
| 模型管理 推理服务 | 模型管理 | |
| 模型管理 推理服务 | 推理服务 | |
| 监控 | 整体资源 | |
| 监控 | 监控体系 | |
| AIHUB | 应用sdk | |
| AIHUB | 应用sdk | |
| AIHUB | 应用sdk | |
| AIHUB | 预训练模型 | |
| AIHUB | 模型市场 | |
| AIHUB | 模型一键开发 | |
| AIHUB | 模型一键微调 | |
| AIHUB | 模型一键部署web | |
| AIHUB | 模型自动化标注 | |
| AIHUB | pipeline对接aihub | |
| 大模型 | 大模型分布式多机多卡 | |
| 大模型 | 支持大模型推理aihub形式 | |
| 大模型 | 支持大模型推理 | |
| 大模型 | 支持大模型微调 | |
| 大模型 | 支持大模型量化评估剪枝 | |
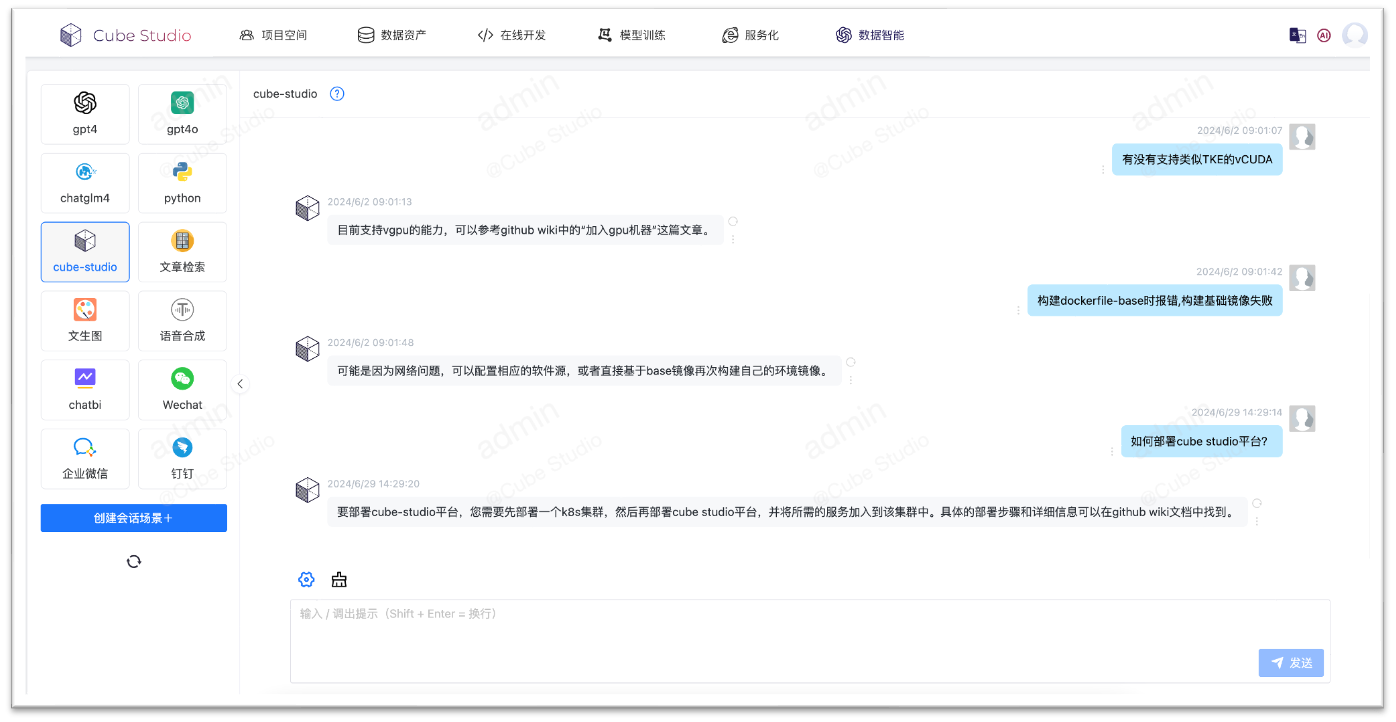
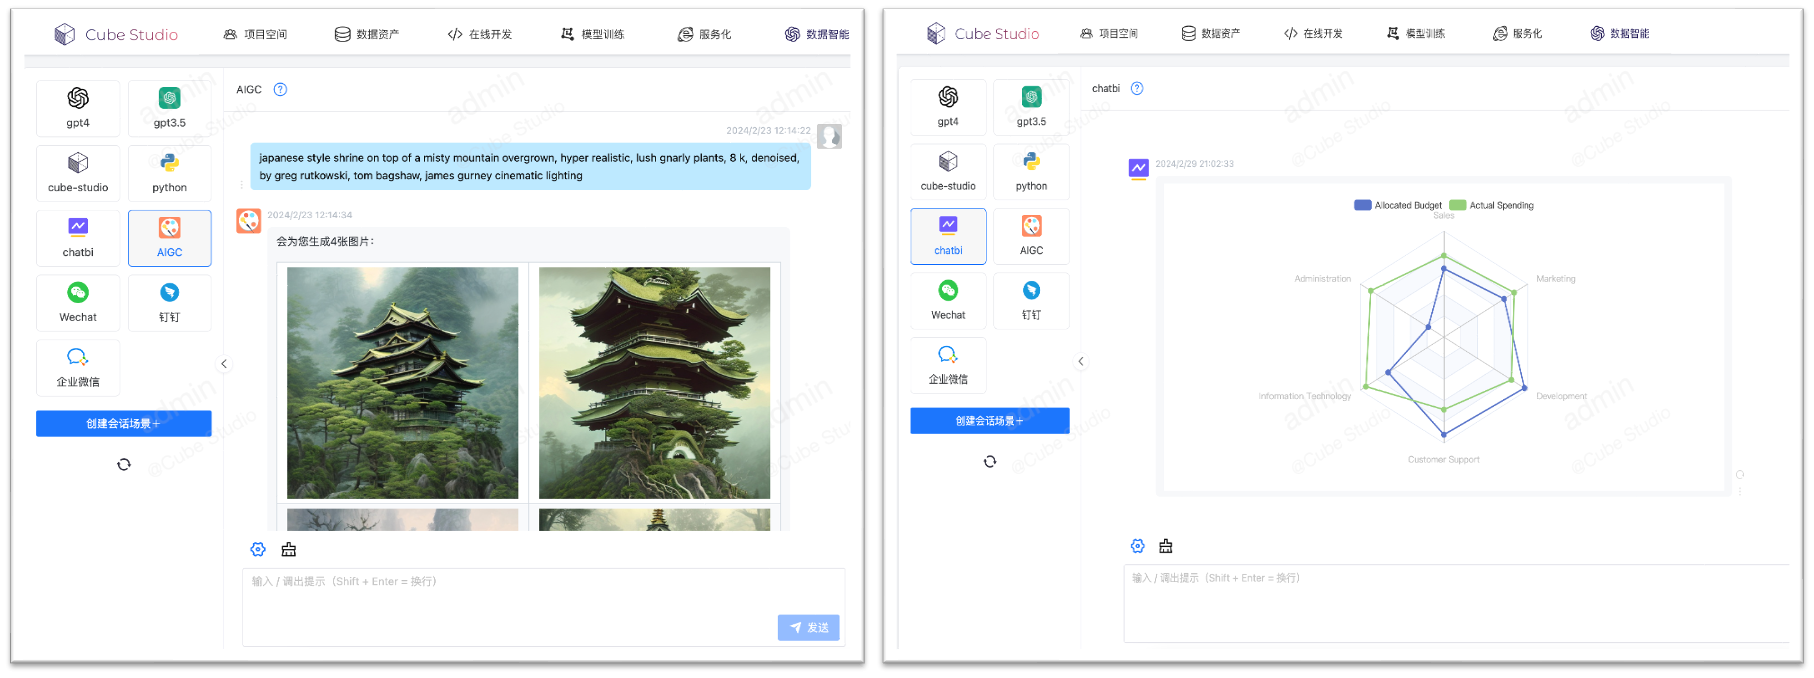
| 大模型 | 智能对话 | |
| 大模型 | 智能对话 | |
| 大模型 | 智能对话 |
传统算法落地流程:从申请机器,配置环境,拉取数据,处理数据,算法训练,调试,模型测试,服务化上线全流程,算法工程师在上面的每个环节都浪费了很多时间,而不是把精力主要集中在算法模型的构建上。
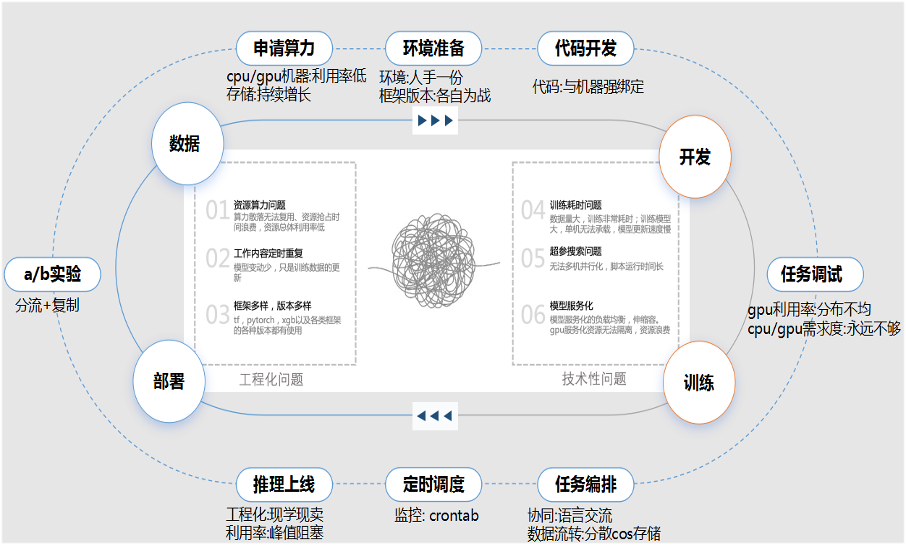
如上图所示,工程师在数据、开发、训练、部署各环节被迫处理大量非算法本质的问题:
cubestudio 一站式的机器学习平台,正是从平台架构上系统性地解决上述工程化与技术性问题,做了一系列更贴近用户实用化的考虑。
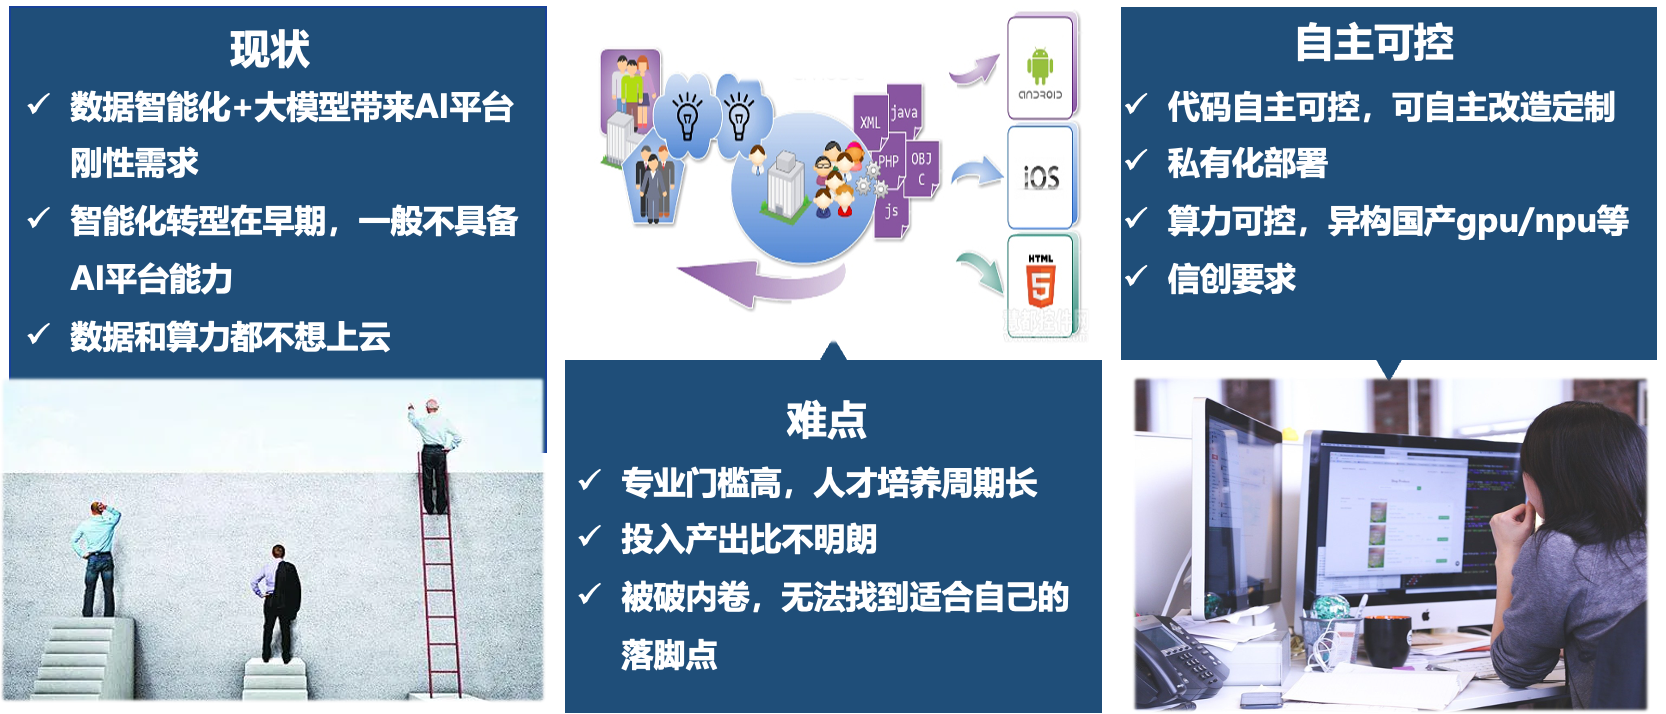
现状:
难点:
自主可控:
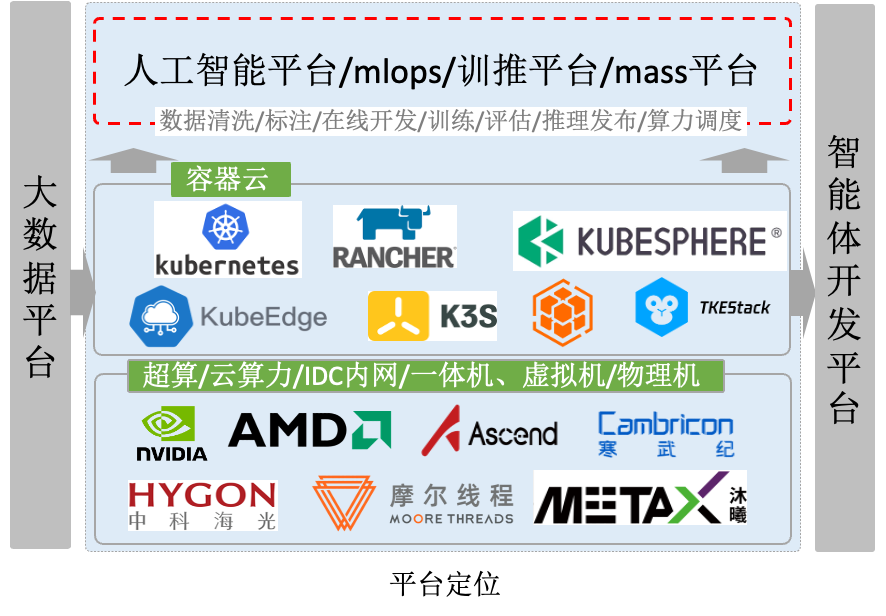
平台定位:如上图所示,cubestudio 位于"大数据平台"与"智能体开发平台"之间,作为一站式 AI / MLOps / 训推 / MaaS 平台承上启下,向上承接大数据平台的数据资产,向下输出到智能体开发平台,贯通数据清洗、标注、在线开发、训练、评估、推理发布、算力调度全链路。
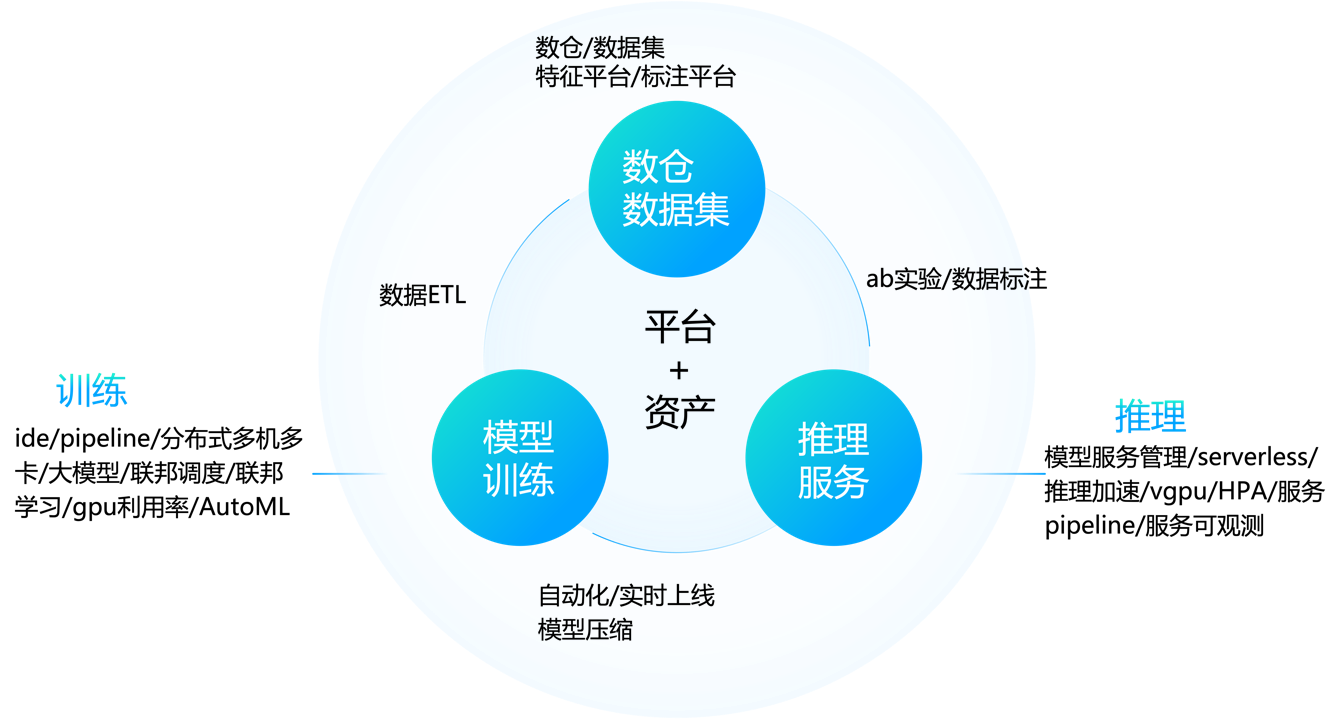
cube-studio 是开源的云原生一站式机器学习 / 深度学习 / 大模型 AI 平台,核心能力包括:
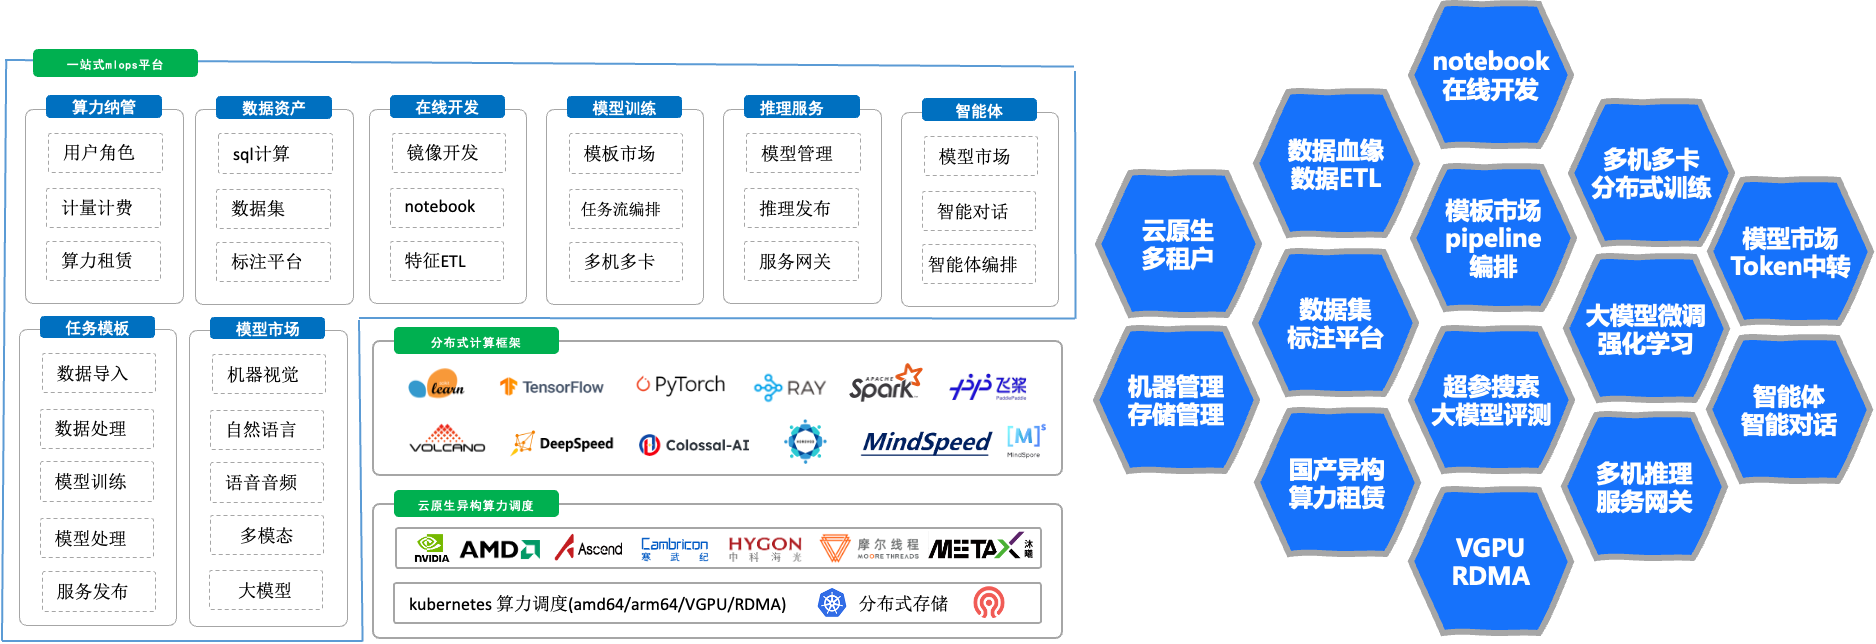
一站式 MLOps 平台,自底向上分层(对应上图左侧):
右侧六边形为平台核心能力集:云原生多租户、机器管理 / 存储管理、数据集 / 标注平台、数据血缘 / 数据 ETL、模板市场 / Pipeline 编排、超参搜索 / 大模型评测、notebook 在线开发、多机多卡分布式训练、大模型微调 / 强化学习、多机推理 / 服务网关、模型市场 / Token 中转、智能体 / 智能对话、国产异构算力租赁、VGPU / RDMA 等。
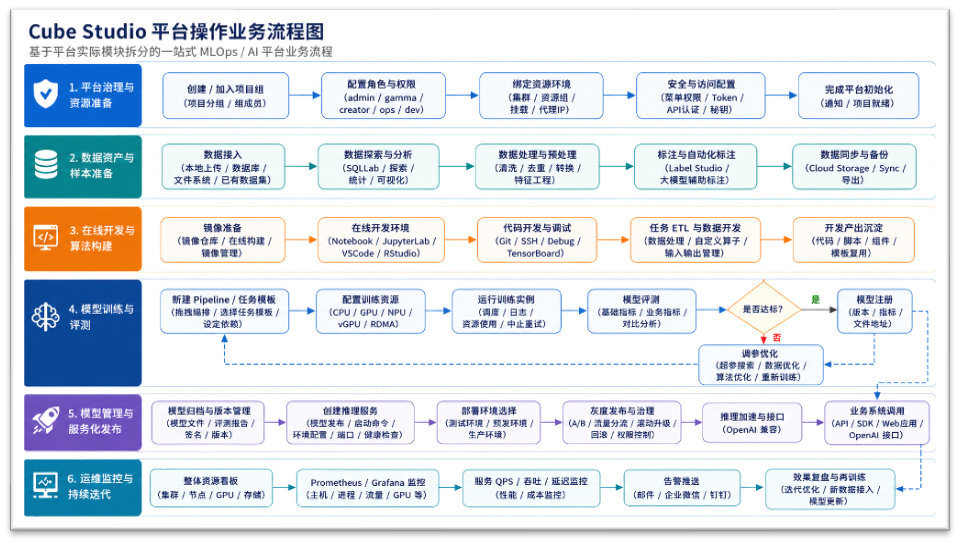
基于平台实际模块拆分的一站式 MLOps / AI 平台业务流程,自左向右、自上而下分为六大阶段闭环:
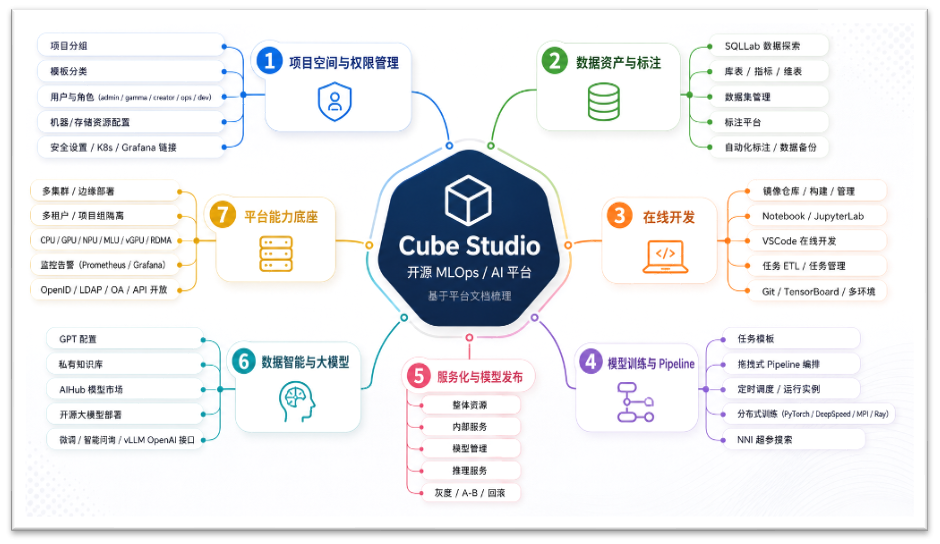
以 cube-studio 开源 MLOps / AI 平台为核心,功能模块覆盖从底座算力到大模型应用的全链路。按用户实际使用路径,可归纳为九大能力域,依次为:用户与权限 → 算力纳管 → 在线开发 → 数据管理与标注 → 模型训练 → 推理服务 → 监控 → AIHub 模型市场 → 大模型,另有贯穿全栈的国产化支持能力。
统一账号接入与多租户隔离,是平台安全登录与资源分权的入口。
以 Kubernetes 为底座,云原生统筹 CPU/GPU/NPU 异构算力,实现多集群、多资源组的隔离调度与计量。
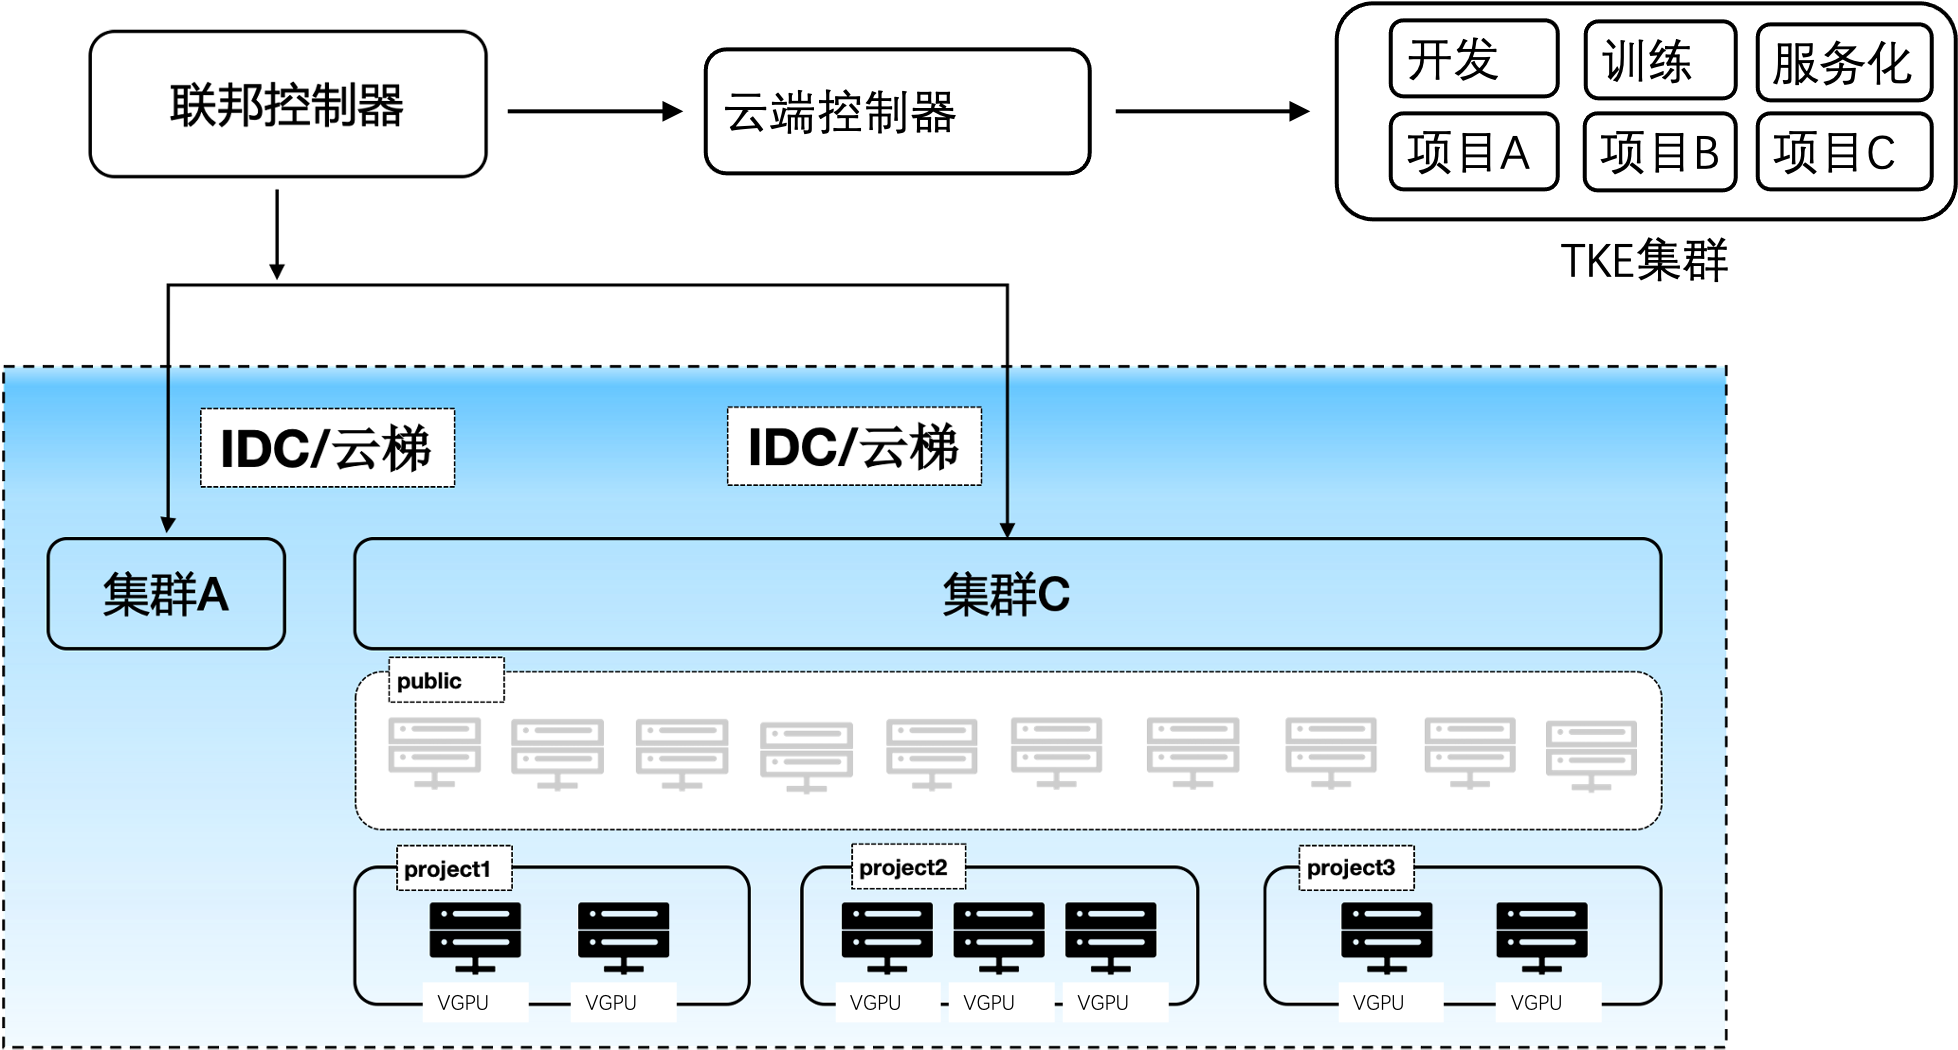
单个 k8s 集群的部署拓扑图:

cubestudio 支持多集群调度,可同时管控多个训练或推理集群。单集群内既能隔离一个项目组的在线开发、训练、推理,也能隔离同一 k8s 集群下多个项目组的算力;不同项目组算力间具备动态均衡能力,可在公共算力池与私有化算力池间共享,做到成本最低化。
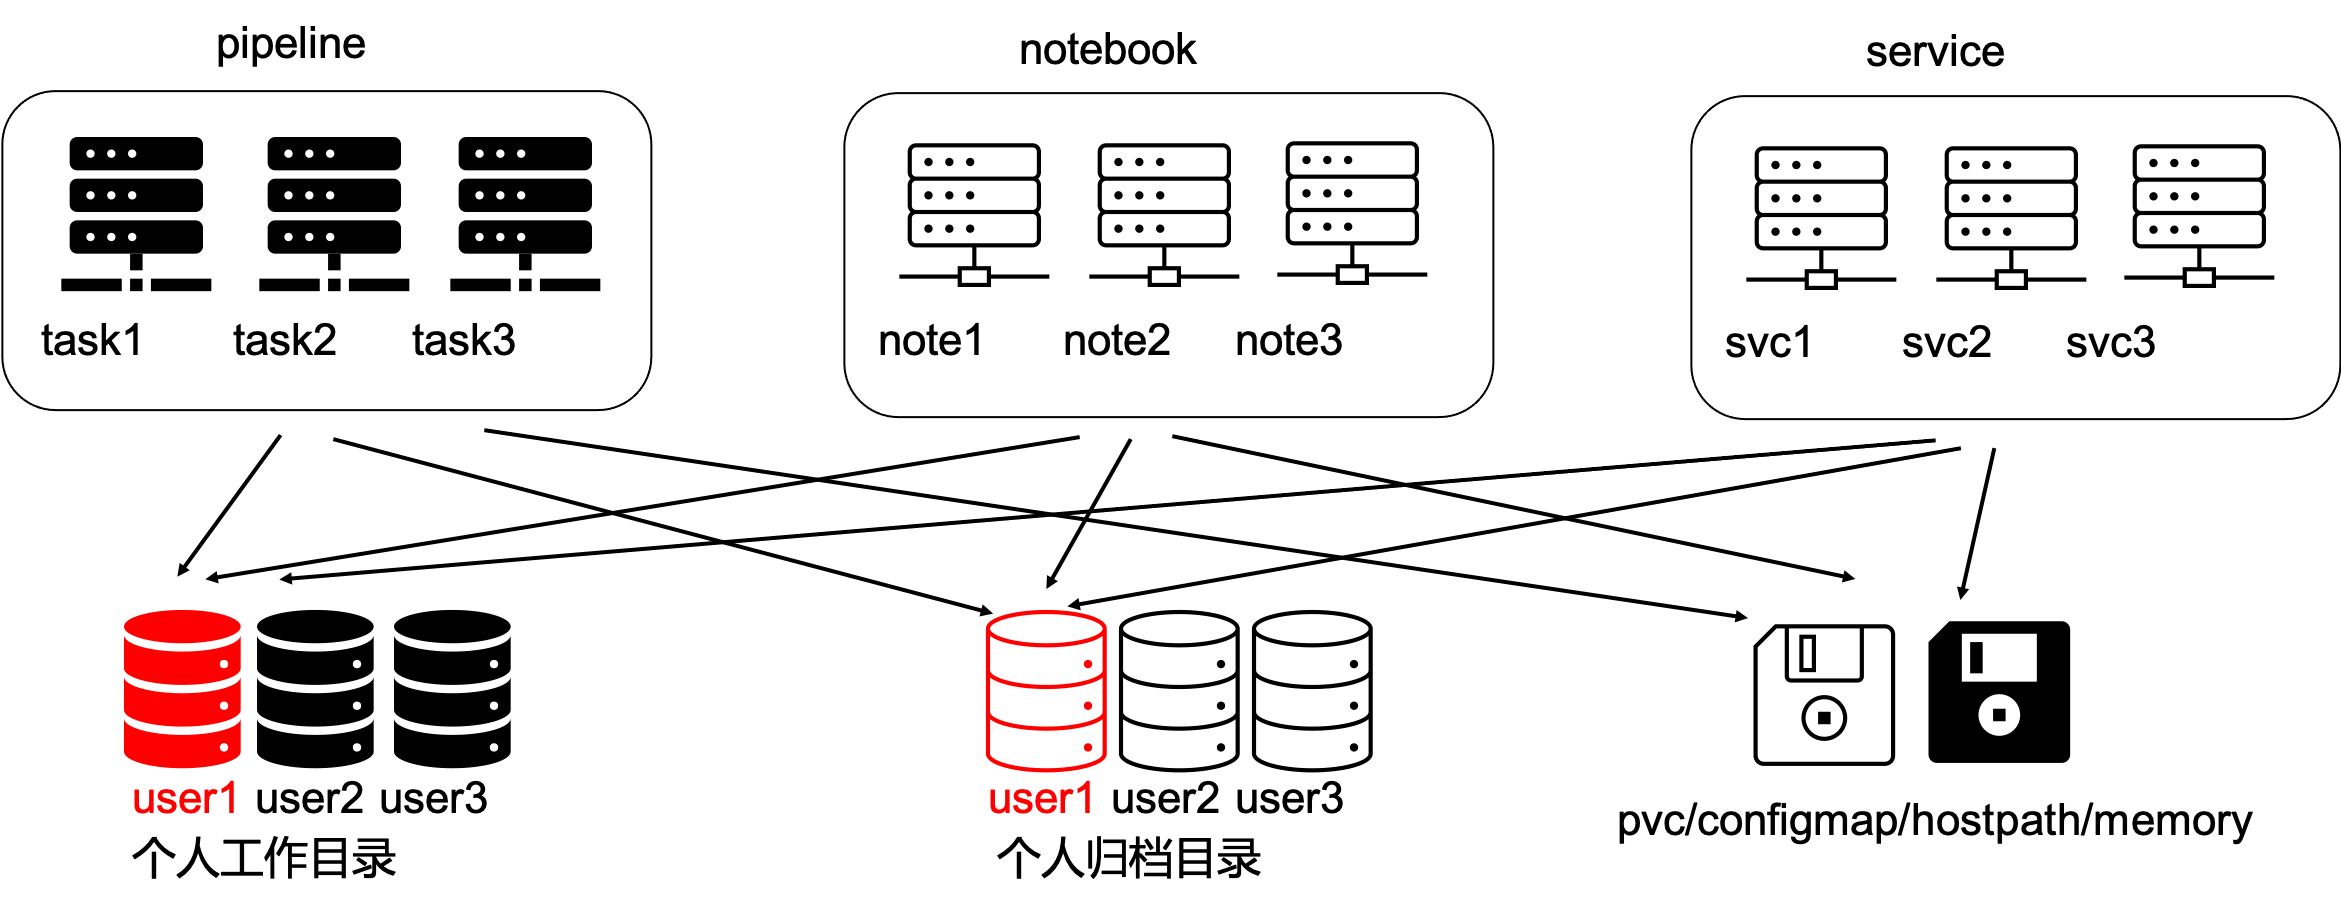
cubestudio 自动为用户挂载个人目录,同一用户在平台任意位置启动的容器,其个人子目录均为 /mnt/$username;可将 pvc/hostpath/memory/configmap 挂载为容器目录,并在项目组中配置默认挂载,实现组内共享同一目录等功能。
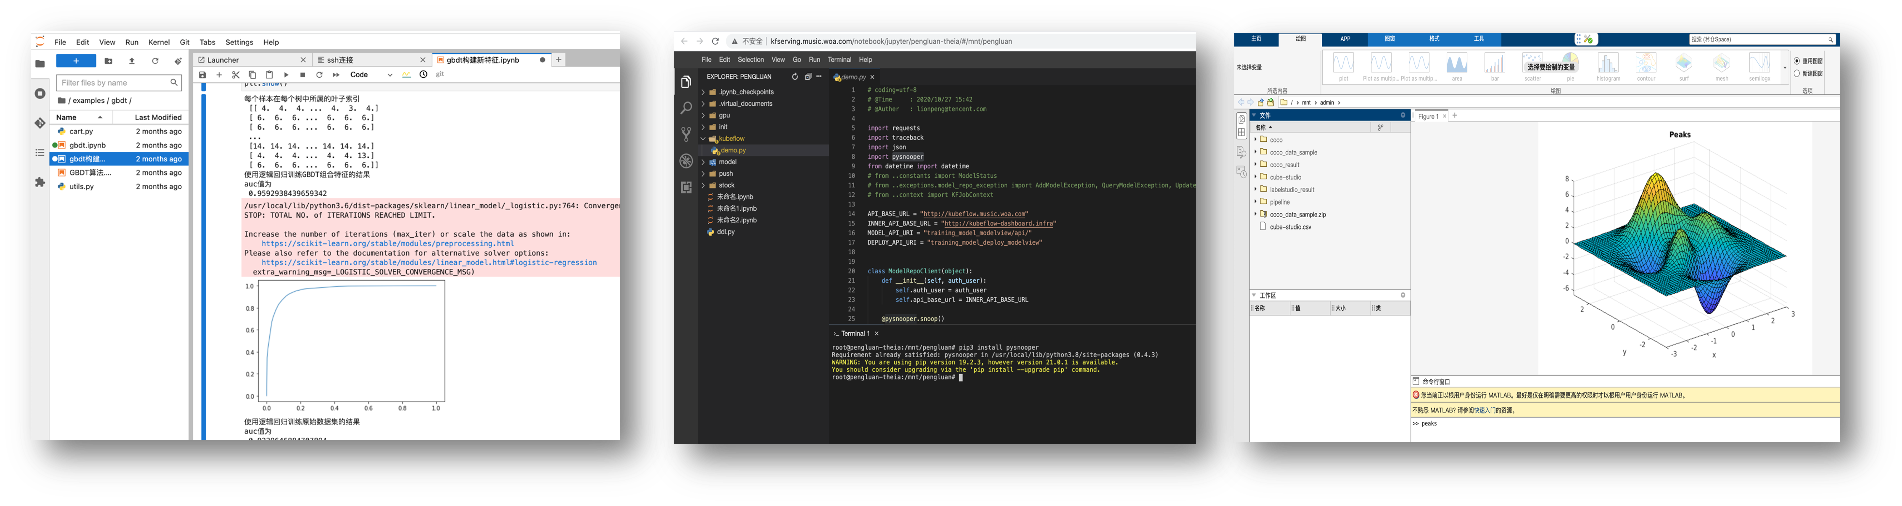
浏览器即开发,多种在线 IDE 与镜像能力,无需本地安装。
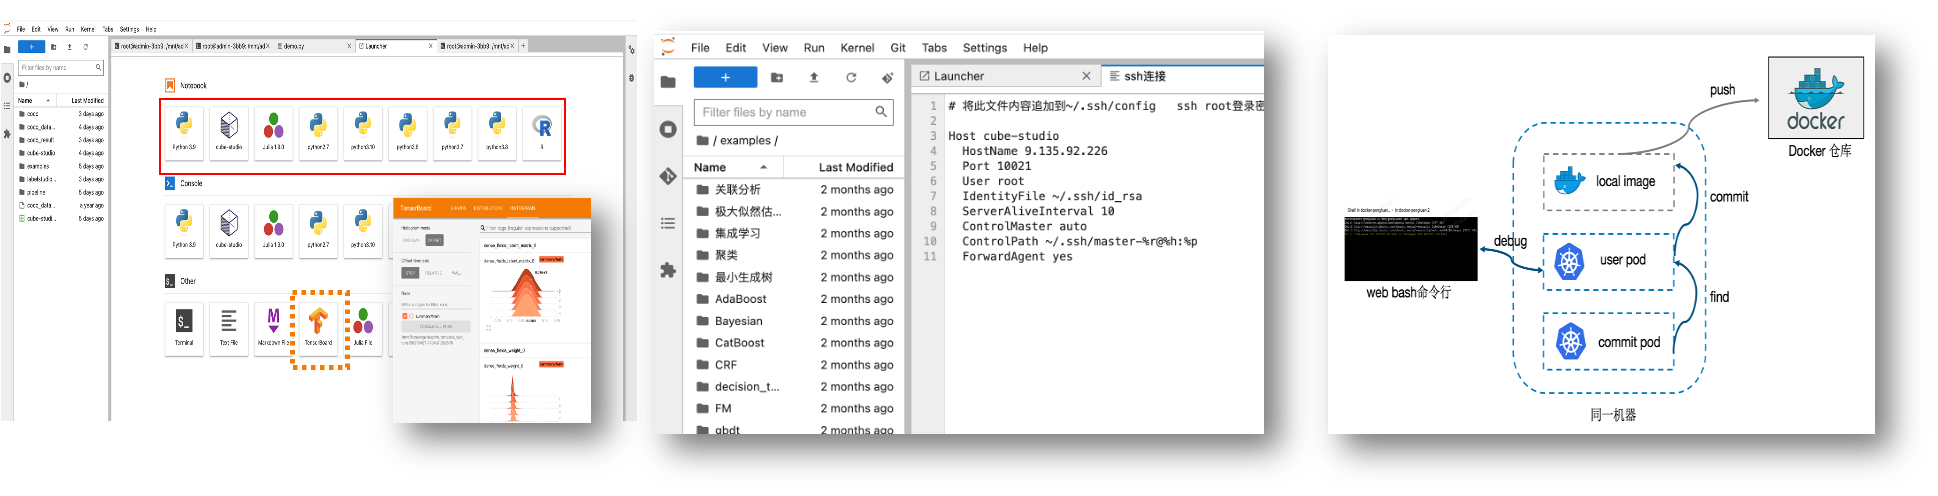
打通数据接入、探索、标注与数据中台,为算法提供高质量样本。
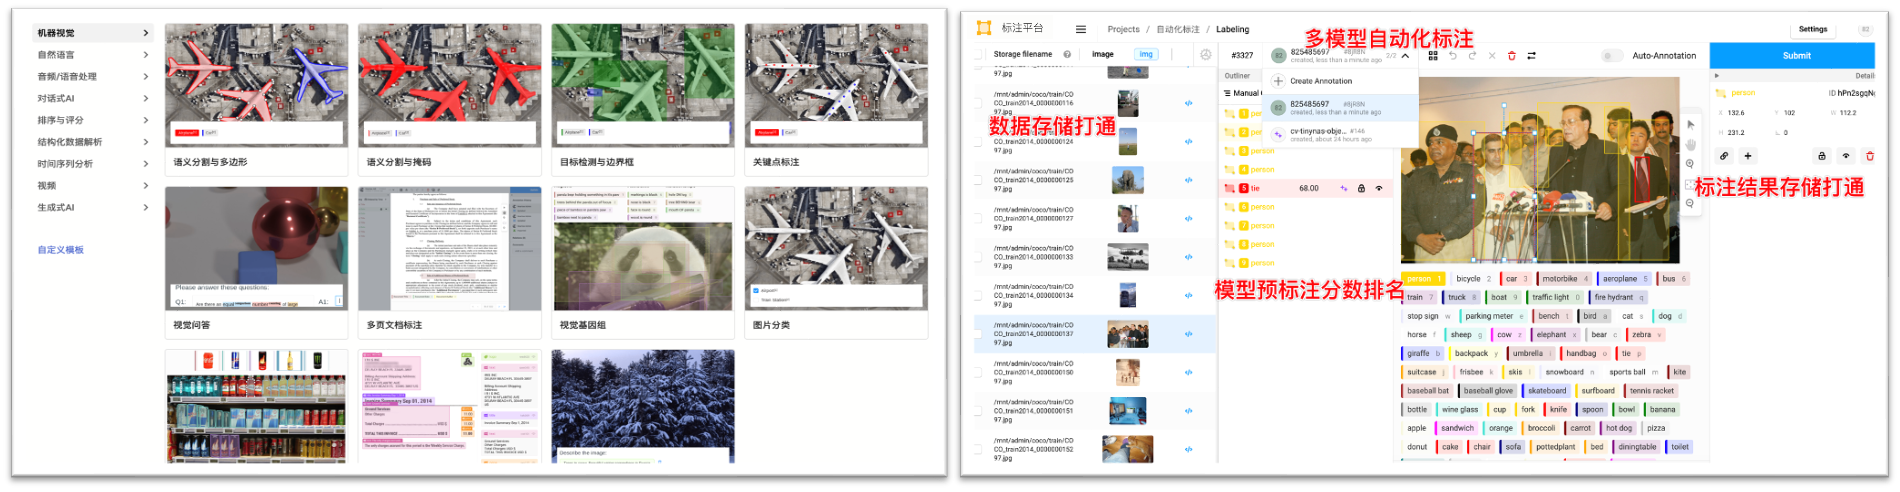
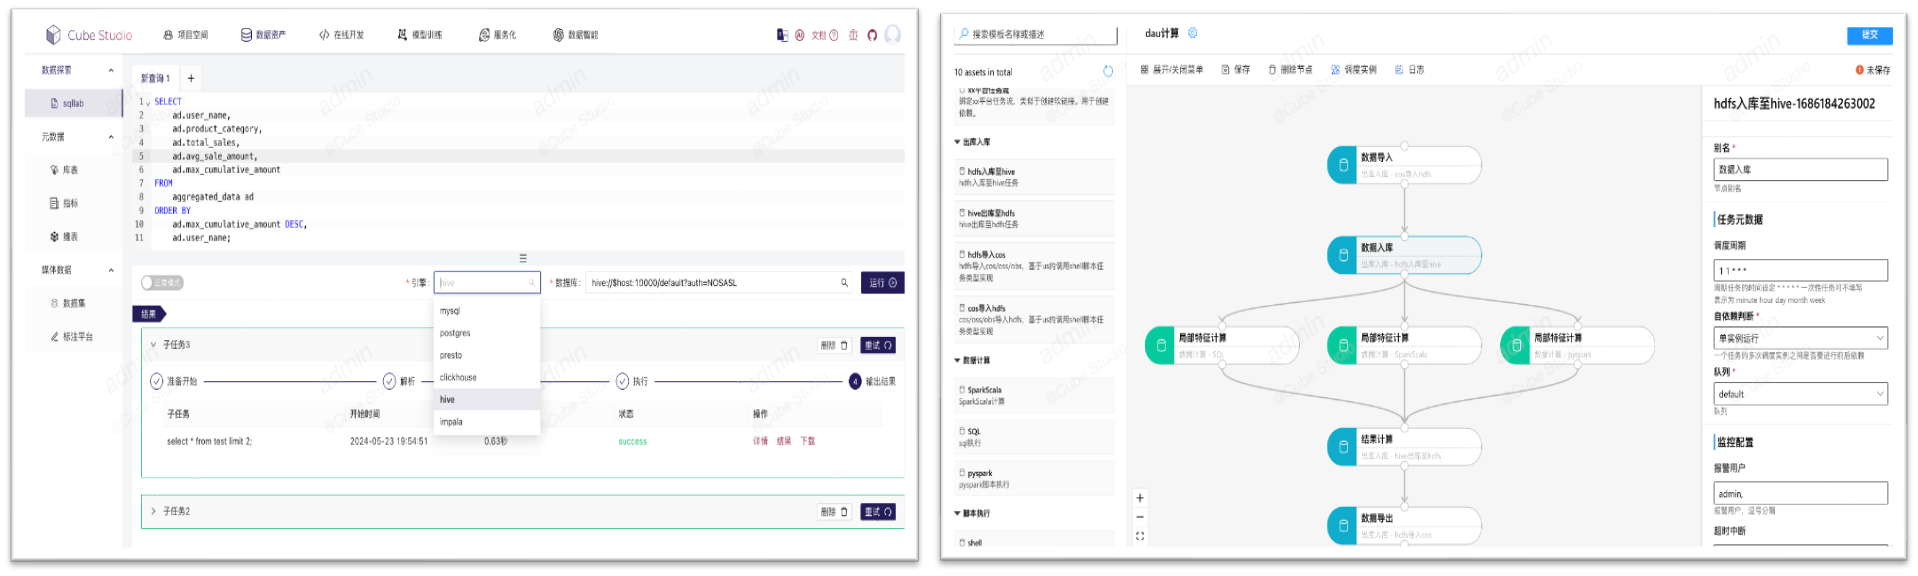
为加速 AI 算法平台的使用,cube-studio 支持对接公司原有数据中台,包括数据计算引擎 SQLLab、元数据管理、维表管理、数据 ETL、数据集管理,提供数据资产开发工具与数据 ETL 可视化链路。
拖拉拽编排 ML 全流程,标准化算子 + 分布式训练 + 超参搜索,覆盖机器学习 / 深度学习 / 大模型。
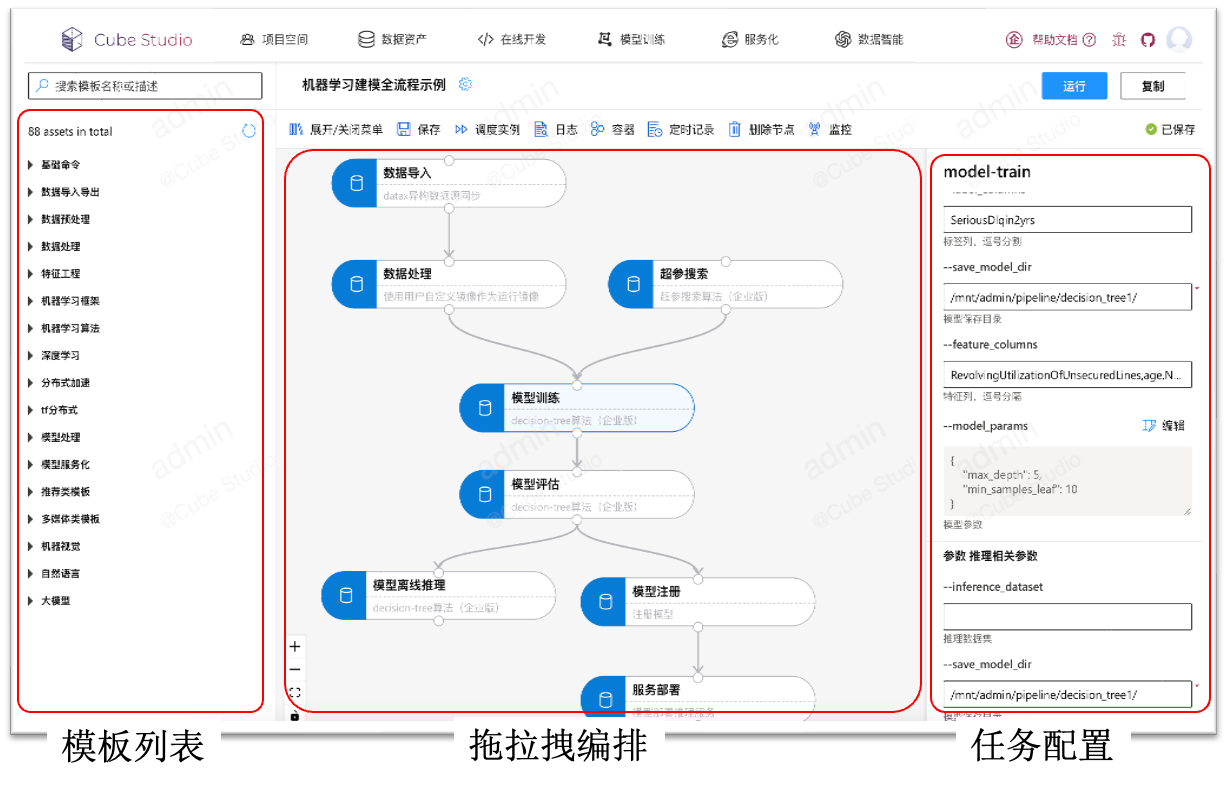
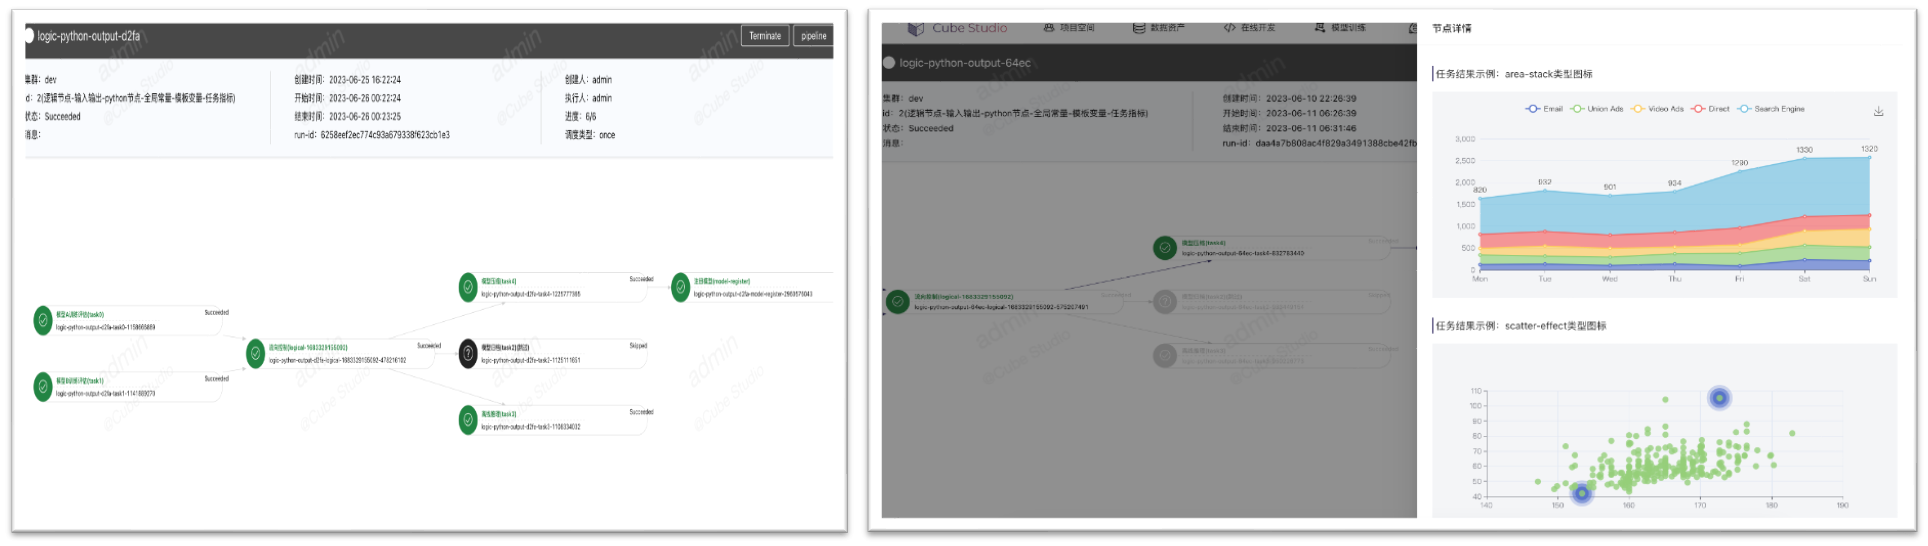
另支持多卡型 / RDMA / 多厂商 GPU 占用、独占共享占用、分布式模板调试用户镜像;任务输入输出与全局常量;文本 / 图片 / CSV/JSON / 表格 / echart 结果可视化;workflow 暂停恢复、运行中端口服务监听、定时调度最大保留实例数、任务流优先级。
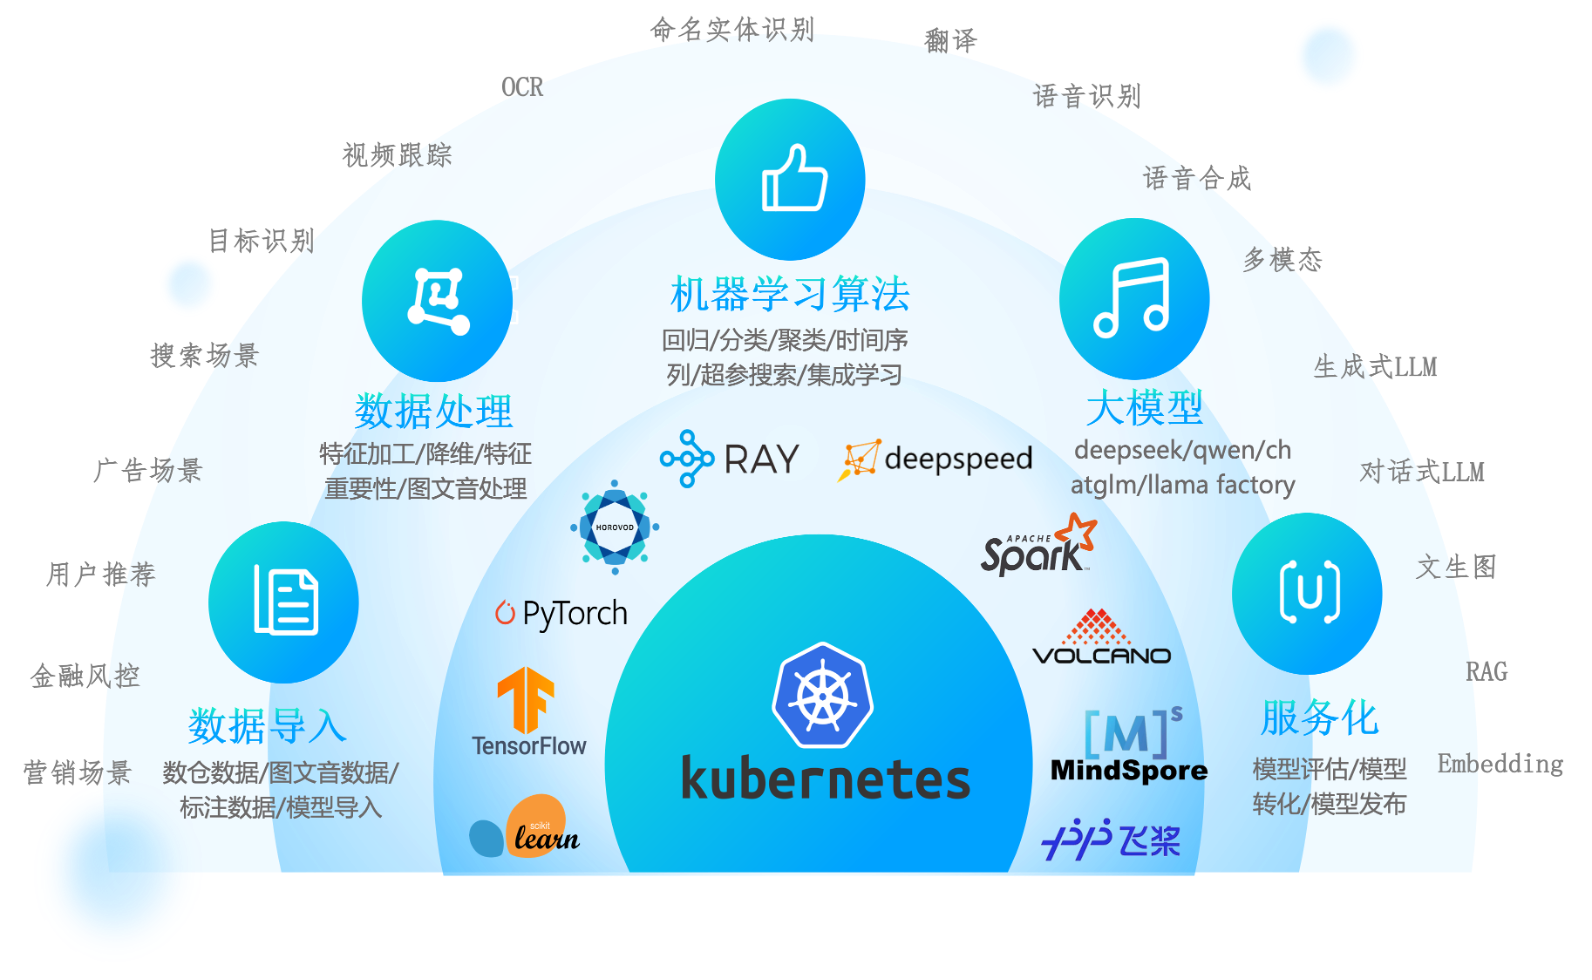
平台以 Kubernetes 为算力底座,向上纳管多种主流计算与训练框架,对外沉淀为标准化算子库,形成"底座 — 框架 — 算子 — 场景"分层能力:
| 算子分层 | 能力说明 |
|---|---|
| 主流功能算子 🟢 | 基础算子(自定义镜像、逻辑节点、python);数据同步(数据集导入、模型导入)。支持 HuggingFace/魔搭数据集与模型导入,datax / datax-import(MySQL/PostgreSQL/ClickHouse)。 |
| 特征处理算子 🔵 (pipeline 算子) | 数据合并/去重/变换(boxcox、二值化、DCT、多项式展开等)、非数值变量处理、异常值检测、统计量、缺失值处理与填充、离散化、标准化/归一化、索引处理、排序、执行 SQL、特征组合、PCA/卡方降维、特征重要性(随机森林/逻辑回归/XGBoost,IV/互信息/方差)、相关性计算、数据拆分、多种采样。 |
| 数据处理工具 🟢 | volcanojob / ray 分布式数据处理、媒体分布式下载与视频提取图片。Hadoop(HDFS/Hive/Spark);文本处理(paddleocr-vl 提取 Markdown、问答对提取扩展、清理/过滤/隐私替换/统计);图像处理(质量评估、去噪、缩放、标准化、裁剪、均衡化、空间与几何变换)。 |
| 传统机器学习 ⭐🟢 | sklearn 单机、ray-sklearn 分布式、XGB 单机训练推理;AR/ARIMA、随机森林(含回归)、LR、LightGBM、KNN、KMeans、GBDT、决策树、PCA、LDA、CatBoost、XGB 及超参搜索。 |
| 分布式深度学习 🟢 | TF / PyTorch 分布式多机多卡训练框架。 |
| CV/NLP/语音预置模型 ⭐🟢 | OCR 文字检测识别(paddleocr)、实例分割(swinb)、图像分类(vit)、文本分类(structbert)、语音合成 TTS(paddlespeech)。 |
| 模型处理与服务化 🟢 | 模型注册、离线处理、部署。模型评估、模型格式转换。 |
| 分布式多机多卡训练 | MPI / Colossal-AI / DeepSpeed / Horovod / Megatron / MindFormer / MXNet / PaddleJob / MindSpore 分布式训练加速框架。 |
| 大模型微调 | DeepSeek/ChatGLM/Qwen/LLaMA LoRA 微调、MindFormers 微调;LLaMA-Factory 大模型 SFT/奖励模型/强化学习;NPU/DCU/沐曦适配的 LLaMA-Factory。 |
| 量化 / 评估 / 剪枝 | 大模型量化;OpenCompass 大模型评估;大模型剪枝。 |
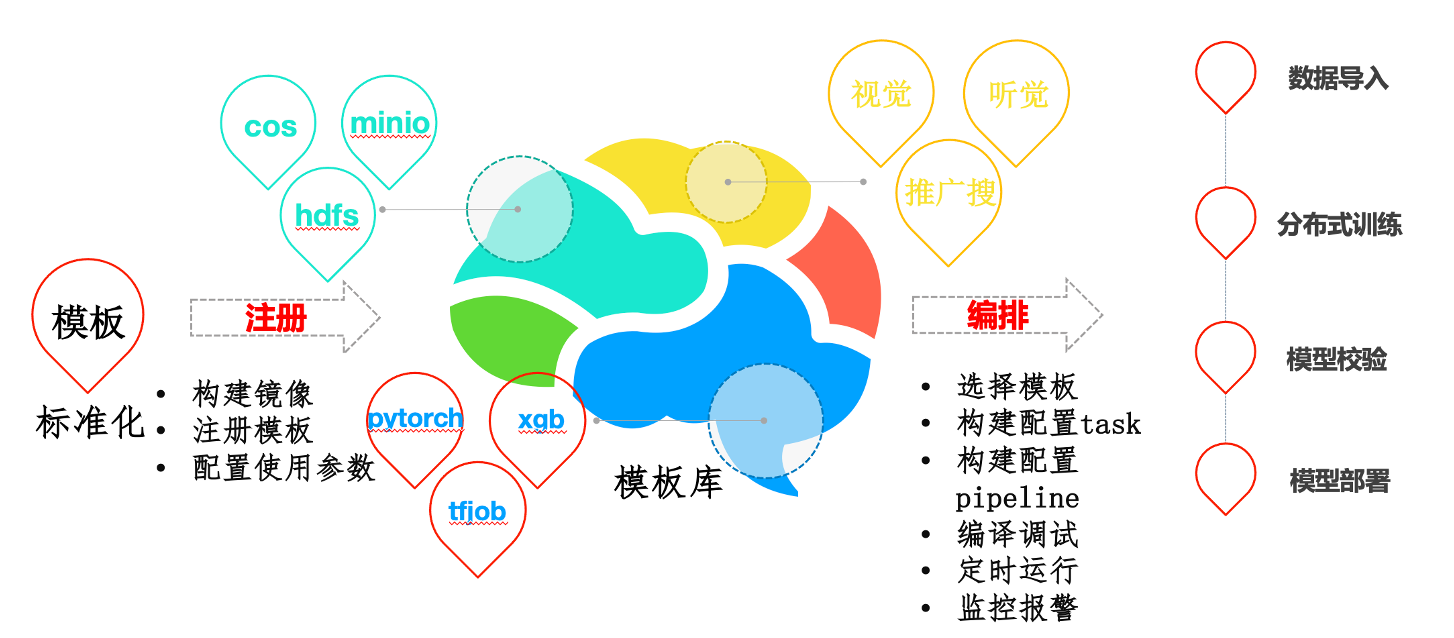
如上图所示,模板机制贯穿"标准化 — 注册 — 模板库 — 编排"全流程:
其核心价值:相比非模板开发建立应用成本更低、无需从零开发平台;模板标准化后迁移迭代只需迁移配置模板;算法与工程分离,避免重复开发。
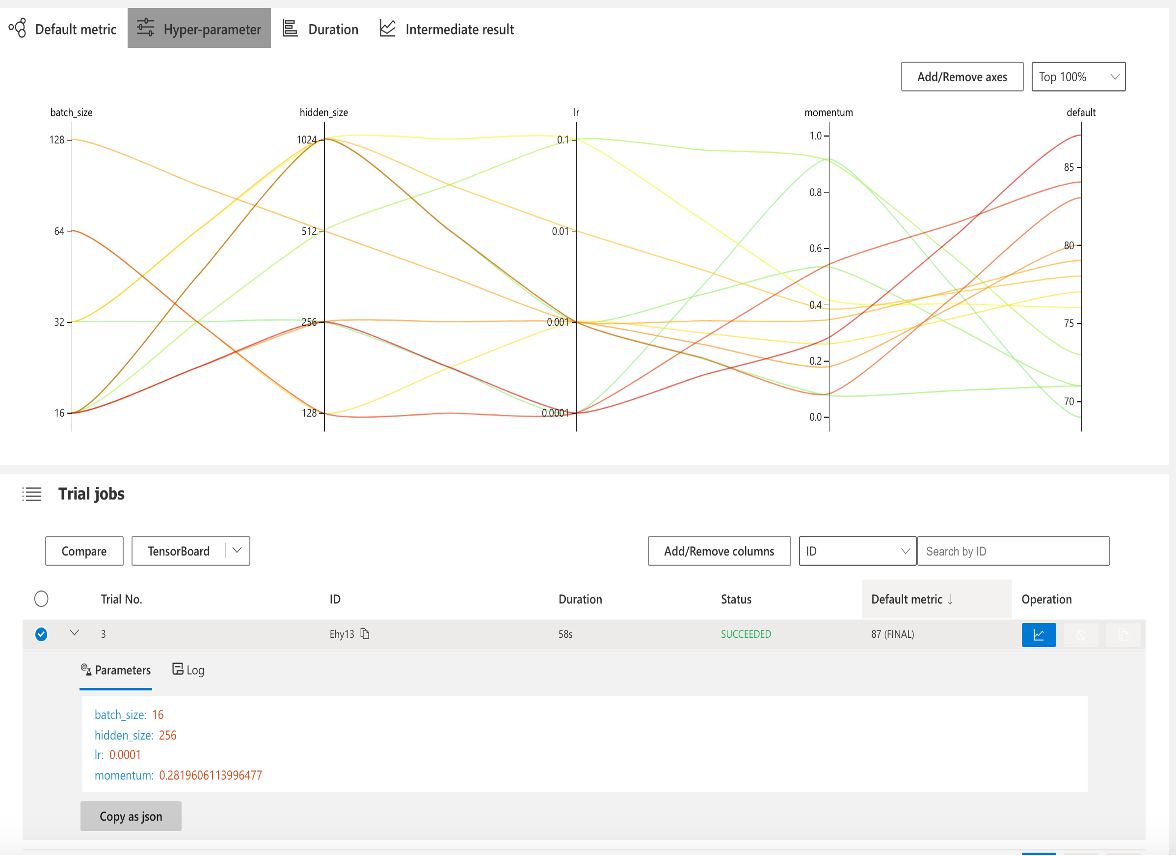
# 上报当前迭代目标值
nni.report_intermediate_result(test_acc)
# 上报最终目标值
nni.report_final_result(test_acc)

# 接收超参数为输入参数
parser.add_argument('--batch_size', type=int)
零代码将模型发布为在线推理服务,支持多集群、异构 GPU、弹性伸缩与灰度治理。
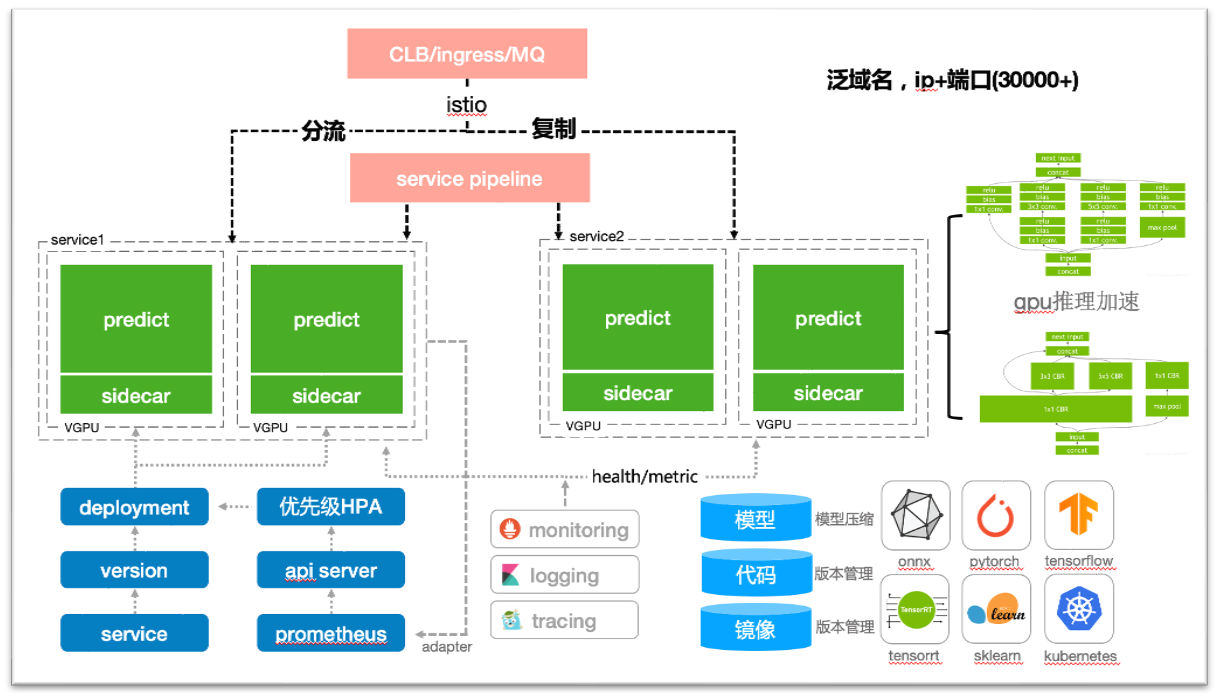
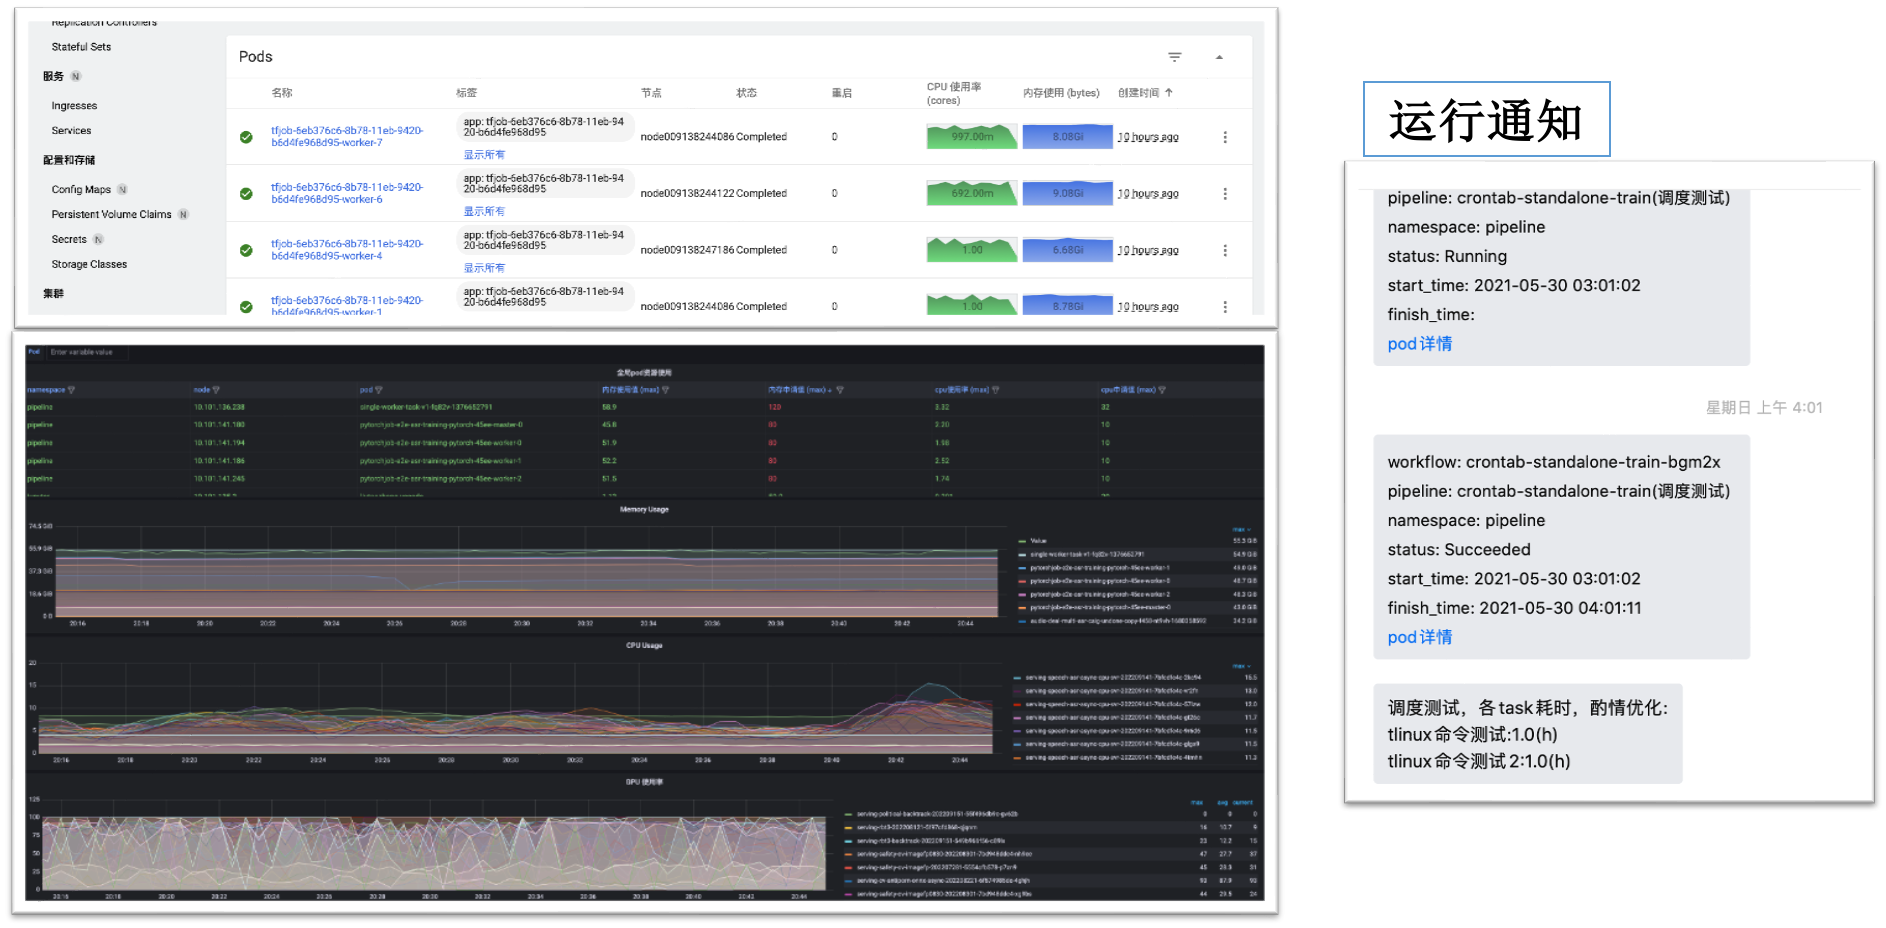
平台提供从底层资源到任务运行的全链路监控与主动报警能力:
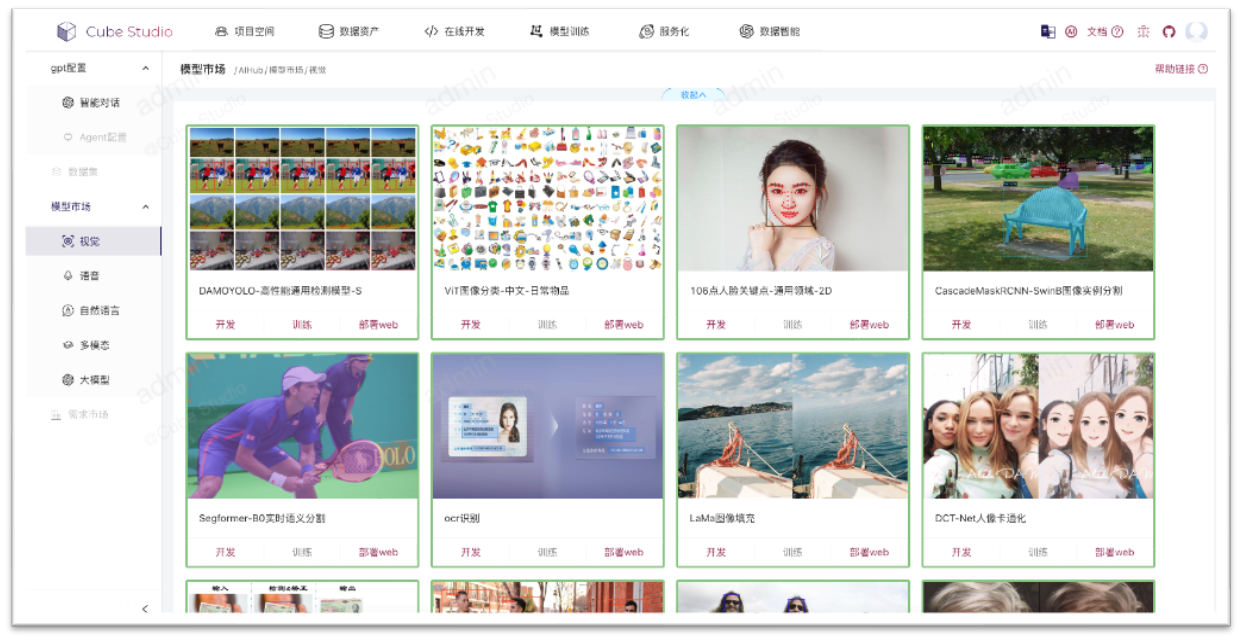
面向模型复用与快速落地的模型市场,一键部署 / 开发 / 微调:
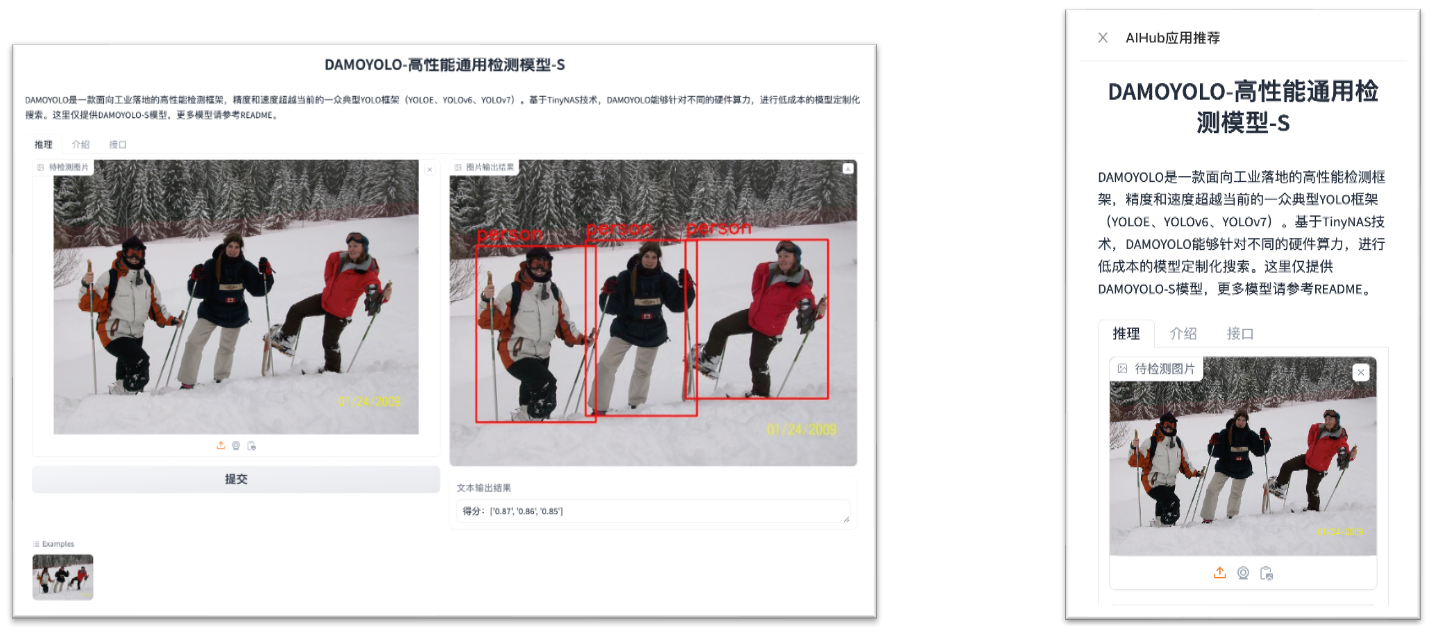
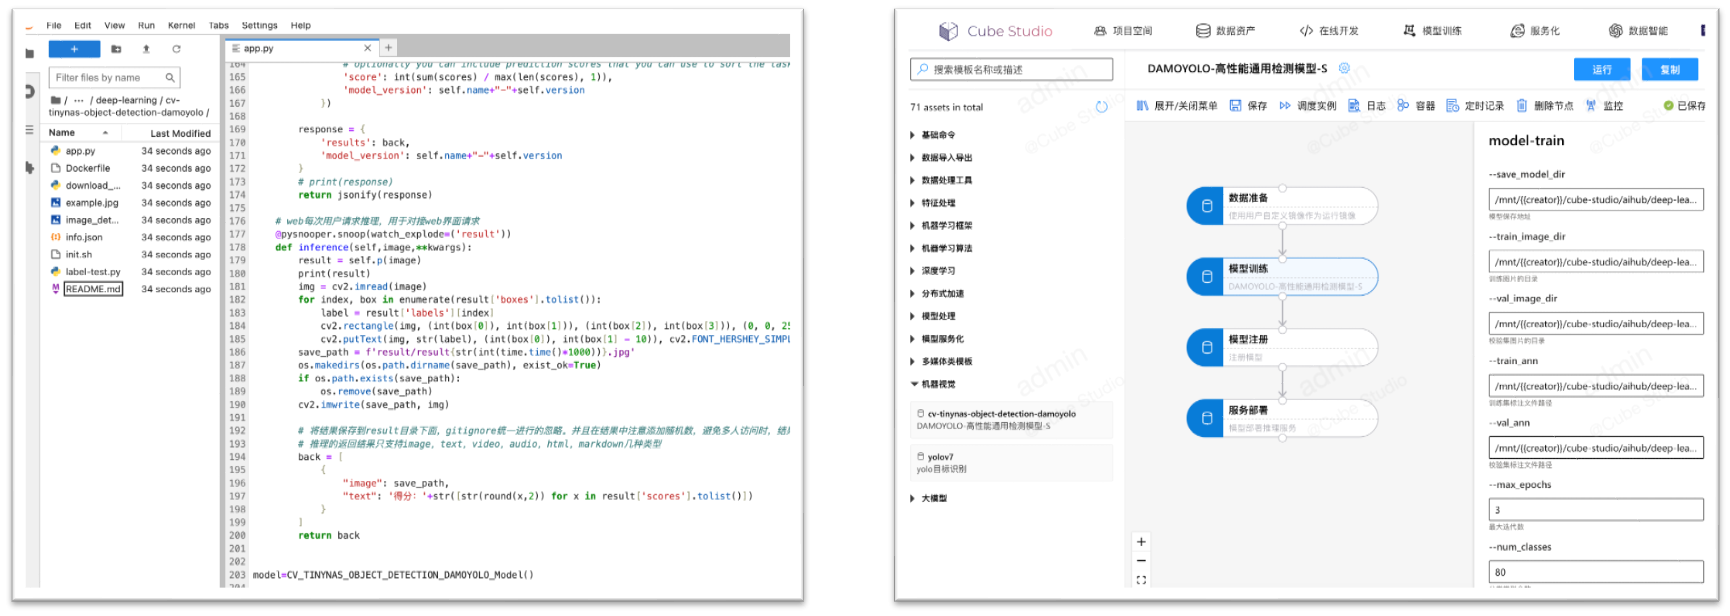
面向大模型训练、微调、推理、评估与智能对话的完整能力。
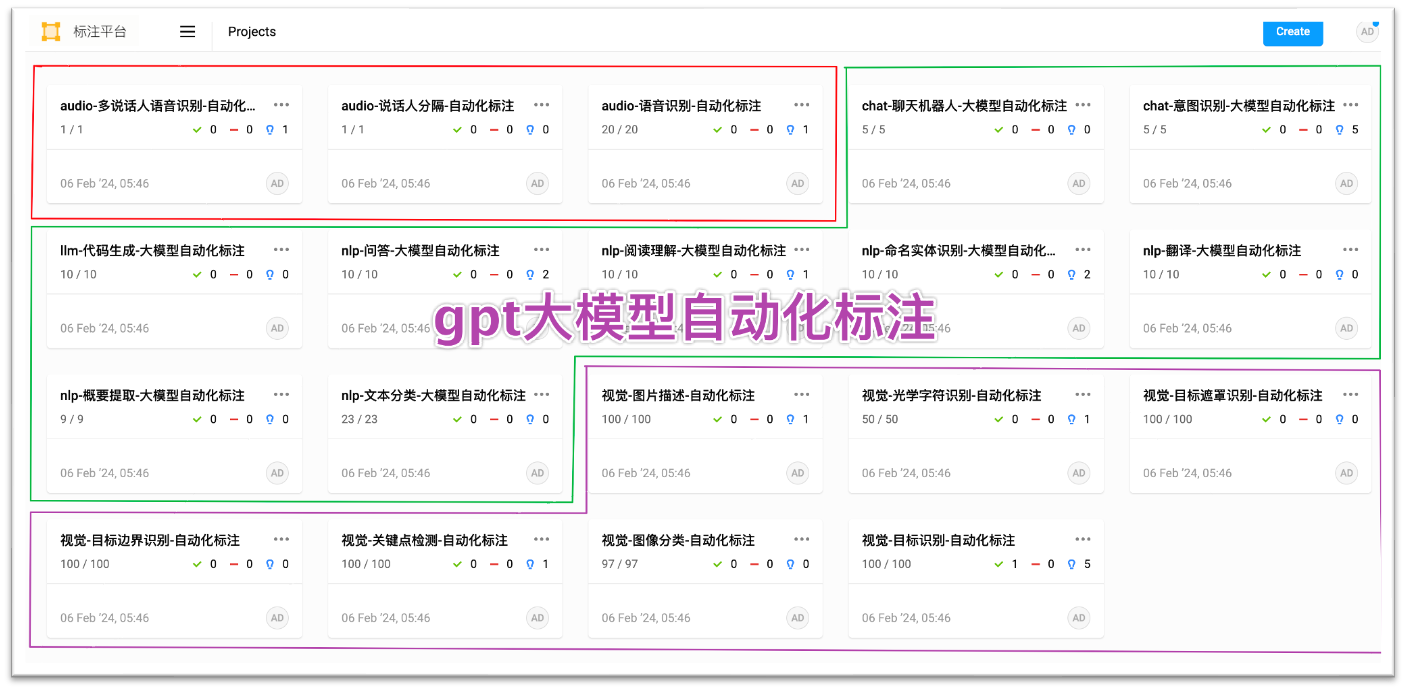
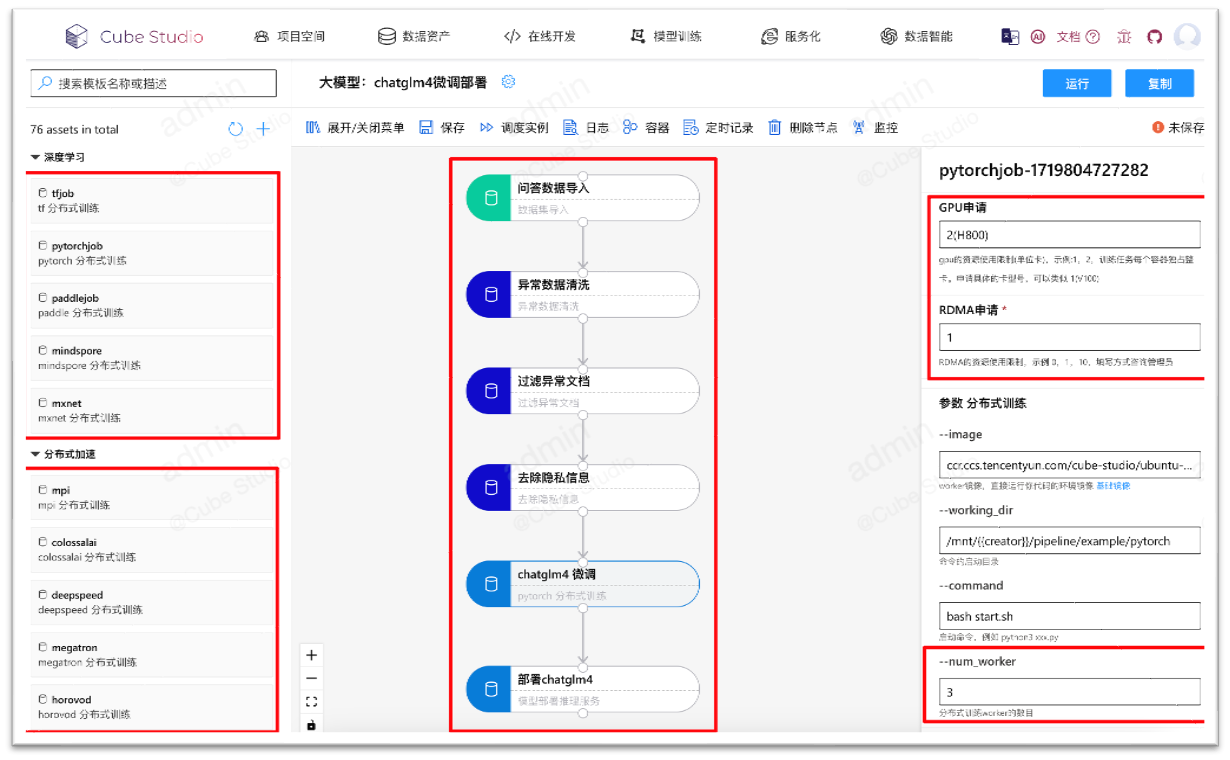
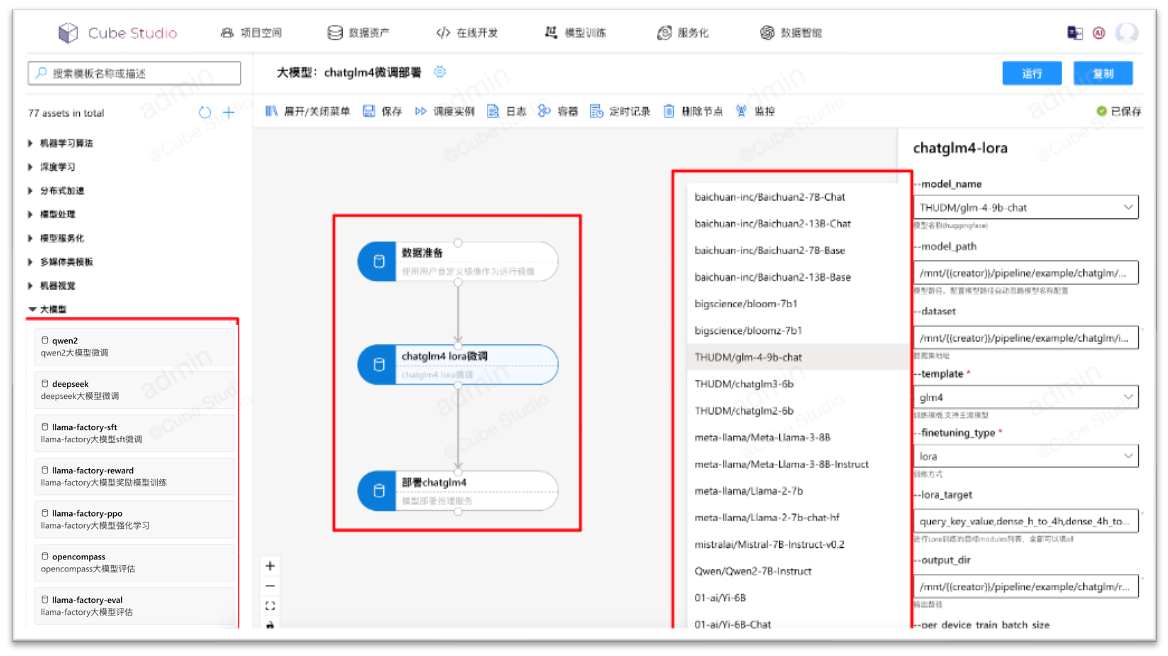
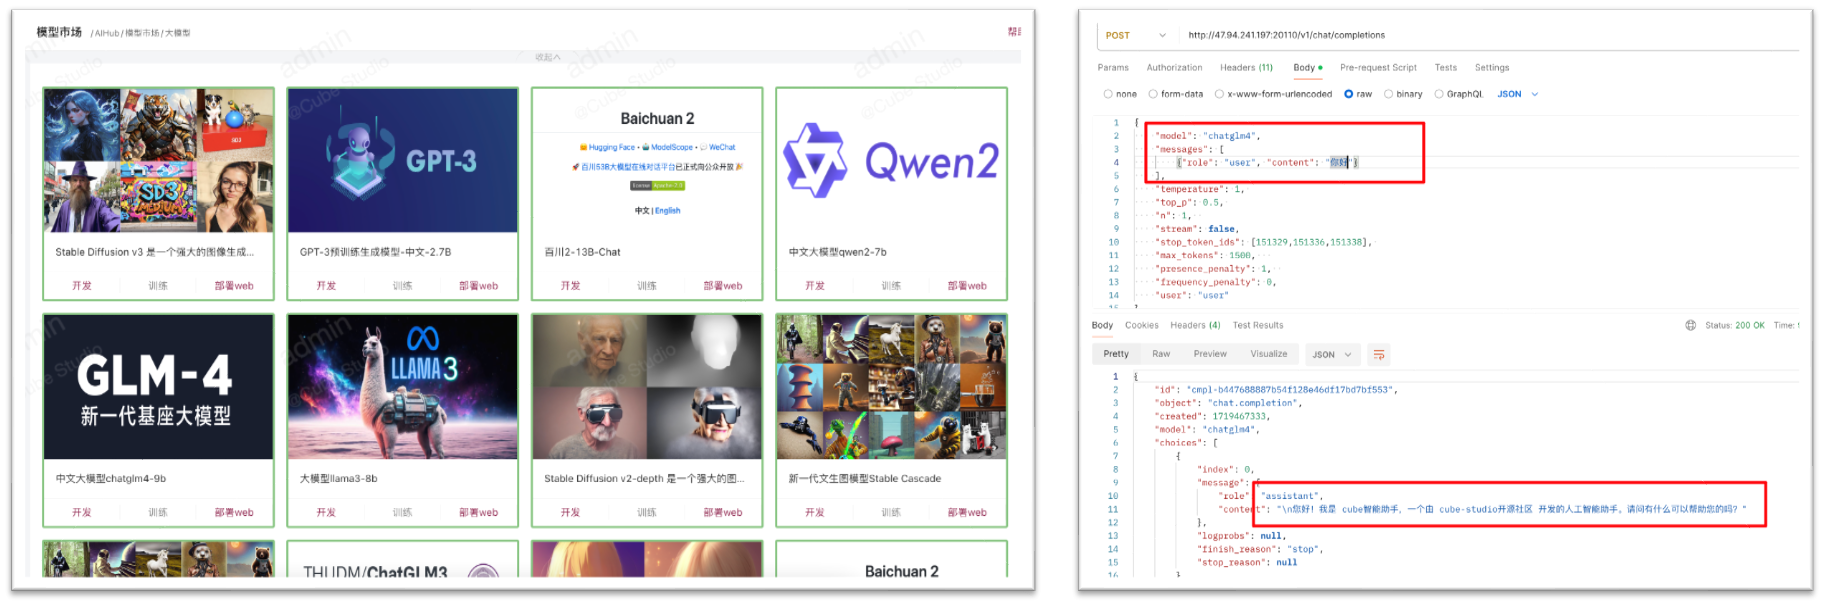
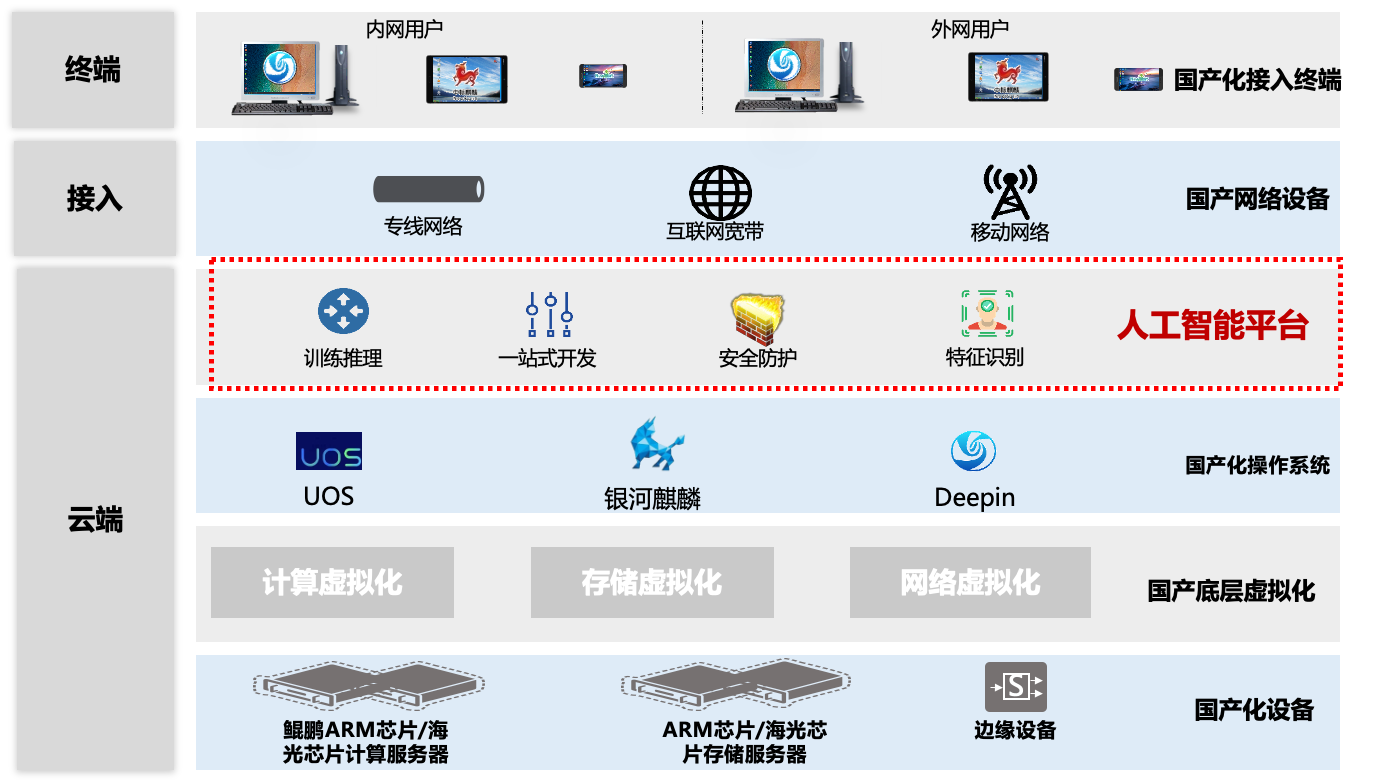
平台原生支持国产化平台部署,以满足客户对国产化产品的安全可信要求。
平台原生支持主流国产 AI 芯片,屏蔽底层异构差异,让训练、微调、推理无缝跑在国产算力上:
配套提供国产算力的整卡 / 共享 / 虚拟卡灵活调度、NPU 专属监控看板、RDMA 高速互联,以及昇腾 MindIE 推理、NPU/DCU/沐曦适配的 LLaMA-Factory 大模型微调等开箱即用能力。
全栈适配鲲鹏等 ARM64 国产 CPU:平台底层组件、前后端、任务模板、Notebook 开发环境、超参搜索均提供 ARM 版本镜像,AI 应用商店约 70% 应用支持 ARM,真正做到国产芯片上"拿来即用"。
采用容器化 + Kubernetes 交付,应用与操作系统解耦,可运行于国产 ARM 服务器与信创软硬件环境,支持全离线私有化部署,满足党政、金融、能源等行业的自主可控与安全合规要求。
4,146 followers · starred Aug 2026
5 followers · starred Apr 2026
53 followers · starred Aug 2024
228 followers · starred May 2026
cubestudio开源云原生一站式机器学习/深度学习/大模型AI平台/MaaS/mlops/人工智能平台/训推平台,算法全链路流程,多租户,算力租赁平台,token中转,拖拉拽任务流pipeline编排,多机多卡分布式训练,超参搜索,推理服务,VGPU虚拟化,云边端协同,边缘计算,自动化标注平台,deepseek等大模型sft微调/奖励模型/强化学习训练,vllm/ollama/mindie大模型多机推理,私有知识库llmops智能体,AI模型市场,支持国产异构算力调度,昇腾/寒武纪/海光/摩尔/沐曦等,支持ib/roce/RDMA,信创支持
See the codeCubeStudio 是一款国产化、云原生的一站式开源人工智能平台,同时覆盖传统机器学习、深度学习与大模型全链路(MLOps / MaaS / 算力调度 / 训推平台),开源协议 MIT,开源免费商用,开源版本已有数千家企业私有化部署。平台提供多租户与算力纳管调度、算力租赁与 Token 中转站、拖拉拽 Pipeline 任务流编排、多机多卡分布式训练、超参搜索、推理服务、vGPU 虚拟化、云边端协同与边缘计算、图文音多模态自动化标注、大模型 SFT 微调 / 奖励模型 / 强化学习训练、vLLM / Ollama / MindIE 大模型多机推理、私有知识库 / LLMOps / 智能体、AI 模型市场,以及从数据到上线的全流程模型部署。原生适配昇腾、寒武纪、海光、摩尔线程、沐曦等国产异构算力与 x86 / ARM CPU 架构,支持 IB / RoCE / RDMA 高速网络及信创私有化、内网离线部署。
https://github.com/data-infra/cube-studio/wiki
学习、部署、体验、开源建设、商业合作 欢迎来撩。或添加微信luanpeng1234,备注<开源建设>
| 模块分组 | 功能 | 功能描述 |
|---|---|---|
| 用户权限 | SSO单点登录 | |
| 用户权限 | 项目组管理 | |
| 用户权限 | 用户管理 角色管理/权限管理 | |
| 算力调度 | 数据大屏 | |
| 算力调度 | 多资源组/多集群 | |
| 算力调度 | gpu调度能力 | |
| 算力调度 | 支持多种算力 | |
| 算力调度 | 算力市场 | |
| 算力调度 | 租赁实例 | |
| 算力调度 | 计量计费功能 | |
| 算力调度 | 机器资源管理 | |
| 算力调度 | 存储盘管理 | |
| 基础能力 | 网络 | |
| 基础能力 | 数据库存储 | |
| 基础能力 | 国际化能力 | |
| 数据管理 | 数据地图 | |
| 数据管理 | 数据计算 | |
| 数据管理 | 数据集管理 | |
| 数据标注 | 数据标注 | |
| 数据标注 | 数据标注 | |
| 在线开发 | 镜像功能 | |
| 在线开发 | notebook | |
| 模型训练 | 拖拉拽任务流编排调试 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 主流功能算子 | |
| 模型训练 | 算子自定义 | |
| 模型训练 | 链路共享 | |
| 模型训练 | 自定义镜像 | |
| 模型训练 | 自动调参 | |
| 模型训练 | TensorBoard作业 | |
| 模型管理 推理服务 | 内部服务 | |
| 模型管理 推理服务 | 模型管理 | |
| 模型管理 推理服务 | 推理服务 | |
| 监控 | 整体资源 | |
| 监控 | 监控体系 | |
| AIHUB | 应用sdk | |
| AIHUB | 应用sdk | |
| AIHUB | 应用sdk | |
| AIHUB | 预训练模型 | |
| AIHUB | 模型市场 | |
| AIHUB | 模型一键开发 | |
| AIHUB | 模型一键微调 | |
| AIHUB | 模型一键部署web | |
| AIHUB | 模型自动化标注 | |
| AIHUB | pipeline对接aihub | |
| 大模型 | 大模型分布式多机多卡 | |
| 大模型 | 支持大模型推理aihub形式 | |
| 大模型 | 支持大模型推理 | |
| 大模型 | 支持大模型微调 | |
| 大模型 | 支持大模型量化评估剪枝 | |
| 大模型 | 智能对话 | |
| 大模型 | 智能对话 | |
| 大模型 | 智能对话 |
传统算法落地流程:从申请机器,配置环境,拉取数据,处理数据,算法训练,调试,模型测试,服务化上线全流程,算法工程师在上面的每个环节都浪费了很多时间,而不是把精力主要集中在算法模型的构建上。
如上图所示,工程师在数据、开发、训练、部署各环节被迫处理大量非算法本质的问题:
cubestudio 一站式的机器学习平台,正是从平台架构上系统性地解决上述工程化与技术性问题,做了一系列更贴近用户实用化的考虑。
现状:
难点:
自主可控:
平台定位:如上图所示,cubestudio 位于"大数据平台"与"智能体开发平台"之间,作为一站式 AI / MLOps / 训推 / MaaS 平台承上启下,向上承接大数据平台的数据资产,向下输出到智能体开发平台,贯通数据清洗、标注、在线开发、训练、评估、推理发布、算力调度全链路。
cube-studio 是开源的云原生一站式机器学习 / 深度学习 / 大模型 AI 平台,核心能力包括:
一站式 MLOps 平台,自底向上分层(对应上图左侧):
右侧六边形为平台核心能力集:云原生多租户、机器管理 / 存储管理、数据集 / 标注平台、数据血缘 / 数据 ETL、模板市场 / Pipeline 编排、超参搜索 / 大模型评测、notebook 在线开发、多机多卡分布式训练、大模型微调 / 强化学习、多机推理 / 服务网关、模型市场 / Token 中转、智能体 / 智能对话、国产异构算力租赁、VGPU / RDMA 等。
基于平台实际模块拆分的一站式 MLOps / AI 平台业务流程,自左向右、自上而下分为六大阶段闭环:
以 cube-studio 开源 MLOps / AI 平台为核心,功能模块覆盖从底座算力到大模型应用的全链路。按用户实际使用路径,可归纳为九大能力域,依次为:用户与权限 → 算力纳管 → 在线开发 → 数据管理与标注 → 模型训练 → 推理服务 → 监控 → AIHub 模型市场 → 大模型,另有贯穿全栈的国产化支持能力。
统一账号接入与多租户隔离,是平台安全登录与资源分权的入口。
以 Kubernetes 为底座,云原生统筹 CPU/GPU/NPU 异构算力,实现多集群、多资源组的隔离调度与计量。
单个 k8s 集群的部署拓扑图:
cubestudio 支持多集群调度,可同时管控多个训练或推理集群。单集群内既能隔离一个项目组的在线开发、训练、推理,也能隔离同一 k8s 集群下多个项目组的算力;不同项目组算力间具备动态均衡能力,可在公共算力池与私有化算力池间共享,做到成本最低化。
cubestudio 自动为用户挂载个人目录,同一用户在平台任意位置启动的容器,其个人子目录均为 /mnt/$username;可将 pvc/hostpath/memory/configmap 挂载为容器目录,并在项目组中配置默认挂载,实现组内共享同一目录等功能。
浏览器即开发,多种在线 IDE 与镜像能力,无需本地安装。
打通数据接入、探索、标注与数据中台,为算法提供高质量样本。
为加速 AI 算法平台的使用,cube-studio 支持对接公司原有数据中台,包括数据计算引擎 SQLLab、元数据管理、维表管理、数据 ETL、数据集管理,提供数据资产开发工具与数据 ETL 可视化链路。
拖拉拽编排 ML 全流程,标准化算子 + 分布式训练 + 超参搜索,覆盖机器学习 / 深度学习 / 大模型。
另支持多卡型 / RDMA / 多厂商 GPU 占用、独占共享占用、分布式模板调试用户镜像;任务输入输出与全局常量;文本 / 图片 / CSV/JSON / 表格 / echart 结果可视化;workflow 暂停恢复、运行中端口服务监听、定时调度最大保留实例数、任务流优先级。
平台以 Kubernetes 为算力底座,向上纳管多种主流计算与训练框架,对外沉淀为标准化算子库,形成"底座 — 框架 — 算子 — 场景"分层能力:
| 算子分层 | 能力说明 |
|---|---|
| 主流功能算子 🟢 | 基础算子(自定义镜像、逻辑节点、python);数据同步(数据集导入、模型导入)。支持 HuggingFace/魔搭数据集与模型导入,datax / datax-import(MySQL/PostgreSQL/ClickHouse)。 |
| 特征处理算子 🔵 (pipeline 算子) | 数据合并/去重/变换(boxcox、二值化、DCT、多项式展开等)、非数值变量处理、异常值检测、统计量、缺失值处理与填充、离散化、标准化/归一化、索引处理、排序、执行 SQL、特征组合、PCA/卡方降维、特征重要性(随机森林/逻辑回归/XGBoost,IV/互信息/方差)、相关性计算、数据拆分、多种采样。 |
| 数据处理工具 🟢 | volcanojob / ray 分布式数据处理、媒体分布式下载与视频提取图片。Hadoop(HDFS/Hive/Spark);文本处理(paddleocr-vl 提取 Markdown、问答对提取扩展、清理/过滤/隐私替换/统计);图像处理(质量评估、去噪、缩放、标准化、裁剪、均衡化、空间与几何变换)。 |
| 传统机器学习 ⭐🟢 | sklearn 单机、ray-sklearn 分布式、XGB 单机训练推理;AR/ARIMA、随机森林(含回归)、LR、LightGBM、KNN、KMeans、GBDT、决策树、PCA、LDA、CatBoost、XGB 及超参搜索。 |
| 分布式深度学习 🟢 | TF / PyTorch 分布式多机多卡训练框架。 |
| CV/NLP/语音预置模型 ⭐🟢 | OCR 文字检测识别(paddleocr)、实例分割(swinb)、图像分类(vit)、文本分类(structbert)、语音合成 TTS(paddlespeech)。 |
| 模型处理与服务化 🟢 | 模型注册、离线处理、部署。模型评估、模型格式转换。 |
| 分布式多机多卡训练 | MPI / Colossal-AI / DeepSpeed / Horovod / Megatron / MindFormer / MXNet / PaddleJob / MindSpore 分布式训练加速框架。 |
| 大模型微调 | DeepSeek/ChatGLM/Qwen/LLaMA LoRA 微调、MindFormers 微调;LLaMA-Factory 大模型 SFT/奖励模型/强化学习;NPU/DCU/沐曦适配的 LLaMA-Factory。 |
| 量化 / 评估 / 剪枝 | 大模型量化;OpenCompass 大模型评估;大模型剪枝。 |
如上图所示,模板机制贯穿"标准化 — 注册 — 模板库 — 编排"全流程:
其核心价值:相比非模板开发建立应用成本更低、无需从零开发平台;模板标准化后迁移迭代只需迁移配置模板;算法与工程分离,避免重复开发。
# 上报当前迭代目标值
nni.report_intermediate_result(test_acc)
# 上报最终目标值
nni.report_final_result(test_acc)

# 接收超参数为输入参数
parser.add_argument('--batch_size', type=int)
零代码将模型发布为在线推理服务,支持多集群、异构 GPU、弹性伸缩与灰度治理。
平台提供从底层资源到任务运行的全链路监控与主动报警能力:
面向模型复用与快速落地的模型市场,一键部署 / 开发 / 微调:
面向大模型训练、微调、推理、评估与智能对话的完整能力。
平台原生支持国产化平台部署,以满足客户对国产化产品的安全可信要求。
平台原生支持主流国产 AI 芯片,屏蔽底层异构差异,让训练、微调、推理无缝跑在国产算力上:
配套提供国产算力的整卡 / 共享 / 虚拟卡灵活调度、NPU 专属监控看板、RDMA 高速互联,以及昇腾 MindIE 推理、NPU/DCU/沐曦适配的 LLaMA-Factory 大模型微调等开箱即用能力。
全栈适配鲲鹏等 ARM64 国产 CPU:平台底层组件、前后端、任务模板、Notebook 开发环境、超参搜索均提供 ARM 版本镜像,AI 应用商店约 70% 应用支持 ARM,真正做到国产芯片上"拿来即用"。
采用容器化 + Kubernetes 交付,应用与操作系统解耦,可运行于国产 ARM 服务器与信创软硬件环境,支持全离线私有化部署,满足党政、金融、能源等行业的自主可控与安全合规要求。
4,146 followers · starred Aug 2026
5 followers · starred Apr 2026
53 followers · starred Aug 2024
228 followers · starred May 2026