AI 基础知识 - GPU 架构、CUDA 编程、大模型基础及AI Agent 相关知识。
See the code本仓库是一个全面的人工智能基础设施(AI Infrastructure)学习资源集合,涵盖从硬件基础到高级应用的完整技术栈。内容包括 GPU 架构与编程、CUDA 开发、大语言模型、AI 系统设计、性能优化、企业级部署等核心领域,旨在为 AI 工程师、研究人员和技术爱好者提供系统性的学习路径和实践指导。
- 适用人群:AI 工程师、系统架构师、GPU 编程开发者、大模型应用开发者、技术研究人员。
- 技术栈:CUDA、GPU 架构、LLM、AI 系统、分布式计算、容器化部署、性能优化。
Star History:
涵盖单机基础计算芯片(GPU、TPU)设计原理,PCIe、NVLink 高速互连总线协议,GPUDirect 跨节点直通技术,以及 NVIDIA GB300 NVL72 等异构融合超级芯片的系统级架构与延迟金字塔模型。详细内容请访问:硬件架构与互连技术。
构建高吞吐 AI 计算集群的完整运维体系,涵盖基于 Device Query、nvidia-smi 和 nvtop 的 GPU 状态监控,InfiniBand (IB) 网络架构与健康检查,以及 NCCL 分布式通信库的基准测试与多节点部署实战。详细内容请访问:AI 集群运维与通信。
基于 Kubernetes 的 AI 基础设施构建方案,涵盖 NVIDIA Container Toolkit 与 Device Plugin 底层机制、Kueue/HAMi 细粒度 GPU 资源切分与池化、LWS/llm-d 分布式推理调度,以及 JuiceFS、DeepSeek 3FS 等高性能分布式存储系统的架构实践。详细内容请访问:云原生 AI 平台。
解析 Kubernetes AI 场景核心组件,包括容器运行时 GPU 支持底层机制、设备插件源码分析、Kueue 调度整合,以及基于 LWS 的大模型分布式训练与推理架构。
提供异构算力环境下的 GPU 资源精细化管理方案,涵盖硬件级/内核态/用户态虚拟化机制、CUDA 流与 MPS 调度优化,并提供 HAMi 资源隔离与 Flex AI 的生产环境落地配置。
基础系列文档:
HAMi 专题:
代码实现与配置:
针对 AI 训练中海量小文件读取与跨节点共享的性能瓶颈,解析 JuiceFS 数据与元数据分离架构、DeepSeek 3FS 高性能设计及面向推理的 ICMS (KV Cache) 存储层机制。
系统级 AI 底层编程路径,剖析 GPU 并行架构、CUDA 线程/网格与流处理机制、SIMT 与 Tile-Based (TileLang) 编程模型对比,以及基于 DOCA 框架的数据处理单元 (DPU) 核心编程范式。
涵盖 NVIDIA 容器镜像构建、CUDA 线程块/网格与流并发机制、SIMT 与 Tile-Based 编程模型对比、TileLang 算子开发,以及 nvbandwidth 显存与 PCIe 带宽调优实战,并链接 200+ Tensor Core/CUDA Core 优化内核的进阶学习资源。详细内容请访问:GPU 编程基础。
开发环境配置:
核心编程范式:
Tile-Based 编程:
性能分析与调优:
进阶学习资源:
基于 DOCA 框架的数据处理单元 (DPU) 开发指南,解析架构组件与网络加速、零拷贝 DMA、控制平面卸载、压缩、NVMe 模拟及近数据处理等典型场景的编程实践。详细内容请访问:DPU 编程。
基于昇腾 NPU 硬件特性和 CANN 软件栈的系统级编程路径,涵盖 Da Vinci 架构、PyTorch NPU 适配与迁移、MindSpore 原生框架、Ascend 工具链、自定义算子开发,以及 RAG pipeline、FlashAttention、Mini-GPT 和 LLM 推理(Qwen2.5-7B BF16 + LoRA 微调)等端到端实战。详细内容请访问:华为 NPU 编程入门。
探索以自然语言驱动与 Agent 自主决策为核心的 Software 3.0 开发范式,包含 Spring AI 企业级 Java 接入、LangGraph 有状态多智能体图计算模型,以及 Coze/n8n 无代码工作流编排技术。详细的深度探讨可参考 大模型编程指南。
剖析 Java 生态 AI 开发技术栈,通过 Spring AI 工程框架实现企业级 Java 应用对 LLM 能力的接入,并演示基于 Spring AI 构建高效 LLM 代理的工程实践。
LangGraph 通过图计算模型解决 LLM 应用在循环逻辑与状态持久化上的瓶颈,提供状态机机制以支持多轮推理、自我反思的复杂 Agent 工作流构建(如 AI 客服系统 Notebook 实战)。
无代码/低代码(No-Code/Low-Code)AI 应用落地指南,包含 Coze 私有化部署配置、n8n 多智能体编排实践,以及 Dify、Ragflow 等主流开源编排平台的架构与商业许可对比。文章收录于 7.5 工作流编排与应用平台(文件在 06_llm_theory_and_fundamentals/workflow/)。
基于 NJU 与 SJTU 课程资源的系统化学习路径,涵盖线性代数与概率论等数学基础、SVM 与 HMM 等核心算法数学原理(《统计学习方法》《PRML》),并提供心脏病预测与房价评估等项目驱动的代码实战。
结合特征工程、模型评估与超参数调优,系统讲解监督/无监督学习、集成学习、推荐系统与概率图模型,配套心脏病预测、鸢尾花分类与房价预测等项目完成从理论推导到工程化实战的完整闭环。
动手学机器学习 - 全面的机器学习学习资源库,包含理论讲解、代码实现和实战案例。
核心特色:
汇集 3Blue1Brown 线性代数可视化、MIT 18.06 线性代数课程、李航《统计学习方法》、周志华《机器学习》与 Bishop《PRML》等经典教材,以及 Andrew Ng Coursera 入门课程、Stanford CS229 进阶课程与 Kaggle 竞赛实战平台资源。
数学基础:
经典教材:
在线课程与实战:
LLM 核心理论与架构基石,深入解析 Tokenizer 分词机制、Embedding 向量表示学习、混合专家模型 (MoE) 与模型压缩量化技术,并前瞻思维链 (CoT) 推理增强、基于 LLM 的意图识别及 Deep Research (深度研究) 前沿应用架构。
详细内容请访问:LLM 理论与基础 - 核心文档门户,涵盖基础理论、深度研究与工作流编排。
拆解 LLM 底层运作机制,包括 Tiktokenizer 分词编码、大模型文件格式存储规范、Chain-of-Thought (CoT) 逻辑推理增强技术,以及模型幻觉 (Hallucination) 的成因分析与工程化应对策略。
modeling_llama.py。离散文本到连续向量的表示学习体系,解析 Text Embeddings 的演变历史、距离度量算法,以及独立 Embedding 模型与 LLM 原生 Embedding 层的架构选型与应用权衡。
探索提升模型性能与压缩比的关键技术,通过可视化指南解析 MoE 稀疏激活原理与量化加速机制,并结合 ChatBox 实战剖析基于 LLM 的语义理解与意图检测系统设计。
多步推理规划在复杂信息检索中的应用,解构 DeepWiki、通义 DeepResearch 与 Cursor DeepSearch 等主流系统架构,并提供面向科研助手与复杂订单履约场景的 Agent 需求分析与架构设计方案。
将 LLM 能力转化为自动化业务流,横向评测 Dify、AnythingLLM 等开源应用编排平台功能与商用许可,并提供基于 Coze 与 n8n 构建多智能体系统的私有化部署实践。
精选《大模型技术 30 讲》《Hands-On Large Language Models》《百面大模型》等著作,涵盖从 Transformer 理论解构、模型从零预训练到全栈工程落地的系统性阅读指南。
从芯片到 Agent:AI 基础设施的阅读地图 - 按本仓库章节体系组织的系统书单,覆盖硬件、集群、云原生、GPU 编程、LLM 理论/训练/推理、Agent、RAG 全链路。
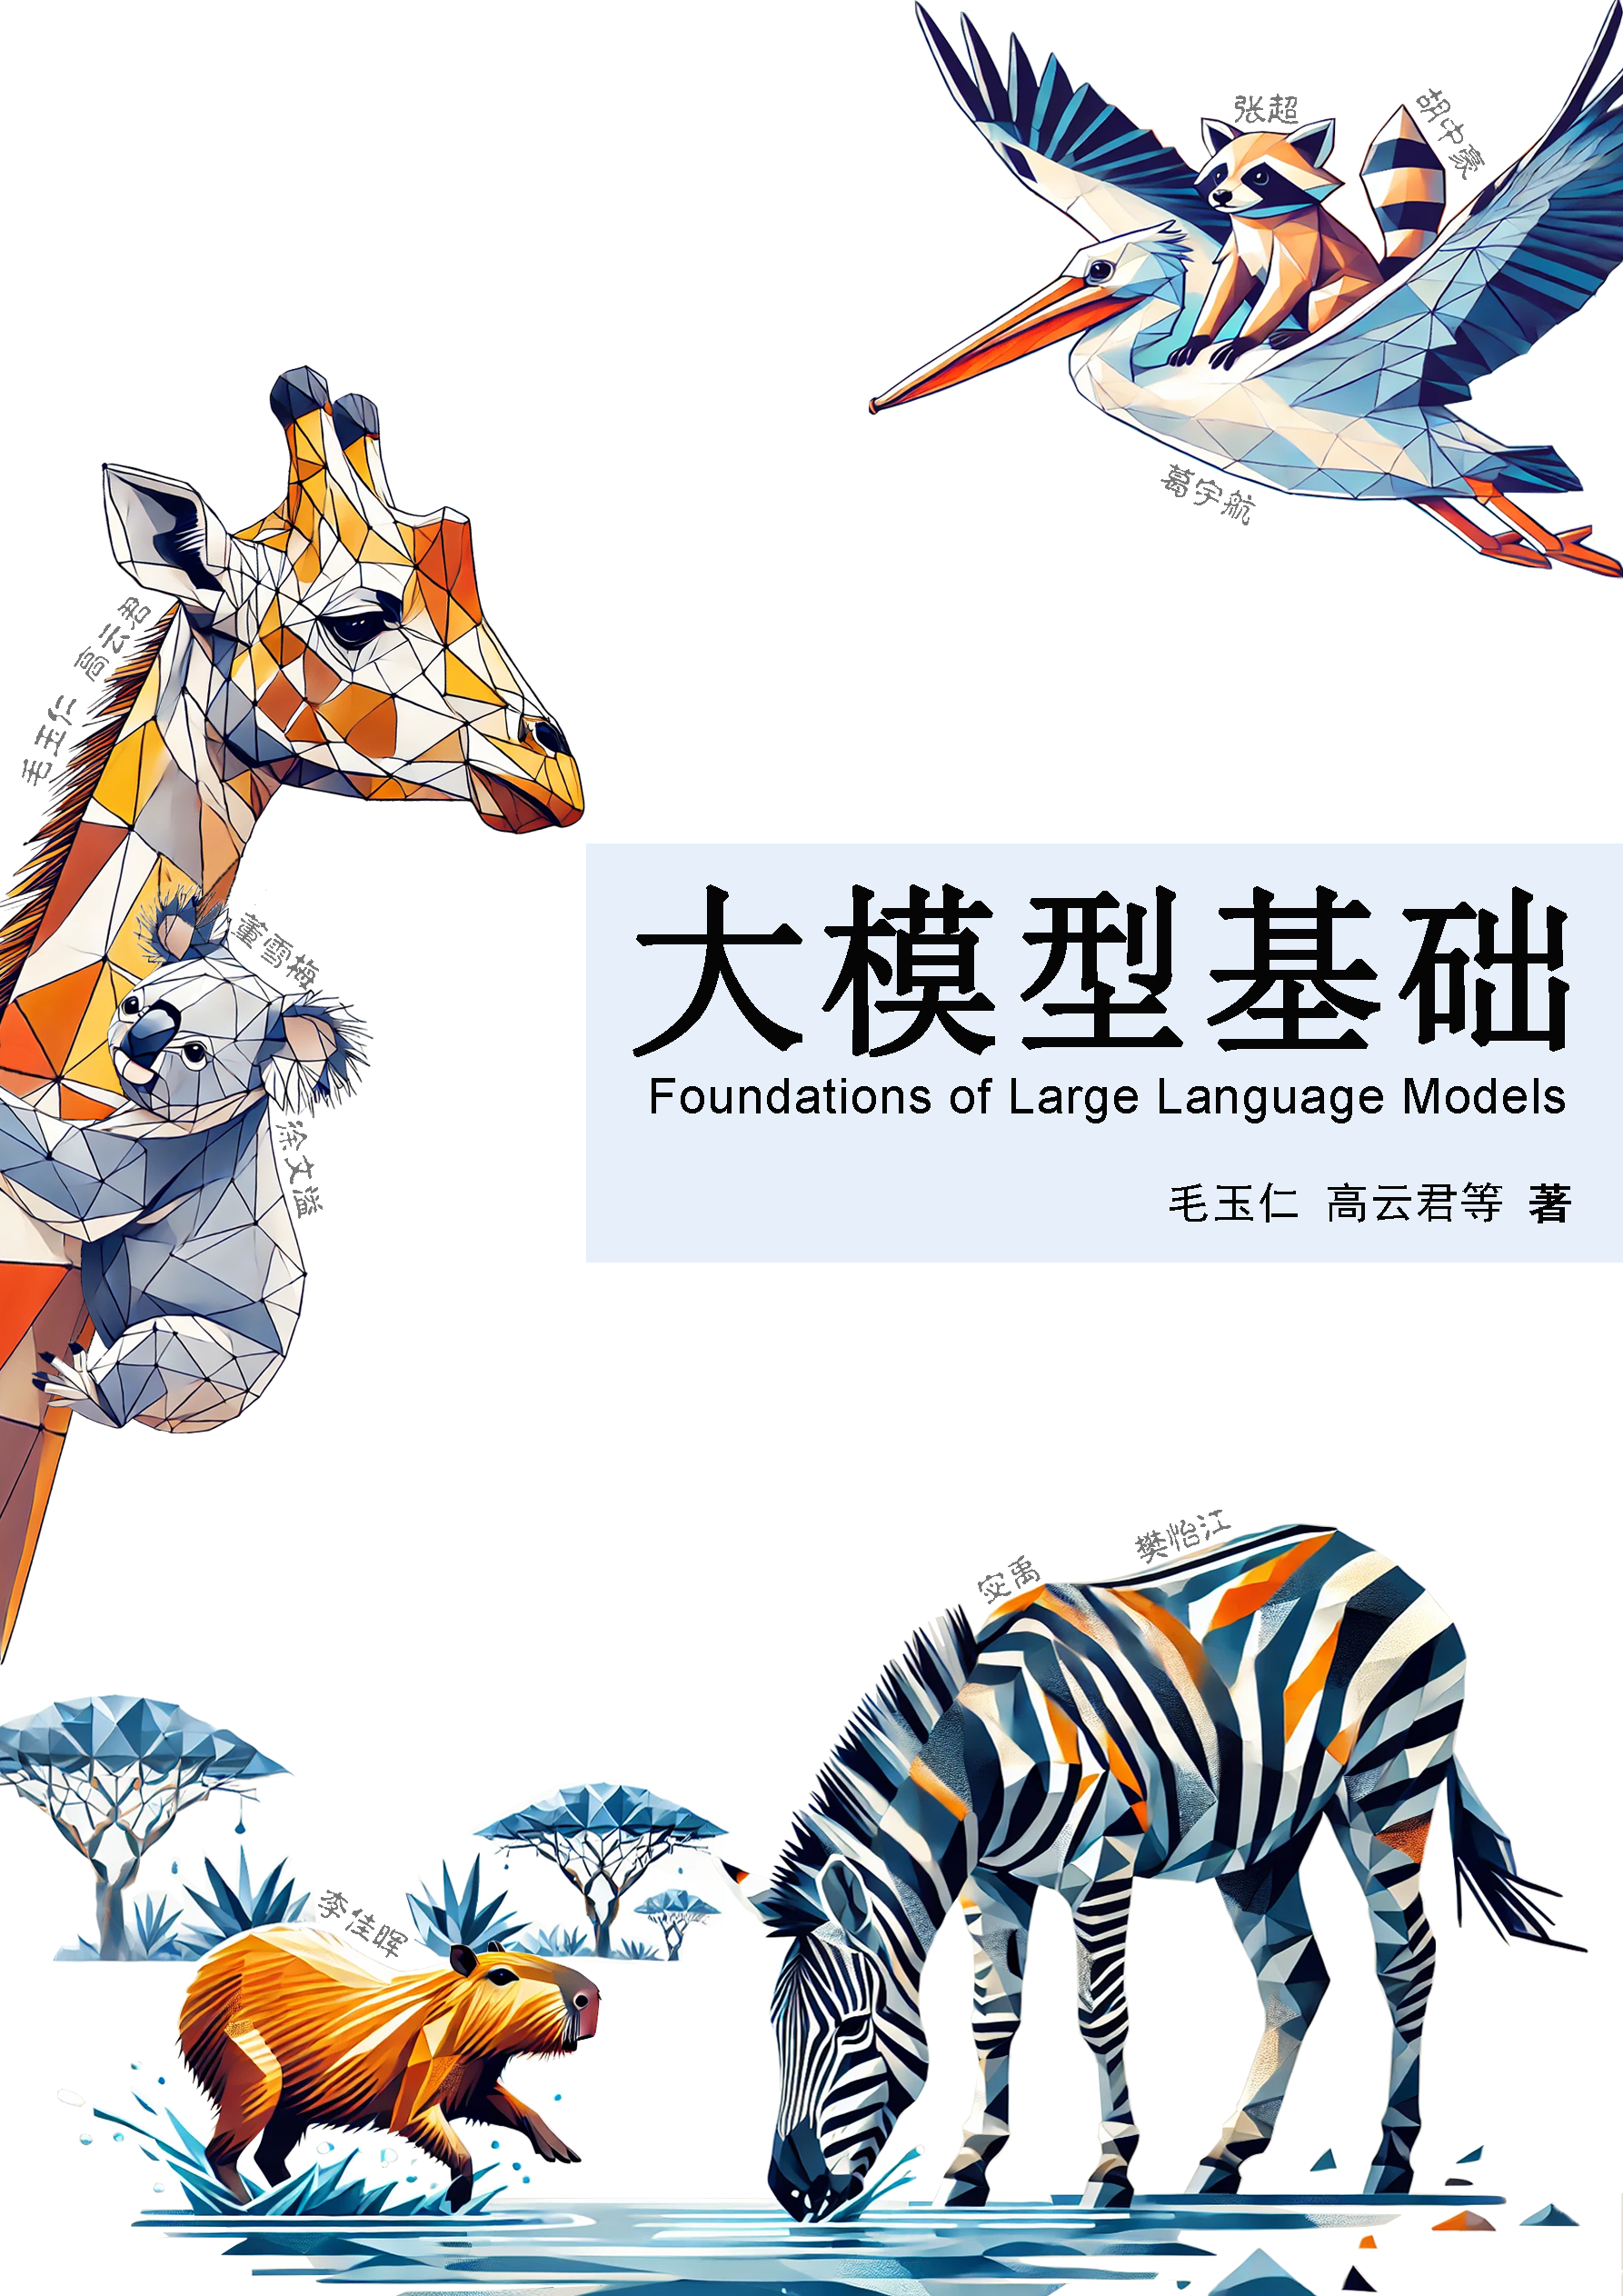
大模型技术 30 讲 - 大模型时代,智能体崛起:从技术解构到工程落地的全栈指南。
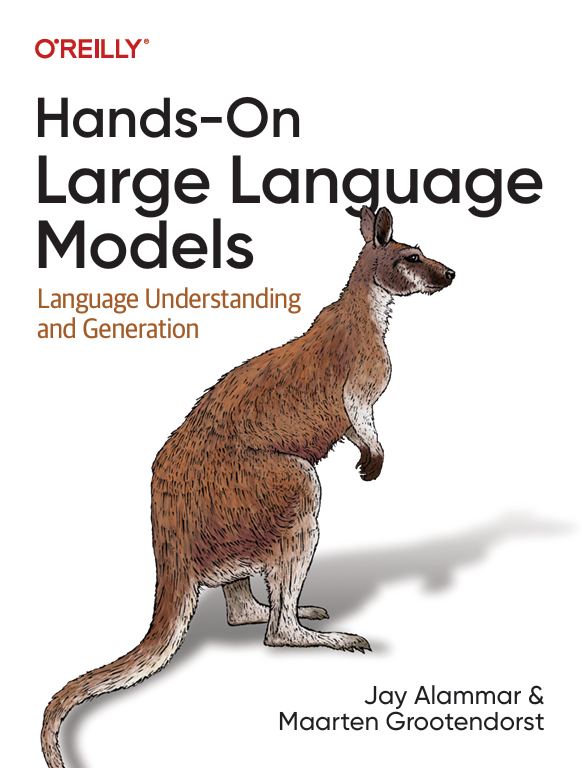
Hands-On Large Language Models
从零构建大模型 - 从理论到实践,手把手教你打造自己的大语言模型。
百面大模型 - 打通大模型求职与实战的关键一书。
图解大模型:生成式 AI 原理与实践 - 超过 300 幅全彩图示 × 实战级项目代码 × 中文独家 DeepSeek-R1 彩蛋内容。
涵盖从 SFT 监督微调、RL 后训练到大规模预训练的完整工程路径,结合 70B 模型从零训练实战,剖析数据清洗、硬件集群配置、超参数优化 (CARBS) ,以及面向 AIOps 场景的 Kubernetes 模型后训练 (Post-Training) 与评估框架设计。详细指南可参考:模型训练与微调总览 。
基于高质量指令-响应数据的模型行为对齐技术,包含 Qwen 2 大模型的微调 Notebook 实战,以及垂直领域模型 SFT 的理论指南与最佳实践。
复盘 70B 参数模型从零训练全生命周期,深度解析开源数据集清洗与评估策略、裸金属基础设施配置与自动化脚本,以及扩展至超大规模参数的优化器选型策略。
保障模型生产环境表现的评估体系,解析 AIOps 后训练策略、基于 Kubernetes 的自动化模型评估框架构建,以及基准测试数据集的生成方法。
SFT 之后把推理能力推上去要靠 RL,而 RL 的 rollout 由推理引擎产生、梯度由训练框架计算——两个系统对同一份权重算出的 log-probability 并不相同,这个差异会直接把策略梯度带偏。
企业级大模型推理系统落地指南,解构 Mooncake 以 KV Cache 为中心的调度架构、vLLM/llm-d 核心推理框架底层机制,深度剖析 LMCache 多层存储体系与 Tair 跨实例缓存共享,并提供 DeepSeek 等前沿模型在多硬件平台的部署调优实践。
剖析现代推理系统的底层架构创新,重点解构 Mooncake 等以 KV Cache 为中心的高效 LLM 调度系统设计模式与性能调优策略。
云原生推理基础设施全景,涵盖基于 LWS 的 Kubernetes 多机多卡分布式推理调度,以及高性能 llm-d 框架在不同集群规模下的技术选型与最佳实践。
长文本与高并发推理的核心瓶颈突破,解析自回归生成机制、Prefix Caching 前缀缓存与 RadixTree 自动复用原理,并深度对比 LMCache 分层架构与阿里云 Tair KVCache 的企业级分布式部署方案。
本小节详细解析 LMCache 的四层存储架构及其在跨实例缓存复用中的技术细节。
基础与架构概览:
核心运行时组件:
存储后端实现:
控制面:
高级特性:
本小节介绍阿里云企业级的 KVCache 管理系统架构及大规模部署实践。
SGLang 以 RadixAttention 前缀缓存和高效调度器著称,涵盖 KV Cache 管理源码系列(UnifiedRadixTree、KV Pool、HiCache、HiSparse)、调度器源码(Chunked Prefill、Overlap Scheduling)、版本解读、超大规模推理调优实践与交互式可视化演示。
多维度提升推理吞吐的系统级技术,包含 vLLM 注意力机制演进 (MLA/NSA)、CUDA Graphs 与 Hybrid KV Cache 管理,结合参数显存占用估算、KV Block Manager 内存机制与 Layer-wise 流水线进行深度调优。
vLLM 核心机制分析:
显存与缓存优化:
网络与模型工具:
企业级 LLM 推理服务全流程实施指南,从集群规模特征评估、异构执行图调度架构设计,到边缘设备/多模态模型专项优化,并提供安全合规、指标体系与上线检查清单。
基础理论与技术选型:
架构设计与评估体系:
专业领域优化:
实施落地与运维:
大模型推理成本的定量分析与容量规划决策,涵盖 API 按量计费与 Coding Plan 包月订阅的定价数据建模,以及基于业务前缀复用率的 KV Cache 各级存储(HBM/DRAM/NVMe)容量推演。
推理成本分析 — 基于 OpenRouter 的多模型成本测算与动态抓取脚本
Coding Plan 订阅对比 — 11 款 AI 编程工具订阅成本与隐藏条款解析
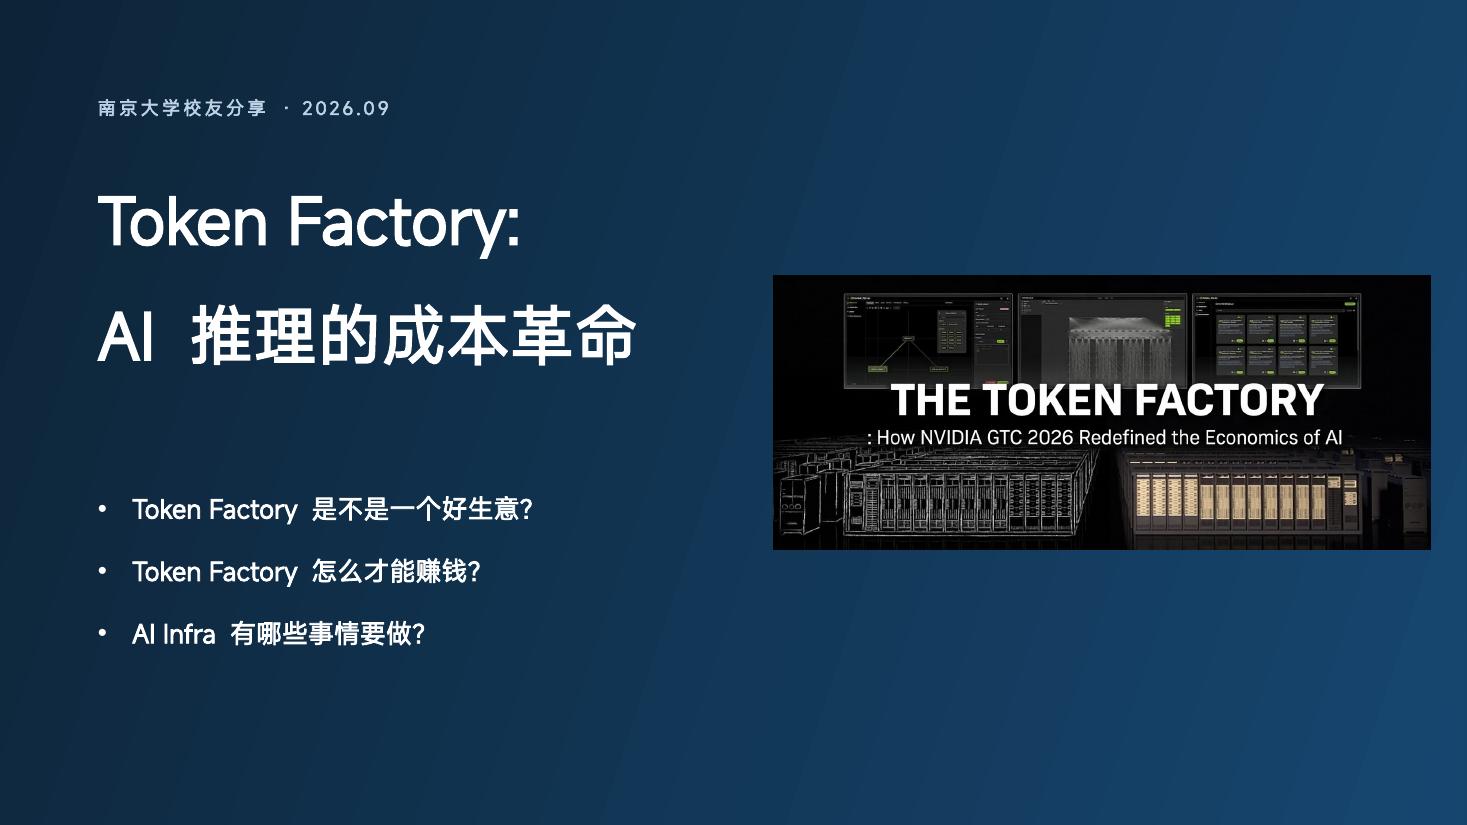
Token Factory:AI 推理的成本革命(图文讲解) — 对外演讲的 PPT 24 页逐页配图讲解:AI 白菜化与 Token 单位化 → 从「算力房东」到「产品制造商」→ 提升产能的成本革命 → 让 token 更值钱,附国产算力差距的现场互动。配套素材库(可排练提纲 + 产能度量文档 + 12 份参考资料)见 项目 README
L1 KV Pool 与系统并发上限 — 并发上限公式、三态记账与指标观测;为什么 L2 空余救不了 P99 TTFT(SGLang/vLLM 对照)
KV Cache 容量规划 — GLM-5 显存容量推演与 ROI 评估
KV Cache 压缩技术 — INT8/FP8 量化、稀疏化与注意力优化
Claude Prompt Caching 机制分析 — 提示词缓存的终端 Agent 源码实现与成本优化
跨硬件平台的模型服务化落地指南,涵盖 Mac 本地 DeepSeek-R1 运行、Ollama 架构原理,以及 DeepSeek-V3 MoE 在 H20、Qwen2-VL 在华为昇腾、B300 在 Blackwell Ultra 上的专项部署调优。
DeepSeek 模型极致性能优化实战,深度解析 vLLM 宽端点 (Wide Endpoint) 专有并行架构,以及在 Blackwell 等下一代高性能计算平台上的可扩展性评估与部署策略。
构建生产级 AI Agent 的系统化指南,涵盖 BDI 认知理论、ReAct/12-Factor 等架构模式,深度拆解动态上下文工程、MemoryOS 多层记忆架构与 MCP 互操作协议,并提供基于 LangGraph 的企业级多智能体系统与 Kagent 基础设施演进分析。
详细内容请访问:AI Agent 开发与实践 - 核心文档门户,涵盖理论、架构与实战。
解析多智能体协作机制与企业级落地框架,包含 ReAct 推理机制、复杂写作/指代消解系统设计模式,并深度剖析世界模型认知引擎与 Data Agent 数据智能体的新兴架构范式。
多智能体系统:
智能体设计模式:
数据智能体 (Data Agents):
认知与基础理论:
解构构建高可靠 Agent 的底层支撑体系,涵盖动态上下文组装与压缩工程、Claude/Mem0 记忆架构机制、MCP 工具互操作协议规范,以及 Agent Sandbox 与 Kubernetes 运维智能体基础设施演进。
上下文与记忆系统:
工具及协议:
Agent Skill:
AI Agent Infra:
从理论走向落地的工程实践代码库,包含基于异步通信总线的企业级多智能体系统、多轮指代消解微服务、MCP 客户端/服务端交互 Demo,以及结合 LangChain 的记忆功能与 PDF 智能翻译器实现。
完整端到端系统:
专项工具与演示:
汇集 24 种主流 Agent Workflow 模式综述、Deep Research 深度研究架构等核心学术论文,以及 2025 年度 LangChain 开发者诉求与 Agent 工程化现状等权威行业报告。
学习路径:
学术论文:
行业报告:
解构从非结构化数据解析到高可信知识库构建的完整技术栈,涵盖 Naive/Advanced RAG 架构演进、Embedding 选型与 Chunking 策略,并深入 GraphRAG (Neo4j/KAG) 复杂关系推理与 MinerU/Marker 等文档智能解析引擎应用。
详细内容请访问:rag 与工具生态 - 核心文档门户,涵盖
RAG、GraphRAG与文档智能工具。
RAG 技术全景演进导航,对比不同检索架构优劣势,系统评估文本分块 (Chunking) 策略,并提供面向中文场景的 Embedding 模型深度评测与选型指南。
RAG 技术全景导航,涵盖基础概念到进阶优化RAG 架构(Naive RAG、Advanced RAG 等)的优劣势分析Embedding 模型评测与推荐解决复杂多跳关系推理难题的图计算架构,深度解析 GraphRAG 核心概念与 KAG 框架,并提供图数据库 Neo4j 安装配置与 Cypher 查询语言的实战教程。
GraphRAG 的核心概念、架构原理与入门路径Knowledge Augmented Generation(KAG)框架深度解析Neo4j 的安装、配置与企业级实战Neo4j 查询语言 Cypher 完整教程构建高可信、可解释智能应用的最佳实践,结合完整源码与图谱数据,深入剖析基于 LLM+KG 架构的银行反电诈智能风控系统设计方案。
LLM + KG 的金融风控系统设计方案,实战反欺诈场景突破 RAG 系统的数据质量瓶颈,解析 MinerU 与 Marker 等基于深度学习的复杂 PDF 布局检测与公式提取引擎,以及 Microsoft MarkItDown 跨格式文档转换工具。
PDF 高效解析PDF 解析与布局分析引擎Markdown 的高质量转换系统化学习路径与进阶指南集合,包含 ZOMI 酱 AI System 全栈硬件架构、大模型底层原理与演进基础、Trae AI 辅助编程实战,以及基于 LangGraph 的企业级多智能体系统培训资源。
ZOMI 酱主导的高分开源 AI 基础设施架构体系,从底层 AI 芯片架构、硬件加速器到 AI 编译器原理、推理性能调优与分布式框架设计进行深度解构。
AISystem - AI 系统全栈课程代码与资料库。
面向初学者的 AI 基础设施普及讲座(90 分钟),围绕一条主线:一切 AI 基础设施优化的最终目标,都是降低每 token 成本。沿"模型架构 → 硬件 → 推理引擎 → 基础设施与生态"四层杠杆展开,覆盖 2026 年最新格局(DeepSeek-V4、Kimi K3、开源价格战、1M 上下文、Agentic 编程)。
系统掌握 AI 辅助开发工作流,从 IDE 环境配置与交互模式,进阶至 Web 开发、数据库设计与 DevOps 微服务架构等复杂场景的实战演练。
课程结构:
面向企业研发团队的生产级架构指南,深度解析 LangGraph 核心调度机制、LangSmith 监控平台集成以及企业级 Multi-Agent 架构设计模式。
由微软提供的初学者课程,旨在帮助学习者全面了解 AI Agent 的构建与应用。
以"认知性质决定技术分层"为裁断准则的 AI Native 方法论体系,包含应用架构(Agent / Skill / Tool 三层 + 七项工程治理)和 DevOps(AI 增强而非替代的全流程协同框架),通过真实电力交易场景推导可复用架构。详细内容请访问:AI Native 全栈实践,配套 DevOps 参考:ai-native-devops(在线版)。
软件工程正向以 Agent First 与自主推理为核心的 Software 3.0 时代演进,涵盖驾驭工程 (Harness Engineering) 体系与 Spec 驱动开发工作流。
AI 进入开发流程与应用架构之外,还有一条线:进入客户的业务流程。这一步发生在组织边界之外,靠的不只是工具链,还有人的派驻、语义层的沉淀和交付模式的设计。
如果您觉得本项目对您有帮助,欢迎购买我一杯咖啡,支持我继续创作和维护。
| 微信 | 支付宝 |
|---|---|
 |  |
(top 24 of 29)
AI 基础知识 - GPU 架构、CUDA 编程、大模型基础及AI Agent 相关知识。
See the code本仓库是一个全面的人工智能基础设施(AI Infrastructure)学习资源集合,涵盖从硬件基础到高级应用的完整技术栈。内容包括 GPU 架构与编程、CUDA 开发、大语言模型、AI 系统设计、性能优化、企业级部署等核心领域,旨在为 AI 工程师、研究人员和技术爱好者提供系统性的学习路径和实践指导。
- 适用人群:AI 工程师、系统架构师、GPU 编程开发者、大模型应用开发者、技术研究人员。
- 技术栈:CUDA、GPU 架构、LLM、AI 系统、分布式计算、容器化部署、性能优化。
Star History:
涵盖单机基础计算芯片(GPU、TPU)设计原理,PCIe、NVLink 高速互连总线协议,GPUDirect 跨节点直通技术,以及 NVIDIA GB300 NVL72 等异构融合超级芯片的系统级架构与延迟金字塔模型。详细内容请访问:硬件架构与互连技术。
构建高吞吐 AI 计算集群的完整运维体系,涵盖基于 Device Query、nvidia-smi 和 nvtop 的 GPU 状态监控,InfiniBand (IB) 网络架构与健康检查,以及 NCCL 分布式通信库的基准测试与多节点部署实战。详细内容请访问:AI 集群运维与通信。
基于 Kubernetes 的 AI 基础设施构建方案,涵盖 NVIDIA Container Toolkit 与 Device Plugin 底层机制、Kueue/HAMi 细粒度 GPU 资源切分与池化、LWS/llm-d 分布式推理调度,以及 JuiceFS、DeepSeek 3FS 等高性能分布式存储系统的架构实践。详细内容请访问:云原生 AI 平台。
解析 Kubernetes AI 场景核心组件,包括容器运行时 GPU 支持底层机制、设备插件源码分析、Kueue 调度整合,以及基于 LWS 的大模型分布式训练与推理架构。
提供异构算力环境下的 GPU 资源精细化管理方案,涵盖硬件级/内核态/用户态虚拟化机制、CUDA 流与 MPS 调度优化,并提供 HAMi 资源隔离与 Flex AI 的生产环境落地配置。
基础系列文档:
HAMi 专题:
代码实现与配置:
针对 AI 训练中海量小文件读取与跨节点共享的性能瓶颈,解析 JuiceFS 数据与元数据分离架构、DeepSeek 3FS 高性能设计及面向推理的 ICMS (KV Cache) 存储层机制。
系统级 AI 底层编程路径,剖析 GPU 并行架构、CUDA 线程/网格与流处理机制、SIMT 与 Tile-Based (TileLang) 编程模型对比,以及基于 DOCA 框架的数据处理单元 (DPU) 核心编程范式。
涵盖 NVIDIA 容器镜像构建、CUDA 线程块/网格与流并发机制、SIMT 与 Tile-Based 编程模型对比、TileLang 算子开发,以及 nvbandwidth 显存与 PCIe 带宽调优实战,并链接 200+ Tensor Core/CUDA Core 优化内核的进阶学习资源。详细内容请访问:GPU 编程基础。
开发环境配置:
核心编程范式:
Tile-Based 编程:
性能分析与调优:
进阶学习资源:
基于 DOCA 框架的数据处理单元 (DPU) 开发指南,解析架构组件与网络加速、零拷贝 DMA、控制平面卸载、压缩、NVMe 模拟及近数据处理等典型场景的编程实践。详细内容请访问:DPU 编程。
基于昇腾 NPU 硬件特性和 CANN 软件栈的系统级编程路径,涵盖 Da Vinci 架构、PyTorch NPU 适配与迁移、MindSpore 原生框架、Ascend 工具链、自定义算子开发,以及 RAG pipeline、FlashAttention、Mini-GPT 和 LLM 推理(Qwen2.5-7B BF16 + LoRA 微调)等端到端实战。详细内容请访问:华为 NPU 编程入门。
探索以自然语言驱动与 Agent 自主决策为核心的 Software 3.0 开发范式,包含 Spring AI 企业级 Java 接入、LangGraph 有状态多智能体图计算模型,以及 Coze/n8n 无代码工作流编排技术。详细的深度探讨可参考 大模型编程指南。
剖析 Java 生态 AI 开发技术栈,通过 Spring AI 工程框架实现企业级 Java 应用对 LLM 能力的接入,并演示基于 Spring AI 构建高效 LLM 代理的工程实践。
LangGraph 通过图计算模型解决 LLM 应用在循环逻辑与状态持久化上的瓶颈,提供状态机机制以支持多轮推理、自我反思的复杂 Agent 工作流构建(如 AI 客服系统 Notebook 实战)。
无代码/低代码(No-Code/Low-Code)AI 应用落地指南,包含 Coze 私有化部署配置、n8n 多智能体编排实践,以及 Dify、Ragflow 等主流开源编排平台的架构与商业许可对比。文章收录于 7.5 工作流编排与应用平台(文件在 06_llm_theory_and_fundamentals/workflow/)。
基于 NJU 与 SJTU 课程资源的系统化学习路径,涵盖线性代数与概率论等数学基础、SVM 与 HMM 等核心算法数学原理(《统计学习方法》《PRML》),并提供心脏病预测与房价评估等项目驱动的代码实战。
结合特征工程、模型评估与超参数调优,系统讲解监督/无监督学习、集成学习、推荐系统与概率图模型,配套心脏病预测、鸢尾花分类与房价预测等项目完成从理论推导到工程化实战的完整闭环。
动手学机器学习 - 全面的机器学习学习资源库,包含理论讲解、代码实现和实战案例。
核心特色:
汇集 3Blue1Brown 线性代数可视化、MIT 18.06 线性代数课程、李航《统计学习方法》、周志华《机器学习》与 Bishop《PRML》等经典教材,以及 Andrew Ng Coursera 入门课程、Stanford CS229 进阶课程与 Kaggle 竞赛实战平台资源。
数学基础:
经典教材:
在线课程与实战:
LLM 核心理论与架构基石,深入解析 Tokenizer 分词机制、Embedding 向量表示学习、混合专家模型 (MoE) 与模型压缩量化技术,并前瞻思维链 (CoT) 推理增强、基于 LLM 的意图识别及 Deep Research (深度研究) 前沿应用架构。
详细内容请访问:LLM 理论与基础 - 核心文档门户,涵盖基础理论、深度研究与工作流编排。
拆解 LLM 底层运作机制,包括 Tiktokenizer 分词编码、大模型文件格式存储规范、Chain-of-Thought (CoT) 逻辑推理增强技术,以及模型幻觉 (Hallucination) 的成因分析与工程化应对策略。
modeling_llama.py。离散文本到连续向量的表示学习体系,解析 Text Embeddings 的演变历史、距离度量算法,以及独立 Embedding 模型与 LLM 原生 Embedding 层的架构选型与应用权衡。
探索提升模型性能与压缩比的关键技术,通过可视化指南解析 MoE 稀疏激活原理与量化加速机制,并结合 ChatBox 实战剖析基于 LLM 的语义理解与意图检测系统设计。
多步推理规划在复杂信息检索中的应用,解构 DeepWiki、通义 DeepResearch 与 Cursor DeepSearch 等主流系统架构,并提供面向科研助手与复杂订单履约场景的 Agent 需求分析与架构设计方案。
将 LLM 能力转化为自动化业务流,横向评测 Dify、AnythingLLM 等开源应用编排平台功能与商用许可,并提供基于 Coze 与 n8n 构建多智能体系统的私有化部署实践。
精选《大模型技术 30 讲》《Hands-On Large Language Models》《百面大模型》等著作,涵盖从 Transformer 理论解构、模型从零预训练到全栈工程落地的系统性阅读指南。
从芯片到 Agent:AI 基础设施的阅读地图 - 按本仓库章节体系组织的系统书单,覆盖硬件、集群、云原生、GPU 编程、LLM 理论/训练/推理、Agent、RAG 全链路。
大模型技术 30 讲 - 大模型时代,智能体崛起:从技术解构到工程落地的全栈指南。
Hands-On Large Language Models
从零构建大模型 - 从理论到实践,手把手教你打造自己的大语言模型。
百面大模型 - 打通大模型求职与实战的关键一书。
图解大模型:生成式 AI 原理与实践 - 超过 300 幅全彩图示 × 实战级项目代码 × 中文独家 DeepSeek-R1 彩蛋内容。
涵盖从 SFT 监督微调、RL 后训练到大规模预训练的完整工程路径,结合 70B 模型从零训练实战,剖析数据清洗、硬件集群配置、超参数优化 (CARBS) ,以及面向 AIOps 场景的 Kubernetes 模型后训练 (Post-Training) 与评估框架设计。详细指南可参考:模型训练与微调总览 。
基于高质量指令-响应数据的模型行为对齐技术,包含 Qwen 2 大模型的微调 Notebook 实战,以及垂直领域模型 SFT 的理论指南与最佳实践。
复盘 70B 参数模型从零训练全生命周期,深度解析开源数据集清洗与评估策略、裸金属基础设施配置与自动化脚本,以及扩展至超大规模参数的优化器选型策略。
保障模型生产环境表现的评估体系,解析 AIOps 后训练策略、基于 Kubernetes 的自动化模型评估框架构建,以及基准测试数据集的生成方法。
SFT 之后把推理能力推上去要靠 RL,而 RL 的 rollout 由推理引擎产生、梯度由训练框架计算——两个系统对同一份权重算出的 log-probability 并不相同,这个差异会直接把策略梯度带偏。
企业级大模型推理系统落地指南,解构 Mooncake 以 KV Cache 为中心的调度架构、vLLM/llm-d 核心推理框架底层机制,深度剖析 LMCache 多层存储体系与 Tair 跨实例缓存共享,并提供 DeepSeek 等前沿模型在多硬件平台的部署调优实践。
剖析现代推理系统的底层架构创新,重点解构 Mooncake 等以 KV Cache 为中心的高效 LLM 调度系统设计模式与性能调优策略。
云原生推理基础设施全景,涵盖基于 LWS 的 Kubernetes 多机多卡分布式推理调度,以及高性能 llm-d 框架在不同集群规模下的技术选型与最佳实践。
长文本与高并发推理的核心瓶颈突破,解析自回归生成机制、Prefix Caching 前缀缓存与 RadixTree 自动复用原理,并深度对比 LMCache 分层架构与阿里云 Tair KVCache 的企业级分布式部署方案。
本小节详细解析 LMCache 的四层存储架构及其在跨实例缓存复用中的技术细节。
基础与架构概览:
核心运行时组件:
存储后端实现:
控制面:
高级特性:
本小节介绍阿里云企业级的 KVCache 管理系统架构及大规模部署实践。
SGLang 以 RadixAttention 前缀缓存和高效调度器著称,涵盖 KV Cache 管理源码系列(UnifiedRadixTree、KV Pool、HiCache、HiSparse)、调度器源码(Chunked Prefill、Overlap Scheduling)、版本解读、超大规模推理调优实践与交互式可视化演示。
多维度提升推理吞吐的系统级技术,包含 vLLM 注意力机制演进 (MLA/NSA)、CUDA Graphs 与 Hybrid KV Cache 管理,结合参数显存占用估算、KV Block Manager 内存机制与 Layer-wise 流水线进行深度调优。
vLLM 核心机制分析:
显存与缓存优化:
网络与模型工具:
企业级 LLM 推理服务全流程实施指南,从集群规模特征评估、异构执行图调度架构设计,到边缘设备/多模态模型专项优化,并提供安全合规、指标体系与上线检查清单。
基础理论与技术选型:
架构设计与评估体系:
专业领域优化:
实施落地与运维:
大模型推理成本的定量分析与容量规划决策,涵盖 API 按量计费与 Coding Plan 包月订阅的定价数据建模,以及基于业务前缀复用率的 KV Cache 各级存储(HBM/DRAM/NVMe)容量推演。
推理成本分析 — 基于 OpenRouter 的多模型成本测算与动态抓取脚本
Coding Plan 订阅对比 — 11 款 AI 编程工具订阅成本与隐藏条款解析
Token Factory:AI 推理的成本革命(图文讲解) — 对外演讲的 PPT 24 页逐页配图讲解:AI 白菜化与 Token 单位化 → 从「算力房东」到「产品制造商」→ 提升产能的成本革命 → 让 token 更值钱,附国产算力差距的现场互动。配套素材库(可排练提纲 + 产能度量文档 + 12 份参考资料)见 项目 README
L1 KV Pool 与系统并发上限 — 并发上限公式、三态记账与指标观测;为什么 L2 空余救不了 P99 TTFT(SGLang/vLLM 对照)
KV Cache 容量规划 — GLM-5 显存容量推演与 ROI 评估
KV Cache 压缩技术 — INT8/FP8 量化、稀疏化与注意力优化
Claude Prompt Caching 机制分析 — 提示词缓存的终端 Agent 源码实现与成本优化
跨硬件平台的模型服务化落地指南,涵盖 Mac 本地 DeepSeek-R1 运行、Ollama 架构原理,以及 DeepSeek-V3 MoE 在 H20、Qwen2-VL 在华为昇腾、B300 在 Blackwell Ultra 上的专项部署调优。
DeepSeek 模型极致性能优化实战,深度解析 vLLM 宽端点 (Wide Endpoint) 专有并行架构,以及在 Blackwell 等下一代高性能计算平台上的可扩展性评估与部署策略。
构建生产级 AI Agent 的系统化指南,涵盖 BDI 认知理论、ReAct/12-Factor 等架构模式,深度拆解动态上下文工程、MemoryOS 多层记忆架构与 MCP 互操作协议,并提供基于 LangGraph 的企业级多智能体系统与 Kagent 基础设施演进分析。
详细内容请访问:AI Agent 开发与实践 - 核心文档门户,涵盖理论、架构与实战。
解析多智能体协作机制与企业级落地框架,包含 ReAct 推理机制、复杂写作/指代消解系统设计模式,并深度剖析世界模型认知引擎与 Data Agent 数据智能体的新兴架构范式。
多智能体系统:
智能体设计模式:
数据智能体 (Data Agents):
认知与基础理论:
解构构建高可靠 Agent 的底层支撑体系,涵盖动态上下文组装与压缩工程、Claude/Mem0 记忆架构机制、MCP 工具互操作协议规范,以及 Agent Sandbox 与 Kubernetes 运维智能体基础设施演进。
上下文与记忆系统:
工具及协议:
Agent Skill:
AI Agent Infra:
从理论走向落地的工程实践代码库,包含基于异步通信总线的企业级多智能体系统、多轮指代消解微服务、MCP 客户端/服务端交互 Demo,以及结合 LangChain 的记忆功能与 PDF 智能翻译器实现。
完整端到端系统:
专项工具与演示:
汇集 24 种主流 Agent Workflow 模式综述、Deep Research 深度研究架构等核心学术论文,以及 2025 年度 LangChain 开发者诉求与 Agent 工程化现状等权威行业报告。
学习路径:
学术论文:
行业报告:
解构从非结构化数据解析到高可信知识库构建的完整技术栈,涵盖 Naive/Advanced RAG 架构演进、Embedding 选型与 Chunking 策略,并深入 GraphRAG (Neo4j/KAG) 复杂关系推理与 MinerU/Marker 等文档智能解析引擎应用。
详细内容请访问:rag 与工具生态 - 核心文档门户,涵盖
RAG、GraphRAG与文档智能工具。
RAG 技术全景演进导航,对比不同检索架构优劣势,系统评估文本分块 (Chunking) 策略,并提供面向中文场景的 Embedding 模型深度评测与选型指南。
RAG 技术全景导航,涵盖基础概念到进阶优化RAG 架构(Naive RAG、Advanced RAG 等)的优劣势分析Embedding 模型评测与推荐解决复杂多跳关系推理难题的图计算架构,深度解析 GraphRAG 核心概念与 KAG 框架,并提供图数据库 Neo4j 安装配置与 Cypher 查询语言的实战教程。
GraphRAG 的核心概念、架构原理与入门路径Knowledge Augmented Generation(KAG)框架深度解析Neo4j 的安装、配置与企业级实战Neo4j 查询语言 Cypher 完整教程构建高可信、可解释智能应用的最佳实践,结合完整源码与图谱数据,深入剖析基于 LLM+KG 架构的银行反电诈智能风控系统设计方案。
LLM + KG 的金融风控系统设计方案,实战反欺诈场景突破 RAG 系统的数据质量瓶颈,解析 MinerU 与 Marker 等基于深度学习的复杂 PDF 布局检测与公式提取引擎,以及 Microsoft MarkItDown 跨格式文档转换工具。
PDF 高效解析PDF 解析与布局分析引擎Markdown 的高质量转换系统化学习路径与进阶指南集合,包含 ZOMI 酱 AI System 全栈硬件架构、大模型底层原理与演进基础、Trae AI 辅助编程实战,以及基于 LangGraph 的企业级多智能体系统培训资源。
ZOMI 酱主导的高分开源 AI 基础设施架构体系,从底层 AI 芯片架构、硬件加速器到 AI 编译器原理、推理性能调优与分布式框架设计进行深度解构。
AISystem - AI 系统全栈课程代码与资料库。
面向初学者的 AI 基础设施普及讲座(90 分钟),围绕一条主线:一切 AI 基础设施优化的最终目标,都是降低每 token 成本。沿"模型架构 → 硬件 → 推理引擎 → 基础设施与生态"四层杠杆展开,覆盖 2026 年最新格局(DeepSeek-V4、Kimi K3、开源价格战、1M 上下文、Agentic 编程)。
系统掌握 AI 辅助开发工作流,从 IDE 环境配置与交互模式,进阶至 Web 开发、数据库设计与 DevOps 微服务架构等复杂场景的实战演练。
课程结构:
面向企业研发团队的生产级架构指南,深度解析 LangGraph 核心调度机制、LangSmith 监控平台集成以及企业级 Multi-Agent 架构设计模式。
由微软提供的初学者课程,旨在帮助学习者全面了解 AI Agent 的构建与应用。
以"认知性质决定技术分层"为裁断准则的 AI Native 方法论体系,包含应用架构(Agent / Skill / Tool 三层 + 七项工程治理)和 DevOps(AI 增强而非替代的全流程协同框架),通过真实电力交易场景推导可复用架构。详细内容请访问:AI Native 全栈实践,配套 DevOps 参考:ai-native-devops(在线版)。
软件工程正向以 Agent First 与自主推理为核心的 Software 3.0 时代演进,涵盖驾驭工程 (Harness Engineering) 体系与 Spec 驱动开发工作流。
AI 进入开发流程与应用架构之外,还有一条线:进入客户的业务流程。这一步发生在组织边界之外,靠的不只是工具链,还有人的派驻、语义层的沉淀和交付模式的设计。
如果您觉得本项目对您有帮助,欢迎购买我一杯咖啡,支持我继续创作和维护。
| 微信 | 支付宝 |
|---|---|
| |
(top 24 of 29)



