最后一次大修:2026 年 8 月 31 日 本文优先解释计算过程和硬件限制。具体型号、软件版本和命令可能继续变化。
Hello!大家好,这里是 Anser!
这是一篇关于本地部署大语言模型(LLM)的教程。
内容包括本地聊天、代码与文档处理,也包括为几十到几百名用户部署内部推理服务。阅读本文不要求机器学习或高性能计算基础。
LLM 的硬件和软件仍在快速更新。如果你发现事实错误或过时内容,欢迎提交 Issue 或 PR。
赞助我:微信赞助(点击查看二维码) · Buy me a coffee
也感谢 r/LocalLLaMA 中公开硬件测试、运行参数和故障排查过程的各位。
先按照使用场景选择推理程序:
| 使用场景 | 程序 |
|---|---|
| 第一次部署,希望使用图形界面 | LM Studio |
| 想用一条命令启动模型,给别的软件调用 | Ollama |
| Windows、macOS、Linux 都想跑,或者只有 CPU/核显 | llama.cpp |
| 有 NVIDIA/AMD GPU,想给多人提供高吞吐 API | vLLM |
| 只使用 NVIDIA GPU,模型和硬件固定,可以投入时间编译和调优 | TensorRT-LLM |
| 公司需要经过验证的容器、监控、生命周期和支持 | NVIDIA NIM |
| Intel CPU、核显或独显,且需要 Intel 官方路线 | OpenVINO GenAI |
第一次测试可以使用 7B~14B 模型的 Q4 或 Q5 量化版本,并把上下文长度设为 4K~8K。这个配置先把权重和 KV cache 占用控制在较小范围,便于分别排查模型兼容性、GPU 后端和内存容量。基础配置运行正常后,再增加模型大小和上下文长度。
LLM 的输入和输出单位是 Token,而不是字符或单词。
比如 unbelievable 可能被切成一个或几个 Token;中文的一个汉字有时是一个 Token,有时多个字会合成一个 Token。不同模型使用的 tokenizer 也不同,所以两个模型都显示 50 token/s,并不代表它们每秒生成的中文字符一定一样多。
Tokenizer 通常不是神经网络。它把文本转换成整数 ID 序列;模型的 embedding layer 再把每个 ID 映射为向量。
目前绝大多数聊天 LLM 的主体依然属于 decoder-only Transformer。Transformer 最初发表于 Attention Is All You Need。3Blue1Brown 的 But what is a GPT? 提供了不要求数学基础的可视化说明。
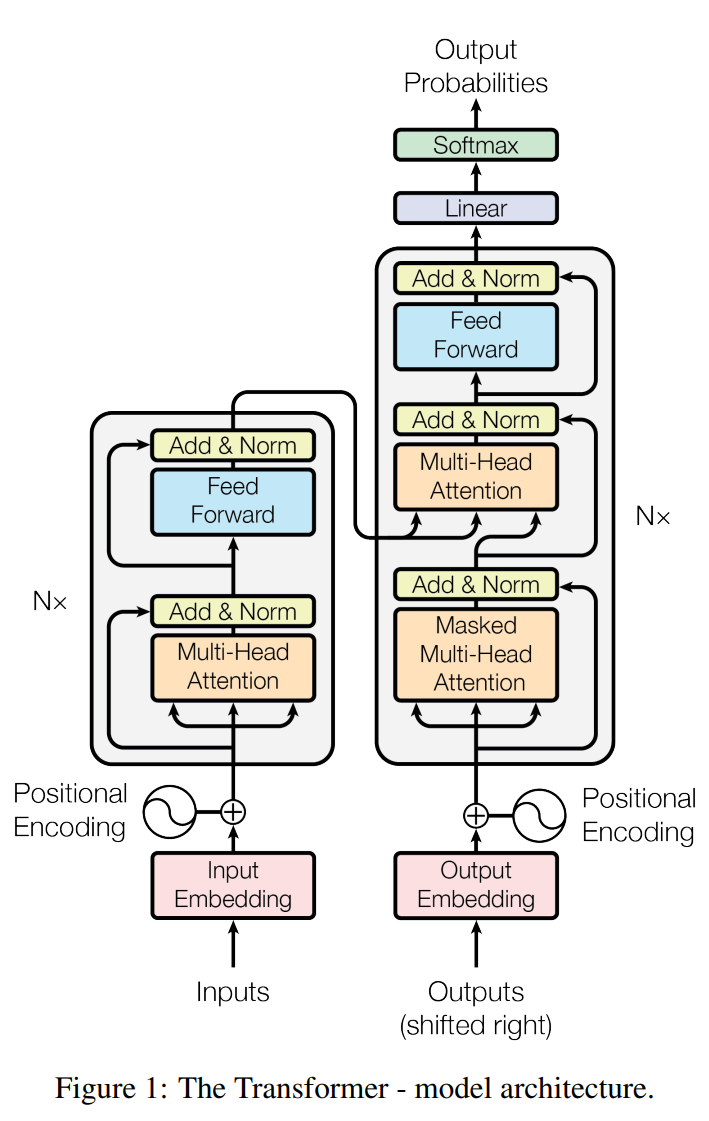
自回归生成按以下步骤进行:
因此,普通 LLM 每次 forward pass 只确定一个新 Token。生成 1000 个 Token,通常需要约 1000 次顺序执行的解码步骤;后面的步骤必须等待前面的 Token 确定,无法全部并行。
一次 LLM 请求分为两个阶段:
Prefill(预填充):模型一次性读取你的 system prompt、聊天记录、文档和问题,为这些输入 Token 计算中间状态,并生成第一个新 Token。
Decode(解码):之后一个 Token 一个 Token 地继续生成答案。
Prefill 和 Decode 对硬件的使用方式不同:
以一个 BF16 权重矩阵为例,读取一个权重需要 2 bytes,一次乘加约产生 2 FLOPs。batch size 为 1 时,忽略 cache 后的算术强度大约只有 1 FLOP/byte。H100 的 FP16/BF16 Tensor Core 计算吞吐与 HBM 带宽之比是数百 FLOPs/byte,因此这种工作负载远未达到计算上限,内存带宽会先被占满。batch size 增大后,同一份权重可以同时服务多个 Token,算术强度近似随 batch 增长,工作负载才可能转为 compute-bound。
因此,评估单用户生成速度时要同时看模型实际权重大小和内存带宽;评估长输入处理或高并发吞吐时,还要看低精度矩阵计算吞吐与 batch 调度效率。
在 causal Transformer 中,前面的 Token 看不到未来。第 100 个 Token 的出现,不会回头改变第 1~99 个 Token 已经算出的 Key 和 Value。
生成第 101 个 Token 时,不需要重新计算前 100 个 Token 在各层的 Key 和 Value。这些保存在内存中的张量称为 KV cache。
没有 KV cache 时,第 t 个生成步骤需要重新计算前 t-1 个 Token 在每一层的 Key 和 Value。有 KV cache 时,这些张量只在对应 Token 第一次进入模型时计算一次;以后直接从显存或内存读取。
KV cache 的容量随上下文长度、并发序列数和每个元素的字节数线性增长。
对于标准 MHA/GQA,可按下式估算:
KV cache 字节数 ≈ 2 × 层数 × KV head 数 × head dimension
                 × 每个元素字节数 × 已缓存 Token 数 × 并发序列数
前面的 2 是 K 和 V 两份。
例如一个 32 层、8 个 KV heads、head dimension 为 128 的 GQA 模型,用 BF16 保存 KV,单个 32K 上下文大约需要:
2 × 32 × 8 × 128 × 2 bytes × 32768 ≈ 4 GiB
该结果不包括模型权重、运行时 workspace 和其他请求的 KV cache。
因此,20GB 权重不能可靠地部署在只剩 4GB 空间的 24GB 显卡上并同时使用很长上下文。以上述模型为例,单个 32K BF16 KV cache 已经约为 4GiB;128K 时约为 16GiB。并发 8 个相同长度的序列还要再乘 8。
现代模型使用 GQA、MQA 或 MLA 减少每个 Token 保存的 Key/Value 数量。部分运行时还支持 FP8、INT8 或 NVFP4 KV cache。低精度 KV cache 能减少容量和带宽需求,但可能影响长上下文准确率;如果运行时缺少对应低精度 attention kernel,它也可能只节省容量而不提高速度。
KV cache 可以在同一次生成中使用,也可以跨请求复用。
假设 100 个员工都在询问同一本 200 页的公司手册:
[完全相同的 system prompt]
[完全相同的公司手册]
[每个人不同的问题]
前两部分的 Token 前缀完全一致,那么它们对应的 KV cache 也一致。服务器第一次算完后,后续请求可以直接复用这部分缓存,只计算各自不同的问题。
这种跨请求复用称为 prefix caching(前缀缓存)。它减少命中部分的 prefill 计算,不减少新输出 Token 的 Decode 计算。vLLM 的 Automatic Prefix Caching 实现了这一功能。
复用条件通常是模型、tokenizer、Token ID 序列和位置完全相同。文本语义相似不构成命中;时间戳、随机 ID、JSON 字段顺序或聊天模板中的任一差异,都会使差异位置之后的前缀无法复用。
普通自回归生成每次只确认一个 Token,因此输出长度为 N 时至少需要 N 个顺序解码步骤。
Multi-Token Prediction(MTP) 的训练目标,是让额外的预测模块学习预测更远的未来 Token,而不只学习紧邻的下一个 Token。公开工作主要使用它完成两件事:
Speculative decoding 的流程如下:
正确实现的验证算法可以保持目标模型的输出分布。draft model 只负责提出候选,最终接受哪些 Token 仍由目标模型决定。加速来自目标模型一次并行验证多个候选,而不是降低目标模型精度。
MTP 是训练目标和模型结构;speculative decoding 是推理算法。 两者可以组合使用,但 speculative decoding 也可以使用独立 draft model、EAGLE 等方法生成候选。
DeepSeek-V3 的公开权重包括单独的 MTP 模块;vLLM 也提供 MTP speculative decoding 支持。实际加速取决于候选接受率、每次验证的候选数、batch size、模型结构和 kernel 开销;支持 MTP 本身不能保证固定的加速倍数。
MTP 不一定等于“再运行一个完整的小模型”。独立 draft model 会增加一份 draft 权重和 KV cache;内置 MTP 通常只增加若干预测层或 head。两种方法都在增加候选生成和验证计算,但目标模型一次读取权重后可以并行验证多个位置。如果一次验证接受了 k 个 Token,目标模型权重的读取成本就近似由 k 个输出 Token 分摊;代价是 draft 计算、被拒绝候选的计算和额外 KV 管理。
这解释了为什么 speculative decoding 常用于单请求、memory-bound 的 Decode。此时矩阵单元原本没有达到峰值吞吐,可以用剩余计算能力减少每个已接受 Token 对应的权重读取次数。计算能力与显存带宽之比较高的 GPU,例如 RTX 4090,可能比计算能力较低但带宽相近的 GPU 获得更大收益。高 batch serving 已经可以通过多个请求复用权重,工作负载更接近 compute-bound;此时 draft 开销可能抵消收益。
公开实测可以说明数量级,但不能代替本机 A/B 测试:Qwen3.8-27B MTP 社区记录在相同模型上报告了 RTX 4090 从 47.7 提高到 76.3 token/s,以及另一种 Q4 配置从 36.1 提高到 74.8 token/s;两组都使用 n-max=2,记录的接受率范围不同。该项目同时报告 speculative decoding 的单流收益在 --parallel 4 时消失。Sequoia则从更一般的 speculative decoding 角度说明,收益会随硬件的 compute/bandwidth ratio、draft tree、接受率和 offload 方式变化。
因此测试 MTP 时至少固定模型与量化、prompt、输出长度、temperature、并发数和运行时版本,然后记录 baseline 与 MTP 的 token/s、接受率、TTFT、显存占用和功耗。代码和 JSON 等可预测结构可能有较高接受率;开放式文本可能更低。增加 draft token 数也不保证更快,因为被拒绝候选仍消耗计算。
买硬件时需要分别计算以下三个指标:
容量(GB):决定能否同时存放模型权重、KV cache、activation 和运行时 workspace。容量不足时必须减小模型或上下文、降低精度、减少并发,或者把数据分布到其他设备;峰值 TFLOPS 不能解决容量不足。
内存带宽(GB/s 或 TB/s):每秒可以从内存向计算单元传输多少权重和 KV 数据。单用户、batch size 很小的 Decode 通常首先受它限制。
计算能力(FLOPS/TOPS):每秒可以完成多少运算。Prefill、训练和高 batch 的矩阵乘法通常首先受计算吞吐限制。
互联带宽决定显卡或机器之间交换 activation、梯度和 MoE Token 的速度。模型跨显卡、跨机器或跨 MoE 专家时,PCIe、NVLink、Infinity Fabric 或网络都可能成为瓶颈。
在 batch size 为 1、Decode 受权重读取带宽限制时,可以用以下公式估算理论上限:
理论 Decode 速度上限(token/s)≈ 可用内存带宽 ÷ 每 Token 需要读取的权重字节数
例如一个 8B 密集模型,量化后的有效大小是 5GB,设备真实可用带宽假设是 250GB/s:
250 ÷ 5 ≈ 50 token/s
50 token/s 是只计算权重读取的上限。实际速度还要扣除 attention、KV cache 读取、量化解码、kernel 启动和调度开销。设备标称 250GB/s 也不代表推理程序能持续利用全部带宽,所以实测结果应低于这个数字。
NVIDIA 公布的 H200 SXM 规格是 141GB HBM3e、4.8TB/s 显存带宽和 3,958 TFLOPS FP8 Tensor Core 吞吐;官方表格注明该 FP8 数字使用结构化稀疏。下面按不使用稀疏的约 1,979 TFLOPS 计算。假设 27B 模型所有权重都以 1 byte/parameter 的 FP8 保存,忽略 scale 和未量化层,则权重约为 27GB。
先算 batch size 为 1 的 Decode。每生成一个 Token,需要读取约 27GB 权重,并完成约 2 × 27B = 54 GFLOPs 的线性层运算:
带宽上限 = 4,800 GB/s ÷ 27 GB ≈ 178 token/s
计算上限 = 1,979,000 GFLOPs/s ÷ 54 GFLOPs ≈ 36,648 token/s
实际理论上限 = min(178, 36,648) = 178 token/s
两个上限相差约 206 倍,所以这个理想化的单流 Decode 明确是 memory-bound。141GB 容量使 27GB 权重可以常驻显存,并留下约 114GB 给 KV cache、workspace 和并发请求;容量本身不会把 178 token/s 的带宽上限提高。
再看权重被多个 Token 复用的情况。FP8 权重每个参数 1 byte,每个 Token 对每个参数约做 2 FLOPs。如果一次矩阵乘法同时处理 M 个 Token,线性层的算术强度近似为 2M FLOPs/byte。H200 在上述假设下的机器计算/带宽比是:
1,979 TFLOPS ÷ 4.8 TB/s ≈ 412 FLOPs/byte
临界 M ≈ 412 ÷ 2 ≈ 206 Token
当 M=64 时,权重带宽对应的吞吐上限约为 4,800 × 64 ÷ 27 = 11,378 token/s,仍低于 36,648 token/s 的计算上限,线性层仍偏 memory-bound。当 M=256 时,带宽上限提高到约 45,511 token/s,超过计算上限,线性层转为 compute-bound。
Prefill 的线性层会同时处理整段输入。单个 2,048 Token prompt 的投影层和 MLP,其 M 已远高于上述约 206 Token 的临界值,所以在这个简化 roofline 模型中会受 FP8 计算吞吐限制。实际 Prefill 还包含 attention;full attention 的计算量随序列长度近似按平方增长,因此实际每秒处理的输入 Token 会低于 36,648,并随模型结构和输入长度变化。
这个例子使用的是硬件峰值和简化的 2 × 参数量 计算量。真实结果还要扣除 scale、embedding、未量化层、attention、KV cache、activation 读写、kernel 效率和调度开销。判断方法不变:分别计算带宽上限与计算上限,较小的那个才是当前负载的上限。
批量增大后,一次读入的权重可以服务更多 Token,算术强度上升,工作负载可能从 bandwidth-bound 逐渐变成 compute-bound。因此,单用户测试结果不能直接预测 100 个并发用户下的吞吐。
硬件规格见 NVIDIA H200 官方页面。计算过程可参考 NVIDIA 对 prefill 与 decode 以及 roofline 模型 的说明。
测试前需要确定主要指标及其约束。
**Latency(延迟)**描述单个请求的等待时间:
**Throughput(吞吐)**关心整台服务器单位时间做多少工作:总 output tokens/s、requests/s,以及在某个延迟 SLA 下每张 GPU 每秒能处理多少 Token。
如果只给自己聊天,你一般希望 batch 小、TTFT 低、每个对话 token/s 高。
如果几十到几百人共用一个模型,主要指标应包括总吞吐、最大并发、P95/P99 延迟和每百万 Token 的成本。在延迟 SLA 允许的范围内增加 continuous batch,可以让一次权重读取服务更多 Token,从而提高总吞吐。
这些指标存在直接冲突。增大 batch 可以让一次权重读取服务更多请求,提高总 tokens/s;但请求可能需要等待调度器组成 batch,TTFT 随之上升。例如调度器额外等待 20ms 可能提高满载吞吐,却会给每个请求增加最多约 20ms 排队延迟。具体收益取决于到达率、输入长度分布和 GPU 利用率,必须在目标 P95/P99 延迟约束下测试。
纯权重容量的下限为:
模型权重 GB ≈ 参数量(B)× 每参数 bit 数 ÷ 8
所以 8B 模型:
| 理论精度 | 纯权重理论大小 |
|---|---|
| FP32 | 32GB |
| FP16/BF16 | 16GB |
| FP8/INT8 | 8GB |
| 4-bit | 4GB |
实际文件还包括 scale、zero point、embedding、metadata 和未量化层。GGUF 的 Q4_K_M 也不等于严格的 4 bit/parameter;初步预算可按 4.5~5 bit/parameter 计算,下载后应以文件大小和运行时实际占用为准。
完整内存预算应该是:
模型权重 + KV cache + 临时 activation / workspace + 推理框架开销 + 操作系统和其他程序
不能把显卡标称容量全部分配给权重。CUDA context、模型 activation、临时 workspace 和 KV cache 都需要显存。没有模型配置时,可以先给这些项目预留 10%~20%;确定层数、KV heads、head dimension、context 和并发后,应改用前面的 KV cache 公式计算,而不是继续使用固定百分比。
训练除了权重,还可能需要梯度、optimizer states、master weights 和 activation。以常见的混合精度 Adam 训练作近似估算,仅参数、梯度和优化器状态就可能达到每参数 16 bytes 左右,还没有包括 activation;BF16 推理权重只有每参数 2 bytes。LoRA/QLoRA、gradient checkpointing、ZeRO/FSDP 能减少占用,因此推理所需内存不能用于推断训练所需内存。
Mixture of Experts(MoE)模型会把部分 FFN 层拆成很多“专家”,再用 router 为每个 Token 选择少数几个专家。
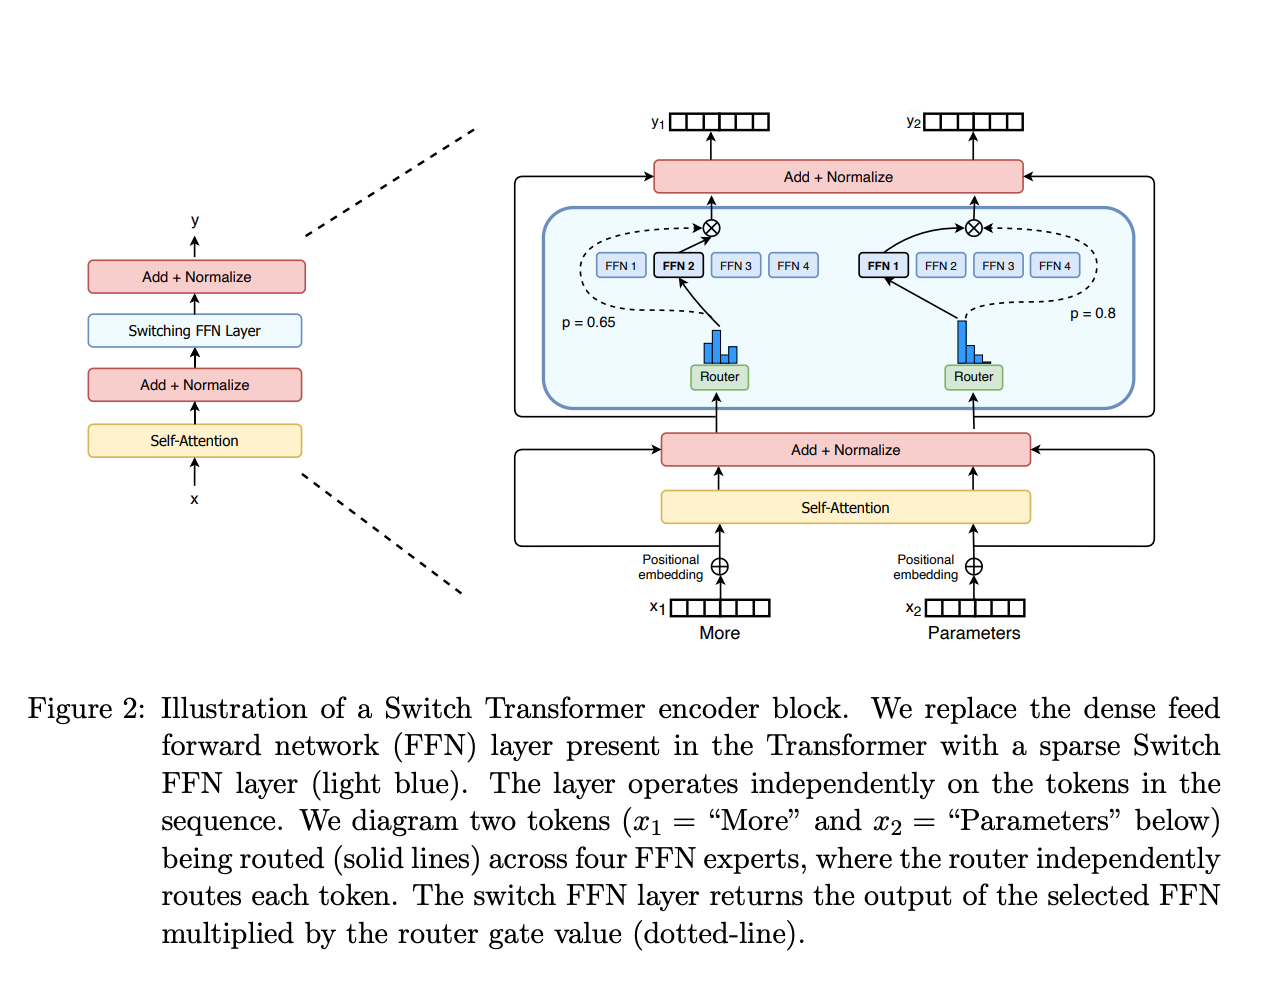
因此 MoE 有两个参数数字:
比如 Qwen3-Next-80B-A3B 是约 80B 总参数、每 Token 激活 3B;2026 年 8 月发布的 Qwen3.8-Flash-Next 是 125B 主模型参数、每 Token 激活 6B,另外还有 51B N-gram embedding。内存需要容纳 80B 或 125B 主模型的权重以及随 checkpoint 提供的额外模块,而每 Token 的 MoE 计算只经过其中 3B 或 6B 激活参数。
因此,128GB、256GB 或更大容量的 LPDDR5X/统一内存系统可以容纳总参数较大的量化 MoE。其内存带宽低于 HBM GPU,但每个 Token 只访问少数专家时,单用户 Decode 的权重读取量可能显著低于同总参数的密集模型。
例如,80B 总参数模型按平均 4.5 bit/parameter 计算,纯权重约为 45GB,因此可以装入 64GB 以上的可用内存。若每 Token 激活 3B 参数,对应的激活权重下限约为 3B × 4.5 / 8 = 1.69GB。在 256GB/s 内存系统上,只按这部分权重读取计算的上限约为 151 token/s。实际还要读取 attention、shared expert、embedding、KV cache 和量化 scale,并承担路由与 kernel 开销,所以真实速度会明显低于 151 token/s。这个估算只能用于解释为什么该类硬件可能达到可交互速度,不能代替 benchmark。
激活参数少不等于 MoE 不受带宽限制,原因包括:
MoE 的实际吞吐取决于 fused MoE kernel、expert parallel、负载均衡和互联带宽。评测时需要同时固定总参数、激活参数、batch size、并行方式和运行时版本。
降低位宽不会使模型质量按固定比例下降。结果取决于数值格式、block 大小、scale、校准数据、量化算法、模型结构和任务;位宽同时影响权重文件大小、内存流量和可用的硬件指令。
| 格式 | 典型用途 | 特点 |
|---|---|---|
| FP32 | 科学计算、部分累加和 master weight | 每元素 4 bytes;8-bit exponent、23-bit mantissa |
| TF32 | NVIDIA Tensor Core 上的矩阵乘法 | 使用 FP32 的 8-bit exponent 和 10-bit mantissa;输入与输出仍以 FP32 表示 |
| FP16 | 训练、推理 | 每元素 2 bytes;5-bit exponent、10-bit mantissa,动态范围小于 BF16 |
| BF16 | 训练、推理 | 每元素 2 bytes;8-bit exponent、7-bit mantissa,指数范围与 FP32 相同 |
| FP8 | 训练、推理 | 每元素 1 byte;E4M3 提供较多尾数位,E5M2 提供较大动态范围 |
| INT4 / GGUF Q4 | 消费级本地推理 | 原始权重每元素 0.5 byte,另需 scale 等 metadata;多数执行 W4A16 |
| MXFP4 | OCP 标准微缩放 FP4 | 32 个 E2M1 值共享一个 E8M0 scale |
| NVFP4 | NVIDIA 的 FP4 recipe | 16 个 E2M1 值共享 E4M3 scale,另有全 tensor FP32 scale |
权重存储精度和矩阵乘法的执行精度是两个独立参数。 “权重以 4 bit 保存”不等于“GPU 用原生 FP4 做矩阵乘法”。
没有原生 FP4 矩阵指令的 GPU 通常把 4-bit 权重读入寄存器或 shared memory,反量化成 FP16/BF16,再执行 W4A16 运算。这样可以减少权重容量和内存流量,但矩阵乘法仍使用 FP16/BF16 指令,并增加反量化开销。
FP4 E2M1 只有 1 个 sign bit、2 个 exponent bit 和 1 个 mantissa bit。它能表达的非负数大致只有:
0, 0.5, 1, 1.5, 2, 3, 4, 6
如果一组权重的绝对值范围是 0.001~200,直接转换为未缩放的 E2M1 会让小值舍入为 0,并让超过 6 的值饱和或溢出。
低精度量化需要先计算 scale,把一组数映射到 FP4 可以表示的范围:
量化:q = round_to_fp4(x / scale)
还原:x_hat = q × scale
整个 tensor 共用一个 scale 所需的 scale metadata 最少,但一个较大的离群值会增大 scale,使其他数值量化后集中在 0 和相邻的少数表示值。Block scaling 将 tensor 划分为小块,并为每个 block 单独计算 scale。
例如一个 block 的最大绝对值为 6 时,可以使用 scale=1;如果最大绝对值为 0.06,可以使用 scale=0.01,把 0.06 映射为 FP4 中的 6。若这两组数共用 scale=1,0.06 会被舍入为 0,信息直接丢失。较小 block 可以让不同范围的数据使用不同 scale,通常降低误差;代价是需要存储更多 scale,并增加量化、内存布局和 kernel 处理开销。
两者的元素主体都是 E2M1 FP4,区别主要在缩放方法。
OCP Microscaling Formats (MX) 规范规定 MXFP4:
x ≈ fp4_value × block_scale_E8M0
NVIDIA 的 NVFP4 使用两级缩放:
x ≈ fp4_value × block_scale_E4M3 × global_scale_FP32
E4M3 scale 有 3 个 mantissa bits,不限于 2 的整数次幂;NVFP4 的 block 也从 32 个元素减为 16 个。两项设计增加了可选 scale 的密度,通常降低量化误差,同时增加 scale metadata 和 recipe/kernel 的实现要求。
NVIDIA 的 NVFP4 训练 recipe 还使用二维 16×16 weight scaling、Random Hadamard Transform 和 stochastic rounding。二维 scaling 使按行和按列使用的量化权重保持一致;Hadamard Transform 用于重新分布离群值;stochastic rounding 减少反复量化时的系统性舍入偏差。因此,比较 FP4 模型时需要同时确认元素格式、scale 类型、block 大小、量化 recipe 和执行 kernel,不能只比较“4 bit”这个数字。
下面是面向 LLM 用户的简化表。具体型号和软件栈仍然可能有差异:
| 硬件架构 | 原生低精度矩阵能力 | 部署含义 |
|---|---|---|
| NVIDIA Turing(RTX 20/T4) | FP16、INT8、INT4 Tensor Core | 可使用 INT4/INT8 weight-only 或 FP16;没有 BF16/FP8 原生矩阵加速 |
| NVIDIA Ampere(RTX 30/A100) | FP16、BF16、TF32、INT8、INT4 | 可原生执行 BF16/FP16 Tensor Core 矩阵乘法;没有原生 FP8/FP4 |
| NVIDIA Ada(RTX 40/L4/L40) | 增加 FP8 Tensor Core | FP8 可有计算优势;FP4 通常仍是 weight-only 路线 |
| NVIDIA Hopper(H100/H200) | FP8、BF16、FP16、TF32、INT8 | FP8 有原生矩阵加速;没有原生 FP4 Tensor Core |
| NVIDIA Blackwell(B100/B200、RTX 50/RTX PRO Blackwell、GB10) | FP4/FP6/FP8、BF16/FP16 等 | NVFP4/MXFP4 才能获得原生 4-bit 矩阵加速 |
| AMD CDNA2(MI200) | FP16、BF16、INT8 等 | 训练/推理以 16-bit 和整数为主 |
| AMD CDNA3(MI300/MI325) | 增加 FP8/BF8 | 可使用原生 FP8;没有 CDNA4 的原生 MXFP4 |
| AMD CDNA4(MI350/MI355) | MXFP4、MXFP6、MXFP8、OCP FP8 | 原生支持标准 microscaling 低精度 |
| Apple Silicon / AMD RDNA 核显 | 依赖 Metal/MLX、Vulkan/HIP 等优化 kernel | 4-bit 多数表示权重存储与 weight-only 推理,不要套用 NVIDIA 峰值表 |
资料可参考 NVIDIA 的 Ampere、Hopper 与 Blackwell NVFP4 说明,以及 AMD 的 CDNA 架构页面。
H100 可以通过软件 kernel 读取 NVFP4 权重,但它没有原生 FP4 Tensor Core。常见兼容路径是在 kernel 内把 FP4 权重反量化到 BF16/FP16,做 W4A16;某些路径也可能转换到其他受支持精度。因此它可能节省显存和带宽,但不能获得 Blackwell 的原生 FP4 矩阵吞吐,并可能慢于使用 H100 原生 FP8 指令的 checkpoint。NVIDIA NIM 也把 pre-Blackwell 的 NVFP4 路径称为 emulation,并提示它可能慢于同卡原生精度。
在 H100 上应比较同一模型的官方 FP8、BF16 和 NVFP4 实测结果;在 Blackwell 上再把原生 NVFP4/MXFP4 作为主要候选。
| 场景 | 优先测试的精度 | 原因与限制 |
|---|---|---|
| 从零预训练 | BF16 + FP32 累加/optimizer state | BF16 与 FP32 具有相同的 8-bit exponent;矩阵输入减半存储,累加与优化器保留更高精度 |
| Hopper/Ada/CDNA3 大规模训练 | 经过验证的 FP8 mixed precision | 省内存和计算,但要用动态/块缩放 recipe |
| Blackwell/CDNA4 大规模训练 | NVFP4 或 MXFP4 mixed precision(需严格验证) | 可能进一步提高吞吐,但不是所有层都适合 4-bit |
| LoRA/QLoRA 微调 | 4-bit frozen base + BF16/FP16 compute + 16-bit adapter | 大幅减小显存,训练参数仍保留较高精度 |
| 消费级单用户推理 | GGUF Q4_K_M/Q5_K_M 或 AWQ/GPTQ INT4 | 原始 4-bit 权重约为 BF16 的 1/4;质量损失需要按任务实测 |
| Hopper 生产推理 | FP8 或具有对应 kernel 的 INT4 weight-only | 在固定模型、batch 和延迟约束下比较吞吐 |
| Blackwell 生产推理 | 经过任务评测的 NVFP4/MXFP4/FP8 | 可使用原生 FP4/FP6/FP8 矩阵指令;按任务准确率决定最低可用精度 |
| KV cache | 先测 BF16/FP16,再测 FP8/INT8/FP4 | 从 16-bit 降到 8-bit 可把 KV 容量减半;需要检查长上下文准确率和 attention kernel |
消费级本地推理可以先测试 Q4 和 Q5。Q2/Q3 进一步减少内存,但通常会增加数学、代码、工具调用和长上下文任务的准确率损失;小模型对量化误差通常更敏感。“较大模型的 Q2 一定优于较小模型的 Q5”没有普遍保证,需要在目标任务上分别测量成功率。
训练中的不同 tensor 通常使用不同精度。现代 mixed-precision recipe 会给敏感层、累加、梯度和 optimizer state 保留更高精度。理论 FP4 FLOPS 不包括量化、缩放、数据移动和非矩阵算子开销;矩阵尺寸或 batch 较小时也可能无法达到峰值吞吐。
下载 4-bit 模型前,需要确认运行时能否加载、目标 GPU 是否有对应 kernel、执行路径是 W4A16 还是 W4A4、KV cache 使用什么精度,以及量化报告是否公开了校准数据、评测任务和相对未量化模型的结果。
根据模型权重、KV cache 和并发计算内存需求后,再选择硬件。只按显卡型号或峰值 FLOPS 购买,无法确认目标模型能否完整装入内存。
NVIDIA GPU 的主要软件优势是 CUDA 生态。vLLM、TensorRT-LLM、FlashAttention 和多种量化 kernel 通常首先提供 CUDA 实现,新模型架构发布后也经常先获得 CUDA 支持。
挑卡时大致按这个顺序:
对于需要约 20GB 权重、还要分配 KV cache 的模型,24GB RTX 3090 可能比新一代 16GB 显卡更合适,因为 16GB 显卡必须把部分权重放在系统 RAM。若两张卡都能完整容纳权重和 KV cache,则需要比较显存带宽、支持精度、矩阵计算吞吐和运行时 kernel;新架构在 Prefill 和高 batch 场景通常具有更高计算吞吐。
显存不足时可以把部分层放在 CPU 和系统 RAM 中。这样可以运行超过显存容量的模型,但每个 Token 都要执行 CPU 层,或通过 PCIe 传输中间数据,因此速度取决于 CPU 内存带宽、PCIe 带宽和切分位置。系统 RAM 容量不能视为同等性能的显存容量。
非原厂扩容至 48GB 的游戏卡通常涉及显存焊接、BIOS 修改和散热改造,并可能失去原厂保修。购买前需要验证驱动识别、ECC/显存错误、满载温度、长期稳定性和售后责任;这些风险与原厂 48GB 专业卡不同。
AMD 独显和 Instinct 可通过 ROCm、vLLM、SGLang 和 llama.cpp 运行部分模型。购买前需要按具体 GPU、操作系统、模型架构和量化 kernel 核对支持矩阵;“支持 ROCm”不能说明某个模型、量化格式或 attention kernel 已受支持。
统一内存系统让 CPU 和 GPU 访问同一组物理内存,模型不需要在独立的系统 RAM 与显存之间逐层复制。它可以用较低成本提供 128GB 以上的 GPU 可访问内存。限制是 LPDDR5X 带宽通常低于数据中心 HBM,软件也必须为相应 GPU 后端和模型结构提供有效 kernel。因此,这类系统主要用于大容量 MoE 的单用户或低并发推理,而不是直接替代高并发 HBM GPU 服务器。
截至 2026-08-31,相关平台的公开规格如下:
| 平台 | 内存与带宽 | 可用软件与场景 | 限制 |
|---|---|---|---|
| Apple M5 Ultra Mac Studio | 最高 512GB unified memory,1.2TB/s | MLX、Metal、llama.cpp;可容纳超过 100B 参数的量化模型 | 2026-08-25 发布,9 月开始供货;CUDA-only 工具不能直接使用 |
| Apple M5 Max | 最高 128GB,最高 614GB/s | 便携/桌面单用户,中大型量化模型 | 软件主要走 MLX/Metal/llama.cpp |
| NVIDIA DGX Spark(GB10) | 128GB coherent LPDDR5X,273GB/s | CUDA/Blackwell 开发、FP4、约 200B 以内模型实验 | 带宽远低于 HBM 卡;“1 PFLOP FP4”包含特定精度/稀疏条件 |
| AMD Strix Halo / Ryzen AI Max+ 395 | 最高 128GB LPDDR5X,256GB/s | Windows/Linux,llama.cpp Vulkan/HIP 与部分 ROCm 路线 | RDNA 3.5 不是 CDNA4,不具有 MI350 的原生 MXFP4 矩阵能力 |
| Intel Crescent Island | 最高 480GB LPDDR5X,350W PCIe 卡 | 未来的大容量数据中心推理 | Intel 计划 2026 年下半年向客户采样;尚未公布广泛上市日期 |
官方规格来源:Apple M5 Ultra、DGX Spark、Ryzen AI Halo、Intel Crescent Island 2025 年采样计划与 Hot Chips 2026 规格更新。
Crescent Island 是未来半年值得关注的产品,但“客户采样”不等于零售或广泛供货。Intel 当前公开信息把它定位为 Xe3P 架构、风冷、面向数据中心推理的大容量 GPU;在正式供货、软件支持和第三方实测出现之前,不能用纸面容量代替购买建议。
以 Qwen3-Next-80B-A3B 为例,按 4.5 bit/parameter 估算的纯权重约为 45GB;128GB 统一内存扣除 45GB 权重后,还剩约 83GB 供操作系统、运行时、未量化层和 KV cache 使用。每 Token 激活 3B 参数,对应的激活权重读取下限约为 1.69GB。购买前还需要用目标运行时的实测 token/s 和内存占用验证,因为专家 kernel、共享层和量化格式会使实际结果偏离这两个下限。
同时服务约 100 名用户时,应按请求到达率、平均输入/输出长度和延迟 SLA 计算所需总 tokens/s。高并发会增加 Prefill 计算量、KV cache 占用和同时被访问的专家数量。此时多张数据中心 GPU 的 HBM 带宽、矩阵吞吐、expert parallel 与 serving 软件通常比单个统一内存 SoC 提供更高吞吐。两类系统面向的负载不同。
多卡有两个不同目标:
“两张 32GB 显卡一共有 64GB”只说明物理容量总和。两张卡的显存仍然彼此独立,运行时必须决定哪些权重放在哪张卡,以及推理过程中何时跨卡传输数据。不同并行方式不能只按名称比较,需要看三件事:权重如何放置、每次传输什么、传输在一层模型中发生几次。
| 方法 | 权重如何放置 | 推理时主要传什么 | 适合解决的问题 |
|---|---|---|---|
| Data Parallel(DP) | 每个 replica 保存一份完整模型;一个 replica 也可以由一组 TP/PP GPU 构成 | 不同 replica 之间通常没有逐层 activation 通信 | 模型已经能装下,希望处理更多独立请求 |
| Tensor Parallel(TP) | 每一层的大矩阵沿行或列切到多张 GPU | 每层 attention 和 MLP 的中间 activation,需要 all-reduce、all-gather 或 reduce-scatter | 单卡装不下,且 GPU 之间有低延迟、高带宽互联 |
| Pipeline Parallel(PP) | 连续的层分别放到不同 GPU,例如 80 层模型两卡各放约 40 层 | 每个 microbatch 在 stage 边界传一次 hidden state | 单卡装不下,但跨卡互联比 NVLink 慢;或需要跨机器切分 |
| Expert Parallel(EP) | MoE 的不同 expert 放到不同 GPU;attention、router 和 shared expert 可能复制或另行 TP | 每个 MoE 层把 Token hidden state 发给被选中的 expert,再把结果发回,通常是两次 all-to-all | MoE expert 权重装不下或需要并行计算多个 expert |
如果一个模型连同 KV cache 能装进单张 GPU,DP 是提高多用户吞吐最直接的方法。两张 GPU 各加载一份模型,请求 A 交给 GPU 0,请求 B 交给 GPU 1。两张卡不需要在每一层同步 activation,因此即使两张卡之间只有 PCIe,甚至两台机器之间只有普通网络,也可以工作。
DP 不会增加单个 replica 的模型容量。一个 40GB 权重模型不能因为有两张 32GB 卡就使用纯 DP;它仍然需要 TP 或 PP 把一个 replica 切开。另一方面,如果 20GB 模型已经能装进每张卡,两张卡做 DP 通常比把同一个请求做 TP 更适合提高总 requests/s。理想情况下总吞吐接近 replica 数量的倍数,直到 API 网关、CPU、网络、请求分布或某个 replica 的 KV cache 成为限制。
TP 会切分每一层的权重。例如一个线性层的权重矩阵可以按输出列切开,两张 GPU 各计算一半;下一步需要把结果合并,或把下一层输入按另一种方式切开。大矩阵的每卡占用接近原来的 1 / TP,但 norm、部分 embedding 和 metadata 可能复制;attention 的 KV heads 通常随 TP 切分,GQA 模型在 KV head 数不能整除 TP degree 时也可能复制,所以每卡显存不会严格等于总占用除以卡数。Megatron 风格的 Transformer TP 通常在一个 Transformer layer 中为 attention output 和 MLP output 各进行一次 collective;具体是 all-reduce、all-gather 还是 reduce-scatter,取决于模型和运行时。
下图是 vLLM 官方博客中的两卡 TP 例子:同一个输入 X 交给两张 GPU,每张卡只保存和计算权重矩阵的一部分,再通过 collective 合并结果。图来自 vLLM《Distributed Inference and Serving》。

TP 传输的是 activation,不是每一步重新传整份模型权重。设一次 collective 的 activation payload 为:
S = 本次参与计算的 Token 数 M × hidden size H × 每元素 bytes
使用 ring all-reduce 时,P 张卡中每张卡的发送量近似为 2 × (P-1) / P × S,接收量也近似相同。假设模型 hidden size 为 8,192,activation 使用 BF16,TP=2,并且每层有两次同等大小的 collective:
M = 1:S = 1 × 8,192 × 2 bytes = 16KiB
每层每张卡约发送 2 × 16KiB = 32KiB,同时接收约 32KiB
80 层约发送 2.5MiB,同时接收约 2.5MiB,但会启动约 160 次 collective

M = 2,048:S = 32MiB
80 层约发送 5GiB,同时接收约 5GiB
M=1 时总字节数不大,但 160 次同步的启动延迟可能比传输时间更重要;M=2,048 时数据量明显增大,互联带宽更重要。因此 TP 同时要求低延迟和高带宽。NVLink/NVSwitch 更适合 TP;跨 NUMA 的 PCIe 或跨机器 Ethernet 即使能够运行,也可能抵消一部分计算加速。上面的数字用于说明数量级,GQA、sequence parallel、fused collective 和不同 TP 实现会改变实际通信次数和 payload。
PP 不切一层内部的矩阵。假设模型有 80 层,PP=2 时可以让 GPU 0 保存前 40 层、GPU 1 保存后 40 层。KV cache 也按层保存在对应 GPU。每个 microbatch 经过第一个 stage 后,只需要把边界处的 hidden state 发给第二个 stage。
hidden size 仍为 8,192、BF16 时,单个 Token 通过一个 stage 边界的 payload 约为:
8,192 × 2 bytes = 16KiB
两阶段 PP 每个 Token 只跨一个边界;TP=2 则几乎每层都要同步。因此 PP 对慢互联更宽容。代价是一个请求必须先完成前半模型,再计算后半模型。只有一个 Decode 请求时,两张卡不能同时计算这个 Token 的不同层,单请求 latency 通常不会因为 PP=2 减半。请求或 microbatch 足够多时,GPU 0 可以处理下一批请求的前半段,同时 GPU 1 处理上一批的后半段,才会形成流水线。stage 的层数、计算量或 KV 占用不均衡时,较慢的 stage 决定总吞吐。
EP 只适用于 MoE。router 为每个 Token 选择 top-k expert 后,运行时需要把该 Token 的 hidden state 发到保存相应 expert 的 GPU;expert 完成计算后再把结果送回原来的 Token 顺序。一次 MoE 层通常至少包括 dispatch 和 combine 两次 all-to-all。
忽略协议和 padding,单方向的原始 payload 下限约为:
Token 数 M × top-k × hidden size H × 每元素 bytes
例如 M=256、top-k=2、H=8,192、BF16 时,dispatch 数据约为 8MiB,返回结果又约为 8MiB;如果有 64 个 MoE 层,所有层的这部分原始数据总和约为 1GiB。实际流量还受 expert 分布、负载不均、capacity/padding、量化和通信实现影响。EP 的 all-to-all 会同时使用多条链路,因此比只跨 stage 边界一次的 PP 更依赖互联拓扑。大量 Token 被路由到少数 expert 时,即使总带宽足够,也会出现部分 GPU 忙、部分 GPU 等待。
下面是当前 vLLM 中最直接相关的参数。参数名需要以实际安装版本的 vllm serve --help 为准;旧教程中的默认值不一定仍然有效。
| 参数 | 控制什么 | 容易混淆的地方 |
|---|---|---|
--tensor-parallel-size N / -tp N | 一个 replica 内,每一层切到多少张 GPU | TP 越大,每卡权重通常越少,但逐层 collective 的参与卡数也越多 |
--pipeline-parallel-size N / -pp N | 一个 replica 分成多少个连续 layer stage | PP 解决容量时很有效;低并发下会有 pipeline bubble,单请求 latency 不会按 stage 数等比例下降 |
--data-parallel-size N / -dp N | 建立多少个模型 replica | 每个 DP rank 都保存自己的一套权重和 KV cache;--max-num-seqs 按每个 rank 计算 |
--enable-expert-parallel / -ep | MoE layer 使用 EP,而不是仅按 TP 切 expert 权重 | attention 等非 MoE 部分仍可能使用 TP;还要测试 all-to-all backend 和 expert 负载均衡 |
--distributed-executor-backend mp|ray | worker 由本机多进程还是 Ray 管理 | 单机通常可用 mp;官方多节点示例通常使用 Ray,也可按当前文档配置原生多进程 |
--gpu-memory-utilization 0.90 | 每个 vLLM instance 可使用的 GPU 显存比例 | 这是每个 instance 的比例,不是整台机器共享的一笔显存 |
--kv-cache-memory-bytes ... | 明确指定每张 GPU 的 KV cache 大小 | 设定后会覆盖基于 gpu-memory-utilization 的 KV cache 自动估算 |
--max-model-len N | 服务允许的最大序列长度 | 设得过大可能压缩可用并发;实际占用还取决于已经缓存的 Token 数 |
--max-num-seqs N | 一次 scheduler iteration 最多包含多少条 sequence | 它不是 HTTP waiting queue 的长度,也不是同时连接数 |
--max-num-batched-tokens N | 一次 iteration 最多安排多少 Token | 较大值通常有利于 Prefill throughput,但可能增加 Decode 的 ITL |
--cpu-offload-gb N | 每张 GPU 额外从 CPU 内存换入多少 GiB 权重 | 这是以 PCIe 传输换容量;每次 forward 都可能付出传输成本 |
常见配置可以直接写成下面几种形式。
# 4 张有高速 NVLink/NVSwitch 互联的 GPU:一个 TP=4 replica
vllm serve MODEL \
  --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.90

# 两张没有 NVLink 的消费卡:按层分成两个 pipeline stage
CUDA_VISIBLE_DEVICES=0,1 vllm serve MODEL \
  --tensor-parallel-size 1 \
  --pipeline-parallel-size 2 \
  --gpu-memory-utilization 0.90

# 两个节点、每节点 8 张高速互联 GPU:节点内 TP=8,节点间 PP=2
vllm serve MODEL \
  --tensor-parallel-size 8 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray

# 8 张 GPU:两个 replica,每个 replica 内 TP=4
vllm serve MODEL \
  --data-parallel-size 2 \
  --tensor-parallel-size 4

# MoE:8 张 GPU 切分 expert,并启用 expert load balancing
vllm serve MODEL \
  --tensor-parallel-size 8 \
  --enable-expert-parallel \
  --enable-eplb
第二个例子不是说“两张无 NVLink GPU 永远应该 PP=2”。它来自 vLLM 当前对无 NVLink GPU 的一般建议:如果 TP 的高频 collective 太慢,可以用 PP 减少通信。模型结构是否能均匀分层、请求并发能否填充 pipeline、PCIe P2P 是否可用,都会改变结果。先分别跑 TP=2 和 PP=2,再比较相同负载下的 TTFT、ITL、总 tokens/s 和每卡显存。
vLLM 官方对多节点的一般建议是:高速互联留给 TP,较慢的节点边界使用 PP。下图左侧表示一个主进程控制同一 replica 内的多个 GPU worker;每个 worker 持有自己 rank 对应的模型分片。图来自 vLLM《Anatomy of vLLM》。

下面的“增加/减少”都是在模型、精度和请求分布相同,并且没有出现其他瓶颈时的常见方向,不是固定倍数。
| 改动 | 模型容量 | 单请求 latency / token speed | 多用户 throughput | 主要代价 |
|---|---|---|---|---|
| DP 从 1 增到 2 | 单个 replica 容量不变,总显存保存两份权重 | 单个请求基本不变 | 请求足够多时可接近 2 倍 | 权重和 KV cache 复制;负载均衡不均会损失吞吐 |
| TP 从 1 增到 2 | 每卡权重通常接近减半 | 大矩阵并行可能加快;低 batch Decode 可能被 collective latency 抵消 | 更大的 batch/KV 容量可能提高吞吐 | 几乎每层通信,依赖低延迟和高带宽 |
| PP 从 1 增到 2 | 每卡层数通常接近减半 | 单请求不会把两个 stage 同时填满,latency 通常不降,甚至增加 | 请求足够多时两个 stage 可以并行处理不同 microbatch | pipeline bubble、最慢 stage、stage 边界通信 |
| EP 从 1 增到多卡 | 每卡保存更少 expert | 小 batch 时 all-to-all 开销可能明显 | Token 足够多且 expert 均衡时可并行更多 expert | 每个 MoE layer 的 dispatch/combine 与热点 expert |
并行扩展有时会出现“看起来超过卡数倍数”的 throughput 增长,但这不表示第二张 GPU 凭空提供了超过一张卡的计算能力。一个具体的官方案例是:vLLM 0.7.0、Llama 3.1 70B FP8、输入 1,024 Token、输出 128 Token 时,单张 H100 只能留下 923 个 GPU KV block,而 TP=2 后增加到 12,830 个;总吞吐从 2,282 增到 8,967 token/s。原因是单卡配置的权重几乎占满显存,KV cache 才是主要限制;第二张卡不仅增加计算,还释放了大量 KV cache 空间。下图及数据来自 vLLM《Distributed Inference and Serving》。这个结果不能外推为“TP=2 永远有 3.9 倍吞吐”。

两张 RTX 5090,主板将每张卡协商为 PCIe 5.0 x8。 PCI-SIG 给出的 PCIe 5.0 x8 单向理论 payload 带宽约为 31.5GB/s;实际带宽更低。RTX 5090 官方规格为 32GB GDDR7,并明确不支持 NVLink。
继续使用前面的 80 层、hidden size 8,192、BF16 例子:当 M=2,048 时,TP=2 每张卡累计发送约 5GiB,单按 31.5GB/s 相除,链路传输时间下限已经约为 0.17 秒;PP=2 只在一个 stage 边界发送约 32MiB,对应下限约为 1 毫秒。实际程序还会受到协议、同步和带宽利用率影响。这不是说 PP 的端到端速度必然快 170 倍,因为两种方式的 GPU 计算重叠和流水线利用率不同;它说明两者需要互联传输的数据量不是同一个数量级。
两台 DGX Spark,通过 ConnectX-7 直连。 每台 Spark 有 128GB LPDDR5X、273GB/s 本地内存带宽;每个 ConnectX-7 QSFP 端口最高 200Gb/s,即 25GB/s 原始单向网络带宽,而且官方当前只支持 Ethernet 配置。两台机器的 256GB 是分布式容量,不是一块 256GB 共享内存。
--tensor-parallel-size 2。需要现成、已给出具体命令的方案时,应先使用这个 TP=2 配置并实测,而不是假设 PP 已在同一模型和容器上得到相同程度的验证。双路 CPU、八张 GPU 的服务器。 nvidia-smi 能看到八张卡,不代表任意两张卡之间的路径相同。常见设计是 GPU 0~3 接近 CPU/NUMA 0,GPU 4~7 接近 CPU/NUMA 1。若拓扑矩阵中同组显示 PIX、PXB 或 NV#,而跨组显示 SYS,跨组流量就需要经过 PCIe host bridge 和 CPU 间的 UPI/QPI 类 NUMA 互联。
TP=4, PP=2。跨 SYS 边界只传 pipeline activation,不在每层做八卡 TP all-reduce。NV#,TP/EP 可以跨更大的 GPU group;如果只有部分 GPU 直连 NVLink,group 应按实际 NVLink clique 划分。NVIDIA 驱动提供以下检查:
nvidia-smi topo -m          # GPU、NIC、CPU/NUMA affinity 与连接矩阵
nvidia-smi topo -p2p p      # PCIe P2P 能力
nvidia-smi topo -p2p n      # NVLink P2P 能力
nvidia-smi topo -cpu        # GPU 对应的 CPU 和内存 NUMA affinity
nvidia-smi nvlink -s        # NVLink 是否 active,以及驱动报告的链路带宽
下面是一台真实的双路 CPU、8×RTX 6000 Ada 服务器的 nvidia-smi topo -m 摘要。GPU 0~3 绑定 NUMA 0,GPU 4~7 绑定 NUMA 1;同一组内主要是 PIX 或 NODE,跨组全部是 SYS。原始输出来自 NVIDIA Developer Forums 上的 Supermicro 421GE-TNRT 案例。为了便于阅读,下面省略了 NIC 列,但没有改变 GPU 间路径标记。
        GPU0 GPU1 GPU2 GPU3 GPU4 GPU5 GPU6 GPU7 CPU Affinity   NUMA
GPU0     X   NODE NODE NODE SYS  SYS  SYS  SYS  0-35,72-107    0
GPU1    NODE  X   PIX  PIX  SYS  SYS  SYS  SYS  0-35,72-107    0
GPU2    NODE PIX   X   PIX  SYS  SYS  SYS  SYS  0-35,72-107    0
GPU3    NODE PIX  PIX   X   SYS  SYS  SYS  SYS  0-35,72-107    0
GPU4    SYS  SYS  SYS  SYS   X   PIX NODE NODE 36-71,108-143  1
GPU5    SYS  SYS  SYS  SYS  PIX   X  NODE NODE 36-71,108-143  1
GPU6    SYS  SYS  SYS  SYS  NODE NODE  X   PIX 36-71,108-143  1
GPU7    SYS  SYS  SYS  SYS  NODE NODE PIX   X  36-71,108-143  1
这个输出直接说明为什么不应随意选择 TP=8:它会让逐层 collective 反复跨过两个 CPU socket。若模型能在四张卡中装下,可以建立两个 TP=4 的 DP replica;若一个 replica 必须使用八张卡,可以先测试 NUMA 域内 TP=4、跨域 PP=2。如果另一台服务器的矩阵在所有 GPU 对之间都显示 NV#,结论会不同,必须按那台机器的拓扑重新分组。
拓扑矩阵中的常见标记为:
PIX:最多经过一个 PCIe switch;PXB:经过多个 PCIe switch,但不经过 CPU host bridge;PHB:经过 PCIe host bridge,通常是 CPU;NODE:经过同一 NUMA node 内的多个 host bridge;SYS:还要经过不同 NUMA node 之间的 SMP 互联,例如 UPI/QPI;NV#:存在一组由 # 条 NVLink 组成的连接。这些命令描述路径和驱动能力,不等于实测吞吐。应再用 NVIDIA nccl-tests 测 all_reduce_perf、all_gather_perf 和 alltoall_perf,并使用与真实 Prefill/Decode 接近的消息大小。并行策略的通常顺序是:模型能单卡运行时先比较单卡与 DP;需要单机切分时优先把 TP/EP 放在 NVLink/NVSwitch 域内;跨较慢的 NUMA 或机器边界使用 PP;最后用目标并发、TTFT、ITL 和总 tokens/s 验证。
规格与行为来源:vLLM Parallelism and Scaling、vLLM Optimization and Tuning、RTX 5090 官方规格、DGX Spark 硬件、DGX Spark ConnectX-7、双 Spark vLLM 流程与 nvidia-smi 文档。
模型排名没有意义,除非模型能在目标硬件、运行时和延迟要求下工作。筛选顺序可以固定为:
例如一张 24GB 显卡若给 KV cache、workspace 和桌面程序留下 6GB,可用于权重的预算约为 18GB。27B 模型按平均 4.5 bit/parameter 计算,纯权重约为 15.2GB,加入 scale 和未量化层后可能仍能完整放入显存;70B 模型的纯权重已经约为 39.4GB,不在候选范围内。如果该卡实测显存带宽约为 1TB/s、模型实际权重占 17GB,则单流 Decode 的权重读取上限约为 1,000 ÷ 17 = 59 token/s,实测应低于该数字。
在比较模型前,还需要写出服务目标。例如个人聊天可以要求 P95 TTFT 小于 2 秒、单流输出不低于 30 token/s;内部服务可以要求 32 并发下 P95 TTFT 小于 5 秒、总吞吐不低于 500 output token/s。没有这些约束,“速度快”无法对应具体选择。
选择模型至少要同时看:任务、dense/MoE、thinking/instruct、总参数与激活参数、context、tokenizer、运行时支持、量化、许可证,以及你的硬件上的 TTFT、token/s、并发和功耗。
排行榜用于产生候选名单,不用于直接决定生产模型。固定、公开的 benchmark 会面临两类问题:测试题可能进入预训练或微调数据;即使没有直接泄漏,训练方也可以针对公开任务的题型、prompt、评分器和总分反复选择数据、checkpoint 与推理参数。多次围绕同一测试集做选择,本身就会逐步过拟合该测试集。
这不表示公开 benchmark 没有用。数学、代码、长上下文、工具调用和人类偏好测量的是不同能力,多个独立结果可以用于缩小范围。需要检查 benchmark 的题目来源、更新时间、评分方法、是否允许 reasoning、每题采样次数和置信区间。LiveBench通过频繁更新题目和使用可自动核对的答案降低污染风险,但仍不能保证其任务分布等于你的实际工作。
LMArena 的核心方法不是固定选择题,而是匿名展示两个模型对同一真实用户 prompt 的回答,让用户选择 A、B、平局或都不好,再用成对偏好数据计算排名。Chatbot Arena 论文介绍了其 pairwise comparison 方法。它的优点是问题来自真实用户,评分直接反映人类看到完整回答后的偏好,并且没有一套长期固定的标准答案。
它测量的仍然是“LMArena 用户在该 prompt 分布下更喜欢哪个回答”,不是所有任务的正确率。结果会受到回答长度、格式、措辞、拒答方式、用户语言、题目类别和投票人群影响;它也不测量你的硬件能否运行模型、量化后的质量、许可证、TTFT、并发吞吐或任务成本。模型训练方还可以针对 Arena 中常见的回答风格优化。因此 LMArena 适合发现候选模型和比较通用对话偏好,不能替代代码单元测试、企业文档抽取准确率或特定写作风格的内部评测。
Artificial Analysis 同时提供 Intelligence Index、首 Token 延迟、输出速度、缓存价格、reasoning token 使用量和每任务成本,可用于初步筛选 API 模型。
它的 methodology 说明了各 benchmark 的构成、权重和成本算法,并区分“每百万 Token 的标价”和“完成一个任务的成本”。
Artificial Analysis Index 是多个 benchmark 的加权组合,其任务分布和权重不一定等于你的业务分布。它可以用于缩小候选范围,最终选择仍应由业务 eval 决定。
模型技术报告用于确认架构、context、训练方法和许可证。Artificial Analysis、LMArena、固定 benchmark 和技术报告测量的内容不同,不能相互替代。
最终选择应使用没有公开发布、与实际任务一致的 private benchmark。可以先收集 30~200 个真实任务,删除个人和公司敏感信息,为每一题预先规定评分方法,并保留一部分从未用于调 prompt 或选模型的 held-out 集合。
| 任务类型 | 评分方法示例 |
|---|---|
| 代码修改 | 在隔离环境运行单元测试,记录通过数、编译错误和超时 |
| 结构化抽取 | 比较字段值、JSON schema、漏项率和多余字段率 |
| 数学与规则推理 | 使用标准答案或程序 verifier;把最终答案和过程格式分开评分 |
| RAG/企业问答 | 核对引用位置、事实正确率、无依据陈述和拒答正确率 |
| 工具调用 | 检查工具选择、参数 schema、调用次数和最终任务是否完成 |
| 客服、总结、翻译 | 使用固定 rubric,由不知道模型名称的评审者盲评 |
| 小说与开放式写作 | 盲评情节一致性、人物声音、风格遵循、约束满足和重复程度 |
每次评测应记录完整配置:模型和 checkpoint、量化、chat template、system prompt、temperature、reasoning effort、context、运行时版本和硬件。性能至少分别测量 512、4K 和目标长输入下的 TTFT,单流 ITL,以及并发 1、4、16、目标峰值时的总 throughput 和 P95/P99 延迟。质量结果还应配套记录平均输入/输出/reasoning Token、失败与重试次数、峰值内存和功耗。
private benchmark 也会被自己过拟合。调 prompt、选择量化或修改 agent 流程时只使用开发集;最终比较使用 held-out 集。可以每月替换 10%~20% 题目并保留历史版本,既观察新任务,也检查模型升级是否让旧任务退步。样本量较小时报告每类任务的原始成功数,例如“代码 37/50、抽取 44/50”,不要只报一个加权总分。
选择流程可以分成两轮:先淘汰容量、许可证、格式正确率或任务成功率不达标的模型;再在合格模型中比较满足延迟 SLA 时的 throughput、功耗和每个成功任务成本。这样不会让一个便宜但经常失败的模型仅凭 Token 单价胜出。
当前主流模型通常提供 thinking/reasoning 模式,部分模型也提供可关闭推理的 instruct 模式。
很多模型通过 reinforcement learning 学会在回答前进行更长的推理。RLVR(Reinforcement Learning with Verifiable Rewards)使用可以自动检查的结果作为奖励,例如数学最终答案、代码单元测试、逻辑约束和输出格式。DeepSeek-R1 等工作显示了数学和代码任务上的提升;OpenAI 也公开说明部分 reasoning 能力会随训练时 RL compute 和测试时 thinking compute 增长。
RLVR 的直接训练信号在哪些任务上最可靠,reasoning 的收益通常就在哪些任务上最容易测量。数学题可以核对答案,代码可以运行测试,工具调用可以检查 schema 和环境状态;小说质量、语气、审美和开放式建议没有唯一正确答案,不能直接使用同一种 verifier。专门研究写作训练的 Writing-Zero正是因为普通 RLVR 与非可验证写作任务之间存在这一缺口,才另外设计 pairwise generative reward model 和训练方法。
因此不能从“模型是 reasoning model”直接推出“打开 reasoning 后小说一定写得更好”。规划长篇结构、检查人物关系或满足明确写作约束可能受益,但文风、创意和人物声音未必提高;更长的推理还可能增加重复、解释性文字、延迟和成本。模型厂商也可能混合使用 SFT、偏好训练、RLVR、模型评审和专门写作数据,所以不能只根据模型标签推断训练内容。
对于小说、翻译、总结、分类和普通聊天,应在同一模型上比较 non-thinking、低 reasoning effort 和高 reasoning effort。写作任务可以固定 50 个 prompt 和输出长度,由不知道配置的评审者做成对盲评;同时记录平均输出 Token、端到端延迟和每个被选中回答的成本。如果 reasoning 版本的胜率没有提高,就不应为额外 trajectory 付费或占用本地 GPU。
只比较每百万 Token 的单价会遗漏每个任务消耗的 Token 数:
一个输出价格 $1 / 1M token 的模型,不一定真的只有 $10 / 1M token 模型的十分之一成本。
原因是前者可能为了得到同样正确率,生成十几倍甚至几十倍的 reasoning trajectory。
真实成本大致应该按任务算:
任务成本 = 非缓存输入 Token × 输入价
         + 缓存输入 Token × 缓存价
         +(reasoning Token + 可见答案 Token)× 输出价
自部署不产生按 Token 计费的 API 账单,但 reasoning 仍消耗计算资源:更长的 trajectory 会增加端到端延迟、GPU 时间和电力,并在固定硬件上降低可服务的并发数。
因此比较 reasoning 模型时至少记录任务成功率、平均 reasoning + answer tokens、end-to-end latency、每个成功任务的成本,以及不同 reasoning effort 下的能力曲线。
提高 reasoning effort 通常会增加测试时计算量,并可能提高复杂数学、代码和规划任务的成功率,但收益不会随 Token 数线性增长。模型也可能产生重复或无效推理。抽取、翻译和分类任务应分别测试低 reasoning effort 或 non-thinking 模式,因为这些任务的额外推理可能只增加延迟和成本。
“权重可以下载”不等于符合 OSI 开源定义,也不等于许可证允许不受限制的商业使用。
检查商业用途、用户规模限制、attribution、蒸馏/再分发、地区与用途限制,以及训练数据、代码和权重是否使用不同许可证。
Apache-2.0、MIT 和各类自定义 community license 的义务不同,应阅读权重仓库中对应版本的许可证原文。正式商业部署还应由法律人员核对商用、再分发、attribution、使用范围和衍生模型条款。
LM Studio 提供模型搜索、GGUF 下载、上下文配置、聊天界面和本地 OpenAI-compatible API,使用时不需要命令行。
基本流程:安装后在 Discover 搜索模型,先选 Q4_K_M 或 Q5_K_M;context 先设 4K/8K;确认 GPU offload;运行正常后再逐渐增加 context。
LM Studio 适合图形界面的单机测试和本地 API。自动选择的 context、GPU offload 和量化未必具有最高吞吐;需要 continuous batching、分布式并行或数十个并发请求时,应同时测试 vLLM/SGLang。
Ollama 通过模型 manifest 管理下载、运行参数和本地 API。
ollama run qwen3:8b
ollama list
它默认提供本地 HTTP API,可连接 Open WebUI、编辑器插件和其他程序。
Ollama 支持 macOS、Windows 和 Linux,并提供统一的模型管理与 API。部分底层参数和新模型特性可能晚于 llama.cpp/vLLM 暴露;下载前应在模型 manifest 中核对具体量化、context 和模板,而不是只看模型标签。
llama.cpp 支持 CPU、CUDA、Metal、Vulkan、HIP 等后端,并定义和使用 GGUF 模型格式。
llama-server -hf Qwen/Qwen3-8B-GGUF:Q4_K_M \
  -ngl 99 \
  -c 8192 \
  --port 8080
Windows 下可执行文件可能叫 llama-server.exe。
-ngl 99:尽量把所有层 offload 到 GPU;-c 8192:最大 context 先设 8K;--port 8080:启动本地服务。如果出现 out-of-memory,先减小 context 或 GPU layers。若速度明显低于同类硬件公开结果,检查启动日志确认 CUDA、Metal 或 Vulkan 后端已经加载,并核对实际 offload 的层数。
llama.cpp 可用于单用户、边缘设备、Apple Silicon、AMD APU 和没有 CUDA 的系统,也可以启动 HTTP 服务。几十到几百个并发用户的部署还应测试 vLLM/SGLang,因为它们提供 continuous batching、分布式并行和面向服务的 KV cache 调度。
vLLM 是面向批量和并发请求的 LLM serving engine。它提供 continuous batching、PagedAttention、prefix caching、tensor/pipeline/expert parallel、量化和 OpenAI-compatible API。
vLLM 的原生部署环境是 Linux。Windows 可以通过 WSL2 使用,但需要分别检查 GPU passthrough、网络端口映射和 Windows/WSL 文件路径。
python -m venv .venv
source .venv/bin/activate
pip install vllm

vllm serve Qwen/Qwen3-8B \
  --dtype auto \
  --max-model-len 8192 \
  --enable-prefix-caching \
  --port 8000
调用 OpenAI-compatible API:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-8B",
    "messages": [{"role": "user", "content": "你好!请介绍一下你自己。"}]
  }'
两张 GPU 的 tensor parallel 可使用 --tensor-parallel-size 2。测试时先固定短 context 和单 GPU 基线,再分别启用量化、TP、speculative decoding、长 context 和高并发;每次只改变一个变量并记录 TTFT、ITL、吞吐和显存占用。
SGLang 是另一个 serving framework,提供 structured generation、radix cache、MoE、speculative decoding 和分布式部署。vLLM 与 SGLang 的模型和硬件支持范围随版本变化。
团队部署应在相同模型、量化、prompt length、output length、并发和延迟限制下测试两者。不同测试若没有固定这些变量,throughput 数字不能直接比较。
TensorRT-LLM 是 NVIDIA GPU 专用的 LLM 推理工具包,支持 in-flight batching、paged KV cache、量化、speculative decoding 和多 GPU/多节点部署。
TensorRT-LLM 仅面向 NVIDIA GPU,适用于模型和硬件固定、可以投入 engine build 与版本匹配工作的部署。vLLM 直接加载 Hugging Face 模型的路径通常更短;TensorRT-LLM 可针对固定配置生成和选择更专门的 kernel。最终性能需要在同一负载下测试。
NIM 没有过时。2026 年的 NIM LLM 提供经过验证的容器、模型 profile、健康检查、监控、安全更新和企业支持。当前 NIM LLM 2.x 使用直接对齐上游版本的 vLLM 作为核心 inference backend;NIM 的主要功能是打包、配置验证和运维支持,而不是定义新的 Transformer 推理算法。
个人或研究环境可以直接使用 vLLM。需要 CVE 修复、兼容性验证、稳定更新周期和厂商支持的企业环境可以评估 NIM。
OpenVINO GenAI 当前仍在维护,并支持 continuous batching、prefix caching、speculative decoding、paged attention 和 Intel CPU/GPU/NPU。
Intel 硬件应测试 OpenVINO 的官方执行路径。ONNX Runtime 仍是通用推理运行时,但新 LLM 架构的模型转换、量化和生成式服务功能需要逐项验证,不应仅根据 ONNX 模型能加载就推断其吞吐。
IPEX-LLM:项目已经在 2026-01-28 被 Intel 官方归档。仓库明确写明不再维护、不再修复,并提示存在已知安全问题。新部署不要继续选择它;Intel 路线优先看 OpenVINO GenAI、llama.cpp 的 Intel 后端或当前 Intel 官方推荐栈。
旧的 NIM 1.x 多 backend 说明:很多旧文章会说 NIM 自动在 TensorRT-LLM、vLLM 等 backend 间选择。NIM 2.x 已改成 one-container/one-backend,当前文档要以对应版本为准。
把 Hugging Face Transformers 直接当生产服务器:Transformers 可作为开发和研究基线,但单独调用 model.generate() 不提供生产服务所需的请求调度、continuous batching、跨请求 KV 管理、监控和限流。
传统做法常为每个请求预留一块连续的最大 KV cache。
请求的输入与输出长度不固定。如果按照最大长度为每个请求预留连续 KV cache,短请求会留下大量未使用空间;如果运行中不断申请不同大小的连续空间,则会产生内存碎片。两种情况都会减少同一时刻可以保留的序列数量。
PagedAttention 使用与操作系统虚拟内存相似的 block 映射:
请求 A 的逻辑 KV: [0] [1] [2] [3]
                       │   │   │   │
物理显存 block:     [17] [04] [91] [22]

请求 B 的相同前缀: [0] [1] [2] [8]
                       │   │   │   │
                      [17] [04] [91] [36]
PagedAttention 不改变模型的 attention 定义。它改变 KV cache 的物理存储和地址映射,使内存按 block 分配,并把浪费主要限制在每个序列最后一个未填满的 block。可用显存因此可以容纳更多活跃序列,提高 continuous batch 的大小和总 throughput。
下面这张 vLLM 官方图把请求调度和 KV block 放在了一起:三个不同长度的请求被压成一次没有右侧 padding 的 token sequence;CPU 端的 block table 决定每个逻辑 block 对应 GPU 上的哪个物理 KV block;后续 Decode 只追加新 Token,并通过 slot_mapping 写入对应位置。图中每个 sequence 的历史 KV 不需要在显存中连续。图来自 vLLM《Anatomy of vLLM》。

静态 batching 会先固定一组请求,再运行到整组完成。假设四个请求分别输出 32、128、512 和 1,024 Token:第一个请求完成后,它原来的位置不能立刻交给新请求,整组通常仍要等 1,024 Token 的请求结束。输出长度差异越大,空闲位置越多。
Continuous batching 不把“一个 batch”视为从开始到结束不变的请求集合。vLLM 的调度器会在每一次模型迭代前重新决定本轮处理哪些 Token。当前调度受三个不同上限约束:
max_num_batched_tokens:一次迭代最多处理多少 Token;max_num_seqs:一次迭代最多包含多少条 sequence;以普通自回归 Decode 为例,一条正在运行的 sequence 在一次迭代中通常只请求计算一个新 Token;Prefill 则可能一次提交数百或数千个输入 Token。一次典型调度过程如下:
max_num_seqs、Token budget 和剩余 KV cache 允许的范围内选择本轮 sequence;vLLM 默认调度策略是 FCFS,也可以使用 priority。当前 vLLM V1 在可以启用 chunked prefill 时,会先调度等待中的 Decode,再用 max_num_batched_tokens 的剩余预算处理 Prefill;一个长 prompt 如果放不下,会拆成多个 chunk。这样做可以避免一条 100,000 Token 的 Prefill 独占整次迭代,也可以在同一个 batch 中混合 compute-bound 的 Prefill 和 memory-bound 的 Decode。
假设设置为:
max_num_seqs = 256
max_num_batched_tokens = 8,192
某轮已经有 200 条 Decode sequence,每条需要下一个 Token,那么它们先使用约 200 个 Token budget;剩余约 7,992 个可以用于新请求的 Prefill chunk。这里的 256 是单次迭代的 sequence 上限,不表示服务器最多只能接收 256 个 HTTP 请求。其余请求可以继续排队;能否同时保留 256 条活跃 sequence,还要看它们的上下文占用是否超过 KV cache。
调度器能够直接填满的是 Token budget 和 sequence slots,不是一个精确的 FLOP budget。一个带有很长 KV context 的 Decode Token、一个短上下文 Decode Token 和一个 Prefill Token 的实际计算量、内存访问量并不相同。因此 max_num_batched_tokens=8,192 不能直接换算成固定 GPU 利用率,仍需用真实长度分布测量。
如果 KV cache 不足,调度器不能只靠增加 max_num_seqs 解决。vLLM 可能需要 preempt 一些 sequence,并在之后重新计算被释放的 KV;频繁 preemption 会浪费计算。启动日志中的 GPU KV cache size 和 Maximum concurrency 是容量估算,实际并发仍会随每条请求的真实上下文长度变化。
需要把四个数字分开:到达并发、活跃 sequence 数、总 output tokens/s、每条请求的 token/s。它们不是同一个指标。
| 请求负载 | GPU 与活跃 batch | 总吞吐 | 单条活跃请求速度 | 排队与 TTFT |
|---|---|---|---|---|
| 很低 | GPU 经常没有足够 Token 可算 | 增加请求通常会明显提高总 tokens/s | 通常最高或接近最高 | 很低 |
| 接近饱和 | 权重读取和矩阵计算被更多 Token 复用,活跃 batch 增大 | 继续上升,但增幅逐渐变小 | 可能开始下降 | P95/P99 TTFT 开始上升 |
| 已饱和 | GPU、KV cache 或调度上限已满 | 接近平台上限,不再随请求数线性增加 | 大致受“总吞吐 ÷ 活跃 Decode 数”限制 | 新请求主要进入 waiting queue |
| 长期超载 | 请求进入速度高于完成速度 | 仍停在平台上限 | 不会因队列更长而提高 | 队列持续增长,超时和取消增加 |
举一个只说明数量关系的例子。假设某个模型在目标输出长度下实测为 8,000 output token/s,最多保持约 256 条活跃请求,现在同时到达 10,000 条请求,并且每条都要输出 512 Token。如果 256 条活跃请求都处于 Decode,并近似公平地分享调度时间:
活跃请求平均可分到的速度 ≈ 8,000 ÷ 256 = 31.25 token/s
总输出量 = 10,000 × 512 = 5,120,000 Token
忽略 Prefill 的理想最短清空时间 = 5,120,000 ÷ 8,000 = 640 秒
Continuous batching 会让先完成的请求立即被 waiting queue 中的新请求替换,但它不能把 8,000 token/s 变成无限吞吐。后面的请求可能等待数分钟才开始 Prefill。实际时间还要加入输入 Prefill、长度差异、采样、网络和调度开销,因此会超过 640 秒。
同样可以用到达率判断服务是否会持续积压。如果平均每个请求输出 512 Token,8,000 output token/s 对应的 Decode 完成率上限约为 8,000 ÷ 512 = 15.6 requests/s,而请求长期以 20 requests/s 到达,那么只考虑输出也会每秒积压约 4.4 个请求。增加 queue 长度只能减少立即拒绝,不能消除这个容量缺口。
总吞吐达到平台后,继续提高并发通常会降低每个用户看到的 token/s,并提高 TTFT 和 end-to-end latency。反过来,把并发限制得过低又可能使 GPU 的矩阵单元和内存带宽没有被充分利用。因此正确目标不是“batch 越大越好”,而是在 P95/P99 TTFT、ITL 和错误率约束下找到最高总吞吐。
调 max_num_batched_tokens 时也存在具体取舍。较小的值限制每轮插入的 Prefill 工作量,通常有利于 Decode ITL;较大的值能一次处理更多 Prefill Token,可能缩短长 prompt 的 TTFT 并提高总吞吐,但也会让混合 batch 中的 Decode 等待更久。vLLM 当前文档对小模型和大 GPU 给出过大于 8,192 的吞吐建议,这不是所有模型的固定最优值。需要按真实 prompt/output 长度、请求到达率和 GPU 重新 sweep。
vLLM 原始 PagedAttention 论文在论文所用模型、硬件和基线下报告了同等延迟时 2~4 倍的 serving throughput 提升;早期博客在其他旧基线下报告过更大的倍数。这些数字不能直接外推到不同模型、运行时版本和 GPU,当前部署需要使用相同负载重新测试。
部署时常见的优化顺序:
max-model-len,不要直接使用模型声明的最大值,因为 KV cache 预留和可支持并发会受其影响;优化 throughput 时应同时记录 TTFT、ITL、P50/P95/P99、GPU memory、cache hit rate 和错误率。单独一个 tokens/s 数字不能说明是单请求生成速度、所有请求的总速度,还是以更高延迟换取的吞吐。
Prefix cache 的命中条件是完全一致的 Token 前缀。可以采用以下配置提高命中率:
提高共享前缀长度的布局:
[固定 system prompt]
[固定工具定义]
[固定公司知识/文档]
[稳定的历史对话]
[本轮用户问题]
动态字段截断共享前缀的布局:
[当前时间 + 随机 request id]
[本轮问题]
[固定 system prompt]
[固定公司文档]
共享 KV cache 可能产生跨租户侧信道和数据隔离问题。多租户服务应使用 cache salt/namespace、租户隔离和访问控制;不同客户的敏感前缀不应进入同一缓存命名空间。vLLM 提供 cache_salt 等机制,具体行为应以部署版本的文档和安全测试为准。
本地推理是否省钱,不能只比较显卡价格和 API 的每百万 Token 单价。至少要同时计算硬件折旧、电力、实际产出的 Token,以及这些 Token 如果改用 API 会产生多少费用。
先定义:
C_buy:整机购置价;C_resale:三年后的残值;P_idle:开机但没有生成 Token 时的整机墙上功耗;P_load:持续推理时的整机墙上功耗;u:三年中真正以实测速度生产 Token 的时间比例;R_C:有 C 个活跃请求时的聚合 output token/s;这里的 C=1、C=4、C=8 分别使用后面的公开实测值;p_e:电价,单位为美元/kWh;H = 3 × 365 × 24 = 26,280 小时(按每年 365 天;如果实际三年周期包含闰日,再加 24 小时)。这里的 u 不是 nvidia-smi 显示的瞬时 GPU utilization。u=20% 表示在三年总时间中,有 20% 的时间能持续达到对应并发下的 R_C;排队为空、模型加载、故障和维护时间都不能算入这 20%。
三年折旧 = C_buy - C_resale

平均墙上功耗 = P_idle + u × (P_load - P_idle)
三年用电量 = 平均墙上功耗(kW) × 26,280h
三年电费 = 三年用电量 × p_e

三年 output Token = R_C × 26,280 × 3,600 × u
本地总成本 = 三年折旧 + 三年电费
本地每百万 output Token 成本 = 本地总成本 ÷ (三年 output Token / 1,000,000)
这组公式假设机器三年始终开机;机器没有请求时按 P_idle 计电,真正有 C 个活跃请求并达到实测速度时按 P_load 计电。如果空闲时会关机,应把关机时间和功耗单独列出。机房还需要用 PUE 修正制冷和配电:设施总用电 = IT 用电 × PUE。下面的桌面工作站例子取 PUE=1,不计额外空调。
截至 2026 年 8 月,公开且带有完整测量说明的一组数据来自 NInfer 的 Qwen3.8-27B NVFP4 model card。NInfer 不是 vLLM;这组数据用于说明单卡的实际量级,不能当作 vLLM 的 benchmark。测试使用一张 RTX 5090、CUDA 13.1、NVFP4 权重、INT8 group-64 KV cache、CUDA Graphs、MTP=3、1,024-token prefill chunk,并关闭 prefix reuse。它测的是 75 个固定请求组成的完整 corpus;C 是同时保持活跃的请求数,不是把一条请求复制成静态 batch。原始结果如下:
活跃请求数 C | 平均 batch | 聚合 Decode throughput | 约合每请求速度 |
|---|---|---|---|
| 1 | 1.00 | 161.1 token/s | 161.1 token/s |
| 4 | 3.29 | 432.9 token/s | 108.2 token/s |
| 8 | 2.36 | 334.2 token/s | 41.8 token/s |
这个结果说明三件事:第一,多个请求可以让 GPU 同时服务更多 Token,C=4 的总 throughput 约为 C=1 的 2.69 倍;第二,单请求速度会从 161.1 降到约 108.2 token/s;第三,C=8 并没有比 C=4 更快,因为显存压力使平均 batch 降到 2.36,完整 corpus 的聚合速度反而降到 334.2 token/s。不能把“同时八个请求”自动等同于“吞吐八倍”。
这是一个特定量化、特定引擎和特定请求集合的公开实测,不是 RTX 5090 的硬件上限。另一份使用 SGLang、NVFP4 和 DFlash2 的独立报告给出单请求 prose/code 约 144/256 token/s、两路并发聚合约 261/451 token/s,也说明量化格式、推测解码、上下文长度和模型服务程序会改变数字;参见 该报告。下面的成本表只使用第一组可复现表格中的 C=1、C=4、C=8 数字。
下面把上面的公开实测接到你给定的硬件和折旧条件上:
| 输入 | 假设值 |
|---|---|
| 整机购置价 | $4,000 |
| 三年后残值 | $2,000,即购置价的 50% |
| 三年折旧 | $2,000 |
| 空闲整机墙上功耗 | 40W |
| 推理整机墙上功耗 | 700W |
| 忙碌时速度 | C=1、C=4、C=8 分别为 161.1、432.9、334.2 output token/s |
| 电价 | $0.18/kWh |
| PUE | 1.0 |
电价使用美国能源信息署(EIA)截至 2026 年 6 月的全美居民用电年内平均值 18.16 美分/kWh,并四舍五入为 18 美分。美国不同州、商业用电和分时电价可能相差很大,实际计算应替换为电费账单中的边际电价。来源:EIA Electric Power Monthly, Table 5.6.B。
按 P_idle=40W、P_load=700W,平均墙上功耗和电费只由占用率决定:
持续占用率 u | 平均整机功耗 | 三年用电量 | 三年电费 | 折旧 + 电费 |
|---|---|---|---|---|
| 20% | 172W | 4,520kWh | $814 | $2,814 |
| 50% | 370W | 9,724kWh | $1,750 | $3,750 |
| 80% | 568W | 14,927kWh | $2,687 | $4,687 |
计算式以 20% 为例:
平均功耗 = 40W + 20% × (700W - 40W) = 172W
电费 = 0.172kW × 26,280h × $0.18/kWh = $813.63
本地成本 = $2,000 折旧 + $813.63 电费 = $2,813.63
把三种并发情况和三档占用率合在一起,得到下面的三年 output Token 产量与 API 等价价值。API 价值使用 Alibaba Cloud Model Studio 为 qwen3.8-27b 列出的中国(北京)原价:输入 $0.424/M、输出 $1.696/M;本表只计算 output Token,因此没有虚构一个与模型无关的 API 价格。官方页面最后更新于 2026 年 8 月 28 日,原价不含临时促销,来源是 官方模型页面。
活跃请求 C | 占用率 u | 三年 output Token | 本地成本 | 本地成本/M output Token | 按 $1.696/M 的 API 等价价值 | 相对本地节省 |
|---|---|---|---|---|---|---|
| 1 | 20% | 30.48 亿 | $2,814 | $0.92 | $5,170 | $2,356 |
| 1 | 50% | 76.21 亿 | $3,750 | $0.49 | $12,925 | $9,174 |
| 1 | 80% | 121.93 亿 | $4,687 | $0.38 | $20,679 | $15,993 |
| 4 | 20% | 81.91 亿 | $2,814 | $0.34 | $13,892 | $11,079 |
| 4 | 50% | 204.78 亿 | $3,750 | $0.18 | $34,731 | $30,980 |
| 4 | 80% | 327.65 亿 | $4,687 | $0.14 | $55,569 | $50,882 |
| 8 | 20% | 63.24 亿 | $2,814 | $0.45 | $10,725 | $7,911 |
| 8 | 50% | 158.09 亿 | $3,750 | $0.24 | $26,812 | $23,062 |
| 8 | 80% | 252.94 亿 | $4,687 | $0.19 | $42,899 | $38,212 |
例如 C=4、占用率 50% 的一行:
Token = 432.9 token/s × 26,280h × 3,600s/h × 50%
      = 20,477.9 百万 output Token
API 等价价值 = 20,477.9 × $1.696 = $34,730.52
节省额 = $34,730.52 - $3,750.25 = $30,980.27
C=8 的结果低于 C=4,不是计算错误,而是直接沿用实测的 C=8 聚合速度 334.2 token/s;该测试报告 C=8 受到显存压力,平均 batch 只有 2.36。增加并发只有在聚合吞吐继续上升时才会增加 Token 产量。
如果使用 Alibaba Cloud 的新加坡国际端点,官方输出价格是 $3/M,输入价格是 $0.5/M。上表 API 等价价值和节省额可以按 3 ÷ 1.696 ≈ 1.769 乘算;这仍然是同一个 Qwen3.8-27B API 的公开价格,不是任意假设。
实际决策时至少替换以下数据:
P_idle 和目标并发下的 P_load,不要只使用显卡 TDP;u,并把模型切换、重启、故障和没有请求的时间排除;真实 API 账单通常还要区分输入、缓存输入和输出:
API 等价成本 = 非缓存输入 Token / 1M × 输入价格
             + 缓存输入 Token / 1M × 缓存输入价格
             + 输出 Token / 1M × 输出价格
上表故意只计算 output Token,所以它更接近“持续生成服务”的简化比较。长文档 Prefill 很多、缓存命中率很高或 reasoning 输出很长时,应分别带入三类 Token。隐私、离线可用性和数据驻留也可能是本地部署的独立价值,但不要把这些价值伪装成已经节省的现金。
如果 workload 里有大量共享长文档,prefix cache 会非常重要;如果回答特别长,speculative decoding、低 bit 权重和 Decode 带宽更重要;如果输入特别长,prefill 算力和 chunked prefill 更重要。
不一定。24GB 还需要容纳 KV cache、activation、workspace 和 runtime;前文示例中的单个 32K BF16 KV cache 已约为 4GiB。
不一定。4-bit 权重的原始容量约为 FP16 的 1/4,但还包括 scale;W4A16 在矩阵乘法前需要反量化,且实际吞吐受内存带宽、kernel 和 GPU 指令支持限制。
不是。Hopper 原生支持 FP8 Tensor Core;原生 FP4 Tensor Core 从 Blackwell 开始提供。
不是。内存仍要容纳全部专家和共享层;激活参数主要影响每 Token 的计算量和理想权重读取量。
容量可以通过模型切分利用,但 TP、PP 和 EP 会引入不同的同步与通信开销,吞吐不会按卡数自动线性增长。
不应默认这样设置。context 上限会影响 KV cache 预算和可支持并发;长输入也会增加 prefill 时间。应根据实际输入长度分布设置,并用目标任务测试长上下文 recall。
不一定。reasoning 长度、tokenizer、缓存率、重试次数和任务成功率都会改变每个成功任务的成本。
不会。Prefix caching 只跳过命中前缀的 prefill;新输出的 Decode 仍要逐 Token 计算。
不一定。最终选择需要使用目标数据、prompt、量化、运行时和硬件评测。
以下资料以论文、项目官方文档和芯片厂商文档为主:
部署前先确定模型、上下文长度、并发和延迟目标,再计算权重与 KV cache 容量,并使用真实任务测量准确率、TTFT、ITL、throughput 和功耗。
模型能够启动只说明当前配置满足最低运行条件。是否适合长期部署,还取决于输出质量、延迟、吞吐、稳定性和总成本。
如果这篇教程对你有帮助,欢迎支持后续更新:
最后一次大修:2026 年 8 月 31 日 本文优先解释计算过程和硬件限制。具体型号、软件版本和命令可能继续变化。
Hello!大家好,这里是 Anser!
这是一篇关于本地部署大语言模型(LLM)的教程。
内容包括本地聊天、代码与文档处理,也包括为几十到几百名用户部署内部推理服务。阅读本文不要求机器学习或高性能计算基础。
LLM 的硬件和软件仍在快速更新。如果你发现事实错误或过时内容,欢迎提交 Issue 或 PR。
赞助我:微信赞助(点击查看二维码) · Buy me a coffee
也感谢 r/LocalLLaMA 中公开硬件测试、运行参数和故障排查过程的各位。
先按照使用场景选择推理程序:
| 使用场景 | 程序 |
|---|---|
| 第一次部署,希望使用图形界面 | LM Studio |
| 想用一条命令启动模型,给别的软件调用 | Ollama |
| Windows、macOS、Linux 都想跑,或者只有 CPU/核显 | llama.cpp |
| 有 NVIDIA/AMD GPU,想给多人提供高吞吐 API | vLLM |
| 只使用 NVIDIA GPU,模型和硬件固定,可以投入时间编译和调优 | TensorRT-LLM |
| 公司需要经过验证的容器、监控、生命周期和支持 | NVIDIA NIM |
| Intel CPU、核显或独显,且需要 Intel 官方路线 | OpenVINO GenAI |
第一次测试可以使用 7B~14B 模型的 Q4 或 Q5 量化版本,并把上下文长度设为 4K~8K。这个配置先把权重和 KV cache 占用控制在较小范围,便于分别排查模型兼容性、GPU 后端和内存容量。基础配置运行正常后,再增加模型大小和上下文长度。
LLM 的输入和输出单位是 Token,而不是字符或单词。
比如 unbelievable 可能被切成一个或几个 Token;中文的一个汉字有时是一个 Token,有时多个字会合成一个 Token。不同模型使用的 tokenizer 也不同,所以两个模型都显示 50 token/s,并不代表它们每秒生成的中文字符一定一样多。
Tokenizer 通常不是神经网络。它把文本转换成整数 ID 序列;模型的 embedding layer 再把每个 ID 映射为向量。
目前绝大多数聊天 LLM 的主体依然属于 decoder-only Transformer。Transformer 最初发表于 Attention Is All You Need。3Blue1Brown 的 But what is a GPT? 提供了不要求数学基础的可视化说明。
自回归生成按以下步骤进行:
因此,普通 LLM 每次 forward pass 只确定一个新 Token。生成 1000 个 Token,通常需要约 1000 次顺序执行的解码步骤;后面的步骤必须等待前面的 Token 确定,无法全部并行。
一次 LLM 请求分为两个阶段:
Prefill(预填充):模型一次性读取你的 system prompt、聊天记录、文档和问题,为这些输入 Token 计算中间状态,并生成第一个新 Token。
Decode(解码):之后一个 Token 一个 Token 地继续生成答案。
Prefill 和 Decode 对硬件的使用方式不同:
以一个 BF16 权重矩阵为例,读取一个权重需要 2 bytes,一次乘加约产生 2 FLOPs。batch size 为 1 时,忽略 cache 后的算术强度大约只有 1 FLOP/byte。H100 的 FP16/BF16 Tensor Core 计算吞吐与 HBM 带宽之比是数百 FLOPs/byte,因此这种工作负载远未达到计算上限,内存带宽会先被占满。batch size 增大后,同一份权重可以同时服务多个 Token,算术强度近似随 batch 增长,工作负载才可能转为 compute-bound。
因此,评估单用户生成速度时要同时看模型实际权重大小和内存带宽;评估长输入处理或高并发吞吐时,还要看低精度矩阵计算吞吐与 batch 调度效率。
在 causal Transformer 中,前面的 Token 看不到未来。第 100 个 Token 的出现,不会回头改变第 1~99 个 Token 已经算出的 Key 和 Value。
生成第 101 个 Token 时,不需要重新计算前 100 个 Token 在各层的 Key 和 Value。这些保存在内存中的张量称为 KV cache。
没有 KV cache 时,第 t 个生成步骤需要重新计算前 t-1 个 Token 在每一层的 Key 和 Value。有 KV cache 时,这些张量只在对应 Token 第一次进入模型时计算一次;以后直接从显存或内存读取。
KV cache 的容量随上下文长度、并发序列数和每个元素的字节数线性增长。
对于标准 MHA/GQA,可按下式估算:
KV cache 字节数 ≈ 2 × 层数 × KV head 数 × head dimension
                 × 每个元素字节数 × 已缓存 Token 数 × 并发序列数
前面的 2 是 K 和 V 两份。
例如一个 32 层、8 个 KV heads、head dimension 为 128 的 GQA 模型,用 BF16 保存 KV,单个 32K 上下文大约需要:
2 × 32 × 8 × 128 × 2 bytes × 32768 ≈ 4 GiB
该结果不包括模型权重、运行时 workspace 和其他请求的 KV cache。
因此,20GB 权重不能可靠地部署在只剩 4GB 空间的 24GB 显卡上并同时使用很长上下文。以上述模型为例,单个 32K BF16 KV cache 已经约为 4GiB;128K 时约为 16GiB。并发 8 个相同长度的序列还要再乘 8。
现代模型使用 GQA、MQA 或 MLA 减少每个 Token 保存的 Key/Value 数量。部分运行时还支持 FP8、INT8 或 NVFP4 KV cache。低精度 KV cache 能减少容量和带宽需求,但可能影响长上下文准确率;如果运行时缺少对应低精度 attention kernel,它也可能只节省容量而不提高速度。
KV cache 可以在同一次生成中使用,也可以跨请求复用。
假设 100 个员工都在询问同一本 200 页的公司手册:
[完全相同的 system prompt]
[完全相同的公司手册]
[每个人不同的问题]
前两部分的 Token 前缀完全一致,那么它们对应的 KV cache 也一致。服务器第一次算完后,后续请求可以直接复用这部分缓存,只计算各自不同的问题。
这种跨请求复用称为 prefix caching(前缀缓存)。它减少命中部分的 prefill 计算,不减少新输出 Token 的 Decode 计算。vLLM 的 Automatic Prefix Caching 实现了这一功能。
复用条件通常是模型、tokenizer、Token ID 序列和位置完全相同。文本语义相似不构成命中;时间戳、随机 ID、JSON 字段顺序或聊天模板中的任一差异,都会使差异位置之后的前缀无法复用。
普通自回归生成每次只确认一个 Token,因此输出长度为 N 时至少需要 N 个顺序解码步骤。
Multi-Token Prediction(MTP) 的训练目标,是让额外的预测模块学习预测更远的未来 Token,而不只学习紧邻的下一个 Token。公开工作主要使用它完成两件事:
Speculative decoding 的流程如下:
正确实现的验证算法可以保持目标模型的输出分布。draft model 只负责提出候选,最终接受哪些 Token 仍由目标模型决定。加速来自目标模型一次并行验证多个候选,而不是降低目标模型精度。
MTP 是训练目标和模型结构;speculative decoding 是推理算法。 两者可以组合使用,但 speculative decoding 也可以使用独立 draft model、EAGLE 等方法生成候选。
DeepSeek-V3 的公开权重包括单独的 MTP 模块;vLLM 也提供 MTP speculative decoding 支持。实际加速取决于候选接受率、每次验证的候选数、batch size、模型结构和 kernel 开销;支持 MTP 本身不能保证固定的加速倍数。
MTP 不一定等于“再运行一个完整的小模型”。独立 draft model 会增加一份 draft 权重和 KV cache;内置 MTP 通常只增加若干预测层或 head。两种方法都在增加候选生成和验证计算,但目标模型一次读取权重后可以并行验证多个位置。如果一次验证接受了 k 个 Token,目标模型权重的读取成本就近似由 k 个输出 Token 分摊;代价是 draft 计算、被拒绝候选的计算和额外 KV 管理。
这解释了为什么 speculative decoding 常用于单请求、memory-bound 的 Decode。此时矩阵单元原本没有达到峰值吞吐,可以用剩余计算能力减少每个已接受 Token 对应的权重读取次数。计算能力与显存带宽之比较高的 GPU,例如 RTX 4090,可能比计算能力较低但带宽相近的 GPU 获得更大收益。高 batch serving 已经可以通过多个请求复用权重,工作负载更接近 compute-bound;此时 draft 开销可能抵消收益。
公开实测可以说明数量级,但不能代替本机 A/B 测试:Qwen3.8-27B MTP 社区记录在相同模型上报告了 RTX 4090 从 47.7 提高到 76.3 token/s,以及另一种 Q4 配置从 36.1 提高到 74.8 token/s;两组都使用 n-max=2,记录的接受率范围不同。该项目同时报告 speculative decoding 的单流收益在 --parallel 4 时消失。Sequoia则从更一般的 speculative decoding 角度说明,收益会随硬件的 compute/bandwidth ratio、draft tree、接受率和 offload 方式变化。
因此测试 MTP 时至少固定模型与量化、prompt、输出长度、temperature、并发数和运行时版本,然后记录 baseline 与 MTP 的 token/s、接受率、TTFT、显存占用和功耗。代码和 JSON 等可预测结构可能有较高接受率;开放式文本可能更低。增加 draft token 数也不保证更快,因为被拒绝候选仍消耗计算。
买硬件时需要分别计算以下三个指标:
容量(GB):决定能否同时存放模型权重、KV cache、activation 和运行时 workspace。容量不足时必须减小模型或上下文、降低精度、减少并发,或者把数据分布到其他设备;峰值 TFLOPS 不能解决容量不足。
内存带宽(GB/s 或 TB/s):每秒可以从内存向计算单元传输多少权重和 KV 数据。单用户、batch size 很小的 Decode 通常首先受它限制。
计算能力(FLOPS/TOPS):每秒可以完成多少运算。Prefill、训练和高 batch 的矩阵乘法通常首先受计算吞吐限制。
互联带宽决定显卡或机器之间交换 activation、梯度和 MoE Token 的速度。模型跨显卡、跨机器或跨 MoE 专家时,PCIe、NVLink、Infinity Fabric 或网络都可能成为瓶颈。
在 batch size 为 1、Decode 受权重读取带宽限制时,可以用以下公式估算理论上限:
理论 Decode 速度上限(token/s)≈ 可用内存带宽 ÷ 每 Token 需要读取的权重字节数
例如一个 8B 密集模型,量化后的有效大小是 5GB,设备真实可用带宽假设是 250GB/s:
250 ÷ 5 ≈ 50 token/s
50 token/s 是只计算权重读取的上限。实际速度还要扣除 attention、KV cache 读取、量化解码、kernel 启动和调度开销。设备标称 250GB/s 也不代表推理程序能持续利用全部带宽,所以实测结果应低于这个数字。
NVIDIA 公布的 H200 SXM 规格是 141GB HBM3e、4.8TB/s 显存带宽和 3,958 TFLOPS FP8 Tensor Core 吞吐;官方表格注明该 FP8 数字使用结构化稀疏。下面按不使用稀疏的约 1,979 TFLOPS 计算。假设 27B 模型所有权重都以 1 byte/parameter 的 FP8 保存,忽略 scale 和未量化层,则权重约为 27GB。
先算 batch size 为 1 的 Decode。每生成一个 Token,需要读取约 27GB 权重,并完成约 2 × 27B = 54 GFLOPs 的线性层运算:
带宽上限 = 4,800 GB/s ÷ 27 GB ≈ 178 token/s
计算上限 = 1,979,000 GFLOPs/s ÷ 54 GFLOPs ≈ 36,648 token/s
实际理论上限 = min(178, 36,648) = 178 token/s
两个上限相差约 206 倍,所以这个理想化的单流 Decode 明确是 memory-bound。141GB 容量使 27GB 权重可以常驻显存,并留下约 114GB 给 KV cache、workspace 和并发请求;容量本身不会把 178 token/s 的带宽上限提高。
再看权重被多个 Token 复用的情况。FP8 权重每个参数 1 byte,每个 Token 对每个参数约做 2 FLOPs。如果一次矩阵乘法同时处理 M 个 Token,线性层的算术强度近似为 2M FLOPs/byte。H200 在上述假设下的机器计算/带宽比是:
1,979 TFLOPS ÷ 4.8 TB/s ≈ 412 FLOPs/byte
临界 M ≈ 412 ÷ 2 ≈ 206 Token
当 M=64 时,权重带宽对应的吞吐上限约为 4,800 × 64 ÷ 27 = 11,378 token/s,仍低于 36,648 token/s 的计算上限,线性层仍偏 memory-bound。当 M=256 时,带宽上限提高到约 45,511 token/s,超过计算上限,线性层转为 compute-bound。
Prefill 的线性层会同时处理整段输入。单个 2,048 Token prompt 的投影层和 MLP,其 M 已远高于上述约 206 Token 的临界值,所以在这个简化 roofline 模型中会受 FP8 计算吞吐限制。实际 Prefill 还包含 attention;full attention 的计算量随序列长度近似按平方增长,因此实际每秒处理的输入 Token 会低于 36,648,并随模型结构和输入长度变化。
这个例子使用的是硬件峰值和简化的 2 × 参数量 计算量。真实结果还要扣除 scale、embedding、未量化层、attention、KV cache、activation 读写、kernel 效率和调度开销。判断方法不变:分别计算带宽上限与计算上限,较小的那个才是当前负载的上限。
批量增大后,一次读入的权重可以服务更多 Token,算术强度上升,工作负载可能从 bandwidth-bound 逐渐变成 compute-bound。因此,单用户测试结果不能直接预测 100 个并发用户下的吞吐。
硬件规格见 NVIDIA H200 官方页面。计算过程可参考 NVIDIA 对 prefill 与 decode 以及 roofline 模型 的说明。
测试前需要确定主要指标及其约束。
**Latency(延迟)**描述单个请求的等待时间:
**Throughput(吞吐)**关心整台服务器单位时间做多少工作:总 output tokens/s、requests/s,以及在某个延迟 SLA 下每张 GPU 每秒能处理多少 Token。
如果只给自己聊天,你一般希望 batch 小、TTFT 低、每个对话 token/s 高。
如果几十到几百人共用一个模型,主要指标应包括总吞吐、最大并发、P95/P99 延迟和每百万 Token 的成本。在延迟 SLA 允许的范围内增加 continuous batch,可以让一次权重读取服务更多 Token,从而提高总吞吐。
这些指标存在直接冲突。增大 batch 可以让一次权重读取服务更多请求,提高总 tokens/s;但请求可能需要等待调度器组成 batch,TTFT 随之上升。例如调度器额外等待 20ms 可能提高满载吞吐,却会给每个请求增加最多约 20ms 排队延迟。具体收益取决于到达率、输入长度分布和 GPU 利用率,必须在目标 P95/P99 延迟约束下测试。
纯权重容量的下限为:
模型权重 GB ≈ 参数量(B)× 每参数 bit 数 ÷ 8
所以 8B 模型:
| 理论精度 | 纯权重理论大小 |
|---|---|
| FP32 | 32GB |
| FP16/BF16 | 16GB |
| FP8/INT8 | 8GB |
| 4-bit | 4GB |
实际文件还包括 scale、zero point、embedding、metadata 和未量化层。GGUF 的 Q4_K_M 也不等于严格的 4 bit/parameter;初步预算可按 4.5~5 bit/parameter 计算,下载后应以文件大小和运行时实际占用为准。
完整内存预算应该是:
模型权重 + KV cache + 临时 activation / workspace + 推理框架开销 + 操作系统和其他程序
不能把显卡标称容量全部分配给权重。CUDA context、模型 activation、临时 workspace 和 KV cache 都需要显存。没有模型配置时,可以先给这些项目预留 10%~20%;确定层数、KV heads、head dimension、context 和并发后,应改用前面的 KV cache 公式计算,而不是继续使用固定百分比。
训练除了权重,还可能需要梯度、optimizer states、master weights 和 activation。以常见的混合精度 Adam 训练作近似估算,仅参数、梯度和优化器状态就可能达到每参数 16 bytes 左右,还没有包括 activation;BF16 推理权重只有每参数 2 bytes。LoRA/QLoRA、gradient checkpointing、ZeRO/FSDP 能减少占用,因此推理所需内存不能用于推断训练所需内存。
Mixture of Experts(MoE)模型会把部分 FFN 层拆成很多“专家”,再用 router 为每个 Token 选择少数几个专家。
因此 MoE 有两个参数数字:
比如 Qwen3-Next-80B-A3B 是约 80B 总参数、每 Token 激活 3B;2026 年 8 月发布的 Qwen3.8-Flash-Next 是 125B 主模型参数、每 Token 激活 6B,另外还有 51B N-gram embedding。内存需要容纳 80B 或 125B 主模型的权重以及随 checkpoint 提供的额外模块,而每 Token 的 MoE 计算只经过其中 3B 或 6B 激活参数。
因此,128GB、256GB 或更大容量的 LPDDR5X/统一内存系统可以容纳总参数较大的量化 MoE。其内存带宽低于 HBM GPU,但每个 Token 只访问少数专家时,单用户 Decode 的权重读取量可能显著低于同总参数的密集模型。
例如,80B 总参数模型按平均 4.5 bit/parameter 计算,纯权重约为 45GB,因此可以装入 64GB 以上的可用内存。若每 Token 激活 3B 参数,对应的激活权重下限约为 3B × 4.5 / 8 = 1.69GB。在 256GB/s 内存系统上,只按这部分权重读取计算的上限约为 151 token/s。实际还要读取 attention、shared expert、embedding、KV cache 和量化 scale,并承担路由与 kernel 开销,所以真实速度会明显低于 151 token/s。这个估算只能用于解释为什么该类硬件可能达到可交互速度,不能代替 benchmark。
激活参数少不等于 MoE 不受带宽限制,原因包括:
MoE 的实际吞吐取决于 fused MoE kernel、expert parallel、负载均衡和互联带宽。评测时需要同时固定总参数、激活参数、batch size、并行方式和运行时版本。
降低位宽不会使模型质量按固定比例下降。结果取决于数值格式、block 大小、scale、校准数据、量化算法、模型结构和任务;位宽同时影响权重文件大小、内存流量和可用的硬件指令。
| 格式 | 典型用途 | 特点 |
|---|---|---|
| FP32 | 科学计算、部分累加和 master weight | 每元素 4 bytes;8-bit exponent、23-bit mantissa |
| TF32 | NVIDIA Tensor Core 上的矩阵乘法 | 使用 FP32 的 8-bit exponent 和 10-bit mantissa;输入与输出仍以 FP32 表示 |
| FP16 | 训练、推理 | 每元素 2 bytes;5-bit exponent、10-bit mantissa,动态范围小于 BF16 |
| BF16 | 训练、推理 | 每元素 2 bytes;8-bit exponent、7-bit mantissa,指数范围与 FP32 相同 |
| FP8 | 训练、推理 | 每元素 1 byte;E4M3 提供较多尾数位,E5M2 提供较大动态范围 |
| INT4 / GGUF Q4 | 消费级本地推理 | 原始权重每元素 0.5 byte,另需 scale 等 metadata;多数执行 W4A16 |
| MXFP4 | OCP 标准微缩放 FP4 | 32 个 E2M1 值共享一个 E8M0 scale |
| NVFP4 | NVIDIA 的 FP4 recipe | 16 个 E2M1 值共享 E4M3 scale,另有全 tensor FP32 scale |
权重存储精度和矩阵乘法的执行精度是两个独立参数。 “权重以 4 bit 保存”不等于“GPU 用原生 FP4 做矩阵乘法”。
没有原生 FP4 矩阵指令的 GPU 通常把 4-bit 权重读入寄存器或 shared memory,反量化成 FP16/BF16,再执行 W4A16 运算。这样可以减少权重容量和内存流量,但矩阵乘法仍使用 FP16/BF16 指令,并增加反量化开销。
FP4 E2M1 只有 1 个 sign bit、2 个 exponent bit 和 1 个 mantissa bit。它能表达的非负数大致只有:
0, 0.5, 1, 1.5, 2, 3, 4, 6
如果一组权重的绝对值范围是 0.001~200,直接转换为未缩放的 E2M1 会让小值舍入为 0,并让超过 6 的值饱和或溢出。
低精度量化需要先计算 scale,把一组数映射到 FP4 可以表示的范围:
量化:q = round_to_fp4(x / scale)
还原:x_hat = q × scale
整个 tensor 共用一个 scale 所需的 scale metadata 最少,但一个较大的离群值会增大 scale,使其他数值量化后集中在 0 和相邻的少数表示值。Block scaling 将 tensor 划分为小块,并为每个 block 单独计算 scale。
例如一个 block 的最大绝对值为 6 时,可以使用 scale=1;如果最大绝对值为 0.06,可以使用 scale=0.01,把 0.06 映射为 FP4 中的 6。若这两组数共用 scale=1,0.06 会被舍入为 0,信息直接丢失。较小 block 可以让不同范围的数据使用不同 scale,通常降低误差;代价是需要存储更多 scale,并增加量化、内存布局和 kernel 处理开销。
两者的元素主体都是 E2M1 FP4,区别主要在缩放方法。
OCP Microscaling Formats (MX) 规范规定 MXFP4:
x ≈ fp4_value × block_scale_E8M0
NVIDIA 的 NVFP4 使用两级缩放:
x ≈ fp4_value × block_scale_E4M3 × global_scale_FP32
E4M3 scale 有 3 个 mantissa bits,不限于 2 的整数次幂;NVFP4 的 block 也从 32 个元素减为 16 个。两项设计增加了可选 scale 的密度,通常降低量化误差,同时增加 scale metadata 和 recipe/kernel 的实现要求。
NVIDIA 的 NVFP4 训练 recipe 还使用二维 16×16 weight scaling、Random Hadamard Transform 和 stochastic rounding。二维 scaling 使按行和按列使用的量化权重保持一致;Hadamard Transform 用于重新分布离群值;stochastic rounding 减少反复量化时的系统性舍入偏差。因此,比较 FP4 模型时需要同时确认元素格式、scale 类型、block 大小、量化 recipe 和执行 kernel,不能只比较“4 bit”这个数字。
下面是面向 LLM 用户的简化表。具体型号和软件栈仍然可能有差异:
| 硬件架构 | 原生低精度矩阵能力 | 部署含义 |
|---|---|---|
| NVIDIA Turing(RTX 20/T4) | FP16、INT8、INT4 Tensor Core | 可使用 INT4/INT8 weight-only 或 FP16;没有 BF16/FP8 原生矩阵加速 |
| NVIDIA Ampere(RTX 30/A100) | FP16、BF16、TF32、INT8、INT4 | 可原生执行 BF16/FP16 Tensor Core 矩阵乘法;没有原生 FP8/FP4 |
| NVIDIA Ada(RTX 40/L4/L40) | 增加 FP8 Tensor Core | FP8 可有计算优势;FP4 通常仍是 weight-only 路线 |
| NVIDIA Hopper(H100/H200) | FP8、BF16、FP16、TF32、INT8 | FP8 有原生矩阵加速;没有原生 FP4 Tensor Core |
| NVIDIA Blackwell(B100/B200、RTX 50/RTX PRO Blackwell、GB10) | FP4/FP6/FP8、BF16/FP16 等 | NVFP4/MXFP4 才能获得原生 4-bit 矩阵加速 |
| AMD CDNA2(MI200) | FP16、BF16、INT8 等 | 训练/推理以 16-bit 和整数为主 |
| AMD CDNA3(MI300/MI325) | 增加 FP8/BF8 | 可使用原生 FP8;没有 CDNA4 的原生 MXFP4 |
| AMD CDNA4(MI350/MI355) | MXFP4、MXFP6、MXFP8、OCP FP8 | 原生支持标准 microscaling 低精度 |
| Apple Silicon / AMD RDNA 核显 | 依赖 Metal/MLX、Vulkan/HIP 等优化 kernel | 4-bit 多数表示权重存储与 weight-only 推理,不要套用 NVIDIA 峰值表 |
资料可参考 NVIDIA 的 Ampere、Hopper 与 Blackwell NVFP4 说明,以及 AMD 的 CDNA 架构页面。
H100 可以通过软件 kernel 读取 NVFP4 权重,但它没有原生 FP4 Tensor Core。常见兼容路径是在 kernel 内把 FP4 权重反量化到 BF16/FP16,做 W4A16;某些路径也可能转换到其他受支持精度。因此它可能节省显存和带宽,但不能获得 Blackwell 的原生 FP4 矩阵吞吐,并可能慢于使用 H100 原生 FP8 指令的 checkpoint。NVIDIA NIM 也把 pre-Blackwell 的 NVFP4 路径称为 emulation,并提示它可能慢于同卡原生精度。
在 H100 上应比较同一模型的官方 FP8、BF16 和 NVFP4 实测结果;在 Blackwell 上再把原生 NVFP4/MXFP4 作为主要候选。
| 场景 | 优先测试的精度 | 原因与限制 |
|---|---|---|
| 从零预训练 | BF16 + FP32 累加/optimizer state | BF16 与 FP32 具有相同的 8-bit exponent;矩阵输入减半存储,累加与优化器保留更高精度 |
| Hopper/Ada/CDNA3 大规模训练 | 经过验证的 FP8 mixed precision | 省内存和计算,但要用动态/块缩放 recipe |
| Blackwell/CDNA4 大规模训练 | NVFP4 或 MXFP4 mixed precision(需严格验证) | 可能进一步提高吞吐,但不是所有层都适合 4-bit |
| LoRA/QLoRA 微调 | 4-bit frozen base + BF16/FP16 compute + 16-bit adapter | 大幅减小显存,训练参数仍保留较高精度 |
| 消费级单用户推理 | GGUF Q4_K_M/Q5_K_M 或 AWQ/GPTQ INT4 | 原始 4-bit 权重约为 BF16 的 1/4;质量损失需要按任务实测 |
| Hopper 生产推理 | FP8 或具有对应 kernel 的 INT4 weight-only | 在固定模型、batch 和延迟约束下比较吞吐 |
| Blackwell 生产推理 | 经过任务评测的 NVFP4/MXFP4/FP8 | 可使用原生 FP4/FP6/FP8 矩阵指令;按任务准确率决定最低可用精度 |
| KV cache | 先测 BF16/FP16,再测 FP8/INT8/FP4 | 从 16-bit 降到 8-bit 可把 KV 容量减半;需要检查长上下文准确率和 attention kernel |
消费级本地推理可以先测试 Q4 和 Q5。Q2/Q3 进一步减少内存,但通常会增加数学、代码、工具调用和长上下文任务的准确率损失;小模型对量化误差通常更敏感。“较大模型的 Q2 一定优于较小模型的 Q5”没有普遍保证,需要在目标任务上分别测量成功率。
训练中的不同 tensor 通常使用不同精度。现代 mixed-precision recipe 会给敏感层、累加、梯度和 optimizer state 保留更高精度。理论 FP4 FLOPS 不包括量化、缩放、数据移动和非矩阵算子开销;矩阵尺寸或 batch 较小时也可能无法达到峰值吞吐。
下载 4-bit 模型前,需要确认运行时能否加载、目标 GPU 是否有对应 kernel、执行路径是 W4A16 还是 W4A4、KV cache 使用什么精度,以及量化报告是否公开了校准数据、评测任务和相对未量化模型的结果。
根据模型权重、KV cache 和并发计算内存需求后,再选择硬件。只按显卡型号或峰值 FLOPS 购买,无法确认目标模型能否完整装入内存。
NVIDIA GPU 的主要软件优势是 CUDA 生态。vLLM、TensorRT-LLM、FlashAttention 和多种量化 kernel 通常首先提供 CUDA 实现,新模型架构发布后也经常先获得 CUDA 支持。
挑卡时大致按这个顺序:
对于需要约 20GB 权重、还要分配 KV cache 的模型,24GB RTX 3090 可能比新一代 16GB 显卡更合适,因为 16GB 显卡必须把部分权重放在系统 RAM。若两张卡都能完整容纳权重和 KV cache,则需要比较显存带宽、支持精度、矩阵计算吞吐和运行时 kernel;新架构在 Prefill 和高 batch 场景通常具有更高计算吞吐。
显存不足时可以把部分层放在 CPU 和系统 RAM 中。这样可以运行超过显存容量的模型,但每个 Token 都要执行 CPU 层,或通过 PCIe 传输中间数据,因此速度取决于 CPU 内存带宽、PCIe 带宽和切分位置。系统 RAM 容量不能视为同等性能的显存容量。
非原厂扩容至 48GB 的游戏卡通常涉及显存焊接、BIOS 修改和散热改造,并可能失去原厂保修。购买前需要验证驱动识别、ECC/显存错误、满载温度、长期稳定性和售后责任;这些风险与原厂 48GB 专业卡不同。
AMD 独显和 Instinct 可通过 ROCm、vLLM、SGLang 和 llama.cpp 运行部分模型。购买前需要按具体 GPU、操作系统、模型架构和量化 kernel 核对支持矩阵;“支持 ROCm”不能说明某个模型、量化格式或 attention kernel 已受支持。
统一内存系统让 CPU 和 GPU 访问同一组物理内存,模型不需要在独立的系统 RAM 与显存之间逐层复制。它可以用较低成本提供 128GB 以上的 GPU 可访问内存。限制是 LPDDR5X 带宽通常低于数据中心 HBM,软件也必须为相应 GPU 后端和模型结构提供有效 kernel。因此,这类系统主要用于大容量 MoE 的单用户或低并发推理,而不是直接替代高并发 HBM GPU 服务器。
截至 2026-08-31,相关平台的公开规格如下:
| 平台 | 内存与带宽 | 可用软件与场景 | 限制 |
|---|---|---|---|
| Apple M5 Ultra Mac Studio | 最高 512GB unified memory,1.2TB/s | MLX、Metal、llama.cpp;可容纳超过 100B 参数的量化模型 | 2026-08-25 发布,9 月开始供货;CUDA-only 工具不能直接使用 |
| Apple M5 Max | 最高 128GB,最高 614GB/s | 便携/桌面单用户,中大型量化模型 | 软件主要走 MLX/Metal/llama.cpp |
| NVIDIA DGX Spark(GB10) | 128GB coherent LPDDR5X,273GB/s | CUDA/Blackwell 开发、FP4、约 200B 以内模型实验 | 带宽远低于 HBM 卡;“1 PFLOP FP4”包含特定精度/稀疏条件 |
| AMD Strix Halo / Ryzen AI Max+ 395 | 最高 128GB LPDDR5X,256GB/s | Windows/Linux,llama.cpp Vulkan/HIP 与部分 ROCm 路线 | RDNA 3.5 不是 CDNA4,不具有 MI350 的原生 MXFP4 矩阵能力 |
| Intel Crescent Island | 最高 480GB LPDDR5X,350W PCIe 卡 | 未来的大容量数据中心推理 | Intel 计划 2026 年下半年向客户采样;尚未公布广泛上市日期 |
官方规格来源:Apple M5 Ultra、DGX Spark、Ryzen AI Halo、Intel Crescent Island 2025 年采样计划与 Hot Chips 2026 规格更新。
Crescent Island 是未来半年值得关注的产品,但“客户采样”不等于零售或广泛供货。Intel 当前公开信息把它定位为 Xe3P 架构、风冷、面向数据中心推理的大容量 GPU;在正式供货、软件支持和第三方实测出现之前,不能用纸面容量代替购买建议。
以 Qwen3-Next-80B-A3B 为例,按 4.5 bit/parameter 估算的纯权重约为 45GB;128GB 统一内存扣除 45GB 权重后,还剩约 83GB 供操作系统、运行时、未量化层和 KV cache 使用。每 Token 激活 3B 参数,对应的激活权重读取下限约为 1.69GB。购买前还需要用目标运行时的实测 token/s 和内存占用验证,因为专家 kernel、共享层和量化格式会使实际结果偏离这两个下限。
同时服务约 100 名用户时,应按请求到达率、平均输入/输出长度和延迟 SLA 计算所需总 tokens/s。高并发会增加 Prefill 计算量、KV cache 占用和同时被访问的专家数量。此时多张数据中心 GPU 的 HBM 带宽、矩阵吞吐、expert parallel 与 serving 软件通常比单个统一内存 SoC 提供更高吞吐。两类系统面向的负载不同。
多卡有两个不同目标:
“两张 32GB 显卡一共有 64GB”只说明物理容量总和。两张卡的显存仍然彼此独立,运行时必须决定哪些权重放在哪张卡,以及推理过程中何时跨卡传输数据。不同并行方式不能只按名称比较,需要看三件事:权重如何放置、每次传输什么、传输在一层模型中发生几次。
| 方法 | 权重如何放置 | 推理时主要传什么 | 适合解决的问题 |
|---|---|---|---|
| Data Parallel(DP) | 每个 replica 保存一份完整模型;一个 replica 也可以由一组 TP/PP GPU 构成 | 不同 replica 之间通常没有逐层 activation 通信 | 模型已经能装下,希望处理更多独立请求 |
| Tensor Parallel(TP) | 每一层的大矩阵沿行或列切到多张 GPU | 每层 attention 和 MLP 的中间 activation,需要 all-reduce、all-gather 或 reduce-scatter | 单卡装不下,且 GPU 之间有低延迟、高带宽互联 |
| Pipeline Parallel(PP) | 连续的层分别放到不同 GPU,例如 80 层模型两卡各放约 40 层 | 每个 microbatch 在 stage 边界传一次 hidden state | 单卡装不下,但跨卡互联比 NVLink 慢;或需要跨机器切分 |
| Expert Parallel(EP) | MoE 的不同 expert 放到不同 GPU;attention、router 和 shared expert 可能复制或另行 TP | 每个 MoE 层把 Token hidden state 发给被选中的 expert,再把结果发回,通常是两次 all-to-all | MoE expert 权重装不下或需要并行计算多个 expert |
如果一个模型连同 KV cache 能装进单张 GPU,DP 是提高多用户吞吐最直接的方法。两张 GPU 各加载一份模型,请求 A 交给 GPU 0,请求 B 交给 GPU 1。两张卡不需要在每一层同步 activation,因此即使两张卡之间只有 PCIe,甚至两台机器之间只有普通网络,也可以工作。
DP 不会增加单个 replica 的模型容量。一个 40GB 权重模型不能因为有两张 32GB 卡就使用纯 DP;它仍然需要 TP 或 PP 把一个 replica 切开。另一方面,如果 20GB 模型已经能装进每张卡,两张卡做 DP 通常比把同一个请求做 TP 更适合提高总 requests/s。理想情况下总吞吐接近 replica 数量的倍数,直到 API 网关、CPU、网络、请求分布或某个 replica 的 KV cache 成为限制。
TP 会切分每一层的权重。例如一个线性层的权重矩阵可以按输出列切开,两张 GPU 各计算一半;下一步需要把结果合并,或把下一层输入按另一种方式切开。大矩阵的每卡占用接近原来的 1 / TP,但 norm、部分 embedding 和 metadata 可能复制;attention 的 KV heads 通常随 TP 切分,GQA 模型在 KV head 数不能整除 TP degree 时也可能复制,所以每卡显存不会严格等于总占用除以卡数。Megatron 风格的 Transformer TP 通常在一个 Transformer layer 中为 attention output 和 MLP output 各进行一次 collective;具体是 all-reduce、all-gather 还是 reduce-scatter,取决于模型和运行时。
下图是 vLLM 官方博客中的两卡 TP 例子:同一个输入 X 交给两张 GPU,每张卡只保存和计算权重矩阵的一部分,再通过 collective 合并结果。图来自 vLLM《Distributed Inference and Serving》。
TP 传输的是 activation,不是每一步重新传整份模型权重。设一次 collective 的 activation payload 为:
S = 本次参与计算的 Token 数 M × hidden size H × 每元素 bytes
使用 ring all-reduce 时,P 张卡中每张卡的发送量近似为 2 × (P-1) / P × S,接收量也近似相同。假设模型 hidden size 为 8,192,activation 使用 BF16,TP=2,并且每层有两次同等大小的 collective:
M = 1:S = 1 × 8,192 × 2 bytes = 16KiB
每层每张卡约发送 2 × 16KiB = 32KiB,同时接收约 32KiB
80 层约发送 2.5MiB,同时接收约 2.5MiB,但会启动约 160 次 collective

M = 2,048:S = 32MiB
80 层约发送 5GiB,同时接收约 5GiB
M=1 时总字节数不大,但 160 次同步的启动延迟可能比传输时间更重要;M=2,048 时数据量明显增大,互联带宽更重要。因此 TP 同时要求低延迟和高带宽。NVLink/NVSwitch 更适合 TP;跨 NUMA 的 PCIe 或跨机器 Ethernet 即使能够运行,也可能抵消一部分计算加速。上面的数字用于说明数量级,GQA、sequence parallel、fused collective 和不同 TP 实现会改变实际通信次数和 payload。
PP 不切一层内部的矩阵。假设模型有 80 层,PP=2 时可以让 GPU 0 保存前 40 层、GPU 1 保存后 40 层。KV cache 也按层保存在对应 GPU。每个 microbatch 经过第一个 stage 后,只需要把边界处的 hidden state 发给第二个 stage。
hidden size 仍为 8,192、BF16 时,单个 Token 通过一个 stage 边界的 payload 约为:
8,192 × 2 bytes = 16KiB
两阶段 PP 每个 Token 只跨一个边界;TP=2 则几乎每层都要同步。因此 PP 对慢互联更宽容。代价是一个请求必须先完成前半模型,再计算后半模型。只有一个 Decode 请求时,两张卡不能同时计算这个 Token 的不同层,单请求 latency 通常不会因为 PP=2 减半。请求或 microbatch 足够多时,GPU 0 可以处理下一批请求的前半段,同时 GPU 1 处理上一批的后半段,才会形成流水线。stage 的层数、计算量或 KV 占用不均衡时,较慢的 stage 决定总吞吐。
EP 只适用于 MoE。router 为每个 Token 选择 top-k expert 后,运行时需要把该 Token 的 hidden state 发到保存相应 expert 的 GPU;expert 完成计算后再把结果送回原来的 Token 顺序。一次 MoE 层通常至少包括 dispatch 和 combine 两次 all-to-all。
忽略协议和 padding,单方向的原始 payload 下限约为:
Token 数 M × top-k × hidden size H × 每元素 bytes
例如 M=256、top-k=2、H=8,192、BF16 时,dispatch 数据约为 8MiB,返回结果又约为 8MiB;如果有 64 个 MoE 层,所有层的这部分原始数据总和约为 1GiB。实际流量还受 expert 分布、负载不均、capacity/padding、量化和通信实现影响。EP 的 all-to-all 会同时使用多条链路,因此比只跨 stage 边界一次的 PP 更依赖互联拓扑。大量 Token 被路由到少数 expert 时,即使总带宽足够,也会出现部分 GPU 忙、部分 GPU 等待。
下面是当前 vLLM 中最直接相关的参数。参数名需要以实际安装版本的 vllm serve --help 为准;旧教程中的默认值不一定仍然有效。
| 参数 | 控制什么 | 容易混淆的地方 |
|---|---|---|
--tensor-parallel-size N / -tp N | 一个 replica 内,每一层切到多少张 GPU | TP 越大,每卡权重通常越少,但逐层 collective 的参与卡数也越多 |
--pipeline-parallel-size N / -pp N | 一个 replica 分成多少个连续 layer stage | PP 解决容量时很有效;低并发下会有 pipeline bubble,单请求 latency 不会按 stage 数等比例下降 |
--data-parallel-size N / -dp N | 建立多少个模型 replica | 每个 DP rank 都保存自己的一套权重和 KV cache;--max-num-seqs 按每个 rank 计算 |
--enable-expert-parallel / -ep | MoE layer 使用 EP,而不是仅按 TP 切 expert 权重 | attention 等非 MoE 部分仍可能使用 TP;还要测试 all-to-all backend 和 expert 负载均衡 |
--distributed-executor-backend mp|ray | worker 由本机多进程还是 Ray 管理 | 单机通常可用 mp;官方多节点示例通常使用 Ray,也可按当前文档配置原生多进程 |
--gpu-memory-utilization 0.90 | 每个 vLLM instance 可使用的 GPU 显存比例 | 这是每个 instance 的比例,不是整台机器共享的一笔显存 |
--kv-cache-memory-bytes ... | 明确指定每张 GPU 的 KV cache 大小 | 设定后会覆盖基于 gpu-memory-utilization 的 KV cache 自动估算 |
--max-model-len N | 服务允许的最大序列长度 | 设得过大可能压缩可用并发;实际占用还取决于已经缓存的 Token 数 |
--max-num-seqs N | 一次 scheduler iteration 最多包含多少条 sequence | 它不是 HTTP waiting queue 的长度,也不是同时连接数 |
--max-num-batched-tokens N | 一次 iteration 最多安排多少 Token | 较大值通常有利于 Prefill throughput,但可能增加 Decode 的 ITL |
--cpu-offload-gb N | 每张 GPU 额外从 CPU 内存换入多少 GiB 权重 | 这是以 PCIe 传输换容量;每次 forward 都可能付出传输成本 |
常见配置可以直接写成下面几种形式。
# 4 张有高速 NVLink/NVSwitch 互联的 GPU:一个 TP=4 replica
vllm serve MODEL \
  --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.90

# 两张没有 NVLink 的消费卡:按层分成两个 pipeline stage
CUDA_VISIBLE_DEVICES=0,1 vllm serve MODEL \
  --tensor-parallel-size 1 \
  --pipeline-parallel-size 2 \
  --gpu-memory-utilization 0.90

# 两个节点、每节点 8 张高速互联 GPU:节点内 TP=8,节点间 PP=2
vllm serve MODEL \
  --tensor-parallel-size 8 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray

# 8 张 GPU:两个 replica,每个 replica 内 TP=4
vllm serve MODEL \
  --data-parallel-size 2 \
  --tensor-parallel-size 4

# MoE:8 张 GPU 切分 expert,并启用 expert load balancing
vllm serve MODEL \
  --tensor-parallel-size 8 \
  --enable-expert-parallel \
  --enable-eplb
第二个例子不是说“两张无 NVLink GPU 永远应该 PP=2”。它来自 vLLM 当前对无 NVLink GPU 的一般建议:如果 TP 的高频 collective 太慢,可以用 PP 减少通信。模型结构是否能均匀分层、请求并发能否填充 pipeline、PCIe P2P 是否可用,都会改变结果。先分别跑 TP=2 和 PP=2,再比较相同负载下的 TTFT、ITL、总 tokens/s 和每卡显存。
vLLM 官方对多节点的一般建议是:高速互联留给 TP,较慢的节点边界使用 PP。下图左侧表示一个主进程控制同一 replica 内的多个 GPU worker;每个 worker 持有自己 rank 对应的模型分片。图来自 vLLM《Anatomy of vLLM》。
下面的“增加/减少”都是在模型、精度和请求分布相同,并且没有出现其他瓶颈时的常见方向,不是固定倍数。
| 改动 | 模型容量 | 单请求 latency / token speed | 多用户 throughput | 主要代价 |
|---|---|---|---|---|
| DP 从 1 增到 2 | 单个 replica 容量不变,总显存保存两份权重 | 单个请求基本不变 | 请求足够多时可接近 2 倍 | 权重和 KV cache 复制;负载均衡不均会损失吞吐 |
| TP 从 1 增到 2 | 每卡权重通常接近减半 | 大矩阵并行可能加快;低 batch Decode 可能被 collective latency 抵消 | 更大的 batch/KV 容量可能提高吞吐 | 几乎每层通信,依赖低延迟和高带宽 |
| PP 从 1 增到 2 | 每卡层数通常接近减半 | 单请求不会把两个 stage 同时填满,latency 通常不降,甚至增加 | 请求足够多时两个 stage 可以并行处理不同 microbatch | pipeline bubble、最慢 stage、stage 边界通信 |
| EP 从 1 增到多卡 | 每卡保存更少 expert | 小 batch 时 all-to-all 开销可能明显 | Token 足够多且 expert 均衡时可并行更多 expert | 每个 MoE layer 的 dispatch/combine 与热点 expert |
并行扩展有时会出现“看起来超过卡数倍数”的 throughput 增长,但这不表示第二张 GPU 凭空提供了超过一张卡的计算能力。一个具体的官方案例是:vLLM 0.7.0、Llama 3.1 70B FP8、输入 1,024 Token、输出 128 Token 时,单张 H100 只能留下 923 个 GPU KV block,而 TP=2 后增加到 12,830 个;总吞吐从 2,282 增到 8,967 token/s。原因是单卡配置的权重几乎占满显存,KV cache 才是主要限制;第二张卡不仅增加计算,还释放了大量 KV cache 空间。下图及数据来自 vLLM《Distributed Inference and Serving》。这个结果不能外推为“TP=2 永远有 3.9 倍吞吐”。
两张 RTX 5090,主板将每张卡协商为 PCIe 5.0 x8。 PCI-SIG 给出的 PCIe 5.0 x8 单向理论 payload 带宽约为 31.5GB/s;实际带宽更低。RTX 5090 官方规格为 32GB GDDR7,并明确不支持 NVLink。
继续使用前面的 80 层、hidden size 8,192、BF16 例子:当 M=2,048 时,TP=2 每张卡累计发送约 5GiB,单按 31.5GB/s 相除,链路传输时间下限已经约为 0.17 秒;PP=2 只在一个 stage 边界发送约 32MiB,对应下限约为 1 毫秒。实际程序还会受到协议、同步和带宽利用率影响。这不是说 PP 的端到端速度必然快 170 倍,因为两种方式的 GPU 计算重叠和流水线利用率不同;它说明两者需要互联传输的数据量不是同一个数量级。
两台 DGX Spark,通过 ConnectX-7 直连。 每台 Spark 有 128GB LPDDR5X、273GB/s 本地内存带宽;每个 ConnectX-7 QSFP 端口最高 200Gb/s,即 25GB/s 原始单向网络带宽,而且官方当前只支持 Ethernet 配置。两台机器的 256GB 是分布式容量,不是一块 256GB 共享内存。
--tensor-parallel-size 2。需要现成、已给出具体命令的方案时,应先使用这个 TP=2 配置并实测,而不是假设 PP 已在同一模型和容器上得到相同程度的验证。双路 CPU、八张 GPU 的服务器。 nvidia-smi 能看到八张卡,不代表任意两张卡之间的路径相同。常见设计是 GPU 0~3 接近 CPU/NUMA 0,GPU 4~7 接近 CPU/NUMA 1。若拓扑矩阵中同组显示 PIX、PXB 或 NV#,而跨组显示 SYS,跨组流量就需要经过 PCIe host bridge 和 CPU 间的 UPI/QPI 类 NUMA 互联。
TP=4, PP=2。跨 SYS 边界只传 pipeline activation,不在每层做八卡 TP all-reduce。NV#,TP/EP 可以跨更大的 GPU group;如果只有部分 GPU 直连 NVLink,group 应按实际 NVLink clique 划分。NVIDIA 驱动提供以下检查:
nvidia-smi topo -m          # GPU、NIC、CPU/NUMA affinity 与连接矩阵
nvidia-smi topo -p2p p      # PCIe P2P 能力
nvidia-smi topo -p2p n      # NVLink P2P 能力
nvidia-smi topo -cpu        # GPU 对应的 CPU 和内存 NUMA affinity
nvidia-smi nvlink -s        # NVLink 是否 active,以及驱动报告的链路带宽
下面是一台真实的双路 CPU、8×RTX 6000 Ada 服务器的 nvidia-smi topo -m 摘要。GPU 0~3 绑定 NUMA 0,GPU 4~7 绑定 NUMA 1;同一组内主要是 PIX 或 NODE,跨组全部是 SYS。原始输出来自 NVIDIA Developer Forums 上的 Supermicro 421GE-TNRT 案例。为了便于阅读,下面省略了 NIC 列,但没有改变 GPU 间路径标记。
        GPU0 GPU1 GPU2 GPU3 GPU4 GPU5 GPU6 GPU7 CPU Affinity   NUMA
GPU0     X   NODE NODE NODE SYS  SYS  SYS  SYS  0-35,72-107    0
GPU1    NODE  X   PIX  PIX  SYS  SYS  SYS  SYS  0-35,72-107    0
GPU2    NODE PIX   X   PIX  SYS  SYS  SYS  SYS  0-35,72-107    0
GPU3    NODE PIX  PIX   X   SYS  SYS  SYS  SYS  0-35,72-107    0
GPU4    SYS  SYS  SYS  SYS   X   PIX NODE NODE 36-71,108-143  1
GPU5    SYS  SYS  SYS  SYS  PIX   X  NODE NODE 36-71,108-143  1
GPU6    SYS  SYS  SYS  SYS  NODE NODE  X   PIX 36-71,108-143  1
GPU7    SYS  SYS  SYS  SYS  NODE NODE PIX   X  36-71,108-143  1
这个输出直接说明为什么不应随意选择 TP=8:它会让逐层 collective 反复跨过两个 CPU socket。若模型能在四张卡中装下,可以建立两个 TP=4 的 DP replica;若一个 replica 必须使用八张卡,可以先测试 NUMA 域内 TP=4、跨域 PP=2。如果另一台服务器的矩阵在所有 GPU 对之间都显示 NV#,结论会不同,必须按那台机器的拓扑重新分组。
拓扑矩阵中的常见标记为:
PIX:最多经过一个 PCIe switch;PXB:经过多个 PCIe switch,但不经过 CPU host bridge;PHB:经过 PCIe host bridge,通常是 CPU;NODE:经过同一 NUMA node 内的多个 host bridge;SYS:还要经过不同 NUMA node 之间的 SMP 互联,例如 UPI/QPI;NV#:存在一组由 # 条 NVLink 组成的连接。这些命令描述路径和驱动能力,不等于实测吞吐。应再用 NVIDIA nccl-tests 测 all_reduce_perf、all_gather_perf 和 alltoall_perf,并使用与真实 Prefill/Decode 接近的消息大小。并行策略的通常顺序是:模型能单卡运行时先比较单卡与 DP;需要单机切分时优先把 TP/EP 放在 NVLink/NVSwitch 域内;跨较慢的 NUMA 或机器边界使用 PP;最后用目标并发、TTFT、ITL 和总 tokens/s 验证。
规格与行为来源:vLLM Parallelism and Scaling、vLLM Optimization and Tuning、RTX 5090 官方规格、DGX Spark 硬件、DGX Spark ConnectX-7、双 Spark vLLM 流程与 nvidia-smi 文档。
模型排名没有意义,除非模型能在目标硬件、运行时和延迟要求下工作。筛选顺序可以固定为:
例如一张 24GB 显卡若给 KV cache、workspace 和桌面程序留下 6GB,可用于权重的预算约为 18GB。27B 模型按平均 4.5 bit/parameter 计算,纯权重约为 15.2GB,加入 scale 和未量化层后可能仍能完整放入显存;70B 模型的纯权重已经约为 39.4GB,不在候选范围内。如果该卡实测显存带宽约为 1TB/s、模型实际权重占 17GB,则单流 Decode 的权重读取上限约为 1,000 ÷ 17 = 59 token/s,实测应低于该数字。
在比较模型前,还需要写出服务目标。例如个人聊天可以要求 P95 TTFT 小于 2 秒、单流输出不低于 30 token/s;内部服务可以要求 32 并发下 P95 TTFT 小于 5 秒、总吞吐不低于 500 output token/s。没有这些约束,“速度快”无法对应具体选择。
选择模型至少要同时看:任务、dense/MoE、thinking/instruct、总参数与激活参数、context、tokenizer、运行时支持、量化、许可证,以及你的硬件上的 TTFT、token/s、并发和功耗。
排行榜用于产生候选名单,不用于直接决定生产模型。固定、公开的 benchmark 会面临两类问题:测试题可能进入预训练或微调数据;即使没有直接泄漏,训练方也可以针对公开任务的题型、prompt、评分器和总分反复选择数据、checkpoint 与推理参数。多次围绕同一测试集做选择,本身就会逐步过拟合该测试集。
这不表示公开 benchmark 没有用。数学、代码、长上下文、工具调用和人类偏好测量的是不同能力,多个独立结果可以用于缩小范围。需要检查 benchmark 的题目来源、更新时间、评分方法、是否允许 reasoning、每题采样次数和置信区间。LiveBench通过频繁更新题目和使用可自动核对的答案降低污染风险,但仍不能保证其任务分布等于你的实际工作。
LMArena 的核心方法不是固定选择题,而是匿名展示两个模型对同一真实用户 prompt 的回答,让用户选择 A、B、平局或都不好,再用成对偏好数据计算排名。Chatbot Arena 论文介绍了其 pairwise comparison 方法。它的优点是问题来自真实用户,评分直接反映人类看到完整回答后的偏好,并且没有一套长期固定的标准答案。
它测量的仍然是“LMArena 用户在该 prompt 分布下更喜欢哪个回答”,不是所有任务的正确率。结果会受到回答长度、格式、措辞、拒答方式、用户语言、题目类别和投票人群影响;它也不测量你的硬件能否运行模型、量化后的质量、许可证、TTFT、并发吞吐或任务成本。模型训练方还可以针对 Arena 中常见的回答风格优化。因此 LMArena 适合发现候选模型和比较通用对话偏好,不能替代代码单元测试、企业文档抽取准确率或特定写作风格的内部评测。
Artificial Analysis 同时提供 Intelligence Index、首 Token 延迟、输出速度、缓存价格、reasoning token 使用量和每任务成本,可用于初步筛选 API 模型。
它的 methodology 说明了各 benchmark 的构成、权重和成本算法,并区分“每百万 Token 的标价”和“完成一个任务的成本”。
Artificial Analysis Index 是多个 benchmark 的加权组合,其任务分布和权重不一定等于你的业务分布。它可以用于缩小候选范围,最终选择仍应由业务 eval 决定。
模型技术报告用于确认架构、context、训练方法和许可证。Artificial Analysis、LMArena、固定 benchmark 和技术报告测量的内容不同,不能相互替代。
最终选择应使用没有公开发布、与实际任务一致的 private benchmark。可以先收集 30~200 个真实任务,删除个人和公司敏感信息,为每一题预先规定评分方法,并保留一部分从未用于调 prompt 或选模型的 held-out 集合。
| 任务类型 | 评分方法示例 |
|---|---|
| 代码修改 | 在隔离环境运行单元测试,记录通过数、编译错误和超时 |
| 结构化抽取 | 比较字段值、JSON schema、漏项率和多余字段率 |
| 数学与规则推理 | 使用标准答案或程序 verifier;把最终答案和过程格式分开评分 |
| RAG/企业问答 | 核对引用位置、事实正确率、无依据陈述和拒答正确率 |
| 工具调用 | 检查工具选择、参数 schema、调用次数和最终任务是否完成 |
| 客服、总结、翻译 | 使用固定 rubric,由不知道模型名称的评审者盲评 |
| 小说与开放式写作 | 盲评情节一致性、人物声音、风格遵循、约束满足和重复程度 |
每次评测应记录完整配置:模型和 checkpoint、量化、chat template、system prompt、temperature、reasoning effort、context、运行时版本和硬件。性能至少分别测量 512、4K 和目标长输入下的 TTFT,单流 ITL,以及并发 1、4、16、目标峰值时的总 throughput 和 P95/P99 延迟。质量结果还应配套记录平均输入/输出/reasoning Token、失败与重试次数、峰值内存和功耗。
private benchmark 也会被自己过拟合。调 prompt、选择量化或修改 agent 流程时只使用开发集;最终比较使用 held-out 集。可以每月替换 10%~20% 题目并保留历史版本,既观察新任务,也检查模型升级是否让旧任务退步。样本量较小时报告每类任务的原始成功数,例如“代码 37/50、抽取 44/50”,不要只报一个加权总分。
选择流程可以分成两轮:先淘汰容量、许可证、格式正确率或任务成功率不达标的模型;再在合格模型中比较满足延迟 SLA 时的 throughput、功耗和每个成功任务成本。这样不会让一个便宜但经常失败的模型仅凭 Token 单价胜出。
当前主流模型通常提供 thinking/reasoning 模式,部分模型也提供可关闭推理的 instruct 模式。
很多模型通过 reinforcement learning 学会在回答前进行更长的推理。RLVR(Reinforcement Learning with Verifiable Rewards)使用可以自动检查的结果作为奖励,例如数学最终答案、代码单元测试、逻辑约束和输出格式。DeepSeek-R1 等工作显示了数学和代码任务上的提升;OpenAI 也公开说明部分 reasoning 能力会随训练时 RL compute 和测试时 thinking compute 增长。
RLVR 的直接训练信号在哪些任务上最可靠,reasoning 的收益通常就在哪些任务上最容易测量。数学题可以核对答案,代码可以运行测试,工具调用可以检查 schema 和环境状态;小说质量、语气、审美和开放式建议没有唯一正确答案,不能直接使用同一种 verifier。专门研究写作训练的 Writing-Zero正是因为普通 RLVR 与非可验证写作任务之间存在这一缺口,才另外设计 pairwise generative reward model 和训练方法。
因此不能从“模型是 reasoning model”直接推出“打开 reasoning 后小说一定写得更好”。规划长篇结构、检查人物关系或满足明确写作约束可能受益,但文风、创意和人物声音未必提高;更长的推理还可能增加重复、解释性文字、延迟和成本。模型厂商也可能混合使用 SFT、偏好训练、RLVR、模型评审和专门写作数据,所以不能只根据模型标签推断训练内容。
对于小说、翻译、总结、分类和普通聊天,应在同一模型上比较 non-thinking、低 reasoning effort 和高 reasoning effort。写作任务可以固定 50 个 prompt 和输出长度,由不知道配置的评审者做成对盲评;同时记录平均输出 Token、端到端延迟和每个被选中回答的成本。如果 reasoning 版本的胜率没有提高,就不应为额外 trajectory 付费或占用本地 GPU。
只比较每百万 Token 的单价会遗漏每个任务消耗的 Token 数:
一个输出价格 $1 / 1M token 的模型,不一定真的只有 $10 / 1M token 模型的十分之一成本。
原因是前者可能为了得到同样正确率,生成十几倍甚至几十倍的 reasoning trajectory。
真实成本大致应该按任务算:
任务成本 = 非缓存输入 Token × 输入价
         + 缓存输入 Token × 缓存价
         +(reasoning Token + 可见答案 Token)× 输出价
自部署不产生按 Token 计费的 API 账单,但 reasoning 仍消耗计算资源:更长的 trajectory 会增加端到端延迟、GPU 时间和电力,并在固定硬件上降低可服务的并发数。
因此比较 reasoning 模型时至少记录任务成功率、平均 reasoning + answer tokens、end-to-end latency、每个成功任务的成本,以及不同 reasoning effort 下的能力曲线。
提高 reasoning effort 通常会增加测试时计算量,并可能提高复杂数学、代码和规划任务的成功率,但收益不会随 Token 数线性增长。模型也可能产生重复或无效推理。抽取、翻译和分类任务应分别测试低 reasoning effort 或 non-thinking 模式,因为这些任务的额外推理可能只增加延迟和成本。
“权重可以下载”不等于符合 OSI 开源定义,也不等于许可证允许不受限制的商业使用。
检查商业用途、用户规模限制、attribution、蒸馏/再分发、地区与用途限制,以及训练数据、代码和权重是否使用不同许可证。
Apache-2.0、MIT 和各类自定义 community license 的义务不同,应阅读权重仓库中对应版本的许可证原文。正式商业部署还应由法律人员核对商用、再分发、attribution、使用范围和衍生模型条款。
LM Studio 提供模型搜索、GGUF 下载、上下文配置、聊天界面和本地 OpenAI-compatible API,使用时不需要命令行。
基本流程:安装后在 Discover 搜索模型,先选 Q4_K_M 或 Q5_K_M;context 先设 4K/8K;确认 GPU offload;运行正常后再逐渐增加 context。
LM Studio 适合图形界面的单机测试和本地 API。自动选择的 context、GPU offload 和量化未必具有最高吞吐;需要 continuous batching、分布式并行或数十个并发请求时,应同时测试 vLLM/SGLang。
Ollama 通过模型 manifest 管理下载、运行参数和本地 API。
ollama run qwen3:8b
ollama list
它默认提供本地 HTTP API,可连接 Open WebUI、编辑器插件和其他程序。
Ollama 支持 macOS、Windows 和 Linux,并提供统一的模型管理与 API。部分底层参数和新模型特性可能晚于 llama.cpp/vLLM 暴露;下载前应在模型 manifest 中核对具体量化、context 和模板,而不是只看模型标签。
llama.cpp 支持 CPU、CUDA、Metal、Vulkan、HIP 等后端,并定义和使用 GGUF 模型格式。
llama-server -hf Qwen/Qwen3-8B-GGUF:Q4_K_M \
  -ngl 99 \
  -c 8192 \
  --port 8080
Windows 下可执行文件可能叫 llama-server.exe。
-ngl 99:尽量把所有层 offload 到 GPU;-c 8192:最大 context 先设 8K;--port 8080:启动本地服务。如果出现 out-of-memory,先减小 context 或 GPU layers。若速度明显低于同类硬件公开结果,检查启动日志确认 CUDA、Metal 或 Vulkan 后端已经加载,并核对实际 offload 的层数。
llama.cpp 可用于单用户、边缘设备、Apple Silicon、AMD APU 和没有 CUDA 的系统,也可以启动 HTTP 服务。几十到几百个并发用户的部署还应测试 vLLM/SGLang,因为它们提供 continuous batching、分布式并行和面向服务的 KV cache 调度。
vLLM 是面向批量和并发请求的 LLM serving engine。它提供 continuous batching、PagedAttention、prefix caching、tensor/pipeline/expert parallel、量化和 OpenAI-compatible API。
vLLM 的原生部署环境是 Linux。Windows 可以通过 WSL2 使用,但需要分别检查 GPU passthrough、网络端口映射和 Windows/WSL 文件路径。
python -m venv .venv
source .venv/bin/activate
pip install vllm

vllm serve Qwen/Qwen3-8B \
  --dtype auto \
  --max-model-len 8192 \
  --enable-prefix-caching \
  --port 8000
调用 OpenAI-compatible API:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-8B",
    "messages": [{"role": "user", "content": "你好!请介绍一下你自己。"}]
  }'
两张 GPU 的 tensor parallel 可使用 --tensor-parallel-size 2。测试时先固定短 context 和单 GPU 基线,再分别启用量化、TP、speculative decoding、长 context 和高并发;每次只改变一个变量并记录 TTFT、ITL、吞吐和显存占用。
SGLang 是另一个 serving framework,提供 structured generation、radix cache、MoE、speculative decoding 和分布式部署。vLLM 与 SGLang 的模型和硬件支持范围随版本变化。
团队部署应在相同模型、量化、prompt length、output length、并发和延迟限制下测试两者。不同测试若没有固定这些变量,throughput 数字不能直接比较。
TensorRT-LLM 是 NVIDIA GPU 专用的 LLM 推理工具包,支持 in-flight batching、paged KV cache、量化、speculative decoding 和多 GPU/多节点部署。
TensorRT-LLM 仅面向 NVIDIA GPU,适用于模型和硬件固定、可以投入 engine build 与版本匹配工作的部署。vLLM 直接加载 Hugging Face 模型的路径通常更短;TensorRT-LLM 可针对固定配置生成和选择更专门的 kernel。最终性能需要在同一负载下测试。
NIM 没有过时。2026 年的 NIM LLM 提供经过验证的容器、模型 profile、健康检查、监控、安全更新和企业支持。当前 NIM LLM 2.x 使用直接对齐上游版本的 vLLM 作为核心 inference backend;NIM 的主要功能是打包、配置验证和运维支持,而不是定义新的 Transformer 推理算法。
个人或研究环境可以直接使用 vLLM。需要 CVE 修复、兼容性验证、稳定更新周期和厂商支持的企业环境可以评估 NIM。
OpenVINO GenAI 当前仍在维护,并支持 continuous batching、prefix caching、speculative decoding、paged attention 和 Intel CPU/GPU/NPU。
Intel 硬件应测试 OpenVINO 的官方执行路径。ONNX Runtime 仍是通用推理运行时,但新 LLM 架构的模型转换、量化和生成式服务功能需要逐项验证,不应仅根据 ONNX 模型能加载就推断其吞吐。
IPEX-LLM:项目已经在 2026-01-28 被 Intel 官方归档。仓库明确写明不再维护、不再修复,并提示存在已知安全问题。新部署不要继续选择它;Intel 路线优先看 OpenVINO GenAI、llama.cpp 的 Intel 后端或当前 Intel 官方推荐栈。
旧的 NIM 1.x 多 backend 说明:很多旧文章会说 NIM 自动在 TensorRT-LLM、vLLM 等 backend 间选择。NIM 2.x 已改成 one-container/one-backend,当前文档要以对应版本为准。
把 Hugging Face Transformers 直接当生产服务器:Transformers 可作为开发和研究基线,但单独调用 model.generate() 不提供生产服务所需的请求调度、continuous batching、跨请求 KV 管理、监控和限流。
传统做法常为每个请求预留一块连续的最大 KV cache。
请求的输入与输出长度不固定。如果按照最大长度为每个请求预留连续 KV cache,短请求会留下大量未使用空间;如果运行中不断申请不同大小的连续空间,则会产生内存碎片。两种情况都会减少同一时刻可以保留的序列数量。
PagedAttention 使用与操作系统虚拟内存相似的 block 映射:
请求 A 的逻辑 KV: [0] [1] [2] [3]
                       │   │   │   │
物理显存 block:     [17] [04] [91] [22]

请求 B 的相同前缀: [0] [1] [2] [8]
                       │   │   │   │
                      [17] [04] [91] [36]
PagedAttention 不改变模型的 attention 定义。它改变 KV cache 的物理存储和地址映射,使内存按 block 分配,并把浪费主要限制在每个序列最后一个未填满的 block。可用显存因此可以容纳更多活跃序列,提高 continuous batch 的大小和总 throughput。
下面这张 vLLM 官方图把请求调度和 KV block 放在了一起:三个不同长度的请求被压成一次没有右侧 padding 的 token sequence;CPU 端的 block table 决定每个逻辑 block 对应 GPU 上的哪个物理 KV block;后续 Decode 只追加新 Token,并通过 slot_mapping 写入对应位置。图中每个 sequence 的历史 KV 不需要在显存中连续。图来自 vLLM《Anatomy of vLLM》。
静态 batching 会先固定一组请求,再运行到整组完成。假设四个请求分别输出 32、128、512 和 1,024 Token:第一个请求完成后,它原来的位置不能立刻交给新请求,整组通常仍要等 1,024 Token 的请求结束。输出长度差异越大,空闲位置越多。
Continuous batching 不把“一个 batch”视为从开始到结束不变的请求集合。vLLM 的调度器会在每一次模型迭代前重新决定本轮处理哪些 Token。当前调度受三个不同上限约束:
max_num_batched_tokens:一次迭代最多处理多少 Token;max_num_seqs:一次迭代最多包含多少条 sequence;以普通自回归 Decode 为例,一条正在运行的 sequence 在一次迭代中通常只请求计算一个新 Token;Prefill 则可能一次提交数百或数千个输入 Token。一次典型调度过程如下:
max_num_seqs、Token budget 和剩余 KV cache 允许的范围内选择本轮 sequence;vLLM 默认调度策略是 FCFS,也可以使用 priority。当前 vLLM V1 在可以启用 chunked prefill 时,会先调度等待中的 Decode,再用 max_num_batched_tokens 的剩余预算处理 Prefill;一个长 prompt 如果放不下,会拆成多个 chunk。这样做可以避免一条 100,000 Token 的 Prefill 独占整次迭代,也可以在同一个 batch 中混合 compute-bound 的 Prefill 和 memory-bound 的 Decode。
假设设置为:
max_num_seqs = 256
max_num_batched_tokens = 8,192
某轮已经有 200 条 Decode sequence,每条需要下一个 Token,那么它们先使用约 200 个 Token budget;剩余约 7,992 个可以用于新请求的 Prefill chunk。这里的 256 是单次迭代的 sequence 上限,不表示服务器最多只能接收 256 个 HTTP 请求。其余请求可以继续排队;能否同时保留 256 条活跃 sequence,还要看它们的上下文占用是否超过 KV cache。
调度器能够直接填满的是 Token budget 和 sequence slots,不是一个精确的 FLOP budget。一个带有很长 KV context 的 Decode Token、一个短上下文 Decode Token 和一个 Prefill Token 的实际计算量、内存访问量并不相同。因此 max_num_batched_tokens=8,192 不能直接换算成固定 GPU 利用率,仍需用真实长度分布测量。
如果 KV cache 不足,调度器不能只靠增加 max_num_seqs 解决。vLLM 可能需要 preempt 一些 sequence,并在之后重新计算被释放的 KV;频繁 preemption 会浪费计算。启动日志中的 GPU KV cache size 和 Maximum concurrency 是容量估算,实际并发仍会随每条请求的真实上下文长度变化。
需要把四个数字分开:到达并发、活跃 sequence 数、总 output tokens/s、每条请求的 token/s。它们不是同一个指标。
| 请求负载 | GPU 与活跃 batch | 总吞吐 | 单条活跃请求速度 | 排队与 TTFT |
|---|---|---|---|---|
| 很低 | GPU 经常没有足够 Token 可算 | 增加请求通常会明显提高总 tokens/s | 通常最高或接近最高 | 很低 |
| 接近饱和 | 权重读取和矩阵计算被更多 Token 复用,活跃 batch 增大 | 继续上升,但增幅逐渐变小 | 可能开始下降 | P95/P99 TTFT 开始上升 |
| 已饱和 | GPU、KV cache 或调度上限已满 | 接近平台上限,不再随请求数线性增加 | 大致受“总吞吐 ÷ 活跃 Decode 数”限制 | 新请求主要进入 waiting queue |
| 长期超载 | 请求进入速度高于完成速度 | 仍停在平台上限 | 不会因队列更长而提高 | 队列持续增长,超时和取消增加 |
举一个只说明数量关系的例子。假设某个模型在目标输出长度下实测为 8,000 output token/s,最多保持约 256 条活跃请求,现在同时到达 10,000 条请求,并且每条都要输出 512 Token。如果 256 条活跃请求都处于 Decode,并近似公平地分享调度时间:
活跃请求平均可分到的速度 ≈ 8,000 ÷ 256 = 31.25 token/s
总输出量 = 10,000 × 512 = 5,120,000 Token
忽略 Prefill 的理想最短清空时间 = 5,120,000 ÷ 8,000 = 640 秒
Continuous batching 会让先完成的请求立即被 waiting queue 中的新请求替换,但它不能把 8,000 token/s 变成无限吞吐。后面的请求可能等待数分钟才开始 Prefill。实际时间还要加入输入 Prefill、长度差异、采样、网络和调度开销,因此会超过 640 秒。
同样可以用到达率判断服务是否会持续积压。如果平均每个请求输出 512 Token,8,000 output token/s 对应的 Decode 完成率上限约为 8,000 ÷ 512 = 15.6 requests/s,而请求长期以 20 requests/s 到达,那么只考虑输出也会每秒积压约 4.4 个请求。增加 queue 长度只能减少立即拒绝,不能消除这个容量缺口。
总吞吐达到平台后,继续提高并发通常会降低每个用户看到的 token/s,并提高 TTFT 和 end-to-end latency。反过来,把并发限制得过低又可能使 GPU 的矩阵单元和内存带宽没有被充分利用。因此正确目标不是“batch 越大越好”,而是在 P95/P99 TTFT、ITL 和错误率约束下找到最高总吞吐。
调 max_num_batched_tokens 时也存在具体取舍。较小的值限制每轮插入的 Prefill 工作量,通常有利于 Decode ITL;较大的值能一次处理更多 Prefill Token,可能缩短长 prompt 的 TTFT 并提高总吞吐,但也会让混合 batch 中的 Decode 等待更久。vLLM 当前文档对小模型和大 GPU 给出过大于 8,192 的吞吐建议,这不是所有模型的固定最优值。需要按真实 prompt/output 长度、请求到达率和 GPU 重新 sweep。
vLLM 原始 PagedAttention 论文在论文所用模型、硬件和基线下报告了同等延迟时 2~4 倍的 serving throughput 提升;早期博客在其他旧基线下报告过更大的倍数。这些数字不能直接外推到不同模型、运行时版本和 GPU,当前部署需要使用相同负载重新测试。
部署时常见的优化顺序:
max-model-len,不要直接使用模型声明的最大值,因为 KV cache 预留和可支持并发会受其影响;优化 throughput 时应同时记录 TTFT、ITL、P50/P95/P99、GPU memory、cache hit rate 和错误率。单独一个 tokens/s 数字不能说明是单请求生成速度、所有请求的总速度,还是以更高延迟换取的吞吐。
Prefix cache 的命中条件是完全一致的 Token 前缀。可以采用以下配置提高命中率:
提高共享前缀长度的布局:
[固定 system prompt]
[固定工具定义]
[固定公司知识/文档]
[稳定的历史对话]
[本轮用户问题]
动态字段截断共享前缀的布局:
[当前时间 + 随机 request id]
[本轮问题]
[固定 system prompt]
[固定公司文档]
共享 KV cache 可能产生跨租户侧信道和数据隔离问题。多租户服务应使用 cache salt/namespace、租户隔离和访问控制;不同客户的敏感前缀不应进入同一缓存命名空间。vLLM 提供 cache_salt 等机制,具体行为应以部署版本的文档和安全测试为准。
本地推理是否省钱,不能只比较显卡价格和 API 的每百万 Token 单价。至少要同时计算硬件折旧、电力、实际产出的 Token,以及这些 Token 如果改用 API 会产生多少费用。
先定义:
C_buy:整机购置价;C_resale:三年后的残值;P_idle:开机但没有生成 Token 时的整机墙上功耗;P_load:持续推理时的整机墙上功耗;u:三年中真正以实测速度生产 Token 的时间比例;R_C:有 C 个活跃请求时的聚合 output token/s;这里的 C=1、C=4、C=8 分别使用后面的公开实测值;p_e:电价,单位为美元/kWh;H = 3 × 365 × 24 = 26,280 小时(按每年 365 天;如果实际三年周期包含闰日,再加 24 小时)。这里的 u 不是 nvidia-smi 显示的瞬时 GPU utilization。u=20% 表示在三年总时间中,有 20% 的时间能持续达到对应并发下的 R_C;排队为空、模型加载、故障和维护时间都不能算入这 20%。
三年折旧 = C_buy - C_resale

平均墙上功耗 = P_idle + u × (P_load - P_idle)
三年用电量 = 平均墙上功耗(kW) × 26,280h
三年电费 = 三年用电量 × p_e

三年 output Token = R_C × 26,280 × 3,600 × u
本地总成本 = 三年折旧 + 三年电费
本地每百万 output Token 成本 = 本地总成本 ÷ (三年 output Token / 1,000,000)
这组公式假设机器三年始终开机;机器没有请求时按 P_idle 计电,真正有 C 个活跃请求并达到实测速度时按 P_load 计电。如果空闲时会关机,应把关机时间和功耗单独列出。机房还需要用 PUE 修正制冷和配电:设施总用电 = IT 用电 × PUE。下面的桌面工作站例子取 PUE=1,不计额外空调。
截至 2026 年 8 月,公开且带有完整测量说明的一组数据来自 NInfer 的 Qwen3.8-27B NVFP4 model card。NInfer 不是 vLLM;这组数据用于说明单卡的实际量级,不能当作 vLLM 的 benchmark。测试使用一张 RTX 5090、CUDA 13.1、NVFP4 权重、INT8 group-64 KV cache、CUDA Graphs、MTP=3、1,024-token prefill chunk,并关闭 prefix reuse。它测的是 75 个固定请求组成的完整 corpus;C 是同时保持活跃的请求数,不是把一条请求复制成静态 batch。原始结果如下:
活跃请求数 C | 平均 batch | 聚合 Decode throughput | 约合每请求速度 |
|---|---|---|---|
| 1 | 1.00 | 161.1 token/s | 161.1 token/s |
| 4 | 3.29 | 432.9 token/s | 108.2 token/s |
| 8 | 2.36 | 334.2 token/s | 41.8 token/s |
这个结果说明三件事:第一,多个请求可以让 GPU 同时服务更多 Token,C=4 的总 throughput 约为 C=1 的 2.69 倍;第二,单请求速度会从 161.1 降到约 108.2 token/s;第三,C=8 并没有比 C=4 更快,因为显存压力使平均 batch 降到 2.36,完整 corpus 的聚合速度反而降到 334.2 token/s。不能把“同时八个请求”自动等同于“吞吐八倍”。
这是一个特定量化、特定引擎和特定请求集合的公开实测,不是 RTX 5090 的硬件上限。另一份使用 SGLang、NVFP4 和 DFlash2 的独立报告给出单请求 prose/code 约 144/256 token/s、两路并发聚合约 261/451 token/s,也说明量化格式、推测解码、上下文长度和模型服务程序会改变数字;参见 该报告。下面的成本表只使用第一组可复现表格中的 C=1、C=4、C=8 数字。
下面把上面的公开实测接到你给定的硬件和折旧条件上:
| 输入 | 假设值 |
|---|---|
| 整机购置价 | $4,000 |
| 三年后残值 | $2,000,即购置价的 50% |
| 三年折旧 | $2,000 |
| 空闲整机墙上功耗 | 40W |
| 推理整机墙上功耗 | 700W |
| 忙碌时速度 | C=1、C=4、C=8 分别为 161.1、432.9、334.2 output token/s |
| 电价 | $0.18/kWh |
| PUE | 1.0 |
电价使用美国能源信息署(EIA)截至 2026 年 6 月的全美居民用电年内平均值 18.16 美分/kWh,并四舍五入为 18 美分。美国不同州、商业用电和分时电价可能相差很大,实际计算应替换为电费账单中的边际电价。来源:EIA Electric Power Monthly, Table 5.6.B。
按 P_idle=40W、P_load=700W,平均墙上功耗和电费只由占用率决定:
持续占用率 u | 平均整机功耗 | 三年用电量 | 三年电费 | 折旧 + 电费 |
|---|---|---|---|---|
| 20% | 172W | 4,520kWh | $814 | $2,814 |
| 50% | 370W | 9,724kWh | $1,750 | $3,750 |
| 80% | 568W | 14,927kWh | $2,687 | $4,687 |
计算式以 20% 为例:
平均功耗 = 40W + 20% × (700W - 40W) = 172W
电费 = 0.172kW × 26,280h × $0.18/kWh = $813.63
本地成本 = $2,000 折旧 + $813.63 电费 = $2,813.63
把三种并发情况和三档占用率合在一起,得到下面的三年 output Token 产量与 API 等价价值。API 价值使用 Alibaba Cloud Model Studio 为 qwen3.8-27b 列出的中国(北京)原价:输入 $0.424/M、输出 $1.696/M;本表只计算 output Token,因此没有虚构一个与模型无关的 API 价格。官方页面最后更新于 2026 年 8 月 28 日,原价不含临时促销,来源是 官方模型页面。
活跃请求 C | 占用率 u | 三年 output Token | 本地成本 | 本地成本/M output Token | 按 $1.696/M 的 API 等价价值 | 相对本地节省 |
|---|---|---|---|---|---|---|
| 1 | 20% | 30.48 亿 | $2,814 | $0.92 | $5,170 | $2,356 |
| 1 | 50% | 76.21 亿 | $3,750 | $0.49 | $12,925 | $9,174 |
| 1 | 80% | 121.93 亿 | $4,687 | $0.38 | $20,679 | $15,993 |
| 4 | 20% | 81.91 亿 | $2,814 | $0.34 | $13,892 | $11,079 |
| 4 | 50% | 204.78 亿 | $3,750 | $0.18 | $34,731 | $30,980 |
| 4 | 80% | 327.65 亿 | $4,687 | $0.14 | $55,569 | $50,882 |
| 8 | 20% | 63.24 亿 | $2,814 | $0.45 | $10,725 | $7,911 |
| 8 | 50% | 158.09 亿 | $3,750 | $0.24 | $26,812 | $23,062 |
| 8 | 80% | 252.94 亿 | $4,687 | $0.19 | $42,899 | $38,212 |
例如 C=4、占用率 50% 的一行:
Token = 432.9 token/s × 26,280h × 3,600s/h × 50%
      = 20,477.9 百万 output Token
API 等价价值 = 20,477.9 × $1.696 = $34,730.52
节省额 = $34,730.52 - $3,750.25 = $30,980.27
C=8 的结果低于 C=4,不是计算错误,而是直接沿用实测的 C=8 聚合速度 334.2 token/s;该测试报告 C=8 受到显存压力,平均 batch 只有 2.36。增加并发只有在聚合吞吐继续上升时才会增加 Token 产量。
如果使用 Alibaba Cloud 的新加坡国际端点,官方输出价格是 $3/M,输入价格是 $0.5/M。上表 API 等价价值和节省额可以按 3 ÷ 1.696 ≈ 1.769 乘算;这仍然是同一个 Qwen3.8-27B API 的公开价格,不是任意假设。
实际决策时至少替换以下数据:
P_idle 和目标并发下的 P_load,不要只使用显卡 TDP;u,并把模型切换、重启、故障和没有请求的时间排除;真实 API 账单通常还要区分输入、缓存输入和输出:
API 等价成本 = 非缓存输入 Token / 1M × 输入价格
             + 缓存输入 Token / 1M × 缓存输入价格
             + 输出 Token / 1M × 输出价格
上表故意只计算 output Token,所以它更接近“持续生成服务”的简化比较。长文档 Prefill 很多、缓存命中率很高或 reasoning 输出很长时,应分别带入三类 Token。隐私、离线可用性和数据驻留也可能是本地部署的独立价值,但不要把这些价值伪装成已经节省的现金。
如果 workload 里有大量共享长文档,prefix cache 会非常重要;如果回答特别长,speculative decoding、低 bit 权重和 Decode 带宽更重要;如果输入特别长,prefill 算力和 chunked prefill 更重要。
不一定。24GB 还需要容纳 KV cache、activation、workspace 和 runtime;前文示例中的单个 32K BF16 KV cache 已约为 4GiB。
不一定。4-bit 权重的原始容量约为 FP16 的 1/4,但还包括 scale;W4A16 在矩阵乘法前需要反量化,且实际吞吐受内存带宽、kernel 和 GPU 指令支持限制。
不是。Hopper 原生支持 FP8 Tensor Core;原生 FP4 Tensor Core 从 Blackwell 开始提供。
不是。内存仍要容纳全部专家和共享层;激活参数主要影响每 Token 的计算量和理想权重读取量。
容量可以通过模型切分利用,但 TP、PP 和 EP 会引入不同的同步与通信开销,吞吐不会按卡数自动线性增长。
不应默认这样设置。context 上限会影响 KV cache 预算和可支持并发;长输入也会增加 prefill 时间。应根据实际输入长度分布设置,并用目标任务测试长上下文 recall。
不一定。reasoning 长度、tokenizer、缓存率、重试次数和任务成功率都会改变每个成功任务的成本。
不会。Prefix caching 只跳过命中前缀的 prefill;新输出的 Decode 仍要逐 Token 计算。
不一定。最终选择需要使用目标数据、prompt、量化、运行时和硬件评测。
以下资料以论文、项目官方文档和芯片厂商文档为主:
部署前先确定模型、上下文长度、并发和延迟目标,再计算权重与 KV cache 容量,并使用真实任务测量准确率、TTFT、ITL、throughput 和功耗。
模型能够启动只说明当前配置满足最低运行条件。是否适合长期部署,还取决于输出质量、延迟、吞吐、稳定性和总成本。
如果这篇教程对你有帮助,欢迎支持后续更新:



