55+ ComfyUI自定义节点合集,涵盖提示词生成/扩写、多平台翻译、AI视觉理解、图像处理、视频提示词生成等功能。界面支持中、英文语言。 55+ ComfyUI custom nodes featuring prompt generation/expansion, multi-platform translation, AI vision understanding, image processing, and video prompt tools. Interface supports Chinese and English languages.
JavaScript
180
343 commits
updated Oct 1, 2026
这是一个由 Binity 精心创建的 ComfyUI 自定义节点工具合集,旨在为用户提供一系列实用、高效的节点,以增强和扩展 ComfyUI 的功能。本节点集包含55+功能节点,涵盖文本处理、提示词优化、图像处理、翻译工具、音乐创作辅助、AI视觉理解、Latent处理等多个方面,为您的 AI 创作提供全方位支持。
如果这个项目对您有帮助,请给我们一个⭐Star!您的支持是我们持续改进的动力。
节点包自带中英双语词典,跟随 ComfyUI 的「语言 / Language」设置自动切换节点语言,无需安装任何第三方翻译插件。
🔄 多引擎翻译节点:集成百度、腾讯、有道、谷歌在线等5大翻平台,支持中英互译,可自动识别输入语言,自由切换翻译平台。
📝 全面文本处理:提供多行文本编辑、文本合并分离、内容提取修改、语言过滤等文本操作节点。
🎯 智能提示词系统:标签选择器、图像编辑预设、摄影提示词生成器、万相视频提示词生成器等专业的提示词生成工具。
🖼️ 实用图像工具:支持多算法图像缩放、智能切换、颜色移除等等。
🔥 以下是本节点集中重点推荐的特色节点:
| 节点名称 | 类别 | 核心功能 |
|---|---|---|
标签选择器TagSelector | 提示词处理 | 新一代智能标签管理系统,集成海量预设标签库、自定义标签管理、角色提取器和内置AI扩写功能。提供可视化标签选择界面,支持随机标签生成和多模式扩写。 |
摄影提示词生成器PhotographPromptGenerator | 提示词处理 | 专业摄影风格提示词生成器,涵盖人物、场景、镜头、光线、服装等16个维度。支持输出模式切换(标签组合/模板文本),集成AI扩写功能。配有用户自定义选项扩展和模板编辑助手界面。 |
LM工作室节点LMStudioNode | AI视觉理解 | 连接本地LM Studio服务器的视觉理解节点,支持图像分析和文本生成。通过LM Studio本地部署的大模型,实现无需云端API的私有化图像分析。支持多种预设模板、输出语言控制和多图像输入。 |
💡 使用建议:新用户建议从 标签选择器 或 摄影提示词生成器 开始体验,快速提升您的创作灵感和效率。
本节点集包含众多功能各异的节点,分为以下几个主要类别:
| 节点名称 | 功能描述 |
|---|---|
多行文本MultiLineTextNode | 提供一个支持多行输入的文本框,并带注释功能。

|
优先级文本切换PriorityTextSwitch | 优先级文本切换节点:当同时接入文本A和文本B端口时,优先输出B端口;如果B端口为空或未连接,则输出文本A端口;如果两个端口都为空,则返回空字符串。
特点:

|
提示词合并器(可注释)TextCombinerNode | 合并两个文本输入,并可通过独立的开关控制每个文本的输出,并带注释功能。可用于动态组合不同的提示词部分,灵活构建完整提示。

|
文本合并器TextMergerNode | 将多个文本输入合并为一个输出文本,支持灵活配置输入端口数量。user_text 输入框内容优先显示在最前面,后续通过 inputcount 滑块控制 text_2 到 text_N 端口数量。所有非空文本按顺序用分隔符连接,适用于批量合并多个提示词或文本片段。

|
文本修改器TextModifier | 根据指定的起始和结束标记提取文本内容,并自动去除多余的空白字符。适合从复杂文本中提取特定部分,或进行格式清理。

|
中英文本提取器TextExtractor | 从混合文本中提取纯中文或纯英文字符,支持标点和数字的提取,并自动清理格式。对于处理双语提示词或分离不同语言内容非常有用。
|
提示词删除PromptDelete | 提示词删除节点:支持动态数量的查找与删除操作,适合批量删除不需要的触发词、风格词或模型相关文本。并支持自动格式化功能,清理残留符号。

|
提示词替换PromptReplace | 提示词替换节点:支持动态数量的查找与替换操作,适合批量替换触发词、风格词或模型相关文本。

|
显示任何ShowAny | 用于在ComfyUI界面中显示任意类型内容的节点,支持多行文本展示,可实时显示上游节点传递的文本信息,便于调试和查看中间结果。支持标准模式和排错模式两种显示方式。 |
文本编辑器(继续运行)TextEditorWithContinue | 交互式文本编辑节点,暂停工作流执行并提供可编辑文本区域,用户可在运行时修改文本内容,点击继续按钮恢复工作流执行。
特点:
使用场景:

|
字体设计师TypeDesigner | 提供可视化界面,让用户浏览和选择各种字体艺术风格(如3D、霓虹、金属等),自动提供对应的预设提示词,方便进行艺术字创作。


|
| 节点名称 | 功能描述 |
|---|---|
图像编辑预设ImageEditingPresets | 提供专业的图像编辑预设库,包含多种专业预设,为图像生成提供风格化指导,帮助用户快速应用常见的艺术风格和效果。 |
摄影提示词生成器PhotographPromptGenerator |
根据预设的摄影要素(如相机、镜头、光照、场景等)组合生成专业的摄影风格提示词。 特点:


|
万相视频提示词生成器WanPromptGenerator |
基于万相2.2官方文档编写的全能型提示词生成器,支持自定义和预设两种组合方法,涵盖运镜、场景、光线、构图等16个维度的专业视频提示词生成。 特点:

|
提示词预设 - 单选PromptPresetOneChoice | 提供6个预设选项,用户可以方便地在不同预设之间切换。适合保存常用的提示词模板,快速应用到不同场景。

|
提示词预设 - 多选PromptPresetMultipleChoice | 支持同时选择多个预设,并将它们合并输出,每个预设都带有独立的开关和注释功能。适合构建复杂的组合提示词,灵活控制各部分的启用状态。

|
触发词合并器TriggerWordMerger | 将特定的触发词(Trigger Words)与主文本智能合并,并支持权重控制(例如 (word:1.5))。适用于添加模型特定的触发词或风格词,并精确控制其影响强度。

|
系统引导词加载器SystemPromptLoader | 从预设文件夹动态加载系统级引导词(System Prompt),并可选择性地与用户输入合并。适合管理和应用复杂的系统提示模板,提高生成结果的一致性和质量。
|
额外选项列表ExtraOptions | 一个通用的额外选项列表,类似于 JoyCaption 的设计,设有总开关和独立的引导词输入框。适合添加辅助提示或控制参数,增强工作流的灵活性。
|
提示词卡选择器PromptCardSelector | 支持随机/顺序抽取模式、单卡/多卡加载、多种分割方式及卡池洗牌策略,内置卡池管理器提供浏览/搜索/编辑功能,支持导入/导出卡文件,适用于提示词组合与批量管理。
特点:


|
提示词图库PromptGallery | 提示词图库节点:从指定目录加载包含缩略图和文本的图文库,从用户选择的图片输出与图片同名的 .txt 文件内容(提示词文本)。适用于将"图像-提示词"成对管理并在工作流中快速取用。

|
提示词扩写器PromptExpander | 使用AI大模型将简短的提示词扩展为详细、高质量的内容。
特点:

|
| 节点名称 | 功能描述 |
|---|---|
获取图像尺寸GetImageSizes | 提取输入图像的宽度和高度信息,并在节点上实时显示尺寸预览。支持多种图像格式输入,提供准确的像素尺寸信息。

|
图像宽高比设置ImageAspectRatio | 智能图像宽高比设置工具,支持多种预设模式和自定义尺寸配置。
特点:


|
图像缩放器ImageScaler | 提供多种插值算法对图像进行缩放,并可选择保持原始宽高比。支持高质量的图像尺寸调整,适用于预处理或后处理阶段。

|
颜色移除ColorRemoval | 从图像中移除彩色,输出灰度图像。适用于创建黑白效果或作为特定图像处理流程的预处理步骤。 |
图像旋转工具ImageRotateTool |
专业的图像旋转和翻转工具,支持预设角度和自定义角度旋转。 特点:

|
图像预览/对比PreviewOrCompareImages | 多功能图像预览和对比节点,支持单张图像预览或两张图像的并排对比显示。image_1为必需输入,image_2为可选输入,当提供两张图像时自动启用对比模式。
特点:

|
图像格式转换器ImageFormatConverter |
专业的图像格式转换工具,支持批量转换多种图像格式,具备智能格式检测和高级压缩选项。 支持格式:
特点:

|
批量图像加载器BatchLoadingOfImages |
从指定目录批量加载图像文件,支持多种排序方式和加载控制。 特点:

|
| 节点名称 | 功能描述 |
|---|---|
胶片颗粒效果FilmGrain |
为图像添加逼真的胶片颗粒效果,营造经典胶片质感。

|
拉普拉斯锐化LaplacianSharpen |
基于拉普拉斯算子的边缘锐化工具,通过二阶微分检测图像边缘并增强细节,适合风景和人像的细节增强。

|
索贝尔锐化SobelSharpen |
采用索贝尔算子的方向性锐化工具,通过梯度计算同时增强水平和垂直边缘,适合需要强调纹理的场景。

|
USM锐化USMSharpen |
使用经典USM锐化技术来增强细节,对目标图像进行自然的锐化处理。

|
色彩匹配ColorMatchToReference |
智能色彩匹配工具,可将参考图像的色调风格应用到目标图像,实现专业级色彩统一。

|
| 节点名称 | 功能描述 |
|---|---|
视频帧提取器VideoFrameExtractor |
专业的视频帧提取工具,支持从视频文件中提取指定数量的帧或按间隔提取帧,适用于视频分析、预览和后续处理。
特点:

|
| 节点名称 | 功能描述 |
|---|---|
Suno歌词生成器SunoLyricsGenerator |
专业的AI歌词创作工具,基于在线LLM生成结构化的可演唱歌词,支持多种音乐风格和语言。

|
Suno歌曲风格提示词生成器SunoSongStylePromptGenerator |
专业的歌曲风格提示词生成工具,结合用户偏好和音乐元素,生成结构化的Suno风格提示词,用于快速构建风格一致的歌曲。

|
音频时长计算器AudioDuration |
计算音频文件的时长信息,输出秒数、格式化时间和毫秒数三种格式。
特点:
|
| 节点名称 | 功能描述 |
|---|---|
Qwen3-VL基础版Qwen3VLBasic |
基于阿里巴巴Qwen3-VL模型的基础视觉理解节点,提供简洁高效的图像和视频分析功能,支持多种模型版本和量化选项,为Qwen3-VL高级版简化而来的版本。

|
Qwen3-VL高级版Qwen3VLAdvanced |
基于阿里巴巴Qwen3-VL模型的专业级视觉理解节点,集成众多预设提示词模板,支持智能批量处理、高级量化技术和思维链推理功能。提供从标签生成到创意分析的多种预设模式,具备解锁限制、多语言输出、批量处理等高级特性。
参数详解文档:Qwen3VL_Parameters_Guide.md 
|
Qwen3-VL在线版Qwen3VLAPI |
功能强大的云端视觉理解节点,支持多平台在线API调用和批量图像分析,提供丰富的模型选择和灵活的配置方式。
支持平台:
核心特点:


|
Qwen3-VL额外选项Qwen3VLExtraOptions |
为Qwen3-VL节点提供详细的输出控制选项,包括人物信息、光照分析、相机角度、水印检测等高级配置参数。

|
Qwen3-VL图像加载器ImageLoader |
专为Qwen3-VL优化的图像加载节点,支持多种图像格式和批量加载功能。

|
Qwen3-VL视频加载器VideoLoader |
专为Qwen3-VL优化的视频加载节点,支持多种视频格式和帧提取功能。

|
Qwen3-VL多路径输入MultiplePathsInput |
支持同时处理多个文件路径的输入节点,便于批量处理图像和视频文件。

|
Qwen3-VL路径切换器PathSwitch |
双通道路径切换器,支持手动和自动两种切换模式。可在2个来自MultiplePathsInput节点的路径输入之间智能切换,支持注释标签便于管理。手动模式下可指定选择通道,自动模式下智能选择第一个非空输入,适用于工作流中的条件分支和动态切换。输出可直接连接到Qwen3-VL高级版的source_path输入。

|
Florence2 PlusFlorence2Plus |
基于微软Florence-2视觉理解模型的专业图像分析节点,支持多种任务类型和批量处理功能。
核心特性:
使用建议:


|
Sa2VA高级版Sa2VAAdvanced |
基于字节跳动Sa2VA模型的专业级图像分割节点,提供精确的智能分割功能,支持多种模型版本和量化配置。通过自然语言提示词控制分割区域,实现对图像中特定对象的精准分割,输出高质量的遮罩数据。
核心功能:


|
Sa2VA分割预设Sa2VASegmentationPreset |
提供交互式分割预设选择的工具节点,可在界面中选择常见部位/对象并生成中文分割提示文本输出,用于驱动 Sa2VA 高级版的分割。将本节点的 segmentation_preset 输出连接到 Sa2VA 高级版的同名输入即可生效。若该输入为空,Sa2VA 高级版将改用字符串输入框中的 segmentation_prompt。

|
LM Studio节点LMStudioNode |
连接本地LM Studio服务器的视觉理解节点,支持图像分析和文本生成。通过LM Studio本地部署的大模型,实现无需云端API的私有化图像分析。
前置要求:
核心功能:
配套节点:

|
| 节点名称 | 功能描述 |
|---|---|
🏷️TAG标签选择器TagSelector |
新一代智能标签管理系统,集成海量预设标签库、自定义标签功能、角色提取器和内置AI扩写能力,提供前所未有的标签选择体验,快速构建复杂提示词,提升创作效率。 核心功能:
参数说明:


|
Latent切换器(双模式)LatentSwitchDualMode | 支持可变数量的潜变量输入的双模式切换器。通过滑块 inputcount 控制端口数量,并点击按钮 Update inputs 同步增删端口;手动模式下按索引选择输出(select_channel 选项随 inputcount 自动更新);自动模式仅在存在唯一非空输入时输出,检测到多个非空输入将提示错误。新增的潜变量输入端口均为非必连,适合在不同生成路径之间灵活切换与对比实验。

|
文本切换器(双模式)TextSwitchDualMode | 支持可变数量的文本输入的双模式切换器。通过滑块 inputcount 控制端口数量,并点击按钮 Update inputs 同步增删端口;手动模式下按索引选择输出(select_text 选项随 inputcount 自动更新);自动模式仅在存在唯一非空输入时输出,检测到多个非空输入将提示错误。新增的文本输入端口均为非必连,适合在不同版本提示词之间灵活切换与对比实验。

|
图像切换器(双模式)ImageSwitchDualMode | 支持可变数量的图像输入的双模式切换器。通过滑块 inputcount 控制端口数量,并点击按钮 Update inputs 同步增删端口;手动模式下按索引选择输出(select_image 选项随 inputcount 自动更新);自动模式仅在存在唯一非空输入时输出,检测到多个非空输入将提示错误。新增的图像输入端口均为非必连,便于在不同生成结果或不同处理路径之间进行灵活对比。

|
优先级图像切换PriorityImageSwitch | 智能优先级图像切换节点,当同时接入图像A和图像B端口时,优先输出B端口的内容;如果B端口无输入,则输出图像A端口的内容;如果两个端口都无输入,则弹出提示要求至少连接一个输入端口。
特点:

|
多平台翻译MultiPlatformTranslate |
多平台翻译节点,支持百度、阿里云、有道、智谱AI和免费翻译服务。用户可以通过配置管理界面设置各平台的API密钥,实现高质量的专业翻译服务。 特点:

|
资源清理器ResourceCleaner |
系统资源清理工具,提供独立的内存(RAM)、显存(VRAM)和缓存清理控制,可选择性释放系统资源。 特点:
|
工作流暂停器PauseWorkflow |
智能工作流控制节点,可在任意位置暂停工作流执行,等待用户交互后继续或取消执行。 特点:
|
预留显存设置器ReservedVRAMSetter |
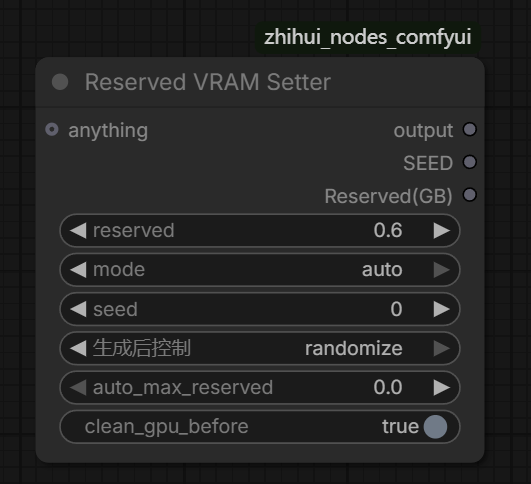
专业的GPU显存预留管理工具,用于控制ComfyUI的显存使用策略,有效防止显存溢出(OOM)错误,提升工作流稳定性。支持手动和自动两种模式,自动模式可根据当前GPU使用情况智能计算合适的预留显存量。 特点:
|
释放文本编码器(采样前)TextEncoderRelease |
文本编码器释放工具,在采样前把所连的 CLIP(文本编码器)从显存中卸载,提前腾出显存,适合文本编码器体积大、采样需要完整显存的工作流。 特点:
|
整数节点IntNode |
输出可配置整数值的工具节点,用于统一的参数控制。支持-2147483648到2147483647范围的整数输入,适用于需要精确数值控制的场景。 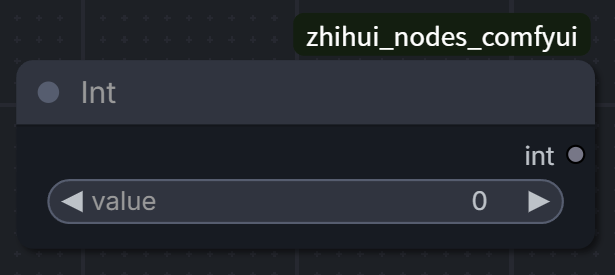
|
组开关管理器GroupSwitchManager |
可视化群组开关管理工具,自动检测工作流中的所有群组,提供一键启用/禁用功能,支持颜色过滤、标题匹配、拖拽排序和群组联动配置。 核心功能:


|
zhihui_nodes_comfyui 并点击 "Install" 按钮进入 ComfyUI 的 custom_nodes 目录,执行以下命令:
git clone https://github.com/ZhiHui6/zhihui_nodes_comfyui.git
重启 ComfyUI 即可使用。
zhihui_nodes_comfyui 文件夹复制到 ComfyUI 的 custom_nodes 目录下本节点集大部分功能无需额外依赖,开箱即用。部分在线功能(如翻译、提示词优化)需要网络连接。
如需手动安装依赖,可执行:
pip install -r requirements.txt
我们欢迎各种形式的贡献,包括但不限于:
如果您有任何想法或建议,请随时提出 Issue 或 Pull Request。
55+ ComfyUI自定义节点合集,涵盖提示词生成/扩写、多平台翻译、AI视觉理解、图像处理、视频提示词生成等功能。界面支持中、英文语言。 55+ ComfyUI custom nodes featuring prompt generation/expansion, multi-platform translation, AI vision understanding, image processing, and video prompt tools. Interface supports Chinese and English languages.
JavaScript
180
343 commits
updated Oct 1, 2026
这是一个由 Binity 精心创建的 ComfyUI 自定义节点工具合集,旨在为用户提供一系列实用、高效的节点,以增强和扩展 ComfyUI 的功能。本节点集包含55+功能节点,涵盖文本处理、提示词优化、图像处理、翻译工具、音乐创作辅助、AI视觉理解、Latent处理等多个方面,为您的 AI 创作提供全方位支持。
如果这个项目对您有帮助,请给我们一个⭐Star!您的支持是我们持续改进的动力。
节点包自带中英双语词典,跟随 ComfyUI 的「语言 / Language」设置自动切换节点语言,无需安装任何第三方翻译插件。
🔄 多引擎翻译节点:集成百度、腾讯、有道、谷歌在线等5大翻平台,支持中英互译,可自动识别输入语言,自由切换翻译平台。
📝 全面文本处理:提供多行文本编辑、文本合并分离、内容提取修改、语言过滤等文本操作节点。
🎯 智能提示词系统:标签选择器、图像编辑预设、摄影提示词生成器、万相视频提示词生成器等专业的提示词生成工具。
🖼️ 实用图像工具:支持多算法图像缩放、智能切换、颜色移除等等。
🔥 以下是本节点集中重点推荐的特色节点:
| 节点名称 | 类别 | 核心功能 |
|---|---|---|
标签选择器TagSelector | 提示词处理 | 新一代智能标签管理系统,集成海量预设标签库、自定义标签管理、角色提取器和内置AI扩写功能。提供可视化标签选择界面,支持随机标签生成和多模式扩写。 |
摄影提示词生成器PhotographPromptGenerator | 提示词处理 | 专业摄影风格提示词生成器,涵盖人物、场景、镜头、光线、服装等16个维度。支持输出模式切换(标签组合/模板文本),集成AI扩写功能。配有用户自定义选项扩展和模板编辑助手界面。 |
LM工作室节点LMStudioNode | AI视觉理解 | 连接本地LM Studio服务器的视觉理解节点,支持图像分析和文本生成。通过LM Studio本地部署的大模型,实现无需云端API的私有化图像分析。支持多种预设模板、输出语言控制和多图像输入。 |
💡 使用建议:新用户建议从 标签选择器 或 摄影提示词生成器 开始体验,快速提升您的创作灵感和效率。
本节点集包含众多功能各异的节点,分为以下几个主要类别:
| 节点名称 | 功能描述 |
|---|---|
多行文本MultiLineTextNode | 提供一个支持多行输入的文本框,并带注释功能。
|
优先级文本切换PriorityTextSwitch | 优先级文本切换节点:当同时接入文本A和文本B端口时,优先输出B端口;如果B端口为空或未连接,则输出文本A端口;如果两个端口都为空,则返回空字符串。
特点:
|
提示词合并器(可注释)TextCombinerNode | 合并两个文本输入,并可通过独立的开关控制每个文本的输出,并带注释功能。可用于动态组合不同的提示词部分,灵活构建完整提示。
|
文本合并器TextMergerNode | 将多个文本输入合并为一个输出文本,支持灵活配置输入端口数量。user_text 输入框内容优先显示在最前面,后续通过 inputcount 滑块控制 text_2 到 text_N 端口数量。所有非空文本按顺序用分隔符连接,适用于批量合并多个提示词或文本片段。
|
文本修改器TextModifier | 根据指定的起始和结束标记提取文本内容,并自动去除多余的空白字符。适合从复杂文本中提取特定部分,或进行格式清理。
|
中英文本提取器TextExtractor | 从混合文本中提取纯中文或纯英文字符,支持标点和数字的提取,并自动清理格式。对于处理双语提示词或分离不同语言内容非常有用。
|
提示词删除PromptDelete | 提示词删除节点:支持动态数量的查找与删除操作,适合批量删除不需要的触发词、风格词或模型相关文本。并支持自动格式化功能,清理残留符号。
|
提示词替换PromptReplace | 提示词替换节点:支持动态数量的查找与替换操作,适合批量替换触发词、风格词或模型相关文本。
|
显示任何ShowAny | 用于在ComfyUI界面中显示任意类型内容的节点,支持多行文本展示,可实时显示上游节点传递的文本信息,便于调试和查看中间结果。支持标准模式和排错模式两种显示方式。 |
文本编辑器(继续运行)TextEditorWithContinue | 交互式文本编辑节点,暂停工作流执行并提供可编辑文本区域,用户可在运行时修改文本内容,点击继续按钮恢复工作流执行。
特点:
使用场景:
|
字体设计师TypeDesigner | 提供可视化界面,让用户浏览和选择各种字体艺术风格(如3D、霓虹、金属等),自动提供对应的预设提示词,方便进行艺术字创作。
|
| 节点名称 | 功能描述 |
|---|---|
图像编辑预设ImageEditingPresets | 提供专业的图像编辑预设库,包含多种专业预设,为图像生成提供风格化指导,帮助用户快速应用常见的艺术风格和效果。 |
摄影提示词生成器PhotographPromptGenerator |
根据预设的摄影要素(如相机、镜头、光照、场景等)组合生成专业的摄影风格提示词。 特点:
|
万相视频提示词生成器WanPromptGenerator |
基于万相2.2官方文档编写的全能型提示词生成器,支持自定义和预设两种组合方法,涵盖运镜、场景、光线、构图等16个维度的专业视频提示词生成。 特点:
|
提示词预设 - 单选PromptPresetOneChoice | 提供6个预设选项,用户可以方便地在不同预设之间切换。适合保存常用的提示词模板,快速应用到不同场景。
|
提示词预设 - 多选PromptPresetMultipleChoice | 支持同时选择多个预设,并将它们合并输出,每个预设都带有独立的开关和注释功能。适合构建复杂的组合提示词,灵活控制各部分的启用状态。
|
触发词合并器TriggerWordMerger | 将特定的触发词(Trigger Words)与主文本智能合并,并支持权重控制(例如 (word:1.5))。适用于添加模型特定的触发词或风格词,并精确控制其影响强度。
|
系统引导词加载器SystemPromptLoader | 从预设文件夹动态加载系统级引导词(System Prompt),并可选择性地与用户输入合并。适合管理和应用复杂的系统提示模板,提高生成结果的一致性和质量。
|
额外选项列表ExtraOptions | 一个通用的额外选项列表,类似于 JoyCaption 的设计,设有总开关和独立的引导词输入框。适合添加辅助提示或控制参数,增强工作流的灵活性。
|
提示词卡选择器PromptCardSelector | 支持随机/顺序抽取模式、单卡/多卡加载、多种分割方式及卡池洗牌策略,内置卡池管理器提供浏览/搜索/编辑功能,支持导入/导出卡文件,适用于提示词组合与批量管理。
特点:
|
提示词图库PromptGallery | 提示词图库节点:从指定目录加载包含缩略图和文本的图文库,从用户选择的图片输出与图片同名的 .txt 文件内容(提示词文本)。适用于将"图像-提示词"成对管理并在工作流中快速取用。
|
提示词扩写器PromptExpander | 使用AI大模型将简短的提示词扩展为详细、高质量的内容。
特点:
|
| 节点名称 | 功能描述 |
|---|---|
获取图像尺寸GetImageSizes | 提取输入图像的宽度和高度信息,并在节点上实时显示尺寸预览。支持多种图像格式输入,提供准确的像素尺寸信息。
|
图像宽高比设置ImageAspectRatio | 智能图像宽高比设置工具,支持多种预设模式和自定义尺寸配置。
特点:
|
图像缩放器ImageScaler | 提供多种插值算法对图像进行缩放,并可选择保持原始宽高比。支持高质量的图像尺寸调整,适用于预处理或后处理阶段。
|
颜色移除ColorRemoval | 从图像中移除彩色,输出灰度图像。适用于创建黑白效果或作为特定图像处理流程的预处理步骤。 |
图像旋转工具ImageRotateTool |
专业的图像旋转和翻转工具,支持预设角度和自定义角度旋转。 特点:
|
图像预览/对比PreviewOrCompareImages | 多功能图像预览和对比节点,支持单张图像预览或两张图像的并排对比显示。image_1为必需输入,image_2为可选输入,当提供两张图像时自动启用对比模式。
特点:
|
图像格式转换器ImageFormatConverter |
专业的图像格式转换工具,支持批量转换多种图像格式,具备智能格式检测和高级压缩选项。 支持格式:
特点:
|
批量图像加载器BatchLoadingOfImages |
从指定目录批量加载图像文件,支持多种排序方式和加载控制。 特点:
|
| 节点名称 | 功能描述 |
|---|---|
胶片颗粒效果FilmGrain |
为图像添加逼真的胶片颗粒效果,营造经典胶片质感。
|
拉普拉斯锐化LaplacianSharpen |
基于拉普拉斯算子的边缘锐化工具,通过二阶微分检测图像边缘并增强细节,适合风景和人像的细节增强。
|
索贝尔锐化SobelSharpen |
采用索贝尔算子的方向性锐化工具,通过梯度计算同时增强水平和垂直边缘,适合需要强调纹理的场景。
|
USM锐化USMSharpen |
使用经典USM锐化技术来增强细节,对目标图像进行自然的锐化处理。
|
色彩匹配ColorMatchToReference |
智能色彩匹配工具,可将参考图像的色调风格应用到目标图像,实现专业级色彩统一。
|
| 节点名称 | 功能描述 |
|---|---|
视频帧提取器VideoFrameExtractor |
专业的视频帧提取工具,支持从视频文件中提取指定数量的帧或按间隔提取帧,适用于视频分析、预览和后续处理。
特点:
|
| 节点名称 | 功能描述 |
|---|---|
Suno歌词生成器SunoLyricsGenerator |
专业的AI歌词创作工具,基于在线LLM生成结构化的可演唱歌词,支持多种音乐风格和语言。
|
Suno歌曲风格提示词生成器SunoSongStylePromptGenerator |
专业的歌曲风格提示词生成工具,结合用户偏好和音乐元素,生成结构化的Suno风格提示词,用于快速构建风格一致的歌曲。
|
音频时长计算器AudioDuration |
计算音频文件的时长信息,输出秒数、格式化时间和毫秒数三种格式。
特点:
|
| 节点名称 | 功能描述 |
|---|---|
Qwen3-VL基础版Qwen3VLBasic |
基于阿里巴巴Qwen3-VL模型的基础视觉理解节点,提供简洁高效的图像和视频分析功能,支持多种模型版本和量化选项,为Qwen3-VL高级版简化而来的版本。
|
Qwen3-VL高级版Qwen3VLAdvanced |
基于阿里巴巴Qwen3-VL模型的专业级视觉理解节点,集成众多预设提示词模板,支持智能批量处理、高级量化技术和思维链推理功能。提供从标签生成到创意分析的多种预设模式,具备解锁限制、多语言输出、批量处理等高级特性。
参数详解文档:Qwen3VL_Parameters_Guide.md
|
Qwen3-VL在线版Qwen3VLAPI |
功能强大的云端视觉理解节点,支持多平台在线API调用和批量图像分析,提供丰富的模型选择和灵活的配置方式。
支持平台:
核心特点:
|
Qwen3-VL额外选项Qwen3VLExtraOptions |
为Qwen3-VL节点提供详细的输出控制选项,包括人物信息、光照分析、相机角度、水印检测等高级配置参数。
|
Qwen3-VL图像加载器ImageLoader |
专为Qwen3-VL优化的图像加载节点,支持多种图像格式和批量加载功能。
|
Qwen3-VL视频加载器VideoLoader |
专为Qwen3-VL优化的视频加载节点,支持多种视频格式和帧提取功能。
|
Qwen3-VL多路径输入MultiplePathsInput |
支持同时处理多个文件路径的输入节点,便于批量处理图像和视频文件。
|
Qwen3-VL路径切换器PathSwitch |
双通道路径切换器,支持手动和自动两种切换模式。可在2个来自MultiplePathsInput节点的路径输入之间智能切换,支持注释标签便于管理。手动模式下可指定选择通道,自动模式下智能选择第一个非空输入,适用于工作流中的条件分支和动态切换。输出可直接连接到Qwen3-VL高级版的source_path输入。
|
Florence2 PlusFlorence2Plus |
基于微软Florence-2视觉理解模型的专业图像分析节点,支持多种任务类型和批量处理功能。
核心特性:
使用建议:
|
Sa2VA高级版Sa2VAAdvanced |
基于字节跳动Sa2VA模型的专业级图像分割节点,提供精确的智能分割功能,支持多种模型版本和量化配置。通过自然语言提示词控制分割区域,实现对图像中特定对象的精准分割,输出高质量的遮罩数据。
核心功能:
|
Sa2VA分割预设Sa2VASegmentationPreset |
提供交互式分割预设选择的工具节点,可在界面中选择常见部位/对象并生成中文分割提示文本输出,用于驱动 Sa2VA 高级版的分割。将本节点的 segmentation_preset 输出连接到 Sa2VA 高级版的同名输入即可生效。若该输入为空,Sa2VA 高级版将改用字符串输入框中的 segmentation_prompt。
|
LM Studio节点LMStudioNode |
连接本地LM Studio服务器的视觉理解节点,支持图像分析和文本生成。通过LM Studio本地部署的大模型,实现无需云端API的私有化图像分析。
前置要求:
核心功能:
配套节点:
|
| 节点名称 | 功能描述 |
|---|---|
🏷️TAG标签选择器TagSelector |
新一代智能标签管理系统,集成海量预设标签库、自定义标签功能、角色提取器和内置AI扩写能力,提供前所未有的标签选择体验,快速构建复杂提示词,提升创作效率。 核心功能:
参数说明:
|
Latent切换器(双模式)LatentSwitchDualMode | 支持可变数量的潜变量输入的双模式切换器。通过滑块 inputcount 控制端口数量,并点击按钮 Update inputs 同步增删端口;手动模式下按索引选择输出(select_channel 选项随 inputcount 自动更新);自动模式仅在存在唯一非空输入时输出,检测到多个非空输入将提示错误。新增的潜变量输入端口均为非必连,适合在不同生成路径之间灵活切换与对比实验。
|
文本切换器(双模式)TextSwitchDualMode | 支持可变数量的文本输入的双模式切换器。通过滑块 inputcount 控制端口数量,并点击按钮 Update inputs 同步增删端口;手动模式下按索引选择输出(select_text 选项随 inputcount 自动更新);自动模式仅在存在唯一非空输入时输出,检测到多个非空输入将提示错误。新增的文本输入端口均为非必连,适合在不同版本提示词之间灵活切换与对比实验。
|
图像切换器(双模式)ImageSwitchDualMode | 支持可变数量的图像输入的双模式切换器。通过滑块 inputcount 控制端口数量,并点击按钮 Update inputs 同步增删端口;手动模式下按索引选择输出(select_image 选项随 inputcount 自动更新);自动模式仅在存在唯一非空输入时输出,检测到多个非空输入将提示错误。新增的图像输入端口均为非必连,便于在不同生成结果或不同处理路径之间进行灵活对比。
|
优先级图像切换PriorityImageSwitch | 智能优先级图像切换节点,当同时接入图像A和图像B端口时,优先输出B端口的内容;如果B端口无输入,则输出图像A端口的内容;如果两个端口都无输入,则弹出提示要求至少连接一个输入端口。
特点:
|
多平台翻译MultiPlatformTranslate |
多平台翻译节点,支持百度、阿里云、有道、智谱AI和免费翻译服务。用户可以通过配置管理界面设置各平台的API密钥,实现高质量的专业翻译服务。 特点:
|
资源清理器ResourceCleaner |
系统资源清理工具,提供独立的内存(RAM)、显存(VRAM)和缓存清理控制,可选择性释放系统资源。 特点:
|
工作流暂停器PauseWorkflow |
智能工作流控制节点,可在任意位置暂停工作流执行,等待用户交互后继续或取消执行。 特点:
|
预留显存设置器ReservedVRAMSetter |
专业的GPU显存预留管理工具,用于控制ComfyUI的显存使用策略,有效防止显存溢出(OOM)错误,提升工作流稳定性。支持手动和自动两种模式,自动模式可根据当前GPU使用情况智能计算合适的预留显存量。 特点:
|
释放文本编码器(采样前)TextEncoderRelease |
文本编码器释放工具,在采样前把所连的 CLIP(文本编码器)从显存中卸载,提前腾出显存,适合文本编码器体积大、采样需要完整显存的工作流。 特点:
|
整数节点IntNode |
输出可配置整数值的工具节点,用于统一的参数控制。支持-2147483648到2147483647范围的整数输入,适用于需要精确数值控制的场景。
|
组开关管理器GroupSwitchManager |
可视化群组开关管理工具,自动检测工作流中的所有群组,提供一键启用/禁用功能,支持颜色过滤、标题匹配、拖拽排序和群组联动配置。 核心功能:
|
zhihui_nodes_comfyui 并点击 "Install" 按钮进入 ComfyUI 的 custom_nodes 目录,执行以下命令:
git clone https://github.com/ZhiHui6/zhihui_nodes_comfyui.git
重启 ComfyUI 即可使用。
zhihui_nodes_comfyui 文件夹复制到 ComfyUI 的 custom_nodes 目录下本节点集大部分功能无需额外依赖,开箱即用。部分在线功能(如翻译、提示词优化)需要网络连接。
如需手动安装依赖,可执行:
pip install -r requirements.txt
我们欢迎各种形式的贡献,包括但不限于:
如果您有任何想法或建议,请随时提出 Issue 或 Pull Request。



