
Экранный словарь для игр: распознавание текста, словари и перевод по контексту локальной языковой моделью (llama.cpp). EN/JA/ZH → RU
C#
2
57 commits
updated Oct 3, 2026
README
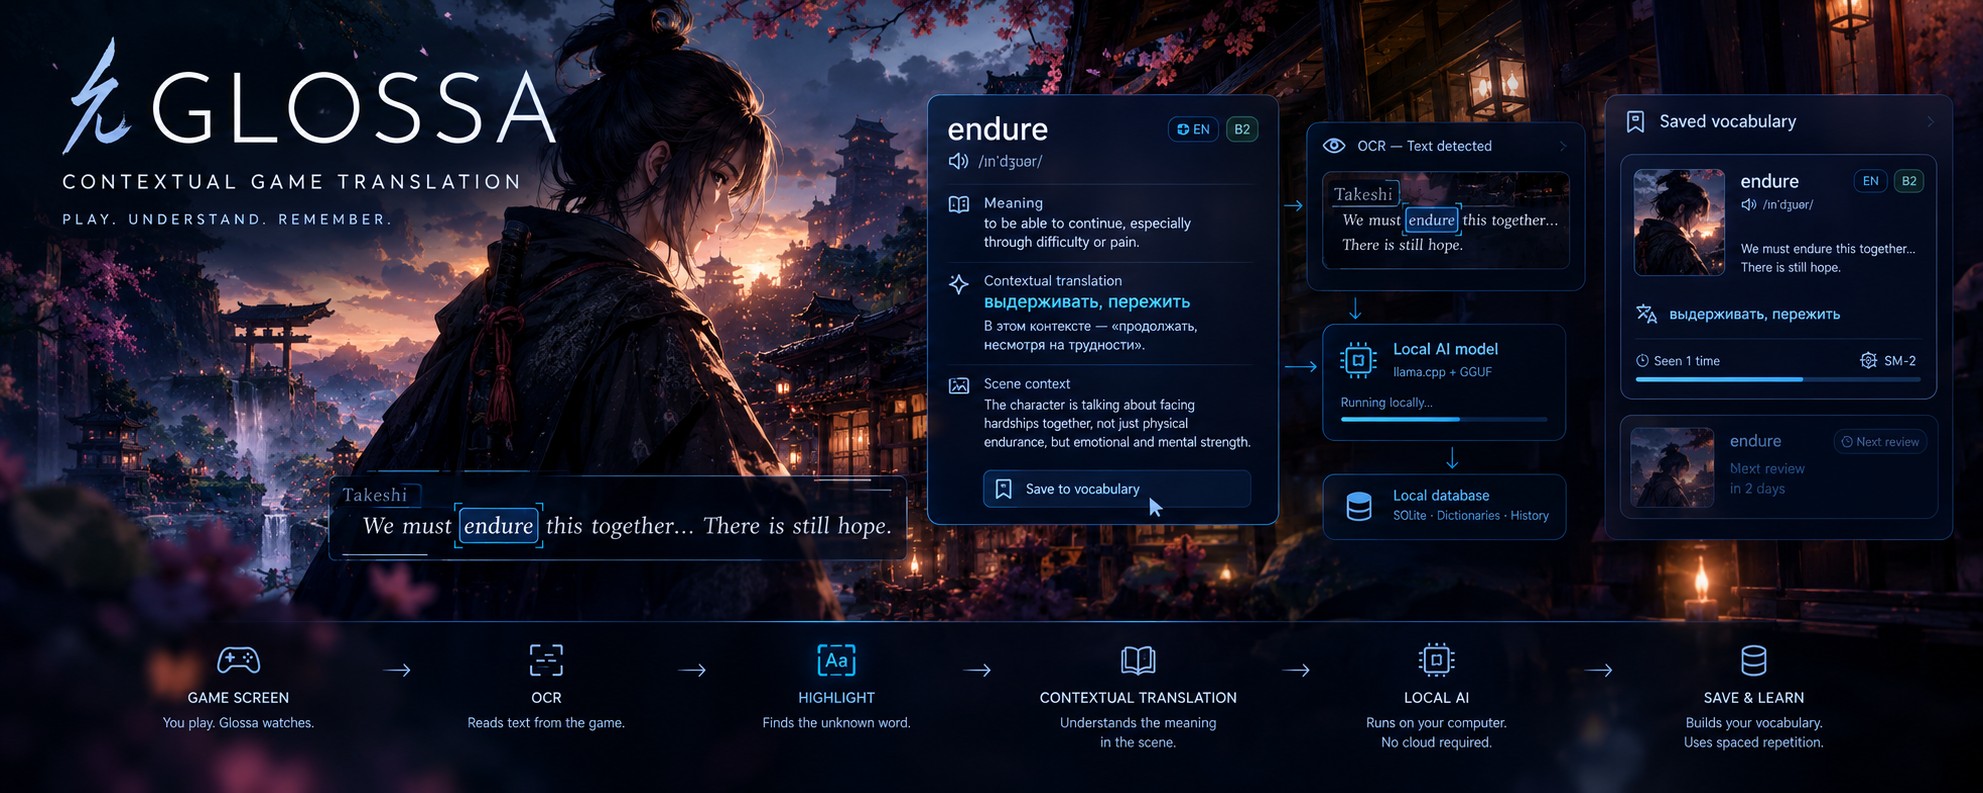
Экранный словарь для игр. Наведи курсор на слово в игре, нажми Alt+Q - рядом откроется карточка
с переводом по смыслу сцены.
Английский, японский и китайский -> русский. Локальная модель, без интернета. Мат и сленг - как есть.
Слова из игр потом повторяются по расписанию, как в Anki.



Возможности | Модели | Установка | Приватность | Лицензия
Что такое Glossa
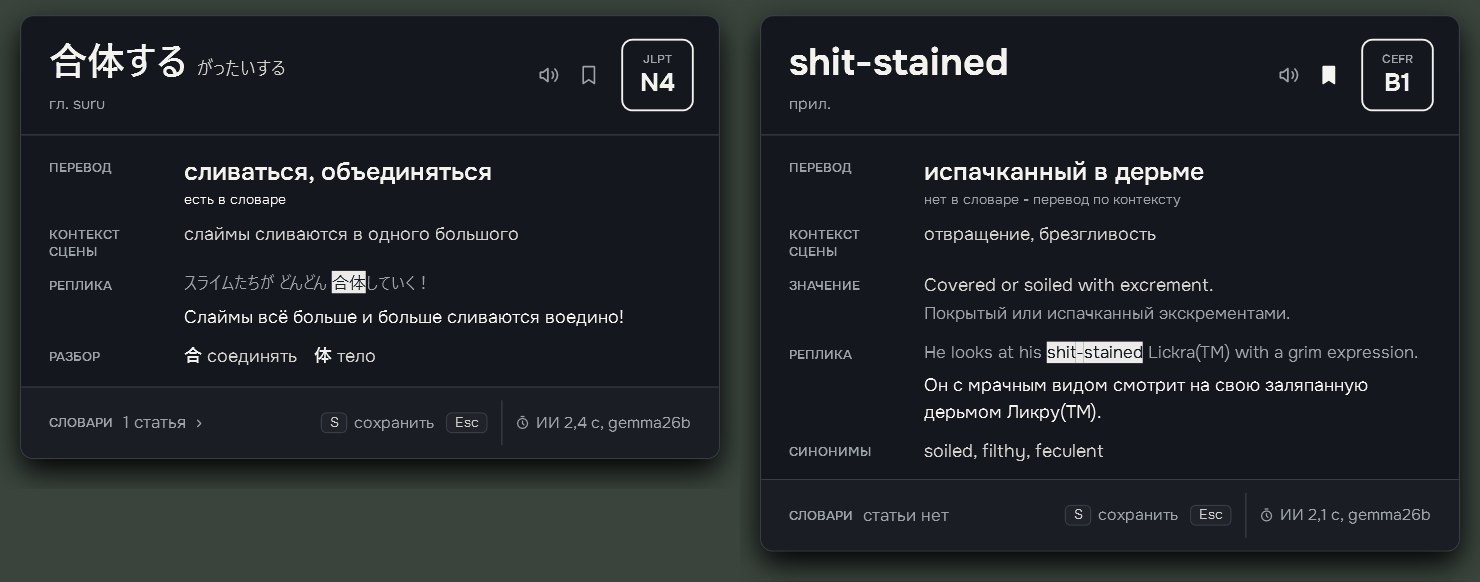
Играешь в игру на английском, японском или китайском и встречаешь незнакомое слово. Glossa находит его прямо на экране: снимает кадр, распознаёт текст, берёт слово под курсором и всю реплику. Сначала сразу показывает статьи словарей, следом - перевод слова и реплики от локальной языковой модели, которая видит контекст сцены. Фокус у игры не отбирается, карточка закрывается клавишей Esc.
Каждое найденное слово попадает в "Словарь" вместе с кадром из игры и репликой. Оттуда слова уходят в "Учёбу": повторение по расписанию один в один как в Anki, где на лицевой стороне карточки - та самая сцена из игры. Или в сам Anki, если привычнее он.
Всё работает на твоём компьютере. Интернет нужен, только чтобы по кнопке скачать модель, движок или справочник.
Возможности
| Раздел | Что делает |
|---|---|
| Карточка слова | Перевод по смыслу сцены, контекст, значение, реплика с переводом, синонимы, чтение и пиньинь, разбор иероглифов, уровни JLPT / HSK / CEFR, пометки "мат" и "сленг"; японский текст читается и в строку, и столбцами сверху вниз |
| Только перевод | Без словаря и учёбы: перевод реплики под курсором, зоны, всего экрана абзацами или живые субтитры поверх игры; переведённые реплики сохраняются цитатами с кадром |
| Словарь | Слова с кадрами и репликами, коллекции вручную и по фильтру, поиск, правка, выделение и копирование текста, экспорт в Anki (.apkg, AnkiConnect), Quizlet и CSV, кадры в папку с обведённым словом, озвучка голосами Windows |
| Учёба | Расписание повторений Anki (SM-2, те же шаги, интервалы и разброс), карточки в обе стороны (слово -> перевод и перевод -> слово), картинка значения, напоминания, сессии по языку и игре, пометка "Не могу запомнить", серия дней |
| Игры | Профиль на каждую игру, стоп-кадр для игр, которые держат курсор, пауза игры на время карточки, вызов одной клавишей или сочетанием, геймпады, кнопки мыши 4/5, отметки знакомых слов на стоп-кадре |
| Справочники | Каталог с установкой из программы (Warodai, JMdict, БКРС, CC-CEDICT, Wiktionary), импорт DSL, StarDict, MDX, Yomitan |
| Нагрузка | Модель выгружается без дела и уступает видеопамять игре, низкий приоритет, распознавание на процессоре в несколько потоков |
| Оформление | Тёмная, светлая и "Диско" темы; вид карточки: "Меньше", "Стандарт", "Больше" или "Свой" с прозрачностью и цветом |
Карточка слова
Словари отвечают сразу, модель дописывает поля по мере ответа: первое поле - примерно через 0,4 с, вся карточка - за 2,5-3,5 с на видеокарте с 16 ГБ. Модель переводит не слово вообще, а слово в этой реплике, и объясняет, почему здесь именно так ("Контекст сцены"). Мат и сленг переводятся с тем же регистром, без смягчений.
Клавиши, пока карточка открыта: S - сохранить, P - произнести, Tab - подробнее, Esc - закрыть.
В игре: стоп-кадр и геймпад
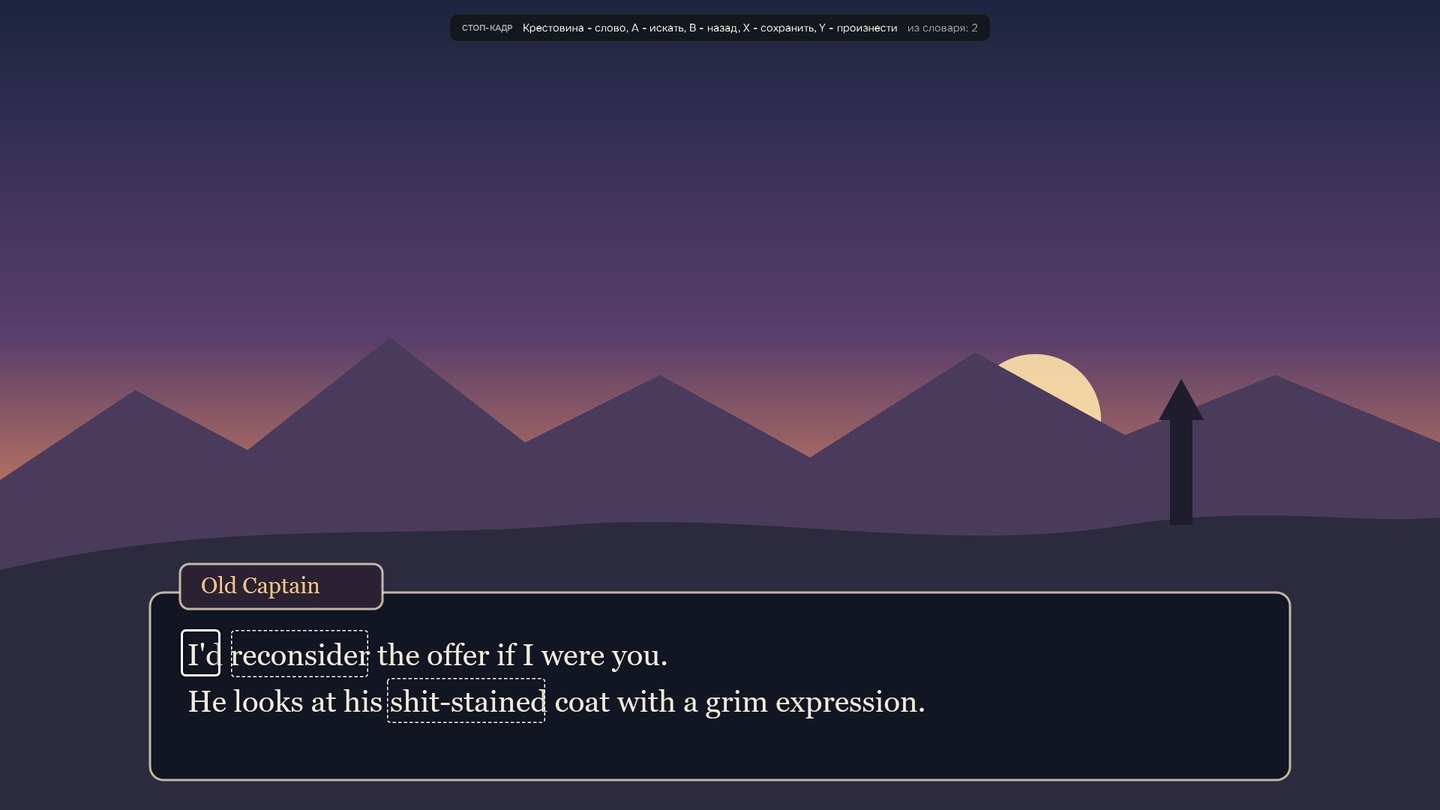
Для игр, которые прячут курсор или не любят, когда их окно теряет фокус, Glossa останавливает кадр и показывает карточку на снимке. С геймпада (например, LB + RB) слово выбирается крестовиной, A - искать, X - сохранить. Слова, которые уже есть в словаре, отмечены прямо на кадре; трудные - заметнее.
Только перевод
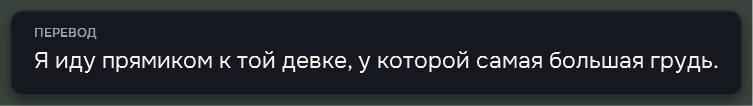
Режим для тех, кому нужен просто перевод, без словаря и учёбы:
- Реплика - перевод всей реплики под курсором, около 1,5 с;
- Весь экран - кадр останавливается, поверх каждого абзаца ложится его перевод;
- Живой перевод - Glossa следит за экраном и переводит каждую новую реплику субтитром над ней.
Словарь
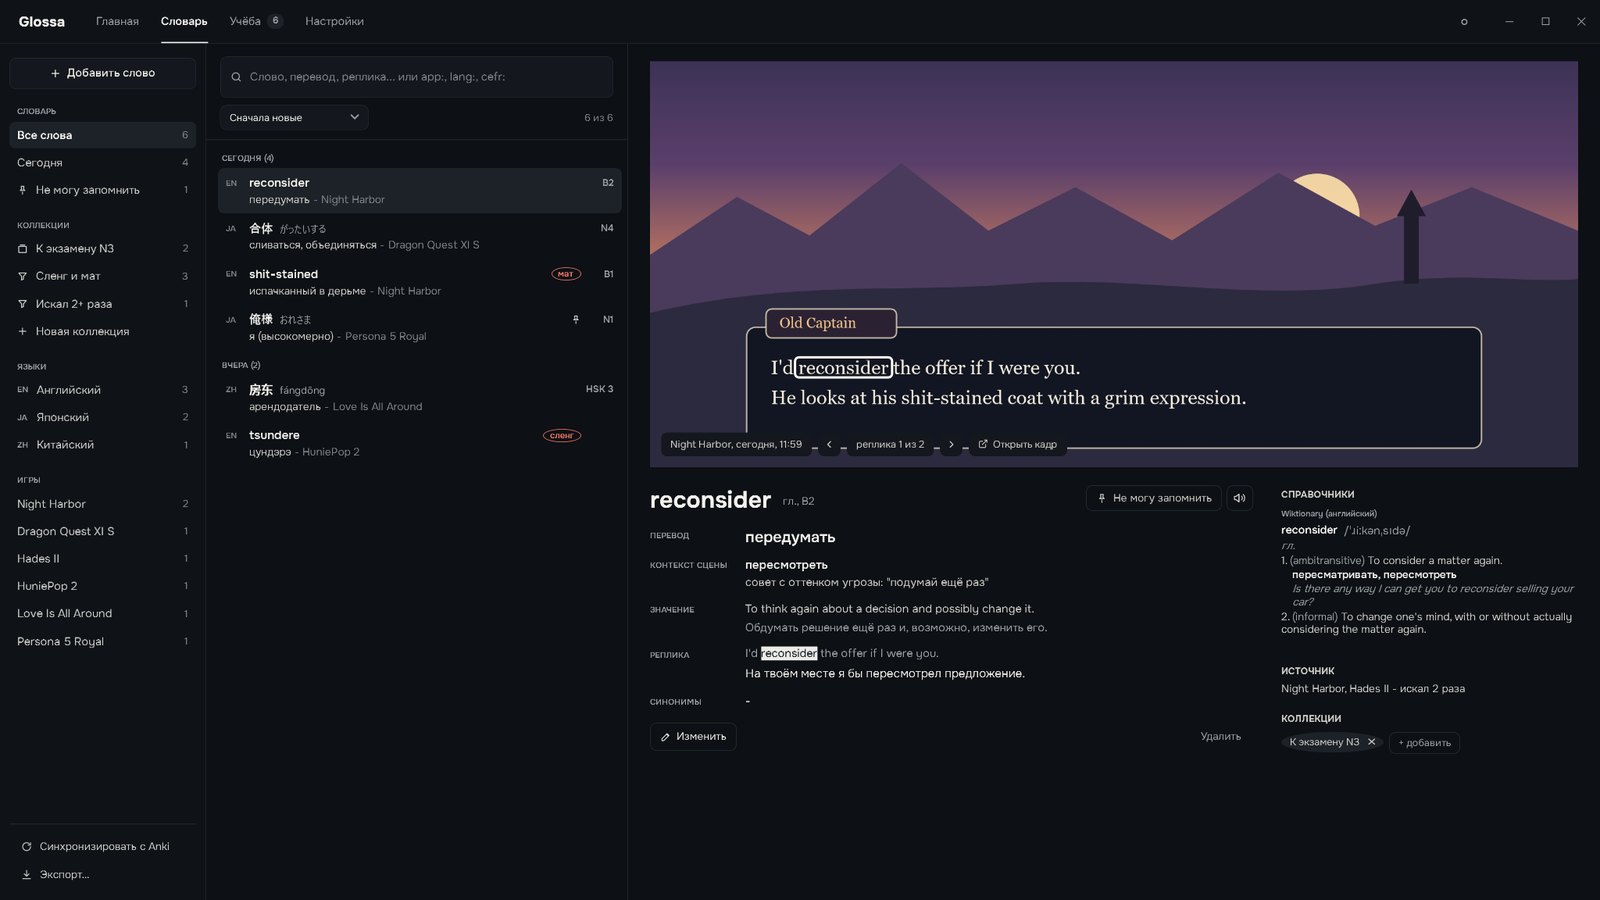
Одно слово - одна запись, сколько бы реплик с ним ни встретилось: реплики листаются, у каждой свой кадр и свой
перевод. Коллекции собираются вручную или по фильтру ("сленг и мат", "искал 2 раза и больше"), статьи справочников
открываются рядом. Экспорт в Anki - колодой .apkg или напрямую через AnkiConnect.
Учёба
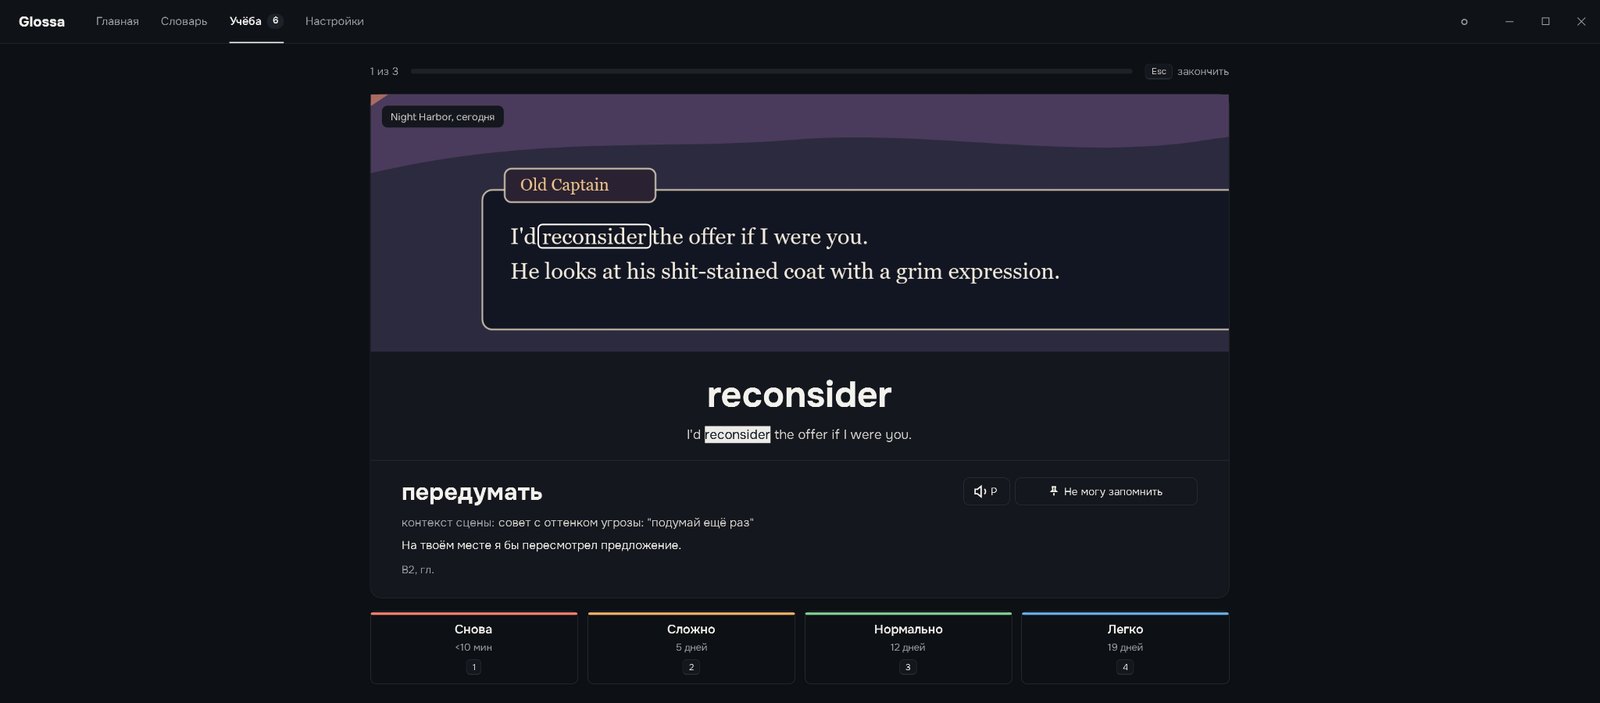
Расписание перенесено из Anki один в один: учебные шаги 1 и 10 минут, дальше интервалы в днях с учётом лёгкости слова, разброс и выравнивание нагрузки. На кнопках - настоящий следующий интервал для этого слова. Сессия собирается из слов с пометкой "Не могу запомнить" (до половины), слов, которым пора, и новых (20 в день); когда новые на сегодня кончились, кнопка "Ещё 20 слов" добавляет порцию сверх нормы, сколько угодно раз в день. Фильтр по языку и игре. Клавиши: Пробел - перевод, 1-4 - ответ, P - произнести, Esc - закончить.
Спутник
На главной живёт пиксельный спутник - персонаж из игр. Он выпадает при первом открытии, на удачу: обычные, редкие, эпические и легендарные. Спутник дышит и моргает, а его настроение зависит от того, как идут занятия: радуется выполненной норме дня или пройденной учёбе, устаёт после большой работы, грустит после пропуска и засыпает, если серия прервалась. Говорит своими фразами в облачке: при щелчке, при смене настроения, когда пора повторить карточки или серия вот-вот оборвётся; вечерние напоминания в трее тоже приходят его голосом. У каждого есть места, на которые он отвечает по-своему.
Подкрутить спутника можно попробовать, но он заметит и обидится.
Модели и движок
Модели и llama.cpp не входят в сборку - они скачиваются из программы: Настройки -> ИИ и модели -> "Скачать". Каждый файл закреплён за версией и контрольной суммой SHA-256, прерванная загрузка продолжается с места.
| Модель | Файл | Видеопамять |
|---|---|---|
| Gemma 4 26B A4B (по умолчанию) | UD-IQ4_XS, 13,4 ГБ | ~13 ГБ; в режиме "минимум видеопамяти" ~3 ГБ |
| Gemma 4 12B | Q4_K_M, 7,4 ГБ | ~7 ГБ |
| Gemma 4 E4B - для слабых ПК | Q4_K_M, 5,3 ГБ | ~3 ГБ |
| Своя модель | любой GGUF-файл | - |
Глаза - Qwen3-VL 4B (3,3 ГБ, скачиваются там же) для 12B, E4B и своей модели: читают стилизованный текст (неоновые кнопки меню, обводка, свечение), который не нашло распознавание. По умолчанию работают на процессоре (около 4 ГБ ОЗУ, около 10 с на надпись на среднем ПК), можно перевести на видеокарту (около 4,2 ГБ видеопамяти, около 1 с). Gemma 4 26B читает такой текст сама.
Движок - официальный релиз llama.cpp (b11243): для NVIDIA - сборка CUDA 13.4 (карты Turing и новее, драйвер 580+), для остальных видеокарт - Vulkan. Программа предлагает подходящую сама. Вместо локальной модели можно подключить своё API: OpenAI-совместимые, Anthropic, OpenRouter, DeepSeek, Gemini, LM Studio, Ollama (ключи хранятся зашифрованными).
Установка
[!NOTE] Ранняя версия (0.1.x): основное работает, но возможны шероховатости.
- Поставь .NET 8 Desktop Runtime (x64), если его ещё нет.
- Скачай
Glossa-<версия>-win-x64.zipсо страницы Releases и распакуй в папку, куда можно писать (не вProgram Files). Данные программы хранятся рядом с ней, вGlossaData. - Запусти
Glossa.exe. Закрытое окно оставляет Glossa в трее. - Открой Настройки -> ИИ и модели и нажми "Скачать" у движка и модели, в Настройки -> Справочники - у нужных словарей.
- Запусти игру, наведи курсор на слово и нажми Alt+Q.
| Минимум | Рекомендуется | |
|---|---|---|
| Система | Windows 10/11, 64 бита | Windows 11 |
| Память | 16 ГБ | 32 ГБ |
| Видеокарта | 6 ГБ (модель E4B) или без неё, со своим API | 16 ГБ (Gemma 4 26B целиком) |
| Диск | 10 ГБ | 25 ГБ на SSD (модель, движок, справочники) |
Приватность
- Кадры, слова и история учёбы лежат только на твоём компьютере (папка данных Glossa).
- Модель работает локально. Сеть нужна, только когда ты сам нажимаешь "Скачать" (модель, движок, справочник) или подключаешь своё API.
- Ключи API хранятся зашифрованными средствами Windows (DPAPI).
Как это устроено
- Снимок экрана - DXGI. Карточка видна и поверх игры в эксклюзивном полноэкранном режиме; если такая игра от неё выходит из полного экрана, Glossa скажет об этом, а при двух мониторах может показывать карточку на другом.
- Распознавание текста - PP-OCR (RapidOcrNet, ONNX) на процессоре: поиск строк v5, чтение v6 medium. Слово, которого нет в словарях (курсор игры поверх букв, необычный шрифт), модель перечитывает по кадру и исправляет.
- Японский - границы слов, словарная форма и чтение по UniDic; китайский - слова и пиньинь по CC-CEDICT.
- Справочники - свои пакеты SQLite, поиск по словарной форме и устойчивым выражениям.
- Модель - llama-server из официальной сборки llama.cpp; веса подгоняются под свободную видеопамять с запасом для игры, ответ приходит строгим JSON по схеме и показывается по мере генерации.
- Словарь и история учёбы - SQLite; расписание - перенос планировщика Anki (v3, SM-2) с тестами на все его примеры.
- Интерфейс - WPF на .NET 8, шрифты Onest, Literata и Press Start 2P.
Сборка из исходников
Нужны Windows 10/11 x64 и .NET 8 SDK.
dotnet build src/Glossa.App
dotnet test src/Glossa.Tests
tools/publish.ps1 собирает Release и ставит копию в D:\Programs\Glossa с ярлыком на рабочем столе.
Данные программы лежат в D:\GlossaData (другое место - переменная окружения GLOSSA_DATA). Пока нет мастера
первого запуска, туда нужно положить:
- модели распознавания -
tools/export_ocr_models.py(берёт их из Python-пакетаrapidocr, v6 medium - с Hugging Face); - UniDic для японского - содержимое пакета
unidic-liteвdict\unidic-lite.
Справочники, модели и llama.cpp ставятся из программы. glossa-cli (src/Glossa.Cli) - то же без окна: установка и
проверка словарей, загрузка llama.cpp, прогон перевода на наборе реплик.
Спутников в репозитории нет: их рисунки и ключи есть только в официальной сборке, поэтому сборка из исходников работает без спутника.
Лицензия
GPL-3.0. Шрифты Onest, Literata и Press Start 2P - SIL Open Font License 1.1 (src/Glossa.App/Assets/Fonts).
Персонажи-спутники принадлежат правообладателям своих игр; их рисунки не входят в исходники и под GPL не подпадают.
llama.cpp (MIT), модели и словари скачиваются отдельно и распространяются на своих условиях. Игровая сцена на снимках
экрана нарисована самой программой для примера.
Similar repos


Languages
C#
98.0%
Python
1.3%
Экранный словарь для игр: распознавание текста, словари и перевод по контексту локальной языковой моделью (llama.cpp). EN/JA/ZH → RU
C#
2
57 commits
updated Oct 3, 2026
README
Экранный словарь для игр. Наведи курсор на слово в игре, нажми Alt+Q - рядом откроется карточка
с переводом по смыслу сцены.
Английский, японский и китайский -> русский. Локальная модель, без интернета. Мат и сленг - как есть.
Слова из игр потом повторяются по расписанию, как в Anki.
Возможности | Модели | Установка | Приватность | Лицензия
Что такое Glossa
Играешь в игру на английском, японском или китайском и встречаешь незнакомое слово. Glossa находит его прямо на экране: снимает кадр, распознаёт текст, берёт слово под курсором и всю реплику. Сначала сразу показывает статьи словарей, следом - перевод слова и реплики от локальной языковой модели, которая видит контекст сцены. Фокус у игры не отбирается, карточка закрывается клавишей Esc.
Каждое найденное слово попадает в "Словарь" вместе с кадром из игры и репликой. Оттуда слова уходят в "Учёбу": повторение по расписанию один в один как в Anki, где на лицевой стороне карточки - та самая сцена из игры. Или в сам Anki, если привычнее он.
Всё работает на твоём компьютере. Интернет нужен, только чтобы по кнопке скачать модель, движок или справочник.
Возможности
| Раздел | Что делает |
|---|---|
| Карточка слова | Перевод по смыслу сцены, контекст, значение, реплика с переводом, синонимы, чтение и пиньинь, разбор иероглифов, уровни JLPT / HSK / CEFR, пометки "мат" и "сленг"; японский текст читается и в строку, и столбцами сверху вниз |
| Только перевод | Без словаря и учёбы: перевод реплики под курсором, зоны, всего экрана абзацами или живые субтитры поверх игры; переведённые реплики сохраняются цитатами с кадром |
| Словарь | Слова с кадрами и репликами, коллекции вручную и по фильтру, поиск, правка, выделение и копирование текста, экспорт в Anki (.apkg, AnkiConnect), Quizlet и CSV, кадры в папку с обведённым словом, озвучка голосами Windows |
| Учёба | Расписание повторений Anki (SM-2, те же шаги, интервалы и разброс), карточки в обе стороны (слово -> перевод и перевод -> слово), картинка значения, напоминания, сессии по языку и игре, пометка "Не могу запомнить", серия дней |
| Игры | Профиль на каждую игру, стоп-кадр для игр, которые держат курсор, пауза игры на время карточки, вызов одной клавишей или сочетанием, геймпады, кнопки мыши 4/5, отметки знакомых слов на стоп-кадре |
| Справочники | Каталог с установкой из программы (Warodai, JMdict, БКРС, CC-CEDICT, Wiktionary), импорт DSL, StarDict, MDX, Yomitan |
| Нагрузка | Модель выгружается без дела и уступает видеопамять игре, низкий приоритет, распознавание на процессоре в несколько потоков |
| Оформление | Тёмная, светлая и "Диско" темы; вид карточки: "Меньше", "Стандарт", "Больше" или "Свой" с прозрачностью и цветом |
Карточка слова
Словари отвечают сразу, модель дописывает поля по мере ответа: первое поле - примерно через 0,4 с, вся карточка - за 2,5-3,5 с на видеокарте с 16 ГБ. Модель переводит не слово вообще, а слово в этой реплике, и объясняет, почему здесь именно так ("Контекст сцены"). Мат и сленг переводятся с тем же регистром, без смягчений.
Клавиши, пока карточка открыта: S - сохранить, P - произнести, Tab - подробнее, Esc - закрыть.
В игре: стоп-кадр и геймпад
Для игр, которые прячут курсор или не любят, когда их окно теряет фокус, Glossa останавливает кадр и показывает карточку на снимке. С геймпада (например, LB + RB) слово выбирается крестовиной, A - искать, X - сохранить. Слова, которые уже есть в словаре, отмечены прямо на кадре; трудные - заметнее.
Только перевод
Режим для тех, кому нужен просто перевод, без словаря и учёбы:
- Реплика - перевод всей реплики под курсором, около 1,5 с;
- Весь экран - кадр останавливается, поверх каждого абзаца ложится его перевод;
- Живой перевод - Glossa следит за экраном и переводит каждую новую реплику субтитром над ней.
Словарь
Одно слово - одна запись, сколько бы реплик с ним ни встретилось: реплики листаются, у каждой свой кадр и свой
перевод. Коллекции собираются вручную или по фильтру ("сленг и мат", "искал 2 раза и больше"), статьи справочников
открываются рядом. Экспорт в Anki - колодой .apkg или напрямую через AnkiConnect.
Учёба
Расписание перенесено из Anki один в один: учебные шаги 1 и 10 минут, дальше интервалы в днях с учётом лёгкости слова, разброс и выравнивание нагрузки. На кнопках - настоящий следующий интервал для этого слова. Сессия собирается из слов с пометкой "Не могу запомнить" (до половины), слов, которым пора, и новых (20 в день); когда новые на сегодня кончились, кнопка "Ещё 20 слов" добавляет порцию сверх нормы, сколько угодно раз в день. Фильтр по языку и игре. Клавиши: Пробел - перевод, 1-4 - ответ, P - произнести, Esc - закончить.
Спутник
На главной живёт пиксельный спутник - персонаж из игр. Он выпадает при первом открытии, на удачу: обычные, редкие, эпические и легендарные. Спутник дышит и моргает, а его настроение зависит от того, как идут занятия: радуется выполненной норме дня или пройденной учёбе, устаёт после большой работы, грустит после пропуска и засыпает, если серия прервалась. Говорит своими фразами в облачке: при щелчке, при смене настроения, когда пора повторить карточки или серия вот-вот оборвётся; вечерние напоминания в трее тоже приходят его голосом. У каждого есть места, на которые он отвечает по-своему.
Подкрутить спутника можно попробовать, но он заметит и обидится.
Модели и движок
Модели и llama.cpp не входят в сборку - они скачиваются из программы: Настройки -> ИИ и модели -> "Скачать". Каждый файл закреплён за версией и контрольной суммой SHA-256, прерванная загрузка продолжается с места.
| Модель | Файл | Видеопамять |
|---|---|---|
| Gemma 4 26B A4B (по умолчанию) | UD-IQ4_XS, 13,4 ГБ | ~13 ГБ; в режиме "минимум видеопамяти" ~3 ГБ |
| Gemma 4 12B | Q4_K_M, 7,4 ГБ | ~7 ГБ |
| Gemma 4 E4B - для слабых ПК | Q4_K_M, 5,3 ГБ | ~3 ГБ |
| Своя модель | любой GGUF-файл | - |
Глаза - Qwen3-VL 4B (3,3 ГБ, скачиваются там же) для 12B, E4B и своей модели: читают стилизованный текст (неоновые кнопки меню, обводка, свечение), который не нашло распознавание. По умолчанию работают на процессоре (около 4 ГБ ОЗУ, около 10 с на надпись на среднем ПК), можно перевести на видеокарту (около 4,2 ГБ видеопамяти, около 1 с). Gemma 4 26B читает такой текст сама.
Движок - официальный релиз llama.cpp (b11243): для NVIDIA - сборка CUDA 13.4 (карты Turing и новее, драйвер 580+), для остальных видеокарт - Vulkan. Программа предлагает подходящую сама. Вместо локальной модели можно подключить своё API: OpenAI-совместимые, Anthropic, OpenRouter, DeepSeek, Gemini, LM Studio, Ollama (ключи хранятся зашифрованными).
Установка
[!NOTE] Ранняя версия (0.1.x): основное работает, но возможны шероховатости.
- Поставь .NET 8 Desktop Runtime (x64), если его ещё нет.
- Скачай
Glossa-<версия>-win-x64.zipсо страницы Releases и распакуй в папку, куда можно писать (не вProgram Files). Данные программы хранятся рядом с ней, вGlossaData. - Запусти
Glossa.exe. Закрытое окно оставляет Glossa в трее. - Открой Настройки -> ИИ и модели и нажми "Скачать" у движка и модели, в Настройки -> Справочники - у нужных словарей.
- Запусти игру, наведи курсор на слово и нажми Alt+Q.
| Минимум | Рекомендуется | |
|---|---|---|
| Система | Windows 10/11, 64 бита | Windows 11 |
| Память | 16 ГБ | 32 ГБ |
| Видеокарта | 6 ГБ (модель E4B) или без неё, со своим API | 16 ГБ (Gemma 4 26B целиком) |
| Диск | 10 ГБ | 25 ГБ на SSD (модель, движок, справочники) |
Приватность
- Кадры, слова и история учёбы лежат только на твоём компьютере (папка данных Glossa).
- Модель работает локально. Сеть нужна, только когда ты сам нажимаешь "Скачать" (модель, движок, справочник) или подключаешь своё API.
- Ключи API хранятся зашифрованными средствами Windows (DPAPI).
Как это устроено
- Снимок экрана - DXGI. Карточка видна и поверх игры в эксклюзивном полноэкранном режиме; если такая игра от неё выходит из полного экрана, Glossa скажет об этом, а при двух мониторах может показывать карточку на другом.
- Распознавание текста - PP-OCR (RapidOcrNet, ONNX) на процессоре: поиск строк v5, чтение v6 medium. Слово, которого нет в словарях (курсор игры поверх букв, необычный шрифт), модель перечитывает по кадру и исправляет.
- Японский - границы слов, словарная форма и чтение по UniDic; китайский - слова и пиньинь по CC-CEDICT.
- Справочники - свои пакеты SQLite, поиск по словарной форме и устойчивым выражениям.
- Модель - llama-server из официальной сборки llama.cpp; веса подгоняются под свободную видеопамять с запасом для игры, ответ приходит строгим JSON по схеме и показывается по мере генерации.
- Словарь и история учёбы - SQLite; расписание - перенос планировщика Anki (v3, SM-2) с тестами на все его примеры.
- Интерфейс - WPF на .NET 8, шрифты Onest, Literata и Press Start 2P.
Сборка из исходников
Нужны Windows 10/11 x64 и .NET 8 SDK.
dotnet build src/Glossa.App
dotnet test src/Glossa.Tests
tools/publish.ps1 собирает Release и ставит копию в D:\Programs\Glossa с ярлыком на рабочем столе.
Данные программы лежат в D:\GlossaData (другое место - переменная окружения GLOSSA_DATA). Пока нет мастера
первого запуска, туда нужно положить:
- модели распознавания -
tools/export_ocr_models.py(берёт их из Python-пакетаrapidocr, v6 medium - с Hugging Face); - UniDic для японского - содержимое пакета
unidic-liteвdict\unidic-lite.
Справочники, модели и llama.cpp ставятся из программы. glossa-cli (src/Glossa.Cli) - то же без окна: установка и
проверка словарей, загрузка llama.cpp, прогон перевода на наборе реплик.
Спутников в репозитории нет: их рисунки и ключи есть только в официальной сборке, поэтому сборка из исходников работает без спутника.
Лицензия
GPL-3.0. Шрифты Onest, Literata и Press Start 2P - SIL Open Font License 1.1 (src/Glossa.App/Assets/Fonts).
Персонажи-спутники принадлежат правообладателям своих игр; их рисунки не входят в исходники и под GPL не подпадают.
llama.cpp (MIT), модели и словари скачиваются отдельно и распространяются на своих условиях. Игровая сцена на снимках
экрана нарисована самой программой для примера.
Similar repos
Languages
C#
98.0%
Python
1.3%