
A curated list of papers on post-training for end-to-end autonomous driving: distillation, preference alignment, reinforcement learning, and test-time refinement.
36
7 commits
updated Jul 28, 2026
README
Awesome Post-Training in Autonomous Driving Papers
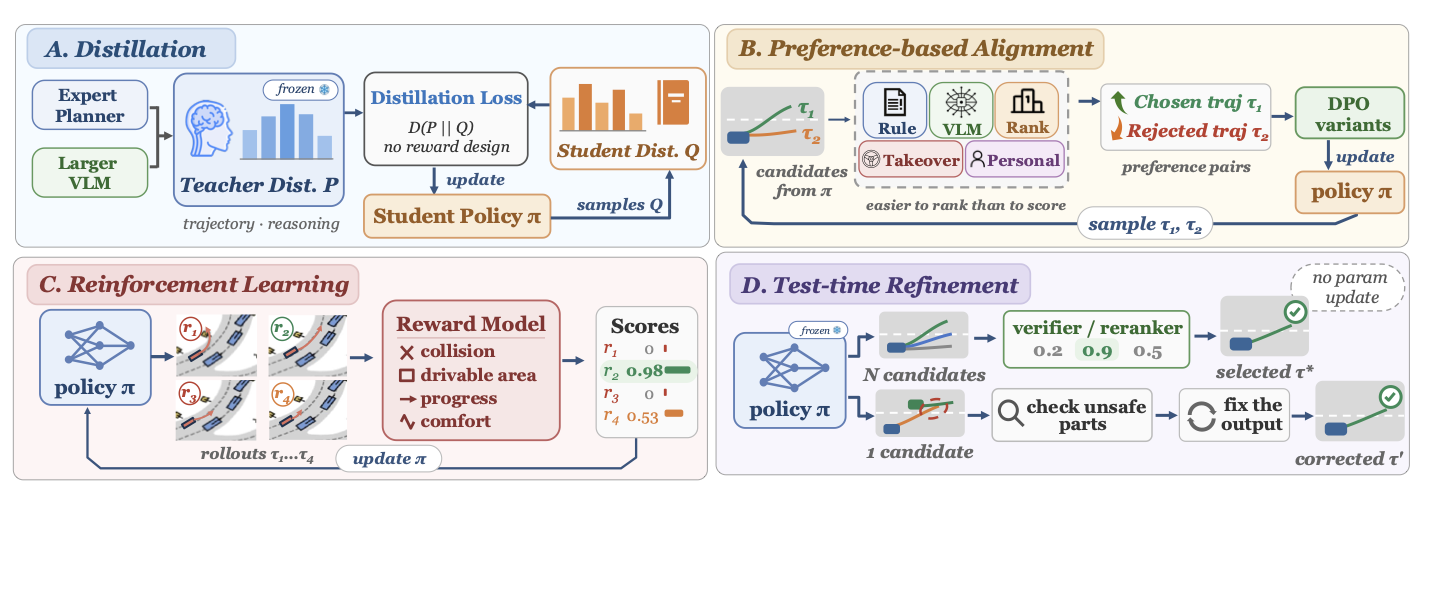
A curated list of papers on post-training for end-to-end autonomous driving, the stage that refines a driving policy after imitation learning, using supervision beyond offline expert demonstrations. This includes distillation, preference-based alignment, reinforcement learning (RL), and test-time refinement.
This repository accompanies our survey:
Post-Training in End-to-End Autonomous Driving: A Unified View
Ruining Yang*, Muxing Wang*, Yixiao Chen, Tongfei Guo, Yi Xu, Can Cui, Zichong Yang, Yitian Zhang, Ziran Wang, Yun Fu, Lili Su.
(* Equal contribution. Northeastern University & Purdue University.)
🧭 Taxonomy
We organize post-training methods into four families by the form of supervision they use:
| Family | Supervision signal |
|---|---|
| Distillation | Teacher policy / teacher target |
| Preference Alignment | Preferred–rejected pairs |
| Reinforcement Learning | Scalar reward |
| Test-time Refinement | Verifier score (no parameter update) |
Family tags used below: [Distill] · [Preference] · [RL] · [Test-time] · [SFT] (continued / targeted supervised fine-tuning) · [Planner-RL] (RL post-training on non-foundation-model planners).
Each entry also carries a venue tag in front (e.g. [CVPR], [ICLR], [NeurIPS], [arXiv]) so the publication venue is visible at a glance.
📌 Contents
📄 Papers by Year
Papers are grouped by the year of first public (arXiv) release, and clustered by family within each year. Each entry is prefixed with a venue tag and its family tag; the published venue is also noted in italics. A paper is listed under its primary family; some methods span multiple families.
2026
-
[Comm. Transp. Res.][Distill]Found-RL: Foundation Model-Enhanced Reinforcement Learning for Autonomous Driving, Communications in Transportation Research 2026. arXiv Code -
[CVPR][Distill]PaIR-Drive: Fine-tuning is not Enough — A Parallel Framework for Collaborative Imitation and Reinforcement Learning in End-to-End Autonomous Driving, CVPR 2026. arXiv Code -
[arXiv][Distill]CRAFT: Counterfactual-to-Interactive Reinforcement Fine-Tuning for Driving Policies, arXiv 2026. arXiv Project -
[arXiv][Distill]CoPhy: Distill to Think, Foresee to Act — Cognitive-Physical Reinforcement Learning for Autonomous Driving, arXiv 2026. arXiv -
[CVPR][Preference]Drive My Way: Preference Alignment of Vision-Language-Action Model for Personalized Driving, CVPR 2026. arXiv Code -
[arXiv][Preference]Causal Scene Narration with Runtime Safety Supervision for Vision-Language-Action Driving (CSN), arXiv 2026. arXiv -
[arXiv][Preference]CPO++: Towards Robust Endogenous Reasoning — Unifying Drift Adaptation in Non-Stationary Tuning, arXiv 2026. arXiv -
[ICRA][Preference]VL-DPO: Vision-Language-Guided Finetuning for Preference-Aligned Autonomous Driving, ICRA 2026. arXiv -
[arXiv][RL]ThinkDrive: Chain-of-Thought Guided Progressive Reinforcement Learning Fine-Tuning for Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]FLARE: Learning Future-Aware Latent Representations from Vision-Language Models for Autonomous Driving, arXiv 2026. arXiv -
[CVPR][RL]NoRD: A Data-Efficient Vision-Language-Action Model that Drives without Reasoning, CVPR 2026. arXiv Code -
[CVPR][RL]MindDriver: Introducing Progressive Multimodal Reasoning for Autonomous Driving, CVPR 2026. arXiv Code -
[CVPR][RL]PanoEnv: Exploring 3D Spatial Intelligence in Panoramic Environments with Reinforcement Learning, CVPR 2026. arXiv Code -
[CVPR][RL]ELF-VLA: Unleashing VLA Potentials in Autonomous Driving via Explicit Learning from Failures, CVPR 2026. arXiv Code -
[arXiv][RL]TakeVLA: Learning from Mistakes — Post-Training for Driving VLA with Takeover Data, arXiv 2026. arXiv -
[CVPR][RL]Neuro-Cognitive Reward Modeling for Human-Centered Autonomous Vehicle Control, CVPR 2026. arXiv Project -
[arXiv][RL]DreamerAD: Efficient Reinforcement Learning via Latent World Model for Autonomous Driving, arXiv 2026. arXiv -
[ICLR][RL]AutoDrive-P³: Unified Chain of Perception-Prediction-Planning Thought via Reinforcement Fine-Tuning, ICLR 2026. arXiv Code -
[ECCV][RL]ExploreVLA: Dense World Modeling and Exploration for End-to-End Autonomous Driving, ECCV 2026. arXiv Project -
[arXiv][RL]SCORP: Scene-Consistent Multi-agent Diffusion Planning with Stable Online Reinforcement Post-Training for Cooperative Driving, arXiv 2026. arXiv -
[arXiv][RL]FeaXDrive: Feasibility-aware Trajectory-Centric Diffusion Planning for End-to-End Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]SpanVLA: Efficient Action Bridging and Learning from Negative-Recovery Samples for Vision-Language-Action Model, arXiv 2026. arXiv Code -
[arXiv][RL]DIAL: Driving Intents Amplify Planning-Oriented Reinforcement Learning, arXiv 2026. arXiv -
[arXiv][RL]MAPLE: Latent Multi-Agent Play for End-to-End Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]SafeAlign-VLA: A Negative-Enhanced Safe Alignment Framework for Risk-Aware Autonomous Driving, arXiv 2026. arXiv -
[IJCNN][RL]SARAD: LLM-Based Safety-Aware Hybrid Reinforcement Learning with Collision Prediction for Autonomous Driving, IJCNN 2026. arXiv -
[arXiv][RL]BPF: Before Parc Fermé — RL-Time Pruning for Efficient Embodied LLMs in Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]DriveAnchor: Progressive Anchor-based Flow Learning for Autonomous Driving Planning, arXiv 2026. arXiv -
[CVPR][Planner-RL]PlannerRFT: Reinforcing Diffusion Planners through Closed-Loop and Sample-Efficient Fine-Tuning, CVPR 2026. arXiv -
[arXiv][Planner-RL]HDP: Unleashing the Potential of Diffusion Models for End-to-End Autonomous Driving, arXiv 2026. arXiv Code -
[arXiv][Planner-RL]RAD-2: Scaling Reinforcement Learning in a Generator-Discriminator Framework, arXiv 2026. arXiv Project -
[arXiv][SFT]LaST-VLA: Thinking in Latent Spatio-Temporal Space for Vision-Language-Action in Autonomous Driving, arXiv 2026. arXiv Code -
[arXiv][SFT]VLM-AutoDrive: Post-Training Vision-Language Models for Safety-Critical Autonomous Driving Events, arXiv 2026. arXiv -
[CVPR][SFT]The Blind Spot of Adaptation: Quantifying and Mitigating Forgetting in Fine-tuned Driving Models, CVPR 2026. arXiv -
[CVPR][SFT]Learning Vision-Language-Action World Models for Autonomous Driving (VLA-World), CVPR 2026 (Findings). arXiv Project -
[arXiv][SFT]EponaV2: Driving World Model with Comprehensive Future Reasoning, arXiv 2026. arXiv Code -
[arXiv][Test-time]C-CoT: Counterfactual Chain-of-Thought with Vision-Language Models for Safe Autonomous Driving, arXiv 2026. arXiv -
[arXiv][Test-time]Fast-dDrive: Efficient Block-Diffusion VLM for Autonomous Driving, arXiv 2026. arXiv
2025
-
[ICLR][Preference]TrajHF: Learning Personalized Driving Styles via Reinforcement Learning from Human Feedback, ICLR 2026. arXiv -
[NeurIPS][Preference]DriveDPO: Policy Learning via Safety DPO for End-to-End Autonomous Driving, NeurIPS 2025. arXiv -
[RA-L][Preference]TakeAD: Preference-Based Post-Optimization for End-to-End Autonomous Driving with Expert Takeover Data, IEEE RA-L 2025. arXiv -
[arXiv][RL]AlphaDrive: Unleashing the Power of VLMs in Autonomous Driving via Reinforcement Learning and Reasoning, arXiv 2025. arXiv Code -
[arXiv][RL]DriveMind: A Dual Visual Language Model-based Reinforcement Learning Framework for Autonomous Driving, arXiv 2025. arXiv -
[arXiv][RL]Poutine: Vision-Language-Trajectory Pre-Training and Reinforcement Learning Post-Training Enable Robust End-to-End Autonomous Driving, arXiv 2025 (1st place, Waymo WOD-E2E Challenge). arXiv -
[NeurIPS][RL]AutoVLA: A Vision-Language-Action Model for End-to-End Autonomous Driving with Adaptive Reasoning and Reinforcement Fine-Tuning, NeurIPS 2025. arXiv Code -
[AAAI][RL]Drive-R1: Bridging Reasoning and Planning in VLMs for Autonomous Driving with Reinforcement Learning, AAAI 2026. arXiv Code -
[ICCV-W][RL]LaViPlan: Language-Guided Visual Path Planning with RLVR, ICCV 2025 Workshop. arXiv -
[ICLR][RL]DriveAgent-R1: Advancing VLM-based Autonomous Driving with Active Perception and Hybrid Thinking, ICLR 2026. arXiv Code -
[arXiv][RL]IRL-VLA: Training a Vision-Language-Action Policy via Reward World Model, arXiv 2025. arXiv Code -
[ICLR][RL]AutoDrive-R²: Incentivizing Reasoning and Self-Reflection Capacity for VLA Model in Autonomous Driving, ICLR 2026. arXiv Code -
[ICRA][RL]AdaThinkDrive: Adaptive Thinking via Reinforcement Learning for Autonomous Driving, ICRA 2026. arXiv Code -
[arXiv][RL]VDRive: Leveraging Reinforced VLA and Diffusion Policy for End-to-End Autonomous Driving, arXiv 2025. arXiv -
[arXiv][RL]Alpamayo-R1: Bridging Reasoning and Action Prediction for Generalizable Autonomous Driving in the Long Tail, arXiv 2025 (NVIDIA). arXiv Code -
[arXiv][RL]WAM-Diff: A Masked Diffusion VLA Framework with MoE and Online Reinforcement Learning for Autonomous Driving, arXiv 2025. arXiv Code -
[CVPR][RL]OmniDrive-R1: Reinforcement-driven Interleaved Multi-modal Chain-of-Thought for Trustworthy Vision-Language Autonomous Driving, CVPR 2026. arXiv -
[NeurIPS][Planner-RL]RAD: Training an End-to-End Driving Policy via Large-Scale 3DGS-based Reinforcement Learning, NeurIPS 2025. arXiv Code -
[ICLR][Planner-RL]Plan-R1: Safe and Feasible Trajectory Planning as Language Modeling, ICLR 2026. arXiv Code -
[arXiv][Planner-RL]EvaDrive: Evolutionary Adversarial Policy Optimization for End-to-End Autonomous Driving, arXiv 2025. arXiv -
[arXiv][Planner-RL]TSA-MPR: Autoregressive End-to-End Planning with Time-Invariant Spatial Alignment and Multi-Objective Policy Refinement, arXiv 2025. arXiv Project -
[arXiv][Planner-RL]DiffusionDriveV2: Reinforcement Learning-Constrained Truncated Diffusion Modeling in End-to-End Autonomous Driving, arXiv 2025. arXiv Code -
[arXiv][SFT]CoReVLA: A Dual-Stage End-to-End Autonomous Driving Framework for Long-Tail Scenarios via Collect-and-Refine, arXiv 2025. arXiv Code -
[arXiv][SFT]Reasoning-VLA: A Fast and General Vision-Language-Action Reasoning Model for Autonomous Driving, arXiv 2025. arXiv Code -
[arXiv][SFT]LLaViDA: A Large Language Vision Driving Assistant for Explicit Reasoning and Enhanced Trajectory Planning, arXiv 2025. arXiv -
[arXiv][Test-time]ReflectDrive: Discrete Diffusion for Reflective Vision-Language-Action Models in Autonomous Driving, arXiv 2025. arXiv Code -
[ICRA][Test-time]DriveCritic: Towards Context-Aware, Human-Aligned Evaluation for Autonomous Driving with Vision-Language Models, ICRA 2026. arXiv Project -
[arXiv][Test-time]Post-Training and Test-Time Scaling of Generative Agent Behavior Models for Interactive Autonomous Driving, arXiv 2025. arXiv -
[CVPR][Test-time]Counterfactual VLA: Self-reflective Vision-Language-Action Model with Adaptive Reasoning, CVPR 2026. arXiv
2024
-
[CoRL][Distill]VLM-AD: End-to-End Autonomous Driving through Vision-Language Model Supervision, CoRL 2025. arXiv -
[arXiv][Distill]RAPID: Robust RL with LLM-Driven Data Synthesis and Policy Adaptation for Autonomous Driving, arXiv 2024. arXiv -
[UbiComp][RL]Optimizing Autonomous Driving for Safety: A Human-Centric Approach with LLM-Enhanced RLHF, UbiComp/ISWC 2024 Companion (ACM). arXiv
📊 Benchmarks & Simulators
Post-training targets closed-loop driving quality, so evaluation increasingly relies on (pseudo-)closed-loop simulators and driving-specific scores.
-
NAVSIM: Data-Driven Non-Reactive Autonomous Vehicle Simulation and Benchmarking, NeurIPS 2024 (Datasets & Benchmarks). One-shot non-reactive simulation with the PDMS score. arXiv Code
-
NAVSIM v2, CoRL 2025. Two-stage pseudo-closed-loop protocol with the EPDMS score and the
navhardsplit. arXiv Code -
Bench2Drive: Towards Multi-Ability Benchmarking of Closed-Loop End-To-End Autonomous Driving, NeurIPS 2024 (Datasets & Benchmarks). Fully closed-loop on CARLA with reactive traffic; reports Driving Score (DS) and Success Rate (SR). arXiv Code
-
WOD-E2E: Waymo Open Dataset for End-to-End Driving in Challenging Long-Tail Scenarios, CVPR 2026. Long-tail open-loop benchmark with the Rater Feedback Score (RFS). arXiv Code
-
nuScenes: A Multimodal Dataset for Autonomous Driving, CVPR 2020. Standard open-loop benchmark (L2 / collision rate). arXiv Code
-
nuReasoning: A Reasoning-Centric Dataset and Benchmark for Long-Tail Autonomous Driving, arXiv 2026. NAVSIM-style safety-gated NPS score with 5-second ADE. arXiv Project
-
AlpaSim: A Modular, Lightweight, and Data-Driven Research Simulator for Autonomous Driving, NVIDIA 2025. Neural-rendering photorealistic sensor simulation for closed-loop testing. Code
-
NVIDIA OmniDreams: Real-Time Generative World Model for Closed-Loop Autonomous Vehicle Simulation, arXiv 2026. arXiv Code
Related Surveys
-
Vision-Language-Action Models for Autonomous Driving: Past, Present, and Future, arXiv 2025. arXiv Repo
-
A Survey on Vision-Language-Action Models for Autonomous Driving, ICCV 2025 Workshop. arXiv Repo
-
A Survey for Foundation Models in Autonomous Driving, ICCVDM 2025. arXiv
-
Survey of General End-to-End Autonomous Driving: A Unified Perspective, 2025. TechRxiv
-
A Survey on End-to-End Autonomous Driving Training from the Perspectives of Data, Strategy, and Platform, IEEE T-ITS 2026. Repo
Citation
If you find this repository or our survey useful, please consider citing:
@article{yang2026post,
  title={Post-Training in End-to-End Autonomous Driving},
  author={Yang, Ruining and Wang, Muxing and Chen, Yixiao and Guo, Tongfei and Xu, Yi and Cui, Can and Yang, Zichong and Zhang, Yitian and Wang, Ziran and Fu, Yun and others},
  journal={arXiv preprint arXiv:2607.08072},
  year={2026}
}
🤝 Contributing
Contributions are welcome!
You can simply open an issue to suggest a paper, report a broken link, or correct a venue.
⭐ Star History
If this list helps your research, please consider giving it a star. It helps others discover it.
Similar repos


A curated list of papers on post-training for end-to-end autonomous driving: distillation, preference alignment, reinforcement learning, and test-time refinement.
36
7 commits
updated Jul 28, 2026
README
Awesome Post-Training in Autonomous Driving Papers
A curated list of papers on post-training for end-to-end autonomous driving, the stage that refines a driving policy after imitation learning, using supervision beyond offline expert demonstrations. This includes distillation, preference-based alignment, reinforcement learning (RL), and test-time refinement.
This repository accompanies our survey:
Post-Training in End-to-End Autonomous Driving: A Unified View
Ruining Yang*, Muxing Wang*, Yixiao Chen, Tongfei Guo, Yi Xu, Can Cui, Zichong Yang, Yitian Zhang, Ziran Wang, Yun Fu, Lili Su.
(* Equal contribution. Northeastern University & Purdue University.)
🧭 Taxonomy
We organize post-training methods into four families by the form of supervision they use:
| Family | Supervision signal |
|---|---|
| Distillation | Teacher policy / teacher target |
| Preference Alignment | Preferred–rejected pairs |
| Reinforcement Learning | Scalar reward |
| Test-time Refinement | Verifier score (no parameter update) |
Family tags used below: [Distill] · [Preference] · [RL] · [Test-time] · [SFT] (continued / targeted supervised fine-tuning) · [Planner-RL] (RL post-training on non-foundation-model planners).
Each entry also carries a venue tag in front (e.g. [CVPR], [ICLR], [NeurIPS], [arXiv]) so the publication venue is visible at a glance.
📌 Contents
📄 Papers by Year
Papers are grouped by the year of first public (arXiv) release, and clustered by family within each year. Each entry is prefixed with a venue tag and its family tag; the published venue is also noted in italics. A paper is listed under its primary family; some methods span multiple families.
2026
-
[Comm. Transp. Res.][Distill]Found-RL: Foundation Model-Enhanced Reinforcement Learning for Autonomous Driving, Communications in Transportation Research 2026. arXiv Code -
[CVPR][Distill]PaIR-Drive: Fine-tuning is not Enough — A Parallel Framework for Collaborative Imitation and Reinforcement Learning in End-to-End Autonomous Driving, CVPR 2026. arXiv Code -
[arXiv][Distill]CRAFT: Counterfactual-to-Interactive Reinforcement Fine-Tuning for Driving Policies, arXiv 2026. arXiv Project -
[arXiv][Distill]CoPhy: Distill to Think, Foresee to Act — Cognitive-Physical Reinforcement Learning for Autonomous Driving, arXiv 2026. arXiv -
[CVPR][Preference]Drive My Way: Preference Alignment of Vision-Language-Action Model for Personalized Driving, CVPR 2026. arXiv Code -
[arXiv][Preference]Causal Scene Narration with Runtime Safety Supervision for Vision-Language-Action Driving (CSN), arXiv 2026. arXiv -
[arXiv][Preference]CPO++: Towards Robust Endogenous Reasoning — Unifying Drift Adaptation in Non-Stationary Tuning, arXiv 2026. arXiv -
[ICRA][Preference]VL-DPO: Vision-Language-Guided Finetuning for Preference-Aligned Autonomous Driving, ICRA 2026. arXiv -
[arXiv][RL]ThinkDrive: Chain-of-Thought Guided Progressive Reinforcement Learning Fine-Tuning for Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]FLARE: Learning Future-Aware Latent Representations from Vision-Language Models for Autonomous Driving, arXiv 2026. arXiv -
[CVPR][RL]NoRD: A Data-Efficient Vision-Language-Action Model that Drives without Reasoning, CVPR 2026. arXiv Code -
[CVPR][RL]MindDriver: Introducing Progressive Multimodal Reasoning for Autonomous Driving, CVPR 2026. arXiv Code -
[CVPR][RL]PanoEnv: Exploring 3D Spatial Intelligence in Panoramic Environments with Reinforcement Learning, CVPR 2026. arXiv Code -
[CVPR][RL]ELF-VLA: Unleashing VLA Potentials in Autonomous Driving via Explicit Learning from Failures, CVPR 2026. arXiv Code -
[arXiv][RL]TakeVLA: Learning from Mistakes — Post-Training for Driving VLA with Takeover Data, arXiv 2026. arXiv -
[CVPR][RL]Neuro-Cognitive Reward Modeling for Human-Centered Autonomous Vehicle Control, CVPR 2026. arXiv Project -
[arXiv][RL]DreamerAD: Efficient Reinforcement Learning via Latent World Model for Autonomous Driving, arXiv 2026. arXiv -
[ICLR][RL]AutoDrive-P³: Unified Chain of Perception-Prediction-Planning Thought via Reinforcement Fine-Tuning, ICLR 2026. arXiv Code -
[ECCV][RL]ExploreVLA: Dense World Modeling and Exploration for End-to-End Autonomous Driving, ECCV 2026. arXiv Project -
[arXiv][RL]SCORP: Scene-Consistent Multi-agent Diffusion Planning with Stable Online Reinforcement Post-Training for Cooperative Driving, arXiv 2026. arXiv -
[arXiv][RL]FeaXDrive: Feasibility-aware Trajectory-Centric Diffusion Planning for End-to-End Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]SpanVLA: Efficient Action Bridging and Learning from Negative-Recovery Samples for Vision-Language-Action Model, arXiv 2026. arXiv Code -
[arXiv][RL]DIAL: Driving Intents Amplify Planning-Oriented Reinforcement Learning, arXiv 2026. arXiv -
[arXiv][RL]MAPLE: Latent Multi-Agent Play for End-to-End Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]SafeAlign-VLA: A Negative-Enhanced Safe Alignment Framework for Risk-Aware Autonomous Driving, arXiv 2026. arXiv -
[IJCNN][RL]SARAD: LLM-Based Safety-Aware Hybrid Reinforcement Learning with Collision Prediction for Autonomous Driving, IJCNN 2026. arXiv -
[arXiv][RL]BPF: Before Parc Fermé — RL-Time Pruning for Efficient Embodied LLMs in Autonomous Driving, arXiv 2026. arXiv -
[arXiv][RL]DriveAnchor: Progressive Anchor-based Flow Learning for Autonomous Driving Planning, arXiv 2026. arXiv -
[CVPR][Planner-RL]PlannerRFT: Reinforcing Diffusion Planners through Closed-Loop and Sample-Efficient Fine-Tuning, CVPR 2026. arXiv -
[arXiv][Planner-RL]HDP: Unleashing the Potential of Diffusion Models for End-to-End Autonomous Driving, arXiv 2026. arXiv Code -
[arXiv][Planner-RL]RAD-2: Scaling Reinforcement Learning in a Generator-Discriminator Framework, arXiv 2026. arXiv Project -
[arXiv][SFT]LaST-VLA: Thinking in Latent Spatio-Temporal Space for Vision-Language-Action in Autonomous Driving, arXiv 2026. arXiv Code -
[arXiv][SFT]VLM-AutoDrive: Post-Training Vision-Language Models for Safety-Critical Autonomous Driving Events, arXiv 2026. arXiv -
[CVPR][SFT]The Blind Spot of Adaptation: Quantifying and Mitigating Forgetting in Fine-tuned Driving Models, CVPR 2026. arXiv -
[CVPR][SFT]Learning Vision-Language-Action World Models for Autonomous Driving (VLA-World), CVPR 2026 (Findings). arXiv Project -
[arXiv][SFT]EponaV2: Driving World Model with Comprehensive Future Reasoning, arXiv 2026. arXiv Code -
[arXiv][Test-time]C-CoT: Counterfactual Chain-of-Thought with Vision-Language Models for Safe Autonomous Driving, arXiv 2026. arXiv -
[arXiv][Test-time]Fast-dDrive: Efficient Block-Diffusion VLM for Autonomous Driving, arXiv 2026. arXiv
2025
-
[ICLR][Preference]TrajHF: Learning Personalized Driving Styles via Reinforcement Learning from Human Feedback, ICLR 2026. arXiv -
[NeurIPS][Preference]DriveDPO: Policy Learning via Safety DPO for End-to-End Autonomous Driving, NeurIPS 2025. arXiv -
[RA-L][Preference]TakeAD: Preference-Based Post-Optimization for End-to-End Autonomous Driving with Expert Takeover Data, IEEE RA-L 2025. arXiv -
[arXiv][RL]AlphaDrive: Unleashing the Power of VLMs in Autonomous Driving via Reinforcement Learning and Reasoning, arXiv 2025. arXiv Code -
[arXiv][RL]DriveMind: A Dual Visual Language Model-based Reinforcement Learning Framework for Autonomous Driving, arXiv 2025. arXiv -
[arXiv][RL]Poutine: Vision-Language-Trajectory Pre-Training and Reinforcement Learning Post-Training Enable Robust End-to-End Autonomous Driving, arXiv 2025 (1st place, Waymo WOD-E2E Challenge). arXiv -
[NeurIPS][RL]AutoVLA: A Vision-Language-Action Model for End-to-End Autonomous Driving with Adaptive Reasoning and Reinforcement Fine-Tuning, NeurIPS 2025. arXiv Code -
[AAAI][RL]Drive-R1: Bridging Reasoning and Planning in VLMs for Autonomous Driving with Reinforcement Learning, AAAI 2026. arXiv Code -
[ICCV-W][RL]LaViPlan: Language-Guided Visual Path Planning with RLVR, ICCV 2025 Workshop. arXiv -
[ICLR][RL]DriveAgent-R1: Advancing VLM-based Autonomous Driving with Active Perception and Hybrid Thinking, ICLR 2026. arXiv Code -
[arXiv][RL]IRL-VLA: Training a Vision-Language-Action Policy via Reward World Model, arXiv 2025. arXiv Code -
[ICLR][RL]AutoDrive-R²: Incentivizing Reasoning and Self-Reflection Capacity for VLA Model in Autonomous Driving, ICLR 2026. arXiv Code -
[ICRA][RL]AdaThinkDrive: Adaptive Thinking via Reinforcement Learning for Autonomous Driving, ICRA 2026. arXiv Code -
[arXiv][RL]VDRive: Leveraging Reinforced VLA and Diffusion Policy for End-to-End Autonomous Driving, arXiv 2025. arXiv -
[arXiv][RL]Alpamayo-R1: Bridging Reasoning and Action Prediction for Generalizable Autonomous Driving in the Long Tail, arXiv 2025 (NVIDIA). arXiv Code -
[arXiv][RL]WAM-Diff: A Masked Diffusion VLA Framework with MoE and Online Reinforcement Learning for Autonomous Driving, arXiv 2025. arXiv Code -
[CVPR][RL]OmniDrive-R1: Reinforcement-driven Interleaved Multi-modal Chain-of-Thought for Trustworthy Vision-Language Autonomous Driving, CVPR 2026. arXiv -
[NeurIPS][Planner-RL]RAD: Training an End-to-End Driving Policy via Large-Scale 3DGS-based Reinforcement Learning, NeurIPS 2025. arXiv Code -
[ICLR][Planner-RL]Plan-R1: Safe and Feasible Trajectory Planning as Language Modeling, ICLR 2026. arXiv Code -
[arXiv][Planner-RL]EvaDrive: Evolutionary Adversarial Policy Optimization for End-to-End Autonomous Driving, arXiv 2025. arXiv -
[arXiv][Planner-RL]TSA-MPR: Autoregressive End-to-End Planning with Time-Invariant Spatial Alignment and Multi-Objective Policy Refinement, arXiv 2025. arXiv Project -
[arXiv][Planner-RL]DiffusionDriveV2: Reinforcement Learning-Constrained Truncated Diffusion Modeling in End-to-End Autonomous Driving, arXiv 2025. arXiv Code -
[arXiv][SFT]CoReVLA: A Dual-Stage End-to-End Autonomous Driving Framework for Long-Tail Scenarios via Collect-and-Refine, arXiv 2025. arXiv Code -
[arXiv][SFT]Reasoning-VLA: A Fast and General Vision-Language-Action Reasoning Model for Autonomous Driving, arXiv 2025. arXiv Code -
[arXiv][SFT]LLaViDA: A Large Language Vision Driving Assistant for Explicit Reasoning and Enhanced Trajectory Planning, arXiv 2025. arXiv -
[arXiv][Test-time]ReflectDrive: Discrete Diffusion for Reflective Vision-Language-Action Models in Autonomous Driving, arXiv 2025. arXiv Code -
[ICRA][Test-time]DriveCritic: Towards Context-Aware, Human-Aligned Evaluation for Autonomous Driving with Vision-Language Models, ICRA 2026. arXiv Project -
[arXiv][Test-time]Post-Training and Test-Time Scaling of Generative Agent Behavior Models for Interactive Autonomous Driving, arXiv 2025. arXiv -
[CVPR][Test-time]Counterfactual VLA: Self-reflective Vision-Language-Action Model with Adaptive Reasoning, CVPR 2026. arXiv
2024
-
[CoRL][Distill]VLM-AD: End-to-End Autonomous Driving through Vision-Language Model Supervision, CoRL 2025. arXiv -
[arXiv][Distill]RAPID: Robust RL with LLM-Driven Data Synthesis and Policy Adaptation for Autonomous Driving, arXiv 2024. arXiv -
[UbiComp][RL]Optimizing Autonomous Driving for Safety: A Human-Centric Approach with LLM-Enhanced RLHF, UbiComp/ISWC 2024 Companion (ACM). arXiv
📊 Benchmarks & Simulators
Post-training targets closed-loop driving quality, so evaluation increasingly relies on (pseudo-)closed-loop simulators and driving-specific scores.
-
NAVSIM: Data-Driven Non-Reactive Autonomous Vehicle Simulation and Benchmarking, NeurIPS 2024 (Datasets & Benchmarks). One-shot non-reactive simulation with the PDMS score. arXiv Code
-
NAVSIM v2, CoRL 2025. Two-stage pseudo-closed-loop protocol with the EPDMS score and the
navhardsplit. arXiv Code -
Bench2Drive: Towards Multi-Ability Benchmarking of Closed-Loop End-To-End Autonomous Driving, NeurIPS 2024 (Datasets & Benchmarks). Fully closed-loop on CARLA with reactive traffic; reports Driving Score (DS) and Success Rate (SR). arXiv Code
-
WOD-E2E: Waymo Open Dataset for End-to-End Driving in Challenging Long-Tail Scenarios, CVPR 2026. Long-tail open-loop benchmark with the Rater Feedback Score (RFS). arXiv Code
-
nuScenes: A Multimodal Dataset for Autonomous Driving, CVPR 2020. Standard open-loop benchmark (L2 / collision rate). arXiv Code
-
nuReasoning: A Reasoning-Centric Dataset and Benchmark for Long-Tail Autonomous Driving, arXiv 2026. NAVSIM-style safety-gated NPS score with 5-second ADE. arXiv Project
-
AlpaSim: A Modular, Lightweight, and Data-Driven Research Simulator for Autonomous Driving, NVIDIA 2025. Neural-rendering photorealistic sensor simulation for closed-loop testing. Code
-
NVIDIA OmniDreams: Real-Time Generative World Model for Closed-Loop Autonomous Vehicle Simulation, arXiv 2026. arXiv Code
Related Surveys
-
Vision-Language-Action Models for Autonomous Driving: Past, Present, and Future, arXiv 2025. arXiv Repo
-
A Survey on Vision-Language-Action Models for Autonomous Driving, ICCV 2025 Workshop. arXiv Repo
-
A Survey for Foundation Models in Autonomous Driving, ICCVDM 2025. arXiv
-
Survey of General End-to-End Autonomous Driving: A Unified Perspective, 2025. TechRxiv
-
A Survey on End-to-End Autonomous Driving Training from the Perspectives of Data, Strategy, and Platform, IEEE T-ITS 2026. Repo
Citation
If you find this repository or our survey useful, please consider citing:
@article{yang2026post,
  title={Post-Training in End-to-End Autonomous Driving},
  author={Yang, Ruining and Wang, Muxing and Chen, Yixiao and Guo, Tongfei and Xu, Yi and Cui, Can and Yang, Zichong and Zhang, Yitian and Wang, Ziran and Fu, Yun and others},
  journal={arXiv preprint arXiv:2607.08072},
  year={2026}
}
🤝 Contributing
Contributions are welcome!
You can simply open an issue to suggest a paper, report a broken link, or correct a venue.
⭐ Star History
If this list helps your research, please consider giving it a star. It helps others discover it.