KejiaZhang-Robust/Awesome-LM-SM-Domain-Collaboration

Survey and resources on large-small model collaboration for domain-specific AI.

24

10 commits

updated Jul 3, 2026

See the code

README

Awesome LM-SM Domain Collaboration

License: MIT PRs Welcome arXiv Last Commit

[Paper]    [PDF]    [Contents]   

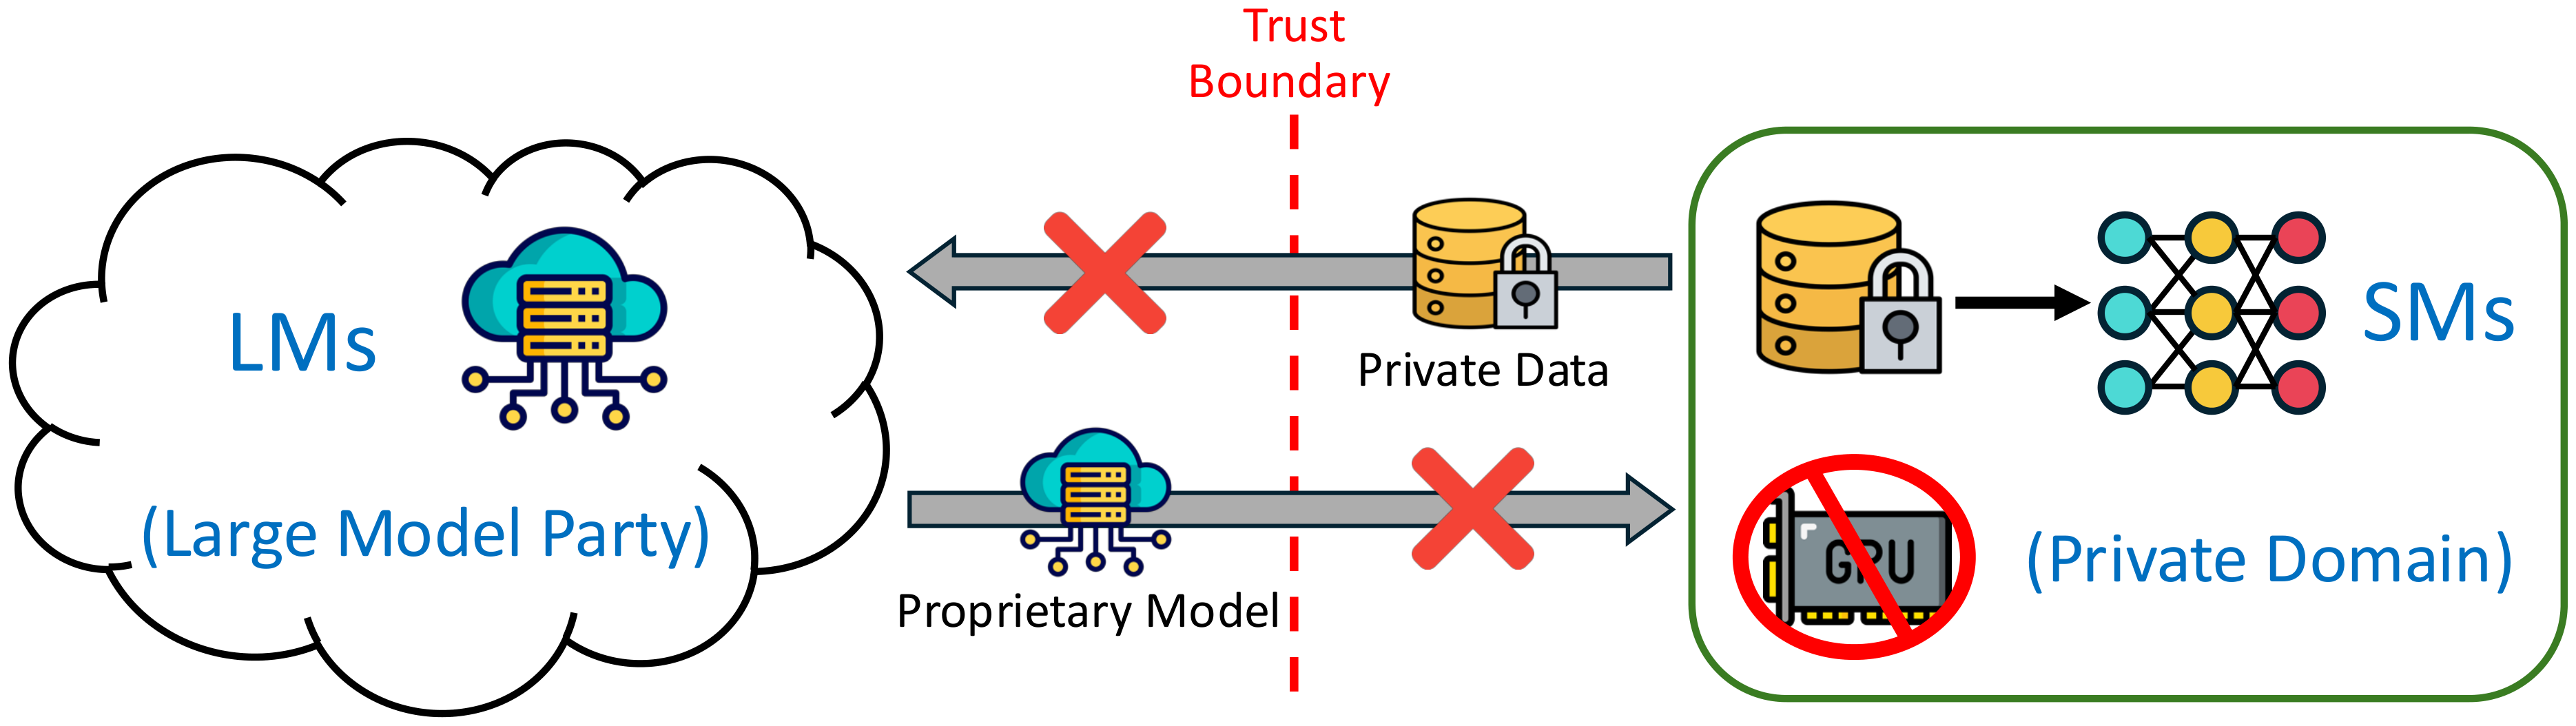
Large and small models collaborating across the trust boundary under privacy, ownership, and hardware constraints

Towards Harnessing the Collaborative Power of Large and Small Models for Domain Tasks [arXiv]

Yang Liu†,*,1, Kejia Zhang*,1, Bingjie Yan1, Tianyuan Zou2, Jianqing Zhang2,3, Zixuan Gu2,5, Xiangsen Chen1, Jianbing Ding4, Xidong Wang4, Jingyi Li4, Xiaozhou Ye4, Ye Ouyang4, Qiang Yang1, Ya-Qin Zhang2

1The Hong Kong Polytechnic University, 2Institute for AI Industry Research, Tsinghua University, 3Shanghai Jiao Tong University, 4AsiaInfo Technologies, 5School of Software, Tsinghua University

* Equal Contribution. † Corresponding Author (yang-veronica.liu@polyu.edu.hk).

[!TIP] If this repository or our survey paper helps your work, please consider citing it.

We also welcome pull requests and issues for missing papers, metadata fixes, taxonomy improvements, and content clarification.

📝 Citation

@article{liu2025towards,
  title={Towards Harnessing the Collaborative Power of Large and Small Models for Domain Tasks},
  author={Liu, Yang and Zhang, Kejia and Yan, Bingjie and Zou, Tianyuan and Zhang, Jianqing and Gu, Zixuan and Chen, Xiangsen and Ding, Jianbing and Wang, Xidong and Li, Jingyi and Ye, Xiaozhou and Ouyang, Ye and Yang, Qiang and Zhang, Ya-Qin},
  journal={arXiv preprint arXiv:2504.17421},
  year={2026}
}

🔥 News

  • [2026-06-28] Released the survey paper and this public repository.

🎯 Motivation

Domain tasks often involve private data, proprietary models, and limited local resources, which make centralized adaptation of large models impractical. LM-SM collaboration addresses this setting by combining the broad generalization of large models with the efficiency and locality of small models. This repository organizes representative methods by transfer direction and inference-time collaboration, with attention to privacy, model security, and resource constraints.

Taxonomy
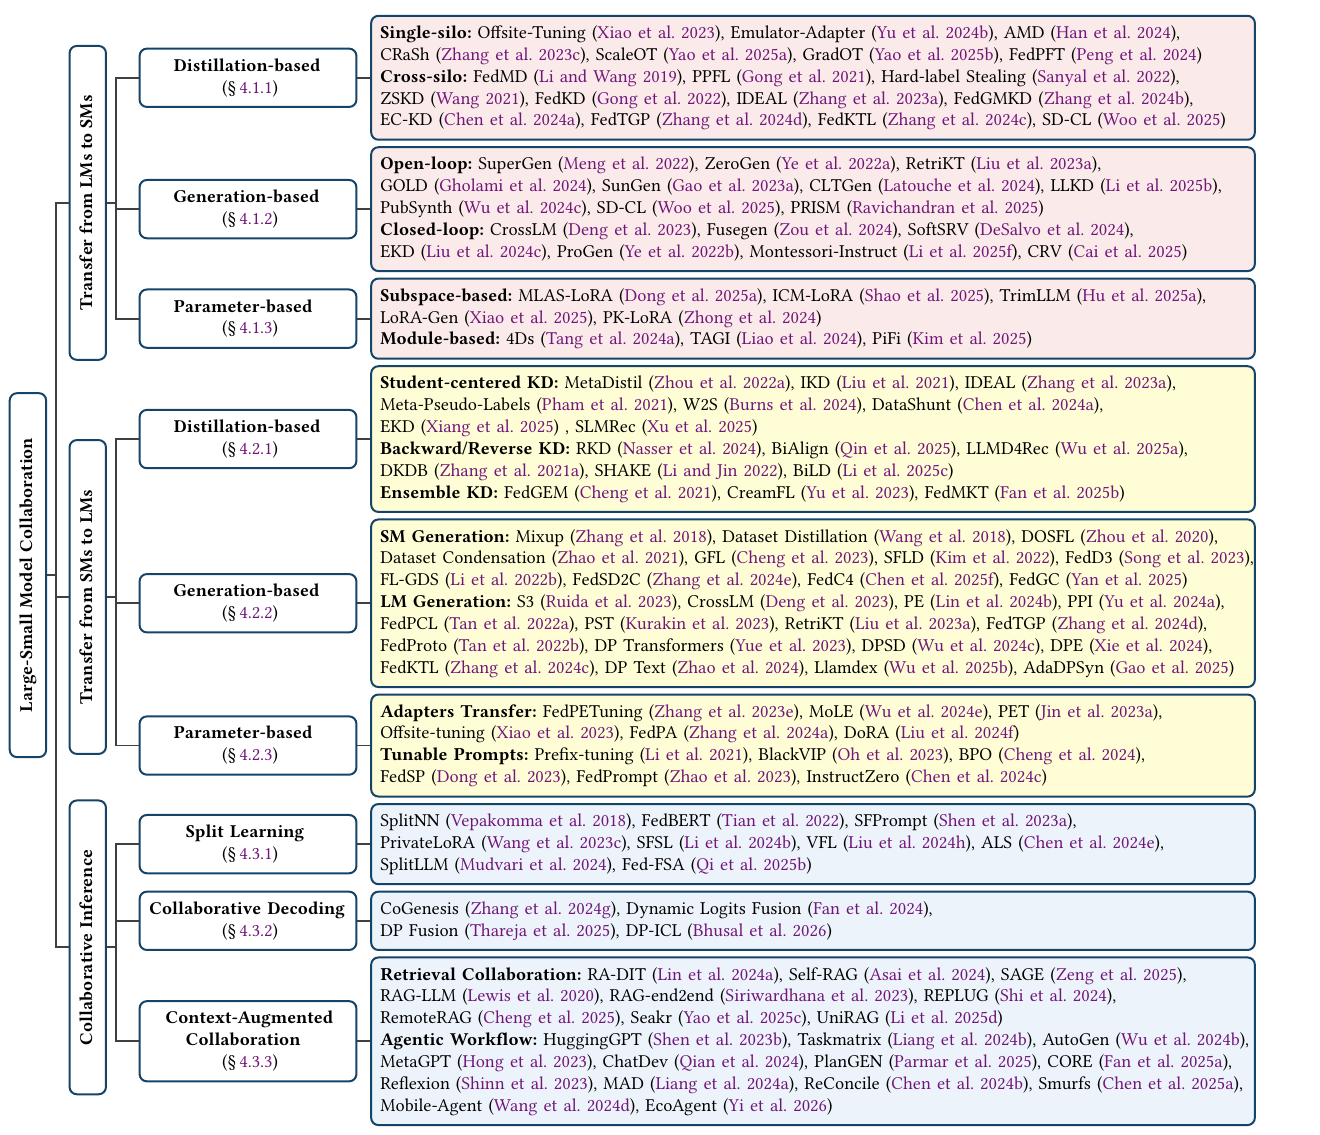
Taxonomy of large-small model collaboration for domain tasks

📚 Contents

Badge legend
  • arXiv Badge arXiv papers
  • PDF Badge conference/journal papers
  • Star Badge code repository stars
  • Categories Badge method categories

LM2SM Knowledge Transfer from LMs to SMs

Distillation-based Transfer
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
FedMD: Heterogenous Federated Learning via Model Distillation
Daliang Li, Junpu Wang
FedMDCross-Silo DistillationPaper
Code
PDF
Ensemble Attention Distillation for Privacy-Preserving Federated Learning
Xuan Gong, Abhishek Sharma, Srikrishna Karanam, et al.
PPFLCross-Silo DistillationPaper
PDF arXiv Star
Zero-Shot Knowledge Distillation from a Decision-Based Black-Box Model
Zi Wang
ZSKDCross-Silo DistillationPaper
Code
PDF arXiv
Preserving Privacy in Federated Learning with Ensemble Cross-Domain Knowledge Distillation
Xuan Gong, Abhishek Sharma, Srikrishna Karanam, et al.
FedKDCross-Silo DistillationPaper
PDF arXiv Star
Towards Data-Free Model Stealing in a Hard Label Setting
Sunandini Sanyal, Sravanti Addepalli, R Venkatesh Babu
Hard-label StealingCross-Silo DistillationPaper
Code
arXiv Star
Offsite-Tuning: Transfer Learning without Full Model
Guangxuan Xiao, Ji Lin, Song Han
Offsite-TuningSingle-Silo DistillationPaper
Code
PDF arXiv
CRaSh: Clustering, Removing, and Sharing Enhance Fine-Tuning without Full Large Language Model
Kai-yan Zhang, Ning Ding, Biqing Qi, et al.
CRaShSingle-Silo DistillationPaper
PDF arXiv Star
IDEAL: Query-Efficient Data-Free Learning from Black-Box Models
Jie Zhang, et al.
IDEALCross-Silo DistillationPaper
Code
PDF Star
Data Shunt: Collaboration of Small and Large Models for Lower Costs and Better Performance
Dong Chen, Yueting Zhuang, Shuo Zhang, et al.
EC-KDCross-Silo DistillationPaper
Code
PDF arXiv Star
FedTGP: Trainable Global Prototypes with Adaptive-Margin-Enhanced Contrastive Learning for Data and Model Heterogeneity in Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedTGPCross-Silo DistillationPaper
Code
PDF arXiv Star
An Upload-Efficient Scheme for Transferring Knowledge from a Server-Side Pre-Trained Generator to Clients in Heterogeneous Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedKTLCross-Silo DistillationPaper
Code
PDF arXiv
AMD: Automatic Multi-Step Distillation of Large-Scale Vision Models
Cheng Han, Qifan Wang, Sohail A Dianat, et al.
AMDSingle-Silo DistillationPaper
PDF arXiv
Orchestration of Emulator Assisted 6G Mobile Edge Tuning for AI Foundation Models: A Multi-Agent Deep Reinforcement Learning Approach
Wenhan Yu, Terence Jie Chua, Jun Zhao
Emulator-AdapterSingle-Silo DistillationPaper
PDF arXiv
FedPFT: Federated Proxy Fine-Tuning of Foundation Models
Zhaopeng Peng, Xiaoliang Fan, Yufan Chen, et al.
FedPFTSingle-Silo DistillationPaper
PDF
FedGMKD: An Efficient Prototype Federated Learning Framework Through Knowledge Distillation and Discrepancy-Aware Aggregation
Jian-qiao Zhang, Cai-feng Shan, Jungong Han
FedGMKDCross-Silo DistillationPaper
PDF arXiv
ScaleOT: Privacy-Utility-Scalable Offsite-Tuning with Dynamic LayerReplace and Selective Rank Compression
Kai Yao, zhaorui Tan, Tiandi Ye, et al.
ScaleOTSingle-Silo DistillationPaper
PDF arXiv
GradOT: Training-Free Gradient-Preserving Offsite-Tuning for Large Language Models
Kai Yao, Zhaorui Tan, Penglei Gao, et al.
GradOTSingle-Silo DistillationPaper
PDF
Synthetic Data Distillation Enables the Extraction of Clinical Information at Scale
Elizabeth Geena Woo, Michael C Burkhart, Emily Alsentzer, et al.
SD-CLCross-Silo DistillationPaper

(back to top ↑)

Generation-based Transfer
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
ZeroGen: Efficient Zero-Shot Learning via Dataset Generation
Jiacheng Ye, Jiahui Gao, Qintong Li, et al.
ZeroGenOpen-loop GenerationPaper
Code
PDF arXiv Star
ProGen: Progressive Zero-Shot Dataset Generation via in-Context Feedback
Jiacheng Ye, Jiahui Gao, Zhiyong Wu, et al.
ProGenClosed-loop GenerationPaper
Code
PDF arXiv Star
Generating Training Data with Language Models: Towards Zero-Shot Language Understanding
Yu Meng, Jiaxin Huang, Yu Zhang, et al.
SuperGenOpen-loop GenerationPaper
Code
arXiv
Mutual Enhancement of Large and Small Language Models with Cross-Silo Knowledge Transfer
Yongheng Deng, Ziqing Qiao, Ju Ren, et al.
CrossLMClosed-loop GenerationPaper
PDF arXiv
Retrieval-Based Knowledge Transfer: An Effective Approach for Extreme Large Language Model Compression
Jiduan Liu, Jiahao Liu, Qifan Wang, et al.
RetriKTOpen-loop GenerationPaper
PDF arXiv Star
Self-Guided Noise-Free Data Generation for Efficient Zero-Shot Learning
Jiahui Gao, Renjie Pi, Lin Yong, et al.
SunGenOpen-loop GenerationPaper
Code
arXiv
No More Hard Prompts: SoftSRV Prompting for Synthetic Data Generation
Giulia DeSalvo, Jean-Fracois Kagy, Lazaros Karydas, et al.
SoftSRVClosed-loop GenerationPaper
PDF arXiv
Evolving Knowledge Distillation with Large Language Models and Active Learning
Chengyuan Liu, Fubang Zhao, Kun Kuang, et al.
EKDClosed-loop GenerationPaper
PDF arXiv
Prompt Public Large Language Models to Synthesize Data for Private On-device Applications
Shanshan Wu, Zheng Xu, Yanxiang Zhang, et al.
PubSynthOpen-loop GenerationPaper
PDF arXiv Star
Fusegen: PLM Fusion for Data-Generation Based Zero-Shot Learning
Tianyuan Zou, Yang Liu, Peng Li, et al.
FusegenClosed-loop GenerationPaper
Code
PDF arXiv
Zero-Shot Cross-Lingual Transfer for Synthetic Data Generation in Grammatical Error Detection
Gaetan Latouche, Marc-André Carbonneau, Ben Swanson
CLTGenOpen-loop GenerationPaper
PDF arXiv Star
GOLD: Generalized Knowledge Distillation via Out-of-Distribution-Guided Language Data Generation
Mohsen Gholami, Mohammad Akbari, Tianxi Hu, et al.
GOLDOpen-loop GenerationPaper
Code
PDF arXiv Star
Distilling On-device Language Models for Robot Planning with Minimal Human Intervention
Zachary Ravichandran, Ignacio Hounie, Fernando Cladera, et al.
PRISMOpen-loop GenerationPaper
Code
PDF arXiv
Enhancing Reasoning Abilities of Small LLMs with Cognitive Alignment
Wenrui Cai, Chengyu Wang, Junbing Yan, et al.
CRVClosed-loop GenerationPaper
PDF arXiv Star
Montessori-Instruct: Generate Influential Training Data Tailored for Student Learning
Xiaochuan Li, Zichun Yu, Chenyan Xiong
Montessori-InstructClosed-loop GenerationPaper
Code
PDF arXiv Star
Learning with Less: Knowledge Distillation from Large Language Models via Unlabeled Data
Juanhui Li, Sreyashi Nag, Hui Liu, et al.
LLKDOpen-loop GenerationPaper
Code
PDF Star
Synthetic Data Distillation Enables the Extraction of Clinical Information at Scale
Elizabeth Geena Woo, Michael C Burkhart, Emily Alsentzer, et al.
SD-CLOpen-loop GenerationPaper
Code

(back to top ↑)

Parameter-based Transfer

(back to top ↑)

SM2LM Knowledge Transfer from SMs to LMs

Distillation-based Transfer
Title & AuthorsMethodCategoryLinks
arXiv
FedGEMS: Federated Learning of Larger Server Models via Selective Knowledge Fusion
Sijie Cheng, Jingwen Wu, Yanghua Xiao, et al.
FedGEMEnsemble KDPaper
arXiv
Learning to Teach with Student Feedback
Yi-tao Liu, Tian-xiang Sun, Xi-peng Qiu, et al.
IKDStudent-centered KDPaper
PDF arXiv Star
Meta Pseudo Labels
Hieu Pham, Zihang Dai, Qizhe Xie, et al.
Meta-Pseudo-LabelsStudent-centered KDPaper
Code
PDF
Dual Knowledge Distillation for Bidirectional Neural Machine Translation
Huaao Zhang, Shigui Qiu, Shilong Wu
DKDBBackward/Reverse KDPaper
PDF arXiv Star
BERT Learns to Teach: Knowledge Distillation with Meta Learning
Wangchunshu Zhou, Canwen Xu, Julian McAuley
MetaDistilStudent-centered KDPaper
Code
PDF Star
Shadow Knowledge Distillation: Bridging Offline and Online Knowledge Transfer
Lujun Li, Zhe Jin
SHAKEBackward/Reverse KDPaper
Code
PDF arXiv Star
IDEAL: Query-Efficient Data-Free Learning from Black-Box Models
Jie Zhang, et al.
IDEALStudent-centered KDPaper
Code
PDF arXiv Star
Multimodal Federated Learning via Contrastive Representation Ensemble
Qiying Yu, Yang Liu, Yimu Wang, et al.
CreamFLEnsemble KDPaper
Code
PDF Star
DataShunt: Collaboration of Small and Large Models for Lower Costs and Better Performance
Dong Chen, Yueting Zhuang, Shuo Zhang, et al.
DataShuntStudent-centered KDPaper
Code
PDF arXiv
Weak-To-Strong Generalization: Eliciting Strong Capabilities with Weak Supervision
Collin Burns, et al.
W2SStudent-centered KDPaper
PDF arXiv Star
Reverse Knowledge Distillation: Training a Large Model Using a Small One for Retinal Image Matching on Limited Data
Sahar Almahfouz Nasser, Nihar Gupte, Amit Sethi
RKDBackward/Reverse KDPaper
Code
PDF arXiv
Beyond Output Matching: Bidirectional Alignment for Enhanced in-Context Learning
Chengwei Qin, Wenhan Xia, Fangkai Jiao, et al.
BiAlignBackward/Reverse KDPaper
arXiv
Bidirectional Knowledge Distillation for Enhancing Sequential Recommendation with Large Language Models
Jiongran Wu, Jiahao Liu, Dongsheng Li, et al.
LLMD4RecBackward/Reverse KDPaper
PDF arXiv Star
BiLD: Bi-Directional Logits Difference Loss for Large Language Model Distillation
Minchong Li, Feng Zhou, Xiaohui Song
BiLDBackward/Reverse KDPaper
Code
PDF arXiv Star
FedMKT: Federated Mutual Knowledge Transfer for Large and Small Language Models
Tao Fan, Guoqiang Ma, Yan Kang, et al.
FedMKTEnsemble KDPaper
Code
PDF Star
Evidential Knowledge Distillation
Liangyu Xiang, Junyu Gao, Changsheng Xu
EKDStudent-centered KDPaper
Code
PDF arXiv Star
SLMRec: Distilling Large Language Models into Small for Sequential Recommendation
Wujiang Xu, Qitian Wu, Zujie Liang, et al.
SLMRecStudent-centered KDPaper
Code

(back to top ↑)

Generation-based Transfer
Title & AuthorsMethodCategoryLinks
arXiv Star
Dataset Distillation
Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba, et al.
Dataset DistillationSM GenerationPaper
Code
PDF arXiv Star
Mixup: Beyond Empirical Risk Minimization
Hongyi Zhang, Moustapha Cisse, Yann N. Dauphin, et al.
MixupSM GenerationPaper
Code
arXiv
Distilled One-Shot Federated Learning
Yanlin Zhou, George Pu, Xiyao Ma, et al.
DOSFLSM GenerationPaper
PDF arXiv Star
Dataset Condensation with Gradient Matching
Bo Zhao, et al.
Dataset CondensationSM GenerationPaper
Code
PDF arXiv Star
FedProto: Federated Prototype Learning Across Heterogeneous Clients
Yue Tan, et al.
FedProtoLM GenerationPaper
Code
PDF arXiv
Federated Learning with Gan-Based Data Synthesis for Non-IID Clients
Zi-jian Li, Jia-wei Shao, Yu-yi Mao, et al.
FL-GDSSM GenerationPaper
PDF Star
Stable Federated Learning with Dataset Condensation
Seong-Woong Kim, et al.
SFLDSM GenerationPaper
Code
PDF arXiv Star
Federated Learning from Pre-Trained Models: A Contrastive Learning Approach
Yue Tan, Guodong Long, Jie Ma, et al.
FedPCLLM GenerationPaper
Code
PDF arXiv
Synthetic Text Generation with Differential Privacy: A Simple and Practical Recipe
Xiang Yue, Huseyin Inan, Xuechen Li, et al.
DP TransformersLM GenerationPaper
arXiv
Harnessing Large-Language Models to Generate Private Synthetic Text
Alexey Kurakin, Natalia Ponomareva, Umar Syed, et al.
PSTLM GenerationPaper
arXiv
Mutual Enhancement of Large and Small Language Models with Cross-Silo Knowledge Transfer
Yongheng Deng, Ziqing Qiao, Ju Ren, et al.
CrossLMLM GenerationPaper
PDF arXiv Star
Let's Synthesize Step by Step: Iterative Dataset Synthesis with Large Language Models by Extrapolating Errors from Small Models
WANG Ruida, Wangchunshu Zhou, Mrinmaya Sachan
S3LM GenerationPaper
Code
PDF arXiv
Retrieval-Based Knowledge Transfer: An Effective Approach for Extreme Large Language Model Compression
Jiduan Liu, Jiahao Liu, Qifan Wang, et al.
RetriKTLM GenerationPaper
PDF arXiv
Federated Learning via Decentralized Dataset Distillation in Resource-Constrained Edge Environments
Rui Song, Dai Liu, Dave Zhenyu Chen, et al.
FedD3SM GenerationPaper
PDF
GFL: Federated Learning on Non-IID Data via Privacy-Preserving Synthetic Data
Yihang Cheng, Lan Zhang, Anran Li
GFLSM GenerationPaper
PDF arXiv Star
FedTGP: Trainable Global Prototypes with Adaptive-Margin-Enhanced Contrastive Learning for Data and Model Heterogeneity in Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedTGPLM GenerationPaper
Code
PDF arXiv Star
Prompt Public Large Language Models to Synthesize Data for Private On-device Applications
Shan-Shan Wu, Zheng Xu, Yanxiang Zhang, et al.
DPSDLM GenerationPaper
Code
PDF arXiv Star
An Upload-Efficient Scheme for Transferring Knowledge from a Server-Side Pre-Trained Generator to Clients in Heterogeneous Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedKTLLM GenerationPaper
Code
PDF arXiv Star
Differentially Private Synthetic Data via Foundation Model APIs 1: Images
Zinan Lin, et al.
PELM GenerationPaper
Code
PDF arXiv Star
Differentially Private Synthetic Data via Foundation Model APIs 2: Text
Chulin Xie, Zinan Lin, Arturs Backurs, et al.
DPELM GenerationPaper
Code
PDF arXiv Star
Privacy-Preserving Instructions for Aligning Large Language Models
Da Yu, Peter Kairouz, Sewoong Oh, et al.
PPILM GenerationPaper
Code
PDF
Generate Synthetic Text Approximating the Private Distribution with Differential Privacy
Wenhao Zhao, Shaoyang Song, Chunlai Zhou
DP TextLM GenerationPaper
PDF arXiv Star
One-Shot Federated Learning via Synthetic Distiller-Distillate Communication
Junyuan Zhang, Songhua Liu, Xinchao Wang
FedSD2CSM GenerationPaper
Code
PDF arXiv Star
Federated Graph Condensation with Information Bottleneck Principles
Bo Yan, Sihao He, Cheng Yang, et al.
FedGCSM GenerationPaper
Code
arXiv
FedC4: Graph Condensation Meets Client-Client Collaboration for Efficient and Private Federated Graph Learning
Ze-kai Chen, Xun-kai Li, Yin-lin Zhu, et al.
FedC4SM GenerationPaper
PDF
Model-Based Large Language Model Customization as Service
Zhaomin Wu, Jizhou Guo, Junyi Hou, et al.
LlamdexLM GenerationPaper
PDF arXiv
Data-Adaptive Differentially Private Prompt Synthesis for in-Context Learning
Fengyu Gao, Ruida Zhou, Tianhao Wang, et al.
AdaDPSynLM GenerationPaper

(back to top ↑)

Parameter-based Transfer
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
Prefix-tuning: Optimizing Continuous Prompts for Generation
Xiang-Lisa Li, et al.
Prefix-tuningTunable PromptsPaper
Code
PDF Star
FedPETuning: When Federated Learning Meets the Parameter-Efficient Tuning Methods of Pre-Trained Language Models
Zhuo Zhang, Yuanhang Yang, Yong Dai, et al.
FedPETuningAdapters TransferPaper
Code
arXiv Star
Offsite-tuning: Transfer Learning without Full Model
Guangxuan Xiao, Ji Lin, Song Han
Offsite-tuningAdapters TransferPaper
Code
PDF arXiv Star
BlackVIP: Black-Box Visual Prompting for Robust Transfer Learning
Changdae Oh, Hyeji Hwang, Hee-young Lee, et al.
BlackVIPTunable PromptsPaper
Code
PDF
Parameter-Efficient Tuning for Large Language Model without Calculating Its Gradients
Feihu Jin, Jiajun Zhang, Chengqing Zong
PETAdapters TransferPaper
PDF arXiv Star
Tunable Soft Prompts Are Messengers in Federated Learning
Chenhe Dong, Yuexiang Xie, Bolin Ding, et al.
FedSPTunable PromptsPaper
Code
PDF arXiv
FedPrompt: Communication-Efficient and Privacy-Preserving Prompt Tuning in Federated Learning
Haodong Zhao, Wei Du, Fangqi Li, et al.
FedPromptTunable PromptsPaper
PDF arXiv Star
Black-Box Prompt Optimization: Aligning Large Language Models without Model Training
Jiale Cheng, Xiao Liu, Kehan Zheng, et al.
BPOTunable PromptsPaper
Code
PDF arXiv
Mixture of LoRA Experts
Xun Wu, Shaohan Huang, Furu Wei
MoLEAdapters TransferPaper
PDF arXiv Star
DoRA: Weight-Decomposed Low-Rank Adaptation
Shih-Yang Liu, Chien-Yi Wang, Hongxu Yin, et al.
DoRAAdapters TransferPaper
Code
PDF arXiv Star
InstructZero: Efficient Instruction Optimization for Black-Box Large Language Models6518
Lichang Chen, Jiuhai Chen, Tom Goldstein, et al.
InstructZeroTunable PromptsPaper
Code
PDF arXiv Star
Federated Adaptation for Foundation Model-Based Recommendations
Chun-xu Zhang, Guo-dong Long, Hong-kuan Guo, et al.
FedPAAdapters TransferPaper
Code

(back to top ↑)

Collab Cross-silo Collaborative Inference

Split Execution

(back to top ↑)

Collaborative Decoding
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
DExperts: Decoding-Time Controlled Text Generation with Experts and Anti-Experts
Alisa Liu, Maarten Sap, Ximing Lu, et al.
DExpertsProxy TuningPaper
Code
PDF arXiv Star
Contrastive Decoding: Open-Ended Text Generation as Optimization
Xiang Lisa Li, Ari Holtzman, Daniel Fried, et al.
CDContrastive DecodingPaper
Code
PDF arXiv Star
CombLM: Adapting Black-Box Language Models Through Small Fine-Tuned Models
Aitor Ormazabal, Mikel Artetxe, Eneko Agirre
CombLMProxy TuningPaper
Code
PDF arXiv Star
Fast Inference from Transformers via Speculative Decoding
Yaniv Leviathan, Matan Kalman, Yossi Matias
FIT-SDSpeculative DecodingPaper
Code
PDF arXiv Star
CoGenesis: A Framework Collaborating Large and Small Language Models for Secure Context-Aware Instruction Following
Kaiyan Zhang, Jianyu Wang, Ermo Hua, et al.
CoGenesisSignal-sharing DecodingPaper
Code
PDF Star
Controlled Text Generation for Black-Box Language Models via Score-Based Progressive Editor
Sangwon Yu, Changmin Lee, Hojin Lee, et al.
ScoPEProxy TuningPaper
Code
PDF arXiv Star
Small Models Are Valuable Plug-Ins for Large Language Models
Canwen Xu, Yichong Xu, Shuohang Wang, et al.
SuperICLProxy TuningPaper
Code
PDF arXiv Star
Tuning Language Models by Proxy
A-lisa Liu, Xiao-chuang Han, Yi-zhong Wang, et al.
Proxy-TuneProxy TuningPaper
Code
PDF arXiv Star
Mitigating Object Hallucinations in Large Vision-Language Models Through Visual Contrastive Decoding
Sicong Leng, Hang Zhang, Guanzheng Chen, et al.
VCDContrastive DecodingPaper
Code
PDF arXiv Star
Adaptive Contrastive Search: Uncertainty-Guided Decoding for Open-Ended Text Generation
Esteban Garces Arias, Julian Rodemann, Meimingwei Li, et al.
ACSContrastive DecodingPaper
Code
PDF arXiv
An Emulator for Fine-Tuning Large Language Models Using Small Language Models
Eric Mitchell, Rafael Rafailov, Archit Sharma, et al.
EFTProxy TuningPaper
PDF arXiv Star
DoLa: Decoding by Contrasting Layers Improves Factuality in Large Language Models
Yung-Sung Chuang, Yujia Xie, Hongyin Luo, et al.
DoLaContrastive DecodingPaper
Code
PDF arXiv Star
Online Speculative Decoding
Xiao-xuan Liu, Lan-xiang Hu, Peter Bailis, et al.
OSDSpeculative DecodingPaper
Code
PDF arXiv
Trusting Your Evidence: Hallucinate Less with Context-Aware Decoding
Weijia Shi, Xiaochuang Han, Mike Lewis, et al.
CADContrastive DecodingPaper
PDF arXiv Star
Cascade Speculative Drafting for Even Faster LLM Inference
Zi-yi Chen, Xiao-cong Yang, Jia-cheng Lin, et al.
CSSpeculative DecodingPaper
Code
PDF arXiv Star
On Giant's Shoulders: Effortless Weak to Strong by Dynamic Logits Fusion
Chenghao Fan, Zhenyi Lu, Wei Wei, et al.
Dynamic Logits FusionSignal-sharing DecodingPaper
Code
PDF arXiv
SpecTr: Fast Speculative Decoding via Optimal Transport
Zi-teng Sun, Ananda Theertha Suresh, Jae Hun Ro, et al.
SpecTrSpeculative DecodingPaper
PDF arXiv Star
Speculative Decoding with Big Little Decoder
Sehoon Kim, Karttikeya Mangalam, Suhong Moon, et al.
BiLDSpeculative DecodingPaper
Code
arXiv
CoSteer: Collaborative Decoding-Time Personalization via Local Delta Steering
Hang Lv, Sheng Liang, Hao Wang, et al.
CoSterrProxy TuningPaper
PDF arXiv
Active Layer-Contrastive Decoding Reduces Hallucination in Large Language Model Generation
Hongxiang Zhang, Hao Chen, Muhao Chen, et al.
ActLCDContrastive DecodingPaper
PDF arXiv
Faster Cascades via Speculative Decoding
Harikrishna Narasimhan, Wittawat Jitkrittum, Ankit Singh Rawat, et al.
FCSDSpeculative DecodingPaper
PDF arXiv
Judge Decoding: Faster Speculative Sampling Requires Going Beyond Model Alignment
Gregor Bachmann, Sotiris Anagnostidis, Albert Pumarola, et al.
JDSpeculative DecodingPaper
PDF arXiv
Logits Are All We Need to Adapt Closed Models
Gaurush Hiranandani, Haolun Wu, Subhojyoti Mukherjee, et al.
PluginProxy TuningPaper
PDF arXiv
Privacy Preserving in-Context-Learning Framework for Large Language Models
Bishnu Bhusal, Manoj Acharya, Ramneet Kaur, et al.
DP-ICLSignal-sharing DecodingPaper
arXiv
SpecSteer: Synergizing Local Context and Global Reasoning for Efficient Personalized Generation
Hang Lv, Sheng Liang, Hao Wang, et al.
SpecSteerProxy TuningPaper
arXiv
Thinking by Subtraction: Confidence-Driven Contrastive Decoding for LLM Reasoning
Lexiang Tang, Weihao Gao, Bingchen Zhao, et al.
CCDContrastive DecodingPaper
arXiv
Training-Free Adaptation of New-Generation LLMs Using Legacy Clinical Models
Sasha Ronaghi, Chloe Stanwyck, Asad Aali, et al.
CAPTProxy TuningPaper
PDF arXiv
DP Fusion: Token-Level Differentially Private Inference for Large Language Models
Rushil Thareja, Preslav Nakov, Praneeth Vepakomma, et al.
DP FusionSignal-sharing DecodingPaper

(back to top ↑)

Context-Augmented Collaboration

Retrieval Collaboration

Title & AuthorsMethodCategoryLinks
PDF arXiv Star
Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Patrick Lewis, Ethan Perez, Aleksandra Piktus, et al.
RAG-LLMRetrieval CollaborationPaper
Code
PDF arXiv Star
Improving the Domain Adaptation of Retrieval Augmented Generation (RAG) Models for Open Domain Question Answering
Shamane Siriwardhana, Rivindu Weerasekera, Elliott Wen, et al.
RAG-end2endRetrieval CollaborationPaper
Code
PDF arXiv
RA-DIT: Retrieval-Augmented Dual Instruction Tuning
Xi Victoria Lin, Xilun Chen, Mingda Chen, et al.
RA-DITRetrieval CollaborationPaper
PDF arXiv Star
Self-RAG: Learning to Retrieve, Generate, and Critique Through Self-Reflection
Akari Asai, Zeqiu Wu, Yizhong Wang, et al.
Self-RAGRetrieval CollaborationPaper
Code
PDF arXiv Star
REPLUG: Retrieval-Augmented Black-Box Language Models
Weijia Shi, Sewon Min, Michihiro Yasunaga, et al.
REPLUGRetrieval CollaborationPaper
Code
PDF arXiv Star
Seakr: Self-Aware Knowledge Retrieval for Adaptive Retrieval Augmented Generation
Zijun Yao, Weijian Qi, Liangming Pan, et al.
SeakrRetrieval CollaborationPaper
Code
PDF
UniRAG: Unified Query Understanding Method for Retrieval Augmented Generation
Rui Li, Liyang He, Qi Liu, et al.
UniRAGRetrieval CollaborationPaper
PDF arXiv
RemoteRAG: A Privacy-Preserving LLM Cloud RAG Service
Yihang Cheng, Lan Zhang, Junyang Wang, et al.
RemoteRAGRetrieval CollaborationPaper
PDF arXiv
Mitigating the Privacy Issues in Retrieval-Augmented Generation (RAG) via Pure Synthetic Data
Shenglai Zeng, Jiankun Zhang, Pengfei He, et al.
SAGERetrieval CollaborationPaper

Agentic Workflow

Title & AuthorsMethodCategoryLinks
PDF arXiv Star
MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework
Sirui Hong, Mingchen Zhuge, Jonathan Chen, et al.
MetaGPTAgentic WorkflowPaper
Code
PDF arXiv Star
HuggingGPT: Solving AI Tasks with ChatGPT and Its Friends in Hugging Face
Yongliang Shen, Kaitao Song, Xu Tan, et al.
HuggingGPTAgentic WorkflowPaper
Code
PDF arXiv Star
Reflexion: Language Agents with Verbal Reinforcement Learning
Noah Shinn, Federico Cassano, Ashwin Gopinath, et al.
ReflexionAgentic WorkflowPaper
Code
PDF arXiv Star
ChatDev: Communicative Agents for Software Development
Chen Qian, Wei Liu, Hongzhang Liu, et al.
ChatDevAgentic WorkflowPaper
Code
PDF arXiv Star
ReConcile: Round-Table Conference Improves Reasoning via Consensus among Diverse LLMs
Justin Chen, Swarnadeep Saha, Mohit Bansal
ReConcileAgentic WorkflowPaper
Code
PDF arXiv Star
AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversations
Qingyun Wu, Gagan Bansal, Jieyu Zhang, et al.
AutoGenAgentic WorkflowPaper
Code
PDF arXiv Star
Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate
Tian Liang, Zhiwei He, Wenxiang Jiao, et al.
MADAgentic WorkflowPaper
Code
PDF arXiv Star
TaskMatrix.AI: Completing Tasks by Connecting Foundation Models with Millions of APIs
Yaobo Liang, Chenfei Wu, Ting Song, et al.
TaskmatrixAgentic WorkflowPaper
Code
PDF arXiv Star
Mobile-Agent-V2: Mobile Device Operation Assistant with Effective Navigation via Multi-Agent Collaboration
Junyang Wang, Haiyang Xu, Haitao Jia, et al.
Mobile-AgentAgentic WorkflowPaper
Code
PDF arXiv
PlanGEN: A Multi-Agent Framework for Generating Planning and Reasoning Trajectories for Complex Problem Solving
Mihir Parmar, Xin Liu, Palash Goyal, et al.
PlanGENAgentic WorkflowPaper
PDF Star
Smurfs: Multi-Agent System Using Context-Efficient DFSDT for Tool Planning
Junzhi Chen, Juhao Liang, Benyou Wang
SmurfsAgentic WorkflowPaper
Code
PDF arXiv Star
CORE: Reducing UI Exposure in Mobile Agents via Collaboration Between Cloud and Local LLMs
Gucongcong Fan, Chaoyue Niu, Fan Wu, et al.
COREAgentic WorkflowPaper
Code
PDF arXiv Star
EcoAgent: An Efficient Edge-Cloud Collaborative Multi-Agent Framework for Mobile Automation
Biao Yi, Xavier Hu, Yurun Chen, et al.
EcoAgentAgentic WorkflowPaper
Code

(back to top ↑)


📄 License

This project is licensed under the MIT License.


✨ Star History

Star History Chart

Contributors

KejiaZhang-Robust/Awesome-LM-SM-Domain-Collaboration

Survey and resources on large-small model collaboration for domain-specific AI.

24

10 commits

updated Jul 3, 2026

See the code

README

Awesome LM-SM Domain Collaboration

License: MIT PRs Welcome arXiv Last Commit

[Paper]    [PDF]    [Contents]   

Large and small models collaborating across the trust boundary under privacy, ownership, and hardware constraints

Towards Harnessing the Collaborative Power of Large and Small Models for Domain Tasks [arXiv]

Yang Liu†,*,1, Kejia Zhang*,1, Bingjie Yan1, Tianyuan Zou2, Jianqing Zhang2,3, Zixuan Gu2,5, Xiangsen Chen1, Jianbing Ding4, Xidong Wang4, Jingyi Li4, Xiaozhou Ye4, Ye Ouyang4, Qiang Yang1, Ya-Qin Zhang2

1The Hong Kong Polytechnic University, 2Institute for AI Industry Research, Tsinghua University, 3Shanghai Jiao Tong University, 4AsiaInfo Technologies, 5School of Software, Tsinghua University

* Equal Contribution. † Corresponding Author (yang-veronica.liu@polyu.edu.hk).

[!TIP] If this repository or our survey paper helps your work, please consider citing it.

We also welcome pull requests and issues for missing papers, metadata fixes, taxonomy improvements, and content clarification.

📝 Citation

@article{liu2025towards,
  title={Towards Harnessing the Collaborative Power of Large and Small Models for Domain Tasks},
  author={Liu, Yang and Zhang, Kejia and Yan, Bingjie and Zou, Tianyuan and Zhang, Jianqing and Gu, Zixuan and Chen, Xiangsen and Ding, Jianbing and Wang, Xidong and Li, Jingyi and Ye, Xiaozhou and Ouyang, Ye and Yang, Qiang and Zhang, Ya-Qin},
  journal={arXiv preprint arXiv:2504.17421},
  year={2026}
}

🔥 News

  • [2026-06-28] Released the survey paper and this public repository.

🎯 Motivation

Domain tasks often involve private data, proprietary models, and limited local resources, which make centralized adaptation of large models impractical. LM-SM collaboration addresses this setting by combining the broad generalization of large models with the efficiency and locality of small models. This repository organizes representative methods by transfer direction and inference-time collaboration, with attention to privacy, model security, and resource constraints.

Taxonomy

Taxonomy of large-small model collaboration for domain tasks

📚 Contents

Badge legend
  • arXiv Badge arXiv papers
  • PDF Badge conference/journal papers
  • Star Badge code repository stars
  • Categories Badge method categories

LM2SM Knowledge Transfer from LMs to SMs

Distillation-based Transfer
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
FedMD: Heterogenous Federated Learning via Model Distillation
Daliang Li, Junpu Wang
FedMDCross-Silo DistillationPaper
Code
PDF
Ensemble Attention Distillation for Privacy-Preserving Federated Learning
Xuan Gong, Abhishek Sharma, Srikrishna Karanam, et al.
PPFLCross-Silo DistillationPaper
PDF arXiv Star
Zero-Shot Knowledge Distillation from a Decision-Based Black-Box Model
Zi Wang
ZSKDCross-Silo DistillationPaper
Code
PDF arXiv
Preserving Privacy in Federated Learning with Ensemble Cross-Domain Knowledge Distillation
Xuan Gong, Abhishek Sharma, Srikrishna Karanam, et al.
FedKDCross-Silo DistillationPaper
PDF arXiv Star
Towards Data-Free Model Stealing in a Hard Label Setting
Sunandini Sanyal, Sravanti Addepalli, R Venkatesh Babu
Hard-label StealingCross-Silo DistillationPaper
Code
arXiv Star
Offsite-Tuning: Transfer Learning without Full Model
Guangxuan Xiao, Ji Lin, Song Han
Offsite-TuningSingle-Silo DistillationPaper
Code
PDF arXiv
CRaSh: Clustering, Removing, and Sharing Enhance Fine-Tuning without Full Large Language Model
Kai-yan Zhang, Ning Ding, Biqing Qi, et al.
CRaShSingle-Silo DistillationPaper
PDF arXiv Star
IDEAL: Query-Efficient Data-Free Learning from Black-Box Models
Jie Zhang, et al.
IDEALCross-Silo DistillationPaper
Code
PDF Star
Data Shunt: Collaboration of Small and Large Models for Lower Costs and Better Performance
Dong Chen, Yueting Zhuang, Shuo Zhang, et al.
EC-KDCross-Silo DistillationPaper
Code
PDF arXiv Star
FedTGP: Trainable Global Prototypes with Adaptive-Margin-Enhanced Contrastive Learning for Data and Model Heterogeneity in Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedTGPCross-Silo DistillationPaper
Code
PDF arXiv Star
An Upload-Efficient Scheme for Transferring Knowledge from a Server-Side Pre-Trained Generator to Clients in Heterogeneous Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedKTLCross-Silo DistillationPaper
Code
PDF arXiv
AMD: Automatic Multi-Step Distillation of Large-Scale Vision Models
Cheng Han, Qifan Wang, Sohail A Dianat, et al.
AMDSingle-Silo DistillationPaper
PDF arXiv
Orchestration of Emulator Assisted 6G Mobile Edge Tuning for AI Foundation Models: A Multi-Agent Deep Reinforcement Learning Approach
Wenhan Yu, Terence Jie Chua, Jun Zhao
Emulator-AdapterSingle-Silo DistillationPaper
PDF arXiv
FedPFT: Federated Proxy Fine-Tuning of Foundation Models
Zhaopeng Peng, Xiaoliang Fan, Yufan Chen, et al.
FedPFTSingle-Silo DistillationPaper
PDF
FedGMKD: An Efficient Prototype Federated Learning Framework Through Knowledge Distillation and Discrepancy-Aware Aggregation
Jian-qiao Zhang, Cai-feng Shan, Jungong Han
FedGMKDCross-Silo DistillationPaper
PDF arXiv
ScaleOT: Privacy-Utility-Scalable Offsite-Tuning with Dynamic LayerReplace and Selective Rank Compression
Kai Yao, zhaorui Tan, Tiandi Ye, et al.
ScaleOTSingle-Silo DistillationPaper
PDF arXiv
GradOT: Training-Free Gradient-Preserving Offsite-Tuning for Large Language Models
Kai Yao, Zhaorui Tan, Penglei Gao, et al.
GradOTSingle-Silo DistillationPaper
PDF
Synthetic Data Distillation Enables the Extraction of Clinical Information at Scale
Elizabeth Geena Woo, Michael C Burkhart, Emily Alsentzer, et al.
SD-CLCross-Silo DistillationPaper

(back to top ↑)

Generation-based Transfer
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
ZeroGen: Efficient Zero-Shot Learning via Dataset Generation
Jiacheng Ye, Jiahui Gao, Qintong Li, et al.
ZeroGenOpen-loop GenerationPaper
Code
PDF arXiv Star
ProGen: Progressive Zero-Shot Dataset Generation via in-Context Feedback
Jiacheng Ye, Jiahui Gao, Zhiyong Wu, et al.
ProGenClosed-loop GenerationPaper
Code
PDF arXiv Star
Generating Training Data with Language Models: Towards Zero-Shot Language Understanding
Yu Meng, Jiaxin Huang, Yu Zhang, et al.
SuperGenOpen-loop GenerationPaper
Code
arXiv
Mutual Enhancement of Large and Small Language Models with Cross-Silo Knowledge Transfer
Yongheng Deng, Ziqing Qiao, Ju Ren, et al.
CrossLMClosed-loop GenerationPaper
PDF arXiv
Retrieval-Based Knowledge Transfer: An Effective Approach for Extreme Large Language Model Compression
Jiduan Liu, Jiahao Liu, Qifan Wang, et al.
RetriKTOpen-loop GenerationPaper
PDF arXiv Star
Self-Guided Noise-Free Data Generation for Efficient Zero-Shot Learning
Jiahui Gao, Renjie Pi, Lin Yong, et al.
SunGenOpen-loop GenerationPaper
Code
arXiv
No More Hard Prompts: SoftSRV Prompting for Synthetic Data Generation
Giulia DeSalvo, Jean-Fracois Kagy, Lazaros Karydas, et al.
SoftSRVClosed-loop GenerationPaper
PDF arXiv
Evolving Knowledge Distillation with Large Language Models and Active Learning
Chengyuan Liu, Fubang Zhao, Kun Kuang, et al.
EKDClosed-loop GenerationPaper
PDF arXiv
Prompt Public Large Language Models to Synthesize Data for Private On-device Applications
Shanshan Wu, Zheng Xu, Yanxiang Zhang, et al.
PubSynthOpen-loop GenerationPaper
PDF arXiv Star
Fusegen: PLM Fusion for Data-Generation Based Zero-Shot Learning
Tianyuan Zou, Yang Liu, Peng Li, et al.
FusegenClosed-loop GenerationPaper
Code
PDF arXiv
Zero-Shot Cross-Lingual Transfer for Synthetic Data Generation in Grammatical Error Detection
Gaetan Latouche, Marc-André Carbonneau, Ben Swanson
CLTGenOpen-loop GenerationPaper
PDF arXiv Star
GOLD: Generalized Knowledge Distillation via Out-of-Distribution-Guided Language Data Generation
Mohsen Gholami, Mohammad Akbari, Tianxi Hu, et al.
GOLDOpen-loop GenerationPaper
Code
PDF arXiv Star
Distilling On-device Language Models for Robot Planning with Minimal Human Intervention
Zachary Ravichandran, Ignacio Hounie, Fernando Cladera, et al.
PRISMOpen-loop GenerationPaper
Code
PDF arXiv
Enhancing Reasoning Abilities of Small LLMs with Cognitive Alignment
Wenrui Cai, Chengyu Wang, Junbing Yan, et al.
CRVClosed-loop GenerationPaper
PDF arXiv Star
Montessori-Instruct: Generate Influential Training Data Tailored for Student Learning
Xiaochuan Li, Zichun Yu, Chenyan Xiong
Montessori-InstructClosed-loop GenerationPaper
Code
PDF arXiv Star
Learning with Less: Knowledge Distillation from Large Language Models via Unlabeled Data
Juanhui Li, Sreyashi Nag, Hui Liu, et al.
LLKDOpen-loop GenerationPaper
Code
PDF Star
Synthetic Data Distillation Enables the Extraction of Clinical Information at Scale
Elizabeth Geena Woo, Michael C Burkhart, Emily Alsentzer, et al.
SD-CLOpen-loop GenerationPaper
Code

(back to top ↑)

Parameter-based Transfer

(back to top ↑)

SM2LM Knowledge Transfer from SMs to LMs

Distillation-based Transfer
Title & AuthorsMethodCategoryLinks
arXiv
FedGEMS: Federated Learning of Larger Server Models via Selective Knowledge Fusion
Sijie Cheng, Jingwen Wu, Yanghua Xiao, et al.
FedGEMEnsemble KDPaper
arXiv
Learning to Teach with Student Feedback
Yi-tao Liu, Tian-xiang Sun, Xi-peng Qiu, et al.
IKDStudent-centered KDPaper
PDF arXiv Star
Meta Pseudo Labels
Hieu Pham, Zihang Dai, Qizhe Xie, et al.
Meta-Pseudo-LabelsStudent-centered KDPaper
Code
PDF
Dual Knowledge Distillation for Bidirectional Neural Machine Translation
Huaao Zhang, Shigui Qiu, Shilong Wu
DKDBBackward/Reverse KDPaper
PDF arXiv Star
BERT Learns to Teach: Knowledge Distillation with Meta Learning
Wangchunshu Zhou, Canwen Xu, Julian McAuley
MetaDistilStudent-centered KDPaper
Code
PDF Star
Shadow Knowledge Distillation: Bridging Offline and Online Knowledge Transfer
Lujun Li, Zhe Jin
SHAKEBackward/Reverse KDPaper
Code
PDF arXiv Star
IDEAL: Query-Efficient Data-Free Learning from Black-Box Models
Jie Zhang, et al.
IDEALStudent-centered KDPaper
Code
PDF arXiv Star
Multimodal Federated Learning via Contrastive Representation Ensemble
Qiying Yu, Yang Liu, Yimu Wang, et al.
CreamFLEnsemble KDPaper
Code
PDF Star
DataShunt: Collaboration of Small and Large Models for Lower Costs and Better Performance
Dong Chen, Yueting Zhuang, Shuo Zhang, et al.
DataShuntStudent-centered KDPaper
Code
PDF arXiv
Weak-To-Strong Generalization: Eliciting Strong Capabilities with Weak Supervision
Collin Burns, et al.
W2SStudent-centered KDPaper
PDF arXiv Star
Reverse Knowledge Distillation: Training a Large Model Using a Small One for Retinal Image Matching on Limited Data
Sahar Almahfouz Nasser, Nihar Gupte, Amit Sethi
RKDBackward/Reverse KDPaper
Code
PDF arXiv
Beyond Output Matching: Bidirectional Alignment for Enhanced in-Context Learning
Chengwei Qin, Wenhan Xia, Fangkai Jiao, et al.
BiAlignBackward/Reverse KDPaper
arXiv
Bidirectional Knowledge Distillation for Enhancing Sequential Recommendation with Large Language Models
Jiongran Wu, Jiahao Liu, Dongsheng Li, et al.
LLMD4RecBackward/Reverse KDPaper
PDF arXiv Star
BiLD: Bi-Directional Logits Difference Loss for Large Language Model Distillation
Minchong Li, Feng Zhou, Xiaohui Song
BiLDBackward/Reverse KDPaper
Code
PDF arXiv Star
FedMKT: Federated Mutual Knowledge Transfer for Large and Small Language Models
Tao Fan, Guoqiang Ma, Yan Kang, et al.
FedMKTEnsemble KDPaper
Code
PDF Star
Evidential Knowledge Distillation
Liangyu Xiang, Junyu Gao, Changsheng Xu
EKDStudent-centered KDPaper
Code
PDF arXiv Star
SLMRec: Distilling Large Language Models into Small for Sequential Recommendation
Wujiang Xu, Qitian Wu, Zujie Liang, et al.
SLMRecStudent-centered KDPaper
Code

(back to top ↑)

Generation-based Transfer
Title & AuthorsMethodCategoryLinks
arXiv Star
Dataset Distillation
Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba, et al.
Dataset DistillationSM GenerationPaper
Code
PDF arXiv Star
Mixup: Beyond Empirical Risk Minimization
Hongyi Zhang, Moustapha Cisse, Yann N. Dauphin, et al.
MixupSM GenerationPaper
Code
arXiv
Distilled One-Shot Federated Learning
Yanlin Zhou, George Pu, Xiyao Ma, et al.
DOSFLSM GenerationPaper
PDF arXiv Star
Dataset Condensation with Gradient Matching
Bo Zhao, et al.
Dataset CondensationSM GenerationPaper
Code
PDF arXiv Star
FedProto: Federated Prototype Learning Across Heterogeneous Clients
Yue Tan, et al.
FedProtoLM GenerationPaper
Code
PDF arXiv
Federated Learning with Gan-Based Data Synthesis for Non-IID Clients
Zi-jian Li, Jia-wei Shao, Yu-yi Mao, et al.
FL-GDSSM GenerationPaper
PDF Star
Stable Federated Learning with Dataset Condensation
Seong-Woong Kim, et al.
SFLDSM GenerationPaper
Code
PDF arXiv Star
Federated Learning from Pre-Trained Models: A Contrastive Learning Approach
Yue Tan, Guodong Long, Jie Ma, et al.
FedPCLLM GenerationPaper
Code
PDF arXiv
Synthetic Text Generation with Differential Privacy: A Simple and Practical Recipe
Xiang Yue, Huseyin Inan, Xuechen Li, et al.
DP TransformersLM GenerationPaper
arXiv
Harnessing Large-Language Models to Generate Private Synthetic Text
Alexey Kurakin, Natalia Ponomareva, Umar Syed, et al.
PSTLM GenerationPaper
arXiv
Mutual Enhancement of Large and Small Language Models with Cross-Silo Knowledge Transfer
Yongheng Deng, Ziqing Qiao, Ju Ren, et al.
CrossLMLM GenerationPaper
PDF arXiv Star
Let's Synthesize Step by Step: Iterative Dataset Synthesis with Large Language Models by Extrapolating Errors from Small Models
WANG Ruida, Wangchunshu Zhou, Mrinmaya Sachan
S3LM GenerationPaper
Code
PDF arXiv
Retrieval-Based Knowledge Transfer: An Effective Approach for Extreme Large Language Model Compression
Jiduan Liu, Jiahao Liu, Qifan Wang, et al.
RetriKTLM GenerationPaper
PDF arXiv
Federated Learning via Decentralized Dataset Distillation in Resource-Constrained Edge Environments
Rui Song, Dai Liu, Dave Zhenyu Chen, et al.
FedD3SM GenerationPaper
PDF
GFL: Federated Learning on Non-IID Data via Privacy-Preserving Synthetic Data
Yihang Cheng, Lan Zhang, Anran Li
GFLSM GenerationPaper
PDF arXiv Star
FedTGP: Trainable Global Prototypes with Adaptive-Margin-Enhanced Contrastive Learning for Data and Model Heterogeneity in Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedTGPLM GenerationPaper
Code
PDF arXiv Star
Prompt Public Large Language Models to Synthesize Data for Private On-device Applications
Shan-Shan Wu, Zheng Xu, Yanxiang Zhang, et al.
DPSDLM GenerationPaper
Code
PDF arXiv Star
An Upload-Efficient Scheme for Transferring Knowledge from a Server-Side Pre-Trained Generator to Clients in Heterogeneous Federated Learning
Jianqing Zhang, Yang Liu, Yang Hua, et al.
FedKTLLM GenerationPaper
Code
PDF arXiv Star
Differentially Private Synthetic Data via Foundation Model APIs 1: Images
Zinan Lin, et al.
PELM GenerationPaper
Code
PDF arXiv Star
Differentially Private Synthetic Data via Foundation Model APIs 2: Text
Chulin Xie, Zinan Lin, Arturs Backurs, et al.
DPELM GenerationPaper
Code
PDF arXiv Star
Privacy-Preserving Instructions for Aligning Large Language Models
Da Yu, Peter Kairouz, Sewoong Oh, et al.
PPILM GenerationPaper
Code
PDF
Generate Synthetic Text Approximating the Private Distribution with Differential Privacy
Wenhao Zhao, Shaoyang Song, Chunlai Zhou
DP TextLM GenerationPaper
PDF arXiv Star
One-Shot Federated Learning via Synthetic Distiller-Distillate Communication
Junyuan Zhang, Songhua Liu, Xinchao Wang
FedSD2CSM GenerationPaper
Code
PDF arXiv Star
Federated Graph Condensation with Information Bottleneck Principles
Bo Yan, Sihao He, Cheng Yang, et al.
FedGCSM GenerationPaper
Code
arXiv
FedC4: Graph Condensation Meets Client-Client Collaboration for Efficient and Private Federated Graph Learning
Ze-kai Chen, Xun-kai Li, Yin-lin Zhu, et al.
FedC4SM GenerationPaper
PDF
Model-Based Large Language Model Customization as Service
Zhaomin Wu, Jizhou Guo, Junyi Hou, et al.
LlamdexLM GenerationPaper
PDF arXiv
Data-Adaptive Differentially Private Prompt Synthesis for in-Context Learning
Fengyu Gao, Ruida Zhou, Tianhao Wang, et al.
AdaDPSynLM GenerationPaper

(back to top ↑)

Parameter-based Transfer
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
Prefix-tuning: Optimizing Continuous Prompts for Generation
Xiang-Lisa Li, et al.
Prefix-tuningTunable PromptsPaper
Code
PDF Star
FedPETuning: When Federated Learning Meets the Parameter-Efficient Tuning Methods of Pre-Trained Language Models
Zhuo Zhang, Yuanhang Yang, Yong Dai, et al.
FedPETuningAdapters TransferPaper
Code
arXiv Star
Offsite-tuning: Transfer Learning without Full Model
Guangxuan Xiao, Ji Lin, Song Han
Offsite-tuningAdapters TransferPaper
Code
PDF arXiv Star
BlackVIP: Black-Box Visual Prompting for Robust Transfer Learning
Changdae Oh, Hyeji Hwang, Hee-young Lee, et al.
BlackVIPTunable PromptsPaper
Code
PDF
Parameter-Efficient Tuning for Large Language Model without Calculating Its Gradients
Feihu Jin, Jiajun Zhang, Chengqing Zong
PETAdapters TransferPaper
PDF arXiv Star
Tunable Soft Prompts Are Messengers in Federated Learning
Chenhe Dong, Yuexiang Xie, Bolin Ding, et al.
FedSPTunable PromptsPaper
Code
PDF arXiv
FedPrompt: Communication-Efficient and Privacy-Preserving Prompt Tuning in Federated Learning
Haodong Zhao, Wei Du, Fangqi Li, et al.
FedPromptTunable PromptsPaper
PDF arXiv Star
Black-Box Prompt Optimization: Aligning Large Language Models without Model Training
Jiale Cheng, Xiao Liu, Kehan Zheng, et al.
BPOTunable PromptsPaper
Code
PDF arXiv
Mixture of LoRA Experts
Xun Wu, Shaohan Huang, Furu Wei
MoLEAdapters TransferPaper
PDF arXiv Star
DoRA: Weight-Decomposed Low-Rank Adaptation
Shih-Yang Liu, Chien-Yi Wang, Hongxu Yin, et al.
DoRAAdapters TransferPaper
Code
PDF arXiv Star
InstructZero: Efficient Instruction Optimization for Black-Box Large Language Models6518
Lichang Chen, Jiuhai Chen, Tom Goldstein, et al.
InstructZeroTunable PromptsPaper
Code
PDF arXiv Star
Federated Adaptation for Foundation Model-Based Recommendations
Chun-xu Zhang, Guo-dong Long, Hong-kuan Guo, et al.
FedPAAdapters TransferPaper
Code

(back to top ↑)

Collab Cross-silo Collaborative Inference

Split Execution
(back to top ↑)

Collaborative Decoding
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
DExperts: Decoding-Time Controlled Text Generation with Experts and Anti-Experts
Alisa Liu, Maarten Sap, Ximing Lu, et al.
DExpertsProxy TuningPaper
Code
PDF arXiv Star
Contrastive Decoding: Open-Ended Text Generation as Optimization
Xiang Lisa Li, Ari Holtzman, Daniel Fried, et al.
CDContrastive DecodingPaper
Code
PDF arXiv Star
CombLM: Adapting Black-Box Language Models Through Small Fine-Tuned Models
Aitor Ormazabal, Mikel Artetxe, Eneko Agirre
CombLMProxy TuningPaper
Code
PDF arXiv Star
Fast Inference from Transformers via Speculative Decoding
Yaniv Leviathan, Matan Kalman, Yossi Matias
FIT-SDSpeculative DecodingPaper
Code
PDF arXiv Star
CoGenesis: A Framework Collaborating Large and Small Language Models for Secure Context-Aware Instruction Following
Kaiyan Zhang, Jianyu Wang, Ermo Hua, et al.
CoGenesisSignal-sharing DecodingPaper
Code
PDF Star
Controlled Text Generation for Black-Box Language Models via Score-Based Progressive Editor
Sangwon Yu, Changmin Lee, Hojin Lee, et al.
ScoPEProxy TuningPaper
Code
PDF arXiv Star
Small Models Are Valuable Plug-Ins for Large Language Models
Canwen Xu, Yichong Xu, Shuohang Wang, et al.
SuperICLProxy TuningPaper
Code
PDF arXiv Star
Tuning Language Models by Proxy
A-lisa Liu, Xiao-chuang Han, Yi-zhong Wang, et al.
Proxy-TuneProxy TuningPaper
Code
PDF arXiv Star
Mitigating Object Hallucinations in Large Vision-Language Models Through Visual Contrastive Decoding
Sicong Leng, Hang Zhang, Guanzheng Chen, et al.
VCDContrastive DecodingPaper
Code
PDF arXiv Star
Adaptive Contrastive Search: Uncertainty-Guided Decoding for Open-Ended Text Generation
Esteban Garces Arias, Julian Rodemann, Meimingwei Li, et al.
ACSContrastive DecodingPaper
Code
PDF arXiv
An Emulator for Fine-Tuning Large Language Models Using Small Language Models
Eric Mitchell, Rafael Rafailov, Archit Sharma, et al.
EFTProxy TuningPaper
PDF arXiv Star
DoLa: Decoding by Contrasting Layers Improves Factuality in Large Language Models
Yung-Sung Chuang, Yujia Xie, Hongyin Luo, et al.
DoLaContrastive DecodingPaper
Code
PDF arXiv Star
Online Speculative Decoding
Xiao-xuan Liu, Lan-xiang Hu, Peter Bailis, et al.
OSDSpeculative DecodingPaper
Code
PDF arXiv
Trusting Your Evidence: Hallucinate Less with Context-Aware Decoding
Weijia Shi, Xiaochuang Han, Mike Lewis, et al.
CADContrastive DecodingPaper
PDF arXiv Star
Cascade Speculative Drafting for Even Faster LLM Inference
Zi-yi Chen, Xiao-cong Yang, Jia-cheng Lin, et al.
CSSpeculative DecodingPaper
Code
PDF arXiv Star
On Giant's Shoulders: Effortless Weak to Strong by Dynamic Logits Fusion
Chenghao Fan, Zhenyi Lu, Wei Wei, et al.
Dynamic Logits FusionSignal-sharing DecodingPaper
Code
PDF arXiv
SpecTr: Fast Speculative Decoding via Optimal Transport
Zi-teng Sun, Ananda Theertha Suresh, Jae Hun Ro, et al.
SpecTrSpeculative DecodingPaper
PDF arXiv Star
Speculative Decoding with Big Little Decoder
Sehoon Kim, Karttikeya Mangalam, Suhong Moon, et al.
BiLDSpeculative DecodingPaper
Code
arXiv
CoSteer: Collaborative Decoding-Time Personalization via Local Delta Steering
Hang Lv, Sheng Liang, Hao Wang, et al.
CoSterrProxy TuningPaper
PDF arXiv
Active Layer-Contrastive Decoding Reduces Hallucination in Large Language Model Generation
Hongxiang Zhang, Hao Chen, Muhao Chen, et al.
ActLCDContrastive DecodingPaper
PDF arXiv
Faster Cascades via Speculative Decoding
Harikrishna Narasimhan, Wittawat Jitkrittum, Ankit Singh Rawat, et al.
FCSDSpeculative DecodingPaper
PDF arXiv
Judge Decoding: Faster Speculative Sampling Requires Going Beyond Model Alignment
Gregor Bachmann, Sotiris Anagnostidis, Albert Pumarola, et al.
JDSpeculative DecodingPaper
PDF arXiv
Logits Are All We Need to Adapt Closed Models
Gaurush Hiranandani, Haolun Wu, Subhojyoti Mukherjee, et al.
PluginProxy TuningPaper
PDF arXiv
Privacy Preserving in-Context-Learning Framework for Large Language Models
Bishnu Bhusal, Manoj Acharya, Ramneet Kaur, et al.
DP-ICLSignal-sharing DecodingPaper
arXiv
SpecSteer: Synergizing Local Context and Global Reasoning for Efficient Personalized Generation
Hang Lv, Sheng Liang, Hao Wang, et al.
SpecSteerProxy TuningPaper
arXiv
Thinking by Subtraction: Confidence-Driven Contrastive Decoding for LLM Reasoning
Lexiang Tang, Weihao Gao, Bingchen Zhao, et al.
CCDContrastive DecodingPaper
arXiv
Training-Free Adaptation of New-Generation LLMs Using Legacy Clinical Models
Sasha Ronaghi, Chloe Stanwyck, Asad Aali, et al.
CAPTProxy TuningPaper
PDF arXiv
DP Fusion: Token-Level Differentially Private Inference for Large Language Models
Rushil Thareja, Preslav Nakov, Praneeth Vepakomma, et al.
DP FusionSignal-sharing DecodingPaper

(back to top ↑)

Context-Augmented Collaboration

Retrieval Collaboration

Title & AuthorsMethodCategoryLinks
PDF arXiv Star
Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Patrick Lewis, Ethan Perez, Aleksandra Piktus, et al.
RAG-LLMRetrieval CollaborationPaper
Code
PDF arXiv Star
Improving the Domain Adaptation of Retrieval Augmented Generation (RAG) Models for Open Domain Question Answering
Shamane Siriwardhana, Rivindu Weerasekera, Elliott Wen, et al.
RAG-end2endRetrieval CollaborationPaper
Code
PDF arXiv
RA-DIT: Retrieval-Augmented Dual Instruction Tuning
Xi Victoria Lin, Xilun Chen, Mingda Chen, et al.
RA-DITRetrieval CollaborationPaper
PDF arXiv Star
Self-RAG: Learning to Retrieve, Generate, and Critique Through Self-Reflection
Akari Asai, Zeqiu Wu, Yizhong Wang, et al.
Self-RAGRetrieval CollaborationPaper
Code
PDF arXiv Star
REPLUG: Retrieval-Augmented Black-Box Language Models
Weijia Shi, Sewon Min, Michihiro Yasunaga, et al.
REPLUGRetrieval CollaborationPaper
Code
PDF arXiv Star
Seakr: Self-Aware Knowledge Retrieval for Adaptive Retrieval Augmented Generation
Zijun Yao, Weijian Qi, Liangming Pan, et al.
SeakrRetrieval CollaborationPaper
Code
PDF
UniRAG: Unified Query Understanding Method for Retrieval Augmented Generation
Rui Li, Liyang He, Qi Liu, et al.
UniRAGRetrieval CollaborationPaper
PDF arXiv
RemoteRAG: A Privacy-Preserving LLM Cloud RAG Service
Yihang Cheng, Lan Zhang, Junyang Wang, et al.
RemoteRAGRetrieval CollaborationPaper
PDF arXiv
Mitigating the Privacy Issues in Retrieval-Augmented Generation (RAG) via Pure Synthetic Data
Shenglai Zeng, Jiankun Zhang, Pengfei He, et al.
SAGERetrieval CollaborationPaper

Agentic Workflow
Title & AuthorsMethodCategoryLinks
PDF arXiv Star
MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework
Sirui Hong, Mingchen Zhuge, Jonathan Chen, et al.
MetaGPTAgentic WorkflowPaper
Code
PDF arXiv Star
HuggingGPT: Solving AI Tasks with ChatGPT and Its Friends in Hugging Face
Yongliang Shen, Kaitao Song, Xu Tan, et al.
HuggingGPTAgentic WorkflowPaper
Code
PDF arXiv Star
Reflexion: Language Agents with Verbal Reinforcement Learning
Noah Shinn, Federico Cassano, Ashwin Gopinath, et al.
ReflexionAgentic WorkflowPaper
Code
PDF arXiv Star
ChatDev: Communicative Agents for Software Development
Chen Qian, Wei Liu, Hongzhang Liu, et al.
ChatDevAgentic WorkflowPaper
Code
PDF arXiv Star
ReConcile: Round-Table Conference Improves Reasoning via Consensus among Diverse LLMs
Justin Chen, Swarnadeep Saha, Mohit Bansal
ReConcileAgentic WorkflowPaper
Code
PDF arXiv Star
AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversations
Qingyun Wu, Gagan Bansal, Jieyu Zhang, et al.
AutoGenAgentic WorkflowPaper
Code
PDF arXiv Star
Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate
Tian Liang, Zhiwei He, Wenxiang Jiao, et al.
MADAgentic WorkflowPaper
Code
PDF arXiv Star
TaskMatrix.AI: Completing Tasks by Connecting Foundation Models with Millions of APIs
Yaobo Liang, Chenfei Wu, Ting Song, et al.
TaskmatrixAgentic WorkflowPaper
Code
PDF arXiv Star
Mobile-Agent-V2: Mobile Device Operation Assistant with Effective Navigation via Multi-Agent Collaboration
Junyang Wang, Haiyang Xu, Haitao Jia, et al.
Mobile-AgentAgentic WorkflowPaper
Code
PDF arXiv
PlanGEN: A Multi-Agent Framework for Generating Planning and Reasoning Trajectories for Complex Problem Solving
Mihir Parmar, Xin Liu, Palash Goyal, et al.
PlanGENAgentic WorkflowPaper
PDF Star
Smurfs: Multi-Agent System Using Context-Efficient DFSDT for Tool Planning
Junzhi Chen, Juhao Liang, Benyou Wang
SmurfsAgentic WorkflowPaper
Code
PDF arXiv Star
CORE: Reducing UI Exposure in Mobile Agents via Collaboration Between Cloud and Local LLMs
Gucongcong Fan, Chaoyue Niu, Fan Wu, et al.
COREAgentic WorkflowPaper
Code
PDF arXiv Star
EcoAgent: An Efficient Edge-Cloud Collaborative Multi-Agent Framework for Mobile Automation
Biao Yi, Xavier Hu, Yurun Chen, et al.
EcoAgentAgentic WorkflowPaper
Code

(back to top ↑)


📄 License

This project is licensed under the MIT License.


✨ Star History

Star History Chart

Contributors