面向初学者的 LeRobot 入门教程,包含 ACT、Pi0、SmolVLA 等具身智能模型的原理解析与实践记录。
Jupyter Notebook
13
10 commits
updated Jun 9, 2026
面向初学者的 LeRobot 入门教程,包含 ACT、Pi0、SmolVLA 等具身智能模型的原理解析与实践记录。
这个项目的核心运行逻辑是:
人类遥操作 → 生成演示数据 → 训练模型 → 模型学会操作 → 在仿真中执行
Linux系统:Ubuntu22.04
编程IDE::Vscode
下载链接:https://code.visualstudio.com/
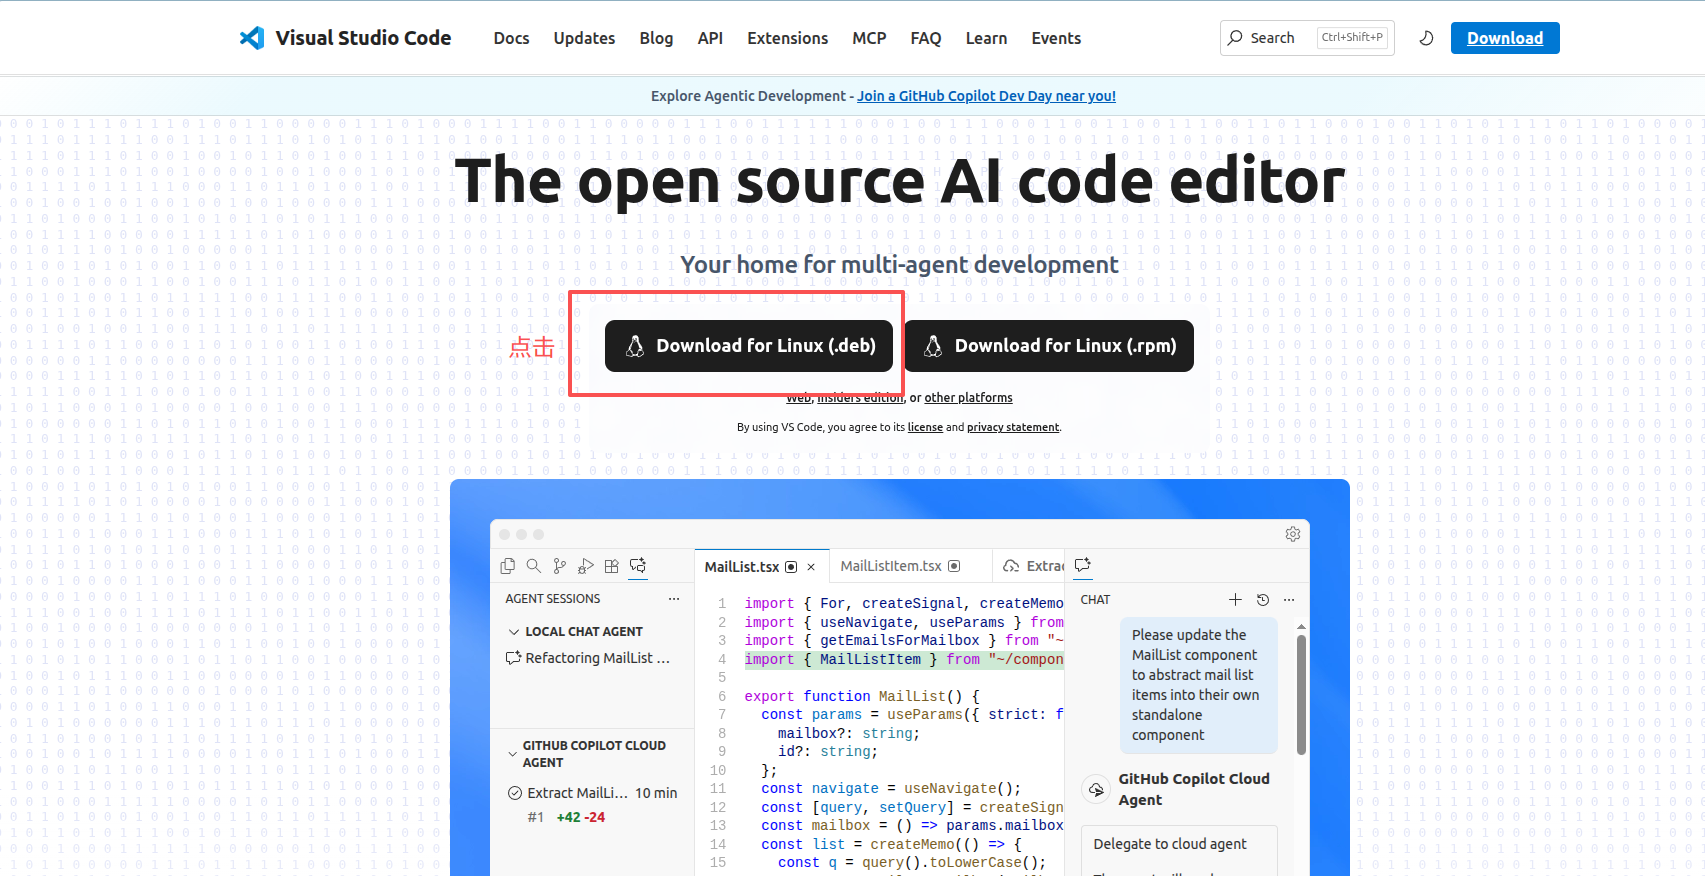
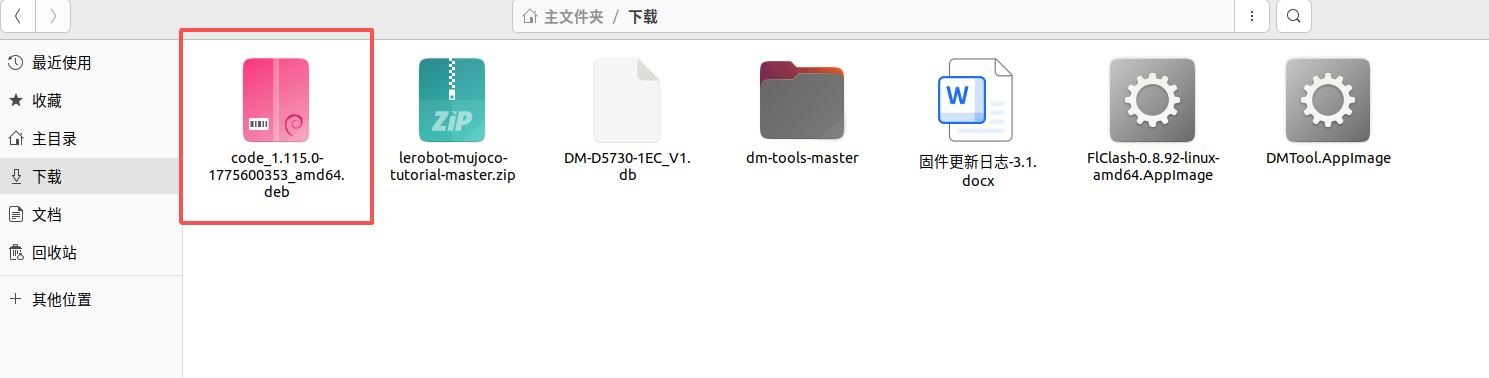
在这个下载页面,右键并选择“在终端打开”:
在终端内输入:
sudo dpkg -i xxxxxxxxxx这里的xxxxxxxxxx替换为下载文件名称,如图所示:
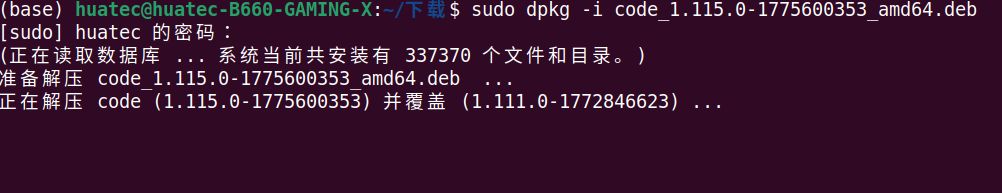
即可安装完成vscode
可以直接下载这个压缩包,并解压:
暂时无法在飞书文档外展示此内容
也可以在官网上下载:
文件网址:https://github.com/jeongeun980906/lerobot-mujoco-tutorial?tab=readme-ov-file#installation
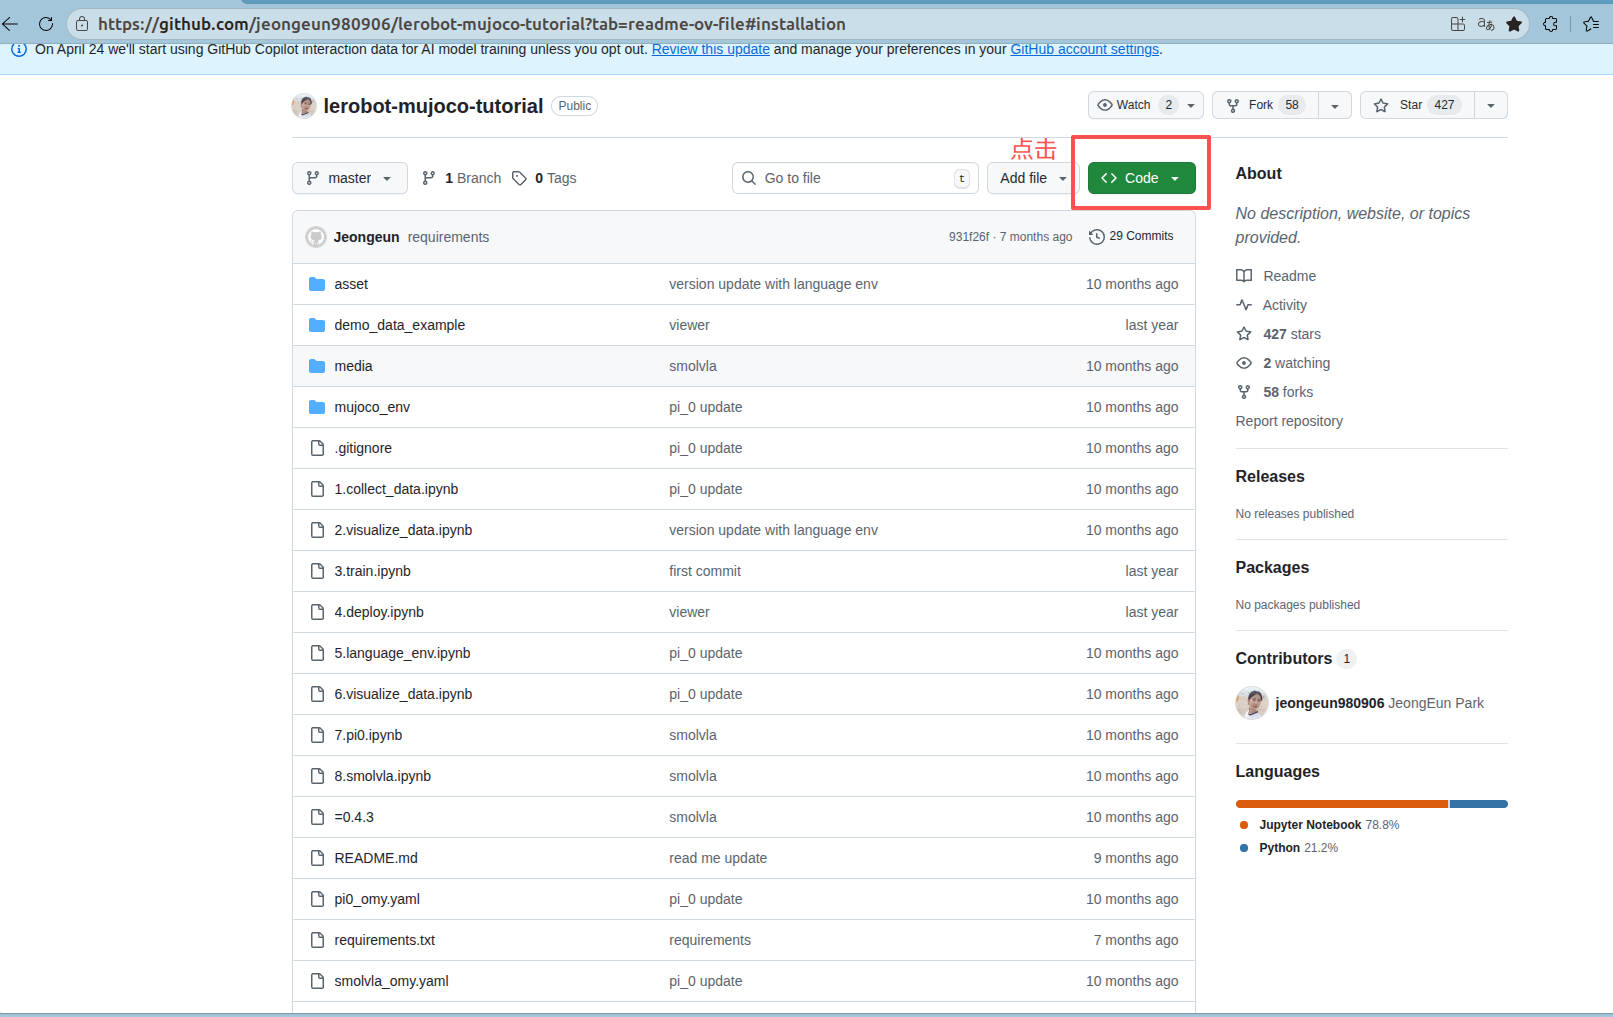
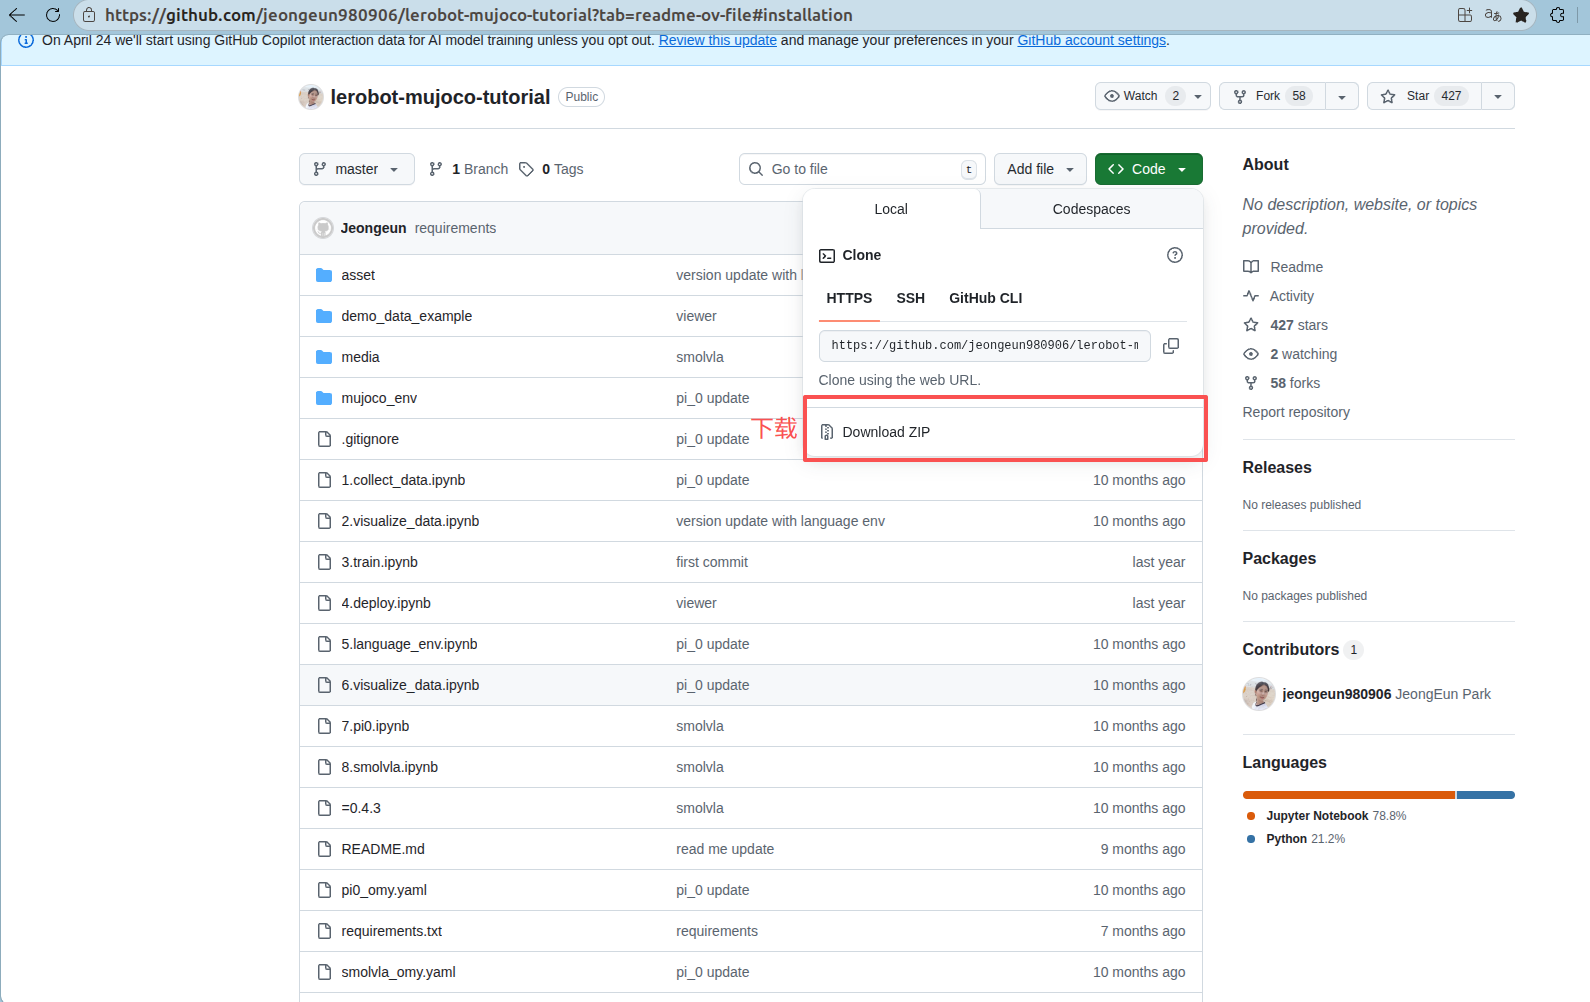
并将文件夹放在主目录下:
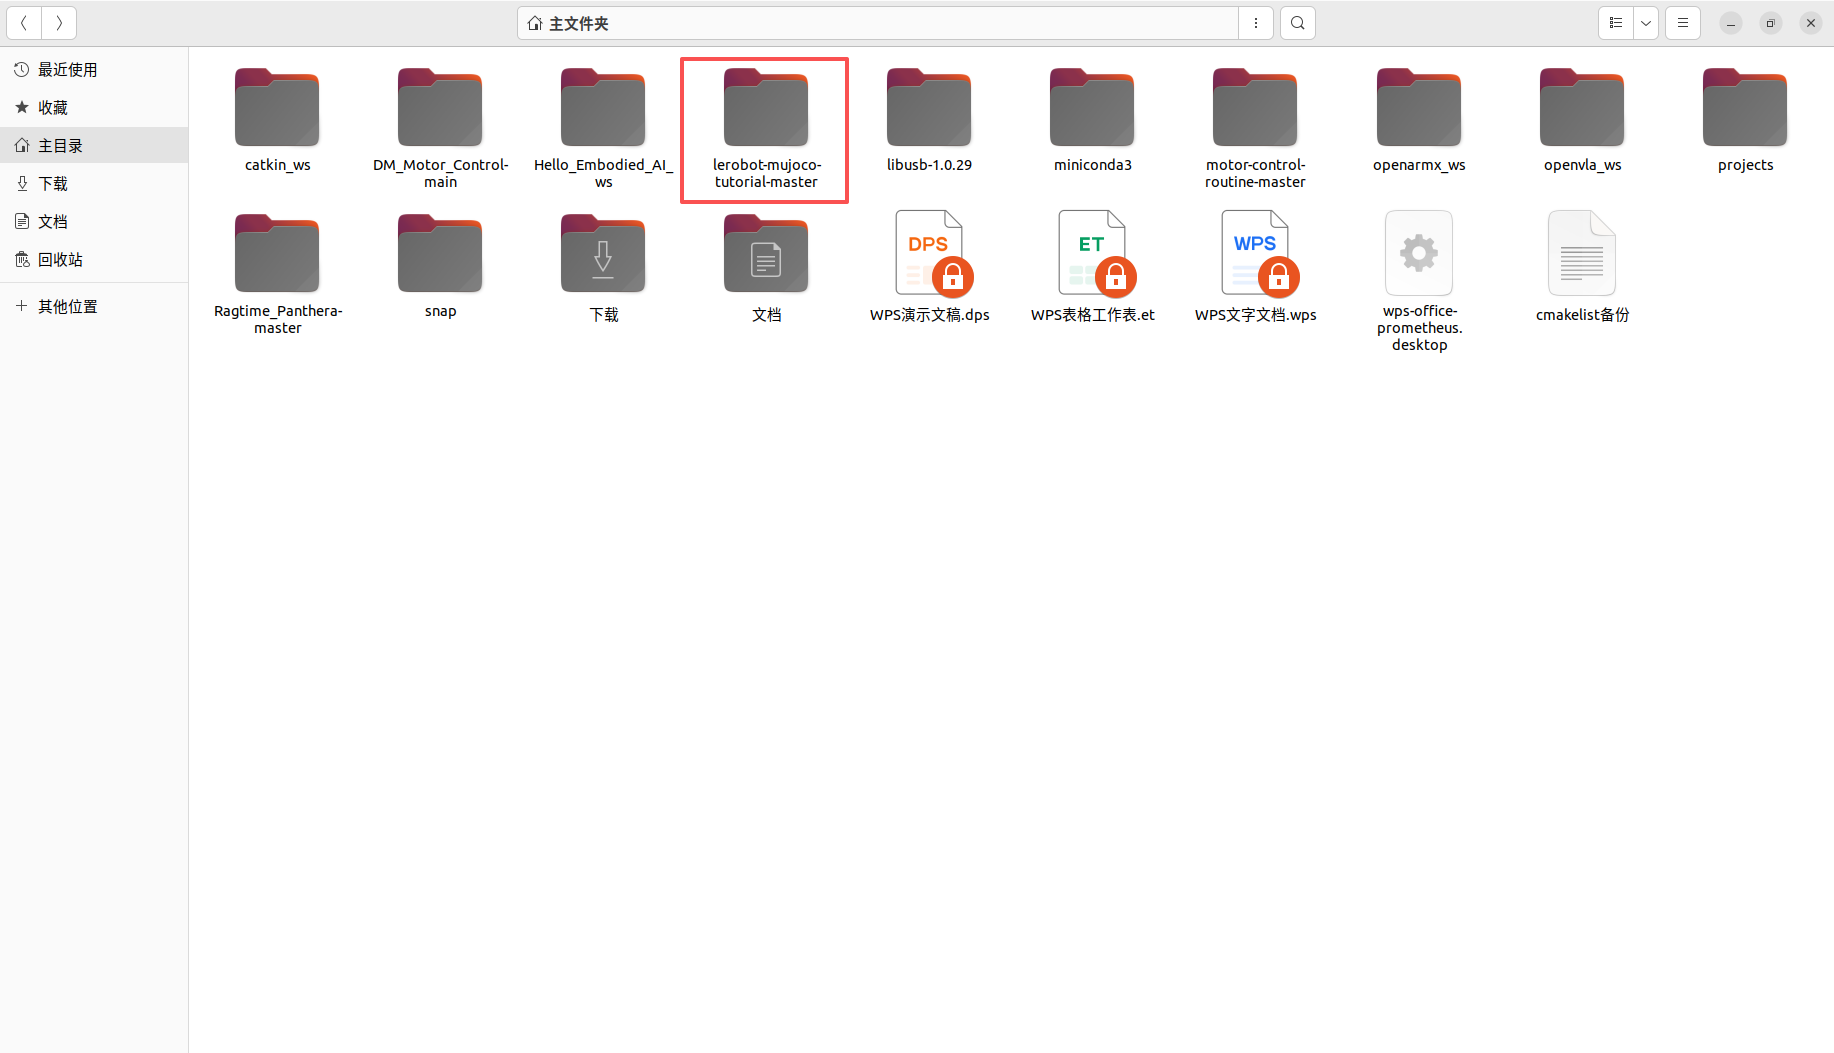
安装mujoco依赖和Lerobot:
按住ctrl+alt+T打开终端,依次输入:
cd lerobot-mujoco-tutorial-master
pip install typeguard pytest
pip install -r requirements.txt
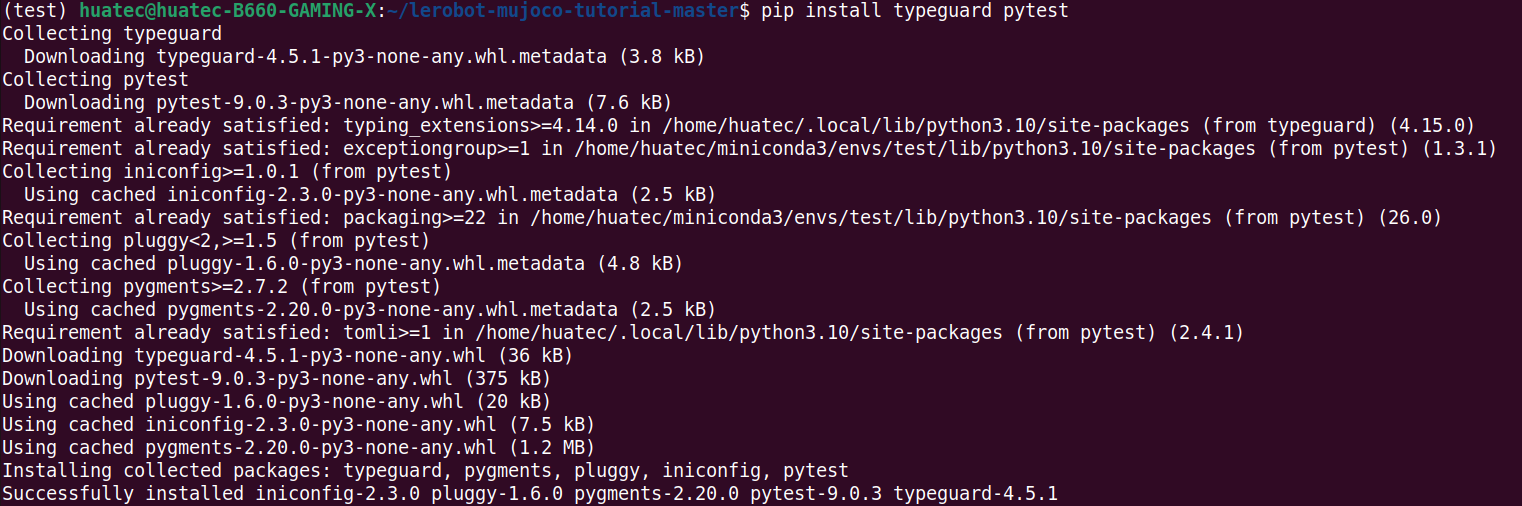
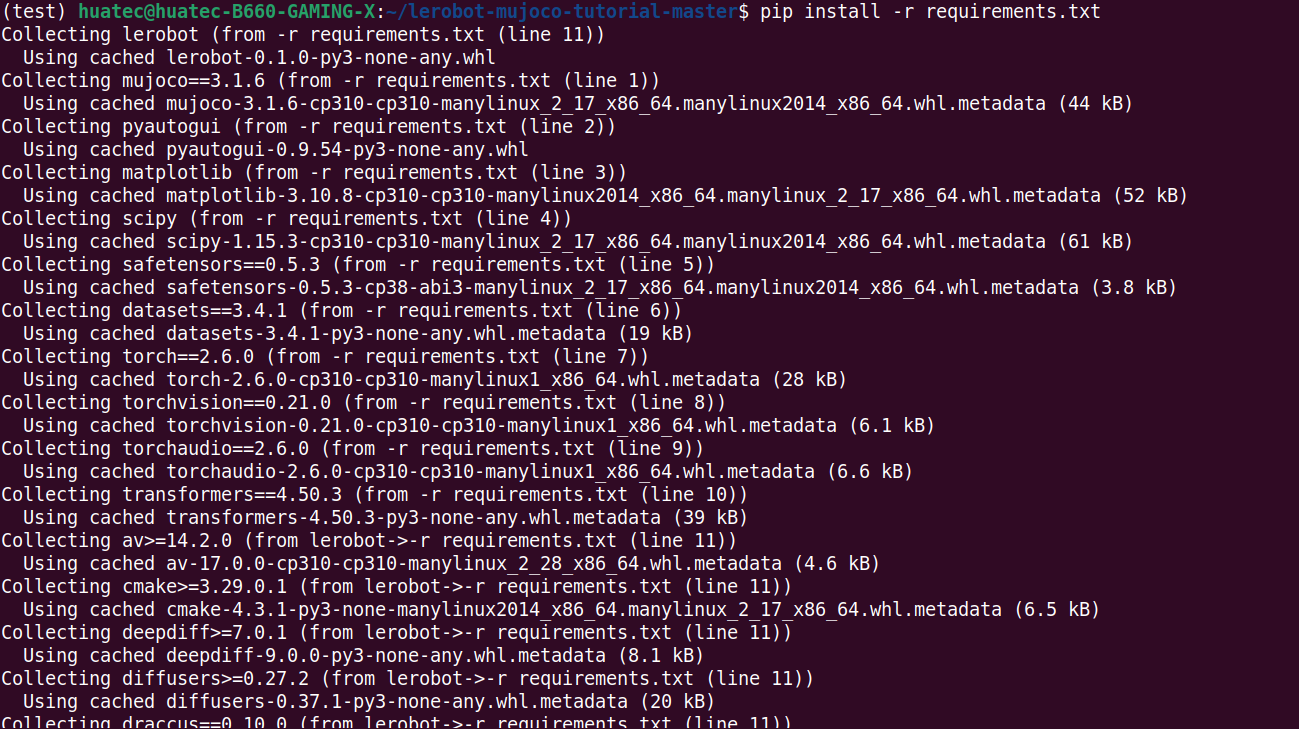
再解压文件,在终端继续输入:
cd asset/objaverse
unzip plate_11.zip
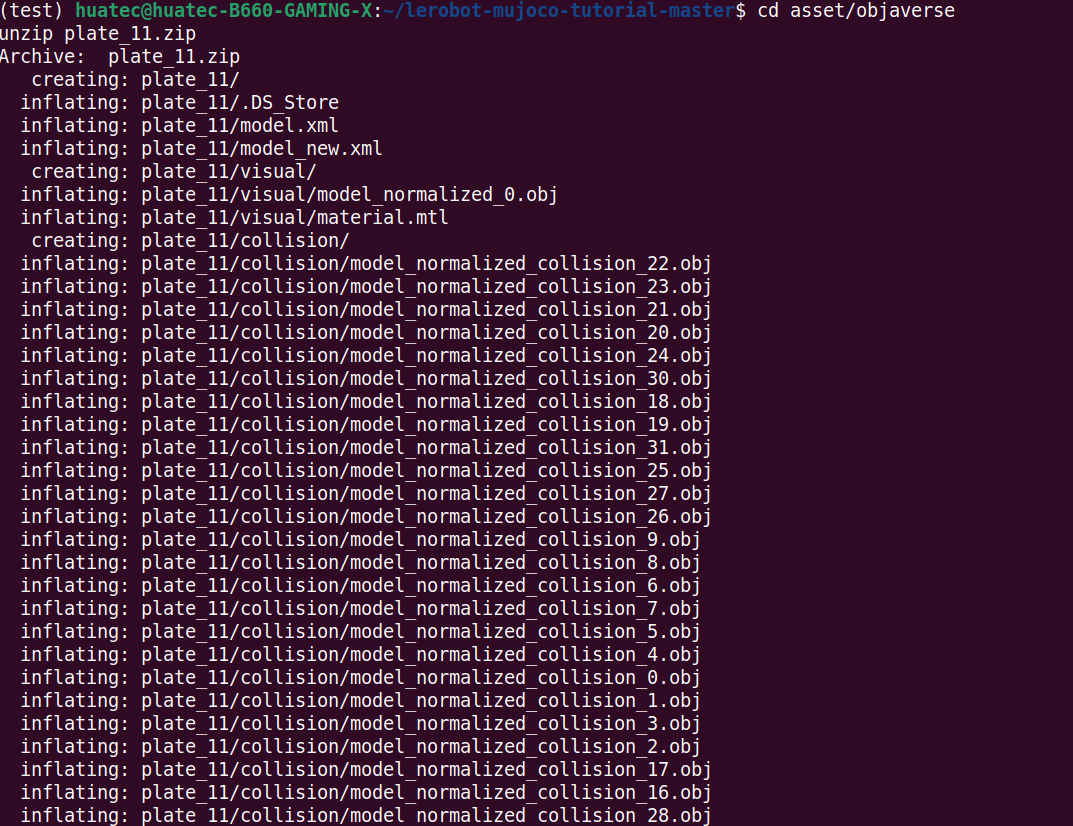
打开之前下载的lerobot-mujoco-tutorial-master文件,并右键,选择“在终端中打开”
输入代码,打开vscode:
code .

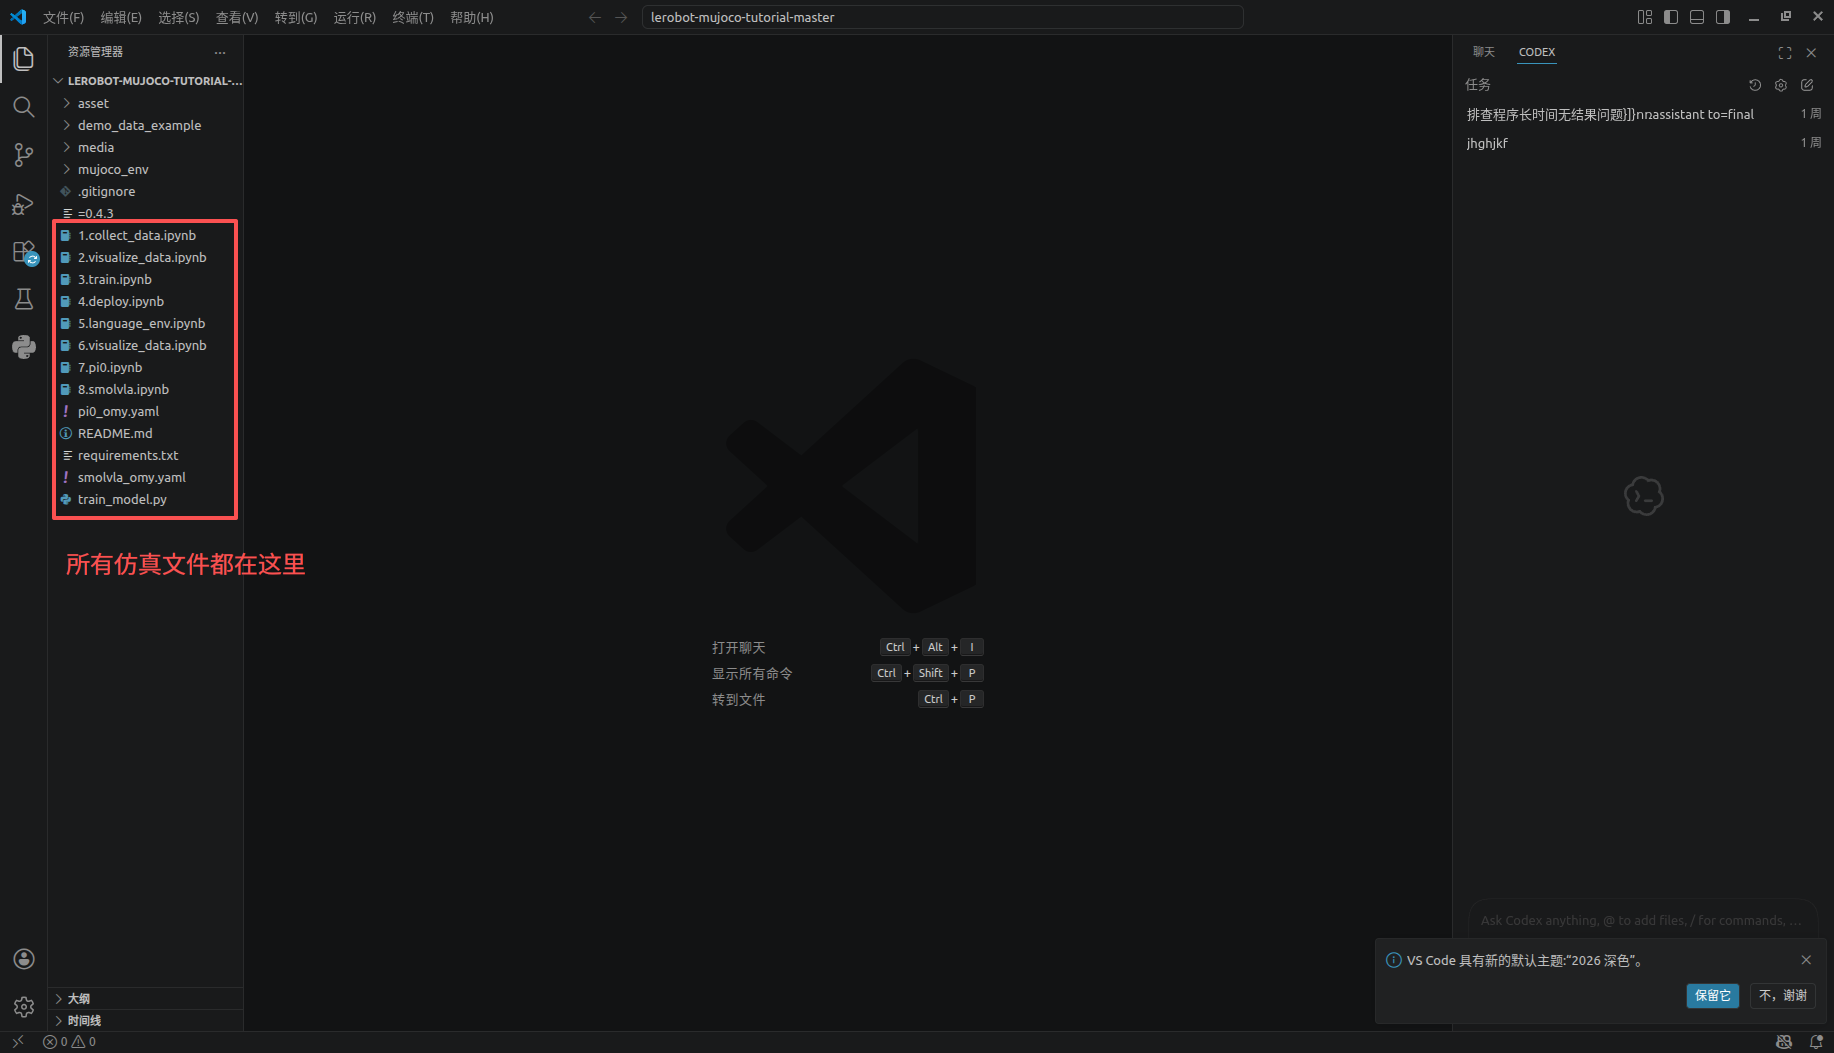
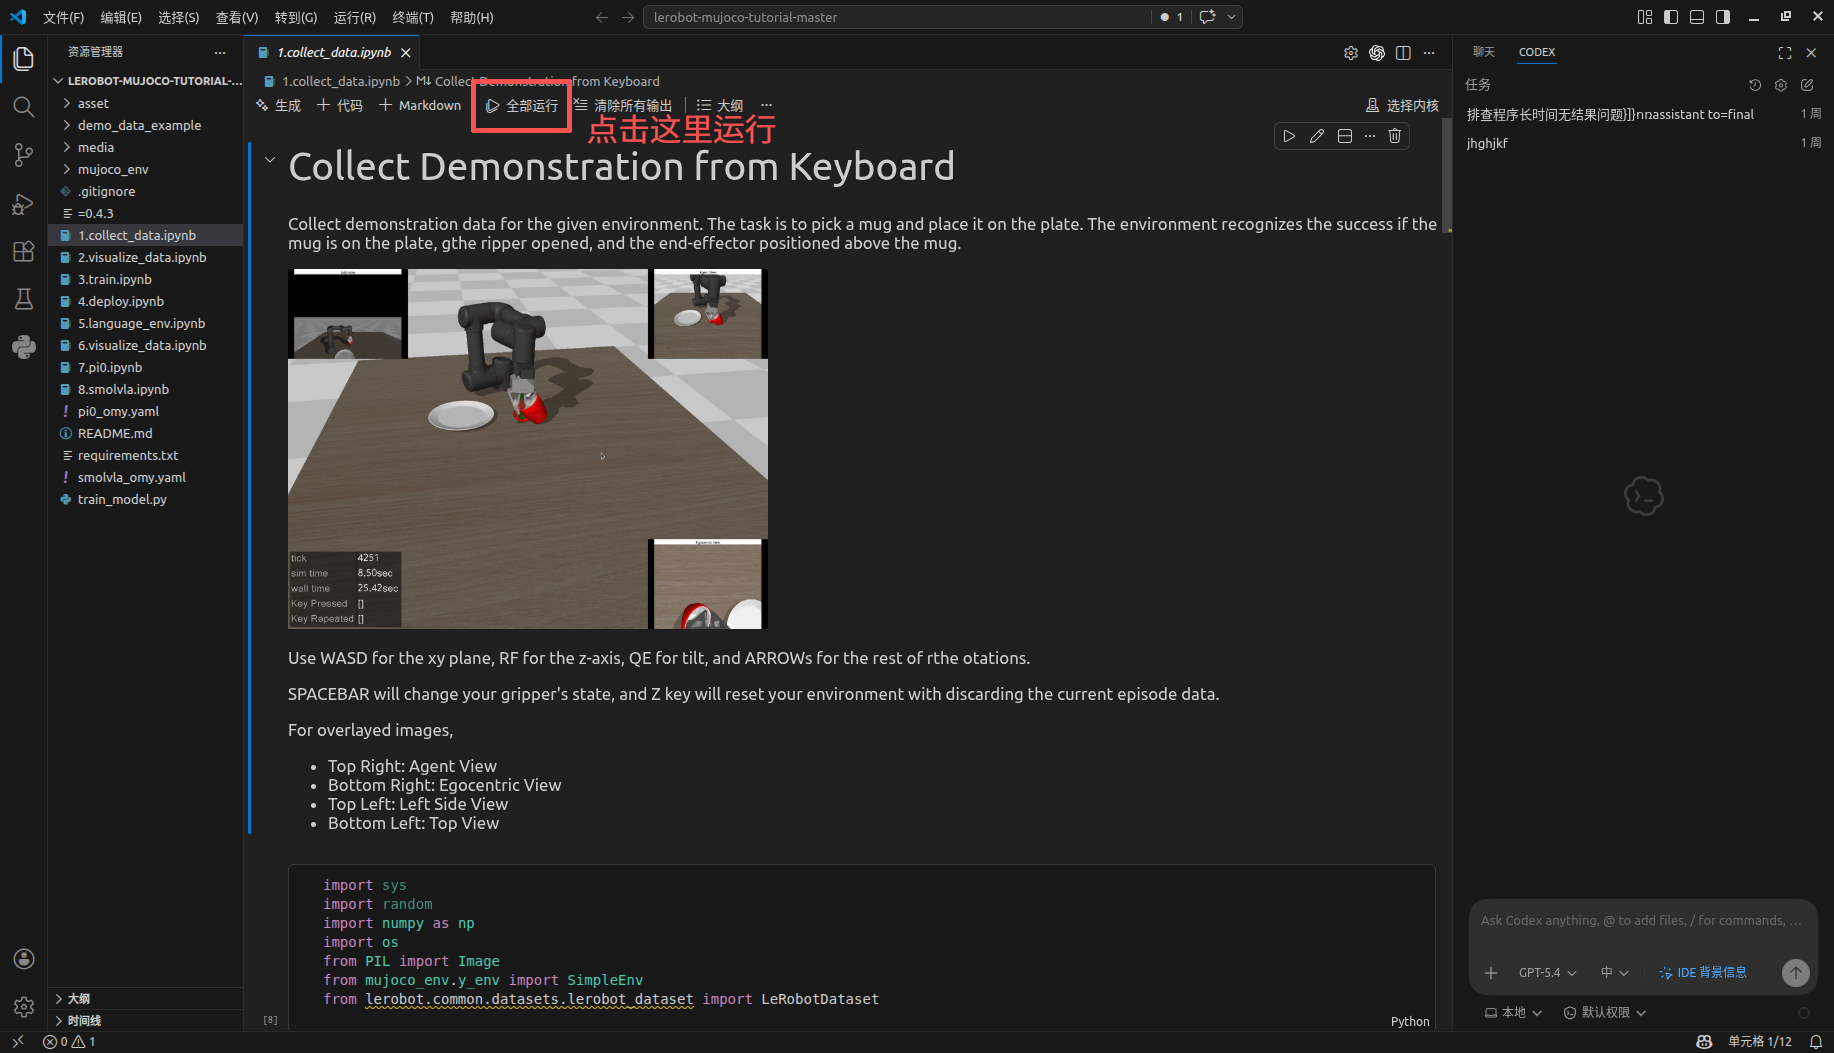
点击第一个collect_date.ipynb:
点击“全部运行”运行程序:
运行程序后会自动弹出仿真窗口:
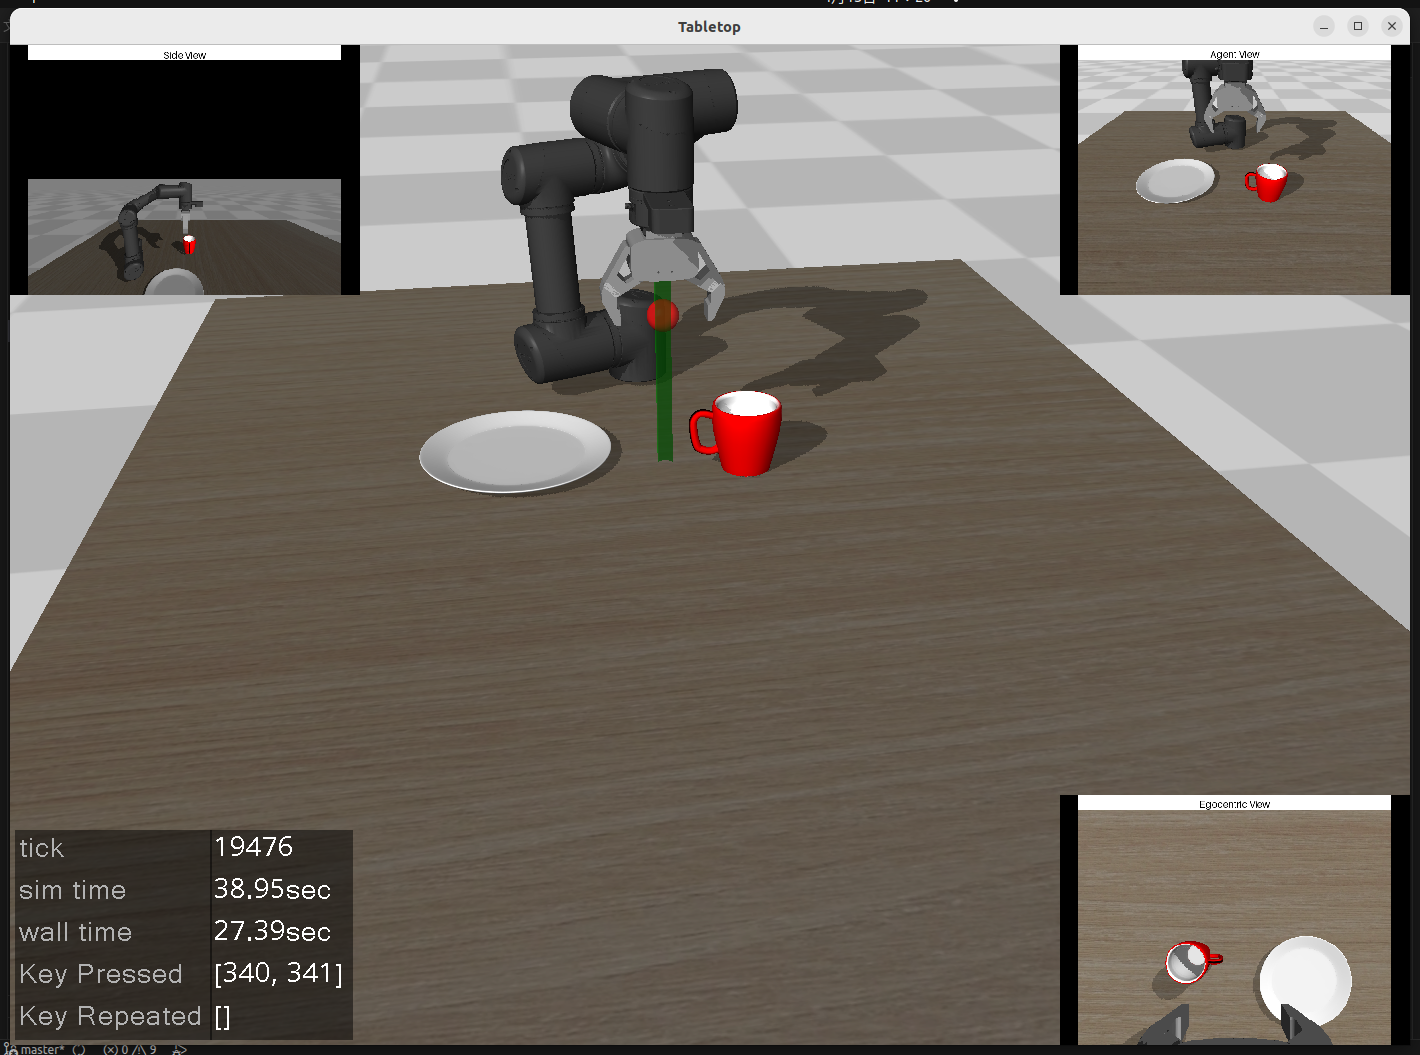
WASD → 平面移动
RF → 上下
QE → 倾斜
方向键 → 旋转
空格 → 开/关夹爪
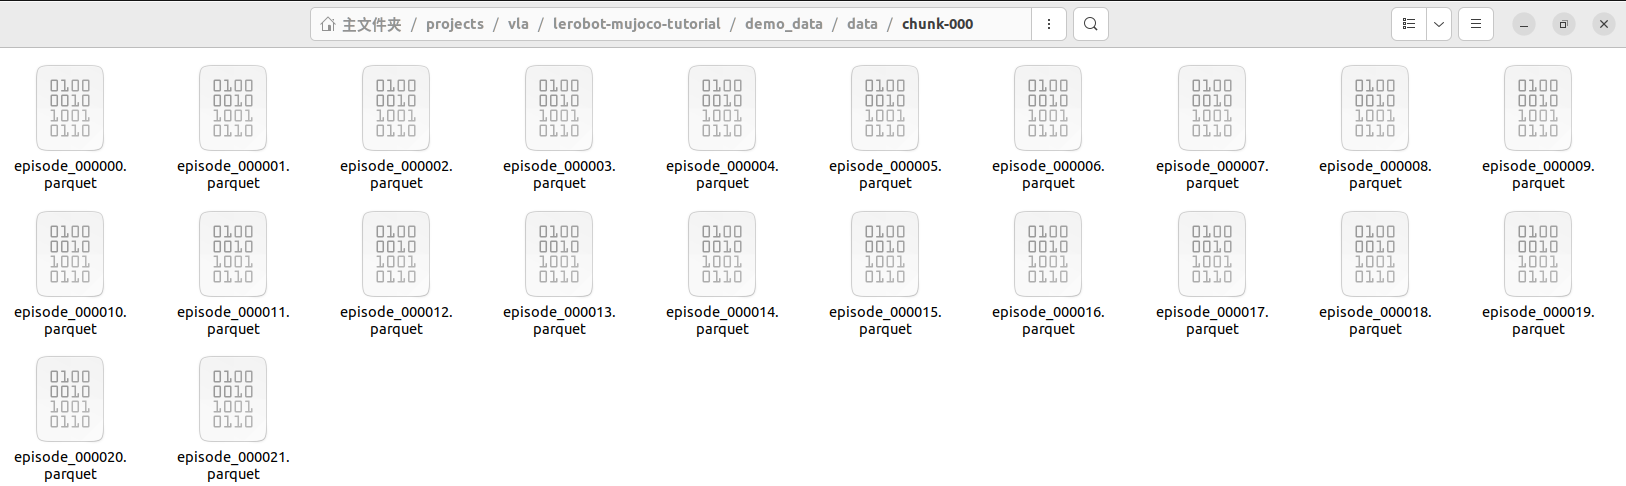
将红色杯子放置到盘子内程序会自动终止并保存数据文件到 /lerobot-mujoco-tutorial/demo_data 文件夹内:
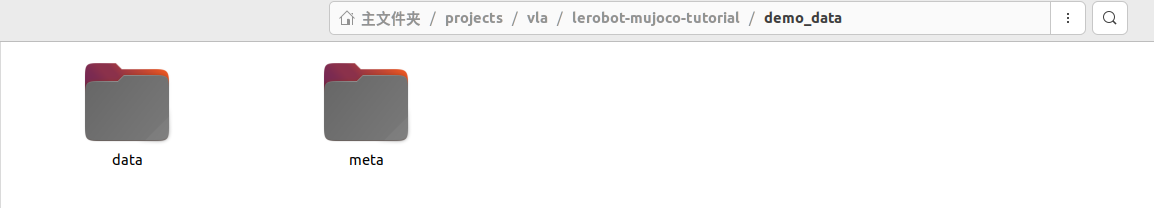
此时的文件夹内结构应该是这样的:
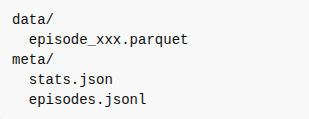
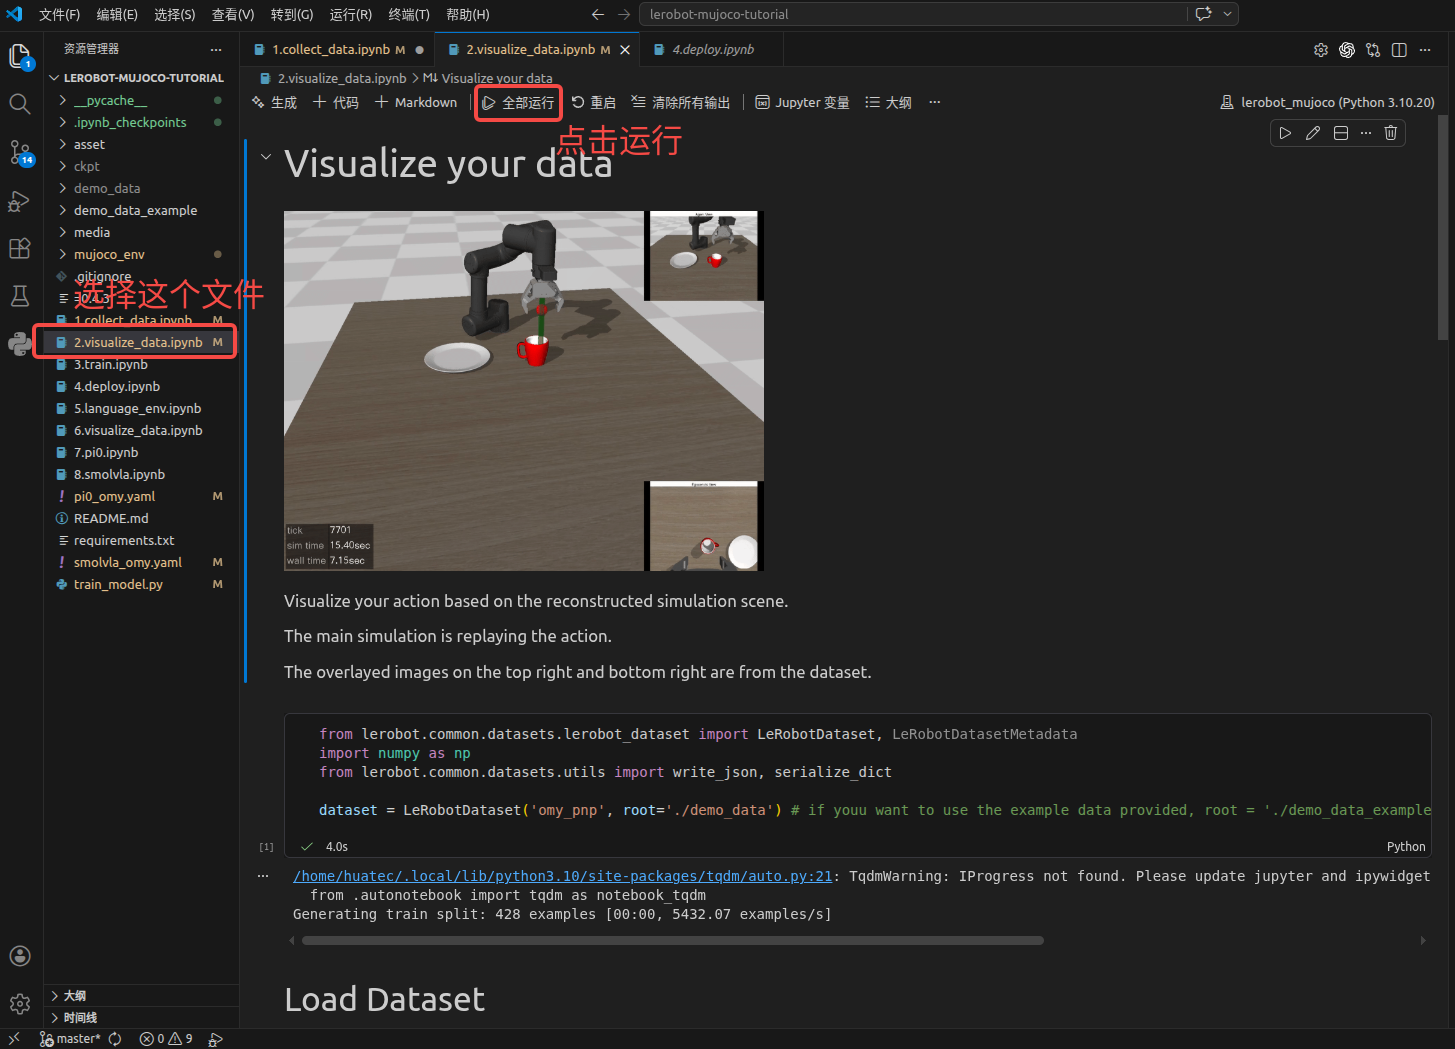
运行2.collect_data.ipynb文件:
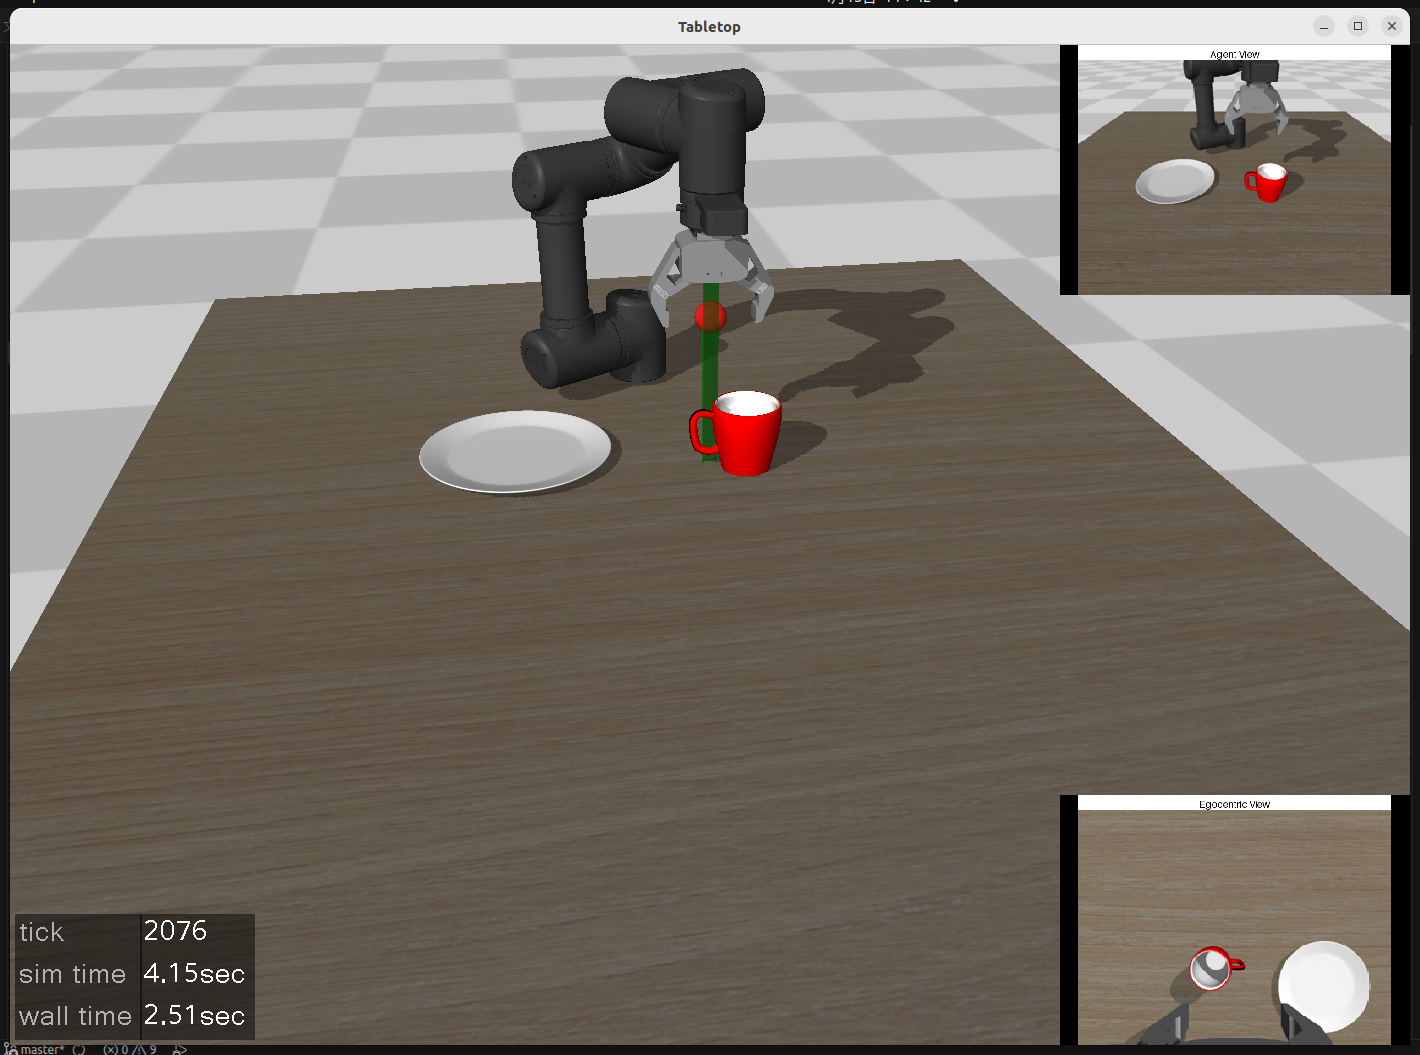
可以看到刚刚自己采的数据过程:
再次点击程序运行,并在这里的文本框输入“n”,点击回车:
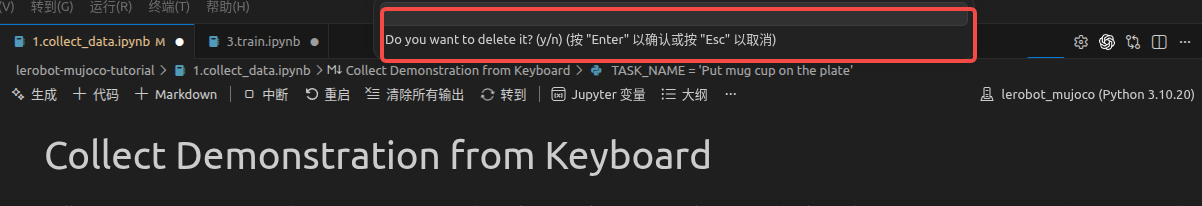
重复刚刚的流程,采集20组以上的数据
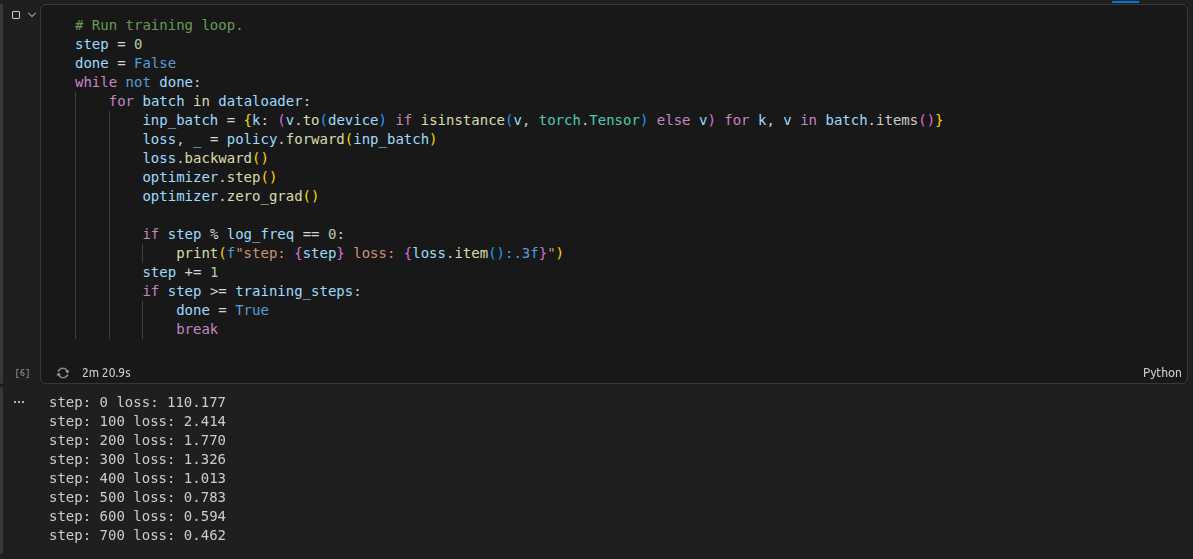
打开 3.train.ipynb,点击“全部运行”,进行模型训练,这里可以看到训练过程:
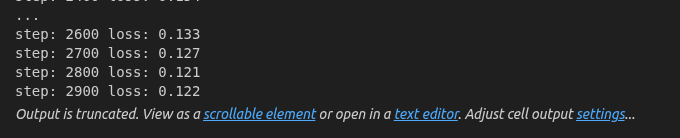
训练结束:
保存的模型和权重会保存在ckpt文件夹内:
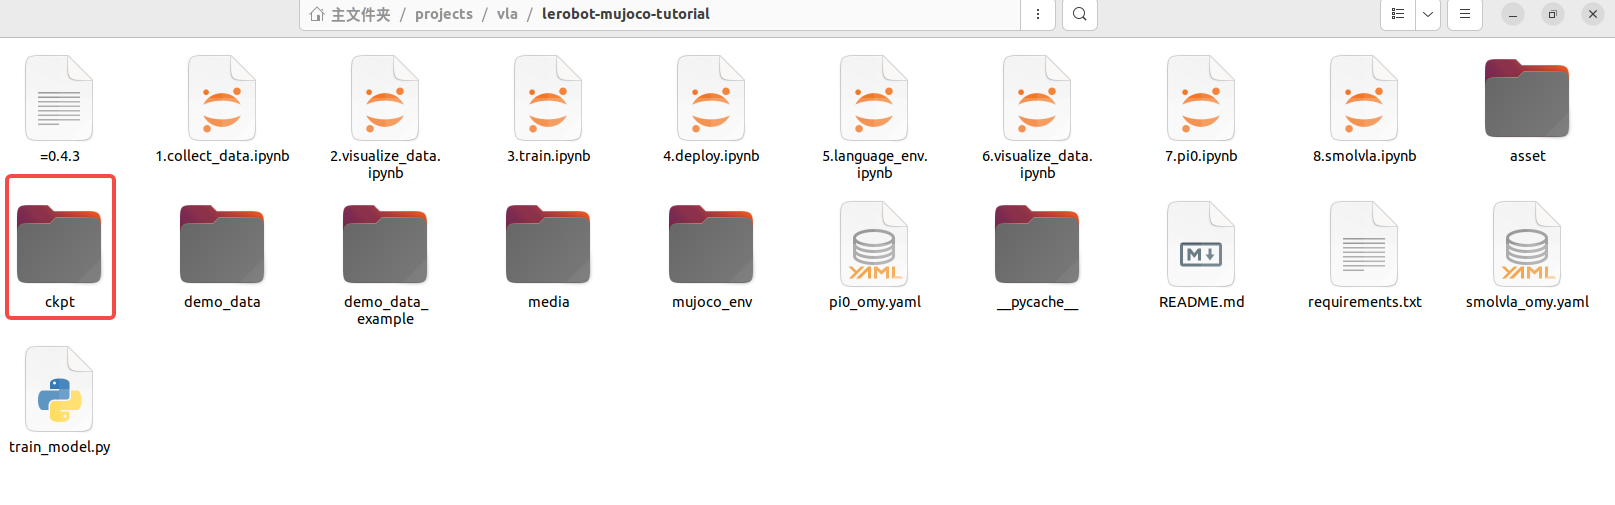
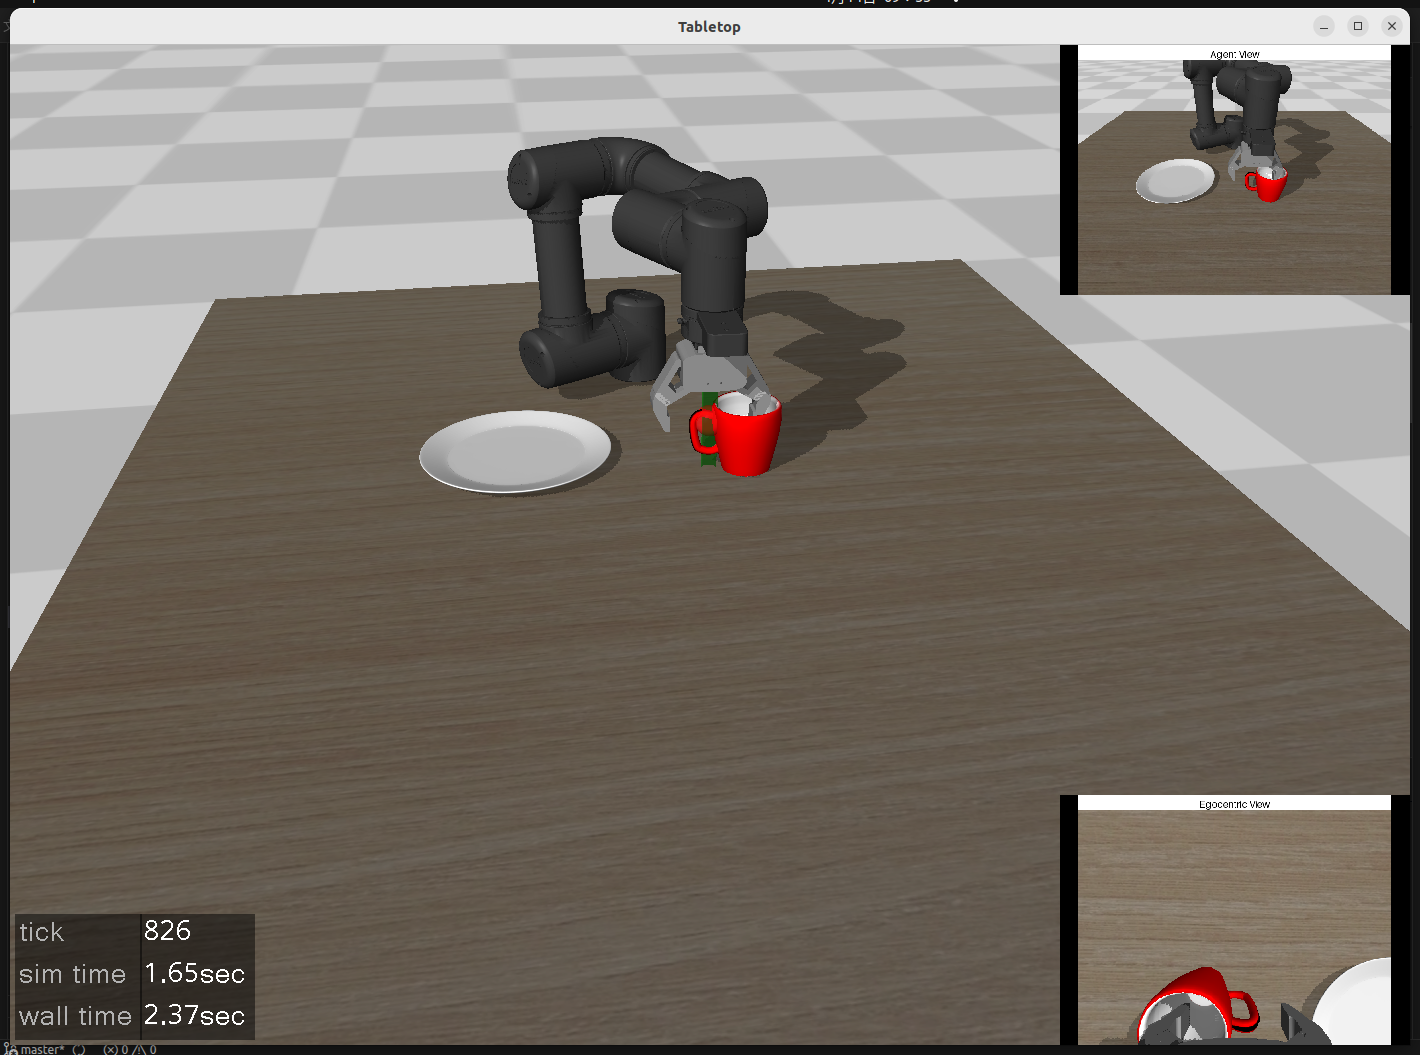
打开 4.deploy,ipynb 文件,点击“全部运行”部署刚刚训练好的模型,会弹出仿真窗口,机械臂会使用训练的模型进行抓取:
P.S. 如果电脑没有GPU,也可以直接下载google上面的训练好的模型进行部署:
暂时无法在飞书文档外展示此内容
将这个文件夹进行解压,放在lerobot_mujoco_tutorial目录下:
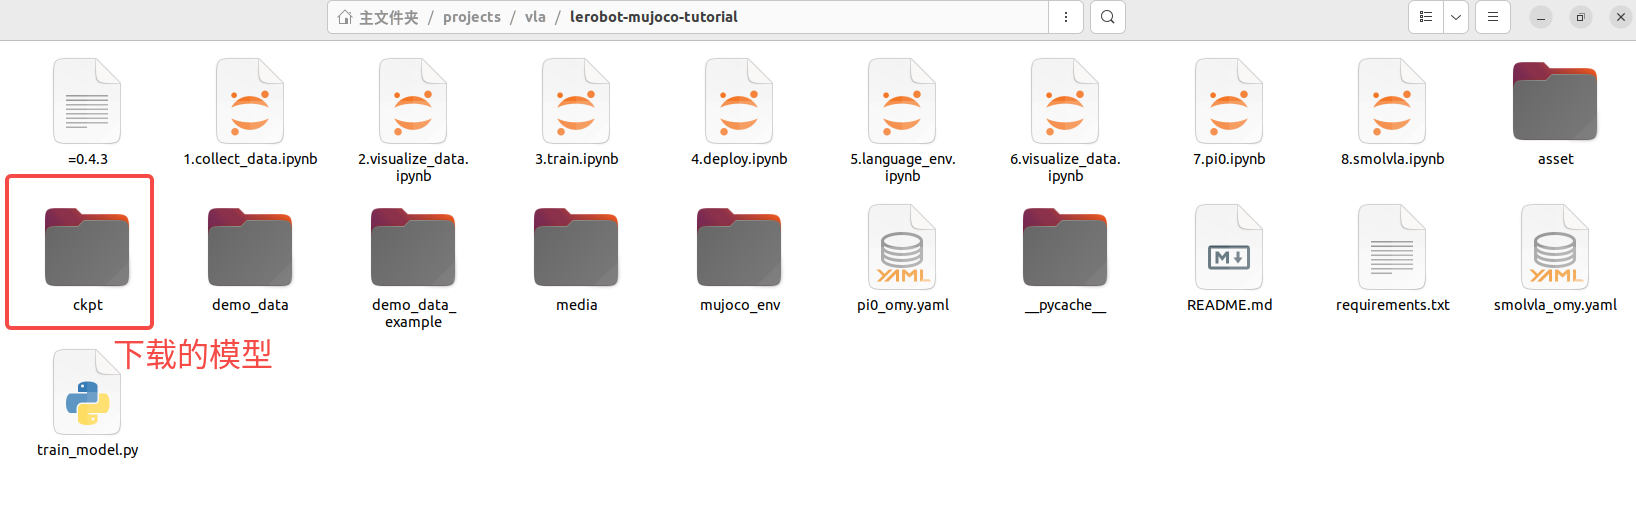
同样的方法,打开文件全部运行即可查看模型效果
前面是纯视觉+动作(ACT),下面的仿真项目才是真正的 VLA(Vision-Language-Action)
在前面的 ACT 模型中,模型主要学习的是 视觉输入到动作输出 的映射关系,也就是根据相机图像预测机械臂下一步应该执行的动作。这个过程可以理解为:
Image → Action
而在 Pi0 和 SmolVLA 相关任务中,模型不仅需要理解视觉信息,还需要结合语言指令来完成对应动作,因此它更接近真正的 VLA(Vision-Language-Action) 任务。
VLA 的输入和输出可以简单理解为:
Image + Language → Action
也就是说,模型不仅要“看见”环境中的物体,还要理解语言指令中指定的目标。例如:
Pick up the red cup and put it on the plate.
在这个任务中,模型需要完成三个步骤:
相比 ACT 这类纯模仿学习任务,VLA 任务增加了语言条件,因此模型需要具备更强的泛化能力。例如,当环境中同时存在红色杯子和蓝色杯子时,模型需要根据语言提示选择正确的目标,而不是简单地重复固定动作。
本节的仿真任务主要围绕 Pi0 和 SmolVLA 展开,流程包括:
语言条件数据采集 → 数据可视化 → 模型训练 → 模型部署
其中,SmolVLA 可以理解为一个面向具身智能任务的小型 VLA 模型,用于学习视觉、语言和动作之间的对应关系。通过这个仿真实验,可以初步理解具身智能中“看懂环境、听懂指令、执行动作”的基本流程。
运行 5.language_env.ipynb:
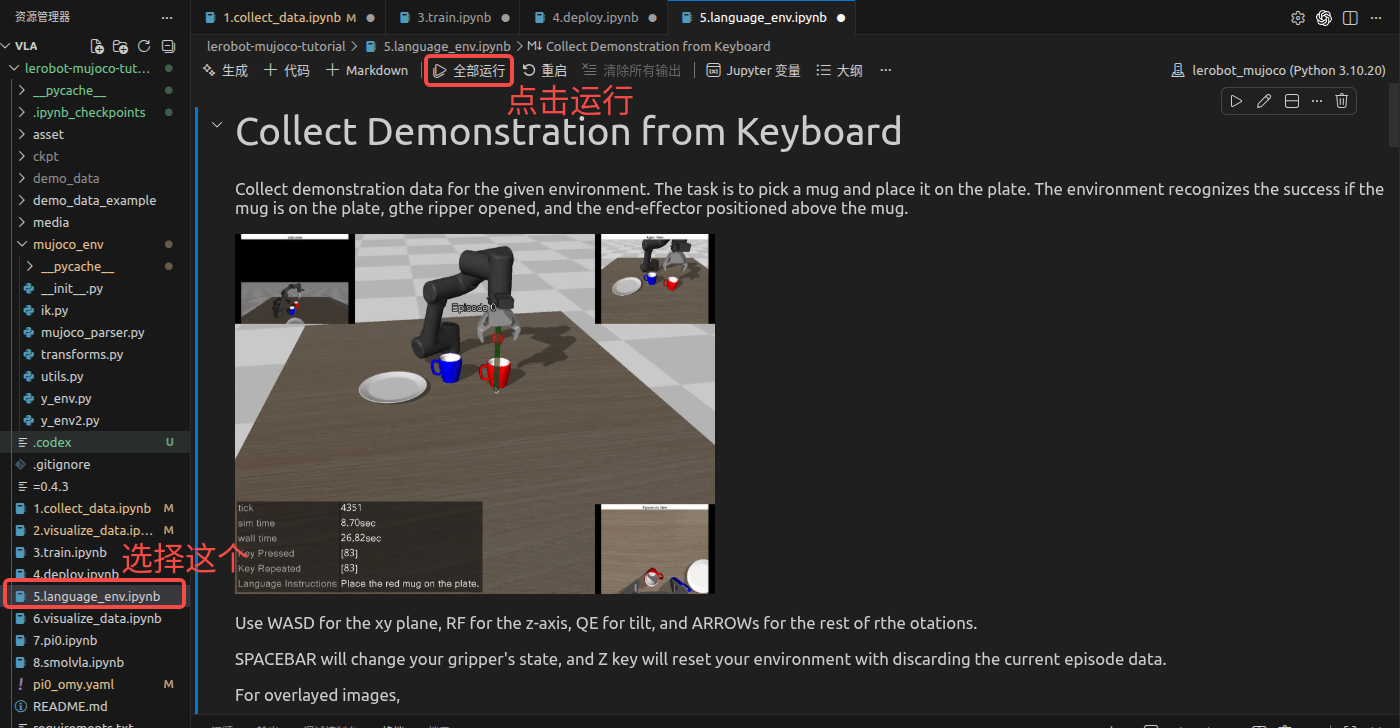
会出现这样的窗口:
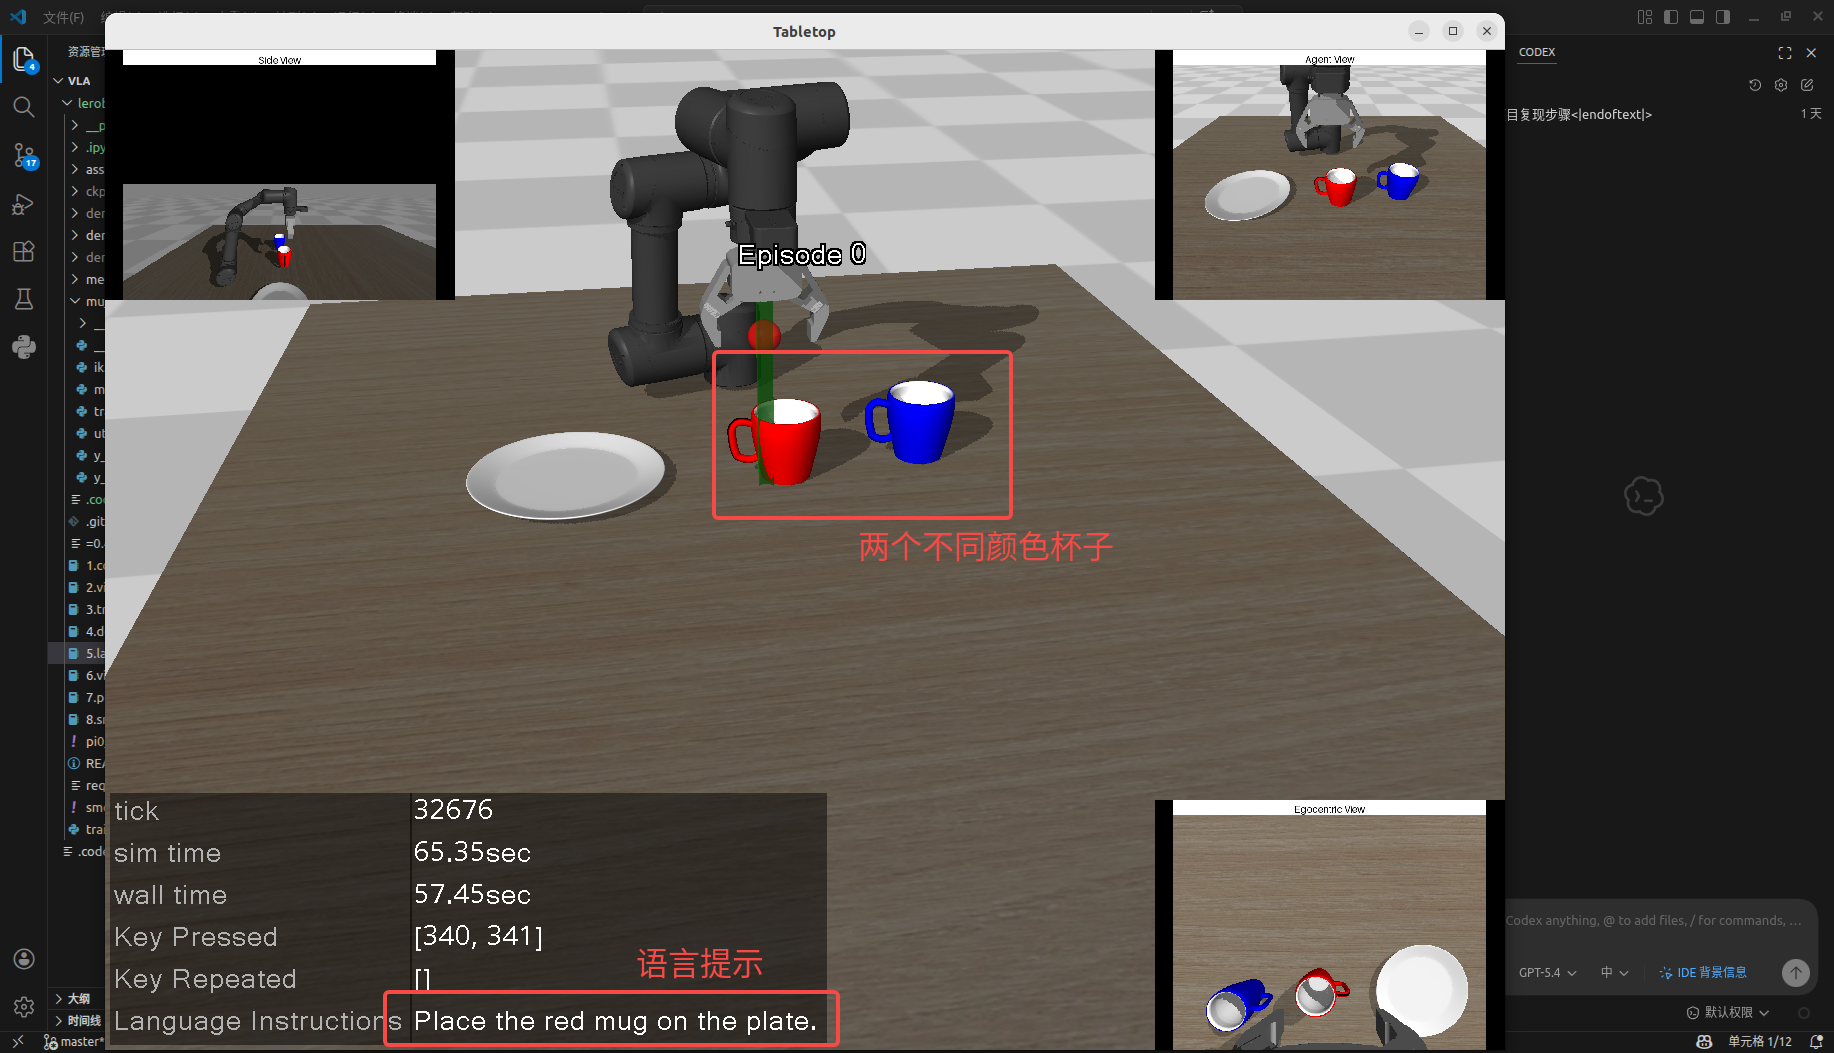
操纵机械臂,将红色的杯子抓取并放置到盘子里。
这里的语言提示是随机的,也可能会让你抓取蓝色的杯子,采集数据时注意辨别。
同样的,采集的数据会被保存到:lerobot-mujoco-tutorial/demo_data_language文件夹内
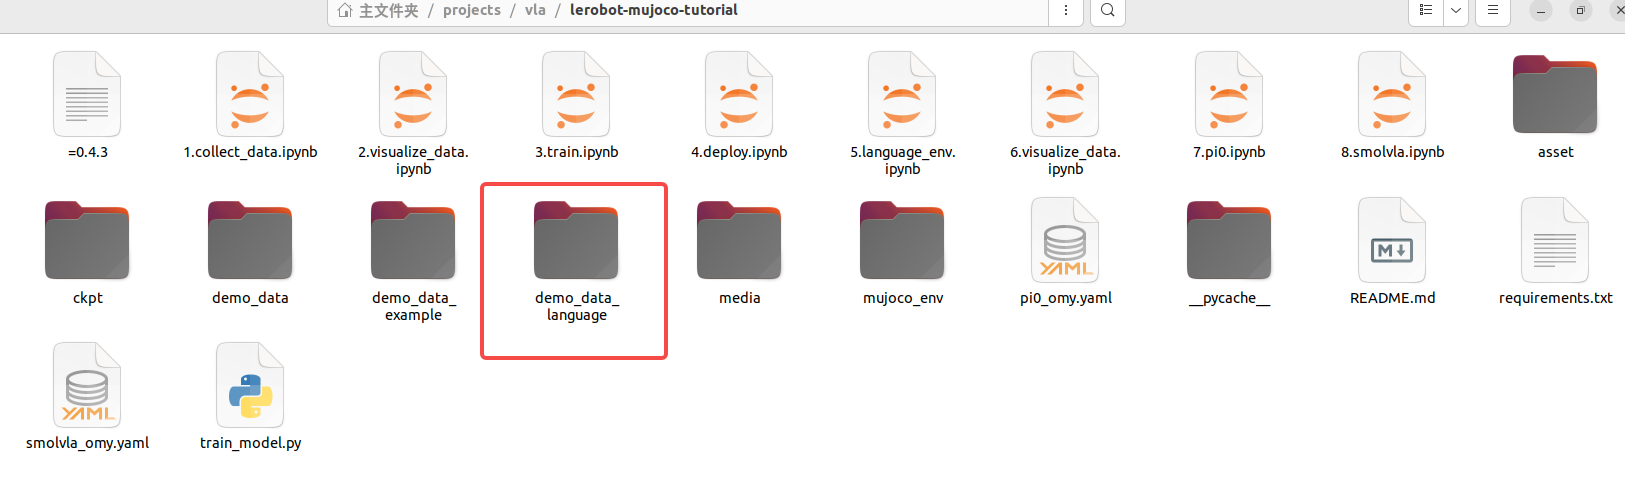
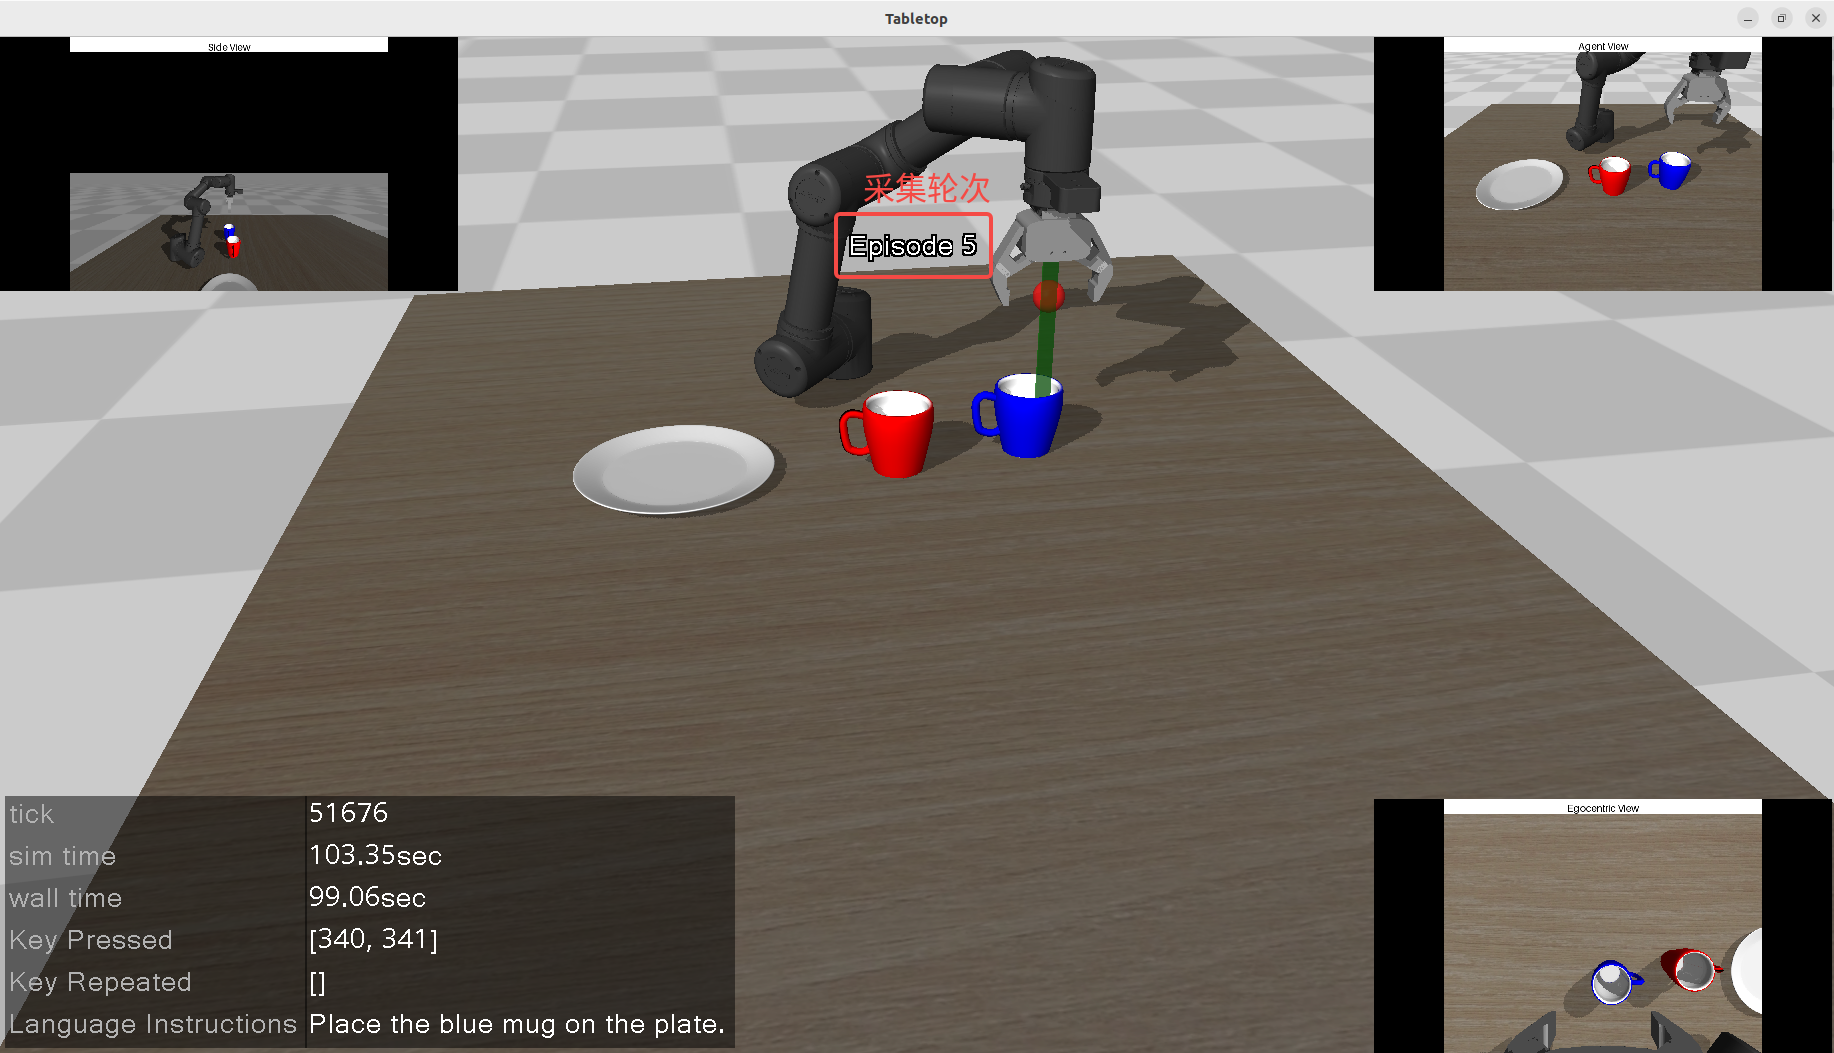
一共会采集20组数据,采集结束程序会自动终止
点击 6.visualize_data.ipynb,并点击“全部运行”:
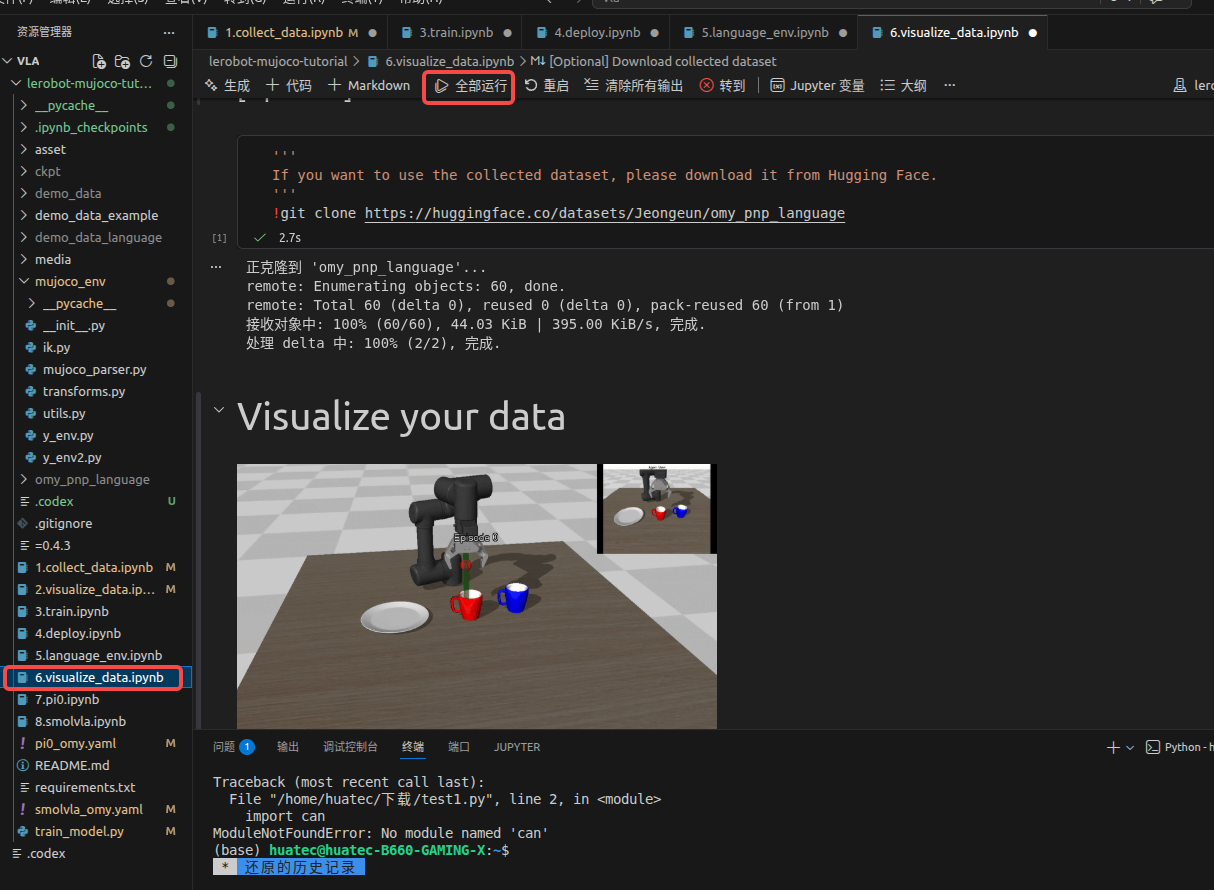
在lerobot_mujoco_tutorial文件夹下打开终端,输入指令并运行:
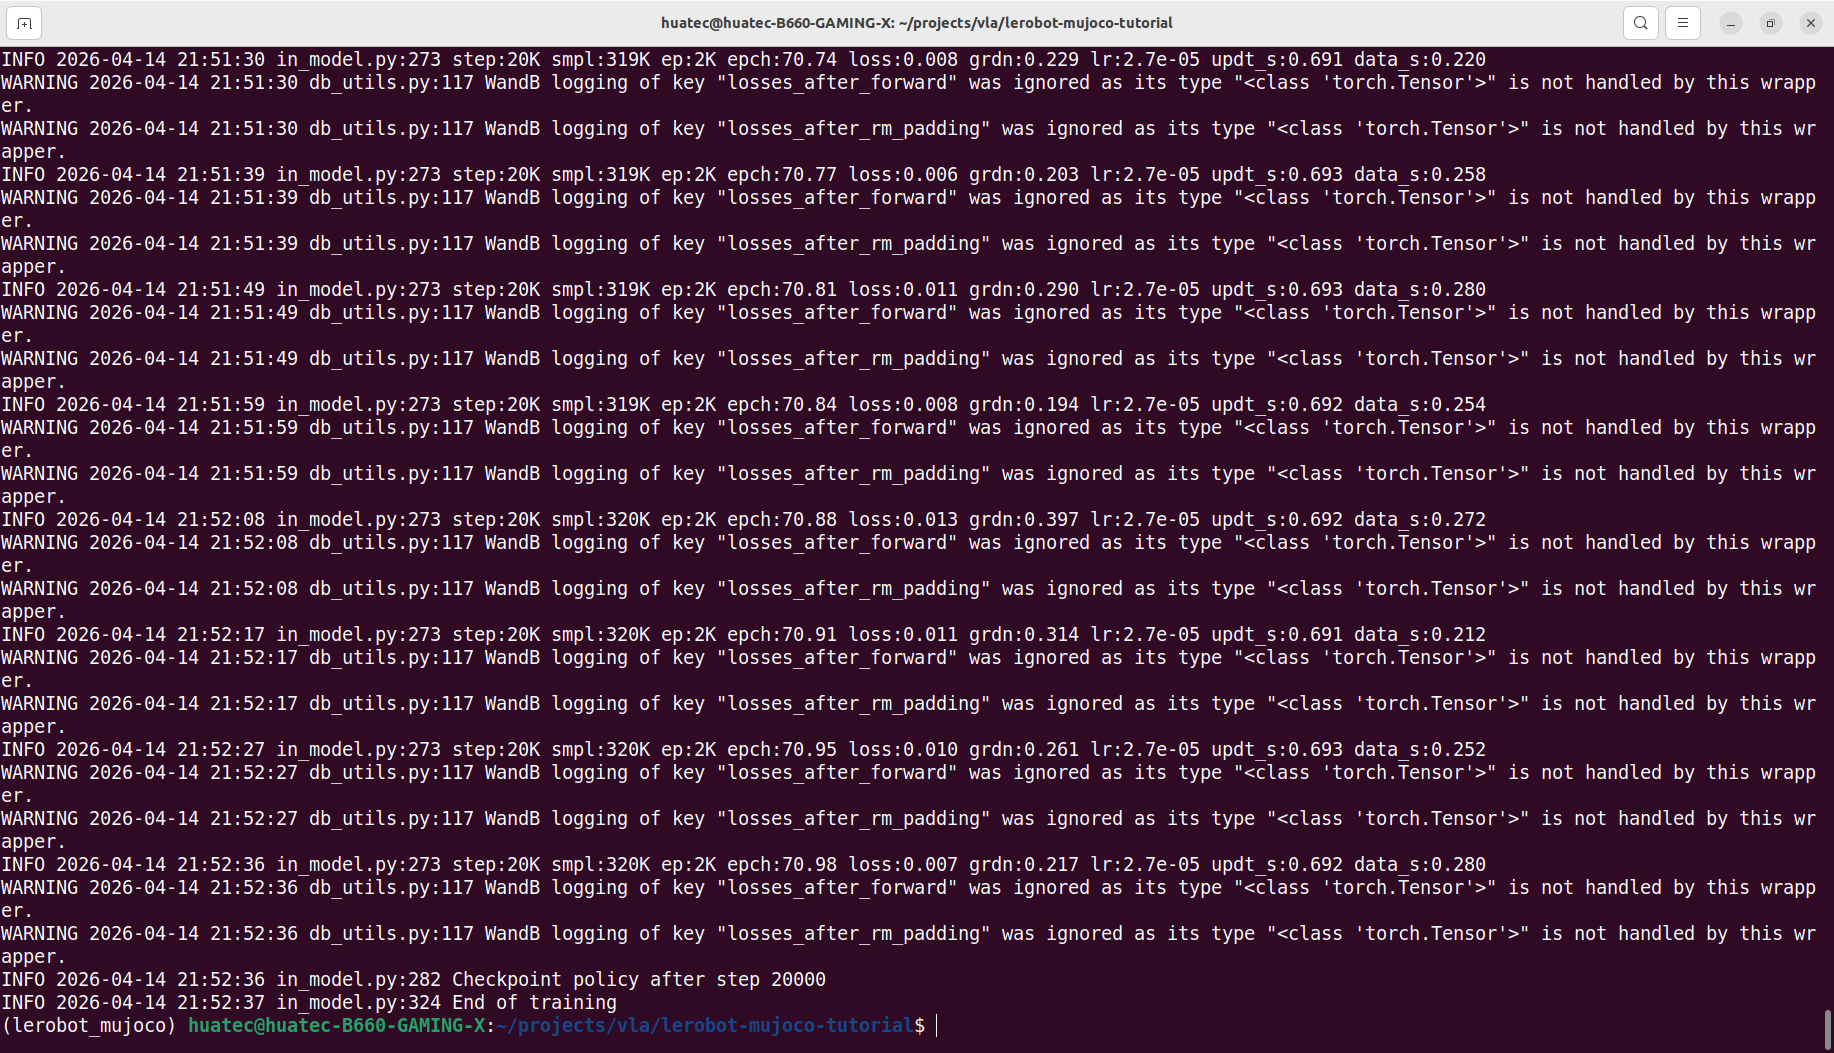
python train_model.py --config_path smolvla_omy.yaml
即可开始训练,这个过程可能会持续几个小时
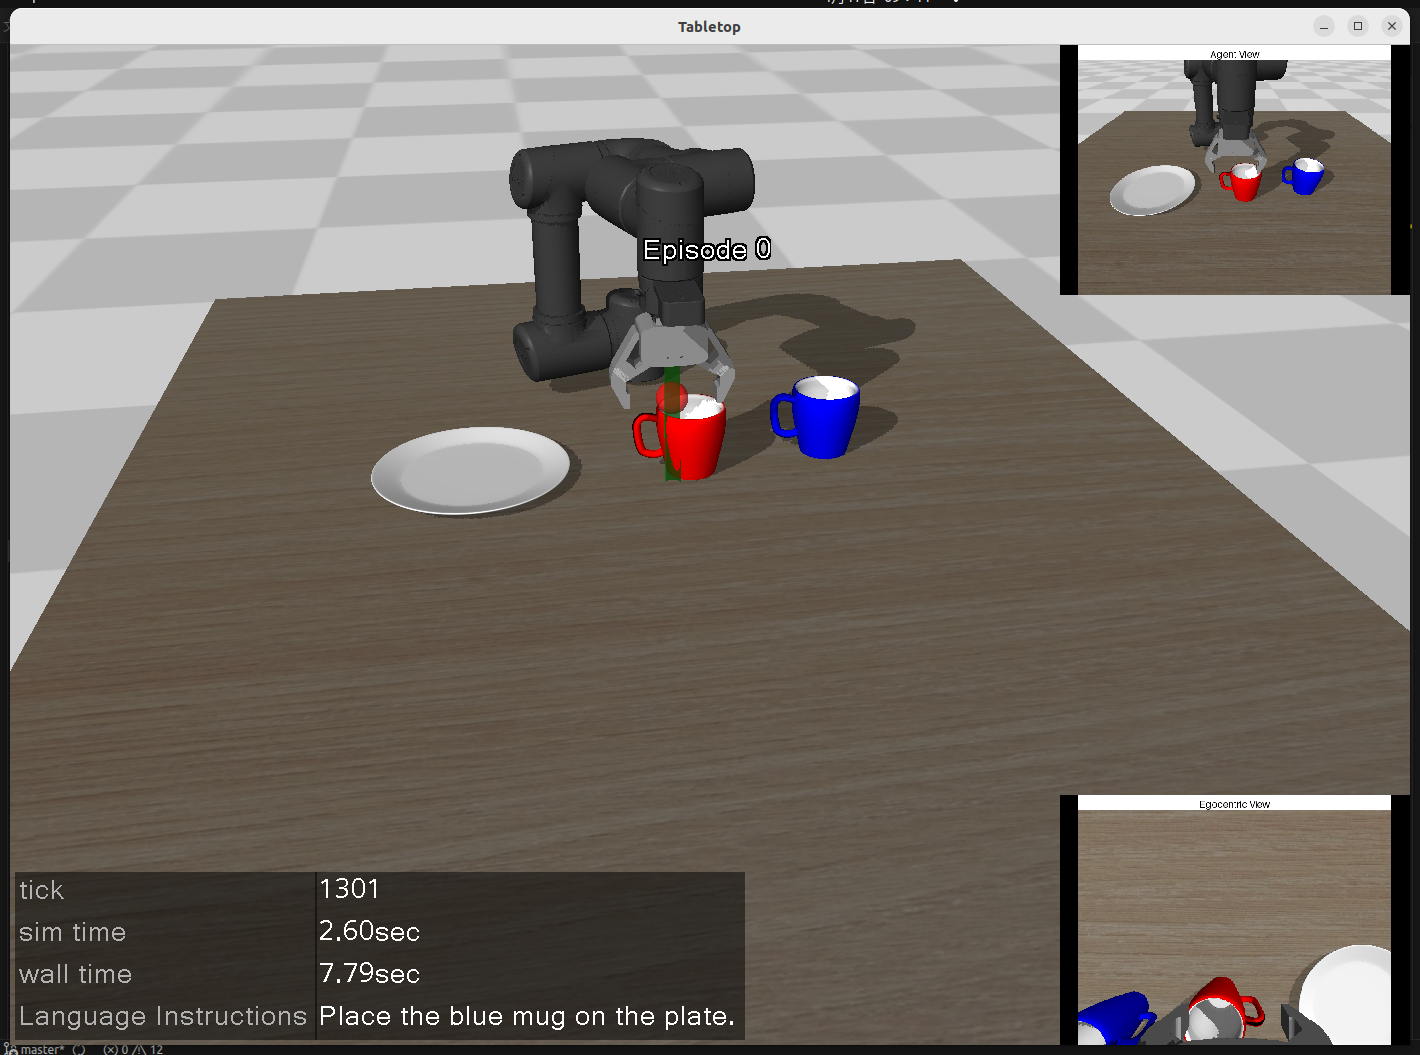
打开8.smolvla.ipynb,点击“全部运行”,查看模型训练效果:
面向初学者的 LeRobot 入门教程,包含 ACT、Pi0、SmolVLA 等具身智能模型的原理解析与实践记录。
Jupyter Notebook
13
10 commits
updated Jun 9, 2026
面向初学者的 LeRobot 入门教程,包含 ACT、Pi0、SmolVLA 等具身智能模型的原理解析与实践记录。
这个项目的核心运行逻辑是:
人类遥操作 → 生成演示数据 → 训练模型 → 模型学会操作 → 在仿真中执行
Linux系统:Ubuntu22.04
编程IDE::Vscode
下载链接:https://code.visualstudio.com/
在这个下载页面,右键并选择“在终端打开”:
在终端内输入:
sudo dpkg -i xxxxxxxxxx这里的xxxxxxxxxx替换为下载文件名称,如图所示:
即可安装完成vscode
可以直接下载这个压缩包,并解压:
暂时无法在飞书文档外展示此内容
也可以在官网上下载:
文件网址:https://github.com/jeongeun980906/lerobot-mujoco-tutorial?tab=readme-ov-file#installation
并将文件夹放在主目录下:
安装mujoco依赖和Lerobot:
按住ctrl+alt+T打开终端,依次输入:
cd lerobot-mujoco-tutorial-master
pip install typeguard pytest
pip install -r requirements.txt
再解压文件,在终端继续输入:
cd asset/objaverse
unzip plate_11.zip
打开之前下载的lerobot-mujoco-tutorial-master文件,并右键,选择“在终端中打开”
输入代码,打开vscode:
code .
点击第一个collect_date.ipynb:
点击“全部运行”运行程序:
运行程序后会自动弹出仿真窗口:
WASD → 平面移动
RF → 上下
QE → 倾斜
方向键 → 旋转
空格 → 开/关夹爪
将红色杯子放置到盘子内程序会自动终止并保存数据文件到 /lerobot-mujoco-tutorial/demo_data 文件夹内:
此时的文件夹内结构应该是这样的:
运行2.collect_data.ipynb文件:
可以看到刚刚自己采的数据过程:
再次点击程序运行,并在这里的文本框输入“n”,点击回车:
重复刚刚的流程,采集20组以上的数据
打开 3.train.ipynb,点击“全部运行”,进行模型训练,这里可以看到训练过程:
训练结束:
保存的模型和权重会保存在ckpt文件夹内:
打开 4.deploy,ipynb 文件,点击“全部运行”部署刚刚训练好的模型,会弹出仿真窗口,机械臂会使用训练的模型进行抓取:
P.S. 如果电脑没有GPU,也可以直接下载google上面的训练好的模型进行部署:
暂时无法在飞书文档外展示此内容
将这个文件夹进行解压,放在lerobot_mujoco_tutorial目录下:
同样的方法,打开文件全部运行即可查看模型效果
前面是纯视觉+动作(ACT),下面的仿真项目才是真正的 VLA(Vision-Language-Action)
在前面的 ACT 模型中,模型主要学习的是 视觉输入到动作输出 的映射关系,也就是根据相机图像预测机械臂下一步应该执行的动作。这个过程可以理解为:
Image → Action
而在 Pi0 和 SmolVLA 相关任务中,模型不仅需要理解视觉信息,还需要结合语言指令来完成对应动作,因此它更接近真正的 VLA(Vision-Language-Action) 任务。
VLA 的输入和输出可以简单理解为:
Image + Language → Action
也就是说,模型不仅要“看见”环境中的物体,还要理解语言指令中指定的目标。例如:
Pick up the red cup and put it on the plate.
在这个任务中,模型需要完成三个步骤:
相比 ACT 这类纯模仿学习任务,VLA 任务增加了语言条件,因此模型需要具备更强的泛化能力。例如,当环境中同时存在红色杯子和蓝色杯子时,模型需要根据语言提示选择正确的目标,而不是简单地重复固定动作。
本节的仿真任务主要围绕 Pi0 和 SmolVLA 展开,流程包括:
语言条件数据采集 → 数据可视化 → 模型训练 → 模型部署
其中,SmolVLA 可以理解为一个面向具身智能任务的小型 VLA 模型,用于学习视觉、语言和动作之间的对应关系。通过这个仿真实验,可以初步理解具身智能中“看懂环境、听懂指令、执行动作”的基本流程。
运行 5.language_env.ipynb:
会出现这样的窗口:
操纵机械臂,将红色的杯子抓取并放置到盘子里。
这里的语言提示是随机的,也可能会让你抓取蓝色的杯子,采集数据时注意辨别。
同样的,采集的数据会被保存到:lerobot-mujoco-tutorial/demo_data_language文件夹内
一共会采集20组数据,采集结束程序会自动终止
点击 6.visualize_data.ipynb,并点击“全部运行”:
在lerobot_mujoco_tutorial文件夹下打开终端,输入指令并运行:
python train_model.py --config_path smolvla_omy.yaml
即可开始训练,这个过程可能会持续几个小时
打开8.smolvla.ipynb,点击“全部运行”,查看模型训练效果:



