
"DeepInnovator: AI Research Assistant - Idea Spark & Scientific Discovery"
See the codeREADME
DeepInnovator: AI Research Assistant - Idea Spark & Scientific Discovery
| 💡 Generate Research Ideas and Hypotheses | 🔗 Discovers Cross-Disciplinary Connections |
| 🔍 Research Gap & Trend Analysis | 🛠️ AI-Powered Scientific Problem Solving |


🔬 DeepInnovator is an AI research copilot powered by our built scientific foundation model trained specifically.
💡 DeepInnovator transforms how researchers discover and develop breakthrough ideas for research discovery.
🧠 DeepInnovator's Key Features
1. 💡 AI Research Idea Generator
- Autonomously generates innovative research ideas and directions.
- Identifies unexplored opportunities and knowledge gaps in scientific fields.
2. 🔗 Cross-Disciplinary Innovation Engine
- Discovers interdisciplinary research connections and fusion opportunities.
- Synthesizes breakthrough concepts from multiple scientific domains.
3. ❓ Scientific Hypothesis & Question Formation
- Automatically constructs scientifically valuable research questions.
- Generates testable scientific hypotheses and predicts experimental designs.
4. 📊 Research Gap & Trend Analysis
- Intelligently identifies gaps and limitations in current research.
- Predicts development trends and emerging hotspots in scientific fields.
5. ⚙️ Innovation Methodology Framework
- "Standing on shoulders of giants": Extracts innovative insights from vast literature.
- "Conjectures and refutations": Iterative idea generation and optimization.
6. 🎯 Creative Problem-Solving Assistant
- Provides multi-angle solutions for complex scientific problems.
- Inspires researchers' innovative thinking and guides strategic resource allocation.
🚀 DeepInnovator's Performance
Strong Baseline Improvement:
• DeepInnovator-14B significantly outperforms Qwen-14B-Instruct across all evaluation dimensions.
• It achieves impressive win rates of 80.53%-93.81% against the base model in automated evaluations.
Competitive with top-tier LLMs (GPT-4o and Gemini-2.5-pro)
• Despite smaller parameter size, DeepInnovator matches performance of GPT-4o and Gemini-2.5-pro.
• DeepInnovator even surpasses GPT-4o in well-justified rationale evaluation, scoring 82.3% vs 77.9%
Excellent cross-domain generalization:
• The model shows strong zero-shot transfer capabilities to completely unseen research domains.
• It generates high-quality research ideas in law, education, and biotechnology despite being trained on STEM.
| Domain | Metric | Much Better | Better | Worse | Much Worse | Both Bad | Avg. Winrate (vs Qwen-14B-IT / vs GPT-4o) |
|---|---|---|---|---|---|---|---|
| Law | Novelty | 0 / 0 | 9 / 7 | 3 / 6 | 1 / 0 | 0 / 0 | 69.2% / 53.8% |
| Feasibility | 1 / 0 | 5 / 4 | 3 / 7 | 1 / 1 | 3 / 1 | 60.0% / 33.3% | |
| Effectiveness | 2 / 1 | 5 / 4 | 2 / 3 | 1 / 3 | 3 / 2 | 70.0% / 45.5% | |
| Detailedness | 7 / 1 | 3 / 4 | 2 / 5 | 1 / 0 | 0 / 3 | 76.9% / 50.0% | |
| Education | Novelty | 3 / 0 | 9 / 9 | 2 / 5 | 1 / 1 | 0 / 0 | 80.0% / 60.0% |
| Feasibility | 3 / 0 | 5 / 0 | 5 / 7 | 1 / 3 | 1 / 5 | 57.1% / 0.0% | |
| Effectiveness | 2 / 0 | 6 / 0 | 4 / 5 | 3 / 4 | 0 / 6 | 53.3% / 0.0% | |
| Detailedness | 1 / 0 | 8 / 4 | 3 / 5 | 0 / 2 | 3 / 4 | 75.0% / 36.4% | |
| Biotech | Novelty | 3 / 2 | 8 / 6 | 1 / 5 | 0 / 0 | 2 / 2 | 91.7% / 61.5% |
| Feasibility | 2 / 0 | 6 / 5 | 0 / 3 | 0 / 5 | 6 / 2 | 100.0% / 38.5% | |
| Effectiveness | 1 / 2 | 6 / 5 | 4 / 2 | 1 / 4 | 2 / 2 | 58.3% / 53.8% | |
| Detailedness | 6 / 3 | 4 / 2 | 1 / 4 | 0 / 5 | 3 / 1 | 90.9% / 35.7% |
• DeepInnovator-14B achieves 100% win rate in Biotech Feasibility against Qwen2.5-14B-IT
• Demonstrates 91.7% win rate in Biotech Novelty versus the baseline model
• Secures 90.9% win rate in Biotech Detailedness compared to Qwen2.5-14B-IT
• Maintains 61.5% win rate in Biotech Novelty when benchmarked against GPT-4o
• Shows 60.0% win rate in Education Novelty against the advanced GPT-4o model
🏗️ DeepInnovator's Architecture
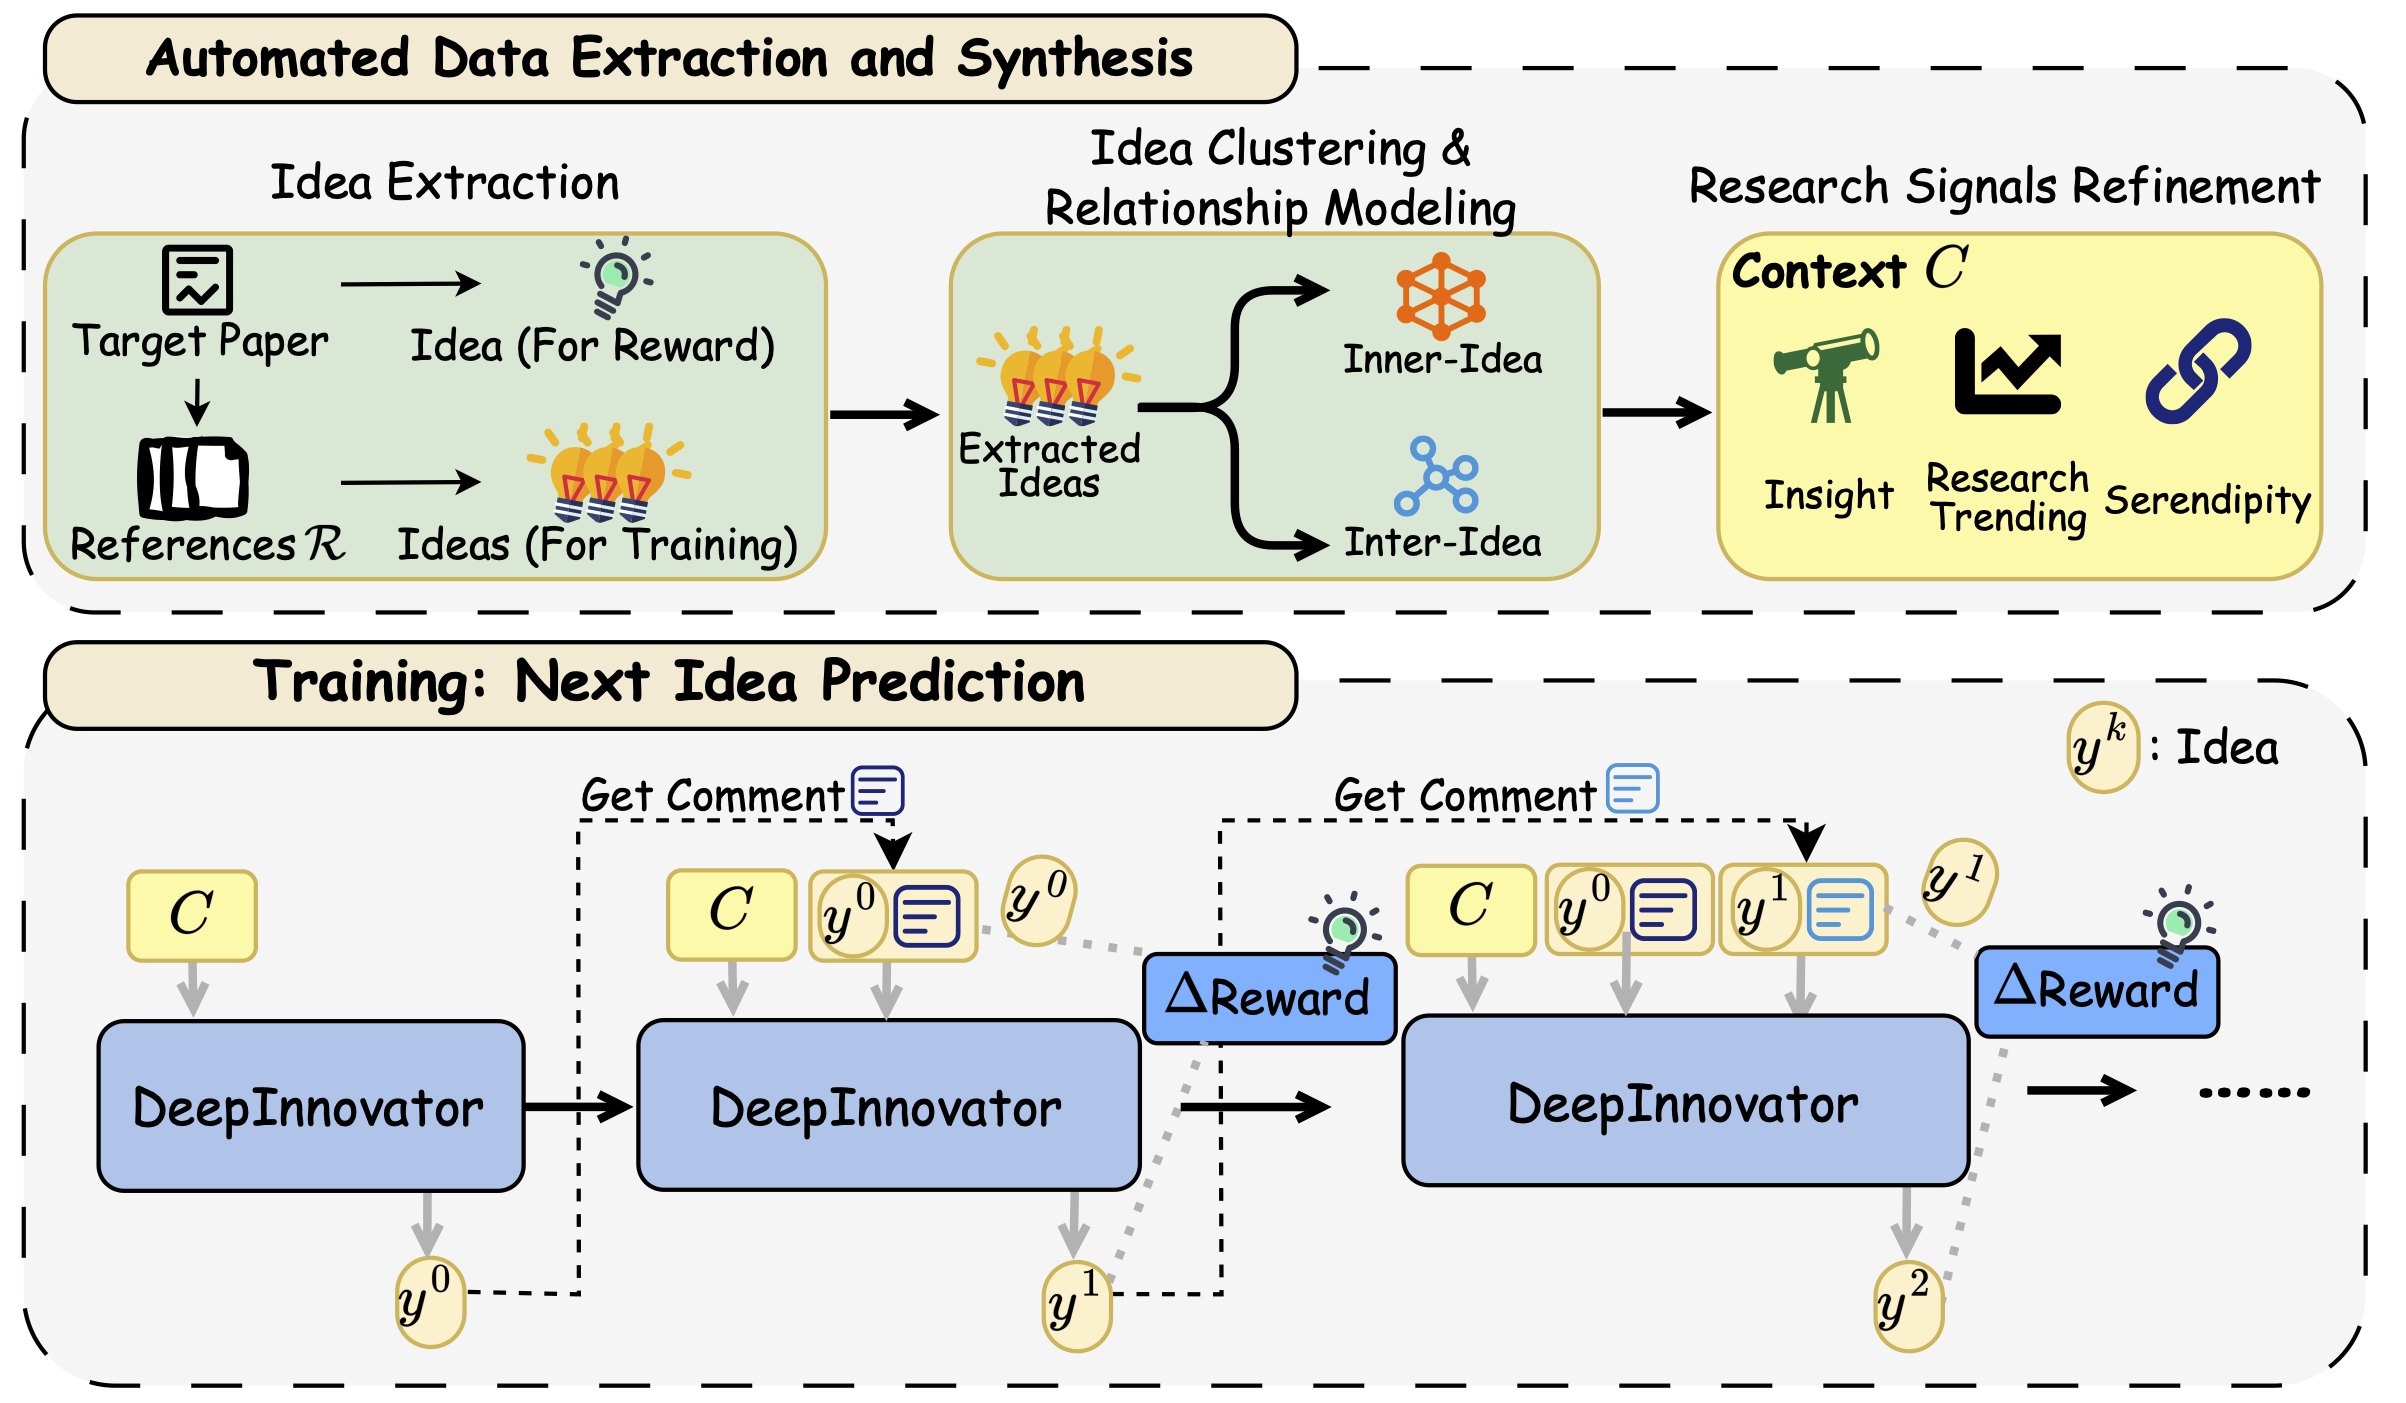
• Intelligent Knowledge Synthesis Pipeline:
- Transforms dense literature into structured cognitive primitives (Insight, Research Trending, Serendipity).
- Mimics human scientific reasoning through hierarchical abstraction and relationship modeling.
- Maintains computational efficiency while preserving semantic completeness.
• Next Idea Prediction Training Paradigm:
- Introduces an iterative refinement framework that models research idea generation as a sequential process.
- Enables continuous predicting, evaluating, and improving of ideas through systematic cycles.
- Mimics the "conjectures and refutations" methodology of authentic scientific discovery.
• Decoupled Reward-Comment RL Architecture:
- First to separate guidance from scoring in scientific domains, solving key RL challenges for creative tasks.
- Prevents reward hacking through independent feedback streams, unlike single-reward RL systems.
- Ensures optimization for genuine idea quality rather than reward model exploitation.
Project Structure
DeepInnovator/
├── recipe/
│   └── DeepInnovator/
│       ├── data_preparation/      # Data preparation pipeline
│       │   ├── config/           # Agent and model configurations
│       │   ├── data_prepare/     # Pipeline scripts
│       │   ├── run.sh           # Quick run script
│       │   └── README.md        # Data preparation documentation
│       ├── config/               # Training configurations
│       │   ├── agent.yaml       # Agent loop configuration
│       │   ├── reward_config.yaml  # Reward function configuration
│       │   └── ResearchGAN_interaction_config.yaml  # Interaction configuration
│       ├── metrics/              # Reward metrics
│       │   ├── basic_reward.py
│       │   ├── delta_reward.py
│       │   └── token_amount.py
│       ├── preprocess.py        # Dataset preprocessing script
│       ├── preprocess.sh        # Preprocessing script runner
│       ├── reward_function.py   # Main reward function
│       ├── DeepInnovator_interation.py  # Interaction logic
│       ├── DeepInnovator_agent_loop.py  # Agent loop implementation
│       ├── train_rl.sh          # Training script
│       └── utils.py             # Utility functions
└── verl/                        # VERL framework (for RL training)
Prerequisites
- Python 3.8+
- CUDA-capable GPU (for training)
- VERL framework (for RL training)
- Required Python packages (see installation section)
Environment Setup
1. Install Dependencies
# Core dependencies
pip install openai omegaconf python-dotenv feedparser requests PyPDF2 tqdm python-dateutil
pip install datasets numpy torch transformers
2. Configure Environment Variables
Create a .env file in the project root:
# API Configuration for data preparation
OPENAI_API_BASE=your_api_base_url
OPENAI_API_KEY=your_api_key

# For training (if needed)
WANDB_API_KEY=your_wandb_api_key
WANDB_BASE_URL=your_wandb_base_url
3. Configure Model Settings
Edit recipe/DeepInnovator/data_preparation/config/models/providers.yaml to set your API endpoints:
openai:
  base_url: ${env:OPENAI_API_BASE}
  api_key: ${env:OPENAI_API_KEY}
Data Preparation
The data preparation pipeline processes academic papers through multiple stages to generate training data.
Quick Start
Run the complete pipeline:
cd recipe/DeepInnovator/data_preparation
bash run.sh [total_papers] [datapath]
Example:
cd recipe/DeepInnovator/data_preparation
bash run.sh 100 ./data/arxiv_data
Step-by-Step Process
Step 1: Download Papers
Download papers from arXiv across predefined categories (cs, stat, q-fin, math):
cd recipe/DeepInnovator/data_preparation
python data_prepare/pull_papers.py --total_papers 100 --datapath ./data/arxiv_data
Parameters:
--total_papers: Total number of papers to download--datapath: Data save path
Output: Papers saved to {datapath}/raw_paper/ directory
Step 2: Extract Target Paper Ideas
Extract ideas from target papers:
cd recipe/DeepInnovator/data_preparation
python data_prepare/get_target_paper_idea.py --datapath ./data/arxiv_data
Output: {datapath}/{paper_id}/target_paper/raw_paper/paper_idea.json
Step 3: Generate Training Data
Process papers through the full pipeline (step1-step4) to generate training data:
cd recipe/DeepInnovator/data_preparation
python data_prepare/get_training_data.py
Output Structure:
layer0/: Paper analysis resultslayer1/: Paper groups and memorieslayer2/: Connections, serendipity, and trendsinsights/: Generated research ideas
Data Preprocessing
After generating training data, preprocess it for RL training:
cd recipe/DeepInnovator
python preprocess.py \
    --input_dir ./data/arxiv_data \
    --output_dir ./data/train \
    --task_desc "refine a research idea" \
    --validation_size 0.1 \
    --seed 42 \
    --num_proc 1 \
    --dataset_type "rl" \
    --test False \
    --layer0 False \
    --layer1 False \
    --layer2 True
Parameters:
--input_dir: Input directory containing processed papers--output_dir: Output directory for preprocessed data--task_desc: Task description for the dataset--validation_size: Validation split ratio (default: 0.1)--seed: Random seed (default: 42)--num_proc: Number of parallel workers (default: 1)--dataset_type: Dataset type - "rl" or "sft" (default: "rl")--test: Test mode - sample fixed number of examples (default: True)--layer0/1/2: Include layer data in prompts (default: False)
Output:
rl_train.parquet: Training datasetrl_validation.parquet: Validation dataset
Or use the convenience script:
cd recipe/DeepInnovator
bash preprocess.sh
Training
Configuration
Before training, configure the following files:
-
recipe/DeepInnovator/config/reward_config.yaml: Configure reward function parametersconfig: metric_weights: delta_reward: 5 token_amount: 0.1 default_reward_kwargs: model: "your model" api_key: "your api key" api_base: "your api base" -
recipe/DeepInnovator/config/ResearchGAN_interaction_config.yaml: Configure interaction settingsinteraction: - name: "DeepInnovator" discriminator_kwargs: discriminator_model: "your model" api_key: "your api key" api_base: "your api base" -
recipe/DeepInnovator/train_rl.sh: Update training parametersMODEL_DIR: Path to base modelDATASET_DIR: Path to preprocessed datasetWANDB_PROJECT_NAME: Weights & Biases project nameWANDB_EXPERIMENT_NAME: Experiment name- GPU settings, batch sizes, etc.
Start Training
cd recipe/DeepInnovator
bash train_rl.sh [resume_path]
Parameters:
resume_path(optional): Path to checkpoint to resume from
Training Configuration:
- Base model: Qwen2.5-14B-IT
- Algorithm: GRPO (Group Relative Policy Optimization)
- Multi-turn interaction: Up to 5 user turns, 6 assistant turns
- Reward: Combination of delta_reward and token_amount metrics
- Training epochs: 3
- Batch size: 16 (train), 4 (PPO mini-batch)
Training Process
The training process involves:
- Agent Loop: Generates research ideas iteratively
- Discriminator: Evaluates idea authenticity (real vs fictional)
- Reward Computation: Calculates rewards based on:
- Delta reward: Improvement over iterations
- Token amount: Length-based reward
- Policy Update: Updates agent policy using PPO algorithm
Key Components
Reward Function (recipe/DeepInnovator/reward_function.py)
Computes conversation-level rewards by combining multiple metrics:
delta_reward: Measures improvement between iterationstoken_amount: Length-based reward- Configurable weights via
reward_config.yaml
Interaction (recipe/DeepInnovator/DeepInnovator_interation.py)
Implements the interaction logic:
- Extracts ideas from agent responses
- Uses discriminator to evaluate authenticity
- Manages multi-turn conversations
- Handles termination conditions
Agent Loop (recipe/DeepInnovator/DeepInnovator_agent_loop.py)
Manages the agent's decision-making process:
- Processes user prompts
- Generates responses
- Handles multi-turn interactions
- Manages agent state
Output Structure
After data preparation:
data/
└── {paper_id}/
    ├── target_paper/          # Target paper and references
    │   └── raw_paper/
    │       ├── paper_md/      # Markdown files
    │       └── paper_idea.json  # Extracted ideas
    ├── raw_paper/             # Raw downloaded papers
    ├── layer0/                # Paper analysis
    │   └── paper_memory/      # Structured paper data
    ├── layer1/                # Paper grouping
    │   ├── inner_paper_memory.json
    │   └── inter_paper_group.json
    ├── layer2/                # Connections and insights
    │   ├── connections.json
    │   ├── serendipity.json
    │   └── research_trending.json
    └── insights/              # Generated ideas
        └── idea_spark.json
After preprocessing:
data/train/
├── rl_train.parquet          # Training dataset
└── rl_validation.parquet      # Validation dataset
License
This project is licensed under the MIT License - see the LICENSE file for details.
🌟Citation
@article{fan2026deepinnovator,
  title={DeepInnovator: Triggering the Innovative Capabilities of LLMs},
  author={Fan, Tianyu and Zhang, Fengji and Zheng, Yuxiang and Chen, Bei and Niu, Xinyao and Huang, Chengen and Lin, Junyang and Huang, Chao},
  journal={arXiv preprint arXiv:2602.18920},
  year={2026}
}
Thanks for visiting ✨ DeepInnovator!


Similar repos


Languages
Python
96.2%
Shell
3.8%
"DeepInnovator: AI Research Assistant - Idea Spark & Scientific Discovery"
See the codeREADME
DeepInnovator: AI Research Assistant - Idea Spark & Scientific Discovery
| 💡 Generate Research Ideas and Hypotheses | 🔗 Discovers Cross-Disciplinary Connections |
| 🔍 Research Gap & Trend Analysis | 🛠️ AI-Powered Scientific Problem Solving |
🔬 DeepInnovator is an AI research copilot powered by our built scientific foundation model trained specifically.
💡 DeepInnovator transforms how researchers discover and develop breakthrough ideas for research discovery.
🧠 DeepInnovator's Key Features
1. 💡 AI Research Idea Generator
- Autonomously generates innovative research ideas and directions.
- Identifies unexplored opportunities and knowledge gaps in scientific fields.
2. 🔗 Cross-Disciplinary Innovation Engine
- Discovers interdisciplinary research connections and fusion opportunities.
- Synthesizes breakthrough concepts from multiple scientific domains.
3. ❓ Scientific Hypothesis & Question Formation
- Automatically constructs scientifically valuable research questions.
- Generates testable scientific hypotheses and predicts experimental designs.
4. 📊 Research Gap & Trend Analysis
- Intelligently identifies gaps and limitations in current research.
- Predicts development trends and emerging hotspots in scientific fields.
5. ⚙️ Innovation Methodology Framework
- "Standing on shoulders of giants": Extracts innovative insights from vast literature.
- "Conjectures and refutations": Iterative idea generation and optimization.
6. 🎯 Creative Problem-Solving Assistant
- Provides multi-angle solutions for complex scientific problems.
- Inspires researchers' innovative thinking and guides strategic resource allocation.
🚀 DeepInnovator's Performance
Strong Baseline Improvement:
• DeepInnovator-14B significantly outperforms Qwen-14B-Instruct across all evaluation dimensions.
• It achieves impressive win rates of 80.53%-93.81% against the base model in automated evaluations.
Competitive with top-tier LLMs (GPT-4o and Gemini-2.5-pro)
• Despite smaller parameter size, DeepInnovator matches performance of GPT-4o and Gemini-2.5-pro.
• DeepInnovator even surpasses GPT-4o in well-justified rationale evaluation, scoring 82.3% vs 77.9%
Excellent cross-domain generalization:
• The model shows strong zero-shot transfer capabilities to completely unseen research domains.
• It generates high-quality research ideas in law, education, and biotechnology despite being trained on STEM.
| Domain | Metric | Much Better | Better | Worse | Much Worse | Both Bad | Avg. Winrate (vs Qwen-14B-IT / vs GPT-4o) |
|---|---|---|---|---|---|---|---|
| Law | Novelty | 0 / 0 | 9 / 7 | 3 / 6 | 1 / 0 | 0 / 0 | 69.2% / 53.8% |
| Feasibility | 1 / 0 | 5 / 4 | 3 / 7 | 1 / 1 | 3 / 1 | 60.0% / 33.3% | |
| Effectiveness | 2 / 1 | 5 / 4 | 2 / 3 | 1 / 3 | 3 / 2 | 70.0% / 45.5% | |
| Detailedness | 7 / 1 | 3 / 4 | 2 / 5 | 1 / 0 | 0 / 3 | 76.9% / 50.0% | |
| Education | Novelty | 3 / 0 | 9 / 9 | 2 / 5 | 1 / 1 | 0 / 0 | 80.0% / 60.0% |
| Feasibility | 3 / 0 | 5 / 0 | 5 / 7 | 1 / 3 | 1 / 5 | 57.1% / 0.0% | |
| Effectiveness | 2 / 0 | 6 / 0 | 4 / 5 | 3 / 4 | 0 / 6 | 53.3% / 0.0% | |
| Detailedness | 1 / 0 | 8 / 4 | 3 / 5 | 0 / 2 | 3 / 4 | 75.0% / 36.4% | |
| Biotech | Novelty | 3 / 2 | 8 / 6 | 1 / 5 | 0 / 0 | 2 / 2 | 91.7% / 61.5% |
| Feasibility | 2 / 0 | 6 / 5 | 0 / 3 | 0 / 5 | 6 / 2 | 100.0% / 38.5% | |
| Effectiveness | 1 / 2 | 6 / 5 | 4 / 2 | 1 / 4 | 2 / 2 | 58.3% / 53.8% | |
| Detailedness | 6 / 3 | 4 / 2 | 1 / 4 | 0 / 5 | 3 / 1 | 90.9% / 35.7% |
• DeepInnovator-14B achieves 100% win rate in Biotech Feasibility against Qwen2.5-14B-IT
• Demonstrates 91.7% win rate in Biotech Novelty versus the baseline model
• Secures 90.9% win rate in Biotech Detailedness compared to Qwen2.5-14B-IT
• Maintains 61.5% win rate in Biotech Novelty when benchmarked against GPT-4o
• Shows 60.0% win rate in Education Novelty against the advanced GPT-4o model
🏗️ DeepInnovator's Architecture
• Intelligent Knowledge Synthesis Pipeline:
- Transforms dense literature into structured cognitive primitives (Insight, Research Trending, Serendipity).
- Mimics human scientific reasoning through hierarchical abstraction and relationship modeling.
- Maintains computational efficiency while preserving semantic completeness.
• Next Idea Prediction Training Paradigm:
- Introduces an iterative refinement framework that models research idea generation as a sequential process.
- Enables continuous predicting, evaluating, and improving of ideas through systematic cycles.
- Mimics the "conjectures and refutations" methodology of authentic scientific discovery.
• Decoupled Reward-Comment RL Architecture:
- First to separate guidance from scoring in scientific domains, solving key RL challenges for creative tasks.
- Prevents reward hacking through independent feedback streams, unlike single-reward RL systems.
- Ensures optimization for genuine idea quality rather than reward model exploitation.
Project Structure
DeepInnovator/
├── recipe/
│   └── DeepInnovator/
│       ├── data_preparation/      # Data preparation pipeline
│       │   ├── config/           # Agent and model configurations
│       │   ├── data_prepare/     # Pipeline scripts
│       │   ├── run.sh           # Quick run script
│       │   └── README.md        # Data preparation documentation
│       ├── config/               # Training configurations
│       │   ├── agent.yaml       # Agent loop configuration
│       │   ├── reward_config.yaml  # Reward function configuration
│       │   └── ResearchGAN_interaction_config.yaml  # Interaction configuration
│       ├── metrics/              # Reward metrics
│       │   ├── basic_reward.py
│       │   ├── delta_reward.py
│       │   └── token_amount.py
│       ├── preprocess.py        # Dataset preprocessing script
│       ├── preprocess.sh        # Preprocessing script runner
│       ├── reward_function.py   # Main reward function
│       ├── DeepInnovator_interation.py  # Interaction logic
│       ├── DeepInnovator_agent_loop.py  # Agent loop implementation
│       ├── train_rl.sh          # Training script
│       └── utils.py             # Utility functions
└── verl/                        # VERL framework (for RL training)
Prerequisites
- Python 3.8+
- CUDA-capable GPU (for training)
- VERL framework (for RL training)
- Required Python packages (see installation section)
Environment Setup
1. Install Dependencies
# Core dependencies
pip install openai omegaconf python-dotenv feedparser requests PyPDF2 tqdm python-dateutil
pip install datasets numpy torch transformers
2. Configure Environment Variables
Create a .env file in the project root:
# API Configuration for data preparation
OPENAI_API_BASE=your_api_base_url
OPENAI_API_KEY=your_api_key

# For training (if needed)
WANDB_API_KEY=your_wandb_api_key
WANDB_BASE_URL=your_wandb_base_url
3. Configure Model Settings
Edit recipe/DeepInnovator/data_preparation/config/models/providers.yaml to set your API endpoints:
openai:
  base_url: ${env:OPENAI_API_BASE}
  api_key: ${env:OPENAI_API_KEY}
Data Preparation
The data preparation pipeline processes academic papers through multiple stages to generate training data.
Quick Start
Run the complete pipeline:
cd recipe/DeepInnovator/data_preparation
bash run.sh [total_papers] [datapath]
Example:
cd recipe/DeepInnovator/data_preparation
bash run.sh 100 ./data/arxiv_data
Step-by-Step Process
Step 1: Download Papers
Download papers from arXiv across predefined categories (cs, stat, q-fin, math):
cd recipe/DeepInnovator/data_preparation
python data_prepare/pull_papers.py --total_papers 100 --datapath ./data/arxiv_data
Parameters:
--total_papers: Total number of papers to download--datapath: Data save path
Output: Papers saved to {datapath}/raw_paper/ directory
Step 2: Extract Target Paper Ideas
Extract ideas from target papers:
cd recipe/DeepInnovator/data_preparation
python data_prepare/get_target_paper_idea.py --datapath ./data/arxiv_data
Output: {datapath}/{paper_id}/target_paper/raw_paper/paper_idea.json
Step 3: Generate Training Data
Process papers through the full pipeline (step1-step4) to generate training data:
cd recipe/DeepInnovator/data_preparation
python data_prepare/get_training_data.py
Output Structure:
layer0/: Paper analysis resultslayer1/: Paper groups and memorieslayer2/: Connections, serendipity, and trendsinsights/: Generated research ideas
Data Preprocessing
After generating training data, preprocess it for RL training:
cd recipe/DeepInnovator
python preprocess.py \
    --input_dir ./data/arxiv_data \
    --output_dir ./data/train \
    --task_desc "refine a research idea" \
    --validation_size 0.1 \
    --seed 42 \
    --num_proc 1 \
    --dataset_type "rl" \
    --test False \
    --layer0 False \
    --layer1 False \
    --layer2 True
Parameters:
--input_dir: Input directory containing processed papers--output_dir: Output directory for preprocessed data--task_desc: Task description for the dataset--validation_size: Validation split ratio (default: 0.1)--seed: Random seed (default: 42)--num_proc: Number of parallel workers (default: 1)--dataset_type: Dataset type - "rl" or "sft" (default: "rl")--test: Test mode - sample fixed number of examples (default: True)--layer0/1/2: Include layer data in prompts (default: False)
Output:
rl_train.parquet: Training datasetrl_validation.parquet: Validation dataset
Or use the convenience script:
cd recipe/DeepInnovator
bash preprocess.sh
Training
Configuration
Before training, configure the following files:
-
recipe/DeepInnovator/config/reward_config.yaml: Configure reward function parametersconfig: metric_weights: delta_reward: 5 token_amount: 0.1 default_reward_kwargs: model: "your model" api_key: "your api key" api_base: "your api base" -
recipe/DeepInnovator/config/ResearchGAN_interaction_config.yaml: Configure interaction settingsinteraction: - name: "DeepInnovator" discriminator_kwargs: discriminator_model: "your model" api_key: "your api key" api_base: "your api base" -
recipe/DeepInnovator/train_rl.sh: Update training parametersMODEL_DIR: Path to base modelDATASET_DIR: Path to preprocessed datasetWANDB_PROJECT_NAME: Weights & Biases project nameWANDB_EXPERIMENT_NAME: Experiment name- GPU settings, batch sizes, etc.
Start Training
cd recipe/DeepInnovator
bash train_rl.sh [resume_path]
Parameters:
resume_path(optional): Path to checkpoint to resume from
Training Configuration:
- Base model: Qwen2.5-14B-IT
- Algorithm: GRPO (Group Relative Policy Optimization)
- Multi-turn interaction: Up to 5 user turns, 6 assistant turns
- Reward: Combination of delta_reward and token_amount metrics
- Training epochs: 3
- Batch size: 16 (train), 4 (PPO mini-batch)
Training Process
The training process involves:
- Agent Loop: Generates research ideas iteratively
- Discriminator: Evaluates idea authenticity (real vs fictional)
- Reward Computation: Calculates rewards based on:
- Delta reward: Improvement over iterations
- Token amount: Length-based reward
- Policy Update: Updates agent policy using PPO algorithm
Key Components
Reward Function (recipe/DeepInnovator/reward_function.py)
Computes conversation-level rewards by combining multiple metrics:
delta_reward: Measures improvement between iterationstoken_amount: Length-based reward- Configurable weights via
reward_config.yaml
Interaction (recipe/DeepInnovator/DeepInnovator_interation.py)
Implements the interaction logic:
- Extracts ideas from agent responses
- Uses discriminator to evaluate authenticity
- Manages multi-turn conversations
- Handles termination conditions
Agent Loop (recipe/DeepInnovator/DeepInnovator_agent_loop.py)
Manages the agent's decision-making process:
- Processes user prompts
- Generates responses
- Handles multi-turn interactions
- Manages agent state
Output Structure
After data preparation:
data/
└── {paper_id}/
    ├── target_paper/          # Target paper and references
    │   └── raw_paper/
    │       ├── paper_md/      # Markdown files
    │       └── paper_idea.json  # Extracted ideas
    ├── raw_paper/             # Raw downloaded papers
    ├── layer0/                # Paper analysis
    │   └── paper_memory/      # Structured paper data
    ├── layer1/                # Paper grouping
    │   ├── inner_paper_memory.json
    │   └── inter_paper_group.json
    ├── layer2/                # Connections and insights
    │   ├── connections.json
    │   ├── serendipity.json
    │   └── research_trending.json
    └── insights/              # Generated ideas
        └── idea_spark.json
After preprocessing:
data/train/
├── rl_train.parquet          # Training dataset
└── rl_validation.parquet      # Validation dataset
License
This project is licensed under the MIT License - see the LICENSE file for details.
🌟Citation
@article{fan2026deepinnovator,
  title={DeepInnovator: Triggering the Innovative Capabilities of LLMs},
  author={Fan, Tianyu and Zhang, Fengji and Zheng, Yuxiang and Chen, Bei and Niu, Xinyao and Huang, Chengen and Lin, Junyang and Huang, Chao},
  journal={arXiv preprint arXiv:2602.18920},
  year={2026}
}
Thanks for visiting ✨ DeepInnovator!
Similar repos
Significant stargazers
Languages
Python
96.2%
Shell
3.8%