기존 LLM 기반 Decompile은 한 토큰씩 생성하는 Autoregressive(AR) 방식에 의존하지만, 코드 구조 복원은 전역 제약이 강해 단방향 생성에 불리합니다. Diffusion model은 시퀀스 전체를 양방향으로 정제하므로 전역 구조 복원에 유리할 수 있습니다. 본 연구는 AST skeleton 복원 단계에 Diffusion을 적용하고, 동일 계열 backbone에서 파생된 Diffusion·AR 모델을 같은 데이터·같은 크기 LoRA로 학습하여 두 방식을 통제 비교합니다.
데이터에 noise를 조금씩 더해 망가뜨린 뒤, 그 과정을 거꾸로 되돌리도록 학습하여 noise로부터 데이터를 복원하는 생성 모델입니다. 주로 생성형 이미지 모델에 사용되지만, Text 기반 Diffusion은 token이 이산 값이라 Gaussian noise 대신 MASK로 치환하는 Masked Diffusion을 사용합니다.
컴파일된 프로그램(바이너리)를 사람이 읽을 수 있는 고수준 소스 코드로 복구하는 과정입니다.
디스어셈블 → IR 승격 → 제어흐름·데이터흐름 분석 → 타입 복원·구조화(=AST 복원) → code 생성
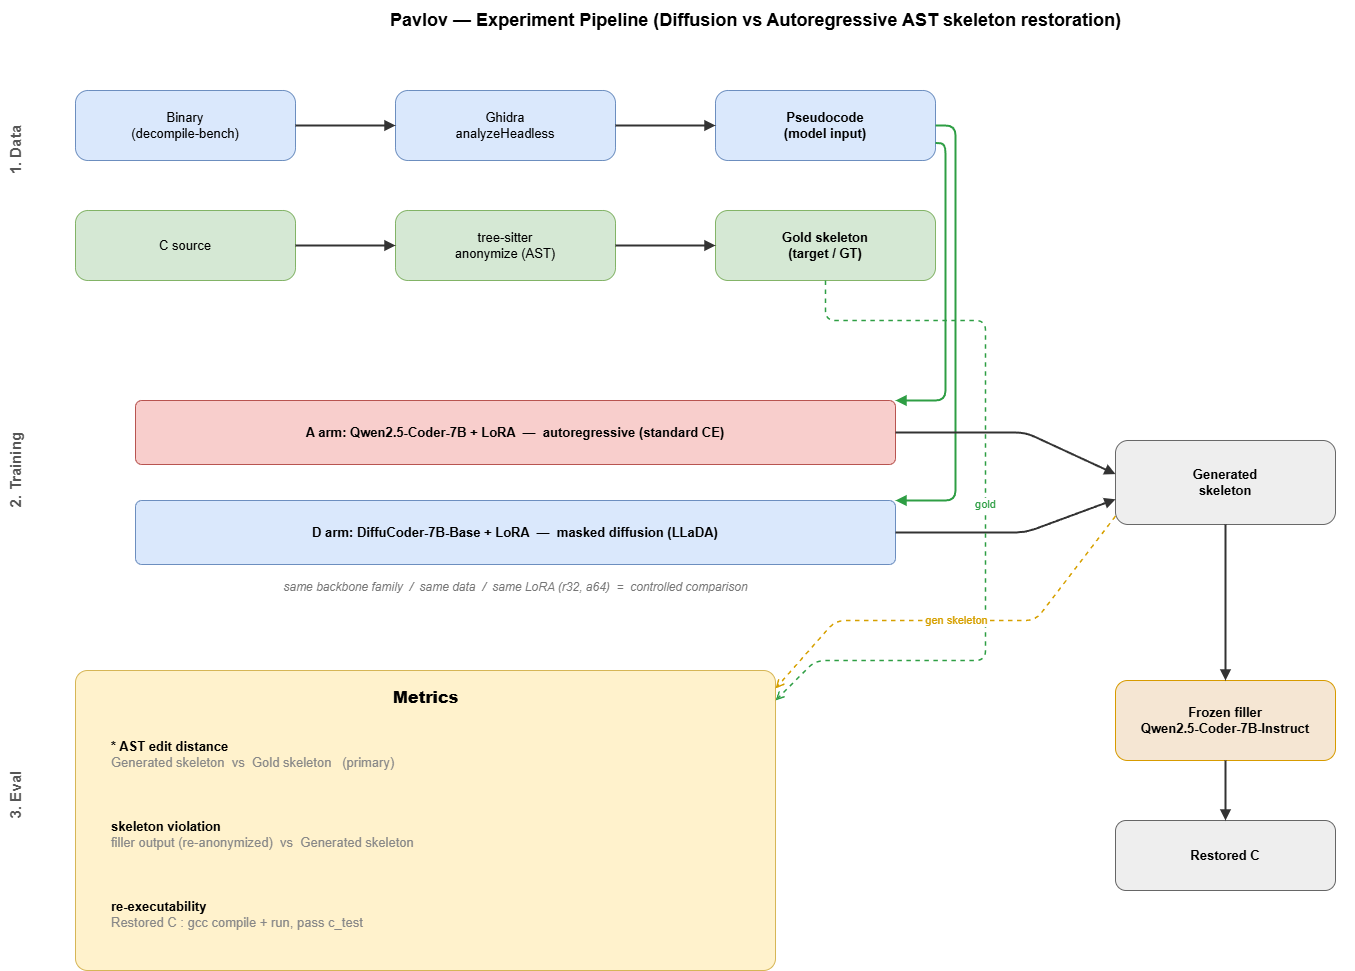
LLM4Binary/decompile-bench에서 source 함수와 컴파일된 binary를 가져옴 (binary는 split zip에서 필요 구간만 부분 추출)analyzeHeadless로 함수별 pseudocode를 jsonl로 추출LoRA 설정: r=32, alpha=64, 학습 파라미터 약 80M (전체의 1.05%)
| Arm | 방식 | Backbone | 학습 방법 |
|---|---|---|---|
| A arm | Autoregressive | Qwen2.5-Coder-7B | 표준 cross entropy, prompt·pad는 -100 마스킹 |
| D arm | Diffusion | DiffuCoder-7B-Base | Masked diffusion (LLaDA recipe): target을 확률 t로 [MASK] 치환 후 masked 위치 cross entropy에 1/t 가중 |
DiffuCoder-7B-Base는 Qwen2.5-Coder-7B와 같은 계열 모델로, 두 arm의 backbone은 동일합니다.
decompile-eval 240 balanced subset = 60 함수 × O0–O3c_test와 gcc 컴파일·격리 실행하여 assert 전부 통과 시 인정| 항목 | 내용 |
|---|---|
| 환경 | A100 80GB, torch 2.9.1+cu130, transformers 4.51.3, peft 0.19.1 |
| 모델 | D: DiffuCoder-7B-Base / A: Qwen2.5-Coder-7B |
| LoRA | r32 / α64, bf16, 동일 학습량 |
| 학습 | train_set 17,760, 2000 step, effective batch 16, gen-len 512, seed 0/1 |
| 비교 방법 | A·D arm + 공통 frozen filler |
| 생성 | A는 greedy, D는 diffusion_generate (denoising step 충분히 적용) |
| 학습방법 | AST edit distance | skeleton 위반율 | re-executability |
|---|---|---|---|
| A arm (Autoregressive) | 0.534 | 82.9% | 26.7% |
| D arm (Diffusion) | 0.531 | 75.8% | 20.4% |
| 학습방법 | AST edit distance | skeleton 위반율 | re-executability |
|---|---|---|---|
| A arm (Autoregressive) | 0.504 | 83.8% | 27.5% |
| D arm (Diffusion) | 0.484 | 76.2% | 22.1% |
| 문서 | 내용 |
|---|---|
docs/research.md | 연구 개요와 방법 — 배경, RQ, 데이터 전처리·학습·평가 전 과정, 실험 설계, 한계 |
docs/data_pipeline.md | 데이터 파이프라인 — 추출 → Ghidra → matching → anonymization → 학습셋 |
docs/training.md | 학습 재현 — 환경, 커맨드, 하이퍼파라미터 |
docs/evaluation.md | 평가 harness — 생성, Gate 3, filler, re-executability |
학습한 LoRA 어댑터는 GitHub Releases에 있습니다.
| Release | 내용 |
|---|---|
| v0.3-adapters-s1 | seed 1 (diff_s1, ar_s1), gen_len 512 |
| v0.2-adapters | seed 0 (diff_s0, ar_s0), gen_len 512, shift-fixed |
| v0.1-adapters | 초기 버전 |
기존 LLM 기반 Decompile은 한 토큰씩 생성하는 Autoregressive(AR) 방식에 의존하지만, 코드 구조 복원은 전역 제약이 강해 단방향 생성에 불리합니다. Diffusion model은 시퀀스 전체를 양방향으로 정제하므로 전역 구조 복원에 유리할 수 있습니다. 본 연구는 AST skeleton 복원 단계에 Diffusion을 적용하고, 동일 계열 backbone에서 파생된 Diffusion·AR 모델을 같은 데이터·같은 크기 LoRA로 학습하여 두 방식을 통제 비교합니다.
데이터에 noise를 조금씩 더해 망가뜨린 뒤, 그 과정을 거꾸로 되돌리도록 학습하여 noise로부터 데이터를 복원하는 생성 모델입니다. 주로 생성형 이미지 모델에 사용되지만, Text 기반 Diffusion은 token이 이산 값이라 Gaussian noise 대신 MASK로 치환하는 Masked Diffusion을 사용합니다.
컴파일된 프로그램(바이너리)를 사람이 읽을 수 있는 고수준 소스 코드로 복구하는 과정입니다.
디스어셈블 → IR 승격 → 제어흐름·데이터흐름 분석 → 타입 복원·구조화(=AST 복원) → code 생성
LLM4Binary/decompile-bench에서 source 함수와 컴파일된 binary를 가져옴 (binary는 split zip에서 필요 구간만 부분 추출)analyzeHeadless로 함수별 pseudocode를 jsonl로 추출LoRA 설정: r=32, alpha=64, 학습 파라미터 약 80M (전체의 1.05%)
| Arm | 방식 | Backbone | 학습 방법 |
|---|---|---|---|
| A arm | Autoregressive | Qwen2.5-Coder-7B | 표준 cross entropy, prompt·pad는 -100 마스킹 |
| D arm | Diffusion | DiffuCoder-7B-Base | Masked diffusion (LLaDA recipe): target을 확률 t로 [MASK] 치환 후 masked 위치 cross entropy에 1/t 가중 |
DiffuCoder-7B-Base는 Qwen2.5-Coder-7B와 같은 계열 모델로, 두 arm의 backbone은 동일합니다.
decompile-eval 240 balanced subset = 60 함수 × O0–O3c_test와 gcc 컴파일·격리 실행하여 assert 전부 통과 시 인정| 항목 | 내용 |
|---|---|
| 환경 | A100 80GB, torch 2.9.1+cu130, transformers 4.51.3, peft 0.19.1 |
| 모델 | D: DiffuCoder-7B-Base / A: Qwen2.5-Coder-7B |
| LoRA | r32 / α64, bf16, 동일 학습량 |
| 학습 | train_set 17,760, 2000 step, effective batch 16, gen-len 512, seed 0/1 |
| 비교 방법 | A·D arm + 공통 frozen filler |
| 생성 | A는 greedy, D는 diffusion_generate (denoising step 충분히 적용) |
| 학습방법 | AST edit distance | skeleton 위반율 | re-executability |
|---|---|---|---|
| A arm (Autoregressive) | 0.534 | 82.9% | 26.7% |
| D arm (Diffusion) | 0.531 | 75.8% | 20.4% |
| 학습방법 | AST edit distance | skeleton 위반율 | re-executability |
|---|---|---|---|
| A arm (Autoregressive) | 0.504 | 83.8% | 27.5% |
| D arm (Diffusion) | 0.484 | 76.2% | 22.1% |
| 문서 | 내용 |
|---|---|
docs/research.md | 연구 개요와 방법 — 배경, RQ, 데이터 전처리·학습·평가 전 과정, 실험 설계, 한계 |
docs/data_pipeline.md | 데이터 파이프라인 — 추출 → Ghidra → matching → anonymization → 학습셋 |
docs/training.md | 학습 재현 — 환경, 커맨드, 하이퍼파라미터 |
docs/evaluation.md | 평가 harness — 생성, Gate 3, filler, re-executability |
학습한 LoRA 어댑터는 GitHub Releases에 있습니다.
| Release | 내용 |
|---|---|
| v0.3-adapters-s1 | seed 1 (diff_s1, ar_s1), gen_len 512 |
| v0.2-adapters | seed 0 (diff_s0, ar_s0), gen_len 512, shift-fixed |
| v0.1-adapters | 초기 버전 |



