Turn a song and its lyrics into Japanese karaoke videos with per-syllable wipes: furigana, vocal separation, mora-level alignment and burned-in subtitles.
Python
45
141 commits
updated Oct 13, 2026
用一首歌和它的歌词,做出逐字扫光的日语卡拉OK视频。




本软件受 StrangeUtaGame 启发。MiliKara 是自动对齐工具,不是卡拉OK手动打轴软件;如果需要手动打轴,请使用 StrangeUtaGame 原软件。
名称说明:本项目原名 KiraKara,因与 KiraKara player 及其相关项目重名,从 v1.1.0 起改名为 MiliKara(两者之间没有关系)。旧版本的项目和设置在新版本里可以直接使用。
放入视频(或音频 + 背景图),粘贴网易云 / QQ 音乐的歌曲链接或 LRC 歌词,MiliKara 会自动给汉字注音、分离人声、把每一个假名(拍)对齐到演唱的时间上,然后把带注音、翻译和歌曲信息的卡拉OK字幕直接烧录进视频。全部在本机运行。
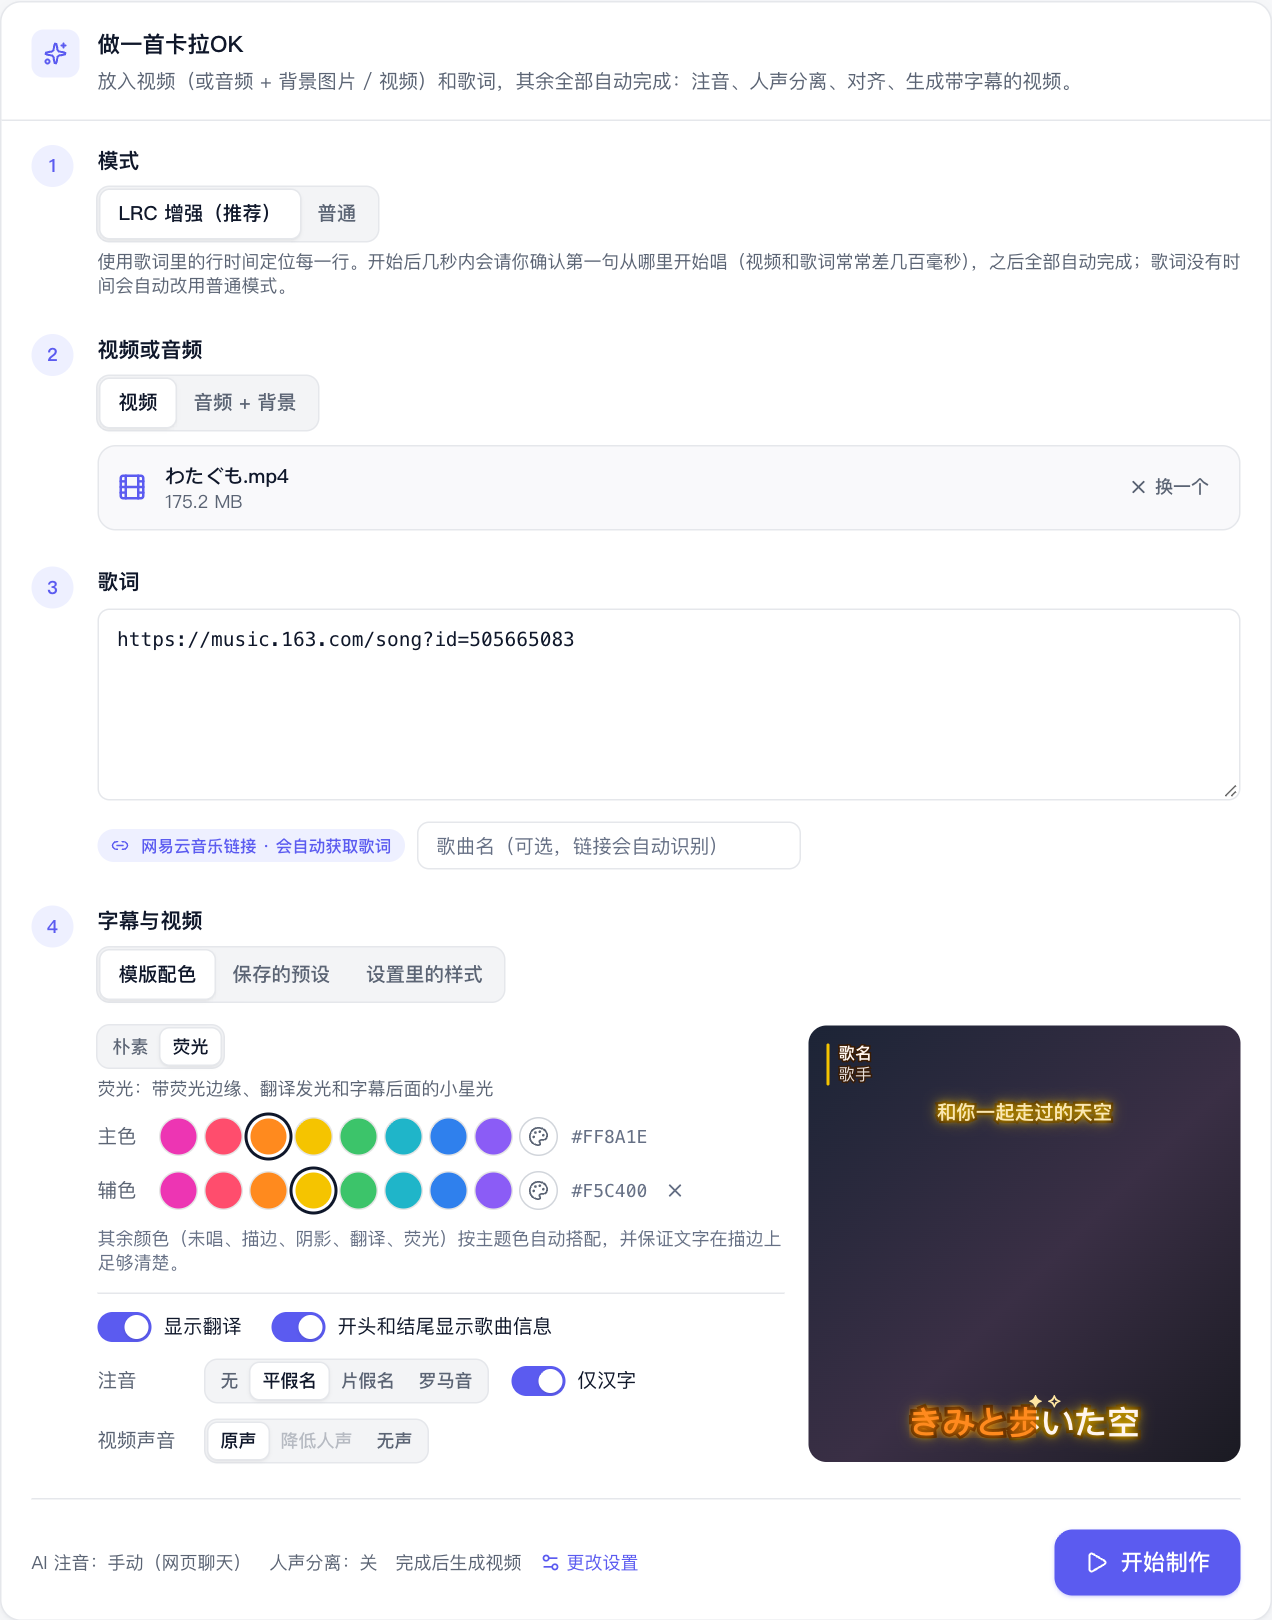
极简模式:放入视频,粘贴歌曲链接,选好字幕配色,点“开始制作”
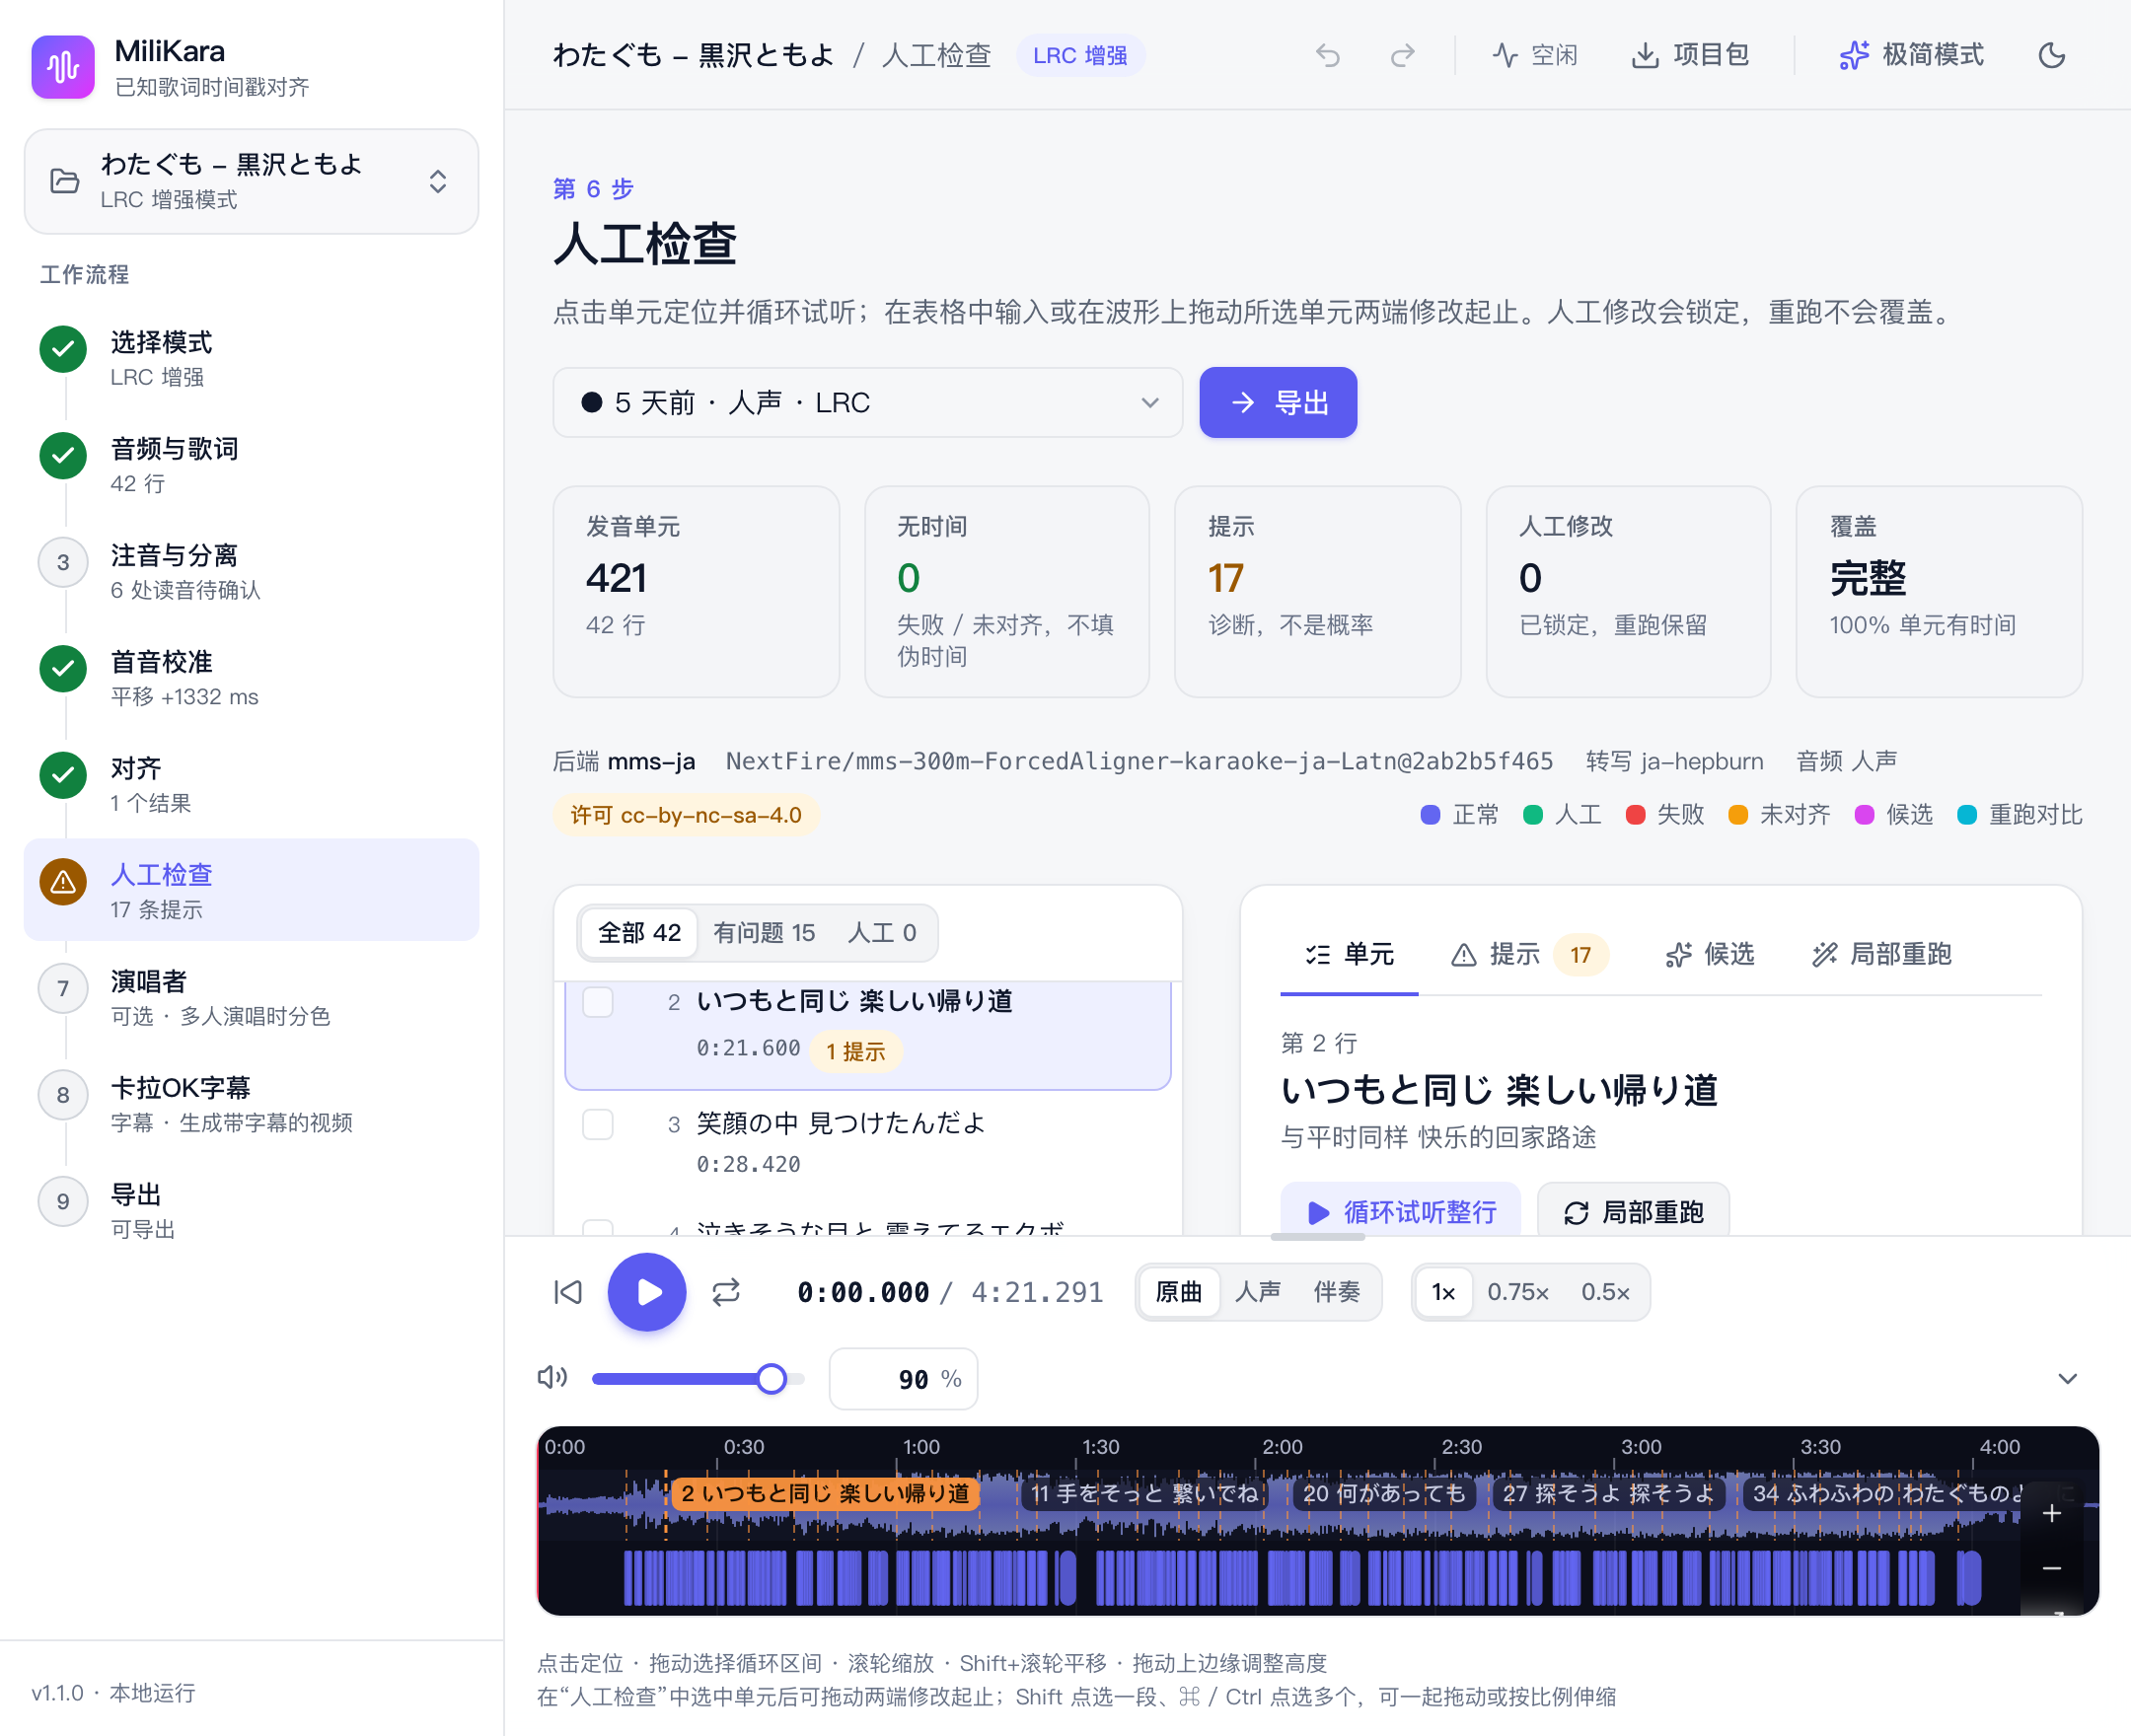
详细模式(人工检查):每一行、每一个假名的时间都可以试听、拖动修改和局部重跑
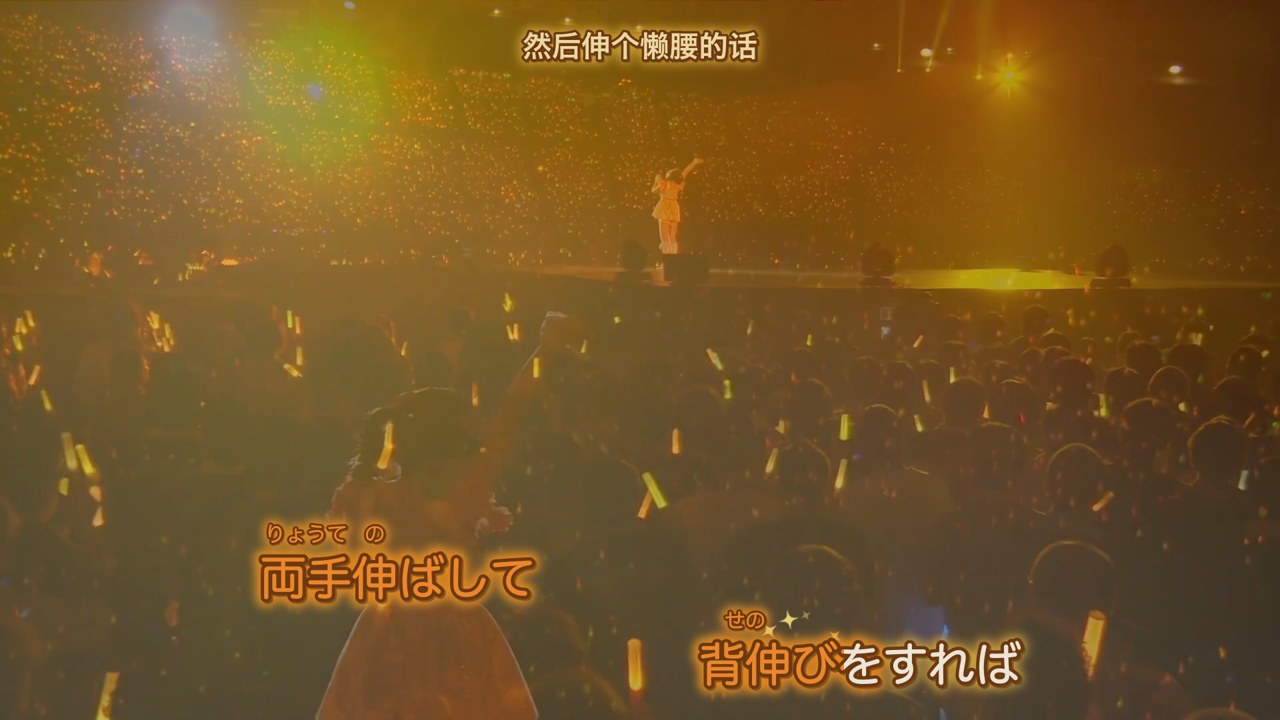
成品视频的一帧:逐字扫光、汉字注音,顶部是中文翻译
Windows 离线版:在 Releases 里下载 MiliKara-…-windows-x64-cpu.7z(CPU 版)、…-cuda.7z(NVIDIA 显卡版,需要 570 或更新的驱动)或 …-rocm.7z(AMD 显卡版,v1.2.0 起:Radeon RX 6800 / 6900、RX 7000 / 9000 系列,以及 Ryzen 的 780M / 760M、Ryzen AI 300 系列和 Ryzen AI Max 核显,请把显卡驱动更新到最新)。超过 2 GB 时分成 .7z.001、.7z.002… 几个分卷,需要全部下载。用 7-Zip 解压,双击 MiliKara.bat。自带 Python、依赖、ffmpeg 和两个默认模型,不需要联网。
macOS 离线版(Apple 芯片,macOS 14.8.5 或更新):下载 MiliKara-…-macos-arm64.zip,解压后第一次在访达里右键点 MiliKara.command →“打开”,以后双击即可。
更新离线版:关闭 MiliKara 后双击文件夹里的 更新.bat(macOS:更新.command),只下载有变化的部分(程序约 1 MB;从 v1.0 更新时还会补上约 32 MB 的字体),模型、依赖和项目都不用重新下载,出问题可以退回上一版。v1.1.0 之前的旧版(KiraKara)没有这个文件:在 Releases 里下载 MiliKara-updater-windows.bat(macOS:MiliKara-updater-macos.zip,解压)放进原来的文件夹,双击即可。访问 GitHub 慢时,也可以把程序更新包 MiliKara-版本-app.zip 放进文件夹,更新程序会直接用它。
离线版都由 GitHub Actions 构建(.github/workflows/windows-package.yml、macos-package.yml;打包脚本在 packaging/)。
从源码安装:需要 Python 3.11+、uv,以及带 libass 的 ffmpeg(macOS:brew install ffmpeg-full)。目前主要在 macOS(Apple 芯片)上使用和测试;Linux / Windows 上可以用 CPU、NVIDIA 显卡或 AMD 显卡(见下)运行。
git clone <仓库地址> MiliKara && cd MiliKara
uv venv --python 3.12 .venv
uv pip install -e ".[ml,separation]"    # 对齐模型(torch + transformers)和人声分离
AMD 显卡(ROCm):在上面的 uv pip install -e … 之前,先从 AMD 的软件源装上与显卡对应的 torch:
uv pip install "torch[device-gfx1100]" --index-url https://stable.repo.amd.com/rocm/whl-next/
把 gfx1100 换成你的显卡:RX 7900 系列 gfx1100,RX 7800 / 7700 gfx1101,RX 7600 gfx1102,RX 9070 系列 gfx1201,RX 9060 gfx1200;Radeon 890M / 880M gfx1150,Ryzen AI Max gfx1151,780M / 760M gfx1103(完整列表见 AMD 的说明)。显卡驱动请更新到最新(AMD 列出的配套驱动是 Adrenalin 26.10.41.05)。装好后 python -c "import torch; print(torch.cuda.is_available())" 应输出 True,诊断信息里显示 ROCm … · 显卡名;“自动”会使用这块显卡(同时有核显时用独立显卡)。RX 7900 XT 上一首 3 分钟的歌人声分离约 40 秒(同一台电脑上 CPU 版约 6 分钟)。AMD 的 torch 用 CPU 计算时比 CPU 版慢十几倍:显卡用不了时,请删掉 .venv 按上面的步骤重新安装(跳过这一步)。
模型在第一次使用时下载到项目目录的 models/ 里(对齐模型约 1.2 GB,默认的分离模型约 1 GB),之后可以离线使用。环境变量 KARA_ALIGN_MODELS 可以把它指到别处。
可选:python packaging/fetch_fonts.py 下载内置的中日文字体 Noto Sans CJK(约 40 MB,SIL OFL)到 fonts/。Windows / Linux 上它是默认字体,歌词、翻译或歌曲信息里有当前字体没有的字时也会用它;离线包里已经自带。
.venv/bin/milikara serve # 然后打开 http://127.0.0.1:8765
默认打开极简模式:
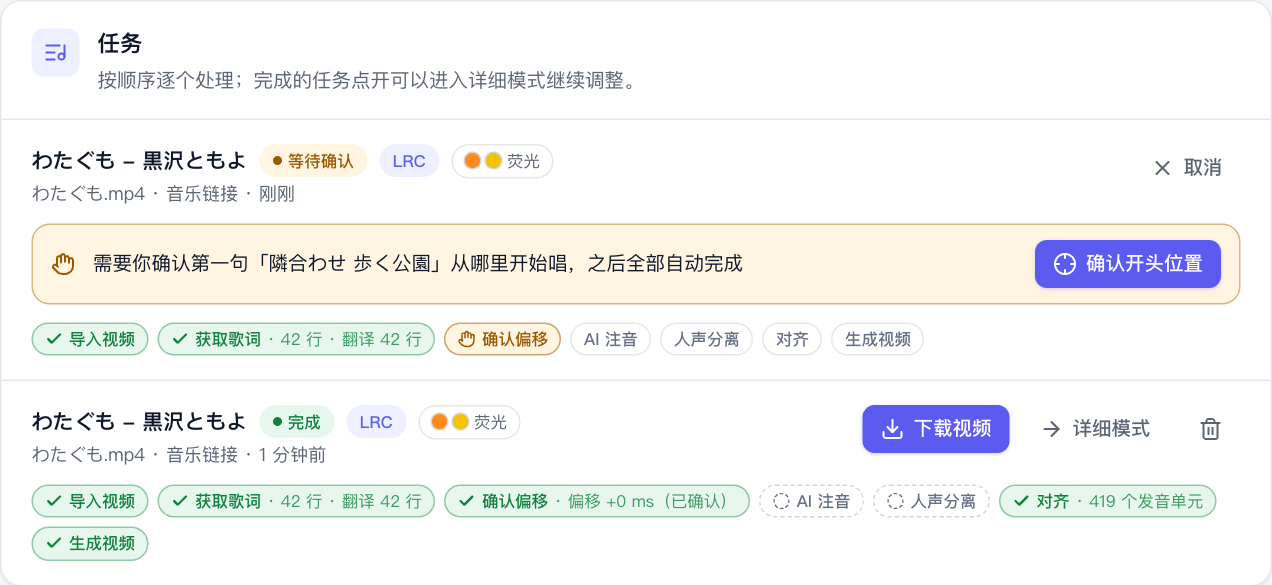
任务列表:上面的任务在等你确认第一句的位置,下面的已经完成,可以下载视频
NextFire/mms-300m-ForcedAligner-karaoke-ja-Latn 的许可是 CC-BY-NC-SA-4.0(非商用);人声分离使用 python-audio-separator 和它的模型,许可以上游为准。Turn a song and its lyrics into Japanese karaoke videos with per-syllable wipes: furigana, vocal separation, mora-level alignment and burned-in subtitles.
Python
45
141 commits
updated Oct 13, 2026
用一首歌和它的歌词,做出逐字扫光的日语卡拉OK视频。
本软件受 StrangeUtaGame 启发。MiliKara 是自动对齐工具,不是卡拉OK手动打轴软件;如果需要手动打轴,请使用 StrangeUtaGame 原软件。
名称说明:本项目原名 KiraKara,因与 KiraKara player 及其相关项目重名,从 v1.1.0 起改名为 MiliKara(两者之间没有关系)。旧版本的项目和设置在新版本里可以直接使用。
放入视频(或音频 + 背景图),粘贴网易云 / QQ 音乐的歌曲链接或 LRC 歌词,MiliKara 会自动给汉字注音、分离人声、把每一个假名(拍)对齐到演唱的时间上,然后把带注音、翻译和歌曲信息的卡拉OK字幕直接烧录进视频。全部在本机运行。
极简模式:放入视频,粘贴歌曲链接,选好字幕配色,点“开始制作”
详细模式(人工检查):每一行、每一个假名的时间都可以试听、拖动修改和局部重跑
成品视频的一帧:逐字扫光、汉字注音,顶部是中文翻译
Windows 离线版:在 Releases 里下载 MiliKara-…-windows-x64-cpu.7z(CPU 版)、…-cuda.7z(NVIDIA 显卡版,需要 570 或更新的驱动)或 …-rocm.7z(AMD 显卡版,v1.2.0 起:Radeon RX 6800 / 6900、RX 7000 / 9000 系列,以及 Ryzen 的 780M / 760M、Ryzen AI 300 系列和 Ryzen AI Max 核显,请把显卡驱动更新到最新)。超过 2 GB 时分成 .7z.001、.7z.002… 几个分卷,需要全部下载。用 7-Zip 解压,双击 MiliKara.bat。自带 Python、依赖、ffmpeg 和两个默认模型,不需要联网。
macOS 离线版(Apple 芯片,macOS 14.8.5 或更新):下载 MiliKara-…-macos-arm64.zip,解压后第一次在访达里右键点 MiliKara.command →“打开”,以后双击即可。
更新离线版:关闭 MiliKara 后双击文件夹里的 更新.bat(macOS:更新.command),只下载有变化的部分(程序约 1 MB;从 v1.0 更新时还会补上约 32 MB 的字体),模型、依赖和项目都不用重新下载,出问题可以退回上一版。v1.1.0 之前的旧版(KiraKara)没有这个文件:在 Releases 里下载 MiliKara-updater-windows.bat(macOS:MiliKara-updater-macos.zip,解压)放进原来的文件夹,双击即可。访问 GitHub 慢时,也可以把程序更新包 MiliKara-版本-app.zip 放进文件夹,更新程序会直接用它。
离线版都由 GitHub Actions 构建(.github/workflows/windows-package.yml、macos-package.yml;打包脚本在 packaging/)。
从源码安装:需要 Python 3.11+、uv,以及带 libass 的 ffmpeg(macOS:brew install ffmpeg-full)。目前主要在 macOS(Apple 芯片)上使用和测试;Linux / Windows 上可以用 CPU、NVIDIA 显卡或 AMD 显卡(见下)运行。
git clone <仓库地址> MiliKara && cd MiliKara
uv venv --python 3.12 .venv
uv pip install -e ".[ml,separation]"    # 对齐模型(torch + transformers)和人声分离
AMD 显卡(ROCm):在上面的 uv pip install -e … 之前,先从 AMD 的软件源装上与显卡对应的 torch:
uv pip install "torch[device-gfx1100]" --index-url https://stable.repo.amd.com/rocm/whl-next/
把 gfx1100 换成你的显卡:RX 7900 系列 gfx1100,RX 7800 / 7700 gfx1101,RX 7600 gfx1102,RX 9070 系列 gfx1201,RX 9060 gfx1200;Radeon 890M / 880M gfx1150,Ryzen AI Max gfx1151,780M / 760M gfx1103(完整列表见 AMD 的说明)。显卡驱动请更新到最新(AMD 列出的配套驱动是 Adrenalin 26.10.41.05)。装好后 python -c "import torch; print(torch.cuda.is_available())" 应输出 True,诊断信息里显示 ROCm … · 显卡名;“自动”会使用这块显卡(同时有核显时用独立显卡)。RX 7900 XT 上一首 3 分钟的歌人声分离约 40 秒(同一台电脑上 CPU 版约 6 分钟)。AMD 的 torch 用 CPU 计算时比 CPU 版慢十几倍:显卡用不了时,请删掉 .venv 按上面的步骤重新安装(跳过这一步)。
模型在第一次使用时下载到项目目录的 models/ 里(对齐模型约 1.2 GB,默认的分离模型约 1 GB),之后可以离线使用。环境变量 KARA_ALIGN_MODELS 可以把它指到别处。
可选:python packaging/fetch_fonts.py 下载内置的中日文字体 Noto Sans CJK(约 40 MB,SIL OFL)到 fonts/。Windows / Linux 上它是默认字体,歌词、翻译或歌曲信息里有当前字体没有的字时也会用它;离线包里已经自带。
.venv/bin/milikara serve # 然后打开 http://127.0.0.1:8765
默认打开极简模式:
任务列表:上面的任务在等你确认第一句的位置,下面的已经完成,可以下载视频
NextFire/mms-300m-ForcedAligner-karaoke-ja-Latn 的许可是 CC-BY-NC-SA-4.0(非商用);人声分离使用 python-audio-separator 和它的模型,许可以上游为准。


