AISRT - 本地 AI 字幕生成工具 / local AI subtitle generator for video/audio to SRT, multilingual ASR, timestamp alignment, GUI/CLI batch processing, and local SRT translation.
Python
3
26 commits
updated Jul 24, 2026
语言:简体中文 | English
AISRT 是面向 Windows 桌面和命令行的本地 AI 字幕生成工具,专注把视频、音频转换为带时间轴的 .srt 字幕。它支持多语言 ASR、字幕时间轴对齐、GUI 多文件队列、CLI 批量处理和本地 SRT 翻译;媒体文件、字幕、缓存和日志默认保留在本机,适合离线字幕生成、视频转 SRT、音频转 SRT 和隐私敏感的个人字幕工作流。
你可以用 AISRT:
mp4、mkv、mov、mp3、wav 等常见媒体文件生成 .srt 字幕。movie.preview.srt 预览字幕,完成后得到最终 movie.srt。项目定位很明确:个人桌面/命令行工具,优先保证简单、稳定、可维护。不做 Web UI,不做服务端,不接数据库。
常见搜索场景:本地 AI 字幕生成、视频转 SRT、音频转 SRT、离线字幕工具、多语言 ASR、语音识别字幕、字幕时间轴对齐、SRT 翻译、Windows 字幕生成、GUI 字幕软件和 CLI 字幕批处理。
ai-sub-gui。ai-sub ".\media" --recursive。ai-sub-translate。| 能力 | 说明 |
|---|---|
| 多语言识别 | 支持自动识别,也可以手动指定常用语种。 |
| 时间轴对齐 | 使用本地强制对齐模型生成更贴近语音节奏的字幕时间轴。 |
| 本地推理 | 默认在本机运行模型,不调用 DashScope API,不依赖 qwen3-asr-toolkit。 |
| 批量处理 | GUI 支持多文件队列;CLI 支持单文件和目录批处理。 |
| 字幕后处理 | 自动去重、修复时间重叠、整理长行、清理 CJK 空格并重新编号。 |
| 预览字幕 | 识别过程中写入 movie.preview.srt,便于长视频先查看已完成片段。 |
| 本地 SRT 翻译 | 使用本地 HY-MT 翻译已有 SRT,支持多种翻译语言,并保留原编号和时间轴。 |
说明:项目公开名称不使用模型厂商商标;Qwen3-ASR 与 Qwen3-ForcedAligner 只作为模型 ID 和技术依赖出现。
适合:
.srt 字幕。不适合:
视频/音频文件
  -> FFmpeg 提取 16k 单声道临时 WAV
  -> 本地 ASR 模型识别语音文本
  -> 本地强制对齐模型生成时间戳
  -> 字幕后处理
  -> 输出 .srt 文件
Windows 10/11 是主要支持环境。Linux 和 macOS 可自行验证。
开始前先确认:
ffmpeg、ffprobe 能在命令行中直接运行。git clone https://github.com/zkwi/AiSRT.git
cd AiSRT
py -3.11 -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install -U pip
python -m pip install -r requirements.txt
ai-sub doctor
ai-sub-gui --check
启动图形界面:
ai-sub-gui
命令行处理单个文件:
ai-sub "movie.mp4" --overwrite
完成后,默认会在 movie.mp4 旁边生成 movie.srt。长视频处理期间可以打开同目录的 movie.preview.srt 查看已识别片段;全部完成后会自动删除预览文件并重写最终字幕。
也可以双击:
activate_env.bat:进入项目虚拟环境,并设置项目内模型缓存目录。open_ui.bat:用当前虚拟环境启动 GUI。当前默认安装使用 CUDA 版 PyTorch,具体固定项放在 requirements-torch-cu130.txt:
torch==2.11.0+cu130
torchaudio==2.11.0+cu130
如果你的 CUDA/PyTorch 环境不同,请先按 PyTorch 官方安装方式调整 requirements-torch-cu130.txt,或手动安装匹配版本后再安装本项目依赖。
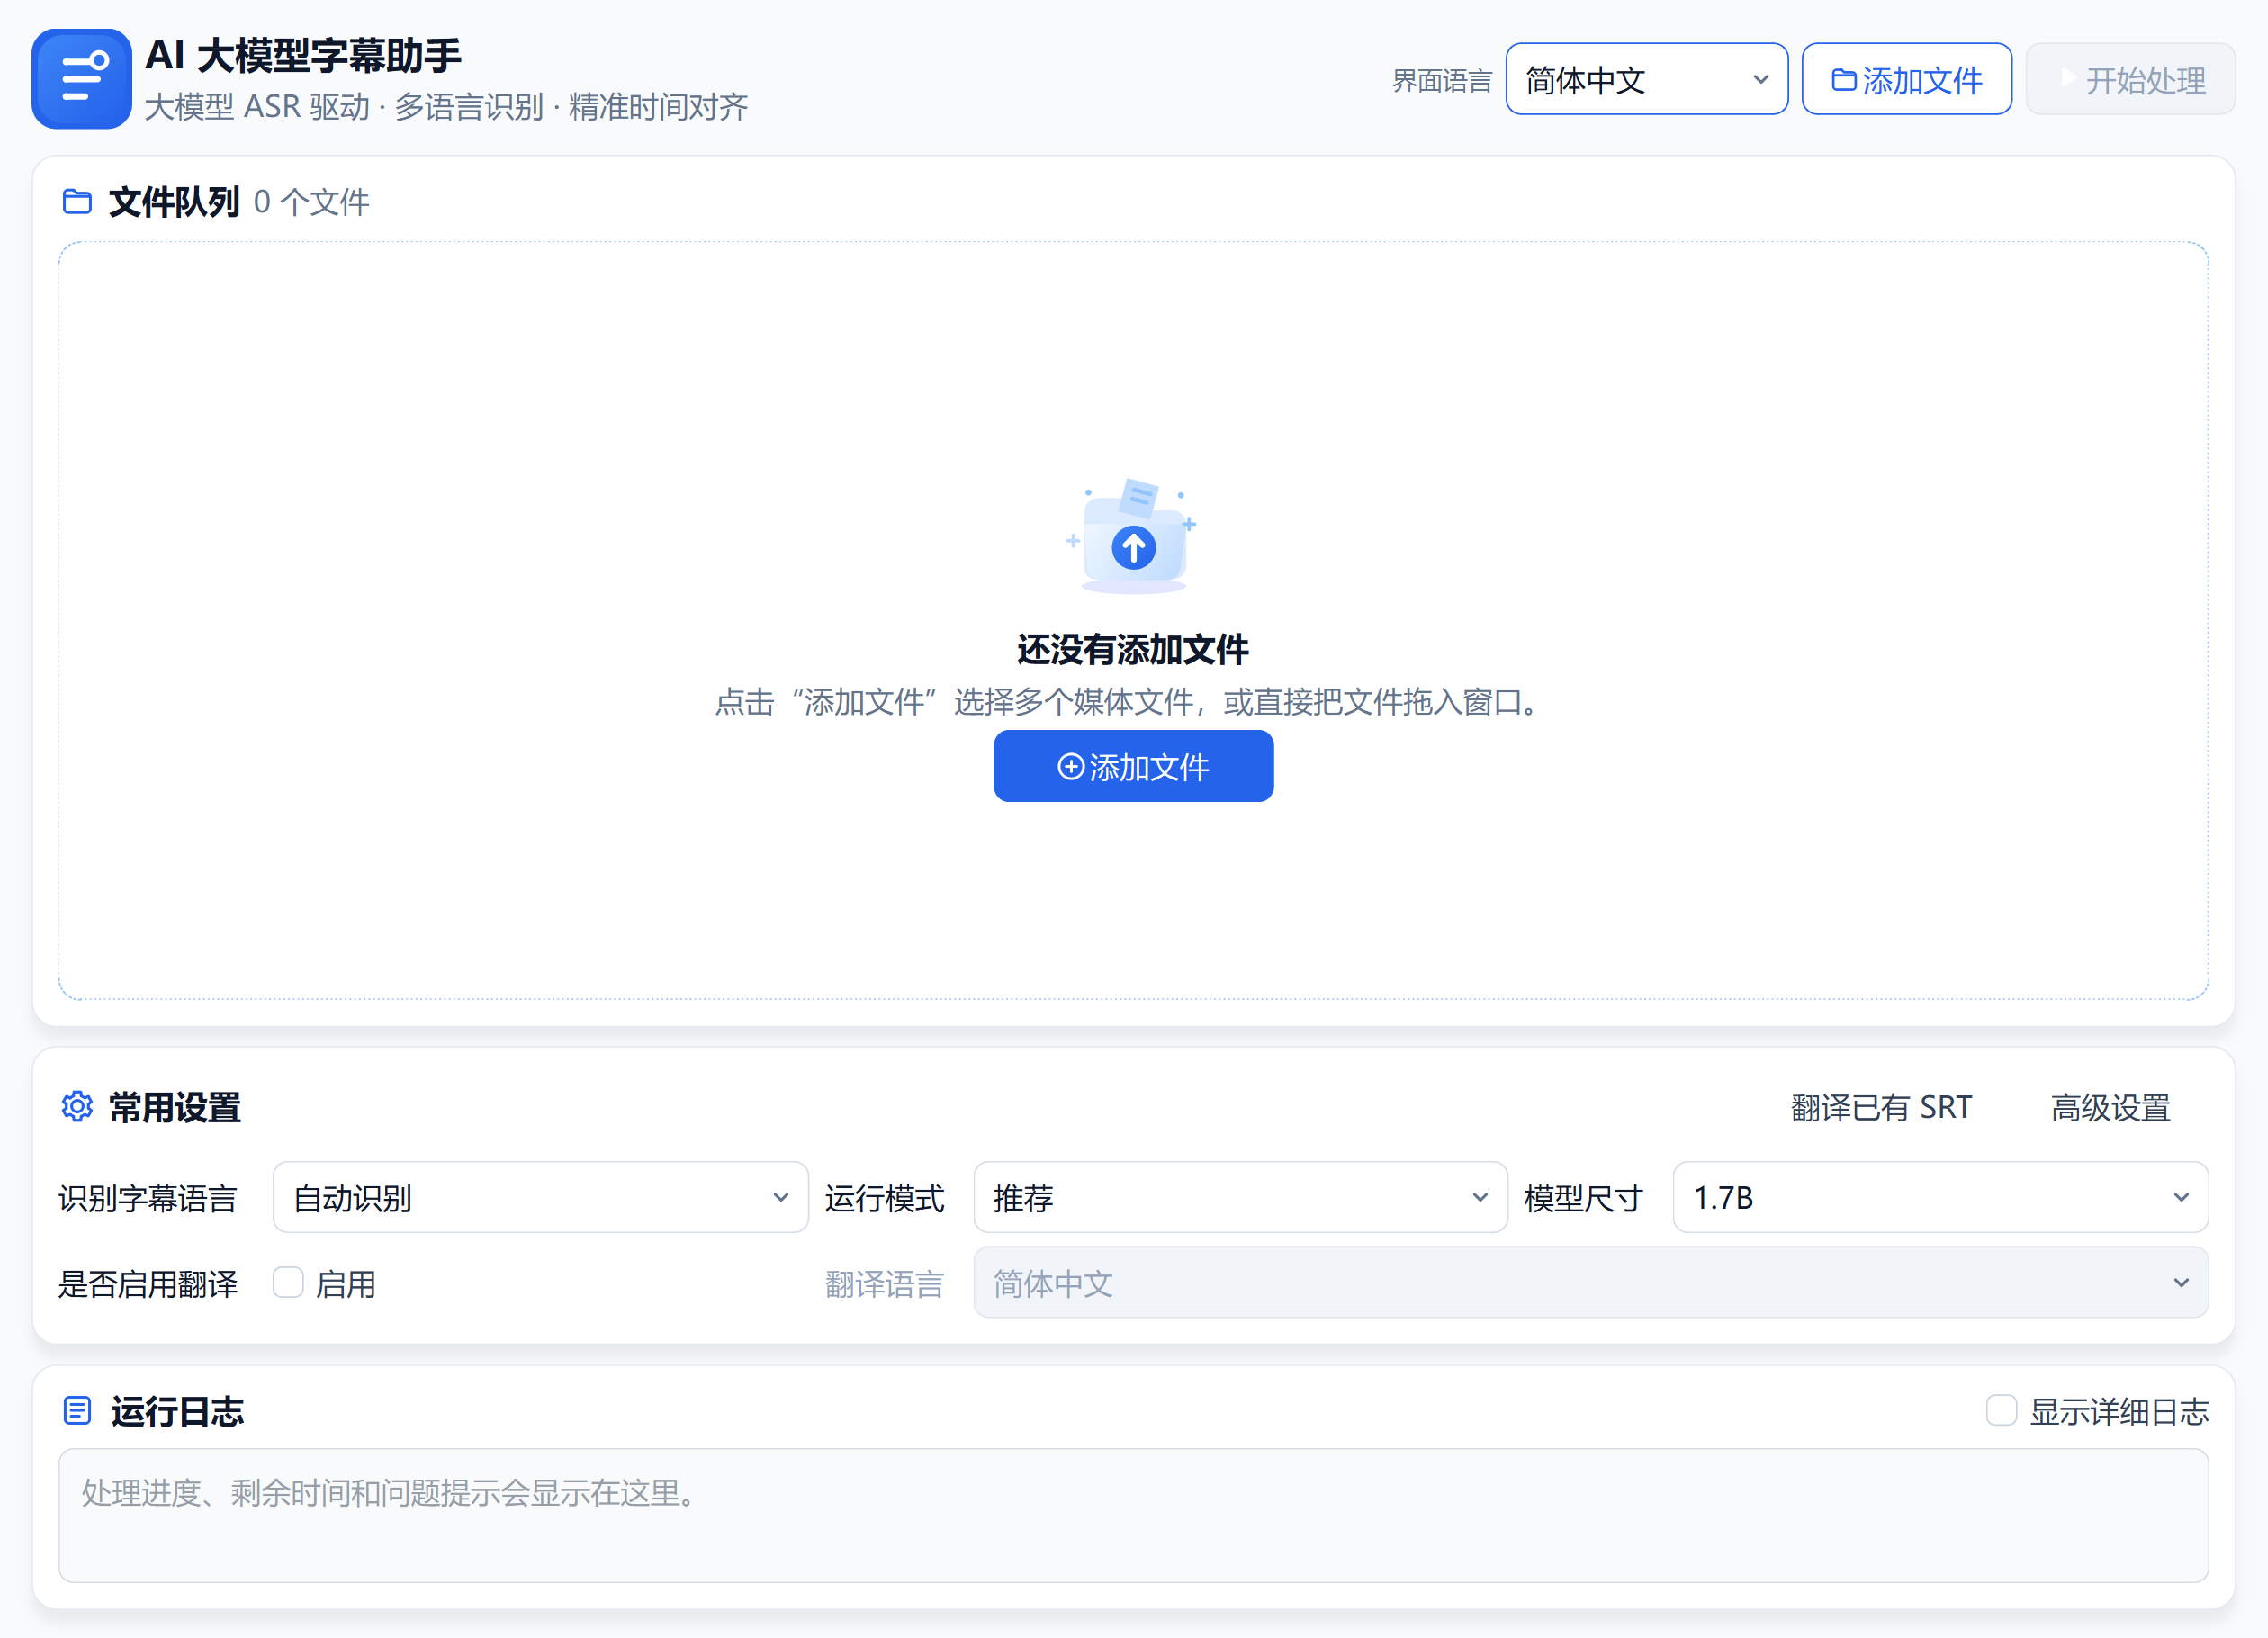
GUI 面向普通用户,主界面只保留高频操作:
分钟:秒。默认行为:
.srt,发现同名输出会先询问。推荐设置:
| 设置 | 默认值 | 建议 |
|---|---|---|
| 识别字幕语言 | 自动识别 | 不确定时保持默认;明确视频或音频里的说话语言时手动指定更稳定。 |
| 启用翻译 | 关闭 | 需要同时生成翻译语言字幕时再勾选;会保留原始字幕。 |
| 运行模式 | 推荐 | 显存不足时切换到低显存。 |
| 模型尺寸 | 1.7B | 质量优先用 1.7B;速度或显存优先用 0.6B。 |
| 音频分块 | 推荐(45 秒) | 识别不稳定时改为稳妥(30 秒)。 |
| 字幕样式 | 推荐 | 想让每条字幕更短时使用短句。 |
软件不调用第三方翻译 API,也不会自动上传字幕文件。主界面的“翻译已有 SRT”按钮会打开本地翻译窗口:
.srt 文件。翻译逻辑只把字幕正文发给本地 HY-MT 模型,SRT 编号和时间轴由程序保留并合并。默认质量模式使用官方 HY-MT 1.8B 模型;快速模式使用轻量量化模型,适合先快速预览。翻译模型复用当前 .venv 中的 PyTorch/CUDA 环境,不需要用户额外安装另一套 Python 或 CUDA。
主界面勾选“启用翻译”后,适合从音视频一步生成双语结果。例如识别字幕语言设为英语、翻译语言设为简体中文时,会在媒体文件旁生成:
movie.srt      # ASR 识别后的英文原始字幕
movie.zh.srt   # 本地翻译模型生成的简体中文字幕
启用翻译后,处理流程会先写入 ASR 原始字幕,再加载翻译模型。若翻译模型缺失或翻译失败,原始字幕会保留,队列状态会提示“翻译失败,已保留原字幕”,可在模型准备好后重试失败项。
单文件处理:
ai-sub "movie.mp4" --overwrite
使用轻量模型:
ai-sub "movie.mp4" --model-size 0.6B --overwrite
批量处理目录:
ai-sub ".\media" -o ".\subtitles" --recursive --overwrite
翻译已有 SRT:
ai-sub-translate "sample.srt" --to 简体中文 --overwrite
使用快速轻量翻译模型:
ai-sub-translate "sample.srt" --to English --model-mode fast --overwrite
使用本地已下载模型:
ai-sub "movie.mp4" `
  --model .\models\Qwen3-ASR-1.7B `
  --aligner .\models\Qwen3-ForcedAligner-0.6B `
  --local-files-only `
  --overwrite
常用参数:
| 参数 | 说明 |
|---|---|
--model-size | ASR 模型尺寸,默认 1.7B,可选 1.7B 或 0.6B。 |
--model | 自定义 ASR 模型路径或 Hugging Face ID;设置后覆盖 --model-size。 |
--aligner | 强制对齐模型路径或 Hugging Face ID。 |
--language | 识别语言,默认 auto;GUI 常用预设包括 English、Chinese、Japanese、Korean、Spanish、French、German 等,CLI 可传入模型支持的语言名。 |
-c, --context | 可选上下文提示,适合填写片名、角色名、人名、地名等具体词。 |
-d, --duration | ASR 分块目标秒数,默认 45;低声、稀疏对白或识别为空时可改为 30。 |
--device | 推理设备,默认 auto;常用值为 auto、cuda:0、cpu。 |
--max-new-tokens | 每个音频块最大生成 token 数,默认 1536;长对白漏字时可临时调高。 |
--local-files-only | 只读取本地模型,不联网下载。 |
完整参数:
ai-sub --help
默认模型:
Qwen/Qwen3-ASR-1.7B
Qwen/Qwen3-ForcedAligner-0.6B
可选 ASR 尺寸:
1.7B  默认,质量更好,显存占用更高
0.6B  更轻量,速度更快,适合低显存或快速预览
首次运行如果使用 Hugging Face ID,会自动下载模型权重。建议把缓存放在项目目录 .hf_cache/,便于清理和开源发布时忽略。
手动下载示例:
mkdir models
huggingface-cli download Qwen/Qwen3-ASR-1.7B --local-dir .\models\Qwen3-ASR-1.7B
huggingface-cli download Qwen/Qwen3-ASR-0.6B --local-dir .\models\Qwen3-ASR-0.6B
huggingface-cli download Qwen/Qwen3-ForcedAligner-0.6B --local-dir .\models\Qwen3-ForcedAligner-0.6B
运行时会在 .hf_cache/audio_tmp/ 下生成临时 WAV。该目录属于运行缓存,不应提交到 Git。
默认输出:
movie.srt
处理过程中会临时写入预览字幕,方便提前查看已识别内容;完整处理成功后会删除预览文件,并重新写入最终字幕:
movie.preview.srt
AISRT 只会清理本次运行实际创建的预览文件,不会按媒体文件名猜测并删除同名的 .txt 或 .raw.srt。批量任务会在加载模型前检查最终字幕、翻译字幕和预览字幕的文件名冲突;所有字幕文件均通过原子替换写入,失败时保留已有文件。
AISRT 是面向个人使用的本地 AI 字幕生成工具,支持从视频或音频生成 .srt 字幕,也支持对已有 SRT 字幕做本地翻译。
常用工作流包括:视频转 SRT、音频转 SRT、多语言语音识别、字幕时间轴对齐、SRT 字幕翻译、GUI 多文件队列处理和 CLI 批量处理。
不会。AISRT 默认在本机运行 ASR、强制对齐和翻译模型,不调用云端翻译 API,也不会自动上传媒体、字幕或日志。
运行:
ai-sub doctor
如果 ffmpeg 或 ffprobe 不可用,请先安装 FFmpeg,并确认 ffmpeg、ffprobe 能在命令行中直接运行。
首次运行可能会下载模型权重,并进行模型加载。模型体积较大,耗时取决于网络、磁盘和显卡环境。
优先尝试:
0.6B。--device cpu 作为兜底,但速度会明显变慢。提前把模型下载到 models/ 目录,然后使用 --local-files-only 和本地模型路径。
可尝试:
-c, --context 提供片名、人名、地名或专有名词。aisrt/
cli.py CLI 入口、音频准备、单文件处理编排
gui.py PyQt 主窗口与用户交互
gui_worker.py GUI 后台处理线程
gui_i18n.py GUI 多语言文案和日志本地化
gui_theme.py GUI QSS 样式
local_asr.py 本地 ASR 调用、分块识别、时间戳整理
local_translate.py 本地 SRT 翻译、分段和译文合并
translate_cli.py SRT 翻译命令行入口
translate_worker.py GUI 翻译后台线程
postprocess.py SRT 解析、清洗、去重、断行和时间轴修复
diagnostics.py 本地环境检查
tests/ 单元测试和 GUI offscreen 测试
docs/ 工程治理、发布检查和维护文档
安装开发、测试和打包依赖:
.\.venv\Scripts\python.exe -m pip install -r requirements-dev.txt
依赖文件分工:
requirements.txt:普通运行环境,安装默认 CUDA PyTorch 栈和 AISRT 包。requirements-dev.txt:开发环境,复用默认 CUDA PyTorch 栈,并以 editable 模式安装开发工具。requirements-torch-cu130.txt:默认 CUDA PyTorch 固定项;切换 CUDA/CPU 版本时优先改这里。常用检查:
.\.venv\Scripts\python.exe -m pytest -q
.\.venv\Scripts\python.exe -m compileall -q aisrt tests
.\.venv\Scripts\python.exe -m pip check
.\.venv\Scripts\python.exe -m aisrt --help
.\.venv\Scripts\python.exe -m aisrt doctor
.\.venv\Scripts\python.exe -m aisrt.gui --check
git diff --check
Windows portable 包采用“轻量下载 + 首次启动自动安装依赖”的方式:ZIP 不包含 Python、PyTorch/CUDA 运行库、模型权重、FFmpeg、.venv、缓存、媒体、字幕、截图或日志,避免安装包体积失控。目标产物为:
dist/release/AiSRT-v0.1.5-windows-portable.zip
dist/release/aisrt-0.1.5-py3-none-any.whl
dist/release/SHA256SUMS.txt
构建命令:
.\scripts\build_portable.ps1 -InstallDeps
约束:
AISRT.bat,普通用户解压后优先双击它。AISRT.bat 时会自动调用 install_runtime.bat,在当前目录创建 .venv 并安装 requirements.txt 中的 Python 依赖;后续启动会直接打开 GUI。PATH 中直接运行。start_gui.bat 和 open_shell.bat 保留给需要手动启动或排查命令行环境的用户。SHA256SUMS.txt 三个文件。packaging/aisrt_portable.spec 仅保留给维护者本地试验完整运行时打包,默认 Release 不使用它。发布到 GitHub 前请确认:
.env、模型缓存、音频缓存、测试媒体、截图、生成字幕、运行日志没有进入 Git。建议发布前额外执行:
git status --short --ignored
.\.venv\Scripts\python.exe -m pytest tests/test_open_source_hygiene.py -q
本项目使用 MIT License,详见 LICENSE。
AISRT - 本地 AI 字幕生成工具 / local AI subtitle generator for video/audio to SRT, multilingual ASR, timestamp alignment, GUI/CLI batch processing, and local SRT translation.
Python
3
26 commits
updated Jul 24, 2026
语言:简体中文 | English
AISRT 是面向 Windows 桌面和命令行的本地 AI 字幕生成工具,专注把视频、音频转换为带时间轴的 .srt 字幕。它支持多语言 ASR、字幕时间轴对齐、GUI 多文件队列、CLI 批量处理和本地 SRT 翻译;媒体文件、字幕、缓存和日志默认保留在本机,适合离线字幕生成、视频转 SRT、音频转 SRT 和隐私敏感的个人字幕工作流。
你可以用 AISRT:
mp4、mkv、mov、mp3、wav 等常见媒体文件生成 .srt 字幕。movie.preview.srt 预览字幕,完成后得到最终 movie.srt。项目定位很明确:个人桌面/命令行工具,优先保证简单、稳定、可维护。不做 Web UI,不做服务端,不接数据库。
常见搜索场景:本地 AI 字幕生成、视频转 SRT、音频转 SRT、离线字幕工具、多语言 ASR、语音识别字幕、字幕时间轴对齐、SRT 翻译、Windows 字幕生成、GUI 字幕软件和 CLI 字幕批处理。
ai-sub-gui。ai-sub ".\media" --recursive。ai-sub-translate。| 能力 | 说明 |
|---|---|
| 多语言识别 | 支持自动识别,也可以手动指定常用语种。 |
| 时间轴对齐 | 使用本地强制对齐模型生成更贴近语音节奏的字幕时间轴。 |
| 本地推理 | 默认在本机运行模型,不调用 DashScope API,不依赖 qwen3-asr-toolkit。 |
| 批量处理 | GUI 支持多文件队列;CLI 支持单文件和目录批处理。 |
| 字幕后处理 | 自动去重、修复时间重叠、整理长行、清理 CJK 空格并重新编号。 |
| 预览字幕 | 识别过程中写入 movie.preview.srt,便于长视频先查看已完成片段。 |
| 本地 SRT 翻译 | 使用本地 HY-MT 翻译已有 SRT,支持多种翻译语言,并保留原编号和时间轴。 |
说明:项目公开名称不使用模型厂商商标;Qwen3-ASR 与 Qwen3-ForcedAligner 只作为模型 ID 和技术依赖出现。
适合:
.srt 字幕。不适合:
视频/音频文件
  -> FFmpeg 提取 16k 单声道临时 WAV
  -> 本地 ASR 模型识别语音文本
  -> 本地强制对齐模型生成时间戳
  -> 字幕后处理
  -> 输出 .srt 文件
Windows 10/11 是主要支持环境。Linux 和 macOS 可自行验证。
开始前先确认:
ffmpeg、ffprobe 能在命令行中直接运行。git clone https://github.com/zkwi/AiSRT.git
cd AiSRT
py -3.11 -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install -U pip
python -m pip install -r requirements.txt
ai-sub doctor
ai-sub-gui --check
启动图形界面:
ai-sub-gui
命令行处理单个文件:
ai-sub "movie.mp4" --overwrite
完成后,默认会在 movie.mp4 旁边生成 movie.srt。长视频处理期间可以打开同目录的 movie.preview.srt 查看已识别片段;全部完成后会自动删除预览文件并重写最终字幕。
也可以双击:
activate_env.bat:进入项目虚拟环境,并设置项目内模型缓存目录。open_ui.bat:用当前虚拟环境启动 GUI。当前默认安装使用 CUDA 版 PyTorch,具体固定项放在 requirements-torch-cu130.txt:
torch==2.11.0+cu130
torchaudio==2.11.0+cu130
如果你的 CUDA/PyTorch 环境不同,请先按 PyTorch 官方安装方式调整 requirements-torch-cu130.txt,或手动安装匹配版本后再安装本项目依赖。
GUI 面向普通用户,主界面只保留高频操作:
分钟:秒。默认行为:
.srt,发现同名输出会先询问。推荐设置:
| 设置 | 默认值 | 建议 |
|---|---|---|
| 识别字幕语言 | 自动识别 | 不确定时保持默认;明确视频或音频里的说话语言时手动指定更稳定。 |
| 启用翻译 | 关闭 | 需要同时生成翻译语言字幕时再勾选;会保留原始字幕。 |
| 运行模式 | 推荐 | 显存不足时切换到低显存。 |
| 模型尺寸 | 1.7B | 质量优先用 1.7B;速度或显存优先用 0.6B。 |
| 音频分块 | 推荐(45 秒) | 识别不稳定时改为稳妥(30 秒)。 |
| 字幕样式 | 推荐 | 想让每条字幕更短时使用短句。 |
软件不调用第三方翻译 API,也不会自动上传字幕文件。主界面的“翻译已有 SRT”按钮会打开本地翻译窗口:
.srt 文件。翻译逻辑只把字幕正文发给本地 HY-MT 模型,SRT 编号和时间轴由程序保留并合并。默认质量模式使用官方 HY-MT 1.8B 模型;快速模式使用轻量量化模型,适合先快速预览。翻译模型复用当前 .venv 中的 PyTorch/CUDA 环境,不需要用户额外安装另一套 Python 或 CUDA。
主界面勾选“启用翻译”后,适合从音视频一步生成双语结果。例如识别字幕语言设为英语、翻译语言设为简体中文时,会在媒体文件旁生成:
movie.srt      # ASR 识别后的英文原始字幕
movie.zh.srt   # 本地翻译模型生成的简体中文字幕
启用翻译后,处理流程会先写入 ASR 原始字幕,再加载翻译模型。若翻译模型缺失或翻译失败,原始字幕会保留,队列状态会提示“翻译失败,已保留原字幕”,可在模型准备好后重试失败项。
单文件处理:
ai-sub "movie.mp4" --overwrite
使用轻量模型:
ai-sub "movie.mp4" --model-size 0.6B --overwrite
批量处理目录:
ai-sub ".\media" -o ".\subtitles" --recursive --overwrite
翻译已有 SRT:
ai-sub-translate "sample.srt" --to 简体中文 --overwrite
使用快速轻量翻译模型:
ai-sub-translate "sample.srt" --to English --model-mode fast --overwrite
使用本地已下载模型:
ai-sub "movie.mp4" `
  --model .\models\Qwen3-ASR-1.7B `
  --aligner .\models\Qwen3-ForcedAligner-0.6B `
  --local-files-only `
  --overwrite
常用参数:
| 参数 | 说明 |
|---|---|
--model-size | ASR 模型尺寸,默认 1.7B,可选 1.7B 或 0.6B。 |
--model | 自定义 ASR 模型路径或 Hugging Face ID;设置后覆盖 --model-size。 |
--aligner | 强制对齐模型路径或 Hugging Face ID。 |
--language | 识别语言,默认 auto;GUI 常用预设包括 English、Chinese、Japanese、Korean、Spanish、French、German 等,CLI 可传入模型支持的语言名。 |
-c, --context | 可选上下文提示,适合填写片名、角色名、人名、地名等具体词。 |
-d, --duration | ASR 分块目标秒数,默认 45;低声、稀疏对白或识别为空时可改为 30。 |
--device | 推理设备,默认 auto;常用值为 auto、cuda:0、cpu。 |
--max-new-tokens | 每个音频块最大生成 token 数,默认 1536;长对白漏字时可临时调高。 |
--local-files-only | 只读取本地模型,不联网下载。 |
完整参数:
ai-sub --help
默认模型:
Qwen/Qwen3-ASR-1.7B
Qwen/Qwen3-ForcedAligner-0.6B
可选 ASR 尺寸:
1.7B  默认,质量更好,显存占用更高
0.6B  更轻量,速度更快,适合低显存或快速预览
首次运行如果使用 Hugging Face ID,会自动下载模型权重。建议把缓存放在项目目录 .hf_cache/,便于清理和开源发布时忽略。
手动下载示例:
mkdir models
huggingface-cli download Qwen/Qwen3-ASR-1.7B --local-dir .\models\Qwen3-ASR-1.7B
huggingface-cli download Qwen/Qwen3-ASR-0.6B --local-dir .\models\Qwen3-ASR-0.6B
huggingface-cli download Qwen/Qwen3-ForcedAligner-0.6B --local-dir .\models\Qwen3-ForcedAligner-0.6B
运行时会在 .hf_cache/audio_tmp/ 下生成临时 WAV。该目录属于运行缓存,不应提交到 Git。
默认输出:
movie.srt
处理过程中会临时写入预览字幕,方便提前查看已识别内容;完整处理成功后会删除预览文件,并重新写入最终字幕:
movie.preview.srt
AISRT 只会清理本次运行实际创建的预览文件,不会按媒体文件名猜测并删除同名的 .txt 或 .raw.srt。批量任务会在加载模型前检查最终字幕、翻译字幕和预览字幕的文件名冲突;所有字幕文件均通过原子替换写入,失败时保留已有文件。
AISRT 是面向个人使用的本地 AI 字幕生成工具,支持从视频或音频生成 .srt 字幕,也支持对已有 SRT 字幕做本地翻译。
常用工作流包括:视频转 SRT、音频转 SRT、多语言语音识别、字幕时间轴对齐、SRT 字幕翻译、GUI 多文件队列处理和 CLI 批量处理。
不会。AISRT 默认在本机运行 ASR、强制对齐和翻译模型,不调用云端翻译 API,也不会自动上传媒体、字幕或日志。
运行:
ai-sub doctor
如果 ffmpeg 或 ffprobe 不可用,请先安装 FFmpeg,并确认 ffmpeg、ffprobe 能在命令行中直接运行。
首次运行可能会下载模型权重,并进行模型加载。模型体积较大,耗时取决于网络、磁盘和显卡环境。
优先尝试:
0.6B。--device cpu 作为兜底,但速度会明显变慢。提前把模型下载到 models/ 目录,然后使用 --local-files-only 和本地模型路径。
可尝试:
-c, --context 提供片名、人名、地名或专有名词。aisrt/
cli.py CLI 入口、音频准备、单文件处理编排
gui.py PyQt 主窗口与用户交互
gui_worker.py GUI 后台处理线程
gui_i18n.py GUI 多语言文案和日志本地化
gui_theme.py GUI QSS 样式
local_asr.py 本地 ASR 调用、分块识别、时间戳整理
local_translate.py 本地 SRT 翻译、分段和译文合并
translate_cli.py SRT 翻译命令行入口
translate_worker.py GUI 翻译后台线程
postprocess.py SRT 解析、清洗、去重、断行和时间轴修复
diagnostics.py 本地环境检查
tests/ 单元测试和 GUI offscreen 测试
docs/ 工程治理、发布检查和维护文档
安装开发、测试和打包依赖:
.\.venv\Scripts\python.exe -m pip install -r requirements-dev.txt
依赖文件分工:
requirements.txt:普通运行环境,安装默认 CUDA PyTorch 栈和 AISRT 包。requirements-dev.txt:开发环境,复用默认 CUDA PyTorch 栈,并以 editable 模式安装开发工具。requirements-torch-cu130.txt:默认 CUDA PyTorch 固定项;切换 CUDA/CPU 版本时优先改这里。常用检查:
.\.venv\Scripts\python.exe -m pytest -q
.\.venv\Scripts\python.exe -m compileall -q aisrt tests
.\.venv\Scripts\python.exe -m pip check
.\.venv\Scripts\python.exe -m aisrt --help
.\.venv\Scripts\python.exe -m aisrt doctor
.\.venv\Scripts\python.exe -m aisrt.gui --check
git diff --check
Windows portable 包采用“轻量下载 + 首次启动自动安装依赖”的方式:ZIP 不包含 Python、PyTorch/CUDA 运行库、模型权重、FFmpeg、.venv、缓存、媒体、字幕、截图或日志,避免安装包体积失控。目标产物为:
dist/release/AiSRT-v0.1.5-windows-portable.zip
dist/release/aisrt-0.1.5-py3-none-any.whl
dist/release/SHA256SUMS.txt
构建命令:
.\scripts\build_portable.ps1 -InstallDeps
约束:
AISRT.bat,普通用户解压后优先双击它。AISRT.bat 时会自动调用 install_runtime.bat,在当前目录创建 .venv 并安装 requirements.txt 中的 Python 依赖;后续启动会直接打开 GUI。PATH 中直接运行。start_gui.bat 和 open_shell.bat 保留给需要手动启动或排查命令行环境的用户。SHA256SUMS.txt 三个文件。packaging/aisrt_portable.spec 仅保留给维护者本地试验完整运行时打包,默认 Release 不使用它。发布到 GitHub 前请确认:
.env、模型缓存、音频缓存、测试媒体、截图、生成字幕、运行日志没有进入 Git。建议发布前额外执行:
git status --short --ignored
.\.venv\Scripts\python.exe -m pytest tests/test_open_source_hygiene.py -q
本项目使用 MIT License,详见 LICENSE。



