
这个资源库包含了为 Prompt 工程手工整理的资源中文清单,重点是GPT、ChatGPT、PaLM 等(自动持续更新)
See the codeREADME
神奇的Prompt工程 🧙♂️
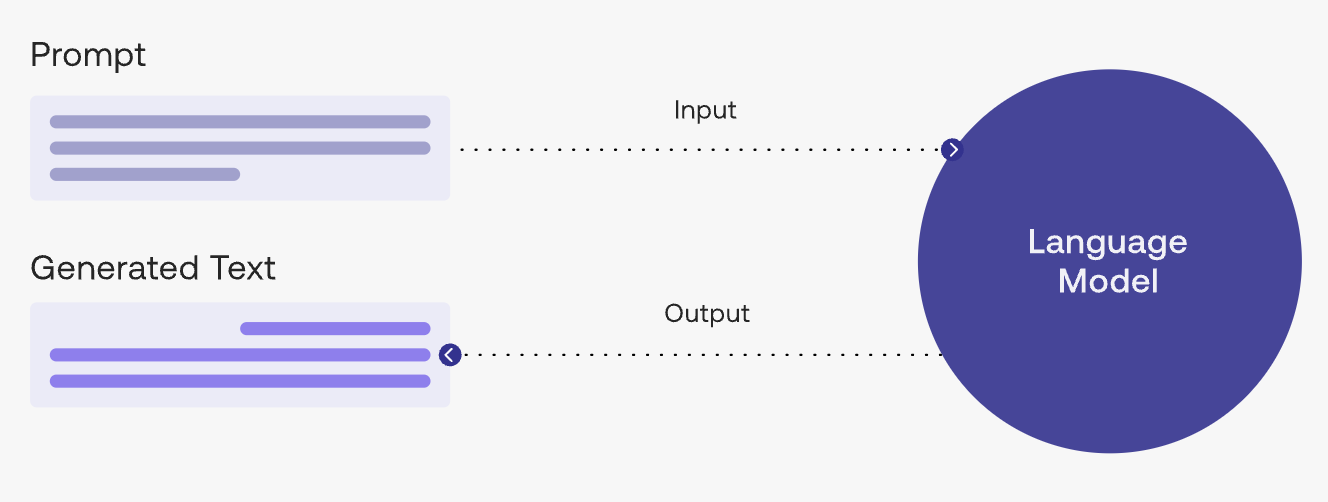
该存储库包含一个手动筛选的Prompt工程资源,重点关注于生成式预训练变压器(GPT)、ChatGPT、PaLM等。
Prompt工程课即将来临...



Prompt工程课即将来临...
目录
论文
📄
-
Prompt工程技术:
- 使用Prompt Pattern目录增强ChatGPT Prompt工程的方法 [2023] (Arxiv)
- 基于梯度的离散优化用于Prompt微调和发现 [2023] (Arxiv)。- 综合提示:为大型语言模型生成思维链演示 [2023](Arxiv)
- 渐进提示:语言模型的连续学习 [2023](Arxiv)
- 批处理提示:带有LLM API的高效推断 [2023](Arxiv)
- 连续提示以解决复杂问题 [2022](Arxiv)
- 结构提示:将上下文学习扩展到1,000个示例 [2022](Arxiv)
- 大型语言模型是人类水平的提示工程师 [2022](Arxiv)
- 问我任何事:提示语言模型的简单策略 [2022](Arxiv)
- 提示GPT-3要可靠 [2022](Arxiv)
- 分解提示:解决复杂任务的模块化方法 [2022](Arxiv)
- PromptChainer:通过视觉编程链接大型语言模型提示 [2022](Arxiv)
- 调查扩散模型中的提示工程 [2022](Arxiv)
- 展示您的工作:使用语言模型进行中间计算的草稿本 [2021](Arxiv)
- 重新构思GPTk的教学提示 [2021](Arxiv)
- 奇妙有序的提示及其发现:克服小样本提示顺序敏感性 [2021](Arxiv)
- 规模的力量用于参数高效提示调整 [2021](Arxiv)
- 为大型语言模型编程:超越小样本范例 [2021](Arxiv)- Prefix-Tuning: 优化连续提示以进行生成 [2021] (Arxiv)
-
推理和上下文学习:
- 语言模型中的多模态思维链推理 [2023] (Arxiv)
- 转念一想,我们不走单步思考的路!零-shot推理中的偏见和有害性 [2022] (Arxiv)
- ReAct:语言模型中推理和行动的协同作用 [2022] (Arxiv)
- 语言模型是贪婪的推理者:对思维链的系统形式分析 [2022] (Arxiv)
- 关于使语言模型变得更好的推理的进展 [2022] (Arxiv)
- 大型语言模型是零-shot推理者 [2022] (Arxiv)
- 像程序执行器一样推理 [2022] (Arxiv)
- 自洽性提高了语言模型中的思维链推理 [2022] (Arxiv)
- 重新思考演示的作用:什么使上下文学习起作用? [2022] (Arxiv)
- 学会解释:通过思维链进行科学问答的多模态推理 [2022] (Arxiv)
- Thought Chain提示在大型语言模型中引发推理 [2021] (Arxiv)
- 针对常识推理的生成知识提示 [2021] (Arxiv)
- BERTese:学会与BERT交流 [2021] (Acl)
-
评估和改进语言模型:
- 大型语言模型容易被无关上下文干扰 [2023] (Arxiv)
- 爬取语言模型的内部知识库 [2023] (Arxiv)- 发掘语言模型行为的方法:模型编写的评估 [2022] (Arxiv) 原文链接
- 使用前校准:提高语言模型的少样本性能 [2021] (Arxiv) 原文链接
-
语言模型的应用:
- 多模态恶意模因分类的提示 [2023] (Arxiv) 原文链接
- 用于社交对话合成的提示语言模型 [2023] (Arxiv) 原文链接
- 针对可控移情对话生成的常识感知提示 [2023] (Arxiv) 原文链接
- 程序辅助语言模型 [2023] (Arxiv) 原文链接
- 用于多语言法律判断预测的法律提示编写 [2023] (Arxiv) 原文链接
- 使用自然语言解决CS1问题的提示工程探究 [2022] (Arxiv) 原文链接
- 使用预训练语言模型进行情节创作 [2022] (Acl) 原文链接
- AutoPrompt:使用自动生成的提示语从语言模型中引出知识 [2020] (Arxiv) 原文链接
-
威胁检测和对抗示例:
-
少样本学习和性能优化:
- Promptagator:从8个示例进行少样本密集检索 [2022] (Arxiv)
- Few-Shot提示进行文本推理的解释不可靠性 [2022] (Arxiv)
- 使预训练语言模型成为更好的少样本学习器 [2021] (Acl)
- 语言模型是少样本学习器 [2020] (Arxiv)
-
文本到图像生成:
- 一种用于文本到图像生成的提示修饰符分类 [2022] (Arxiv)
- Prompt工程文本到图像生成模型的设计指南 [2021] (Arxiv)
- 使用潜在扩散模型进行高分辨率图像合成 [2021] (Arxiv)
- DALL·E:从文本中创建图像 [2021] (Arxiv)
-
文本到音乐/声音生成:
- MusicLM:从文本生成音乐 [2023] (Arxiv)
- ERNIE-Music:使用扩散模型进行文本到波形音乐生成 [2023] (Arxiv)
- Noise2Music:使用扩散模型进行文本调制音乐生成 [2023) (Arxiv)
- AudioLM:一种基于语言建模的音频生成方法 [2023] (Arxiv)
- Make-An-Audio:使用增强提示扩散模型进行文本到音频生成 [2023] (Arxiv)
-
文本到视频生成:
- Dreamix:视频扩散模型是通用视频编辑器 [2023] (Arxiv)。- 调整视频:一次性调整图像扩散模型用于文本到视频生成 [2022] (Arxiv)
- 噪声到音乐:基于扩散模型的文本条件音乐生成 [2023] (Arxiv)
- 音频LM:一种语言模型生成音频的方法 [2023] (Arxiv)
-
概述:
工具和代码
🔧
| 名称 | 描述 | 链接 |
|---|---|---|
| GPT Index | GPT Index 是一个由一组数据结构组成的项目,旨在使使用大型外部知识库与 LLM 更轻松。 | [Github] |
| WFGY 16 Problem Map | 一个针对 LLM 流水线的供应商中立故障排查地图,重点关注 RAG、向量存储和长上下文提示。定义了 16 种具体的故障模式,并提供症状说明和最小化修复策略。 | [Github] |
| Promptify | 使用 LLM 解决 NLP 问题,使用 Promptify 轻松为 GPT、PaLM 等流行生成模型生成不同的 NLP 任务提示 | [Github] |
| Better Prompt | 在将 LLM 提示推送到生产之前测试测试套件 | [Github] |
| Interactive Composition Explorerx | ICE 是一个 Python 库和语言模型程序的跟踪可视化器。 | [Github] |
| LangChainx | 通过组合使用 LLM 构建应用程序 | [Github] |
| OpenPrompt | 一个用于 Prompt 学习的开源框架 | [Github] |
| Prompt Engine | 此存储库包含用于创建和维护大语言模型 (LLMs) Prompt 的 NPM 实用程序库。 | [Github] |
| Prompts AI | GPT-3 的高级工作场所 | [Github] |
| Prompt Source | PromptSource 是一个用于创建、共享和使用自然语言提示的工具包。 | [Github] |
| ThoughtSource | 一个用于机器思考科学的框架 | [Github] |
Api
💻
| 名称 | 描述 | URL | 付费或开源 |
|---|---|---|---|
| OpenAI | 用于自然语言任务的 GPT-n,用于将自然语言翻译成代码的 Codex,以及用于创建和编辑原始图像的 DALL·E。 | [OpenAI] | 付费 |
| CohereAI | Cohere 通过一个 API 提供对先进的大型语言模型和自然语言处理工具的访问。 | [CohereAI] | 付费 |
| Anthropic | 即将推出 | [Anthropic] | 付费 |
| FLAN-T5 XXL | 即将推出 | [HugginFace] | 开源 |
数据集
💾
| 名称 | 描述 | URL |
|---|---|---|
| P3 (Public Pool of Prompts) | P3 (Public Pool of Prompts) 是一个包含各种 NLP 任务的 prompted English 数据集集合。 | [HuggingFace] |
| Awesome ChatGPT Prompts | 该仓库包括用于更好地使用 ChatGPT 的 ChatGPT prompt curation。 | [Github] |
🧠
| 名称 | 描述 | 链接 |
|---|---|---|
| ChatGPT | ChatGPT | [OpenAI] |
| Codex | Codex 模型是我们的 GPT-3 模型的后代,可以理解和生成代码。其训练数据包含自然语言和 GitHub 上数十亿行公共代码 | [Github] |
| Bloom | BigScience 大型开放科学开放获取多语言语言模型 | [HuggingFace] |
| Facebook LLM | OPT-175B 是 Meta 训练的 GPT-3 等效模型。它是目前可用的最大的预训练语言模型,具有 1750 亿个参数 | [Alpa] |
| GPT-NeoX | GPT-NeoX-20B,一个经过训练的 200 亿个参数的自回归语言模型 | [HuggingFace] |
| FLAN-T5 XXL | Flan-T5 是一种指令调整模型,这意味着当作为提示的一部分给出指令时,它会表现出零射击行为。 | [HuggingFace/Google] |
| XLM-RoBERTa-XL | XLM-RoBERTa-XL 模型在 2.5TB 的经过过滤的 CommonCrawl 数据上进行了预训练,其中包含 100 种语言 | [HuggingFace] |
| GPT-J | 它是在 Pile 数据集上训练的类似于 GPT-2 的因果语言模型 | [HuggingFace] |
| 写作提示 | 包含从在线论坛(reddit)抓取的 300K 个人编写的故事与写作提示的大型数据集 | [Kaggle] | | Midjourney 提示 | 从 MidJourney 的公共 Discord 服务器中抓取的文本提示和图像 URL | [HuggingFace] || PaLM-rlhf-pytorch | RLHF(通过人类反馈的强化学习)在PaLM架构中的实现。基本上是ChatGPT,但加上了PaLM | [Github] | | GPT-Neo | 使用网格张量库实现模型并行的GPT-2和类GPT-3模型的实现。| [Github] | | LaMDA-rlhf-pytorch | Google的LaMDA的开源预训练实现,使用PyTorch。添加类似于ChatGPT的RLHF。 | [Github] | | RLHF | 通过人的反馈实现强化学习的实现 | [Github] | | GLM-130B | GLM-130B:一个开放的双语预训练模型| [Github] |
AI内容检测器
🔎
| 名称 | 描述 | URL |
|---|---|---|
| AI文本分类器 | AI文本分类器是一个经过精细调整的GPT模型,可以预测一段文本是来自于各种来源(如ChatGPT)的AI生成的可能性。 | [OpenAI] |
| GPT-2输出检测器 | 这是一个基于🤗/Transformers实现的RoBERTa的在线演示 | [HuggingFace] |
| Openai检测器 | 用于指示由AI编写的文本的AI分类器(OpenAI Detector Python wrapper) | [GitHub] |
教程
📚
-
Prompt工程简介
-
生成式语言模型入门指南
-
Prompt 工程的最佳实践
-
完整的 Prompt 工程指南
-
Prompt 工程的技术方面
-
Prompt 工程的资源
视频
- ChatGPT:面向初学者的5个Prompt工程秘诀
- CMU高级自然语言处理2022:Prompting
- Prompt工程-一个新的职业?
- ChatGPT指南:使用更好的Prompt让你的结果提升10倍
- 语言模型和Prompt工程:NLP中Prompting方法的系统调查
- Prompt工程101:自动完成、零样本、单样本和少样本提示
社区
🤝
如何贡献
我们欢迎贡献这个列表!实际上,这也是我创建它的主要原因——鼓励贡献和鼓励人们订阅更改以便及时了解大型语言模型(LLMs)和Prompt工程领域的新的、令人兴奋的发展动态。
在贡献之前,请花点时间查看我们的贡献指南。这些指南将有助于确保您的贡献与我们的目标一致,并符合我们的质量和相关性标准。感谢您有兴趣为这个项目做出贡献!
图片来源:docs.cohere.ai


Similar repos


Languages
Python
100.0%
这个资源库包含了为 Prompt 工程手工整理的资源中文清单,重点是GPT、ChatGPT、PaLM 等(自动持续更新)
See the codeREADME
神奇的Prompt工程 🧙♂️
该存储库包含一个手动筛选的Prompt工程资源,重点关注于生成式预训练变压器(GPT)、ChatGPT、PaLM等。
Prompt工程课即将来临...
Prompt工程课即将来临...
目录
论文
📄
-
Prompt工程技术:
- 使用Prompt Pattern目录增强ChatGPT Prompt工程的方法 [2023] (Arxiv)
- 基于梯度的离散优化用于Prompt微调和发现 [2023] (Arxiv)。- 综合提示:为大型语言模型生成思维链演示 [2023](Arxiv)
- 渐进提示:语言模型的连续学习 [2023](Arxiv)
- 批处理提示:带有LLM API的高效推断 [2023](Arxiv)
- 连续提示以解决复杂问题 [2022](Arxiv)
- 结构提示:将上下文学习扩展到1,000个示例 [2022](Arxiv)
- 大型语言模型是人类水平的提示工程师 [2022](Arxiv)
- 问我任何事:提示语言模型的简单策略 [2022](Arxiv)
- 提示GPT-3要可靠 [2022](Arxiv)
- 分解提示:解决复杂任务的模块化方法 [2022](Arxiv)
- PromptChainer:通过视觉编程链接大型语言模型提示 [2022](Arxiv)
- 调查扩散模型中的提示工程 [2022](Arxiv)
- 展示您的工作:使用语言模型进行中间计算的草稿本 [2021](Arxiv)
- 重新构思GPTk的教学提示 [2021](Arxiv)
- 奇妙有序的提示及其发现:克服小样本提示顺序敏感性 [2021](Arxiv)
- 规模的力量用于参数高效提示调整 [2021](Arxiv)
- 为大型语言模型编程:超越小样本范例 [2021](Arxiv)- Prefix-Tuning: 优化连续提示以进行生成 [2021] (Arxiv)
-
推理和上下文学习:
- 语言模型中的多模态思维链推理 [2023] (Arxiv)
- 转念一想,我们不走单步思考的路!零-shot推理中的偏见和有害性 [2022] (Arxiv)
- ReAct:语言模型中推理和行动的协同作用 [2022] (Arxiv)
- 语言模型是贪婪的推理者:对思维链的系统形式分析 [2022] (Arxiv)
- 关于使语言模型变得更好的推理的进展 [2022] (Arxiv)
- 大型语言模型是零-shot推理者 [2022] (Arxiv)
- 像程序执行器一样推理 [2022] (Arxiv)
- 自洽性提高了语言模型中的思维链推理 [2022] (Arxiv)
- 重新思考演示的作用:什么使上下文学习起作用? [2022] (Arxiv)
- 学会解释:通过思维链进行科学问答的多模态推理 [2022] (Arxiv)
- Thought Chain提示在大型语言模型中引发推理 [2021] (Arxiv)
- 针对常识推理的生成知识提示 [2021] (Arxiv)
- BERTese:学会与BERT交流 [2021] (Acl)
-
评估和改进语言模型:
- 大型语言模型容易被无关上下文干扰 [2023] (Arxiv)
- 爬取语言模型的内部知识库 [2023] (Arxiv)- 发掘语言模型行为的方法:模型编写的评估 [2022] (Arxiv) 原文链接
- 使用前校准:提高语言模型的少样本性能 [2021] (Arxiv) 原文链接
-
语言模型的应用:
- 多模态恶意模因分类的提示 [2023] (Arxiv) 原文链接
- 用于社交对话合成的提示语言模型 [2023] (Arxiv) 原文链接
- 针对可控移情对话生成的常识感知提示 [2023] (Arxiv) 原文链接
- 程序辅助语言模型 [2023] (Arxiv) 原文链接
- 用于多语言法律判断预测的法律提示编写 [2023] (Arxiv) 原文链接
- 使用自然语言解决CS1问题的提示工程探究 [2022] (Arxiv) 原文链接
- 使用预训练语言模型进行情节创作 [2022] (Acl) 原文链接
- AutoPrompt:使用自动生成的提示语从语言模型中引出知识 [2020] (Arxiv) 原文链接
-
威胁检测和对抗示例:
-
少样本学习和性能优化:
- Promptagator:从8个示例进行少样本密集检索 [2022] (Arxiv)
- Few-Shot提示进行文本推理的解释不可靠性 [2022] (Arxiv)
- 使预训练语言模型成为更好的少样本学习器 [2021] (Acl)
- 语言模型是少样本学习器 [2020] (Arxiv)
-
文本到图像生成:
- 一种用于文本到图像生成的提示修饰符分类 [2022] (Arxiv)
- Prompt工程文本到图像生成模型的设计指南 [2021] (Arxiv)
- 使用潜在扩散模型进行高分辨率图像合成 [2021] (Arxiv)
- DALL·E:从文本中创建图像 [2021] (Arxiv)
-
文本到音乐/声音生成:
- MusicLM:从文本生成音乐 [2023] (Arxiv)
- ERNIE-Music:使用扩散模型进行文本到波形音乐生成 [2023] (Arxiv)
- Noise2Music:使用扩散模型进行文本调制音乐生成 [2023) (Arxiv)
- AudioLM:一种基于语言建模的音频生成方法 [2023] (Arxiv)
- Make-An-Audio:使用增强提示扩散模型进行文本到音频生成 [2023] (Arxiv)
-
文本到视频生成:
- Dreamix:视频扩散模型是通用视频编辑器 [2023] (Arxiv)。- 调整视频:一次性调整图像扩散模型用于文本到视频生成 [2022] (Arxiv)
- 噪声到音乐:基于扩散模型的文本条件音乐生成 [2023] (Arxiv)
- 音频LM:一种语言模型生成音频的方法 [2023] (Arxiv)
-
概述:
工具和代码
🔧
| 名称 | 描述 | 链接 |
|---|---|---|
| GPT Index | GPT Index 是一个由一组数据结构组成的项目,旨在使使用大型外部知识库与 LLM 更轻松。 | [Github] |
| WFGY 16 Problem Map | 一个针对 LLM 流水线的供应商中立故障排查地图,重点关注 RAG、向量存储和长上下文提示。定义了 16 种具体的故障模式,并提供症状说明和最小化修复策略。 | [Github] |
| Promptify | 使用 LLM 解决 NLP 问题,使用 Promptify 轻松为 GPT、PaLM 等流行生成模型生成不同的 NLP 任务提示 | [Github] |
| Better Prompt | 在将 LLM 提示推送到生产之前测试测试套件 | [Github] |
| Interactive Composition Explorerx | ICE 是一个 Python 库和语言模型程序的跟踪可视化器。 | [Github] |
| LangChainx | 通过组合使用 LLM 构建应用程序 | [Github] |
| OpenPrompt | 一个用于 Prompt 学习的开源框架 | [Github] |
| Prompt Engine | 此存储库包含用于创建和维护大语言模型 (LLMs) Prompt 的 NPM 实用程序库。 | [Github] |
| Prompts AI | GPT-3 的高级工作场所 | [Github] |
| Prompt Source | PromptSource 是一个用于创建、共享和使用自然语言提示的工具包。 | [Github] |
| ThoughtSource | 一个用于机器思考科学的框架 | [Github] |
Api
💻
| 名称 | 描述 | URL | 付费或开源 |
|---|---|---|---|
| OpenAI | 用于自然语言任务的 GPT-n,用于将自然语言翻译成代码的 Codex,以及用于创建和编辑原始图像的 DALL·E。 | [OpenAI] | 付费 |
| CohereAI | Cohere 通过一个 API 提供对先进的大型语言模型和自然语言处理工具的访问。 | [CohereAI] | 付费 |
| Anthropic | 即将推出 | [Anthropic] | 付费 |
| FLAN-T5 XXL | 即将推出 | [HugginFace] | 开源 |
数据集
💾
| 名称 | 描述 | URL |
|---|---|---|
| P3 (Public Pool of Prompts) | P3 (Public Pool of Prompts) 是一个包含各种 NLP 任务的 prompted English 数据集集合。 | [HuggingFace] |
| Awesome ChatGPT Prompts | 该仓库包括用于更好地使用 ChatGPT 的 ChatGPT prompt curation。 | [Github] |
🧠
| 名称 | 描述 | 链接 |
|---|---|---|
| ChatGPT | ChatGPT | [OpenAI] |
| Codex | Codex 模型是我们的 GPT-3 模型的后代,可以理解和生成代码。其训练数据包含自然语言和 GitHub 上数十亿行公共代码 | [Github] |
| Bloom | BigScience 大型开放科学开放获取多语言语言模型 | [HuggingFace] |
| Facebook LLM | OPT-175B 是 Meta 训练的 GPT-3 等效模型。它是目前可用的最大的预训练语言模型,具有 1750 亿个参数 | [Alpa] |
| GPT-NeoX | GPT-NeoX-20B,一个经过训练的 200 亿个参数的自回归语言模型 | [HuggingFace] |
| FLAN-T5 XXL | Flan-T5 是一种指令调整模型,这意味着当作为提示的一部分给出指令时,它会表现出零射击行为。 | [HuggingFace/Google] |
| XLM-RoBERTa-XL | XLM-RoBERTa-XL 模型在 2.5TB 的经过过滤的 CommonCrawl 数据上进行了预训练,其中包含 100 种语言 | [HuggingFace] |
| GPT-J | 它是在 Pile 数据集上训练的类似于 GPT-2 的因果语言模型 | [HuggingFace] |
| 写作提示 | 包含从在线论坛(reddit)抓取的 300K 个人编写的故事与写作提示的大型数据集 | [Kaggle] | | Midjourney 提示 | 从 MidJourney 的公共 Discord 服务器中抓取的文本提示和图像 URL | [HuggingFace] || PaLM-rlhf-pytorch | RLHF(通过人类反馈的强化学习)在PaLM架构中的实现。基本上是ChatGPT,但加上了PaLM | [Github] | | GPT-Neo | 使用网格张量库实现模型并行的GPT-2和类GPT-3模型的实现。| [Github] | | LaMDA-rlhf-pytorch | Google的LaMDA的开源预训练实现,使用PyTorch。添加类似于ChatGPT的RLHF。 | [Github] | | RLHF | 通过人的反馈实现强化学习的实现 | [Github] | | GLM-130B | GLM-130B:一个开放的双语预训练模型| [Github] |
AI内容检测器
🔎
| 名称 | 描述 | URL |
|---|---|---|
| AI文本分类器 | AI文本分类器是一个经过精细调整的GPT模型,可以预测一段文本是来自于各种来源(如ChatGPT)的AI生成的可能性。 | [OpenAI] |
| GPT-2输出检测器 | 这是一个基于🤗/Transformers实现的RoBERTa的在线演示 | [HuggingFace] |
| Openai检测器 | 用于指示由AI编写的文本的AI分类器(OpenAI Detector Python wrapper) | [GitHub] |
教程
📚
-
Prompt工程简介
-
生成式语言模型入门指南
-
Prompt 工程的最佳实践
-
完整的 Prompt 工程指南
-
Prompt 工程的技术方面
-
Prompt 工程的资源
视频
- ChatGPT:面向初学者的5个Prompt工程秘诀
- CMU高级自然语言处理2022:Prompting
- Prompt工程-一个新的职业?
- ChatGPT指南:使用更好的Prompt让你的结果提升10倍
- 语言模型和Prompt工程:NLP中Prompting方法的系统调查
- Prompt工程101:自动完成、零样本、单样本和少样本提示
社区
🤝
如何贡献
我们欢迎贡献这个列表!实际上,这也是我创建它的主要原因——鼓励贡献和鼓励人们订阅更改以便及时了解大型语言模型(LLMs)和Prompt工程领域的新的、令人兴奋的发展动态。
在贡献之前,请花点时间查看我们的贡献指南。这些指南将有助于确保您的贡献与我们的目标一致,并符合我们的质量和相关性标准。感谢您有兴趣为这个项目做出贡献!
图片来源:docs.cohere.ai
Similar repos
Languages
Python
100.0%