RAG-powered chatbot for Fukuyama City official documents with Streamlit UI, FAISS semantic search, and GPU optimization for Google Colab Pro
Python
0
22 commits
updated Oct 3, 2025


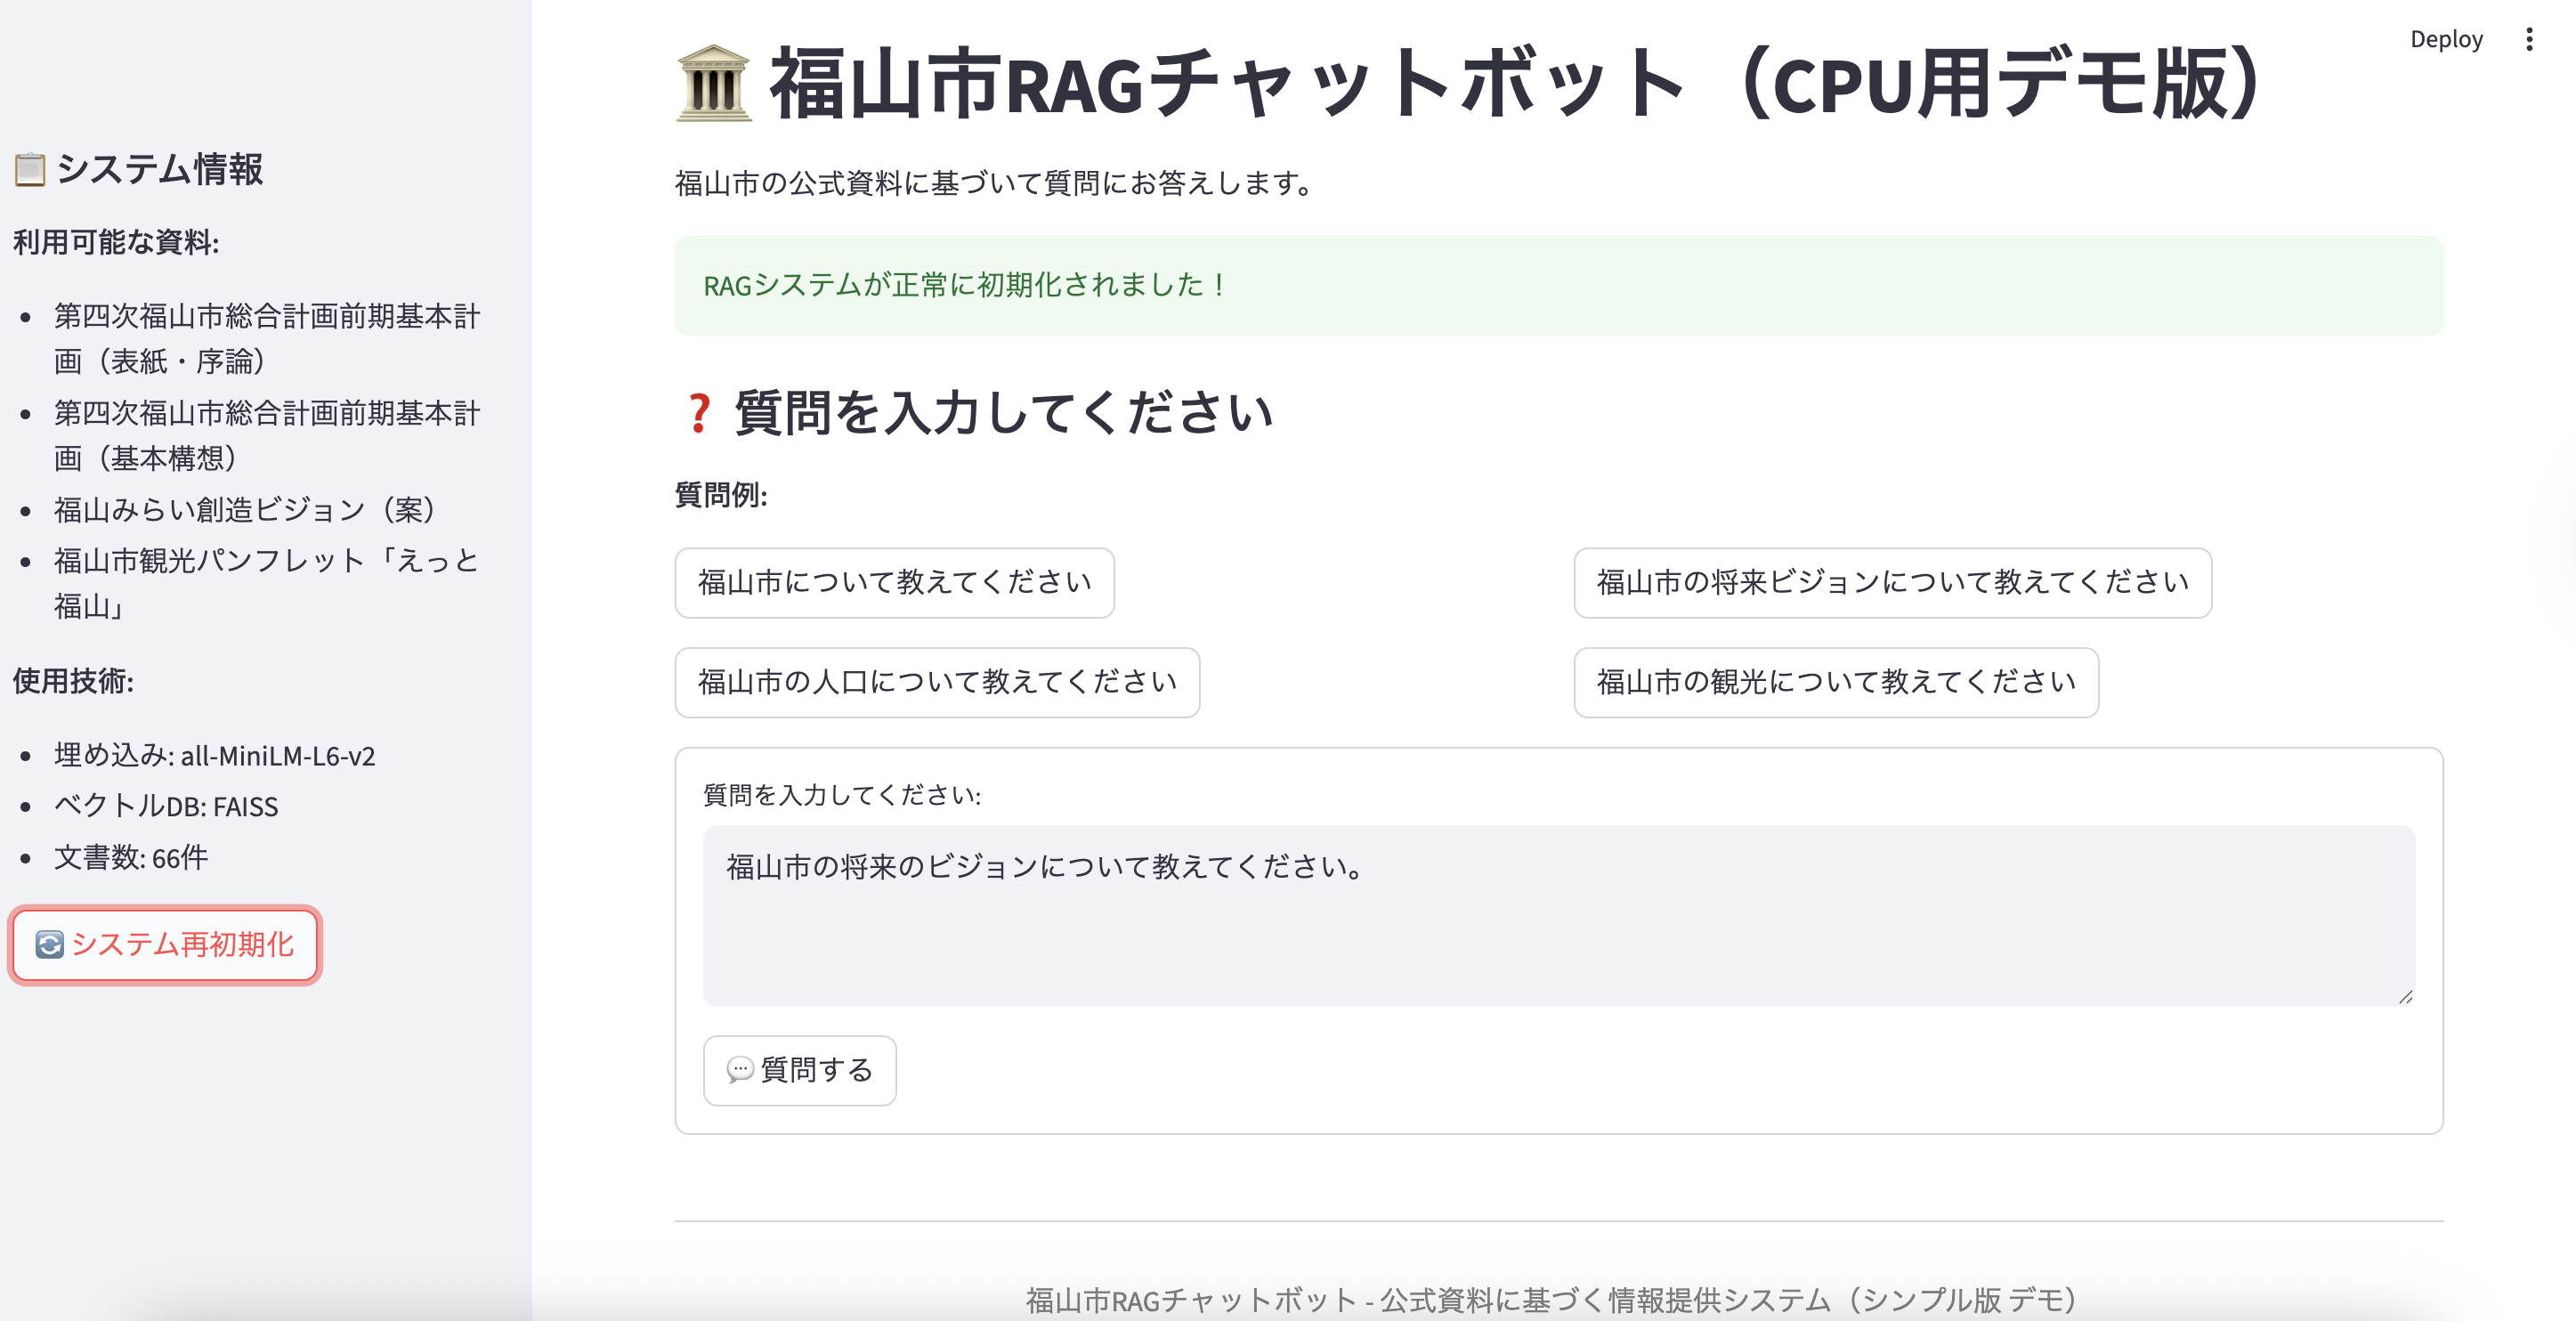
RAG(Retrieval-Augmented Generation)を使用したチャットボットとして、福山市の公式PDF資料を活用したデモを作成しました。収集した福山市の公式文書から関連情報を検索し、質問に対してPDF資料から関連情報を検索して回答を生成する仕組みです。
from langchain_community.vectorstores import FAISS
from langchain_huggingface import HuggingFaceEmbeddings
| ライブラリ | 役割 | 選定理由 |
|---|---|---|
| langchain-community | ベクトルストア管理 | FAISSとの統合、ドキュメント検索の簡素化 |
| langchain-huggingface | 埋め込みモデル統合 | HuggingFaceモデルとLangChainの橋渡し |
実装方式: ハイブリッドアプローチ
| ライブラリ | 役割 | 技術的特徴 |
|---|---|---|
| transformers | LLM推論エンジン | HuggingFace標準、モデル読み込み・推論 |
| torch | 深層学習フレームワーク | GPU加速、テンソル演算 |
| sentence-transformers | 埋め込み生成 | セマンティック検索用ベクトル化 |
| bitsandbytes | モデル量子化 | 4bit量子化によるメモリ効率化 |
| accelerate | GPU最適化 | マルチGPU、混合精度計算 |
| ライブラリ | 役割 | パフォーマンス |
|---|---|---|
| FAISS | 高速ベクトル検索 | Facebook製、10億規模対応 |
| PyMuPDF (fitz) | PDF解析 | 高速テキスト抽出、メタデータ保持 |
| pickle | データ永続化 | ドキュメントメタデータ保存 |
| ライブラリ | 役割 | 利点 |
|---|---|---|
| streamlit | Webアプリフレームワーク | 高速プロトタイピング、リアルタイム更新 |
| pyngrok | トンネリング | Google Colab外部アクセス |
# requirements.txtからの抜粋
streamlit                 # Webアプリフレームワーク
transformers>=4.36.0      # HuggingFace transformers
torch>=2.0.0             # PyTorch深層学習フレームワーク
langchain>=0.3.0         # LangChainコア
langchain-community>=0.3.0  # LangChainコミュニティ拡張
langchain-huggingface>=0.1.0  # HuggingFace統合
faiss-gpu                # GPU対応FAISS
sentence-transformers>=2.2.0  # セマンティック埋め込み
PyMuPDF                  # PDF処理
accelerate>=0.20.0       # GPU最適化
bitsandbytes>=0.41.0     # 量子化ライブラリ
huggingface_hub>=0.16.0  # HuggingFaceハブ
python-dotenv            # 環境変数管理
graph TB
    A[PDF文書] --> B[PyMuPDF]
    B --> C[テキスト抽出]
    C --> D[LangChain TextSplitter]
    D --> E[文書チャンク化]
    E --> F[sentence-transformers]
    F --> G[ベクトル化]
    G --> H[FAISS Vector Store]

    I[ユーザー質問] --> J[HuggingFace Embeddings]
    J --> K[クエリベクトル化]
    K --> H
    H --> L[類似度検索]
    L --> M[関連文書取得]

    M --> N{回答生成方式}
    N -->|シンプル版| O[テンプレート回答]
    N -->|LLM版| P[transformers + torch]
    P --> Q[Llama-3.1-Swallow-8B-Instruct]
    Q --> R[AI生成回答]

    O --> S[Streamlit UI]
    R --> S
処理フロー
| 資料名 | ファイルサイズ | 内容 | RAG適性 |
|---|---|---|---|
| 第四次福山市総合計画前期基本計画(表紙・目次・序論) | 9.3MB | 福山市の総合計画の表紙、目次、序論部分 | ★★★★☆ |
| 第四次福山市総合計画前期基本計画(基本構想) | 4.7MB | 福山市の将来都市像、基本理念、施策の方向性 | ★★★★★ |
| 福山みらい創造ビジョン(案) | 3.7MB | 第五次福山市総合計画の基本構想 | ★★★★★ |
| 福山市観光パンフレット「えっと福山」 | 37.6MB | 福山市の観光スポット、グルメ、イベント情報 | ★★★★★ |
総データサイズ: 約53MB(4ファイル)
git clone https://github.com/yf591/rag_chatbot_demo.git
cd rag_chatbot_demo
# 仮想環境の作成
python -m venv .venv

# 仮想環境の有効化
.venv\Scripts\Activate.ps1

# または、実行ポリシーで問題がある場合
.venv\Scripts\activate.bat
# 仮想環境の作成
python3 -m venv .venv

# 仮想環境の有効化
source .venv/bin/activate
pip install -r requirements.txt
"pip install -r requirements.txt" の実行でエラーが出る場合は、以下のコマンドで依存関係をインストールしてください。
pip install -r requirements_colab.txt
# .env_templateを.envにコピーして、トークンを設定
cp .env_template .env
# .envファイルを編集してHUGGINGFACE_TOKENを設定
python pdf_processor_light.py
python fix_vector_store.py
# メイン版(GPU自動対応・推奨)
streamlit run app.py

# シンプル版(軽量・高速)
streamlit run app_simple.py
rag_chatbot_demo.ipynb を使用した統合ソリューション(Google Colab Pro L4で実証済み ✅)
# 1. Google Colab ProでGPU有効化(T4/L4/A100推奨)
# 2. リポジトリクローン
!git clone https://github.com/yf591/rag_chatbot_demo.git
%cd rag_chatbot_demo

# 3. rag_chatbot_demo.ipynb を開いて順次実行
# - GPU環境確認
# - 環境変数設定
# - FAISS問題自動対策
# - ベクトルストア診断・作成
# - アプリ起動
🎯 主な機能:
import torch
print(f"✅ CUDA利用可能: {torch.cuda.is_available()}")
if torch.cuda.is_available():
    print(f"🎯 GPU名: {torch.cuda.get_device_name(0)}")
    print(f"💾 GPU メモリ: {torch.cuda.get_device_properties(0).total_memory / 1e9:.1f}GB")
1. GPU認識されない
# ランタイム再起動
# メニュー: ランタイム → ランタイムを再起動
2. モデル読み込みエラー
# HuggingFaceトークンの確認
import os
print("Token:", os.getenv("HUGGINGFACE_TOKEN", "未設定"))
3. メモリ不足
アプリケーションへのアクセス
http://localhost:8501 にアクセス質問の入力
回答の確認
rag_chatbot_demo/
├── app.py                          # メインアプリケーション(GPU対応)
├── app_original.py                 # オリジナル版(バックアップ)
├── app_simple.py                   # シンプル版アプリケーション
├── rag_system.py                   # RAGシステム(LLM版)
├── rag_system_simple.py            # RAGシステム(シンプル版)
├── pdf_processor_light.py          # PDF前処理スクリプト(軽量版)
├── pdf_processor.py                # PDF前処理スクリプト(詳細版)
├── fix_vector_store.py             # ベクトルストア修復スクリプト
├── check_vector_store.py           # ベクトルストア確認スクリプト
├── rag_chatbot_demo.ipynb          # Google Colab統合ノートブック(実証済み✅)
├── requirements.txt                # 依存関係
├── requirements_colab.txt          # Google Colab用依存関係
├── README.md                       # プロジェクト説明書
├── LICENSE                         # ライセンス
├── vector_store/                   # ベクトルストア
│   ├── index.faiss                 # FAISSインデックス
│   ├── index.pkl                   # インデックスメタデータ
│   └── documents.pkl               # 文書データ
├── *.pdf                          # 福山市PDF資料(4ファイル)
└── docs/                          # ドキュメント
    ├── app_comparison.md           # アプリ比較ガイド
    ├── python_implementation_guide.md  # Python実装詳細ガイド
    └── 福山市RAG用PDFデータについて.md  # データ詳細
### 指示
{input}
### 回答:
すべてのPDFファイルは福山市公式サイトからの正確な情報です。
このプロジェクトはMITライセンスの下で公開されています。詳細はLICENSEファイルをご覧ください。
問題やバグを発見した場合は、GitHubのIssuesにてお知らせください。
RAG-powered chatbot for Fukuyama City official documents with Streamlit UI, FAISS semantic search, and GPU optimization for Google Colab Pro
Python
0
22 commits
updated Oct 3, 2025
RAG(Retrieval-Augmented Generation)を使用したチャットボットとして、福山市の公式PDF資料を活用したデモを作成しました。収集した福山市の公式文書から関連情報を検索し、質問に対してPDF資料から関連情報を検索して回答を生成する仕組みです。
from langchain_community.vectorstores import FAISS
from langchain_huggingface import HuggingFaceEmbeddings
| ライブラリ | 役割 | 選定理由 |
|---|---|---|
| langchain-community | ベクトルストア管理 | FAISSとの統合、ドキュメント検索の簡素化 |
| langchain-huggingface | 埋め込みモデル統合 | HuggingFaceモデルとLangChainの橋渡し |
実装方式: ハイブリッドアプローチ
| ライブラリ | 役割 | 技術的特徴 |
|---|---|---|
| transformers | LLM推論エンジン | HuggingFace標準、モデル読み込み・推論 |
| torch | 深層学習フレームワーク | GPU加速、テンソル演算 |
| sentence-transformers | 埋め込み生成 | セマンティック検索用ベクトル化 |
| bitsandbytes | モデル量子化 | 4bit量子化によるメモリ効率化 |
| accelerate | GPU最適化 | マルチGPU、混合精度計算 |
| ライブラリ | 役割 | パフォーマンス |
|---|---|---|
| FAISS | 高速ベクトル検索 | Facebook製、10億規模対応 |
| PyMuPDF (fitz) | PDF解析 | 高速テキスト抽出、メタデータ保持 |
| pickle | データ永続化 | ドキュメントメタデータ保存 |
| ライブラリ | 役割 | 利点 |
|---|---|---|
| streamlit | Webアプリフレームワーク | 高速プロトタイピング、リアルタイム更新 |
| pyngrok | トンネリング | Google Colab外部アクセス |
# requirements.txtからの抜粋
streamlit                 # Webアプリフレームワーク
transformers>=4.36.0      # HuggingFace transformers
torch>=2.0.0             # PyTorch深層学習フレームワーク
langchain>=0.3.0         # LangChainコア
langchain-community>=0.3.0  # LangChainコミュニティ拡張
langchain-huggingface>=0.1.0  # HuggingFace統合
faiss-gpu                # GPU対応FAISS
sentence-transformers>=2.2.0  # セマンティック埋め込み
PyMuPDF                  # PDF処理
accelerate>=0.20.0       # GPU最適化
bitsandbytes>=0.41.0     # 量子化ライブラリ
huggingface_hub>=0.16.0  # HuggingFaceハブ
python-dotenv            # 環境変数管理
graph TB
    A[PDF文書] --> B[PyMuPDF]
    B --> C[テキスト抽出]
    C --> D[LangChain TextSplitter]
    D --> E[文書チャンク化]
    E --> F[sentence-transformers]
    F --> G[ベクトル化]
    G --> H[FAISS Vector Store]

    I[ユーザー質問] --> J[HuggingFace Embeddings]
    J --> K[クエリベクトル化]
    K --> H
    H --> L[類似度検索]
    L --> M[関連文書取得]

    M --> N{回答生成方式}
    N -->|シンプル版| O[テンプレート回答]
    N -->|LLM版| P[transformers + torch]
    P --> Q[Llama-3.1-Swallow-8B-Instruct]
    Q --> R[AI生成回答]

    O --> S[Streamlit UI]
    R --> S
処理フロー
| 資料名 | ファイルサイズ | 内容 | RAG適性 |
|---|---|---|---|
| 第四次福山市総合計画前期基本計画(表紙・目次・序論) | 9.3MB | 福山市の総合計画の表紙、目次、序論部分 | ★★★★☆ |
| 第四次福山市総合計画前期基本計画(基本構想) | 4.7MB | 福山市の将来都市像、基本理念、施策の方向性 | ★★★★★ |
| 福山みらい創造ビジョン(案) | 3.7MB | 第五次福山市総合計画の基本構想 | ★★★★★ |
| 福山市観光パンフレット「えっと福山」 | 37.6MB | 福山市の観光スポット、グルメ、イベント情報 | ★★★★★ |
総データサイズ: 約53MB(4ファイル)
git clone https://github.com/yf591/rag_chatbot_demo.git
cd rag_chatbot_demo
# 仮想環境の作成
python -m venv .venv

# 仮想環境の有効化
.venv\Scripts\Activate.ps1

# または、実行ポリシーで問題がある場合
.venv\Scripts\activate.bat
# 仮想環境の作成
python3 -m venv .venv

# 仮想環境の有効化
source .venv/bin/activate
pip install -r requirements.txt
"pip install -r requirements.txt" の実行でエラーが出る場合は、以下のコマンドで依存関係をインストールしてください。
pip install -r requirements_colab.txt
# .env_templateを.envにコピーして、トークンを設定
cp .env_template .env
# .envファイルを編集してHUGGINGFACE_TOKENを設定
python pdf_processor_light.py
python fix_vector_store.py
# メイン版(GPU自動対応・推奨)
streamlit run app.py

# シンプル版(軽量・高速)
streamlit run app_simple.py
rag_chatbot_demo.ipynb を使用した統合ソリューション(Google Colab Pro L4で実証済み ✅)
# 1. Google Colab ProでGPU有効化(T4/L4/A100推奨)
# 2. リポジトリクローン
!git clone https://github.com/yf591/rag_chatbot_demo.git
%cd rag_chatbot_demo

# 3. rag_chatbot_demo.ipynb を開いて順次実行
# - GPU環境確認
# - 環境変数設定
# - FAISS問題自動対策
# - ベクトルストア診断・作成
# - アプリ起動
🎯 主な機能:
import torch
print(f"✅ CUDA利用可能: {torch.cuda.is_available()}")
if torch.cuda.is_available():
    print(f"🎯 GPU名: {torch.cuda.get_device_name(0)}")
    print(f"💾 GPU メモリ: {torch.cuda.get_device_properties(0).total_memory / 1e9:.1f}GB")
1. GPU認識されない
# ランタイム再起動
# メニュー: ランタイム → ランタイムを再起動
2. モデル読み込みエラー
# HuggingFaceトークンの確認
import os
print("Token:", os.getenv("HUGGINGFACE_TOKEN", "未設定"))
3. メモリ不足
アプリケーションへのアクセス
http://localhost:8501 にアクセス質問の入力
回答の確認
rag_chatbot_demo/
├── app.py                          # メインアプリケーション(GPU対応)
├── app_original.py                 # オリジナル版(バックアップ)
├── app_simple.py                   # シンプル版アプリケーション
├── rag_system.py                   # RAGシステム(LLM版)
├── rag_system_simple.py            # RAGシステム(シンプル版)
├── pdf_processor_light.py          # PDF前処理スクリプト(軽量版)
├── pdf_processor.py                # PDF前処理スクリプト(詳細版)
├── fix_vector_store.py             # ベクトルストア修復スクリプト
├── check_vector_store.py           # ベクトルストア確認スクリプト
├── rag_chatbot_demo.ipynb          # Google Colab統合ノートブック(実証済み✅)
├── requirements.txt                # 依存関係
├── requirements_colab.txt          # Google Colab用依存関係
├── README.md                       # プロジェクト説明書
├── LICENSE                         # ライセンス
├── vector_store/                   # ベクトルストア
│   ├── index.faiss                 # FAISSインデックス
│   ├── index.pkl                   # インデックスメタデータ
│   └── documents.pkl               # 文書データ
├── *.pdf                          # 福山市PDF資料(4ファイル)
└── docs/                          # ドキュメント
    ├── app_comparison.md           # アプリ比較ガイド
    ├── python_implementation_guide.md  # Python実装詳細ガイド
    └── 福山市RAG用PDFデータについて.md  # データ詳細
### 指示
{input}
### 回答:
すべてのPDFファイルは福山市公式サイトからの正確な情報です。
このプロジェクトはMITライセンスの下で公開されています。詳細はLICENSEファイルをご覧ください。
問題やバグを発見した場合は、GitHubのIssuesにてお知らせください。



