
Windows tag editor for LoRA / character image datasets: booru tag editing with Chinese UI & translation, WD14/PixAI/CL ONNX auto-tagging, LLM captioning, AI character-tag audit (dual-character support), RMBG background removal, image editor, video frame extraction. Fork of starik222/BooruDatasetTagManager.
C#
18
29 commits
updated Oct 2, 2026
README
BooruDatasetTagManager+ 1.2.7
面向 LoRA / 角色数据集的 Windows 打标工具,fork 自 starik222/BooruDatasetTagManager。
每张图配一个同名 .txt 存放标签,加载文件夹就能改。也能用 LLM 或本地 Tag 推标(原名 ONNX 推标;引擎是 WD14 / PixAI / CL / OppaiOracle)自动打标,并做角色审查、用中文搜标签。界面默认简体中文。MIT License。
更新日志
- 1.2.7(当前)— Tag 推标接入 OppaiOracle(V1 320 / V1.1 448,约 1.9 万 general 标签,不含角色,非 gated);修复多重切割 YOLO 把过小检测框误报成「没有检测到目标」;角色审查改为逐标签流程,视觉阶段点名待上色标签与同槽位簇,并新增定向解析请求(每角色最多 3 次),复核网格同簇着色。发布说明
- 1.2.6 — ONNX 推标改名 Tag 推标(工具菜单、窗口标题、右键;引擎仍是本地 ONNX);错误标签修复可关闭角色类替换;YOLO 检测比例可按图自动识别;图片标签恢复 Shift / Ctrl 多选;Win10 上原生库加载失败与大批量推标内存峰值已加固。其余多为界面与流程优化:工具菜单分段、快速替换独立窗口、预分桶按批次配平与 Gradient、若干窗口说明与布局收紧。发布说明
- 1.2.5 — 新增批量裁剪、多重切割、YOLO 检测、预分桶、标签一二级筛选、按标签分类到文件夹;配置改存用户文档。修复 ONNX 下载误删模型、翻译卡住。发布说明
- 1.2.4 — 修复 WD14 错色标签、超长文件名无法保存、多人审查下拉不同步;ONNX 按置信度排序;随机百分比抽帧;数据集可按文件类型排序。发布说明
- 1.2.3 — 扫描坏图;透明背景可按文件夹 / 全部批量替换;修复标签筛选「点 NOT 得 OR」;密钥与路径安全加固。发布说明
- 1.2.2 — 相似图筛选、多角色审查(最多 4 人)、类别筛选、平铺视图、错误标签修复、命令行 CLI、F5 重载数据集;修复「跳过已有标签」白扣费。发布说明
- 1.2.1 — 移除 Python 后端;文件夹可多选筛选;审查失败可只重试未完成角色;首载更快、安全加固。发布说明
- 1.2.0 — 文件夹分组浏览器与内嵌预览;标签按类别着色 / 排序;内置 Danbooru 角色名单。发布说明
- 1.1.3 — 图片编辑器、CL 系列 ONNX、中文字典搜索;保存失败不丢编辑等 I/O 加固。发布说明
- 1.1.2 — 统一 LLM 打标窗口;本地 RMBG 抠图;崩溃兜底与密钥加密。发布说明
- 1.1.1 — 角色审查保存加速;统一裁剪图片对话框。发布说明
- 1.1 — WD14 全系列、按模型记阈值、PixAI 修复。发布说明
- 1.0.5 — 统一 ONNX 推标、视频工具。发布说明
快速开始
从 Releases 下载 BooruDatasetTagManagerPlus-*-win-x64.zip,解压后运行 BooruDatasetTagManagerPlus.exe(自包含,无需安装 .NET)。
- 文件 → 加载文件夹;「加载文件夹(自定义选项)…」还可以关闭预览图(大数据集更快)或从图片元数据读取初始标签(适合刚出图、还没写
.txt的数据集);「重新导入当前数据集」(F5)随时从磁盘刷新当前目录 - 直接编辑标签:「全部标签」与「图片标签」搜索框支持中文字典(输入「头发」即可定位 long hair、black hair 等);图片标签可用 Shift / Ctrl 多选后批量删除、复制、改权重;双击「全部标签」行可执行快速操作(默认打开「全部替换」,可在设置更换);遇到生词可开 Danbooru Wiki
- 使用 LLM 功能前,先在 LLM 设置 配置 OpenAI 兼容端点与模型
- 按需打开 工具:处理工具(替换透明背景 / 视频工具 / 背景移除 / 批量裁剪 / 多重切割 / YOLO 检测)、标注工具(Tag 推标 / LLM 打标 / 角色标签审查 / 快速替换)、预处理工具(查找相似图片 / 扫描坏图 / 按标签分类到文件夹 / 预分桶);测试功能 窗口里还有错误标签修复
- 自动化脚本可直接用同一个 exe 的命令行:
BooruDatasetTagManagerPlus.exe help列出全部命令(统计 / 批量改标 / 导出 / fix-tags 修复 / onnx-tag 推标 / audit 审查)
从源码构建
dotnet build BooruDatasetTagManager.sln -c Debug -f net8.0-windows
dotnet test BooruDatasetTagManager.Tests\BooruDatasetTagManager.Tests.csproj
dotnet publish BooruDatasetTagManager\BooruDatasetTagManager.csproj -c Release -f net8.0-windows -r win-x64 --self-contained true -o dist
test_start.bat— 启动 Release(或 Debug)quick_build.bat— 本地快速打包至dist/(首次构建自动下载 FFmpeg)
运行后程序目录会生成 Models/(下载的 ONNX 模型)、Cache/(缓存)。settings.json(API 与偏好设置)保存在「文档\BooruDatasetTagManagerPlus」,换安装目录也能读到同一份;文档里还没有文件时会从程序目录整份复制,若文档里已是空配置而程序目录仍能识别到旧的 API(端点 / 密钥 / 站点配置),则只把这些 API 字段迁过去。均为本地自动生成数据,可随时删除——设置恢复默认,模型可在应用内重新下载。
功能一览
| 类别 | 包含 |
|---|---|
| 打标 | LLM(标签 / 自然语言)· Tag 推标(本地 ONNX:WD14 / PixAI / CL / OppaiOracle)· 角色审查(最多 4 人) |
| 标签 | 中文搜索、类别着色与一二级筛选、错误标签修复、按标签筛图 |
| 图片 | 编辑器、批量裁剪、多重切割(含 YOLO)、预分桶、抠图 / 换透明底 |
| 整理 | 文件夹浏览与预览、按标签分文件夹、按分辨率分桶、相似图、坏图扫描、视频转换 / 抽帧 |
| 命令行 | 同一 exe:统计、批量改标、导出、Tag 推标(onnx-tag)、审查 |
功能详解
数据集浏览与预览
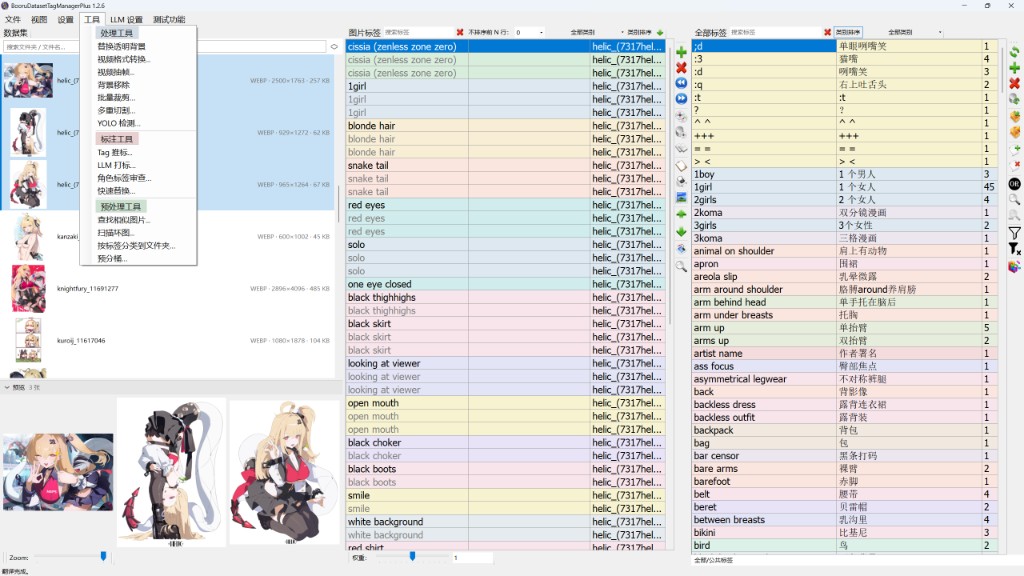
数据集面板是一个统一浏览器:顶部搜索框同时过滤文件夹与文件名;kohya 重复文件夹显示为可折叠分组(多文件夹默认全部折叠,搜索框右侧有全部展开 / 全部折叠、平铺视图与排序按钮;平铺开启时忽略文件夹分组、把当前范围与筛选结果摊平为一列),点击文件夹名即可把数据集范围限定到该文件夹(全部标签计数、批量操作与审查向导同步跟随);图片行显示缩略图、文件名与「格式 · 像素 · 大小」,选择操作与文件管理器一致(Ctrl / Shift / Ctrl+A / 方向键 / 右键菜单 / Delete)。
- 排序:搜索框右侧按钮可按文件名、类型或修改时间排列。类型按扩展名分组(jpg / jpeg 一类,png、webp、mp4、webm 等各自一类,视频与图片同一规则),同类内仍按文件名;选择会记住
- 文件夹右键:重命名文件夹(磁盘与内存同步改名,未保存的编辑不丢失);组头也可 F2 或 双击 改名;批量重命名图片(前缀 + 数字 / 字母 / 保留原名 + 后缀,实时预览,
.txt同步改名);Tag 推标此文件夹 / LLM 打标此文件夹 - 内嵌预览:数据集底部可折叠预览面板(视图 → 显示预览,状态记忆);多选时并排显示前 4 张,双击任一格在独立窗口打开;独立预览窗支持光标缩放、拖拽平移、双击适应 ↔ 100%、Ctrl+0 / Ctrl+1
- 标签着色与类别排序:两个标签面板按通用标签一级着色并分组(头发 / 服装 / 角色…);图片标签工具栏的「类别排序」是记忆开关:勾选后每张选中图自动按一级排序(遵守「不排序前 N 行」),状态持久保存;全部标签面板的类别排序默认关闭,可在其工具栏勾选
- 类别筛选:两个面板各有一个左右两栏菜单。左侧勾选一级即筛整个大类;悬停后右侧列出二级,可多选、可搜索。与文字搜索、次数过滤叠加
- 通用标签目录:约 10 万条 Danbooru 通用标签(
Data/danbooru_dataset_general.csv)带一二级分类,启动时加载;long_hair与long hair都能对上。查不到的标签进「一般」 - 角色名单:内置约 33 万条 Danbooru 角色标签(
Data/danbooru_character_tags.csv,含约 2.6 万条真实父子关系),角色标签精确识别着色,翻译显示为「译名 (作品)」;可在 设置 → 翻译 关闭。CSV 不含角色名,角色类仍靠这份表 / Danbooru 类型列

工具菜单
工具 是一段平铺下拉,用淡色底栏分成三类(标题不可点,混色方式与标签类别着色相同,浅色 / 深色主题都能看清):
- 处理工具:替换透明背景、视频格式转换、视频抽帧、背景移除、批量裁剪、多重切割、YOLO 检测
- 标注工具:Tag 推标、LLM 打标、角色标签审查、快速替换
- 预处理工具:查找相似图片、扫描坏图、按标签分类到文件夹、预分桶
错误标签修复仍在顶栏 测试功能 窗口;角色标签审查在标注工具和该窗口都能打开。
LLM 打标
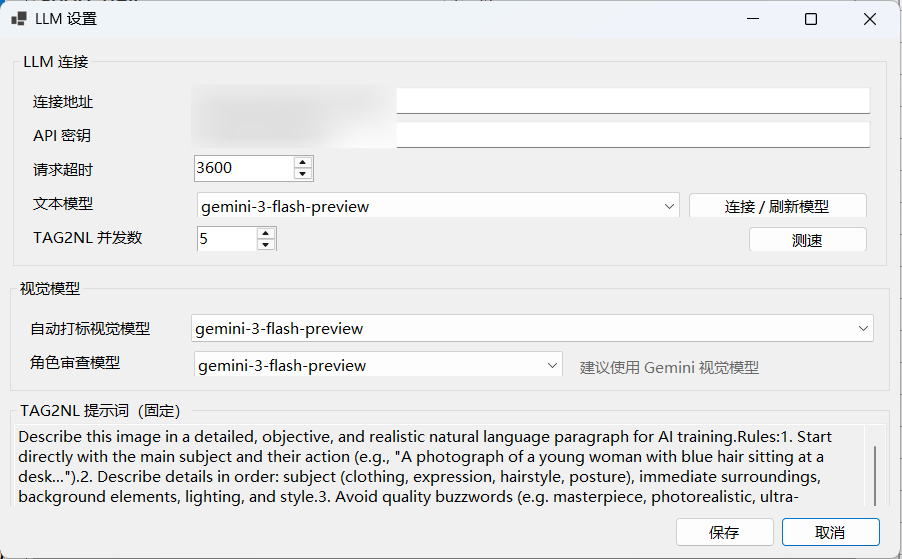
入口:工具 → LLM 打标…、数据集右键,或标签工具栏「自动生成标签」。使用前先在 LLM 设置 配置 OpenAI 兼容端点、文本 / 视觉模型与全局 LLM 并发(默认 5,范围 1–100)。
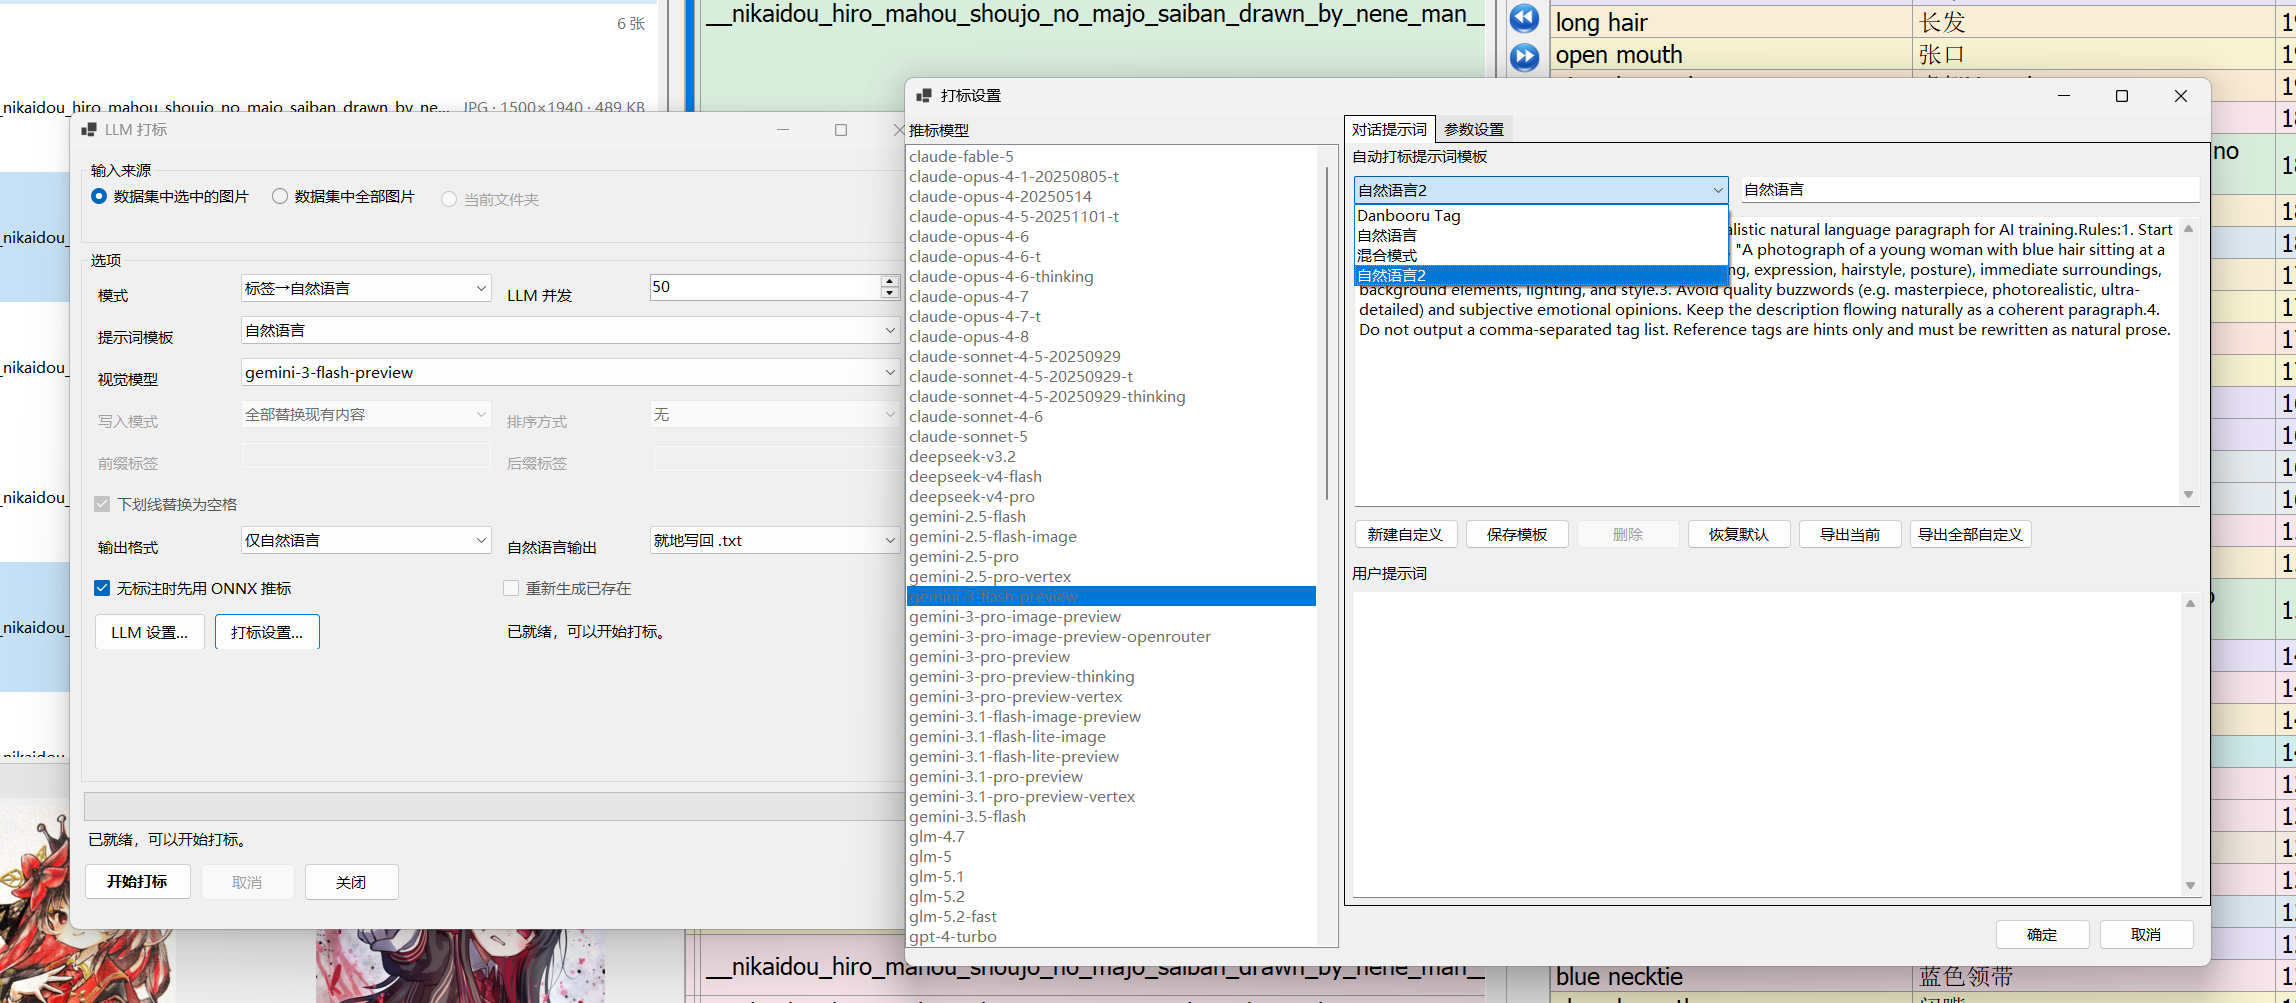
- 标签模式:图片 → 标签,按写入模式(全部替换 / 追加 / 跳过已有)直接写回数据集,支持排序、前后缀与下划线后处理;提示词模板内置 4 套(Danbooru Tag / 自然语言 / 混合模式 / 自然语言2),可自定义并导出 JSON(不含凭据)
- 标签→自然语言模式(原 TAG2NL):标签 + 图片 → 自然语言描述;输出格式可选 标签+自然语言 / 仅自然语言;默认另存副本到
数据集目录_captioned/(源.txt只读、可跳过已有),也可就地写回原图.txt - 无标注时先用 Tag 推标:勾选后,对没有标签的图片先走 Tag 推标(同一套本地 ONNX 模型),再交给 LLM 生成描述——标签→自然语言的自动流水线
角色标签审查
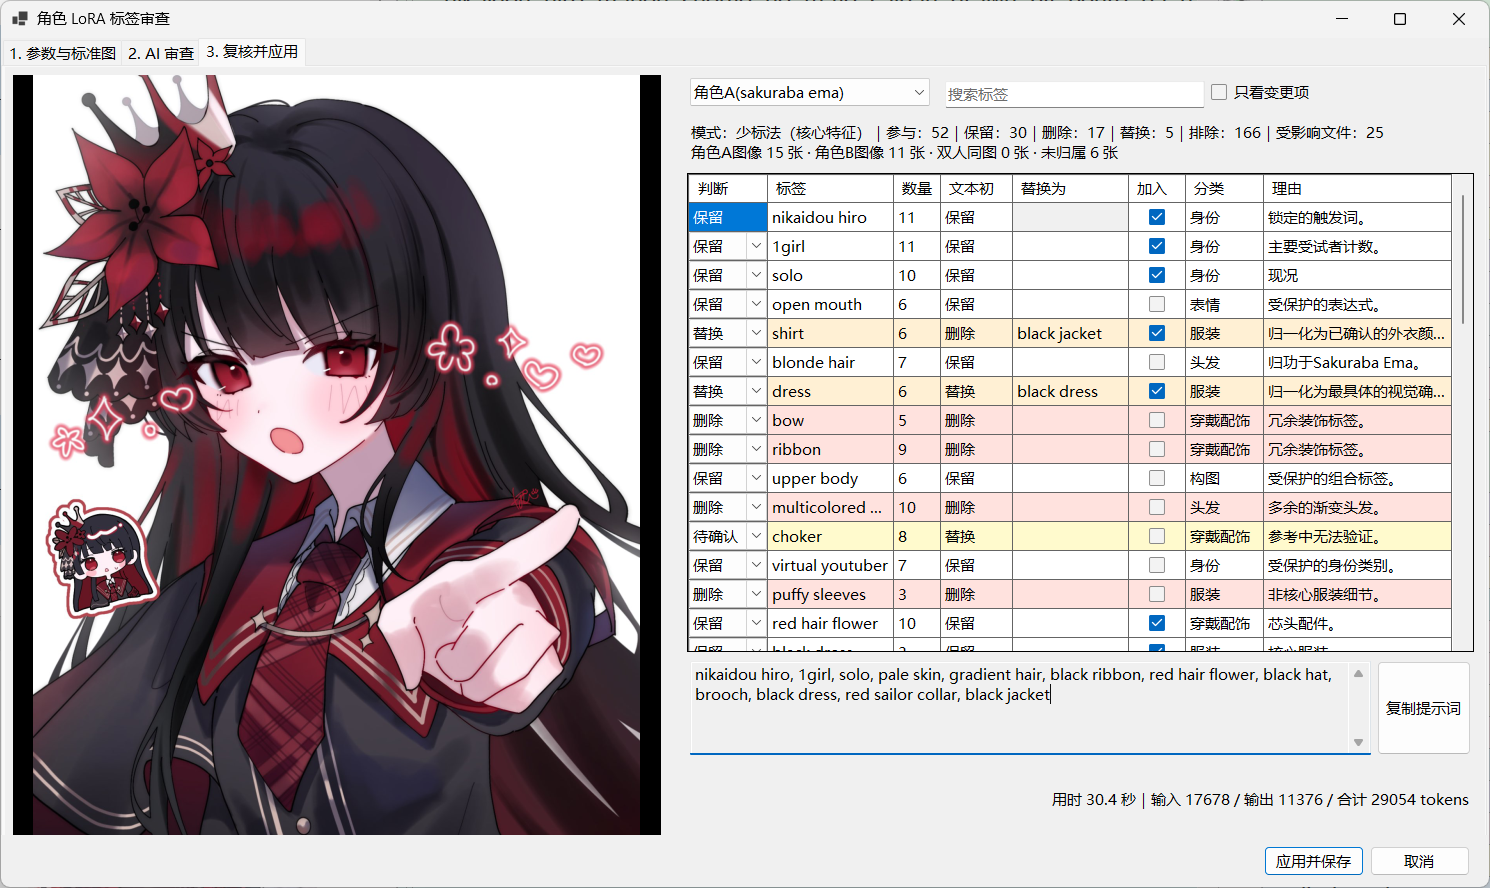
入口:工具 → 角色标签审查…(测试功能 窗口里也有同一入口)。设定锁定触发词(强制保留)、标签方法(少标法只留核心特征 / 全标法保留全部正确细节)、最小出现次数与标准图后,AI 按角色最多发起 3 次请求:文本初筛、视觉复核,再对仍无颜色的穿戴标签与同槽位簇(如 bow / hair ribbon / hairband)做一次定向解析(流程不可回退,改参数请取消后重开)。最后逐条复核(保留 / 删除 / 替换 / 不确定):同簇标签加同色底纹,悬停列出簇成员;替换目标优先用词表内已有标签。预览最终角色提示词后,应用并保存为事务写盘、失败自动回滚。
支持多角色数据集(最多 4 人):主体模式选择 双人 或 多角色 后,为每个角色设定触发词、标准图与性别(留空的角色行自动跳过,因此三人数据集也适用);图片按触发词、再按文件夹自动归属,多人同图自动补齐 2girls、multiple girls 等主体数标签,AI 审查、逐条复核与应用均逐角色进行,某个角色失败时可只重试该角色(已完成角色的结果保留)。
Tag 推标
原名 ONNX 推标。1.2.6 起界面统一为 Tag 推标(英文 Tag tagger):工具 → 标注工具 菜单、推标窗口标题、数据集右键 Tag 重新推标、文件夹右键 Tag 推标此文件夹…。引擎是本机 ONNX(WD14 / PixAI / CL / OppaiOracle),权重仍下到 Models/,命令行动词仍是 onnx-tag / onnx-models。
入口:工具 → Tag 推标…,或数据集右键 Tag 重新推标(自动开始);文件夹右键 Tag 推标此文件夹… 会预选「当前文件夹」来源,确认设置后再开始。
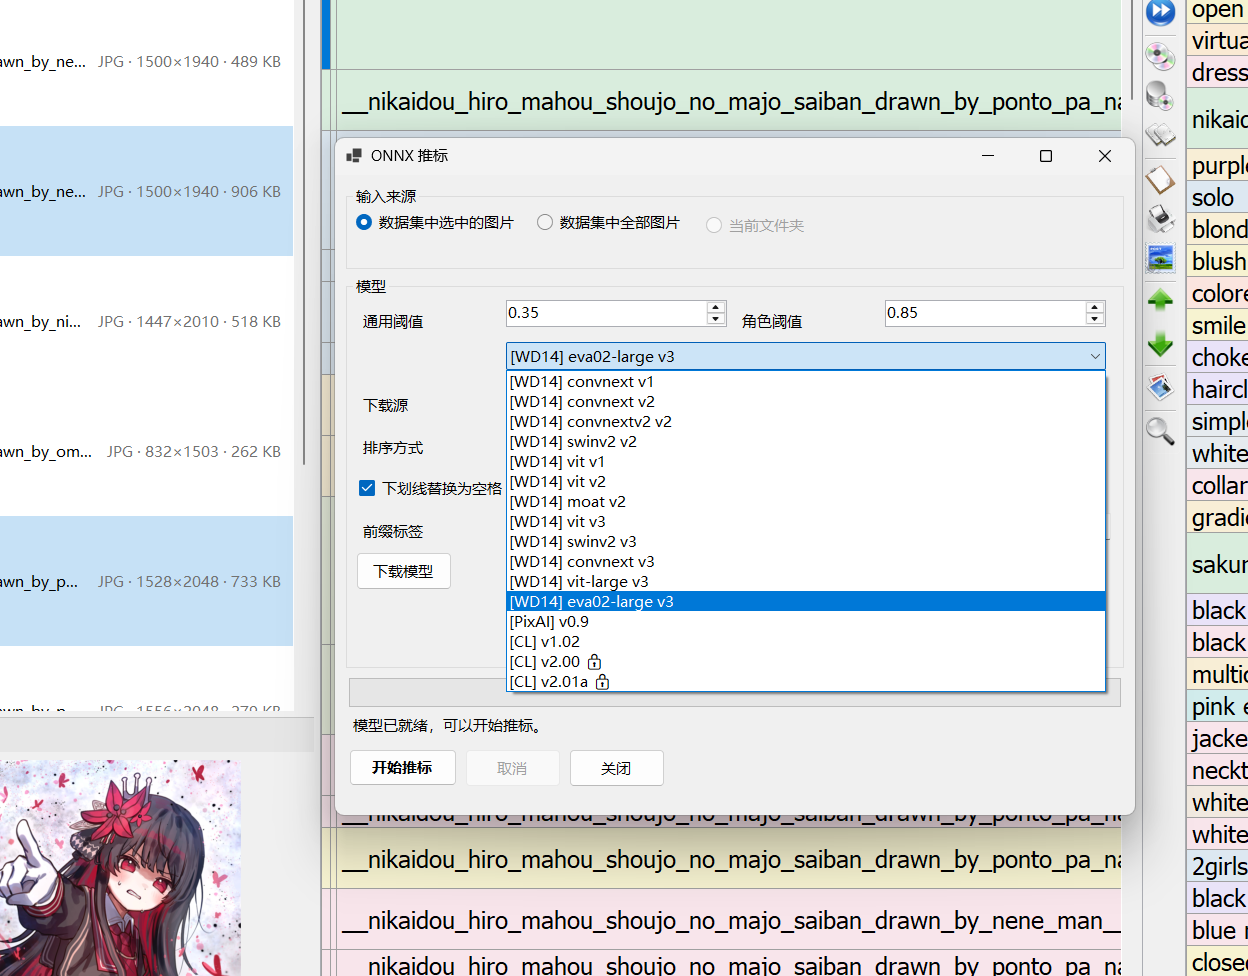
- 模型:WD14 全系列 12 款 + PixAI 0.9 + CL 系列(cl_tagger v1.02、cl_tagger_v2 v2.00 / v2.01a 🔒) + OppaiOracle(V1 320 / V1.1 448,约 1.9 万 general 标签,不含角色,非 gated;该家族隐藏角色阈值,默认阈值 V1 0.55 / V1.1 0.65);各模型阈值与设置独立保存;HuggingFace 官方或镜像下载
- 下载完成后会校验模型;文件被杀毒/索引短暂占用时会重试并保留,不会当成损坏自动删除。缺运行库等环境错误也不会清掉已下完的文件
- cl_tagger_v2 为受限(gated)仓库,作者许可禁止再分发与捆绑分发——软件不附带模型;下载前弹出许可提示,需自行在 HuggingFace 申请访问并填入 Access Token(DPAPI 加密保存),或手动下载放入
Models目录 - 写入模式(全部替换 / 追加 / 跳过已有)、可选排序、下划线→空格、前后缀标签;批量推标带进度条;「跳过已有标签列表」模式在推理前就跳过已有标签的图片,完成时如实报告写入 / 跳过数量
快速替换
入口:工具 → 快速替换…。左侧选规范词、设阈值,右侧预览将并入的同类低频标签,底栏左侧显示当前状态,确认后整库替换。同类按最后一个词判断(black shoes → shoes);出现次数低于阈值才会被换。
背景移除
入口:工具 → 背景移除,或数据集右键 移除背景。内置 RMBG-1.4 ONNX 本地抠图,无需外部服务;首次使用一键下载模型(约 176 MB,或量化版约 44 MB,官方 / 镜像源)。
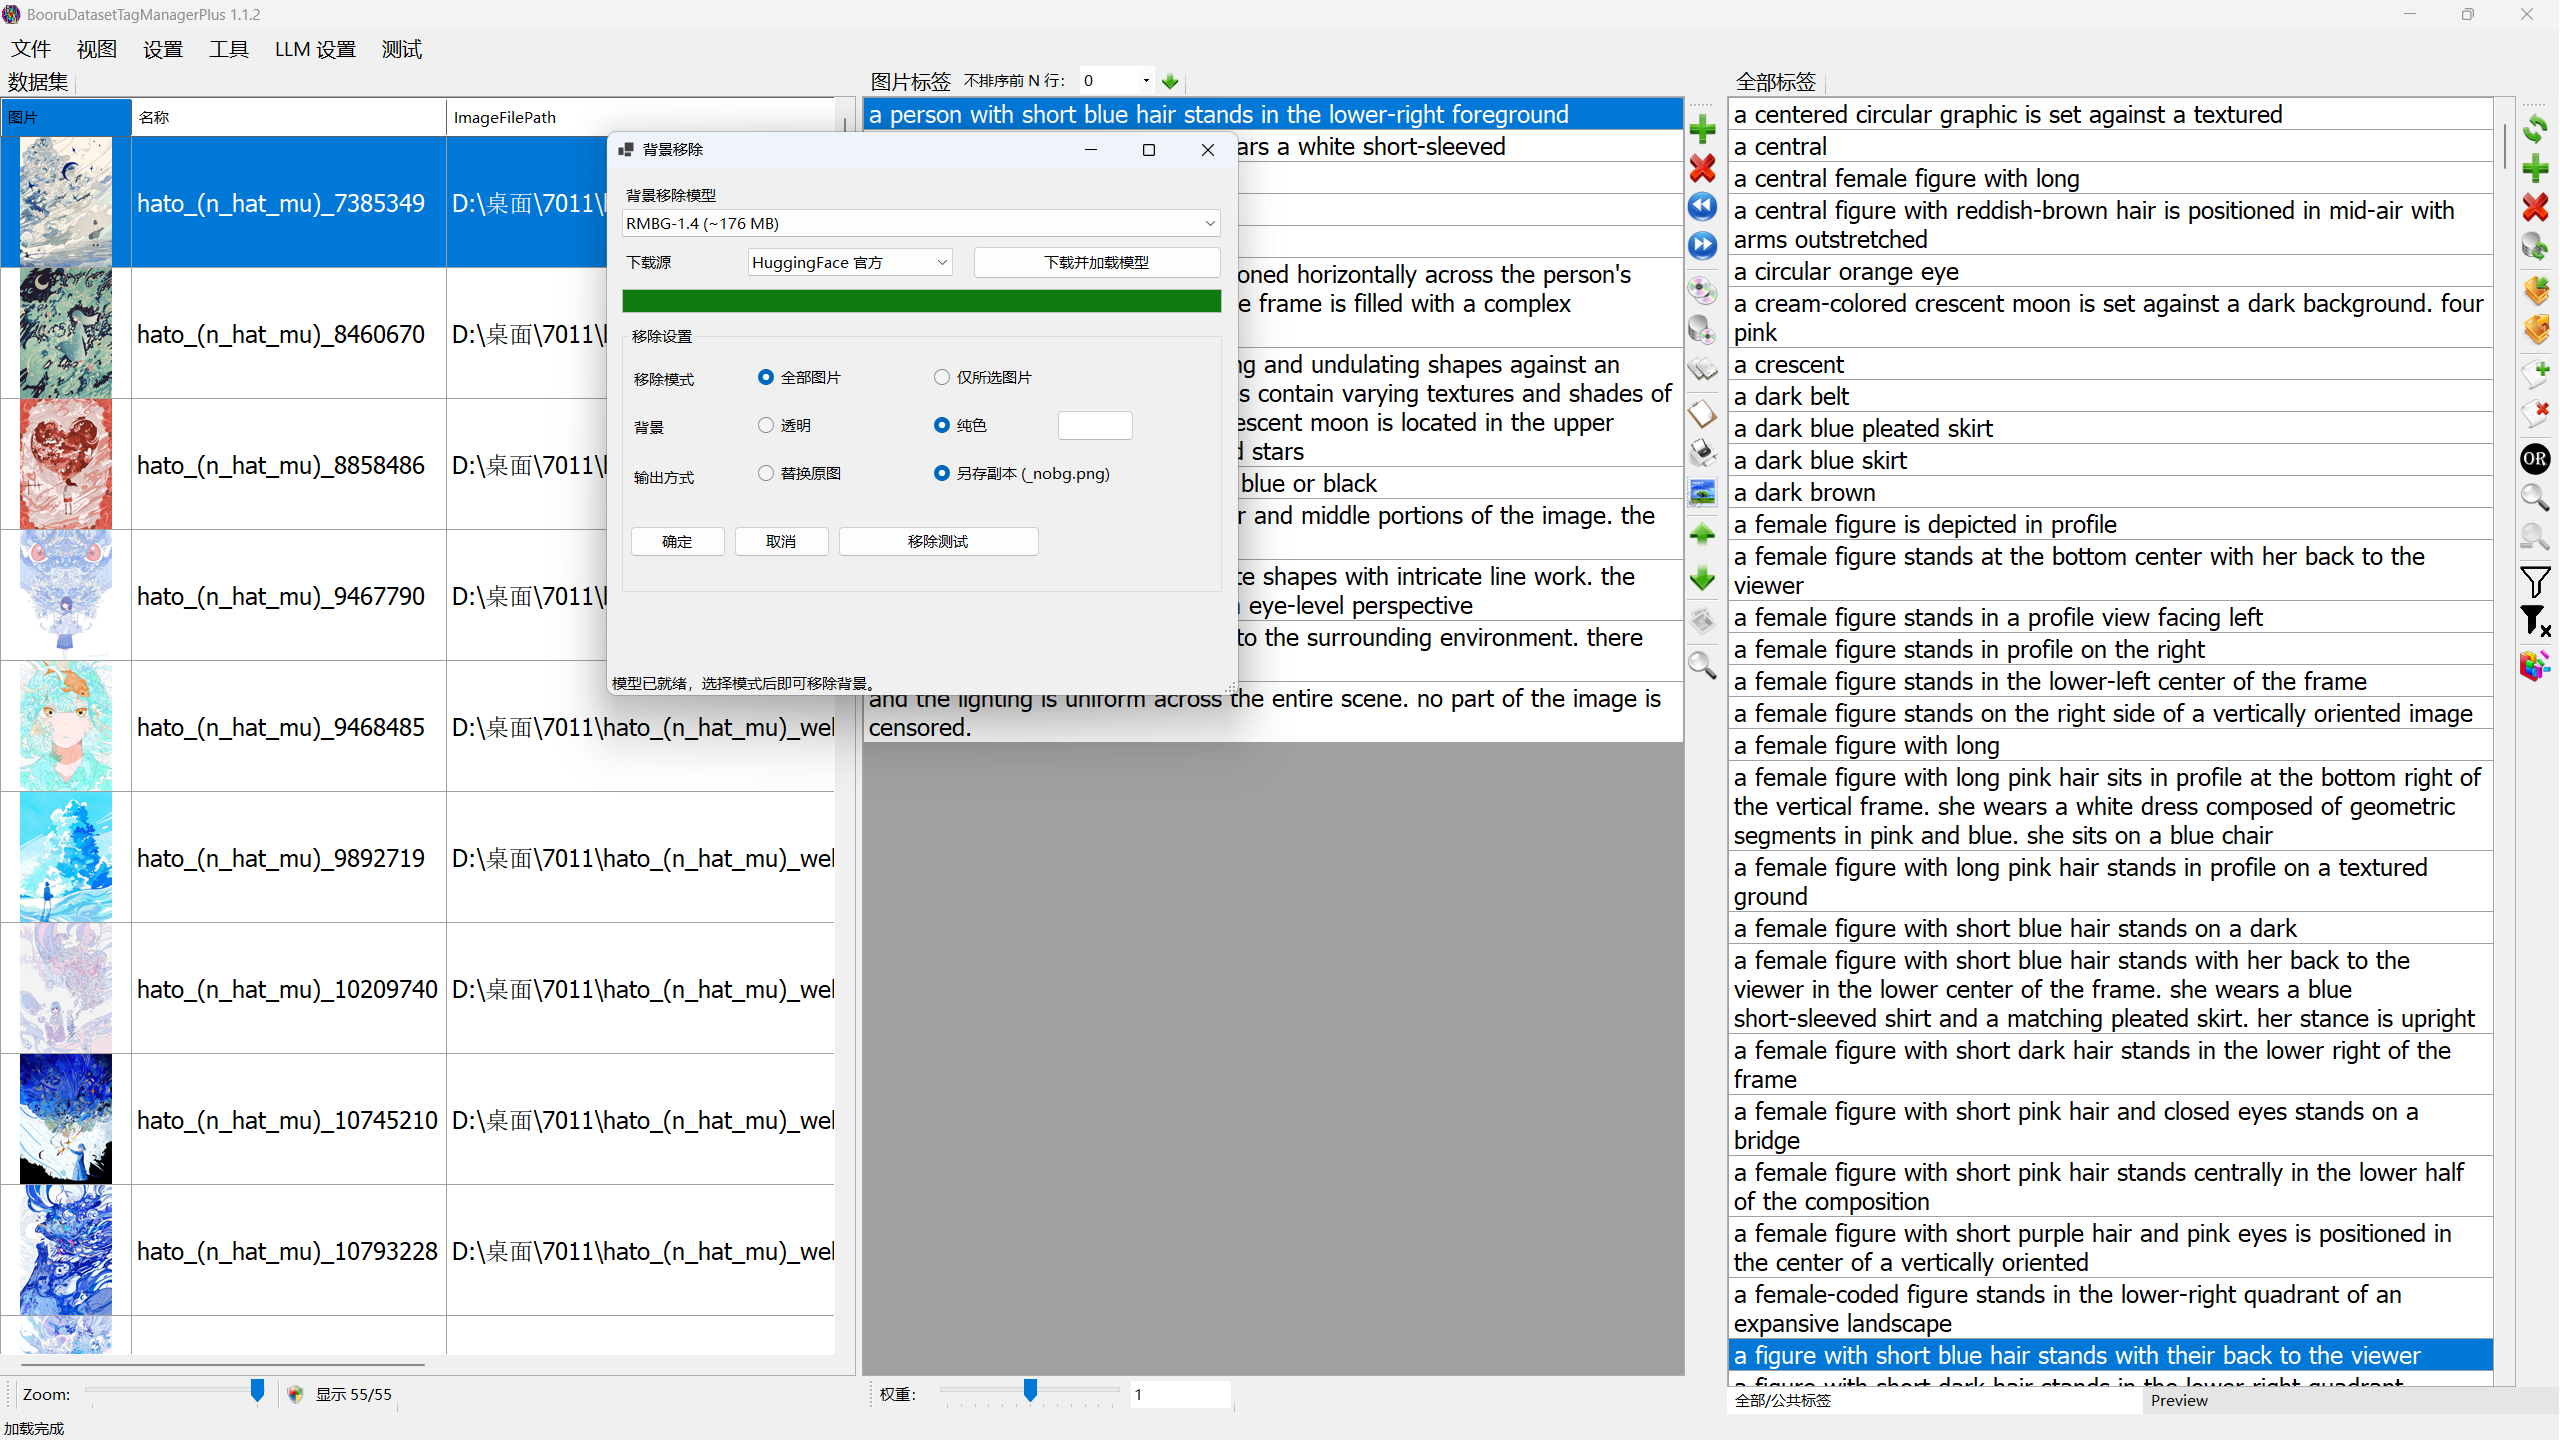
- 范围:全部图片或仅所选;背景:透明或纯色(默认白,带取色器);「移除测试」可先对单张预览
- 输出:替换原图或另存
_nobg.png副本(选项记忆);完成后自动刷新缩略图或导入副本
图片编辑器
入口:数据集右键 编辑图片。仿 Photoshop 布局:左侧紧凑工具箱、顶部选项栏、底部状态栏。
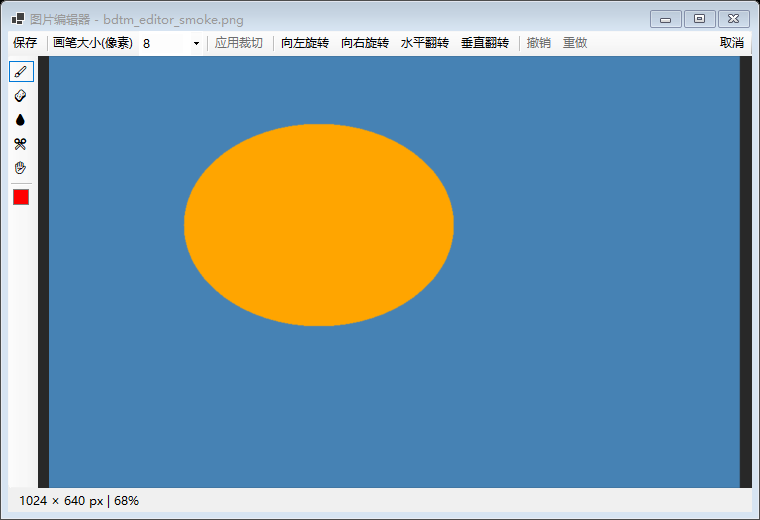
- 快捷键与 PS 一致:B 画笔、E 橡皮擦、I 吸管、C 裁切、H 抓手(或按住空格)、
[/]笔刷大小、Alt+点击 临时取色、滚轮以光标为中心缩放、Ctrl+0 适应窗口、Ctrl+1 100%、Ctrl+Z / Ctrl+Shift+Z / Ctrl+Y 撤销重做(整笔一步,最多 15 步)、Enter 应用裁切、Ctrl+S 保存 - 保存可覆盖原图(原子写,失败不损坏原文件)或另存
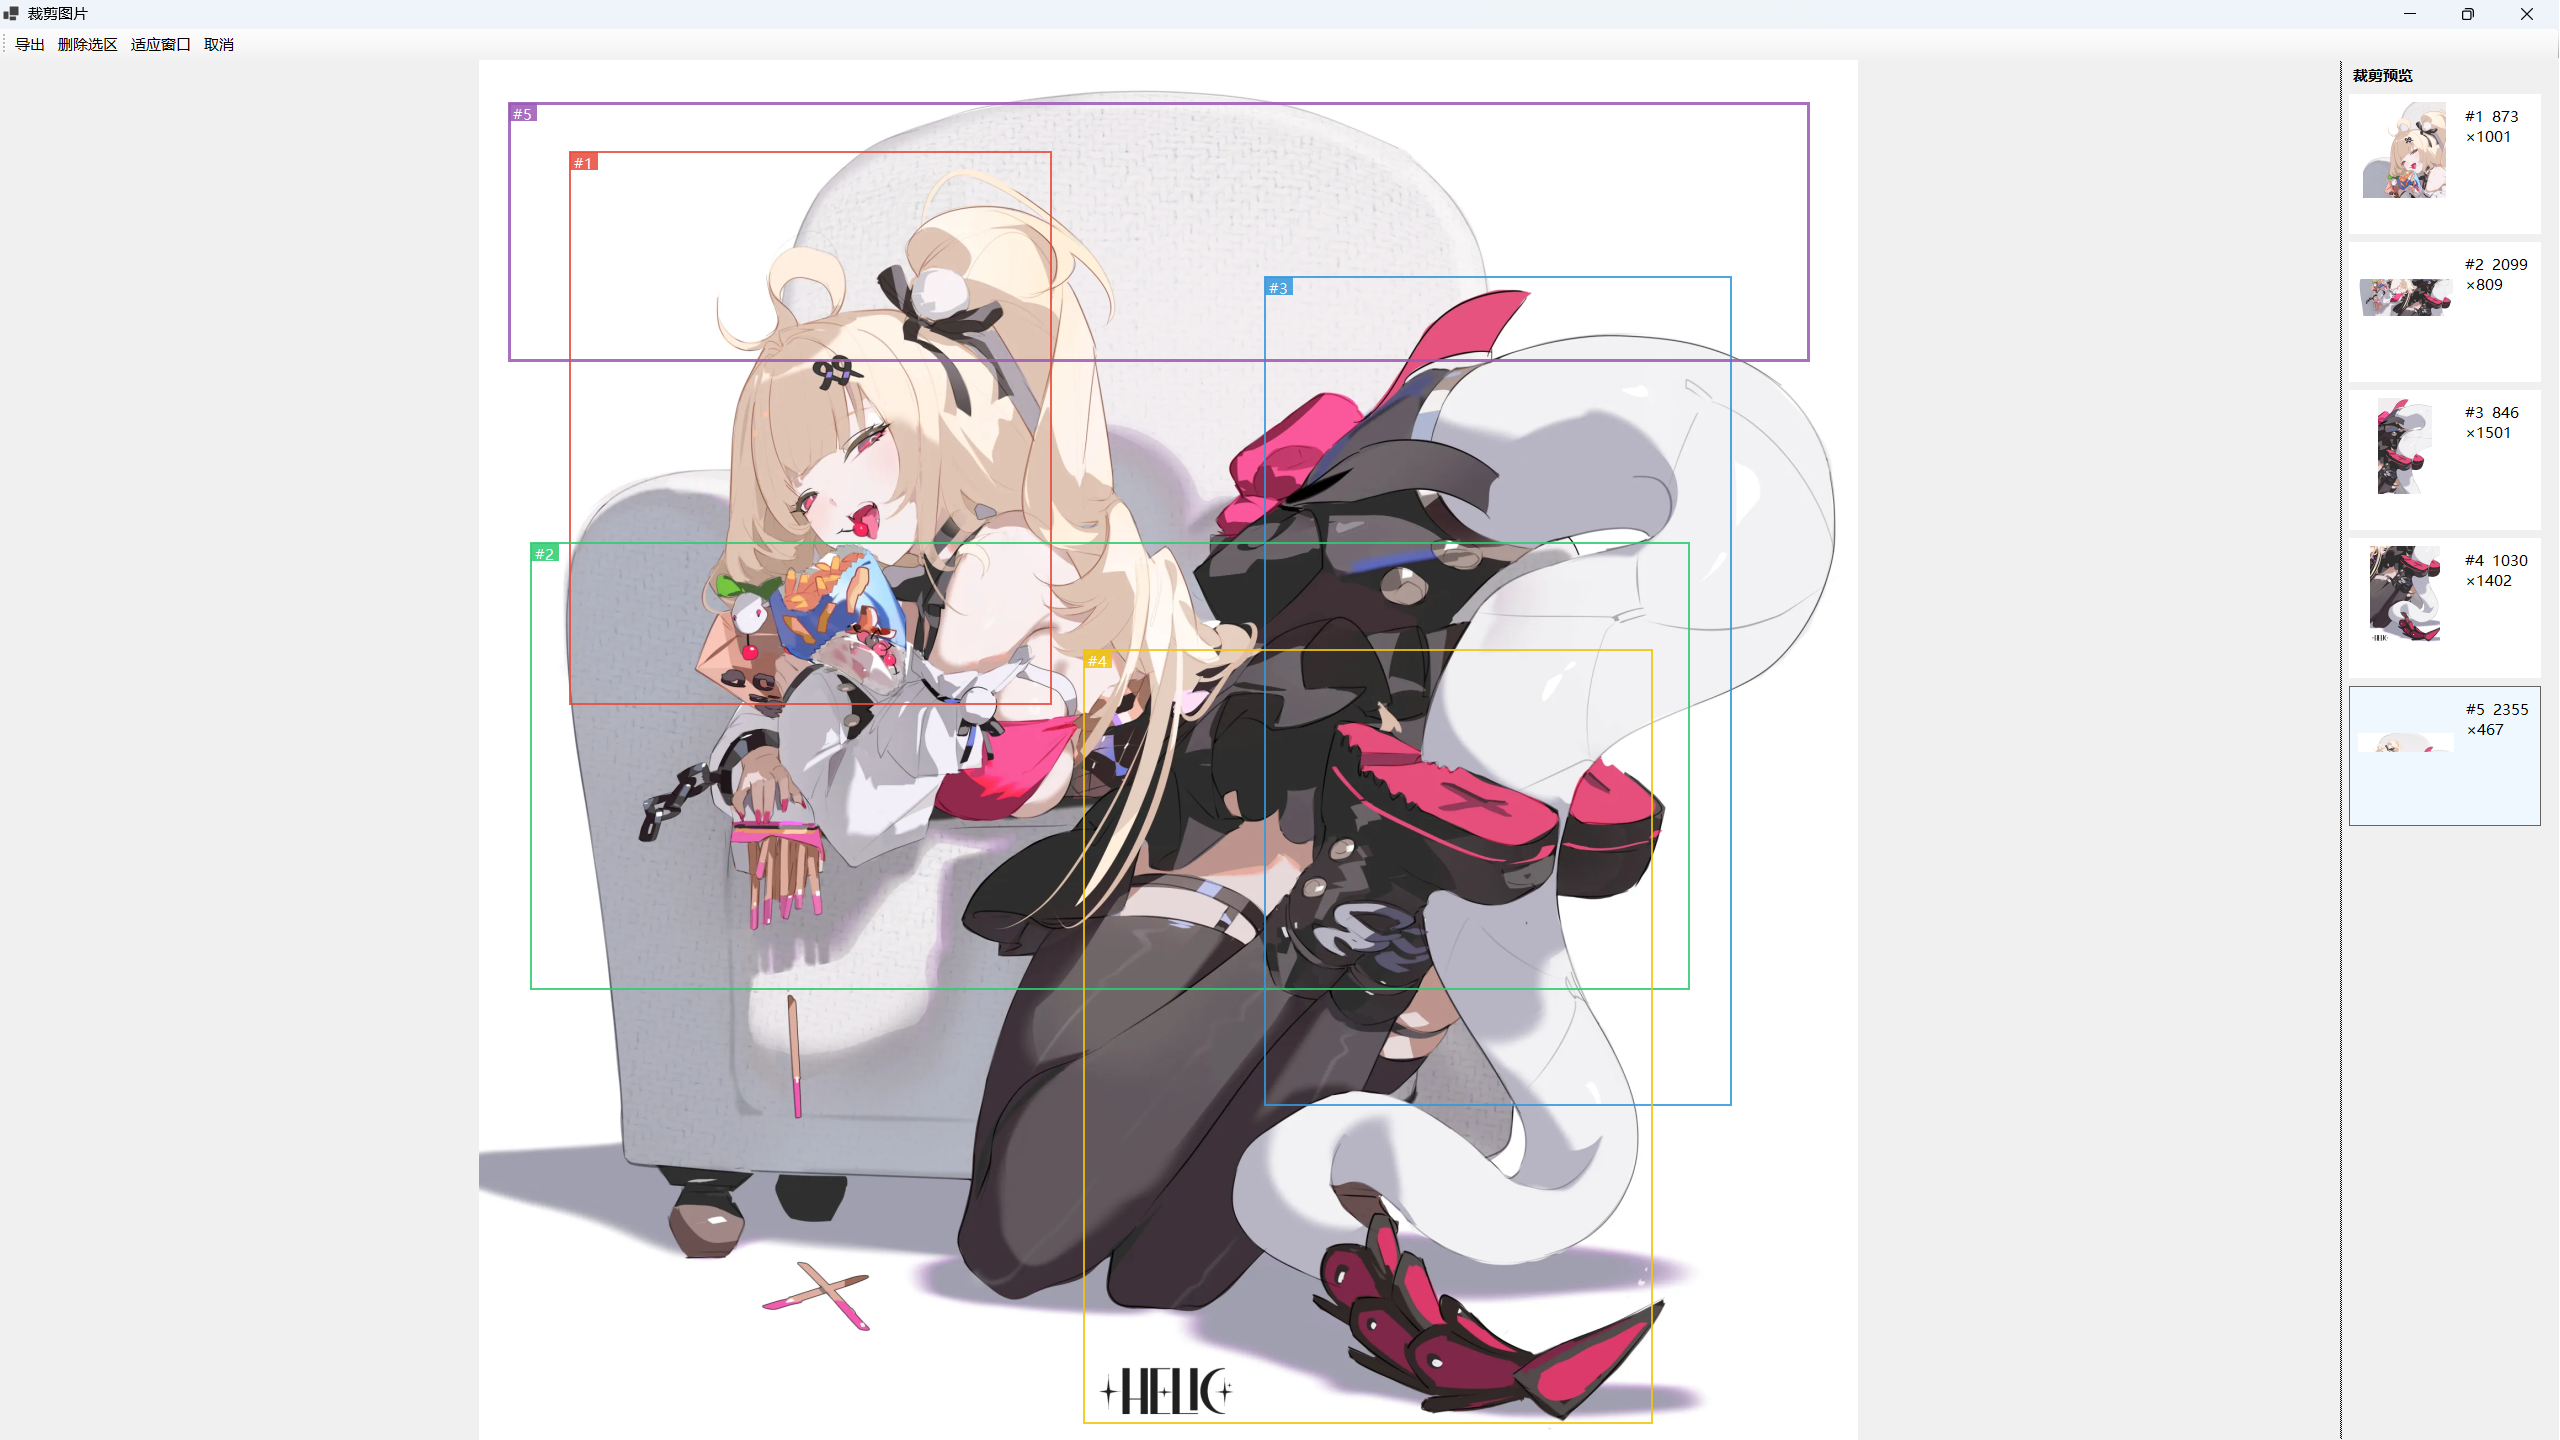
_edit副本(自动克隆同名标签文件并导入数据集);默认方式在 设置 → 界面 选择 - 另有数据集右键 裁剪图片:一次画多个选区,导出同目录
_r1/_r2…并自动导入数据集 - 批量裁剪:数据集右键或 工具 → 批量裁剪;在参考图上自由框选(可锁 1:1 / 2:3 / 16:9 等比例,也可自定义),同一分辨率的图片共用这个选区;可覆盖原图或另存
_crop副本(标签文件一并复制)
多重切割工具
入口:数据集右键、文件夹组头右键,或 工具 → 多重切割…。不必先点一张图:来源可选 选中的图片 / 当前文件夹 / 全部图片。窗口左侧预览第一张来源图的切割框(YOLO 模式不在此跑检测)。把大图按训练档位压缩或切到指定比例,尽量留住高频细节;原图始终保留,每个勾选档位各出一份新文件并复制标签后导入数据集。
- 仅等比例压缩:保持原图比例,把长边压到勾选档位
- 居中裁切到比例:先按 1:1 / 2:3 / 16:9 等取图内最大居中矩形,再压到档位
- 切片分割到比例:在原图像素空间铺档位大小的窗口(末行/末列贴边吃掉余量),能切就不降采样
- 随机位置切割:每张切 N 块(默认 1,最多 32),比例矩形在可滑动范围内随机落点,再压到档位
- YOLO 检测:下拉选择 deepghs 动漫检测器——全身 Person(v1.1 n/s/m、v1.2 s、v1.3 s,默认 v1.1 small)、脸 Face(v1.3 s、v1.4 n/s)、头 Head(v1.6 s、v2.0 n/s);均为 MIT、非 gated 的 YOLOv8 ONNX。按检测框中心扩成选定比例后压档;扩比例后长边仍小于勾选档位时,按 64 对齐的原尺寸写出,不再整批当成「没有检测到目标」;对齐后不足 64px 或完全未检出才跳过。也可导入自己的 YOLOv8 ONNX;下载源与 Tag 推标 共用(HuggingFace / hf-mirror)
- 档位默认 512 / 768 / 896 / 1024 / 1280 / 1536,可多选,也可自定义 64–8192(向下对齐到 64);Lanczos 缩小且不放大;已经小于该档的图会跳过
- 另有 工具 → YOLO 检测…:单独开窗画检测框、勾选保留,可选 在 Tag 推标中打开 给保留的切图打标,再导出切图;同样有模型下拉、下载源和「下载模型」。画面比例默认 自动(按每张图宽高就近匹配 1:1 / 2:3 / 16:9 等预设),也可锁定某一比例
预分桶
入口:数据集右键、文件夹组头右键,或 工具 → 预分桶…。来源为当前文件夹或全部图片。按分辨率 / 最小·最大边 / 划分单位算出桶,把每张图等比例放入、四周加白边扩到该桶的精确宽高,写出到当前数据集下的 {宽}x{高} 文件夹。标签文件一并复制;写完后删除已分出的原图和已空的原文件夹。
- 为什么要预分桶:训练器按分辨率分桶后,每个桶都要凑满 batch,桶一多实际步数会明显高于理论值。提前把图画到更少的固定分辨率上,训练时桶数就是你定好的那些
- 分桶设置:分辨率(默认 1536×1536)、最小 / 最大边、划分单位(通常 64)。「不放大(只加白边)」默认开启,小图只垫白边、不拉伸
- 目标桶数:可填数量,或一键 4 / 8 / 12 / 16。填 0 = 按宽高比各成一桶;填 N 则把相近比例合并到 N 个文件夹
- 配平:按当前批次把每桶补到能整除,列里只显示多复制了几张(23 + 批次 5 → +2,总数 25)。不按批次 × Gradient 去补
- 步数估算:按重复 / 批次 / Gradient / Epochs 估算理论步数和分桶后的实际步数。Gradient 只影响优化器步数:批次 2、Gradient 2 时等效 BS=4,但每次仍读 2 张
视频处理
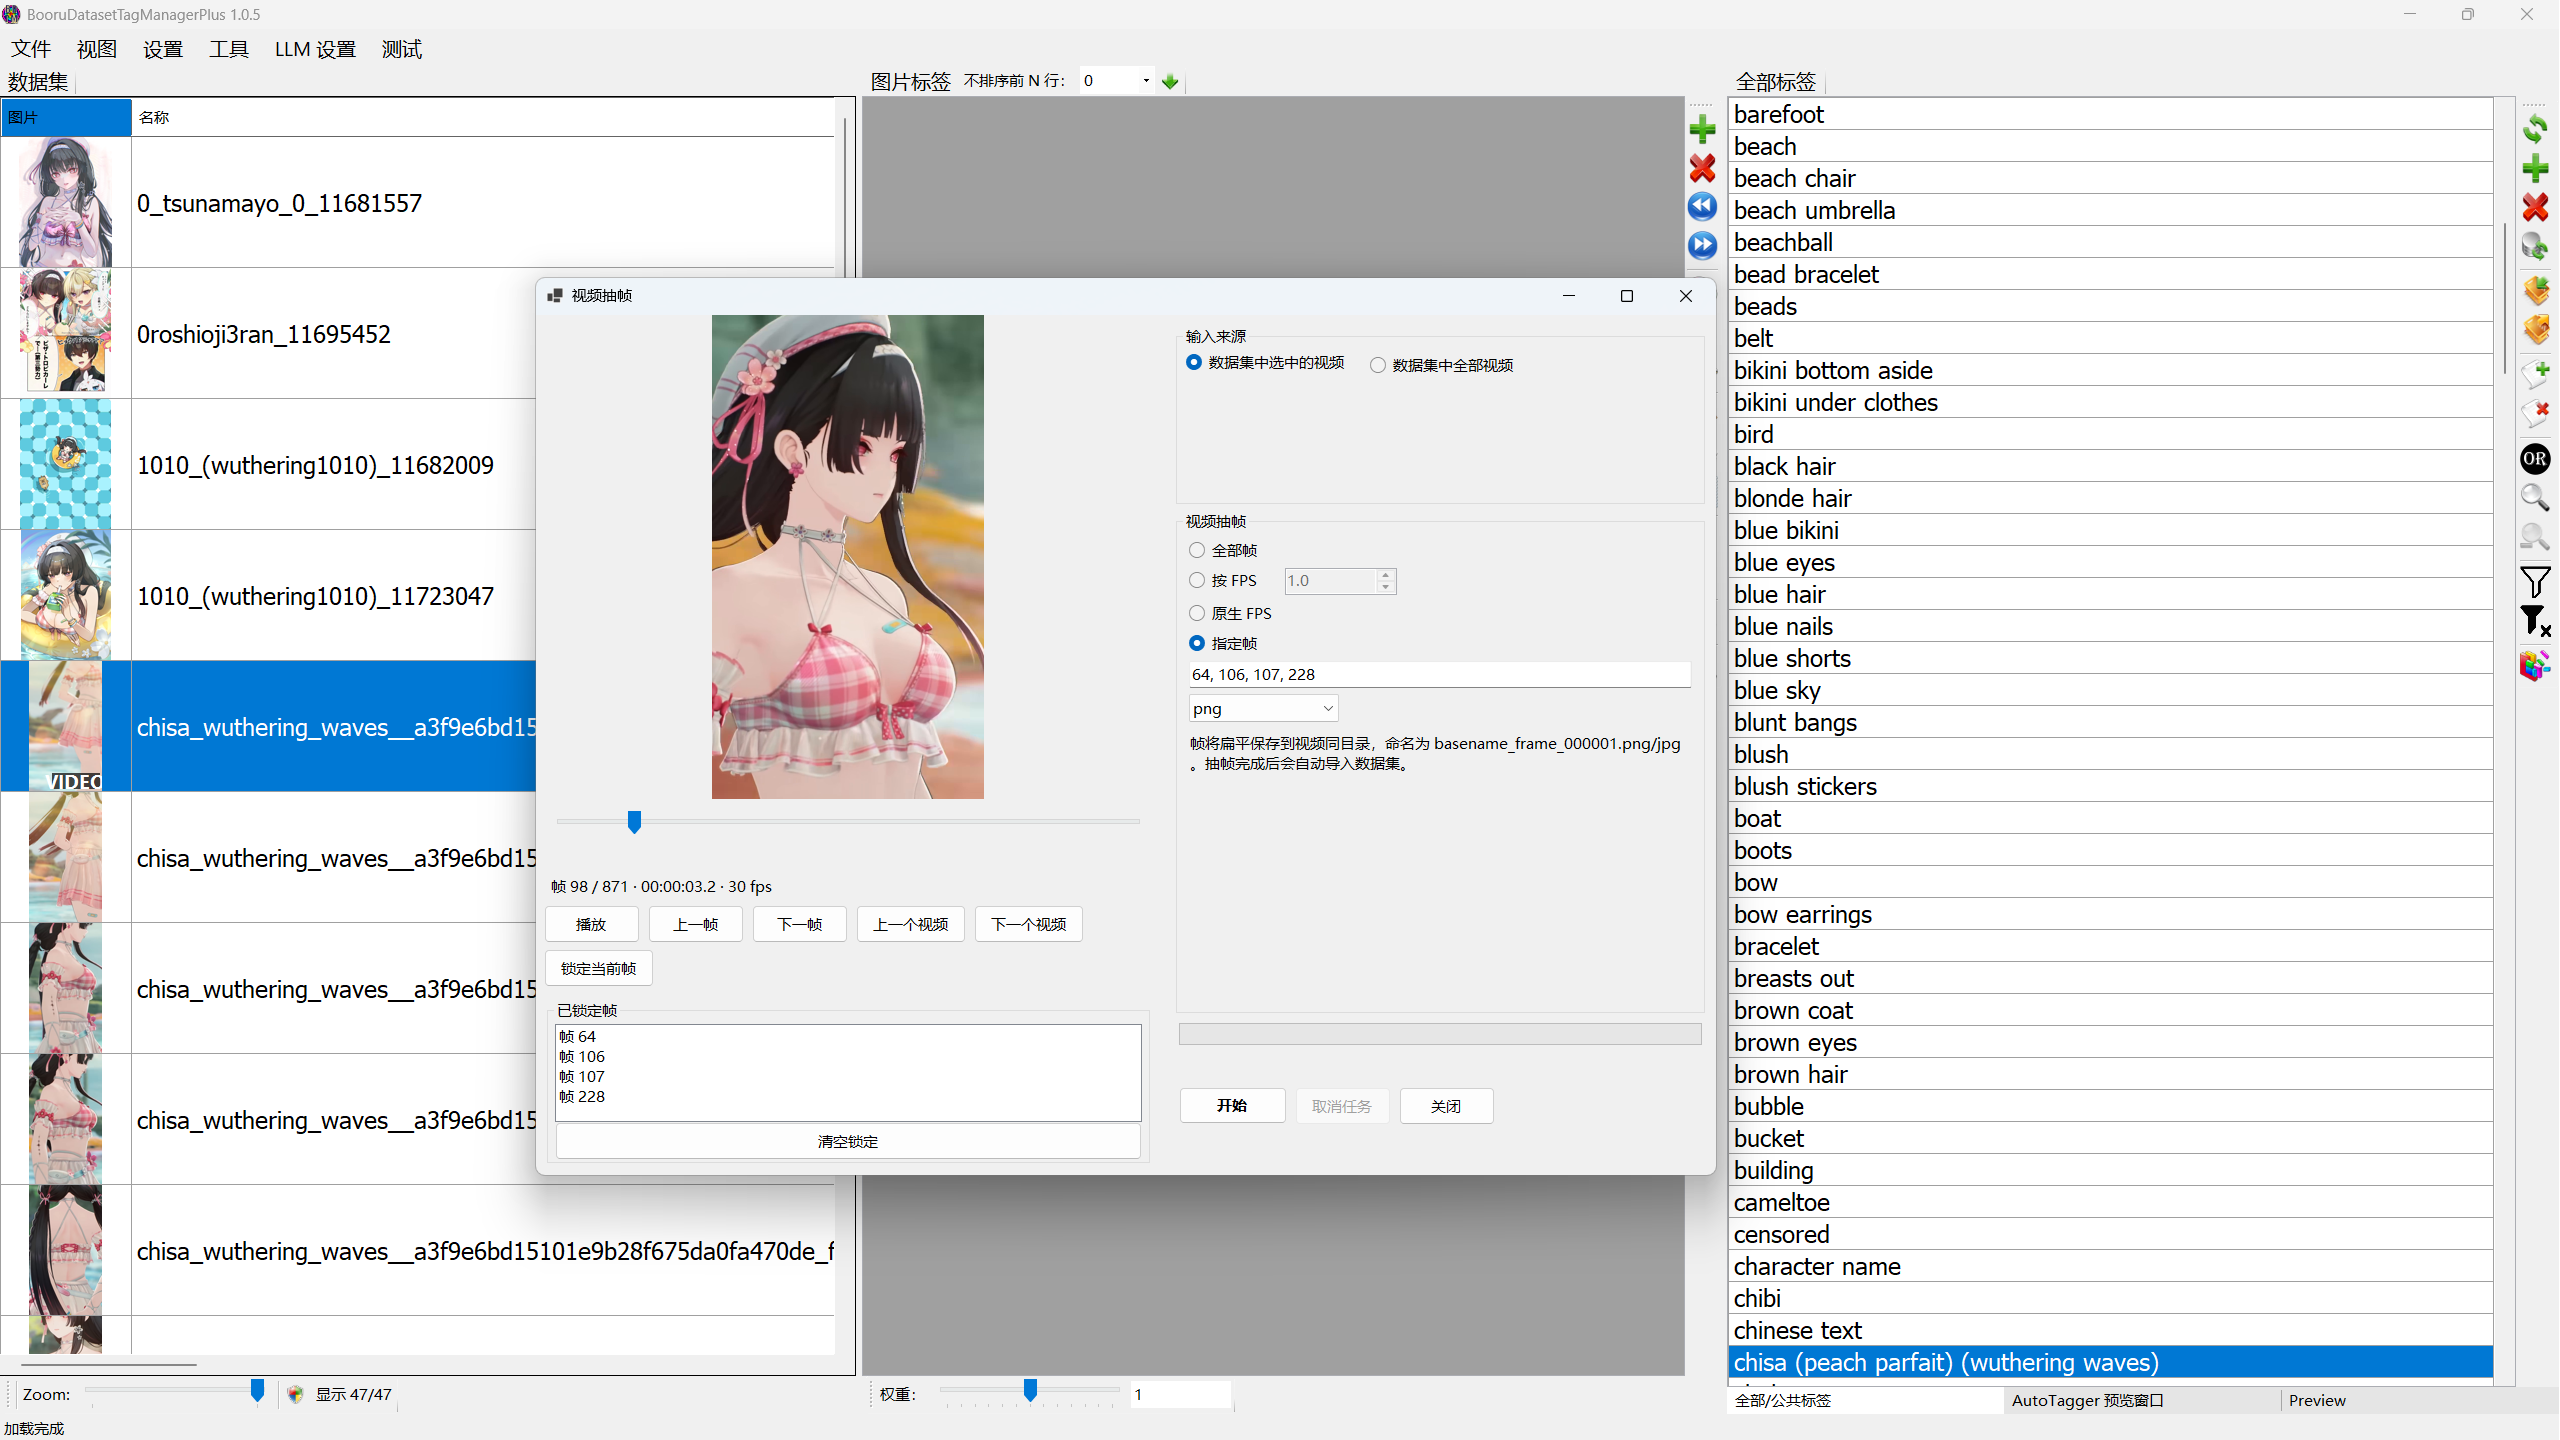
工具 → 视频格式转换… / 视频抽帧…。mp4 / mkv / avi / webm / mov / flv 互转(可替换原文件);全部帧 / 按 FPS / 原生 FPS / 指定帧号 / 随机百分比抽帧(分布抽帧或区域抽帧,滑条默认 10%),带预览与锁定帧流程;结果自动导入数据集。Release 包内置 FFmpeg。
多选标签校对
多选图片后按 Shift+T 打开可视化编辑器:左侧标签列表(含出现次数、按频次排序)点击切换校对目标;绿框 = 已有该标签,红框 = 没有,点击图片上的 是/否 即可增删;跨标签修改一次「保存」统一生效。

按标签分类到文件夹
入口:工具 → 按标签分类到文件夹…。勾选若干标签,确认后把同时带齐这些标签的图片移动到数据集根下的一个新文件夹,.txt / .caption 一起走。
- 怎么分:必须同时拥有全部勾选标签才移动;缺任何一个的留在原位
- 文件夹名:可自己填写;留空则为
Mix。已有同名文件夹时自动变成Mix_2、Mix_3 - 范围:可选全部图片或当前文件夹。列表可搜索,右侧预览将移入多少张
- 改名:分类后组头 F2 或 双击(或右键重命名)即可改成 kohya 风格名称,例如
10_miku
相似图片筛选
入口:工具 → 查找相似图片…。参考 czkawka 的感知哈希方案(dHash + 汉明距离),直接用内存中的缩略图计算,数千张图秒级完成;选中某个文件夹时只扫描该范围,视频自动跳过。
- 相似度四档(极高 / 高 / 中 / 低),结果按组展示;绿框 = 保留,红框 = 待删除,左键切换,右键查看原图,悬停显示文件名与大小,滑块调缩略图尺寸
- 每组保留一张(最大文件) 一键把其余标记为待删除(czkawka 同款默认策略),也可手动逐张调整
- 删除标红图片 走与主界面相同的事务化删除(图片与标签文件一起暂存-删除,失败自动恢复),完成后自动重新扫描
扫描坏图
入口:工具 → 扫描坏图…。在当前数据集(含文件夹范围)内逐张尝试解码,找出损坏、空文件或已缺失的图片;视频自动跳过。
- 结果以审查墙展示;绿框 = 保留,红框 = 待删除(默认全部标红),左键切换,悬停显示文件名与损坏原因,滑块调缩略图尺寸
- 删除标红图片 走与主界面相同的事务化删除,完成后自动重新扫描
替换透明背景
入口:工具 → 替换透明背景(选中图片);数据集浏览器文件夹组头右键 → 替换透明背景(当前文件夹) / 替换透明背景(全部图片)。把透明底填成指定纯色、随机色,或从自建颜色列表里随机取色。
- 先扫描再替换:先按扩展名筛出能带 alpha 的格式(PNG / WebP / GIF),再逐张解码确认真的有透明像素;JPG 等无 alpha 格式与整张不透明的 PNG / WebP 一律跳过,不会被重新编码
- 解码走 ImageSharp(
ImageLoader),编码按目标扩展名走ImageEditorSaveService,WebP / TIFF / GIF 都能正常读写(旧版对 WebP 会报「Out of Memory」) - 文件夹右键处理右键点中的文件夹(多选时为这几个文件夹的并集),「全部图片」处理整个数据集;确认框写明「将替换 N 张(已检查 M 张)」,扫描与替换过程状态栏都有进度;视频自动跳过
- 覆盖写入走原子替换,中途失败不会毁掉原图;单张失败只汇总报错,不中断整批
错误标签修复
入口:测试功能 菜单窗口的「错误标签修复」分组。扫描当前数据集(或选中的文件夹范围),把矛盾标签整理成「图片 / 移除 / 保留 / 原因」预览表,确认后一键应用——应用为普通编辑,可逐图撤销,不会自动写盘。
- 人数标签冲突:
1boy与2boys并存删低留高(同性别保留最大人数);多人图中的solo一并清除,含义不同的solo focus永不误伤 - 角色父子 / 变体重复(测试模块可勾选,默认开启):同一角色家族的多个标签同图出现时按数据集出现量投票保留胜者;家族判定用角色表内置的真实父子关系(
racing miku↔hatsune miku这类改名变体也能配对,同名不同人不会误合并)。不需要改角色名时取消勾选,人数冲突与solo仍会处理 - 子级并入父级(角色类修复开启时可勾选,默认关闭):勾选后,子级变体在数据集中出现次数低于阈值(默认 30)时不被信任,自动并入父级标签——零散小变体合流到主标签,训练特征更集中。关闭角色类修复时此项自动关掉。预览表可逐条勾选要改的行。
命令行(CLI)
BooruDatasetTagManagerPlus.exe 本身就是命令行工具:第一个参数是已知命令时无窗口运行(输出可重定向,退出码 0/1/2 = 成功/运行错误/用法错误),否则照常打开界面。help 查看全部用法:
- 数据集操作:
stats统计;list-images/list-tags/classify-tags查询(按标签、一二级类别、次数过滤;--category可写「头发」或Hair,头发/发色筛二级);add-tags/remove-tags/replace-tag批量改标(条件筛选、--dry-run预演);export导出 JSON fix-tags:错误标签修复的命令行版,--no-character-variants跳过角色类替换,--child-threshold调信任阈值(默认 0 关闭;与--no-character-variants同时使用无效)、--catalog指定自定义关系表onnx-models/onnx-tag:Tag 推标 的命令行版(本地 ONNX)——列出 / 自动下载模型(受限模型支持--hf-token),阈值与写入模式与界面同语义,「跳过已有」在推理前过滤。OppaiOracle 示例:onnx-tag --model oo:Grio43/OppaiOracle:v1.1。动词名未改,与旧脚本兼容audit:LLM 角色标签审查——沿用界面保存的 API 配置与审查提示词,两阶段审查后事务化写回,--report输出 JSON 报告,--dry-run只看决策- 所有写盘走原子替换;标签格式(逗号分隔、小写去重)与界面一致,可与手工编辑混用
数据与隐私
- LLM 打标与角色标签审查会把图片发送到你配置的端点;Tag 推标、背景移除与视频处理全部在本机完成
- 配置文件
settings.json(界面偏好 + LLM/API,密钥 DPAPI 加密)写在「文档\BooruDatasetTagManagerPlus」;设置 → 常规 显示实际路径。换 Debug / Release /dist会读同一份;文档里还没有时整份复制程序目录旧文件(含.bak);文档里已有空配置、但程序目录仍能识别到旧 API 时,只把端点 / 密钥 / 站点配置迁过去,不覆盖界面偏好,也不删旧文件。换电脑仍需重填密钥 - 标签保存为原子写,批量图片操作先写临时文件、成功后才替换;删除经暂存目录两段执行,中途失败会自动恢复。注意:视频转换勾选"替换原文件"时,转换成功后会删除源视频
- 「设置 → 常规」可启用调试模式(默认关闭):开启后菜单栏出现 Debug 菜单,运行信息与异常会记录到程序目录的
debug.log(菜单内可一键打开),便于反馈问题时附上日志
致谢与许可
- starik222 — BooruDatasetTagManager 原作者,本项目在其基础上开发
- FFmpeg — 视频处理(GPL 组件,随 Release 打包)
- 本项目遵循 MIT License;分发修改版构建时请保留原作者版权声明
Similar repos


Windows tag editor for LoRA / character image datasets: booru tag editing with Chinese UI & translation, WD14/PixAI/CL ONNX auto-tagging, LLM captioning, AI character-tag audit (dual-character support), RMBG background removal, image editor, video frame extraction. Fork of starik222/BooruDatasetTagManager.
C#
18
29 commits
updated Oct 2, 2026
README
BooruDatasetTagManager+ 1.2.7
面向 LoRA / 角色数据集的 Windows 打标工具,fork 自 starik222/BooruDatasetTagManager。
每张图配一个同名 .txt 存放标签,加载文件夹就能改。也能用 LLM 或本地 Tag 推标(原名 ONNX 推标;引擎是 WD14 / PixAI / CL / OppaiOracle)自动打标,并做角色审查、用中文搜标签。界面默认简体中文。MIT License。
更新日志
- 1.2.7(当前)— Tag 推标接入 OppaiOracle(V1 320 / V1.1 448,约 1.9 万 general 标签,不含角色,非 gated);修复多重切割 YOLO 把过小检测框误报成「没有检测到目标」;角色审查改为逐标签流程,视觉阶段点名待上色标签与同槽位簇,并新增定向解析请求(每角色最多 3 次),复核网格同簇着色。发布说明
- 1.2.6 — ONNX 推标改名 Tag 推标(工具菜单、窗口标题、右键;引擎仍是本地 ONNX);错误标签修复可关闭角色类替换;YOLO 检测比例可按图自动识别;图片标签恢复 Shift / Ctrl 多选;Win10 上原生库加载失败与大批量推标内存峰值已加固。其余多为界面与流程优化:工具菜单分段、快速替换独立窗口、预分桶按批次配平与 Gradient、若干窗口说明与布局收紧。发布说明
- 1.2.5 — 新增批量裁剪、多重切割、YOLO 检测、预分桶、标签一二级筛选、按标签分类到文件夹;配置改存用户文档。修复 ONNX 下载误删模型、翻译卡住。发布说明
- 1.2.4 — 修复 WD14 错色标签、超长文件名无法保存、多人审查下拉不同步;ONNX 按置信度排序;随机百分比抽帧;数据集可按文件类型排序。发布说明
- 1.2.3 — 扫描坏图;透明背景可按文件夹 / 全部批量替换;修复标签筛选「点 NOT 得 OR」;密钥与路径安全加固。发布说明
- 1.2.2 — 相似图筛选、多角色审查(最多 4 人)、类别筛选、平铺视图、错误标签修复、命令行 CLI、F5 重载数据集;修复「跳过已有标签」白扣费。发布说明
- 1.2.1 — 移除 Python 后端;文件夹可多选筛选;审查失败可只重试未完成角色;首载更快、安全加固。发布说明
- 1.2.0 — 文件夹分组浏览器与内嵌预览;标签按类别着色 / 排序;内置 Danbooru 角色名单。发布说明
- 1.1.3 — 图片编辑器、CL 系列 ONNX、中文字典搜索;保存失败不丢编辑等 I/O 加固。发布说明
- 1.1.2 — 统一 LLM 打标窗口;本地 RMBG 抠图;崩溃兜底与密钥加密。发布说明
- 1.1.1 — 角色审查保存加速;统一裁剪图片对话框。发布说明
- 1.1 — WD14 全系列、按模型记阈值、PixAI 修复。发布说明
- 1.0.5 — 统一 ONNX 推标、视频工具。发布说明
快速开始
从 Releases 下载 BooruDatasetTagManagerPlus-*-win-x64.zip,解压后运行 BooruDatasetTagManagerPlus.exe(自包含,无需安装 .NET)。
- 文件 → 加载文件夹;「加载文件夹(自定义选项)…」还可以关闭预览图(大数据集更快)或从图片元数据读取初始标签(适合刚出图、还没写
.txt的数据集);「重新导入当前数据集」(F5)随时从磁盘刷新当前目录 - 直接编辑标签:「全部标签」与「图片标签」搜索框支持中文字典(输入「头发」即可定位 long hair、black hair 等);图片标签可用 Shift / Ctrl 多选后批量删除、复制、改权重;双击「全部标签」行可执行快速操作(默认打开「全部替换」,可在设置更换);遇到生词可开 Danbooru Wiki
- 使用 LLM 功能前,先在 LLM 设置 配置 OpenAI 兼容端点与模型
- 按需打开 工具:处理工具(替换透明背景 / 视频工具 / 背景移除 / 批量裁剪 / 多重切割 / YOLO 检测)、标注工具(Tag 推标 / LLM 打标 / 角色标签审查 / 快速替换)、预处理工具(查找相似图片 / 扫描坏图 / 按标签分类到文件夹 / 预分桶);测试功能 窗口里还有错误标签修复
- 自动化脚本可直接用同一个 exe 的命令行:
BooruDatasetTagManagerPlus.exe help列出全部命令(统计 / 批量改标 / 导出 / fix-tags 修复 / onnx-tag 推标 / audit 审查)
从源码构建
dotnet build BooruDatasetTagManager.sln -c Debug -f net8.0-windows
dotnet test BooruDatasetTagManager.Tests\BooruDatasetTagManager.Tests.csproj
dotnet publish BooruDatasetTagManager\BooruDatasetTagManager.csproj -c Release -f net8.0-windows -r win-x64 --self-contained true -o dist
test_start.bat— 启动 Release(或 Debug)quick_build.bat— 本地快速打包至dist/(首次构建自动下载 FFmpeg)
运行后程序目录会生成 Models/(下载的 ONNX 模型)、Cache/(缓存)。settings.json(API 与偏好设置)保存在「文档\BooruDatasetTagManagerPlus」,换安装目录也能读到同一份;文档里还没有文件时会从程序目录整份复制,若文档里已是空配置而程序目录仍能识别到旧的 API(端点 / 密钥 / 站点配置),则只把这些 API 字段迁过去。均为本地自动生成数据,可随时删除——设置恢复默认,模型可在应用内重新下载。
功能一览
| 类别 | 包含 |
|---|---|
| 打标 | LLM(标签 / 自然语言)· Tag 推标(本地 ONNX:WD14 / PixAI / CL / OppaiOracle)· 角色审查(最多 4 人) |
| 标签 | 中文搜索、类别着色与一二级筛选、错误标签修复、按标签筛图 |
| 图片 | 编辑器、批量裁剪、多重切割(含 YOLO)、预分桶、抠图 / 换透明底 |
| 整理 | 文件夹浏览与预览、按标签分文件夹、按分辨率分桶、相似图、坏图扫描、视频转换 / 抽帧 |
| 命令行 | 同一 exe:统计、批量改标、导出、Tag 推标(onnx-tag)、审查 |
功能详解
数据集浏览与预览
数据集面板是一个统一浏览器:顶部搜索框同时过滤文件夹与文件名;kohya 重复文件夹显示为可折叠分组(多文件夹默认全部折叠,搜索框右侧有全部展开 / 全部折叠、平铺视图与排序按钮;平铺开启时忽略文件夹分组、把当前范围与筛选结果摊平为一列),点击文件夹名即可把数据集范围限定到该文件夹(全部标签计数、批量操作与审查向导同步跟随);图片行显示缩略图、文件名与「格式 · 像素 · 大小」,选择操作与文件管理器一致(Ctrl / Shift / Ctrl+A / 方向键 / 右键菜单 / Delete)。
- 排序:搜索框右侧按钮可按文件名、类型或修改时间排列。类型按扩展名分组(jpg / jpeg 一类,png、webp、mp4、webm 等各自一类,视频与图片同一规则),同类内仍按文件名;选择会记住
- 文件夹右键:重命名文件夹(磁盘与内存同步改名,未保存的编辑不丢失);组头也可 F2 或 双击 改名;批量重命名图片(前缀 + 数字 / 字母 / 保留原名 + 后缀,实时预览,
.txt同步改名);Tag 推标此文件夹 / LLM 打标此文件夹 - 内嵌预览:数据集底部可折叠预览面板(视图 → 显示预览,状态记忆);多选时并排显示前 4 张,双击任一格在独立窗口打开;独立预览窗支持光标缩放、拖拽平移、双击适应 ↔ 100%、Ctrl+0 / Ctrl+1
- 标签着色与类别排序:两个标签面板按通用标签一级着色并分组(头发 / 服装 / 角色…);图片标签工具栏的「类别排序」是记忆开关:勾选后每张选中图自动按一级排序(遵守「不排序前 N 行」),状态持久保存;全部标签面板的类别排序默认关闭,可在其工具栏勾选
- 类别筛选:两个面板各有一个左右两栏菜单。左侧勾选一级即筛整个大类;悬停后右侧列出二级,可多选、可搜索。与文字搜索、次数过滤叠加
- 通用标签目录:约 10 万条 Danbooru 通用标签(
Data/danbooru_dataset_general.csv)带一二级分类,启动时加载;long_hair与long hair都能对上。查不到的标签进「一般」 - 角色名单:内置约 33 万条 Danbooru 角色标签(
Data/danbooru_character_tags.csv,含约 2.6 万条真实父子关系),角色标签精确识别着色,翻译显示为「译名 (作品)」;可在 设置 → 翻译 关闭。CSV 不含角色名,角色类仍靠这份表 / Danbooru 类型列
工具菜单
工具 是一段平铺下拉,用淡色底栏分成三类(标题不可点,混色方式与标签类别着色相同,浅色 / 深色主题都能看清):
- 处理工具:替换透明背景、视频格式转换、视频抽帧、背景移除、批量裁剪、多重切割、YOLO 检测
- 标注工具:Tag 推标、LLM 打标、角色标签审查、快速替换
- 预处理工具:查找相似图片、扫描坏图、按标签分类到文件夹、预分桶
错误标签修复仍在顶栏 测试功能 窗口;角色标签审查在标注工具和该窗口都能打开。
LLM 打标
入口:工具 → LLM 打标…、数据集右键,或标签工具栏「自动生成标签」。使用前先在 LLM 设置 配置 OpenAI 兼容端点、文本 / 视觉模型与全局 LLM 并发(默认 5,范围 1–100)。
- 标签模式:图片 → 标签,按写入模式(全部替换 / 追加 / 跳过已有)直接写回数据集,支持排序、前后缀与下划线后处理;提示词模板内置 4 套(Danbooru Tag / 自然语言 / 混合模式 / 自然语言2),可自定义并导出 JSON(不含凭据)
- 标签→自然语言模式(原 TAG2NL):标签 + 图片 → 自然语言描述;输出格式可选 标签+自然语言 / 仅自然语言;默认另存副本到
数据集目录_captioned/(源.txt只读、可跳过已有),也可就地写回原图.txt - 无标注时先用 Tag 推标:勾选后,对没有标签的图片先走 Tag 推标(同一套本地 ONNX 模型),再交给 LLM 生成描述——标签→自然语言的自动流水线
角色标签审查
入口:工具 → 角色标签审查…(测试功能 窗口里也有同一入口)。设定锁定触发词(强制保留)、标签方法(少标法只留核心特征 / 全标法保留全部正确细节)、最小出现次数与标准图后,AI 按角色最多发起 3 次请求:文本初筛、视觉复核,再对仍无颜色的穿戴标签与同槽位簇(如 bow / hair ribbon / hairband)做一次定向解析(流程不可回退,改参数请取消后重开)。最后逐条复核(保留 / 删除 / 替换 / 不确定):同簇标签加同色底纹,悬停列出簇成员;替换目标优先用词表内已有标签。预览最终角色提示词后,应用并保存为事务写盘、失败自动回滚。
支持多角色数据集(最多 4 人):主体模式选择 双人 或 多角色 后,为每个角色设定触发词、标准图与性别(留空的角色行自动跳过,因此三人数据集也适用);图片按触发词、再按文件夹自动归属,多人同图自动补齐 2girls、multiple girls 等主体数标签,AI 审查、逐条复核与应用均逐角色进行,某个角色失败时可只重试该角色(已完成角色的结果保留)。
Tag 推标
原名 ONNX 推标。1.2.6 起界面统一为 Tag 推标(英文 Tag tagger):工具 → 标注工具 菜单、推标窗口标题、数据集右键 Tag 重新推标、文件夹右键 Tag 推标此文件夹…。引擎是本机 ONNX(WD14 / PixAI / CL / OppaiOracle),权重仍下到 Models/,命令行动词仍是 onnx-tag / onnx-models。
入口:工具 → Tag 推标…,或数据集右键 Tag 重新推标(自动开始);文件夹右键 Tag 推标此文件夹… 会预选「当前文件夹」来源,确认设置后再开始。
- 模型:WD14 全系列 12 款 + PixAI 0.9 + CL 系列(cl_tagger v1.02、cl_tagger_v2 v2.00 / v2.01a 🔒) + OppaiOracle(V1 320 / V1.1 448,约 1.9 万 general 标签,不含角色,非 gated;该家族隐藏角色阈值,默认阈值 V1 0.55 / V1.1 0.65);各模型阈值与设置独立保存;HuggingFace 官方或镜像下载
- 下载完成后会校验模型;文件被杀毒/索引短暂占用时会重试并保留,不会当成损坏自动删除。缺运行库等环境错误也不会清掉已下完的文件
- cl_tagger_v2 为受限(gated)仓库,作者许可禁止再分发与捆绑分发——软件不附带模型;下载前弹出许可提示,需自行在 HuggingFace 申请访问并填入 Access Token(DPAPI 加密保存),或手动下载放入
Models目录 - 写入模式(全部替换 / 追加 / 跳过已有)、可选排序、下划线→空格、前后缀标签;批量推标带进度条;「跳过已有标签列表」模式在推理前就跳过已有标签的图片,完成时如实报告写入 / 跳过数量
快速替换
入口:工具 → 快速替换…。左侧选规范词、设阈值,右侧预览将并入的同类低频标签,底栏左侧显示当前状态,确认后整库替换。同类按最后一个词判断(black shoes → shoes);出现次数低于阈值才会被换。
背景移除
入口:工具 → 背景移除,或数据集右键 移除背景。内置 RMBG-1.4 ONNX 本地抠图,无需外部服务;首次使用一键下载模型(约 176 MB,或量化版约 44 MB,官方 / 镜像源)。
- 范围:全部图片或仅所选;背景:透明或纯色(默认白,带取色器);「移除测试」可先对单张预览
- 输出:替换原图或另存
_nobg.png副本(选项记忆);完成后自动刷新缩略图或导入副本
图片编辑器
入口:数据集右键 编辑图片。仿 Photoshop 布局:左侧紧凑工具箱、顶部选项栏、底部状态栏。
- 快捷键与 PS 一致:B 画笔、E 橡皮擦、I 吸管、C 裁切、H 抓手(或按住空格)、
[/]笔刷大小、Alt+点击 临时取色、滚轮以光标为中心缩放、Ctrl+0 适应窗口、Ctrl+1 100%、Ctrl+Z / Ctrl+Shift+Z / Ctrl+Y 撤销重做(整笔一步,最多 15 步)、Enter 应用裁切、Ctrl+S 保存 - 保存可覆盖原图(原子写,失败不损坏原文件)或另存
_edit副本(自动克隆同名标签文件并导入数据集);默认方式在 设置 → 界面 选择 - 另有数据集右键 裁剪图片:一次画多个选区,导出同目录
_r1/_r2…并自动导入数据集 - 批量裁剪:数据集右键或 工具 → 批量裁剪;在参考图上自由框选(可锁 1:1 / 2:3 / 16:9 等比例,也可自定义),同一分辨率的图片共用这个选区;可覆盖原图或另存
_crop副本(标签文件一并复制)
多重切割工具
入口:数据集右键、文件夹组头右键,或 工具 → 多重切割…。不必先点一张图:来源可选 选中的图片 / 当前文件夹 / 全部图片。窗口左侧预览第一张来源图的切割框(YOLO 模式不在此跑检测)。把大图按训练档位压缩或切到指定比例,尽量留住高频细节;原图始终保留,每个勾选档位各出一份新文件并复制标签后导入数据集。
- 仅等比例压缩:保持原图比例,把长边压到勾选档位
- 居中裁切到比例:先按 1:1 / 2:3 / 16:9 等取图内最大居中矩形,再压到档位
- 切片分割到比例:在原图像素空间铺档位大小的窗口(末行/末列贴边吃掉余量),能切就不降采样
- 随机位置切割:每张切 N 块(默认 1,最多 32),比例矩形在可滑动范围内随机落点,再压到档位
- YOLO 检测:下拉选择 deepghs 动漫检测器——全身 Person(v1.1 n/s/m、v1.2 s、v1.3 s,默认 v1.1 small)、脸 Face(v1.3 s、v1.4 n/s)、头 Head(v1.6 s、v2.0 n/s);均为 MIT、非 gated 的 YOLOv8 ONNX。按检测框中心扩成选定比例后压档;扩比例后长边仍小于勾选档位时,按 64 对齐的原尺寸写出,不再整批当成「没有检测到目标」;对齐后不足 64px 或完全未检出才跳过。也可导入自己的 YOLOv8 ONNX;下载源与 Tag 推标 共用(HuggingFace / hf-mirror)
- 档位默认 512 / 768 / 896 / 1024 / 1280 / 1536,可多选,也可自定义 64–8192(向下对齐到 64);Lanczos 缩小且不放大;已经小于该档的图会跳过
- 另有 工具 → YOLO 检测…:单独开窗画检测框、勾选保留,可选 在 Tag 推标中打开 给保留的切图打标,再导出切图;同样有模型下拉、下载源和「下载模型」。画面比例默认 自动(按每张图宽高就近匹配 1:1 / 2:3 / 16:9 等预设),也可锁定某一比例
预分桶
入口:数据集右键、文件夹组头右键,或 工具 → 预分桶…。来源为当前文件夹或全部图片。按分辨率 / 最小·最大边 / 划分单位算出桶,把每张图等比例放入、四周加白边扩到该桶的精确宽高,写出到当前数据集下的 {宽}x{高} 文件夹。标签文件一并复制;写完后删除已分出的原图和已空的原文件夹。
- 为什么要预分桶:训练器按分辨率分桶后,每个桶都要凑满 batch,桶一多实际步数会明显高于理论值。提前把图画到更少的固定分辨率上,训练时桶数就是你定好的那些
- 分桶设置:分辨率(默认 1536×1536)、最小 / 最大边、划分单位(通常 64)。「不放大(只加白边)」默认开启,小图只垫白边、不拉伸
- 目标桶数:可填数量,或一键 4 / 8 / 12 / 16。填 0 = 按宽高比各成一桶;填 N 则把相近比例合并到 N 个文件夹
- 配平:按当前批次把每桶补到能整除,列里只显示多复制了几张(23 + 批次 5 → +2,总数 25)。不按批次 × Gradient 去补
- 步数估算:按重复 / 批次 / Gradient / Epochs 估算理论步数和分桶后的实际步数。Gradient 只影响优化器步数:批次 2、Gradient 2 时等效 BS=4,但每次仍读 2 张
视频处理
工具 → 视频格式转换… / 视频抽帧…。mp4 / mkv / avi / webm / mov / flv 互转(可替换原文件);全部帧 / 按 FPS / 原生 FPS / 指定帧号 / 随机百分比抽帧(分布抽帧或区域抽帧,滑条默认 10%),带预览与锁定帧流程;结果自动导入数据集。Release 包内置 FFmpeg。
多选标签校对
多选图片后按 Shift+T 打开可视化编辑器:左侧标签列表(含出现次数、按频次排序)点击切换校对目标;绿框 = 已有该标签,红框 = 没有,点击图片上的 是/否 即可增删;跨标签修改一次「保存」统一生效。
按标签分类到文件夹
入口:工具 → 按标签分类到文件夹…。勾选若干标签,确认后把同时带齐这些标签的图片移动到数据集根下的一个新文件夹,.txt / .caption 一起走。
- 怎么分:必须同时拥有全部勾选标签才移动;缺任何一个的留在原位
- 文件夹名:可自己填写;留空则为
Mix。已有同名文件夹时自动变成Mix_2、Mix_3 - 范围:可选全部图片或当前文件夹。列表可搜索,右侧预览将移入多少张
- 改名:分类后组头 F2 或 双击(或右键重命名)即可改成 kohya 风格名称,例如
10_miku
相似图片筛选
入口:工具 → 查找相似图片…。参考 czkawka 的感知哈希方案(dHash + 汉明距离),直接用内存中的缩略图计算,数千张图秒级完成;选中某个文件夹时只扫描该范围,视频自动跳过。
- 相似度四档(极高 / 高 / 中 / 低),结果按组展示;绿框 = 保留,红框 = 待删除,左键切换,右键查看原图,悬停显示文件名与大小,滑块调缩略图尺寸
- 每组保留一张(最大文件) 一键把其余标记为待删除(czkawka 同款默认策略),也可手动逐张调整
- 删除标红图片 走与主界面相同的事务化删除(图片与标签文件一起暂存-删除,失败自动恢复),完成后自动重新扫描
扫描坏图
入口:工具 → 扫描坏图…。在当前数据集(含文件夹范围)内逐张尝试解码,找出损坏、空文件或已缺失的图片;视频自动跳过。
- 结果以审查墙展示;绿框 = 保留,红框 = 待删除(默认全部标红),左键切换,悬停显示文件名与损坏原因,滑块调缩略图尺寸
- 删除标红图片 走与主界面相同的事务化删除,完成后自动重新扫描
替换透明背景
入口:工具 → 替换透明背景(选中图片);数据集浏览器文件夹组头右键 → 替换透明背景(当前文件夹) / 替换透明背景(全部图片)。把透明底填成指定纯色、随机色,或从自建颜色列表里随机取色。
- 先扫描再替换:先按扩展名筛出能带 alpha 的格式(PNG / WebP / GIF),再逐张解码确认真的有透明像素;JPG 等无 alpha 格式与整张不透明的 PNG / WebP 一律跳过,不会被重新编码
- 解码走 ImageSharp(
ImageLoader),编码按目标扩展名走ImageEditorSaveService,WebP / TIFF / GIF 都能正常读写(旧版对 WebP 会报「Out of Memory」) - 文件夹右键处理右键点中的文件夹(多选时为这几个文件夹的并集),「全部图片」处理整个数据集;确认框写明「将替换 N 张(已检查 M 张)」,扫描与替换过程状态栏都有进度;视频自动跳过
- 覆盖写入走原子替换,中途失败不会毁掉原图;单张失败只汇总报错,不中断整批
错误标签修复
入口:测试功能 菜单窗口的「错误标签修复」分组。扫描当前数据集(或选中的文件夹范围),把矛盾标签整理成「图片 / 移除 / 保留 / 原因」预览表,确认后一键应用——应用为普通编辑,可逐图撤销,不会自动写盘。
- 人数标签冲突:
1boy与2boys并存删低留高(同性别保留最大人数);多人图中的solo一并清除,含义不同的solo focus永不误伤 - 角色父子 / 变体重复(测试模块可勾选,默认开启):同一角色家族的多个标签同图出现时按数据集出现量投票保留胜者;家族判定用角色表内置的真实父子关系(
racing miku↔hatsune miku这类改名变体也能配对,同名不同人不会误合并)。不需要改角色名时取消勾选,人数冲突与solo仍会处理 - 子级并入父级(角色类修复开启时可勾选,默认关闭):勾选后,子级变体在数据集中出现次数低于阈值(默认 30)时不被信任,自动并入父级标签——零散小变体合流到主标签,训练特征更集中。关闭角色类修复时此项自动关掉。预览表可逐条勾选要改的行。
命令行(CLI)
BooruDatasetTagManagerPlus.exe 本身就是命令行工具:第一个参数是已知命令时无窗口运行(输出可重定向,退出码 0/1/2 = 成功/运行错误/用法错误),否则照常打开界面。help 查看全部用法:
- 数据集操作:
stats统计;list-images/list-tags/classify-tags查询(按标签、一二级类别、次数过滤;--category可写「头发」或Hair,头发/发色筛二级);add-tags/remove-tags/replace-tag批量改标(条件筛选、--dry-run预演);export导出 JSON fix-tags:错误标签修复的命令行版,--no-character-variants跳过角色类替换,--child-threshold调信任阈值(默认 0 关闭;与--no-character-variants同时使用无效)、--catalog指定自定义关系表onnx-models/onnx-tag:Tag 推标 的命令行版(本地 ONNX)——列出 / 自动下载模型(受限模型支持--hf-token),阈值与写入模式与界面同语义,「跳过已有」在推理前过滤。OppaiOracle 示例:onnx-tag --model oo:Grio43/OppaiOracle:v1.1。动词名未改,与旧脚本兼容audit:LLM 角色标签审查——沿用界面保存的 API 配置与审查提示词,两阶段审查后事务化写回,--report输出 JSON 报告,--dry-run只看决策- 所有写盘走原子替换;标签格式(逗号分隔、小写去重)与界面一致,可与手工编辑混用
数据与隐私
- LLM 打标与角色标签审查会把图片发送到你配置的端点;Tag 推标、背景移除与视频处理全部在本机完成
- 配置文件
settings.json(界面偏好 + LLM/API,密钥 DPAPI 加密)写在「文档\BooruDatasetTagManagerPlus」;设置 → 常规 显示实际路径。换 Debug / Release /dist会读同一份;文档里还没有时整份复制程序目录旧文件(含.bak);文档里已有空配置、但程序目录仍能识别到旧 API 时,只把端点 / 密钥 / 站点配置迁过去,不覆盖界面偏好,也不删旧文件。换电脑仍需重填密钥 - 标签保存为原子写,批量图片操作先写临时文件、成功后才替换;删除经暂存目录两段执行,中途失败会自动恢复。注意:视频转换勾选"替换原文件"时,转换成功后会删除源视频
- 「设置 → 常规」可启用调试模式(默认关闭):开启后菜单栏出现 Debug 菜单,运行信息与异常会记录到程序目录的
debug.log(菜单内可一键打开),便于反馈问题时附上日志
致谢与许可
- starik222 — BooruDatasetTagManager 原作者,本项目在其基础上开发
- FFmpeg — 视频处理(GPL 组件,随 Release 打包)
- 本项目遵循 MIT License;分发修改版构建时请保留原作者版权声明