
ComfyUI deployment kit for Qwen-Image-2.1 Uncensored (GGUF): ready-to-use t2i & image-edit workflows, ComfyUI-GGUF architecture patches, and a 14-second lossless Q8_0 quantization repair tool that fixes 'weight shape [136] vs normalized_shape [128]'. Runs on 8 GB VRAM. Weights NOT included.
See the codeREADME
Qwen-Image-2.1 Uncensored · ComfyUI 部署套件
Qwen-Image-2.1 Uncensored (GGUF) — ComfyUI deployment kit 工作流 / 节点补丁 / Q8_0 修复工具 / 踩坑记录,一站式。 ComfyUI workflow · GGUF · text-to-image · image editing · 8 GB VRAM · low-VRAM · quantization fix



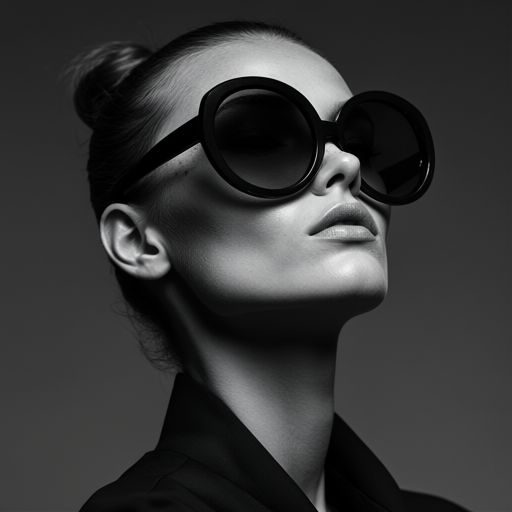
实测直出 · 512×512 / 20 步 / cfg 1.0 · RTX 5060 Laptop 8 GB · 32.3 秒 · 未经后期
⚠️ 重要:本仓库不含模型权重
模型权重合计 32.74 GB,远超 GitHub 的单文件 100 MB 硬限制(Release 上限 2 GB、Git LFS 免费额度仅 1 GB),技术上无法托管。
本仓库只提供权重之外的整套配套,权重请从 Hugging Face 原仓库获取 → 模型下载
| 层 | 来源 | 本仓库是否包含 |
|---|---|---|
GGUF 扩散模型 qwen-image-2.1-Q8_0.gguf | abenzerps/Qwen-Image-2.1-Uncensored-GGUF | ❌ 仅提供下载脚本 |
文本编码器 qwen3vl_8b_int8_convrot.safetensors | Comfy-Org/Qwen-Image-2.1 | ❌ 仅提供下载脚本 |
VAE qwen_image_2.1_vae_bf16.safetensors | Comfy-Org/Qwen-Image-2.1 | ❌ 仅提供下载脚本 |
| 工作流 / 脚本 / 补丁 / 文档 | 本仓库 | ✅ |
📖 这是什么
在 ComfyUI 上跑 Qwen-Image-2.1 Uncensored GGUF 的完整配套。原模型发布包开箱即用会撞上三个坑,本仓库把坑和补丁一并解决:
| # | 问题 | 症状 | 本仓库的解法 |
|---|---|---|---|
| 1 | GGUF 元数据被剥离 | Unknown model architecture! | patches/qwen_image21_arch.patch |
| 2 | GGUF 节点多副本并存 | 补丁打了没生效 | patches/README.md 说明 |
| 3 | Q8_0 一维张量被错误量化 | weight of shape [136] and normalized_shape = [128] | tools/gguf_1d_repair.py 就地重写 |
坑 3 是发布方的量化缺陷:64 个 RMSNorm 权重(128 维)被压成 Q8_0 的 136 字节。本仓库提供一个 14 秒、无损、零额外下载的修复器。
🖥 环境要求
| 项 | 要求 | 本套件实测配置 |
|---|---|---|
| ComfyUI | ≥ 0.37.0(原生 Qwen-Image-2.1 节点在此版本引入) | 0.37.0 |
| PyTorch | ≥ 2.6(推荐 cu130 轮子) | 2.13.0+cu130 |
| 显存 | ≥ 8 GB | RTX 5060 Laptop 8 GB |
| 系统内存 | ≥ 32 GB(TE 8.9 GB + DiT 转 bf16 约 13 GB 需并存) | 33.7 GB |
| 节点 | ComfyUI-GGUF(UnetLoaderGGUF) | city96 / leejet 分支 |
| Python | 3.10+(ComfyUI 便携版自带即可) | 3.13.12 |
⚠️ 内存比显存更容易成为瓶颈。加载阶段 TE(8.9 GB staged)+ DiT(7 GB Q8_0 → bf16 ≈ 13 GB)会同时驻留,内存不足会导致进程被杀且日志无 traceback。
📁 文件结构
qwen-image2.1-uncensored-comfyui/
├── README.md                                  # 本文件
├── NOTICE.md                                  # 来源、许可与免责声明
├── LICENSE                                    # MIT
├── .gitignore                                 # 排除 *.gguf / *.safetensors 等权重
│
├── assets/
│   └── sample_t2i_512x512.png                 # 实测出图(8 GB 显卡直出)
│
├── workflows/                                 # 可直接载入 ComfyUI 的工作流
│   ├── qwen_image_2.1_t2i_gguf.json           # 文生图(GGUF)
│   └── qwen_image_2.1_multi_image_edit.json   # 多图片编辑(参考图输入)
│
├── patches/                                   # ComfyUI-GGUF 节点补丁
│   ├── qwen_image21_arch.patch                # 架构识别(tools/convert.py)
│   ├── qwen_image21_loader.patch              # IMG_ARCH_LIST(loader.py)
│   └── README.md                              # 补丁应用与多副本处理说明
│
├── tools/                                     # 模型修复与校验工具
│   ├── gguf_1d_repair.py                      # 【推荐】通用修复器 scan / fix / verify
│   ├── fix_q8_0_gguf.py                       # 专用修复脚本(本模型一键版)
│   └── verify_gguf_rewrite.py                 # 逐张量字节级无损校验
│
├── scripts/                                   # 权重获取
│   ├── download_models.py                     # 断点续传下载(HF 主站 → hf-mirror 回退)
│   └── download_models.bat                    # 一键双击版(Windows)
│
└── docs/
    ├── FILE_STRUCTURE.md                      # 模型目录落位详解(含路径表)
    ├── TROUBLESHOOTING.md                     # 三个坑的完整排查过程
    └── VERIFICATION.md                        # 实测数据与无损校验报告
🚀 快速开始
第 0 步 · 准备 ComfyUI
需要一个 ≥ 0.37.0 的 ComfyUI(Windows 便携版 / 源码版均可)。低于此版本没有 TextEncodeQwenImage21 等原生节点,工作流会满屏红节点。
第 1 步 · 安装 GGUF 节点并打补丁
# 进入 ComfyUI 的 custom_nodes 目录
cd <ComfyUI>/custom_nodes

# 克隆 GGUF 节点(二选一,leejet 分支已原生支持 qwen_image21,可跳过补丁)
git clone https://github.com/city96/ComfyUI-GGUF
# git clone https://github.com/leejet/ComfyUI-GGUF
如果用的是 city96 原版,需要打上本仓库的补丁:
cd ComfyUI-GGUF
patch -p1 < <本仓库>/patches/qwen_image21_arch.patch
patch -p1 < <本仓库>/patches/qwen_image21_loader.patch
🚨 如果你的环境里存在多份
ComfyUI-GGUF副本(例如同时被extra_model_paths.yaml外挂注册),ComfyUI 会并行加载且注册顺序不确定 —— 必须每一份都打补丁,否则改了也不生效。详见patches/README.md。
第 2 步 · 下载权重
python scripts/download_models.py --dir <ComfyUI>/models
# 或 Windows 直接双击 scripts/download_models.bat
下载后按 docs/FILE_STRUCTURE.md 核对落位。
第 3 步 · 修复 Q8_0 量化缺陷 ⭐
这一步不能跳,否则采样时必然报 [136] vs [128]:
# 用 ComfyUI 便携版自带的 python(内含 gguf + numpy)
<ComfyUI>/../python_embeded/python.exe tools/gguf_1d_repair.py scan   <models>/diffusion_models/qwen-image-2.1-Q8_0.gguf
<ComfyUI>/../python_embeded/python.exe tools/gguf_1d_repair.py fix    <models>/diffusion_models/qwen-image-2.1-Q8_0.gguf <models>/diffusion_models/qwen-image-2.1-Q8_0_fixed.gguf --arch qwen_image21
<ComfyUI>/../python_embeded/python.exe tools/gguf_1d_repair.py verify <models>/diffusion_models/qwen-image-2.1-Q8_0.gguf <models>/diffusion_models/qwen-image-2.1-Q8_0_fixed.gguf
预期:scan 报 65 个待修张量 → fix 约 14 秒完成、体积仅 +31.5 KB → verify 输出 === PASS ===。
不想折腾也可以用 Q6_K / Q5_K_M / Q4_K_M 档位(这些档位 1D 张量通常正确保留 F32),把工作流里
UnetLoaderGGUF的下拉换掉即可。
第 4 步 · 载入工作流出图
把 workflows/*.json 拖进 ComfyUI 窗口。检查三个加载器指向的文件名与实际落位逐字一致:
| 节点 | 应指向 |
|---|---|
UnetLoaderGGUF | qwen-image-2.1-Q8_0_fixed.gguf |
CLIPLoader(type = qwen_image) | qwen3vl_8b_int8_convrot.safetensors |
VAELoader | qwen_image_2.1_vae_bf16.safetensors |
首次加载会比较慢(要反量化 7 GB GGUF 并转 bf16)。
⚙️ 参数建议
基于 RTX 5060 Laptop 8 GB 显存的实测:
| 分辨率 | 步数 | cfg | 显存峰值 | 耗时 | 结论 |
|---|---|---|---|---|---|
| 512×512 | 20 | 1.0 | 7.48 / 8.15 GB | 32.3 s | ✅ 安全区 |
| 768×768 | 20 | 1.0 | — | — | ⚠️ 余量很小,需实测 |
| 1024×1024(≈1 MP) | 25 | 1.0 | — | — | ❌ 8 GB 极易 OOM/被系统杀进程 |
- 分辨率必须是 32 的倍数;8 GB 卡建议从 512×512 起步验证链路。
- Qwen-Image 系列使用 cfg = 1.0(
TextEncodeQwenImage21的负面词留空即可)。 - 内存紧张时可先降低分辨率验证链路,再逐步上调。
- 若日志出现
loaded partially; ... MB offloaded,说明已触发 CPU offload,速度会明显下降但可跑完。
🧪 实测数据
| 项 | 数值 |
|---|---|
| 生成 | 512×512 / 20 步 / cfg 1.0 / euler+simple |
| 耗时 | 32.3 秒(约 1.15 it/s) |
| 显存峰值 | 7477 / 8151 MiB |
| 温度 / 功耗峰值 | 76 °C / 100.8 W |
| 修复器耗时 | 14 秒(7.07 GB 文件) |
| 修复器体积变化 | +31.5 KB(+0.0004%) |
| 无损校验 | 232 张量逐字节相同、65 张量数值零漂移 |
完整报告见 docs/VERIFICATION.md。
🔧 已知问题速查
| 报错 | 原因 | 解决 |
|---|---|---|
This model is not currently supported - (Unknown model architecture!) | GGUF 缺 general.architecture | 打 patches/qwen_image21_arch.patch |
Expected weight to be of same shape as normalized_shape, but got weight of shape [136] and normalized_shape = [128] | Q8_0 一维张量被错误量化 | 跑 tools/gguf_1d_repair.py fix |
| 补丁打了仍报架构错 | 多份 GGUF 节点副本,生效的不是你改的那份 | 每份都打(看 traceback 定位文件路径) |
Given normalized_shape=[4096] ... got input of size[1,N,2560] | TE 用了 4B 模型(隐藏维 2560) | TE 必须用 Qwen3-VL-8B(4096) |
| 进程无故消失、日志无 traceback | 系统内存耗尽被强杀 | 关掉其他占内存程序;降分辨率 |
| 拉了工作流但模型下拉是空/旧名 | ComfyUI 未重新扫描 | 重启 ComfyUI + 浏览器 Ctrl+F5 |
📦 模型下载
| 文件 | 大小 | 来源 |
|---|---|---|
diffusion_models/qwen-image-2.1-Q8_0.gguf | 7.07 GB | HF abenzerps/Qwen-Image-2.1-Uncensored-GGUF |
text_encoders/qwen3vl_8b_int8_convrot.safetensors | 8.71 GB | HF Comfy-Org/Qwen-Image-2.1 |
text_encoders/qwen3vl_8b_bf16.safetensors | 16.33 GB | HF Comfy-Org/Qwen-Image-2.1(可选,显存充裕时用) |
vae/qwen_image_2.1_vae_bf16.safetensors | 0.63 GB | HF Comfy-Org/Qwen-Image-2.1 |
# 国内网络建议走镜像
python scripts/download_models.py --dir <ComfyUI>/models --mirror
8 GB 显存请优先用 int8_convrot 文本编码器(8.71 GB),不要用 bf16(16.33 GB)。
📄 许可与来源
- 本仓库内容(工作流、脚本、文档、补丁):MIT。该许可仅覆盖本仓库原创内容;模型权重、TE/VAE 重打包件、ComfyUI-GGUF 节点均为第三方资产,各有其上游许可,详见 NOTICE.md
- 模型权重:版权归原作者,未包含在本仓库中,请遵循上游仓库的许可条款
- Qwen-Image-2.1 基座:
Qwen/Qwen-Image-2.1 - GGUF 量化版:
abenzerps/Qwen-Image-2.1-Uncensored-GGUF - ComfyUI-GGUF 节点:
city96/ComfyUI-GGUF/leejet/ComfyUI-GGUF
免责声明:Uncensored 指上游移除了内容过滤,可生成更宽泛的题材。使用者需自行确保生成内容符合所在地法律法规及使用平台的政策。本仓库仅提供技术配套,不对生成内容承担责任,与上游模型作者及 ComfyUI 官方均无隶属关系。
整理自一次真实的 8 GB 显存部署实战 · 2026-09
Similar repos





ComfyUI deployment kit for Qwen-Image-2.1 Uncensored (GGUF): ready-to-use t2i & image-edit workflows, ComfyUI-GGUF architecture patches, and a 14-second lossless Q8_0 quantization repair tool that fixes 'weight shape [136] vs normalized_shape [128]'. Runs on 8 GB VRAM. Weights NOT included.
See the codeREADME
Qwen-Image-2.1 Uncensored · ComfyUI 部署套件
Qwen-Image-2.1 Uncensored (GGUF) — ComfyUI deployment kit 工作流 / 节点补丁 / Q8_0 修复工具 / 踩坑记录,一站式。 ComfyUI workflow · GGUF · text-to-image · image editing · 8 GB VRAM · low-VRAM · quantization fix
实测直出 · 512×512 / 20 步 / cfg 1.0 · RTX 5060 Laptop 8 GB · 32.3 秒 · 未经后期
⚠️ 重要:本仓库不含模型权重
模型权重合计 32.74 GB,远超 GitHub 的单文件 100 MB 硬限制(Release 上限 2 GB、Git LFS 免费额度仅 1 GB),技术上无法托管。
本仓库只提供权重之外的整套配套,权重请从 Hugging Face 原仓库获取 → 模型下载
| 层 | 来源 | 本仓库是否包含 |
|---|---|---|
GGUF 扩散模型 qwen-image-2.1-Q8_0.gguf | abenzerps/Qwen-Image-2.1-Uncensored-GGUF | ❌ 仅提供下载脚本 |
文本编码器 qwen3vl_8b_int8_convrot.safetensors | Comfy-Org/Qwen-Image-2.1 | ❌ 仅提供下载脚本 |
VAE qwen_image_2.1_vae_bf16.safetensors | Comfy-Org/Qwen-Image-2.1 | ❌ 仅提供下载脚本 |
| 工作流 / 脚本 / 补丁 / 文档 | 本仓库 | ✅ |
📖 这是什么
在 ComfyUI 上跑 Qwen-Image-2.1 Uncensored GGUF 的完整配套。原模型发布包开箱即用会撞上三个坑,本仓库把坑和补丁一并解决:
| # | 问题 | 症状 | 本仓库的解法 |
|---|---|---|---|
| 1 | GGUF 元数据被剥离 | Unknown model architecture! | patches/qwen_image21_arch.patch |
| 2 | GGUF 节点多副本并存 | 补丁打了没生效 | patches/README.md 说明 |
| 3 | Q8_0 一维张量被错误量化 | weight of shape [136] and normalized_shape = [128] | tools/gguf_1d_repair.py 就地重写 |
坑 3 是发布方的量化缺陷:64 个 RMSNorm 权重(128 维)被压成 Q8_0 的 136 字节。本仓库提供一个 14 秒、无损、零额外下载的修复器。
🖥 环境要求
| 项 | 要求 | 本套件实测配置 |
|---|---|---|
| ComfyUI | ≥ 0.37.0(原生 Qwen-Image-2.1 节点在此版本引入) | 0.37.0 |
| PyTorch | ≥ 2.6(推荐 cu130 轮子) | 2.13.0+cu130 |
| 显存 | ≥ 8 GB | RTX 5060 Laptop 8 GB |
| 系统内存 | ≥ 32 GB(TE 8.9 GB + DiT 转 bf16 约 13 GB 需并存) | 33.7 GB |
| 节点 | ComfyUI-GGUF(UnetLoaderGGUF) | city96 / leejet 分支 |
| Python | 3.10+(ComfyUI 便携版自带即可) | 3.13.12 |
⚠️ 内存比显存更容易成为瓶颈。加载阶段 TE(8.9 GB staged)+ DiT(7 GB Q8_0 → bf16 ≈ 13 GB)会同时驻留,内存不足会导致进程被杀且日志无 traceback。
📁 文件结构
qwen-image2.1-uncensored-comfyui/
├── README.md                                  # 本文件
├── NOTICE.md                                  # 来源、许可与免责声明
├── LICENSE                                    # MIT
├── .gitignore                                 # 排除 *.gguf / *.safetensors 等权重
│
├── assets/
│   └── sample_t2i_512x512.png                 # 实测出图(8 GB 显卡直出)
│
├── workflows/                                 # 可直接载入 ComfyUI 的工作流
│   ├── qwen_image_2.1_t2i_gguf.json           # 文生图(GGUF)
│   └── qwen_image_2.1_multi_image_edit.json   # 多图片编辑(参考图输入)
│
├── patches/                                   # ComfyUI-GGUF 节点补丁
│   ├── qwen_image21_arch.patch                # 架构识别(tools/convert.py)
│   ├── qwen_image21_loader.patch              # IMG_ARCH_LIST(loader.py)
│   └── README.md                              # 补丁应用与多副本处理说明
│
├── tools/                                     # 模型修复与校验工具
│   ├── gguf_1d_repair.py                      # 【推荐】通用修复器 scan / fix / verify
│   ├── fix_q8_0_gguf.py                       # 专用修复脚本(本模型一键版)
│   └── verify_gguf_rewrite.py                 # 逐张量字节级无损校验
│
├── scripts/                                   # 权重获取
│   ├── download_models.py                     # 断点续传下载(HF 主站 → hf-mirror 回退)
│   └── download_models.bat                    # 一键双击版(Windows)
│
└── docs/
    ├── FILE_STRUCTURE.md                      # 模型目录落位详解(含路径表)
    ├── TROUBLESHOOTING.md                     # 三个坑的完整排查过程
    └── VERIFICATION.md                        # 实测数据与无损校验报告
🚀 快速开始
第 0 步 · 准备 ComfyUI
需要一个 ≥ 0.37.0 的 ComfyUI(Windows 便携版 / 源码版均可)。低于此版本没有 TextEncodeQwenImage21 等原生节点,工作流会满屏红节点。
第 1 步 · 安装 GGUF 节点并打补丁
# 进入 ComfyUI 的 custom_nodes 目录
cd <ComfyUI>/custom_nodes

# 克隆 GGUF 节点(二选一,leejet 分支已原生支持 qwen_image21,可跳过补丁)
git clone https://github.com/city96/ComfyUI-GGUF
# git clone https://github.com/leejet/ComfyUI-GGUF
如果用的是 city96 原版,需要打上本仓库的补丁:
cd ComfyUI-GGUF
patch -p1 < <本仓库>/patches/qwen_image21_arch.patch
patch -p1 < <本仓库>/patches/qwen_image21_loader.patch
🚨 如果你的环境里存在多份
ComfyUI-GGUF副本(例如同时被extra_model_paths.yaml外挂注册),ComfyUI 会并行加载且注册顺序不确定 —— 必须每一份都打补丁,否则改了也不生效。详见patches/README.md。
第 2 步 · 下载权重
python scripts/download_models.py --dir <ComfyUI>/models
# 或 Windows 直接双击 scripts/download_models.bat
下载后按 docs/FILE_STRUCTURE.md 核对落位。
第 3 步 · 修复 Q8_0 量化缺陷 ⭐
这一步不能跳,否则采样时必然报 [136] vs [128]:
# 用 ComfyUI 便携版自带的 python(内含 gguf + numpy)
<ComfyUI>/../python_embeded/python.exe tools/gguf_1d_repair.py scan   <models>/diffusion_models/qwen-image-2.1-Q8_0.gguf
<ComfyUI>/../python_embeded/python.exe tools/gguf_1d_repair.py fix    <models>/diffusion_models/qwen-image-2.1-Q8_0.gguf <models>/diffusion_models/qwen-image-2.1-Q8_0_fixed.gguf --arch qwen_image21
<ComfyUI>/../python_embeded/python.exe tools/gguf_1d_repair.py verify <models>/diffusion_models/qwen-image-2.1-Q8_0.gguf <models>/diffusion_models/qwen-image-2.1-Q8_0_fixed.gguf
预期:scan 报 65 个待修张量 → fix 约 14 秒完成、体积仅 +31.5 KB → verify 输出 === PASS ===。
不想折腾也可以用 Q6_K / Q5_K_M / Q4_K_M 档位(这些档位 1D 张量通常正确保留 F32),把工作流里
UnetLoaderGGUF的下拉换掉即可。
第 4 步 · 载入工作流出图
把 workflows/*.json 拖进 ComfyUI 窗口。检查三个加载器指向的文件名与实际落位逐字一致:
| 节点 | 应指向 |
|---|---|
UnetLoaderGGUF | qwen-image-2.1-Q8_0_fixed.gguf |
CLIPLoader(type = qwen_image) | qwen3vl_8b_int8_convrot.safetensors |
VAELoader | qwen_image_2.1_vae_bf16.safetensors |
首次加载会比较慢(要反量化 7 GB GGUF 并转 bf16)。
⚙️ 参数建议
基于 RTX 5060 Laptop 8 GB 显存的实测:
| 分辨率 | 步数 | cfg | 显存峰值 | 耗时 | 结论 |
|---|---|---|---|---|---|
| 512×512 | 20 | 1.0 | 7.48 / 8.15 GB | 32.3 s | ✅ 安全区 |
| 768×768 | 20 | 1.0 | — | — | ⚠️ 余量很小,需实测 |
| 1024×1024(≈1 MP) | 25 | 1.0 | — | — | ❌ 8 GB 极易 OOM/被系统杀进程 |
- 分辨率必须是 32 的倍数;8 GB 卡建议从 512×512 起步验证链路。
- Qwen-Image 系列使用 cfg = 1.0(
TextEncodeQwenImage21的负面词留空即可)。 - 内存紧张时可先降低分辨率验证链路,再逐步上调。
- 若日志出现
loaded partially; ... MB offloaded,说明已触发 CPU offload,速度会明显下降但可跑完。
🧪 实测数据
| 项 | 数值 |
|---|---|
| 生成 | 512×512 / 20 步 / cfg 1.0 / euler+simple |
| 耗时 | 32.3 秒(约 1.15 it/s) |
| 显存峰值 | 7477 / 8151 MiB |
| 温度 / 功耗峰值 | 76 °C / 100.8 W |
| 修复器耗时 | 14 秒(7.07 GB 文件) |
| 修复器体积变化 | +31.5 KB(+0.0004%) |
| 无损校验 | 232 张量逐字节相同、65 张量数值零漂移 |
完整报告见 docs/VERIFICATION.md。
🔧 已知问题速查
| 报错 | 原因 | 解决 |
|---|---|---|
This model is not currently supported - (Unknown model architecture!) | GGUF 缺 general.architecture | 打 patches/qwen_image21_arch.patch |
Expected weight to be of same shape as normalized_shape, but got weight of shape [136] and normalized_shape = [128] | Q8_0 一维张量被错误量化 | 跑 tools/gguf_1d_repair.py fix |
| 补丁打了仍报架构错 | 多份 GGUF 节点副本,生效的不是你改的那份 | 每份都打(看 traceback 定位文件路径) |
Given normalized_shape=[4096] ... got input of size[1,N,2560] | TE 用了 4B 模型(隐藏维 2560) | TE 必须用 Qwen3-VL-8B(4096) |
| 进程无故消失、日志无 traceback | 系统内存耗尽被强杀 | 关掉其他占内存程序;降分辨率 |
| 拉了工作流但模型下拉是空/旧名 | ComfyUI 未重新扫描 | 重启 ComfyUI + 浏览器 Ctrl+F5 |
📦 模型下载
| 文件 | 大小 | 来源 |
|---|---|---|
diffusion_models/qwen-image-2.1-Q8_0.gguf | 7.07 GB | HF abenzerps/Qwen-Image-2.1-Uncensored-GGUF |
text_encoders/qwen3vl_8b_int8_convrot.safetensors | 8.71 GB | HF Comfy-Org/Qwen-Image-2.1 |
text_encoders/qwen3vl_8b_bf16.safetensors | 16.33 GB | HF Comfy-Org/Qwen-Image-2.1(可选,显存充裕时用) |
vae/qwen_image_2.1_vae_bf16.safetensors | 0.63 GB | HF Comfy-Org/Qwen-Image-2.1 |
# 国内网络建议走镜像
python scripts/download_models.py --dir <ComfyUI>/models --mirror
8 GB 显存请优先用 int8_convrot 文本编码器(8.71 GB),不要用 bf16(16.33 GB)。
📄 许可与来源
- 本仓库内容(工作流、脚本、文档、补丁):MIT。该许可仅覆盖本仓库原创内容;模型权重、TE/VAE 重打包件、ComfyUI-GGUF 节点均为第三方资产,各有其上游许可,详见 NOTICE.md
- 模型权重:版权归原作者,未包含在本仓库中,请遵循上游仓库的许可条款
- Qwen-Image-2.1 基座:
Qwen/Qwen-Image-2.1 - GGUF 量化版:
abenzerps/Qwen-Image-2.1-Uncensored-GGUF - ComfyUI-GGUF 节点:
city96/ComfyUI-GGUF/leejet/ComfyUI-GGUF
免责声明:Uncensored 指上游移除了内容过滤,可生成更宽泛的题材。使用者需自行确保生成内容符合所在地法律法规及使用平台的政策。本仓库仅提供技术配套,不对生成内容承担责任,与上游模型作者及 ComfyUI 官方均无隶属关系。
整理自一次真实的 8 GB 显存部署实战 · 2026-09