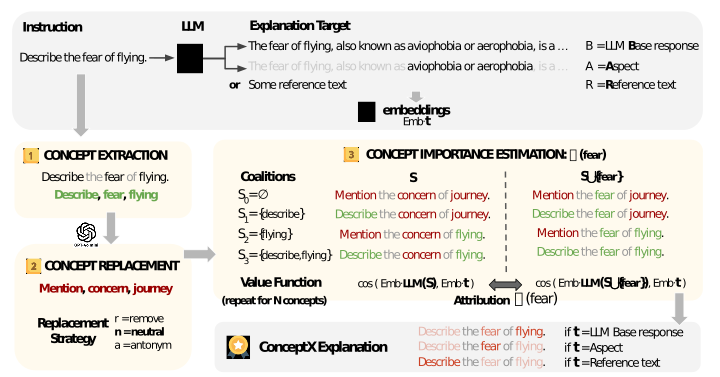
ConceptX is a model-agnostic, concept-level attribution method that enables interpretable and controllable large language model (LLM) behavior. Built on a coalition-based Shapley framework, ConceptX:
ConceptX can be used both for auditing (e.g., detecting bias) and steering (e.g., prompt interventions to shift sentence sentiment or reduce harmfulness), all without retraining the model.
See the papers for more details.
Install the required packages:
pip install -r requirements.txt
Models sourced from HuggingFace:
Model supported via API:
From SBERT:
all-MiniLM-L6-v2 — Compact, 384-dim embeddingsall-mpnet-base-v2 — Larger, 768-dim embeddingsSentiment Classifier
RoBERTa-base, fine-tuned on TweetEval
cardiffnlp/twitter-roberta-base-sentiment-latest
Safety Classifier
MD-Judge-v0_2-internlm2_7b
Labels: safe / unsafe, plus a 1–5 safety score
OpenSafetyLab/MD-Judge-v0_2-internlm2_7b
⚠️ Requires transformers==4.41.2
To generate explanations:
python src/explain.py --dataset [dataset] --model_name [model] --explainer [method] --seed [seed]
To compute faithfulness scores for the generated explanations:
python src/faithfulness.py --dataset [dataset] --model_name [model] --explainer [method] --seed [seed]
To compute accuracy scores for the generated explanations on genderbias:
python src/accuracy.py
Parameters:
dataset: One of alpaca, sst2, genderbias, saladbenchmodel_name: Decoder-only LLM, e.g., gpt4o-mini, mistral-7b-it, gemma-3-4b, llama-3-3bexplainer: One of random, tokenshap, conceptx-B-r, conceptx-B-n, conceptx-A-rseed: Random seed for reproducibility (e.g., 0)python src/sentiment_classifier.py --dataset [dataset] --model_name [model] --explainer [method] --steer_replace [steer_replace] --seed [seed]
Parameters:
dataset: One of sst2, sp1786explainer: e.g., random, tokenshap, conceptx-B-r, conceptx-B-n, conceptx-B-a, conceptx-A-rsteer_replace: One of neutral, antonymFirst, generate LLM responses:
python src/generate_answers.py --dataset [dataset] --model_name [model] --explainer [method] --steer_replace [steer_replace] --seed [seed]
Then, evaluate safety of the generated responses:
python src/safety_classifier.py --dataset [dataset] --model_name [model] --defender [method] --steer_replace [steer_replace] --seed [seed]
Parameters:
dataset: saladbenchdefender: One of selfreminder, selfparaphrase, gpt4o-mini, random, tokenshap, conceptx-B-r, conceptx-B-n, conceptx-A-rsteer_replace: One of neutral, antonymIf using ConceptX, args.explainer should follow the format:
conceptx-<T>-<R> where:
<T> is one of:
A → aspect-based explanationR → reference-basedB → base (general explanation)<R> is one of:
r → removen → neutrala → antonymExample: conceptx-A-n means aspect-based explanation using neutral replacements.
Code snippet to parse and validate:
if args.explainer.startswith("conceptx"):
    parts = args.explainer.split("-")
    assert parts[1] in ("A", "R", "B"), f"Invalid code in parts[1]: {parts[1]}"
    assert parts[2] in ("r", "n", "a"), f"Invalid code in parts[2]: {parts[2]}"

    args.target = (
        "aspect" if parts[1] == "A" else
        "reference" if parts[1] == "R" else
        "base"
    )

    args.coalition_replace = (
        "neutral" if parts[2] == "n" else
        "antonym" if parts[2] == "a" else
        "remove"
    )
If you use ConceptX in your research, please cite:
@article{Anonymous,
  title = {Concept-Level Explainability for Auditing and Steering LLM Responses},
  author = {Anonymous},
  journal = {Anonymous},
  year = {2025}
}
Please open a GitHub issue for support or feedback.



