Projeto de pós-graduação que compara seis configurações de sumarização e cinco contrastes planejados no FINDSum Liquidity. Preparação, recuperação e métricas são locais; a geração usa a API do OpenRouter. O objetivo é medir a semelhança dos resumos gerados com as referências do FINDSum, mantendo documentos e instruções comparáveis entre os braços.
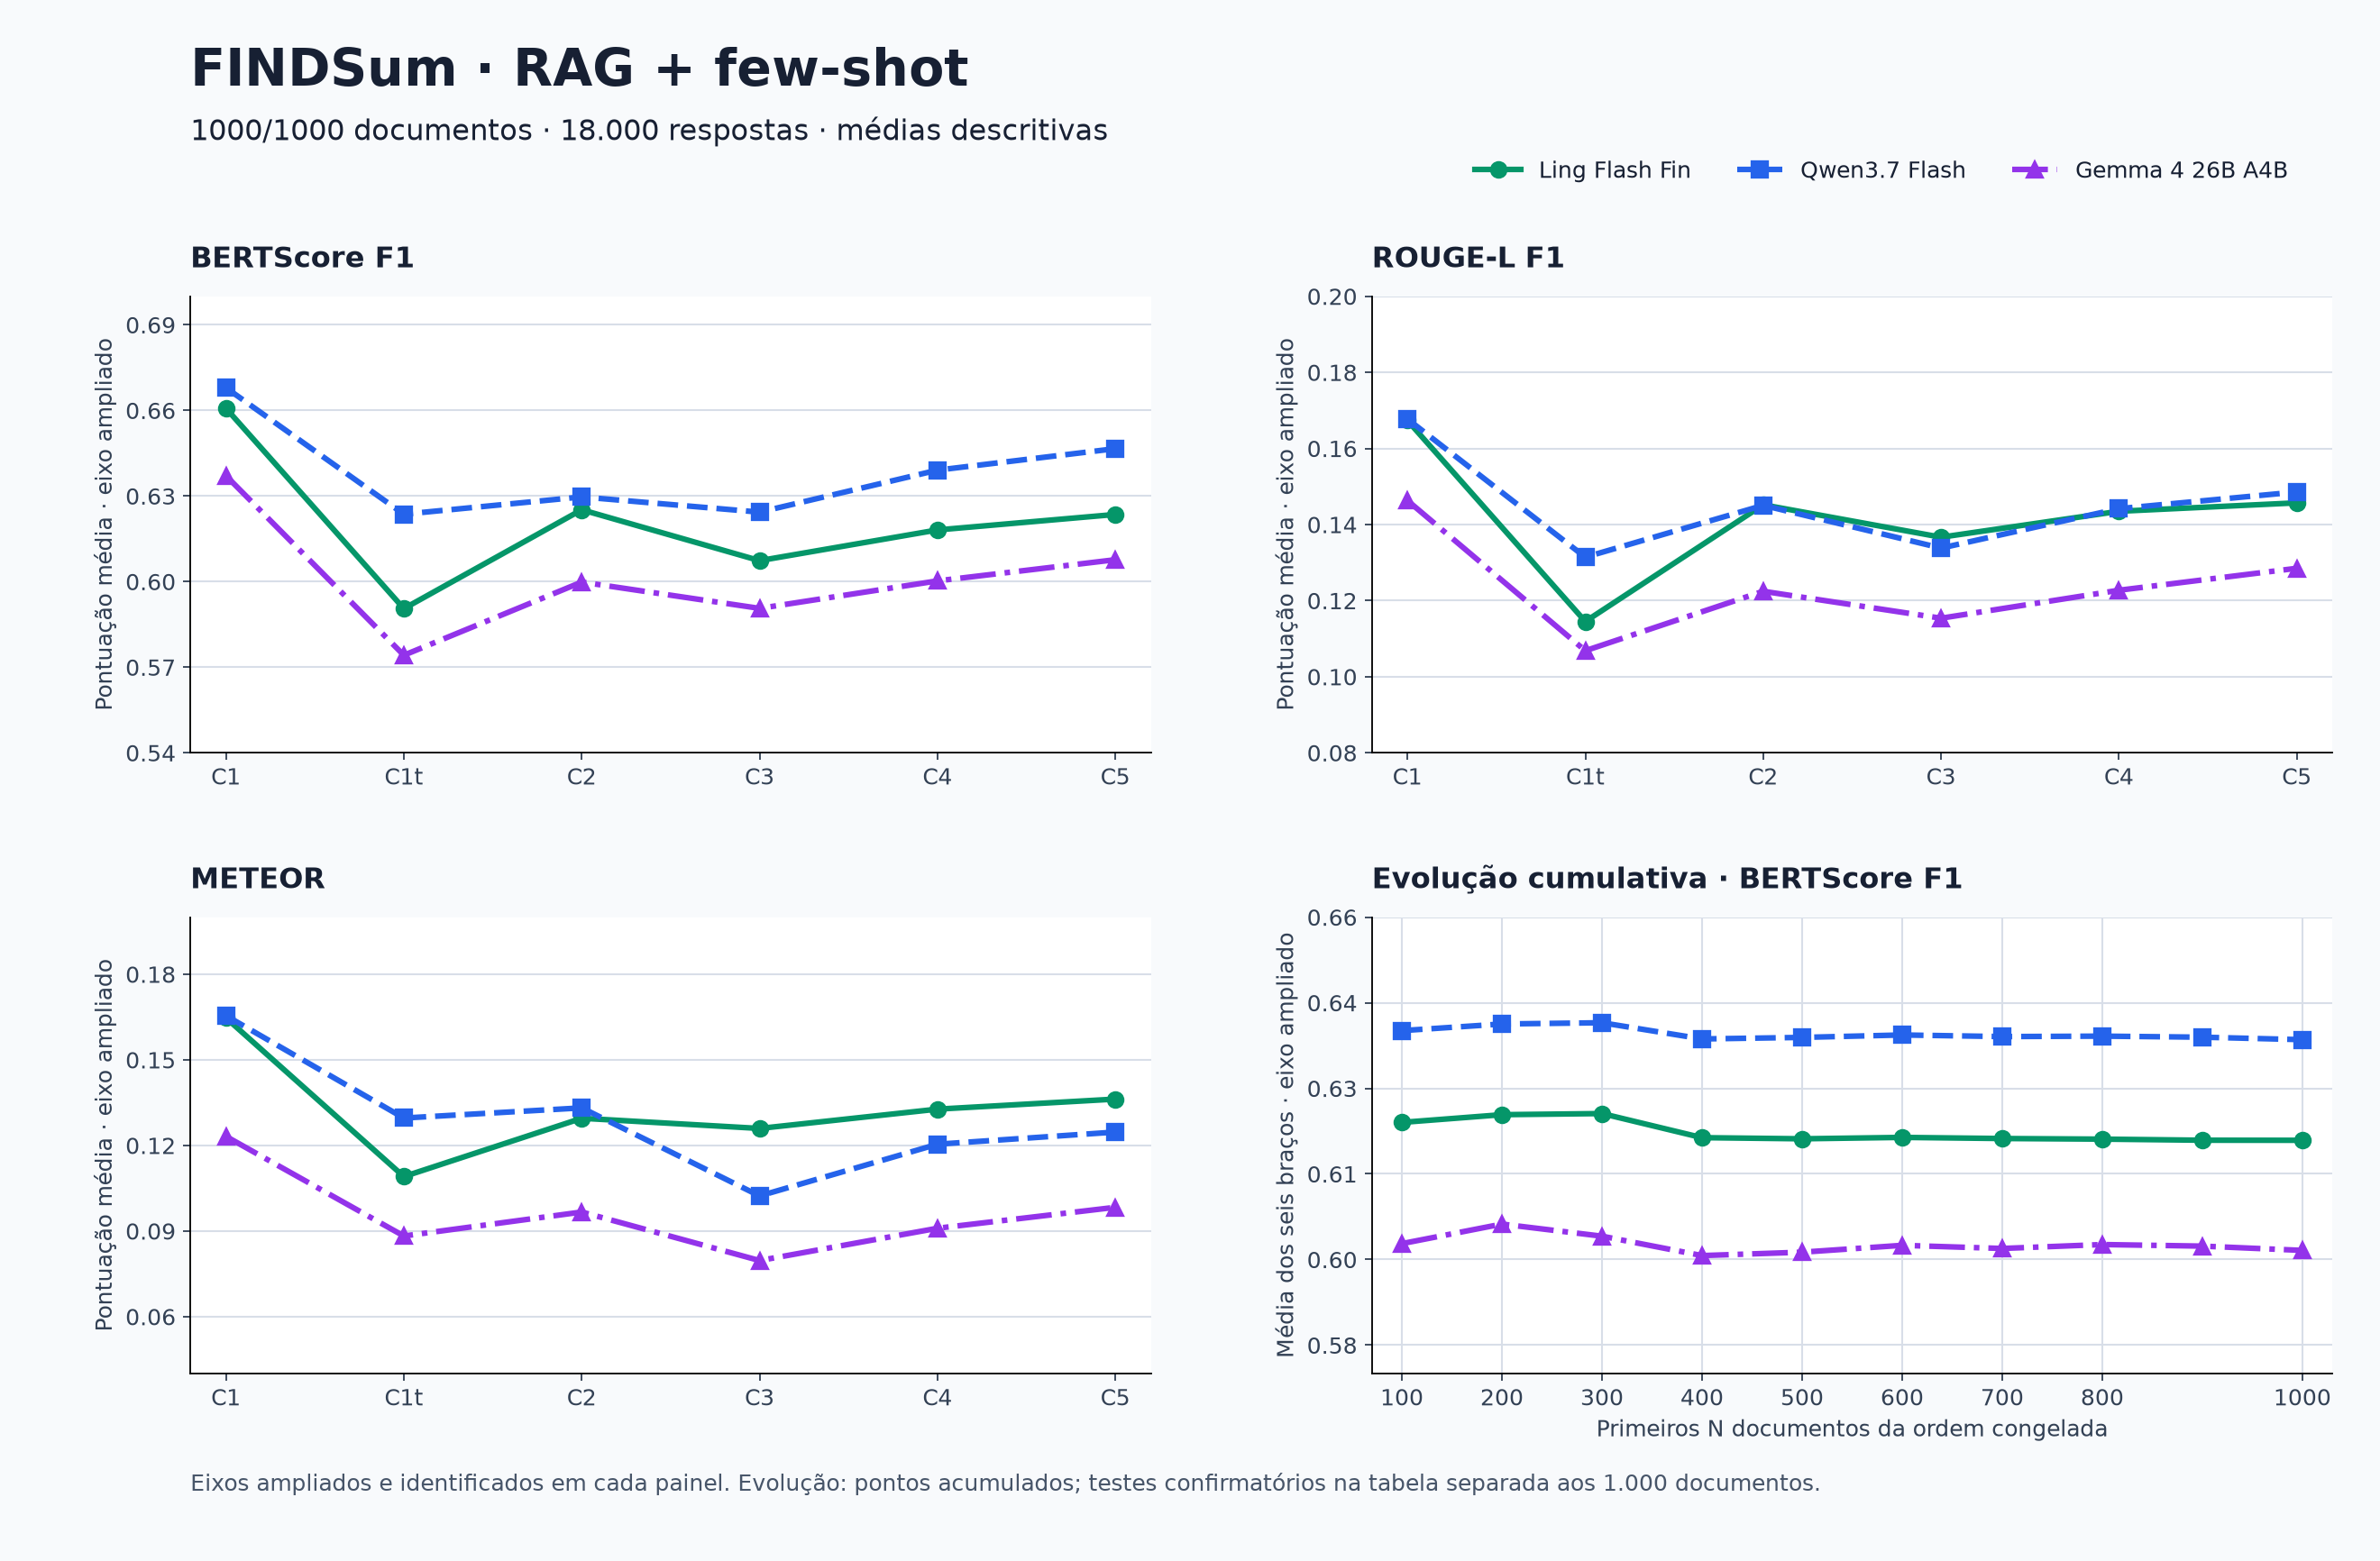
BERTScore ampliado · ROUGE-L ampliado · METEOR ampliado · Evolução ampliada
1.000 documentos concluídos nos três modelos: 18.000 respostas e scores. O painel apresenta as médias descritivas por braço e modelo. Testes das hipóteses na coorte completa.
Cada contraste usa os mesmos documentos em dois braços. Δ positivo significa maior similaridade média com a referência no primeiro braço; Δ negativo, menor. As diferenças abaixo são pontos da escala 0 a 1, não percentuais de acerto.
| Hipótese | Comparação | Pergunta |
|---|---|---|
| H1 | C2 - C1 | RAG versus fonte inteira |
| H1b | C2 - C1t | RAG versus prefixo de igual orçamento |
| H2 | C3 - C2 | Quatro exemplos fixos versus zero-shot RAG |
| H3 | C4 - C3 | Aleatórios versus fixos: controle de sensibilidade |
| H4 | C5 - C4 | Similares versus aleatórios |
H3 é um controle de sensibilidade à escolha dos exemplos: uma diferença não significativa ao final não provaria equivalência. As métricas primárias são BERTScore F1 e ROUGE-L F1; METEOR e BERTScore precisão/recall são descritivos.
Recorte atual: 1000 documentos por modelo. Contrastes entre médias dos braços, arredondados a quatro casas:
| Modelo | Hipótese | Δ BERTScore F1 | Δ ROUGE-L F1 |
|---|---|---|---|
| Ling Flash Fin | H1 | -0,0356 | -0,0222 |
| Ling Flash Fin | H1b | +0,0346 | +0,0307 |
| Ling Flash Fin | H2 | -0,0178 | -0,0085 |
| Ling Flash Fin | H3 | +0,0108 | +0,0068 |
| Ling Flash Fin | H4 | +0,0054 | +0,0022 |
| Qwen3.7 Flash | H1 | -0,0382 | -0,0227 |
| Qwen3.7 Flash | H1b | +0,0061 | +0,0136 |
| Qwen3.7 Flash | H2 | -0,0053 | -0,0112 |
| Qwen3.7 Flash | H3 | +0,0147 | +0,0104 |
| Qwen3.7 Flash | H4 | +0,0075 | +0,0044 |
| Gemma 4 26B A4B | H1 | -0,0372 | -0,0239 |
| Gemma 4 26B A4B | H1b | +0,0256 | +0,0156 |
| Gemma 4 26B A4B | H2 | -0,0092 | -0,0071 |
| Gemma 4 26B A4B | H3 | +0,0096 | +0,0074 |
| Gemma 4 26B A4B | H4 | +0,0074 | +0,0058 |
Nos três modelos, H1 é negativa e H1b é positiva: o RAG ficou abaixo da fonte inteira, mas acima do prefixo com o mesmo orçamento de contexto. H2 é negativa: quatro exemplos fixos reduziram as duas métricas primárias frente ao RAG sem exemplos. H3 e H4 são positivas, com ganho menor em H4. Isso descreve este recorte e não estabelece eficácia causal ou qualidade factual.
Este painel apresenta diferenças descritivas. Os testes completos estão na tabela de comparações, calculados a partir do CSV versionado. O plano usa Wilcoxon bilateral emparelhado e Holm sobre dez testes por modelo. As saídas length permanecem na análise e podem afetar as médias. Os contrastes entre modelos não isolam arquitetura, tokenizador ou provedor.
A análise completa detectou diferenças em 28 dos 30 testes. Isso não confirma cinco hipóteses de melhora: H1 e H2 tiveram diferenças negativas nos três modelos. H1b no BERTScore do Qwen (p Holm = 0,1229) e H4 no ROUGE-L do Ling (p Holm = 0,0732) não foram significativas. Veja os testes, tamanhos de efeito e limites de interpretação. A última rodada de 480 documentos custou US$ 10,0683 de débito observado, deixando US$ 4,2149 na conta consultada.
Na raiz do repositório, com Python 3.12 e uv:
uv sync --locked
bash rodar_rodada.sh 100 --dry-run  # valida sem chamadas de geração
bash rodar_rodada.sh 100            # executa/retoma o mesmo grupo nos três modelos
bash rodar_rodada.sh --metrics-only # atualiza apenas métricas e painel, sem API
A preparação integral já existe neste workspace em outputs/full-{ling,qwen,gemma}-prepared. Uma nova instalação precisa do dataset, dos modelos locais e desses artefatos preparados; eles não estão no Git. O caminho da credencial é ../.env, variável OPEN_ROUTER_KEY. Nunca adicione esse arquivo ao repositório.
Cada documento tem seis gerações por modelo, além de retries. O script preserva a rodada incompleta e as respostas aceitas. Só avança para outro grupo na próxima invocação após a rodada atual estar completa. O prefixo gerado e pontuado está no painel acima; a próxima execução normal seleciona os documentos ainda não processados.
A coorte de 1.000 documentos está concluída: neste workspace, não há casos faltantes para novas chamadas. Preserve os artefatos; não remova respostas para repetir o experimento. --metrics-only permite conferir e reconstruir o painel a partir das gerações salvas.
A execução normal envia chamadas pagas de Qwen/Gemma. --dry-run, --metrics-only e --audit-ling-batch 1 são modos locais. Não apague outputs/full-rounds/active-round.json, os ledgers ou as pastas de respostas para tentar avançar.
| Modelo / provedor fixo | Ritmo máximo | Teto cumulativo de geração |
|---|---|---|
| Ling 3.0 Flash Fin gratuito / Novita | 20 RPM | US$ 0 |
| Ling 3.0 Flash Fin pago / Novita, apenas rodadas com adendo registrado | 500 RPM, adaptativo | US$ 5,00 cumulativo após autorização de 521–1000 |
| Qwen3.7 Flash / Alibaba | 500 RPM, adaptativo | US$ 18 |
| Gemma 4 26B A4B / Darkbloom | 500 RPM, adaptativo | US$ 9 |
Os tetos não garantem vazão sustentada ou conclusão com esse saldo. Nos pagos, erros transitórios reduzem ritmo/concorrência, respeitam Retry-After e voltam à fila, com até seis tentativas por ciclo. Resultado de transporte desconhecido ou resposta fora do contrato exige auditoria. Não há troca automática de modelo/provedor. O Ling pago foi autorizado para as rodadas 161–320, 321–520 e 521–1000, cada uma em adendo separado; o comportamento padrão continua gratuito. O adendo 521–1000 fixa tetos incrementais de US$ 3,20 para Ling, US$ 7,30 para Qwen e US$ 3,50 para Gemma: US$ 14,00 sobre o custo retido das tentativas, abaixo do saldo inicial consultado de US$ 14,2832. Uma nova rodada paga exige novo adendo antes da execução.
Uma tentativa interrompida sem resposta salva conserva sua reserva máxima de custo. Sua retomada exige uma auditoria local com SHA-256, conferência do request congelado e confirmação de que a resposta não existe. O script nunca repete uma resposta já aceita.
Ao encerrar, o Bash atualiza results/progress/ usando somente o prefixo completo comum aos três modelos. Usa cache para evitar recálculo. Não faz commit ou push automaticamente:
A avaliação calcula somente os pares ausentes no cache comum, em blocos de 120, com cobertura integral dos textos. O término de cada modelo não recalcula os 6.000 pares separadamente. Com os 1.000 documentos completos nos três modelos, o Bash também grava comparisons.csv, comparisons.json e analysis.json, aplicando o plano congelado ao CSV versionado. Os testes não exigem chamadas adicionais à API.
git add results/progress README.md
git commit -m "results: atualiza acompanhamento do experimento"
git push origin main
src/findsum_rag/       Biblioteca: dados, RAG, prompts, API e métricas
scripts/
  data/               Download do FINDSum e criação de splits
  preparation/        Prompts, tokenizers, preflight e congelamento
  execution/          Rodadas, lotes, concorrência e retomada
  evaluation/         Métricas, auditoria e painel incremental
  reports/            Exportadores e templates de relatórios locais
  experiments/        PoCs, diagnósticos e benchmarks auxiliares
  common/             Contratos compartilhados dos scripts
configs/              Configuração, coorte e locks de integridade
tests/                Testes automatizados
results/              Métricas e gráficos versionados
docs/                 Guias e interpretação das métricas
outputs/              Artefatos locais e notas históricas (fora do Git)
Os scripts são módulos Python; use python -m scripts.<grupo>.<modulo>. Comandos e responsabilidades. Os comandos findsum e o Bash continuam sendo as entradas principais. Os módulos científicos em src/findsum_rag/ mantêm seus caminhos.
Os HTMLs gerados ficam em outputs/reports/. Notas de execução, diagnósticos e documentos antigos foram retirados da árvore atual do Git; o histórico de commits permanece disponível. A reorganização local preservou cópias em outputs/arquivo-local/.
Usamos os trechos selecionados e os resumos de referência em inglês da tarefa Liquidity do FINDSum. Os splits originais train, val e test foram reunidos antes da partição deste estudo. Registros sem resumo utilizável ou com menos de 100 palavras na referência foram descartados; para cada empresa, foi mantido deterministicamente o relatório mais recente. A semente 42 distribuiu empresas distintas entre 1.000 pares de exemplos, 500 documentos dev e 1.000 documentos eval. Os IDs, a origem de cada registro e a partição estão no manifesto congelado. Dev foi usado para validar a pipeline; eval é a coorte reservada para os resultados do artigo. Esta repartição impede que relatórios da mesma empresa cruzem esses conjuntos, mas não permite comparar diretamente nossos números com resultados publicados para o split oficial do FINDSum.
A ordem de execução de eval foi sorteada sem reposição com a semente cohort:42:eval e está registrada, com os IDs, em full-eval-cohort.csv. Como eval contém exatamente 1.000 documentos e o experimento usa os 1.000, o sorteio altera a ordem dos lotes, não a composição da amostra. Os lotes de 100 seguem essa ordem congelada; falhas são retomadas no mesmo documento, sem substituir casos difíceis por outros. O painel de resultados usa apenas o prefixo consecutivo concluído nos seis braços dos três modelos, de modo que todas as médias do recorte se referem aos mesmos documentos.
“Fonte inteira” significa a entrada disponível no FINDSum, composta pela prosa limpa selecionada pelo dataset e pelas tabelas brutas da seção Liquidity serializadas; não é o formulário 10-K original completo. A prosa de C1 não é montada pela concatenação dos chunks sobrepostos, evitando duplicação. A serialização mantém os valores brutos das células com conteúdo, inclusive ambiguidades; não fazemos correção financeira prévia ou filtro por valor.
| Braço | Evidência do documento-alvo | Demonstrações de outros documentos |
|---|---|---|
| C1 | Fonte inteira disponível | Nenhuma |
| C1t | Prefixo da fonte inteira, ajustado ao orçamento de C2 | Nenhuma |
| C2 | Trechos selecionados por RAG | Nenhuma |
| C3 | Mesmo contexto de C2 | Quatro exemplos fixos |
| C4 | Mesmo contexto de C2 | Quatro exemplos sorteados por documento |
| C5 | Mesmo contexto de C2 | Quatro exemplos similares ao documento-alvo |
C1t e C2 têm a mesma contagem de tokens de evidência e do prompt zero-shot completo, aferida com o tokenizador de cada modelo. Assim, H1b compara o conteúdo selecionado pelo RAG com um prefixo sob o mesmo orçamento. C2–C5 recebem exatamente o mesmo texto recuperado dentro de cada modelo; somente as demonstrações mudam. Como o corte usa o tokenizador de cada modelo, o contexto final pode diferir entre Ling, Qwen e Gemma.
O índice de contexto é construído separadamente para cada relatório-alvo; não consulta relatórios de outras empresas. Os trechos de prosa já delimitados pelo FINDSum são preservados e os maiores são divididos em janelas de 220 palavras com sobreposição de 40. As tabelas da seção Liquidity viram trechos próprios, mantendo cada linha/célula inteira. O índice contém trechos da prosa e dessas tabelas, mas só os selecionados e comportados no orçamento chegam ao prompt RAG.
O codificador local sentence-transformers/all-MiniLM-L6-v2 produz embeddings normalizados; textos longos são processados em janelas e agregados, cobrindo toda a prosa. O FAISS IndexFlatIP faz busca exata por similaridade de cosseno. A consulta do RAG é o embedding da instrução da tarefa Liquidity (fluxos de caixa, crédito, dívida e mudanças entre períodos), igual em texto para todos os alvos. A busca retorna até 12 trechos do próprio relatório, em ordem de similaridade. O contexto entregue é cortado em no máximo 3.072 tokens de evidência, respeitando linhas de tabela; C1t é ajustado ao mesmo tamanho efetivo. Esta recuperação seleciona evidência para resumir o alvo e é distinta da busca de exemplos de C5.
O banco few-shot contém apenas pares prosa do relatório + resumo de referência do conjunto examples, sem tabelas. Cada demonstração mostra o texto e o resumo integral desse outro documento; a configuração atual não aplica corte de palavras aos exemplos. A referência do documento avaliado nunca aparece no prompt nem no índice. Os quatro doc_id escolhidos por braço e por alvo ficam gravados nos artefatos preparados, permitindo identificar exatamente o que o modelo recebeu.
| Braço | Regra de escolha dos quatro exemplos |
|---|---|
| C3, fixos | Os quatro primeiros doc_id do banco de exemplos em ordem alfabética; os mesmos para todos os alvos. |
| C4, aleatórios | Para cada doc_id avaliado, random.Random(f"42:{doc_id}").sample(pool, 4): sorteio sem reposição no banco de exemplos, excluindo o próprio ID. O resultado muda entre alvos, mas se repete em retomadas e nos três modelos. |
| C5, similares | Embedding da prosa integral do alvo comparado aos embeddings das prosas integrais dos exemplos no FAISS; entram os quatro mais similares, excluindo o próprio ID. Os resumos de referência não participam da busca. |
O sorteio de C4 é independente do sorteio que definiu a ordem da coorte eval. C4 sorteia exemplos para cada alvo; não sorteia novos documentos de avaliação nem refaz o sorteio a cada chamada da API. C3, C4 e C5 usam o mesmo RAG de C2, isolando na comparação a regra de escolha das demonstrações.
Os seis braços usam as mesmas instruções de sistema e da tarefa Liquidity; variam apenas o conteúdo de TARGET_REPORT e a presença/seleção de EXAMPLES. As instruções estão em inglês e dizem que exemplos demonstram estilo e não são evidência sobre o alvo; pedem prosa contínua com até 750 palavras, fidelidade a valores e períodos, e omissão de afirmações sem suporte. Cada modelo gera via OpenRouter com provedor fixado, temperature=0, top_p=1, reasoning desligado, sem fallback e sem enviar seed. Temperatura zero não garante respostas idênticas se uma requisição precisar ser refeita.
Antes da geração, os 6.000 prompts de cada modelo (1.000 alvos × seis braços) são montados e validados com seu tokenizador: até 49.152 tokens de entrada, 8.192 reservados para saída e 256 de margem dentro da janela do endpoint. Um prompt que exceda o limite bloqueia a execução; não há corte silencioso de C1, exemplos ou instruções para fazê-lo caber. O orçamento de 3.072 tokens aplica-se só ao contexto RAG e ao controle C1t, não à fonte inteira de C1. Respostas com término length permanecem no conjunto, com sinalização; não repetimos uma geração só porque o resumo parece fraco. A política de retries cobre falhas transitórias da API e preserva respostas já aceitas.
Os cinco contrastes pré-definidos estão na tabela de hipóteses e contrastes observados: H1 (C2−C1) pergunta se selecionar trechos supera usar toda a fonte; H1b (C2−C1t) separa a seleção do efeito de reduzir o tamanho do contexto; H2 (C3−C2) testa acrescentar quatro exemplos fixos; H3 (C4−C3) mede a sensibilidade à troca dos exemplos fixos por sorteados; H4 (C5−C4) compara seleção por similaridade com sorteio. H3 não é teste de equivalência: um resultado sem significância não demonstra que C3 e C4 sejam iguais.
As métricas primárias são BERTScore F1 e ROUGE-L F1 contra o resumo de referência de cada alvo. BERTScore precisão/recall, ROUGE-1/2 e METEOR são descritivas. BERTScore usa xlnet-base-cased, camada 5, sem IDF/reescala e com auditoria da cobertura integral dos tokens, sem corte definitivo em 512 tokens. Diferenças são medidas nos mesmos documentos em cada par de braços e para cada modelo separadamente. Com os 1.000 documentos completos, a análise confirmatória usa Wilcoxon bilateral emparelhado, correção Holm nos dez testes por modelo (cinco contrastes × duas métricas), alfa 0,05, e rejeita dados incompletos. As médias e os gráficos do painel são descritivos; os 30 testes finais e sua interpretação são apresentados separadamente.
Essas métricas estimam semelhança com a referência, não a porcentagem de fatos corretos. O protocolo atual não inclui avaliação numérica separada nem revisão humana. Os resultados dizem respeito a empresas reservadas dentro do FINDSum, sem demonstrar generalização para outro corpus. Também não atribuímos diferenças entre modelos apenas à arquitetura: tokenizadores e provedores variam.
O manifesto, a ordem da coorte, a configuração científica, os modelos e limites, o lock, o código e as métricas individuais versionadas registram seleção, parâmetros e resultados. Localmente, outputs/full-{ling,qwen,gemma}-prepared/ conserva textos de entrada, contextos, IDs dos exemplos, prompts, contagens de tokens e preflight; outputs/full-{ling,qwen,gemma}-batches/ conserva tentativas e respostas, e outputs/full-rounds/ registra os planos de execução. O dataset bruto e esses artefatos locais não estão no Git: os resultados exatos não podem ser recalculados apenas a partir de um clone, sem o dataset e as respostas arquivadas. A publicação externa desses artefatos ainda depende do depósito planejado.
Coorte, parâmetros e versões permanecem congelados. Não ajustamos o protocolo com base nas métricas parciais de eval. findsum verify-full valida o lock antes de gerar ou recalcular os resultados. A auditoria final também depende de outputs/round-521-1000-20260929/, que guarda os backups anteriores à rodada, a auditoria da interrupção, a proveniência do reaproveitamento de scores e o monitoramento do saldo; inclua essa pasta no depósito externo.
uv run --locked findsum verify-full
uv run --locked pytest -q -m 'not slow' --ignore=tests/test_real_data.py
uv run --locked ruff check src scripts tests
O lock verifica código, dados, modelos locais, versões e compatibilidade dos artefatos preparados antes da geração. A migração de caminhos está documentada por hashes em configs/repository-layout.json; ela não autoriza alterações nos insumos científicos.
Esta revisão passou em 338 testes da suíte sem slow e test_real_data.py; a correção posterior da exportação CSV passou nos 20 testes de test_full_round.py. Ruff e verificação do lock também passaram. Os scores auditados têm IDs únicos e cobertura integral do texto; o snapshot dos primeiros 520 documentos permanece congelado.
Projeto de pós-graduação que compara seis configurações de sumarização e cinco contrastes planejados no FINDSum Liquidity. Preparação, recuperação e métricas são locais; a geração usa a API do OpenRouter. O objetivo é medir a semelhança dos resumos gerados com as referências do FINDSum, mantendo documentos e instruções comparáveis entre os braços.
BERTScore ampliado · ROUGE-L ampliado · METEOR ampliado · Evolução ampliada
1.000 documentos concluídos nos três modelos: 18.000 respostas e scores. O painel apresenta as médias descritivas por braço e modelo. Testes das hipóteses na coorte completa.
Cada contraste usa os mesmos documentos em dois braços. Δ positivo significa maior similaridade média com a referência no primeiro braço; Δ negativo, menor. As diferenças abaixo são pontos da escala 0 a 1, não percentuais de acerto.
| Hipótese | Comparação | Pergunta |
|---|---|---|
| H1 | C2 - C1 | RAG versus fonte inteira |
| H1b | C2 - C1t | RAG versus prefixo de igual orçamento |
| H2 | C3 - C2 | Quatro exemplos fixos versus zero-shot RAG |
| H3 | C4 - C3 | Aleatórios versus fixos: controle de sensibilidade |
| H4 | C5 - C4 | Similares versus aleatórios |
H3 é um controle de sensibilidade à escolha dos exemplos: uma diferença não significativa ao final não provaria equivalência. As métricas primárias são BERTScore F1 e ROUGE-L F1; METEOR e BERTScore precisão/recall são descritivos.
Recorte atual: 1000 documentos por modelo. Contrastes entre médias dos braços, arredondados a quatro casas:
| Modelo | Hipótese | Δ BERTScore F1 | Δ ROUGE-L F1 |
|---|---|---|---|
| Ling Flash Fin | H1 | -0,0356 | -0,0222 |
| Ling Flash Fin | H1b | +0,0346 | +0,0307 |
| Ling Flash Fin | H2 | -0,0178 | -0,0085 |
| Ling Flash Fin | H3 | +0,0108 | +0,0068 |
| Ling Flash Fin | H4 | +0,0054 | +0,0022 |
| Qwen3.7 Flash | H1 | -0,0382 | -0,0227 |
| Qwen3.7 Flash | H1b | +0,0061 | +0,0136 |
| Qwen3.7 Flash | H2 | -0,0053 | -0,0112 |
| Qwen3.7 Flash | H3 | +0,0147 | +0,0104 |
| Qwen3.7 Flash | H4 | +0,0075 | +0,0044 |
| Gemma 4 26B A4B | H1 | -0,0372 | -0,0239 |
| Gemma 4 26B A4B | H1b | +0,0256 | +0,0156 |
| Gemma 4 26B A4B | H2 | -0,0092 | -0,0071 |
| Gemma 4 26B A4B | H3 | +0,0096 | +0,0074 |
| Gemma 4 26B A4B | H4 | +0,0074 | +0,0058 |
Nos três modelos, H1 é negativa e H1b é positiva: o RAG ficou abaixo da fonte inteira, mas acima do prefixo com o mesmo orçamento de contexto. H2 é negativa: quatro exemplos fixos reduziram as duas métricas primárias frente ao RAG sem exemplos. H3 e H4 são positivas, com ganho menor em H4. Isso descreve este recorte e não estabelece eficácia causal ou qualidade factual.
Este painel apresenta diferenças descritivas. Os testes completos estão na tabela de comparações, calculados a partir do CSV versionado. O plano usa Wilcoxon bilateral emparelhado e Holm sobre dez testes por modelo. As saídas length permanecem na análise e podem afetar as médias. Os contrastes entre modelos não isolam arquitetura, tokenizador ou provedor.
A análise completa detectou diferenças em 28 dos 30 testes. Isso não confirma cinco hipóteses de melhora: H1 e H2 tiveram diferenças negativas nos três modelos. H1b no BERTScore do Qwen (p Holm = 0,1229) e H4 no ROUGE-L do Ling (p Holm = 0,0732) não foram significativas. Veja os testes, tamanhos de efeito e limites de interpretação. A última rodada de 480 documentos custou US$ 10,0683 de débito observado, deixando US$ 4,2149 na conta consultada.
Na raiz do repositório, com Python 3.12 e uv:
uv sync --locked
bash rodar_rodada.sh 100 --dry-run  # valida sem chamadas de geração
bash rodar_rodada.sh 100            # executa/retoma o mesmo grupo nos três modelos
bash rodar_rodada.sh --metrics-only # atualiza apenas métricas e painel, sem API
A preparação integral já existe neste workspace em outputs/full-{ling,qwen,gemma}-prepared. Uma nova instalação precisa do dataset, dos modelos locais e desses artefatos preparados; eles não estão no Git. O caminho da credencial é ../.env, variável OPEN_ROUTER_KEY. Nunca adicione esse arquivo ao repositório.
Cada documento tem seis gerações por modelo, além de retries. O script preserva a rodada incompleta e as respostas aceitas. Só avança para outro grupo na próxima invocação após a rodada atual estar completa. O prefixo gerado e pontuado está no painel acima; a próxima execução normal seleciona os documentos ainda não processados.
A coorte de 1.000 documentos está concluída: neste workspace, não há casos faltantes para novas chamadas. Preserve os artefatos; não remova respostas para repetir o experimento. --metrics-only permite conferir e reconstruir o painel a partir das gerações salvas.
A execução normal envia chamadas pagas de Qwen/Gemma. --dry-run, --metrics-only e --audit-ling-batch 1 são modos locais. Não apague outputs/full-rounds/active-round.json, os ledgers ou as pastas de respostas para tentar avançar.
| Modelo / provedor fixo | Ritmo máximo | Teto cumulativo de geração |
|---|---|---|
| Ling 3.0 Flash Fin gratuito / Novita | 20 RPM | US$ 0 |
| Ling 3.0 Flash Fin pago / Novita, apenas rodadas com adendo registrado | 500 RPM, adaptativo | US$ 5,00 cumulativo após autorização de 521–1000 |
| Qwen3.7 Flash / Alibaba | 500 RPM, adaptativo | US$ 18 |
| Gemma 4 26B A4B / Darkbloom | 500 RPM, adaptativo | US$ 9 |
Os tetos não garantem vazão sustentada ou conclusão com esse saldo. Nos pagos, erros transitórios reduzem ritmo/concorrência, respeitam Retry-After e voltam à fila, com até seis tentativas por ciclo. Resultado de transporte desconhecido ou resposta fora do contrato exige auditoria. Não há troca automática de modelo/provedor. O Ling pago foi autorizado para as rodadas 161–320, 321–520 e 521–1000, cada uma em adendo separado; o comportamento padrão continua gratuito. O adendo 521–1000 fixa tetos incrementais de US$ 3,20 para Ling, US$ 7,30 para Qwen e US$ 3,50 para Gemma: US$ 14,00 sobre o custo retido das tentativas, abaixo do saldo inicial consultado de US$ 14,2832. Uma nova rodada paga exige novo adendo antes da execução.
Uma tentativa interrompida sem resposta salva conserva sua reserva máxima de custo. Sua retomada exige uma auditoria local com SHA-256, conferência do request congelado e confirmação de que a resposta não existe. O script nunca repete uma resposta já aceita.
Ao encerrar, o Bash atualiza results/progress/ usando somente o prefixo completo comum aos três modelos. Usa cache para evitar recálculo. Não faz commit ou push automaticamente:
A avaliação calcula somente os pares ausentes no cache comum, em blocos de 120, com cobertura integral dos textos. O término de cada modelo não recalcula os 6.000 pares separadamente. Com os 1.000 documentos completos nos três modelos, o Bash também grava comparisons.csv, comparisons.json e analysis.json, aplicando o plano congelado ao CSV versionado. Os testes não exigem chamadas adicionais à API.
git add results/progress README.md
git commit -m "results: atualiza acompanhamento do experimento"
git push origin main
src/findsum_rag/       Biblioteca: dados, RAG, prompts, API e métricas
scripts/
  data/               Download do FINDSum e criação de splits
  preparation/        Prompts, tokenizers, preflight e congelamento
  execution/          Rodadas, lotes, concorrência e retomada
  evaluation/         Métricas, auditoria e painel incremental
  reports/            Exportadores e templates de relatórios locais
  experiments/        PoCs, diagnósticos e benchmarks auxiliares
  common/             Contratos compartilhados dos scripts
configs/              Configuração, coorte e locks de integridade
tests/                Testes automatizados
results/              Métricas e gráficos versionados
docs/                 Guias e interpretação das métricas
outputs/              Artefatos locais e notas históricas (fora do Git)
Os scripts são módulos Python; use python -m scripts.<grupo>.<modulo>. Comandos e responsabilidades. Os comandos findsum e o Bash continuam sendo as entradas principais. Os módulos científicos em src/findsum_rag/ mantêm seus caminhos.
Os HTMLs gerados ficam em outputs/reports/. Notas de execução, diagnósticos e documentos antigos foram retirados da árvore atual do Git; o histórico de commits permanece disponível. A reorganização local preservou cópias em outputs/arquivo-local/.
Usamos os trechos selecionados e os resumos de referência em inglês da tarefa Liquidity do FINDSum. Os splits originais train, val e test foram reunidos antes da partição deste estudo. Registros sem resumo utilizável ou com menos de 100 palavras na referência foram descartados; para cada empresa, foi mantido deterministicamente o relatório mais recente. A semente 42 distribuiu empresas distintas entre 1.000 pares de exemplos, 500 documentos dev e 1.000 documentos eval. Os IDs, a origem de cada registro e a partição estão no manifesto congelado. Dev foi usado para validar a pipeline; eval é a coorte reservada para os resultados do artigo. Esta repartição impede que relatórios da mesma empresa cruzem esses conjuntos, mas não permite comparar diretamente nossos números com resultados publicados para o split oficial do FINDSum.
A ordem de execução de eval foi sorteada sem reposição com a semente cohort:42:eval e está registrada, com os IDs, em full-eval-cohort.csv. Como eval contém exatamente 1.000 documentos e o experimento usa os 1.000, o sorteio altera a ordem dos lotes, não a composição da amostra. Os lotes de 100 seguem essa ordem congelada; falhas são retomadas no mesmo documento, sem substituir casos difíceis por outros. O painel de resultados usa apenas o prefixo consecutivo concluído nos seis braços dos três modelos, de modo que todas as médias do recorte se referem aos mesmos documentos.
“Fonte inteira” significa a entrada disponível no FINDSum, composta pela prosa limpa selecionada pelo dataset e pelas tabelas brutas da seção Liquidity serializadas; não é o formulário 10-K original completo. A prosa de C1 não é montada pela concatenação dos chunks sobrepostos, evitando duplicação. A serialização mantém os valores brutos das células com conteúdo, inclusive ambiguidades; não fazemos correção financeira prévia ou filtro por valor.
| Braço | Evidência do documento-alvo | Demonstrações de outros documentos |
|---|---|---|
| C1 | Fonte inteira disponível | Nenhuma |
| C1t | Prefixo da fonte inteira, ajustado ao orçamento de C2 | Nenhuma |
| C2 | Trechos selecionados por RAG | Nenhuma |
| C3 | Mesmo contexto de C2 | Quatro exemplos fixos |
| C4 | Mesmo contexto de C2 | Quatro exemplos sorteados por documento |
| C5 | Mesmo contexto de C2 | Quatro exemplos similares ao documento-alvo |
C1t e C2 têm a mesma contagem de tokens de evidência e do prompt zero-shot completo, aferida com o tokenizador de cada modelo. Assim, H1b compara o conteúdo selecionado pelo RAG com um prefixo sob o mesmo orçamento. C2–C5 recebem exatamente o mesmo texto recuperado dentro de cada modelo; somente as demonstrações mudam. Como o corte usa o tokenizador de cada modelo, o contexto final pode diferir entre Ling, Qwen e Gemma.
O índice de contexto é construído separadamente para cada relatório-alvo; não consulta relatórios de outras empresas. Os trechos de prosa já delimitados pelo FINDSum são preservados e os maiores são divididos em janelas de 220 palavras com sobreposição de 40. As tabelas da seção Liquidity viram trechos próprios, mantendo cada linha/célula inteira. O índice contém trechos da prosa e dessas tabelas, mas só os selecionados e comportados no orçamento chegam ao prompt RAG.
O codificador local sentence-transformers/all-MiniLM-L6-v2 produz embeddings normalizados; textos longos são processados em janelas e agregados, cobrindo toda a prosa. O FAISS IndexFlatIP faz busca exata por similaridade de cosseno. A consulta do RAG é o embedding da instrução da tarefa Liquidity (fluxos de caixa, crédito, dívida e mudanças entre períodos), igual em texto para todos os alvos. A busca retorna até 12 trechos do próprio relatório, em ordem de similaridade. O contexto entregue é cortado em no máximo 3.072 tokens de evidência, respeitando linhas de tabela; C1t é ajustado ao mesmo tamanho efetivo. Esta recuperação seleciona evidência para resumir o alvo e é distinta da busca de exemplos de C5.
O banco few-shot contém apenas pares prosa do relatório + resumo de referência do conjunto examples, sem tabelas. Cada demonstração mostra o texto e o resumo integral desse outro documento; a configuração atual não aplica corte de palavras aos exemplos. A referência do documento avaliado nunca aparece no prompt nem no índice. Os quatro doc_id escolhidos por braço e por alvo ficam gravados nos artefatos preparados, permitindo identificar exatamente o que o modelo recebeu.
| Braço | Regra de escolha dos quatro exemplos |
|---|---|
| C3, fixos | Os quatro primeiros doc_id do banco de exemplos em ordem alfabética; os mesmos para todos os alvos. |
| C4, aleatórios | Para cada doc_id avaliado, random.Random(f"42:{doc_id}").sample(pool, 4): sorteio sem reposição no banco de exemplos, excluindo o próprio ID. O resultado muda entre alvos, mas se repete em retomadas e nos três modelos. |
| C5, similares | Embedding da prosa integral do alvo comparado aos embeddings das prosas integrais dos exemplos no FAISS; entram os quatro mais similares, excluindo o próprio ID. Os resumos de referência não participam da busca. |
O sorteio de C4 é independente do sorteio que definiu a ordem da coorte eval. C4 sorteia exemplos para cada alvo; não sorteia novos documentos de avaliação nem refaz o sorteio a cada chamada da API. C3, C4 e C5 usam o mesmo RAG de C2, isolando na comparação a regra de escolha das demonstrações.
Os seis braços usam as mesmas instruções de sistema e da tarefa Liquidity; variam apenas o conteúdo de TARGET_REPORT e a presença/seleção de EXAMPLES. As instruções estão em inglês e dizem que exemplos demonstram estilo e não são evidência sobre o alvo; pedem prosa contínua com até 750 palavras, fidelidade a valores e períodos, e omissão de afirmações sem suporte. Cada modelo gera via OpenRouter com provedor fixado, temperature=0, top_p=1, reasoning desligado, sem fallback e sem enviar seed. Temperatura zero não garante respostas idênticas se uma requisição precisar ser refeita.
Antes da geração, os 6.000 prompts de cada modelo (1.000 alvos × seis braços) são montados e validados com seu tokenizador: até 49.152 tokens de entrada, 8.192 reservados para saída e 256 de margem dentro da janela do endpoint. Um prompt que exceda o limite bloqueia a execução; não há corte silencioso de C1, exemplos ou instruções para fazê-lo caber. O orçamento de 3.072 tokens aplica-se só ao contexto RAG e ao controle C1t, não à fonte inteira de C1. Respostas com término length permanecem no conjunto, com sinalização; não repetimos uma geração só porque o resumo parece fraco. A política de retries cobre falhas transitórias da API e preserva respostas já aceitas.
Os cinco contrastes pré-definidos estão na tabela de hipóteses e contrastes observados: H1 (C2−C1) pergunta se selecionar trechos supera usar toda a fonte; H1b (C2−C1t) separa a seleção do efeito de reduzir o tamanho do contexto; H2 (C3−C2) testa acrescentar quatro exemplos fixos; H3 (C4−C3) mede a sensibilidade à troca dos exemplos fixos por sorteados; H4 (C5−C4) compara seleção por similaridade com sorteio. H3 não é teste de equivalência: um resultado sem significância não demonstra que C3 e C4 sejam iguais.
As métricas primárias são BERTScore F1 e ROUGE-L F1 contra o resumo de referência de cada alvo. BERTScore precisão/recall, ROUGE-1/2 e METEOR são descritivas. BERTScore usa xlnet-base-cased, camada 5, sem IDF/reescala e com auditoria da cobertura integral dos tokens, sem corte definitivo em 512 tokens. Diferenças são medidas nos mesmos documentos em cada par de braços e para cada modelo separadamente. Com os 1.000 documentos completos, a análise confirmatória usa Wilcoxon bilateral emparelhado, correção Holm nos dez testes por modelo (cinco contrastes × duas métricas), alfa 0,05, e rejeita dados incompletos. As médias e os gráficos do painel são descritivos; os 30 testes finais e sua interpretação são apresentados separadamente.
Essas métricas estimam semelhança com a referência, não a porcentagem de fatos corretos. O protocolo atual não inclui avaliação numérica separada nem revisão humana. Os resultados dizem respeito a empresas reservadas dentro do FINDSum, sem demonstrar generalização para outro corpus. Também não atribuímos diferenças entre modelos apenas à arquitetura: tokenizadores e provedores variam.
O manifesto, a ordem da coorte, a configuração científica, os modelos e limites, o lock, o código e as métricas individuais versionadas registram seleção, parâmetros e resultados. Localmente, outputs/full-{ling,qwen,gemma}-prepared/ conserva textos de entrada, contextos, IDs dos exemplos, prompts, contagens de tokens e preflight; outputs/full-{ling,qwen,gemma}-batches/ conserva tentativas e respostas, e outputs/full-rounds/ registra os planos de execução. O dataset bruto e esses artefatos locais não estão no Git: os resultados exatos não podem ser recalculados apenas a partir de um clone, sem o dataset e as respostas arquivadas. A publicação externa desses artefatos ainda depende do depósito planejado.
Coorte, parâmetros e versões permanecem congelados. Não ajustamos o protocolo com base nas métricas parciais de eval. findsum verify-full valida o lock antes de gerar ou recalcular os resultados. A auditoria final também depende de outputs/round-521-1000-20260929/, que guarda os backups anteriores à rodada, a auditoria da interrupção, a proveniência do reaproveitamento de scores e o monitoramento do saldo; inclua essa pasta no depósito externo.
uv run --locked findsum verify-full
uv run --locked pytest -q -m 'not slow' --ignore=tests/test_real_data.py
uv run --locked ruff check src scripts tests
O lock verifica código, dados, modelos locais, versões e compatibilidade dos artefatos preparados antes da geração. A migração de caminhos está documentada por hashes em configs/repository-layout.json; ela não autoriza alterações nos insumos científicos.
Esta revisão passou em 338 testes da suíte sem slow e test_real_data.py; a correção posterior da exportação CSV passou nos 20 testes de test_full_round.py. Ruff e verificação do lock também passaram. Os scores auditados têm IDs únicos e cobertura integral do texto; o snapshot dos primeiros 520 documentos permanece congelado.



