
README
llm-course-chn
许可
向mlabonne申请了中文的翻译许可!
https://github.com/mlabonne/llm-course/issues/57
🗣️ 大语言模型课程
🐦 在X上关注我 • 🤗 Hugging Face • 💻 博客 • 📙 动手学图神经网络 • 🗣️ 交互式GPT
大语言模型课程分为三个部分:
- 🧩 LLM基础 涵盖关于数学、Python和神经网络的基础知识。
- 🧑🔬 LLM科学家 侧重于使用最新技术构建最佳的LLM。
- 👷 LLM工程师 侧重于创建基于LLM的应用程序并部署它们。
📝 笔记本
与大语言模型相关的笔记本和文章列表。
工具
| 笔记本 | 描述 | 笔记本 |
|---|---|---|
| 🧐 LLM自动评估 | 使用RunPod自动评估您的LLM |  |
| 🥱 LazyMergekit | 使用mergekit一键轻松合并模型。 | |
| 🦎 LazyAxolotl | 一键在云上微调模型。 | |
| ⚡ AutoGGUF | 一键将LLM量化为GGUF格式。 | |
| 🌳 模型家族树 | 可视化合并模型的家族树。 | |
微调
| 笔记本 | 描述 | 文章 | 笔记本 |
|---|---|---|---|
| 在Google Colab中微调Llama 2 | 一步一步指导如何微调您的第一个Llama 2模型。 | 文章 | |
| 使用Axolotl微调LLM | 微调的最新工具的端到端指南。 | 文章 | |
| 使用DPO微调Mistral-7b | 通过DPO提升监督微调模型的性能。 | 文章 | |
量化
| 笔记本 | 描述 | 文章 | 笔记本 |
|---|---|---|---|
| 1. 量化入门 | 使用8位量化优化大型语言模型。 | 文章 | |
| 2. 使用GPTQ进行4位量化 | 将您自己的开源LLM量化,以便在消费硬件上运行。 | 文章 | |
| 3. 使用GGUF和llama.cpp量化 | 使用llama.cpp量化Llama 2模型,并将GGUF版本上传到HF Hub。 | 文章 | |
| 4. ExLlamaV2:最快的运行LLM库 | 量化并运行EXL2模型,并将它们上传到HF Hub。 | 文章 | |
其他
| 笔记本 | 描述 | 文章 | 笔记本 |
|---|---|---|---|
| 大型语言模型中的解码策略 | 从束搜索到核心抽样的文本生成指南 | 文章 | |
| 可视化GPT-2的损失 | 基于权重扰动的损失3D图。 | 推文 | |
| 用知识图谱改善ChatGPT | 用知识图谱增强ChatGPT的回答。 | 文章 | |
| 使用mergekit合并LLM | 轻松创建您自己的模型,无需GPU! | 文章 | |
🧩 LLM基础
1. 机器学习的数学
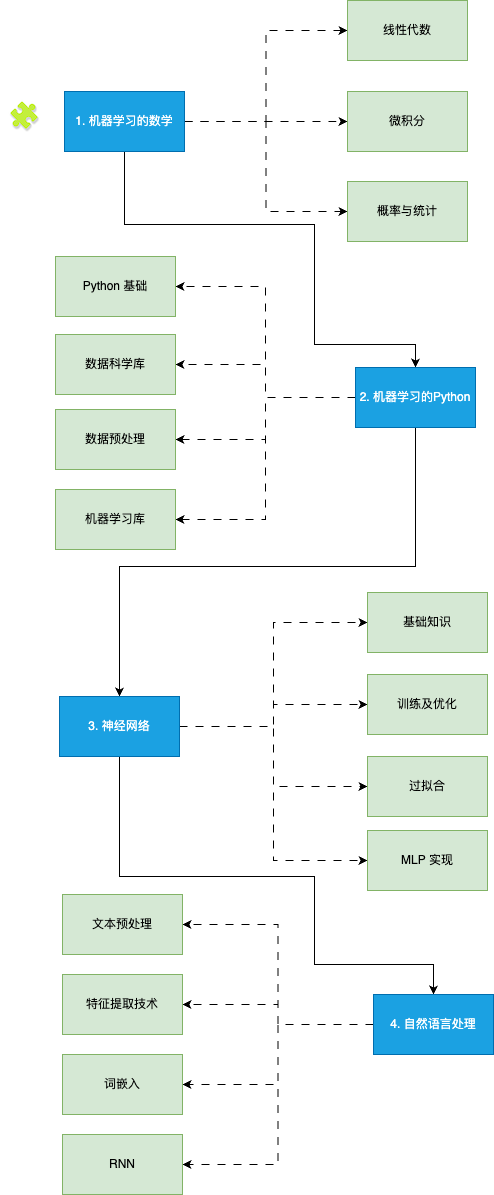
在掌握机器学习之前,了解驱动这些算法的基本数学概念非常重要。
- 线性代数:这对于理解许多算法尤其是在深度学习中使用的算法至关重要。关键概念包括向量、矩阵、行列式、特征值和特征向量、向量空间和线性变换。
- 微积分:许多机器学习算法涉及连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分和梯度概念也很重要。
- 概率与统计:这些对于理解模型如何从数据中学习并做出预测至关重要。关键概念包括概率论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。
📚 资源:
- 3Blue1Brown - 线性代数的精髓:一系列视频,提供了这些概念的几何直观感受。
- StatQuest with Josh Starmer - 统计学基础:为许多统计概念提供简单明了的解释。
- AP Statistics Intuition by Ms Aerin:Medium文章列表,提供了每个概率分布背后的直觉理解。
- 沉浸式线性代数:线性代数的另一种视觉解读。
- Khan Academy - 线性代数:非常适合初学者,以非常直观的方式解释概念。
- Khan Academy - 微积分:一个涵盖所有基础微积分概念的互动课程。
- Khan Academy - 概率与统计:以易于理解的格式提供材料。
2. 机器学习的Python
Python是一种功能强大且灵活的编程语言,特别适用于机器学习,这得益于其可读性、一致性和健壮的数据科学库生态系统。
- Python基础:Python编程需要理解基本语法、数据类型、错误处理和面向对象编程。
- 数据科学库:熟悉NumPy进行数值操作,用Pandas进行数据处理和分析,用Matplotlib和Seaborn做数据可视化。
- 数据预处理:涉及特征缩放和规范化、处理缺失数据、异常检测、类别数据编码,以及将数据分割为训练、验证和测试集。
- 机器学习库:熟练使用Scikit-learn,这是一个提供广泛的监督和无监督学习算法的python库,至关重要。理解如何实现线性回归、逻辑回归、决策树、随机森林、最近邻(K-NN)和K均值聚类等算法很重要。降维技术如PCA和t-SNE对于可视化高维数据也很有帮助。
📚 资源:
- Real Python:一个全面的资源,提供针对Python初学者和高级概念的文章和教程。
- freeCodeCamp - 学习Python:提供Python所有核心概念全面介绍的长视频。
- Python数据科学手册:一个很好的学习pandas、NumPy、Matplotlib和Seaborn的免费数字书。
- freeCodeCamp - 机器学习入门:为初学者提供不同机器学习算法的实用介绍。
- Udacity - 机器学习入门:一个免费课程,涵盖了PCA和其他几个机器学习概
3. 神经网络
神经网络是许多机器学习模型的基础部分,特别是在深度学习领域。为了有效地利用它们,对它们的设计和机制有一个全面的理解是必要的。
- 基础知识:这包括了解神经网络的结构,如层、权重、偏差和激活函数(sigmoid、tanh、ReLU等)。
- 训练和优化:熟悉反向传播和不同类型的损失函数,如均方误差(MSE)和交叉熵。理解各种优化算法,如梯度下降、随机梯度下降、RMSprop和Adam。
- 过拟合:理解过拟合的概念(模型在训练数据上表现良好但在未见数据上表现不佳)并学习各种正则化技术(dropout、L1/L2正则化、提前停止、数据增强)来防止它。
- 实现多层感知机(MLP):使用PyTorch构建一个MLP,也称为全连接网络。
📚 资源:
- 3Blue1Brown - 神经网络是什么?:这个视频直观地解释了神经网络及其内部工作原理。
- freeCodeCamp - 深度学习速成课:这个视频高效地介绍了深度学习中所有最重要的概念。
- Fast.ai - 实用深度学习:为有编程经验想学习深度学习的人设计的免费课程。
- Patrick Loeber - PyTorch教程:一系列视频,让完全的初学者学习PyTorch。
4. 自然语言处理(NLP)
NLP是人工智能的一个迷人分支,它桥接了人类语言与机器理解之间的差距。从简单的文本处理到理解语言细微差别,NLP在许多应用中发挥着关键作用,如翻译、情感分析、聊天机器人等等。
- 文本预处理:学习各种文本预处理步骤,如分词(将文本分割成单词或句子)、词干提取(将词汇还原到其根形式)、词形还原(类似于词干提取但考虑上下文)、停用词移除等。
- 特征提取技术:熟悉将文本数据转换为机器学习算法能理解的格式的技术。关键方法包括词袋(BoW)、词频-逆文档频率(TF-IDF)和n-gram。
- 词嵌入:词嵌入是一种词表示方式,允许意义相近的词有相似的表示。关键方法包括Word2Vec、GloVe和FastText。
- 循环神经网络(RNNs):理解RNN的工作原理,RNN是一种设计用来处理序列数据的神经网络。探索LSTM和GRU,这两种RNN变体能够学习长期依赖。
📚 资源:
- RealPython - 使用spaCy进行Python自然语言处理:关于Python中spaCy库进行NLP任务的详尽指南。
- Kaggle - NLP指南:一些笔记本和资源,用于Python中NLP的实践解释。
- Jay Alammar - Word2Vec图解:理解著名的Word2Vec架构的好参考。
- Jake Tae - 从零开始的PyTorch RNN:在PyTorch中实践和简单实现RNN、LSTM和GRU模型。
- colah的博客 - 理解LSTM网络:关于LSTM网络的更理论化文章。
🧑🔬 LLM科学家
本课程部分侧重于学习如何使用最新技术构建最佳的LLM。
1. LLM架构
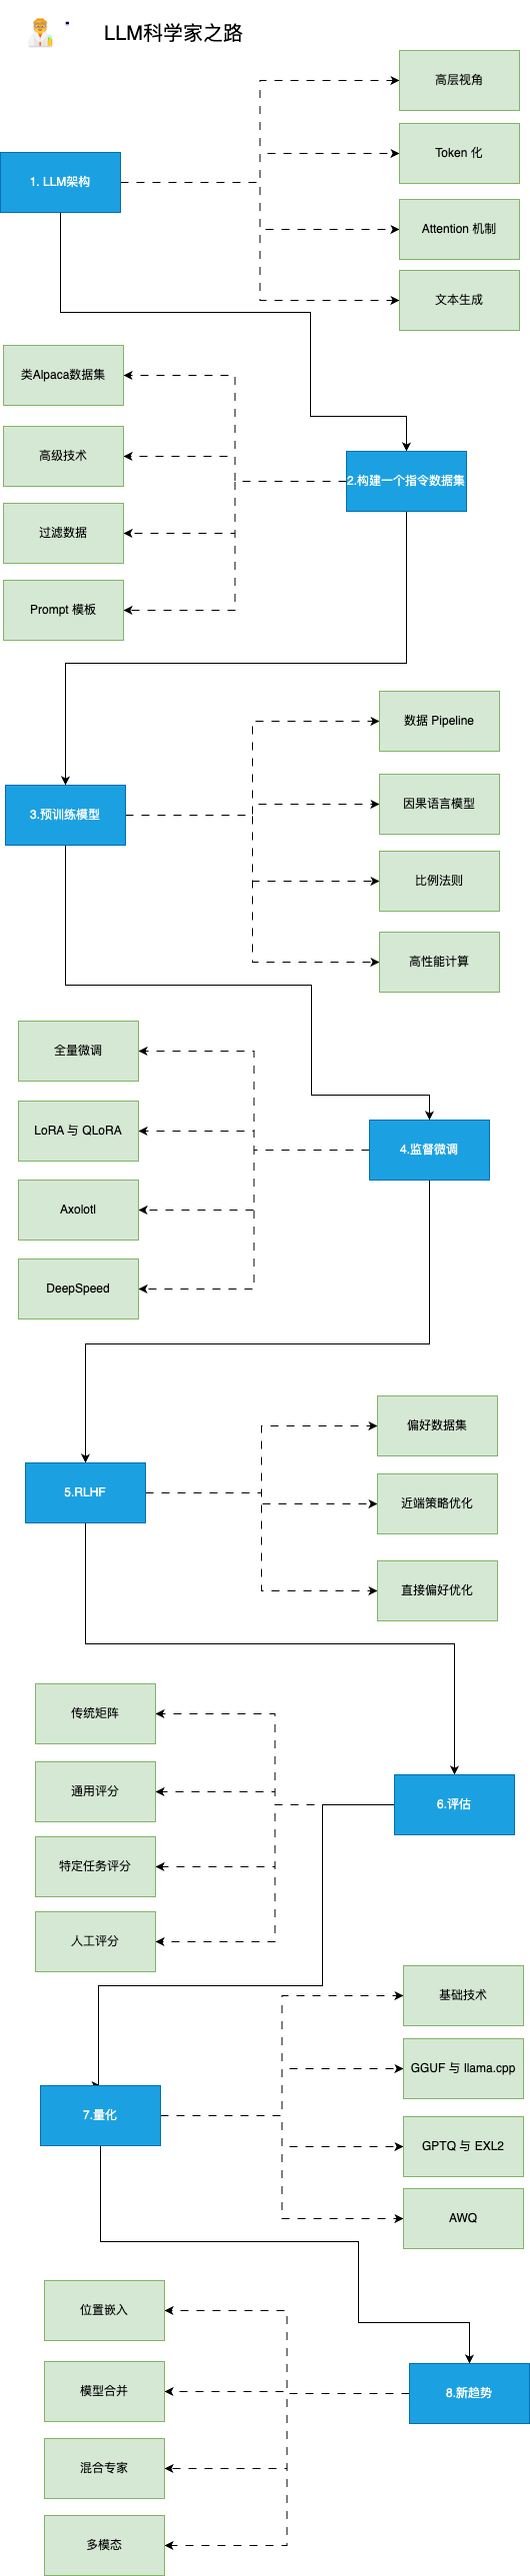
虽然不需要深入了解Transformer架构,但重要的是要很好地理解它的输入(令牌)和输出(logits)。原始注意力机制是另一个需要掌握的关键组成部分,因为后续会介绍它的改进版本。
- 高层视图:回顾编码器-解码器Transformer架构,更具体地说是在每个现代LLM中使用的仅解码器GPT架构。
- 令牌化:理解如何将原始文本数据转换成模型可以理解的格式,这涉及将文本分割成令牌(通常是单词或子词)。
- 注意力机制:掌握注意力机制背后的理论,包括自注意力和缩放点积注意力,这使得模型在产生输出时能够关注输入的不同部分。
- 文本生成:了解模型可以生成输出序列的不同方式。常见策略包括贪婪解码、束搜索、Top-k采样和核采样。
📚 参考资料:
- 插图式Transformer 作者Jay Alammar:对Transformer模型的直观和视觉解释。
- 插图式GPT-2 作者Jay Alammar:比前一篇文章更重要,它专注于GPT架构,与Llama非常相似。
- LLM可视化 作者Brendan Bycroft:令人难以置信的LLM内部3D可视化。
- nanoGPT 作者Andrej Karpathy:一个2小时长的YouTube视频,从头开始重新实现GPT(面向程序员)。
- 注意力?注意力! 作者Lilian Weng:以更正式的方式介绍注意力的需求。
- LLM中的解码策略:提供代码和直观介绍不同文本生成解码策略。
2. 构建指令数据集
虽然从维基百科和其他网站找到原始数据很容易,但在野外收集指令和答案的配对却很难。就像在传统机器学习中一样,数据集的质量将直接影响模型的质量,这就是为什么它可能是微调过程中最重要的组件。
- Alpaca-样数据集:使用OpenAI API(GPT)从头生成合成数据。您可以指定种子和系统提示来创建多样化的数据集。
- 高级技术:了解如何使用Evol-Instruct改进现有数据集,如何像Orca和phi-1论文中那样生成高质量合成数据。
- 过滤数据:传统技术包括使用正则表达式、删除近似重复项、专注于含有大量令牌的答案等。
- 提示模板:没有真正的标准格式来格式化指令和答案,这就是为什么了解不同的聊天模板很重要,例如ChatML、Alpaca等。
📚 参考资料:
- 为指令调优准备数据集 作者Thomas Capelle:探索Alpaca和Alpaca-GPT4数据集及其格式化方式。
- 生成葡萄牙语临床指令数据集 作者Solano Todeschini:教程,介绍如何使用GPT-4创建合成指令数据集。
- 使用GPT 3.5进行新闻分类 作者Kshitiz Sahay:使用GPT 3.5创建指令数据集,以微调Llama 2进行新闻分类。
- 微调LLM的数据集创建:包含一些过滤数据集并上传结果的技术的笔记本。
- 聊天模板 作者Matthew Carrigan:Hugging Face关于提示模板的页面。
3. 预训练模型
预训练是一个非常漫长且成本高昂的过程,这就是为什么这不是本课程的重点。了解预训练期间发生的事情的某种程度是好的,但不需要亲手实践。
- 数据管道:预训练需要巨大的数据集(例如,Llama 2是在2万亿令牌上训练的)需要过滤、令牌化,并与预定义的词汇表协同。
- 因果语言建模:了解因果和掩码语言建模的区别,以及在这种情况下使用的损失函数。为了高效预训练,进一步了解Megatron-LM或gpt-neox。
- 规模定律:规模定律根据模型大小、数据集大小和用于训练的计算量描述了预期的模型性能。
- 高性能计算:这里不在讨论范围内,但如果你计划从头开始创建自己的LLM(硬件、分布式工作负载等),更多关于HPC的知识是基础。
📚 参考资料:
- LLMDataHub 作者Junhao Zhao:为预训练、微调和RLHF精心策划的数据集列表。
- 从头开始预训练因果语言模型 作者Hugging Face:使用transformers库从头开始预训练GPT-2模型。
- TinyLlama 作者Zhang等:查看此项目以深入了解如何从头开始训练Llama模型。
- 因果语言建模 作者Hugging Face:解释因果和掩码语言建模的区别,以及如何快速微调DistilGPT-2模型。
- Chinchilla的狂野含义 作者nostalgebraist:讨论规模定律并解释它们对LLM通常意味着什么。
- BLOOM 作者BigScience:Notion页面描述了如何构建BLOOM模型,包含大量关于工程部分和遇到的问题的有用信息。
- OPT-175日志 作者Meta:研究日志显示了什么出了问题,什么做得对。如果你计划预训练一个非常大的语言模型(在这种情况下,175B参数),这非常有用。
- LLM 360:一个开源LLM的框架,包含训练和数据准备代码、数据、指标和模型。
4. 监督式微调
预训练模型仅在下一个令牌预测任务上进行训练,这就是为什么它们不是有用的助手。SFT允许您调整它们以响应指令。此外,它允许您在任何数据上(私有的,GPT-4未见过的等)微调模型,并在不必支付OpenAI等API费用的情况下使用它。
- 全面微调:全面微调指的是训练模型中的所有参数。这不是一种高效的技术,但它产生略微更好的结果。
- LoRA:一种基于低秩适配器的参数高效技术(PEFT)。我们不是训练所有参数,而只训练这些适配器。
- QLoRA:另一种基于LoRA的PEFT,它还将模型的权重量化为4比特,并引入分页优化器来管理内存峰值。结合Unsloth在免费的Colab笔记本上高效运行。
- Axolotl:一个用户友好且功能强大的微调工具,用于许多最先进的开源模型。
- DeepSpeed:高效的预训练和微调LLM,适用于多GPU和多节点设置(在Axolotl中实现)。
📚 参考资料:
- 新手LLM训练指南 作者Alpin:微调LLM时考虑的主要概念和参数的概览。
- LoRA洞见 作者Sebastian Raschka:关于LoRA的实践见解以及如何选择最佳参数。
- 微调你自己的Llama 2模型:手把手教程,介绍如何使用Hugging Face库微调Llama 2模型。
- 为因果LLM填充训练示例 作者Benjamin Marie:因果LLM填充训练示例的最佳实践
- LLM微调入门指南:教程,介绍如何使用Axolotl微调CodeLlama模型。
5. 人类反馈的强化学习
在监督式微调之后,RLHF是用来将LLM的答案与人类期望对齐的一步。其思想是从人类(或人工)反馈中学习偏好,这可以用来减少偏见、审查模型或使其以更有用的方式行动。它比SFT更复杂,通常被视为可选的。
- 偏好数据集:这些数据集通常包含有某种排名的几个答案,这使得它们比指令数据集更难产出。
- 近端策略优化:这种算法利用一个奖励模型,预测给定文本是否由人类高度评价。然后,这个预测被用来优化SFT模型,基于KL散度的惩罚。
- 直接偏好优化:DPO通过将问题重构为一个分类问题来简化过程。它使用一个参考模型而不是奖励模型(无需训练),只需要一个超参数,使其更稳定和高效。
📚 参考资料:
- 使用RLHF训练LLM的介绍 作者Ayush Thakur:解释为什么使用RLHF减少偏见和提高LLM的性能是可取的。
- RLHF插图 作者Hugging Face:使用奖励模型训练和强化学习微调的RLHF介绍。
- StackLLaMA 作者Hugging Face:使用transformers库高效对齐LLaMA模型与RLHF的教程。
- LLM训练:RLHF及其替代方案 作者Sebastian Rashcka:RLHF过程及其替代方案如RLAIF的概览。
- 使用DPO微调Mistral-7b:使用DPO微调Mistral-7b模型并复制NeuralHermes-2.5的教程。
6. 评估
评估LLM是流程中一个被低估的部分,它既耗时又相对可靠。您的下游任务应该决定您想要评估什么,但总是记得好特德法则:“当一个度量成为目标时,它就不再是一个好的度量。”
- 传统指标:像困惑度和BLEU分数这样的指标因为在大多数情境下都存在缺陷而不再流行。了解它们并知道它们何时可以应用仍然很重要。
- 通用基准:基于语言模型评估工具包,Open LLM排行榜是通用LLM(如ChatGPT)的主要基准。还有其他流行的基准,如BigBench、MT-Bench等。
- 任务特定基准:如摘要、翻译和问答任务有专门的基准、指标,甚至子领域(医学、金融等),例如生物医学问答的PubMedQA。
- 人类评估:最可靠的评估是用户的接受率或人类进行的比较。如果您想知道模型是否表现良好,最简单但最确实的方式是自己使用它。
📚 参考资料:
- 固定长度模型的困惑度 作者Hugging Face:使用transformers库实现困惑度的概览及代码。
- 自担风险的BLEU 作者Rachael Tatman:BLEU分数及其众多问题的概览及示例。
- LLM评估综述 作者Chang等:关于评估什么、在哪里评估以及如何评估的综合论文。
- 聊天机器人竞技场排行榜 作者lmsys:基于人类比较的通用用途LLM的Elo评分。
7. 量化
量化是使用较低精度转换模型的权重(和激活)的过程。例如,使用16位存储的权重可以转换为4位表示。这项技术变得越来越重要,以减少与LLM相关的计算和内存成本。
- 基础技术:了解不同精度级别(FP32、FP16、INT8等)以及如何使用absmax和零点技术进行简单量化。
- GGUF和llama.cpp:最初设计用于在CPU上运行,llama.cpp和GGUF格式已成为在消费级硬件上运行LLM的最受欢迎的工具。
- GPTQ和EXL2:GPTQ特别是EXL2格式提供了令人难以置信的速度,但只能在GPU上运行。模型量化也需要很长时间。
- AWQ:这种新格式比GPTQ更精确(困惑度更低),但使用的VRAM更多,不一定更快。
📚 参考资料:
- 量化入门:量化的概览,absmax和零点量化,以及LLM.int8()的代码。
- 使用llama.cpp量化Llama模型:使用llama.cpp和GGUF格式量化Llama 2模型的教程。
- 使用GPTQ进行4位LLM量化:使用GPTQ算法和AutoGPTQ量化LLM的教程。
- ExLlamaV2:运行LLM的最快库:使用EXL2格式量化Mistral模型并使用ExLlamaV2库运行它的指南。
- 了解激活感知权重量化 作者FriendliAI:AWQ技术及其优点的概览。
8. 新趋势
- 位置嵌入:了解LLM如何编码位置,尤其是像RoPE这样的相对位置编码方案。实现YaRN(通过温度因子乘以注意力矩阵)或ALiBi(基于令牌距离的注意力惩罚)以扩展上下文长度。
- 模型合并:合并训练好的模型已成为一种流行的创建性能模型而无需任何微调的方式。流行的mergekit库实现了最流行的合并方法,如SLERP、DARE和TIES。
- 专家混合:Mixtral由于其出色的性能重新使MoE架构流行起来。同时,通过合并模型(如Phixtral)在OSS社区中出现了一种frankenMoE,这是一个更便宜且高性能的选项。
- 多模态模型:这些模型(如CLIP、Stable Diffusion或LLaVA)能够使用统一的嵌入空间处理多种类型的输入(文本、图像、音频等),解锁了强大的应用,如文本到图像。
📚 参考资料:
- 扩展RoPE 作者EleutherAI:总结不同位置编码技术的文章。
- 理解YaRN 作者Rajat Chawla:YaRN介绍。
- 使用mergekit合并LLM:使用mergekit进行模型合并的教程。
- 专家混合解释 作者Hugging Face:关于MoE及其工作原理的详尽指南。
- 大型多模态模型 作者Chip Huyen:多模态系统及该领域近期历史的概览。
👷 LLM工程师
本课程部分专注于学习如何构建LLM驱动的可以用于生产的应用程序,重点是增强模型和部署它们。
1. 运行LLM
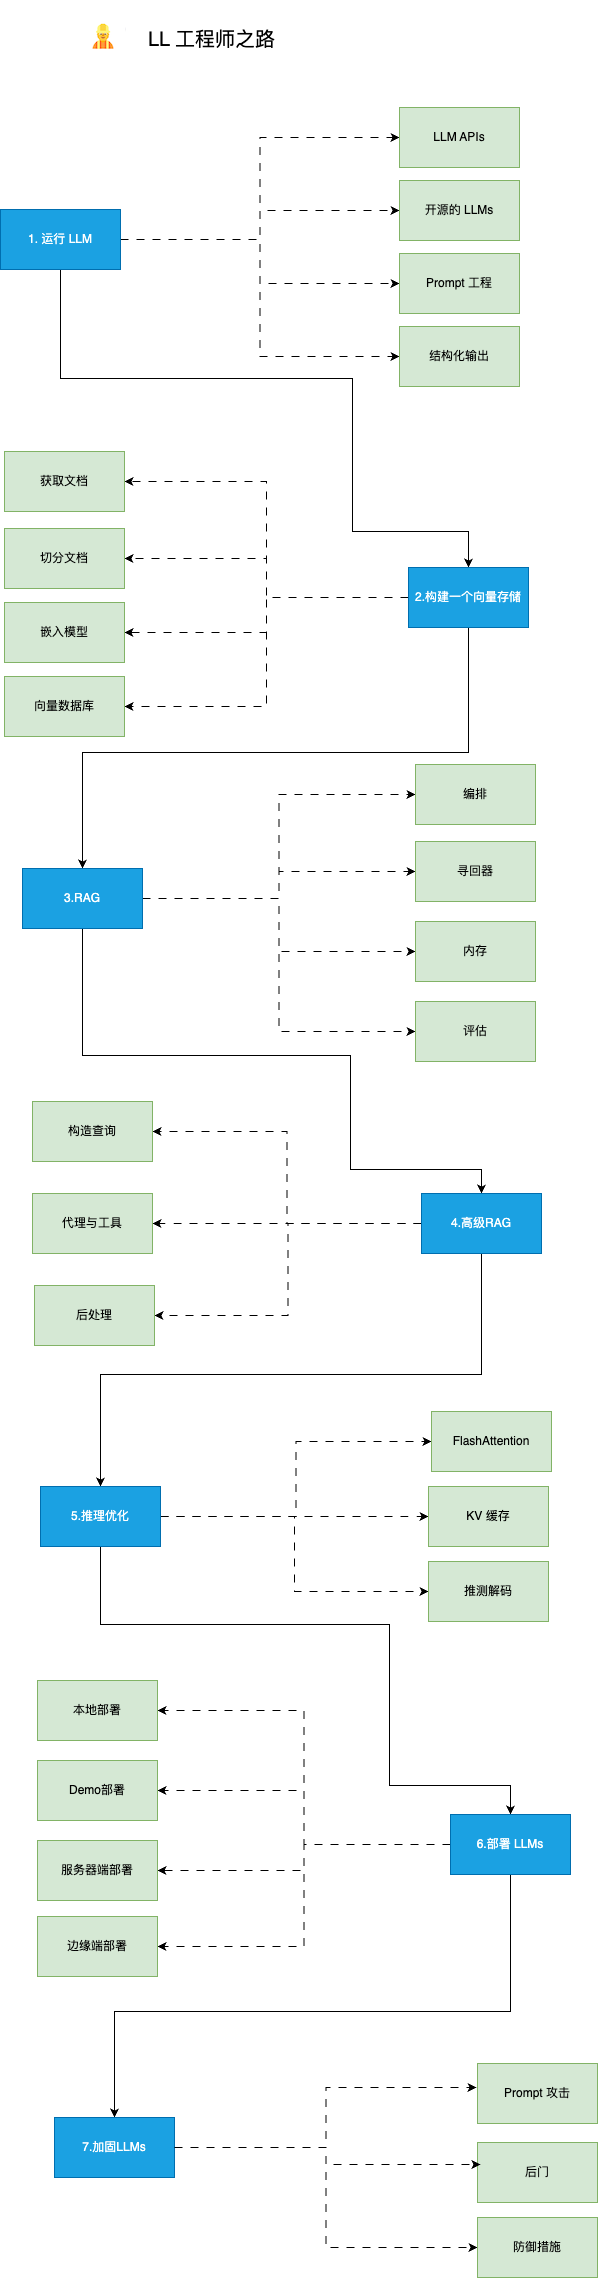
由于高硬件要求,运行LLM可能很困难。根据您的用例,您可能希望简单地通过API(如GPT-4)消费模型,或者在本地运行它。无论哪种情况,额外的提示和引导技术都可以改善和约束您应用程序的输出。
- LLM API:API是部署LLM的便捷方式。这个领域分为私有LLM(OpenAI、Google、Anthropic、Cohere等)和开源LLM(OpenRouter、Hugging Face、Together AI等)。
- 开源LLM:Hugging Face Hub是寻找LLM的好地方。您可以直接在Hugging Face Spaces中运行其中一些,或者下载并在诸如LM Studio的应用中或通过CLI与llama.cpp或Ollama在本地运行它们。
- 提示工程:常见技术包括零次提示、少次提示、思维链和ReAct。它们在更大的模型上效果更好,但可以适应较小的模型。
- 结构化输出:许多任务需要结构化输出,如严格的模板或JSON格式。库如LMQL、Outlines、Guidance等可用于引导生成并遵循给定结构。
📚 参考资料:
- 使用LM Studio在本地运行LLM 作者Nisha Arya:如何使用LM Studio的简短指南。
- 提示工程指南 作者DAIR.AI:带有示例的提示技术的详尽列表。
- Outlines - 快速入门:Outlines启用的引导生成技术列表。
- LMQL - 概览:LMQL语言的介绍。
2. 构建向量存储
创建向量存储是构建检索增强生成(RAG)管道的第一步。文档被加载、拆分,相关块被用来生成向量表示(嵌入),这些向量表示存储以备将来在推理中使用。
- 文档摄入:文档加载器是方便的包装器,可以处理多种格式:PDF、JSON、HTML、Markdown等。它们还可以直接从一些数据库和API(GitHub、Reddit、Google Drive等)检索数据。
- 文档拆分:文本拆分器将文档拆分成较小的、语义上有意义的块。与在n个字符后拆分文本相比,最好是按标题或递归拆分,附带一些额外的元数据。
- 嵌入模型:嵌入模型将文本转换为向量表示。这对于进行语义搜索是必要的,因为它允许更深入、更细腻的理解语言。
- 向量数据库:向量数据库(如Chroma、Pinecone、Milvus、FAISS、Annoy等)被设计用于存储嵌入向量。它们使得基于向量相似度快速检索与查询“最相似”的数据成为可能。
📚 参考资料:
- LangChain - 文本拆分器:LangChain中实现的不同文本拆分器的列表。
- 句子转换器库:嵌入模型的流行库。
- MTEB排行榜:嵌入模型的排行榜。
- 前5大向量数据库 作者Moez Ali:最佳和最流行的向量数据库的比较。
3. 检索增强生成
使用RAG,LLM从数据库检索上下文文档以提高其回答的准确性。RAG是一种增强模型知识而无需任何微调的流行方式。
- 协调器:协调器(如LangChain、LlamaIndex、FastRAG等)是流行的框架,用于将LLM与工具、数据库、记忆等连接并增强其能力。
- 检索器:用户指令不是为检索优化的。可以应用不同技术(例如,多查询检索器、HyDE等)来重述/扩展它们并提高性能。
- 记忆:为了记住之前的指令和答案,像ChatGPT这样的LLM和聊天机器人将这些历史添加到其上下文窗口中。这个缓冲区可以通过摘要(例如,使用较小的LLM)、向量存储+RAG等进行改进。
- 评估:我们需要评估文档检索(上下文的精确度和召回率)和生成阶段(忠实度和答案相关性)。可以使用工具Ragas和DeepEval来简化这一过程。
📚 参考资料:
- Llamaindex - 高层概念:构建RAG管道时需要了解的主要概念。
- Pinecone - 检索增强:检索增强过程的概览。
- LangChain - 问答与RAG:构建典型RAG管道的分步教程。
- LangChain - 记忆类型:不同类型记忆及其相关用途的列表。
- RAG管道 - 指标:用于评估RAG管道的主要指标概览。
4. 高级 RAG
现实生活中的应用可能需要复杂的流程,包括 SQL 或图数据库,以及自动选择相关工具和 API。这些高级技术可以改进基线解决方案,并提供额外的功能。
- 查询构建:存储在传统数据库中的结构化数据需要特定的查询语言,如 SQL、Cypher、元数据等。我们可以直接将用户指令翻译成查询语言,以查询构建方式访问数据。
- 代理和工具:代理通过自动选择最相关的工具来增强 LLM 的功能,以提供答案。这些工具可以简单到使用 Google 或 Wikipedia,也可以复杂到使用 Python 解释器或 Jira。
- 后处理:喂给 LLM 的输入的最终处理步骤。它通过重排序、RAG-融合 和分类来提高检索文档的相关性和多样性。
📚 参考资料:
- LangChain - 查询构建:关于不同类型查询构建的博客文章。
- LangChain - SQL:关于如何使用 LLM 与 SQL 数据库交互的教程,包括 Text-to-SQL 和一个可选的 SQL 代理。
- Pinecone - LLM 代理:介绍代理和工具的不同类型。
- 由 Lilian Weng 编写的 LLM 动力自主代理:关于 LLM 代理的更理论性文章。
- LangChain - OpenAI 的 RAG:概述 OpenAI 采用的 RAG 策略,包括后处理。
5. 推理优化
文本生成是一个成本高昂的过程,需要昂贵的硬件。除了量化,还提出了各种技术来最大化吞吐量和减少推理成本。
- 快速注意力:优化注意力机制,将其复杂性从二次方降低到线性,加速训练和推理。
- 键值缓存:了解键值缓存及在 多查询注意力(MQA)和 分组查询注意力(GQA)中引入的改进。
- 推测性解码:使用小模型产生草稿,然后由更大的模型复审,以加速文本生成。
📚 参考资料:
- Hugging Face 的 GPU 推理:解释如何在 GPU 上优化推理。
- Databricks 的 LLM 推理:关于如何在生产中优化 LLM 推理的最佳实践。
- 为速度和内存优化 LLM 由 Hugging Face 提供:解释三种主要优化速度和内存的技术,即量化、快速注意力和架构创新。
- 辅助生成 由 Hugging Face 提供:HF 版本的推测性解码,这是一个有趣的博客文章,介绍了它是如何工作的,并提供了实现它的代码。
6. 部署 LLM
在多个GPU 集群上部署 LLM 是一项工程壮举。在其他场景中,演示和本地应用可以通过更低的复杂性来实现。
- 本地部署:隐私是开源 LLM 相对于私有 LLM 的一个重要优势。本地 LLM 服务器(如 LM Studio、Ollama、oobabooga、kobold.cpp 等)利用这一优势为本地应用提供动力。
- 演示部署:像 Gradio 和 Streamlit 这样的框架有助于原型应用的开发和演示分享。你也可以轻松地在线托管它们,例如使用 Hugging Face Spaces。
- 服务器部署:在大规模部署 LLM 需要云(参见 SkyPilot)或本地基础设施,并且经常利用优化的文本生成框架,如 TGI、vLLM 等。
- 边缘部署:在受限环境中,如 MLC LLM 和 mnn-llm 这样的高性能框架可以在网络浏览器、Android 和 iOS 中部署 LLM。
📚 参考资料:
- Streamlit - 构建基础 LLM 应用:使用 Streamlit 构建基本的 ChatGPT 类应用的教程。
- HF LLM 推理容器:使用 Hugging Face 的推理容器在 Amazon SageMaker 上部署 LLM。
- Philschmid 博客 由 Philipp Schmid 编写:关于使用 Amazon SageMaker 部署 LLM 的高质量文章集合。
- 优化延迟 由 Hamel Husain 编写:比较了 TGI、vLLM、CTranslate2 和 mlc 在吞吐量和延迟方面的优势。
7. 保护LLM
除了与软件相关的传统安全问题外,由于LLM的训练和提示方式,它们还存在独特的弱点。
- 提示攻击:与提示工程相关的不同技术,包括提示注入(额外的指令以劫持模型的答案)、数据/提示泄露(检索其原始数据/提示)和越狱(制作提示以绕过安全特性)。
- 后门:攻击向量可以直接针对训练数据本身,通过污染训练数据(例如,使用错误信息)或创建后门(在推理期间改变模型行为的秘密触发器)。
- 防御措施:保护您的LLM应用程序的最佳方式是对这些漏洞进行测试(例如,使用红队测试和像garak这样的检查)并在生产中观察它们(使用像langfuse这样的框架)。
📚 参考资料:
- OWASP LLM十大安全问题 作者HEGO Wiki:LLM应用程序中观察到的10个最严重的安全漏洞列表。
- 提示注入入门 作者Joseph Thacker:专为工程师准备的提示注入简短指南。
- LLM安全 作者@llm_sec:与LLM安全相关的广泛资源列表。
- LLM红队测试 作者Microsoft:如何对LLM进行红队测试的指南。
鸣谢
这份路线图的灵感来自于Milan Milanović和Romano Roth出色的DevOps路线图。
特别感谢:
- Thomas Thelen激励我创建这份路线图
- André Frade对初稿的投入和审阅
- Dino Dunn提供有关LLM安全性的资源
免责声明:我与此处列出的任何来源无关。
Contributors

4 commits
Similar repos


Languages
Jupyter Notebook
100.0%
README
llm-course-chn
许可
向mlabonne申请了中文的翻译许可!
https://github.com/mlabonne/llm-course/issues/57
🗣️ 大语言模型课程
🐦 在X上关注我 • 🤗 Hugging Face • 💻 博客 • 📙 动手学图神经网络 • 🗣️ 交互式GPT
大语言模型课程分为三个部分:
- 🧩 LLM基础 涵盖关于数学、Python和神经网络的基础知识。
- 🧑🔬 LLM科学家 侧重于使用最新技术构建最佳的LLM。
- 👷 LLM工程师 侧重于创建基于LLM的应用程序并部署它们。
📝 笔记本
与大语言模型相关的笔记本和文章列表。
工具
| 笔记本 | 描述 | 笔记本 |
|---|---|---|
| 🧐 LLM自动评估 | 使用RunPod自动评估您的LLM | |
| 🥱 LazyMergekit | 使用mergekit一键轻松合并模型。 | |
| 🦎 LazyAxolotl | 一键在云上微调模型。 | |
| ⚡ AutoGGUF | 一键将LLM量化为GGUF格式。 | |
| 🌳 模型家族树 | 可视化合并模型的家族树。 | |
微调
| 笔记本 | 描述 | 文章 | 笔记本 |
|---|---|---|---|
| 在Google Colab中微调Llama 2 | 一步一步指导如何微调您的第一个Llama 2模型。 | 文章 | |
| 使用Axolotl微调LLM | 微调的最新工具的端到端指南。 | 文章 | |
| 使用DPO微调Mistral-7b | 通过DPO提升监督微调模型的性能。 | 文章 | |
量化
| 笔记本 | 描述 | 文章 | 笔记本 |
|---|---|---|---|
| 1. 量化入门 | 使用8位量化优化大型语言模型。 | 文章 | |
| 2. 使用GPTQ进行4位量化 | 将您自己的开源LLM量化,以便在消费硬件上运行。 | 文章 | |
| 3. 使用GGUF和llama.cpp量化 | 使用llama.cpp量化Llama 2模型,并将GGUF版本上传到HF Hub。 | 文章 | |
| 4. ExLlamaV2:最快的运行LLM库 | 量化并运行EXL2模型,并将它们上传到HF Hub。 | 文章 | |
其他
| 笔记本 | 描述 | 文章 | 笔记本 |
|---|---|---|---|
| 大型语言模型中的解码策略 | 从束搜索到核心抽样的文本生成指南 | 文章 | |
| 可视化GPT-2的损失 | 基于权重扰动的损失3D图。 | 推文 | |
| 用知识图谱改善ChatGPT | 用知识图谱增强ChatGPT的回答。 | 文章 | |
| 使用mergekit合并LLM | 轻松创建您自己的模型,无需GPU! | 文章 | |
🧩 LLM基础
1. 机器学习的数学
在掌握机器学习之前,了解驱动这些算法的基本数学概念非常重要。
- 线性代数:这对于理解许多算法尤其是在深度学习中使用的算法至关重要。关键概念包括向量、矩阵、行列式、特征值和特征向量、向量空间和线性变换。
- 微积分:许多机器学习算法涉及连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分和梯度概念也很重要。
- 概率与统计:这些对于理解模型如何从数据中学习并做出预测至关重要。关键概念包括概率论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。
📚 资源:
- 3Blue1Brown - 线性代数的精髓:一系列视频,提供了这些概念的几何直观感受。
- StatQuest with Josh Starmer - 统计学基础:为许多统计概念提供简单明了的解释。
- AP Statistics Intuition by Ms Aerin:Medium文章列表,提供了每个概率分布背后的直觉理解。
- 沉浸式线性代数:线性代数的另一种视觉解读。
- Khan Academy - 线性代数:非常适合初学者,以非常直观的方式解释概念。
- Khan Academy - 微积分:一个涵盖所有基础微积分概念的互动课程。
- Khan Academy - 概率与统计:以易于理解的格式提供材料。
2. 机器学习的Python
Python是一种功能强大且灵活的编程语言,特别适用于机器学习,这得益于其可读性、一致性和健壮的数据科学库生态系统。
- Python基础:Python编程需要理解基本语法、数据类型、错误处理和面向对象编程。
- 数据科学库:熟悉NumPy进行数值操作,用Pandas进行数据处理和分析,用Matplotlib和Seaborn做数据可视化。
- 数据预处理:涉及特征缩放和规范化、处理缺失数据、异常检测、类别数据编码,以及将数据分割为训练、验证和测试集。
- 机器学习库:熟练使用Scikit-learn,这是一个提供广泛的监督和无监督学习算法的python库,至关重要。理解如何实现线性回归、逻辑回归、决策树、随机森林、最近邻(K-NN)和K均值聚类等算法很重要。降维技术如PCA和t-SNE对于可视化高维数据也很有帮助。
📚 资源:
- Real Python:一个全面的资源,提供针对Python初学者和高级概念的文章和教程。
- freeCodeCamp - 学习Python:提供Python所有核心概念全面介绍的长视频。
- Python数据科学手册:一个很好的学习pandas、NumPy、Matplotlib和Seaborn的免费数字书。
- freeCodeCamp - 机器学习入门:为初学者提供不同机器学习算法的实用介绍。
- Udacity - 机器学习入门:一个免费课程,涵盖了PCA和其他几个机器学习概
3. 神经网络
神经网络是许多机器学习模型的基础部分,特别是在深度学习领域。为了有效地利用它们,对它们的设计和机制有一个全面的理解是必要的。
- 基础知识:这包括了解神经网络的结构,如层、权重、偏差和激活函数(sigmoid、tanh、ReLU等)。
- 训练和优化:熟悉反向传播和不同类型的损失函数,如均方误差(MSE)和交叉熵。理解各种优化算法,如梯度下降、随机梯度下降、RMSprop和Adam。
- 过拟合:理解过拟合的概念(模型在训练数据上表现良好但在未见数据上表现不佳)并学习各种正则化技术(dropout、L1/L2正则化、提前停止、数据增强)来防止它。
- 实现多层感知机(MLP):使用PyTorch构建一个MLP,也称为全连接网络。
📚 资源:
- 3Blue1Brown - 神经网络是什么?:这个视频直观地解释了神经网络及其内部工作原理。
- freeCodeCamp - 深度学习速成课:这个视频高效地介绍了深度学习中所有最重要的概念。
- Fast.ai - 实用深度学习:为有编程经验想学习深度学习的人设计的免费课程。
- Patrick Loeber - PyTorch教程:一系列视频,让完全的初学者学习PyTorch。
4. 自然语言处理(NLP)
NLP是人工智能的一个迷人分支,它桥接了人类语言与机器理解之间的差距。从简单的文本处理到理解语言细微差别,NLP在许多应用中发挥着关键作用,如翻译、情感分析、聊天机器人等等。
- 文本预处理:学习各种文本预处理步骤,如分词(将文本分割成单词或句子)、词干提取(将词汇还原到其根形式)、词形还原(类似于词干提取但考虑上下文)、停用词移除等。
- 特征提取技术:熟悉将文本数据转换为机器学习算法能理解的格式的技术。关键方法包括词袋(BoW)、词频-逆文档频率(TF-IDF)和n-gram。
- 词嵌入:词嵌入是一种词表示方式,允许意义相近的词有相似的表示。关键方法包括Word2Vec、GloVe和FastText。
- 循环神经网络(RNNs):理解RNN的工作原理,RNN是一种设计用来处理序列数据的神经网络。探索LSTM和GRU,这两种RNN变体能够学习长期依赖。
📚 资源:
- RealPython - 使用spaCy进行Python自然语言处理:关于Python中spaCy库进行NLP任务的详尽指南。
- Kaggle - NLP指南:一些笔记本和资源,用于Python中NLP的实践解释。
- Jay Alammar - Word2Vec图解:理解著名的Word2Vec架构的好参考。
- Jake Tae - 从零开始的PyTorch RNN:在PyTorch中实践和简单实现RNN、LSTM和GRU模型。
- colah的博客 - 理解LSTM网络:关于LSTM网络的更理论化文章。
🧑🔬 LLM科学家
本课程部分侧重于学习如何使用最新技术构建最佳的LLM。
1. LLM架构
虽然不需要深入了解Transformer架构,但重要的是要很好地理解它的输入(令牌)和输出(logits)。原始注意力机制是另一个需要掌握的关键组成部分,因为后续会介绍它的改进版本。
- 高层视图:回顾编码器-解码器Transformer架构,更具体地说是在每个现代LLM中使用的仅解码器GPT架构。
- 令牌化:理解如何将原始文本数据转换成模型可以理解的格式,这涉及将文本分割成令牌(通常是单词或子词)。
- 注意力机制:掌握注意力机制背后的理论,包括自注意力和缩放点积注意力,这使得模型在产生输出时能够关注输入的不同部分。
- 文本生成:了解模型可以生成输出序列的不同方式。常见策略包括贪婪解码、束搜索、Top-k采样和核采样。
📚 参考资料:
- 插图式Transformer 作者Jay Alammar:对Transformer模型的直观和视觉解释。
- 插图式GPT-2 作者Jay Alammar:比前一篇文章更重要,它专注于GPT架构,与Llama非常相似。
- LLM可视化 作者Brendan Bycroft:令人难以置信的LLM内部3D可视化。
- nanoGPT 作者Andrej Karpathy:一个2小时长的YouTube视频,从头开始重新实现GPT(面向程序员)。
- 注意力?注意力! 作者Lilian Weng:以更正式的方式介绍注意力的需求。
- LLM中的解码策略:提供代码和直观介绍不同文本生成解码策略。
2. 构建指令数据集
虽然从维基百科和其他网站找到原始数据很容易,但在野外收集指令和答案的配对却很难。就像在传统机器学习中一样,数据集的质量将直接影响模型的质量,这就是为什么它可能是微调过程中最重要的组件。
- Alpaca-样数据集:使用OpenAI API(GPT)从头生成合成数据。您可以指定种子和系统提示来创建多样化的数据集。
- 高级技术:了解如何使用Evol-Instruct改进现有数据集,如何像Orca和phi-1论文中那样生成高质量合成数据。
- 过滤数据:传统技术包括使用正则表达式、删除近似重复项、专注于含有大量令牌的答案等。
- 提示模板:没有真正的标准格式来格式化指令和答案,这就是为什么了解不同的聊天模板很重要,例如ChatML、Alpaca等。
📚 参考资料:
- 为指令调优准备数据集 作者Thomas Capelle:探索Alpaca和Alpaca-GPT4数据集及其格式化方式。
- 生成葡萄牙语临床指令数据集 作者Solano Todeschini:教程,介绍如何使用GPT-4创建合成指令数据集。
- 使用GPT 3.5进行新闻分类 作者Kshitiz Sahay:使用GPT 3.5创建指令数据集,以微调Llama 2进行新闻分类。
- 微调LLM的数据集创建:包含一些过滤数据集并上传结果的技术的笔记本。
- 聊天模板 作者Matthew Carrigan:Hugging Face关于提示模板的页面。
3. 预训练模型
预训练是一个非常漫长且成本高昂的过程,这就是为什么这不是本课程的重点。了解预训练期间发生的事情的某种程度是好的,但不需要亲手实践。
- 数据管道:预训练需要巨大的数据集(例如,Llama 2是在2万亿令牌上训练的)需要过滤、令牌化,并与预定义的词汇表协同。
- 因果语言建模:了解因果和掩码语言建模的区别,以及在这种情况下使用的损失函数。为了高效预训练,进一步了解Megatron-LM或gpt-neox。
- 规模定律:规模定律根据模型大小、数据集大小和用于训练的计算量描述了预期的模型性能。
- 高性能计算:这里不在讨论范围内,但如果你计划从头开始创建自己的LLM(硬件、分布式工作负载等),更多关于HPC的知识是基础。
📚 参考资料:
- LLMDataHub 作者Junhao Zhao:为预训练、微调和RLHF精心策划的数据集列表。
- 从头开始预训练因果语言模型 作者Hugging Face:使用transformers库从头开始预训练GPT-2模型。
- TinyLlama 作者Zhang等:查看此项目以深入了解如何从头开始训练Llama模型。
- 因果语言建模 作者Hugging Face:解释因果和掩码语言建模的区别,以及如何快速微调DistilGPT-2模型。
- Chinchilla的狂野含义 作者nostalgebraist:讨论规模定律并解释它们对LLM通常意味着什么。
- BLOOM 作者BigScience:Notion页面描述了如何构建BLOOM模型,包含大量关于工程部分和遇到的问题的有用信息。
- OPT-175日志 作者Meta:研究日志显示了什么出了问题,什么做得对。如果你计划预训练一个非常大的语言模型(在这种情况下,175B参数),这非常有用。
- LLM 360:一个开源LLM的框架,包含训练和数据准备代码、数据、指标和模型。
4. 监督式微调
预训练模型仅在下一个令牌预测任务上进行训练,这就是为什么它们不是有用的助手。SFT允许您调整它们以响应指令。此外,它允许您在任何数据上(私有的,GPT-4未见过的等)微调模型,并在不必支付OpenAI等API费用的情况下使用它。
- 全面微调:全面微调指的是训练模型中的所有参数。这不是一种高效的技术,但它产生略微更好的结果。
- LoRA:一种基于低秩适配器的参数高效技术(PEFT)。我们不是训练所有参数,而只训练这些适配器。
- QLoRA:另一种基于LoRA的PEFT,它还将模型的权重量化为4比特,并引入分页优化器来管理内存峰值。结合Unsloth在免费的Colab笔记本上高效运行。
- Axolotl:一个用户友好且功能强大的微调工具,用于许多最先进的开源模型。
- DeepSpeed:高效的预训练和微调LLM,适用于多GPU和多节点设置(在Axolotl中实现)。
📚 参考资料:
- 新手LLM训练指南 作者Alpin:微调LLM时考虑的主要概念和参数的概览。
- LoRA洞见 作者Sebastian Raschka:关于LoRA的实践见解以及如何选择最佳参数。
- 微调你自己的Llama 2模型:手把手教程,介绍如何使用Hugging Face库微调Llama 2模型。
- 为因果LLM填充训练示例 作者Benjamin Marie:因果LLM填充训练示例的最佳实践
- LLM微调入门指南:教程,介绍如何使用Axolotl微调CodeLlama模型。
5. 人类反馈的强化学习
在监督式微调之后,RLHF是用来将LLM的答案与人类期望对齐的一步。其思想是从人类(或人工)反馈中学习偏好,这可以用来减少偏见、审查模型或使其以更有用的方式行动。它比SFT更复杂,通常被视为可选的。
- 偏好数据集:这些数据集通常包含有某种排名的几个答案,这使得它们比指令数据集更难产出。
- 近端策略优化:这种算法利用一个奖励模型,预测给定文本是否由人类高度评价。然后,这个预测被用来优化SFT模型,基于KL散度的惩罚。
- 直接偏好优化:DPO通过将问题重构为一个分类问题来简化过程。它使用一个参考模型而不是奖励模型(无需训练),只需要一个超参数,使其更稳定和高效。
📚 参考资料:
- 使用RLHF训练LLM的介绍 作者Ayush Thakur:解释为什么使用RLHF减少偏见和提高LLM的性能是可取的。
- RLHF插图 作者Hugging Face:使用奖励模型训练和强化学习微调的RLHF介绍。
- StackLLaMA 作者Hugging Face:使用transformers库高效对齐LLaMA模型与RLHF的教程。
- LLM训练:RLHF及其替代方案 作者Sebastian Rashcka:RLHF过程及其替代方案如RLAIF的概览。
- 使用DPO微调Mistral-7b:使用DPO微调Mistral-7b模型并复制NeuralHermes-2.5的教程。
6. 评估
评估LLM是流程中一个被低估的部分,它既耗时又相对可靠。您的下游任务应该决定您想要评估什么,但总是记得好特德法则:“当一个度量成为目标时,它就不再是一个好的度量。”
- 传统指标:像困惑度和BLEU分数这样的指标因为在大多数情境下都存在缺陷而不再流行。了解它们并知道它们何时可以应用仍然很重要。
- 通用基准:基于语言模型评估工具包,Open LLM排行榜是通用LLM(如ChatGPT)的主要基准。还有其他流行的基准,如BigBench、MT-Bench等。
- 任务特定基准:如摘要、翻译和问答任务有专门的基准、指标,甚至子领域(医学、金融等),例如生物医学问答的PubMedQA。
- 人类评估:最可靠的评估是用户的接受率或人类进行的比较。如果您想知道模型是否表现良好,最简单但最确实的方式是自己使用它。
📚 参考资料:
- 固定长度模型的困惑度 作者Hugging Face:使用transformers库实现困惑度的概览及代码。
- 自担风险的BLEU 作者Rachael Tatman:BLEU分数及其众多问题的概览及示例。
- LLM评估综述 作者Chang等:关于评估什么、在哪里评估以及如何评估的综合论文。
- 聊天机器人竞技场排行榜 作者lmsys:基于人类比较的通用用途LLM的Elo评分。
7. 量化
量化是使用较低精度转换模型的权重(和激活)的过程。例如,使用16位存储的权重可以转换为4位表示。这项技术变得越来越重要,以减少与LLM相关的计算和内存成本。
- 基础技术:了解不同精度级别(FP32、FP16、INT8等)以及如何使用absmax和零点技术进行简单量化。
- GGUF和llama.cpp:最初设计用于在CPU上运行,llama.cpp和GGUF格式已成为在消费级硬件上运行LLM的最受欢迎的工具。
- GPTQ和EXL2:GPTQ特别是EXL2格式提供了令人难以置信的速度,但只能在GPU上运行。模型量化也需要很长时间。
- AWQ:这种新格式比GPTQ更精确(困惑度更低),但使用的VRAM更多,不一定更快。
📚 参考资料:
- 量化入门:量化的概览,absmax和零点量化,以及LLM.int8()的代码。
- 使用llama.cpp量化Llama模型:使用llama.cpp和GGUF格式量化Llama 2模型的教程。
- 使用GPTQ进行4位LLM量化:使用GPTQ算法和AutoGPTQ量化LLM的教程。
- ExLlamaV2:运行LLM的最快库:使用EXL2格式量化Mistral模型并使用ExLlamaV2库运行它的指南。
- 了解激活感知权重量化 作者FriendliAI:AWQ技术及其优点的概览。
8. 新趋势
- 位置嵌入:了解LLM如何编码位置,尤其是像RoPE这样的相对位置编码方案。实现YaRN(通过温度因子乘以注意力矩阵)或ALiBi(基于令牌距离的注意力惩罚)以扩展上下文长度。
- 模型合并:合并训练好的模型已成为一种流行的创建性能模型而无需任何微调的方式。流行的mergekit库实现了最流行的合并方法,如SLERP、DARE和TIES。
- 专家混合:Mixtral由于其出色的性能重新使MoE架构流行起来。同时,通过合并模型(如Phixtral)在OSS社区中出现了一种frankenMoE,这是一个更便宜且高性能的选项。
- 多模态模型:这些模型(如CLIP、Stable Diffusion或LLaVA)能够使用统一的嵌入空间处理多种类型的输入(文本、图像、音频等),解锁了强大的应用,如文本到图像。
📚 参考资料:
- 扩展RoPE 作者EleutherAI:总结不同位置编码技术的文章。
- 理解YaRN 作者Rajat Chawla:YaRN介绍。
- 使用mergekit合并LLM:使用mergekit进行模型合并的教程。
- 专家混合解释 作者Hugging Face:关于MoE及其工作原理的详尽指南。
- 大型多模态模型 作者Chip Huyen:多模态系统及该领域近期历史的概览。
👷 LLM工程师
本课程部分专注于学习如何构建LLM驱动的可以用于生产的应用程序,重点是增强模型和部署它们。
1. 运行LLM
由于高硬件要求,运行LLM可能很困难。根据您的用例,您可能希望简单地通过API(如GPT-4)消费模型,或者在本地运行它。无论哪种情况,额外的提示和引导技术都可以改善和约束您应用程序的输出。
- LLM API:API是部署LLM的便捷方式。这个领域分为私有LLM(OpenAI、Google、Anthropic、Cohere等)和开源LLM(OpenRouter、Hugging Face、Together AI等)。
- 开源LLM:Hugging Face Hub是寻找LLM的好地方。您可以直接在Hugging Face Spaces中运行其中一些,或者下载并在诸如LM Studio的应用中或通过CLI与llama.cpp或Ollama在本地运行它们。
- 提示工程:常见技术包括零次提示、少次提示、思维链和ReAct。它们在更大的模型上效果更好,但可以适应较小的模型。
- 结构化输出:许多任务需要结构化输出,如严格的模板或JSON格式。库如LMQL、Outlines、Guidance等可用于引导生成并遵循给定结构。
📚 参考资料:
- 使用LM Studio在本地运行LLM 作者Nisha Arya:如何使用LM Studio的简短指南。
- 提示工程指南 作者DAIR.AI:带有示例的提示技术的详尽列表。
- Outlines - 快速入门:Outlines启用的引导生成技术列表。
- LMQL - 概览:LMQL语言的介绍。
2. 构建向量存储
创建向量存储是构建检索增强生成(RAG)管道的第一步。文档被加载、拆分,相关块被用来生成向量表示(嵌入),这些向量表示存储以备将来在推理中使用。
- 文档摄入:文档加载器是方便的包装器,可以处理多种格式:PDF、JSON、HTML、Markdown等。它们还可以直接从一些数据库和API(GitHub、Reddit、Google Drive等)检索数据。
- 文档拆分:文本拆分器将文档拆分成较小的、语义上有意义的块。与在n个字符后拆分文本相比,最好是按标题或递归拆分,附带一些额外的元数据。
- 嵌入模型:嵌入模型将文本转换为向量表示。这对于进行语义搜索是必要的,因为它允许更深入、更细腻的理解语言。
- 向量数据库:向量数据库(如Chroma、Pinecone、Milvus、FAISS、Annoy等)被设计用于存储嵌入向量。它们使得基于向量相似度快速检索与查询“最相似”的数据成为可能。
📚 参考资料:
- LangChain - 文本拆分器:LangChain中实现的不同文本拆分器的列表。
- 句子转换器库:嵌入模型的流行库。
- MTEB排行榜:嵌入模型的排行榜。
- 前5大向量数据库 作者Moez Ali:最佳和最流行的向量数据库的比较。
3. 检索增强生成
使用RAG,LLM从数据库检索上下文文档以提高其回答的准确性。RAG是一种增强模型知识而无需任何微调的流行方式。
- 协调器:协调器(如LangChain、LlamaIndex、FastRAG等)是流行的框架,用于将LLM与工具、数据库、记忆等连接并增强其能力。
- 检索器:用户指令不是为检索优化的。可以应用不同技术(例如,多查询检索器、HyDE等)来重述/扩展它们并提高性能。
- 记忆:为了记住之前的指令和答案,像ChatGPT这样的LLM和聊天机器人将这些历史添加到其上下文窗口中。这个缓冲区可以通过摘要(例如,使用较小的LLM)、向量存储+RAG等进行改进。
- 评估:我们需要评估文档检索(上下文的精确度和召回率)和生成阶段(忠实度和答案相关性)。可以使用工具Ragas和DeepEval来简化这一过程。
📚 参考资料:
- Llamaindex - 高层概念:构建RAG管道时需要了解的主要概念。
- Pinecone - 检索增强:检索增强过程的概览。
- LangChain - 问答与RAG:构建典型RAG管道的分步教程。
- LangChain - 记忆类型:不同类型记忆及其相关用途的列表。
- RAG管道 - 指标:用于评估RAG管道的主要指标概览。
4. 高级 RAG
现实生活中的应用可能需要复杂的流程,包括 SQL 或图数据库,以及自动选择相关工具和 API。这些高级技术可以改进基线解决方案,并提供额外的功能。
- 查询构建:存储在传统数据库中的结构化数据需要特定的查询语言,如 SQL、Cypher、元数据等。我们可以直接将用户指令翻译成查询语言,以查询构建方式访问数据。
- 代理和工具:代理通过自动选择最相关的工具来增强 LLM 的功能,以提供答案。这些工具可以简单到使用 Google 或 Wikipedia,也可以复杂到使用 Python 解释器或 Jira。
- 后处理:喂给 LLM 的输入的最终处理步骤。它通过重排序、RAG-融合 和分类来提高检索文档的相关性和多样性。
📚 参考资料:
- LangChain - 查询构建:关于不同类型查询构建的博客文章。
- LangChain - SQL:关于如何使用 LLM 与 SQL 数据库交互的教程,包括 Text-to-SQL 和一个可选的 SQL 代理。
- Pinecone - LLM 代理:介绍代理和工具的不同类型。
- 由 Lilian Weng 编写的 LLM 动力自主代理:关于 LLM 代理的更理论性文章。
- LangChain - OpenAI 的 RAG:概述 OpenAI 采用的 RAG 策略,包括后处理。
5. 推理优化
文本生成是一个成本高昂的过程,需要昂贵的硬件。除了量化,还提出了各种技术来最大化吞吐量和减少推理成本。
- 快速注意力:优化注意力机制,将其复杂性从二次方降低到线性,加速训练和推理。
- 键值缓存:了解键值缓存及在 多查询注意力(MQA)和 分组查询注意力(GQA)中引入的改进。
- 推测性解码:使用小模型产生草稿,然后由更大的模型复审,以加速文本生成。
📚 参考资料:
- Hugging Face 的 GPU 推理:解释如何在 GPU 上优化推理。
- Databricks 的 LLM 推理:关于如何在生产中优化 LLM 推理的最佳实践。
- 为速度和内存优化 LLM 由 Hugging Face 提供:解释三种主要优化速度和内存的技术,即量化、快速注意力和架构创新。
- 辅助生成 由 Hugging Face 提供:HF 版本的推测性解码,这是一个有趣的博客文章,介绍了它是如何工作的,并提供了实现它的代码。
6. 部署 LLM
在多个GPU 集群上部署 LLM 是一项工程壮举。在其他场景中,演示和本地应用可以通过更低的复杂性来实现。
- 本地部署:隐私是开源 LLM 相对于私有 LLM 的一个重要优势。本地 LLM 服务器(如 LM Studio、Ollama、oobabooga、kobold.cpp 等)利用这一优势为本地应用提供动力。
- 演示部署:像 Gradio 和 Streamlit 这样的框架有助于原型应用的开发和演示分享。你也可以轻松地在线托管它们,例如使用 Hugging Face Spaces。
- 服务器部署:在大规模部署 LLM 需要云(参见 SkyPilot)或本地基础设施,并且经常利用优化的文本生成框架,如 TGI、vLLM 等。
- 边缘部署:在受限环境中,如 MLC LLM 和 mnn-llm 这样的高性能框架可以在网络浏览器、Android 和 iOS 中部署 LLM。
📚 参考资料:
- Streamlit - 构建基础 LLM 应用:使用 Streamlit 构建基本的 ChatGPT 类应用的教程。
- HF LLM 推理容器:使用 Hugging Face 的推理容器在 Amazon SageMaker 上部署 LLM。
- Philschmid 博客 由 Philipp Schmid 编写:关于使用 Amazon SageMaker 部署 LLM 的高质量文章集合。
- 优化延迟 由 Hamel Husain 编写:比较了 TGI、vLLM、CTranslate2 和 mlc 在吞吐量和延迟方面的优势。
7. 保护LLM
除了与软件相关的传统安全问题外,由于LLM的训练和提示方式,它们还存在独特的弱点。
- 提示攻击:与提示工程相关的不同技术,包括提示注入(额外的指令以劫持模型的答案)、数据/提示泄露(检索其原始数据/提示)和越狱(制作提示以绕过安全特性)。
- 后门:攻击向量可以直接针对训练数据本身,通过污染训练数据(例如,使用错误信息)或创建后门(在推理期间改变模型行为的秘密触发器)。
- 防御措施:保护您的LLM应用程序的最佳方式是对这些漏洞进行测试(例如,使用红队测试和像garak这样的检查)并在生产中观察它们(使用像langfuse这样的框架)。
📚 参考资料:
- OWASP LLM十大安全问题 作者HEGO Wiki:LLM应用程序中观察到的10个最严重的安全漏洞列表。
- 提示注入入门 作者Joseph Thacker:专为工程师准备的提示注入简短指南。
- LLM安全 作者@llm_sec:与LLM安全相关的广泛资源列表。
- LLM红队测试 作者Microsoft:如何对LLM进行红队测试的指南。
鸣谢
这份路线图的灵感来自于Milan Milanović和Romano Roth出色的DevOps路线图。
特别感谢:
- Thomas Thelen激励我创建这份路线图
- André Frade对初稿的投入和审阅
- Dino Dunn提供有关LLM安全性的资源
免责声明:我与此处列出的任何来源无关。
Similar repos
Contributors
4 commits
Languages
Jupyter Notebook
100.0%