
README
Deep Learning Theory
整理了一些深度学习的理论相关内容,持续更新。
2026-03 更新:先补一版
2025–2026 Highlights,集中记录最近在Lean形式化、AI for Math、machine-assisted proof 方向上的一些代表性进展。
Contents
2025–2026 Highlights:最近一年左右最值得优先看的少量代表性进展。Overview:深度学习理论与智能理论综述。Course:课程、讲义与系统性学习资源。Architecture / Approximation / Optimization / Geometry:若干专题条目。AI4Math / 数学家 / 近似:数学与 AI 交叉方向的历史条目与延伸阅读。
2025–2026 Highlights
Lean / Formalization
-
🔥 Sphere Packing in Lean / official post:Maryna Viazovska 2022 Fields Medal 相关的
8维与24维球堆积结果在 Lean 中得到完整形式化。Math, Inc. 官方页给出的说法是:Gauss 在约5天内补完8维剩余部分,约2周完成24维与周期唯一性。这是近年最有代表性的 autoformalization 事件之一。 -
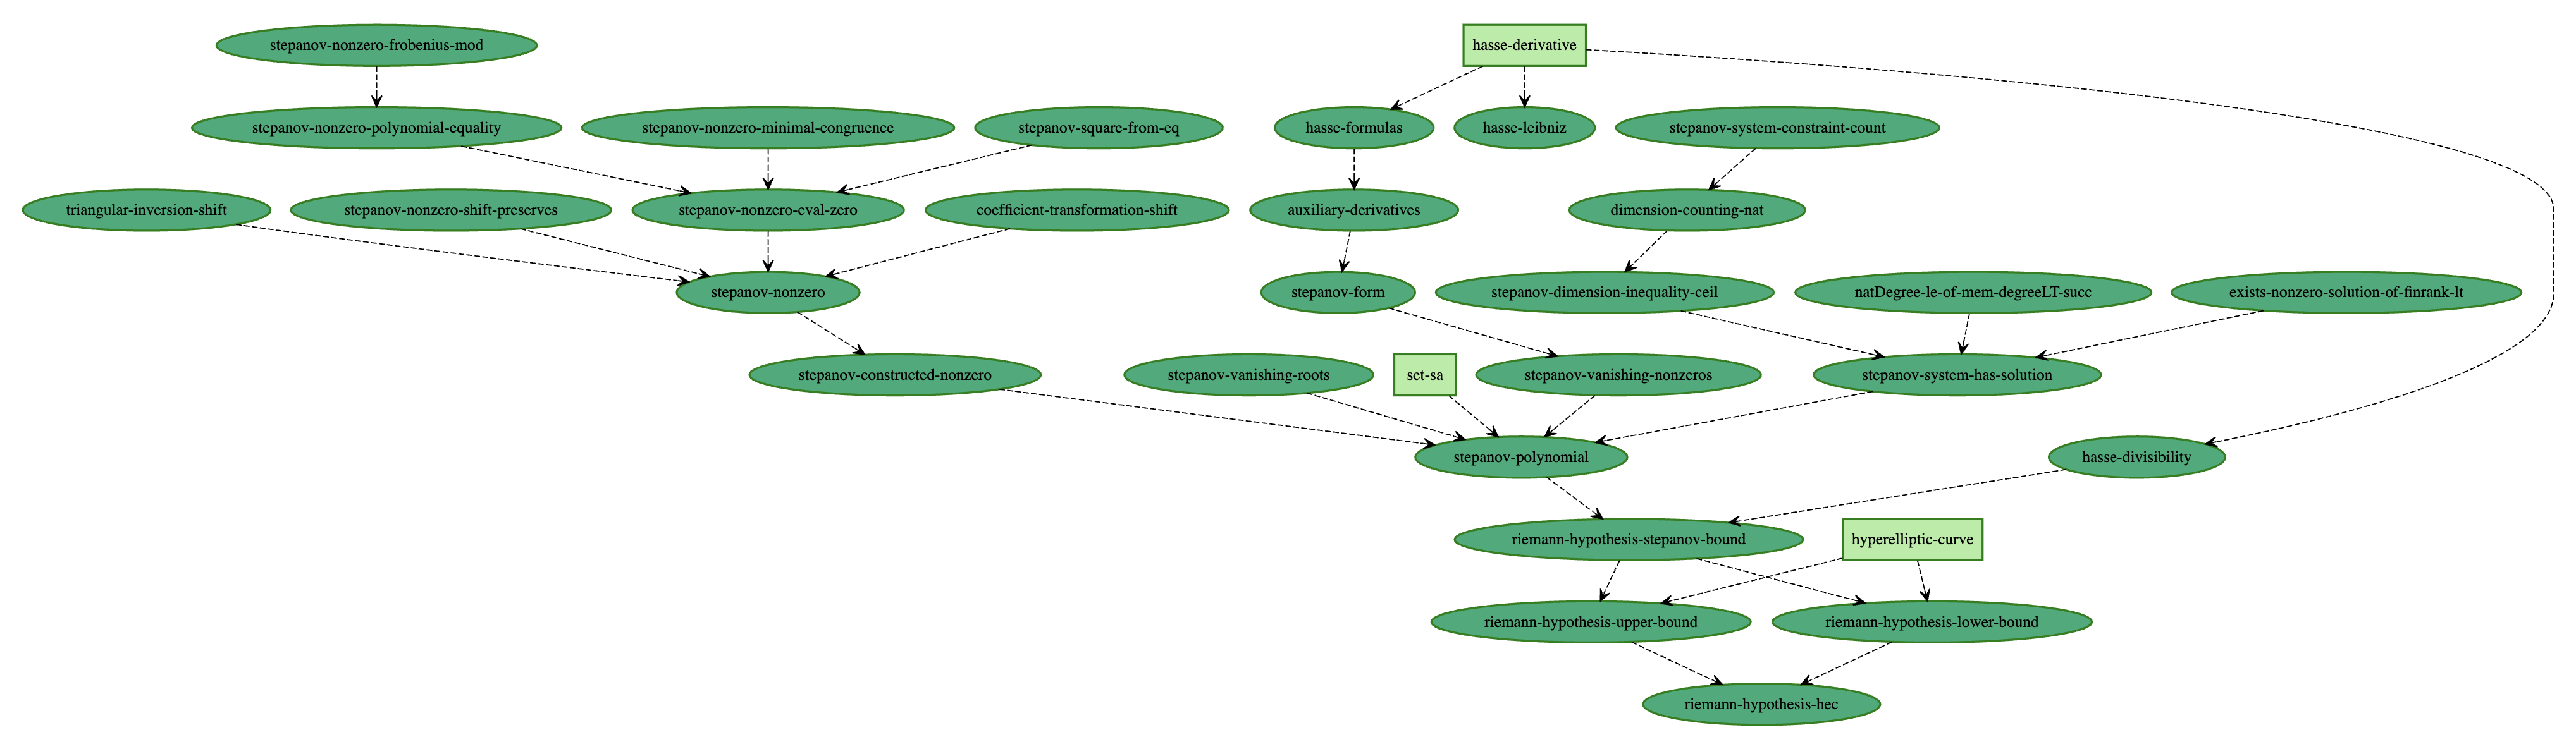
The Riemann Hypothesis for curves, autoformalized:有限域上超椭圆曲线的 Riemann-Hypothesis 型估计被形式化,README 给出规模约
4000行 Lean。这个项目很适合作为 AI-assisted formal verification 进入数论 / 代数几何边界的代表案例。 -
Archon: An Agentic System for Formalizing Research-Level Mathematics:这篇文章强调的重点不是传统 benchmark,而是 repository-level 的研究级形式化:Plan Agent 与 Lean Agent 协同,把复杂证明拆分成模块、循环规划并逐步填补
sorry。文中报告 Archon 全自动 formalize 了FirstProof Problem 6,并在几乎自动的条件下完成了Problem 4。 -
The Equational Theories Project: Advancing Collaborative Mathematical Research at Scale:一个非常值得单列的案例:人类协作、自动证明与 Lean 验证深度结合,Terence Tao 参与其中。摘要写得很直接:项目确定了
4694个最简单 magma 等式律之间全部22,028,942条蕴含边,是 machine-assisted collaborative mathematics 的里程碑事件。

AI for Math / Discovery
-
Eigenweights for arithmetic Hirzebruch Proportionality (Tony Feng, 2026):这篇文章明确记录了一个基于
Gemini Deep Think的定制 AI agent。它借助代数组合与对称群表示论,把 arithmetic Hirzebruch proportionality 里出现的eigenweights计算推广到所有 classical groups,是 AI 深入代数几何 / 表示论工作流的一个漂亮案例。 -
The motivic class of the space of genus 0 maps to the flag variety:摘要中直接说明:论文中的结果是在
Google Gemini及相关工具协助下得到的;同时正文仍然保持人类作者主导的写法。这类工作很值得关注,因为它不是 formalization,而是 AI 直接参与研究发现与证明构思。
A Case Study: Murmurations
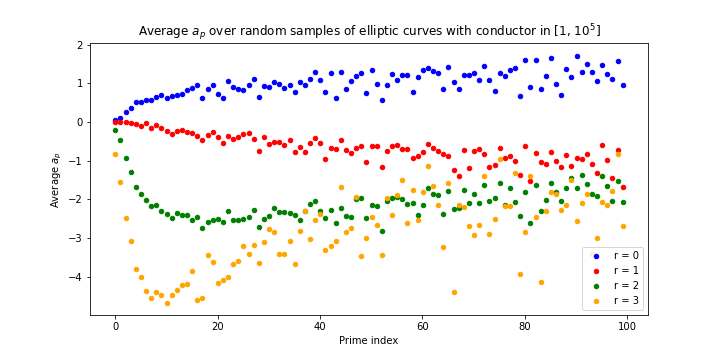
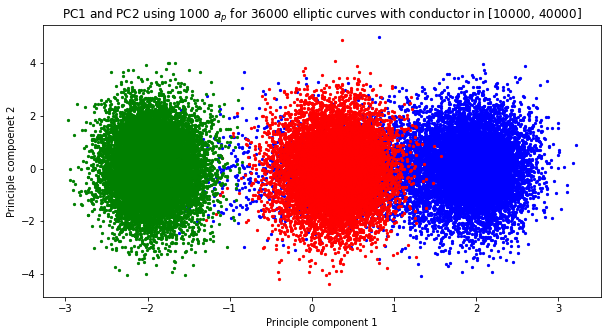
Murmurations of elliptic curves 不是最近一年的论文,但我倾向于把它保留成一个单独案例:它很可能是很多人第一次真正感受到“AI / 数据分析已经开始进入数论研究工作流”的代表作之一。论文研究的是不同 rank 椭圆曲线族的 Frobenius trace,也就是各个素数上的 a_p 系数。
- 数据表示:作者把每条椭圆曲线表示成由一串
a_p构成的高维向量,再把这些向量当作 point cloud 来处理。 - 使用方法:方法并不花哨,主要是
logistic regression、PCA等基础机器学习工具,但已经足以暴露出稳定而醒目的模式。 - 关键现象:一方面,不同 rank 的曲线在 PCA 平面上出现了相当清晰的簇分离;另一方面,对固定 rank 的曲线族取
a_p平均后,会出现非常显著的振荡图样,且不同 rank 之间像鸟群转向一样彼此呼应,因此被称作murmurations。 - 为什么重要:它展示的不是 magical theorem proving,而是一种新的数论实验方法——先把对象编码成可分析的数据,再用简单统计学习方法寻找人眼不容易直接看出的结构。
- 更深一层的意义:这篇文章的重要性不只在于“用机器学习分了类”,而在于它提示人们:即使方法并不复杂,数据驱动的观察也可能先暴露出此前并未被理论充分解释的结构,再反过来刺激新的数论问题。
- 后续线索:相关延伸工作已经出现,例如 Murmurations of Mestre-Nagao sums,说明这种“先观察 pattern,再追问其数论机制”的路线并不是一次性的尝试。
Open Repositories / Communities
-
Optimization Constants in Mathematics:这是一个很有意思的问题基础设施项目:整理各类数学优化常数的最好上下界、来源、验证状态与可更新条目。它并不是 theorem proving 仓库,但非常适合观察 AI、计算与协作如何改变数学研究的组织方式。相关博文可见 Terence Tao: A crowdsourced repository for optimization constants?
-
math-inc:这一组织近来连续公开了
Sphere-Packing-Lean、RiemannHypothesisCurves、KakeyaFiniteFields、ZkLinalg等项目。无论是否完全接受其叙事,这些仓库都值得持续跟踪,因为它们代表了前沿 autoformalization 的最新公开样本。
Overview
-
Recent advances in deep learning theory 总结了目前深度学习理论研究的六个方向的一些结果,概述型,没做深入探讨(2021)。
-
1.1 complexity and capacity-basedapproaches for analyzing the generalizability of deep learning;
-
1.2 stochastic differential equations andtheir dynamic systems for modelling stochastic gradient descent and its variants, which characterizethe optimization and generalization of deep learning, partially inspired by Bayesian inference;
-
1.3 thegeometrical structures of the loss landscape that drives the trajectories of the dynamic systems;
-
1.4 theroles of over-parameterization of deep neural networks from both positive and negative perspectives;
-
1.5 theoretical foundations of several special structures in network architectures;
-
1.6 the increasinglyintensive concerns in ethics and security and their relationships with generalizability
-
-
🔥 On the Principles of Parsimony and Self-Consistency for the Emergence of Intelligence(2022.7.马毅、沈向洋、曹颖)"任何一个智能系统,作为一个看似简单的自主闭环:信息、控制、对策、优化、神经网络,紧密结合,缺一不可。总而言之,人工智能的研究从现在开始,应该能够也必须与科学、数学、和计算紧密结合。从最根本、最基础的第一性原理(简约、自洽)出发,把基于经验的归纳方法与基于基础原理的演绎方法严格地、系统地结合起来发展。理论与实践紧密结合、相辅相成、共同推进我们对智能的理解。" 知乎解读可看:https://zhuanlan.zhihu.com/p/543041107 。
-
Machine Learning in Physics and Geometry(2023.3)总结了ml在几何和理论物理上的一些进展,主要涉及到pca,t-sne,k-means,nn,svm,数据拓扑分析技术内容,理论物理包含了Polytopes,Amoebae,Quivers,Brane Webs。
-
Machine-Assisted Proofs(2025)Terence Tao 将探讨机器在数学中使用的历史和近期发展。他还将推测机器辅助在该领域的未来作用。
Course
- Theory of Deep LearningTTIC,西北大学等组织的一系列课程和讲座,基础课程涉及DL的基础(符号化,简化后的数学问题和结论),信息论和学习,统计和计算,信息论,统计学习和强化学习(2020)。
2+. 2021 Deep learning theory lecture note + 2.1 逼近,优化,通用性,三方面做了总结,核心内容网页可见,比较友好。
-
MathsDL-spring19,MathDL系列,18,19,20年均有。
-
3.1 Geometry of Data
- Euclidean Geometry: transportation metrics, CNNs , scattering.
- Non-Euclidean Geometry: Graph Neural Networks.
- Unsupervised Learning under Geometric Priors (Implicit vs explicit models, microcanonical, transportation metrics).
- Applications and Open Problems: adversarial examples, graph inference, inverse problems.
-
3.2 Geometry of Optimization and Generalization
- Stochastic Optimization (Robbins & Munro, Convergence of SGD)
- Stochastic Differential Equations (Fokker-Plank, Gradient Flow, Langevin + + Dynamics, links with SGD; open problems) Dynamics of Neural Network Optimization (Mean Field Models using Optimal Transport, Kernel Methods)
- Landscape of Deep Learning Optimization (Tensor/Matrix factorization, Deep Nets; open problems).
- Generalization in Deep Learning.
-
3.3 Open qustions on Reinforcement Learning
-
-
IFT 6169: Theoretical principles for deep learning(2022 Winter),大多内容较为基础,传统。
- 4.1 拟定课题
- Generalization: theoretical analysis and practical bounds
- Information theory and its applications in ML (information bottleneck, lower bounds etc.)
- Generative models beyond the pretty pictures: a tool for traversing the data manifold, projections, completion, substitutions etc.
- Taming adversarial objectives: Wasserstein GANs, regularization approaches and + controlling the dynamics
- The expressive power of deep networks (deep information propagation, mean-field analysis of random networks etc.)
- 4.1 拟定课题
-
深度学习几何课程(2022, Michael Bronstein)内容比较高级.
-
5.1 2022 年的 GDL100 共包含 12 节常规课程、3 节辅导课程和 5 次专题研讨。12 节常规课程主要介绍了几何深度学习的基本概念知识,包括高维学习、几何先验知识、图与集合、网格(grid)、群、测地线(geodesic)、流形(manifold)、规范(gauge)等。3 节辅导课主要面向表达型图神经网络、群等变神经网络和几何图神经网络。
-
5 次专题研讨的话题分别是:
- 从多粒子动力学和梯度流的角度分析神经网络;
- 表达能力更强的 GNN 子图;
- 机器学习中的等变性;
- 神经 sheaf 扩散:从拓扑的角度分析 GNN 中的异质性和过度平滑;
- 使用 AlphaFold 进行高度准确的蛋白质结构预测。
-
-
Advanced Topics in Machine Learning and Game Theory游戏,强化方面的课程,2022。
-
AMS-ASA-SIAM Special Session on Mathematics of Deep Learning: A High-Dimensional Probability Perspective, I(2025)高维概率角度视角课程。
Architecture
- Partial Differential Equations is All You Need for Generating Neural Architectures -- A Theory for Physical Artificial Intelligence Systems 将统计物理的反应扩散方程,量子力学中的薛定谔方程,傍轴光学中的亥姆霍兹方程统一整合到神经网络偏微分方程中(NPDE),利用有限元方法找到数值解,从离散过程中,构造了多层感知,卷积网络,和循环网络,并提供了优化方法L-BFGS等,主要是建立了经典物理模型和经典神经网络的联系(2021)。
- 🔥KAN: Kolmogorov-Arnold Networks(2024.4)利用Kolmogorov-Arnold表示定理,设计的可学习激活函数的神经网络,并且激活函数能被B样条具体表示,在连续函数,一些物理问题等精度较高,可解释强,后期发展空间比较大。相关书籍可参考S. Ya. Khavinson - Best Approximation by Linear Superpositions (Approximate Nomography)-American Mathematical Society。
- Deep Learning Alternatives of the Kolmogorov Superposition Theorem(2025)其中文解读可参考麻省理工KAN被ICLR25接收为Oral Paper,宾夕法尼亚大学提出新版KAN求解偏微分方程!作为一个最近重新引起广泛关注的研究领域,KST(Kolmogorov Complexity Theory)与深度学习的有效整合有许多有前景的方向,同时对定理的适用性和局限性有许多未解的问题。鉴于这些问题,我们提出了 ActNet,这是一种受 Laczkovich(2021)中 KST 的 Laczkovich 版本启发的深度学习架构。该公式与 KANs(Kolmogorov Architectures)及其他类似方法存在若干差异。ActNet 的基本构建块是 ActLayer,其公式源自 KST,并且可以进一步被视为一个多头 MLP(多层感知器)层,其中每个头都有一个可训练的激活函数(因此名称为 ActNet。
Approximation
- NN Approximation Theory
- 6.0 Universal approximation theoremNN逼近从这里开始(1991)
- 6.1 Cybenko’s Theorem and the capabilityof a neural networkas function approximator一二维shallow神经网络的可视化证明(2019)
- 6.2 Depth Separation for Neural Networks 三层神经网络的表示能力比两层有优越性的简化证明 (2017)
- 6.3 赵拓等三篇(2019)
- 6.4 Neural Networks with Small Weights and Depth-Separation Barriers Gal Vardi等证明了对某些类型的神经网络, 用k层的多项式规模网络需要任意weight, 但用3k+3层的多项式规模网络只需要多项式大小的 weight(2020)。
- 6.5 Universality of Deep Convolutional Neural Networks卷积网络的通用逼近能力,及其核心要素,Ding-Xuan Zhou(2018),20年发表。
- 6.6 Deep Learning and Approximation theory 2023 关于DL和逼近理论的notes,62页,比较清晰完善。
Optimization
-
SGD
-
offconvex几个学术工作者维护的AI博客。
- 8.1 beyondNTK 什么时候NN强于NTK?
- 8.2 instahide 如何在不泄露数据的情况下优化模型?
- 8.3 implicit regularization in DL explained by norms?
-
- 9.1 deep-learning-dynamics-paper-list关于DL优化动力学方面研究的资料收集。
- 9.2 Adai Adam的优化版本Adai,Adam逃离鞍点很快,但是不能像SGD一样擅长找到flat minima。作者设计一类新的自适应优化器Adai结合SGD和Adam的优点。Adai逃离鞍点速度接近Adam,寻找flat minima能接近SGD。其知乎介绍可看Adai-zhihu
-
Smooth momentum: improving lipschitzness in gradient descent 提出了平滑动量,一种新的优化器,它改善了在”陡峭墙壁”上的行为。作者对所提出的优化器的特性进行了数学分析,并证明了平滑动量展现出改进的利普希茨特性和收敛性,这允许在梯度下降中稳定且更快的收敛。 (2023)
-
Muon(2024).作者解读.中文解析可参考Muon优化器赏析:从向量到矩阵的本质跨越
Geometry
- Optima transmission
- 9.1 深度学习的几何学解释(2020)
Book
-
Theory of Deep Learning(draft)Rong Ge 等(2019)。
-
Spectral Learning on Matrices and TensorsMajid Janzamin等(2020)
-
Deep Learning Architectures A Mathematical Approach(2020),你可以libgen获取,内容如其名字,大概包含:工业问题,DL基础(激活,结构,优化等),函数逼近,万有逼近,RELU等逼近新研究,函数表示,以及两大方向,信息角度,几何角度等相关知识,实际场景中的卷积,池化,循环,生成,随机网络等具体实用内容的数学化,另外附录集合论,测度论,概率论,泛函,实分析等基础知识。
-
The Principles of Deep Learning Theory(2021)Daniel A. Roberts and Sho Yaida(mit),Beginning from a first-principles component-level picture of networks,本书解释了如何通过求解层到层迭代方程和非线性学习动力学来确定训练网络输出的准确描述。一个主要的结果是网络的预测是由近高斯分布描述的,网络的深度与宽度的纵横比控制着与无限宽度高斯描述的偏差。本书解释了这些有效深度网络如何从训练中学习非平凡的表示,并更广泛地分析非线性模型的表示学习机制。从近内核方法的角度来看,发现这些模型的预测对底层学习算法的依赖可以用一种简单而通用的方式来表达。为了获得这些结果,作者开发了表示组流(RG 流)的概念来表征信号通过网络的传播。通过将网络调整到临界状态,他们为梯度爆炸和消失问题提供了一个实用的解决方案。作者进一步解释了 RG 流如何导致近乎普遍的行为,从而可以将由不同激活函数构建的网络做类别划分。Altogether, they show that the depth-to-width ratio governs the effective model complexity of the ensemble of trained networks。利用信息理论,作者估计了模型性能最好的最佳深宽比,并证明了残差连接能将深度推向任意深度。利用以上理论工具,就可以更加细致的研究架构的归纳偏差,超参数,优化。原作者的视频说明(2021.12.1)
-
Physics-based Deep Learning(2021)N. Thuerey, P. Holl,etc.github resources深度学习与物理学的联系。比如基于物理的损失函数,可微流体模拟,逆问题的求解,Navier-Stokes方程的前向模拟,Controlling Burgers’ Equation和强化学习的关系等。
-
Geometric Deep Learning: Grids, Groups, Graphs, Geodesics, and Gauges(Michael M. Bronstein, Joan Bruna, Taco Cohen, Petar Veličković,2021),见上面课程5:深度学习几何课程.
-
dynamical systems and ml 2, 2020看起来写得很好,有Connection between ResNets and Dynamical Systems。
-
Mathematical Introduction to Deep Learning: Methods, Implementations, and Theory 这本书把深度学习的理论和实践结合的比较紧密,并且配有代码。主要包含了ANN相关的的基础组件分析、逼近、优化、KL散度、生成的概率误差分析、DL在PDE的应用(PINN,DKM)。另外比较好的是。LaTeX工作室给出了对应的tex源码。《深度学习的数学介绍》LaTeX 代码下载2023。
Session
- Foundations of Deep Learning(2019),西蒙研究中心会议。
- Deep Learning Theory 4(2021, ICML)Claire Monteleoni主持...,深度学习理论会议4,包含论文和视频。
- Deep Learning Theory 5 (2021,ICML)MaYi主持...,深度学习理论会议5,包含论文和视频。
- DeLTA 2023 : 4th International Conference on Deep Learning Theory and Applications 会议包含RNN,CNN,DHN,GAN,AE,EV,Dimensionality Reduction等基本模型内容,具体啥内容未知,ML的基本内容,强化,度量,核,图表示,聚类,分类,回归等,还有大数据,图像的具体应用方向,语言理解方向。看起来都是比较基础内容。
- 和动力系统的会议 2023。里面收到的文章列表
generalization
-
Robust Learning with Jacobian Regularization(2019)Judy Hoffman...,
-
Predicting Generalization using GANs(2022.6),用GAN来评估泛化性.
-
Implicit Regularization in Tensor Factorization: Can Tensor Rank Shed Light on Generalization in Deep Learning?(2021.7)Tensor Rank 能否揭示深度学习中的泛化?
-
如何通过Meta Learning实现域泛化Domain Generalization(2022.4),Domain Generalization CVPR2022博文参考.
-
Generalization-Causality 一博士关于domain generalization等工作的实时汇总。
-
Implicit Regularization in Hierarchical Tensor Factorization and Deep Convolutional Networks(Noam Razin • Jul 15, 2022)
-
6.1 Across three different neural network types (equivalent to matrix, tensor, and hierarchical tensor factorizations), we have an architecture-dependant notion of rank that is implicitly lowered. Moreover, the underlying mechanism for this implicit regularization is identical in all cases. This leads us to believe that implicit regularization towards low rank may be a general phenomenon. If true, finding notions of rank lowered for different architectures can facilitate an understanding of generalization in deep learning.
-
6.2 Our findings imply that the tendency of modern convolutional networks towards locality may largely be due to implicit regularization, and not an inherent limitation of expressive power as often believed. More broadly, they showcase that deep learning architectures considered suboptimal for certain tasks can be greatly improved through a right choice of explicit regularization. Theoretical understanding of implicit regularization may be key to discovering such regularizers.
-
Others
-
Theoretical issues in deep networks 表明指数型损失函数中存在隐式的正则化,其优化的结果和一般损失函数优化结果一致,优化收敛结果和梯度流的迹有关,目前还不能证明哪个结果最优(2020)。
-
The Dawning of a New Erain Applied MathematicsWeinan E关于在DL的新处境下结合历史的工作范式给出的指导性总结(2021)。
-
redunet_paper白盒神经网络代码。
-
Theory of Deep Convolutional Neural Networks:Downsampling下采样的数学分析Ding-Xuan Zhou(2020)
-
Theory of deep convolutional neural networks II: Spherical analysis还有III:radial functions 逼近,(2020)。不过这些工作到底如何,只是用数学转换了一下,理论上没做过多贡献,或者和实际结合没难么紧密,还不得而知。
-
The Modern Mathematics of Deep Learning(2021)主要是deep laerning的数学分析描述,涉及的问题包括:超参数网络的通用能力,深度在深度模型中的核心作用,深度学习对维度灾难的克服,优化在非凸优化问题的成功,学习的表示特征的数学分析,为何深度模型在物理问题上有超常表现,模型架构中的哪些因素以何种方式影响不同任务的学习中的不同方面。
-
Topos and Stacks of Deep Neural Networks(2021)每一个已知的深度神经网络(DNN)对应于一个典型的 Grothendieck 的 topos 中的一个对象; 它的学习动态对应于这个 topos 中的一个态射流。层中的不变性结构(如 CNNs 或 LSTMs)与Giraud's stacks相对应。这种不变性被认为是泛化性质的原因,即从约束条件下的学习数据进行推断。纤维代表前语义类别(Culioli,Thom) ,其上人工语言的定义,内部逻辑,直觉主义,经典或线性(Girard)。网络的语义功能是用这种语言表达理论的能力,用于回答输入数据输出中的问题。语义信息的量和空间的定义与香农熵的同源解释相类似。他们推广了 Carnap 和 Bar-Hillel (1952)所发现的度量。令人惊讶的是,上述语义结构被分类为几何纤维对象在一个封闭的Quillen模型范畴,然后他们引起同时局部不变的 dnn 和他们的语义功能。Intentional type theories (Martin-Loef)组织这些对象和它们之间的纤维化。信息内容和交换由 Grothendieck's derivators分析。
-
Visualizing the Emergence of Intermediate Visual Patterns in DNNs(2021,NIPS)文章设计了一种神经网络中层特征的可视化方法,使得能 (1)更直观地分析神经网络中层特征的表达能力,并且展示中层特征表达能力的时空涌现; (2)量化神经网络中层知识点,从而定量地分析神经网络中层特征的质量; (3)为一些深度学习技术(如对抗攻击、知识蒸馏)提供新见解。
-
神经网络的博弈交互解释性(知乎)。上交大张拳石团队研究论文整理而得,作为博弈交互解释性的体系框架(不怎么稳固)。
-
Advancing mathematics by guiding human intuition with AI(2021,nature)机器学习和数学家工作的一个有机结合,主要利用机器学习分析众多特征和目标变量的主要相关因子,加强数学家的直觉,该论文得到了两个漂亮的定理,一个拓扑,一个表示论。可参考回答。
-
🔥A New Perspective of Entropy(2022) 通过莱布尼兹微分法则(Leibniz rule)将信息熵,抽象代数,拓 扑学联系起来。该文章是一个零基础可阅读的综述,具体参考Entropy as a Topological Operad Derivation (2021.7,Tai-Danae Bradley.)
-
minerva(2022)google提出的解题模型,在公共高等数学等考试中比人类平均分高.[测试地址](https://minerva-demo. github.io/#category=Algebra&index=1).
-
🔥An automatic theorem proving project菲尔兹获得者数学家高尔斯关于 自动证明数学定理的项目进展How can it be feasible to find proofs?(2022, W.T. Gowers).
-
GRAND: Graph Neural Diffusion (2021)该网站包含了一些相似论文资料,[项目地址graph-neural-pde](https://github.com/twitter-research /graph-neural-pde),其优化版本GRAND++.(2022).有博文介绍图神经网络的困境,用微分几何和代数拓扑解决仅供参 考.
-
Weinan È-A Mathematical Perspective on Machine Learning(2022.icm),room1最后一排,鄂维南在icm的演讲视频.
-
contrastive learning证明包括InfoNCE在内的一大类对比学习目标函数,等价于一个有两类变量(或者说两类玩家)参与的交替优化(或者说游戏)过程.
-
可解释性:Batch Normalization未必客观地反应损失函数信息2022,张拳石等.
-
Homotopy Theoretic and Categorical Models of Neural Information Networks该工作第一作者俄罗斯数学家Yuri Manin,2020工作,2022年8月arxiv有更新。ncatlab有讨论。博文讲解。
-
Deep learning via dynamical systems: An approximation perspective动力系统逼近。论文见。
-
群论角度群论角度去理解的一系列视频,群论视角,2014年出现过,视频系统讲解,2022年。
-
Constructions in combinatorics via neural networks作者Adam Zsolt Wagner通过神经网络和强化学习构建了一系列反例,推翻了几个组合学的猜想,2021年。
-
不动点2023这篇文章主要研究任意深度的一维神经网络中的固定点问题。首先,文章介绍了一种新的方法,通过代数拓扑理论来研究神经网络中的固定点。然后,文章证明了任意深度的一维神经网络在某些情况下一定存在固定点。特别地,当网络中的激活函数为sigmoid函数时,网络在存在足够多的神经元时必定存在固定点。此外,文章还证明了某些特殊情况下,任意深度的一维神经网络中的固定点是稠密的,即在网络参数的空间中,存在无限多的参数可以使得网络的输出为固定值。这项研究具有深入探究神经网络理论的意义,有助于深入理解神经网络在不同条件下的表现和性质。后面内容是直接输入题目,chatgpt总结的。
-
Overparameterized ReLU Neural Networks Learn the Simplest Model: Neural Isometry and Phase Transitions2023,这是一篇关于深度学习理论的论文,研究了过参数化的ReLU神经网络的训练和泛化性能,以及其学习的模型复杂度。研究表明,即使神经网络的参数数量极高,它们也能够学习出非常简单的模型,这与传统的统计智慧相矛盾。本文采用了凸优化和稀疏恢复的视角,提出了神经同构和相变的概念,来解释神经网络学习简单模型的原因。 本文的主要贡献包括以下几个方面:
- 对于两层ReLU网络,研究了其训练和泛化性能,并证明只有学习简单模型的参数是有意义的。
- 提出了神经同构的概念,即输入空间和输出空间之间的等距变换,这有助于解释神经网络学习简单模型的原因。
- 提出了相变的概念,并证明在随机生成的数据上,神经网络的恢复性能存在相变现象。当样本数量与维度之比超过一个数值阈值时,恢复成功的概率很高;否则,失败的概率很高。
- 研究了具有跳跃连接或归一化层的ReLU网络,并提出了相应的等距条件,以确保准确恢复种植的神经元。
总之,本文通过理论分析和数值实验,证明了过参数化的ReLU神经网络能够学习最简单的模型,这为深度学习的理论研究和实际应用提供了重要的启示。(问chatgpt论文题目给的回复)
-
FAST COMPUTATION OF PERMUTATION EQUIVARIANT LAYERS WITH THE PARTITION ALGEBRA 2023.1, 该论文主要介绍了一种快速计算置换等变层的方法,该方法使用了分区代数。
-
Omnigrok: Grokking Beyond Algorithmic Data2022.10. Grokking 是算法数据集的一种不寻常现象,在过度拟合训练数据后很久就会发生泛化,这种现象仍然难以捉摸。我们的目标是通过分析神经网络的损失情况来理解 grokking,将训练和测试损失之间的不匹配确定为 grokking 的原因。我们将此称为“LU 机制”,因为训练和测试损失(针对模型权重范数)通常分别类似于“L”和“U”。这种简单的机制可以很好地解释 grokking 的许多方面:数据大小依赖性、权重衰减依赖性、表示的出现等。在直观图片的指导下,我们能够在涉及图像、语言和分子的任务上诱导 grokking。在相反的方向,我们能够消除算法数据集的 grokking。我们将算法数据集的 grokking 的戏剧性归因于表征学习。
-
Grokking modular arithmetic2023.1 我们提出了一个简单的神经网络,它可以学习模块化算术任务并表现出泛化的突然跳跃,称为“grokking”。具体来说,我们提出(i)完全连接的两层网络,在没有任何正则化的情况下,在普通梯度下降下使用 MSE 损失函数表现出对各种模块化算术任务的 grokking; (ii) 证据表明 grokking 模块化算法对应于学习其结构由任务确定的特定特征图; (iii) 权重的解析表达式——以及特征图——解决一大类模块化算术任务; (iv) 证明这些特征图也可以通过普通梯度下降法和 AdamW 找到,从而建立网络学习表示的完整可解释性。
-
Progress measures for grokking via mechanistic interpretability2023.2神经网络可解释性方面研究。研究表明,grokking不是突然的转变,而是源于权重中编码的结构化机制的逐渐放大,随后是记忆组件的删除。
-
awesome-deep-phenomena 2022.5, 神经网络表现出的各种现象的研究git整理。
-
Deep Learning for Mathematical Reasoning (DL4MATH)DL和数学相关的资料git整理。
-
PCAST Working Group on Generative AI Invites Public Input2023.5.13. 陶哲轩将主持美国总统科技顾问委员会(PCAST)成立的一个生成式人工智能工作组的会议。
-
🔥CRATE 白盒ai 训练进展.知乎上有人讨论, 该文章拼凑比较多,且论文和代码相差十万八千里。 知乎参考。(2023)
-
An Ambiguity Measure for Recognizing the Unknowns in Deep Learning自华为香港研究中心的学者,给出了模型对未知量(类)的模糊性度量框架。该模糊度量能够判断未知量和已知模型所能判断的范围的相关性大小。(2023)
-
flow_matching(2025)meta在扩散模型中的流模型的基础理论研究与实践。
-
Harmonic Loss Trains Interpretable AI Models(2025)在本文中,我们引入了谐波损失作为训练神经网络和大型语言模型(LLMs)的标准交叉熵损失的替代方案。谐波损失通过其尺度不变性和设计上的有限收敛点(可解释为类别中心),实现了更好的可解释性和更快的收敛。我们首先在算法、视觉和语言数据集上验证了谐波模型的性能。通过广泛的实验,我们证明了使用谐波损失训练的模型在以下方面优于标准模型:(a) 增强可解释性,(b) 泛化所需的训练数据更少,(c) 减少“顿悟”(grokking)现象。此外,我们将使用谐波损失训练的 GPT-2 模型与标准 GPT-2 模型进行比较,表明谐波模型能够生成更具可解释性的表示。展望未来,我们认为谐波损失有潜力成为数据可用性有限的领域或对可解释性和可靠性要求极高的高风险应用中的重要工具,为更稳健、更高效的神经网络模型铺平道路。(grok译)
DeepModeling
- DeepModeling鄂维南等组织,一种新的研究范式,将DL建模渗透到科研中,这里会开源很多对新或旧问题的DL建模方案.[其github地址](https://github.com/deepmode ling).空了看情况解析某些工作.
- deepflameDL向的流体力学包。
- FunSearch大语言模型和自动评估器的联合迭代,发现了帽集问题的新解决方案,在一些设定下发现了有史以来最大的帽集。DeepMind团队还决定将FunSearch应用于发现更有效的解决“装箱问题”(bin packing)的算法。(2023)
- Applications of Deep Learning to Scientific ComputingPINN, DeepONet等用来解物理相关的PDE方程的一篇来自ETH的博士论文。(2023)
- An ML approach to resolution of singularities作者介绍了一种新的Hironaka游戏方法,它使用强化学习代理来寻找奇点的最优分辨率(Resolutions)。在某些领域,训练有素的模型在执行多项式加法的总次数方面优于现有的最先进的选择启发式方法,这证明了机器学习的最新发展有潜力提高符号计算中算法的性能。(2023)
- 如何为神经网络的输出添加约束文章介绍了很多如何给DL输出添加约束的思路,历史工作,并附有新工作LinSATNet的代码:通过将 Sinkhorn 算法扩展到多组边缘分布(据我们所知,我们是首次研究具有多组边缘分布的 Sinkhorn 算法)。然后,通过将约束转化为边缘分布来施加正线性约束。文章中验证了LinSATNet方法能够处理复杂的回路约束(用于求解旅行商问题的变种)、部分图匹配的约束(用于处理图匹配中,只有部分子图互相匹配的问题)、一般的线性约束(用于特定偏好下的投资组合问题)。这些问题都可以用正线性约束来表示、且可用LinSATNet方法进行处理。(不知道能不能用在onnx之类的图优化上面)(2023)
数学形式主义与计算机
- The Future of Mathematics? (2019) Kevin Buzzard就lean的一场讲座,评论区有对应讲义资料。
- 数学形式主义的兴起(2022.7)Kevin Buzzard教授在2022本届国际数学家大会一小时报告演讲中提供了一些信息和思考见解。讲述了数学 形式主义与人工智能、机器学习和开源社区的共同努力,用计算机做奥数题、检查数学证明过程是否有误、甚至自动发现和形式化证明数学定理,在理论和实践中又会碰撞出什么火花,又会如何囿于...
- 专访ICM 2022国际数学家大会一小时报告者Kevin Buzzard:计算机可以成为数学家吗?——译自量子杂志比较好的采访,值得看看.数学家让计算机科学家了解到数学很难,这个部分,在被逐渐理解,且计算机系统检查,可能会解决这个难点.还有那些炫酷的项目,球面外翻,费马大定理,非常值得关注.
- Deep Maths-machine learning and mathematics,重新发现Euler多面体公式 (对之前工作的细节的更进一步说明),涉及组合不变量猜想,庞加莱猜想,瑟斯顿几何猜想,扭结图等(涉及的面很大,但都是一带而过)。(2023)
- Would it be possible to create a tool to automatically diagram papers? Tao在IPAM组织用机器学习来帮助证明的workshops。
- 数学的形式化与AI for Mathematics北大没找到具体内容,可以忽略(具体内容已由原作者分享了,可私聊),2023.3。
- To Teach Computers Math, Researchers Merge AI Approaches大模型,自然语言的数学证明能力探索(2023.4)。
- Is deep learning a useful tool for the pure mathematician?Geordie Williamson,2023.4。Claude内容总结:这篇文章主要探讨了深度学习对纯数学家的实用性。文章认为:1. 深度学习的许多成就都依赖于遵循简单规则的大规模统计建模,这与数学家寻找简洁而深刻的理论不同。因此,深度学习可能不会直接推动数学理论的发展。2. 但是,深度学习可以产生一些有趣的数学问题。例如,理解神经网络为什么在某些任务上表现优异,探索这些网络学习的表达形式和算法基础,这可能会产生一些有价值的数学理论。3. 深度学习也可以成为一种发现新的数学关系和结构的工具。研究人员已经探索了使用深度学习来理解复杂系统的拓扑和几何结构。这可以为数学家提供一些有趣的新思路和见解。4. 深度学习也被用来加速定理证明和公式推导等传统的数学工作。这可以使数学研究变得更加数据驱动和自动化。一些研究已经取得了早期成功,这是一个值得期待的新方向。5. 总体而言,尽管深度学习和数学理论有不同的动机与方法论,但两者之间存在潜在的协同性。深度学习可以成为数学发现和理解的有力工具,推动更广泛地跨学科合作。但它不太可能直接影响数学基础理论的发展。文章认为,深度学习可以成为数学家的一个有用工具,特别是在推动新发现、新见解和新方向上。但它可能无法直接推动更加基础的数学理论建设。两者有潜在的互补与协同作用,值得加强跨领域合作与理解。overall,深度学习有助于扩展和拓展当前的数学体系,但不会颠覆其基本建立的理论基础。
- Learning proofs for the classification of nilpotent semigroupsCarlos Simpson,2021.6。Claude总结:这篇文章探索了使用神经网络进行nilpotent半群的分类定理证明,并在实验上取得了初步成功。但是完全自动化和令人理解的定理证明还需要更多工作。机器学习在这一过程中更可能起辅助作用,成为发现定理和理解代数结构的有力工具。这是一个涉及数学与人工智能交叉的有趣主题,值得进一步探讨与实践。
- Lean for the Curious Mathematician 20232023年举办的“Lean for the Curious Mathematician”活动。讲座将从基础开始(如何安装和使用Lean,形式化数学的基本机制,浏览proof library mathlib等),然后构建更高级的主题,以说明形式化在不同数学领域的工作方式。具体的领域取决于参与者的兴趣(如实分析、复分析、微分几何、数论、拓扑学、组合数学、范畴论等)。
- Fermat's Last Theorem for regular primes Lean在费马大定理指数为正则素数(REGULAR PRIMES)情形的证明。数学证明可参考(2023.5.15)。迈出了一步,但离完整版的证明,差距还是比较大的。
- LeanDojo: Theorem Proving with Retrieval-Augmented Language Models (2023)将大语言模型和形式化证明结合起来,官方相关部署LeanCopilot都在做。
- pfr 一个由四位著名数学家组成的团队,包括两位菲尔兹奖得主,证明了一个被描述为“加法组合学圣杯”(holy grail of additive combinatorics)的猜想。在一个月内他们松散地合作,用计算机辅助证明验证了它。辅助证明:蓝图可以创建一个图表 dep graph document 描述证明中涉及的各种逻辑步骤,Lean来形式化证明验证。 相关报告参考1,参考2
- Goedel-Prover: AFrontier ModelforOpen-SourceAutomated Theorem Proving(2025)新模型在 Lean Workbook 数学题库中成功解决了 29.7K 道题目,这个成绩差不多是其他顶尖模型(InternLM2.5-StepProver 和 InternLMMath-Plus)的两倍。在 PutnamBench 上,新模型解决了 7 个问题(Pass@512),位列排行榜第一。
- DeepSeek-Prover-V1.5(2025)在高中阶段的 miniF2F 基准测试 (63.5%) 和本科阶段的 ProofNet 基准测试集 (25.3%) 上取得了新的最先进的结果。
Discussion
- 怎样看待Ali Rahimi 获得 NIPS 2017 Test-of-time Award后的演讲?17年就有人(张心欣,王刚等)指出了DL的缺陷,和这个领域中人的特点,过去5年了,还是那样.不过如23 能看出,meta的做应用的田渊栋还在坚守理论.
- 深度学习领域有哪些瓶颈?张拳石新的吐槽,以及最新成果汇集.
- ChatGPT/GPT4虽然和理论无关,但实用性很好的一个进展,目前准确率(!胡扯率)貌似能达到0.8+。
- 数值pde与深度学习结合是未来发展方向吗?
- 大语言模型中的涌现现象是不是伪科学?
AI4Math
- Deep Learning Symmetries and Their Lie Groups, Algebras, and Subalgebras from First Principles (2023)论文提出了一种深度学习算法,旨在发现和识别标记数据集中存在的连续对称性群。作者使用全连接神经网络来模拟对称性变换和相应的生成器。他们构建了损失函数,以确保应用的变换是对称的,并且生成器的集合形成了一个封闭的(子)代数。该研究通过多个示例进行了验证,这些示例展示了由对称性保留的不同类型守恒量。作者分析了旋转群SO(2)、SO(3)和SO(4)以及洛伦兹群SO(1, 3)的完整子群结构。其他示例包括压缩映射、分段不连续标签和SO(10),展示了该方法的普遍性及其在物理和数据科学中的潜在应用。论文还讨论了将机器学习应用于李群及其属性的数学研究,为数学领域的机器学习方法打开了大门。作者提供了详细的研究方法,包括他们在分析中使用的设置和符号、深度学习方法以及线性代数方法,以帮助不熟悉深度学习的读者。论文分为多个章节,涵盖了引言、设置和符号、深度学习方法、线性代数方法以及不同维度下的长度保持变换、洛伦兹变换和不连续预言的例子。作者以讨论其方法在理解数据对称性和其对基于模拟的推断及参数检索的潜在应用的含义结束。(from kimi chat).
- 小乐数学科普:事关BSD猜想,AI人工智能发现椭圆曲线的“椋鸟群飞murmuration”现象——译自量子杂志 (2020-2023), Machine-Learning Arithmetic Curves(2020) 能够高精度地预测椭圆曲线的秩;Machine-Learning Number Fields (2020) 利用机器学习对数论中的其他对象进行分类;Murmurations of elliptic curves Murmurations of Elliptic Curves(2022);Murmurations (2023)Zubrilina证明了这种类型的椋鸟群飞遵循她发现的明确公式。视频交流。
- Deep-Learning the Landscape (2023, Yang-Hui He)这篇论文的摘要提出了一种范式,用于深度学习在数学物理和粒子现象学中出现的不断扩大的数据库,这些数据库的多样性涵盖了弦真空的统计、组合和代数几何等领域。作为具体的例子,作者建立了多层神经网络,既可以作为分类器也可以作为预测器,并用从卡拉比-丘流形和向量丛到规范理论的箭袋表示法等多种可用数据对它们进行训练。研究发现,即使是相对简单的神经网络也能在几分钟内学习到许多重要数量,并以惊人的准确性进行预测,同时还能预测以前未遇到的结果。这种范式应该成为物理学景观以及纯数学中各种调查的有价值的工具。(kimi chat)
- two-announcements-ai-for-math-resources-and-erdosproblems-com(2024.4)陶哲轩等列的AI for math 资料,以及爱多士问题网站。
- Gold-medalist Performance in Solving Olympiad Geometry with AlphaGeometry2(2025)AG2 在 2000 年至 2024 年所有 IMO 几何问题上的解决率达到了新的最高水平 84%,相比之下,AG1 的解决率仅为 54%。这表明 AI 在应对具有挑战性的数学推理任务方面取得了重大飞跃,超越了平均 IMO 金牌得主的水平。
- Kervaire不变量问题的彻底解决2024年北大校庆期间,三位北大数学校友林伟南(2011级)、王国祯(2004级)、徐宙利(2004级)在北京数学杂志(Peking Mathematical Journal)会议上公布了Kervaire不变量问题的彻底解决。这一结果为这个悬置六十余年的拓扑学问题画上完美句点,也因最后一个未知的维数是126维为北京大学献上了126岁的生日祝福。其中计算机程序(非ai)起到了简化筛查作用。
- What makes math problems hard for reinforcement learning: a case study(2024)我们利用组合群论中一个长期存在的猜想,从多个角度探索寻找稀有实例所面临的挑战,这些实例带有不成比例的高回报。基于在 Andrews-Curtis 猜想定义的背景下所获得的经验教训,我们提出了算法改进和一种拓扑难度度量,这些改进对一类广泛的搜索问题具有启示意义。作为我们研究的一部分,我们还处理了几个开放的数学问题。值得注意的是,我们证明了 Akbulut-Kirby 系列(1981)中除两个表示外的所有表示的长度可约性,并解决了 Miller-Schupp 系列(1991)中的各种潜在反例,包括三个无限子家族。(grok译),其开源地址AC-Solver。
数学家
懒得分类了,随便新加了一类
- 林力行háng(Lek-Heng Lim)使用代数、几何和拓扑工具来回答机器学习中的问题。一篇采访quantamagazine采访和中文版
- 1.1 Topology of deep neural networks 将神经网络表达的物体视为拓扑流形,不同类别在相片层面具有很大相似度的流形会以非常复杂的方式交织在一起,作者进行了实验,证明这些流形能被简化,并利用计算拓扑中的持续同调persistent homology来测量这些物体的形状。简单来说,作者用它来测量流形穿过神经网络层时的形状。最终,证明它简化为最简单的形式。这对神经网络的可解释性有帮助。
- 1.2 Recht-Ré Noncommutative Arithmetic-Geometric Mean Conjecture is False我的博士生Zehua Lai和我展示了机器学习中一个长期存在的猜想是错误的。“现代机器学习问题通常涉及将大量参数与大量数据拟合。GPT-4是ChatGPT底层引擎的下一次迭代,据传有1万亿到100万亿个参数。现有的计算机无法同时处理这些参数。因此,在每一步中,算法都会随机选择一小部分参数(无论计算机可以处理什么),然后只使用这些参数。选取一个小的随机子集称为抽样(取样)。现在的问题是:在算法的后续步骤中,它应该选择我们之前在前面的步骤中已经选择的参数,还是应该排除这些参数?换句话说,它应该对参数进行替换还是不替换?当我们的算法涉及随机化时,这是一个我们总是需要考虑的问题,所以这是一个非常基本和重要的问题。大约10年前,Ben Recht和Chris Ré表明,不替换采样比替换更好,前提是特定不平等的某种类似物成立。多年来,人们证明了这种不平等的各种案例。我们表明,总的来说,这种不平等并不成立。回答这个问题的方法是使用代数几何中的一种称为非交换正点(noncommutative Positivstellensatz)的工具。这是一个又长又拗口的词。它是一个德语单词,本质上意味着多项式正点的位置。“
- 1.3 LU decomposition and Toeplitz decomposition of a neural network摘要: It is well-known that any matrix $A$ has an LU decomposition. Less well-known is the fact that it has a 'Toeplitz decomposition' $A=T_1 T_2 \cdots T_r$ where $T_i$ 's are Toeplitz matrices. We will prove that any continuous function $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ has an approximation to arbitrary accuracy by a neural network that takes the form $L_1 \sigma_1 U_1 \sigma_2 L_2 \sigma_3 U_2 \cdots L_r \sigma_{2 r-1} U_r$, i.e., where the weight matrices alternate between lower and upper triangular matrices, $\sigma_i(x):=\sigma\left(x-b_i\right)$ for some bias vector $b_i$, and the activation $\sigma$ may be chosen to be essentially any uniformly continuous nonpolynomial function. The same result also holds with Toeplitz matrices, i.e., $f \approx T_1 \sigma_1 T_2 \sigma_2 \cdots \sigma_{r-1} T_r$ to arbitrary accuracy, and likewise for Hankel matrices. A consequence of our Toeplitz result is a fixed-width universal approximation theorem for convolutional neural networks, which so far have only arbitrary width versions. Since our results apply in particular to the case when $f$ is a general neural network, we may regard them as LU and Toeplitz decompositions of a neural network. The practical implication of our results is that one may vastly reduce the number of weight parameters in a neural network without sacrificing its power of universal approximation. We will present several experiments on real data sets to show that imposing such structures on the weight matrices sharply reduces the number of training parameters with almost no noticeable effect on test accuracy.
- 1.4 What is … an equivariant neural network?文章证明了AlphaFold2和ImageNet classification with deep convolutional neural networks在没有神经网络的等变性假设情况下是等价(Equivariant)的。
- Rate of Loss Characterization That Resolves the Dilemma of the Wall Pursuit Game Solution"2023年年初,在博弈论领域,一个新发表的成果宣告解决了一个困扰学者们60多年的问题:追墙博弈(wall pursuit game)永远存在最优博弈策略。这一成果甚至可以说对我们的日常出行都有着重要意义,自动驾驶"。
- An Invitation to Neuroalgebraic Geometry(2025)在这篇阐述性工作中,我们通过代数几何的视角,倡导研究由机器学习模型参数化的函数空间。为此,我们聚焦于代数模型,例如具有多项式激活函数的神经网络,其关联的函数空间属于半代数簇。我们勾勒出一套对应关系,将这些半代数簇的代数几何不变量(如维度、次数和奇点)与机器学习的基本方面(如样本复杂度、表达能力、训练动态和隐性偏见)联系起来。在此过程中,我们回顾了相关文献,并探讨了超越代数领域的想法。这项工作为连接代数几何与深度学习的研究方向奠定了基础,我们将其称为“神经代数几何”。(grok翻译)
近似
- 压缩下一个 token 通向超过人类的智能(2023)
- Scaling Laws for Neural Language Models论文提出语言模型的计算复杂度随着参数数量的增加呈线性关系,而不是平方关系。这为巨大规模语言模型的训练提供了理论支持。(2020)
- 扩散模型与能量模型,Score-Matching和SDE,ODE的关系对扩散模型同随机微分方程等的联系,做了比较清晰的梳理(2022)。更详细的参考What are Diffusion Models? (2021)。
- Why Can GPT Learn In-Context? Language Models Secretly Perform Gradient Descent as Meta-Optimizers该论文从优化的角度发现GPT预训练实际上同时进行两层优化:一层进行语言模型参数学习,一层进行元优化以生成最优序列。这种嵌套优化机制赋予GPT强大的泛化和自适应能力。这为理解自监督学习模型的训练原理和泛化性能提供了全新的视角。(2022.12)
- GPT-PINN: 生成式预训练内嵌物理知识神经网络 CAM传习录(2023.4)。
- 从 Transformer 到边界值反问题(一) CAM传习录(2023.4)。
- Defining and Quantifying the Emergence of Sparse Concepts in DNNs神经网络中的符号概念涌现,其中文官方介绍AI从技术到科学:神经网络中的概念符号涌现的发现与证明(2023.4)
Contributors

39 commits
Similar repos


README
Deep Learning Theory
整理了一些深度学习的理论相关内容,持续更新。
2026-03 更新:先补一版
2025–2026 Highlights,集中记录最近在Lean形式化、AI for Math、machine-assisted proof 方向上的一些代表性进展。
Contents
2025–2026 Highlights:最近一年左右最值得优先看的少量代表性进展。Overview:深度学习理论与智能理论综述。Course:课程、讲义与系统性学习资源。Architecture / Approximation / Optimization / Geometry:若干专题条目。AI4Math / 数学家 / 近似:数学与 AI 交叉方向的历史条目与延伸阅读。
2025–2026 Highlights
Lean / Formalization
-
🔥 Sphere Packing in Lean / official post:Maryna Viazovska 2022 Fields Medal 相关的
8维与24维球堆积结果在 Lean 中得到完整形式化。Math, Inc. 官方页给出的说法是:Gauss 在约5天内补完8维剩余部分,约2周完成24维与周期唯一性。这是近年最有代表性的 autoformalization 事件之一。 -
The Riemann Hypothesis for curves, autoformalized:有限域上超椭圆曲线的 Riemann-Hypothesis 型估计被形式化,README 给出规模约
4000行 Lean。这个项目很适合作为 AI-assisted formal verification 进入数论 / 代数几何边界的代表案例。 -
Archon: An Agentic System for Formalizing Research-Level Mathematics:这篇文章强调的重点不是传统 benchmark,而是 repository-level 的研究级形式化:Plan Agent 与 Lean Agent 协同,把复杂证明拆分成模块、循环规划并逐步填补
sorry。文中报告 Archon 全自动 formalize 了FirstProof Problem 6,并在几乎自动的条件下完成了Problem 4。 -
The Equational Theories Project: Advancing Collaborative Mathematical Research at Scale:一个非常值得单列的案例:人类协作、自动证明与 Lean 验证深度结合,Terence Tao 参与其中。摘要写得很直接:项目确定了
4694个最简单 magma 等式律之间全部22,028,942条蕴含边,是 machine-assisted collaborative mathematics 的里程碑事件。
AI for Math / Discovery
-
Eigenweights for arithmetic Hirzebruch Proportionality (Tony Feng, 2026):这篇文章明确记录了一个基于
Gemini Deep Think的定制 AI agent。它借助代数组合与对称群表示论,把 arithmetic Hirzebruch proportionality 里出现的eigenweights计算推广到所有 classical groups,是 AI 深入代数几何 / 表示论工作流的一个漂亮案例。 -
The motivic class of the space of genus 0 maps to the flag variety:摘要中直接说明:论文中的结果是在
Google Gemini及相关工具协助下得到的;同时正文仍然保持人类作者主导的写法。这类工作很值得关注,因为它不是 formalization,而是 AI 直接参与研究发现与证明构思。
A Case Study: Murmurations
Murmurations of elliptic curves 不是最近一年的论文,但我倾向于把它保留成一个单独案例:它很可能是很多人第一次真正感受到“AI / 数据分析已经开始进入数论研究工作流”的代表作之一。论文研究的是不同 rank 椭圆曲线族的 Frobenius trace,也就是各个素数上的 a_p 系数。
- 数据表示:作者把每条椭圆曲线表示成由一串
a_p构成的高维向量,再把这些向量当作 point cloud 来处理。 - 使用方法:方法并不花哨,主要是
logistic regression、PCA等基础机器学习工具,但已经足以暴露出稳定而醒目的模式。 - 关键现象:一方面,不同 rank 的曲线在 PCA 平面上出现了相当清晰的簇分离;另一方面,对固定 rank 的曲线族取
a_p平均后,会出现非常显著的振荡图样,且不同 rank 之间像鸟群转向一样彼此呼应,因此被称作murmurations。 - 为什么重要:它展示的不是 magical theorem proving,而是一种新的数论实验方法——先把对象编码成可分析的数据,再用简单统计学习方法寻找人眼不容易直接看出的结构。
- 更深一层的意义:这篇文章的重要性不只在于“用机器学习分了类”,而在于它提示人们:即使方法并不复杂,数据驱动的观察也可能先暴露出此前并未被理论充分解释的结构,再反过来刺激新的数论问题。
- 后续线索:相关延伸工作已经出现,例如 Murmurations of Mestre-Nagao sums,说明这种“先观察 pattern,再追问其数论机制”的路线并不是一次性的尝试。
Open Repositories / Communities
-
Optimization Constants in Mathematics:这是一个很有意思的问题基础设施项目:整理各类数学优化常数的最好上下界、来源、验证状态与可更新条目。它并不是 theorem proving 仓库,但非常适合观察 AI、计算与协作如何改变数学研究的组织方式。相关博文可见 Terence Tao: A crowdsourced repository for optimization constants?
-
math-inc:这一组织近来连续公开了
Sphere-Packing-Lean、RiemannHypothesisCurves、KakeyaFiniteFields、ZkLinalg等项目。无论是否完全接受其叙事,这些仓库都值得持续跟踪,因为它们代表了前沿 autoformalization 的最新公开样本。
Overview
-
Recent advances in deep learning theory 总结了目前深度学习理论研究的六个方向的一些结果,概述型,没做深入探讨(2021)。
-
1.1 complexity and capacity-basedapproaches for analyzing the generalizability of deep learning;
-
1.2 stochastic differential equations andtheir dynamic systems for modelling stochastic gradient descent and its variants, which characterizethe optimization and generalization of deep learning, partially inspired by Bayesian inference;
-
1.3 thegeometrical structures of the loss landscape that drives the trajectories of the dynamic systems;
-
1.4 theroles of over-parameterization of deep neural networks from both positive and negative perspectives;
-
1.5 theoretical foundations of several special structures in network architectures;
-
1.6 the increasinglyintensive concerns in ethics and security and their relationships with generalizability
-
-
🔥 On the Principles of Parsimony and Self-Consistency for the Emergence of Intelligence(2022.7.马毅、沈向洋、曹颖)"任何一个智能系统,作为一个看似简单的自主闭环:信息、控制、对策、优化、神经网络,紧密结合,缺一不可。总而言之,人工智能的研究从现在开始,应该能够也必须与科学、数学、和计算紧密结合。从最根本、最基础的第一性原理(简约、自洽)出发,把基于经验的归纳方法与基于基础原理的演绎方法严格地、系统地结合起来发展。理论与实践紧密结合、相辅相成、共同推进我们对智能的理解。" 知乎解读可看:https://zhuanlan.zhihu.com/p/543041107 。
-
Machine Learning in Physics and Geometry(2023.3)总结了ml在几何和理论物理上的一些进展,主要涉及到pca,t-sne,k-means,nn,svm,数据拓扑分析技术内容,理论物理包含了Polytopes,Amoebae,Quivers,Brane Webs。
-
Machine-Assisted Proofs(2025)Terence Tao 将探讨机器在数学中使用的历史和近期发展。他还将推测机器辅助在该领域的未来作用。
Course
- Theory of Deep LearningTTIC,西北大学等组织的一系列课程和讲座,基础课程涉及DL的基础(符号化,简化后的数学问题和结论),信息论和学习,统计和计算,信息论,统计学习和强化学习(2020)。
2+. 2021 Deep learning theory lecture note + 2.1 逼近,优化,通用性,三方面做了总结,核心内容网页可见,比较友好。
-
MathsDL-spring19,MathDL系列,18,19,20年均有。
-
3.1 Geometry of Data
- Euclidean Geometry: transportation metrics, CNNs , scattering.
- Non-Euclidean Geometry: Graph Neural Networks.
- Unsupervised Learning under Geometric Priors (Implicit vs explicit models, microcanonical, transportation metrics).
- Applications and Open Problems: adversarial examples, graph inference, inverse problems.
-
3.2 Geometry of Optimization and Generalization
- Stochastic Optimization (Robbins & Munro, Convergence of SGD)
- Stochastic Differential Equations (Fokker-Plank, Gradient Flow, Langevin + + Dynamics, links with SGD; open problems) Dynamics of Neural Network Optimization (Mean Field Models using Optimal Transport, Kernel Methods)
- Landscape of Deep Learning Optimization (Tensor/Matrix factorization, Deep Nets; open problems).
- Generalization in Deep Learning.
-
3.3 Open qustions on Reinforcement Learning
-
-
IFT 6169: Theoretical principles for deep learning(2022 Winter),大多内容较为基础,传统。
- 4.1 拟定课题
- Generalization: theoretical analysis and practical bounds
- Information theory and its applications in ML (information bottleneck, lower bounds etc.)
- Generative models beyond the pretty pictures: a tool for traversing the data manifold, projections, completion, substitutions etc.
- Taming adversarial objectives: Wasserstein GANs, regularization approaches and + controlling the dynamics
- The expressive power of deep networks (deep information propagation, mean-field analysis of random networks etc.)
- 4.1 拟定课题
-
深度学习几何课程(2022, Michael Bronstein)内容比较高级.
-
5.1 2022 年的 GDL100 共包含 12 节常规课程、3 节辅导课程和 5 次专题研讨。12 节常规课程主要介绍了几何深度学习的基本概念知识,包括高维学习、几何先验知识、图与集合、网格(grid)、群、测地线(geodesic)、流形(manifold)、规范(gauge)等。3 节辅导课主要面向表达型图神经网络、群等变神经网络和几何图神经网络。
-
5 次专题研讨的话题分别是:
- 从多粒子动力学和梯度流的角度分析神经网络;
- 表达能力更强的 GNN 子图;
- 机器学习中的等变性;
- 神经 sheaf 扩散:从拓扑的角度分析 GNN 中的异质性和过度平滑;
- 使用 AlphaFold 进行高度准确的蛋白质结构预测。
-
-
Advanced Topics in Machine Learning and Game Theory游戏,强化方面的课程,2022。
-
AMS-ASA-SIAM Special Session on Mathematics of Deep Learning: A High-Dimensional Probability Perspective, I(2025)高维概率角度视角课程。
Architecture
- Partial Differential Equations is All You Need for Generating Neural Architectures -- A Theory for Physical Artificial Intelligence Systems 将统计物理的反应扩散方程,量子力学中的薛定谔方程,傍轴光学中的亥姆霍兹方程统一整合到神经网络偏微分方程中(NPDE),利用有限元方法找到数值解,从离散过程中,构造了多层感知,卷积网络,和循环网络,并提供了优化方法L-BFGS等,主要是建立了经典物理模型和经典神经网络的联系(2021)。
- 🔥KAN: Kolmogorov-Arnold Networks(2024.4)利用Kolmogorov-Arnold表示定理,设计的可学习激活函数的神经网络,并且激活函数能被B样条具体表示,在连续函数,一些物理问题等精度较高,可解释强,后期发展空间比较大。相关书籍可参考S. Ya. Khavinson - Best Approximation by Linear Superpositions (Approximate Nomography)-American Mathematical Society。
- Deep Learning Alternatives of the Kolmogorov Superposition Theorem(2025)其中文解读可参考麻省理工KAN被ICLR25接收为Oral Paper,宾夕法尼亚大学提出新版KAN求解偏微分方程!作为一个最近重新引起广泛关注的研究领域,KST(Kolmogorov Complexity Theory)与深度学习的有效整合有许多有前景的方向,同时对定理的适用性和局限性有许多未解的问题。鉴于这些问题,我们提出了 ActNet,这是一种受 Laczkovich(2021)中 KST 的 Laczkovich 版本启发的深度学习架构。该公式与 KANs(Kolmogorov Architectures)及其他类似方法存在若干差异。ActNet 的基本构建块是 ActLayer,其公式源自 KST,并且可以进一步被视为一个多头 MLP(多层感知器)层,其中每个头都有一个可训练的激活函数(因此名称为 ActNet。
Approximation
- NN Approximation Theory
- 6.0 Universal approximation theoremNN逼近从这里开始(1991)
- 6.1 Cybenko’s Theorem and the capabilityof a neural networkas function approximator一二维shallow神经网络的可视化证明(2019)
- 6.2 Depth Separation for Neural Networks 三层神经网络的表示能力比两层有优越性的简化证明 (2017)
- 6.3 赵拓等三篇(2019)
- 6.4 Neural Networks with Small Weights and Depth-Separation Barriers Gal Vardi等证明了对某些类型的神经网络, 用k层的多项式规模网络需要任意weight, 但用3k+3层的多项式规模网络只需要多项式大小的 weight(2020)。
- 6.5 Universality of Deep Convolutional Neural Networks卷积网络的通用逼近能力,及其核心要素,Ding-Xuan Zhou(2018),20年发表。
- 6.6 Deep Learning and Approximation theory 2023 关于DL和逼近理论的notes,62页,比较清晰完善。
Optimization
-
SGD
-
offconvex几个学术工作者维护的AI博客。
- 8.1 beyondNTK 什么时候NN强于NTK?
- 8.2 instahide 如何在不泄露数据的情况下优化模型?
- 8.3 implicit regularization in DL explained by norms?
-
- 9.1 deep-learning-dynamics-paper-list关于DL优化动力学方面研究的资料收集。
- 9.2 Adai Adam的优化版本Adai,Adam逃离鞍点很快,但是不能像SGD一样擅长找到flat minima。作者设计一类新的自适应优化器Adai结合SGD和Adam的优点。Adai逃离鞍点速度接近Adam,寻找flat minima能接近SGD。其知乎介绍可看Adai-zhihu
-
Smooth momentum: improving lipschitzness in gradient descent 提出了平滑动量,一种新的优化器,它改善了在”陡峭墙壁”上的行为。作者对所提出的优化器的特性进行了数学分析,并证明了平滑动量展现出改进的利普希茨特性和收敛性,这允许在梯度下降中稳定且更快的收敛。 (2023)
-
Muon(2024).作者解读.中文解析可参考Muon优化器赏析:从向量到矩阵的本质跨越
Geometry
- Optima transmission
- 9.1 深度学习的几何学解释(2020)
Book
-
Theory of Deep Learning(draft)Rong Ge 等(2019)。
-
Spectral Learning on Matrices and TensorsMajid Janzamin等(2020)
-
Deep Learning Architectures A Mathematical Approach(2020),你可以libgen获取,内容如其名字,大概包含:工业问题,DL基础(激活,结构,优化等),函数逼近,万有逼近,RELU等逼近新研究,函数表示,以及两大方向,信息角度,几何角度等相关知识,实际场景中的卷积,池化,循环,生成,随机网络等具体实用内容的数学化,另外附录集合论,测度论,概率论,泛函,实分析等基础知识。
-
The Principles of Deep Learning Theory(2021)Daniel A. Roberts and Sho Yaida(mit),Beginning from a first-principles component-level picture of networks,本书解释了如何通过求解层到层迭代方程和非线性学习动力学来确定训练网络输出的准确描述。一个主要的结果是网络的预测是由近高斯分布描述的,网络的深度与宽度的纵横比控制着与无限宽度高斯描述的偏差。本书解释了这些有效深度网络如何从训练中学习非平凡的表示,并更广泛地分析非线性模型的表示学习机制。从近内核方法的角度来看,发现这些模型的预测对底层学习算法的依赖可以用一种简单而通用的方式来表达。为了获得这些结果,作者开发了表示组流(RG 流)的概念来表征信号通过网络的传播。通过将网络调整到临界状态,他们为梯度爆炸和消失问题提供了一个实用的解决方案。作者进一步解释了 RG 流如何导致近乎普遍的行为,从而可以将由不同激活函数构建的网络做类别划分。Altogether, they show that the depth-to-width ratio governs the effective model complexity of the ensemble of trained networks。利用信息理论,作者估计了模型性能最好的最佳深宽比,并证明了残差连接能将深度推向任意深度。利用以上理论工具,就可以更加细致的研究架构的归纳偏差,超参数,优化。原作者的视频说明(2021.12.1)
-
Physics-based Deep Learning(2021)N. Thuerey, P. Holl,etc.github resources深度学习与物理学的联系。比如基于物理的损失函数,可微流体模拟,逆问题的求解,Navier-Stokes方程的前向模拟,Controlling Burgers’ Equation和强化学习的关系等。
-
Geometric Deep Learning: Grids, Groups, Graphs, Geodesics, and Gauges(Michael M. Bronstein, Joan Bruna, Taco Cohen, Petar Veličković,2021),见上面课程5:深度学习几何课程.
-
dynamical systems and ml 2, 2020看起来写得很好,有Connection between ResNets and Dynamical Systems。
-
Mathematical Introduction to Deep Learning: Methods, Implementations, and Theory 这本书把深度学习的理论和实践结合的比较紧密,并且配有代码。主要包含了ANN相关的的基础组件分析、逼近、优化、KL散度、生成的概率误差分析、DL在PDE的应用(PINN,DKM)。另外比较好的是。LaTeX工作室给出了对应的tex源码。《深度学习的数学介绍》LaTeX 代码下载2023。
Session
- Foundations of Deep Learning(2019),西蒙研究中心会议。
- Deep Learning Theory 4(2021, ICML)Claire Monteleoni主持...,深度学习理论会议4,包含论文和视频。
- Deep Learning Theory 5 (2021,ICML)MaYi主持...,深度学习理论会议5,包含论文和视频。
- DeLTA 2023 : 4th International Conference on Deep Learning Theory and Applications 会议包含RNN,CNN,DHN,GAN,AE,EV,Dimensionality Reduction等基本模型内容,具体啥内容未知,ML的基本内容,强化,度量,核,图表示,聚类,分类,回归等,还有大数据,图像的具体应用方向,语言理解方向。看起来都是比较基础内容。
- 和动力系统的会议 2023。里面收到的文章列表
generalization
-
Robust Learning with Jacobian Regularization(2019)Judy Hoffman...,
-
Predicting Generalization using GANs(2022.6),用GAN来评估泛化性.
-
Implicit Regularization in Tensor Factorization: Can Tensor Rank Shed Light on Generalization in Deep Learning?(2021.7)Tensor Rank 能否揭示深度学习中的泛化?
-
如何通过Meta Learning实现域泛化Domain Generalization(2022.4),Domain Generalization CVPR2022博文参考.
-
Generalization-Causality 一博士关于domain generalization等工作的实时汇总。
-
Implicit Regularization in Hierarchical Tensor Factorization and Deep Convolutional Networks(Noam Razin • Jul 15, 2022)
-
6.1 Across three different neural network types (equivalent to matrix, tensor, and hierarchical tensor factorizations), we have an architecture-dependant notion of rank that is implicitly lowered. Moreover, the underlying mechanism for this implicit regularization is identical in all cases. This leads us to believe that implicit regularization towards low rank may be a general phenomenon. If true, finding notions of rank lowered for different architectures can facilitate an understanding of generalization in deep learning.
-
6.2 Our findings imply that the tendency of modern convolutional networks towards locality may largely be due to implicit regularization, and not an inherent limitation of expressive power as often believed. More broadly, they showcase that deep learning architectures considered suboptimal for certain tasks can be greatly improved through a right choice of explicit regularization. Theoretical understanding of implicit regularization may be key to discovering such regularizers.
-
Others
-
Theoretical issues in deep networks 表明指数型损失函数中存在隐式的正则化,其优化的结果和一般损失函数优化结果一致,优化收敛结果和梯度流的迹有关,目前还不能证明哪个结果最优(2020)。
-
The Dawning of a New Erain Applied MathematicsWeinan E关于在DL的新处境下结合历史的工作范式给出的指导性总结(2021)。
-
redunet_paper白盒神经网络代码。
-
Theory of Deep Convolutional Neural Networks:Downsampling下采样的数学分析Ding-Xuan Zhou(2020)
-
Theory of deep convolutional neural networks II: Spherical analysis还有III:radial functions 逼近,(2020)。不过这些工作到底如何,只是用数学转换了一下,理论上没做过多贡献,或者和实际结合没难么紧密,还不得而知。
-
The Modern Mathematics of Deep Learning(2021)主要是deep laerning的数学分析描述,涉及的问题包括:超参数网络的通用能力,深度在深度模型中的核心作用,深度学习对维度灾难的克服,优化在非凸优化问题的成功,学习的表示特征的数学分析,为何深度模型在物理问题上有超常表现,模型架构中的哪些因素以何种方式影响不同任务的学习中的不同方面。
-
Topos and Stacks of Deep Neural Networks(2021)每一个已知的深度神经网络(DNN)对应于一个典型的 Grothendieck 的 topos 中的一个对象; 它的学习动态对应于这个 topos 中的一个态射流。层中的不变性结构(如 CNNs 或 LSTMs)与Giraud's stacks相对应。这种不变性被认为是泛化性质的原因,即从约束条件下的学习数据进行推断。纤维代表前语义类别(Culioli,Thom) ,其上人工语言的定义,内部逻辑,直觉主义,经典或线性(Girard)。网络的语义功能是用这种语言表达理论的能力,用于回答输入数据输出中的问题。语义信息的量和空间的定义与香农熵的同源解释相类似。他们推广了 Carnap 和 Bar-Hillel (1952)所发现的度量。令人惊讶的是,上述语义结构被分类为几何纤维对象在一个封闭的Quillen模型范畴,然后他们引起同时局部不变的 dnn 和他们的语义功能。Intentional type theories (Martin-Loef)组织这些对象和它们之间的纤维化。信息内容和交换由 Grothendieck's derivators分析。
-
Visualizing the Emergence of Intermediate Visual Patterns in DNNs(2021,NIPS)文章设计了一种神经网络中层特征的可视化方法,使得能 (1)更直观地分析神经网络中层特征的表达能力,并且展示中层特征表达能力的时空涌现; (2)量化神经网络中层知识点,从而定量地分析神经网络中层特征的质量; (3)为一些深度学习技术(如对抗攻击、知识蒸馏)提供新见解。
-
神经网络的博弈交互解释性(知乎)。上交大张拳石团队研究论文整理而得,作为博弈交互解释性的体系框架(不怎么稳固)。
-
Advancing mathematics by guiding human intuition with AI(2021,nature)机器学习和数学家工作的一个有机结合,主要利用机器学习分析众多特征和目标变量的主要相关因子,加强数学家的直觉,该论文得到了两个漂亮的定理,一个拓扑,一个表示论。可参考回答。
-
🔥A New Perspective of Entropy(2022) 通过莱布尼兹微分法则(Leibniz rule)将信息熵,抽象代数,拓 扑学联系起来。该文章是一个零基础可阅读的综述,具体参考Entropy as a Topological Operad Derivation (2021.7,Tai-Danae Bradley.)
-
minerva(2022)google提出的解题模型,在公共高等数学等考试中比人类平均分高.[测试地址](https://minerva-demo. github.io/#category=Algebra&index=1).
-
🔥An automatic theorem proving project菲尔兹获得者数学家高尔斯关于 自动证明数学定理的项目进展How can it be feasible to find proofs?(2022, W.T. Gowers).
-
GRAND: Graph Neural Diffusion (2021)该网站包含了一些相似论文资料,[项目地址graph-neural-pde](https://github.com/twitter-research /graph-neural-pde),其优化版本GRAND++.(2022).有博文介绍图神经网络的困境,用微分几何和代数拓扑解决仅供参 考.
-
Weinan È-A Mathematical Perspective on Machine Learning(2022.icm),room1最后一排,鄂维南在icm的演讲视频.
-
contrastive learning证明包括InfoNCE在内的一大类对比学习目标函数,等价于一个有两类变量(或者说两类玩家)参与的交替优化(或者说游戏)过程.
-
可解释性:Batch Normalization未必客观地反应损失函数信息2022,张拳石等.
-
Homotopy Theoretic and Categorical Models of Neural Information Networks该工作第一作者俄罗斯数学家Yuri Manin,2020工作,2022年8月arxiv有更新。ncatlab有讨论。博文讲解。
-
Deep learning via dynamical systems: An approximation perspective动力系统逼近。论文见。
-
群论角度群论角度去理解的一系列视频,群论视角,2014年出现过,视频系统讲解,2022年。
-
Constructions in combinatorics via neural networks作者Adam Zsolt Wagner通过神经网络和强化学习构建了一系列反例,推翻了几个组合学的猜想,2021年。
-
不动点2023这篇文章主要研究任意深度的一维神经网络中的固定点问题。首先,文章介绍了一种新的方法,通过代数拓扑理论来研究神经网络中的固定点。然后,文章证明了任意深度的一维神经网络在某些情况下一定存在固定点。特别地,当网络中的激活函数为sigmoid函数时,网络在存在足够多的神经元时必定存在固定点。此外,文章还证明了某些特殊情况下,任意深度的一维神经网络中的固定点是稠密的,即在网络参数的空间中,存在无限多的参数可以使得网络的输出为固定值。这项研究具有深入探究神经网络理论的意义,有助于深入理解神经网络在不同条件下的表现和性质。后面内容是直接输入题目,chatgpt总结的。
-
Overparameterized ReLU Neural Networks Learn the Simplest Model: Neural Isometry and Phase Transitions2023,这是一篇关于深度学习理论的论文,研究了过参数化的ReLU神经网络的训练和泛化性能,以及其学习的模型复杂度。研究表明,即使神经网络的参数数量极高,它们也能够学习出非常简单的模型,这与传统的统计智慧相矛盾。本文采用了凸优化和稀疏恢复的视角,提出了神经同构和相变的概念,来解释神经网络学习简单模型的原因。 本文的主要贡献包括以下几个方面:
- 对于两层ReLU网络,研究了其训练和泛化性能,并证明只有学习简单模型的参数是有意义的。
- 提出了神经同构的概念,即输入空间和输出空间之间的等距变换,这有助于解释神经网络学习简单模型的原因。
- 提出了相变的概念,并证明在随机生成的数据上,神经网络的恢复性能存在相变现象。当样本数量与维度之比超过一个数值阈值时,恢复成功的概率很高;否则,失败的概率很高。
- 研究了具有跳跃连接或归一化层的ReLU网络,并提出了相应的等距条件,以确保准确恢复种植的神经元。
总之,本文通过理论分析和数值实验,证明了过参数化的ReLU神经网络能够学习最简单的模型,这为深度学习的理论研究和实际应用提供了重要的启示。(问chatgpt论文题目给的回复)
-
FAST COMPUTATION OF PERMUTATION EQUIVARIANT LAYERS WITH THE PARTITION ALGEBRA 2023.1, 该论文主要介绍了一种快速计算置换等变层的方法,该方法使用了分区代数。
-
Omnigrok: Grokking Beyond Algorithmic Data2022.10. Grokking 是算法数据集的一种不寻常现象,在过度拟合训练数据后很久就会发生泛化,这种现象仍然难以捉摸。我们的目标是通过分析神经网络的损失情况来理解 grokking,将训练和测试损失之间的不匹配确定为 grokking 的原因。我们将此称为“LU 机制”,因为训练和测试损失(针对模型权重范数)通常分别类似于“L”和“U”。这种简单的机制可以很好地解释 grokking 的许多方面:数据大小依赖性、权重衰减依赖性、表示的出现等。在直观图片的指导下,我们能够在涉及图像、语言和分子的任务上诱导 grokking。在相反的方向,我们能够消除算法数据集的 grokking。我们将算法数据集的 grokking 的戏剧性归因于表征学习。
-
Grokking modular arithmetic2023.1 我们提出了一个简单的神经网络,它可以学习模块化算术任务并表现出泛化的突然跳跃,称为“grokking”。具体来说,我们提出(i)完全连接的两层网络,在没有任何正则化的情况下,在普通梯度下降下使用 MSE 损失函数表现出对各种模块化算术任务的 grokking; (ii) 证据表明 grokking 模块化算法对应于学习其结构由任务确定的特定特征图; (iii) 权重的解析表达式——以及特征图——解决一大类模块化算术任务; (iv) 证明这些特征图也可以通过普通梯度下降法和 AdamW 找到,从而建立网络学习表示的完整可解释性。
-
Progress measures for grokking via mechanistic interpretability2023.2神经网络可解释性方面研究。研究表明,grokking不是突然的转变,而是源于权重中编码的结构化机制的逐渐放大,随后是记忆组件的删除。
-
awesome-deep-phenomena 2022.5, 神经网络表现出的各种现象的研究git整理。
-
Deep Learning for Mathematical Reasoning (DL4MATH)DL和数学相关的资料git整理。
-
PCAST Working Group on Generative AI Invites Public Input2023.5.13. 陶哲轩将主持美国总统科技顾问委员会(PCAST)成立的一个生成式人工智能工作组的会议。
-
🔥CRATE 白盒ai 训练进展.知乎上有人讨论, 该文章拼凑比较多,且论文和代码相差十万八千里。 知乎参考。(2023)
-
An Ambiguity Measure for Recognizing the Unknowns in Deep Learning自华为香港研究中心的学者,给出了模型对未知量(类)的模糊性度量框架。该模糊度量能够判断未知量和已知模型所能判断的范围的相关性大小。(2023)
-
flow_matching(2025)meta在扩散模型中的流模型的基础理论研究与实践。
-
Harmonic Loss Trains Interpretable AI Models(2025)在本文中,我们引入了谐波损失作为训练神经网络和大型语言模型(LLMs)的标准交叉熵损失的替代方案。谐波损失通过其尺度不变性和设计上的有限收敛点(可解释为类别中心),实现了更好的可解释性和更快的收敛。我们首先在算法、视觉和语言数据集上验证了谐波模型的性能。通过广泛的实验,我们证明了使用谐波损失训练的模型在以下方面优于标准模型:(a) 增强可解释性,(b) 泛化所需的训练数据更少,(c) 减少“顿悟”(grokking)现象。此外,我们将使用谐波损失训练的 GPT-2 模型与标准 GPT-2 模型进行比较,表明谐波模型能够生成更具可解释性的表示。展望未来,我们认为谐波损失有潜力成为数据可用性有限的领域或对可解释性和可靠性要求极高的高风险应用中的重要工具,为更稳健、更高效的神经网络模型铺平道路。(grok译)
DeepModeling
- DeepModeling鄂维南等组织,一种新的研究范式,将DL建模渗透到科研中,这里会开源很多对新或旧问题的DL建模方案.[其github地址](https://github.com/deepmode ling).空了看情况解析某些工作.
- deepflameDL向的流体力学包。
- FunSearch大语言模型和自动评估器的联合迭代,发现了帽集问题的新解决方案,在一些设定下发现了有史以来最大的帽集。DeepMind团队还决定将FunSearch应用于发现更有效的解决“装箱问题”(bin packing)的算法。(2023)
- Applications of Deep Learning to Scientific ComputingPINN, DeepONet等用来解物理相关的PDE方程的一篇来自ETH的博士论文。(2023)
- An ML approach to resolution of singularities作者介绍了一种新的Hironaka游戏方法,它使用强化学习代理来寻找奇点的最优分辨率(Resolutions)。在某些领域,训练有素的模型在执行多项式加法的总次数方面优于现有的最先进的选择启发式方法,这证明了机器学习的最新发展有潜力提高符号计算中算法的性能。(2023)
- 如何为神经网络的输出添加约束文章介绍了很多如何给DL输出添加约束的思路,历史工作,并附有新工作LinSATNet的代码:通过将 Sinkhorn 算法扩展到多组边缘分布(据我们所知,我们是首次研究具有多组边缘分布的 Sinkhorn 算法)。然后,通过将约束转化为边缘分布来施加正线性约束。文章中验证了LinSATNet方法能够处理复杂的回路约束(用于求解旅行商问题的变种)、部分图匹配的约束(用于处理图匹配中,只有部分子图互相匹配的问题)、一般的线性约束(用于特定偏好下的投资组合问题)。这些问题都可以用正线性约束来表示、且可用LinSATNet方法进行处理。(不知道能不能用在onnx之类的图优化上面)(2023)
数学形式主义与计算机
- The Future of Mathematics? (2019) Kevin Buzzard就lean的一场讲座,评论区有对应讲义资料。
- 数学形式主义的兴起(2022.7)Kevin Buzzard教授在2022本届国际数学家大会一小时报告演讲中提供了一些信息和思考见解。讲述了数学 形式主义与人工智能、机器学习和开源社区的共同努力,用计算机做奥数题、检查数学证明过程是否有误、甚至自动发现和形式化证明数学定理,在理论和实践中又会碰撞出什么火花,又会如何囿于...
- 专访ICM 2022国际数学家大会一小时报告者Kevin Buzzard:计算机可以成为数学家吗?——译自量子杂志比较好的采访,值得看看.数学家让计算机科学家了解到数学很难,这个部分,在被逐渐理解,且计算机系统检查,可能会解决这个难点.还有那些炫酷的项目,球面外翻,费马大定理,非常值得关注.
- Deep Maths-machine learning and mathematics,重新发现Euler多面体公式 (对之前工作的细节的更进一步说明),涉及组合不变量猜想,庞加莱猜想,瑟斯顿几何猜想,扭结图等(涉及的面很大,但都是一带而过)。(2023)
- Would it be possible to create a tool to automatically diagram papers? Tao在IPAM组织用机器学习来帮助证明的workshops。
- 数学的形式化与AI for Mathematics北大没找到具体内容,可以忽略(具体内容已由原作者分享了,可私聊),2023.3。
- To Teach Computers Math, Researchers Merge AI Approaches大模型,自然语言的数学证明能力探索(2023.4)。
- Is deep learning a useful tool for the pure mathematician?Geordie Williamson,2023.4。Claude内容总结:这篇文章主要探讨了深度学习对纯数学家的实用性。文章认为:1. 深度学习的许多成就都依赖于遵循简单规则的大规模统计建模,这与数学家寻找简洁而深刻的理论不同。因此,深度学习可能不会直接推动数学理论的发展。2. 但是,深度学习可以产生一些有趣的数学问题。例如,理解神经网络为什么在某些任务上表现优异,探索这些网络学习的表达形式和算法基础,这可能会产生一些有价值的数学理论。3. 深度学习也可以成为一种发现新的数学关系和结构的工具。研究人员已经探索了使用深度学习来理解复杂系统的拓扑和几何结构。这可以为数学家提供一些有趣的新思路和见解。4. 深度学习也被用来加速定理证明和公式推导等传统的数学工作。这可以使数学研究变得更加数据驱动和自动化。一些研究已经取得了早期成功,这是一个值得期待的新方向。5. 总体而言,尽管深度学习和数学理论有不同的动机与方法论,但两者之间存在潜在的协同性。深度学习可以成为数学发现和理解的有力工具,推动更广泛地跨学科合作。但它不太可能直接影响数学基础理论的发展。文章认为,深度学习可以成为数学家的一个有用工具,特别是在推动新发现、新见解和新方向上。但它可能无法直接推动更加基础的数学理论建设。两者有潜在的互补与协同作用,值得加强跨领域合作与理解。overall,深度学习有助于扩展和拓展当前的数学体系,但不会颠覆其基本建立的理论基础。
- Learning proofs for the classification of nilpotent semigroupsCarlos Simpson,2021.6。Claude总结:这篇文章探索了使用神经网络进行nilpotent半群的分类定理证明,并在实验上取得了初步成功。但是完全自动化和令人理解的定理证明还需要更多工作。机器学习在这一过程中更可能起辅助作用,成为发现定理和理解代数结构的有力工具。这是一个涉及数学与人工智能交叉的有趣主题,值得进一步探讨与实践。
- Lean for the Curious Mathematician 20232023年举办的“Lean for the Curious Mathematician”活动。讲座将从基础开始(如何安装和使用Lean,形式化数学的基本机制,浏览proof library mathlib等),然后构建更高级的主题,以说明形式化在不同数学领域的工作方式。具体的领域取决于参与者的兴趣(如实分析、复分析、微分几何、数论、拓扑学、组合数学、范畴论等)。
- Fermat's Last Theorem for regular primes Lean在费马大定理指数为正则素数(REGULAR PRIMES)情形的证明。数学证明可参考(2023.5.15)。迈出了一步,但离完整版的证明,差距还是比较大的。
- LeanDojo: Theorem Proving with Retrieval-Augmented Language Models (2023)将大语言模型和形式化证明结合起来,官方相关部署LeanCopilot都在做。
- pfr 一个由四位著名数学家组成的团队,包括两位菲尔兹奖得主,证明了一个被描述为“加法组合学圣杯”(holy grail of additive combinatorics)的猜想。在一个月内他们松散地合作,用计算机辅助证明验证了它。辅助证明:蓝图可以创建一个图表 dep graph document 描述证明中涉及的各种逻辑步骤,Lean来形式化证明验证。 相关报告参考1,参考2
- Goedel-Prover: AFrontier ModelforOpen-SourceAutomated Theorem Proving(2025)新模型在 Lean Workbook 数学题库中成功解决了 29.7K 道题目,这个成绩差不多是其他顶尖模型(InternLM2.5-StepProver 和 InternLMMath-Plus)的两倍。在 PutnamBench 上,新模型解决了 7 个问题(Pass@512),位列排行榜第一。
- DeepSeek-Prover-V1.5(2025)在高中阶段的 miniF2F 基准测试 (63.5%) 和本科阶段的 ProofNet 基准测试集 (25.3%) 上取得了新的最先进的结果。
Discussion
- 怎样看待Ali Rahimi 获得 NIPS 2017 Test-of-time Award后的演讲?17年就有人(张心欣,王刚等)指出了DL的缺陷,和这个领域中人的特点,过去5年了,还是那样.不过如23 能看出,meta的做应用的田渊栋还在坚守理论.
- 深度学习领域有哪些瓶颈?张拳石新的吐槽,以及最新成果汇集.
- ChatGPT/GPT4虽然和理论无关,但实用性很好的一个进展,目前准确率(!胡扯率)貌似能达到0.8+。
- 数值pde与深度学习结合是未来发展方向吗?
- 大语言模型中的涌现现象是不是伪科学?
AI4Math
- Deep Learning Symmetries and Their Lie Groups, Algebras, and Subalgebras from First Principles (2023)论文提出了一种深度学习算法,旨在发现和识别标记数据集中存在的连续对称性群。作者使用全连接神经网络来模拟对称性变换和相应的生成器。他们构建了损失函数,以确保应用的变换是对称的,并且生成器的集合形成了一个封闭的(子)代数。该研究通过多个示例进行了验证,这些示例展示了由对称性保留的不同类型守恒量。作者分析了旋转群SO(2)、SO(3)和SO(4)以及洛伦兹群SO(1, 3)的完整子群结构。其他示例包括压缩映射、分段不连续标签和SO(10),展示了该方法的普遍性及其在物理和数据科学中的潜在应用。论文还讨论了将机器学习应用于李群及其属性的数学研究,为数学领域的机器学习方法打开了大门。作者提供了详细的研究方法,包括他们在分析中使用的设置和符号、深度学习方法以及线性代数方法,以帮助不熟悉深度学习的读者。论文分为多个章节,涵盖了引言、设置和符号、深度学习方法、线性代数方法以及不同维度下的长度保持变换、洛伦兹变换和不连续预言的例子。作者以讨论其方法在理解数据对称性和其对基于模拟的推断及参数检索的潜在应用的含义结束。(from kimi chat).
- 小乐数学科普:事关BSD猜想,AI人工智能发现椭圆曲线的“椋鸟群飞murmuration”现象——译自量子杂志 (2020-2023), Machine-Learning Arithmetic Curves(2020) 能够高精度地预测椭圆曲线的秩;Machine-Learning Number Fields (2020) 利用机器学习对数论中的其他对象进行分类;Murmurations of elliptic curves Murmurations of Elliptic Curves(2022);Murmurations (2023)Zubrilina证明了这种类型的椋鸟群飞遵循她发现的明确公式。视频交流。
- Deep-Learning the Landscape (2023, Yang-Hui He)这篇论文的摘要提出了一种范式,用于深度学习在数学物理和粒子现象学中出现的不断扩大的数据库,这些数据库的多样性涵盖了弦真空的统计、组合和代数几何等领域。作为具体的例子,作者建立了多层神经网络,既可以作为分类器也可以作为预测器,并用从卡拉比-丘流形和向量丛到规范理论的箭袋表示法等多种可用数据对它们进行训练。研究发现,即使是相对简单的神经网络也能在几分钟内学习到许多重要数量,并以惊人的准确性进行预测,同时还能预测以前未遇到的结果。这种范式应该成为物理学景观以及纯数学中各种调查的有价值的工具。(kimi chat)
- two-announcements-ai-for-math-resources-and-erdosproblems-com(2024.4)陶哲轩等列的AI for math 资料,以及爱多士问题网站。
- Gold-medalist Performance in Solving Olympiad Geometry with AlphaGeometry2(2025)AG2 在 2000 年至 2024 年所有 IMO 几何问题上的解决率达到了新的最高水平 84%,相比之下,AG1 的解决率仅为 54%。这表明 AI 在应对具有挑战性的数学推理任务方面取得了重大飞跃,超越了平均 IMO 金牌得主的水平。
- Kervaire不变量问题的彻底解决2024年北大校庆期间,三位北大数学校友林伟南(2011级)、王国祯(2004级)、徐宙利(2004级)在北京数学杂志(Peking Mathematical Journal)会议上公布了Kervaire不变量问题的彻底解决。这一结果为这个悬置六十余年的拓扑学问题画上完美句点,也因最后一个未知的维数是126维为北京大学献上了126岁的生日祝福。其中计算机程序(非ai)起到了简化筛查作用。
- What makes math problems hard for reinforcement learning: a case study(2024)我们利用组合群论中一个长期存在的猜想,从多个角度探索寻找稀有实例所面临的挑战,这些实例带有不成比例的高回报。基于在 Andrews-Curtis 猜想定义的背景下所获得的经验教训,我们提出了算法改进和一种拓扑难度度量,这些改进对一类广泛的搜索问题具有启示意义。作为我们研究的一部分,我们还处理了几个开放的数学问题。值得注意的是,我们证明了 Akbulut-Kirby 系列(1981)中除两个表示外的所有表示的长度可约性,并解决了 Miller-Schupp 系列(1991)中的各种潜在反例,包括三个无限子家族。(grok译),其开源地址AC-Solver。
数学家
懒得分类了,随便新加了一类
- 林力行háng(Lek-Heng Lim)使用代数、几何和拓扑工具来回答机器学习中的问题。一篇采访quantamagazine采访和中文版
- 1.1 Topology of deep neural networks 将神经网络表达的物体视为拓扑流形,不同类别在相片层面具有很大相似度的流形会以非常复杂的方式交织在一起,作者进行了实验,证明这些流形能被简化,并利用计算拓扑中的持续同调persistent homology来测量这些物体的形状。简单来说,作者用它来测量流形穿过神经网络层时的形状。最终,证明它简化为最简单的形式。这对神经网络的可解释性有帮助。
- 1.2 Recht-Ré Noncommutative Arithmetic-Geometric Mean Conjecture is False我的博士生Zehua Lai和我展示了机器学习中一个长期存在的猜想是错误的。“现代机器学习问题通常涉及将大量参数与大量数据拟合。GPT-4是ChatGPT底层引擎的下一次迭代,据传有1万亿到100万亿个参数。现有的计算机无法同时处理这些参数。因此,在每一步中,算法都会随机选择一小部分参数(无论计算机可以处理什么),然后只使用这些参数。选取一个小的随机子集称为抽样(取样)。现在的问题是:在算法的后续步骤中,它应该选择我们之前在前面的步骤中已经选择的参数,还是应该排除这些参数?换句话说,它应该对参数进行替换还是不替换?当我们的算法涉及随机化时,这是一个我们总是需要考虑的问题,所以这是一个非常基本和重要的问题。大约10年前,Ben Recht和Chris Ré表明,不替换采样比替换更好,前提是特定不平等的某种类似物成立。多年来,人们证明了这种不平等的各种案例。我们表明,总的来说,这种不平等并不成立。回答这个问题的方法是使用代数几何中的一种称为非交换正点(noncommutative Positivstellensatz)的工具。这是一个又长又拗口的词。它是一个德语单词,本质上意味着多项式正点的位置。“
- 1.3 LU decomposition and Toeplitz decomposition of a neural network摘要: It is well-known that any matrix $A$ has an LU decomposition. Less well-known is the fact that it has a 'Toeplitz decomposition' $A=T_1 T_2 \cdots T_r$ where $T_i$ 's are Toeplitz matrices. We will prove that any continuous function $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ has an approximation to arbitrary accuracy by a neural network that takes the form $L_1 \sigma_1 U_1 \sigma_2 L_2 \sigma_3 U_2 \cdots L_r \sigma_{2 r-1} U_r$, i.e., where the weight matrices alternate between lower and upper triangular matrices, $\sigma_i(x):=\sigma\left(x-b_i\right)$ for some bias vector $b_i$, and the activation $\sigma$ may be chosen to be essentially any uniformly continuous nonpolynomial function. The same result also holds with Toeplitz matrices, i.e., $f \approx T_1 \sigma_1 T_2 \sigma_2 \cdots \sigma_{r-1} T_r$ to arbitrary accuracy, and likewise for Hankel matrices. A consequence of our Toeplitz result is a fixed-width universal approximation theorem for convolutional neural networks, which so far have only arbitrary width versions. Since our results apply in particular to the case when $f$ is a general neural network, we may regard them as LU and Toeplitz decompositions of a neural network. The practical implication of our results is that one may vastly reduce the number of weight parameters in a neural network without sacrificing its power of universal approximation. We will present several experiments on real data sets to show that imposing such structures on the weight matrices sharply reduces the number of training parameters with almost no noticeable effect on test accuracy.
- 1.4 What is … an equivariant neural network?文章证明了AlphaFold2和ImageNet classification with deep convolutional neural networks在没有神经网络的等变性假设情况下是等价(Equivariant)的。
- Rate of Loss Characterization That Resolves the Dilemma of the Wall Pursuit Game Solution"2023年年初,在博弈论领域,一个新发表的成果宣告解决了一个困扰学者们60多年的问题:追墙博弈(wall pursuit game)永远存在最优博弈策略。这一成果甚至可以说对我们的日常出行都有着重要意义,自动驾驶"。
- An Invitation to Neuroalgebraic Geometry(2025)在这篇阐述性工作中,我们通过代数几何的视角,倡导研究由机器学习模型参数化的函数空间。为此,我们聚焦于代数模型,例如具有多项式激活函数的神经网络,其关联的函数空间属于半代数簇。我们勾勒出一套对应关系,将这些半代数簇的代数几何不变量(如维度、次数和奇点)与机器学习的基本方面(如样本复杂度、表达能力、训练动态和隐性偏见)联系起来。在此过程中,我们回顾了相关文献,并探讨了超越代数领域的想法。这项工作为连接代数几何与深度学习的研究方向奠定了基础,我们将其称为“神经代数几何”。(grok翻译)
近似
- 压缩下一个 token 通向超过人类的智能(2023)
- Scaling Laws for Neural Language Models论文提出语言模型的计算复杂度随着参数数量的增加呈线性关系,而不是平方关系。这为巨大规模语言模型的训练提供了理论支持。(2020)
- 扩散模型与能量模型,Score-Matching和SDE,ODE的关系对扩散模型同随机微分方程等的联系,做了比较清晰的梳理(2022)。更详细的参考What are Diffusion Models? (2021)。
- Why Can GPT Learn In-Context? Language Models Secretly Perform Gradient Descent as Meta-Optimizers该论文从优化的角度发现GPT预训练实际上同时进行两层优化:一层进行语言模型参数学习,一层进行元优化以生成最优序列。这种嵌套优化机制赋予GPT强大的泛化和自适应能力。这为理解自监督学习模型的训练原理和泛化性能提供了全新的视角。(2022.12)
- GPT-PINN: 生成式预训练内嵌物理知识神经网络 CAM传习录(2023.4)。
- 从 Transformer 到边界值反问题(一) CAM传习录(2023.4)。
- Defining and Quantifying the Emergence of Sparse Concepts in DNNs神经网络中的符号概念涌现,其中文官方介绍AI从技术到科学:神经网络中的概念符号涌现的发现与证明(2023.4)
Similar repos
Contributors
39 commits