RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval (EMNLP 2026 Full Paper Main Conference)
Python
3
10 commits
updated Sep 27, 2026



Emre Kuru · Mehmet Onur Keskin · Reza Farahbakhsh · Noel Crespi
This repository is the official implementation of RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval.
Motivation · Results · Models & Data · Quick Start · Repository · Citation
Document retrieval pipelines make different trade-offs across modality, architecture, effectiveness, and cost. Figure 1 shows why a fixed pipeline is inadequate: visual references require multimodal retrieval, direct factoids may need only BM25, and long-context comparisons benefit from fine-grained interaction.
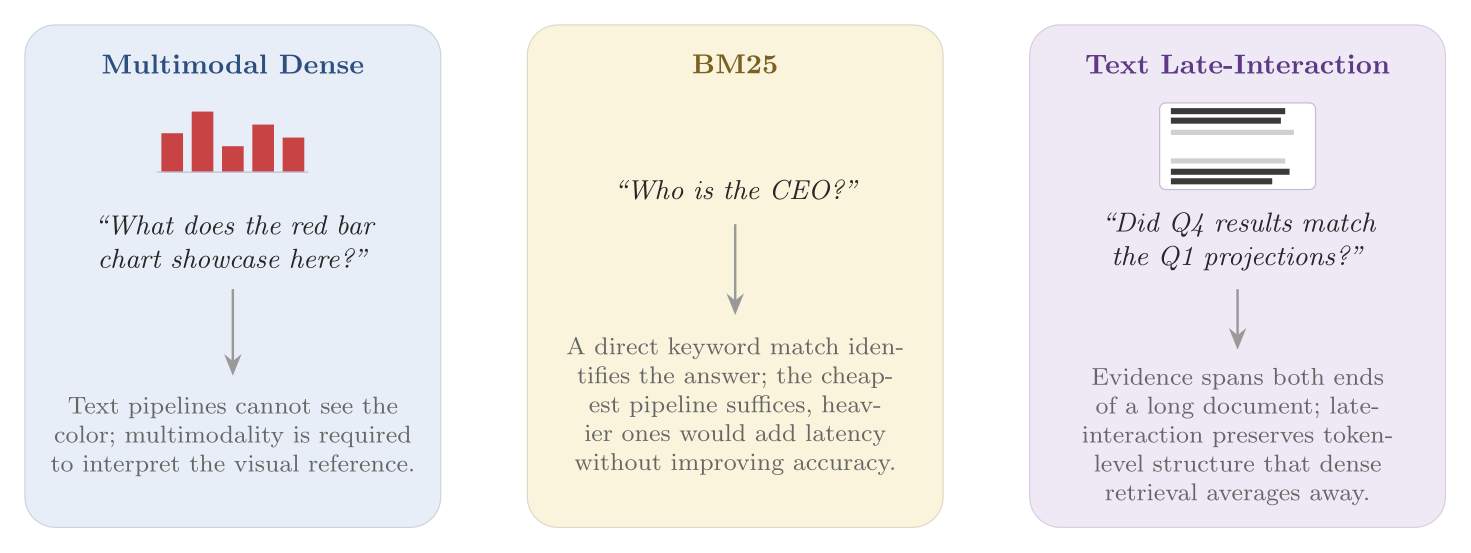
Different queries require different retrieval capabilities.
Across benchmarks spanning financial and scientific corpora, no static pipeline dominates. RetrievalRouter learns, from the query text alone, which retrieval pipeline best fits each query. For every static baseline, RetrievalRouter offers an operating point that is simultaneously more accurate and faster.
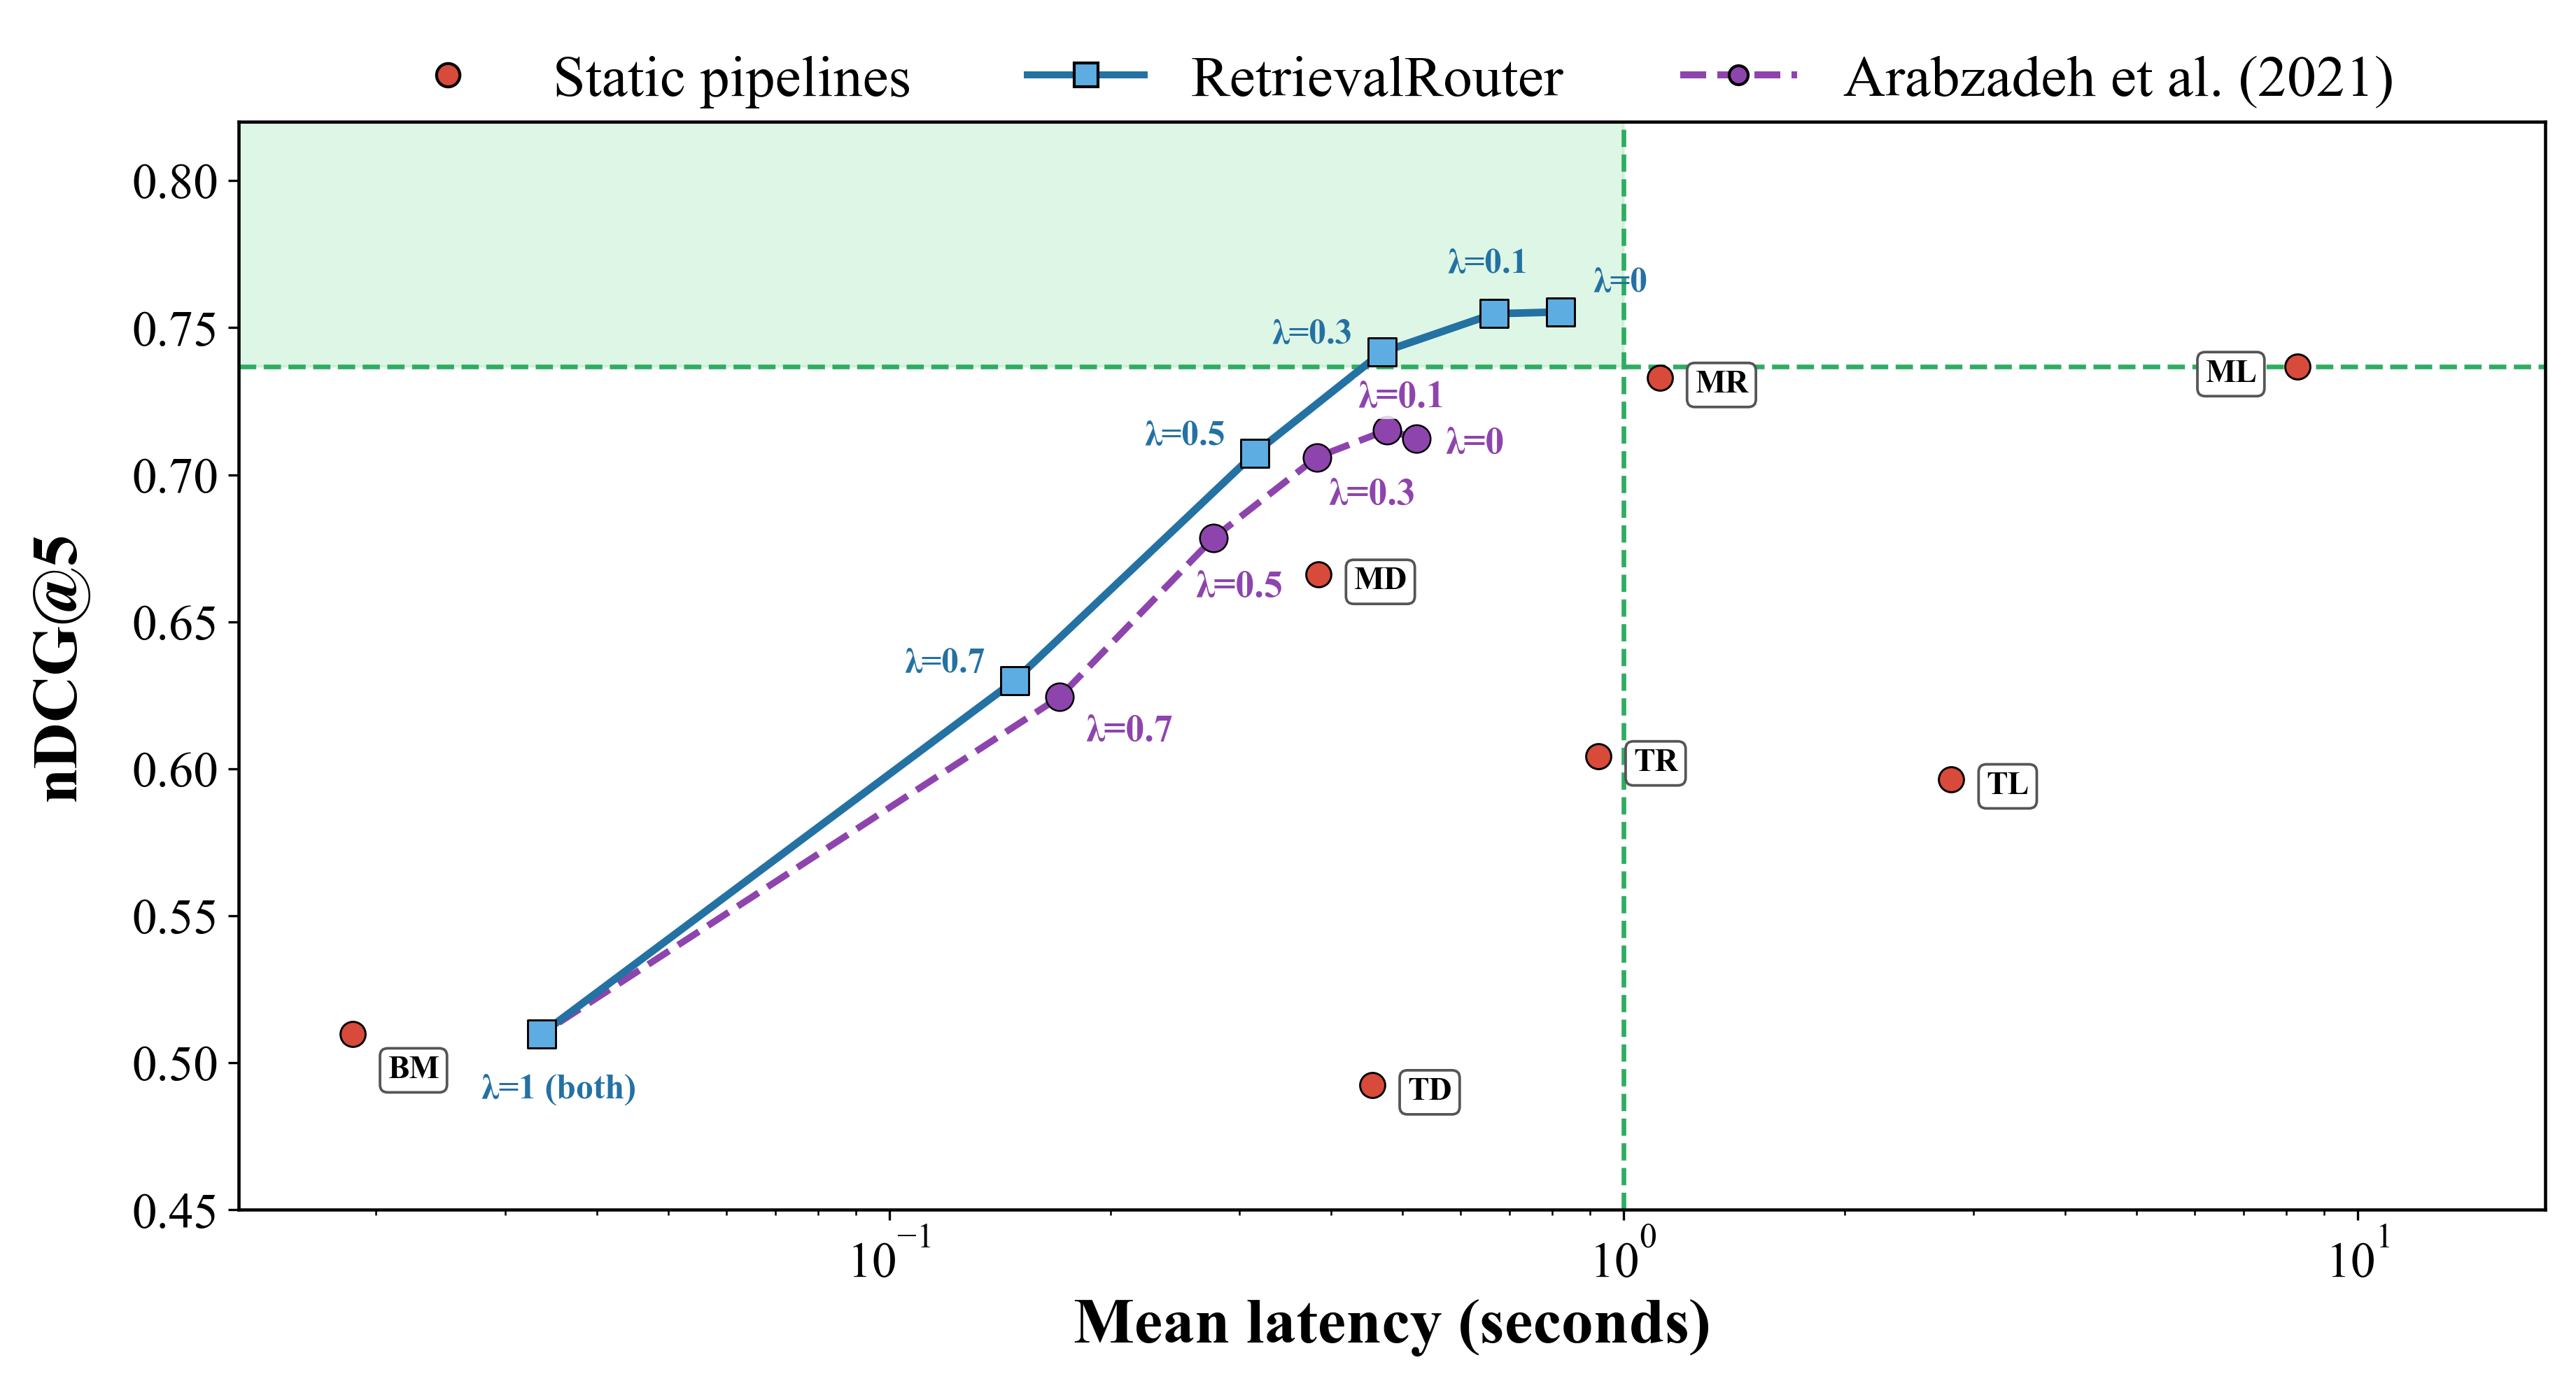
Static pipelines, RetrievalRouter operating points, and the adapted Arabzadeh et al. (2021) baseline. Adaptive latency includes 15 ms of policy inference once per query.
The Hugging Face collection provides every released dataset and all trained RetrievalRouter and baseline checkpoints.
| Benchmark | Dataset | Queries | Documents | Avg. tokens |
|---|---|---|---|---|
| REAL-MM-RAG | FinReport | 853 | 2,687 | 1,053 |
| REAL-MM-RAG | FinSlides | 1,048 | 2,280 | 275 |
| T2-RAGBench | FinQA | 6,232 | 2,789 | 965 |
| T2-RAGBench | ConvFinQA | 3,431 | 1,806 | 966 |
| T2-RAGBench | VQAonBD | 9,772 | 1,787 | 780 |
| T2-RAGBench | TAT-DQA | 27,127 | 2,758 | 852 |
| MMDocRAG | ArxivQA | 9,034 | 4,749 | 1,110 |
| MMDocRAG | Wiki-SS | 14,968 | 12,752 | 777 |
| MMDocRAG | MP-DocVQA | 5,581 | 2,350 | 388 |
| MMDocRAG | SciQAG | 4,496 | 2,595 | 1,196 |
| MMDocRAG | DUDE | 2,561 | 2,073 | 516 |
Total: 85,103 queries across 11 datasets.
This repository also includes the final five-arm training data and all test prediction files used in the paper:
train/data/updated_dataset.xlsx
evaluation/predictions/
├── retrievalrouter_l00.xlsx
├── retrievalrouter_l10.xlsx
├── retrievalrouter_l30.xlsx
├── retrievalrouter_l50.xlsx
├── retrievalrouter_l70.xlsx
├── retrievalrouter_l100.xlsx
└── baseline.xlsx
Each prediction file contains the same 8,506 unique test queries and the raw pipeline metrics required to reproduce aggregate results and paired significance tests.
git clone https://github.com/emrekuruu/retrieval-router.git
cd retrieval-router
Run BM25 on a configured dataset:
python -m venv .venv-retrieval
source .venv-retrieval/bin/activate
pip install -r requirements/base_pipelines_requirements.txt

TASK=finqa DATASET=<hugging-face-dataset-id> ./scripts/retrieval/bm25.sh
Text and multimodal indexing/retrieval launchers are available under scripts/.
Train RetrievalRouter at $\lambda=0.1$:
python -m venv .venv-training
source .venv-training/bin/activate
pip install -r requirements/training_requirements.txt

OBJECTIVE=retrievalrouter LAMBDA=0.1 python -m train.prepare_data
OBJECTIVE=retrievalrouter LAMBDA=0.1 python -m train.train
Use another LAMBDA value for a different frontier point, or set OBJECTIVE=baseline to train the adapted baseline.
Reproduce the headline result from the included predictions:
python -m venv .venv-eval
source .venv-eval/bin/activate
pip install -r requirements/evaluation_requirements.txt

python -m evaluation.overall_metrics \
  --predictions evaluation/predictions/retrievalrouter_l10.xlsx \
  --output evaluation/metrics_summary.xlsx
Expected result:
nDCG@5:       0.754739
Mean latency: 0.665978 s
Paired significance scripts are provided for static pipelines and the adaptive baseline.
retrieval-router/
├── arms.py                         # Pipelines, router arms, names, colors, overhead
├── assets/                         # Paper figures used in this README
├── data_collection/
│   ├── dataset_loader.py
│   ├── embedders/                  # Text and multimodal embedders
│   ├── pipelines/                  # BM25, indexing, retrieval, and reranking
│   └── vector_databases/           # Qdrant abstraction and implementation
├── train/
│   ├── data/updated_dataset.xlsx   # Final five-arm training data
│   ├── objectives/
│   │   ├── retrievalrouter.py
│   │   └── baseline.py
│   ├── hf_model/                   # Hugging Face RetrievalRouter implementation
│   ├── prepare_data.py
│   ├── train.py
│   └── inference.py
├── evaluation/
│   ├── predictions/                # RetrievalRouter and baseline predictions
│   ├── overall_metrics.py
│   ├── statistical_testing.py
│   ├── run_static_significance.py
│   └── run_adaptive_significance.py
├── scripts/                         # Indexing and retrieval launchers
└── requirements/                    # Retrieval, training, and evaluation environments
@misc{kuru2026retrievalrouterjointmodalityarchitecture,
      title={RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval},
      author={Emre Kuru and Mehmet Onur Keskin and Reza Farahbakhsh and Noel Crespi},
      year={2026},
      eprint={2608.25625},
      archivePrefix={arXiv},
      primaryClass={cs.IR},
      url={https://arxiv.org/abs/2608.25625},
}
This repository is released under the MIT License.
RetrievalRouter builds on open-source work from Qdrant, PyLate, ColPali, Hugging Face, and the broader document-retrieval community.
RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval (EMNLP 2026 Full Paper Main Conference)
Python
3
10 commits
updated Sep 27, 2026
Emre Kuru · Mehmet Onur Keskin · Reza Farahbakhsh · Noel Crespi
This repository is the official implementation of RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval.
Motivation · Results · Models & Data · Quick Start · Repository · Citation
Document retrieval pipelines make different trade-offs across modality, architecture, effectiveness, and cost. Figure 1 shows why a fixed pipeline is inadequate: visual references require multimodal retrieval, direct factoids may need only BM25, and long-context comparisons benefit from fine-grained interaction.
Different queries require different retrieval capabilities.
Across benchmarks spanning financial and scientific corpora, no static pipeline dominates. RetrievalRouter learns, from the query text alone, which retrieval pipeline best fits each query. For every static baseline, RetrievalRouter offers an operating point that is simultaneously more accurate and faster.
Static pipelines, RetrievalRouter operating points, and the adapted Arabzadeh et al. (2021) baseline. Adaptive latency includes 15 ms of policy inference once per query.
The Hugging Face collection provides every released dataset and all trained RetrievalRouter and baseline checkpoints.
| Benchmark | Dataset | Queries | Documents | Avg. tokens |
|---|---|---|---|---|
| REAL-MM-RAG | FinReport | 853 | 2,687 | 1,053 |
| REAL-MM-RAG | FinSlides | 1,048 | 2,280 | 275 |
| T2-RAGBench | FinQA | 6,232 | 2,789 | 965 |
| T2-RAGBench | ConvFinQA | 3,431 | 1,806 | 966 |
| T2-RAGBench | VQAonBD | 9,772 | 1,787 | 780 |
| T2-RAGBench | TAT-DQA | 27,127 | 2,758 | 852 |
| MMDocRAG | ArxivQA | 9,034 | 4,749 | 1,110 |
| MMDocRAG | Wiki-SS | 14,968 | 12,752 | 777 |
| MMDocRAG | MP-DocVQA | 5,581 | 2,350 | 388 |
| MMDocRAG | SciQAG | 4,496 | 2,595 | 1,196 |
| MMDocRAG | DUDE | 2,561 | 2,073 | 516 |
Total: 85,103 queries across 11 datasets.
This repository also includes the final five-arm training data and all test prediction files used in the paper:
train/data/updated_dataset.xlsx
evaluation/predictions/
├── retrievalrouter_l00.xlsx
├── retrievalrouter_l10.xlsx
├── retrievalrouter_l30.xlsx
├── retrievalrouter_l50.xlsx
├── retrievalrouter_l70.xlsx
├── retrievalrouter_l100.xlsx
└── baseline.xlsx
Each prediction file contains the same 8,506 unique test queries and the raw pipeline metrics required to reproduce aggregate results and paired significance tests.
git clone https://github.com/emrekuruu/retrieval-router.git
cd retrieval-router
Run BM25 on a configured dataset:
python -m venv .venv-retrieval
source .venv-retrieval/bin/activate
pip install -r requirements/base_pipelines_requirements.txt

TASK=finqa DATASET=<hugging-face-dataset-id> ./scripts/retrieval/bm25.sh
Text and multimodal indexing/retrieval launchers are available under scripts/.
Train RetrievalRouter at $\lambda=0.1$:
python -m venv .venv-training
source .venv-training/bin/activate
pip install -r requirements/training_requirements.txt

OBJECTIVE=retrievalrouter LAMBDA=0.1 python -m train.prepare_data
OBJECTIVE=retrievalrouter LAMBDA=0.1 python -m train.train
Use another LAMBDA value for a different frontier point, or set OBJECTIVE=baseline to train the adapted baseline.
Reproduce the headline result from the included predictions:
python -m venv .venv-eval
source .venv-eval/bin/activate
pip install -r requirements/evaluation_requirements.txt

python -m evaluation.overall_metrics \
  --predictions evaluation/predictions/retrievalrouter_l10.xlsx \
  --output evaluation/metrics_summary.xlsx
Expected result:
nDCG@5:       0.754739
Mean latency: 0.665978 s
Paired significance scripts are provided for static pipelines and the adaptive baseline.
retrieval-router/
├── arms.py                         # Pipelines, router arms, names, colors, overhead
├── assets/                         # Paper figures used in this README
├── data_collection/
│   ├── dataset_loader.py
│   ├── embedders/                  # Text and multimodal embedders
│   ├── pipelines/                  # BM25, indexing, retrieval, and reranking
│   └── vector_databases/           # Qdrant abstraction and implementation
├── train/
│   ├── data/updated_dataset.xlsx   # Final five-arm training data
│   ├── objectives/
│   │   ├── retrievalrouter.py
│   │   └── baseline.py
│   ├── hf_model/                   # Hugging Face RetrievalRouter implementation
│   ├── prepare_data.py
│   ├── train.py
│   └── inference.py
├── evaluation/
│   ├── predictions/                # RetrievalRouter and baseline predictions
│   ├── overall_metrics.py
│   ├── statistical_testing.py
│   ├── run_static_significance.py
│   └── run_adaptive_significance.py
├── scripts/                         # Indexing and retrieval launchers
└── requirements/                    # Retrieval, training, and evaluation environments
@misc{kuru2026retrievalrouterjointmodalityarchitecture,
      title={RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval},
      author={Emre Kuru and Mehmet Onur Keskin and Reza Farahbakhsh and Noel Crespi},
      year={2026},
      eprint={2608.25625},
      archivePrefix={arXiv},
      primaryClass={cs.IR},
      url={https://arxiv.org/abs/2608.25625},
}
This repository is released under the MIT License.
RetrievalRouter builds on open-source work from Qdrant, PyLate, ColPali, Hugging Face, and the broader document-retrieval community.



