
Updating collection of summarization datasets in 100+ languages, based on our paper "The State and Fate of Summarization Datasets: A Survey".
See the codeREADME
Awesome-Summarization-Datasets
The collection and ontology is a result of our paper The State and Fate of Summarization Datasets: A Survey (NAACL 2025).
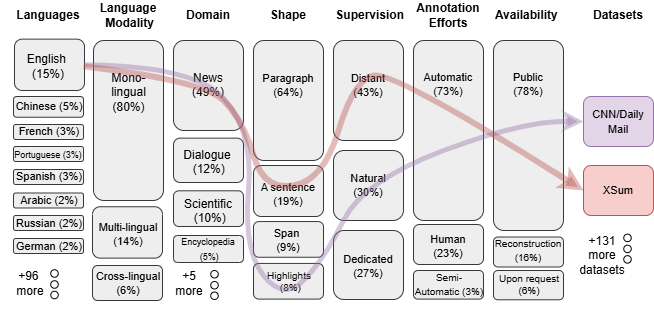
Citing
If our survey contributes to your research, please reference the following paper in your work:
@inproceedings{dahan-stanovsky-2025-state,
    title = "The State and Fate of Summarization Datasets: A Survey",
    author = "Dahan, Noam  and
      Stanovsky, Gabriel",
    editor = "Chiruzzo, Luis  and
      Ritter, Alan  and
      Wang, Lu",
    booktitle = "Proceedings of the 2025 Conference of the Nations of the Americas Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers)",
    month = apr,
    year = "2025",
    address = "Albuquerque, New Mexico",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2025.naacl-long.372/",
    pages = "7259--7278",
    ISBN = "979-8-89176-189-6"
}
Data Card
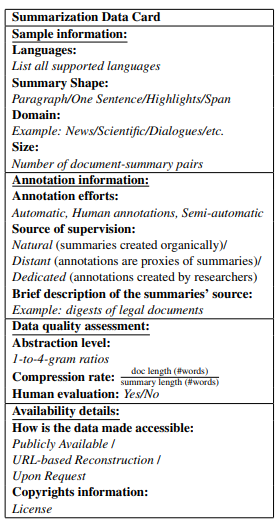
For standardization, we recommend using the Summarization Data Card, which follows findings from our survey.
📋 Click here to copy the LaTeX code
\begin{table}[tb!]
\resizebox{\columnwidth}{!}{%
\begin{tabular}{|p{7.5cm}|}

\hline
\textbf{Summarization Data Card}                                                                                      \\ \hline
\textbf{\underline{Sample information:}}
\\
\textbf{Languages:}
\newline
\textit{List all supported languages}                                                                               \\
\textbf{Summary Shape:}
\newline
\textit{Paragraph/One Sentence/Highlights/Span}                                                                \\
\textbf{Domain:}
\newline
\textit{Example: News/Scientific/Dialogues/etc.}                                                                       \\
\textbf{Size:}
\newline
\textit{Number of document-summary pairs}                                                                                \\ \hline
\textbf{\underline{Annotation information:}}                                                                                      \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Annotation efforts:} \\ \textit{Automatic, Human annotations, Semi-automatic}\end{tabular}   \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Source of supervision:}\\ \textit{Natural} (summaries created organically)/ \\ \textit{Distant} (annotations are proxies of summaries)/\\ \textit{Dedicated} (annotations created by researchers)\end{tabular} \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Brief description of the summaries' source:} \\ \textit{Example:
digests of legal documents}\end{tabular} \\ \hline
\textbf{\underline{Data quality assessment:}}                                                                                     \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Abstraction level:} \\ \textit{1-to-4-gram ratios} \end{tabular} \\
\textbf{Compression rate:}
$ \frac{\text{doc length (\#words)}}{\text{summary length (\#words)}}$                                                                                                    \\
\textbf{Human evaluation:} \textit{Yes/No}                                                                                              \\ \hline
\textbf{\underline{Availability details:}}                                                                                        \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{How is the data made accessible:} \\ \textit{Publicly Available} / \\
\textit{URL-based Reconstruction} / \\ \textit{Upon Request}\end{tabular}    \\
\begin{tabular}[c]{@{}l@{}}\textbf{Copyrights information:} \\ \textit{License}\end{tabular}                                            \\ \hline
\end{tabular}%
}
\caption{Template for a summarization data card.}
\label{tab:datacard}

\end{table}
Explore Interactively
Use our platform to easily explore and search for datasets by category. Please note that it only features the datasets included in the survey.
Datasets
If you'd like to contribute a dataset, please submit a pull request.
Paragraph
These datasets contain output texts composed of one or more paragraphs of coherent free text.
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| DUC 2001-2007 | The Document Understanding Conference (DUC) | English | Monolingual | News | Dedicated | Human | Upon Request | Multidocument, Query-focused | 45 | - |
| MultiLing 2013 | Multi-document multilingual summarization and evaluation tracks in ACL 2013 MultiLing Workshop | Arabic, Czech, English, French, Modern Greek, Hebrew, Hindi, Chinese, Romanian, Spanish | Multilingual | News | Naturally | Automatic | Upon Request | Multidocument | 150 | - |
| MultiLing 2015, 2017 | MultiLing 2017 Overview | Afrikaans, Arabic, Azerbaijani, Bulgarian, Bosnian, Catalan, Czech, German, Modern Greek, English, Esperanto, Spanish, Basque, Persian, Finnish, French, Croatian, Indonesian, Italian, Japanese, Javanese, Georgian, Korean, Limburgish, Latvian, Marathi, Malay, Dutch, Norwegian, Polish, Portuguese, Romanian, Russian, Slovak, Thai, Turkish, Tagalog, Ukrainian, Chinese | Multilingual | Encyclopedia | Distant | Automatic | Upon Request | - | 38 | - |
| New York Times Corpus | The New York Times Annotated Corpus | English | Monolingual | News | Dedicated | Human | Not Sure It Is Still Availiable | - | 650,000 | - |
| NEWSROOM | Newsroom: A Dataset of 1.3 Million Summaries with Diverse Extractive Strategies | English | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1,321,995 | - |
| DaNewsroom | DaNewsroom: A Large-scale Danish Summarisation Dataset | Danish | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1,132,734 | - |
| Multi-News | Multi-News: a Large-Scale Multi-Document Summarization Dataset and Abstractive Hierarchical Model | English | Monolingual | News | Naturally | Automatic | Publicly Available (License) | Multidocument Summarization | 250,000 | - |
| DACSA | DACSA: A large-scale Dataset for Automatic summarization of Catalan and Spanish newspaper Articles | Catalan, Spanish | Multilingual | News | Naturally | Automatic | Upon Request | - | 2,845,833 | - |
| MENSA | Select and Summarize: Scene Saliency for Movie Script Summarization | English | Monolingual | Dialogue | Naturally | Semi-Automatic | Publicly Available | - | 100 | - |
| PoemSum | Unveiling the Essence of Poetry: Introducing a Comprehensive Dataset and Benchmark for Poem Summarization | English | Monolingual | Litrature | Naturally | Automatic | Publicly Available | Poem | 3011 | - |
| MILDSum | MILDSum: A Novel Benchmark Dataset for Multilingual Summarization of Indian Legal Case Judgments | English, Hindi | Multilingual | Legal | Naturally | Automatic | Publicly Available | - | 3,122 | - |
| LR-Sum | LR-Sum: Summarization for Less-Resourced Languages | Albanian, Amharic, Armenian, Azerbaijani, Bengali, Bosnian, Burmese, Dari, English, French, Georgian, Modern Greek, Haitian, Hausa, Indonesian, Central Khmer, Kinyarwanda, Korean, Kurdish, Lao, Macedonian, Chinese, North Ndebele, Pashto, Persian, Portuguese, Russian, Serbian, Shona, Somali, Spanish, Swahili, Thai, Tibetan, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese | Multilingual | News | Distant | Automatic | Publicly Available (License) | - | 315,530 | - |
| MLSUM | MLSUM: The Multilingual Summarization Corpus | French, German, Spanish, Russian, Turkish | Multilingual | News | Distant | Automatic | URL-based reconstruction | - | 1571041 | - |
| Wikisum | Wikisum: Coherent Summarization Dataset for Efficient Human-Evaluation | English | Monolingual | Instructional | Naturally | Automatic | Publicly Available (License) | - | 39,775 | - |
| Fanpage | Two New Datasets for Italian-Language Abstractive Text Summarization | Italian | Monolingual | News | Distant | Automatic | Publicly Available | - | 84,308 | - |
| IlPost | Two New Datasets for Italian-Language Abstractive Text Summarization | Italian | Monolingual | News | Distant | Automatic | Publicly Available | - | 44,025 | - |
| GOVREPORT | Efficient Attentions for Long Document Summarization | English | Monolingual | Gov | Naturally | Automatic | Publicly Available | Long Document | 19,466 | - |
| VCSUM | VCSUM: A Versatile Chinese Meeting Summarization Dataset | Chinese | Monolingual | Dialogue | Dedicated | Human | Publicly Available | Meeting | 239 | - |
| MassiveSumm | MassiveSumm: a very large-scale, very multilingual, newswire summarisation dataset | Swahili, Hausa, Somali, Afrikaans, Kinyarwanda, Amharic, North Ndebele, Shona, Rundi, Tigrinya, Oromo, Malagasy, Xhosa, Bambara, Yoruba, Igbo, Lingala, Fulah, Russian, Spanish, Ukrainian, Persian, Arabic, Chinese, German, Urdu, Hindi, French, Polish, Vietnamese, Bulgarian, Tamil, Hungarian, Lithuanian, Armenian, Kannada, Italian, Albanian, Malayalam, Czech, Slovak, Marathi, Gujarati, Oriya, Modern Greek, Turkish, Portuguese, Latvian, Azerbaijani, Bosnian, Pashto, Thai, Nepali, Macedonian, Panjabi, Icelandic, Bengali, Japanese, Telugu, English, Georgian, Slovenian, Burmese, Welsh, Tajik, Kurdish, Serbian, Uzbek, Hebrew, Central Khmer, Lao, Dari, Croatian, Assamese, Tibetan, Romanian, Sinhala, Kirghiz, Scottish Gaelic, Dutch, Irish, Catalan, Mongolian, Swedish, Danish, Esperanto, Haitian, Indonesian, Filipino, Tetum, Bislama, Aymara | Multilingual | News | Distant | Automatic | URL-based reconstruction | - | 28879290 | - |
| BigPatent | BIGPATENT: A Large-Scale Dataset for Abstractive and Coherent Summarization | English | Monolingual | Patent | Distant | Automatic | Publicly Available | - | 1,341,362 | - |
| Global Voices | Global Voices: Crossing Borders in Automatic News Summarization | English, Spanish, Malagasy, Bengali, French, Portuguese, Russian, Arabic, Italian, Macedonian, Modern Greek, German, Japanese, Swahili, Dutch | Multilingual | News | Distant | Automatic | Upon Request | - | 41,939 | - |
| Global Voices (human annotated) | Global Voices: Crossing Borders in Automatic News Summarization | English, Spanish, Malagasy, Bengali, French, Portuguese, Russian, Arabic, Italian, Macedonian, Modern Greek, German, Japanese, Swahili, Dutch | Multilingual | News | Dedicated | Human | Upon Request | - | 3,437 | - |
| TeSum | TeSum: Human-Generated Abstractive Summarization Corpus for Telugu | Telugu | Monolingual | News | Dedicated | Human | URL-based reconstruction | - | 20329 | yes |
| BillSum | BillSum: A Corpus for Automatic Summarization of US Legislation | English | Monolingual | Legal | Naturally | Automatic | Publicly Available | - | 22218 | - |
| Opinosis | Opinosis: A Graph-Based Approach to Abstractive Summarization of Highly Redunda | English | Monolingual | Opinions/ Arguments | Dedicated | Human | Publicly Available | Opinionated Texts | 51 | - |
| PubMed,arXiv | A discourse-aware attention model for abstractive summarization of long documents | English | Monolingual | Scientific | Distant | Automatic | Publicly Available (License) | longer-form documents | 348000 | - |
| Reddit TIFU | Abstractive Summarization of Reddit Posts with Multi-level Memory Networks | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available (License) | Tldr Of Posts Or Their Title, Written By The User Who Wrote The Reddit Post | 122933 | - |
| Samsum | Samsum corpus: A human-annotated dialogue dataset for abstractive summarization. | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available | - | 16369 | yes |
| MediaSum | MediaSum: A Large-scale Media Interview Dataset for Dialogue Summarization | English | Monolingual | Dialogue | Distant | Automatic | Publicly Available | - | 463596 | - |
| CLIDSUM | ClidSum: A Benchmark Dataset for Cross-Lingual Dialogue Summarization | English, Chinese, German | Crosslingual | Dialogue | Dedicated | Human | Publicly Available | - | 56,369 | - |
| Scisummnet | ScisummNet: A Large Annotated Corpus and Content-Impact Models for Scientific Paper Summarization with Citation Networks | English | Monolingual | Scientific | Dedicated | Semi-Automatic | Publicly Available (License) | - | 1000 | yes |
| TGSum | Build tweet guided multi-document summarization dataset. | English | Monolingual | News | Dedicated | Automatic | Publicly Available | multidocument summarization, news-tweets coupling | 204 | yes |
| UrduMASD | UrduMASD: A Multimodal Abstractive Summarization Dataset for Urdu | Urdu | Monolingual | News | Distant | Automatic | Upon Request, Research Only | Multimodal | 15,374 | - |
| KurdSum | KurdSum: A new benchmark dataset for the Kurdish text summarization | Kurdish | Monolingual | News | Dedicated | Human | Publicly Available | - | 40,000 | - |
| AsomiyaPratidin | An abstractive text summarization using deep learning in Assamese | Assamese | Monolingual | News | Distant | Automatic | Unknown | - | 10,000 | - |
| BanglaCHQ-Summ | BanglaCHQ-Summ: An Abstractive Summarization Dataset for Medical Queries in Bangla Conversational Speech | Bengali | Monolingual | Medical | Dedicated | Human | Publicly Available (License) | Chq Summarization | 2,350 | yes |
| CSTNews | CSTNews - A Discourse-Annotated Corpus for Single and Multi-Document Summarization of News Texts in Brazilian Portuguese | Portuguese | Monolingual | News | Dedicated | Human | Publicly Available | Multidocument Summarization | 140 | - |
| RecognaSumm | RecognaSumm: A Novel Brazilian Summarization Dataset | Portuguese | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 135,272 | - |
| MiRANews | MiRANews: Dataset and Benchmarks for Multi-Resource-Assisted News Summarization | English | Monolingual | News | Naturally | Automatic | Publicly Available | "Generate A Summary For The Corresponding Document With The Support Of Related Assisting Documents." | 147838 | - |
| Wikinews | Towards Automatic Construction of News Overview Articles by News Synthesis | English | Monolingual | News | Naturally | Automatic | Publicly Available | "Automatically Constructing An Overview Article From A Given Set Of News Articles About A News Event" | 18,121 | - |
| WCEP | A Large-Scale Multi-Document Summarization Dataset from the Wikipedia Current Events Portal | English | Monolingual | News | Distant | Automatic | Publicly Available (License) | multidocument summarization, news-tweets coupling | 10,200 | - |
| TLDR9+ | TLDR9+: A Large Scale Resource for Extreme Summarization of Social Media Posts | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available (License) | extreme summarization - but it is not though | 9227437 | yes |
| SlovakSum | SlovakSum: A Large Scale Slovak Summarization Dataset | Slovak | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 208,519 | - |
| SMESum | A Summarization Dataset of Slovak News Articles | Slovak | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 80,003 | - |
| WikiAsp | WikiAsp: A Dataset for Multi-domain Aspect-based Summarization | English | Monolingual | Encyclopedia | Distant | Automatic | Publicly Available | Aspect-based summarization | 320,272 | - |
| CLTS | CLTS: A New Chinese Long Text Summarization Dataset | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | Long Texts | 185,397 | - |
| CLTS+ | CLTS+: A New Chinese Long Text Summarization Dataset with Abstractive Summaries | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | Long Texts | 181,401 | yes |
| SumTitles | SumTitles: a Summarization Dataset with Low Extractiveness | English | Monolingual | Dialogue | Naturally | Automatic | URL-based reconstruction | - | 131,864 | - |
| NEWSFARM | NEWSFARM: A Large-Scale Chinese Corpus of Long News Summarization | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | Long Texts | 224,480 | yes |
| CLES | A large-scale chinese long-text extractive summarization corpus | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | - | 103,839 | yes |
| LANS | LANS: Large-scale Arabic News Summarization Corpus | Arabic | Monolingual | News | Distant | Automatic | Upon Request | - | 8,443,484 | yes |
| ANT | An Arabic Multi-source News Corpus: Experimenting on Single-document Extractive Summarization | Arabic | Monolingual | News | Distant | Automatic | Publicly Available | - | 31,798 | - |
| Hromadske.ua | Abstractive Summarization for the Ukrainian Language: Multi-Task Learning with Hromadske.ua News Dataset | Ukrainian | Monolingual | News | Distant | Automatic | Publicly Available | - | 36,488 | - |
| Gazeta | Dataset for Automatic Summarization of Russian News | Russian | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 63,435 | - |
| BigSurvey (CAST) | Generating a Structured Summary of Numerous Academic Papers: Dataset and Method | English | Monolingual | Scientific | Naturally | Automatic | Publicly Available (License) | Multidocument | 4,478 | - |
| WikiMulti | WikiMulti: a Corpus for Cross-Lingual SummarizationWikiMulti: a Corpus for Cross-Lingual Summarization | English, French, Spanish, Italian, Russian, German, Portuguese, Japanese, Polish, Chinese, Swedish, Dutch, Arabic, Ukrainian, Vietnamese | Crosslingual | Encyclopedia | Distant | Automatic | Publicly Available | - | 22061 | - |
| XWikis | Models and datasets for cross-lingual summarisation | Czech, English, French, German | Crosslingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 213,911 | yes |
| W-MS (Spektrum) | A Novel Wikipedia based Dataset for Monolingual and Cross-Lingual Summarization | English | Monolingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 46,180 | - |
| W-CLS (Spektrum) | A Novel Wikipedia based Dataset for Monolingual and Cross-Lingual Summarization | English, German | Crosslingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 5,132 | - |
| S-CLS (Spektrum) | A Novel Wikipedia based Dataset for Monolingual and Cross-Lingual Summarization | English, German | Crosslingual | Encyclopedia | Naturally | Semi-Automatic | Publicly Available (License) | - | 1,510 | - |
| AMI | The AMI Meeting Corpus | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 100 | - |
| Webis-TLDR-17 | TL;DR: Mining Reddit to learn au- ¨ tomatic summarization. | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available | - | 4044501 | - |
| DialogSum | DialogSum: A Real-Life Scenario Dialogue Summarization Dataset | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available | - | 13,460 | - |
| SumPubMed | SumPubMed: Summarization Dataset of PubMed Scientific Articles | English | Monolingual | Scientific | Distant | Automatic | Publicly Available (License) | - | 33,772 | yes |
| BOOKSUM | BookSum: A Collection of Datasets for Long-form Narrative Summarization | English | Monolingual | Litrature | Distant | Automatic | URL-based reconstruction | Narrative Summarization | 405 | - |
| NovelChapters | Exploring Content Selection in Summarization of Novel Chapters | English | Monolingual | Litrature | Naturally | Automatic | URL-based reconstruction | - | 8,088 | - |
| S2ORC extended | What’s New? Summarizing Contributions in Scientific Literature | English | Monolingual | Scientific | Dedicated | Automatic | Publicly Available (License) | - | 895523 | yes (on usefuleness) |
| GameWikiSum | GameWikiSum: a Novel Large Multi-Document Summarization Dataset | English | Monolingual | Opinions/ Arguments | Distant | Automatic | Publicly Available (License) | multi-document | 14652 | - |
| SQuALITY | SQuALITY: Building a Long-Document Summarization Dataset the Hard Wa | English | Monolingual | Litrature | Dedicated | Human | Publicly Available (License) | Question-focused summarization (QFS) | 625 | - |
| Liputan6 | Liputan6: A Large-scale Indonesian Dataset for Text Summarization | Indonesian | Monolingual | News | Naturally | Automatic | URL-based reconstruction | - | 215827 | - |
| TWEETSUMM | TWEETSUMM - A Dialog Summarization Dataset for Customer Service | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 1100 | yes |
| SumeCzech | SumeCzech: Large Czech News-Based Summarization Dataset | Czech | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1001593 | - |
| Indosum | Indosum: A New Benchmark Dataset for Indonesian Text Summarization | Indonesian | Monolingual | News | Naturally | Automatic | Publicly Available (License) | - | 18774 | - |
| VNDS | VNDS: A Vietnamese Dataset for Summarization | Vietnamese | Monolingual | News | Distant | Automatic | Publicly Available | - | 150704 | - |
| ViMs | ViMs: a high-quality Vietnamese dataset for abstractive multi-document summarization | Vietnamese | Monolingual | News | Dedicated | Human | Publicly Available | multi-document | 300 | - |
| Multi-XScience | Multi-XScience: A Large-scale Dataset for Extreme Multi-document Summarization of Scientific Articles | English | Monolingual | Scientific | Distant | Automatic | Publicly Available (License) | multi-document, writing the related-work section given the abstract and the abstract of the cited papers | 40528 | yes |
| SummScreen | SummScreen: A Dataset for Abstractive Screenplay Summarization | English | Monolingual | Dialogue | Naturally | Automatic | Publicly Available | - | 26851 | - |
| FacetSum | Bringing Structure into Summaries: a Faceted Summarization Dataset for Long Scientific Documents | English | Monolingual | Scientific | Naturally | Automatic | Publicly Available (License) | Faceted Summarization | 60,024 | - |
| ForumSum | ForumSum: A Multi-Speaker Conversation Summarization Dataset | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available | - | 4058 | - |
| QMSum | QMSum: A New Benchmark for Query-based Multi-domain Meeting Summarization | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | query based, Multi-domain | 1,808 | yes |
| Ubuntu/NYC | Summarizing Online Forum Discussions – Can Dialog Acts of Individual Messages Help? | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (Research Purposes) | Dialogue | 100 | - |
| BC3 | A Publicly Available Annotated Corpus for Supervised Email Summarization | English | Monolingual | Emails | Dedicated | Human | Publicly Available (Research Purposes) | - | 90 | - |
| MMS | Multi-modal Summarization for Asynchronous Collection of Text, Image, Audio and Video | English, Chinese | Multilingual | News | Dedicated | Human | Publicly Available | Multi-document, multimodal | 50 | - |
| CSDS | CSDS: A Fine-Grained Chinese Dataset for Customer Service Dialogue Summarization | Chinese | Monolingual | Dialogue | Dedicated | Human | Publicly Available | topic-based structural (kind of like faced) | 10,701 | - |
| HeSum | HeSum: a Novel Dataset for Abstractive Text Summarization in Hebrew | Hebrew | Monolingual | News | Distant | Automatic | Publicly Available | - | 10000 | - |
| HunSum-2 | From News to Summaries: Building a Hungarian Corpus for Extractive and Abstractive Summarization | Hungarian | Monolingual | News | Distant | Automatic | Publicly Available | - | 1817850 | - |
| OrangeSum | BARThez: a Skilled Pretrained French Sequence-to-Sequence Model | French | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 33600 | - |
| pn-summary | Leveraging parsbert and pretrained mt5 for persian abstractive text summarization | Persian | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 93,207 | - |
| ScriptBase | Movie Script Summarization as Graph-based Scene Extraction | English | Monolingual | Dialogue | Naturally | Automatic | Publicly Available | - | 1,276 | - |
| How2 | How2: a large-scale dataset for multimodal language understanding | English, Portuguese | Multilingual | Instructional | Distant | Automatic | URL-based reconstruction | Multimodal | 79,114 | - |
| MLGSum | Contrastive aligned joint learning for multilingual summarization. | German, English, Russian, French, Chinese, Hindi, Spanish, Indonesian, Turkish, Vietnamese, Ukrainian, Portuguese | Multilingual | News | Distant | Automatic | URL-based reconstruction | - | 1,168,276 | - |
| Auto-hMDS | Automatic Construction of a Large Heterogeneous Multilingual MultiDocument Summarization Corpus | German, English | Multilingual | Diverse | Distant | Automatic | URL-based reconstruction | multi-document | 7,316 | - |
| hMDS | The Next Step for Multi-Document Summarization : A Heterogeneous Multi-Genre Corpus Built with a Novel Construction Approach | English | Monolingual | Diverse | Distant | Others | URL-based reconstruction | multi-document | 1,265 | - |
| ACL TA-DA | ACL TA-DA: A Dataset for Text Summarization and Generation | English | Monolingual | Scientific | Distant | Automatic | Publicly Available | - | 22,315 | - |
| OPENASP | OPENASP: A Benchmark for Multi-document Open Aspect-based Summarization | English | Monolingual | News | Dedicated | Human | Publicly Available (License) | Multi-document, Open Aspect | 1,310 | yes |
Single-sentence summary
The summaries in these datasets range from a few words (like titles) to a lengthy sentence, composed of several dozen words. This format is sometimes referred to as "extreme summarization" or "headline generation".
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| LCSTS | LCSTS: A Large Scale Chinese Short Text Summarization Dataset | Chinese | Monolingual | Social Media | Naturally | Automatic | Upon Request | Meadure | 2,400,591 | yes |
| xlsum | XL-Sum: Large-Scale Multilingual Abstractive Summarization for 44 Languages | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Hindi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Multilingual | News | Distant | Automatic | Publicly Available (License) | - | 1,300,000 | yes |
| ilsum | FIRE 2022 ILSUM Track: Indian Language Summarization | Hindi, Gujarati, English | Multilingual | News | Naturally | Automatic | Availiable | - | 28978 | - |
| X-SCITLDR | Cross-lingual extreme summarization of scholarly documents | English, German, Italian, Chinese | Crosslingual | Scientific | Naturally | Semi-Automatic | Publicly Available (License) | - | 3,229 | - |
| X-SCITLDR | Cross-lingual extreme summarization of scholarly documents | English, Japanese | Crosslingual | Scientific | Naturally | Automatic | Publicly Available (License) | - | 2,004 | - |
| SCITLDR | TLDR: Extreme Summarization of Scientific Documents | English | Monolingual | Scientific | Naturally | Automatic | Publicly Available | - | 3,935 | - |
| SCITLDR (test set) | TLDR: Extreme Summarization of Scientific Documents | English | Monolingual | Scientific | Dedicated | Semi-Automatic | Publicly Available | - | 1,237 | - |
| ACLSum | ACLSum: A New Dataset for Aspect-based Summarization of Scientific Publications | English | Monolingual | Scientific | Dedicated | Human | Publicly Available | Multiaspect Summarization | 250 | yes |
| CCSum | CCSum: A Large-Scale and High-Quality Dataset for Abstractive News Summarization | English | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 1,369,911 | yes |
| PMIndiaSum | PMIndiaSum: Multilingual and Cross-lingual Headline Summarization for Languages in India | Kannada, Malayalam, Tamil, Telugu, Assamese, Bengali, Gujarati, Hindi, Marathi, Oriya, Panjabi, Urdu, English, Manipuri | Multilingual | News | Naturally | Automatic | Publicly Available (License) | - | 76,680 | - |
| CrossSum | CrossSum: Beyond English-Centric Cross-Lingual Summarization for 1,500+ Language Pairs | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Indi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Crosslingual | News | Naturally | Automatic | Publicly Available (License) | - | 1680000 | yes (for the allignment) |
| MM-CLS | MCLS: A Large-Scale Multimodal Cross-Lingual Summarization Dataset | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Indi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Crosslingual | News | Naturally | Automatic | ???? | Multimodal Summarization, Cl | 1,100,000 | - |
| Gigaword | Annotated Gigaword | English | Monolingual | News | Distant | Automatic | Publicly Available | sentence-level summarization. | 4000000 | - |
| This Email Could Save Your Life: Introducing the Task of Email Subject Line Generation | English | Monolingual | Emails | Dedicated | Human | Publicly Available (License) | Email Subject Line Generation | 18302 | - | |
| Rotten Tomatoes | Neural network-based abstract generation for opinions and arguments. | English | Monolingual | Opinions/ Arguments | Naturally | Automatic | Publicly Available | Claim Generation | 3,731 | - |
| Idebate | Neural network-based abstract generation for opinions and arguments. | English | Monolingual | Opinions/ Arguments | Naturally | Automatic | Publicly Available | Claim Generation | 17359 | - |
| Reddit TIFU (extreme) | Abstractive Summarization of Reddit Posts with Multi-level Memory Networks | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available (License) | Tldr Od Posts Or Their Title, Written By The User Who Wrote The Reddit Post | 122933 | - |
| XSum | Don’t give me the details, just the summary! topic-aware convolutional neural networks for extreme summarization. | English | Monolingual | News | Distant | Automatic | Publicly Available | - | 226711 | - |
| MeQSum | On the Summarization of Consumer Health Questions | English | Monolingual | Medical | Dedicated | Human | Publicly Available (License) | Chq Summarization | 1,000 | - |
| CHQ-Summ | CHQ-Summ: A DATASET FOR CONSUMER HEALTHCARE QUESTION SUMMARIZATION | English | Monolingual | Medical | Dedicated | Human | URL-based reconstruction | Chq Summarization | 1,507 | - |
| WikiDes | WikiDes: A Wikipedia-Based Dataset for Generating Short Descriptions from Paragraphs | English | Monolingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 81419 | - |
| SumeCzech (extreme ) | SumeCzech: Large Czech News-Based Summarization Dataset | Czech | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1001593 | - |
| MMSS | Multi-modal Sentence Summarization with Modality Attention and Image Filtering | English | Monolingual | News | Distant | Automatic | Publicly Available | Multimodal | 66,000 | - |
| MM-Sum | Summary-Oriented Vision Modeling for Multimodal Abstractive Summarization | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Hindi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Multilingual | News | Distant | Automatic | Publicly Available | Multimodal | 1,078,215 | - |
| MultiSumm | MultiSumm: Towards a Unified Model for Multi-Lingual Abstractive Summarization | Bosnian, Croatian | Multilingual | News | Distant | Automatic | Publicly Available | - | 382154 | - |
| OrangeSum | BARThez: a Skilled Pretrained French Sequence-to-Sequence Model | French | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 33600 | - |
| M3LS | Large Scale Multi-Lingual Multi-Modal Summarization Dataset | English, Chinese, Spanish, Russian, French, Ukrainian, Portuguese, Japanese, Tamil, Hindi, Marathi, Gujarati, Bengali, Sinhala, Urdu, Pashto, Indonesian, Telugu, Panjabi, Nepali | Multilingual | News | Distant | Automatic | Publicly Available (License) | Multimodal | 1,100,000 | yes |
| VMSMO | Vmsmo: Learning to generate multimodal summary for video-based news articles | Chinese | Monolingual | News | Naturally | Automatic | Publicly Available | Multimodal | 184,920 | - |
Highlights
The summaries in these datasets are constructed from a few, possibly independent sentences. For example, they could be bullet points (e.g., from news articles).
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN/daily mail | Neural Summarization by Extracting Sentences and Words | English | Monolingual | News | Naturally | Automatic | Publicly Available (License) | - | 312085 | - |
| EUR-Lex-Sum (English) | Summarizing Legal Regulatory Documents using Transformers | English | Monolingual | Legal | Naturally | Automatic | Publicly Available | - | 4,595 | - |
| EUR-Lex-Sum (Multilingual) | EUR-Lex-Sum: A Multi- and Cross-lingual Dataset for Long-form Summarization in the Legal Domain | English, German, Italian, Portuguese, Dutch, Danish, Modern Greek, Finnish, Swedish, Romanian, Hungarian, Czech, Polish, Bulgarian, Latvian, Slovenian, Estonian, Lithuanian, Slovak, Maltese, Croatian, Irish | Multilingual | Legal | Naturally | Automatic | Publicly Available | - | 1,500 | - |
| WikiLingua | WikiLingua: A New Benchmark Dataset for Cross-Lingual Abstractive Summarization | English, Spanish, Portuguese, French, German, Russian, Italian, Indonesian, Dutch, Arabic, Chinese, Vietnamese, Thai, Japanese, Korean, Hindi, Czech, Turkish | Crosslingual | Instructional | Distant | Automatic | Publicly Available (License) | - | 141,457 | - |
| WikiHow | WikiHow: A Large Scale Text Summarization Dataset | English | Monolingual | Instructional | Distant | Automatic | Publicly Available (License) | - | 204, 004 | - |
| WG/USAToday-CNN | Utilizing microblogs for automatic news highlights extraction. | English | Monolingual | News | Distant | Automatic | Publicly Available | news-tweets coupling,news highlights production | 121 | - |
| NCLS | NCLS: Neural Cross-Lingual Summarization | English, Chinese | Crosslingual | News | Naturally | Automatic | Publicly Available | - | 2,070,400 | - |
| MSMO | MSMO: Multimodal Summarization with Multimodal Output | English | Monolingual | News | Naturally | Automatic | Publicly Available | Multimodal Input And Output | 314581 | - |
| E-DailyMail | Abstractive Text-Image Summarization Using Multi-Modal Attentional Hierarchical RNN | English | Monolingual | News | Naturally | Automatic | ????? | Multimodal | 219100 | - |
| 20 Minuten (bigger) | 20 Minuten: A Multi-task News Summarisation Dataset for German | German | Monolingual | News | Naturally | Automatic | Publicly Available (License) | - | 51,357 | - |
| CSPubSum | A supervised approach to extractive summarisation of scientific papers. | English | Monolingual | Scientific | Naturally | Automatic | URL-based reconstruction | - | 10148 | - |
Span Summarries
These datasets use spans of text directly taken from the document as summaries.
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| EASC | Using Mechanical Turk to Create a Corpus of Arabic Summaries | Arabic | Monolingual | Diverse | Dedicated | Human | Publicly Available | - | 765 | - |
| ACLSum (extractive) | ACLSum: A New Dataset for Aspect-based Summarization of Scientific Publications | English | Monolingual | Scientific | Dedicated | Human | Publicly Available | Multiaspect Summarization | 250 | yes |
| VCSUM (extractive) | VCSUM: A Versatile Chinese Meeting Summarization Dataset | Chinese | Monolingual | Dialogue | Dedicated | Human | Publicly Available | Meeting | 239 | - |
| CAST | Building better corpora for summarisation | English | Monolingual | Diverse | Dedicated | Human | Publicly Available (License) | - | 163 | - |
| The CNN-Corpus | The CNN-Corpus: A Large Textual Corpus for Single-Document Extractive Summarization | English | Monolingual | News | Dedicated | Semi-Automatic | Publicly Available (License) | - | 3000 | - |
| KALIMAT | KALIMAT a Multipurpose Arabic Corpus | Arabic | Monolingual | News | Dedicated | Automatic | Publicly Available | Multidocument Summarization (Small Part Of 2057 Articles) | 20,291 | - |
| Webis-EditorialSum-2020 | News Editorials: Towards Summarizing Long Argumentative Texts | English | Monolingual | Opinions/ Arguments | Dedicated | Human | Publicly Available | Opinionated Texts | 266 | yes |
| QBSUM | QBSUM: a Large-Scale Query-Based Document Summarization Dataset from Real-world Applications | Chinese | Monolingual | News | Dedicated | Human | Publicly Available | Query-Based | 49,535 | - |
| AMI | The AMI Meeting Corpus | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 100 | - |
| TWEETSUMM (extractive ) | TWEETSUMM - A Dialog Summarization Dataset for Customer Service | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 1100 | yes |
| DebateSum | DebateSum: A large-scale argument mining and summarization dataset | English | Monolingual | Opinions/ Arguments | Naturally | Automatic |
Truncated — view the full README on GitHub.
Similar repos




Updating collection of summarization datasets in 100+ languages, based on our paper "The State and Fate of Summarization Datasets: A Survey".
See the codeREADME
Awesome-Summarization-Datasets
The collection and ontology is a result of our paper The State and Fate of Summarization Datasets: A Survey (NAACL 2025).
Citing
If our survey contributes to your research, please reference the following paper in your work:
@inproceedings{dahan-stanovsky-2025-state,
    title = "The State and Fate of Summarization Datasets: A Survey",
    author = "Dahan, Noam  and
      Stanovsky, Gabriel",
    editor = "Chiruzzo, Luis  and
      Ritter, Alan  and
      Wang, Lu",
    booktitle = "Proceedings of the 2025 Conference of the Nations of the Americas Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers)",
    month = apr,
    year = "2025",
    address = "Albuquerque, New Mexico",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2025.naacl-long.372/",
    pages = "7259--7278",
    ISBN = "979-8-89176-189-6"
}
Data Card
For standardization, we recommend using the Summarization Data Card, which follows findings from our survey.
📋 Click here to copy the LaTeX code
\begin{table}[tb!]
\resizebox{\columnwidth}{!}{%
\begin{tabular}{|p{7.5cm}|}

\hline
\textbf{Summarization Data Card}                                                                                      \\ \hline
\textbf{\underline{Sample information:}}
\\
\textbf{Languages:}
\newline
\textit{List all supported languages}                                                                               \\
\textbf{Summary Shape:}
\newline
\textit{Paragraph/One Sentence/Highlights/Span}                                                                \\
\textbf{Domain:}
\newline
\textit{Example: News/Scientific/Dialogues/etc.}                                                                       \\
\textbf{Size:}
\newline
\textit{Number of document-summary pairs}                                                                                \\ \hline
\textbf{\underline{Annotation information:}}                                                                                      \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Annotation efforts:} \\ \textit{Automatic, Human annotations, Semi-automatic}\end{tabular}   \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Source of supervision:}\\ \textit{Natural} (summaries created organically)/ \\ \textit{Distant} (annotations are proxies of summaries)/\\ \textit{Dedicated} (annotations created by researchers)\end{tabular} \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Brief description of the summaries' source:} \\ \textit{Example:
digests of legal documents}\end{tabular} \\ \hline
\textbf{\underline{Data quality assessment:}}                                                                                     \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{Abstraction level:} \\ \textit{1-to-4-gram ratios} \end{tabular} \\
\textbf{Compression rate:}
$ \frac{\text{doc length (\#words)}}{\text{summary length (\#words)}}$                                                                                                    \\
\textbf{Human evaluation:} \textit{Yes/No}                                                                                              \\ \hline
\textbf{\underline{Availability details:}}                                                                                        \\
\begin{tabular}[|p{7.5cm}|]{@{}l@{}}\textbf{How is the data made accessible:} \\ \textit{Publicly Available} / \\
\textit{URL-based Reconstruction} / \\ \textit{Upon Request}\end{tabular}    \\
\begin{tabular}[c]{@{}l@{}}\textbf{Copyrights information:} \\ \textit{License}\end{tabular}                                            \\ \hline
\end{tabular}%
}
\caption{Template for a summarization data card.}
\label{tab:datacard}

\end{table}
Explore Interactively
Use our platform to easily explore and search for datasets by category. Please note that it only features the datasets included in the survey.
Datasets
If you'd like to contribute a dataset, please submit a pull request.
Paragraph
These datasets contain output texts composed of one or more paragraphs of coherent free text.
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| DUC 2001-2007 | The Document Understanding Conference (DUC) | English | Monolingual | News | Dedicated | Human | Upon Request | Multidocument, Query-focused | 45 | - |
| MultiLing 2013 | Multi-document multilingual summarization and evaluation tracks in ACL 2013 MultiLing Workshop | Arabic, Czech, English, French, Modern Greek, Hebrew, Hindi, Chinese, Romanian, Spanish | Multilingual | News | Naturally | Automatic | Upon Request | Multidocument | 150 | - |
| MultiLing 2015, 2017 | MultiLing 2017 Overview | Afrikaans, Arabic, Azerbaijani, Bulgarian, Bosnian, Catalan, Czech, German, Modern Greek, English, Esperanto, Spanish, Basque, Persian, Finnish, French, Croatian, Indonesian, Italian, Japanese, Javanese, Georgian, Korean, Limburgish, Latvian, Marathi, Malay, Dutch, Norwegian, Polish, Portuguese, Romanian, Russian, Slovak, Thai, Turkish, Tagalog, Ukrainian, Chinese | Multilingual | Encyclopedia | Distant | Automatic | Upon Request | - | 38 | - |
| New York Times Corpus | The New York Times Annotated Corpus | English | Monolingual | News | Dedicated | Human | Not Sure It Is Still Availiable | - | 650,000 | - |
| NEWSROOM | Newsroom: A Dataset of 1.3 Million Summaries with Diverse Extractive Strategies | English | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1,321,995 | - |
| DaNewsroom | DaNewsroom: A Large-scale Danish Summarisation Dataset | Danish | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1,132,734 | - |
| Multi-News | Multi-News: a Large-Scale Multi-Document Summarization Dataset and Abstractive Hierarchical Model | English | Monolingual | News | Naturally | Automatic | Publicly Available (License) | Multidocument Summarization | 250,000 | - |
| DACSA | DACSA: A large-scale Dataset for Automatic summarization of Catalan and Spanish newspaper Articles | Catalan, Spanish | Multilingual | News | Naturally | Automatic | Upon Request | - | 2,845,833 | - |
| MENSA | Select and Summarize: Scene Saliency for Movie Script Summarization | English | Monolingual | Dialogue | Naturally | Semi-Automatic | Publicly Available | - | 100 | - |
| PoemSum | Unveiling the Essence of Poetry: Introducing a Comprehensive Dataset and Benchmark for Poem Summarization | English | Monolingual | Litrature | Naturally | Automatic | Publicly Available | Poem | 3011 | - |
| MILDSum | MILDSum: A Novel Benchmark Dataset for Multilingual Summarization of Indian Legal Case Judgments | English, Hindi | Multilingual | Legal | Naturally | Automatic | Publicly Available | - | 3,122 | - |
| LR-Sum | LR-Sum: Summarization for Less-Resourced Languages | Albanian, Amharic, Armenian, Azerbaijani, Bengali, Bosnian, Burmese, Dari, English, French, Georgian, Modern Greek, Haitian, Hausa, Indonesian, Central Khmer, Kinyarwanda, Korean, Kurdish, Lao, Macedonian, Chinese, North Ndebele, Pashto, Persian, Portuguese, Russian, Serbian, Shona, Somali, Spanish, Swahili, Thai, Tibetan, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese | Multilingual | News | Distant | Automatic | Publicly Available (License) | - | 315,530 | - |
| MLSUM | MLSUM: The Multilingual Summarization Corpus | French, German, Spanish, Russian, Turkish | Multilingual | News | Distant | Automatic | URL-based reconstruction | - | 1571041 | - |
| Wikisum | Wikisum: Coherent Summarization Dataset for Efficient Human-Evaluation | English | Monolingual | Instructional | Naturally | Automatic | Publicly Available (License) | - | 39,775 | - |
| Fanpage | Two New Datasets for Italian-Language Abstractive Text Summarization | Italian | Monolingual | News | Distant | Automatic | Publicly Available | - | 84,308 | - |
| IlPost | Two New Datasets for Italian-Language Abstractive Text Summarization | Italian | Monolingual | News | Distant | Automatic | Publicly Available | - | 44,025 | - |
| GOVREPORT | Efficient Attentions for Long Document Summarization | English | Monolingual | Gov | Naturally | Automatic | Publicly Available | Long Document | 19,466 | - |
| VCSUM | VCSUM: A Versatile Chinese Meeting Summarization Dataset | Chinese | Monolingual | Dialogue | Dedicated | Human | Publicly Available | Meeting | 239 | - |
| MassiveSumm | MassiveSumm: a very large-scale, very multilingual, newswire summarisation dataset | Swahili, Hausa, Somali, Afrikaans, Kinyarwanda, Amharic, North Ndebele, Shona, Rundi, Tigrinya, Oromo, Malagasy, Xhosa, Bambara, Yoruba, Igbo, Lingala, Fulah, Russian, Spanish, Ukrainian, Persian, Arabic, Chinese, German, Urdu, Hindi, French, Polish, Vietnamese, Bulgarian, Tamil, Hungarian, Lithuanian, Armenian, Kannada, Italian, Albanian, Malayalam, Czech, Slovak, Marathi, Gujarati, Oriya, Modern Greek, Turkish, Portuguese, Latvian, Azerbaijani, Bosnian, Pashto, Thai, Nepali, Macedonian, Panjabi, Icelandic, Bengali, Japanese, Telugu, English, Georgian, Slovenian, Burmese, Welsh, Tajik, Kurdish, Serbian, Uzbek, Hebrew, Central Khmer, Lao, Dari, Croatian, Assamese, Tibetan, Romanian, Sinhala, Kirghiz, Scottish Gaelic, Dutch, Irish, Catalan, Mongolian, Swedish, Danish, Esperanto, Haitian, Indonesian, Filipino, Tetum, Bislama, Aymara | Multilingual | News | Distant | Automatic | URL-based reconstruction | - | 28879290 | - |
| BigPatent | BIGPATENT: A Large-Scale Dataset for Abstractive and Coherent Summarization | English | Monolingual | Patent | Distant | Automatic | Publicly Available | - | 1,341,362 | - |
| Global Voices | Global Voices: Crossing Borders in Automatic News Summarization | English, Spanish, Malagasy, Bengali, French, Portuguese, Russian, Arabic, Italian, Macedonian, Modern Greek, German, Japanese, Swahili, Dutch | Multilingual | News | Distant | Automatic | Upon Request | - | 41,939 | - |
| Global Voices (human annotated) | Global Voices: Crossing Borders in Automatic News Summarization | English, Spanish, Malagasy, Bengali, French, Portuguese, Russian, Arabic, Italian, Macedonian, Modern Greek, German, Japanese, Swahili, Dutch | Multilingual | News | Dedicated | Human | Upon Request | - | 3,437 | - |
| TeSum | TeSum: Human-Generated Abstractive Summarization Corpus for Telugu | Telugu | Monolingual | News | Dedicated | Human | URL-based reconstruction | - | 20329 | yes |
| BillSum | BillSum: A Corpus for Automatic Summarization of US Legislation | English | Monolingual | Legal | Naturally | Automatic | Publicly Available | - | 22218 | - |
| Opinosis | Opinosis: A Graph-Based Approach to Abstractive Summarization of Highly Redunda | English | Monolingual | Opinions/ Arguments | Dedicated | Human | Publicly Available | Opinionated Texts | 51 | - |
| PubMed,arXiv | A discourse-aware attention model for abstractive summarization of long documents | English | Monolingual | Scientific | Distant | Automatic | Publicly Available (License) | longer-form documents | 348000 | - |
| Reddit TIFU | Abstractive Summarization of Reddit Posts with Multi-level Memory Networks | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available (License) | Tldr Of Posts Or Their Title, Written By The User Who Wrote The Reddit Post | 122933 | - |
| Samsum | Samsum corpus: A human-annotated dialogue dataset for abstractive summarization. | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available | - | 16369 | yes |
| MediaSum | MediaSum: A Large-scale Media Interview Dataset for Dialogue Summarization | English | Monolingual | Dialogue | Distant | Automatic | Publicly Available | - | 463596 | - |
| CLIDSUM | ClidSum: A Benchmark Dataset for Cross-Lingual Dialogue Summarization | English, Chinese, German | Crosslingual | Dialogue | Dedicated | Human | Publicly Available | - | 56,369 | - |
| Scisummnet | ScisummNet: A Large Annotated Corpus and Content-Impact Models for Scientific Paper Summarization with Citation Networks | English | Monolingual | Scientific | Dedicated | Semi-Automatic | Publicly Available (License) | - | 1000 | yes |
| TGSum | Build tweet guided multi-document summarization dataset. | English | Monolingual | News | Dedicated | Automatic | Publicly Available | multidocument summarization, news-tweets coupling | 204 | yes |
| UrduMASD | UrduMASD: A Multimodal Abstractive Summarization Dataset for Urdu | Urdu | Monolingual | News | Distant | Automatic | Upon Request, Research Only | Multimodal | 15,374 | - |
| KurdSum | KurdSum: A new benchmark dataset for the Kurdish text summarization | Kurdish | Monolingual | News | Dedicated | Human | Publicly Available | - | 40,000 | - |
| AsomiyaPratidin | An abstractive text summarization using deep learning in Assamese | Assamese | Monolingual | News | Distant | Automatic | Unknown | - | 10,000 | - |
| BanglaCHQ-Summ | BanglaCHQ-Summ: An Abstractive Summarization Dataset for Medical Queries in Bangla Conversational Speech | Bengali | Monolingual | Medical | Dedicated | Human | Publicly Available (License) | Chq Summarization | 2,350 | yes |
| CSTNews | CSTNews - A Discourse-Annotated Corpus for Single and Multi-Document Summarization of News Texts in Brazilian Portuguese | Portuguese | Monolingual | News | Dedicated | Human | Publicly Available | Multidocument Summarization | 140 | - |
| RecognaSumm | RecognaSumm: A Novel Brazilian Summarization Dataset | Portuguese | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 135,272 | - |
| MiRANews | MiRANews: Dataset and Benchmarks for Multi-Resource-Assisted News Summarization | English | Monolingual | News | Naturally | Automatic | Publicly Available | "Generate A Summary For The Corresponding Document With The Support Of Related Assisting Documents." | 147838 | - |
| Wikinews | Towards Automatic Construction of News Overview Articles by News Synthesis | English | Monolingual | News | Naturally | Automatic | Publicly Available | "Automatically Constructing An Overview Article From A Given Set Of News Articles About A News Event" | 18,121 | - |
| WCEP | A Large-Scale Multi-Document Summarization Dataset from the Wikipedia Current Events Portal | English | Monolingual | News | Distant | Automatic | Publicly Available (License) | multidocument summarization, news-tweets coupling | 10,200 | - |
| TLDR9+ | TLDR9+: A Large Scale Resource for Extreme Summarization of Social Media Posts | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available (License) | extreme summarization - but it is not though | 9227437 | yes |
| SlovakSum | SlovakSum: A Large Scale Slovak Summarization Dataset | Slovak | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 208,519 | - |
| SMESum | A Summarization Dataset of Slovak News Articles | Slovak | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 80,003 | - |
| WikiAsp | WikiAsp: A Dataset for Multi-domain Aspect-based Summarization | English | Monolingual | Encyclopedia | Distant | Automatic | Publicly Available | Aspect-based summarization | 320,272 | - |
| CLTS | CLTS: A New Chinese Long Text Summarization Dataset | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | Long Texts | 185,397 | - |
| CLTS+ | CLTS+: A New Chinese Long Text Summarization Dataset with Abstractive Summaries | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | Long Texts | 181,401 | yes |
| SumTitles | SumTitles: a Summarization Dataset with Low Extractiveness | English | Monolingual | Dialogue | Naturally | Automatic | URL-based reconstruction | - | 131,864 | - |
| NEWSFARM | NEWSFARM: A Large-Scale Chinese Corpus of Long News Summarization | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | Long Texts | 224,480 | yes |
| CLES | A large-scale chinese long-text extractive summarization corpus | Chinese | Monolingual | News | Distant | Automatic | Publicly Available | - | 103,839 | yes |
| LANS | LANS: Large-scale Arabic News Summarization Corpus | Arabic | Monolingual | News | Distant | Automatic | Upon Request | - | 8,443,484 | yes |
| ANT | An Arabic Multi-source News Corpus: Experimenting on Single-document Extractive Summarization | Arabic | Monolingual | News | Distant | Automatic | Publicly Available | - | 31,798 | - |
| Hromadske.ua | Abstractive Summarization for the Ukrainian Language: Multi-Task Learning with Hromadske.ua News Dataset | Ukrainian | Monolingual | News | Distant | Automatic | Publicly Available | - | 36,488 | - |
| Gazeta | Dataset for Automatic Summarization of Russian News | Russian | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 63,435 | - |
| BigSurvey (CAST) | Generating a Structured Summary of Numerous Academic Papers: Dataset and Method | English | Monolingual | Scientific | Naturally | Automatic | Publicly Available (License) | Multidocument | 4,478 | - |
| WikiMulti | WikiMulti: a Corpus for Cross-Lingual SummarizationWikiMulti: a Corpus for Cross-Lingual Summarization | English, French, Spanish, Italian, Russian, German, Portuguese, Japanese, Polish, Chinese, Swedish, Dutch, Arabic, Ukrainian, Vietnamese | Crosslingual | Encyclopedia | Distant | Automatic | Publicly Available | - | 22061 | - |
| XWikis | Models and datasets for cross-lingual summarisation | Czech, English, French, German | Crosslingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 213,911 | yes |
| W-MS (Spektrum) | A Novel Wikipedia based Dataset for Monolingual and Cross-Lingual Summarization | English | Monolingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 46,180 | - |
| W-CLS (Spektrum) | A Novel Wikipedia based Dataset for Monolingual and Cross-Lingual Summarization | English, German | Crosslingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 5,132 | - |
| S-CLS (Spektrum) | A Novel Wikipedia based Dataset for Monolingual and Cross-Lingual Summarization | English, German | Crosslingual | Encyclopedia | Naturally | Semi-Automatic | Publicly Available (License) | - | 1,510 | - |
| AMI | The AMI Meeting Corpus | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 100 | - |
| Webis-TLDR-17 | TL;DR: Mining Reddit to learn au- ¨ tomatic summarization. | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available | - | 4044501 | - |
| DialogSum | DialogSum: A Real-Life Scenario Dialogue Summarization Dataset | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available | - | 13,460 | - |
| SumPubMed | SumPubMed: Summarization Dataset of PubMed Scientific Articles | English | Monolingual | Scientific | Distant | Automatic | Publicly Available (License) | - | 33,772 | yes |
| BOOKSUM | BookSum: A Collection of Datasets for Long-form Narrative Summarization | English | Monolingual | Litrature | Distant | Automatic | URL-based reconstruction | Narrative Summarization | 405 | - |
| NovelChapters | Exploring Content Selection in Summarization of Novel Chapters | English | Monolingual | Litrature | Naturally | Automatic | URL-based reconstruction | - | 8,088 | - |
| S2ORC extended | What’s New? Summarizing Contributions in Scientific Literature | English | Monolingual | Scientific | Dedicated | Automatic | Publicly Available (License) | - | 895523 | yes (on usefuleness) |
| GameWikiSum | GameWikiSum: a Novel Large Multi-Document Summarization Dataset | English | Monolingual | Opinions/ Arguments | Distant | Automatic | Publicly Available (License) | multi-document | 14652 | - |
| SQuALITY | SQuALITY: Building a Long-Document Summarization Dataset the Hard Wa | English | Monolingual | Litrature | Dedicated | Human | Publicly Available (License) | Question-focused summarization (QFS) | 625 | - |
| Liputan6 | Liputan6: A Large-scale Indonesian Dataset for Text Summarization | Indonesian | Monolingual | News | Naturally | Automatic | URL-based reconstruction | - | 215827 | - |
| TWEETSUMM | TWEETSUMM - A Dialog Summarization Dataset for Customer Service | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 1100 | yes |
| SumeCzech | SumeCzech: Large Czech News-Based Summarization Dataset | Czech | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1001593 | - |
| Indosum | Indosum: A New Benchmark Dataset for Indonesian Text Summarization | Indonesian | Monolingual | News | Naturally | Automatic | Publicly Available (License) | - | 18774 | - |
| VNDS | VNDS: A Vietnamese Dataset for Summarization | Vietnamese | Monolingual | News | Distant | Automatic | Publicly Available | - | 150704 | - |
| ViMs | ViMs: a high-quality Vietnamese dataset for abstractive multi-document summarization | Vietnamese | Monolingual | News | Dedicated | Human | Publicly Available | multi-document | 300 | - |
| Multi-XScience | Multi-XScience: A Large-scale Dataset for Extreme Multi-document Summarization of Scientific Articles | English | Monolingual | Scientific | Distant | Automatic | Publicly Available (License) | multi-document, writing the related-work section given the abstract and the abstract of the cited papers | 40528 | yes |
| SummScreen | SummScreen: A Dataset for Abstractive Screenplay Summarization | English | Monolingual | Dialogue | Naturally | Automatic | Publicly Available | - | 26851 | - |
| FacetSum | Bringing Structure into Summaries: a Faceted Summarization Dataset for Long Scientific Documents | English | Monolingual | Scientific | Naturally | Automatic | Publicly Available (License) | Faceted Summarization | 60,024 | - |
| ForumSum | ForumSum: A Multi-Speaker Conversation Summarization Dataset | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available | - | 4058 | - |
| QMSum | QMSum: A New Benchmark for Query-based Multi-domain Meeting Summarization | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | query based, Multi-domain | 1,808 | yes |
| Ubuntu/NYC | Summarizing Online Forum Discussions – Can Dialog Acts of Individual Messages Help? | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (Research Purposes) | Dialogue | 100 | - |
| BC3 | A Publicly Available Annotated Corpus for Supervised Email Summarization | English | Monolingual | Emails | Dedicated | Human | Publicly Available (Research Purposes) | - | 90 | - |
| MMS | Multi-modal Summarization for Asynchronous Collection of Text, Image, Audio and Video | English, Chinese | Multilingual | News | Dedicated | Human | Publicly Available | Multi-document, multimodal | 50 | - |
| CSDS | CSDS: A Fine-Grained Chinese Dataset for Customer Service Dialogue Summarization | Chinese | Monolingual | Dialogue | Dedicated | Human | Publicly Available | topic-based structural (kind of like faced) | 10,701 | - |
| HeSum | HeSum: a Novel Dataset for Abstractive Text Summarization in Hebrew | Hebrew | Monolingual | News | Distant | Automatic | Publicly Available | - | 10000 | - |
| HunSum-2 | From News to Summaries: Building a Hungarian Corpus for Extractive and Abstractive Summarization | Hungarian | Monolingual | News | Distant | Automatic | Publicly Available | - | 1817850 | - |
| OrangeSum | BARThez: a Skilled Pretrained French Sequence-to-Sequence Model | French | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 33600 | - |
| pn-summary | Leveraging parsbert and pretrained mt5 for persian abstractive text summarization | Persian | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 93,207 | - |
| ScriptBase | Movie Script Summarization as Graph-based Scene Extraction | English | Monolingual | Dialogue | Naturally | Automatic | Publicly Available | - | 1,276 | - |
| How2 | How2: a large-scale dataset for multimodal language understanding | English, Portuguese | Multilingual | Instructional | Distant | Automatic | URL-based reconstruction | Multimodal | 79,114 | - |
| MLGSum | Contrastive aligned joint learning for multilingual summarization. | German, English, Russian, French, Chinese, Hindi, Spanish, Indonesian, Turkish, Vietnamese, Ukrainian, Portuguese | Multilingual | News | Distant | Automatic | URL-based reconstruction | - | 1,168,276 | - |
| Auto-hMDS | Automatic Construction of a Large Heterogeneous Multilingual MultiDocument Summarization Corpus | German, English | Multilingual | Diverse | Distant | Automatic | URL-based reconstruction | multi-document | 7,316 | - |
| hMDS | The Next Step for Multi-Document Summarization : A Heterogeneous Multi-Genre Corpus Built with a Novel Construction Approach | English | Monolingual | Diverse | Distant | Others | URL-based reconstruction | multi-document | 1,265 | - |
| ACL TA-DA | ACL TA-DA: A Dataset for Text Summarization and Generation | English | Monolingual | Scientific | Distant | Automatic | Publicly Available | - | 22,315 | - |
| OPENASP | OPENASP: A Benchmark for Multi-document Open Aspect-based Summarization | English | Monolingual | News | Dedicated | Human | Publicly Available (License) | Multi-document, Open Aspect | 1,310 | yes |
Single-sentence summary
The summaries in these datasets range from a few words (like titles) to a lengthy sentence, composed of several dozen words. This format is sometimes referred to as "extreme summarization" or "headline generation".
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| LCSTS | LCSTS: A Large Scale Chinese Short Text Summarization Dataset | Chinese | Monolingual | Social Media | Naturally | Automatic | Upon Request | Meadure | 2,400,591 | yes |
| xlsum | XL-Sum: Large-Scale Multilingual Abstractive Summarization for 44 Languages | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Hindi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Multilingual | News | Distant | Automatic | Publicly Available (License) | - | 1,300,000 | yes |
| ilsum | FIRE 2022 ILSUM Track: Indian Language Summarization | Hindi, Gujarati, English | Multilingual | News | Naturally | Automatic | Availiable | - | 28978 | - |
| X-SCITLDR | Cross-lingual extreme summarization of scholarly documents | English, German, Italian, Chinese | Crosslingual | Scientific | Naturally | Semi-Automatic | Publicly Available (License) | - | 3,229 | - |
| X-SCITLDR | Cross-lingual extreme summarization of scholarly documents | English, Japanese | Crosslingual | Scientific | Naturally | Automatic | Publicly Available (License) | - | 2,004 | - |
| SCITLDR | TLDR: Extreme Summarization of Scientific Documents | English | Monolingual | Scientific | Naturally | Automatic | Publicly Available | - | 3,935 | - |
| SCITLDR (test set) | TLDR: Extreme Summarization of Scientific Documents | English | Monolingual | Scientific | Dedicated | Semi-Automatic | Publicly Available | - | 1,237 | - |
| ACLSum | ACLSum: A New Dataset for Aspect-based Summarization of Scientific Publications | English | Monolingual | Scientific | Dedicated | Human | Publicly Available | Multiaspect Summarization | 250 | yes |
| CCSum | CCSum: A Large-Scale and High-Quality Dataset for Abstractive News Summarization | English | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 1,369,911 | yes |
| PMIndiaSum | PMIndiaSum: Multilingual and Cross-lingual Headline Summarization for Languages in India | Kannada, Malayalam, Tamil, Telugu, Assamese, Bengali, Gujarati, Hindi, Marathi, Oriya, Panjabi, Urdu, English, Manipuri | Multilingual | News | Naturally | Automatic | Publicly Available (License) | - | 76,680 | - |
| CrossSum | CrossSum: Beyond English-Centric Cross-Lingual Summarization for 1,500+ Language Pairs | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Indi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Crosslingual | News | Naturally | Automatic | Publicly Available (License) | - | 1680000 | yes (for the allignment) |
| MM-CLS | MCLS: A Large-Scale Multimodal Cross-Lingual Summarization Dataset | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Indi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Crosslingual | News | Naturally | Automatic | ???? | Multimodal Summarization, Cl | 1,100,000 | - |
| Gigaword | Annotated Gigaword | English | Monolingual | News | Distant | Automatic | Publicly Available | sentence-level summarization. | 4000000 | - |
| This Email Could Save Your Life: Introducing the Task of Email Subject Line Generation | English | Monolingual | Emails | Dedicated | Human | Publicly Available (License) | Email Subject Line Generation | 18302 | - | |
| Rotten Tomatoes | Neural network-based abstract generation for opinions and arguments. | English | Monolingual | Opinions/ Arguments | Naturally | Automatic | Publicly Available | Claim Generation | 3,731 | - |
| Idebate | Neural network-based abstract generation for opinions and arguments. | English | Monolingual | Opinions/ Arguments | Naturally | Automatic | Publicly Available | Claim Generation | 17359 | - |
| Reddit TIFU (extreme) | Abstractive Summarization of Reddit Posts with Multi-level Memory Networks | English | Monolingual | Social Media | Naturally | Automatic | Publicly Available (License) | Tldr Od Posts Or Their Title, Written By The User Who Wrote The Reddit Post | 122933 | - |
| XSum | Don’t give me the details, just the summary! topic-aware convolutional neural networks for extreme summarization. | English | Monolingual | News | Distant | Automatic | Publicly Available | - | 226711 | - |
| MeQSum | On the Summarization of Consumer Health Questions | English | Monolingual | Medical | Dedicated | Human | Publicly Available (License) | Chq Summarization | 1,000 | - |
| CHQ-Summ | CHQ-Summ: A DATASET FOR CONSUMER HEALTHCARE QUESTION SUMMARIZATION | English | Monolingual | Medical | Dedicated | Human | URL-based reconstruction | Chq Summarization | 1,507 | - |
| WikiDes | WikiDes: A Wikipedia-Based Dataset for Generating Short Descriptions from Paragraphs | English | Monolingual | Encyclopedia | Distant | Automatic | Publicly Available (License) | - | 81419 | - |
| SumeCzech (extreme ) | SumeCzech: Large Czech News-Based Summarization Dataset | Czech | Monolingual | News | Distant | Automatic | URL-based reconstruction | - | 1001593 | - |
| MMSS | Multi-modal Sentence Summarization with Modality Attention and Image Filtering | English | Monolingual | News | Distant | Automatic | Publicly Available | Multimodal | 66,000 | - |
| MM-Sum | Summary-Oriented Vision Modeling for Multimodal Abstractive Summarization | Amharic, Arabic, Azerbaijani, Bengali, Burmese, Chinese, Chinese, English, French, Gujarati, Hausa, Hindi, Igbo, Indonesian, Japanese, Rundi, Korean, Kirghiz, Marathi, Nepali, Oromo, Pashto, Persian, West African Pidgin English, Portuguese, Panjabi, Russian, Scottish Gaelic, Scottish Gaelic, Serbian, Serbian, Sinhala, Somali, Spanish, Swahili, Tamil, Telugu, Thai, Tigrinya, Turkish, Ukrainian, Urdu, Uzbek, Vietnamese, Welsh, Yoruba | Multilingual | News | Distant | Automatic | Publicly Available | Multimodal | 1,078,215 | - |
| MultiSumm | MultiSumm: Towards a Unified Model for Multi-Lingual Abstractive Summarization | Bosnian, Croatian | Multilingual | News | Distant | Automatic | Publicly Available | - | 382154 | - |
| OrangeSum | BARThez: a Skilled Pretrained French Sequence-to-Sequence Model | French | Monolingual | News | Distant | Automatic | Publicly Available (License) | - | 33600 | - |
| M3LS | Large Scale Multi-Lingual Multi-Modal Summarization Dataset | English, Chinese, Spanish, Russian, French, Ukrainian, Portuguese, Japanese, Tamil, Hindi, Marathi, Gujarati, Bengali, Sinhala, Urdu, Pashto, Indonesian, Telugu, Panjabi, Nepali | Multilingual | News | Distant | Automatic | Publicly Available (License) | Multimodal | 1,100,000 | yes |
| VMSMO | Vmsmo: Learning to generate multimodal summary for video-based news articles | Chinese | Monolingual | News | Naturally | Automatic | Publicly Available | Multimodal | 184,920 | - |
Highlights
The summaries in these datasets are constructed from a few, possibly independent sentences. For example, they could be bullet points (e.g., from news articles).
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN/daily mail | Neural Summarization by Extracting Sentences and Words | English | Monolingual | News | Naturally | Automatic | Publicly Available (License) | - | 312085 | - |
| EUR-Lex-Sum (English) | Summarizing Legal Regulatory Documents using Transformers | English | Monolingual | Legal | Naturally | Automatic | Publicly Available | - | 4,595 | - |
| EUR-Lex-Sum (Multilingual) | EUR-Lex-Sum: A Multi- and Cross-lingual Dataset for Long-form Summarization in the Legal Domain | English, German, Italian, Portuguese, Dutch, Danish, Modern Greek, Finnish, Swedish, Romanian, Hungarian, Czech, Polish, Bulgarian, Latvian, Slovenian, Estonian, Lithuanian, Slovak, Maltese, Croatian, Irish | Multilingual | Legal | Naturally | Automatic | Publicly Available | - | 1,500 | - |
| WikiLingua | WikiLingua: A New Benchmark Dataset for Cross-Lingual Abstractive Summarization | English, Spanish, Portuguese, French, German, Russian, Italian, Indonesian, Dutch, Arabic, Chinese, Vietnamese, Thai, Japanese, Korean, Hindi, Czech, Turkish | Crosslingual | Instructional | Distant | Automatic | Publicly Available (License) | - | 141,457 | - |
| WikiHow | WikiHow: A Large Scale Text Summarization Dataset | English | Monolingual | Instructional | Distant | Automatic | Publicly Available (License) | - | 204, 004 | - |
| WG/USAToday-CNN | Utilizing microblogs for automatic news highlights extraction. | English | Monolingual | News | Distant | Automatic | Publicly Available | news-tweets coupling,news highlights production | 121 | - |
| NCLS | NCLS: Neural Cross-Lingual Summarization | English, Chinese | Crosslingual | News | Naturally | Automatic | Publicly Available | - | 2,070,400 | - |
| MSMO | MSMO: Multimodal Summarization with Multimodal Output | English | Monolingual | News | Naturally | Automatic | Publicly Available | Multimodal Input And Output | 314581 | - |
| E-DailyMail | Abstractive Text-Image Summarization Using Multi-Modal Attentional Hierarchical RNN | English | Monolingual | News | Naturally | Automatic | ????? | Multimodal | 219100 | - |
| 20 Minuten (bigger) | 20 Minuten: A Multi-task News Summarisation Dataset for German | German | Monolingual | News | Naturally | Automatic | Publicly Available (License) | - | 51,357 | - |
| CSPubSum | A supervised approach to extractive summarisation of scientific papers. | English | Monolingual | Scientific | Naturally | Automatic | URL-based reconstruction | - | 10148 | - |
Span Summarries
These datasets use spans of text directly taken from the document as summaries.
| Dataset Name | Paper | Languages | Language Modality | Domain | Supervision | Annotation Efforts | Availability | Sub-Task | #Samples | Human Eval On Data |
|---|---|---|---|---|---|---|---|---|---|---|
| EASC | Using Mechanical Turk to Create a Corpus of Arabic Summaries | Arabic | Monolingual | Diverse | Dedicated | Human | Publicly Available | - | 765 | - |
| ACLSum (extractive) | ACLSum: A New Dataset for Aspect-based Summarization of Scientific Publications | English | Monolingual | Scientific | Dedicated | Human | Publicly Available | Multiaspect Summarization | 250 | yes |
| VCSUM (extractive) | VCSUM: A Versatile Chinese Meeting Summarization Dataset | Chinese | Monolingual | Dialogue | Dedicated | Human | Publicly Available | Meeting | 239 | - |
| CAST | Building better corpora for summarisation | English | Monolingual | Diverse | Dedicated | Human | Publicly Available (License) | - | 163 | - |
| The CNN-Corpus | The CNN-Corpus: A Large Textual Corpus for Single-Document Extractive Summarization | English | Monolingual | News | Dedicated | Semi-Automatic | Publicly Available (License) | - | 3000 | - |
| KALIMAT | KALIMAT a Multipurpose Arabic Corpus | Arabic | Monolingual | News | Dedicated | Automatic | Publicly Available | Multidocument Summarization (Small Part Of 2057 Articles) | 20,291 | - |
| Webis-EditorialSum-2020 | News Editorials: Towards Summarizing Long Argumentative Texts | English | Monolingual | Opinions/ Arguments | Dedicated | Human | Publicly Available | Opinionated Texts | 266 | yes |
| QBSUM | QBSUM: a Large-Scale Query-Based Document Summarization Dataset from Real-world Applications | Chinese | Monolingual | News | Dedicated | Human | Publicly Available | Query-Based | 49,535 | - |
| AMI | The AMI Meeting Corpus | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 100 | - |
| TWEETSUMM (extractive ) | TWEETSUMM - A Dialog Summarization Dataset for Customer Service | English | Monolingual | Dialogue | Dedicated | Human | Publicly Available (License) | - | 1100 | yes |
| DebateSum | DebateSum: A large-scale argument mining and summarization dataset | English | Monolingual | Opinions/ Arguments | Naturally | Automatic |
Truncated — view the full README on GitHub.