Hailo H10 NPU 탑재 소형 LLM(1~2B)을 위한 RAG 추론 엔진과, 이를 서빙하는 FastAPI 백엔드 + React 대시보드.
헬기 정비 도메인 문서를 기반으로 하이브리드 RAG 파이프라인을 구성하고, 대시보드를 통해 실시간 RAG 챗봇 시연 및 모델별 답변 품질 비교를 지원한다.
| 모듈 | 설명 |
|---|---|
mrod_engine/ | RAG 추론 엔진 코어 패키지 — 모델 로드, 검색, 라우팅, 생성, 스트리밍 |
dashboard/backend/ | FastAPI 서버 — REST API + SSE 스트리밍, 프론트엔드 연결 |
dashboard/frontend/ | Vite + React + TS — 4탭 실시간 대시보드 |
test_qa_rag.py | 탑재 모델 선정용 QA 생성 스크립트 |
judge_qa.py | LLM Judge 자동 채점 스크립트 |
data/ | 청크 스토어 + ChromaDB + BM25 인덱스 |
results_qa/ | 모델별 평가 결과 JSON |
백엔드와 평가 스크립트가 공통으로 사용하는 추론 엔진 코어. FastAPI 의존 없음.
| 기능 | 구현 |
|---|---|
| GPU / CPU 백엔드 전환 | select_backend() — 런타임 hot-swap, 이전 모델 자동 언로드 |
| 모델 로드/언로드 | HuggingFace Transformers(FP16 GPU) + llama-cpp-python(GGUF CPU) 이중 경로 |
| JSON 강제 디코딩 | lm-format-enforcer — 라우터 출력을 토큰 단위로 JSON 스키마 강제 |
| 스트리밍 생성 | TextIteratorStreamer — 별도 스레드에서 토큰 델타 yield, SSE는 서빙 레이어 담당 |
| 보일러플레이트 필터 | 표지·목차·저작권 페이지 정규식 자동 제거 (is_boilerplate()) |
| 쿼리 라우팅 | 스몰토크 분류 + 검색 질의 재작성 (최근 4턴 컨텍스트 반영) |
BM25 (ko_kiwi, top10)    ─┐
KURE-v1 semantic (top10) ─┤ HybridCC (mm 정규화, 0.7/0.3) → top3
                           │
                           ▼
                  child ID → parent 원문 교환 → 컨텍스트 주입
GET  /api/health              GPU 상태·로드 모델·RAG 준비 여부
GET  /api/backend             현재 backend(gpu/cpu) 조회
POST /api/backend/select      backend 전환
GET  /api/models              후보 모델 목록
POST /api/models/select       모델 로드 (이전 모델 자동 언로드)
POST /api/chat                질문 → 답변 + RAG 참고 문서 (단건 JSON)
POST /api/chat/stream         질문 → 답변 토큰 SSE 스트리밍
GET  /api/sessions            전체 세션 이력
GET  /api/judge/analyze       Judge 채점 결과 집계
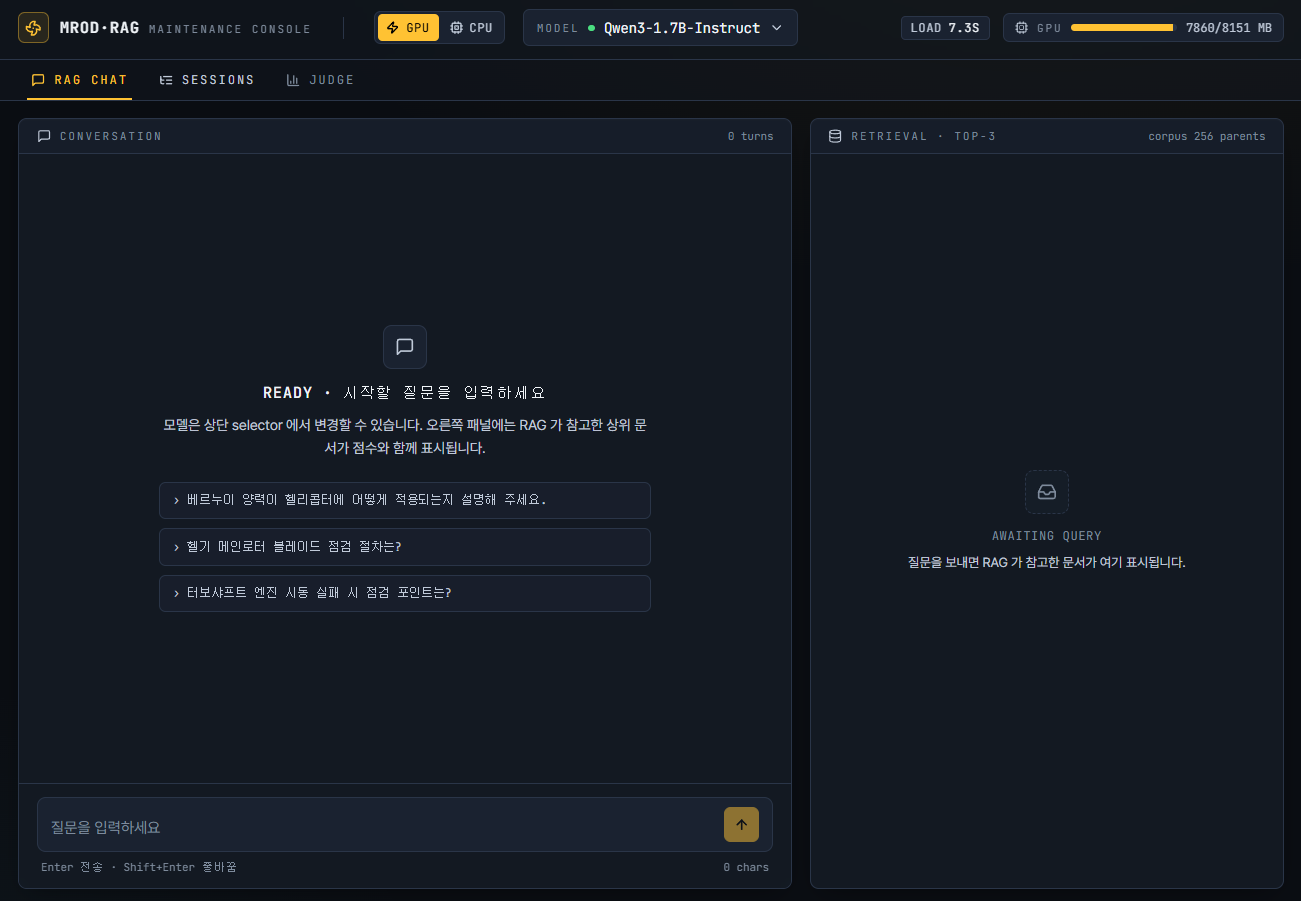
| 탭 / 패널 | 기능 |
|---|---|
| RAG CHAT | 대화 패널, 예시 질문 버튼 3개, Enter 전송 / Shift+Enter 줄바꿈 |
| RETRIEVAL | RAG 검색 근거 TOP-3 원문 + 유사도 점수 실시간 표시 |
| SESSIONS | 전체 세션 대화 이력 조회 (모니터링) |
| JUDGE | 모델별 LLM Judge 채점 결과 (정확성·근거·관련성·완성도 1~5점) |
| 헤더 | GPU/CPU 토글 · 모델 드롭다운 · 로드 시간 · VRAM 사용량 실시간 |
| 모델 | 파라미터 |
|---|---|
| Qwen3-1.7B-Instruct | 1.7B |
| Qwen2.5-1.5B-Instruct | 1.5B |
| Qwen2-1.5B-Instruct | 1.5B |
| Qwen2-1.5B-Instruct-Function-Calling-v1 | 1.5B |
| Qwen2.5-Coder-1.5B-Instruct | 1.5B |
| Llama-3.2-1B-Instruct | 1B (gated) |
Hailo-RAG-Engine/
├── mrod_engine/
│   ├── engine.py          # 추론 엔진 코어 (라우팅·생성·스트리밍·RAG)
│   ├── rag_pipeline.py    # HybridRagPipeline (KURE + BM25 + HybridCC)
│   ├── llama_runner.py    # CPU(GGUF) 경로
│   ├── prompts.py         # 시스템 프롬프트
│   ├── schemas.py         # ROUTER_SCHEMA (JSON 강제 디코딩용)
│   └── config.py
├── dashboard/
│   ├── backend/
│   │   ├── main.py              # FastAPI 진입점 (REST + SSE)
│   │   ├── build_kure_index.py  # ChromaDB + BM25 인덱스 빌드 (1회)
│   │   └── results.py           # Judge 결과 조회
│   ├── frontend/                # Vite + React + TypeScript + Tailwind
│   ├── README.md
│   └── RAGCHAT_API.md
├── data/
│   ├── parent_store.json        # parent 청크 원문 + 메타
│   ├── child_store.json         # child 청크 (인덱스 재빌드 입력)
│   ├── chroma_kure_v1/          # KURE-v1 ChromaDB (child) — git 제외
│   └── bm25_kiwi_store/         # BM25 ko_kiwi 인덱스 — git 제외
├── docs/
│   ├── API_SPEC.md
│   ├── BACKEND.md
│   └── screenshot_dashboard.png
├── results_qa/                  # 모델별 평가 결과 JSON
├── test_qa_rag.py               # 모델 선정용 QA 생성
├── judge_qa.py                  # LLM Judge 채점
├── EXPO_PLAN_D7.md
├── requirements.txt
└── .env.example
python -m venv venv

# GPU (CUDA 12.1)
venv/Scripts/pip install torch==2.5.1 --index-url https://download.pytorch.org/whl/cu121
venv/Scripts/pip install -r requirements.txt
cp .env.example .env
# HF_TOKEN=hf_...   (Llama-3.2-1B 사용 시)
venv/Scripts/python dashboard/backend/build_kure_index.py
# 백엔드
cd dashboard/backend && ../../venv/Scripts/python main.py

# 프론트엔드 (별도 터미널)
cd dashboard/frontend && npm install && npm run dev
| 구분 | 내용 |
|---|---|
| LLM 실행 | HuggingFace Transformers (FP16) / llama-cpp-python (GGUF) |
| 임베딩 | nlpai-lab/KURE-v1 |
| 형태소 분석 | kiwipiepy (BM25 한국어 토크나이징) |
| 벡터 DB | ChromaDB |
| 형식 강제 | lm-format-enforcer |
| 백엔드 | FastAPI + Uvicorn |
| 프론트엔드 | Vite + React + TypeScript + Tailwind CSS |
Hailo H10 NPU 탑재 소형 LLM(1~2B)을 위한 RAG 추론 엔진과, 이를 서빙하는 FastAPI 백엔드 + React 대시보드.
헬기 정비 도메인 문서를 기반으로 하이브리드 RAG 파이프라인을 구성하고, 대시보드를 통해 실시간 RAG 챗봇 시연 및 모델별 답변 품질 비교를 지원한다.
| 모듈 | 설명 |
|---|---|
mrod_engine/ | RAG 추론 엔진 코어 패키지 — 모델 로드, 검색, 라우팅, 생성, 스트리밍 |
dashboard/backend/ | FastAPI 서버 — REST API + SSE 스트리밍, 프론트엔드 연결 |
dashboard/frontend/ | Vite + React + TS — 4탭 실시간 대시보드 |
test_qa_rag.py | 탑재 모델 선정용 QA 생성 스크립트 |
judge_qa.py | LLM Judge 자동 채점 스크립트 |
data/ | 청크 스토어 + ChromaDB + BM25 인덱스 |
results_qa/ | 모델별 평가 결과 JSON |
백엔드와 평가 스크립트가 공통으로 사용하는 추론 엔진 코어. FastAPI 의존 없음.
| 기능 | 구현 |
|---|---|
| GPU / CPU 백엔드 전환 | select_backend() — 런타임 hot-swap, 이전 모델 자동 언로드 |
| 모델 로드/언로드 | HuggingFace Transformers(FP16 GPU) + llama-cpp-python(GGUF CPU) 이중 경로 |
| JSON 강제 디코딩 | lm-format-enforcer — 라우터 출력을 토큰 단위로 JSON 스키마 강제 |
| 스트리밍 생성 | TextIteratorStreamer — 별도 스레드에서 토큰 델타 yield, SSE는 서빙 레이어 담당 |
| 보일러플레이트 필터 | 표지·목차·저작권 페이지 정규식 자동 제거 (is_boilerplate()) |
| 쿼리 라우팅 | 스몰토크 분류 + 검색 질의 재작성 (최근 4턴 컨텍스트 반영) |
BM25 (ko_kiwi, top10)    ─┐
KURE-v1 semantic (top10) ─┤ HybridCC (mm 정규화, 0.7/0.3) → top3
                           │
                           ▼
                  child ID → parent 원문 교환 → 컨텍스트 주입
GET  /api/health              GPU 상태·로드 모델·RAG 준비 여부
GET  /api/backend             현재 backend(gpu/cpu) 조회
POST /api/backend/select      backend 전환
GET  /api/models              후보 모델 목록
POST /api/models/select       모델 로드 (이전 모델 자동 언로드)
POST /api/chat                질문 → 답변 + RAG 참고 문서 (단건 JSON)
POST /api/chat/stream         질문 → 답변 토큰 SSE 스트리밍
GET  /api/sessions            전체 세션 이력
GET  /api/judge/analyze       Judge 채점 결과 집계
| 탭 / 패널 | 기능 |
|---|---|
| RAG CHAT | 대화 패널, 예시 질문 버튼 3개, Enter 전송 / Shift+Enter 줄바꿈 |
| RETRIEVAL | RAG 검색 근거 TOP-3 원문 + 유사도 점수 실시간 표시 |
| SESSIONS | 전체 세션 대화 이력 조회 (모니터링) |
| JUDGE | 모델별 LLM Judge 채점 결과 (정확성·근거·관련성·완성도 1~5점) |
| 헤더 | GPU/CPU 토글 · 모델 드롭다운 · 로드 시간 · VRAM 사용량 실시간 |
| 모델 | 파라미터 |
|---|---|
| Qwen3-1.7B-Instruct | 1.7B |
| Qwen2.5-1.5B-Instruct | 1.5B |
| Qwen2-1.5B-Instruct | 1.5B |
| Qwen2-1.5B-Instruct-Function-Calling-v1 | 1.5B |
| Qwen2.5-Coder-1.5B-Instruct | 1.5B |
| Llama-3.2-1B-Instruct | 1B (gated) |
Hailo-RAG-Engine/
├── mrod_engine/
│   ├── engine.py          # 추론 엔진 코어 (라우팅·생성·스트리밍·RAG)
│   ├── rag_pipeline.py    # HybridRagPipeline (KURE + BM25 + HybridCC)
│   ├── llama_runner.py    # CPU(GGUF) 경로
│   ├── prompts.py         # 시스템 프롬프트
│   ├── schemas.py         # ROUTER_SCHEMA (JSON 강제 디코딩용)
│   └── config.py
├── dashboard/
│   ├── backend/
│   │   ├── main.py              # FastAPI 진입점 (REST + SSE)
│   │   ├── build_kure_index.py  # ChromaDB + BM25 인덱스 빌드 (1회)
│   │   └── results.py           # Judge 결과 조회
│   ├── frontend/                # Vite + React + TypeScript + Tailwind
│   ├── README.md
│   └── RAGCHAT_API.md
├── data/
│   ├── parent_store.json        # parent 청크 원문 + 메타
│   ├── child_store.json         # child 청크 (인덱스 재빌드 입력)
│   ├── chroma_kure_v1/          # KURE-v1 ChromaDB (child) — git 제외
│   └── bm25_kiwi_store/         # BM25 ko_kiwi 인덱스 — git 제외
├── docs/
│   ├── API_SPEC.md
│   ├── BACKEND.md
│   └── screenshot_dashboard.png
├── results_qa/                  # 모델별 평가 결과 JSON
├── test_qa_rag.py               # 모델 선정용 QA 생성
├── judge_qa.py                  # LLM Judge 채점
├── EXPO_PLAN_D7.md
├── requirements.txt
└── .env.example
python -m venv venv

# GPU (CUDA 12.1)
venv/Scripts/pip install torch==2.5.1 --index-url https://download.pytorch.org/whl/cu121
venv/Scripts/pip install -r requirements.txt
cp .env.example .env
# HF_TOKEN=hf_...   (Llama-3.2-1B 사용 시)
venv/Scripts/python dashboard/backend/build_kure_index.py
# 백엔드
cd dashboard/backend && ../../venv/Scripts/python main.py

# 프론트엔드 (별도 터미널)
cd dashboard/frontend && npm install && npm run dev
| 구분 | 내용 |
|---|---|
| LLM 실행 | HuggingFace Transformers (FP16) / llama-cpp-python (GGUF) |
| 임베딩 | nlpai-lab/KURE-v1 |
| 형태소 분석 | kiwipiepy (BM25 한국어 토크나이징) |
| 벡터 DB | ChromaDB |
| 형식 강제 | lm-format-enforcer |
| 백엔드 | FastAPI + Uvicorn |
| 프론트엔드 | Vite + React + TypeScript + Tailwind CSS |



