🌟100+ 原创 LLM / RL 原理图📚,《大模型算法》作者巨献!💥(100+ LLM/RL Algorithm Maps )
See the code


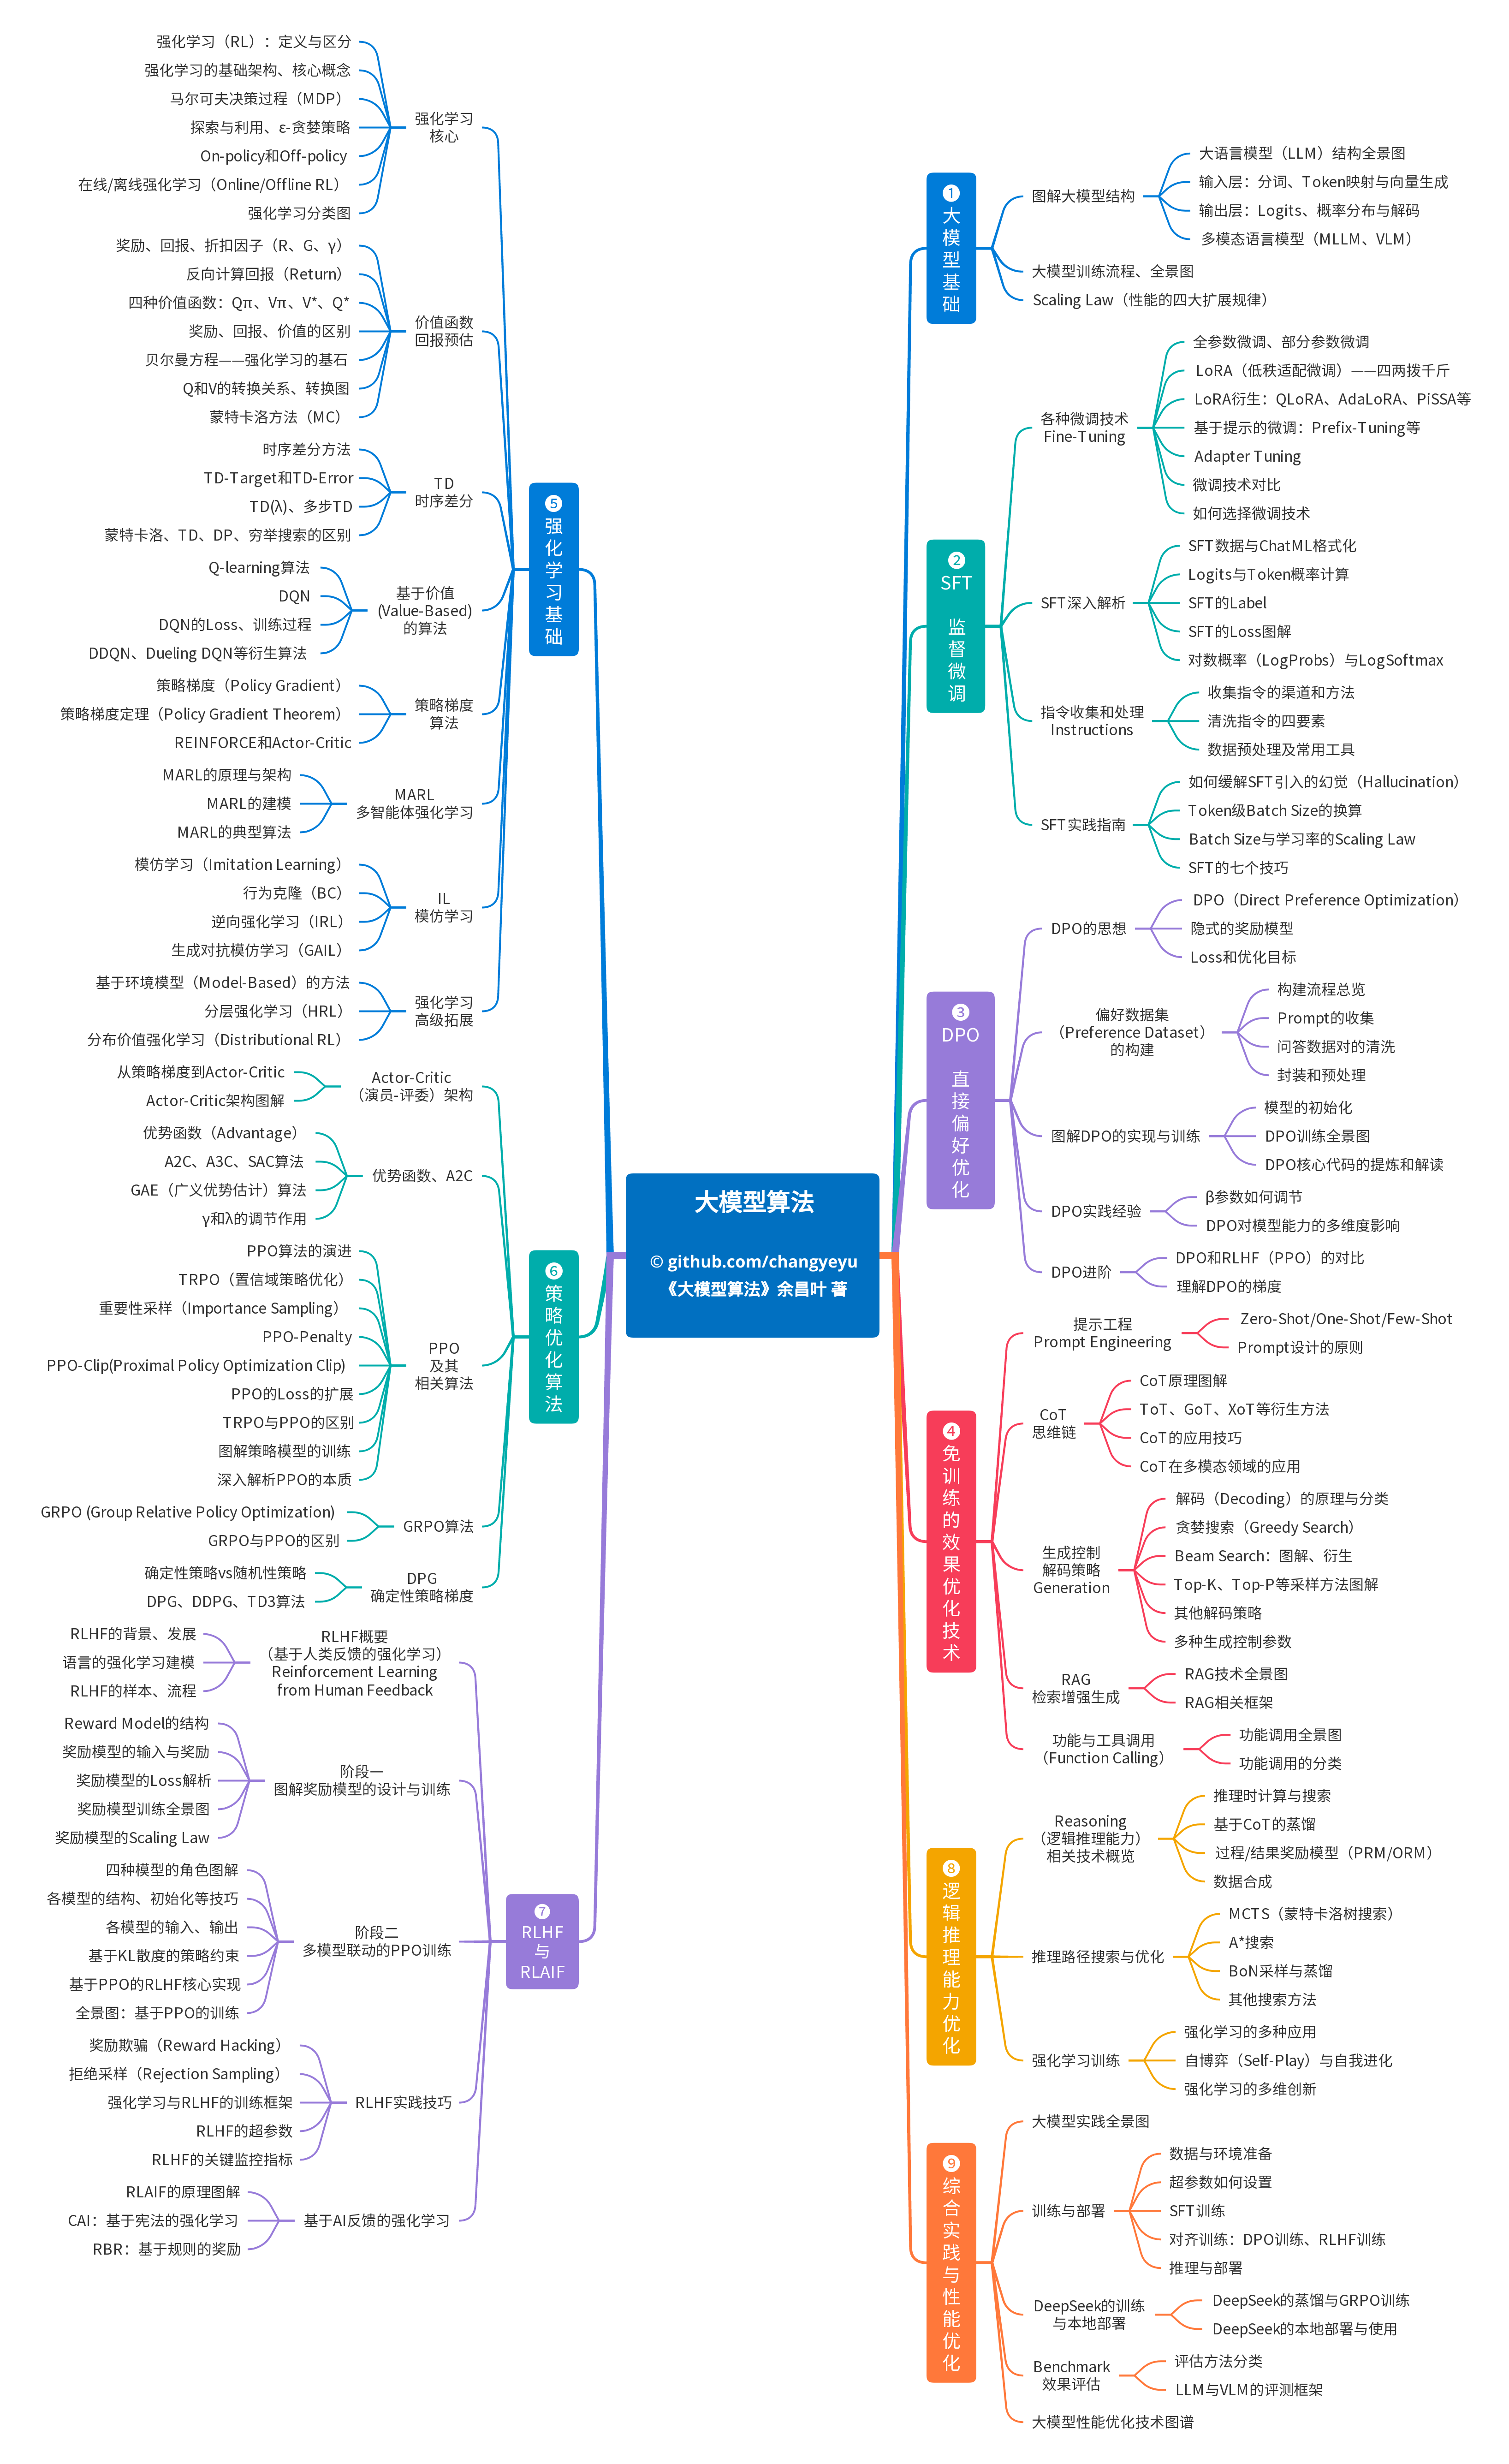
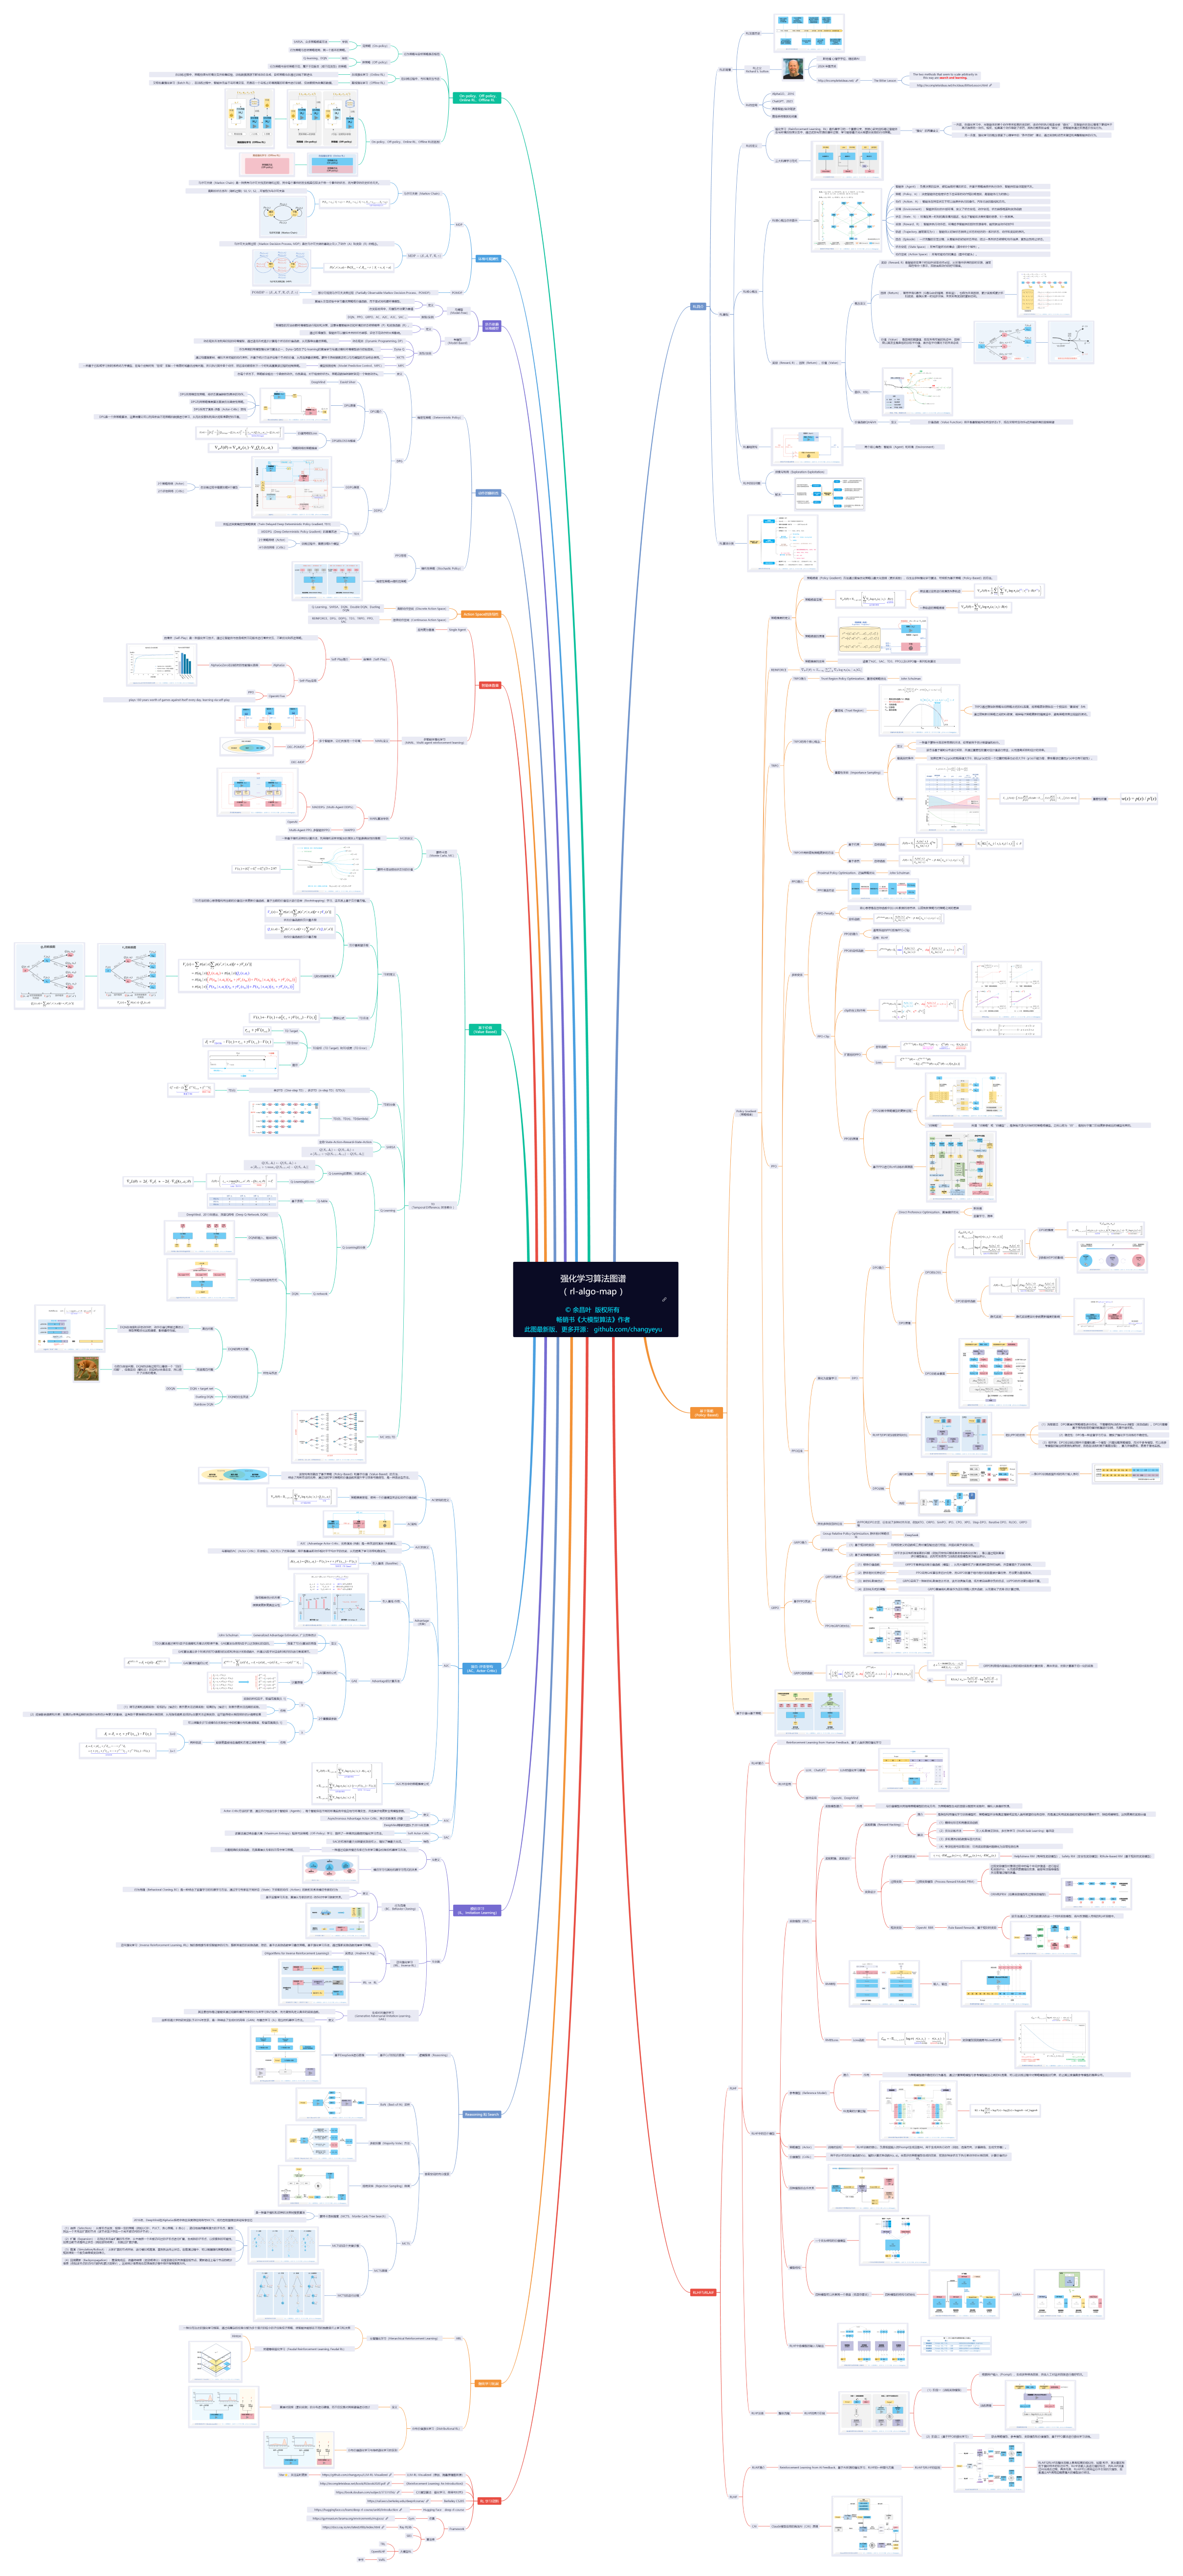
🎉 原创 100+ 架构图,系统讲解大模型、强化学习,涵盖:LLM / VLM 等大模型原理、训练算法(RL、RLHF、GRPO、DPO、SFT 与 CoT 蒸馏等)、效果优化与 RAG 等。
🎉 关于架构图更详细的解读可参考:《大模型算法:强化学习、微调与对齐》 (豆瓣高分,多次京东AI图书Top 5 !)
🎉 本仓库长期勘误、追加,欢迎点击仓库顶部的 Star ⭐ 关注,感谢鼓励✨
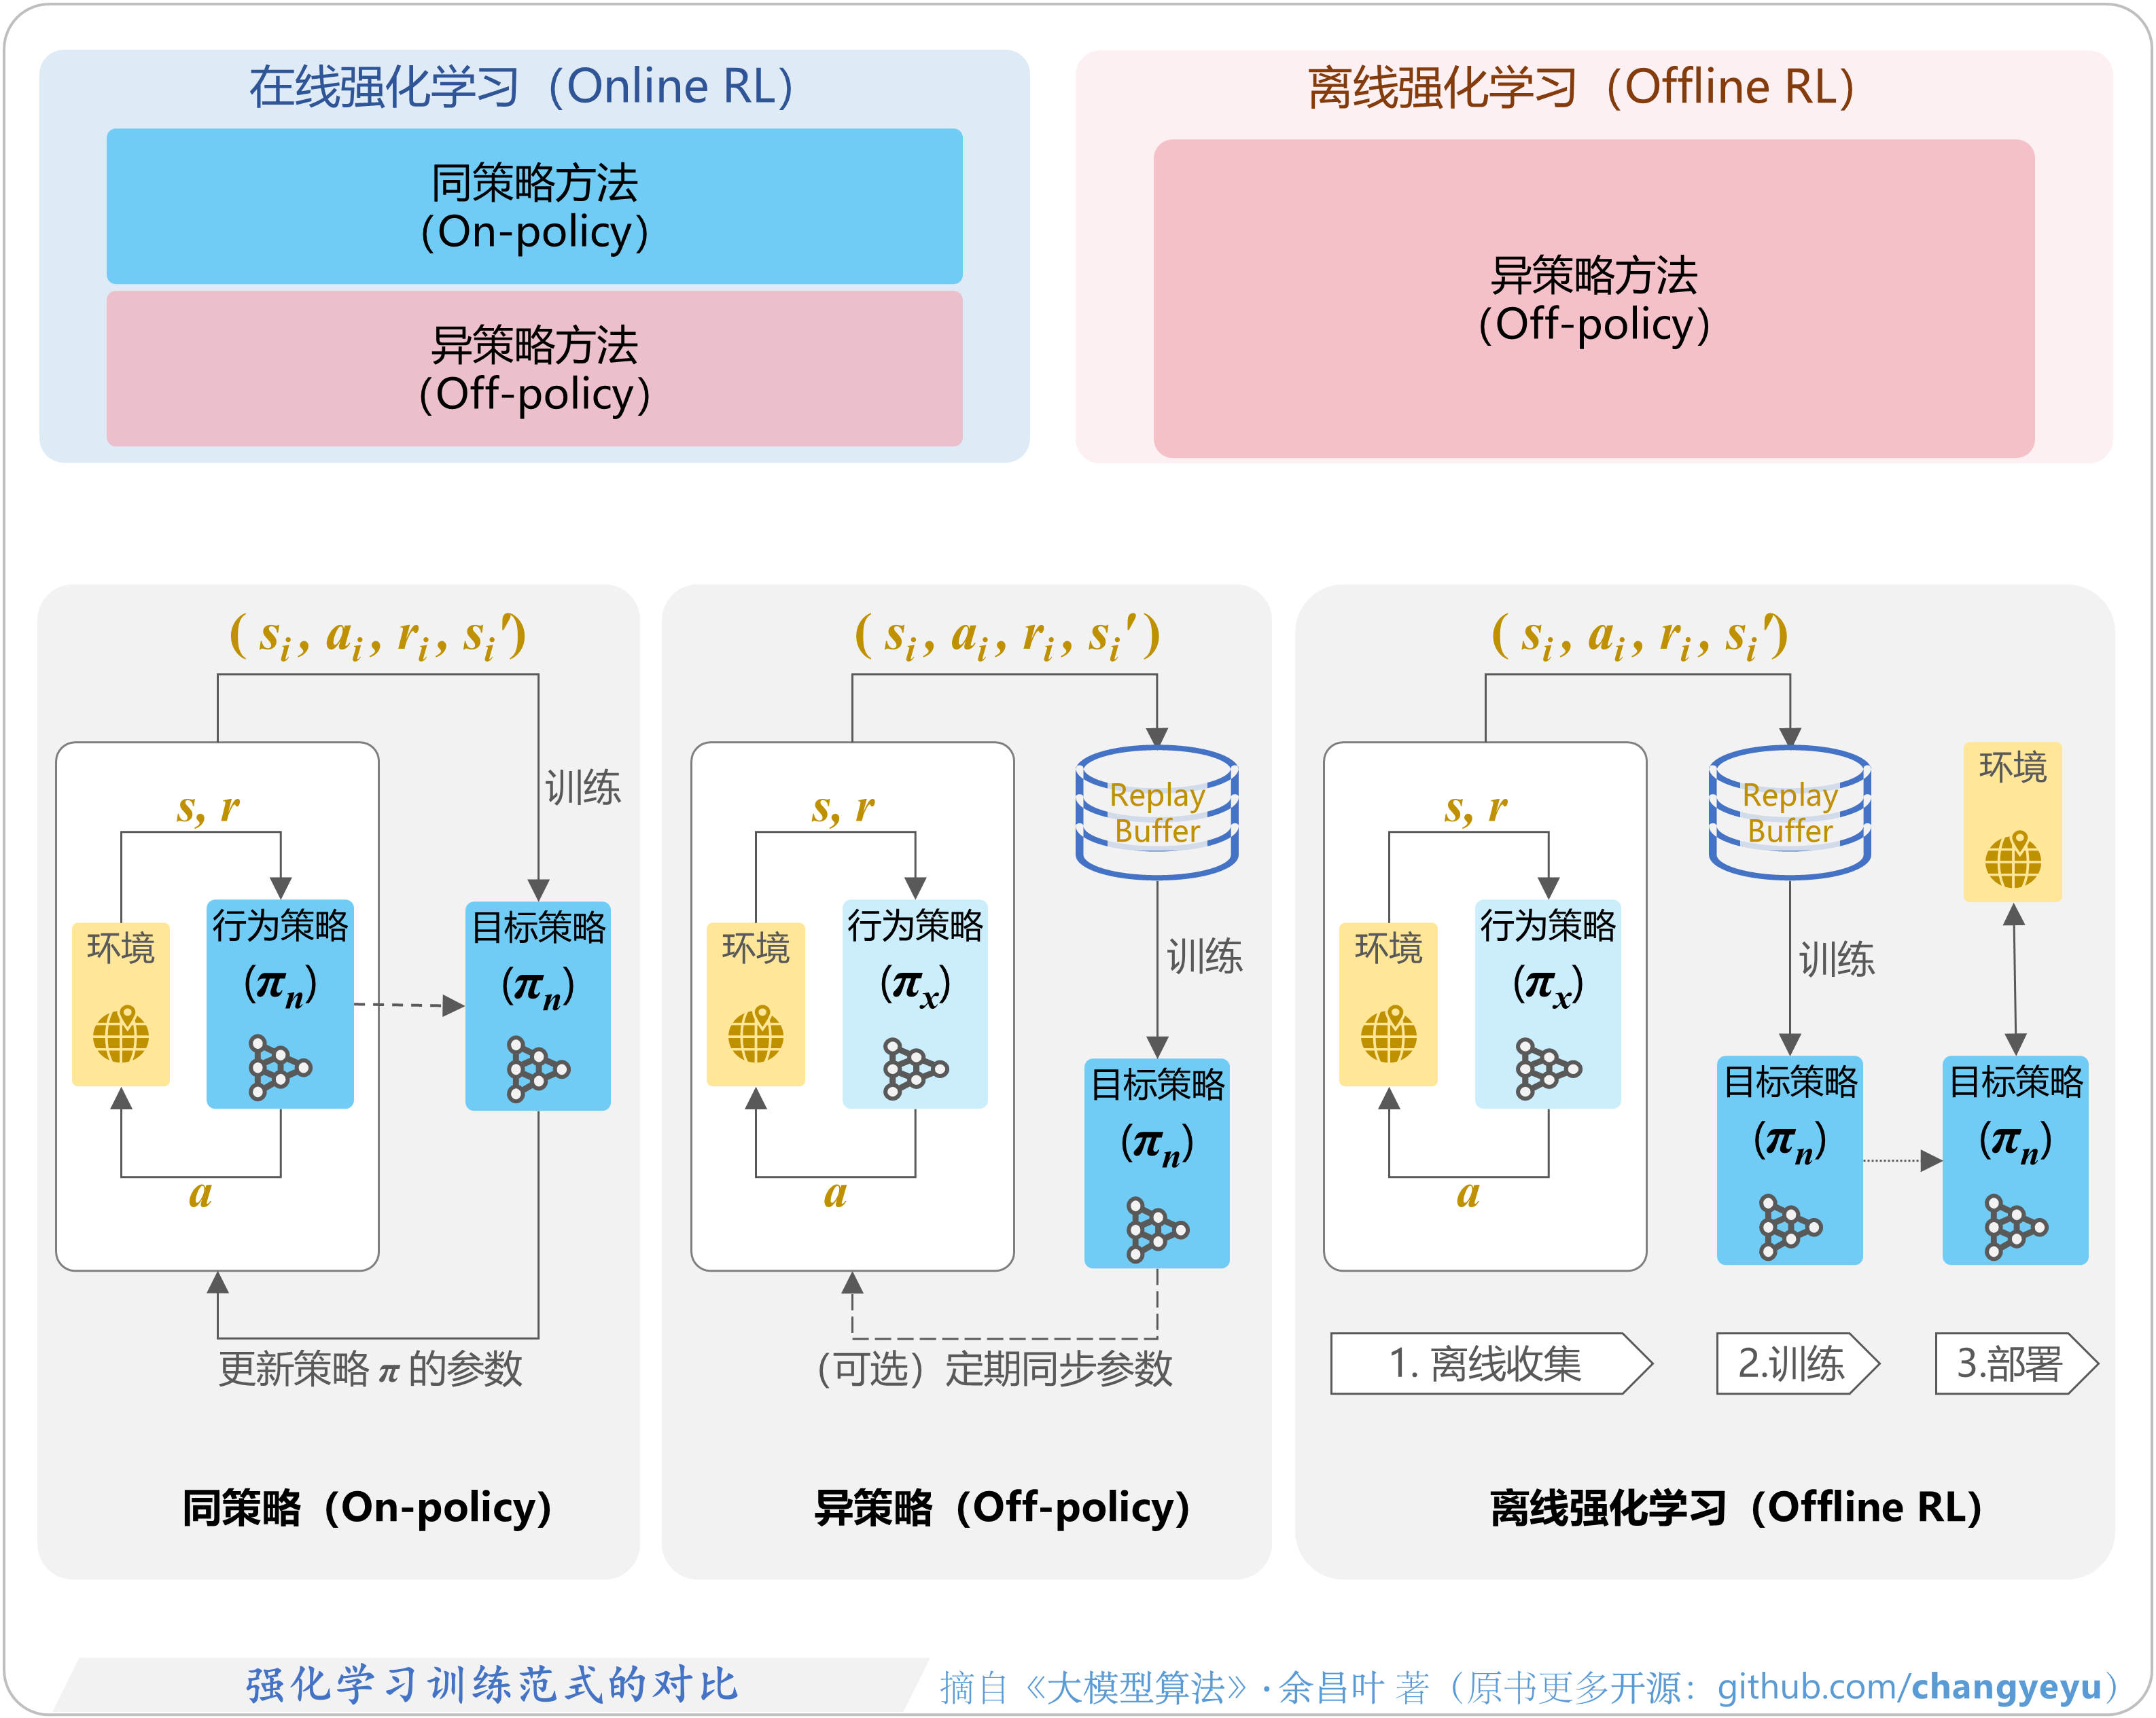
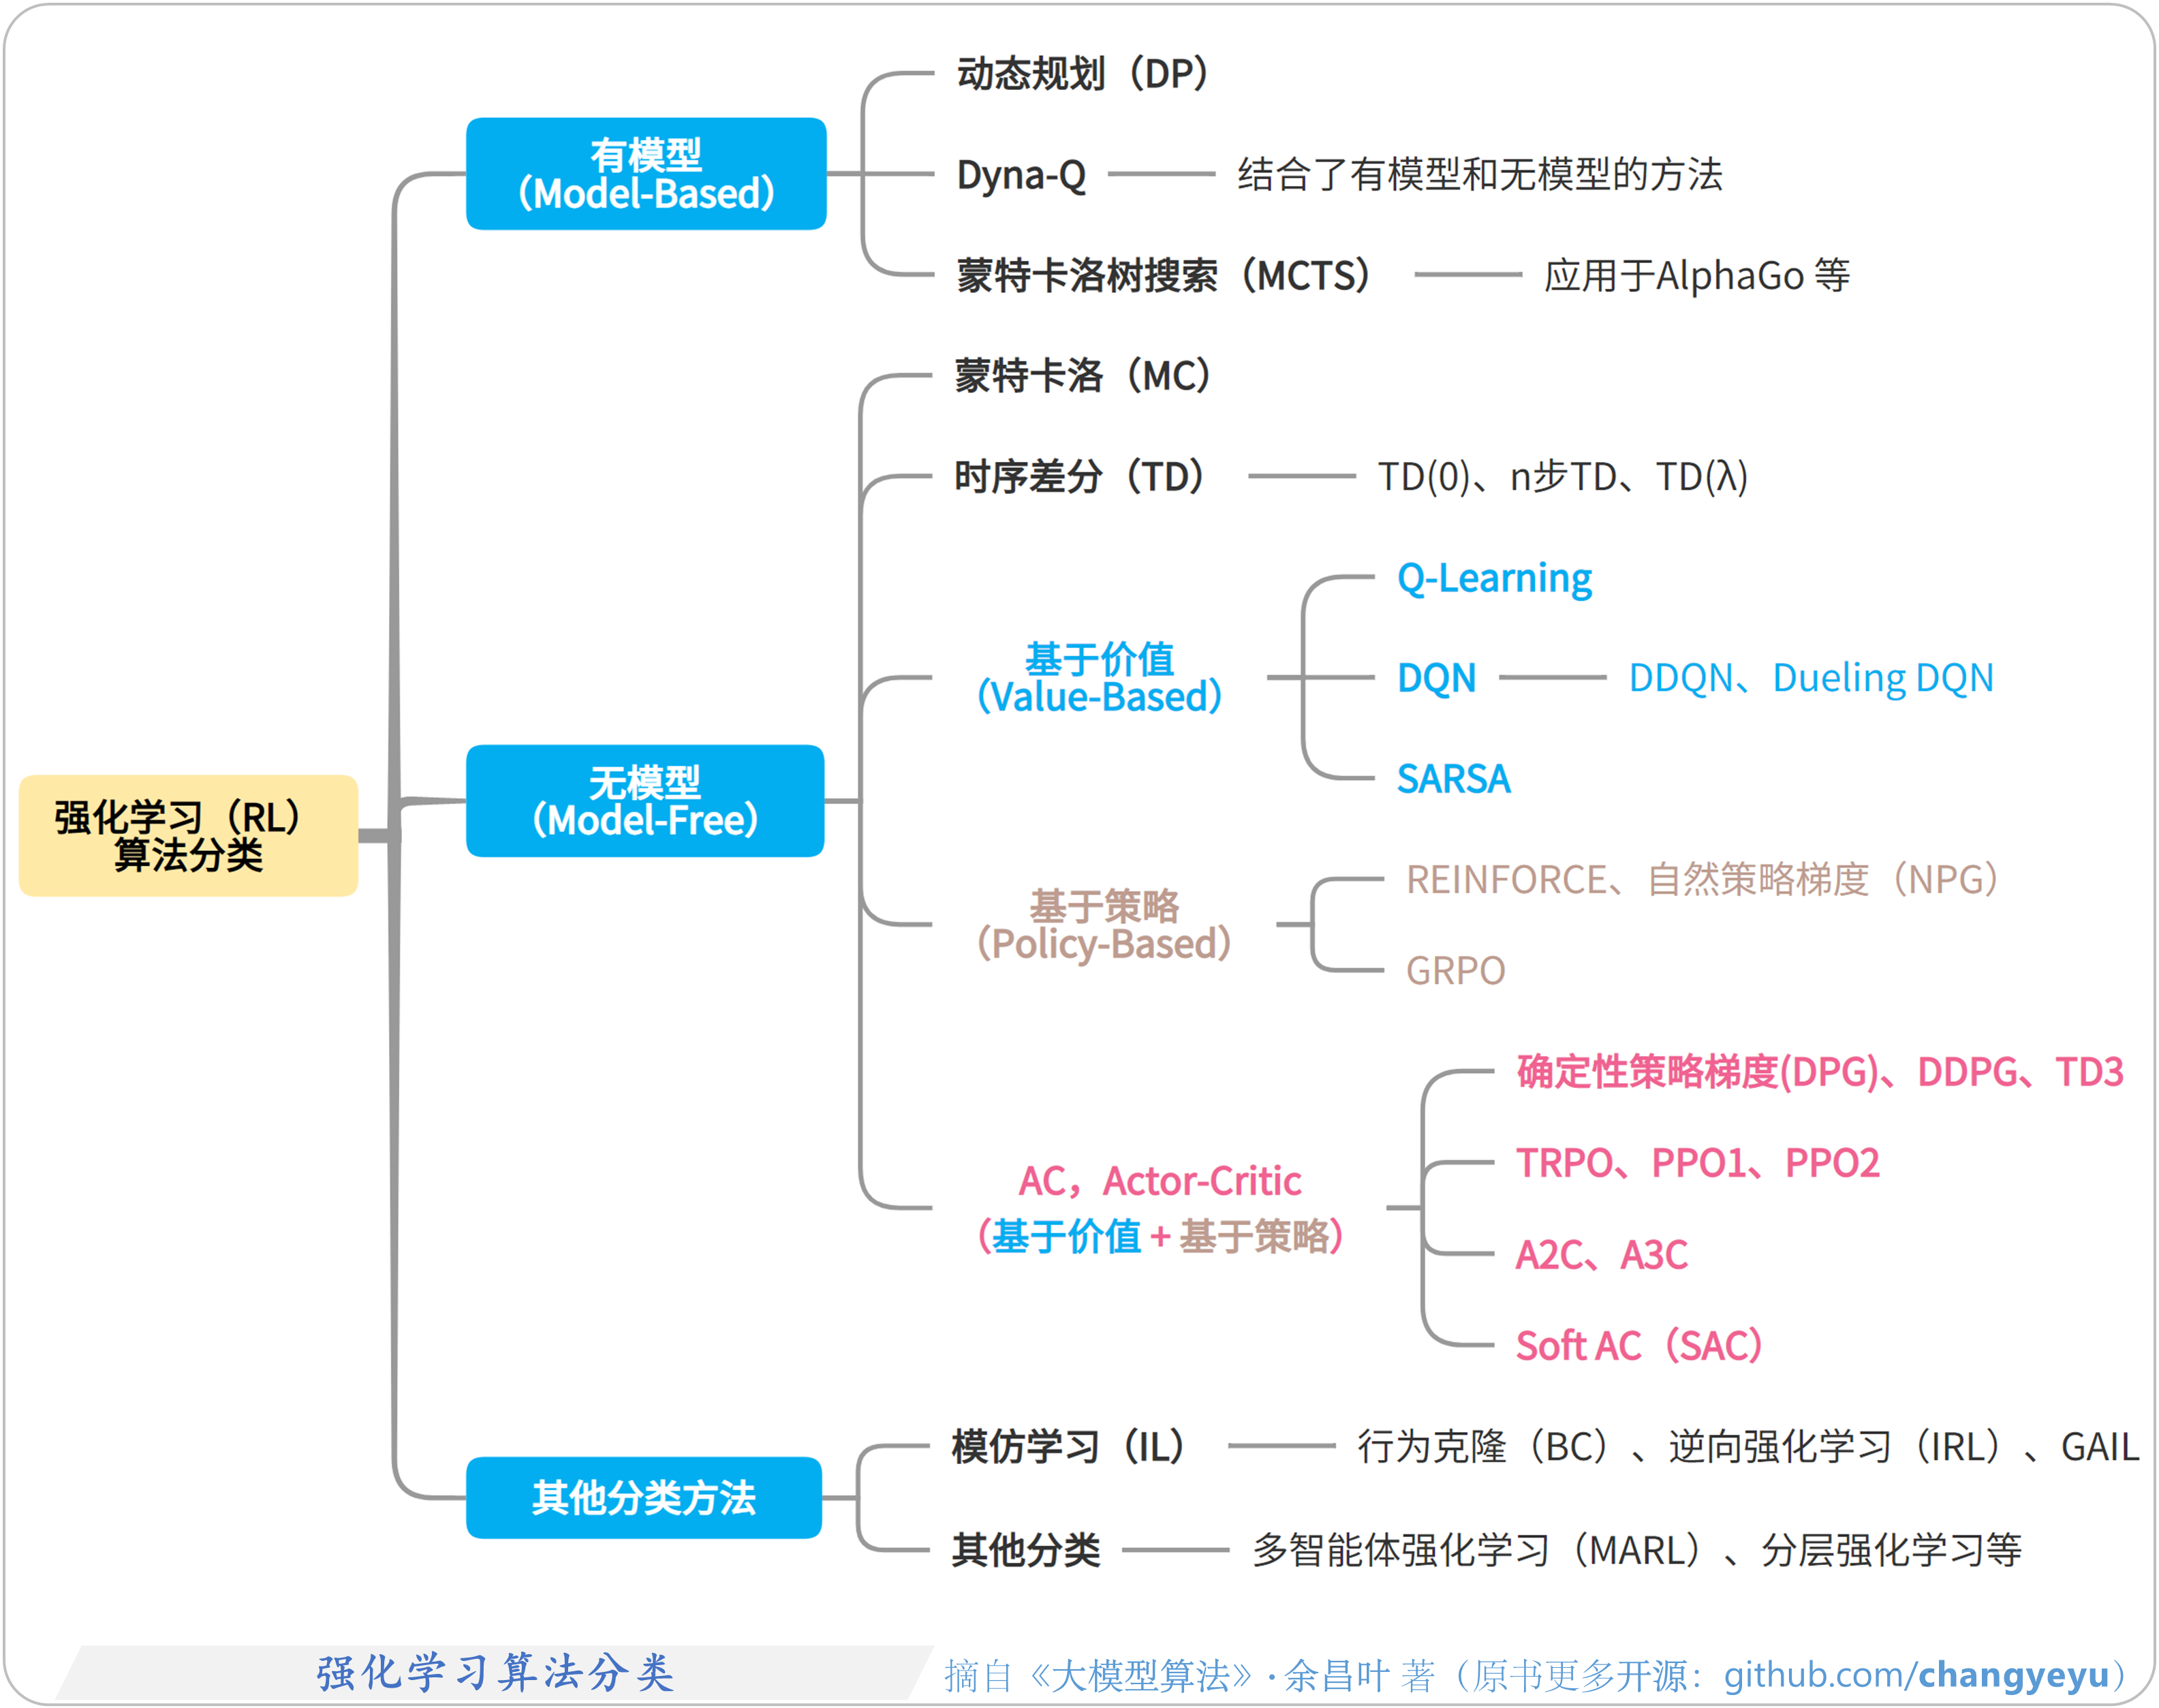
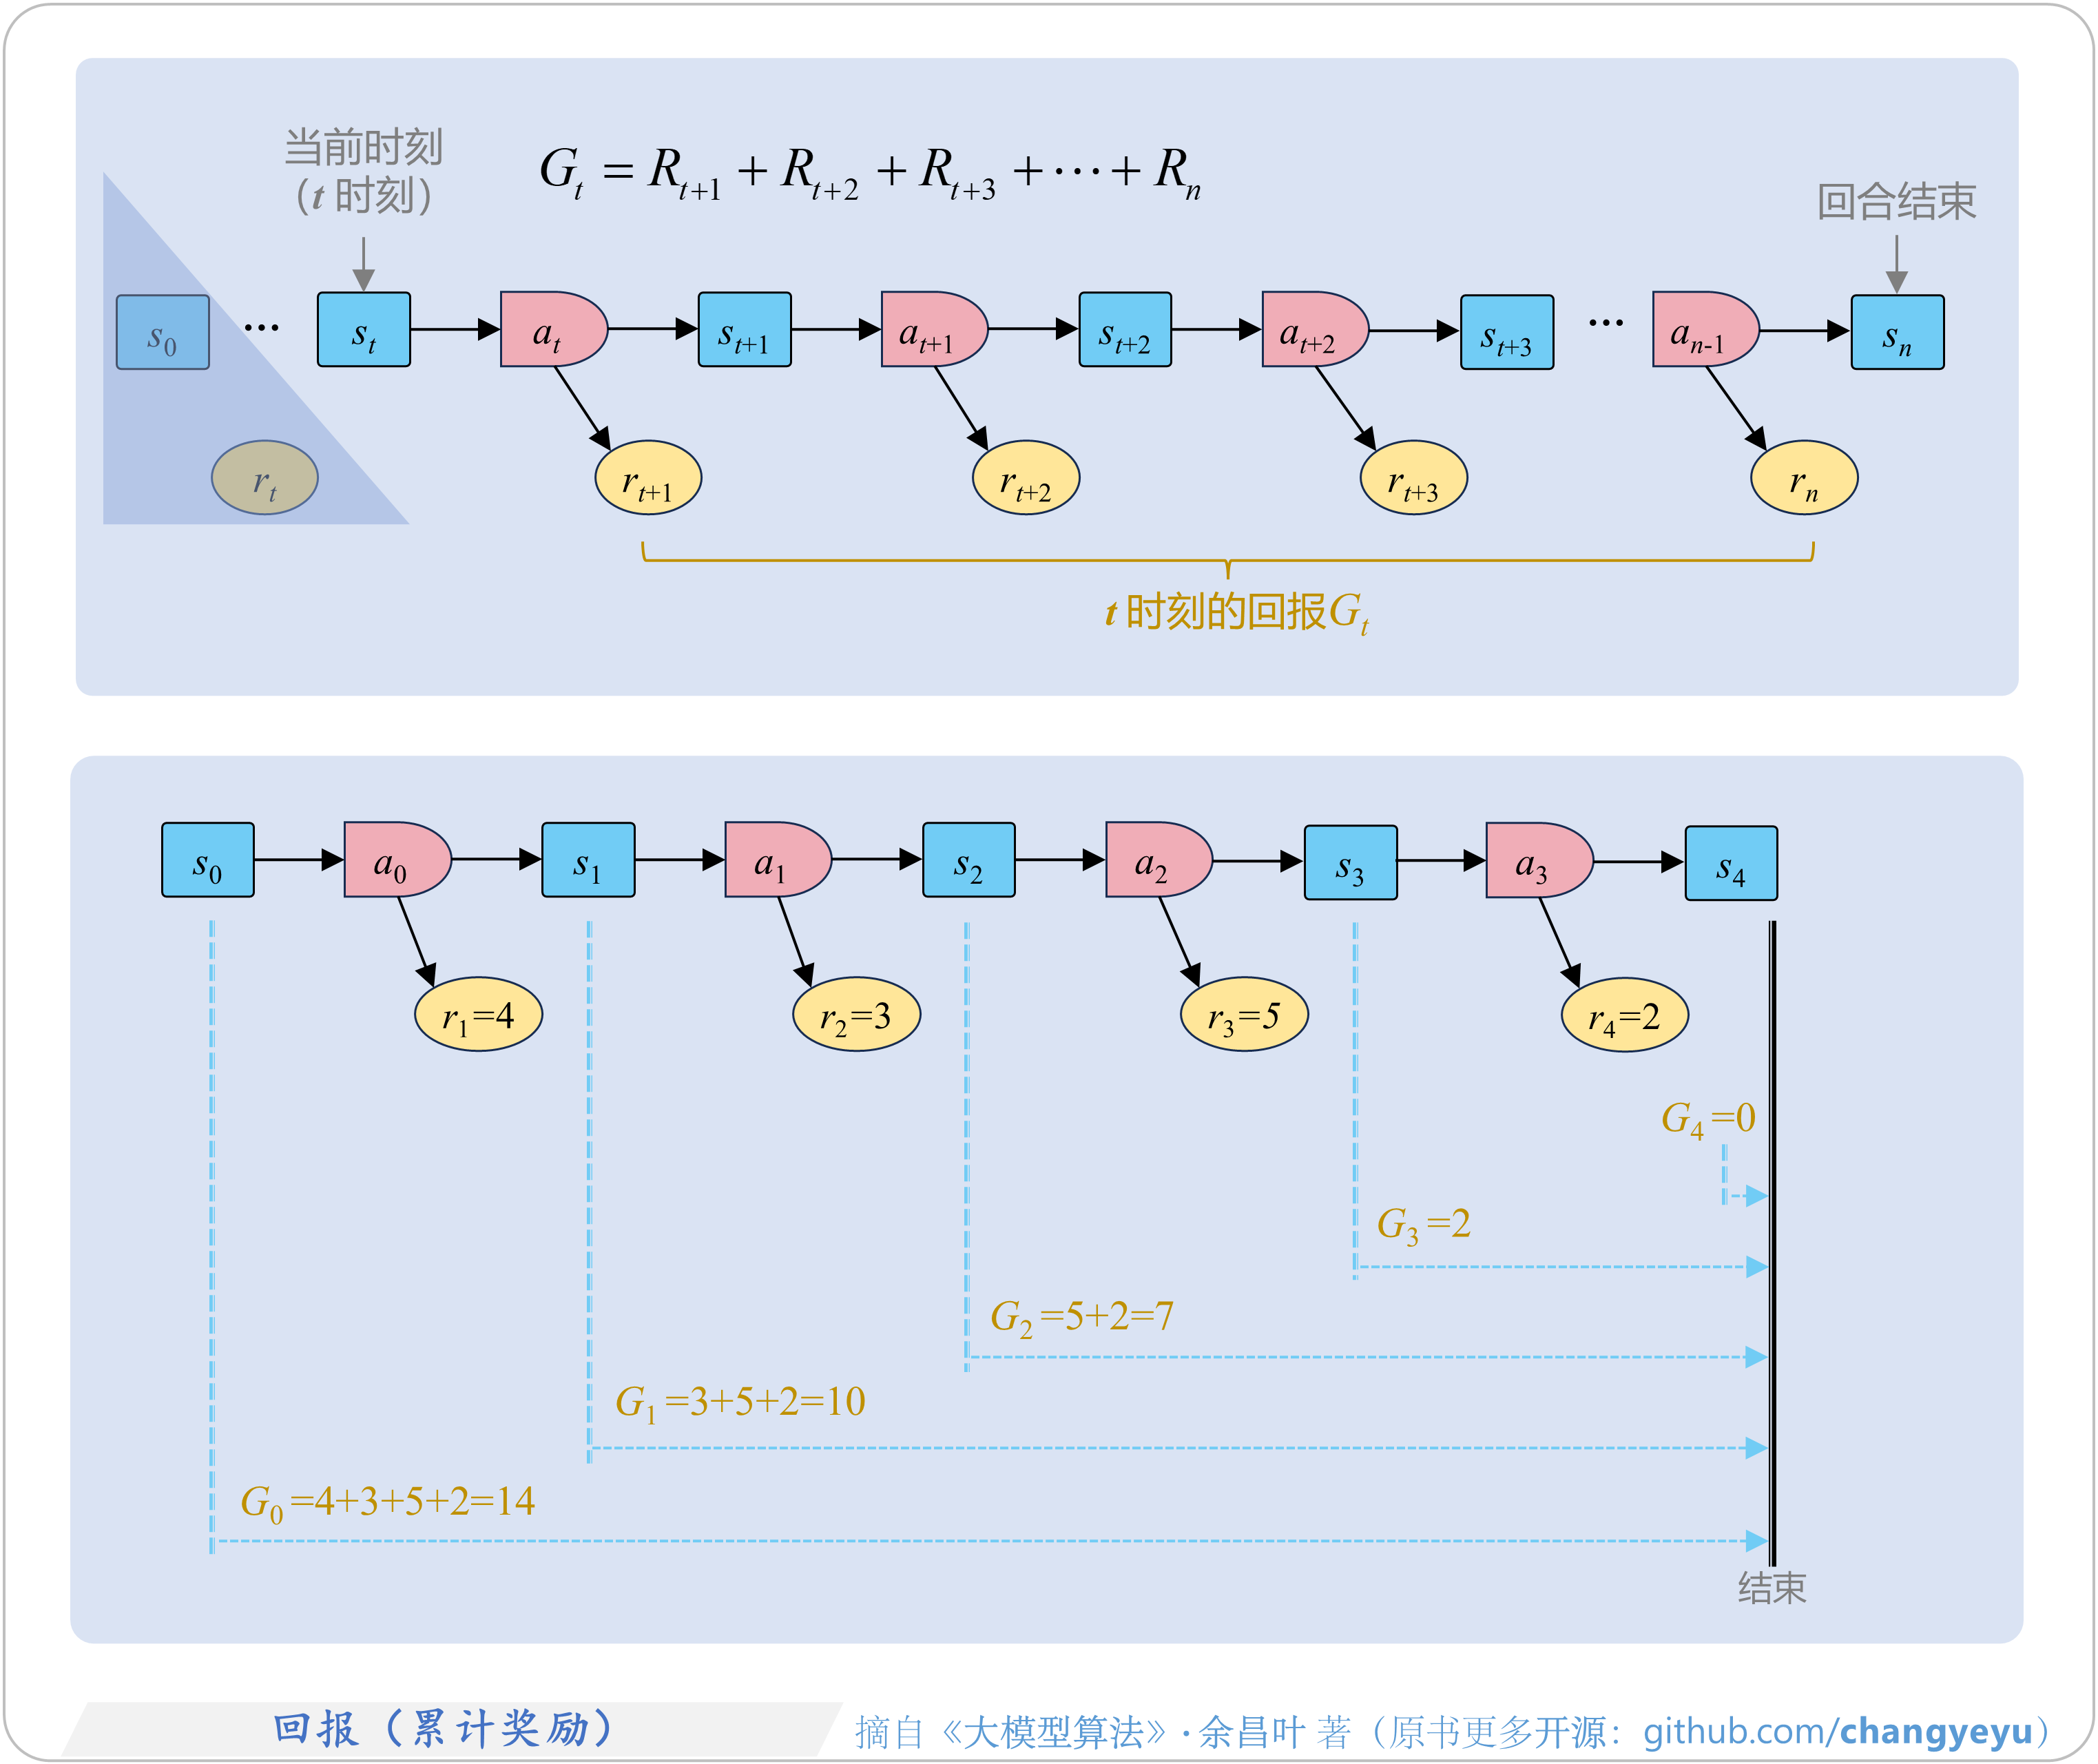
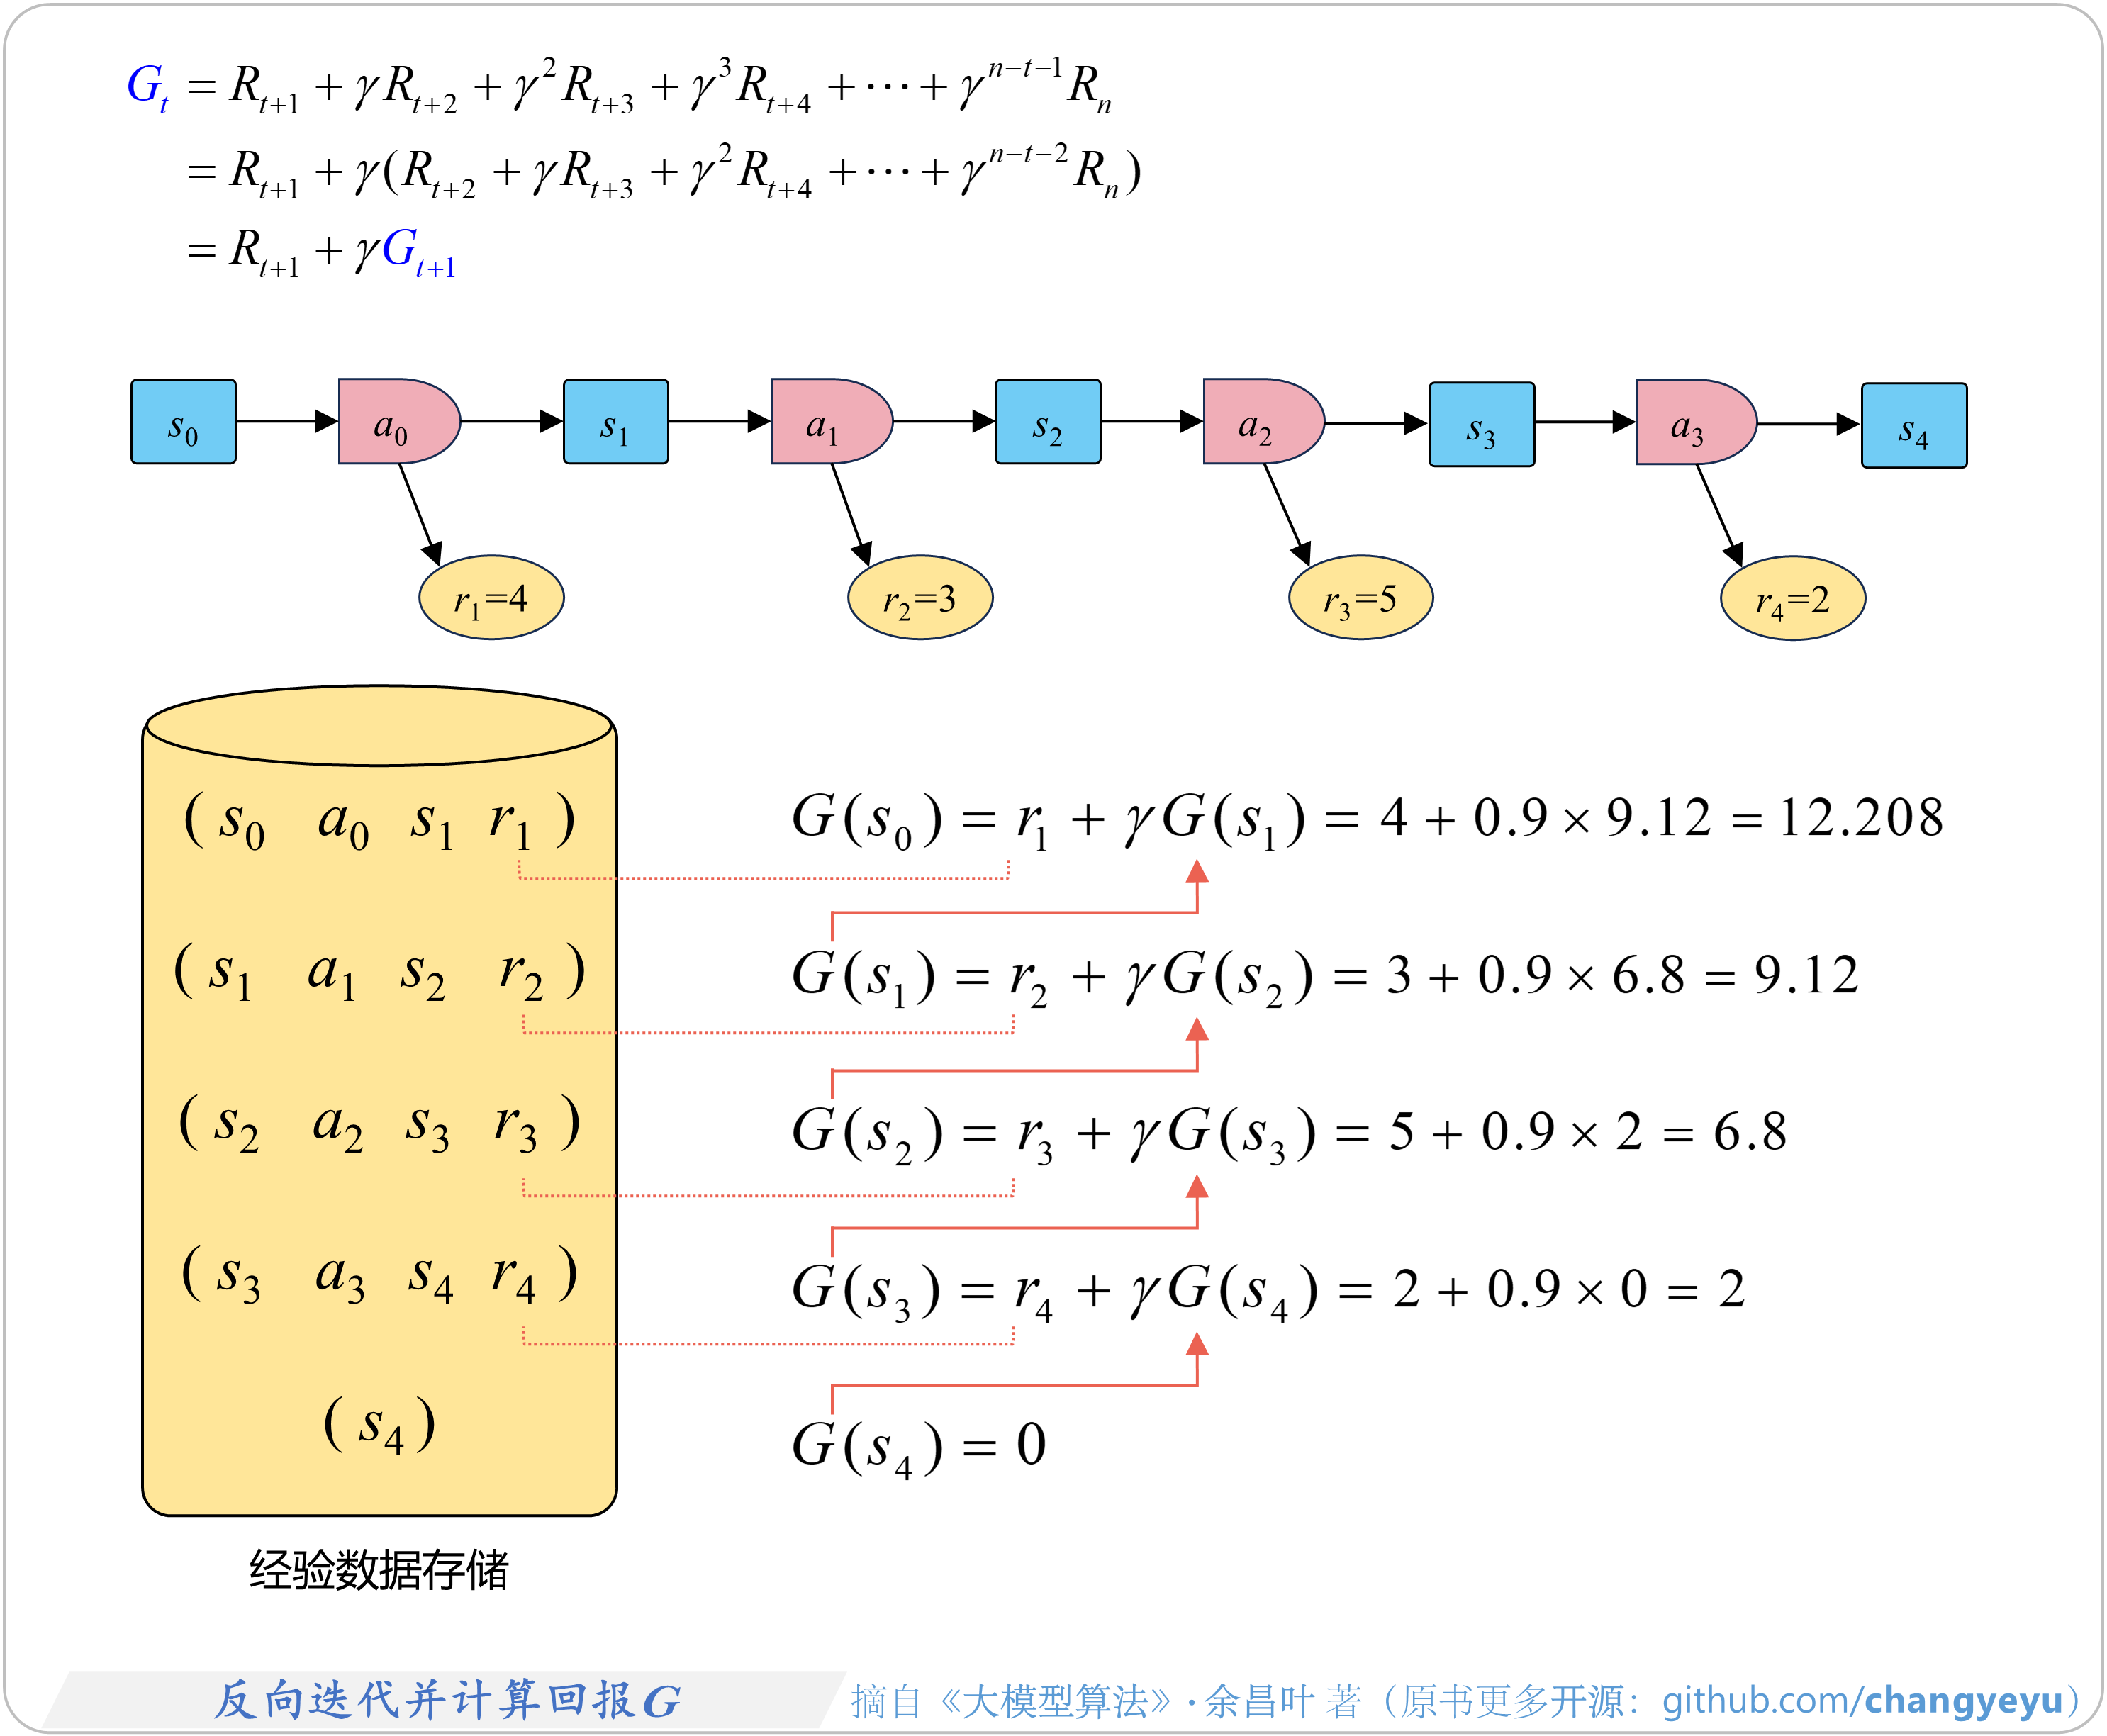
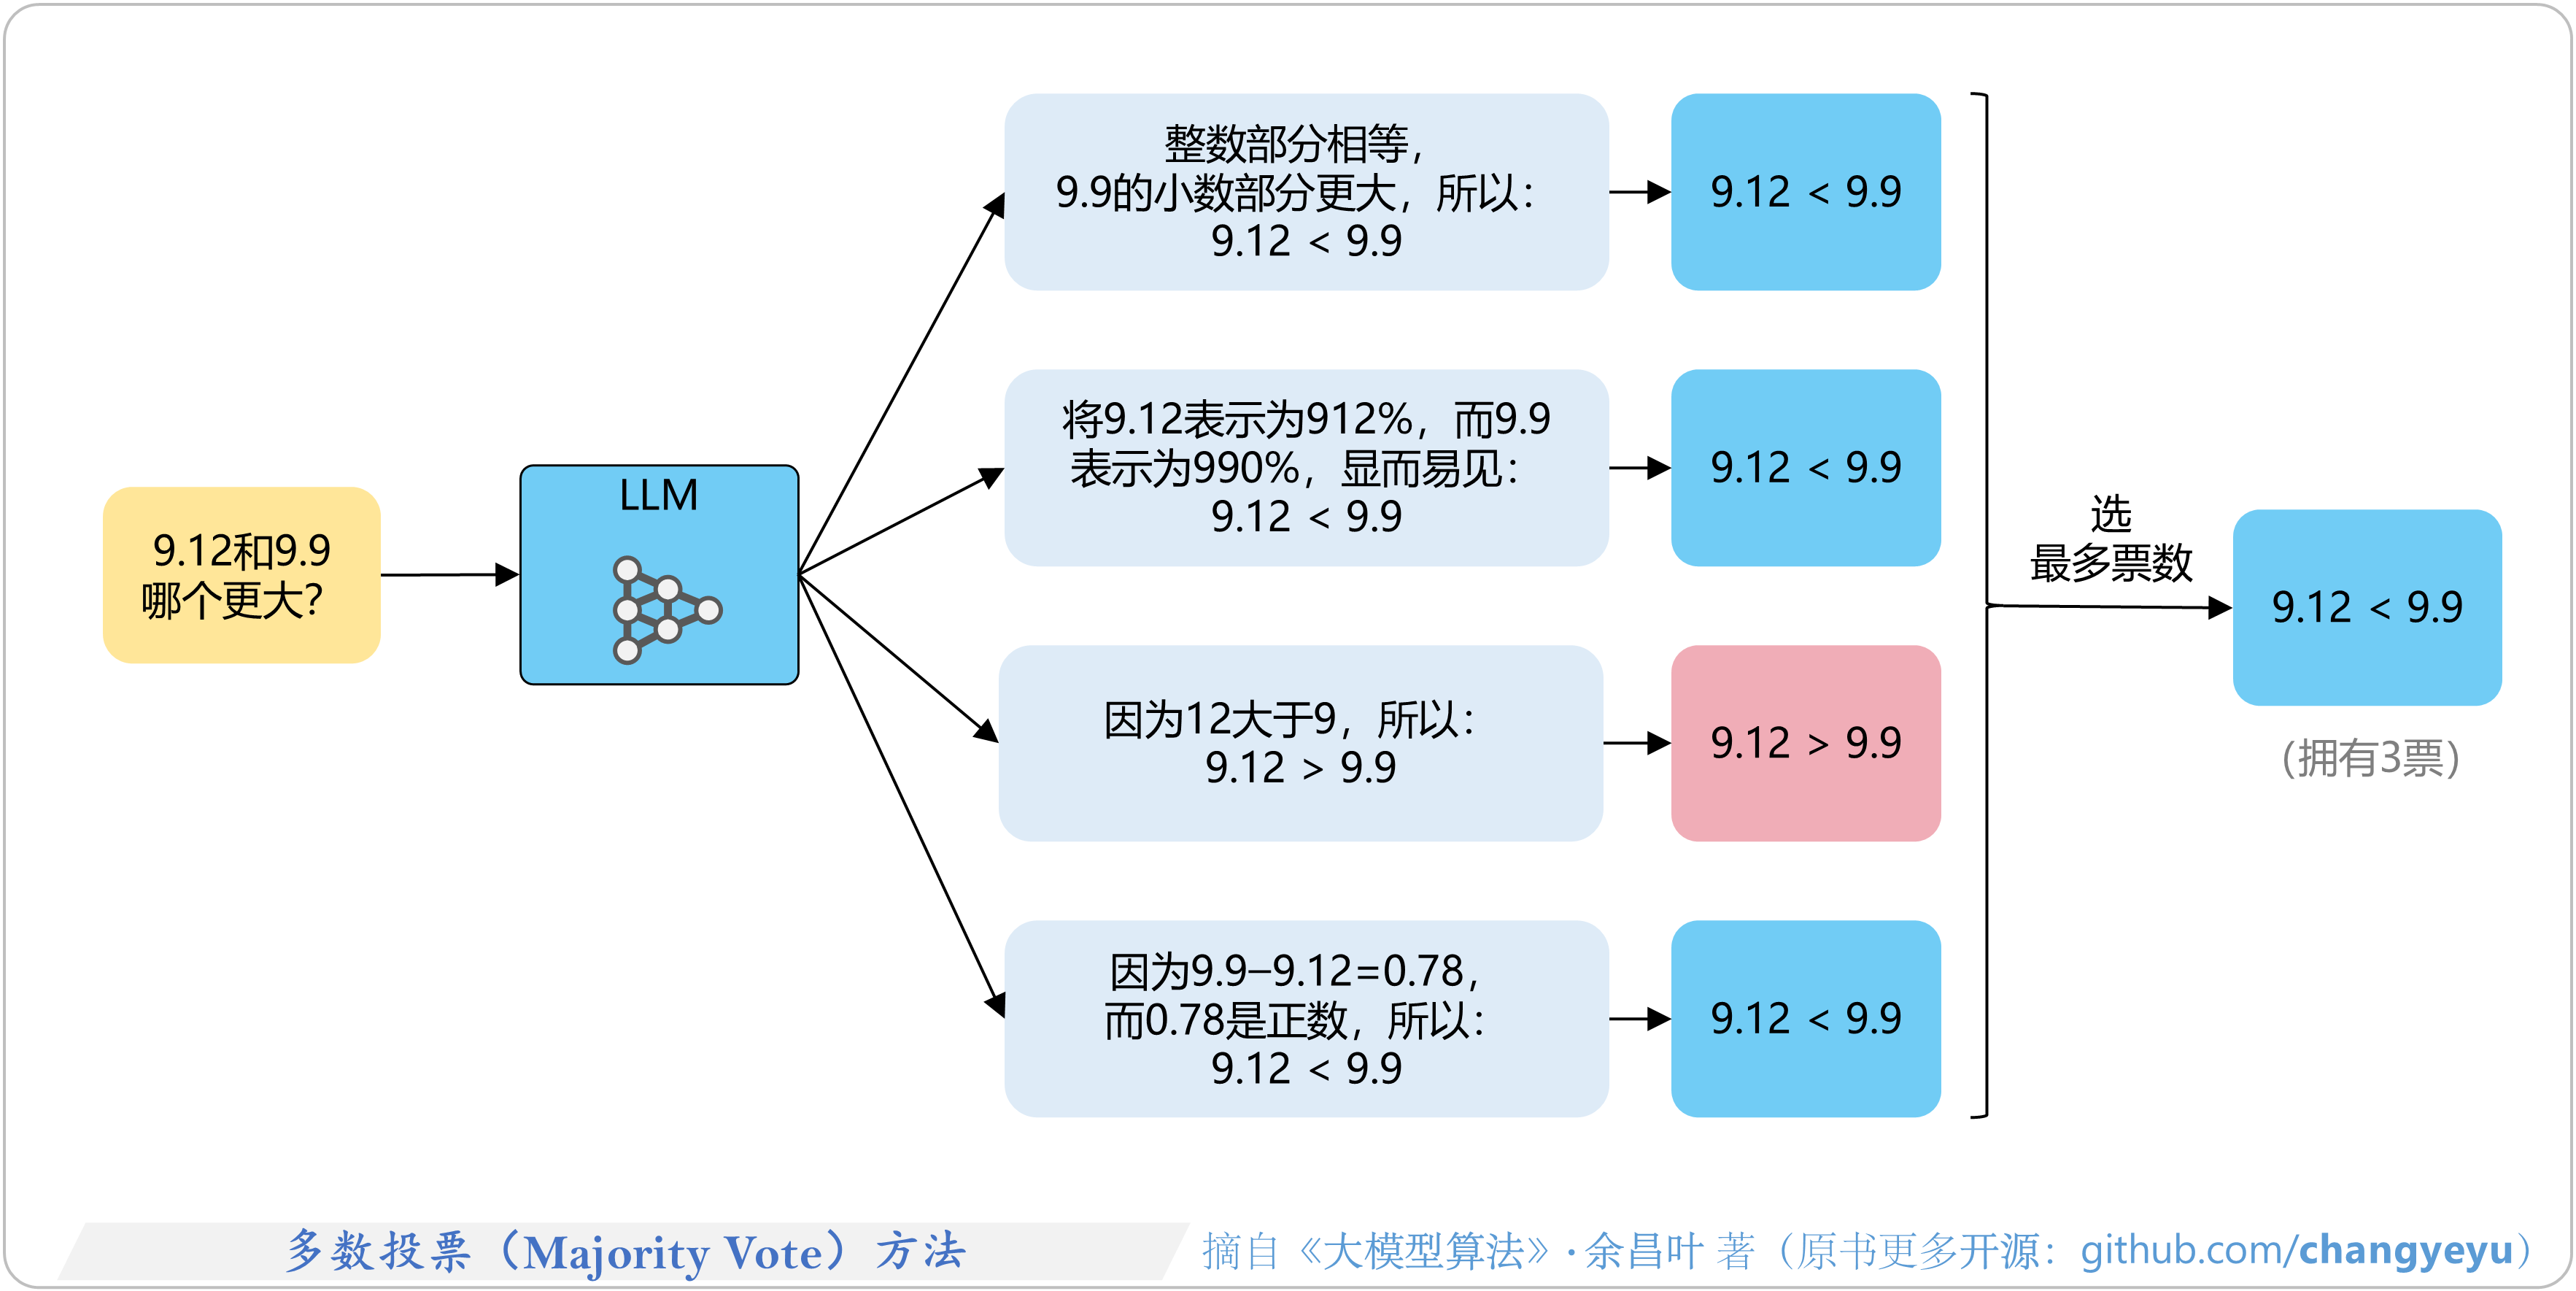
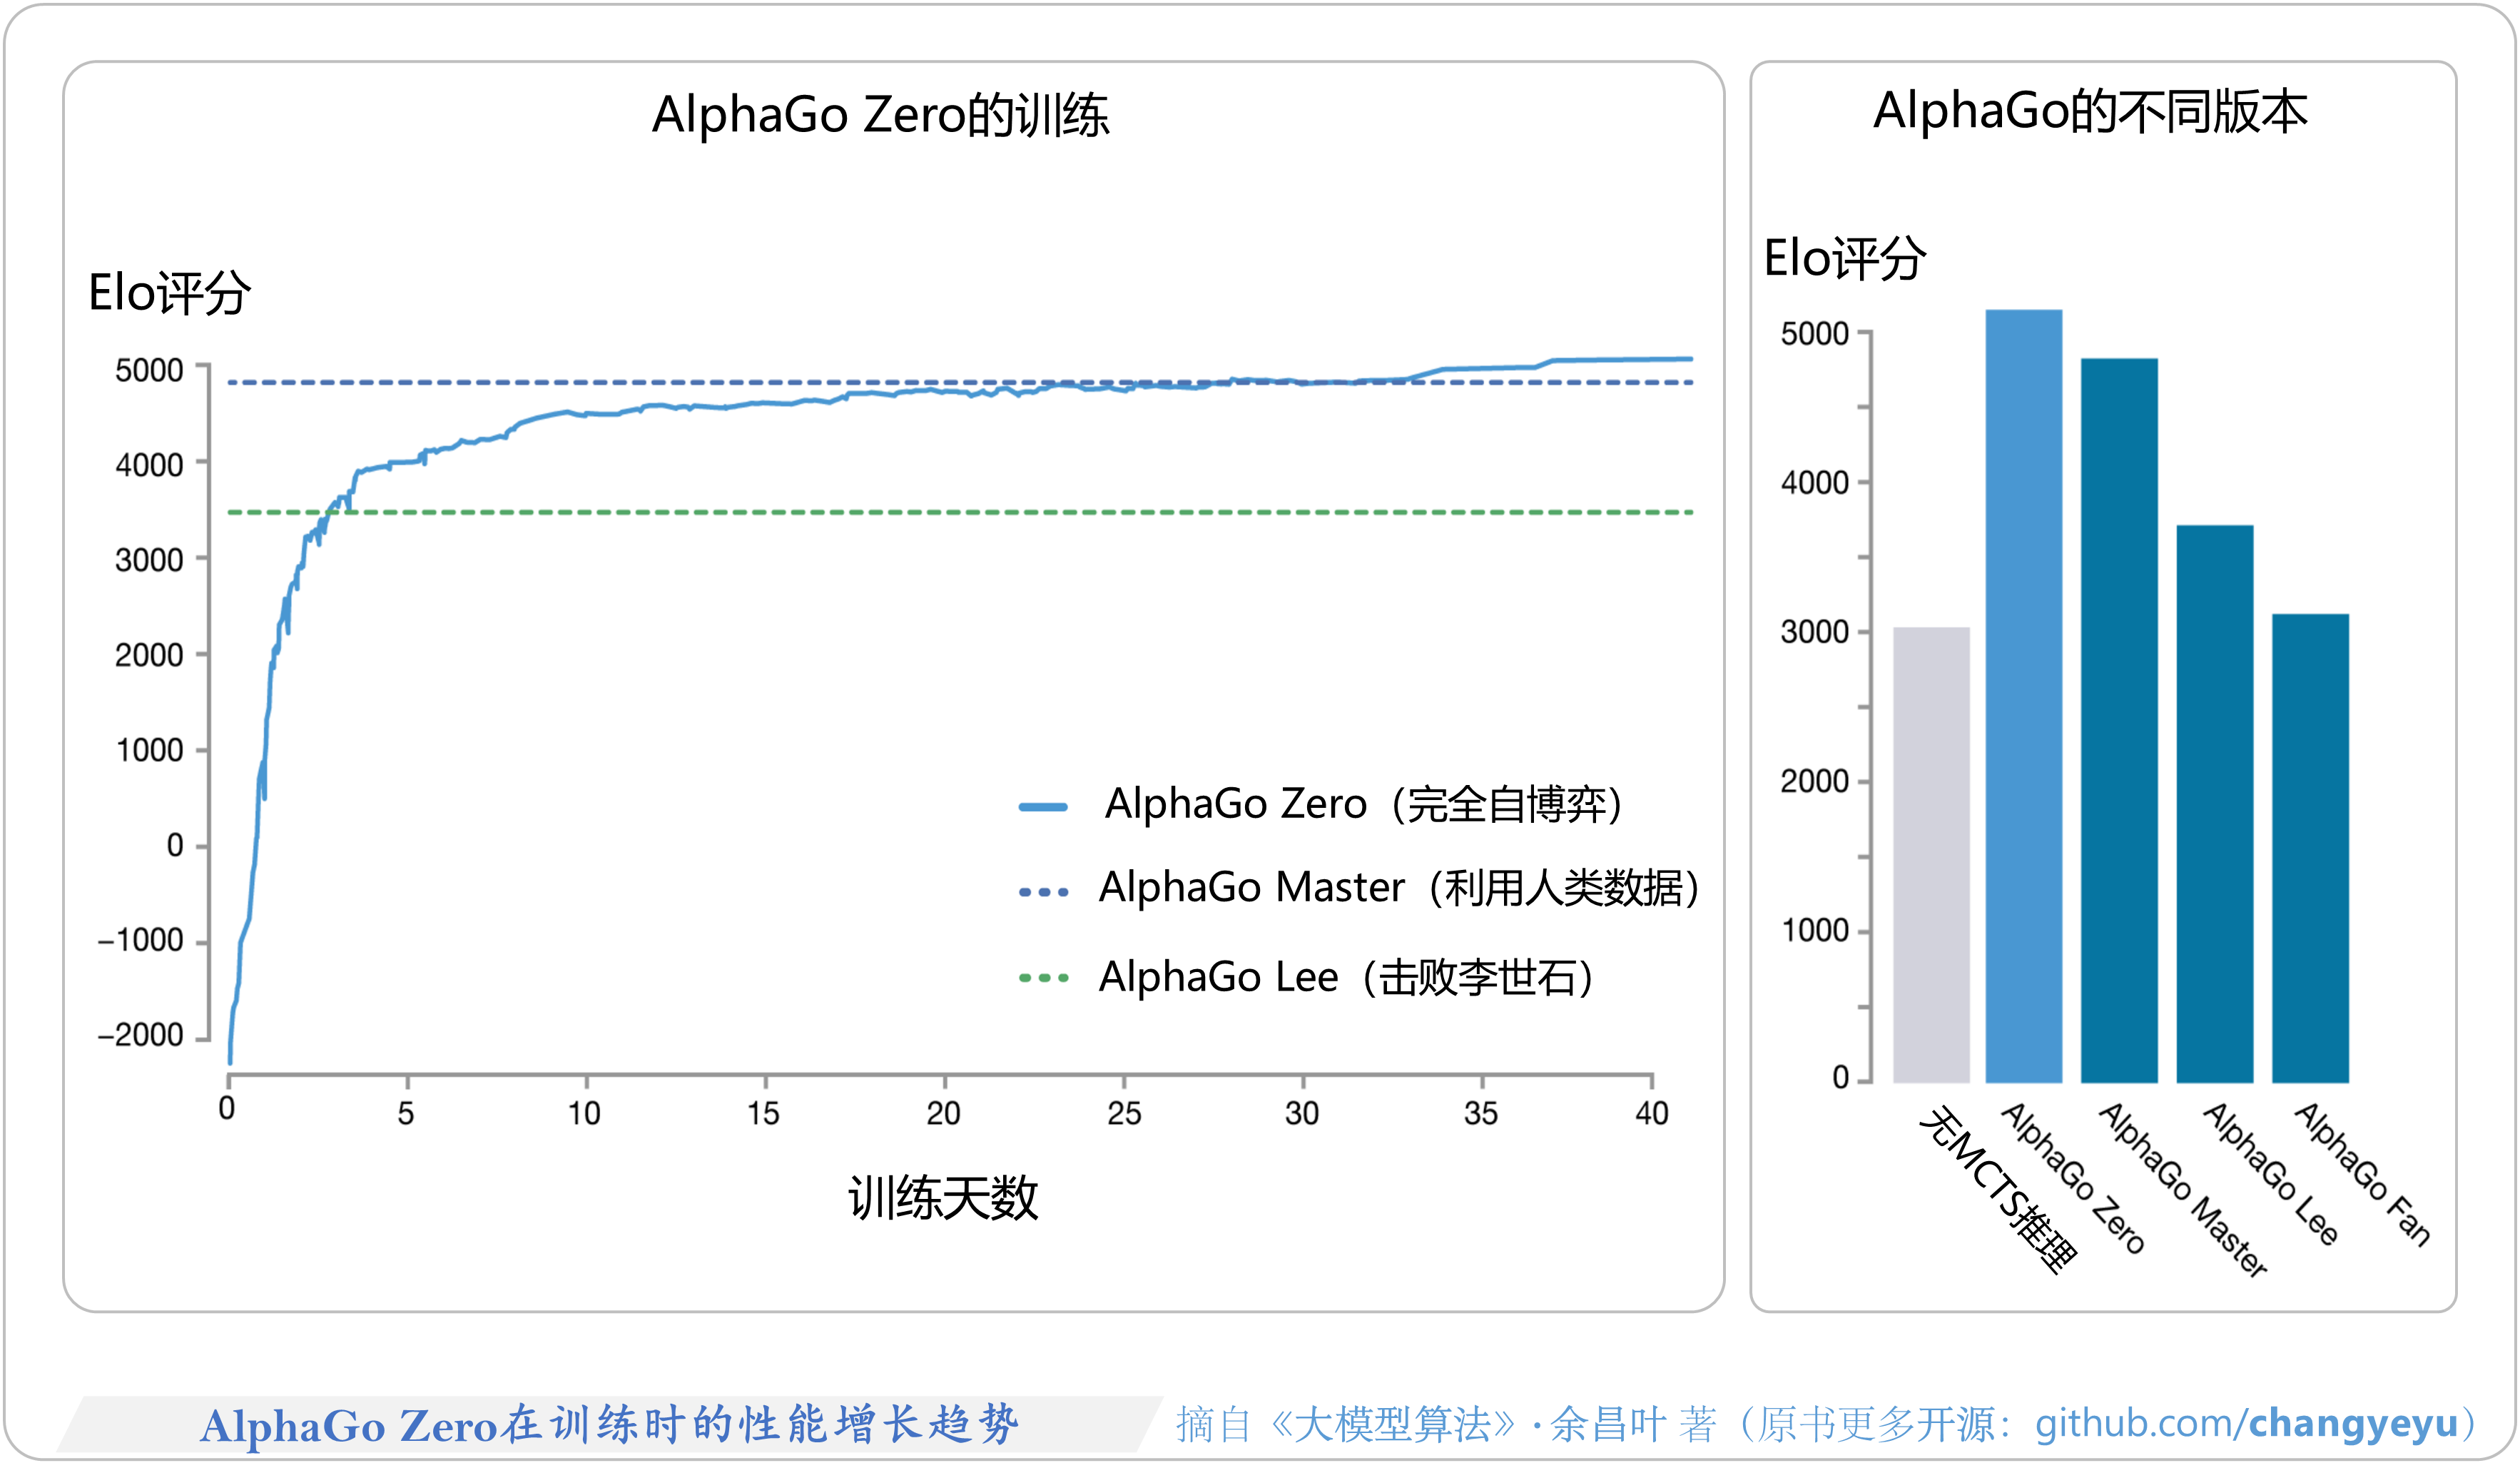
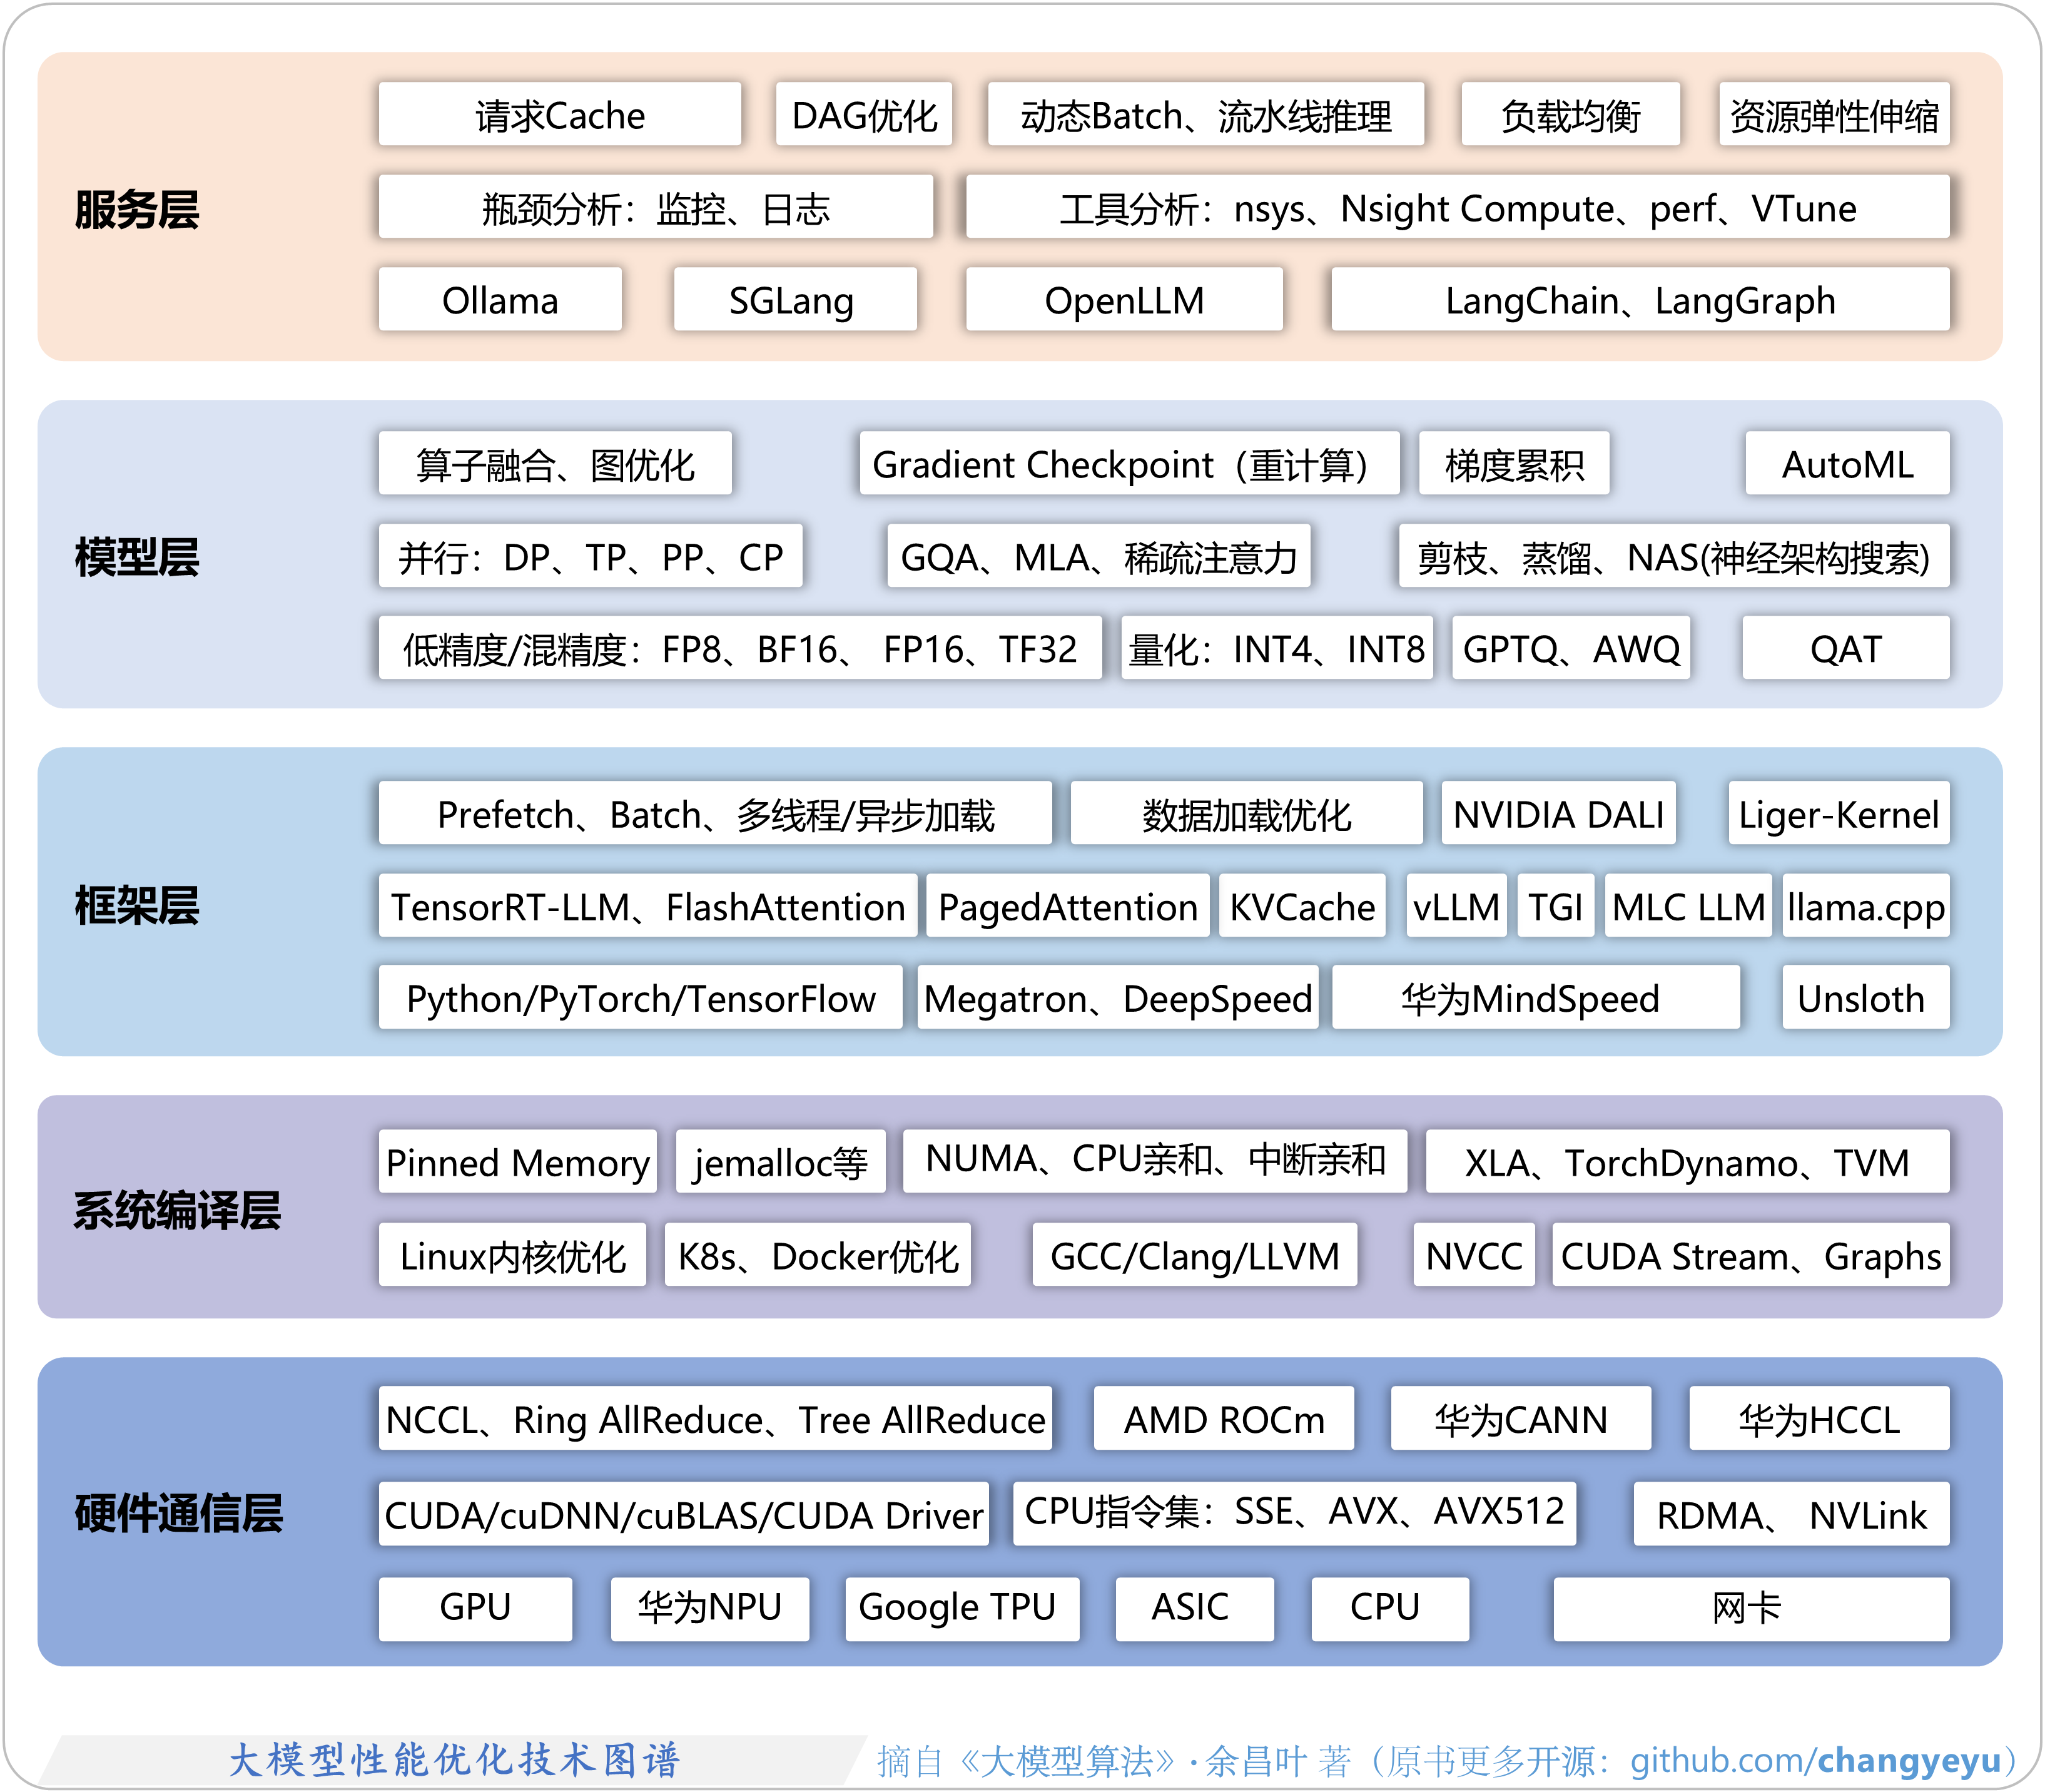
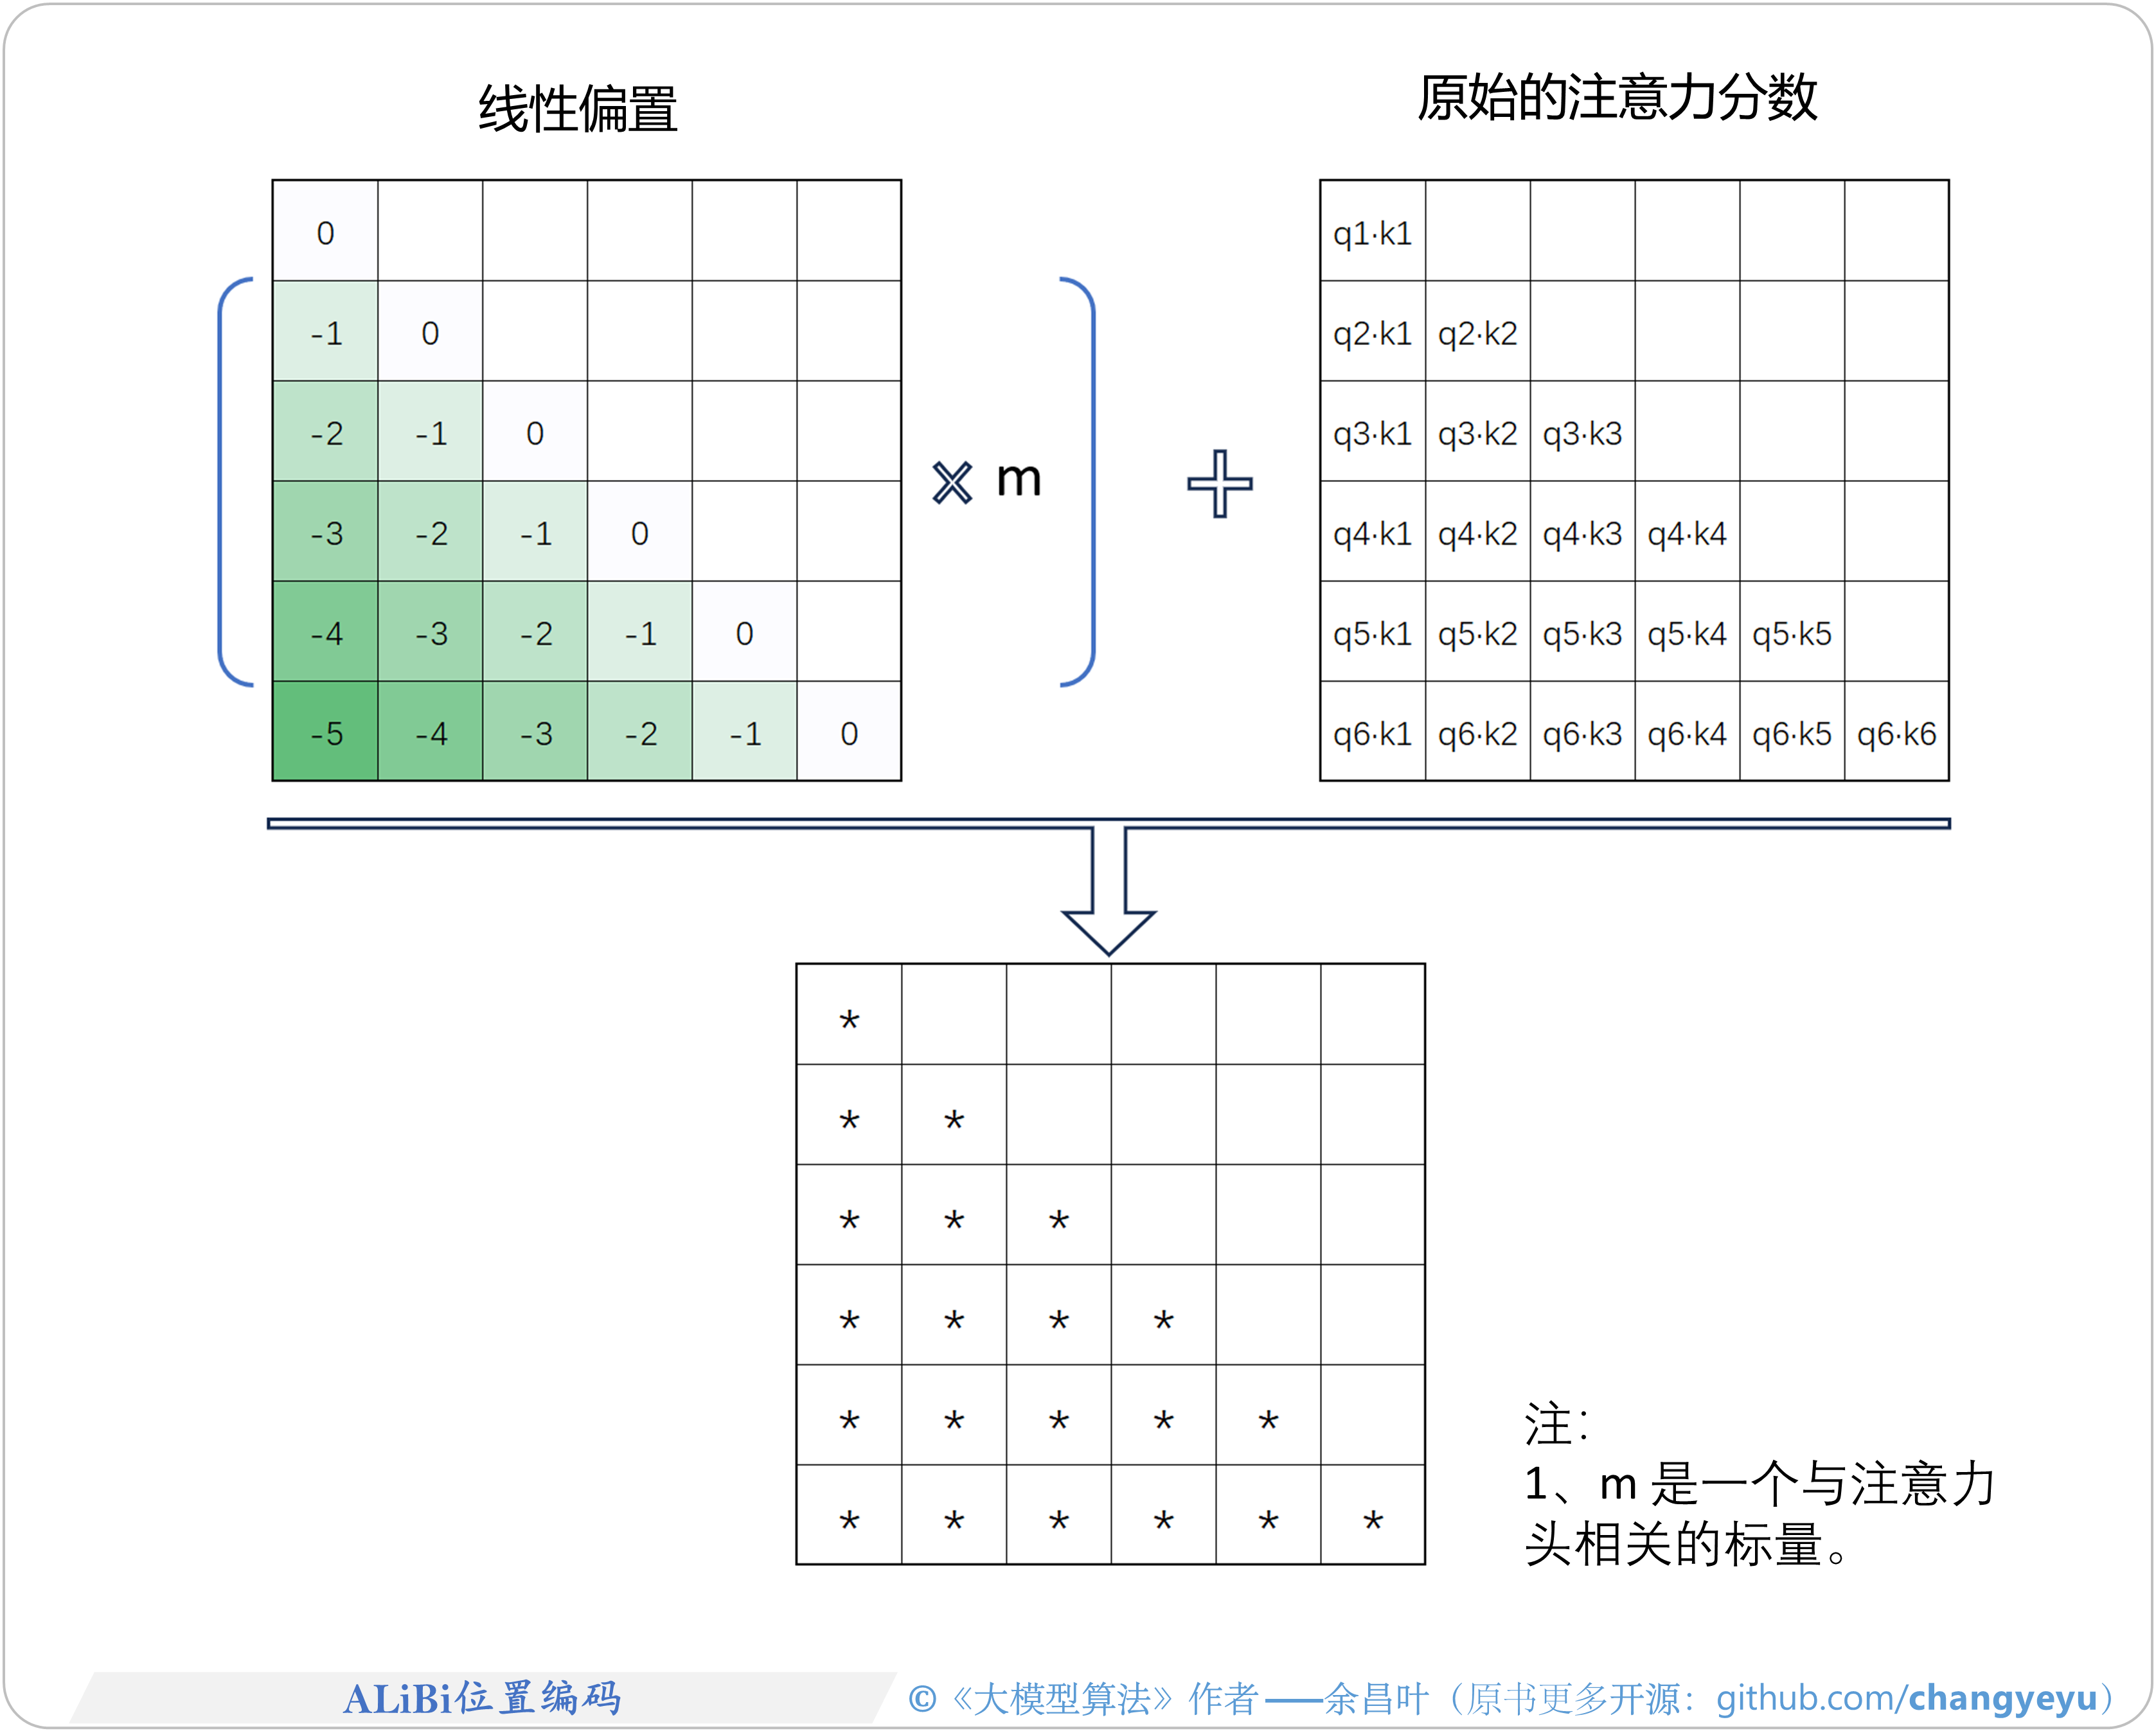
🎉 单击图片可看高清大图,或浏览仓库目录中的 .svg 格式矢量图(活图,可无限缩放、可选择文字)


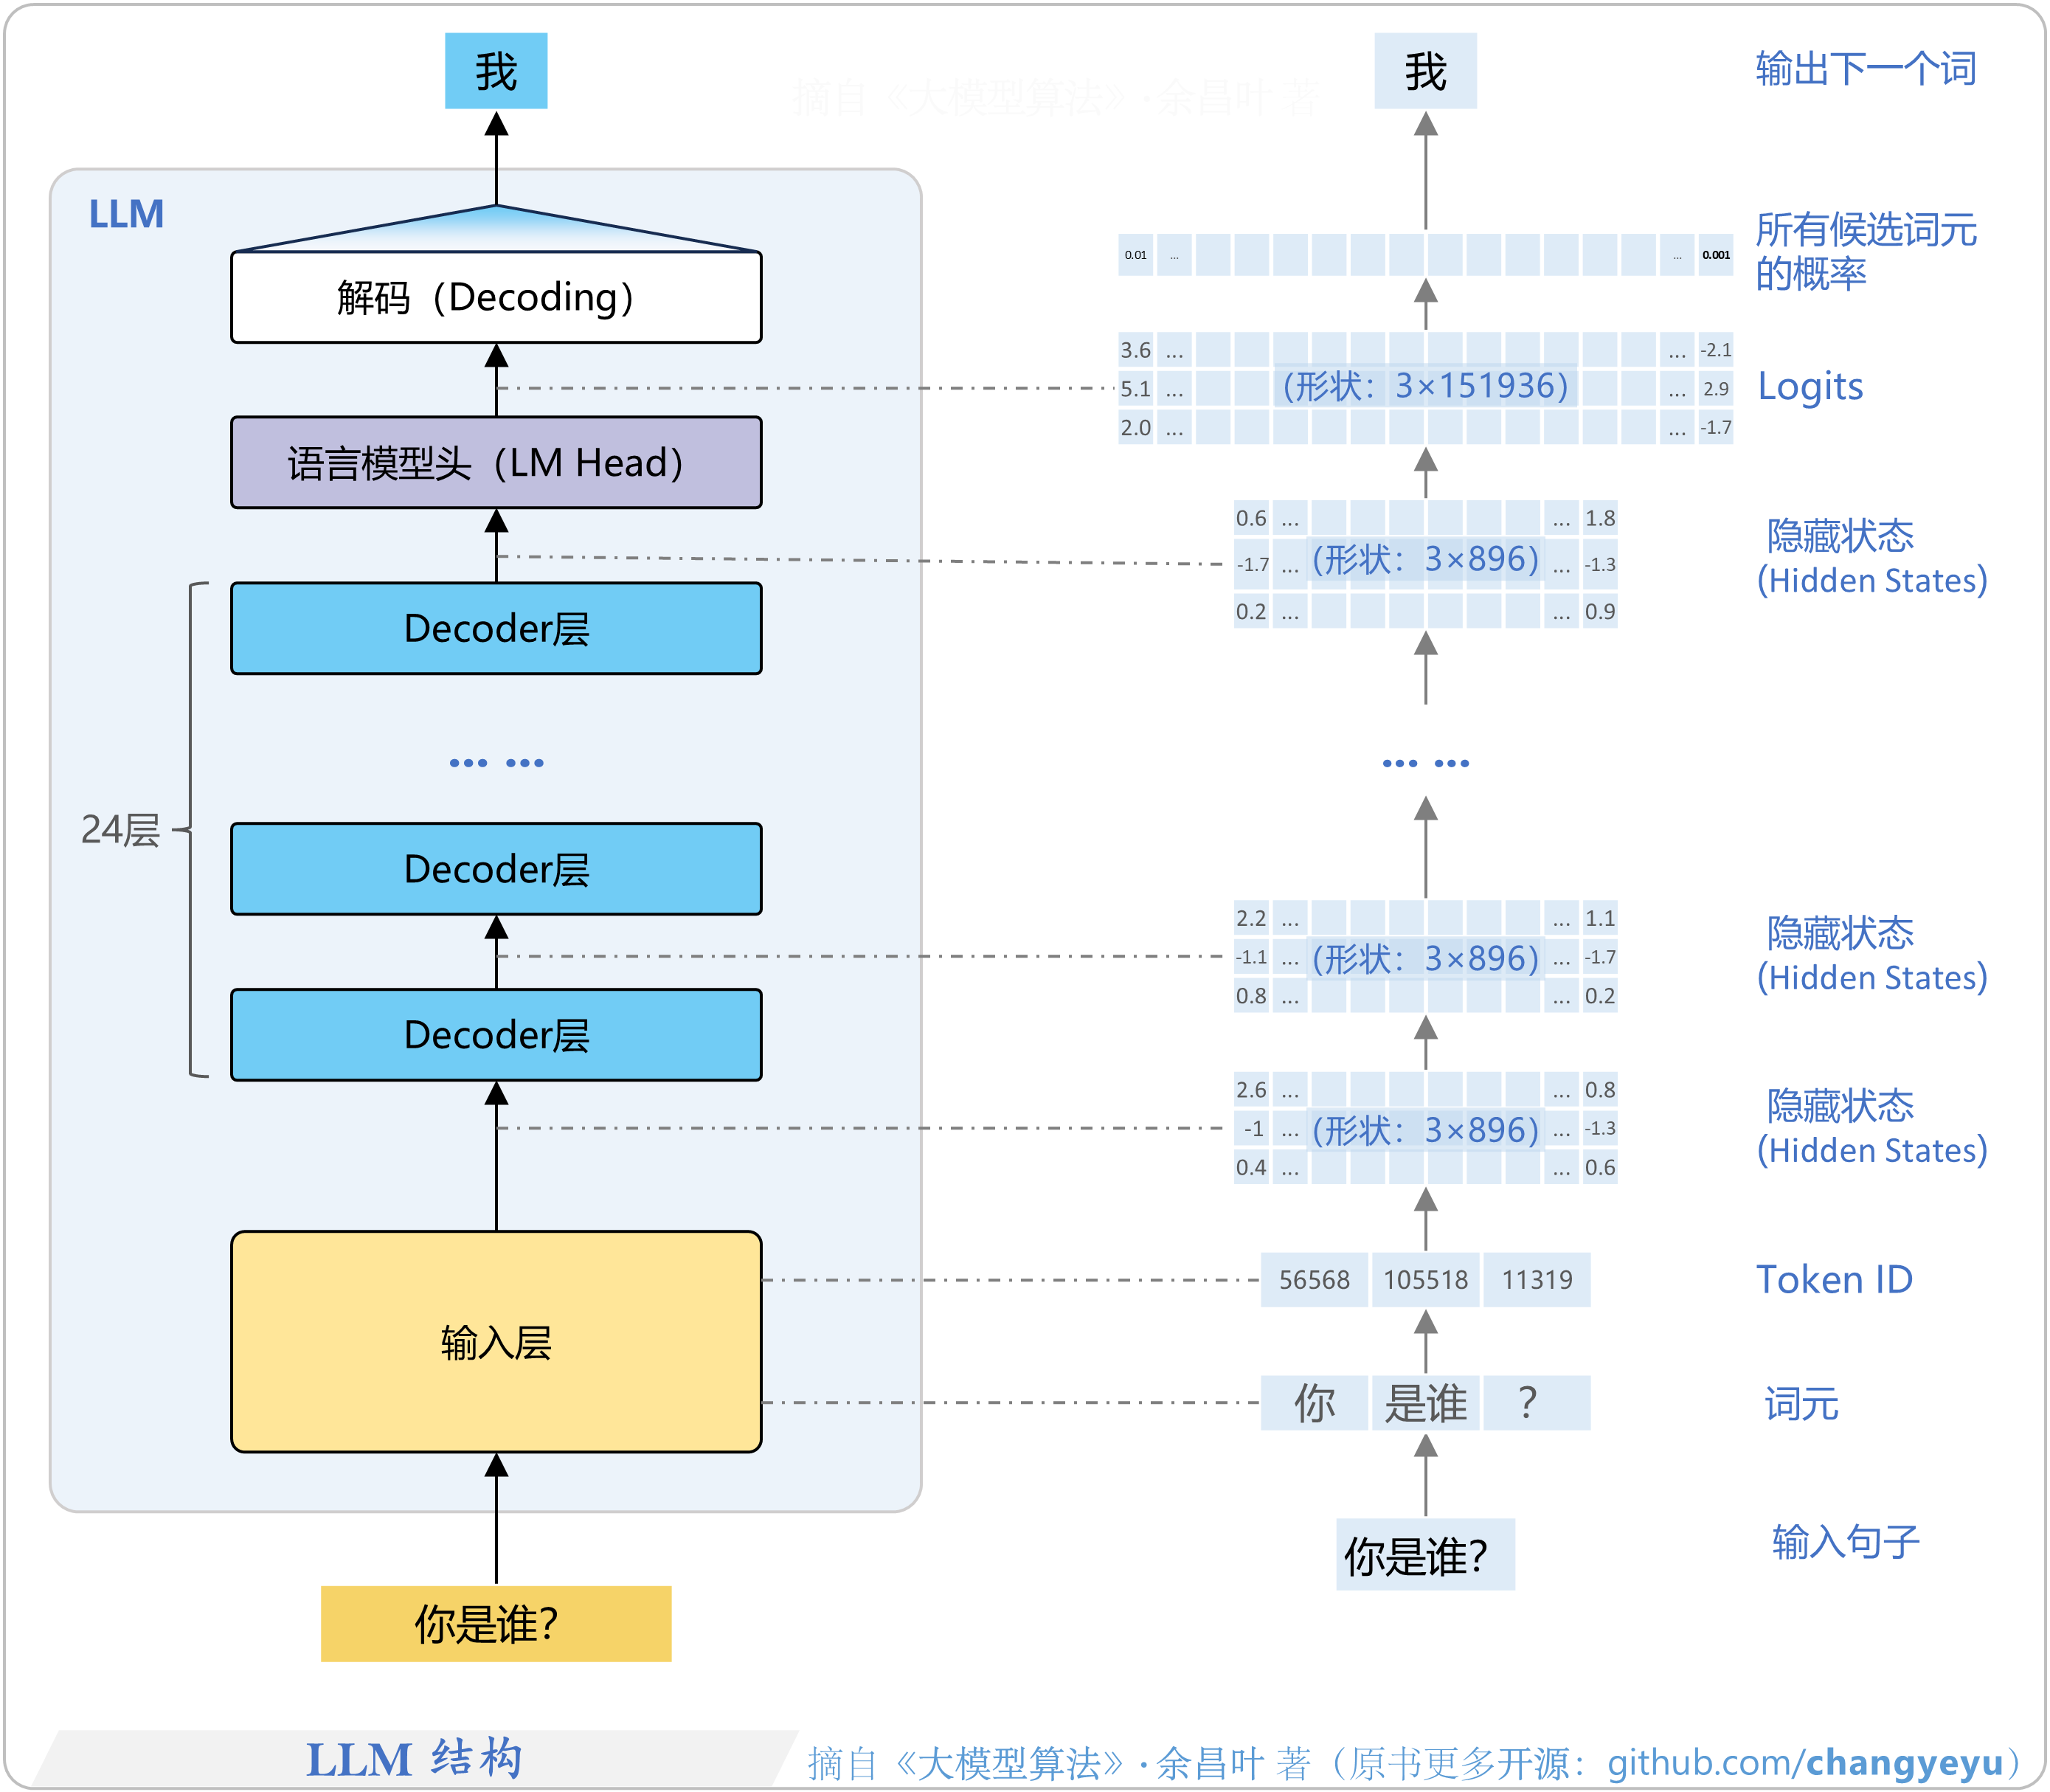
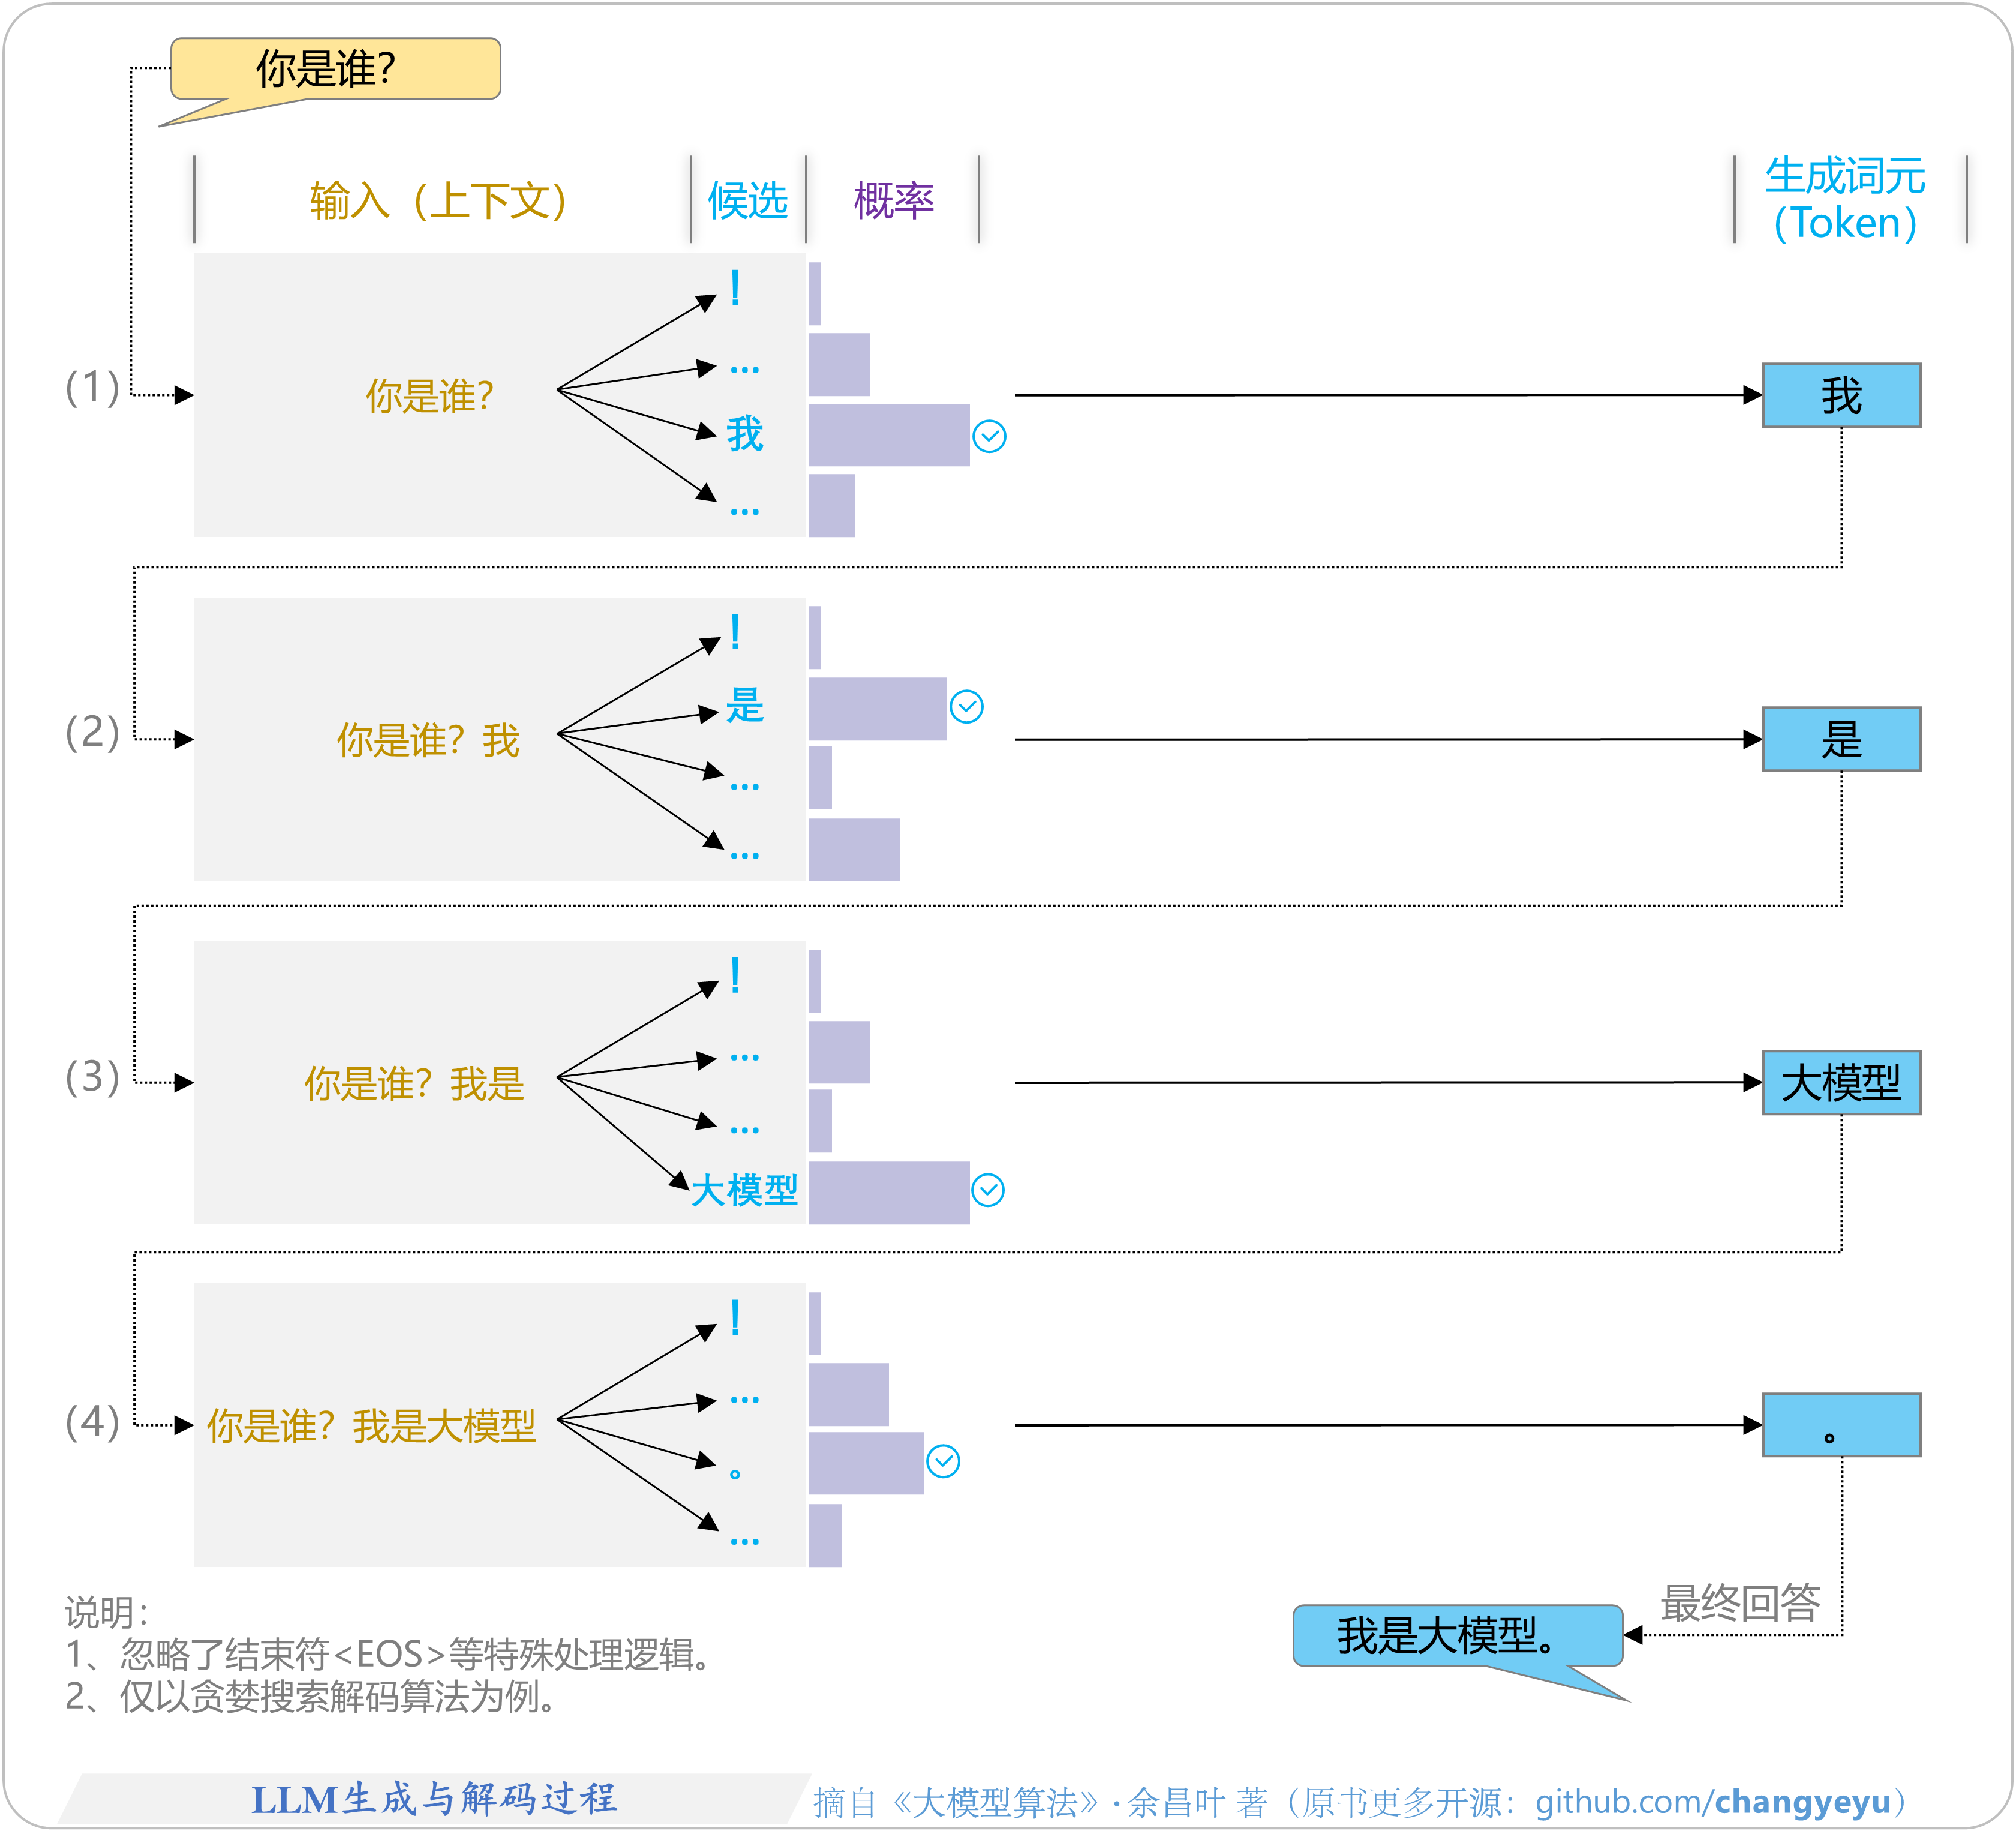
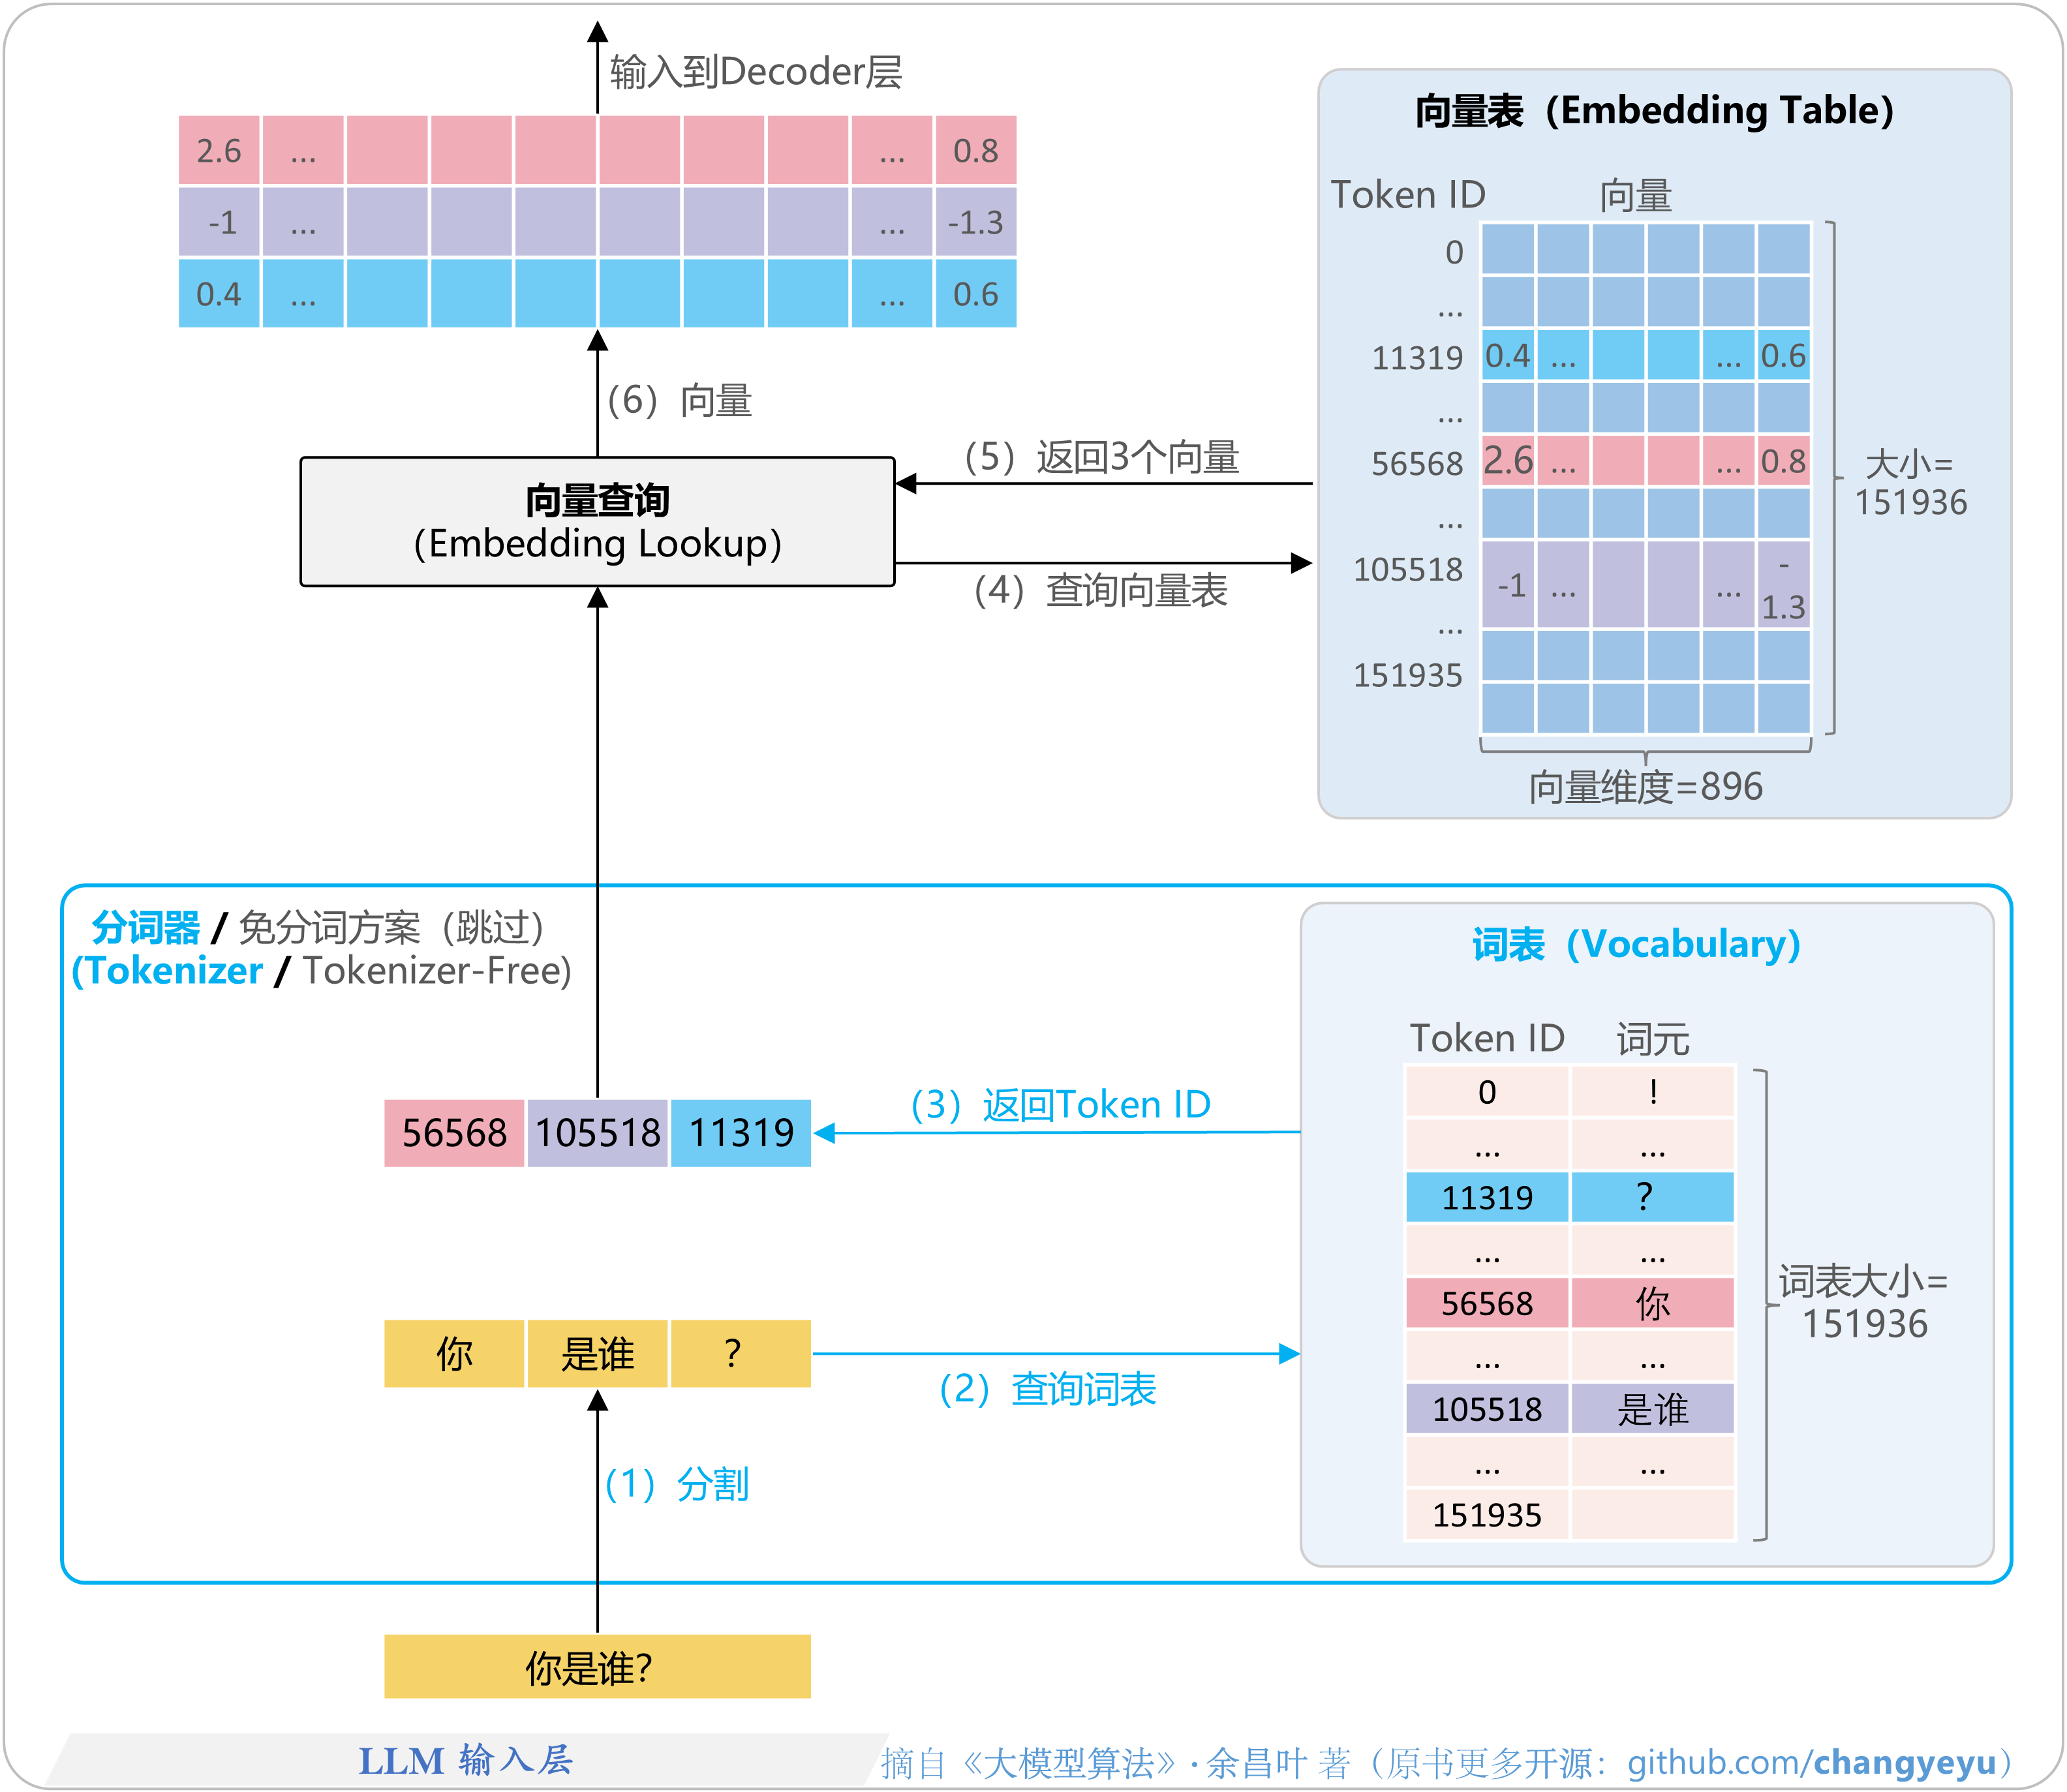
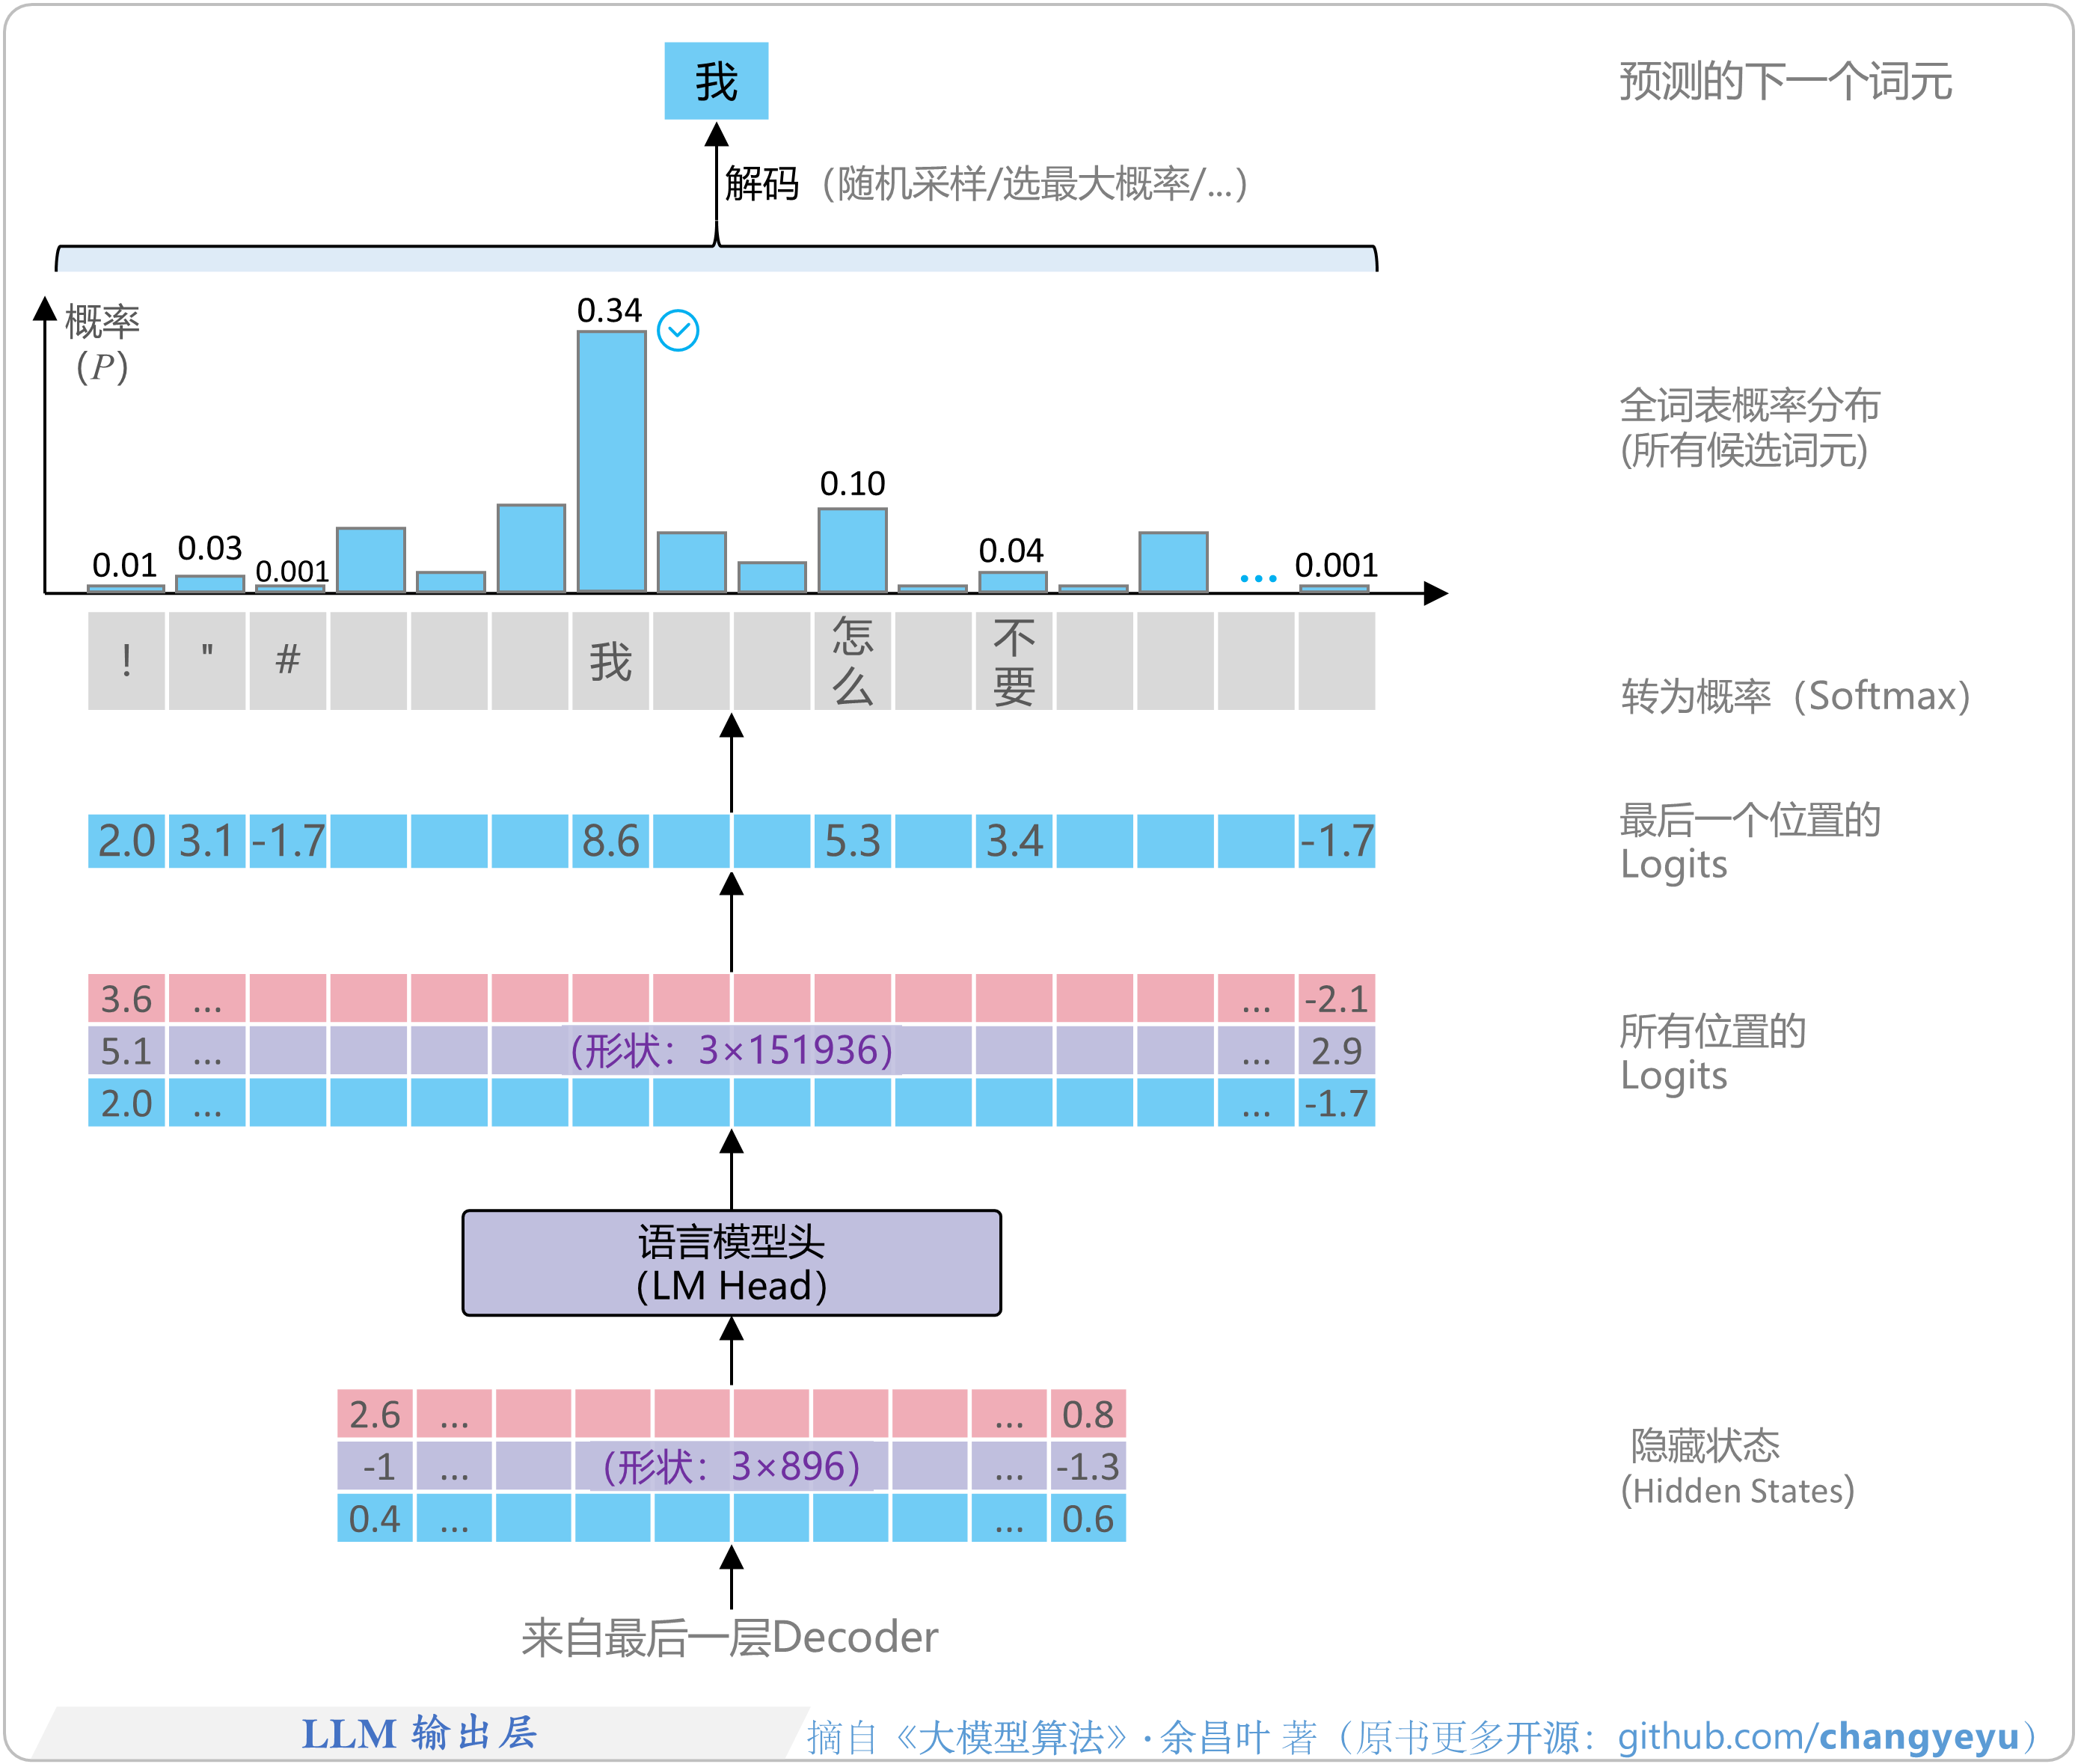
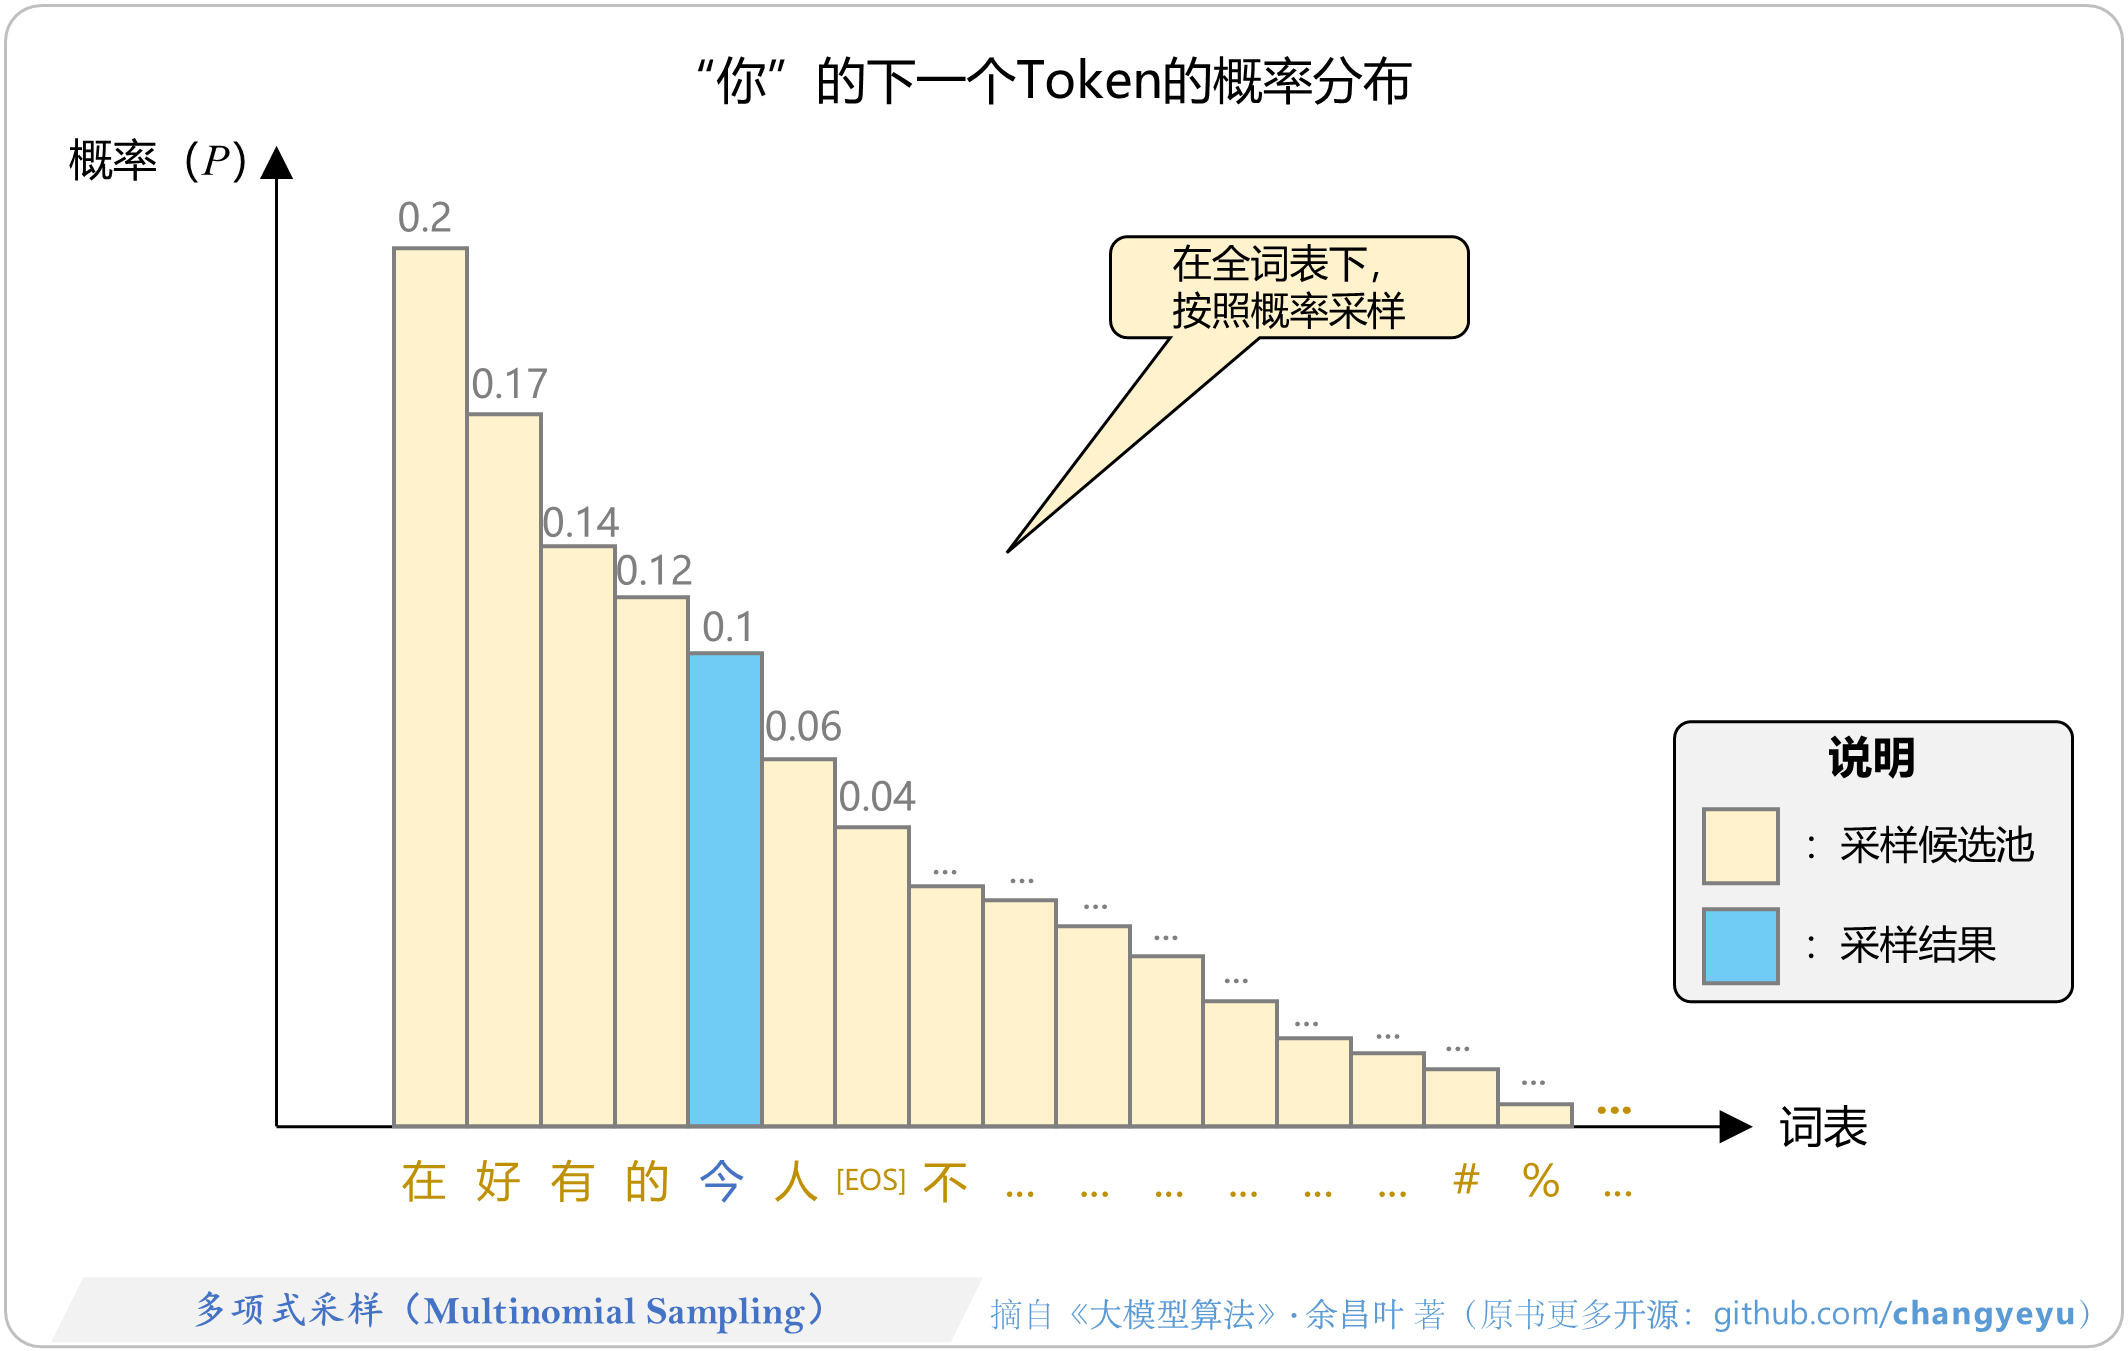
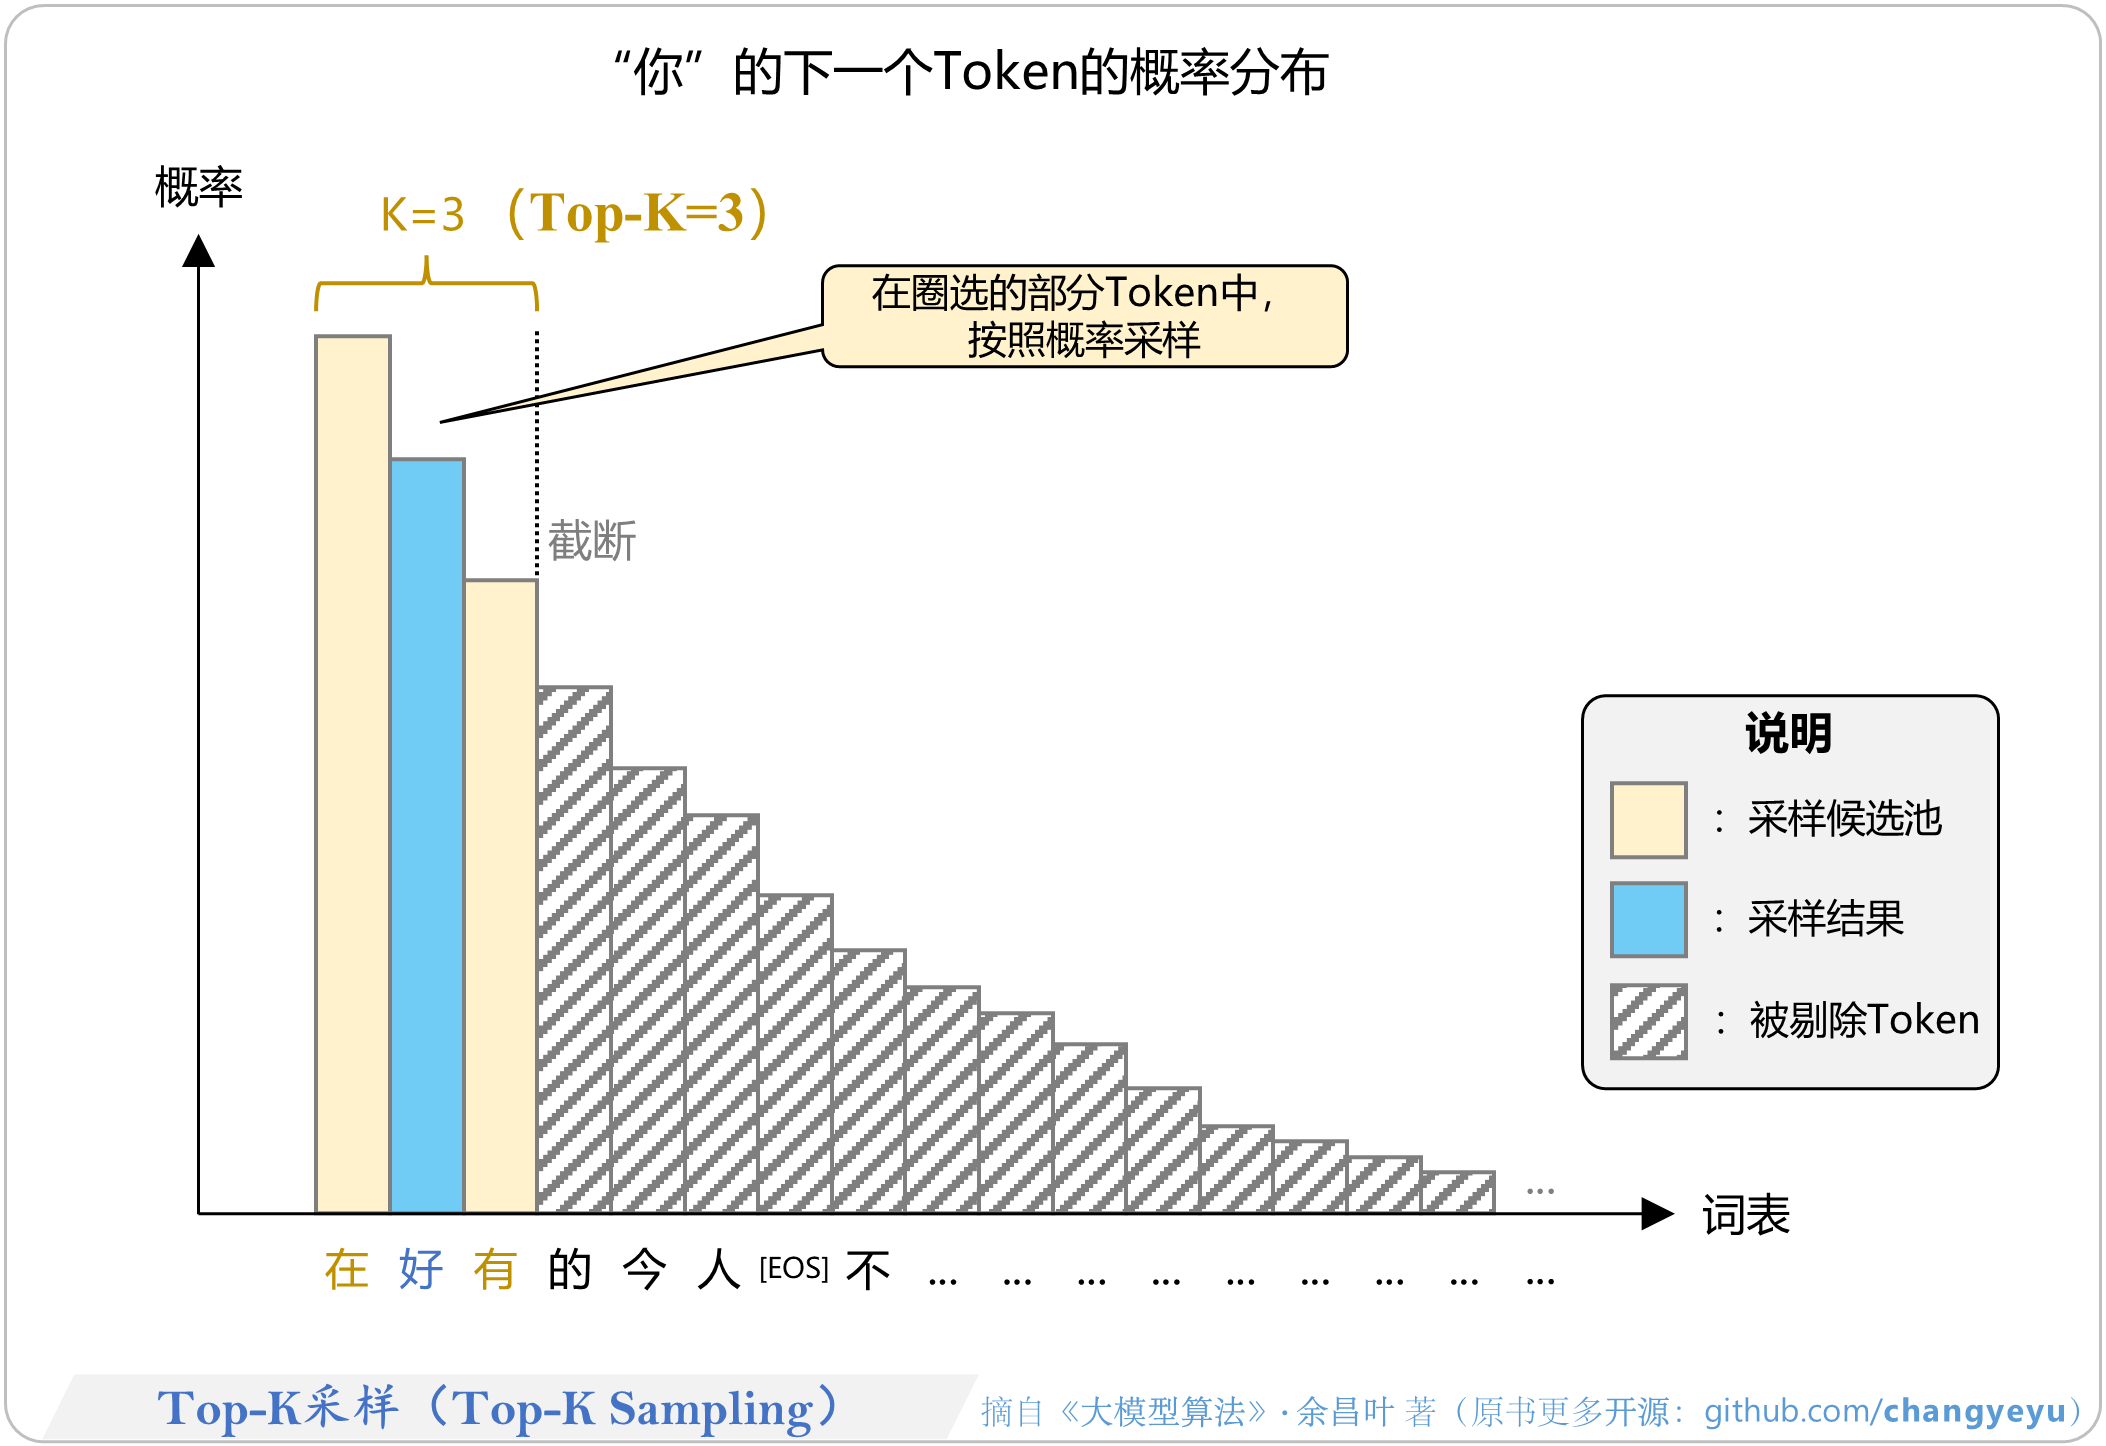
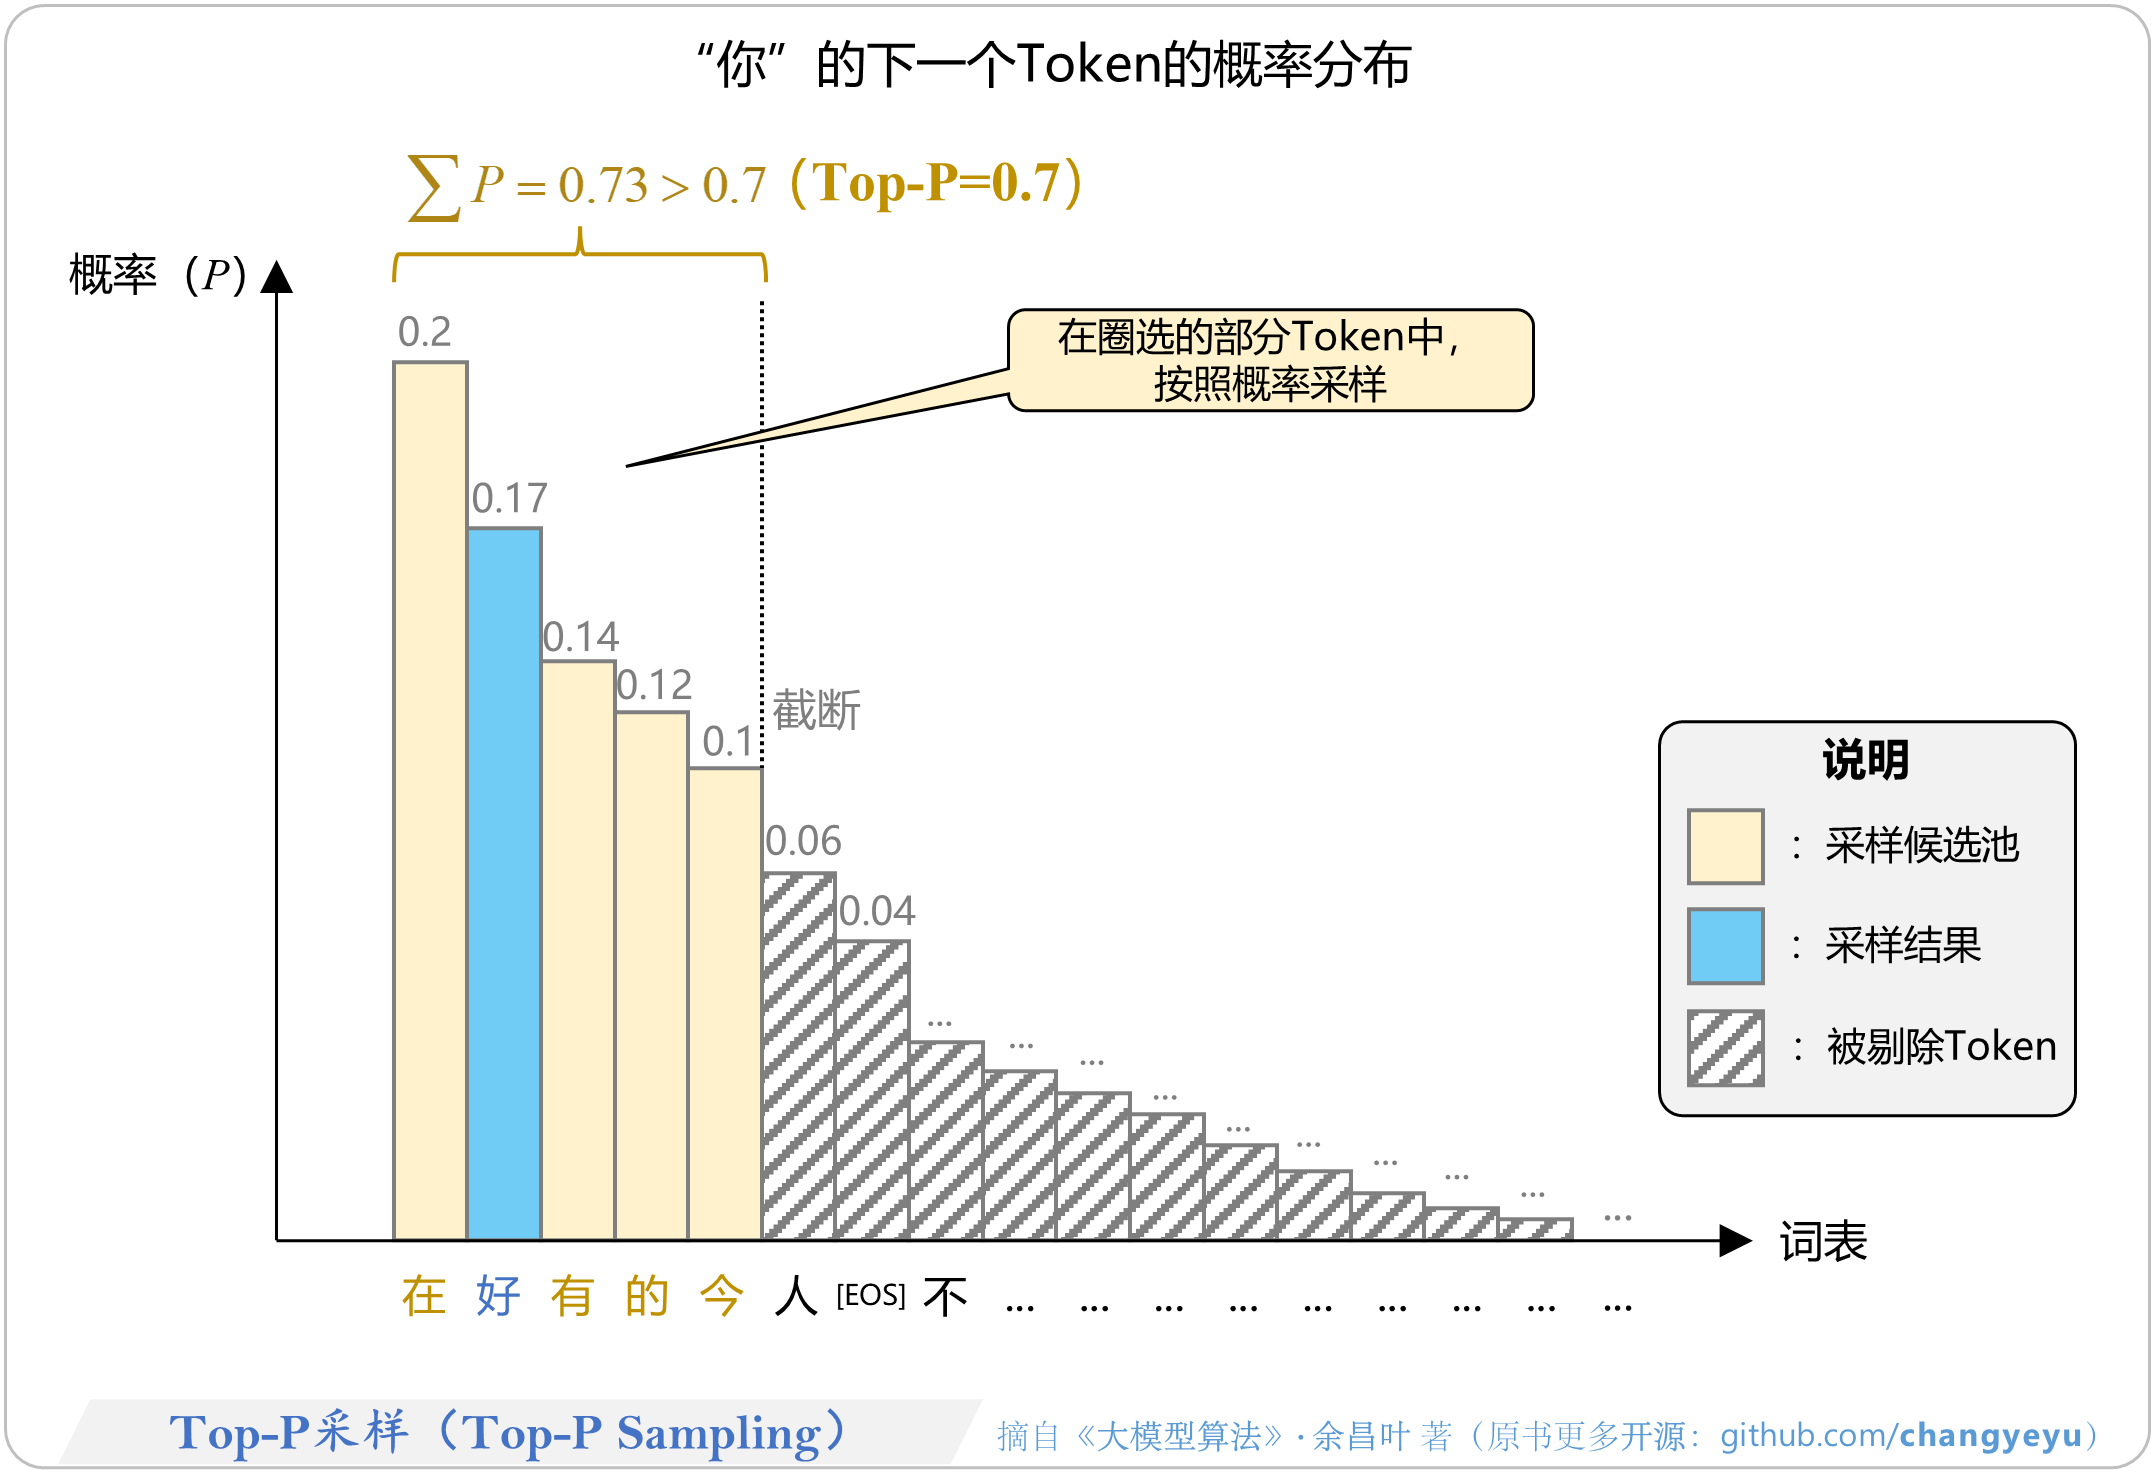
LLM的输出层负责根据隐藏状态(多维数值矩阵)预测下一个词元(文本)。处理流程如图所示:
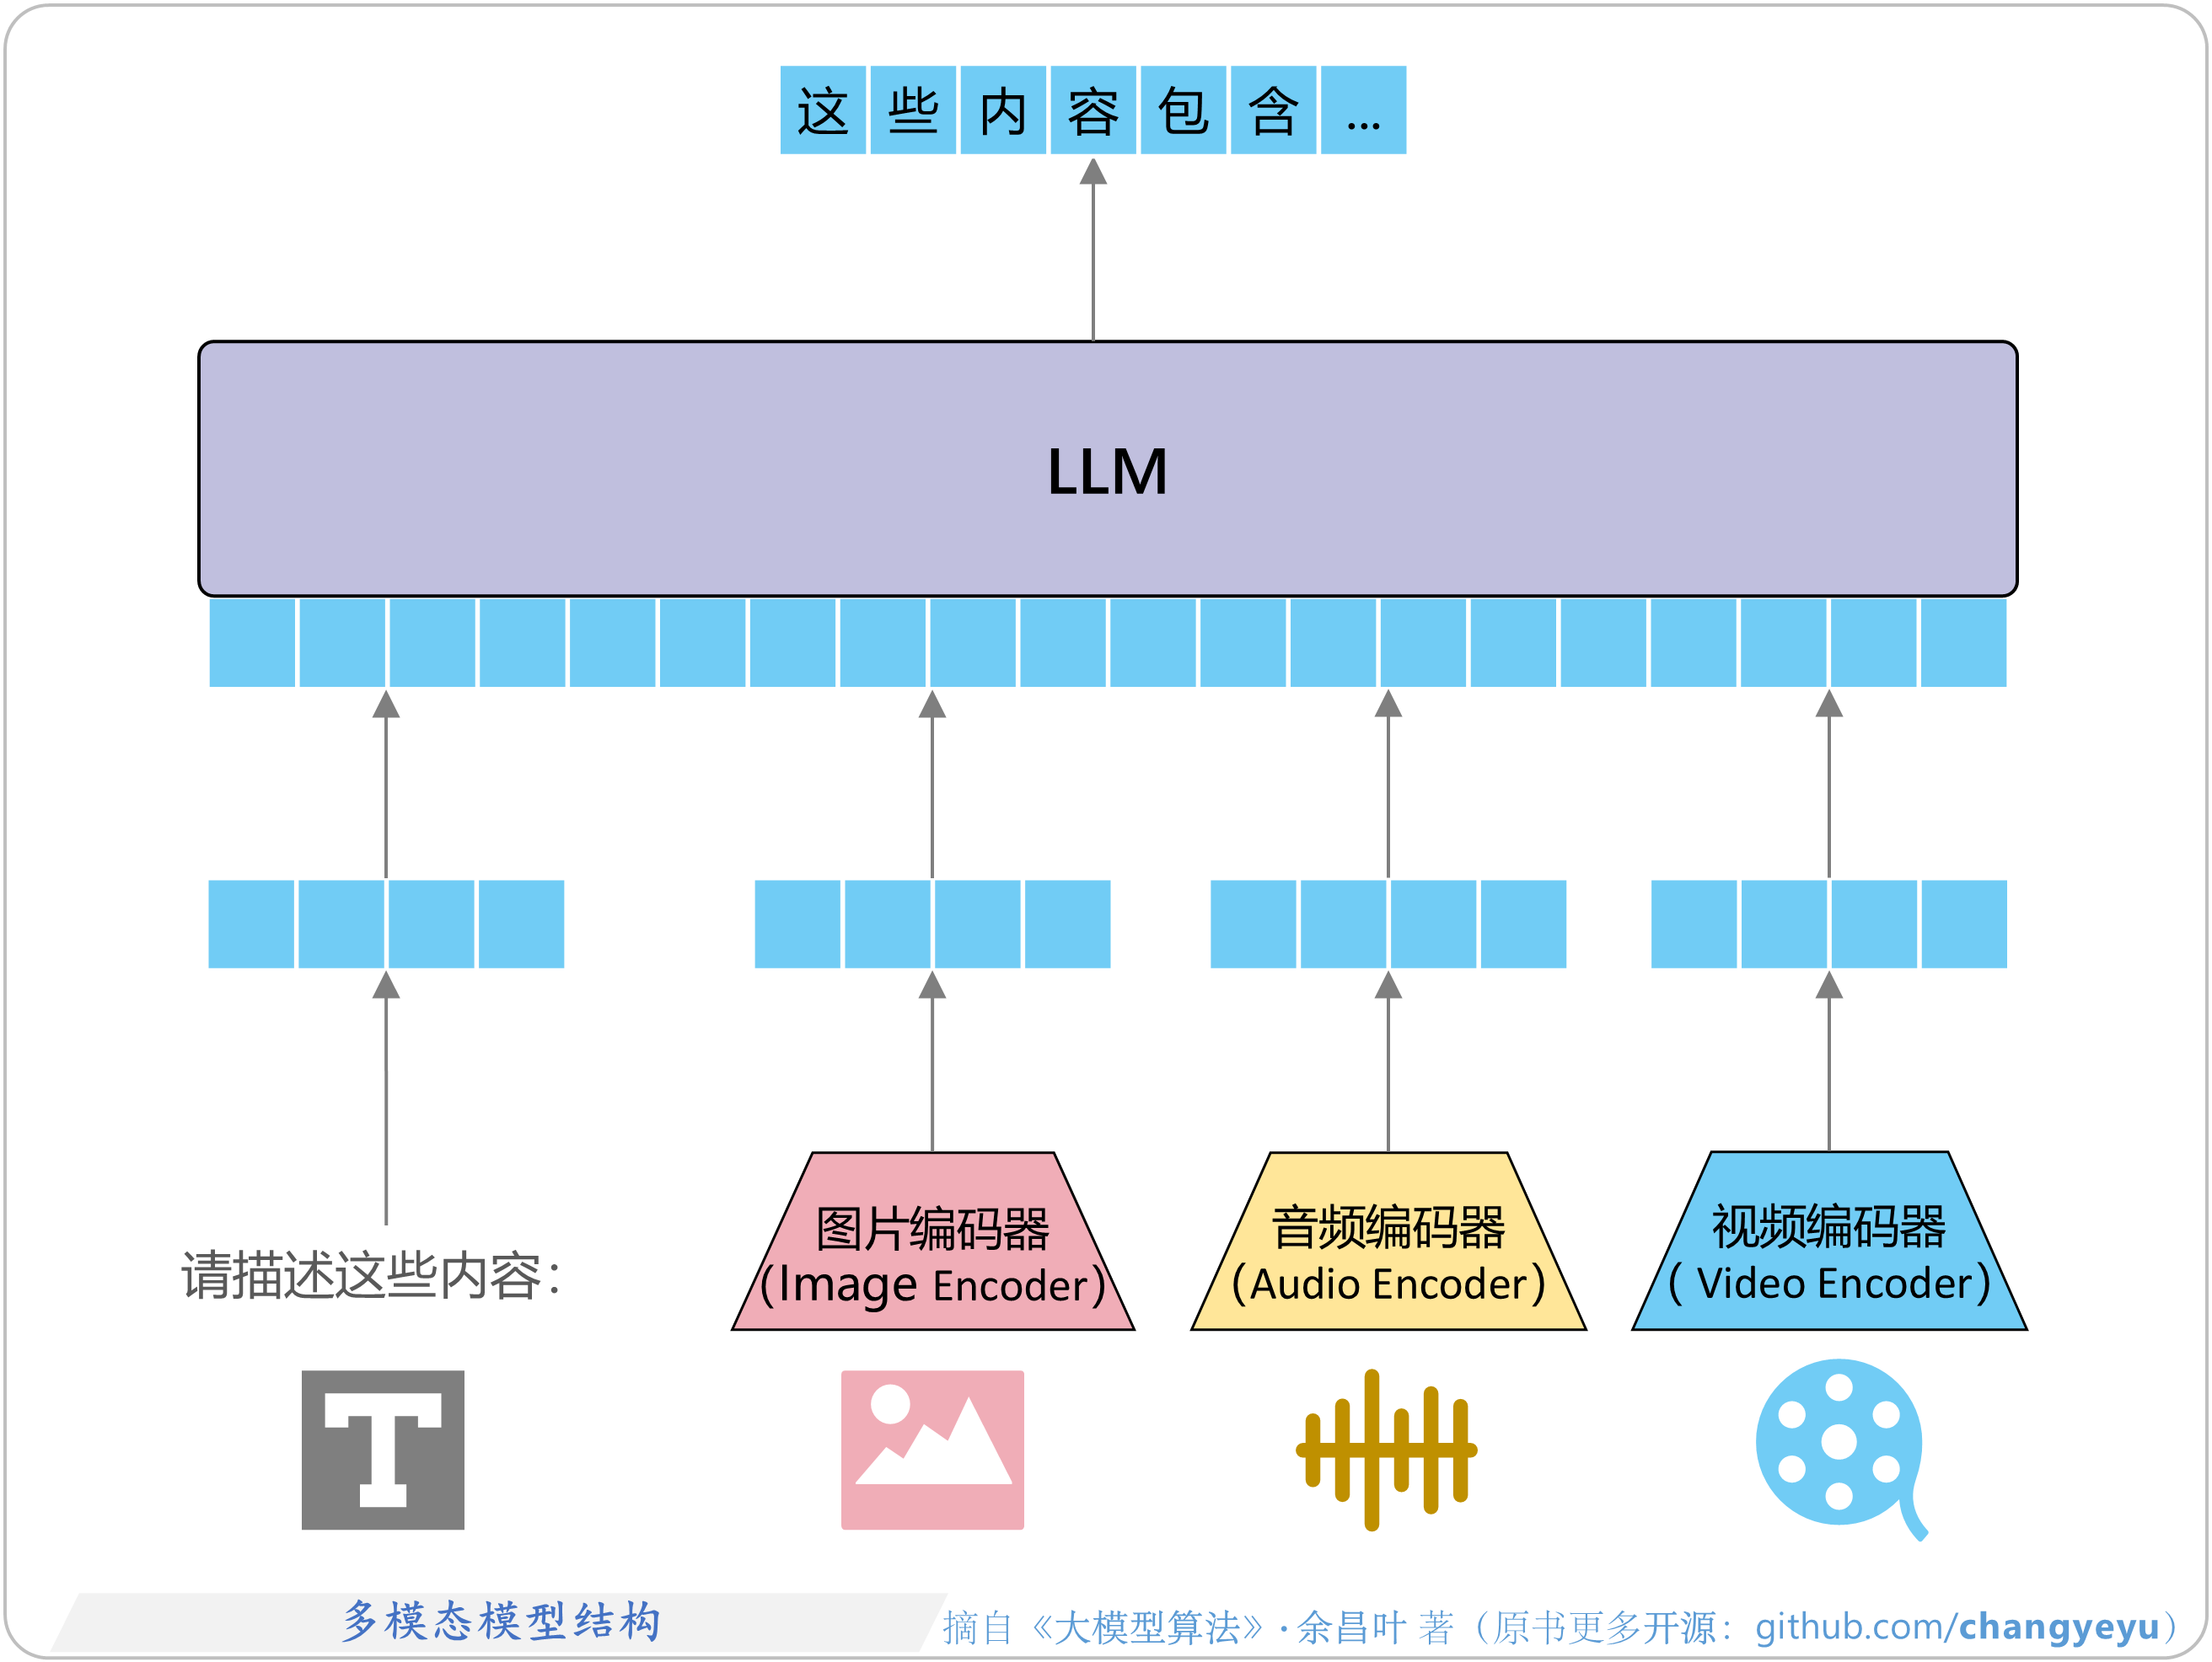
多模态模型根据侧重不同,通常有以下多种称呼:
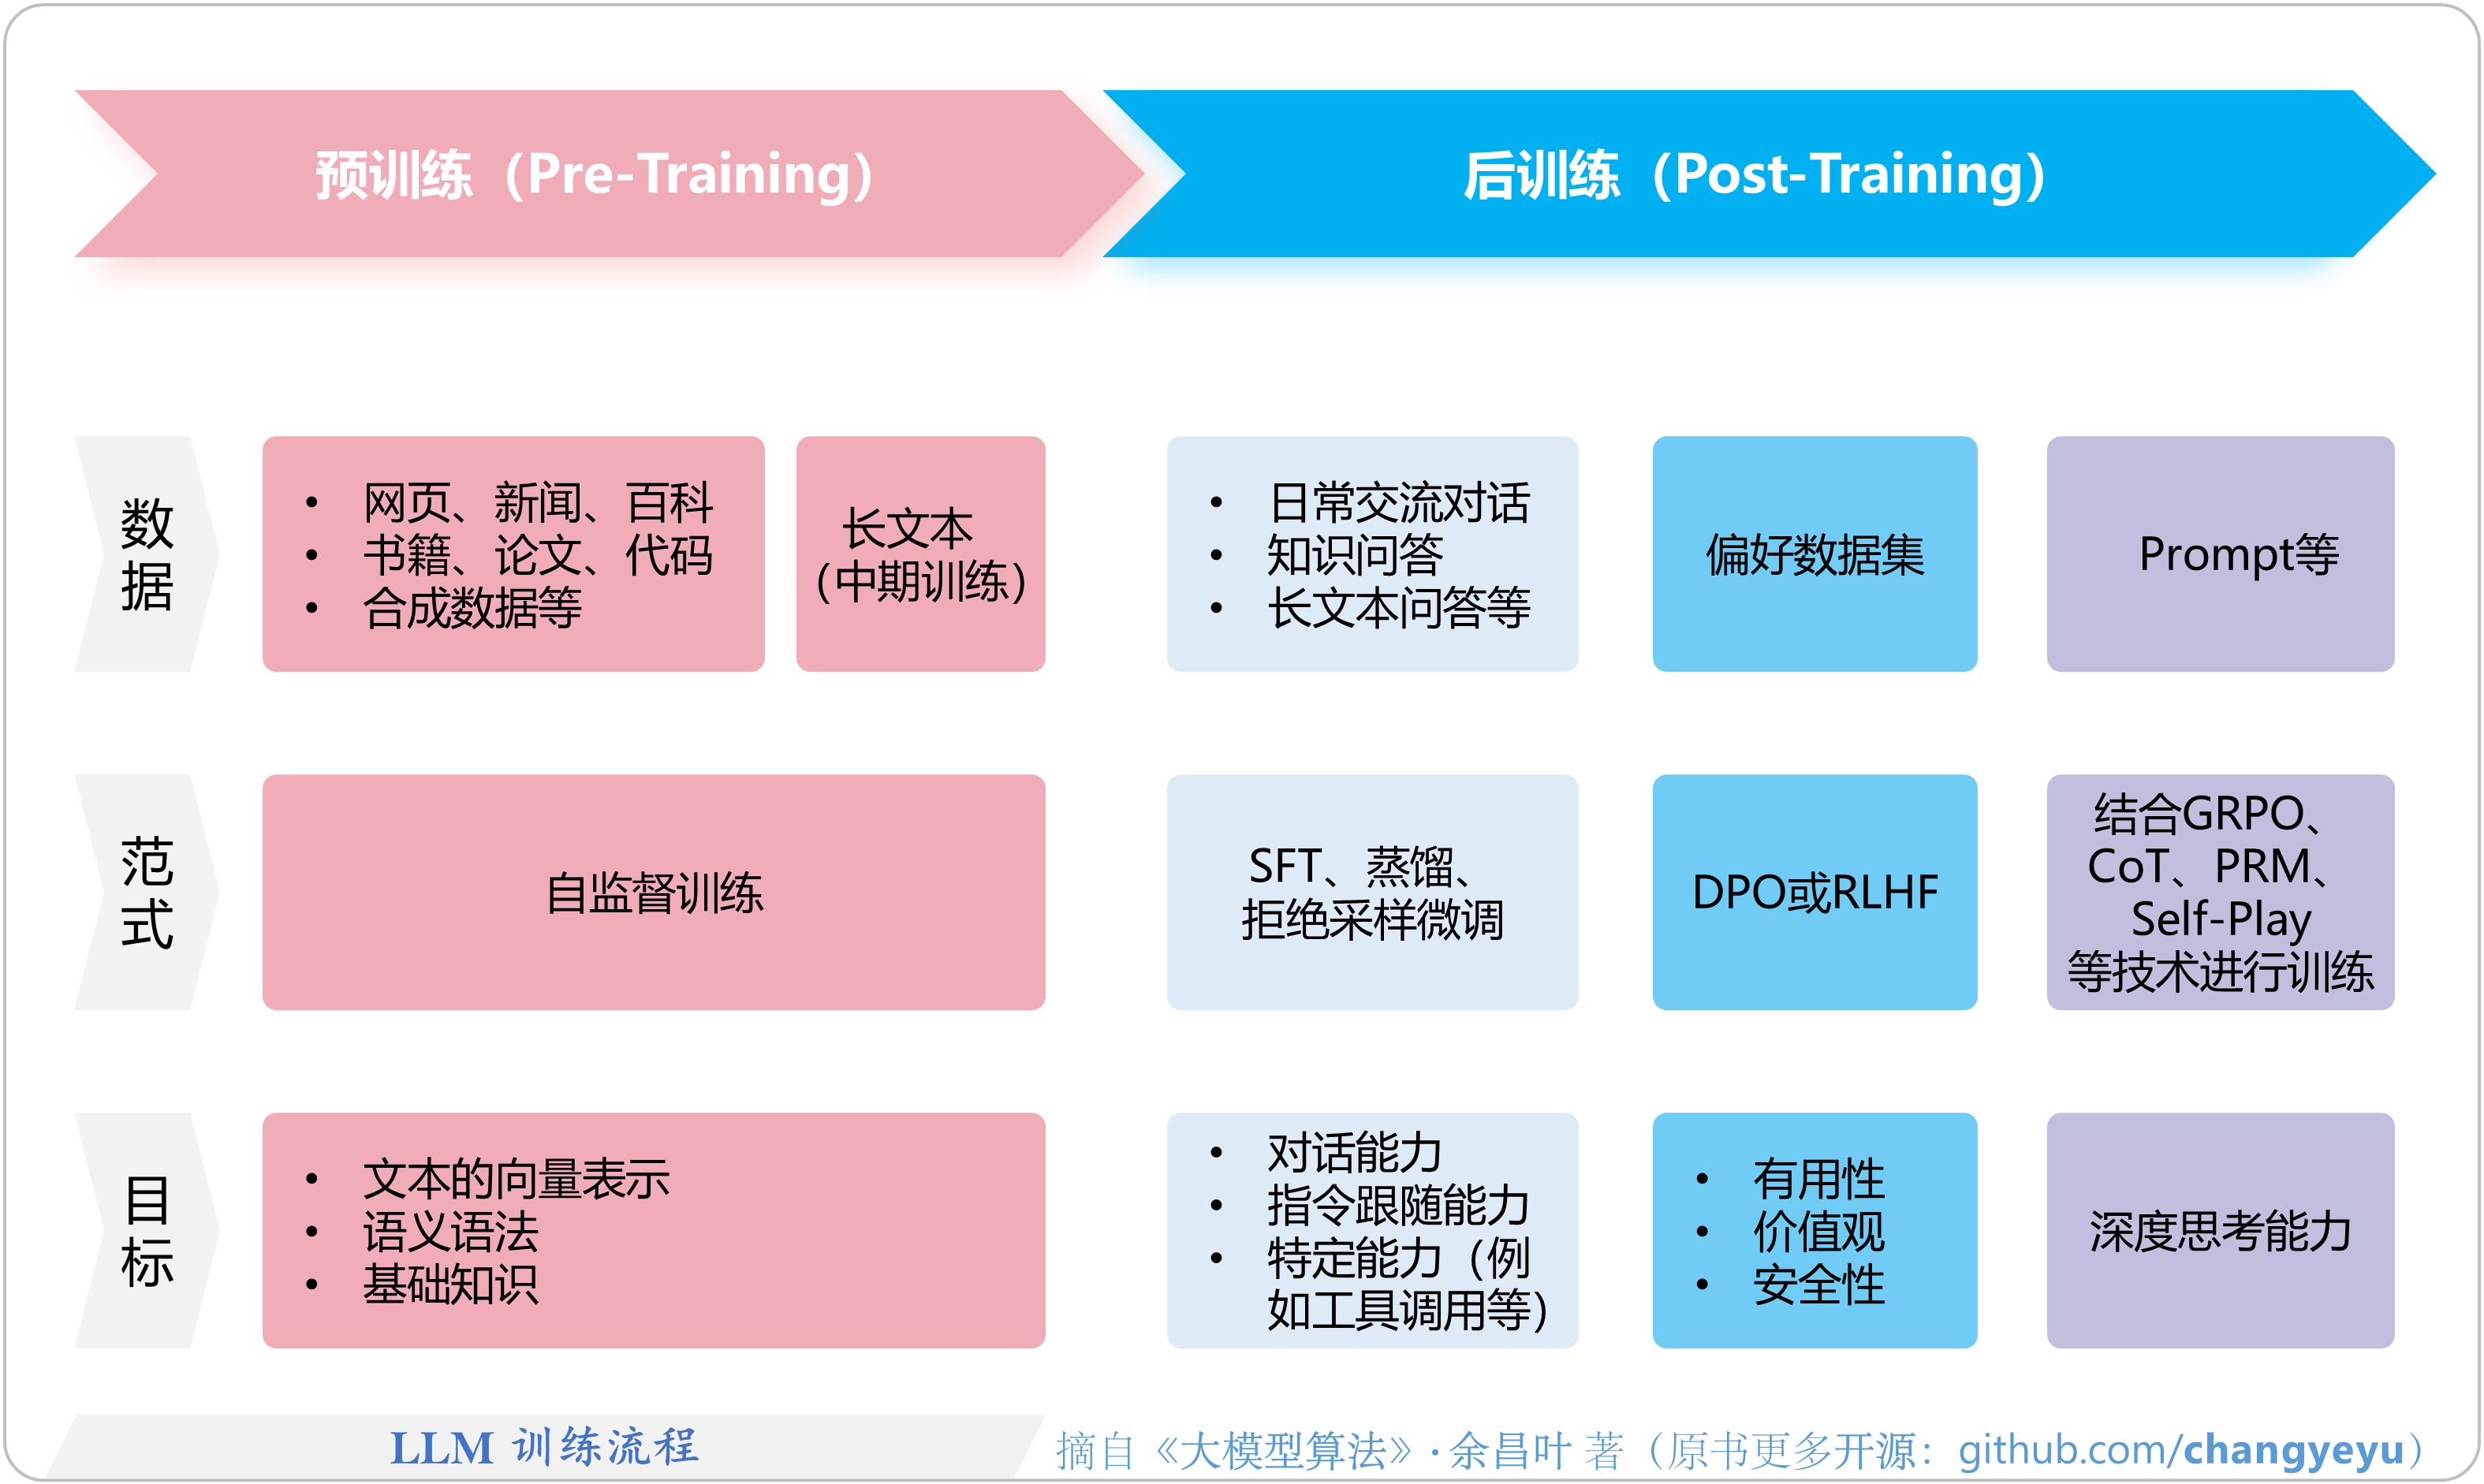
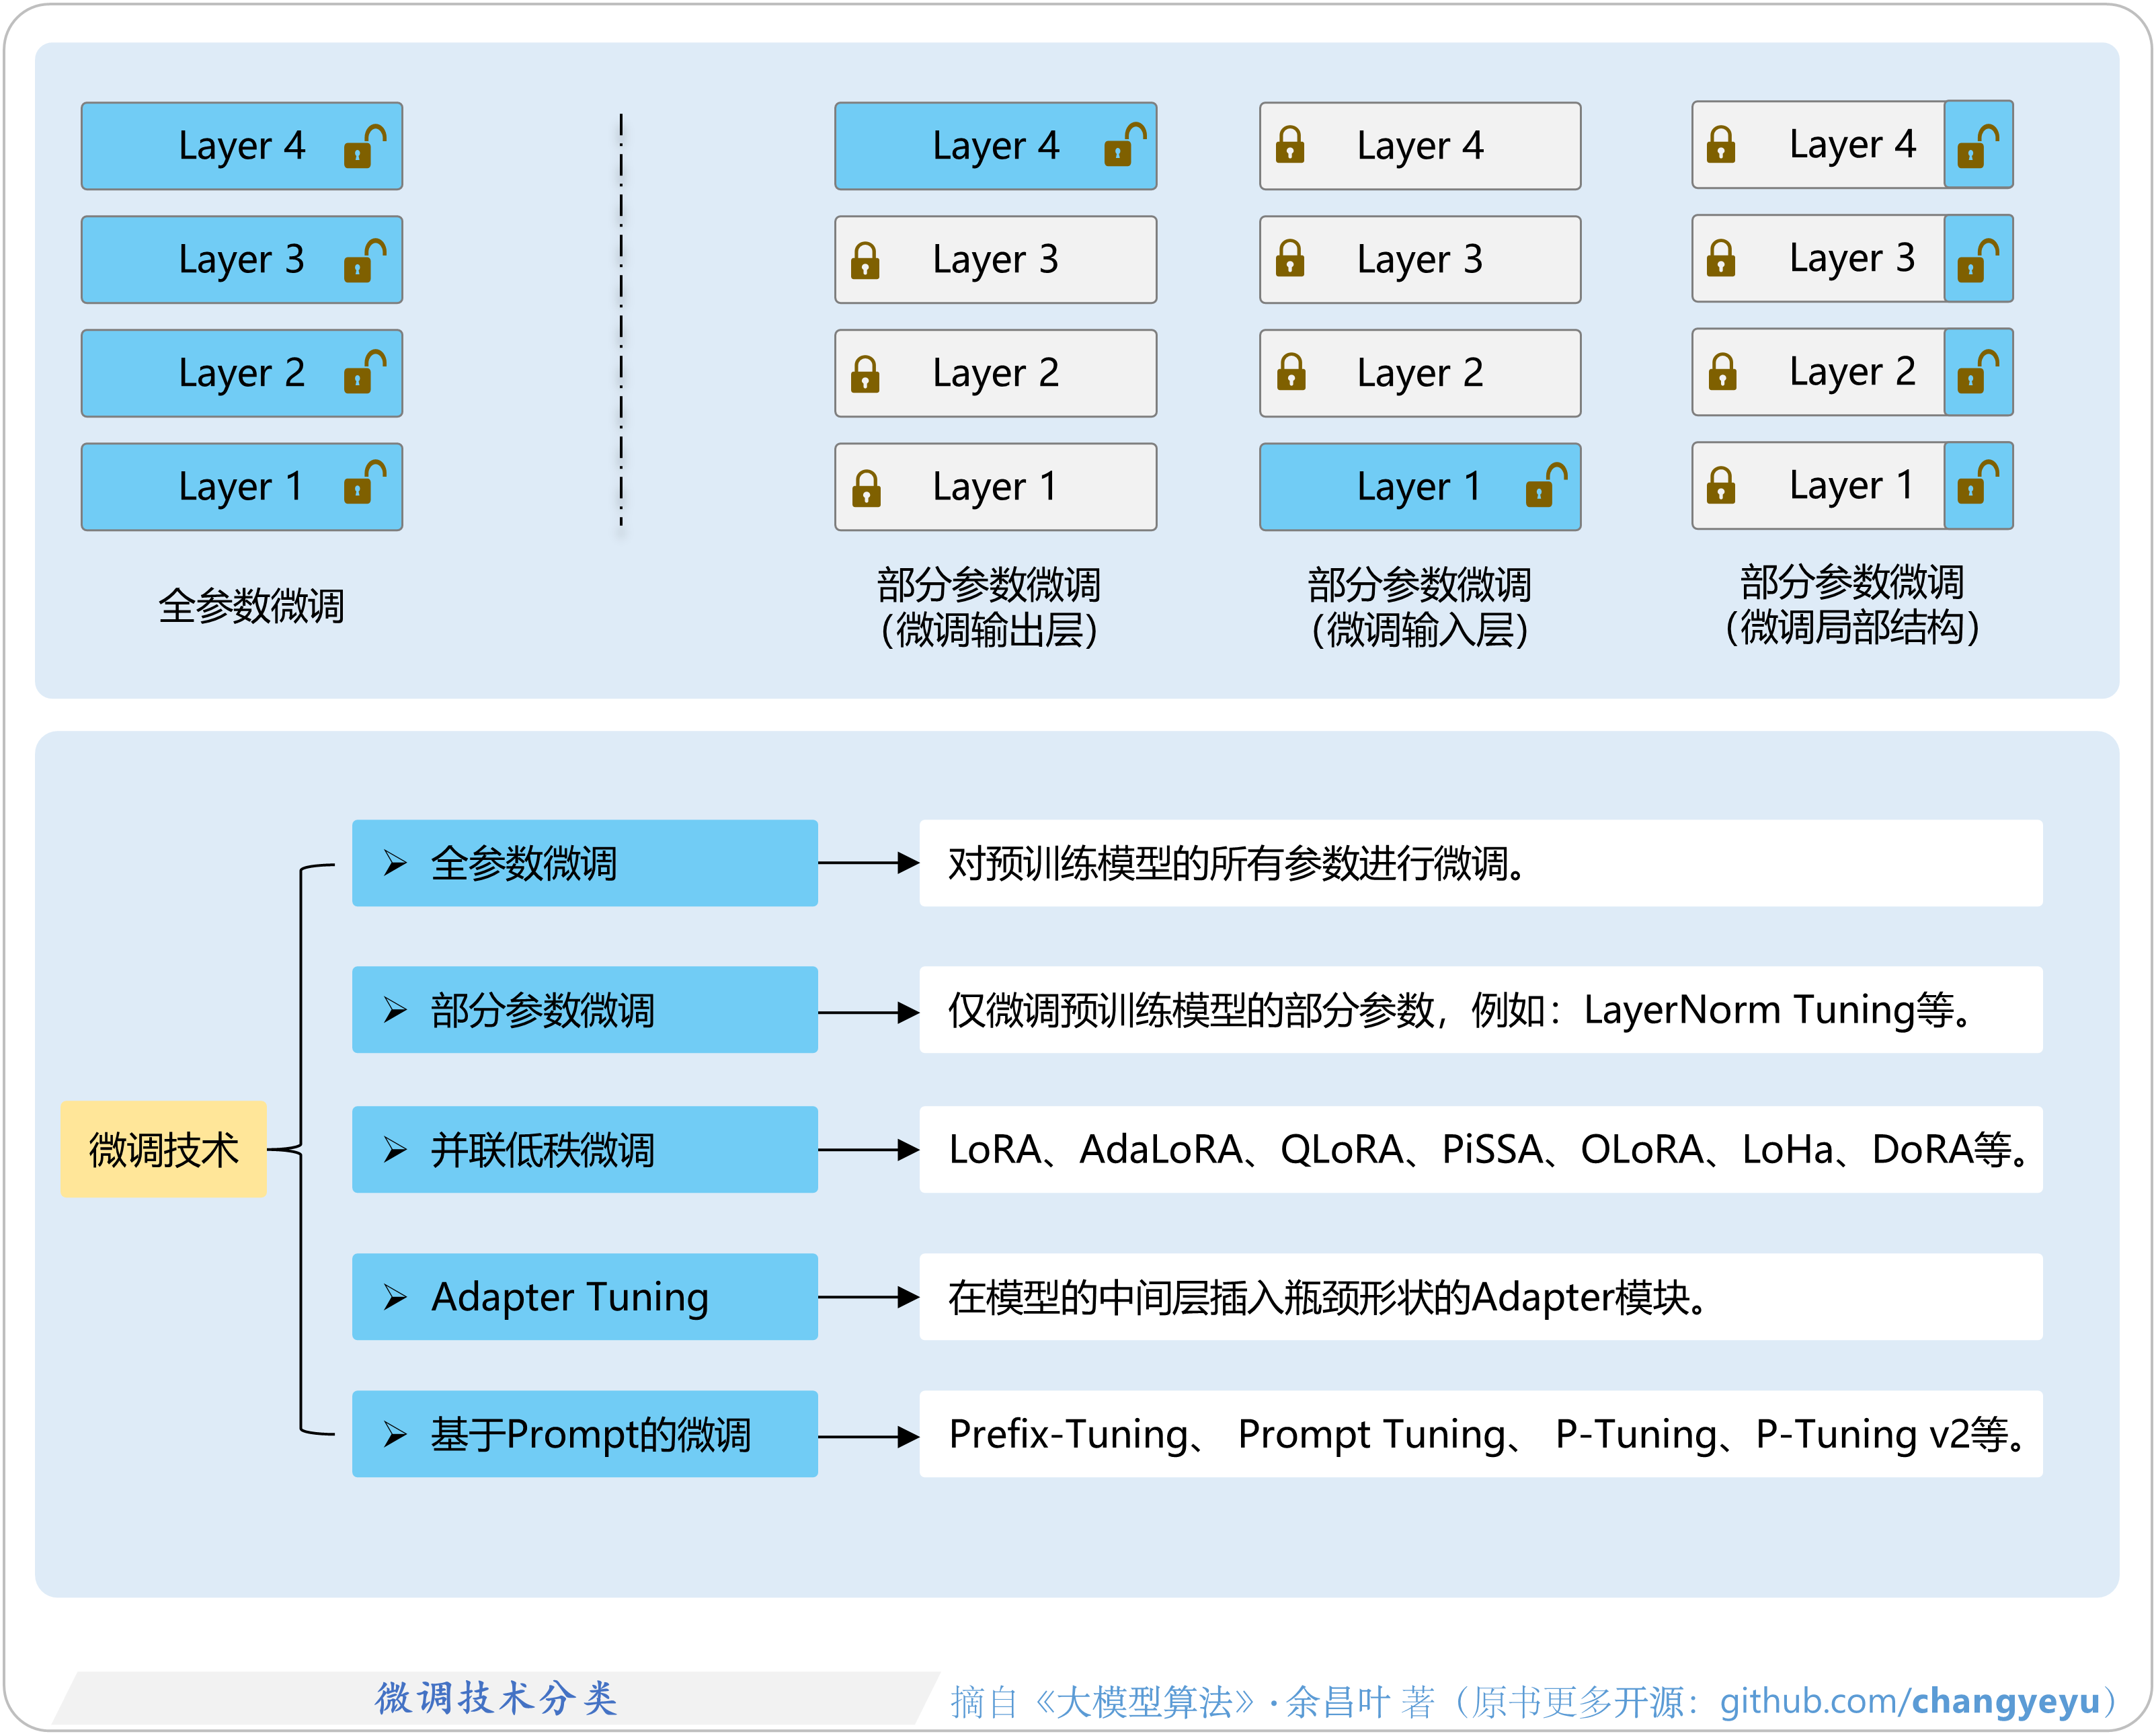
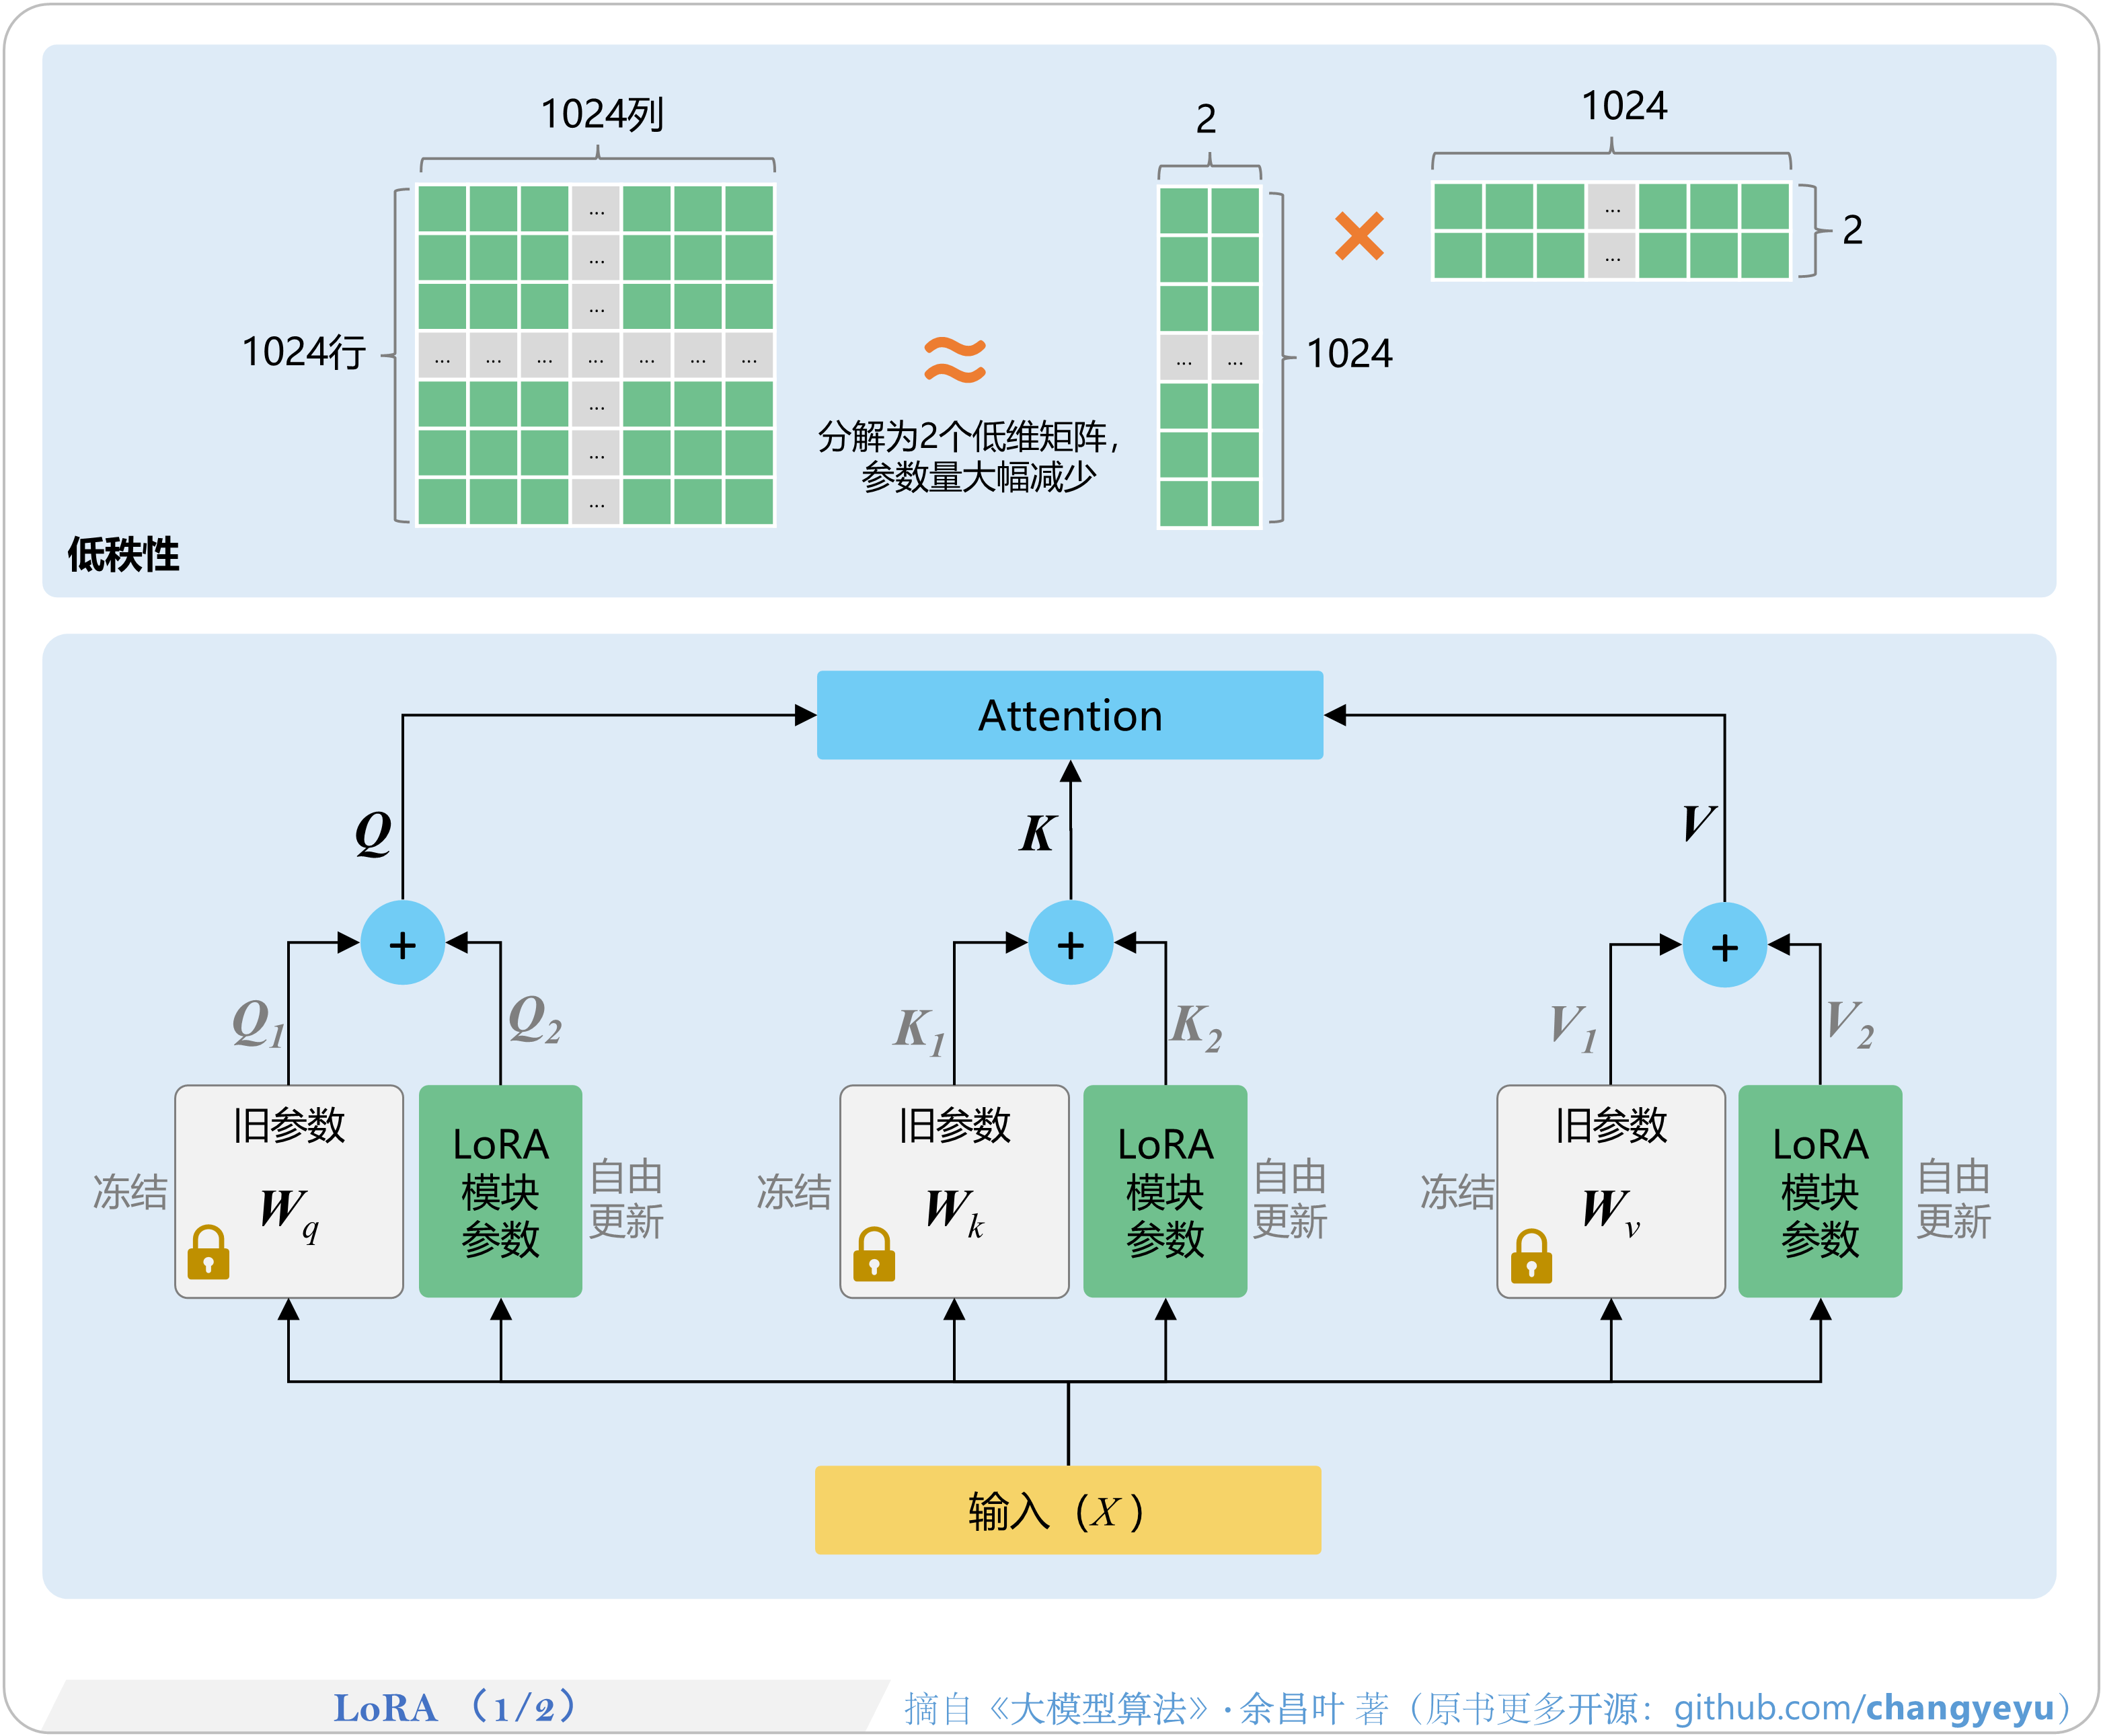
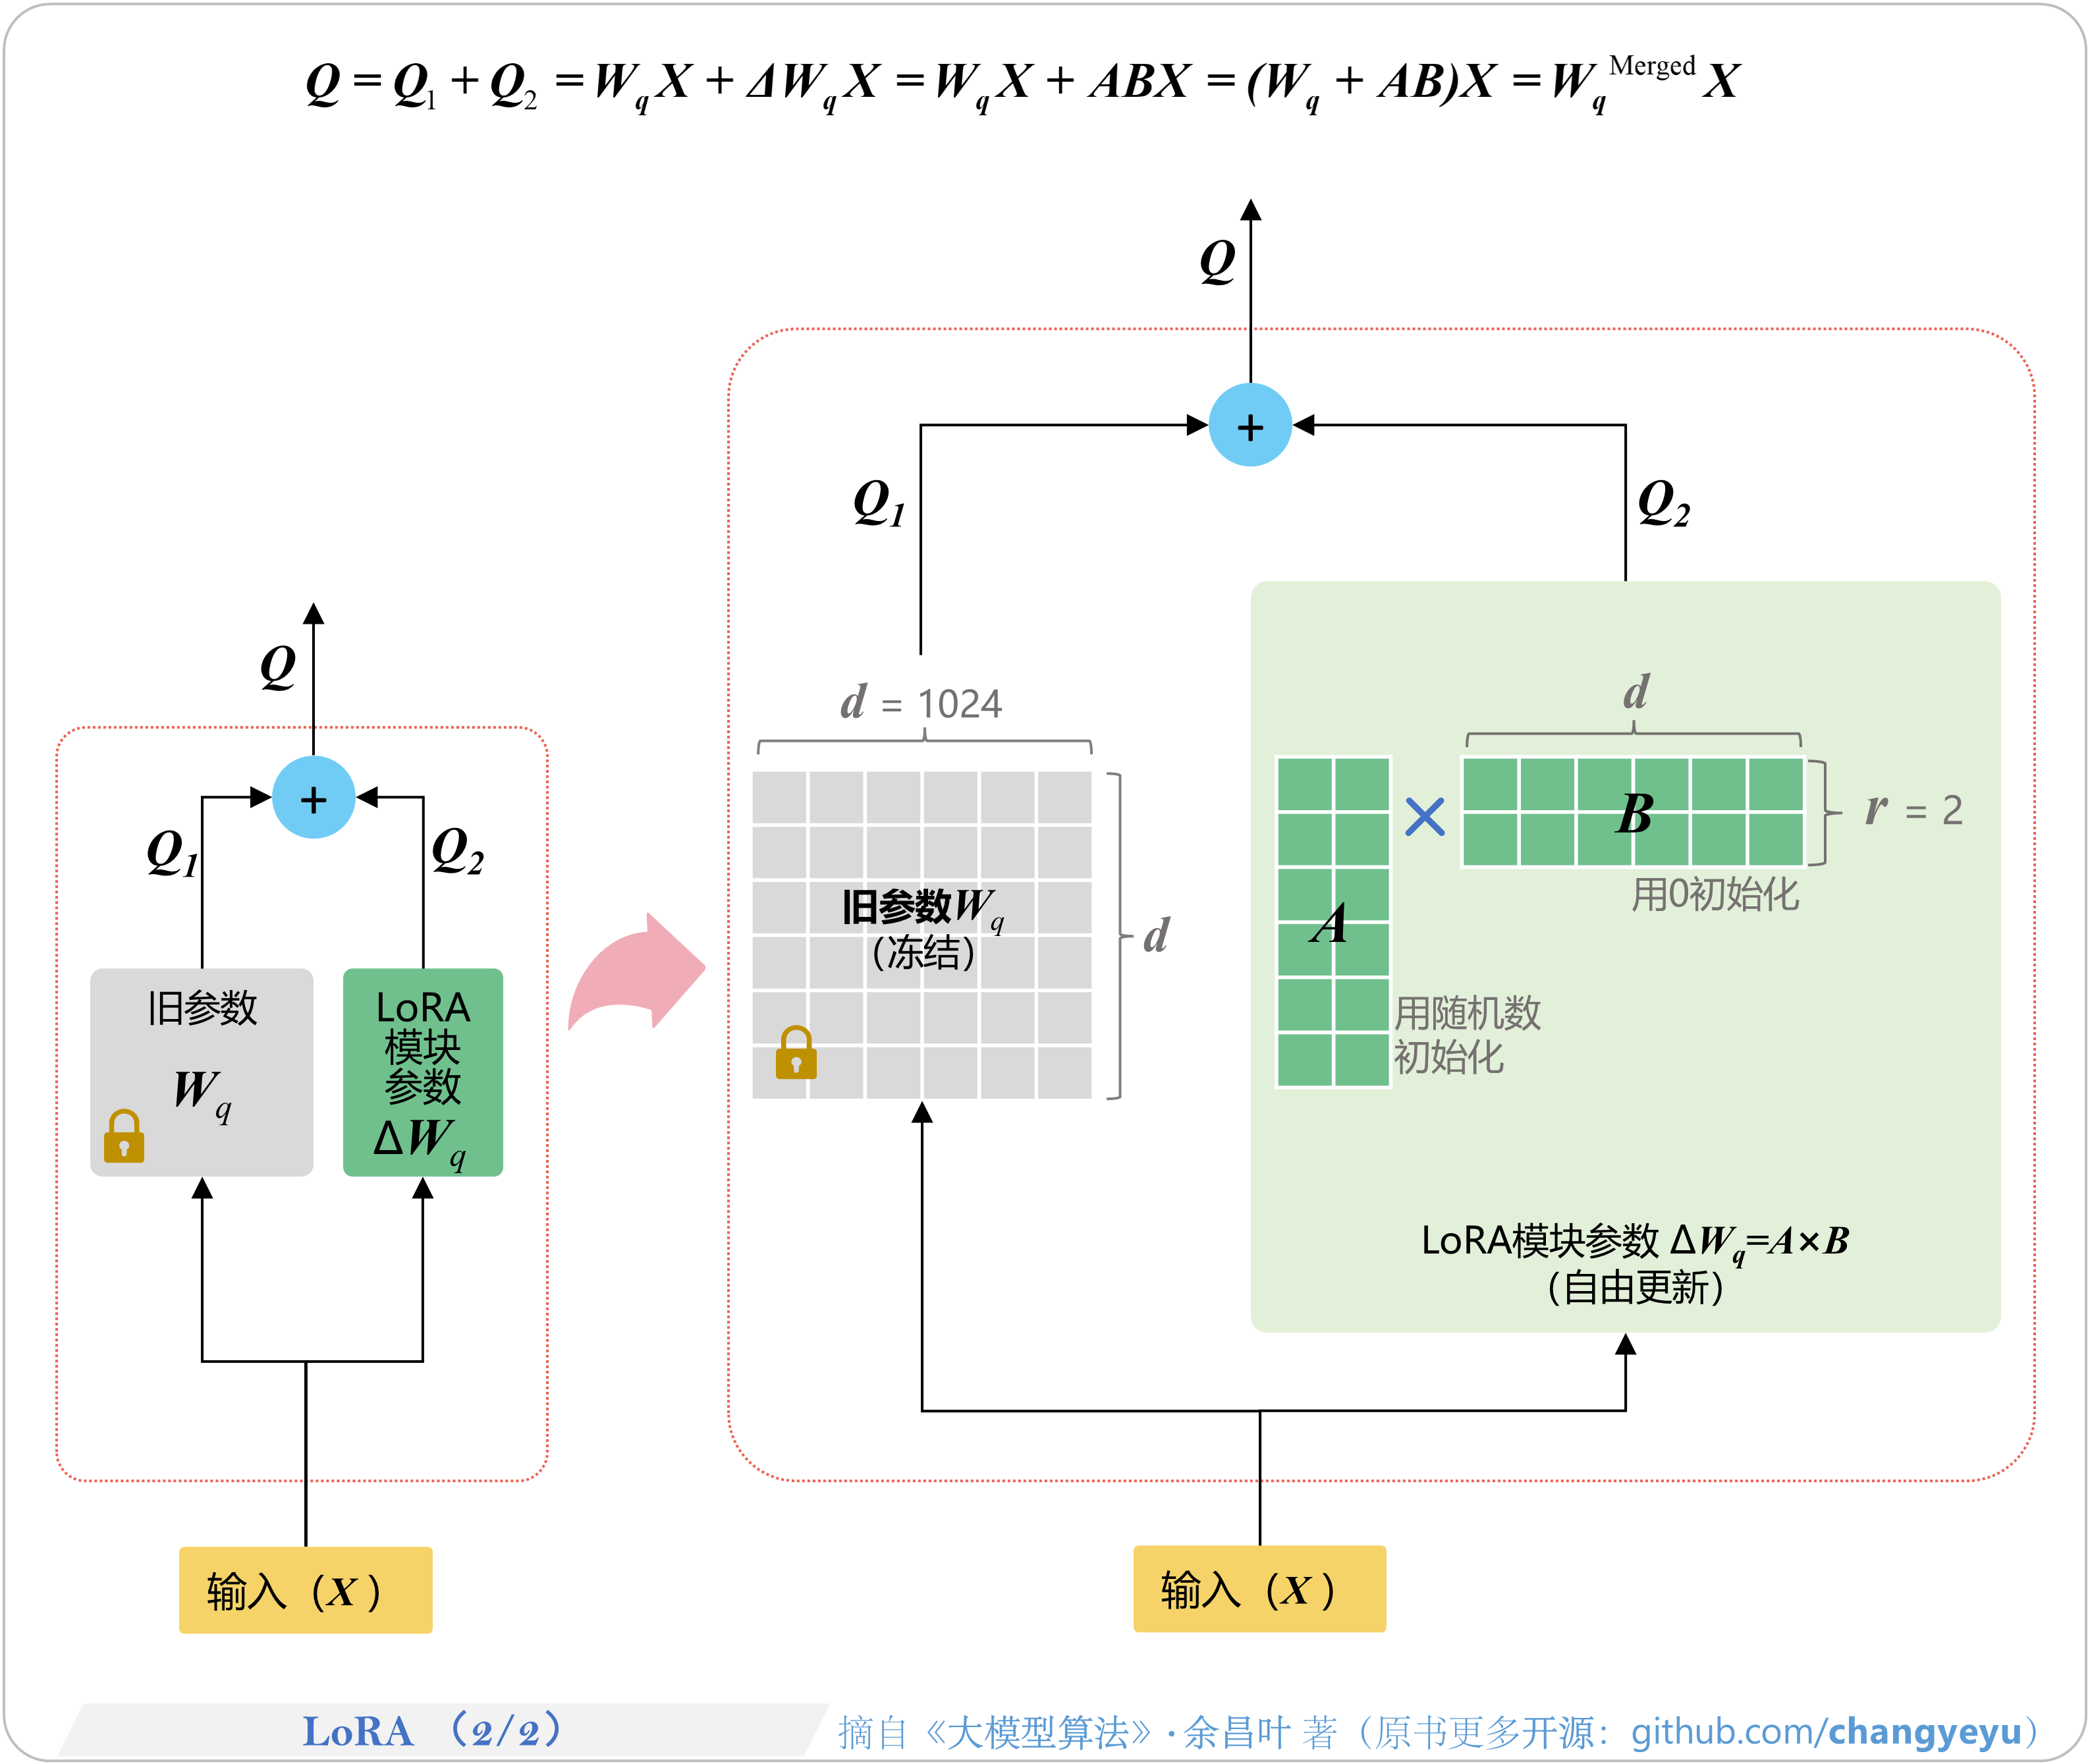
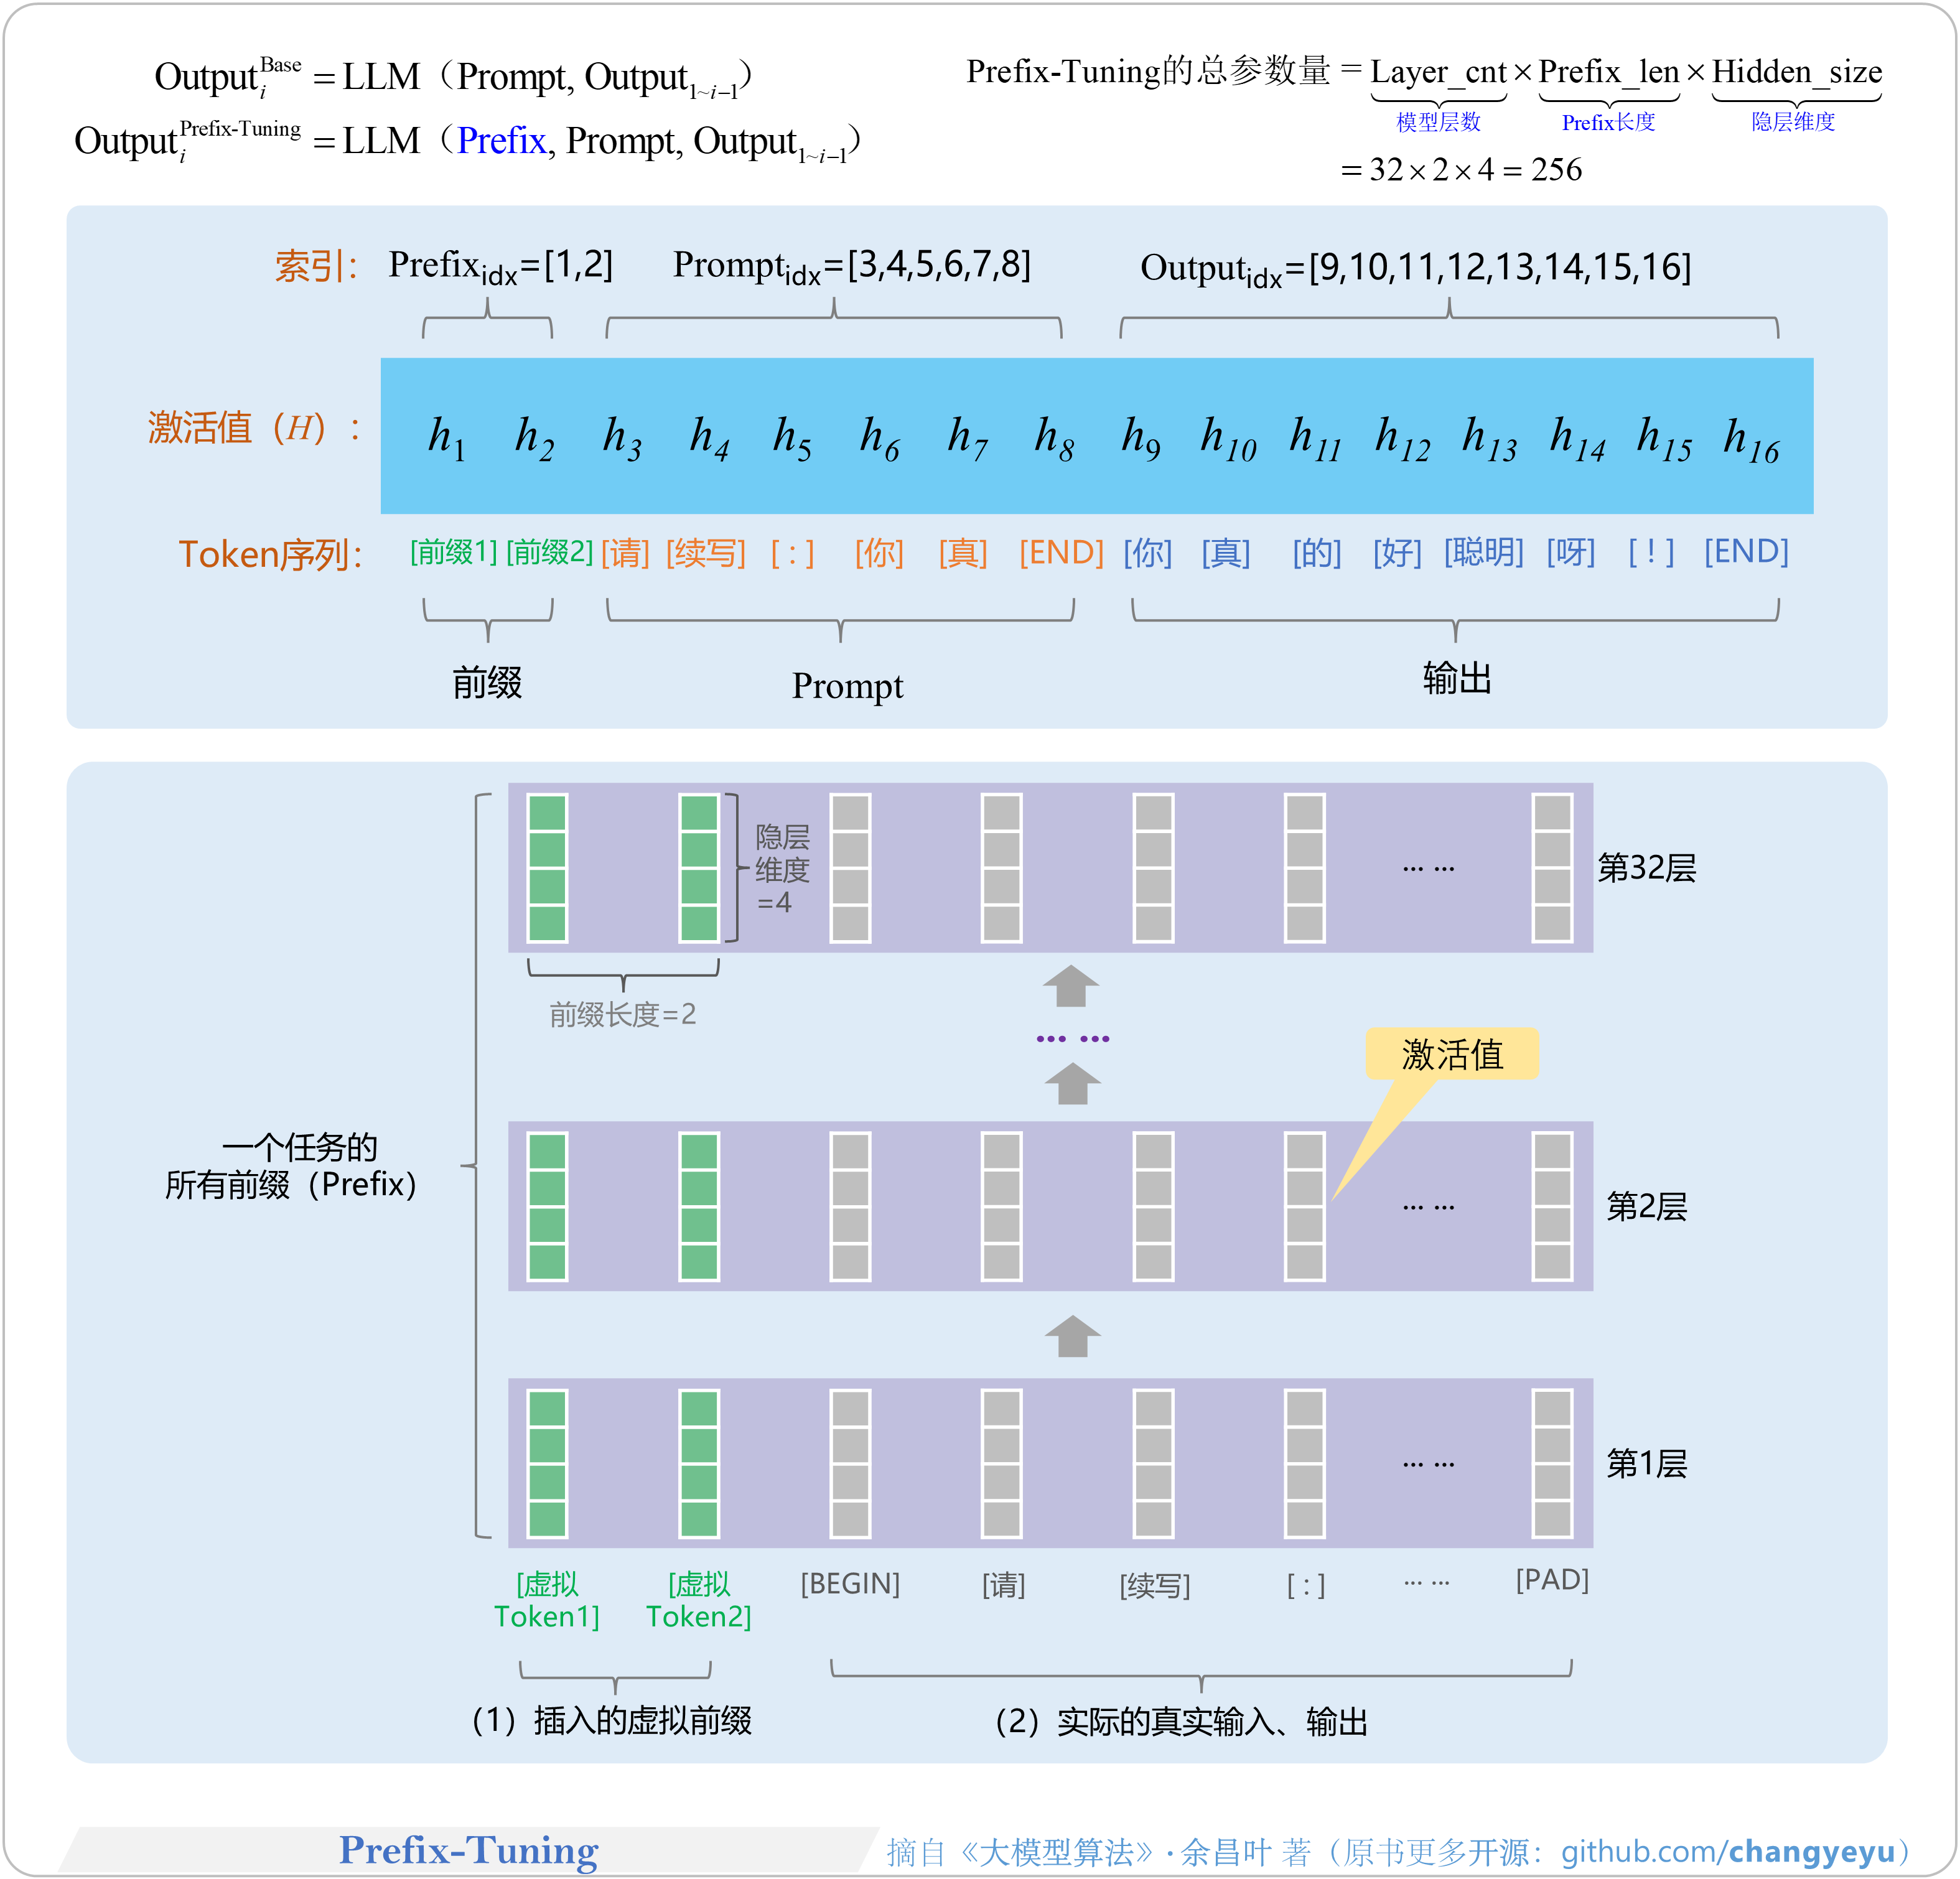
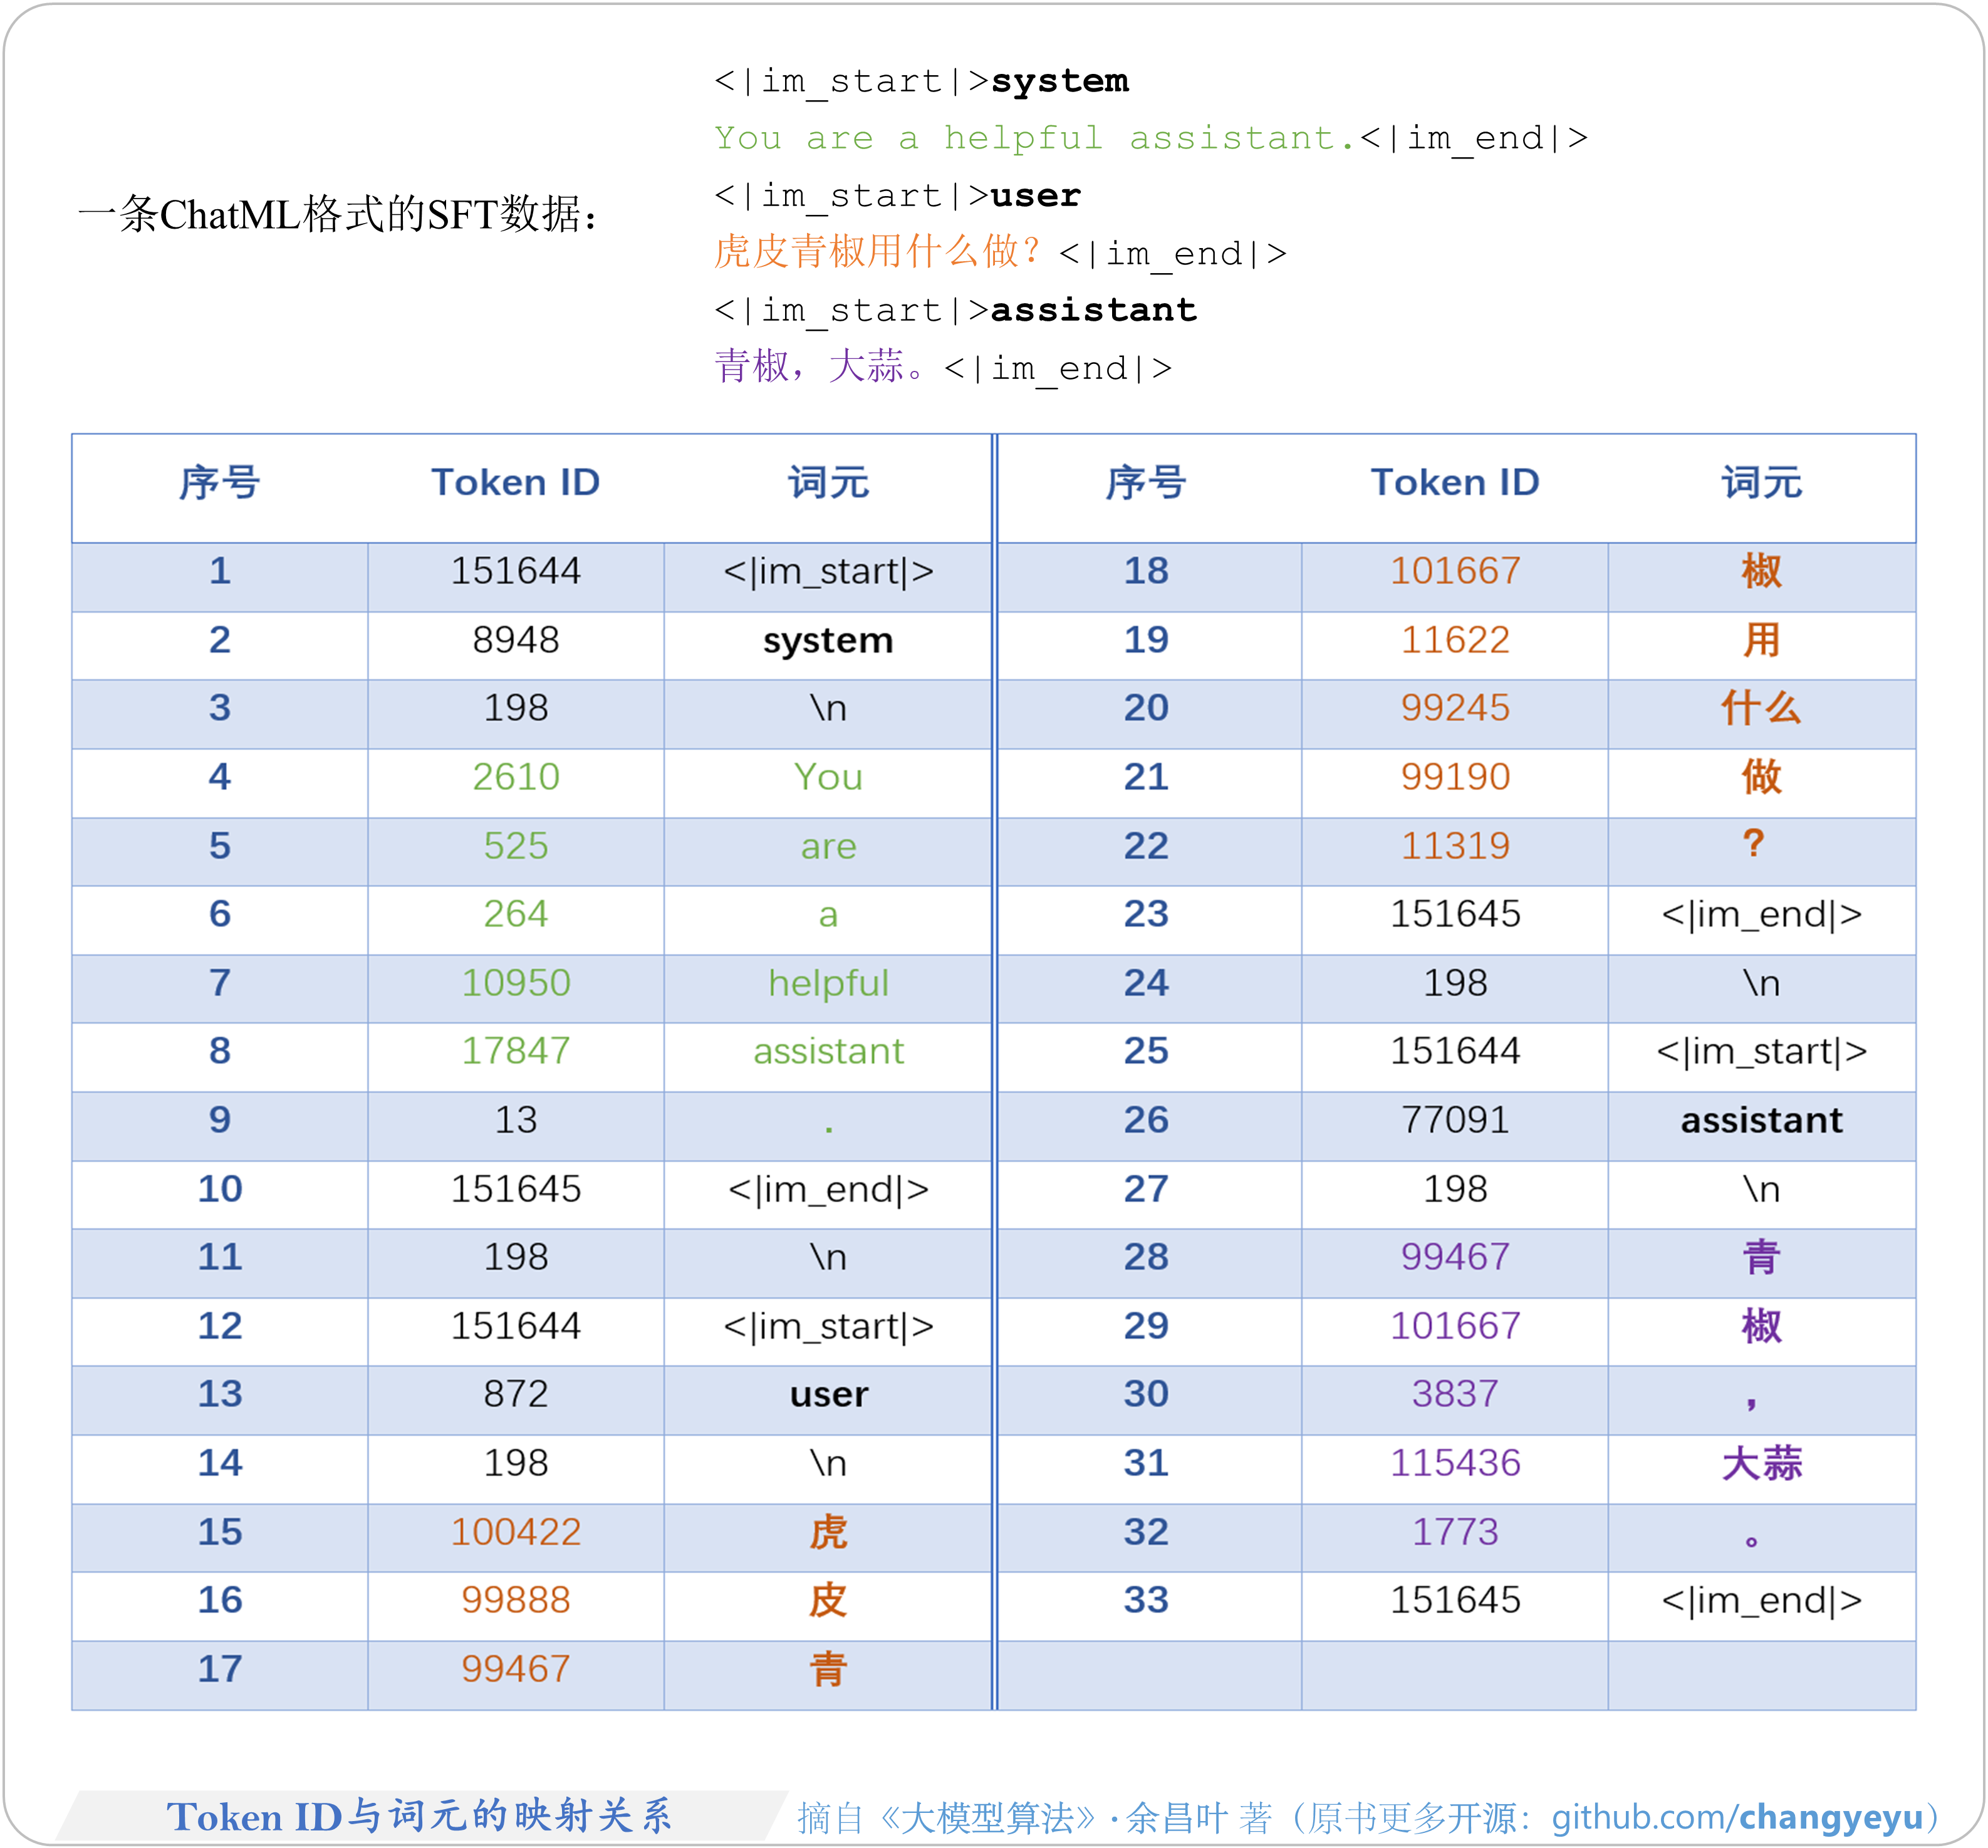
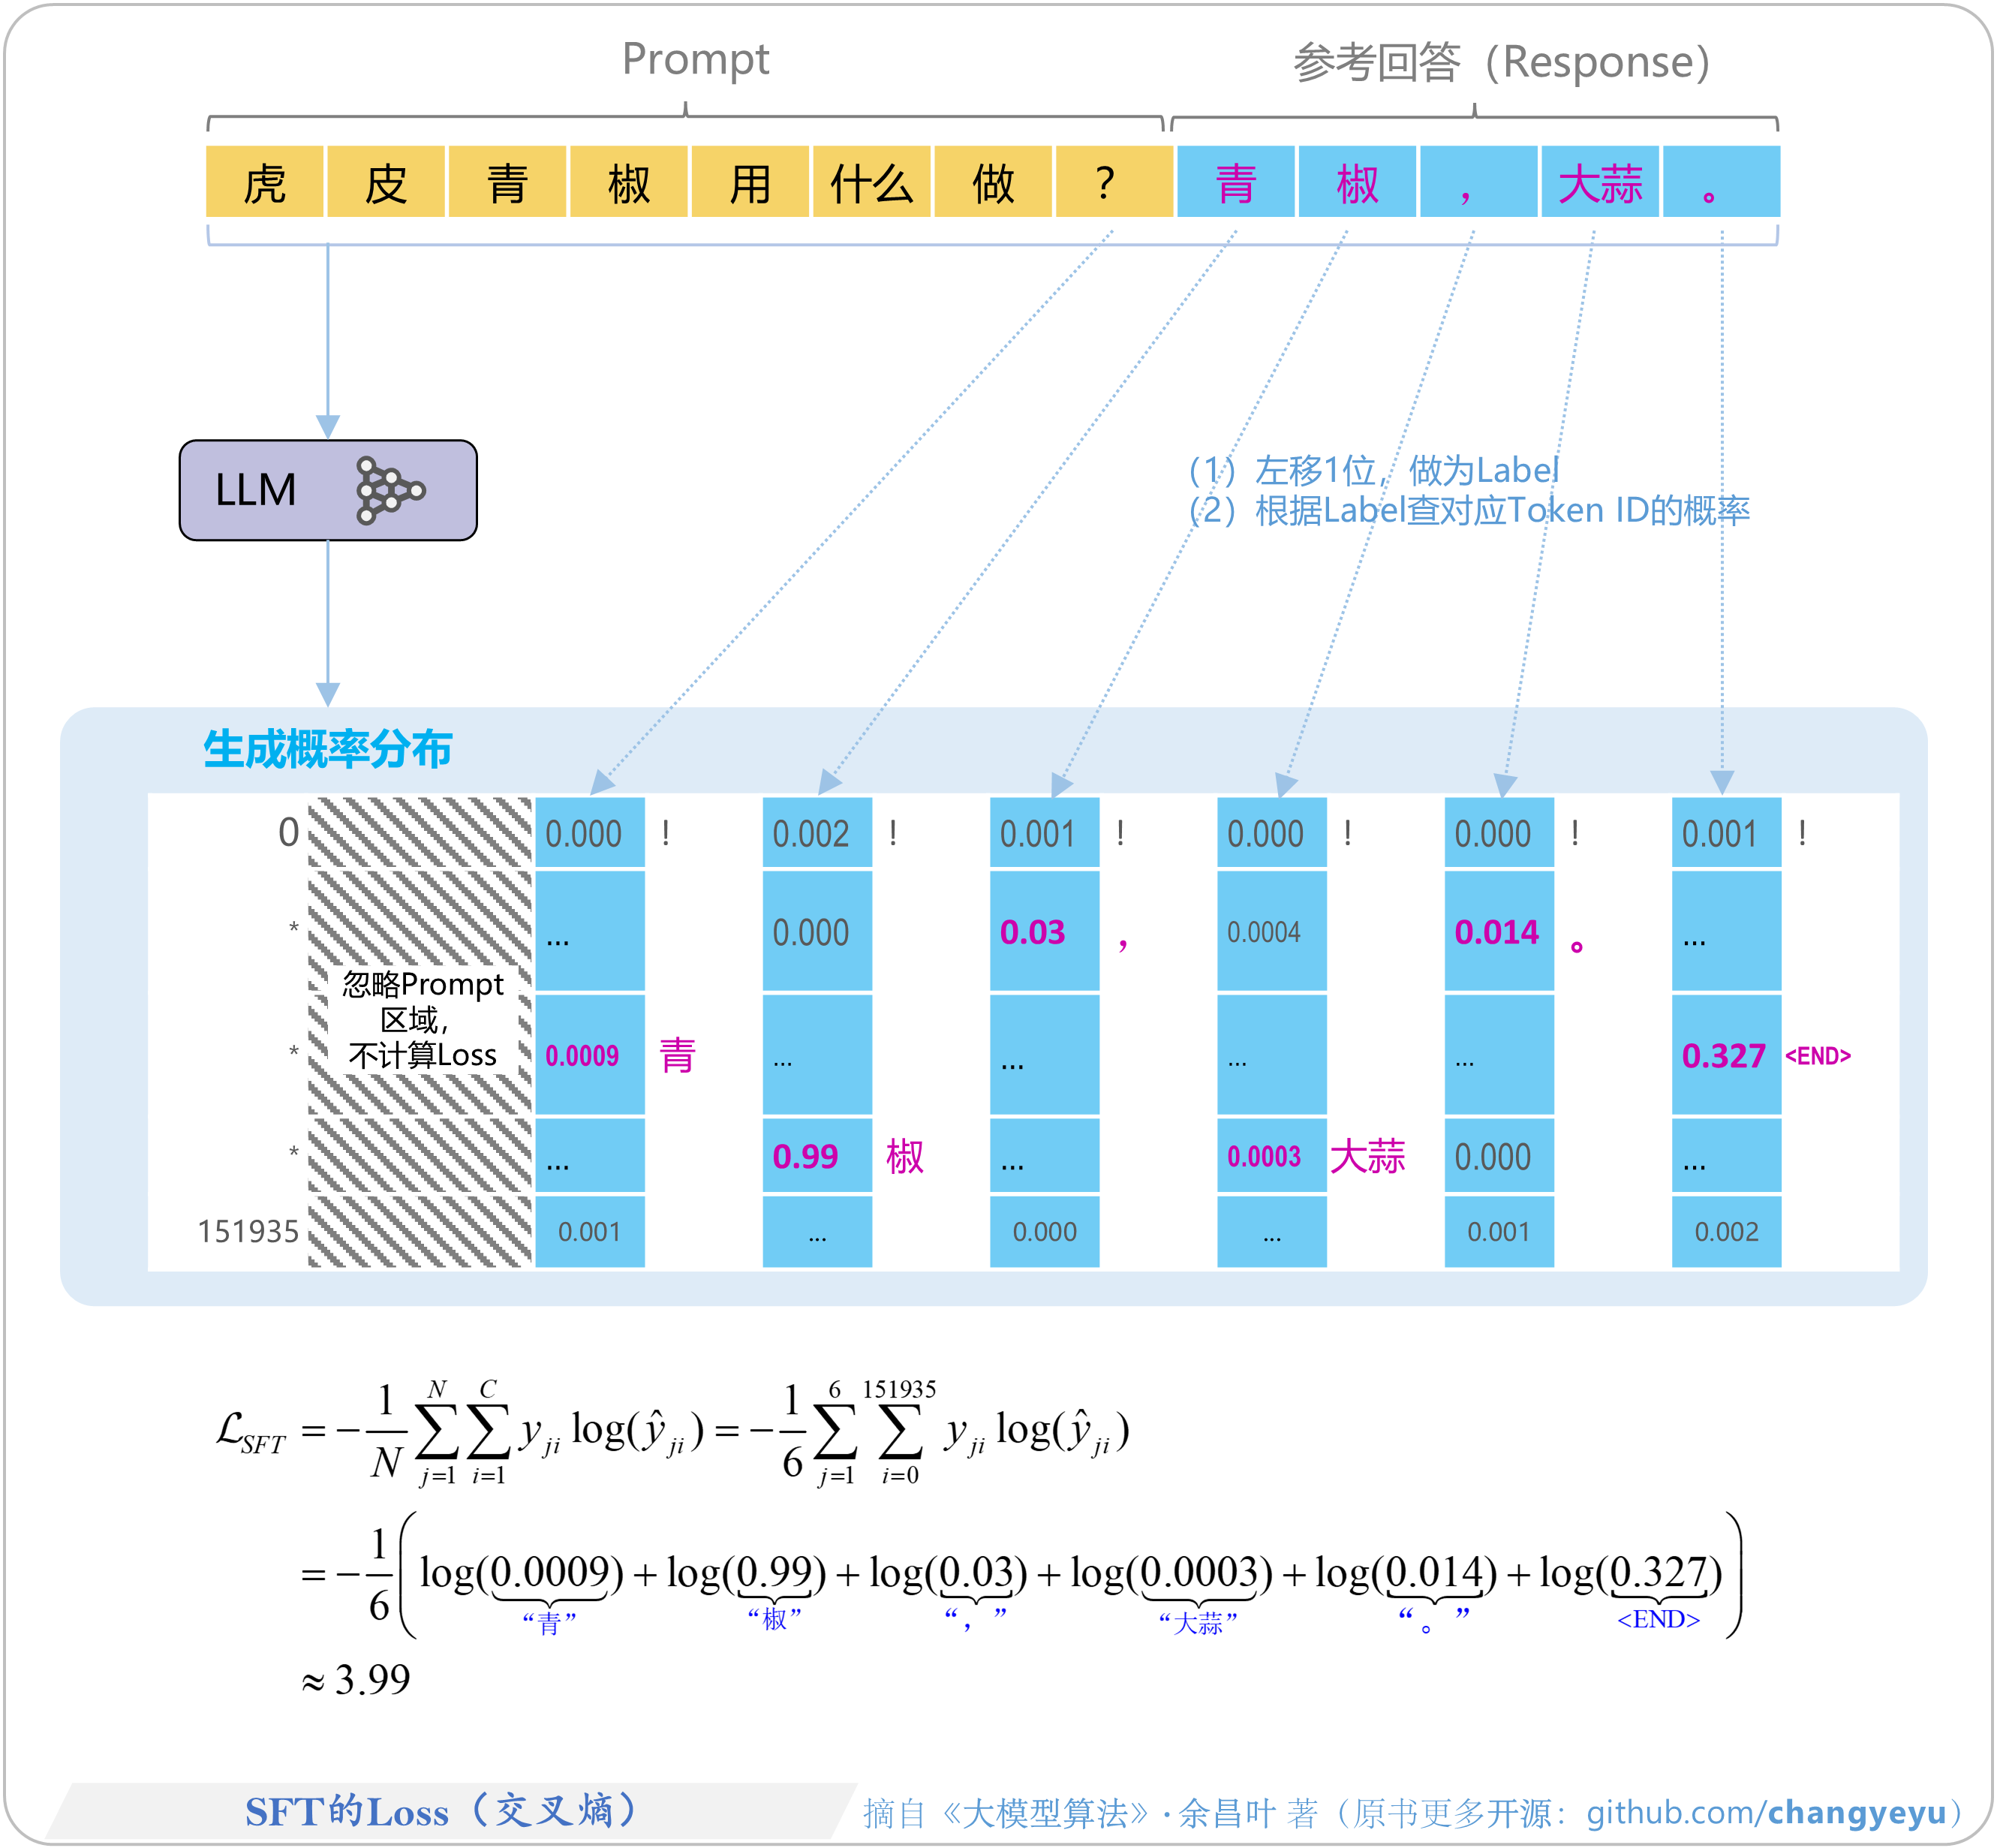
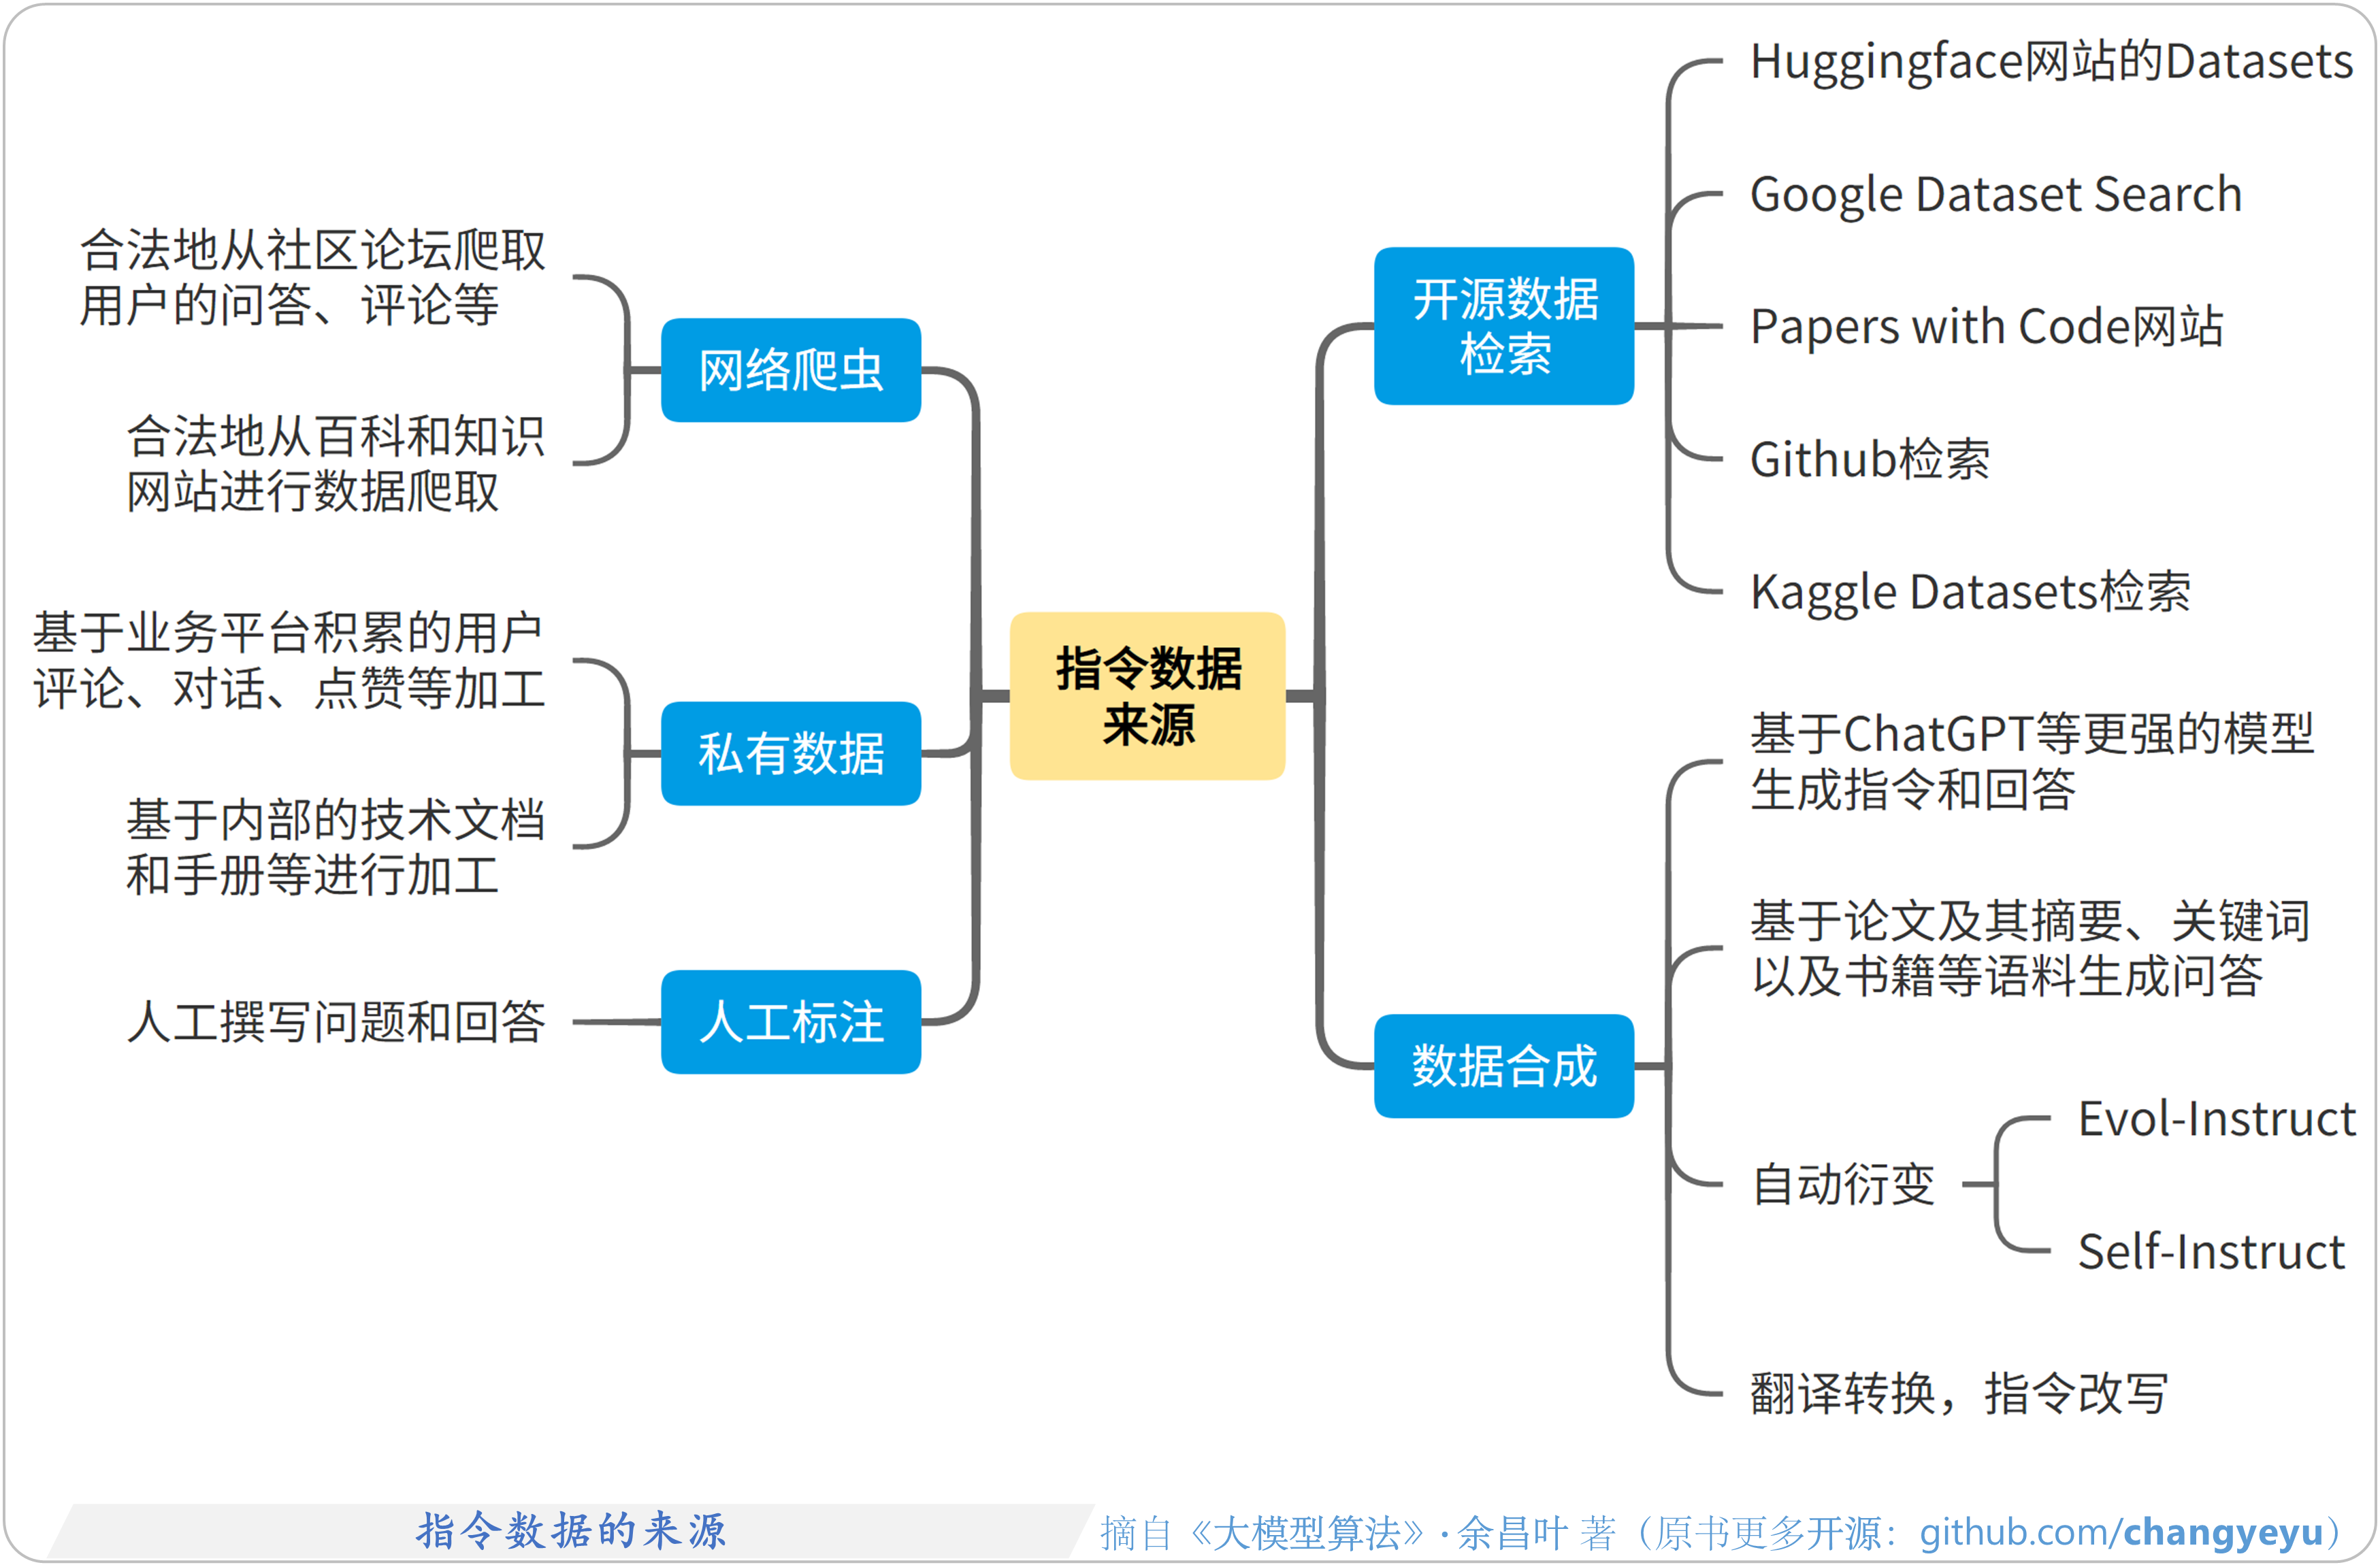
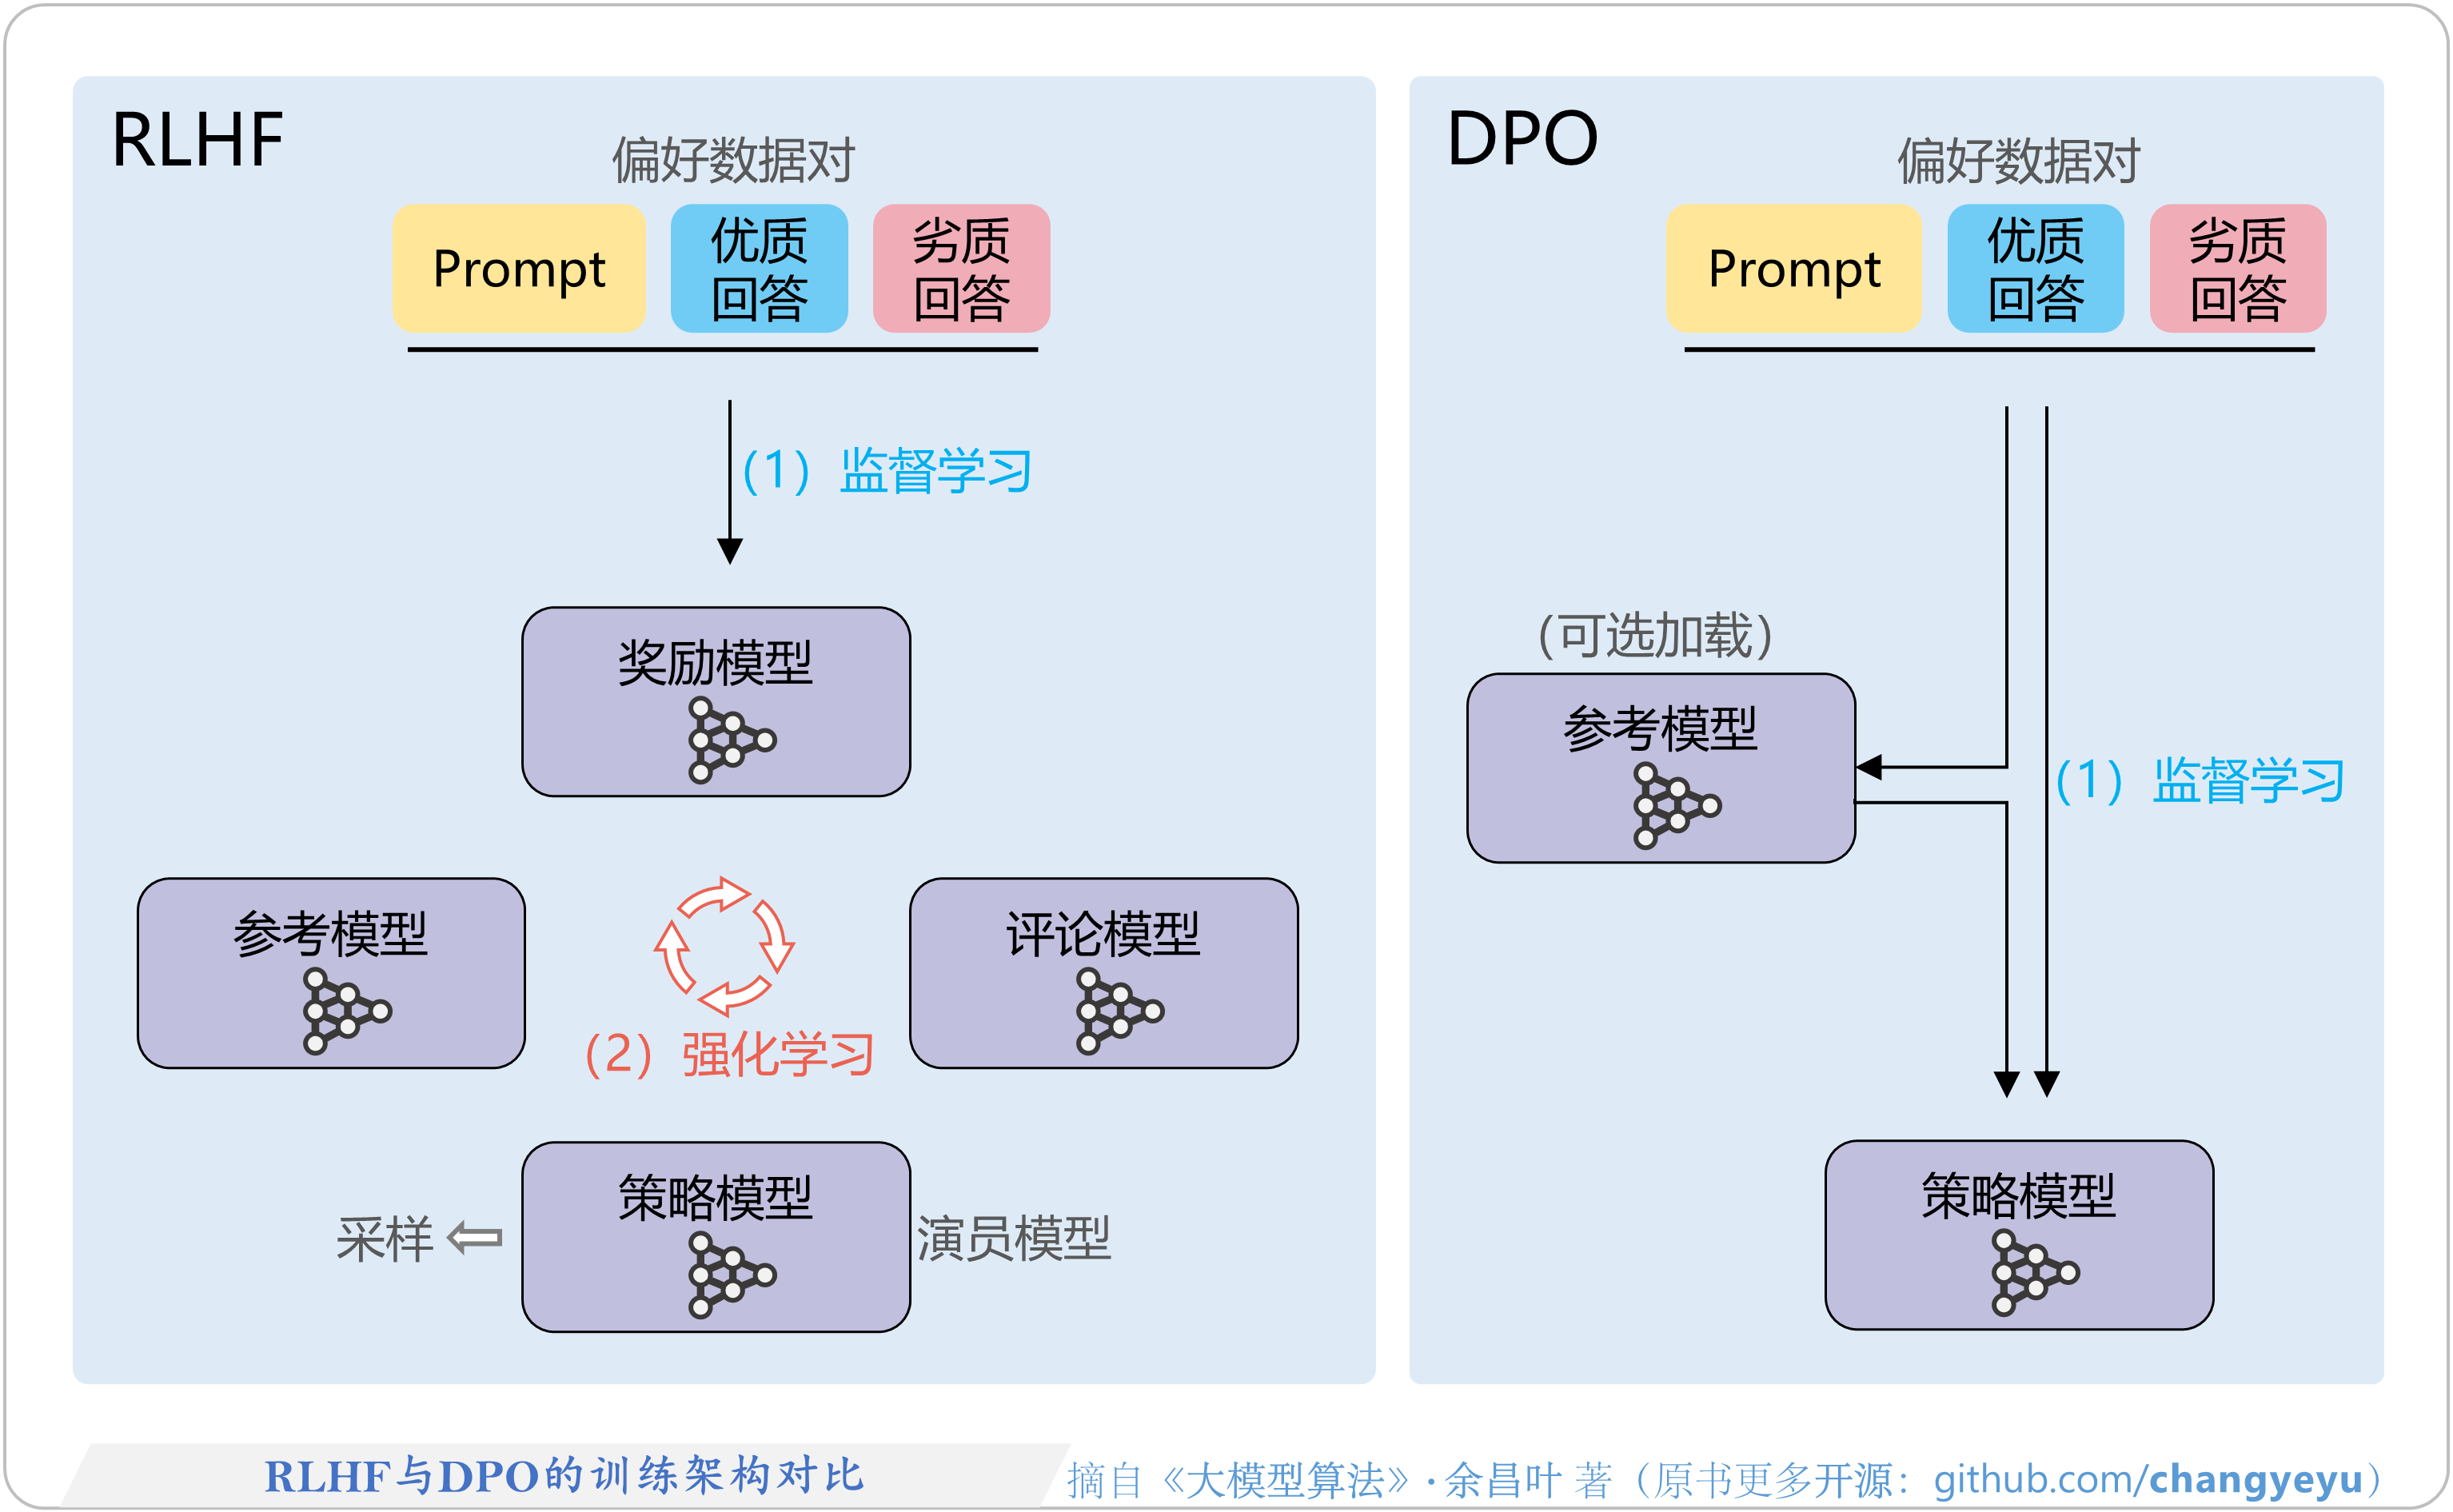
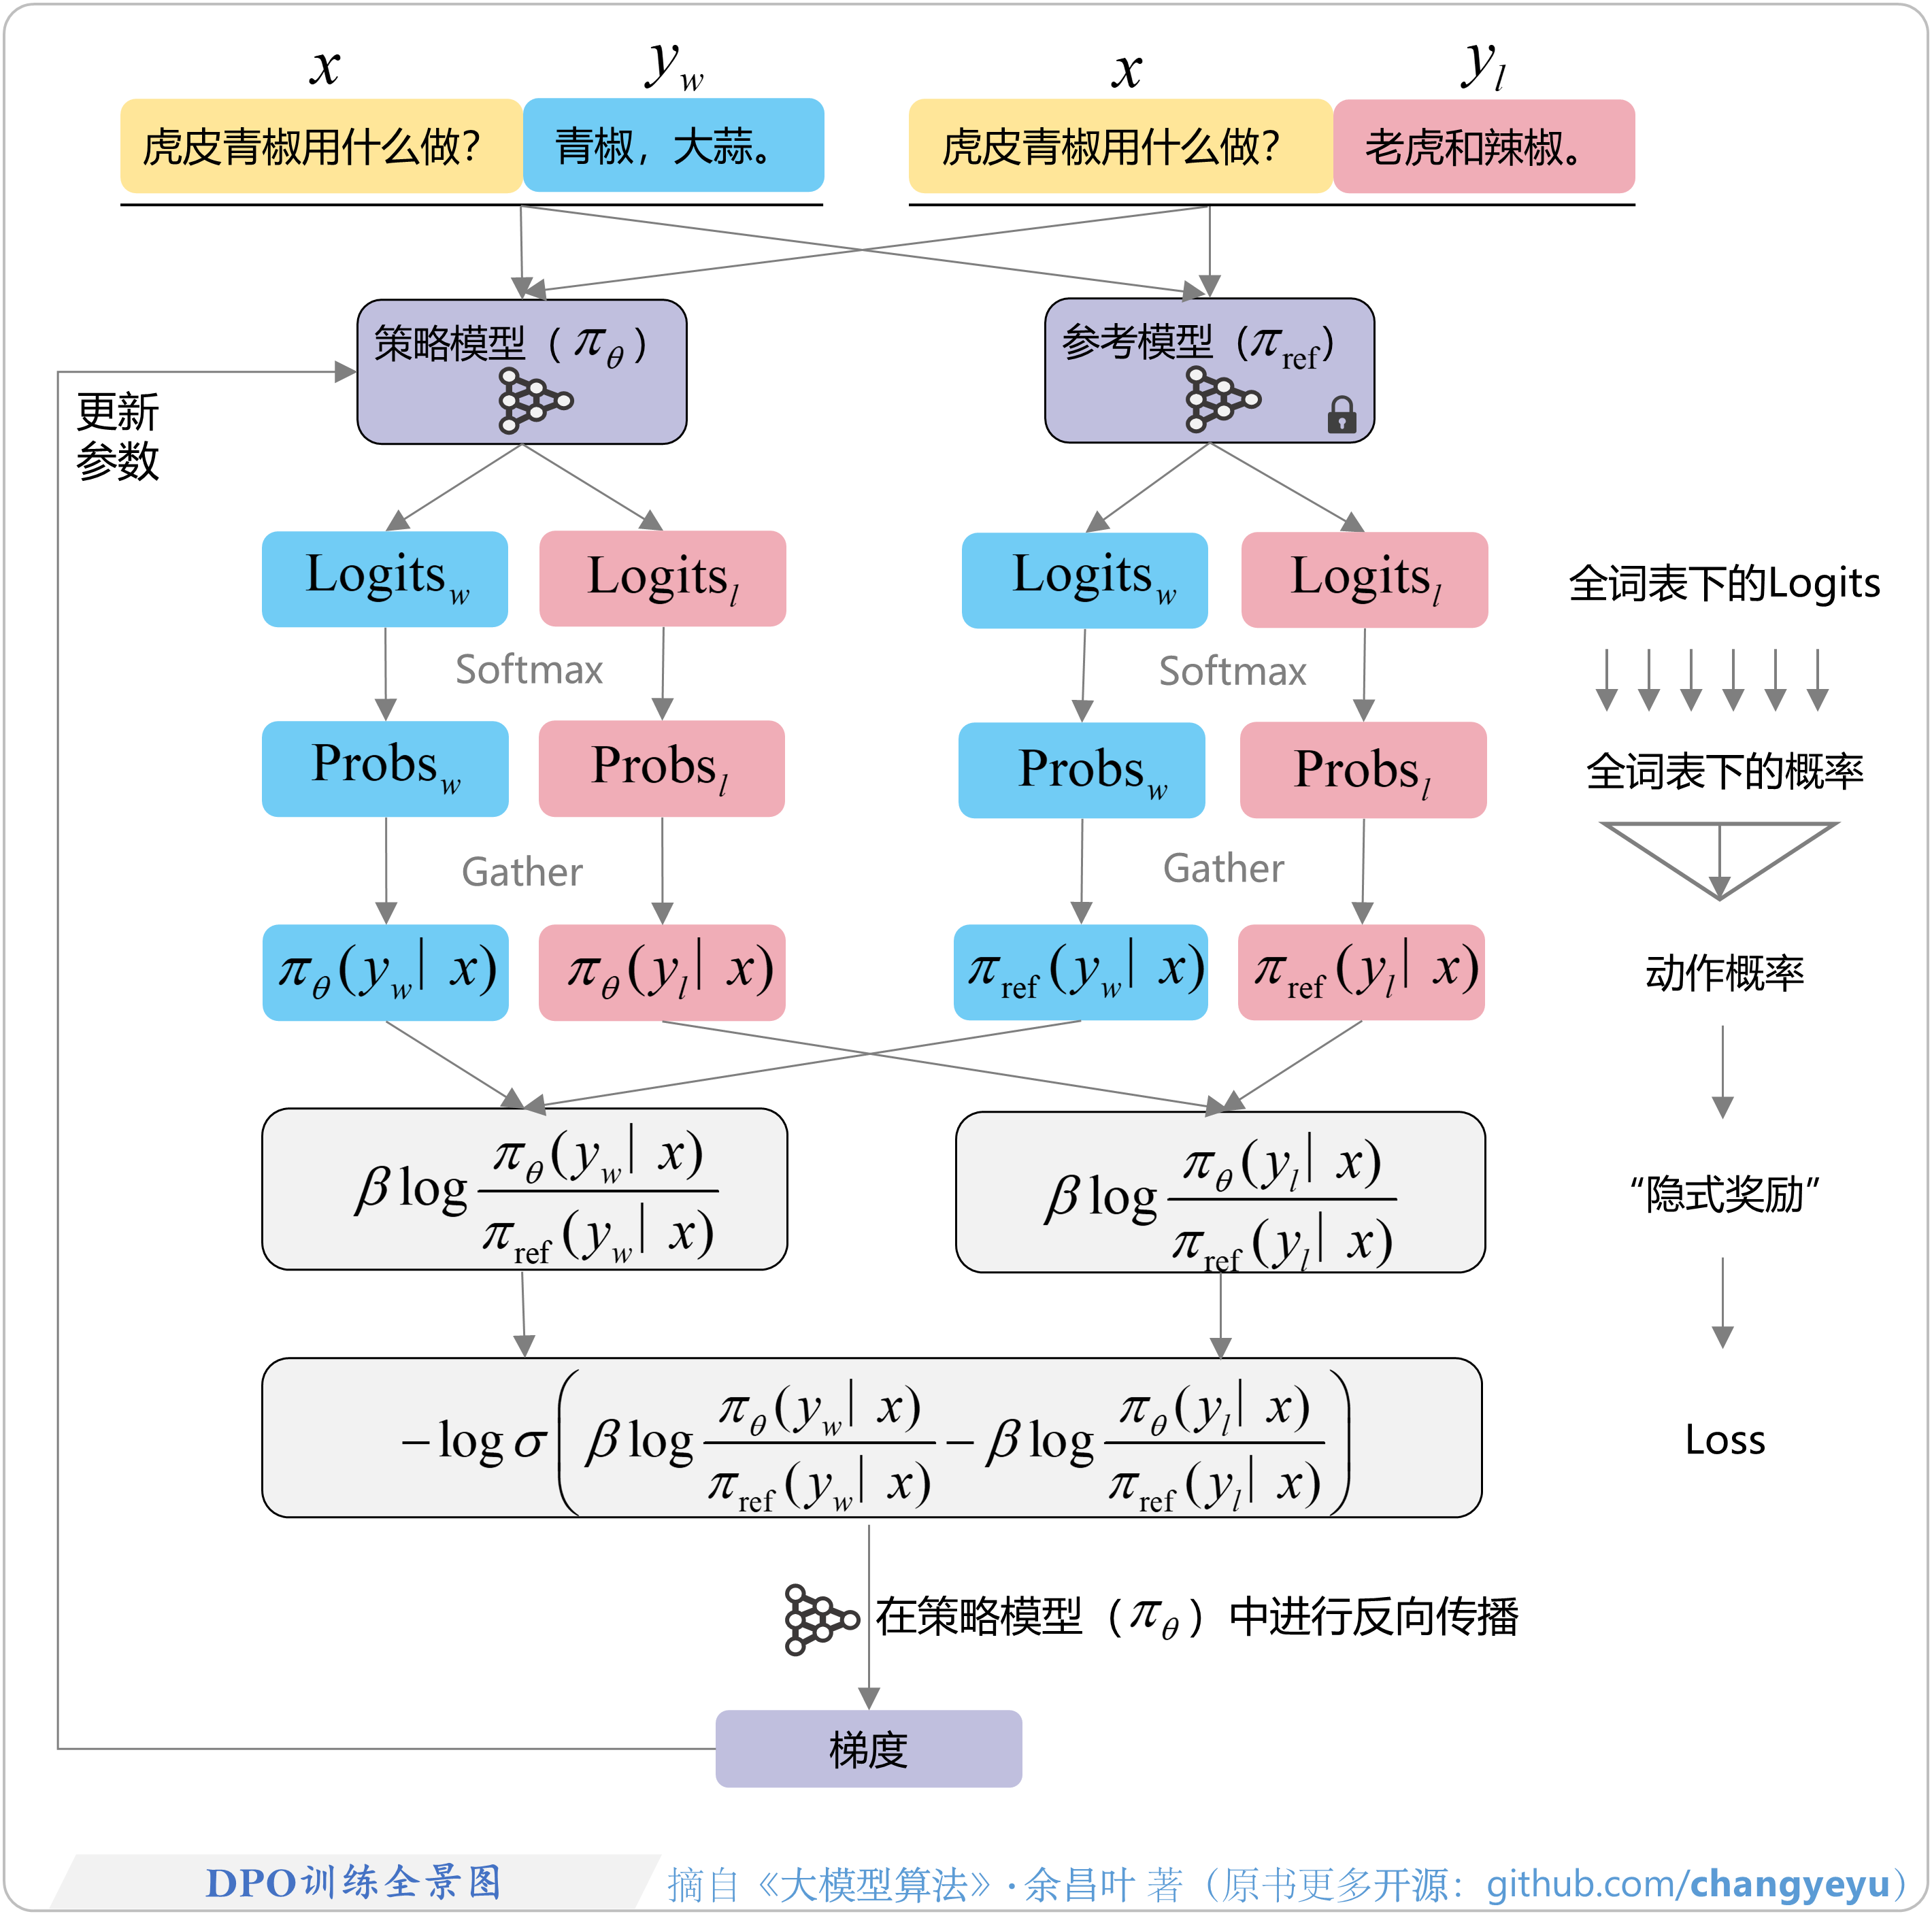
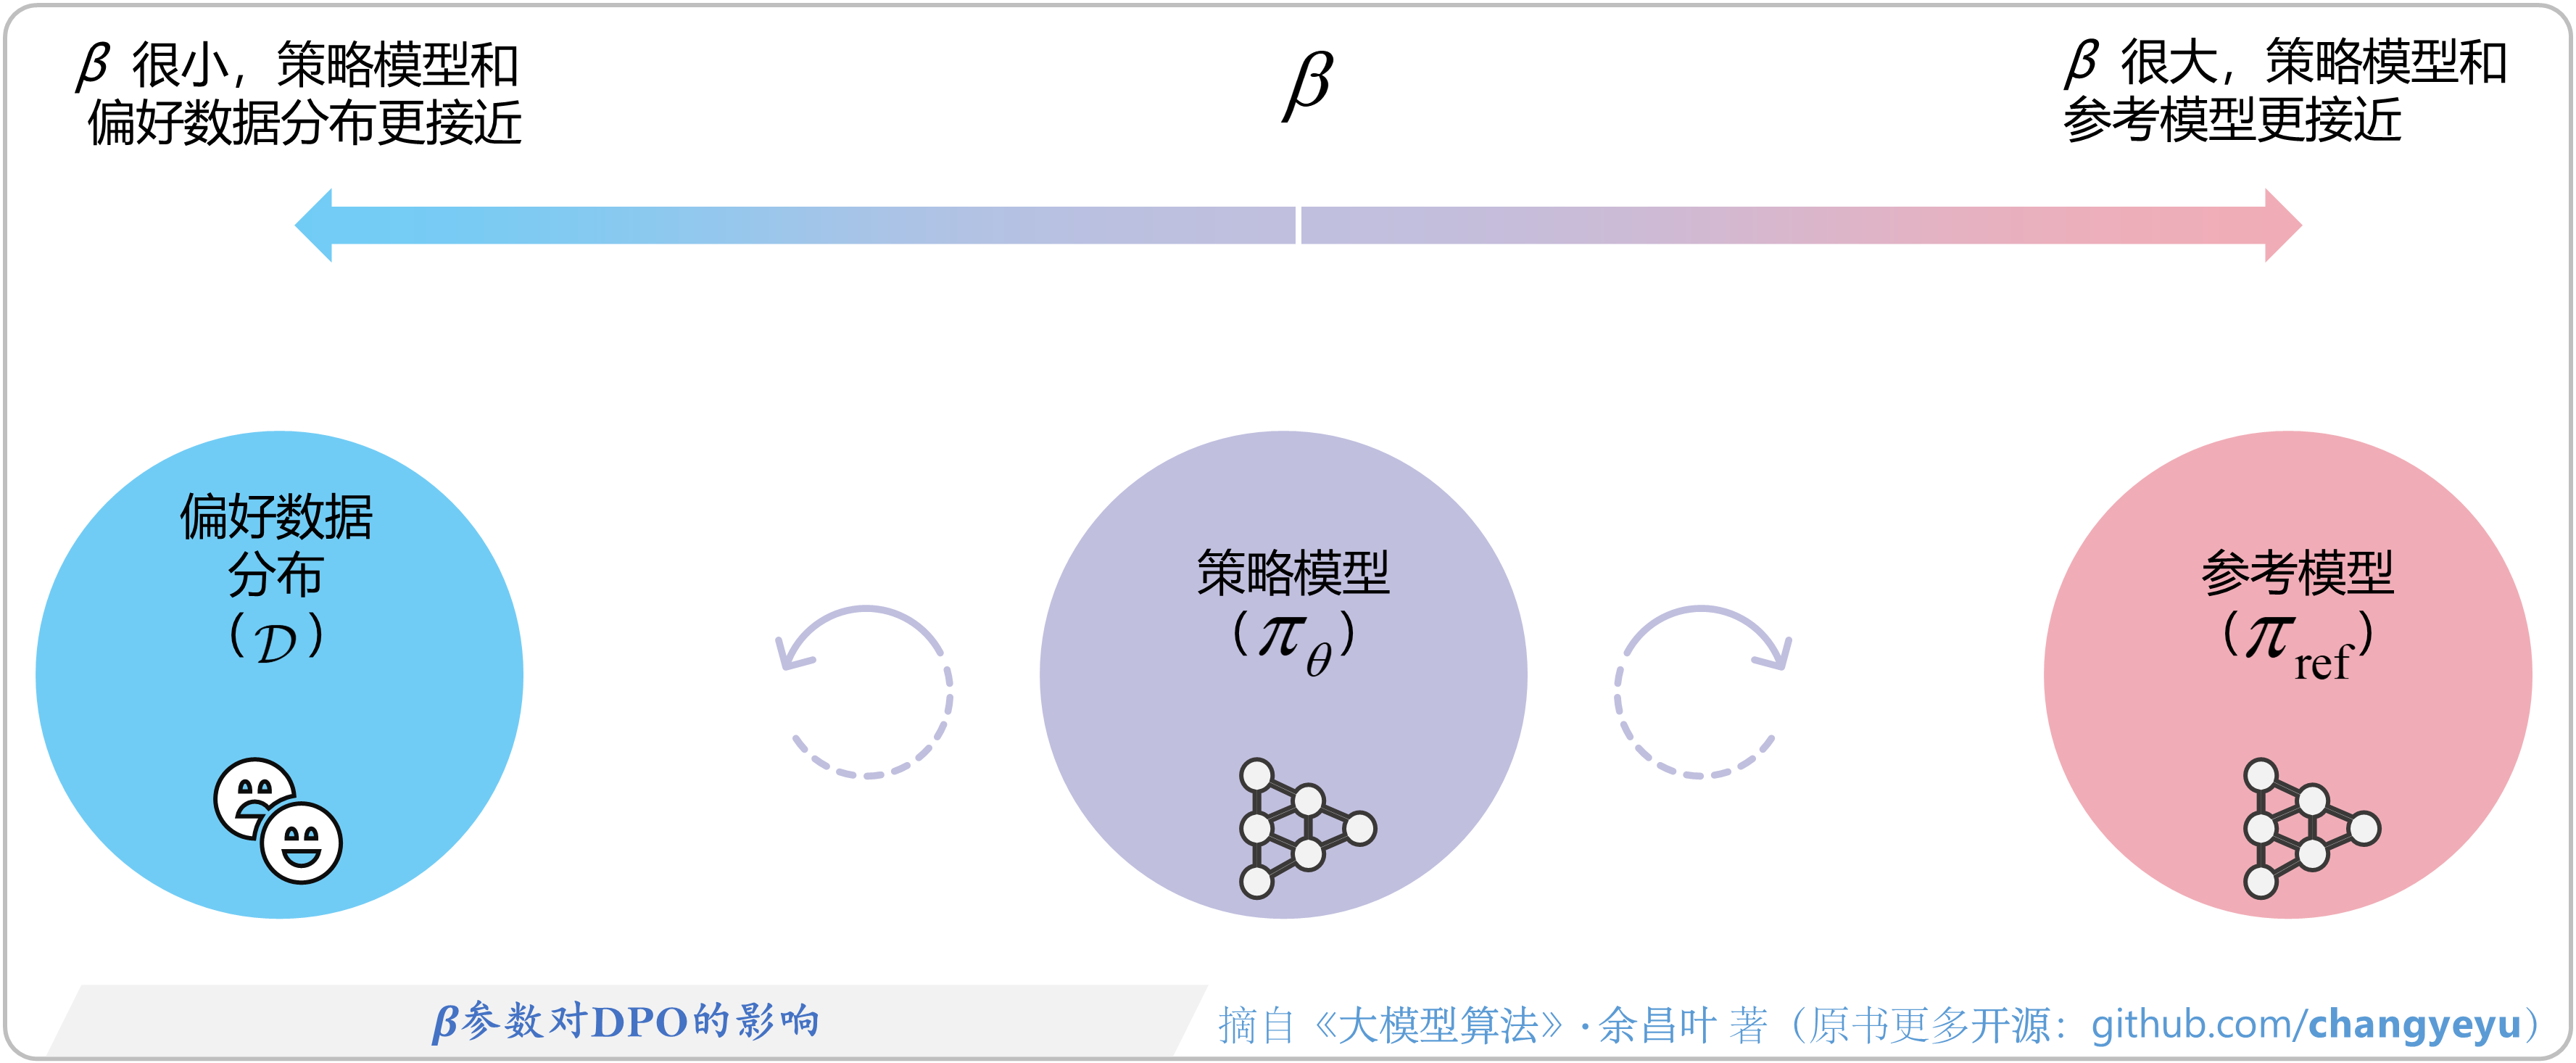
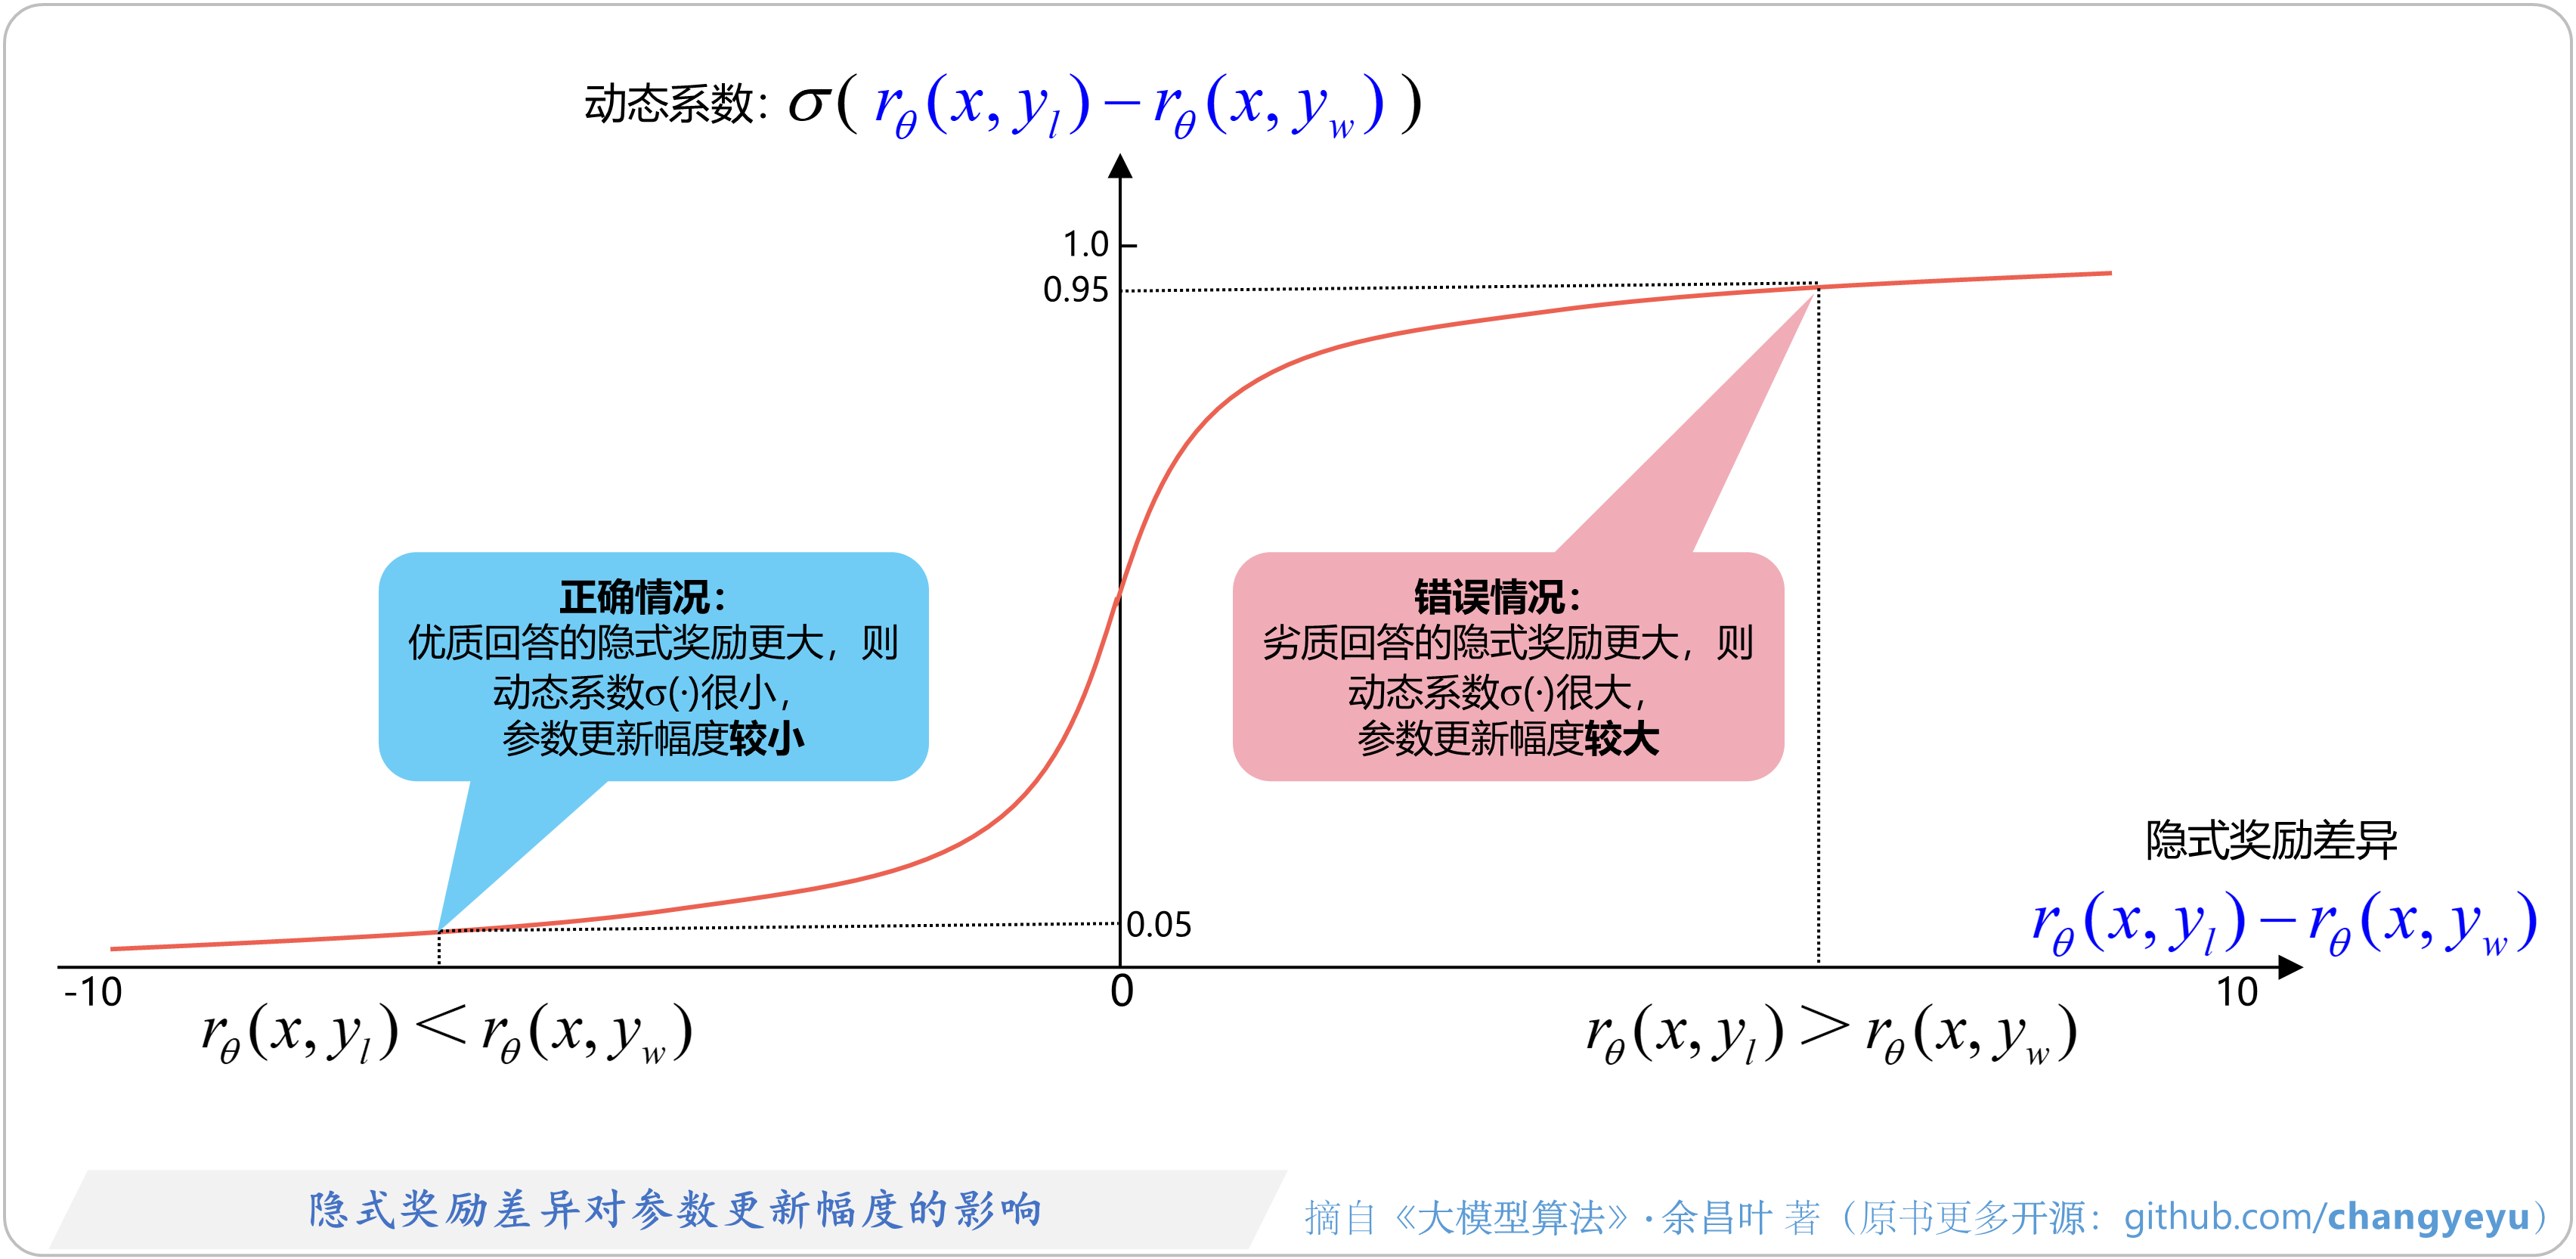
不同于RLHF,DPO以监督学习的训练方式,大幅简化了对齐训练:
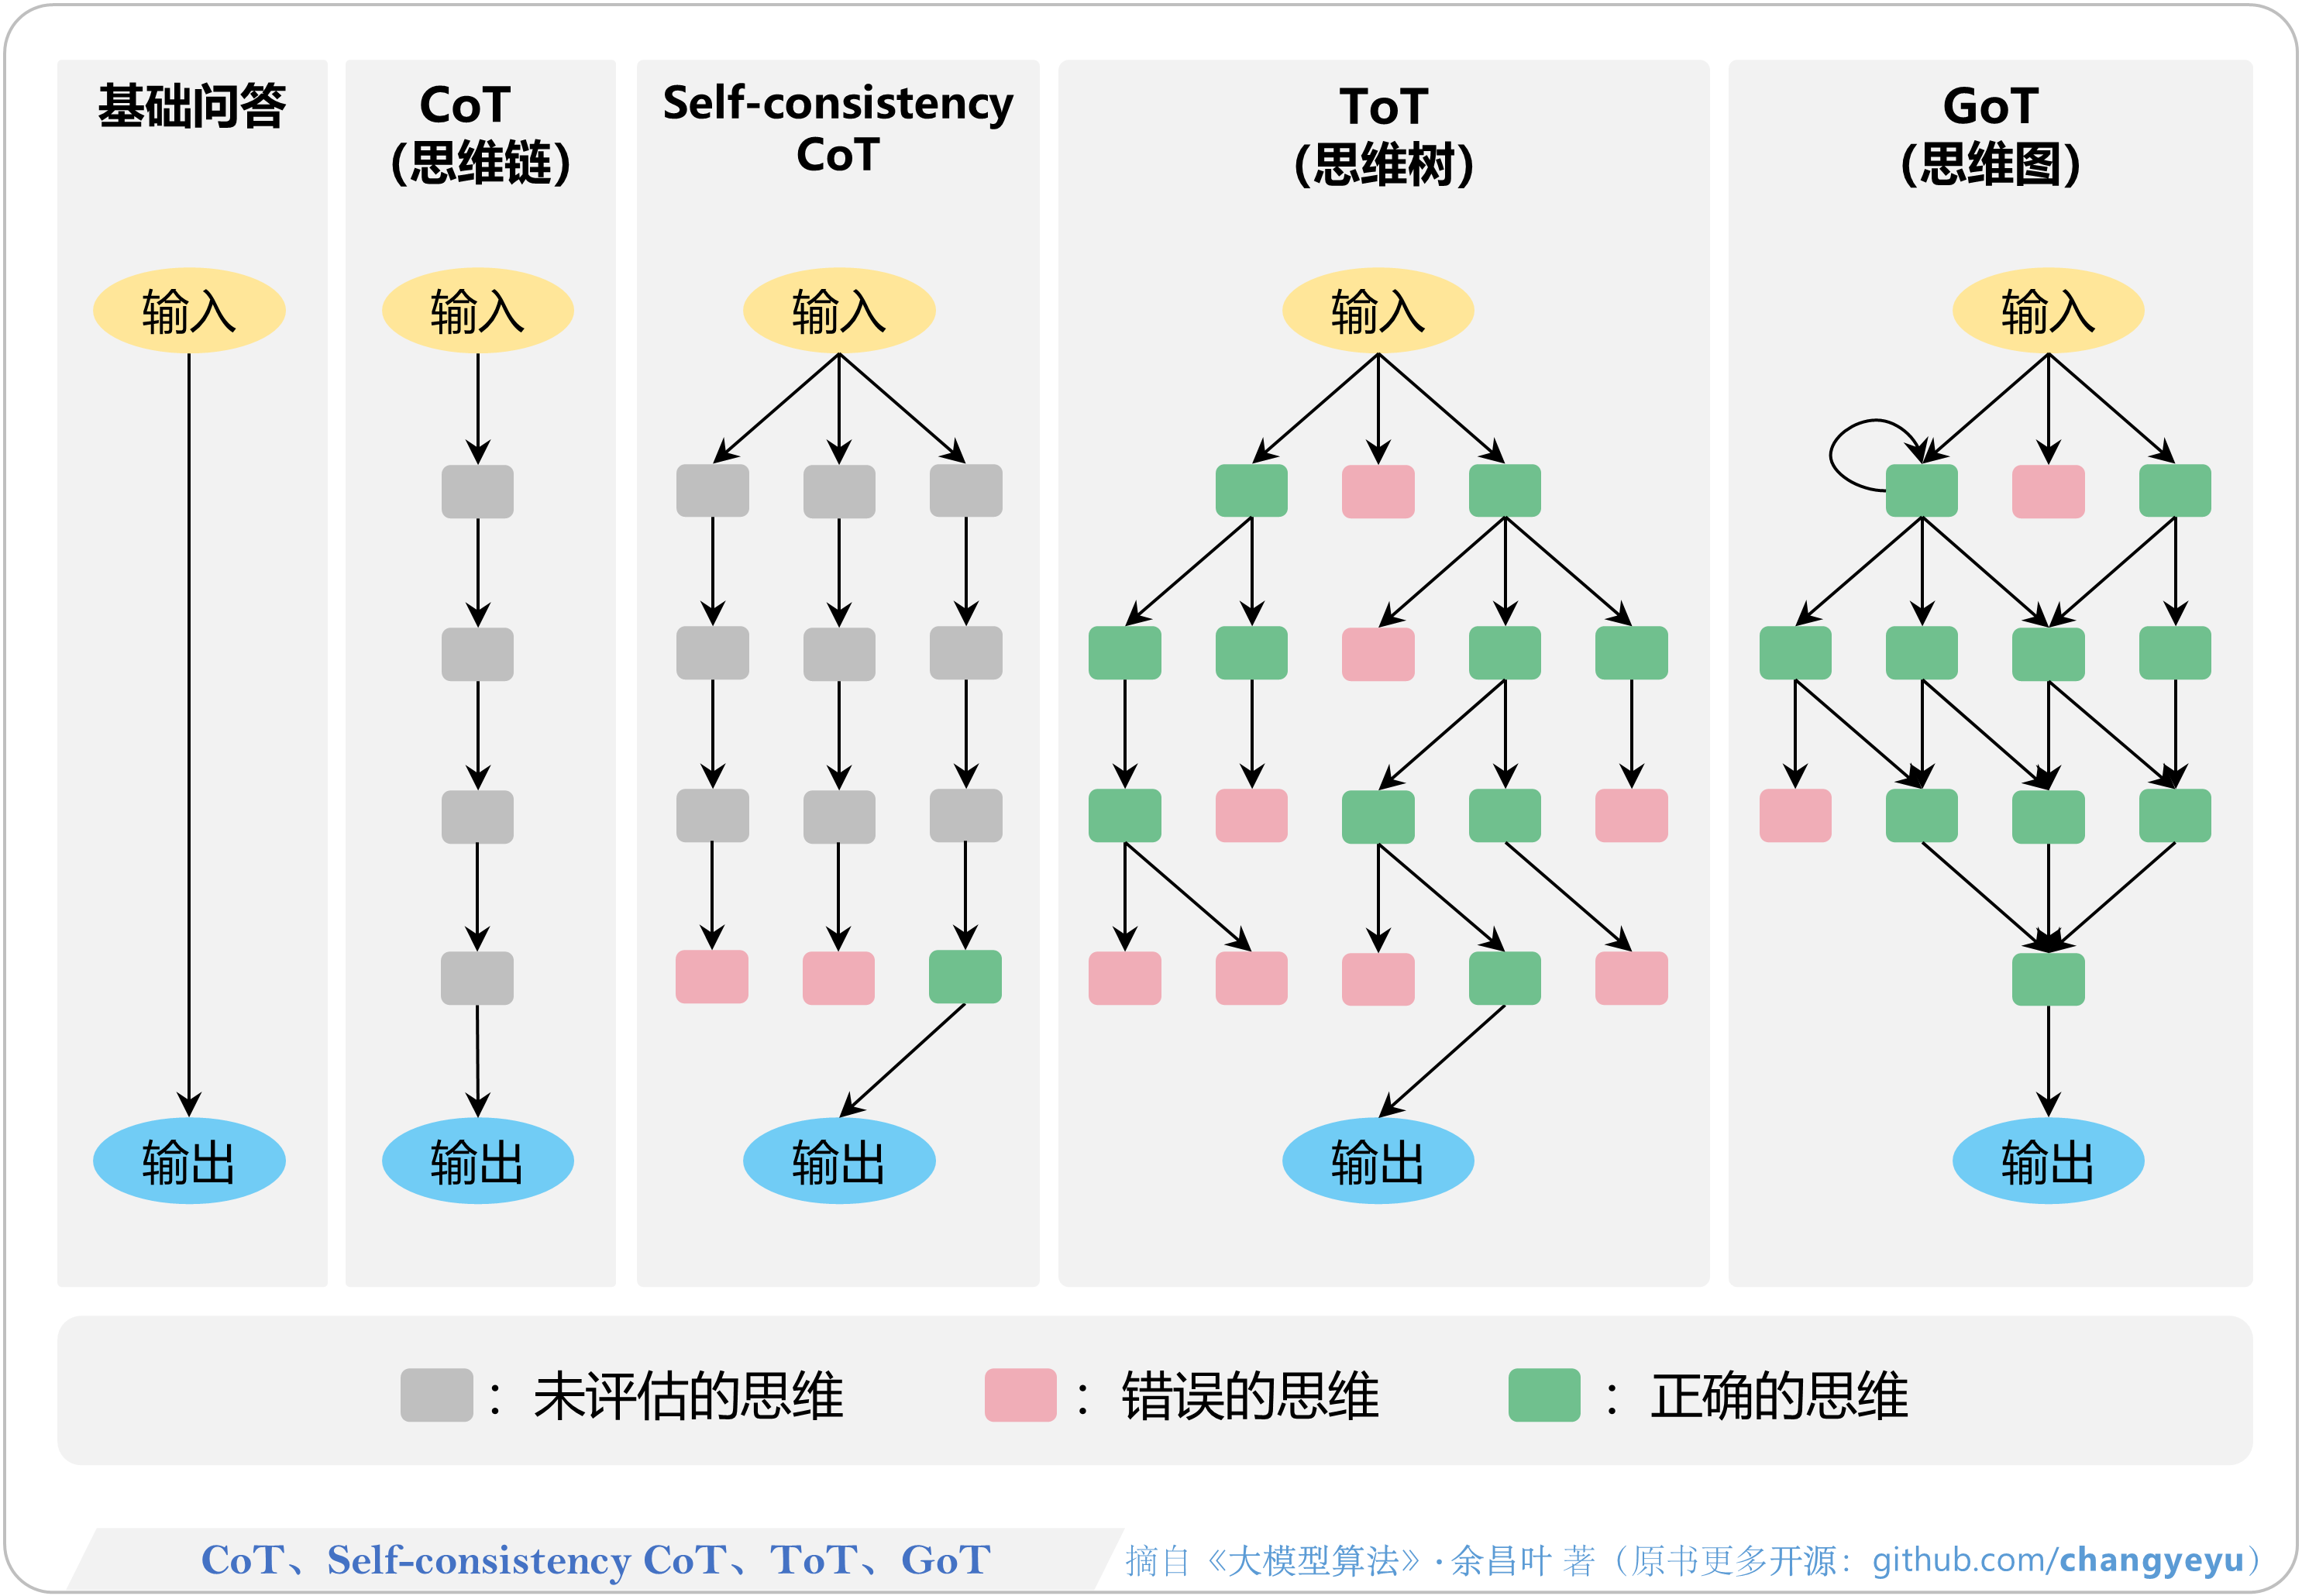
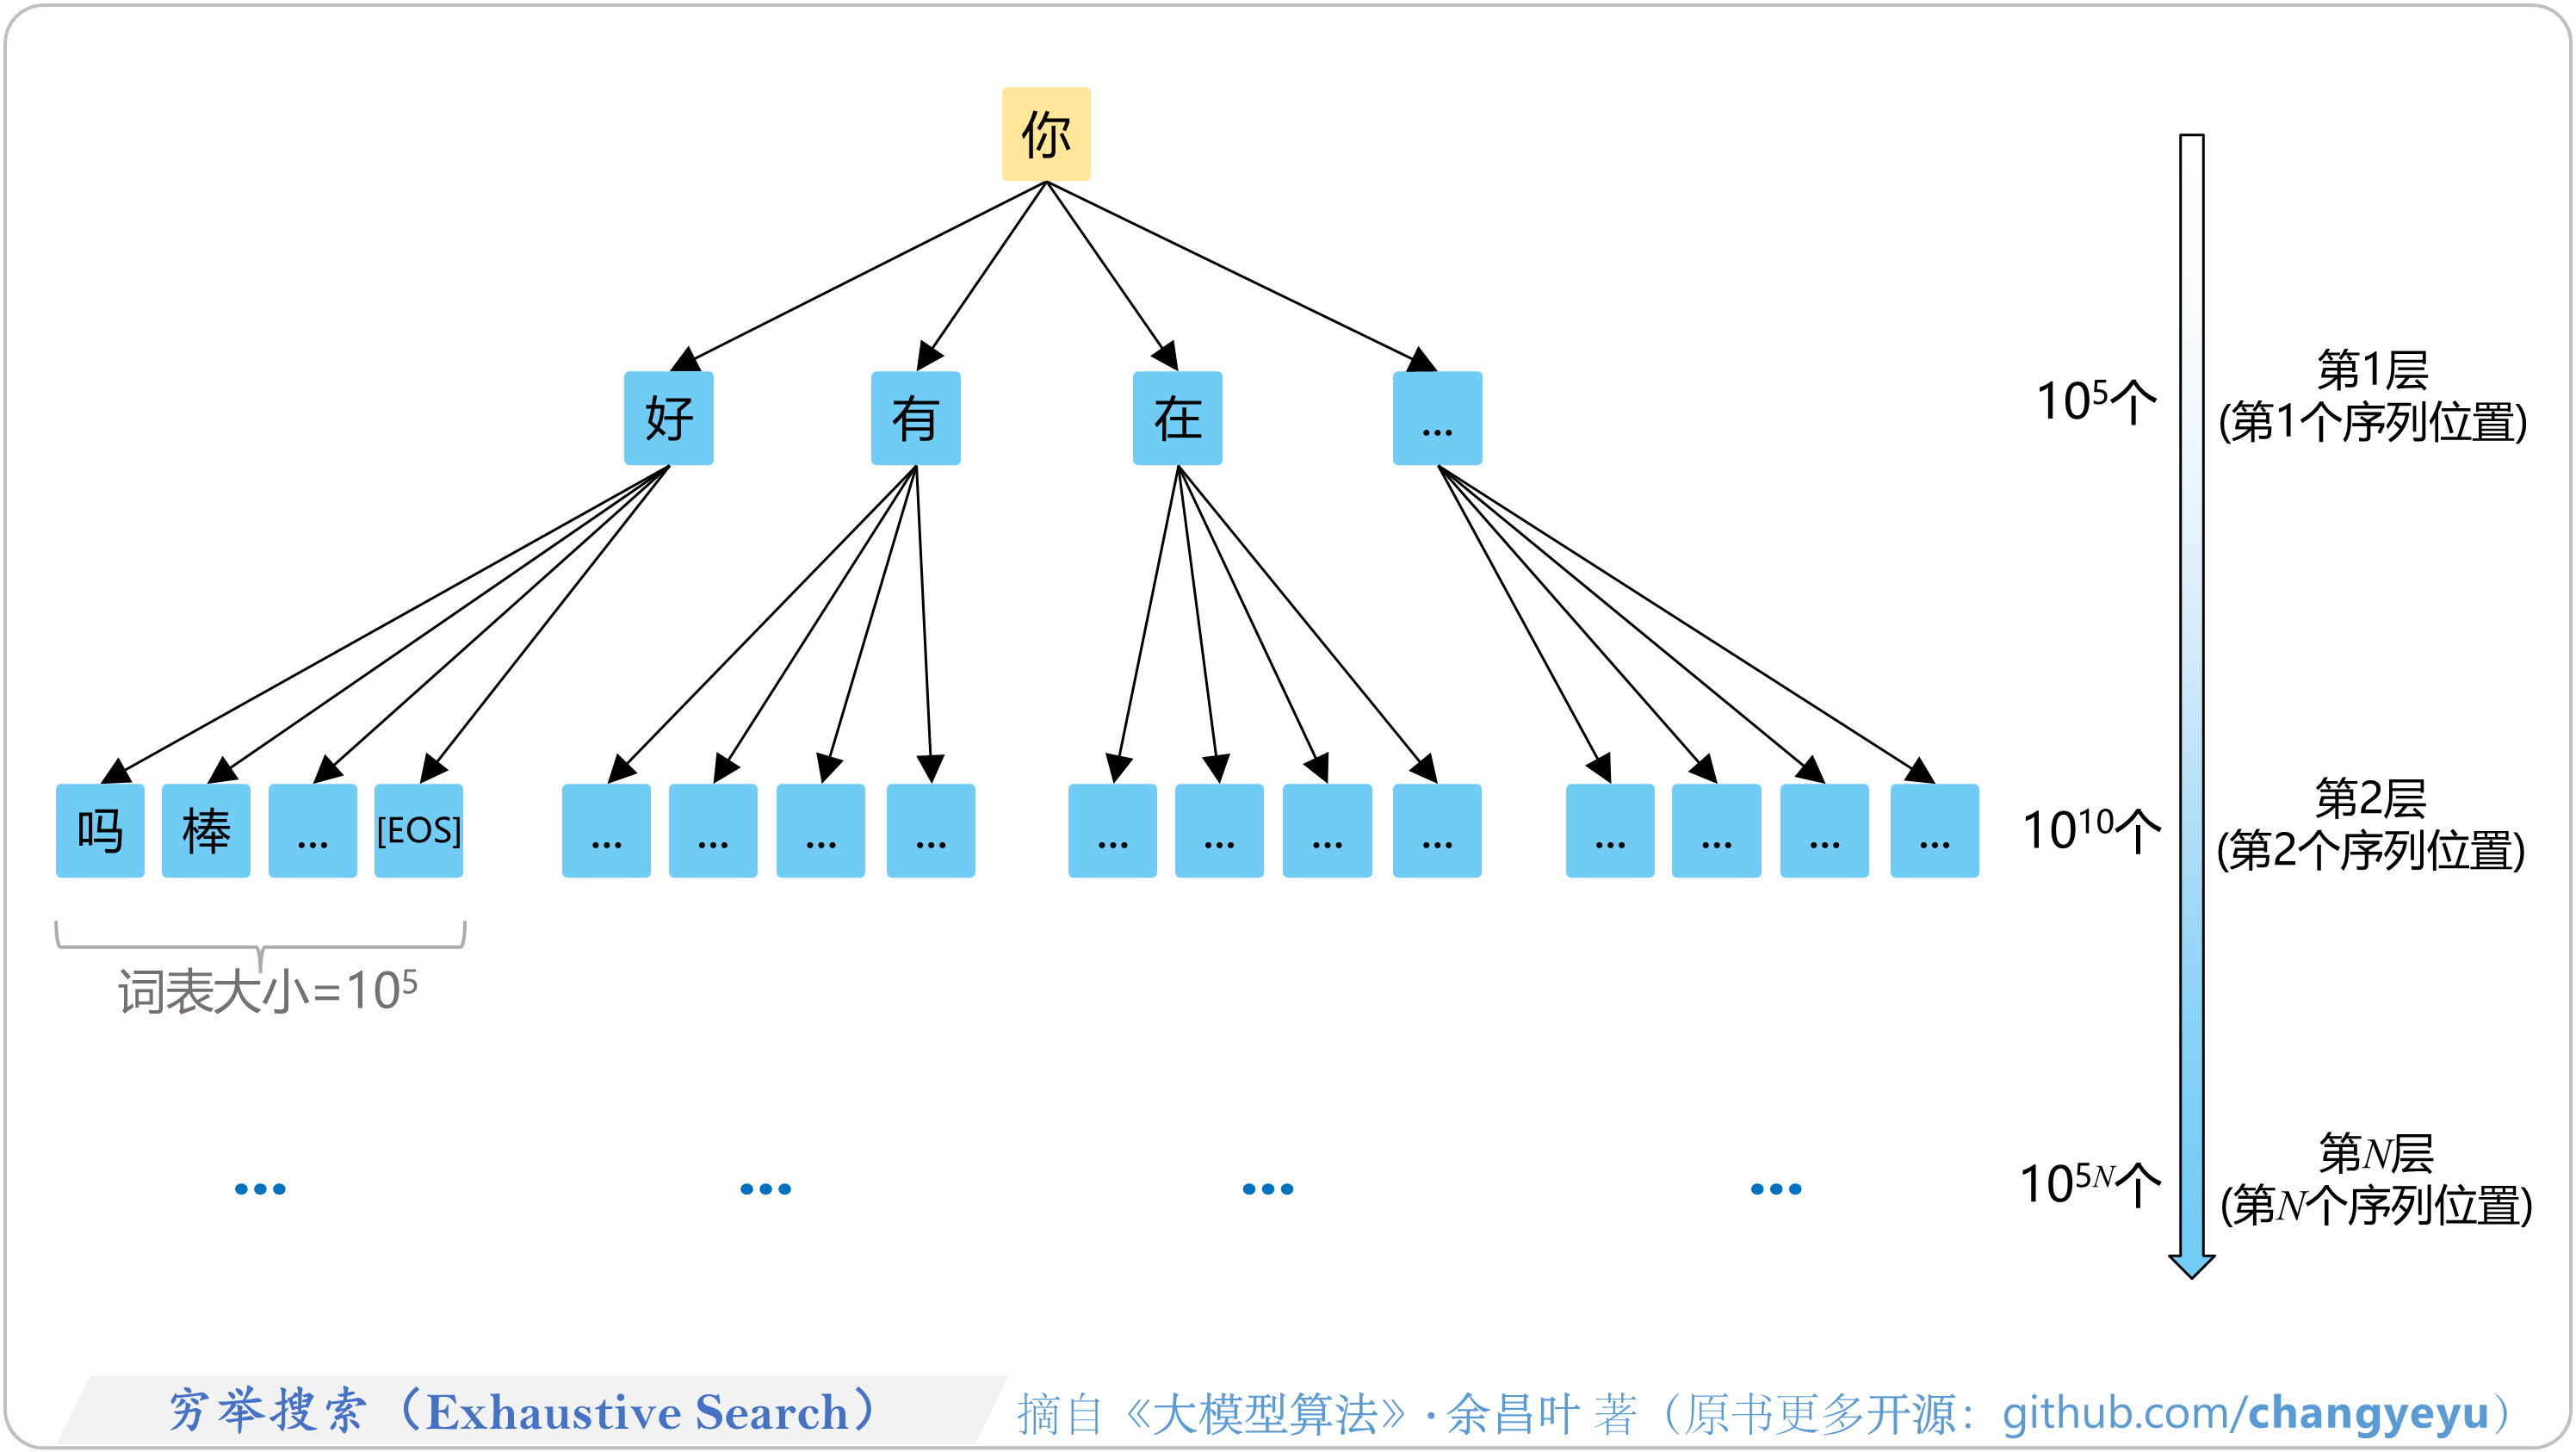
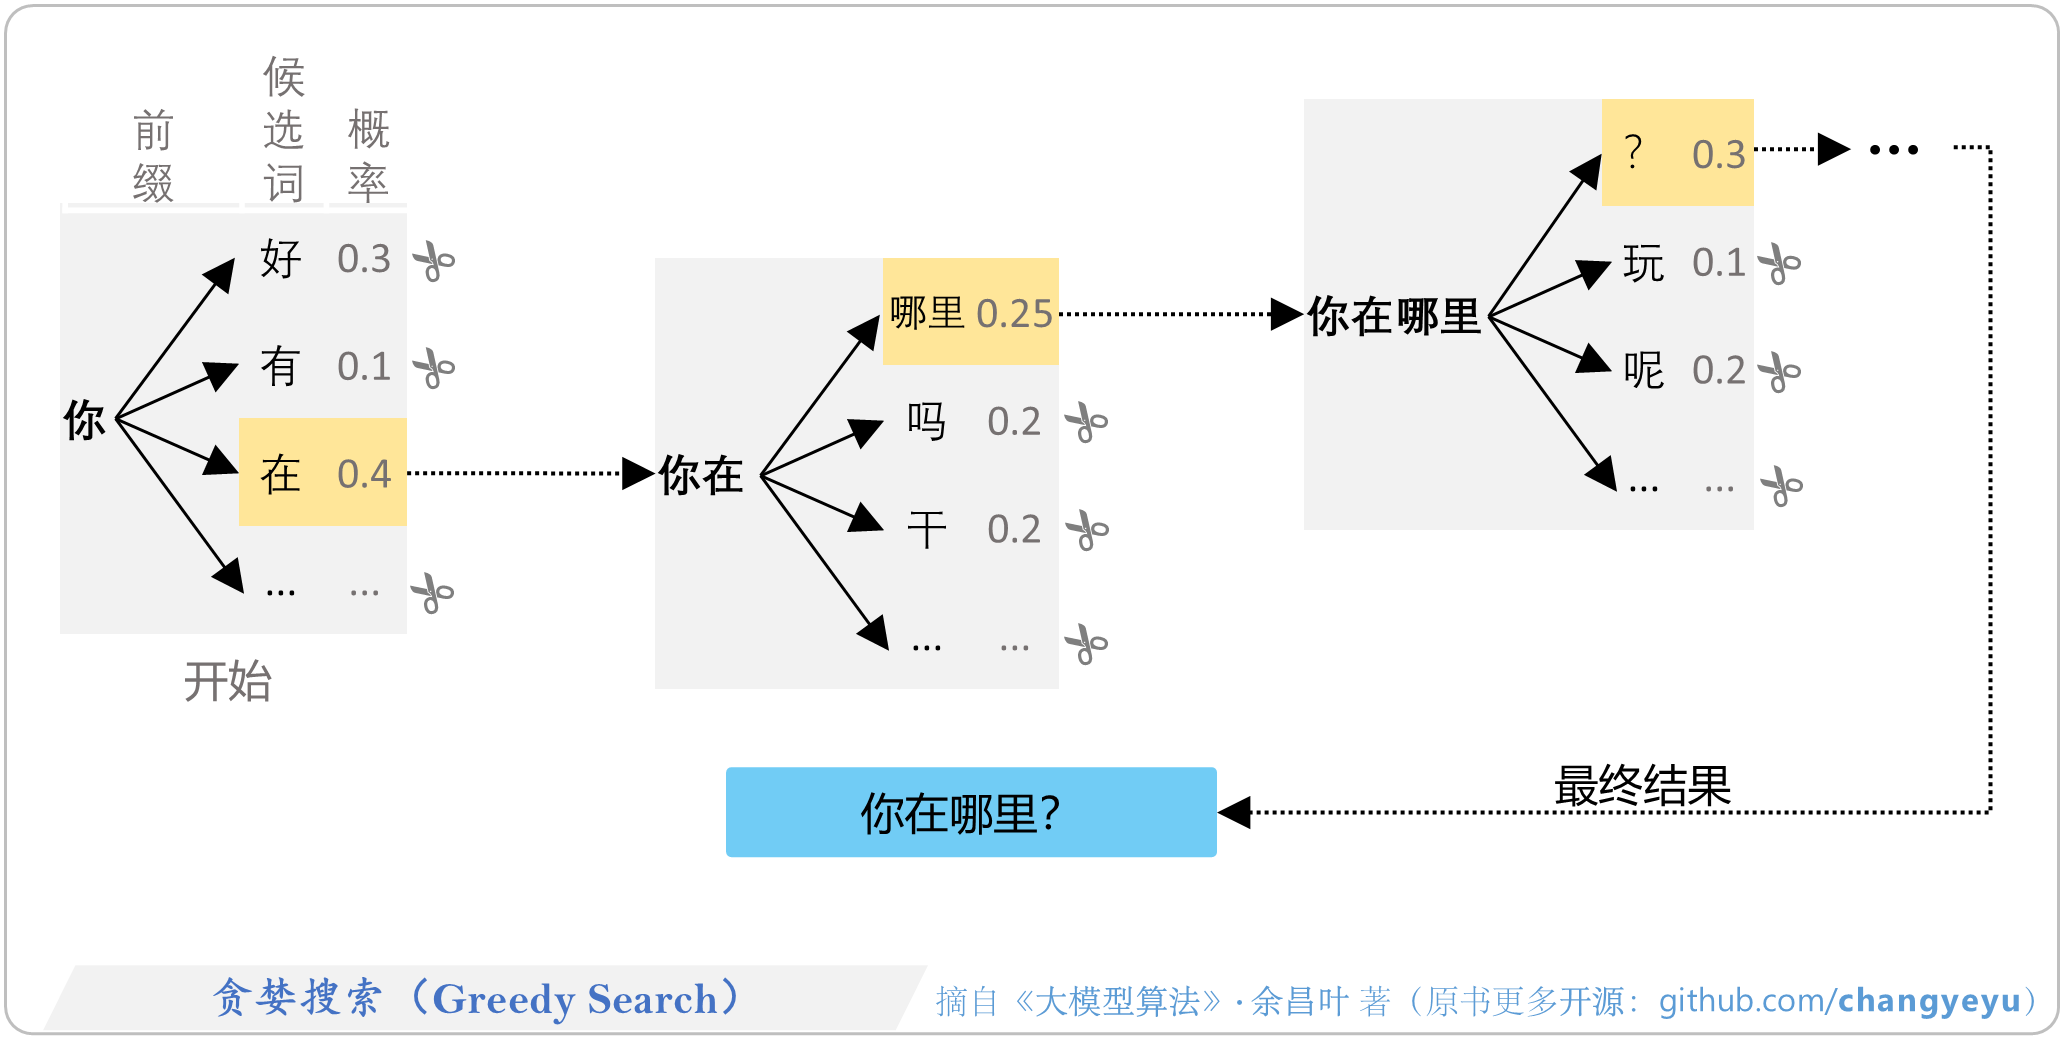
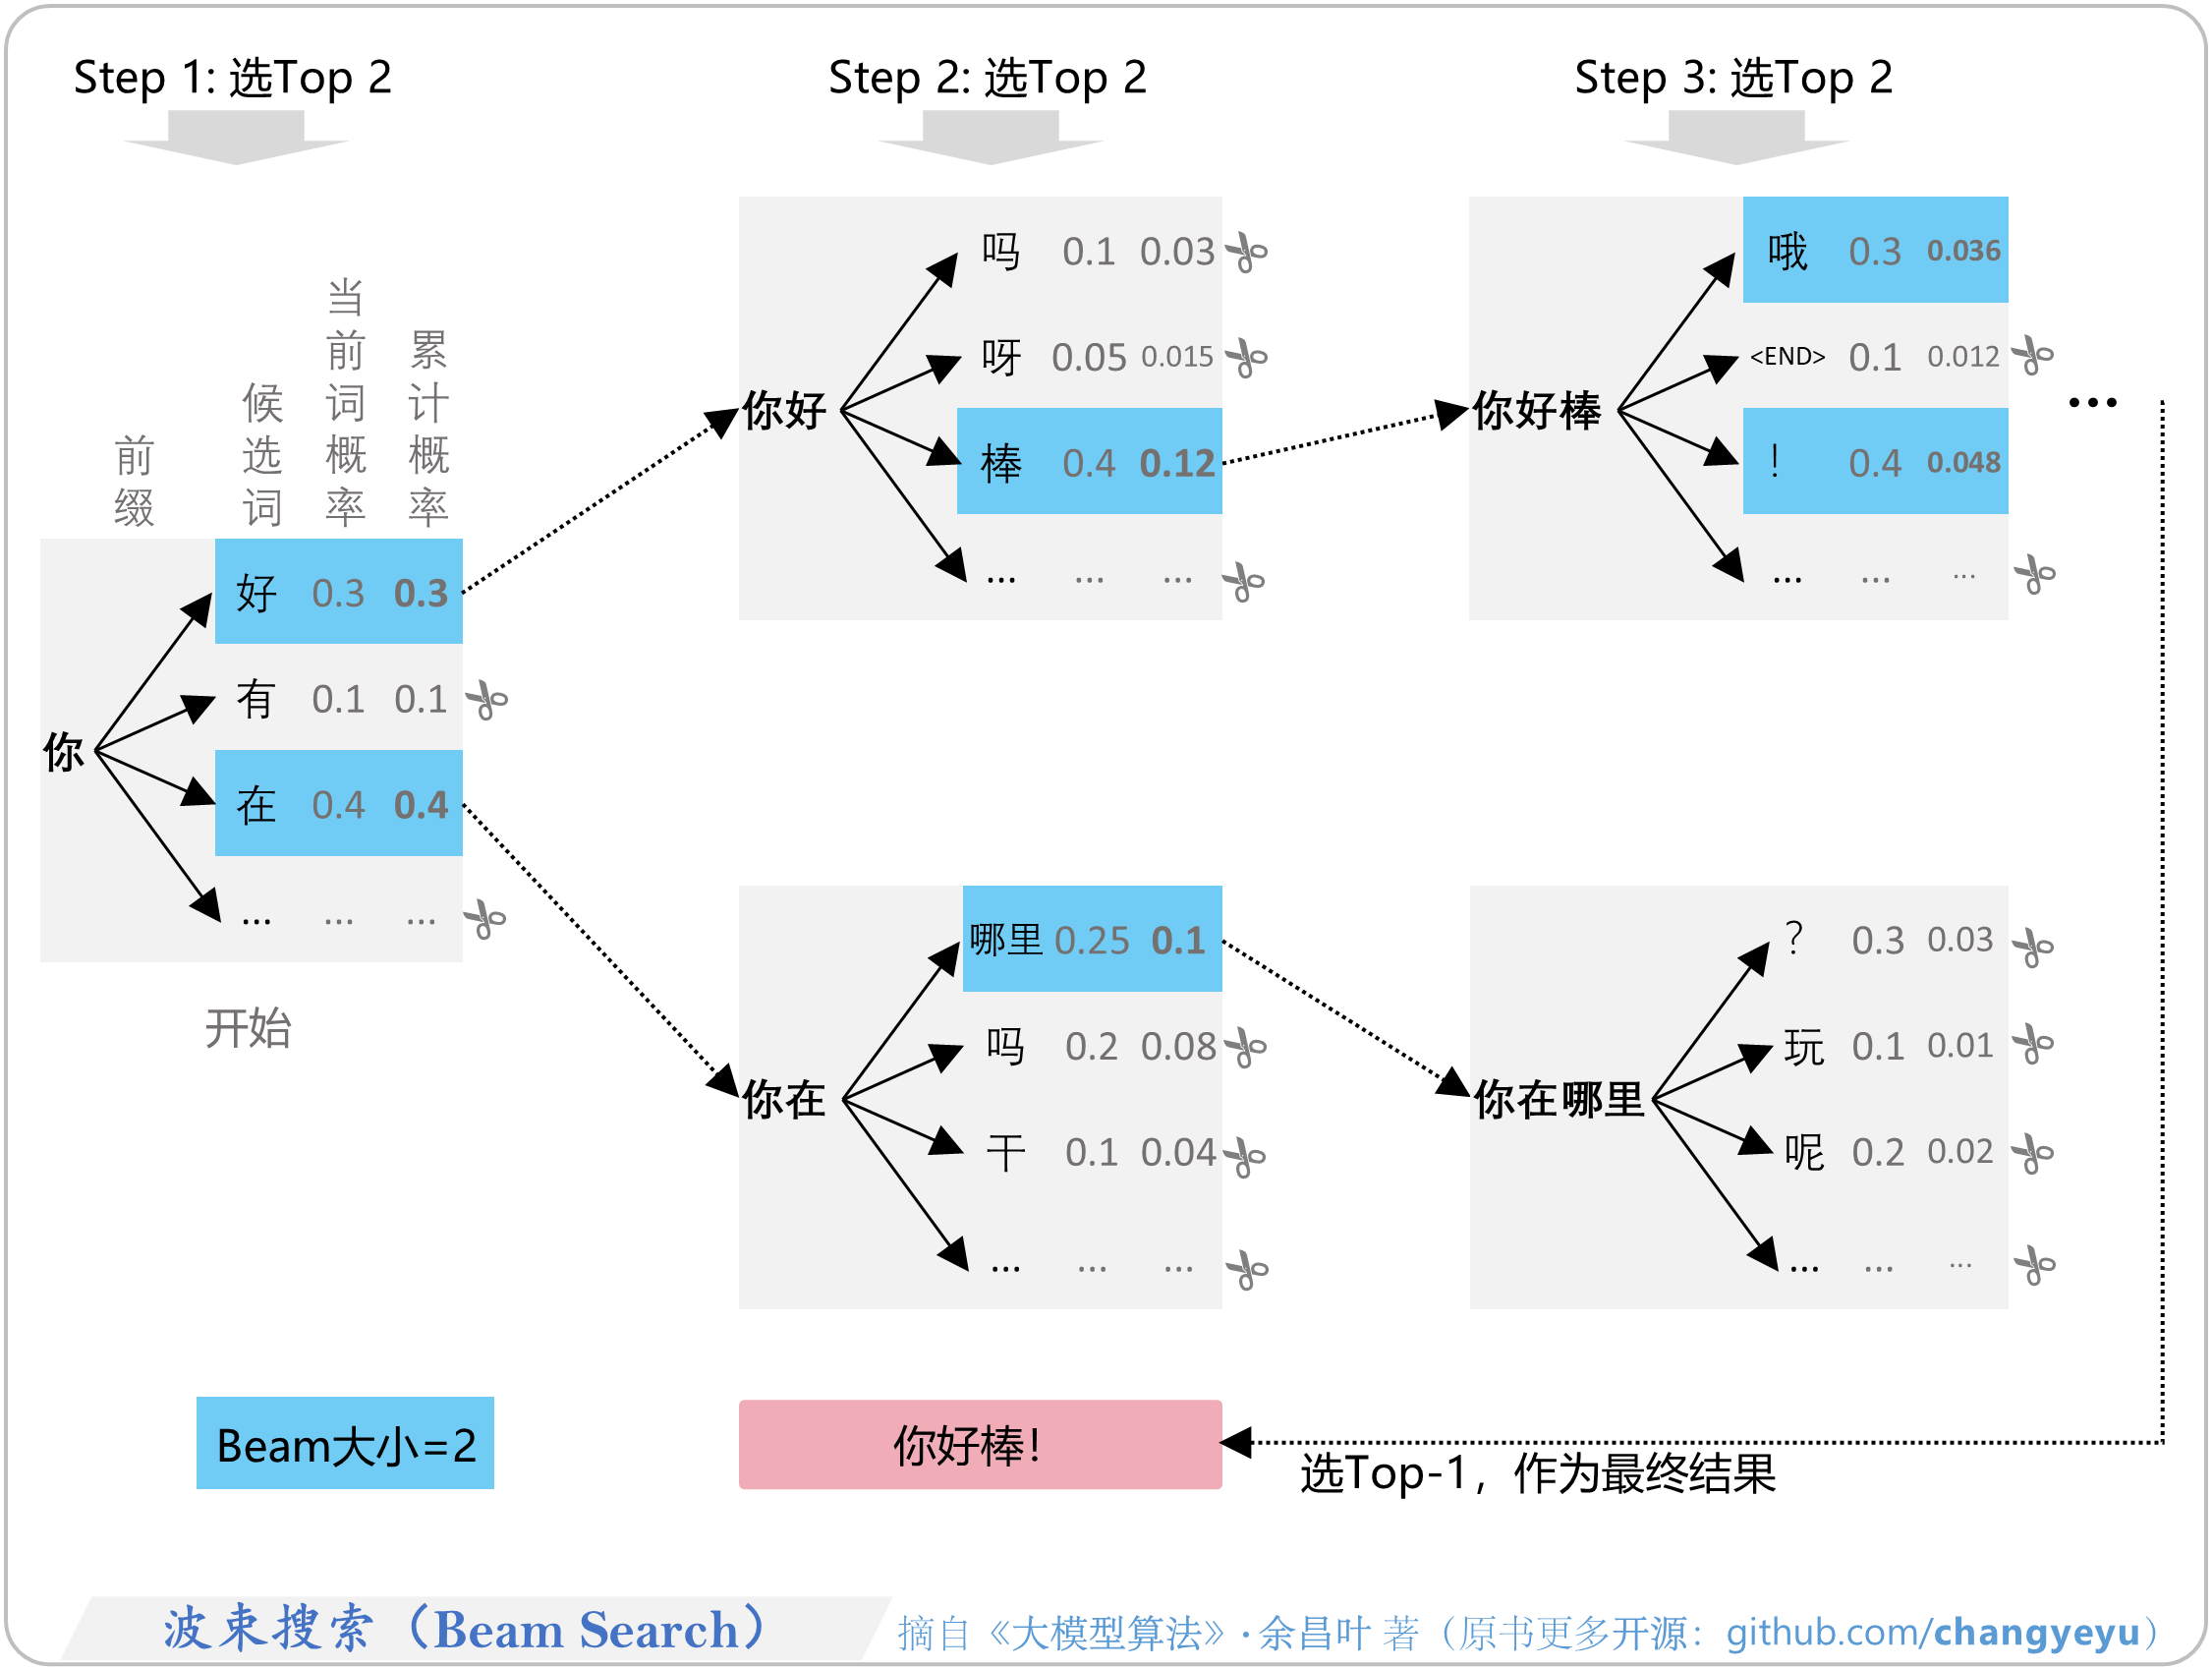
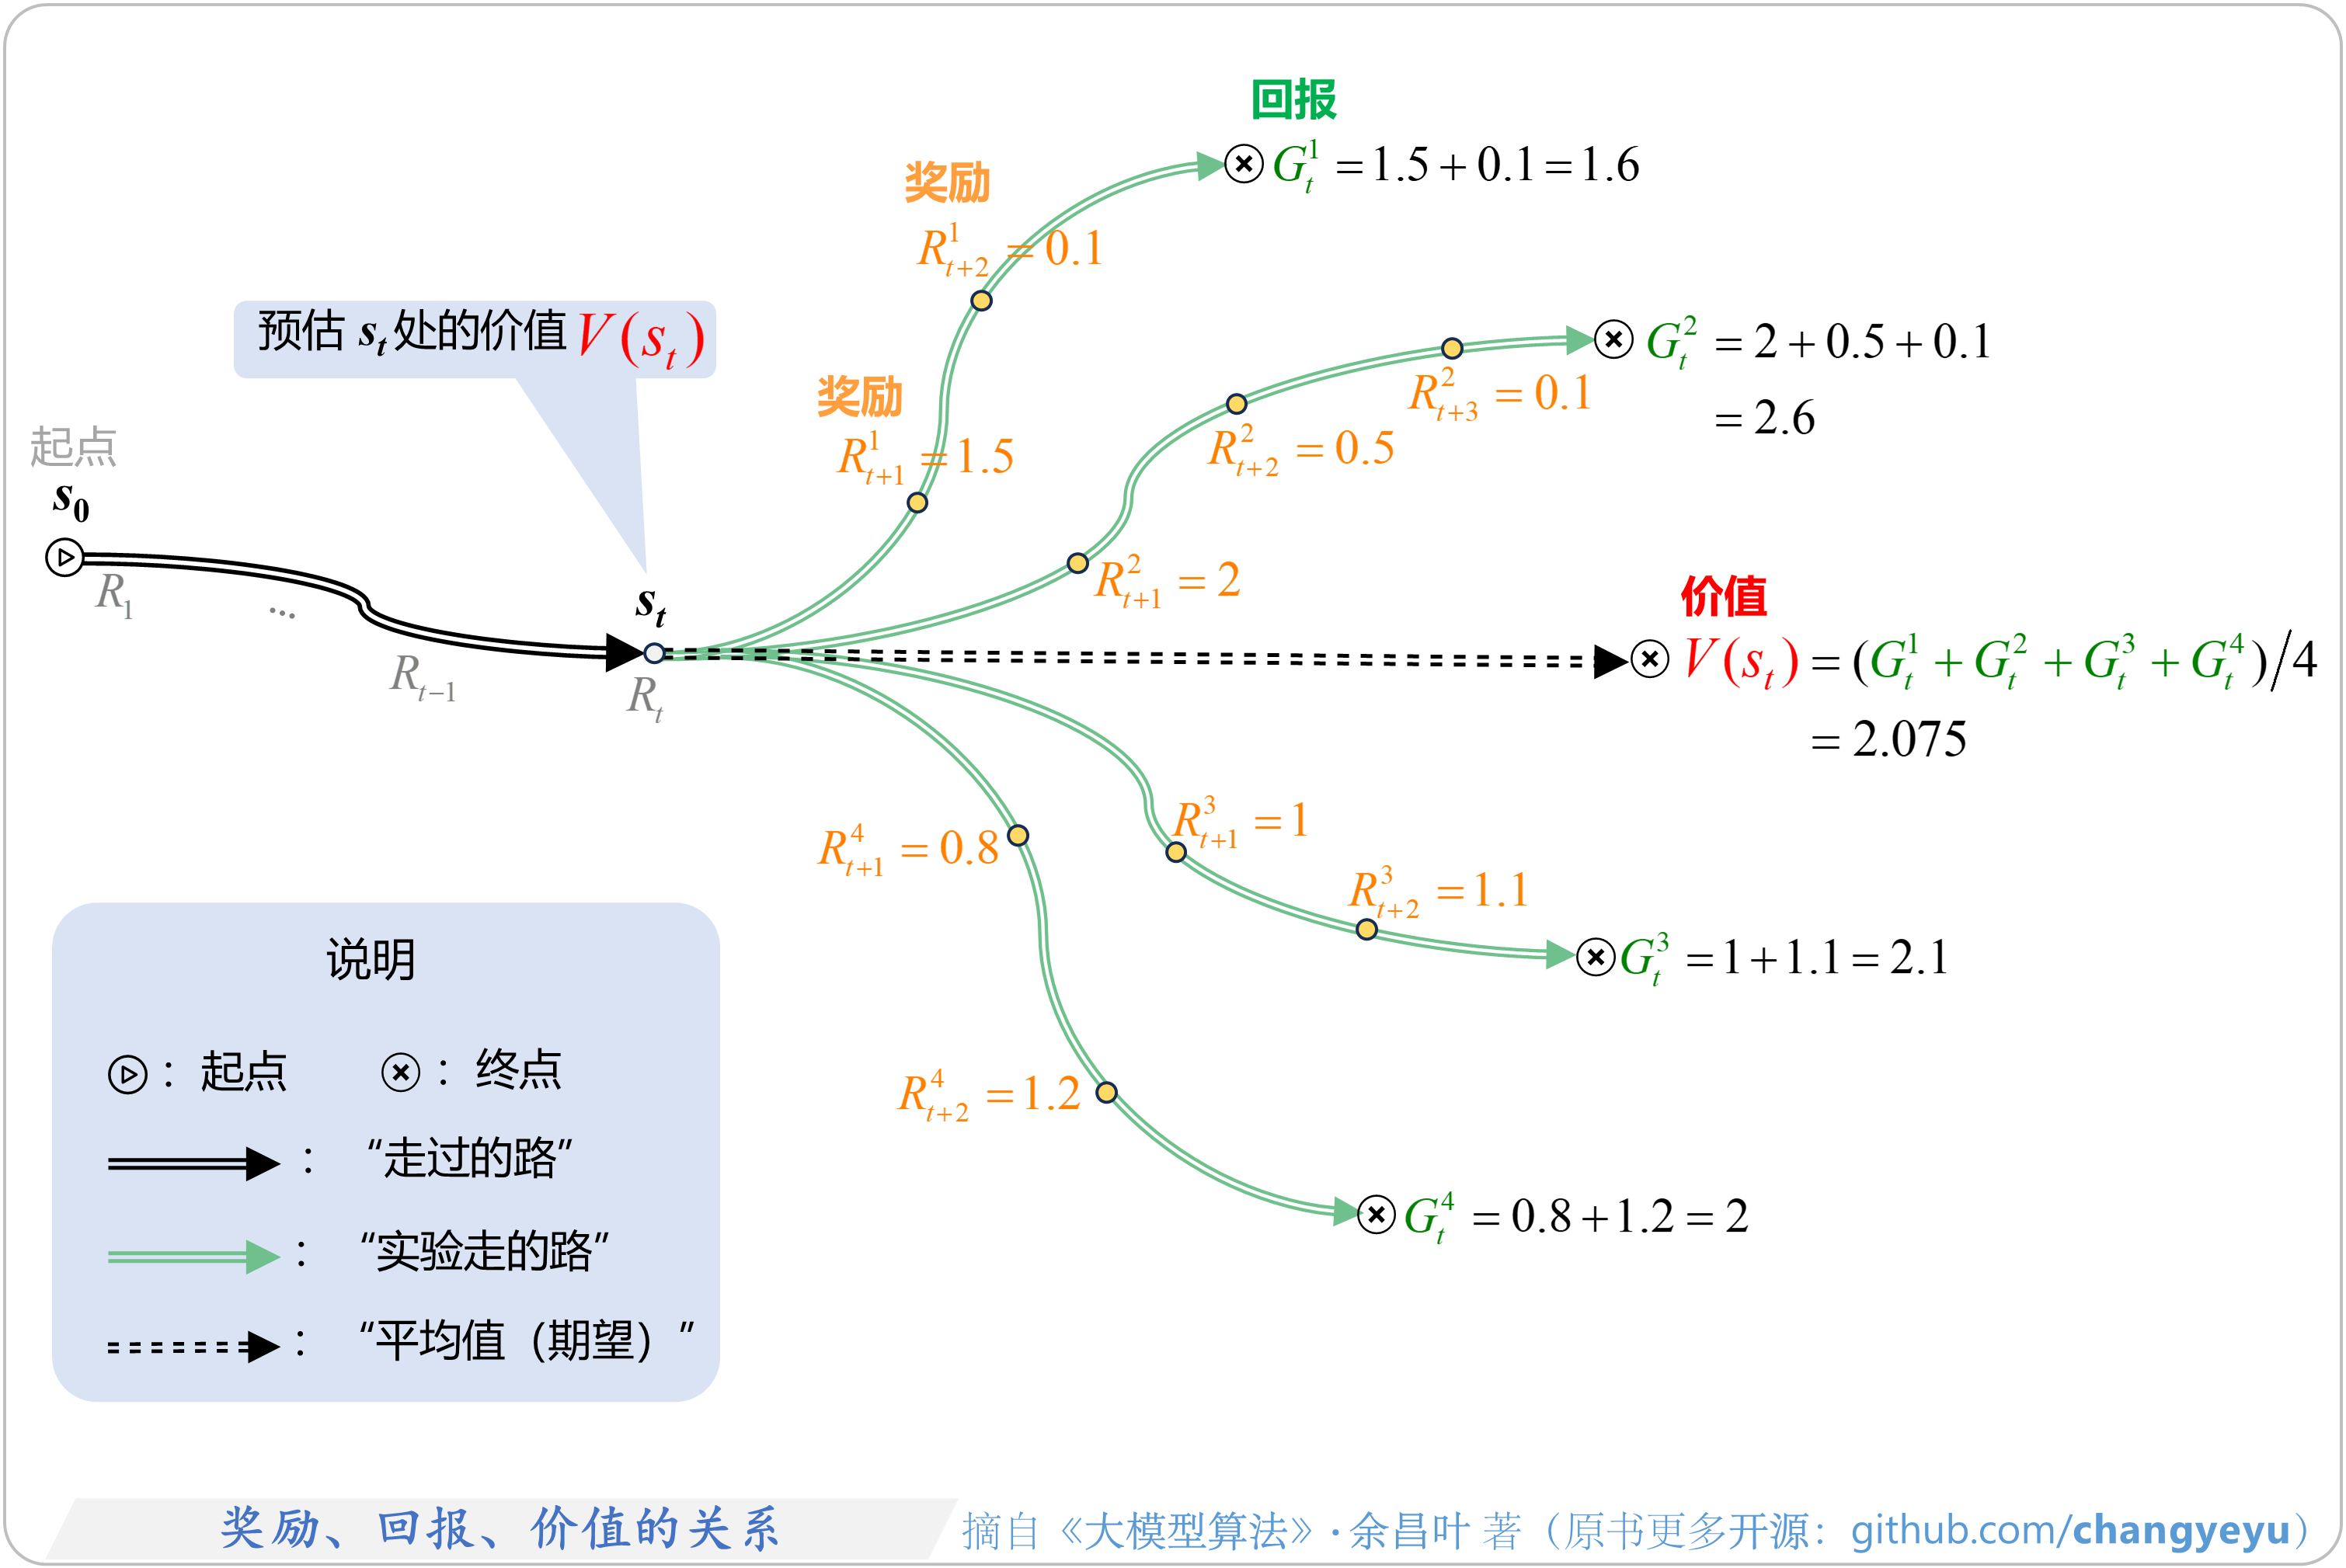
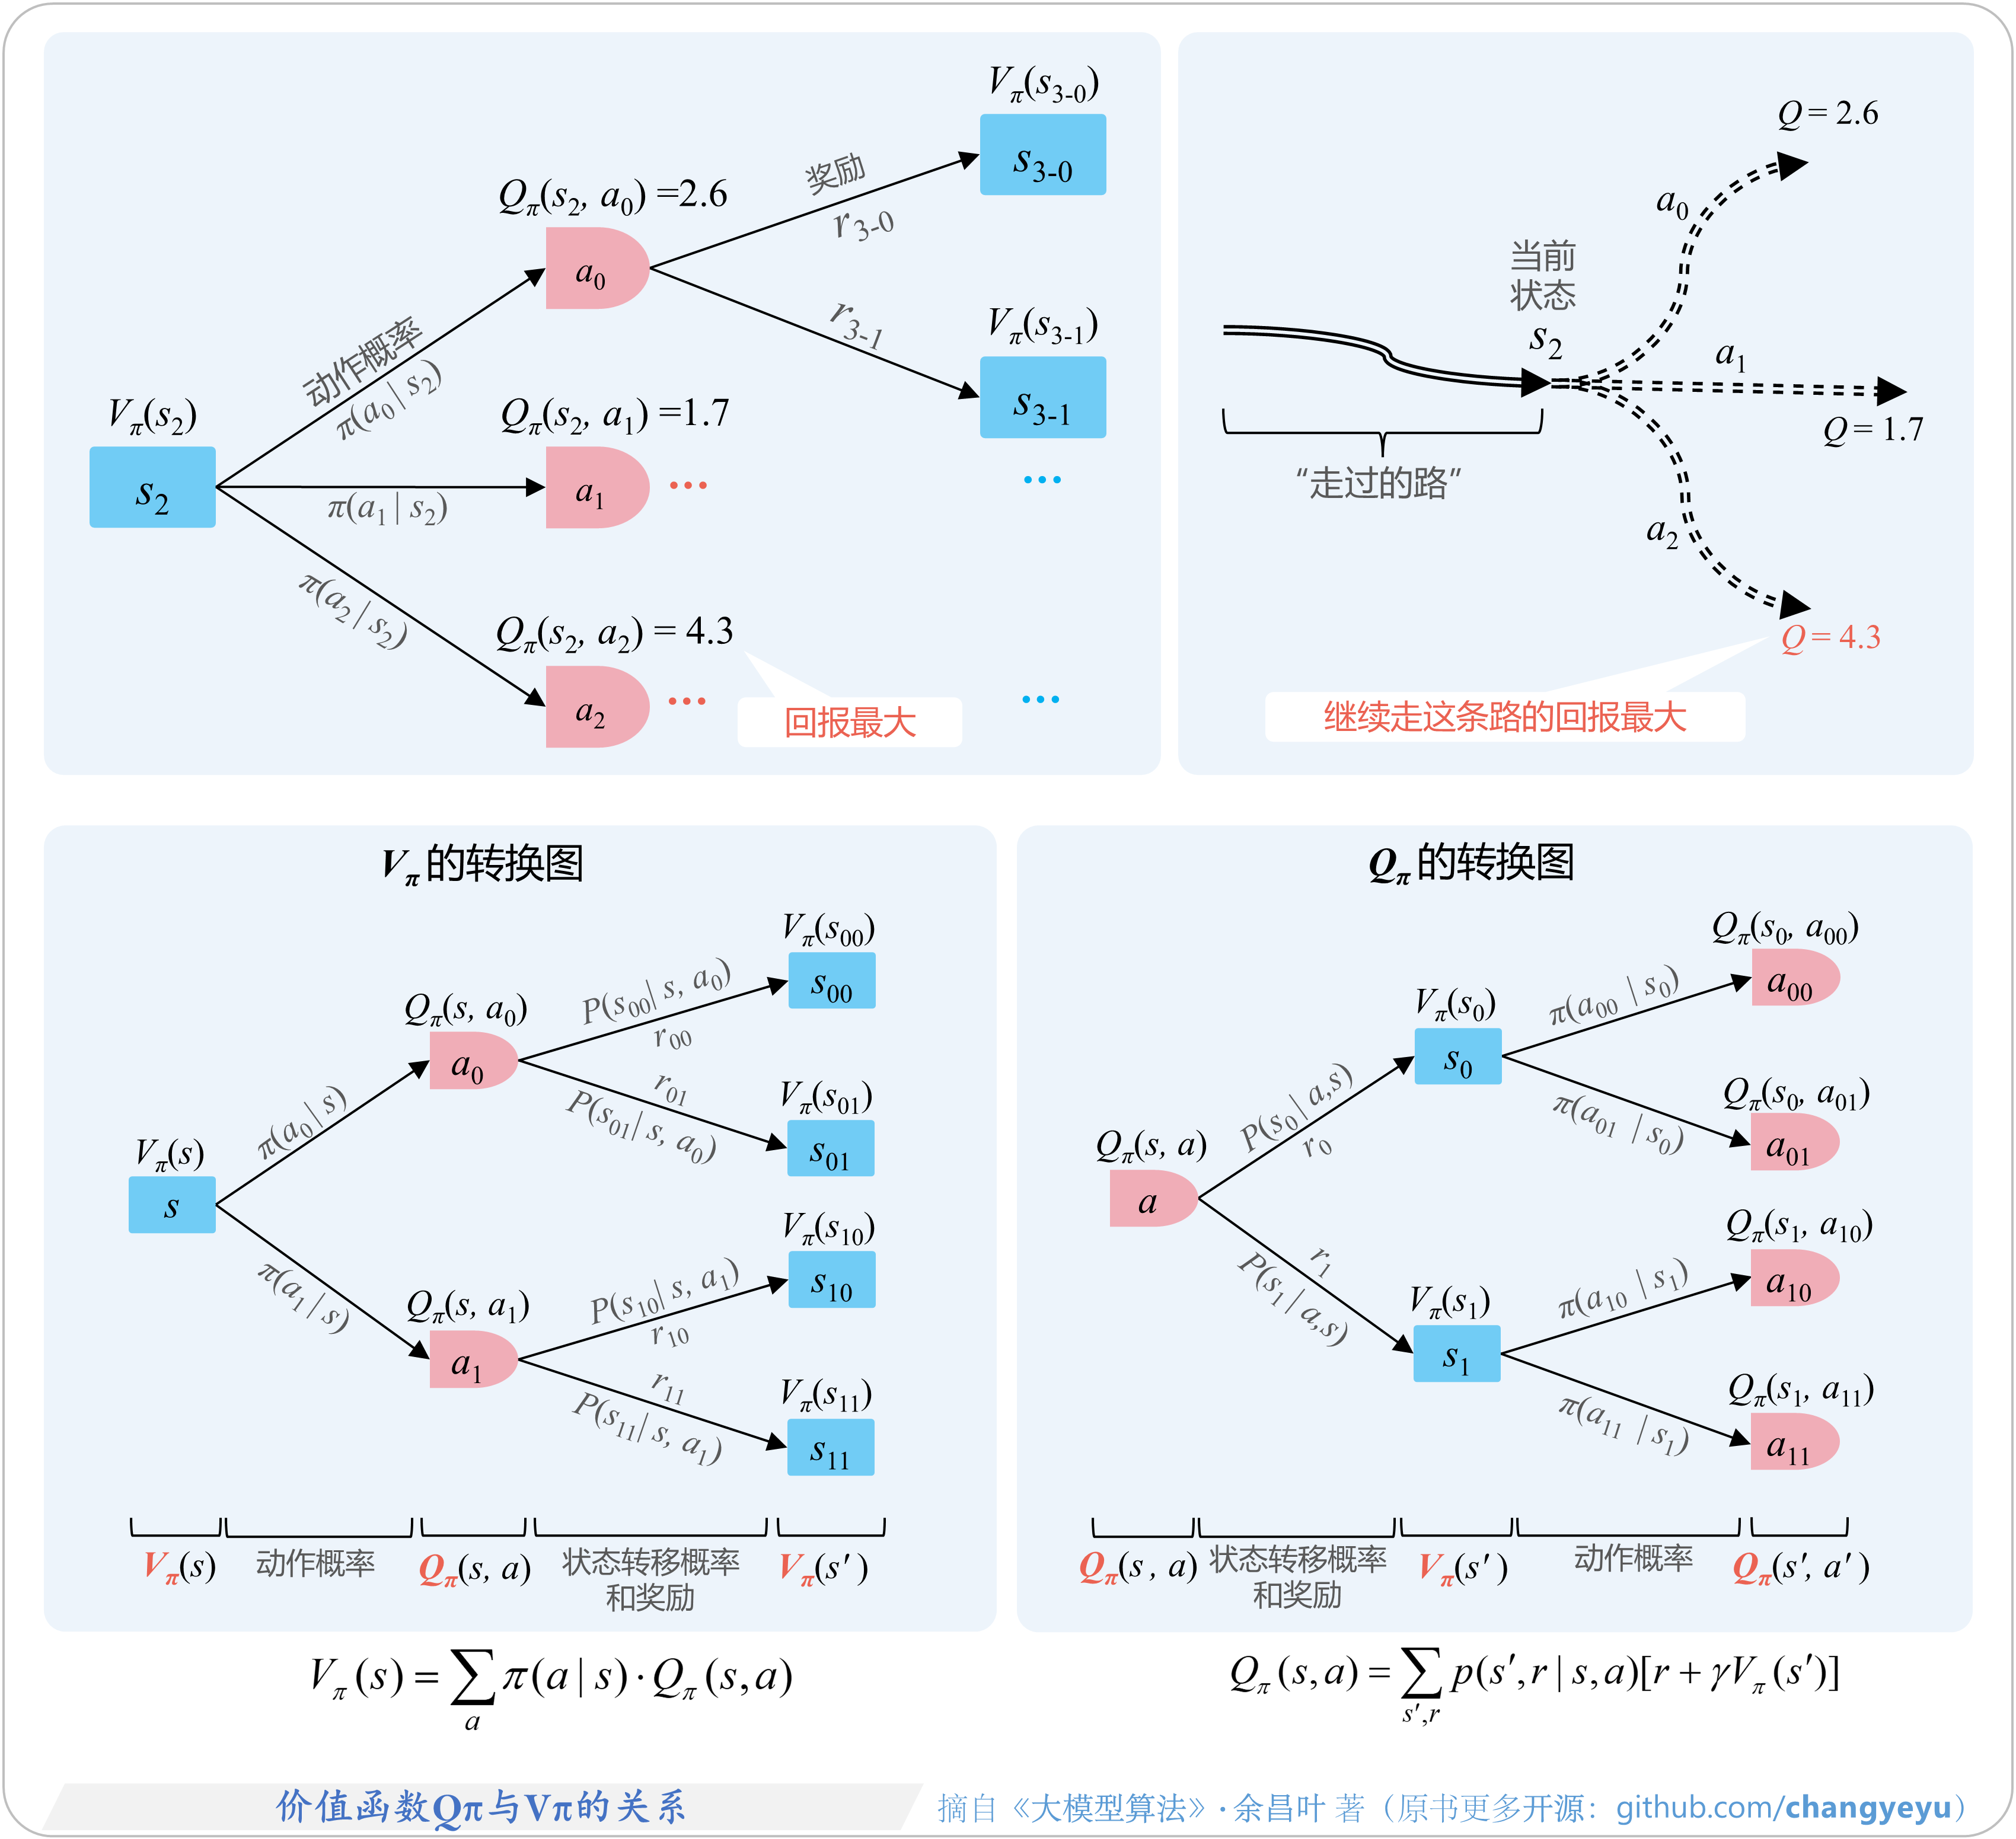
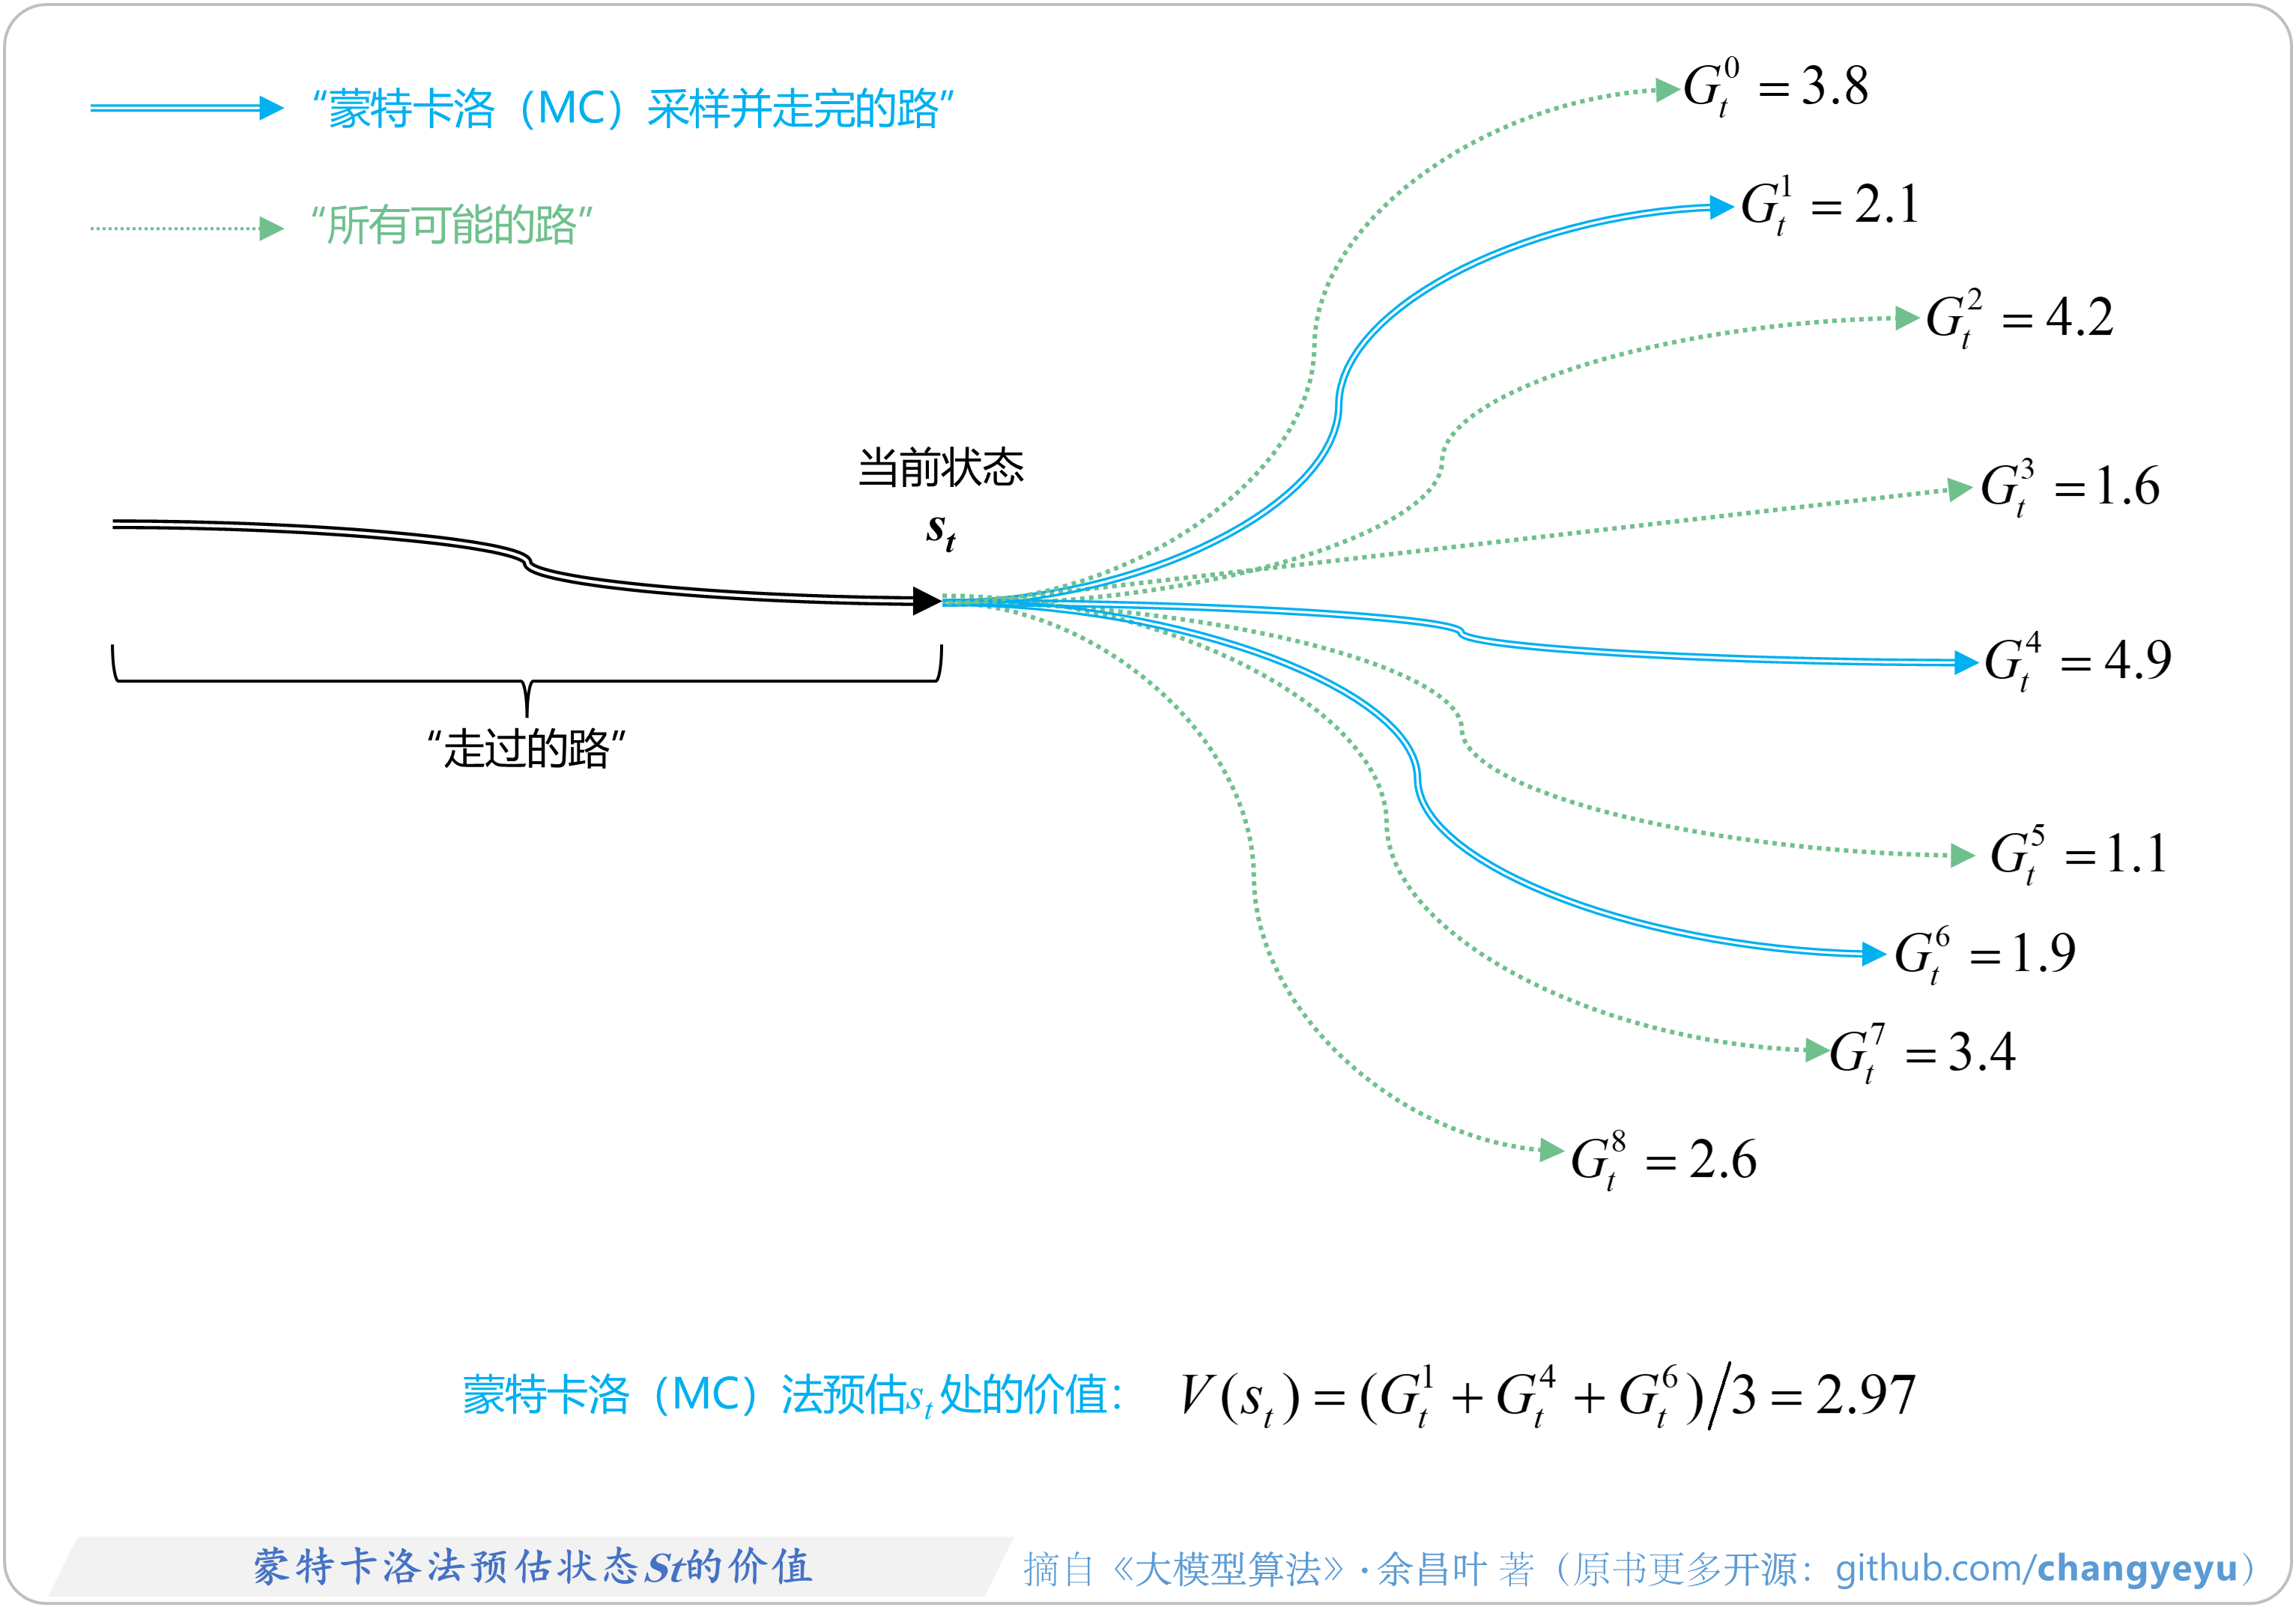
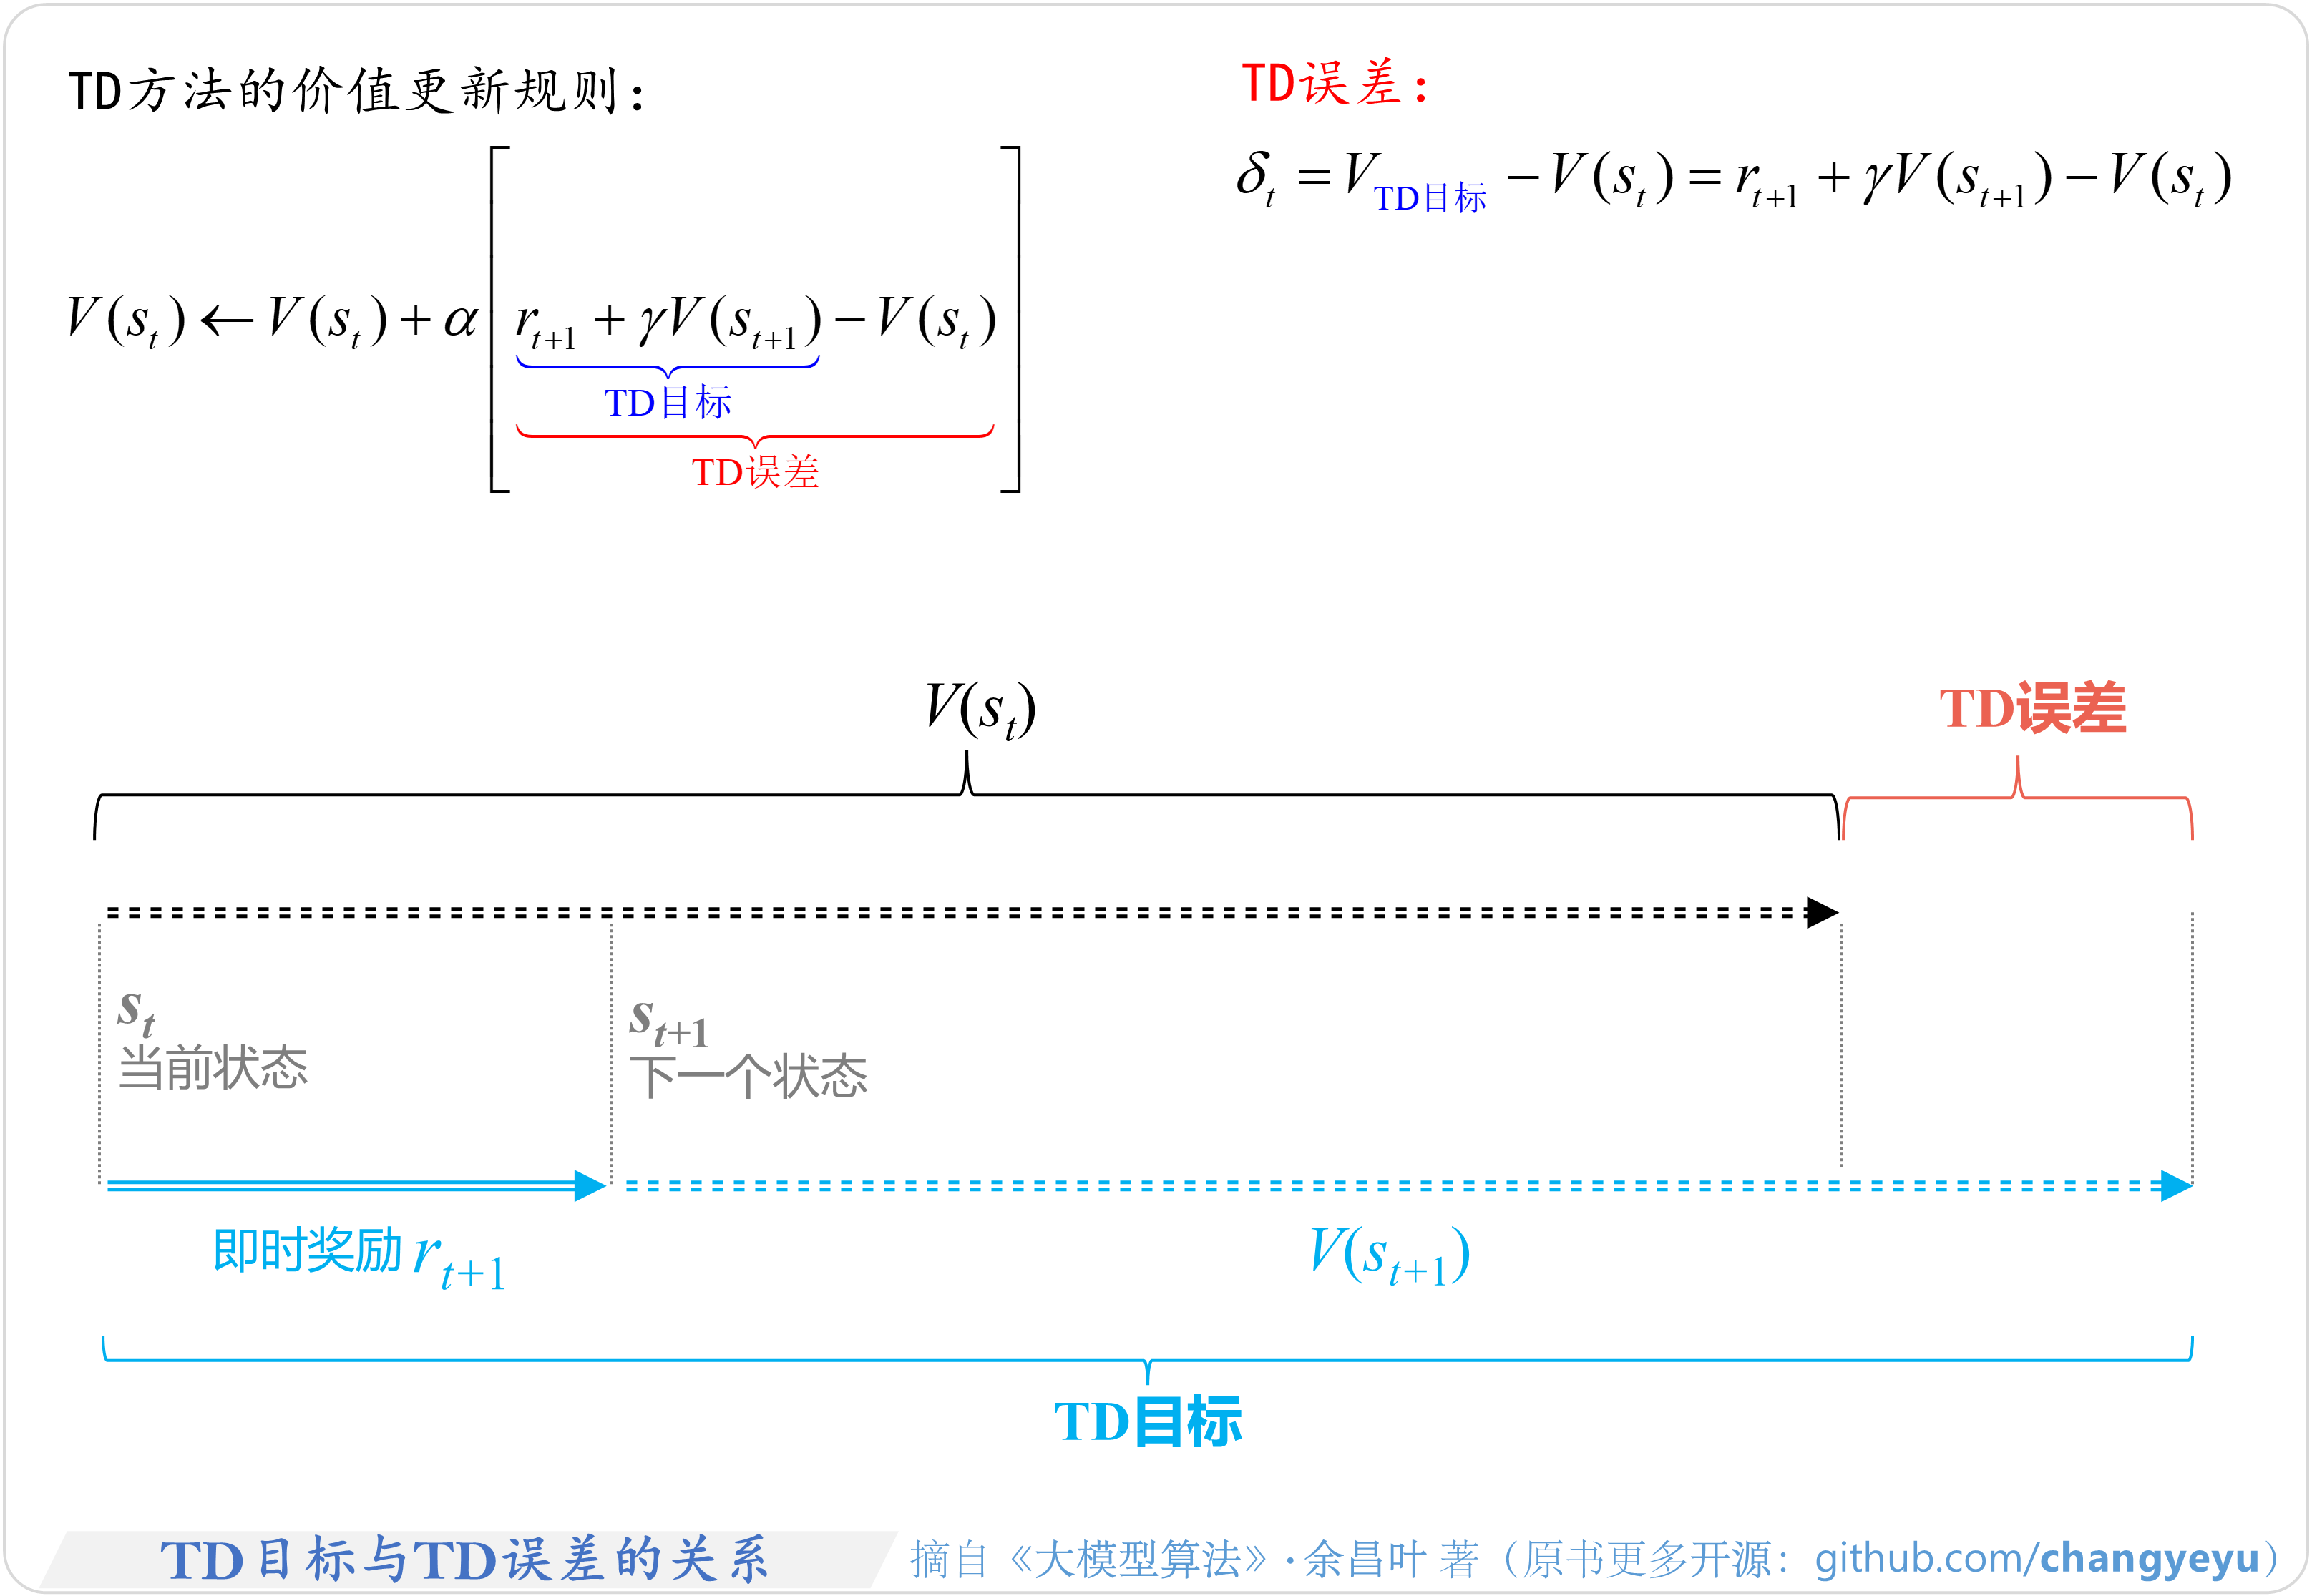
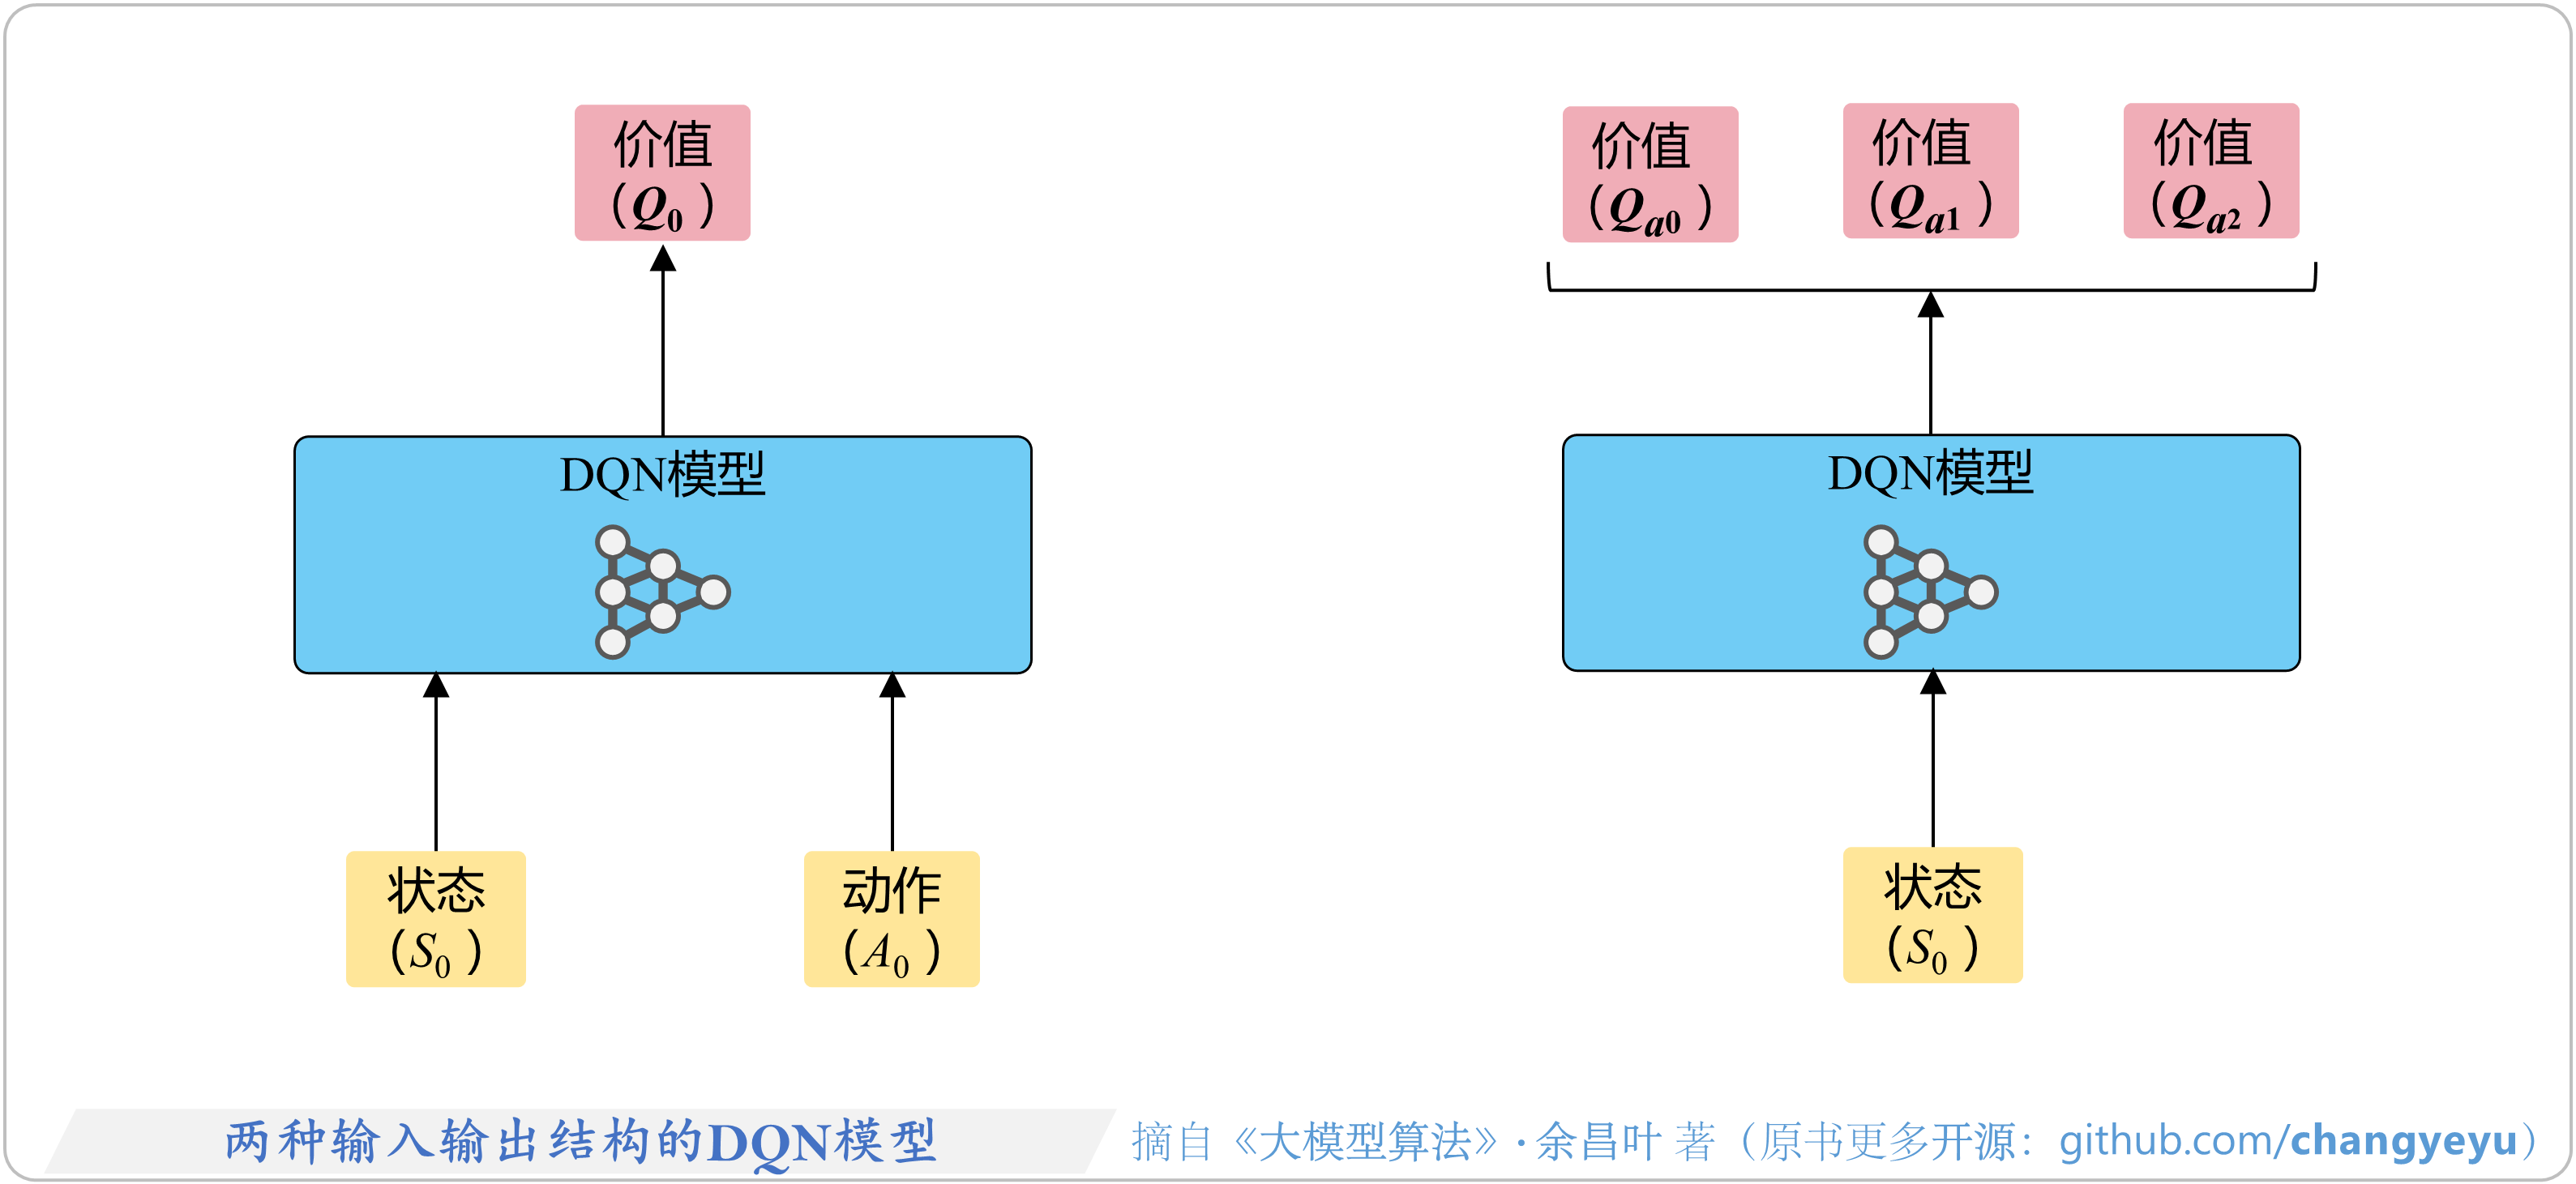
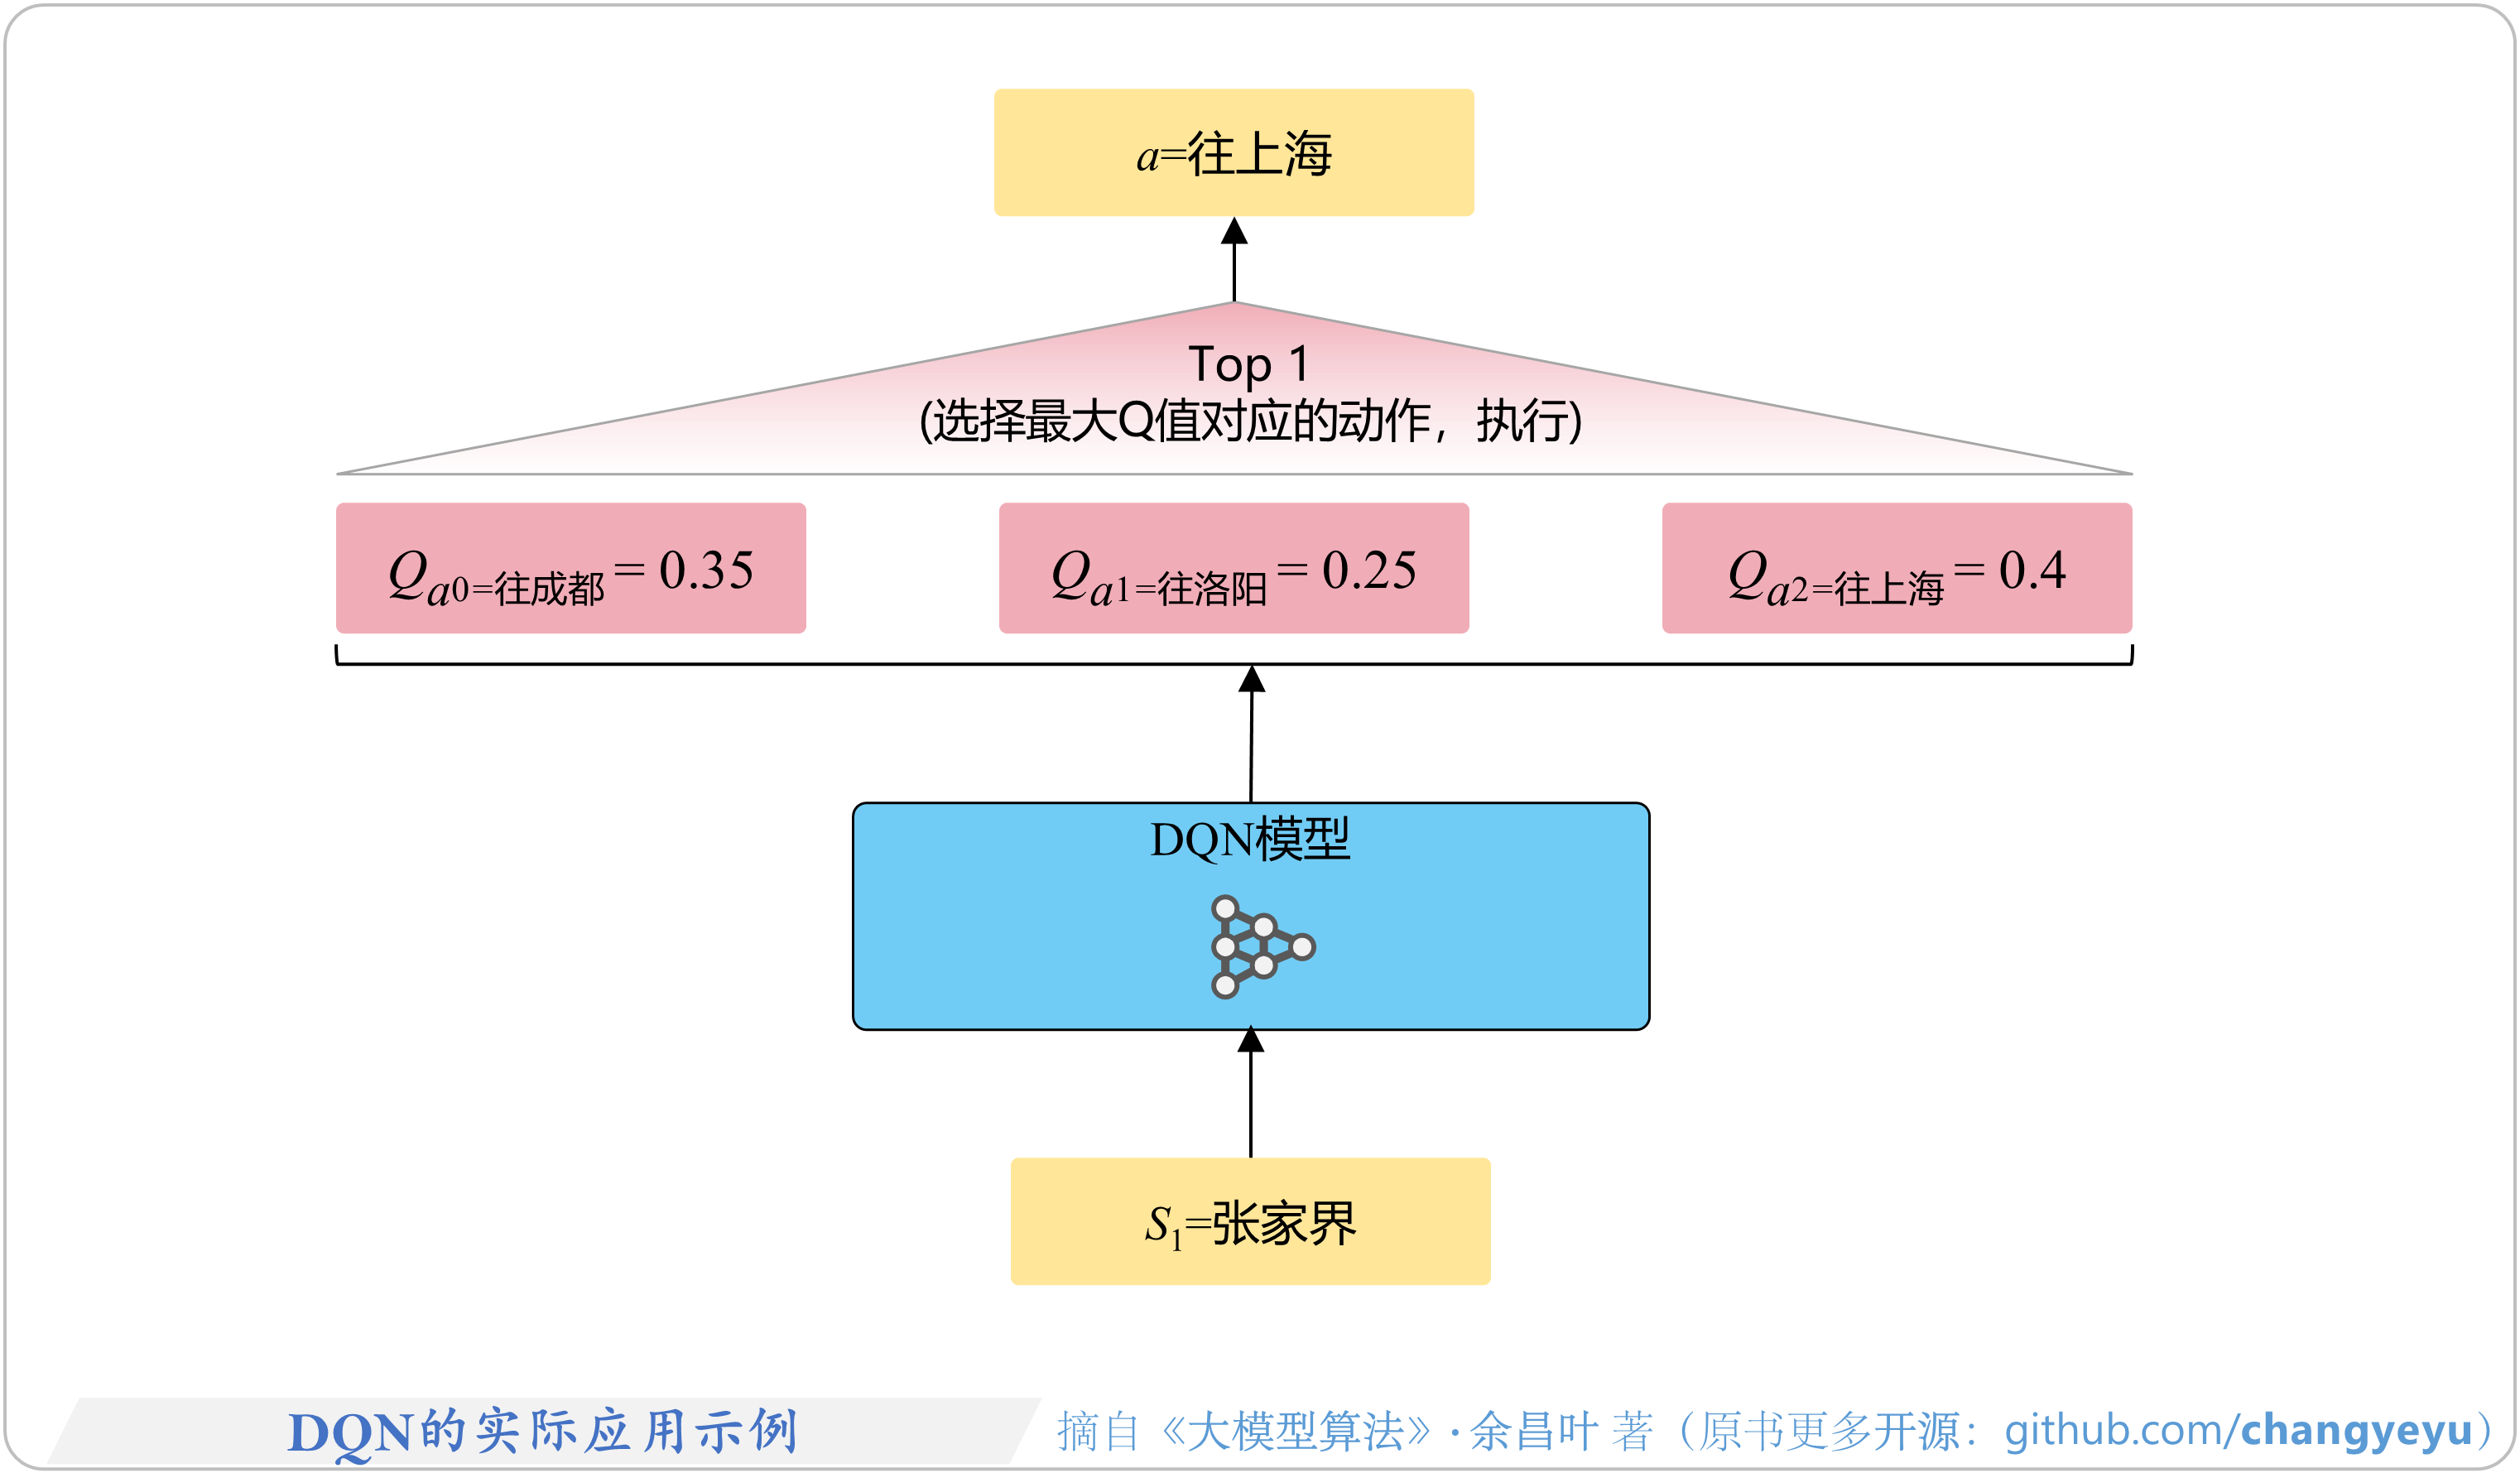
DQN模型的输入输出结构有两种类型:
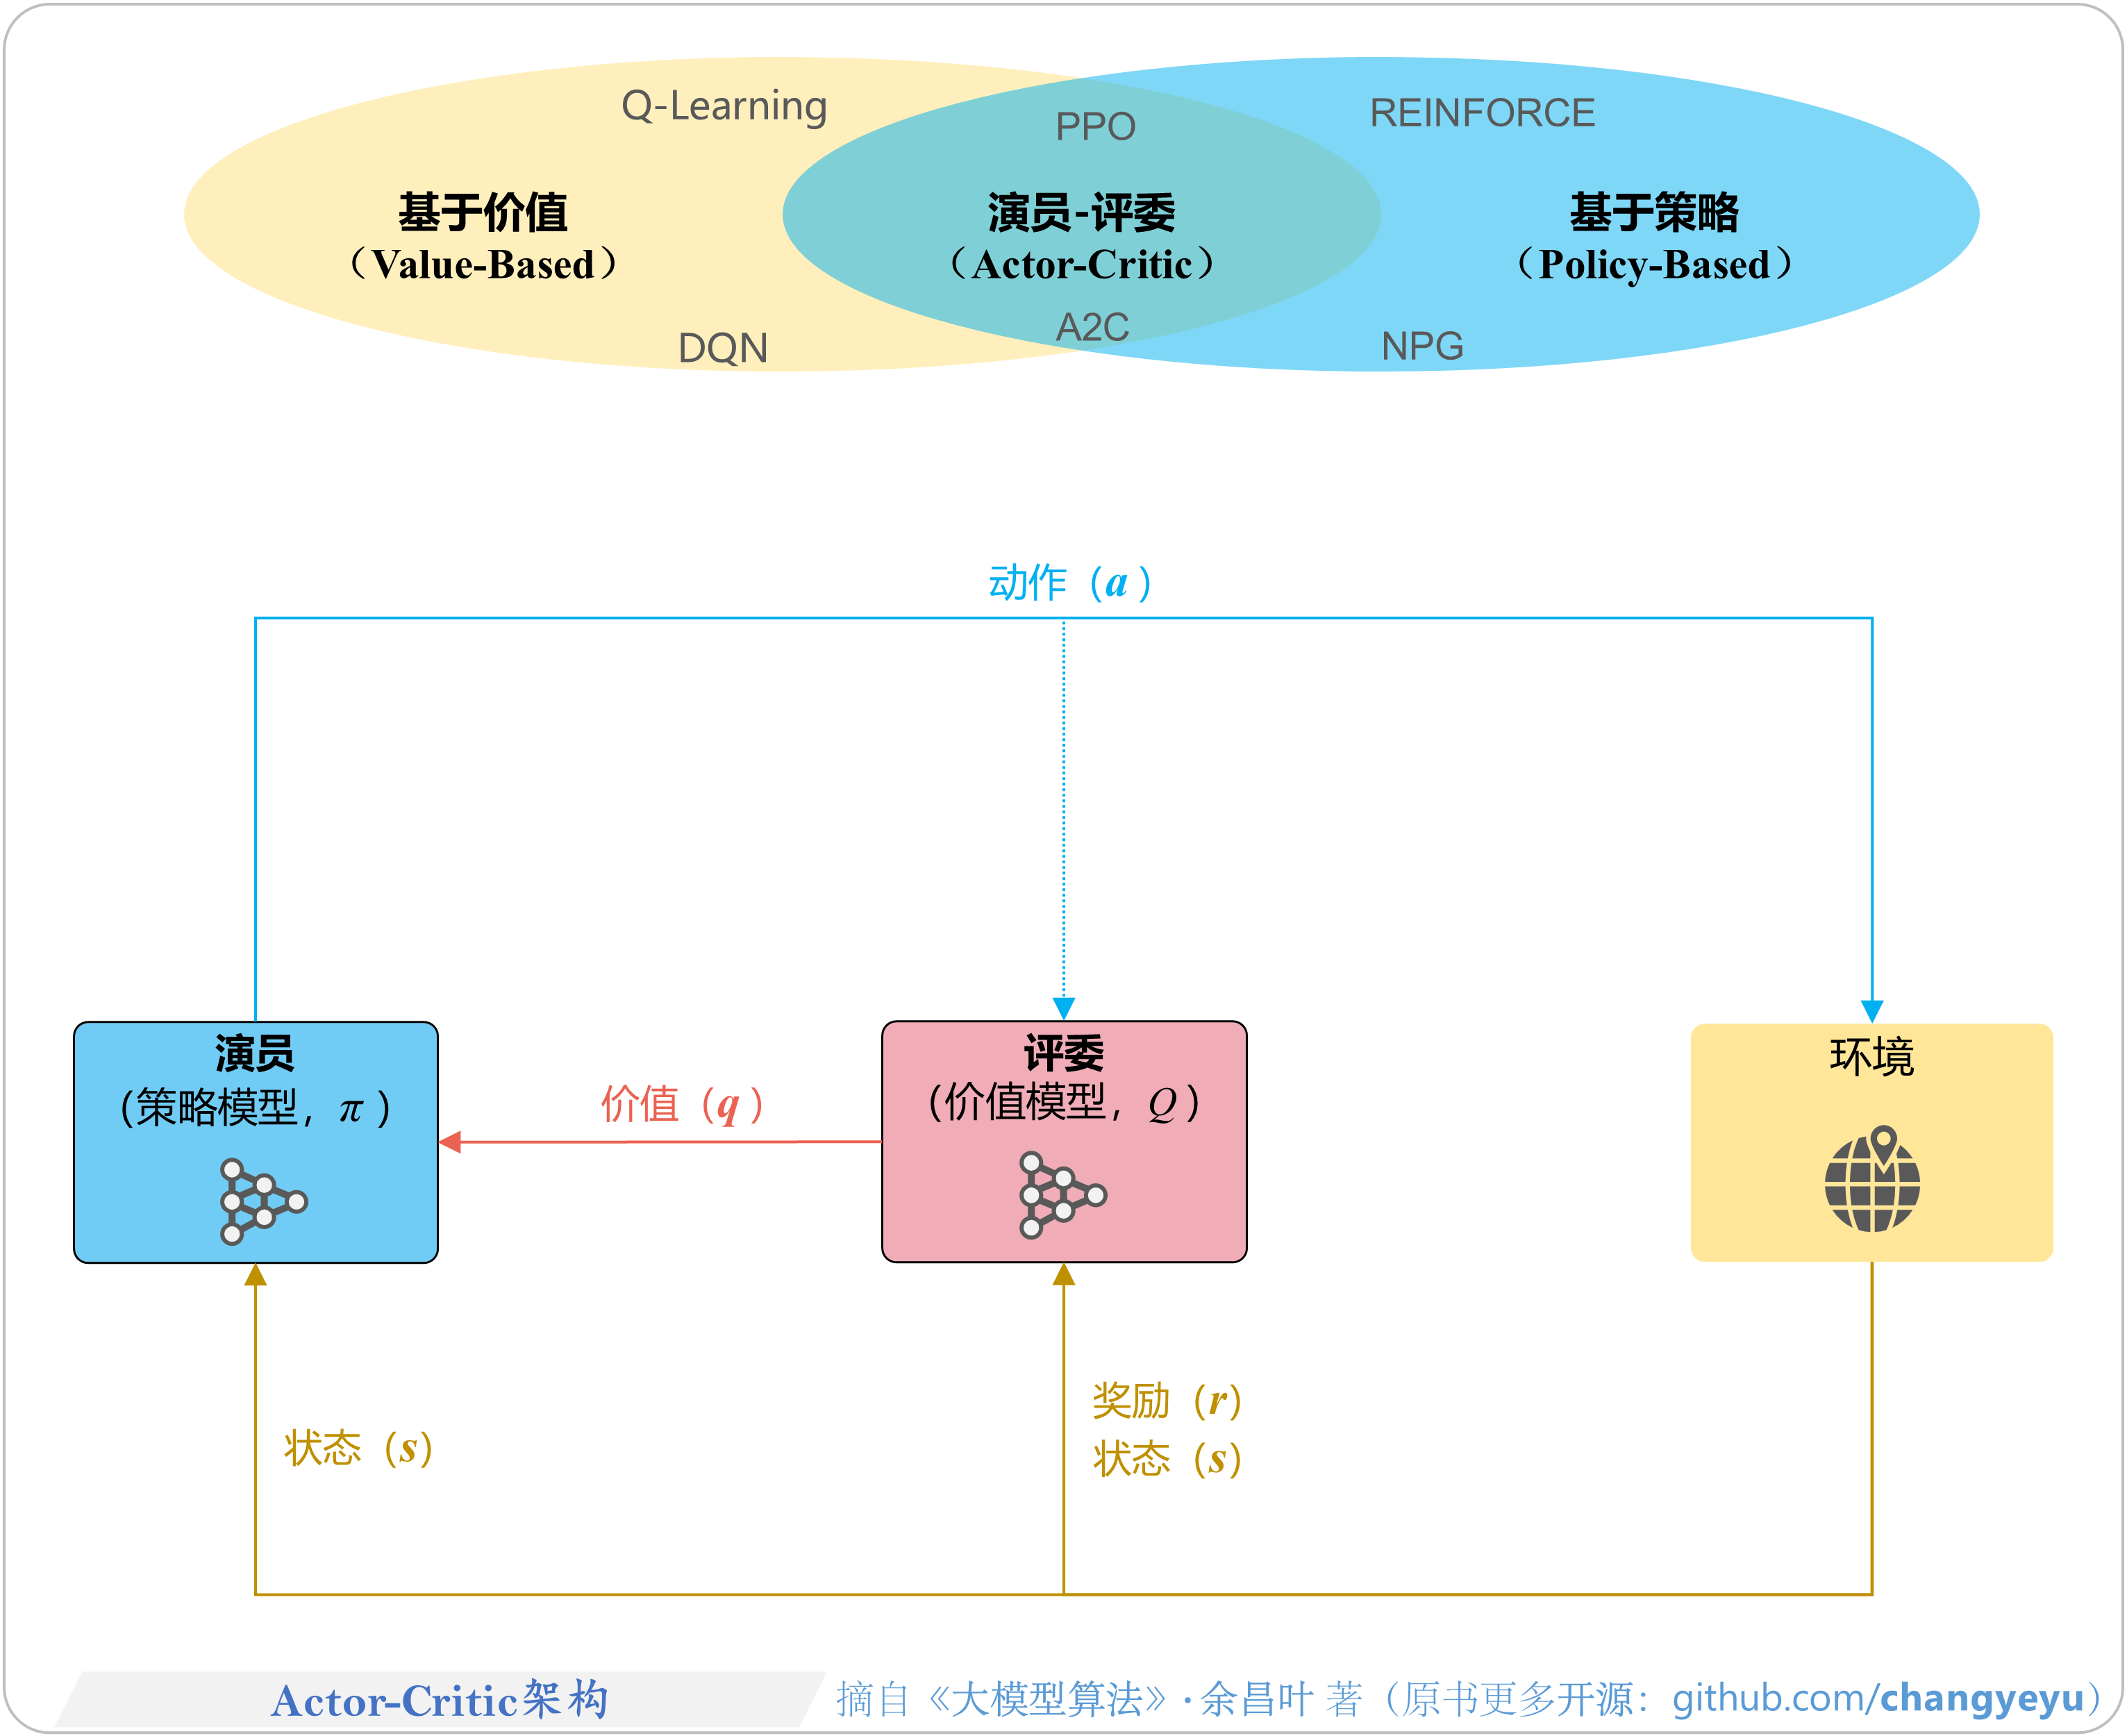
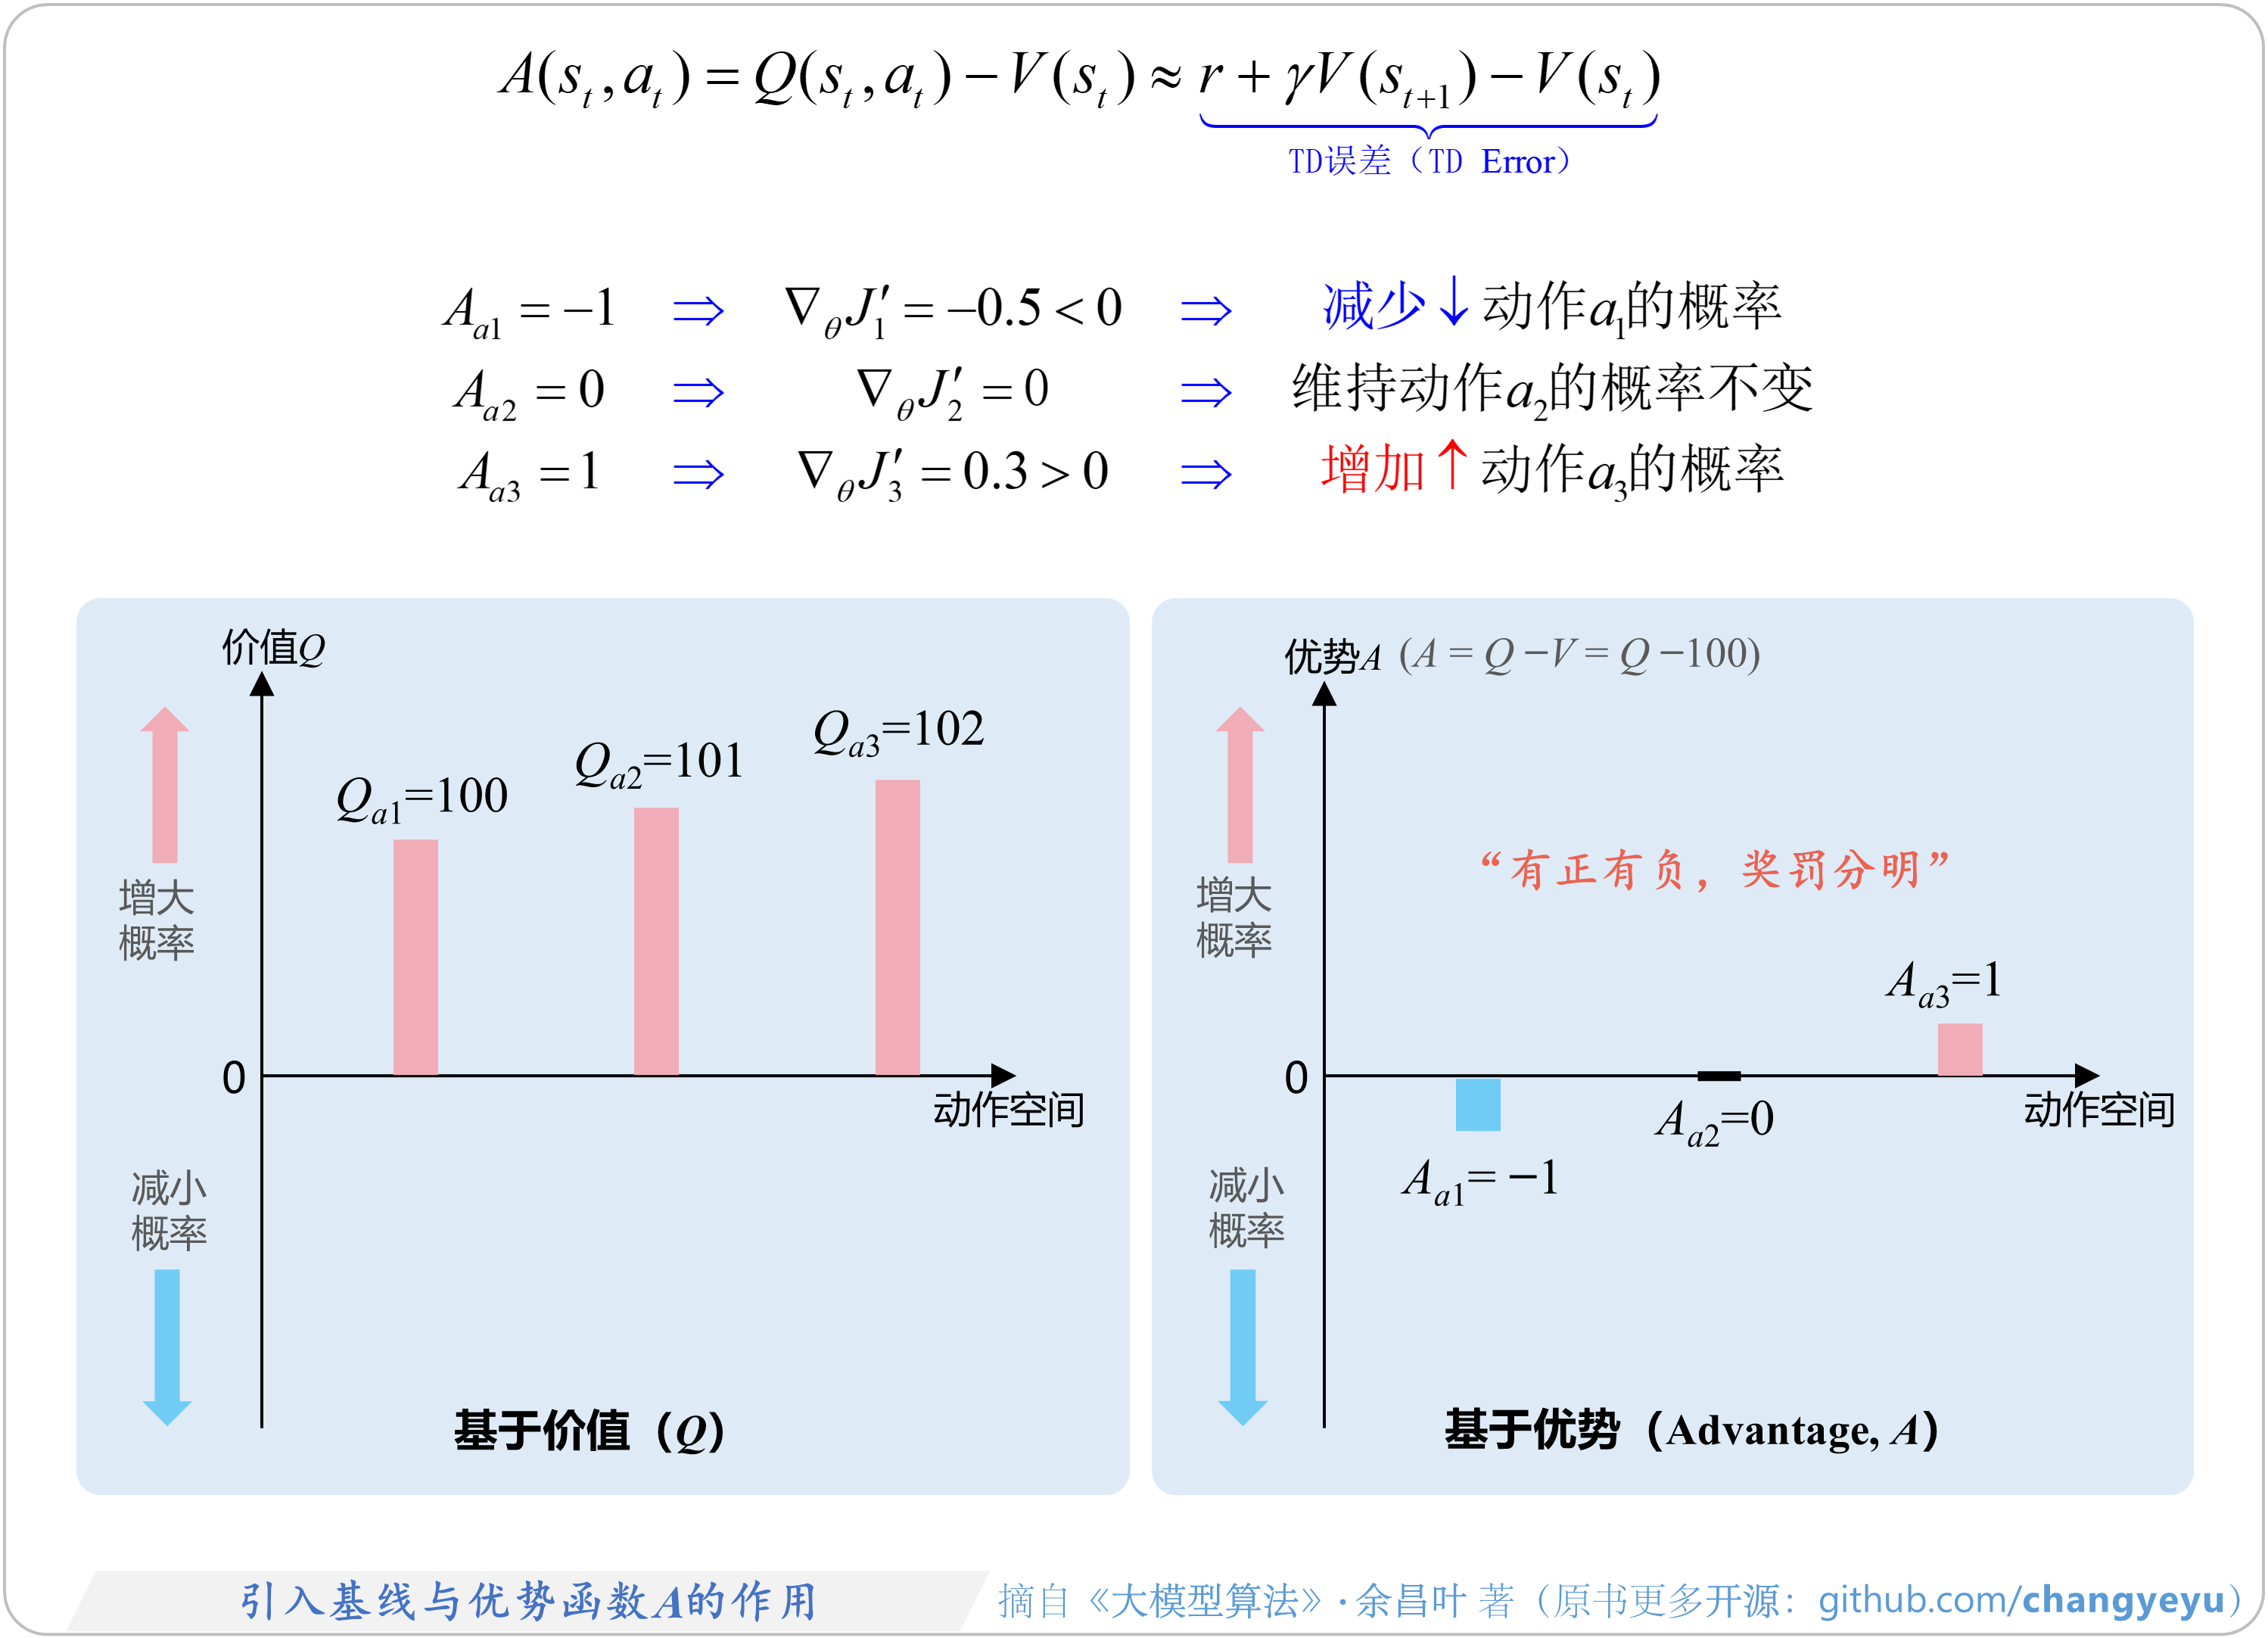
import numpy as np

def compute_gae(rewards, values, gamma=0.99, lambda_=0.95):
    """
    参数:
        rewards (list 或 np.ndarray): 每个时间步收集到的奖励 r,形状为 (T,)
        values  (list 或 np.ndarray): 每个状态的价值估计 V,形状为 (T+1,)
        gamma   (float): 折扣因子 γ
        lambda_ (float): GAE 的衰减参数 λ
    返回:
        np.ndarray: 优势估计 A,形状为 (T,)。例如对于 T=5,A=[A0, A1, A2, A3, A4]
    """
    T = len(rewards)            # 时间步数 T,终止时间步为 t=T-1
    advantages = np.zeros(T)    # 优势估计数组,例如 [A0, A1, A2, A3, A4]
    gae = 0                     # 初始化 GAE 累计值为 0

    # 反向从时间步 t=T-1 到 t=0 进行迭代计算,总共迭代 T 次
    for t in reversed(range(T)):
        # δ_t = r_t + γ * V(s_{t+1}) - V(s_t)
        delta = rewards[t] + gamma * values[t + 1] - values[t]
        # A_t = δ_t + γ * λ * A_{t+1}
        gae = delta + gamma * lambda_ * gae
        advantages[t] = gae

    return advantages
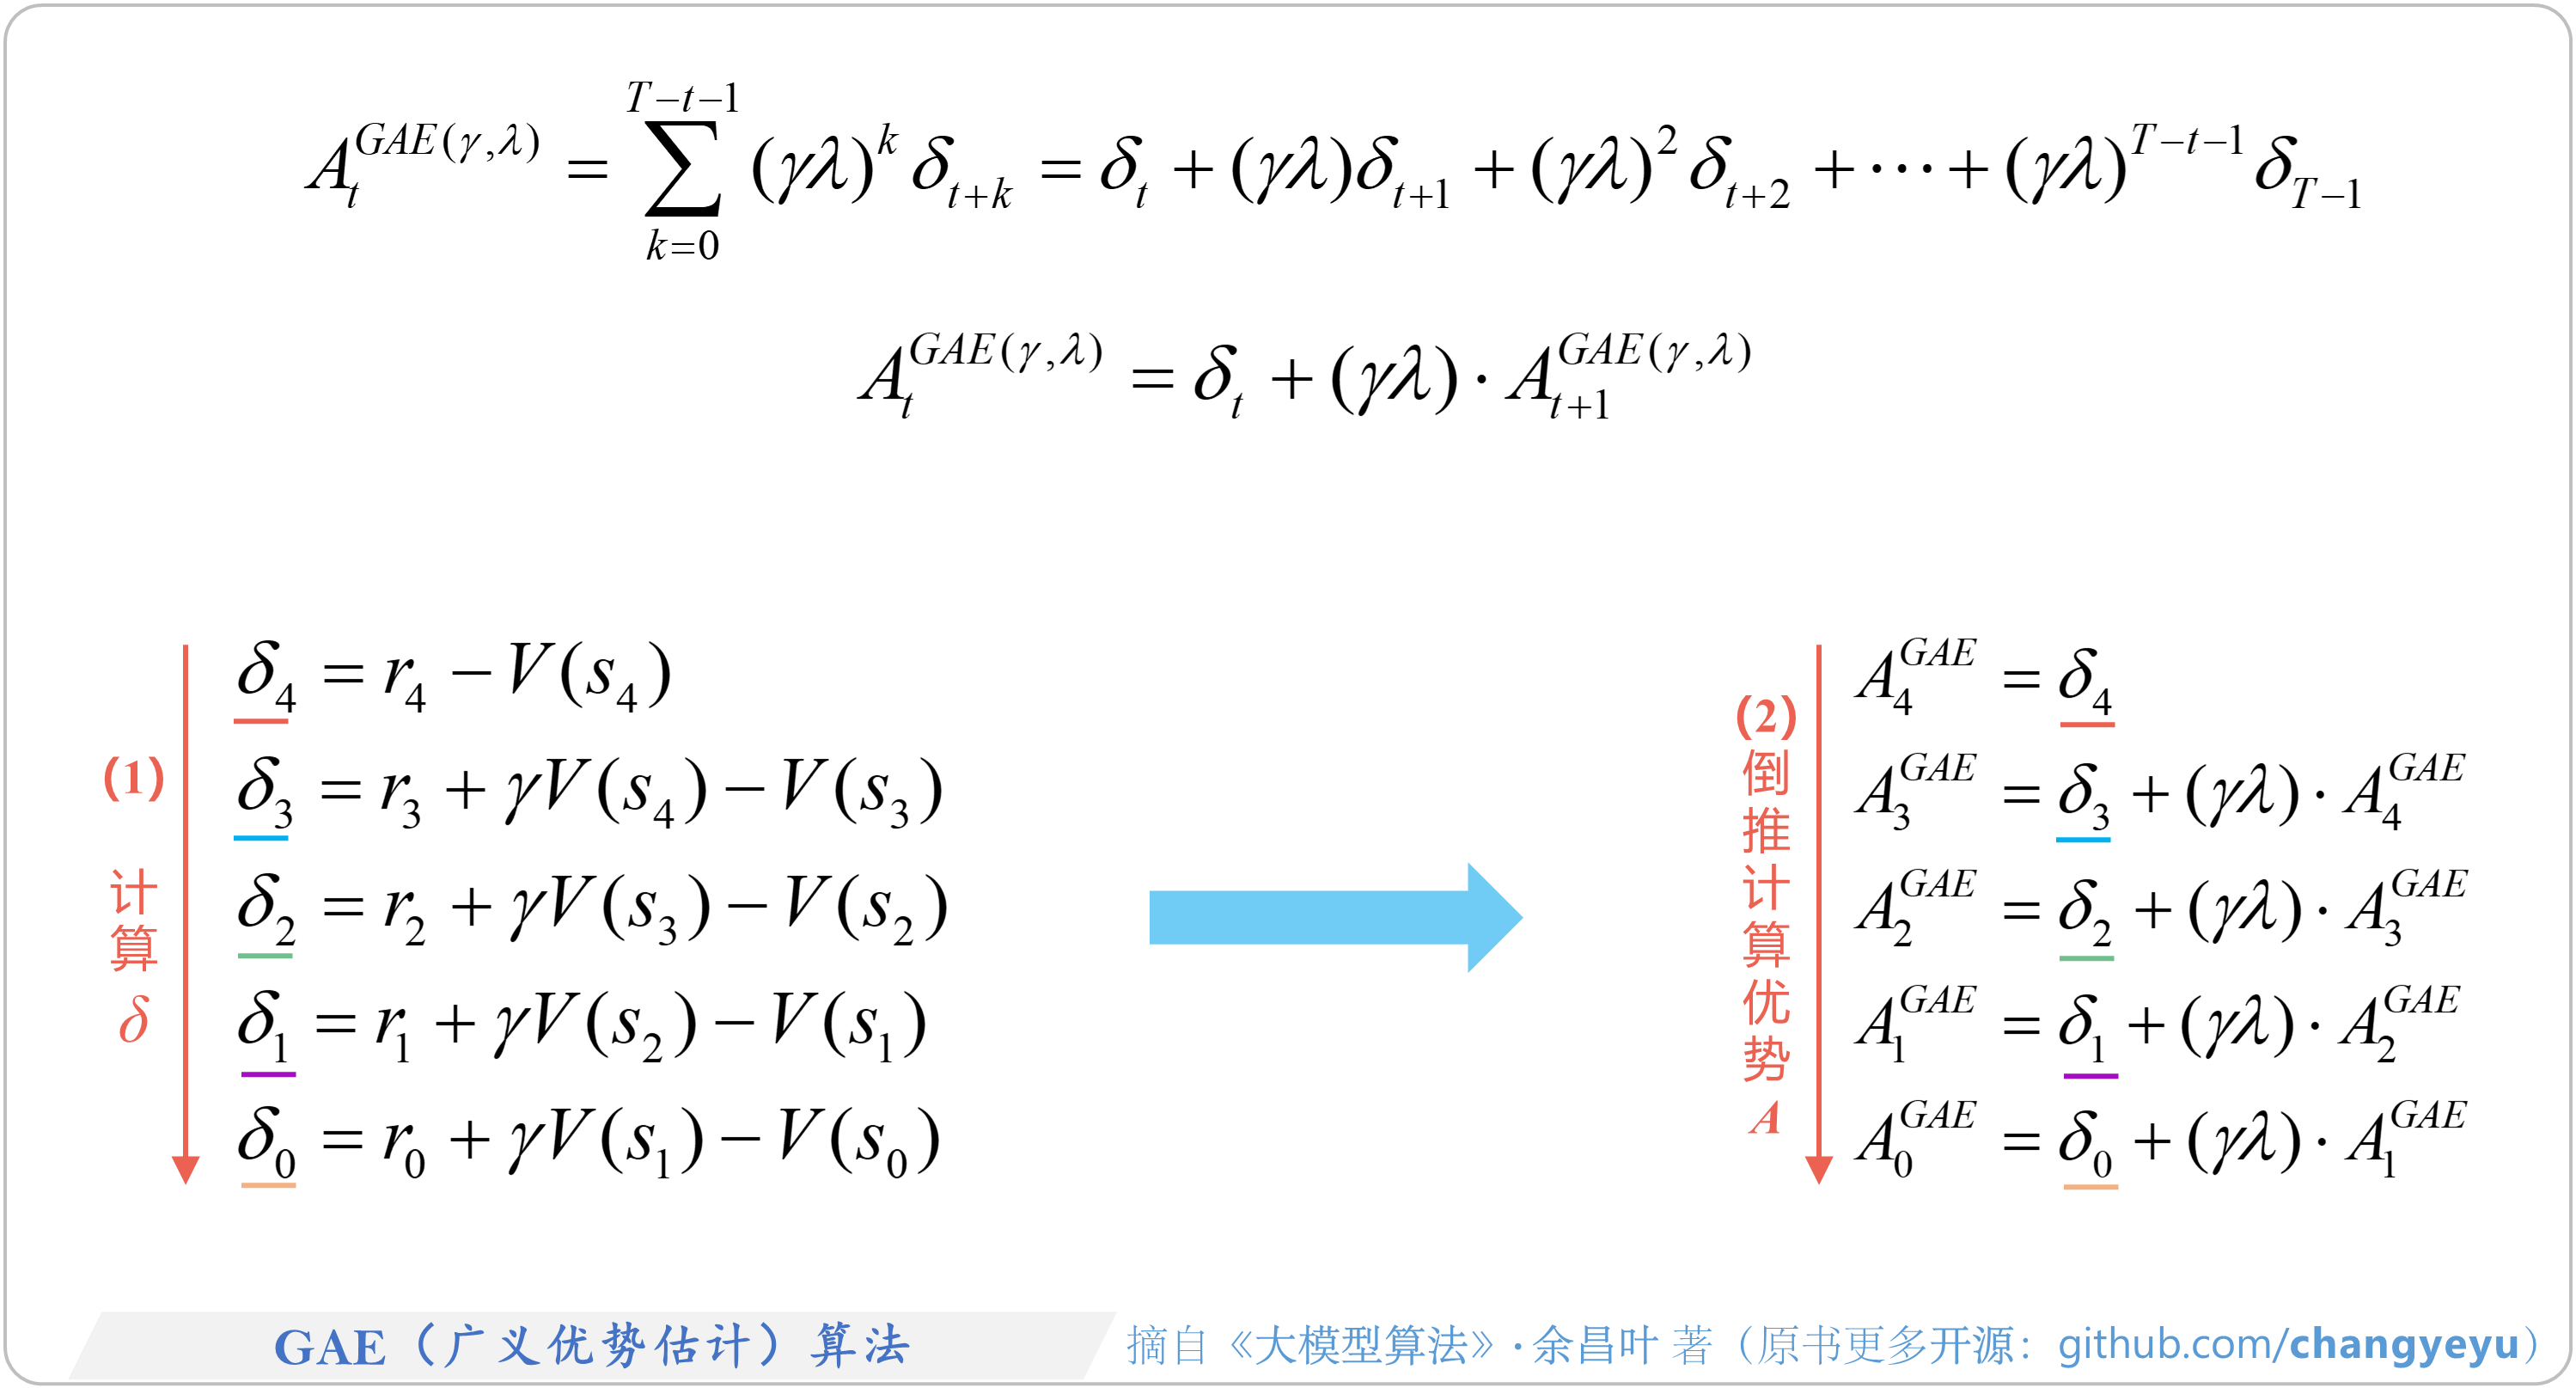
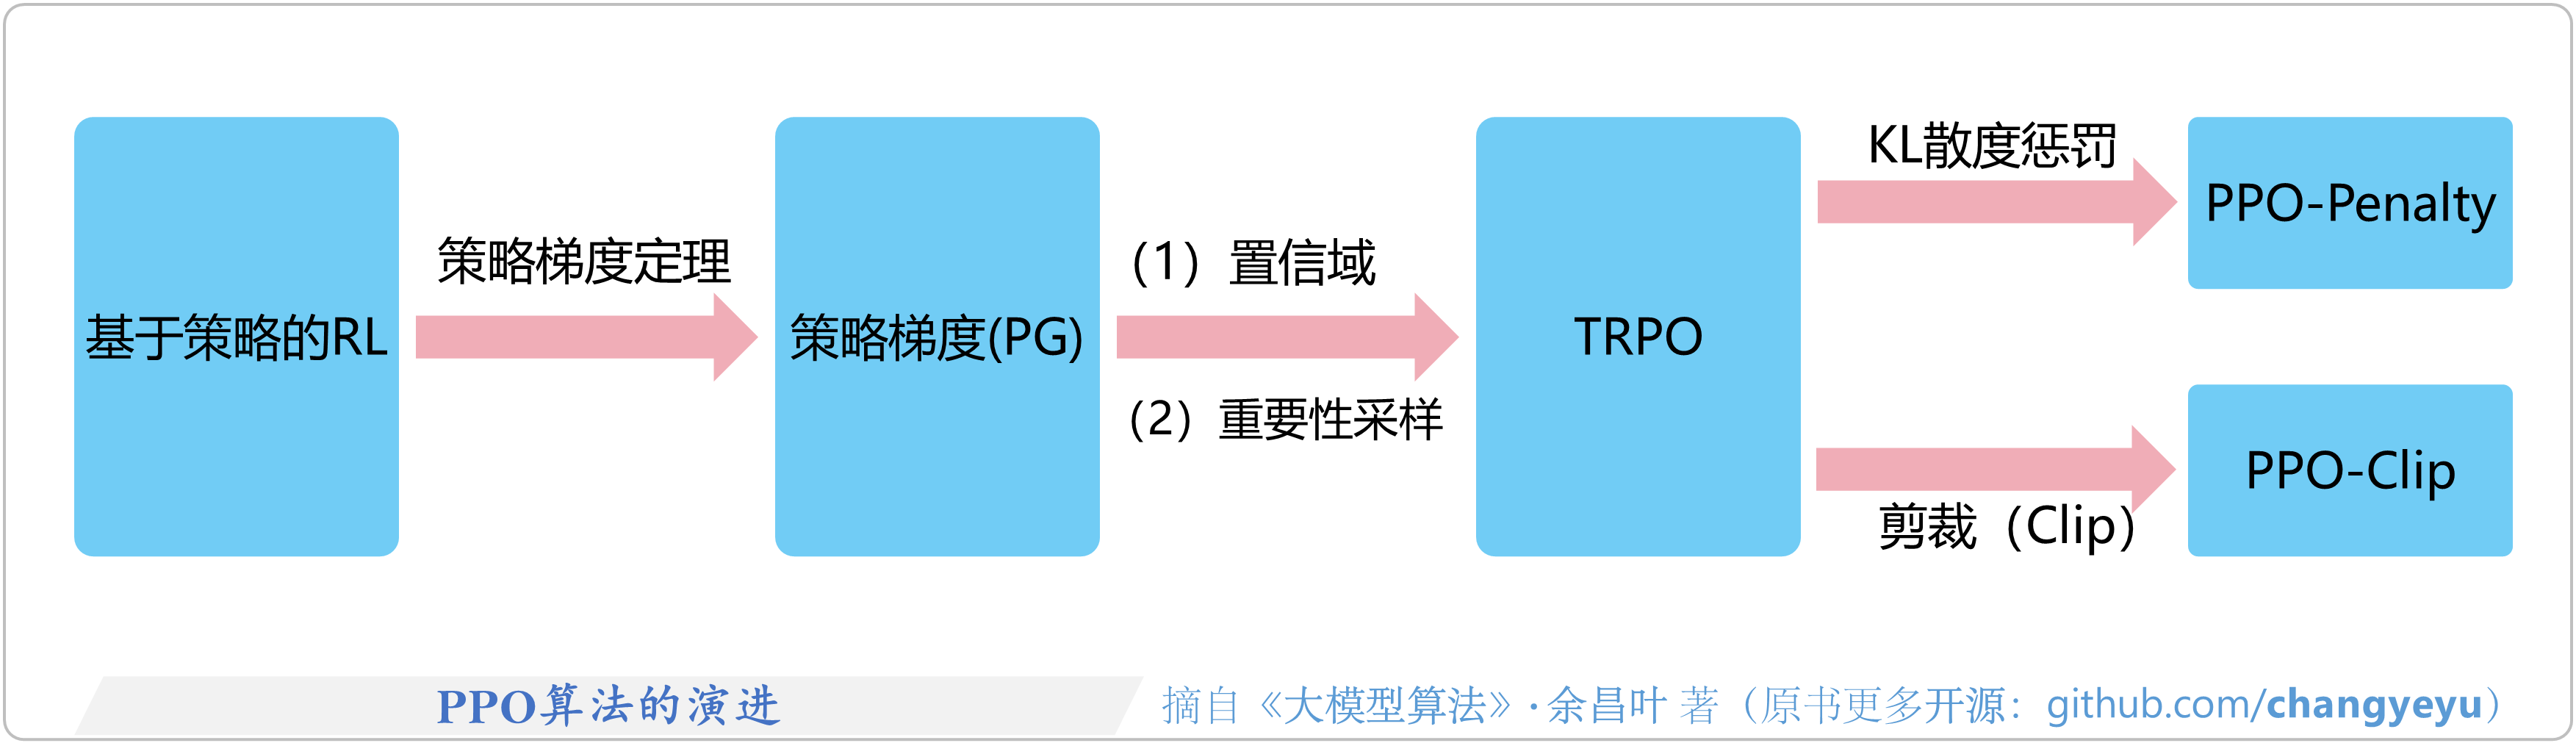
# 简写 R:rewards, V:values, Adv:advantages, J:objective, P:probability
for iteration in range(num_iterations):  # 进行num_iterations个训练迭代
    #【1/2】收集样本(prompt, response_old, logP_old, Adv, V_target)
    prompt_batch, response_old_batch = [], []
    logP_old_batch, Adv_batch, V_target_batch = [], [], []
    for _ in range(num_examples):
        logP_old, response_old  = actor_model(prompt)
        V_old    = critic_model(prompt, response_old)
        R        = reward_model(prompt, response_old)[-1]
        logP_ref = ref_model(prompt, response_old)

        # KL距离惩罚。注意:上面的R只取了最后一个token对应的奖励分数
        KL = logP_old - logP_ref
        R_with_KL = R - scale_factor * KL

        # 通过GAE算法计算优势Adv
        Adv = GAE_Advantage(R_with_KL, V_old, gamma, λ)
        V_target = Adv + V_old

        prompt_batch        += prompt
        response_old_batch  += response_old
        logP_old_batch      += logP_old
        Adv_batch           += Adv
        V_target_batch      += V_target

    # 【2/2】多轮PPO训练,多次参数更新
    for _ in range(ppo_epochs):
        mini_batches = shuffle_split( (prompt_batch, response_old_batch,
            logP_old_batch, Adv_batch, V_target_batch), mini_batch_size )

        for prompt, response_old, logP_old, Adv, V_target in mini_batches:
            logits, logP_new = actor_model(prompt, response_old)
            V_new            = critic_model(prompt, response_old)

            # 策略概率比: ratio(θ) = π_θ(a|s) / π_θ_old (a|s)
            ratios = exp(logP_new - logP_old)

            # 计算策略模型Loss
            L_clip = -mean( min( ratios * Adv,
                                clip(ratios, 1 - ε, 1 + ε) * Adv ) )

            S_entropy = mean( compute_entropy(logits) )  # 计算策略的熵

            Loss_V = mean((V_new - V_target) ** 2)   # 计算价值模型Loss

            Loss = L_clip + C1 * Loss_V - C2 * S_entropy # 总损失
            backward_update(Loss, L_clip, Loss_V) # 反向传播; 更新模型参数
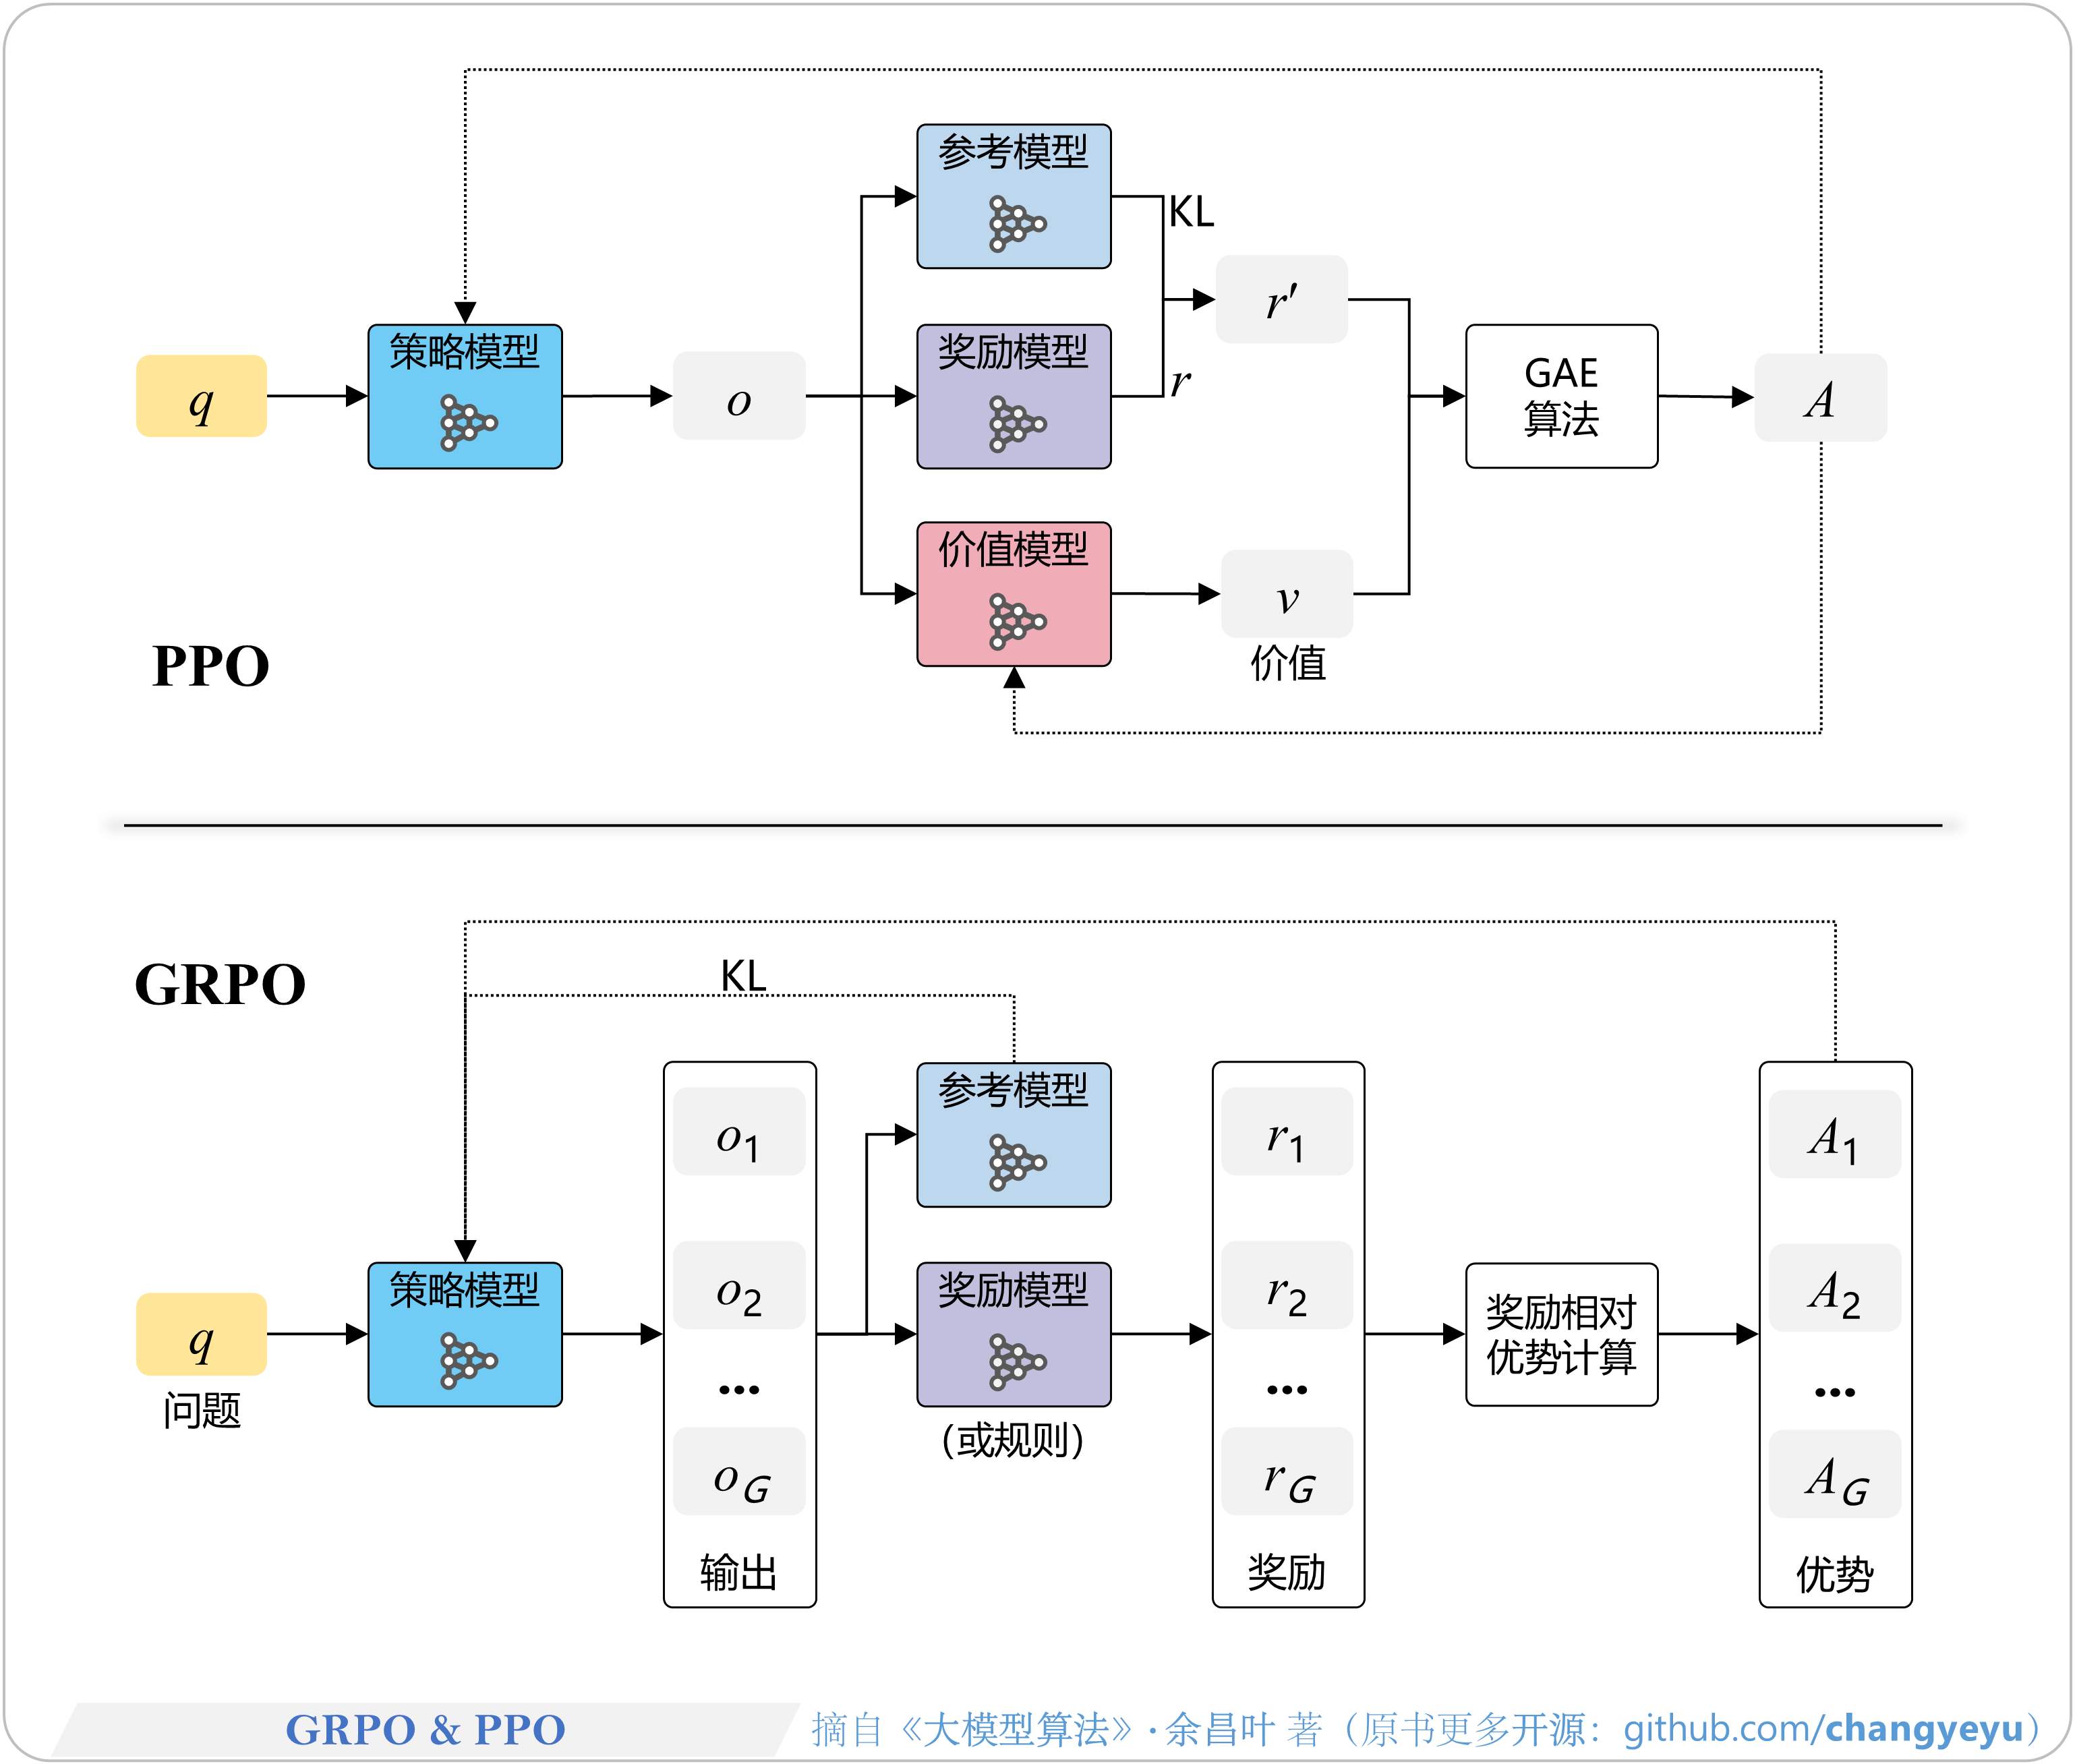
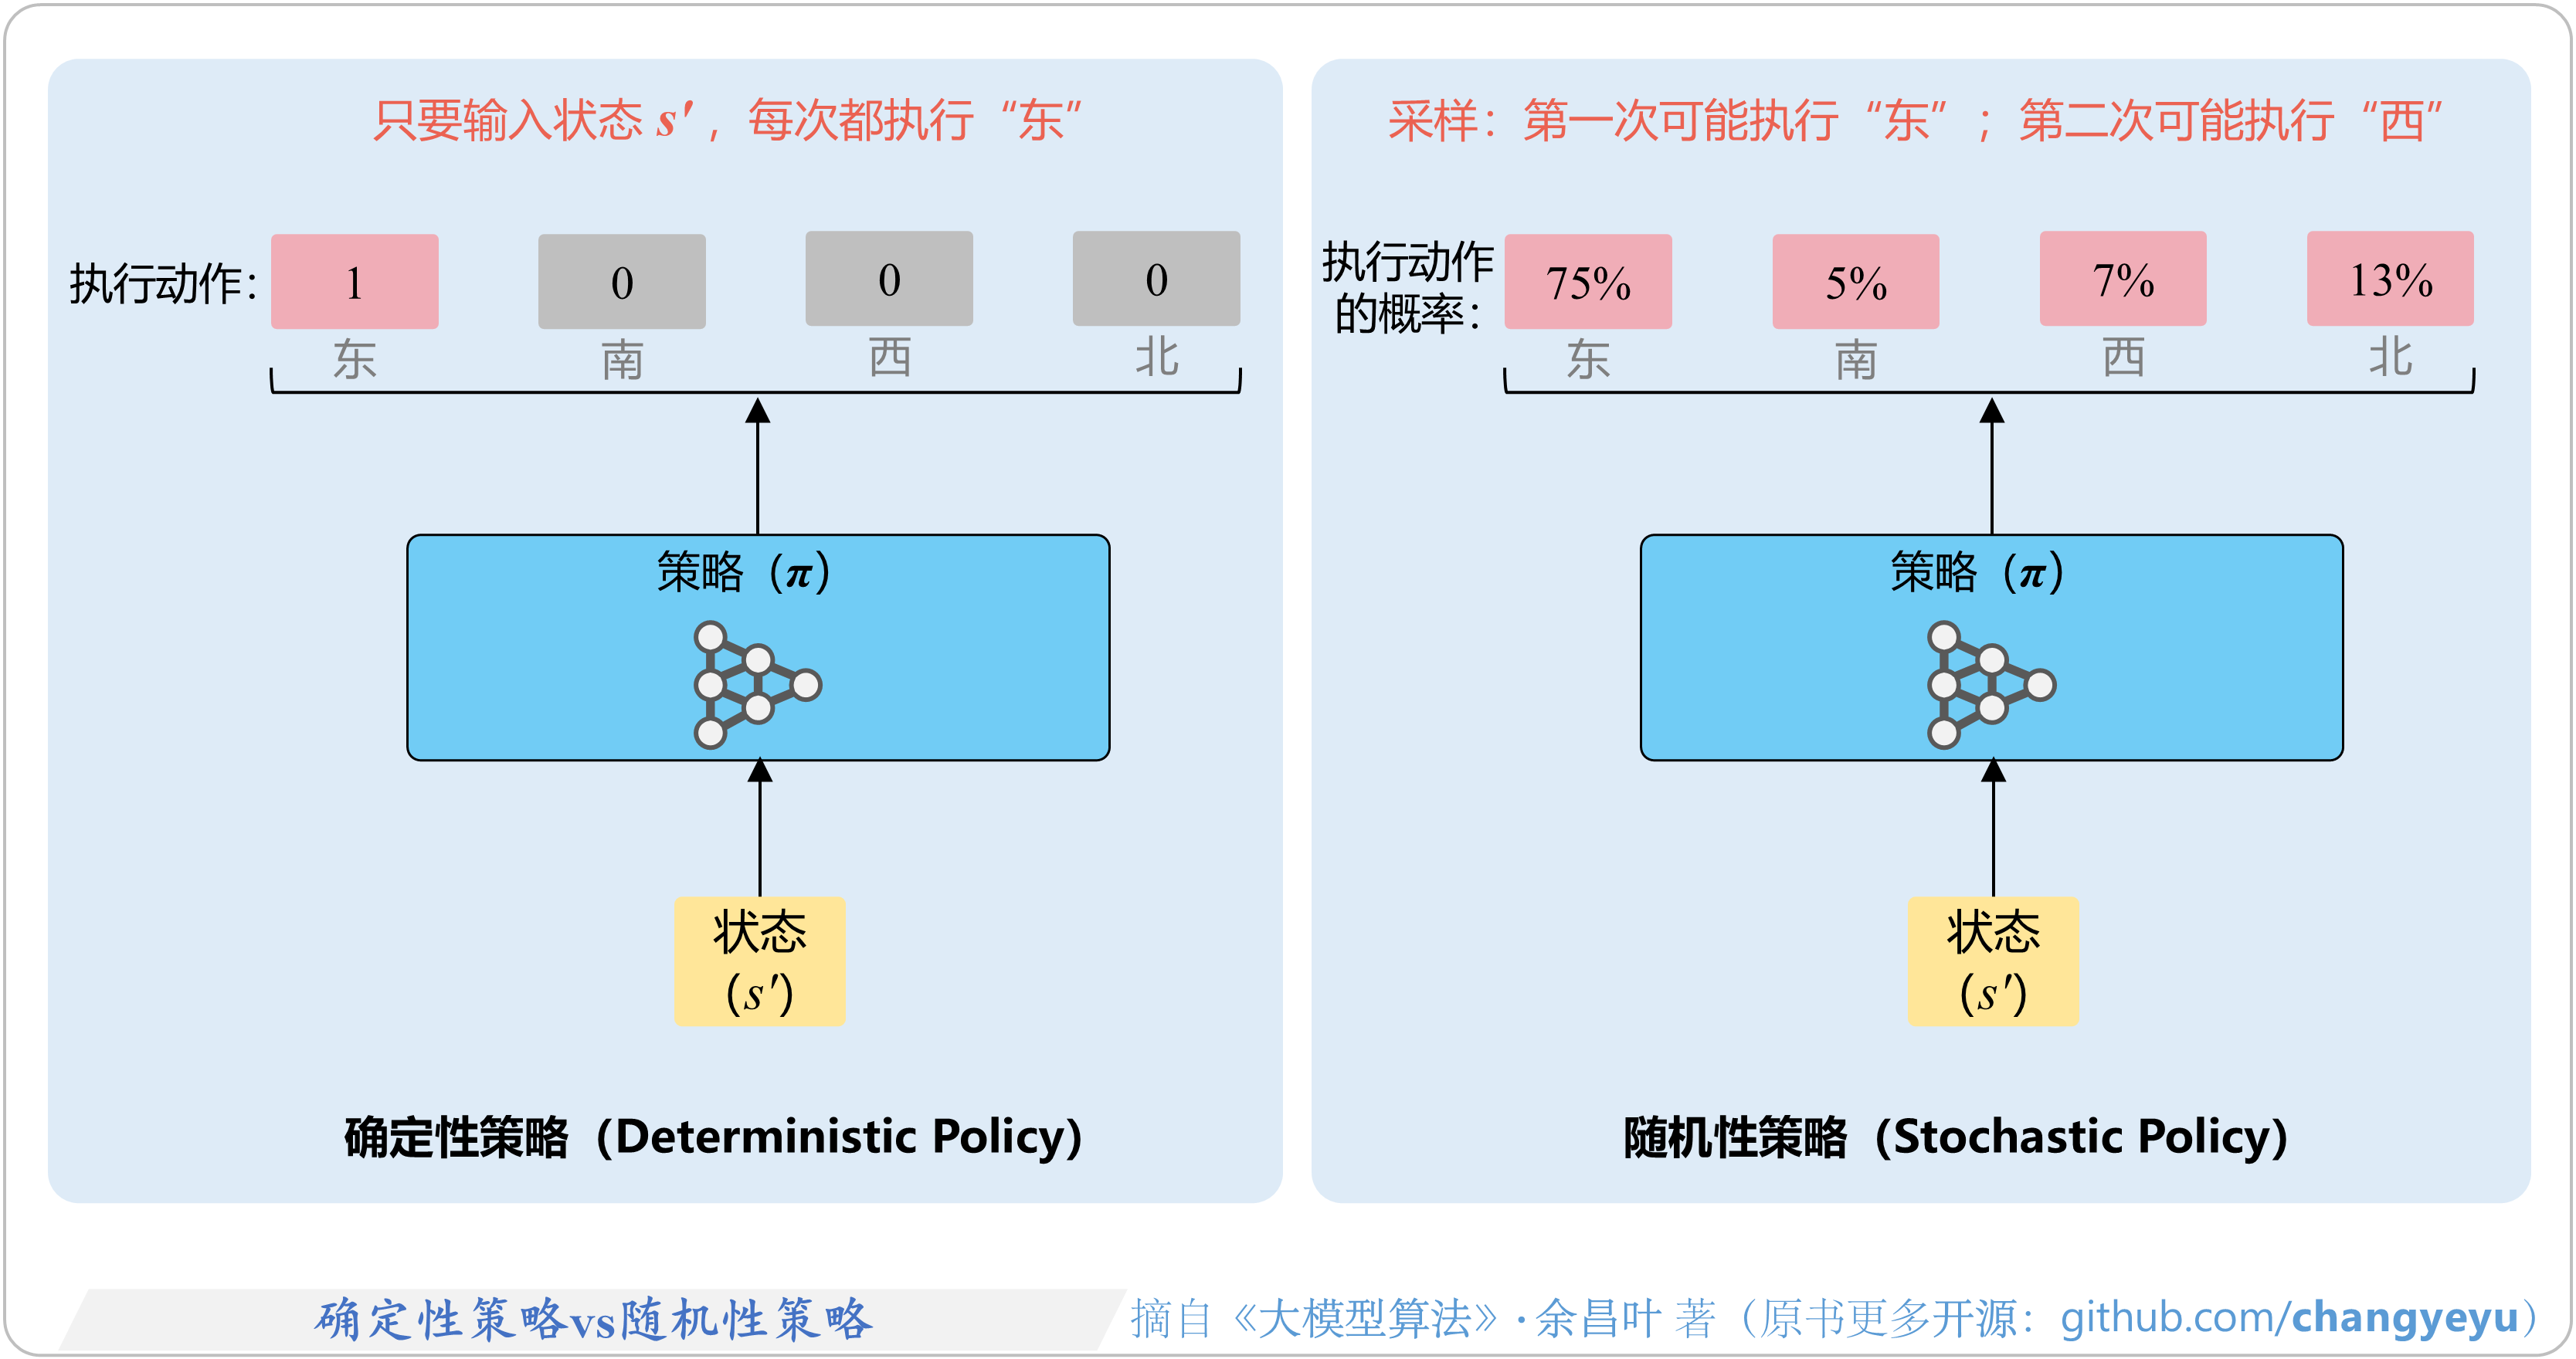
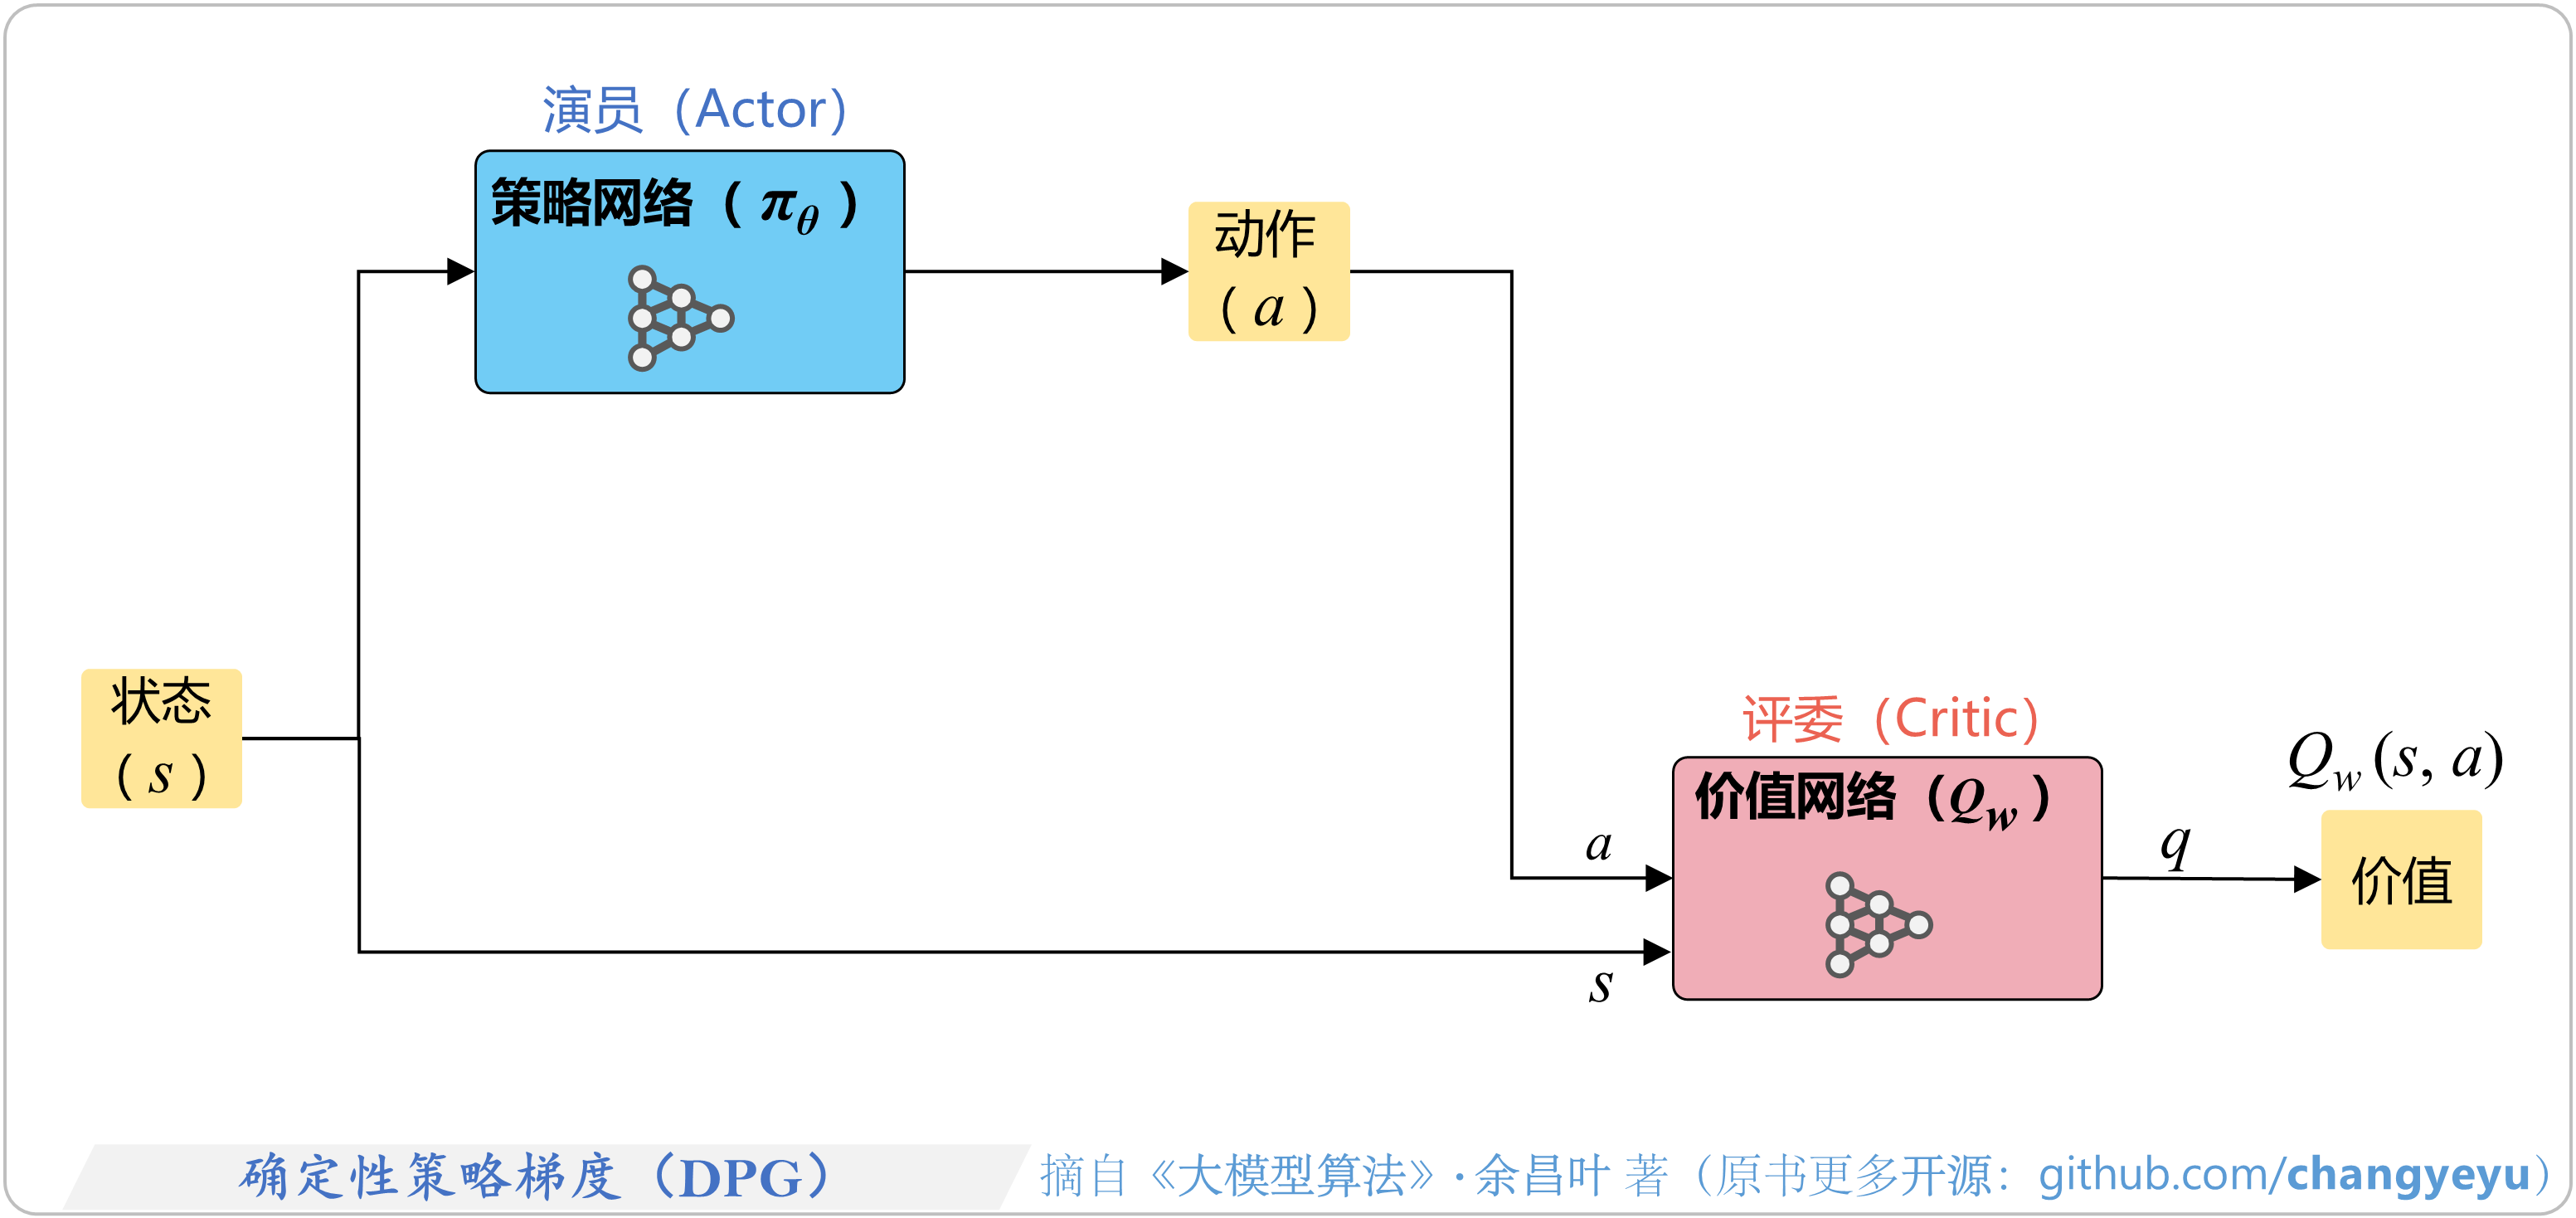
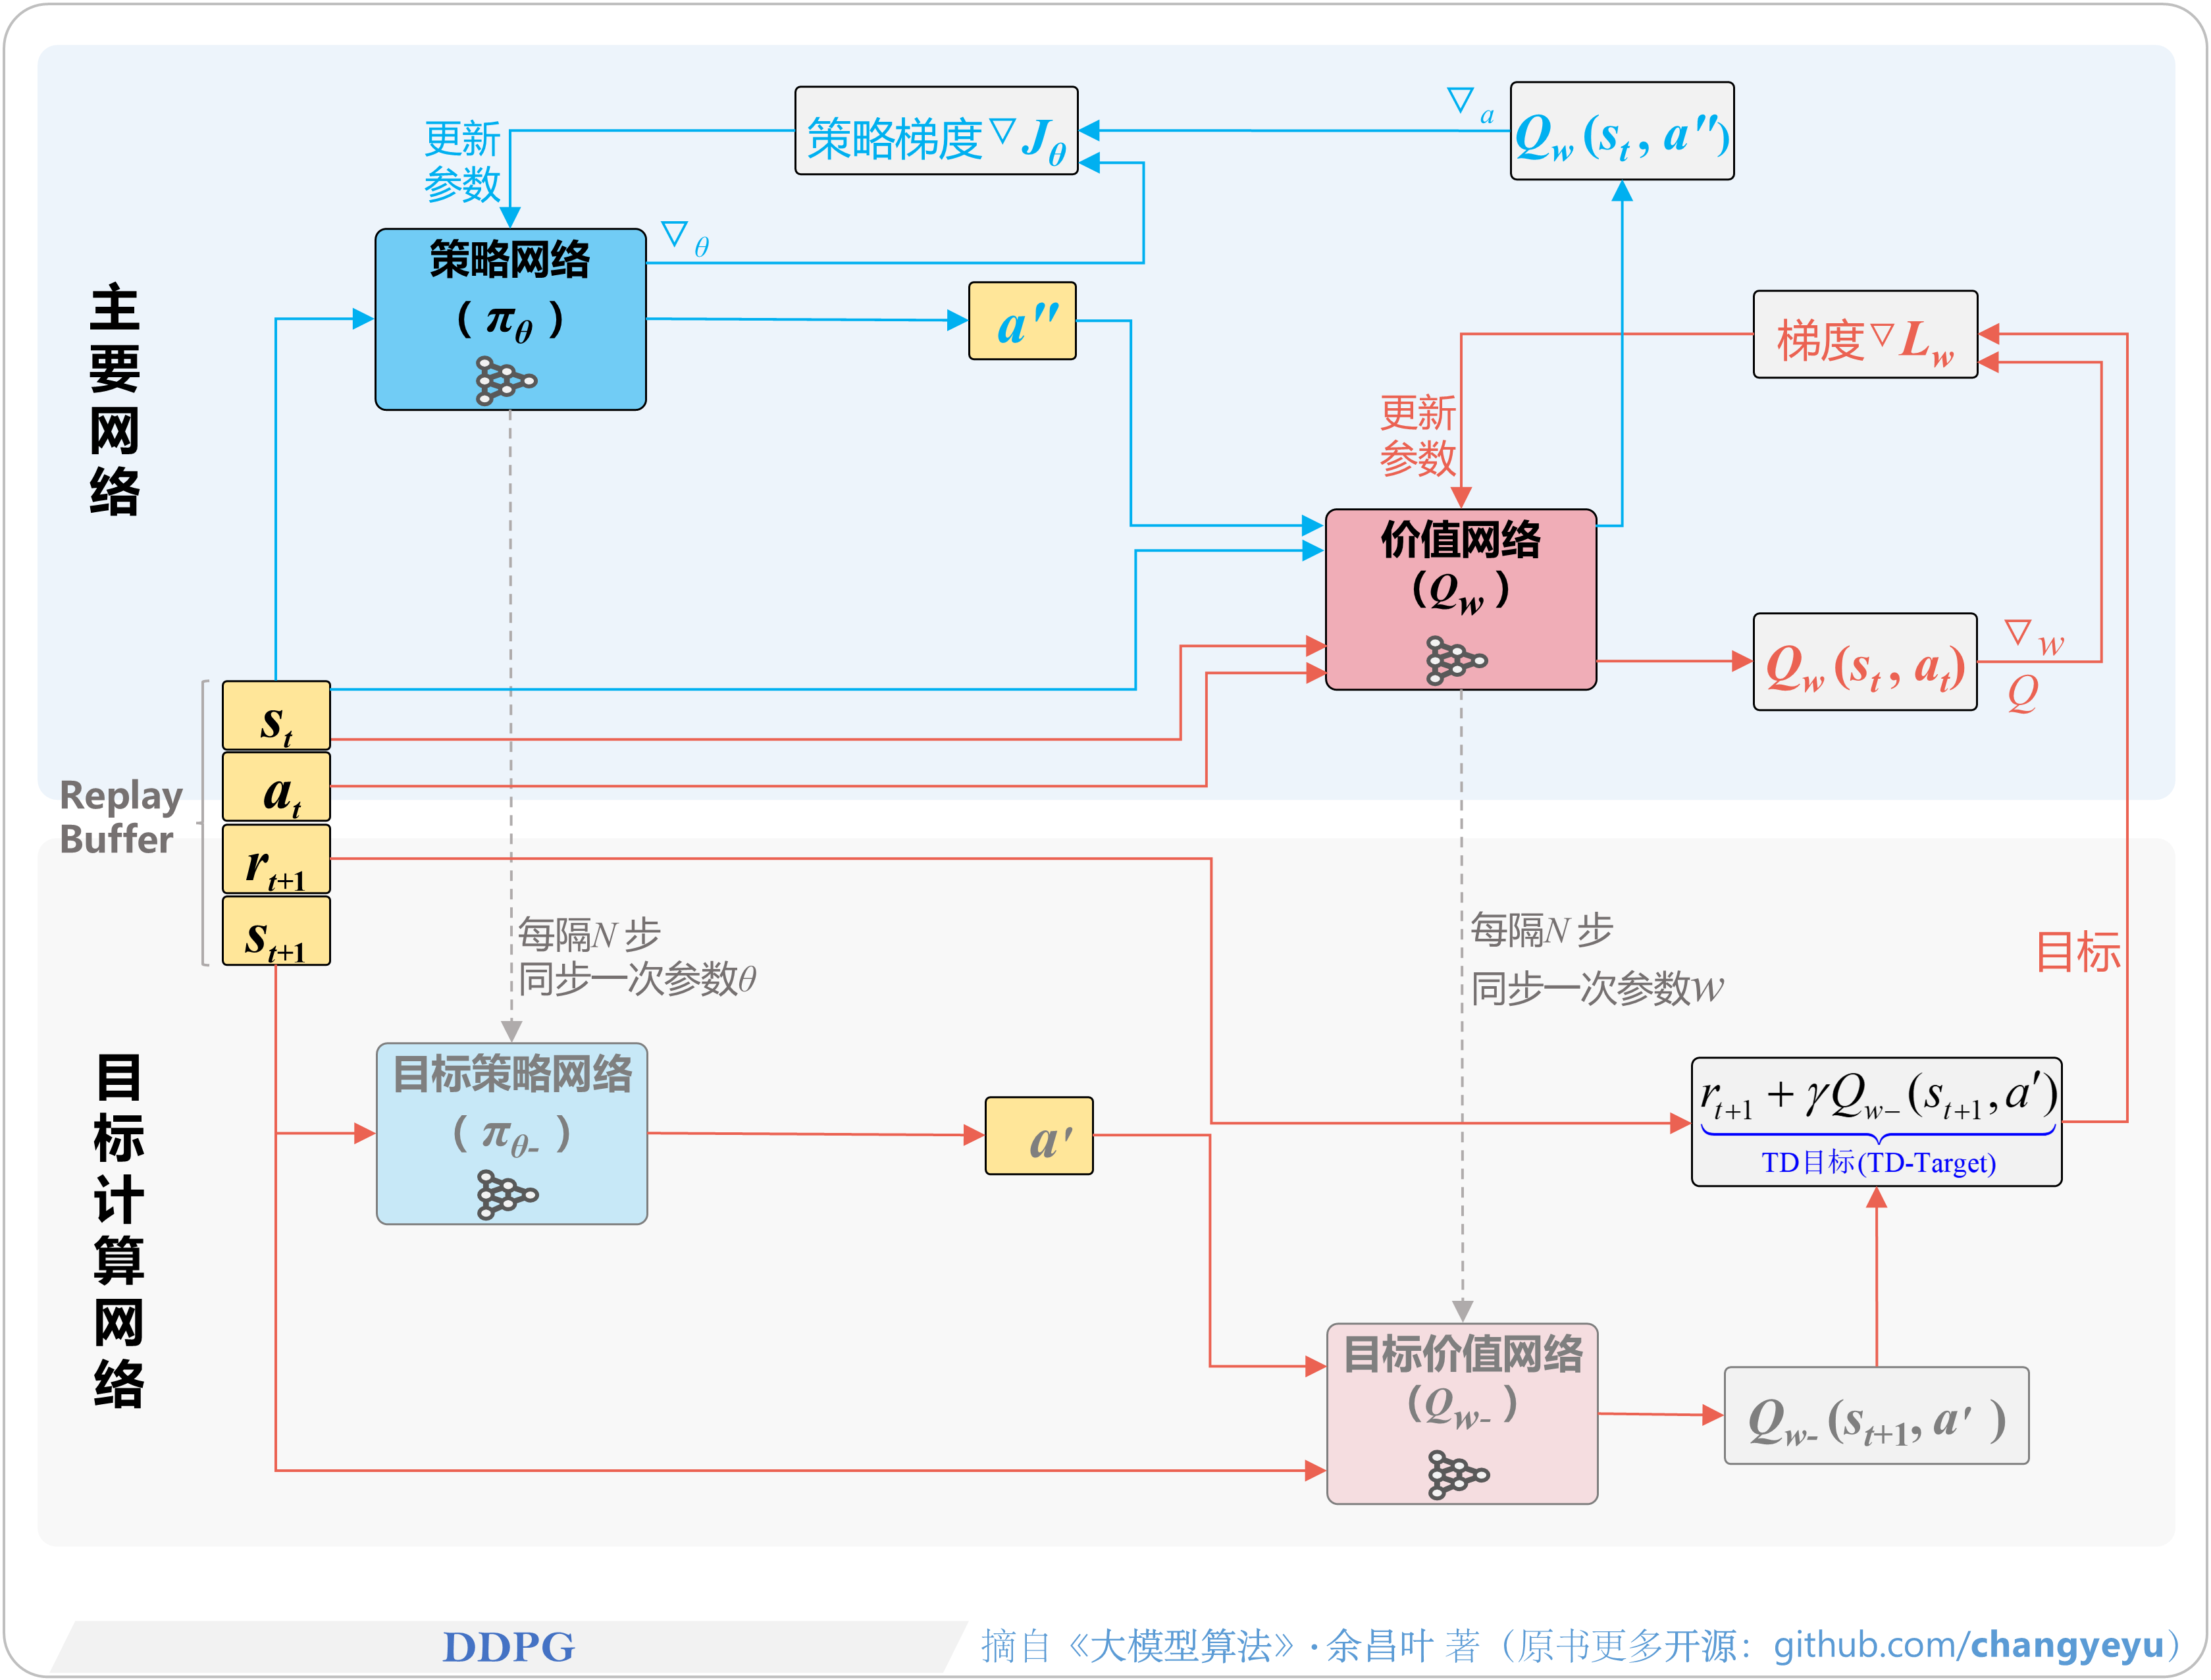
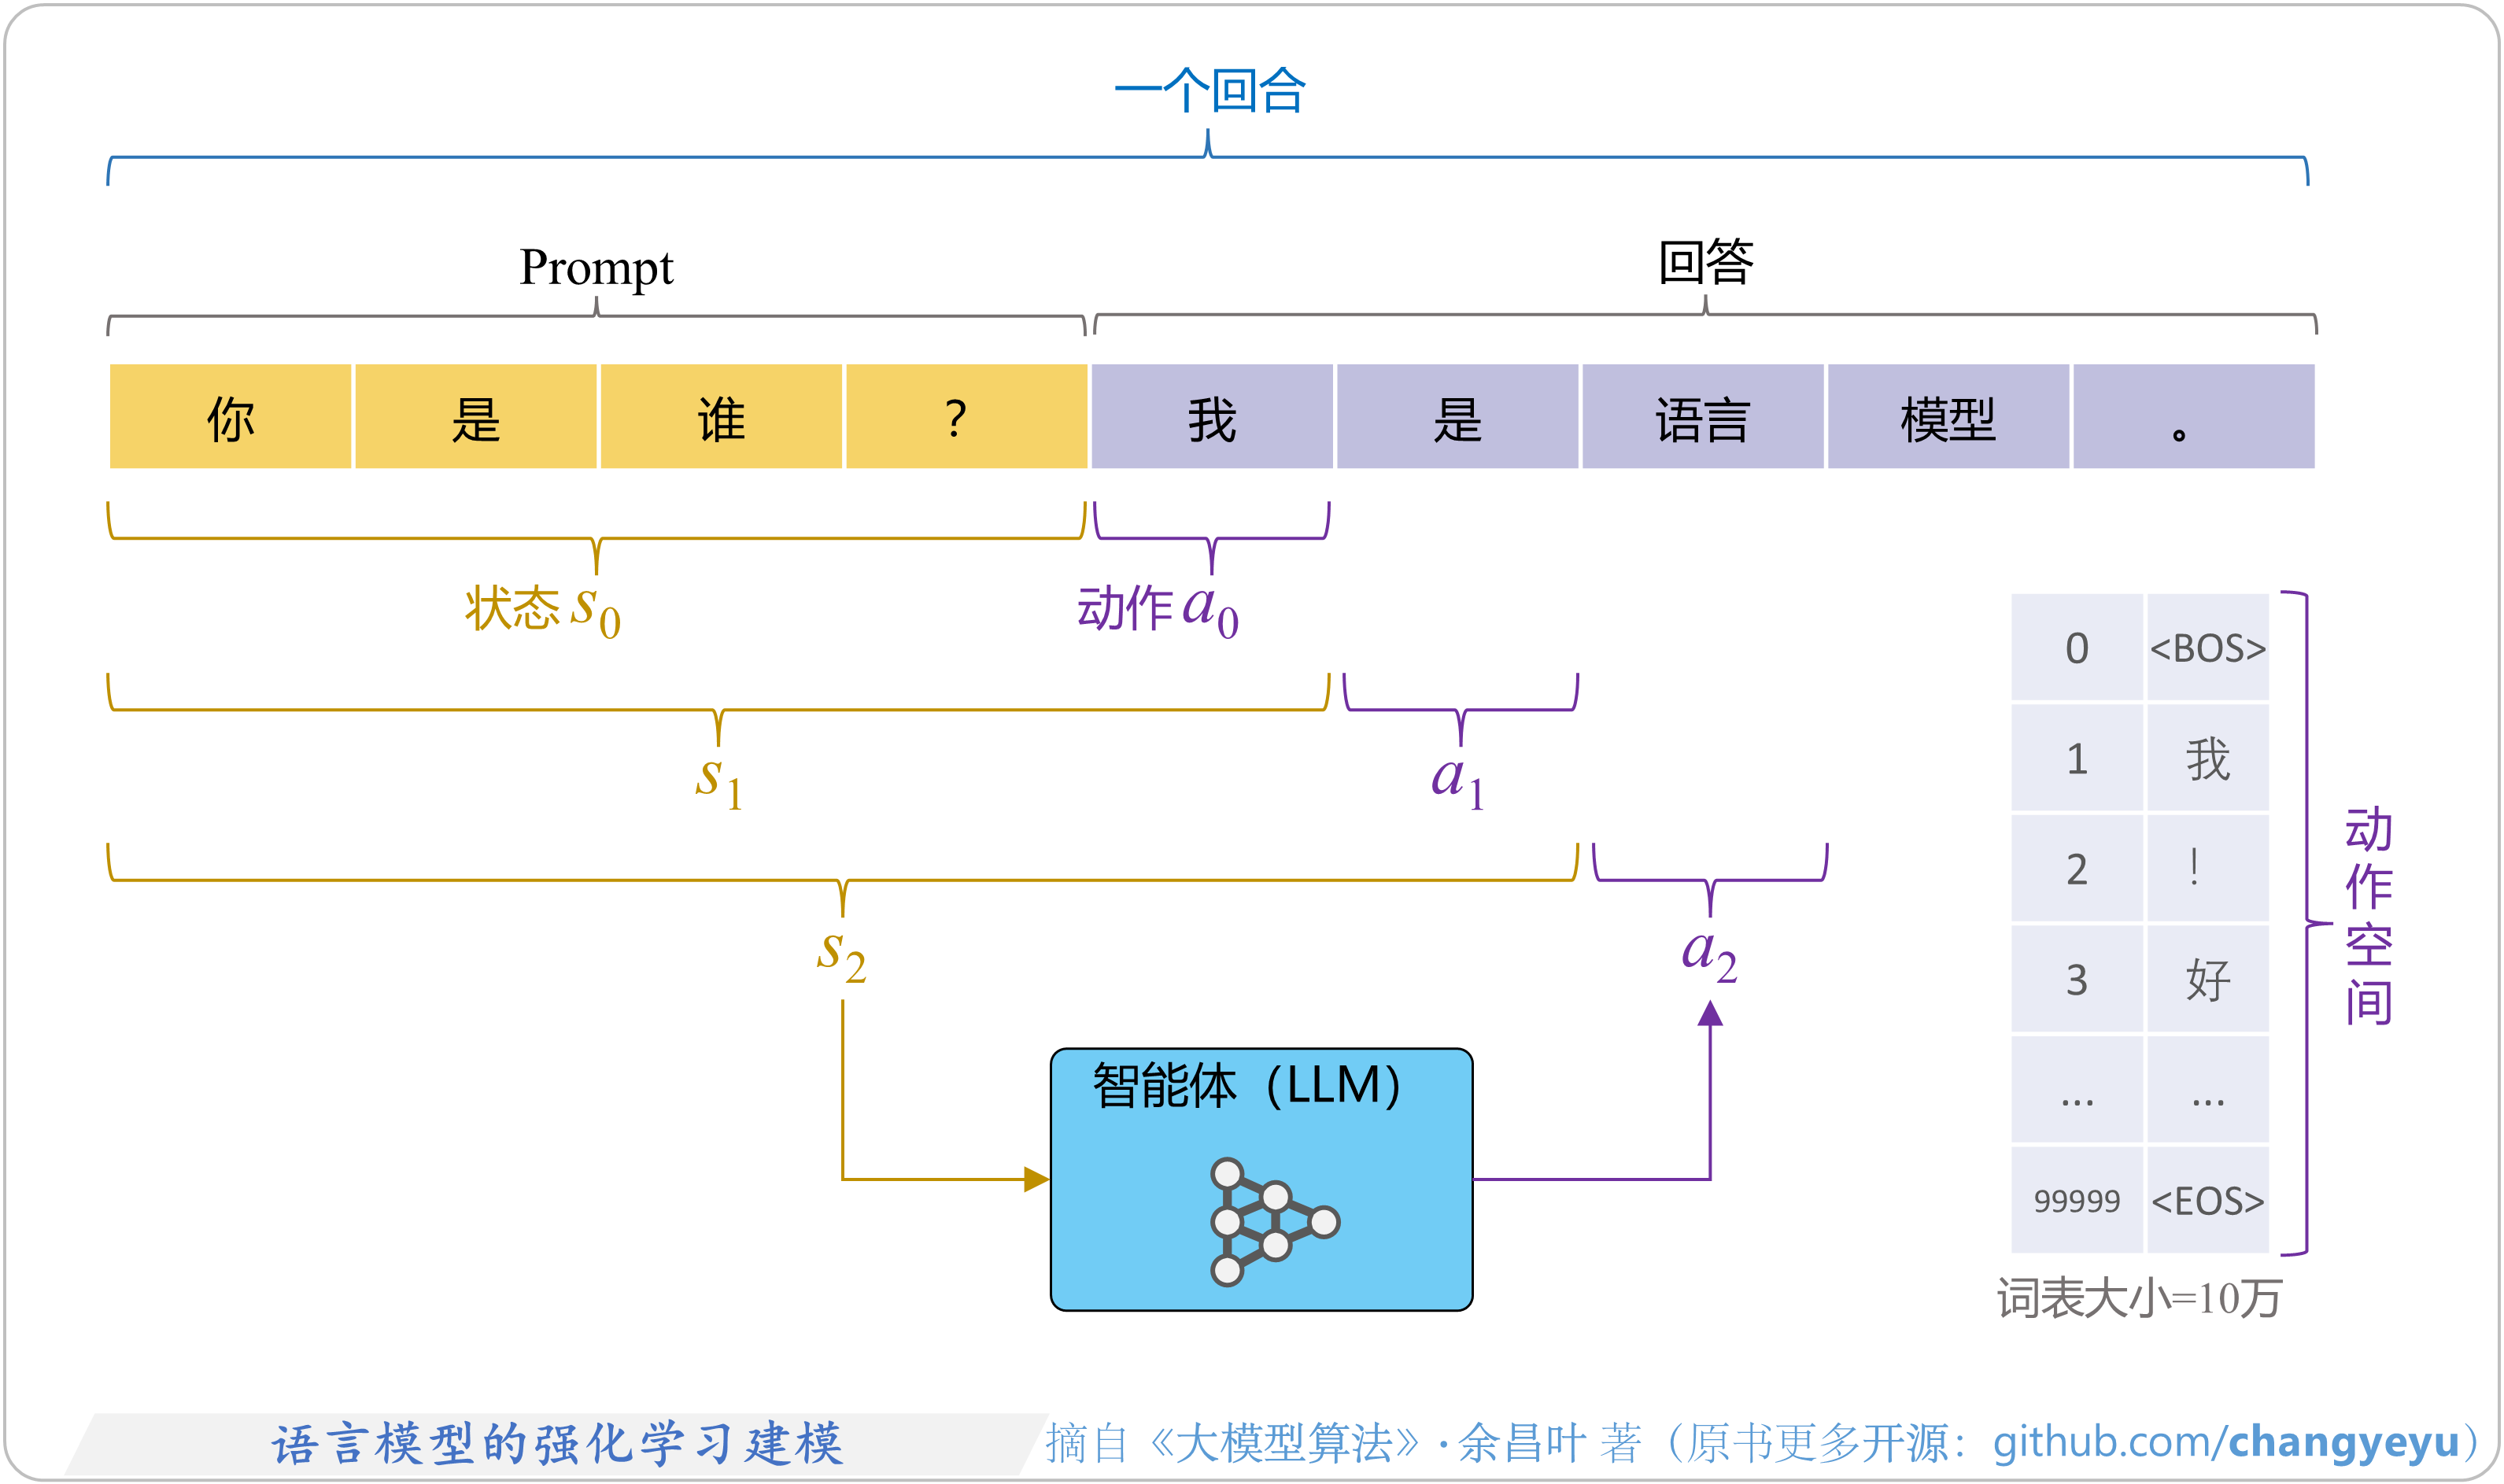
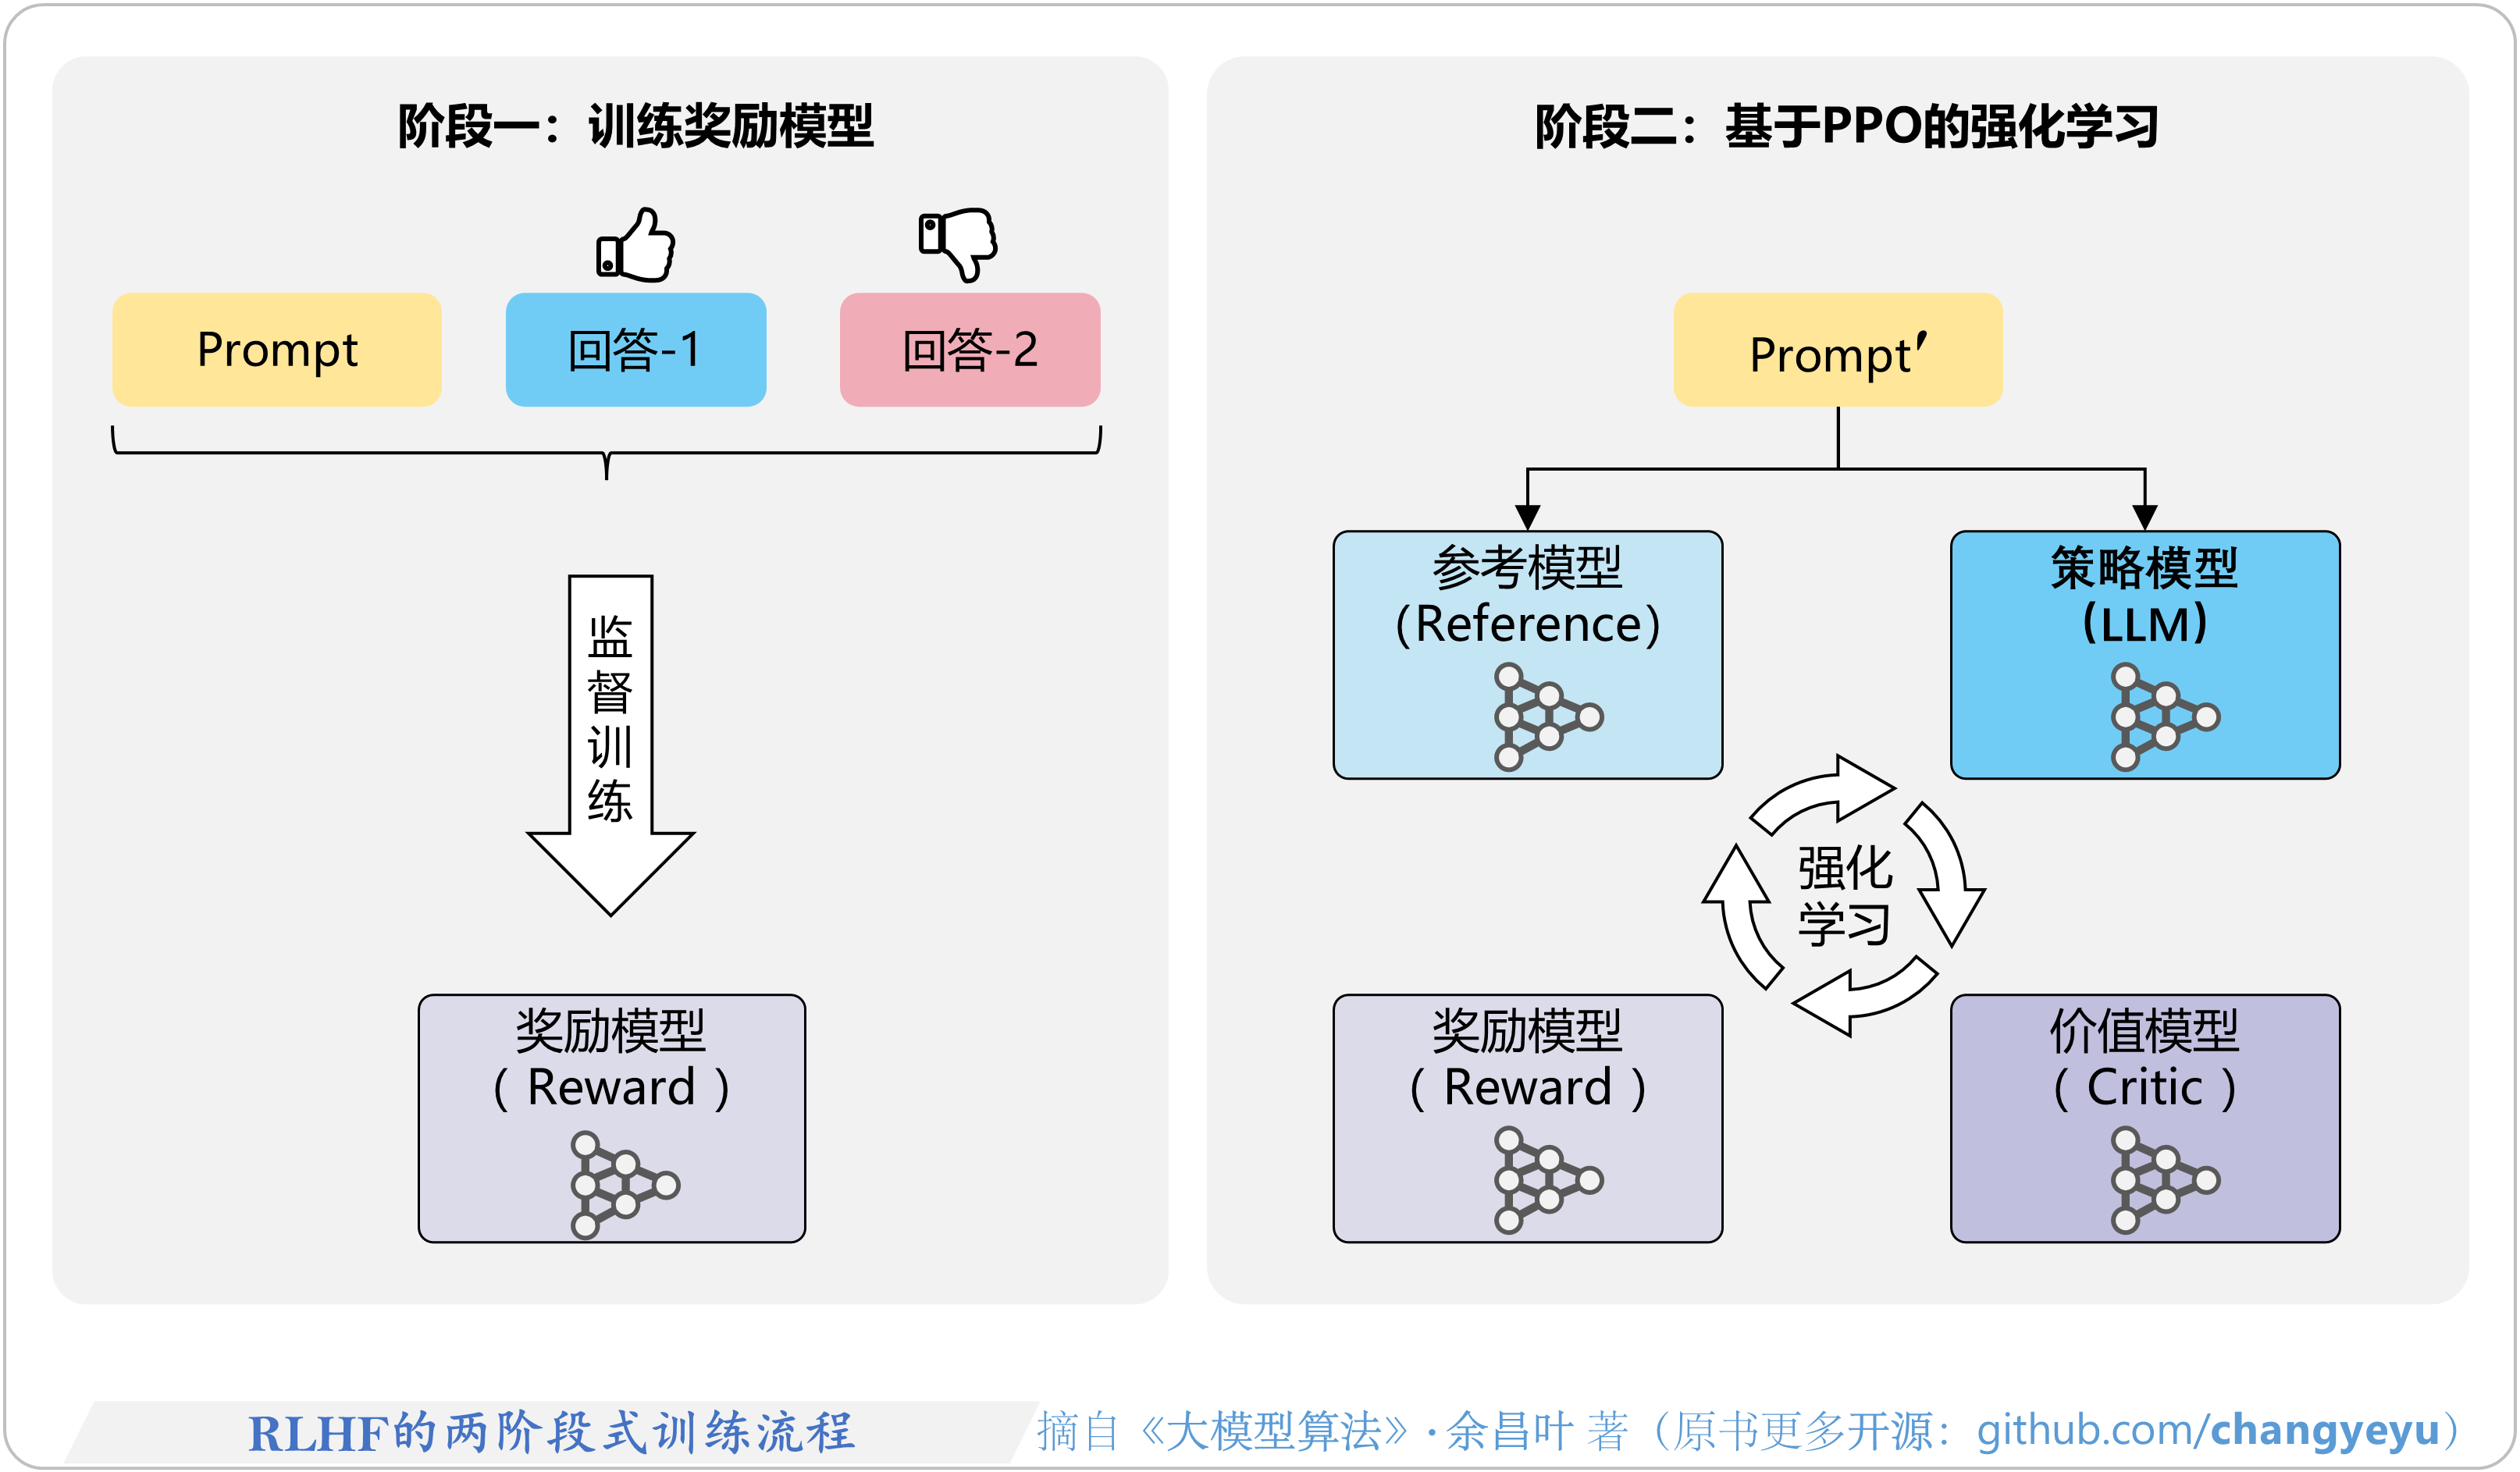
RLHF训练可以分为两个阶段:
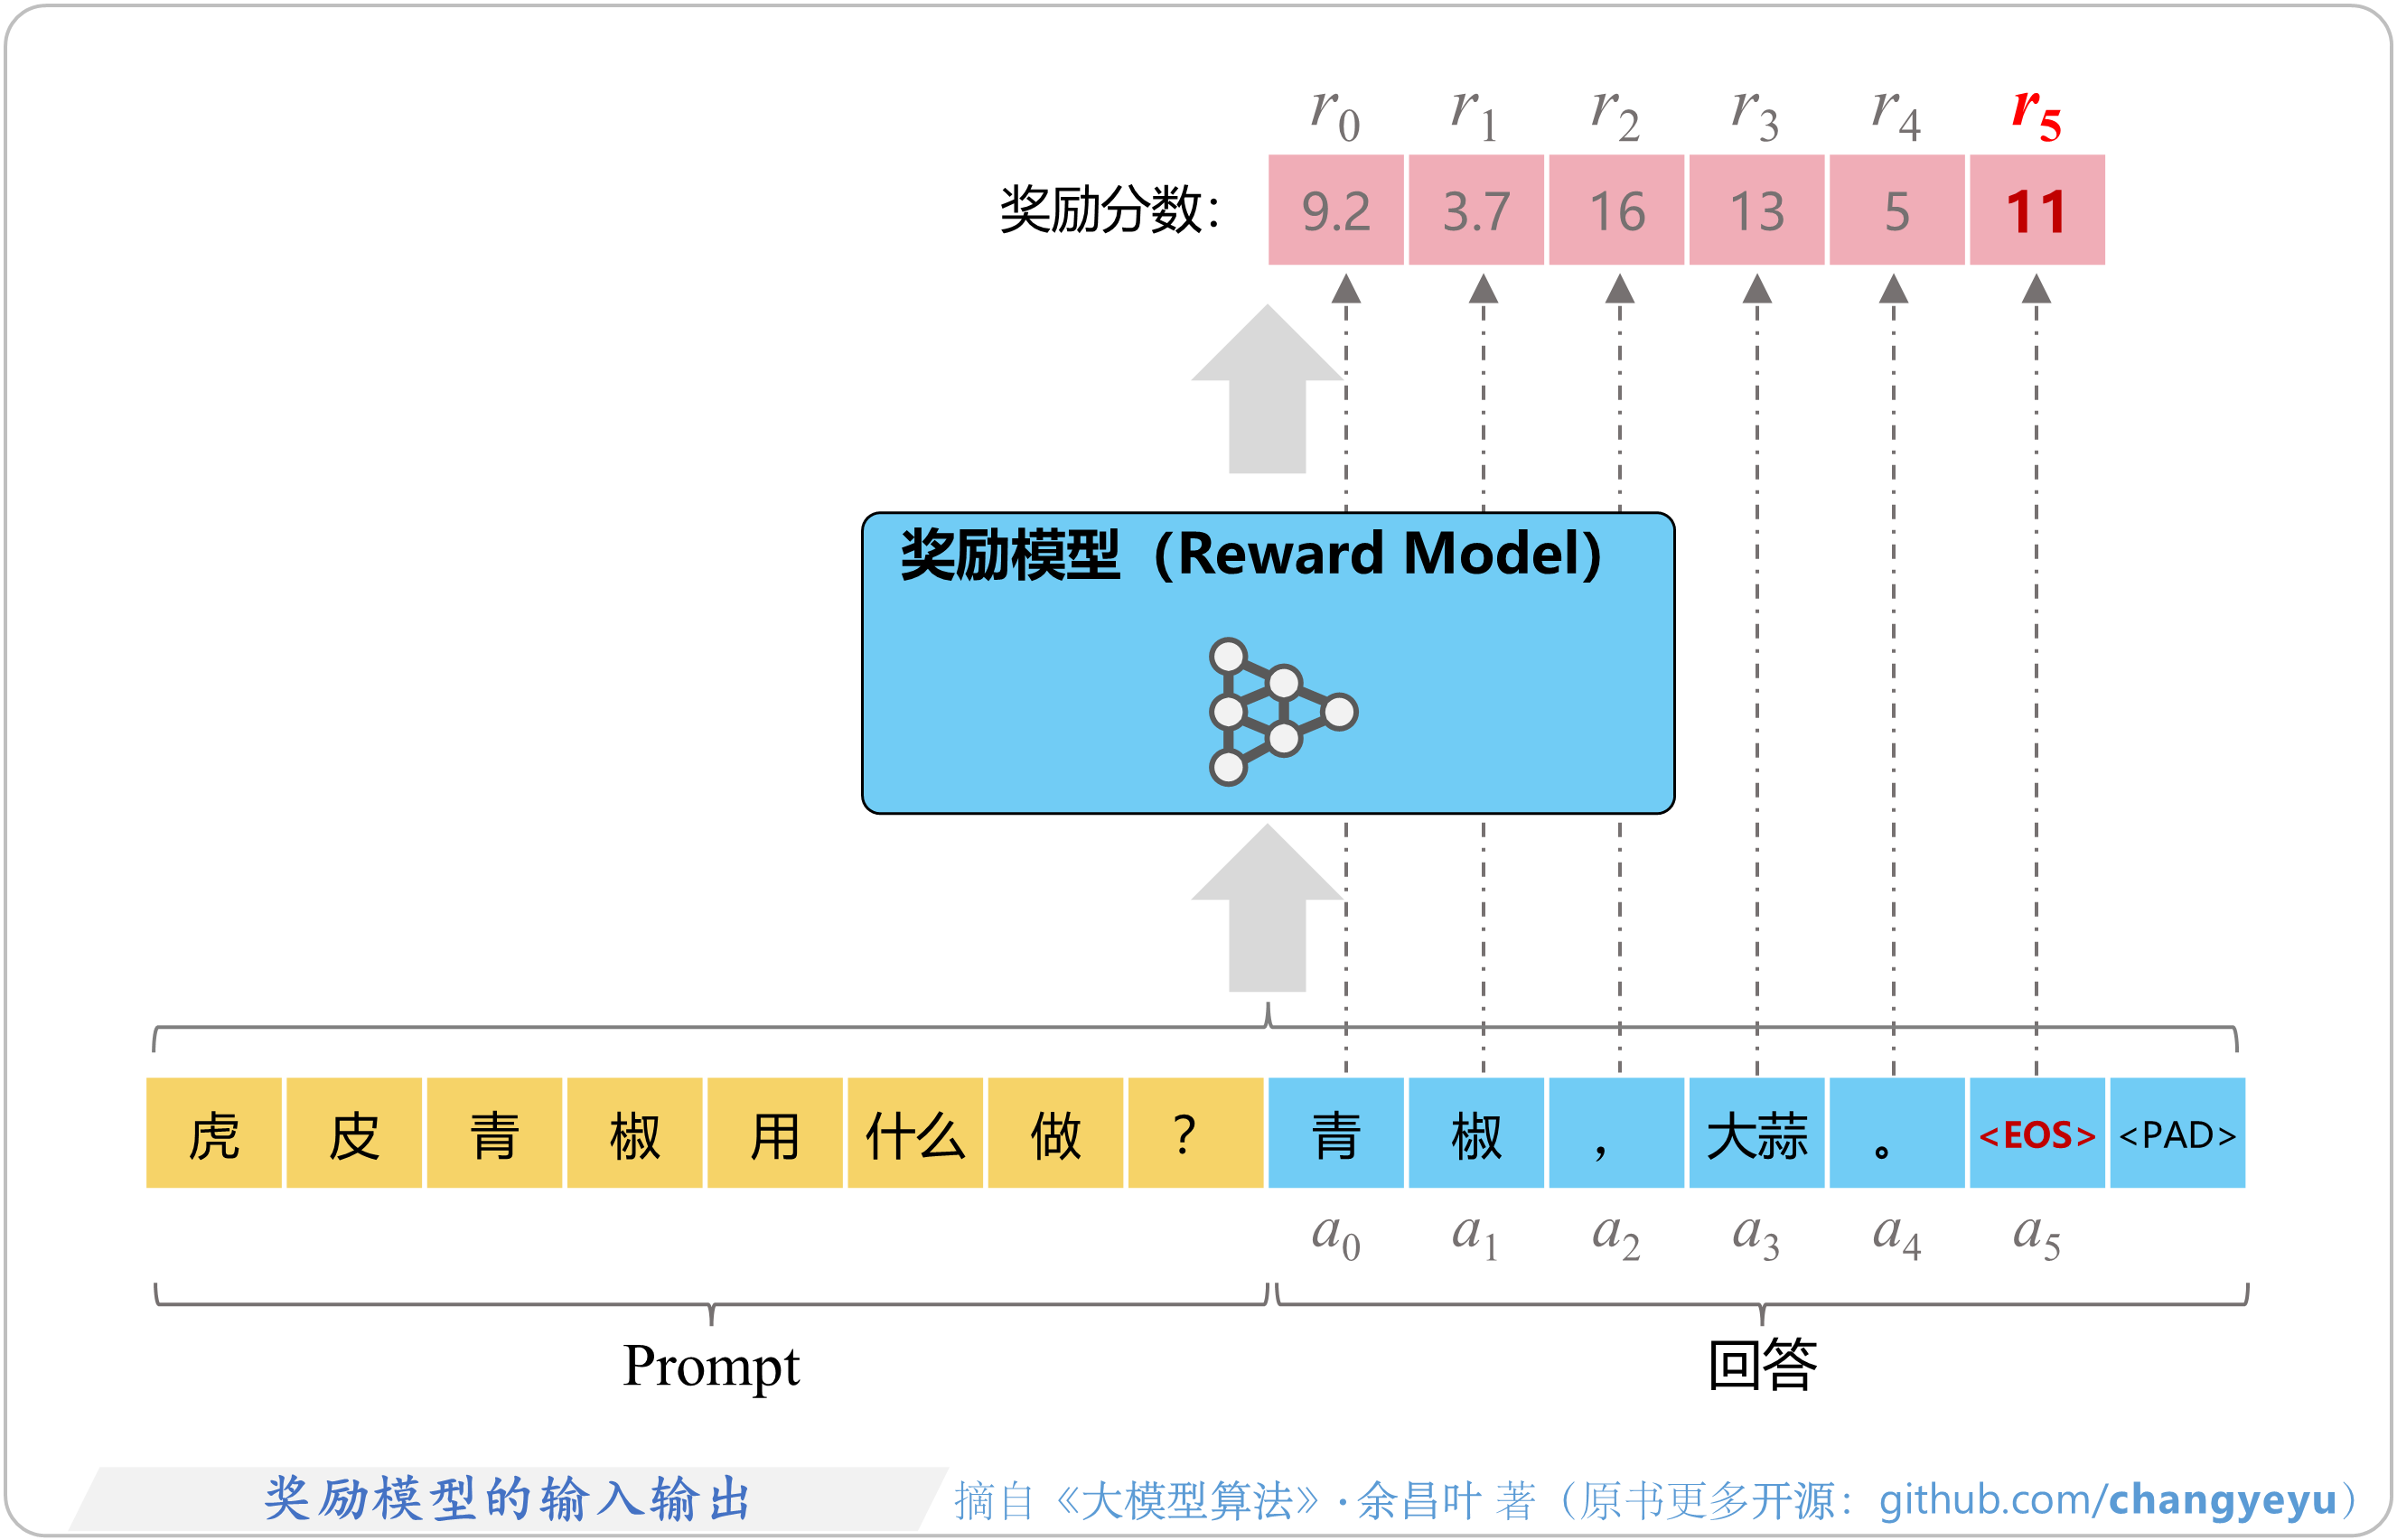
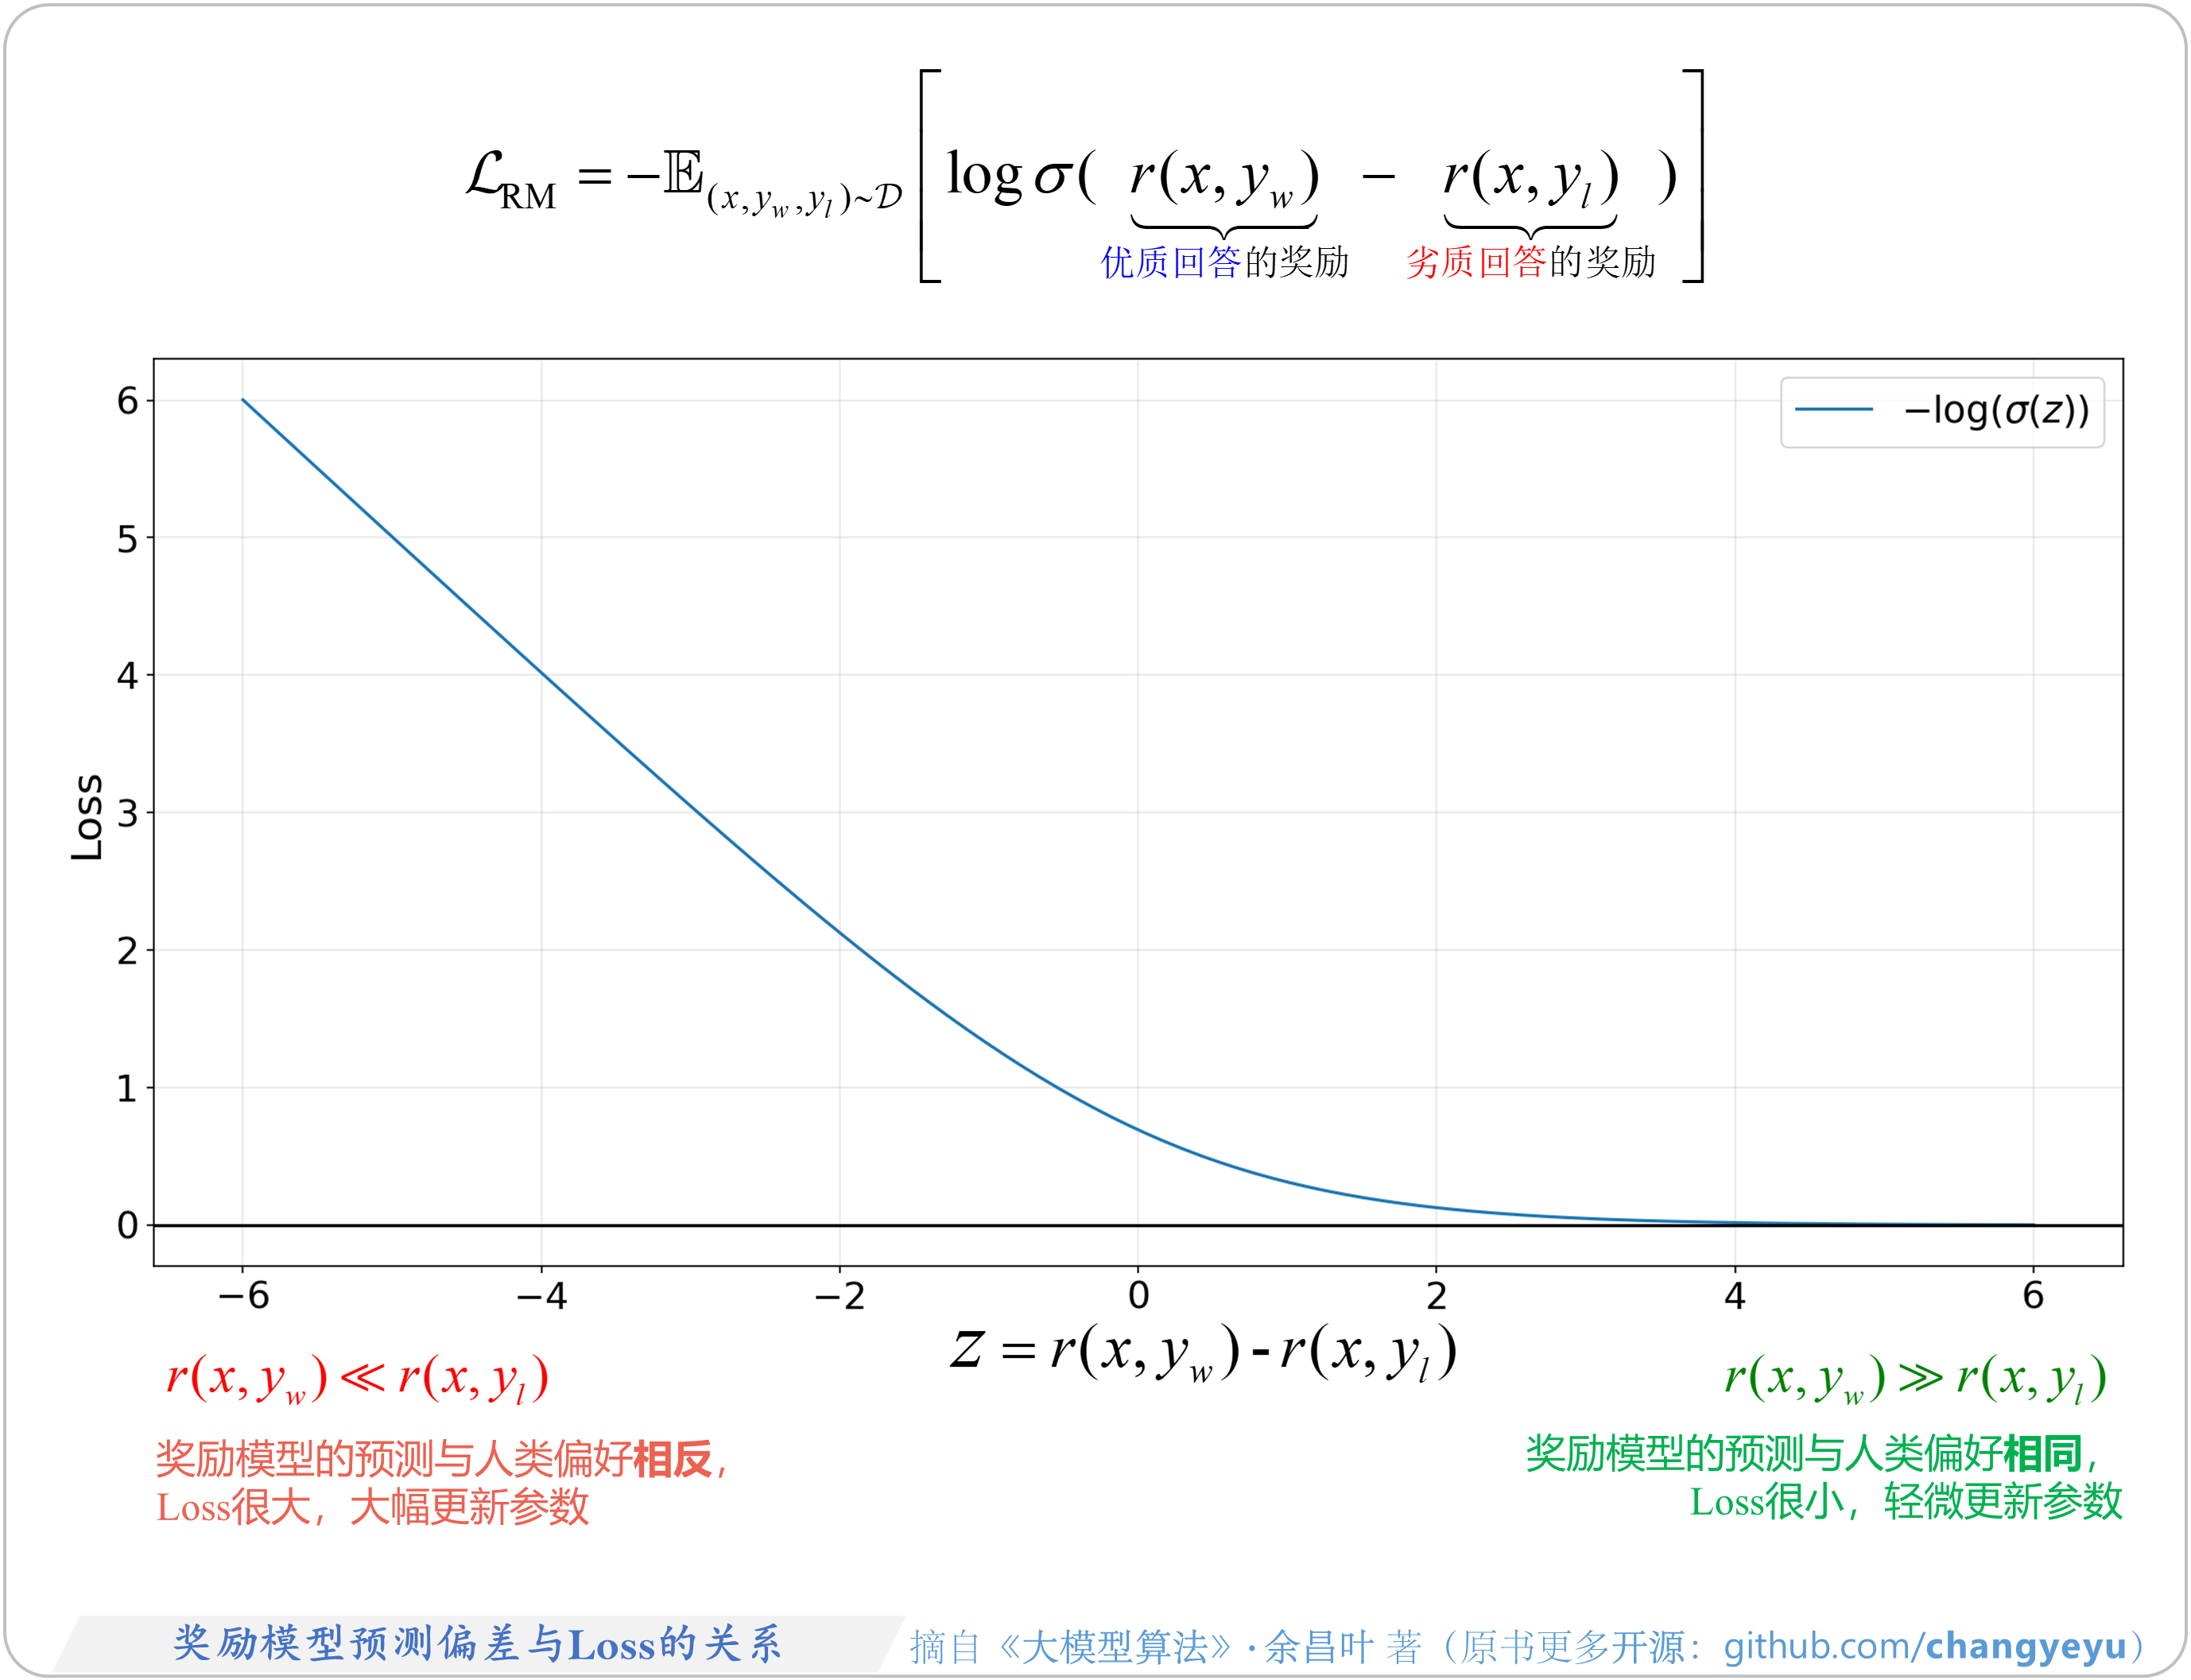
如图所示,其中,yw和 yl是针对同一个Prompt(图中的x)生成的两个回答,且 yw 优于 yl ,这包含了人类反馈(偏好)信息。训练步骤如下:
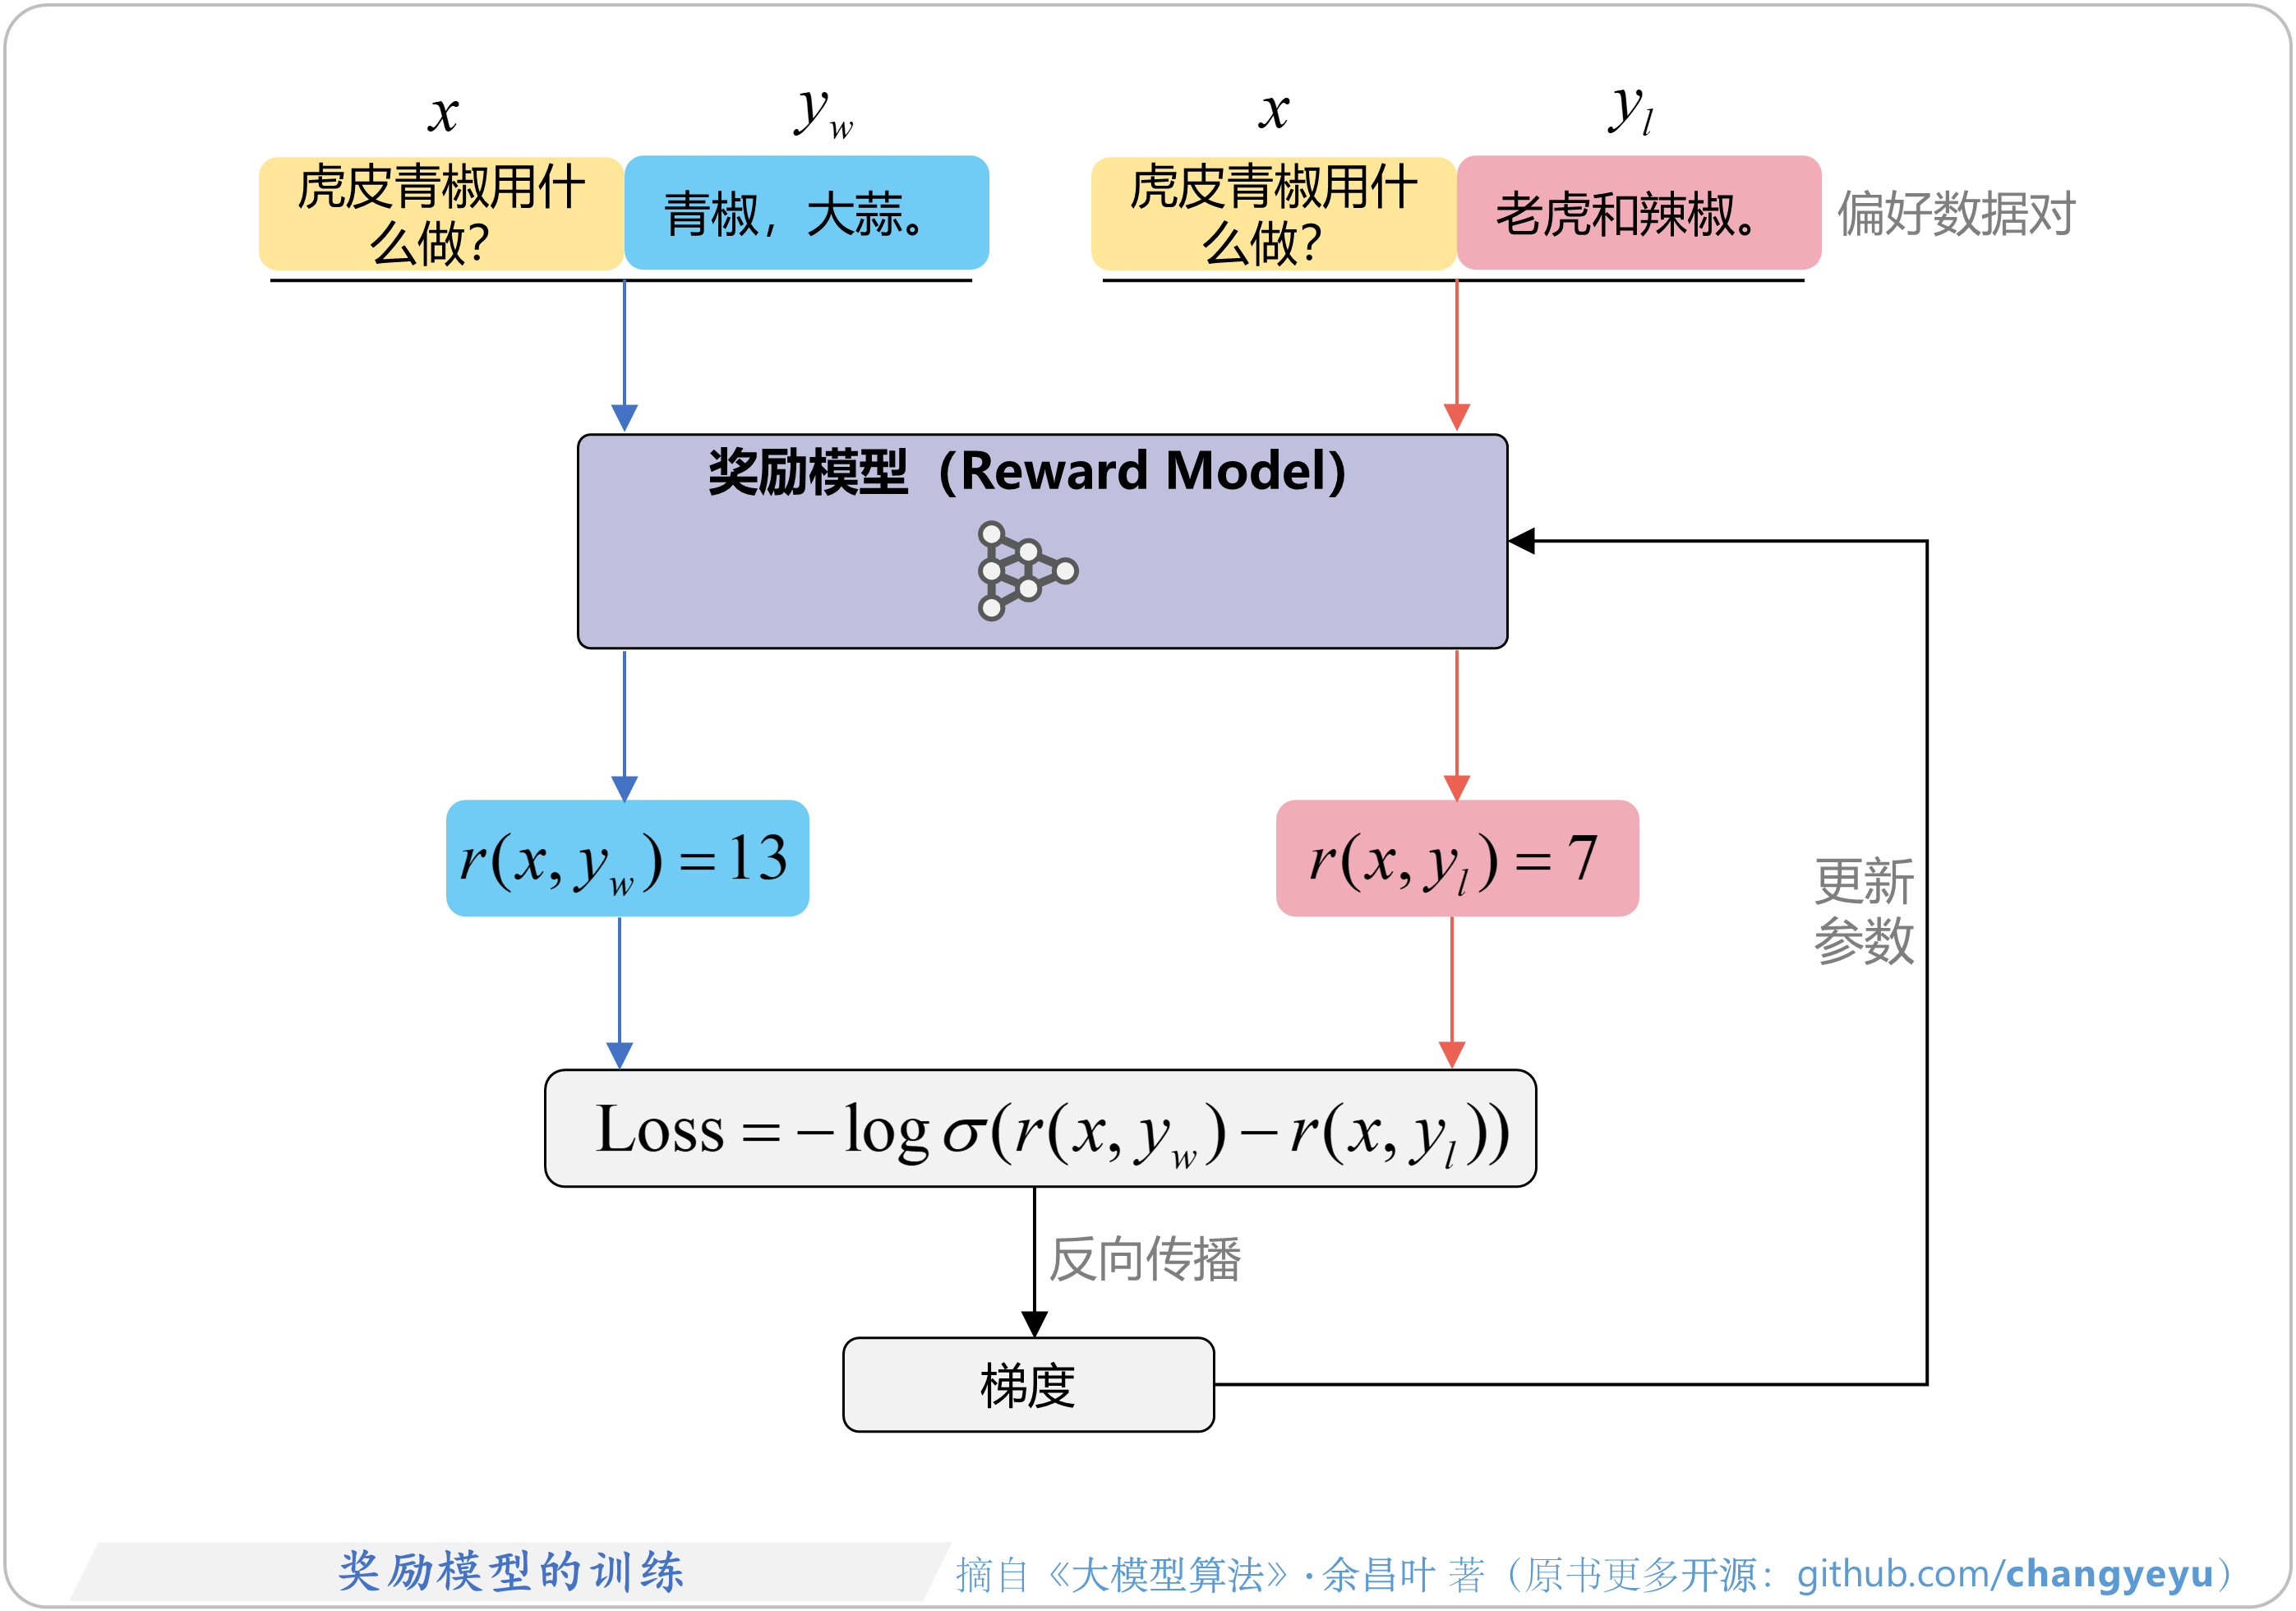
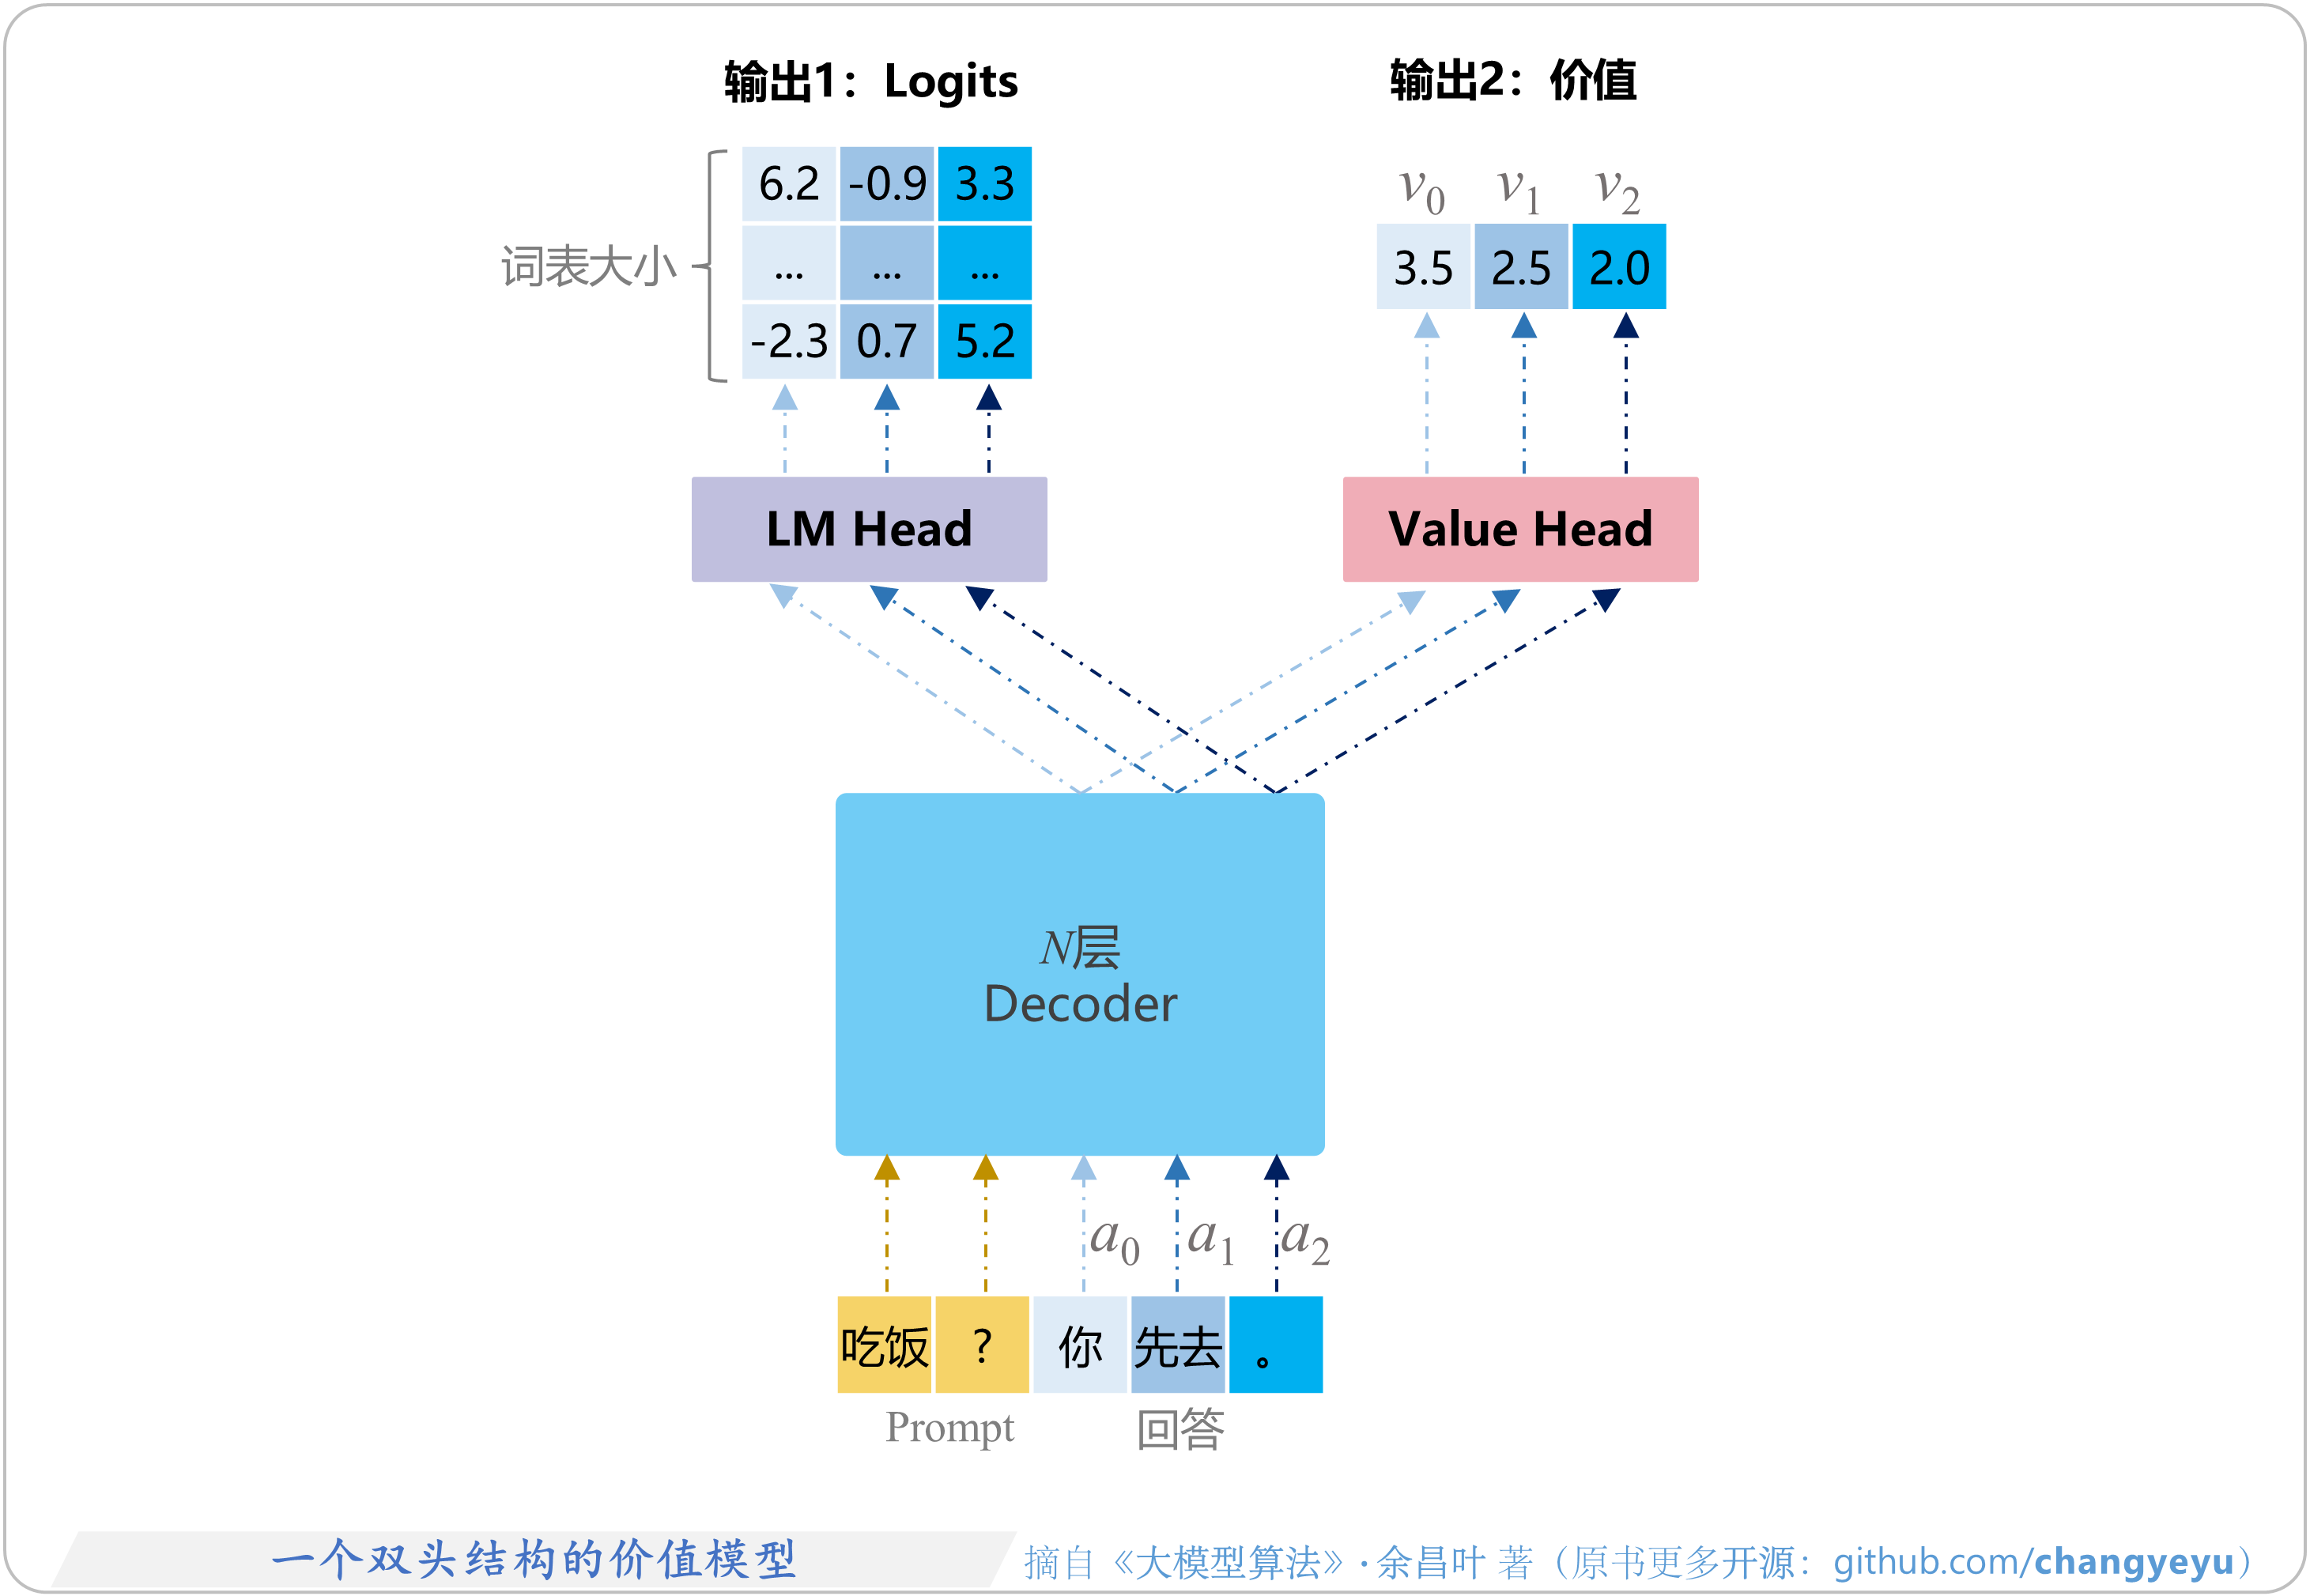
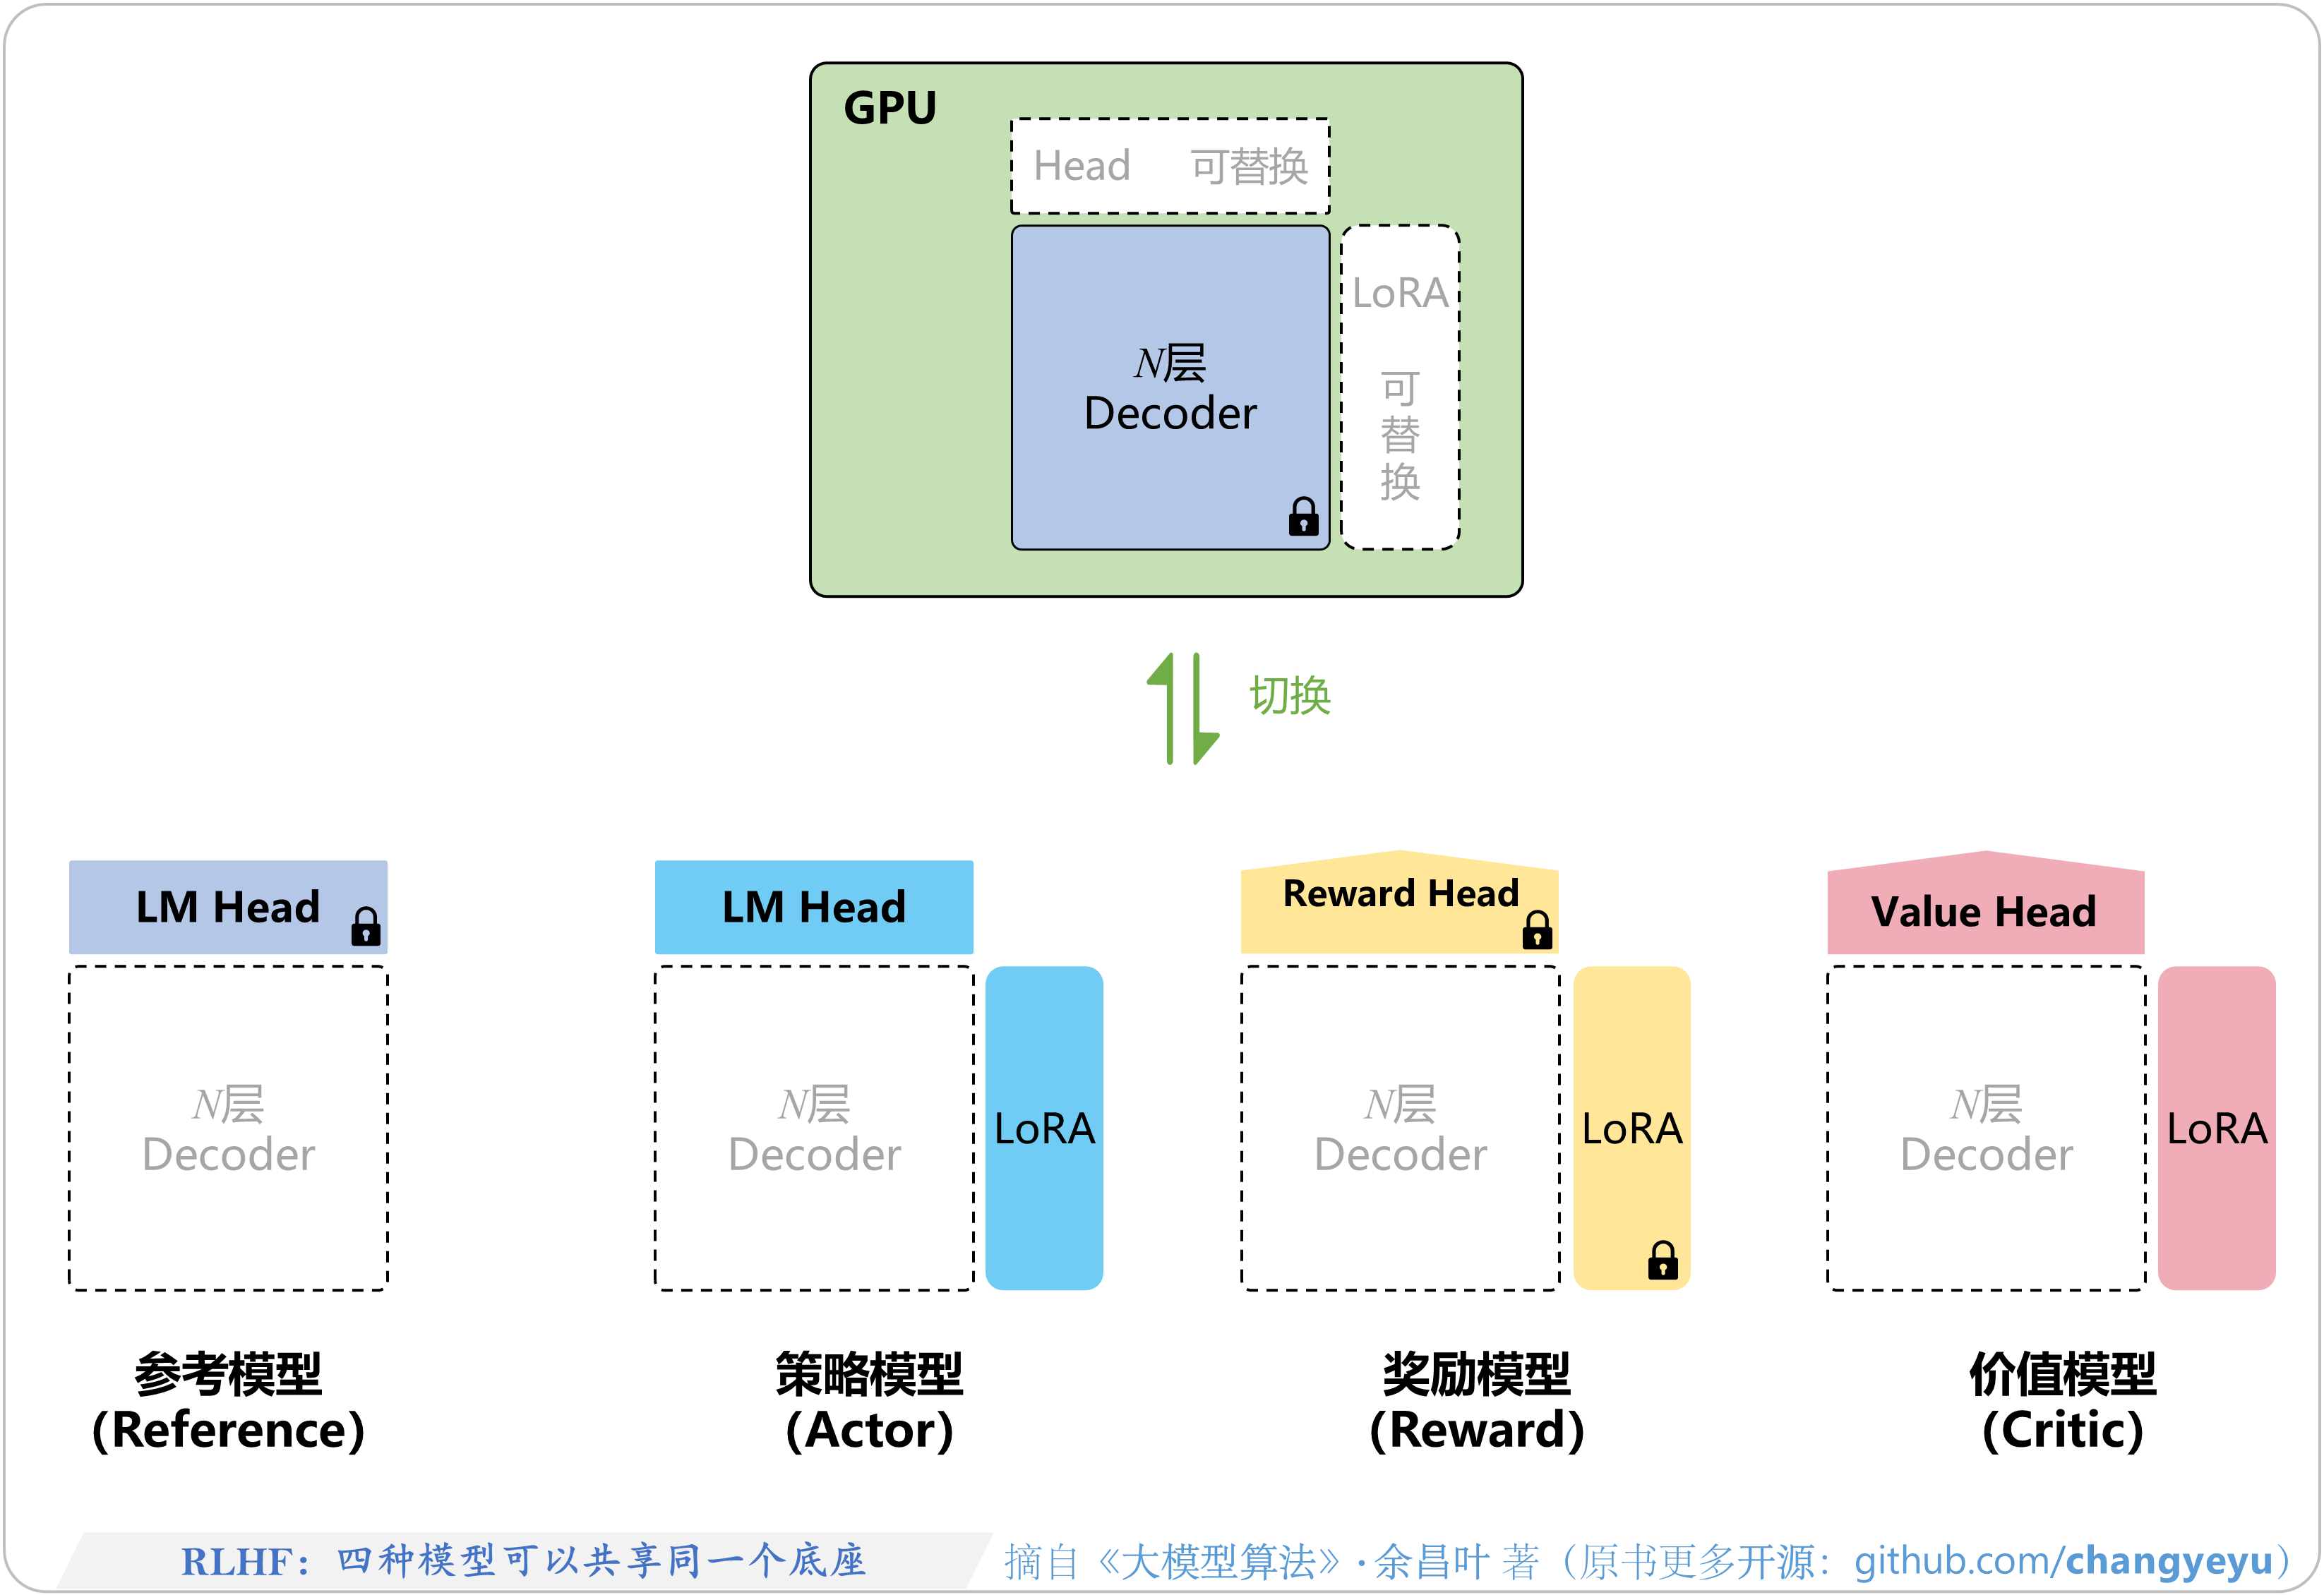
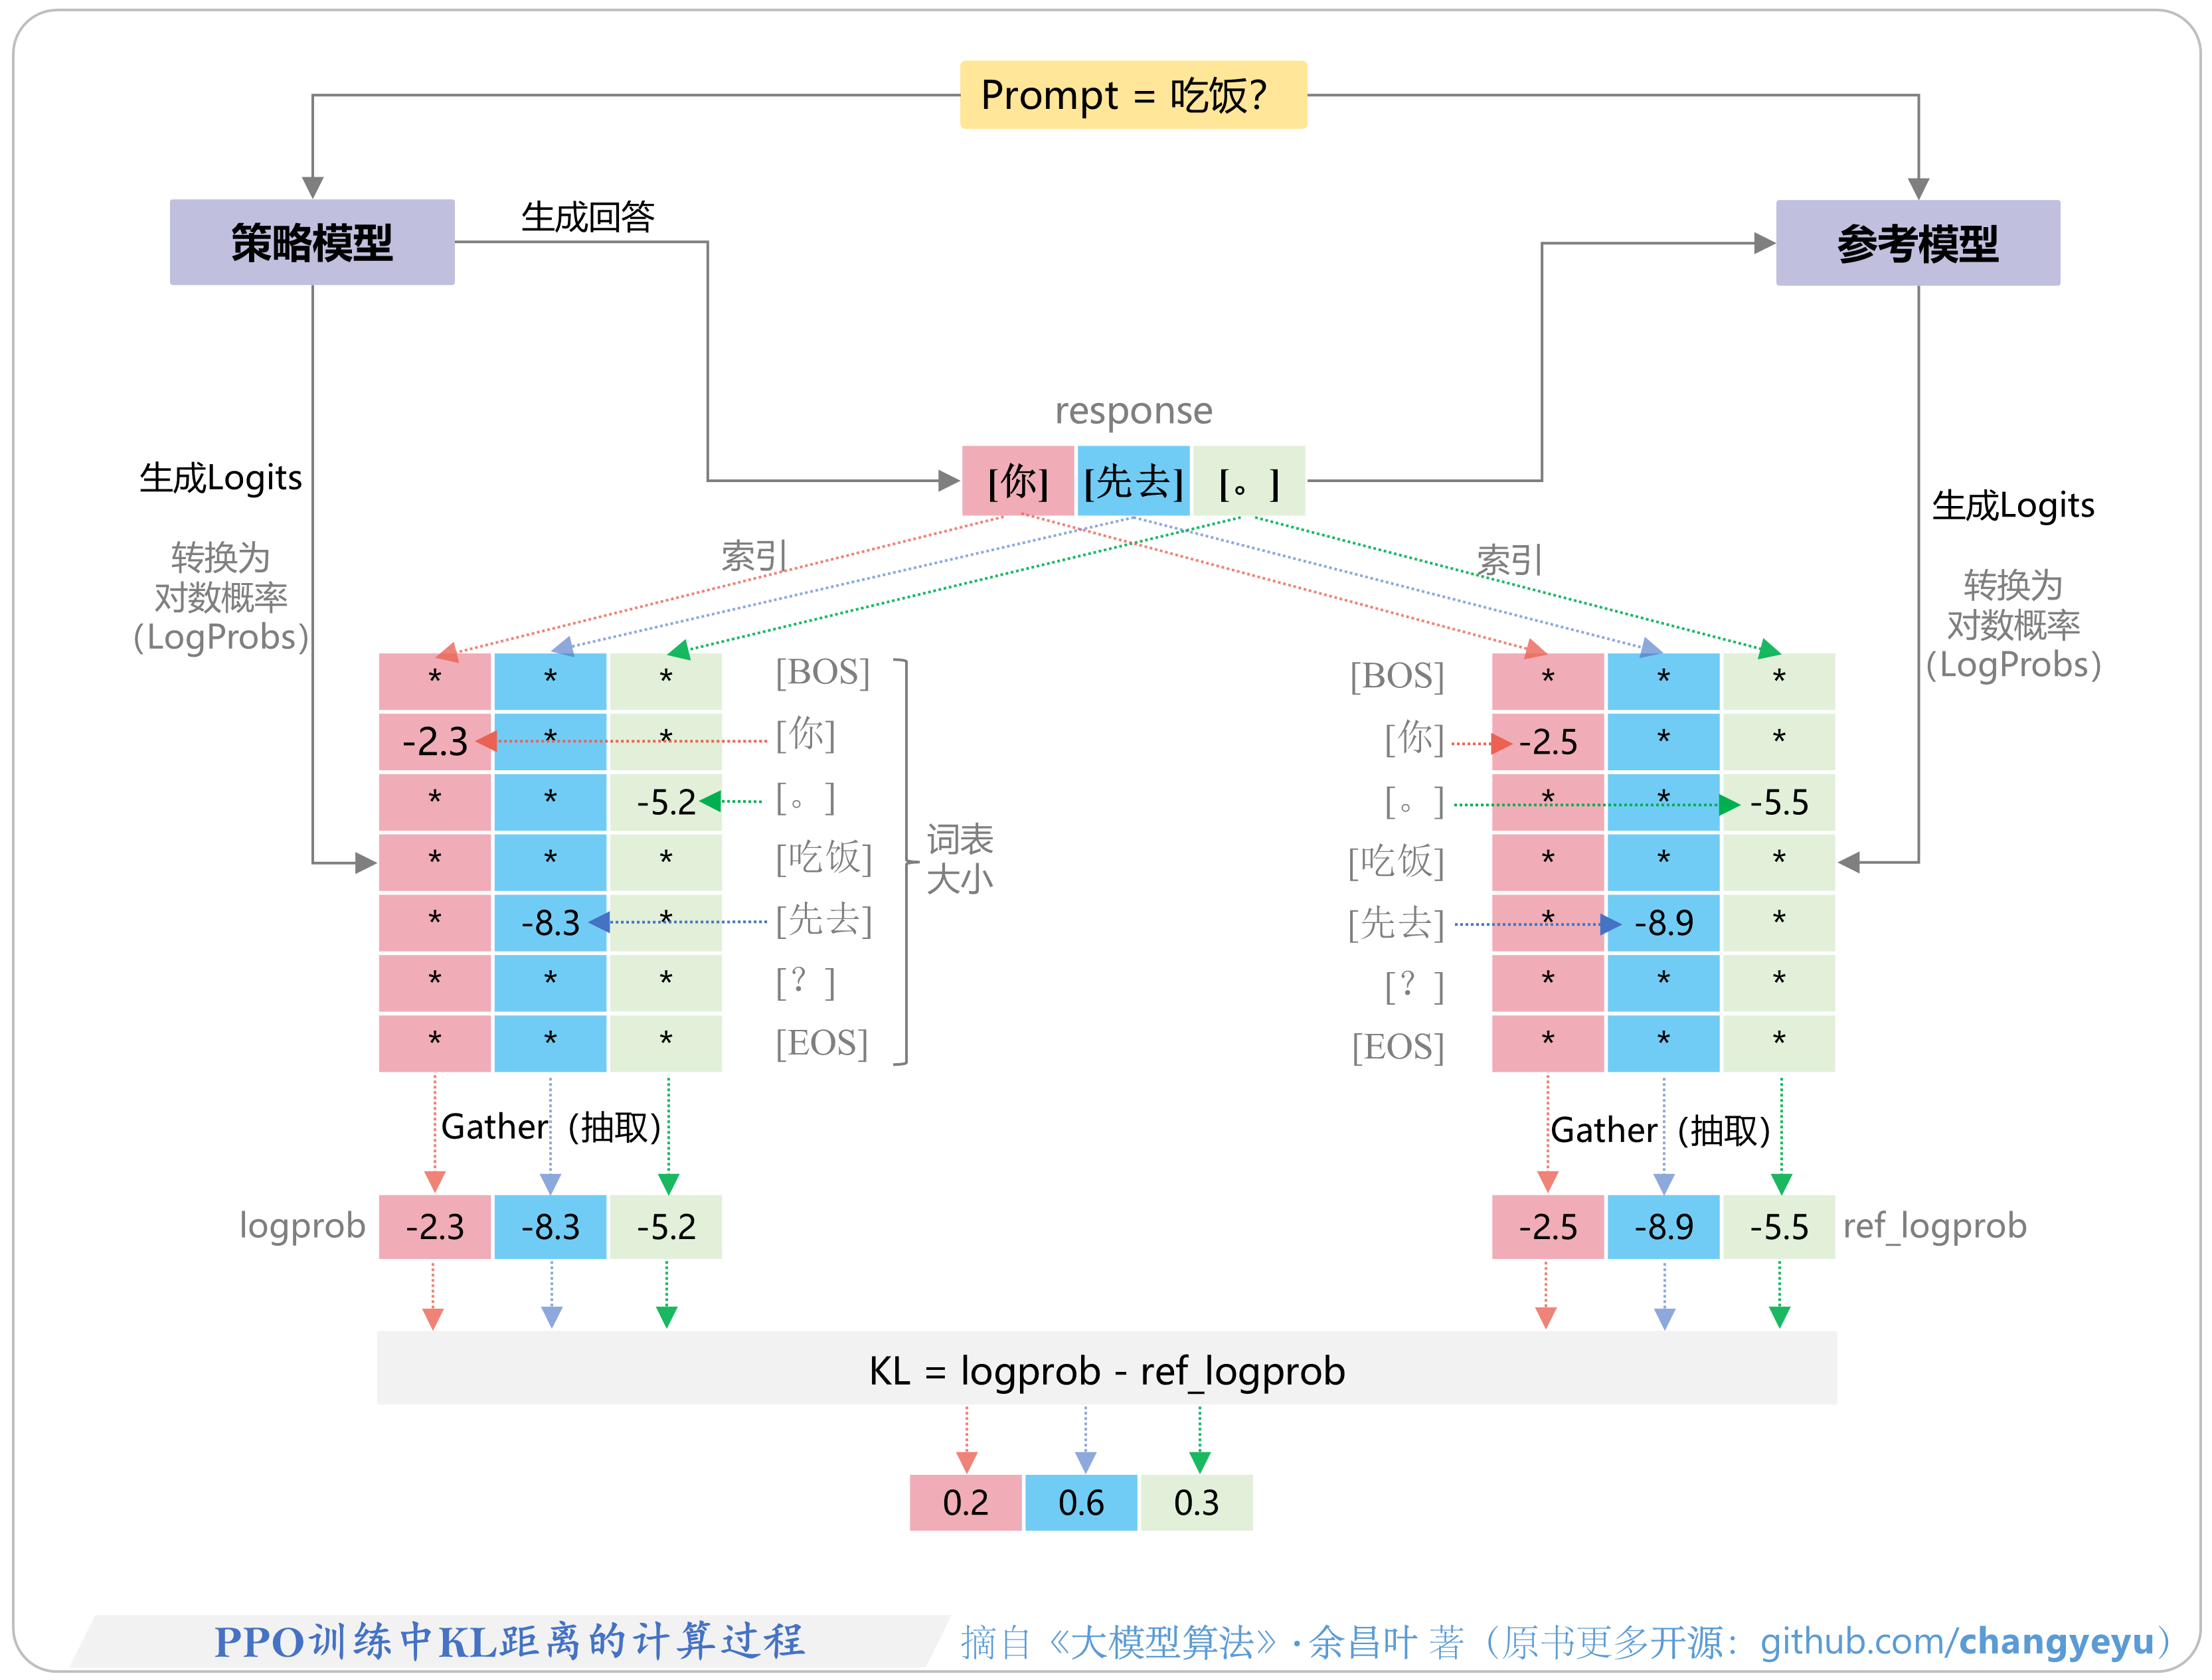
如图所示,RLHF的第二阶段需要加载四个模型进行强化学习训练。这四种模型的角色和相互关系如下:
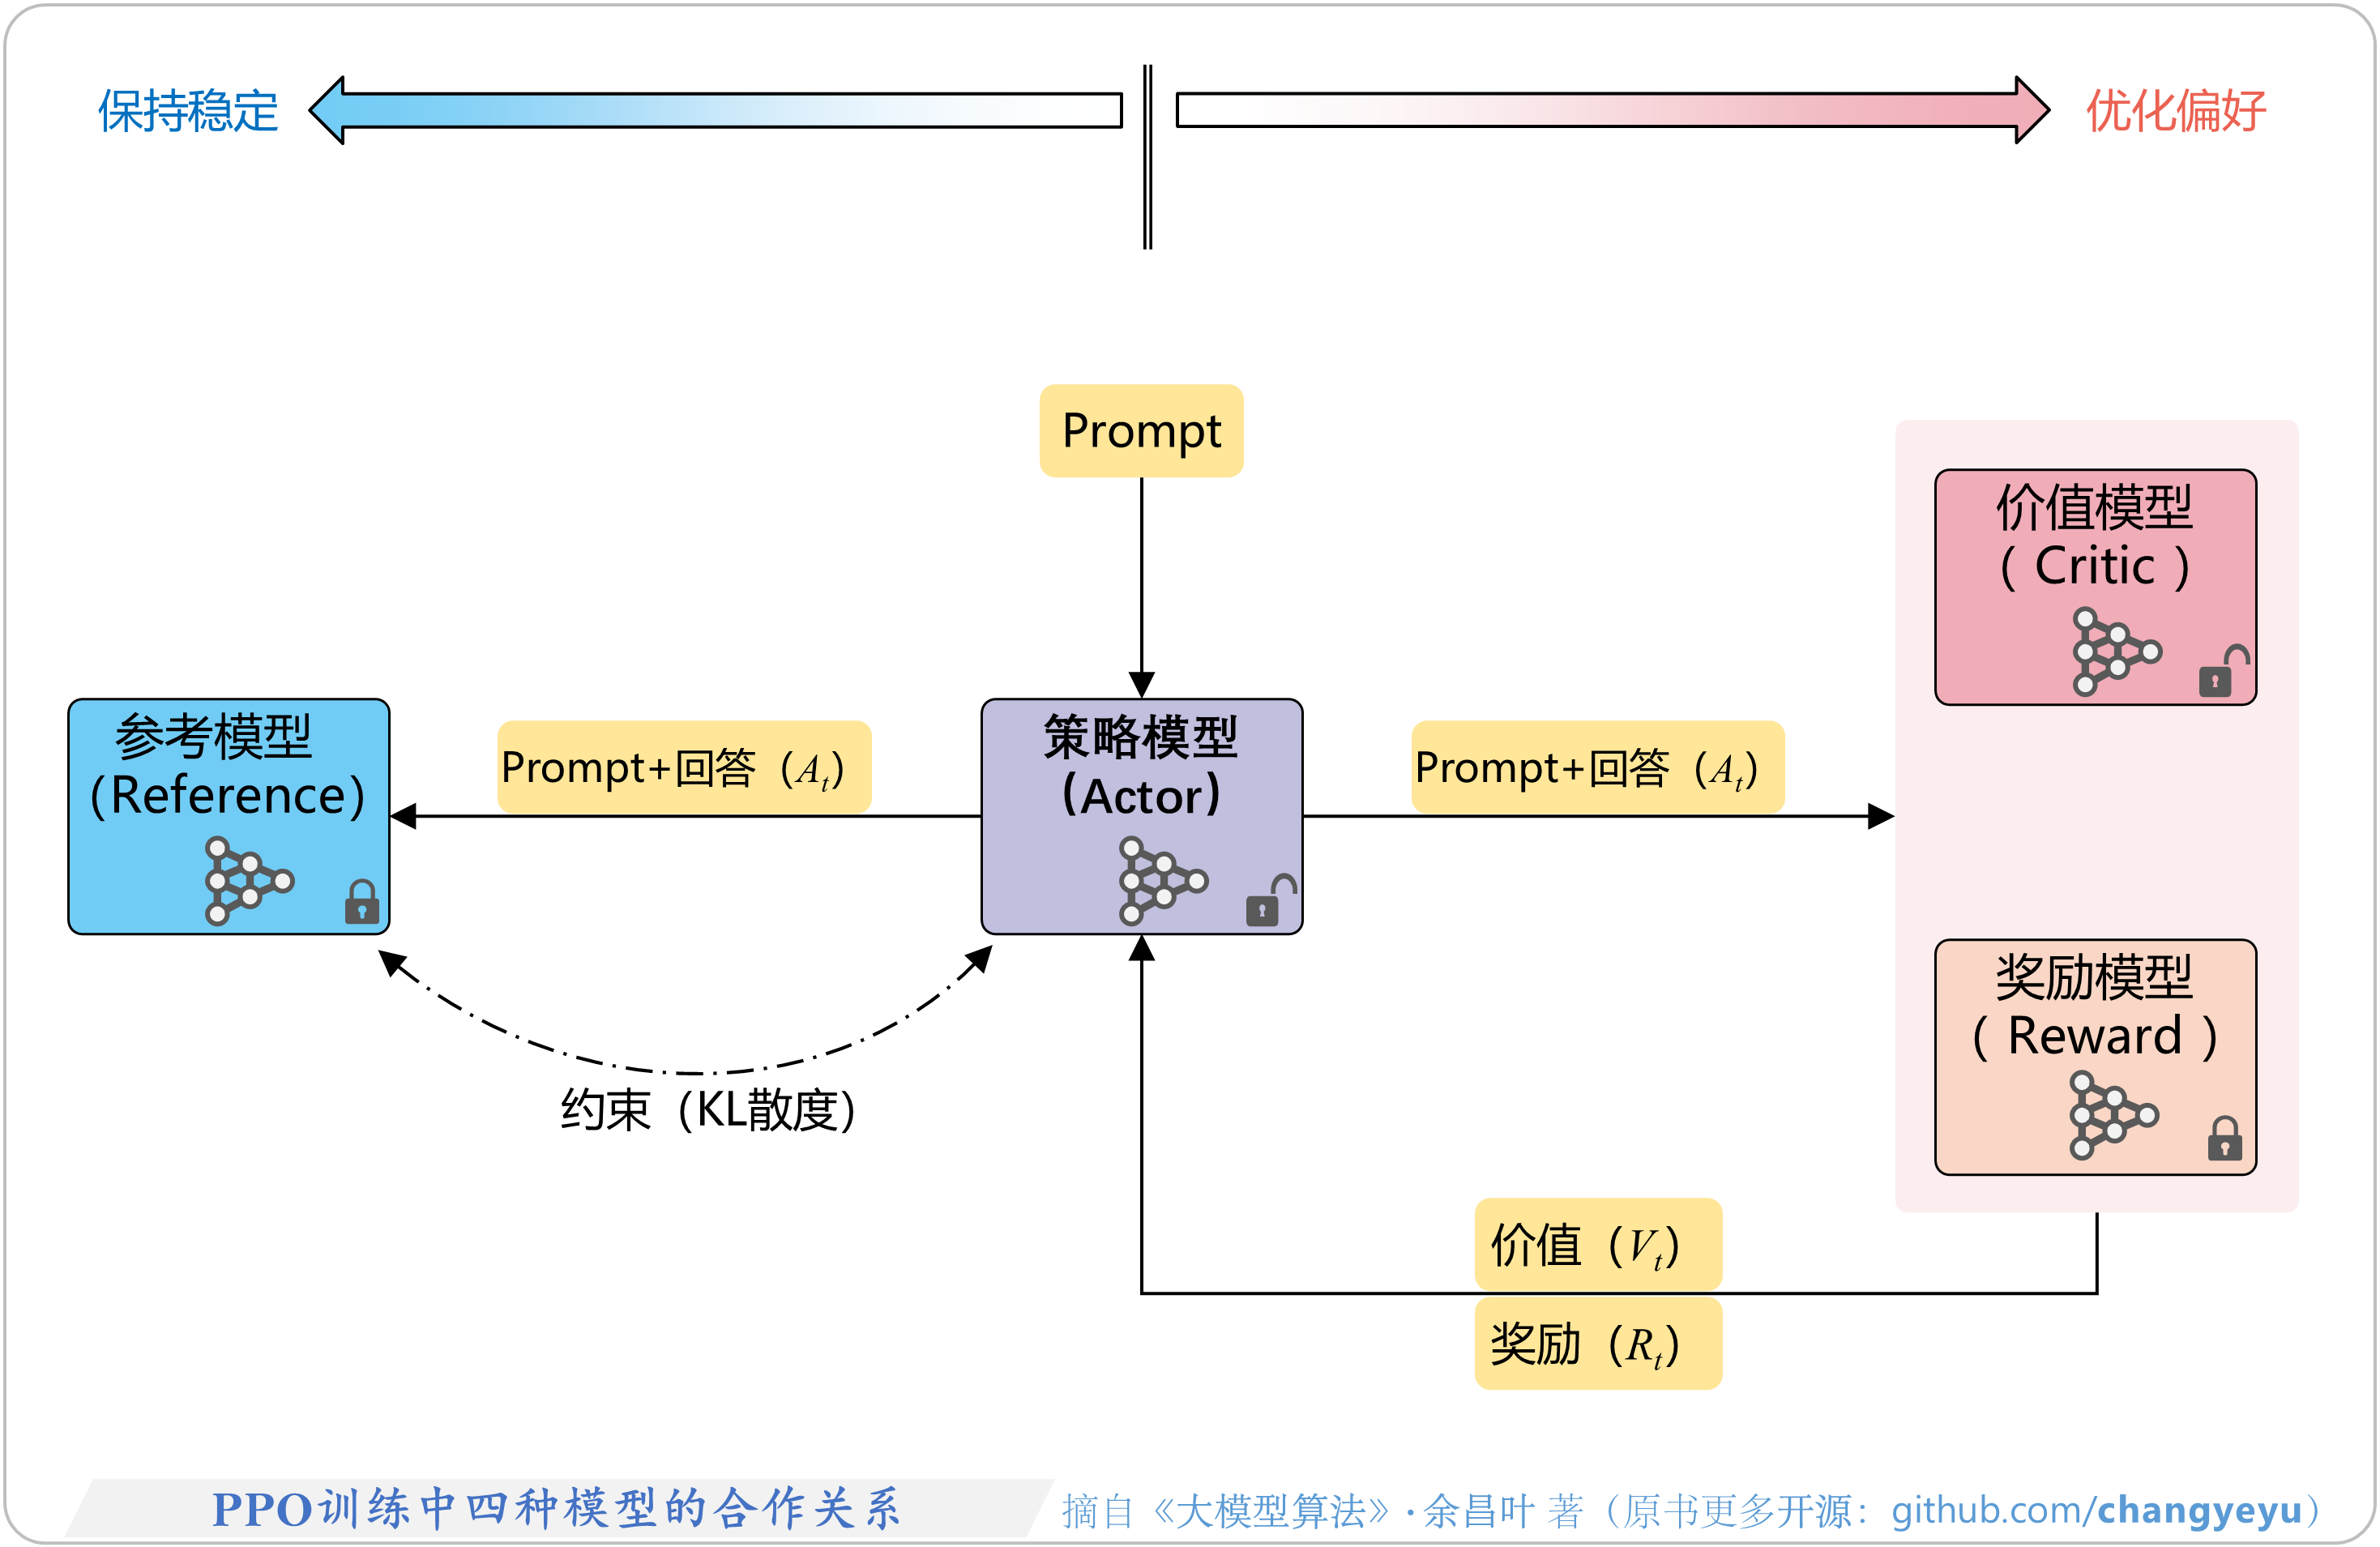
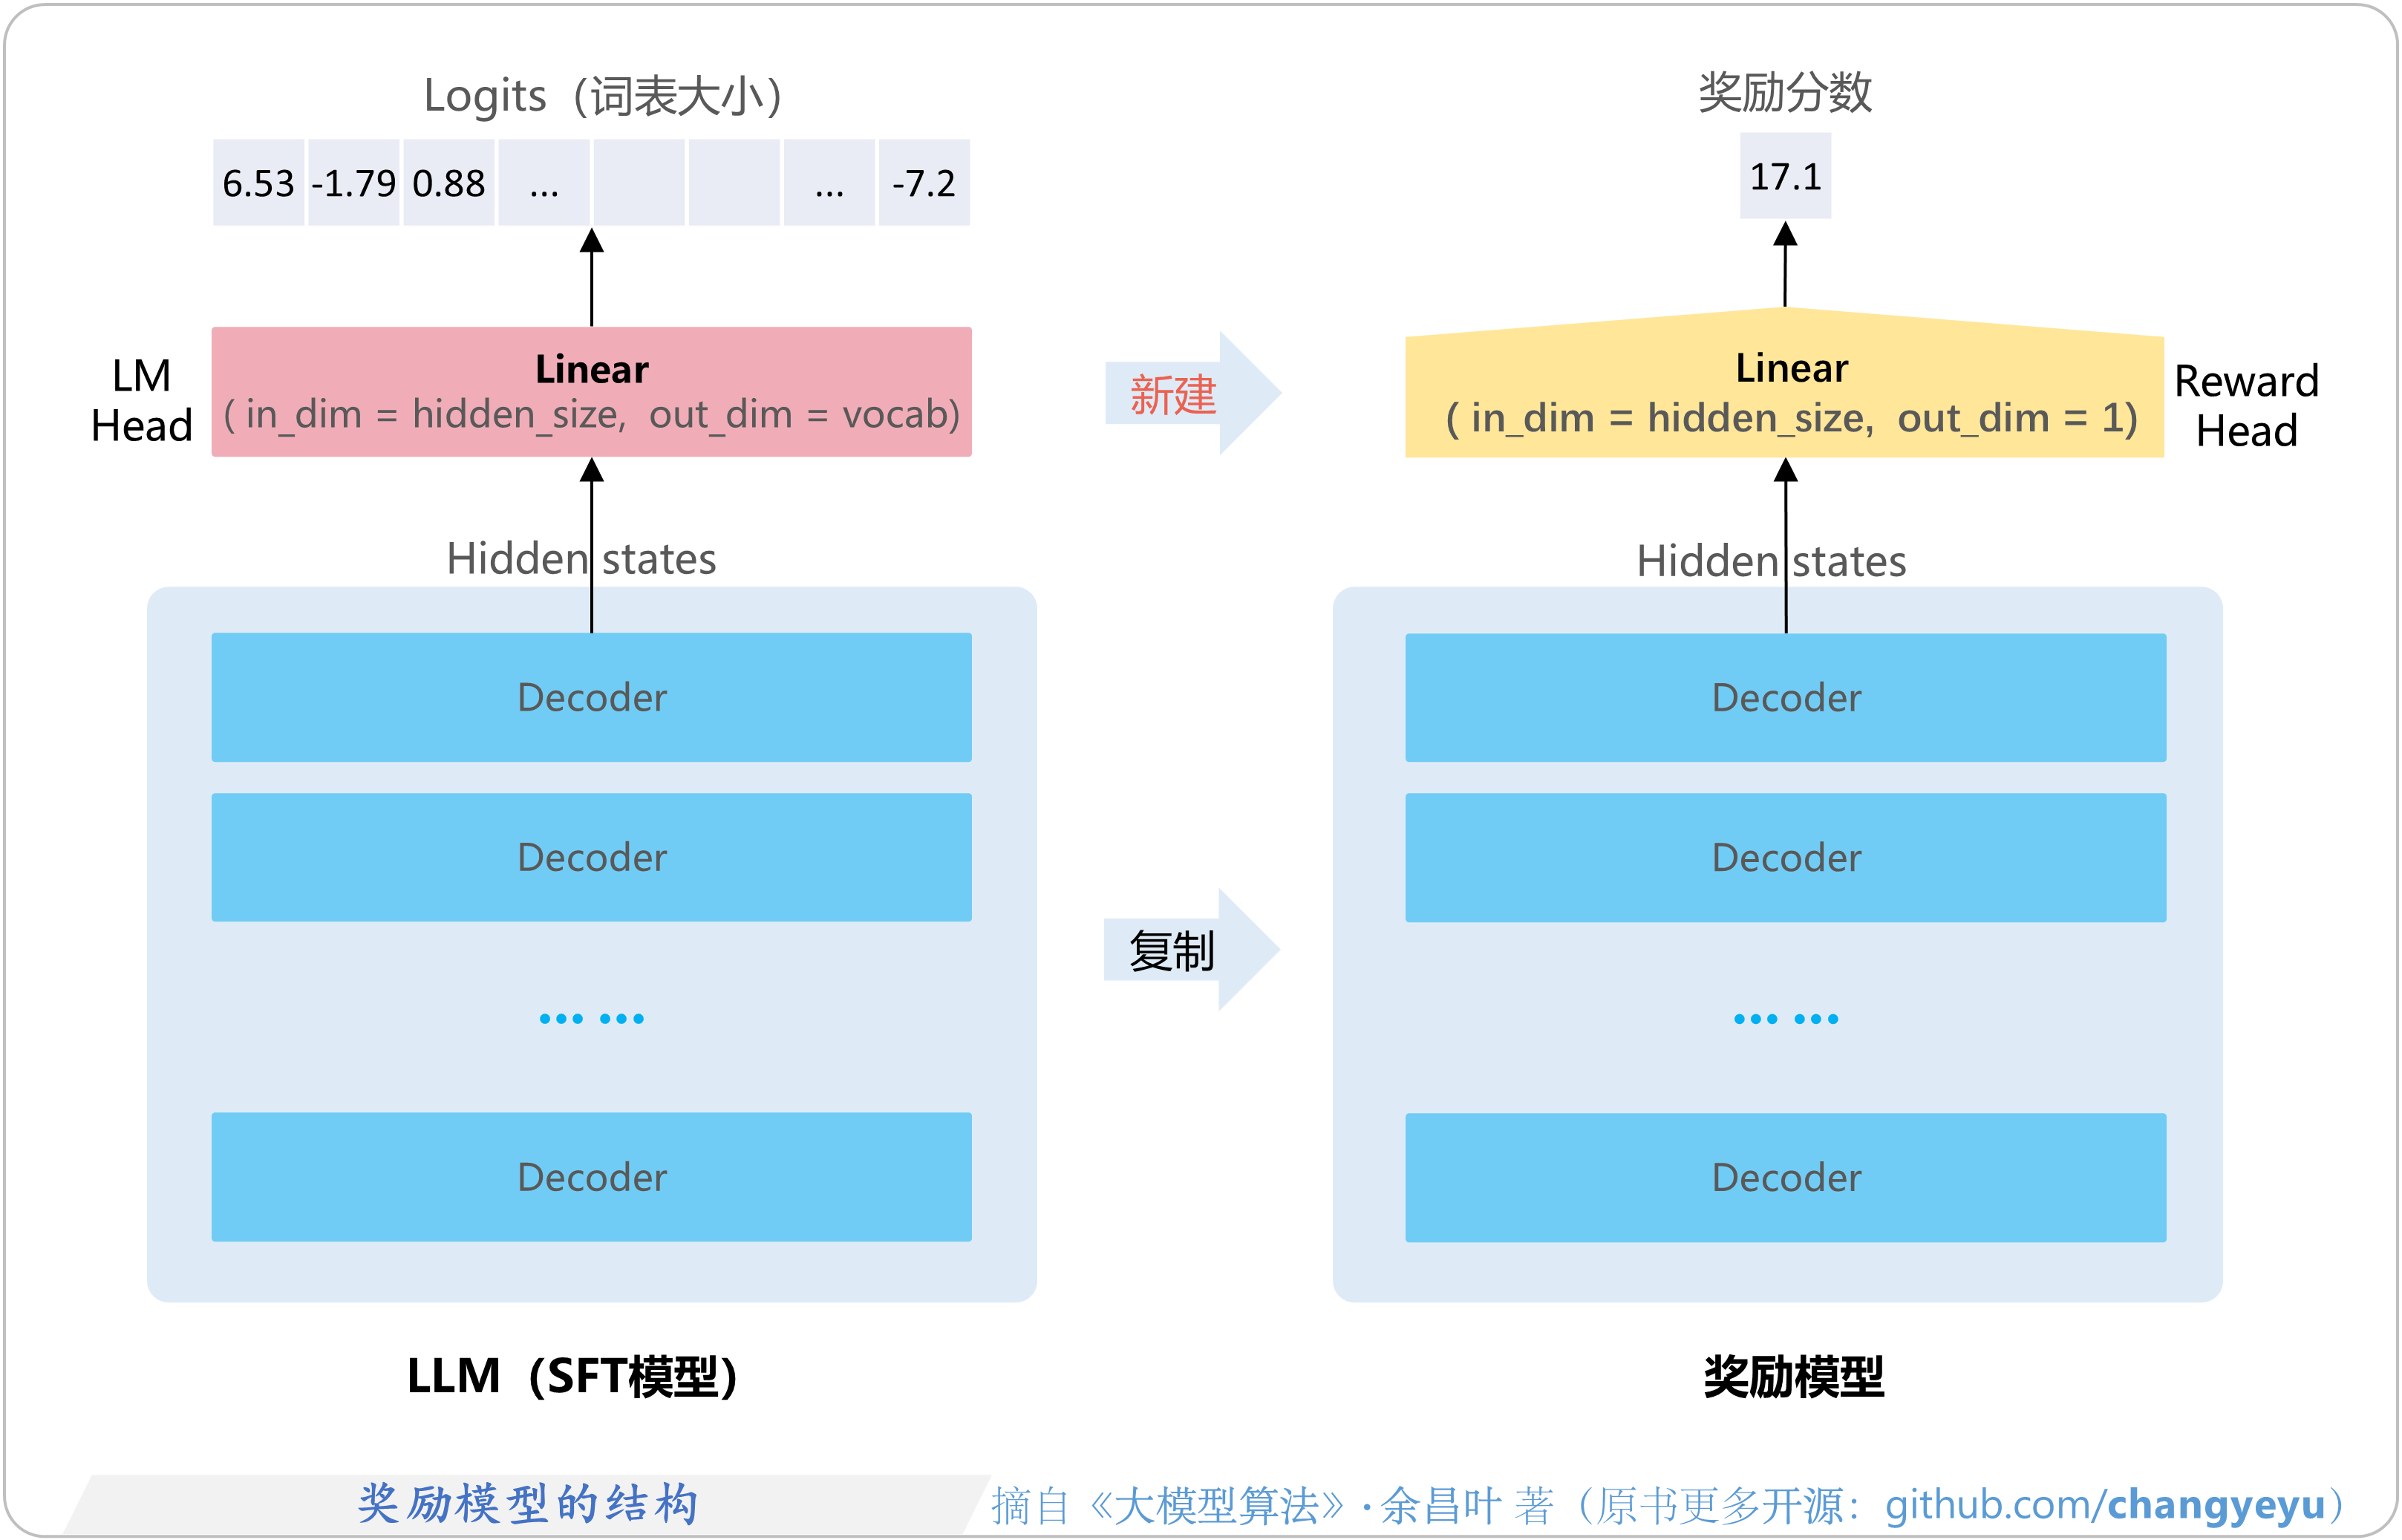
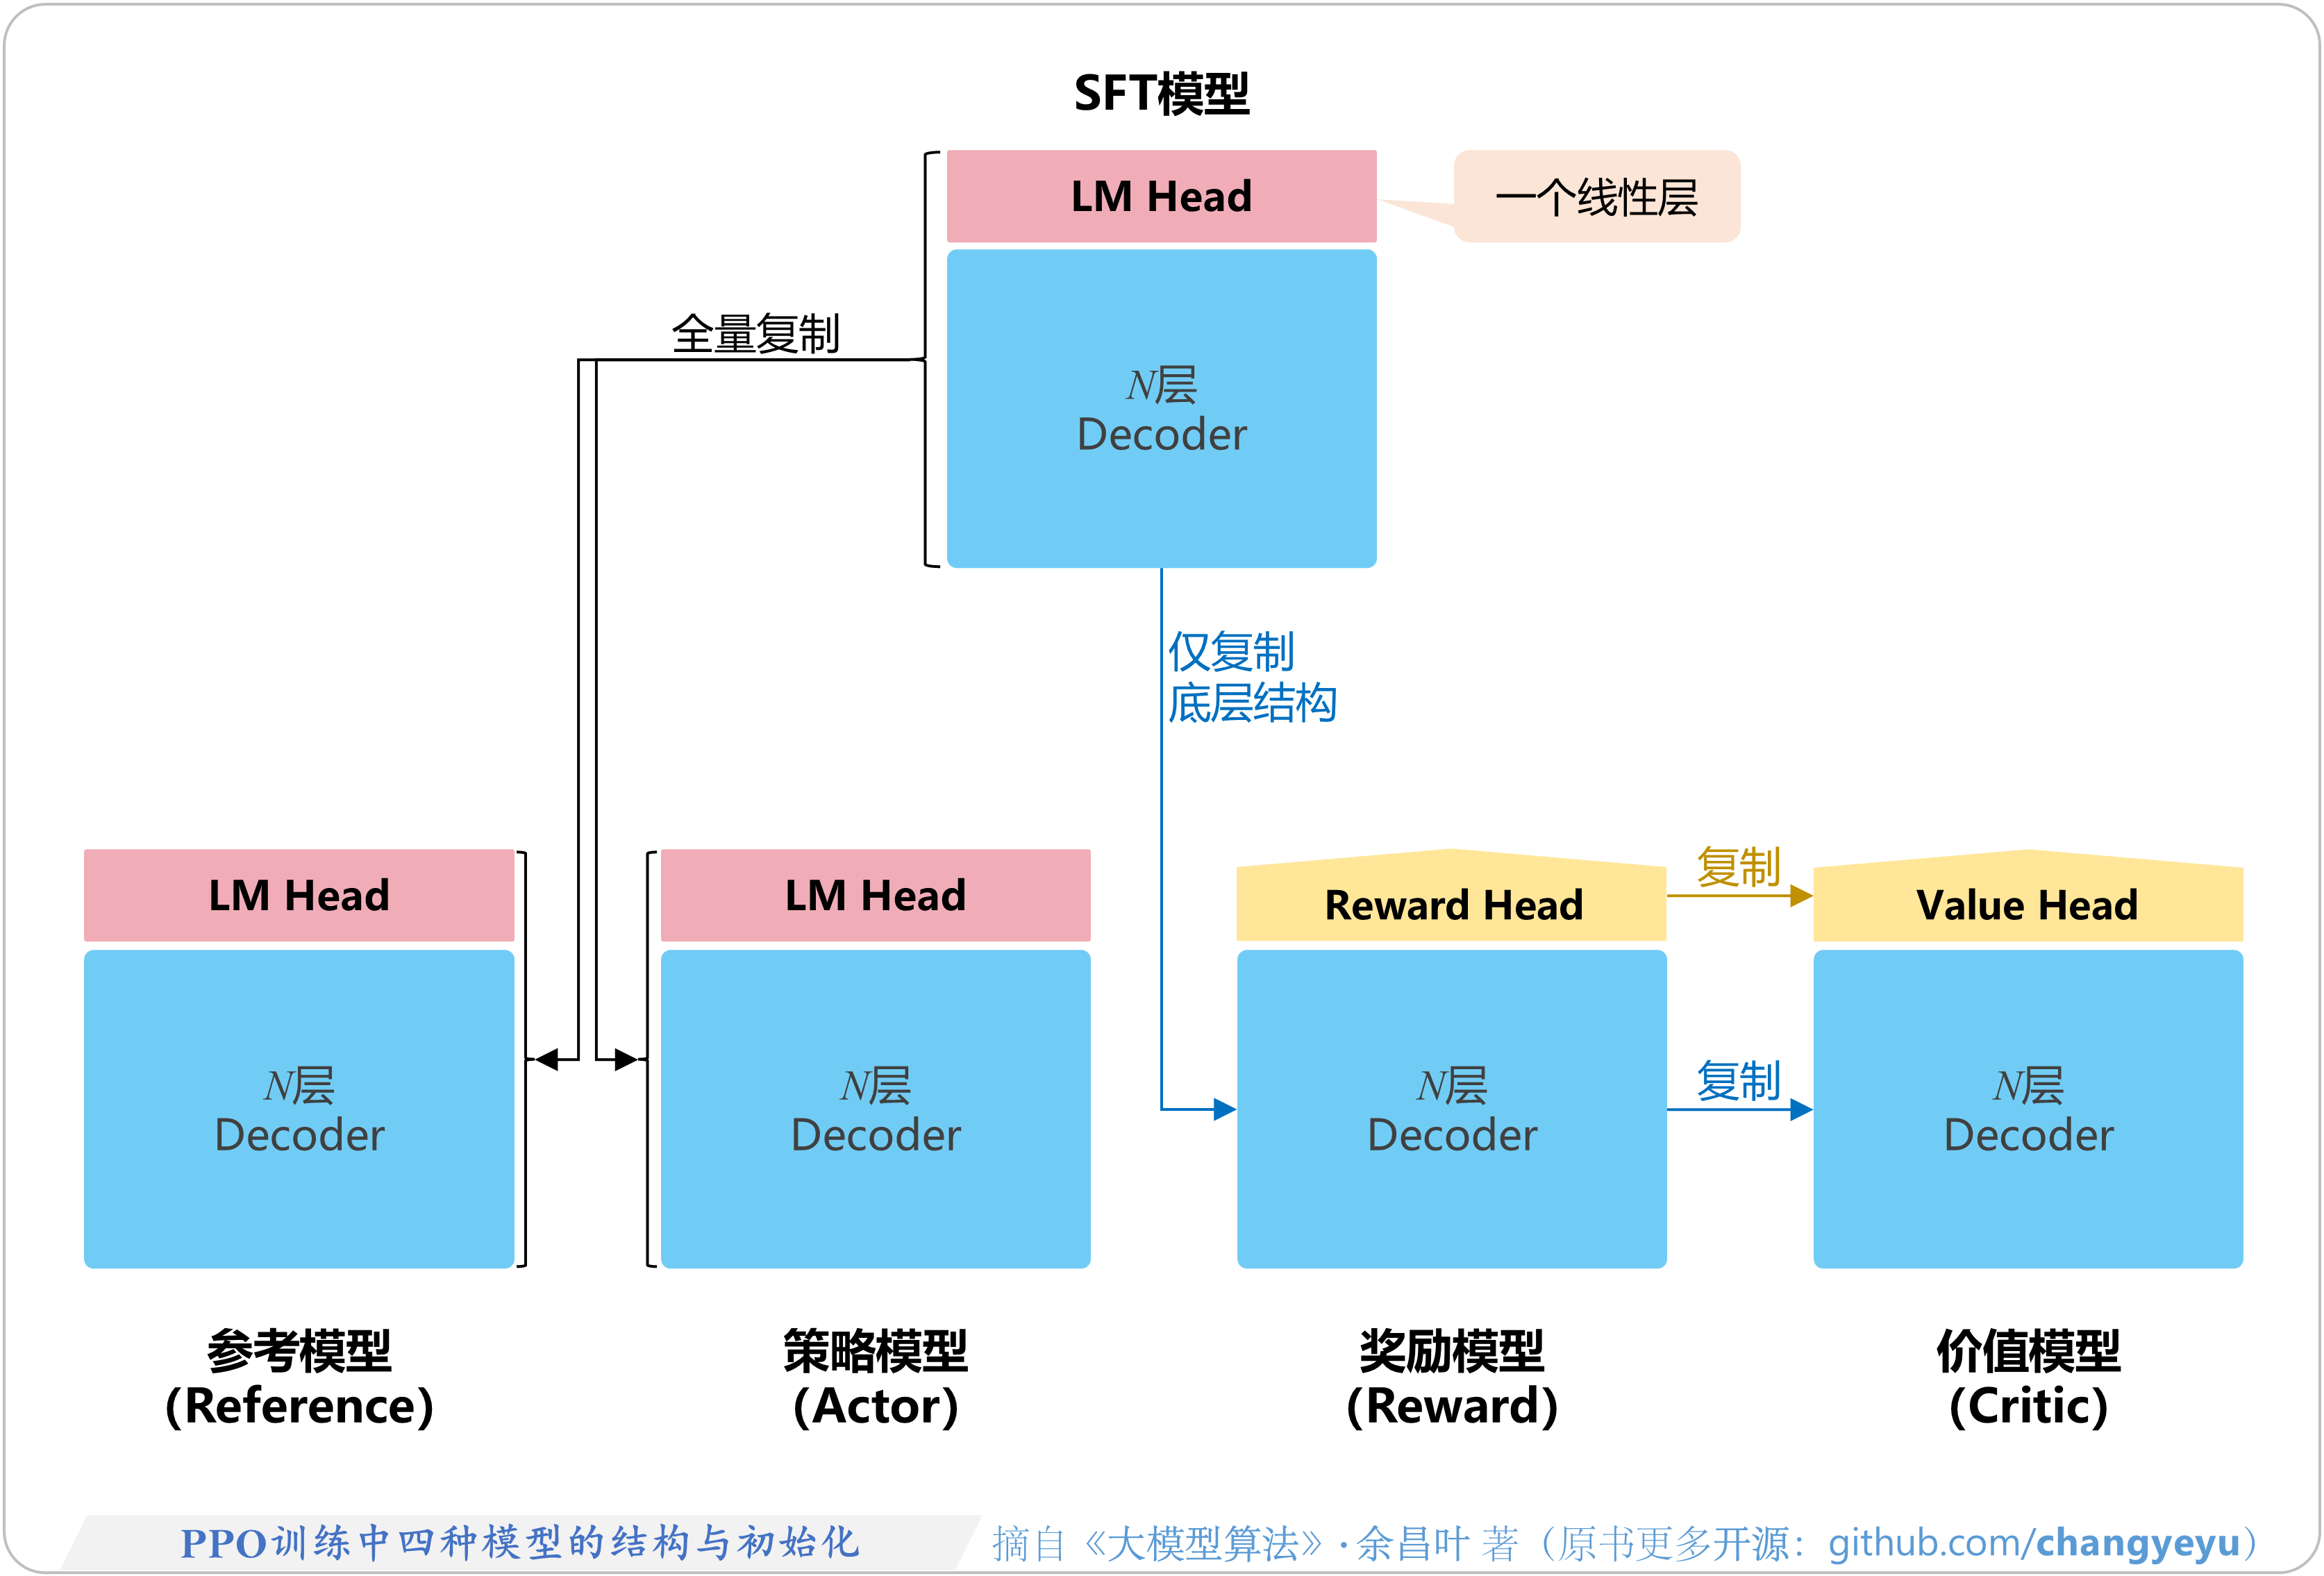
通常,在通用&低成本场景下,可以简化模型设计,RLHF涉及的四种模型拥有类似的结构,主要区别在于各模型的头部(Head)。这些模型可以基于SFT模型(经过有监督微调后的LLM版本)进行改造和初始化,如图所示:
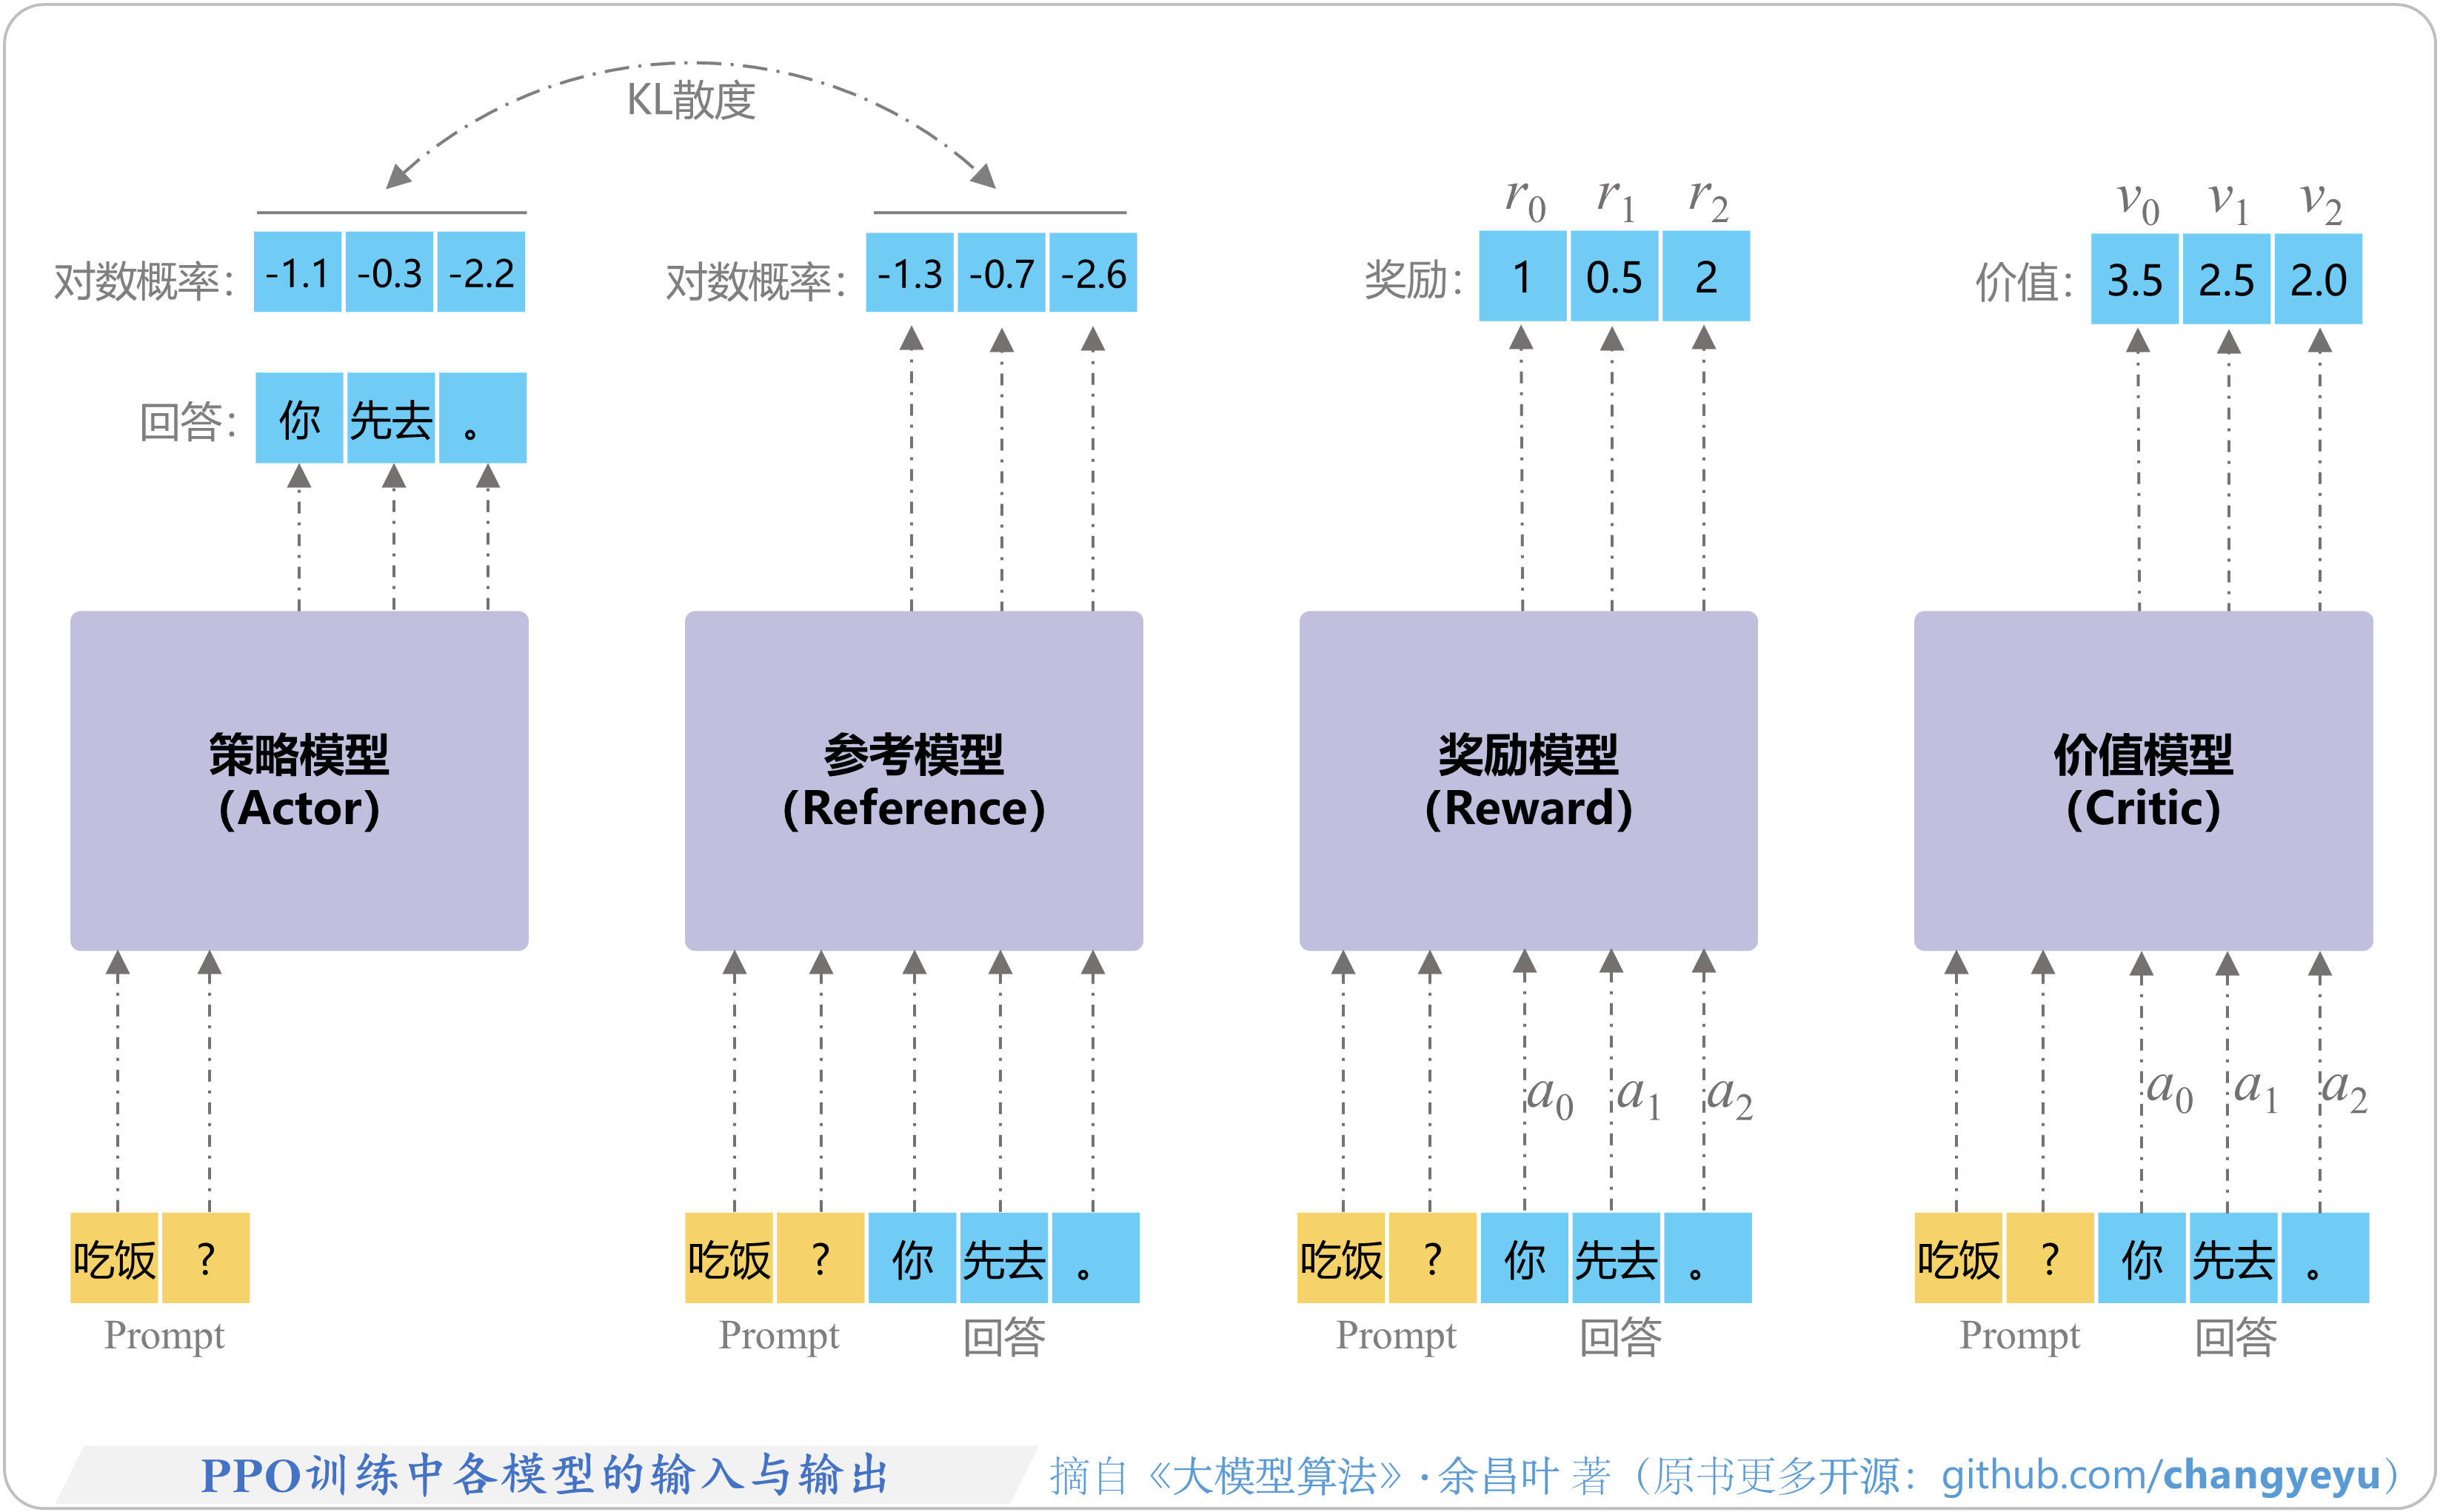
PPO训练中各模型的输入与输出
| 模型 | 输入 | 输出 |
|---|---|---|
| 策略模型 | Prompt(或上下文) | 回答及其对应的对数概率(LogProbs) |
| 参考模型 | Prompt(或上下文) + 回答 | 回答对应的对数概率(LogProbs) |
| 奖励模型 | Prompt(或上下文) + 回答 | 回答对应的每个 token 的奖励值 |
| 价值模型 | Prompt(或上下文) + 回答 | 回答对应的每个 token 的价值估计 |
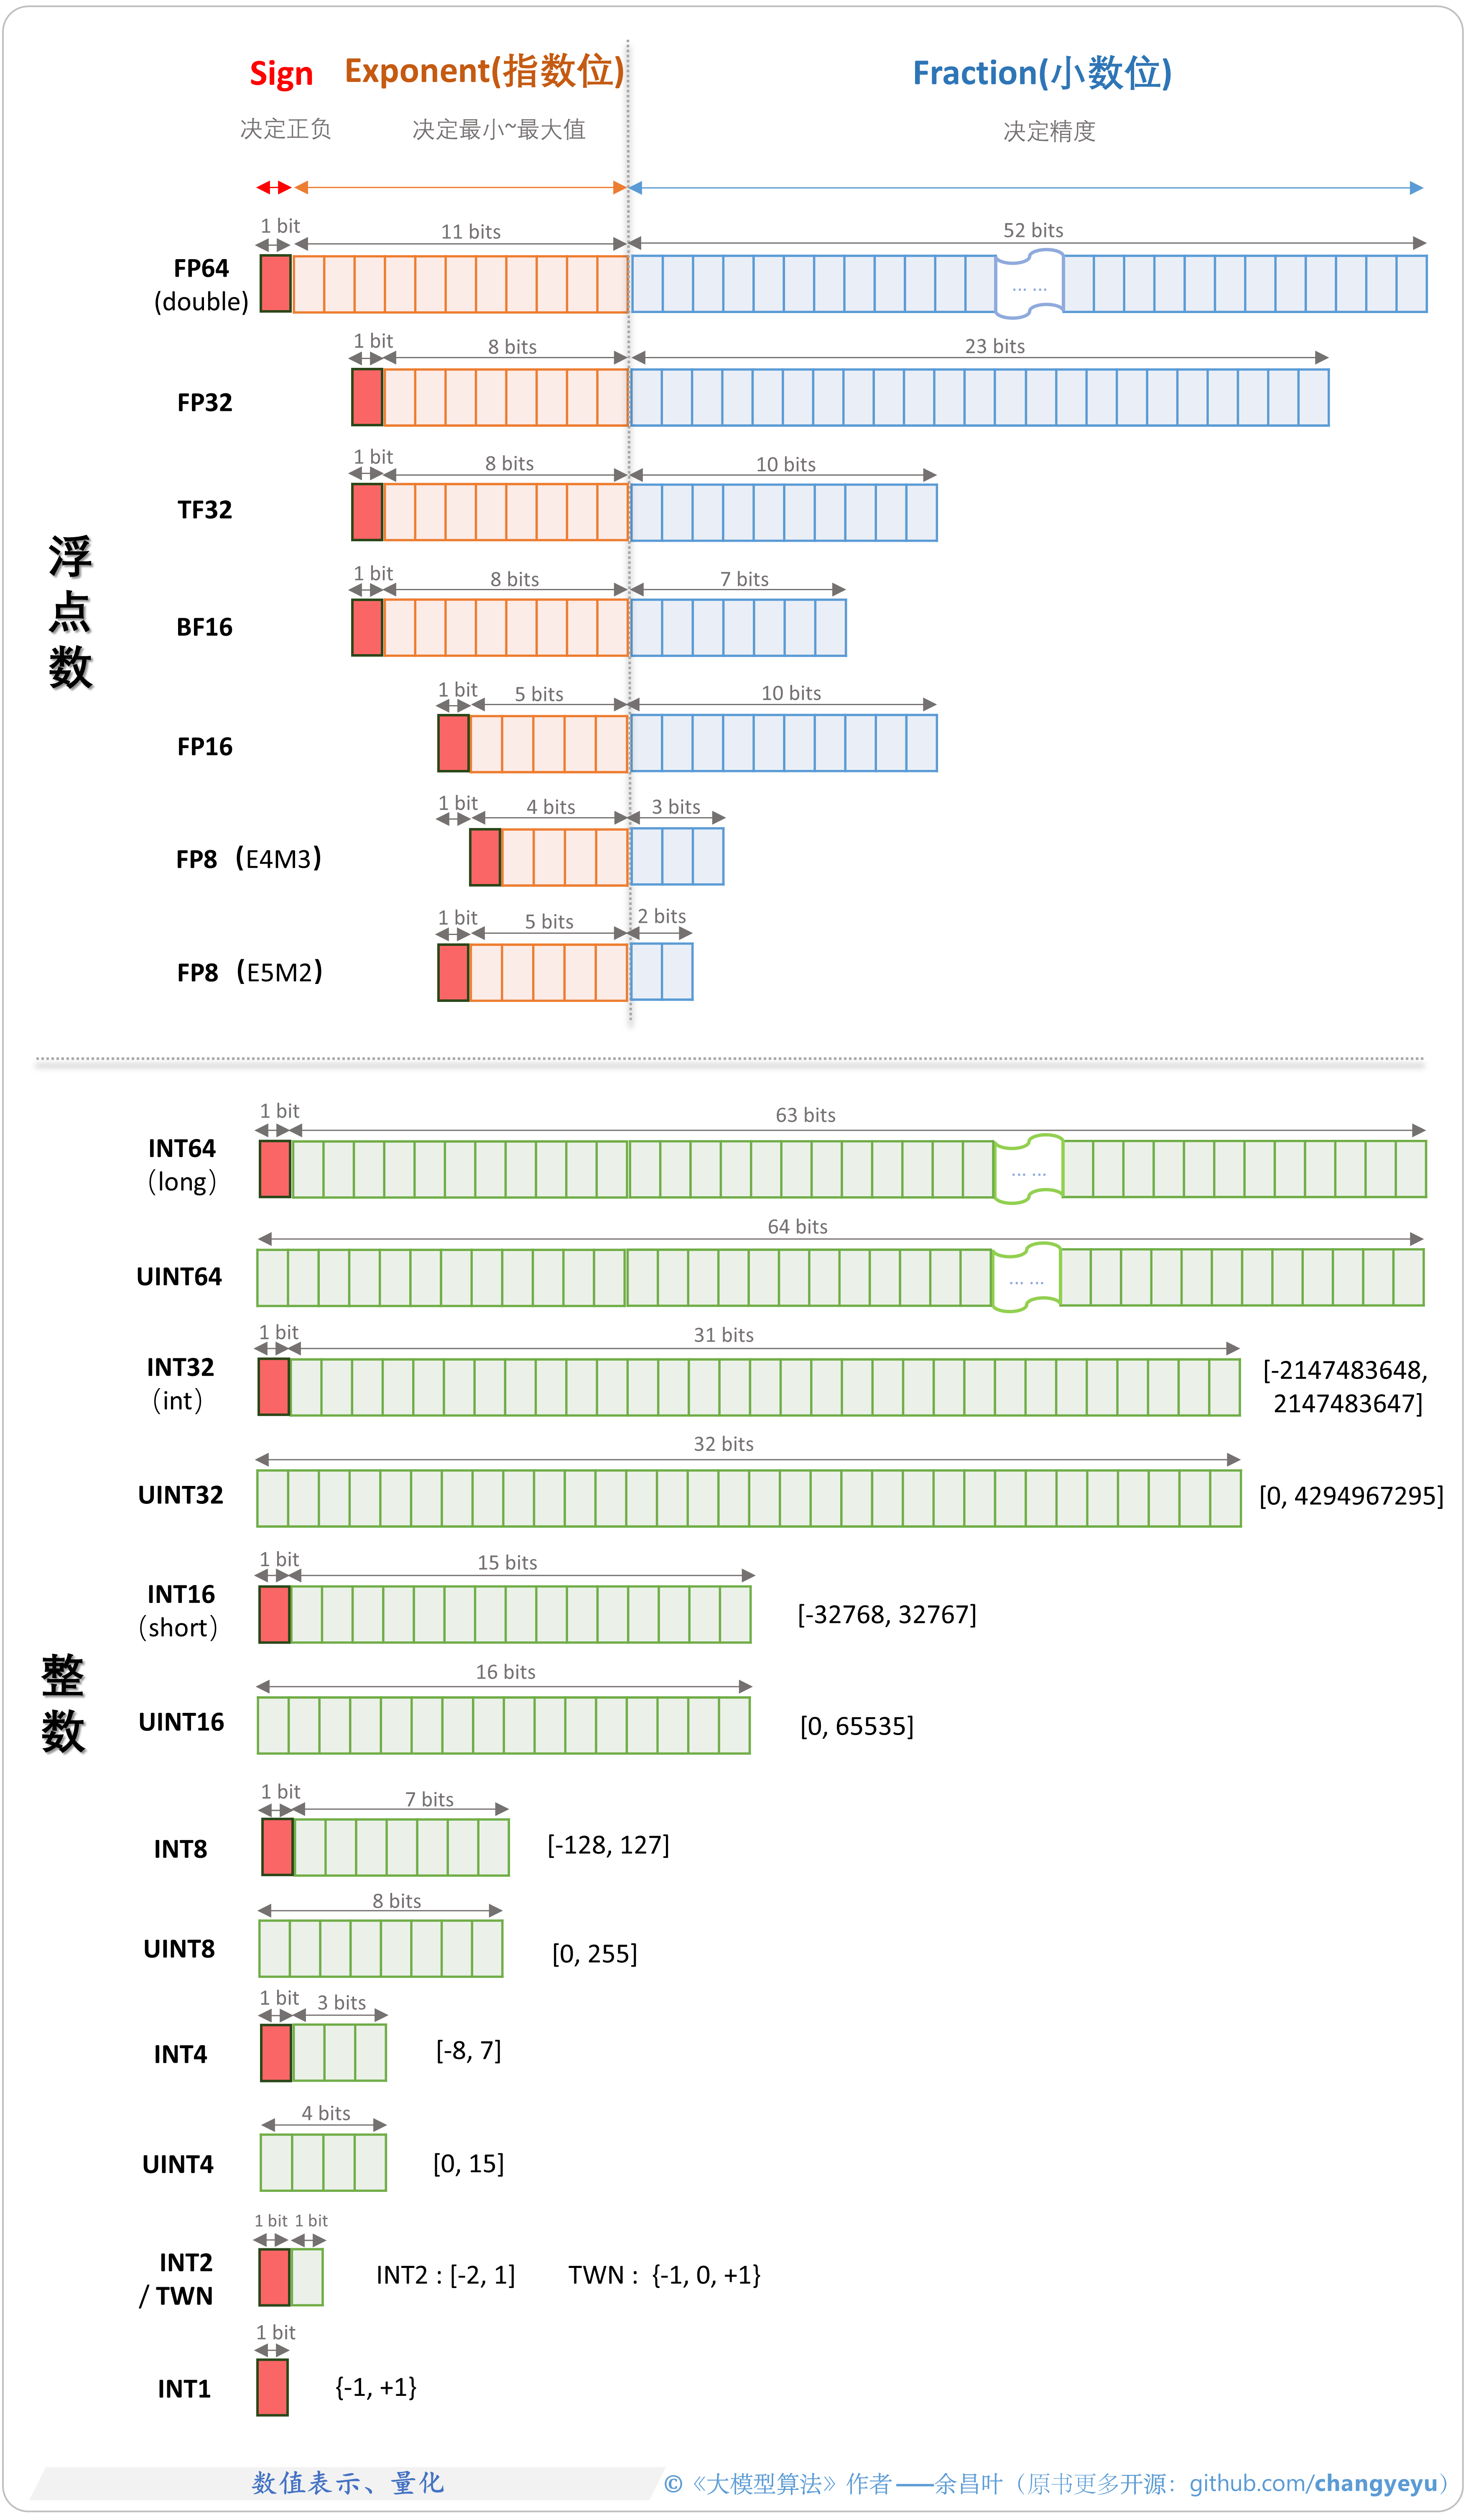
| 类型 | 总位数 | 符号位 | 指数位 | 尾数位 / 整数位 |
|---|---|---|---|---|
| FP64 | 64 | 1 | 11 | 52 (尾数) |
| FP32 | 32 | 1 | 8 | 23 (尾数) |
| TF32 | 19 | 1 | 8 | 10 (尾数) |
| BF16 | 16 | 1 | 8 | 7 (尾数) |
| FP16 | 16 | 1 | 5 | 10 (尾数) |
| INT64 | 64 | 1 | – | 63 (整数值) |
| INT32 | 32 | 1 | – | 31 (整数值) |
| INT8 | 8 | 1 | – | 7 (整数值) |
| UINT8 | 8 | 0 | – | 8 (整数值) |
| INT4 | 4 | 1 | – | 3 (整数值) |
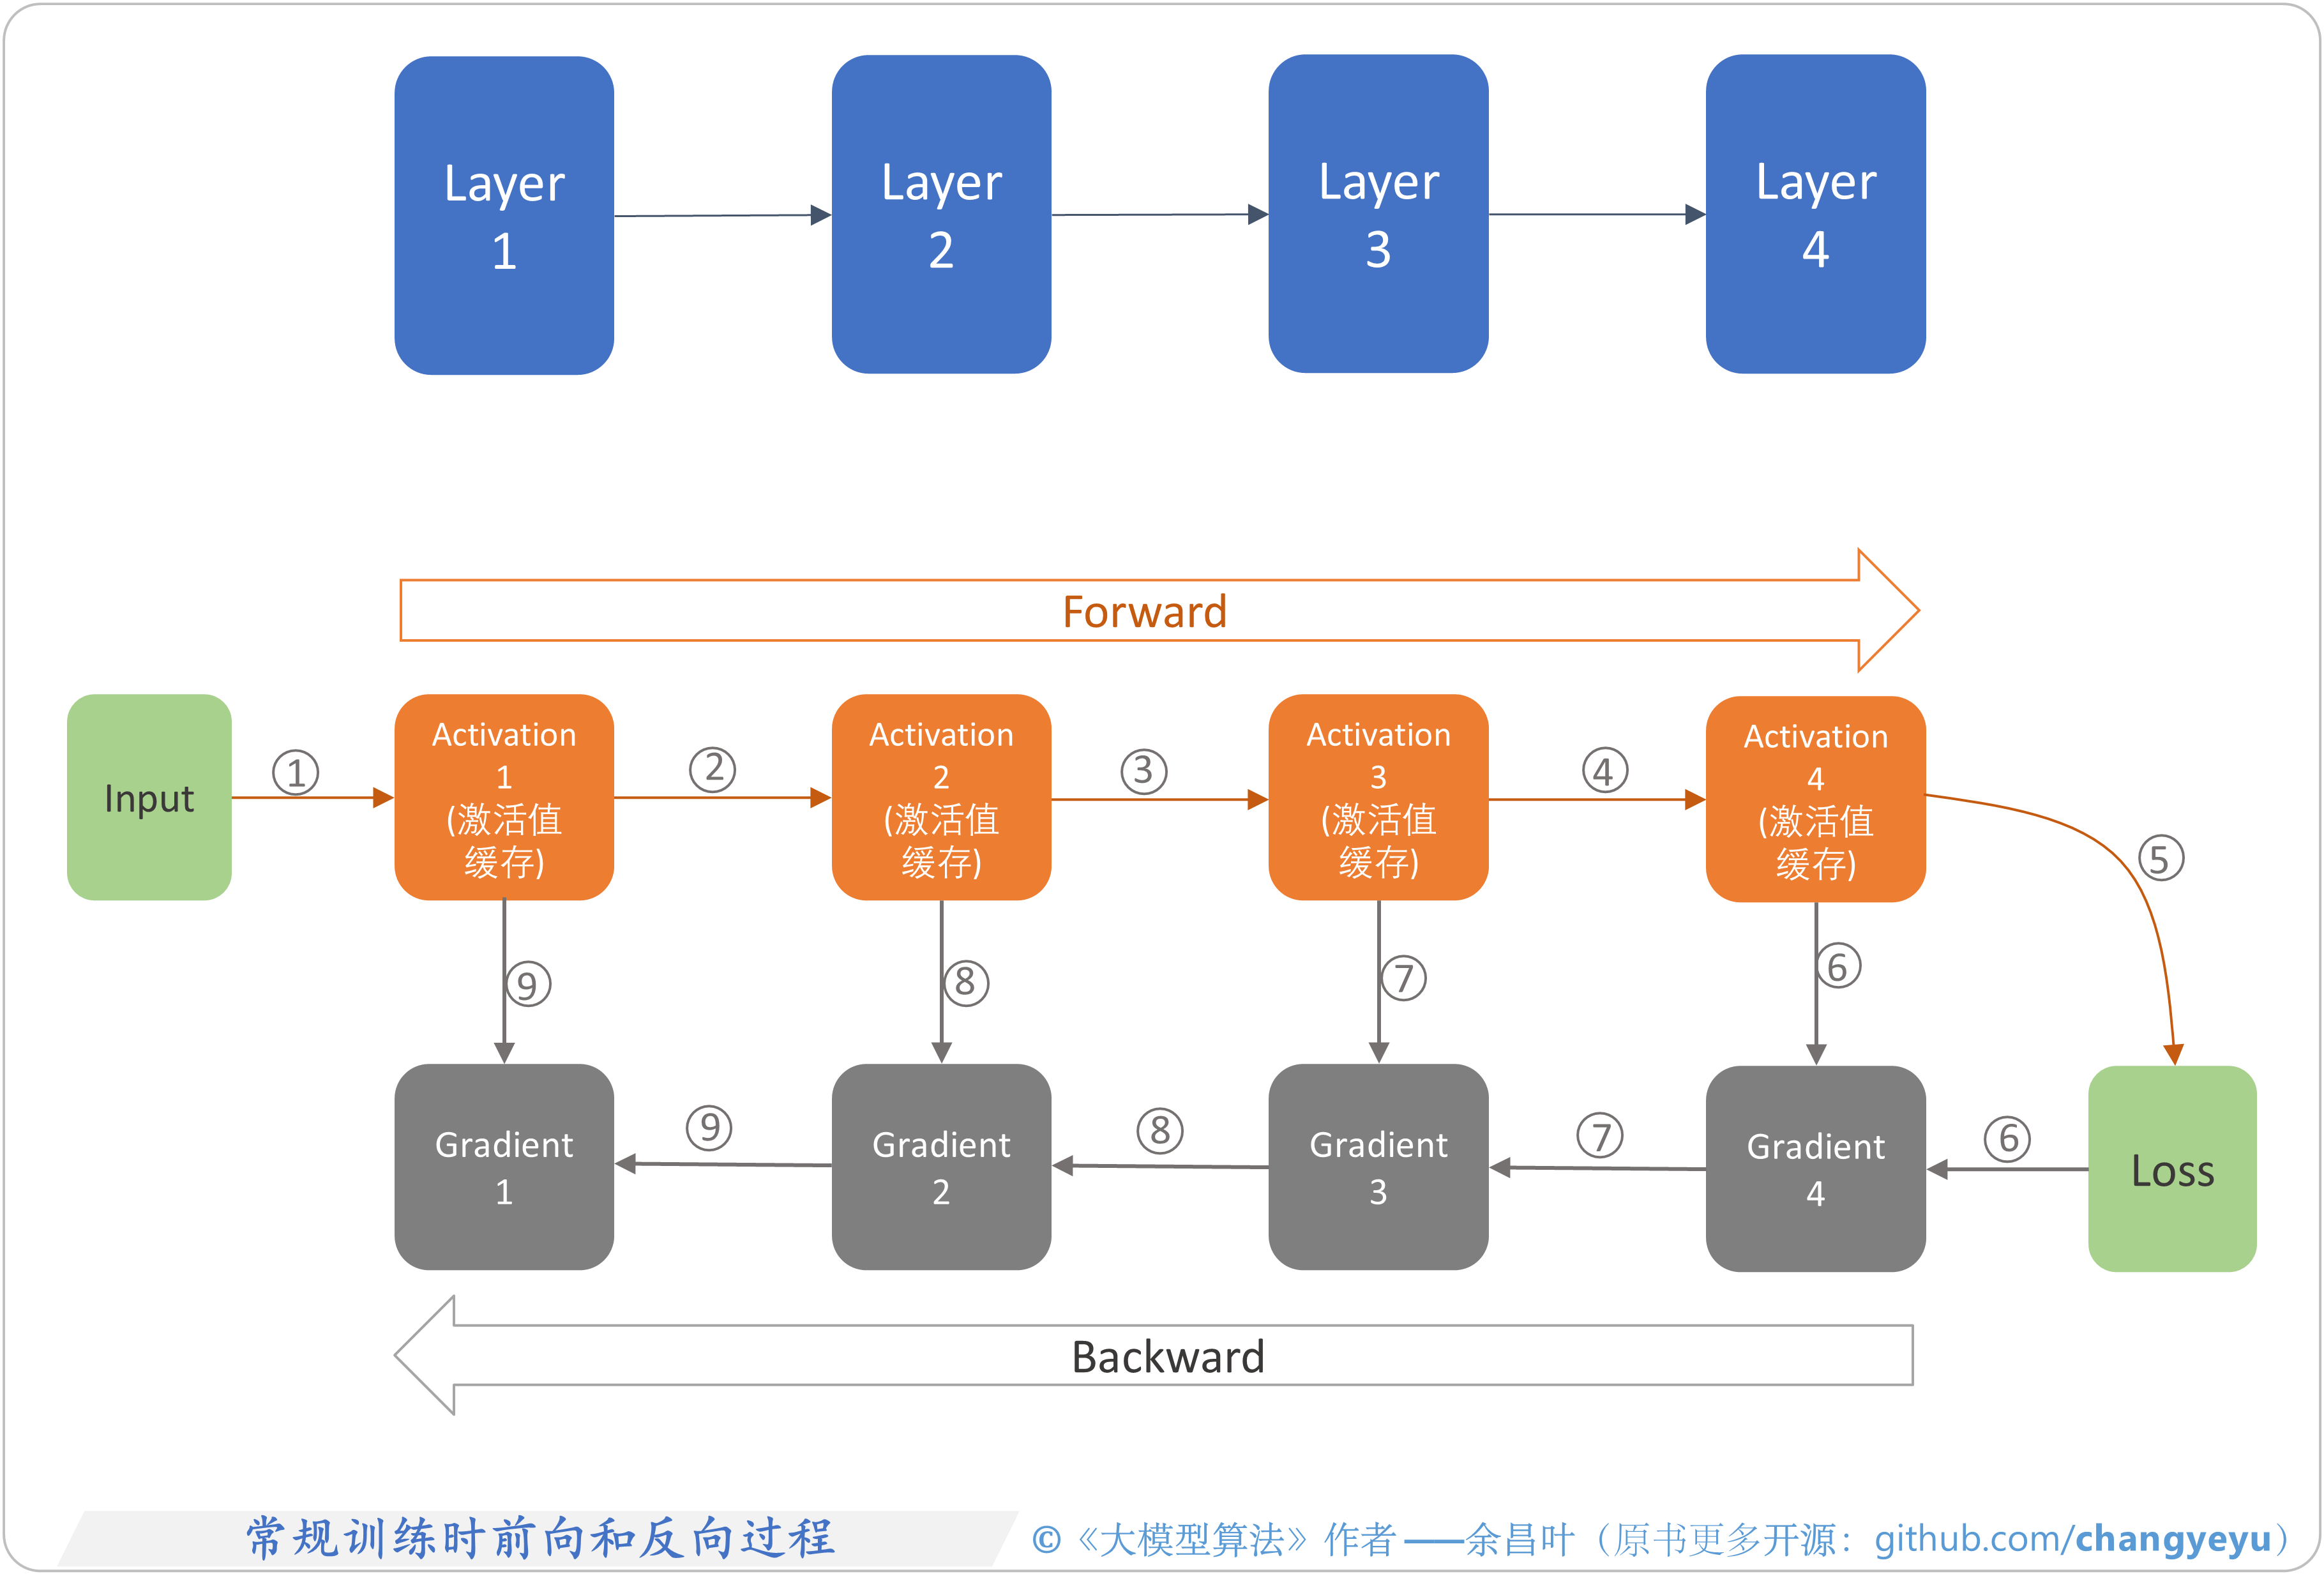
这张图展示了神经网络在常规训练中的前向传播(Forward)和反向传播(Backward)流程:
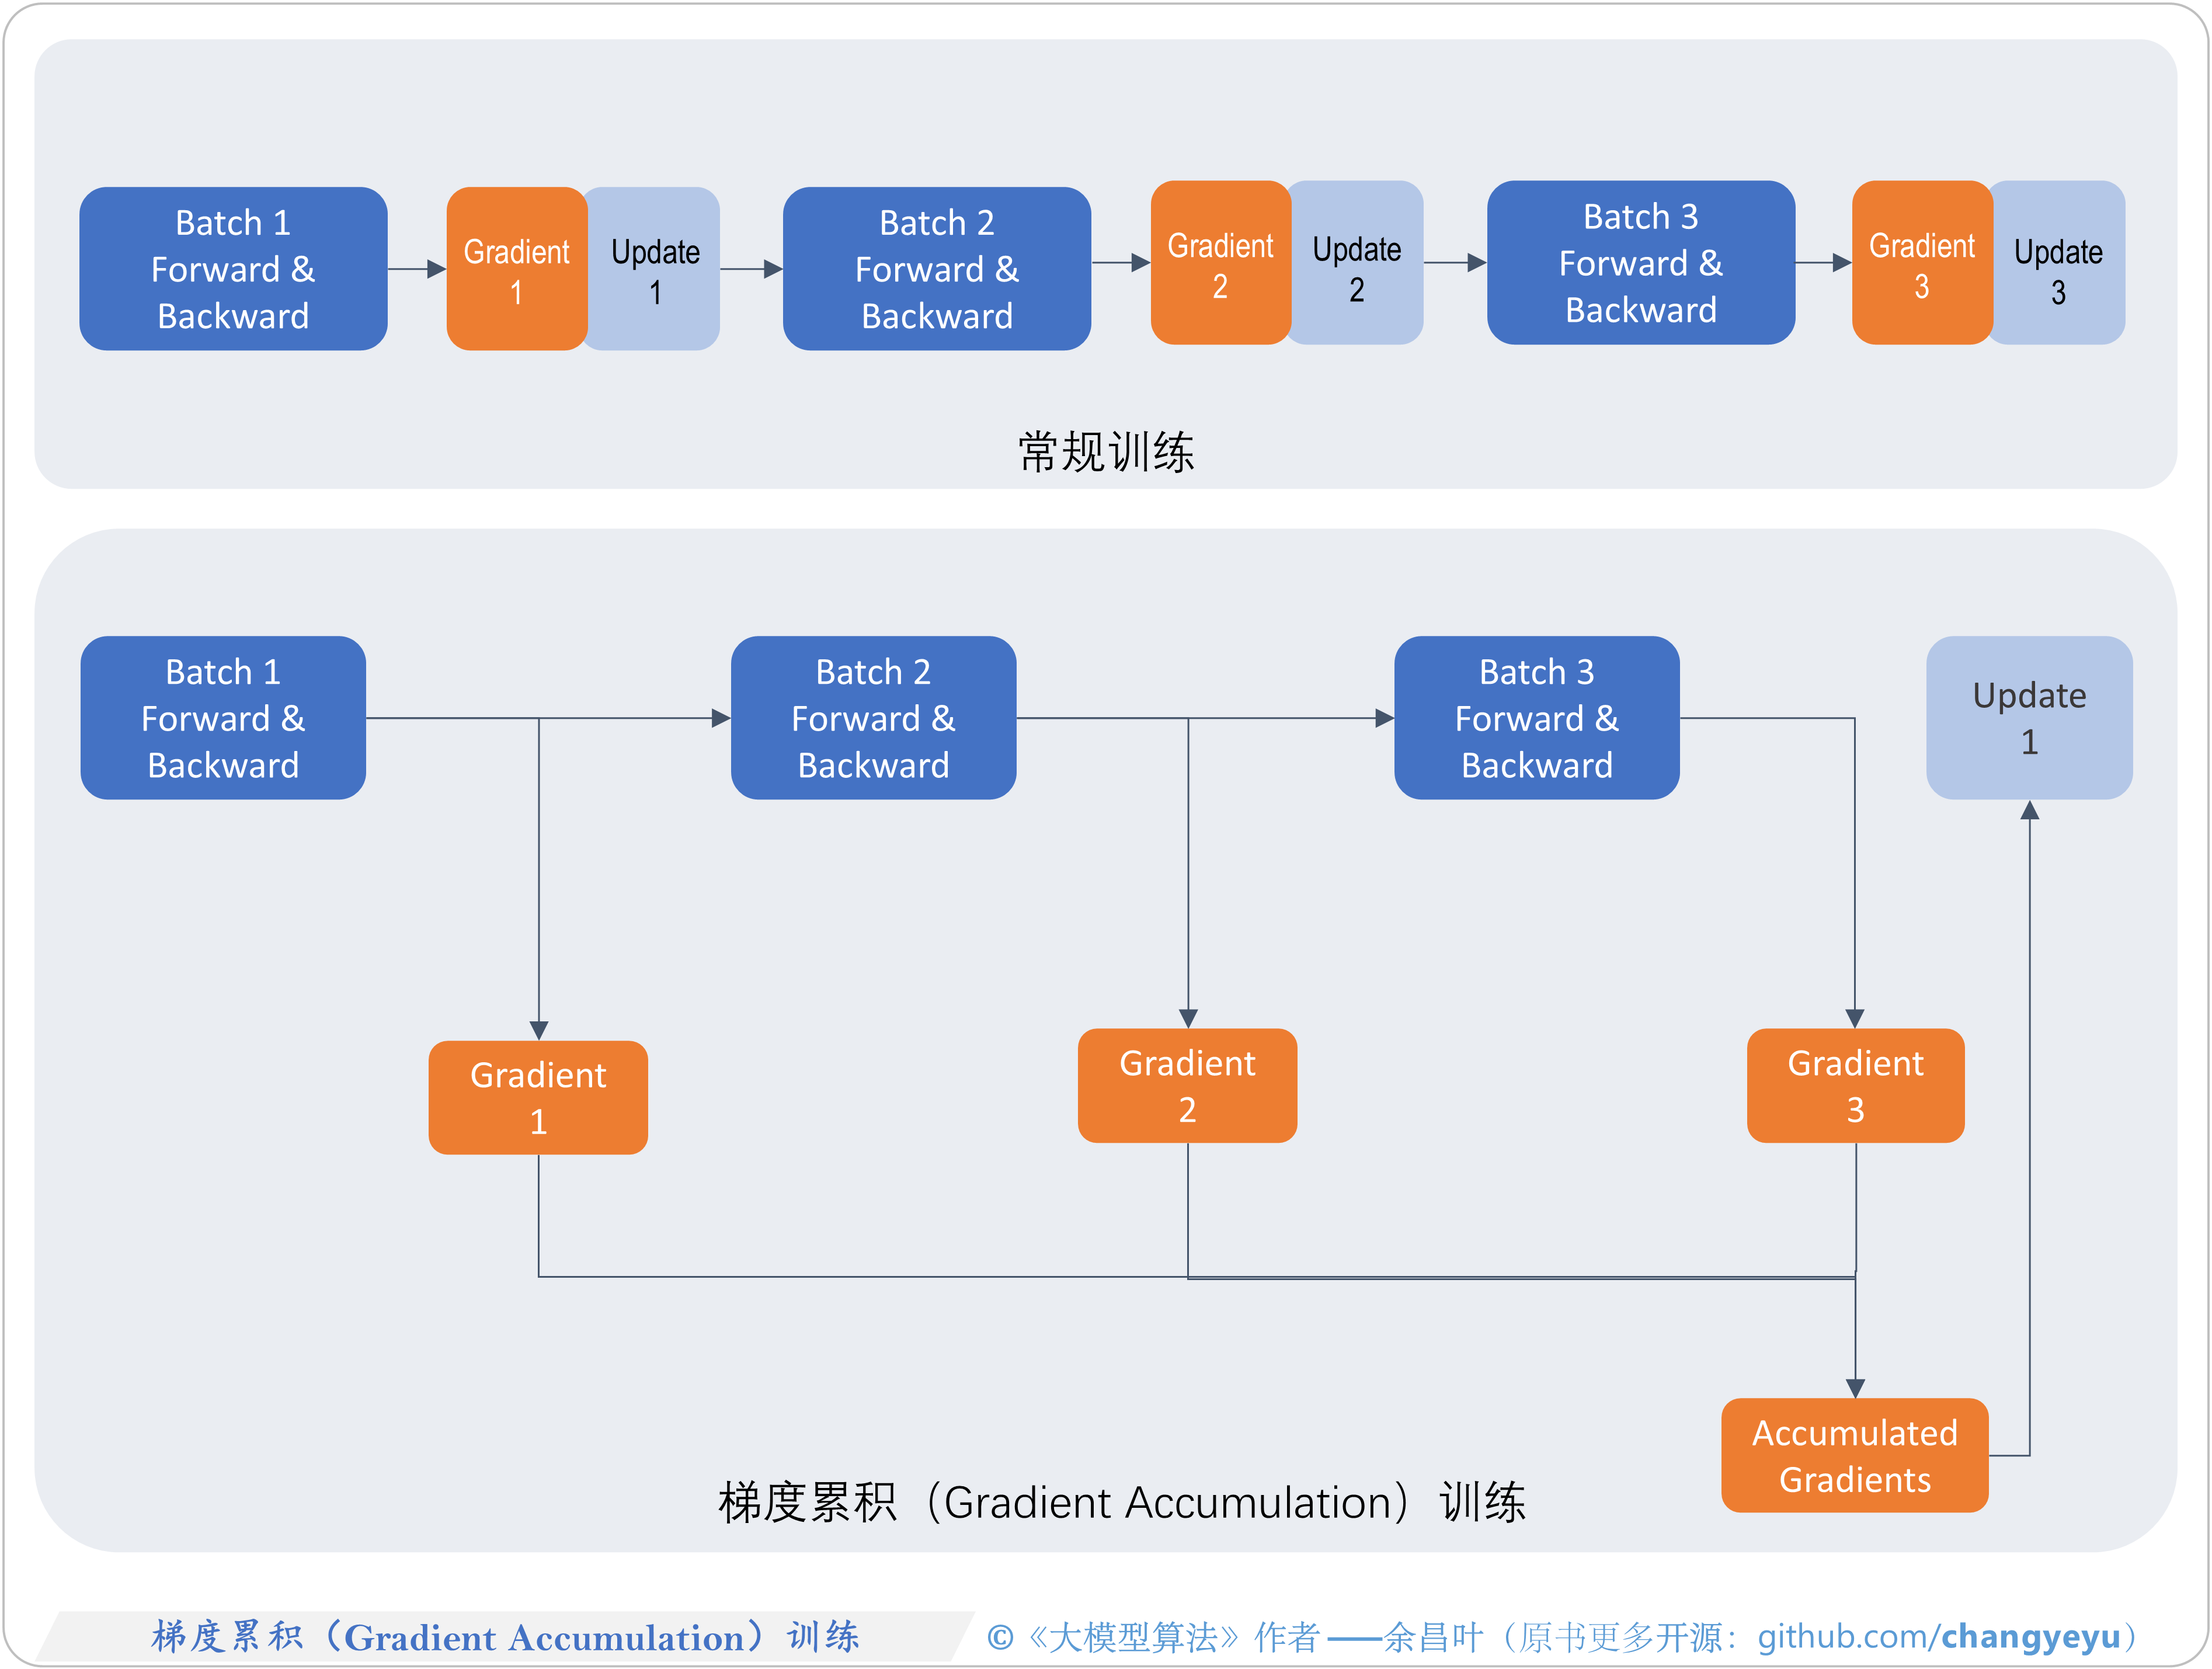
这张图对比了常规训练与梯度累积(Gradient Accumulation)训练的差异:
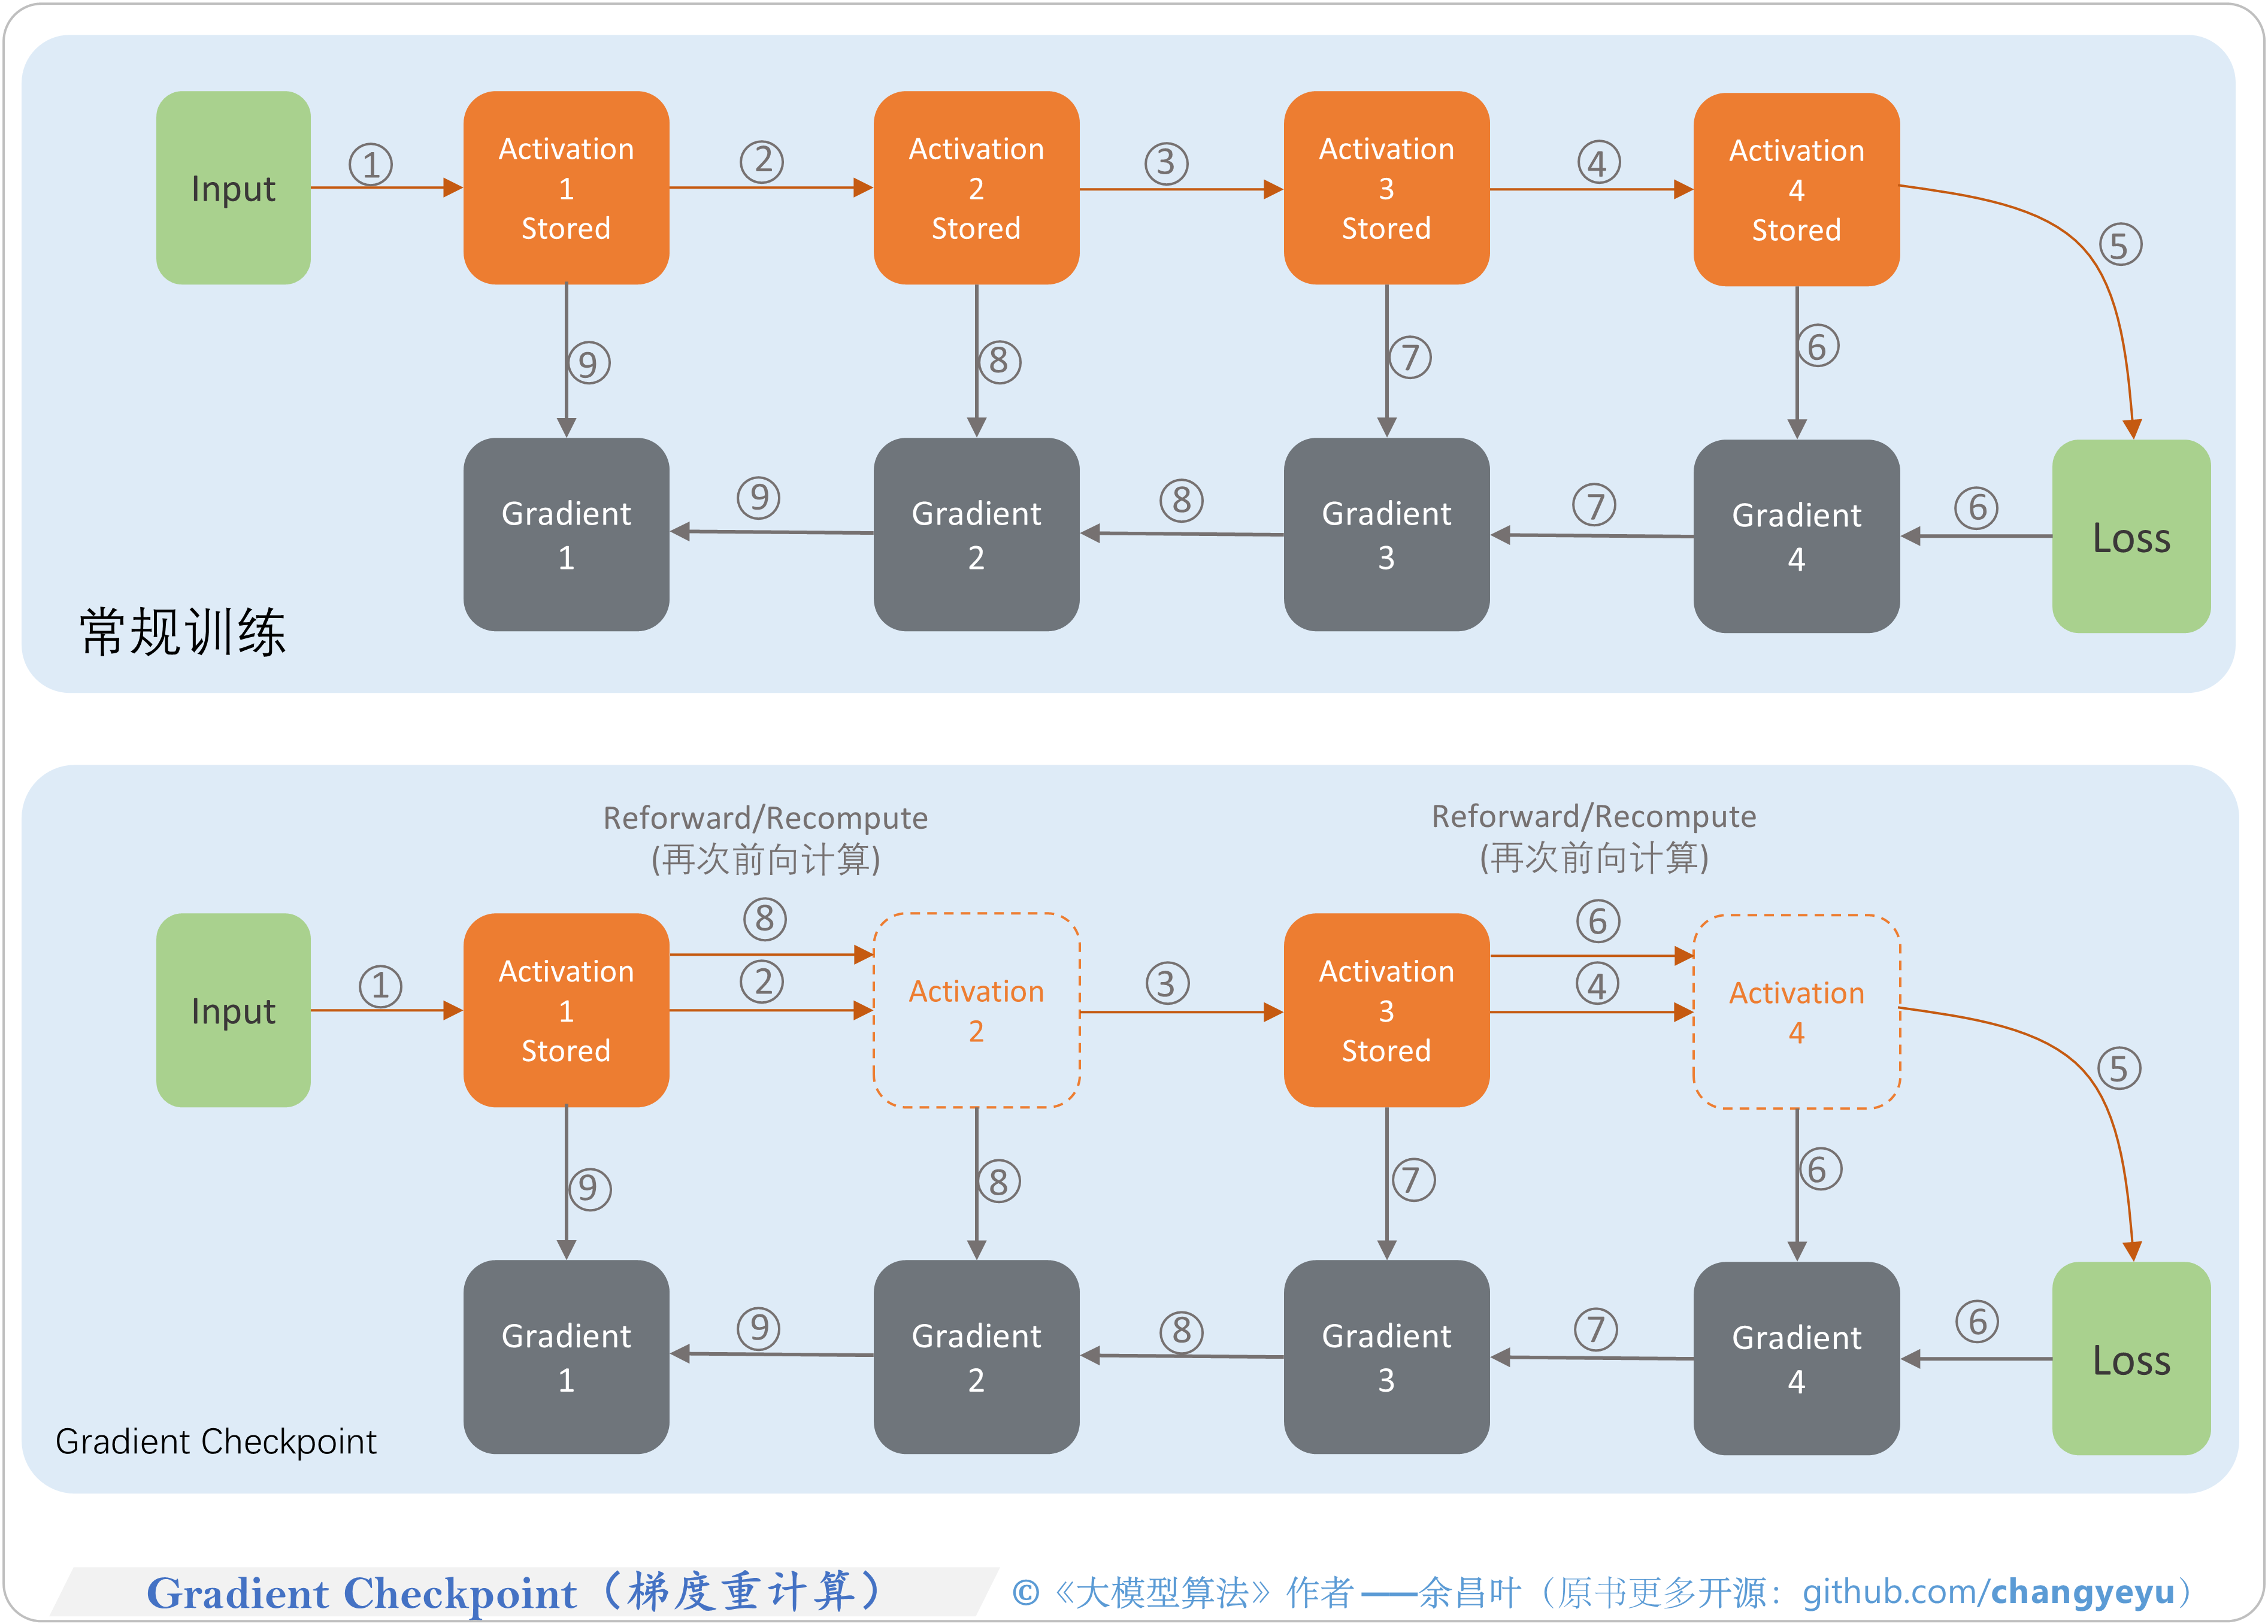
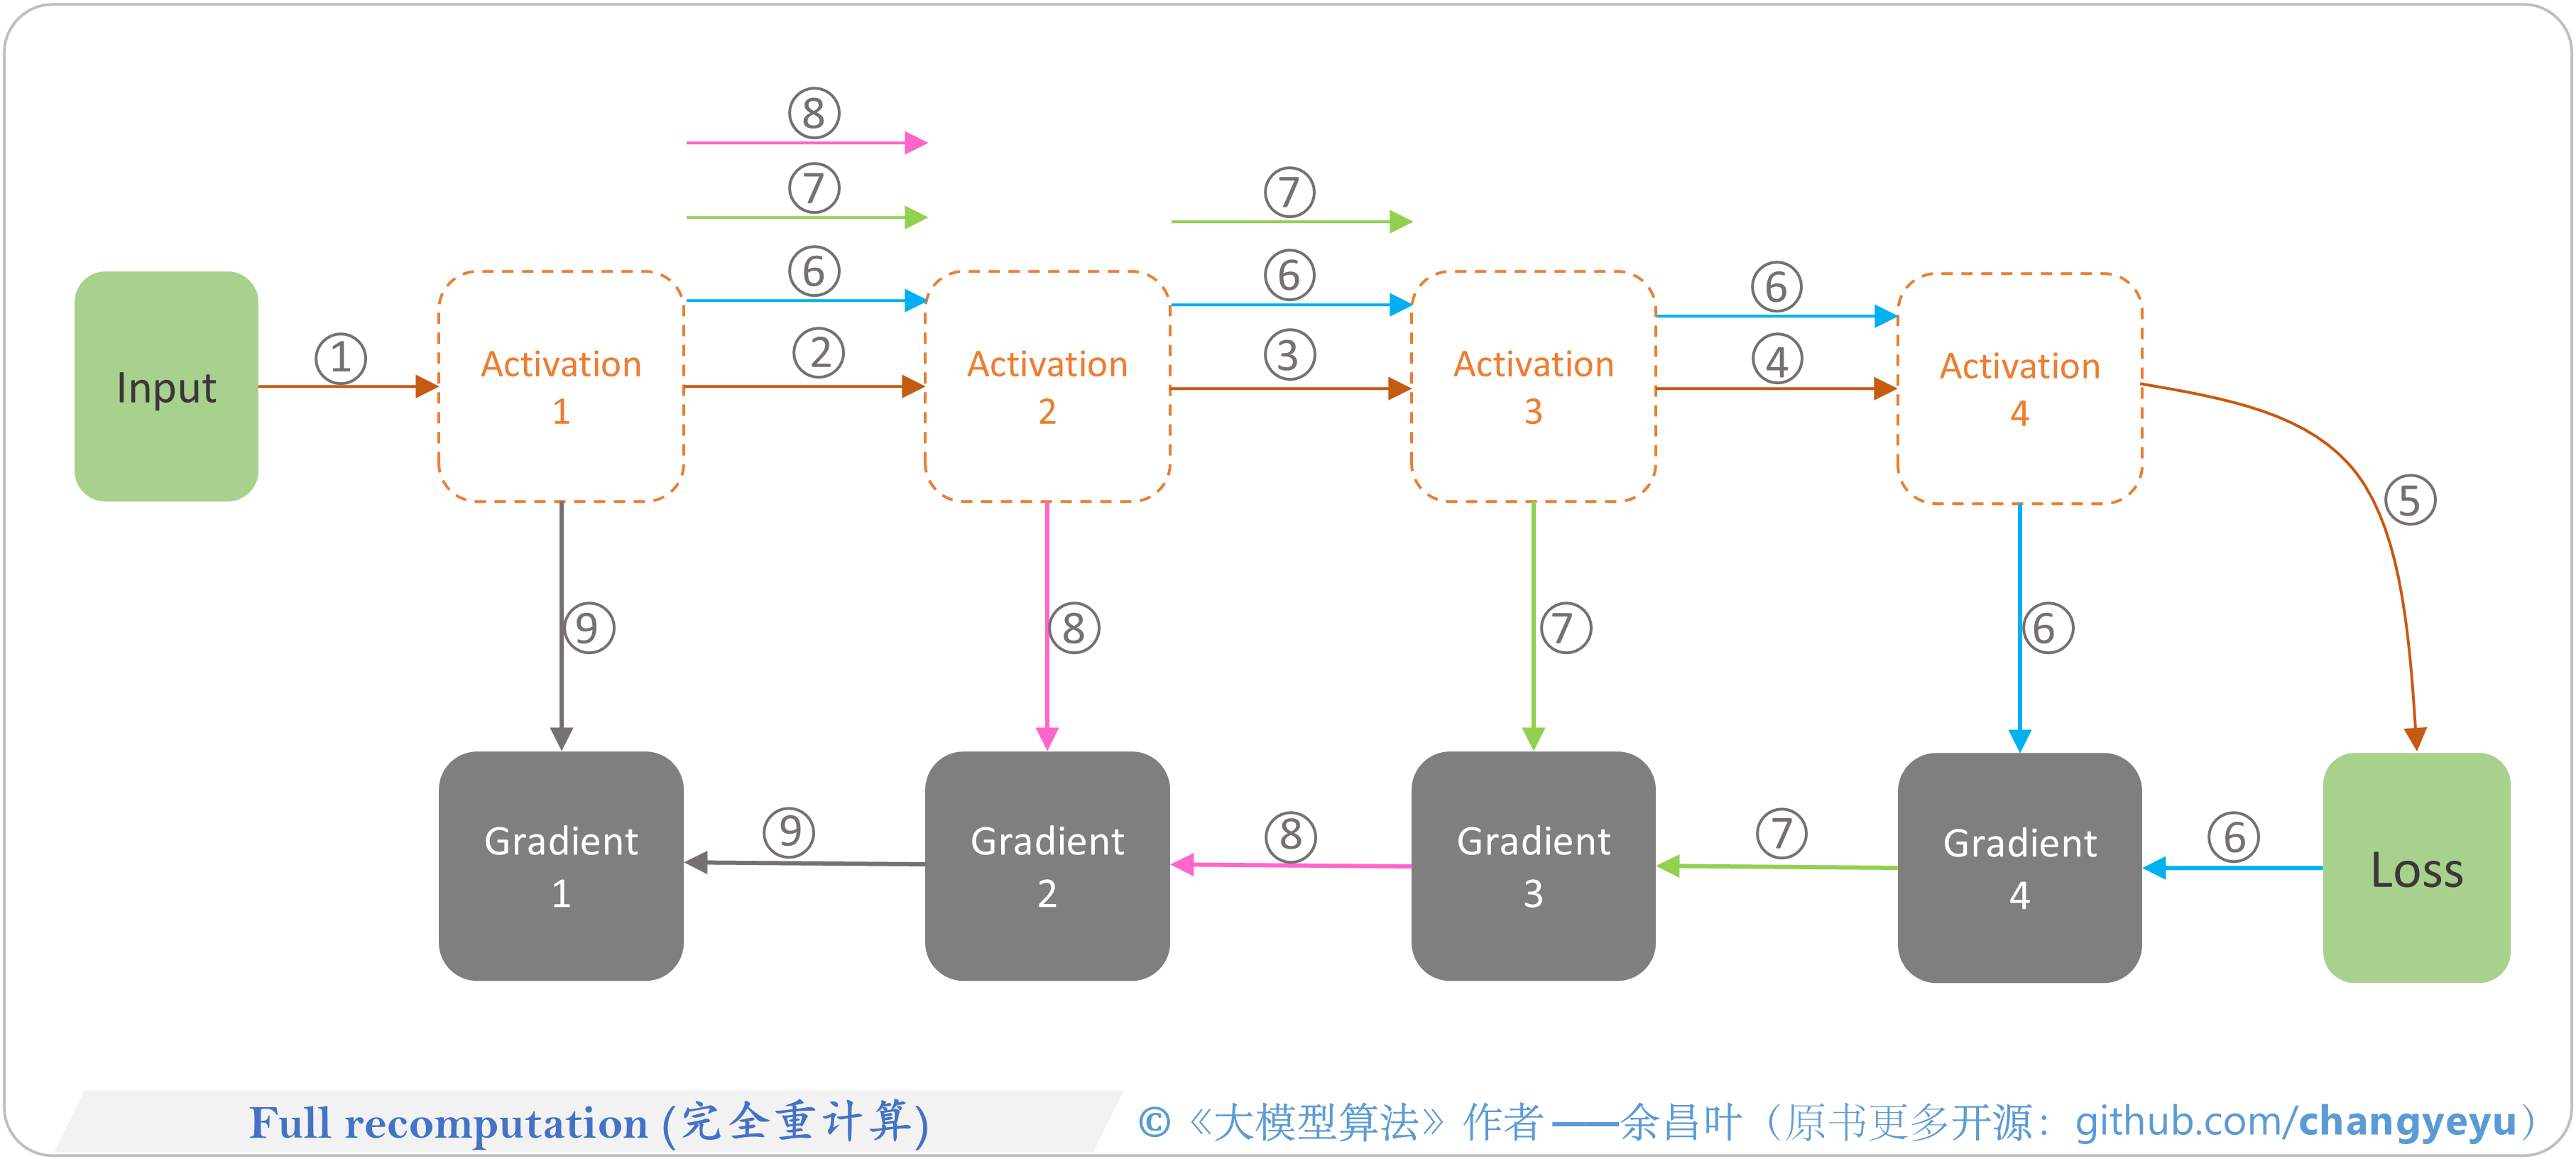
这张图对比了常规训练与梯度重计算(Gradient Checkpoint)训练的不同:
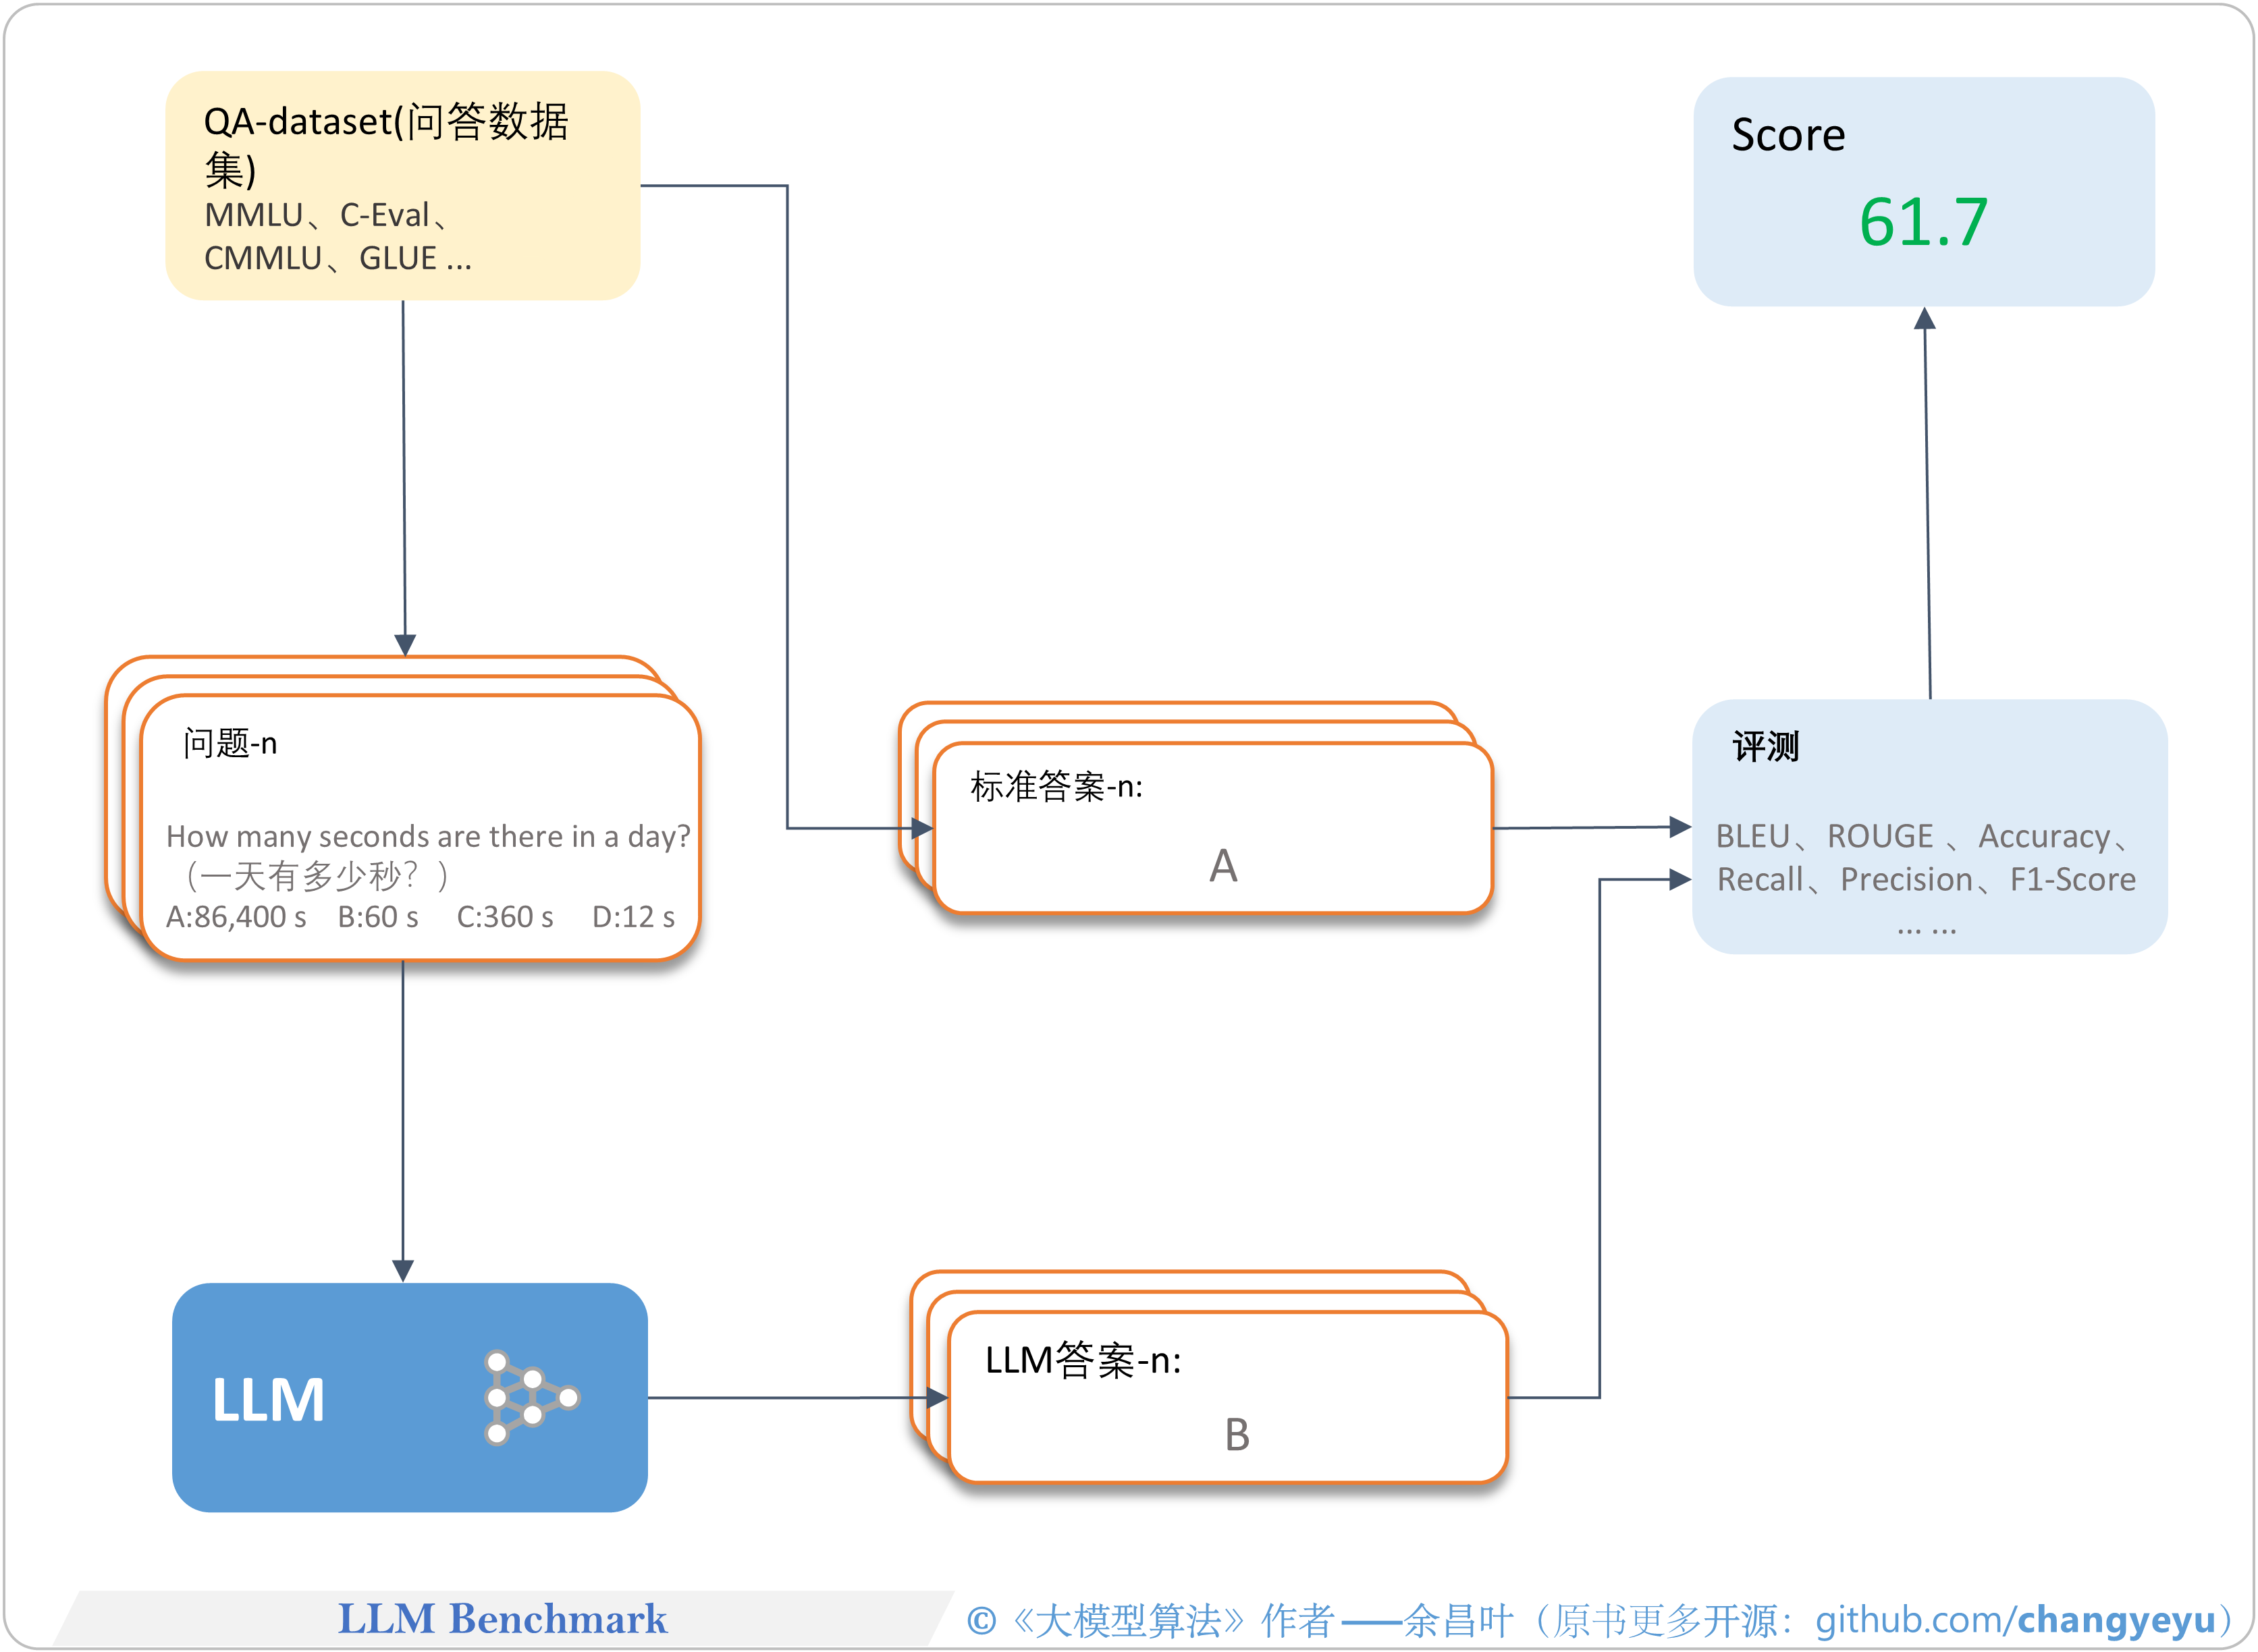
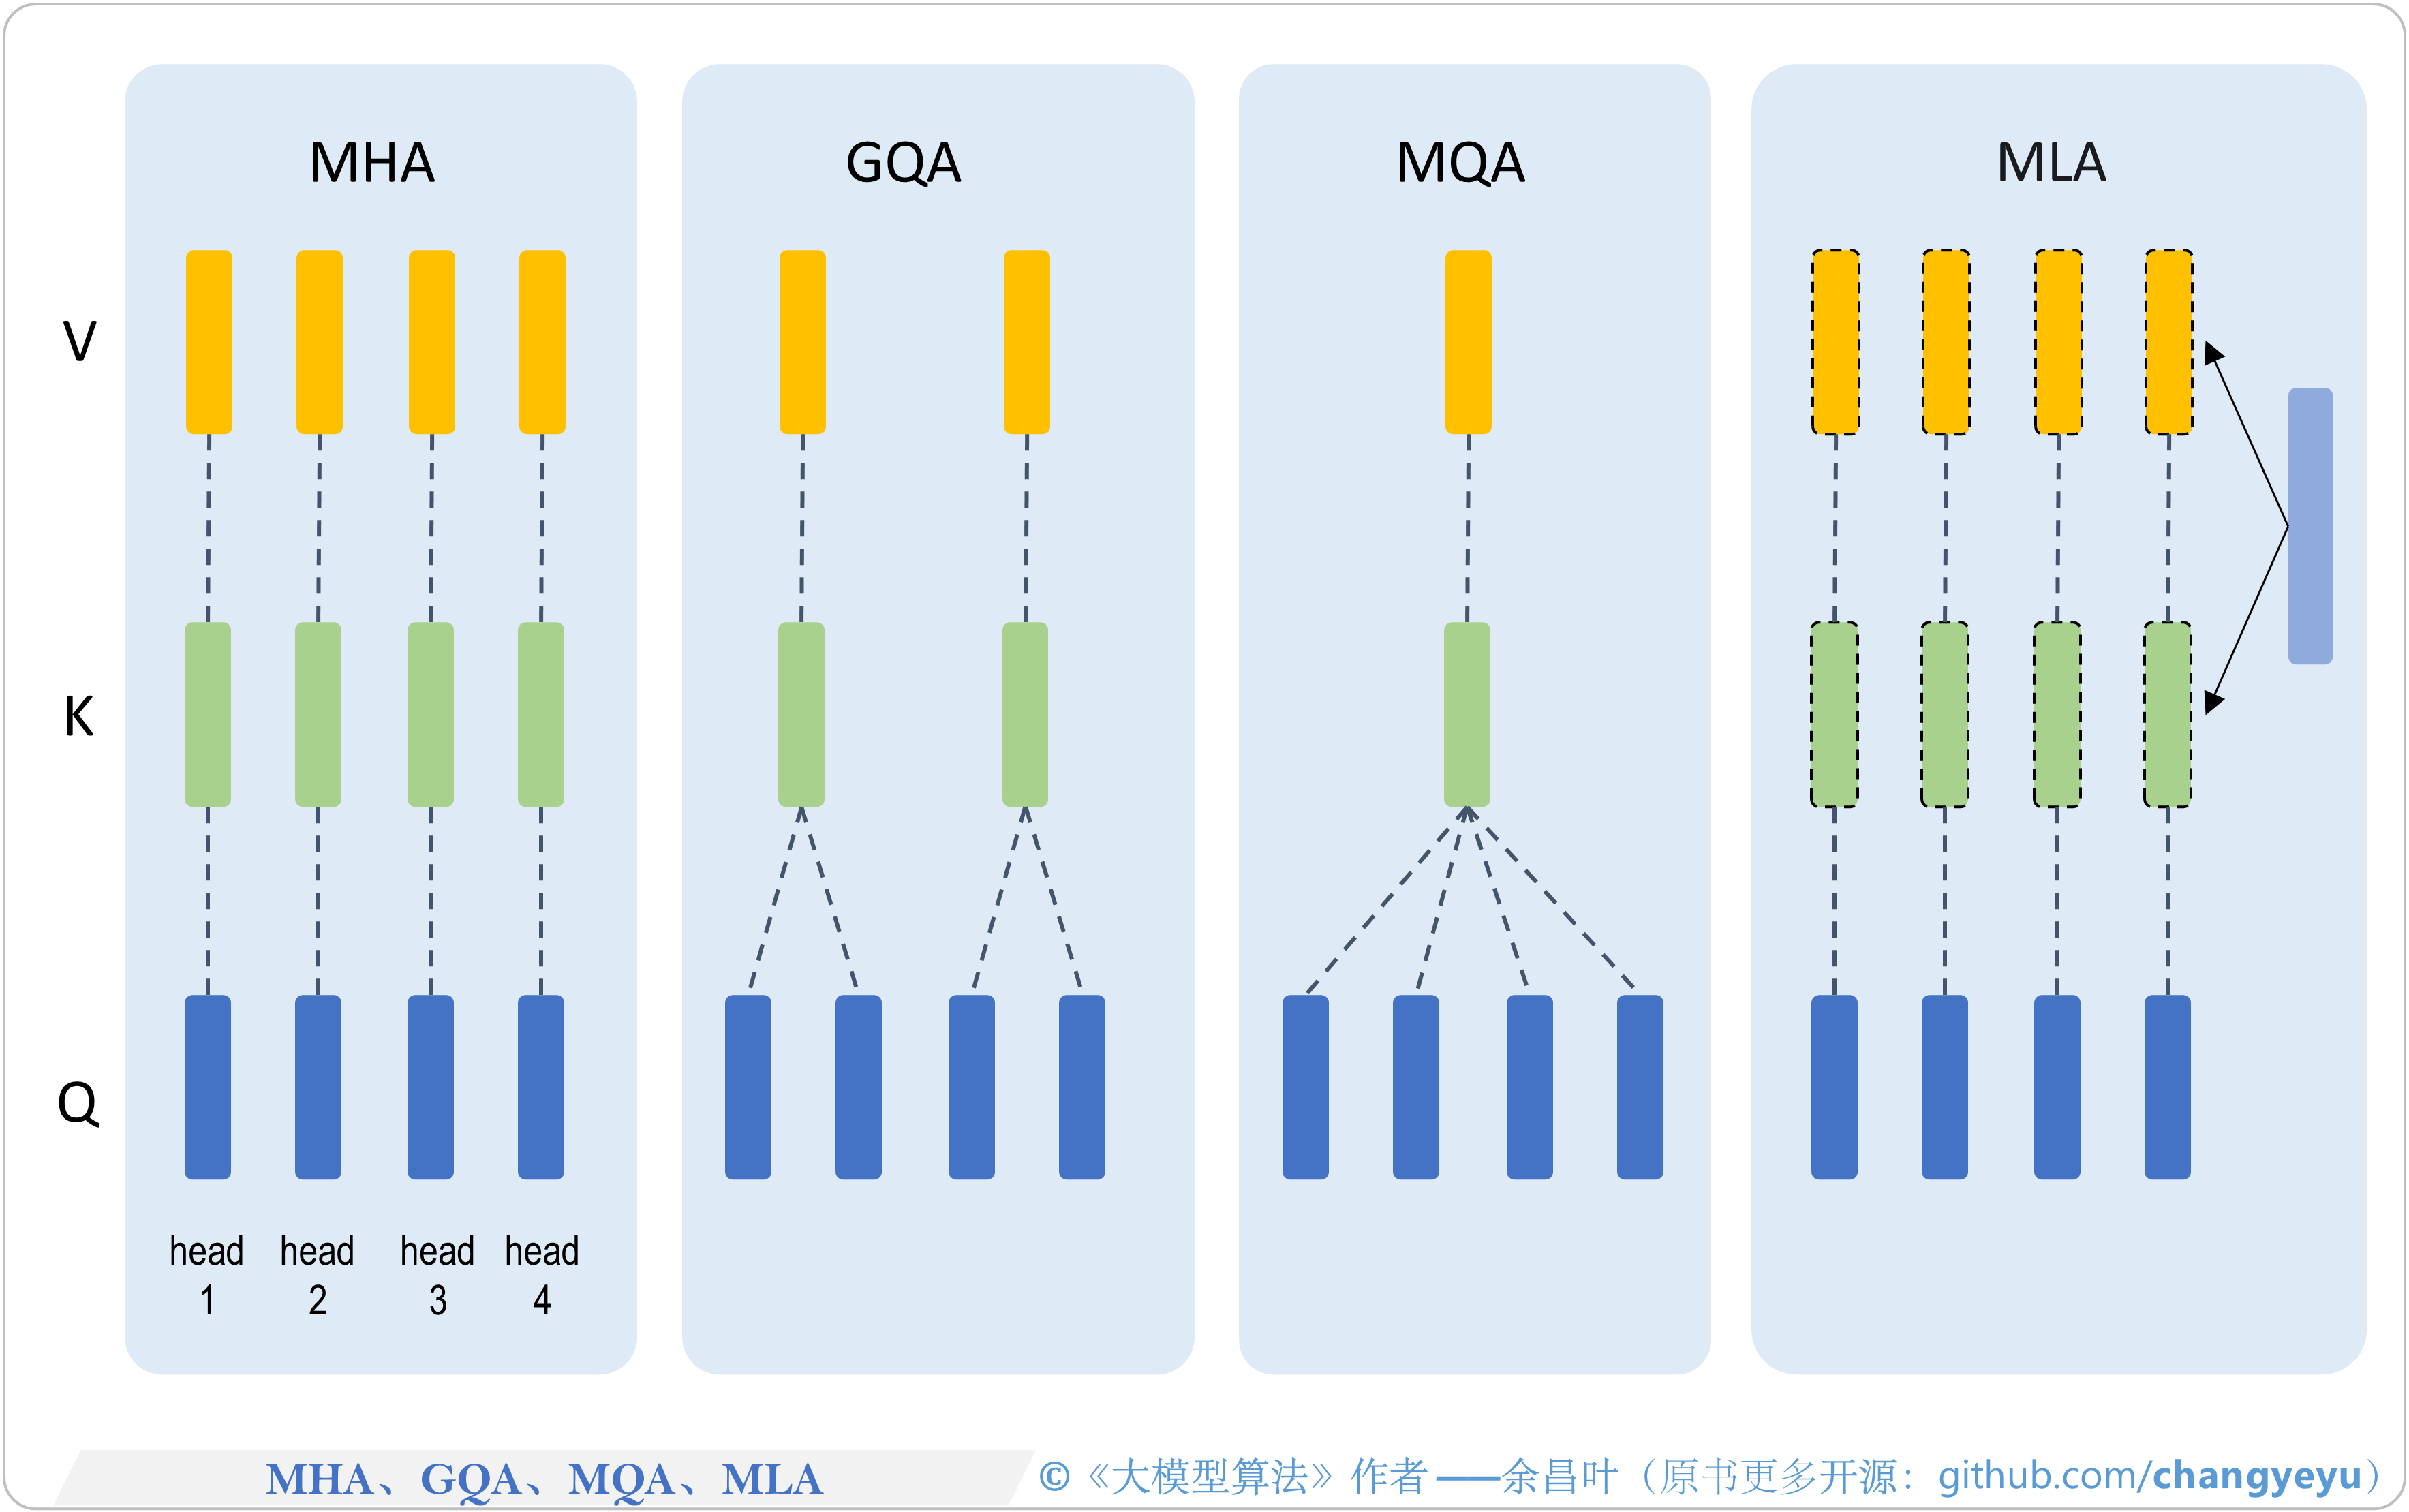
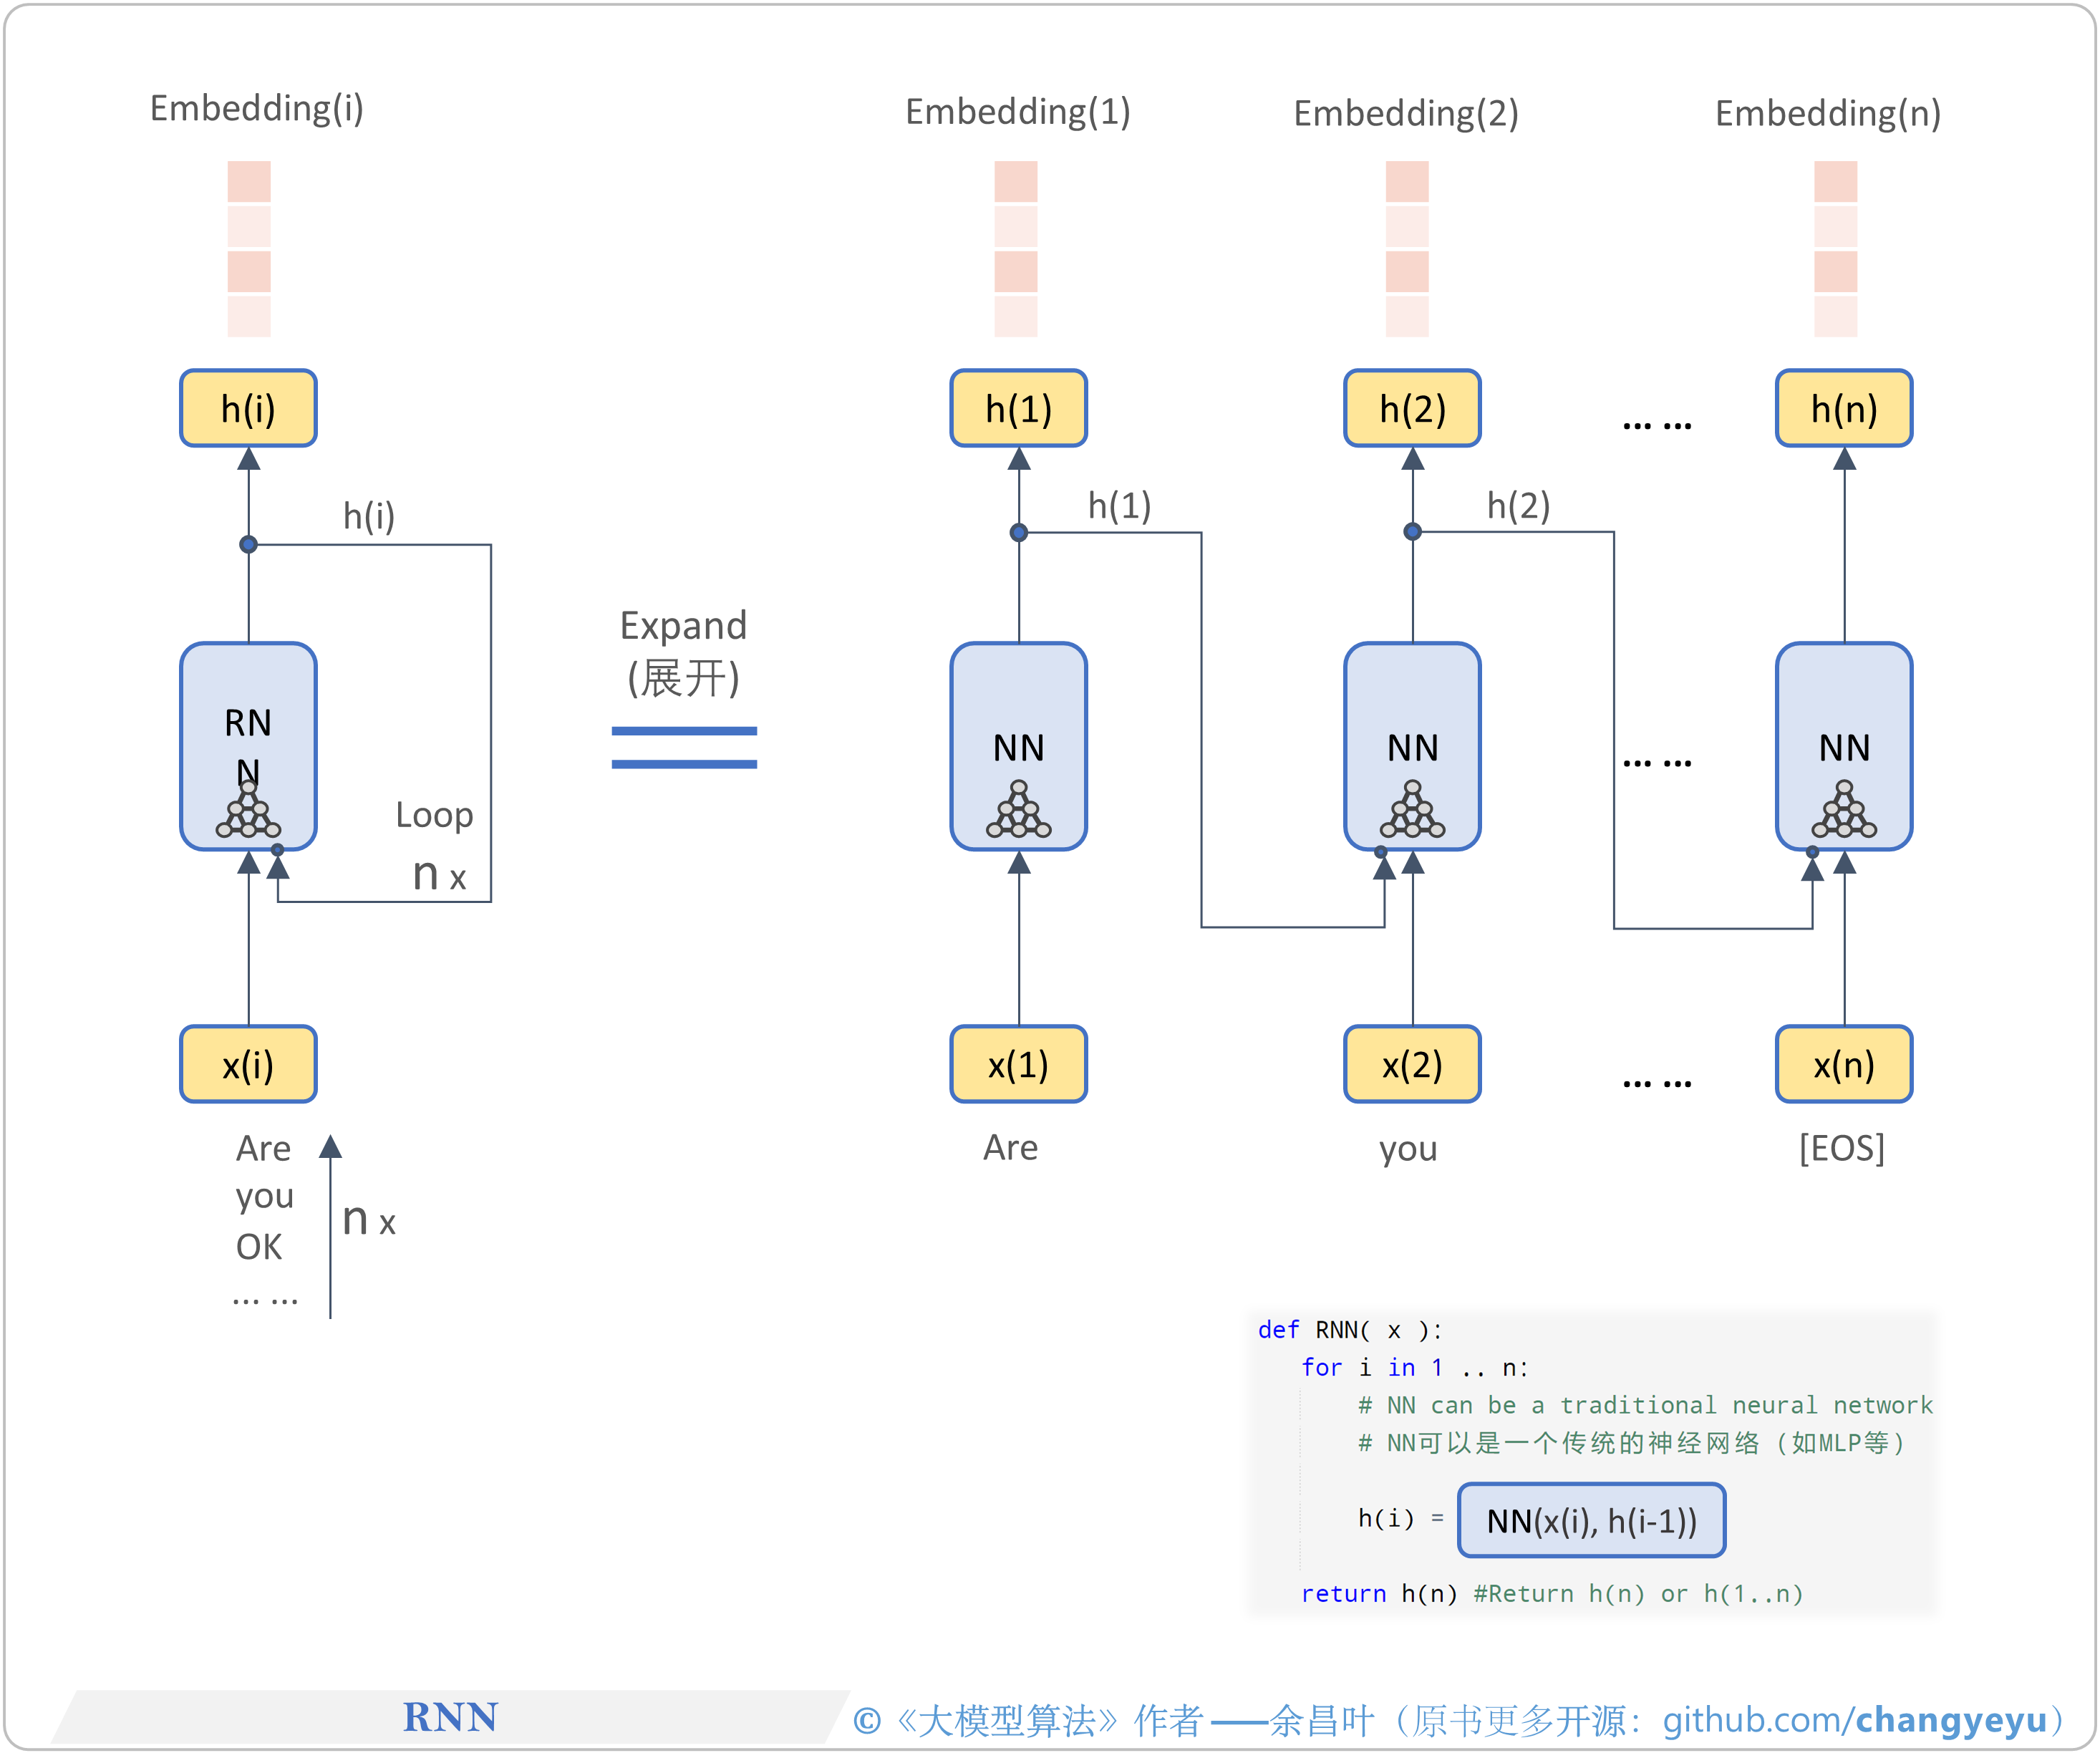
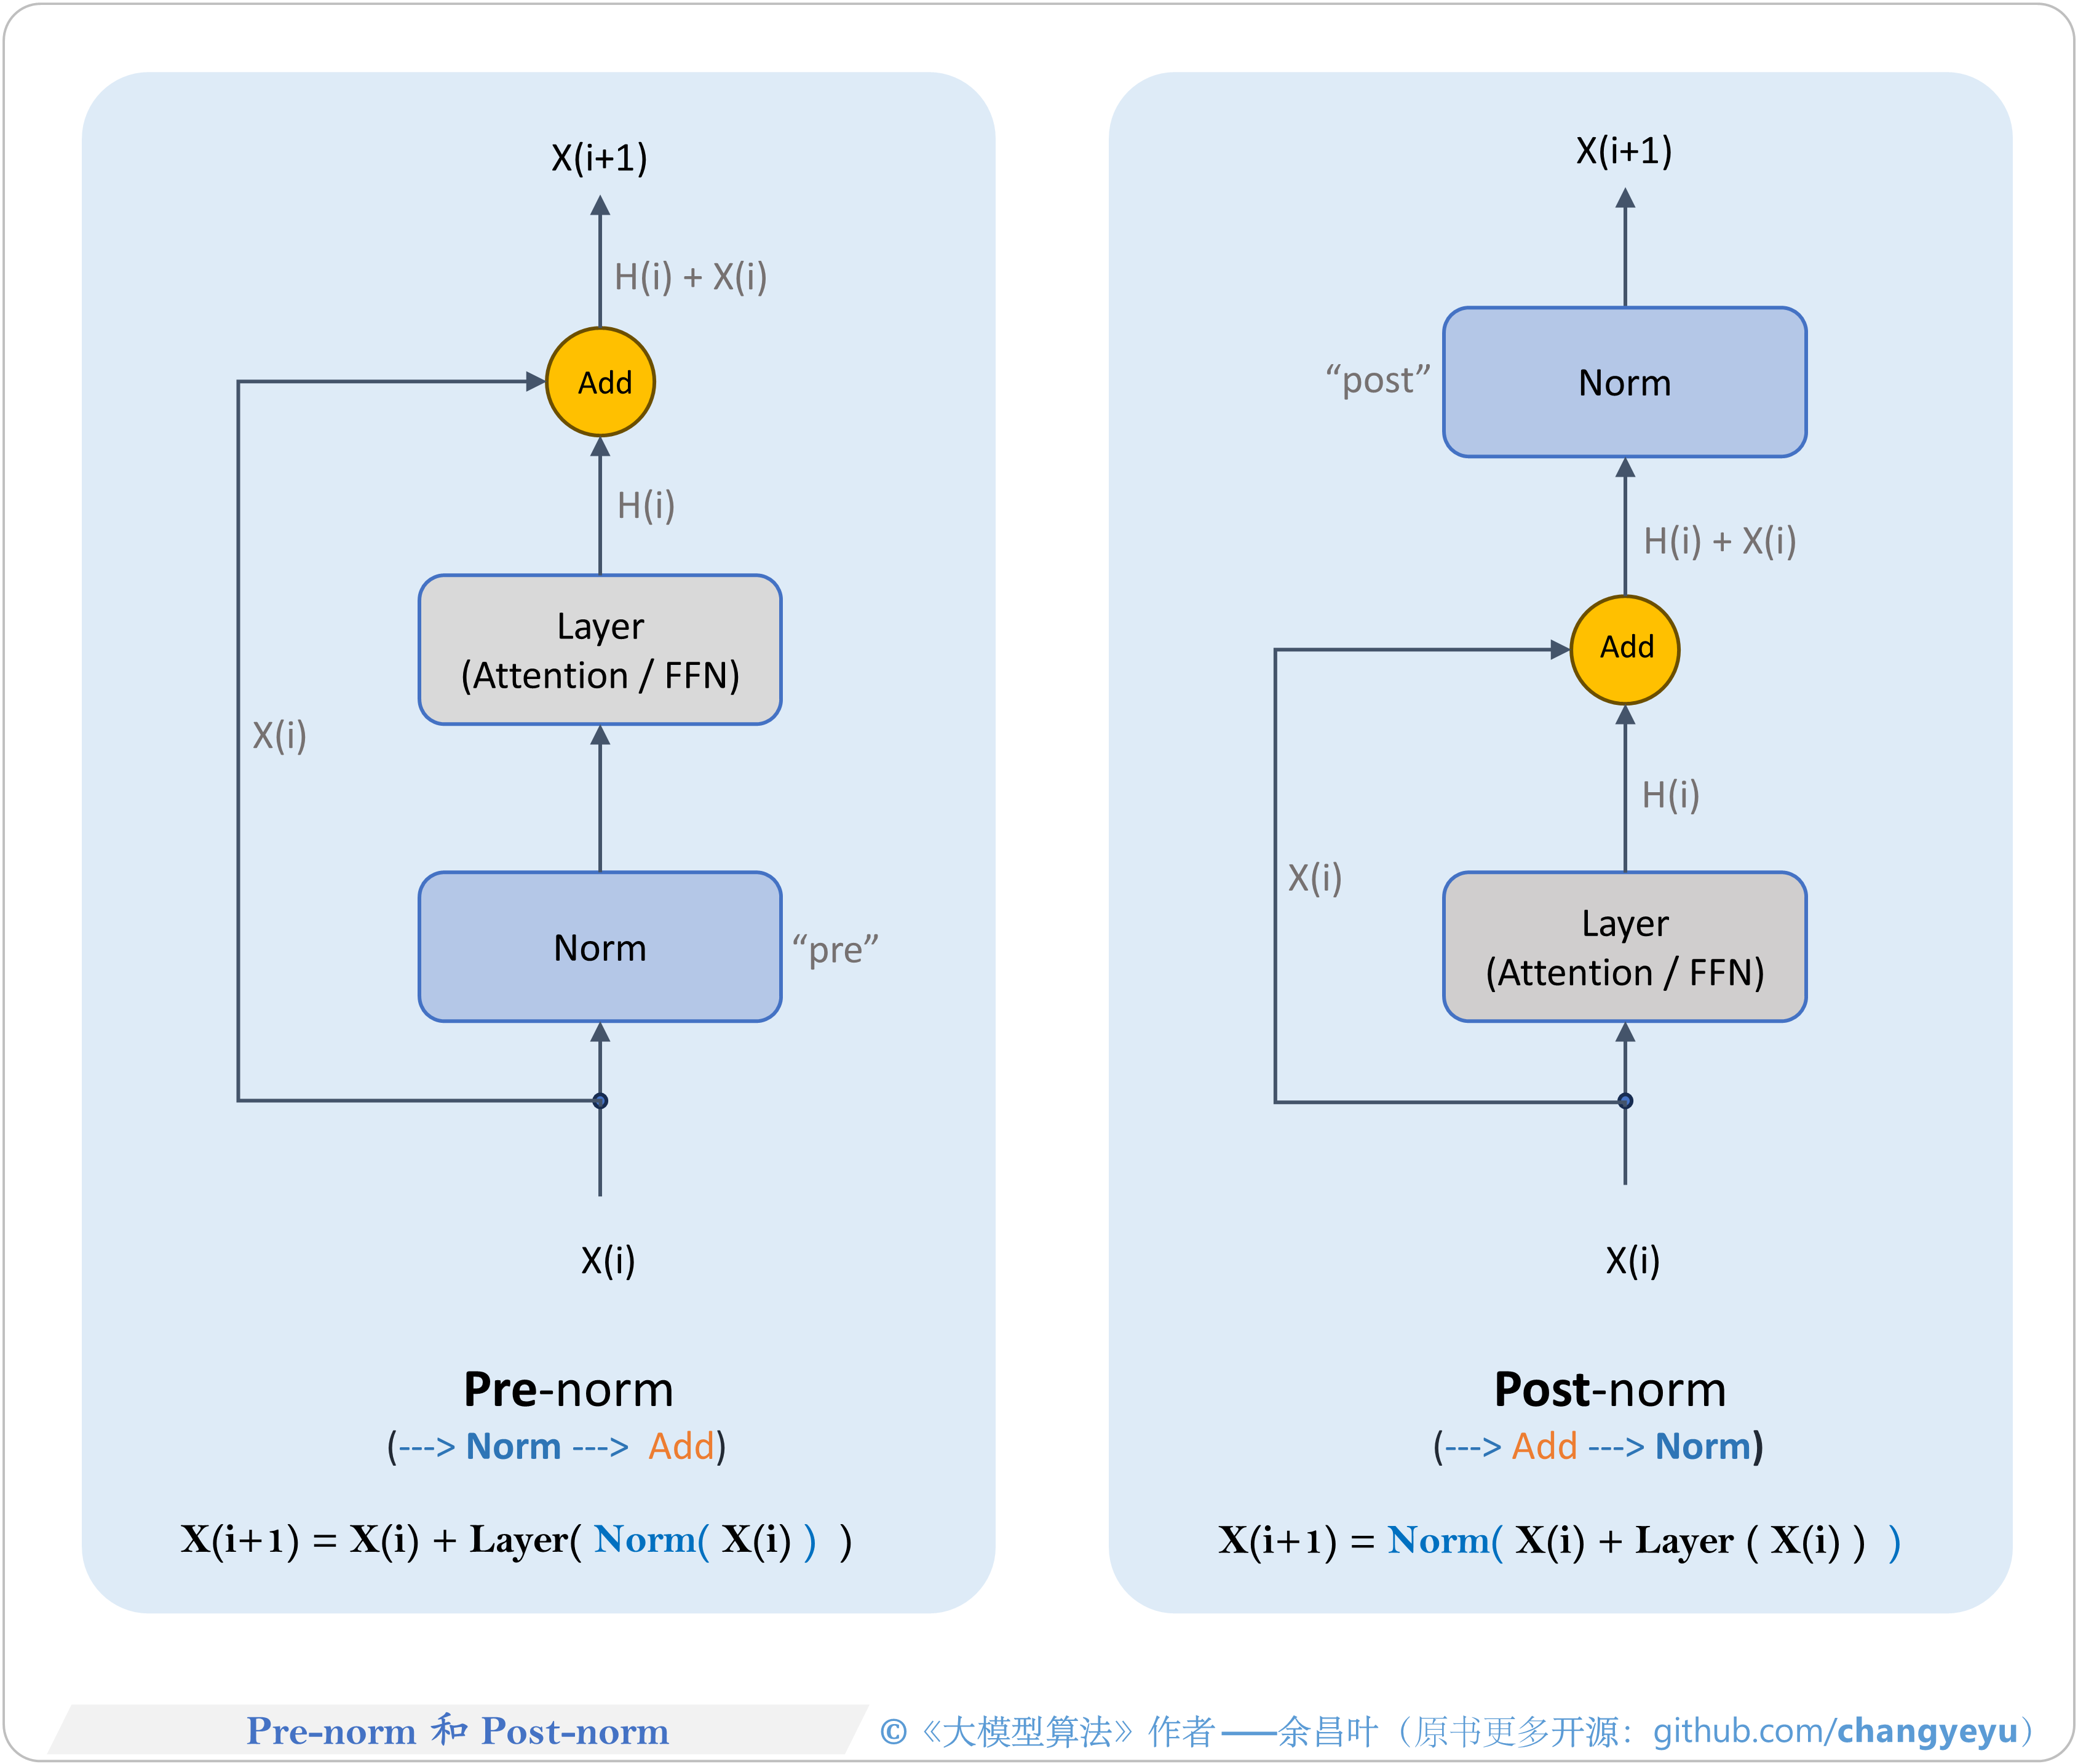
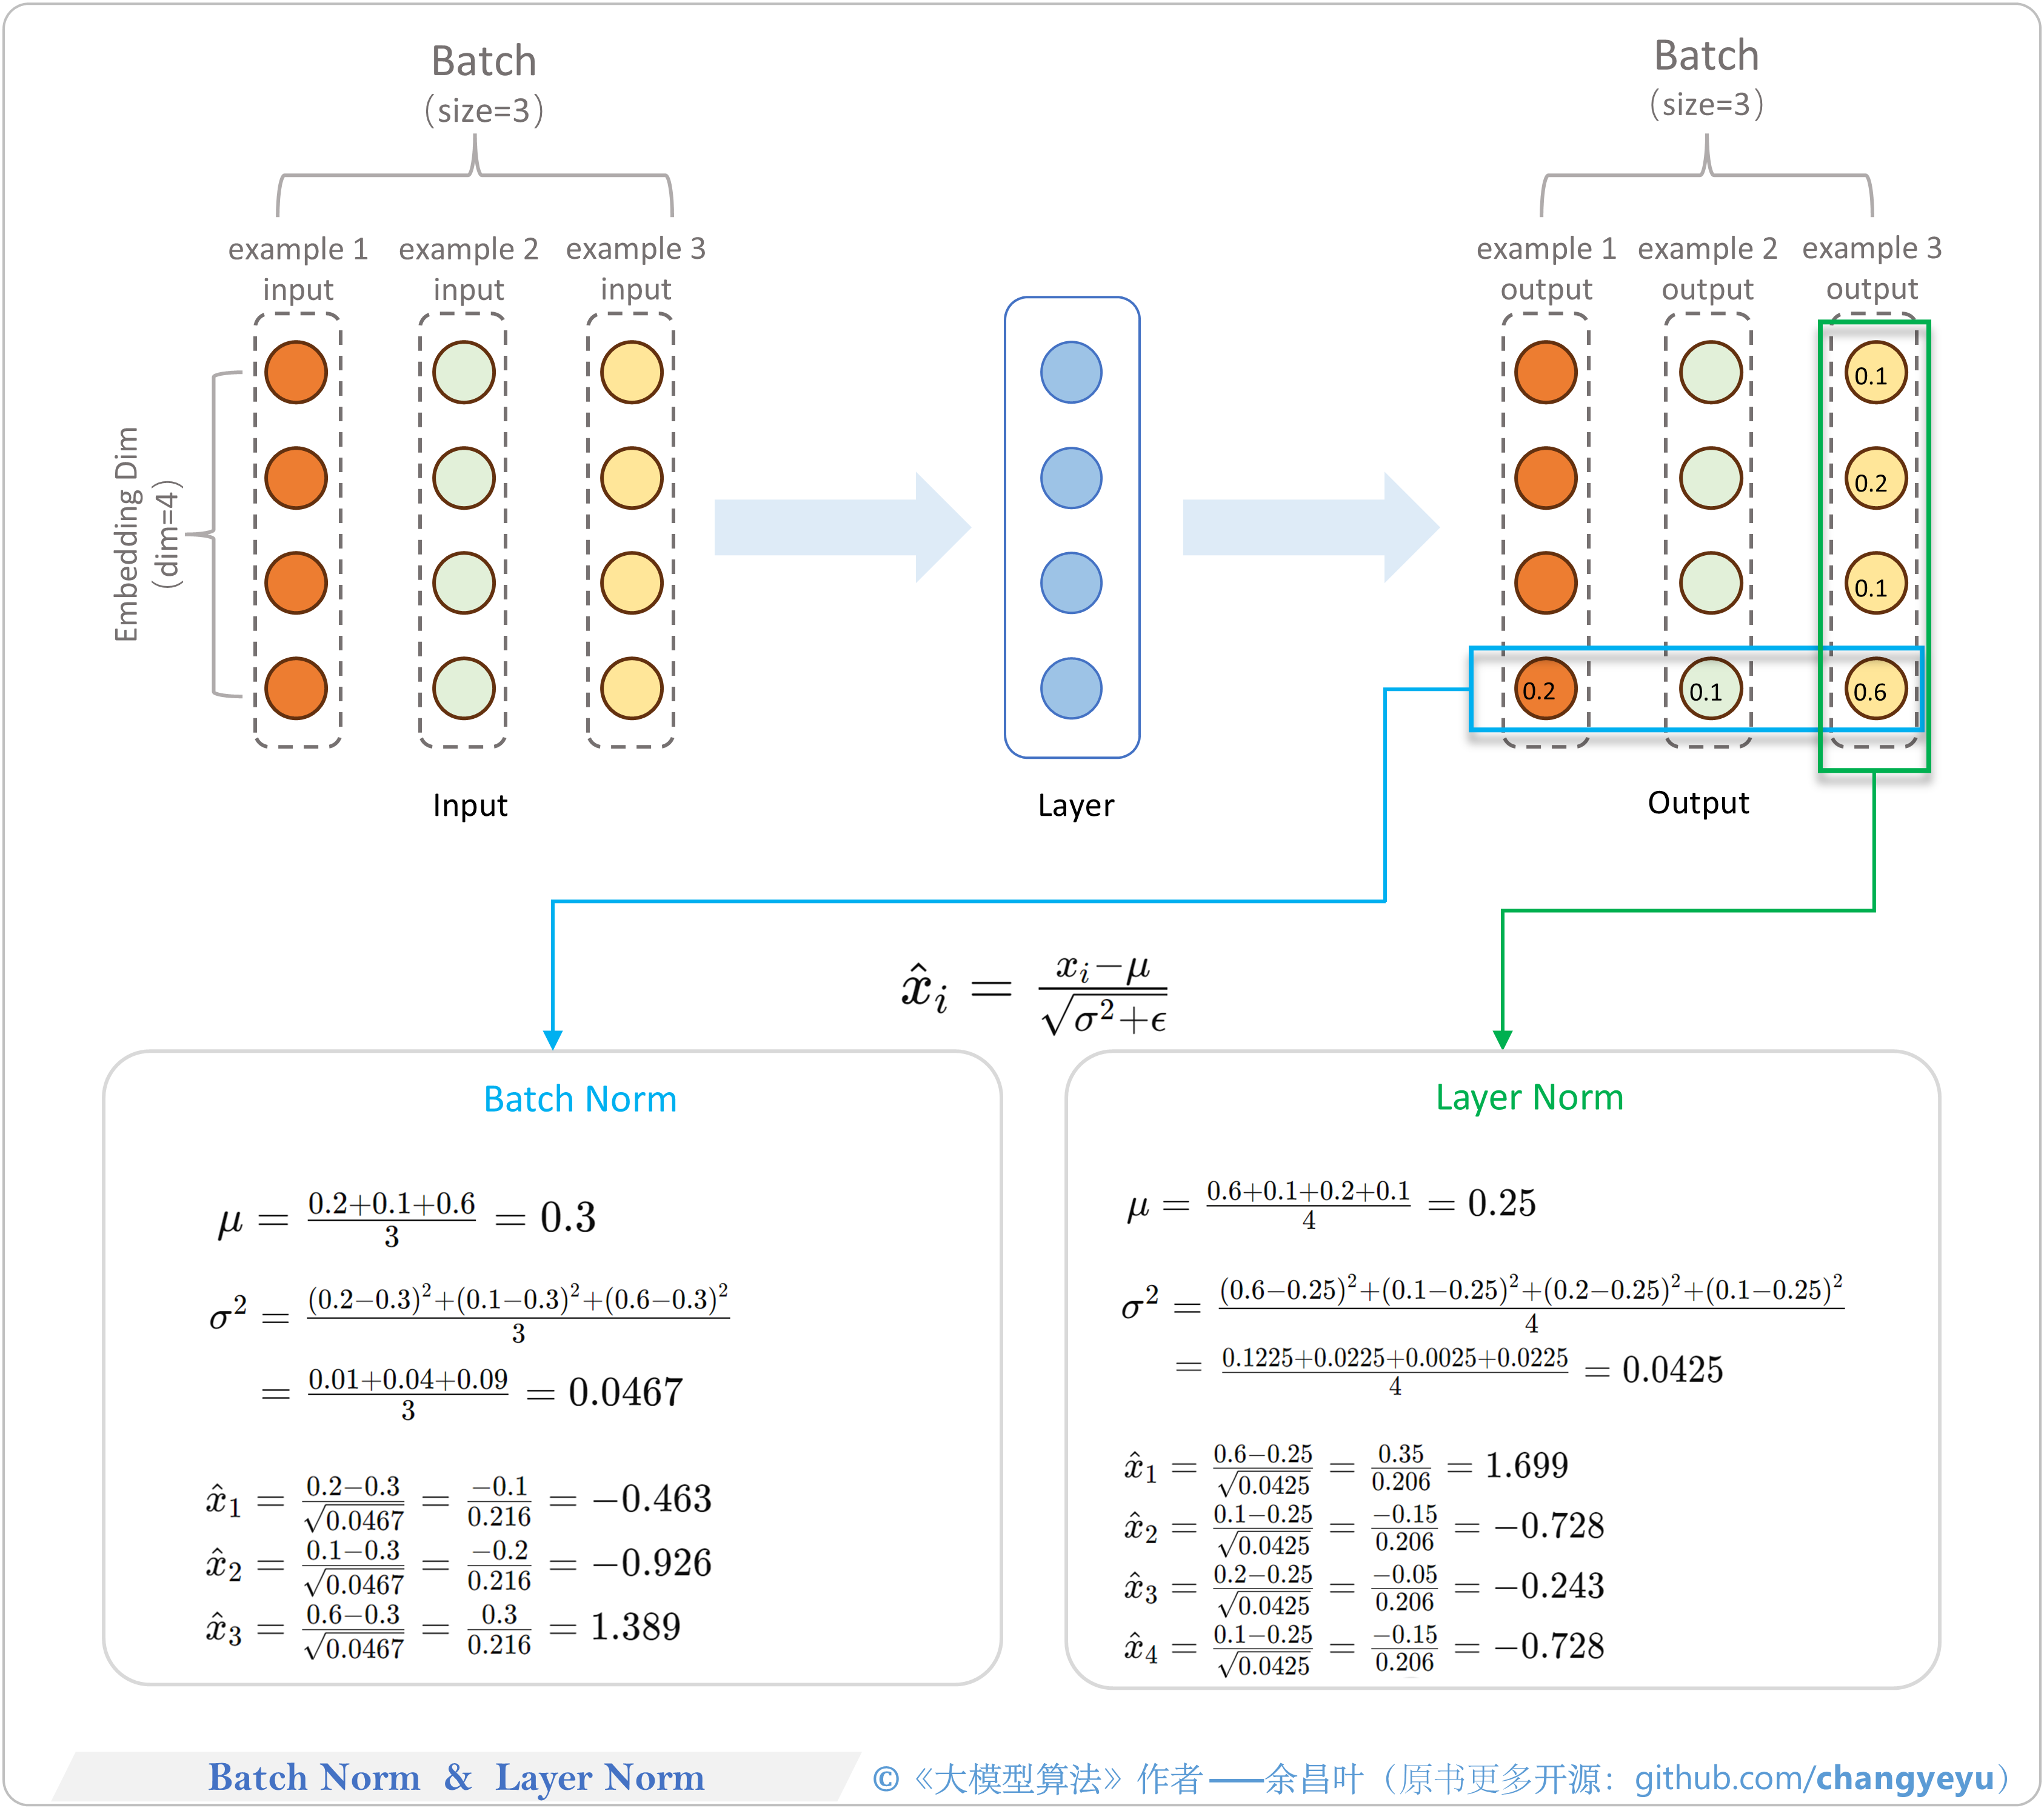
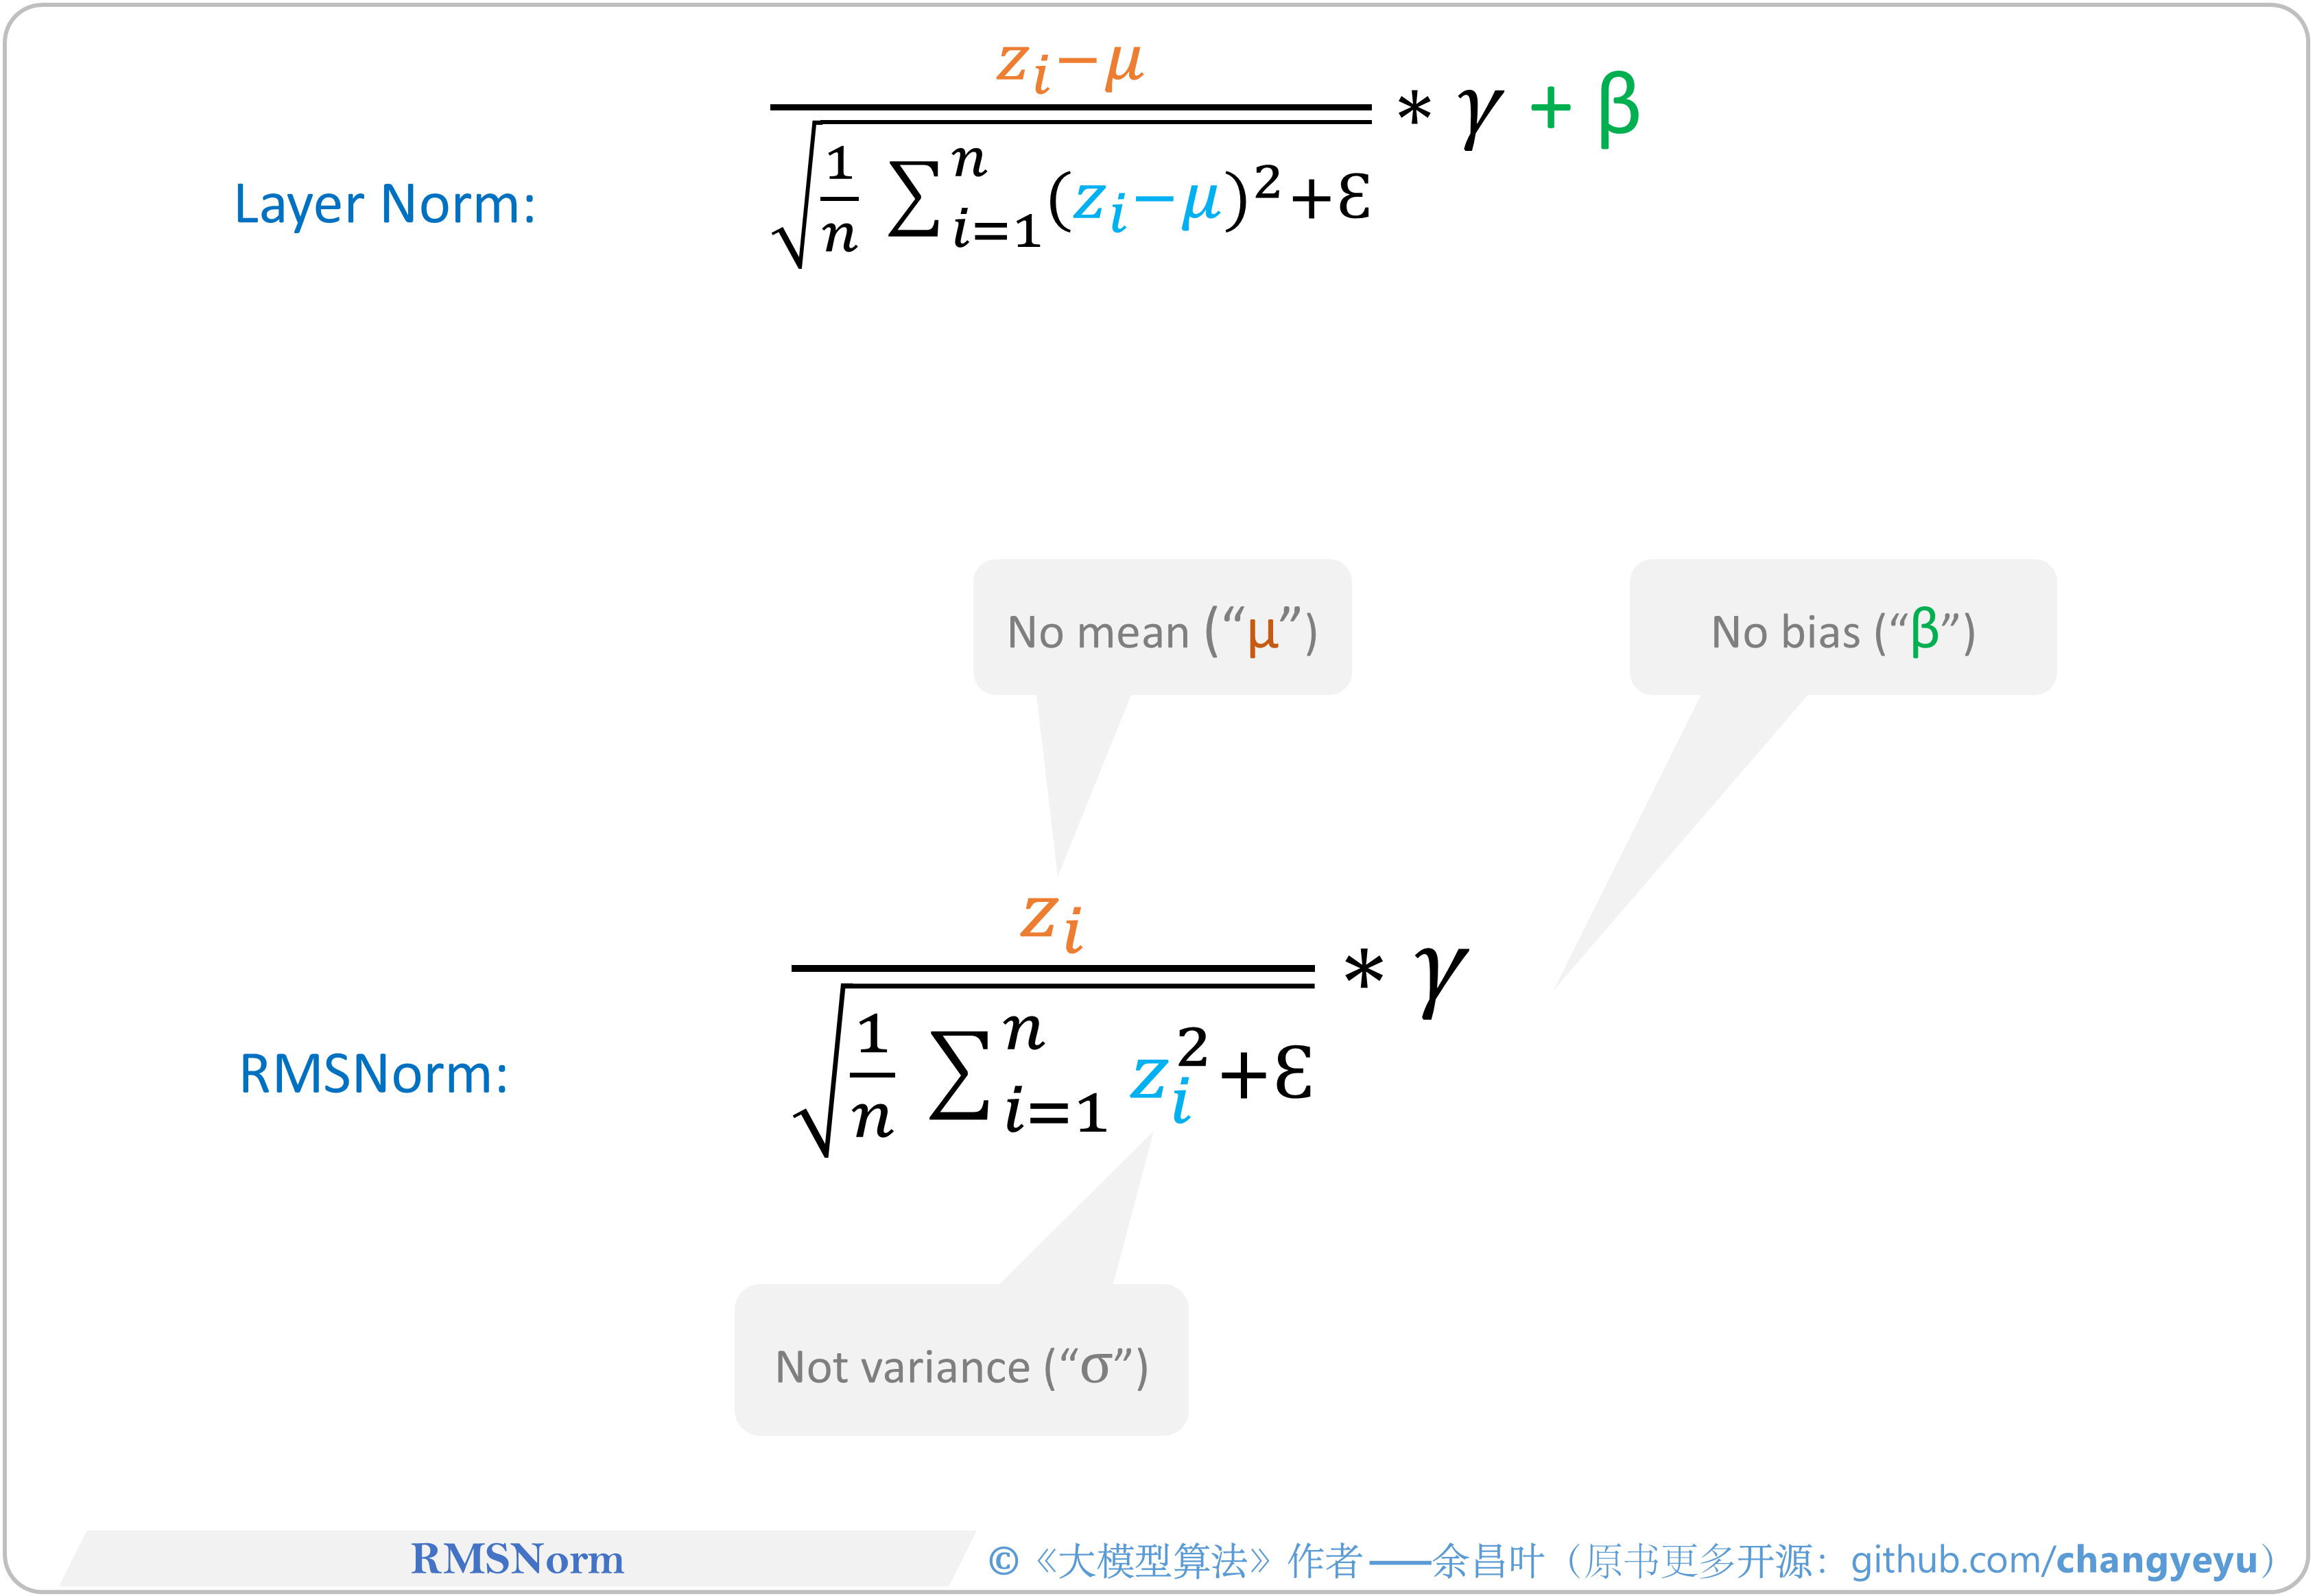
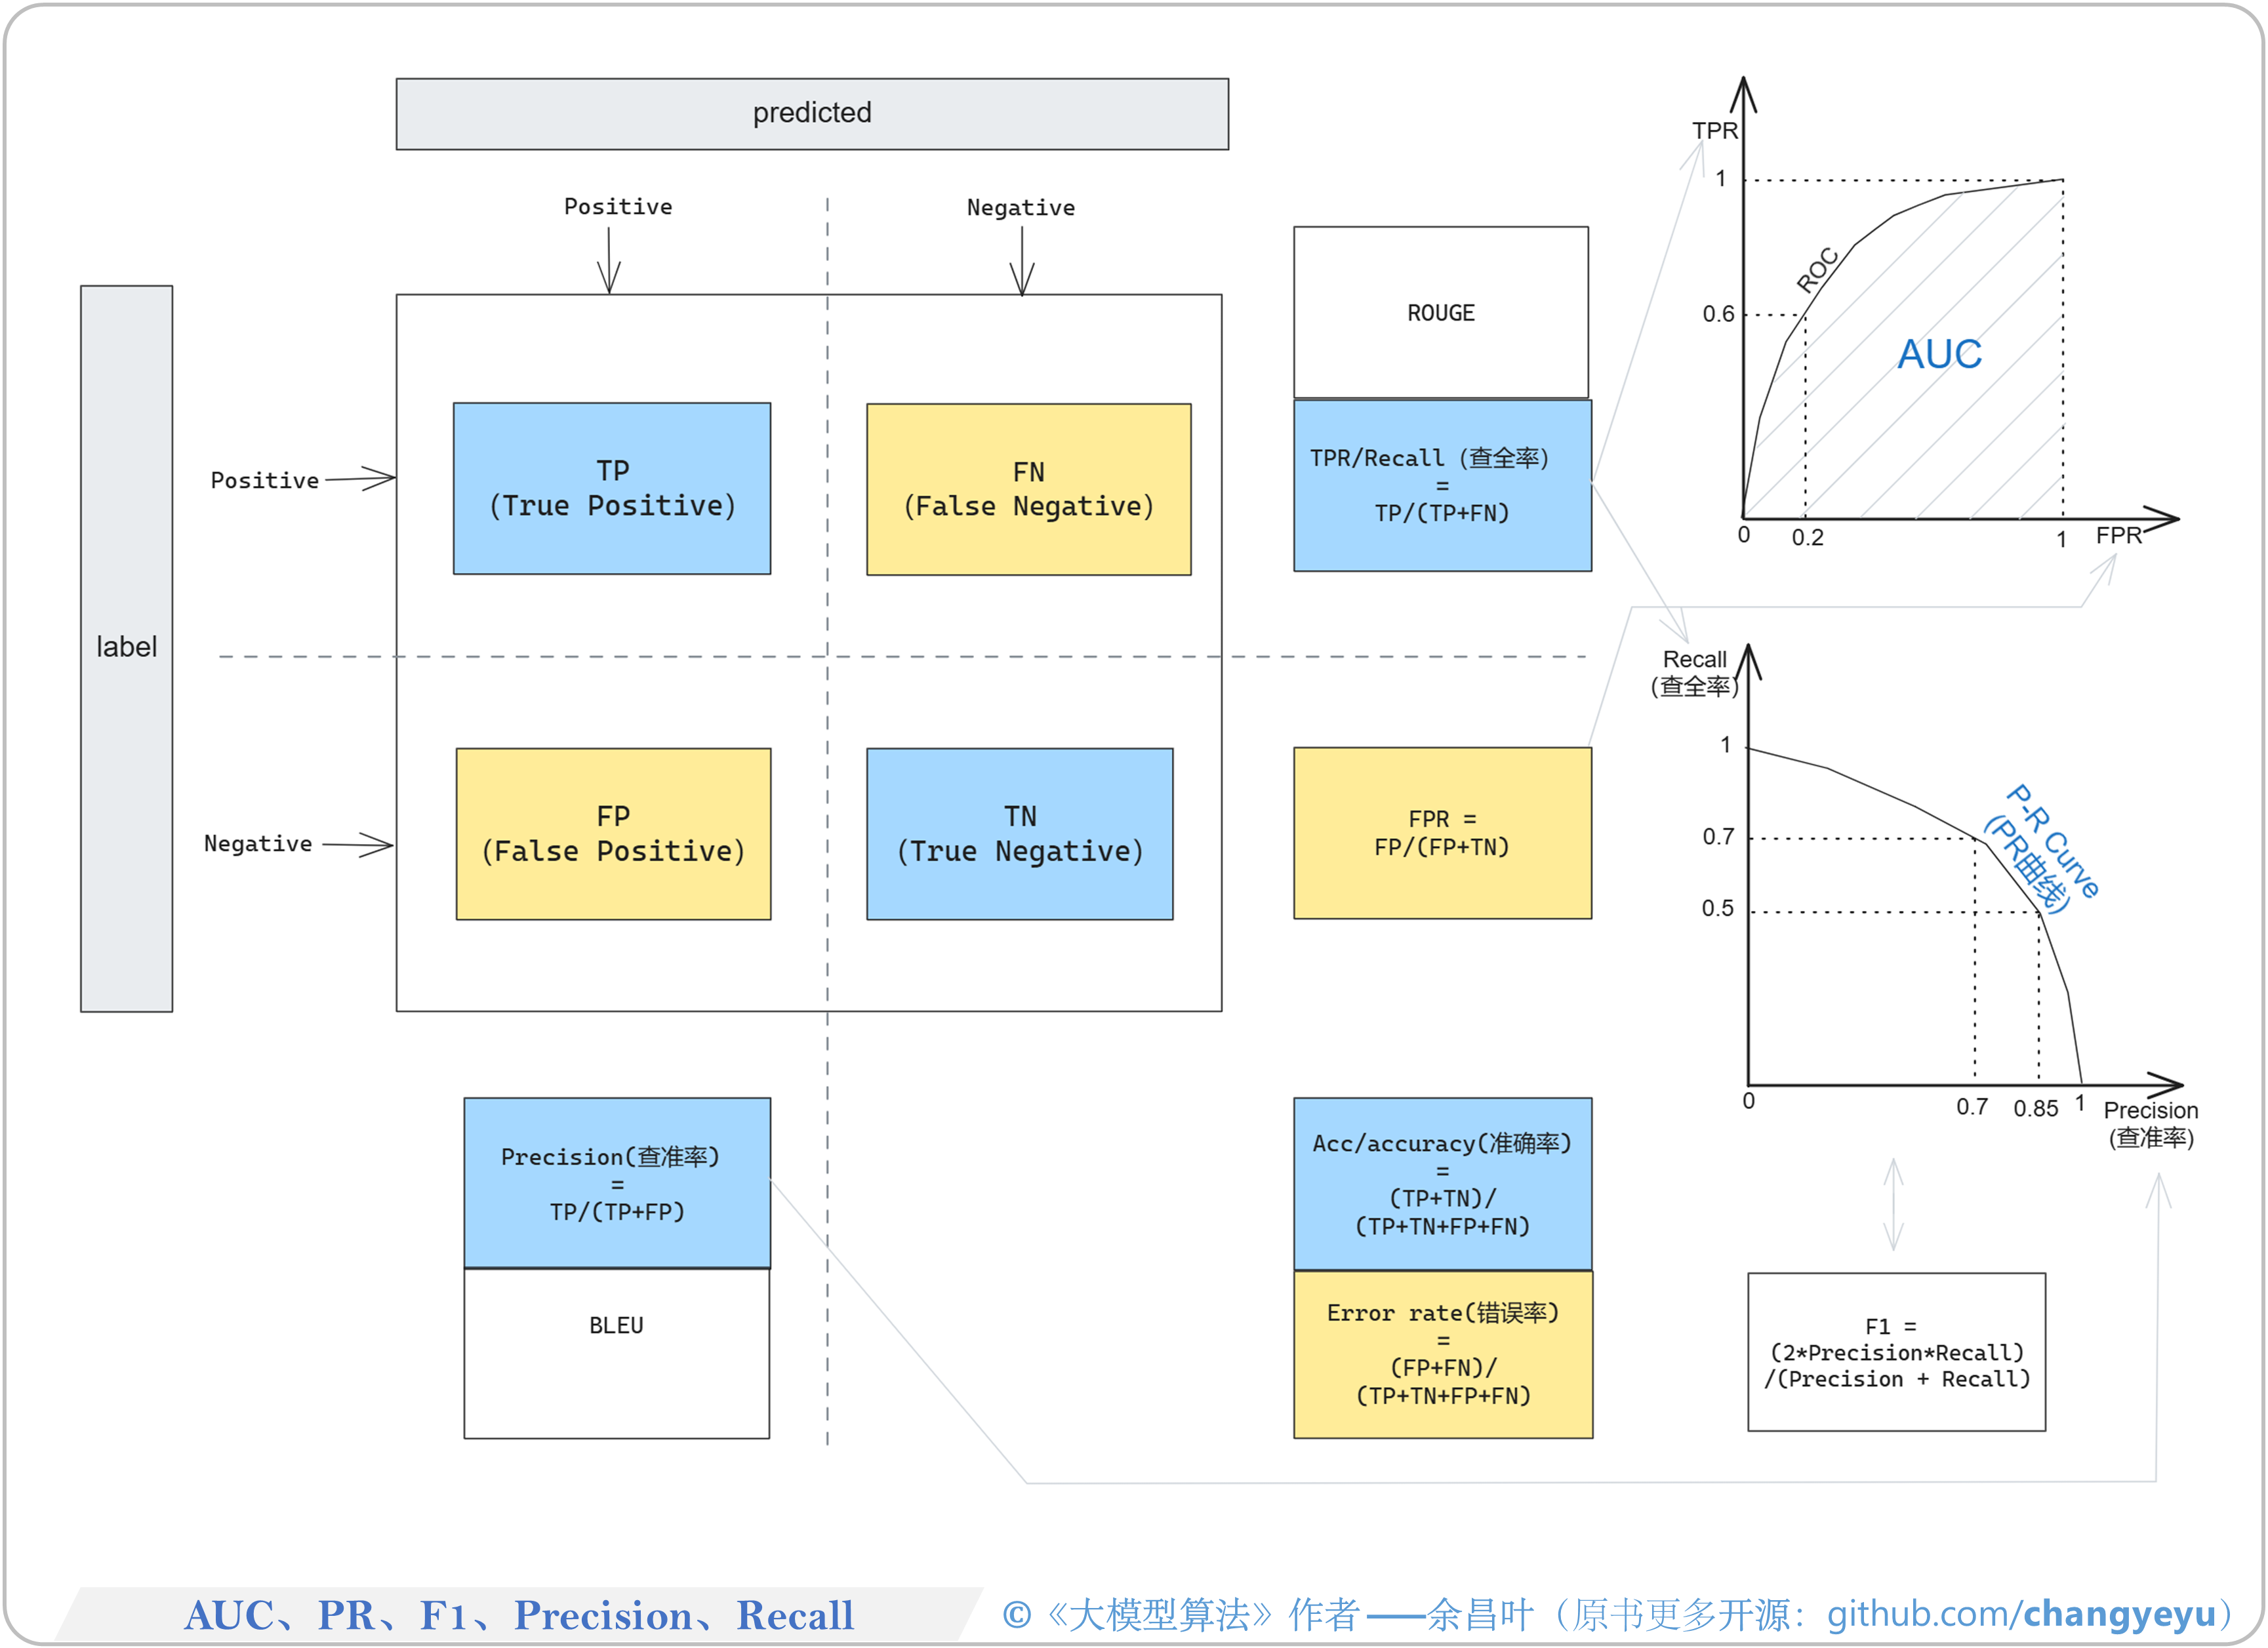
被面试者、工程师经常混淆的算法常用指标,我画了一张图来对比总结,区别一目了然。
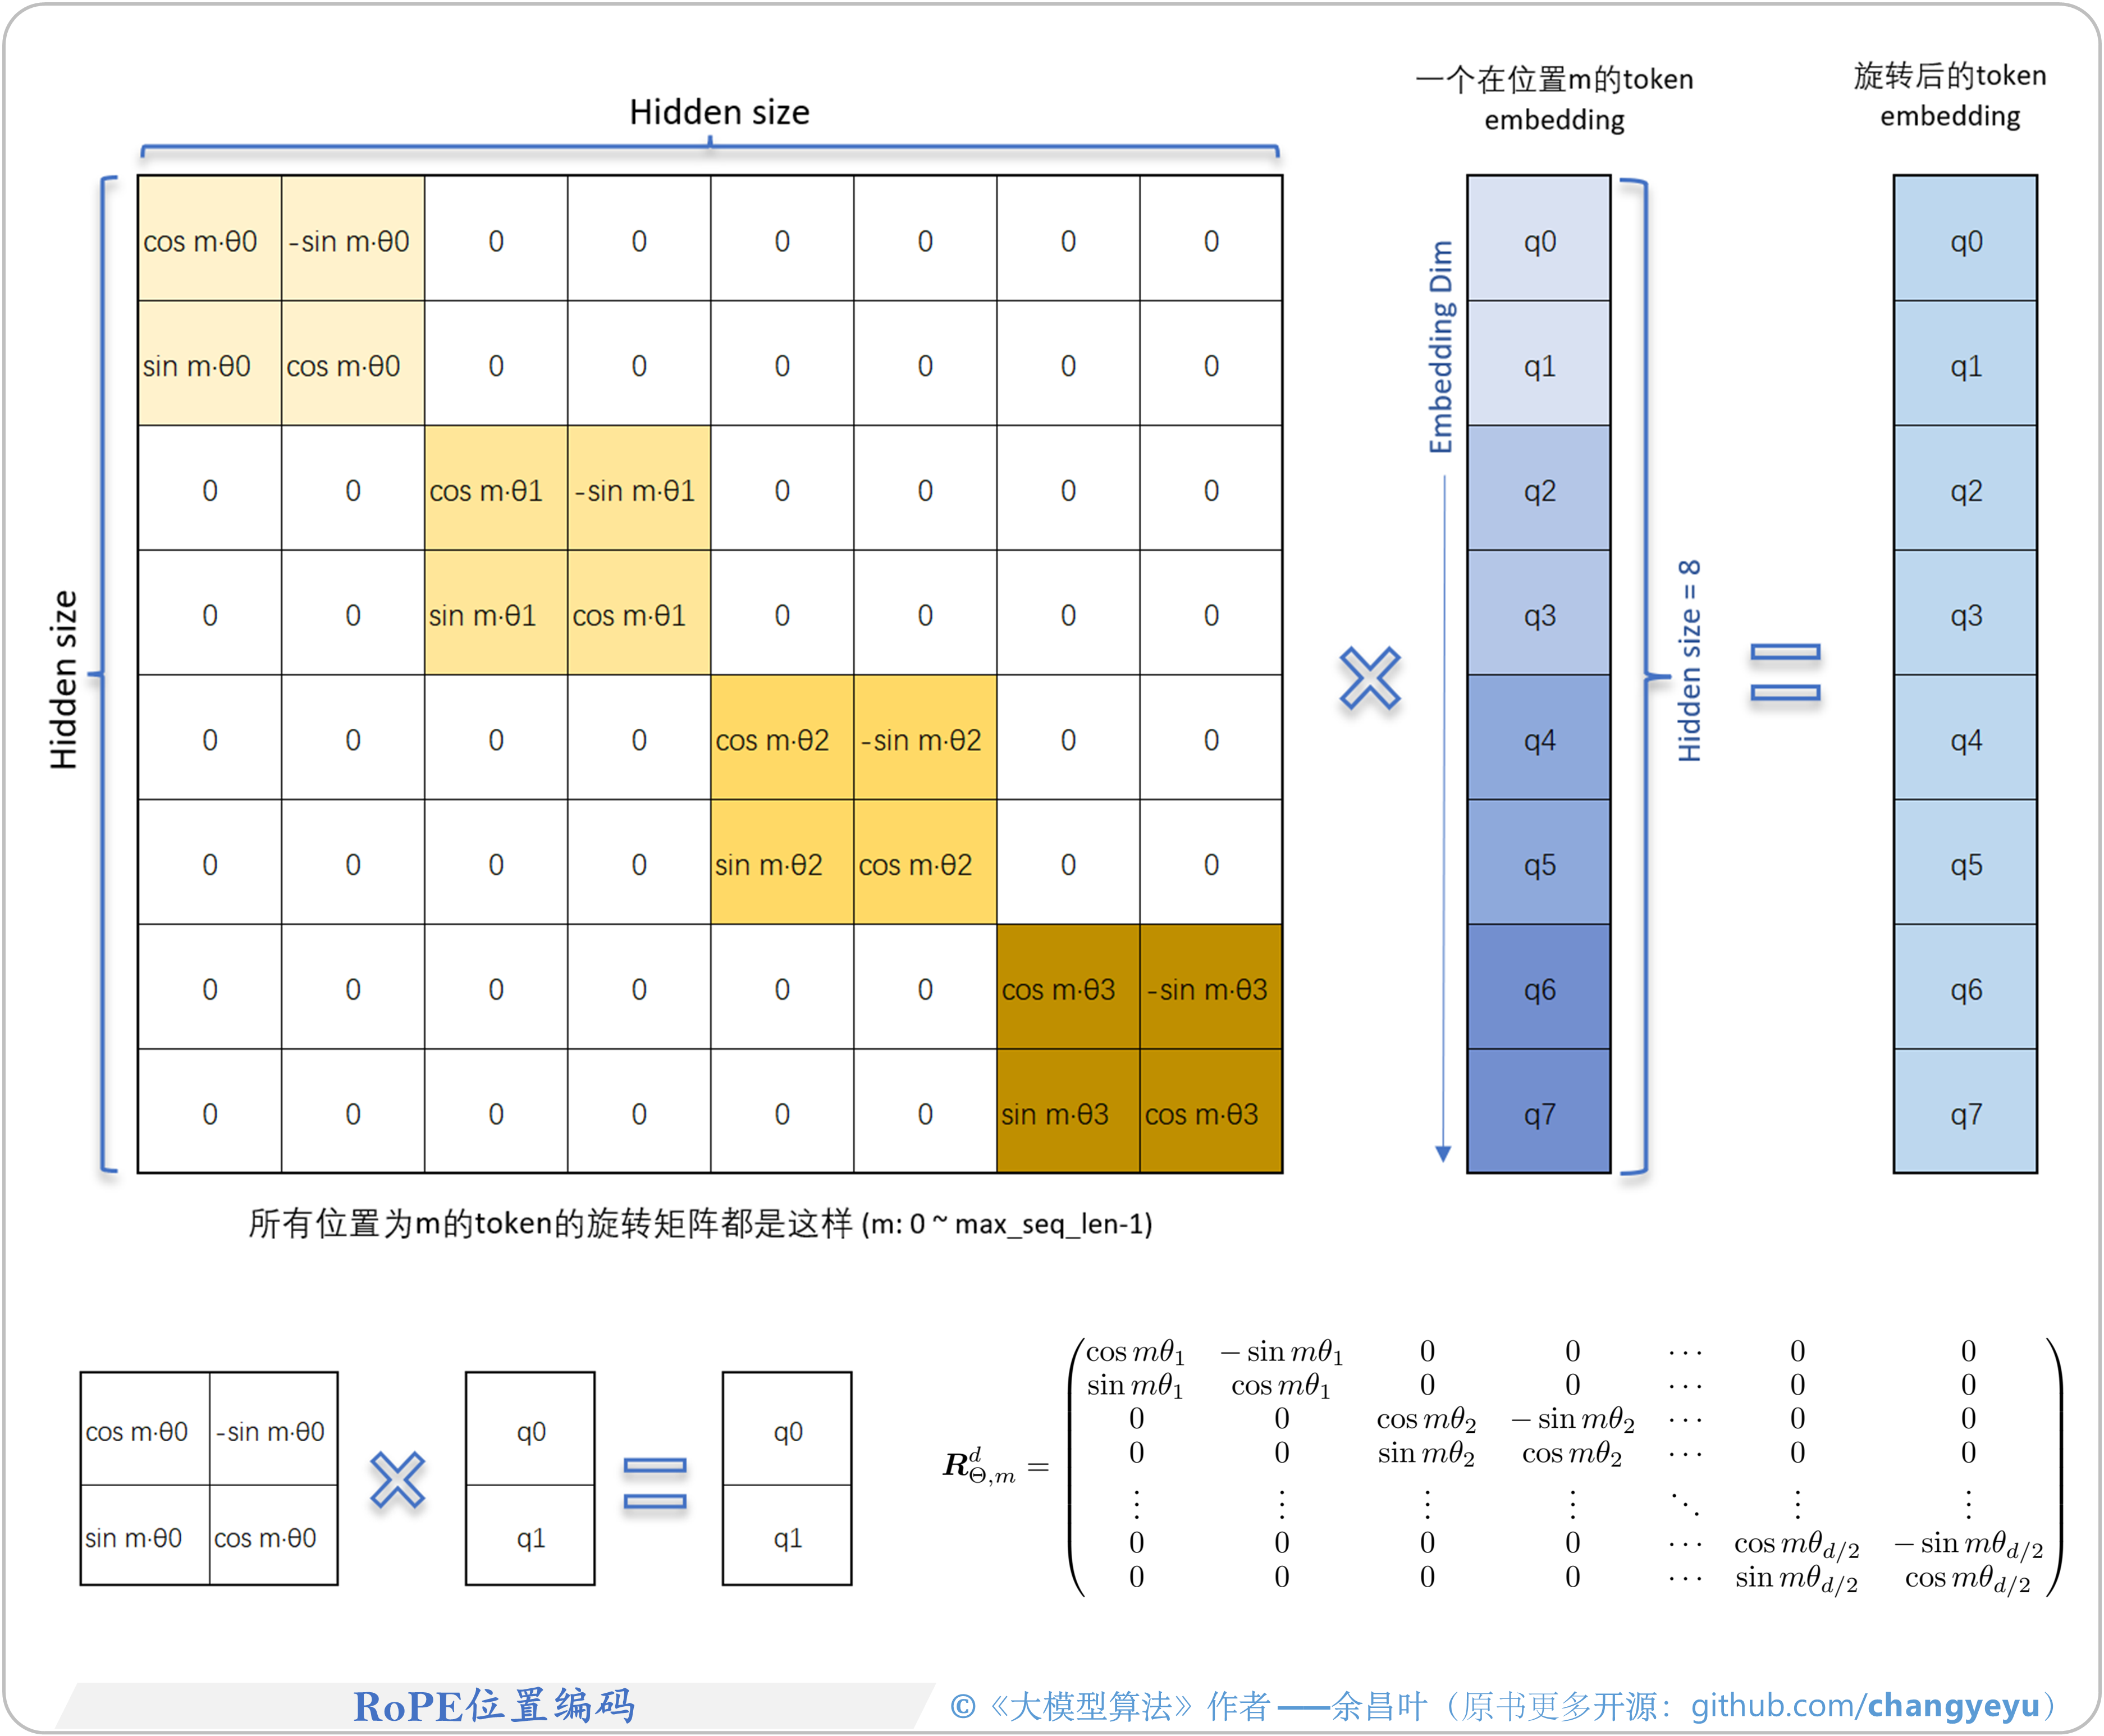
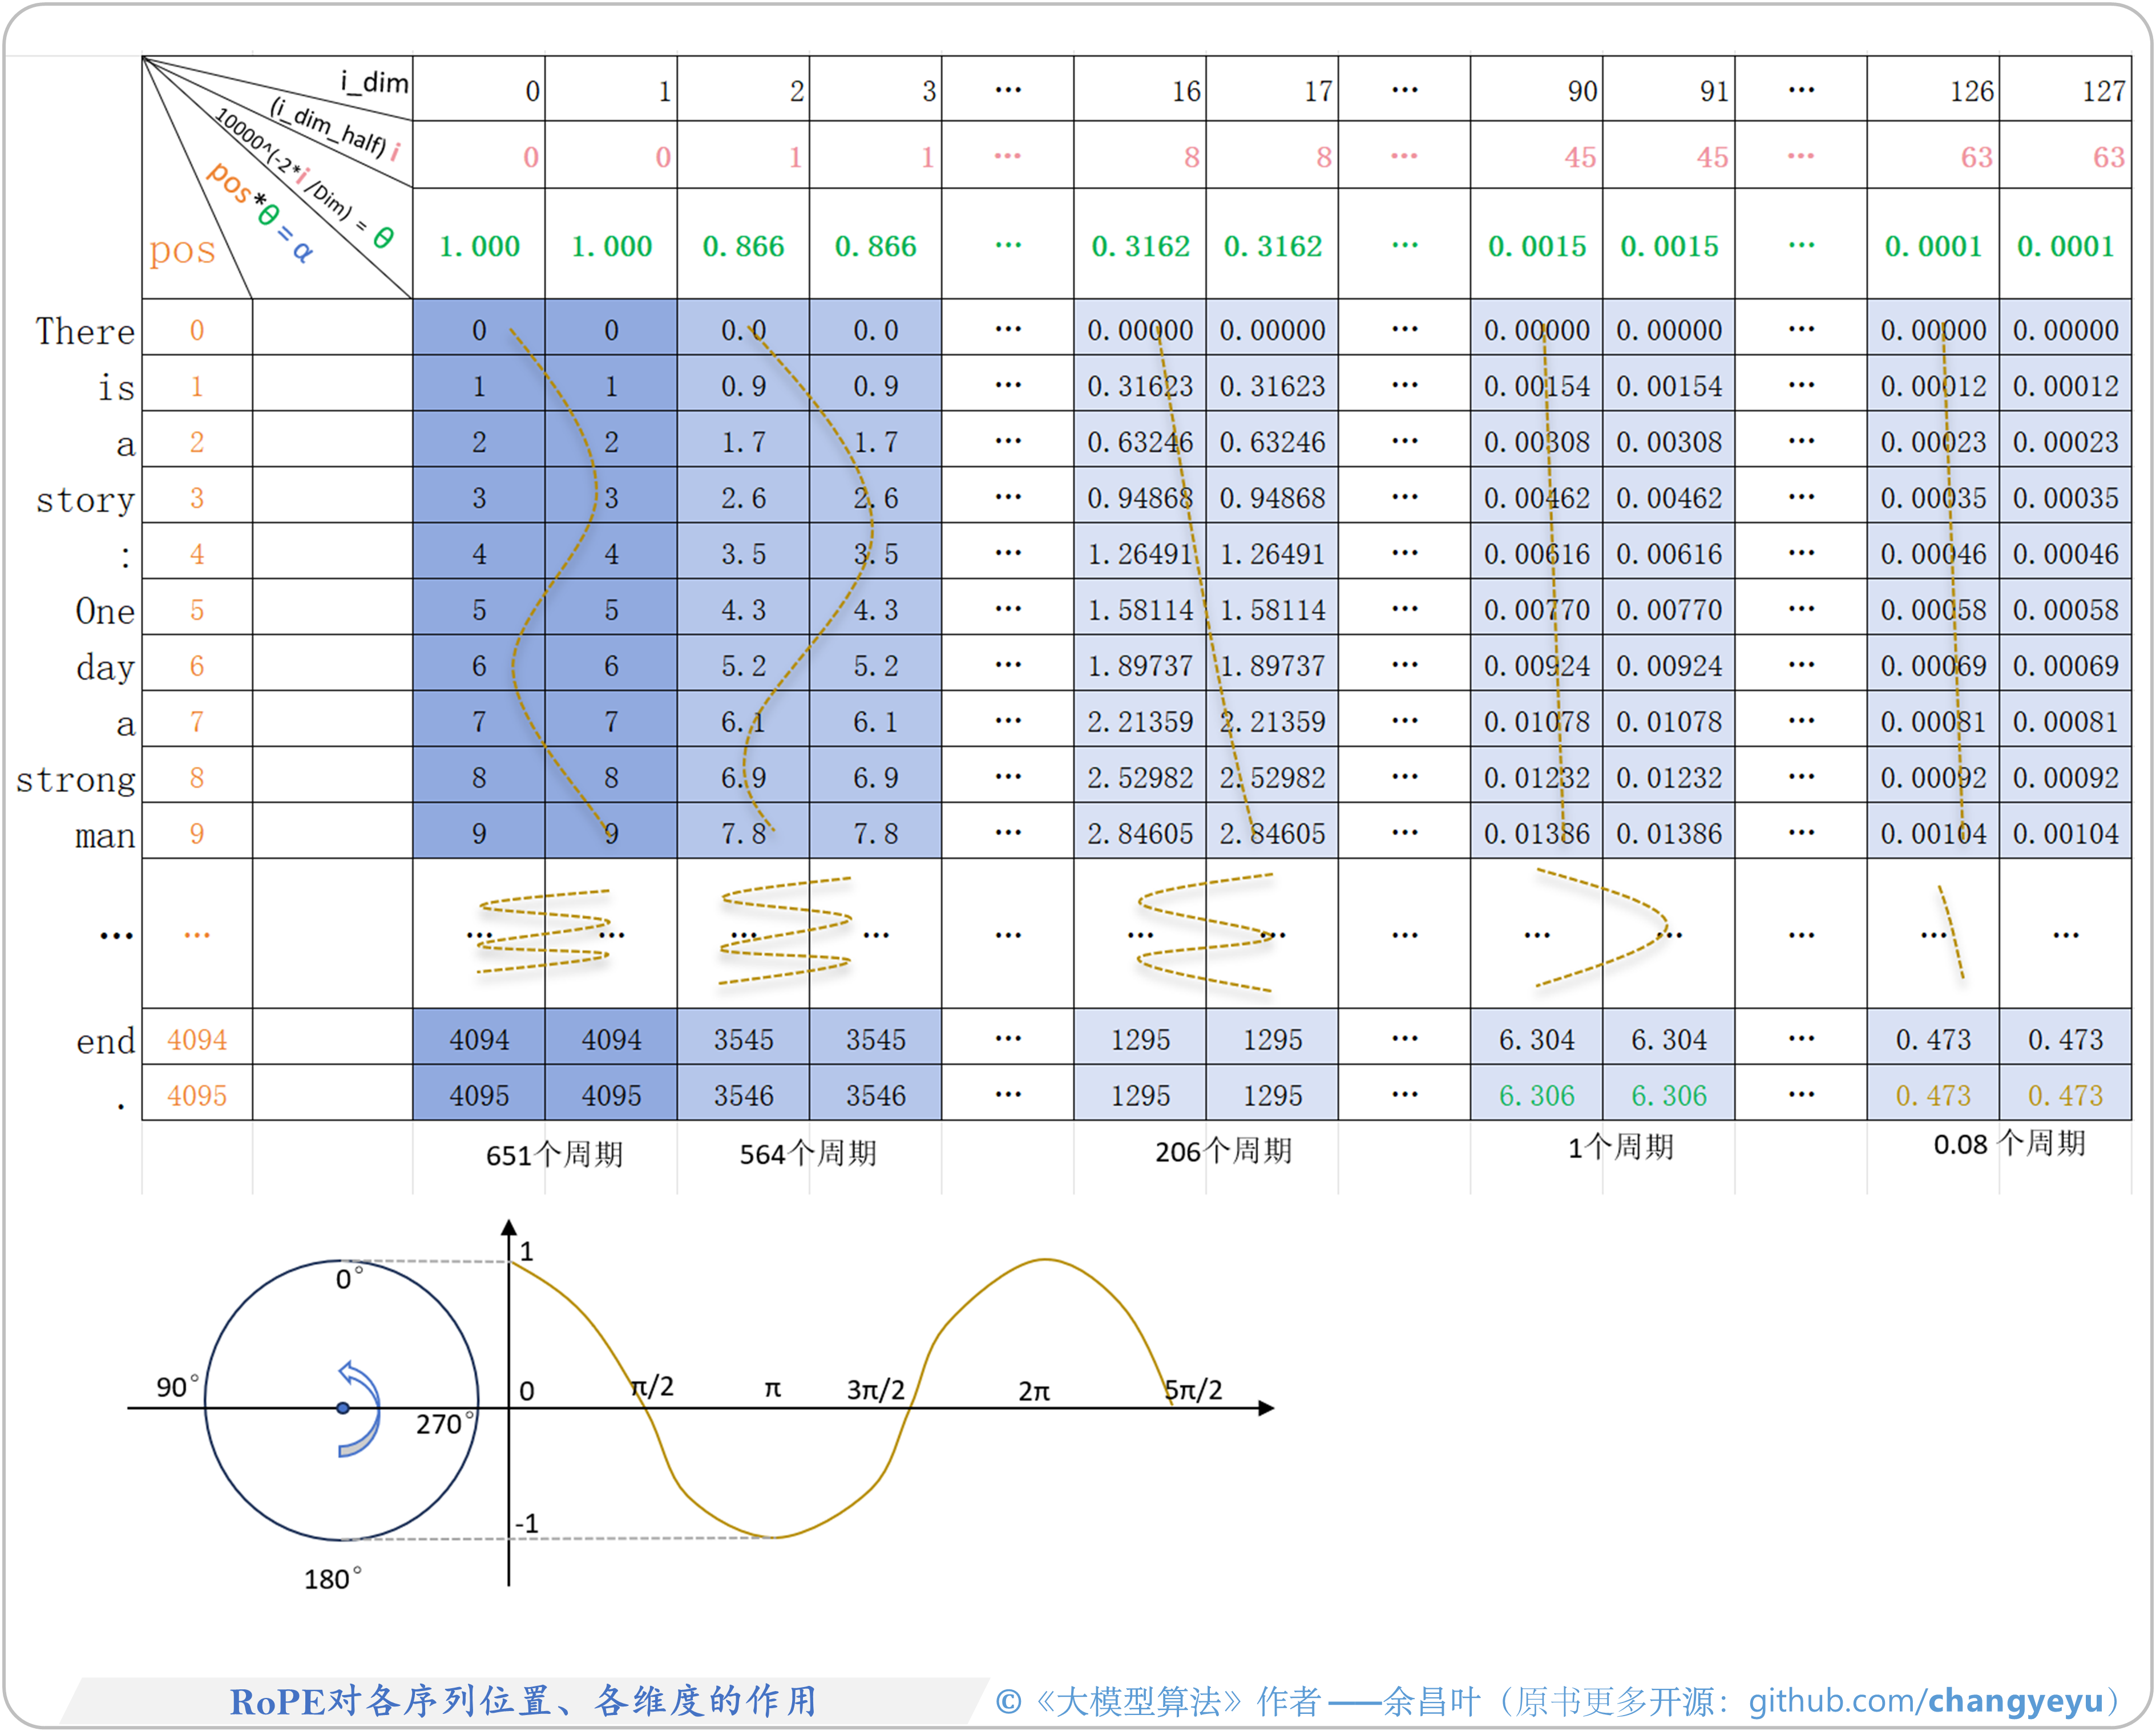
第1章 大模型原理与技术概要
    1.1 图解大模型结构
        1.1.1 大语言模型(LLM)结构全景图
        1.1.2 输入层:分词、Token映射与向量生成
        1.1.3 输出层:Logits、概率分布与解码
        1.1.4 多模态语言模型(MLLM)与视觉语言模型(VLM)
    1.2 大模型训练全景图
    1.3 Scaling Law(性能的四大扩展规律)
第2章 SFT(监督微调)
    2.1 多种微调技术图解
        2.1.1 全参数微调、部分参数微调
        2.1.2 LoRA(低秩适配微调)——四两拨千斤
        2.1.3 LoRA衍生:QLoRA、AdaLoRA、PiSSA等
        2.1.4 基于提示的微调:Prefix-Tuning、Prompt Tuning等
        2.1.5 Adapter Tuning
        2.1.6 微调技术对比
        2.1.7 如何选择微调技术
    2.2 SFT原理深入解析
        2.2.1 SFT数据与ChatML格式化
        2.2.2 Logits与Token概率计算
        2.2.3 SFT的Label
        2.2.4 SFT的Loss图解
        2.2.5 对数概率(LogProbs)与LogSoftmax
    2.3 指令收集和处理
        2.3.1 收集指令的渠道和方法
        2.3.2 清洗指令的四要素
        2.3.3 数据预处理及常用工具
    2.4 SFT实践指南
        2.4.1 如何缓解SFT引入的幻觉?
        2.4.2 Token级Batch Size的换算
        2.4.3 Batch Size与学习率的Scaling Law
        2.4.4 SFT的七个技巧
第3章 DPO(直接偏好优化)
    3.1 DPO的核心思想
        3.1.1 DPO的提出背景与意义
        3.1.2 隐式的奖励模型
        3.1.3 Loss和优化目标
    3.2 偏好数据集的构建
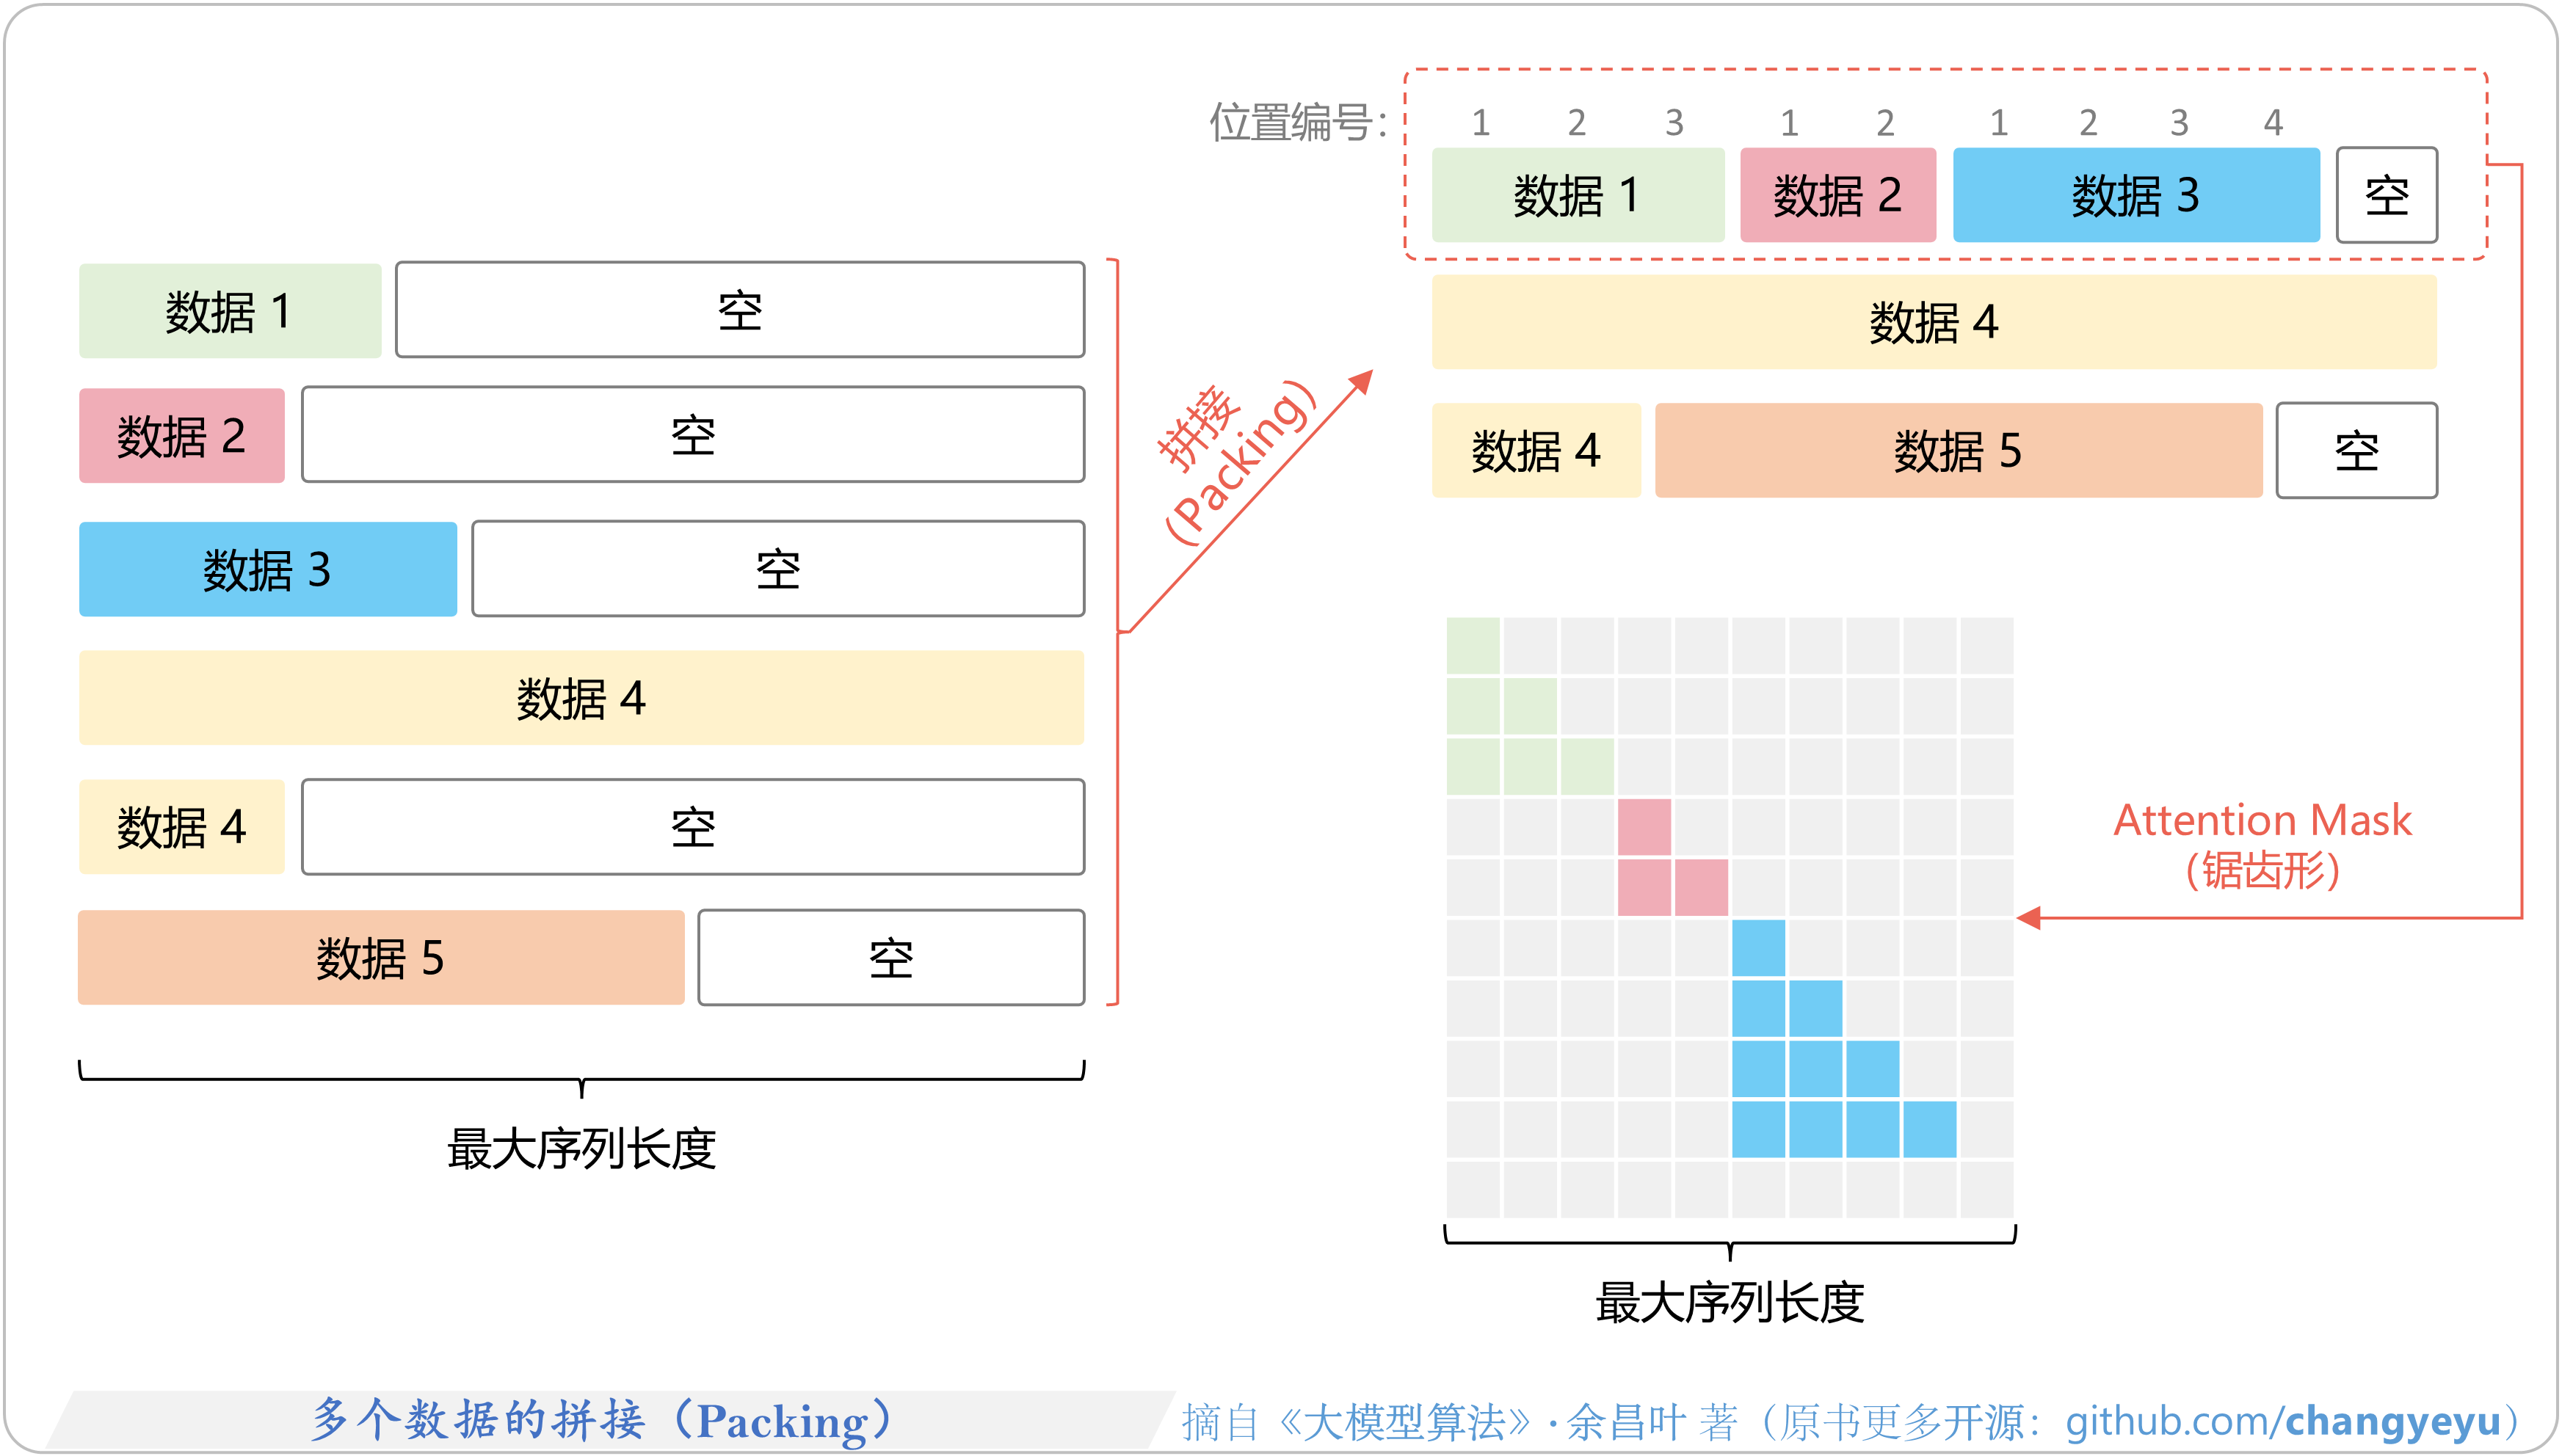
        3.2.1 构建流程总览
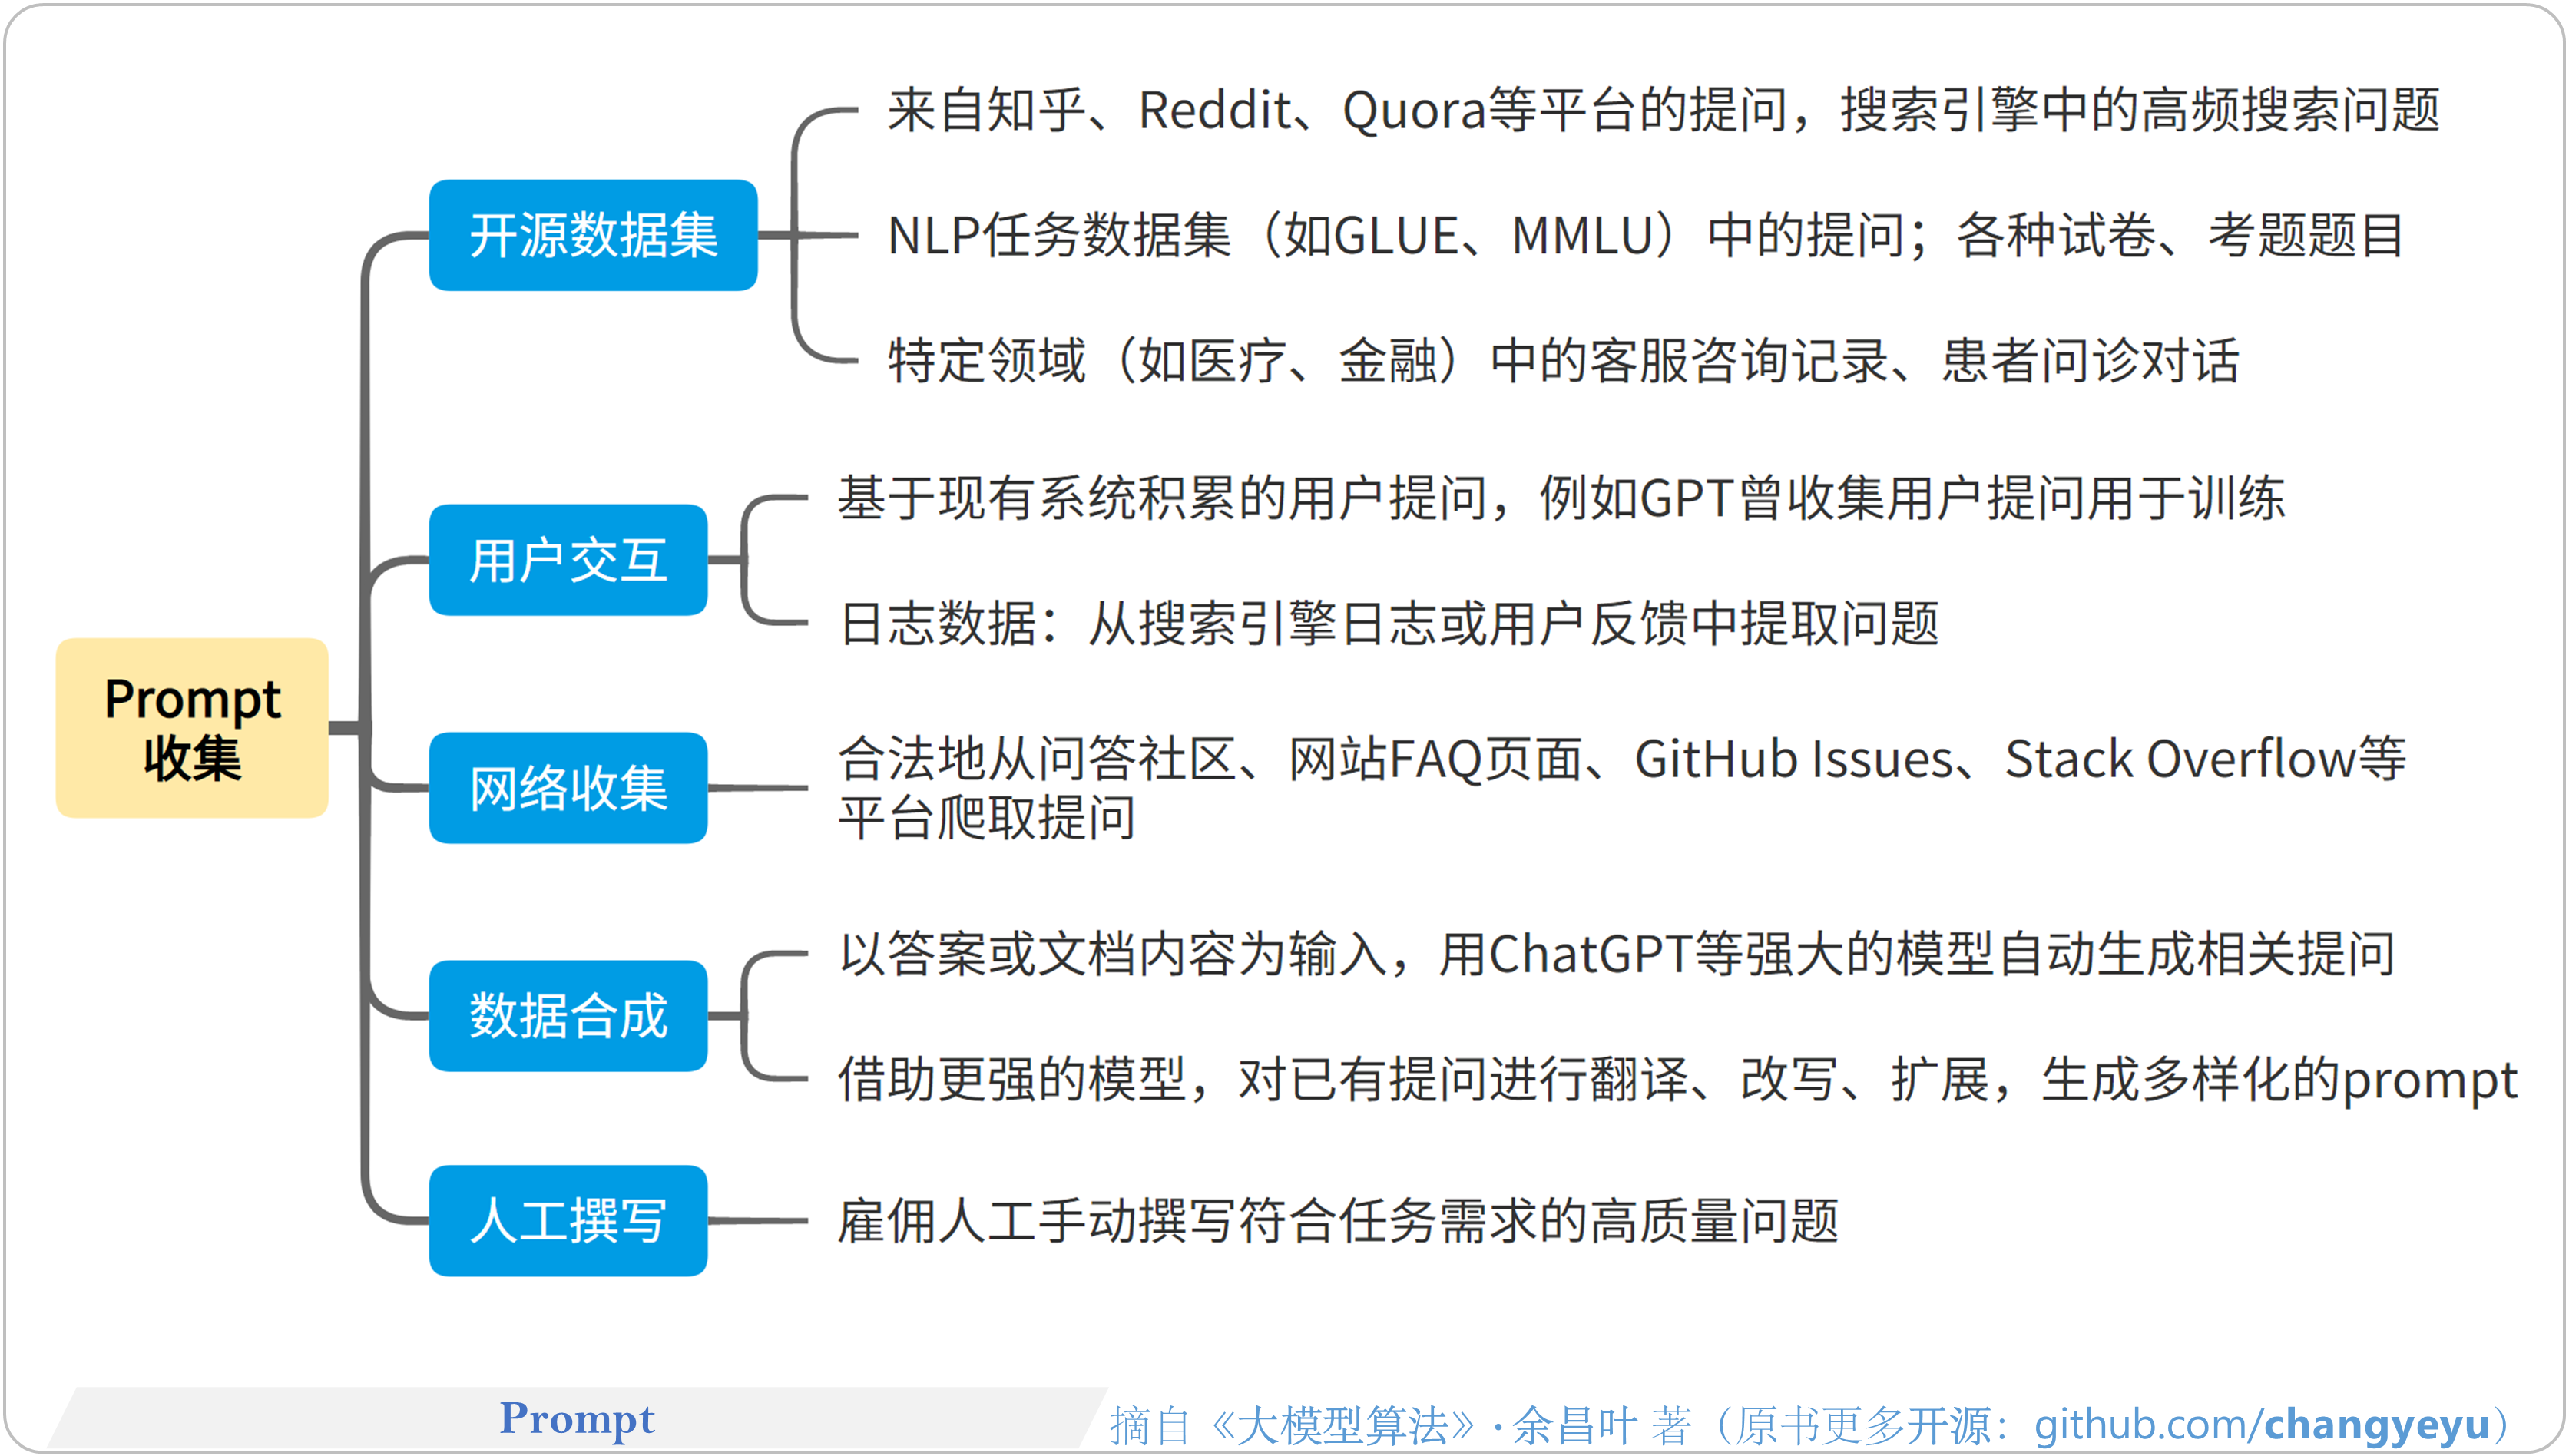
        3.2.2 Prompt的收集
        3.2.3 问答数据对的清洗
        3.2.4 封装和预处理
    3.3 图解DPO的实现与训练
        3.3.1 模型的初始化
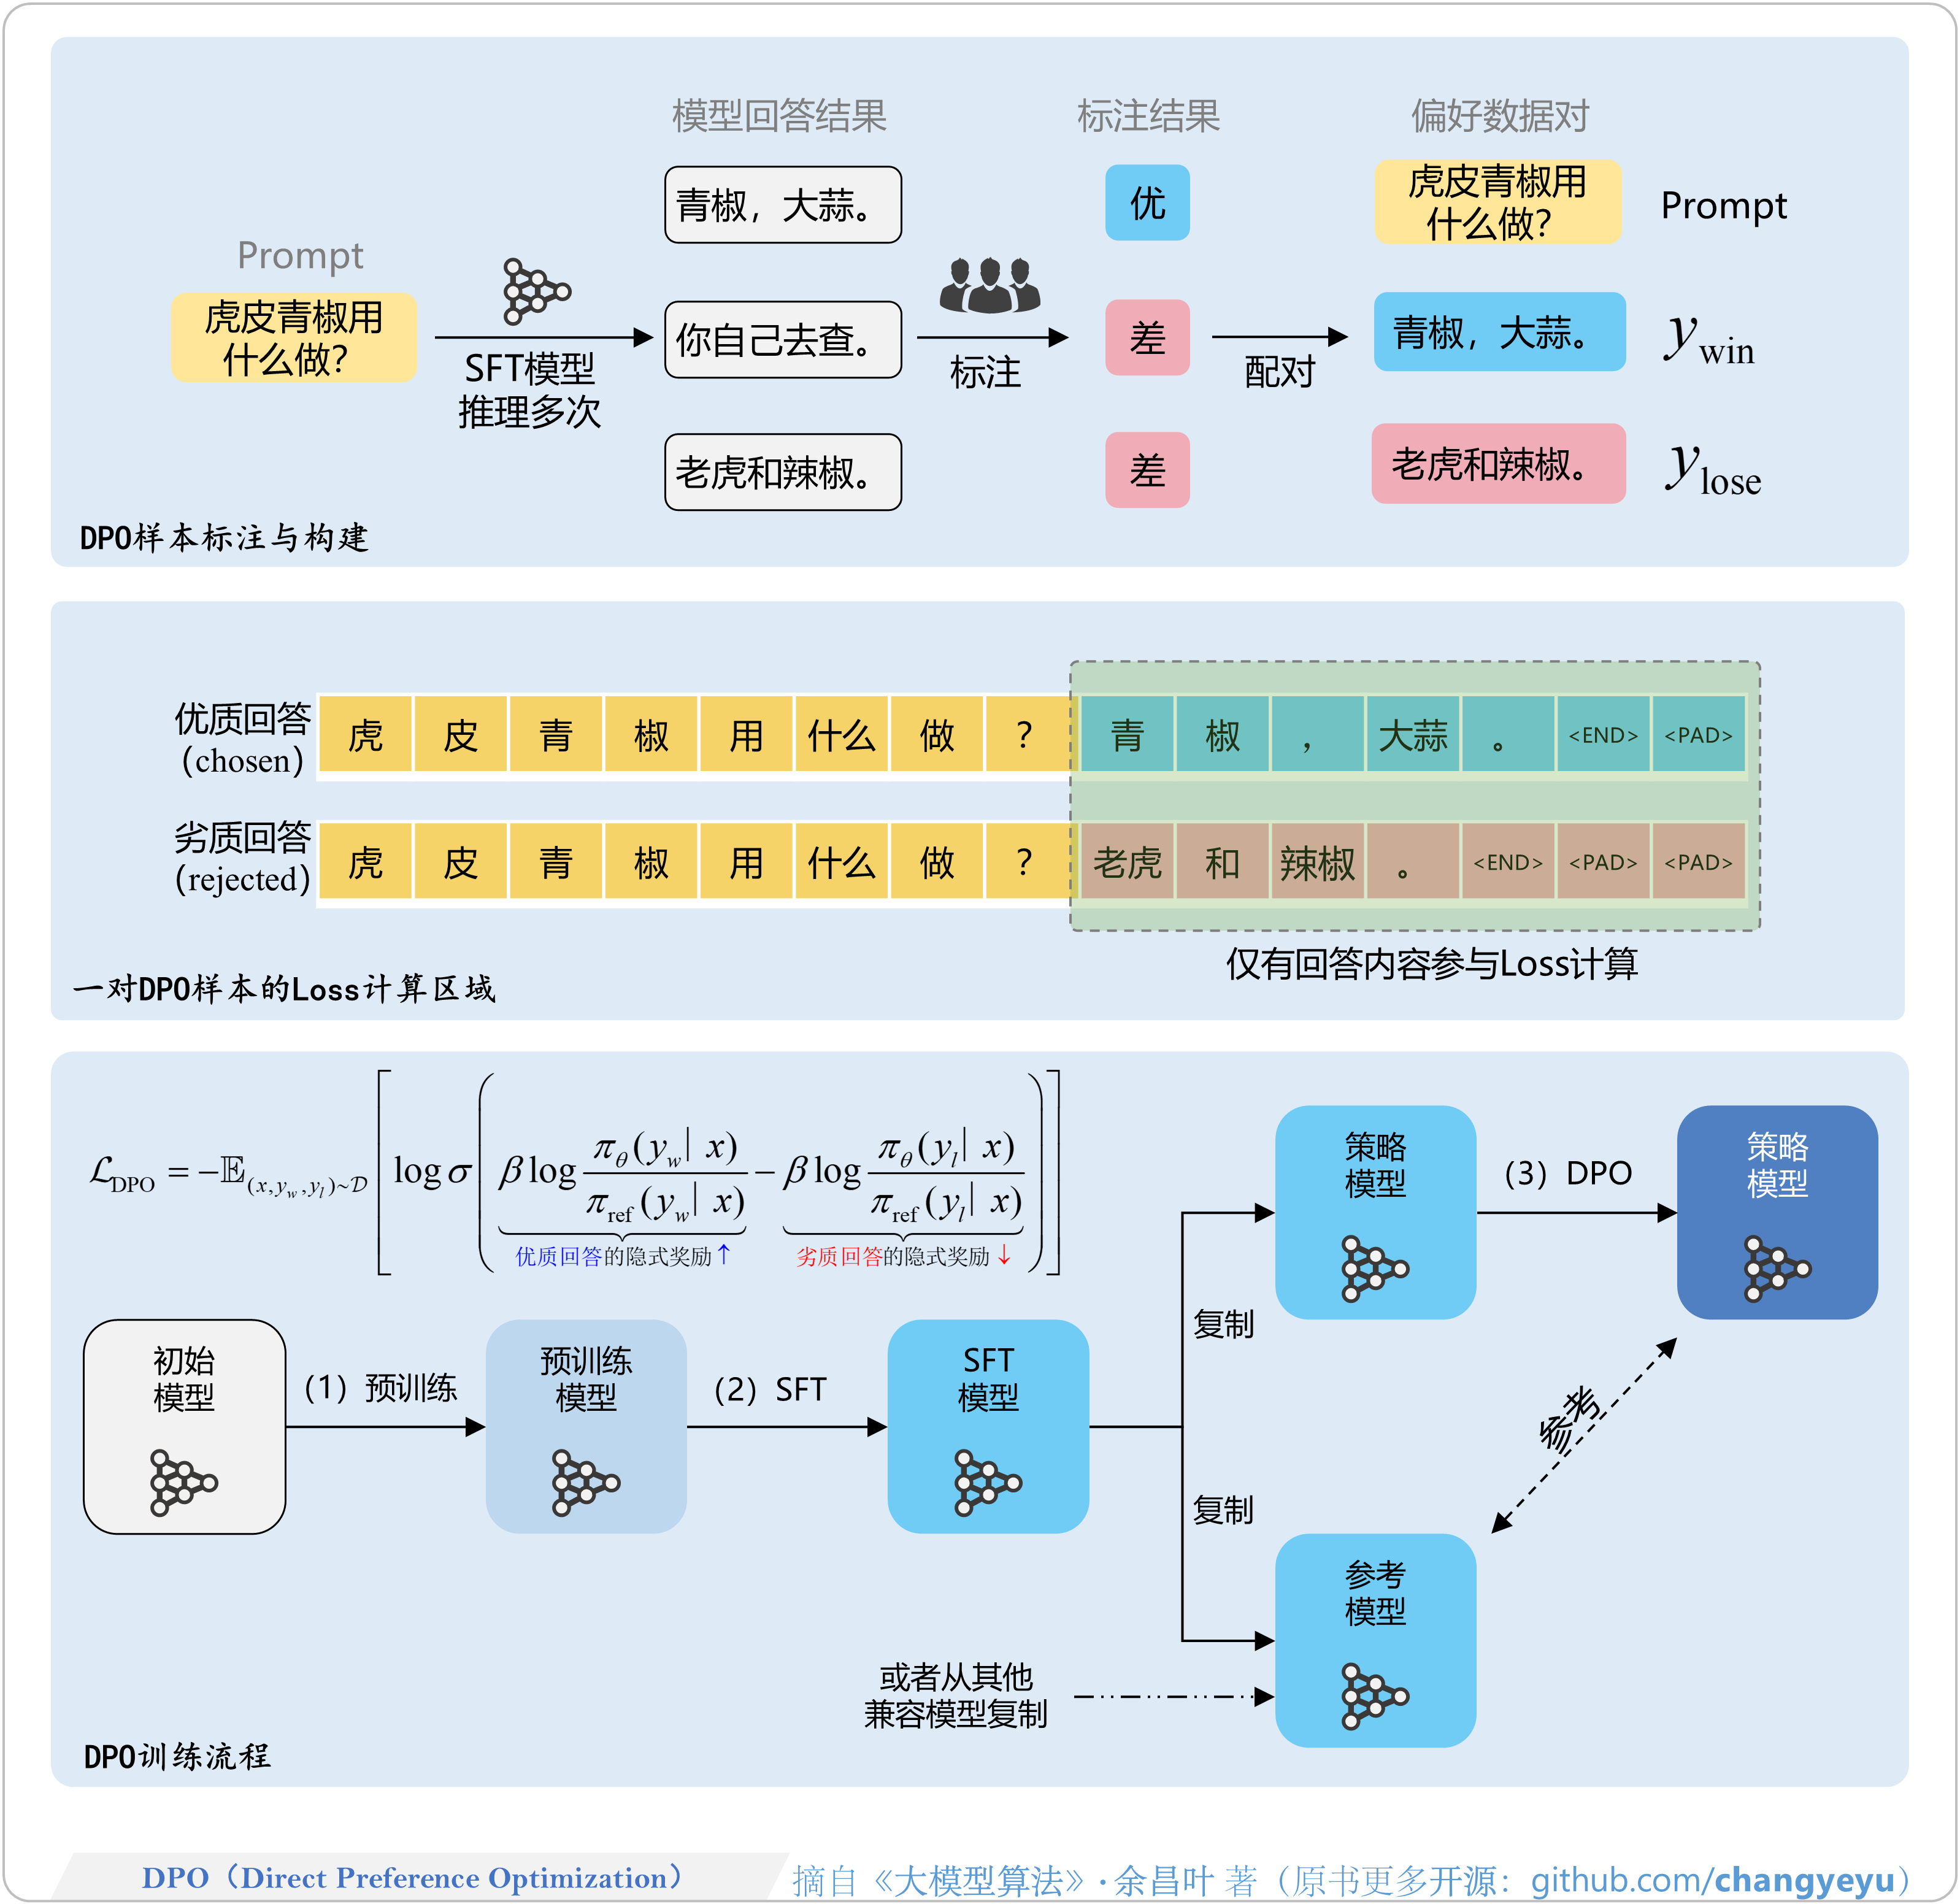
        3.3.2 DPO训练全景图
        3.3.3 DPO核心代码的提炼和解读
    3.4 DPO实践经验
        3.4.1 β参数如何调节
        3.4.2 DPO对模型能力的多维度影响
    3.5 DPO进阶
        3.5.1 DPO和RLHF(PPO)的对比
        3.5.2 理解DPO的梯度
第4章 免训练的效果优化技术
    4.1 提示工程
        4.1.1 Zero-Shot、One-Shot、Few-Shot
        4.1.2 Prompt设计的原则
    4.2 CoT(思维链)
        4.2.1 CoT原理图解
        4.2.2 ToT、GoT、XoT等衍生方法
        4.2.3 CoT的应用技巧
        4.2.4 CoT在多模态领域的应用
    4.3 生成控制和解码策略
        4.3.1 解码的原理与分类
        4.3.2 贪婪搜索
        4.3.3 Beam Search(波束搜索):图解、衍生方法
        4.3.4 Top-K、Top-P等采样方法图解
        4.3.5 其他解码策略
        4.3.6 多种生成控制参数
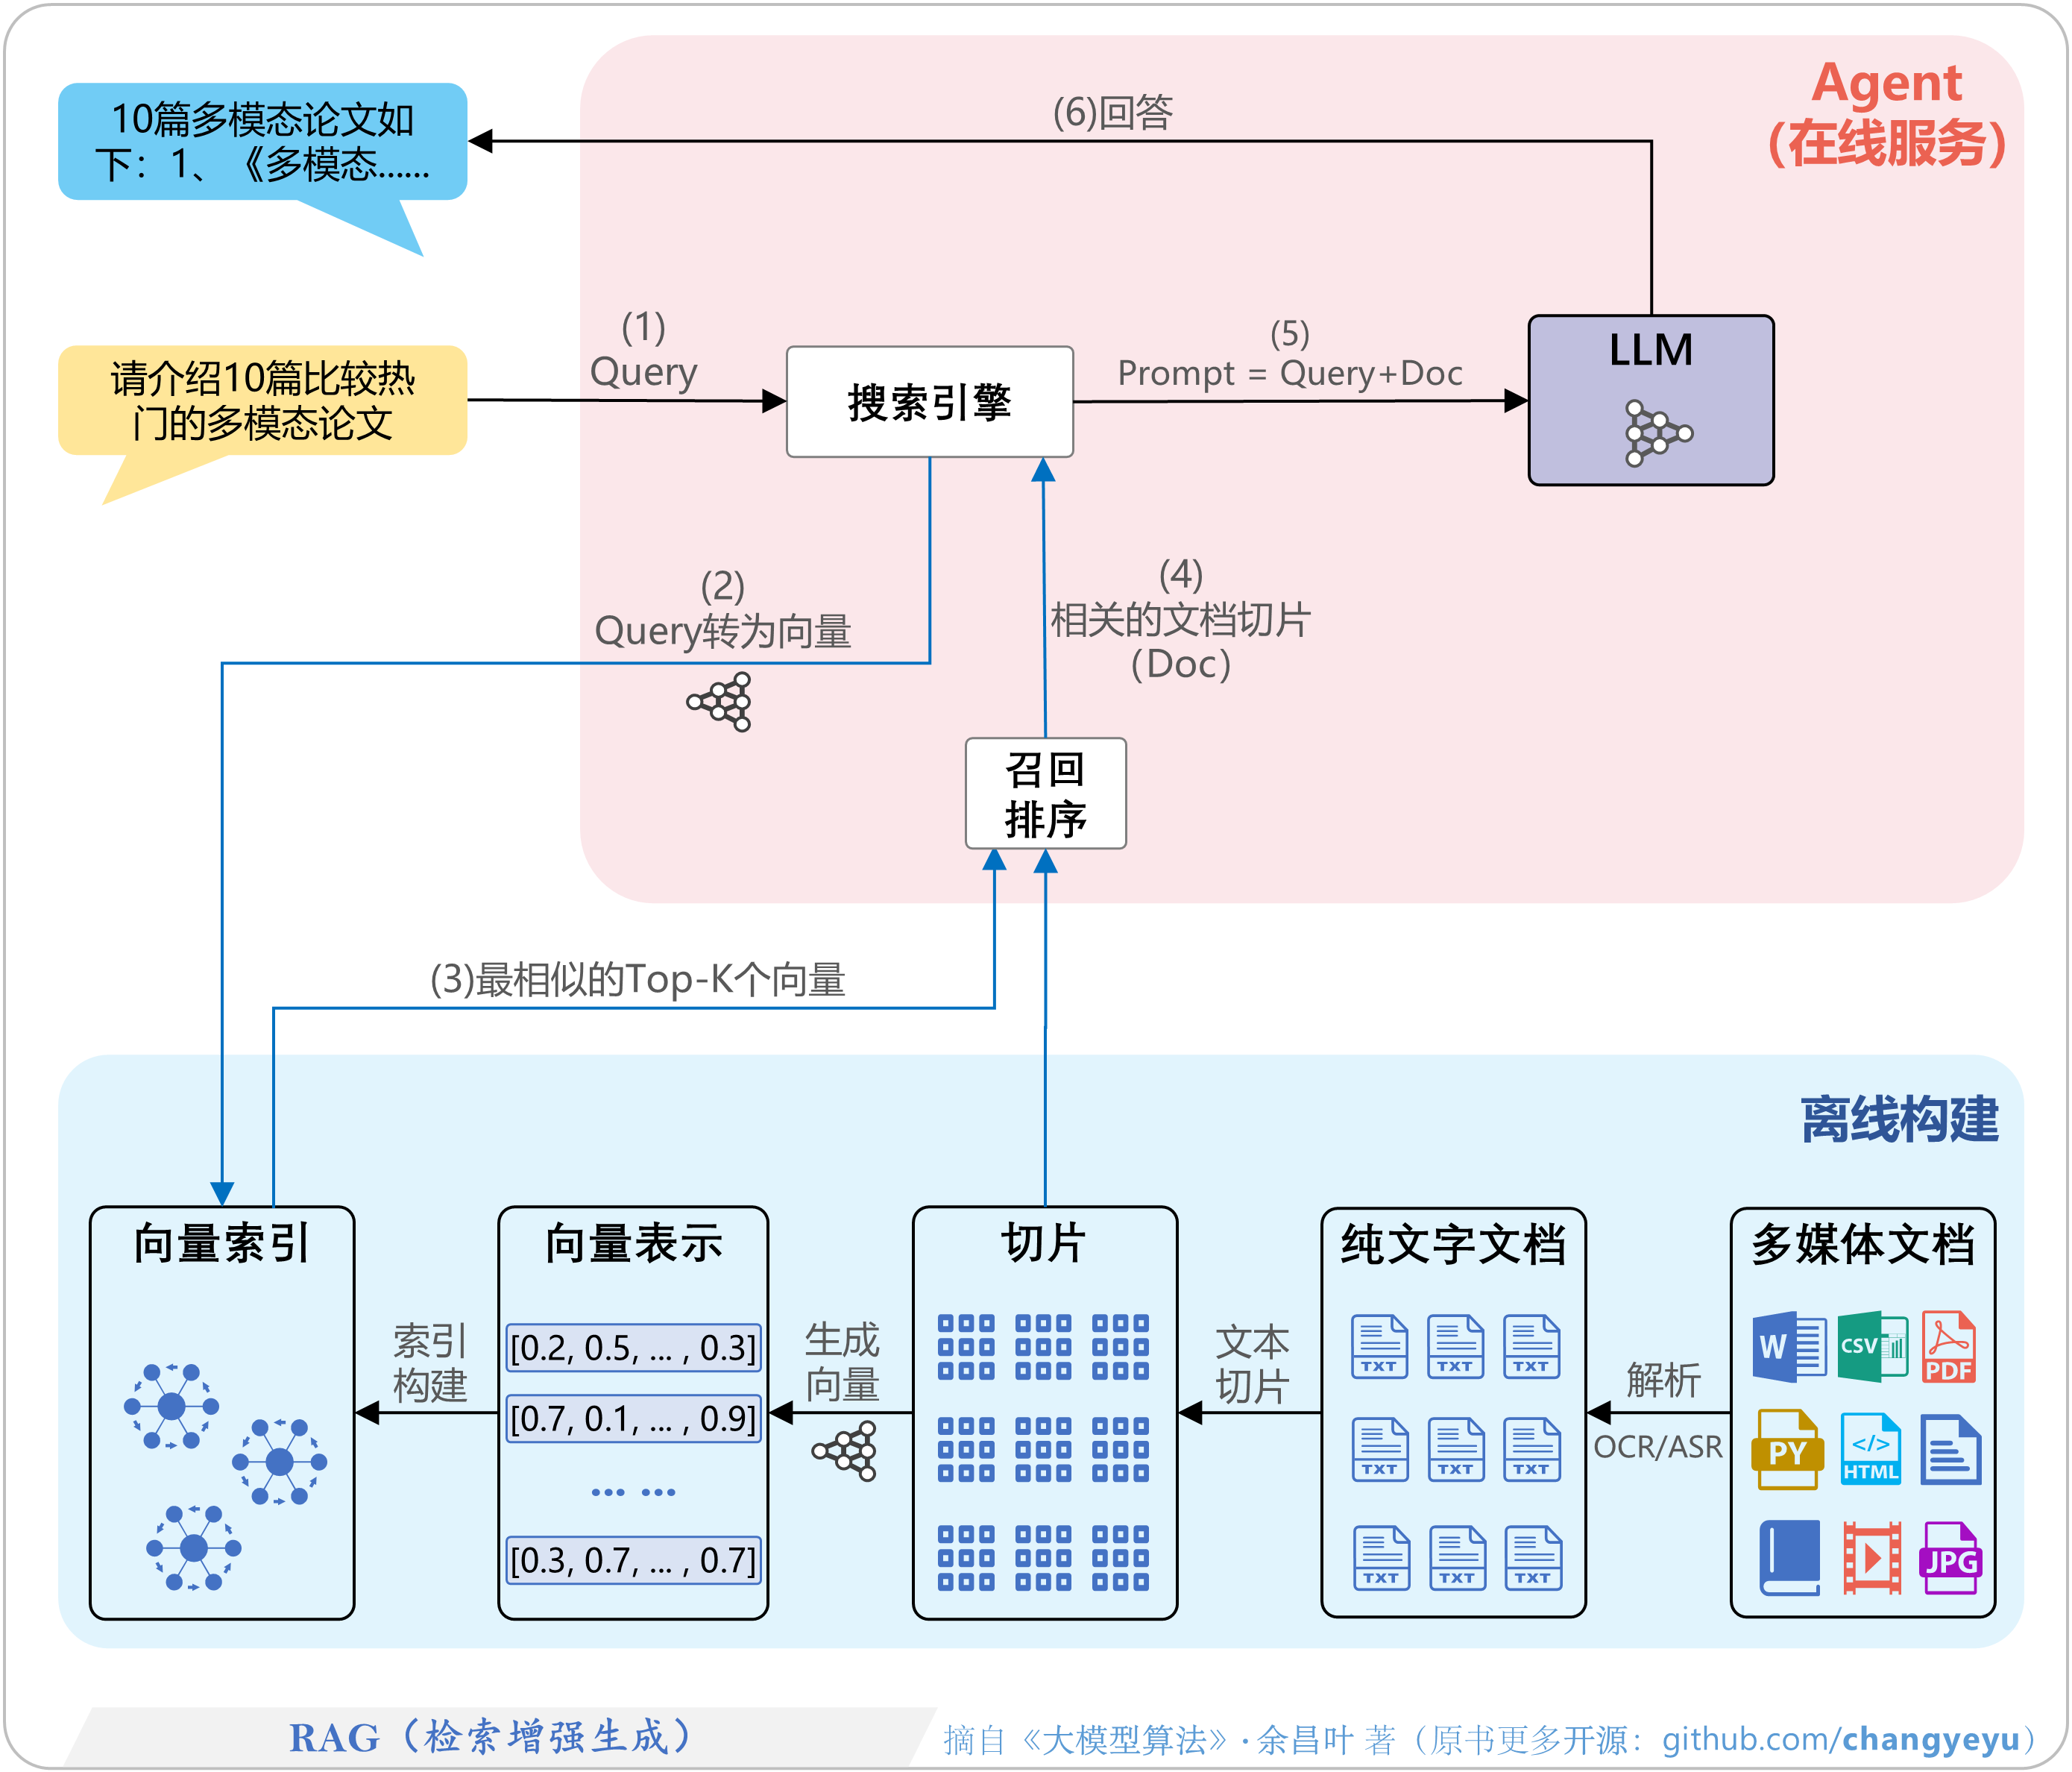
    4.4 RAG(检索增强生成)
        4.4.1 RAG技术全景图
        4.4.2 RAG相关框架
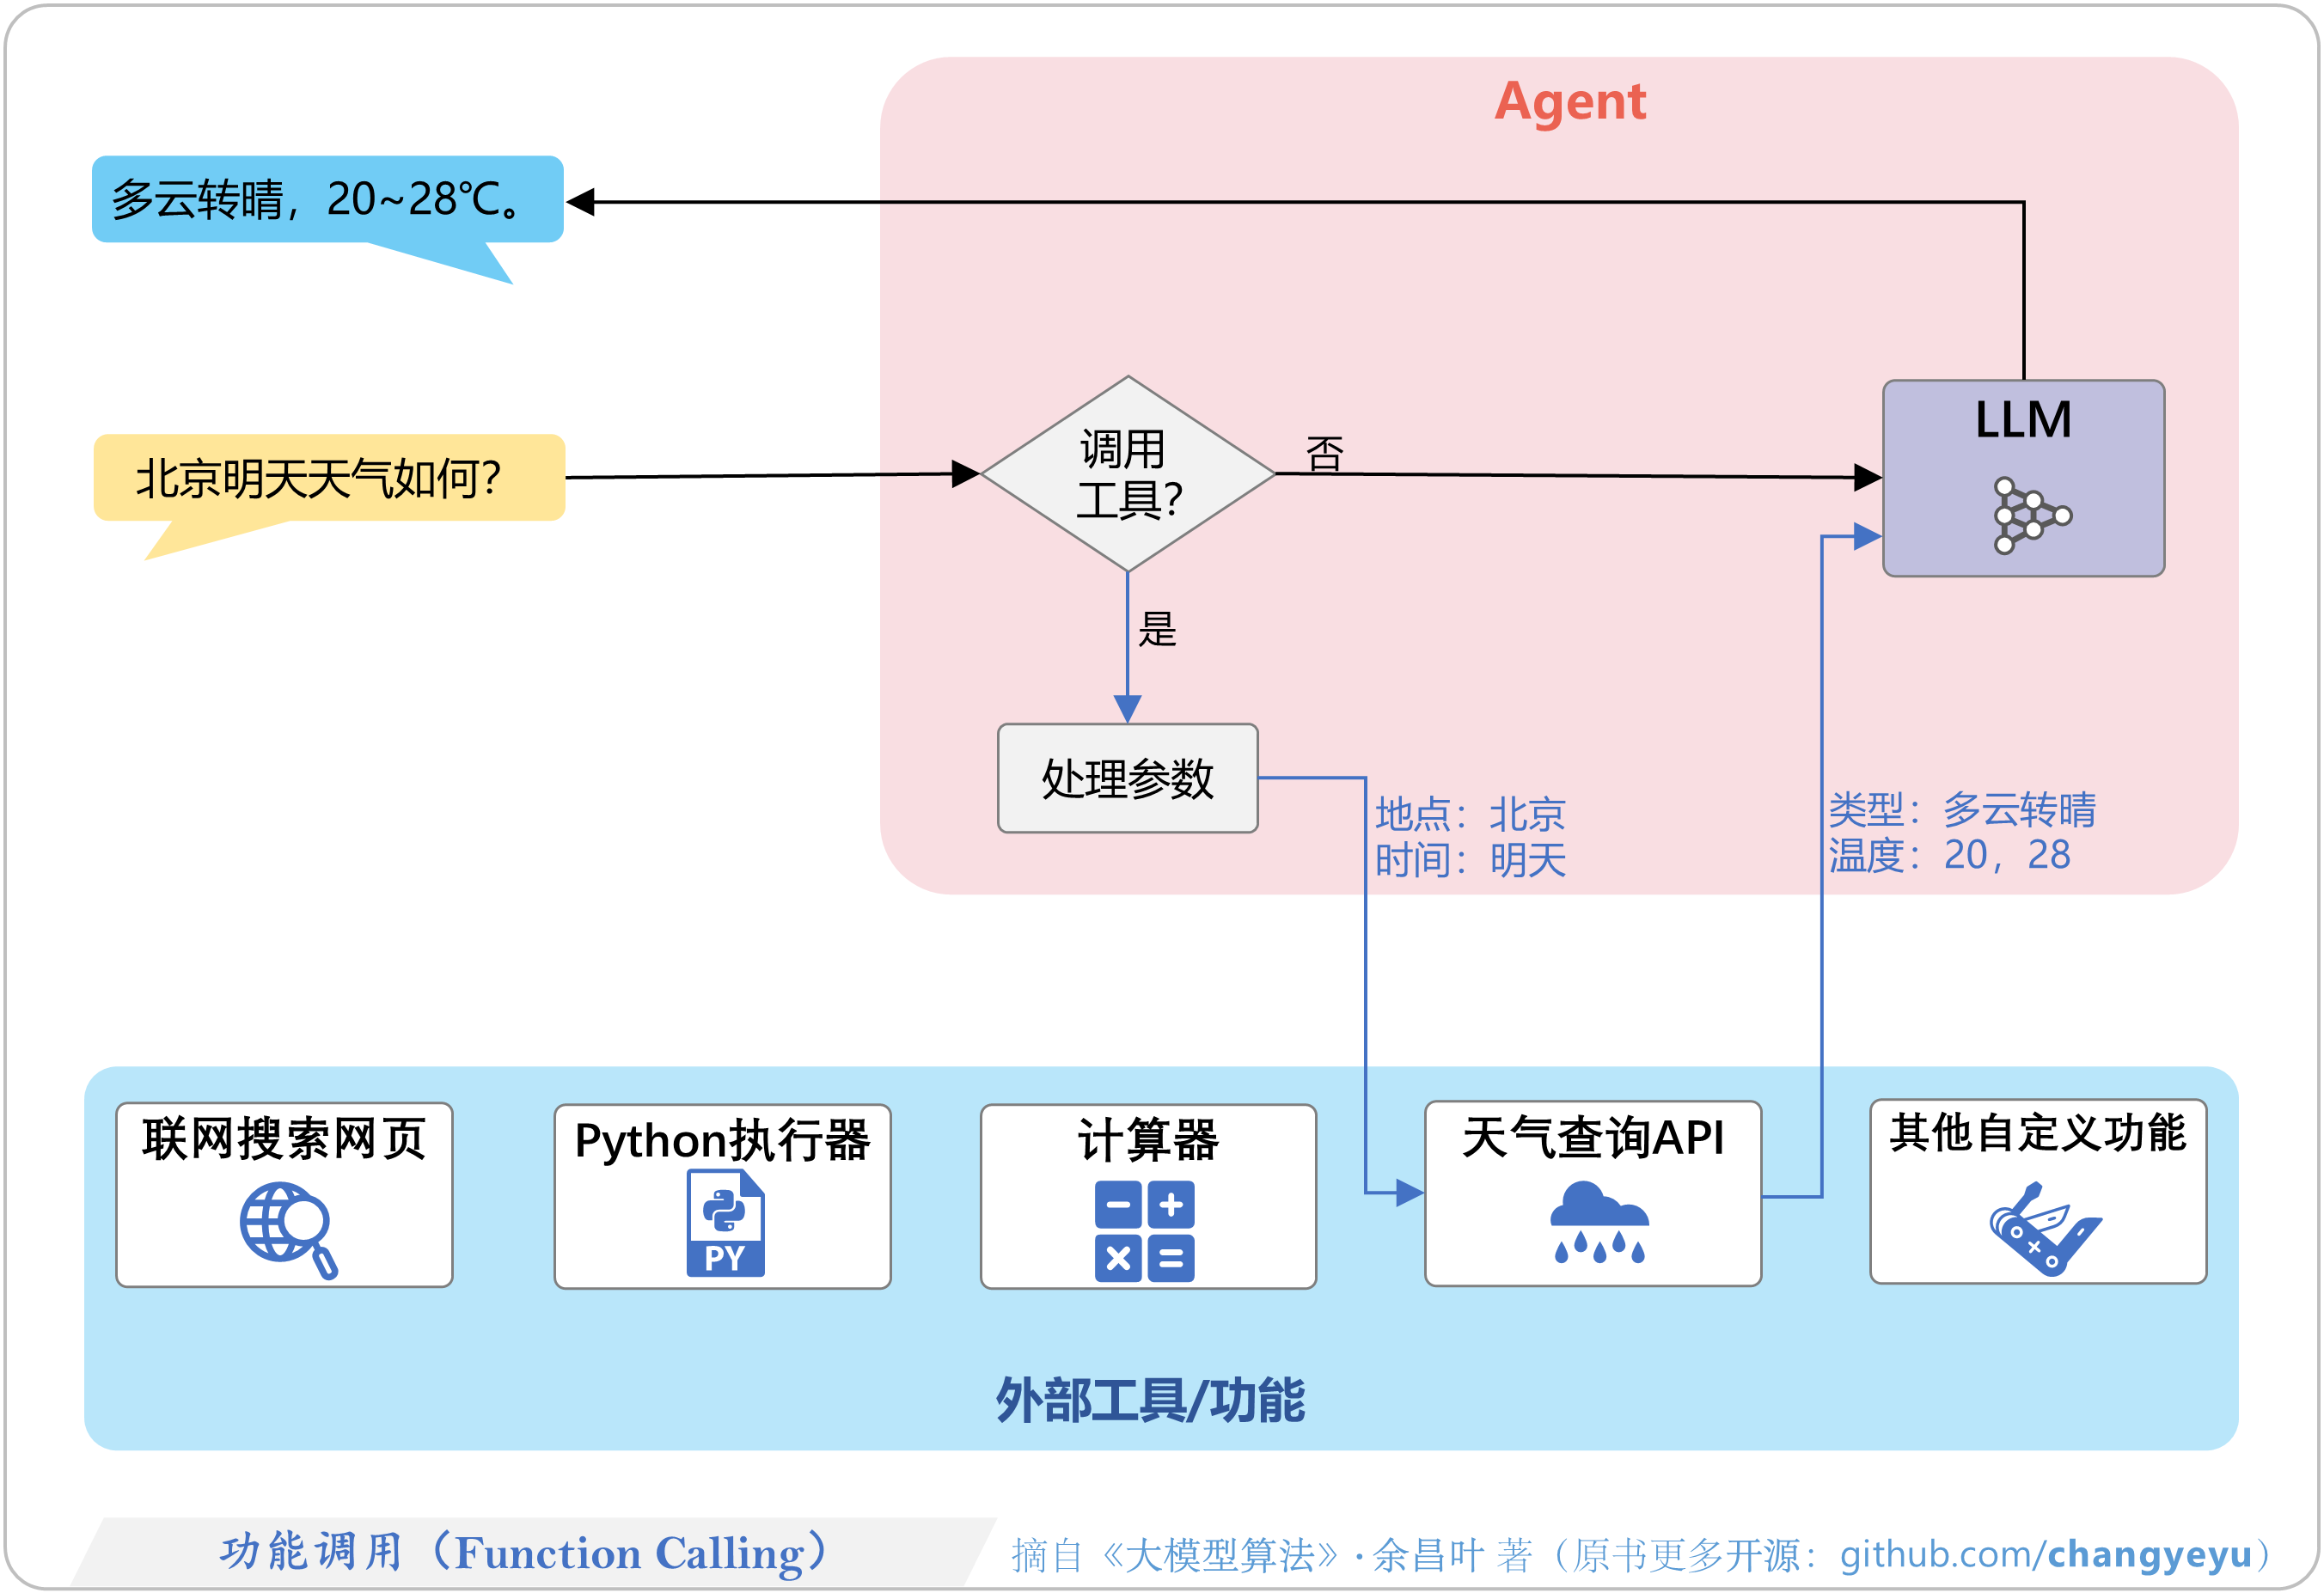
    4.5 功能与工具调用(Function Calling)
        4.5.1 功能调用全景图
        4.5.2 功能调用的分类
第5章 强化学习基础
    5.1 强化学习核心
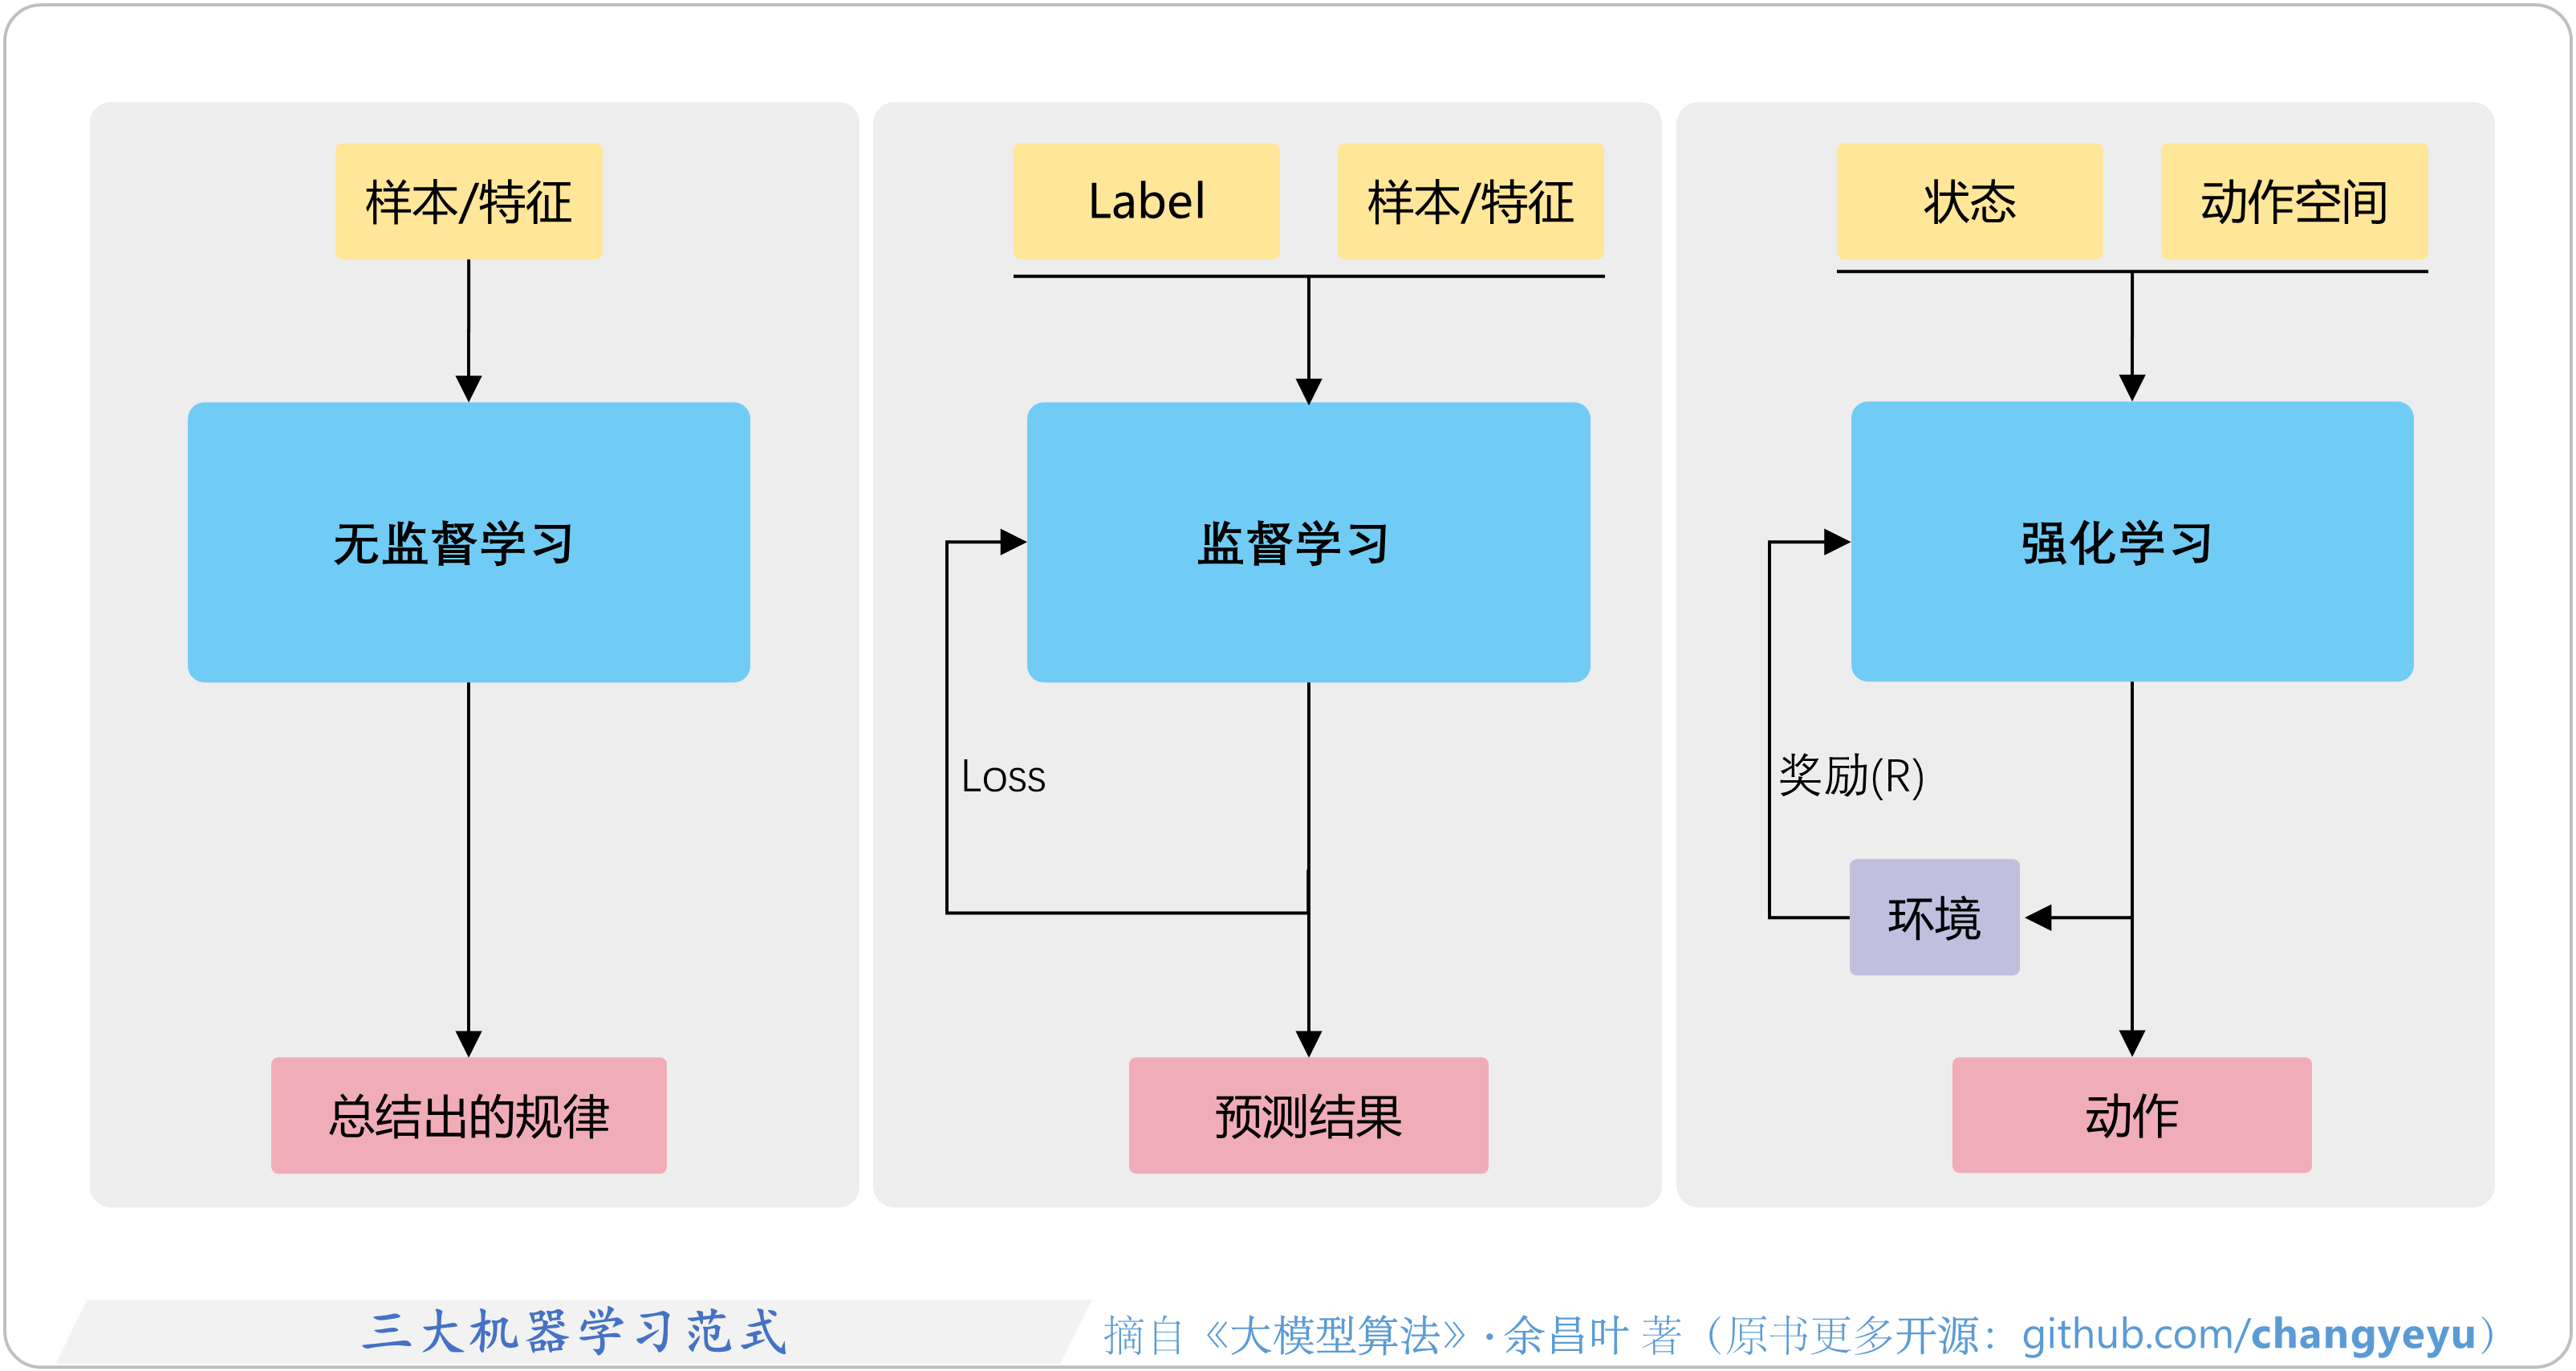
        5.1.1 强化学习:定义与区分
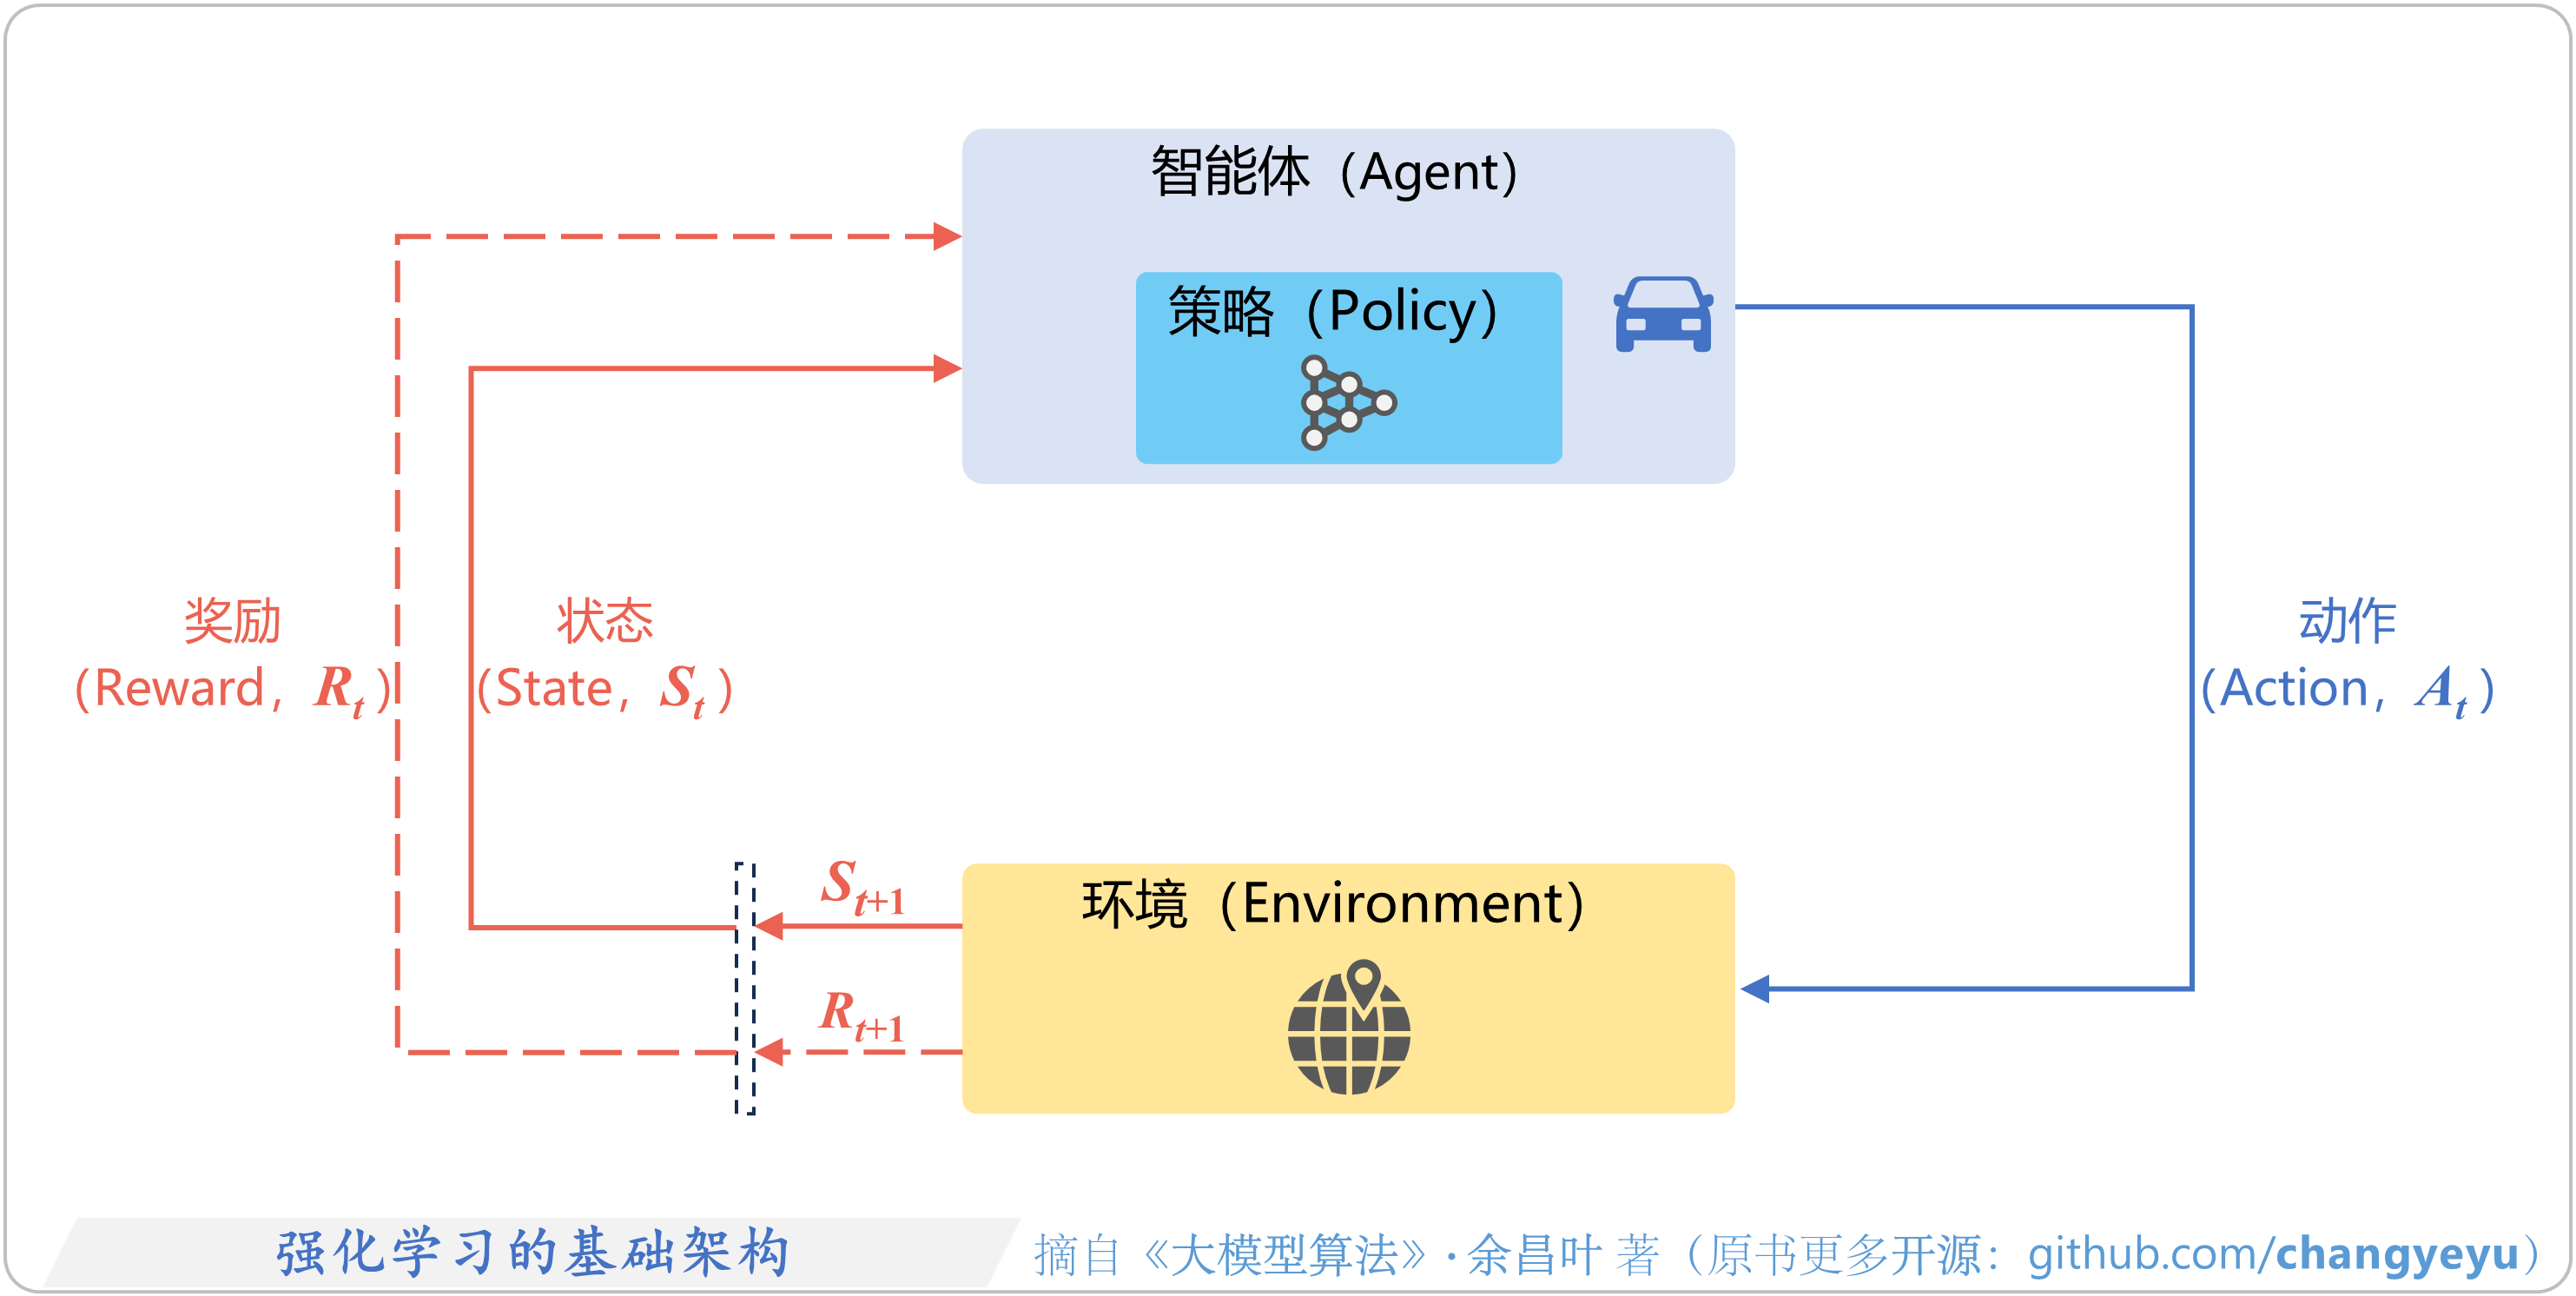
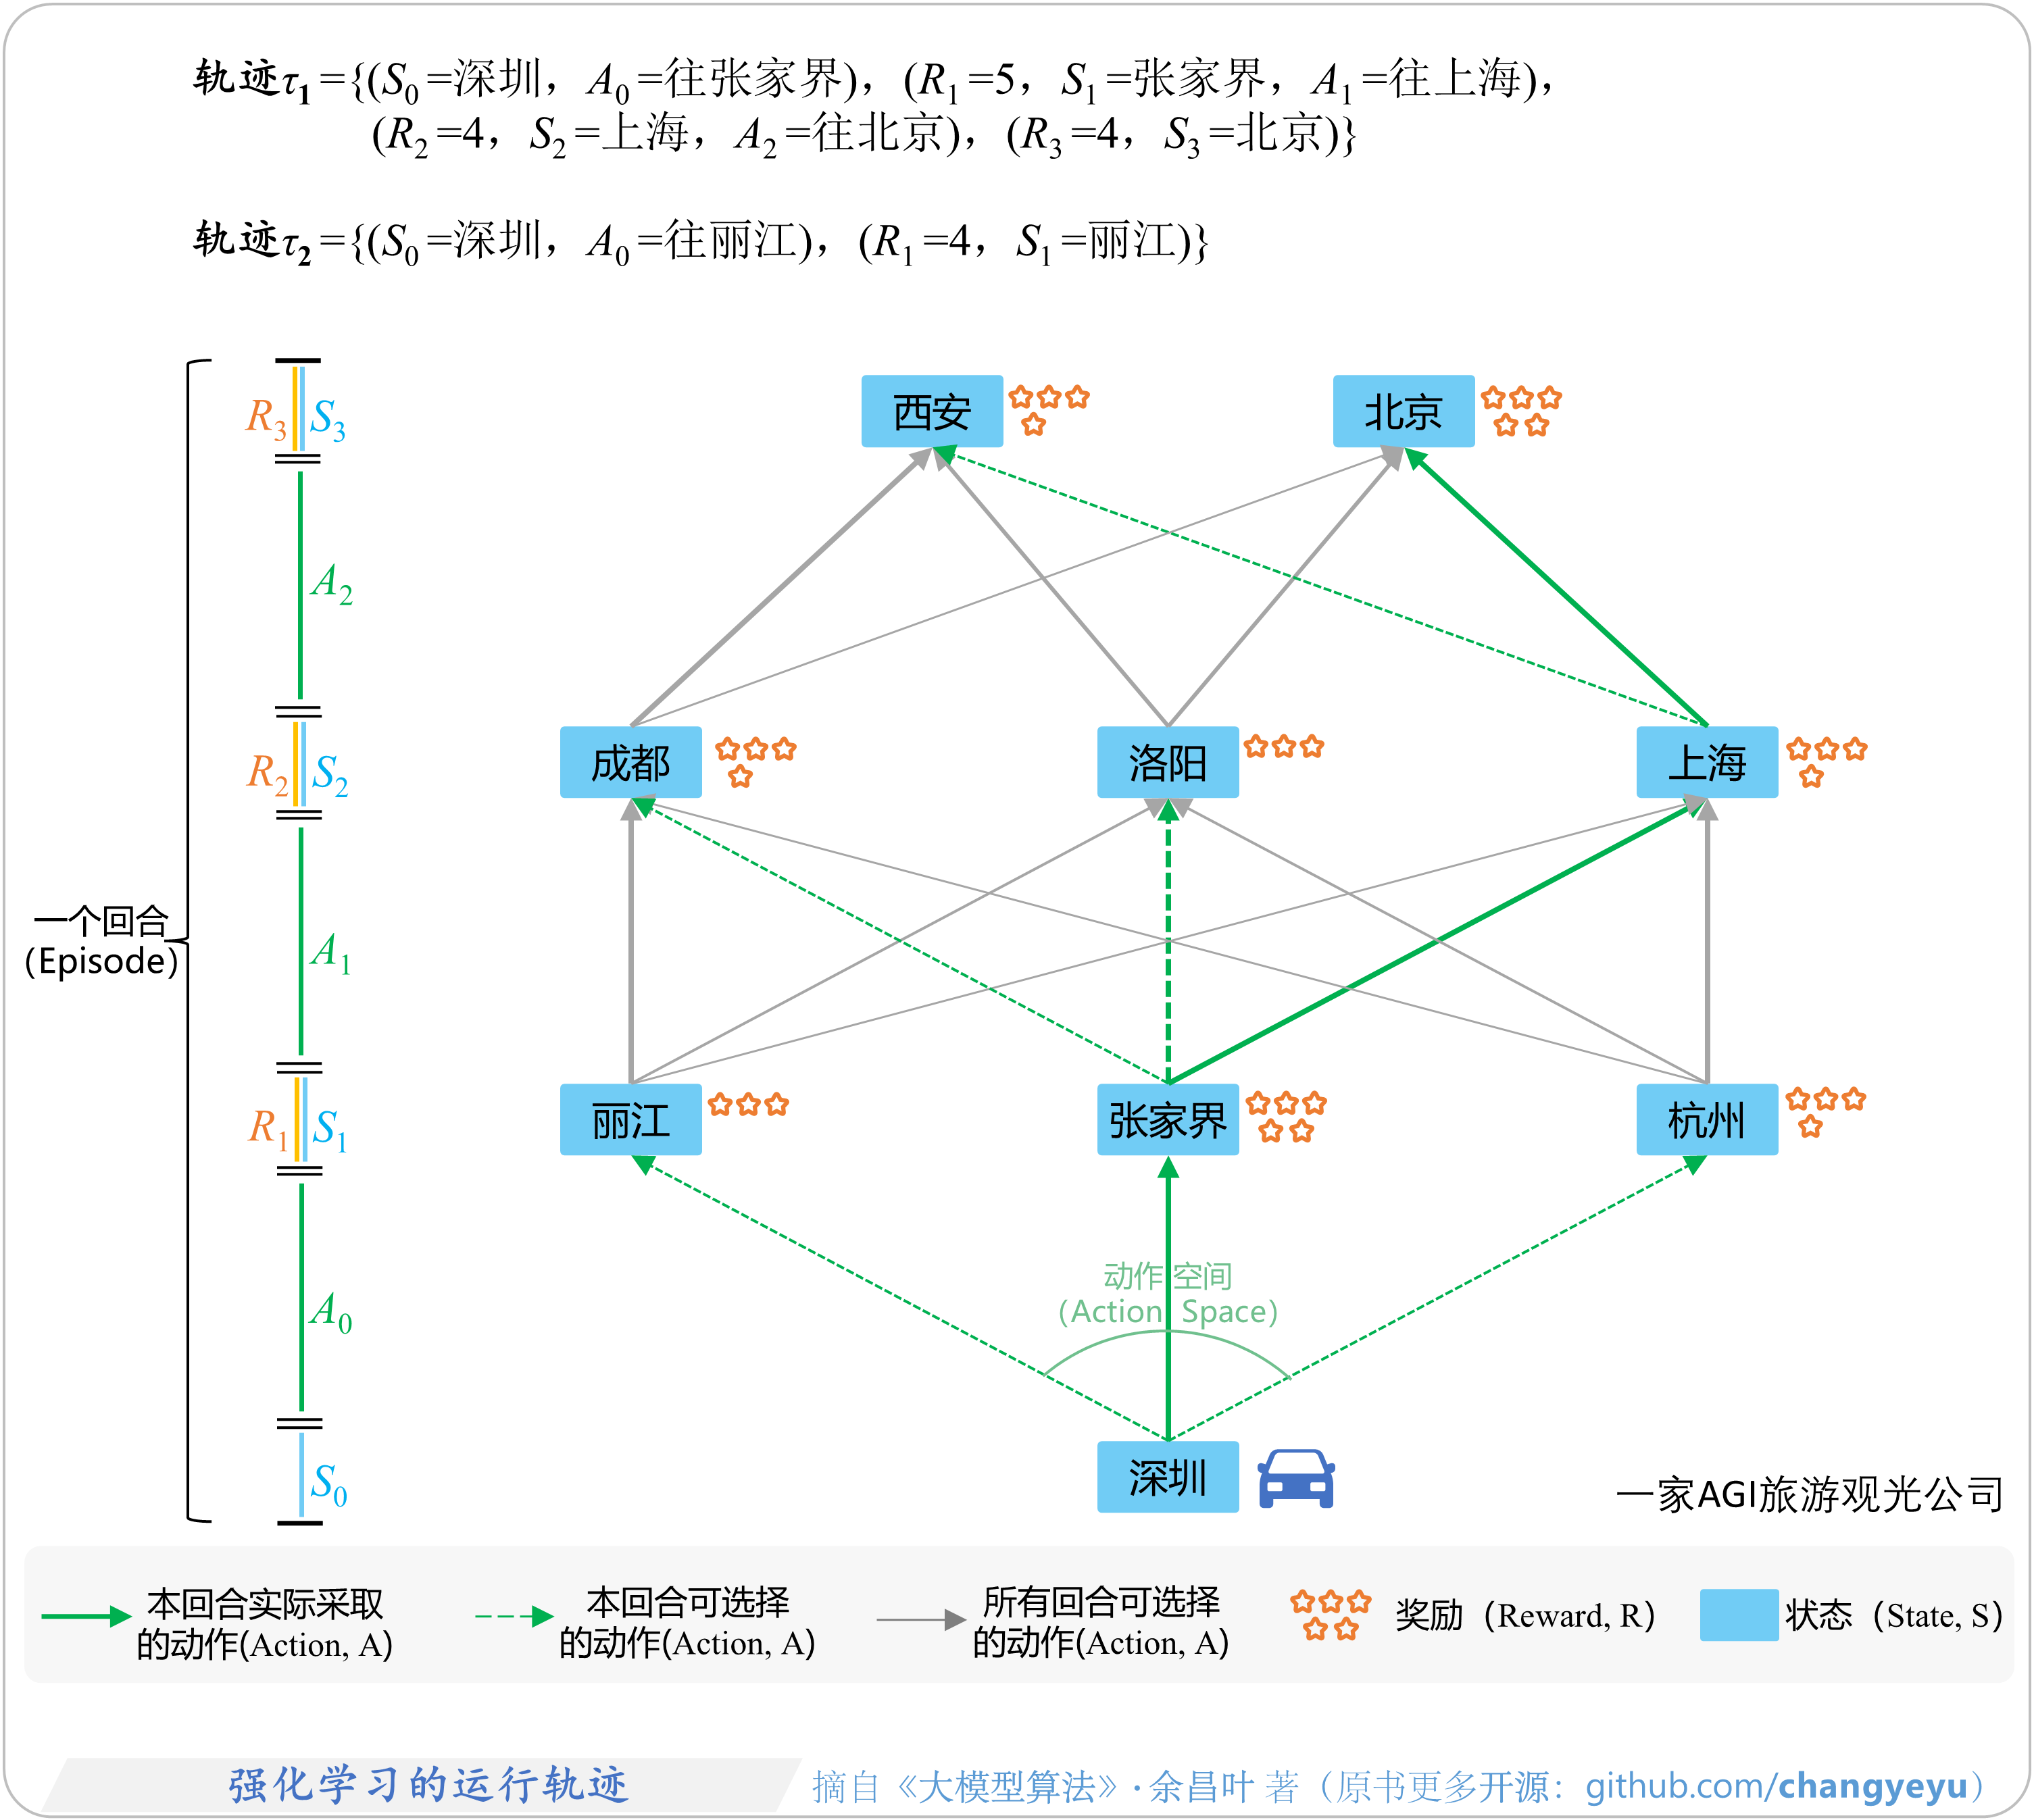
        5.1.2 强化学习的基础架构、核心概念
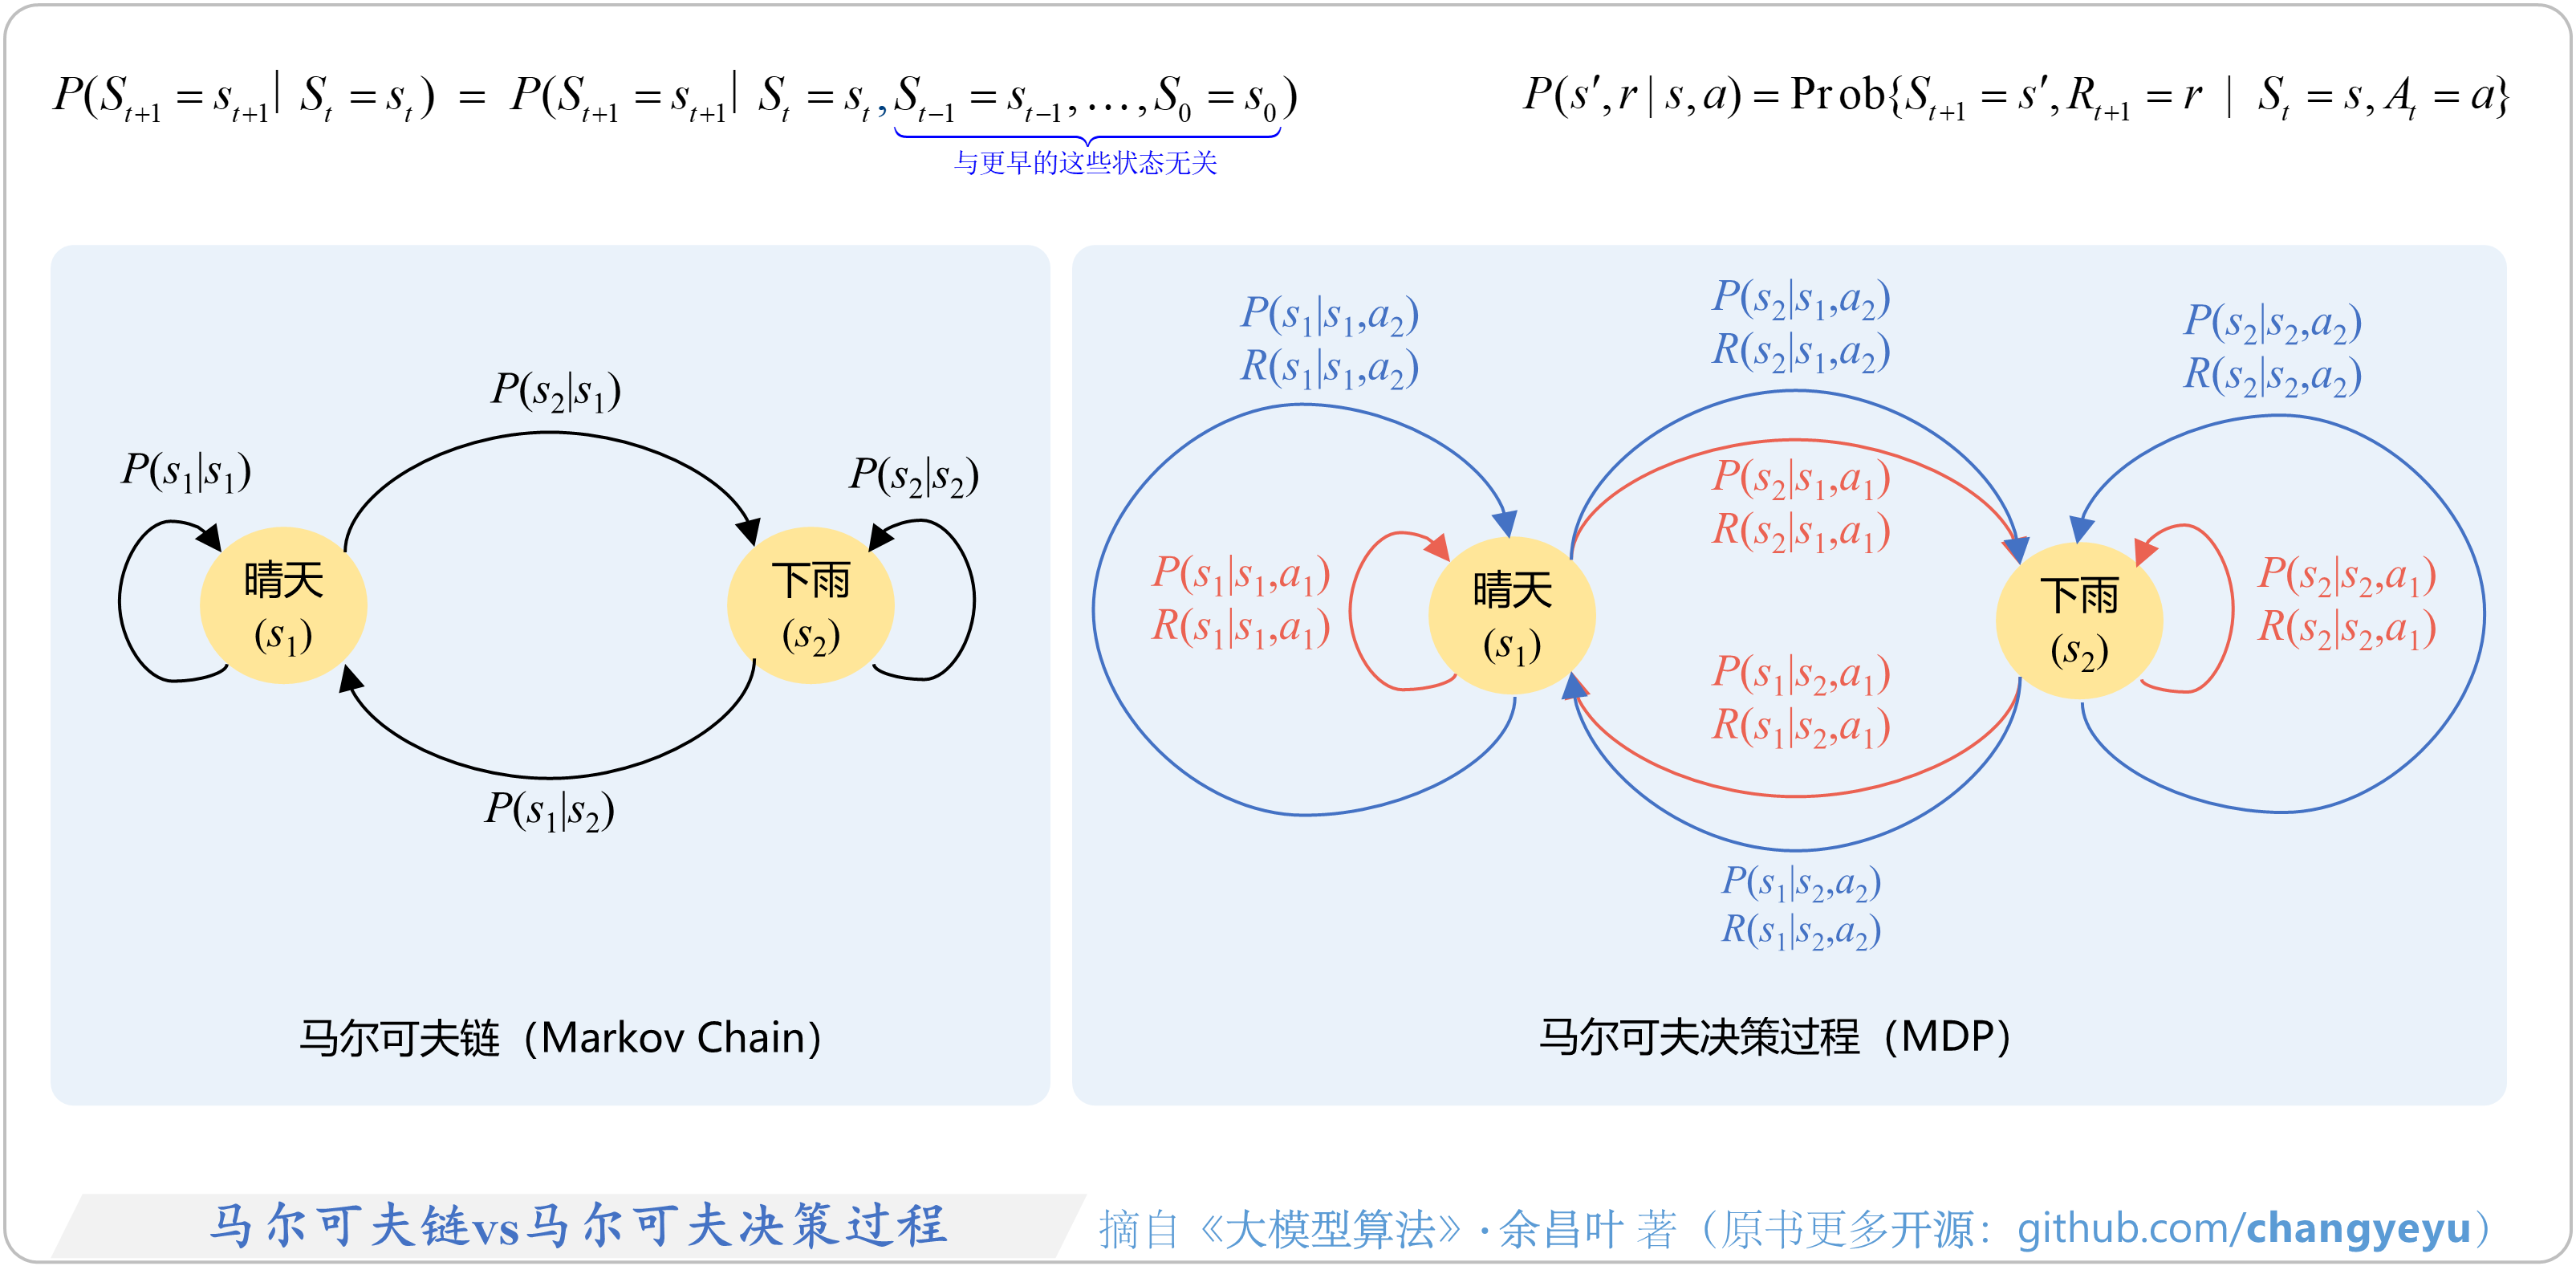
        5.1.3 马尔可夫决策过程(MDP)
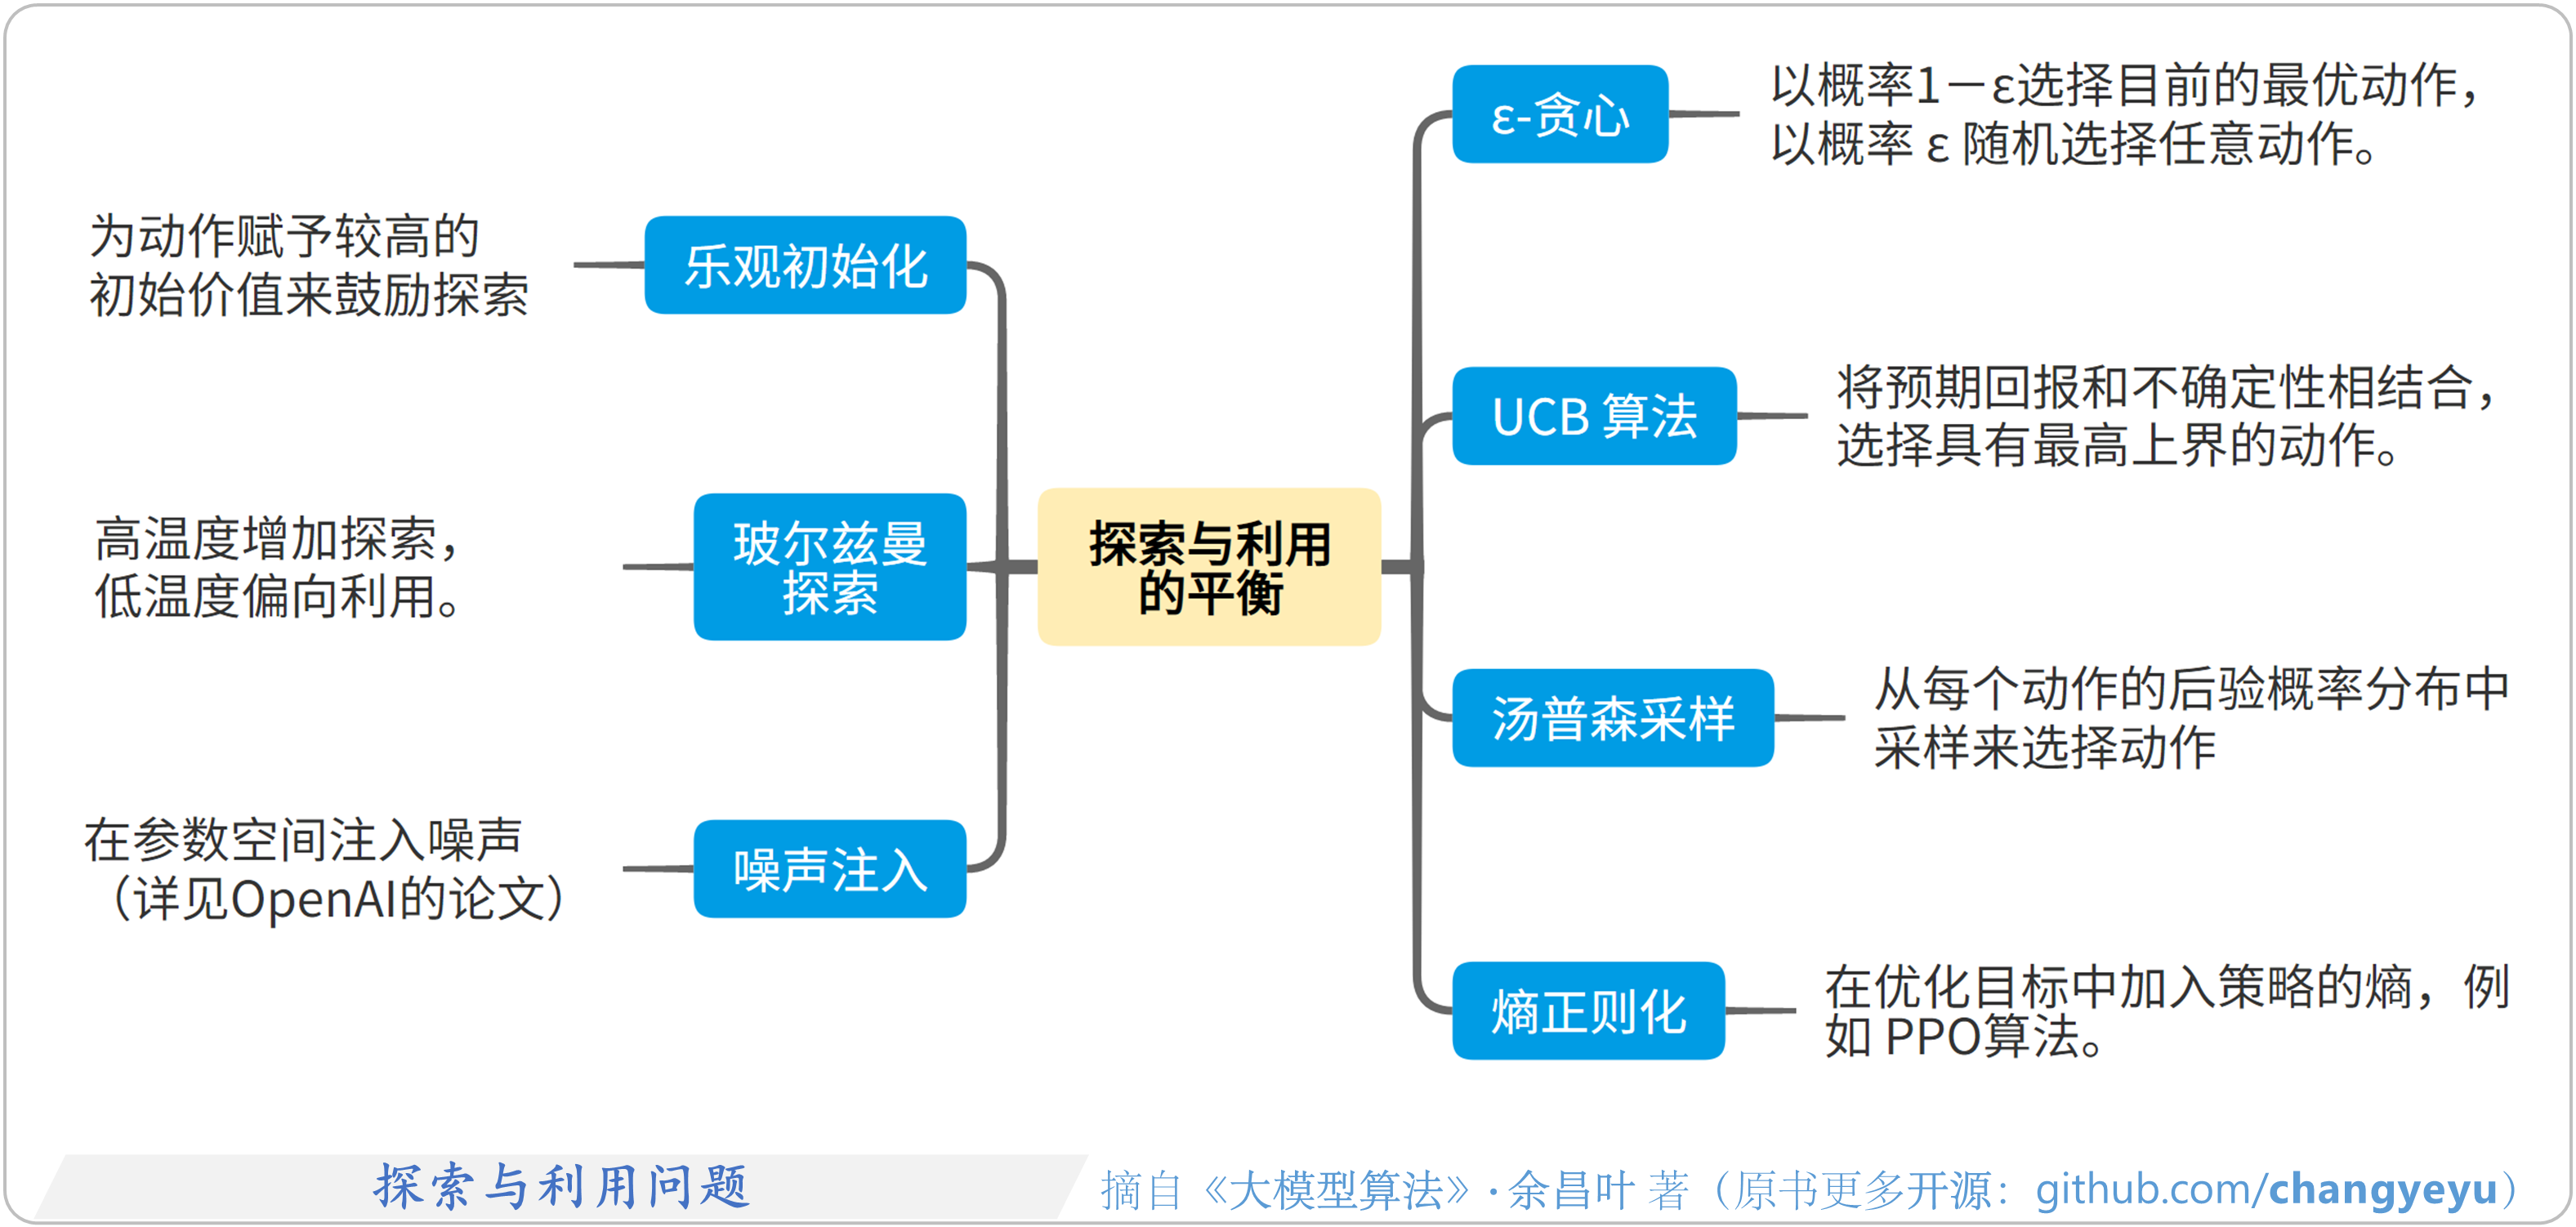
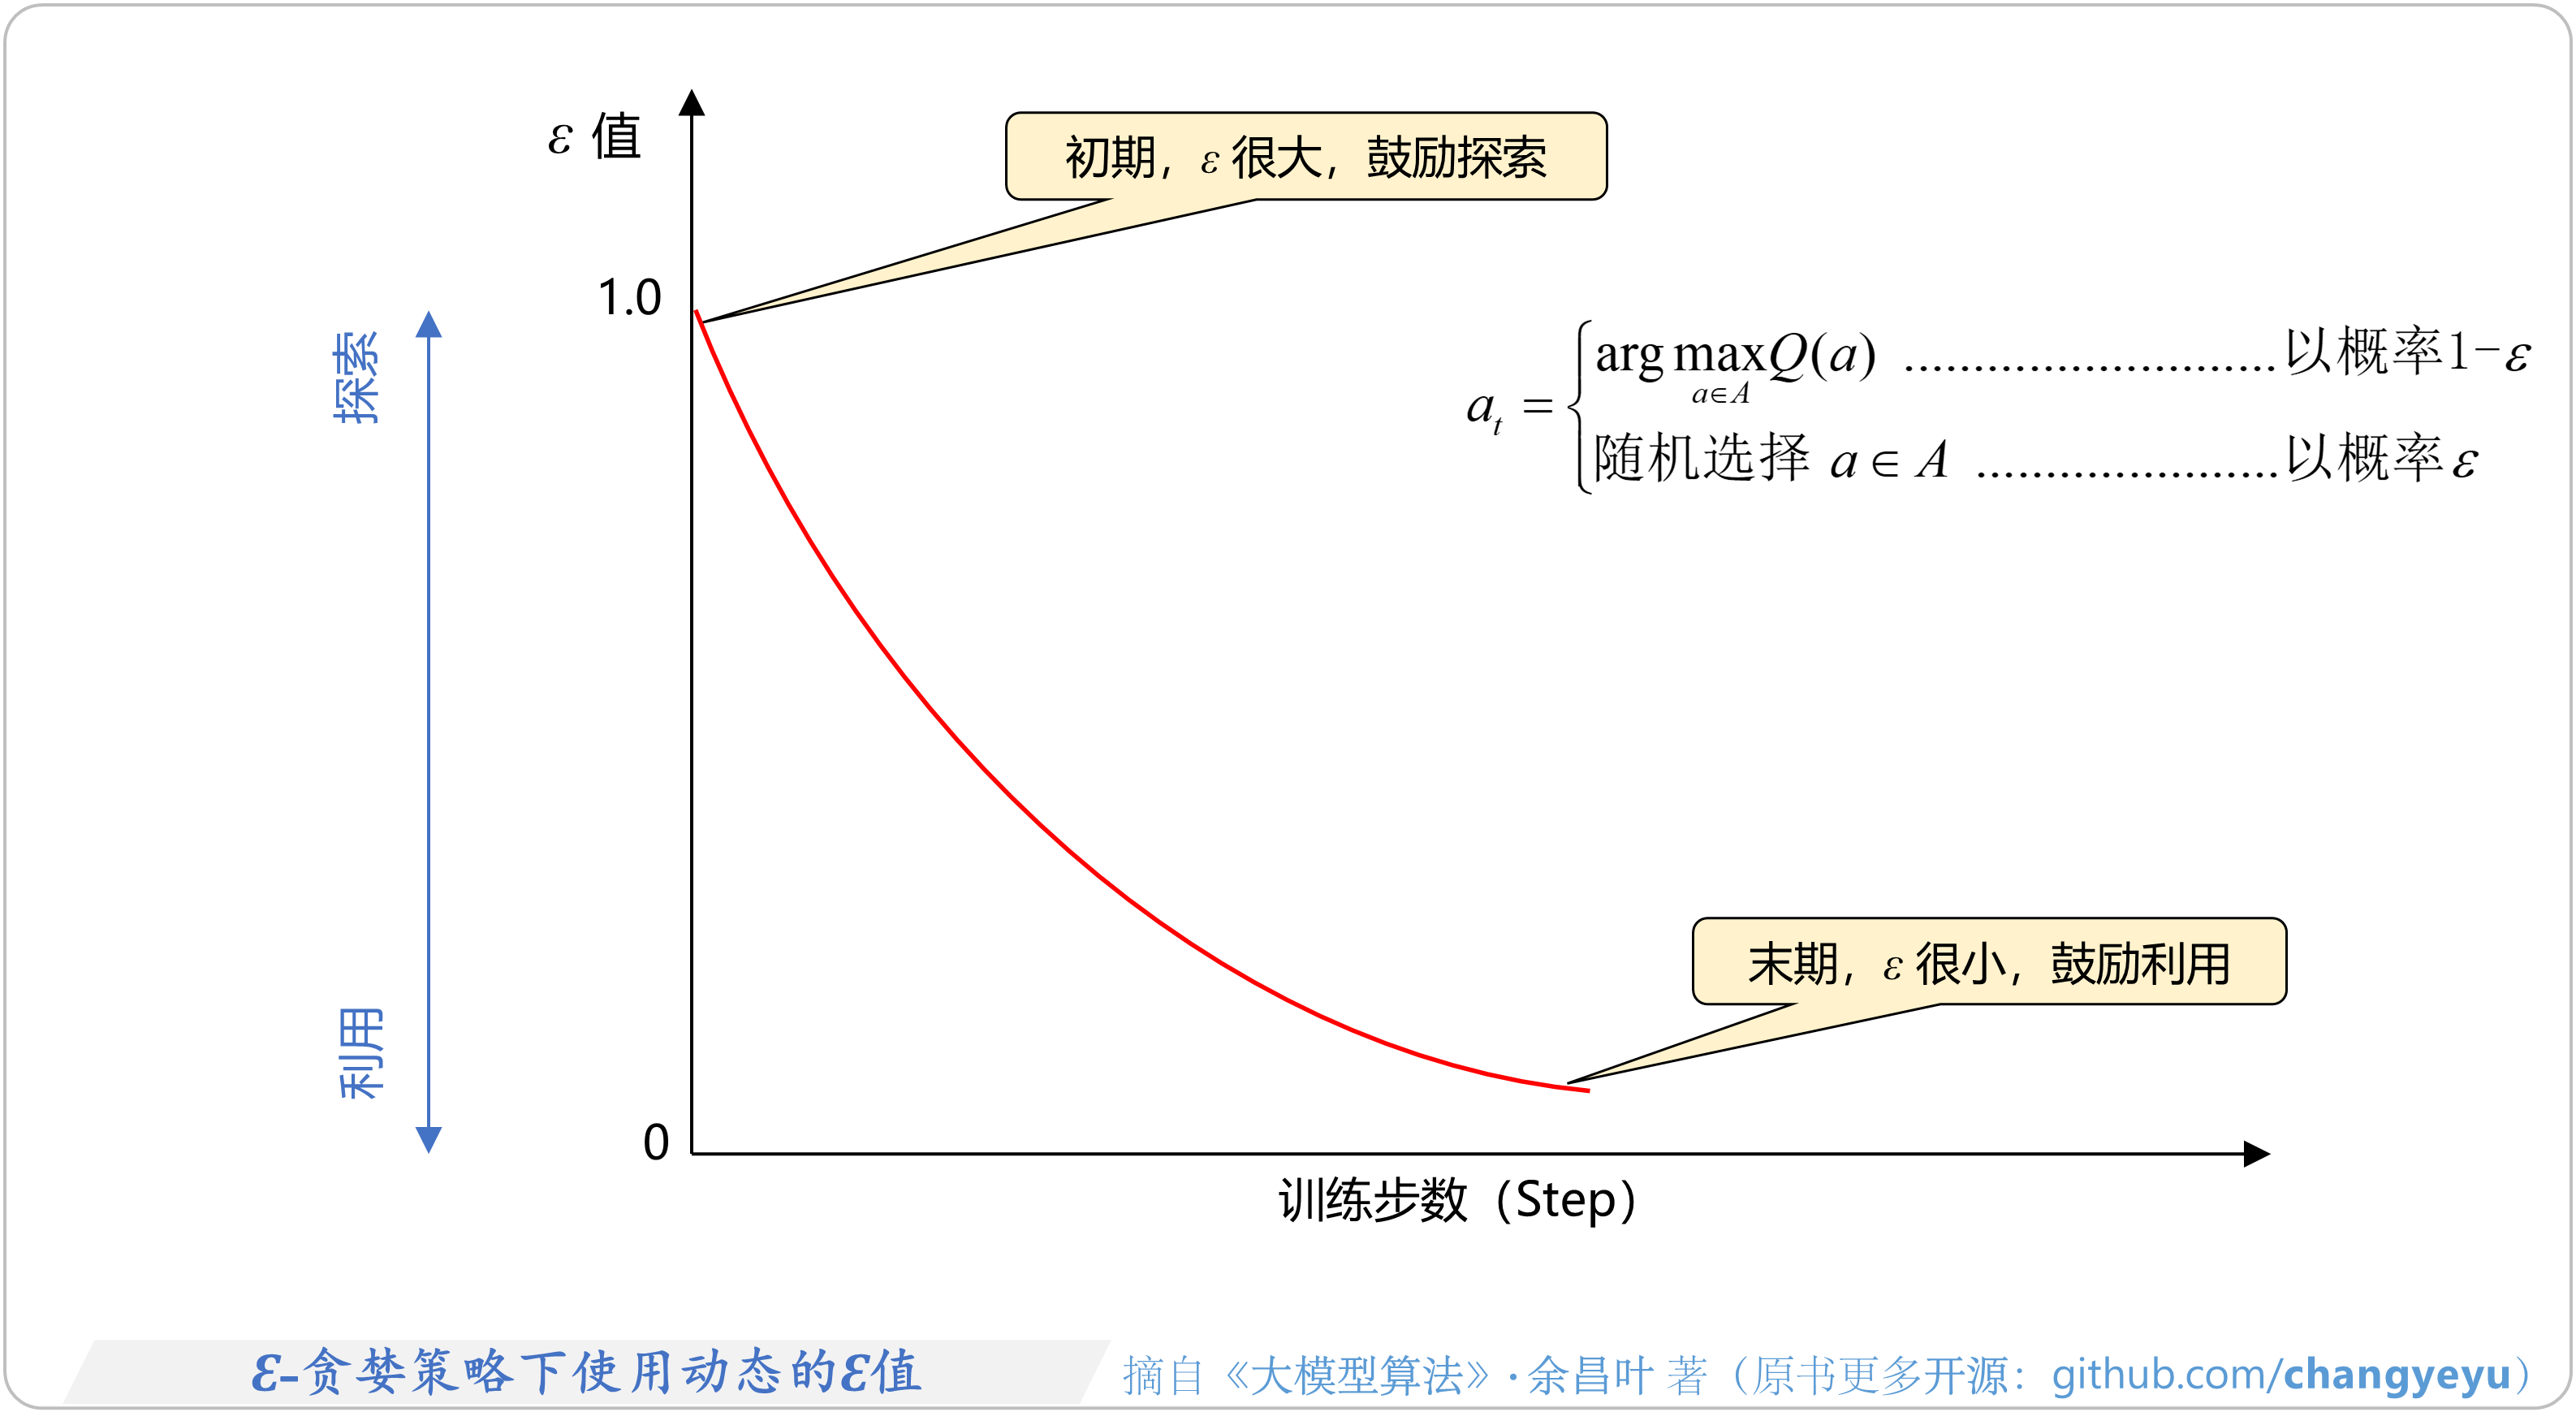
        5.1.4 探索与利用、ε-贪婪策略
        5.1.5 同策略(On-policy)、异策略(Off-policy)
        5.1.6 在线/离线强化学习(Online/Offline RL)
        5.1.7 强化学习分类图
    5.2 价值函数、回报预估
        5.2.1 奖励、回报、折扣因子(R、G、γ)
        5.2.2 反向计算回报
        5.2.3 四种价值函数:Qπ、Vπ、V*、Q*
        5.2.4 奖励、回报、价值的区别
        5.2.5 贝尔曼方程——强化学习的基石
        5.2.6 Q和V的转换关系、转换图
        5.2.7 蒙特卡洛方法(MC)
    5.3 时序差分(TD)
        5.3.1 时序差分方法
        5.3.2 TD-Target和TD-Error
        5.3.3 TD(λ)、多步TD
        5.3.4 蒙特卡洛、TD、DP、穷举搜索的区别
    5.4 基于价值的算法
        5.4.1 Q-learning算法
        5.4.2 DQN
        5.4.3 DQN的Loss、训练过程
        5.4.4 DDQN、Dueling DQN等衍生算法
    5.5 策略梯度算法
        5.5.1 策略梯度(Policy Gradient)
        5.5.2 策略梯度定理
        5.5.3 REINFORCE和Actor-Critic:策略梯度的应用
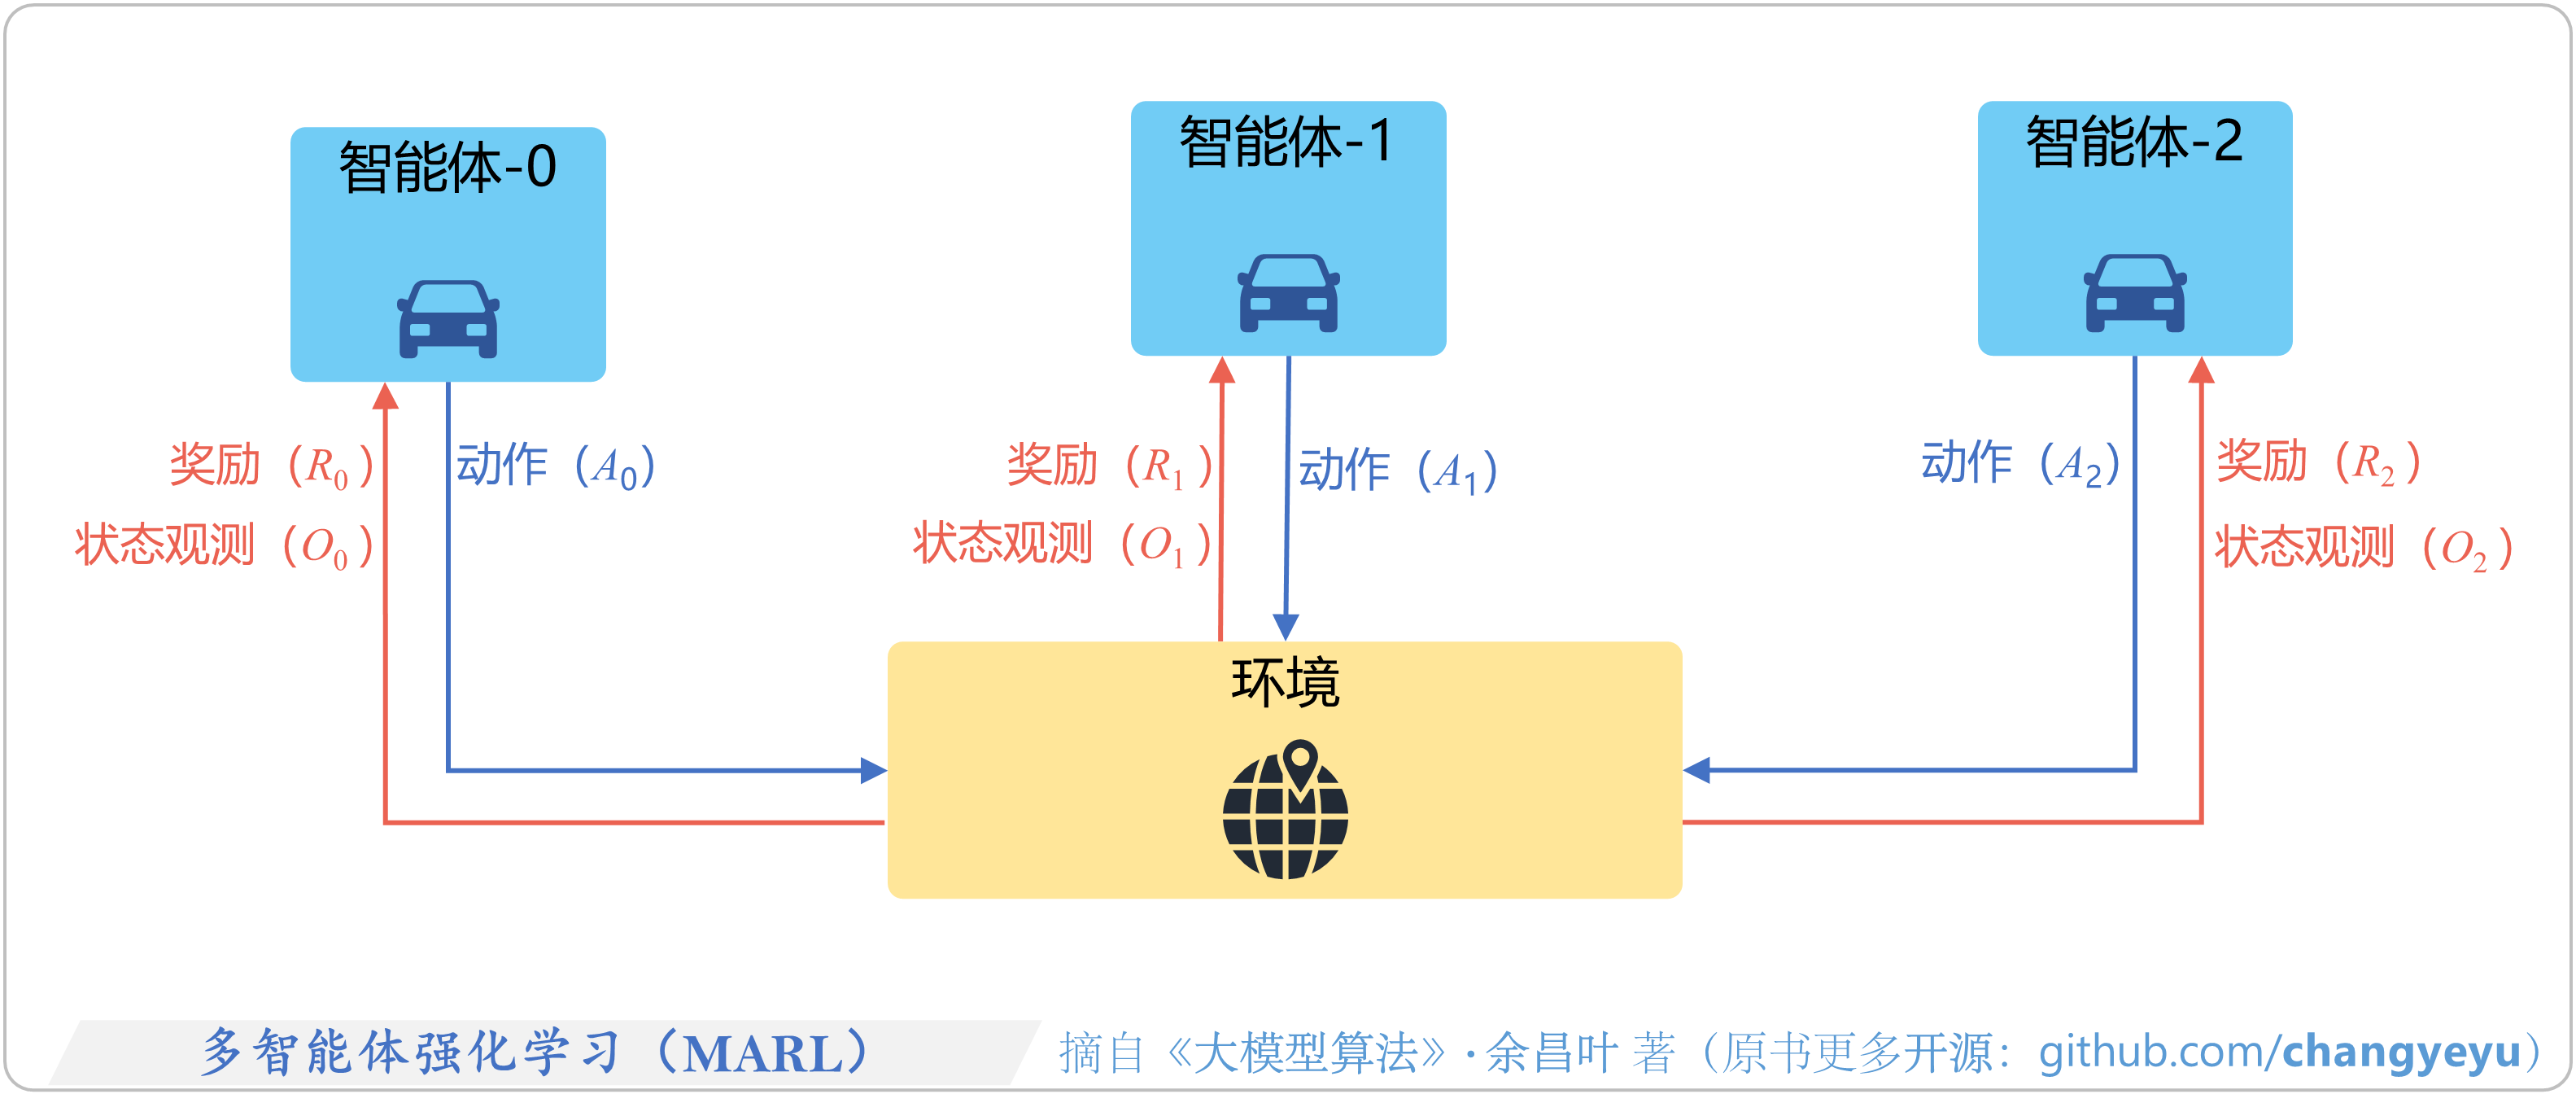
    5.6 多智能体强化学习(MARL)
        5.6.1 MARL的原理与架构
        5.6.2 MARL的建模
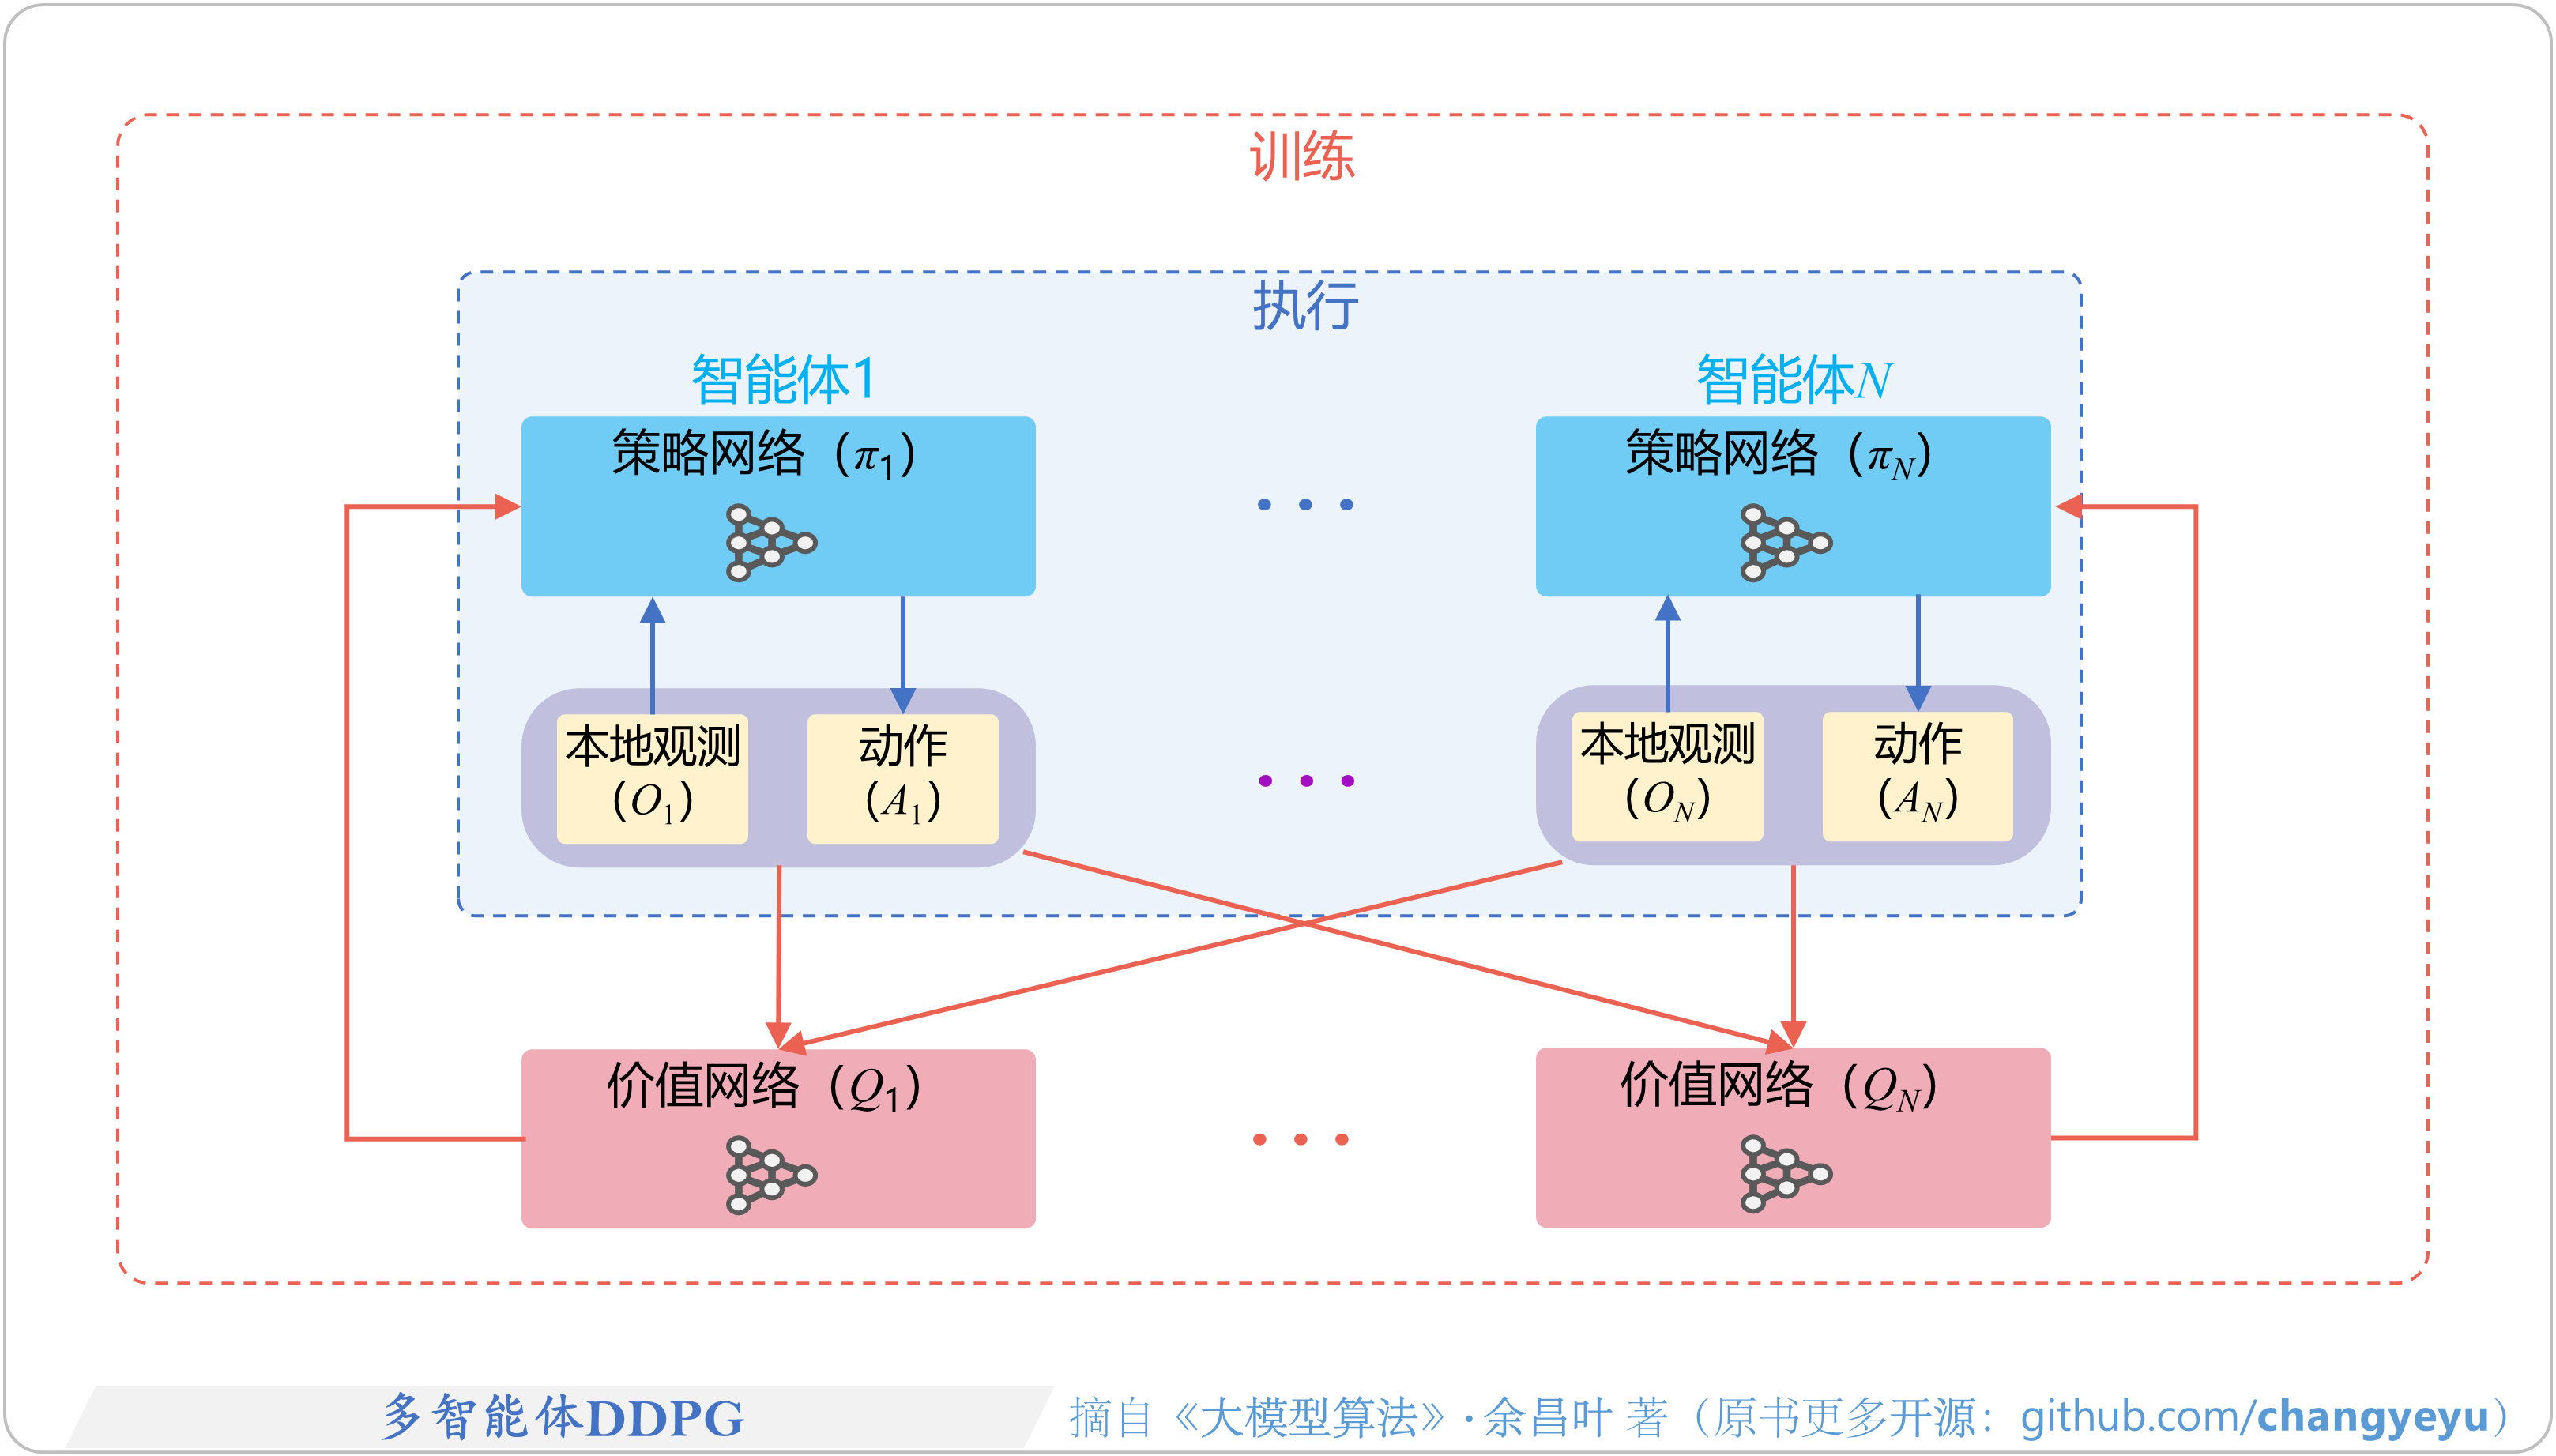
        5.6.3 MARL的典型算法
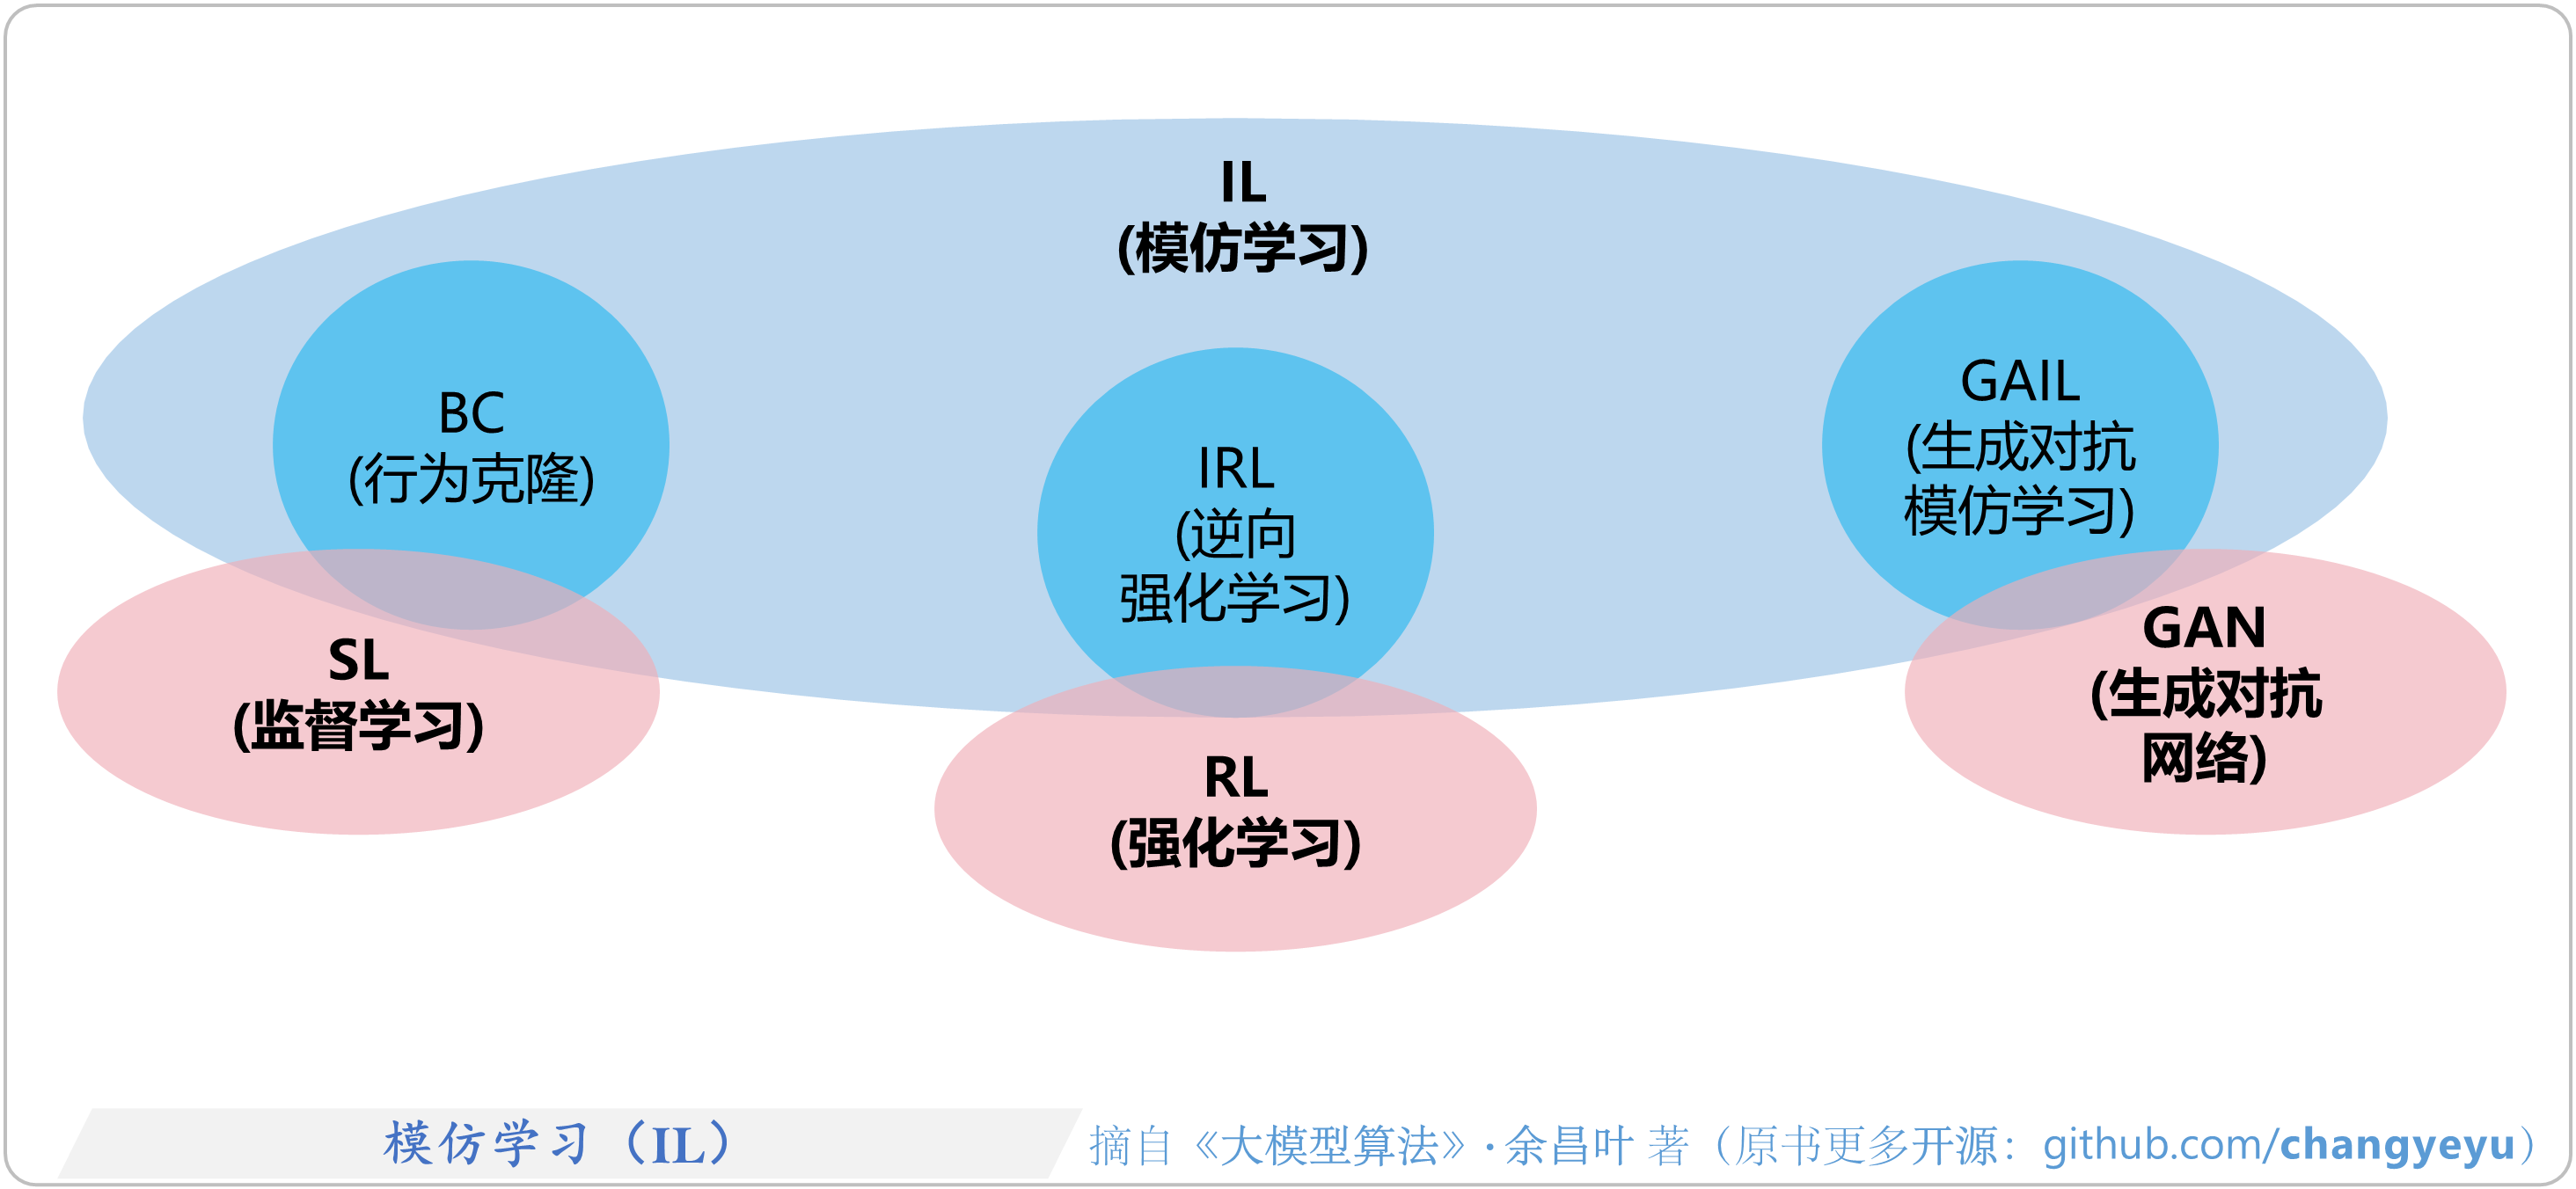
    5.7 模仿学习(IL)
        5.7.1 模仿学习的定义、分类
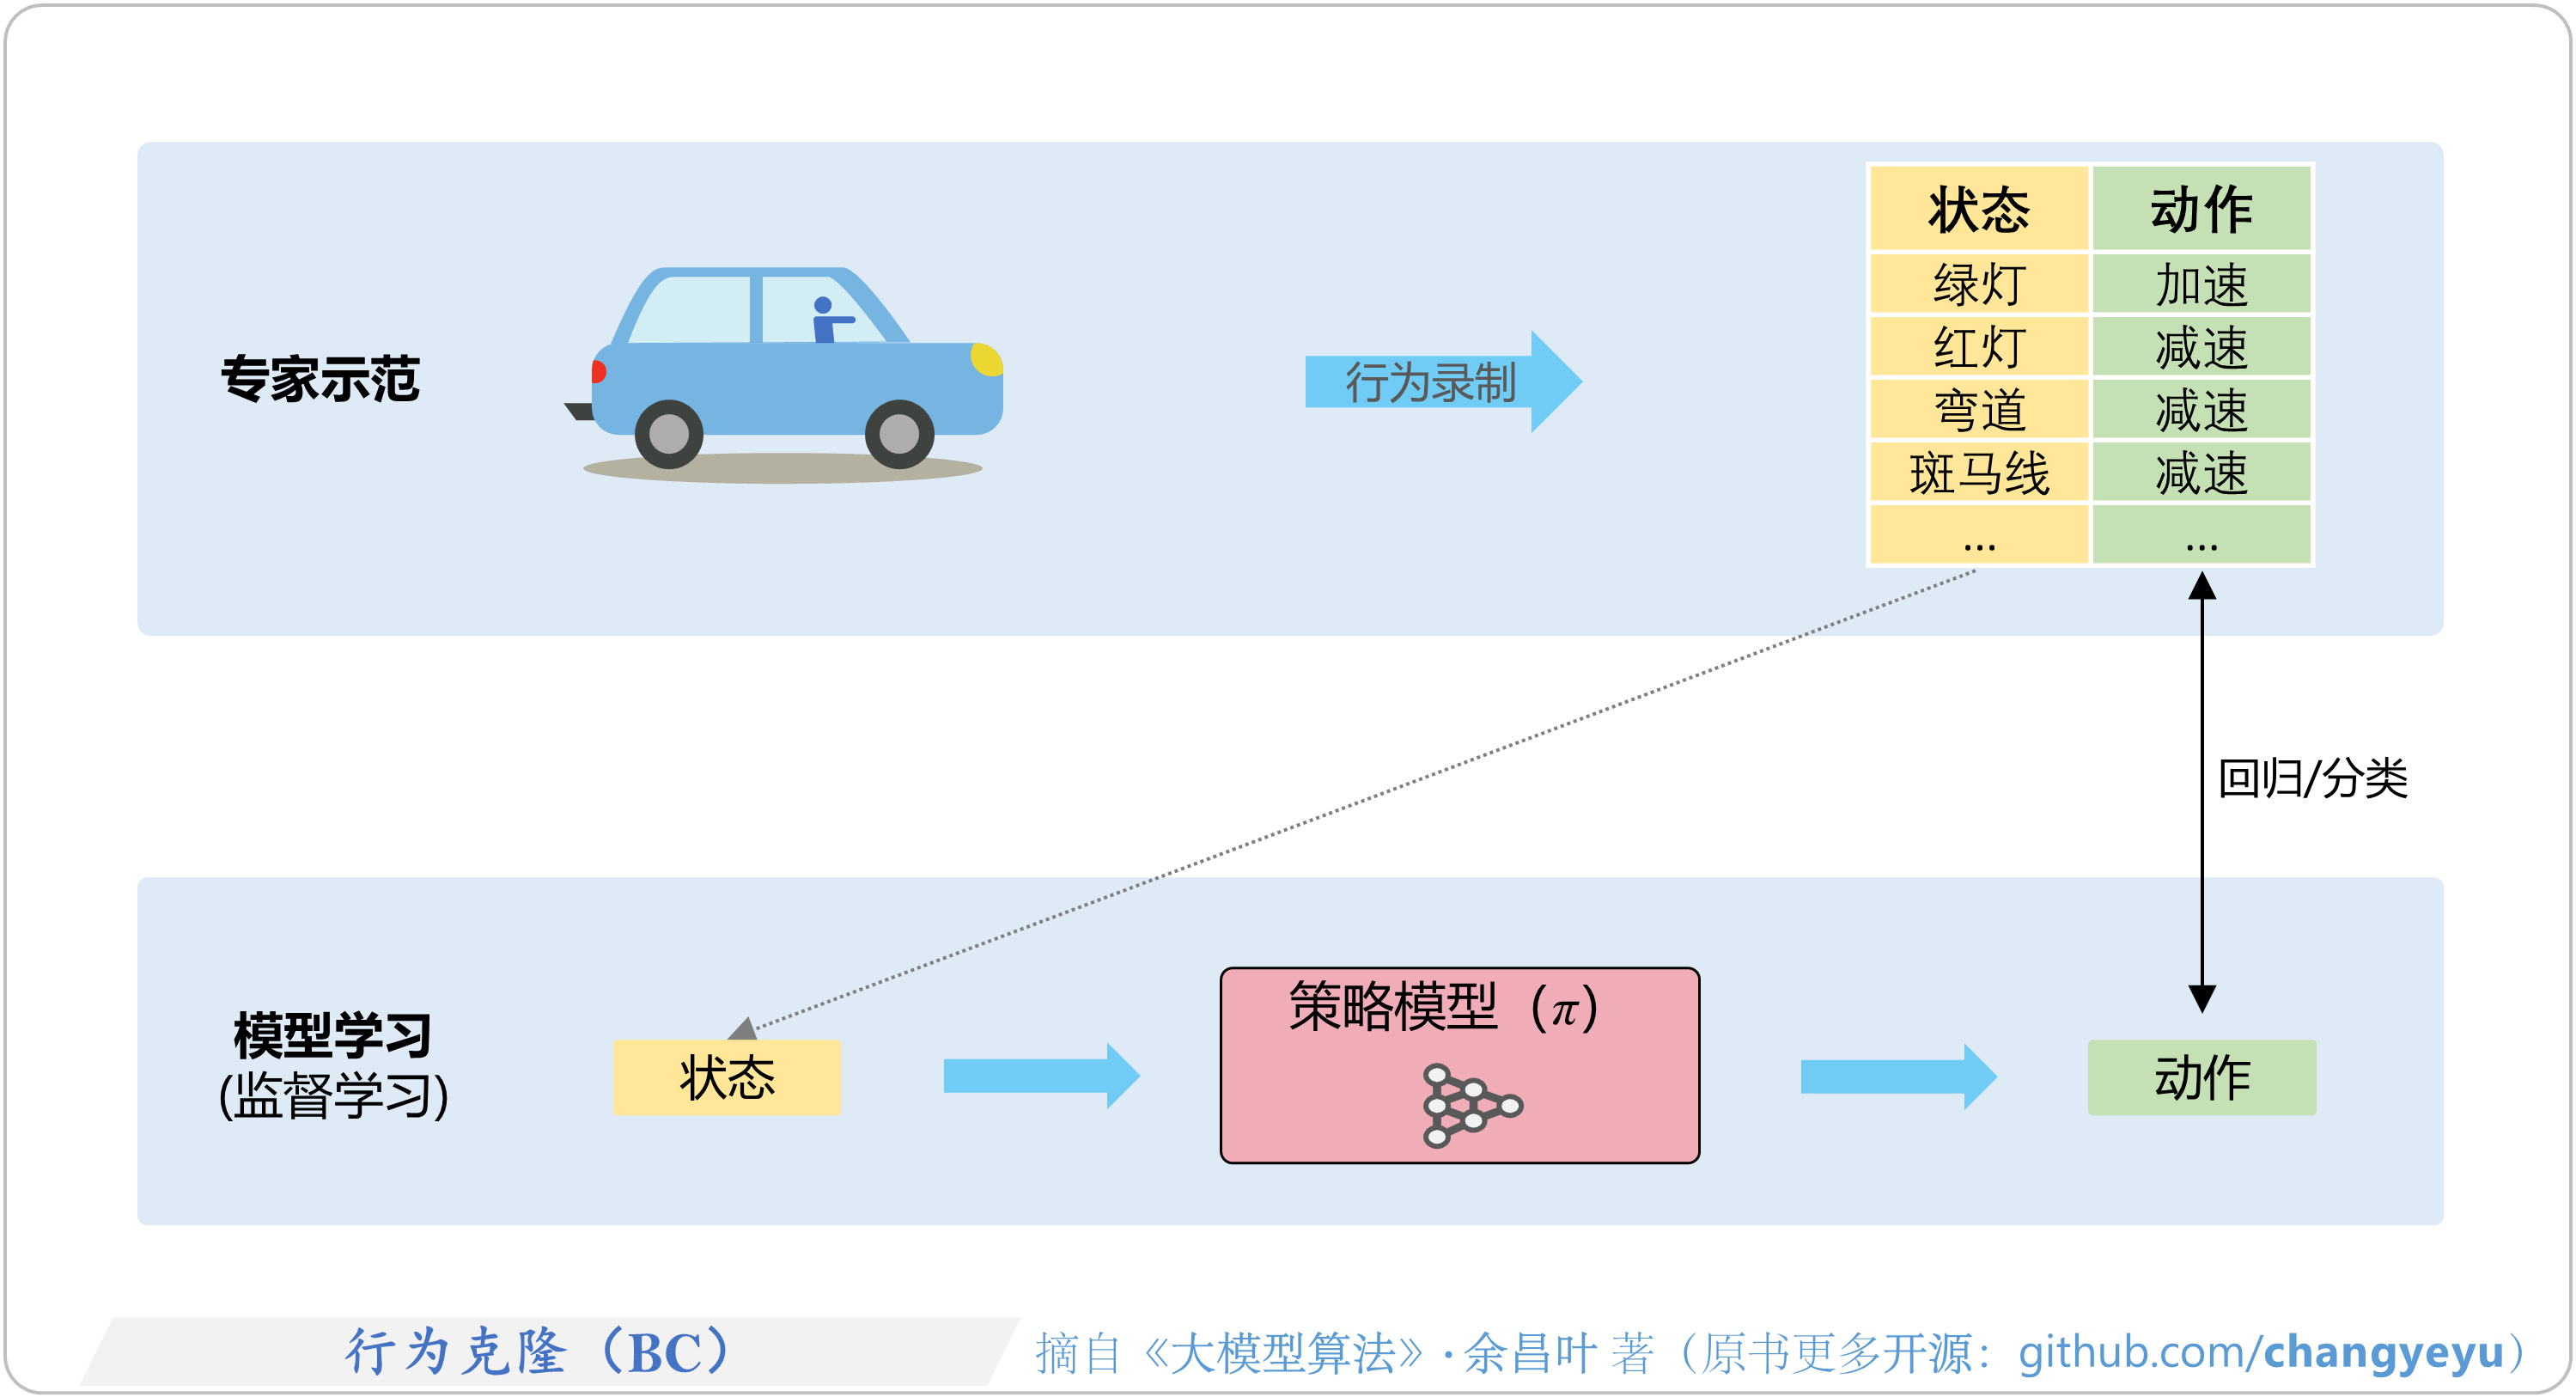
        5.7.2 行为克隆(BC)
        5.7.3 逆向强化学习(IRL)
        5.7.4 生成对抗模仿学习(GAIL)
    5.8 强化学习高级拓展
        5.8.1 基于环境模型(Model-Based)的方法
        5.8.2 分层强化学习(HRL)
        5.8.3 分布价值强化学习(Distributional RL)
第6章 策略优化算法
    6.1 Actor-Critic(演员-评委)架构
        6.1.1 从策略梯度到Actor-Critic
        6.1.2 Actor-Critic架构图解
    6.2 优势函数与A2C
        6.2.1 优势函数(Advantage)
        6.2.2 A2C、A3C、SAC算法
        6.2.3 GAE(广义优势估计)算法
        6.2.4 γ和λ的调节作用
    6.3 PPO及其相关算法
        6.3.1 PPO算法的演进
        6.3.2 TRPO(置信域策略优化)
        6.3.3 重要性采样(Importance Sampling)
        6.3.4 PPO-Penalty
        6.3.5 PPO-Clip
        6.3.6 PPO的Loss的扩展
        6.3.7 TRPO与PPO的区别
        6.3.8 图解策略模型的训练
        6.3.9 深入解析PPO的本质
    6.4 GRPO算法
        6.4.1 GRPO的原理
        6.4.2 GRPO与PPO的区别
    6.5 确定性策略梯度(DPG)
        6.5.1 确定性策略vs随机性策略
        6.5.2 DPG、DDPG、TD3算法
第7章 RLHF与RLAIF
    7.1 RLHF(基于人类反馈的强化学习)概要
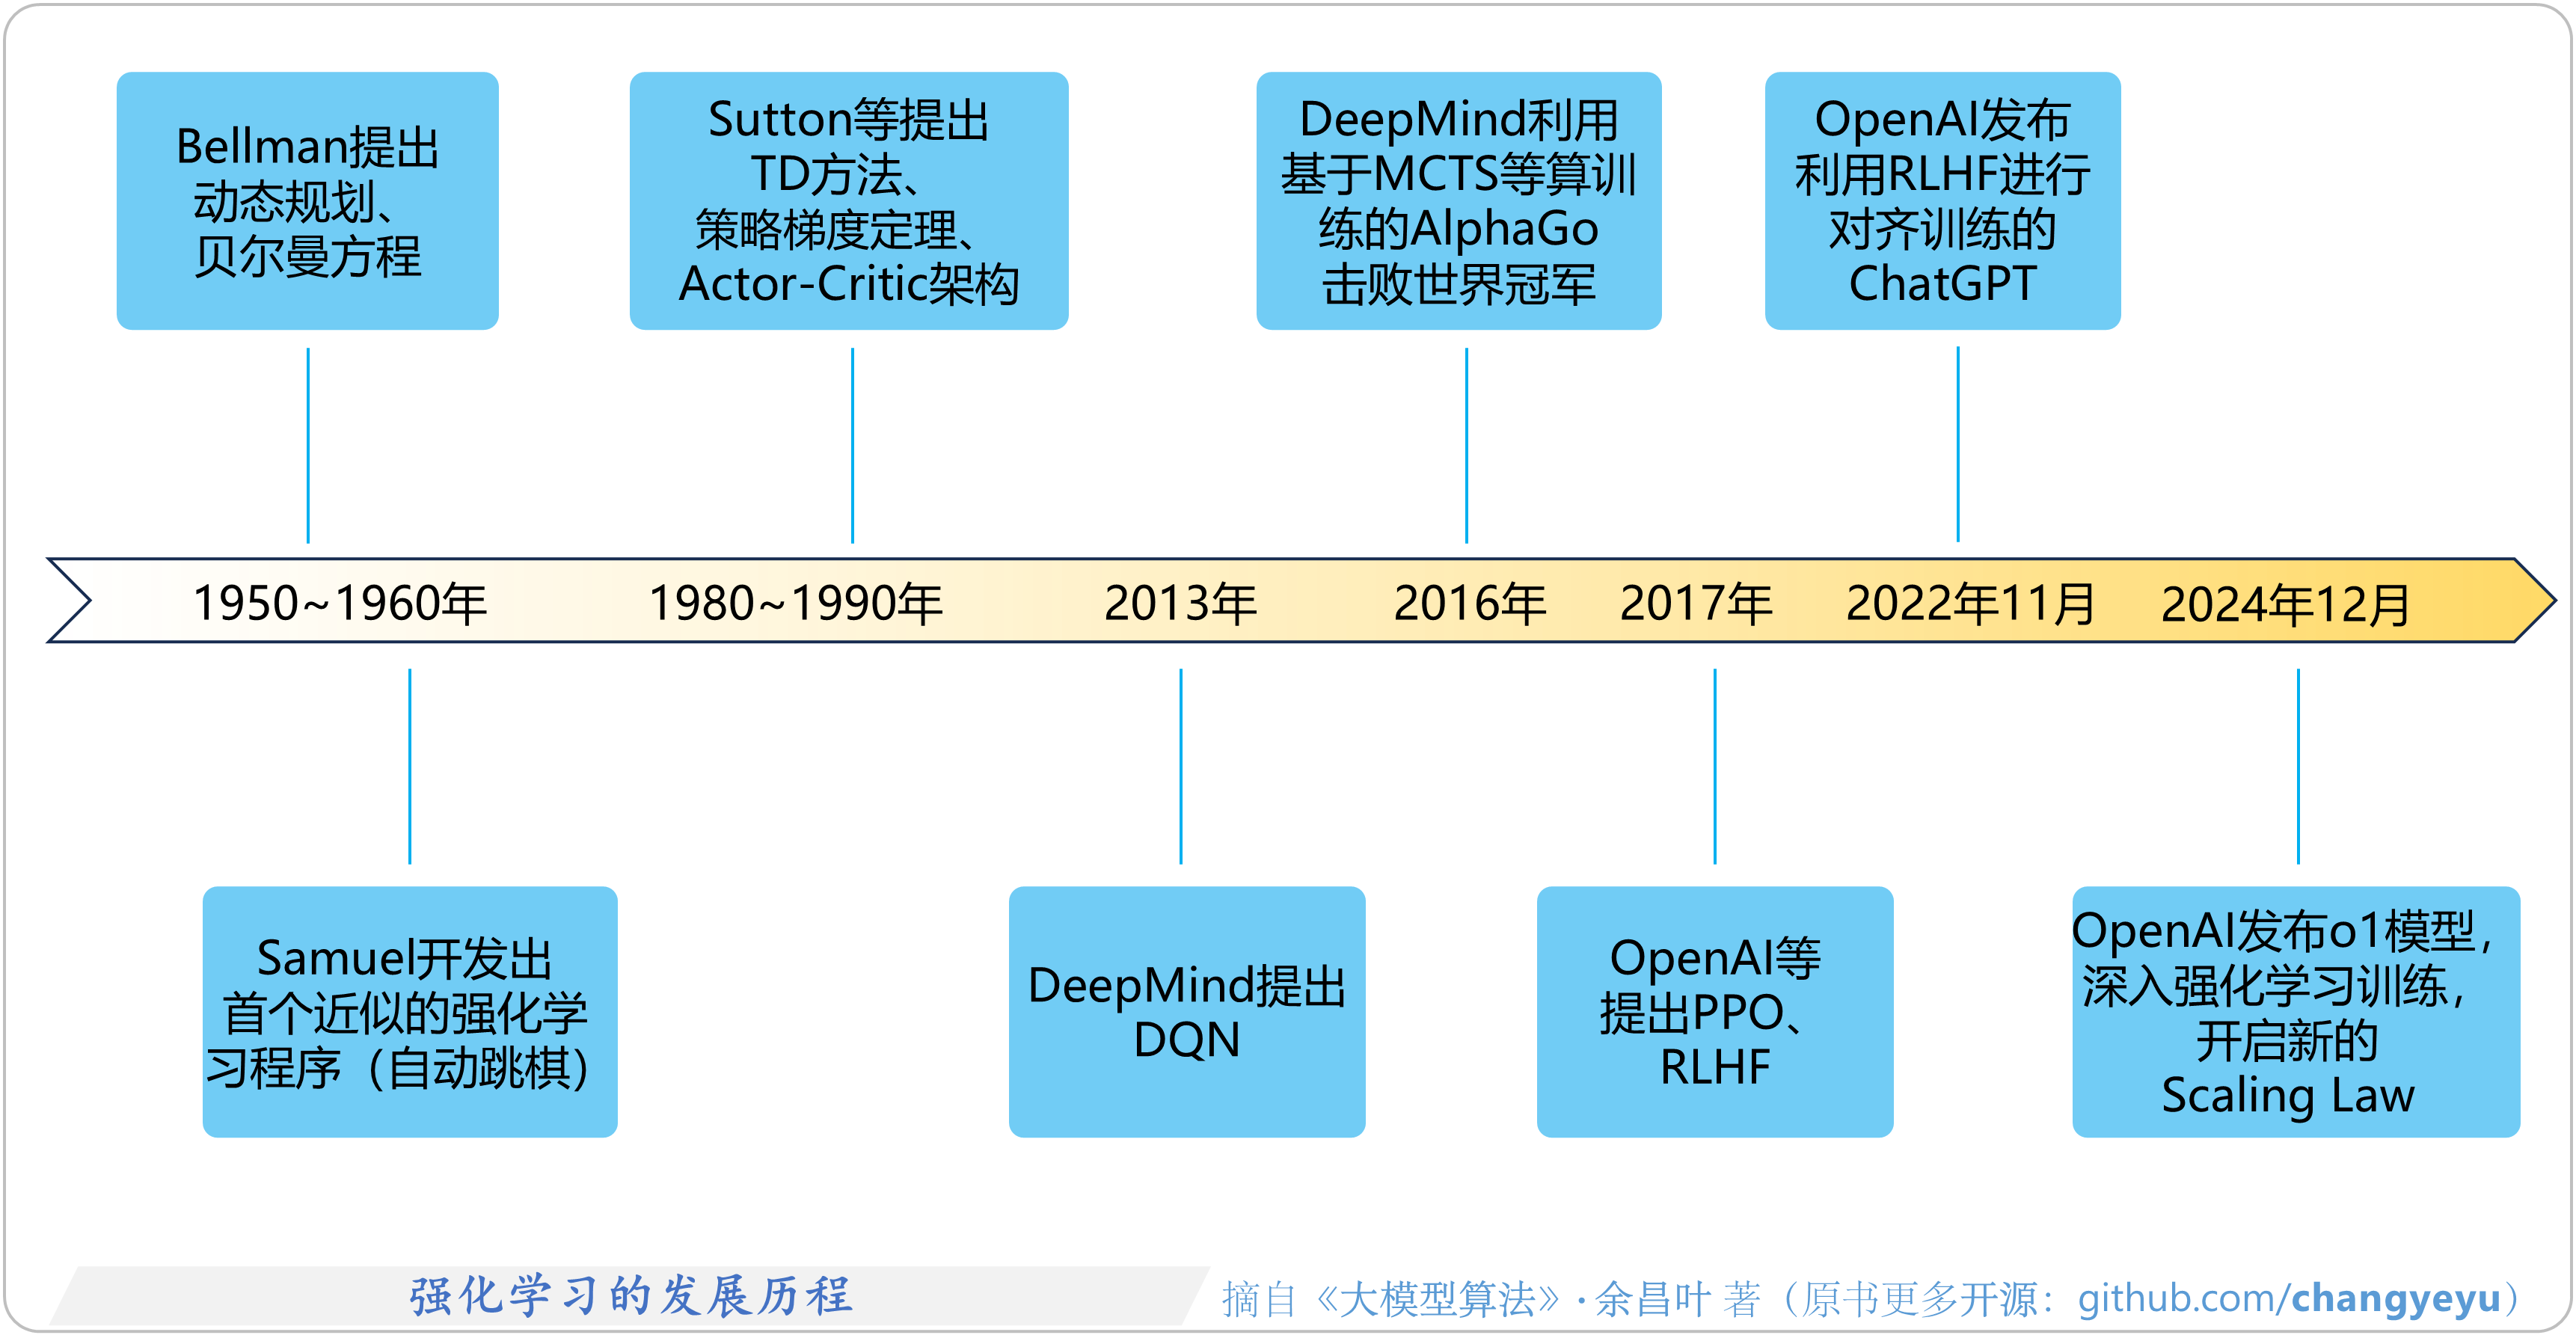
        7.1.1 RLHF的背景、发展
        7.1.2 语言模型的强化学习建模
        7.1.3 RLHF的训练样本、总流程
    7.2 阶段一:图解奖励模型的设计与训练
        7.2.1 奖励模型(Reward Model)的结构
        7.2.2 奖励模型的输入与奖励分数
        7.2.3 奖励模型的Loss解析
        7.2.4 奖励模型训练全景图
        7.2.5 奖励模型的Scaling Law
    7.3 阶段二:多模型联动的PPO训练
        7.3.1 四种模型的角色图解
        7.3.2 各模型的结构、初始化、实践技巧
        7.3.3 各模型的输入、输出
        7.3.4 基于KL散度的策略约束
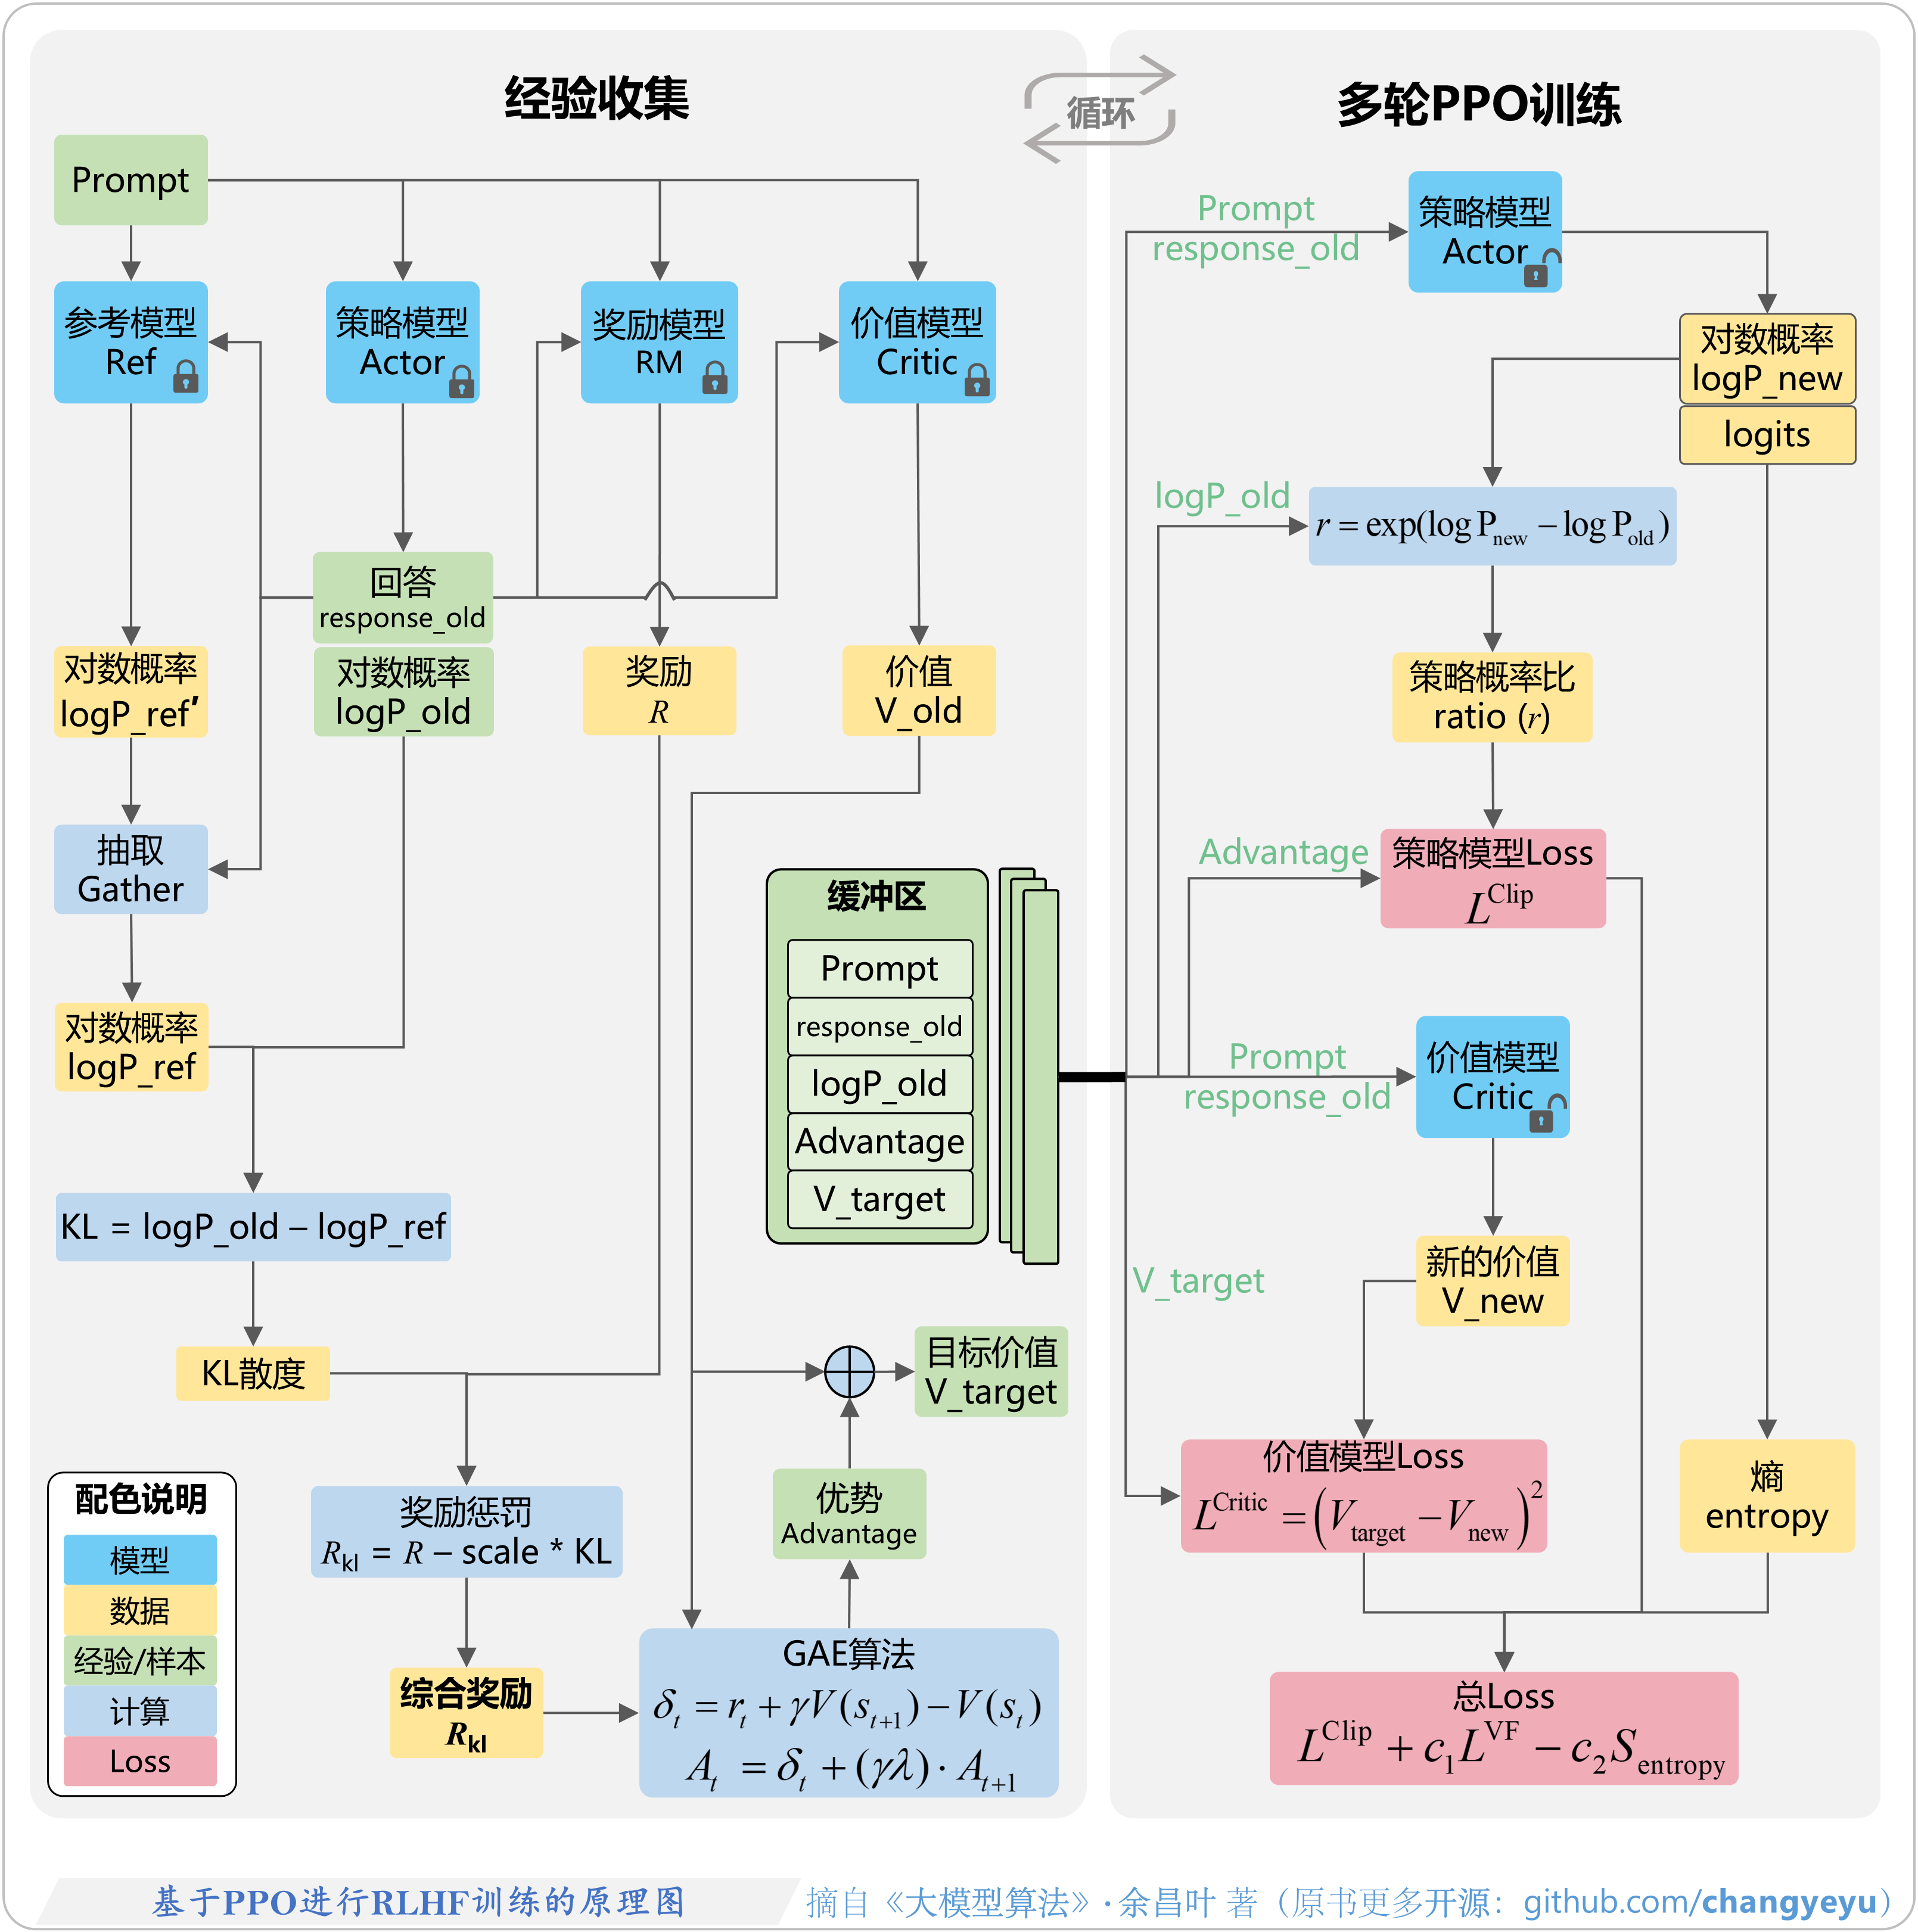
        7.3.5 基于PPO的RLHF核心实现
        7.3.6 全景图:基于PPO的训练
    7.4 RLHF实践技巧
        7.4.1 奖励欺骗(Reward Hacking)的挑战与应对
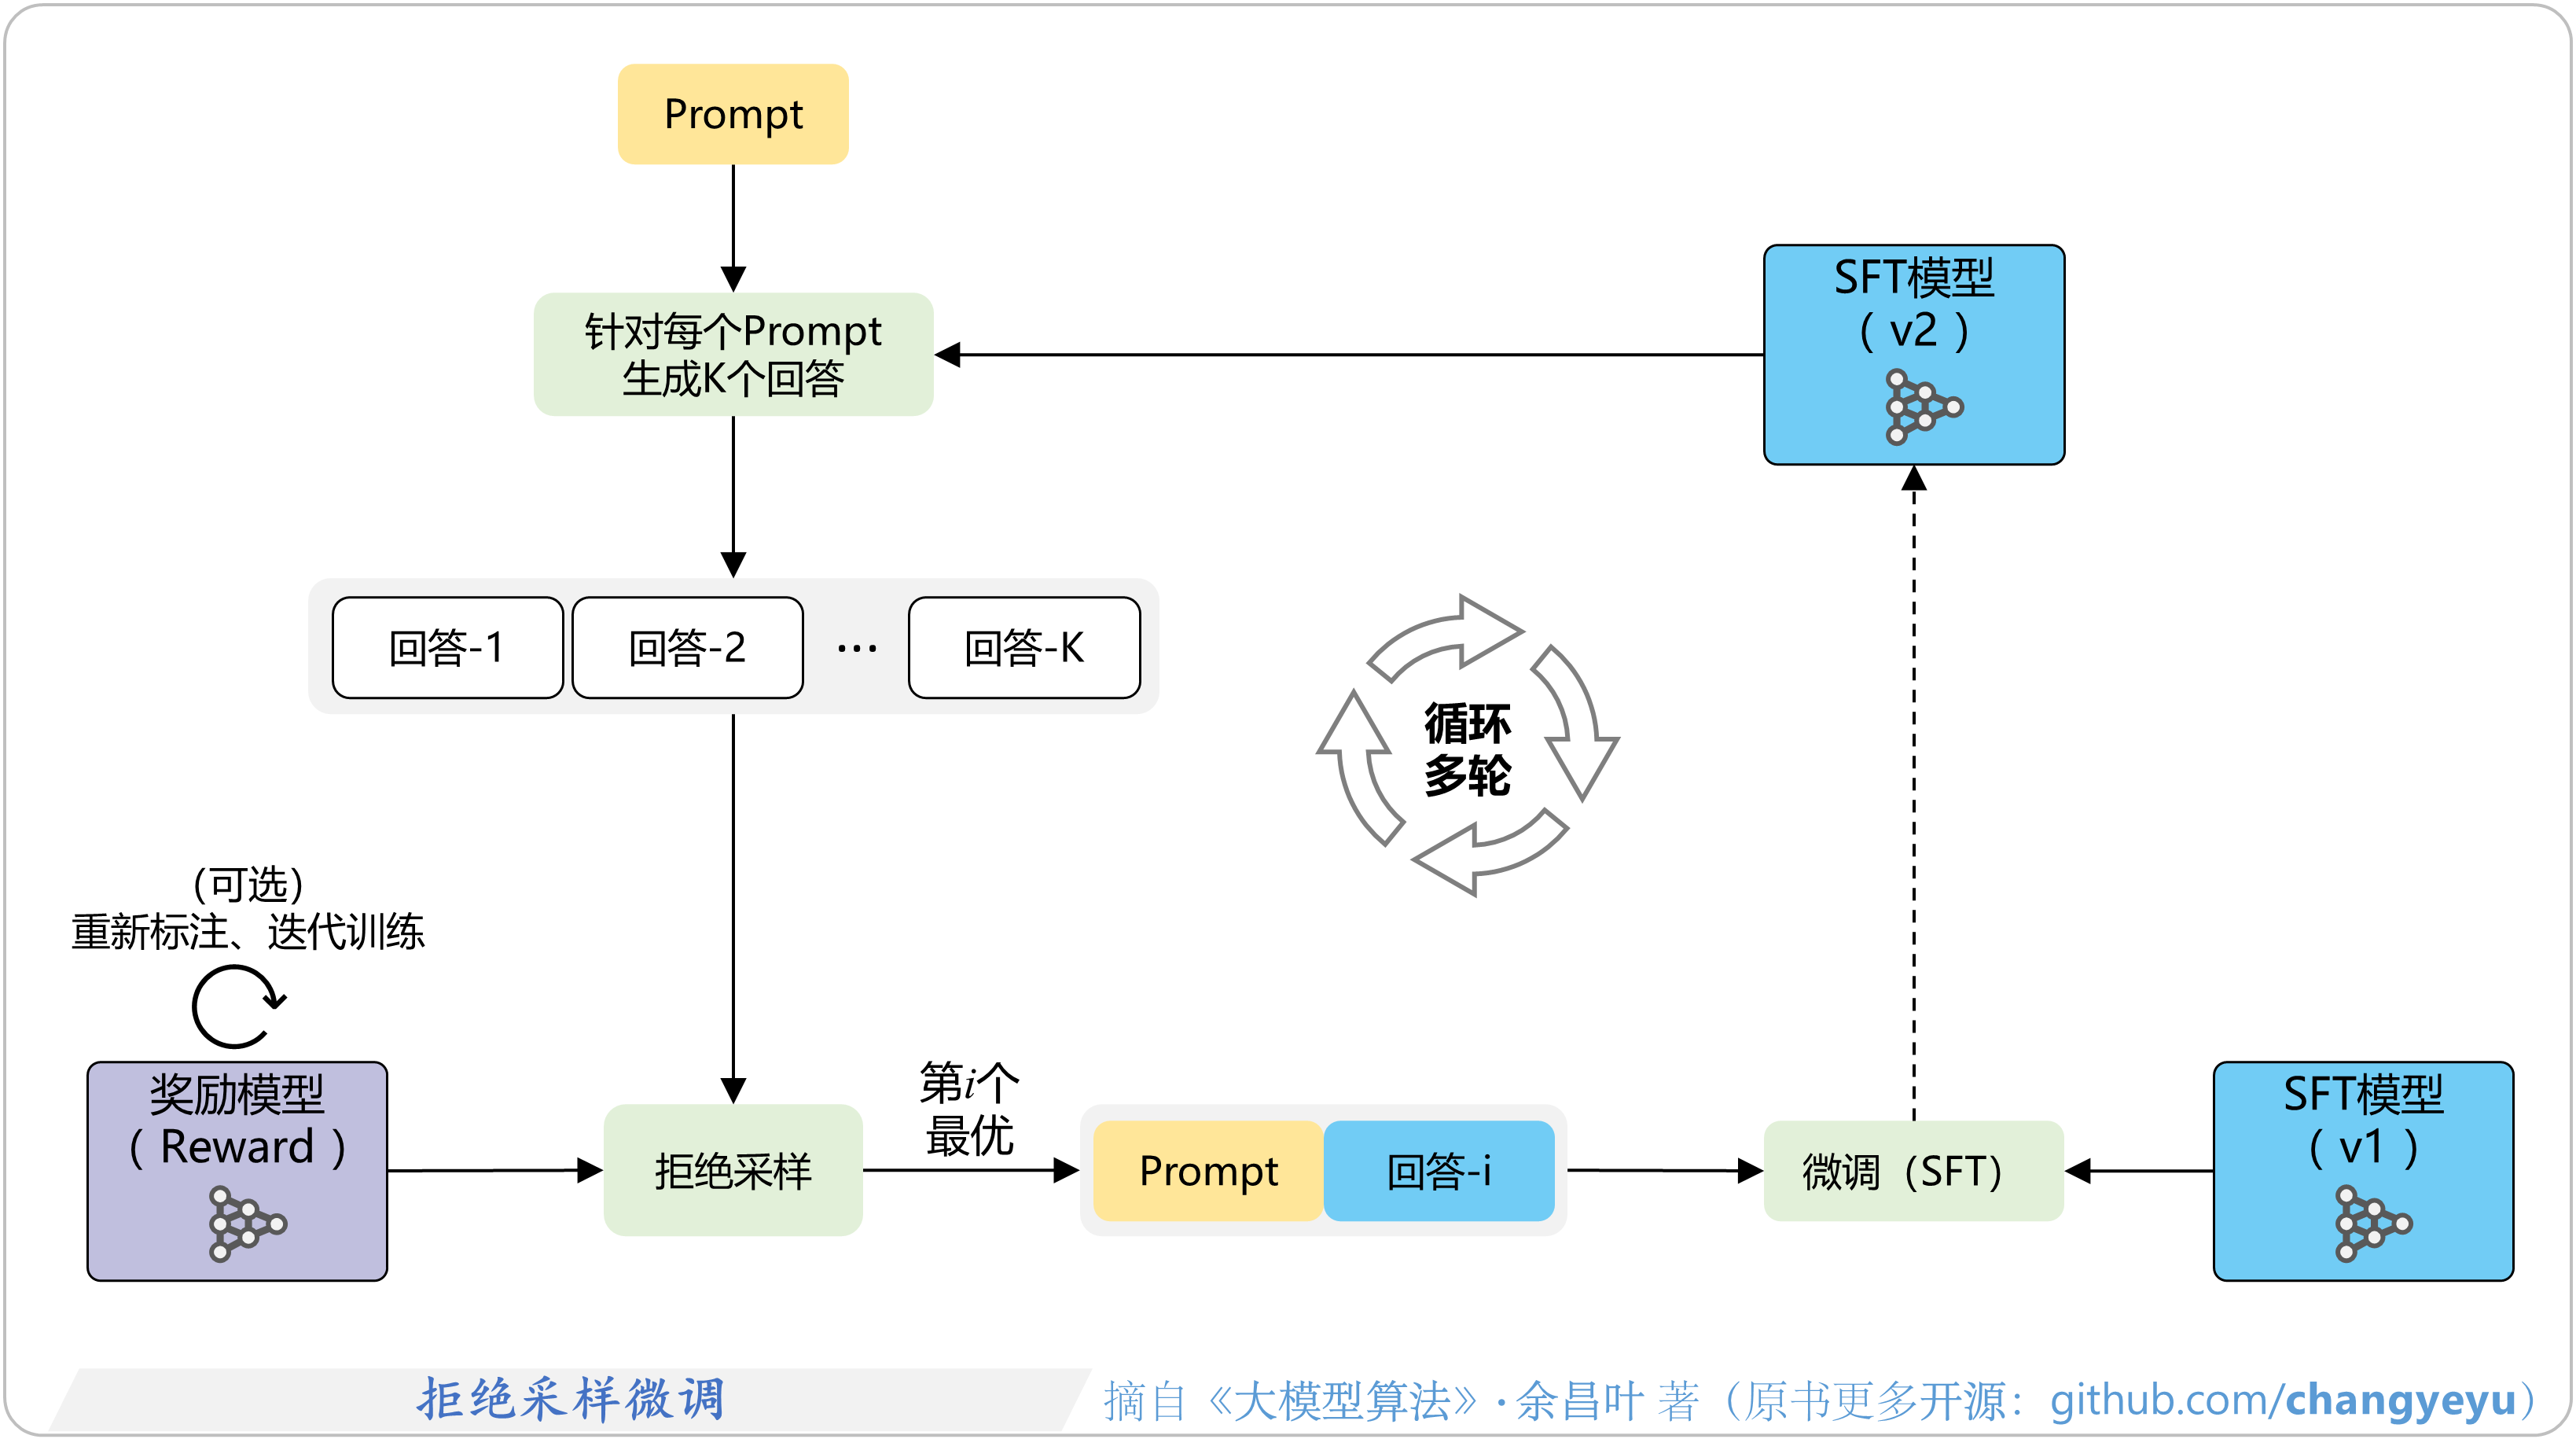
        7.4.2 拒绝采样(Rejection Sampling)微调
        7.4.3 强化学习与RLHF的训练框架
        7.4.4 RLHF的超参数
        7.4.5 RLHF的关键监控指标
    7.5 基于AI反馈的强化学习
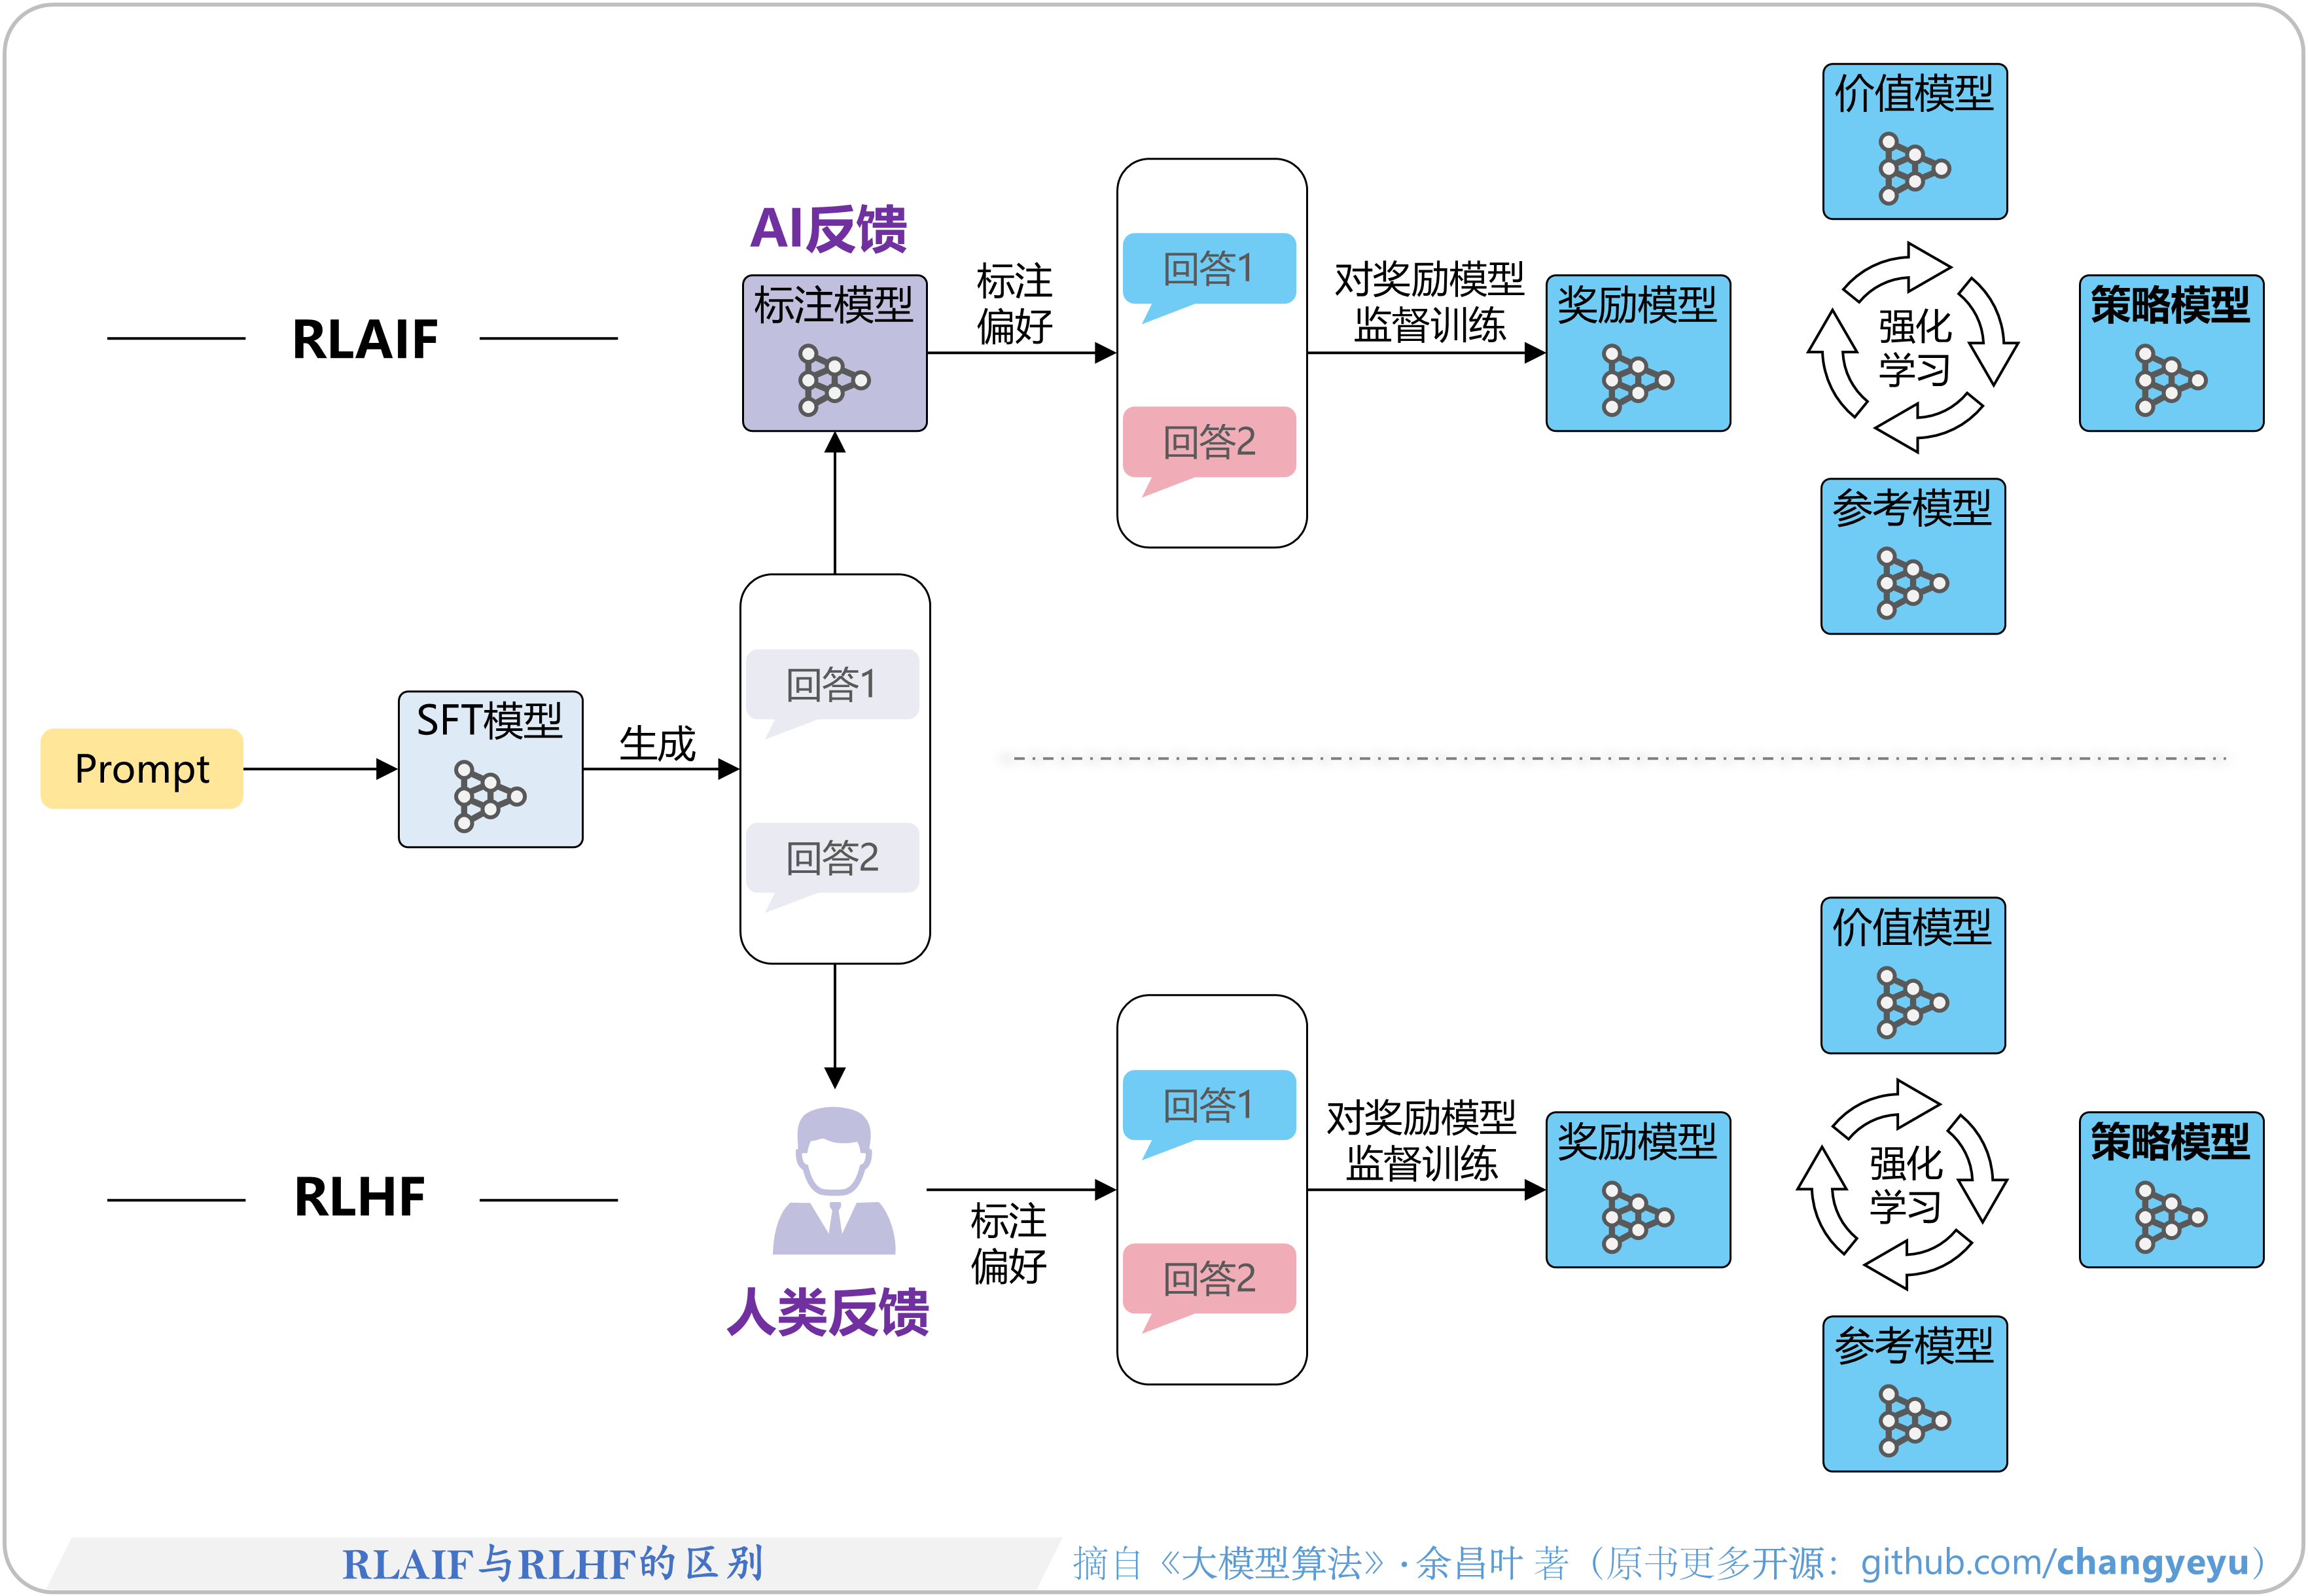
        7.5.1 RLAIF的原理图解
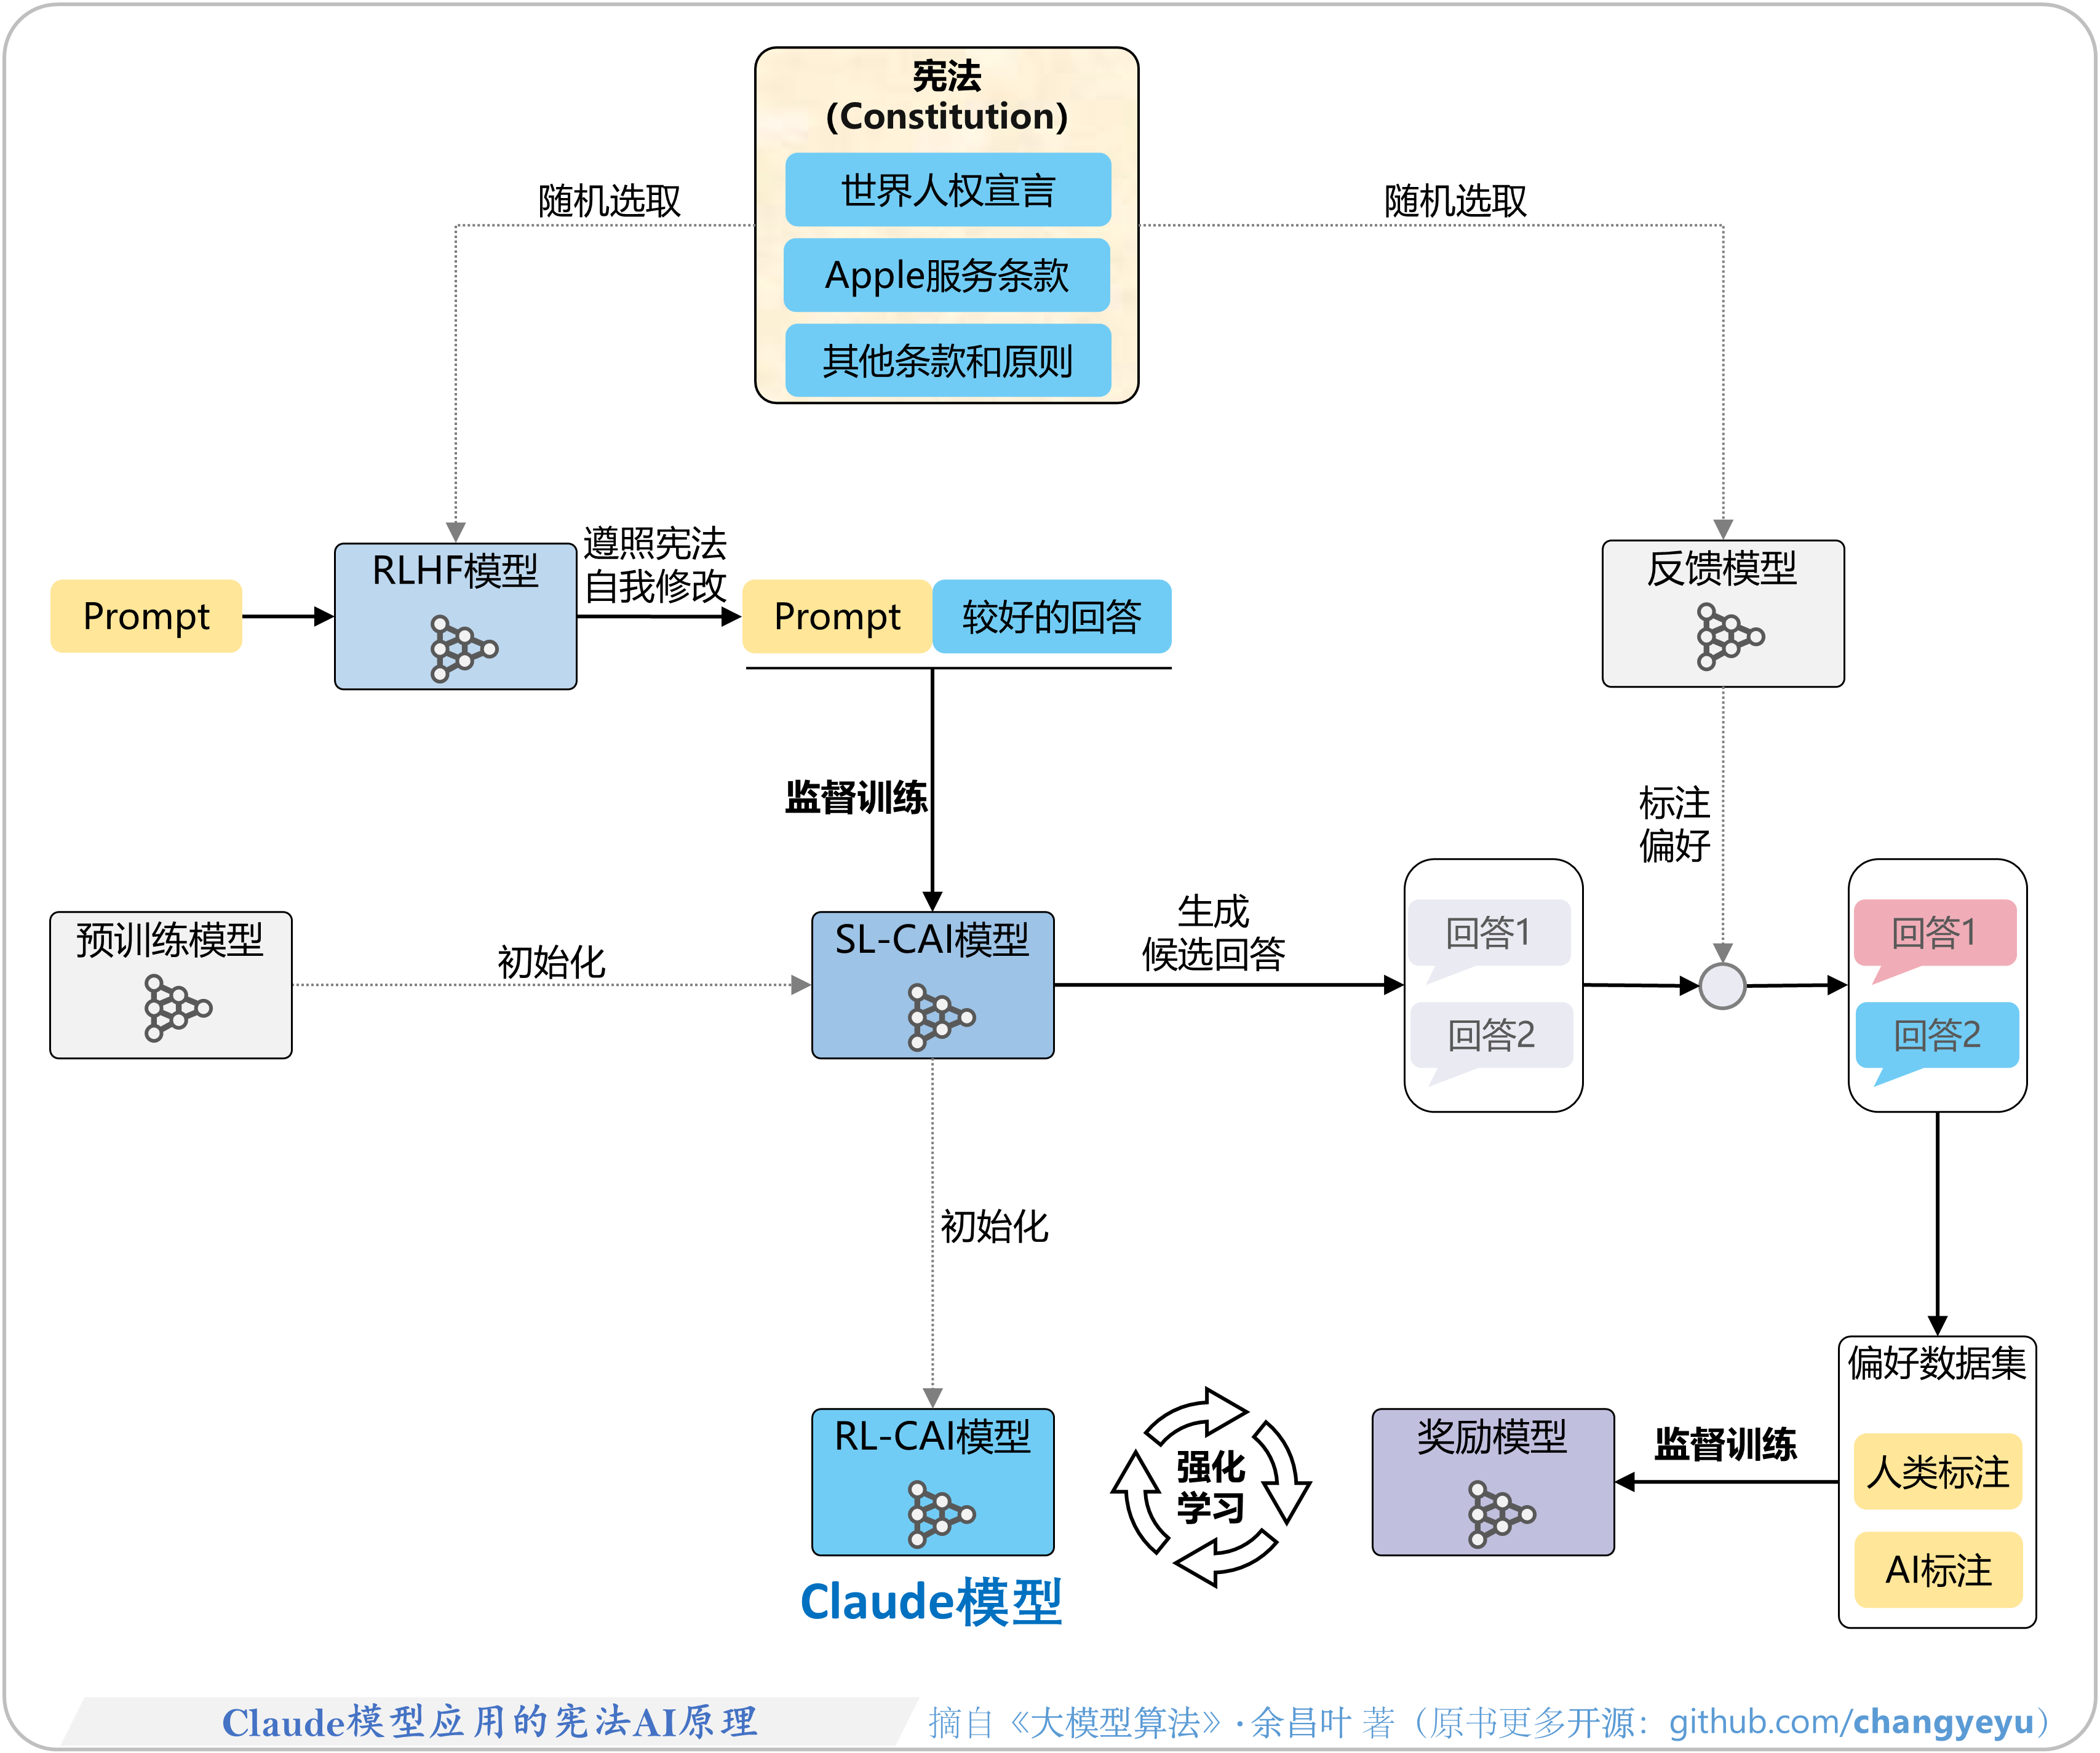
        7.5.2 CAI:基于宪法的强化学习
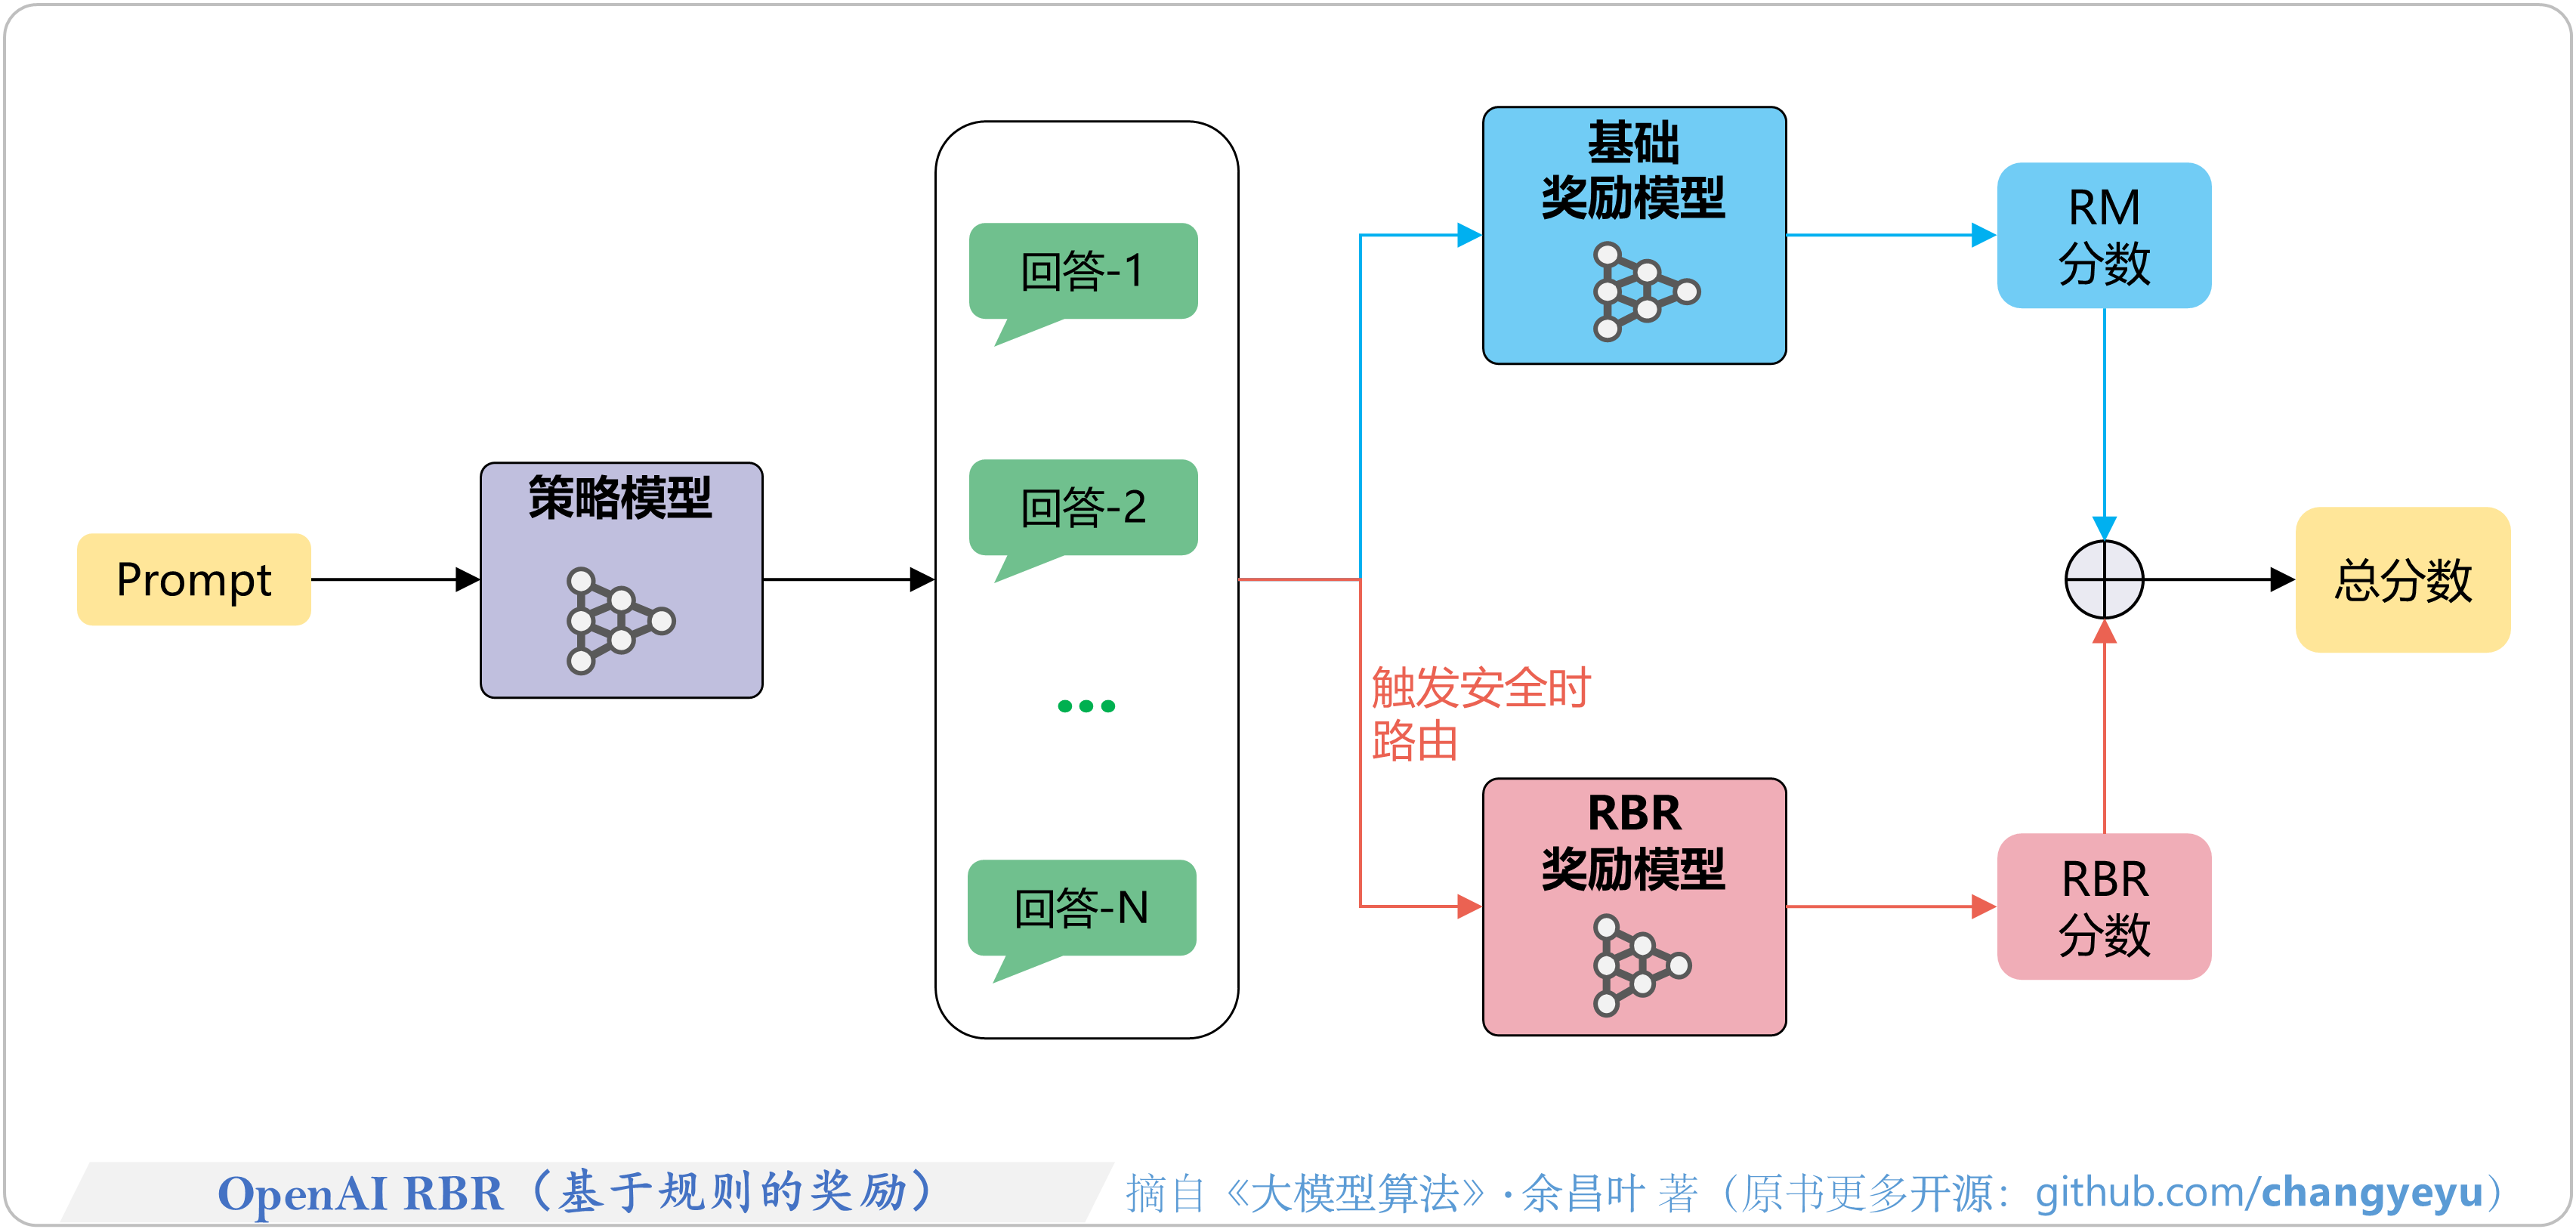
        7.5.3 RBR:基于规则的奖励
第8章 逻辑推理能力优化
    8.1 逻辑推理(Reasoning)相关技术概览
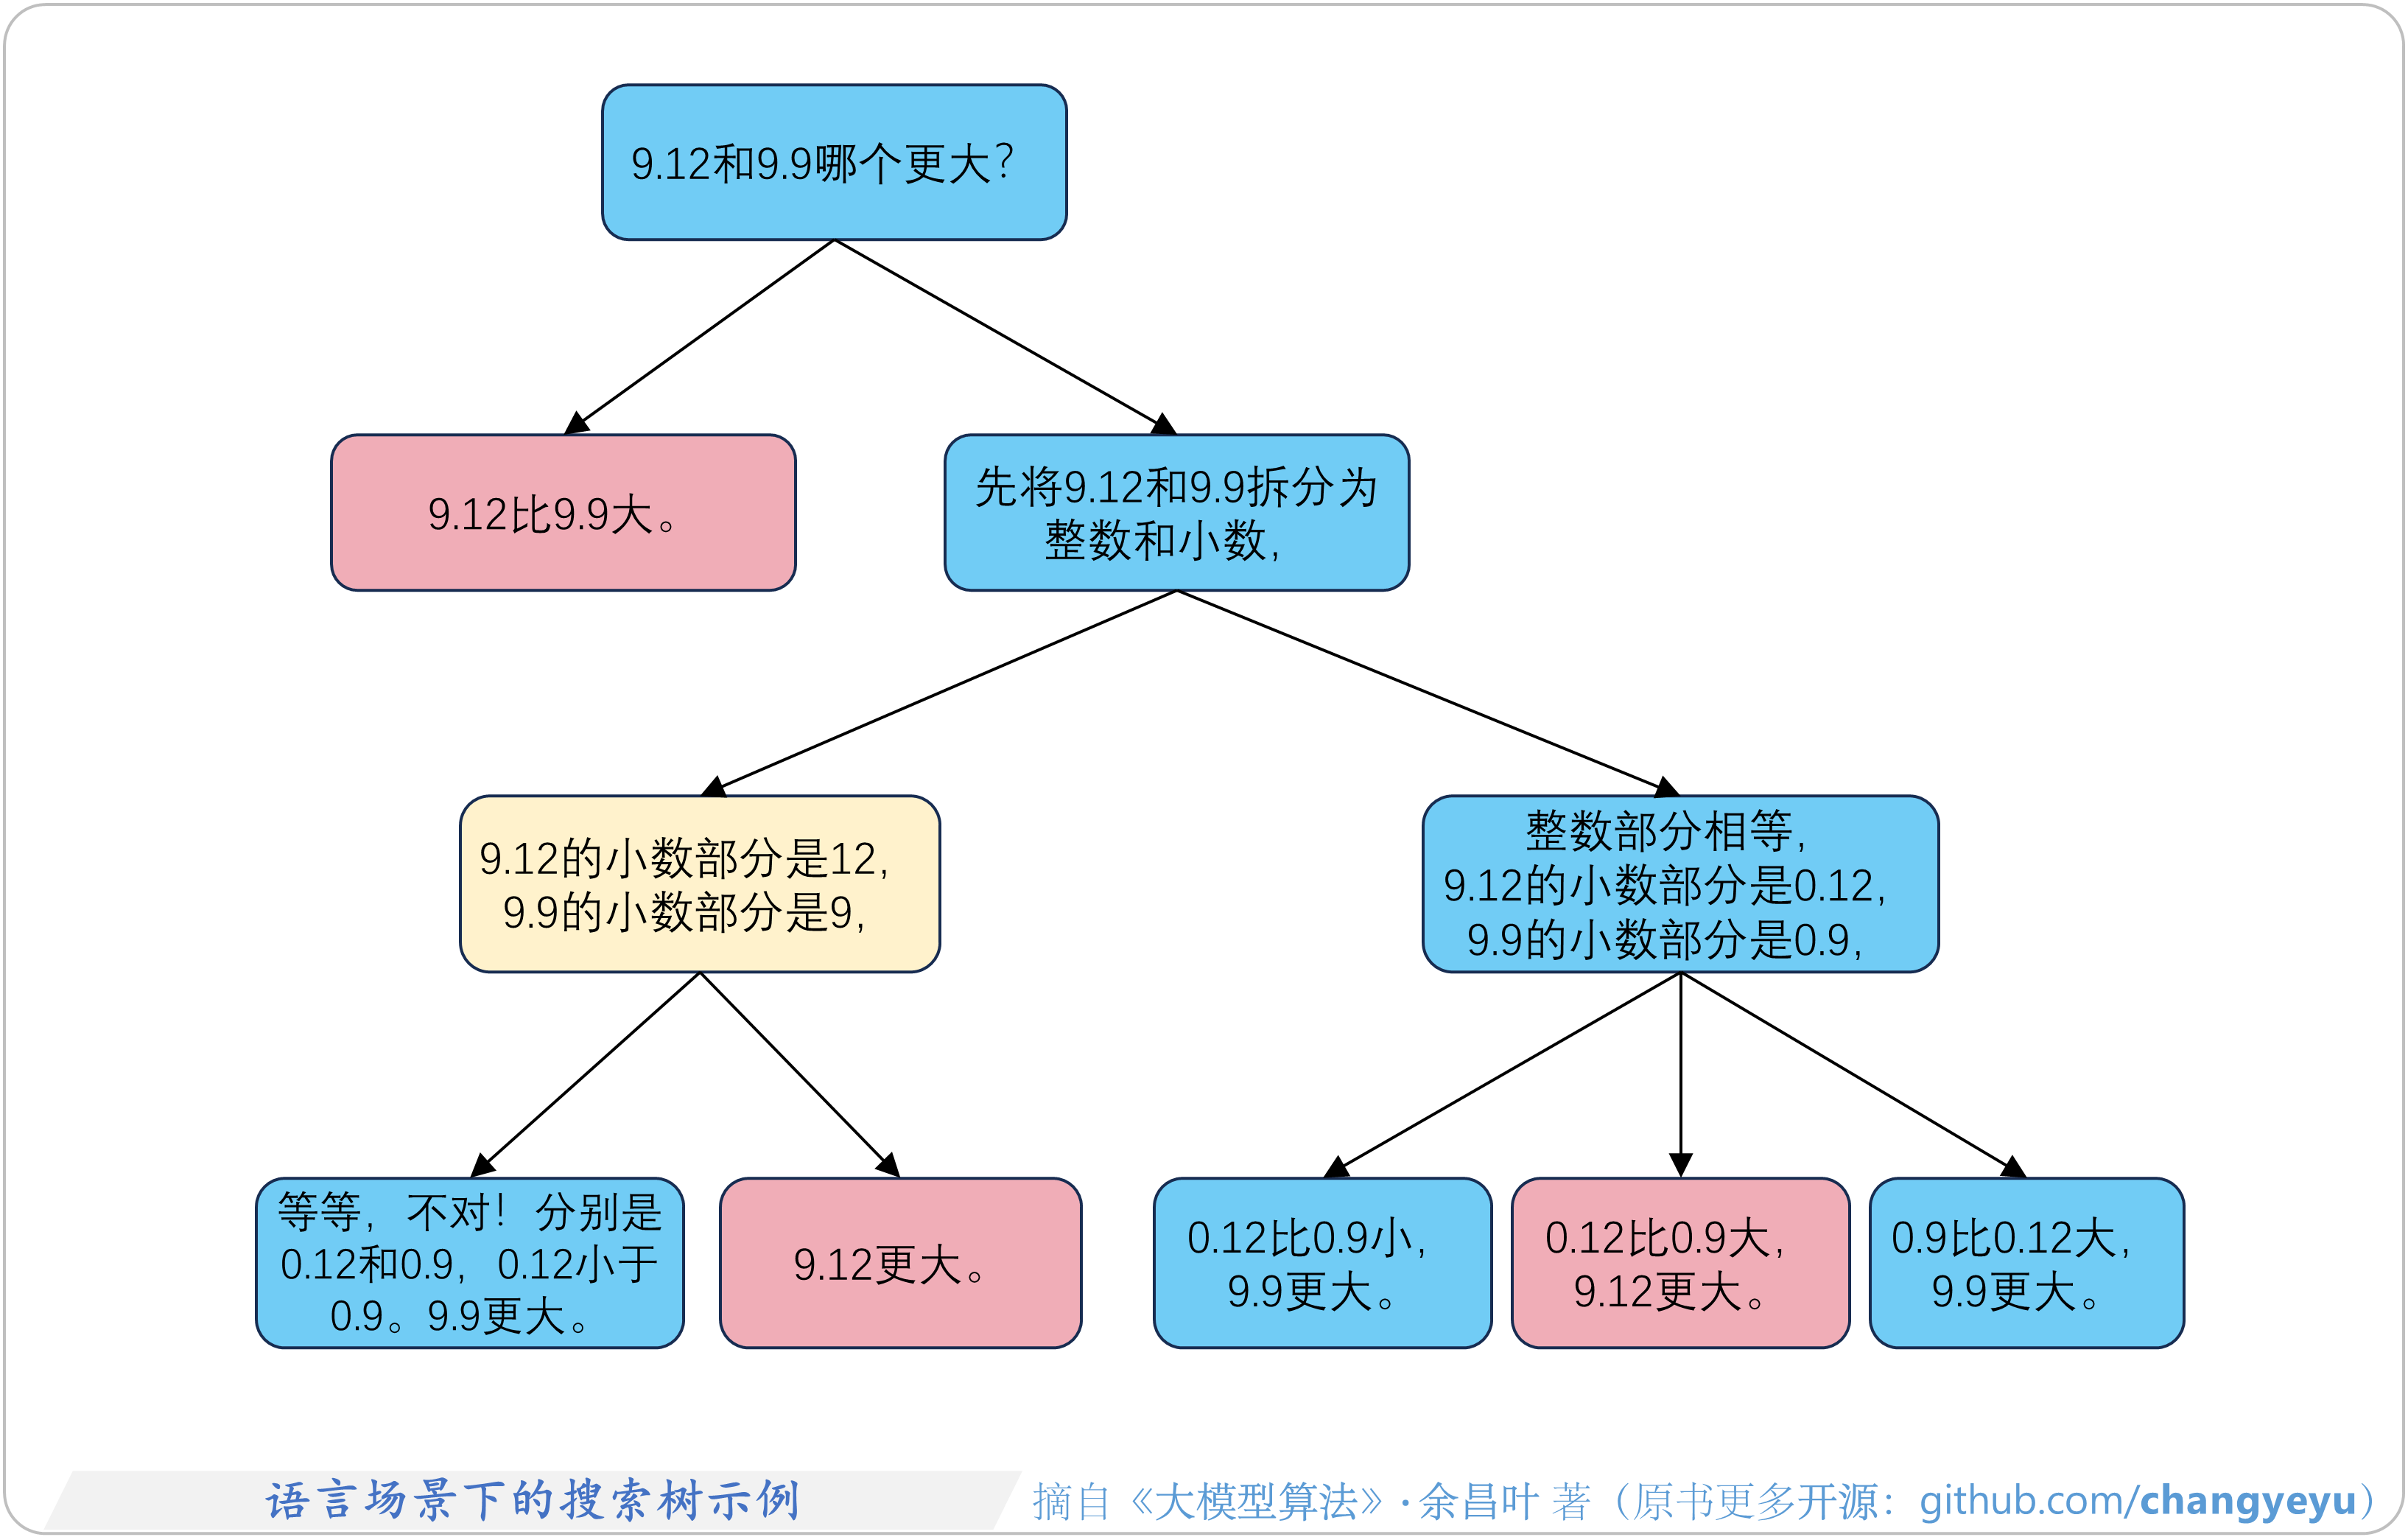
        8.1.1 推理时计算与搜索
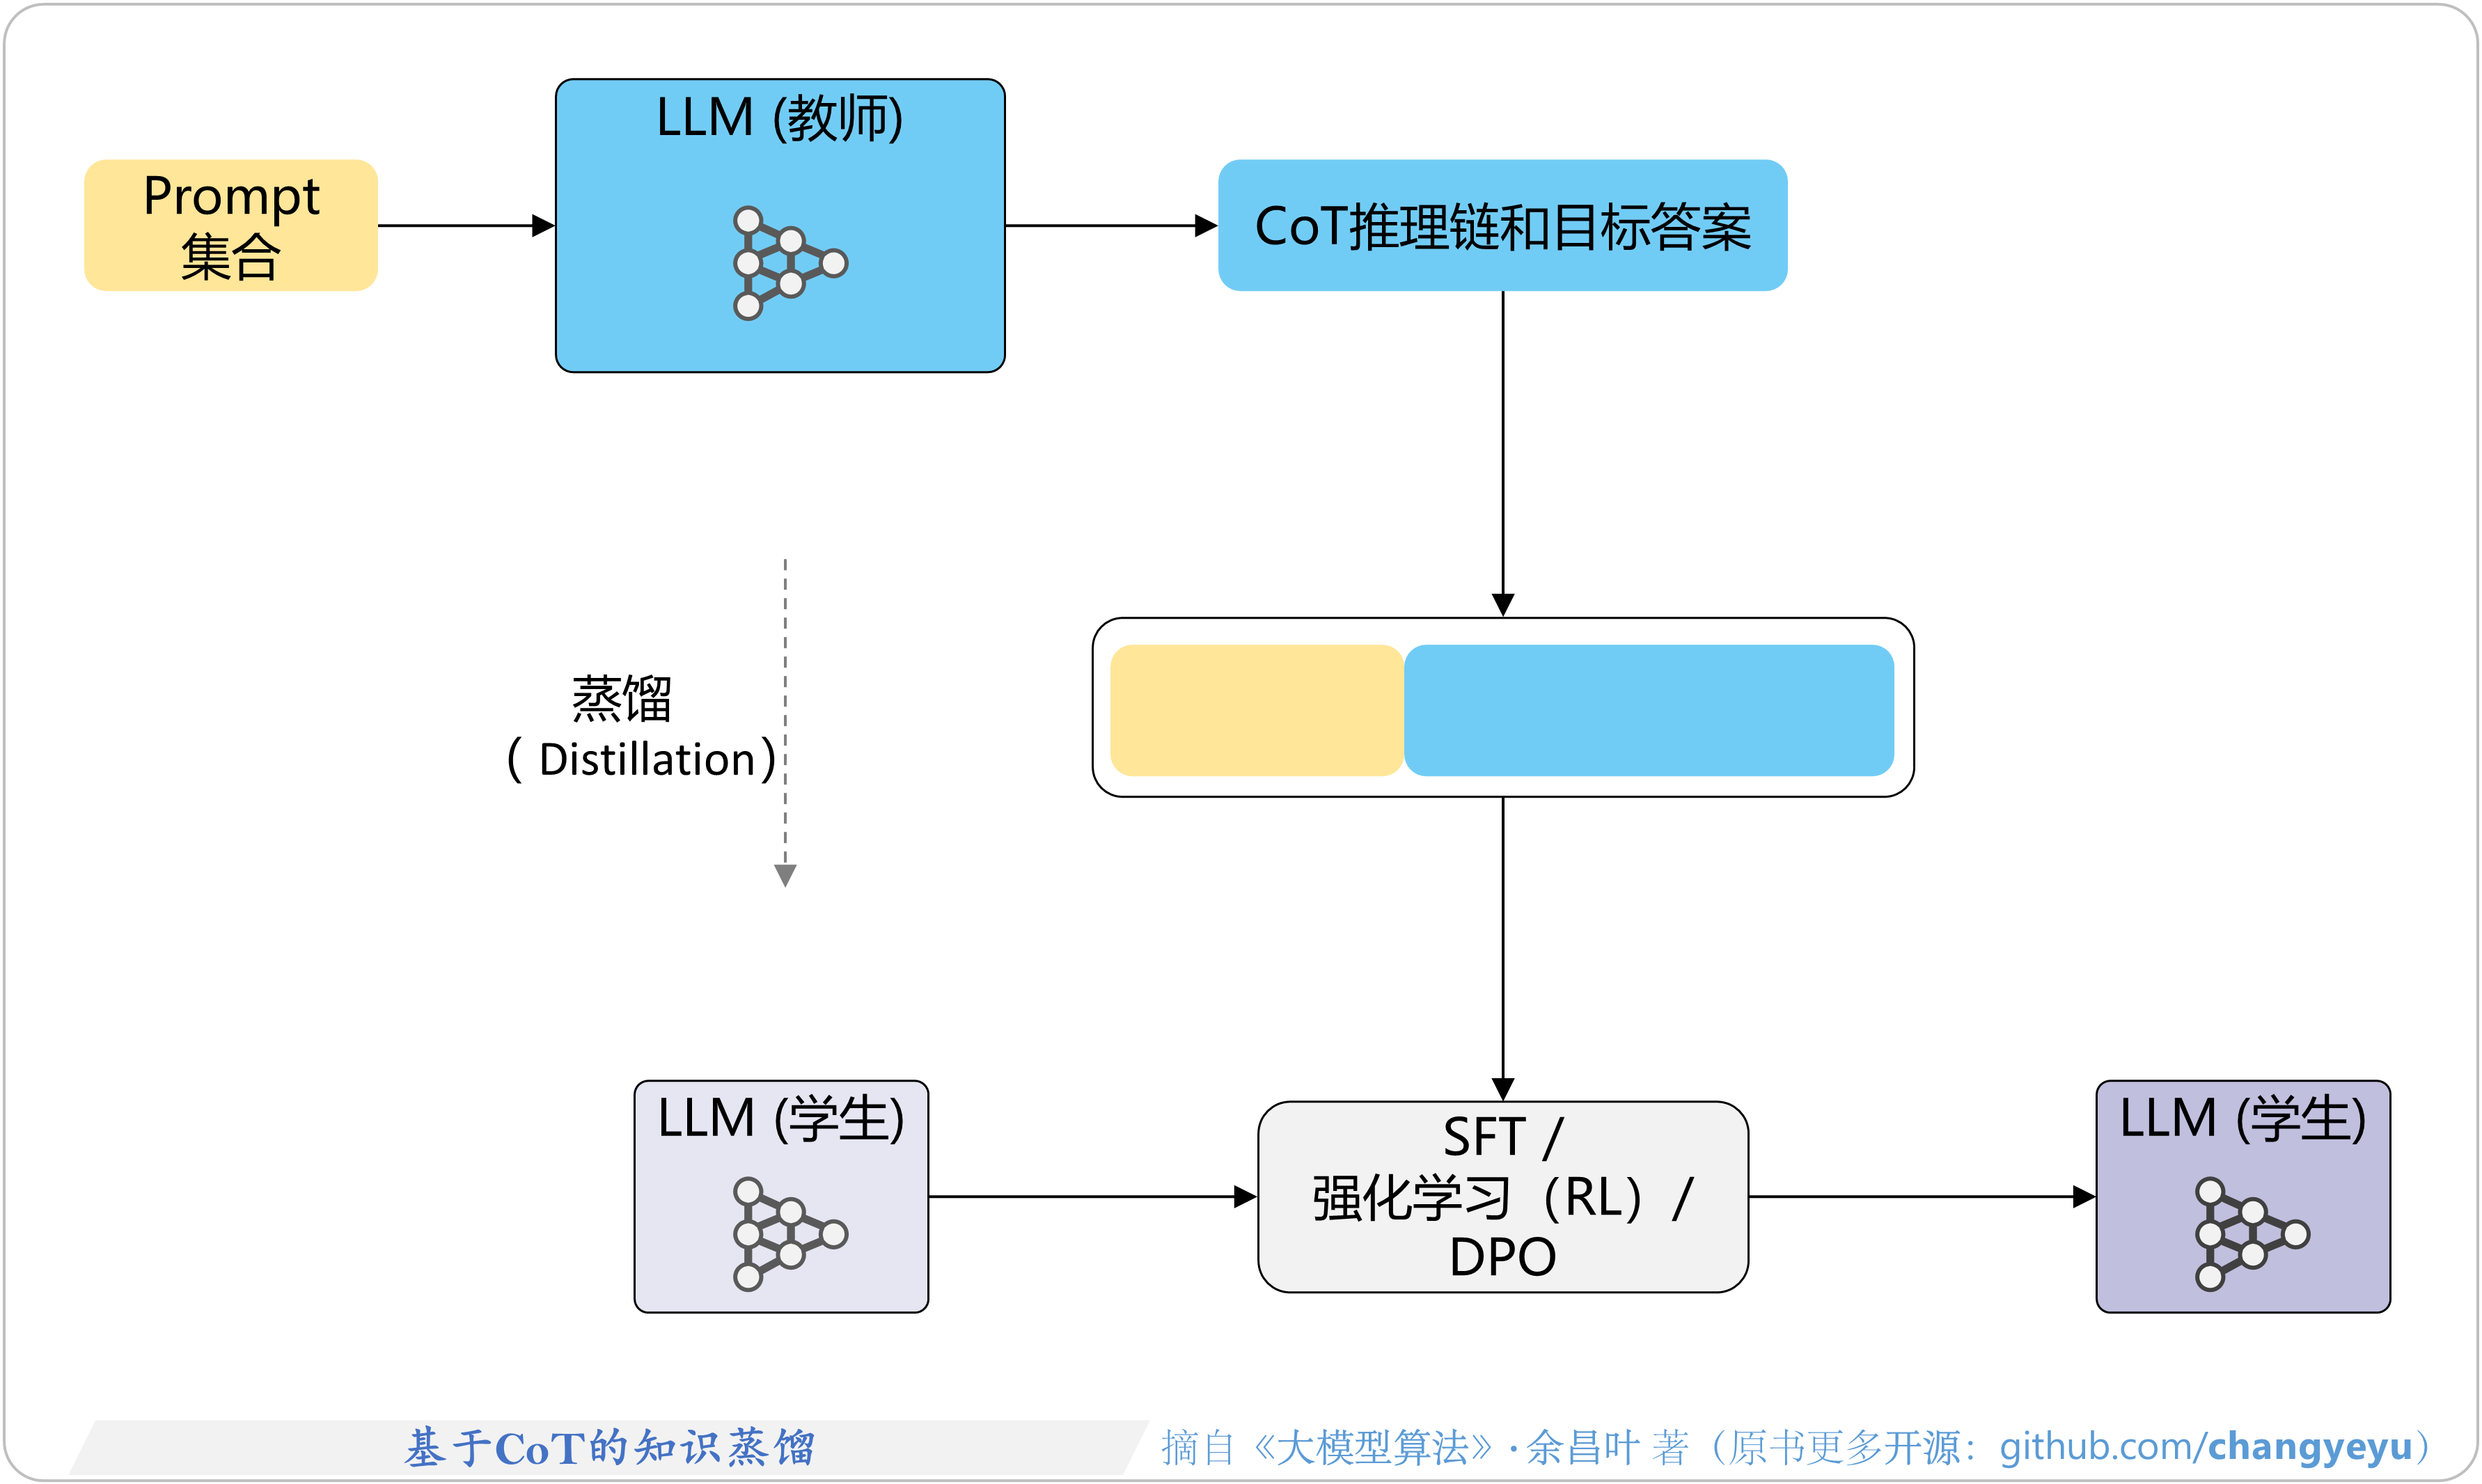
        8.1.2 基于CoT的蒸馏
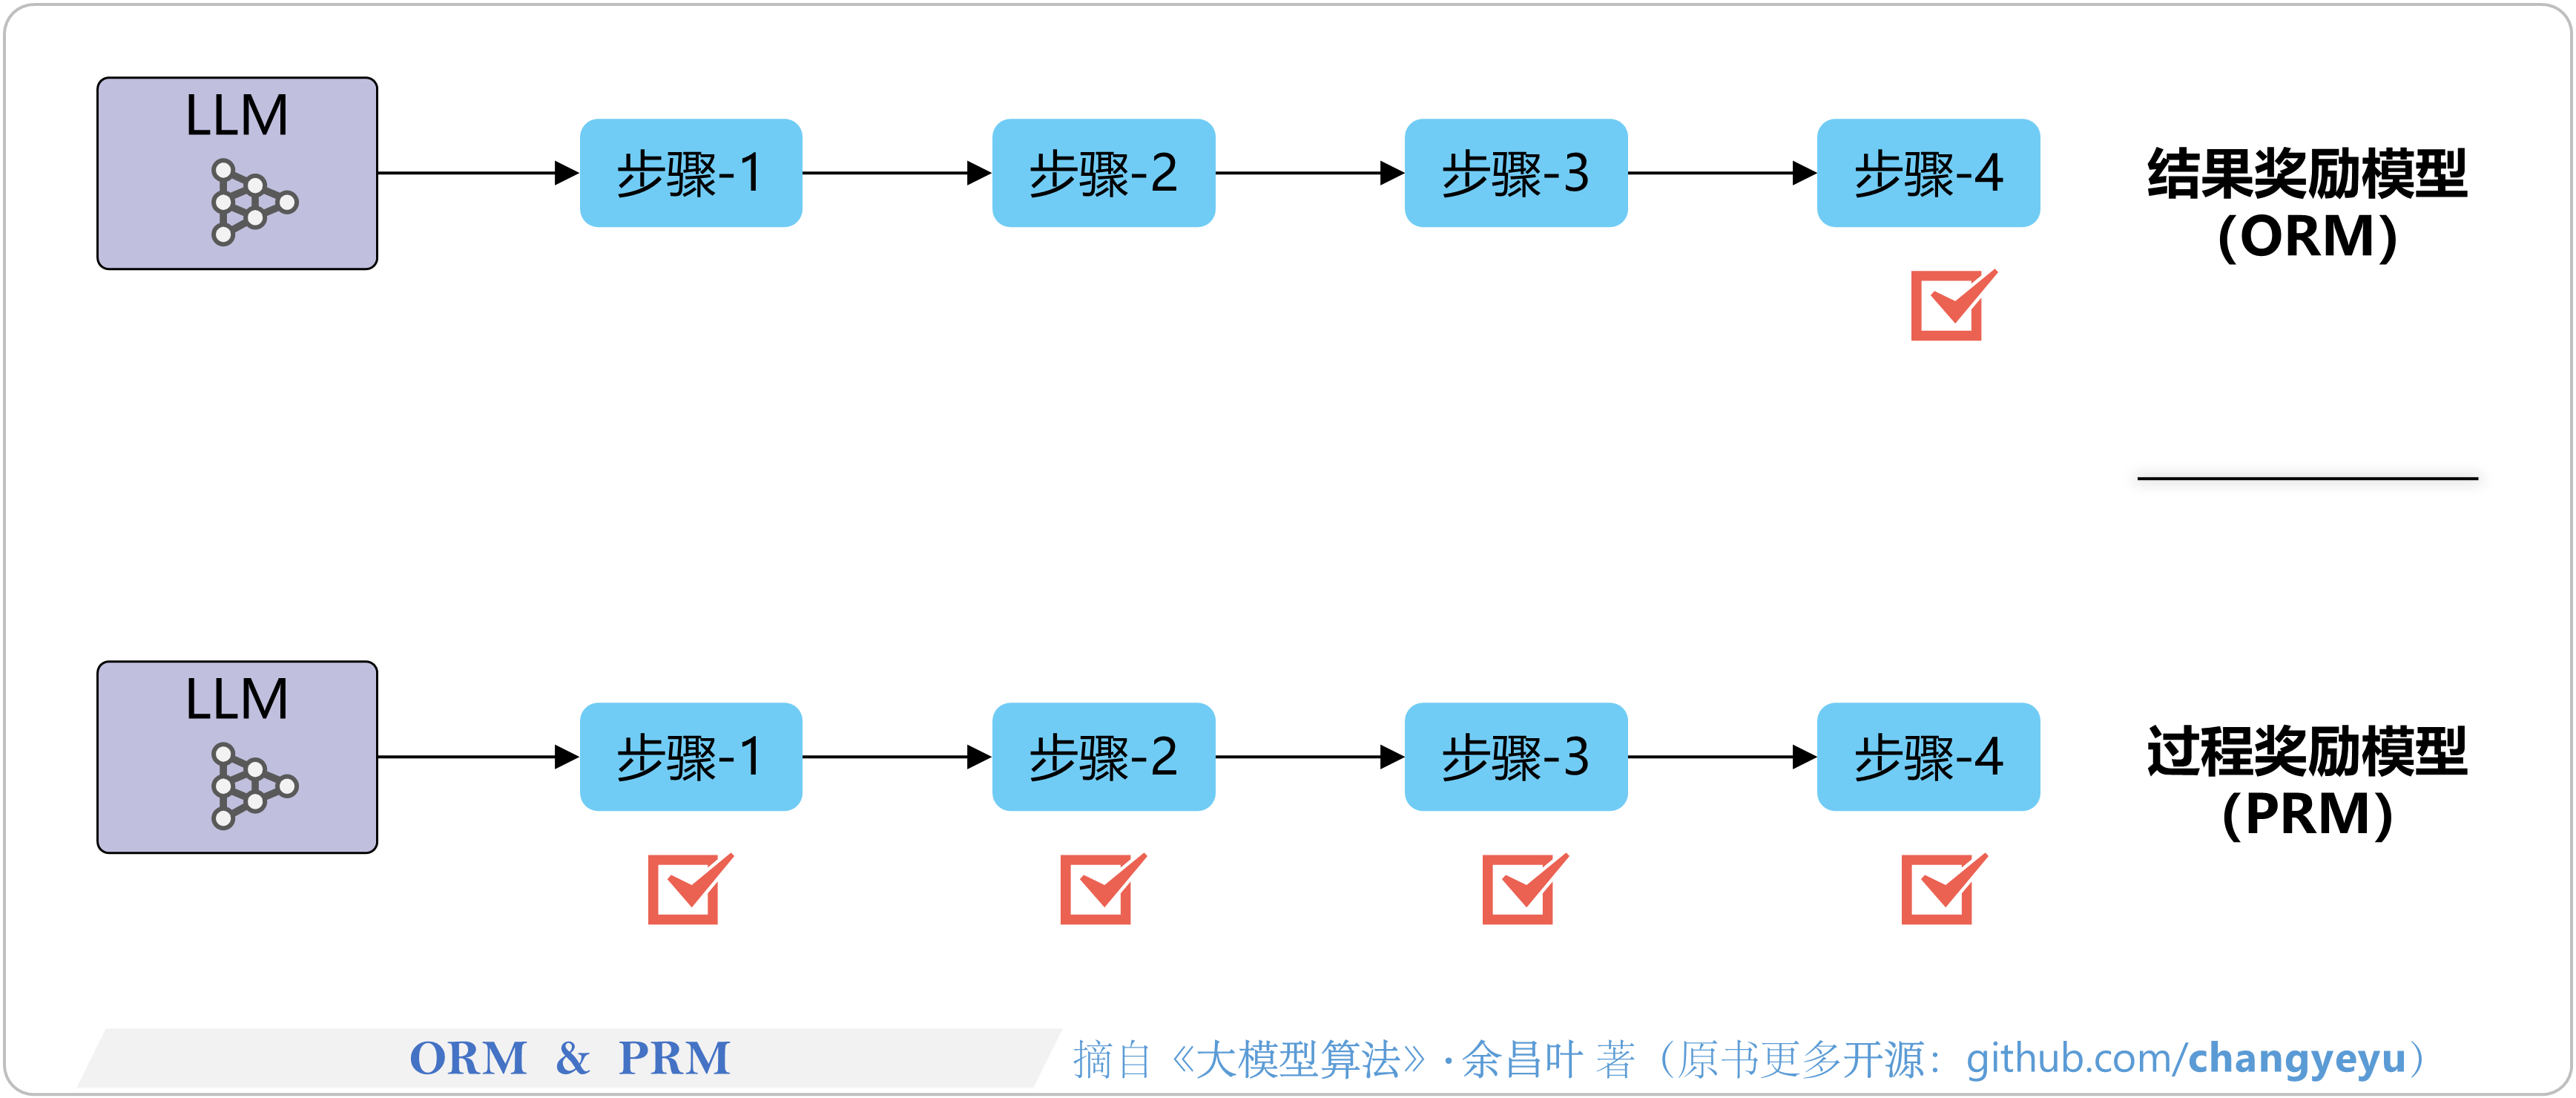
        8.1.3 过程奖励模型与结果奖励模型(PRM/ORM)
        8.1.4 数据合成
    8.2 推理路径搜索与优化
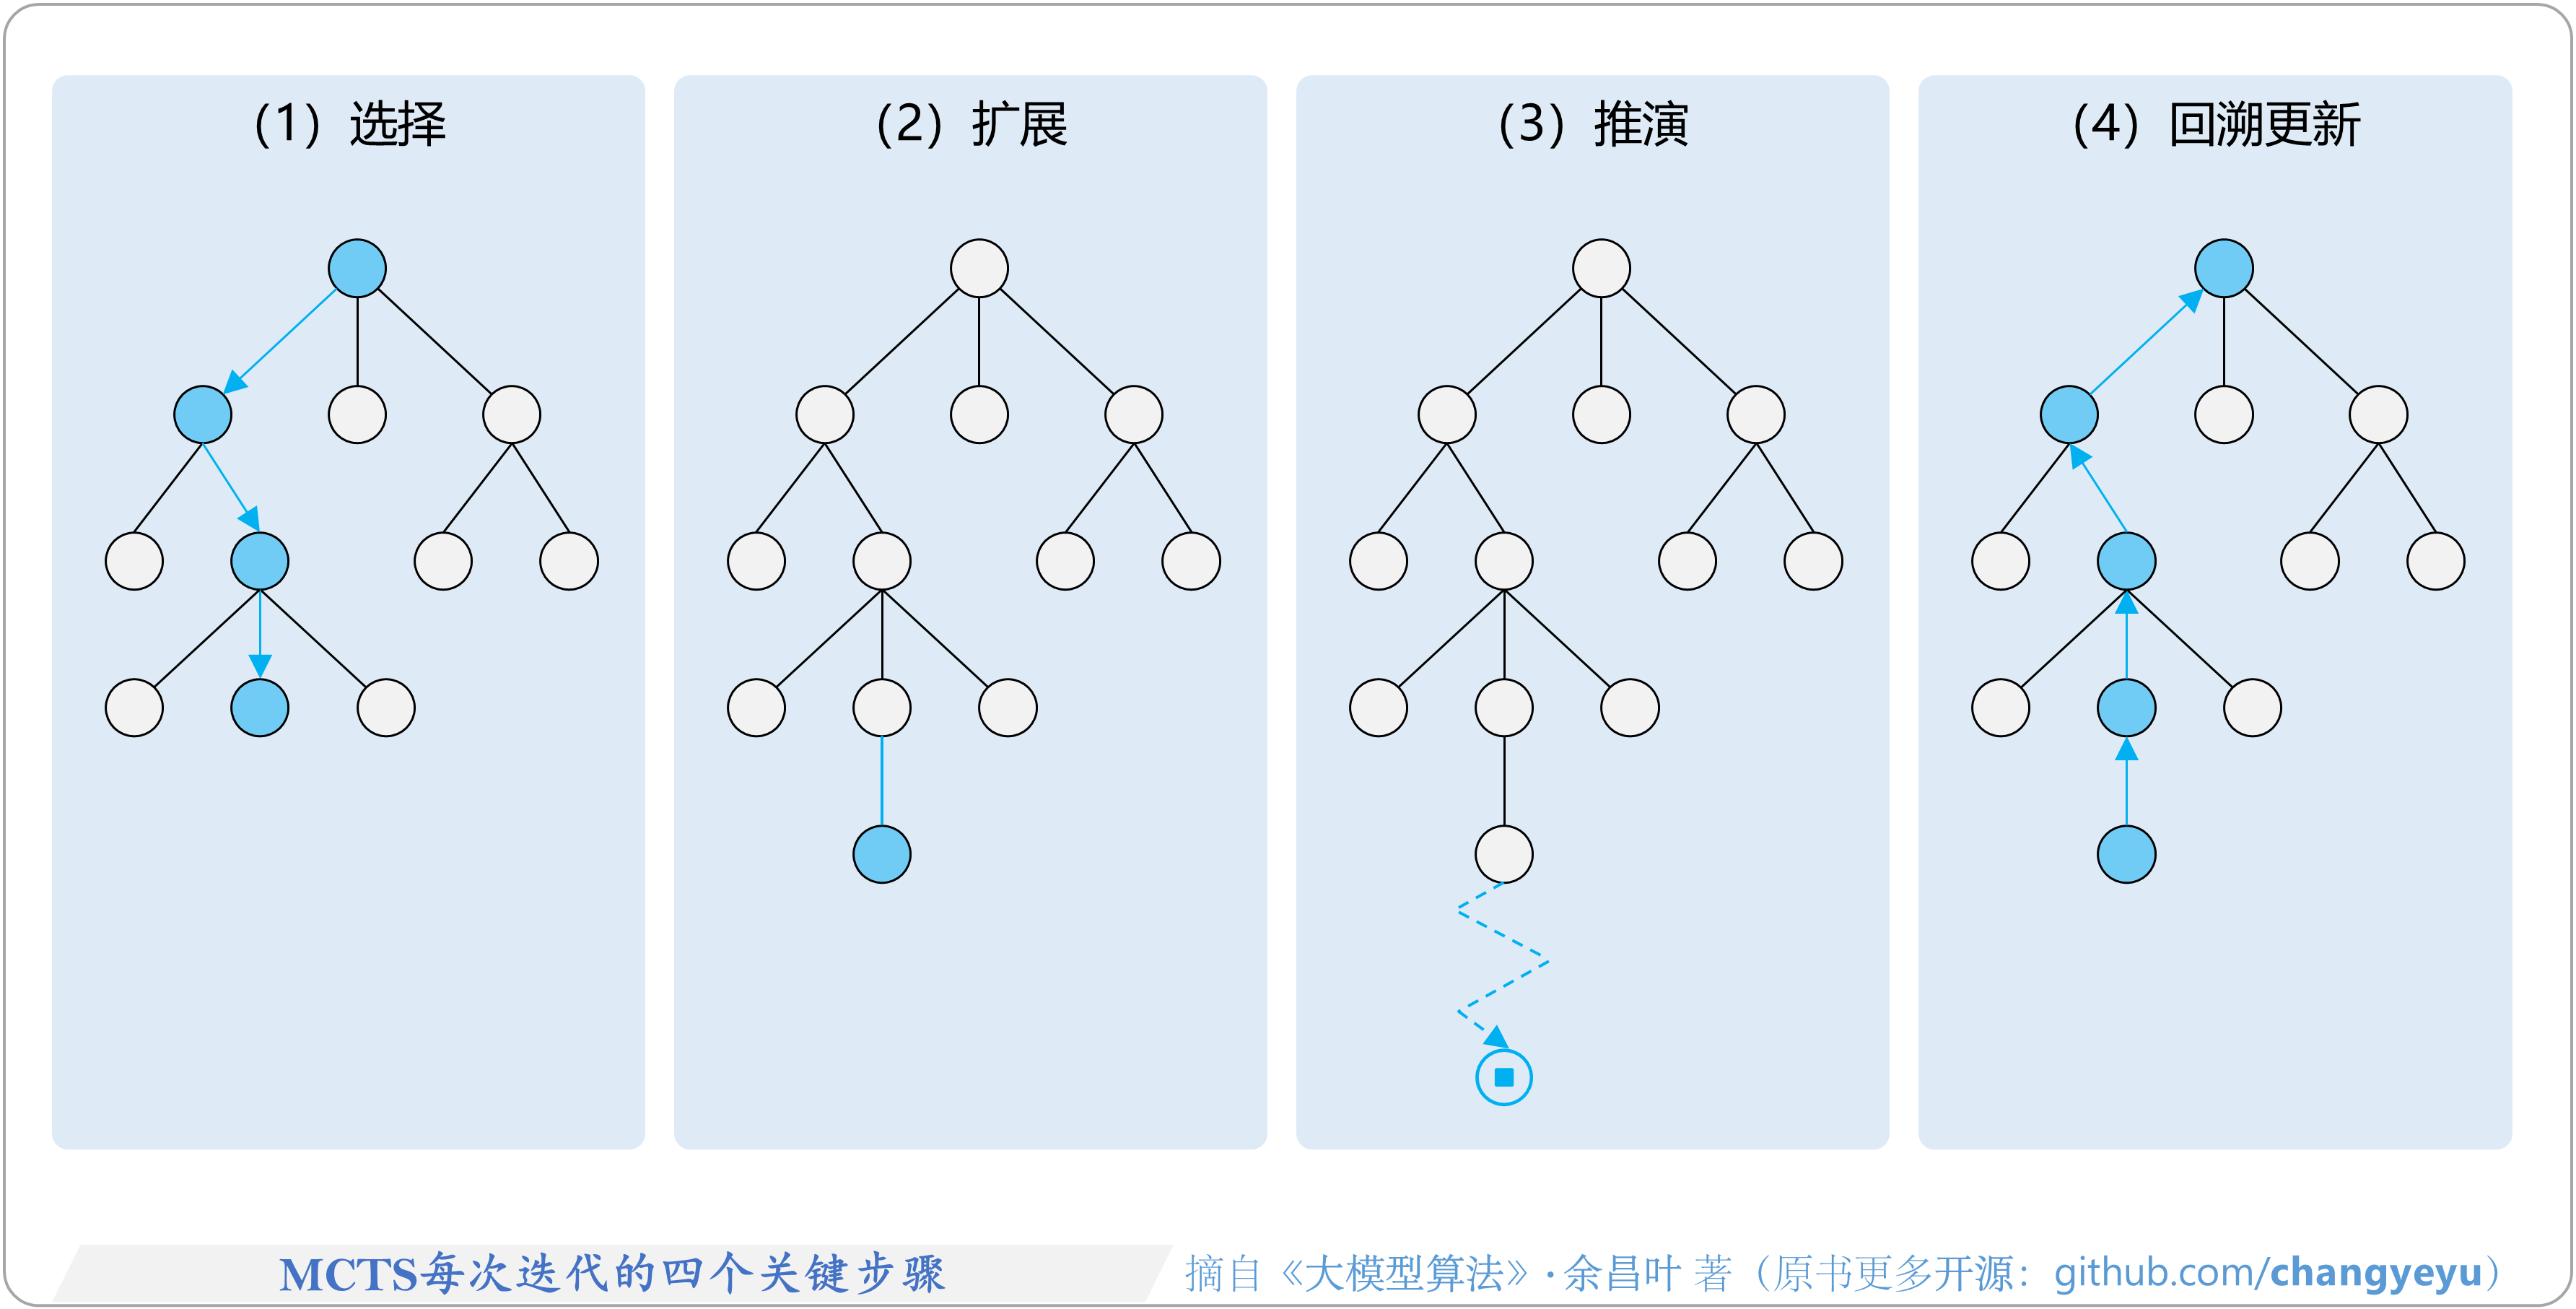
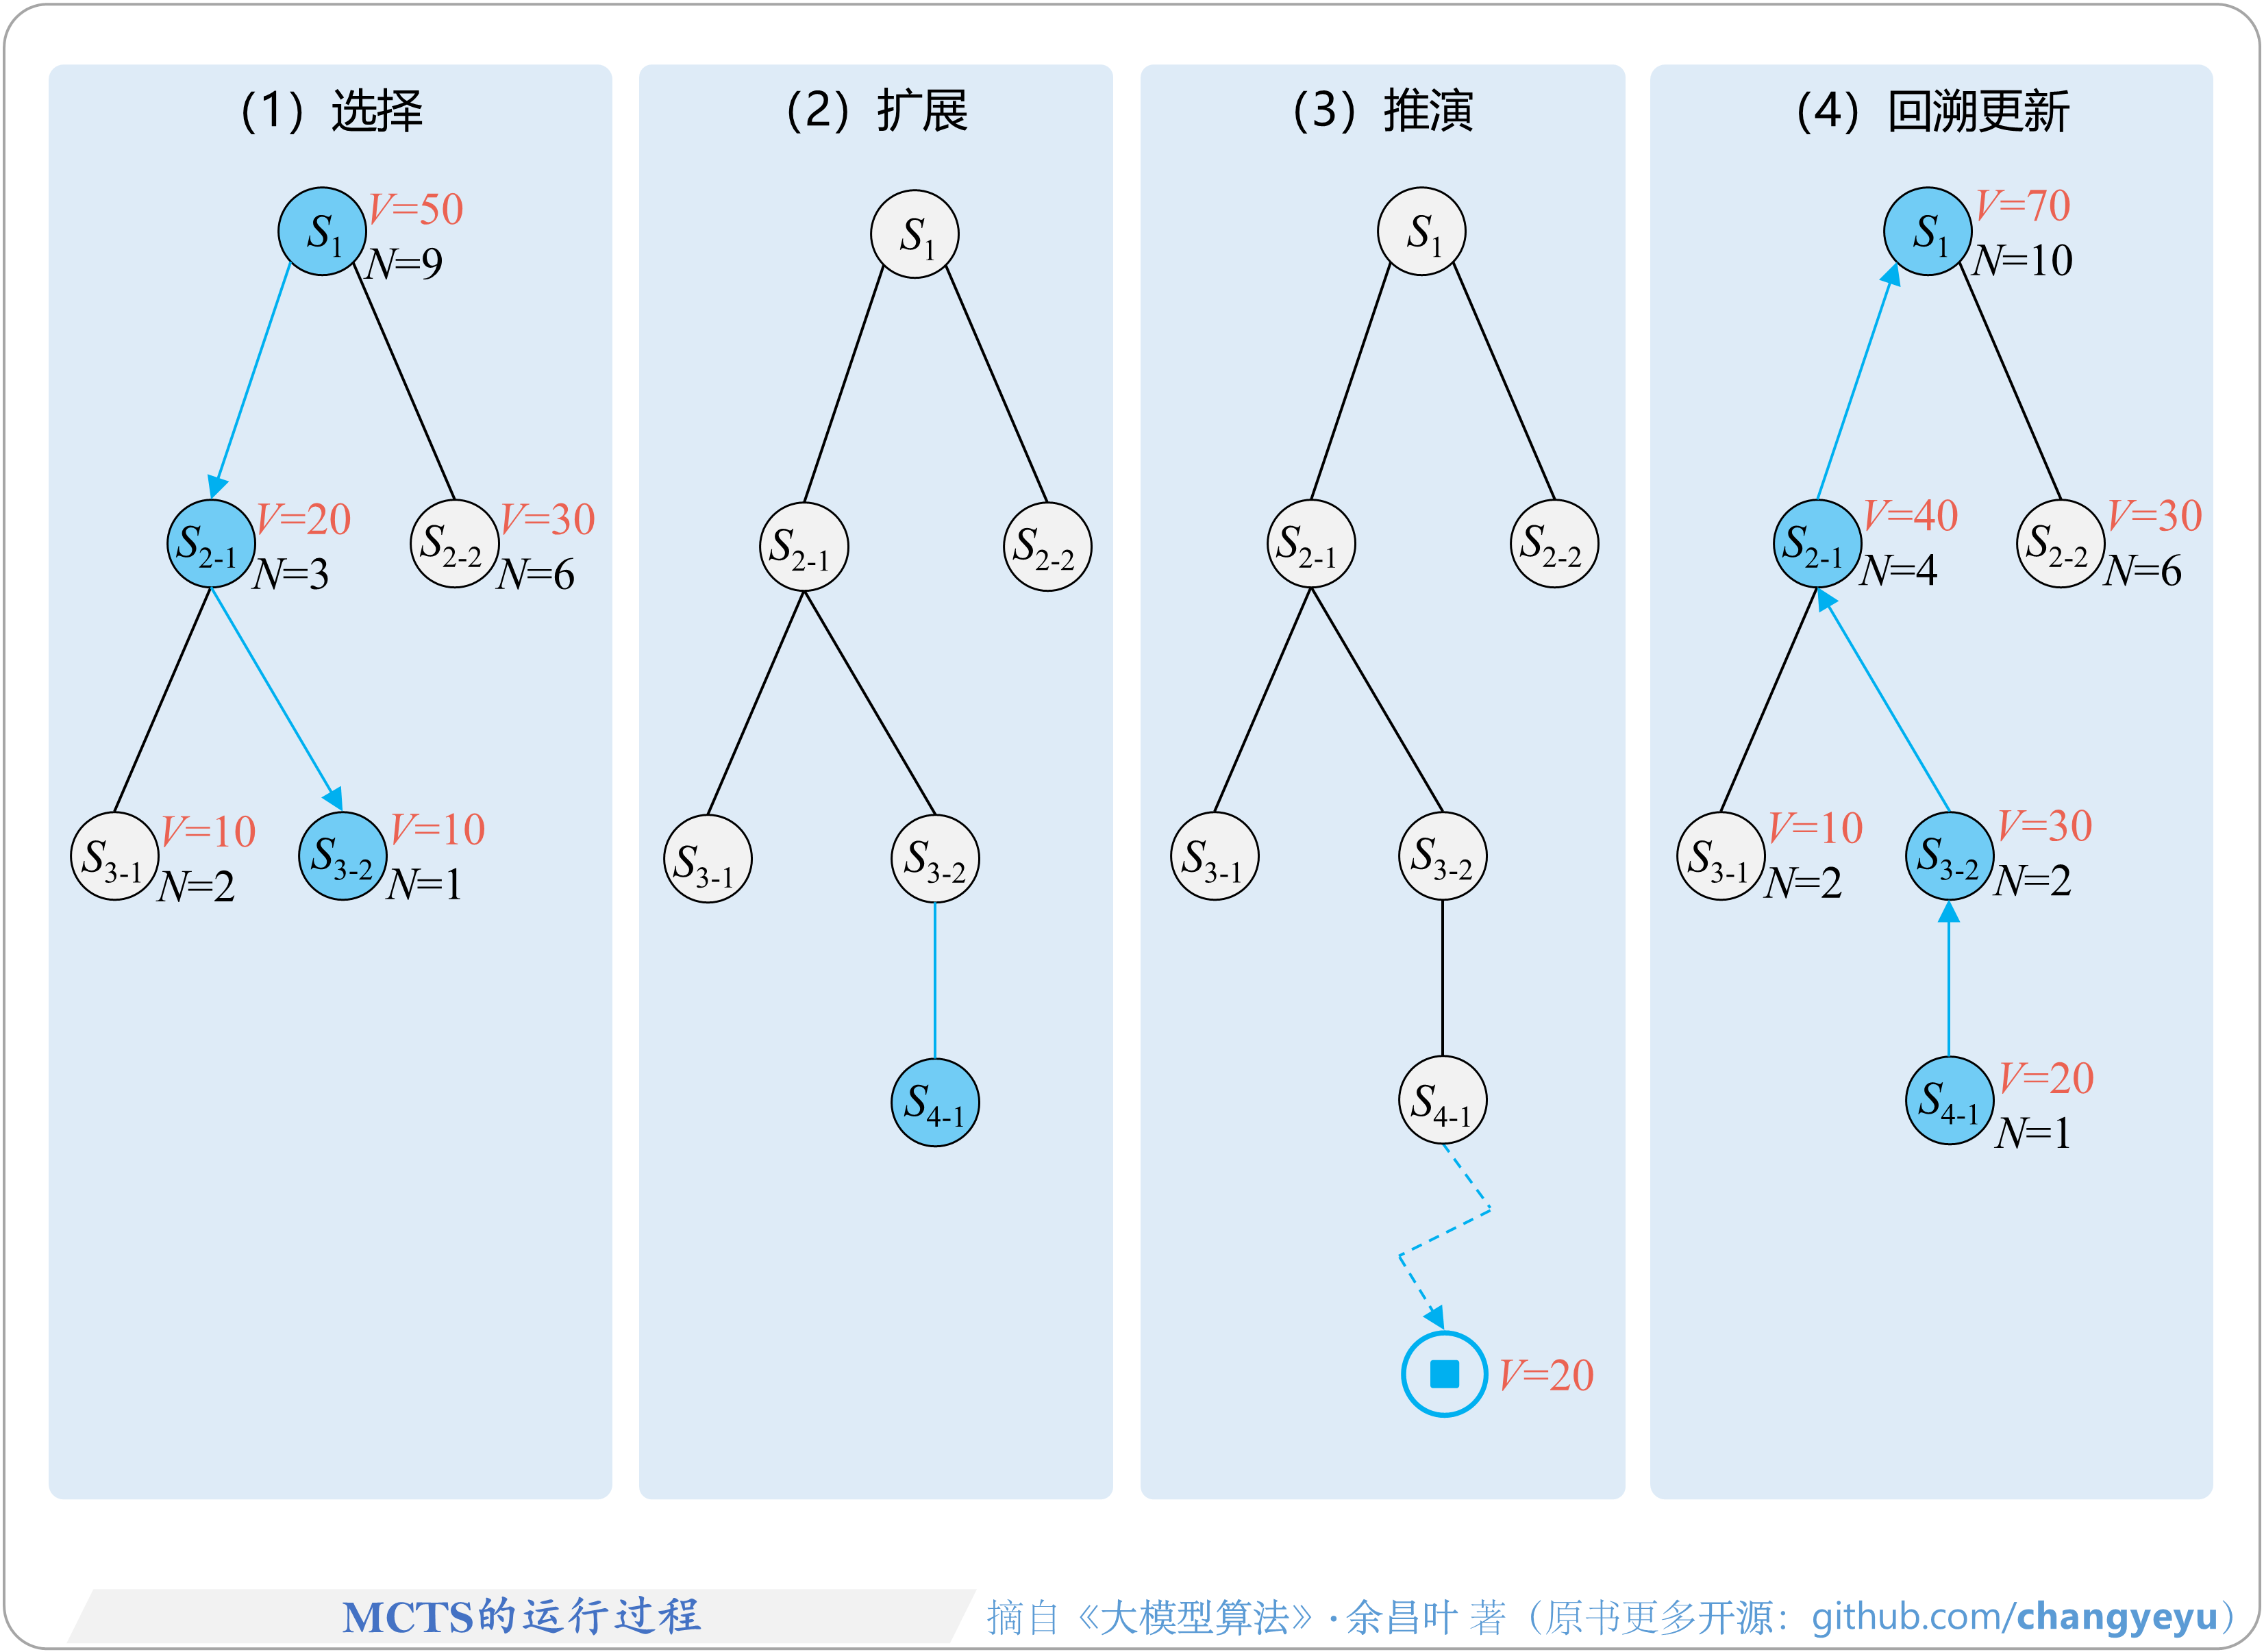
        8.2.1 MCTS(蒙特卡洛树搜索)
        8.2.2 A*搜索
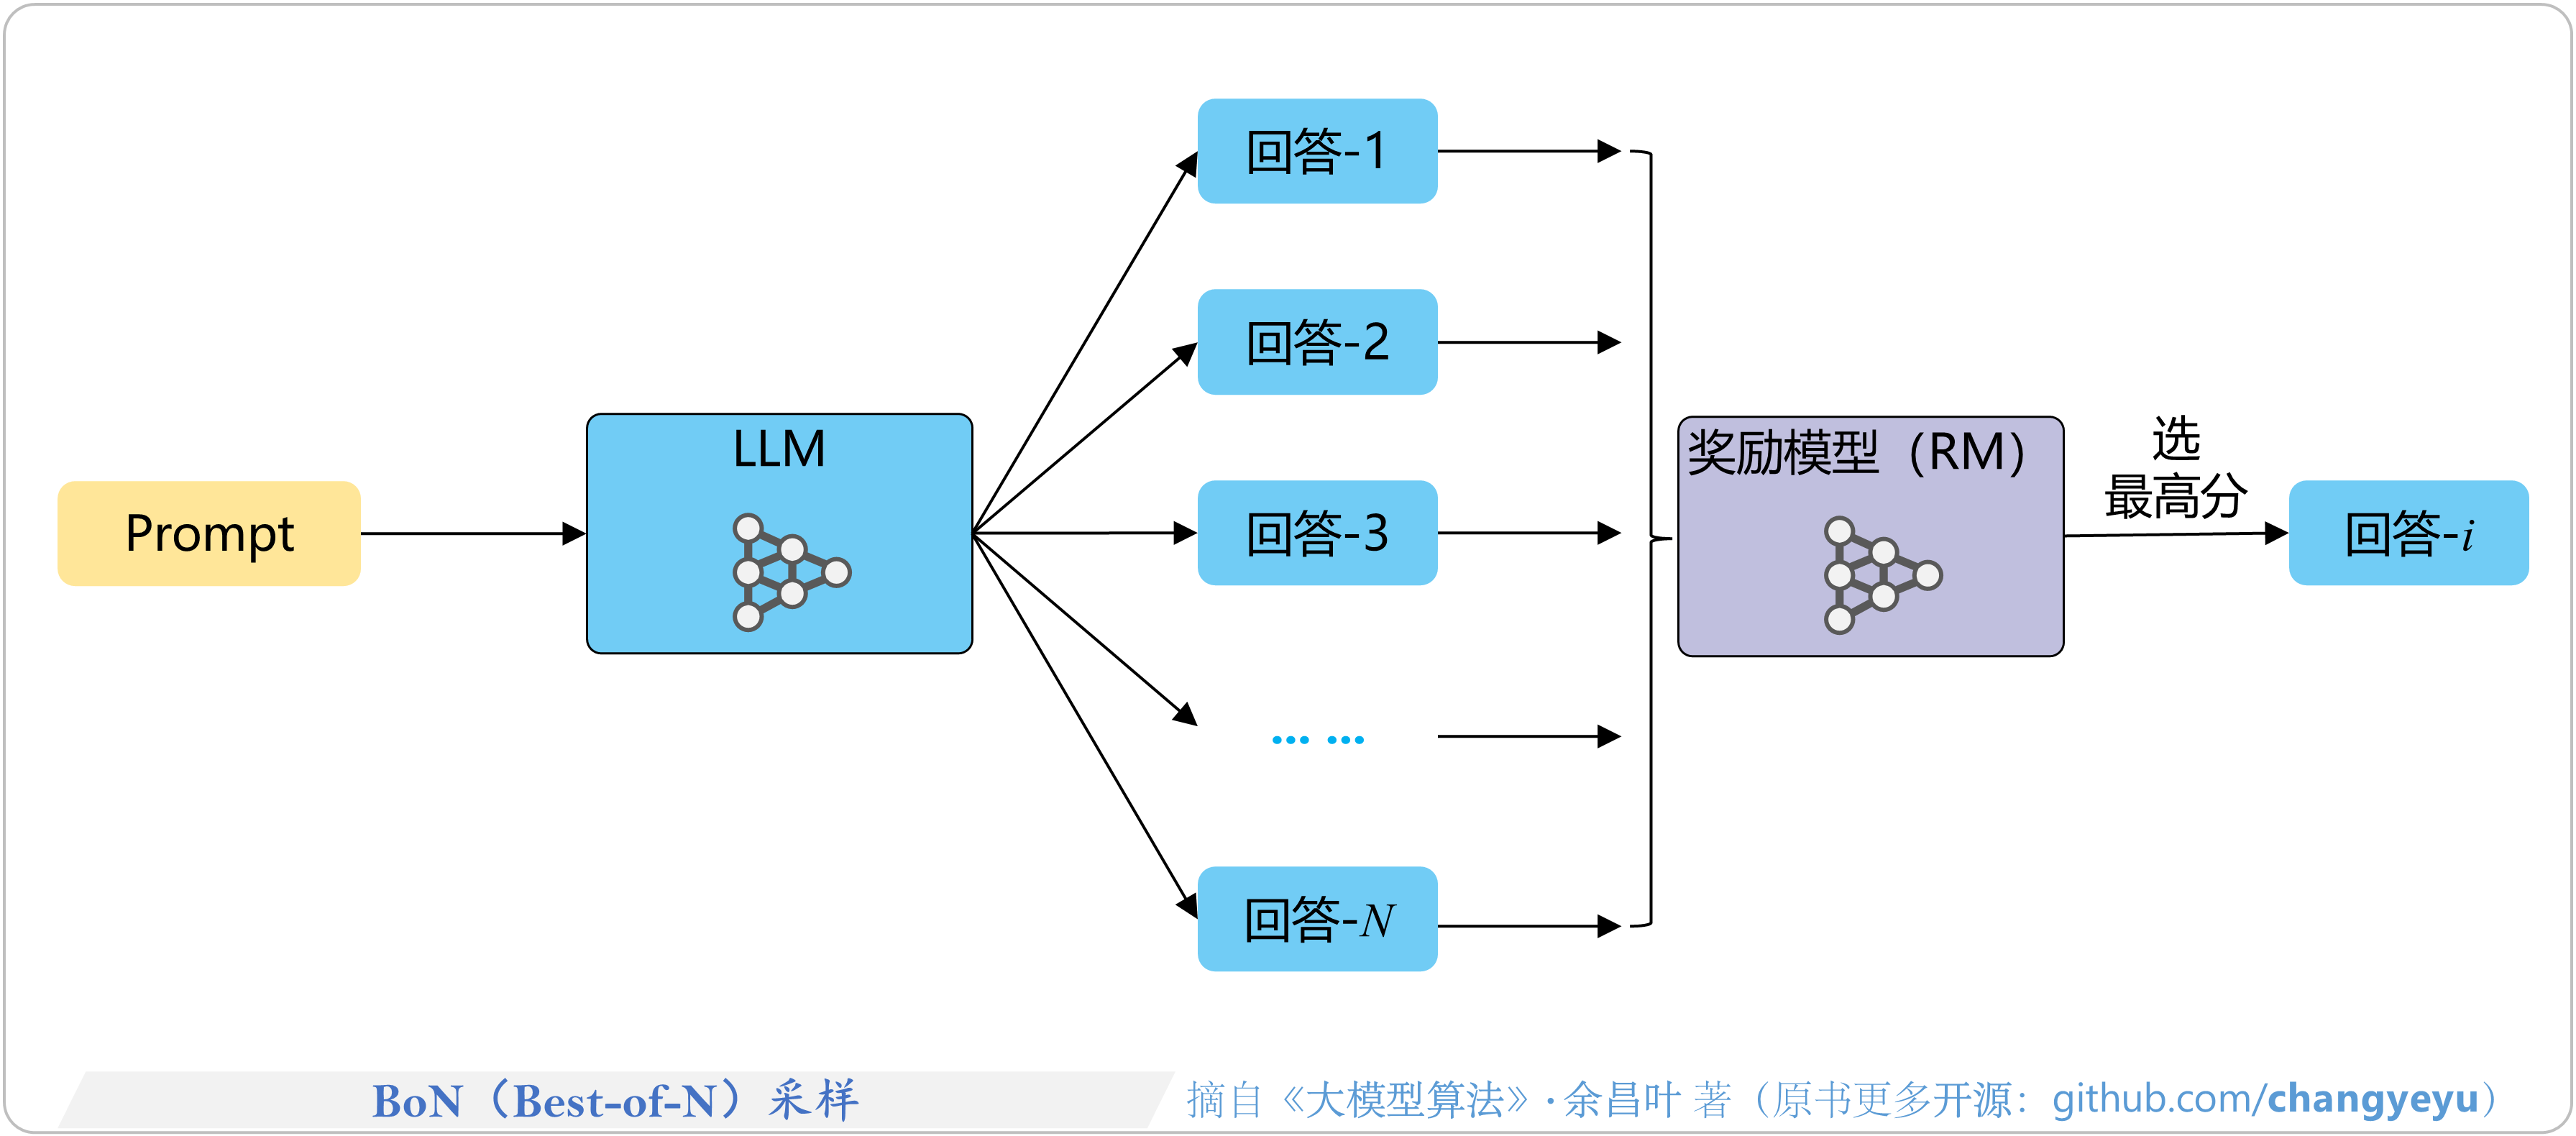
        8.2.3 BoN采样与蒸馏
        8.2.4 其他搜索方法
    8.3 强化学习训练
        8.3.1 强化学习的多种应用
        8.3.2 自博弈(Self-Play)与自我进化
        8.3.3 强化学习的多维创新
第9章 综合实践与性能优化
    9.1 实践全景图
    9.2 训练与部署
        9.2.1 数据与环境准备
        9.2.2 超参数如何设置
        9.2.3 SFT训练
        9.2.4 对齐训练:DPO训练、RLHF训练
        9.2.5 推理与部署
    9.3 DeepSeek的训练与本地部署
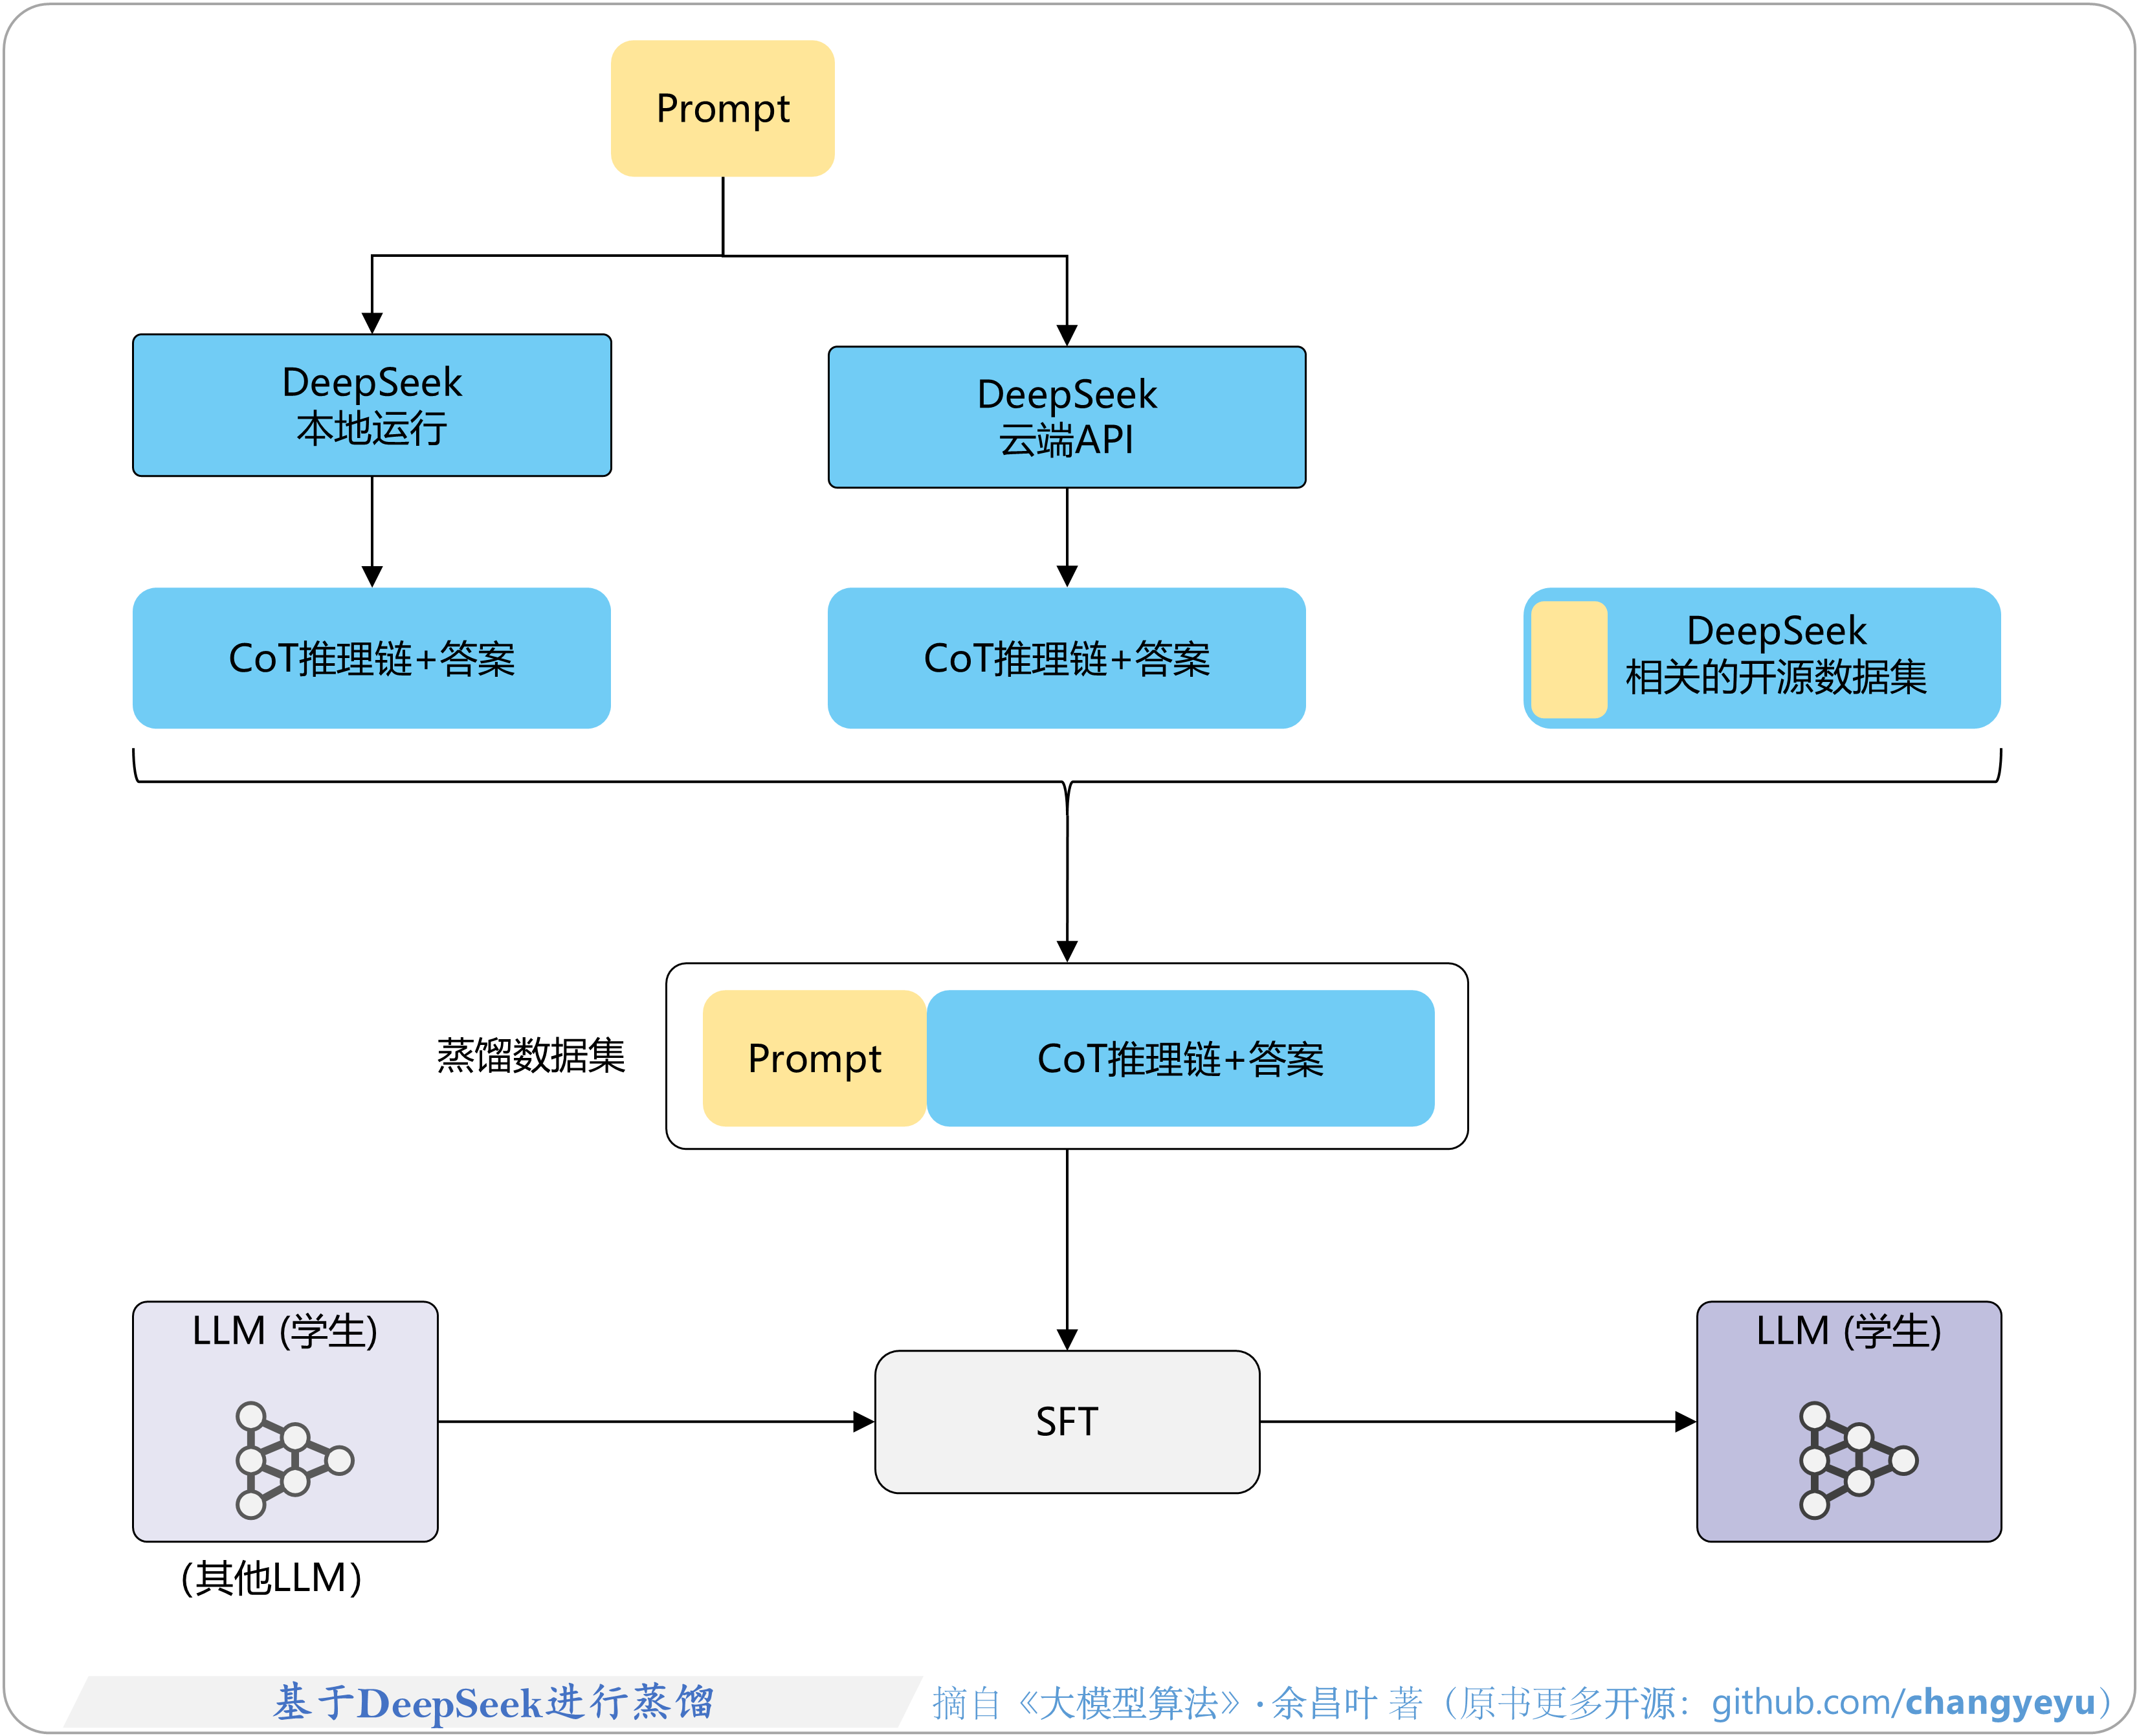
        9.3.1 DeepSeek的蒸馏与GRPO训练
        9.3.2 DeepSeek的本地部署与使用
    9.4 效果评估
        9.4.1 评估方法分类
        9.4.2 LLM与VLM的评测框架
    9.5 大模型性能优化技术图谱

#71CCF5) ; 浅黄(编码#FFE699); 蓝紫(编码#C0BFDE) ; 粉红(编码#F0ADB7)。本仓库内所有图片均依据 LICENSE 进行授权。只要遵守下方条款,你就可以自由地使用、修改及二次创作这些材料:
同时,你必须遵守以下条款:
余昌叶. 大模型算法:强化学习、微调与对齐[M]. 北京: 电子工业出版社, 2025. https://github.com/changyeyu/LLM-RL-Visualized
Yu, Changye. Large Model Algorithms: Reinforcement Learning, Fine-Tuning, and Alignment.
Beijing: Publishing House of Electronics Industry, 2025. https://github.com/changyeyu/LLM-RL-Visualized
中文 BibTeX(推荐):
@book{yu2025largemodel,
  title     = {大模型算法:强化学习、微调与对齐},
  author    = {余昌叶},
  publisher = {电子工业出版社},
  year      = {2025},
  address   = {北京},
  isbn      = {9787121500725},
  url       = {https://github.com/changyeyu/LLM-RL-Visualized},
  language  = {zh}
}
英文(English) BibTeX:
@book{yu2025largemodel_en,
  title     = {Large Model Algorithms: Reinforcement Learning, Fine-Tuning, and Alignment},
  author    = {Yu, Changye},
  publisher = {Publishing House of Electronics Industry},
  year      = {2025},
  address   = {Beijing},
  isbn      = {9787121500725},
  url       = {https://github.com/changyeyu/LLM-RL-Visualized},
  language  = {en}
}
欢迎点击仓库顶部的 Star ⭐ 关注, 感谢鼓励✨
79 followers · starred Jul 2025
134 followers · starred Mar 2026
13,415 followers · starred Jul 2025
142 followers · starred Jan 2026
🌟100+ 原创 LLM / RL 原理图📚,《大模型算法》作者巨献!💥(100+ LLM/RL Algorithm Maps )
See the code
🎉 原创 100+ 架构图,系统讲解大模型、强化学习,涵盖:LLM / VLM 等大模型原理、训练算法(RL、RLHF、GRPO、DPO、SFT 与 CoT 蒸馏等)、效果优化与 RAG 等。
🎉 关于架构图更详细的解读可参考:《大模型算法:强化学习、微调与对齐》 (豆瓣高分,多次京东AI图书Top 5 !)
🎉 本仓库长期勘误、追加,欢迎点击仓库顶部的 Star ⭐ 关注,感谢鼓励✨
🎉 单击图片可看高清大图,或浏览仓库目录中的 .svg 格式矢量图(活图,可无限缩放、可选择文字)
LLM的输出层负责根据隐藏状态(多维数值矩阵)预测下一个词元(文本)。处理流程如图所示:
多模态模型根据侧重不同,通常有以下多种称呼:
不同于RLHF,DPO以监督学习的训练方式,大幅简化了对齐训练:
DQN模型的输入输出结构有两种类型:
import numpy as np

def compute_gae(rewards, values, gamma=0.99, lambda_=0.95):
    """
    参数:
        rewards (list 或 np.ndarray): 每个时间步收集到的奖励 r,形状为 (T,)
        values  (list 或 np.ndarray): 每个状态的价值估计 V,形状为 (T+1,)
        gamma   (float): 折扣因子 γ
        lambda_ (float): GAE 的衰减参数 λ
    返回:
        np.ndarray: 优势估计 A,形状为 (T,)。例如对于 T=5,A=[A0, A1, A2, A3, A4]
    """
    T = len(rewards)            # 时间步数 T,终止时间步为 t=T-1
    advantages = np.zeros(T)    # 优势估计数组,例如 [A0, A1, A2, A3, A4]
    gae = 0                     # 初始化 GAE 累计值为 0

    # 反向从时间步 t=T-1 到 t=0 进行迭代计算,总共迭代 T 次
    for t in reversed(range(T)):
        # δ_t = r_t + γ * V(s_{t+1}) - V(s_t)
        delta = rewards[t] + gamma * values[t + 1] - values[t]
        # A_t = δ_t + γ * λ * A_{t+1}
        gae = delta + gamma * lambda_ * gae
        advantages[t] = gae

    return advantages
# 简写 R:rewards, V:values, Adv:advantages, J:objective, P:probability
for iteration in range(num_iterations):  # 进行num_iterations个训练迭代
    #【1/2】收集样本(prompt, response_old, logP_old, Adv, V_target)
    prompt_batch, response_old_batch = [], []
    logP_old_batch, Adv_batch, V_target_batch = [], [], []
    for _ in range(num_examples):
        logP_old, response_old  = actor_model(prompt)
        V_old    = critic_model(prompt, response_old)
        R        = reward_model(prompt, response_old)[-1]
        logP_ref = ref_model(prompt, response_old)

        # KL距离惩罚。注意:上面的R只取了最后一个token对应的奖励分数
        KL = logP_old - logP_ref
        R_with_KL = R - scale_factor * KL

        # 通过GAE算法计算优势Adv
        Adv = GAE_Advantage(R_with_KL, V_old, gamma, λ)
        V_target = Adv + V_old

        prompt_batch        += prompt
        response_old_batch  += response_old
        logP_old_batch      += logP_old
        Adv_batch           += Adv
        V_target_batch      += V_target

    # 【2/2】多轮PPO训练,多次参数更新
    for _ in range(ppo_epochs):
        mini_batches = shuffle_split( (prompt_batch, response_old_batch,
            logP_old_batch, Adv_batch, V_target_batch), mini_batch_size )

        for prompt, response_old, logP_old, Adv, V_target in mini_batches:
            logits, logP_new = actor_model(prompt, response_old)
            V_new            = critic_model(prompt, response_old)

            # 策略概率比: ratio(θ) = π_θ(a|s) / π_θ_old (a|s)
            ratios = exp(logP_new - logP_old)

            # 计算策略模型Loss
            L_clip = -mean( min( ratios * Adv,
                                clip(ratios, 1 - ε, 1 + ε) * Adv ) )

            S_entropy = mean( compute_entropy(logits) )  # 计算策略的熵

            Loss_V = mean((V_new - V_target) ** 2)   # 计算价值模型Loss

            Loss = L_clip + C1 * Loss_V - C2 * S_entropy # 总损失
            backward_update(Loss, L_clip, Loss_V) # 反向传播; 更新模型参数
RLHF训练可以分为两个阶段:
如图所示,其中,yw和 yl是针对同一个Prompt(图中的x)生成的两个回答,且 yw 优于 yl ,这包含了人类反馈(偏好)信息。训练步骤如下:
如图所示,RLHF的第二阶段需要加载四个模型进行强化学习训练。这四种模型的角色和相互关系如下:
通常,在通用&低成本场景下,可以简化模型设计,RLHF涉及的四种模型拥有类似的结构,主要区别在于各模型的头部(Head)。这些模型可以基于SFT模型(经过有监督微调后的LLM版本)进行改造和初始化,如图所示:
PPO训练中各模型的输入与输出
| 模型 | 输入 | 输出 |
|---|---|---|
| 策略模型 | Prompt(或上下文) | 回答及其对应的对数概率(LogProbs) |
| 参考模型 | Prompt(或上下文) + 回答 | 回答对应的对数概率(LogProbs) |
| 奖励模型 | Prompt(或上下文) + 回答 | 回答对应的每个 token 的奖励值 |
| 价值模型 | Prompt(或上下文) + 回答 | 回答对应的每个 token 的价值估计 |
| 类型 | 总位数 | 符号位 | 指数位 | 尾数位 / 整数位 |
|---|---|---|---|---|
| FP64 | 64 | 1 | 11 | 52 (尾数) |
| FP32 | 32 | 1 | 8 | 23 (尾数) |
| TF32 | 19 | 1 | 8 | 10 (尾数) |
| BF16 | 16 | 1 | 8 | 7 (尾数) |
| FP16 | 16 | 1 | 5 | 10 (尾数) |
| INT64 | 64 | 1 | – | 63 (整数值) |
| INT32 | 32 | 1 | – | 31 (整数值) |
| INT8 | 8 | 1 | – | 7 (整数值) |
| UINT8 | 8 | 0 | – | 8 (整数值) |
| INT4 | 4 | 1 | – | 3 (整数值) |
这张图展示了神经网络在常规训练中的前向传播(Forward)和反向传播(Backward)流程:
这张图对比了常规训练与梯度累积(Gradient Accumulation)训练的差异:
这张图对比了常规训练与梯度重计算(Gradient Checkpoint)训练的不同:
被面试者、工程师经常混淆的算法常用指标,我画了一张图来对比总结,区别一目了然。
第1章 大模型原理与技术概要
    1.1 图解大模型结构
        1.1.1 大语言模型(LLM)结构全景图
        1.1.2 输入层:分词、Token映射与向量生成
        1.1.3 输出层:Logits、概率分布与解码
        1.1.4 多模态语言模型(MLLM)与视觉语言模型(VLM)
    1.2 大模型训练全景图
    1.3 Scaling Law(性能的四大扩展规律)
第2章 SFT(监督微调)
    2.1 多种微调技术图解
        2.1.1 全参数微调、部分参数微调
        2.1.2 LoRA(低秩适配微调)——四两拨千斤
        2.1.3 LoRA衍生:QLoRA、AdaLoRA、PiSSA等
        2.1.4 基于提示的微调:Prefix-Tuning、Prompt Tuning等
        2.1.5 Adapter Tuning
        2.1.6 微调技术对比
        2.1.7 如何选择微调技术
    2.2 SFT原理深入解析
        2.2.1 SFT数据与ChatML格式化
        2.2.2 Logits与Token概率计算
        2.2.3 SFT的Label
        2.2.4 SFT的Loss图解
        2.2.5 对数概率(LogProbs)与LogSoftmax
    2.3 指令收集和处理
        2.3.1 收集指令的渠道和方法
        2.3.2 清洗指令的四要素
        2.3.3 数据预处理及常用工具
    2.4 SFT实践指南
        2.4.1 如何缓解SFT引入的幻觉?
        2.4.2 Token级Batch Size的换算
        2.4.3 Batch Size与学习率的Scaling Law
        2.4.4 SFT的七个技巧
第3章 DPO(直接偏好优化)
    3.1 DPO的核心思想
        3.1.1 DPO的提出背景与意义
        3.1.2 隐式的奖励模型
        3.1.3 Loss和优化目标
    3.2 偏好数据集的构建
        3.2.1 构建流程总览
        3.2.2 Prompt的收集
        3.2.3 问答数据对的清洗
        3.2.4 封装和预处理
    3.3 图解DPO的实现与训练
        3.3.1 模型的初始化
        3.3.2 DPO训练全景图
        3.3.3 DPO核心代码的提炼和解读
    3.4 DPO实践经验
        3.4.1 β参数如何调节
        3.4.2 DPO对模型能力的多维度影响
    3.5 DPO进阶
        3.5.1 DPO和RLHF(PPO)的对比
        3.5.2 理解DPO的梯度
第4章 免训练的效果优化技术
    4.1 提示工程
        4.1.1 Zero-Shot、One-Shot、Few-Shot
        4.1.2 Prompt设计的原则
    4.2 CoT(思维链)
        4.2.1 CoT原理图解
        4.2.2 ToT、GoT、XoT等衍生方法
        4.2.3 CoT的应用技巧
        4.2.4 CoT在多模态领域的应用
    4.3 生成控制和解码策略
        4.3.1 解码的原理与分类
        4.3.2 贪婪搜索
        4.3.3 Beam Search(波束搜索):图解、衍生方法
        4.3.4 Top-K、Top-P等采样方法图解
        4.3.5 其他解码策略
        4.3.6 多种生成控制参数
    4.4 RAG(检索增强生成)
        4.4.1 RAG技术全景图
        4.4.2 RAG相关框架
    4.5 功能与工具调用(Function Calling)
        4.5.1 功能调用全景图
        4.5.2 功能调用的分类
第5章 强化学习基础
    5.1 强化学习核心
        5.1.1 强化学习:定义与区分
        5.1.2 强化学习的基础架构、核心概念
        5.1.3 马尔可夫决策过程(MDP)
        5.1.4 探索与利用、ε-贪婪策略
        5.1.5 同策略(On-policy)、异策略(Off-policy)
        5.1.6 在线/离线强化学习(Online/Offline RL)
        5.1.7 强化学习分类图
    5.2 价值函数、回报预估
        5.2.1 奖励、回报、折扣因子(R、G、γ)
        5.2.2 反向计算回报
        5.2.3 四种价值函数:Qπ、Vπ、V*、Q*
        5.2.4 奖励、回报、价值的区别
        5.2.5 贝尔曼方程——强化学习的基石
        5.2.6 Q和V的转换关系、转换图
        5.2.7 蒙特卡洛方法(MC)
    5.3 时序差分(TD)
        5.3.1 时序差分方法
        5.3.2 TD-Target和TD-Error
        5.3.3 TD(λ)、多步TD
        5.3.4 蒙特卡洛、TD、DP、穷举搜索的区别
    5.4 基于价值的算法
        5.4.1 Q-learning算法
        5.4.2 DQN
        5.4.3 DQN的Loss、训练过程
        5.4.4 DDQN、Dueling DQN等衍生算法
    5.5 策略梯度算法
        5.5.1 策略梯度(Policy Gradient)
        5.5.2 策略梯度定理
        5.5.3 REINFORCE和Actor-Critic:策略梯度的应用
    5.6 多智能体强化学习(MARL)
        5.6.1 MARL的原理与架构
        5.6.2 MARL的建模
        5.6.3 MARL的典型算法
    5.7 模仿学习(IL)
        5.7.1 模仿学习的定义、分类
        5.7.2 行为克隆(BC)
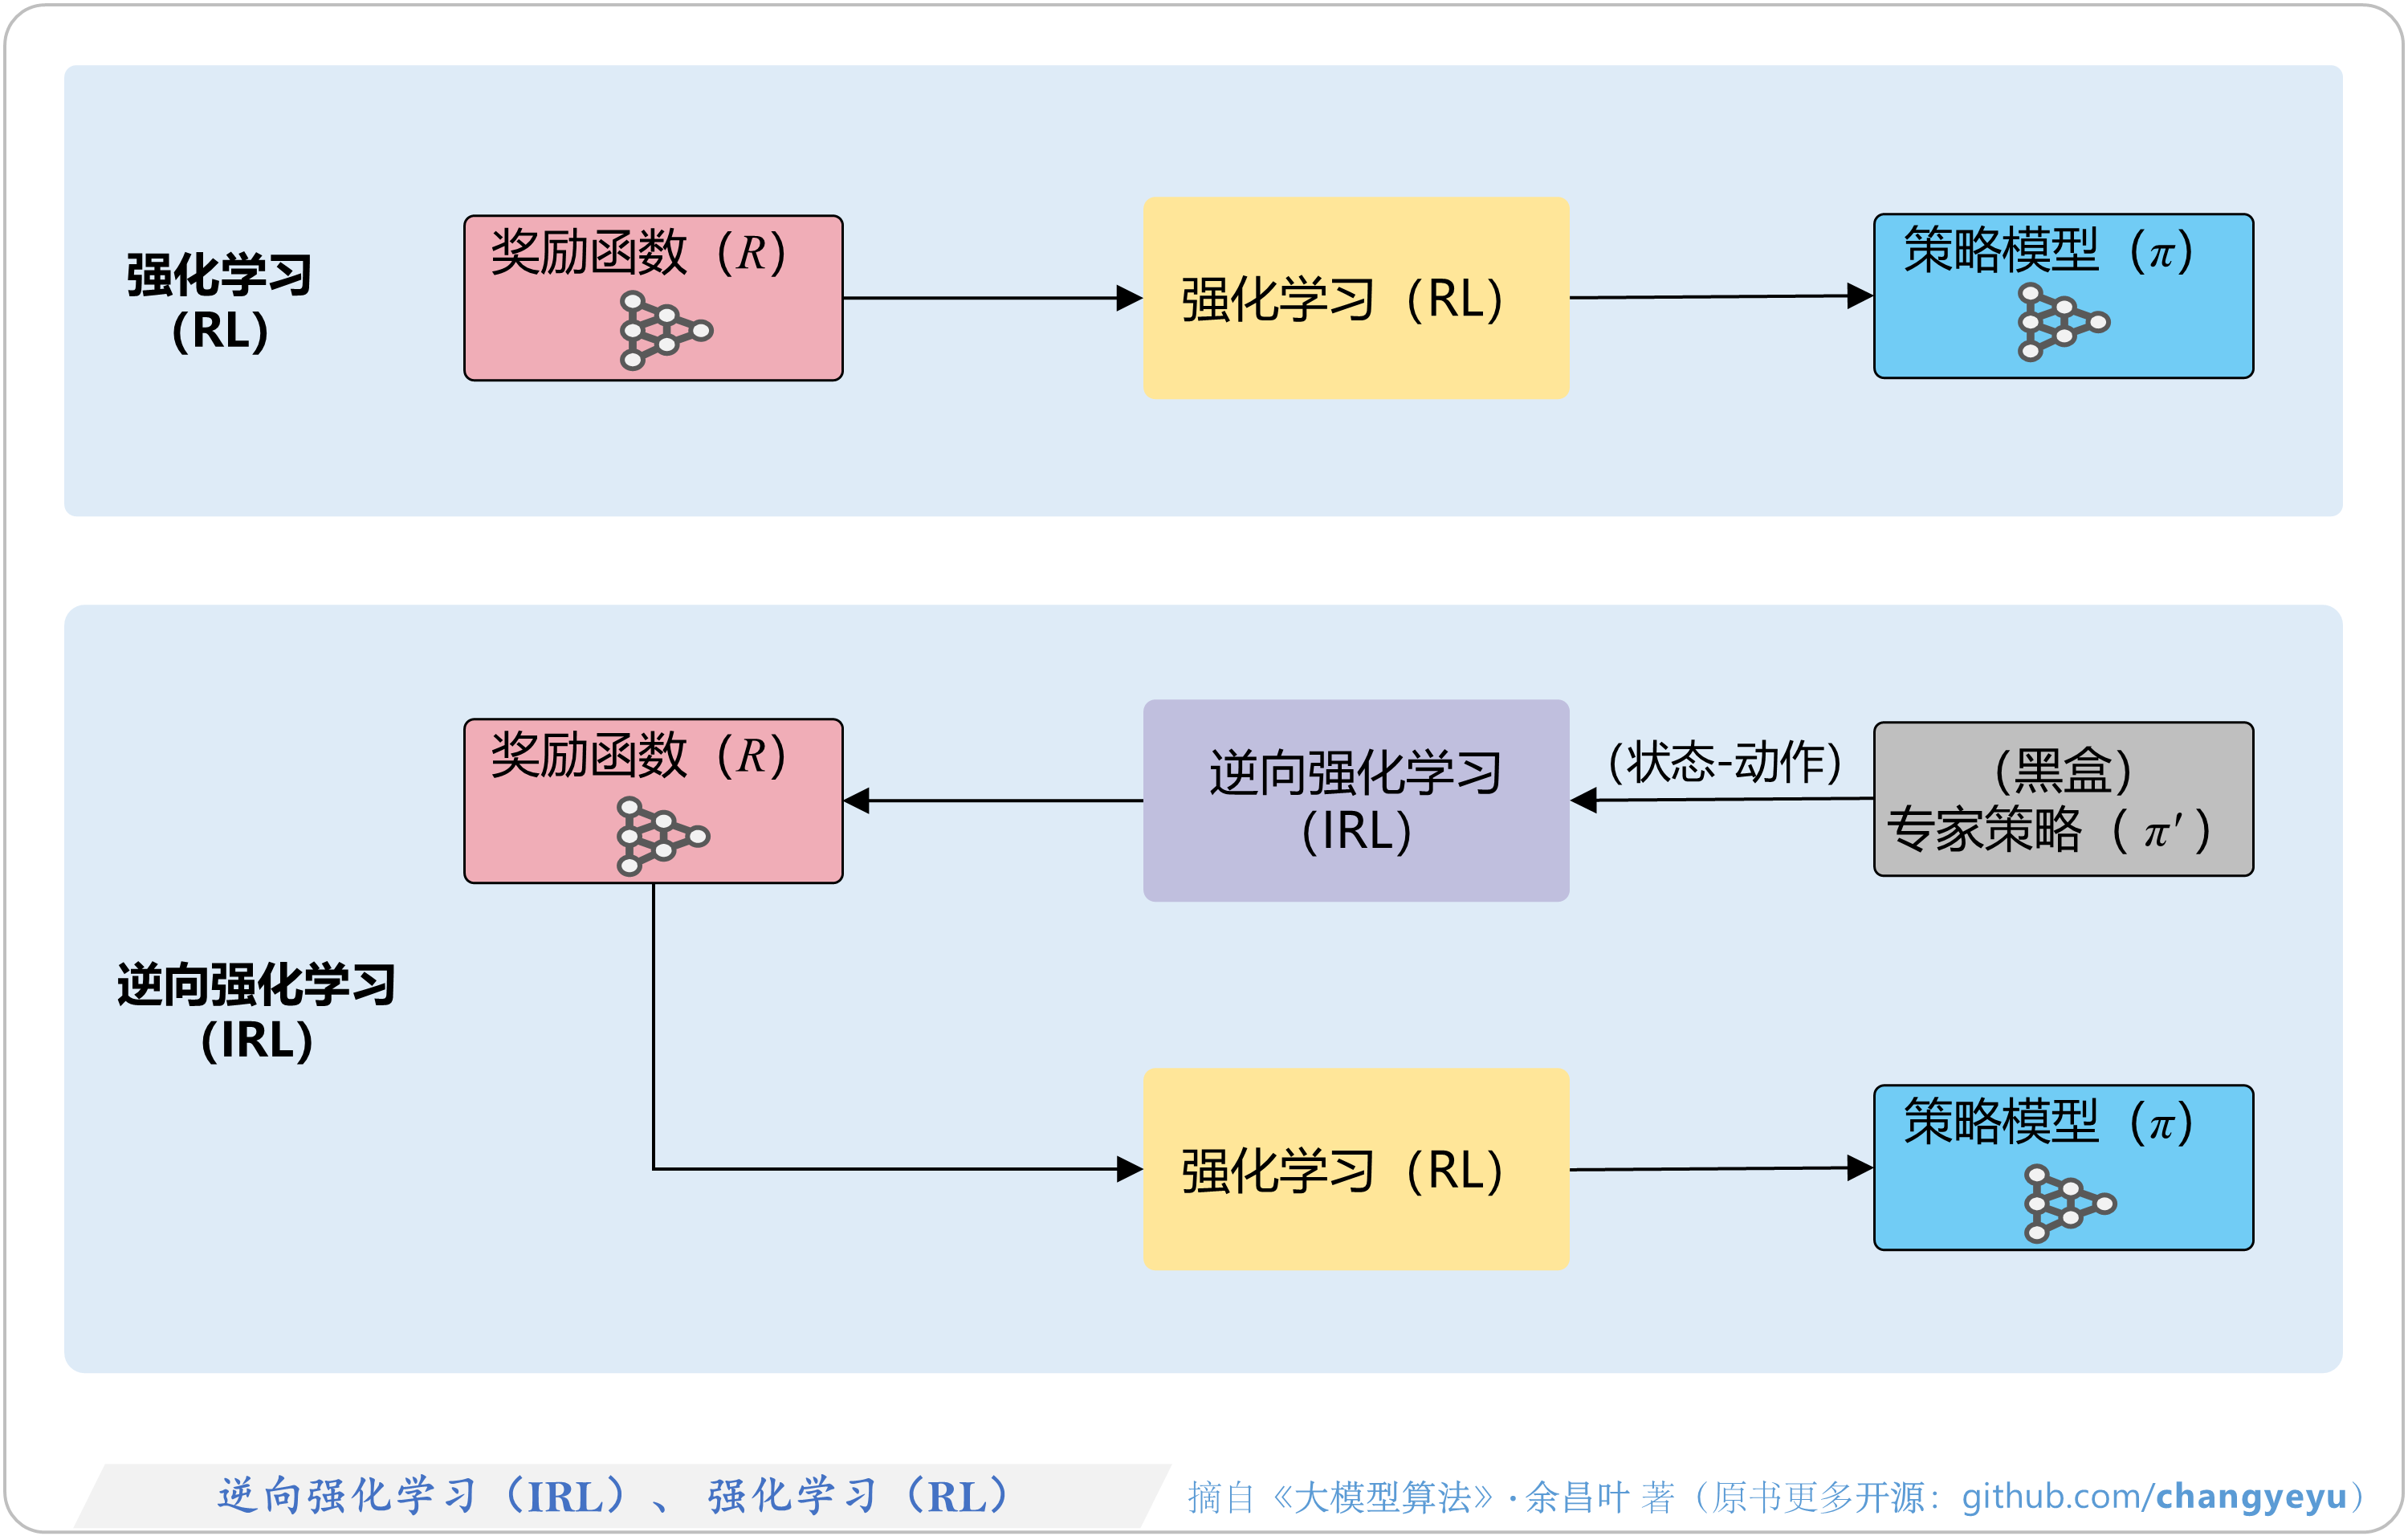
        5.7.3 逆向强化学习(IRL)
        5.7.4 生成对抗模仿学习(GAIL)
    5.8 强化学习高级拓展
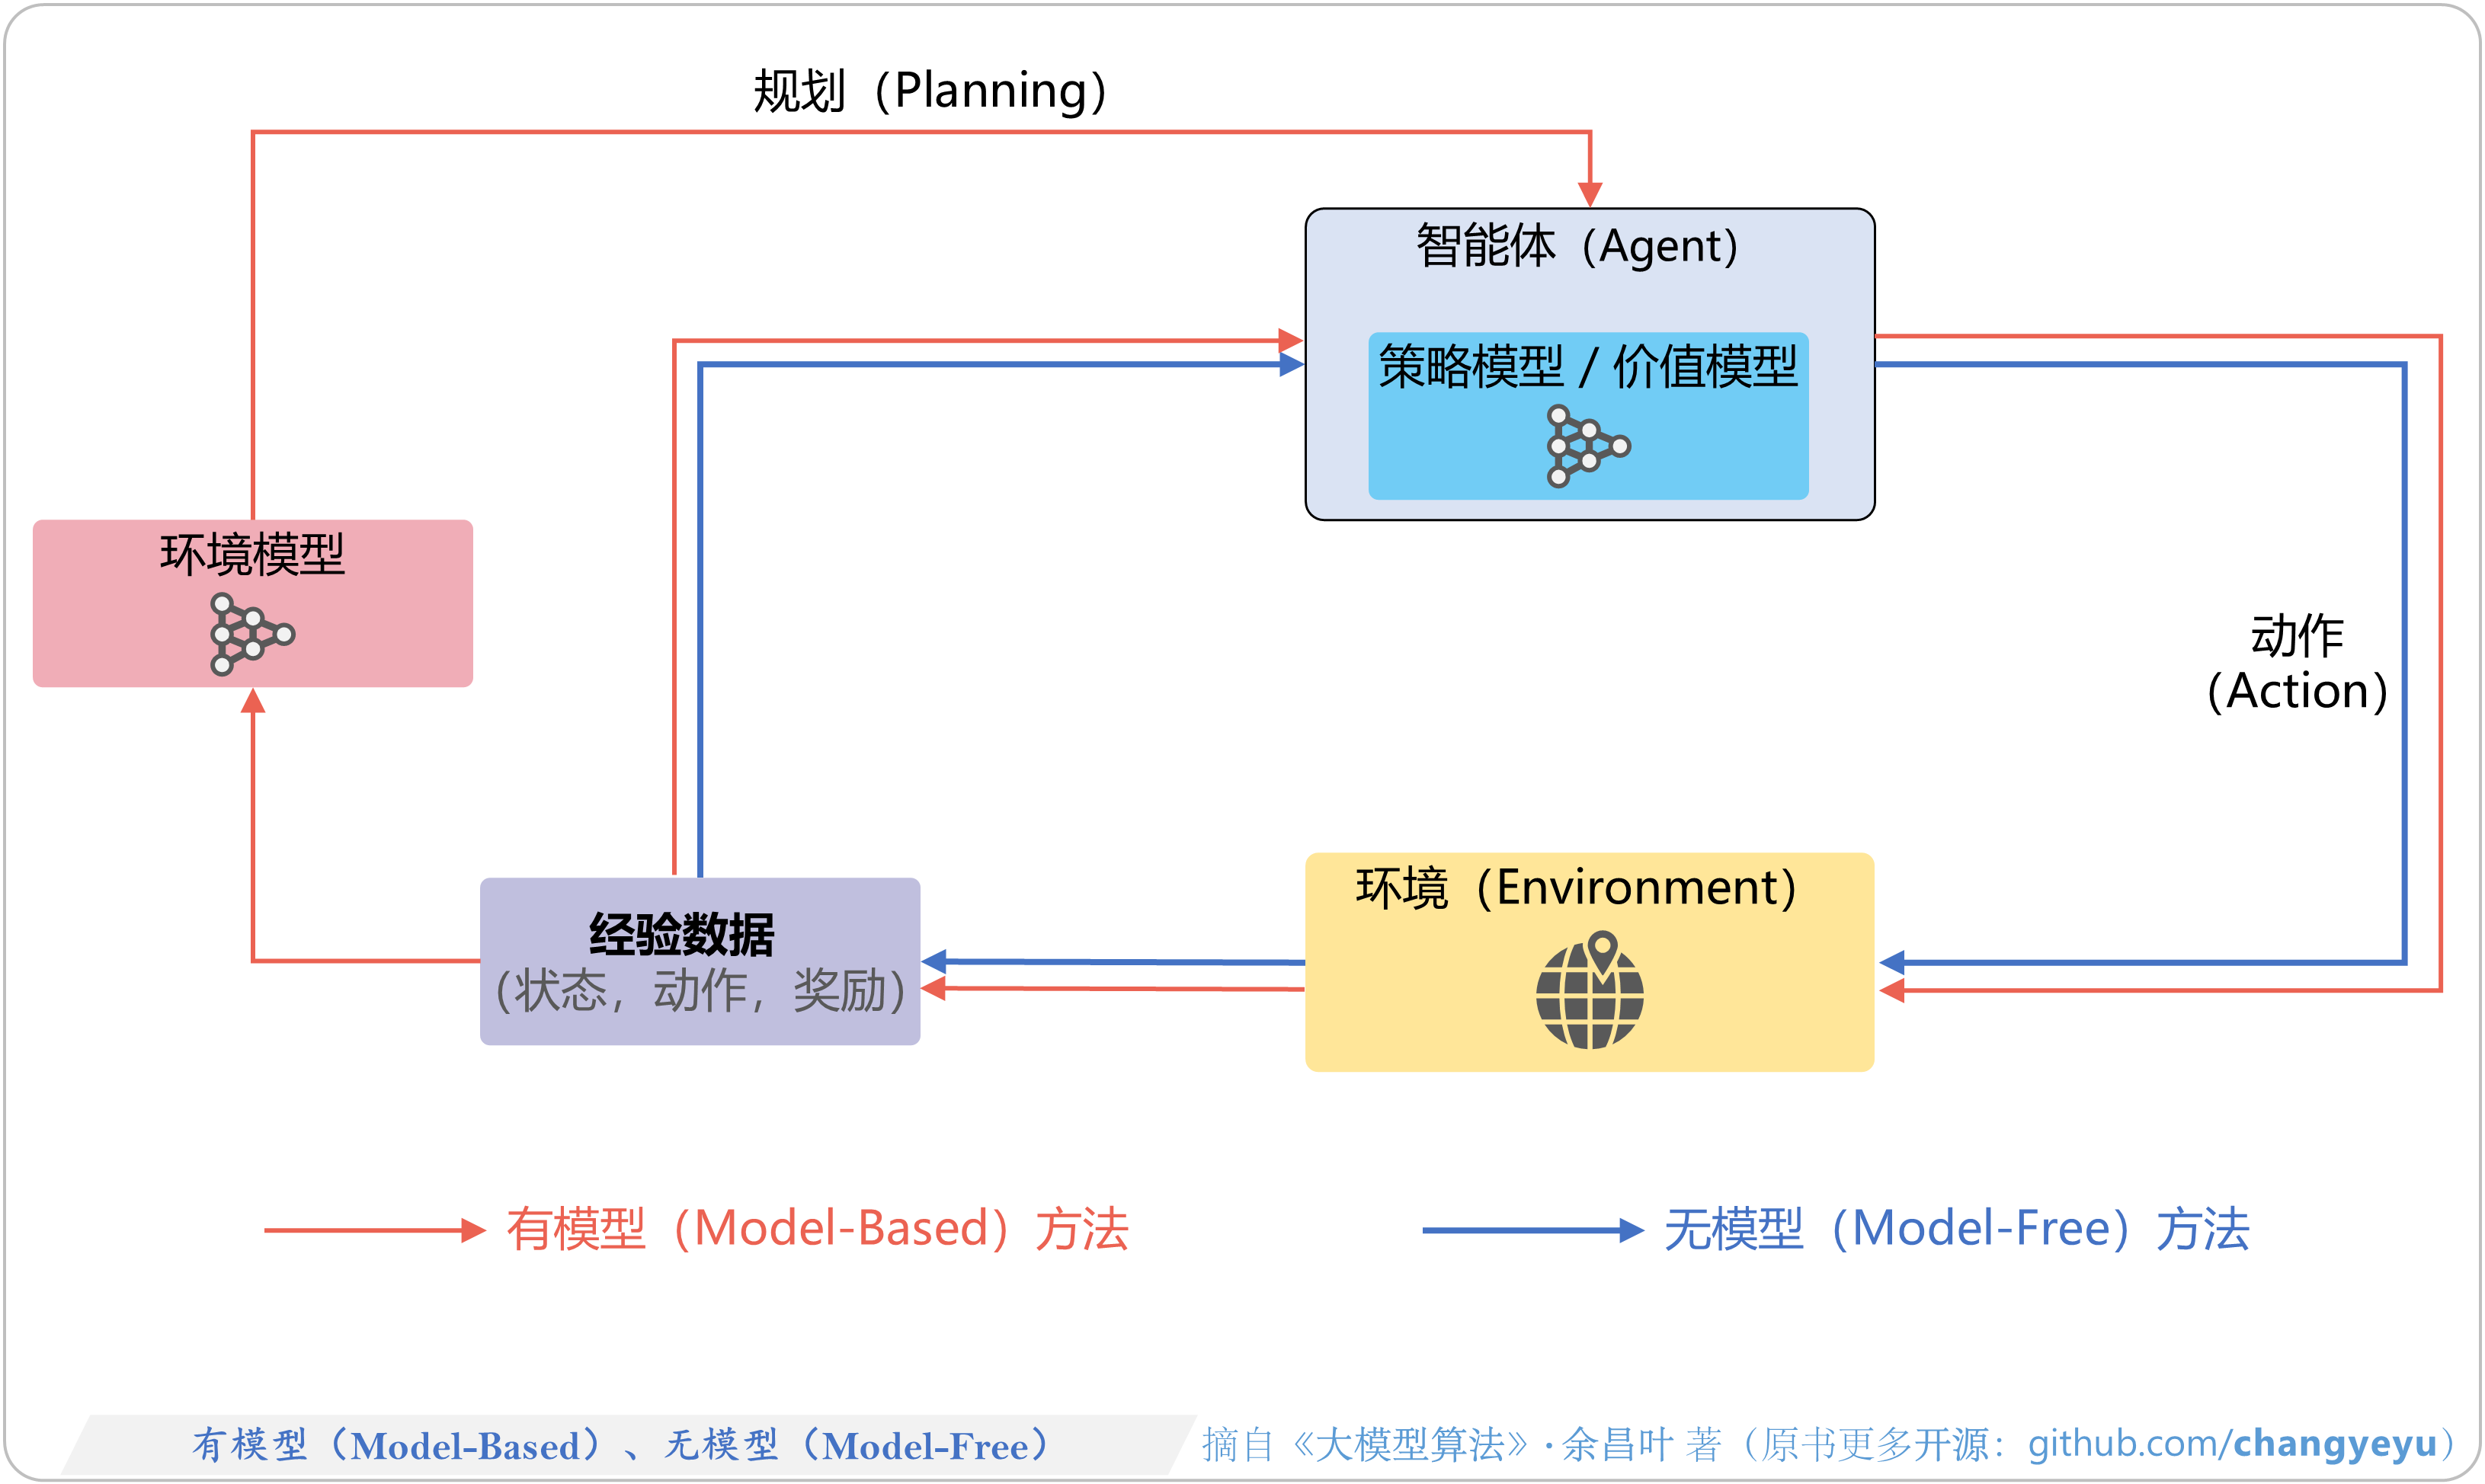
        5.8.1 基于环境模型(Model-Based)的方法
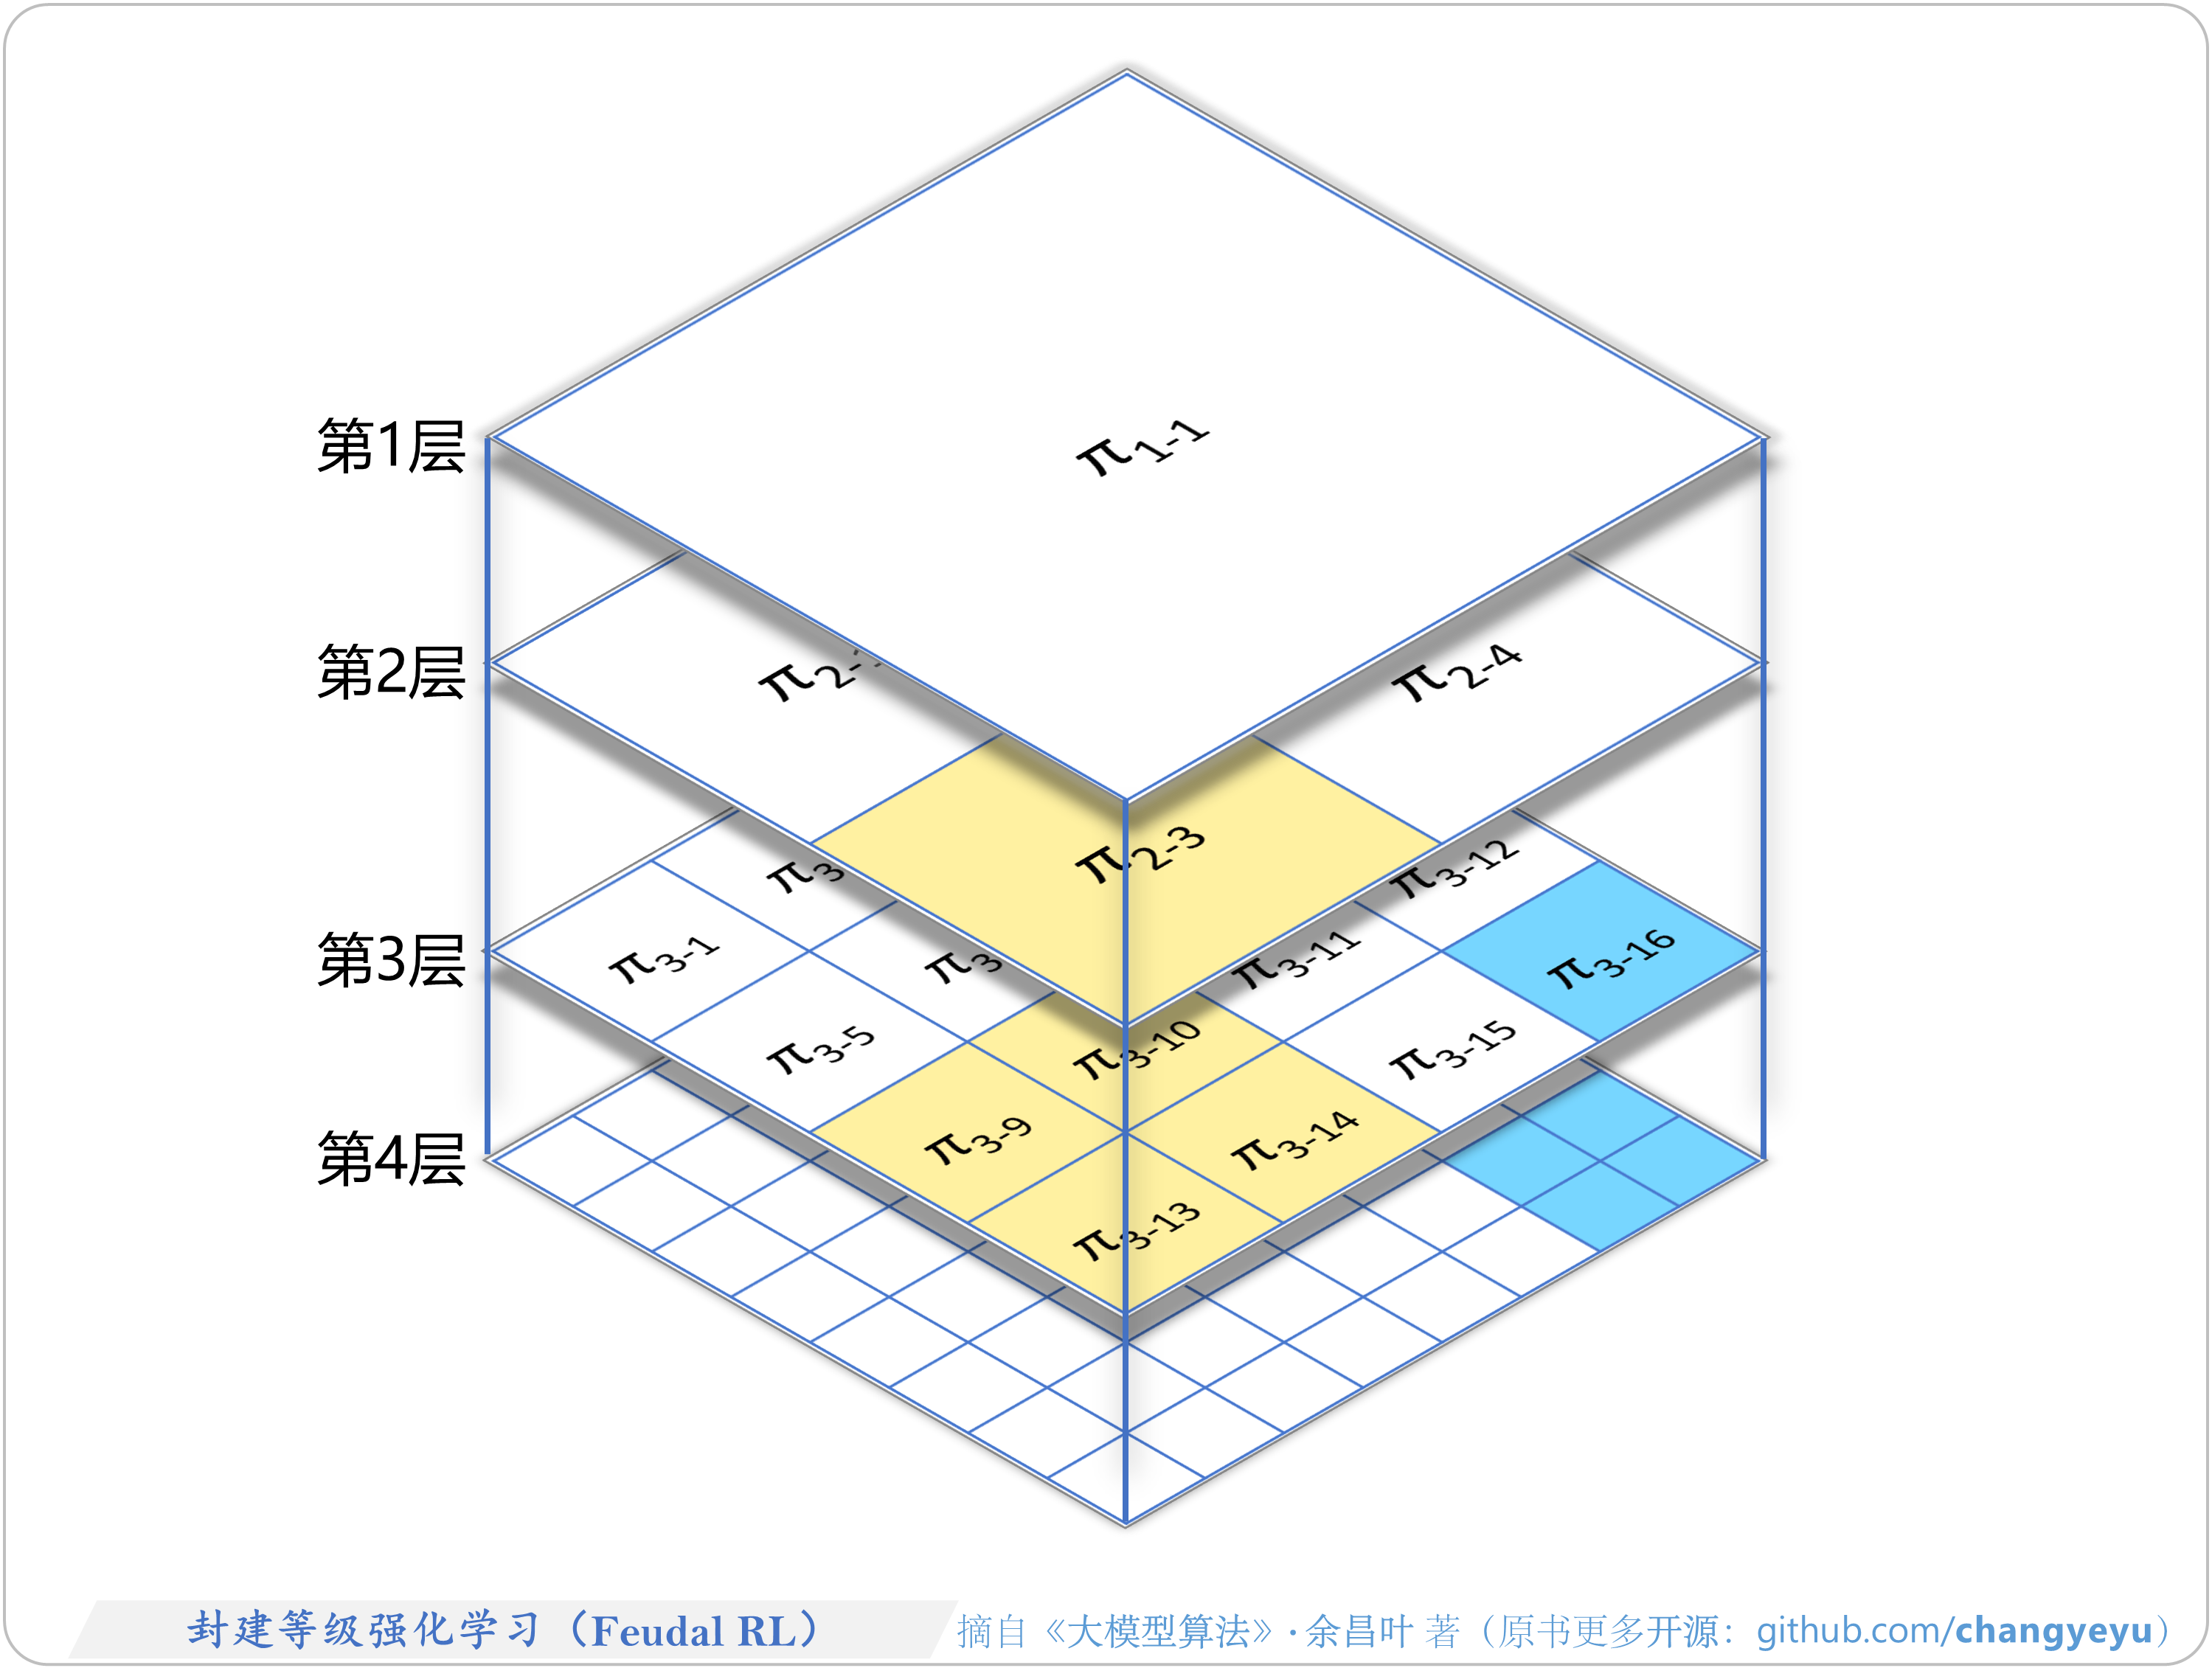
        5.8.2 分层强化学习(HRL)
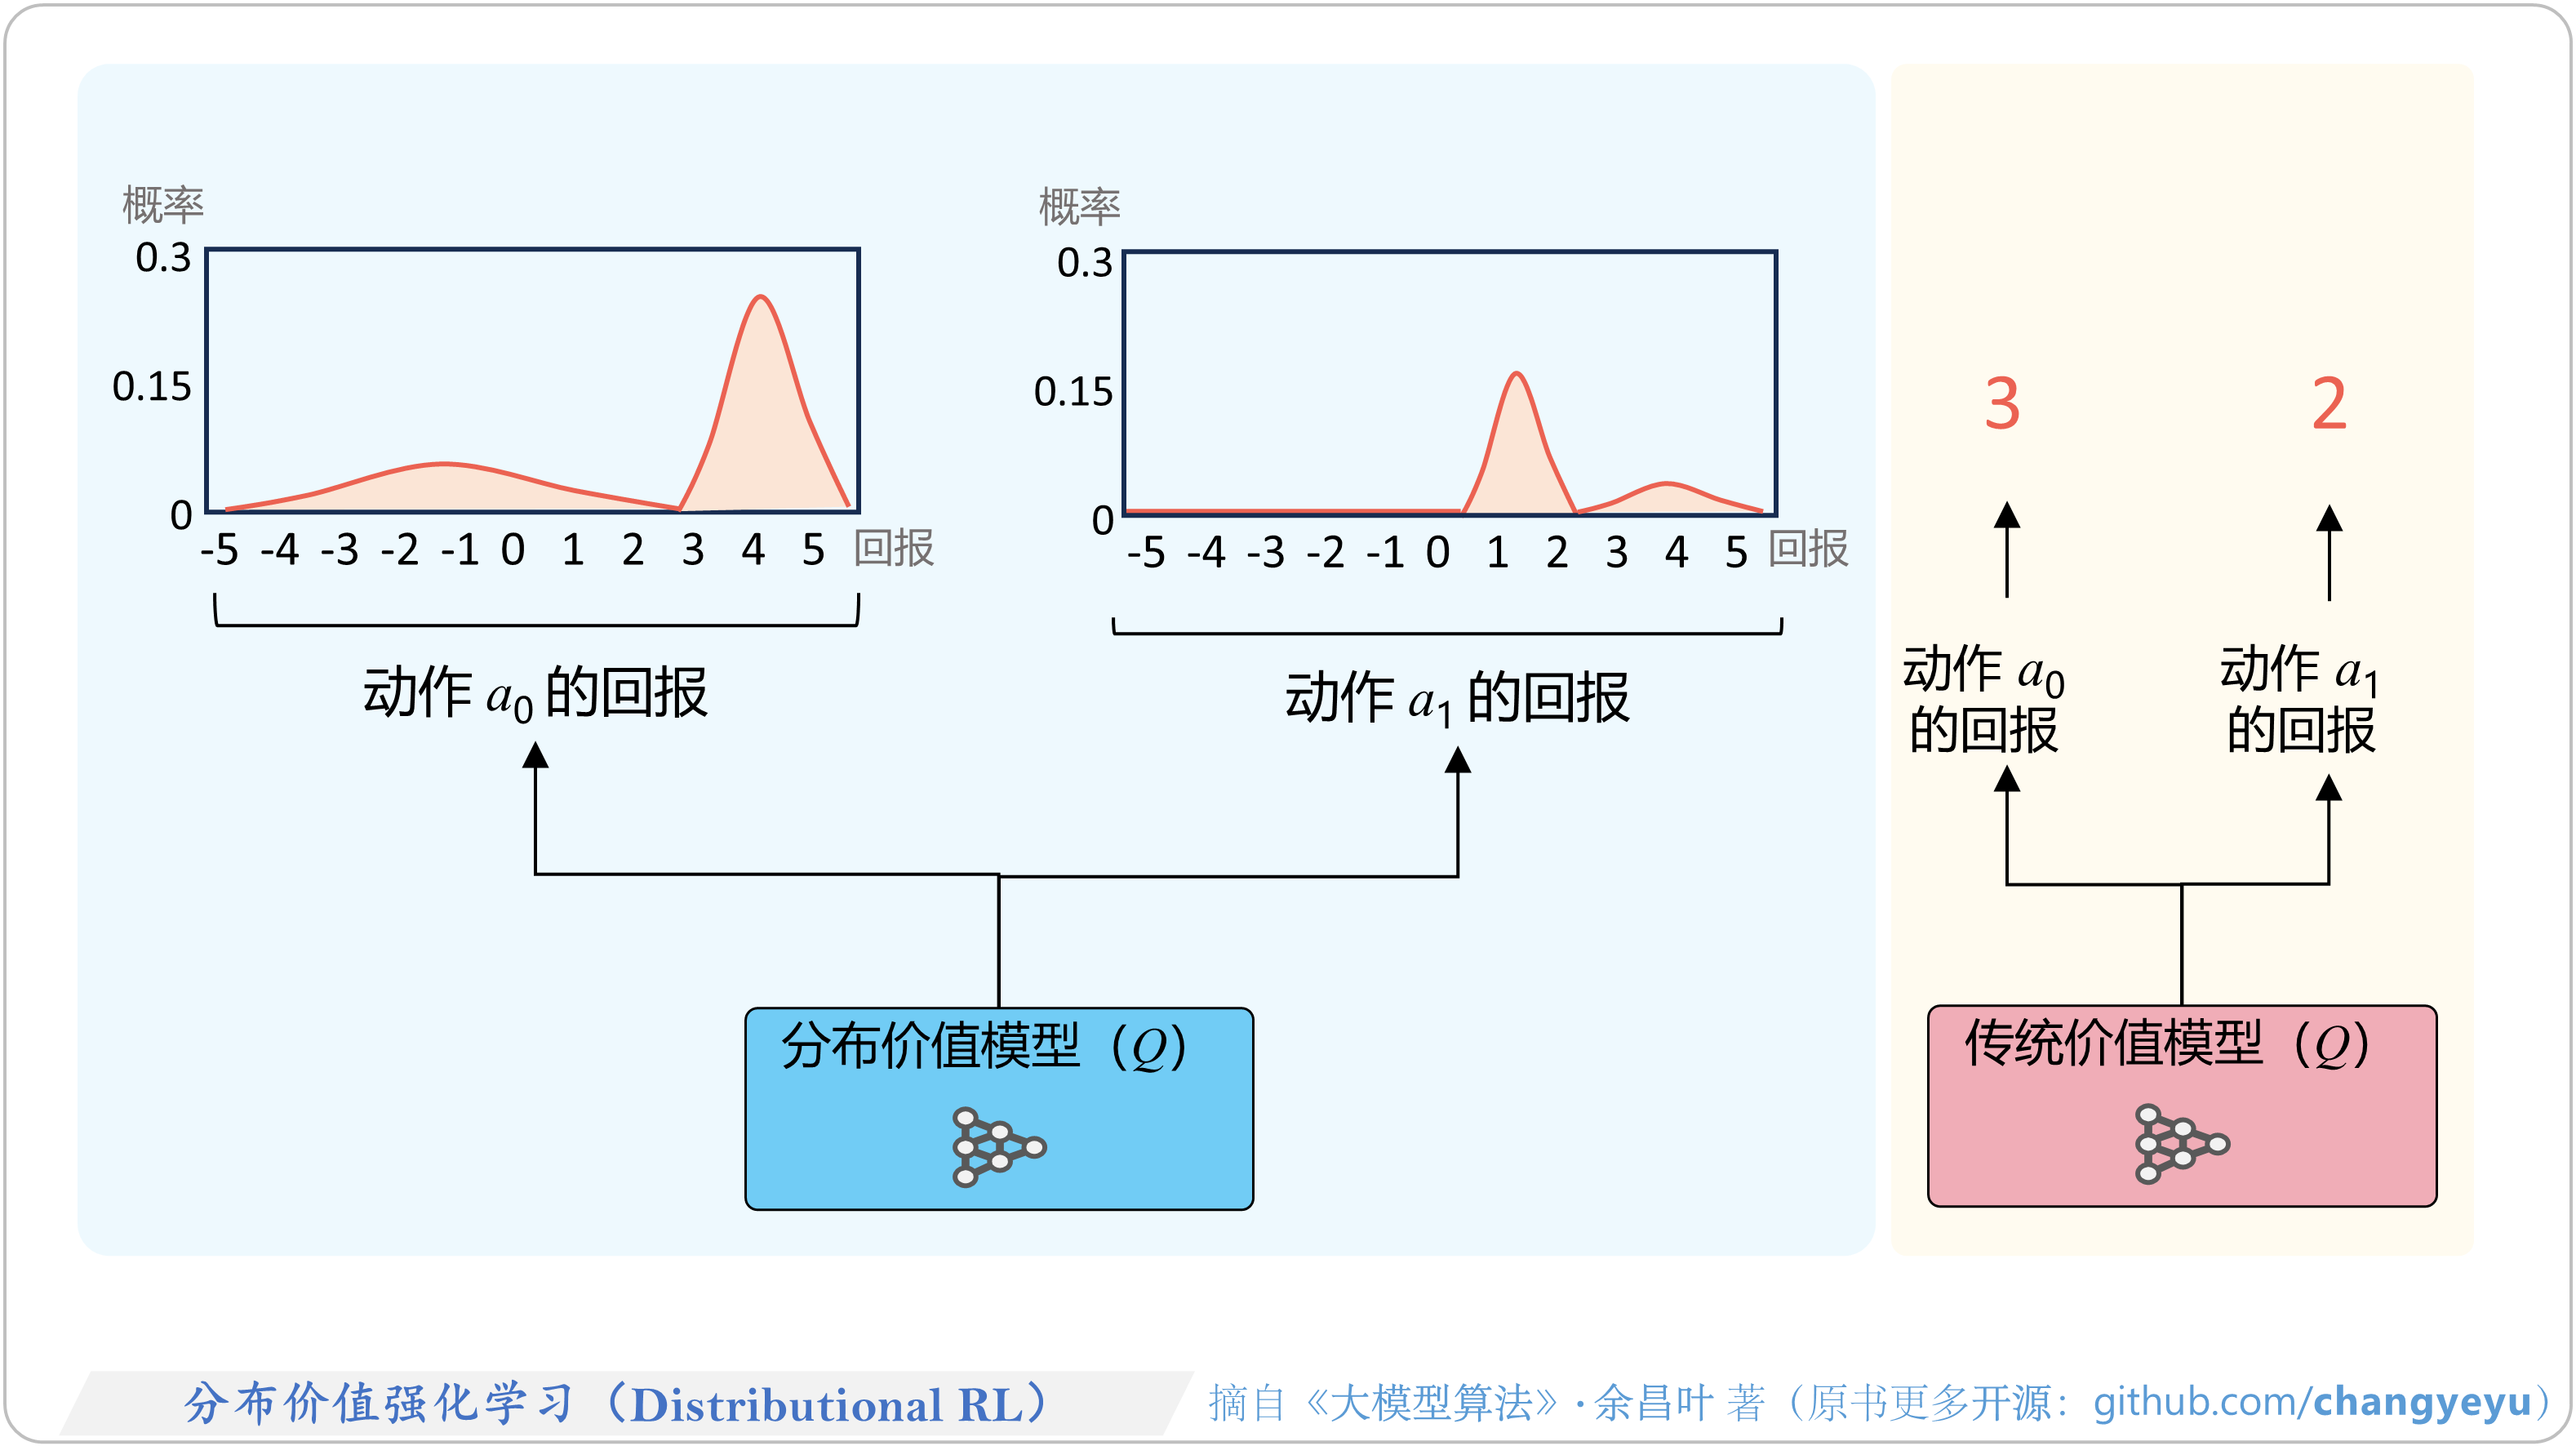
        5.8.3 分布价值强化学习(Distributional RL)
第6章 策略优化算法
    6.1 Actor-Critic(演员-评委)架构
        6.1.1 从策略梯度到Actor-Critic
        6.1.2 Actor-Critic架构图解
    6.2 优势函数与A2C
        6.2.1 优势函数(Advantage)
        6.2.2 A2C、A3C、SAC算法
        6.2.3 GAE(广义优势估计)算法
        6.2.4 γ和λ的调节作用
    6.3 PPO及其相关算法
        6.3.1 PPO算法的演进
        6.3.2 TRPO(置信域策略优化)
        6.3.3 重要性采样(Importance Sampling)
        6.3.4 PPO-Penalty
        6.3.5 PPO-Clip
        6.3.6 PPO的Loss的扩展
        6.3.7 TRPO与PPO的区别
        6.3.8 图解策略模型的训练
        6.3.9 深入解析PPO的本质
    6.4 GRPO算法
        6.4.1 GRPO的原理
        6.4.2 GRPO与PPO的区别
    6.5 确定性策略梯度(DPG)
        6.5.1 确定性策略vs随机性策略
        6.5.2 DPG、DDPG、TD3算法
第7章 RLHF与RLAIF
    7.1 RLHF(基于人类反馈的强化学习)概要
        7.1.1 RLHF的背景、发展
        7.1.2 语言模型的强化学习建模
        7.1.3 RLHF的训练样本、总流程
    7.2 阶段一:图解奖励模型的设计与训练
        7.2.1 奖励模型(Reward Model)的结构
        7.2.2 奖励模型的输入与奖励分数
        7.2.3 奖励模型的Loss解析
        7.2.4 奖励模型训练全景图
        7.2.5 奖励模型的Scaling Law
    7.3 阶段二:多模型联动的PPO训练
        7.3.1 四种模型的角色图解
        7.3.2 各模型的结构、初始化、实践技巧
        7.3.3 各模型的输入、输出
        7.3.4 基于KL散度的策略约束
        7.3.5 基于PPO的RLHF核心实现
        7.3.6 全景图:基于PPO的训练
    7.4 RLHF实践技巧
        7.4.1 奖励欺骗(Reward Hacking)的挑战与应对
        7.4.2 拒绝采样(Rejection Sampling)微调
        7.4.3 强化学习与RLHF的训练框架
        7.4.4 RLHF的超参数
        7.4.5 RLHF的关键监控指标
    7.5 基于AI反馈的强化学习
        7.5.1 RLAIF的原理图解
        7.5.2 CAI:基于宪法的强化学习
        7.5.3 RBR:基于规则的奖励
第8章 逻辑推理能力优化
    8.1 逻辑推理(Reasoning)相关技术概览
        8.1.1 推理时计算与搜索
        8.1.2 基于CoT的蒸馏
        8.1.3 过程奖励模型与结果奖励模型(PRM/ORM)
        8.1.4 数据合成
    8.2 推理路径搜索与优化
        8.2.1 MCTS(蒙特卡洛树搜索)
        8.2.2 A*搜索
        8.2.3 BoN采样与蒸馏
        8.2.4 其他搜索方法
    8.3 强化学习训练
        8.3.1 强化学习的多种应用
        8.3.2 自博弈(Self-Play)与自我进化
        8.3.3 强化学习的多维创新
第9章 综合实践与性能优化
    9.1 实践全景图
    9.2 训练与部署
        9.2.1 数据与环境准备
        9.2.2 超参数如何设置
        9.2.3 SFT训练
        9.2.4 对齐训练:DPO训练、RLHF训练
        9.2.5 推理与部署
    9.3 DeepSeek的训练与本地部署
        9.3.1 DeepSeek的蒸馏与GRPO训练
        9.3.2 DeepSeek的本地部署与使用
    9.4 效果评估
        9.4.1 评估方法分类
        9.4.2 LLM与VLM的评测框架
    9.5 大模型性能优化技术图谱
#71CCF5) ; 浅黄(编码#FFE699); 蓝紫(编码#C0BFDE) ; 粉红(编码#F0ADB7)。本仓库内所有图片均依据 LICENSE 进行授权。只要遵守下方条款,你就可以自由地使用、修改及二次创作这些材料:
同时,你必须遵守以下条款:
余昌叶. 大模型算法:强化学习、微调与对齐[M]. 北京: 电子工业出版社, 2025. https://github.com/changyeyu/LLM-RL-Visualized
Yu, Changye. Large Model Algorithms: Reinforcement Learning, Fine-Tuning, and Alignment.
Beijing: Publishing House of Electronics Industry, 2025. https://github.com/changyeyu/LLM-RL-Visualized
中文 BibTeX(推荐):
@book{yu2025largemodel,
  title     = {大模型算法:强化学习、微调与对齐},
  author    = {余昌叶},
  publisher = {电子工业出版社},
  year      = {2025},
  address   = {北京},
  isbn      = {9787121500725},
  url       = {https://github.com/changyeyu/LLM-RL-Visualized},
  language  = {zh}
}
英文(English) BibTeX:
@book{yu2025largemodel_en,
  title     = {Large Model Algorithms: Reinforcement Learning, Fine-Tuning, and Alignment},
  author    = {Yu, Changye},
  publisher = {Publishing House of Electronics Industry},
  year      = {2025},
  address   = {Beijing},
  isbn      = {9787121500725},
  url       = {https://github.com/changyeyu/LLM-RL-Visualized},
  language  = {en}
}
欢迎点击仓库顶部的 Star ⭐ 关注, 感谢鼓励✨
79 followers · starred Jul 2025
134 followers · starred Mar 2026
13,415 followers · starred Jul 2025
142 followers · starred Jan 2026



