VoiceStudio 中文版:开源、完全本地的 ElevenLabs 替代品——语音克隆、语音设计、视频配音、听写、转写与有声书,646 种语言(译自 debpalash/VoiceStudio,AGPL-3.0)
Python
68
2 commits
updated Aug 31, 2026
本仓库是 debpalash/VoiceStudio(AGPL-3.0,1.2 万+ 星)的中文版镜像:主 README 采用项目官方中文翻译,英文原版见 README.en.md;应用源码零改动(详见 NOTICE)。本仓库未保留原项目的赞助与捐赠内容。
原名 OmniVoice-Studio
在一个开源桌面工作室里完成克隆、设计、配音、听写和有声书制作。
默认本地优先。没有订阅,也没有用量计费;联网服务始终由你主动选择。
快速开始 · 功能 · 为什么选择 VoiceStudio · 引擎 · API · 参与贡献 · Discord · English



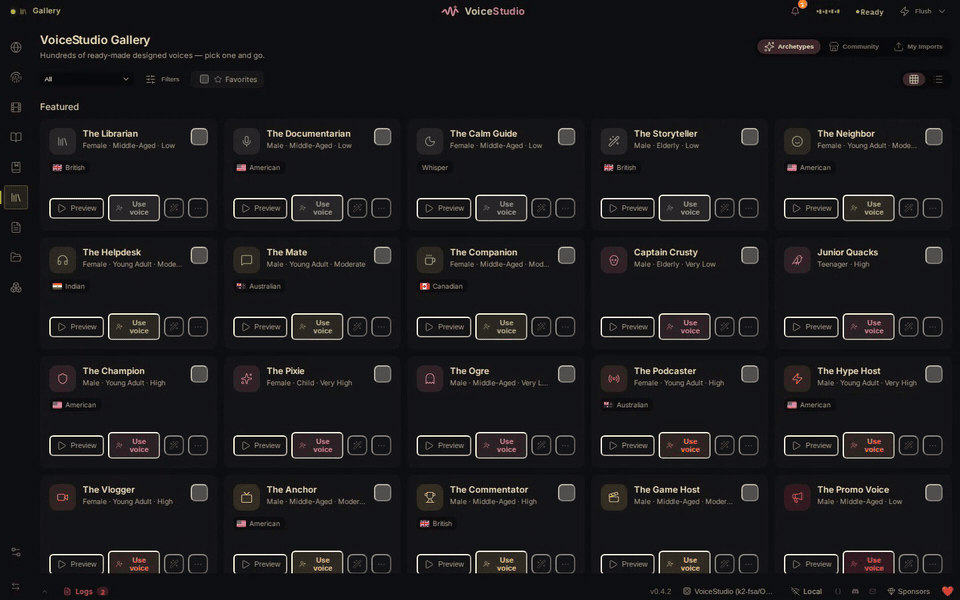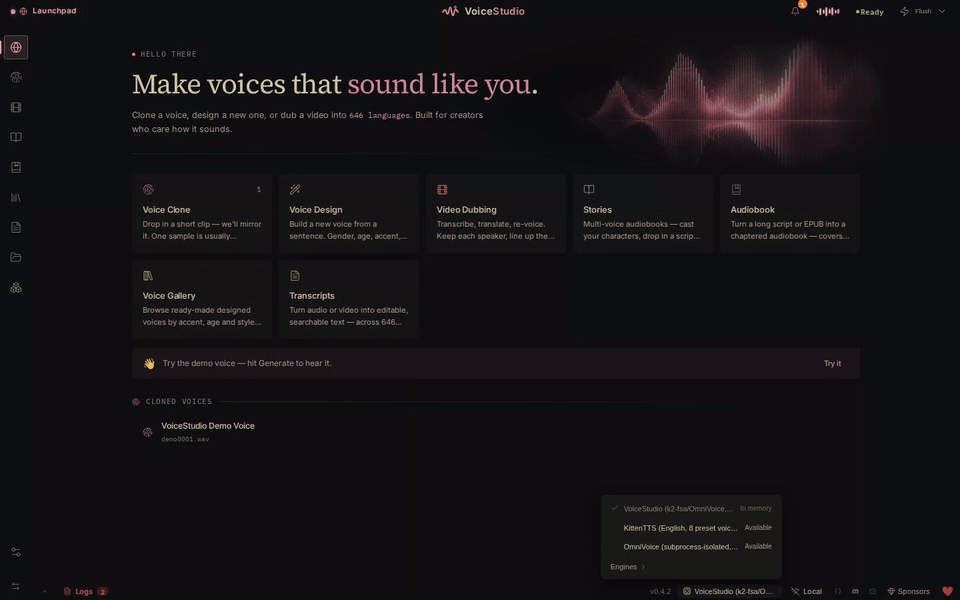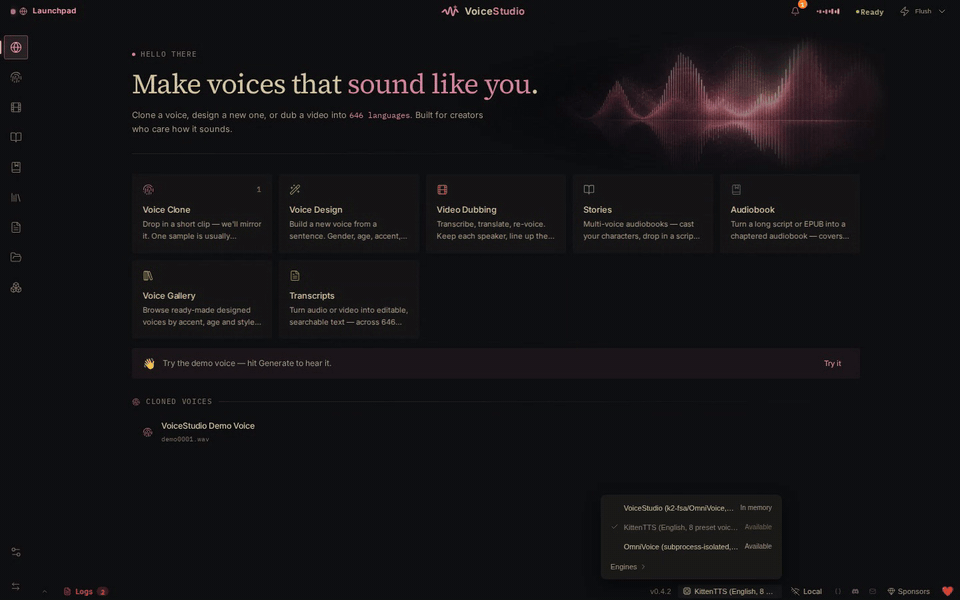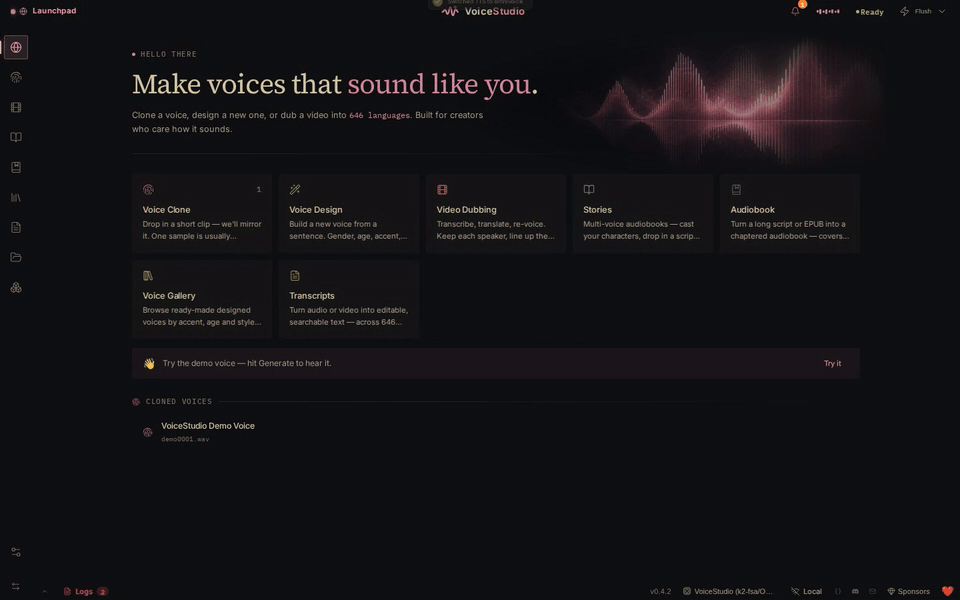
声音很私人,创作空间也应该真正属于你。 VoiceStudio 的核心流程运行在你的硬件上:克隆、设计、配音、听写,并以 646 种语言创作,不需要订阅,也没有用量计费。联网引擎和服务始终是清晰可见的可选项,而不是隐藏依赖。
[!WARNING] 活跃 Beta 阶段。 各版本之间可能出现故障——如需最新修复,请从源码运行。非常欢迎 Bug 报告和 PR:提交 Issue 或 加入 Discord。


选择你的操作系统,按指南从头到尾操作:
palashdeb/omnivoice-studio三步克隆出你的第一个声音:
觉得慢?docs/performance.md 讲清了生成时间到底花在哪里、有哪些调优开关,以及“它变慢了”的三个经典原因。各引擎/设备的实测数据见 docs/benchmarks.md。
正在从 CorentinJ/Real-Time-Voice-Cloning(现已归档)迁移过来?我们有专门的迁移指南:docs/migration/real-time-voice-cloning.md。
先运行内置自检——在应用中打开 设置 → 关于 → “运行自检”,或在源码检出目录中执行
uv run python backend/main.py --diagnose(加 --deep 还会实际加载当前引擎进行测试)。然后查看
docs/install/troubleshooting.md 中排名前
10 的安装错误。运行时出错时,应用内的错误界面会直接深链到对应条目;设置 → 关于 →
“保存诊断包” 会把脱敏日志与自检报告打包,方便附在 Bug 报告里。
Hugging Face Token 的配置见 docs/setup/huggingface-token.md。说话人分离相关的模型访问门槛见 docs/features/diarization.md。下载速度、⚡ 快速下载(Xet)状态,以及受限网络 / 镜像选项见 docs/downloading-models.md。
八大主打功能——折叠区里还有十二项等你展开。
🎙️ 语音克隆3 秒音频 → 复刻任何声音。 |
🎨 声音设计性别、年龄、口音、音高、语速、 |
🎬 视频配音YouTube 链接或文件 → 转录 → |
📖 有声书编辑器导入文本、EPUB 或 PDF。自动分章、 |
🎭 故事模式多声音编辑器。逐行分配声音、 |
⌨️ 听写工具在任何应用中按 ⌘+⇧+Space。 |
🔐 本地优先核心创作流程 |
🤖 MCP 服务器从 Claude、Cursor 或 |
TTSBackend,约 50 行代码即可接入任意引擎。.ovsvoice 包:身份 + 水印。云端语音工具很方便,但工作流会依赖账号、用量计费和他人的基础设施。VoiceStudio 在你的硬件上提供完整工作室;只有你主动选择时,才会使用联网集成。
| ElevenLabs | VoiceStudio | |
|---|---|---|
| 价格 | 订阅与用量限制 | 免费且开源(AGPL-3.0)· 专有用途可选 商业许可证 |
| 语音克隆 | ✅ 3 秒音频 | ✅ 3 秒音频,零样本 |
| 声音设计 | ✅ 性别、年龄 | ✅ 性别、年龄、口音、音高、风格、方言 |
| 有声书 / 故事 | ❌ | ✅ 完整有声书编辑器 + 多声音故事(EPUB/PDF 导入,.m4b 导出) |
| 语言 | 取决于套餐和模型 | 646 |
| 视频配音 | ✅ 仅云端 | ✅ 完全本地 |
| 数据隐私 | 音频在远端处理 | 核心流程在本地运行;联网服务必须主动选择 |
| API 密钥 | 需要账号 | 本地流程不需要 |
| GPU 支持 | 不适用(云端) | CUDA · Apple Silicon · ROCm(Linux)· CPU |
| 桌面应用 | ❌ | ✅ macOS · Windows · Linux |
| TTS 引擎 | 1 | 16 — 完整矩阵 |
| ASR 引擎 | 1 | 11 — 完整阵容 |
| MCP 服务器 | ❌ | ✅ 可从 Claude、Cursor 及任何 MCP 客户端使用 |
| 自检 | ❌ | ✅ 诊断套件、错误日志、脱敏调试包 |
| 可定制 | ❌ 闭源 | ✅ 随你 Fork、扩展、发布 |
专业级语音 AI,去掉订阅,也去掉云端。

| 最低配置 | 推荐配置 | |
|---|---|---|
| 操作系统 | Windows 10、macOS 12+(Apple Silicon)、Ubuntu 24.04+(glibc 2.39+) | 任意现代 64 位操作系统 |
| 内存 | 8 GB | 16 GB+ |
| 显存(GPU) | 4 GB(自动将 TTS 卸载到 CPU) | 8 GB+(NVIDIA RTX 3060+) |
| 硬盘 | 10 GB 可用空间(模型 + 缓存) | 20 GB+ SSD |
| Python | 3.10+(由 uv 管理) | 3.11–3.12 |
| GPU | 可选——CPU 也能跑 | NVIDIA CUDA · Apple Silicon MPS · AMD ROCm(仅 Linux) |
[!TIP] 对于显存 ≤8 GB 的 GPU,VoiceStudio 会在转录期间自动将 TTS 卸载到 CPU——无需配置。不需要专用 GPU;整条流水线都可以在 CPU 上运行(只是慢一些)。
[!NOTE] AMD GPU: ROCm 加速仅限 Linux 且需手动开启——在首次运行的设置界面选择 “AMD GPU (ROCm)”,或设置
OMNIVOICE_TORCH_VARIANT=rocm(docs/install/linux.md)。在 Docker/Podman 中请改用专门的 ROCm 镜像:ghcr.io/debpalash/omnivoice-studio:rocm(docs/install/docker.md)。在 Windows 上,AMD GPU(含 Ryzen AI 核显)只能以 CPU 运行:PyTorch 没有 Windows 版 ROCm 轮子,因此 Windows 上的 GPU 加速仅限 NVIDIA/CUDA(docs/install/windows.md)。
[!IMPORTANT] macOS Intel(x86_64)不支持本地后端: 应用 UI 可以安装,但 Python 后端无法运行,因为 PyTorch 已不再发布 Intel Mac 轮子(#889)。Intel Mac 用户仍可让 UI 指向另一台机器上的远程后端——参见 docs/install/macos.md。
16 个引擎,一个选择器。 VoiceStudio(默认,支持 600+ 语言)始终可用;另有七个引擎可选装并自动检测(CosyVoice 3、GPT-SoVITS、VoxCPM2、MOSS-TTS-Nano、KittenTTS、MLX-Audio、Sherpa-ONNX),外加八个按需延迟安装的引擎(IndexTTS 2.5、OmniVoice GGUF、OmniVoice 子进程版、PocketTTS、Supertonic 3、MOSS-TTS-v1.5、dots.tts、Confucius4-TTS)。在 设置 → TTS 引擎 中切换;所选引擎将应用于所有语音合成场景。每个引擎都有独立指南:docs/engines(英文)。
| 引擎 | 语言 | 克隆 | 指令 | Linux | macOS ARM | Windows | 许可证 |
|---|---|---|---|---|---|---|---|
| VoiceStudio(默认,由 k2-fsa/OmniVoice 驱动) | 600+ | ✅ | ✅ | ✅ CUDA/CPU | ✅ MPS | ✅ CUDA/CPU | 内置 |
| CosyVoice 3 | 9 + 18 种方言 | ✅ | ✅ | ✅ CUDA/CPU | ✅ MPS | ✅ CUDA/CPU | Apache-2.0 |
| GPT-SoVITS | 5 | ✅ | — | ✅ CUDA/CPU | — | ✅ CUDA/CPU | MIT |
| VoxCPM2 | 30 | ✅ | ✅ | ✅ CUDA/CPU | ✅ MPS | ✅ CUDA/CPU | Apache-2.0 |
| MOSS-TTS-Nano | 20 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
| KittenTTS | 英语 | — | — | ✅ CPU | ✅ CPU | ✅ CPU | MIT |
| MLX-Audio(Kokoro、Qwen3-TTS、CSM、Dia 等) | 多语言 | 因模型而异 | 因模型而异 | ❌ | ✅ 原生 | ❌ | 因模型而异 |
| Sherpa-ONNX | 20+ | — | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
| IndexTTS 2.5 ⚡ | 中文 · 英语 · 日语 · 西班牙语 · 阿拉伯语 | ✅ | — | ✅ CUDA | — | ✅ CUDA | Bilibili 模型许可¹ |
| OmniVoice GGUF ⚡ | 600+ | ✅ | ✅ | ✅ CPU | ✅ CPU | ✅ CPU | 内置 |
| Supertonic 3 ⚡ | 31 | — | — | ✅ CPU | ✅ CPU | ✅ CPU | OpenRAIL-M |
| MOSS-TTS-v1.5 ⚡(8B) | 31 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
| dots.tts ⚡(2B) | 24 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ❌ | Apache-2.0 |
| Confucius4-TTS ⚡ | 14 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
¹ 若月活跃用户超过 1 亿,或年收入超过人民币 10 亿元,使用 IndexTTS 2.5 前必须另行取得 Bilibili 的书面许可。启用可选边车前,请审阅其 模型许可。
CUDA = GPU 加速 · MPS = Apple Silicon Metal · CPU = 随处可运行,大模型较慢 · KittenTTS 和 MOSS-TTS-Nano 可在 CPU 上实时运行 · MLX-Audio 仅限 Apple Silicon · ⚡ = 延迟注册(首次使用时安装)
克隆能力的意义不止于单段生成:视频配音(以及任何固定了声音的批量任务)需要参考音频克隆来保持说话人身份,因此把不支持克隆的引擎(KittenTTS、Sherpa-ONNX、Supertonic 3)设为当前引擎时,这些任务会在开始前就给出可操作的失败提示,而不是静默回退到 VoiceStudio。
MOSS-TTS-v1.5(8B,约 16 GB)、dots.tts(2B,约 9 GB)和 Confucius4-TTS 是重量级可选引擎,从本地克隆在各自独立的 venv 中运行。三者均不支持 Apple Silicon MPS(在 Mac 上以 CPU 运行);dots.tts 没有 Windows 路径;Confucius4 建议使用 CUDA(CPU 可用,约为实时时长的 17 倍)。详情:MOSS-TTS-v1.5 · dots.tts · Confucius4-TTS。
11 个引擎——它们驱动听写、视频配音和字幕。WhisperX 是跨平台的默认引擎(约 100 种语言,词级时间对齐);其余引擎均为可选装并自动检测。在 设置 → 引擎 中切换。十个完全在本地设备上运行;第十一个(OpenAI 兼容)是可选的远程客户端,可用于 Qwen3-ASR 或任何兼容的服务器。
| 引擎 | OMNIVOICE_ASR_BACKEND | 语言 | 最适合 |
|---|---|---|---|
| WhisperX(默认) | whisperx | ~100 | 配音与字幕——通过 wav2vec2 强制对齐实现词级时间对齐 |
| Faster-Whisper | faster-whisper | ~100 | Linux / macOS / Windows 上的快速转录(CTranslate2) |
| Faster-Whisper(隔离) | faster-whisper-isolated | ~100 | 与 Faster-Whisper 相同,但在子进程中崩溃隔离——ASR 崩溃不会拖垮整个应用 |
| MLX Whisper | mlx-whisper | ~100 | Apple Silicon 原生速度(Apple MLX / Metal) |
| PyTorch Whisper | pytorch-whisper | ~100 | 经 🤗 Transformers 的 CUDA / CPU 兜底方案(无需 cuDNN 8) |
| Parakeet TDT | nemo-parakeet | 英语 + 25 种欧洲语言 | 即使在 CPU 上也能以约 10 倍实时速度达到 SOTA 精度,自动语言检测(NVIDIA NeMo,CUDA/CPU) |
| Moonshine | moonshine | 英语 | 边缘设备 / 低延迟,ONNX |
| FunASR | funasr | 50+ | 多语言一体化——内置 VAD + 行内说话人分离(SenseVoice) |
| sherpa-onnx(实时听写) | sherpa-onnx-asr | 25 种欧洲语言 + 90+ | 实时、快于实时的听写——小体积流式/离线 ONNX 模型(Parakeet TDT v3/v2、流式 Zipformer 与 Paraformer、Whisper Tiny),CPU 运行,macOS / Windows / Linux 表现完全一致。在 设置 → 语音 中按模型选择。 |
| OpenAI 兼容 ⚠️ 远程 | openai-compat-asr | 取决于服务器 | 当下通往 Qwen3-ASR 的路径(自托管服务器,无需等 transformers 支持)、任何 OpenAI 兼容的转录端点,或 OpenAI 官方 API——无需安装,在 设置 → 引擎(ASR 标签页)中配置并测试连接。音频会离开你的设备,发送到你指定的任何服务器;参见 docs/engines/openai-compatible-asr.md。 |
Whisper 系列引擎覆盖约 100 种语言;FunASR / SenseVoice 额外提供一条多语言一体化路径,内置语音活动检测与行内说话人分离。sherpa-onnx 驱动实时听写的模型选择器——你边说,文字边出现。除可选的 OpenAI 兼容远程客户端外,所有引擎都在本地设备上运行——无需 API 密钥,无需云端。
GPU 不支持高效 float16? 在较老的 NVIDIA GPU(Maxwell/Pascal、GTX 16xx)上,或在 CTranslate2/cuDNN 版本不匹配之后,CTranslate2 系 ASR 引擎(WhisperX、Faster-Whisper)无法运行
float16,VoiceStudio 会自动改用int8重试——无需配置。如果转录仍然失败,可用ASR_COMPUTE_TYPE环境变量固定计算类型(逃生舱口):ASR_COMPUTE_TYPE=int8(CPU 用float32)。将其设为int8并重启后端。
┌─────────────────────────────────────────────────────────────┐
│                    Frontend (React)                          │
│  DubTab · VoiceConsole · Stories · Audiobook · Gallery     │
│  Dictation · BatchQueue · Diagnostics · MCP Client          │
├─────────────────────────────────────────────────────────────┤
│                  Backend (FastAPI)                           │
│  100+ API endpoints · SSE+WSS streaming · SQLite            │
├──────────┬──────────┬──────────┬──────────┬────────────────┤
│ WhisperX │  Demucs  │VoiceStudio │ Pyannote │ Engine Routing  │
│  (+7 ASR │  Source  │  (+10    │ Diariz-  │ ↳ GPU preflight │
│ engines) │  Sep.    │  TTS)    │ ation    │ ↳ No silent CPU │
└──────────┴──────────┴──────────┴──────────┴────────────────┘
         CUDA / MPS / ROCm / CPU (auto-detected + routed)
已经有会说 OpenAI 音频 API 的脚本、智能体或工具?把它指向 http://localhost:3900/v1 即可——不需要密钥,也不用改代码。后端为音频端点内置了即插即用的兼容接口,直接接到你当前启用的 TTS/ASR 引擎(没错,voice 参数接受你克隆的声音配置 ID)。
| 端点 | 作用 |
|---|---|
POST /v1/audio/speech | TTS——输入文本;输出 mp3 / wav / flac / opus / pcm。tts-1 / tts-1-hd 映射到你当前启用的引擎;也接受 OpenAI 的声音名称(alloy 等)。 |
POST /v1/audio/transcriptions | STT——输入音频文件;输出 json、text、verbose_json、srt 或 vtt。whisper-1 映射到你当前启用的 ASR 引擎。 |
GET /v1/audio/voices | VoiceStudio 扩展——列出所有声音配置和引擎,客户端可据此发现你的克隆声音。 |
curl http://localhost:3900/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model": "tts-1", "voice": "alloy", "input": "Generated on my own hardware.", "response_format": "wav"}' \
  --output speech.wav
from openai import OpenAI
client = OpenAI(base_url="http://localhost:3900/v1", api_key="none")  # any string works — nothing checks it

result = client.audio.transcriptions.create(model="whisper-1", file=open("clip.wav", "rb"))
print(result.text)
想要完整的接口(100+ 端点)?完整的 REST API 参考已内嵌在应用中——设置 → OpenAPI 参考(由 Scalar 驱动),或点击页脚的 {} 按钮。

没有本地 GPU?官方笔记本(notebooks/OmniVoice_Studio_Colab.ipynb)可在免费的 Colab T4 上启动完整应用(包含 Web 界面):在笔记本内直接构建前端,用 uv 安装后端(复用 Colab 预装的 CUDA PyTorch),并通过 Colab 内置端口代理打开界面。无需第三方隧道,也无需任何 API 密钥。随后还有一套覆盖全部主要功能的 API 导览,全部可在笔记本内直接播放:多语言 TTS、声音克隆与声音设计、已保存的声音档案、语音转写、AI 水印检测、OpenAI 兼容 API、多角色故事、带章节的 m4b 有声书,以及一个附带人声分离音轨的迷你视频配音。
用一条命令教会你的 AI 智能体(Claude Code、Cursor、Codex 等)使用 VoiceStudio:
npx skills add debpalash/omnivoice-studio
内含两个 skills:omnivoice——让任何智能体通过你的本地安装进行语音合成与转录(包括你克隆的声音),免费且离线;以及 oss-maintainer——本项目所遵循的维护者方法论,适合任何用智能体运营自己开源项目的人。
| 分类 | 功能 |
|---|---|
| 长内容 | 有声书编辑器(文本/EPUB/PDF → 分章 .m4b)、Stories 多声音编辑器、两遍响度归一母带处理、渲染中断后的崩溃续渲、发音控制 + SSML-lite 韵律 |
| 配音 | 完整流水线(转录→翻译→合成→封装)、场景感知分割、唇形同步评分、流式 TTS、逐说话人声音分配、Smart Fit 时长匹配 + 二次 QC、独立的配音主页 |
| 声音 | 零样本克隆、声音设计、A/B 对比、声音预览控件、支持收藏/标签的声音库、便携声音角色包(.ovsvoice)、声音控制台工作区 |
| 音频 | Demucs 人声分离、逐段增益、选择性音轨导出、分轨/SRT/VTT/MP3 导出、按句分块实现的无限长 TTS |
| 多语言 | 多语言批量选择器、顺序 GPU 执行的批量配音队列 |
| 说话人分离 | Pyannote 机器学习分离、自动说话人克隆提取、逐说话人声音分配 |
| ASR | 9 个引擎(WhisperX、Faster-Whisper、隔离版 Faster-Whisper、MLX Whisper、PyTorch Whisper、Parakeet TDT、Moonshine、FunASR/SenseVoice、sherpa-onnx 实时听写)、崩溃隔离的子进程后端 |
| TTS | 14 个引擎(VoiceStudio、CosyVoice 3、GPT-SoVITS、VoxCPM2、MOSS-TTS-Nano、KittenTTS、MLX-Audio、Sherpa-ONNX,+ 延迟安装:IndexTTS 2.5、OmniVoice GGUF、Supertonic 3、MOSS-TTS-v1.5、dots.tts、Confucius4-TTS)、带 GPU 预检的引擎路由 |
| 基础设施 | Docker 部署、CUDA/MPS/ROCm 自动检测、cuDNN 8 兼容、显存感知模型卸载、引擎路由(绝不静默回退 CPU)、诊断套件与错误日志、受限网络镜像支持 |
| AI 溯源 | AudioSeal 不可见水印(类似 SynthID)、视频徽标叠加、水印检测 API |
| 用户体验 | 撤销/重做、键盘快捷键、拖放、会话持久化、首次启动按屏幕推荐界面缩放,以及原生 WebKitGTK 缩放 |
| 实时事件 | WebSocket 事件总线——数据变更时即时刷新侧边栏、指数退避重连 |
| 状态管理 | Zustand 状态迁移——uiSlice、pillSlice、dubSlice、generateSlice、prefsSlice、glossarySlice |
| 桌面 | 跨平台 Tauri 安装程序(macOS DMG——Apple Silicon;Intel 不支持本地后端,#889——Windows MSI、Linux deb/AppImage)、自动更新基础设施、单实例约束、关闭最小化到托盘、macOS Gatekeeper 修复 |
| 听写 | 全局系统级热键(⌘+⇧+Space)、无边框浮动控件、WebSocket 流式 ASR、自动粘贴、可自定义热键、本地 LLM 转录润色 |
| 批量流水线 | 完整批量 TTS:提取 → 转录 → 翻译 → 生成 → 混音 → 导出,带实时进度追踪 |
| MCP 服务器 | 让 VoiceStudio 成为 Claude、Cursor 及任何 MCP 客户端的本地 TTS/STT 提供方 |
| 远程后端 | 让桌面 UI 指向远程后端 URL,支持 Bearer 认证(附 Tailscale 文档) |
| 可靠性 | 启动开屏的卡死看门狗、逐引擎 GPU 兼容矩阵、引擎二进制不可执行时的可操作报错、setuptools 自动修复 |

| 频道 | 那里发生什么 |
|---|---|
#announcements | 发布消息与重大时刻——新版本最先在这里公布 |
#releases + #changelog | 每一个构建,以及里面究竟有什么 |
#issues | 以论坛帖子形式提交的 Bug 报告——直接分诊进 GitHub Issues |
#ideas | 功能请求,供讨论与投票 |
#discuss-ideas | 动手之前的设计讨论 |
#general | 安装帮助、GPU 疑难排查,以及晒你的配音成果 |
非常欢迎——Bug 修复、新的 TTS 引擎适配器、UI 改进、文档、翻译。统统欢迎。
VoiceStudio 真正有竞争力的地方:从干净的参考音频进行语音克隆(最先进的开源扩散 TTS)、语言覆盖(646 种语言对他们的 32 种),以及所有结构性优势——没有按字符计费、没有用量上限、音频不离开你的设备、完整的流水线可定制性(14 个 TTS 引擎、10 个 ASR 引擎、翻译方案随你选)。
ElevenLabs 仍然领先的地方:开箱即用的稳定性与打磨程度,尤其是英语 TTS。他们的单一模型经过深度调优;我们的质量取决于你选择的引擎、你的硬件,以及(对克隆而言)参考音频——干燥、近麦的音频比嘈杂或有回声的音频克隆效果好得多。
具体到配音:配音是一条链——转录 → 翻译 → 克隆 → 合成——在你的素材上,它只取决于最薄弱的一环。如果部分输出语无伦次,先检查片段表里的原文:当转录本身就错了,换一个 ASR 引擎或使用更干净的源音频——修复点通常在这里,而不是声音。
拿你的真实素材试试——免费,下载一次即可。许多用户直接用它替换了 ElevenLabs;也有人两个都留着。这两种结果我们都乐见。
backend/services/tts_backend.py 中继承 TTSBackend,并将其添加到 _REGISTRY 字典中——约 50 行代码。十四个内置引擎均以此方式实现;参见 TTS 引擎。
如果你选择同意(也可随时在 设置 → 隐私 → “帮助改进 VoiceStudio” 中开关),发送的只是匿名、不含内容的使用统计:生成信息(引擎、语言、生成耗时、字符数量、错误类型),以及应用生命周期——一次安装信号、版本更新(版本号之间)、崩溃(错误类别和分桶后的运行时长,绝不含日志)、错误类型(有上限、去重),以及卸载时的一次告别信号。绝不包含你的文本、音频、文件名或任何可识别信息——这由代码中的属性白名单强制保证(backend/core/analytics.py),而不只是一句承诺。源码构建根本没有分析数据的接收端,因此根本不会询问。你自己的统计数字在 设置 → 用量 中查看,本地计算,不发送到任何地方。
scripts/uninstall.sh(macOS/Linux)或 scripts\uninstall.ps1(Windows)——它会先以干跑方式列出每个文件夹及其大小,加 --yes 才会真正删除。完整的各平台路径列表和应用移除步骤见 docs/install/uninstall.md。
VoiceStudio 是基于 GNU Affero 通用公共许可证 v3.0(AGPL-3.0) 的自由开源软件。
可免费用于任何用途——包括商业和企业内部用途。 运行它、出售用它生成的音频、为自己或客户的视频配音、在团队中推广——全部免费,无需许可证。作为一份网络著佐权(copyleft)许可证,AGPL 增加了一项义务:如果你修改了 VoiceStudio 并通过网络向他人提供该修改版本,你必须依据相同的 AGPL-3.0 条款向他们提供该修改版本的完整对应源代码。
希望将 VoiceStudio 嵌入闭源或专有产品或服务、又不受 AGPL-3.0 著佐权义务约束的组织,可获取商业许可证。定价方案即将推出。 咨询:VoiceStudio@palash.dev。
捆绑的 omnivoice/ TTS 模型(作者 Han Zhu)在上游仍为 Apache-2.0 许可。完整且具约束力的条款请参见 LICENSE。
VoiceStudio 站在这些杰出开源工作的肩膀上:
| 项目 | 作用 |
|---|---|
| VoiceStudio (k2-fsa) | 零样本扩散 TTS 引擎——核心语音合成模型 |
| WhisperX | 词级别语音识别与时间对齐 |
| Demucs (Meta) | 音乐源分离,用于人声分离 |
| Pyannote | 说话人分离——谁说了什么 |
| CTranslate2 | CPU 和 GPU 上的优化 Transformer 推理 |
| AudioSeal (Meta) | 用于 AI 溯源的不可见神经音频水印 |
| Tauri | 原生桌面应用框架 |
| Supertone / Supertonic 3 | ONNX TTS 引擎——31 种语言,CPU 高效 |
| Sherpa-ONNX | 支持 WASM 的通用 TTS/ASR 运行时 |
| GPT-SoVITS | 零样本 TTS 引擎——5 种语言,RTF 0.014 |
喜欢这种本地优先的理念?它是一脉相承的——同一位作者,同一条准则:你的数据只留在你的设备上。 全部项目见 palash.dev。
Opal 💠播放一切。AI 时代的媒体播放器。 视频、动漫、漫画、种子、Jellyfin 和 Plex——一个播放器全部搞定,并内置本地 AI 记忆与上下文。使用 Zig 编写,支持 macOS 和 Windows。
|

memxt 🧠经基准测试验证的最快开源 AI 记忆系统。 为 Claude Code 和编码智能体提供本地长期记忆——基于 SQLite + 嵌入向量的 MCP 服务器,100% 在你的设备上运行。你的智能体终于能记住昨天了。
|
VoiceStudio 中文版:开源、完全本地的 ElevenLabs 替代品——语音克隆、语音设计、视频配音、听写、转写与有声书,646 种语言(译自 debpalash/VoiceStudio,AGPL-3.0)
Python
68
2 commits
updated Aug 31, 2026
本仓库是 debpalash/VoiceStudio(AGPL-3.0,1.2 万+ 星)的中文版镜像:主 README 采用项目官方中文翻译,英文原版见 README.en.md;应用源码零改动(详见 NOTICE)。本仓库未保留原项目的赞助与捐赠内容。
原名 OmniVoice-Studio
在一个开源桌面工作室里完成克隆、设计、配音、听写和有声书制作。
默认本地优先。没有订阅,也没有用量计费;联网服务始终由你主动选择。
快速开始 · 功能 · 为什么选择 VoiceStudio · 引擎 · API · 参与贡献 · Discord · English
声音很私人,创作空间也应该真正属于你。 VoiceStudio 的核心流程运行在你的硬件上:克隆、设计、配音、听写,并以 646 种语言创作,不需要订阅,也没有用量计费。联网引擎和服务始终是清晰可见的可选项,而不是隐藏依赖。
[!WARNING] 活跃 Beta 阶段。 各版本之间可能出现故障——如需最新修复,请从源码运行。非常欢迎 Bug 报告和 PR:提交 Issue 或 加入 Discord。
选择你的操作系统,按指南从头到尾操作:
palashdeb/omnivoice-studio三步克隆出你的第一个声音:
觉得慢?docs/performance.md 讲清了生成时间到底花在哪里、有哪些调优开关,以及“它变慢了”的三个经典原因。各引擎/设备的实测数据见 docs/benchmarks.md。
正在从 CorentinJ/Real-Time-Voice-Cloning(现已归档)迁移过来?我们有专门的迁移指南:docs/migration/real-time-voice-cloning.md。
先运行内置自检——在应用中打开 设置 → 关于 → “运行自检”,或在源码检出目录中执行
uv run python backend/main.py --diagnose(加 --deep 还会实际加载当前引擎进行测试)。然后查看
docs/install/troubleshooting.md 中排名前
10 的安装错误。运行时出错时,应用内的错误界面会直接深链到对应条目;设置 → 关于 →
“保存诊断包” 会把脱敏日志与自检报告打包,方便附在 Bug 报告里。
Hugging Face Token 的配置见 docs/setup/huggingface-token.md。说话人分离相关的模型访问门槛见 docs/features/diarization.md。下载速度、⚡ 快速下载(Xet)状态,以及受限网络 / 镜像选项见 docs/downloading-models.md。
八大主打功能——折叠区里还有十二项等你展开。
🎙️ 语音克隆3 秒音频 → 复刻任何声音。 |
🎨 声音设计性别、年龄、口音、音高、语速、 |
🎬 视频配音YouTube 链接或文件 → 转录 → |
📖 有声书编辑器导入文本、EPUB 或 PDF。自动分章、 |
🎭 故事模式多声音编辑器。逐行分配声音、 |
⌨️ 听写工具在任何应用中按 ⌘+⇧+Space。 |
🔐 本地优先核心创作流程 |
🤖 MCP 服务器从 Claude、Cursor 或 |
TTSBackend,约 50 行代码即可接入任意引擎。.ovsvoice 包:身份 + 水印。云端语音工具很方便,但工作流会依赖账号、用量计费和他人的基础设施。VoiceStudio 在你的硬件上提供完整工作室;只有你主动选择时,才会使用联网集成。
| ElevenLabs | VoiceStudio | |
|---|---|---|
| 价格 | 订阅与用量限制 | 免费且开源(AGPL-3.0)· 专有用途可选 商业许可证 |
| 语音克隆 | ✅ 3 秒音频 | ✅ 3 秒音频,零样本 |
| 声音设计 | ✅ 性别、年龄 | ✅ 性别、年龄、口音、音高、风格、方言 |
| 有声书 / 故事 | ❌ | ✅ 完整有声书编辑器 + 多声音故事(EPUB/PDF 导入,.m4b 导出) |
| 语言 | 取决于套餐和模型 | 646 |
| 视频配音 | ✅ 仅云端 | ✅ 完全本地 |
| 数据隐私 | 音频在远端处理 | 核心流程在本地运行;联网服务必须主动选择 |
| API 密钥 | 需要账号 | 本地流程不需要 |
| GPU 支持 | 不适用(云端) | CUDA · Apple Silicon · ROCm(Linux)· CPU |
| 桌面应用 | ❌ | ✅ macOS · Windows · Linux |
| TTS 引擎 | 1 | 16 — 完整矩阵 |
| ASR 引擎 | 1 | 11 — 完整阵容 |
| MCP 服务器 | ❌ | ✅ 可从 Claude、Cursor 及任何 MCP 客户端使用 |
| 自检 | ❌ | ✅ 诊断套件、错误日志、脱敏调试包 |
| 可定制 | ❌ 闭源 | ✅ 随你 Fork、扩展、发布 |
专业级语音 AI,去掉订阅,也去掉云端。
| 最低配置 | 推荐配置 | |
|---|---|---|
| 操作系统 | Windows 10、macOS 12+(Apple Silicon)、Ubuntu 24.04+(glibc 2.39+) | 任意现代 64 位操作系统 |
| 内存 | 8 GB | 16 GB+ |
| 显存(GPU) | 4 GB(自动将 TTS 卸载到 CPU) | 8 GB+(NVIDIA RTX 3060+) |
| 硬盘 | 10 GB 可用空间(模型 + 缓存) | 20 GB+ SSD |
| Python | 3.10+(由 uv 管理) | 3.11–3.12 |
| GPU | 可选——CPU 也能跑 | NVIDIA CUDA · Apple Silicon MPS · AMD ROCm(仅 Linux) |
[!TIP] 对于显存 ≤8 GB 的 GPU,VoiceStudio 会在转录期间自动将 TTS 卸载到 CPU——无需配置。不需要专用 GPU;整条流水线都可以在 CPU 上运行(只是慢一些)。
[!NOTE] AMD GPU: ROCm 加速仅限 Linux 且需手动开启——在首次运行的设置界面选择 “AMD GPU (ROCm)”,或设置
OMNIVOICE_TORCH_VARIANT=rocm(docs/install/linux.md)。在 Docker/Podman 中请改用专门的 ROCm 镜像:ghcr.io/debpalash/omnivoice-studio:rocm(docs/install/docker.md)。在 Windows 上,AMD GPU(含 Ryzen AI 核显)只能以 CPU 运行:PyTorch 没有 Windows 版 ROCm 轮子,因此 Windows 上的 GPU 加速仅限 NVIDIA/CUDA(docs/install/windows.md)。
[!IMPORTANT] macOS Intel(x86_64)不支持本地后端: 应用 UI 可以安装,但 Python 后端无法运行,因为 PyTorch 已不再发布 Intel Mac 轮子(#889)。Intel Mac 用户仍可让 UI 指向另一台机器上的远程后端——参见 docs/install/macos.md。
16 个引擎,一个选择器。 VoiceStudio(默认,支持 600+ 语言)始终可用;另有七个引擎可选装并自动检测(CosyVoice 3、GPT-SoVITS、VoxCPM2、MOSS-TTS-Nano、KittenTTS、MLX-Audio、Sherpa-ONNX),外加八个按需延迟安装的引擎(IndexTTS 2.5、OmniVoice GGUF、OmniVoice 子进程版、PocketTTS、Supertonic 3、MOSS-TTS-v1.5、dots.tts、Confucius4-TTS)。在 设置 → TTS 引擎 中切换;所选引擎将应用于所有语音合成场景。每个引擎都有独立指南:docs/engines(英文)。
| 引擎 | 语言 | 克隆 | 指令 | Linux | macOS ARM | Windows | 许可证 |
|---|---|---|---|---|---|---|---|
| VoiceStudio(默认,由 k2-fsa/OmniVoice 驱动) | 600+ | ✅ | ✅ | ✅ CUDA/CPU | ✅ MPS | ✅ CUDA/CPU | 内置 |
| CosyVoice 3 | 9 + 18 种方言 | ✅ | ✅ | ✅ CUDA/CPU | ✅ MPS | ✅ CUDA/CPU | Apache-2.0 |
| GPT-SoVITS | 5 | ✅ | — | ✅ CUDA/CPU | — | ✅ CUDA/CPU | MIT |
| VoxCPM2 | 30 | ✅ | ✅ | ✅ CUDA/CPU | ✅ MPS | ✅ CUDA/CPU | Apache-2.0 |
| MOSS-TTS-Nano | 20 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
| KittenTTS | 英语 | — | — | ✅ CPU | ✅ CPU | ✅ CPU | MIT |
| MLX-Audio(Kokoro、Qwen3-TTS、CSM、Dia 等) | 多语言 | 因模型而异 | 因模型而异 | ❌ | ✅ 原生 | ❌ | 因模型而异 |
| Sherpa-ONNX | 20+ | — | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
| IndexTTS 2.5 ⚡ | 中文 · 英语 · 日语 · 西班牙语 · 阿拉伯语 | ✅ | — | ✅ CUDA | — | ✅ CUDA | Bilibili 模型许可¹ |
| OmniVoice GGUF ⚡ | 600+ | ✅ | ✅ | ✅ CPU | ✅ CPU | ✅ CPU | 内置 |
| Supertonic 3 ⚡ | 31 | — | — | ✅ CPU | ✅ CPU | ✅ CPU | OpenRAIL-M |
| MOSS-TTS-v1.5 ⚡(8B) | 31 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
| dots.tts ⚡(2B) | 24 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ❌ | Apache-2.0 |
| Confucius4-TTS ⚡ | 14 | ✅ | — | ✅ CUDA/CPU | ✅ CPU | ✅ CUDA/CPU | Apache-2.0 |
¹ 若月活跃用户超过 1 亿,或年收入超过人民币 10 亿元,使用 IndexTTS 2.5 前必须另行取得 Bilibili 的书面许可。启用可选边车前,请审阅其 模型许可。
CUDA = GPU 加速 · MPS = Apple Silicon Metal · CPU = 随处可运行,大模型较慢 · KittenTTS 和 MOSS-TTS-Nano 可在 CPU 上实时运行 · MLX-Audio 仅限 Apple Silicon · ⚡ = 延迟注册(首次使用时安装)
克隆能力的意义不止于单段生成:视频配音(以及任何固定了声音的批量任务)需要参考音频克隆来保持说话人身份,因此把不支持克隆的引擎(KittenTTS、Sherpa-ONNX、Supertonic 3)设为当前引擎时,这些任务会在开始前就给出可操作的失败提示,而不是静默回退到 VoiceStudio。
MOSS-TTS-v1.5(8B,约 16 GB)、dots.tts(2B,约 9 GB)和 Confucius4-TTS 是重量级可选引擎,从本地克隆在各自独立的 venv 中运行。三者均不支持 Apple Silicon MPS(在 Mac 上以 CPU 运行);dots.tts 没有 Windows 路径;Confucius4 建议使用 CUDA(CPU 可用,约为实时时长的 17 倍)。详情:MOSS-TTS-v1.5 · dots.tts · Confucius4-TTS。
11 个引擎——它们驱动听写、视频配音和字幕。WhisperX 是跨平台的默认引擎(约 100 种语言,词级时间对齐);其余引擎均为可选装并自动检测。在 设置 → 引擎 中切换。十个完全在本地设备上运行;第十一个(OpenAI 兼容)是可选的远程客户端,可用于 Qwen3-ASR 或任何兼容的服务器。
| 引擎 | OMNIVOICE_ASR_BACKEND | 语言 | 最适合 |
|---|---|---|---|
| WhisperX(默认) | whisperx | ~100 | 配音与字幕——通过 wav2vec2 强制对齐实现词级时间对齐 |
| Faster-Whisper | faster-whisper | ~100 | Linux / macOS / Windows 上的快速转录(CTranslate2) |
| Faster-Whisper(隔离) | faster-whisper-isolated | ~100 | 与 Faster-Whisper 相同,但在子进程中崩溃隔离——ASR 崩溃不会拖垮整个应用 |
| MLX Whisper | mlx-whisper | ~100 | Apple Silicon 原生速度(Apple MLX / Metal) |
| PyTorch Whisper | pytorch-whisper | ~100 | 经 🤗 Transformers 的 CUDA / CPU 兜底方案(无需 cuDNN 8) |
| Parakeet TDT | nemo-parakeet | 英语 + 25 种欧洲语言 | 即使在 CPU 上也能以约 10 倍实时速度达到 SOTA 精度,自动语言检测(NVIDIA NeMo,CUDA/CPU) |
| Moonshine | moonshine | 英语 | 边缘设备 / 低延迟,ONNX |
| FunASR | funasr | 50+ | 多语言一体化——内置 VAD + 行内说话人分离(SenseVoice) |
| sherpa-onnx(实时听写) | sherpa-onnx-asr | 25 种欧洲语言 + 90+ | 实时、快于实时的听写——小体积流式/离线 ONNX 模型(Parakeet TDT v3/v2、流式 Zipformer 与 Paraformer、Whisper Tiny),CPU 运行,macOS / Windows / Linux 表现完全一致。在 设置 → 语音 中按模型选择。 |
| OpenAI 兼容 ⚠️ 远程 | openai-compat-asr | 取决于服务器 | 当下通往 Qwen3-ASR 的路径(自托管服务器,无需等 transformers 支持)、任何 OpenAI 兼容的转录端点,或 OpenAI 官方 API——无需安装,在 设置 → 引擎(ASR 标签页)中配置并测试连接。音频会离开你的设备,发送到你指定的任何服务器;参见 docs/engines/openai-compatible-asr.md。 |
Whisper 系列引擎覆盖约 100 种语言;FunASR / SenseVoice 额外提供一条多语言一体化路径,内置语音活动检测与行内说话人分离。sherpa-onnx 驱动实时听写的模型选择器——你边说,文字边出现。除可选的 OpenAI 兼容远程客户端外,所有引擎都在本地设备上运行——无需 API 密钥,无需云端。
GPU 不支持高效 float16? 在较老的 NVIDIA GPU(Maxwell/Pascal、GTX 16xx)上,或在 CTranslate2/cuDNN 版本不匹配之后,CTranslate2 系 ASR 引擎(WhisperX、Faster-Whisper)无法运行
float16,VoiceStudio 会自动改用int8重试——无需配置。如果转录仍然失败,可用ASR_COMPUTE_TYPE环境变量固定计算类型(逃生舱口):ASR_COMPUTE_TYPE=int8(CPU 用float32)。将其设为int8并重启后端。
┌─────────────────────────────────────────────────────────────┐
│                    Frontend (React)                          │
│  DubTab · VoiceConsole · Stories · Audiobook · Gallery     │
│  Dictation · BatchQueue · Diagnostics · MCP Client          │
├─────────────────────────────────────────────────────────────┤
│                  Backend (FastAPI)                           │
│  100+ API endpoints · SSE+WSS streaming · SQLite            │
├──────────┬──────────┬──────────┬──────────┬────────────────┤
│ WhisperX │  Demucs  │VoiceStudio │ Pyannote │ Engine Routing  │
│  (+7 ASR │  Source  │  (+10    │ Diariz-  │ ↳ GPU preflight │
│ engines) │  Sep.    │  TTS)    │ ation    │ ↳ No silent CPU │
└──────────┴──────────┴──────────┴──────────┴────────────────┘
         CUDA / MPS / ROCm / CPU (auto-detected + routed)
已经有会说 OpenAI 音频 API 的脚本、智能体或工具?把它指向 http://localhost:3900/v1 即可——不需要密钥,也不用改代码。后端为音频端点内置了即插即用的兼容接口,直接接到你当前启用的 TTS/ASR 引擎(没错,voice 参数接受你克隆的声音配置 ID)。
| 端点 | 作用 |
|---|---|
POST /v1/audio/speech | TTS——输入文本;输出 mp3 / wav / flac / opus / pcm。tts-1 / tts-1-hd 映射到你当前启用的引擎;也接受 OpenAI 的声音名称(alloy 等)。 |
POST /v1/audio/transcriptions | STT——输入音频文件;输出 json、text、verbose_json、srt 或 vtt。whisper-1 映射到你当前启用的 ASR 引擎。 |
GET /v1/audio/voices | VoiceStudio 扩展——列出所有声音配置和引擎,客户端可据此发现你的克隆声音。 |
curl http://localhost:3900/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model": "tts-1", "voice": "alloy", "input": "Generated on my own hardware.", "response_format": "wav"}' \
  --output speech.wav
from openai import OpenAI
client = OpenAI(base_url="http://localhost:3900/v1", api_key="none")  # any string works — nothing checks it

result = client.audio.transcriptions.create(model="whisper-1", file=open("clip.wav", "rb"))
print(result.text)
想要完整的接口(100+ 端点)?完整的 REST API 参考已内嵌在应用中——设置 → OpenAPI 参考(由 Scalar 驱动),或点击页脚的 {} 按钮。
没有本地 GPU?官方笔记本(notebooks/OmniVoice_Studio_Colab.ipynb)可在免费的 Colab T4 上启动完整应用(包含 Web 界面):在笔记本内直接构建前端,用 uv 安装后端(复用 Colab 预装的 CUDA PyTorch),并通过 Colab 内置端口代理打开界面。无需第三方隧道,也无需任何 API 密钥。随后还有一套覆盖全部主要功能的 API 导览,全部可在笔记本内直接播放:多语言 TTS、声音克隆与声音设计、已保存的声音档案、语音转写、AI 水印检测、OpenAI 兼容 API、多角色故事、带章节的 m4b 有声书,以及一个附带人声分离音轨的迷你视频配音。
用一条命令教会你的 AI 智能体(Claude Code、Cursor、Codex 等)使用 VoiceStudio:
npx skills add debpalash/omnivoice-studio
内含两个 skills:omnivoice——让任何智能体通过你的本地安装进行语音合成与转录(包括你克隆的声音),免费且离线;以及 oss-maintainer——本项目所遵循的维护者方法论,适合任何用智能体运营自己开源项目的人。
| 分类 | 功能 |
|---|---|
| 长内容 | 有声书编辑器(文本/EPUB/PDF → 分章 .m4b)、Stories 多声音编辑器、两遍响度归一母带处理、渲染中断后的崩溃续渲、发音控制 + SSML-lite 韵律 |
| 配音 | 完整流水线(转录→翻译→合成→封装)、场景感知分割、唇形同步评分、流式 TTS、逐说话人声音分配、Smart Fit 时长匹配 + 二次 QC、独立的配音主页 |
| 声音 | 零样本克隆、声音设计、A/B 对比、声音预览控件、支持收藏/标签的声音库、便携声音角色包(.ovsvoice)、声音控制台工作区 |
| 音频 | Demucs 人声分离、逐段增益、选择性音轨导出、分轨/SRT/VTT/MP3 导出、按句分块实现的无限长 TTS |
| 多语言 | 多语言批量选择器、顺序 GPU 执行的批量配音队列 |
| 说话人分离 | Pyannote 机器学习分离、自动说话人克隆提取、逐说话人声音分配 |
| ASR | 9 个引擎(WhisperX、Faster-Whisper、隔离版 Faster-Whisper、MLX Whisper、PyTorch Whisper、Parakeet TDT、Moonshine、FunASR/SenseVoice、sherpa-onnx 实时听写)、崩溃隔离的子进程后端 |
| TTS | 14 个引擎(VoiceStudio、CosyVoice 3、GPT-SoVITS、VoxCPM2、MOSS-TTS-Nano、KittenTTS、MLX-Audio、Sherpa-ONNX,+ 延迟安装:IndexTTS 2.5、OmniVoice GGUF、Supertonic 3、MOSS-TTS-v1.5、dots.tts、Confucius4-TTS)、带 GPU 预检的引擎路由 |
| 基础设施 | Docker 部署、CUDA/MPS/ROCm 自动检测、cuDNN 8 兼容、显存感知模型卸载、引擎路由(绝不静默回退 CPU)、诊断套件与错误日志、受限网络镜像支持 |
| AI 溯源 | AudioSeal 不可见水印(类似 SynthID)、视频徽标叠加、水印检测 API |
| 用户体验 | 撤销/重做、键盘快捷键、拖放、会话持久化、首次启动按屏幕推荐界面缩放,以及原生 WebKitGTK 缩放 |
| 实时事件 | WebSocket 事件总线——数据变更时即时刷新侧边栏、指数退避重连 |
| 状态管理 | Zustand 状态迁移——uiSlice、pillSlice、dubSlice、generateSlice、prefsSlice、glossarySlice |
| 桌面 | 跨平台 Tauri 安装程序(macOS DMG——Apple Silicon;Intel 不支持本地后端,#889——Windows MSI、Linux deb/AppImage)、自动更新基础设施、单实例约束、关闭最小化到托盘、macOS Gatekeeper 修复 |
| 听写 | 全局系统级热键(⌘+⇧+Space)、无边框浮动控件、WebSocket 流式 ASR、自动粘贴、可自定义热键、本地 LLM 转录润色 |
| 批量流水线 | 完整批量 TTS:提取 → 转录 → 翻译 → 生成 → 混音 → 导出,带实时进度追踪 |
| MCP 服务器 | 让 VoiceStudio 成为 Claude、Cursor 及任何 MCP 客户端的本地 TTS/STT 提供方 |
| 远程后端 | 让桌面 UI 指向远程后端 URL,支持 Bearer 认证(附 Tailscale 文档) |
| 可靠性 | 启动开屏的卡死看门狗、逐引擎 GPU 兼容矩阵、引擎二进制不可执行时的可操作报错、setuptools 自动修复 |
| 频道 | 那里发生什么 |
|---|---|
#announcements | 发布消息与重大时刻——新版本最先在这里公布 |
#releases + #changelog | 每一个构建,以及里面究竟有什么 |
#issues | 以论坛帖子形式提交的 Bug 报告——直接分诊进 GitHub Issues |
#ideas | 功能请求,供讨论与投票 |
#discuss-ideas | 动手之前的设计讨论 |
#general | 安装帮助、GPU 疑难排查,以及晒你的配音成果 |
非常欢迎——Bug 修复、新的 TTS 引擎适配器、UI 改进、文档、翻译。统统欢迎。
VoiceStudio 真正有竞争力的地方:从干净的参考音频进行语音克隆(最先进的开源扩散 TTS)、语言覆盖(646 种语言对他们的 32 种),以及所有结构性优势——没有按字符计费、没有用量上限、音频不离开你的设备、完整的流水线可定制性(14 个 TTS 引擎、10 个 ASR 引擎、翻译方案随你选)。
ElevenLabs 仍然领先的地方:开箱即用的稳定性与打磨程度,尤其是英语 TTS。他们的单一模型经过深度调优;我们的质量取决于你选择的引擎、你的硬件,以及(对克隆而言)参考音频——干燥、近麦的音频比嘈杂或有回声的音频克隆效果好得多。
具体到配音:配音是一条链——转录 → 翻译 → 克隆 → 合成——在你的素材上,它只取决于最薄弱的一环。如果部分输出语无伦次,先检查片段表里的原文:当转录本身就错了,换一个 ASR 引擎或使用更干净的源音频——修复点通常在这里,而不是声音。
拿你的真实素材试试——免费,下载一次即可。许多用户直接用它替换了 ElevenLabs;也有人两个都留着。这两种结果我们都乐见。
backend/services/tts_backend.py 中继承 TTSBackend,并将其添加到 _REGISTRY 字典中——约 50 行代码。十四个内置引擎均以此方式实现;参见 TTS 引擎。
如果你选择同意(也可随时在 设置 → 隐私 → “帮助改进 VoiceStudio” 中开关),发送的只是匿名、不含内容的使用统计:生成信息(引擎、语言、生成耗时、字符数量、错误类型),以及应用生命周期——一次安装信号、版本更新(版本号之间)、崩溃(错误类别和分桶后的运行时长,绝不含日志)、错误类型(有上限、去重),以及卸载时的一次告别信号。绝不包含你的文本、音频、文件名或任何可识别信息——这由代码中的属性白名单强制保证(backend/core/analytics.py),而不只是一句承诺。源码构建根本没有分析数据的接收端,因此根本不会询问。你自己的统计数字在 设置 → 用量 中查看,本地计算,不发送到任何地方。
scripts/uninstall.sh(macOS/Linux)或 scripts\uninstall.ps1(Windows)——它会先以干跑方式列出每个文件夹及其大小,加 --yes 才会真正删除。完整的各平台路径列表和应用移除步骤见 docs/install/uninstall.md。
VoiceStudio 是基于 GNU Affero 通用公共许可证 v3.0(AGPL-3.0) 的自由开源软件。
可免费用于任何用途——包括商业和企业内部用途。 运行它、出售用它生成的音频、为自己或客户的视频配音、在团队中推广——全部免费,无需许可证。作为一份网络著佐权(copyleft)许可证,AGPL 增加了一项义务:如果你修改了 VoiceStudio 并通过网络向他人提供该修改版本,你必须依据相同的 AGPL-3.0 条款向他们提供该修改版本的完整对应源代码。
希望将 VoiceStudio 嵌入闭源或专有产品或服务、又不受 AGPL-3.0 著佐权义务约束的组织,可获取商业许可证。定价方案即将推出。 咨询:VoiceStudio@palash.dev。
捆绑的 omnivoice/ TTS 模型(作者 Han Zhu)在上游仍为 Apache-2.0 许可。完整且具约束力的条款请参见 LICENSE。
VoiceStudio 站在这些杰出开源工作的肩膀上:
| 项目 | 作用 |
|---|---|
| VoiceStudio (k2-fsa) | 零样本扩散 TTS 引擎——核心语音合成模型 |
| WhisperX | 词级别语音识别与时间对齐 |
| Demucs (Meta) | 音乐源分离,用于人声分离 |
| Pyannote | 说话人分离——谁说了什么 |
| CTranslate2 | CPU 和 GPU 上的优化 Transformer 推理 |
| AudioSeal (Meta) | 用于 AI 溯源的不可见神经音频水印 |
| Tauri | 原生桌面应用框架 |
| Supertone / Supertonic 3 | ONNX TTS 引擎——31 种语言,CPU 高效 |
| Sherpa-ONNX | 支持 WASM 的通用 TTS/ASR 运行时 |
| GPT-SoVITS | 零样本 TTS 引擎——5 种语言,RTF 0.014 |
喜欢这种本地优先的理念?它是一脉相承的——同一位作者,同一条准则:你的数据只留在你的设备上。 全部项目见 palash.dev。
Opal 💠播放一切。AI 时代的媒体播放器。 视频、动漫、漫画、种子、Jellyfin 和 Plex——一个播放器全部搞定,并内置本地 AI 记忆与上下文。使用 Zig 编写,支持 macOS 和 Windows。
|
memxt 🧠经基准测试验证的最快开源 AI 记忆系统。 为 Claude Code 和编码智能体提供本地长期记忆——基于 SQLite + 嵌入向量的 MCP 服务器,100% 在你的设备上运行。你的智能体终于能记住昨天了。
|