Este proyecto tiene como objetivo entrenar y evaluar modelos de lenguaje para la detección automática de sarcasmo en textos en español utilizando modelos basados en transformers.
Se ha reemplazado el dataset anterior realizado con semval por uno nuevo más adecuado para el idioma español:
Ernesto-1997/Sarcastic_spanish_datasetSe probaron dos variantes de modelos preentrenados en español para evaluar el rendimiento en la tarea de detección de sarcasmo:
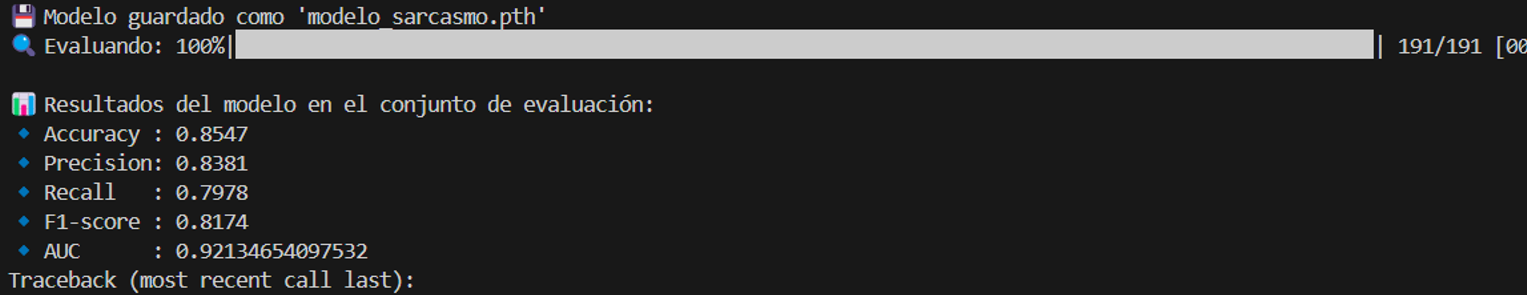
dccuchile/bert-base-spanish-wwm-uncasedAutoModelForSequenceClassificationBCEWithLogitsLoss para clasificación binaria.pysentimiento/robertuito-base-uncasedAutoModelForSequenceClassificationBCEWithLogitsLoss con pos_weight para manejar desbalanceo.Adam optimizador.Cada modelo fue evaluado usando el mismo conjunto de prueba con métricas estándar para comparar su rendimiento en la clasificación binaria (sarcasmo vs no sarcasmo).
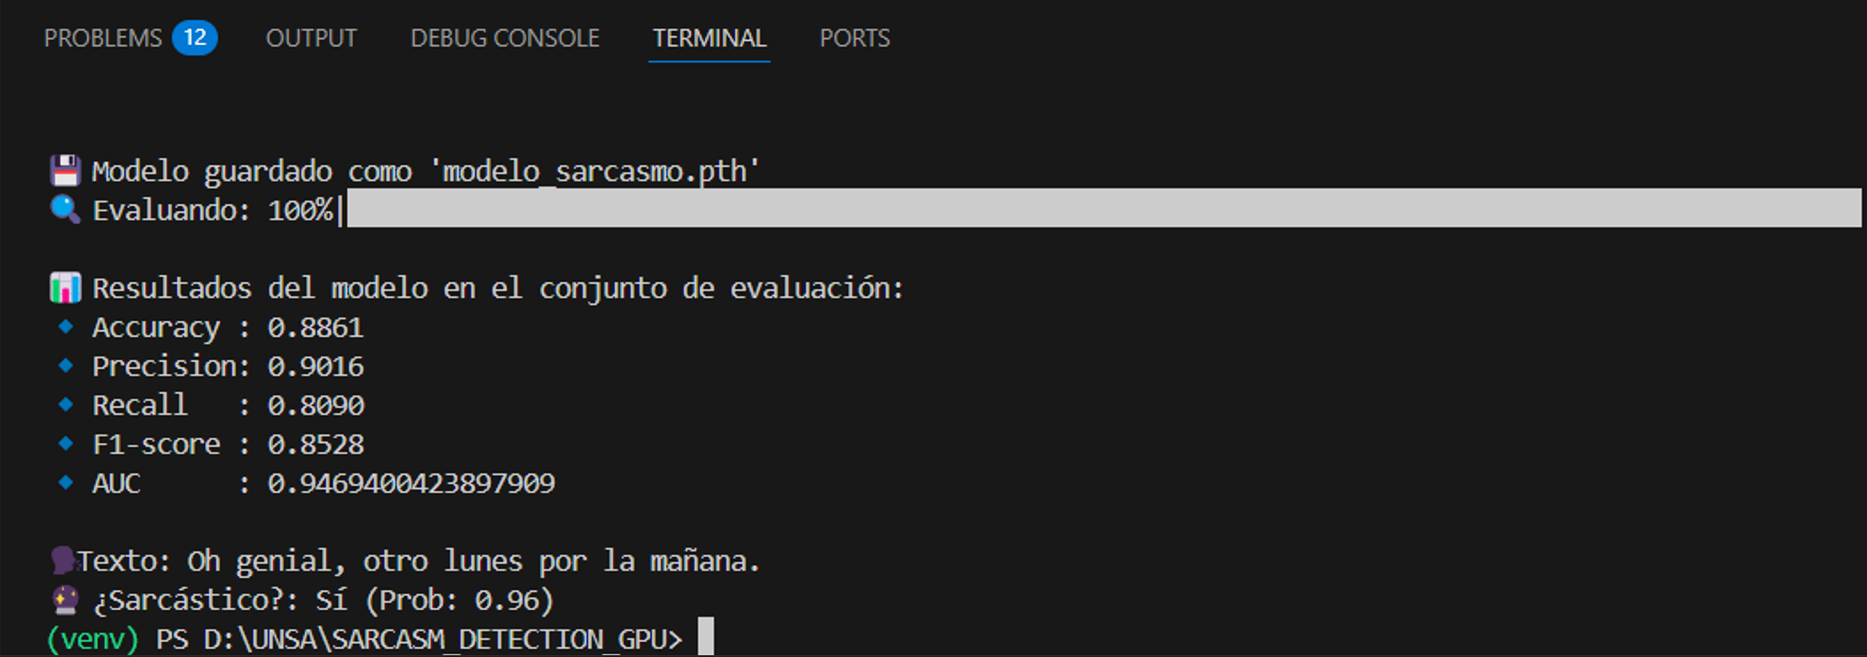
Este proyecto tiene como objetivo entrenar y evaluar modelos de lenguaje para la detección automática de sarcasmo en textos en español utilizando modelos basados en transformers.
Se ha reemplazado el dataset anterior realizado con semval por uno nuevo más adecuado para el idioma español:
Ernesto-1997/Sarcastic_spanish_datasetSe probaron dos variantes de modelos preentrenados en español para evaluar el rendimiento en la tarea de detección de sarcasmo:
dccuchile/bert-base-spanish-wwm-uncasedAutoModelForSequenceClassificationBCEWithLogitsLoss para clasificación binaria.pysentimiento/robertuito-base-uncasedAutoModelForSequenceClassificationBCEWithLogitsLoss con pos_weight para manejar desbalanceo.Adam optimizador.Cada modelo fue evaluado usando el mismo conjunto de prueba con métricas estándar para comparar su rendimiento en la clasificación binaria (sarcasmo vs no sarcasmo).