 Awesome-Vision2Audio
A curated list of Vision to Audio Generation
 Paper List
Tags: 🔉 general audio / sound effects · 🎶 music · 📊 benchmark / evaluation
2026
- 2026 Aug. 🔉 HarmoniDPO: Video-guided Audio Generation via Preference-Optimized Diffusion. 📄 Paper
- 2026 Aug. 🎶 Dialogue-Aware Video-to-Music Generation Using Public Domain Film Collections. 📄 Paper
- 2026 Aug. 🔉 Visual Representation Matters: Exploiting Temporal Differences in Video-to-Audio Generation. 📄 Paper
- 2026 Jul. 🔉 Precise Video-to-Audio Generation with Cross-Modal Alignment in Latent Space, accepted to ECCV'26. 📄 Paper
- 2026 Jun. 🔉 FoleyGenEx: Unified Video-to-Audio Generation with Multi-Modal Control, Temporal Alignment, and Semantic Precision, accepted to INTERSPEECH'26. 📄 Paper
- 2026 Jun. 🔉🎶 AudioX-Turbo: A Unified Framework for Efficient Anything-to-Audio Generation. 📄 Paper
- 2026 Jun. 🔉 SMC-ITA: Sequential Monte Carlo Inference-Time Alignment for Video-to-Audio Generation. 📄 Paper
- 2026 Jun. 🔉 Audio Imitator: Controlling Timbre and Tempo in Video2Audio Synthesis with Audio Reference. 📄 Paper
- 2026 May. 🔉📊 Benchmarking Single-Factor Physical Video-to-Audio Generation, CVPR'26. 📄 Paper
- 2026 Apr. 🎶 Video-Robin: Autoregressive Diffusion Planning for Intent-Grounded Video-to-Music Generation. 📄 Paper
- 2026 Apr. 🔉 ControlFoley: Unified and Controllable Video-to-Audio Generation with Cross-Modal Conflict Handling. 📄 Paper
- 2026 Apr. 🔉🎶📊 VidAudio-Bench: Benchmarking V2A and VT2A Generation across Four Audio Categories. 📄 Paper
- 2026 Apr. 🔉 OmniSonic: Towards Universal and Holistic Audio Generation from Video and Text, CVPR'26. 📄 Paper
- 2026 Mar. 🔉 FoleyDirector: Fine-Grained Temporal Steering for Video-to-Audio Generation via Structured Scripts, CVPR'26. 📄 Paper
- 2026 Mar. 🔉 AC-Foley: Reference-Audio-Guided Video-to-Audio Synthesis with Acoustic Transfer, ICLR'26. 📄 Paper
- 2026 Mar. 🔉 V2A-DPO: Omni-Preference Optimization for Video-to-Audio Generation, accepted to ICASSP'26. 📄 Paper
- 2026 Mar. 🎶 V2M-Zero: Zero-Pair Time-Aligned Video-to-Music Generation. 📄 Paper
- 2026 Feb. 🔉 Echoes Over Time: Unlocking Length Generalization in Video-to-Audio Generation Models, CVPR'26. 📄 Paper
- 2026 Jan. 🔉 Omni2Sound: Towards Unified Video-Text-to-Audio Generation, CVPR'26. 📄 Paper
2025
- 2025 🔉 MMAudio: Taming Multimodal Joint Training for High-Quality Video-to-Audio Synthesis, CVPR'25
- 2025 🔉 VAFlow: Video-to-Audio Generation with Cross-Modality Flow Matching, ICCV'25
- 2025 🔉 Foley-Flow: Coordinated Video-to-Audio Generation with Masked Audio-Visual Alignment and Dynamic Conditional Flows, CVPR'25
- 2025 🔉 Synchronized Video-to-Audio Generation via Mel Quantization-Continuum Decomposition (Mel-QCD), CVPR'25
- 2025 🔉 VinTAGe: Joint Video and Text Conditioning for Holistic Audio Generation, CVPR'25
- 2025 🔉 MultiFoley: Video-Guided Foley Sound Generation with Multimodal Controls, CVPR'25
- 2025 🔉 Animate and Sound an Image, CVPR'25
- 2025 🔉 TARO: Timestep-Adaptive Representation Alignment with Onset-Aware Conditioning for Synchronized Video-to-Audio Synthesis, ICCV'25
- 2025 🔉 ThinkSound: Chain-of-Thought Reasoning in Multimodal LLMs for Audio Generation and Editing, NeurIPS'25
- 2025 🔉 OmniAudio: Generating Spatial Audio from 360-degree Video, ICML'25
- 2025 🔉 Temporally Aligned Audio for Video with Autoregression, ICASSP'25
- 2025 🔉 TAGMO: Temporal Control Audio Generation for Multiple Visual Objects Without Training, ICASSP'25
- 2025 🔉 MambaFoley: Foley Sound Generation Using Selective State-Space Models, ICASSP'25
- 2025 🔉 Video-to-Audio Generation with Fine-grained Temporal Semantics, INTERSPEECH'25
- 2025 🔉 Kling-Foley: Multimodal Diffusion Transformer for High-Quality Video-to-Audio Generation
- 2025 🔉 HunyuanVideo-Foley: Multimodal Diffusion with Representation Alignment for High-Fidelity Foley Audio Generation
- 2025 🔉 Tri-Ergon: Fine-grained Video-to-Audio Generation with Multi-modal Conditions and LUFS Control, AAAI'25
- 2025 🔉 PrismAudio: Decomposed Chain-of-Thought and Multi-dimensional Rewards for Video-to-Audio Generation, ICLR'26
- 2025 🔉 DreamFoley: Scalable VLMs for High-Fidelity Video-to-Audio Generation
- 2025 🔉 MGAudio: Model-Guided Dual-Role Alignment for High-Fidelity Open-Domain Video-to-Audio Generation, NeurIPS'25
- 2025 🔉 FoleyGRAM: Video-to-Audio Generation with GRAM-Aligned Multimodal Encoders, IJCNN'25
- 2025 🔉 Hear What Matters! Text-conditioned Selective Video-to-Audio Generation, CVPR'26
- 2025 🔉 MFM-Mapper: Efficient Video-to-Audio Generation via Multiple Foundation Models Mapper
- 2025 🔉 SpecMaskFoley: Steering Pretrained Spectral Masked Generative Transformer Toward Synchronized Video-to-Audio Synthesis via ControlNet, WASPAA'25
- 2025 🔉 StereoFoley: Object-Aware Stereo Audio Generation from Video, ICASSP'26
- 2025 🔉 MMAudioSep: Taming Video-to-Audio Generative Model towards Video/Text-Queried Sound Separation, ICASSP'26
- 2025 🔉 MDG: Training-Free Multimodal Guidance for Video to Audio Generation, ICASSP'26
- 2025 🔉 YingSound: Video-Guided Sound Effects Generation with Multi-modal Chain-of-Thought Controls
- 2025 🔉 Coherent Audio-Visual Editing via Conditional Audio Generation Following Video Edits
- 2025 🎶 GVMGen: A General Video-to-Music Generation Model with Hierarchical Attentions, AAAI'25
- 2025 🔉🎶 AudioX: A Unified Framework for Anything-to-Audio Generation, ICLR'26
- 2025 🎶 FilmComposer: LLM-Driven Music Production for Silent Film Clips, CVPR'25
- 2025 🎶 HarmonySet: A Comprehensive Dataset for Understanding Video-Music Semantic Alignment and Temporal Synchronization, CVPR'25
- 2025 🎶 Extending Visual Dynamics for Video-to-Music Generation
- 2025 🎶 SONIQUE: Video Background Music Generation Using Unpaired Audio-Visual Data, ICASSP'25
2024
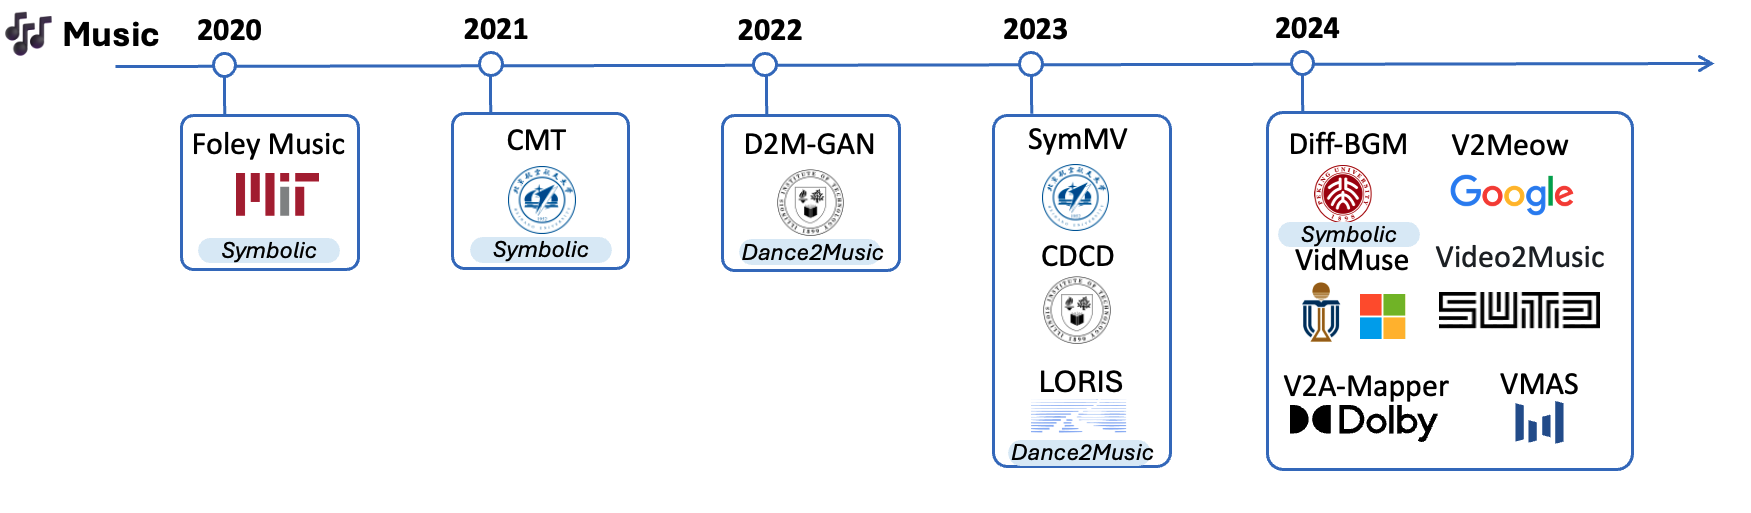
- 2024 🎶 VMAs: Video-to-Music Generation via Semantic Alignment in Web Music Videos, ByteDance, WACV'25. 🌐 Demo
- 2024 🎶 MM-LDM: Multi-Modal Latent Diffusion Model for Sounding Video Generation, Institute of automation, MM'24
- 2024 Jul. 🔉 FoleyCrafter: Bring Silent Videos to Life with Lifelike and Synchronized Sounds. Shanghai Artificial Intelligence Laboratory, Chinese University of Hong Kong, Shenzhen. IJCV'26. 🌐 Demo 🔗 Code 🤗 HF Datasets (VGGSound, AVSync15)
- 2024 Jul. 🔉 FRIEREN: Efficient Video-to-Audio Generation Network with Rectified Flow Matching. ZheJiang University. NeurIPS'24. 🌐 Demo Datastes (VGGSound)
- 2024 Jul. 🔉 Masked Generative Video-to-Audio Transformers with Enhanced Synchronicity. Dolby Lab. ECCV'24. 🌐 Demo Datastes (VGGSound)
- 2024 Jul. 🔉 Read, Watch and Scream! Sound Generation from Text and Video, NAVER. AAAI'25. 🌐 Demo Datastes (VGGSound)
- 2024 June. 🎶 VidMuse: A Simple Video-to-Music Generation Framework with Long-Short-Term Modeling, HKUST, Microsoft Research Asia, CVPR'25. 🔗 Code Datasets (V2M).
- 2024 May. 🔉 Visual Echoes: A Simple Unified Transformer for Audio-Visual Generation, Sony. [image2audio]. 🌐 Demo Datasets (VGGSound)
- 2024 Feb. 🔉 Seeing and Hearing: Open-domain Visual-Audio Generation with Diffusion Latent Aligners, HKUST, CVPR'24. 🌐 Demo 🔗 Code Datasets (VGGSound)
- 2024 🎶 V2Meow: Meowing to the Visual Beat via Video-to-Music Generation, Google. AAAI'24. 🌐 Demo Dataset (MV100K)
- 2024 🎶 Diff-BGM: A Diffusion Model for Video Background Music Generation, PKU, CVPR'24. 🔗 Code Datasets (BGM909)
- 2024 🎶 MeLFusion: Synthesizing Music from Image and Language Cues using Diffusion Models, Adobe, CVPR'24. 🔗 Code 🌐 Demo
- 2024 🔉 From Vision to Audio and Beyond: A Unified Model for Audio-Visual Representation and Generation, University of Washington, ICML'24.
- 2024 🔉 SonicVisionLM: Playing Sound with Vision Language Models, Shanghai University, CVPR'24 🌐 Demo
- 2024 🎶 Video2Music: Suitable music generation from videos using an Affective Multimodal Transformer model, SUTD, Expert Systems with Applications, vol. 249 (2024). 🔗 Code. Datasets (MuVi-Sync)
- 2024 🔉 V2A-Mapper: A Lightweight Solution for Vision-to-Audio Generation by Connecting Foundation Models, Dolby, AAAI'24. 🌐 Demo
- 2024 🎶 DanceComposer: Dance-to-Music Generation Using a Progressive Conditional Music Generator, Sun Yat-sen University, TMM'24
- 2024 🔉 Video-Foley: Two-Stage Video-To-Sound Generation via Temporal Event Condition For Foley Sound, KAIST, IEEE TASLPRO'25. 🌐 Demo
- 2024 🔉 LoVA: Long-form Video-to-Audio Generation, RUC, ICASSP'25. Datasets(AudioSet, VGGSound, UnAV100)
- 2024 🔉 Tell What You Hear From What You See - Video to Audio Generation Through Text, University of Washington, NeurIPS'24 🔗 Code
2023
- 2023 Aug. 🎶 Video Background Music Generation: Dataset, Method and Evaluation, Beihang University, ICCV'23. 🔗 Code Datasets (SymMV)
- 2023 Jun. 🔉 DiffFoley: Synchronized Video-to-Audio Synthesis with Latent Diffusion Models, Tsinghua University, NeurIPS'23. 🌐 Demo 🔗 Code Datasets (VGGSound, AudioSet)
- 2023 Feb. 🎶 Discrete Contrastive Diffusion for Cross-Modal Music and Image Generation, Illinois Institute of Technology, ICLR'23. 🌐 Demo 🔗 Code Datasets (AIST++, Tiktok Dance-Music)
- 2023 🔉 MM-Diffusion: Learning Multi-Modal Diffusion Models for Joint Audio and Video Generation, Renmin University of China CVPR'23. 🔗 Code Datasets (Landscape, AIST++)
- 2023 🔉 Conditional Generation of Audio from Video via Foley Analogies, University of Michigan, Adobe, CVPR'23 🌐 Demo 🔗 Code
- 2023 🎶 Long-Term Rhythmic Video Soundtracker,Shanghai Artificial Intelligence Laboratory, ICML'23 🌐 Demo 🔗 Code
- 2023 🔉 CMMD: Contrastive Multi-Modal Diffusion for Video-Audio Conditional Modeling, Microsoft, ECCV Workshops'24
2022
- 2022 Jul. 🎶 Quantized GAN for Complex Music Generation from Dance Videos, Illinois Institute of Technology, ECCV'22. 🌐 Demo 🔗 Code Datasets (AIST++, Tiktok Dance-Music)
2021
- 2021 Nov. 🎶 Video Background Music Generation with Controllable Music Transformer, Beihang University, MM'21. 🌐 Demo 🔗 Code 🌟
- 2021 🔉 How Does it Sound? Generation of Rhythmic Soundtracks for Human Movement Videos. University of Washington, NeurIPS'21 🔗 Code
2020
- 2020 Jul. 🔉 Generating Visually Aligned Sound from Videos, South China University of Technology, TIP'20. 🌐 Demo 🔗 Code
- 2020 Jul. 🎶 Foley Music: Learning to Generate Music from Videos, MIT, ECCV'20.
- 2020 Jun. 🎶 Audeo: Audio Generation for a Silent Performance Video, University of Washington, NeurIPS'20.
2019
- 2019, 🎶 AIST Dance Video Database: Multi-Genre, Multi-Dancer, and Multi-Camera Database for Dance Information Processing, AIST, ISMIR'19.
2018
- 2018 Jun. 🔉 Visual to Sound: Generating Natural Sound for Videos in the Wild, University of North Carolina, CVPR'18.
- 2018, 🔉 Visually Indicated Sound Generation by Perceptually Optimized Classification, University of Southern California, ECCV MULA workshop'18. 🔗 Code
2016
- 2016 🔉 Visually Indicated Sounds, MIT, CVPR'16. 🌐 Demo 🔗 Code
 Survey
- 2025 Mar. A Survey on Vision-to-Music Generation: Methods, Datasets, Evaluation, and Challenges, ISMIR'25. 🔗 Code.
- 2024 Aug. Foundation Models for Music: A Survey, Queen Mary University of London.
- 2024 Jun. LLMs Meet Multimodal Generation and Editing: A Survey, HKUST. 🔗 Code.
- 2022 Aug. Learning in Audio-visual Context: A Review, Analysis, and New Perspective, Renmin University of China.
- 2023 Sep. Sparks of Large Audio Models: A Survey and Outlook, Queensland University of Technology.
 Datasets
- 🎶 V2M (Unpublished): VidMuse: A Simple Video-to-Music Generation Framework with Long-Short-Term Modeling. (Movie trailer, 190K for training, 20K for finetuning, 300 for benchmarking).
- 🔉 VGGSound: Vggsound: A large-scale audio-visual dataset. ICASSP'20
- Landscape
- 🎶 Tiktok Dance Dataset
- 🔉 AVSync15: Audio-synchronized visual animation.
- 🎶 BGM909. Piano version music. Diff-BGM: A Diffusion Model for Video Background Music Generation
- 🎶 MV100K: V2Meow
- 🎶 MMTrailer: A Multimodal Trailer Video Dataset with Language and Music Descriptions.
- 🎶 SymMV: Video Background Music Generation: Dataset, Method and Evaluation.
- 🔉 VAS: Generating Visually Aligned Sound from Videos.
- 🎶 AIST++. Dance-to-Music
- 🎶 AIST. Dance-to-Music
- 🎶 MuVi-Sync. Video2Music: Suitable Music Generation from Videos using an Affective Multimodal Transformer model
 Evaluation Metrics
🧩 Want to Contribute?
We welcome contributions! Please feel free to submit a PR or open an issue if you'd like to add new papers, tools, or correct any mistakes.
✅ Guidelines:
- Add relevant papers or projects related to Vision2Audio.
- Use consistent formatting.
- Include links where available.



